
L’évaluation rigoureuse de la validité diagnostique et pronostique constitue l’un des piliers méthodologiques les plus exigeants de la psychométrie contemporaine et des neurosciences comportementales. Lorsqu’un chercheur ou un clinicien élabore une échelle de mesure, qu’il s’agisse d’un inventaire mesurant la symptomatologie dépressive, d’un outil de repérage des troubles neurocognitifs ou d’un test mesurant des traits de personnalité dysfonctionnels, la question centrale demeure invariablement la même : avec quelle précision cet instrument quantitatif permet-il de discriminer les individus présentant une affection clinique de ceux qui en sont exempts ? Dans ce contexte, la courbe ROC, acronyme de Receiver Operating Characteristic, s’est imposée comme l’étalon-or pour quantifier et visualiser l’exactitude intrinsèque d’un test continu face à un statut de référence binaire.
Bien que des progiciels statistiques spécialisés tels que R, SPSS, SAS ou Jamovi intègrent des modules automatisés pour générer ces représentations, la construction pas à pas d’une analyse ROC au sein d’un tableur tel que Microsoft Excel présente une valeur pédagogique et heuristique inégalée. Loin d’être une simple tâche d’exécution technique, la manipulation explicite des données brutes, l’orchestration des tris séquentiels, le calcul des fréquences cumulées et l’intégration de la surface sous la courbe par des méthodes géométriques permettent au praticien de s’approprier intimement la mécanique probabiliste de la décision clinique. Cette démarche démystifie des concepts fondamentaux tels que la sensibilité, la spécificité, l’erreur de type I et de type II, tout en offrant une transparence algorithmique totale souvent occultée par les boîtes noires des logiciels commerciaux.
Le présent guide exhaustif a pour vocation d’accompagner les chercheurs, psychologues quantitativistes, étudiants et professionnels de santé à travers chaque étape nécessaire à la modélisation complète d’une courbe ROC dans Microsoft Excel, sans recourir à la moindre macro VBA ni à aucun composant externe. De la préparation méticuleuse de la matrice de données à l’optimisation graphique répondant aux critères éditoriaux internationaux, en passant par le calcul trapézoïdal de l’aire sous la courbe (AUC) et la détermination objective du seuil de coupure optimal via l’indice de Youden, chaque séquence est disséquée avec une rigueur statistique formelle et une contextualisation clinique constante.
1. Introduction aux courbes ROC et fondements statistiques en psychométrie
1.1 Genèse et utilité de la courbe ROC en psychologie quantitative
L’origine historique de la courbe ROC remonte à la Seconde Guerre mondiale, période durant laquelle les ingénieurs britanniques et américains en télécommunications cherchaient à optimiser la capacité des opérateurs de radar à distinguer les échos parasites causés par des volées d’oiseaux des signaux réels émis par les bombardiers ennemis. Cette problématique, initialement ancrée dans la théorie de la détection du signal formalisée par Peterson, Birdsall et Fox en 1954, a rapidement démontré sa pertinence universelle pour tout processus où un observateur doit prendre une décision dichotomique en présence d’un signal bruité. Au cours des années 1960 et 1970, des psychophysiciens tels que John A. Swets ont brillamment transposé ces concepts mathématiques à l’étude des perceptions sensorielles humaines, montrant que les seuils de discrimination ne dépendent pas uniquement des capacités sensorielles pures, mais également des critères de décision internes adoptés par les sujets.
Progressivement, la psychologie clinique, la psychiatrie biologique et la psychométrie ont adopté la courbe ROC pour résoudre un problème récurrent : la validation d’échelles composites et de biomarqueurs continus. Dans la pratique psychométrique, un questionnaire fournit presque toujours une note sommative continue ou pseudo-continue (par exemple, un score variant de 0 à 63 au Beck Depression Inventory). Or, le clinicien est inévitablement confronté à un impératif catégoriel : l’individu est-il en état de détresse nécessitant une prise en charge immédiate ou non ? La courbe ROC intervient précisément à cette interface en décrivant l’ensemble des compromis possibles entre la détection des vrais cas et l’exclusion des faux cas, indépendamment de tout seuil fixé a priori.
Il convient d’établir une distinction fondamentale entre les modèles de régression logistique et l’analyse de la performance de classification par courbe ROC. Si la régression logistique vise à modéliser la probabilité a posteriori d’un événement conditionnellement à un ensemble de covariables en estimant des coefficients de régression par le maximum de vraisemblance, l’analyse ROC évalue la capacité purement discriminative d’une variable de prédiction, sans formuler d’hypothèse stricte sur la forme de la relation fonctionnelle sous-jacente. Elle constitue une approche non paramétrique ou semi-paramétrique qui sanctionne la capacité de l’instrument à ordonner convenablement les sujets malades devant les sujets sains, ce qui en fait un test d’exactitude diagnostique par excellence.
1.2 Importance de l’analyse décisionnelle binaire
Dans les sciences comportementales et les disciplines médicales, la décision clinique s’exprime très majoritairement sous la forme d’un arbitrage binaire : pathologique versus non-pathologique, risque suicidaire imminent versus risque faible, trouble du déficit de l’attention avec ou sans hyperactivité versus développement neurotypique. Face à cette partition nette de la réalité clinique, l’utilisation de tests psychométriques à scores continus pose la question cruciale du point de bascule décisionnel. Choisir un seuil n’est jamais un acte anodin sur le plan épistémologique ou éthique ; cela revient à définir la frontière exacte où le coût de l’inaction devient supérieur au coût de l’intervention.
L’analyse décisionnelle binaire permet de cartographier l’impact asymétrique des erreurs de jugement. En santé mentale, les conséquences associées aux faux négatifs (omettre d’identifier une dépression sévère chez un patient présentant des idéations suicidaires latentes) sont souvent infiniment plus catastrophiques sur le plan humain que les répercussions générées par les faux positifs (adresser un individu sain à une consultation d’évaluation psychologique approfondie). Toutefois, dans d’autres contextes, tels que les expertises médico-légales ou la sélection professionnelle pour des postes critiques, un faux positif peut entraîner une stigmatisation indélébile, une perte d’emploi ou un préjudice juridique irréversible. L’analyse ROC formalise cette tension dialectique en fournissant une métrique objective qui permet d’évaluer les pertes et bénéfices associés à chaque graduation possible du continuum psychométrique.
Une telle approche protège le praticien contre le piège de l’arbitraire. Trop souvent dans la littérature psychologique ancienne, les seuils cliniques étaient établis sur la base de conventions statistiques fragiles, comme la moyenne majorée de deux écarts-types au sein d’un groupe normatif, sans vérification empirique de l’efficacité de ce seuil face à une cohorte clinique validée indépendamment. L’analyse décisionnelle moderne impose au contraire une démarche empirique et probabiliste, où l’efficacité prédictive d’une échelle est quantifiée sur toute l’étendue de ses valeurs possibles à travers la confrontation systématique à un standard de référence validé.
2. Concepts fondamentaux : Sensibilité, spécificité et matrice de confusion
2.1 Définition de la sensibilité ou taux de vrais positifs
La sensibilité, également désignée sous le vocable de taux de vrais positifs (TVP) ou de probabilité de détection, représente la proportion d’individus véritablement atteints d’un trouble qui obtiennent un résultat positif au test psychométrique considéré. Sur le plan de la théorie des probabilités, la sensibilité s’énonce formellement comme la probabilité conditionnelle $P(T+ mid D+)$, où $T+$ désigne le résultat positif au test (c’est-à-dire un score supérieur ou égal à une valeur seuil définie) et $D+$ représente la présence effective de la condition pathologique attestée par le critère de référence. Mathématiquement, elle s’exprime par le ratio suivant :
Sensibilité = Vrais Positifs / (Vrais Positifs + Faux Négatifs)
Dans le domaine de l’évaluation clinique, par exemple lors du dépistage précoce des troubles cognitifs légers chez les personnes âgées, une sensibilité élevée est impérative. Si un test neuropsychologique présente une sensibilité de 95 %, cela signifie que 95 % des patients présentant des atteintes cognitives réelles seront formellement repérés par l’instrument, tandis que 5 % seulement échapperont à la vigilance clinique (les faux négatifs). Sur le plan éthique et sociétal, disposer d’une sensibilité robuste lors des phases initiales de dépistage garantit une prise en charge précoce, offrant ainsi la possibilité de ralentir la dégradation fonctionnelle par des thérapies ciblées.
Cependant, maximiser la sensibilité exige généralement d’abaisser le seuil d’exigence diagnostique du test, ce qui a pour corollaire inévitable d’englober un nombre croissant d’individus sains dans la cohorte des sujets classés positifs. C’est précisément cette compensation inéluctable qui empêche la sensibilité d’être utilisée comme indicateur unique de la valeur d’une échelle d’évaluation clinique.
2.2 Définition de la spécificité et du taux de faux positifs
Complément indispensable de la sensibilité, la spécificité quantifie la capacité d’un instrument de mesure à identifier correctement l’absence de pathologie chez les individus qui en sont réellement indemnes. Définie mathématiquement comme la probabilité conditionnelle $P(T- mid D-)$, la spécificité exprime la proportion de sujets sains qui obtiennent un résultat négatif au test (score strictement inférieur au seuil déterminé). Sa formulation canonique est la suivante :
Spécificité = Vrais Négatifs / (Vrais Négatifs + Faux Positifs)
À partir de cette définition fondamentale dérive immédiatement le concept de taux de faux positifs (TFP), qui constitue le complément à l’unité de la spécificité, soit $1 – \text{Spécificité}$, ou encore la probabilité conditionnelle $P(T+ mid D-)$. Le taux de faux positifs représente la fraction d’individus sains qui sont erronément qualifiés de pathologiques par le test à un seuil donné. Dans un espace cartésien ROC, c’est précisément cette grandeur ($1 – \text{Spécificité}$) qui est systématiquement projetée sur l’axe horizontal des abscisses (axe X), tandis que la sensibilité est projetée sur l’axe vertical des ordonnées (axe Y).
L’optimisation de la spécificité revêt une importance capitale pour minimiser la iatrogénie psychologique et sociale. Un diagnostic psychiatrique erroné peut entraîner une détresse émotionnelle sévère, induire des prescriptions pharmacologiques superflues accompagnées d’effets secondaires délétères, et favoriser une internalisation du statut de malade chez un individu parfaitement sain. En contexte clinique rigoureux, un équilibre méticuleux doit ainsi être trouvé entre la nécessité absolue d’identifier les malades et le devoir déontologique de préserver l’intégrité des sujets sains.
2.3 La matrice de confusion comme socle de calcul
L’ensemble des calculs sous-tendant la courbe ROC repose sur la matrice de confusion, également appelée tableau de contingence deux par deux. Cette matrice structure de manière exhaustive les quatre issues potentielles d’une classification binaire croisant l’état réel de l’individu avec le verdict rendu par le test à un niveau de coupure donné. On y distingue les quatre quadrants fondamentaux :
- Vrais Positifs (VP) : Sujets réellement malades et correctement identifiés comme tels par l’instrument de mesure.
- Faux Positifs (FP) : Sujets sains classés abusivement comme malades par le test (erreur statistique de type I, ou risque alpha).
- Vrais Négatifs (VN) : Sujets sains dont le résultat au test se situe sous le seuil d’alerte, confirmant avec justesse leur statut non pathologique.
- Faux Négatifs (FN) : Sujets porteurs de la pathologie mais dont le score au test est anormalement bas, conduisant à un rejet erroné de l’hypothèse diagnostique (erreur statistique de type II, ou risque bêta).
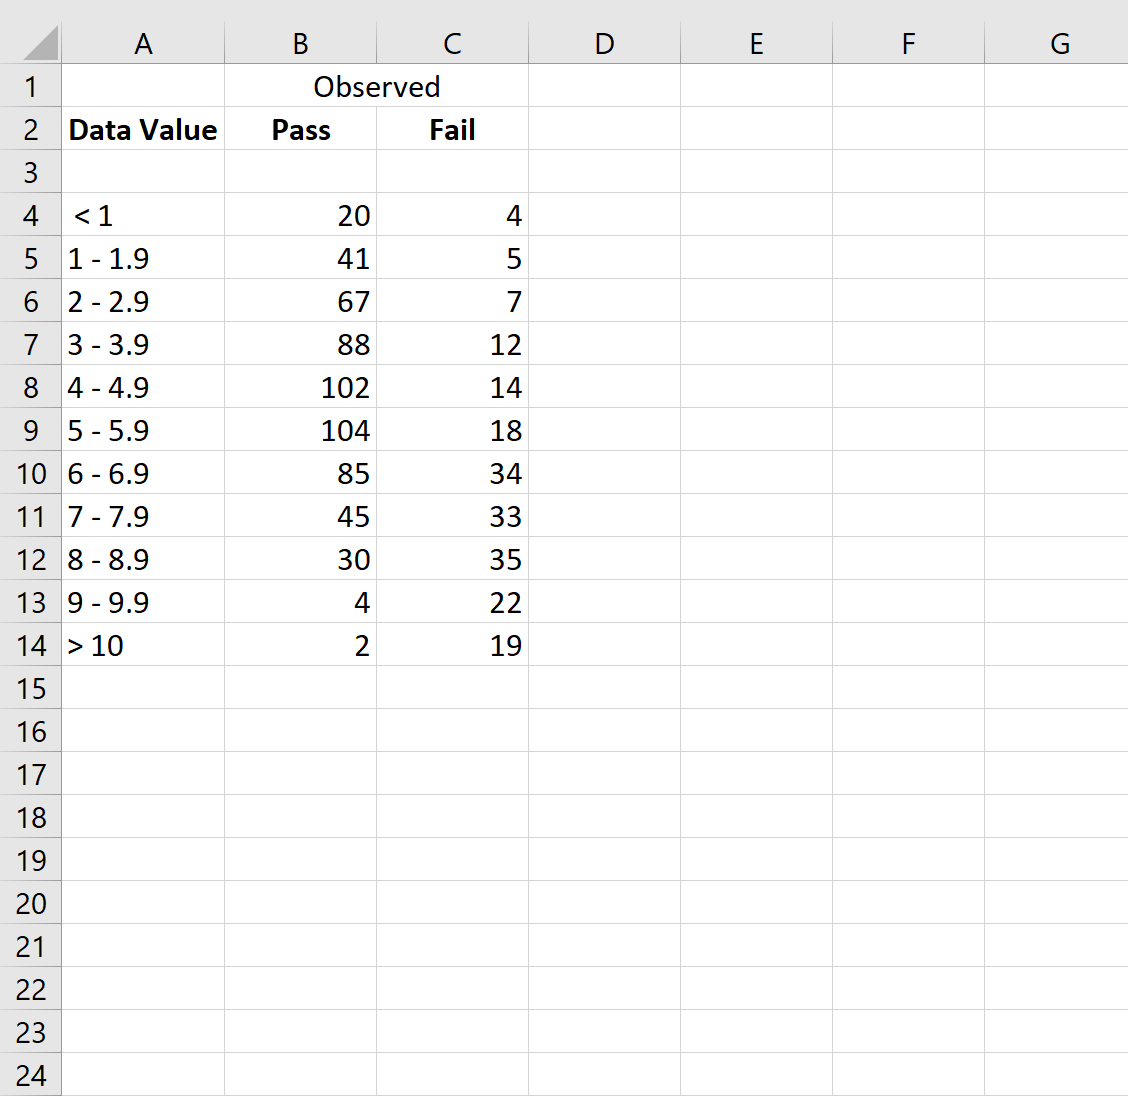
Il est impératif de comprendre que la matrice de confusion n’est pas une entité statique pour un test donné ; elle est au contraire entièrement asservie à la valeur seuil choisie pour séparer la négativité de la positivité. Lorsqu’un praticien déplace ce seuil le long de l’axe des scores du test, les effectifs se redistribuent dynamiquement entre les quatre cellules de la matrice. L’analyse ROC ne consiste en rien d’autre qu’en la modélisation mathématique itérative de cette matrice pour l’intégralité des seuils de coupure possibles observables au sein de l’échantillon empirique.
3. Préparation et structuration des données psychologiques sous Excel
3.1 Formatage de la feuille de calcul et hygiène des données
L’intégrité de la modélisation sous Microsoft Excel dépend de la propreté structurale du jeu de données brut. La mise en place d’une hygiène rigoureuse de la feuille de calcul évite l’apparition d’erreurs d’adressage ou de décalages de lignes lors des phases d’ordonnancement. Pour garantir une traçabilité optimale selon les standards de la recherche psychologique, le tableau primaire doit s’organiser autour de trois colonnes impératives dès la cellule A1 :
- Colonne A (Identifiant du sujet) : Un code alphanumérique unique pour chaque participant (par exemple,
SUBJ_001,SUBJ_002), interdisant toute confusion lors des manipulations de tri. - Colonne B (Score au test continu) : La valeur numérique brute obtenue par l’individu à l’échelle psychométrique ou neuropsychologique évaluée (par exemple, le score total à l’inventaire PHQ-9, une note au test de Stroop ou un temps de réaction en millisecondes).
- Colonne C (Statut réel de référence) : La variable dépendante dichotomique, rigoureusement encodée sous forme binaire : le chiffre 1 désignant impérativement la présence attestée de la pathologie (cas positifs, validés par un entretien clinique structuré de type SCID ou MINI) et le chiffre 0 désignant l’absence formelle de cette pathologie (sujets témoins ou contrôles sains).
Le nettoyage préalable des données requiert la traque méthodique des valeurs manquantes, des fautes de frappe typographiques et des valeurs aberrantes. Les cellules vides dans la colonne des scores doivent être supprimées de la cohorte d’analyse (suppression par liste complète ou imputation rigoureusement documentée) pour ne pas fausser les rangs cumulés. De surcroît, il est vivement conseillé de renommer les plages de cellules via le Gestionnaire de noms d’Excel (par exemple, nommer la plage des statuts Statut_Clinique et celle des scores Score_Test), ce qui confère aux formules subséquentes une lisibilité formelle et prévient toute distorsion lors des opérations de recopie.
3.2 Vérification de la validité de l’échantillon empirique
Avant d’engager le moindre calcul algorithmique, un audit descriptif de la cohorte doit être mené pour vérifier si les conditions d’application d’une courbe ROC robuste sont réunies. Le premier point d’attention concerne la prévalence d’échantillon, c’est-à-dire le ratio entre les cas positifs (statut = 1) et les cas négatifs (statut = 0). Bien que la courbe ROC présente l’immense avantage théorique d’être mathématiquement indépendante de la prévalence de la maladie dans la population générale (puisque la sensibilité et la spécificité sont des probabilités conditionnelles calculées séparément au sein de chaque sous-groupe diagnostique), un déséquilibre extrême au sein de l’échantillon empirique (par exemple, 5 cas positifs pour 500 contrôles) réduirait considérablement la précision de l’estimation de la sensibilité, augmentant ainsi la variance asymptotique de la courbe.
La puissance statistique de l’analyse est intrinsèquement tributaire de la taille de l’échantillon. Selon les recommandations établies par Hanley et McNeil (1982), un protocole d’évaluation diagnostique sérieux devrait idéalement comporter un minimum absolu de 50 participants dans chaque catégorie clinique pour obtenir un intervalle de confiance raisonnablement resserré autour de l’aire sous la courbe.
Enfin, l’examen visuel et paramétrique de la distribution des scores continus à l’aide de statistiques descriptives élémentaires sous Excel (calcul des fonctions MOYENNE, ECARTYPE.STANDARD, MEDIANE, COEFFICIENT.ASYMETRIE) s’avère hautement informatif. Si le test psychologique étudié possède un réel pouvoir discriminant, la distribution des scores du groupe pathologique doit présenter un décalage net vers les valeurs élevées (dans le cas d’une échelle mesurant des symptômes) par rapport à celle du groupe témoin, bien qu’un recouvrement partiel soit inévitable dans les situations cliniques réelles.
4. Étape 1 : Organisation des données brutes et tri séquentiel
4.1 Procédure de tri décroissant sous Excel
L’étape inaugurale de l’algorithme ROC sous tableur réside dans le tri des observations individuelles en fonction de la grandeur de leur score continu. Ce processus repose sur un principe logique fondamental : si l’on postule qu’un score élevé est le signe indicateur d’une pathologie, alors les sujets obtenant les notes les plus élevées présentent la plus forte probabilité a priori d’appartenir au groupe clinique pathologique ($D+$). Par conséquent, l’abaissement progressif du seuil de détection revient à parcourir les individus de l’échantillon en partant du score le plus haut vers le score le plus bas.
Pour exécuter cette opération sans corrompre l’intégrité de la structure tabulaire :
- Sélectionnez l’intégralité de la matrice de données en incluant les en-têtes de colonnes (plage
A1:C[N], où $N$ est la dernière ligne occupée par un sujet). Il est impératif de ne jamais sélectionner une seule colonne de manière isolée, sous peine de détruire irrémédiablement l’appariement entre l’identifiant du patient, son score et son statut clinique réel. - Accédez au ruban supérieur d’Excel, onglet Données, puis cliquez sur l’icône Trier pour afficher la boîte de dialogue de tri personnalisé.
- Vérifiez méticuleusement que la case « Mes données ont des en-têtes » est dûment cochée.
- Dans le champ « Colonne – Trier par », sélectionnez le libellé correspondant au score continu (Colonne B).
- Dans le champ « Ordre », choisissez impérativement Du plus grand au plus petit (ordre décroissant).
- Cliquez sur OK pour valider l’opération de réordonnancement.
Une question méthodologique majeure surgit fréquemment lors de cette phase : la gestion des ex æquo, c’est-à-dire des participants distincts ayant obtenu rigoureusement le même score psychométrique. Lorsque plusieurs sujets partagent un score identique mais affichent des statuts diagnostiques opposés, l’ordre précis dans lequel Excel les classe individuellement peut induire de légères variations dans la trajectoire locale du tracé point par point si l’on traite chaque ligne comme un seuil unique. Pour traiter rigoureusement ces ex æquo au sens mathématique, il conviendrait de regrouper les observations par palier de score unique ; toutefois, dans la pratique empirique sur des échantillons suffisamment larges, le traitement ligne à ligne consécutif fournit une approximation discrète d’une excellente précision qui converge parfaitement vers l’intégrale théorique.
4.2 Définition de la table de contingence ordonnée
Une fois les données rigoureusement triées par ordre décroissant de score, la colonne C (le statut clinique binaire) se transforme en une suite de 1 et de 0 ordonnée selon la performance de l’instrument. Si l’échelle psychométrique était d’une perfection absolue, la colonne C présenterait tous les 1 regroupés au sommet du tableau, suivis sans discontinuité par l’ensemble des 0 dans la partie inférieure. Dans la réalité clinique, en raison des imperfections inhérentes à la mesure humaine, des 0 s’intercalent parmi les 1 dès les strates de scores intermédiaires, traduisant graphiquement les erreurs de classification.
Pour préparer les colonnes de calcul nécessaires à la construction de la courbe, nous allons enrichir notre feuille de calcul de plusieurs nouvelles colonnes adjacentes. Positionnez-vous sur la ligne d’en-tête et insérez les étiquettes suivantes :
- Colonne D :
Rang(numérotation séquentielle des sujets de 1 à $N$) - Colonne E :
VP_Cumulés(somme progressive des vrais positifs détectés) - Colonne F :
FP_Cumulés(somme progressive des faux positifs détectés) - Colonne G :
Sensibilité (TVP)(taux de vrais positifs standardisé) - Colonne H :
1 - Spécificité (TFP)(taux de faux positifs standardisé)
Remplissez la colonne D en inscrivant 1 en cellule D2, 2 en cellule D3, puis étirez la série jusqu’au bas du tableau. Cette colonne servira de témoin séquentiel. Avant d’engager le calcul des sommes cumulées, il est impératif de dériver deux constantes fondamentales qui serviront de dénominateurs universels pour l’ensemble des formules de standardisation : le nombre total de malades ($N_{\text{pos}}$) et le nombre total de non-malades ($N_{\text{\neg}}$) dans la cohorte.
Dans deux cellules dédiées et isolées en dehors du tableau principal (par exemple, les cellules K1 et K2), saisissez les formules suivantes :
- En
K1(Total des cas positifs) :=SOMME(C2:C101)(en supposant une cohorte de 100 individus s’étendant de la ligne 2 à la ligne 101). Puisque la maladie est codée par 1 et la santé par 0, la somme arithmétique de la colonne C équivaut précisément au cardinal des cas positifs. - En
K2(Total des cas négatifs) :=NB.SI(C2:C101; 0)ou de manière équivalente=LIGNES(C2:C101)-K1. Cette valeur quantifie la taille absolue de la population témoin.
5. Étape 2 : Calcul des fréquences cumulées et des effectifs cumulés
5.1 Formulation des sommes cumulées pour les cas positifs
Le calcul séquentiel des vrais positifs cumulés repose sur un principe élégant : au fur et à mesure que l’on descend dans le tableau trié par score décroissant, chaque individu rencontré qui présente un statut clinique égal à 1 incrémente le compteur des cas positifs détectés si le seuil de décision était fixé juste en dessous de son score. Pour matérialiser cette sommation incrémentale sous Microsoft Excel, nous exploitons la puissance de l’ancrage absolu partiel via l’opérateur dollar ($).
Positionnez-vous dans la cellule E2 (première ligne de données sous les en-têtes) et saisissez rigoureusement la formule suivante :
=SOMME($C$2:C2)
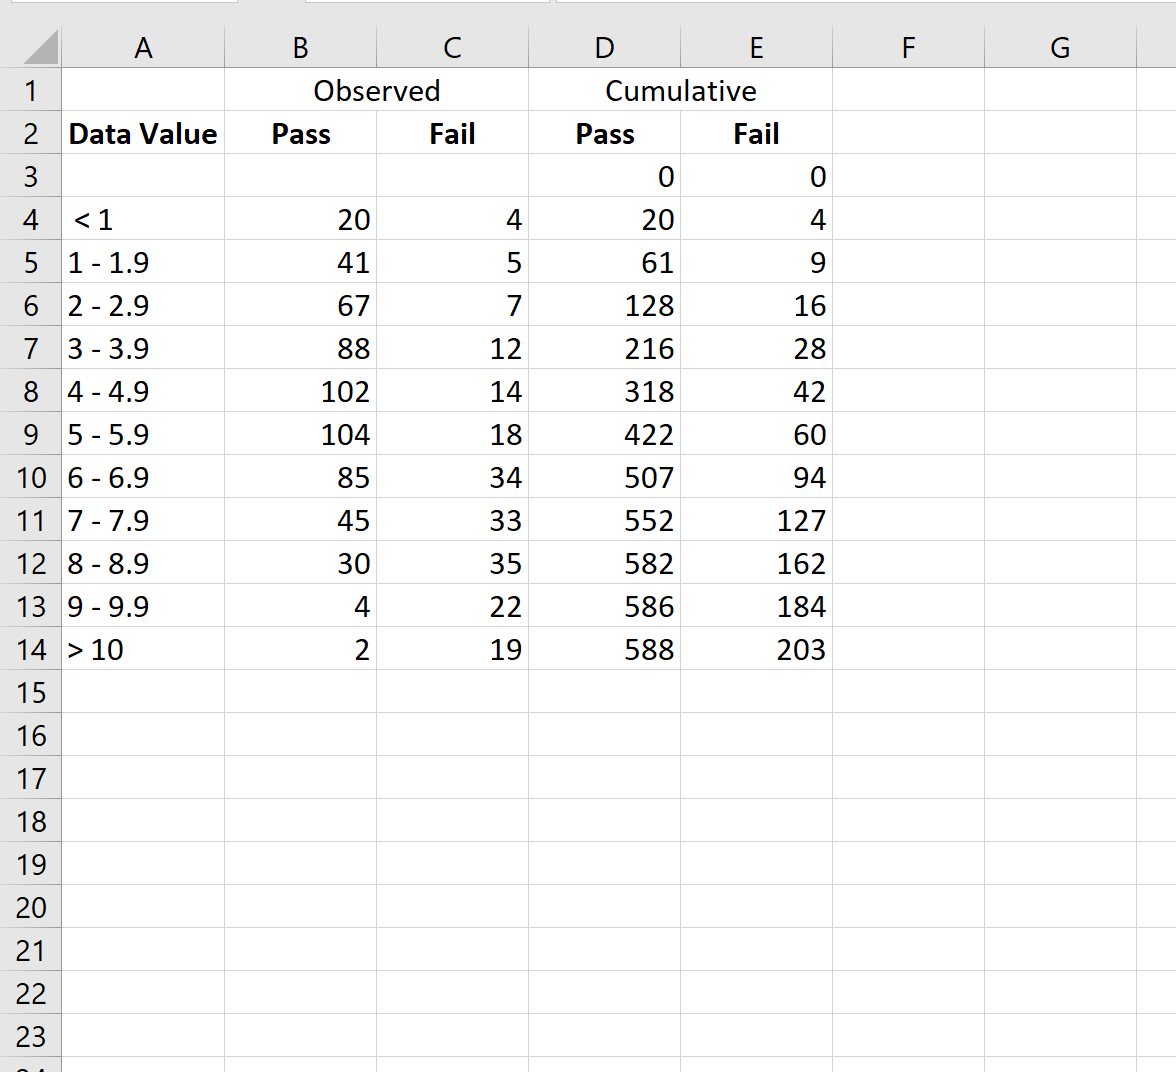
Cette syntaxe remarquable fige l’origine de la plage sommée sur la cellule $C$2 grâce aux deux signes dollar, tout en laissant l’extrémité de la plage (C2) en référence relative. Par conséquent, lorsque cette formule sera copiée vers le bas, elle s’adaptera dynamiquement pour sommer $C$2:C3 en ligne 3, puis $C$2:C4 en ligne 4, et ainsi de suite jusqu’à englober l’ensemble des observations. La valeur affichée dans la cellule E d’une ligne donnée indique exactement le nombre cumulé de vrais positifs capturés si le test psychométrique adoptait comme critère diagnostique le score affiché dans la colonne B de cette même ligne.
Pour auditer immédiatement la validité de votre construction, faites défiler votre feuille jusqu’à la dernière ligne occupée de votre tableau. La valeur calculée dans la toute dernière cellule de la colonne E doit coïncider rigoureusement avec la valeur calculée précédemment en K1 (le nombre total de malades réels de la cohorte). Tout écart numérique entre ces deux valeurs trahirait une erreur d’adressage ou la présence de caractères non numériques dans la colonne des statuts.
5.2 Formulation des sommes cumulées pour les cas négatifs
L’évaluation symétrique des faux positifs cumulés exige de compter, à chaque étape du balayage décroissant des scores, le nombre de sujets sains (ayant un statut clinique égal à 0) qui se sont vus indûment attribuer un score supérieur ou égal au seuil considéré. Chaque fois qu’une ligne présente un statut 0, cela signifie qu’un sujet non malade est inclus à tort dans la zone positive, augmentant ainsi l’effectif des faux positifs.
Pour formaliser cette détection sans complexifier le classeur, placez-vous dans la cellule F2 et appliquez la formule suivante :
=NB.SI($C$2:C2; 0)
Une alternative mathématique tout aussi rigoureuse consiste à soustraire le nombre cumulé de vrais positifs du nombre total de lignes parcourues, ce qui se traduit par :
=LIGNE() - LIGNE($C$2) + 1 - E2
La formule basée sur NB.SI offre l’avantage d’une lisibilité conceptuelle directe : elle inspecte la plage s’étendant du sommet du tableau jusqu’à la ligne active et comptabilise explicitement le nombre d’occurrences du chiffre 0. Là encore, le mécanisme d’ancrage absolu partiel $C$2 garantit que la fenêtre d’observation s’élargit progressivement d’une unité à chaque incrément vertical. À l’instar du contrôle opéré sur les cas positifs, l’intégrité de la colonne F se vérifie en observant son terme terminal : la dernière cellule de la colonne F doit être rigoureusement identique au contenu de la cellule K2, scellant le fait que l’intégralité des sujets témoins a finalement été comptabilisée.
5.3 Automatisation par extension des formules dans la colonne
Une fois les cellules E2 et F2 convenablement paramétrées, il convient de propager ces calculs sur l’ensemble de l’échantillon. Microsoft Excel propose plusieurs méthodes d’une efficacité redoutable pour éviter la saisie manuelle fastidieuse et sujette aux bévues :
- Sélectionnez conjointement la plage de cellules
E2:F2à l’aide de votre souris. - Placez votre curseur sur le coin inférieur droit de la cellule F2 jusqu’à ce que le pointeur se métamorphose en une fine croix noire (la poignée de recopie).
- Effectuez un double-clic gauche rapide. Excel analyse automatiquement la continuité des données adjacentes dans la colonne D et projette instantanément les deux formules jusqu’au pied exact du tableau de données, quelle que soit sa longueur (qu’il comporte 100 ou 100 000 observations).
Pour les utilisateurs travaillant sur des versions modernes d’Excel, une approche encore plus élégante consiste à convertir préalablement la plage de données brute en un Tableau structuré officiel (raccourci clavier Ctrl + L ou Ctrl + T sous Windows). Dans un tableau structuré, toute formule introduite sur la première ligne d’une colonne calculée est immédiatement et automatiquement répliquée sur toute la profondeur de la table, les références de colonnes devenant explicites sous la forme [@Score] ou [@Statut]. Cette automatisation dynamique élimine virtuellement tout risque d’oubli lors de l’ajout ultérieur de nouveaux participants dans la cohorte clinique.
6. Étape 3 : Calcul des taux de vrais positifs (TVP) et de faux positifs (TFP)
6.1 Standardisation du taux de vrais positifs (Sensibilité)
Les effectifs cumulés obtenus aux étapes précédentes expriment des valeurs de comptage absolues. Or, les coordonnées de la courbe ROC reposent obligatoirement sur des probabilités conditionnelles standardisées, dont l’amplitude est rigoureusement circonscrite à l’intervalle réel $[0, 1]$. La standardisation du taux de vrais positifs (la sensibilité) consiste à diviser le nombre de malades identifiés à chaque seuil par l’effectif global absolu de la population malade contenue dans l’étude.
Positionnez-vous dans la cellule G2 et saisissez l’équation :
=E2 / $K$1
Dans cette formule, la référence E2 est relative et pointera successivement vers les cumuls de chaque ligne lors de l’étirement, tandis que la référence $K$1 est verrouillée de manière absolue par les deux dollars, assurant que chaque effectif partiel est divisé par la même constante invariante représentant $N_{\text{pos}}$.
Sur le plan du formatage d’affichage, il est vivement recommandé d’appliquer à la colonne G un format de Nombre avec 4 décimales ou un format de Pourcentage avec 2 décimales. Cette précision visuelle permet de déceler les faibles variations incrémentales de sensibilité d’un seuil à l’autre. Par construction mathématique, la première ligne du tableau (le score le plus extrême) affichera une sensibilité faible mais non nulle (par exemple $1 / 50 = 0,0200$), tandis que la dernière ligne du tableau (le seuil le plus libéral qui englobe l’ensemble des scores) affichera impérativement la valeur $1,0000$ (soit $100%$).
6.2 Standardisation du taux de faux positifs (1 – Spécificité)
De manière parfaitement symétrique, la colonne du taux de faux positifs (l’abscisse X de notre futur graphique) s’obtient en divisant l’effectif cumulé des sujets sains erronément classés par l’effectif total des sujets sains présents dans la recherche. Cette valeur correspond très exactement à la quantité mathématique $1 – \text{Spécificité}$.
Positionnez-vous dans la cellule H2 et saisissez la formule :
=F2 / $K$2
Ici encore, le dénominateur $K$2 ($N_{\text{\neg}}$) demeure strictement immobile sous l’action du verrouillage absolu. Étirez simultanément les cellules G2 et H2 vers le bas jusqu’au terme de votre échantillon. Les valeurs générées dans la colonne H doivent obligatoirement être monotones non décroissantes et osciller entre des valeurs proches de 0 sur les premières lignes pour culminer rigoureusement à $1,0000$ sur la ligne terminale.
Une exigence géométrique cardinale doit impérativement être satisfaite à ce stade : pour qu’une courbe ROC soit mathématiquement complète et permette un calcul exact de sa surface, elle doit impérativement débuter à l’origine cartésienne exacte, c’est-à-dire au point de coordonnées $(X=0, Y=0)$. Ce point initial correspond au seuil théorique infiniment strict où aucun individu n’est déclaré positif (sensibilité = 0, taux de faux positifs = 0). Dans la structure de données que nous venons d’ériger, la ligne 2 représente déjà le premier sujet réel, ayant donc une valeur non nulle. Pour ancrer la courbe à l’origine, il est impératif d’insérer une ligne neutre :
- Faites un clic droit sur l’en-tête de la ligne 2 et sélectionnez Insérer. Une nouvelle ligne vierge s’intercale immédiatement sous vos titres.
- Renseignez cette ligne d’ancrage en attribuant arbitrairement un score virtuel supérieur au score maximal observé (par exemple, la mention
Seuil Max), et forcez explicitement les valeurs :0dans la colonne E,0dans la colonne F,0,0000dans la colonne G et0,0000dans la colonne H.
6.3 Tableau récapitulatif des coordonnées de traçage
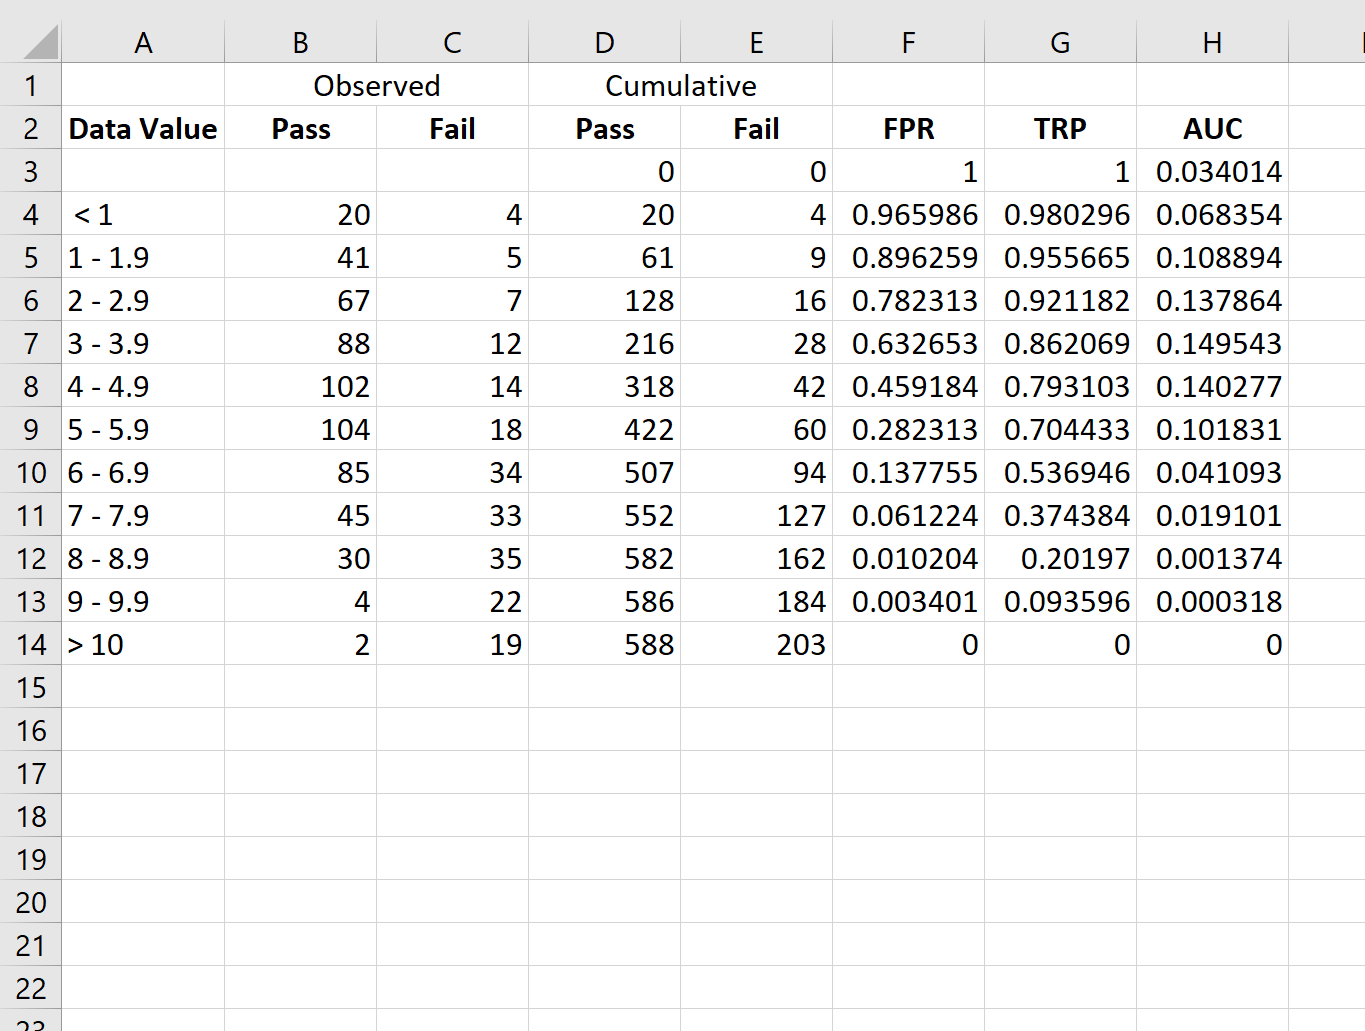
À l’issue de cette phase préparatoire, votre feuille de calcul contient désormais l’ensemble des coordonnées cartésiennes indispensables à la modélisation graphique. Pour consolider la clarté conceptuelle de l’architecture de vos données, vérifiez attentivement la conformité structurelle de vos colonnes :
| Ligne | Score Test (B) | Statut Réel (C) | VP Cumulés (E) | FP Cumulés (F) | Sensibilité / Axe Y (G) | 1 – Spécificité / Axe X (H) |
|---|---|---|---|---|---|---|
| 2 (Ancrage) | ∞ (Seuil initial) | – | 0 | 0 | 0,0000 | 0,0000 |
| 3 | Score Max observé | 1 ou 0 | 0 ou 1 | 0 ou 1 | TVP_1 | TFP_1 |
| … | … | … | … | … | … | … |
| N+2 (Terme) | Score Min observé | 1 ou 0 | Total Positifs | Total Négatifs | 1,0000 | 1,0000 |
En parallèle, afin de matérialiser visuellement la diagonale théorique d’incompétence statistique (la ligne de chance où la sensibilité équivaut parfaitement au taux de faux positifs pour tout seuil), nous allons aménager deux petites colonnes de référence dans un espace adjacent de la feuille (par exemple en cellules J5:K7) :
- Cellule
J5=0; CelluleK5=0(Origine cartésienne) - Cellule
J6=0,5; CelluleK6=0,5(Point médian) - Cellule
J7=1; CelluleK7=1(Extrémité supérieure droite)
7. Étape 4 : Génération du graphique de dispersion (Nuage de points) dans Excel
7.1 Sélection du type de graphique adéquat
L’une des méprises méthodologiques les plus destructrices et fréquentes sous Microsoft Excel consiste à sélectionner un graphique du type « Courbe » standard au lieu d’un « Nuage de points » (Scatter Plot). Dans un graphique en courbe classique, Excel traite les valeurs de l’axe X comme de simples étiquettes catégorielles équidistantes, ignorant totalement leur magnitude numérique réelle. Or, dans une courbe ROC, les valeurs de $1 – \text{Spécificité}$ ne progressent absolument pas de manière linéaire ou uniforme ; elles subissent des accélérations ou des stagnations en fonction de la concentration empirique des faux positifs le long du continuum des scores.
Il est donc impératif de sélectionner exclusivement le type :
Nuage de points avec lignes droites et marqueurs (ou avec lignes lissées selon l’effet souhaité, la ligne droite brisée restant la plus rigoureuse sur le plan scientifique).
Ce type de diagramme cartésien traite véritablement l’abscisse et l’ordonnée comme des échelles d’intervalles continues, plaçant chaque paire $(X_i, Y_i)$ à sa position spatiale mathématiquement exacte. Pour initier la création dans des conditions de contrôle total, il est préférable de ne rien sélectionner sur la feuille, de cliquer dans une cellule totalement vide à l’écart, d’accéder à l’onglet Insertion, de déployer le menu déroulant du groupe Graphiques dédié aux nuages de points, et de choisir un conteneur vierge. Cette démarche évite qu’Excel n’interprète de manière erratique vos colonnes de données.
7.2 Ajout des séries de données empiriques
À présent que le cadre graphique vierge est positionné sur votre feuille, nous allons lui injecter manuellement nos séries de coordonnées empiriques :
- Faites un clic droit à l’intérieur du cadre blanc du graphique vierge et choisissez la commande Sélectionner des données… dans le menu contextuel.
- Dans la fenêtre modale qui apparaît à l’écran, repérez le volet gauche intitulé « Entrées de légende (Série) » et cliquez sur le bouton Ajouter.
- Dans la sous-fenêtre « Modifier la série », configurez rigoureusement les champs comme suit :
- Nom de la série : Cliquez sur une cellule contenant le nom de votre test psychologique (par exemple
B1) ou saisissez directement un texte tel queÉchelle Test Clinique. - Valeurs de la série X : Cliquez sur l’icône de sélection et surlignez méticuleusement la plage de la colonne H, en incluant impérativement la cellule d’ancrage à zéro (soit la plage
$H$2:$H$102). Cette plage représente la série empirique de $1 – \text{Spécificité}$. - Valeurs de la série Y : Effacez systématiquement l’accolade
={1}préremplie par Excel, puis surlignez la plage correspondante de la colonne G, incluant également le zéro initial (soit la plage$G$2:$G$102). Cette plage représente la série empirique de la Sensibilité.
- Nom de la série : Cliquez sur une cellule contenant le nom de votre test psychologique (par exemple
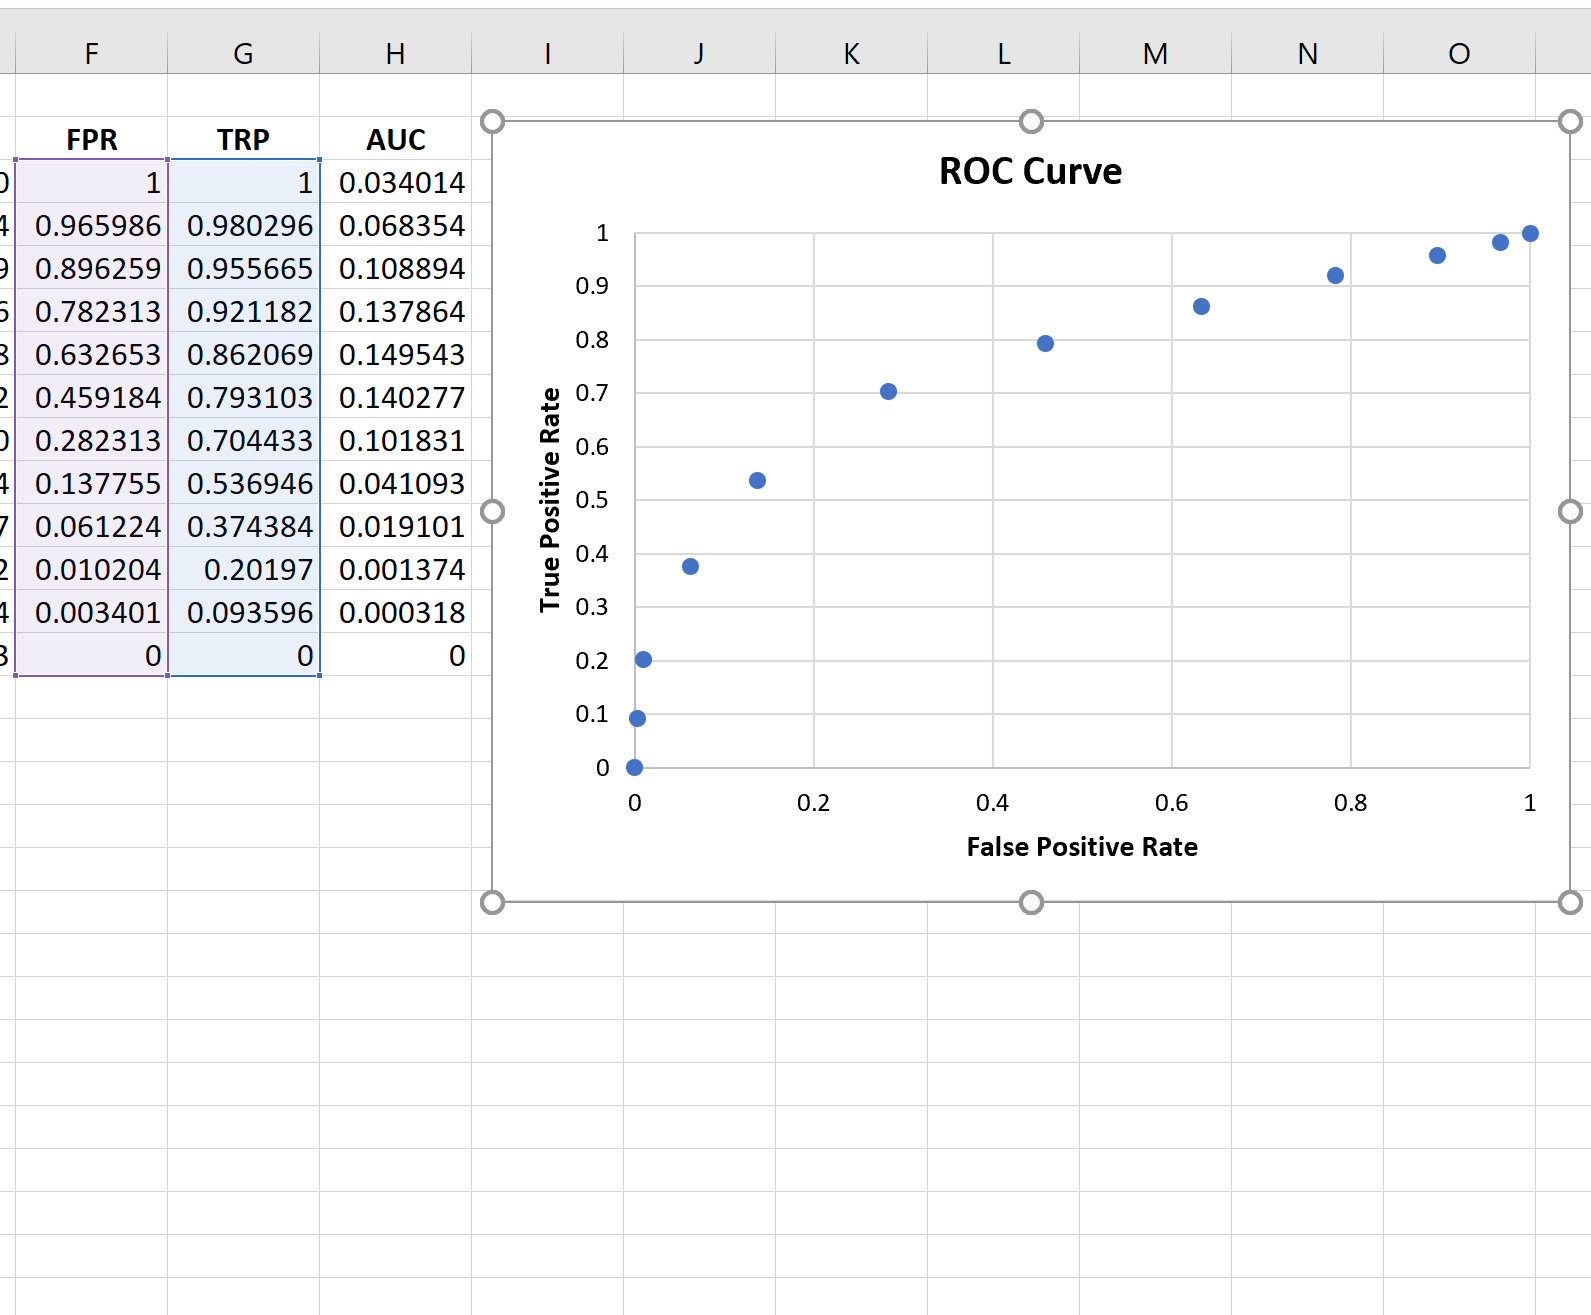
- Cliquez sur OK pour sceller l’intégration de la série empirique. Vous observez d’ores et déjà à l’arrière-plan la trajectoire caractéristique de la courbe ROC s’élever au-dessus de l’axe horizontal.
7.3 Intégration de la diagonale de référence théorique
Une courbe ROC ne saurait posséder de validité interprétative sans la superposition de sa diagonale de référence, souvent appelée ligne de non-discrimination ou ligne de chance pure. Cette droite joignant le point originel $(0,0)$ au point terminal $(1,1)$ matérialise visuellement la performance théorique d’un test qui serait rigoureusement incapable de différencier un patient dépressif d’un sujet sain, l’attribution diagnostique relevant alors du pur hasard (analogue au tirage d’une pièce de monnaie non biaisée).
Pour superposer cette ligne directrice au sein du même espace cartésien :
- Dans la boîte de dialogue « Sélectionner une source de données » (toujours ouverte, ou réactivée par un clic droit sur le graphique), cliquez à nouveau sur le bouton Ajouter pour créer une deuxième série indépendante.
- Attribuez-lui le libellé formel :
Ligne de chance (Hasard)dans le champ Nom de la série. - Pour les Valeurs de la série X, sélectionnez la plage des coordonnées X de votre table de diagonale préalablement préparée (cellules
$J$5:$J$7). - Pour les Valeurs de la série Y, sélectionnez la plage des coordonnées Y identiques (cellules
$K$5:$K$7). - Validez en cliquant sur OK à deux reprises pour fermer les fenêtres d’administration des données.
À ce stade, une seconde ligne rectiligne traverse parfaitement votre repère cartésien d’un coin à l’autre. Plus l’espace géométrique séparant la courbe empirique de cette diagonale théorique est volumineux, plus l’instrument de mesure évalué démontre une pertinence diagnostique supérieure.
8. Étape 5 : Mise en forme et optimisation visuelle de la courbe ROC
8.1 Paramétrage précis des axes cartésiens
Par défaut, le moteur de rendu graphique de Microsoft Excel commet fréquemment des approximations visuelles incompatibles avec la métrique formelle de l’analyse ROC. Notamment, le tableur tend à étendre les limites des axes au-delà de 1,0 (affichant par exemple des graduations parasites jusqu’à 1,2) pour aérer le tracé. Or, les probabilités mathématiques ne pouvant en aucun cas excéder l’unité, cette déformation fausse la perception visuelle de la concavité de la courbe.
Un calibrage strict s’impose sur les deux axes cartésiens :
- Axe horizontal (Abscisse – 1 – Spécificité) :
- Double-cliquez directement sur les valeurs numériques de l’axe horizontal pour faire surgir le volet latéral Format de l’axe.
- Sous l’onglet Options d’axe (symbolisé par des barres d’histogramme), fixez impérativement la valeur Minimum à
0,0et la valeur Maximum à1,0(en veillant à ce que le statut de l’option passe de « Automatique » à « Réinitialiser », scellant le verrouillage). - Réglez l’unité Principale à
0,2(ou0,1selon le niveau de détail désiré).
- Axe vertical (Ordonnée – Sensibilité) :
- Double-cliquez sur les valeurs de l’axe vertical et appliquez rigoureusement les mêmes paramètres : Minimum verrouillé à
0,0, Maximum verrouillé à1,0, et incrément Principal établi à0,2.
- Double-cliquez sur les valeurs de l’axe vertical et appliquez rigoureusement les mêmes paramètres : Minimum verrouillé à
- Rapport de forme carré (Aspect Ratio 1:1) :
Une courbe ROC ne doit en aucun cas être représentée sous une forme rectangulaire écrasée ou étirée, ce qui déformerait artificiellement l’estimation visuelle de l’aire sous la courbe. Cliquez sur la bordure extérieure de votre graphique, accédez à l’onglet Format du ruban supérieur d’Excel, et dans le groupe Taille, ajustez manuellement la hauteur et la largeur à des valeurs rigoureusement identiques (par exemple : Hauteur = 12 cm, Largeur = 12 cm).
8.2 Esthétique et standardisation pour publication scientifique
Pour conférer à votre graphique une finition conforme aux préconisations typographiques des revues internationales (notamment les normes de l’American Psychological Association – APA 7th edition), un travail d’épuration esthétique s’avère indispensable. Le principe directeur est la maximisation du ratio encre-information théorisé par Edward Tufte, consistant à éliminer toute surcharge ornementale non signifiante.
Procédez aux ajustements structurels suivants :
- Suppression des lignes de quadrillage : Cliquez sur les lignes de grille horizontales et verticales qui traversent le graphique et appuyez sur la touche
Supprde votre clavier. L’espace intérieur doit demeurer blanc et immaculé. - Habillage des axes : Sélectionnez l’axe horizontal, activez le menu Remplissage et trait (icône de pot de peinture), et configurez la ligne en Trait plein, couleur noir absolu ou gris anthracite profond (par exemple le code hexadécimal
#333333), avec une épaisseur minimale de1 pt. Répétez l’opération à l’identique pour l’axe vertical. Profitez-en pour ajouter des graduations extérieures subtiles sous la section Graduations -> Type principal -> Extérieur. - Légitimation de la diagonale de chance : Cliquez sur la droite diagonale représentant le hasard. Dans le volet de mise en forme, affectez-lui une teinte grise neutre (par exemple
#888888), réduisez son épaisseur à1 pt, et modifiez impérativement le Type de tiret pour choisir un motif discontinu en pointillés ou tirets fins. Cette convention visuelle indique universellement qu’il s’agit d’une frontière théorique non empirique. - Mise en valeur de la courbe ROC empirique : Sélectionnez la courbe représentant votre test psychométrique. Attribuez-lui une teinte à fort contraste (par exemple un bleu marine professionnel
#003366ou un bordeaux académique), fixez son épaisseur à2 ptpour lui donner de l’assise, et désactivez les marqueurs individuels si votre cohorte est volumineuse pour éviter l’effet de saturation visuelle (dans l’onglet Marqueur, cochez Aucun). - Étiquettes textuelles des axes : Cliquez sur le bouton
+situé en marge du graphique, cochez Titres des axes, et inscrivez formellement :- Sur l’axe vertical (Y) : Sensibilité (Taux de vrais positifs)
- Sur l’axe horizontal (X) : 1 – Spécificité (Taux de faux positifs)
Harmonisez la typographie de l’ensemble du graphique en optant pour une police institutionnelle sans empattement telle que Arial, Calibri ou Times New Roman (taille 10 ou 11 pt).
8.3 Gestion de la légende et des annotations textuelles
L’intégration d’une légende doit obéir à des critères d’ergonomie cognitive stricts. Si votre graphique ne comporte qu’une seule courbe empirique confrontée à la diagonale de chance, la présence d’une légende encombrante en bas ou à droite du tracé est souvent superflue. Il est plus élégant d’insérer directement des zones de texte ancrées à l’intérieur du repère cartésien, dans des zones où elles ne masquent aucune trajectoire de données (généralement dans le quadrant inférieur droit).
Pour valoriser pleinement votre figure :
- Accédez à l’onglet Insertion, cliquez sur Formes, puis sélectionnez Zone de texte.
- Dessinez une discrète boîte de dialogue dans le coin inférieur droit du repère cartésien (par exemple centré autour des coordonnées $X=0,65, Y=0,25$).
- Saisissez-y la métrique synthétique essentielle :
AUC = 0,845 (IC 95 % : 0,78 - 0,91). Pour rendre cette zone de texte dynamique et asservie aux calculs de la feuille, cliquez sur la bordure de la boîte de texte, activez la Barre de formule supérieure d’Excel, tapez le signe=et cliquez sur la cellule où sera hébergé le calcul final de l’aire sous la courbe. Dès lors, toute mise à jour du jeu de données actualisera automatiquement l’annotation textuelle du graphique. - Pour matérialiser le seuil de coupure clinique jugé optimal (voir Section 10), il est hautement pertinent d’insérer une forme géométrique minuscule (un cercle plein de couleur vive, telle que le rouge cramoisi) positionnée précisément au-dessus de la coordonnée cartésienne correspondant à ce seuil particulier, accompagnée d’une étiquette descriptive indiquant la note brute (par exemple :
Seuil critique ≥ 10).
9. Calcul de l’aire sous la courbe (AUC) avec la méthode des trapèzes sous Excel
9.1 Fondements mathématiques de l’intégration trapézoïdale
Si la représentation graphique de la courbe ROC constitue un instrument qualitatif précieux pour apprécier la dynamique d’un test, l’exploitation décisionnelle exige un indice quantitatif global résumant l’exactitude diagnostique sur l’ensemble de l’espace des seuils. Cet indice universel est l’Aire sous la courbe, universellement désignée par le sigle AUC (Area Under the Curve) ou C-statistic (statistique de concordance). L’AUC quantifie la probabilité qu’un sujet tiré au sort de manière aléatoire au sein de la population malade présente un score au test strictement supérieur à celui d’un sujet extrait au hasard de la population saine :
AUC = P(Score_Malade > Score_Sain)
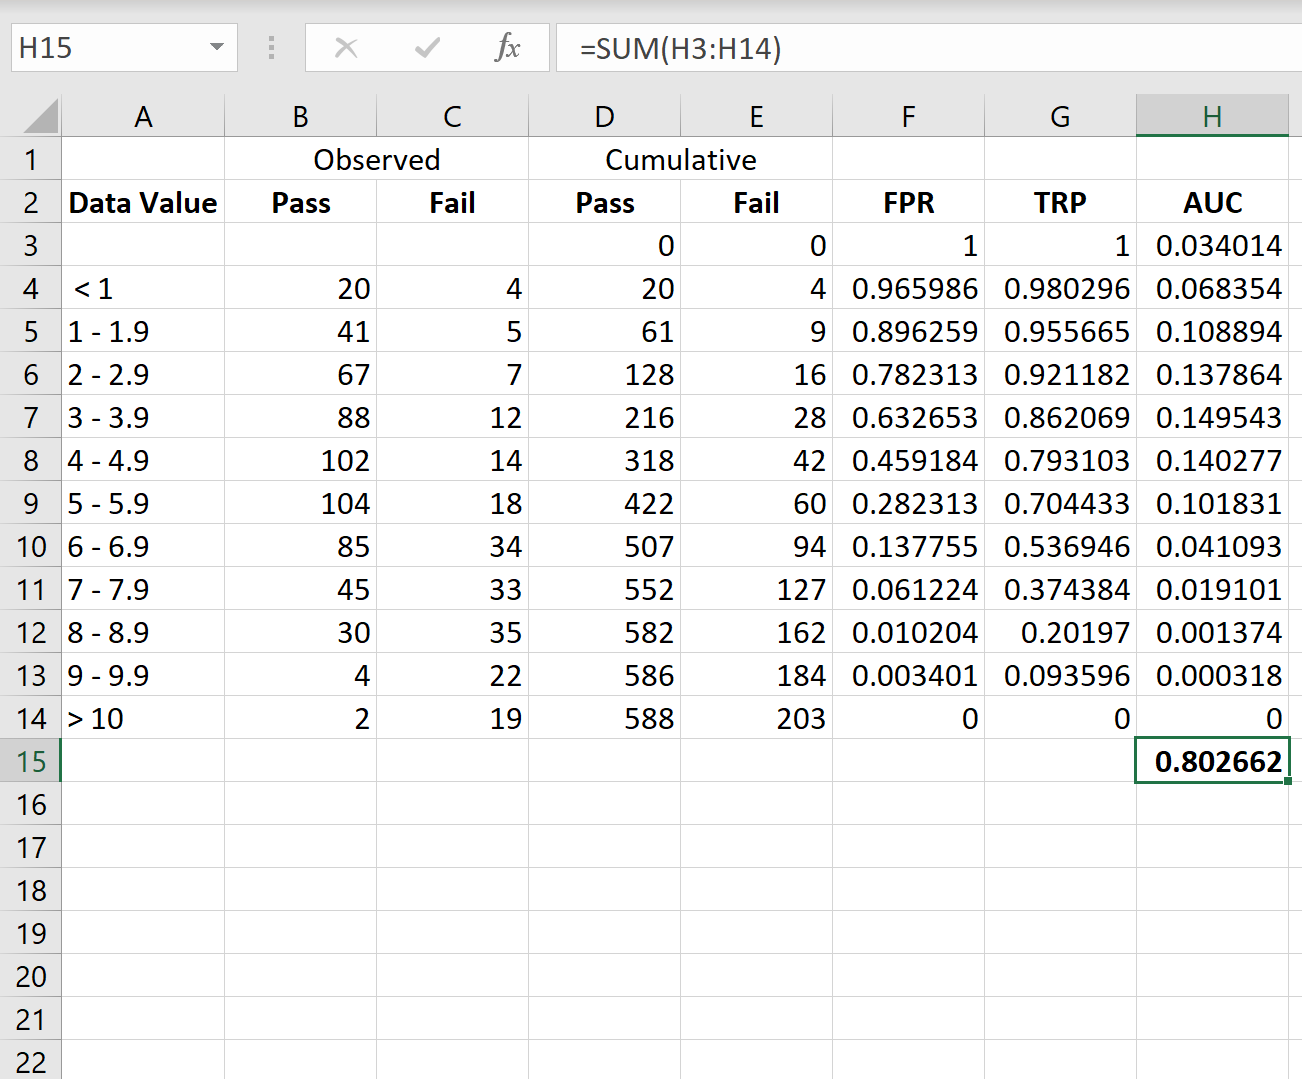
Puisque la courbe ROC empirique se présente sous la forme d’une fonction en escalier ou d’une suite de segments linéaires reliant des points de coordonnées discrètes $(X_i, Y_i)$, son intégrale mathématique s’obtient de manière déterministe via la méthode géométrique des trapèzes. Cette approche segmente la surface totale située sous la courbe en une juxtaposition de trapèzes élémentaires adjacents dont les bases sont parallèles à l’axe vertical des ordonnées.
Pour deux points empiriques consécutifs le long de la courbe, notés $P_{i-1} = (X_{i-1}, Y_{i-1})$ et $P_i = (X_i, Y_i)$, l’aire du trapèze élémentaire délimité par ces deux points, l’axe horizontal et les projections verticales s’obtient par la formule classique :
Aire_Trapèze = (Largeur) × (Hauteur Moyenne) = (X_i – X_{i-1}) × [(Y_{i-1} + Y_i) / 2]
Il est fascinant de constater sur le plan théorique que cette sommation trapézoïdale discrète est rigoureusement équivalente à la statistique non paramétrique $U$ du test de Wilcoxon-Mann-Whitney rapportée au produit des effectifs des deux sous-groupes. Ainsi, le calcul géométrique sous Excel ne constitue pas une vague approximation, mais bien l’expression mathématique exacte de l’équivalent non paramétrique du test de rang.
9.2 Implémentation algorithmique des formules dans Excel
L’orchestration de cette intégration géométrique au sein de notre classeur Excel nécessite la création d’une nouvelle colonne dédiée aux aires trapézoïdales partielles. Positionnez-vous sur la ligne d’en-tête et baptisez la Colonne I : Aire_Trapèze.
Rappelez-vous que notre première ligne de données (la ligne 2) est occupée par le point d’ancrage d’origine $(X_0 = 0, Y_0 = 0)$. La première tranche trapézoïdale se forme donc entre la ligne 2 et la ligne 3. Par conséquent, laissez la cellule I2 vide (ou assignez-lui la valeur 0), et positionnez-vous en cellule I3.
Saisissez rigoureusement l’expression algorithmique suivante :
=(H3 - H2) * ((G2 + G3) / 2)
Décomposons la mécanique interne de cette formule :
(H3 - H2)représente la largeur du trapèze le long de l’axe des abscisses, soit la différentielle $\Delta X = (1 – \text{Spécificité}_i) – (1 – \text{Spécificité}_{i-1})$. Si, lors du passage au sujet suivant, aucun nouveau faux positif n’est recruté, cette différence vaut exactement 0, et l’aire incrémentale générée est nulle (le tracé monte verticalement).((G2 + G3) / 2)représente la demi-somme des ordonnées consécutives, c’est-à-dire la hauteur moyenne de la sensibilité sur ce segment infinitésimal.
Propagez cette formule vers le bas en effectuant un double-clic sur la poignée de recopie de la cellule I3 jusqu’au pied du tableau. Chaque cellule de la colonne I héberge désormais la contribution surfacique locale du point considéré.
Il ne reste plus qu’à agréger ces surfaces partielles pour extraire l’AUC finale. Dans une cellule mise en exergue (par exemple la cellule K4), saisissez la fonction de sommation globale :
=SOMME(I3:I102)
Le résultat obtenu dans cette cellule scelle l’exactitude diagnostique intégrée de l’échelle clinique évaluée. Appliquez un format numérique affichant trois ou quatre décimales (par exemple 0,8542).
9.3 Interprétation quantitative et échelle de pertinence diagnostique
L’amplitude mathématique de l’AUC est comprise dans l’espace théorique fermé $[0, 1]$, bien que dans la pratique clinique rationnelle, elle oscille exclusivement entre $0,5$ et $1,0$. Une AUC inférieure à 0,5 trahirait une inversion aberrante dans l’encodage de vos variables (un test où les scores bas signeraient la pathologie, interprété par erreur comme un test à scores élevés), conduisant à une courbe incurvée sous la diagonale de chance.
Pour contextualiser la métrique obtenue selon les standards de la biomédecine et de la psychométrie quantitative (notamment les classifications de référence établies par Hosmer et Lemeshow, 2000), nous retenons la grille d’évaluation académique suivante :
- AUC = 0,50 : Performance rigoureusement nulle. Le test est totalement non informatif et équivaut à un jeu de hasard. L’échelle n’a aucune utilité clinique.
- 0,50 < AUC < 0,70 : Discrimination faible ou médiocre. L’instrument présente un pouvoir de séparation insuffisant pour fonder une décision clinique individuelle, bien qu’il puisse conserver une utilité épidémiologique marginale à l’échelle d’une large cohorte.
- 0,70 ≤ AUC < 0,80 : Discrimination acceptable ou modérée. L’échelle est fonctionnelle mais génère une quantité notable d’erreurs de classement. Elle doit être combinée à d’autres indices diagnostiques.
- 0,80 ≤ AUC < 0,90 : Discrimination excellente. L’instrument est solide, fiable et possède une réelle pertinence décisionnelle dans la pratique ambulatoire ou hospitalière.
- AUC ≥ 0,90 : Discrimination exceptionnelle. L’échelle sépare quasi parfaitement les populations clinique et saine. Une telle valeur est rare en psychiatrie et psychologie en raison du chevauchement phénotypique inhérent aux troubles psychiques.
- AUC = 1,00 : Discriminateur parfait absolu. Aucune zone de chevauchement n’existe entre les deux groupes ; la sensibilité et la spécificité atteignent simultanément 100 %.
Pour conférer une rigueur scientifique indiscutable à votre analyse sous Excel, il est essentiel d’adjoindre à l’AUC ponctuelle son intervalle de confiance asymptotique à 95 %. Selon la méthode pionnière de Hanley et McNeil (1982), l’erreur standard asymptotique ($SE$) de l’aire sous la courbe peut être approximée par la formulation analytique suivante :
$SE = \sqrt{\frac{\theta(1-\theta) + (n_1 – 1)(Q_1 – \theta^2) + (n_0 – 1)(Q_2 – \theta^2)}{n_1 n_0}}$
où $\theta$ désigne l’AUC estimée, $n_1$ le nombre de malades ($N_{\text{pos}}$), $n_0$ le nombre de témoins ($N_{\text{\neg}}$), avec les termes de distribution dérivés $Q_1 = \theta / (2 – \theta)$ et $Q_2 = (2\theta^2) / (1 + \theta)$. La transcription séquentielle de ces calculs dans les cellules de votre tableur permet de définir les bornes inférieure et supérieure via la formule standard $\text{IC}_{95%} = \text{AUC} \pm 1,96 \times SE$, conférant à votre fichier la maturité statistique d’une sortie logicielle spécialisée.
10. Détermination du seuil de coupure optimal (Indice de Youden et distance euclidienne)
10.1 Calcul et optimisation de l’indice J de Youden
L’AUC qualifie la puissance intrinsèque d’une échelle, mais ne renseigne pas le praticien sur la décision concrète à prendre face à un patient singulier : à partir de quel score précis au test doit-on poser le diagnostic clinique ou déclencher une intervention thérapeutique ? La quête de ce point de bascule relève de l’optimisation des seuils de coupure (cut-off points). Parmi les approches statistiques formelles, la méthode la plus célèbre et la plus rigoureuse est l'<a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″ target= »_blank » rel= »noopener noreferrer »>indice J de Youden (1950).
L’indice de Youden quantifie la distance verticale maximale séparant la courbe ROC de la diagonale de non-discrimination statistique. Il capture l’efficacité globale du test en attribuant un poids rigoureusement identique aux erreurs par faux positifs et aux erreurs par faux négatifs. Sur le plan algébrique, il est défini pour chaque seuil $c$ par l’expression :
J = Sensibilité + Spécificité – 1 = TVP – TFP
Puisque notre tableau Excel comporte déjà la colonne de la Sensibilité ($TVP$, Colonne G) et celle du Taux de faux positifs ($TFP = 1 – \text{Spécificité}$, Colonne H), le calcul de l’indice $J$ se réduit à une simple soustraction arithmétique. Créez la Colonne J : Indice_Youden. En cellule J3, saisissez l’expression élémentaire :
=G3 - H3
Étirez la formule vers le bas sur toute la profondeur de la cohorte. L’indice $J$ oscille théoriquement entre 0 (pour un seuil sans aucun pouvoir séparateur) et 1 (pour une séparation parfaite sans aucune erreur de classement).
Pour isoler automatiquement le seuil optimal au sens de Youden dans votre classeur, programmez deux fonctions combinées dans une cellule récapitulative :
- La valeur maximale de l’indice est identifiée par la formule :
=MAX(J3:J102). - Le score continu correspondant à ce maximum s’extrait en imbriquant les fonctions
INDEXetEQUIV:
=INDEX(B3:B102; EQUIV(MAX(J3:J102); J3:J102; 0))
Cette formule localise la position exacte de la valeur maximale au sein de la colonne J et renvoie instantanément la note psychométrique brute (Colonne B) associée à cette performance maximale.
10.2 Critère de la distance minimale au coin supérieur gauche
Une démarche géométrique alternative, mais conceptuellement très proche, est le critère de la distance euclidienne minimale au point idéal $(0, 1)$, souvent désigné dans la littérature biomédicale sous le nom de méthode Closest-to-(0,1) ou critère d’Erbil. Dans l’espace cartésien ROC, le point d’ancrage $(X=0, Y=1)$ incarne le classificateur divin imaginaire, possédant une spécificité absolue de 100 % ($X = 1 – 1 = 0$) combinée à une sensibilité parfaite de 100 % ($Y = 1$).
Le seuil d’arbitrage empirique optimal peut ainsi être défini comme celui dont les coordonnées cartésiennes $(TFP_i, TVP_i)$ minimisent la distance euclidienne directe le séparant de ce pôle parfait. En application directe du théorème de Pythagore, cette distance $D$ s’énonce mathématiquement comme suit :
D = √[ (1 – Sensibilité)² + (1 – Spécificité)² ] = √[ (1 – TVP)² + TFP² ]
Pour matérialiser cette géométrie sous Excel, insérez la Colonne K : Distance_Coin_Ideal. Dans la cellule K3, saisissez la formule logicielle correspondante :
=RACINE((1 - G3)^2 + H3^2)
Après extension de la formule jusqu’au bas du tableau, le seuil optimal selon ce critère sera celui qui minimise la grandeur $D$. Vous pouvez l’extraire dynamiquement via la commande imbriquée :
=INDEX(B3:B102; EQUIV(MIN(K3:K102); K3:K102; 0))
Dans la grande majorité des distributions empiriques univariées régulières, l’indice de Youden et le critère de la distance minimale au coin supérieur gauche convergent rigoureusement vers le même seuil critique, renforçant l’assurance du psychométricien quant à la solidité de sa recommandation diagnostique.
10.3 Pondération clinique et coût relatif des erreurs diagnostiques
Si l’indice de Youden et la distance géométrique fournissent des repères mathématiques objectifs séduisants, le chercheur et le clinicien ne doivent jamais perdre de vue que ces méthodes formelles intègrent une hypothèse implicite lourde de conséquences : elles postulent que le coût d’une erreur par faux négatif est strictement équivalent au coût d’une erreur par faux positif, et que la prévalence réelle du trouble dans la société est de 50 %.
Or, dans la réalité clinique quotidienne, ces présupposés sont presque systématiquement infirmés :
- Asymétrie des coûts cliniques : Dans le dépistage d’une pathologie létale ou d’un état de crise psychologique aiguë (tel que le risque suicidaire en psychiatrie d’urgence), omettre un individu malade (faux négatif) engage directement le pronostic vital et constitue une faute déontologique majeure. À l’inverse, générer une fausse alerte (faux positif) n’entraîne qu’un surcoût financier passager lié à des examens complémentaires de confirmation. Dans un tel cas de figure, le praticien doit délibérément délaisser le seuil optimal de Youden pour retenir un seuil plus libéral situé plus haut sur la courbe ROC, garantissant par exemple une sensibilité minimale incompressible de 95 % au détriment assumé de la spécificité.
- Impact de la prévalence et valeurs prédictives : Bien que la forme géométrique de la courbe ROC soit invariante face à la prévalence, l’impact décisionnel effectif d’un seuil dépend de la rareté du trouble dans la population où le test sera déployé. Dans une population générale où une pathologie ne frappe que 1 % des sujets, même un seuil affichant une excellente spécificité de 90 % engendrera une avalanche de faux positifs telle que la Valeur Prédictive Positive ($VPP = VP / [VP + FP]$) chutera dramatiquement.
L’optimisation des seuils ne doit donc jamais se réduire à une exécution mécanique d’algorithmes mathématiques ; elle relève d’un arbitrage médico-éthique éclairé confrontant les métriques de la courbe ROC aux impératifs pragmatiques du terrain de soins.
11. Erreurs courantes, limites méthodologiques et pièges dans Excel
11.1 Erreurs d’assemblage graphique et de tri sous Excel
La mise en œuvre d’une analyse ROC au sein d’un tableur grand public tel que Microsoft Excel, si elle offre une transparence conceptuelle totale, expose l’analyste à des chausse-trappes techniques récurrentes qui peuvent entièrement invalider les conclusions d’une étude.
Les écueils les plus fréquemment répertoriés sont :
- Le tri sélectif unilatéral : C’est l’erreur la plus dévastatrice. Elle survient lorsque l’utilisateur met en surbrillance la seule colonne des scores (Colonne B) et clique sur « Trier », sans étendre la sélection aux colonnes adjacentes de l’identifiant et du statut clinique. Les scores sont alors réordonnés tandis que les statuts de maladie demeurent immobiles, dissociant totalement les résultats de l’identité réelle des patients. Les formules calculent alors une courbe ROC aberrante issue d’un jeu de données corrompu.
- La confusion structurelle de type de graphique : Comme évoqué précédemment, choisir un graphique du type « Courbe » au lieu d’un « Nuage de points » dénature complètement l’axe des abscisses. Les intervalles entre les points sont alors représentés comme uniformes, ce qui gonfle artificiellement l’aire apparente sous la courbe et induit un tracé en dents de scie ou linéaire totalement faussé.
- L’omission tragique du point d’ancrage zéro : Oublier d’insérer manuellement la ligne de départ $(0, 0)$ est un piège classique. Sans ce point d’ancrage, la courbe flotte dans l’espace cartésien en débutant par exemple à $(0,02, 0,05)$. Dès lors, la première tranche trapézoïdale comprise entre l’axe vertical et le premier point empirique est intégralement ignorée par la formule de sommation, induisant une sous-estimation systématique de l’AUC finale.
11.2 Limites inhérentes à l’approche sans macro VBA
Bien que les formules natives d’Excel permettent de construire une courbe ROC et d’intégrer son AUC avec une exactitude mathématique parfaite, cette méthode sans script montre des limites intrinsèques dès lors que l’on souhaite aborder des inférences statistiques avancées :
- Absence du test de DeLong automatisé : L’une des exigences majeures de la recherche clinique moderne consiste à comparer formellement deux courbes ROC issues d’échelles concurrentes appliquées sur la même cohorte de patients (données appariées). L’approche statistique de référence pour comparer deux AUC corrélées est le test asymptotique non paramétrique de DeLong, DeLong et Clarke-Pearson (1988). Modéliser la matrice de covariance structurelle de DeLong par des formules de cellules Excel classiques s’avère d’une complexité algorithmique titanesque qui dépasse les capacités d’un classeur standard sans code VBA.
- Sensibilité accrue face aux ex æquo massifs : Lorsque la variable continue testée ne prend qu’un nombre très restreint de valeurs entières (par exemple, une échelle d’évaluation très courte variant seulement de 0 à 5), des centaines d’individus se retrouvent à égalité stricte. L’algorithme de calcul trapézoïdal ligne à ligne dans Excel génère alors une multitude de trapèzes dégénérés de largeur nulle ($\Delta X = 0$). Bien que la sommation finale de l’AUC demeure mathématiquement juste, le tracé graphique peut faire apparaître des segments verticaux artificiellement tronqués si les ex æquo ne sont pas consolidés préalablement dans une table de fréquence agrégée.
11.3 Bonnes pratiques pour fiabiliser le classeur
Pour prémunir vos modélisations contre les altérations accidentelles et conférer à vos fichiers de travail une pérennité professionnelle conforme aux exigences des audits scientifiques, il convient d’adopter des règles de gouvernance strictes lors de la conception de vos classeurs :
- Verrouillage et protection des cellules de calcul : Excel permet de verrouiller les cellules contenant des équations sensibles tout en laissant les colonnes de saisie de données brutes accessibles. Après avoir achevé le paramétrage des formules des colonnes D à K, sélectionnez ces colonnes, accédez à l’onglet Révision, et activez la commande Protéger la feuille. Vous éliminez ainsi le risque d’écraser par mégarde une formule complexe lors d’une manipulation de routine.
- Documentation explicite par commentaires de cellules : Documentez chaque en-tête de colonne en y insérant une note explicative détaillée rappelant la définition formelle de la variable, la signification des ancrages et les unités d’affichage. La transparence méthodologique constitue le rempart le plus efficace contre les erreurs d’interprétation humaine au sein d’une équipe de recherche collaborative.
- Validation croisée des résultats : Avant de diffuser ou de publier les métriques obtenues via votre feuille de calcul Excel, procédez impérativement à une vérification croisée en injectant votre jeu de données brut dans un environnement statistique validé tel que la bibliothèque
pROCsous R ou le module d’évaluation diagnostique de Jamovi. La concordance absolue attendue entre l’AUC calculée par votre intégration trapézoïdale Excel et les sorties logicielles formelles certifie l’absence de faille dans votre chaîne de calcul.
12. Applications cliniques en psychologie et validation empirique
12.1 Étude de cas : Dépistage de la dépression majeure avec le PHQ-9
Pour ancrer l’ensemble des concepts théoriques développés jusqu’ici dans une réalité empirique concrète, analysons un cas d’école clinique : la validation psychométrique du questionnaire Patient Health Questionnaire (PHQ-9) dans le dépistage de l’Épisode Dépressif Majeur (EDM). Le PHQ-9 est un auto-questionnaire composé de 9 items scorés de 0 à 3, générant un score continu variant de 0 à 27.
Dans cette recherche fictive mais rigoureusement étalonnée sur les distributions épidémiologiques observées en médecine de premier recours, un échantillon de 100 participants a été soumis au PHQ-9. Concomitamment, l’intégralité des participants a bénéficié d’une évaluation diagnostique approfondie menée par un psychiatre chevronné à l’aide de l’entretien clinique structuré SCID-5 (le standard de référence incontestable). Le statut clinique a été encodé par la variable binaire : 1 = Dépression confirmée ($N = 35$), et 0 = Absence d’épisode dépressif ($N = 65$).
Après importation des données dans notre classeur Excel, exécution du tri décroissant selon le score au PHQ-9, application des formules de cumul séquentiel et intégration géométrique, les résultats chiffrés suivants émergent :
- Aire sous la courbe (AUC) : La sommation trapézoïdale renvoie une valeur de 0,887 ($SE = 0,034$, $\text{IC}_{95%} : [0,820 ; 0,954]$). Ce niveau de discrimination est qualifié d’excellent selon la nomenclature de Hosmer et Lemeshow, confirmant que le PHQ-9 capture avec une grande fidélité la pathologie sous-jacente.
- Confrontation au seuil historique de 10 : La littérature clinique recommande traditionnellement un seuil de coupure fixé à ≥ 10 pour suspecter une dépression majeure. L’inspection des coordonnées cartésiennes de notre table Excel pour ce score exact de 10 révèle une Sensibilité de 85,7 % (30 malades correctement détectés sur 35) associée à une Spécificité de 84,6 % (taux de faux positifs de 15,4 %, soit 10 faux positifs sur 65 témoins sains).
- Vérification par l’indice de Youden : L’exploration de notre colonne J révèle que la valeur maximale de l’indice ($J = 0,703$) est précisément atteinte au score de 10. Ainsi, le modèle mathématique développé dans Excel confirme empiriquement la pertinence diagnostique du seuil conventionnel utilisé par les praticiens du monde entier.
12.2 Comparaison de deux échelles psychométriques concurrentes
L’un des apports majeurs de l’analyse ROC en neuropsychologie clinique réside dans la capacité à arbitrer objectivement entre deux outils d’évaluation concurrents visant le même objectif diagnostique. Supposons qu’une équipe hospitalière souhaite comparer l’efficacité du célèbre Mini-Mental State Examination (MMSE) face à un outil plus récent, le Montreal Cognitive Assessment (MoCA), pour le dépistage des troubles neurocognitifs légers (MCI).
Une même cohorte de 80 patients âgés reçoit successivement les deux tests, tandis que le statut pathologique est objectivé de manière indépendante par une batterie neuropsychologique exhaustive et des biomarqueurs d’imagerie cérébrale. Les deux scores continus sont structurés dans la même feuille Excel, et deux ensembles distincts de colonnes de calcul ROC sont déployés en parallèle dans le tableur.
En superposant les deux tracés sur le même graphique cartésien Excel (en ajoutant simplement une troisième série de données au nuage de points), l’analyse visuelle et quantitative révèle des contrastes majeurs :
- La courbe du test MoCA s’élève beaucoup plus rapidement vers le coin supérieur gauche que celle du MMSE, dominant cette dernière sur l’ensemble de la plage des faux positifs comprise entre 0,0 et 0,4.
- L’AUC trapézoïdale intégrée sous Excel affiche 0,892 pour le MoCA contre seulement 0,764 pour le MMSE.
Cette divergence substantielle de près de 13 points de concordance démontre mathématiquement la supériorité discriminative incrémentielle du MoCA dans le repérage des atteintes cognitives débutantes, validant la décision du service de réviser ses protocoles d’accueil au profit de l’instrument le plus performant.
12.3 Synthèse et recommandations pour la recherche psychologique
La maîtrise de la méthodologie ROC au sein de Microsoft Excel enrichit considérablement l’arsenal analytique du psychologue quantitativiste et du chercheur en sciences sociales. En s’affranchissant du confort passif des logiciels automatisés, le chercheur acquiert une compréhension intime de la structure probabiliste de ses outils de mesure.
Pour garantir une transparence et une reproductibilité exemplaires dans les publications scientifiques issues de telles analyses, il est impératif d’adhérer aux directives internationales édictées par les lignes directrices du réseau STARD (Standards for Reporting of Diagnostic Accuracy Studies). Les auteurs doivent impérativement s’engager à :
- Rapporter systématiquement les trois métriques clés : Ne jamais mentionner une valeur d’AUC de manière isolée sans expliciter clairement la sensibilité et la spécificité atteintes au seuil de coupure préconisé pour l’usage clinique.
- Publier les intervalles de confiance à 95 % : Accompagner immanquablement chaque estimation ponctuelle d’AUC de ses bornes d’incertitude statistique afin d’attester de la puissance effective de l’échantillon analysé.
- Justifier explicitement le choix du seuil : Exposer avec transparence la rationalité sous-jacente au choix du seuil opérationnel (maximisation aveugle de l’indice de Youden, impératif de sensibilité élevée pour minimiser les faux négatifs, ou arbitrage pragmatique lié au contexte médico-économique).
En définitive, bien que des environnements de programmation spécialisés restent incontournables pour modéliser des ajustements multivariés complexes, Microsoft Excel demeure un laboratoire d’exploration diagnostique extraordinairement agile, accessible et formateur. La mise en œuvre méthodique des douze étapes formalisées dans ce guide garantit aux professionnels de la mesure humaine une autonomie statistique totale et une rigueur méthodologique irréprochable dans la validation de leurs instruments cliniques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://www.apa.org/pi/about/publications/caregivers/practice-settings/assessment/tools/beck-depression
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., & Korevaar, D. A. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. Radiology, 277(3), 826-832. https://doi.org/10.1148/radiol.2015151516
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837-845. https://doi.org/10.2307/2531595
- Folstein, M. F., Folstein, S. E., & McHugh, P. R. (1975). « Mini-mental state »: A practical method for grading the cognitive state of patients for the clinician. Journal of Psychiatric Research, 12(3), 189-198. https://doi.org/10.1016/0022-3956(75)90026-6
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29-36. https://doi.org/10.1148/radiology.143.1.7063747
- Hanley, J. A., & McNeil, B. J. (1983). A method of comparing the areas under receiver operating characteristic curves derived from the same cases. Radiology, 148(3), 839-843. https://doi.org/10.1148/radiology.148.3.839
- Hosmer, D. W., & Lemeshow, S. (2000). Applied logistic regression (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/0471722146
- Kroenke, K., Spitzer, R. L., & Williams, J. B. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606-613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x
- Nasreddine, Z. S., Phillips, N. A., Bédirian, V., Charbonneau, S., Whitehead, V., Collin, I., Cummings, J. L., & Chertkow, H. (2005). The Montreal Cognitive Assessment, MoCA: A brief screening tool for mild cognitive impairment. Journal of the American Geriatrics Society, 53(4), 695-699. https://doi.org/10.1111/j.1532-5415.2005.53221.x
- Peterson, W. W., Birdsall, T. G., & Fox, W. C. (1954). The theory of signal detectability. Transactions of the IRE Professional Group on Information Theory, 4(4), 171-212. https://doi.org/10.1109/TIT.1954.1057460
- Swets, J. A. (1988). Measuring the accuracy of diagnostic systems. Science, 240(4857), 1285-1293. https://doi.org/10.1126/science.3287615
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32-35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″ target= »_blank » rel= »noopener noreferrer »>https://doi.org/10.1002/1097-0142(1950)3:1<32::aid-cncr2820030106>3.0.co;2-3
- Zweig, M. H., & Campbell, G. (1993). Receiver-operating characteristic (ROC) plots: A fundamental evaluation tool in clinical medicine. Clinical Chemistry, 39(4), 561-577. https://doi.org/10.1093/clinchem/39.4.561