
La modélisation des phénomènes psychologiques et comportementaux repose sur une prémisse épistémologique fondamentale : la variabilité humaine, loin de constituer un bruit aléatoire et désordonné, obéit fréquemment à des régularités statistiques remarquables. Au cœur de cette architecture quantitative se trouve la distribution normale, communément désignée sous le vocable de courbe en cloche ou distribution de Gauss-Laplace. Des échelles d’intelligence standardisées aux inventaires de personnalité, en passant par les temps de réaction neuropsychologiques et les mesures psychophysiques, la fonction de densité gaussienne sert d’étalon universel pour situer un individu au sein d’une population de référence, quantifier les écarts cliniques et tester des hypothèses de recherche rigoureuses.
Toutefois, l’accès aux outils d’analyse et de visualisation statistique a longtemps été l’apanage de logiciels spécialisés, onéreux ou dotés d’une courbe d’apprentissage abrupte, tels que SPSS, SAS, R ou Python. Si ces environnements demeurent indispensables pour les modélisations multivariées complexes, l’émergence d’outils collaboratifs en nuage a profondément démocratisé le calcul scientifique. Parmi eux, Google Sheets s’est imposé comme une plateforme d’une souplesse remarquable, alliant une accessibilité multiplateforme immédiate à un moteur de calcul matriciel capable de rivaliser avec les tableurs de bureau traditionnels pour la modélisation statistique univariée.
Le présent traité méthodologique propose une exploration exhaustive, pas à pas et conceptuellement ancrée, de la construction d’une courbe en cloche dynamique au sein de Google Sheets. Conçu spécifiquement pour les chercheurs, praticiens de la psychologie, psychométristes, étudiants et analystes de données, ce guide détaille non seulement la syntaxe opérationnelle des formules et les subtilités du moteur graphique, mais explicite également les fondements mathématiques et les implications cliniques sous-jacents. De la standardisation des scores z à l’ombrage des aires sous la courbe selon la règle empirique, chaque étape est disséquée avec une rigueur académique sans compromis.
1. Fondements théoriques de la courbe en cloche en sciences psychologiques
1.1 Définition mathématique et propriétés de la distribution normale
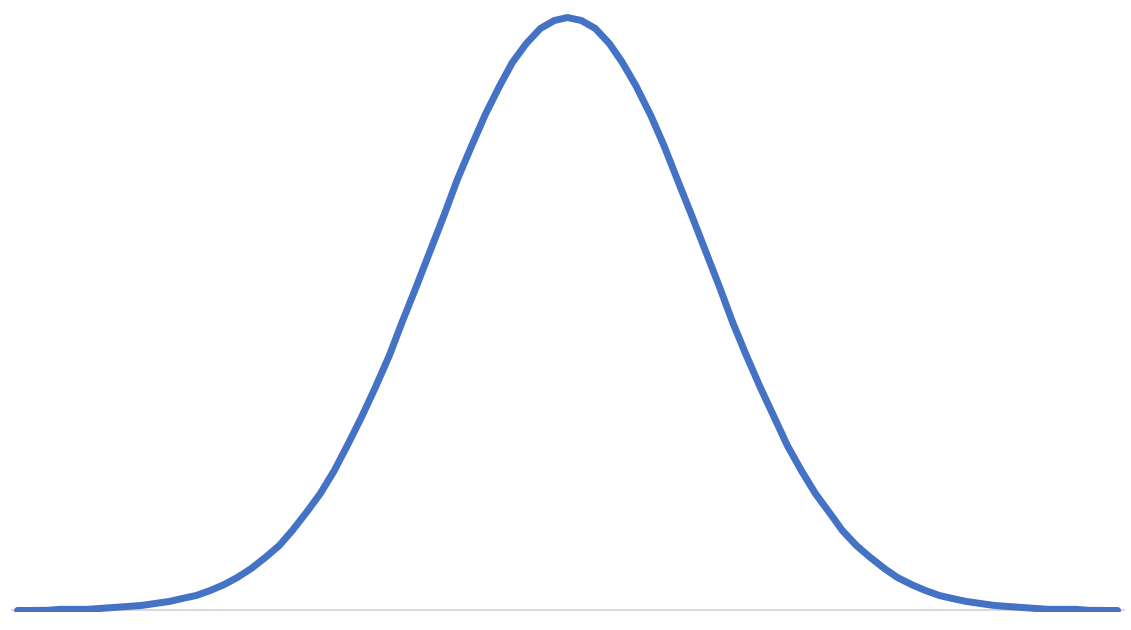
La distribution normale, théorisée initialement par Abraham de Moivre et formalisée de manière indépendante par Carl Friedrich Gauss et Pierre-Simon de Laplace, constitue la pierre angulaire de l’inférence statistique paramétrique. Sur le plan géométrique et analytique, la fonction de densité de probabilité (PDF) d’une variable aléatoire continue suivant une loi normale se caractérise par trois propriétés intrinsèques indissociables : une symétrie axiale parfaite autour de sa valeur centrale, une unimodalité stricte et un comportement asymptotique vers l’infini positif et négatif. La symétrie implique que la probabilité d’observer une déviation d’une magnitude donnée au-dessus de la moyenne est strictement identique à celle d’observer cette même déviation en deçà. L’asymptotisme signifie quant à lui que la courbe ne touche jamais l’axe des abscisses, postulant théoriquement qu’aucun événement, aussi extrême soit-il, ne possède une probabilité rigoureusement nulle.
L’expression analytique de cette fonction de densité de probabilité repose sur une équation différentielle traduisant le taux de variation proportionnel à l’écart à la moyenne. Pour une variable aléatoire continue X définie sur l’ensemble des nombres réels, conditionnée par deux paramètres fondamentaux — l’espérance mathématique ou moyenne populationnelle notée $\mu$ (mu) et l’écart type populationnel noté $\sigma$ (sigma) —, la densité de probabilité $f(x)$ est régie par la formulation suivante :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right)$$
Cette formulation élégante combine les deux constantes transcendantes majeures des mathématiques, le nombre $\pi$ (pi) et la base du logarithme népérien $e$. Le facteur normalisateur situé au dénominateur assure que l’intégrale impropre de la fonction, calculée de moins l’infini à plus l’infini, soit exactement égale à l’unité (1), respectant ainsi le second axiome fondamental de Kolmogorov pour les mesures de probabilité. L’exposant quadratique négatif est le moteur de la décroissance exponentielle rapide au fur et à mesure que la distance entre la valeur observée et la moyenne augmente.
Une conséquence remarquable de cette structure mathématique symétrique et unimodale réside dans l’équivalence parfaite des trois principaux indicateurs de tendance centrale : la moyenne arithmétique, la médiane et le mode coïncident rigoureusement au sommet exact de la courbe. Le mode correspond au point d’inflexion où la dérivée première de la fonction s’annule et où la dérivée seconde est strictement négative, ce qui localise l’ordonnée maximale à l’abscisse $x = \mu$. La médiane sépare l’aire totale en deux moitiés équiprobables de 0,5 chacune. Enfin, la moyenne arithmétique agit comme le barycentre géométrique de l’ensemble de la distribution.
1.2 Pertinence épistémologique en psychométrie et psychologie différentielle
L’omniprésence de la courbe en cloche dans les sciences du comportement ne relève pas d’une simple convention esthétique, mais d’une nécessité épistémologique formulée dès le XIXe siècle par Adolphe Quetelet et Francis Galton. Dans le cadre de la psychométrie contemporaine et des théories des traits latents, les attributs psychologiques complexes — tels que l’efficience cognitive générale, l’extraversion, la résilience ou l’anxiété-trait — ne sont pas directement observables. Ils sont appréhendés à travers des batteries d’épreuves composites ou des questionnaires psychométriques. L’étalonnage standard des échelles d’intelligence, à l’instar des matrices de Wechsler (WAIS, WISC), postule délibérément une distribution normale des scores de quotients intellectuels (QI), calibrée conventionnellement sur une moyenne de 100 et un écart type de 15.
Cette normalité émergente trouve sa justification théorique la plus robuste dans le théorème central limite (TCL). Selon ce principe probabiliste cardinal, la somme ou la moyenne d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées (ou même faiblement corrélées, sous le respect des conditions de Lindeberg-Feller) converge asymptotiquement vers une loi normale, indépendamment de la forme de distribution des variables sous-jacentes. Dans le champ psychobiologique, un phénotype comportemental ou cognitif complexe résulte de l’interaction cumulative de centaines de variants génétiques (effets polygéniques additifs) conjugués à une multitude de micro-événements environnementaux. Chaque facteur pris isolément peut présenter une distribution binaire ou asymétrique, mais leur agrégation statistique produit spontanément une morphologie gaussienne.
Néanmoins, la transposition aveugle du postulat de normalité constitue un écueil méthodologique majeur contre lequel les cliniciens doivent se prémunir. Dans de nombreuses cohortes cliniques ou neuropsychologiques, les données empiriques dévient substantiellement de l’idéal théorique. Deux indicateurs statistiques d’ordre supérieur quantifient ces déformations morphologiques : le coefficient d’asymétrie (skewness), qui mesure le déport unilatéral des observations vers la gauche ou la droite, et le coefficient d’aplatissement (kurtosis), qui évalue l’épaisseur relative des queues de distribution et l’acuité du sommet. Par exemple, une évaluation de la symptomatologie dépressive au sein d’une population générale non clinique présente invariablement une asymétrie positive prononcée, la vaste majorité des sujets obtenant des scores proches de zéro, créant un effet de plancher qui invalide l’application directe des propriétés de la loi normale.
1.3 Intérêt de Google Sheets pour la modélisation statistique computationnelle
L’utilisation d’un tableur basé sur le web tel que Google Sheets pour la modélisation stochastique représente une avancée pragmatique décisive pour les environnements de recherche translationnelle et la pratique clinique quotidienne. Contrairement aux scripts de programmation complexes dont l’exécution requiert l’installation d’environnements locaux, de compilateurs et de dépendances logicielles strictes, la feuille de calcul dans le nuage garantit une accessibilité multiplateforme universelle. Tout praticien ou chercheur peut répliquer, auditer et manipuler les modèles algorithmiques depuis n’importe quel terminal connecté, éliminant ainsi les barrières techniques liées à la reproductibilité des protocoles de traitement des données psychométriques.
Bien que traditionnellement perçu comme un outil de gestion administrative ou financière, Google Sheets intègre un moteur de calcul statistique doté d’une précision arithmétique conforme aux normes à virgule flottante IEEE 754. Les fonctions stochastiques natives implémentées dans son infrastructure — notamment les routines de calcul des lois normales directes et inverses, des régressions polynomiales et des matrices de covariance — sont exécutées sur des serveurs distants à haute performance. Cette architecture assure une stabilité computationnelle remarquable et une réévaluation instantanée des formules matricielles lors de l’ajustement dynamique des paramètres fondamentaux que sont la moyenne et l’écart type.
Enfin, la synergie intrinsèque entre les capacités de calcul tabulaire et le moteur de rendu vectoriel de Google Sheets offre un vecteur de communication visuelle particulièrement puissant. Les cliniciens peuvent concevoir des tableaux de bord dynamiques au sein desquels la modification instantanée d’un score patient génère une actualisation visuelle immédiate de la courbe de référence, permettant d’objectiver en temps réel la position relative du sujet par rapport à sa cohorte d’âge. Cette dimension interactive transforme l’abstraction mathématique de la loi de densité en un outil didactique concret, optimisant l’explication des diagnostics différentiels auprès des équipes multidisciplinaires et des usagers du système de santé mentale.
2. Étape 1 : Définition de la moyenne empirique et de l’écart type
2.1 Identification conceptuelle de la moyenne arithmétique
La première phase opérationnelle de la conception d’un modèle gaussien sous tableur consiste à ancrer le centre de gravité gravitationnel de la distribution. En notation statistique formelle, ce centre correspond à l’espérance mathématique $E(X) = \mu$. Dans un modèle théorique pur, $\mu$ représente l’axe de symétrie absolue le long duquel la dérivée de la fonction de densité s’annule. Dans la pratique psychométrique appliquée, ce paramètre résulte de la compilation standardisée des données d’un groupe d’étalonnage représentatif. Pour exemplifier ce protocole, nous retiendrons l’échelle de l’Indice de Compréhension Verbale (ICV) issue d’une batterie de Wechsler standard, conventionnellement calibrée sur une valeur centrale de 100.
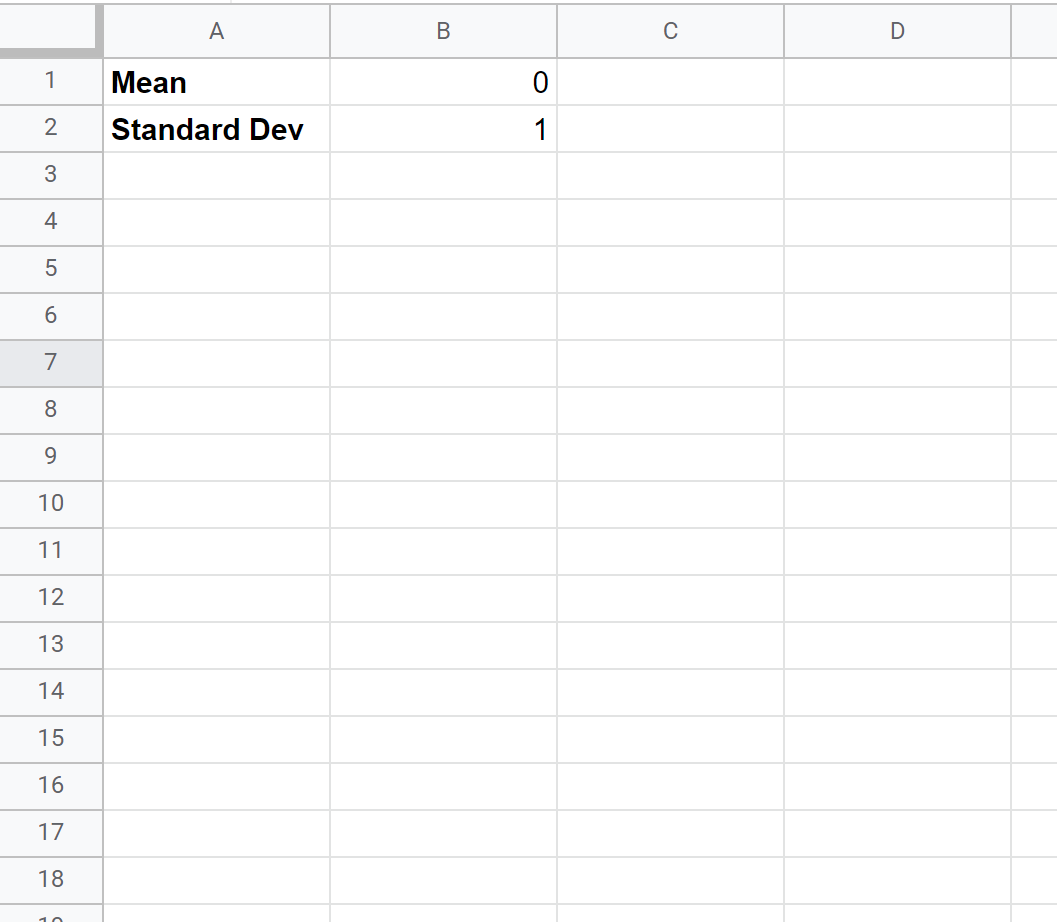
Au sein de l’interface de Google Sheets, l’opérateur doit formaliser cette valeur dans une cellule dédiée, exempte de tout caractère textuel parasitaire, afin de permettre l’évaluation arithmétique par les fonctions matricielles subséquentes. Par convention ergonomique et pour maintenir une structure de données hautement auditable, nous réservons les coordonnées cellulaires situées en tête de feuille pour l’hébergement de ces constantes paramétriques. La valeur « 100 » sera donc rigoureusement saisie dans la cellule B1, la cellule adjacente A1 faisant office d’étiquette textuelle descriptive identifiée comme « Moyenne (mu) ».
Il est impératif d’établir une distinction conceptuelle nette entre la moyenne populationnelle théorique ($\mu$) et la moyenne empirique issue d’un échantillon fini de sujets, couramment désignée par $\bar{x}$. La moyenne théorique assignée à notre modèle correspond à un postulat a priori qui dicte la position de la courbe idéale. La moyenne d’échantillon, quant à elle, fluctue en vertu des lois de l’échantillonnage aléatoire. Confondre ces deux niveaux d’abstraction conduit fréquemment à des erreurs d’interprétation des seuils de significativité clinique lors de la comparaison des performances d’un individu aux normes nationales standardisées.
2.2 Quantification de la dispersion par l’écart type
Si la moyenne arithmétique dicte la translation horizontale de la courbe le long de l’abscisse, l’écart type — symbolisé par la lettre grecque $\sigma$ pour un paramètre populationnel ou par s pour une statistique d’échantillon — constitue le facteur d’échelle régissant l’amplitude de sa dispersion horizontale et l’altitude de son sommet. Mathématiquement défini comme la racine carrée positive de la variance ($\sigma = \sqrt{\sigma^2}$), l’écart type quantifie la distance quadratique moyenne qui sépare chaque observation de la moyenne générale. Dans le cadre de notre exemple psychométrique standardisé, la dispersion normative de référence est calibrée avec une valeur de $\sigma = 15$.
L’incidence géométrique de l’écart type sur la morphologie de la fonction de densité de probabilité est directe et contre-intuitive pour les débutants. En raison de l’obligation mathématique maintenant l’aire totale sous la courbe rigoureusement égale à 1, toute augmentation de l’écart type entraîne simultanément un élargissement de l’emprise au sol de la cloche et un abaissement substantiel de son ordonnée maximale. À l’inverse, un écart type très restreint compresse la distribution vers son axe central et projette son sommet vers le haut. Les points d’inflexion morphologiques — c’est-à-dire les zones exactes où la concavité de la courbe passe d’une orientation descendante à une orientation ascendante — sont situés précisément à une distance de $\pm 1\sigma$ par rapport au centre $\mu$.
Lorsqu’un praticien manipule des données brutes récoltées sur une cohorte clinique restreinte pour concevoir un étalonnage local, la prudence statistique commande de calculer l’écart type en appliquant la correction de Bessel. Cette correction consiste à substituer le diviseur d’échantillon $N-1$ au diviseur théorique $N$ dans le calcul de la somme des écarts au carré, afin de neutraliser le biais de sous-estimation systématique inhérent aux petits effectifs. Dans Google Sheets, cette rigueur computationnelle est garantie par l’invocation explicite de la fonction ECARTYPE.STANDARD (équivalente à STDEV.S) au détriment de ECARTYPE.P (réservée à la population exhaustive).
2.3 Préparation matricielle initiale dans la feuille de calcul
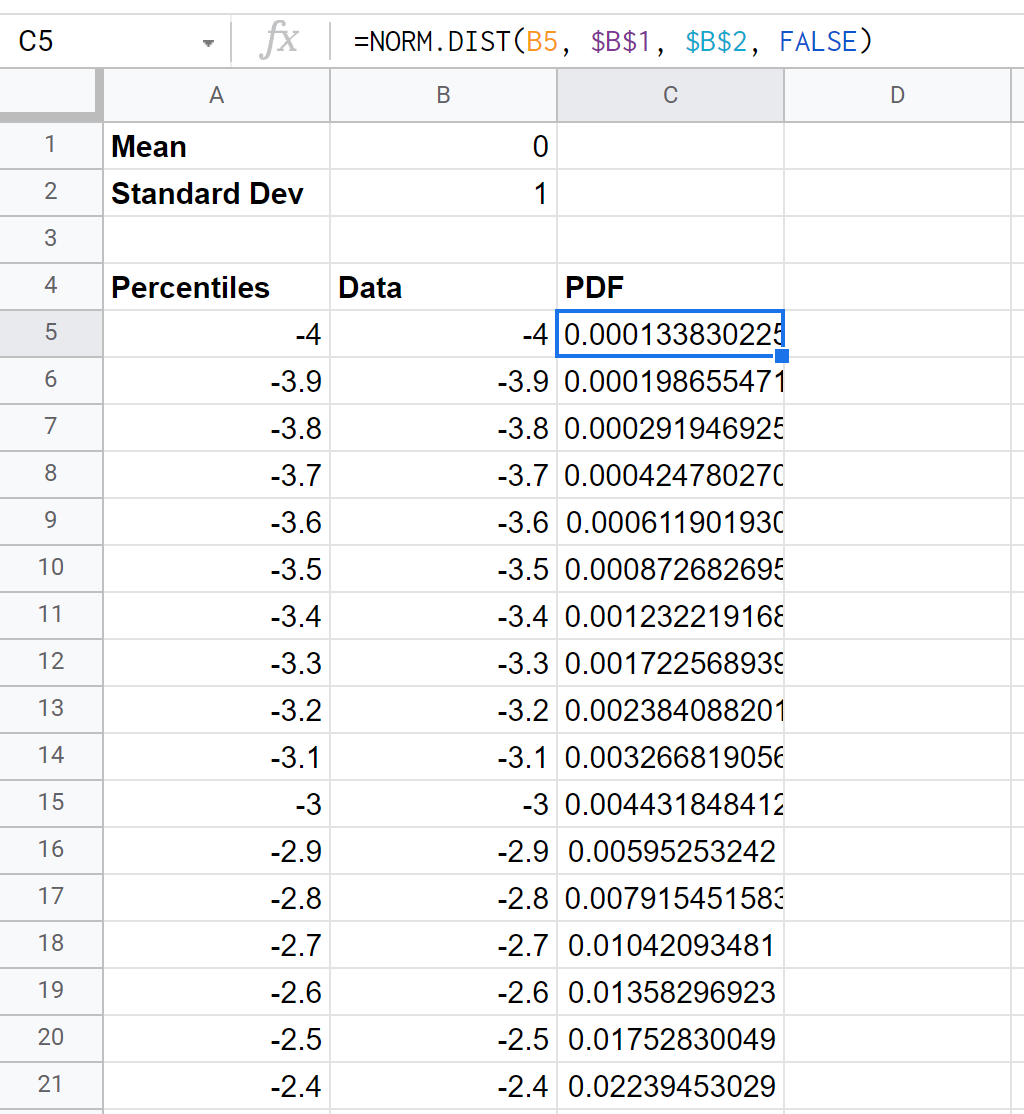
La structuration spatiale d’un modèle stochastique dans un tableur conditionne l’évolutivité, la lisibilité et l’immunité aux erreurs de référence circulaire. Nous débutons l’implémentation par la configuration rigoureuse du bloc des paramètres fondamentaux dans le coin supérieur gauche de la grille de calcul. Cette zone fera office de panneau de contrôle universel auquel toutes les équations subséquentes se référeront de manière dynamique. Nous formalisons cette architecture selon la topographie matricielle standardisée suivante :
- Cellule
A1: Libellé alphanumérique « Moyenne (mu) » ; CelluleB1: Valeur numérique « 100 » - Cellule
A2: Libellé alphanumérique « Ecart-type (sigma) » ; CelluleB2: Valeur numérique « 15 » - Cellule
A3: Libellé alphanumérique « Pas de calcul » ; CelluleB3: Valeur numérique « 0,1 »
Pour optimiser la lisibilité des algorithmes ultérieurs et s’affranchir de la syntaxe contraignante des coordonnées absolues, il est hautement recommandé d’exploiter le gestionnaire de plages nommées de Google Sheets (accessible via le menu Données > Plages nommées). En assignant explicitement le nom « mu » à la cellule B1 et « sigma » à la cellule B2, les formules mathématiques insérées dans les colonnes d’ordonnées gagneront en clarté sémantique et réduiront drastiquement le risque d’erreurs d’inattention lors de manipulations complexes.
Enfin, une vérification immédiate du paramétrage régional et des formats numériques s’impose. Selon les préférences linguistiques configurées dans Google Sheets (accessibles sous Fichier > Paramètres > Paramètres régionaux), le séparateur décimal par défaut peut être la virgule (norme francophone internationale) ou le point (norme anglo-saxonne). Une incompatibilité à ce niveau transforme les valeurs numériques saisies en chaînes de texte inertes, provoquant l’interruption prématurée des calculs stochastiques par le déclenchement intempestif d’erreurs typologiques. L’ensemble des cellules de paramètres numériques doit être explicitement verrouillé sous le format « Nombre » avec affichage standardisé à deux décimales.
3. Étape 2 : Définition de l’échelle des scores z et des percentiles
3.1 Théorie de la standardisation et scores z
L’incommensurabilité des unités de mesure brutes en psychologie — qu’il s’agisse de millisecondes lors d’épreuves d’attention informatisées, de totaux de points sur une échelle d’évaluation de la dépression, ou du nombre de mots correctement mémorisés — constitue une entrave majeure à la synthèse clinique. L’opération statistique de standardisation résout cette aporie en transmutant des distributions métriques hétérogènes en une unité d’écart invariant : le score standard, universellement désigné sous le terme de score z. Développé conceptuellement pour la première fois par le statisticien Edwin Bidwell Wilson, le score z quantifie l’éloignement d’une observation brute $X$ par rapport à sa moyenne arithmétique $\mu$, exprimé en multiples entiers ou fractionnaires de son écart type $\sigma$.
L’équation de standardisation s’exprime sous la forme d’une transformation linéaire fondamentale :
$$z = \frac{x – \mu}{\sigma}$$
Une distribution normale standardisée se définit formellement par une moyenne nulle ($\mu = 0$) et une variance unitaire ($\sigma^2 = \sigma = 1$), notée $N(0, 1)$. Pour modéliser graphiquement une cloche avec une fidélité computationnelle optimale, il est nécessaire d’établir un domaine de définition symétrique sur l’axe des z. En vertu des propriétés d’intégration de la loi gaussienne, l’intervalle canonique s’étendant de $z = -3$ à $z = +3$ circonscrit exactement 99,73 % de l’aire totale. Néanmoins, pour intégrer l’analyse des cas exceptionnels en neurodéveloppement ou en psychopathologie sévère, nous bornerons délibérément notre continuum entre $z = -4$ et $z = +4$, englobant ainsi une proportion phénoménale de 99,9937 % de la population théorique.
Sur le plan de l’interprétation diagnostique, les scores z extrêmes constituent les balises objectives de la nosographie clinique. Un score $z le -2$ signe conventionnellement une altération fonctionnelle statistiquement significative (délimitant les 2,28 % inférieurs de la courbe), seuil diagnostique privilégié pour la caractérisation d’un déficit intellectuel ou d’un trouble spécifique des apprentissages. Inversement, un score $z ge +2$ délimite le domaine des aptitudes cognitives hautement supérieures. Les valeurs extrêmes situées au-delà de $\pm 3$ écarts types identifient des profils neurocognitifs d’une rareté extrême, n’apparaissant que chez environ un individu sur mille dans la population générale.
3.2 Génération de la séquence arithmétique incrémentale
La restitution d’une courbe continue et harmonieuse au sein d’un moteur graphique discret repose sur la densité d’échantillonnage des points calculés. Si l’intervalle séparant deux points consécutifs est trop large (par exemple un pas de $\Delta z = 1$), le tracé produit une forme polygonale anguleuse, dépourvue de la fluidité morphologique caractéristique de la loi normale. À l’opposé, une micro-incrémentation excessive (telle que $\Delta z = 0,001$) surcharge inutilement la mémoire vive allouée par le navigateur et dégrade la réactivité de la feuille de calcul sans gain perceptible de qualité visuelle.
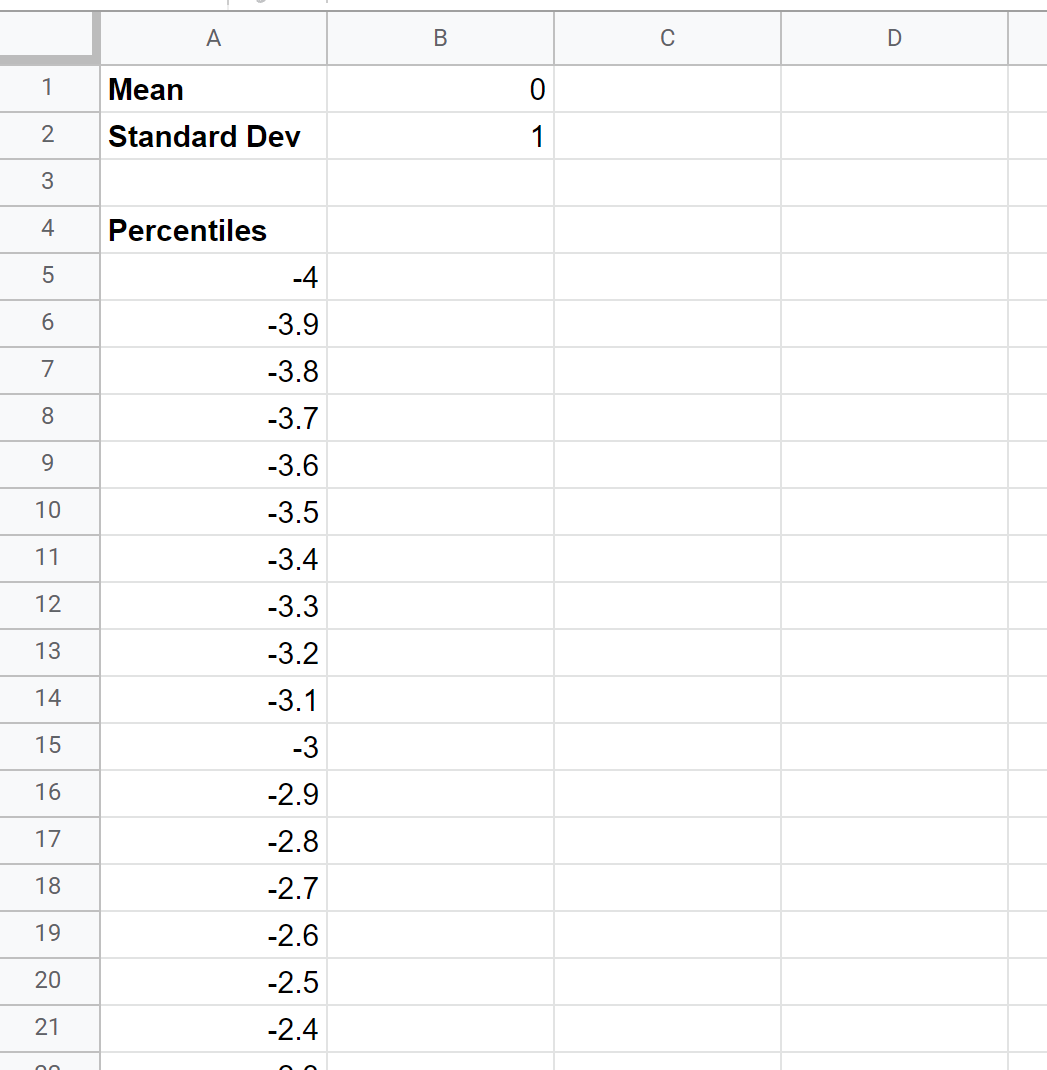
Un consensus algorithmique particulièrement efficace consiste à adopter un pas d’incrémentation constant de $\Delta z = 0,1$. Sur notre intervalle s’étendant de $-4$ à $+4$, cette résolution génère exactement 81 points de calcul discrets, un volume de données idéal qui combine une fluidité graphique parfaite et une charge de calcul quasi instantanée pour le processeur de Google Sheets. Pour implémenter cette séquence, nous réservons la colonne C de notre feuille de calcul, que nous identifions par l’en-tête « Score z » en cellule C5.
Deux méthodologies opérationnelles permettent de construire cette séquence. La première, manuelle mais universelle, consiste à saisir la borne d’origine « -4,0 » dans la cellule C6, puis la valeur « -3,9 » dans la cellule C7. La sélection conjointe de ces deux cellules suivie d’un étirement vertical via la poignée de recopie vers le bas jusqu’à la cellule C86 force le tableur à extrapoler la progression linéaire. La seconde approche, infiniment plus moderne et élégante, tire parti des capacités matricielles de Google Sheets en exploitant la fonction SEQUENCE. En inscrivant en C6 la formule =SEQUENCE(81; 1; -4; 0,1), le tableur génère instantanément la totalité de la série mathématique sans aucune manipulation d’étirement manuel, garantissant une absence absolue d’erreur de recopie.
3.3 Contrôle de conformité de la colonne des scores standardisés
Avant d’engager les calculs de densité et de valeurs psychométriques brutes, une procédure rigoureuse d’audit qualité doit être appliquée à la colonne des scores z nouvellement générée. La première validation concerne la stricte cardinalité de la série : l’opérateur doit vérifier visuellement et structurellement que la dernière valeur numérique, positionnée en cellule C86, soit rigoureusement égale à « 4,0 ». Toute discordance par rapport à cette valeur borne traduit un paramétrage erroné de l’incrément ou une troncature accidentelle de la plage matricielle lors du processus d’étirement.
La deuxième vérification porte sur l’uniformité du formatage numérique. En raison des calculs en virgule flottante sous-jacents, certaines suites d’additions itératives de valeurs fractionnaires (comme 0,1) peuvent introduire de minimes artefacts de troncature binaire, affichant ponctuellement des valeurs aberrantes telles que « 1,8000000000000003 ». Pour neutraliser ce désordre visuel et homogénéiser la matrice, il est indispensable de sélectionner l’intégralité de la plage C6:C86, d’accéder au menu Format > Nombre > Format numérique personnalisé et d’appliquer la syntaxe de verrouillage 0,0. Cette directive contraint le tableur à restituer chaque valeur avec exactement un chiffre après le séparateur décimal.
Enfin, l’opérateur doit s’assurer de l’alignement intrinsèque des données au sein de la colonne. Par défaut, Google Sheets applique un alignement typologique immédiat : les valeurs numériques valides sont automatiquement alignées sur le bord droit de la cellule, tandis que les données interprétées comme du texte libre sont alignées sur la gauche. Si une fraction des valeurs de la colonne C apparaît ferrée à gauche, cela révèle une corruption typologique, généralement provoquée par une confusion entre points et virgules lors de la saisie manuelle. Cette anomalie bloquerait inexorablement les calculs subséquents de la transformation linéaire inverse.
4. Étape 3 : Calcul des valeurs brutes de la variable psychologique
4.1 Transformation inverse des scores z vers l’échelle d’origine
La manipulation exclusive des scores z présente des limites d’utilisabilité pratiques en psychologie clinique : les patients, leurs accompagnants et la plupart des professionnels de santé non-statisticiens peinent à se représenter intuitivement la signification d’un résultat exprimé sous la forme de déviations relatives centrées sur zéro. Il est par conséquent indispensable de convertir l’échelle standardisée abstraite vers l’échelle métrique d’origine du test administré. Cette réversion algébrique s’opère par le biais de la fonction linéaire inverse de standardisation.
Partant de l’équation constitutive $z = (x – \mu) / \sigma$, l’isolation de la variable brute $x$ s’obtient par une opération élémentaire de réarrangement algébrique : en multipliant les deux membres par l’écart type $\sigma$ puis en y ajoutant l’espérance mathématique $\mu$, nous obtenons l’équation inverse de projection :
$$x = \mu + (z \cdot \sigma)$$
Dans le paradigme de notre échelle psychométrique de Wechsler ($\mu = 100$, $\sigma = 15$), cette transformation linéaire confère une signification clinique directe à chaque niveau de standardisation. Un score standardisé $z = 0$ correspond immédiatement à la note brute $100 + (0 \cdot 15) = 100$. Un score $z = -2$, correspondant au seuil conventionnel de suspicion de déficience intellectuelle, se traduit par la valeur métrique brute $100 + (-2 \cdot 15) = 70$. Inversement, la borne de haute potentialité cognitive fixée à $z = +2$ se projette rigoureusement sur le score brut standardisé de 130. Les valeurs extrêmes de notre modèle, délimitées à $z = \pm 4$, couvriront l’éventail complet des scores possibles compris entre 40 et 160 points.
4.2 Implémentation technique de la formule dans Google Sheets
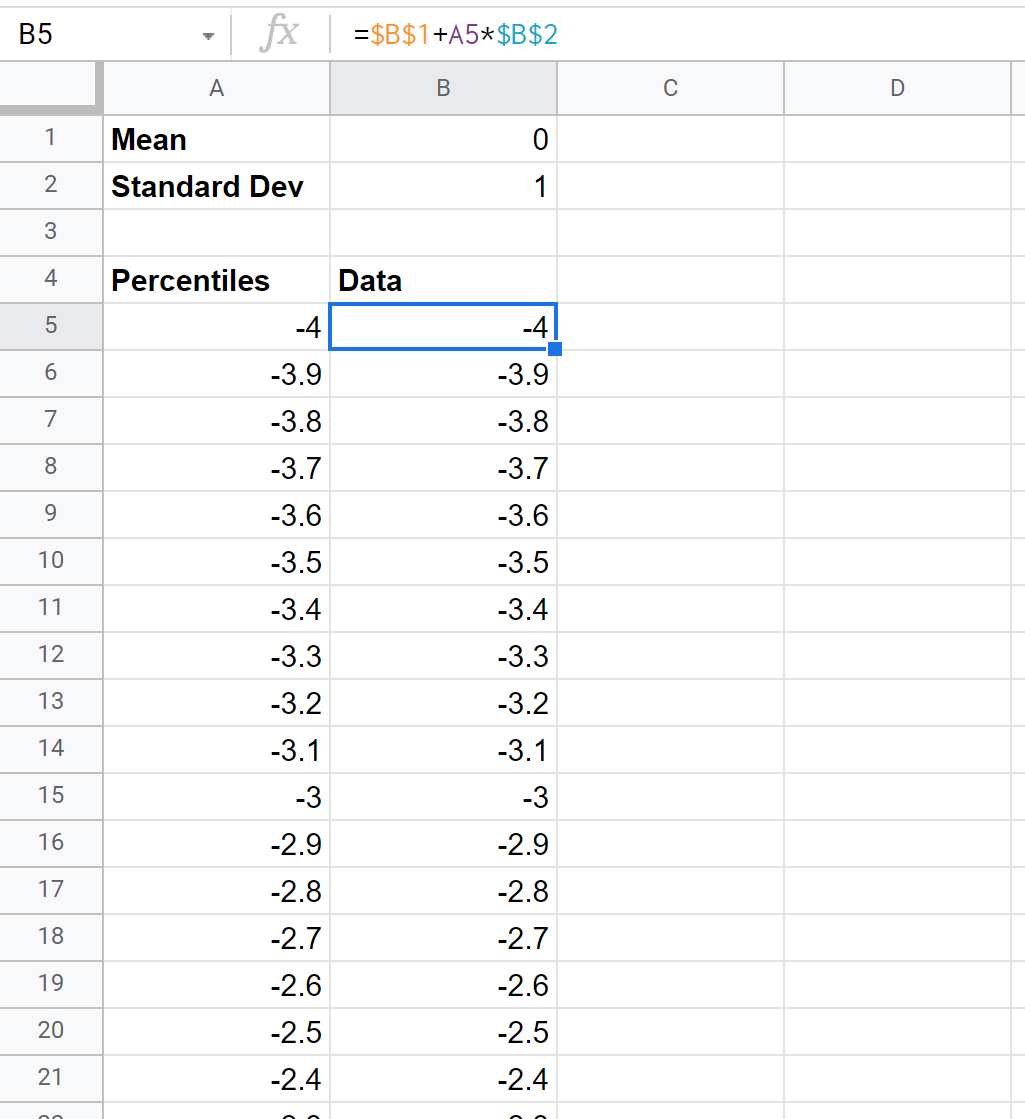
Pour héberger les valeurs brutes ainsi recalculées, nous assignons la colonne D de notre matrice de calcul, sous l’étiquette descriptive « Score brut (x) » logée dans la cellule D5. L’implémentation de la fonction de réversion algébrique requiert une attention méthodologique particulière quant à la gestion des modes d’adressage cellulaire. La valeur du score z varie à chaque ligne d’échantillonnage (adressage relatif), tandis que les paramètres de moyenne ($\mu$) et d’écart type ($\sigma$) demeurent invariablement fixes et logés dans leurs cellules respectives B1 et B2 (adressage absolu).
L’équation saisie dans la première ligne de traitement actif, en l’occurrence la cellule D6, doit être rédigée selon l’une des deux syntaxes autorisées suivantes :
- Syntaxe basée sur les coordonnées absolues :
=$B$1 + (C6 * $B$2) - Syntaxe sémantique utilisant les plages nommées :
=mu + (C6 * sigma)
L’omission des symboles de dollar ($) dans la première syntaxe constitue une erreur classique : lors de l’étirement vertical de la formule vers le bas, les références aux cellules B1 et B2 glisseraient de manière incontrôlée vers B2, B3, puis B4, introduisant des valeurs nulles ou textuelles qui ruineraient l’intégrité arithmétique de la modélisation. Une fois la formule saisie avec ses verrouillages absolus dans la cellule D6, elle doit être propagée sans discontinuité jusqu’à la cellule D86, soit par double-clic sur le coin inférieur droit de la cellule, soit par la combinaison classique de copier-coller.
4.3 Validation de l’échelle des valeurs générées
L’assurance qualité de cette étape repose sur une vérification de la cohérence interne de la série métrique brute nouvellement calculée. L’opérateur doit scruter avec rigueur les points cardinaux de la matrice pour garantir l’absence de toute distorsion de translation. La première inspection porte sur la ligne médiane exacte de la série : à l’abscisse où le score z affiche rigoureusement la valeur « 0,0 » (localisée très précisément au niveau de la cellule C46 si la série a débuté à la ligne 6), le score brut correspondant en colonne D doit impérativement afficher la valeur exacte de la moyenne déclarée, en l’occurrence « 100,0 ».
La seconde vérification concerne le respect des bornes extrêmes théoriques. La cellule supérieure D6, associée à $z = -4$, doit restituer sans ambiguïté la valeur « 40,0 », tandis que la cellule terminale D86, associée à $z = +4$, doit afficher un résultat de « 160,0 ». Toute déviation, même marginale, par rapport à ces valeurs attendues trahit une altération de la référence absolue vers le paramètre d’écart type ou une formule altérée par une priorité erronée des opérateurs arithmétiques.
Enfin, l’opérateur doit vérifier la parfaite régularité des intervalles métriques observés entre deux lignes consécutives. Étant donné que le pas de notre variable z a été fixé à 0,1 et que notre écart type vaut 15, le différentiel d’incrémentation entre chaque score brut consécutif doit être rigoureusement identique et égal à :
$$\Delta x = \Delta z \cdot \sigma = 0,1 \cdot 15 = 1,5$$
Toute variation locale de ce pas arithmétique (comme un saut brutal de 1,5 à 3,0 ou 0) mettrait en évidence une duplication de lignes ou un saut accidentel lors de l’étirement initial de la série des scores standardisés.
5. Étape 4 : Calcul de la fonction de densité de probabilité (PDF)
5.1 Compréhension de la densité de probabilité par rapport à la probabilité cumulée
L’un des écueils conceptuels les plus persistants chez les analystes de données novices réside dans la confusion entre la probabilité ponctuelle d’un événement et la valeur prise par la fonction de densité de probabilité (PDF). Dans le cadre d’une variable aléatoire continue, la probabilité d’observer une valeur ponctuelle infiniment précise — par exemple obtenir un score de QI rigoureusement égal à 104,83724… — est formellement égale à zéro ($P(X = x) = 0$). Cela découle du fait qu’il existe une infinité indénombrable de valeurs possibles sur un continuum réel donné.
L’ordonnée $f(x)$ calculée pour chaque point de l’abscisse ne représente donc pas une probabilité absolue, mais une densité relative de probabilité. La probabilité réelle ne se matérialise que sous la forme d’une intégrale définie, correspondant à la surface géométrique délimitée sous la courbe entre deux bornes finies $[a, b]$ :
$$P(a le X le b) = \int_{a}^{b} f(x) , dx$$
À l’abscisse centrale $x = \mu$, la densité de probabilité atteint son ordonnée maximale absolue $f(\mu)$. En substituant $x = \mu$ dans l’équation gaussienne, l’exposant négatif devient identiquement nul ($e^0 = 1$), réduisant la densité maximale à son facteur multiplicatif :
$$f(\mu) = \frac{1}{\sigma \sqrt{2\pi}}$$
Pour notre étalonnage psychométrique où $\sigma = 15$, cette altitude maximale théorique vaut très précisément :
$$f(100) = \frac{1}{15 \sqrt{2 \cdot 3,14159}} \approx \frac{1}{37,5994} \approx 0,026596$$
Cette valeur de crête d’environ 0,0266 ne signifie en aucun cas qu’il n’y a que 2,66 % de chances d’obtenir le score moyen, mais constitue simplement l’ordonnée d’échelle nécessaire pour que la superficie géométrique globale sous la cloche soit unitaire.
5.2 Maîtrise de la fonction native LOI.NORMALE / NORMDIST
Google Sheets dispose d’une infrastructure algorithmique stochastique particulièrement robuste grâce à sa fonction native dédiée à la modélisation gaussienne univariée, accessible sous la dénomination française LOI.NORMALE ou sa nomenclature universelle anglaise NORMDIST. Cette fonction élimine l’obligation fastidieuse et propice aux fautes de saisie consistant à rédiger manuellement l’intégralité de l’équation différentielle exponentielle avec les fonctions EXP, PI et RACINE.
La signature syntaxique complète de cette fonction requiert rigoureusement quatre arguments positionnels obligatoires :
=LOI.NORMALE(valeur; moyenne; ecart_type; cumulatif)
L’analyse détaillée de ces paramètres révèle la structure suivante :
valeur: L’abscisse pour laquelle on souhaite évaluer la courbe (notre score brut $x$ situé dans la colonne D).moyenne: L’espérance mathématique de la distribution de référence (notre celluleB1ou plage nommée mu).ecart_type: L’indice de dispersion de l’étalonnage (notre celluleB2ou plage nommée sigma).cumulatif: Argument booléen déterminant. L’assignation de la directiveFAUX(ouFALSE) force le moteur de calcul à restituer la hauteur ponctuelle de la fonction de densité de probabilité (PDF). À l’opposé, l’assignation deVRAI(ouTRUE) produirait la fonction de répartition cumulative (CDF), qui générerait une courbe sigmoïde en « S » mesurant les percentiles cumulés de 0 à 1, inappropriée pour le tracé d’une courbe en cloche classique.
5.3 Déploiement et vérification des ordonnées calculées
Pour intégrer ces ordonnées mathématiques à notre modèle, nous ouvrons la colonne E sous le libellé « Densité f(x) » en cellule E5. Dans la cellule de calcul initiale E6, nous implémentons la formule exploitant notre paramétrage absolu :
=LOI.NORMALE(D6; $B$1; $B$2; FAUX)
Ou, de manière alternative en exploitant l’adressage sémantique nommé :
=LOI.NORMALE(D6; mu; sigma; FAUX)
Nous propageons ensuite cette expression mathématique sans interruption jusqu’à la cellule terminale E86. Dès le déploiement de la colonne, une série de contrôles d’assurance qualité stochastique doit être exécutée. En premier lieu, l’ordonnée maximale absolue doit obligatoirement se matérialiser en cellule E46, en regard immédiat de l’abscisse $x = 100$, et afficher la valeur exacte calculée précédemment de 0,026596. Toute délocalisation de cette crête vers une ligne adjacente révèle une corruption de la formule de liaison.
En second lieu, la propriété fondamentale de symétrie axiale doit être immédiatement constatable par une comparaison deux à deux des ordonnées équidistantes de la moyenne. La valeur de densité calculée pour $x = 85$ ($z = -1$, cellule E36) doit être mathématiquement identique, jusqu’à la dernière décimale affichée, à celle mesurée pour $x = 115$ ($z = +1$, cellule E56), affichant toutes deux approximativement 0,01613. Enfin, toutes les valeurs de la colonne E doivent être strictement positives, tendant de façon infinitésimale vers zéro aux bornes extrêmes sans jamais adopter de valeurs négatives, ce qui serait contraire aux lois de la probabilité.
6. Étape 5 : Construction et insertion du graphique de la courbe en cloche
6.1 Sélection des plages de données matricielles
Une fois les coordonnées cartésiennes complètement générées et validées sur le plan arithmétique, la phase de représentation visuelle peut débuter. La confection d’un graphique scientifiquement irréprochable exige une sélection méticuleuse des seules variables contribuant à la morphologie bivariée de la distribution : la série des scores bruts (abscisses $X$) et la série des densités de probabilité associées (ordonnées $Y$). Les colonnes de calcul intermédiaire, telles que les scores standardisés $z$, ne doivent en aucun cas être intégrées directement au tracé afin d’éviter toute confusion au sein du moteur d’analyse graphique de Google Sheets.
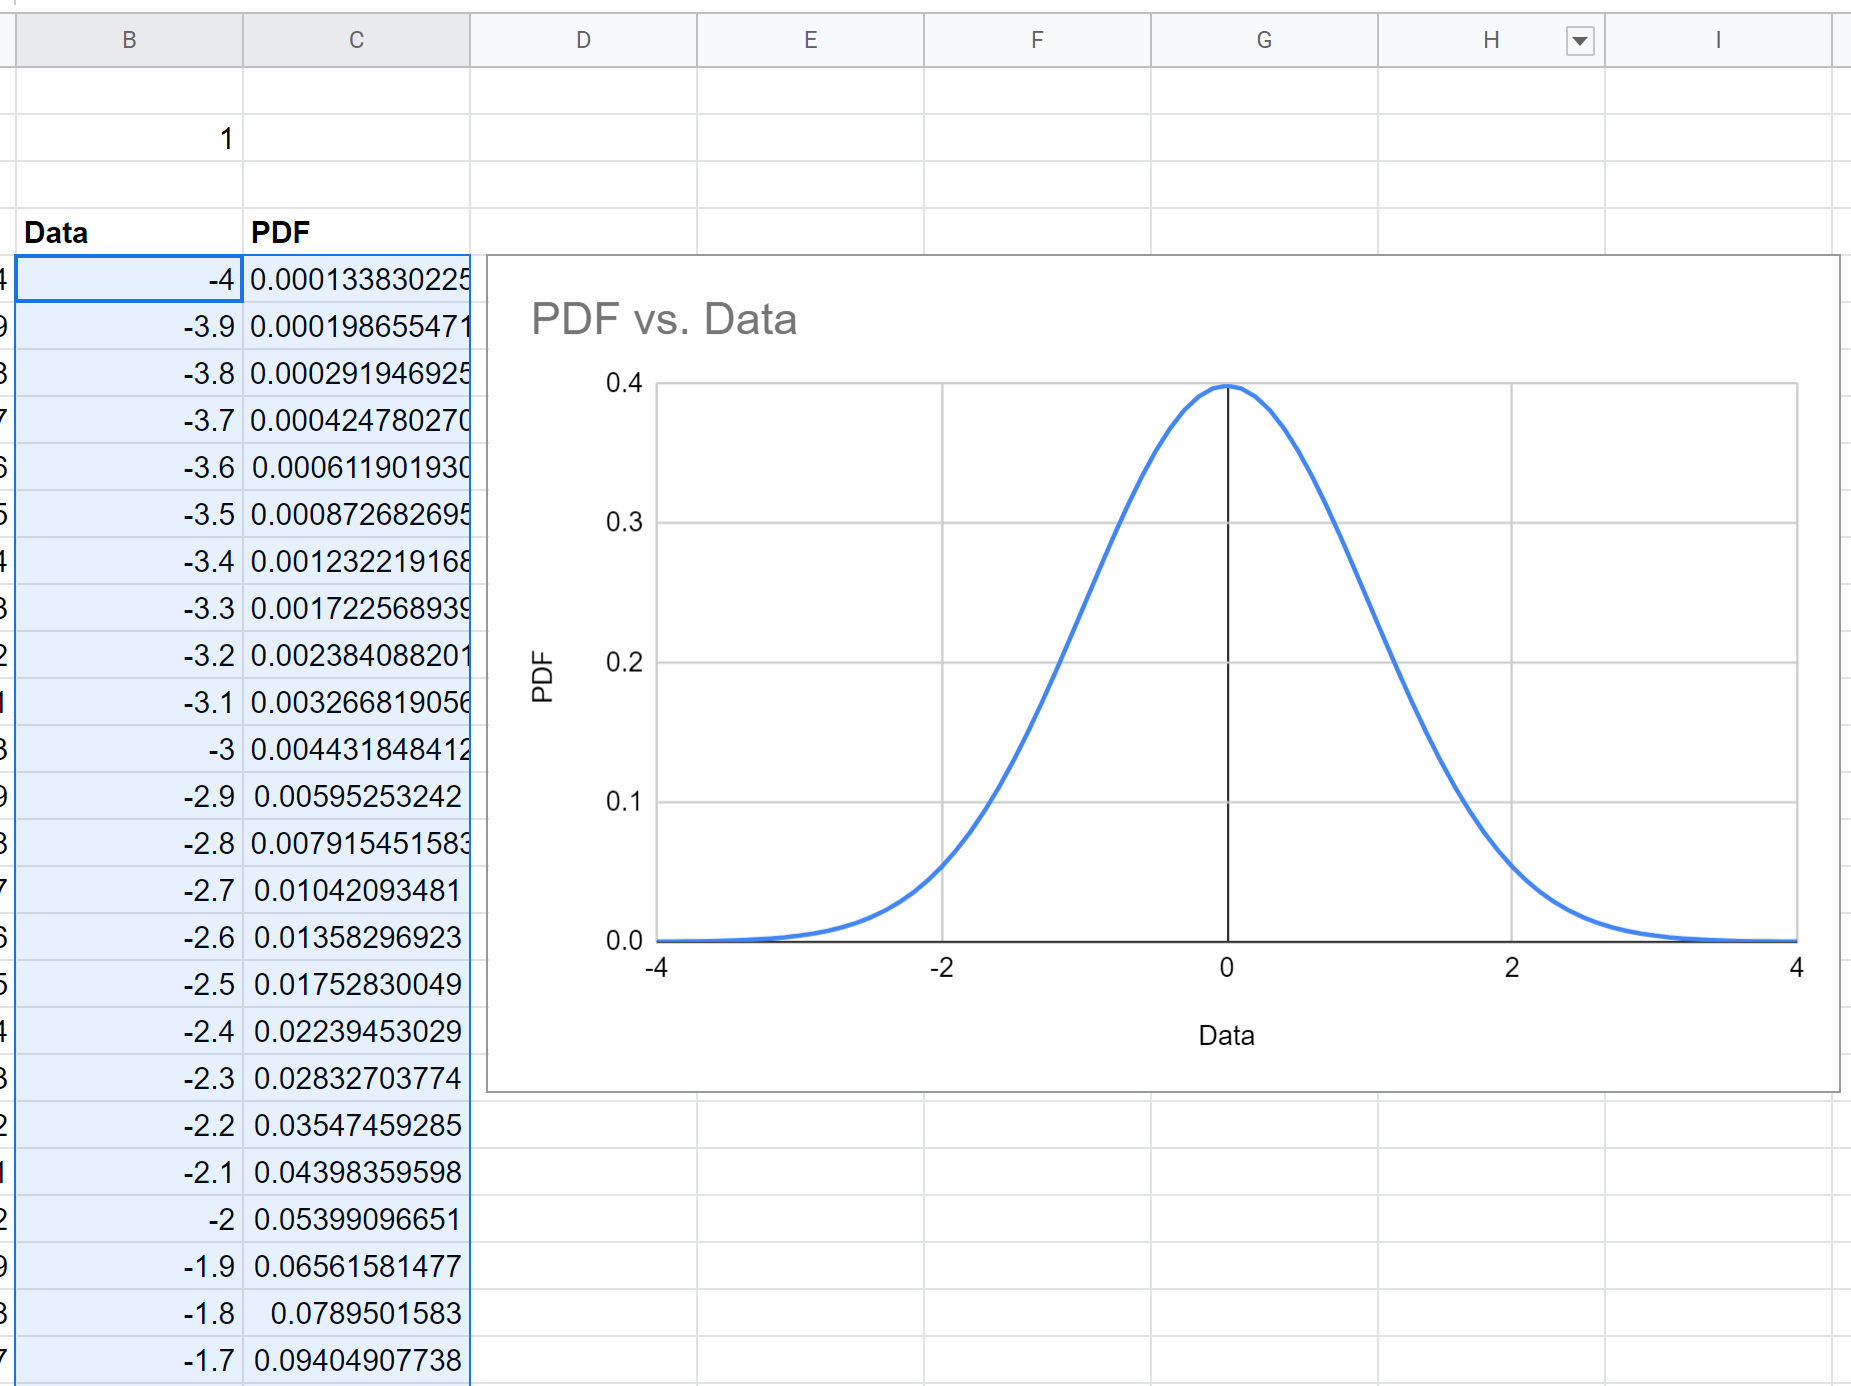
L’opérateur procède à la sélection de la plage continue bivariée couvrant les colonnes D et E, depuis les étiquettes descriptives situées sur la ligne d’en-tête jusqu’à la dernière ligne d’échantillonnage, soit précisément la matrice D5:E86. L’inclusion délibérée de la ligne d’en-tête 5 est une excellente pratique : elle permet à l’algorithme d’inférence de Google Sheets d’identifier instantanément le nom des séries de données et d’assigner automatiquement les étiquettes d’axes initiales sans intervention manuelle ultérieure.
La sélection matricielle étant active, la création du composant graphique s’initialise en naviguant dans la barre supérieure de navigation et en sélectionnant le menu Insertion > Graphique. Immédiatement, Google Sheets alloue un conteneur graphique flottant sur la grille de calcul et déploie sur la droite de l’écran le panneau contextuel intitulé « Éditeur de graphiques », structuré autour de deux onglets opérationnels majeurs : « Configuration » et « Personnaliser ».
6.2 Sélection du type de diagramme approprié
Par défaut, le moteur heuristique de Google Sheets tente fréquemment d’interpréter les jeux de données tabulaires sous la forme d’histogrammes en bâtons ou de graphiques à barres empilées, configurations qui s’avèrent catastrophiques pour la modélisation théorique d’une densité continue. De tels tracés suggèrent faussement la présence de catégories discrètes disjointes et segmentent artificiellement l’espace métrique. Le premier acte d’optimisation dans l’onglet « Configuration » consiste donc à modifier drastiquement le champ « Type de graphique ».
Deux typologies de diagrammes sont scientifiquement éligibles pour représenter une fonction de densité de probabilité continue :
- Le graphique de dispersion (XY / Nuage de points) : Il constitue la modélisation la plus rigoureuse sur le plan cartésien car il projette les valeurs selon une véritable échelle numérique continue sur l’axe horizontal, respectant scrupuleusement la métrique des distances entre chaque point $X$.
- Le graphique à lignes lissées : Il offre l’esthétique la plus fluide en appliquant une interpolation spline cubique continue entre les ordonnées de densité calculées, éliminant tout artefact polygonal résiduel.
Pour concilier rigueur cartésienne et élégance visuelle, nous sélectionnons l’option Graphique de dispersion ou Graphique à lignes lissées. Dans la section d’agencement des données, l’opérateur doit impérativement s’assurer que la colonne « Score brut (x) » est explicitement affectée au paramètre « Axe X », tandis que la colonne « Densité f(x) » est désignée comme « Série » d’ordonnées unique. Il est également nécessaire de cocher les options structurelles « Utiliser la ligne 5 comme en-têtes » et « Utiliser la colonne D comme étiquettes » pour garantir la dissociation fonctionnelle parfaite entre les coordonnées d’abscisse et les ordonnées.
6.3 Initialisation du tracé visuel par le moteur de rendu
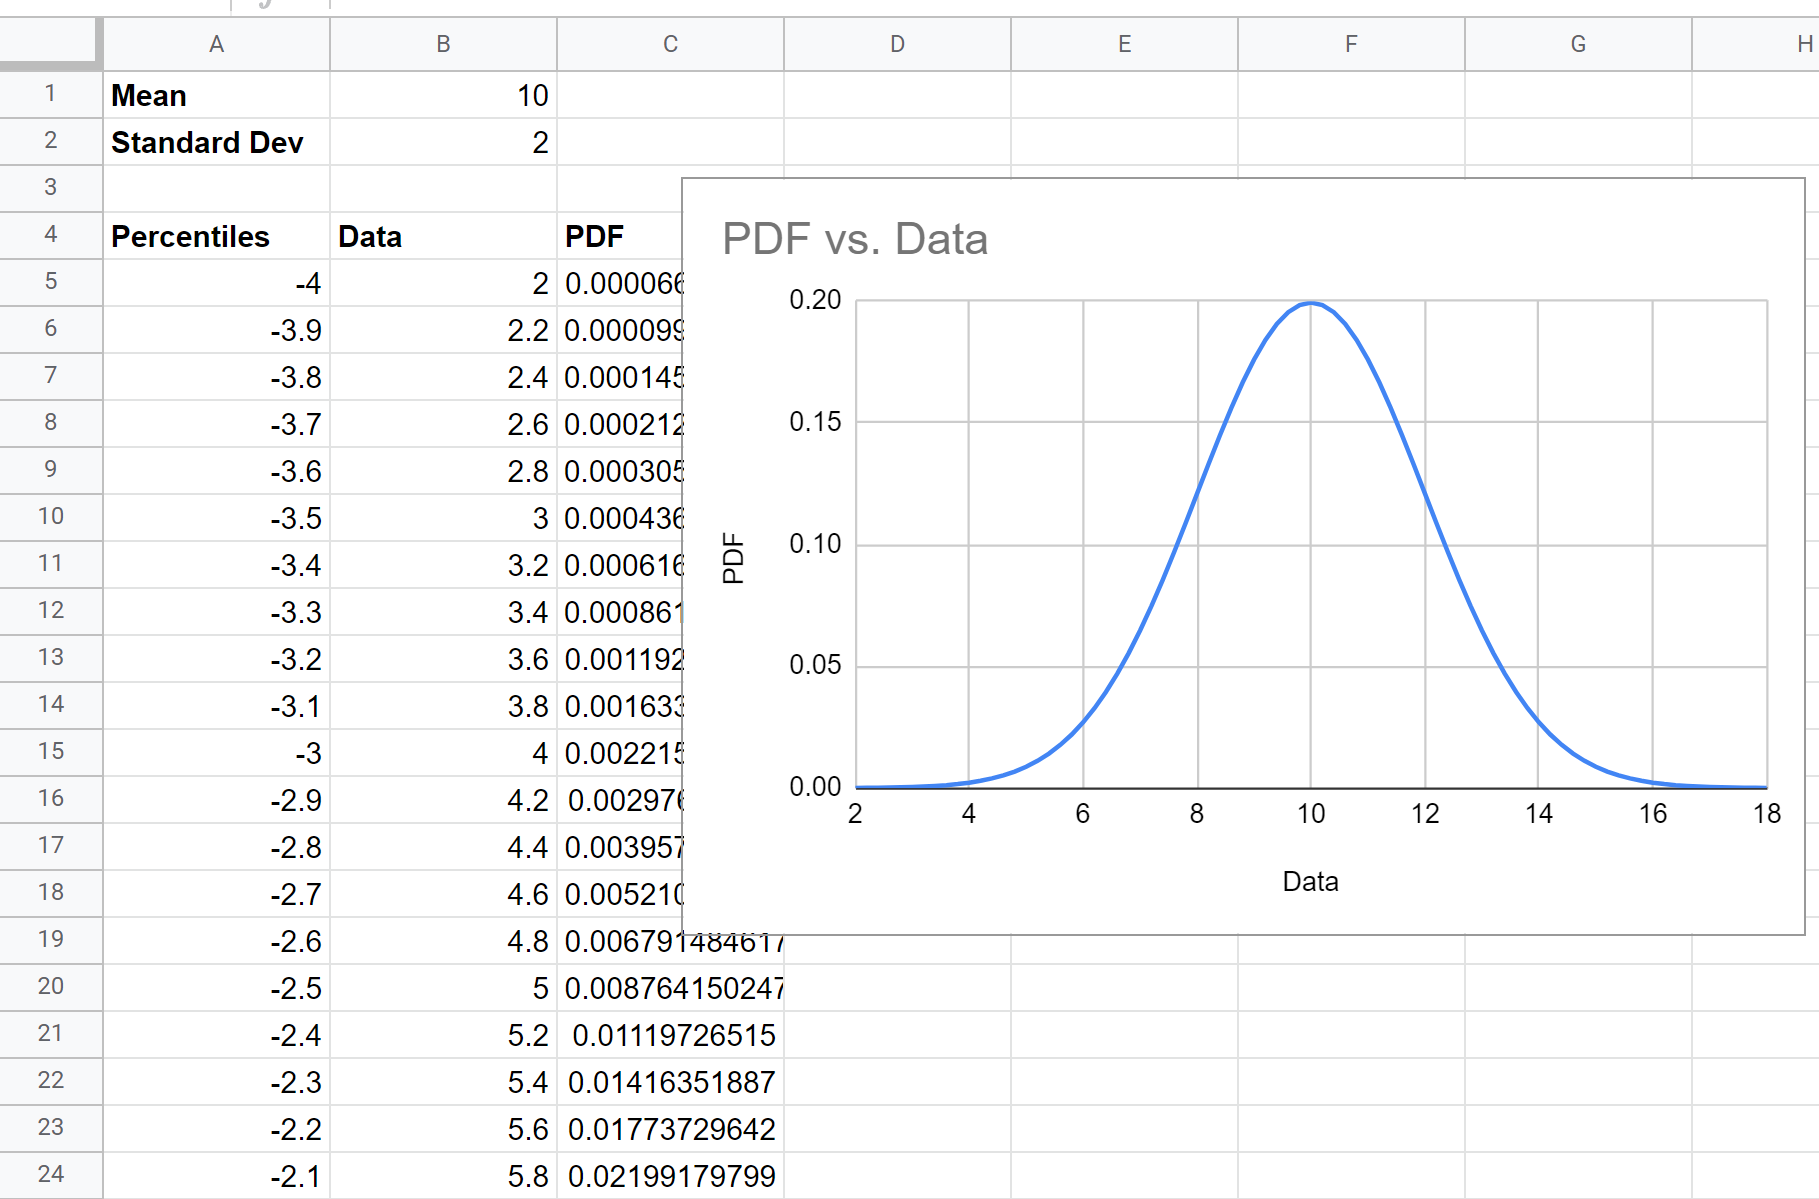
Dès la validation de cette configuration topologique, le moteur de rendu vectoriel de Google Sheets projette sur le canevas le dessin initial de la fonction gaussienne. Cette étape offre une opportunité immédiate de contrôle visuel pour détecter les aberrations potentielles de tracé. La morphologie affichée doit présenter une harmonie parfaite : un monticule régulier, strictement centré sur l’abscisse 100, s’élevant graduellement depuis les marges extérieures pour culminer à son apogée avant de redescendre de manière rigoureusement symétrique.
Une anomalie visuelle fréquente à ce stade est le phénomène de « cassure angulaire » ou d’aplatissement asymétrique d’un flanc de la cloche. Ce défaut apparaît généralement si l’opérateur a par inadvertance inversé l’ordre de tri de l’axe des scores $x$ ou si le tracé a été configuré par erreur comme un graphique à lignes ordinaires (non lissées) sur un jeu de points insuffisant. L’absence de discontinuités géométriques ou de segments verticaux abrupts confirme que l’interpolation mathématique s’exécute convenablement.
Enfin, il convient de s’assurer que les queues de distribution ne s’affaissent pas brutalement en deçà de l’axe zéro. Les franges de la courbe à $x = 40$ et $x = 160$ doivent flotter de manière infinitésimale au-dessus de la ligne d’abscisse sans jamais s’interrompre de façon séquentielle tronquée. Cette parfaite continuité morphologique valide le passage à la phase cruciale de standardisation stylistique et d’optimisation sémiotique du diagramme.
7. Optimisation stylistique et lisibilité scientifique du graphique
7.1 Paramétrage précis des axes cartésiens
Un tracé brut issu du moteur graphique de Google Sheets ne répond pas spontanément aux critères d’exigence des publications scientifiques ou des rapports psychologiques formels. L’optimisation cartésienne s’opère dans l’onglet « Personnaliser » de l’Éditeur de graphiques. La première intervention vise la rationalisation de l’axe horizontal (« Axe horizontal »). Par défaut, le tableur tend à choisir des bornes d’affichage arbitraires qui ne correspondent pas aux intervalles psychométriques pertinents. L’analyste doit définir manuellement les valeurs « Min » à 40 et « Max » à 160, encadrant parfaitement la plage d’étude à $\pm 4\sigma$.
Le sous-menu « Quadrillage et graduations » permet d’ajuster l’échelle de lecture cognitive. Il est hautement recommandé de calibrer les quadrillages principaux sur un pas correspondant exactement à l’écart type du test, soit un intervalle de 15 unités. En fixant le décompte des quadrillages principaux ou leur espacement sur une valeur de 15, les lignes verticales directrices viendront s’ancrer précisément sur les seuils d’étalonnage clinique majeurs : 55, 70, 85, 100, 115, 130 et 145. Cette disposition spatiale offre une lecture directe des seuils de déviation standard par rapport à la moyenne sans encombrer la zone d’affichage.
Quant à l’axe vertical (« Axe vertical »), il convient de s’interroger sur sa pertinence didactique. Pour un clinicien ou un patient, les valeurs de densité de probabilité exprimées en décimales infinitésimales (de 0 à 0,027) n’apportent aucune valeur informative directe et génèrent souvent une surcharge cognitive superflue. Il est donc opportun soit d’atténuer le contraste typographique des libellés de l’axe vertical, soit d’en supprimer purement et simplement les étiquettes numériques, en conservant uniquement la ligne d’assise zéro. L’attention du lecteur demeure ainsi focalisée sur la forme morphologique et la dispersion relative le long de la variable psychologique d’intérêt.
7.2 Sémiologie graphique et esthétique académique
La crédibilité méthodologique d’une recherche repose également sur la sémiologie graphique appliquée à ses figures statistiques. Les styles visuels par défaut des tableurs grand public — caractérisés par des lignes épaisses multicolores, des fonds grisés ou des ombrages artificiels — doivent être proscrits au profit d’une sobriété rigoureuse conforme aux standards de l’American Psychological Association (normes APA). Dans le panneau « Style de graphique », la couleur de fond de la zone de traçage doit être impérativement configurée en blanc pur (sans transparence) et la bordure périphérique du graphique doit être désactivée pour permettre une intégration fluide dans un document textuel.
Dans la section « Série », l’épaisseur du trait de la courbe doit être ajustée avec précision : un tracé de 2 pixels de largeur représente l’équilibre idéal entre lisibilité visuelle et finesse analytique. Une ligne trop épaisse masquerait la courbure infinitésimale aux points d’inflexion, tandis qu’un trait d’un pixel apparaîtrait dégradé lors des conversions PDF ou de l’impression papier. Pour la coloration du trait, les nuances monochromatiques ou à faible saturation sont privilégiées : un bleu ardoise sobre, un bleu marine profond ou un gris anthracite confèrent une assise professionnelle incontestable.
De surcroît, il est primordial de désactiver la restitution des marqueurs ponctuels individuels. Si le graphique a été conçu sous forme de nuage de points XY, Google Sheets affiche par défaut un cercle plein sur chacun des 81 points d’échantillonnage, ce qui sature visuellement la courbe et donne l’impression d’une chaîne perlée disgracieuse. En configurant la « Taille en pixels des points » sur « Aucun » (0 px), les marqueurs s’effacent intégralement, laissant place à la seule ligne d’interpolation continue qui incarne avec pureté la fonction de probabilité continue théorique.
7.3 Annotation et contextualisation didactique
Un graphique stochastique ne peut être interprété valablement sans une contextualisation documentaire sans équivoque. Dans la sous-section « Titres du graphique et des axes », il convient de concevoir un titre formel respectant la grammaire descriptive académique. Au lieu d’une étiquette sommaire telle que « Courbe en cloche », le titre doit expliciter la nature de la distribution, la variable psychométrique investiguée et la taille de l’échantillon normatif. Une formulation exemplaire sera : « Distribution théorique normale de l’Indice de Compréhension Verbale (N = 1000, mu = 100, sigma = 15) ».
L’étiquette de l’axe horizontal doit spécifier clairement le nom de la variable ainsi que son unité d’expression : « Score standardisé (Indice psychométrique global) ». La typographie de l’ensemble des éléments textuels doit être harmonisée. Google Sheets propose des polices de caractères universellement reconnues dans le champ de l’édition scientifique, telles qu’Arial ou Roboto. L’ensemble des polices doit adopter une teinte uniforme gris foncé (#333333) plutôt qu’un noir pur (#000000), afin d’adoucir le contraste de lecture et d’optimiser le rendu typographique sur les écrans haute définition.
Enfin, la légende générée automatiquement par le tableur doit être scrupuleusement purgée si elle n’identifie qu’une seule série continue. Une légende indiquant simplement « Densité f(x) » au sommet du tracé constitue un parasitage visuel inutile qui ampute la surface disponible pour la projection de la courbe. Dans le panneau « Légende », nous sélectionnons l’option « Aucune », maximisant ainsi l’emprise spatiale du système d’axes cartésiens et renforçant l’élégance architecturale de la figure finale.
8. Dynamisation des paramètres et analyse de sensibilité computationnelle
8.1 Effet cinétique de la modification de la moyenne
L’avantage décisif d’un modèle stochastique implémenté sur une infrastructure dynamique comme Google Sheets réside dans la réactivité instantanée du tracé face à la modification des paramètres centraux. Lorsque l’analyste modifie la valeur de la moyenne arithmétique ancrée dans la cellule B1 (par exemple en faisant passer $\mu$ de 100 à 115), le moteur de calcul réévalue immédiatement la fonction inverse de standardisation dans la colonne D, ce qui provoque une cinétique graphique remarquable : une translation horizontale pure de la cloche le long de l’abscisse.
Cette cinétique s’exécute sans la moindre altération morphologique de la courbe : la hauteur maximale, la largeur aux points d’inflexion et la courbure asymptotique demeurent rigoureusement invariables. Cette propriété illustre concrètement le rôle de la moyenne en tant que pur paramètre de position ou de localisation. Dans l’exercice clinique, cette manipulation permet de visualiser instantanément l’écart existant entre les performances moyennes d’un groupe d’âge spécifique et celles de la population de référence globale, matérialisant visuellement le concept de décalage ou de retard de développement.
Toutefois, une translation importante de la moyenne impose un réajustement des bornes cartésiennes de l’axe horizontal du graphique. Si la moyenne passe à 130, une portion substantielle du flanc droit de la cloche dépassera la limite d’affichage fixée initialement à 160, provoquant une troncature visuelle artificielle. L’analyste doit alors modifier les limites minimales et maximales de l’axe dans l’éditeur de graphique afin de réaligner l’intervalle d’affichage sur les nouvelles coordonnées $\mu \pm 4\sigma$, restaurant la parfaite centralité de la distribution.
8.2 Effet cinétique de l’ajustement de l’écart type
L’ajustement paramétrique de la cellule B2 hébergeant l’écart type ($\sigma$) produit une dynamique de déformation visuelle radicalement différente et structurellement plus spectaculaire. Si l’on réduit l’écart type de 15 à 7,5 (traduisant une réduction de moitié de la dispersion intragroupe), la courbe subit une métamorphose spectaculaire caractérisée par un resserrement latéral prononcé et une élévation vertigineuse de son sommet. Ce comportement illustre le concept de leptocurticité relative, typique des populations hautement sélectionnées ou homogènes au sein desquelles les sujets sont fortement concentrés autour du niveau central.
Inversement, si l’on accroît la valeur de l’écart type à 30, la morphologie gaussienne s’affaisse et s’étale largement sur les côtés, manifestant une platycurticité accrue. Cette déformation aplatie caractérise les cohortes cliniques hétérogènes où la dispersion des aptitudes est considérablement plus vaste que dans les étalonnages normatifs habituels. Durant ces modifications morphologiques intenses, un invariant statistique fondamental demeure scrupuleusement respecté par le moteur mathématique : l’intégrale totale de la fonction, matérialisée par l’aire totale circonscrite sous la courbe, demeure rigoureusement égale à 1.
L’élévation du sommet observée lors de la diminution de $\sigma$ découle mécaniquement de l’ajustement du dénominateur dans le terme de normalisation $1 / (\sigma \sqrt{2\pi})$. Lorsque la largeur de la base se réduit, la hauteur doit impérativement augmenter en proportion inverse pour maintenir constante la masse unitaire de probabilité. Cette manipulation interactive constitue un formidable levier pédagogique pour enseigner aux cliniciens et étudiants pourquoi la variance ne représente pas simplement une marge d’incertitude accessoire, mais un déterminant fondamental de la morphologie et de l’étalonnage psychométrique.
8.3 Utilisation de curseurs et contrôles interactifs
Pour transformer la feuille de calcul en un simulateur statistique véritablement interactif, Google Sheets permet d’intégrer des contrôles de saisie modernes sans nécessiter la rédaction d’une seule ligne de code JavaScript. L’analyste peut implémenter des menus déroulants contextuels ou des règles de validation de données directement dans les cellules de pilotage B1 et B2 (via le menu Données > Validation des données). Cette configuration permet de borner strictement les saisies de l’écart type à des valeurs strictement positives, éliminant tout risque d’interruption accidentelle des calculs par la saisie d’un écart type négatif ou nul, mathématiquement prohibé.
En outre, il est aisé d’associer un tableau de profils cliniques types à ces cellules de commande. Par exemple, un menu déroulant situé dans une cellule adjacente permet de commuter instantanément entre différents profils d’étalonnage standardisés :
- Échelle globale de quotient intellectuel : $\mu = 100$, $\sigma = 15$
- Scores standardisés T de personnalité (ex. MMPI) : $\mu = 50$, $\sigma = 10$
- Notes stanines du système éducatif : $\mu = 5$, $\sigma = 2$
- Scores sous-épreuves composites : $\mu = 10$, $\sigma = 3$
La sélection d’un profil répercute immédiatement les nouvelles constantes dans les cellules $B1$ et $B2$ au moyen d’une simple fonction de recherche de tableur (telle que RECHERCHEV ou INDEX/EQUIV). L’intégralité des 81 lignes de calcul ainsi que le graphique de la cloche s’actualisent en une fraction de seconde, offrant un support d’enseignement et d’analyse différentielle incomparable pour la formation continue des professionnels de santé mentale.
9. Intégration et superposition de données psychologiques empiriques
9.1 Confrontation de la distribution théorique aux données réelles
L’utilité ultime de la modélisation gaussienne dans la recherche translationnelle réside dans la confrontation empirique : vérifier dans quelle mesure un groupe clinique concret se conforme ou dévie de la distribution idéale de référence. Pour illustrer cette méthodologie avancée, imaginons l’intégration d’un échantillon de $N = 150$ scores bruts obtenus par des patients présentant un trouble déficit de l’attention avec hyperactivité (TDAH) lors d’un test standardisé de mémoire de travail. Ces données brutes empiriques sont compilées dans une nouvelle colonne indépendante, par exemple la plage G6:G155.
La première phase analytique consiste à quantifier les paramètres statistiques descriptifs propres à cet échantillon réel, directement au sein de cellules d’analyse dédiées :
- Moyenne observée :
=MOYENNE(G6:G155) - Écart type d’échantillon corrigé :
=ECARTYPE.STANDARD(G6:G155) - Taille de l’échantillon :
=NB(G6:G155)
Pour confronter ces observations individuelles à la courbe théorique, les données empiriques continues doivent être agrégées sous forme de fréquences discrètes par le biais d’un processus de découpage en classes (binning). À l’aide de la fonction matricielle FREQUENCE(G6:G155; D6:D86), Google Sheets calcule instantanément le nombre de sujets réels dont les scores tombent dans les intervalles définis par notre colonne d’abscisses de scores bruts. Ces effectifs observés sont ensuite convertis en proportions relatives, puis normalisés pour correspondre exactement à l’échelle de densité de la courbe théorique.
9.2 Technique de superposition graphique bivariée
L’intégration harmonieuse d’un histogramme empirique et d’une courbe continue de référence au sein d’un même graphique Google Sheets fait appel aux diagrammes de type combiné (accessible sous le libellé « Graphique combiné » dans l’Éditeur de graphiques). Ce format polyvalent permet d’assigner des typologies de rendu distinctes à différentes séries de données partageant le même axe horizontal d’abscisses.
Dans la configuration du graphique combiné, l’opérateur procède à l’agencement suivant :
- La série de la distribution théorique normale continue est expressément configurée en mode « Ligne lissée », avec un tracé d’un bleu profond de 2 pixels d’épaisseur, sans aucun marqueur discret.
- La série des densités de fréquences empiriques observées est configurée en mode « Colonnes » (histogramme vertical). La couleur des barres doit adopter une teinte contrastante mais pastel (par exemple un gris perle ou un bleu ciel atténué avec une transparence de 40 %) pour éviter de masquer la trajectoire de la courbe idéale.
Cette superposition visuelle immédiate met en exergue les points de convergence et de divergence entre la modélisation mathématique attendue et la réalité clinique du terrain. L’examinateur peut immédiatement apprécier si le sommet de l’histogramme empirique concorde avec l’apogée de la cloche théorique ou s’il s’en écarte de manière substantielle, illustrant de facto un déplacement de l’efficience moyenne au sein de cette sous-population clinique.
9.3 Interprétation des écarts cliniques à la normalité
L’analyse visuelle et computationnelle des déviations par rapport à la courbe normale permet d’extraire des indicateurs diagnostiques de premier ordre. Le premier dysfonctionnement structurel observable est l’effet de plancher ou de plafond. Si l’histogramme des données réelles présente une accumulation massive d’effectifs dans les colonnes les plus basses (flanc gauche extrême), cela indique que l’épreuve psychométrique était d’un niveau de difficulté disproportionné pour la population testée, tronquant artificiellement la variance et empêchant la discrimination fine des profils les plus altérés.
Le deuxième phénomène clinique majeur révélé par la superposition graphique est la bimodalité. Si l’histogramme empirique se fragmente en deux sommets distincts séparés par un creux intermédiaire, alors même que la courbe univariée théorique impose une silhouette unimodale, cela met en évidence l’hétérogénéité sous-jacente de l’échantillon. En psychopathologie, cette structure bivariée trahit fréquemment la contamination de l’échantillon par deux sous-populations nosologiquement distinctes : par exemple des patients présentant un déclin neurodégénératif avéré masqués au sein d’un groupe souffrant d’un simple ralentissement dépressif bénin.
Enfin, la détection visuelle d’une asymétrie ou d’une leptocurticité empirique prononcée doit inciter le chercheur à dépasser la simple inspection graphique pour exécuter des tests formels de normalité. Bien que Google Sheets ne propose pas directement les routines de Kolmogorov-Smirnov ou de Shapiro-Wilk dans son jeu de fonctions natives de base, les coefficients d’asymétrie empirique et d’aplatissement peuvent être extraits instantanément au moyen des fonctions COEFFICIENT.ASYMETRIE(G6:G155) et KURTOSIS(G6:G155), fournissant les critères formels nécessaires pour confirmer ou réfuter la validité de l’inférence gaussienne standard.
10. Délimitation des zones sous la courbe et calculs de percentiles
10.1 La règle empirique des 68-95-99,7 en évaluation psychologique
La puissance prédictive et diagnostique de la distribution normale repose sur la constance absolue de la répartition de son aire géométrique relative, un axiome universellement consacré sous l’appellation de règle empirique des trois sigmas ou règle des 68-95-99,7. En vertu de l’intégration analytique de la fonction de Gauss sur des intervalles bornés par des multiples entiers de la variance, toute variable normalement distribuée présente une partition prévisible de ses effectifs :
- L’intervalle circonscrit entre $z = -1$ et $z = +1$ (soit entre 85 et 115 points de QI) englobe rigoureusement 68,27 % de la population théorique. Cet intervalle d’un écart type de part et d’autre de la moyenne définit formellement la zone de normalité moyenne au sens psychométrique strict.
- L’intervalle étendu entre $z = -2$ et $z = +2$ (soit entre 70 et 130 points) concentre très exactement 95,45 % de l’ensemble de la population, délimitant les frontières de la variation attendue au sein de l’espèce humaine.
- L’intervalle compris entre $z = -3$ et $z = +3$ (soit entre 55 et 145 points) absorbe 99,73 % des cas, ne reléguant au-delà de ses frontières que les profils neurodéveloppementaux ou pathologiques les plus rares (environ un individu sur 370 pour chaque queue de distribution).
Sur le plan diagnostique, l’intégration de cette règle est capitale. Elle permet au clinicien de convertir instantanément un score standardisé en une estimation probabiliste concrète de rareté relative. Un sujet obtenant un score brut de 70 ($z = -2$) ne se situe pas simplement « en dessous de la moyenne » : il se positionne exactement à la frontière des 2,28 % des scores les plus faibles de l’humanité, un seuil épidémiologique déterminant pour l’attribution des droits d’accompagnement médico-social ou l’établissement d’une invalidité.
10.2 Coloration différentielle des aires sous la courbe dans Google Sheets
L’impact didactique d’un graphique de courbe en cloche est décuplé lorsque les zones d’importance clinique majeure sont visuellement isolées par des aplats de couleur translucides disposés sous la ligne de densité. Google Sheets ne possède pas d’outil de pinceau vectoriel direct pour peindre sélectivement l’aire sous une fonction mathématique ; la concrétisation de cette visualisation nécessite par conséquent une élégante astuce de partitionnement matriciel par séries conditionnelles.
Pour ombrer spécifiquement la zone correspondant à la déficience intellectuelle potentielle ($z le -2$, scores bruts $le 70$), nous introduisons une colonne dédiée en F intitulée « Zone Déficit » en cellule F5. Dans la cellule F6, nous implémentons une formule conditionnelle logique exploitant la fonction SI :
=SI(D6 <= 70; E6; 0)
Cette directive ordonne au tableur de reproduire scrupuleusement la valeur de densité de la colonne E tant que le score brut demeure dans la zone clinique ciblée, et d’attribuer une valeur nulle dès que le score franchit le seuil supérieur de 70. Cette formule est déployée sur l’ensemble des 81 lignes de calcul jusqu’en cellule F86. Nous pouvons réitérer cette opération dans une colonne G intitulée « Zone Supérieure » pour capturer la frange de haute potentialité cognitive ($z ge +2$, scores bruts $ge 130$) avec la syntaxe =SI(D6 >= 130; E6; 0).
Pour injecter ces aires colorées dans le graphique existant, l’analyste élargit la plage de données source du graphique pour englober les nouvelles colonnes (soit D5:G86) et sélectionne le type Graphique combiné ou Graphique de zone superposée. Dans l’onglet « Personnaliser > Série », la série de la courbe globale est maintenue sous forme de ligne continue sobre, tandis que les nouvelles séries conditionnelles sont configurées sous la forme de tracés de type « Zone » avec un coefficient d’opacité de 30 % ou 40 %. La zone inférieure se pare conventionnellement d’une teinte ambrée ou corail douce, tandis que la zone supérieure adopte un bleu azur lumineux, produisant une sectorisation visuelle immédiate des profils atypiques.
10.3 Conversion opérationnelle entre scores z, percentiles et rangs
La transmission d’un bilan psychométrique impose de restituer les données quantitatives sous une modalité intelligible pour les non-spécialistes. Si les scores bruts et les scores z demeurent des abstractions arithmétiques pour la majorité des usagers, la notion de rang percentile présente une clarté cognitive universelle. Le rang percentile désigne le pourcentage exact d’individus de la population d’étalonnage dont la performance est strictement inférieure ou égale à celle réalisée par le sujet évalué.
Google Sheets permet d’exécuter cette conversion de façon rigoureuse au moyen de la fonction stochastique cumulative. Pour convertir un score z quelconque en son rang percentile théorique direct, la formule universelle s’énonce :
=LOI.NORMALE.STANDARD.N(score_z; VRAI)
Ainsi, pour un score $z = 0$, la fonction retourne précisément la valeur « 0,50 », signifiant que 50 % de la cohorte obtient un résultat inférieur ou égal à ce niveau. Pour un score d’efficience intellectuelle de $130$ ($z = +2$), la conversion cumulative génère la valeur « 0,9772 », ce qui situe immédiatement le sujet au 98e percentile : l’examiné surpasse ainsi 97,7 % de la population générale, ne laissant qu’environ 2,3 % des individus au-dessus de sa trajectoire.
Dans l’autre sens, la psychométrie clinique a fréquemment besoin de résoudre le problème inverse : identifier le score seuil correspondant à un percentile donné (par exemple localiser le seuil d’échec coupant les 5 % inférieurs de la distribution). Cette opération repose sur l’appel à la fonction inverse de la loi normale standard :
=LOI.NORMALE.STANDARD.INVERSE(0,05)
Le tableur retourne instantanément le score $z = -1,6448$. Il suffit ensuite d’appliquer notre formule d’échelle de la section 4 pour projeter ce seuil en note brute : $100 + (-1,6448 \cdot 15) = 75,3$. Cette articulation computationnelle bidirectionnelle fluide consolide l’exactitude éthique de la restitution des bilans psychologiques, garantissant que chaque diagnostic repose sur un calcul stochastique formel et auditable.
11. Diagnostic et résolution des erreurs courantes dans Google Sheets
11.1 Anomalies de référence et erreurs de calcul
Le déploiement de modèles mathématiques continus dans un tableur est jalonné de pièges syntaxiques susceptibles de corrompre silencieusement les résultats ou de bloquer l’évaluation arithmétique globale. L’anomalie la plus pernicieuse se manifeste sous la forme de l’erreur typologique #VALEUR!. Dans la grande majorité des cas, cette défaillance résulte d’un conflit de séparateurs décimaux entre les paramètres linguistiques régionaux du système hôte et les données collées depuis une source externe. Si votre feuille de calcul est calibrée sur les paramètres régionaux français et que des nombres comportant des points décimaux anglo-saxons sont insérés, Google Sheets classe ces données comme du texte inerte, ce qui paralyse les algorithmes de la fonction LOI.NORMALE.
La deuxième anomalie structurante est l’apparition ubiquitaire du message #REF!. Cette interruption critique se produit presque systématiquement lorsque l’opérateur a étiré vers le bas la formule du score brut (colonne D) ou de la densité (colonne E) sans avoir préalablement figé les coordonnées des cellules de paramètres centraux au moyen de l’opérateur absolu $. Les références relatives glissent alors dans le vide matriciel, pointant vers des lignes vierges ou des en-têtes textuels incompatibles. L’adoption scrupuleuse des plages nommées (mu et sigma) constitue l’antidote absolu contre cette vulnérabilité.
Enfin, l’apparition de l’erreur #NUM! signale une transgression flagrante des axiomes mathématiques fondamentaux régissant les lois de probabilité. Cette exception est systématiquement levée si la cellule hébergeant l’écart type ($\sigma$) se voit attribuer une valeur nulle (0) ou strictement négative. Dans la fonction de densité gaussienne, l’écart type intervient au dénominateur du terme de normalisation et sous forme de variance quadratique dans l’exponentielle ; une division par zéro étant indéfinie dans l’anneau des réels, le moteur de calcul interrompt la chaîne d’évaluation pour préserver l’intégrité du système.
11.2 Dysfonctionnements de configuration graphique
L’incompréhension des spécificités du moteur graphique de Google Sheets est à l’origine de déformations visuelles frustrantes. Le dysfonctionnement le plus couramment rapporté est l’aplatissement de la courbe en cloche sous la forme d’un escalier discontinu ou d’un tracé asymétrique penché d’un côté. Ce phénomène se produit lorsque l’opérateur a configuré par erreur l’axe horizontal en mode « Catégorie textuelle » plutôt qu’en mode « Échelle numérique continue ». Dans ce mode erroné, le tableur accorde un espacement physique constant entre chaque ligne sans tenir compte de la véritable distance arithmétique séparant les valeurs de l’axe des abscisses.
Un autre désordre visuel majeur réside dans la présence de replis ou de boucles aberrantes dans le tracé vectoriel de la courbe. Ce problème émerge quasi exclusivement lorsque la série des scores d’abscisse de la colonne D n’est pas rigoureusement triée par ordre arithmétique strictement croissant. Si, par suite d’une mauvaise manipulation de tri ou d’un copier-coller désordonné, une valeur inférieure est intercalée entre deux valeurs plus élevées, le moteur de tracé tente de relier les points selon leur ordre séquentiel d’apparition dans le tableau, traçant des allers-retours désastreux au milieu de la cloche.
Enfin, l’absence de lissage visuel provient fréquemment d’une confusion entre les options de graphiques linéaires ordinaires et les graphiques de dispersion. Un graphique linéaire standard relie les points d’échantillonnage par des segments de droite rigides. Si le pas d’incrémentation choisi dans la séquence initiale était un peu trop large (par exemple $\Delta z = 0,2$ ou $0,5$), la cloche ressemblera à un polygone triangulaire grossier. L’activation impérative de l’option « Ligne lissée » dans l’éditeur de graphique restaure l’interpolation continue par splines cubiques, redonnant à la courbe sa rondeur gaussienne canonique.
11.3 Optimisation des performances et de la précision
Bien que Google Sheets soit hébergé sur une infrastructure en nuage robuste, l’accumulation effrénée de fonctions volatiles ou de calculs matriciels non optimisés peut rapidement dégrader les performances d’interaction, en particulier lors de la manipulation de vastes bases de données psychométriques regroupant plusieurs centaines d’évaluations longitudinales. Pour préserver une réactivité fluide lors du glissement des graphiques ou de l’ajustement dynamique des paramètres, l’analyste doit veiller à limiter l’usage de fonctions de recalcul itératif comme INDIRECT, OFFSET ou MAINTENANT dans les matrices de calcul stochastique.
Une bonne pratique architecturale consiste à isoler la matrice de calcul mathématique (colonnes C à E) au sein d’un onglet de travail spécifique dédié (par exemple nommé « Moteur_Calcul »), distinct de l’onglet de restitution clinique ou de présentation visuelle (baptisé « Tableau_Bord »). Cette ségrégation fonctionnelle permet de verrouiller l’onglet de calcul en lecture seule pour éviter les altérations accidentelles de formules par des collaborateurs non avertis, tout en laissant le praticien interagir librement avec les paramètres fondamentaux dans l’interface de présentation.
Enfin, pour garantir la portabilité opérationnelle du travail clinique et pérenniser la méthode au sein d’une institution hospitalière ou d’un laboratoire de recherche, il est vivement conseillé de sauvegarder la feuille de calcul vierge sous la forme d’un « Modèle maître » en lecture seule. À chaque nouvelle session d’évaluation diagnostique, le clinicien effectue une duplication de ce modèle via le menu Fichier > Créer une copie, préservant ainsi l’intégrité de la structure matricielle initiale et garantissant une standardisation absolue des pratiques d’analyse à l’échelle de l’organisation.
12. Synthèse méthodologique et bonnes pratiques de publication
12.1 Récapitulatif de l’algorithme de création pas à pas
Au terme de cette démonstration technique et conceptuelle, il est opportun de formaliser la séquence logique globale sous la forme d’un algorithme standardisé d’assurance qualité, garantissant une reproductibilité sans faille lors de toute démarche de conception future :
- Phase paramétrique : Déclaration isolée des variables d’ancrage que sont la moyenne populationnelle ($\mu$) et l’écart type ($\sigma$) au sein de cellules fixes réservées, complétée par l’assignation de plages nommées pour sécuriser les formules futures.
- Phase de standardisation canonique : Construction de l’échelle d’échantillonnage des scores $z$ centrés sur zéro, s’étendant de $-4,0$ à $+4,0$ avec un pas d’incrémentation constant de $0,1$, générant une grille matricielle de 81 points discrets via la fonction
SEQUENCE. - Phase de réversion métrique : Projection des scores standardisés $z$ vers l’échelle de mesure brute du test clinique via la transformation linéaire inverse $x = \mu + (z \cdot \sigma)$, en utilisant des références cellulaires rigoureusement absolues.
- Phase de calcul de densité : Évaluation de l’ordonnée de la fonction de densité de probabilité au moyen de la formule univariée
LOI.NORMALE(x; mu; sigma; FAUX), en s’assurant de l’affectation du booléen de non-cumul. - Phase de modélisation visuelle : Génération d’un graphique de dispersion continue à lignes lissées, suppression des marqueurs ponctuels individuels, calibration des axes majeurs sur les multiples de l’écart type normatif et stylisation conforme aux standards de publication scientifique.
L’exécution disciplinée de cet algorithme pas à pas immunise l’analyste contre l’ensemble des distorsions méthodologiques courantes et garantit la conformité des tracés produits avec les standards d’auditabilité statistique exigés par les comités de lecture académiques et les instances d’évaluation médicale.
12.2 Exportation et intégration dans des rapports cliniques ou mémoires
L’aboutissement naturel d’une modélisation graphique réside dans son insertion au sein d’un rapport psychologique d’expertise, d’un mémoire universitaire ou d’un manuscrit soumis à publication scientifique. Pour préserver la perfection géométrique de la courbe en cloche, la méthodologie d’exportation adoptée depuis Google Sheets s’avère déterminante. L’exportation directe sous forme d’image matricielle standard (format PNG basse résolution) doit être évitée si le document cible est destiné à une impression papier professionnelle, car elle induit une pixelisation disgracieuse des contours de la cloche et des libellés typographiques.
L’approche privilégiée consiste à sélectionner les trois points verticaux logés dans le coin supérieur droit du conteneur graphique de Google Sheets, à naviguer vers Télécharger > Graphique vectoriel modulable (.svg) ou Document PDF (.pdf). Le format vectoriel SVG encode les tracés de la courbe sous forme d’équations géométriques polynomiales plutôt que sous forme d’une grille de pixels : la netteté du rendu demeure absolue et infinie, quel que soit le facteur d’agrandissement ou la résolution de l’imprimante professionnelle utilisée.
Si la rédaction du mémoire ou du bilan est effectuée au sein de la suite collaborative via Google Docs, une synergie technologique native encore plus performante peut être exploitée. Lors de l’insertion du graphique (menu Insertion > Graphique > À partir de Sheets), l’opérateur doit cocher l’option « Associer à la feuille de calcul ». Cette passerelle dynamique préserve un lien vivant entre le document textuel et le tableur source : si les scores du patient sont révisés ultérieurement ou si l’étalonnage est réajusté dans la feuille de calcul, un bouton contextuel « Mettre à jour » apparaît instantanément au sommet de la figure dans Google Docs, synchronisant la courbe vectorielle sans obliger à des manipulations d’exportation et d’importation manuelles réitérées.
12.3 Perspectives avancées de modélisation statistique
La maîtrise de la courbe en cloche gaussienne dans un tableur comme Google Sheets constitue un socle méthodologique fondamental, mais ne représente qu’une première étape dans l’arsenal computationnel du psychologue quantitativiste ou du chercheur contemporain. Dans les investigations neurocognitives de pointe, de nombreux phénomènes dynamiques — à l’instar des temps de réaction motrice ou des distributions de latence dans les tâches d’inhibition attentionnelle — refusent d’adopter une silhouette symétrique et sont modélisés avec une fidélité bien supérieure par des lois de probabilité asymétriques à queues lourdes, telles que la distribution log-normale, la distribution ex-gaussienne ou la loi de Weibull.
Pour dépasser les limites inhérentes aux fonctions tabulaires natives sans abandonner l’accessibilité de l’écosystème Google, les praticiens avancés peuvent exploiter Google Apps Script, l’environnement de script intégré basé sur JavaScript. La programmation de macros personnalisées permet d’automatiser le traçage dynamique de courbes adaptées aux données individuelles d’un patient et de générer en un clic des bilans de restitution personnalisés au format PDF, intégrant des analyses de percentiles et des graphiques de profil complets.
Enfin, lorsque les exigences de la modélisation statistique s’orientent vers des architectures multivariées complexes — telles que les analyses factorielles confirmatoires de fidélité métrologique, les modèles d’équations structurelles ou les approches bayésiennes hiérarchiques —, Google Sheets doit être envisagé comme un outil préparatoire de collecte collaborative et de nettoyage tabulaire des données brutes, agissant en passerelle directe vers des environnements de calcul statistique avancés tels que R ou Python. La compréhension profonde des lois de distribution acquise par l’implémentation manuelle de la courbe en cloche dans un tableur reste l’un des meilleurs prérequis pour appréhender avec sérénité ces modélisations probabilistes de haut niveau.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
De Moivre, A. (1738). The doctrine of chances: Or, a method of calculating the probabilities of events in play (2nd ed.). H. Woodfall.
Galton, F. (1889). Natural inheritance. Macmillan and Co. https://doi.org/10.1037/10041-000
Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
Laplace, P. S. (1812). Théorie analytique des probabilités. Courcier.
Quetelet, A. (1835). Sur l’homme et le développement de ses facultés, ou Essai de physique sociale. Bachelier.
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953