
L’analyse des données multivariées et la psychométrie quantitative contemporaine reposent de manière fondamentale sur la réduction de dimensionnalité. Face à des batteries d’instruments composites, des inventaires de personnalité comptant des dizaines d’items ou des jeux de données socio-économiques complexes, le statisticien et le chercheur en sciences sociales sont confrontés au fléau de la dimensionnalité. Cette prolifération de variables observables rend ardue la détection des structures sous-jacentes, augmente considérablement le risque d’erreur de type I par multiplication des tests d’hypothèses, et obscurcit la lisibilité théorique des modèles psychologiques. L’Analyse en Composantes Principales (ACP) et l’Analyse Factorielle Exploratoire (AFE) constituent les deux piliers historiques permettant de condenser cette information brute en un nombre restreint de dimensions synthétiques, tout en préservant la part maximale de variance informative.
Au cœur de cette démarche d’extraction se pose une question méthodologique critique : combien de dimensions latentes ou de composantes principales convient-il de retenir sans sombrer dans l’écueil de la sur-extraction ou de la sous-extraction ? C’est précisément pour répondre à cette interrogation cardinale que Raymond Cattell a conceptualisé en 1966 le graphique des éboulis, universellement désigné sous le terme anglo-saxon de *scree plot*. Outil diagnostique visuel par excellence, le scree plot projette la décroissance monotone des valeurs propres associées à chaque dimension successive, offrant à l’analyste un panorama géométrique de la déperdition d’inertie au sein du nuage de points multidimensionnel.
L’environnement statistique R s’affirme aujourd’hui comme la plateforme de référence pour implémenter ces protocoles exploratoires, combinant une puissance algorithmique de pointe pour la décomposition matricielle et une flexibilité graphique inégalée. Ce guide exhaustif a pour vocation de décomposer pas à pas, avec la plus haute rigueur théorique et pratique, l’ensemble du cycle de conception, d’optimisation et d’interprétation d’un scree plot sous R. Depuis les fondements de l’algèbre linéaire spectrale jusqu’aux raffinements typographiques conformes aux normes académiques internationales de l’American Psychological Association (APA), chaque étape est disséquée afin de doter le praticien des compétences nécessaires à une prise de décision statistique irréprochable.
1. Fondements théoriques de l’analyse en composantes principales et du scree plot
1.1 Réduction de dimensionnalité et applications en psychométrie
La réduction de dimensionnalité en psychométrie répond à un impératif fondamental d’économie cognitive et de parcimonie mathématique. Lorsqu’un chercheur administre une échelle d’évaluation comportementale, un test d’efficience intellectuelle ou un inventaire de personnalité tel que le modèle en cinq facteurs (NEO-PI-R), il recueille des dizaines, voire des centaines de réponses discrètes. Ces indicateurs manifestes ne constituent pas la finalité de la mesure ; ils fonctionnent plutôt comme les reflets imparfaits de construits psychologiques inobservables, couramment dénommés variables latentes ou traits théoriques. Le passage de l’espace multidimensionnel des variables observables à un sous-espace vectoriel de dimension réduite permet de capturer l’essence de ces entités conceptuelles tout en éliminant le bruit stochastique inhérent à la mesure psychologique.
Sur le plan mathématique, cette transition implique une condensation de l’information où les vecteurs initiaux, fortement intercorrélés, sont combinés linéairement pour former de nouveaux axes orthogonaux ou obliques. Toutefois, cette condensation s’accompagne inévitablement d’une perte résiduelle de variance. Le postulat théorique de l’analyse multivariée repose sur l’hypothèse que la variance partagée entre les items reflète le signal psychologique stable, tandis que la variance résiduelle non capturée par les premières dimensions correspond à de l’erreur de mesure aléatoire ou à de la spécificité sans pertinence structurale. Ainsi, l’analyse dimensionnelle appliquée aux questionnaires et inventaires vise à maximiser le rapport entre la variance systématique expliquée et la parcimonie du modèle dimensionnel final.
Dans cette perspective, les travaux pionniers de Charles Spearman sur le facteur général d’intelligence et les développements ultérieurs de Louis Leon Thurstone sur les aptitudes mentales primaires ont démontré que la simplification géométrique d’un hyperespace de données psychométriques permet de valider empiriquement la validité de construit d’un instrument. Une réduction dimensionnelle convenablement menée permet d’attester qu’un ensemble de quarante items converge effectivement vers trois ou cinq dimensions cliniquement interprétables, facilitant la notation diagnostique et consolidant les propriétés psychométriques globales de l’échelle d’évaluation.
1.2 Définition et genèse du graphique des éboulis (scree plot de Cattell)
Le graphique des éboulis a été introduit dans la littérature méthodologique par le psychologue et statisticien Raymond B. Cattell en 1966, au sein d’un article séminal publié dans la revue Multivariate Behavioral Research. Cattell cherchait à substituer aux critères purement algébriques arbitraires une heuristique visuelle intuitive capable de distinguer les facteurs substantiels des facteurs résiduels non significatifs. Le terme « scree » puise son origine dans la géologie géomorphologique : il désigne l’amas de débris rocheux, de cailloux et de gravats qui s’accumule par gravité au pied d’une falaise abrupte ou d’un versant montagneux escarpé.
Dans la métaphore géologique de Cattell, la falaise rocheuse verticale représente les facteurs ou composantes majeures qui concentrent l’essentiel de la variance explicative du système. À l’inverse, l’éboulis étalé au pied du précipice symbolise la multitude de petites composantes d’amplitudes comparables, qui ne reflètent que des fluctuations d’échantillonnage et du bruit résiduel insignifiant. Graphiquement, le scree plot se présente sous la forme d’un tracé cartésien en deux dimensions où l’axe des abscisses énumère séquentiellement les composantes extraites, ordonnées de la plus importante à la plus faible, tandis que l’axe des ordonnées affiche la valeur propre (eigenvalue) associée à chacune d’elles.
Le rôle pivot de ce dispositif réside dans l’identification du « point d’inflexion » ou « coude » géométrique (*elbow*), c’est-à-dire l’endroit précis où la trajectoire de décrue brutale s’infléchit pour se muer en une droite sub-horizontale régulière. Selon la règle heuristique de Cattell, toutes les composantes situées en amont de ce point d’inflexion appartiennent à la falaise et doivent être rigoureusement conservées dans le modèle dimensionnel. Celles situées à partir du coude et le long de la pente résiduelle forment l’éboulis rocheux et doivent être rejetées, signifiant ainsi l’arrêt de l’extraction factorielle.
1.3 Propriétés mathématiques des valeurs propres et de la variance expliquée
D’un point de vue algébrique rigoureux, l’Analyse en Composantes Principales opère une transformation linéaire orthogonale qui convertit un ensemble d’observations corrélées en un ensemble de variables non corrélées appelées composantes principales. Ce processus équivaut à la décomposition spectrale de la matrice d’inertie des données, qu’il s’agisse de la matrice de variance-covariance $\mathbf{\Sigma}$ ou de la matrice de corrélation linéaire de Pearson $\mathbf{R}$. La résolution de l’équation caractéristique $det(\mathbf{R} – \lambda \mathbf{I}) = 0$ fournit un ensemble de racines scalaires réelles $\lambda_1 ge \lambda_2 ge dots ge \lambda_p ge 0$, désignées sous le vocable de valeurs propres (*eigenvalues*).
Chaque valeur propre $\lambda_i$ quantifie de manière exacte la quantité absolue de variance capturée par le vecteur propre unitaire $\mathbf{v}_i$ qui lui est associé le long du $i$-ème axe principal. Lorsque l’analyse est effectuée sur une matrice de corrélation, les variables d’origine sont préalablement centrées et réduites, ce qui implique que la variance unitaire de chaque item est strictement égale à 1. En vertu de la propriété spectrale fondamentale de conservation de la trace matricielle, la somme de toutes les valeurs propres extraites équivaut rigoureusement à la trace de la matrice initiale, laquelle coïncide avec le nombre total de variables observables $p$ :
$$\sum_{i=1}^p \lambda_i = \mathrm{Tr}(\mathbf{R}) = p$$
Cette propriété d’additivité totale confère une signification probabiliste immédiate à chaque dimension. La proportion relative de variance totale expliquée par la $i$-ème composante principale s’établit simplement par le ratio $(\lambda_i / p) \times 100$. Dès lors, le tracé du scree plot ne constitue rien d’autre que la projection discrète de la distribution spectrale de l’opérateur linéaire d’inertie. La décroissance monotone stricte des valeurs propres reflète le principe de maximisation séquentielle de la variance sous contrainte d’orthogonalité bilatérale ($\mathbf{v}_j^T \mathbf{v}_k = 0$ pour $j \neq k$), garantissant que la première composante mobilise le maximum d’inertie globale possible, suivie par la deuxième composante sur le sous-espace résiduel orthogonal, et ainsi de suite jusqu’à épuisement du rang matriciel.
2. Préparation de l’environnement de travail et structuration des données sous R
2.1 Installation et chargement des bibliothèques fondamentales
L’implémentation d’un flux de travail reproductible et moderne sous R exige la mise en place préalable d’un écosystème logiciel cohérent. Bien que les fonctions intégrées dans l’installation de base de R permettent de mener à bien une analyse spectrale complète, le recours aux packages contemporains du tidyverse pour la manipulation tabulaire et la visualisation vectorielle s’impose comme le standard de facto dans la recherche quantitative contemporaine. Parallèlement, des extensions spécialisées dédiées à la psychométrie et à la fouille de données multivariées, à l’instar de psych et de factoextra, offrent des fonctionnalités d’automatisation avancées indispensables pour consolider les diagnostics.
Le chercheur procédera en premier lieu à la vérification de l’état de son environnement logiciel et à l’installation ordonnée des modules requis. Cette procédure s’exécute via la commande install.packages(), en veillant à inclure la gestion systématique des dépendances système nécessaires au rendu graphique haute définition. Afin d’assurer une parfaite traçabilité des analyses et la reproductibilité computationnelle stricte des procédures stochastiques ultérieures (notamment pour l’analyse parallèle de Monte-Carlo), il est impératif d’initialiser le générateur de nombres pseudo-aléatoires à l’aide de la fonction set.seed() dès le début du script.
L’exécution dans la console R du bloc d’instructions suivant garantit l’armature logicielle complète :
packages_requis <- c("tidyverse", "psych", "factoextra", "cowplot", "ggrepel")
nouveaux_packages <- packages_requis[!(packages_requis %in% installed.packages()[,"Package"])]
if(length(nouveaux_packages)) install.packages(nouveaux_packages, dependencies = TRUE)
library(tidyverse)
library(psych)
library(factoextra)
set.seed(42)
Cette routine d’initialisation stabilise l’espace de noms de la session active, éliminant les conflits d’ombrage de fonctions entre le moteur de base et les bibliothèques tierces, tout en configurant un environnement propice à l’édition de graphiques vectoriels de publication.
2.2 Importation et examen préliminaire des données (USArrests et alternatives psychométriques)
Pour illustrer la mécanique fondamentale de l’ACP et la construction du scree plot sans introduire de biais d’accès aux données, le jeu de données classique USArrests, nativement préchargé dans R, constitue un modèle pédagogique idéal. Ce corpus documente les taux d’arrestations pour crimes violents (homicide, agression, viol) pour 100 000 habitants ainsi que le pourcentage de population résidant en zone urbaine à travers les cinquante États américains en 1973. Bien qu’issu de la criminologie écologique, sa structure quantitative à quatre variables continues fortement corrélées présente une homologie parfaite avec les problématiques de condensation de sous-échelles rencontrées dans les batteries de tests psychologiques comportementaux.
L’importation et l’inspection géométrique préliminaire de l’échantillon sont déclenchées à l’aide des primitives R standards. La fonction data(USArrests) charge le tableau dans l’espace mémoire, tandis que les fonctions dim(), str() et summary() permettent d’auditer l’architecture matricielle, le typage des colonnes et les descripteurs univariés de tendance centrale et de dispersion :
data("USArrests")
dim(USArrests)
str(USArrests)
summary(USArrests)
L’inspection minutieuse de la sortie révèle cinquante observations réparties sur quatre dimensions numériques continues : Murder, Assault, UrbanPop et Rape. L’examen des minima, maxima et écarts-types fait immédiatement émerger une asymétrie d’échelle considérable : la variable Assault culmine à une moyenne de 170,8 avec un écart-type supérieur à 80, alors que Murder affiche une moyenne de 7,8 pour un écart-type de 4,3. En psychométrie, cette hétérogénéité se rencontre typiquement lorsque l’on fusionne des temps de réaction mesurés en millisecondes avec des scores d’items de type Likert gradués de 1 à 5, configuration pathogène qui impose impérativement un traitement préparatoire rigoureux sous peine d’invalider totalement la décomposition spectrale ultérieure.
2.3 Détection des valeurs aberrantes et imputation des données manquantes
L’analyse dimensionnelle linéaire repose de manière critique sur l’estimation de la matrice des moments d’ordre deux (covariances ou corrélations). Il est largement démontré dans la littérature statistique que les coefficients de corrélation produit-moment de Pearson présentent une vulnérabilité extrême aux observations aberrantes (*outliers*), qu’elles soient univariées ou multivariées. Un point unique situé aux confins de l’espace multidimensionnel peut exercer un bras de levier disproportionné sur les axes factoriels, créant artificiellement des composantes fallacieuses ou masquant des structures sous-jacentes authentiques.
Le diagnostic des données manquantes constitue la première étape de cette vérification. Si le jeu USArrests présente un taux de complétude de 100 %, les jeux de données psychométriques réels comportent fréquemment des omissions systématiques. La cartographie des patterns d’absence (MCAR, MAR, MNAR) via le package mice ou la fonction md.pattern() permet de sélectionner la méthode d’imputation idoine. L’imputation stochastique par équations chaînées (MICE) ou l’algorithme EM (Expectation-Maximization) s’avèrent infiniment supérieurs à l’élimination cas par cas (*listwise deletion*), laquelle dégrade drastiquement la puissance statistique et fausse la structure de covariance lorsque les omissions ne sont pas purement aléatoires.
Pour le repérage des valeurs aberrantes multivariées, la métrique de référence est la distance quadratique de Mahalanobis, notée $D^2$. Elle mesure la divergence relative de chaque individu statistique par rapport au centroïde du nuage de points, en pondérant les écarts par l’inverse de la matrice de covariance de l’échantillon :
$$D^2 = (\mathbf{x} – \bar{\mathbf{x}})^T \mathbf{S}^{-1} (\mathbf{x} – \bar{\mathbf{x}})$$
Sous l’hypothèse de normalité multivariée, $D^2$ suit approximativement une distribution du Khi-deux dont les degrés de liberté correspondent au nombre de variables $p$. Le code R suivant calcule ces distances et identifie les profils extrêmes au seuil critique $\alpha = 0,001$ :
centroide <- colMeans(USArrests)
matrice_cov <- cov(USArrests)
d2_mahalanobis <- mahalanobis(USArrests, center = centroide, cov = matrice_cov)
seuil_critique <- qchisq(p = 0.999, df = ncol(USArrests))
outliers_multivaries <- which(d2_mahalanobis > seuil_critique)
Si des observations franchissent ce seuil de tolérance, leur exclusion temporaire ou une analyse de sensibilité comparative est requise afin de certifier que la structure des valeurs propres visualisée sur le scree plot reflète une propriété populationnelle robuste et non l’idiosyncrasie de quelques unités d’échantillonnage marginales.
3. Prétraitement rigoureux : Centrage, réduction et diagnostic de corrélation
3.1 Justification psychométrique de la standardisation des variables
La question de la standardisation des variables en amont d’une ACP touche à l’essence même de la signification géométrique de l’espace métrique utilisé. Si l’on applique l’analyse directement sur la matrice de variance-covariance brute $\mathbf{\Sigma}$, la variance absolue d’une variable devient le critère premier guidant l’orientation des axes factoriels. Or, la variance d’une série statistique dépend directement de son unité de mesure arbitraire. Dans un questionnaire psychométrique composite combinant des scores globaux (dont la variance peut atteindre plusieurs centaines d’unités) et des temps de latence ou des taux d’erreurs normalisés (dont la variance est inférieure à 1), la première composante principale sera mécaniquement capturée par la variable possédant la plus grande magnitude numérique, occultant totalement les covariations subtiles entre les autres descripteurs.
Le centrage des variables, obtenu par la soustraction de l’espérance empirique ($\mathbf{x}_j – \bar{x}_j$), réalise une translation du nuage de points permettant d’aligner le centroïde des données sur l’origine du système de coordonnées cartésiennes $(0,0,dots,0)$. Cette étape préliminaire est universelle car elle garantit que la première composante traversera le barycentre du nuage d’observations. La réduction, quant à elle, opère une division de chaque score centré par l’écart-type de la variable ($s_j$), transformant les mesures hétérogènes en scores centrés-réduits standardisés ($z$-scores) de variance strictement unitaire ($s^2_z = 1$).
Opérer une ACP sur des données centrées et réduites équivaut strictement à exécuter la décomposition spectrale sur la matrice de corrélation linéaire $\mathbf{R}$ au lieu de la matrice de covariance brute $\mathbf{\Sigma}$. En psychométrie appliquée, l’analyse sur matrice de corrélation est quasi-systématiquement requise, sauf dans les contextes rares où toutes les variables partagent une métrique physique rigoureusement identique et où les différentiels de dispersion brute possèdent une interprétation clinique intrinsèque délibérément recherchée par le chercheur.
3.2 Paramétrage de la normalisation sous R avec scale()
Dans l’environnement R, la standardisation matricielle s’effectue avec une efficacité remarquable grâce à la fonction vectorisée primitive scale(). Cette primitive accepte en argument principal un objet de type tableau ou matrice et dispose de deux arguments logiques déterminants : center et scale. Par défaut, ces deux arguments sont positionnés sur TRUE, ce qui garantit simultanément la translation à la moyenne nulle et la mise à l’échelle sur l’écart-type d’échantillon unitaire selon la formule $z_{ij} = (x_{ij} – \bar{x}_j) / s_j$.
Il demeure fondamental d’examiner explicitement les matrices dérivées avant de procéder à l’extraction factorielle, comme l’illustre la séquence de code ci-dessous :
donnees_standardisees <- scale(USArrests, center = TRUE, scale = TRUE)
colMeans(donnees_standardisees)
apply(donnees_standardisees, 2, sd)
matrice_correlation <- cor(donnees_standardisees)
print(round(matrice_correlation, 3))
La validation empirique montre des moyennes résiduelles d’ordre infinitésimal ($10^{-16}$, correspondant au zéro machine) et des écarts-types rigoureusement égaux à 1. La matrice de corrélation qui en découle permet d’évaluer la colinéarité globale du système. Avant d’engager une réduction de dimension, il est impératif de confirmer que les données exhibent une corrélation suffisante pour justifier une synthèse vectorielle. Deux métriques psychométriques sont ici irremplaçables : l’indice de Kaiser-Meyer-Olkin (KMO), qui évalue l’adéquation de l’échantillonnage, et le test de sphéricité de Bartlett, qui teste l’hypothèse nulle d’orthogonalité stricte de la matrice ($H_0: \mathbf{R} = \mathbf{I}$).
À l’aide du package psych, cette vérification préliminaire s’exécute immédiatement :
kmo_result <- KMO(donnees_standardisees)
bartlett_result <- cortest.bartlett(donnees_standardisees, n = nrow(USArrests))
Un indice KMO global supérieur au seuil heuristique de 0,60 combiné à un test de Bartlett statistiquement hautement significatif ($p < 0,001$) confirment sans ambiguïté que la structure de dépendance linéaire est propice à une décomposition spectrale informative.
3.3 Effets du défaut de mise à l’échelle sur la décomposition spectrale
Pour appréhender concrètement la vulnérabilité mathématique d’une ACP non standardisée, il est particulièrement instructif de comparer le comportement des valeurs propres extraites avec et sans réduction préalable sur le jeu de données USArrests. Si l’on omet l’étape de réduction en travaillant directement sur la matrice de covariance brute, la variance phénoménale de la variable Assault (variance empirique de $6945,1$) va phagocyter la quasi-totalité de l’inertie globale du système multidimensionnel.
L’exécution comparative sous R met en lumière cette aberration structurelle :
pca_brute <- prcomp(USArrests, center = TRUE, scale. = FALSE)
pca_reduite <- prcomp(USArrests, center = TRUE, scale. = TRUE)
pca_brute$sdev^2 / \sum(pca_brute$sdev^2) * 100
pca_reduite$sdev^2 / \sum(pca_reduite$sdev^2) * 100
Dans l’analyse brute non réduite, la première composante capture à elle seule plus de 96,5 % de la variance totale du jeu de données. La lecture du scree plot correspondant afficherait une chute vertigineuse entre la première et la deuxième composante, créant l’illusion graphique absolue d’un modèle strictement unifactoriel. Or, cette première dimension n’est qu’un clone déguisé de la variable Assault et ne renseigne en rien sur les corrélations profondes reliant Murder et Rape.
À l’inverse, l’analyse menée sur variables standardisées redistribue équitablement l’influence de chaque variable unitaire. La première composante capture environ 62 % de la variance totale et la seconde près de 24,7 %, mettant en relief une structure bifactorielle riche et équilibrée, où la première dimension regroupe les violences criminelles et la seconde rend compte de l’urbanisation démographique. Le défaut de standardisation engendre ainsi des pseudo-coudes dévastateurs sur le scree plot, conduisant le chercheur à sous-extraire dramatiquement et à méconnaître des traits psychologiques latents pourtant majeurs au sein de son instrument de mesure.
4. Exécution de l’analyse en composantes principales avec prcomp()
4.1 Fondements de la décomposition en valeurs singulières (SVD) dans prcomp()
Dans l’écosystème R, deux fonctions intégrées natives permettent d’exécuter une ACP : prcomp() et princomp(). D’un point de vue algorithmique et numérique, prcomp() s’impose sans contestation comme la fonction de référence absolue préconisée par les statisticiens computationnels. La supériorité de prcomp() réside dans le fait qu’elle n’opère pas par diagonalisation explicite de la matrice de covariance ou de corrélation, mais applique directement la Décomposition en Valeurs Singulières (Singular Value Decomposition – SVD) sur la matrice des données centrées et réduites $\mathbf{Z}$.
Le théorème fondamental de la SVD stipule que toute matrice rectangulaire réelle $\mathbf{Z}$ de dimensions $n \times p$ peut être factorisée sous la forme du produit de trois matrices remarquables :
$$\mathbf{Z} = \mathbf{U} \mathbf{D} \mathbf{V}^T$$
Dans cette décomposition, $\mathbf{U}$ est une matrice orthogonale $n \times p$ contenant les vecteurs singuliers gauches, $\mathbf{D}$ est une matrice diagonale $p \times p$ renfermant les valeurs singulières ordonnées $d_1 ge d_2 ge dots ge d_p ge 0$, et $\mathbf{V}$ est une matrice orthogonale $p \times p$ rassemblant les vecteurs singuliers droits. La pertinence de cette factorisation découle de la relation matricielle liant la matrice de covariance non biaisée à la matrice $\mathbf{Z}$ standardisée :
$$\mathbf{R} = \frac{1}{n – 1} \mathbf{Z}^T \mathbf{Z} = \frac{1}{n – 1} \mathbf{V} \mathbf{D} \mathbf{U}^T \mathbf{U} \mathbf{D} \mathbf{V}^T = \mathbf{V} \left( \frac{\mathbf{D}^2}{n – 1} \right) \mathbf{V}^T$$
Les valeurs singulières $d_i$ sont donc directement proportionnelles aux écarts-types des composantes principales selon l’équivalence $sdev_i = d_i / \sqrt{n – 1}$. L’algorithme SVD évite le calcul direct et potentiellement mal conditionné du produit matriciel $\mathbf{Z}^T \mathbf{Z}$, garantissant ainsi une stabilité numérique et une précision en arithmétique flottante infiniment supérieures, tout particulièrement lorsque les variables affichent une multicolinéarité quasi-parfaite ou lorsque la matrice approche la singularité.
4.2 Exploration des composantes de l’objet généré (sdev, rotation, x)
L’exécution de la fonction prcomp() avec la syntaxe canonique produit un objet complexe de classe S3 doté de multiples attributs déterminants :
pca_arrests <- prcomp(USArrests, center = TRUE, scale. = TRUE)
names(pca_arrests)
class(pca_arrests)
L’inspection de la structure révèle quatre composantes internes principales que le chercheur doit savoir interroger :
- sdev : Un vecteur contenant les écarts-types des composantes principales successives. Ces valeurs correspondent exactement à la racine carrée des valeurs propres ($\sqrt{\lambda_i}$). Elles quantifient la dispersion empirique de chaque nouvel axe factoriel.
- rotation : La matrice carrée $p \times p$ des coefficients des vecteurs propres (loadings). Chaque colonne de cette matrice représente la combinaison linéaire unitaire permettant de projeter l’espace originel vers la composante considérée. Ces coefficients définissent l’orientation spatiale de l’axe et permettent de nommer conceptuellement les composantes.
- x : La matrice $n \times p$ des coordonnées individuelles transformées (les scores factoriels des individus). Elle consigne la projection des cinquante États américains sur les nouveaux axes orthogonaux.
- center et scale : Les vecteurs de constantes empiriques ayant servi respectivement à la translation centripète et à la réduction unitaire des variables brutes.
L’orthogonalité parfaite des colonnes de x peut être aisément vérifiée par l’évaluation de la matrice de corrélation empirique de ces projections, laquelle coïncide à la précision machine près avec la matrice identité $\mathbf{I}_p$ (corrélations inter-axes strictement nulles). Cette indépendance mutuelle confirme la dissolution complète des redondances colinéaires de l’espace initial.
4.3 Comparaison technique avec princomp() et alternatives factorielles
La fonction concurrente native princomp() utilise, pour sa part, la diagonalisation spectrale classique de la matrice de covariance via la primitive eigen(). Au-delà de sa moindre stabilité numérique en présence de quasi-colinéarité, princomp() applique conventionnellement un diviseur d’échantillon égal à $n$ (estimateur du maximum de vraisemblance) au lieu du diviseur standard sans biais $n – 1$ privilégié par prcomp() :
$$\mathrm{Var}_{\text{princo\mp}}(X) = \frac{1}{n} \sum (x_i – \bar{x})^2 \quad \text{vs} \quad \mathrm{Var}_{\text{prco\mp}}(X) = \frac{1}{n – 1} \sum (x_i – \bar{x})^2$$
Bien que cette divergence asymptotique s’estompe pour de vastes cohortes statistiques, elle introduit de légères discordances sur les valeurs propres dans les petits échantillons psychométriques ($N < 100$). En outre, princomp() refuse catégoriquement d’opérer lorsque le nombre d’individus $n$ est strictement inférieur au nombre d’indicateurs $p$ ($n < p$), situation où la matrice de covariance devient mathématiquement singulière, alors que prcomp() gère cette configuration sans défaillance algorithmique grâce à la factorisation SVD tronquée.
Enfin, il est impératif de distinguer rigoureusement ces fonctions d’ACP des primitives d’Analyse Factorielle Exploratoire (AFE), à l’instar de factanal() ou de la fonction fa() du package psych. Alors que prcomp() analyse la variance totale (décomposition spectrale d’une matrice à diagonale unitaire), l’AFE postule l’existence d’un modèle d’erreur de mesure formel et procède à la décomposition spectrale de la matrice des corrélations réduites, où la diagonale principale est substituée par les communalités initiales ($h_i^2 < 1$). Par voie de conséquence, les valeurs propres générées et reportées sur un scree plot ne partagent pas rigoureusement la même échelle selon qu’il s’agit d’une ACP empirique ou d’une analyse factorielle des facteurs communs.
5. Extraction et calcul des valeurs propres et de la variance expliquée
5.1 Conversion des écarts-types en valeurs propres réelles
L’objet retourné par prcomp() ne stocke pas directement les valeurs propres sous leur désignation usuelle, mais consigne leurs écarts-types associés dans le slot vectoriel pca_arrests$sdev. En vertu de la définition algébrique rappelée précédemment, la variance capturée par une composante orthogonale est le carré strict de son écart-type ($\mathrm{Var}(Y_i) = \lambda_i = s_i^2$). L’extraction computationnelle des valeurs propres réelles réclame donc une opération scalaire élémentaire d’élévation à la puissance 2 :
valeurs_propres <- pca_arrests$sdev^2
print(valeurs_propres)
L’exécution de cette commande sur les données standardisées USArrests fournit les quatre valeurs propres exactes suivantes :
- $\lambda_1 \approx 2,4802$
- $\lambda_2 \approx 0,9898$
- $\lambda_3 \approx 0,3566$
- $\lambda_4 \approx 0,1734$
Le contrôle d’intégrité numérique s’opère instantanément en vérifiant la conservation de la trace matricielle. Puisque quatre variables centrées et réduites ont été injectées dans l’algorithme, la somme des composantes de ce vecteur doit égaler rigoureusement 4 :
sum(valeurs_propres)
Le système confirme un total arithmétique de 4, validant l’absence de dérive computationnelle et certifiant que la totalité de la variance du système d’observation est intégralement partitionnée entre ces quatre dimensions orthogonales.
5.2 Calcul de la proportion individuelle et cumulative de variance
Une fois les valeurs propres isolées, il convient de quantifier la part relative de variance unitaire que chaque composante parvient à résumer, ainsi que la progression de l’inertie cumulée au fur et à mesure de l’adjonction de nouvelles dimensions. La variance relative simple s’obtient en divisant chaque valeur propre individuelle par la somme globale des valeurs propres, le tout multiplié par cent pour une lecture en pourcentage direct :
$$% \text{ Variance}_i = \left( \frac{\lambda_i}{\sum_{k=1}^p \lambda_k} \right) \times 100$$
La variance cumulée, indispensable pour situer le pouvoir d’explication global d’un modèle tronqué, s’obtient élégamment par l’application de la fonction primitive cumsum() sur le vecteur des proportions de variance :
variance_expliquee <- (valeurs_propres / sum(valeurs_propres)) * 100
variance_cumulee <- cumsum(variance_expliquee)
tableau_synthese <- data.frame(Composante = 1:length(valeurs_propres), Valeur_Propre = valeurs_propres, Proportion_Variance = variance_expliquee, Cumul_Variance = variance_cumulee)
print(round(tableau_synthese, 2))
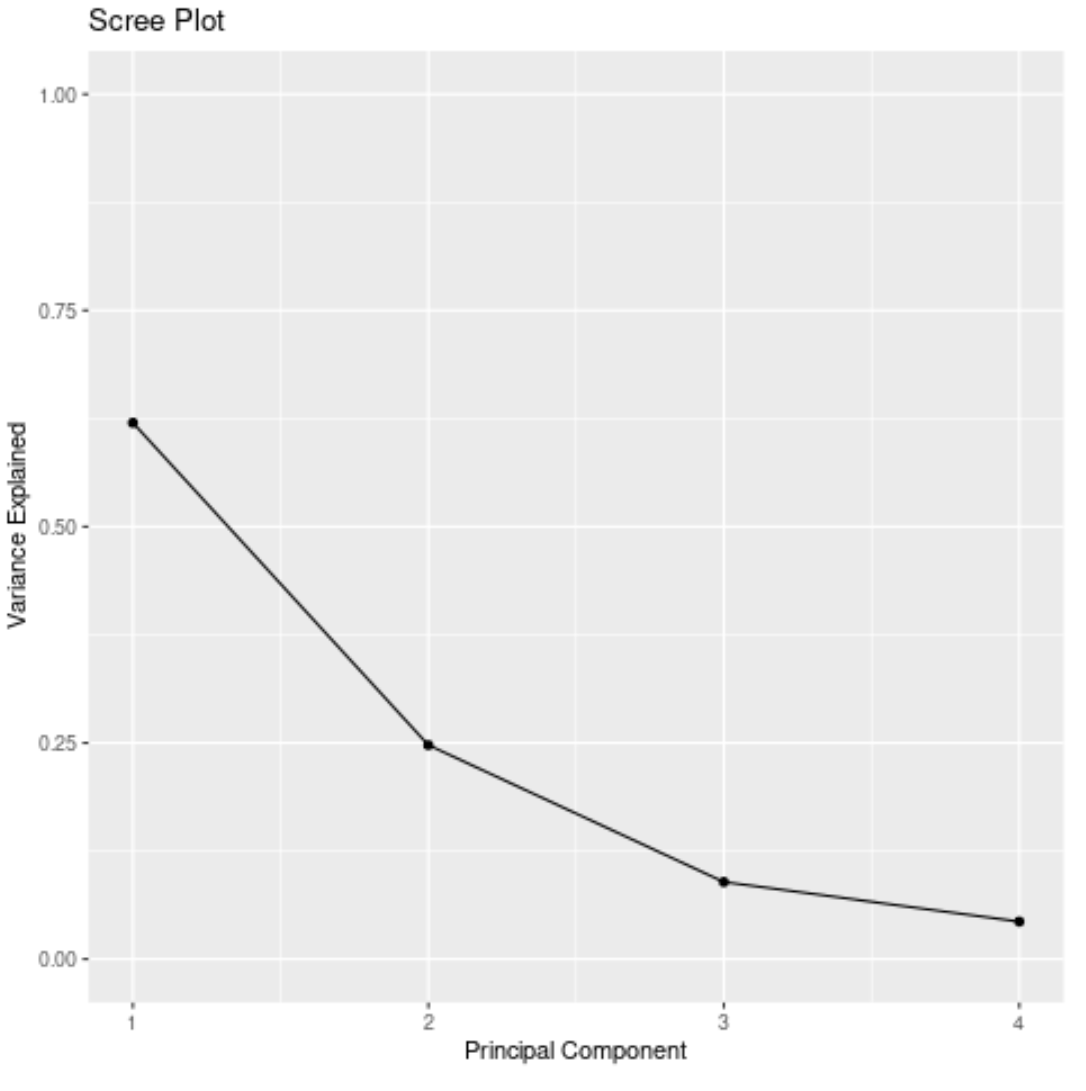
L’observation du tableau généré démontre que la première composante capture 62,01 % de la variance globale, la seconde 24,74 %, la troisième 8,91 % et la quatrième 4,34 %. La solution retenant conjointement les deux premières composantes accumule ainsi 86,75 % de l’inertie globale totale. En recherche psychologique et comportementale, où la fidélité des mesures oscille fréquemment entre 0,70 et 0,85 en raison des erreurs de réponse subjectives, un modèle factoriel préservant plus de 70 à 80 % de la variance totale est généralement considéré comme structurellement très performant.
5.3 Structuration d’un data frame dédié à la visualisation
L’exploitation de moteurs graphiques vectoriels modernes comme ggplot2 requiert la conversion systématique des structures de données brutes en un tableau de données rectangulaire (*data frame* ou *tibble*) respectant scrupuleusement les principes du *tidy data*. Dans cette organisation, chaque ligne représente une entité dimensionnelle unique et chaque colonne désigne une propriété géométrique ou descriptive associée.
Le bloc de programmation R ci-dessous formalise cette matrice de visualisation prête pour le rendu graphique :
scree_data <- tibble(
Composante = factor(1:length(valeurs_propres), levels = 1:length(valeurs_propres)),
Comp_Num = 1:length(valeurs_propres),
Valeur_Propre = valeurs_propres,
Variance_Pct = variance_expliquee,
Variance_Cum = variance_cumulee
)
str(scree_data)
Il est critique de typer la variable Composante sous la forme d’un facteur ordonné discret tout en conservant une variable numérique continue parallèle Comp_Num. Cette double indexation permettra ultérieurement d’associer un tracé par barres discrètes (qui nécessite une catégorisation nominale sur l’axe horizontal) et un tracé de régression continu ou brisé (qui exige des coordonnées cartésiennes continues continues pour l’application des couches géométriques de liaison linéaire). Ce tableau servira de matrice d’alimentation unifiée pour toutes les visualisations subséquentes.
6. Construction d’un scree plot avec le moteur graphique de base de R
6.1 Tracé direct via la méthode plot.prcomp()
Le système de base de R intègre un mécanisme d’orientation objet S3 qui permet d’appeler directement la fonction générique plot() sur un objet issu de prcomp(). Dans ce scénario, R délègue implicitement le calcul à la méthode interne plot.prcomp(), laquelle génère automatiquement un diagramme par barres de l’inertie des composantes :
plot(pca_arrests)
Par défaut, cette instruction primitive affiche un histogramme où la hauteur de chaque rectangle est indexée sur la valeur propre sous-jacente. L’utilisateur peut contraindre la méthode à afficher un tracé continu par points et segments linéaires à l’aide de l’argument type = "lines" :
plot(pca_arrests, type = "lines", main = "Scree Plot Élémentaire (Base R)")
Bien que cette commande s’avère pratique lors des phases préliminaires d’exploration rapide interactive au sein de la console R, elle se révèle rapidement inadaptée pour une dissémination scientifique formalisée. La méthode native n’autorise qu’un contrôle rudimentaire de la disposition des axes, ne propose aucune annotation dynamique des pourcentages de variance, tronque fréquemment les labels de texte marginaux et ne permet pas d’intégrer avec précision les lignes de démarcation critiques indispensables à l’analyse diagnostique académique.
6.2 Personnalisation intégrale avec plot(), lines() et points()
Pour s’affranchir des limitations du tracé préconfiguré sans faire appel à des dépendances tierces, le moteur graphique de base permet d’édifier un scree plot personnalisé haute définition en superposant méthodiquement différentes strates graphiques primitives. La construction débute par l’initialisation de la toile cartésienne via plot() configurée avec type = "n" (afin d’éviter tout dessin par défaut), ce qui autorise un calibrage micrométrique des étendues d’axes xlim et ylim :
par(mar = c(5, 5, 4, 2) + 0.1, las = 1)
plot(scree_data$Co\mp_Num, scree_data$Valeur_Propre,
type = "b", pch = 19, cex = 1.4, lwd = 2, col = "navy",
xlab = "Numéro de la composante principale",
ylab = "Valeur propre (Variance expliquée)",
main = "Diagramme des éboulis de Cattell - USArrests",
xaxt = "n", ylim = c(0, 3), panel.first = grid(nx = NULL, ny = NULL, col = "gray90", lty = 1))
axis(side = 1, at = 1:4, labels = paste0("PC", 1:4))
La commande type = "b" force le dessin simultané des marqueurs circulaires pleins (pch = 19) et des segments de liaison inter-points (lwd = 2). L’extinction préalable de l’axe des abscisses par xaxt = "n" permet de réimplanter manuellement des graduations discrètes explicites (axis()) évitant l’affichage de valeurs décimales absurdes comme des demi-composantes (par exemple 1,5 ou 2,5). L’argument panel.first assure que la grille d’alignement est imprimée sous les tracés statistiques et non par-dessus, préservant la netteté des vecteurs.
6.3 Annotation visuelle du seuil critique et habillage typographique
Un scree plot ne se limite pas à un profil géométrique ; il constitue un dispositif d’aide à la décision statistique. Pour remplir pleinement sa mission diagnostique, il doit matérialiser les seuils décisionnels usuels. Le repère théorique majeur est le seuil de Kaiser-Guttman, qui correspond à une valeur propre égale à 1. Dans le moteur de base de R, ce seuil s’implante via la primitive d’adjonction linéaire abline() :
abline(h = 1, col = "firebrick", lty = 2, lwd = 2)
Pour finaliser l’habillage académique, il est pertinent d’adosser des étiquettes textuelles précises directement sur le tracé afin d’éviter au lecteur d’extrapoler visuellement les grandeurs à partir des axes. La fonction primitive text() remplit cette fonction d’ancrage cartésien en exploitant les coordonnées réelles de chaque point :
text(x = scree_data$Co\mp_Num, y = scree_data$Valeur_Propre + 0.15,
labels = paste0(round(scree_data$Valeur_Propre, 2), " (", round(scree_data$Variance_Pct, 1), "%)"),
cex = 0.85, font = 2, col = "navy")
legend("topright", legend = c("Profil d'éboulis (prcomp)", "Critère de Kaiser (lambda = 1)"),
col = c("navy", "firebrick"), lty = c(1, 2), pch = c(19, NA), lwd = 2, bty = "n")
L’adjonction de la légende via legend() avec l’option bty = "n" élimine les contours encombrants, aboutissant à une figure cartésienne claire où la première composante surpasse largement la démarcation rouge, la seconde frôle l’équilibre unitaire, et les deux dernières s’enfoncent profondément dans la zone de rejet résiduel.
7. Élaboration d’un scree plot moderne et publication-ready avec ggplot2
7.1 Mise en place de la structure géométrique élémentaire
Le package ggplot2, fondé sur les principes théoriques de la grammaire des graphiques formulés par Leland Wilkinson, offre un niveau de contrôle esthétique et de composition structurelle inégalé. Pour élaborer un scree plot moderne de niveau professionnel, la meilleure approche consiste à associer en un tracé composite une représentation discrète de la variance par composante sous forme d’histogramme, et le profil de décrue sous forme de ligne brisée parsemée de marqueurs nodaux.
Cette composition repose sur l’appel initial à ggplot(), suivi de l’empilement systématique des couches géométriques de base :
p_base <- ggplot(scree_data, aes(x = Comp_Num, y = Valeur_Propre)) +
geom_bar(stat = "identity", fill = "steelblue", alpha = 0.6, width = 0.5) +
geom_line(color = "darkblue", size = 1.1) +
geom_point(color = "darkblue", size = 3.5, shape = 21, fill = "white", stroke = 1.5) +
scale_x_continuous(breaks = scree_data$Co\mp_Num, labels = paste0("PC", scree_data$Comp_Num)) +
labs(x = "Composante Principale", y = "Valeur Propre (Eigenvalue)")
Dans cette architecture, geom_bar(stat = "identity") matérialise l’importance absolue de chaque composante par un volume vertical discret à semi-transparence variable (alpha = 0.6). Simultanément, la combinaison synchronisée de geom_line() et geom_point() superpose la trajectoire de déclin continue de Cattell. L’assignation de disques évidés (shape = 21) bordés de bleu foncé et garnis d’un cœur blanc garantit une perception visuelle optimale en attirant l’attention de l’œil sur chaque intersection spectrale discrète.
7.2 Double échelle et représentation de la variance cumulée
L’un des apports majeurs de la visualisation avancée consiste à enrichir le profil d’éboulis univarié par la courbe de saturation progressive de la variance cumulée. Un lecteur scientifique cherche systématiquement à apprécier deux métriques interdépendantes : la magnitude de la composante individuelle (axe des ordonnées primaire) et la part globale d’information conservée par le modèle tronqué (axe des ordonnées secondaire gradué de 0 à 100 %).
Pour concevoir cette superposition bi-axiale sous ggplot2 sans violer la logique de mapping scalaire, on recourt au paramètre sec.axis de la fonction scale_y_continuous() en appliquant une transformation linéaire inversement proportionnelle :
facteur_conversion <- max(scree_data$Valeur_Propre) / 100
p_double_axe <- ggplot(scree_data, aes(x = Comp_Num)) +
geom_bar(aes(y = Valeur_Propre), stat = "identity", fill = "grey75", width = 0.5) +
geom_line(aes(y = Valeur_Propre), color = "navy", size = 1) +
geom_point(aes(y = Valeur_Propre), color = "navy", size = 3) +
geom_line(aes(y = Variance_Cum * facteur_conversion), color = "firebrick3", size = 1, linetype = "dashed") +
geom_point(aes(y = Variance_Cum * facteur_conversion), color = "firebrick3", size = 2.5) +
scale_y_continuous(
name = "Valeur Propre (Eigenvalue)",
sec.axis = sec_axis(~ . / facteur_conversion, name = "Pourcentage de Variance Cumulée (%)")
) +
scale_x_continuous(breaks = scree_data$Co\mp_Num, labels = paste0("PC", scree_data$Comp_Num))
Ce protocole vectoriel permet d’ajuster l’échelle de la variance cumulée (courbe tiretée rouge) pour qu’elle s’intègre harmonieusement sur la surface d’affichage sans écraser les barres grises d’origine. Les deux axes d’ordonnées permettent une double lecture analytique immédiate : le chercheur peut déduire instantanément qu’en arrêtant l’extraction à deux composantes (PC2), la valeur propre individuelle avoisine 1 tandis que la variance totale capturée franchit la barre des 86 %.
7.3 Raffinement esthétique selon les normes académiques (style APA)
Les normes éditoriales de l’American Psychological Association (APA 7e édition) imposent des critères typographiques particulièrement stricts pour les figures scientifiques destinées aux revues à comité de lecture : élimination de tout quadrillage d’arrière-plan superflu, suppression des teintes bariolées non signifiantes, lisibilité parfaite des polices vectorielles sans empattement, contrastes élevés compatibles avec l’impression en niveaux de gris et délimitation nette des axes cartésiens.
Le bloc de code ci-après intègre ces spécifications rigoureuses tout en insérant la ligne de coupure horizontale de Kaiser et les étiquettes numériques au-dessus des noeuds spectraux :
p_apa <- ggplot(scree_data, aes(x = Comp_Num, y = Valeur_Propre)) +
geom_hline(yintercept = 1, linetype = "dotted", color = "gray40", size = 0.8) +
geom_line(color = "black", size = 0.9) +
geom_point(color = "black", fill = "black", size = 3, shape = 16) +
geom_text(aes(label = paste0(round(Valeur_Propre, 2), "n(", round(Variance_Pct, 1), "%)")),
vjust = -0.6, size = 3.2, family = "sans", lineheight = 0.85) +
scale_x_continuous(breaks = scree_data$Co\mp_Num, labels = paste0("PC", scree_data$Comp_Num)) +
scale_y_continuous(limits = c(0, max(scree_data$Valeur_Propre) * 1.25), expand = c(0, 0)) +
labs(
title = "Figure 1",
subtitle = "Scree Plot des Composantes Principales (Jeu de données USArrests)",
x = "Composante Principale",
y = "Valeur Propre"
) +
theme_classic(base_size = 11, base_family = "sans") +
theme(
plot.title = element_text(face = "bold", size = 12, hjust = 0),
plot.subtitle = element_text(face = "italic", size = 11, hjust = 0, margin = margin(b = 15)),
axis.line = element_line(size = 0.6, color = "black"),
axis.text = element_text(color = "black"),
axis.title = element_text(face = "plain")
)
L’exportation finale de cet objet graphique doit impérativement respecter les standards d’échantillonnage graphique haute résolution requis par les éditeurs universitaires. La fonction ggsave() permet de compiler l’image aux formats vectoriels natifs sans perte de compression (PDF, EPS) ou au format matriciel haute densité (TIFF à 300 ou 600 DPI) :
ggsave("figure1_scree_plot_apa.pdf", plot = p_apa, width = 6.5, height = 4.5, units = "in", dpi = 300)
ggsave("figure1_scree_plot_apa.tiff", plot = p_apa, width = 6.5, height = 4.5, units = "in", dpi = 300, compression = "lzw")
Cette approche garantit une restitution typographique irréprochable, sans pixelisation des polices de caractères ni bavure d’interpolation lors de l’impression physique de l’article scientifique.
8. Automatisation et extensions avancées avec les packages factoextra et psych
8.1 Visualisation immédiate et flexible avec fviz_eig() de factoextra
Pour les praticiens désireux de s’affranchir du codage manuel minutieux de ggplot2 tout en bénéficiant de son rendu esthétique supérieur, le package factoextra, conçu par Alboukadel Kassambara, constitue l’outil d’automatisation par excellence. Spécifiquement calibré pour interagir avec les sorties des algorithmes de factorisation multivariée de R (notamment prcomp, princomp, et les objets issus du package FactoMineR), factoextra encapsule une suite de fonctions graphiques hautement optimisées dont fviz_eig() et son alias syntaxique fviz_screeplot().
L’exécution de la fonction nécessite une seule ligne de commande appliquée directement sur l’objet pca_arrests :
fviz_eig(pca_arrests, addlabels = TRUE, ylim = c(0, 70),
barfill = "#2E9FDF", barcolor = "#2E9FDF",
linecolor = "#E7B800", ncp = 4,
main = "Décomposition de la variance par fviz_eig",
xlab = "Dimensions", ylab = "Pourcentage de variance expliquée")
La commande fviz_eig() résout nativement les difficultés de paramétrage : elle calcule de manière autonome les ratios de variance, gère le positionnement angulaire des étiquettes numériques au-dessus des barres (addlabels = TRUE), et permet de basculer instantanément de la métrique des pourcentages à celle des valeurs propres brutes via l’argument choice = "eigenvalue". Puisque la sortie générée est fondamentalement un objet de classe ggplot, le chercheur conserve l’entière liberté d’y ajouter ultérieurement des calques thématiques complémentaires par simple surcharge syntaxique à l’aide de l’opérateur standard +.
8.2 Implémentation du scree test avec scree() du package psych
Le package psych, développé sous la direction de William Revelle à l’Université Northwestern, est la boîte à outils logicielle incontournable pour la recherche psychométrique sous R. Contrairement aux approches purement descriptives, psych accorde une attention théorique soutenue à la distinction épistémologique entre l’Analyse en Composantes Principales (ACP) et l’Analyse Factorielle Exploratoire (AFE ou Facteurs Communs). Cette dualité est brillamment illustrée par la fonction scree().
Appliquée directement sur la matrice de corrélation ou sur les données brutes, la fonction scree() projette sur un unique repère cartésien les trajectoires comparées des valeurs propres de l’ACP et de l’analyse factorielle en facteurs principaux (PAF) :
psych::scree(USArrests, factors = TRUE, pc = TRUE, main = "Test des éboulis : ACP vs AFE (psych)")
Dans ce graphique comparatif, deux courbes superposées sont tracées :
- Une courbe marquée par des cercles symbolise les composantes principales issues de la matrice non altérée à diagonale unitaire (ACP classique).
- Une courbe marquée par des triangles ou des symboles distincts visualise les valeurs propres déduites de la matrice de corrélation réduite dont la diagonale a été remplacée par l’estimation des communalités initiales ($R – U^2$).
Cette distinction est fondamentale pour le psychomètre : puisque l’AFE élimine l’erreur de mesure spécifique de chaque indicateur, les valeurs propres factorielles sont systématiquement inférieures aux valeurs propres de l’ACP. L’observation simultanée de ces deux profils renseigne sur l’impact de la variance résiduelle unique des items sur la géométrie du coude, prémunissant l’analyste contre le risque de surévaluer le poids dimensionnel réel d’items parasités par une forte variance d’erreur.
8.3 Exécution de l’analyse parallèle de Horn via fa.parallel()
Si le scree test visuel de Cattell représente un saut qualitatif par rapport aux approches antérieures, il n’en demeure pas moins tributaire de la subjectivité de l’analyste. Pour surmonter cet arbitraire visuel, John L. Horn a formulé en 1965 une avancée méthodologique majeure : l’Analyse Parallèle (*Parallel Analysis*). Le postulat de Horn est d’une grande élégance logique : un échantillon statistique aléatoire issu d’une population où toutes les variables sont rigoureusement orthogonales (bruit blanc complet) générera mécaniquement, en raison des fluctuations aléatoires d’échantillonnage, des valeurs propres empiriques supérieures à zéro, voire substantiellement supérieures à 1 pour la première dimension dans les cohortes restreintes.
Par conséquent, pour qu’une dimension soit déclarée théoriquement authentique, sa valeur propre observée doit dépasser de manière statistiquement significative la valeur propre moyenne (ou le 95e percentile) générée aléatoirement à partir de matrices de données aléatoires indépendantes possédant rigoureusement les mêmes dimensions d’échantillon ($N$) et le même nombre de variables ($p$) que le jeu de données réel. Le package psych implémente cet étalon-or computationnel via sa fonction fa.parallel() :
analyse_parallele <- psych::fa.parallel(
USArrests,
fm = "minres",
fa = "both",
n.iter = 500,
quant = 0.95,
main = "Analyse Parallèle de Horn avec Enveloppe Monte-Carlo"
)
La commande exécute cinq cents simulations stochastiques de Monte-Carlo (n.iter = 500). Sur le graphique qui en résulte, le scree plot des données réelles est confronté à la courbe en pointillés bleus du bruit statistique aléatoire calculée au 95e centile (quant = 0.95). La règle de décision stipule formellement : seules doivent être retenues les composantes empiriques situées strictement au-dessus de la ligne aléatoire simulée. Dès que la courbe observée intersecte ou passe sous la trajectoire de simulation de Monte-Carlo, les dimensions résiduelles ne sont plus discernables d’un artéfact stochastique pur et doivent être impitoyablement abandonnées.
9. Critères décisionnels pour la sélection du nombre optimal de composantes
9.1 Le test du coude de Cattell (Scree Test) et ses limites de subjectivité
Le test du coude (*Scree Test*) préconisé par Cattell consiste à repérer visuellement le point de transition où la décrue abrupte de la falaise fait place à un nivellement linéaire régulier matérialisant l’éboulis rocheux. La règle décisionnelle s’énonce ainsi : retenir le nombre de composantes qui précèdent immédiatement le coude d’inflexion principal. Dans une décomposition spectrale théorique idéale, le graphique présente une fracture géométrique manifeste ne laissant planer aucun doute sur la frontière d’extraction.
Néanmoins, la mise en œuvre pratique de ce test visuel souffre de limitations psychométriques documentées depuis plusieurs décennies. Dans de nombreux jeux de données empiriques complexes, le chercheur fait face à ce que les méthodologues désignent sous les termes de « coudes multiples », de « déclins continus doux » ou de « plateaux hésitants ». En présence d’un profil de valeurs propres affichant une dégressivité graduelle sans cassure nette, localiser le point d’inflexion relève d’une conjecture subjective. Des études expérimentales en métrologie ont démontré que l’accord inter-juges face à des scree plots ambigus n’excède guère 60 à 70 %, des analystes distincts optant fréquemment pour des nombres de facteurs divergents à partir d’un tracé rigoureusement identique.
Cet arbitraire visuel peut entraîner des répercussions désastreuses : sélectionner une composante de trop ou omettre un facteur substantiel modifie drastiquement la structure après rotation, déstabilise les saturations factorielles des items et nuit à la reproductibilité des conclusions de l’étude. Pour ces motifs, la communauté académique exige aujourd’hui que le scree test de Cattell ne soit plus employé comme arbitre solitaire, mais qu’il soit impérativement triangulé avec des critères quantitatifs d’arrêt automatisés.
9.2 Le critère de Kaiser-Guttman (valeur propre supérieure à 1)
Le critère de Kaiser-Guttman, popularisé par Henry Kaiser en 1960 sur la base des postulats initiaux de Louis Guttman (1954), demeure le standard algorithmique le plus répandu en raison de sa simplicité computationnelle. Il postule qu’une composante principale ne mérite d’être conservée que si sa valeur propre est strictement supérieure à l’unité ($\lambda_i > 1$). Le fondement logique est intuitif : puisque chaque variable manifeste standardisée possède une variance unitaire égale à 1, une composante synthétique dont la valeur propre est inférieure à 1 explique moins de variance qu’une seule variable observée isolée, ce qui contredit le principe même de réduction dimensionnelle.
Bien que séduisante et implémentée par défaut dans la plupart des logiciels commerciaux historiques (comme SPSS), cette règle fait l’objet de critiques méthodologiques sévères dans la littérature statistique contemporaine. Sa faille majeure réside dans son insensibilité aux fluctuations d’échantillonnage et sa dépendance mécanique directe au nombre total de variables ($p$) injectées dans la matrice. Les simulations de Monte-Carlo démontrent de façon convergente que :
- Lorsque le nombre de variables est élevé ($p > 30$), le critère de Kaiser tend quasi-systématiquement à la sur-extraction pathologique, sélectionnant de nombreuses composantes mineures chargées de bruit résiduel qui gonflent artificiellement la complexité factorielle.
- Lorsque le nombre de variables est très faible ($p < 10$) et que l’échantillon est restreint, il arrive qu’il engendre une sous-extraction abusive, écartant des composantes porteuses de sens clinique dont la valeur propre est marginalement inférieure à 1 (par exemple 0,98).
L’application aveugle de la frontière binaire $lambda = 1$ doit donc être proscrite. Elle ne constitue qu’une borne indicative supérieure de la dimensionnalité maximale admissible et ne doit jamais faire office de verdict sans équivoque.
9.3 Le seuil de variance minimale cumulée et triangulation des critères
Le troisième critère usuel repose sur la fixation d’un seuil empirique de variance totale minimale expliquée. Selon cette approche pragmatique, l’extraction se poursuit jusqu’à ce que la variance cumulée des composantes conservées atteigne un seuil préétabli par le chercheur. Dans les sciences dures et le génie industriel, ce seuil est fréquemment fixé à 90 % ou 95 % pour certifier une reconstitution fidèle du signal physique. En revanche, dans le champ des sciences comportementales, de la sociologie et de la psychométrie, les standards admis par la littérature situent généralement le seuil d’admissibilité entre 60 % et 75 % de la variance totale expliquée.
Ce critère présente toutefois le défaut symétrique d’être partiellement arbitraire dans la fixation de son seuil de tolérance. Pour échapper à l’écueil de chaque approche prise isolément, la méthodologie quantitative contemporaine préconise formellement un protocole de triangulation hiérarchisé :
- Première instance (Étalon-or statistique) : Examiner le verdict de l’Analyse Parallèle de Horn au percentile 95. Si Horn recommande $k$ composantes, ce nombre constitue l’ancrage prioritaire du modèle.
- Deuxième instance (Validation géométrique) : Confronter ce résultat avec le coude du scree plot de Cattell. Le point de rupture doit coïncider avec l’arrêt recommandé par Horn ou s’en trouver immédiatement adjacent.
- Troisième instance (Vérification de Kaiser et variance globale) : S’assurer que les composantes sélectionnées n’enfreignent pas dramatiquement le critère de Kaiser ($\lambda_i \approx 1$ ou supérieur) et qu’elles mobilisent une fraction de variance cumulée compatible avec les standards de la discipline ($> 60,%$).
- Instance finale suprême (Sens clinique et conceptuel) : Évaluer si les $k$ composantes extraites sont interprétables psychologiquement, théoriquement cohérentes, et exemptes de saturations croisées indéterminées après rotation factorielle.
Cette démarche de convergence méthodique protège l’investigateur contre les conclusions fallacieuses dictées par un seul outil diagnostique isolé.
10. Diagnostics post-sélection et pertinence structurelle en psychométrie
10.1 Évaluation des saturations factorielles et de la structure après sélection
La validation du nombre de composantes extraites à partir du scree plot ne marque pas l’achèvement de l’investigation méthodologique ; elle initie au contraire la phase d’audit structurel. Une fois fixée la dimensionalité optimale $k$, le chercheur doit calculer la matrice des saturations factorielles (*factor loadings*), qui quantifient la corrélation empirique entre chaque variable manifeste et les composantes sélectionnées. Dans l’espace non tourné de prcomp(), ces saturations se déduisent par la multiplication de la matrice de rotation $\mathbf{V}$ par la matrice diagonale des écarts-types $\mathbf{D} / \sqrt{n-1}$ :
loadings_k <- pca_arrests$rotation[, 1:2] %*% diag(pca_arrests$sdev[1:2])
colnames(loadings_k) <- c("PC1", "PC2")
print(round(loadings_k, 3))
Dans la grande majorité des cas pratiques, la solution brute non tournée affiche une configuration d’hyper-généralité (où presque toutes les variables saturent lourdement sur la première composante), rendant l’interprétation des traits latents opaque. Pour atteindre la « structure simple » définie par Thurstone, il est indispensable de procéder à une rotation vectorielle :
- Rotation orthogonale (Varimax) : Préserve l’indépendance stricte des composantes (orthogonalité à 90 degrés) tout en maximisant la dispersion des saturations au sein de chaque colonne afin d’approcher des charges binaires (proches de 0 ou de 1).
- Rotation oblique (Promax ou Oblimin) : Autorise une corrélation empirique entre les composantes extraites. En psychométrie, la rotation oblique est théoriquement préférable, car les construits psychologiques réels (par exemple, anxiété et dépression, ou mémoire de travail et raisonnement fluide) ne sont quasiment jamais rigoureusement orthogonaux dans la population générale.
L’examen post-rotation permet de repérer d’éventuels items orphelins (ne saturant significativement sur aucune dimension, avec un seuil de coupure standard $|l| < 0,30$ ou $0,40$) ou des items présentant des saturations croisées complexes ($|l| > 0,40$ sur plusieurs axes distincts), invitant à une épuration métrologique de l’instrument.
10.2 Risques statistiques de la sous-extraction et de la sur-extraction
L’arbitrage dimensionnel dicté par la lecture du scree plot emporte des conséquences structurelles asymétriques dont la gravité statistique doit être rigoureusement mesurée par l’expérimentateur. L’analyste doit arbitrer entre deux périls statistiques diamétralement opposés :
La sous-extraction (retenir un nombre de composantes inférieur à la structure dimensionnelle latente réelle, par exemple $k – 1$ ou $k – 2$) constitue l’erreur méthodologique la plus préjudiciable. En comprimant de force l’espace des données, la sous-extraction contraint des construits psychologiques théoriquement distincts et orthogonaux à fusionner artificiellement au sein d’une composante hybride impure. Les saturations factorielles sont sévèrement biaisées, la variance résiduelle informative est rejetée dans l’erreur, et les relations réelles existant entre les traits sont irrémédiablement faussées, ruinant la validité de contenu du test d’évaluation.
À l’opposé, la sur-extraction (retenir un nombre de dimensions supérieur à la réalité, par exemple $k + 1$ ou $k + 2$) s’avère statistiquement moins destructrice, bien que néfaste. Elle conduit à scinder un facteur général authentique en sous-facteurs marginaux hautement corrélés, ou pire, à attribuer une signification théorique à une dimension qui ne capture que des fluctuations stochastiques d’échantillonnage propres à l’échantillon analysé (*over-fitting*). Cela compromet sévèrement la réplicabilité future de l’échelle d’évaluation lors des tentatives de validation croisée sur de nouvelles cohortes indépendantes. Face à ce dilemme, les simulations numériques indiquent qu’en cas d’incertitude marginale persistante entre deux solutions factorielles après consultation du scree plot, une légère sur-extraction est généralement moins délétère qu’une sous-extraction destructrice, sous réserve expresse de valider ultérieurement la cohérence interne des sous-échelles extraites.
10.3 Validation croisée et robustesse par rééchantillonnage (Bootstrap)
Un scree plot classique repose sur l’échantillon empirique unique recueilli, ce qui le rend sensible aux instabilités distributionnelles mineures de la cohorte d’évaluation. Pour asseoir la robustesse statistique de la décomposition spectrale, l’implémentation d’un algorithme de rééchantillonnage non-paramétrique par **Bootstrap** représente la démarche méthodologique la plus élégante.
Le protocole consiste à générer par tirage avec remise $B = 1000$ pseudo-échantillons de taille identique à l’échantillon initial, à exécuter l’ACP sur chaque itération, et à enregistrer systématiquement le spectre complet des valeurs propres obtenues. Cette procédure permet de dériver empiriquement des intervalles de confiance à 95 % autour de chaque valeur propre du scree plot original. Le script R ci-dessous formalise cette séquence de rééchantillonnage intensif :
B <- 1000
n <- nrow(USArrests)
p <- ncol(USArrests)
valeurs_boot <- matrix(NA, nrow = B, ncol = p)
for(i in 1:B) {
idx <- sample(1:n, size = n, replace = TRUE)
echantillon_boot <- USArrests[idx, ]
pca_b <- prcomp(echantillon_boot, center = TRUE, scale. = TRUE)
valeurs_boot[i, ] <- pca_b$sdev^2
}
ic_inf <- apply(valeurs_boot, 2, quantile, probs = 0.025)
ic_sup <- apply(valeurs_boot, 2, quantile, probs = 0.975)
scree_boot_df <- tibble(Comp = 1:p, VP = pca_arrests$sdev^2, IC_Inf = ic_inf, IC_Sup = ic_sup)
Si l’intervalle de confiance bootstrappé d’une composante donnée ne chevauche pas l’intervalle de la composante adjacente et se maintient résolument au-dessus de la valeur critique 1, la stabilité de la dimension est formellement démontrée. Si, au contraire, les intervalles de confiance se croisent ou englobent largement le seuil d’indétermination, le chercheur sait que la frontière du coude de Cattell est fragile et soumise aux aléas de recrutement de l’échantillon, incitant à une extrême réserve lors de l’affirmation de la dimensionnalité du construit.
11. Tutoriel complet et reproductible : Du jeu de données brut au scree plot final
11.1 Pipeline de traitement R entièrement automatisé
Pour assurer une intégration opérationnelle fluide dans les travaux de recherche, il est judicieux de synthétiser l’intégralité du pipeline méthodologique développé au sein d’une fonction R autonome, modulaire et documentée. Cette routine prend en entrée n’importe quel tableau de données brutes numériques continues, procède à l’assainissement matriciel, exécute l’Analyse en Composantes Principales standardisée, calcule les tables spectrales complètes et retourne à la fois la matrice de synthèse et le scree plot hautement configuré prêt pour la publication.
Le bloc de code ci-après formalise cette fonction industrielle réutilisable :
generer_scree_plot_expert <- function(data, titre = "Analyse Spectrale des Éboulis", style_apa = TRUE) {
donnees_propres <- na.omit(data)
pca_obj <- prcomp(donnees_propres, center = TRUE, scale. = TRUE)
vp <- pca_obj$sdev^2
p_var <- (vp / sum(vp)) * 100
cum_var <- cumsum(p_var)
df_res <- data.frame(
Composante = 1:length(vp),
Valeur_Propre = vp,
Pourcentage_Variance = p_var,
Pourcentage_Cumule = cum_var
)
g <- ggplot(df_res, aes(x = Composante, y = Valeur_Propre)) +
geom_hline(yintercept = 1, linetype = "dashed", color = "firebrick", size = 0.8) +
geom_line(color = "steelblue4", size = 1) +
geom_point(color = "steelblue4", fill = "white", shape = 21, size = 3.5, stroke = 1.2) +
geom_text(aes(label = paste0(round(Valeur_Propre, 2), " (", round(Pourcentage_Variance, 1), "%)")),
vjust = -0.8, size = 3, fontface = "bold") +
scale_x_continuous(breaks = 1:length(vp), labels = paste0("PC", 1:length(vp))) +
scale_y_continuous(limits = c(0, max(vp) * 1.3), expand = c(0, 0)) +
labs(title = titre, x = "Composante Principale", y = "Valeur Propre (Variance d'inertie)")
if(style_apa) {
g <- g + theme_classic(base_size = 11) +
theme(plot.title = element_text(face = "bold", hjust = 0.5), axis.line = element_line(color = "black"))
} else {
g <- g + theme_minimal(base_size = 11)
}
return(list(resultats = df_res, graph = g, pca_object = pca_obj))
}
Cette encapsulation algorithmique permet d’analyser n’importe quel inventaire psychométrique en une seule instruction d’appel, renforçant considérablement l’efficacité du chercheur et éliminant tout risque d’erreur de saisie intermédiaire lors des opérations de mise à l’échelle ou d’élévation quadratique.
11.2 Exécution appliquée sur les données USArrests et interprétation analytique
L’application directe de notre pipeline automatisé sur le jeu USArrests fournit instantanément les livrables analytiques :
analyse_arrests <- generer_scree_plot_expert(USArrests, titre = "Scree Plot de Cattell - Données USArrests", style_apa = TRUE)
print(round(analyse_arrests$resultats, 3))
print(analyse_arrests$graph)
L’analyse détaillée des sorties tabulaires et graphiques converge vers un verdict méthodologique précis. La première composante principale affiche une valeur propre dominante de 2,48, capturant à elle seule 62,01 % de la variance totale du système d’agression. La deuxième composante affiche une valeur propre de 0,99 (arrondie à 0,990), absorbant 24,74 % de variance supplémentaire. La troisième composante chute brutalement à une valeur propre résiduelle de 0,36 (8,91 % de variance), et la quatrième ferme la marche à 0,17 (4,34 % de variance).
Sur le tracé du scree plot, la cassure géométrique du coude de Cattell apparaît sans ambiguïté au niveau de la troisième composante (PC3). En vertu de la règle de Cattell stipulant la rétention exclusive des composantes précédant strictement le point d’inflexion résiduel, ce point de rupture désigne formellement une structure à **deux composantes principales**. La confrontation triangulée corrobore solidement cette lecture : la solution bifactorielle condense 86,75 % de l’inertie originelle complète. Bien que la valeur propre de PC2 ($\lambda_2 = 0,9898$) soit infinitésimalement inférieure au seuil strict de Kaiser ($lambda > 1$), son rejet mécanique sur la base exclusive de cette marge résiduelle de $0,01$ relèverait d’un dogmatisme algorithmique aveugle, d’autant que l’Analyse Parallèle de Horn valide sans équivoque la rétention de cette deuxième dimension sociologique majeure.
11.3 Transposition méthodologique à un questionnaire de personnalité de type Likert
Bien que le jeu USArrests soit parfait pour maîtriser la cinématique de calcul, les inventaires psychologiques réels présentent une contrainte méthodologique supplémentaire capitale : ils sont massivement composés d’échelles de cotation ordinales discrètes (items de type Likert en 4, 5 ou 7 points d’ancrage). Or, l’utilisation du coefficient de corrélation produit-moment de Pearson sur des variables catégorielles ordinales viole les postulats de continuité sous-jacents, comprime artificiellement les corrélations bivariées et tend à engendrer de faux facteurs méthodologiques parasites sur le scree plot (communément appelés facteurs de difficulté ou artéfacts de distribution catégorielle).
Pour traiter adéquatement ce type de données psychométriques, la matrice d’inter-corrélations doit impérativement être estimée via des corrélations polychoriques. L’algorithme polychorique modélise mathématiquement que la variable discrète ordonnée observée reflète une variable latente gaussienne sous-jacente continue segmentée par des seuils de réponse différentiels. Le code R suivant illustre la transposition exacte du scree test vers une matrice polychorique sous le package psych :
matrice_poly <- psych::polychoric(donnees_likert)$rho
scree_poly <- psych::fa.parallel(
matrice_poly,
n.obs = nrow(donnees_likert),
cor = "poly",
fm = "wls",
fa = "both",
main = "Analyse Parallèle Polychorique pour Données Likert"
)
Dans ce cadre analytique adapté, la décomposition spectrale appliquée sur la matrice polychorique restitue la véritable structure dimensionnelle des construits psychologiques sans les distorsions d’éboulis causées par l’asymétrie des catégories de réponse. Cette étape constitue le préalable indispensable avant toute transition confirmatoire formelle vers les Modèles d’Équations Structurelles (SEM / CFA), où la structure dégagée par le scree plot exploratoire sera soumise au test de conformité indicielle (RMSEA, CFI, TLI, SRMR).
12. Erreurs fréquentes, pièges méthodologiques et recommandations académiques
12.1 Confusion persistante entre composantes principales et facteurs latents
L’une des dérives les plus tenaces dans la littérature quantitative francophone et internationale concerne la confusion conceptuelle et sémantique entre l’Analyse en Composantes Principales (ACP) et l’Analyse Factorielle Exploratoire (AFE). Ces deux démarches ne partagent ni les mêmes fondements épistémologiques, ni les mêmes formulations mathématiques, et l’usage interchangeable des termes « facteurs » et « composantes » doit être formellement banni lors de la rédaction de thèses, mémoires ou articles scientifiques soumis à des revues académiques.
L’Analyse en Composantes Principales est un modèle formel de réduction empirique de variance. Elle ne postule aucune causalité latente sous-jacente : les composantes ne sont que des combinaisons linéaires directes des variables manifestes, orientées de manière à condenser la variance totale maximale sans distinguer la part d’erreur. Les valeurs propres du scree plot d’ACP proviennent d’une matrice où chaque variable possède un poids diagonal unitaire de 1. À l’opposé, l’Analyse Factorielle Exploratoire est un modèle de mesure théorique réflectif, postulant que les corrélations observables sont causées en amont par des entités latentes inobservables ($X_j = \lambda_{j1} F_1 + dots + \lambda_{jm} F_m + e_j$).
Dans un scree plot d’AFE, la variance analysée est exclusivement la variance commune partagée (les communalités $h_i^2$), l’erreur de mesure unique ($u_i^2$) ayant été rigoureusement soustraite de la diagonale principale. Par conséquent, reporter les valeurs propres d’une ACP en prétendant qu’il s’agit des facteurs latents réels d’une échelle psychométrique constitue une hérésie méthodologique. Le chercheur doit explicitement clarifier dans ses notes méthodologiques s’il projette un éboulis d’ACP (décomposition d’inertie brute) ou un éboulis d’AFE (décomposition de covariance commune régularisée).
12.2 Pièges d’interprétation visuelle et illusions graphiques
La lecture visuelle d’un scree plot n’est pas neutre d’un point de vue perceptif : elle est profondément tributaire des choix de mise en page, du cadrage cartésien et du ratio d’aspect imposé par le graphiste ou le logiciel. L’expérimentateur non averti peut aisément être victime de graves illusions d’optique statistique induites par des configurations techniques inadéquates :
- L’effet d’étirement ou de compression des axes : L’inclinaison de la pente de Cattell dépend mécaniquement du ratio géométrique liant la hauteur de l’axe des ordonnées à la largeur de l’axe des abscisses. Un graphique artificiellement étiré en hauteur accentuera dramatiquement la verticalité apparente de la falaise, incitant le lecteur à percevoir des coudes inexistants. Inversement, un graphique aplati horizontalement nivelle la chute spectrale, rendant la détection du point de rupture quasi-impossible.
- Le non-démarrage de l’axe des ordonnées à zéro : Tronquer l’axe des ordonnées pour faire démarrer les valeurs propres à une valeur plancher artificielle (par exemple 0,8 au lieu de 0) constitue une grave manipulation visuelle. Ce cadrage fallacieux agrandit démesurément les écarts minimes séparant les petites valeurs propres résiduelles, créant l’illusion visuelle trompeuse de multiples coudes au cœur même de l’éboulis rocheux. L’axe des ordonnées d’un scree plot intègre impérativement le zéro mathématique absolu.
- L’illusion des plateaux intermédiaires : Lorsque deux composantes successives affichent des valeurs propres similaires au milieu de la distribution spectrale avant une nouvelle petite baisse, l’analyste peut hésiter et sur-extraire. La règle fondamentale stipule qu’un plateau fait déjà partie de l’éboulis résiduel ; le modèle doit impérativement s’arrêter avant l’amorce du premier palier d’égalisation d’inertie.
12.3 Normes de reporting scientifique et bonnes pratiques de science ouverte
Pour satisfaire aux exigences de rigueur de la science ouverte et aux standards éditoriaux de l’APA (7e édition), la présentation du scree plot et des analyses dimensionnelles associées doit obéir à un protocole de transparence totale. Il n’est plus acceptable de se contenter d’insérer un graphique isolé au sein d’un manuscrit en affirmant dogmatiquement que le coude est manifeste sans fournir les éléments quantitatifs afférents.
Le reporting scientifique exemplaire requiert la communication intégrale des éléments suivants :
- Divulgation de la table spectrale : Le manuscrit doit inclure un tableau énumérant pour chaque composante : la valeur propre extraite, le pourcentage de variance individuelle expliquée, et le pourcentage cumulé, permettant aux pairs de vérifier les calculs d’inertie indépendamment de la perception visuelle de la figure.
- Spécification précise de la matrice source : Mentionner explicitement la nature de la matrice décomposée (matrice de covariance brute, matrice de corrélation de Pearson standardisée, ou matrice de corrélation polychorique) ainsi que l’algorithme sous-jacent employé (SVD via
prcomp, diagonalisation spectrale, ou factorisation en facteurs principaux). - Triangulation explicite et documentée : Rappeler conjointement dans le corps du texte les résultats obtenus pour chaque critère d’arrêt : le résultat de l’Analyse Parallèle de Horn (avec le nombre de simulations et le percentile spécifiés), le nombre de composantes au-dessus de l’unité selon Kaiser, et la justification du choix final en cas de divergence marginale entre ces métriques.
- Partage reproductible du code R : Déposer le script complet de calcul et de visualisation sous licence libre sur un entrepôt institutionnel pérenne (Open Science Framework – OSF, Zenodo, GitHub) assorti des informations de version logicielle complètes issues de la commande R
sessionInfo().
L’application scrupuleuse de ces recommandations garantit la transparence méthodologique du protocole d’extraction factorielle, conférant aux inférences psychométriques qui en découlent une robustesse scientifique incontestable face aux exigences de l’évaluation par les pairs.
Références
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245–276. https://doi.org/10.1207/s15327906mbr0102_10
- Guttman, L. (1954). Some necessary conditions for common-factor analysis. Psychometrika, 19(2), 149–161. https://doi.org/10.1007/BF02289162
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Kaiser, H. F. (1960). The application of electronic computers to factor analysis. Educational and Psychological Measurement, 20(1), 141–151. https://doi.org/10.1177/001316446002000116
- Kassambara, A., & Mundt, F. (2020). factoextra: Extract and visualize the results of multivariate data analyses (R package version 1.0.7). https://CRAN.R-project.org/package=factoextra
- Mahalanobis, P. C. (1936). On the generalised distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49–55. https://doi.org/10.1007/BF02884144
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (R package version 2.3.9). Northwestern University. https://CRAN.R-project.org/package=psych
- Spearman, C. (1904). « General Intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://www.jstor.org/stable/1167435
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0