
La modélisation statistique contemporaine occupe une place prépondérante dans la démarche scientifique, qu’il s’agisse d’évaluer l’efficacité d’une intervention clinique, de modéliser des trajectoires neurocognitives ou d’anticiper des comportements décisionnels complexes. Dans ce contexte, l’inférence prédictive dépasse la simple formulation d’une prédiction ponctuelle issue des moindres carrés ordinaires. Estimer un score futur sans quantifier la variabilité inhérente à ce pronostic expose le chercheur ou le clinicien à une illusion de certitude particulièrement délétère dans les sciences empiriques. C’est précisément pour remédier à cette faille méthodologique que s’impose le recours aux intervalles de prédiction, des constructions probabilistes destinées à borner la réalisation d’une future observation individuelle avec un niveau de confiance rigoureusement spécifié.
L’environnement de programmation statistique R constitue l’écosystème de référence pour l’implémentation, l’évaluation et la visualisation de ces métriques. Grâce à son moteur vectoriel, à la puissance fonctionnelle de ses bibliothèques matricielles et à la flexibilité graphique offerte par des extensions comme ggplot2, R permet de décomposer l’incertitude globale en ses constituants fondamentaux : la variance d’échantillonnage liée à l’estimation des paramètres du modèle et la dispersion stochastique résiduelle propre au phénomène étudié. Malgré cette accessibilité computationnelle, la distinction mathématique et épistémologique entre un intervalle de confiance et un intervalle de prédiction demeure fréquemment méconnue dans les publications scientifiques, entraînant des contresens majeurs dans l’interprétation des données psychologiques et médicales.
Ce guide exhaustif a pour vocation d’articuler les fondements théoriques, les justifications probabilistes et les modalités opératoires sous R pour la construction, la validation et la communication d’intervalles de prédiction rigoureux. En explorant successivement la dérivation analytique des erreurs-types, l’exploitation programmatique des fonctions natives, les procédures d’évaluation de la robustesse résiduelle et les approches non paramétriques de rééchantillonnage, cet article fournit aux chercheurs et praticiens une feuille de route avancée et reproductible garantissant une inférence statistique conforme aux standards méthodologiques les plus exigeants.
1. Introduction conceptuelle aux intervalles de prédiction en modélisation statistique
1.1 Définition formelle et rôle de l’intervalle de prédiction
L’intervalle de prédiction constitue un estimateur d’ensemble probabiliste dont la vocation première est d’encadrer la valeur numérique prise par une nouvelle unité statistique ou une observation future individuelle, notée empiriquement Yn+1, conditionnellement à un ensemble spécifique de valeurs associées aux covariables explicatives Xn+1. Contrairement aux approches axées exclusivement sur les paramètres de tendance centrale, l’intervalle de prédiction appréhende l’aléa statistique non pas comme un bruit marginal qu’il conviendrait de minimiser à l’infini, mais comme une propriété intrinsèque du système étudié, irréductible par la seule augmentation de la taille de l’échantillon d’apprentissage.
D’un point de vue épistémologique, l’estimation ponctuelle fournit une valeur unique conditionnée par l’hypothèse implicite d’une trajectoire déterministe moyenne. Or, en statistique inductive, une telle valeur possède une probabilité théorique nulle de coïncider rigoureusement avec la réalité empirique observée lors d’une nouvelle mesure continue. L’introduction d’un intervalle de prédiction substitue à cette approximation illusoire une quantification probabiliste explicite de l’incertitude, garantissant que sous des hypothèses distributionnelles contrôlées, la future valeur individuelle aura une probabilité prédéterminée, conventionnellement fixée à un niveau 1 – α (généralement 95 %), de s’insérer entre les bornes calculées.
Dans le domaine de la psychométrie et des sciences du comportement, cette distinction est déterminante. Les réponses humaines, soumises à des dynamiques psychologiques multifactorielles, présentent une variabilité résiduelle substantielle qu’aucun modèle additif linéaire ne saurait épuiser. Intégrer l’erreur stochastique individuelle dans l’estimation permet de ne pas surévaluer la précision d’une échelle de mesure comportementale ou d’un biomarqueur psychoneuroendocrinien, offrant ainsi un cadre de décision respectueux de l’hétérogénéité naturelle des populations sous étude.
1.2 Différenciation fondamentale : intervalle de prédiction versus intervalle de confiance
La confusion entre intervalle de confiance et intervalle de prédiction représente l’un des écueils conceptuels les plus récurrents dans la littérature appliquée. L’intervalle de confiance quantifie l’incertitude entourant l’estimation de l’espérance mathématique de la réponse pour une valeur de covariable donnée, formalisée par E(Y | X = x0). Cet intervalle traduit la précision avec laquelle la droite ou l’hyperplan de régression de la population mère est localisé par les données de l’échantillon. Dès lors que l’effectif n croît vers l’infini, la variance d’échantillonnage des coefficients converge asymptotiquement vers zéro, et l’intervalle de confiance se contracte jusqu’à se réduire à une ligne filiforme.
À l’inverse, l’intervalle de prédiction quantifie l’incertitude liée à une unité d’observation singulière. Mathématiquement, la variance de l’erreur de prédiction unitaire agrège deux sources indépendantes d’incertitude : d’une part, la variance d’estimation des coefficients de régression (l’incertitude sur la position de l’hyperplan), et d’autre part, la variance intrinsèque du terme d’erreur stochastique, symbolisée par σ2. Même si la taille de l’échantillon devenait infinie, annulant ainsi l’incertitude sur les coefficients, la variance du terme résiduel demeurerait intacte. Par conséquent, l’intervalle de prédiction conserve une largeur incompressible équivalente à plusieurs écarts-types de l’erreur.
Il en résulte une démonstration théorique sans équivoque : pour un jeu de données, un modèle statistique et un seuil de confiance nominal donnés, l’intervalle de prédiction est strictement et systématiquement plus large que l’intervalle de confiance correspondant. Utiliser par mégarde un intervalle de confiance pour apprécier la réponse plausible d’un sujet individuel aboutit à une sous-estimation massive du risque statistique et à un taux de couverture empirique considérablement inférieur à la valeur nominale revendiquée, oscillant parfois autour de 50 à 60 % pour un niveau théorique supposé de 95 %.
1.3 Applications empiriques dans la recherche psychologique et comportementale
En psychopathologie quantitative, la modélisation pronostique sert fréquemment à prédire le score d’anxiété ou de dépression d’un nouveau patient admis dans une unité de soins, à partir d’un ensemble de prédicteurs incluant l’intensité du cortisol salivaire matinal, la réactivité électrodermale et des scores d’auto-évaluation standardisés. Si un modèle de régression multivarié fournit une prédiction ponctuelle de 24 points sur une échelle de sévérité clinique, ce chiffre seul ne renseigne nullement sur la probabilité que le patient développe un état aigu nécessitant une surveillance continue. L’intervalle de prédiction, en indiquant par exemple une plage comprise entre 14 et 34 points, révèle immédiatement au clinicien la plausibilité d’une décompensation sévère, modifiant radicalement la trajectoire de prise en charge.
De même, dans les bilans neuropsychologiques post-traumatiques ou post-lésionnels, l’estimation des capacités mnésiques ou attentionnelles d’un individu s’appuie sur des modèles normatifs prenant en compte l’âge, le niveau socio-éducatif et la réserve cognitive. L’intervalle de prédiction définit les frontières statistiques de ce qui constitue une réponse typique pour un profil individuel donné. Tout score se situant en deçà de la borne inférieure de cet intervalle signale une altération pathologique potentielle avec un contrôle rigoureux du taux de faux positifs, ce qu’un intervalle de confiance sur la moyenne de la population ne permettrait aucunement d’inférer avec pertinence.
Cette distinction s’érige enfin en impératif déontologique. Asseoir un diagnostic différentiel, une admission dans un programme thérapeutique intensif ou l’orientation d’un apprenant en difficulté sur une valeur ponctuelle expose le praticien à des erreurs de décision lourdes de conséquences. L’intervalle de prédiction matérialise visuellement et numériquement le degré d’ignorance résiduelle du modèle statistique, prémunissant les intervenants contre la surinterprétation de fluctuations aléatoires non prévisibles inhérentes à la condition humaine.
2. Fondements mathématiques et statistiques de l’intervalle de prédiction
2.1 Formulation théorique dans le modèle de régression linéaire simple
Pour appréhender l’architecture mathématique de l’intervalle de prédiction, considérons le modèle de régression linéaire bivarié canonique défini par la relation :
Yi = β0 + β1 Xi + εi
où les perturbations stochastiques εi sont supposées indépendantes et identiquement distribuées selon une loi normale d’espérance nulle et de variance constante σ2, noté εi ~ N(0, σ2). L’estimation des moindres carrés ordinaires (MCO) produit les estimateurs sans biais β̂0 et β̂1. Pour une valeur conditionnelle fixée du prédicteur, désignée par x0, la valeur ponctuelle prédite de la variable dépendante est formulée selon l’expression :
ŷ0 = β̂0 + β̂1 x0
La valeur empirique future Y0 associée à cette même valeur de prédicteur x0 s’exprime quant à elle comme la somme de la composante déterministe sous-jacente et d’un nouveau choc résiduel non observé ε0 :
Y0 = β0 + β1 x0 + ε0
L’erreur de prédiction, formalisée comme la différence algébrique entre l’observation future réelle et la prédiction calculée, devient alors epred = Y0 – ŷ0. En substituant les termes et en exploitant l’indépendance statistique fondamentale entre le jeu de données d’apprentissage (qui conditionne ŷ0) et la nouvelle observation (dont est issu ε0), la variance théorique de cette erreur de prédiction s’établit par l’addition des variances :
Var(epred) = Var(Y0 – ŷ0) = Var(ŷ0) + Var(ε0) = σ2 [ (1 / n) + ((x0 – x̄)2 / ∑(xi – x̄)2) ] + σ2
En factorisant par la variance résiduelle σ2, nous obtenons l’équation maîtresse régissant la variabilité prédictive unitaire :
Var(epred) = σ2 [ 1 + (1 / n) + ((x0 – x̄)2 / ∑(xi – x̄)2) ]
La présence du terme unitaire scalaire au sein des crochets reflète mathématiquement l’incertitude attachée à l’observation future isolée, expliquant pourquoi cette variance ne tend jamais vers zéro quand n s’accroît. Dans la pratique computationnelle, la variance d’erreur σ2 est inconnue et remplacée par son estimateur sans biais, l’erreur quadratique moyenne résiduelle, notée s2. Par voie de conséquence, la quantité standardisée suit une distribution t de Student à n – 2 degrés de liberté. Les bornes inférieure et supérieure de l’intervalle de prédiction pour un seuil bilatéral 1 – α se formalisent ainsi :
ŷ0 ± t(1 – α/2, n – 2) × s × √[ 1 + (1 / n) + ((x0 – x̄)2 / ∑(xi – x̄)2) ]
2.2 Impact de la distance euclidienne à la moyenne du prédicteur
L’examen approfondi du terme (x0 – x̄)2 / ∑(xi – x̄)2 révèle une propriété géométrique déterminante : la largeur de l’intervalle de prédiction est une fonction non linéaire, quadratique et hyperbolique, de l’écart mesuré entre la valeur conditionnelle d’intérêt x0 et le barycentre arithmétique x̄ de l’ensemble d’entraînement. Lorsque la prédiction s’effectue rigoureusement au niveau du barycentre empirique, c’est-à-dire quand x0 = x̄, le numérateur s’annule, minimisant ainsi l’erreur-type de la prédiction.
Au fur et à mesure que la valeur du prédicteur x0 s’éloigne du centre de gravité des données vers les extrémités de la distribution, le terme de distance euclidienne augmente de façon exponentielle par rapport au dénominateur (la somme des carrés des écarts). Cette configuration confère à l’intervalle de prédiction son profil graphique incurvé caractéristique, les bandes d’incertitude s’évasant symétriquement vers la périphérie. Ce phénomène correspond à ce que la littérature statistique nomme l’effet de levier ou sensibilité de point focal : une imprécision infime dans l’estimation de la pente β̂1 amplifie ses répercussions à proportion directe de la distance au centre des observations.
Cette réalité mathématique a des répercussions critiques sur la validité externe des modèles prédictifs. Dès l’instant où un chercheur tente d’opérer une prédiction au-delà des bornes empiriques minimales ou maximales observées dans l’échantillon initial (extrapolation statistique), la marge d’incertitude explose littéralement. Les bornes d’un intervalle de prédiction calculé en zone d’extrapolation deviennent si distendues qu’elles traduisent une indétermination quantitative quasi totale, signalant de manière irréfutable la non-fiabilité de telles démarches inductives.
2.3 Généralisation matricielle pour la régression linéaire multiple
Lorsque le modèle statistique s’élargit pour accueillir un vecteur de covariables de dimension p incluant l’ordonnée à l’origine, le formalisme scalaire devient insuffisant et requiert la syntaxe de l’algèbre linéaire. Le modèle général s’écrit sous forme compacte :
Y = X β + ε
où Y est un vecteur de dimension (n × 1), X est la matrice de dessein de dimension (n × p) de rang plein, β est le vecteur de coefficients de régression de dimension (p × 1), et ε représente le vecteur résiduel distribué selon une loi normale multivariée Nn(0, σ2 In), avec In la matrice identité d’ordre n. L’estimateur classique des moindres carrés s’établit à travers l’équation normale bien connue :
β̂ = (XT X)-1 XT Y
Désignons par x0 le vecteur ligne de dimensions (1 × p) contenant les valeurs numériques assignées à l’ensemble des régresseurs pour une nouvelle observation future, la première composante valant classiquement 1 pour interagir avec le biais β̂0. La prédiction ponctuelle scalaire est alors le produit matriciel ŷ0 = x0 β̂. En application des règles de transfert de covariance matricielle, la variance associée à cette prédiction scalaire s’exprime ainsi :
Var(ŷ0) = Var(x0 β̂) = x0 Cov(β̂) x0T = σ2 x0 (XT X)-1 x0T
L’expression h00 = x0 (XT X)-1 x0T correspond au levier statistique associé à ce nouveau profil d’observation, formalisant sa distance de Mahalanobis multidimensionnelle par rapport au barycentre de l’espace vectoriel des prédicteurs. En réincorporant la variance intrinsèque d’une nouvelle observation unitaire Var(Y0) = σ2, la variance globale d’erreur prédictive se condense sous la formulation matricielle canonique :
Var(epred) = σ2 ( 1 + x0 (XT X)-1 x0T )
Les bornes de l’intervalle de prédiction multivarié au seuil 1 – α sont calculées à l’aide de l’estimateur de l’écart-type résiduel s et des quantiles bilatéraux de la loi de Student ajustés aux degrés de liberté du modèle résiduel n – p :
ŷ0 ± t(1 – α/2, n – p) × s × √[ 1 + x0 (XT X)-1 x0T ]
Cette équation illustre comment la matrice d’information de Fisher inverse, (XT X)-1, véhicule l’intégralité des variances et covariances existant entre les différents régresseurs. Une colinéarité prononcée entre variables explicatives gonfle de façon spectaculaire les valeurs propres de cette matrice inverse, induisant une dégradation immédiate de la précision des prédictions individuelles lorsque le vecteur x0 s’écarte des alignements corrélatifs observés dans le jeu d’apprentissage.
3. Préparation de l’environnement de calcul et des données sous R
3.1 Configuration des bibliothèques R fondamentales
Pour mener à bien le calcul et la modélisation des intervalles de prédiction, il convient d’établir un environnement analytique rigoureux au sein de l’interpréteur R. Le socle computationnel de l’inférence linéaire repose sur le package interne nommé stats, nativement préchargé à chaque démarrage de session. Ce package contient l’infrastructure essentielle requise pour l’estimation par moindres carrés via lm() et les méthodes de diagnostic sous-jacentes. Cependant, pour répondre aux impératifs actuels de manipulation fonctionnelle, de transformation tabulaire et de rendu graphique vectoriel haute résolution, l’adjonction de l’écosystème tidyverse s’impose comme un standard méthodologique incontournable.
L’initialisation optimale d’une session de modélisation implique l’appel explicite de bibliothèques ciblées. Outre ggplot2 pour la sémiologie graphique, les extensions dplyr, tibble et tidyr facilitent l’alignement des structures matricielles issues des prédictions sur les jeux de données tabulaires d’origine. Pour les diagnostics inférentiels avancés, le chargement du package lmtest (permettant les contrôles formels d’hétéroscédasticité) et de boot (pour l’inférence non-paramétrique) garantit un arsenal analytique complet. Il est vivement recommandé d’exécuter l’instruction options(scipen = 999) afin de désactiver l’affichage des notations scientifiques au profit de valeurs décimales directement lisibles lors de la restitution des bornes d’intervalles.
La reproductibilité absolue du flux computationnel exige par ailleurs une gestion stricte des dépendances logicielles. L’utilisation d’outils tels que renv ou la consignation explicite de l’environnement matériel via sessionInfo() permet d’immortaliser les versions d’algorithmes mobilisées, évitant ainsi les divergences infinitésimales de calcul imputables aux révisions des bibliothèques de calcul numérique BLAS et LAPACK intégrées sous le moteur R.
3.2 Sélection et structuration des jeux de données d’apprentissage
Dans le cadre de cet exposé didactique, deux approches complémentaires de mise à disposition des données s’avèrent judicieuses : l’exploitation de jeux de données historiques validés et la synthèse contrôlée de données empiriques simulant des mesures de laboratoire en psychologie expérimentale. L’environnement R intègre nativement des jeux de données classiques tels que cars ou trees, couramment employés pour illustrer l’ajustement bivarié. Néanmoins, pour refléter la complexité des sciences comportementales, la génération programmatique d’un échantillon synthétique structuré offre un cadre pédagogique bien supérieur, permettant d’ancrer les concepts mathématiques dans une réalité clinique tangible.
Considérons la simulation d’une cohorte clinique mesurant l’effet d’une privation chronique de sommeil sur le niveau de réactivité anxieuse d’adultes jeunes. Avant toute analyse inductive, un contrôle d’intégrité formel s’impose pour valider les propriétés numériques du tableau de données généré. La confirmation de l’absence de données manquantes (notées NA sous R) est systématiquement vérifiée à l’aide des fonctions anyNA() ou sum(is.na()), évitant l’altération silencieuse des degrés de liberté du modèle lors des suppressions automatiques de lignes opérées par lm() via l’argument par défaut na.action = na.omit.
Les variables continues doivent être rigoureusement typées au format numérique à virgule flottante (double), tandis que les éventuelles variables de groupement ou facteurs catégoriels requièrent une conversion explicite via la fonction factor() ou as_factor(). L’architecture des données d’apprentissage doit préserver la cohérence des échelles : les variables psychométriques bornées (telles que les scores d’inventaires cliniques) nécessitent une surveillance attentive pour s’assurer que les modèles gaussiens ne prédisent pas des valeurs structurellement absurdes situées en dehors des limites physiques des instruments de mesure.
3.3 Partitionnement méthodologique des observations
Bien que la dérivation des intervalles de prédiction paramétriques repose sur une démarche d’inférence analytique conduite sur l’ensemble de l’échantillon calibré, l’évaluation de la pertinence empirique de ces intervalles (c’est-à-dire la vérification expérimentale de leur taux de couverture nominal) requiert un protocole de partitionnement strict des observations. Ce processus scinde le corpus de données disponible en deux ensembles disjoints : un ensemble d’apprentissage (ou jeu d’entraînement, comprenant généralement entre 70 % et 80 % de l’effectif) et un ensemble d’évaluation (ou jeu de test indépendant, regroupant le solde des observations non vues par l’algorithme).
L’implémentation de cette étape sous R nécessite la fixation impérative d’un générateur de nombres pseudo-aléatoires via la commande set.seed(). Le choix d’une graine d’initialisation arbitraire et invariable assure l’exacte reproductibilité du tirage probabiliste lors de la recompilation du script analytique. Le tirage peut s’effectuer à l’aide de la fonction native sample() sans remise, ou par l’intermédiaire de fonctions spécialisées issues de packages d’apprentissage automatique comme caret ou rsample garantissant un partitionnement stratifié préservant les distributions marginales.
Une fois la partition opérée, une analyse comparative de diagnostics descriptifs (moyennes, médianes, écarts-types, asymétries) doit être conduite sur les sous-échantillons d’apprentissage et de test. Cette vérification prévient les biais de sélection accidentels qui dénatureraient l’estimation de l’erreur résiduelle globale et fausseraient l’évaluation ultérieure du taux d’inclusion des futures observations au sein des bornes prédites.
4. Ajustement du modèle de régression linéaire sous R
4.1 Implémentation de l’ajustement linéaire via la fonction lm()
La formulation syntaxique de la régression linéaire sous R s’articule autour de l’instruction canonique lm(), acronyme de linear models. Cette fonction repose sur un opérateur symbolique standardisé liant la variable réponse (ou variable endogène) aux régresseurs (variables exogènes) au moyen du tilde (~). Dans le cas d’une relation univariée simple modélisant par exemple le score de détresse psychologique selon la dette de sommeil accumulée, l’appel s’écrit de façon épurée :
modele_reg <- lm(anxiete ~ sommeil_dette, data = donnees_train)
Ce formalisme abstrait déclenche en coulisse une résolution numérique sophistiquée reposant sur la décomposition QR de la matrice de dessein X. Cette approche algorithmique confère à R une stabilité arithmétique supérieure face aux risques de quasi-singularité matricielle, surpassant de loin l’inversion directe naïve de la matrice (XT X) par la méthode de Gauss-Jordan. L’objet résultant modele_reg appartient formellement à la classe S3 lm et encapsule l’intégralité des composantes structurales de la régression : les estimations ponctuelles des coefficients β̂, le vecteur des résidus observés, les valeurs ajustées (fitted values), le rang de la matrice ainsi que les degrés de liberté résiduels.
L’assignation explicite du modèle dans un objet nommé est une bonne pratique de programmation. Cet objet sert ultérieurement de pivot pour toutes les méthodes fonctionnelles spécialisées, notamment summary(), anova(), residuals(), fitted(), et au premier chef la fonction générique polymorphe predict(), garantissant une séparation nette entre l’étape d’optimisation paramétrique et les phases subséquentes d’inférence déductive.
4.2 Analyse rigoureuse du sommaire statistique du modèle
L’exploration des paramètres d’ajustement s’effectue au moyen de la méthode générique summary(modele_reg), qui génère un rapport synthétique complet des métriques d’ajustement. L’analyse critique de cette sortie commence par l’examen de l’erreur-type résiduelle de la régression, désignée sous l’étiquette Residual standard error (RSE). Cette valeur scalaire représente l’estimateur sans biais de l’écart-type non expliqué des perturbations, noté s, et constitue la composante fondamentale dans le dimensionnement direct de la largeur de l’intervalle de prédiction.
Le coefficient de détermination multiple, usuellement formalisé par R2, indique la proportion de variance de la réponse capturée par le faisceau de prédicteurs. Bien qu’un R2 élevé soit souvent recherché, il ne constitue nullement une garantie d’étroitesse pour l’intervalle de prédiction. En effet, dans des échantillons de grande dimension, un modèle peut afficher un R2 statistiquement hautement significatif tout en conservant une erreur résiduelle brute s substantielle, générant ainsi des intervalles de prédiction individuels d’une amplitude clinique trop large pour autoriser des prescriptions pratiques sans incertitude majeure.
La validation inférentielle se poursuit par l’évaluation du test omnibus F de Fisher-Snedecor, testant l’hypothèse nulle d’inutilité prédictive conjointe des paramètres exogènes, ainsi que par la lecture des statistiques t de Student et des p-valeurs associées à chaque coefficient individuel. La précision des bornes prédictives dépend étroitement de la significativité statistique de ces termes : des régresseurs non significatifs dégradent inutilement les degrés de liberté résiduels au dénominateur et élargissent artificiellement la valeur critique du quantile de Student intervenant dans le calcul des marges d’erreur.
4.3 Vérification des conditions préalables d’inférence
Avant d’engager toute exploitation prédictive des estimations produites par lm(), il est impératif d’évaluer la conformité des données aux postulats probabilistes de Gauss-Markov et de normalité des résidus. R propose un dispositif de contrôle visuel immédiat en invoquant la fonction graphique native plot(modele_reg), laquelle engendre de manière séquentielle un ensemble de quatre graphiques de diagnostic fondamentaux. Le premier tracé (résidus en fonction des valeurs ajustées) permet de statuer sur la stricte linéarité de l’espérance conditionnelle : une courbure apparente ou une tendance polynomiale des résidus signale immédiatement une erreur de spécification fonctionnelle nécessitant l’incorporation de termes non linéaires.
Le troisième tracé de diagnostic (graphique Scale-Location ou dispersion-localisation représentant la racine carrée des résidus standardisés en fonction des valeurs ajustées) a pour objectif d’identifier une éventuelle rupture d’homoscédasticité. Une structure résiduelle adoptant une morphologie d’entonnoir (expansion ou rétrécissement de la variabilité le long de l’axe des abscisses) trahit la dépendance de la variance de l’erreur vis-à-vis des niveaux du prédicteur, une distorsion qui invaliderait l’application uniforme d’un scalaire unique de variance s2 lors de la fabrication des intervalles de prédiction.
Enfin, le quatrième graphique met en scène la distance de Cook en regard du levier des observations (leverage). Les unités statistiques possédant simultanément un effet de levier disproportionné et des résidus standardisés de forte amplitude exercent une influence excessive sur la trajectoire de la droite d’ajustement. Ces points d’influence majeurs menacent directement la validité des prédictions extrapolées en biaisant les estimateurs de variance résiduelle et doivent faire l’objet d’un examen empirique et théorique approfondi avant d’entériner le calibrage du modèle prédictif.
5. Implémentation technique de la fonction predict() pour les intervalles de prédiction
5.1 Paramétrage fondamental de la fonction predict.lm
Dans l’écosystème fonctionnel de R, l’exécution des calculs d’intervalles probabilistes est déléguée à la méthode spécialisée predict.lm(), appelée implicitement lorsque la fonction polymorphe générique predict() est confrontée à un objet de type lm. Pour configurer l’extraction d’un intervalle de prédiction unitaire, le chercheur doit obligatoirement intervenir sur l’argument nommé interval en lui transmettant explicitement la chaîne de caractères littérale "prediction". L’omission de cet argument n’engendre par défaut que la restitution de l’estimation ponctuelle simple sous forme d’un vecteur numérique dense.
Un deuxième paramètre d’importance capitale réside dans l’argument level, assigné par convention par défaut à la valeur flottante 0.95, correspondant à un taux de couverture nominal de 95 % (soit une erreur de première espèce α = 0.05). Cette valeur peut être modulée de façon dynamique (par exemple level = 0.90 ou level = 0.99) en fonction du niveau d’exigence méthodologique imposé par le cadre d’évaluation. L’appel technique type se formalise ainsi :
intervalles_pred <- predict(modele_reg, newdata = nouvelles_observations, interval = "prediction", level = 0.95)
À l’issue de son exécution, la fonction retourne une structure matricielle bidimensionnelle standard à trois colonnes, rigoureusement nommées : fit, représentant la prédiction ponctuelle déterministe au point considéré ; lwr (pour lower), explicitant la borne inférieure de l’intervalle de prédiction calculée selon les équations de Student ; et upr (pour upper), fournissant la borne supérieure correspondante. Il est essentiel de souligner la dissemblance de syntaxe par rapport à l’obtention d’un intervalle de confiance sur la moyenne, où l’appelant transmettrait la valeur interval = "confidence", générant une matrice structurellement identique quant aux étiquettes de colonnes, mais mathématiquement et numériquement divergente en regard des amplitudes obtenues.
5.2 Préparation rigoureuse du dataframe de nouvelles observations
L’argument newdata de la méthode predict() exige une rigueur syntaxique et structurelle absolue sous peine de déclencher des alertes critiques ou des erreurs bloquantes. L’erreur la plus fréquente consiste à omettre cet argument : dans ce cas précis, R n’interrompt pas le calcul mais applique silencieusement l’algorithme d’intervalle à l’échantillon d’entraînement initial lui-même, ce qui ne répond en rien à la problématique de prédiction pour un nouvel individu cible.
Pour soumettre de nouveaux cas à l’évaluation, l’utilisateur doit instancier un objet de classe data.frame (ou tibble) dont les noms des colonnes doivent reproduire avec une stricte exactitude orthographique et typographique (sensibilité à la casse comprise) les intitulés des prédicteurs employés lors de l’appel originel à lm(). Supposons que nous souhaitions évaluer le profil d’un sujet clinique présentant une dette de sommeil aiguë de 12 heures, la structure se configure ainsi :
profil_patient <- data.frame(sommeil_dette = 12.0)
Dans l’éventualité où le modèle d’ajustement intégrerait plusieurs régresseurs continus et discrets, ce conteneur doit obligatoirement inclure toutes les variables explicatives sans exception. Le non-respect du typage d’origine (par exemple, assigner un vecteur de caractères à un facteur dont les modalités doivent concorder rigoureusement avec les niveaux établis dans les données d’entraînement) provoquera une rupture immédiate de l’évaluation matricielle lors de l’application des contrastes par le moteur R.
5.3 Extraction et intégration programmatique des bornes calculées
La matrice issue de l’exécution de predict.lm présente une nature d’objet vectoriel multidimensionnel qui, bien qu’efficace sur le plan arithmétique, s’intègre mal aux chaînes de traitement modernes du tidyverse sans une étape de conversion typologique préalable. Pour fusionner de manière cohérente les prédictions produites avec les caractéristiques descriptives des profils évalués, il est d’usage de convertir la matrice de sortie en un format tabulaire souple au moyen de la commande as_tibble() ou as.data.frame().
Cette transformation permet la concaténation horizontale directe des prédicteurs cibles et de leurs marges de prédiction via la fonction cbind() ou l’opérateur moderne bind_cols() :
tableau_synthese <- bind_cols(profil_patient, as_tibble(intervalles_pred))
Cette approche séquentielle garantit l’alignement strict des lignes, chaque individu évalué se voyant adjoindre ses valeurs fit, lwr et upr. Les colonnes ainsi extraites peuvent être immédiatement mobilisées pour la restitution textuelle conditionnelle, la publication automatisée de comptes rendus d’évaluation psychométrique ou l’injection dans des mécanismes logiques de tri visant à identifier les individus dont les bornes supérieures excèdent des seuils critiques définis par les recommandations cliniques.
6. Diagnostic approfondi des hypothèses distributionnelles des résidus
6.1 Validation de l’hypothèse de normalité univariée des résidus
Le calcul paramétrique des intervalles de prédiction via les lois de Student repose de manière intrinsèque sur l’hypothèse que les perturbations stochastiques ε sont issues d’un processus générateur gaussien univarié. Si l’estimateur des moindres carrés β̂ bénéficie du théorème central limite garantissant sa normalité asymptotique même en présence de déviations modérées dès lors que l’effectif est volumineux, cette propriété ne s’applique aucunement à la prédiction unitaire individuelle. L’observation future étant elle-même un tirage stochastique direct de la distribution des erreurs, la moindre anomalie dans la forme distributionnelle de ε affecte directement l’exactitude des bornes de prédiction.
Pour diagnostiquer rigoureusement cette propriété sous R, l’analyste procède à l’extraction des résidus standardisés ou studentisés via rstandard(modele_reg) et déploie simultanément des indicateurs graphiques et inférentiels. Le diagramme quantile-quantile (Q-Q plot) normal, enrichi de bandes de confiance à 95 % issues du package car au moyen de la fonction qqPlot(), permet d’inspecter l’alignement des quantiles empiriques sur les quantiles théoriques gaussiens :
Une divergence prononcée au niveau des extrémités du tracé révèle l’existence de queues de distribution lourdes (leptokurticité) ou d’une forte asymétrie. En complément de cette inspection visuelle, le test formel d’ajustement de Shapiro-Wilk s’exécute via la commande shapiro.test(residuals(modele_reg)). L’obtention d’une p-valeur inférieure au seuil de significativité conventionnel (généralement 0.05) commande le rejet de l’hypothèse nulle de normalité résiduelle, signalant que le taux de couverture effectif de l’intervalle paramétrique standard déviera potentiellement de son niveau nominal théorique de 95 %.
6.2 Évaluation de l’homoscédasticité de la variance d’erreur
L’homoscédasticité stipule que la variance conditionnelle des erreurs résiduelles demeure rigoureusement invariante sur l’ensemble du domaine de définition des prédicteurs, ce qui s’énonce formellement par Var(εi | Xi) = σ2 ∀ i. La violation de cette condition essentielle, appelée hétéroscédasticité, se traduit mathématiquement par le fait que l’incertitude stochastique réelle est fonction de l’intensité du prédicteur. Or, l’algorithme standard de predict.lm() emploie un scalaire unique, l’erreur-type résiduelle globale s, pour calculer l’intervalle sur l’ensemble du continuum de la variable explicative.
Pour éprouver formellement cette hypothèse sous R, l’analyste mobilise le test de Breusch-Pagan, disponible dans l’extension lmtest via l’instruction :
bptest(modele_reg)
Ce test repose sur la régression auxiliaire des carrés des résidus standardisés sur les prédicteurs du modèle. Si la statistique du multiplicateur de Lagrange affiche une p-valeur significative, l’hypothèse nulle de variance constante doit être écartée. Les conséquences sur l’intervalle de prédiction sont particulièrement perverses : les bornes calculées deviennent excessivement larges et conservatrices dans les zones où la dispersion réelle est faible, tout en s’avérant dangereusement étroites et sous-estimées dans les sous-espaces où la variance des erreurs réelles explose. La couverture nominale de 95 % est alors factice, masquant une asymétrie flagrante du risque d’erreur selon la position de l’observation future le long de l’axe factoriel.
6.3 Indépendance et absence d’autocorrélation résiduelle
Le troisième postulat fondamental conditionnant la légitimité des intervalles prédictifs réside dans l’absence totale de corrélation linéaire entre les résidus d’observations distinctes, soit Cov(εi, εj) = 0 ∀ i ≠ j. Dans les protocoles de recherche en psychologie clinique ou en sciences sociales, cette condition est fréquemment compromise par l’existence de dépendances hiérarchiques ou de corrélations sérielles consécutives à des mesures répétées dans le temps sur les mêmes sujets (séries temporelles) ou à des regroupements écologiques naturels (élèves nichés au sein de classes scolaires, patients traités au sein d’une même institution hospitalière).
L’évaluation de la dépendance sérielle du premier ordre s’opère par le test classique de Durbin-Watson, accessible au moyen de la fonction dwtest(modele_reg) issue du package lmtest. Une statistique de test s’écartant sensiblement de la valeur théorique de 2 (indiquant soit une autocorrélation positive proche de 0, soit une autocorrélation négative tendant vers 4) associée à une p-valeur statistiquement significative démontre que l’erreur commise sur une unité informe sur l’erreur commise sur la suivante.
En présence d’une structure de dépendance résiduelle, l’erreur-type résiduelle empirique s sous-estime lourdement la variabilité stochastique réelle du système par suite d’une redondance d’information. Les intervalles de prédiction déduits d’un modèle ignorant ces dépendances affichent une largeur artificielle restreinte, induisant des taux d’erreur de prédiction réels bien plus fréquents que le seuil théorique consenti de 5 %. Face à de telles configurations de données, l’abandon du modèle linéaire ordinaire au profit des modèles linéaires mixtes ou des modèles autorégressifs s’avère méthodologiquement indispensable.
7. Visualisation graphique avancée des intervalles de prédiction avec ggplot2
7.1 Génération d’une grille continue de valeurs pour lisser la courbe
La représentation cartographique de l’incertitude prédictive sur l’intégralité du domaine de définition du prédicteur nécessite la création d’un continuum dense de points artificiels, permettant d’interpoler la droite de régression et ses rubans probabilistes sans ruptures géométriques angulaires. Pour ce faire, nous exploitons la fonction vectorielle native seq() afin de subdiviser l’intervalle empirique couvert par la variable explicative en une maille fine composée de plusieurs centaines d’incréments réguliers :
grille_x <- seq(min(donnees$sommeil_dette), \max(donnees$sommeil_dette), length.out = 300)
nouveau_df <- data.frame(sommeil_dette = grille_x)
Une fois cette trame continue formalisée, nous procédons à deux évaluations prédictives successives au moyen de la fonction predict.lm(). La première sollicite l’intervalle de confiance via interval = "confidence", isolant l’incertitude sur la trajectoire moyenne de la population. La seconde génère l’intervalle de prédiction à l’aide de interval = "prediction", intégrant la variabilité individuelle unitaire. Les deux matrices résultantes sont alors renommées et assemblées au vecteur de la grille au sein d’une structure tabulaire unique optimisée pour la couche graphique.
Cette préparation rigoureuse des données est une condition indispensable pour manipuler des coordonnées eulériennes propres dans l’espace de coordonnées cartésiennes de R. En structurant un jeu de données dédié exclusivement au rendu graphique, nous garantissons que l’échantillon d’apprentissage d’origine ne subit aucune distorsion, tout en assurant une fluidité visuelle maximale aux géométries d’incertitude superposées.
7.2 Superposition géométrique des rubans d’incertitude dans ggplot2
La syntaxe déclarative en couches de ggplot2 offre une puissance inégalée pour rendre lisible la différence fondamentale entre les deux formes d’incertitude statistique. L’élément central de cette visualisation repose sur l’emploi conjoint de la géométrie geom_ribbon(), paramétrée par les ordonnées minimales ymin et maximales ymax issues de nos prédictions calculées.
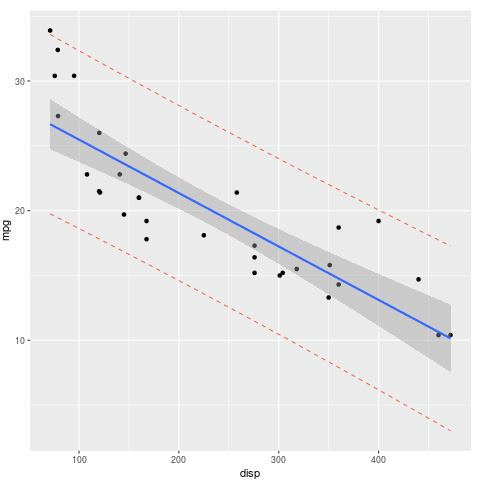
Pour assurer une sémiologie graphique irréprochable évitant l’occultation des surfaces superposées, le ruban de prédiction (le plus large) doit être injecté en premier dans l’arbre d’affichage, affecté d’une couleur d’accentuation douce et d’un indice de translucidité marqué (par exemple alpha = 0.2). Le ruban de confiance (le plus étroit) est positionné au-dessus, caractérisé par une teinte chromatique plus soutenue et un indice d’opacité modéré (alpha = 0.4). La séquence s’achève par le tracé de la droite de régression centrale au moyen de geom_line() et la projection des observations empiriques brutes via geom_point().
Cette hiérarchisation en couches successives confère au graphique une force démonstrative immédiate : l’observateur perçoit instantanément le ruban d’intervalle de confiance comme un fuseau centré sur la droite, tandis que le ruban d’intervalle de prédiction englobe la vaste majorité des points d’observation dispersés dans le plan, concrétisant ainsi visuellement la notion d’erreur résiduelle unitaire.
7.3 Personnalisation académique de l’esthétique du graphique
Les normes éditoriales des revues internationales à comité de lecture imposent un dépouillement graphique strict, bannissant les artefacts visuels superflus ou les fonds grisâtres inesthétiques. L’application d’un thème typographique minimaliste, tel que theme_classic() ou theme_bw(), pose les fondations d’un rendu professionnel conforme aux standards de l’American Psychological Association (APA).
Le paramétrage des axes requiert des étiquettes sémantiques précises mentionnant systématiquement les unités physiques ou psychométriques des mesures étudiées au moyen de la fonction labs(). Les axes cartésiens doivent être calibrés sans forcer de troncatures arbitraires qui risqueraient de masquer des points extrêmes situés aux frontières de l’intervalle de prédiction. Une échelle d’ordonnées bien dimensionnée permet d’apprécier si les bornes calculées demeurent dans des plages théoriquement viables ou si elles empiètent sur des zones numériques impossibles (telles que des scores d’anxiété négatifs sur une échelle strictement positive).
Enfin, l’adjonction d’une légende explicative rigoureuse ou d’une note de bas de figure (caption) renseigne l’audience scientifique sur les spécifications exactes de l’affichage : niveau nominal retenu (typiquement 95 %), taille de l’échantillon d’entraînement n, et désignation univoque des deux enveloppes d’incertitude. Le graphique ainsi finalisé constitue un support d’inférence visuelle robuste, combinant exactitude mathématique et élégance esthétique.
8. Calcul des intervalles de prédiction dans les modèles de régression multiple
8.1 Extension de la méthode à plusieurs covariables continues
La transition d’une régression univariée vers une régression linéaire multiple impliquant plusieurs prédicteurs continus élargit la dimension géométrique du problème : la simple droite d’ajustement cède la place à un hyperplan de régression traversant un espace vectoriel de dimension p. Dans ce cadre multivarié, le calcul de l’intervalle de prédiction au moyen de predict.lm() conserve exactement la même syntaxe programmatique, mais l’interprétation mathématique des bornes requiert une prudence méthodologique décuplée.
Lors de la formulation de nouveaux scénarios prédictifs dans newdata, l’analyste ne peut plus faire varier un seul prédicteur de manière isolée sans expliciter le statut assigné aux autres dimensions du modèle. La démarche conventionnelle consiste à fixer les covariables secondaires à des valeurs représentatives de la population cible, le plus souvent leurs moyennes arithmétiques ou leurs médianes empiriques respectives, tout en faisant varier systématiquement la variable d’intérêt clinique le long d’une grille continue.
Il est crucial de comprendre que la largeur de l’intervalle de prédiction multivarié dépend désormais de la distance de Mahalanobis séparant le profil complet x0 du centre de gravité multidimensionnel des covariables, formulée par x0 (XT X)-1 x0T. Deux observations peuvent présenter des valeurs strictement moyennes sur chaque dimension univariée prise isolément, tout en constituant une combinaison multidimensionnelle extrêmement atypique et marginale au sein de l’espace conjoint. L’intervalle de prédiction s’élargira alors massivement pour compenser l’instabilité de l’hyperplan dans cette région reculée de l’espace factoriel.
8.2 Prise en compte des prédicteurs catégoriels et des facteurs
L’intégration de variables explicatives qualitatives (par exemple, le groupe d’intervention thérapeutique : traitement expérimental versus placebo) introduit une discontinuité structurelle au sein de la modélisation sous R. Lors de l’évaluation par lm(), R procède à un recodage automatique du facteur sous forme de variables indicatrices muettes (dummy variables), en utilisant par défaut un codage par traitement dont le premier niveau alphabétique sert de modalité de référence.
Pour calculer les intervalles de prédiction stratifiés selon les différents bras cliniques, le jeu de données transmis à newdata doit impérativement reproduire les modalités textuelles exactes associées au facteur d’origine :
profils_stratifies <- expand.grid(sommeil_dette = c(4, 8, 12), groupe = c("Controle", "Therapie"))
predict(modele_mult, newdata = profils_stratifies, interval = "prediction")
Sur le plan géométrique, l’intervalle de prédiction conserve une trajectoire continue parallèle le long des valeurs du prédicteur continu, mais subit une translation discrète verticale selon le groupe clinique activé. Si la taille des effectifs diffère significativement entre les strates (plans d’expérience déséquilibrés), le terme d’effet de levier x0 (XT X)-1 x0T sera systématiquement plus élevé pour les modalités sous-représentées numériquement, conduisant à des intervalles de prédiction mécaniquement plus amples pour les patients appartenant aux groupes d’effectifs réduits.
8.3 Gestion des termes d’interaction et de non-linéarité
La modélisation de relations comportementales complexes exige fréquemment l’introduction d’effets modérateurs (termes d’interaction traduits par l’opérateur de produit croisé * ou : dans la formule R) ou de dynamiques curvilignes (polynômes orthogonaux ou puissances directes intégrées via la fonction d’inhibition syntaxique I(), par exemple I(sommeil_dette^2)). L’incorporation de ces termes enrichit la flexibilité descriptive du modèle sans altérer la nature linéaire de l’estimation des paramètres.
Lors de l’appel à predict.lm() avec un intervalle de prédiction sur un modèle incluant de telles non-linéarités, le moteur interne de R calcule automatiquement les transformations mathématiques appropriées sur les colonnes du jeu newdata, pour autant que la formule initiale ait été spécifiée au sein même de l’appel à lm(). Il convient de proscrire absolument la création manuelle préalable de colonnes de variables au carré dans le dataframe avant l’ajustement, car une telle démarche priverait predict() de la trace formelle des opérateurs fonctionnels unissant les variables fondamentales.
Dans un modèle quadratique, les bandes d’intervalle de prédiction épousent fidèlement la trajectoire parabolique ajustée, tout en manifestant une accélération prononcée de leur écartement aux marges. Les termes d’interaction croisés créent quant à eux des enveloppes d’incertitude asymétriques dont la largeur varie de façon non synchrone selon les valeurs conjointes adoptées par les deux prédicteurs en interaction, reflétant fidèlement la dépendance contextuelle de la variance de projection matricielle.
9. Alternatives méthodologiques en cas de violation des postulats classiques
9.1 Intervalles de prédiction par rééchantillonnage non-paramétrique (Bootstrap)
Lorsque les tests de diagnostic résiduel révèlent une violation rédhibitoire de l’hypothèse de normalité univariée (présence d’une forte asymétrie de distribution ou de queues anormalement épaisses), le recours aux quantiles de Student devient infondé et induit des distorsions majeures du taux de couverture réel. La méthodologie computationnelle du bootstrap non-paramétrique résiduel offre alors une alternative d’une remarquable élégance théorique pour concevoir des intervalles de prédiction robustes et affranchis de tout a priori distributionnel.
Le principe fondamental du bootstrap résiduel appliqué à la prédiction unitaire se déroule en plusieurs étapes séquentielles :
- Ajustement du modèle linéaire initial sur les données réelles et extraction du vecteur des résidus observés, préalablement centrés et ajustés par le levier pour éviter toute sous-estimation de leur dispersion.
- Génération d’un vaste ensemble de pseudo-échantillons d’apprentissage (typiquement B = 2000 itérations) par rééchantillonnage aléatoire avec remise au sein du réservoir empirique des résidus.
- Réestimation des coefficients du modèle sur chaque réplique bootstrap, permettant d’agréger la variance d’estimation des paramètres.
- Pour le profil clinique cible x0, calcul de la prédiction ponctuelle bootstrap à laquelle s’additionne un choc résiduel tiré lui aussi de manière aléatoire et indépendante dans le vecteur des résidus rééchantillonnés.
L’intervalle de prédiction bootstrap est ensuite déduit directement en extrayant les percentiles empiriques d’ordre α/2 et 1 – α/2 (respectivement les percentiles 2.5 % et 97.5 % pour un niveau de 95 %) de la distribution des B valeurs futures simulées. Cette approche permet de construire des intervalles asymétriques qui épousent organiquement l’asymétrie propre du phénomène étudié sans nécessiter d’hypothèse paramétrique rigide.
9.2 Transformations de puissance pour corriger la non-gaussicité
Une alternative classique de modélisation paramétrique face aux anomalies résiduelles consiste à modifier l’échelle de mesure de la variable réponse Y via une transformation de puissance continue. La famille des transformations de Box-Cox, disponible dans le package MASS à travers la fonction éponyme boxcox(), permet d’estimer par maximisation de la vraisemblance le paramètre d’optimisation optimal, désigné par λ. Lorsque λ = 0, la méthode équivaut à l’application du logarithme népérien ; lorsque λ = 0.5, elle correspond à la racine carrée.
L’ajustement linéaire s’exécute alors sur la variable dépendante ainsi stabilisée :
modele_trans <- lm(log(anxiete) ~ sommeil_dette, data = donnees)
L’appel à predict(modele_trans, newdata = profil, interval = "prediction") génère des bornes de prédiction rigoureusement valides, mais exprimées sur l’échelle transformée (logarithmique). L’opération déterminante réside dans la rétro-transformation mathématique obligatoire de ces bornes vers l’échelle d’observation métrique d’origine.
Puisque la transformation logarithmique est une fonction strictement monotone croissante, l’application de la fonction exponentielle inverse conserve l’ordre stochastique des quantiles distributionnels. Les bornes inférieure et supérieure finales s’obtiennent donc simplement en calculant exp(lwr) et exp(upr). En revanche, l’exponentiation de la valeur centrale fit produit l’estimation de la médiane conditionnelle et non celle de la moyenne arithmétique, un détail interprétatif fondamental que le statisticien doit expliciter en toute transparence dans ses restitutions cliniques.
9.3 Régression quantile pour l’estimation d’intervalles asymétriques
En présence d’hétéroscédasticité structurelle sévère où la forme même de la dispersion dépend des variables explicatives, les transformations globales globales échouent souvent à uniformiser la variance d’erreur. La régression quantile, conceptualisée par Koenker et Bassett et brillamment implémentée sous R par le package spécialisé quantreg, résout cette impasse méthodologique en modélisant directement n’importe quel percentile conditionnel sans postuler une loi normale sous-jacente.
Au lieu de minimiser la somme des carrés des erreurs résiduelles à l’instar des MCO, la régression quantile minimise des écarts absolus pondérés de manière asymétrique via l’instruction rq(). Pour délimiter un intervalle de prédiction empirique unitaire équivalent à un seuil nominal de 95 %, l’analyste calibre simultanément deux modèles quantiles distincts ciblant les probabilités cumulées τ = 0.025 et τ = 0.975 :
mod_q025 <- rq(anxiete ~ sommeil_dette, tau = 0.025, data = donnees)
mod_q975 <- rq(anxiete ~ sommeil_dette, tau = 0.975, data = donnees)
Les prédictions directes issues de ces deux modèles appliquées à un nouvel individu génèrent instantanément la borne inférieure et la borne supérieure de l’intervalle prédictif personnalisé. Cette architecture méthodologique s’affranchit totalement de toute contrainte de symétrie : si la variabilité des données s’amplifie fortement vers les valeurs élevées du prédicteur, la borne supérieure s’écartera de la médiane de façon bien plus marquée que la borne inférieure. Cette approche se révèle particulièrement féconde lors de l’étude de temps de réaction en chronométrie mentale ou de biomarqueurs immunitaires marqués par une dérive d’asymétrie positive prononcée.
10. Étude de cas pratique appliquée : modélisation de l’anxiété et du sommeil
10.1 Formulation de la question de recherche et exploration des données
Afin de concrétiser l’ensemble de la chaîne méthodologique, examinons une étude empirique fictive mais représentative, conduite auprès de 150 professionnels de santé soumis à un protocole de garde hospitalière prolongée. La problématique scientifique porte sur l’impact fonctionnel de la dette aiguë de sommeil hebdomadaire (quantifiée en heures cumulées de déficit par rapport aux besoins physiologiques individuels, mesurée objectivement par actimétrie) sur l’émergence d’une détresse anxieuse aiguë, évaluée sur l’inventaire standardisé STAI (State-Trait Anxiety Inventory, score variant de 20 à 80 points).
L’exploration initiale des données débute par le calcul des indicateurs descriptifs bivariés. La dette moyenne de sommeil dans cette cohorte s’établit à 6.4 heures (écart-type = 2.8), tandis que le score d’anxiété moyen s’élève à 42.1 points (écart-type = 9.5). L’estimation du coefficient de corrélation linéaire de Pearson révèle une association positive et hautement significative (r = 0.68, p < 0.001). L’inspection du nuage de points bivarié confirme visuellement la pertinence d’une hypothèse de relation linéaire sur l’intervalle d’observation s’étendant de 0 à 14 heures de déficit de sommeil.
L’objectif translationnel fixé à la modélisation statistique consiste à fournir un outil pronostique unitaire permettant de répondre à l’interrogation clinique suivante : lorsqu’un clinicien accueille un médecin ou un infirmier présentant une dette de sommeil aiguë extrême de 11.5 heures, quel est le score d’anxiété attendu, et surtout, dans quelle fourchette prédictive de sévérité psychométrique le score réel de cet individu spécifique a-t-il 95 % de chances de se manifester ?
10.2 Exécution séquentielle du script de modélisation et de prédiction
La mise en œuvre computationnelle commence par l’instanciation du modèle de régression linéaire sous R, suivie de la configuration du profil d’évaluation unitaire. Les instructions s’exécutent de manière séquentielle et sans ambiguïté :
modele_sommeil <- lm(anxiete ~ sommeil_dette, data = cohorte_soignants)
nouveau_soignant <- data.frame(sommeil_dette = 11.5)
resultat_prediction <- predict(modele_sommeil, newdata = nouveau_soignant, interval = "prediction", level = 0.95)
Le sommaire analytique du modèle affiche des estimations paramétriques claires : l’ordonnée à l’origine s’établit à β̂0 = 27.35 et le coefficient de pente s’élève à β̂1 = 2.30 (indiquant une majoration attendue de 2.3 points sur l’échelle d’anxiété pour chaque heure de privation de sommeil additionnelle). L’erreur-type résiduelle de la régression est estimée à s = 6.98 points avec 148 degrés de liberté. La matrice de sortie générée pour notre cas clinique cible retourne les grandeurs numériques suivantes :
fit = 53.80 | lwr = 39.85 | upr = 67.75
En parallèle, l’évaluation de l’intervalle de confiance sur l’espérance mathématique de la réponse pour ce même niveau de privation (interval = "confidence") livre pour sa part un intervalle sensiblement plus resserré : fit = 53.80 | lwr = 51.78 | upr = 55.82. Cet écart saisissant d’amplitude (un intervalle de prédiction d’une largeur de 27.9 points contre un intervalle de confiance s’étalant sur seulement 4.04 points) matérialise avec éclat le gouffre séparant l’incertitude sur la trajectoire moyenne de la cohorte de la prévisibilité d’un soignant particulier.
10.3 Interprétation translationnelle des résultats pour le praticien
L’analyse translationnelle de ces résultats interdit formellement au médecin du travail de délivrer un pronostic péremptoire basé uniquement sur la prédiction ponctuelle de 53.8 points. En effet, bien que le score moyen des individus cumulant 11.5 heures de dette de sommeil se situe dans une zone de détresse modérée (la moyenne de population étant bornée entre 51.8 et 55.8 points avec 95 % de certitude), la réalité clinique du sujet individuel se révèle éminemment hétérogène.
L’intervalle de prédiction indique que le score effectif de ce soignant spécifique peut légitimement osciller entre 39.8 points (ce qui équivaut à un niveau de régulation émotionnelle sub-clinique, le patient s’adaptant remarquablement au stress physiologique sans retentissement anxieux notable) et 67.8 points. Cette borne supérieure de 67.8 franchit très largement les seuils d’alerte psychiatrique standardisés (généralement fixés à 60 ou 65 points sur le STAI), signalant un risque réel et non négligeable de sidération anxieuse aiguë ou d’épuisement émotionnel imminent pouvant compromettre la sécurité des soins dispensés.
La transmission des résultats doit donc s’énoncer de façon probabiliste : « Pour ce profil d’épuisement de sommeil, l’état anxieux attendu se chiffre à 53.8 points, mais la variabilité individuelle incompressible implique un intervalle pronostique compris entre 39.8 et 67.8 points au seuil de 95 %. Un protocole de surveillance active s’impose en raison de la probabilité statistique substantielle que ce sujet bascule au-delà du seuil critique de décompensation clinique. »
11. Erreurs fréquentes, pièges conceptuels et mauvaises interprétations
11.1 Confusion persistante entre confiance moyenne et variabilité individuelle
L’écueil méthodologique le plus dommageable répertorié dans les applications biomédicales et comportementales demeure la substitution injustifiée de l’intervalle de confiance à l’intervalle de prédiction pour guider une prise en charge individuelle. L’illusion cognitive repose sur la méconnaissance des objets statistiques sous-jacents : le chercheur confond l’espérance conditionnelle E(Y | X), entité abstraite représentative d’un agrégat infini de sujets, avec la variable aléatoire unitaire Y0, sujette à son propre terme d’aléa stochastique.
Les conséquences d’une telle méprise peuvent être illustrées par une expérience de simulation de Monte Carlo sous R. Supposons la génération d’un million d’observations futures à partir des paramètres du modèle précédent. Si un praticien utilise l’intervalle de confiance (51.78 à 55.82) pour prédire l’inclusion de ces nouvelles observations individuelles, il constatera avec effarement que son taux de réussite empirique ne dépasse pas 23 %. Près de 77 % des nouveaux sujets franchissent les bornes de cet intervalle indûment restreint. À l’inverse, l’intervalle de prédiction (39.85 à 67.75) capture fidèlement 95 % des observations réelles générées par le processus stochastique.
Une telle défaillance de calibrage prédictif fausse radicalement l’évaluation du risque, induisant un sentiment illusoire de maîtrise statistique susceptible de masquer l’exposition d’un patient à des événements indésirables sévères situés dans les marges résiduelles de l’équation prédictive.
11.2 Extrapolation abusive au-delà des limites du support d’observation
Un deuxième piège majeur réside dans la tentation computationnelle d’alimenter la fonction predict() avec des valeurs d’évaluation situées en dehors du domaine de mesure historique des prédicteurs (extrapolation). Les moteurs logiciels comme R n’émettent aucun avertissement automatique lorsque des coordonnées extrêmes sont soumises dans newdata : l’algorithme se contente de prolonger mécaniquement l’hyperplan linéaire et d’évaluer la formule matricielle x0 (XT X)-1 x0T.
Outre l’élargissement hyperbolique phénoménal des bornes résultant du gonflement exponentiel du levier statistique, l’extrapolation repose sur un postulat ontologique indémontrable : la préservation absolue de la linéarité fonctionnelle dans des territoires empiriques non explorés. En biologie comme en psychologie, les réponses fonctionnelles subissent quasi universellement des phénomènes de saturation asymptotique, d’épuisement homéostatique ou de ruptures d’états (points de bascule) lorsqu’elles sont soumises à des contraintes extrêmes.
Pour immuniser les scripts d’analyse contre ce biais, il est fortement conseillé d’implémenter un mécanisme de test de nouveauté algorithmique avant l’appel prédictif. Ce filtre compare les coordonnées vectorielles de newdata aux valeurs d’enveloppe convexe (ou aux quantiles extrêmes univariés) de la matrice d’entraînement et déclenche une exception bloquante dès qu’une extrapolation est détectée, interdisant ainsi la délivrance de prédictions dénuées de toute assise empirique solide.
11.3 Négligence de la puissance statistique et des petits échantillons
L’estimation conjointe des coefficients β et de l’écart-type résiduel σ s’avère extrêmement sensible à la réduction de la taille d’échantillon n. Dans les protocoles cliniques restreints (par exemple lors de l’étude de pathologies neurodégénératives rares où n ne dépasse guère 15 à 20 sujets), l’utilisation des intervalles de prédiction paramétriques se heurte à une instabilité critique des quantiles de Student.
D’une part, la valeur critique t(1 – α/2, n – p) augmente de manière abrupte lorsque les degrés de liberté résiduels s’effondrent en deçà d’une quinzaine d’unités, dilatant mécaniquement la marge d’erreur calculée. D’autre part, et de manière bien plus pernicieuse, la variance d’échantillonnage de l’estimateur de l’écart-type résiduel s2, gouvernée par une loi du khi-deux à n – p degrés de liberté, devient particulièrement ample. Une sous-estimation accidentelle de s dans un petit échantillon débouche sur un intervalle de prédiction excessivement serré qui échouera lamentablement à garantir sa couverture nominale sur de futures observations indépendantes.
Des règles empiriques consolidées par la modélisation statistique recommandent de ne jamais exploiter d’intervalles de prédiction unitaire issus de modèles d’ajustement basés sur moins de 30 à 50 observations par prédicteur estimé. En deçà de ces effectifs seuils, l’incertitude sur l’estimation de la variance résiduelle compromet gravement la robustesse des frontières probabilistes produites.
12. Normes de restitution scientifique et reproductibilité académique
12.1 Formatage des résultats prédictifs selon les normes APA
La communication des modèles prédictifs dans les publications scientifiques internationales régies par le style APA (7e édition) exige une codification textuelle et typographique standardisée afin de lever toute ambiguïté sur la nature de l’inférence rapportée. Lors de la restitution des résultats au sein du corps du texte, l’intervalle de prédiction doit être désigné sans équivoque par son intitulé complet ou par son acronyme standardisé IP (ou PI en anglais pour Prediction Interval), en veillant à ne jamais employer l’acronyme IC (réservé exclusivement à l’intervalle de confiance).
La formulation académique canonique se structure comme suit :
« Le score ponctuel d’anxiété prédit pour un soignant présentant une dette de sommeil de 11.5 heures s’établit à 53.80 points, assorti d’un intervalle de prédiction à 95 % compris entre 39.85 et 67.75 points, IP 95 % [39.85, 67.75]. À titre comparatif, l’espérance mathématique de la réponse moyenne pour cette sous-population est bornée par un intervalle de confiance à 95 % substantiellement plus resserré, IC 95 % [51.78, 55.82]. »
Dans les tableaux de synthèse récapitulant les performances pronostiques, il est d’usage d’inclure des colonnes dédiées à l’erreur-type résiduelle de la régression (RSE) aux côtés des coefficients standardisés et non standardisés. Lorsque des figures graphiques intègrent simultanément les rubans de confiance et de prédiction, la légende descriptive doit expliciter formellement la signification mathématique de chaque zone texturée, spécifiant explicitement les degrés de liberté du modèle résiduel ayant guidé le calcul des quantiles de Student.
12.2 Structuration d’un script R documenté et entièrement reproductible
Pour répondre aux impératifs d’intégrité de la recherche et faciliter l’audit par les pairs, le pipeline analytique R dédié à la construction des intervalles de prédiction doit être encapsulé au sein d’une architecture modulaire et reproductible. La première étape consiste à sceller les dépendances d’exécution à l’aide d’un gestionnaire d’environnement comme renv, consignant dans un fichier de verrouillage (lockfile) les versions exactes de R et des packages mobilisés.
Le code R doit s’organiser de manière logique et séquentielle au moyen de fonctions dédiées évitant les répétitions redondantes. Une fonction personnalisée typique centralise le calcul, l’extraction et l’annotation sémantique des bornes :
calculer_ip <- function(modele, newdata, alpha = 0.05) {

  pred <- predict(modele, newdata = newdata, interval = "prediction", level = 1 - alpha)

  res <- bind_cols(newdata, as_tibble(pred))

  return(res)

}
L’annotation exhaustive de chaque bloc algorithmique à l’aide de commentaires clairs permet de tracer fidèlement chaque opération mathématique : justifications des transformations fonctionnelles, résultats des tests de diagnostic résiduel, et paramètres de calibrage des graines pseudo-aléatoires. Ce niveau de rigueur formelle permet à n’importe quel chercheur indépendant de réexécuter l’intégralité du pipeline d’analyse et d’obtenir des résultats rigoureusement conformes aux métriques publiées.
12.3 Perspectives avancées : intégration dans des architectures prédictives modernes
L’intervalle de prédiction classique par moindres carrés constitue la fondation conceptuelle d’un champ méthodologique en pleine mutation. Dans le cadre de données à haute dimensionnalité où le nombre de covariables surpasse l’effectif des observations (problématique p > n courante en génomique comportementale ou en neuroimagerie fonctionnelle), les méthodes de pénalisation régularisée Ridge et Lasso supplantent l’ajustement ordinaire. Toutefois, l’obtention d’intervalles de prédiction post-sélection de variables requiert l’adjonction de protocoles de rééchantillonnage de type split-conformal prediction, garantissant une couverture non paramétrique exacte à échantillon fini sans hypothèse d’homoscédasticité.
Une autre trajectoire d’évolution réside dans le déploiement des Modèles Additifs Généralisés (GAM), implémentés sous R via l’extension mgcv. Les GAM remplacent les termes linéaires stricts par des fonctions de lissage spline non paramétriques, permettant aux bandes d’intervalle de prédiction d’épouser des cinétiques biologiques hautement complexes tout en préservant le contrôle rigoureux des degrés de liberté effectifs pénalisés.
Enfin, le paradigme de l’inférence bayésienne propose une réconciliation conceptuelle totale de l’incertitude à travers la notion d’intervalle de crédibilité prédictif a posteriori. En utilisant des moteurs computationnels bayésiens intégrés sous R comme brms ou rstanarm, la distribution prédictive postérieure intègre organiquement et simultanément l’incertitude sur la loi a priori des paramètres, l’erreur d’échantillonnage globale et la stochasticité unitaire résiduelle. Cette approche bayésienne s’affranchit de l’interprétation asymptotique fréquentiste classique, fournissant au chercheur une distribution de probabilité complète sur la réalisation future d’un individu singulier.
Références
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Koenker, R. (2005). Quantile regression. Cambridge University Press. https://doi.org/10.1017/CBO9780511754098
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279