
Dans le domaine des sciences psychologiques, du comportement et des neurosciences cognitives, l’analyse descriptive constitue la pierre angulaire de toute entreprise empirique rigoureuse. Avant de soumettre des scores comportementaux, des temps de réaction ou des indices psychométriques à des modélisations inférentielles complexes — telles que les équations structurelles, les analyses de variance multivariées ou les modèles mixtes linéaires —, le chercheur est impérativement tenu de sonder la morphologie intrinsèque de ses distributions. La transformation d’un ensemble hétérogène d’observations empiriques en une structure intelligible requiert des outils d’exploration visuelle capables de synthétiser la tendance centrale, la variabilité, mais également les déviations par rapport aux postulats théoriques classiques.
Si l’histogramme classique en fréquences absolues demeure un réflexe analytique quasi universel, il présente des limitations méthodologiques majeures dès lors qu’il s’agit de comparer des cohortes d’effectifs divergents ou d’interpréter des données à l’aune de lois de probabilité théoriques. C’est précisément à cette croisée des chemins méthodologiques qu’intervient l’histogramme de fréquence relative. En substituant aux décomptes bruts une métrique standardisée proportionnelle à l’échantillon global, cette représentation graphique s’impose comme un instrument fondamental pour évaluer la répartition probabiliste des construits psychologiques et garantir l’équité des comparaisons intergroupes.
L’environnement de calcul statistique The R Project for Statistical Computing offre un écosystème d’une flexibilité incomparable pour concevoir, affiner et automatiser de telles visualisations. Parmi les différentes approches coexistant au sein du logiciel, le moteur graphique lattice, développé par Deepayan Sarkar et reposant sur les principes fondateurs des graphiques Trellis conçus par William S. Cleveland, se distingue par son élégance formelle et sa puissance algorithmique native pour traiter les fréquences relatives. Ce guide encyclopédique se propose d’explorer de manière exhaustive la théorie, l’implémentation algorithmique sous R et la mise en conformité académique de l’histogramme de fréquence relative, fournissant aux chercheurs un cadre méthodologique robuste pour hisser la qualité de leurs publications scientifiques.
1. Fondements théoriques de l’histogramme de fréquence relative en psychologie
1.1 Distinction conceptuelle entre fréquences absolues et fréquences relatives
La distinction entre fréquences absolues et fréquences relatives relève d’une dichotomie fondamentale en métrologie comportementale et en statistique descriptive. La fréquence absolue, communément désignée sous le vocable d’effectif brut ($n_i$), quantifie le nombre d’observations individuelles tombant strictement dans les bornes d’un intervalle de classe prédéterminé ($C_i$). Si cette mesure possède l’avantage intuitif de rendre compte directement de la matérialité empirique de l’échantillon recueilli, elle présente une dépendance intrinsèque et indésirable vis-à-vis de la taille totale de cet échantillon ($N$). Ainsi, observer 45 individus manifestant un niveau d’anxiété clinique élevé au sein d’une cohorte de 50 patients traduit une prévalence alarmante de 90 %, alors que ce même effectif brut de 45 cas rapporté à une population expérimentale de 500 individus ne reflète qu’une fraction marginale de 9 %. La comparaison directe d’effectifs bruts est par conséquent méthodologiquement caduque dès lors que les groupes observés ne présentent pas une parité numérique absolue.
À l’inverse, la fréquence relative, notée classiquement $f_i$, s’obtient par l’opération de normalisation mathématique élémentaire consistant à diviser l’effectif de la classe considérée par l’effectif global de l’échantillon : $f_i = \frac{n_i}{N}$. Cette grandeur scalaire, comprise structurellement dans l’intervalle fermé $[0, 1]$, peut être convertie en pourcentage par une simple multiplication par 100 ($p_i = f_i \times 100$). En affranchissant l’observateur de la contingence de la taille d’échantillon, la fréquence relative confère à chaque classe une pondération universelle, autorisant une comparaison intergroupe rigoureuse, par exemple entre un groupe témoin composé de plusieurs centaines de sujets sains et un groupe clinique rare restreint à quelques dizaines de patients.
Sur le plan épistémologique, l’adoption de la fréquence relative autorise une transition conceptuelle majeure : le passage d’une description purement comptable des données à une interprétation probabiliste. En vertu de la loi faible des grands nombres, la fréquence relative observée d’un événement psychologique converge asymptotiquement vers sa probabilité théorique sous-jacente au fur et à mesure que l’échantillon s’accroît. Dans le cadre de l’évaluation psychométrique et de l’élaboration d’échelles de mesure, ce saut paradigmatique est indispensable pour cartographier des profils normatifs au sein des populations de référence. L’histogramme de fréquence relative devient dès lors le support d’une fonction de masse empirique, permettant aux chercheurs en sciences cognitives d’estimer avec une précision standardisée la vraisemblance qu’un individu manifeste un score psychométrique situé dans une zone d’intérêt clinique donnée.
1.2 Rôle de la visualisation de distribution en recherche quantitative
Dans la conduite des analyses quantitatives, l’examen visuel minutieux des distributions empiriques précède impérativement toute phase d’inférence statistique. L’histogramme de fréquence relative joue à cet égard le rôle d’un outil de diagnostic exploratoire multifactoriel. L’un de ses premiers mérites réside dans l’estimation visuelle immédiate des moments d’ordre supérieur de la distribution, à savoir le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Dans le champ de la psychométrie différentielle, l’asymétrie renseigne sur la capacité discriminative de l’instrument de mesure : une distribution étirée vers la droite (asymétrie positive) trahit fréquemment une tâche trop ardue où la majorité des participants s’agglutinent sur des scores faibles, tandis qu’une asymétrie négative traduit une épreuve excessivement accessible où les performances culminent vers le haut du spectre.
Cette observation visuelle est indissociable de la détection systématique des effets de plancher (floor effects) et des effets de plafond (ceiling effects). Ces artefacts méthodologiques compromettent sévèrement la validité interne des recherches cognitives en saturant arbitrairement l’échelle de mesure à ses bornes extrêmes. L’histogramme de fréquence relative met ces phénomènes en relief de manière saisissante, en révélant une accumulation disproportionnée de pourcentages sur la classe initiale ou finale. L’identification de telles distorsions alerte le statisticien sur la nécessité de recourir à des transformations mathématiques correctrices (logarithmiques, inverses ou de Box-Cox) ou d’opter pour des modèles non paramétriques plus tolérants face aux non-linéarités extrêmes.
Au-delà de ces anomalies morphologiques, la visualisation sous forme de fréquence relative constitue l’examen préalable indispensable à la vérification des hypothèses de normalité imposées par les tests paramétriques d’usage courant, tels que le test $t$ de Student ou l’analyse de variance (ANOVA). Bien que des tests d’adéquation formels existent (comme le test de Shapiro-Wilk ou de Kolmogorov-Smirnov), ces derniers souffrent paradoxalement d’une hypersensibilité dans les grands échantillons — rejetant la normalité pour des déviations négligeables — et d’un manque de puissance flagrant dans les petits effectifs. L’œil exercé du chercheur, guidé par un histogramme de fréquence relative, demeure l’arbitre le plus fiable pour juger de la normalité pratique d’un construit. Enfin, cet outil se révèle irremplaçable pour déceler l’hétérogénéité sous-jacente au sein de populations cliniques réputées homogènes, matérialisée graphiquement par des configurations bimodales ou multimodales qui suggèrent l’existence de sous-types pathologiques discrets au sein d’une même catégorie diagnostique.
2. Configuration de l’environnement de travail sous R et préparation des données
2.1 Installation et chargement de l’écosystème lattice
L’écosystème logiciel R dispose de multiples paradigmes graphiques reposant sur des architectures distinctes. À côté du moteur graphique historique (souvent qualifié de graphics de base) et de la grammaire des graphiques incarnée par le système ggplot2, la bibliothèque lattice occupe une place singulière et respectée dans la communauté statistique internationale. Développée par Deepayan Sarkar, lattice transpose dans le langage R les préceptes de la méthode Trellis, conçue originellement aux Bell Laboratories par William S. Cleveland et ses collaborateurs. La philosophie directrice de Trellis repose sur l’exploitation systématique du conditionnement graphique, permettant d’isoler et d’ordonner visuellement des relations multivariées complexes à travers des panneaux juxtaposés partageant des échelles strictement calibrées.
Pour exploiter la richesse fonctionnelle de cette bibliothèque au sein d’un script ou d’un bloc-notes RStudio, il est indispensable de procéder à son installation formelle, bien que celle-ci fasse désormais partie des paquets recommandés distribués par défaut avec le cœur de R. La commande canonique d’installation s’exécute ainsi au sein de la console : install.packages("lattice"). Une fois cette étape accomplie, le chargement en mémoire de l’espace de noms du paquet s’opère via la fonction standard : library(lattice). Contrairement aux moteurs graphiques basés sur le flux d’instructions séquentielles impératives (comme les fonctions plot() ou hist() du système de base), lattice génère des objets graphiques de classe trellis. Ces objets encapsulent l’ensemble des métadonnées de la visualisation sous forme de structures de listes complexes qui ne sont restituées sur le périphérique graphique actif que lors de leur évaluation implicite ou explicite via la méthode print().
L’optimisation de la session de travail sous RStudio gagne à être complétée par la configuration préalable des paramètres graphiques globaux. Contrairement aux visualisations standards qui nécessitent souvent des manipulations d’angles ou de marges par le truchement de la fonction par(), le système Trellis isole ses paramètres au sein de son propre dictionnaire de configuration. L’utilisateur averti veillera à vérifier la compatibilité de sa version de R avec les dernières itérations de la bibliothèque lattice, tout en s’assurant que le périphérique de rendu vectoriel par défaut de l’environnement est configuré pour générer un anticrénelage optimal lors des phases de prévisualisation interactive.
2.2 Structuration et nettoyage d’un vecteur de données psychométriques
Avant d’aborder la mécanique graphique proprement dite, il est impératif de concevoir un jeu de données expérimental possédant une cohérence écologique avec la réalité empirique des laboratoires de psychologie cognitive. Imaginons un protocole d’évaluation des fonctions exécutives au sein duquel des participants sont soumis à une épreuve de flexibilité cognitive informatisée. La variable d’intérêt retenue ici correspond à un score composite de précision cognitive standardisé, oscillant théoriquement entre des valeurs basses traduisant une rigidité exécutive et des valeurs élevées reflétant une allocation efficiente des ressources attentionnelles. En pratique, la collecte de ces données s’effectue sous la forme d’un vecteur numérique qui nécessite des opérations rigoureuses de validation structurale.
Dans un contexte d’analyse statistique conforme aux exigences de reproductibilité, les données brutes doivent être encapsulées dans un cadre de données (data.frame) ou assignées à un vecteur numérique isolé. Un enjeu analytique immédiat réside dans le traitement sans concession des valeurs manquantes, désignées sous la nomenclature NA (Not Available) dans l’écosystème R. La présence inopinée de données manquantes, causée par l’abandon d’un sujet, un bogue matériel du tachistoscope ou une omission lors de la passation de l’inventaire psychologique, peut induire des biais sévères si l’algorithme graphique tente de forcer une coercition de type. L’utilisation des fonctions natives de diagnostic structural, telles que str() et summary(), s’avère indispensable pour inspecter la nature scalaire de la variable d’étude :
L’exécution de l’instruction str(scores_cognitifs) permet d’attester que la structure sous-jacente est rigoureusement typée en tant que num (vecteur numérique à virgule flottante) ou int (vecteur d’entiers), excluant formellement la contamination par des chaînes de caractères (chr) qui inhiberait le calcul des classes statistiques. Concomitamment, la fonction summary() délivre les statistiques cardinales de la série : la valeur minimale, le premier quartile, la médiane, la moyenne arithmétique, le troisième quartile, la valeur maximale, ainsi que le dénombrement précis des éventuelles valeurs manquantes. Dans le cadre de l’intégration au sein d’une structure de données rectangulaire associant des métadonnées contextuelles (telles que le sexe biologique, la tranche d’âge ou le groupe de traitement), la création d’un tableau à deux dimensions via data.frame() formalise les relations entre variables et prépare l’application optimale de la syntaxe par formule typique de lattice.
3. Syntaxe fondamentale et fonctionnement de la fonction histogram()
3.1 Anatomie de la commande canonique histogram()
La fonction histogram() au sein de la bibliothèque lattice se singularise par son architecture syntaxique articulée autour du concept d’interface par formule (formula interface). Empruntée à la modélisation statistique standard popularisée par la fonction lm(), cette notation symbolique confère au code R une expressivité sémantique remarquable. La forme canonique de l’instruction univariée s’énonce selon le schéma : histogram(~ x, data = mon_dataframe). Dans cette expression, l’opérateur tilde (~) doit être appréhendé comme une déclaration de modélisation unilatérale : la variable cible x, positionnée à droite du tilde en lieu et place habituel des prédicteurs, est définie comme l’unique dimension de projection spatiale autonome, tandis que l’axe des ordonnées est implicitement dévolu à la métrique de fréquence calculée par le moteur sous-jacent.
Néanmoins, la fonction fait preuve d’une grande souplesse opératoire en autorisant également la spécification directe d’un vecteur numérique sans transiter obligatoirement par un cadre de données. L’instruction peut ainsi être formulée sous la forme synthétique histogram(scores_cognitifs). Dans cette configuration, l’algorithme interne de lattice procède immédiatement à l’inspection du vecteur fourni, détermine son étendue dynamique en extrayant le minimum et le maximum, et applique une routine d’optimisation numérique pour segmenter l’espace en une série de classes continues mutuellement exclusives et exhaustivement jointes.
L’un des attributs fondamentaux de la fonction histogram() réside dans son argument type, qui oriente directement la logique de transformation mathématique appliquée aux décomptes bruts. Contrairement aux approches basiques qui nécessitent de recalculer manuellement les distributions avant de les injecter dans une fonction de traçage de diagrammes en barres, histogram() procède à la discrétisation et à la normalisation de manière totalement intégrée. L’algorithme calcule la largeur de classe ($\Delta x$), dénombre les occurrences empiriques tombant à l’intérieur de chaque frontière d’intervalle — en respectant par défaut la convention d’intervalles semi-ouverts à gauche et fermés à droite ou inversement, selon la configuration du paramètre right —, puis applique la fonction de transfert spécifiée par l’utilisateur pour alimenter l’axe vertical.
3.2 Analyse comparative des options de l’argument type
Le comportement de l’ordonnée au sein de la fonction histogram() est rigoureusement piloté par l’argument scalaire de type chaîne de caractères type. Cette variable de contrôle accepte trois modalités mutuellement exclusives : "percent", "count" et "density". Le choix réfléchi de l’une de ces modalités engage la signification théorique de la visualisation et détermine son adéquation avec les finalités de la recherche et les standards éditoriaux de l’American Psychological Association (APA).
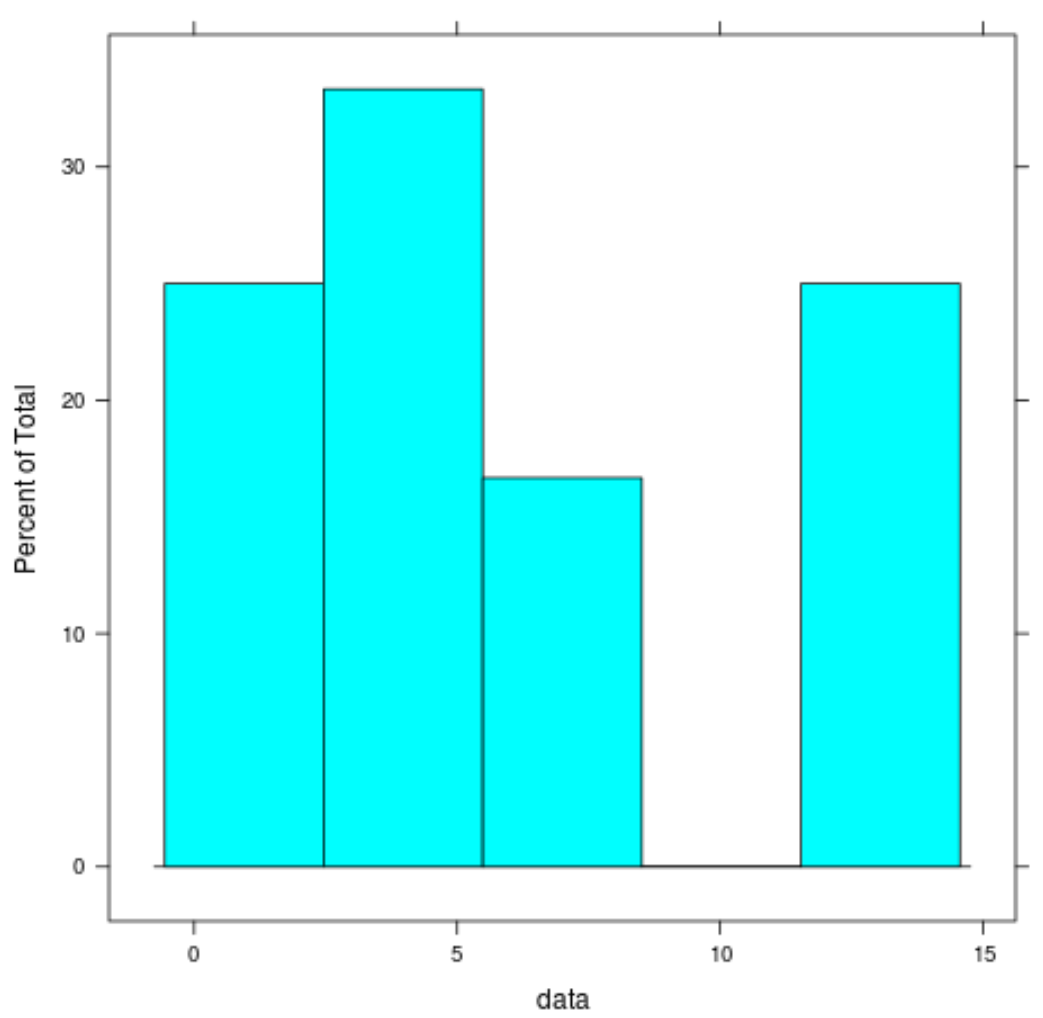
L’option par défaut de histogram() dans la bibliothèque lattice est précisément l’argument type = "percent". Dans cette configuration, la hauteur de chaque rectangle est strictement proportionnelle au pourcentage d’observations issues de l’échantillon global que renferme la classe correspondante. La somme arithmétique de la hauteur de l’intégralité des barres composant l’histogramme converge donc rigoureusement vers 100 %, à condition que la granularité des arrondis numériques ne génère pas d’infimes distorsions résiduelles. Cette modalité représente la quintessence de la fréquence relative appliquée aux sciences humaines : elle est immédiatement intelligible par les cliniciens, intuitive pour les évaluateurs profanes, et garantit une clarté absolue quant à la part relative de chaque segment comportemental dans l’échantillon global.
À l’opposé, la modalité type = "count" opère une régression méthodologique vers l’histogramme d’effectifs bruts. La hauteur des barres reflète alors le dénombrement direct des sujets ($n_i$). Si ce choix graphique peut se justifier dans le cadre d’un rapport d’étape préliminaire visant à vérifier la puissance brute collectée, il demeure proscrit dès lors qu’une confrontation intergroupe ou une comparaison avec une loi continue est requise. Enfin, la modalité type = "density" active une normalisation mathématique plus avancée : les hauteurs de barres sont alors ajustées de telle sorte que l’aire cumulée sous l’histogramme soit exactement égale à l’unité ($1.0$). L’axe vertical n’exprime alors plus un pourcentage direct, mais une unité de densité de probabilité ($p_i / \Delta x$). Bien que cette dernière modalité soit impérative pour projeter des courbes d’ajustement théorique (gaussiennes ou non paramétriques), l’option "percent" demeure l’étalon d’or préconisé par les normes APA pour la communication des proportions d’échantillon au sein des publications empiriques.
4. Génération de l’histogramme de fréquence relative par défaut
4.1 Implémentation du code de base et restitution graphique
Pour matérialiser l’exécution fondamentale de l’histogramme de fréquence relative, nous allons générer une séquence synthétique d’observations simulant les performances d’un groupe d’étudiants à une épreuve de raisonnement logique abstrait. Considérons un vecteur numérique constitué de scores discrets compris entre 10 et 50. Dans le cadre d’une session de programmation sous R, le script s’amorce par l’initialisation explicite du vecteur, suivi de l’invocation élémentaire de la fonction de la bibliothèque lattice :
À l’exécution de cette commande d’une remarquable concision, lattice prend en charge l’intégralité du processus de calcul et d’agencement visuel. Contrairement à la fonction basique hist() de l’écosystème natif de R qui exigerait des recalculs de proportions complexes pour afficher des pourcentages, la commande histogram(scores) génère instantanément un graphique où l’axe vertical affiche sans ambiguïté des valeurs en pourcentages. L’observateur attentif remarque immédiatement l’élégance de la signature visuelle Trellis : un encadrement rectangulaire net, un arrière-plan dépouillé pourvu par défaut d’une trame discrète, et des barres d’histogramme colorées dans une teinte cyan standard caractéristique.
La lecture critique de l’axe vertical confirme l’opérationnalisation du paramètre de fréquence relative. Les graduations ne renvoient nullement aux effectifs bruts (qui s’élèvent ici à quelques unités par observation), mais bien à la proportion mathématique de l’échantillon total représentée par chaque classe. Ainsi, une graduation pointant à 15 indique que 15 % de l’effectif expérimental est encapsulé dans l’intervalle de scores défini sur l’axe horizontal. Cette mise en page brute, bien qu’opérationnelle pour une phase de défrichage exploratoire rapide, requiert toutefois une inspection diagnostique approfondie avant d’être jugée apte à la communication scientifique formelle.
4.2 Interprétation statistique du graphique obtenu
Le graphique obtenu sans paramétrage additionnel permet d’extraire des inférences statistiques substantielles sur la structure du construit psychométrique sous-jacent. L’examen visuel conduit immédiatement à l’identification de la classe modale, c’est-à-dire l’intervalle délimité sur l’abscisse qui arbore la barre la plus élevée de la distribution. Cette classe modale condense la plus forte densité d’occurrences relatives et constitue un indicateur visuel robuste du point d’ancrage empirique de la tendance centrale, particulièrement utile lorsque la moyenne arithmétique est suspectée d’être biaisée par des valeurs extrêmes.
Une vérification formelle de la cohérence interne du graphique impose de s’assurer mentalement ou algorithmiquement que la somme cumulée des hauteurs de l’ensemble des rectangles observés égale très exactement 100 %. Cette propriété de conservation de la masse statistique totale garantit qu’aucune valeur empirique n’a été arbitrairement exclue par un découpage inadéquat des bornes extrêmes. Si des discontinuités ou des espaces vides apparaissent entre certaines barres au sein de l’histogramme, ces « trous » distributionnels ne doivent pas être négligés : dans une étude comportementale, ils traduisent l’absence totale d’individus présentant ce niveau intermédiaire de compétence ou de symptôme, ce qui peut pointer vers une instabilité de la tâche ou vers une polarisation de la réponse chez les sujets testés.
Il convient néanmoins de faire preuve d’une prudence méthodologique rigoureuse face aux artefacts visuels induits par le partitionnement automatique de lattice. Par défaut, l’algorithme sous-jacent cherche à déterminer un compromis esthétique entre la lisibilité des axes et la régularité des graduations, ce qui peut conduire à un nombre de classes soit trop restreint, gommant ainsi des bimodalités subtiles de l’échantillon, soit excessivement morcelé, instillant un bruit d’échantillonnage dénué de pertinence théorique. Ce constat souligne l’impérieuse nécessité pour le chercheur de dépasser la génération automatisée par défaut afin de maîtriser personnellement les leviers de personnalisation sémantique et algorithmique de l’outil.
5. Personnalisation sémantique : titres, étiquettes et axes
5.1 Édition du titre principal et des axes orthonormés
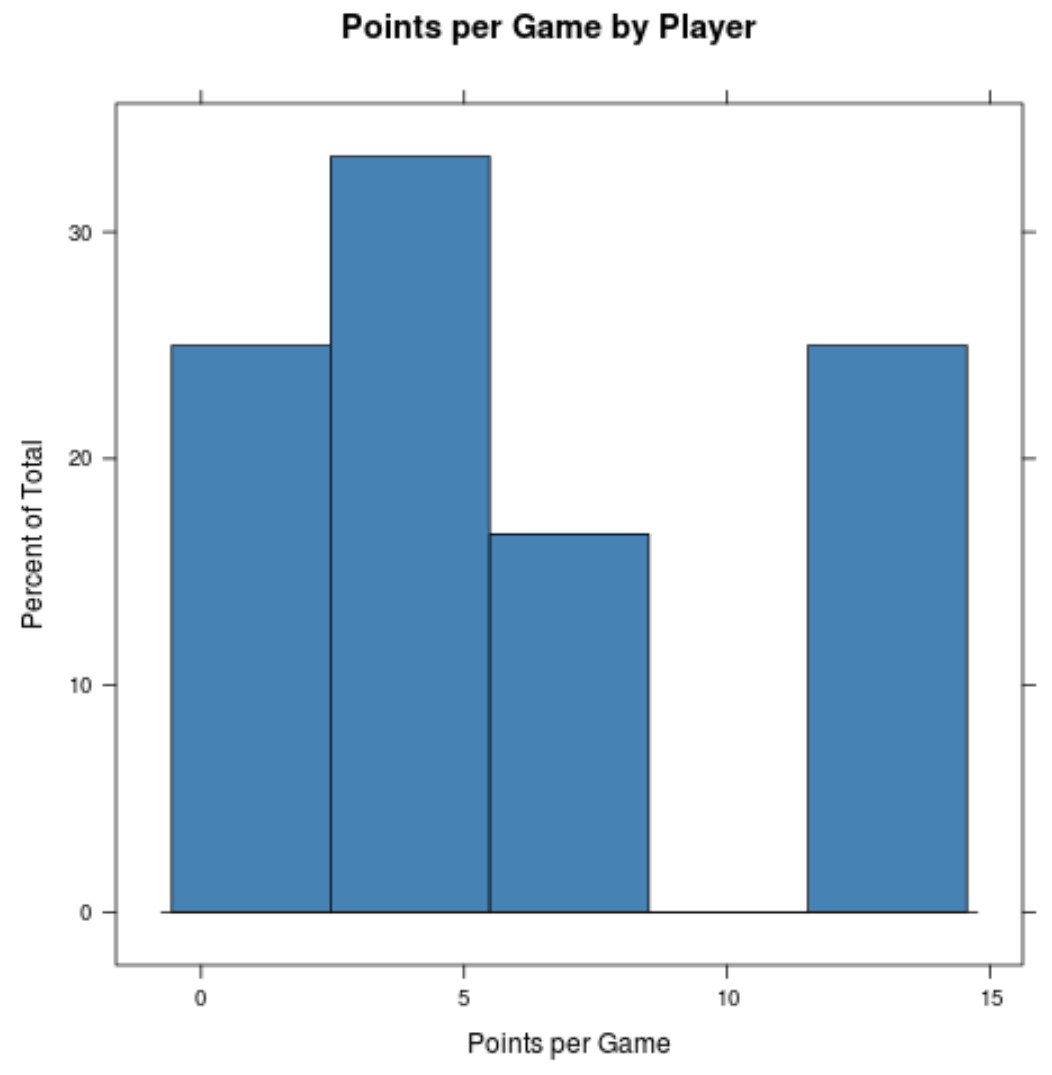
Dans la communication scientifique de haut niveau, un graphique statistique ne saurait être considéré comme achevé sans une contextualisation sémantique irréprochable. L’hermétisme d’un axe étiqueté par le simple nom de variable issu du script R (comme x ou scores) constitue une infraction directe aux principes de clarté de la recherche quantitative. L’insertion d’un titre scientifique explicatif et le libellé rigoureux des dimensions spatiales s’opèrent par l’entremise des arguments dédiés main, xlab et ylab au sein de l’instruction histogram().
L’argument main reçoit une chaîne de caractères définissant le titre principal du graphique. Celui-ci doit synthétiser sans équivoque le phénomène étudié, la nature de l’échantillon et la variable dépendante mesurée. L’argument xlab (abréviation de x-label) permet de qualifier avec précision la variable psychologique projetée sur l’axe des abscisses, en stipulant explicitement l’unité de mesure retenue (par exemple, millisecondes, points d’échelle standardisés ou rangs percentiles). Concomitamment, le paramètre ylab (abréviation de y-label) est fondamental dans le cadre d’un histogramme de fréquence relative : il doit expressément stipuler que la grandeur représentée correspond à un pourcentage total de l’échantillon, dissipant ainsi toute ambiguïté avec un décompte d’effectifs bruts :
L’utilisation judicieuse de chaînes textuelles riches et rigoureusement formatées contribue à respecter l’exigence d’autosuffisance des figures préconisée par les manuels de publication académiques. Une figure statistique doit pouvoir être appréhendée et comprise dans son intégralité par un lecteur sans que celui-ci soit immédiatement contraint de se référer au corps du texte pour décoder la nature des axes.
5.2 Ajustement des échelles et limites d’affichage
Le contrôle chirurgical de l’étendue des axes représente une étape déterminante pour prévenir les distorsions d’interprétation cognitive. Par défaut, les moteurs graphiques ajustent les bornes d’affichage au plus près des minima et maxima observés dans l’échantillon afin de maximiser le remplissage de la zone de traçage. Si cette stratégie algorithmique s’avère efficiente sur le plan spatial, elle induit fréquemment un biais d’illusion d’optique en magnifiant artificiellement des variations insignifiantes ou, inversement, en tronquant l’espace théorique de l’instrument psychométrique. Pour endiguer cette faille, la fonction histogram() met à disposition les arguments vectoriels xlim et ylim.
L’argument xlim = c(min, max) requiert un vecteur numérique de longueur 2 définissant de manière impérative les limites minimale et maximale de l’axe horizontal. Dans le cadre d’un test standardisé dont le plancher théorique est 0 et le plafond 100, borner rigoureusement l’axe via xlim = c(0, 100) permet au lecteur de situer instantanément la performance moyenne de l’échantillon dans le référentiel global de l’épreuve, évitant ainsi de surévaluer un échantillon dont les scores oscilleraient uniquement entre 40 et 60. De manière analogue, l’argument ylim = c(0, max_pourcent) fixe l’altitude maximale de l’axe des ordonnées. Cette configuration s’avère indispensable pour comparer deux graphiques distincts juxtaposés sur une planche éditoriale : en assignant une limite verticale identique (par exemple, ylim = c(0, 40)), on empêche qu’un pic de 20 % dans une cohorte paraisse visuellement équivalent à un pic de 40 % dans une autre.
Par ailleurs, l’ajustement méticuleux des graduations (les repères de coche ou ticks) concourt à maximiser le fameux ratio « données-encre » (data-ink ratio) théorisé par le biostatisticien et théoricien du design d’information Edward Tufte. Selon ce paradigme fondamental de la sémiologie graphique, chaque goutte d’encre utilisée sur une page ou chaque pixel allumé sur un écran doit porter une parcelle d’information substantielle et éliminer la surcharge décorative redondante. Des axes épurés, dépourvus d’incursions graphiques parasites et étalonnés avec des chiffres ronds, facilitent le calcul mental immédiat des proportions par le lecteur sans polluer sa charge cognitive de travail.
6. Esthétique visuelle et conformité graphique pour la publication
6.1 Sélection et application des palettes de couleurs
L’esthétique d’une figure scientifique ne répond pas à de simples impératifs d’agrément visuel ; elle conditionne directement l’efficience de la transmission des résultats et l’accessibilité universelle du contenu. Dans la bibliothèque lattice, la modulation chromatique des barres de l’histogramme s’effectue principalement au moyen des arguments col (couleur de remplissage interne) et border (couleur de la ligne périphérique délimitant chaque rectangle). L’écueil classique du chercheur débutant réside dans l’utilisation de couleurs primaires ultra-saturées ou criardes (telles que le rouge vif ou le vert fluo), qui agressent l’œil et dégradent l’impression de rigueur académique.
L’étiquette éditoriale préconise l’emploi de nuances chromatiques sobres, atténuées et d’inspiration naturelle, telles que les célèbres teintes "steelblue", "cadetblue", "slategray" ou des déclinaisons de gris neutres élégants. L’argument border joue quant à lui un rôle fonctionnel de premier ordre : en spécifiant border = "white" ou border = "gray30", le chercheur introduit une séparation nette et fine entre deux classes contiguës. Cette démarcation géométrique est fondamentale pour permettre à l’œil d’isoler immédiatement chaque barre de l’histogramme, particulièrement lorsque les variations de hauteur entre classes adjacentes sont ténues :
Un autre impératif déontologique et scientifique réside dans la prise en compte de l’accessibilité visuelle pour les personnes affectées de dyschromatopsies (notamment la deutéranopie et la protanopie, qui touchent une fraction significative de la population mondiale). L’emploi aveugle de gradients opposant le vert et le rouge doit être définitivement banni au profit de palettes perceptuellement uniformes et universellement différenciables, telles que celles issues des travaux de Cynthia Brewer (disponibles via le paquet RColorBrewer) ou de la palette scientifique viridis. Une figure méthodologiquement irréprochable doit en outre conserver une lisibilité intégrale lorsqu’elle est convertie en niveaux de gris purs lors de l’impression papier d’une revue scientifique.
6.2 Personnalisation avancée avec trellis.par.set()
Tandis que le moteur graphique standard de R repose sur l’altération de variables d’environnement globales via par(), l’écosystème lattice administre ses attributs formels par l’entremise d’un système de thémage hiérarchique hautement sophistiqué, piloté par les fonctions trellis.par.get() et trellis.par.set(). Ce mécanisme confère au chercheur le pouvoir de reconfigurer en profondeur l’intégralité des paramètres graphiques d’une session de travail sans devoir réinjecter les mêmes spécifications cosmétiques dans chaque appel individuel de la fonction histogram().
Chaque composant graphique sous Trellis — qu’il s’agisse de la couleur du fond du panneau, de l’épaisseur du tracé des axes, de la nature pointillée de la grille d’arrière-plan ou de la typographie des étiquettes — est indexé sous forme de listes nommées. Par exemple, la liste plot.polygon régit l’apparence des polygones pleins (incluant les barres des histogrammes), tandis que la liste panel.background contrôle la réflectance du panneau de données. En modifiant ces paramètres en début de script, l’analyste peut implémenter une charte graphique sur-mesure conforme aux guides de style les plus exigeants :
L’intérêt méthodologique de cette démarche réside dans la standardisation absolue de la production graphique au sein d’un laboratoire ou d’un consortium de recherche. Une fois le thème calibré, chaque graphique produit héritera fidèlement des mêmes propriétés typographiques et chromatiques, assurant une parfaite cohérence visuelle d’un article à l’autre. Par ailleurs, lattice offre la possibilité de sauvegarder l’état initial des paramètres système dans une variable de secours pour restaurer instantanément l’environnement par défaut à l’issue du pipeline de génération des figures, évitant ainsi les conflits d’environnement résiduels lors de l’exécution d’analyses ultérieures.
7. Contrôle algorithmique du partitionnement : l’argument breaks
7.1 Impact du nombre de classes sur l’inférence visuelle
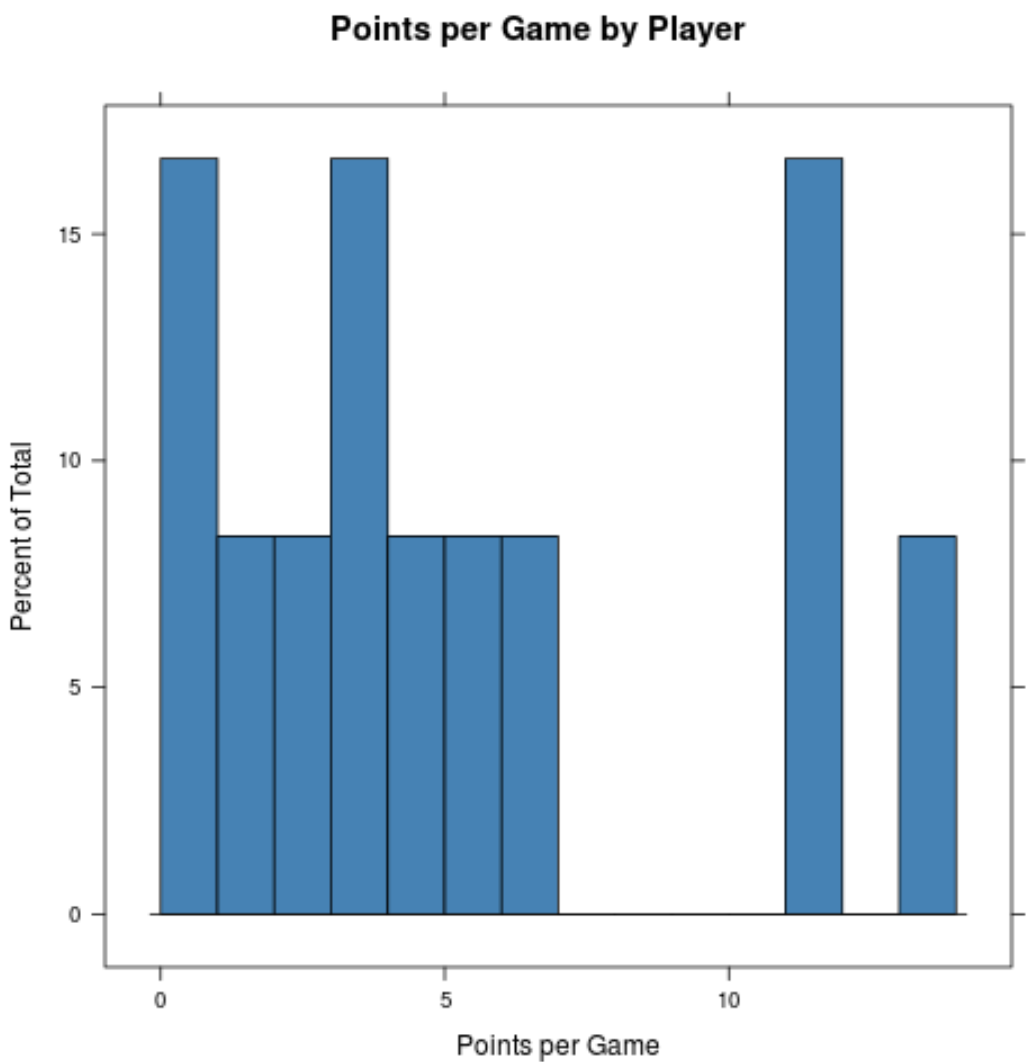
Le talon d’Achille de tout histogramme réside dans le choix de son partitionnement, c’est-à-dire le nombre et la largeur des classes (souvent qualifiées de bins en terminologie anglo-saxonne). Ce choix n’est nullement une affaire de cosmétique : il engage directement l’intégrité de l’inférence statistique visuelle. Deux écueils méthodologiques symétriques menacent l’analyste lors de cette opération : le sur-lissage (underfitting ou sur-agrégation) et la fragmentation excessive (overfitting ou sur-échantillonnage graphique).
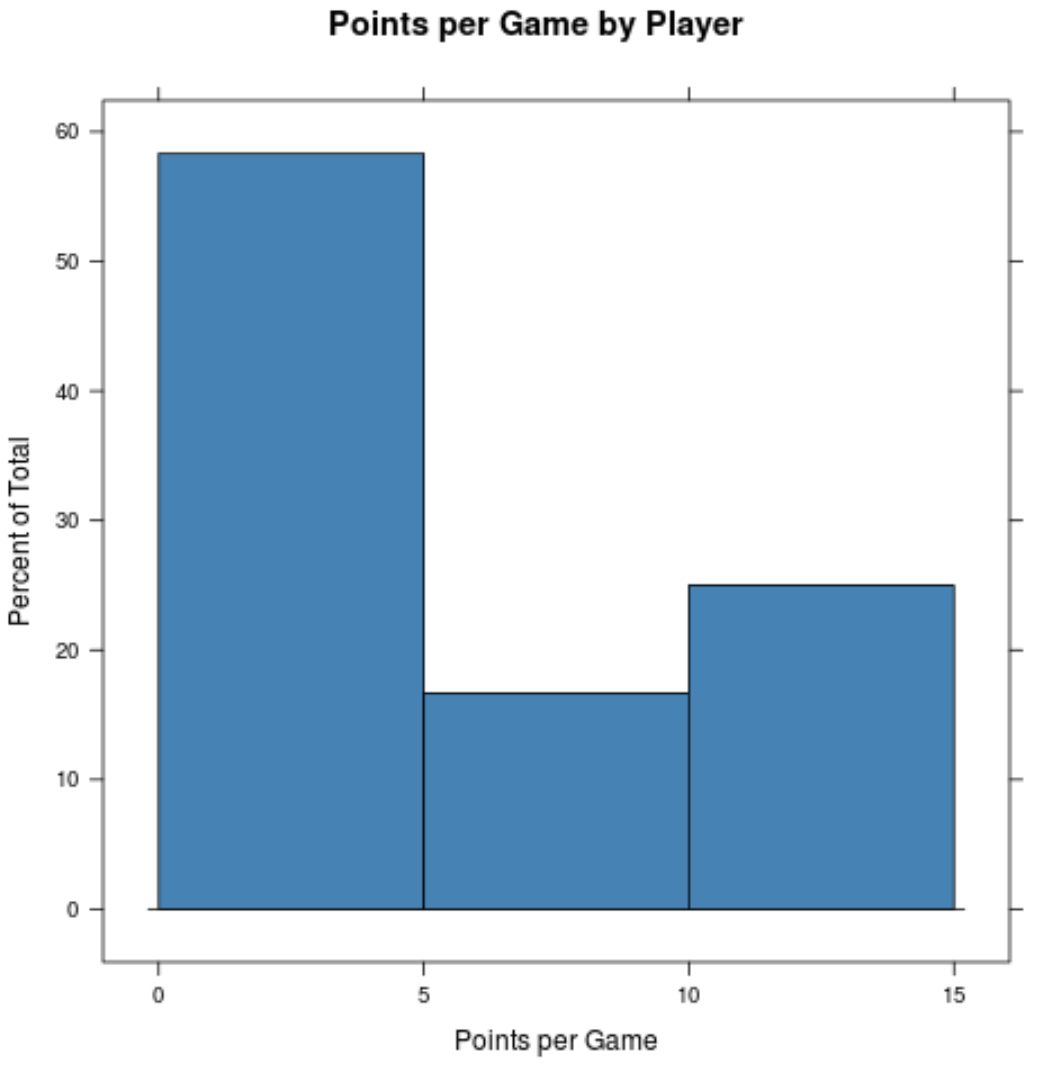
Le sur-lissage résulte d’un nombre trop indigent d’intervalles de classe. Si une variable continue est segmentée en seulement trois ou quatre larges rectangles, l’algorithme comprime l’information morphologique de manière irréversible : les asymétries locales s’annulent, les sous-populations dissimulées sont écrasées et une distribution potentiellement complexe ou multimodale se verra artificiellement parée d’une fausse apparence unimodale et symétrique. À l’inverse, une fragmentation pathologique — induite par un nombre exponentiel de classes pour un échantillon modeste — fait s’effondrer la puissance narrative du graphique. Chaque barre individuelle ne capture alors qu’une fraction infime voire unique d’observations, générant un profil visuel en « dents de scie » où le bruit stochastique propre à l’échantillonnage masque complètement la structure du construit psychologique latent.
Dans la fonction histogram(), l’argument breaks constitue le levier d’action privilégié pour dompter ce phénomène. En spécifiant par exemple breaks = 15, le statisticien intime à l’algorithme d’optimiser le partitionnement pour approcher une quinzaine d’intervalles distincts. Cette flexibilité permet de moduler dynamiquement la résolution spectrale de la distribution, offrant un compromis optimal entre le gommage des fluctuations stochastiques aléatoires et la restitution fidèle des particularités morphologiques authentiques de l’échantillon comportemental.
7.2 Méthodes heuristiques de détermination des bornes
Afin de soustraire la définition du partitionnement à la subjectivité de l’expérimentateur, la théorie statistique a formulé plusieurs heuristiques mathématiques rigoureuses destinées à calculer la largeur optimale de classe ($h$) ou le nombre idéal de coupures ($k$) en fonction des caractéristiques formelles de la série de données. L’algorithme interne de R et de la fonction histogram() intègre ces différentes approches classiques.
La règle la plus ancienne et la plus largement diffusée est la célèbre formule de Sturges, établie par Herbert Sturges en 1926 : $k = \lceil 1 + \log_2(N) \rceil$, où $N$ désigne la taille de l’échantillon. Reposant sur l’hypothèse implicite d’une distribution sous-jacente rigoureusement normale, la règle de Sturges démontre une efficience opérationnelle remarquable sur des échantillons de petite et moyenne taille ($N < 200$). Cependant, sa limitation théorique majeure réside dans son incapacité à s'adapter aux cohortes massives (où elle engendre un sur-lissage sévère) ainsi qu'aux distributions fortement asymétriques ou présentant des traînes épaisses.
Pour contourner les apories du modèle de Sturges, David Scott a formalisé en 1979 une règle adaptative fondée sur la minimisation de l’erreur quadratique intégrée de l’histogramme : $h = \frac{3.49 \times s}{\sqrt[3]{N}}$, où $s$ représente l’écart-type de l’échantillon. En incorporant la dispersion standardisée au numérateur, la formule de Scott calibre la largeur des classes en fonction directe de la variabilité réelle des données. Enfin, David Freedman et Persi Diaconis ont affiné cette logique en 1981 en introduisant la règle de Freedman-Diaconis, qui remplace l’écart-type par l’écart interquartile ($IQR$) : $h = \frac{2 \times IQR}{\sqrt[3]{N}}$. Cette dernière heuristique est largement reconnue comme la plus robuste en psychométrie, car elle demeure totalement insensible aux données aberrantes (outliers) et résiste magistralement aux distorsions distributionnelles aiguës.
Outre ces algorithmes prédéfinis, histogram() autorise une maîtrise absolue en acceptant un vecteur numérique direct pour l’argument breaks, généré typiquement par la fonction séquentielle seq(). Cette modalité permet de fixer avec une exactitude mathématique les bornes inférieures et supérieures de chaque segment, assurant par exemple que les classes coïncident rigoureusement avec les seuils cliniques ou les intervalles de déciles standardisés définis par les référentiels psychométriques :
8. Stratification multivariée : graphiques Trellis et sous-groupes cliniques
8.1 Syntaxe conditionnelle pour l’analyse factorielle
L’un des apports méthodologiques les plus puissants de la bibliothèque lattice réside dans sa capacité native à exécuter des fractionnements multivariés instantanés grâce à sa syntaxe de conditionnement. En recherche psychologique et psychiatrique, une variable continue ne s’analyse que très rarement de manière isolée ; elle doit quasi systématiquement être examinée à la lumière de facteurs contextuels, environnementaux ou génétiques. La comparaison visuelle entre un groupe contrôle et un ou plusieurs groupes expérimentaux ou pathologiques constitue le fondement même de la démarche comparative.
L’implémentation de cette stratification s’opère dans lattice avec une simplicité conceptuelle désarmante grâce à l’opérateur de conditionnement vertical, matérialisé par la barre typographique | (souvent qualifiée de barre de Sheffer ou symbole « pipe »). La syntaxe univariée classique histogram(~ score) se mue alors en une expression conditionnelle bidimensionnelle : histogram(~ score | groupe, data = mon_dataframe). Dès lors que cette instruction est transmise à R, le moteur Trellis segmente automatiquement le jeu de données en fonction des niveaux distincts du facteur catégoriel groupe, calcule de manière totalement autonome les fréquences relatives propres à chaque sous-échantillon, et génère une matrice de sous-graphiques juxtaposés (nommés panneaux ou facettes).
Le bénéfice statistique fondamental de cette architecture Trellis réside dans l’alignement orthonormé automatique des échelles d’axes d’un panneau à l’autre. Contrairement à des graphiques générés séparément puis collés manuellement sur un traitement de texte — pratique risquant d’introduire des décalages d’échelles trompeurs —, les panneaux conditionnels partagent exactement les mêmes limites horizontales et verticales. Ainsi, si le groupe pathologique manifeste un aplatissement marqué de sa distribution de fréquences relatives associé à un étalement vers les scores déficitaires, cette déviation morphologique saute aux yeux de l’observateur par contraste immédiat avec la courbe resserrée et culminante du groupe témoin.
8.2 Disposition spatiale et optimisation des panneaux de facettage
Dès lors que l’analyse factorielle implique plusieurs variables de stratification ou des facteurs comportant de nombreuses modalités (par exemple, des classes d’âge réparties en cohortes décennales ou des protocoles cliniques multicentriques), la disposition spatiale des panneaux d’affichage exige une optimisation géométrique rigoureuse. La fonction histogram() met à disposition du méthodologiste l’argument structural layout pour régir la géométrie matricielle de la grille d’affichage.
L’argument layout s’exprime sous la forme d’un vecteur de deux à trois entiers : layout = c(colonnes, lignes, pages). Par exemple, pour comparer quatre sous-groupes cliniques, le chercheur peut opter soit pour une disposition horizontale étirée layout = c(4, 1) facilitant la comparaison verticale des altitudes de pourcentages, soit pour une matrice carrée équilibrée layout = c(2, 2) favorisant la densité compacte de l’illustration dans le format standard d’une page imprimée en colonnes. Cette souplesse permet de configurer le champ perceptif de manière à faire émerger visuellement les interactions d’ordre supérieur entre facteurs contextuels et variables comportementales.
Parallèlement, la personnalisation des bandeaux supérieurs surmontant chaque panneau (qualifiés de strips) permet d’optimiser l’intelligibilité des conditions expérimentales. L’argument strip permet d’injecter des fonctions de rendu personnalisées, modifiant la teinte de fond de ces bandeaux rectangulaires ou configurant la police de caractères des intitulés catégoriels. Cette granularité de contrôle garantit que les dénominations complexes de sous-échantillons (par exemple, « Sujets Amnésiques Légers », « Sujets Présymptomatiques », « Contrôles Appariés ») s’affichent sans chevauchement disgracieux ni troncature textuelle, satisfaisant ainsi aux exigences typographiques des revues internationales à fort facteur d’impact.
9. Superposition de modèles théoriques et estimation de densité
9.1 Superposition de courbes de densité normale
Dans de nombreux paradigmes de psychométrie quantitative, l’histogramme empirique ne constitue qu’une première approximation destinée à être confrontée à un modèle mathématique idéal, au premier rang desquels figure la loi normale théorique (distribution gaussienne). La question sous-jacente est invariablement : « Dans quelle mesure la dispersion observée de nos scores expérimentaux s’ajuste-t-elle à une distribution de Laplace-Gauss théorique présentant la même moyenne arithmétique et la même variance ? » Pour superposer une telle courbe théorique sur un histogramme sous lattice, une contrainte dimensionnelle absolue doit impérativement être respectée : le basculement vers le paramètre type = "density".
En effet, superposer une courbe dont l’intégrale totale sous la courbe vaut par définition $1$ sur un histogramme dont l’axe vertical exprime des pourcentages bruts (dont la somme cumulée des hauteurs vaut 100) aboutirait à une discordance d’échelles insurmontable, la courbe théorique apparaissant comme une ligne plate écrasée au bas de la figure. En adoptant type = "density", l’aire totale des rectangles est mathématiquement ramenée à l’unité, créant une commensurabilité géométrique parfaite avec la fonction de densité de probabilité gaussienne. L’adjonction de cette composante analytique s’opère sous lattice par le truchement d’une fonction de panneau personnalisée (panel function), qui remplace la séquence d’instructions par défaut par un enchaînement concerté d’opérations géométriques :
La fonction panel.mathdensity() encapsule le calcul rigoureux de l’ordonnée théorique pour chaque incrément d’abscisse en appliquant la formule probabiliste standard de la loi normale centrée et réduite sur les paramètres empiriques de la série. Le tracé qui en résulte — mis en relief par une épaisseur de trait affirmée (lwd = 2) et une couleur contrastante — fournit une évaluation visuelle immédiate et infaillible du degré de conformité des scores recueillis face aux canons théoriques de la distribution normale.
9.2 Ajout d’une estimation de densité par noyau (KDE)
Si la projection d’une courbe normale paramétrique constitue un étalon de référence précieux, elle souffre de l’inconvénient d’imposer a priori une forme théorique symétrique rigide qui peut masquer des singularités comportementales cruciales. Pour explorer la distribution empirique sans préjuger arbitrairement de sa morphologie, les statisticiens privilégient l’estimation de densité par noyau (communément désignée sous l’acronyme KDE pour Kernel Density Estimation). Cette méthodologie d’inférence non paramétrique calcule une fonction de densité continue et lisse en convoluant chaque point empirique avec une fonction noyau élémentaire (usuellement une courbe en cloche gaussienne miniature).
L’intégration de cette estimation au sein de l’environnement lattice s’opère avec une remarquable fluidité grâce à la fonction primitive panel.densityplot(), combinée harmonieusement au tracé classique des barres au sein de la fonction de panneau :
L’un des paramètres critiques conditionnant la validité scientifique de la densité par noyau réside dans la largeur de bande (bandwidth). Une largeur de bande excessivement étroite engendre une courbe hypersensible aux fluctuations d’échantillonnage, matérialisant des ondulations chaotiques dépourvues de signification psychologique. Inversement, une largeur de bande hypertrophiée émousse dramatiquement la courbe et oblitère les spécificités locales. En pratique, l’utilisation de l’algorithme d’estimation de Sheather et Jones (paramétré sous R via l’argument bw = "SJ") garantit une largeur de bande asymptotiquement optimale pour minimiser l’erreur quadratique moyenne intégrée.
Dans l’analyse des temps de réaction en chronométrie mentale ou des latences oculomotrices, l’adjonction de cette courbe non paramétrique superposée à l’histogramme de densité relative se révèle particulièrement révélatrice. Elle permet d’objectiver instantanément la présence de traînes de distribution asymétriques caractéristiques des processus attentionnels altérés ou de mettre en évidence des configurations multimodales subtiles, signalant que des stratégies cognitives divergentes ont été mobilisées par différentes sous-fractions de la cohorte expérimentale.
10. Comparaison méthodologique : lattice, base R et ggplot2
10.1 Construction de fréquences relatives avec la fonction hist() de base
Pour apprécier à sa juste valeur la concision de l’écosystème lattice, il est heuristique de disséquer la chaîne opératoire requise pour générer un histogramme de fréquence relative strict à l’aide des fonctions graphiques natives issues du package graphics de R de base. L’outil historique élémentaire est matérialisé par la fonction hist(). Lorsqu’un chercheur transmet un vecteur de scores à cette fonction sans spécification d’arguments, le système calcule et restitue immanquablement un histogramme en fréquences absolues (les effectifs bruts).
Pour forcer la fonction hist() à basculer vers une échelle standardisée, l’utilisateur doit impérativement déclarer l’argument logique freq = FALSE (ou son équivalent formel probability = TRUE). Néanmoins, une confusion méthodologique pernicieuse guette ici l’analyste imprudent : l’axe vertical produit par cette manœuvre n’exprime nullement des fréquences relatives en pourcentages, mais bien une densité de probabilité continue dont l’intégrale sous la courbe est unitaire. Par conséquent, si la largeur des classes n’est pas rigoureusement égale à $1$, les valeurs projetées sur l’ordonnée ne correspondent en rien aux pourcentages des effectifs d’échantillon, mais à des ratios de densité dont la somme brute des hauteurs de barres est totalement disjointe de 100 %.
Pour obtenir un véritable histogramme de fréquence relative exprimé en pourcentages sous le moteur graphique de base, le chercheur est contraint de recourir à un détournement algorithmique fastidieux : intercepter la structure de liste retournée par un appel préliminaire sans tracé graphique (h <- hist(scores, plot = FALSE)), recalculer manuellement les hauteurs en divisant les effectifs par la taille de l’échantillon puis en les multipliant par cent ($p_i = \frac{h$counts}{sum h$counts} \times 100$), réassigner ces grandeurs transformées au sein de l’objet h$density ou générer un diagramme en barres via barplot() en reconstruisant patiemment l’ensemble des axes et graduations horizontales. Par ailleurs, dès lors qu’il s’agit d’opérer un conditionnement factoriel sur des sous-groupes, le système de base exige l’écriture de boucles impératives (for) associées à un découpage préalable des marges via par(mfrow = c(...)), une procédure verbeuse, sujette à des erreurs de programmation et dénuée de l’automatisation intégrée des échelles caractéristiques de Trellis.
10.2 Construction équivalente avec le package ggplot2
Le paradigme concurrent dominant au sein de la communauté des data scientists sous R est indéniablement incarné par le paquet ggplot2, fer de lance de la suite logicielle tidyverse développée par Hadley Wickham. Reposant sur la formalisation théorique de Leland Wilkinson exposée dans son ouvrage séminal The Grammar of Graphics, ggplot2 décompose chaque élément graphique en couches sémantiques indépendantes (données, esthétiques, géométries, transformations statistiques et systèmes de coordonnées).
Pour matérialiser un histogramme de fréquence relative sous ggplot2, la démarche syntaxique se démarque radicalement de lattice. Tandis que histogram() gère nativement le calcul des pourcentages via l’argument scalaire type = "percent", ggplot2 impose une instruction de transformation statistique différée par l’entremise de la fonction interne after_stat() :
L’expression after_stat(count) / sum(after_stat(count)) intime au moteur graphique d’intercepter les effectifs décomptés par la géométrie geom_histogram(), de les standardiser par la somme cumulée de l’échantillon, tandis que l’appel auxiliaire scales::percent convertit élégamment ces décimales en pourcentages lisibles sur l’ordonnée. Bien que cette formulation offre une flexibilité de composition remarquable et s’insère à la perfection dans un pipeline de transformation de données articulé autour des verbes du paquet dplyr, elle impose une surcharge cognitive et syntaxique non négligeable pour le chercheur qui souhaite simplement visualiser une distribution standardisée.
Sur le plan des performances computationnelles pures et de la concision expressive, lattice conserve un avantage substantiel sur ggplot2 dans le cadre d’analyses exploratoires intensives de cohortes psychométriques massives. Les graphiques Trellis compilent instantanément sans la latence inhérente à l’instanciation des multiples couches de la grammaire des graphiques, et la syntaxe par formule (~ score | condition) demeure la méthode la plus succincte, robuste et élégante jamais conçue pour explorer des interactions multivariées complexes dans l’environnement R.
11. Pièges méthodologiques et bonnes pratiques statistiques
11.1 Erreurs d’interprétation communes liées aux histogrammes relatifs
L’apparente simplicité visuelle de l’histogramme de fréquence relative ne doit pas occulter la complexité des écueils métrologiques qui guettent l’expérimentateur lors de son interprétation. Le premier écueil conceptuel, extrêmement répandu chez les étudiants gradués et les chercheurs non-statisticiens, réside dans la confusion formelle entre densité de probabilité et pourcentage relatif direct. Comme souligné précédemment, une classe d’histogramme affichant une altitude de 0.25 sous un paramétrage type = "density" ne signifie en aucune façon que 25 % des observations résident dans cet intervalle ; cette valeur n’exprime qu’un gradient marginal rapporté à la largeur unitaire du bin. Interpréter l’ordonnée d’une densité continue comme un pourcentage direct aboutit à des déductions cliniques dramatiquement faussées, particulièrement lorsque la largeur des classes est sensiblement différente de l’unité.
Un deuxième piège majeur concerne le danger des largeurs de classes inégales. Si, pour des impératifs théoriques, un chercheur décide de construire un histogramme dont les intervalles présentent des amplitudes hétérogènes (par exemple, des classes étroites au centre et larges aux extrémités), l’histogramme de pourcentage standardisé devient formellement invalide. En effet, l’œil humain perçoit la proportionnalité à travers l’aire géométrique des barres et non pas uniquement à travers leur hauteur. Si une classe deux fois plus large se voit attribuer une hauteur proportionnelle à son pourcentage cumulé brut, son aire visuelle sera doublée, instillant une surévaluation trompeuse de la masse de probabilité dans cette région de la distribution. Dans le cas impératif d’intervalles inégaux, seule la véritable normalisation de densité garantit l’intégrité de la restitution perceptive.
Un troisième travers méthodologique prégnant découle de l’omission systématique de la taille d’échantillon globale ($N$) au sein de la communication visuelle. La standardisation en fréquences relatives possède le pouvoir d’égaliser visuellement des études réalisées sur des cohortes gigantesques de plusieurs milliers de participants avec des pré-tests fragiles conduits sur une douzaine de sujets. Un histogramme de fréquence relative parfaitement équilibré mais dérivé d’un effectif microscopique ($N = 12$) souffre d’une instabilité stochastique extrême : l’ajout d’une seule observation aberrante suffirait à déstructurer complètement le profil de l’ensemble. Enfin, une vigilance critique s’impose face aux distributions empiriques sévèrement censurées ou artificiellement tronquées, où l’accumulation massive de pourcentages sur les bornes limites interdit toute extrapolation sur la nature de la fonction de densité au-delà de ces frontières expérimentales.
11.2 Recommandations pour la reproductibilité et la science ouverte
À l’ère de la crise de la reproductibilité et de l’avènement des principes de la science ouverte (Open Science), la conception des figures statistiques doit s’inscrire dans une démarche de transparence algorithmique absolue. Le premier impératif déontologique réside dans la traçabilité intégrale du code R ayant servi à la génération graphique. Dès lors qu’un protocole expérimental implique des simulations de Monte-Carlo, des imputations de valeurs manquantes ou des fractionnements d’échantillons aléatoires, la fixation rigoureuse d’une graine stochastique à l’aide de l’instruction canonique set.seed() constitue une obligation méthodologique non négociable. Cette précaution élémentaire garantit que l’agencement exact des classes et des estimations de densité sera rigoureusement reproductible à l’identique par les pairs ou les relecteurs des revues scientifiques.
Parallèlement, la documentation explicite de l’ensemble des choix de partitionnement au sein du script R s’impose. Délaisser silencieusement le partitionnement aux seuls algorithmes automatiques sans archiver les hyperparamètres (tels que l’heuristique de Scott ou le vecteur précis fourni à breaks) altère la pérennité des analyses. De surcroît, les normes de publication contemporaines encouragent fortement l’inclusion systématique de la taille effective de l’échantillon ($N$) directement dans les métadonnées de la figure, que ce soit sous forme d’une annotation textuelle discrète dans un angle du graphique, ou au sein du sous-titre de l’axe ou de la légende éditoriale accompagnant l’illustration.
Enfin, la dissémination des visualisations empiriques exige un recours intransigeant à des formats d’exportation vectoriels de haute résolution, garantissant une conservation intégrale de l’information graphique quel que soit le facteur d’agrandissement. L’utilisation des pilotes vectoriels natifs de R, matérialisée par des fonctions telles que cairo_pdf() ou svg(), élimine tout phénomène de pixellisation et autorise l’intégration transparente des polices typographiques académiques conformes aux spécifications de mise en page des éditeurs scientifiques internationaux.
12. Application intégrée : analyse empirique d’un test psychométrique
12.1 Mise en situation sur une batterie d’évaluation du contrôle inhibiteur
Afin de synthétiser l’ensemble des préceptes théoriques et algorithmiques abordés tout au long de cet ouvrage, nous allons déployer une étude de cas intégrée et pleinement reproductible. Considérons un protocole expérimental en neuropsychologie cognitive évaluant le contrôle inhibiteur et la résistance à l’interférence attentionnelle à travers une variante informatisée de la tâche de Stroop. Au cours de cette épreuve chronométrique, des participants doivent identifier le plus rapidement possible la couleur de l’encre de stimuli verbaux dont la sémantique est incongruente (par exemple, le mot « VERT » calligraphié en lettres rouges). La variable dépendante primaire correspond au coût d’interférence de Stroop, quantifié en millisecondes d’allongement du temps de réaction.
Notre cohorte simulée comporte 300 participants répartis en deux sous-groupes cliniques distincts : une condition « Faible Anxiété » et une condition « Forte Anxiété ». Selon la théorie du contrôle attentionnel postulée par Eysenck et ses collaborateurs, une anxiété trait élevée altère l’efficacité des mécanismes inhibiteurs centraux, ce qui devrait se traduire empiriquement par une augmentation du coût d’interférence et par une hétérogénéité accrue des temps de réponse. Avant de soumettre ces données à l’évaluation graphique, un nettoyage statistique préliminaire est mis en œuvre : les temps de réaction manifestement aberrants (inférieurs à 100 ms traduisant une anticipation stochastique ou supérieurs à trois écarts-types au-dessus de la moyenne individuelle traduisant une rupture attentionnelle transitoire) sont rigoureusement isolés et filtrés.
L’implémentation complète du pipeline de modélisation et de visualisation sous l’écosystème lattice s’articule comme suit :
L’examen de cette implémentation révèle l’harmonieuse convergence des mécanismes abordés : fixation de la reproductibilité, simulation probabiliste ancrée dans la nosographie cognitive, partitionnement heuristique uniforme par séquence manuelle garantissant une largeur de classe strictement identique pour les deux conditions, habillage chromatique sobre et accessible, et conditionnement Trellis générant une confrontation spatiale immédiate des deux profils de régulation cognitive.
12.2 Rapport analytique et exportation des figures pour publication
L’aboutissement de toute recherche empirique réside dans la restitution narrative standardisée des résultats dans le corps de l’article scientifique, accompagnée de l’exportation physique de l’illustration sous un format conforme aux protocoles éditoriaux des maisons d’édition académiques. La rédaction du commentaire analytique accompagnant l’histogramme de fréquence relative doit s’astreindre à une rigueur descriptive exemplaire, dénuée de jugements subjectifs et articulée autour des descripteurs formels de la distribution :
« L’inspection visuelle des histogrammes de fréquences relatives stratifiés selon le niveau d’anxiété (Figure 1) met en évidence une divergence morphologique marquée entre les deux sous-cohortes expérimentales. Tandis que les participants affichant un faible niveau d’anxiété présentent une distribution des coûts d’interférence de Stroop unimodale et resserrée autour d’une classe modale située entre 150 et 170 ms (capturant près de 28 % des observations relatives du groupe), les individus caractérisés par une anxiété élevée manifestent un déplacement substantiel de leur distribution vers la droite. Cette dernière se signale par un élargissement de sa variance relative, une classe modale décalée vers l’intervalle 210–230 ms, ainsi qu’une traîne d’asymétrie positive marquée s’étendant au-delà de 290 ms, traduisant une altération sélective de l’efficience du contrôle exécutif chez les sujets anxieux. »
Pour exporter cette figure vers le système de fichiers dans une résolution conforme aux standards d’impression photographique des revues (fixés universellement à un minimum strict de 300 points par pouce, ou dots per inch – DPI), le chercheur mobilisera soit le pilote vectoriel cairo_pdf() assurant une netteté mathématique infinie, soit le pilote matriciel png() configuré à haute densité :
Pour consolider la maîtrise opérationnelle du statisticien, nous présentons ci-après la synthèse des paramètres cardinaux régissant le comportement de la commande histogram() au sein de la bibliothèque lattice :
- Argument
x(Formule univariée) : Spécifie la dimension de projection des données sous la syntaxe symbolique~ variableou conditionnelle~ variable | facteur. - Argument
data: Désigne explicitement le cadre de données (data.frame) contenant les variables invoquées dans l’expression symbolique. - Argument
type: Détermine la métrique de l’ordonnée ; prend les valeurs scalaires"percent"(pourcentages de l’échantillon, étalon pour la fréquence relative),"count"(effectifs discrets bruts) ou"density"(normalisation d’aire unitaire pour superpositions continues). - Argument
breaks: Pilote la discrétisation spatiale ; accepte un entier scalaire suggérant le nombre d’intervalles, un vecteur numérique continu fixant chirurgicalement les bornes de chaque classe, ou une fonction algorithmique d’optimisation (Sturges, Scott, Freedman-Diaconis). - Arguments
xlab/ylab: Définissent respectivement les libellés contextuels des axes horizontaux et verticaux sous forme de chaînes de caractères typographiquement soignées. - Argument
main: Configure le titre descriptif supérieur de la composition graphique. - Arguments
xlim/ylim: Contraignent formellement les étendues numériques minimale et maximale visualisées sur l’abscisse et l’ordonnée, prévenant les biais d’échelle. - Arguments
col/border: Déterminent respectivement la teinte chromatique de remplissage volumique des rectangles et la nuance du trait périphérique délimitant les contours de classe. - Argument
layout: Spécifie l’agencement matriciel des panneaux conditionnels sous forme d’un vecteur de dimensionc(colonnes, lignes). - Argument
panel: Réceptionne une fonction de panneau personnalisée (exécutant par exemplepanel.histogramcouplé àpanel.mathdensity) pour enrichir la visualisation de modèles analytiques théoriques superposés.
En conclusion de ce traité méthodologique, il apparaît manifeste que l’histogramme de fréquence relative sous R transcende le statut de simple graphique exploratoire pour s’affirmer comme un instrument épistémologique indispensable à la recherche quantitative moderne. En conjuguant la rigueur mathématique de la standardisation proportionnelle avec l’architecture graphique modulaire et conditionnelle du système Trellis au sein de lattice, le psychologue, le neuroscientifique ou le biostatisticien dispose d’un appareil visuel d’une précision chirurgicale pour sonder, décortiquer et communiquer fidèlement les architectures distributionnelles qui sous-tendent la complexité infinie des phénomènes comportementaux.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S. (1994). The elements of graphing data (2nd ed.). Hobart Press.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Sarkar, D. (2008). Lattice: Multivariate data visualization with R. Springer Science & Business Media. https://doi.org/10.1007/978-0-387-75969-2
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science & Business Media. https://doi.org/10.1007/0-387-28695-0