
Dans le domaine de l’analyse de données empiriques et de la recherche expérimentale, la représentation graphique constitue l’un des vecteurs fondamentaux de la compréhension et de la communication scientifique. Lorsque les chercheurs et les analystes manipulent des variables dont les dynamiques s’étendent sur plusieurs ordres de grandeur, les systèmes cartésiens conventionnels à axes linéaires révèlent rapidement leurs limites méthodologiques intrinsèques. L’écrasement visuel systématique des observations de faible magnitude, couplé à une exagération disproportionnée des amplitudes élevées, dissimule fréquemment des régularités structurales primordiales telles que des taux de variation constants ou des cinétiques exponentielles sous-jacentes. C’est précisément pour remédier à ces distorsions perceptives que le recours au graphique semi-logarithmique s’impose comme une méthodologie analytique incontournable.
Le tableur Microsoft Excel demeure l’un des environnements computationnels les plus largement déployés au sein des laboratoires universitaires, des départements de recherche clinique et des cabinets d’études quantitatives. Bien qu’il soit souvent perçu à tort comme un simple outil bureautique de gestion comptable, Excel intègre un moteur de visualisation géométrique doté de fonctionnalités avancées de mise à l’échelle non linéaire. La maîtrise des paramètres d’échelle logarithmique sur l’axe des ordonnées permet de transformer instantanément des trajectoires curvilinéaires complexes en droites interprétables, facilitant ainsi l’identification visuelle des modèles de croissance ou de décroissance et la formulation d’hypothèses quantitatives robustes.
Ce guide exhaustif a pour vocation de détailler, avec une rigueur mathématique et technique absolue, l’ensemble du protocole nécessaire à la conception, à la configuration, à l’optimisation et à la valorisation d’un graphique semi-logarithmique sous Microsoft Excel. De l’assainissement préalable des jeux de données brutes jusqu’aux exigences typographiques les plus strictes des normes de publication académique internationales (telles que l’APA ou l’IEEE), chaque étape fait l’objet d’une analyse approfondie. Destiné aux étudiants de cycles supérieurs, aux chercheurs et aux analystes quantitatifs, cet ouvrage de référence déploie une méthodologie pas-à-pas orientée vers l’excellence scientifique et la précision visuelle.
1. Introduction conceptuelle aux graphiques semi-logarithmiques dans Microsoft Excel
1.1 Définition mathématique et principe structural de la représentation semi-logarithmique
Sur le plan de la géométrie analytique, un graphique semi-logarithmique se caractérise par une asymétrie délibérée de ses axes de coordonnées au sein du repère cartésien bidimensionnel. Contrairement au plan cartésien affine standard où les deux dimensions sont soumises à une métrique euclidienne linéaire uniforme, le repère semi-logarithmique conserve un axe des abscisses (noté X) étalonné selon une progression arithmétique régulière, tout en appliquant une transformation non linéaire sur l’axe des ordonnées (noté Y). Cette transformation repose sur l’application d’une fonction logarithmique bijective, convertissant chaque valeur physique brute d’ordonnée en son logarithme respectif, tout en conservant pour le lecteur une échelle visuelle graduée selon les valeurs originales.
La propriété mathématique fondamentale qui justifie l’existence de cette structure réside dans le principe de linéarisation des fonctions exponentielles. Considérons une relation théorique continue de la forme générale :
y(x) = y₀ · e^(k·x)
où y₀ représente la condition initiale au temps ou au point zéro, e la base de l’exponentielle naturelle, et k le taux de croissance instantané. En appliquant le logarithme népérien aux deux membres de cette égalité, l’expression se transforme selon l’équation affine suivante :
ln(y) = ln(y₀) + k·x
Dans un repère où l’axe vertical subit une échelle logarithmique, cette relation exponentielle se projette géométriquement sous la forme stricte d’une ligne droite dont la pente est rigoureusement égale à la constante k. Ce phénomène de redressement géométrique permet à l’œil humain, naturellement peu performant pour évaluer la courbure d’une fonction non linéaire, de détecter instantanément la constance d’un taux de variation proportionnel.
Il convient de distinguer formellement le graphique semi-logarithmique de ses homologues typologiques. Dans un tracé linéaire standard, un intervalle spatial constant correspond invariablement à une différence arithmétique constante (par exemple, chaque graduation vaut dix unités d’écart). Dans un graphique purement log-log (ou bilogarithmique), les deux axes X et Y subissent concomitamment une transformation logarithmique, ce qui permet la linéarisation exclusive des lois de puissance (de type y = a · x^b). Le graphique semi-logarithmique s’avère donc spécifiquement dédié aux phénomènes régis par des taux de croissance ou de décroissance relatifs stables par rapport à une variable indépendante continue. Enfin, cette transformation opère une compression logarithmique des amplitudes extrêmes : elle neutralise l’écrasement visuel sans aucune suppression de données, maintenant la visibilité d’oscillations infinitésimales situées à l’autre extrémité du spectre.
1.2 Justification de l’utilisation d’Excel pour l’analyse graphique semi-logarithmique
L’utilisation de Microsoft Excel dans le cadre de la construction de visualisations semi-logarithmiques répond à des impératifs opérationnels d’accessibilité et de puissance analytique. Si des environnements de programmation dédiés tels que R, Python ou MATLAB offrent une flexibilité algorithmique absolue, Excel demeure l’écosystème logiciel standard par excellence dans de nombreux protocoles de laboratoire et d’analyse institutionnelle. Son moteur de rendu graphique possède une capacité native à appliquer des transformations d’échelle continues sans imposer à l’expérimentateur de modifier ses matrices de données d’origine via des formules de transformation intermédiaires, préservant ainsi l’intégrité de la source primaire.
Un avantage majeur d’Excel réside dans la dissociation complète entre la valeur computationnelle intrinsèque de la cellule et sa projection visuelle sur l’axe. Lorsqu’un utilisateur configure un axe vertical en échelle logarithmique dans Excel, le logiciel n’altère pas la série mathématique contenue dans les colonnes ; il modifie la fonction de transfert métrique du canevas graphique. Cette caractéristique supprime le besoin de créer des colonnes d’ordonnées secondaires calculées (telles que =LOG10(B2)), éliminant de facto les risques d’erreurs de propagation de formules ou de confusion lors de l’exportation des métadonnées vers d’autres plateformes statistiques.
De surcroît, Microsoft Excel intègre de manière native des outils statistiques de régression analytique au sein même de son interface de traçage. L’adjonction immédiate d’une courbe de tendance exponentielle calculée par la méthode des moindres carrés, couplée à l’affichage dynamique de l’équation de la fonction et de son coefficient de détermination empirique R², confère à l’application un statut qui dépasse la simple mise en forme graphique pour atteindre le niveau d’un véritable instrument d’inférence exploratoire. Les chercheurs bénéficient ainsi d’un retour visuel et mathématique en temps réel lors de l’ajustement interactif des bornes d’analyse.
1.3 Champs d’application scientifiques et contextes d’usage
L’utilité méthodologique du tracé semi-logarithmique s’exprime à travers un spectre disciplinaire d’une remarquable amplitude. En psychologie cognitive et en sciences de l’éducation, les modèles de rétention mnésique et les dynamiques d’acquisition de compétences sont fréquemment décrits au moyen de courbes d’oubli ou d’apprentissage. Selon les paradigmes classiques initiés par Hermann Ebbinghaus, l’affaiblissement de la trace mémorielle au cours du temps suit une fonction de décroissance quasi-exponentielle ou logarithmique inverse. L’évaluation de l’efficacité d’un protocole d’apprentissage espacé nécessite une projection semi-logarithmique pour identifier le moment exact où le taux d’oubli se stabilise de manière asymétrique par rapport au temps linéaire écoulé.
En psychophysique et neurobiologie sensorielle, l’étude des seuils perceptifs repose historiquement sur la loi de Weber-Fechner, stipulant que la sensation subjective ressentie par un organisme varie proportionnellement au logarithme de l’intensité de la stimulation physique appliquée. Que l’on mesure l’intensité sonore en acoustique (décibels), la réactivité rétinienne face à des stimuli photoniques d’intensité croissante, ou encore la discrimination gustative, la conversion semi-logarithmique permet aux psychophysiciens d’établir une corrélation linéaire entre la grandeur physique mesurée sur l’axe arithmétique et la perception ordinale ou quantitative observée.
Au-delà des sciences cognitives, la modélisation semi-logarithmique s’avère indispensable en microbiologie pour le traçage des phases de croissance exponentielle des cultures bactériennes, où le nombre d’unités formant colonies double à intervalles réguliers. Dans le domaine de la pharmacocinétique, la clairance plasmatique d’une molécule thérapeutique obéit à une élimination d’ordre un, visualisée de façon optimale par une décroissance linéaire sous ordonnée logarithmique. Enfin, l’économie comportementale et l’épidémiologie utilisent quotidiennement ces représentations pour isoler les phases de contamination communautaire critique ou pour évaluer la vitesse de propagation virale d’une information au sein des réseaux numériques interconnectés.
2. Fondements théoriques et pertinence méthodologique de l’échelle logarithmique
2.1 Comportement des variables à grande variabilité sur l’axe des ordonnées
Le traitement visuel des séries expérimentales présentant une forte asymétrie de dispersion pose un défi méthodologique majeur. Lorsqu’une variable dépendante s’étend sur une amplitude dynamique substantielle — par exemple de 1 à 1 000 000 d’unités —, le traçage sur un axe cartésien linéaire traditionnel génère un artefact de compression géométrique inévitable. Les valeurs numériques appartenant aux décades inférieures (entre 1 et 100) se retrouvent confinées dans une bande spatiale représentant une fraction infime de l’espace graphique total, ne mesurant souvent que quelques pixels d’épaisseur à la base du tracé. Ce phénomène, qualifié d’écrasement structural, rend toute inspection visuelle des fluctuations initiales totalement impossible.
D’un point de vue analytique, cette distorsion visuelle entraîne un biais d’interprétation critique : l’observateur non averti a tendance à percevoir les variations des magnitudes élevées comme qualitativement plus significatives que celles intervenant à des échelles réduites. Or, dans la quasi-totalité des processus multiplicatifs, une augmentation passant de 2 à 4 unités constitue une expansion relative de 100 %, strictement équivalente en termes d’intensité cinétique à une augmentation passant de 500 000 à 1 000 000 d’unités. L’échelle linéaire masque cette équivalence en privilégiant la variation arithmétique absolue (ΔY = 500 000 contre ΔY = 2), ce qui fausse le jugement théorique sur la dynamique intrinsèque du système.
L’échelle logarithmique neutralise ce biais en modifiant la topologie même du plan. Elle substitue la distance arithmétique par une distance métrique proportionnelle au ratio des valeurs. Ainsi, sur un axe logarithmique rigoureusement paramétré, l’intervalle spatial séparant 1 de 10 est rigoureusement identique à l’intervalle séparant 10 de 100, ou 1 000 de 10 000. L’analyste se trouve dès lors en mesure de suivre avec une précision homogène les comportements locaux aux très faibles magnitudes tout en observant simultanément les dynamiques d’échelle des valeurs de crête, autorisant une étude synoptique sans précédent de l’hétérogénéité des observations.
2.2 Bases logarithmiques usuelles : base 10, base népérienne et base 2
Le choix de la base mathématique lors de la construction d’une échelle logarithmique détermine la périodicité géométrique des repères de lecture. La base la plus largement diffusée dans les applications techniques et industrielles sous Microsoft Excel est incontestablement la base 10 (notée log₁₀). Cette prédominance s’explique par sa concordance parfaite avec le système de numération décimale utilisé universellement. Chaque intervalle géométrique régulier, couramment dénommé « décade », correspond à une multiplication par un facteur 10 (0.1, 1, 10, 100, 1 000). Cette convention permet une évaluation mentale instantanée des ordres de grandeur par la simple lecture des exposants associés.
La base népérienne ou naturelle, reposant sur la constante d’Euler (e ≈ 2.71828, notée ln), possède un statut prépondérant dans la dérivation analytique des modèles physiques, biologiques et économiques continus. Les équations différentielles régissant la relaxation d’un potentiel membranaire, la désintégration radioactive ou la cinétique chimique de premier ordre admettent des solutions naturelles dont les arguments sont directement proportionnels à la base e. Bien que les graduations en multiples de e soient rarement adoptées pour la restitution visuelle grand public en raison de la complexité cognitive de leur conversion mentale immédiate, la base naturelle demeure la référence absolue pour le calcul des régressions paramétriques sous-jacentes.
Enfin, la base 2 (notée log₂) s’avère indispensable dans les disciplines traitant des processus stochastiques binaires, de la théorie de l’information (exprimée en bits ou shannons), de la bio-informatique (analyses de pliage d’expression génique en fold change) et de la psychologie cognitive expérimentale. Dans l’étude des temps de réaction guidés par la loi de Hick-Hyman, la vitesse de décision croît proportionnellement au nombre d’alternatives binaires. Une échelle en base 2 permet d’identifier visuellement chaque étape de dédoublement (1, 2, 4, 8, 16, 32…), rendant tangible le coût temporel ou computationnel associé à chaque nouvelle bifurcation structurelle du protocole expérimental.
2.3 Critères d’éligibilité d’un jeu de données pour une visualisation semi-logarithmique
L’application d’une échelle logarithmique ne doit jamais être effectuée de manière arbitraire ; elle doit répondre à des critères méthodologiques rigoureux découlant directement des propriétés statistiques de l’échantillon collecté. Le premier critère opérationnel réside dans l’étendue dynamique de la variable dépendante Y. Il est couramment admis en métrologie qu’une échelle semi-logarithmique commence à démontrer sa supériorité explicative lorsque le ratio entre la valeur maximale et la valeur minimale strictement positive excède un facteur 100 (deux décades pleines), et devient rigoureusement indispensable lorsque ce ratio franchit un facteur 1 000 (trois décades ou plus).
Le second critère concerne la nature même du processus générant les données. L’analyste doit déterminer si le mécanisme sous-jacent est de type additif ou multiplicatif :
- Dynamique additive : La variable augmente par incréments indépendants de son état actuel (Y_(t+1) = Y_t + c). Une échelle cartésienne linéaire standard est alors parfaitement indiquée.
- Dynamique multiplicative : La progression est intrinsèquement liée à l’amplitude instantanée de la variable (Y_(t+1) = Y_t · (1 + r)). Dans ce cas précis, le comportement théorique impose le recours à l’échelle logarithmique pour stabiliser la variance relative.
- Comportement asymptotique : Lorsque la série tend vers une saturation après une croissance accélérée, l’échelle semi-logarithmique met en évidence le point d’inflexion marquant la rupture du régime exponentiel pur.
Enfin, il convient de considérer l’adéquation communicationnelle du tracé avec le public cible. L’analyste doit s’assurer que la transformation logarithmique ne masquera pas une caractéristique fondamentale pour l’interprétation pragmatique des résultats. Si l’enjeu clinique ou industriel réside exclusivement dans la mesure de la masse brute cumulée ou dans le dépassement d’un seuil critique linéaire fixe, le maintien temporaire d’une représentation cartésienne linéaire peut se justifier, quitte à proposer les deux visualisations de façon conjointe dans le rapport scientifique.
3. Étape 1 : Préparation et structuration rigoureuse des données dans la feuille de calcul
3.1 Organisation tabulaire conforme aux prérequis du moteur de graphiques Excel
L’efficience du traçage sous Microsoft Excel repose avant tout sur une rigueur topologique absolue lors de l’agencement des matrices de données au sein de la feuille de calcul. Le moteur d’analyse syntaxique d’Excel interprète les sélections matricielles en formulant des présomptions automatiques sur les variables indépendantes et dépendantes. Pour garantir une reconnaissance sans ambiguïté dès la première injection graphique, les données expérimentales doivent impérativement être structurées sous la forme de deux colonnes contiguës, orientées verticalement.
La règle empirique fondamentale exige le placement strict de la variable explicative indépendante (l’axe X, désignant généralement le temps, la concentration, l’âge ou la condition ordinale) dans la colonne de gauche (par exemple la colonne A), tandis que la variable dépendante observée (l’axe Y, soumise à la future transformation logarithmique) doit être hébergée dans la colonne adjacente immédiate de droite (colonne B). L’adjonction de colonnes intercalaires vides ou de métadonnées descriptives au cœur de la matrice entraîne fréquemment des dissociations de séries dans l’interpréteur graphique natif.
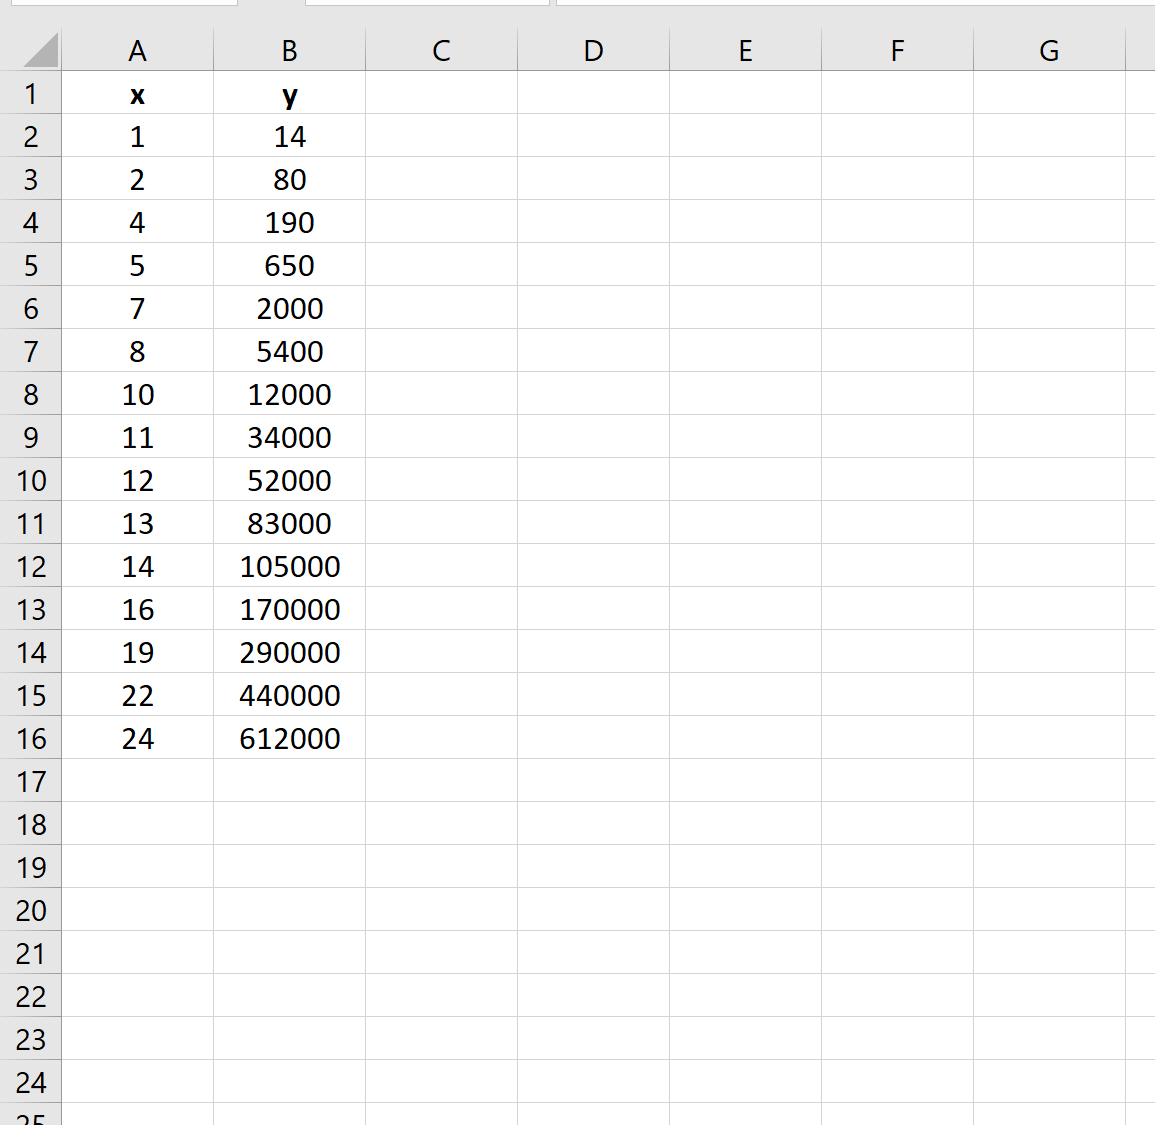
Par ailleurs, la première ligne de chaque colonne doit être réservée à un en-tête purement textuel, exempt de caractères spéciaux non conventionnels, de retours à la ligne forcés ou de symboles arithmétiques complexes risquant d’être interprétés comme des opérateurs de calcul. Enfin, une attention toute particulière doit être accordée au format de cellule : la totalité des cellules contenant les valeurs de mesure doit impérativement être typée en format « Nombre » ou « Scientifique », en s’assurant scrupuleusement que les paramètres régionaux du système d’exploitation n’aient pas substitué les séparateurs décimaux (virgule contre point), ce qui contraindrait Excel à stocker les valeurs en tant que chaînes textuelles inaptes à tout rendu mathématique.
3.2 Contrainte d’exclusion stricte des valeurs nulles et négatives
Sur le plan de l’analyse mathématique élémentaire, la fonction logarithmique f(x) = log_b(x) n’est définie de manière biunivoque que sur l’ensemble ouvert des nombres réels strictement positifs, noté ℝ⁺* ou ]0, +∞[. Lorsque la valeur x tend vers zéro par valeurs positives, la limite de son logarithme tend asymptotiquement vers l’infini négatif :
lim (x → 0⁺) log(x) = -∞
Pour toute valeur nulle ou rigoureusement négative, l’évaluation du logarithme dans le corps des réels est impossible. Microsoft Excel applique rigoureusement cette loi mathématique : toute tentative d’application d’une échelle logarithmique à une série contenant une valeur inférieure ou égale à zéro déclenchera un blocage ou un message d’alerte logiciel explicite.
Le nettoyage préalable de la plage matricielle constitue donc une exigence sine qua non. L’expérimentateur dispose de plusieurs méthodes standardisées pour gérer les occurrences résiduelles nulles ou négatives :
- Filtrage par exclusion directe : Les lignes contenant des zéros ou des valeurs négatives découlant de dérives instrumentales sont extraites et archivées hors de la plage graphique afin d’isoler le sous-ensemble strictement modélisable.
- Introduction d’un décalage infinitésimal (pseudo-logarithme) : Dans les situations expérimentales où la valeur zéro matérialise une absence réelle de réponse mais dont la présence séquentielle est vitale, l’application d’une constante de translation minimale c (telle que Y’ = Y + c, où c est généralement fixée à une fraction infime du seuil de détection) permet la continuité du tracé.
- Remplacement conditionnel par des valeurs d’erreur : La conversion des valeurs invalides en la directive #N/A via une formule conditionnelle permet à Excel d’interpoler ou d’ignorer la ligne sans interrompre la projection du reste de la série.
3.3 Vérification de la continuité et de l’intégrité de la série temporelle ou ordinale
Une fois les contraintes de polarité levées, l’étape subséquente implique une vérification exhaustive de la continuité de la variable indépendante X. Les expérimentations quantitatives génèrent parfois des tableaux lacunaires en raison d’interruptions techniques ou de données perdues. Si une cellule de l’axe des ordonnées est laissée intégralement vide, Microsoft Excel peut adopter différents comportements selon ses options globales de traçage : considérer la cellule comme un zéro mathématique (ce qui réintroduit immédiatement l’incompatibilité logarithmique évoquée précédemment), interpoler linéairement entre les deux points encadrants, ou introduire une brisure visuelle dans le tracé.
Pour configurer manuellement le traitement des valeurs lacunaires, il convient d’accéder au ruban contextuel du graphique, de cliquer sur « Sélectionner des données », puis d’activer l’option « Cellules masquées et cellules vides ». Il est fortement recommandé dans un contexte scientifique de sélectionner « Relier les points de données par une ligne » si l’interpolation est méthodologiquement acceptable, ou de laisser un « Espace » pour documenter visuellement la vacuité de la mesure sans générer d’extrapolations fallacieuses.
En parallèle, l’opérateur doit contrôler la monotonie stricte des valeurs de l’axe X. Si les données représentent une progression temporelle ou une séquence croissante d’intensités physiques, l’ensemble de la plage doit faire l’objet d’un tri croissant préalable sous peine de produire des trajectoires récursives rétrogrades dégradant la lisibilité de la courbe. Enfin, les unités de mesure doivent être méticuleusement uniformisées sur l’ensemble de la colonne : la juxtaposition non corrigée de milligrammes et de grammes fausse l’évaluation comparative des décades.
4. Étape 2 : Insertion du graphique de dispersion initial dans Excel
4.1 Sélection adéquate de la plage de données source
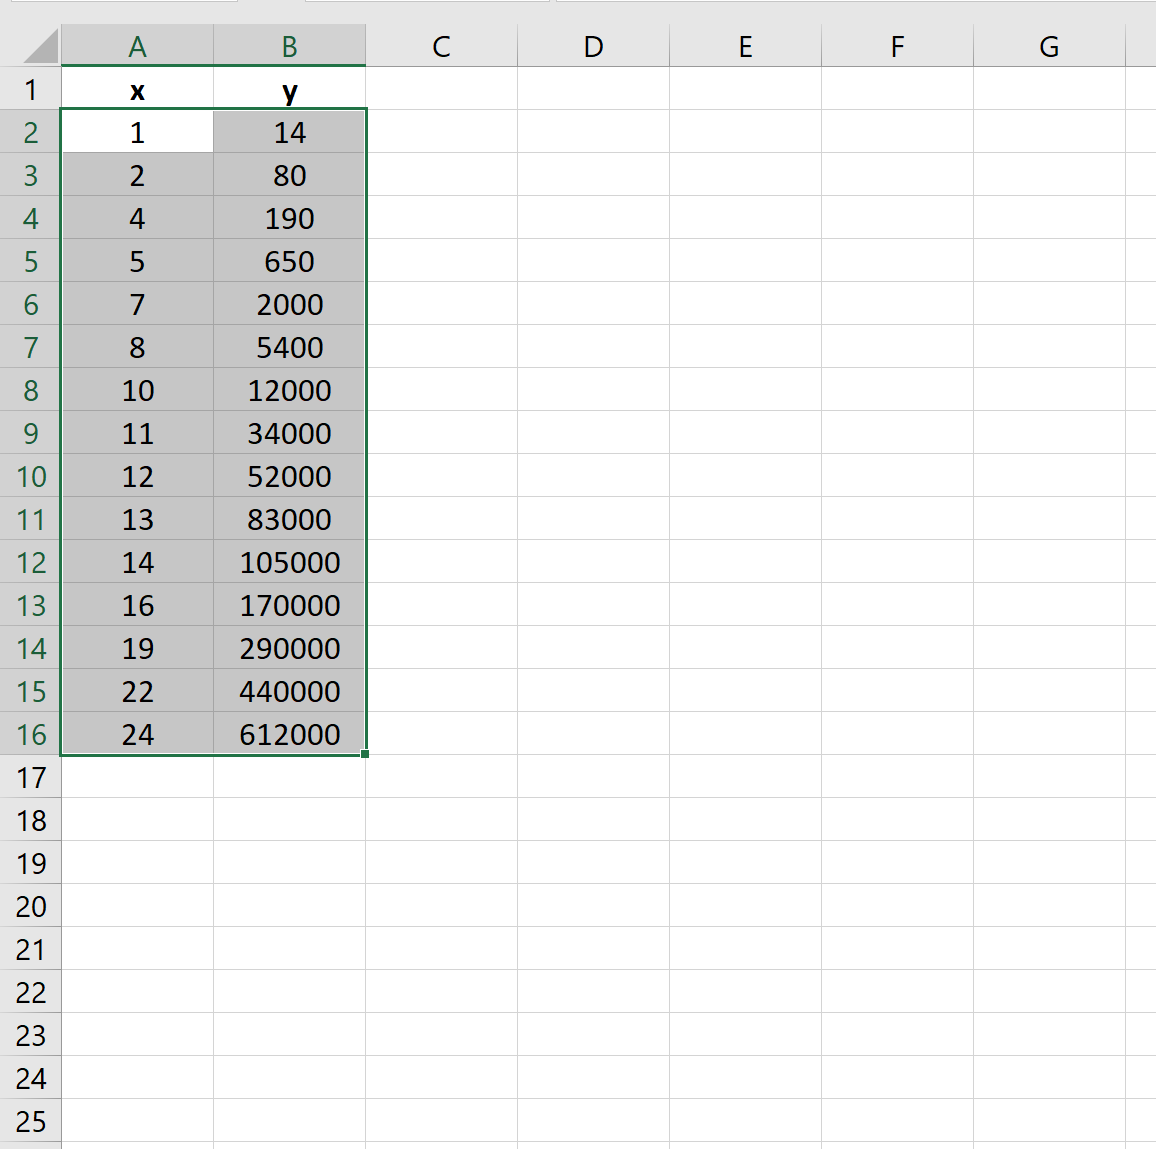
La génération d’un tracé géométrique rigoureux débute par la délimitation opératoire de la matrice source. La sélection doit impérativement englober les en-têtes textuels situés sur la première ligne, car le système de modélisation visuelle d’Excel utilise automatiquement ces libellés pour assigner les titres initiaux des axes et nommer les séries au sein de la légende. Pour les jeux de données contenant plusieurs dizaines de milliers de lignes — situation courante en spectrophotométrie, génomique ou analyse de capteurs haute fréquence —, le défilement manuel à la souris doit être proscrit en raison de son imprécision et du risque d’omission d’enregistrements.
Il convient d’adopter les raccourcis de navigation matricielle professionnels de Microsoft Excel :
- Positionnez le curseur actif sur la cellule supérieure gauche de la matrice (par exemple la cellule A1 hébergeant l’intitulé de la variable X).
- Exécutez la combinaison de touches Ctrl + Maj + Flèche Droite afin d’étendre instantanément la sélection jusqu’à la dernière colonne contiguë de droite.
- Sans relâcher la commande, appliquez immédiatement Ctrl + Maj + Flèche Bas afin de verrouiller la sélection jusqu’à la limite inférieure de la matrice de données.
Avant d’engager toute insertion, une vérification visuelle de la barre d’état s’impose pour confirmer l’exactitude du nombre de points sélectionnés. Il est capital de vérifier qu’aucune colonne ou ligne masquée accidentellement ne soit incluse dans la sélection, ce qui altérerait la cohérence dimensionnelle des vecteurs numériques analysés par le logiciel.
4.2 Choix du type de graphique : pourquoi privilégier le nuage de points
L’une des erreurs méthodologiques les plus destructrices et fréquemment constatées sous Microsoft Excel consiste à sélectionner le type de graphique dénommé « Graphique en courbes » (Line Chart) en lieu et place du « Nuage de points » (Scatter Plot). Cette confusion, encouragée par une nomenclature logicielle ambiguë, engendre des conséquences géométriques majeures sur la représentativité scientifique de la visualisation.
Le graphique en courbes traite l’axe des abscisses comme une succession de catégories discrètes et ordinales, réparties de façon parfaitement équidistante sur le plan horizontal, indépendamment de la véritable valeur numérique sous-jacente. Si vos mesures temporelles ont été effectuées à des intervalles irréguliers (par exemple à 1 minute, 2 minutes, 10 minutes puis 120 minutes), le graphique en courbes attribuera un espacement physique identique entre 1 et 2 qu’entre 10 et 120, introduisant une distorsion temporelle aberrante qui anéantit toute tentative de régression analytique rigoureuse.
À l’inverse, le Nuage de points (XY) traite rigoureusement l’axe des abscisses comme un continuum arithmétique euclidien. Les observations sont positionnées à des coordonnées géométriques dont la distance spatiale est directement proportionnelle à l’intervalle numérique qui les sépare. Pour une analyse semi-logarithmique, l’adoption du Nuage de points constitue le seul choix méthodologique valide. Selon la granularité de votre échantillon et la nature du bruit expérimental, l’utilisateur sélectionnera l’option « Nuage de points avec lignes droites et marqueurs » pour des données discrètes ou « Nuage de points avec lignes directes » sans marqueurs si la densité d’échantillonnage est exceptionnellement élevée.
4.3 Navigation au sein du ruban Excel pour le déploiement visuel
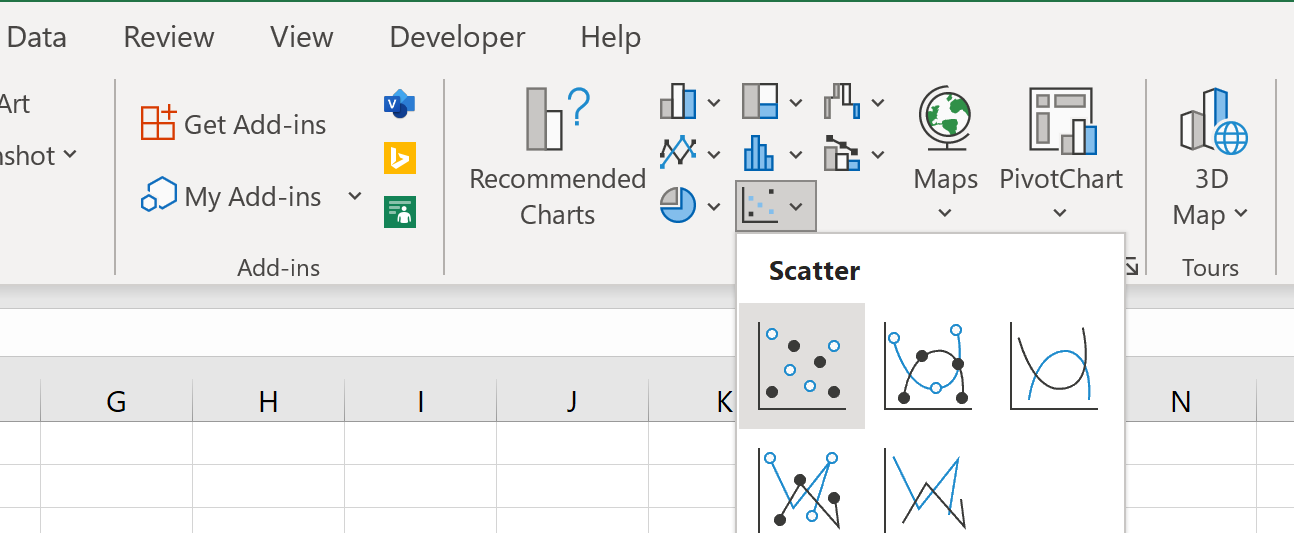
Pour concrétiser l’injection visuelle des données, l’opérateur se dirigera vers le sommet de l’interface utilisateur d’Excel et activera l’onglet Insertion situé dans le ruban principal de commandes. Au sein de cet environnement, la section centrale intitulée Graphiques regroupe la bibliothèque modale des moteurs de rendu vectoriel supportés par l’application.
L’opérateur localisera l’icône figurant une constellation de points non connectés, portant la mention « Insérer un graphique en nuage de points (X, Y) ou un graphique à bulles ». Un clic sur le menu déroulant adjacent déploie les sous-variantes architecturales disponibles :
- Nuage de points standard : Représentation exclusive des marqueurs d’observation, particulièrement adaptée aux nuages denses soumis à régression ultérieure.
- Nuage de points avec lignes lissées : À proscrire rigoureusement dans un cadre analytique formel, car l’algorithme d’interpolation spline introduit des artefacts d’oscillation géométrique non fondés mathématiquement.
- Nuage de points avec lignes droites et marqueurs : Le standard d’excellence pour l’affichage de cinétiques d’échantillonnage discontinu à faible bruit.
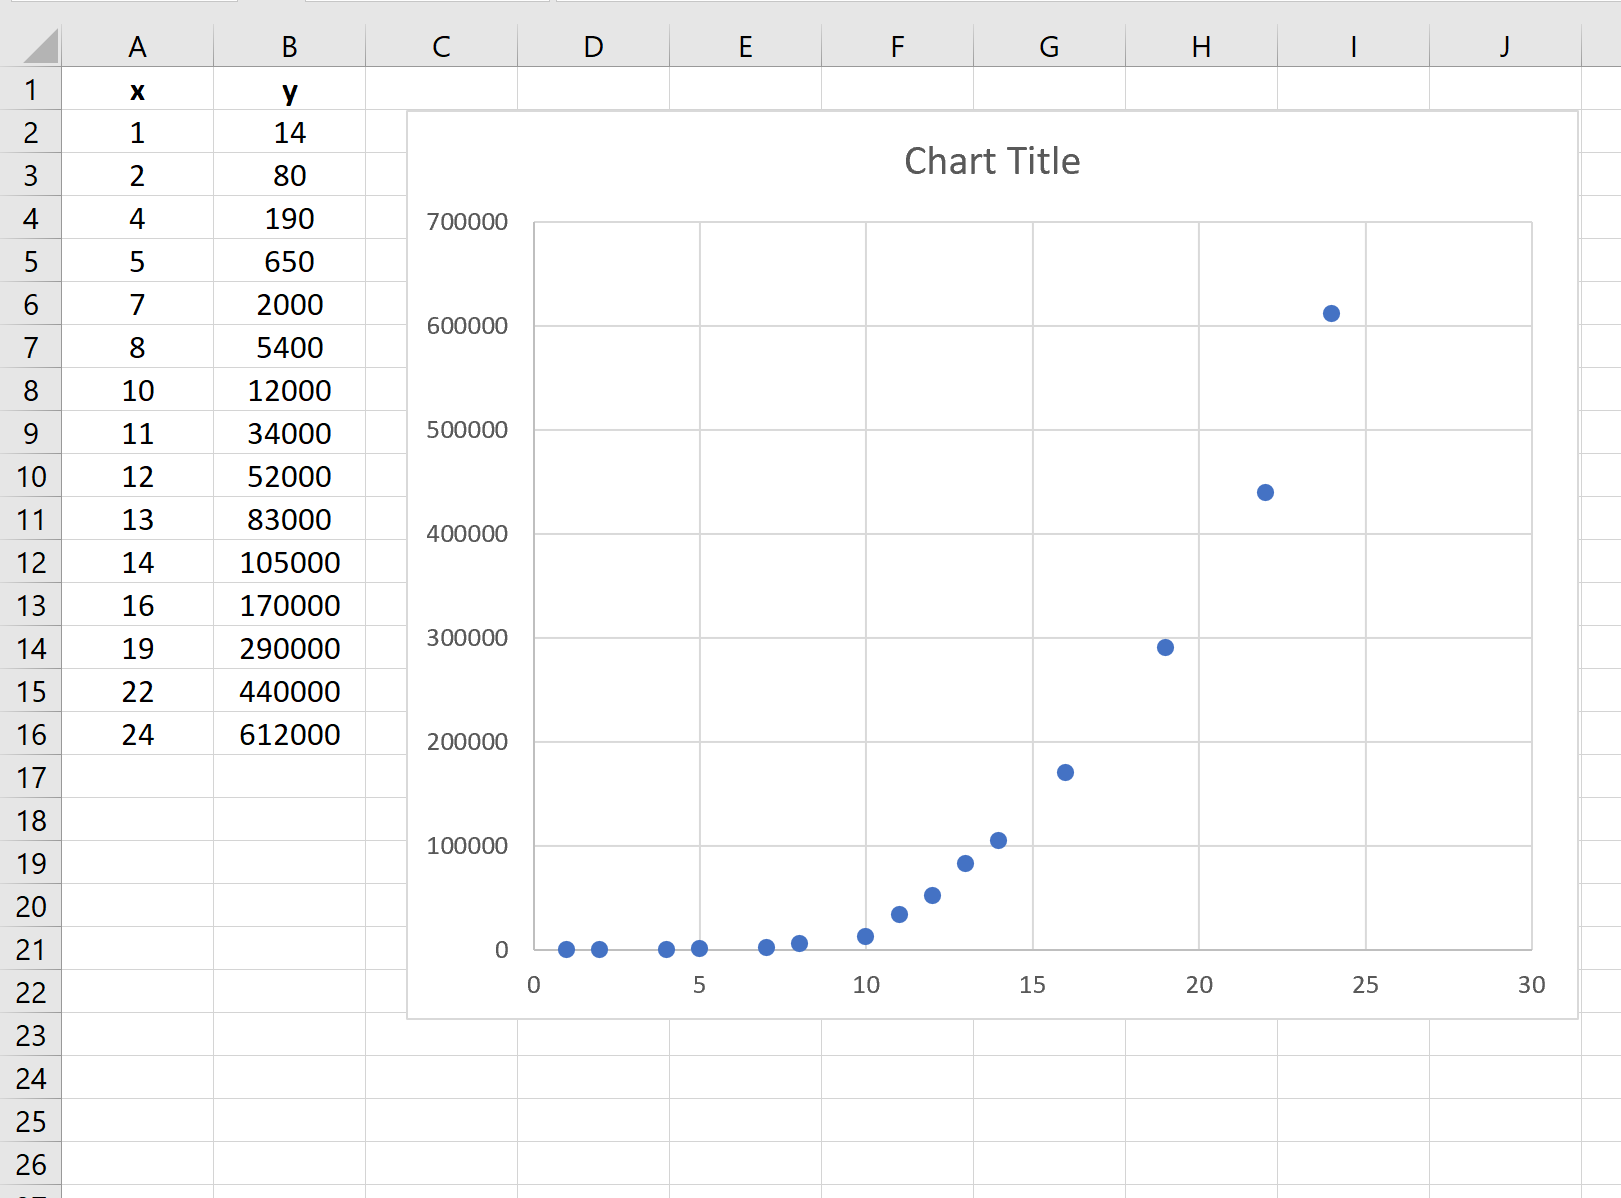
Dès la sélection effectuée, un conteneur graphique vectoriel apparaît au centre de la feuille de calcul active. À ce stade intermédiaire, le graphique affiche une géométrie strictement cartésienne linéaire sur les deux dimensions. L’opérateur effectuera une validation visuelle préliminaire : la variable indépendante X doit s’étendre sur le plan horizontal inférieur, tandis que la variable dépendante Y doit être alignée sur l’axe vertical gauche.
5. Étape 3 : Conversion de l’axe des ordonnées en échelle logarithmique
5.1 Accès au panneau Format de l’axe vertical
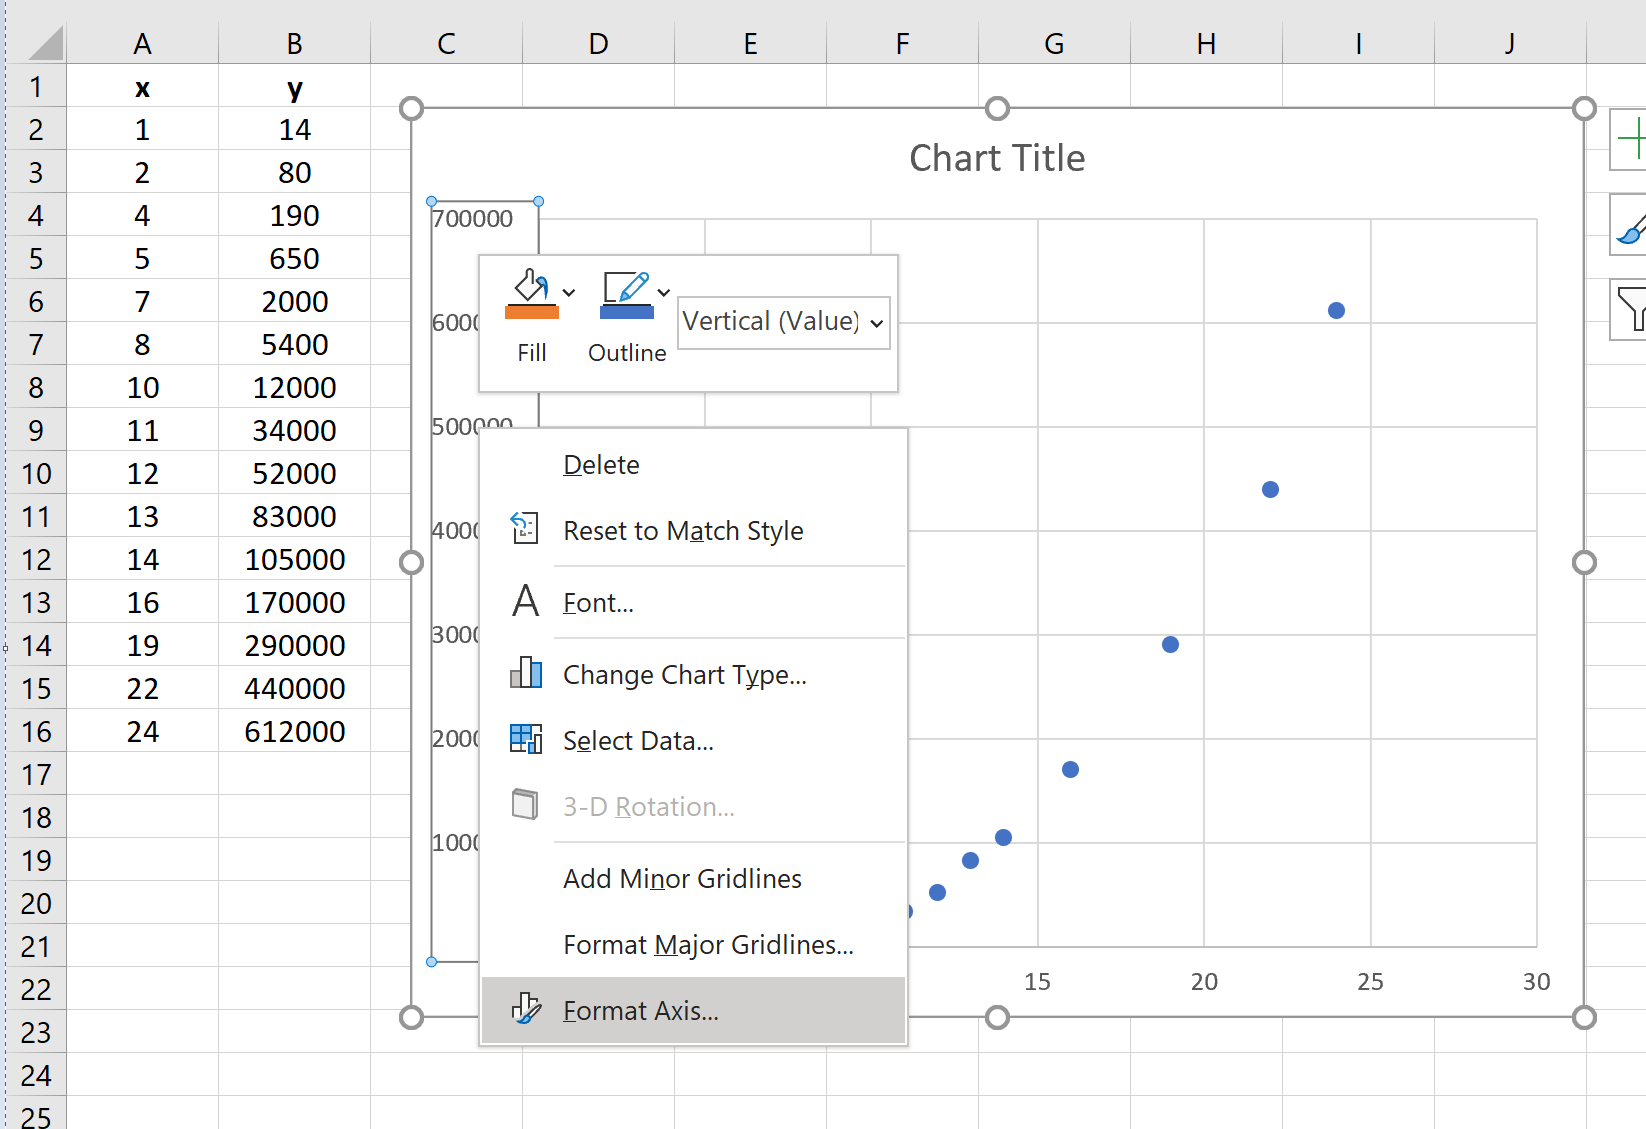
L’activation de l’échelle logarithmique s’opère par l’intermédiaire du panneau de configuration paramétrique dédié à l’axe vertical des ordonnées. L’utilisateur doit cibler précisément l’axe vertical avec le pointeur de la souris. Un simple clic gauche sur l’axe sélectionne l’objet vectoriel, ce que matérialise l’apparition d’un rectangle de délimitation intégrant de légères poignées circulaires aux extrémités supérieure et inférieure de l’axe Y.
Une fois l’élément verrouillé, un clic droit sur la sélection ouvre le menu contextuel flottant. L’analyste choisira la dernière option intitulée formellement Format de l’axe…. Cette action déclenche l’ouverture immédiate d’un panneau latéral ancré sur la marge droite de l’espace de travail d’Excel, intitulé « Format de l’axe ».
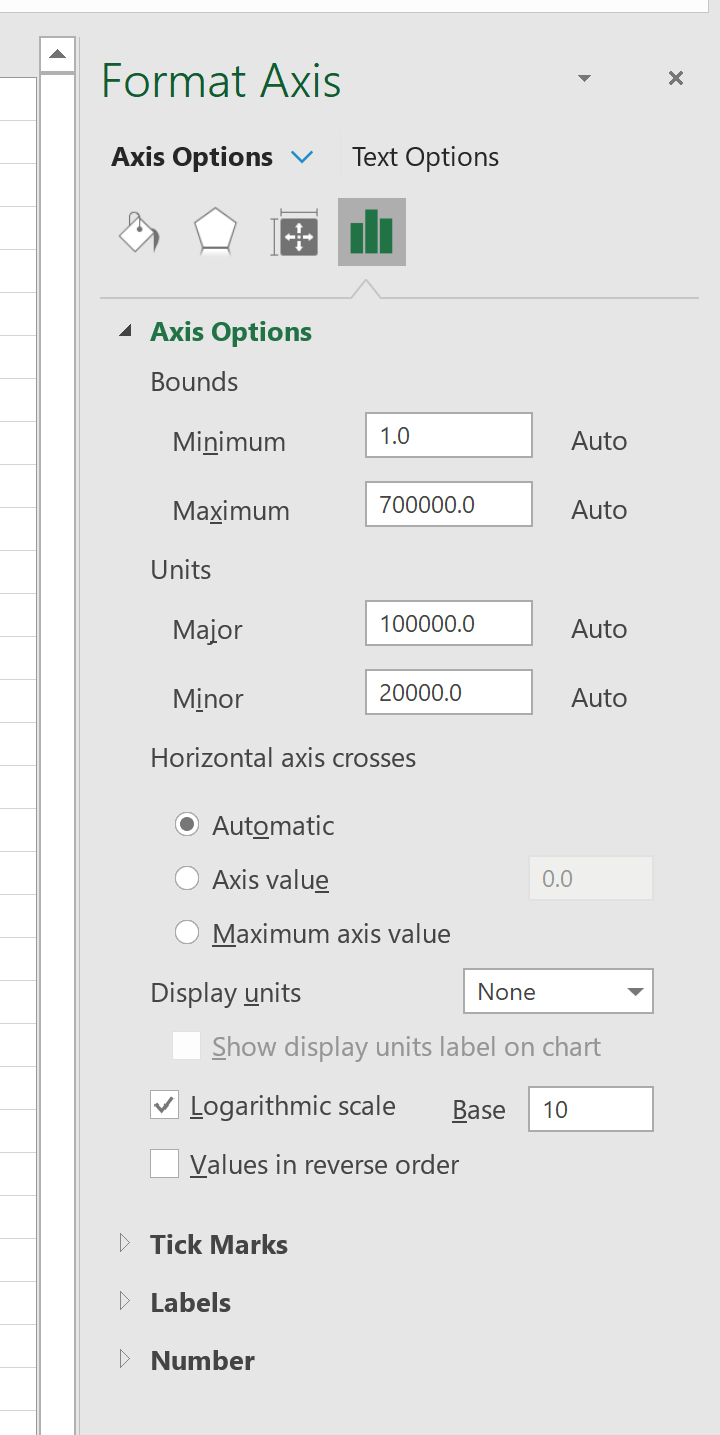
À titre d’alternative ergonomique, il est également possible de double-cliquer directement avec le bouton gauche de la souris sur les chiffres composants la graduation de l’axe vertical pour faire surgir ce même volet contextuel. Dans ce panneau d’options, l’utilisateur s’assurera d’activer l’icône figurant un histogramme à trois colonnes verticales, qui rassemble les Options d’axe fondamentales régissant les fonctions de transfert géométrique et le comportement métrique de l’échelle.
5.2 Activation et configuration de l’option Échelle logarithmique
À l’intérieur du sous-menu déroulant « Options d’axe », l’utilisateur doit faire défiler les paramètres jusqu’à visualiser le groupe de commandes dédié à l’échelle. Une case à cocher explicite, portant l’intitulé Échelle logarithmique (Logarithmic scale), est présente à la base de cette section.
Le protocole d’activation s’articule comme suit :
- Cochez la case Échelle logarithmique. Instantanément, le moteur de calcul visuel réorganise la projection des données le long de l’axe vertical.
- Un champ de saisie numérique adjacent, désigné par le libellé Base, devient actif. Par défaut, Microsoft Excel injecte la constante arithmétique
10, configurant ainsi l’axe en échelle décimale standard. - Si le protocole expérimental requiert une analyse en base binaire ou népérienne, l’analyste peut modifier manuellement ce champ en saisissant respectivement
2ou la valeur approximée2.71828. Toutefois, pour la grande majorité des publications académiques, la base 10 doit impérativement être conservée pour respecter les conventions universelles de décodage visuel.
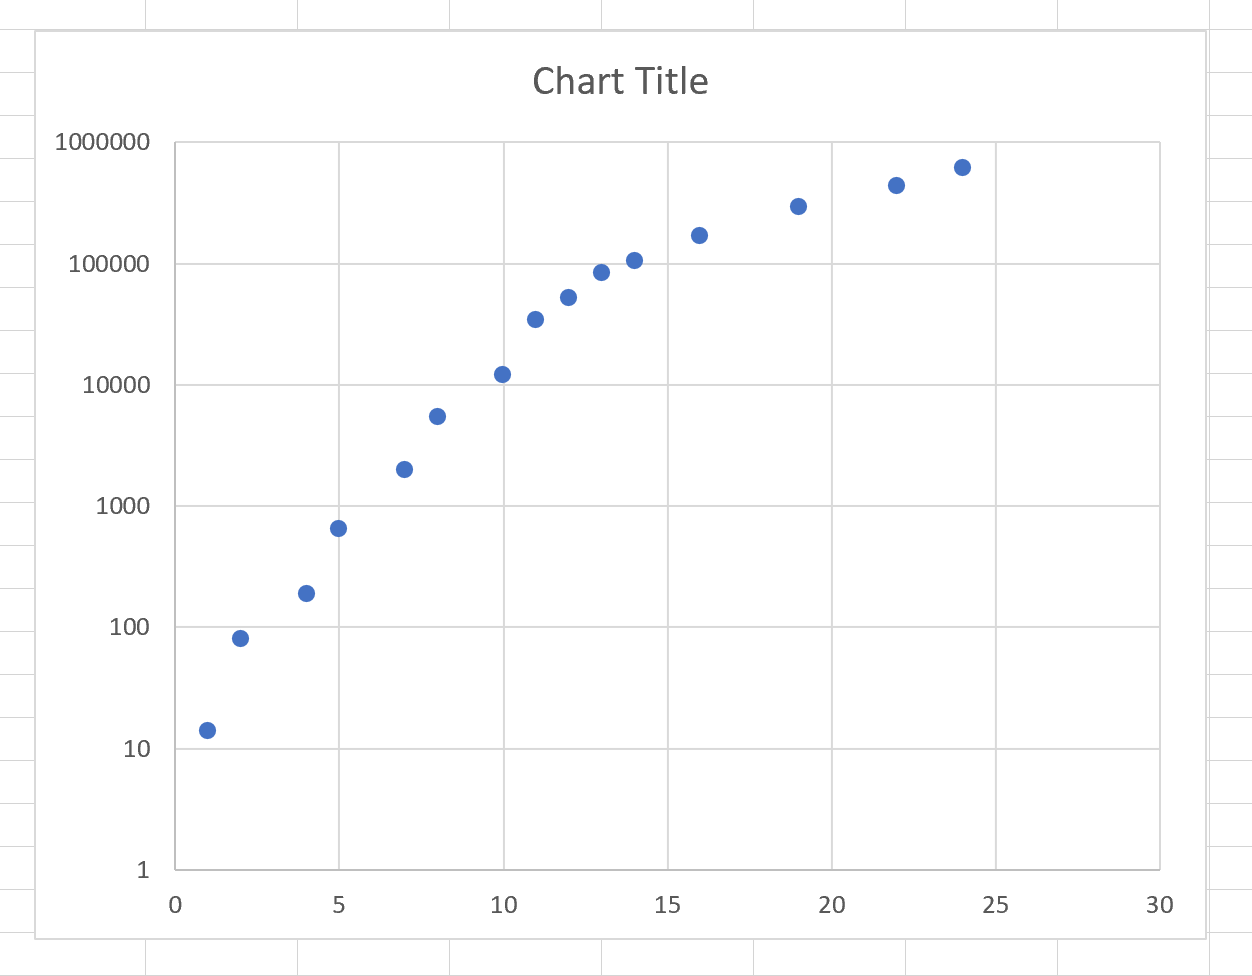
Dès l’application de cette transformation, un phénomène optique spectaculaire se produit : toute trajectoire de points qui présentait initialement une cambrure exponentielle aiguë se redresse immédiatement sous la forme d’un alignement géométrique régulier. Cette linéarisation instantanée confirme visuellement la conformité de vos observations aux hypothèses d’une cinétique à taux proportionnel stable.
5.3 Gestion des alertes logicielles et messages d’erreur lors de la conversion
Dans l’éventualité où le jeu de données comporterait une ou plusieurs valeurs non positives ayant échappé à la phase initiale de nettoyage matriciel, le moteur d’Excel bloque instantanément la transformation et affiche une boîte de dialogue d’alerte critique stipulant : « Les valeurs négatives ou nulles ne peuvent pas être tracées correctement sur des graphiques logarithmiques. Seules les valeurs positives peuvent l’être. »
Face à cet incident, la méthodologie de dépannage doit être systématique :
- Ne tentez pas de forcer l’échelle : fermez la fenêtre d’erreur pour revenir à l’espace de données.
- Activez un filtre automatique sur la colonne Y de votre tableau source (via le menu Données > Filtrer).
- Déployez les options de filtrage numérique et appliquez la condition logique Inférieur ou égal à 0.
- Cette procédure isole instantanément les observations perturbatrices. Vous pourrez alors procéder soit à leur correction si une dérive de virgule flottante a généré un zéro artificiel, soit à leur exclusion formelle en utilisant la formule d’erreur contrôlée
=NA()(ou=#N/A).
Une fois les cellules incriminées neutralisées, la réactivation de la case « Échelle logarithmique » dans le volet latéral s’effectue sans aucune opposition du compilateur graphique d’Excel.
6. Étape 4 : Paramétrage avancé des bornes et des graduations logarithmiques
6.1 Définition manuelle des limites minimale et maximale de l’axe
Par défaut, l’algorithme d’auto-ajustement d’Excel détermine automatiquement les bornes minimale et maximale de l’axe des ordonnées en se basant sur les valeurs extrêmes détectées dans l’échantillon. Toutefois, cette routine logicielle produit fréquemment des résultats sous-optimaux sur une échelle non linéaire, fixant des bornes intermédiaires peu intuitives (telles que 0.35 ou 450) qui perturbent la décomposition en décades entières et dégradent l’élégance de la restitution scientifique.
Pour stabiliser et professionnaliser la visualisation, l’analyste doit impérativement basculer ces paramètres en mode manuel dans les Options d’axe :
- Limite minimale (Minimum Bound) : Fixez manuellement cette valeur sur une puissance stricte de la base sélectionnée. Si vos valeurs minimales oscillent autour de 0.4, attribuez la borne
0.1(soit 10⁻¹). Si vos valeurs débutent à 12, fixez la borne sur10(soit 10¹) ou1(soit 10⁰) selon la proximité du seuil théorique d’origine. - Limite maximale (Maximum Bound) : Ajustez la borne supérieure à la puissance de dix immédiatement supérieure à votre valeur d’observation la plus élevée. Pour un pic mesuré à 78 000 unités, configurez le plafond sur
100 000(soit 10⁵).
La fixation délibérée de ces bornes neutralise tout recalcul dynamique intempestif lors de l’ajout ultérieur de nouvelles données expérimentales et supprime les zones d’espace blanc inutiles au sommet ou au bas de l’épure graphique.
6.2 Réglage des unités principales et secondaires de graduation
La structuration des graduations (les repères métriques émaillant l’axe vertical) conditionne directement la vitesse de décodage cognitif de l’information quantitative. Sur un axe semi-logarithmique standard en base 10, le champ Unités principales (Major Units) doit invariablement conserver la valeur 10. Ce paramètre impose au logiciel de ne faire figurer une valeur numérique explicite que lors du passage d’une décade complète à la suivante (par exemple : 1, 10, 100, 1 000, 10 000).
Le champ Unités secondaires (Minor Units), quant à lui, pilote la subdivision géométrique interne de chaque décade. Bien qu’il soit désactivé par défaut sur les modèles standards, son paramétrage s’avère précieux pour restituer la texture métrologique traditionnelle du tracé semi-logarithmique. Dans la section dédiée aux Graduations :
- Configurez le Type principal sur Extérieur pour faire émerger de légers tirets perpendiculaires pointant hors de la zone de traçage, évitant ainsi d’obstruer le nuage de points.
- Définissez le Type secondaire sur Extérieur ou Intérieur selon la densité d’information souhaitée, matérialisant ainsi les multiples intermédiaires (2, 3, 4, 5, 6, 7, 8, 9 au sein de chaque décade).
Cette distinction hiérarchique entre graduations majeures et mineures reproduit fidèlement la géométrie du papier millimétré semi-logarithmique de laboratoire, offrant au lecteur une repère spatial immédiat pour situer la magnitude relative des points observés.
6.3 Positionnement et croisement de l’axe horizontal (X)
L’activation de l’échelle logarithmique engendre un comportement collatéral classique sous Excel : le repositionnement automatique de l’axe horizontal des abscisses au point d’ordonnée Y = 1. En effet, dans la formulation mathématique standard, log(1) = 0, ce que le logiciel assimile par défaut à l’origine cartésienne relative. Si vos données s’étendent en deçà de 1 (par exemple dans l’intervalle décimal de 0.01 à 0.9), l’axe horizontal viendra barrer le graphique horizontalement en plein milieu de votre nuage de points, compromettant irrémédiablement la lisibilité du tracé.
Pour rétablir une composition visuelle équilibrée :
- Toujours dans le volet « Format de l’axe » de l’axe vertical, localisez la commande intitulée L’axe horizontal coupe (Horizontal axis crosses).
- Désactivez l’option par défaut « Automatique » et cochez la modalité Valeur de l’axe.
- Saisissez rigoureusement dans ce champ la valeur numérique exacte attribuée préalablement à votre Limite minimale (par exemple
0.01ou0.1). - Alternativement, vous pouvez cocher l’option Valeur d’axe minimale, qui contraint de facto l’axe X à s’ancrer au plancher géométrique absolu de la zone de dessin.
Cette opération fondamentale libère l’intégralité du volume graphique central et garantit que les observations de très faible intensité bénéficient d’un dégagement visuel optimal au-dessus de la ligne d’abscisse.
7. Étape 5 : Optimisation du quadrillage et de la lisibilité géométrique
7.1 Activation et personnalisation du quadrillage logarithmique
Le quadrillage structural constitue l’échafaudage perceptif essentiel permettant à l’œil d’interpoler la valeur quantitative des observations sans avoir à projeter continuellement des règles physiques sur le document imprimé ou numérisé. Sur un graphique semi-logarithmique, le quadrillage horizontal assume une fonction géométrique spécifique : en raison du resserrement logarithmique, l’espacement des lignes de repère se contracte de manière caractéristique à mesure que l’on s’approche de la décade supérieure.
Pour déployer ce quadrillage sous Excel :
- Sélectionnez le canevas graphique, puis cliquez sur le symbole + vert (« Éléments de graphique ») flottant dans le coin supérieur droit du cadre.
- Pointez sur la flèche contextuelle située à droite de la mention Quadrillage.
- Cochez impérativement Principal majeur horizontal pour afficher les lignes délimitant les décades entières.
- Cochez également Secondaire majeur horizontal (ou Horizontal secondaire) afin de révéler le réseau dense de lignes intermédiaires non linéaires.
Afin de prévenir toute saturation visuelle, l’analyste se doit d’appliquer une stricte hiérarchie chromatique : sélectionnez le quadrillage secondaire horizontal, ouvrez le volet de mise en forme des lignes, et attribuez-lui une teinte grise très estompée (telle qu’un gris neutre à 25 % d’opacité ou une largeur de trait réduite à 0.25 pt avec motif en pointillés). Le quadrillage majeur, pour sa part, sera tracé en trait plein fin d’une tonalité légèrement plus soutenue, instaurant ainsi un étagement visuel élégant et parfaitement lisible.
7.2 Ajustement du quadrillage vertical pour l’axe linéaire
L’axe horizontal des abscisses fonctionnant selon un étalonnage arithmétique standard, son quadrillage doit répondre à des objectifs d’ordonnancement séquentiel rigoureux. L’activation du Quadrillage principal majeur vertical permet de segmenter l’espace temporel ou factoriel en tranches régulières en totale concordance avec les unités de mesure expérimentales (intervalles de 5 minutes, pas de 10 unités de concentration, etc.).
Il est impératif d’éviter l’écueil de la surcharge graphique : l’adjonction de lignes de quadrillage secondaire vertical sur un axe linéaire s’avère généralement redondante et génère un bruit visuel perturbateur. La règle d’or réside dans la modération : chaque ligne verticale doit correspondre à une étiquette textuelle majeure lisible sur l’axe X. Pour les tracés destinés à des tirages monochromes dans des revues sur papier standard, l’opérateur veillera à maximiser le rapport de contraste en calibrant la blancheur du fond de tracé et la neutralité des gris, garantissant une absence totale de bavure à l’impression.
7.3 Règles ergonomiques de perception visuelle appliquées aux tracés non linéaires
L’encodage visuel d’une dimension non linéaire confronte le système perceptif humain à des biais cognitifs documentés par la psychologie de la forme (théorie du Gestaltisme). La contraction spatiale inhérente à l’axe logarithmique tend à minimiser intuitivement la distance perçue entre les points d’une même décade élevée, alors que leur écart absolu est colossal. L’analyste doit concevoir son architecture visuelle en intégrant délibérément ces contraintes de décodage.
Selon les préceptes universels de design d’information quantitative formulés par Edward Tufte, le ratio « encre-données » (data-ink ratio) doit être maximisé au sein de toute figure scientifique. Ce principe impose l’éradication sans concession de tout élément décoratif dénué de charge sémantique propre (le « chartjunk ») :
- Supprimez systématiquement les ombres portées, les biseaux volumétriques en trois dimensions et les effets de dégradé sur les courbes et marqueurs.
- Éliminez la bordure extérieure rectangulaire du conteneur de graphique en configurant son contour sur « Aucun trait », favorisant ainsi une intégration fluide dans le corps du texte académique.
- Harmonisez l’épaisseur des tracés de données afin qu’ils dominent hiérarchiquement le réseau de lignes de guidage en arrière-plan.
8. Étape 6 : Formatage typographique, étiquetage et mise aux normes académiques
8.1 Normalisation des titres d’axes et explicitation de l’échelle
La règle déontologique primordiale de la communication scientifique stipule qu’une figure doit être intelligible de manière totalement autonome, sans que le lecteur ne soit contraint de se référer perpétuellement au corps textuel principal pour déchiffrer la signification des axes. Sur un tracé semi-logarithmique, l’omission de la mention explicite du caractère logarithmique de l’axe vertical constitue une faute méthodologique grave, susceptible d’induire en erreur le relecteur sur la dynamique des données.
Le protocole de titrage exige une nomenclature standardisée intégrant la grandeur physique ou psychométrique observée, son unité métrologique légale entre crochets ou parenthèses, ainsi que la nature formelle de l’échelle :
- Formulation recommandée : Densité optique [DO à 600 nm] (Échelle logarithmique, base 10)
- Alternative internationale : Temps de réaction [ms] (log₁₀ scale)
En ce qui concerne les étiquettes de données des graduations verticales, il est vivement conseillé, dès lors que l’amplitude excède trois décades, d’abandonner le format d’affichage décimal standard (100, 1000, 10000) au profit de la notation scientifique compacte avec exposants formels (10², 10³, 10⁴). Sous Excel, ce format s’applique en accédant à la section Nombre du volet « Format de l’axe », en sélectionnant la catégorie Scientifique ou en créant un code de format personnalisé adapté.
8.2 Formatage des séries de données, marqueurs et traits de liaison
La distinction formelle des observations individuelles et des tendances structurelles dépend directement de la géométrie des séries tracées. Pour les jeux d’échantillons discontinus, la configuration des Marqueurs (Markers) exige un dimensionnement méticuleux : optez pour un diamètre compris entre 4 et 6 points afin d’éviter le chevauchement massif des points tout en conservant une lisibilité optimale lors d’une réduction d’échelle du document.
Lors de la confrontation simultanée de multiples cohortes expérimentales sur un même canevas :
- Diversifiez les formes géométriques des marqueurs : réservez le cercle plein à la condition contrôle, le carré au premier groupe expérimental, et le triangle au second.
- Adoptez des remplissages contrastés : combinez des marqueurs à fond plein et des marqueurs évidés (fond blanc avec contour coloré épais) pour garantir une différenciation parfaite lors d’une impression monochrome.
- Proscrivez impérativement les traits de liaison continus si les points correspondent à des mesures statiques indépendantes. Réservez la ligne continue uniquement aux trajectoires temporelles longitudinales continues ou aux courbes de régression analytiques déduites de modèles théoriques.
8.3 Mise en page générale selon les standards scientifiques (APA, IEEE)
Les consortiums académiques internationaux tels que l’American Psychological Association (normes APA 7ᵉ édition) ou l’Institute of Electrical and Electronics Engineers (IEEE) édictent des spécifications typographiques extrêmement strictes relatives à l’intégration des graphiques dans les manuscrits scientifiques. Les paramètres graphiques prédéfinis de Microsoft Excel dérogent systématiquement à ces règles et doivent être rectifiés manuellement par l’opérateur.
Le protocole de mise en conformité académique requiert les ajustements systématiques suivants :
- Typographie universelle : Remplacez les polices de caractères décoratives par une police linéale sans empattement hautement lisible, telle qu’Arial, Calibri ou Helvetica, en fixant un corps de 10 à 11 points pour les étiquettes de graduation et de 12 points en gras pour les intitulés d’axes.
- Règles de délimitation : Selon les standards APA, l’axe vertical gauche et l’axe horizontal inférieur doivent être matérialisés par un trait noir continu de 1 point d’épaisseur, tandis que les bordures supérieure et droite du cadre doivent être purement et simplement supprimées pour ouvrir l’espace visuel (rejet absolu du cadre fermé à quatre côtés).
- Disposition de la légende : Positionnez la légende explicative à l’intérieur de la zone de traçage uniquement si celle-ci comporte un secteur vierge substantiel. Dans le cas contraire, placez-la immédiatement sous l’axe des abscisses, horizontalement découpée, sans aucune bordure d’encadrement.
9. Étape 7 : Modélisation analytique et intégration des courbes de tendance
9.1 Ajout d’une courbe de tendance exponentielle sur échelle semi-log
L’un des atouts analytiques majeurs de la modélisation sous Microsoft Excel réside dans l’intégration directe de modèles de régression paramétrique supervisés par l’algorithme des moindres carrés ordinaires. Dès lors qu’une série expérimentale a été projetée sur une échelle semi-logarithmique et exhibe un profil rectiligne, l’analyste se doit d’éprouver formellement l’hypothèse de croissance ou décroissance exponentielle en déployant une ligne d’ajustement analytique.
Le déploiement s’exécute selon la séquence technique suivante :
- Sélectionnez la série de points d’un clic gauche sur l’un des marqueurs au sein du graphique.
- Effectuez un clic droit et choisissez l’option Ajouter une courbe de tendance… (Add Trendline) dans le menu surgissant.
- Dans le volet latéral « Format de la courbe de tendance », la typologie par défaut est généralement configurée sur Linéaire. Cochez explicitement le modèle Exponentiel (Exponential).
Sur le plan géométrique, un résultat remarquable se produit : bien que le modèle mathématique sous-jacent soit formellement non linéaire (de type y = c · e^(bx)), le moteur de rendu d’Excel projette cette régression exponentielle sous la forme d’une ligne droite parfaite sur l’espace semi-logarithmique. La pente apparente de cette droite traduit directement le coefficient exponentiel b, offrant une confirmation graphique immédiate de la validité structurelle du modèle cinétique postulé.
9.2 Affichage de l’équation mathématique et du coefficient de détermination R²
L’estimation graphique ne saurait suffire à l’exigence de quantification expérimentale. L’analyste doit impérativement extraire les paramètres d’ajustement numérique régissant le modèle calculé. Au bas du volet « Format de la courbe de tendance », activez successivement deux options critiques :
- Afficher l’équation sur le graphique : Fait apparaître un bloc de texte flottant contenant la formulation paramétrique exacte du modèle ajusté.
- Afficher le coefficient de détermination (R-carré) sur le graphique : Affiche la métrique de qualité d’ajustement statistique R².
Le coefficient de détermination R², compris entre 0 et 1, quantifie la proportion de la variance totale de la variable transformée expliquée par le modèle exponentiel. Une valeur supérieure à 0.95 atteste d’une concordance expérimentale remarquable. Il importe toutefois de souligner une précaution méthodologique cruciale : l’algorithme d’Excel calcule la courbe de tendance exponentielle en effectuant une transformation logarithmique préalable des données Y, puis en appliquant une régression linéaire des moindres carrés sur les variables transformées (ln(Y) en fonction de X). Ce procédé minimise la somme des carrés des erreurs dans l’espace logarithmique relatif, et non dans l’espace arithmétique absolu d’origine, ce qui confère une pondération statistique homogène à l’ensemble des décades.
9.3 Comparaison entre modèle exponentiel, puissance et linéaire
L’arbitrage entre différentes formulations théoriques constitue l’essence même de la démarche expérimentale. Le chercheur est fréquemment confronté à l’ambiguïté séparant un régime de croissance exponentiel pur d’un régime régi par une loi de puissance (type y = a · x^k). La visualisation semi-logarithmique joue ici un rôle de discrimination diagnostique déterminant :
- Si le tracé des observations adopte une rectitude rigoureuse sur repère semi-logarithmique, la dynamique sous-jacente est indubitablement exponentielle.
- Si le tracé conserve une inflexion curvilinéaire résiduelle persistante sur le graphique semi-logarithmique, le phénomène relève probablement d’une loi de puissance (nécessitant alors un basculement de l’axe X en échelle logarithmique complémentaire pour former un graphique bilogarithmique log-log).
- Si la dispersion se dégrade fortement aux extrémités, l’analyste procédera à une inspection méticuleuse du tracé des résidus afin de détecter d’éventuelles saturations ou bifurcations de régime physique.
Il demeure impératif de proscrire toute extrapolation prédictive hasardeuse de la courbe de tendance au-delà de la plage temporelle ou factorielle empiriquement explorée. Les processus naturels et comportementaux ne maintiennent une cinétique exponentielle stricte que sur des fenêtres limitées, avant d’entrer inéluctablement dans des phases de décélération logistique régies par l’épuisement des ressources ou des contraintes physiologiques systémiques.
10. Diagnostic et résolution des anomalies techniques fréquentes sous Excel
10.1 Traitement des valeurs négatives ou nulles résiduelles dans la série
Lorsqu’un jeu de données expérimental étendu intègre des valeurs parasites nulles ou négatives générées par du bruit d’acquisition de fond, l’interpréteur d’Excel refuse d’exécuter la transition semi-logarithmique ou tronque silencieusement la série. Pour neutraliser ces anomalies sans altérer l’intégrité de la table brute d’enregistrement, l’application de filtres algorithmiques dynamiques au sein de colonnes de traitement calculées constitue l’approche méthodologique la plus robuste.
La méthode de vectorisation conditionnelle consiste à générer une colonne d’analyse secondaire exploitant la fonction logique conditionnelle standard de Microsoft Excel :
=SI(B2>0; B2; NA())
Dans cette syntaxe, si la cellule source brute B2 contient une valeur strictement positive, celle-ci est intégralement préservée au sein de la cellule de calcul. En revanche, si la valeur est nulle ou négative, la formule retourne immédiatement la valeur d’erreur standardisée #N/A. L’intérêt majeur de cette directive réside dans la gestion interne spécifique opérée par le moteur de rendu d’Excel : l’interpréteur graphique ignore gracieusement les enregistrements évalués à #N/A lors de l’application de l’échelle logarithmique sans émettre de message d’alerte bloquant et sans interrompre la continuité du tracé des observations positives valides environnantes.
Dans d’autres contextes expérimentaux spécifiques, notamment en spectrométrie de masse où de faibles signaux de bruit oscillent aléatoirement autour de zéro, certains praticiens optent pour l’adjonction d’une constante de translation positive universelle (Y_ajusté = Y + |Y_min| + δ). Bien que cette pratique permette le tracé simultané de toutes les mesures, elle modifie fondamentalement la géométrie des ratios et doit impérativement faire l’objet d’une mention méthodologique explicite dans les protocoles de publication.
10.2 Résolution des inversions inopinées d’axes ou de séries
Une anomalie technique récurrente sous Microsoft Excel survient lorsque l’application permute involontairement l’assignation des axes, projetant la variable indépendante X sur le plan vertical et la variable dépendante Y sur le plan horizontal. Ce dysfonctionnement se manifeste couramment lorsque la colonne des abscisses héberge des variables numériques sans étiquette textuelle initiale ou lorsque les données temporelles sont formatées sous une syntaxe de dates complexes mal interprétée par le gestionnaire matriciel.
Pour rétablir l’orientation orthogonale correcte :
- Effectuez un clic droit au cœur de la zone de traçage et sélectionnez Sélectionner des données… (Select Data).
- Dans la fenêtre de gestion des séries, mettez en surbrillance la série défaillante et cliquez sur le bouton Modifier.
- Contrôlez méticuleusement les références matricielles assignées aux champs Valeurs de la série X et Valeurs de la série Y. Si une permutation s’est produite, réassignez manuellement les plages de coordonnées appropriées en utilisant le pointeur de sélection.
Par ailleurs, si les graduations de votre axe vertical apparaissent inversées (les magnitudes les plus élevées se situant au bas du tracé et les valeurs infinitésimales au sommet), ouvrez le panneau « Format de l’axe » vertical et assurez-vous que la case à cocher Valeurs en ordre inverse (Values in reverse order) est rigoureusement décochée. Cette modalité spécifique n’est requise que dans de rares contextes métrologiques tels que la bathymétrie ou l’astronomie observationnelle (magnitudes d’éclat stellaire).
10.3 Comportement instable des étiquettes lors de redimensionnements de fenêtre
L’ajustement dynamique des dimensions du canevas graphique sous Excel provoque parfois la disparition inattendue de certaines étiquettes de décades intermédiaires, le logiciel estimant de manière arbitraire que l’espace vectoriel disponible est insuffisant pour héberger l’ensemble du texte. Ce mécanisme d’élagage automatique dégrade gravement la lisibilité de l’axe semi-logarithmique en dissimulant la transition entre ordres de grandeur successifs.
Pour neutraliser cette instabilité typographique et forcer la pérennité visuelle des décades :
- Accédez aux Options d’axe de l’axe des ordonnées, puis déployez le volet Étiquettes (Labels).
- Dans la section régissant l’Intervalle entre les étiquettes, désactivez le calcul automatique et forcez la valeur sur Spécifier l’unité d’intervalle : 1. Cette directive interdit formellement à Excel d’omettre la moindre décade majeure lors des opérations de redimensionnement physique.
- Pour éviter toute déformation lors du redimensionnement général de la feuille de calcul, effectuez un clic droit sur la bordure extérieure du graphique, accédez à Taille et propriétés, et cochez l’option Ne pas déplacer ou dimensionner avec les cellules.
Il convient également de souligner que des écarts de rendu vectoriel peuvent survenir lors du transfert d’un classeur Excel entre les systèmes d’exploitation Microsoft Windows et Apple macOS. La disparité des moteurs de lissage de polices typographiques (DirectWrite contre Core Graphics) exige une vérification visuelle systématique de l’espacement des étiquettes sur la plateforme finale avant tout enregistrement définitif.
11. Applications pratiques : Cas d’études expérimentales et quantitatives
11.1 Étude empirique des temps de réaction et processus de décision
L’exploration chronométrique des architectures cognitives humaines constitue un terrain d’application privilégié pour la méthodologie graphique semi-logarithmique. Dans un protocole expérimental standard évaluant le temps de réaction de choix face à des stimuli visuels complexes, les distributions temporelles brutes ne suivent jamais une loi normale gaussienne symétrique ; elles exhibent systématiquement une asymétrie positive prononcée caractérisée par une longue traîne vers les latences élevées (distribution de type Ex-Gaussienne ou de Wald).
L’analyse de l’acquisition de compétences motrices ou cognitives illustre parfaitement cette dynamique à travers l’étude de la loi de pratique (Power Law of Practice de Newell et Rosenbloom). Lorsque l’on consigne les temps d’exécution (Y, en millisecondes) en fonction du nombre cumulé de sessions d’entraînement (X, en séances linéaires arithmétiques), le traçage sur repère semi-logarithmique décompose précisément le processus en deux dynamiques distinctes :
- Une phase initiale caractérisée par une forte pente négative linéaire sur l’échelle semi-log, attestant d’un gain d’efficience procédurale exponentiellement accéléré.
- Une transition asymétrique vers une rupture de pente, signalant que le sujet s’approche des butées physiologiques incompressibles de conduction synaptique et nerveuse.
L’utilisation d’Excel dans ce contexte permet aux chercheurs de comparer visuellement et statistiquement différentes cohortes de participants (par exemple un groupe contrôle versus un groupe sous privation de sommeil). La superposition des droites de régression semi-logarithmiques permet de quantifier si le déficit cognitif induit par la fatigue altère la vitesse d’apprentissage intrinsèque (variation de la pente de régression) ou modifie simplement le niveau de latence basale structurelle (translation de l’ordonnée à l’origine).
11.2 Vérification expérimentale de relations psychophysiques
La psychophysique expérimentale s’attache à établir des relations fonctionnelles mathématiques rigoureuses entre la métrique physique d’un stimulus et l’intensité de l’expérience perceptive subjective rapportée par un observateur. Deux formulations théoriques majeures s’affrontent historiquement au sein de la littérature académique : la loi logarithmique de Fechner (S = k · log(I)) et la loi de puissance de Stevens (S = k · I^a).
Le tracé semi-logarithmique constitue l’instrument analytique de référence pour valider ou réfuter l’hypothèse fechnérienne. Considérons un protocole expérimental d’estimation de brillance visuelle où l’intensité physique du stimulus lumineux est incrémentée linéairement le long de l’axe des abscisses, tandis que le seuil de discrimination différentiel est consigné sur l’axe des ordonnées configuré en échelle logarithmique. Si la relation postulée par Gustav Fechner est vérifiée expérimentalement :
- Les seuils de sensation se déploient selon un alignement rectiligne rigoureux sur le graphique semi-logarithmique.
- La constante de pente extraite via la fonction de régression d’Excel permet de dériver directement la fraction de Weber caractéristique du système sensoriel investigué.
À l’inverse, si l’ajustement semi-logarithmique révèle une incurvation systématique persistante et que l’adjonction d’une double transformation logarithmique (axe X et axe Y simultanés) rétablit la linéarité géométrique, l’expérimentateur dispose de la preuve formelle que le traitement neurosensoriel obéit préférentiellement au modèle de Stevens. La flexibilité du paramétrage des axes d’Excel autorise cette confrontation d’hypothèses en quelques interactions logicielles fondamentales.
11.3 Modélisation de cinétiques de diffusion d’informations et de comportements
L’analyse quantitative de la propagation de mèmes culturels, de rumeurs ou de comportements d’adoption technologique au sein d’un échantillon démographique contrôlé mobilise des modèles épidémiologiques appliqués aux sciences sociales (modèles SIR ou cinétiques de diffusion de Bass). Durant les phases précoces d’un phénomène de contagion sociale, la diffusion n’est limitée par aucun facteur d’épuisement de population réceptive, ce qui engendre une transmission purement explosive.
En projetant le volume cumulé d’individus ayant adopté le comportement cible (axe vertical en échelle logarithmique base 10) en fonction des unités chronologiques linéaires journalières (axe horizontal arithmétique), l’analyste obtient un outil de monitoring critique :
- Identification du régime exponentiel initial : L’alignement parfait des observations quotidiennes valide le modèle de contamination virale sans résistance contextuelle. La pente de la droite sous-jacente quantifie directement le taux de reproduction effectif du comportement étudié.
- Détection ultra-précoce de la saturation : Dès lors que le tracé s’infléchit vers le bas et s’écarte de la trajectoire rectiligne semi-logarithmique, l’analyste décèle instantanément le point de transition sociologique marquant l’entrée dans la phase logistique de ralentissement, bien avant que celle-ci ne devienne perceptible sur un graphique cartésien linéaire conventionnel.
Ces diagnostics visuels, complétés par l’extraction des résidus statistiques sous Excel, procurent aux analystes quantitatifs et aux sociologues expérimentaux une capacité de modélisation prédictive d’une grande acuité opérationnelle.
12. Automatisation, standardisation et protocoles d’exportation académique
12.1 Création d’un modèle de graphique Excel (.crtx) réutilisable
La mise en conformité manuelle d’un graphique semi-logarithmique aux exigences académiques — réglage des bornes décimales, suppression des bordures parasites, affinement des quadrillages secondaires, calibrage des typographies — constitue une procédure chronophage. Lorsque le chercheur doit générer des dizaines de figures homogènes au sein d’un même projet de recherche, l’automatisation de la standardisation visuelle devient un impératif d’efficacité.
Microsoft Excel offre une fonctionnalité avancée de mémorisation architecturale par le biais des modèles de graphique personnalisés (fichiers au format .crtx) :
- Une fois votre premier graphique semi-logarithmique intégralement finalisé et parfaitement formaté selon les normes de publication, effectuez un clic droit sur une zone neutre du canevas.
- Sélectionnez dans le menu contextuel l’option Enregistrer comme modèle… (Save as Template).
- Attribuez un nom explicite à votre modèle (par exemple SemiLog_Academique_APA.crtx) et validez. Excel archive automatiquement ce fichier de profil dans son répertoire système dédié aux gabarits graphiques.
Pour appliquer instantanément cette matrice stylistique à un nouveau jeu de données brutes, il suffira désormais de sélectionner les nouvelles colonnes, d’aller dans Insertion > Graphiques recommandés > Tous les graphiques > Modèles, et de cliquer sur votre gabarit. L’ensemble des transformations logarithmiques, hiérarchies de quadrillage et contraintes typographiques s’appliquera automatiquement en une fraction de seconde.
12.2 Automatisation de la mise à l’échelle logarithmique via macros VBA
Pour les laboratoires industriels et les plateformes de criblage à haut débit requérant le traitement récurrent de flux massifs de données, le recours au langage de script natif Visual Basic for Applications (VBA) permet de s’affranchir totalement de toute interaction manuelle avec les menus de l’interface graphique.
L’environnement VBA expose directement les propriétés métriques du moteur de traçage d’Excel via le modèle d’objets Excel. La propriété fondamentale permettant de basculer l’axe vertical en mode non linéaire s’énonce conceptuellement par l’assignation de la constante xlLogarithmic à l’attribut ScaleType de l’objet Axes(xlValue). Un script d’automatisation robuste ne se contente pas d’activer ce paramètre binaire ; il procède en amont à une analyse itérative de la plage matricielle dépendante afin d’identifier la valeur minimale strictement positive non nulle, puis affecte dynamiquement cette valeur arrondie à la puissance de dix inférieure comme borne plancher (propriété MinimumScale), écartant tout risque de blocage logiciel lié à des anomalies asymptotiques.
Il est en outre aisé d’associer une macro de ce type à un bouton de contrôle de formulaire interactif ou à un commutateur visuel ancré sur la feuille de calcul. L’expérimentateur peut ainsi alterner instantanément d’un simple clic entre un affichage cartésien arithmétique standard et un affichage semi-logarithmique calibré, optimisant la flexibilité exploratoire lors de réunions de travail ou d’expertises cliniques collégiales.
12.3 Exportation haute résolution et vectorielle pour les publications
L’ultime écueil du processus d’édition scientifique réside dans la dégradation qualitative survenant lors de l’exportation du graphique depuis Microsoft Excel vers le traitement de texte académique (LaTeX, Microsoft Word) ou le logiciel de mise en page de la maison d’édition scientifique. Un graphique capturé par simple copie d’écran ou exporté en format matriciel compressé basse résolution (JPEG à 72 ou 96 DPI) subit une pixellisation désastreuse à l’impression, entraînant systématiquement le rejet de l’article par les comités éditoriaux des revues de rang A.
Pour préserver une netteté absolue et satisfaire aux exigences de résolution (généralement fixées à 300 DPI minimum pour les demi-teintes et 600 à 1200 DPI pour les tracés au trait) :
- Privilégiez le format vectoriel : Copiez le graphique sous Excel (Ctrl + C), basculez dans votre éditeur textuel Word, et utilisez la commande Collage spécial > Image (métafichier amélioré) ou PDF vectoriel. Dans ce mode d’encapsulation, les tracés, courbes et textes ne sont pas transformés en pixels mais conservés sous forme d’instructions géométriques vectorielles, garantissant une netteté infinie quel que soit le niveau de grossissement opéré par l’imprimeur.
- Pour les environnements LaTeX : Imprimez le graphique Excel de façon isolée en utilisant une imprimante virtuelle PDF haute fidélité (sélectionnez la taille d’impression ajustée au graphique), puis recadrez le document via un outil d’édition vectorielle pour générer un fichier
.pdfou.epsdirectement intégrable via le paquetgraphicx. - Pour les exportations matricielles formelles (TIFF/PNG) : Si la revue impose un fichier matriciel autonome, modifiez au préalable la clé de registre Windows
ExportBitmapResolutiond’Office pour contraindre Excel à exporter les sélections graphiques à une résolution native certifiée de 300 ou 600 DPI, écartant définitivement tout flou cinématique de compression.
La mise en application scrupuleuse de ce protocole complet assure à vos visualisations semi-logarithmiques sous Microsoft Excel une exactitude mathématique irréprochable, une puissance de conviction analytique maximale et une conformité intégrale avec les plus hauts standards de l’édition scientifique internationale.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1985). The Elements of Graphing Data. Wadsworth Publ. Co.
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Microsoft Corporation. (2024). Modifier l’échelle de l’axe vertical (valeur) d’un graphique. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive Skills and Their Acquisition (pp. 1–55). Lawrence Erlbaum Associates.
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Weber, E. H. (1834). De pulsu, resorptione, auditu et tactu. Annotationes anatomicae et physiologicae. C. F. Koehler.