
L’exploration visuelle et l’analyse quantitative de phénomènes complexes exigent des instruments graphiques capables de transcender les limites des représentations cartésiennes conventionnelles. Dans une multitude de disciplines scientifiques allant de l’astrophysique à la psychophysique, en passant par l’économétrie, la biologie évolutive et l’écologie quantitative, les chercheurs sont fréquemment confrontés à des distributions caractérisées par une hétérogénéité d’échelle massive, où les variables s’étendent sur plusieurs ordres de grandeur. Dans ce cadre épistémologique, l’échelle linéaire standard s’avère rapidement inopérante, car elle compresse inexorablement les observations de faible magnitude dans un amas illisible au voisinage de l’origine, tout en surreprésentant visuellement les quelques valeurs extrêmes situées dans les queues de distribution.
Le graphique bilogarithmique, couramment désigné sous le vocable de graphique log-log, constitue la réponse méthodologique par excellence à cette asymétrie informationnelle. En appliquant une transformation logarithmique simultanée aux abscisses et aux ordonnées, ce dispositif de visualisation convertit les variations multiplicatives et exponentielles en relations linéaires directes, révélant ainsi les symétries sous-jacentes et les structures cachées des systèmes complexes. Plus spécifiquement, le graphique log-log constitue l’instrument canonique pour détecter et caractériser empiriquement les lois de puissance, ces relations d’invariance d’échelle omniprésentes qui régissent aussi bien la distribution des richesses de Pareto que la loi de perception psychophysique de Stevens ou la dynamique de la mémoire humaine.
Le langage et environnement statistique R s’affirme aujourd’hui comme la plateforme de référence internationale pour le calcul scientifique et la modélisation graphique de haute précision. Grâce à sa double architecture reposant d’une part sur le moteur graphique historique de base (Base R) et d’autre part sur l’écosystème conceptuel de la grammaire des graphiques incarné par le paquet ggplot2, R offre aux analystes et aux chercheurs un contrôle algorithmique absolu sur la spatialisation des données, le calibrage des axes et la modélisation sous-jacente. Ce traité méthodologique propose une immersion exhaustive dans l’art et la science de la construction, de la personnalisation et de l’interprétation des graphiques bilogarithmiques dans l’environnement R, conjuguant rigueur mathématique, fidélité statistique et conformité rigoureuse aux standards de publication scientifique les plus exigeants.
1. Introduction aux graphiques bilogarithmiques dans R
1.1 Définition et principes fondamentaux de l’échelle log-log
Un graphique bilogarithmique, ou tracé log-log, se caractérise par la transformation logarithmique conjointe et indépendante de l’axe des abscisses ($x$) et de l’axe des ordonnées ($y$). Contrairement au repère cartésien arithmétique où la distance métrique entre deux graduations successives représente une différence absolue constante ($\Delta x = x_{i+1} – x_i = c$), l’échelle logarithmique attribue un espacement géométrique constant à des rapports proportionnels constants. Ainsi, la distance physique séparant 1 de 10 équivaut rigoureusement à celle séparant 10 de 100, ou 100 de 1000. Lorsqu’une telle métrique est appliquée simultanément aux deux dimensions de l’espace graphique bidimensionnel, l’observateur cesse d’évaluer des incréments additifs pour analyser des taux de variation relatifs et des élasticités géométriques.
Il convient d’établir une distinction conceptuelle fondamentale entre les trois régimes de projection graphique. L’échelle linéaire pure confronte deux dynamiques additives. L’échelle semi-logarithmique, où un seul axe subit la transformation non linéaire, est spécifiquement dédiée aux dynamiques exponentielles simples, de type $y = a e^{bx}$, transformant une croissance géométrique en une trajectoire rectiligne dont la pente reflète le taux instantané d’accroissement. L’échelle bilogarithmique, quant à elle, opère dans un domaine structurellement distinct : elle neutralise les variations d’ordre géométrique sur les deux variables pour isoler les signatures d’élasticité constante, où un pourcentage de variation infinitésimal de la variable indépendante engendre une réponse proportionnelle constante sur la variable dépendante.
D’un point de vue historico-méthodologique, l’usage de la double transformation logarithmique s’enracine dans les travaux de pionniers des sciences quantitatives comme Francis Galton, Vilfredo Pareto et Karl Pearson. Avant l’avènement du calcul numérique contemporain, la transformation logarithmique constituait une nécessité opératoire pour stabiliser la variance des résidus et manipuler des grandeurs incommensurables sans distorsion visuelle. Aujourd’hui, son utilité analytique demeure intacte : en comprimant les ordres de grandeur considérables sans tronquer l’information, le graphique log-log permet d’aplanir les dynamiques explosives et d’examiner dans un même repère optique des processus qui se déploient simultanément sur des échelles microscopiques et macroscopiques.
1.2 Rôle dans la détection empirique des lois de puissance
La primauté du graphique log-log dans les sciences contemporaines découle de sa capacité singulière à linéariser les fonctions puissances, régies par l’équation algébrique générale $y = a \cdot x^k$, où $a$ représente une constante multiplicative d’échelle et $k$ l’exposant caractéristique du système. Lorsque les deux membres de cette équation sont soumis à un opérateur logarithmique quelconque, qu’il s’agisse du logarithme naturel en base $e$, du logarithme décimal en base 10 ou du logarithme binaire en base 2, les propriétés fondamentales des morphismes logarithmiques décomposent le produit et la puissance selon l’équivalence suivante : $\log(y) = \log(a) + k \cdot \log(x)$.
Cette dérivation formelle démontre qu’en coordonnées bilogarithmiques, toute relation fonctionnelle en loi de puissance se métamorphose en une fonction affine canonique de forme générale $Y = \beta_0 + \beta_1 X$, où la nouvelle variable dépendante $Y = log(y)$ dépend linéairement de la variable indépendante transformée $X = log(x)$. Dans cette configuration géométrique, l’ordonnée à l’origine $\beta_0$ correspond à la valeur logarithmique de la constante d’échelle $log(a)$, tandis que la pente géométrique de la droite, $\beta_1 = k$, constitue l’exposant d’échelle invariant. Cet exposant $k$ traduit l’élasticité directe du système : pour chaque accroissement relatif de $1,%$ de la grandeur $x$, la grandeur $y$ varie invariablement d’environ $k,%$, indépendamment du point de mesure initial.
L’avantage méthodologique de cette transformation linéaire par rapport à l’ajustement non linéaire direct sur données brutes est considérable au stade exploratoire. Les algorithmes d’optimisation non linéaire basés sur les moindres carrés (tels que l’algorithme de Gauss-Newton ou de Levenberg-Marquardt) sont intrinsèquement hypersensibles aux conditions initiales arbitraires fournies pour les paramètres et sont susceptibles de converger vers des minima locaux sous l’effet des points aberrants situés dans les valeurs élevées. La projection log-log offre un diagnostic visuel immédiat : toute déviation d’une trajectoire parfaitement rectiligne révèle instantanément que le phénomène observé n’obéit pas à une loi de puissance pure, guidant l’analyste vers des modèles alternatifs tels que les lois log-normales ou les lois exponentielles tronquées.
1.3 Environnement logiciel et écosystème R
Dans le paysage des technologies de calcul statistique, le logiciel libre R occupe une place centrale grâce à son architecture spécifiquement façonnée autour de la modélisation mathématique et du rendu graphique vectoriel haute performance. Contrairement à des logiciels généralistes dont les moteurs graphiques imposent des présupposés rigides et limitent la personnalisation des échelles, R traite la visualisation non comme une couche cosmétique a posteriori, mais comme un prolongement direct du modèle statistique formel. Les outils de manipulation des structures de données matricielles et de data frames autorisent des transformations mathématiques vectorisées d’une remarquable efficacité computationnelle.
La pratique graphique sous R s’articule autour de deux grands paradigmes conceptuellement contrastés mais parfaitement complémentaires. D’un côté, le moteur graphique traditionnel, communément appelé Base R, s’appuie sur le modèle du tracé direct sur un canevas passif (« modèle du peintre »). Les fonctions primitives comme plot() modifient séquentiellement une matrice de pixels ou un canevas vectoriel sans conserver l’arborescence des objets géométriques sous-jacents, ce qui garantit une vitesse d’exécution optimale et un contrôle tactile absolu de chaque élément graphique. D’un autre côté, l’écosystème moderne dominé par ggplot2 matérialise l’implémentation rigoureuse de la grammaire des graphiques conceptualisée par Leland Wilkinson, structurant la visualisation en strates orthogonales reliant données, esthétiques, géométries et transformations d’échelles formelles.
Pour mener à bien les protocoles d’analyse présentés dans ce manuel, l’environnement de travail R nécessite l’initialisation de plusieurs paquets spécialisés. Outre le moteur de base présent par défaut dans l’installation standard de R, nous exploiterons de manière extensive ggplot2 pour le rendu graphique par couches, scales pour la gestion experte des graduations et notations scientifiques des axes logarithmiques, poweRlaw pour le formalisme statistique rigoureux de l’estimation des paramètres de queues lourdes, et ggpubr pour l’intégration automatisée d’équations statistiques sur les sorties graphiques conformes aux standards académiques.
2. Fondements mathématiques et théoriques des relations en loi de puissance
2.1 Formalisme analytique des lois de puissance
Le concept d’invariance d’échelle constitue le pivot mathématique unificateur de toute distribution en loi de puissance. Une fonction continue $f(x)$ est déclarée invariante d’échelle si, lorsqu’on multiplie son argument $x$ par un facteur d’échelle constant $c$, la valeur de la fonction résultante demeure proportionnelle à la fonction initiale, telle que l’on vérifie l’identité $f(c x) = g(c) f(x)$ pour une fonction multiplicatrice $g(c)$ donnée. Il est mathématiquement démontré que les seules solutions non triviales de cette équation fonctionnelle appartiennent exclusivement à la famille des fonctions puissances $f(x) = a x^k$. Cette propriété fondamentale stipule qu’aucune échelle spatiale, temporelle ou quantitative ne joue de rôle privilégié : la structure du système à petite échelle est l’isomorphe structural direct de sa configuration à grande échelle.
Cette invariance confère aux densités de probabilités régies par des lois de puissance, traditionnellement notées $p(x) propto x^{-\alpha}$ avec un exposant d’échelle critique $\alpha > 1$, des caractéristiques distributionnelles singulières désignées sous l’appellation de distributions à queue lourde ou queue épaisse (heavy-tailed distributions). Contrairement aux lois gaussiennes où la densité s’effondre de manière exponentiellement rapide au-delà de quelques écarts-types de la moyenne, les lois de puissance conservent une masse de probabilité substantielle à des distances considérables de l’espérance mathématique. Selon la valeur numérique de l’exposant $\alpha$, les moments d’ordre supérieur de la distribution divergent vers l’infini : dès lors que $\alpha le 3$, la variance théorique devient mathématiquement infinie, et si $\alpha le 2$, l’espérance arithmétique elle-même diverge, privant les moyennes empiriques simples de leur consistance asymptotique habituelle.
Sur le plan mécanistique, cette rupture avec l’orthodoxie statistique normale s’explique par la nature des processus stochastiques générateurs. Alors que le théorème central limite classique impose une convergence vers une distribution gaussienne lorsque le phénomène résulte de la sommation d’une multitude de fluctuations additives aléatoires et indépendantes, les lois de puissance émergent de processus stochastiques multiplicatifs. L’attachement préférentiel dans les réseaux complexes (principe de Matthew ou « les riches deviennent plus riches »), les cascades critiques d’avalanche d’activation neuronale ou les rétroactions positives non linéaires brisent l’indépendance additrice pour instaurer une dynamique multiplicative intrinsèque. Il importe toutefois de différencier avec la plus grande prudence une loi de puissance pure d’une loi log-normale issue d’un produit d’entropie normale ou d’une loi de puissance avec troncature exponentielle, cette dernière modélisant la limitation physique inhérente à tout système fini ne pouvant soutenir une croissance fractale indéfiniment.
2.2 Transformation logarithmique et propriétés statistiques
Au-delà de son rôle purement géométrique d’aplatissement des représentations visuelles, la transformation logarithmique exerce une influence déterminante sur la structure probabiliste des variables modélisées. Dans l’espace de mesure linéaire d’origine, les phénomènes régis par des dynamiques de puissance s’accompagnent quasi systématiquement d’un schéma d’erreur multiplicatif, où la dispersion des résidus croît proportionnellement à la magnitude moyenne du signal, violant formellement l’hypothèse d’homoscédasticité requise par l’inférence par moindres carrés ordinaires. Le modèle empirique s’écrit formellement sous la forme $y_i = a x_i^k \varepsilon_i$, où le terme d’erreur stochastique $\varepsilon_i$ agit comme un modulateur multiplicatif positif.
L’application de l’opérateur logarithmique transforme cette interaction multiplicative en une relation strictement additive : $\ln(y_i) = \ln(a) + k \ln(x_i) + \ln(\varepsilon_i)$. En posant $e_i = \ln(\varepsilon_i)$, si l’on postule que le facteur multiplicatif initial suit une distribution log-normale, le terme d’erreur transformé $e_i$ obéit alors à une distribution normale classique d’espérance nulle et de variance constante $\sigma^2$. La transformation log stabilise ainsi la variance résiduelle, rétablissant les conditions optimales du théorème de Gauss-Markov et légitimant l’application de la régression linéaire standard pour l’estimation conjointe de l’ordonnée à l’origine transformée et de la pente d’échelle.
Le choix de la base logarithmique constitue une décision méthodologique réversible mais sémantiquement structurante. L’utilisation du logarithme naturel (noté $ln$ ou $log$ dans R) est privilégiée en calcul différentiel et dans les formalisations théoriques en raison de son lien canonique avec les taux d’accroissement continu et les dérivées instantanées. Le logarithme décimal ($\log_{10}$) demeure l’étalon préférentiel en visualisation empirique pour les communications scientifiques, facilitant la lecture intuitive directe des ordres de grandeur physiques ($10^0 = 1$, $10^1 = 10$, $10^2 = 100$, etc.). Le logarithme binaire ($\log_2$) trouve quant à lui son utilité en théorie de l’information et en génomique pour évaluer les doublages successifs (doubling times). Il convient cependant d’alerter l’analyste sur le biais systématique induit par la rétro-transformation exponentielle : l’exponentielle de la moyenne arithmétique d’une variable log-transformée ne restitue pas son espérance arithmétique d’origine, mais sa moyenne géométrique, induisant une sous-estimation systématique de la prédiction moyenne sur l’échelle naturelle qui nécessite, en toute rigueur, l’application d’un facteur de correction de smearing de Duan.
3. Préparation et structuration des données sous R
3.1 Création du jeu de données synthétique
Pour assurer la reproductibilité parfaite des concepts développés dans ce traité, il est méthodologiquement opportun d’élaborer un jeu de données synthétique sous R contrôlant précisément les paramètres de génération de la loi de puissance. Cette approche permet de confronter les représentations graphiques à une vérité terrain rigoureusement calibrée, exempte des incertitudes de mesure inhérentes aux données de terrain, tout en intégrant une composante stochastique réaliste. Nous générons une variable indépendante $x$ uniformément répartie sur plusieurs ordres de grandeur dans l’espace logarithmique, garantissant un échantillonnage homogène sur toute l’étendue de l’échelle considérée.
Le code d’initialisation sous R s’appuie sur la génération d’un vecteur de valeurs de $x$ exponentiellement espacées, simulant par exemple la magnitude d’un stimulus physique ou la population d’entités urbaines. La variable dépendante $y$ est ensuite synthétisée en appliquant la fonction de puissance théorique $y = a \cdot x^k$, où nous fixons arbitrairement l’exposant d’échelle à $k = 0{,}75$ (témoignant d’une dynamique d’allométrie sous-linéaire) et la constante de proportionnalité à $a = 2{,}5$. Une composante d’erreur multiplicative log-normale est introduite via la fonction rlnorm() de R, configurant un bruit stochastique dont la variance relative demeure stable quel que soit l’ordre de grandeur de $x$.
L’inspection minutieuse de ce jeu de données par l’intermédiaire des fonctions str() et summary() confirme l’intégrité de la structure tabulaire sous forme d’un objet data.frame standard. L’analyste s’assure impérativement que les vecteurs générés sont de type double (numérique à virgule flottante) et vérifie l’absence stricte de valeurs négatives ou nulles dans cette phase préparatoire, un préalable incontournable imposé par le domaine de définition de l’opérateur logarithmique. Les descripteurs statistiques initiaux révèlent un écart colossal entre la médiane et la moyenne de $y$, signature préliminaire indubitable de l’asymétrie propre aux dynamiques de puissance.
3.2 Exploration initiale des données brutes
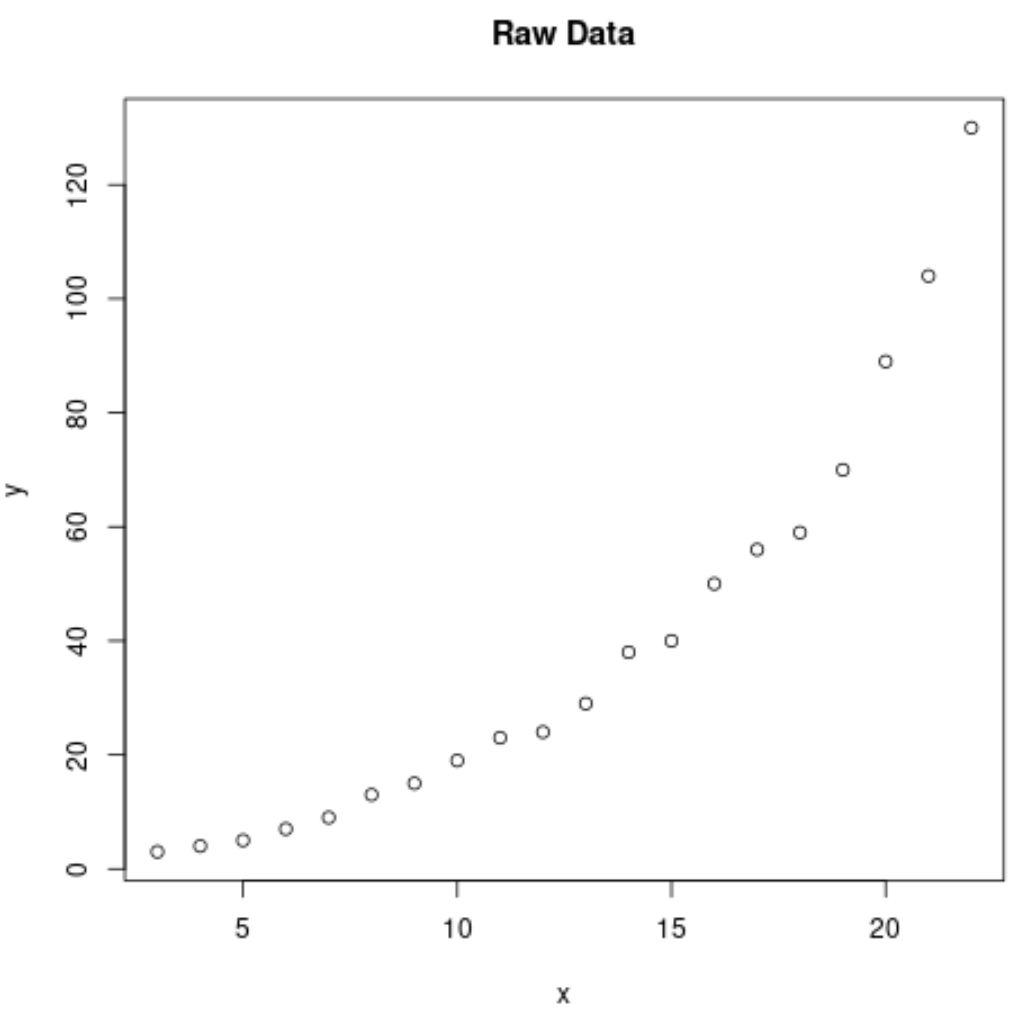
L’affichage initial du nuage de points au moyen de la commande graphique fondamentale plot(df$x, df$y) dans le système de coordonnées linéaires canonique met immédiatement en exergue l’échec structurel du repère arithmétique. En raison de la portée pluridécennale des variables simulées, la quasi-totalité des observations correspondant aux petites et moyennes valeurs de $x$ se trouvent inexorablement condensées le long de la bordure verticale gauche et de l’axe horizontal inférieur. Ce phénomène d’écrasement visuel masque l’intégralité de la dispersion empirique locale, tandis que les rares observations occupant les déciles supérieurs de la distribution s’étalent sur la majeure partie de l’espace graphique disponible, induisant une impression trompeuse de rareté ou de discontinuité fonctionnelle.
Cette distorsion spatiale est corroborée par l’évaluation distributionnelle unidimensionnelle. La construction d’histogrammes conventionnels sur les vecteurs bruts génère des profils ultra-asymétriques (positively skewed) caractérisés par une barre unique hypertrophiée au voisinage du zéro et une traîne infinie s’étirant vers la droite sans granularité informative discernible. Les calculs de quantiles confirment que plus de $80,%$ des données brutes occupent moins de $10,%$ de l’étendue géométrique du repère linéaire. Cette situation crée une perte d’acuité analytique totale pour le chercheur souhaitant appréhender la variance locale des petits signaux.
Cette obstruction visuelle démontre l’absolue nécessité méthodologique d’un changement paradigmatique de repère géométrique. L’échelle linéaire force l’œil humain à appréhender des distances absolues qui n’ont aucune pertinence substantive pour un système intrinsèquement multiplicatif. Pour déverrouiller la lisibilité des données, réconcilier les échelles et transformer cette courbe hyperbolique ou allométrique indéchiffrable en un objet mathématique traitable, la transition vers le graphique bilogarithmique devient un impératif analytique non négociable.
4. Création d’un graphique log-log avec le moteur graphique de base (Base R)
4.1 Transformation explicite des données dans plot()
La méthode la plus immédiate et intuitive pour concevoir un tracé log-log au sein du moteur graphique de Base R consiste à injecter directement les vecteurs préalablement transformés dans la fonction plot(). Cette opération s’articule par l’appel formel plot(log10(df$x), log10(df$y)), qui instruit l’interpréteur R d’appliquer la fonction de logarithme décimal élément par élément aux données vectorielles avant d’en cartographier les coordonnées dans l’espace graphique bidimensionnel. L’affichage obtenu déploie instantanément un alignement linéaire des points, confirmant visuellement l’exactitude de la relation de puissance théorisée dans la phase de modélisation synthétique.
Toutefois, cette modalité d’implémentation impose une rupture sémiotique majeure quant à l’interprétation des axes cartésiens. En transformant explicitement les vecteurs en amont de l’affichage, les axes du graphique résultant ne reflètent plus les unités de mesure physiques originelles du phénomène observé, mais les puissances de dix correspondant aux valeurs transformées. Une valeur de graduation affichant 0, 1, 2 ou 3 correspond ainsi respectivement à des magnitudes physiques de 1, 10, 100 ou 1000 unités d’origine. Cette conversion d’échelle exige une refonte systématique et rigoureuse des étiquettes des axes via les arguments xlab et ylab au sein de l’instruction graphique, en substituant aux libellés bruts des expressions explicites telles que « log10(Variable X) » ou « log10(Grandeur Y) ».
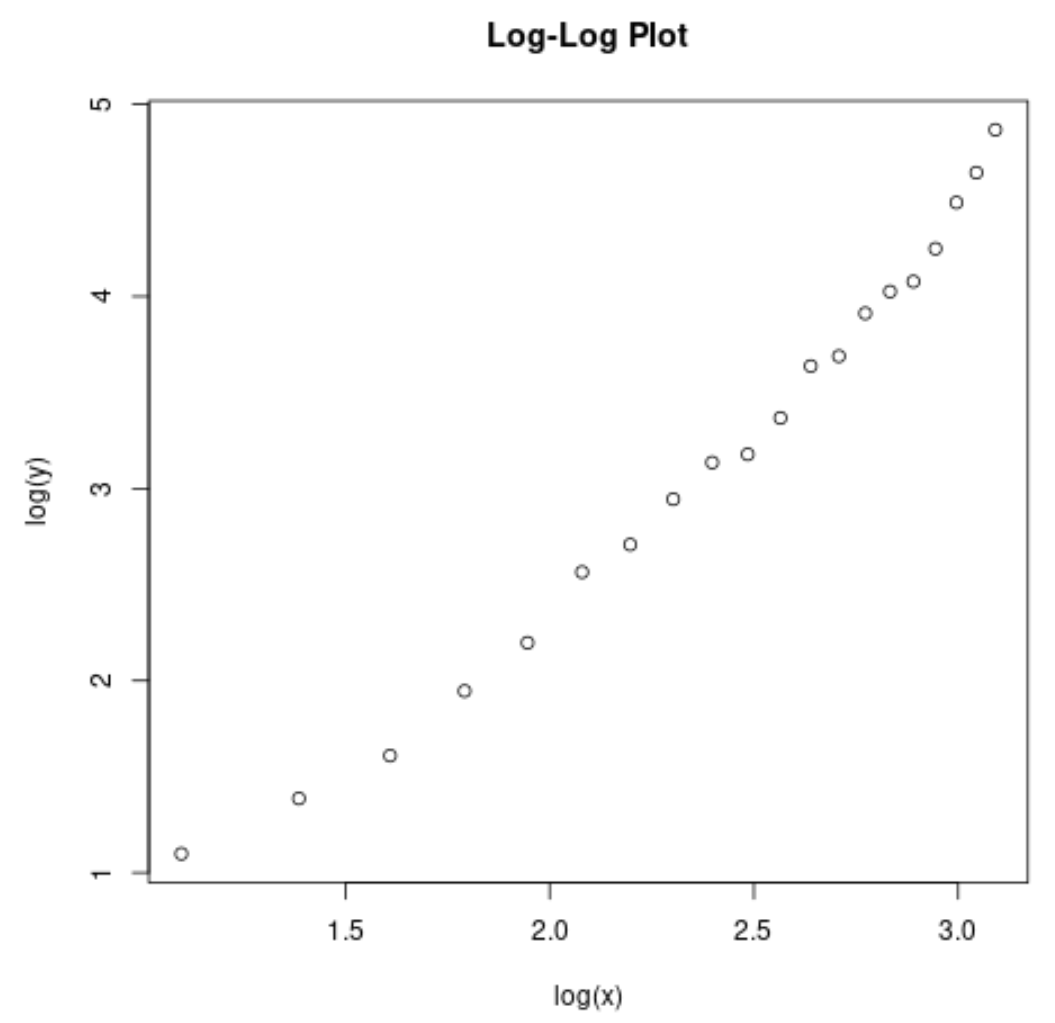
Sur le plan analytique, cette première approche offre une transparence totale quant à la géométrie de la droite obtenue. La pente visuelle perçue par l’observateur correspond rigoureusement à la dérivée $d(log y) / d(log x)$, autorisant une évaluation oculaire directe de l’exposant d’échelle par simple lecture du dénivelé géométrique unitaire. Cette technique s’avère particulièrement adaptée aux phases d’exploration préliminaire rapide, lorsque le chercheur cherche avant tout à valider la conformité d’un alignement empirique sans s’embarrasser des subtilités de formatage des graduations non linéaires.
4.2 Utilisation de l’argument natif log=’xy’
Pour la communication scientifique et la publication de données quantitatives, le moteur graphique de Base R offre un mécanisme infiniment plus puissant et élégant : l’activation de l’argument natif log = « xy ». En exécutant la syntaxe canonique plot(df$x, df$y, log = « xy »), l’analyste transmet à R les vecteurs bruts sans aucune altération mathématique préalable. C’est le moteur de rendu graphique lui-même qui opère la distorsion géométrique de la surface de projection, en assignant une fonction de transfert logarithmique aux métriques spatiales des deux axes orthogonaux.
Le bénéfice sémiologique de cette approche native réside dans la préservation intégrale des coordonnées physiques originelles sur les étiquettes de graduation des axes. Au lieu d’afficher des valeurs abstraites de logarithmes calculés, les axes conservent les unités empiriques réelles du système analysé (par exemple des millisecondes, des Hertz, des concentrations molaires ou des populations). Les graduations majeures sont disposées à intervalles spatiaux constants pour chaque ordre de grandeur ($10^1, 10^2, 10^3$), tandis que les graduations intermédiaires illustrent plastiquement la compression progressive de l’espace métrique au fur et à mesure que l’on progresse vers la borne supérieure de chaque décade.
Cette construction algorithmique combine ainsi le meilleur des deux mondes : d’un côté, elle offre le bénéfice analytique de la linéarisation visuelle des lois de puissance, permettant de constater instantanément la rectitude de la trajectoire globale du nuage de points ; de l’autre, elle garantit l’intelligibilité immédiate des valeurs numériques brutes pour le lecteur, écartant tout risque d’erreur de conversion mentale entre échelles logarithmiques et échelles arithmétiques.
5. Personnalisation avancée du graphique log-log en Base R
5.1 Contrôle des paramètres graphiques globaux avec par()
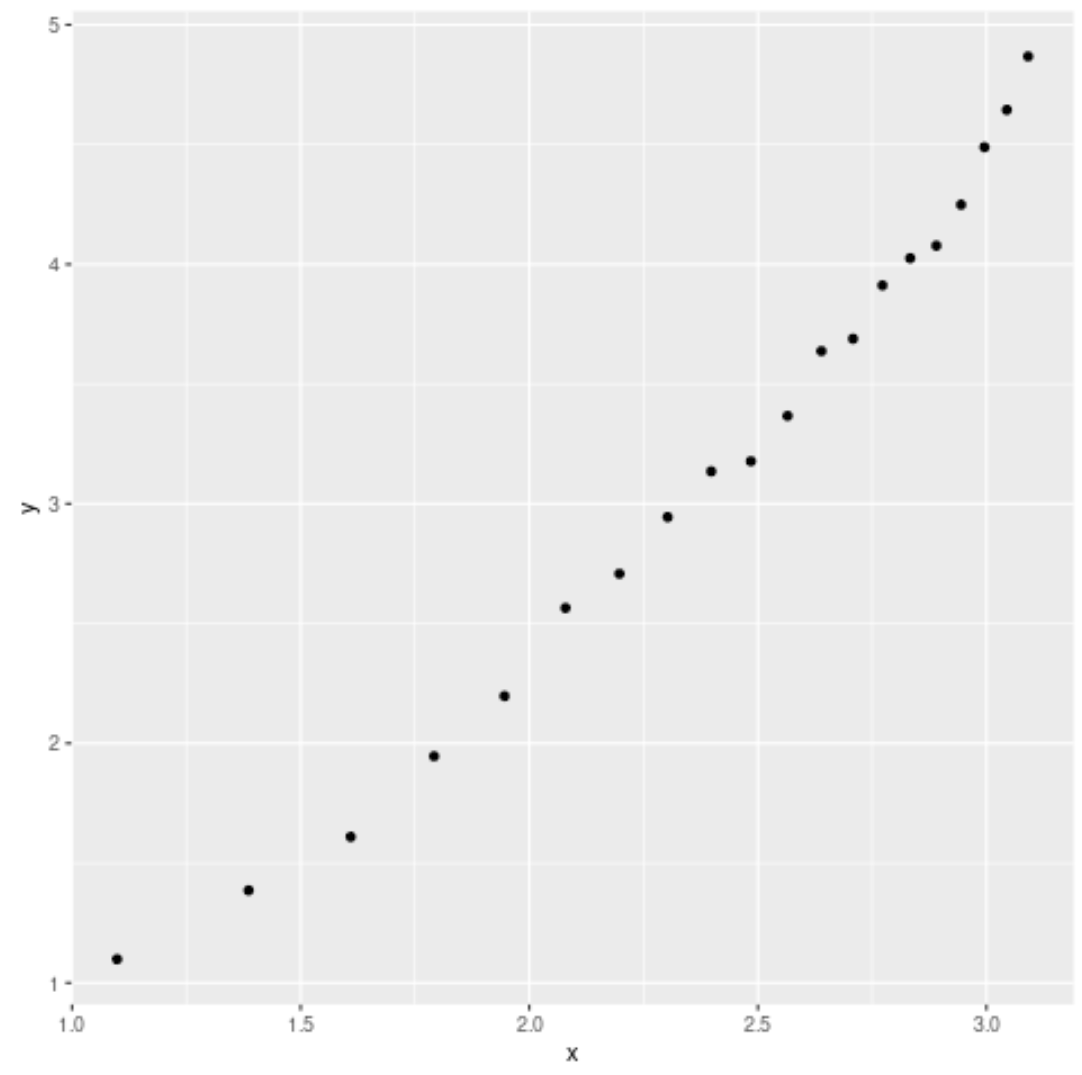
L’accession à une qualité graphique digne des périodiques scientifiques internationaux exige de s’émanciper des paramètres cosmétiques par défaut de Base R. La fonction par() constitue la tour de contrôle du moteur de rendu, permettant d’ajuster avec une précision chirurgicale l’environnement typographique et topologique du canevas avant l’exécution du tracé principal. L’argument fondamental mar, configuré typiquement sous la forme d’un vecteur numérique à quatre composantes par exemple mar = c(4.5, 4.5, 2, 1.5), régit l’épaisseur des marges intérieures (exprimées en lignes de texte) respectivement pour les bordures inférieure, gauche, supérieure et droite, éliminant ainsi les espacements excessifs ou le rognage inopiné des étiquettes dimensionnelles complexes.
La gestion de la typographie et des hiérarchies scalaires passe par la manipulation concertée des modificateurs d’expansion de caractères. Le paramètre global cex.axis régule la taille relative des chiffres positionnés sur les graduations, tandis que cex.lab calibre la magnitude optique des intitulés textuels des axes, assurant une lisibilité sans faille lors des procédures de réduction d’échelle imposées par la mise en page des publications scientifiques. La structure de l’encadrement graphique est quant à elle dictée par l’argument bty (box type) : l’attribution de la chaîne bty = « l » supprime élégamment les lignes supérieure et droite de l’encadrement pour ne conserver que les axes porteurs fonctionnels en forme de « L », allégeant radicalement la charge d’encre non informative selon les préceptes cardinaux d’Edward Tufte en matière de design visuel des données.
L’intégration de ces réglages au sein d’un flux de travail reproductible requiert une discipline de codage rigoureuse. Il est impératif d’assigner l’état initial des paramètres système à une variable tampon (par exemple opar <- par(no.readonly = TRUE)) préalablement à toute modification globale, afin de rétablir scrupuleusement l’environnement graphique par défaut via on.exit(par(opar)) à la clôture de la séquence de calcul, prévenant ainsi toute contamination involontaire des tracés subséquents de la session de travail R.
5.2 Personnalisation des symboles et des annotations d’axes
Pour transcender les limitations du rendu graphique rudimentaire, il est hautement recommandé de déconstruire le mécanisme d’affichage par défaut en stipulant l’argument axes = FALSE au sein de la fonction plot(). Cette directive neutralise la génération automatisée des graduations standards, concédant à l’analyste un contrôle programmatique absolu sur la reconstruction manuelle des axes via des appels spécialisés à la primitive axis(). Cette technique permet de dessiner séparément les graduations majeures décadiques et les graduations mineures intra-décadiques, indispensables à une interprétation visuelle fine sur les échelles logarithmiques étendues.
Le raffinement des marqueurs géométriques repose sur la sélection minutieuse des codes de pointage (pch). L’utilisation des identifiants numériques compris entre 21 et 25 débloque la prise en charge distincte de la couleur de contourure (argument col) et de la nuance de remplissage interne (argument bg). L’emploi d’un disque plein semi-transparent, spécifié par pch = 21, bordé d’un contour sombre et rempli d’une teinte chromatique dotée d’un canal alpha atténué, élimine radicalement les phénomènes délétères d’occultation visuelle (overplotting) dans les segments de forte densité d’échantillonnage, garantissant que chaque observation apporte son poids visuel singulier à la structure globale.
Enfin, le calibrage du repère peut être parachevé par l’adjonction d’une grille logarithmique personnalisée. Contrairement aux grilles linéaires classiques où les lignes de repère s’espacent de manière équidistante, une grille bilogarithmique rigoureuse requiert le tracé de lignes de référence majeures continues aux puissances de dix exactes au moyen de la fonction abline(h = …, v = …), complétées d’un maillage secondaire en pointillés fins pour les valeurs intermédiaires ($2 \times 10^n, 3 \times 10^n, dots, 9 \times 10^n$). Ce canevas structurel permet au lecteur d’interpoler optiquement n’importe quel point expérimental avec une exactitude quantitative rigoureuse sans surcharge visuelle.
6. Construction d’un graphique log-log avec ggplot2 : Transformation des échelles
6.1 Architecture fondamentale de ggplot2 et initialisation
L’avènement de l’écosystème du tidyverse et de la bibliothèque ggplot2 a profondément renouvelé la production de visualisations de données dans le champ de la recherche scientifique. Fondé sur la théorie mathématique de la grammaire des graphiques développée par Leland Wilkinson, ggplot2 formalise la dissociation fonctionnelle absolue entre le substrat de données tabulaires pures, l’espace d’association esthétique (les liens unissant variables et dimensions visuelles telles que position, couleur, taille ou forme), et les couches d’instanciation géométrique (points, lignes, polygones).
La mise en œuvre initiale d’un graphique log-log débute par la définition de l’objet graphique racine via la fonction ggplot(data = df, aes(x = x, y = y)). Dans cette instruction princeps, aucune projection spatiale définitive n’est encore cristallisée ; R établit simplement le couplage formel entre les colonnes du tableau de données et les dimensions spatiales fondamentales du graphique. L’adjonction consécutive de la couche géométrique dédiée geom_point() via l’opérateur de composition + matérialise le nuage de points dans l’espace arithmétique standard.
À ce stade initial du pipeline de traitement, si aucune instruction transformationnelle supplémentaire n’est transmise au système, ggplot2 projette les observations selon les métriques linéaires natives. L’analyste se trouve alors confronté aux mêmes pathologies d’asymétrie visuelle et de condensation périphérique que celles relevées précédemment sous Base R. Toutefois, la force structurale de ggplot2 réside dans sa capacité à insérer des couches d’échelle intermédiaires sans altérer ni les coordonnées stockées dans la structure de données source, ni les primitives géométriques déclarées dans le canevas.
6.2 Implémentation de scale_x_log10() et scale_y_log10()
L’approche canonique et recommandée sous ggplot2 pour transmuter un espace de projection cartésien en repère bilogarithmique repose sur l’intégration séquentielle des fonctions spécialisées scale_x_log10() et scale_y_log10(). Ces couches d’échelle interviennent directement au niveau du moteur de transformation interne : elles reçoivent les données d’entrée brutes, leur appliquent la fonction logarithmique en base 10, réassignent la distribution spatiale des géométries sur le plan, et recomposent de façon entièrement automatisée l’affichage des graduations de repérage.
L’excellence ergonomique de cette méthode réside dans la synergie absolue entre les fonctions d’échelle de ggplot2 et la boîte à outils spécialisée du paquet scales. En combinant les arguments breaks et labels avec les formateurs avancés tels que scales::trans_breaks() et scales::trans_format(), le chercheur s’affranchit de tout codage algorithmique fastidieux pour générer des graduations scientifiquement irréprochables. Il est ainsi trivial d’instruire le moteur de rendu d’afficher des étiquettes sous forme de puissances mathématiques élégantes ($10^1, 10^2, 10^3$) plutôt que sous la forme de décimales récurrentes ou de notations scientifiques tronquées.
Par rapport à la syntaxe Base R, cette implémentation au sein de la grammaire des graphiques garantit une cohérence structurelle totale lorsque l’analyste décide d’adjoindre ultérieurement d’autres attributs de modélisation visuelle, à l’instar des facettes de conditionnement multivarié (facet_wrap ou facet_grid). Les échelles logarithmiques s’adaptent dynamiquement à la morphologie locale de chaque sous-groupe de données tout en conservant une comparabilité métrique rigoureusement unifiée sur l’intégralité du panneau graphique.
6.3 Utilisation de coord_trans() comme alternative conceptuelle
Au sein du répertoire analytique de ggplot2, il subsiste une seconde stratégie méthodologique pour implémenter une géométrie bilogarithmique : l’appel explicite à la fonction de transformation du système de coordonnées coord_trans(x = « log10 », y = « log10 »). Bien que les résultats graphiques bruts puissent sembler superficiellement analogues à ceux générés par scale_x_log10(), cette démarche repose sur une logique computationnelle fondamentalement dissemblable qu’il convient de circonscrire précisément sous peine d’altérations statistiques majeures.
Dans l’architecture de ggplot2, l’opération de transformation par scale_* se produit chronologiquement en amont du calcul de tout résumé statistique ou modèle d’ajustement géométrique. À l’inverse, coord_trans() intervient à l’extrémité finale de la chaîne de traitement graphique, en aval des transformations statistiques. Lorsqu’on intègre des géométries de modélisation dynamique comme geom_smooth(method = « lm »), l’utilisation de scale_x_log10() calcule le modèle de régression linéaire directement sur les données log-transformées (ce qui correspond précisément à l’estimation de l’exposant d’une loi de puissance). En revanche, coord_trans() ordonne au moteur de calculer d’abord une droite de régression linéaire standard sur les données brutes arithmétiques, puis d’en tordre la trajectoire a posteriori pour la projeter sur un repère déformé, aboutissant à une courbe résiduelle dépourvue de sens statistique dans le cadre d’une loi de puissance.
Par conséquent, les règles de bonne pratique en bio-statistique et en sciences quantitatives proscrivent formellement l’utilisation de coord_trans() pour la modélisation des lois de puissance comportant des ajustements linéaires. Son usage doit être strictement réservé à des situations spécifiques où des calculs géométriques particuliers (comme des interpolations de splines sur des coordonnées spatiales naturelles) doivent être projetés sans redéfinition statistique préalable sur une grille de lecture déformée.
7. Construction d’un graphique log-log avec ggplot2 : Transformation directe des variables
7.1 Transformation dans l’esthétique aes()
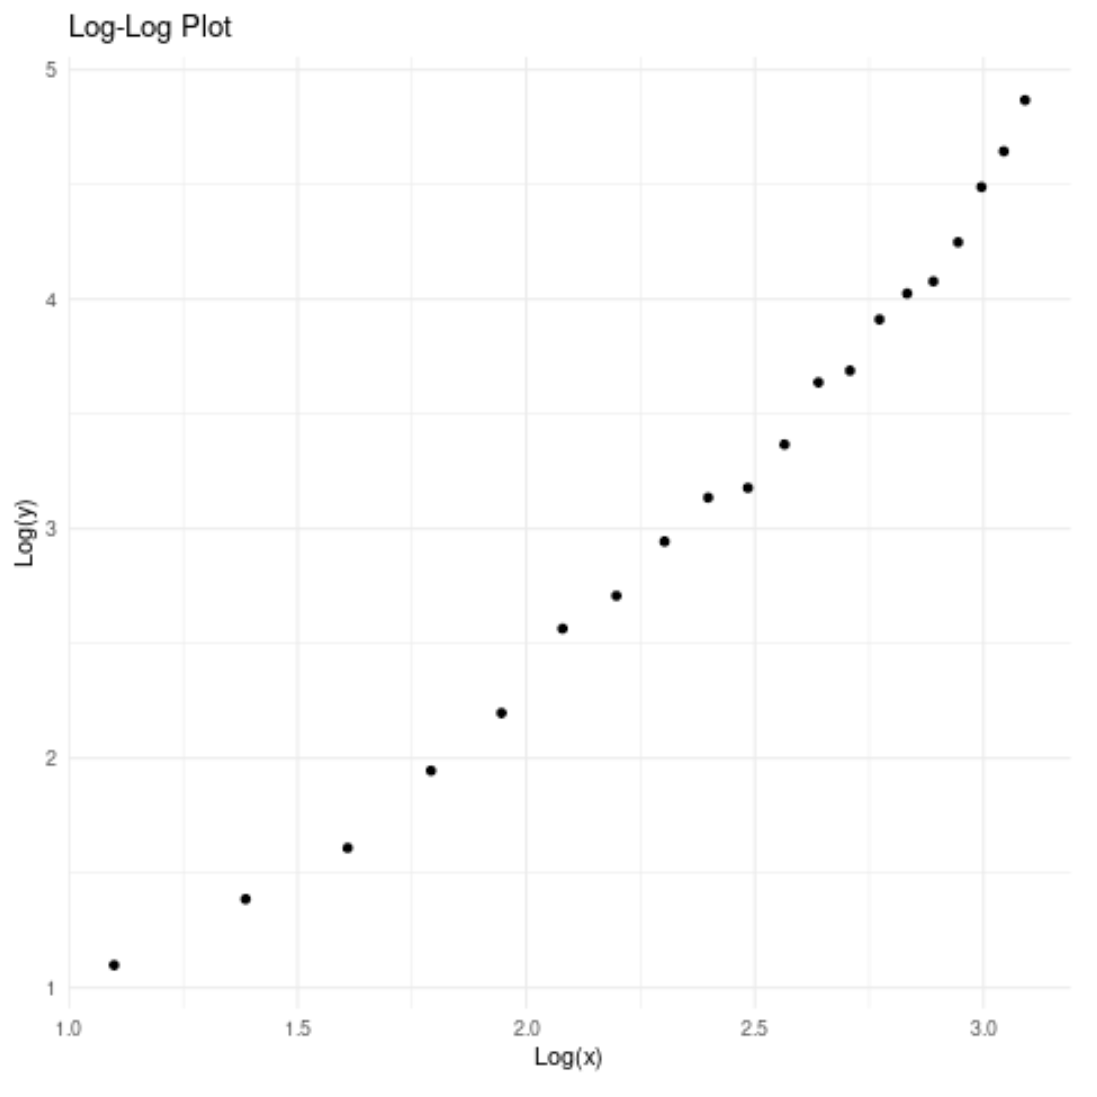
Une démarche alternative au sein du paradigme de ggplot2 consiste à incorporer la transformation mathématique directement au sein des déclarations d’esthétiques fondamentales, en spécifiant par exemple aes(x = log10(x), y = log10(y)). Dans cette configuration opératoire, ggplot2 ne traite plus les axes comme des coordonnées non linéaires déployées sur des variables naturelles, mais appréhende formellement les résultats transformés comme de nouvelles variables numériques autonomes, évoluant dans un espace euclidien standard.
Cette distinction conceptuelle entraîne des conséquences sémiologiques immédiates sur le rendu des axes de lecture. Les étiquettes automatiques de graduation n’affichent plus les grandeurs physiques du système empirique, mais répercutent de manière littérale les valeurs numériques calculées de l’opérateur logarithmique (par exemple 1, 2, 3 pour $10, 100, 1000$). Cela reporte sur l’analyste l’obligation méthodologique de requalifier manuellement les titres d’axes à l’aide des primitives labs(x = « … », y = « … ») ou xlab()/ylab(), sous peine de diffuser des visualisations scientifiquement ambiguës ne précisant pas la base logarithmique mobilisée.
Cette approche par transformation directe dans l’instruction aes() présente un avantage technique indéniable dans des flux d’analyses avancés. Elle s’avère particulièrement appropriée lorsque l’analyste envisage de superposer plusieurs couches d’inférence statistique hétérogènes calculées en dehors de ggplot2, d’extraire directement les pentes angulaires sur le repère affiché, ou d’exporter les coordonnées précises des points transformés vers d’autres moteurs d’annotation géométrique matricielle.
7.2 Application des thèmes académiques dans ggplot2
La conformité d’une figure aux critères de rigueur imposés par les comités éditoriaux des revues de rang international repose sur la neutralisation des artifices graphiques superflus. Le thème gris par défaut de ggplot2 (theme_grey()), bien qu’optimal pour l’exploration interactive sur écran, s’avère rédhibitoire pour l’impression scientifique en raison de sa consommation dispendieuse de fond encré et de la réduction du contraste optique des symboles. L’application immédiate de thèmes épurés tels que theme_classic(), theme_bw() ou theme_light() constitue le premier jalon vers une normalisation professionnelle de la figure.
La personnalisation fine s’orchestre ensuite via l’appel exhaustif à la fonction modulaire theme(). Dans le contexte d’un graphique log-log, la gestion des grilles constitue l’enjeu esthétique et analytique prépondérant. L’analyste calibrera les composantes panel.grid.major au moyen de element_line(color = « grey85 », linewidth = 0.3) pour instaurer des repères d’ordre de grandeur discrets mais perceptibles, tout en désactivant éventuellement les maillages mineurs via element_blank() afin d’éviter toute saturation visuelle dans les segments de haute densité de points.
Le raffinement typographique s’achève par l’harmonisation globale des polices de caractères et de leur orientation spatiale. L’ajustement de axis.text = element_text(size = 11, family = « serif », color = « black ») garantit une intégration harmonieuse au sein de manuscrits composés sous des environnements typographiques exigeants comme LaTeX. L’incorporation d’une palette chromatique sobre et accessible aux personnes atteintes d’anomalies de vision des couleurs (color blindness), en exploitant par exemple les fonctions scale_color_viridis_c() ou scale_color_brewer(), parachève la construction d’une pièce graphique combinant une parfaite rigueur géométrique à un impact visuel optimal.
8. Ajustement et visualisation de modèles de régression linéaire sur données log-log
8.1 Estimation des paramètres de la loi de puissance avec lm()
Dès lors que la configuration visuelle du graphique bilogarithmique valide empiriquement l’hypothèse d’une trajectoire linéaire, l’estimation quantitative des paramètres sous-jacents de la loi de puissance doit être menée avec la plus rigoureuse exactitude statistique. Sous l’environnement R, la fonction fondamentale lm() (modèles linéaires) assure cette tâche computationnelle par la méthode des moindres carrés ordinaires, en spécifiant formellement la relation log-transformée via l’expression de formule syntaxique : modele <- lm(log(y) ~ log(x), data = df).
L’interrogation de l’objet de régression obtenu via la primitive analytique summary(modele) permet d’extraire la structure paramétrique complète du phénomène. Le coefficient associé à l’ordonnée à l’origine (Intercept, dénoté $\beta_0$) correspond à la valeur logarithmique de la constante d’échelle, soit $log(a)$. Par conséquent, l’estimation ponctuelle de la constante physique d’origine s’obtient formellement par l’application de l’opérateur de rétro-transformation exponentielle $\hat{a} = \exp(\hat{\beta}_0)$. Le coefficient associé à la variable prédictive log-transformée ($\beta_1$) correspond sans aucune modification mathématique ultérieure à l’estimation de l’exposant d’échelle de puissance $\hat{k}$, constituant la mesure directe de l’élasticité invariante d’échelle du système.
L’évaluation inférentielle exige un examen scrupuleux du tableau d’analyse de la variance joint. L’analyste consigne avec précision l’erreur standard associée au coefficient de pente, examine la statistique de Student $t$ et la $p$-valeur bilatérale associée pour écarter formellement l’hypothèse nulle d’isométrie ou de nullité d’échelle. Pour transcender les limites inhérentes aux estimations ponctuelles, le recours à la commande confint(modele, level = 0.95) s’avère indispensable pour dériver les bornes des intervalles de confiance à $95,%$ de l’exposant d’échelle, fournissant le domaine des valeurs paramétriques théoriquement compatibles avec les données observées.
8.2 Superposition de la droite de régression en Base R
L’intégration visuelle du modèle de régression linéaire sur un canevas log-log au sein du moteur de Base R requiert une vigilance méthodologique accrue quant à la nature exacte de l’espace graphique préalablement initialisé. Dans le scénario où le graphique a été conçu par transformation explicite des vecteurs (plot(log(df$x), log(df$y))), la superposition de la droite de tendance découle de l’appel direct de la fonction primitive abline(modele, col = « firebrick », lwd = 2). Le moteur trace alors une ligne droite continue dont la pente et l’interception s’alignent rigoureusement avec les coordonnées de l’espace transformé.
En revanche, lorsque l’analyste exploite l’argument d’échelle dynamique log = « xy » sur des données brutes, l’invocation directe de la commande abline(modele) génère une divergence spatiale absolue, car abline() tente de projeter les paramètres logarithmiques sur un espace vectoriel de coordonnées natives. Pour surmonter cette contrainte géométrique sans altérer la nature de l’affichage, il est impératif d’évaluer la fonction de prédiction sur un vecteur continu de valeurs de $x$ fines et régulièrement espacées à l’aide de predict() ou curve(), puis de superposer la prédiction résultante via la fonction de traçage de lignes continues lines(x_seq, exp(pred_log_y), col = « firebrick », lwd = 2).
Pour parachever l’ergonomie documentaire de la figure sous Base R, l’intégration de métadonnées statistiques directement sur la surface du graphique s’opère via la fonction text() ou legend(). En formulant une chaîne de caractères vectorisée dynamique couplant l’équation mathématique du modèle et le coefficient de détermination $R^2$ ajusté par l’entremise de la fonction bquote() ou expression(), le chercheur ancre visuellement l’inférence quantitative au cœur même du document empirique, éliminant tout doute d’interprétation pour le lectorat académique.
8.3 Superposition de la droite de régression dans ggplot2
Dans l’univers conceptuel de ggplot2, l’opération d’ajustement et de superposition graphique d’une modélisation linéaire s’exécute avec une élégance algorithmique remarquable grâce à la géométrie analytique geom_smooth(). Lorsqu’on évolue sur un graphique configuré via scale_x_log10() et scale_y_log10(), l’incorporation de l’instruction geom_smooth(method = « lm », color = « firebrick », fill = « grey70 », se = TRUE) déclenche l’ajustement automatique du modèle linéaire dans l’espace des échelles transformées, garantissant une modélisation théoriquement rigoureuse de la loi de puissance sans exiger la manipulation manuelle de calculs de régression préalables.
L’avantage esthétique et méthodologique majeur de geom_smooth() réside dans le calcul et le tracé automatisés du fuseau d’incertitude représentant l’intervalle de confiance à $95,%$ de la droite d’espérance moyenne, symbolisé par un bandeau d’ombrage semi-transparent d’une précision géométrique absolue. Ce fuseau met immédiatement en évidence la précision de l’ajustement au barycentre des données et l’évasement progressif de l’incertitude inférentielle aux extrémités périphériques du support d’observation, là où l’échantillonnage s’amenuise.
L’enrichissement de la figure par l’incrustation directe de l’équation mathématique formelle et du coefficient de détermination s’opère aujourd’hui de manière fluide via des bibliothèques d’extension spécialisées, au premier rang desquelles figure ggpubr. Par l’adjonction de l’instruction stat_regline_equation() couplée à stat_cor(), ggplot2 intègre automatiquement sur le panneau graphique les estimations numériques des coefficients du modèle, formatées selon les normes typographiques internationales, évitant les erreurs de transcription manuelle et garantissant une reproductibilité numérique parfaite de la chaîne de production visuelle.
9. Gestion des valeurs nulles, négatives et cas limites dans R
9.1 Problématique du zéro mathématique et des nombres négatifs
L’application d’un protocole graphique bilogarithmique se heurte inéluctablement à une frontière théorique infranchissable : le domaine de définition de la fonction logarithmique réelle $\mathbb{R}^{+*} = ]0, +\infty[$. Dès lors qu’une variable quantitative intègre dans sa distribution des mesures négatives ou strictement égales à zéro, l’évaluation de $log(x)$ génère une rupture fonctionnelle majeure. Dans l’environnement informatique R, l’application de log() à une valeur négative retourne obligatoirement la valeur sentinelle NaN (Not a Number) assortie d’un avertissement système (warning), tandis que l’évaluation exacte de $log(0)$ retourne l’infini négatif formel, encodé par l’indicateur -Inf.
Ces entités numériques particulières constituent une source fréquente d’échec ou d’illusion analytique lors de la conception de figures sous R. Confrontés à des occurrences de -Inf ou NaN, les moteurs de rendu graphique de Base R comme ceux de ggplot2 adoptent une stratégie d’exclusion silencieuse ou notifiée des points pathologiques : les observations correspondantes sont purement et simplement supprimées du tracé géométrique. Dans un graphique log-log, cela signifie que tous les individus statistiques caractérisés par une valeur nulle pour l’une ou l’autre des dimensions disparaissent du champ visuel sans laisser de trace tangible, induisant un biais de sélection d’échantillonnage colossal pouvant fausser dramatiquement l’estimation empirique de la pente de régression.
L’analyste a par conséquent l’obligation méthodologique absolue de pratiquer un diagnostic d’intégrité numérique en amont de toute démarche de spatialisation bilogarithmique. L’exécution de requêtes logiques simples telles que any(df$x <= 0) ou \sum(df$y <= 0) permet de dénombrer précisément la prévalence des valeurs critiques. Ce recensement guide le chercheur dans l’arbitrage entre une réévaluation théorique du protocole de mesure (par exemple si le zéro résulte d’une limitation de sensibilité de capteur) et la mise en œuvre de transformations correctrices mathématiquement contrôlées.
9.2 Stratégies d’ajustement et transformations alternatives
Pour contourner la singularité asymptotique en zéro, une pratique empirique largement répandue mais méthodologiquement périlleuse consiste à adjoindre une constante scalaire positive $c$ aux observations, via la transformation additive dite de pseudo-comptes : $x^* = x + c$. Bien que cette translation autorise le calcul formel de $log(x + c)$ y compris pour les mesures nulles, le choix de la constante $c$ n’a rien d’anodin. L’injection d’une valeur arbitraire déforme substantiellement la linéarité logarithmique dans la zone critique proche de zéro, modifie arbitrairement la courbure du nuage de points et induit un biais systématique non négligeable sur l’estimation finale de l’exposant d’échelle de puissance $k$.
Une alternative mathématiquement supérieure consiste à mobiliser la transformation par le sinus hyperbolique inverse, formellement définie par la fonction mathématique :
$$\text{a\sinh}(x) = \ln\left(x + \sqrt{x^2 + 1}\right)$$
Cette fonction transcendantale possède la remarquable propriété géométrique d’être définie sur l’ensemble des réels $\mathbb{R}$ tout entier, incluant les nombres négatifs et le zéro exact. Pour les magnitudes absolues très petites ($|x| ll 1$), la transformation asinh se comporte de manière quasi parfaitement linéaire ($\text{a\sinh}(x) \approx x$), tandis que pour les valeurs élevées ($|x| gg 1$), elle converge asymptotiquement vers une transformation purement logarithmique ($\text{a\sinh}(x) \approx \ln(2x) = \ln(x) + \ln(2)$), préservant ainsi intégralement le comportement d’invariance d’échelle sur les queues de distribution.
Dans l’écosystème ggplot2, cette robustesse de traitement est formalisée de manière élégante par la fonction spécialisée scales::pseudo_log_trans(). En intégrant cette transformation directement dans les couches d’échelle au moyen de l’argument trans, par exemple via scale_x_continuous(trans = scales::pseudo_log_trans(base = 10, sigma = 1)), l’utilisateur instruit R de traiter avec continuité la transition entre le régime linéaire au voisinage immédiat de l’origine et le régime logarithmique déployé sur les ordres de grandeur supérieurs, assurant une représentation visuelle continue et intègre de l’intégralité du spectre expérimental sans rejet d’observation.
10. Applications psychométriques et cognitives : Lois de puissance en psychologie
10.1 Loi de Stevens et perception psychophysique
L’investigation expérimentale des relations reliant l’énergie physique d’une stimulation environnementale à l’intensité subjective de la sensation vécue par l’observateur constitue l’un des piliers historiques de la psychologie scientifique. Rompant avec la formulation logarithmique simple proposée au XIXe siècle par Fechner, le psychophysicien Stanley Smith Stevens a démontré au milieu du XXe siècle que la magnitude subjective de la sensation obéit universellement à une loi de puissance régie par la formule canonique :
$$\psi(I) = \kappa \cdot I^\beta$$
où $I$ représente l’intensité physique objective du stimulus, $psi$ la grandeur phénoménologique perçue, $kappa$ une constante d’étalonnage liée aux unités de mesure, et $\beta$ l’exposant caractéristique propre à la modalité sensorielle investiguée.
Le graphique bilogarithmique constitue l’outil analytique indispensable et exclusif permettant de cartographier la diversité de ces dynamiques sensorielles au sein d’un formalisme théorique unifié. Lorsque les données de magnitude psychophysique sont projetées en coordonnées log-log, la valeur de la pente $\beta$ livre un diagnostic structural immédiat quant à la nature du traitement cognitivo-neural de l’information :
$$\log(\psi) = \log(\kappa) + \beta \log(I)$$
Un exposant $\beta 1$ reflète une dynamique d’expansion sensorielle, où l’appareil perceptif amplifie de manière supra-linéaire le signal pour déclencher des réponses motrices défensives d’urgence, dynamique caractérisant typiquement la perception de la douleur induite par choc électrique corporel ($\beta \approx 3{,}5$).
La mise en œuvre sous R de visualisations psychophysiques rigoureuses permet de confronter simultanément sur un même graphique multi-courbes les réponses de différentes modalités sensorielles. En exploitant des jeux de données d’estimation de magnitude sensorielle normalisés, l’analyste structure sous ggplot2 des géométries de points et d’ajustements linéaires différenciées par modalité via l’esthétique color = modalite, révélant d’un seul coup d’œil la dispersion des pentes angulaires $\beta$ et ancrant les postulats de la psychophysique théorique dans une démonstration visuelle d’une remarquable puissance démonstrative.
10.2 Loi de puissance de la pratique et acquisition des compétences cognitives
L’étude longitudinale de l’acquisition de compétences cognitives et motrices complexes a mis en lumière un invariant empirique fondamental connu sous le nom de loi de puissance de la pratique (Power Law of Practice), formalisée initialement par Snoddy en psychométrie motrice puis universalisée par Allen Newell et Paul Rosenbloom dans le champ des sciences cognitives. Cette loi stipule que le temps de complétion $T$ d’une tâche donnée ou le temps de réaction cognitive diminue de manière systématique en fonction du nombre cumulé d’essais de pratique $N$, selon une formulation de puissance de type :
$$T_N = T_1 \cdot N^{-\alpha}$$
où $T_1$ représente le temps de performance initial au premier essai et $\alpha$ le taux intrinsèque d’apprentissage cognitif.
La représentation de cette dynamique d’automatisation comportementale en coordonnées bilogarithmiques opère une linéarisation spectaculaire des profils d’apprentissage. Sur une échelle arithmétique ordinaire, la progression de l’apprenant paraît spectaculaire lors des premiers essais pour s’atténuer ensuite jusqu’à donner l’illusion graphique fallacieuse d’un plateau d’apprentissage définitif au-delà duquel aucun progrès ne surviendrait. La projection log-log dissipe cette erreur d’interprétation : la persistance d’une droite d’ajustement ininterrompue sur plusieurs ordres de grandeur d’essais prouve formellement que l’optimisation des schémas procéduraux se poursuit indéfiniment à un taux d’efficacité relatif rigoureusement constant.
Dans l’écosystème de calcul R, l’évaluation de cette loi mobilise fréquemment l’analyse de tracés individuels et agrégés. L’utilisation conjointe de geom_point(alpha = 0.2) pour matérialiser la forte variance inter-individuelle brute et de geom_line(stat = « smooth », method = « lm ») permet de superposer avec clarté la trajectoire nomothétique partagée. Cette démarche analytique sous R permet en outre d’engager le débat computationnel contemporain comparant la loi de puissance aux modèles d’apprentissage alternatifs de type exponentiel ($T_N = A + B e^{-rN}$), en confrontant la linéarité résiduelle bilogarithmique à celle observée sur des repères semi-logarithmiques.
10.3 Dynamiques de mémoire et loi de l’oubli de Wickelgren
L’exploration chronologique de l’attrition de la mémoire à long terme s’articule historiquement autour des pionniers de la psychologie expérimentale comme Hermann Ebbinghaus. Cependant, les modélisations mathématiques formelles conduites ultérieurement par Wayne Wickelgren ont affiné notre compréhension des dynamiques mnésiques en démontrant que la probabilité de rétention ou la force de la trace mnésique $d’$ (mesurée en paradigmes de détection du signal) s’érode au fil du temps $t$ selon une relation en loi de puissance modifiée :
$$d'(t) = \lambda (1 + \beta t)^{-\psi}$$
où $lambda$ reflète le degré initial d’encodage mnésique, $\beta$ le paramètre d’échelle temporelle et $psi$ le taux d’oubli structurel.
Lorsque cette équation est projetée dans un système d’axes bilogarithmiques en observant le décours temporel sur des amplitudes considérables (s’étendant de quelques secondes après la phase d’apprentissage à plusieurs semaines ou années de rétention), la cinétique de décroissance converge vers une trajectoire rectiligne dont la pente négative correspond à $-psi$. Cette propriété géométrique remarquable démontre que le taux de perte d’information n’est pas constant dans le temps physique absolu (ce qui correspondrait à une décomposition exponentielle classique), mais décroît lui-même de manière inversement proportionnelle au temps déjà écoulé depuis l’encodage.
Sur le plan neuro-cognitif, cette linéarité en repère log-log visualise avec une clarté exemplaire le principe biologique de consolidation synaptique et systémique. Les souvenirs qui ont survécu aux premières décades temporelles de l’oubli ont franchi une transition d’état, devenant exponentiellement plus résistants à toute détérioration ultérieure. La reconstruction de ces profils de décroissance mémorielle sous R, combinant les échelles temporelles logarithmiques avec les métriques standardisées de discrimination $d’$, fournit un étalon visuel de premier ordre pour évaluer l’impact différentiel d’interventions neuro-pharmacologiques ou de stratégies d’apprentissage distribué sur la robustesse temporelle des représentations mnésiques.
11. Diagnostics graphiques et validation statistique de la linéarité logarithmique
11.1 Analyse critique de la linéarité apparente
L’un des écueils méthodologiques les plus insidieux en analyse de données quantitatives réside dans ce que les statisticiens contemporains qualifient fréquemment de piège de l’apparence linéaire bilogarithmique. En raison de la compression bidirectionnelle monumentale opérée par l’opérateur logarithmique sur plusieurs ordres de grandeur, quasiment n’importe quelle distribution empirique continûment décroissante ou croissante tend à acquérir visuellement un alignement rectiligne superficiellement séduisant lorsqu’elle est projetée dans un repère log-log. Des travaux fondamentaux de la littérature statistique, notamment la célèbre critique formulée par Aaron Clauset, Cosma Shalizi et Mark Newman (2009), ont rigoureusement démontré que la simple obtention d’un coefficient de détermination linéaire élevé ($R^2 > 0{,}95$) sur des variables log-transformées ne constitue en aucune manière une preuve probante de l’existence d’une loi de puissance sous-jacente.
Pour déjouer cette illusion optique, l’analyste sous R ne doit jamais se limiter à la simple contemplation du graphique de dispersion global. Il est impératif d’extraire les résidus de la régression linéaire et de procéder à leur inspection spatiale systématique via des graphiques de diagnostic spécialisés. En construisant un graphique confrontant les résidus transformés $e_i = \ln(y_i) – \widehat{\ln(y_i)}$ aux valeurs ajustées ou aux valeurs de $\ln(x_i)$, toute inadéquation structurale du modèle se révèle instantanément. La présence d’une courbure résiduelle systématique, d’un profil en « U » inversé ou d’une ondulation non stochastique atteste sans appel que le processus physique sous-jacent incorpore des mécanismes de troncature, des effets de seuil ou relève en réalité d’une distribution concurrente, telle qu’une loi log-normale ou une loi de Weibull.
Une discipline graphique rigoureuse implique donc d’adjoindre systématiquement au graphique log-log principal un panneau auxiliaire de résidus studentisés, configuré par exemple au moyen de l’instruction R plot(modele, which = 1). Cette confrontation critique garantit que l’invariance d’échelle postulée ne relève pas d’un simple artefact de projection spatiale mais constitue une propriété structurellement vérifiée du jeu de données empirique analysé.
11.2 Tests formels d’ajustement de loi de puissance sous R
La validation scientifique d’une distribution en loi de puissance exige de dépasser la régression linéaire par moindres carrés pour mobiliser le formalisme probabiliste de l’estimation par maximum de vraisemblance (Maximum Likelihood Estimation, MLE). Cette méthodologie rigoureuse est magnifiquement implémentée dans l’écosystème R par l’intermédiaire du paquet spécialisé poweRlaw, conçu spécifiquement pour identifier le seuil minimal de validité de l’invariance d’échelle ($x_{\min}$) et dériver une estimation non biaisée de l’exposant critique de queue de distribution $\alpha$.
Le protocole analytique sous poweRlaw débute par l’instanciation d’un objet de distribution dédié, par exemple via displ$new(vecteur_donnees) pour des variables discrètes ou conpl$new(vecteur_donnees) pour des mesures continues. L’algorithme opère ensuite l’estimation simultanée de $x_{\min}$ et de $\alpha$ en minimisant la distance statistique de Kolmogorov-Smirnov (KS) entre la distribution empirique observée et la loi de puissance théorique ajustée. Cette procédure élimine toute subjectivité humaine dans le choix de la portion de données soumise à l’ajustement d’invariance d’échelle.
L’inférence statistique se parachève par la mise en œuvre d’un protocole de rééchantillonnage par bootstrap semi-paramétrique via la commande bootstrap_p(). En générant des milliers d’échantillons synthétiques sous l’hypothèse nulle d’une loi de puissance pure calibrée, R dérive une $p$-valeur empirique rigoureuse. Contrairement aux conventions de test standard, une loi de puissance n’est déclarée plausible et statistiquement recevable que si cette $p$-valeur est strictement supérieure au seuil conservateur de $0{,}10$, récusant formellement l’hypothèse d’ajustement dès lors que des fluctuations empiriques excessives s’écartent du modèle théorique. Enfin, la visualisation experte ne s’opère pas sur les densités brutes mais sur la fonction de distribution cumulative complémentaire (Complementary Cumulative Distribution Function, CCDF), qui atténue le bruit stochastique dans les queues de distribution et fournit le diagnostic bilogarithmique le plus robuste de la littérature contemporaine.
12. Bonnes pratiques de publication scientifique et export haute résolution dans R
12.1 Conception graphique rigoureuse pour les revues scientifiques
L’acceptation d’une figure au sein des périodiques scientifiques internationaux les plus exigeants (tels que ceux publiés par l’American Psychological Association, Elsevier, Springer ou Nature Publishing Group) est conditionnée par l’adhésion scrupuleuse à des règles typographiques et sémiologiques standardisées. En matière de représentations bilogarithmiques, la première exigence méthodologique formulée par les normes de l’APA (7e édition) réside dans l’explicitation sans équivoque de la base logarithmique employée. Les libellés d’axes ne doivent jamais comporter la mention isolée et équivoque « Log(X) », mais doivent stipuler précisément « Log_{10}(X) » ou « ln(X) », idéalement accompagnés de l’unité de mesure physique originale entre parenthèses.
La lisibilité universelle et l’accessibilité visuelle commandent de concevoir les figures en anticipant les contraintes physiologiques des lecteurs ainsi que les dégradations potentielles liées aux reproductions imprimées. L’analyste proscrira impérativement les combinaisons chromatiques indifférenciables pour les sujets atteints de dyschromatopsies (notamment l’écueil classique opposant le rouge et le vert), en intégrant systématiquement des palettes perceptuellement uniformes comme Viridis ou des palettes catégorielles optimisées issues de RColorBrewer. De surcroît, le codage de l’information ne doit jamais reposer uniquement sur la couleur : la modulation conjointe de la forme des marqueurs (pch) et du style de tracé des segments de tendance (linetype) assure une transmission intégrale de l’information, y compris lors d’une impression monochrome en noir et blanc.
Le calibrage du ratio encre/information (data-ink ratio) impose un dimensionnement harmonieux des épaisseurs de trait et des corps de texte. Une erreur classique consiste à composer des graphiques de grande dimension sur écran dont les graduations et les points deviennent microscopiques et illisibles une fois réduits à la largeur standard d’une colonne de texte d’un article académique (généralement calibrée entre 8 et 9 centimètres). Les symboles doivent présenter un diamètre minimal de 1,5 millimètre post-réduction, tandis que la typographie finale ne doit en aucun cas descendre en deçà d’un corps de 7 à 8 points typographiques réels.
12.2 Procédures d’export vectoriel et matriciel
L’exportation finale d’un chef-d’œuvre graphique depuis l’environnement R vers les répertoires éditoriaux nécessite une maîtrise rigoureuse des pilotes graphiques (graphics devices). Pour les figures destinées à la soumission d’articles, le format vectoriel constitue l’étalon d’excellence absolu. Contrairement aux images matricielles constituées de grilles de pixels figées, les fichiers vectoriels encodent les éléments graphiques sous forme d’instructions géométriques pures, autorisant un agrandissement ou une réduction d’échelle infinis sans la moindre dégradation de netteté textuelle ou géométrique.
Dans l’écosystème Base R, l’exportation vectorielle s’opère par l’ouverture formelle d’un périphérique dédié via pdf(file = « figure1.pdf », width = 7, height = 5, colormodel = « cmyk ») ou postscript(), immédiatement suivie de l’exécution séquentielle des commandes graphiques, pour se clore impérativement par l’instruction dev.off() qui compile et libère le fichier système. Pour les figures générées sous la grammaire ggplot2, la fonction dédiée ggsave() offre un niveau d’ergonomie supérieur. L’analyste spécifiera précisément les dimensions physiques en centimètres ou pouces réels ainsi que le système d’encapsulation : ggsave(« figure1.pdf », plot = dernier_graphique, width = 18, height = 12, units = « cm », device = cairo_pdf). L’utilisation du pilote cairo_pdf s’avère particulièrement recommandée pour garantir une incorporation parfaite des polices vectorielles de haute technicité et des glyphes mathématiques sans substitution arbitraire lors de la phase de pré-presse.
Dans les scénarios où les directives éditoriales imposent des fichiers d’images matricielles (tels que des rendus photographiques complexes de textures ou de cartographies à haute densité d’échantillonnage), le format TIFF compressé sans perte d’information (compression LZW) constitue le standard de référence de l’industrie. L’exportation doit alors impérativement calibrer une résolution spatiale minimale de 300 DPI (dots per inch) pour les images en demi-teintes et de 600 à 1200 DPI pour les dessins au trait au contraste net, via la commande ggsave(« figure1.tif », dpi = 600, compression = « lzw »). L’intégration de ces protocoles au sein d’un script R documenté et entièrement automatisé garantit une chaîne de reproductibilité scientifique intégrale, reliant de manière transparente la manipulation de la donnée brute au fichier de publication final de qualité muséale.
Références
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Gillespie, C. S. (2015). Fitting heavy tailed distributions: The poweRlaw package. Journal of Statistical Software, 64(2), 1–16. https://doi.org/10.18637/jss.v064.i02
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickelgren, W. A. (1974). Single-trace fragility theory of memory dynamics. Memory & Cognition, 2(4), 775–780. https://doi.org/10.3758/BF03198153
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0