
L’évaluation de la validité d’un modèle de régression linéaire constitue une étape pivotale dans toute démarche de recherche quantitative, particulièrement au sein des sciences du comportement, de la biométrie et de l’économétrie. Bien que les praticiens se concentrent fréquemment sur l’interprétation des coefficients de régression et sur les indices globaux d’ajustement tels que le coefficient de détermination, l’intégrité inférentielle des conclusions repose fondamentalement sur le respect d’un ensemble de postulats stochastiques sous-jacents. L’examen minutieux des écarts entre les observations empiriques et les valeurs théoriques projetées par le modèle — désignés sous le terme de résidus — s’avère indispensable pour déceler d’éventuelles distorsions structurelles, des ruptures d’hypothèses distributionnelles ou l’influence disproportionnée de points singuliers.
L’environnement statistique R s’est imposé comme l’écosystème de référence pour l’analyse des données empiriques, offrant un arsenal analytique complet allant des commandes graphiques de base aux représentations sophistiquées issues de l’univers conceptuel de la grammaire des graphiques. Savoir comment concevoir, paramétrer et interpréter un graphique des résidus ne relève pas simplement d’un savoir-faire technique ; il s’agit d’une compétence épistémologique indispensable pour qui souhaite garantir la reproductibilité et la robustesse de ses inférences statistiques. Un examen superficiel des données, cantonné aux tests d’hypothèse formels, expose le chercheur à des erreurs méthodologiques majeures, rendant caduque toute extrapolation théorique ou décisionnelle.
Ce guide exhaustif a pour vocation d’articuler les principes mathématiques fondamentaux de l’analyse des résidus avec leur déploiement opérationnel rigoureux dans l’environnement R. À travers un continuum didactique explorant tant les approches graphiques natives que l’instrumentation moderne offerte par les paquets spécialisés, nous décortiquerons la sémiologie des représentations d’erreurs, les manifestations visuelles de pathologies statistiques telles que l’hétéroscédasticité ou la non-linéarité, et les protocoles de correction à déployer face à ces anomalies empiriques, le tout calibré selon les standards éditoriaux les plus exigeants de la communauté scientifique internationale.
1. Fondements théoriques de l’analyse des résidus en modélisation statistique
1.1 Définition mathématique et conceptuelle du résidu en régression
Dans le cadre de la théorie générale de la modélisation statistique par régression linéaire, le résidu empirique représente la différence algébrique exacte entre la valeur observée de la variable réponse pour une entité statistique donnée et la valeur conditionnelle estimée par la fonction de régression ajustée. Formellement, pour une observation indicée par la lettre i, le résidu est formulé par l’équation où ei est égal à yi retranché de son estimation ŷi. Ce vecteur de résidus constitue la projection empirique de l’écart stochastique réel au sein de l’espace vectoriel des observations, fonctionnant comme un estimateur ponctuel des erreurs sous-jacentes du processus générateur de données.
Selon les préceptes cardinaux de l’estimation par les moindres carrés ordinaires, l’hyperplan de régression est positionné de telle sorte qu’il minimise la somme des carrés des résidus au sein de l’échantillon. Cette optimisation géométrique impose des propriétés structurelles invariables : la somme arithmétique de l’ensemble des résidus est rigoureusement nulle dès lors qu’une constante d’ordonnée à l’origine est intégrée au modèle, ce qui contraint mécaniquement leur espérance empirique à s’annuler. De surcroît, le vecteur des résidus se situe dans le complément orthogonal du sous-espace linéaire engendré par les vecteurs des variables explicatives, impliquant une corrélation empirique strictement nulle entre chaque régresseur et les résidus d’ajustement.
Sur le plan épistémologique, il convient d’opérer une dissociation conceptuelle fondamentale entre le terme d’erreur théorique, représenté par la lettre grecque εi, et le résidu empirique calculé ei. L’erreur théorique est une quantité non observable, propre à la population sous-jacente, traduisant l’agrégation de toutes les fluctuations idiosyncrasiques, des variables omises et du bruit de mesure intrinsèque. À l’inverse, le résidu est une quantité calculable, conditionnée aux données échantillonnées et aux choix spécifiques de paramétrisation retenus par l’analyste. Il constitue la métrique fondamentale évaluant la part de variance de la variable dépendante non captée par le modèle, jouant ainsi le rôle de baromètre de la fidélité de la modélisation structurelle.
1.2 Postulats de Gauss-Markov et pertinence pour la recherche empirique
Le recours à la régression par moindres carrés ordinaires tire sa légitimité théorique du célèbre théorème de Gauss-Markov, lequel stipule que, sous un ensemble précis d’hypothèses, l’estimateur des moindres carrés est le meilleur estimateur linéaire non biaisé. Le premier postulat stipule la linéarité structurelle de la relation, ce qui signifie que l’espérance conditionnelle de l’erreur, sachant les prédicteurs, est identiquement égale à zéro. La violation de cette condition révèle une inadéquation fonctionnelle, signalant que le modèle échoue à capturer des courbures, des modulations non linéaires ou des dynamiques d’interaction entre les régresseurs du système étudié.
Le second postulat concerne l’homoscédasticité, condition selon laquelle la variance conditionnelle des termes d’erreur demeure constante quelle que soit la valeur prise par les prédicteurs ou par la prédiction elle-même. La méconnaissance de ce postulat engendre le phénomène d’hétéroscédasticité, dans lequel la variabilité de l’erreur dépend systématiquement de l’échelle des mesures. Bien que l’hétéroscédasticité ne biaise pas les coefficients de régression estimés, elle invalide totalement le calcul conventionnel des erreurs types, conduisant à des statistiques de test erronées et à des probabilités critiques faussées, ce qui compromet gravement les décisions de rejet de l’hypothèse nulle.
Le troisième postulat fondamental requiert l’absence d’autocorrélation entre les termes d’erreur, postulant que la covariance entre deux résidus distincts est nulle pour toute paire d’observations indépendantes. Dans la recherche empirique, la violation de ce postulat survient fréquemment dans les protocoles longitudinaux, les mesures répétées ou les échantillonnages à dimension spatiale. Lorsque les résidus sont corrélés sériellement, la précision apparente du modèle est artificiellement gonflée : les erreurs types conventionnelles sont sous-estimées, augmentant dramatiquement le taux d’erreur de première espèce (rejet à tort d’une hypothèse nulle vraie). L’inspection des résidus constitue ainsi le mécanisme de vérification de premier ordre pour certifier l’absence de telles distorsions.
1.3 Importance diagnostique de l’inspection visuelle en psychométrie
Dans les disciplines empiriques quantitatives telles que la psychométrie et les sciences comportementales, les chercheurs s’appuient fréquemment de manière exclusive sur des tests statistiques d’hypothèse formels, à l’instar du test de Shapiro-Wilk pour la normalité ou du test de Breusch-Pagan pour l’homoscédasticité. Néanmoins, cette posture purement confirmatoire comporte des limitations structurelles majeures découlant de la taille de l’échantillon. Dans les grands cohortes, la puissance statistique excessive de ces tests conduit au rejet systématique des hypothèses de validité pour des déviations triviales sans incidence sur la robustesse globale, tandis que dans les petits échantillons cliniques, leur faible puissance échoue à identifier des violations sévères des postulats.
L’inspection graphique des résidus apporte une lecture qualitative nuancée que les métriques agrégées sont incapables de restituer. Les instruments de mesure psychométrique sont intrinsèquement vulnérables à des perturbations spécifiques, telles que les effets de plancher et de plafond, imputables à des échelles de mesure bornées ou à des tests cognitifs inadaptés au niveau d’aptitude des sujets. Ces artefacts se manifestent visuellement par des tronquatures nettes ou des alignements anormaux au sein des nuages de résidus, indices qu’aucun coefficient scalaire ne permet d’appréhender avec autant de clarté et de précision sémiotique.
Par conséquent, l’analyse visuelle et l’analyse inférentielle doivent être conçues non comme des approches concurrentes, mais comme des méthodologies complémentaires d’exploration de la qualité du modèle. L’exploration graphique permet de caractériser précisément la morphologie des déviations, de distinguer les anomalies ponctuelles isolées des ruptures de tendance distributionnelle, et de déceler des non-linéarités complexes, telles que des dynamiques d’accélération ou d’extinction des réponses psychologiques, guidant ainsi le chercheur vers des re-spécifications théoriques rationnellement fondées.
2. Configuration de l’environnement de programmation R et gestion des données
2.1 Initialisation de l’espace de travail R et importation des bibliothèques
Pour mener à bien une campagne diagnostique approfondie sur les résidus d’une régression, la première étape opérationnelle requiert la configuration méthodique de l’espace de travail au sein de la session R ou du projet interactif sous RStudio. La reproductibilité computationnelle exige une gestion transparente des dépendances logicielles. Dès l’entame de votre script, il convient de déclarer et de charger les bibliothèques d’analyse spécialisées, parmi lesquelles se distinguent tidyverse pour la manipulation fluide des tableaux de données et la sémiologie graphique avancée, car pour ses utilitaires diagnostiques indispensables, ainsi que performance, appartenant à l’écosystème easystats.
L’optimisation des paramètres de la console graphique sous RStudio permet de prévenir les troncatures visuelles lors de l’exportation ou de l’affichage interactif. Il est opportun d’ajuster les marges des fenêtres graphiques et les paramètres typographiques globaux via la fonction dédiée aux options graphiques du système. Cette étape garantit que les légendes, les labels d’axes et les annotations contextuelles s’affichent avec une netteté absolue sans chevauchement avec les marqueurs de données.
De surcroît, la rigueur méthodologique impose la fixation délibérée d’une graine stochastique à l’aide de l’instruction dédiée set.seed() lorsque des procédures de rééchantillonnage, des simulations d’enveloppes de confiance ou des algorithmes de jittering graphique sont mobilisés. Cette précaution élémentaire mais fondamentale assure que l’ensemble des représentations graphiques et des métriques générées pourront être répliquées de façon rigoureusement identique par d’autres équipes de recherche indépendantes accédant aux scripts de traitement.
2.2 Structuration et nettoyage d’un jeu de données psychologiques
La préparation minutieuse du tableau de données constitue le garant de la cohérence de toute analyse résiduelle ultérieure. L’évaluation préliminaire de la structure des données implique le contrôle systématique de la typologie des variables, en vérifiant que les prédicteurs catégoriels soient dûment instanciés comme des facteurs munis de leurs contrastes respectifs et que les mesures psychométriques continues adoptent le format numérique adéquat. Cette étape permet d’éviter l’interprétation accidentelle de codages numériques arbitraires comme des échelles d’intervalle par le moteur d’estimation statistique.
La gestion des données manquantes doit obéir à des standards rigoureux compatibles avec les exigences de publication scientifique. L’analyste se doit d’évaluer le mécanisme générateur de ces omissions, en distinguant les données manquant complètement au hasard des structures de non-réponse systématique. Si l’exclusion par liste complète des observations incomplètes demeure la pratique par défaut dans les fonctions d’estimation standards, cette suppression mécanique réduit la puissance statistique et peut induire des biais d’échantillonnage sévères si le patron d’absence est informatif, invitant dans ce cas à des stratégies de compensation par imputation multiple contrôlée.
Enfin, le contrôle minutieux de la distribution des variables avant toute opération d’ajustement permet de documenter les asymétries prononcées, les kurtosis excessifs et la présence de valeurs physiologiquement ou psychologiquement aberrantes. L’identification d’erreurs de saisie ou d’artefacts d’encodage au stade préliminaire de l’inspection descriptive prévient l’apparition ultérieure de déviations résiduelles artificielles dont l’origine résiderait dans une mauvaise hygiène de données plutôt que dans une véritable inadéquation théorique du modèle formulé.
2.3 Utilisation d’échantillons de référence natifs et contextualisés
Dans un contexte d’apprentissage technique et de prototypage d’algorithmes diagnostiques, le recours à des jeux de données d’étalonnage intégrés nativement au noyau de R présente un avantage pédagogique indéniable. L’exploitation du jeu de données classique mtcars ou du tableau de bord biométrique trees permet de tester et de valider les fonctions d’extraction et de rendu visuel sur des distributions aux propriétés mathématiques amplement documentées dans la littérature spécialisée, facilitant ainsi l’identification immédiate d’anomalies de programmation.
Toutefois, la transposition de ces routines analytiques à des cohortes empiriques contextualisées s’avère indispensable pour appréhender les subtilités inhérentes aux sciences humaines. L’analyse de modèles reliant, par exemple, les niveaux de stress perçu et les scores d’anxiété cognitive au temps de réaction mesuré lors d’une tâche de vigilance attentionnelle confronte directement le chercheur à la complexité des réponses humaines, caractérisées par une variabilité interindividuelle substantielle et une sensibilité accrue aux conditions expérimentales.
Avant d’ajuster l’équation de régression sur de tels jeux de données empiriques, il est impératif de générer la matrice des corrélations et des covariances reliant l’ensemble des prédicteurs continus envisagés. L’examen des intercorrélations élevées permet d’anticiper les risques de multicolinéarité sévère, une condition pathologique qui, sans altérer intrinsèquement la distribution brute des résidus globaux, déstabilise l’attribution causale des coefficients individuels et distord l’interprétation des graphiques de résidus partiels abordés ultérieurement.
3. Ajustement du modèle de régression linéaire et extraction des résidus
3.1 Syntaxe formelle de la fonction lm()
L’estimation des paramètres d’une régression linéaire sous R s’opère canoniquement par l’intermédiaire de la fonction lm(), acronyme désignant les modèles linéaires. Cette fonction repose sur un système d’écriture par formule symbolique où la variable réponse est séparée des termes explicatifs par un tilde. La syntaxe permet de spécifier sans ambiguïté des structures univariées simples, des modèles multivariés intégrant de multiples régresseurs additifs, ainsi que des architectures factorielles incluant des termes d’interaction croisés via l’opérateur deux-points ou l’opérateur étoile.
L’attribution de la structure de données à l’argument dédié de la fonction produit un objet statistique de classe spécialisée, encapsulant l’ensemble des résultats de la décomposition matricielle par factorisation QR. L’exécution de la méthode summary() appliquée à cet objet permet d’obtenir un condensé analytique d’une grande densité informationnelle, affichant les estimations ponctuelles des coefficients, leurs erreurs types associées, la statistique t de Student et les seuils de significativité associés à chaque paramètre du système prédictif.
Outre les paramètres individuels, cette restitution fournit des métriques globales d’ajustement au premier rang desquelles figurent le coefficient de détermination R² brut et sa variante ajustée prenant en compte le nombre de degrés de liberté consommés par les variables explicatives. Bien qu’une valeur élevée de R² indique une réduction substantielle de la variance non expliquée par rapport au modèle nul, cet indicateur est notoirement aveugle aux distorsions de modélisation : un modèle fondamentalement non linéaire ou miné par une hétéroscédasticité massive peut présenter un R² très flatteur, d’où l’absolue nécessité de ne jamais clore l’évaluation à ce seul indicateur scalaire.
3.2 Extraction programmatique des vecteurs d’estimation et d’erreur
Une fois l’objet de régression instancié au sein de l’environnement de calcul, l’étape opérationnelle suivante réside dans l’extraction rigoureuse des composantes nécessaires à la construction des diagnostics graphiques. Le langage R propose des fonctions d’accès génériques spécifiquement optimisées pour cette tâche. L’instruction resid(), synonyme de la fonction residuals(), permet d’extraire le vecteur complet des résidus bruts calculés pour chaque observation incluse dans l’estimation finale du modèle.
Conjointement, l’extraction des projections théoriques s’effectue via l’invocation de la fonction fitted(), laquelle renvoie les valeurs prédites conditionnelles pour chaque individu de l’échantillon. Il est méthodologiquement recommandé d’éviter l’extraction manuelle par soustraction directe des valeurs dans le tableau source, car cette pratique rudimentaire peut générer des décalages d’indexation majeurs lorsque des données manquantes ont été automatiquement évincées par l’algorithme d’estimation de lm().
Pour garantir une manipulation optimale au sein des pipelines de traitement modernes, il est hautement conseillé de fusionner immédiatement ces vecteurs au sein d’une structure de données unifiée, qu’il s’agisse d’un data frame classique ou d’un tibble. L’intégration des valeurs observées, des prédictions ajustées, des résidus bruts et des identifiants d’individus dans un conteneur tabulaire homogène facilite les transformations séquentielles et standardise les futures liaisons esthétiques nécessaires aux visualisations graphiques avancées.
3.3 Vérification des propriétés d’orthogonalité
L’intégrité numérique du calcul matriciel réalisé par l’algorithme de moindres carrés peut être certifiée par la vérification computationnelle directe des propriétés d’orthogonalité formelles. En sommant l’ensemble des éléments constituant le vecteur des résidus bruts extrait ou en calculant leur moyenne arithmétique simple, l’analyste doit observer une convergence rigoureuse vers zéro. Toute valeur s’écartant de cette limite théorique, au-delà de la précision infinitésimale de la machine, traduirait une instabilité numérique sévère ou l’omission d’une ordonnance à l’origine dans la formulation de l’équation.
Dans la même logique de vérification structurelle, l’évaluation du produit scalaire ou du coefficient de corrélation linéaire de Pearson reliant les résidus empiriques à chacun des prédicteurs continus intégrés dans le modèle doit systématiquement afficher une valeur statistiquement et numériquement indiscernable de zéro. Cette orthogonalité parfaite constitue une propriété mathématique inhérente à la méthode de projection orthogonale employée et ne prouve aucunement l’adéquation écologique du modèle, mais simplement la conformité de l’algorithme à ses règles géométriques fondamentales.
Enfin, la détermination rigoureuse des degrés de liberté résiduels s’obtient en retranchant le nombre total de paramètres estimés dans l’équation, incluant la constante, de la taille effective de l’échantillon de données exploitées. Cette quantité définit l’espace dimensionnel dans lequel fluctuent librement les résidus. Elle intervient de manière critique dans le calcul de la variance de l’erreur et dans la calibration de tous les seuils statistiques mobilisés ultérieurement lors de l’isolation des valeurs aberrantes ou influentes.
4. Génération du graphique des résidus versus valeurs ajustées avec les graphiques de base
4.1 Implémentation de l’instruction plot() fondamentale
L’infrastructure graphique historique de R, souvent qualifiée de moteur graphique de base, offre une vélocité computationnelle exceptionnelle pour concevoir instantanément un graphique confrontant les résidus aux valeurs ajustées. L’appel de la fonction primitive plot() en lui transmettant le vecteur des valeurs prédites en abscisse et celui des résidus en ordonnée génère un système de coordonnées cartésiennes classique permettant un premier aperçu intuitif de la géométrie de dispersion du modèle.
Pour hisser ce tracé préliminaire aux exigences de la communication scientifique, une personnalisation minutieuse des arguments sémantiques est requise. Les étiquettes des axes doivent être explicitées à l’aide des paramètres xlab et ylab, en substituant aux noms de variables informatiques bruts des dénominations académiques formelles telles que « Valeurs ajustées conditionnelles » et « Résidus ordinaires du modèle ». Le paramètre main permet d’adosser un titre explicatif délimitant sans ambiguïté l’objet de la représentation visuelle.
Le contrôle de l’apparence des glyphes géométriques optimise la lisibilité du nuage de points. L’argument pch gagne à être fixé à des valeurs standards offrant une lisibilité optimale, telles que des cercles pleins de dimension calibrée, tandis que l’argument cex permet de moduler l’échelle physique des points afin de prévenir les artefacts visuels dus à la saturation ou à la coalescence des observations lorsque la taille de l’échantillon devient substantielle.
4.2 Ajout d’une ligne de référence horizontale à zéro
Une visualisation brute des résidus demeure difficilement exploitable sans repère géométrique matérialisant l’espérance mathématique théorique des erreurs sous l’hypothèse de spécification correcte du modèle. L’adjonction d’une ligne horizontale parfaitement alignée sur l’ordonnée zéro s’impose comme une nécessité absolue pour ancrer le regard de l’analyste et structurer l’espace diagnostique de façon rigoureuse.
Cette composante fondamentale s’intègre via l’instruction de bas niveau abline(), en définissant explicitement son argument horizontal h = 0. Pour empêcher que cette ligne directrice ne se confonde avec les motifs empiriques constitués par le nuage de points ou ne surcharge l’image globale, il est d’usage académique de lui assigner un style graphique discontinu grâce à l’argument lty = 2, ainsi qu’une coloration contrastante mais discrète, telle qu’un rouge sobre ou un gris soutenu.
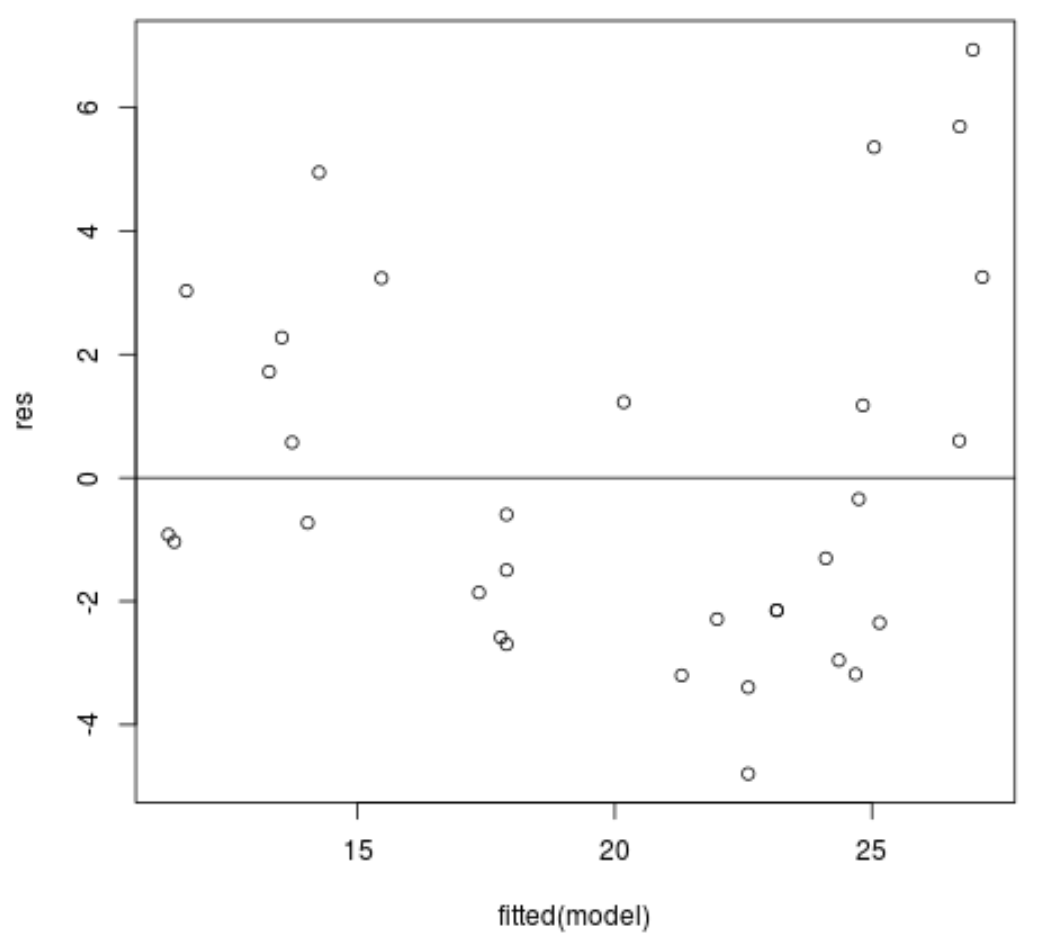
L’utilité diagnostique de cette ligne horizontale est immédiate : elle permet d’évaluer d’un simple coup d’œil la symétrie de la dispersion des résidus de part et d’autre de l’axe central. Dans un modèle exempt de biais prédictif systématique, la densité spatiale des points et leur amplitude d’écartement doivent se répartir de manière équilibrée entre le demi-plan supérieur (surestimation empirique) et le demi-plan inférieur (sous-estimation empirique) sur toute la plage d’estimation.
4.3 Ajout d’une courbe de lissage non paramétrique de type LOWESS
L’œil humain étant naturellement sujet à des illusions d’optique perceptuelles face à des nuages de points complexes, la détection des courbures subtiles requiert l’assistance d’un lissage algorithmique objectif. L’intégration d’une courbe de régression locale pondérée, couramment désignée sous l’acronyme LOWESS (Locally Weighted Scatterplot Smoothing), répond parfaitement à cet impératif diagnostique.
L’implémentation opérationnelle s’effectue par l’instruction combinée lines(lowess(fitted, resid)), qui calcule localement une série de régressions polynomiales pondérées afin de tracer une trajectoire continue décrivant la tendance centrale empirique des résidus. Il est essentiel de contrôler le paramètre d’ajustement ou d’étendue spatiale (couramment nommé f ou span) : une valeur excessivement restreinte provoque un surapprentissage bruité des fluctuations aléatoires, tandis qu’une valeur trop large étouffe les véritables non-linéarités structurelles du phénomène.
L’interprétation de la courbe de lissage constitue un moment clé du diagnostic statistique : si le lissage s’écarte substantiellement de la ligne de référence horizontale pour former des inflexions, des dômes ou des cuvettes prononcées, le chercheur dispose d’une preuve visuelle directe d’un défaut de spécification fonctionnelle. Une telle distorsion indique que la relation reliant la variable réponse aux prédicteurs n’est pas purement linéaire et exige une reformulation structurelle immédiate.
5. Interprétation analytique du graphique résidus versus ajustements
5.1 Identification de l’hétéroscédasticité graphique
La manifestation emblématique d’une violation du postulat d’homoscédasticité sur le graphique des résidus versus valeurs ajustées prend la forme canonique d’un entonnoir ou d’un pavillon de trompette ouvert vers la droite ou vers la gauche. Cette structure géométrique signale sans équivoque que la dispersion stochastique des erreurs s’accroît ou se contracte systématiquement en fonction de l’amplitude de l’espérance conditionnelle estimée pour chaque observation.
Les conséquences méthodologiques de ce profil pathologique sont particulièrement délétères pour la validité des conclusions statistiques. Lorsque la variabilité de l’erreur augmente avec la valeur prédite, la précision de l’estimation se dégrade drastiquement pour les valeurs élevées sans que les erreurs types classiques n’en tiennent compte. Il en résulte des intervalles de confiance artificiellement étroits dans les zones de forte instabilité, induisant des inférences exagérément optimistes et non reproductibles.
Dans la recherche psychologique et clinique, ce motif en entonnoir émerge fréquemment lors de l’emploi d’instruments d’évaluation auto-rapportés ou de questionnaires mesurant des constructs tels que l’épuisement professionnel ou la sévérité dépressive. Chez les sujets présentant des scores d’adaptation bas, la variabilité des réponses tend à être fortement contrainte vers le bas, tandis que chez les sujets en détresse sévère, les manifestations symptomatiques présentent une hétérogénéité d’expression comportementale beaucoup plus marquée, générant naturellement une hétéroscédasticité structurelle qu’il convient de modéliser avec discernement.
5.2 Diagnostic des non-linéarités systématiques
Le second dysfonctionnement structural majeur décelé par l’analyse de ce graphique réside dans la présence de motifs courbés, se manifestant sous la forme de trajectoires en U, de paraboles inversées ou de cycles ondulatoires sinusoïdaux. Une telle configuration spatiale révèle que l’algorithme d’estimation a commis des erreurs de prédiction systématiques conditionnées au niveau de prédiction, sous-estimant les réponses réelles aux extrémités du spectre tout en les surestimant dans la plage intermédiaire, ou vice-versa.
Ces manifestations visuelles traduisent généralement l’omission fautive de termes polynomiaux d’ordre supérieur dans l’équation de régression, à l’instar d’une relation quadratique décrivant la célèbre loi de Yerkes-Dodson reliant l’éveil motivationnel à la performance cognitive. De même, la méconnaissance d’un terme d’interaction synergique ou antagoniste entre deux régresseurs majeurs engendre fréquemment des distorsions résiduelles curvilignes, le modèle additif simple s’avérant incapable de restituer la modulation conditionnelle de l’effet étudié.
Il importe néanmoins d’exercer un sens critique aigu afin de ne pas confondre de légères ondulations locales, imputables aux fluctuations naturelles d’échantillonnage dans les zones clairsemées en données, avec une réelle rupture structurelle de linéarité. L’amplitude des courbures observées doit être mise en perspective avec la largeur de l’enveloppe globale de variabilité des données : seules les déviations continues, transversales à de larges segments du continuum prédictif, justifient une révision structurelle de l’architecture mathématique du modèle.
5.3 Évaluation du nuage de points idéal (homoscédastique et linéaire)
À l’opposé des profils pathologiques décrits précédemment, la représentation visuelle d’un modèle de régression conforme à l’ensemble de ses postulats fondamentaux prend l’aspect d’un nuage de points totalement aléatoire, uniformément réparti au sein d’une bande horizontale d’épaisseur constante, sans agrégation directionnelle ni structure géométrique perceptible. Cette configuration empirique est fréquemment désignée dans la littérature méthodologique sous la métaphore du ciel étoilé ou du motif de dispersion amorphe.
L’évaluation rigoureuse de cette configuration repose sur la vérification minutieuse de deux propriétés fondamentales. D’une part, la ligne moyenne virtuelle reliant les barycentres locaux des résidus doit s’aligner de manière rigoureuse sur l’axe horizontal passant par zéro, témoignant de l’absence totale de biais directionnel résiduel. D’autre part, la largeur verticale englobant la dispersion des points doit demeurer rigoureusement constante depuis les prédictions les plus basses jusqu’aux prédictions les plus élevées, confirmant l’invariance stricte de la variance d’erreur.
Lorsque cette morphologie équilibrée est observée, le chercheur dispose d’une confirmation visuelle directe de la validité de la spécification de son modèle linéaire. Il est alors fondé à considérer que l’ensemble du signal systématique contenu dans les variables explicatives a été intégralement extrait et transféré dans les coefficients de régression, ne laissant dans le réceptacle des résidus qu’un bruit blanc stochastique purement aléatoire, garantissant l’intégrité de ses procédures d’inférence statistique et de test d’hypothèse.
6. Création de graphiques de résidus avancés avec ggplot2
6.1 Construction de la géométrie de base avec geom_point()
L’extension ggplot2, articulée autour de la célèbre grammaire des graphiques développée par Leland Wilkinson, offre un niveau d’expressivité et de contrôle esthétique largement supérieur aux fonctions graphiques de base. La mise en œuvre débute par la conversion de l’objet de régression en un format tabulaire enrichi, opération que la fonction d’augmentation issue du paquet broom réalise avec élégance en compilant au sein d’une même structure les prédicteurs, les réponses, les valeurs ajustées et l’ensemble des variantes de résidus.
L’initialisation de l’instruction ggplot() associe les valeurs ajustées à l’axe des abscisses et les résidus bruts à l’axe des ordonnées au sein du bloc d’assignation esthétique principal. La superposition de la couche géométrique fondamentale s’opère ensuite via la fonction geom_point(). Pour pallier le problème récurrent de chevauchement massif des observations au sein des volumineuses cohortes psychométriques, il est hautement recommandé de moduler la transparence des marqueurs grâce au paramètre d’opacité alpha, permettant d’identifier immédiatement les zones de haute densité probabiliste par gradation visuelle naturelle.
En outre, le dimensionnement physique des glyphes et leur coloration chromatique peuvent être paramétrés pour mettre en exergue des attributs expérimentaux complémentaires. L’assignation de couleurs discrètes ou de formes distinctes permet d’enrichir le diagnostic visuel univarié en intégrant, sans surcharge cognitive, une couche supplémentaire d’information contextuelle relative aux conditions expérimentales ou aux profils démographiques des sujets évalués.
6.2 Intégration d’outils d’ajustement dynamique avec geom_smooth()
L’immense valeur ajoutée de la démarche sous ggplot2 réside dans la facilité déconcertante avec laquelle des couches de modélisation auxiliaires peuvent être combinées pour éclairer le diagnostic résiduel. L’adjonction de la fonction geom_hline(yintercept = 0) matérialise instantanément l’ordonnée d’équilibre théorique, tandis que l’incorporation de la fonction géométrique geom_smooth() superpose une trajectoire d’ajustement non paramétrique dérivée d’un algorithme de type LOESS.
Contrairement aux instructions graphiques natives, geom_smooth() enrichit par défaut cette courbe de lissage empirique d’un ruban semi-transparent délimitant l’intervalle de confiance stochastique à 95 % associé à la tendance locale estimée. Cette délimitation statistique apporte une aide méthodologique inestimable : l’analyste peut déterminer en temps réel si les déviations locales de la courbe vis-à-vis de l’axe zéro constituent des fluctuations compatibles avec le bruit d’échantillonnage ou si elles traduisent une rupture fonctionnelle statistiquement indiscutable requérant un enrichissement structurel du modèle.
L’harmonisation visuelle de l’ensemble s’obtient par l’adjonction de fonctions thématiques sophistiquées conformes aux standards éditoriaux les plus stricts de l’American Psychological Association. L’application de directives telles que theme_classic() ou theme_minimal() permet de supprimer les grilles graphiques superflues et les fonds grisés encombrants, dirigeant l’attention focale du lecteur scientifique exclusivement sur la dynamique spatiale des données d’erreur et sur la rigueur des lignes de référence.
6.3 Segmentation conditionnelle via le facettage graphique
L’une des fonctionnalités les plus puissantes de l’architecture ggplot2 pour l’investigation méthodologique réside dans le facettage systématique, matérialisé par les instructions facet_wrap() et facet_grid(). Cette technique permet de partitionner le graphique global des résidus en une mosaïque matricielle de sous-graphiques homogènes, chacun représentant exclusivement la distribution d’erreur observée au sein d’un sous-ensemble stratifié de l’échantillon analysé.
Cette approche apporte une réponse décisive à l’impératif de vérification de l’invariance de mesure et de la stabilité fonctionnelle du modèle selon les caractéristiques sociodémographiques ou cliniques des répondants. En ventilant les résidus selon des facteurs discrets tels que le sexe, les tranches d’âge ou les sous-types nosologiques, l’analyste peut immédiatement s’assurer que l’absence apparente d’hétéroscédasticité ou de courbure sur le plan agrégé ne masque pas, en réalité, des distorsions sévères et antagonistes se compensant artificiellement d’un sous-groupe à un autre.
Le facettage constitue également une technique d’exploration de premier ordre pour détecter des interactions non encore modélisées. Si la pente locale ou la dispersion des résidus présente des orientations diamétralement divergentes selon les panneaux de la mosaïque graphique, cette hétérogénéité conditionnelle démontre que l’effet des régresseurs principaux est en réalité modulé par le facteur de segmentation retenu, imposant formellement l’intégration d’un terme d’interaction croisé dans l’équation de régression générale.
7. Évaluation de la normalité des résidus : Diagramme Quantile-Quantile (Q-Q Plot)
7.1 Fondements du diagramme Quantile-Quantile normal
Bien que le théorème de Gauss-Markov garantisse les propriétés d’optimalité linéaire des estimateurs sans requérir la distribution gaussienne des erreurs, l’inférence statistique classique — incluant le calcul exact des erreurs types, l’établissement des intervalles de confiance et la validité des tests d’hypothèse de Student et de Fisher — repose formellement sur l’hypothèse de distribution normale des résidus. Le diagramme Quantile-Quantile normal constitue le dispositif graphique par excellence pour évaluer le respect de ce postulat distributionnel fondamental.
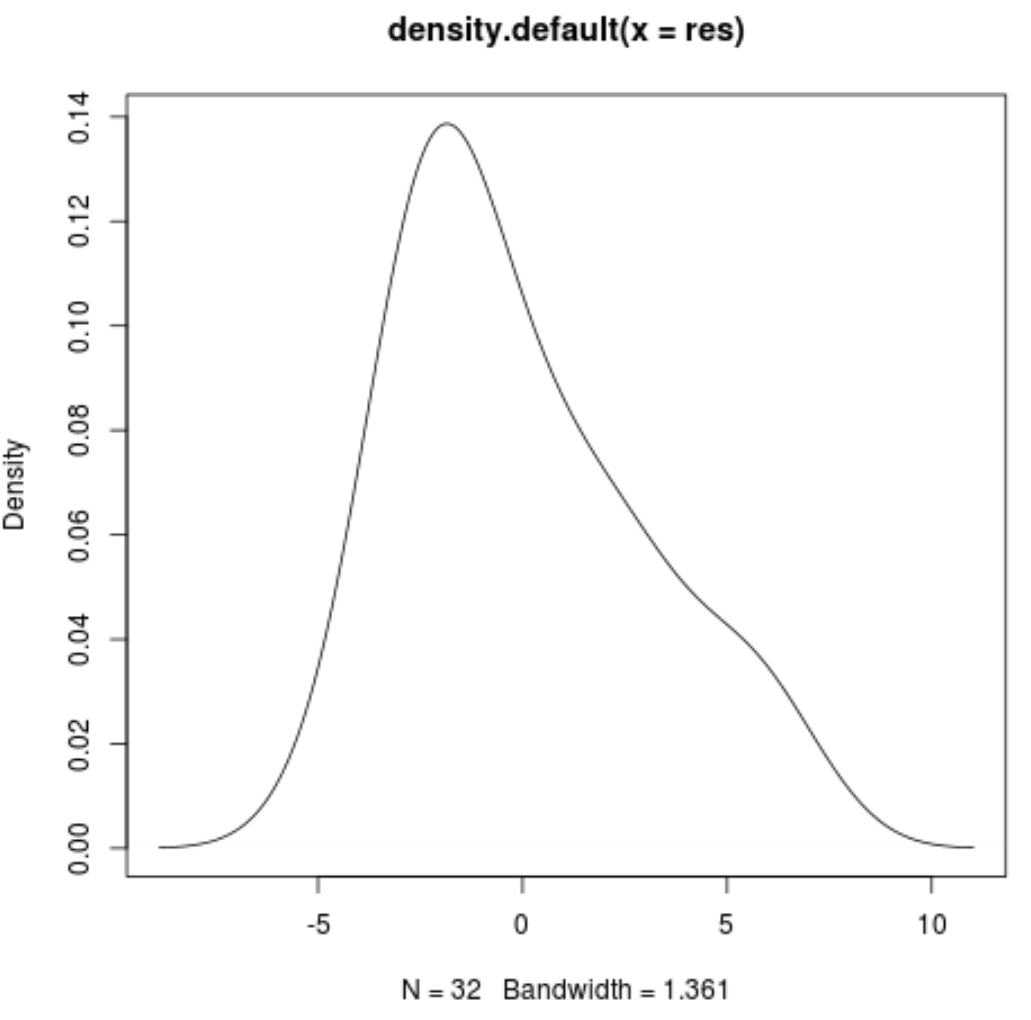
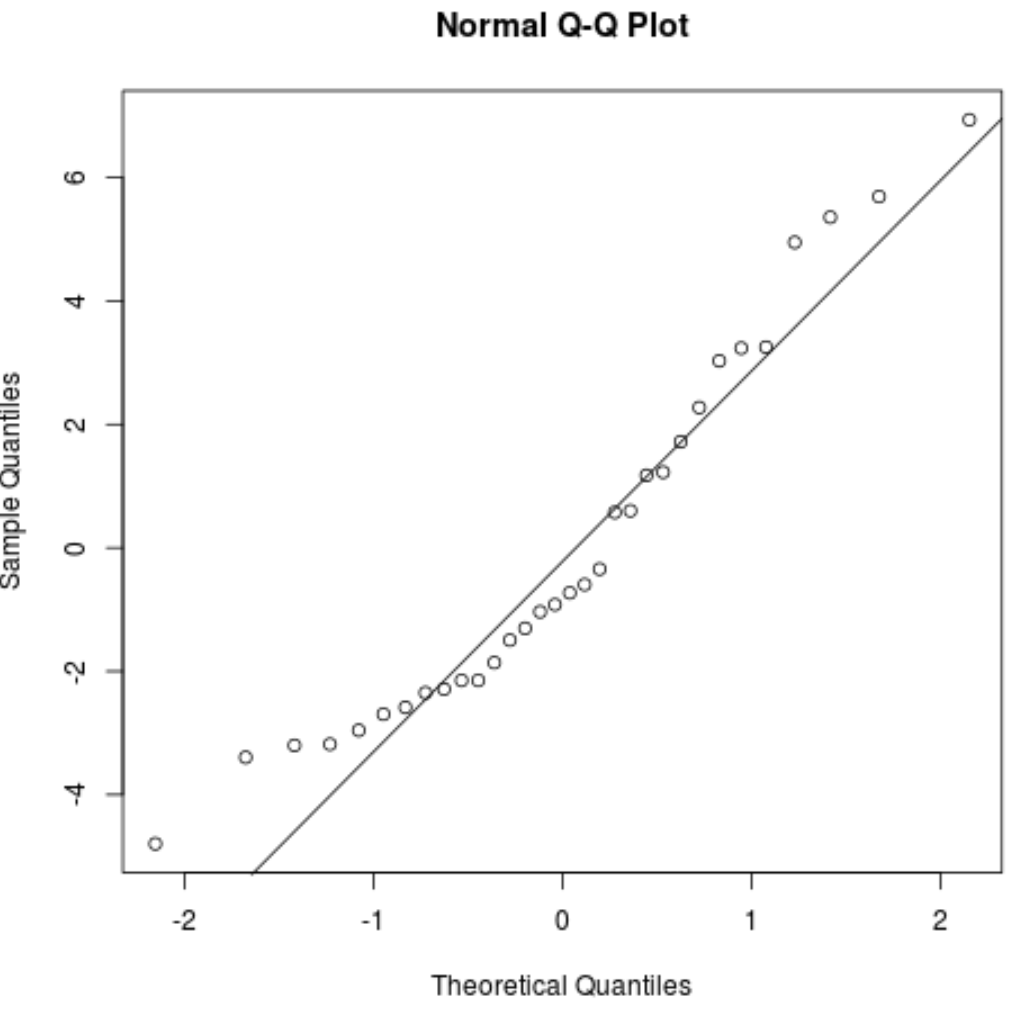
Le principe mathématique sous-jacent au diagramme Q-Q consiste à apparier et à confronter graphiquement deux séries ordonnées de quantiles : les quantiles empiriques, dérivés directement du tri croissant des résidus standardisés calculés sur l’échantillon, et les quantiles théoriques attendus d’une loi normale univariée de moyenne nulle et de variance unitaire. Si les erreurs stochastiques du modèle procèdent fidèlement d’un processus générateur gaussien, les coordonnées résultant de cette confrontation s’alignent rigoureusement le long de la bissectrice identitaire.
Il importe de rappeler l’importance différentielle de cette hypothèse selon la taille de l’échantillon mobilisé. En vertu du théorème central limite, les distributions d’échantillonnage des coefficients de régression convergent asymptotiquement vers la normalité dans les cohortes de dimensions volumineuses, conférant une relative robustesse aux inférences même en présence de résidus non gaussiens. Néanmoins, pour les échantillons de taille restreinte ou modeste fréquemment rencontrés dans les études expérimentales et en neuropsychologie clinique, la non-normalité des résidus détruit la précision des seuils critiques, rendant le contrôle visuel par le tracé Q-Q rigoureusement incontournable.
7.2 Génération du Q-Q plot sous R de base et ggplot2
Le déploiement technique de cette méthode s’avère particulièrement direct au sein du socle applicatif natif de R grâce à la combinaison des instructions primitives qqnorm() et qqline(). La première fonction prend en argument le vecteur des résidus extraits du modèle et projette les coordonnées quantiles sur un canevas graphique dédié. L’appel consécutif de la seconde trace une droite de référence passant de manière robuste par les premier et troisième quartiles de la distribution théorique, offrant ainsi le repère d’alignement indispensable pour jauger visuellement les déviations.
Dans l’environnement de mise en page moderne offert par ggplot2, cette construction s’opère au moyen des fonctions statistiques spécialisées stat_qq() et stat_qq_line(). L’analyste assigne la série de résidus bruts ou standardisés au sein du bloc esthétique univarié à l’aide de l’argument de spécification d’échantillon, permettant aux fonctions sous-jacentes de calculer automatiquement la distribution des quantiles théoriques sans exiger la manipulation manuelle préalable de fonctions de répartition inverse.
Pour enrichir cette restitution visuelle d’une quantification rigoureuse de l’incertitude stochastique, il est particulièrement pertinent de faire appel aux utilitaires avancés de la bibliothèque car, notamment via la fonction qqPlot(). Cet outil perfectionné trace une enveloppe de confiance paramétrique ou simulée par la méthode bootstrap à 95 % entourant la droite de conformité normale. Tout résidu dont la coordonnée perfore ces bandes limites est immédiatement caractérisé comme statistiquement discordant par rapport aux attentes de la théorie gaussienne.
7.3 Typologie des déviations par rapport à la droite de référence
L’interprétation clinique et méthodologique du diagramme Q-Q requiert une excellente maîtrise de la sémiologie des déviations géométriques. Une distorsion fréquemment rencontrée se manifeste sous la forme d’un profil sigmoïdal ou en forme de « S », où les observations s’écartent vers l’extérieur de la ligne de référence aux deux extrémités du spectre. Cette configuration traduit une distribution à queues lourdes, dite leptokurtique, indiquant que le modèle génère des erreurs extrêmes beaucoup plus fréquentes et intenses que ce que ne tolère une distribution normale théorique.
Inversement, une inflexion en forme de « S inversé », où les résidus réels convergent de manière prématurée vers l’axe central aux deux marges de la distribution, caractérise un régime à queues légères ou platykurtique. Cette situation indique une troncature anormale de la variabilité empirique, souvent consécutive à l’usage d’instruments d’évaluation aux échelles d’enregistrement excessivement comprimées ou à l’application de filtres d’exclusion préalables trop drastiques lors du prétraitement des données brutes.
Enfin, les asymétries distributionnelles s’identifient par des déviations unilatérales asymétriques vis-à-vis de la droite théorique. Une courbure continue s’élevant vers le haut aux deux extrémités révèle une asymétrie positive (étalement excessif de la queue supérieure), typique des mesures de latence ou des variables de coût cognitif. À l’opposé, une concavité dirigée uniformément vers le bas dénote une asymétrie négative prononcée. Identifier la nature exacte de cette distorsion morphologique constitue le préalable incontournable au choix judicieux de la transformation mathématique correctrice.
8. Diagnostic des observations atypiques, résidus standardisés et studentisés
8.1 Calcul et visualisation des résidus standardisés
Les résidus bruts calculés par simple soustraction présentent une lacune méthodologique substantielle : leur échelle numérique dépend directement des unités de mesure physiques de la variable dépendante et, plus grave encore, leur variance théorique n’est pas constante d’un point à l’autre de l’échantillon. En raison des contraintes géométriques de la projection orthogonale, les observations situées aux extrémités de l’espace vectoriel des prédicteurs présentent naturellement des résidus de variance plus faible que les observations situées au centre barycentrique des données.
Pour corriger cette hétérogénéité d’échelle et rendre les résidus rigoureusement comparables entre eux, il est indispensable de procéder à leur standardisation. Le résidu standardisé — parfois qualifié de résidu semi-studentisé d’internat — s’obtient en divisant chaque résidu brut par l’estimation de l’écart-type résiduel global ajustée par la racine carrée du facteur de correction de projection dérivé de la matrice chapeau. Au sein du langage R, l’obtention immédiate de ce vecteur s’effectue via l’invocation de la fonction dédiée rstandard().
La représentation graphique des résidus standardisés permet de définir des seuils de criticité universels standardisés pour la détection des points aberrants. En vertu des propriétés de la loi normale centrée réduite, environ 95 % des observations doivent présenter un résidu standardisé compris entre -2 et +2 écarts-types, et plus de 99 % au sein de l’intervalle compris entre -3 et +3. L’adjonction de lignes horizontales marquant ces seuils critiques permet d’isoler visuellement les anomalies extrêmes nécessitant une investigation clinique approfondie.
8.2 Utilisation des résidus studentisés pour détecter les valeurs influentes
Bien que la standardisation classique constitue un progrès analytique notable, elle souffre d’une faiblesse inhérente : si une observation constitue un point aberrant d’une magnitude extrême, elle participe directement au gonflement artificiel de l’estimation de la variance résiduelle globale contenue dans son propre dénominateur, réduisant ainsi artificiellement sa propre déviation apparente. Ce mécanisme pervers d’auto-atténuation statistique justifie le recours aux résidus studentisés d’externat, également dénommés résidus supprimés ou jackknife.
Le principe de ces résidus repose sur l’estimation séquentielle du modèle en omettant délibérément la i-ième observation lors de l’estimation de la variance d’erreur. Si l’observation considérée est réellement atypique, son retrait dégonfle instantanément l’écart-type d’erreur résiduelle de référence, propulsant le résidu studentisé vers une magnitude numérique beaucoup plus élevée et informative. Cette opération computationnelle complexe ne requiert aucun réajustement séquentiel itératif manuel grâce à l’implémentation analytique directe fournie par la fonction native rstudent().
En recherche psychologique appliquée, le tracé graphique de ces résidus studentisés s’avère précieux pour déceler les comportements de passation non coopératifs ou frauduleux. Un participant ayant répondu de manière compulsivement aléatoire à une batterie de tests standardisés se manifestera sur le tracé des résidus studentisés par une divergence extrême franchissant allègrement les limites critiques conventionnelles, fournissant ainsi une base méthodologique solide et transparente pour justifier un éventuel protocole d’exclusion d’observation.
8.3 Confrontation du levier et de la distance de Cook
La détection exhaustive des observations perturbatrices requiert de dissocier rigoureusement deux concepts fondamentaux : l’atypicité dans l’espace de la variable réponse (décelée par l’amplitude du résidu) et l’isolement dans l’espace multidimensionnel des régresseurs, mesuré par le potentiel de levier statistique. Le levier d’une observation, extrait au moyen de la commande hatvalues(), correspond aux éléments diagonaux de la matrice de projection chapeau et quantifie l’éloignement d’un individu par rapport au centroïde des prédicteurs de l’échantillon.
Une observation présentant un fort résidu mais un levier minime constitue une simple curiosité descriptive n’altérant que marginalement l’estimation des paramètres. En revanche, la conjonction simultanée d’un résidu élevé et d’un levier statistique substantiel engendre un point d’influence critique capable de faire basculer l’hyperplan de régression à lui seul. La métrique reine pour mesurer cette influence globale est la distance de Cook, calculable sous R via l’instruction cooks.distance(), qui synthétise le décalage quadratique total induit sur l’ensemble des prédictions du modèle lorsque l’observation ciblée est supprimée de l’échantillon.
La confrontation graphique optimale de ces phénomènes prend la forme d’un tracé articulant les résidus studentisés en ordonnée contre les valeurs de levier en abscisse, sur lequel sont superposées les courbes d’isocontour de la distance de Cook. Les règles méthodologiques usuelles fixent un seuil d’alerte lorsque la distance de Cook dépasse la valeur conventionnelle de 4 divisée par la taille de l’échantillon ou, dans une approche plus conservatrice, lorsqu’elle franchit l’unité. La délimitation de ces zones critiques offre un repérage visuel infaillible des observations exerçant un contrôle disproportionné sur la solution inférentielle.
9. Vérification de l’indépendance sérielle : Graphique des résidus dans l’ordre séquentiel
9.1 Traçage des résidus en fonction de l’ordre d’observation
L’indépendance des termes d’erreur constitue sans conteste l’un des piliers méthodologiques les plus vulnérables des protocoles expérimentaux. Pour investiguer d’éventuelles dépendances stochastiques d’ordre séquentiel, la première disposition graphique consiste à projeter l’ensemble des résidus d’ajustement en fonction de l’ordre temporel ou chronologique d’enregistrement des observations au sein de l’étude. Cette visualisation se construit en positionnant l’index d’ordre séquentiel en abscisse et le vecteur des résidus ordinaires ou standardisés en ordonnée.
Pour maximiser l’efficacité diagnostique de cette représentation visuelle au sein d’un tracé sous ggplot2, il est particulièrement avisé de coupler la couche de dispersion discrète geom_point() avec une composante de liaison séquentielle continue matérialisée par l’instruction geom_line(). Ce tracé joint les résidus successifs par des segments linéaires orientés, révélant immédiatement à l’œil averti la cinétique de succession des erreurs expérimentales.
Ce graphique séquentiel s’avère particulièrement révélateur dans les contextes de recueil de données en laboratoire. Il permet de mettre en lumière des perturbations méthodologiques insidieuses, telles que des dérives instrumentales lentes consécutives à la désynchronisation progressive d’un équipement chronométrique, ou encore des effets de fatigue ou d’apprentissage chez les expérimentateurs, lesquels se traduisent par une altération continue de la fidélité de recueil au fil des sessions d’évaluation.
9.2 Détection visuelle de l’autocorrélation temporelle ou spatiale
La lecture sémiotique du tracé séquentiel repose sur l’identification des régimes de dépendance sérielle des erreurs. La manifestation visuelle de l’autocorrélation positive — la forme de dépendance la plus pernicieuse et la plus récurrente dans les séries temporelles et longitudinales — se caractérise par une dynamique d’inertie stochastique prononcée : les résidus positifs tendent à être suivis de manière persistante par d’autres résidus positifs, tandis que les résidus négatifs forment des dépressions durables sous l’axe d’équilibre zéro, dessinant des vagues sinueuses de basse fréquence spatiale.
À l’inverse, l’autocorrélation sérielle négative se signale sur le graphique par des oscillations hyper-fréquentes et erratiques en dents de scie : chaque observation positive est systématiquement suivie d’une correction excessive dans le cadran opposé, traduisant une surcompensation mécanique d’une mesure à la suivante. Cette forme de dépendance découle parfois de protocoles d’échantillonnage sans remise rigide ou d’artefacts d’alternance induits par des manipulations expérimentales en blocs contrebalancés de taille inadéquate.
Les conséquences de ces violations d’indépendance sur l’inférence statistique sont majeures. En présence d’une autocorrélation positive résiduelle non modélisée, la quantité effective d’information indépendante apportée par chaque sujet est largement surestimée par les formules standards de calcul matriciel. En découle une contraction dramatique et artificielle des erreurs types associées aux coefficients de régression, conduisant à une explosion du taux d’erreur de première espèce et à la déclaration fallacieuse d’effets expérimentaux prétendument significatifs qui ne sont en réalité que de purs artefacts sériels.
9.3 Couplage graphique avec le test de Durbin-Watson
Pour transcender l’appréciation purement subjective du tracé séquentiel des résidus, la bonne pratique méthodologique commande d’étayer l’inspection visuelle par l’exécution formelle d’un test d’hypothèse dédié à la dépendance d’ordre un. L’écosystème statistique de R met à disposition des chercheurs le test de Durbin-Watson, facilement accessible via l’instruction spécialisée durbinWatsonTest() encapsulée dans le paquet car.
Ce test calcule une statistique empirique dont la valeur théorique oscille strictement entre 0 et 4. Une valeur proche de 2 atteste de l’absence totale d’autocorrélation linéaire au premier ordre au sein des erreurs d’ajustement. Une déviation substantielle vers 0 constitue la confirmation paramétrique d’une autocorrélation positive sévère, tandis qu’une convergence vers 4 authentifie un processus d’autocorrélation négative prononcé, le test fournissant une probabilité critique rigoureusement calibrée via des procédures de rééchantillonnage ou d’intégration matricielle exacte.
Lorsque le diagnostic conjoint du graphique séquentiel et du test de Durbin-Watson converge vers le constat d’une dépendance résiduelle structurelle avérée, l’analyste se trouve dans l’obligation formelle d’abandonner l’estimation conventionnelle par les moindres carrés ordinaires. La stratégie d’intervention adéquate consiste alors à basculer vers les modèles des moindres carrés généralisés, implémentés dans la bibliothèque nlme via la fonction gls(), permettant d’expliciter formellement une matrice de corrélation autorégressive de type AR(1) pour restaurer l’intégrité absolue des tests d’inférence statistique.
10. Automatisation des diagnostics graphiques via les paquets spécialisés
10.1 Exploitation de la suite diagnostique native plot(model)
Le socle applicatif de R renferme un dispositif d’évaluation automatisé particulièrement dense : l’application de la méthode générique plot() appliquée directement à un objet de régression de classe lm. Par cette simple instruction, l’interpréteur génère une suite de quatre représentations graphiques analytiques standards spécifiquement agencées pour couvrir l’ensemble des vulnérabilités structurelles du modèle ajusté.
Pour appréhender ces représentations de manière synoptique et éviter le défilement séquentiel interactif dans la console, il est méthodologiquement opportun de partitionner l’espace d’affichage en une grille matricielle à deux lignes et deux colonnes à l’aide de l’instruction par(mfrow = c(2, 2)). Cette configuration rassemble sur une même planche le graphique des résidus versus valeurs ajustées, le diagramme Quantile-Quantile normal, le graphique Scale-Location (ou Spread-Location) et enfin la projection des résidus standardisés en fonction des valeurs de levier avec superposition des distances de Cook.
Parmi cette suite, le graphique Scale-Location mérite une attention analytique particulière : en projetant la racine carrée des résidus standardisés en valeur absolue en fonction des valeurs prédites, il élimine l’effet de signe et stabilise la visualisation de l’hétéroscédasticité. Une tendance ascendante ou descendante de la courbe de lissage rouge sur ce tracé démontre de façon encore plus éclatante l’instabilité de la dispersion stochastique, complétant admirablement l’interprétation du tracé brut initial.
10.2 Modernisation visuelle avec les extensions ggfortify et car
Bien que la suite diagnostique native soit fonctionnellement irréprochable, son rendu visuel tributaire des graphiques de base de R souffre d’un déficit d’adaptabilité esthétique selon les critères de publication actuels. L’extension ggfortify résout élégamment cette limitation en fournissant la méthode spécialisée autoplot(). Cette commande convertit automatiquement l’objet de régression pour produire la matrice complète des quatre diagnostics sous le moteur graphique vectoriel de ggplot2, autorisant l’usage immédiat des thèmes personnalisés, des palettes chromatiques harmonisées et des résolutions typographiques professionnelles.
En parallèle, la bibliothèque car, dirigée par John Fox, enrichit l’arsenal du chercheur de fonctionnalités diagnostiques complémentaires d’une précision remarquable. La fonction crPlots() permet de construire des graphiques de résidus partiels (composante plus résidu) pour chaque prédicteur individuel intégré au modèle. Ces graphiques permettent d’isoler visuellement la contribution non linéaire spécifique d’une variable indépendante donnée tout en purgeant simultanément l’effet partagé avec l’ensemble des autres covariables du système.
La mobilisation conjointe de ces deux bibliothèques permet d’édifier des rapports méthodologiques d’une grande rigueur scientifique. L’analyste s’affranchit ainsi de la fastidieuse programmation manuelle des éléments de détail géométrique tout en garantissant une précision graphique rigoureusement alignée sur les standards les plus exigeants des revues internationales à fort facteur d’impact.
10.3 Diagnostics complets avec le paquet performance et check_model()
L’apogée contemporaine du diagnostic de modélisation sous R est incarnée par le paquet performance, fer de lance de l’initiative easystats. Par l’invocation de sa fonction vedette check_model(), le statisticien déclenche l’exécution automatique d’un audit exhaustif de son modèle linéaire, matérialisé sous la forme d’un tableau de bord visuel intégré regroupant six panneaux diagnostiques harmonisés d’une clarté pédagogique et d’une rigueur formelle inégalées.
Ce tableau de bord couvre de façon synoptique la normalité des résidus, l’homoscédasticité, la colinéarité entre régresseurs, l’influence des points aberrants, la linéarité fonctionnelle et la conformité prédictive globale issue de simulations d’échantillonnage a posteriori. L’immense innovation introduite par cet outil réside dans l’incrustation directe de repères d’interprétation explicatifs au sein même des canevas graphiques, matérialisant en vert les zones de conformité distributionnelle et en teintes d’alerte les déviations statistiques intolérables.
Pour les psychométriciens et les praticiens de l’analyse comportementale, cette automatisation intelligente démocratise l’accès à une expertise diagnostique de haut niveau. Elle élimine les ambiguïtés d’interprétation sémiotique récurrentes face aux tracés bruts abstraits et fournit une assise visuelle didactique, immédiatement mobilisable tant pour la validation collégiale des résultats au sein d’une équipe de recherche que pour la documentation méthodologique transparente destinée aux évaluateurs pairs.
11. Stratégies d’intervention face aux anomalies révélées par les graphiques
11.1 Transformations mathématiques des variables pour restaurer l’homoscédasticité
La découverte d’un motif d’hétéroscédasticité ou d’une non-linéarité prononcée sur le graphique des résidus ne constitue en aucun cas une impasse méthodologique irrémédiable, mais un appel direct à la révision fonctionnelle de l’équation mathématique sous-jacente. L’intervention de première intention la plus éprouvée consiste à opérer une transformation mathématique non linéaire adéquate sur la variable dépendante ou sur certains prédicteurs continus asymétriques.
Lorsque la dispersion résiduelle s’accroît proportionnellement aux valeurs estimées et que la distribution de la variable réponse présente une asymétrie positive marquée, l’application de la transformation logarithmique népérienne produit fréquemment une stabilisation spectaculaire de la variance d’erreur tout en redressant la linéarité structurelle de la relation. Pour les données issues de dénombrements comportementaux ou de fréquences de survenue d’événements discrets, l’usage de la transformation par la racine carrée s’avère particulièrement efficace pour conformer le processus stochastique à l’homogénéité de variance.
Pour déterminer de façon empirique et objective la transformation optimale sans recourir à des tâtonnements subjectifs arbitraires, il est hautement conseillé de déployer la méthodologie formelle de Box et Cox, accessible via la fonction boxcox() incluse dans la bibliothèque MASS. Cette procédure algorithmique estime par maximum de vraisemblance le paramètre lambda d’une famille continue de transformations de puissance, guidant le statisticien avec une certitude mathématique absolue vers la transformation stabilisatrice idéale la plus adaptée à son jeu de données empirique.
11.2 Recours aux régressions robustes et aux erreurs-types corrigées
Lorsque les graphiques diagnostiques mettent en exergue la présence irréductible de résidus extrêmes ou d’observations exerçant une influence démesurée qu’il serait scientifiquement indéfendable d’évincer de manière arbitraire, l’analyste se doit d’abandonner l’estimation conventionnelle des moindres carrés ordinaires. L’alternative méthodologique cardinale réside dans l’adoption d’un paradigme de régression robuste.
L’implémentation opérationnelle de cette approche est assurée sous R par la fonction rlm() issue de la bibliothèque MASS. Cet algorithme met en œuvre une procédure d’estimation par M-estimateurs, s’appuyant sur des fonctions de pondération de Huber ou de Tukey bisquare qui dépondèrent graduellement l’influence mathématique des observations au fur et à mesure que leur résidu s’écarte de la tendance centrale. La comparaison conjointe des graphiques de résidus issus du modèle OLS classique et du modèle robuste illustre immédiatement comment cette approche neutralise l’impact délétère des perturbations locales sans distordre l’estimation générale.
Dans les contextes où seule l’homoscédasticité est violée sans qu’il ne soit souhaitable de modifier l’échelle métrique d’origine par des transformations non linéaires, le recours aux estimateurs de variance-covariance dits sandwich, ou estimateurs cohérents avec l’hétéroscédasticité formulés par Halbert White, constitue la solution de référence. Accessible via la combinaison des fonctions spécialisées du paquet sandwich et de la commande coeftest() du paquet lmtest, cette démarche recalcule les erreurs types et les probabilités critiques de manière à les immuniser contre toute forme d’hétéroscédasticité sans exiger l’altération de la spécification structurelle du modèle.
11.3 Complexification structurelle du modèle statistique
L’identification de courbures polynomiales persistantes sur le graphique des résidus indique formellement que la fonction de liaison purement linéaire est structurellement sous-spécifiée. La réponse analytique requiert alors une complexification contrôlée de l’architecture du modèle via l’intégration délibérée de termes polynomiaux d’ordre supérieur au sein de l’équation saisie dans lm(). L’utilisation de l’opérateur d’inhibition syntaxique I() permet, par exemple, d’incorporer directement un terme quadratique ou cubique afin d’épouser fidèlement l’inflexion empirique identifiée lors du diagnostic préliminaire.
De surcroît, la découverte de dispersions résiduelles hétérogènes selon des regroupements discrets d’individus trahit fréquemment l’existence d’une structure hiérarchique ou de dépendance multiniveau sous-jacente non prise en compte par le modèle d’agrégation simple. Lorsque les sujets de recherche sont imbriqués au sein de structures écologiques telles que des classes scolaires, des unités hospitalières ou des zones géographiques distinctes, l’hypothèse d’indépendance est violée par nature.
Face à une telle configuration empirique, l’analyste doit opérer une transition méthodologique vers les modèles linéaires à effets mixtes, abondamment outillés au sein de la bibliothèque spécialisée lme4 via la fonction maîtresse lmer(). Cette modélisation permet de décomposer rigoureusement la variance résiduelle totale en composantes intra-groupes et inter-groupes en allouant des ordonnées à l’origine ou des pentes stochastiques aléatoires, purgeant ainsi définitivement les graphiques de résidus de toute dépendance groupale résiduelle non modélisée.
12. Recommandations méthodologiques et standards de publication académique
12.1 Conformité avec les normes de restitution de l’APA (American Psychological Association)
La communication scientifique rigoureuse impose une transparence absolue quant aux démarches de validation d’hypothèses statistiques. Selon les préconisations explicites formulées dans la septième édition du manuel de publication de l’American Psychological Association (APA), les chercheurs ne peuvent plus se contenter de proclamer péremptoirement que les postulats de la régression ont été vérifiés sans fournir des preuves documentées à l’appui de ces affirmations.
S’il s’avère matériellement impossible, pour des raisons d’économie éditoriale et de pagination contrainte, d’intégrer l’ensemble de la suite des graphiques de résidus au sein du corps principal de l’article empirique, la pratique académique d’excellence prescrit le dépôt de ces planches diagnostiques haute définition au sein des annexes méthodologiques ou des référentiels de données supplémentaires en ligne. La section des résultats du manuscrit doit quant à elle stipuler formellement et explicitement l’ensemble des contrôles visuels et formels réalisés.
La rédaction des légendes associées aux figures obéit à des règles typographiques strictes : chaque graphique de résidus doit être pourvu d’un titre concis en italique, suivi d’une description textuelle exhaustive explicitant sans équivoque la nature exacte des résidus mobilisés (bruts, standardisés ou studentisés), le mécanisme d’estimation des courbes de lissage superposées, la largeur des intervalles d’incertitude affichés et la signification substantielle des lignes de référence horizontales et des seuils d’alerte critiques intégrés.
12.2 Génération de visualisations reproductibles via R Markdown et Quarto
Dans le paradigme contemporain de la science ouverte et de la recherche computationnelle reproductible, la dissociation entre la rédaction textuelle du rapport de recherche et les routines de traitement statistique constitue une source majeure d’erreurs et de non-reproductibilité. L’adoption d’environnements d’édition dynamique intégrés tels que Quarto ou R Markdown offre un cadre méthodologique optimal pour sceller de façon indissociable le code source d’ajustement statistique et la génération des représentations graphiques diagnostiques.
La configuration rigoureuse des options des blocs de code d’analyse au sein de ces documents computationnels garantit une qualité visuelle irréprochable répondant aux exigences techniques des plus prestigieuses presses universitaires internationales. Il est impératif de paramétrer formellement les options graphiques en fixant une résolution d’au minimum 300 points par pouce (dpi = 300), tout en définissant avec exactitude les dimensions de rendu physique de l’image via les paramètres de largeur et de hauteur proportionnelles.
Par ailleurs, la génération simultanée des figures sous des formats de graphisme vectoriel transparent tels que le PDF ou le SVG permet de préserver l’invariance absolue de la résolution typographique quelle que soit l’échelle d’agrandissement éditoriale finale. L’archivage de ces scripts d’exécution complets au sein de dépôts ouverts pérennes et certifiés, à l’instar de l’Open Science Framework, confère à la démarche de modélisation une auditabilité intégrale, autorisant la communauté des évaluateurs à reproduire à l’identique l’ensemble des diagnostics d’erreurs établis.
12.3 Synthèse des bonnes pratiques décisionnelles basées sur les résidus
Au terme de ce parcours analytique approfondi, il importe de synthétiser les principes directeurs devant gouverner la prise de décision méthodologique du statisticien face aux résidus. Le premier principe réside dans le refus absolu de la sur-interprétation des fluctuations aléatoires locales : un modèle statistique n’a pas vocation à reproduire le bruit idiosyncrasique de l’échantillon, et de légères irrégularités graphiques dans des zones à faible densité d’observation ne justifient pas des complexifications structurelles abusives susceptibles d’engendrer un surajustement nuisible à toute capacité de généralisation externe.
Le second principe épistémologique fondamental articule l’arbitrage permanent entre la fidélité mathématique aux postulats théoriques et le respect du principe de parcimonie scientifique conceptualisé par le rasoir d’Ockham. Face à des déviations marginales ou modérées sur un échantillon de dimension substantielle, la tolérance à une légère hétérogénéité d’erreur est souvent une posture épistémologique largement plus rationnelle que l’engagement dans des architectures de calcul opaques dénuées de toute interprétabilité conceptuelle intelligible.
Enfin, le dernier impératif commande de préserver coûte que coûte la cohérence substantielle des variables soumises à investigation. Les transformations mathématiques correctrices ne doivent jamais être appliquées de façon mécanique et déconnectée de la signification théorique des construits évalués : transformer arbitrairement une échelle psychométrique standardisée risque de rendre les résultats inintelligibles pour les praticiens cliniques. L’analyse des résidus sous R doit ainsi toujours demeurer ce qu’elle est fondamentalement : un instrument d’éclairage critique au service d’une modélisation rigoureuse, réflexive et théoriquement fondée.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Gelman, A., & Hill, J. (2006). Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. https://doi.org/10.1017/CBO9780511790942
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-24277-4