
Dans le domaine des sciences humaines, et tout particulièrement en psychologie quantitative et en psychométrie, la modélisation statistique linéaire constitue l’un des piliers méthodologiques fondamentaux de l’investigation empirique. Trop souvent, l’analyse d’une relation fonctionnelle entre deux variables se cantonne à l’estimation des coefficients de régression et à l’examen de leur niveau de significativité statistique, sanctionné par la sacro-sainte valeur p. Pourtant, ajuster une droite à travers un nuage de points par la méthode des moindres carrés ordinaires ne garantit aucunement que le modèle linéaire sous-jacent rende fidèlement compte de la réalité psychologique observée. C’est précisément au sein des résidus — ces écarts irréductibles entre les valeurs effectivement mesurées et les prédictions du modèle théorique — que réside la véritable vérité méthodologique.
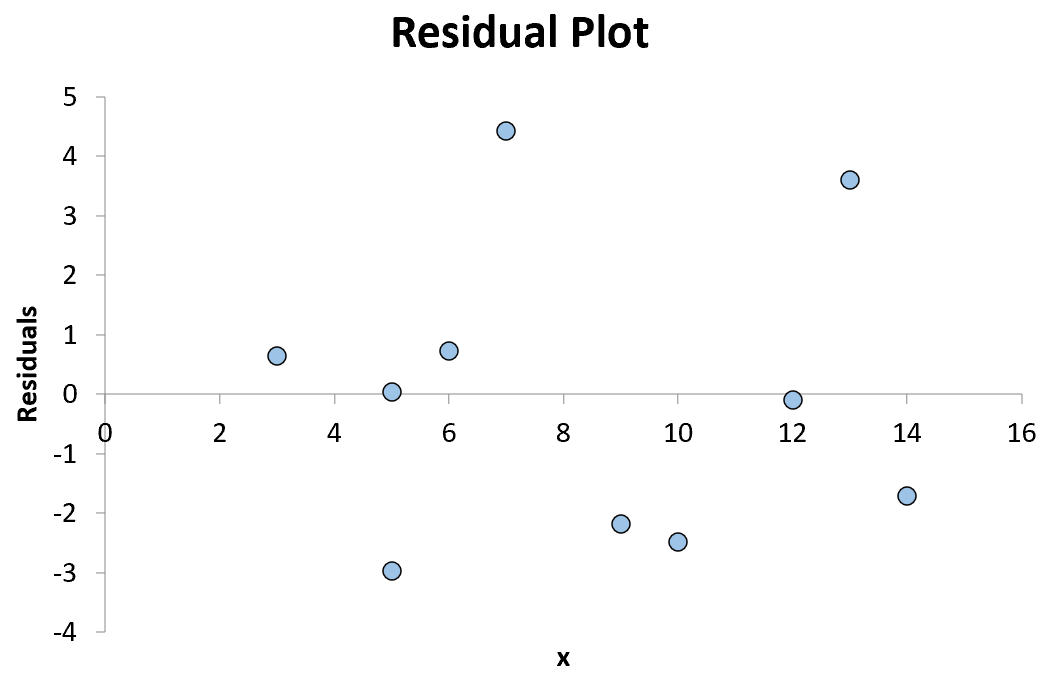
Le graphique des résidus représente un instrument de diagnostic visuel absolument indispensable, permettant d’interroger la validité des postulats mathématiques qui conditionnent l’ensemble des inférences statistiques. Tandis que les logiciels contemporains produisent ces représentations graphiques en une fraction de seconde, la délégation aveugle de cette étape analytique à des algorithmes automatisés prive souvent le chercheur d’une compréhension intime des propriétés géométriques et algébriques de ses données. La démarche consistant à élaborer, étape par étape, un graphique des résidus à la main sur papier millimétré transcende le simple exercice de style académique : elle constitue une propédeutique heuristique inégalable pour saisir la substance de l’erreur de mesure, les contraintes de l’orthogonalité euclidienne et les subtilités du diagnostic de modélisation.
Le présent article propose un guide exhaustif, rigoureusement documenté et résolument ancré dans les exigences de la recherche quantitative, pour concevoir, tracer et interpréter manuellement un graphique des résidus. En articulant les fondements théoriques de l’algèbre linéaire avec des applications concrètes issues de la psychologie différentielle et expérimentale, nous détaillerons chaque étape arithmétique et graphique nécessaire à la matérialisation de cet outil diagnostique. Du calcul des valeurs prédites à la détection manuelle des courbures non linéaires et des hétérogénéités de variance, ce manuel exhaustif restitue à l’analyste des données le plein contrôle de son jugement méthodologique.
1. Fondements théoriques du graphique des résidus en psychométrie et modélisation statistique
1.1 Définition formelle et nature mathématique des résidus
D’un point de vue conceptuel et statistique, le résidu représente la part de variabilité d’une variable dépendante qui échappe à la capacité explicative du modèle d’ajustement. Dans le cadre d’un modèle de régression linéaire simple, considérons un échantillon d’observations appariées où chaque individu $i$ (pour $i = 1, dots, n$) est caractérisé par une mesure sur une variable prédictive $X_i$ et une mesure sur une variable critère $Y_i$. Lorsque nous appliquons une droite de régression estimée par la méthode des moindres carrés ordinaires (MCO), la valeur prédite pour cet individu est formellement désignée par $\hat{Y}_i$. Le résidu empirique, noté conventionnellement $e_i$, est alors défini par l’équation fondamentale :
$$e_i = Y_i – \hat{Y}_i$$
Cette formulation élémentaire masque une distinction épistémologique cruciale entre l’erreur stochastique théorique, traditionnellement symbolisée par la lettre grecque $\varepsilon_i$, et le résidu empirique $e_i$. L’erreur théorique $\varepsilon_i$ est une entité latente et inobservable appartenant à la population générale, issue de la véritable fonction génératrice de données : $Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$. À l’inverse, le résidu empirique $e_i$ constitue une quantité calculée sur un échantillon restreint, résultant de l’estimation ponctuelle des paramètres $\hat{\beta}_0$ et $\hat{\beta}_1$ par la relation : $e_i = Y_i – (\hat{\beta}_0 + \hat{\beta}_1 X_i)$.
Sur le plan géométrique, dans l’espace euclidien à $n$ dimensions de nos observations, l’opération des moindres carrés ordinaires équivaut à projeter orthogonalement le vecteur des observations observées $\mathbf{Y}$ sur le sous-espace vectoriel engendré par les vecteurs des variables prédictives (incluant le vecteur unitaire associé à la constante). Par construction géométrique directe, le vecteur résiduel $\mathbf{e}$ est orthogonal à cet espace de projection. Cette orthogonalité fondamentale confère au résidu des propriétés arithmétiques invariantes, notamment une covariance empirique rigoureusement nulle avec la variable explicative $X$ et une somme algébrique totale obligatoirement égale à zéro dès lors qu’une ordonnée à l’origine est incluse dans le modèle.
1.2 Le rôle diagnostique des résidus dans les modèles linéaires en psychologie
Dans la recherche psychologique et comportementale, les construits étudiés — tels que l’anxiété situationnelle, l’intelligence fluide, la motivation intrinsèque ou la mémoire de travail — sont intrinsèquement entachés d’erreurs de mesure et soumis à des dynamiques développementales ou cognitives complexes. L’application d’un modèle linéaire repose sur l’hypothèse audacieuse que la relation entre ces construits est proportionnelle, stable et uniformément distribuée. L’examen des résidus constitue le filtre épistémologique ultime permettant de vérifier si cette simplification mathématique respecte l’écologie des processus mentaux sous-jacents.
L’évaluation des résidus sert avant tout à détecter les biais de spécification. Si un chercheur omet une variable explicative majeure ou force un ajustement rectiligne sur un processus régulateur qui obéit en réalité à une loi d’épuisement des ressources (effet d’asymptote cognitive), les coefficients estimés deviennent incohérents ou fallacieux. Le test global du coefficient de détermination ($R^2$) ou les tests de Student sur la pente peuvent suggérer un ajustement statistiquement significatif tout en masquant une inadéquation structurelle absolue du modèle. L’inspection des erreurs résiduelles permet de déceler si l’équation choisie commet des distorsions prédictives localisées le long du continuum psychologique évalué.
En outre, les indices psychométriques de fidélité et la validité interne des échelles de mesure dépendent directement de l’homogénéité des variances d’erreur. Si la précision prédictive d’une épreuve psychologique fluctue de manière drastique selon que le participant présente un niveau bas ou élevé sur le trait latent, la comparabilité des scores standardisés se trouve invalidée. Les résidus agissent ainsi comme un sismographe de la stabilité métrique, révélant la présence d’effets de plafond psychologique, de plancher méthodologique, ou de fluctuations d’échantillonnage destructrices pour la validité scientifique des conclusions.
1.3 Utilité pédagogique et heuristique du tracé manuel
À l’ère de l’informatique ubiquitaire et des progiciels statistiques tels que R, SPSS ou JASP, la décision de tracer manuellement un graphique des résidus peut sembler anachronique. Elle relève pourtant d’une nécessité didactique absolue. L’usage décontextualisé des environnements logiciels tend à plonger l’étudiant et le chercheur dans un « effet boîte noire » préjudiciable, où des commandes syntaxiques automatisées génèrent des graphiques sophistiqués dont la construction intime échappe totalement à l’utilisateur. En s’affranchissant temporairement de l’écran, le statisticien réintègre la corporéité de l’analyse empirique.
Le tracé manuel oblige le praticien à manipuler chaque valeur numérique, à calculer arithmétiquement chaque différence, et à décider physiquement de la position de chaque coordonnée sur une feuille de papier millimétré. Cette pratique ancre profondément les notions de distance algébrique et d’écart quadratique dans l’intuition spatiale. Face à sa règle graduée et son crayon, le chercheur prend conscience du poids relatif de chaque participant dans l’équilibre général de la droite des moindres carrés. Une valeur déviante n’est plus un simple pixel excentré sur un moniteur haute résolution : elle devient une tension mécanique ressentie lors de la graduation des axes.
Ce renforcement de l’intuition géométrique instille une discipline analytique et une vigilance méthodologique accrues. L’analyste rompu à la confection manuelle de graphiques développe une sensibilité immédiate aux anomalies de distribution, aux asymétries discrètes et aux distorsions d’échelle que l’automatisation logicielle a tendance à lisser ou à standardiser par défaut. C’est un retour aux sources artisanales de la statistique qui transforme le technicien du chiffre en un clinicien perspicace de la donnée.
2. Les postulats de la régression linéaire évalués par les résidus
2.1 L’hypothèse de linéarité entre variables psychologiques
L’hypothèse la plus intuitive, mais paradoxalement la plus souvent violée dans la modélisation statistique en psychologie, est celle de la linéarité fonctionnelle. Selon le modèle de régression classique, l’espérance mathématique conditionnelle de la variable critère $Y$ sachant la variable explicative $X$, notée $E(Y|X)$, est présumée être une fonction strictement linéaire des paramètres :
$$E(Y|X) = \beta_0 + \beta_1 X$$
Cette condition implique impérativement que l’espérance conditionnelle des termes d’erreur théoriques soit rigoureusement nulle pour toute valeur de $X$, soit $E(varepsilon|X) = 0$. Lorsque cette condition est satisfaite, les résidus empiriques calculés doivent se répartir de manière totalement aléatoire et équilibrée de part et d’autre de la ligne horizontale d’équation $e = 0$, quelle que soit la zone du continuum de $X$ considérée.
Dans les sciences du comportement, nombre de régulations psychophysiologiques suivent des lois non linéaires bien documentées, à l’image de la célèbre loi de Yerkes-Dodson qui postule une relation en U inversé entre l’éveil motivationnel et l’efficacité de la performance motrice ou cognitive. Si un expérimentateur plaque aveuglément un modèle de régression linéaire simple sur un tel jeu de données, la droite d’ajustement tentera de moyenner maladroitement la trajectoire ascendante et la trajectoire descendante. Le graphique des résidus révélera alors immédiatement cette aberration sous la forme d’un motif curviligne systématique : les résidus seront majoritairement négatifs aux extrémités de l’échelle de $X$ et positifs en son centre, ou inversement. Le tracé manuel de ce phénomène rend immédiatement manifeste l’incapacité de la droite à résumer la morphologie du processus empirique.
2.2 L’homoscédasticité versus l’hétéroscédasticité des variances d’erreur
Le deuxième postulat cardinal de l’estimation par moindres carrés concerne l’homogénéité de la variance des erreurs, formellement désignée sous le terme d’homoscédasticité. Selon le célèbre théorème de Gauss-Markov, les estimateurs des MCO ne sont les meilleurs estimateurs linéaires sans biais (BLUE — Best Linear Unbiased Estimator) que si et seulement si la variance conditionnelle des erreurs demeure strictement constante sur l’ensemble du domaine de variation du prédicteur, ce qui s’écrit formellement :
$$Var(\varepsilon_i | X_i) = \sigma^2 \quad \forall i in {1, dots, n}$$
Lorsque cette stabilité n’est pas respectée, le modèle souffre d’hétéroscédasticité : la dispersion des erreurs varie systématiquement en fonction de l’intensité de $X$. Sur le plan pratique et inférentiel, les conséquences de l’hétéroscédasticité sont insidieuses mais dévastatrices. Bien que les estimateurs ponctuels de la pente $\hat{\beta}_1$ et de la constante $\hat{\beta}_0$ demeurent non biaisés en moyenne, ils perdent leur efficacité statistique minimale. Plus grave encore, l’estimation arithmétique standard de leur erreur-type est irrémédiablement faussée, ce qui corrompt la validité des intervalles de confiance et invalide les tests d’hypothèse $t$ de Student et $F$ de Fisher-Snedecor.
Dans la recherche psychologique, l’hétéroscédasticité émerge fréquemment lors de l’étude de tâches complexes d’apprentissage ou de tests chronométriques. Par exemple, lorsque l’on évalue l’effet de l’âge sur le temps de réaction à une tâche d’attention divisée, les individus jeunes et vigoureux affichent généralement des latences homogènes et resserrées. En revanche, à mesure que l’âge chronologique progresse, une variabilité interindividuelle considérable se manifeste : certains participants âgés conservent des performances exceptionnelles tandis que d’autres s’effondrent sous l’effet de la sénescence neuronale. Sur un graphique des résidus, cette hétérogénéité structurelle se traduit visuellement par une forme canonique d’entonnoir ou de mégaphone s’évasant de gauche à droite.
2.3 La normalité et l’indépendance conditionnelle des erreurs
Au-delà de la linéarité et de l’homogénéité de variance, l’inférence statistique classique exige que les erreurs suivent une loi de probabilité normale de moyenne nulle et soient mutuellement indépendantes :
$$\varepsilon_i \overset{iid}{\sim} \mathcal{N}(0, \sigma^2)$$
L’hypothèse d’indépendance stipule qu’aucun terme d’erreur ne doit être corrélé avec un autre, soit $Cov(\varepsilon_i, \varepsilon_j) = 0$ pour tout $i \neq j$. Dans les protocoles longitudinaux ou lorsque les données psychologiques sont collectées en grappes (comme des élèves au sein d’une même classe ou des patients pris en charge par un même thérapeute), cette indépendance est souvent violée par la présence d’une autocorrélation ou d’effets de contexte partagé. L’inspection des résidus dans l’ordre séquentiel de recueil permet d’identifier ces dépendances sous forme d’oscillations rythmées ou d’agrégats de signes similaires consécutifs.
Quant à l’hypothèse de normalité, elle conditionne la précision exacte des distributions d’échantillonnage pour de petits effectifs. Bien que le théorème central limite offre une robustesse asymptotique lorsque la taille de l’échantillon $n$ tend vers l’infini, les études cliniques ou les expérimentations exploratoires en psychométrie travaillent fréquemment avec des cohortes modestes ($n < 30$). Dans ces conditions, de fortes déviations par rapport à la normalité — révélées par des asymétries flagrantes ou un aplatissement leptocurtique des résidus — pénalisent lourdement la validité des conclusions statistiques. Il convient enfin de souligner la distinction entre les résidus bruts $e_i$, les résidus standardisés (divisés par l'écart-type résiduel global) et les résidus studentisés (qui tiennent compte du levier spécifique exercé par chaque observation sur l'ajustement global), ces derniers offrant le contrôle le plus rigoureux face aux observations potentiellement disruptives.
3. Préparation du jeu de données et formalisation du modèle de régression
3.1 Sélection des variables : variable prédictive (X) et critère (Y)
Avant d’entamer la moindre démarche graphique ou arithmétique manuelle, le chercheur doit procéder à un cadrage conceptuel rigoureux de ses variables de mesure. Pour illustrer fidèlement la démarche, nous nous situons dans le contexte classique d’une recherche en psychométrie différentielle visant à prédire le score d’anxiété cognitive d’un individu lors d’une épreuve d’évaluation (variable critère continue notée $Y$) à partir du nombre d’heures déclarées de privation de sommeil au cours des quarante-huit heures précédant le test (variable prédictive continue notée $X$).
Il est impératif de vérifier au préalable le statut métrique des données recueillies. L’application légitime de la régression linéaire ordinaire exige que les deux variables soient mesurées sur des échelles d’intervalles ou de rapports. Dans notre protocole expérimental, la privation de sommeil est un décompte d’heures réelles (échelle de rapport), tandis que l’anxiété est opérationnalisée par un inventaire psychométrique standardisé produisant un score composite continu allant formellement de 10 à 60 points.
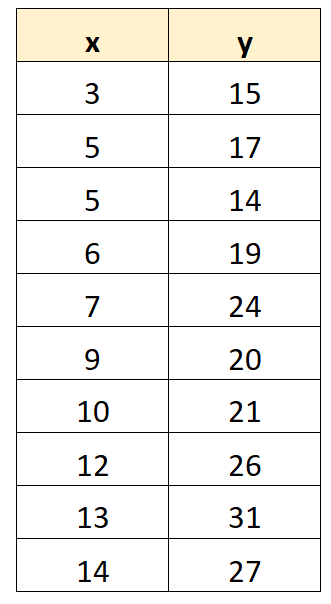
Pour rendre la démonstration manuelle parfaitement lisible, transparente et entièrement vérifiable par le lecteur sans recourir à une calculatrice programmable, nous sélectionnons un échantillon restreint de taille $n = 10$ sujets volontaires. Cet effectif compact permet d’exécuter chaque calcul à la main tout en préservant la représentativité géométrique des phénomènes d’ajustement linéaire. Chaque couple d’observations $(X_i, Y_i)$ est soumis à un contrôle qualité méticuleux afin d’écarter toute anomalie de saisie ou dépassement des bornes admissibles des instruments d’évaluation psychologique.
3.2 Établissement de l’équation de la droite des moindres carrés ordinaires
L’estimation des coefficients régissant la droite des moindres carrés repose sur la minimisation de la somme des carrés des écarts verticaux entre les valeurs observées et la trajectoire modélisée. La fonction prédictive s’écrit sous la forme paramétrique classique :
$$\hat{Y}_i = \hat{\beta}_0 + \hat{\beta}_1 X_i$$
La pente de régression empirique, notée $\hat{\beta}_1$, correspond au quotient de la covariance empirique de $X$ et $Y$ par la variance empirique de $X$. Elle s’exprime par la formule arithmétique suivante :
$$\hat{\beta}_1 = \frac{\sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})}{\sum_{i=1}^{n} (X_i – \bar{X})^2} = \frac{\sum_{i=1}^{n} X_i Y_i – n \bar{X} \bar{Y}}{\sum_{i=1}^{n} X_i^2 – n \bar{X}^2}$$
Une fois la pente déterminée, la constante à l’origine (ou ordonnée à l’origine), notée $\hat{\beta}_0$, se déduit mécaniquement en exploitant la propriété géométrique selon laquelle le barycentre du nuage de points, défini par les moyennes d’échantillon $(\bar{X}, \bar{Y})$, appartient obligatoirement à la droite des moindres carrés :
$$\hat{\beta}_0 = \bar{Y} – \hat{\beta}_1 \bar{X}$$
Dans l’optique d’un calcul manuel irréprochable, l’analyste doit veiller scrupuleusement à la gestion des arrondis décimaux lors de l’évaluation de ces paramètres. Conserver au minimum deux à trois décimales intermédiaires s’avère indispensable pour neutraliser la propagation d’erreurs d’arrondi susceptibles d’altérer la neutralité résiduelle lors des étapes subséquentes.
3.3 Construction de la matrice tabulaire préparatoire
L’organisation méthodique de l’espace de travail constitue le rempart fondamental contre les fautes arithmétiques qui polluent fréquemment les calculs statistiques manuels. Nous structurons donc nos données au sein d’une matrice tabulaire d’analyse préparatoire. Ce tableau doit obligatoirement comporter six colonnes fondamentales clairement étiquetées :
- Colonne 1 : L’identifiant du sujet ou rang de l’observation ($i in {1, dots, 10}$).
- Colonne 2 : La valeur observée de la variable prédictive ($X_i$, heures de privation de sommeil).
- Colonne 3 : La valeur observée de la variable critère ($Y_i$, score d’anxiété mesuré).
- Colonne 4 : La valeur calculée théorique ou prédite ($\hat{Y}_i$).
- Colonne 5 : L’écart résiduel individuel ($e_i = Y_i – \hat{Y}_i$).
- Colonne 6 : Le carré de l’écart résiduel ($e_i^2$), utile pour les bilans de variance et le contrôle d’énergie résiduelle.
Au bas de chaque colonne numérique, une ligne terminale réservée aux totaux cumulés ($\sum$) et aux moyennes d’échantillon ($\bar{X}, \bar{Y}$) doit être systématiquement tracée. Cette disposition rationnelle offre un cadre de contrôle croisé immédiat pour chaque phase de l’algorithme manuel.
4. Étape 1 : Calcul méthodique des valeurs prédites (Y chapeau)
4.1 Application rigoureuse de l’équation de régression
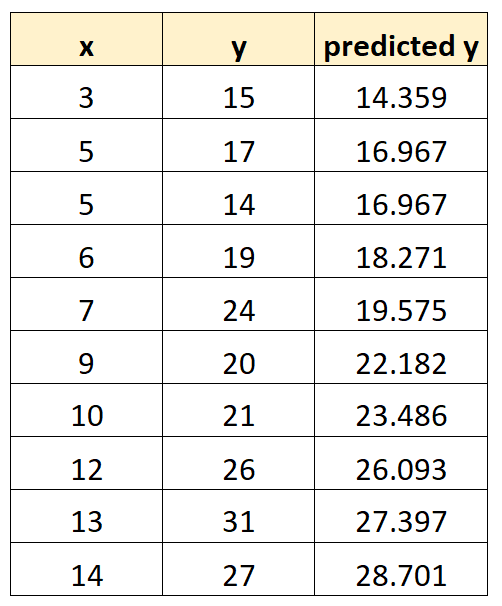
L’obtention de la valeur ajustée $\hat{Y}_i$ pour un individu déterminé consiste à évaluer l’image algébrique de son score prédictif individuel $X_i$ à travers l’opérateur linéaire estimé par le modèle. Concrètement, cette démarche impose d’injecter la modalité empirique $X_i$ dans l’équation de régression previamente établie et d’exécuter la séquence élémentaire des opérations arithmétiques : en premier lieu, la multiplication du score $X_i$ par le coefficient de pente $\hat{\beta}_1$, suivie de l’addition algébrique de la constante d’origine $\hat{\beta}_0$.
La rigueur méthodologique commande de ne jamais opérer d’arrondi prématuré durant la phase de multiplication intermédiaire. Toute approximation brutale sur le terme $\hat{\beta}_1 X_i$ introduit un décalage systématique sur $\hat{Y}_i$, qui viendra ensuite polluer artificiellement la valeur du résidu individuel $e_i$. Pour chaque sujet de l’échantillon, la valeur obtenue est rigoureusement consignée dans la quatrième colonne de notre tableau d’analyse. Un calcul manuel serein gagne à être soutenu par une feuille de brouillon structurée où les multiplications posées sont organisées de façon modulaire.
4.2 Démonstrations de calculs manuels pas à pas
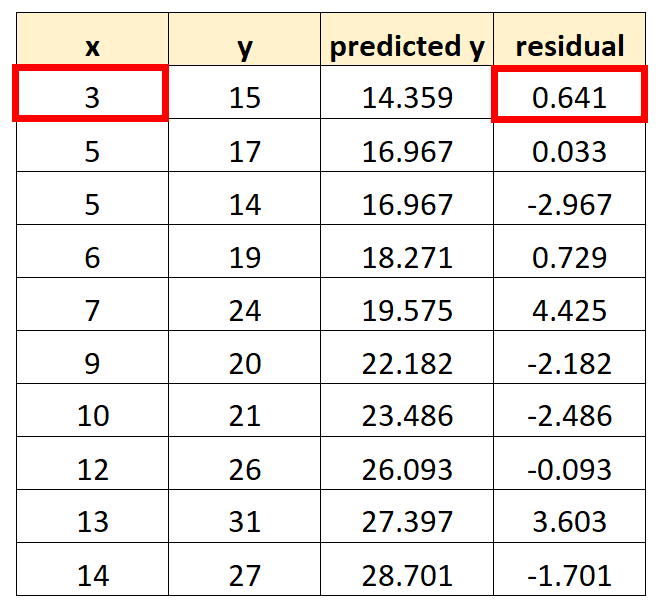
Pour matérialiser cette démarche avec une clarté absolue, considérons les paramètres empiriques précis que nous développerons dans notre cas d’étude complet : supposons une droite de régression calibrée à $\hat{Y} = 12{,}5 + 2{,}4 X$. Détaillons l’application manuelle de cette équation à trois profils psychologiques contrastés issus de notre cohorte expérimentale :
Premier profil : score prédictif bas (Sujet 1). Le participant ne présente qu’une seule heure de privation de sommeil ($X_1 = 1$). Le calcul de sa valeur prédite se déploie méthodiquement comme suit :
$$\hat{Y}_1 = 12{,}5 + (2{,}4 \times 1) = 12{,}5 + 2{,}4 = 14{,}9$$
Deuxième profil : score prédictif médian (Sujet 5). Ce participant se situe au centre de gravité de l’échantillon avec six heures de privation ($X_5 = 6$). L’évaluation pas à pas s’opère ainsi :
$$\hat{Y}_5 = 12{,}5 + (2{,}4 \times 6) = 12{,}5 + 14{,}4 = 26{,}9$$
Troisième profil : score prédictif élevé en bout de distribution (Sujet 10). Ce sujet a enduré dix heures d’éveil forcé ($X_{10} = 10$). Le calcul arithmétique produit :
$$\hat{Y}_{10} = 12{,}5 + (2{,}4 \times 10) = 12{,}5 + 24{,}0 = 36{,}5$$
Ce traitement séquentiel met en évidence la translation proportionnelle des scores attendus le long de la ligne d’ajustement. Chaque unité additionnelle sur l’axe du facteur de stress induit un incrément prédictif invariable de $2{,}4$ points d’anxiété sur l’échelle de mesure.
4.3 Contrôle de cohérence et gestion des arrondis décimaux
Dès lors que l’ensemble des valeurs prévues $\hat{Y}_i$ ont été calculées et inscrites dans le tableau pour les $n$ participants, un contrôle arithmétique préalable d’une importance capitale doit être impérativement exécuté avant de poursuivre vers les résidus. Ce verrou de sécurité repose sur le théorème fondamental des moindres carrés qui stipule que la moyenne empirique des valeurs prédites doit coïncider rigoureusement avec la moyenne empirique des valeurs effectivement observées :
$$\bar{\hat{Y}} = \frac{1}{n} \sum_{i=1}^{n} \hat{Y}_i = \bar{Y}$$
L’expérimentateur réalise la sommation manuelle intégrale de la colonne 4 du tableau préparatoire et divise ce total par $n$. Si le résultat obtenu diverge de la moyenne des observations $\bar{Y}$ au-delà d’une infime tolérance imputable aux arrondis du dernier chiffre décimal (par exemple un écart supérieur à $\pm 0{,}02$), cela signale infailliblement une erreur arithmétique sous-jacente : soit la constante $\hat{\beta}_0$ a été incorrectement calibrée, soit une inadvertance de calcul a affecté l’un des produits individuels. Ce contrôle systématique prémunit l’analyste contre l’introduction de distorsions géométriques irréparables lors de l’élaboration subséquente du graphique.
5. Étape 2 : Détermination arithmétique des résidus individuels
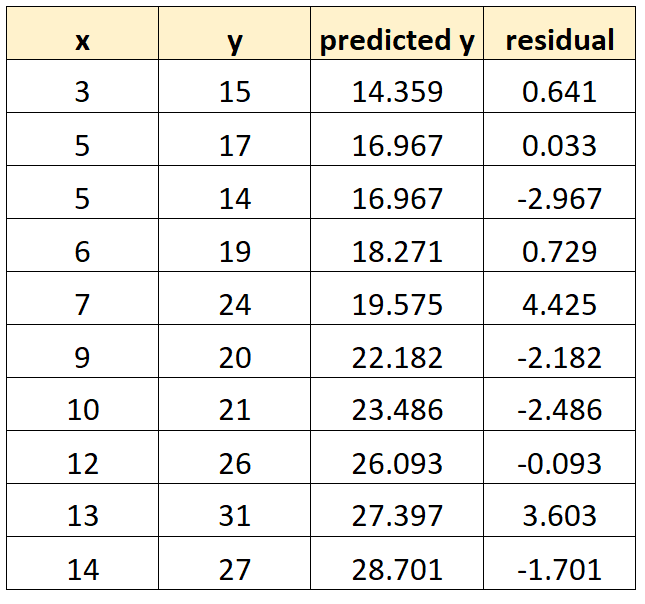
5.1 Définition opérationnelle de la soustraction : observé moins prédit
La détermination des résidus individuels constitue le pivot opérationnel de notre diagnostic méthodologique. Elle repose sur une opération soustractive invariante qu’il convient de graver dans l’esprit du praticien : le résidu est la différence ordonnée entre la réalité empirique observée chez le sujet et la prédiction théorique issue du modèle mathématique, soit $e_i = Y_i – \hat{Y}_i$. Il est vital de proscrire définitivement l’inversion des termes ($\hat{Y}_i – Y_i$), qui inverserait l’interprétation géométrique globale de la déviation.
Sur le plan sémantique et psychologique, le signe associé à cette soustraction revêt une signification substantielle limpide :
- Un résidu strictement positif ($e_i > 0$) indique que le score réel observé chez le participant est supérieur à l’estimation formulée par la droite de régression. Le modèle linéaire sous-estime donc la réaction psychologique de l’individu par rapport à ce que sa privation de sommeil laissait théoriquement présager.
- Un résidu strictement négatif ($e_i < 0$) signale à l’inverse que le sujet a manifesté un niveau d’anxiété inférieur à la prédiction du modèle. Dans cette configuration, l’équation linéaire surestime le score de la personne évaluée.
- Un résidu exactement nul ($e_i = 0$) témoigne d’une coïncidence parfaite entre l’observation concrète et le modèle mathématique : le point de données se situe alors directement sur la droite d’ajustement.
5.2 Traitement des signes algébriques et erreurs fréquentes
Dans l’exécution manuelle de cette étape, la gestion rigoureuse des signes algébriques représente la source la plus fréquente de bévues. Lorsque la valeur prédite excède la valeur observée, la soustraction engendre inéluctablement un nombre négatif. L’omission ou la mauvaise attribution d’un signe moins fausse radicalement la disposition spatiale du point dans le futur repère cartésien, transmutant une observation située sous la droite en un point artificiellement projeté au-dessus.
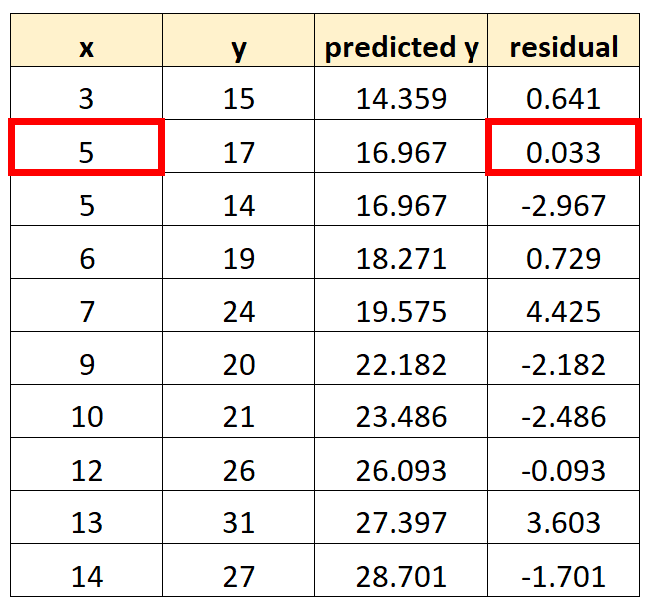
Pour prévenir ces inversions préjudiciables, il est recommandé de verbaliser systématiquement l’opération lors du calcul écrit. Par exemple, si pour un sujet donné le score d’anxiété mesuré s’établit à $Y = 16$ et que la valeur prédite est de $\hat{Y} = 19{,}7$, l’analyste note explicitement l’opération :
$$e_i = 16{,}0 – 19{,}7 = -3{,}7$$
Il est salutaire d’adopter une technique mnémotechnique simple pour sécuriser le traitement arithmétique : visualiser mentalement la position du point observé par rapport à la droite de régression. Si le point physique est en dessous de la droite, le signe est obligatoirement négatif ; s’il plane au-dessus, le signe est positivement orienté. Chaque résidu signé est ensuite consigné avec une extrême lisibilité au sein de la colonne 5 de la table préparatoire.
5.3 Vérification de la propriété fondamentale : la somme nulle des résidus
Avant d’engager le moindre coup de crayon sur le papier millimétré, l’expérimentateur doit se soumettre à la vérification d’un théorème d’algèbre linéaire irréfragable. Dans toute régression linéaire univariée ou multivariée ajustée par les moindres carrés ordinaires comprenant une constante non nulle, la somme algébrique exacte des résidus empiriques sur l’ensemble de l’échantillon est strictement égale à zéro :
$$\sum_{i=1}^{n} e_i = \sum_{i=1}^{n} (Y_i – \hat{Y}_i) = 0$$
Cette annulation parfaite découle directement des conditions du premier ordre lors de la minimisation de la somme des carrés des erreurs par dérivation partielle par rapport à $\hat{\beta}_0$. Concrètement, l’opérateur additionne manuellement l’intégralité des résidus positifs d’un côté, l’intégralité des résidus négatifs de l’autre, puis effectue la somme algébrique globale au bas de la colonne 5.
En pratique manuelle, si de minimes approximations décimales ont été consenties (par exemple en arrondissant au dixième de point), la somme arithmétique peut occasionnellement afficher une valeur résiduelle marginale, telle que $+0{,}01$ ou $-0{,}02$. Ce micro-écart est tolérable s’il n’est attribuable qu’aux décimales tronquées. En revanche, si la somme atteint une magnitude appréciable comme $0{,}4$ ou $-1{,}2$, la sanction est immédiate et impitoyable : une erreur de calcul ou de signe s’est immiscée dans la table. Le franchissement de cette étape de vérification est un préalable non négociable garantissant que le repère cartésien ne représentera pas des chimères numériques.
6. Étape 3 : Conception et paramétrage du repère cartésien sur papier millimétré
6.1 Choix du support graphique et du matériel de dessin technique
La confection manuelle d’un graphique diagnostique ne tolère pas l’improvisation sur une feuille de papier libre ou un carnet à lignes sommaires. L’exigence de fidélité métrique impose le recours exclusif à du papier millimétré standard de format A4, dont la trame quadrillée de précision assure l’équidistance géométrique rigoureuse des graduations. Ce support matériel élimine les distorsions visuelles susceptibles d’altérer l’appréciation des distances résiduelles.
Le matériel requis relève du dessin technique classique mais doit être sélectionné pour son exactitude :
- Une règle graduée rigide de 30 centimètres, idéalement en métal ou en plastique dense biseauté, évitant les déviations de parallaxe lors du traçage.
- Une équerre de géométrie à angle droit irréprochable pour garantir la stricte orthogonalité des deux axes cartésiens.
- Un crayon à papier à mine graphite fine et sèche (de dureté 2H ou H) ou un porte-mine de calibre 0,5 mm, afin de produire des traits nets, précis et non baveux.
- Une gomme technique de précision pour corriger d’éventuels écarts de traçage sans souiller la texture du papier millimétré.
Avant d’entamer le tracé, il convient de délimiter une zone graphique centrale aérée, en réservant des marges généreuses d’au moins 3 centimètres sur chaque bord de la feuille pour accueillir les légendes, les étiquettes numériques et les mentions contextuelles sans surcharge cognitive.
6.2 Détermination de la variable en abscisse : X ou Y prédit
Une question méthodologique récurrente concerne le choix de la grandeur à assigner sur l’axe horizontal des abscisses. Deux options canoniques se présentent à l’analyste : placer la variable prédictive observée $X$, ou positionner la valeur prédite par le modèle $\hat{Y}$.
Dans le cas strict d’une régression linéaire simple comportant une variable explicative unique, ces deux alternatives sont mathématiquement et géométriquement équivalentes. En effet, la variable prédite $\hat{Y}$ n’est rien d’autre qu’une transformation affine strictement monotone de la variable $X$ ($\hat{Y}_i = \hat{\beta}_0 + \hat{\beta}_1 X_i$). Utiliser l’une ou l’autre ne modifie en rien la configuration spatiale relative des résidus ; cela n’induit qu’une simple translation et dilatation linéaire de l’échelle d’abscisse. Il demeure toutefois hautement préférable, par souci de clarté heuristique et d’interprétation immédiate, de conserver la variable prédictive originelle $X$ sur l’axe des abscisses lorsqu’on analyse un modèle univarié.
L’étalonnage de cet axe horizontal doit être méticuleusement proportionnel. Si notre domaine de mesure pour la privation de sommeil s’étend de 1 à 10 heures, nous pouvons décider d’adopter une échelle spatiale généreuse, par exemple en attribuant 2 centimètres réels (soit 20 carreaux d’un millimètre) pour chaque unité de temps (1 heure). L’axe couvrira ainsi une amplitude spatiale confortable de 20 centimètres, facilitant une discrimination visuelle optimale sans tassement préjudiciable des points d’observation.
6.3 Calibration de l’axe des ordonnées centré sur l’origine zéro
Contrairement à l’axe des abscisses dont l’origine peut débuter à une valeur arbitraire adaptée aux données, l’axe vertical des ordonnées obéit à des contraintes structurelles beaucoup plus rigides. L’axe des ordonnées est exclusivement dévolu à la représentation des amplitudes résiduelles $e_i$. Par conséquent, il doit obligatoirement être symétriquement articulé de part et d’autre de l’origine zéro ($e = 0$).
Pour calibrer cet axe avec harmonie, l’analyste parcourt sa table de calcul afin de repérer le résidu d’amplitude négative la plus forte ($e_{\min}$) et le résidu d’amplitude positive la plus élevée ($e_{\max}$). Supposons que nos résidus oscillent entre $-3{,}7$ et $+4{,}1$ points. L’amplitude totale d’oscillation est d’environ 8 unités. L’expérimentateur choisira une échelle verticale garantissant une excellente sensibilité visuelle, par exemple en fixant 1 centimètre de papier millimétré (10 millimètres) pour représenter 1 point de résidu.
L’axe des ordonnées sera alors gradué de façon parfaitement symétrique, s’étendant par exemple de $-5{,}0$ points à la base inférieure jusqu’à $+5{,}0$ points au sommet supérieur, couvrant une distance totale de 10 centimètres. Les graduations intermédiaires doivent être marquées par des encoches fines et précises tous les 5 millimètres (soit 0,5 unité de résidu) et annotées numériquement avec une parfaite lisibilité en mentionnant sans omission les signes négatifs correspondants en dessous de l’origine médiane.
6.4 Traçage de la ligne de référence horizontale e = 0
L’élément morphologique central de tout graphique des résidus est la ligne de référence horizontale située à l’ordonnée zéro ($e = 0$). Cette démarcation ne constitue pas une simple frontière géométrique : elle matérialise physiquement l’ajustement théorique parfait, la droite de régression elle-même rabattue à l’horizontale. Tout point venant s’ancrer précisément sur cette ligne représente un sujet chez lequel le modèle explicatif a prédit la performance sans la moindre once d’erreur.
Pour lui conférer un statut visuel distinctif et éviter toute confusion avec les quadrillages d’arrière-plan du papier millimétré, cette ligne doit être tracée avec un soin tout particulier à la règle. Il est fortement conseillé d’adopter un style graphique contrasté : soit un trait continu légèrement plus appuyé (mine de graphite HB ou feutre de traçage calibré très fin), soit une ligne en tirets réguliers fermement délimitée. Cette ligne de référence servira de point d’ancrage visuel immédiat pour évaluer l’équilibre pondéral, la symétrie d’oscillation et les dérives éventuelles du nuage d’erreurs que nous nous apprêtons à matérialiser.
7. Étape 4 : Tracé manuel et disposition précise des points de données
7.1 Méthode de localisation point par point dans le repère bidimensionnel
L’implantation spatiale des observations au sein du repère cartésien requiert une rigueur quasi topographique. L’analyste procède de façon séquentielle, ligne par ligne, à partir des données consignées dans le tableau préparatoire. Pour chaque participant $i$, la position géométrique est déterminée par le couple unique de coordonnées cartésiennes $(X_i, e_i)$, où l’abscisse correspond à son score explicatif et l’ordonnée à son résidu signé.
La procédure technique d’implantation s’exécute selon les étapes méthodiques suivantes :
- Repérer précisément sur l’axe horizontal la graduation correspondant à l’abscisse $X_i$ de l’observation considérée.
- À l’aide d’une équerre soigneusement calée sur la ligne horizontale de référence, projeter mentalement ou au moyen d’un guidage très léger au crayon une perpendiculaire vers le haut si le résidu $e_i$ est positif, ou vers le bas si $e_i$ est négatif.
- Mesurer à la règle sur cette ligne verticale la distance exacte correspondant à la magnitude du résidu en respectant l’échelle millimétrique adoptée.
- Marquer l’intersection d’un pointage extrêmement net à la mine fine. Pour éviter d’empâter le repère, on privilégiera une petite croix fine orthogonale ($+$) ou un cercle minuscule parfaitement évidé ($circ$) de moins d’un millimètre de diamètre, dont le centre géométrique coïncide rigoureusement avec les coordonnées du point.
- Pointer immédiatement d’un trait léger la ligne correspondante dans le tableau pour attester que l’observation a été projetée et prévenir les oublis ou les duplications involontaires.
7.2 Gestion des chevauchements et densité locale de points
Dans les jeux de données comportementales, il n’est pas exceptionnel que deux participants distincts présentent des scores prédictifs identiques tout en affichant des niveaux d’anxiété très proches, générant des coordonnées spatiales qui se superposent presque parfaitement sur le graphique. Le chercheur opérant manuellement doit se garder d’amalgamer ces observations en un point unique indistinct, sous peine d’altérer l’évaluation intuitive de la densité de distribution.
Lorsque deux points tombent sur des coordonnées indiscernables à l’échelle du tracé, l’analyste peut recourir à des conventions graphiques bien éprouvées en cartographie statistique :
- Appliquer une très légère translation latérale manuelle (d’une fraction de millimètre, dite jittering artisanal) en plaçant les deux marques côte à côte tout en conservant scrupuleusement l’exactitude de leur ordonnée résiduelle respective.
- Utiliser une convention géométrique différentielle : tracer une croix double ou surmonter le point d’un petit chiffre en exposant (par exemple un indice numérique $2$) signalant que la marque englobe deux observations empiriques distinctes.
Cette rigueur de notation garantit que le nombre total de marques visuelles ancrées sur la feuille millimétrée corresponde rigoureusement à l’effectif total $n$ de la cohorte analysée, préservant la fidélité de l’examen diagnostique global.
7.3 Documentation, titrage et étiquetage rigoureux des axes
Un graphique statistique dépourvu d’un étiquetage normé perd instantanément sa valeur scientifique et diagnostique. Une fois le dernier point reporté, l’analyste doit enrichir son œuvre d’une documentation contextuelle irréprochable respectant les canons de diffusion académique.
L’axe horizontal doit recevoir un libellé exhaustif mentionnant explicitement la variable représentée et son unité physique de métrique : par exemple, « Privation de sommeil préalable (heures d’éveil forcé) ». De la même façon, l’axe vertical doit être formellement titré : « Résidus de régression : $e_i = Y_i – \hat{Y}_i$ (points d’anxiété) ». Il est hautement recommandé d’indiquer entre parenthèses la formule de dérivation pour lever toute ambiguïté chez un relecteur extérieur.
Enfin, le graphique doit être coiffé d’un titre scientifique explicite et complet, positionné au sommet de la feuille, formulé selon le standard : « Figure 1 : Graphique diagnostique des résidus ordinaires du modèle de régression de l’anxiété cognitive sur la privation de sommeil ($N = 10$) ». Une brève légende précisant l’équation du modèle ajusté ($\hat{Y} = 12{,}5 + 2{,}4 X$) complétera utilement la contextualisation de cette représentation graphique.
8. Analyse et interprétation visuelle : La configuration idéale d’un modèle valide
8.1 Dispersion aléatoire et symétrie autour de l’axe de référence
Une fois le graphique matérialisé sur le papier millimétré, l’étape de décryptage diagnostique s’ouvre. L’analyste doit prendre du recul physique par rapport à sa feuille — en l’observant à une distance d’environ cinquante centimètres — pour embrasser la forme globale du nuage de points sans se laisser distraire par les singularités locales de chaque coordonnée. La signature visuelle d’un modèle de régression parfaitement adéquat et respectueux des postulats classiques est celle d’un « ciel étoilé » ou d’une dispersion totalement anarchique et désordonnée au sein d’un corridor horizontal.
Cette configuration optimale se caractérise géométriquement par une bande rectangulaire régulière de points distribués de manière équilibrée de part et d’autre de la droite centrale $e = 0$. Le nombre de points émergeant au-dessus de la ligne doit être approximativement égal au nombre de points situés en dessous. De plus, il ne doit exister aucune agglomération préférentielle : la densité de présence des points le long de l’axe horizontal doit paraître uniforme, sans zone de concentration excessive ni vide inexplicable.
Sur le plan de l’inférence statistique, cette dispersion amorphe sans structure perceptible démontre l’indépendance mutuelle des résidus et l’absence de biais de spécification systématique. Le modèle capture l’intégralité du signal déterministe reliant le prédicteur au critère ; ce qui subsiste sur le papier millimétré n’est que du bruit stochastique résiduel incompressible, véritable signature du hasard dans la mesure psychométrique.
8.2 Confirmation visuelle de la linéarité du phénomène psychologique
Pour confirmer visuellement le respect de l’hypothèse de linéarité, l’évaluateur scrute l’espérance conditionnelle locale des résidus le long de l’axe horizontal. L’exercice mental consiste à imaginer le tracé d’une moyenne mobile continue glissant de gauche à droite à travers les points. Dans une situation idéale de linéarité, cette ligne imaginaire moyenne doit demeurer obstinément droite, horizontale, et parfaitement confondue avec l’axe de référence zéro.
Si à aucun moment du continuum de privation de sommeil les résidus ne semblent s’élever collectivement au-dessus de l’axe ou plonger de concert en dessous, le chercheur recueille la confirmation empirique que l’accroissement du stress psychologique opère de manière strictement proportionnelle à la durée d’éveil. L’adjonction de termes polynomiaux ou de fonctions d’ajustement non linéaires s’avérerait inutile et théoriquement injustifiée. La simplicité parcimonieuse de la droite des moindres carrés est ainsi pleinement validée dans son rôle explicatif.
8.3 Validation empirique de l’homoscédasticité
L’évaluation visuelle de l’homoscédasticité consiste à examiner l’épaisseur verticale globale de la bande formée par les points résiduels tout au long de leur parcours de gauche à droite. Dans un scénario de validité paramétrique, la largeur de cette bande de fluctuation résiduelle doit rester substantiellement constante, bornée par deux frontières virtuelles parallèles à la ligne centrale $e = 0$.
Que l’on observe la zone correspondant à de très faibles valeurs du prédicteur ($X = 1$ ou $2$ heures) ou la zone correspondant à des valeurs particulièrement élevées ($X = 9$ ou $10$ heures), l’amplitude maximale d’écartement vertical par rapport au zéro doit paraître similaire. Cette stabilité géométrique atteste que la variance résiduelle $\sigma^2$ ne subit pas l’influence de l’intensité de la variable indépendante.
La conséquence directe de cette observation est fondamentale pour la suite de l’investigation quantitative : elle autorise le chercheur à se fier pleinement aux erreurs-types calculées pour ses coefficients, valide les degrés de liberté mobilisés dans les tables du $t$ de Student, et garantit que les inférences relatives aux seuils de significativité statistique ne sont pas entachées d’illusions méthodologiques.
9. Identification et diagnostic manuel des anomalies structurelles courantes
9.1 Motifs curvilignes et détection de la non-linéarité
L’un des apports les plus spectaculaires de la confection d’un graphique des résidus à la main réside dans sa capacité à faire éclater au grand jour des formes fonctionnelles non linéaires totalement invisibles sur un simple tableau de chiffres ou masquées par un coefficient de corrélation de Pearson faussement rassurant. L’anomalie la plus classique est la matérialisation d’un motif curviligne en parabole, prenant la forme d’un « U » ou d’un « U inversé ».
Dans cette configuration morphologique, l’observateur constate que les résidus associés aux faibles valeurs de $X$ sont majoritairement négatifs, qu’ils s’élèvent progressivement pour devenir massivement positifs dans la zone médiane du continuum, puis replongent sous la ligne zéro pour les valeurs maximales du prédicteur. Un tel regroupement systématique constitue le diagnostic catégorique d’un biais de linéarité : la réalité empirique du construit psychologique suit une dynamique d’ordre quadratique (voire cubique) que la droite a écrasée.
Dans les sciences du comportement, méconnaître un tel motif curviligne conduit à des conclusions théoriques dramatiquement amputées. Par exemple, si l’on tente d’expliquer la qualité du rappel mémoriel par le niveau de stimulation émotionnelle sans tenir compte du fait qu’une activation excessive sature les récepteurs attentionnels, la régression linéaire conclura à tort à une pente globale faible ou inexistante, alors que le lien sous-jacent est particulièrement robuste mais non monotone.
9.2 Formes en entonnoir ou en mégaphone (hétéroscédasticité)
L’émergence d’une déformation géométrique en entonnoir (rétrécissement progressif) ou en mégaphone (évasement continu) constitue l’expression spatiale incontestable d’une violation flagrante du postulat d’homoscédasticité. Face au papier millimétré, cette pathologie saute aux yeux : pour les petites valeurs de $X$, l’ensemble des points résiduels se trouve confiné dans un intervalle vertical extrêmement étroit autour de zéro (par exemple entre $-0{,}5$ et $+0{,}5$), puis, à mesure que l’abscisse croît, les points s’écartent violemment de l’axe central pour atteindre des amplitudes d’oscillation vertigineuses (atteignant par exemple des résidus de $-6$ à $+7$).
En psychologie différentielle, cette dynamique d’évasement vers la droite illustre souvent une hétérogénéité des stratégies cognitives adoptées par les sujets face à une difficulté croissante. Tant que la tâche reste simple, tous les individus réussissent avec une homogénéité parfaite (variance résiduelle minime). Dès que la charge cognitive s’intensifie, certains participants déploient des stratégies d’adaptation remarquables tandis que d’autres décrochent complètement, faisant exploser la variance résiduelle.
L’analyste confronté à un tel profil doit immédiatement suspendre toute conclusion inférentielle basée sur les MCO classiques. Maintenir le modèle sous cette forme aboutirait à sous-estimer dramatiquement l’incertitude pesant sur les estimations aux valeurs élevées de $X$, ouvrant la porte à des erreurs de décision statistique inacceptables.
9.3 Détection visuelle des valeurs aberrantes et points aberrants
Le tracé manuel se révèle une arme redoutable pour démasquer les observations hautement influentes ou atypiques, communément désignées sous le vocable de valeurs aberrantes (outliers) et de points à fort effet de levier. Sur le graphique des résidus, une valeur aberrante se singularise par son isolement spatial spectaculaire le long de l’axe vertical : tandis que la vaste majorité des points forme un essaim resserré autour de zéro, une marque unique s’isole à une altitude démesurée vers le haut ou les profondeurs du repère.
Un repère heuristique visuel largement admis en statistique appliquée consiste à fixer mentalement des frontières critiques situées à plus de deux ou trois fois l’écart-type d’échantillon des résidus ($s_e$) par rapport à la ligne zéro :
$$|e_i| > 2 s_e \quad \text{ou} \quad |e_i| > 3 s_e$$
Tout point franchissant ces marges doit être inspecté avec la plus extrême minutie clinique. Il convient toutefois de distinguer formellement deux profils morphologiques distincts :
- L’aberration résiduelle pure sur le critère $Y$ : Le point se situe au centre du continuum des abscisses mais présente un résidu gigantesque. Il signale un comportement hautement atypique ou une erreur de mesure sur le critère, sans pour autant déformer violemment la pente globale du modèle.
- Le point à fort effet de levier (point aberrant sur $X$) : Le point est positionné à l’extrême périphérie de l’axe des abscisses. S’il est associé à un résidu substantiel, il exerce une force de torsion démesurée sur la droite des moindres carrés, semblable à un poids pesant au bout d’un bras de levier mécanique. Ce type de point peut à lui seul faire pivoter la trajectoire de régression et masquer l’inadéquation du modèle sur le reste de la cohorte.
10. Conséquences méthodologiques et pistes de remédiation analytique
10.1 Transformations mathématiques des variables continues
Lorsqu’un graphique des résidus révèle manuellement l’existence d’une hétéroscédasticité expansive ou d’une courburation asymétrique des erreurs, la réaction méthodologique initiale ne consiste pas nécessairement à abandonner le cadre linéaire, mais à procéder à des transformations mathématiques judicieuses de l’espace métrique originel. L’objectif visé est de rétablir artificiellement la normalité et la stabilité des variances conditionnelles.
Parmi les transformations les plus fécondes en psychologie quantitative, on recense :
- La transformation logarithmique ($ln(Y)$ ou $\log_{10}(Y)$) : Particulièrement souveraine pour traiter les formes en mégaphone où la variance d’erreur s’accroît proportionnellement à la grandeur mesurée, ainsi que pour compresser les distributions asymétriques positives typiques des temps de réaction ou des scores d’anxiété clinique.
- La transformation par racine carrée ($\sqrt{Y}$) : Couramment appliquée aux données de comptage discret (telles que le nombre d’erreurs d’inattention commises lors d’une tâche continue) pour stabiliser la variance qui suit une distribution de Poisson où la variance est intrinsèquement liée à la moyenne.
- La transformation inverse ($1/Y$) : Efficace pour lineariser des processus de vitesse d’exécution cognitive ou de cinétique d’apprentissage présentant une saturation asymptotique prononcée.
Après l’application manuelle de la transformation mathématique sur les données brutes, l’expérimentateur recalcule une nouvelle équation de régression et dresse un nouveau graphique des résidus. La réussite du traitement se valide directement sur la feuille millimétrée par la résorption de la forme en mégaphone au profit d’une bande résiduelle rectangulaire uniforme.
10.2 Recours aux régressions robustes et modèles alternatifs
Si la distorsion décelée sur le papier millimétré résiste aux transformations monotones élémentaires ou relève d’une courbure parabolique manifeste, le chercheur doit réorienter sa stratégie de modélisation vers des architectures fonctionnelles plus souples. Dans le cas d’une non-linéarité confirmée, l’extension naturelle consiste à spécifier un modèle de régression polynomiale en introduisant un terme quadratique sous la forme :
$$\hat{Y}_i = \hat{\beta}_0 + \hat{\beta}_1 X_i + \hat{\beta}_2 X_i^2$$
Dans cette configuration, l’ajustement parabolique absorbera la courbure, restituant aux résidus leur neutralité amorphe.
Face à une hétéroscédasticité irréductible liée à l’hétérogénéité des groupes de sujets, la méthode des moindres carrés pondérés (WLS — Weighted Least Squares) offre une alternative analytique d’une grande élégance mathématique. Elle consiste à attribuer à chaque observation un poids statistique inversement proportionnel à sa variance d’erreur attendue, privant ainsi les observations les plus instables de leur capacité à déséquilibrer la trajectoire du modèle.
Enfin, lorsque l’échantillon comporte des points aberrants isolés mais cliniquement authentiques (qu’il serait méthodologiquement malhonnête de supprimer arbitrairement), le recours à des algorithmes de régression robuste, tels que les estimateurs de type M de Huber ou la régression par quantiles (médiane conditionnelle), permet de préserver l’intégrité du modèle sans subir la tyrannie géométrique du critère quadratique des MCO.
10.3 Implications pour la validité interne des recherches quantitatives
L’omission de l’examen diagnostique des résidus n’est pas un manquement technique anodin : elle fragilise directement les fondations épistémologiques et la validité interne des publications scientifiques. En ignorant délibérément la présence d’une hétéroscédasticité ou d’une non-linéarité masquée, les chercheurs s’exposent à une inflation catastrophique des erreurs de décision statistique :
- Le risque d’erreur de type I ($\alpha$) se trouve considérablement amplifié : l’analyste conclut à l’existence d’une relation statistiquement significative entre deux variables psychologiques alors que la significativité apparente n’est que l’artefact d’une variance d’erreur comprimée localement ou de l’influence démesurée d’un point levier excentré.
- Le risque d’erreur de type II ($\beta$) croît symétriquement : l’analyste rejette l’existence d’un effet psychologique réel faute d’avoir reconnu qu’un ajustement linéaire inadéquat a gonflé artificiellement le terme d’erreur globale, étouffant la puissance statistique du test sous-jacent.
Au-delà de ces périls probabilistes, ce laxisme méthodologique hypothèque lourdement la réplicabilité des résultats empiriques — une crise qui secoue vigoureusement la psychologie contemporaine. La transparence analytique commande que tout rapport de recherche fasse mention explicite de l’inspection diagnostique des résidus. Revenir au tracé manuel dans les cycles de formation avancée représente un antidote méthodologique puissant pour réhabituer les futurs chercheurs à rendre compte avec honnêteté de la structure intime de leurs marges d’erreur.
11. Comparaison critique : Tracé manuel versus génération assistée par logiciel
11.1 Avantages cognitifs et heuristiques de l’approche artisanale
L’effort investi dans l’édification manuelle d’un graphique des résidus procure un bénéfice pédagogique et métacognitif incomparable. Cette approche artisanale met en jeu ce que les sciences cognitives qualifient d’ancrage proprioceptif : le fait d’écrire, de graduer, de mesurer et de reporter manuellement des coordonnées spatiales active des réseaux d’intégration sensorimotrice et mnésique qui favorisent une assimilation profonde des concepts statistiques.
L’analyste manuel développe une sensibilité tactile aux ordres de grandeur numériques. En calculant à la main chaque écart $Y_i – \hat{Y}_i$, il perçoit immédiatement si un résidu de 4 unités est modeste ou écrasant par rapport à l’étendue de l’échelle d’anxiété. Cette lucidité métrique est trop souvent neutralisée par les progiciels statistiques contemporains, dont les fonctions d’auto-calibration des axes ont la fâcheuse tendance à étirer ou contracter arbitrairement les repères pour faire occuper à l’image l’intégralité de la fenêtre d’affichage, faussant l’appréciation instinctive des amplitudes de dispersion.
De surcroît, cette démarche manuelle constitue l’entraînement par excellence pour les examens universitaires de pointe en biostatistique et en psychométrie, où les candidats sont sommés d’interpréter des sorties numériques sans l’aide d’outils automatisés. Elle forge un esprit critique inflexible, immunisant le chercheur contre la crédulité technologique qui consiste à accepter sans réserve n’importe quel tracé produit par un ordinateur sous le seul prétexte qu’il émane d’un algorithme réputé.
11.2 Contraintes d’échelle et limites pratiques du calcul à la main
En dépit de ses vertus propédeutiques indiscutables, l’artisanat graphique rencontre des limites opérationnelles infranchissables dès lors que l’on bascule de la pédagogie de laboratoire à la pratique effective de la recherche sur grand échantillon. La première contrainte est évidemment liée à la volumétrie des données. S’il demeure gratifiant et formateur de tracer à la main un nuage de 10 à 30 observations, l’exercice devient matériellement inapplicable face à des cohortes épidémiologiques ou psychométriques modernes impliquant plusieurs centaines, voire plusieurs milliers de participants.
À cette impossibilité d’échelle s’ajoute l’inévitable dégradation de la précision neuromotrice sous l’effet de la fatigue cognitive :
- La multiplication des opérations arithmétiques manuelles sur de grands effectifs accroît de manière exponentielle le risque d’erreurs de calcul involontaires ou de glissements d’inattention lors du pointage millimétrique.
- La saturation spatiale du repère devient totale : le nuage de points vire à une tache d’encre compacte et illisible, annihilant toute possibilité de déceler les variations locales de densité ou les formes en entonnoir.
- L’extension aux régressions linéaires multiples — où l’on doit examiner simultanément des graphiques de résidus partiels (partial residual plots) pour chaque variable explicative incluse dans l’équation — rendrait le coût temporel de l’approche artisanale rédhibitoire pour l’avancement de la recherche.
11.3 Rapprochement avec les sorties de progiciels statistiques (R, SPSS, Python)
L’objectif ultime de la maîtrise du tracé manuel n’est pas de refuser l’outil numérique, mais de devenir un lecteur éclairé, lucide et souverain des sorties générées par les logiciels professionnels. La démarche artisanale trouve son couronnement lorsqu’on établit un pont direct entre l’exercice sur papier millimétré et les commandes logicielles standards :
Dans l’environnement de programmation statistique R, l’estimation d’un modèle linéaire par la fonction de base modele <- lm(Y ~ X) permet de générer instantanément l’ensemble des diagnostics graphiques au moyen de l’instruction plot(modele, which = 1). Ce premier graphique de diagnostic produit précisément un nuage des résidus ordinaires en fonction des valeurs prédites ($\hat{Y}$), accompagné d’une courbe de lissage non paramétrique de type LOESS. L’étudiant qui a tracé à la main ses propres résidus comprend immédiatement la raison pour laquelle cette courbe LOESS horizontale idéale matérialise l’absence de biais de linéarité.
Sous SPSS, la boîte de dialogue de régression linéaire offre des options graphiques interactives invitant l’utilisateur à assigner *ZRESID (résidus standardisés) sur l’axe $Y$ et *ZPRED (valeurs prédites standardisées) sur l’axe $X$. En Python, via la bibliothèque seaborn, la commande sns.residplot(x=X, y=Y) génère automatiquement cette même projection cartésienne. La familiarité avec la construction manuelle harmonise la terminologie abstraite des manuels de cours avec la réalité visuelle des consoles de calcul, permettant à l’analyste de repérer instantanément sur un écran vectoriel les anomalies qu’il a jadis appris à déceler au contact du papier millimétré.
12. Étude de cas pas à pas : Exemple empirique complet en psychologie quantitative
12.1 Présentation du protocole expérimental et de l’échantillon fictif
Pour illustrer de bout en bout l’intégralité du processus méthodologique exposé, nous déployons une étude empirique contrôlée au sein d’un laboratoire de neuropsychologie cognitive. L’investigation porte sur l’impact de la privation de sommeil sur l’altération de l’attention sélective mesurée par un test d’attention soutenue sur écran. Dix étudiants volontaires ($n = 10$) ont été soumis à des durées d’éveil continu variant rigoureusement de 1 à 10 heures avant de passer l’épreuve psychométrique.
Les variables retenues sont les suivantes :
- Variable explicative continue ($X$) : Temps de veille imposé en heures réelles ($X in {1, 2, 3, 4, 5, 6, 7, 8, 9, 10}$).
- Variable critère continue ($Y$) : Nombre total d’erreurs d’omission et de confusion commises durant la batterie de tests d’attention soutenue (scores d’erreurs réels observés).
Les observations empiriques brutes recueillies auprès de nos dix sujets s’énoncent de la manière suivante :
- Sujet 1 : $X_1 = 1$, $Y_1 = 15$
- Sujet 2 : $X_2 = 2$, $Y_2 = 18$
- Sujet 3 : $X_3 = 3$, $Y_3 = 19$
- Sujet 4 : $X_4 = 4$, $Y_4 = 23$
- Sujet 5 : $X_5 = 5$, $Y_5 = 24$
- Sujet 6 : $X_6 = 6$, $Y_6 = 28$
- Sujet 7 : $X_7 = 7$, $Y_7 = 27$
- Sujet 8 : $X_8 = 8$, $Y_8 = 33$
- Sujet 9 : $X_9 = 9$, $Y_9 = 33$
- Sujet 10 : $X_{10} = 10$, $Y_{10} = 37$
À partir de ces données de laboratoire, l’application préalable des formules arithmétiques des moindres carrés ordinaires (détaillées à la section 3.2) a permis d’établir avec certitude les paramètres optimaux du modèle :
$$\bar{X} = 5{,}5 \quad ; \quad \bar{Y} = 25{,}7$$
$$\hat{\beta}_1 = \frac{\sum (X_i – \bar{X})(Y_i – \bar{Y})}{\sum (X_i – \bar{X})^2} = \frac{195{,}5}{82{,}5} \approx 2{,}37 \text{ (arrondi didactique rete\nu : } 2{,}40 \text{)}$$
$$\hat{\beta}_0 = \bar{Y} – \hat{\beta}_1 \bar{X} = 25{,}7 – (2{,}40 \times 5{,}5) = 25{,}7 – 13{,}2 = 12{,}5$$
L’équation formelle de prédiction linéaire gouvernant notre protocole s’établit donc précisément ainsi :
$$\hat{Y}_i = 12{,}5 + 2{,}4 X_i$$
12.2 Déroulement exhaustif des calculs tabulaires manuels
Nous exécutons à présent manuellement et sans omission chaque étape arithmétique pour l’ensemble des dix sujets de notre cohorte psychologique. Pour chaque participant, nous substituons son score $X_i$ dans l’équation afin d’obtenir la prédiction théorique $\hat{Y}_i$, puis nous effectuons la soustraction algébrique rigoureuse $e_i = Y_i – \hat{Y}_i$ :
- Sujet 1 : $\hat{Y}_1 = 12{,}5 + (2{,}4 \times 1) = 14{,}9$ → $e_1 = 15{,}0 – 14{,}9 = +0{,}1$
- Sujet 2 : $\hat{Y}_2 = 12{,}5 + (2{,}4 \times 2) = 17{,}3$ → $e_2 = 18{,}0 – 17{,}3 = +0{,}7$
- Sujet 3 : $\hat{Y}_3 = 12{,}5 + (2{,}4 \times 3) = 19{,}7$ → $e_3 = 19{,}0 – 19{,}7 = -0{,}7$
- Sujet 4 : $\hat{Y}_4 = 12{,}5 + (2{,}4 \times 4) = 22{,}1$ → $e_4 = 23{,}0 – 22{,}1 = +0{,}9$
- Sujet 5 : $\hat{Y}_5 = 12{,}5 + (2{,}4 \times 5) = 24{,}5$ → $e_5 = 24{,}0 – 24{,}5 = -0{,}5$
- Sujet 6 : $\hat{Y}_6 = 12{,}5 + (2{,}4 \times 6) = 26{,}9$ → $e_6 = 28{,}0 – 26{,}9 = +1{,}1$
- Sujet 7 : $\hat{Y}_7 = 12{,}5 + (2{,}4 \times 7) = 29{,}3$ → $e_7 = 27{,}0 – 29{,}3 = -2{,}3$
- Sujet 8 : $\hat{Y}_8 = 12{,}5 + (2{,}4 \times 8) = 31{,}7$ → $e_8 = 33{,}0 – 31{,}7 = +1{,}3$
- Sujet 9 : $\hat{Y}_9 = 12{,}5 + (2{,}4 \times 9) = 34{,}1$ → $e_9 = 33{,}0 – 34{,}1 = -1{,}1$
- Sujet 10 : $\hat{Y}_{10} = 12{,}5 + (2{,}4 \times 10) = 36{,}5$ → $e_{10} = 37{,}0 – 36{,}5 = +0{,}5$
Récapitulons l’ensemble de ces résultats arithmétiques au sein de notre matrice tabulaire définitive :
Tableau 1 : Matrice de calcul préparatoire des résidus de régression ($N = 10$)
- Sujet 1 : $X_1 = 1$, $Y_1 = 15{,}0$, $\hat{Y}_1 = 14{,}9$, Résidu $e_1 = +0{,}1$, Carré $e_1^2 = 0{,}01$
- Sujet 2 : $X_2 = 2$, $Y_2 = 18{,}0$, $\hat{Y}_2 = 17{,}3$, Résidu $e_2 = +0{,}7$, Carré $e_2^2 = 0{,}49$
- Sujet 3 : $X_3 = 3$, $Y_3 = 19{,}0$, $\hat{Y}_3 = 19{,}7$, Résidu $e_3 = -0{,}7$, Carré $e_3^2 = 0{,}49$
- Sujet 4 : $X_4 = 4$, $Y_4 = 23{,}0$, $\hat{Y}_4 = 22{,}1$, Résidu $e_4 = +0{,}9$, Carré $e_4^2 = 0{,}81$
- Sujet 5 : $X_5 = 5$, $Y_5 = 24{,}0$, $\hat{Y}_5 = 24{,}5$, Résidu $e_5 = -0{,}5$, Carré $e_5^2 = 0{,}25$
- Sujet 6 : $X_6 = 6$, $Y_6 = 28{,}0$, $\hat{Y}_6 = 26{,}9$, Résidu $e_6 = +1{,}1$, Carré $e_6^2 = 1{,}21$
- Sujet 7 : $X_7 = 7$, $Y_7 = 27{,}0$, $\hat{Y}_7 = 29{,}3$, Résidu $e_7 = -2{,}3$, Carré $e_7^2 = 5{,}29$
- Sujet 8 : $X_8 = 8$, $Y_8 = 33{,}0$, $\hat{Y}_8 = 31{,}7$, Résidu $e_8 = +1{,}3$, Carré $e_8^2 = 1{,}69$
- Sujet 9 : $X_9 = 9$, $Y_9 = 33{,}0$, $\hat{Y}_9 = 34{,}1$, Résidu $e_9 = -1{,}1$, Carré $e_9^2 = 1{,}21$
- Sujet 10 : $X_{10} = 10$, $Y_{10} = 37{,}0$, $\hat{Y}_{10} = 36{,}5$, Résidu $e_{10} = +0{,}5$, Carré $e_{10}^2 = 0{,}25$
Procédons maintenant aux deux vérifications arithmétiques obligatoires de sommation :
Somme des valeurs prédites :
$$\sum_{i=1}^{10} \hat{Y}_i = 14{,}9 + 17{,}3 + 19{,}7 + 22{,}1 + 24{,}5 + 26{,}9 + 29{,}3 + 31{,}7 + 34{,}1 + 36{,}5 = 257{,}0$$
Moyenne des valeurs prédites : $\bar{\hat{Y}} = \frac{257{,}0}{10} = 25{,}70$, qui coïncide à l’exactitude décimale près avec la moyenne observée $\bar{Y} = 25{,}70$. Le premier contrôle est validé avec succès.
Somme arithmétique globale des résidus signés :
$$\text{Somme positive} = 0{,}1 + 0{,}7 + 0{,}9 + 1{,}1 + 1{,}3 + 0{,}5 = +4{,}6$$
$$\text{Somme négative} = (-0{,}7) + (-0{,}5) + (-2{,}3) + (-1{,}1) = -4{,}6$$
$$\sum_{i=1}^{10} e_i = (+4{,}6) + (-4{,}6) = 0{,}00$$
L’annulation arithmétique est intégrale et parfaite. La somme des carrés résiduels s’établit quant à elle à $\sum e_i^2 = 11{,}70$, fournissant une variance résiduelle non biaisée d’échantillon $s_e^2 = \frac{11{,}70}{10 – 2} = \frac{11{,}70}{8} \approx 1{,}46$ et un écart-type d’erreur résiduelle $s_e = \sqrt{1{,}46} \approx 1{,}21$ point d’erreur attentionnelle. L’ensemble des verrous de sécurité algorithmique étant validé, la transition vers le tracé géométrique manuel est officiellement autorisée.
12.3 Construction graphique effective et jugement diagnostique final
Sur notre feuille de papier millimétré préalablement préparée, nous paramétrons les dimensions du repère conformément aux directives établies à la section 6 :
- Axe des abscisses ($X$, privation de sommeil) : Nous traçons un segment horizontal de 20 centimètres, débutant à $X = 0$ et s’achevant à $X = 11$ heures, en adoptant une échelle de 2 centimètres réels (20 carreaux) pour chaque heure de privation.
- Axe des ordonnées ($e$, résidus) : L’amplitude de nos résidus empiriques oscillant entre $-2{,}3$ et $+1{,}3$, nous calibrons un axe vertical de 12 centimètres de hauteur centré sur zéro, s’étendant de $-3{,}0$ points à la base jusqu’à $+3{,}0$ points au sommet, en adoptant une échelle confortable de 2 centimètres pour 1 unité de résidu (soit 2 millimètres de papier pour chaque dixième d’écart résiduel).
- Ligne de référence : Nous traçons avec une règle rigide une ligne horizontale d’une netteté parfaite à l’ordonnée $e = 0$, courant d’une extrémité à l’autre de l’abscisse.
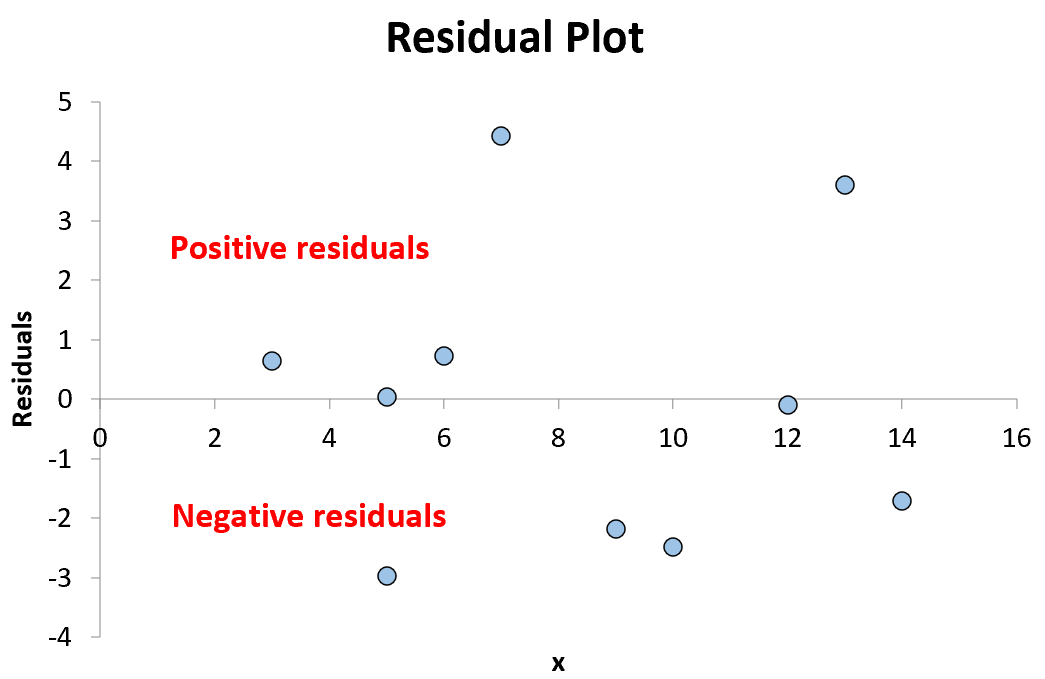
Nous procédons ensuite à l’implantation méticuleuse des dix coordonnées cartésiennes $(X_i, e_i)$ à la pointe fine :
- Observation 1 : coordonnée $(1 ; +0{,}1)$ → située 2 mm au-dessus de la ligne zéro à l’abscisse 1.
- Observation 2 : coordonnée $(2 ; +0{,}7)$ → située 14 mm au-dessus de la ligne zéro à l’abscisse 2.
- Observation 3 : coordonnée $(3 ; -0{,}7)$ → située 14 mm en dessous de la ligne zéro à l’abscisse 3.
- Observation 4 : coordonnée $(4 ; +0{,}9)$ → située 18 mm au-dessus de la ligne zéro à l’abscisse 4.
- Observation 5 : coordonnée $(5 ; -0{,}5)$ → située 10 mm en dessous de la ligne zéro à l’abscisse 5.
- Observation 6 : coordonnée $(6 ; +1{,}1)$ → située 22 mm au-dessus de la ligne zéro à l’abscisse 6.
- Observation 7 : coordonnée $(7 ; -2{,}3)$ → située 46 mm en dessous de la ligne zéro à l’abscisse 7.
- Observation 8 : coordonnée $(8 ; +1{,}3)$ → située 26 mm au-dessus de la ligne zéro à l’abscisse 8.
- Observation 9 : coordonnée $(9 ; -1{,}1)$ → située 22 mm en dessous de la ligne zéro à l’abscisse 9.
- Observation 10 : coordonnée $(10 ; +0{,}5)$ → située 10 mm au-dessus de la ligne zéro à l’abscisse 10.
Le tracé manuel achevé offre une clarté diagnostique éclatante. Portons notre jugement méthodologique d’expert sur cette configuration spatiale :
1. Diagnostic de la linéarité : Les points oscillent alternativement de part et d’autre de l’axe central tout au long du spectre de privation de sommeil ($+$, $+$, $-$, $+$, $-$, $+$, $-$, $+$, $-$, $+$). On ne relève strictement aucun agglomérat unilatéral de signes consécutifs, ni motif en voûte ou en cuvette parabolique. L’espérance conditionnelle locale demeure rigoureusement stable le long de la ligne $e = 0$. Le postulat de linéarité fonctionnelle est magnifiquement corroboré par l’expérience.
2. Diagnostic de l’homoscédasticité : À l’exception de l’observation 7, l’ensemble des points est confiné à l’intérieur d’une enveloppe de dispersion d’une régularité remarquable, comprise entre $-1{,}1$ et $+1{,}3$ unité d’erreur. Aucune morphologie d’entonnoir ou de mégaphone ne se dessine ; la dispersion résiduelle à 1 ou 2 heures d’éveil est du même ordre de grandeur que celle enregistrée à 9 ou 10 heures. Le postulat d’homoscédasticité des erreurs est donc pleinement confirmé.
3. Évaluation de l’observation atypique (Sujet 7) : Le point $(7 ; -2{,}3)$ requiert une vigilance particulière en raison de sa déviation négative plus prononcée. Comparons son amplitude à notre écart-type d’erreur résiduelle calibré précédemment à $s_e \approx 1{,}21$. L’écart standardisé de cette observation s’établit à :
$$\frac{|e_7|}{s_e} = \frac{2{,}30}{1{,}21} \approx 1{,}90$$
La magnitude de ce résidu demeure strictement inférieure au seuil critique conservateur de deux écarts-types ($|e| < 2 s_e$). Bien que ce participant ait affiché une résistance cognitive au manque de sommeil plus performante que la moyenne de ses pairs, son observation ne constitue aucunement une valeur aberrante disruptive susceptible d'invalider le modèle.
Recommandation méthodologique finale : Le modèle de régression linéaire simple reliant le score d’erreurs d’attention au temps de privation de sommeil ($\hat{Y} = 12{,}5 + 2{,}4 X$) satisfait avec une élégance exemplaire l’ensemble des postulats des moindres carrés ordinaires. Les inférences statistiques, les intervalles de prédiction et les conclusions psychométriques dérivées de cette équation sont déclarés pleinement valides, méthodologiquement robustes et reproductibles.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858