
Dans le champ de la métrologie biomédicale, de l’épidémiologie clinique et de la psychométrie, l’évaluation de la concordance entre deux instruments ou méthodes de mesure constitue une étape fondamentale préalable à toute implémentation pratique. Trop souvent, les praticiens et chercheurs recourent de manière inappropriée au coefficient de corrélation linéaire de Pearson pour attester de la substituabilité de deux techniques. Or, deux mesures peuvent afficher une corrélation quasi parfaite tout en présentant un désaccord systématique ou des écarts individuels cliniquement inacceptables. C’est précisément pour surmonter cette aporie méthodologique que le statisticien J. Martin Bland et le biostatisticien Douglas G. Altman ont formalisé, dans les années 1980, l’approche graphique et analytique qui porte aujourd’hui leur nom.
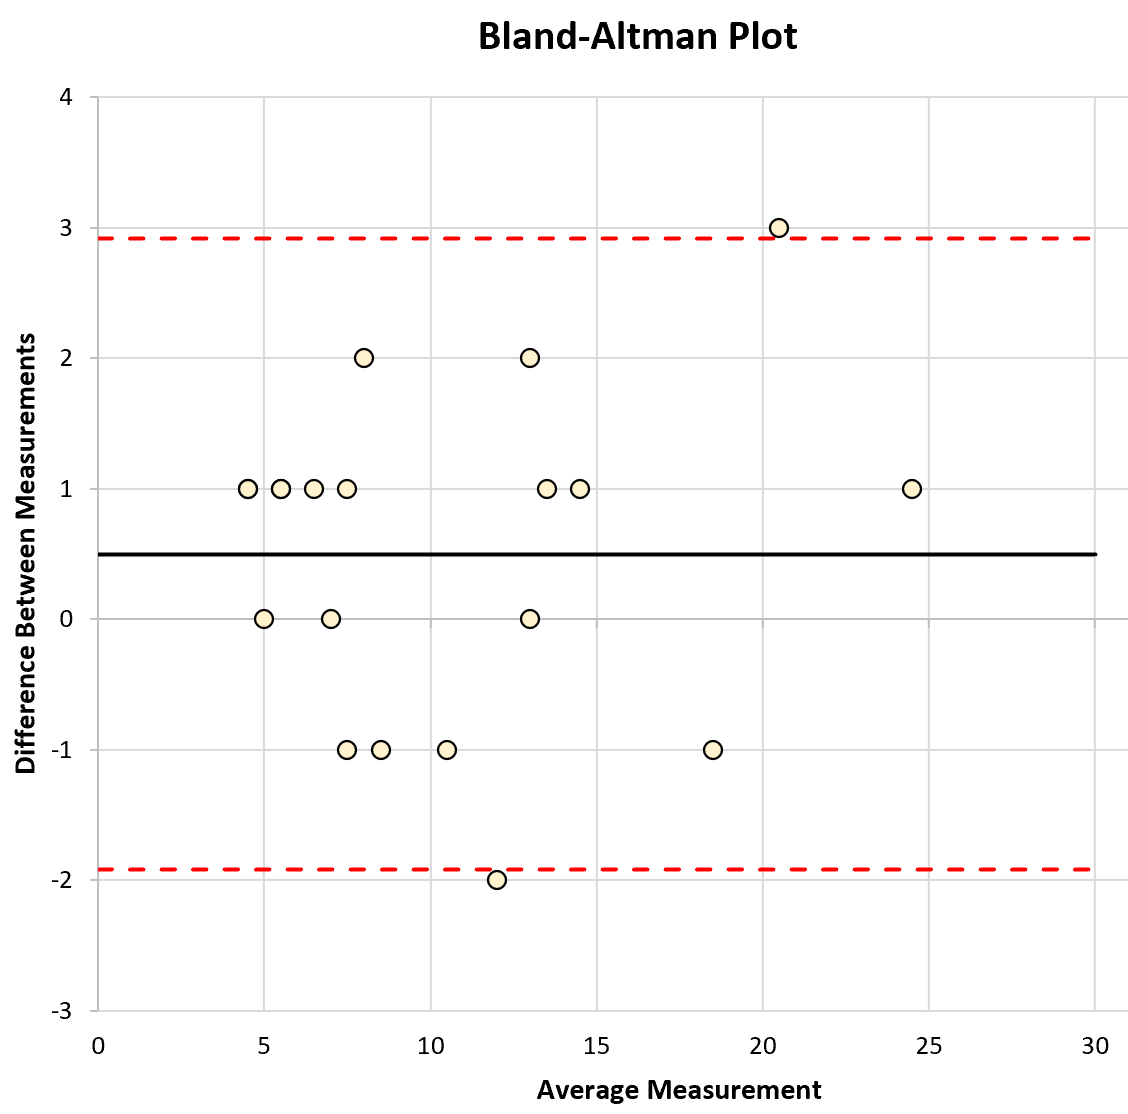
Le graphique de Bland-Altman, également dénommé graphique de Tukey de la différence moyenne, s’est imposé comme le standard de référence pour quantifier le biais systématique et déterminer les limites d’agrément à 95 % entre deux méthodes d’évaluation quantitatives continues. Contrairement aux approches fondées sur des tests d’hypothèse de non-différence ou des régressions asymétriques, ce cadre méthodologique analyse directement la différence entre deux mesures appariées en fonction de leur moyenne arithmétique. Cette démarche offre une représentation visuelle intuitive de la dispersion des erreurs de mesure, de l’éventuelle hétéroscédasticité et de la présence de valeurs aberrantes, tout en maintenant les résultats dans les unités physiques d’origine du mesurande.
Bien que des progiciels statistiques spécialisés tels que R, SAS, SPSS ou MedCalc proposent des modules automatisés pour générer ces représentations, la maîtrise de leur construction au sein de Microsoft Excel demeure une compétence analytique inestimable. Excel offre en effet une flexibilité graphique et algorithmique inégalée, permettant de décomposer minutieusement chaque étape du calcul matriciel, de paramétrer rigoureusement les intervalles de confiance et d’adapter l’esthétique du tracé aux exigences strictes des publications scientifiques internationales. Ce guide exhaustif détaille l’intégralité des fondements théoriques, des formulations mathématiques et des procédures opérationnelles pas à pas requises pour concevoir un graphique de Bland-Altman irréprochable sous Excel.
1. Introduction théorique et fondements du graphique de Bland-Altman
1.1 Historique et genèse de la méthode de Bland et Altman
L’histoire de la métrologie médicale moderne a été profondément marquée par la parution, dans la revue The Lancet en 1986, de l’article princeps de J. Martin Bland et Douglas G. Altman intitulé « Statistical methods for assessing agreement between two methods of clinical measurement ». Bien que les auteurs eussent déjà esquissé leur approche en 1983 au sein d’une publication destinée aux statisticiens (The Statistician), c’est l’article de 1986 qui déclencha une véritable révolution méthodologique dans la recherche clinique. Cet article est rapidement devenu l’un des articles scientifiques les plus cités de tous les temps, accumulant plusieurs dizaines de milliers de citations académiques.
À cette époque, la pratique dominante consistait à évaluer la validité d’une nouvelle technique de mesure en calculant le coefficient de corrélation de Pearson entre les valeurs fournies par cette dernière et celles obtenues par une méthode de référence reconnue. Bland et Altman ont démontré avec une acuité mathématique remarquable que cette utilisation du coefficient de corrélation reposait sur une confusion conceptuelle majeure entre association linéaire et accord métrologique absolu. Deux méthodes mesurant la même grandeur peuvent être fortement corrélées tout en différant systématiquement de plusieurs unités, ou en affichant des variations d’écarts incompatibles avec la sécurité diagnostique d’un patient.
Au fil des décennies suivantes, les travaux de Bland et Altman ont été enrichis pour traiter des cas complexes, tels que les mesures répétées, l’évaluation de la fidélité intra-observateur et inter-observateurs, ou encore l’ajustement aux distributions asymétriques. Aujourd’hui, l’analyse de concordance selon Bland-Altman ne constitue plus seulement une recommandation académique : elle figure expressément dans les lignes directrices de reporting biomédical international, telles que les normes GRRAS (Guidelines for Reporting Reliability and Agreement Studies) et les exigences éditoriales des comités de lecture des revues médicales majeures.
1.2 Principes statistiques sous-jacents à l’analyse de concordance
L’analyse de concordance repose sur une distinction épistémologique cruciale entre l’association statistique et l’interchangeabilité clinique. Deux variables aléatoires peuvent présenter une association statistique extrêmement étroite, formalisée par un coefficient de corrélation approchant l’unité, sans que les deux dispositifs ne soient pour autant interchangeables au chevet du patient ou en laboratoire d’analyse. L’interchangeabilité exige que les différences individuelles entre les deux instruments demeurent confinées à l’intérieur de marges de tolérance qui n’induisent aucun changement dans les décisions thérapeutiques ou pronostiques.
D’un point de vue structural, le modèle sépare l’écart total observé entre les instruments en deux composantes fondamentales : le biais systématique (erreur systématique) et l’erreur aléatoire de mesure. Le biais systématique représente la tendance constante d’un instrument à surévaluer ou sous-évaluer la grandeur mesurée par rapport à l’autre. Il est formalisé par l’espérance mathématique de la différence intra-sujet. L’erreur aléatoire, quant à elle, traduit la variabilité résiduelle imprévisible résultant de l’imprécision inhérente aux deux systèmes de mesure et des fluctuations physiologiques transitoires non contrôlées.
Un postulat statistique central du modèle conventionnel de Bland-Altman réside dans la normalité de la distribution des différences de mesure individuelles. Il importe de souligner avec vigueur qu’il n’est nullement requis que les mesures brutes issues de chaque instrument suivent une distribution normale ; seule la distribution des écarts intra-sujets doit approcher une loi gaussienne. Cette hypothèse de normalité conditionne directement la validité des limites d’agrément à 95 %, lesquelles reposent sur les propriétés probabilistes de la loi normale, stipulant qu’approximativement 95 % des observations d’une variable gaussienne se situent dans un intervalle borné par l’espérance mathématique plus ou moins 1,96 écart-type.
1.3 Applications empiriques dans l’évaluation psychologique et médicale
Dans la recherche translationnelle et clinique, l’analyse de Bland-Altman trouve une première application paradigmatique lors de l’introduction d’un nouveau dispositif médical destiné à remplacer ou compléter une technique de référence lourde, invasive ou onéreuse. Par exemple, la validation d’un spiromètre portable connecté par rapport à la pléthysmographie corporelle en cabine fermée exige de vérifier que les débits expiratoires de pointe mesurés par le dispositif miniaturisé ne s’écartent pas de la référence au-delà de seuils physiopathologiques critiques.
Dans le domaine de l’évaluation psychométrique et neurophysiologique, cette méthode s’avère particulièrement pertinente lors de la transposition d’échelles d’évaluation sous format numérique ou de l’analyse d’algorithmes de détection automatique d’états affectifs via des biocapteurs. Lorsque des chercheurs évaluent le niveau d’anxiété état via un questionnaire digital auto-administré comparativement à une échelle clinique administrée par un psychiatre, la concordance absolue des scores bruts ou standardisés doit être garantie pour préserver l’intégrité des seuils diagnostiques catégoriels.
Enfin, la méthode constitue l’outil par excellence pour l’analyse de la fidélité test-retest et de l’accord inter-évaluateurs sur variables continues. Qu’il s’agisse de mesurer la variabilité de la pression artérielle centrale estimée par tonométrie d’aplanation à 24 heures d’intervalle chez des sujets sains, ou d’évaluer la reproductibilité de la segmentation d’un volume tumoral par résonance magnétique entre deux radiologues indépendants, l’estimation des limites d’agrément quantifie avec exactitude l’amplitude du bruit de mesure inhérent à l’observateur ou au protocole expérimental.
2. Pertinence méthodologique de la concordance par rapport à la corrélation
2.1 Le paradoxe du coefficient de corrélation de Pearson
Le recours exclusif au coefficient de corrélation de Pearson (noté r) pour attester de la validité concurrente d’une méthode de mesure repose sur un paralogisme statistique récurrent. Le coefficient r quantifie l’intensité d’une relation linéaire entre deux variables continues, mais il est intrinsèquement insensible à l’identité absolue de ces mesures. Mathématiquement, le coefficient de Pearson est totalement invariant par transformation linéaire positive. Si une méthode expérimentale B produit systématiquement des valeurs qui correspondent exactement au double des valeurs de la méthode de référence A plus une constante fixe de 10 unités (B = 2A + 10), la corrélation calculée sera rigoureusement égale à 1,000, suggérant fallacieusement une adéquation parfaite, alors même que les deux instruments génèrent des lectures substantiellement discordantes.
De surcroît, le coefficient de corrélation présente une dépendance fonctionnelle directe vis-à-vis de l’étendue de l’échantillon prélevé. Pour un niveau de dispersion des erreurs d’observation strictement identique entre deux techniques, le coefficient r augmentera artificiellement si la population étudiée présente une variabilité interindividuelle très hétérogène et très large. Inversement, si la cohorte est homogène et que l’étendue du mesurande est étroite, le coefficient chutera drastiquement, conduisant l’expérimentateur à conclure à tort à une mauvaise performance de l’instrument. La corrélation ne mesure donc pas la précision de la mesure, mais la capacité du protocole à discriminer les individus au sein d’une distribution donnée.
Ce phénomène induit un risque clinique et scientifique majeur : celui d’homologuer des équipements diagnostiques présentant un biais additif massif ou un facteur d’échelle délétère. Dans le monitorage de paramètres critiques tels que la glycémie capillaire, la saturation en oxygène ou la clairance de la créatinine, se fonder sur une corrélation supérieure à 0,95 pour affirmer la substituabilité d’un capteur relève d’une méprise théorique lourde de conséquences potentielles pour les décisions médicales.
2.2 Comparaison critique avec la régression linéaire ordinaire
Face aux limites de la corrélation, certains investigateurs se tournent vers la régression linéaire ordinaire par les moindres carrés, en postulant que l’obtention d’une pente statistiquement non différente de 1 et d’une ordonnée à l’origine non différente de 0 suffirait à prouver l’équivalence. Cette approche se heurte toutefois à des postulats mathématiques incompatibles avec la métrologie comparative. La régression des moindres carrés ordinaires repose sur une asymétrie fondamentale : elle suppose que la variable indépendante (axe des abscisses, X) est mesurée sans aucune erreur statistique, l’intégralité de la variance d’erreur étant imputée à la variable dépendante (axe des ordonnées, Y).
Or, dans toute étude clinique ou expérimentale, les deux méthodes de mesure sont invariablement entachées d’une erreur stochastique. L’affectation arbitraire de l’instrument A en abscisse et de l’instrument B en ordonnée introduit un biais d’atténuation bien documenté (phénomène de régression vers la moyenne ou biais de Berkson), provoquant une sous-estimation systématique de la pente réelle de la droite. Même le recours à des modèles de régression orthogonale, tels que la régression de Deming ou celle de Passing-Bablok, bien que théoriquement plus adaptés à la présence d’erreurs sur les deux axes, tend à masquer la distribution locale des désaccords individuels en résumant la comparaison à des paramètres globaux de relation.
Le cadre conceptuel introduit par Bland et Altman s’affranchit totalement de cette asymétrie en projetant les données sur un repère orthogonal où la variable dépendante n’est plus l’une des mesures, mais la différence instantanée entre les deux (A – B), confrontée à la meilleure estimation disponible de la grandeur sous-jacente : la moyenne non pondérée des deux mesures ((A + B) / 2). Ce formalisme élimine l’arbitraire du choix de la variable indépendante et neutralise la distorsion géométrique propre aux régressions classiques.
2.3 Avantages spécifiques du cadre d’analyse de Bland-Altman
Le bénéfice primordial de la représentation de Bland-Altman réside dans l’expression immédiate des résultats statistiques au sein des unités métriques naturelles du phénomène mesuré (par exemple en millimètres de mercure, en millimoles par litre ou en points de score clinique). Alors que les indices statistiques standardisés comme le coefficient de corrélation intraclasse (CCI) ou le R² fournissent des valeurs adimensionnelles abstraites, les limites d’agrément quantifient sans intermédiaire l’écart maximal prévisible entre deux mesures individuelles pour 95 % des situations futures.
Par ailleurs, la disposition graphique offre une capacité de diagnostic sémiologique instantanée de la structure de l’erreur. L’œil humain y perçoit immédiatement la présence éventuelle d’une hétéroscédasticité, c’est-à-dire une modification de la dispersion des erreurs en fonction de la magnitude de la mesure, se traduisant graphiquement par un évasement en entonnoir. De même, l’existence d’une dérive instrumentale non linéaire ou d’un biais proportionnel devient visuellement flagrante, là où un calcul matriciel global agrégé occulterait ces anomalies distributionnelles.
Enfin, cette approche impose aux cliniciens et aux chercheurs d’adopter une posture méthodologique rigoureuse en dissociant l’estimation empirique de l’écart de son appréciation qualitative. Les limites d’agrément à 95 % ne stipulent pas si un écart est « acceptable » ou non d’un point de vue clinique ; elles obligent les spécialistes du domaine à définir a priori, sur la base de connaissances physiopathologiques ou métrologiques indépendantes, un intervalle d’équivalence maximal acceptable, auquel les données empiriques seront ensuite confrontées de manière objective.
3. Préparation et structuration des données expérimentales dans Excel
3.1 Organisation matricielle des variables dans la feuille de calcul
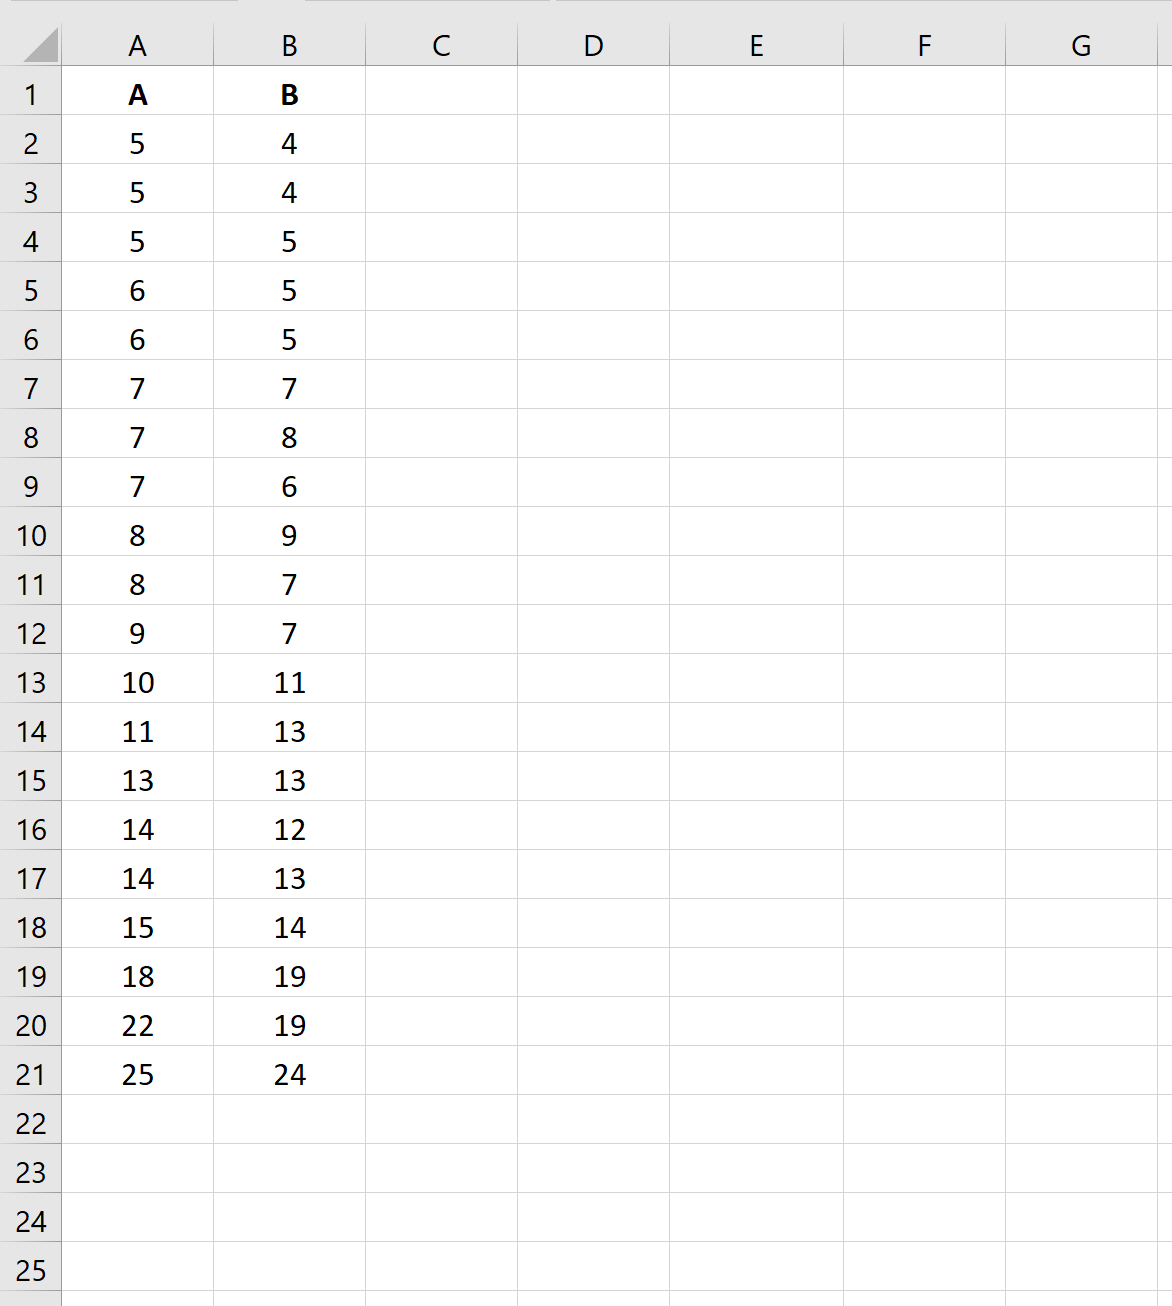
L’implémentation opérationnelle sous Microsoft Excel requiert une architecture de données tabulaire rigoureusement normalisée. Les données doivent être structurées selon les préceptes du « tidy data », où chaque ligne correspond de façon exclusive à une unité observationnelle (un participant unique, ou une observation indépendante appariée) et chaque colonne à une variable métrologique univoque. La première ligne du tableau Excel sera systématiquement réservée aux en-têtes explicites, en évitant les caractères d’échappement complexes ou les espaces superflus qui pourraient corrompre les formules matricielles dynamiques.
La structure minimale indispensable comporte trois colonnes fondamentales ordonnées séquentiellement :
la colonne A accueille l’identifiant univoque du sujet ou de l’échantillon (par exemple « Sujet_001 », « Sujet_002 ») ;
la colonne B stocke la variable continue quantifiée par le premier système d’évaluation, désigné conventionnellement comme « Instrument A » (ou Méthode de Référence) ;
la colonne C recueille la mesure homologue issue du second dispositif, nommé « Instrument B » (ou Nouvelle Méthode). Il est impératif de garantir un appariement strict : la valeur de la cellule C2 doit obligatoirement correspondre à la mesure effectuée sur la même entité biologique ou le même objet que celle consignée en B2.
Dès la phase d’encodage, l’opérateur doit s’assurer du typage adéquat des données dans Excel. Les colonnes B et C doivent impérativement être formatées en tant que « Nombre » (avec un nombre de décimales cohérent avec la résolution instrumentale) et non sous le format générique « Standard » ou « Texte ». Une erreur récurrente réside dans l’utilisation de séparateurs décimaux incohérents (point au lieu de la virgule selon les paramètres régionaux du système d’exploitation), ce qui inhibe l’exécution des fonctions arithmétiques ultérieures et génère des erreurs de type #VALEUR!.
3.2 Nettoyage préliminaire et vérification de la complétude des données
Avant d’engager le moindre traitement algorithmique, un protocole rigoureux d’assainissement de la base s’impose. La gestion des données manquantes constitue une première criticité méthodologique. Dans le cadre d’un protocole apparié de Bland-Altman, toute absence de donnée sur l’un des deux instruments invalide l’estimation de l’écart intra-sujet pour l’observation concernée. Il convient donc de procéder à une exclusion par observation (suppression par liste complète ou « listwise deletion ») des lignes présentant un champ vide en colonne B ou C, tout en documentant scrupuleusement l’effectif initial et final dans le cahier de laboratoire statistique.
L’inspection des valeurs aberrantes ou extrêmes (outliers) doit être effectuée avec discernement. Une valeur peut résulter soit d’une erreur matérielle de transcription (oubli d’une décimale, inversion de chiffres), soit d’un artefact technique transitoire (désynchronisation d’un capteur), soit d’une authentique réponse biologique discordante. L’utilisation de filtres conditionnels ou la formule de détection d’anomalies basée sur l’écart interquartile dans Excel permet d’isoler rapidement les valeurs suspectes. Cependant, aucune observation discordante ne doit être expurgée de l’analyse définitive sans justification expérimentale validée, sous peine de biaiser artificiellement la variance et de sous-estimer l’ampleur réelle du désaccord métrologique.
Enfin, l’homogénéité stricte des unités de mesure entre les deux instruments constitue un prérequis incontournable. Il arrive fréquemment que deux analyseurs biomédicaux expriment la même grandeur selon des unités différentes (par exemple, la glycémie mesurée en milligrammes par décilitre d’un côté et en millimoles par litre de l’autre, ou le débit cardiaque en litres par minute versus millilitres par seconde). L’expérimentateur doit impérativement convertir les données d’un instrument afin qu’elles partagent exactement la même dimension métrique que l’autre avant toute manipulation d’écart ou de moyenne.
3.3 Considérations relatives à la taille d’échantillon nécessaire
Une lacune méthodologique fréquente dans la littérature consiste à déployer une analyse de concordance sur des cohortes d’effectifs résiduels (inférieurs à 20 ou 30 sujets), privant les estimations de toute stabilité statistique. Il convient de souligner que le graphique de Bland-Altman n’a pas pour objectif de rejeter une hypothèse nulle au sens traditionnel, mais d’estimer des paramètres populationnels (le biais et les bornes d’agrément) avec une précision d’échantillonnage déterminée, matérialisée par leurs intervalles de confiance respectifs.
Les recommandations méthodologiques formulées par Bland et Altman préconisent un effectif minimal de 100 paires d’observations pour garantir une largeur raisonnablement étroite de l’intervalle de confiance des limites d’agrément. Lorsque la taille de l’échantillon n est trop modeste, la variance d’échantillonnage de l’écart-type des différences devient considérable, entraînant une incertitude majeure sur le positionnement réel des bornes supérieure et inférieure. Si un effectif de 100 sujets s’avère logistiquement inaccessible, un seuil d’au moins 40 à 50 observations appariées demeure le plancher statistique absolu sous lequel les conclusions doivent être qualifiées de strictly exploratoires.
Sur le plan de la planification expérimentale, la puissance statistique s’évalue ici en termes de précision attendue : si l’objectif de l’étude est de démontrer que l’intervalle d’agrément à 95 % est entièrement contenu à l’intérieur d’une marge de tolérance clinique prédéfinie delta, l’investigateur doit dimensionner son échantillon en fonction de l’écart-type anticipé des différences, de manière à ce que la borne supérieure de l’intervalle de confiance à 95 % de la limite supérieure d’agrément n’excède pas ce seuil critique.
4. Calcul des moyennes individuelles et des écarts intra-sujets
4.1 Formulation mathématique de la moyenne des deux mesures
Le principe fondamental de la projection cartésienne de Bland-Altman réside dans le positionnement de la « vraie » valeur estimée du mesurande sur l’axe des abscisses. En l’absence d’une référence d’exactitude absolue (« gold standard » parfait dépourvu d’erreur), la meilleure approximation non biaisée de la quantité sous-jacente est apportée par la moyenne arithmétique simple des deux observations réalisées sur le même sujet.
D’un point de vue analytique, pour un individu i ayant fait l’objet d’une mesure Ai par l’instrument A et d’une mesure Bi par l’instrument B, la valeur assignée en abscisse correspond à :
Moyennei = (Ai + Bi) / 2
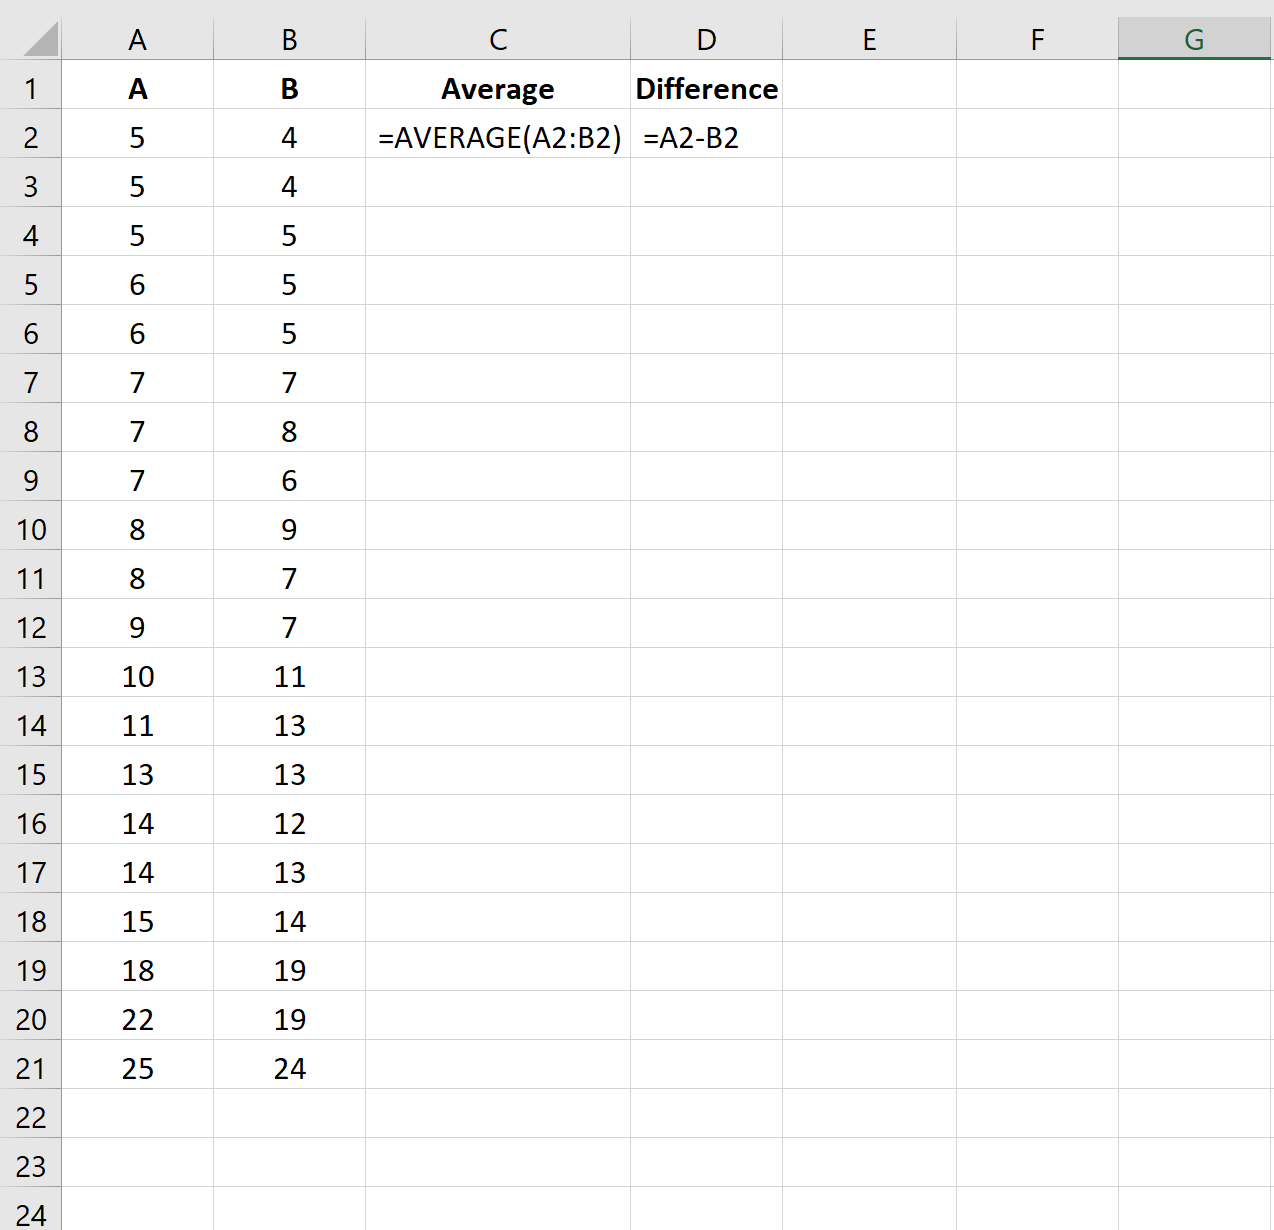
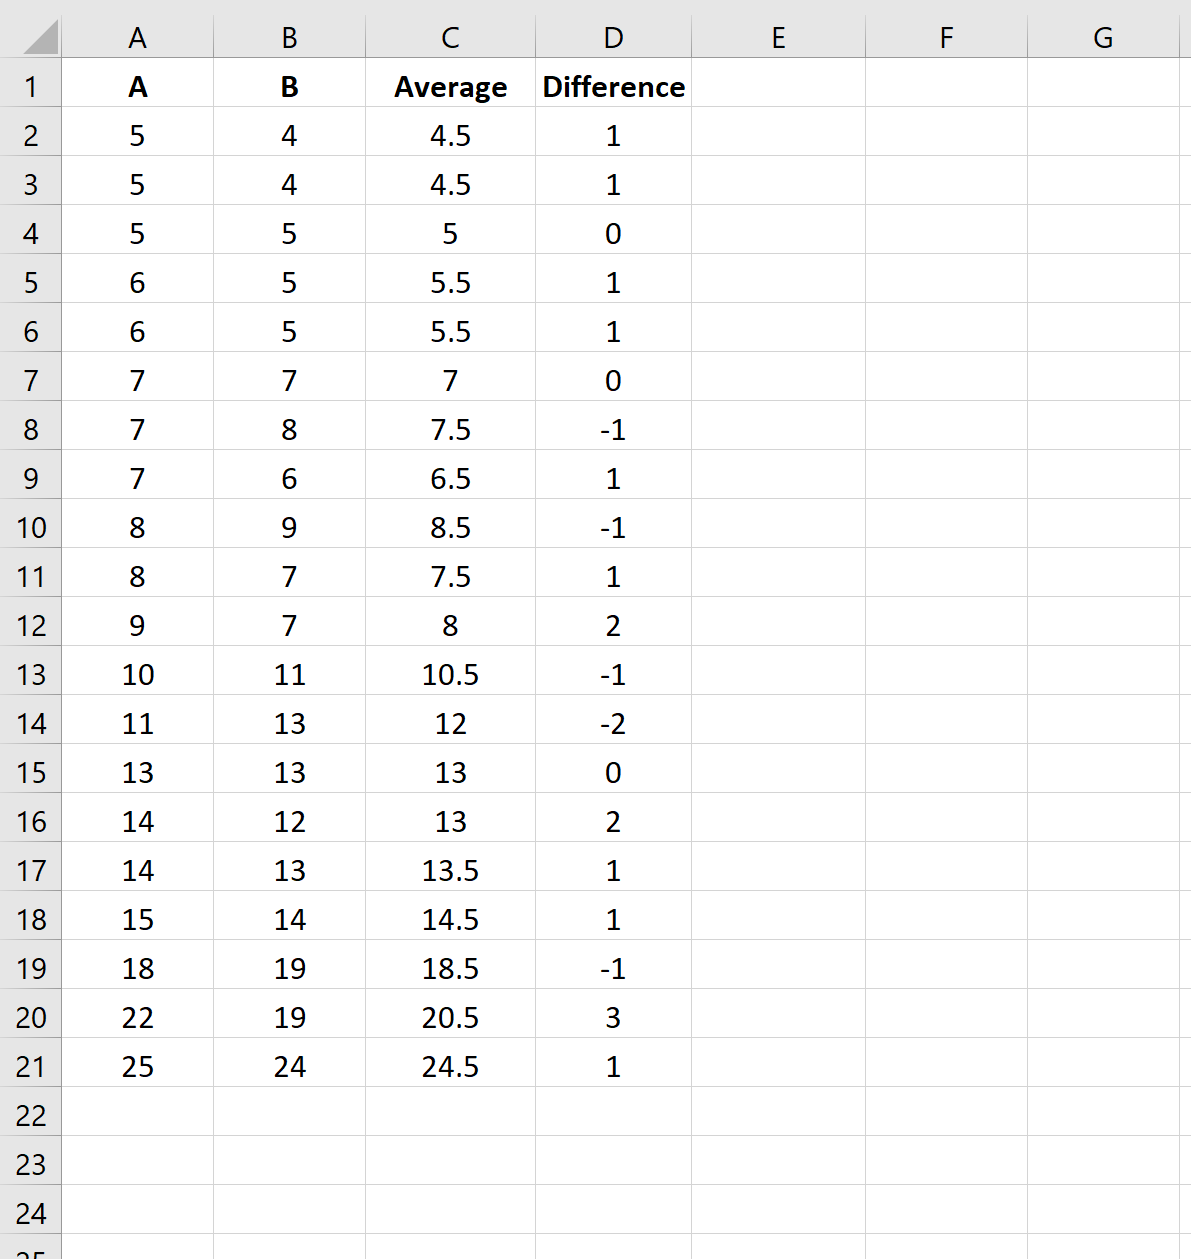
Dans la feuille de calcul Excel, cette opération se concrétise par la création d’une quatrième colonne, conventionnellement labellisée en colonne D par l’en-tête « Moyenne_Individuelle ». En supposant que les données effectives débutent à la ligne 2, l’expérimentateur insère dans la cellule D2 la formule :
=MOYENNE(B2:C2) ou alternativement =(B2+C2)/2
Cette formulation est ensuite répliquée sur l’ensemble des rangées du tableau par double-clic sur la poignée de recopie incrémentale située à l’angle inférieur droit de la cellule active D2, assurant ainsi la propagation instantanée du calcul sur la cohorte complète.
4.2 Calcul algébrique de la différence entre les instruments
La seconde variable directrice, qui constitue l’axe vertical du repère de dispersion, est la différence arithmétique constatée entre les deux dispositifs pour chaque unité expérimentale. Le calcul de cet écart intra-sujet est défini par l’expression algébrique :
Différencei = Ai – Bi
Le choix de l’ordre de la soustraction relève d’une convention arbitraire, mais cette orientation doit être scrupuleusement documentée et maintenue sans altération tout au long de l’interprétation. Conventionnellement, si l’un des instruments représente la technologie standard établie et l’autre la méthode évaluée, on calcule la différence en soustrayant la référence de la nouvelle méthode (Nouvelle Méthode – Référence), ou inversement. Ce choix détermine le sens sémiologique du signe : si l’on applique l’opération A - B, une valeur algébrique positive traduit une surestimation de la mesure par l’instrument A relativement à l’instrument B, tandis qu’une valeur négative dénote une sous-estimation systématique locale.
Dans Excel, cette grandeur est assignée à la colonne E, intitulée « Difference_A_moins_B ». Dans la cellule E2, l’utilisateur encode l’opération arithmétique directe :
=B2-C2
Cette commande est instantanément propagée le long de la série de données. Il est capital d’éviter l’usage de la fonction ABS() (valeur absolue) à ce stade : l’analyse de Bland-Altman repose intrinsèquement sur la conservation de la direction algébrique des écarts individuels afin de pouvoir déceler tout décalage unilatéral de la distribution.
4.3 Gestion des écarts relatifs et en pourcentages si nécessaire
Dans de nombreux contextes biomédicaux, l’amplitude de l’erreur absolue entre deux instruments n’est pas constante sur l’ensemble de l’échelle clinique, mais s’accroît proportionnellement à la grandeur du mesurande. En présence d’un tel comportement métrologique, l’expression de l’écart en unités physiques absolues perd sa pertinence diagnostique, car une différence de 5 unités présente une gravité totalement dissemblable selon que la valeur moyenne du paramètre est de 10 ou de 1000.
Pour remédier à cette dépendance d’échelle, il est d’usage d’adopter une métrique relative en formulant la différence en pourcentage de la moyenne individuelle. La grandeur calculée pour le sujet i prend alors la forme :
Différence Relative (%) = [(Ai – Bi) / Moyennei] * 100
Dans la feuille de calcul Excel, cette variable peut être calculée dans une colonne F dédiée, via la syntaxe appliquée en F2 :
=(E2/D2)*100
Une modélisation alternative encore plus robuste face aux variations multiplicatives repose sur le passage aux logarithmes népériens des mesures brutes, où la différence des logarithmes LN(A) - LN(B) correspond mathématiquement au logarithme du ratio des deux instruments, permettant d’extraire des limites d’agrément exprimées sous forme de ratios multiplicatifs après rétro-transformation exponentielle.
5. Estimation du biais moyen sous Excel
5.1 Définition et calcul de la différence moyenne
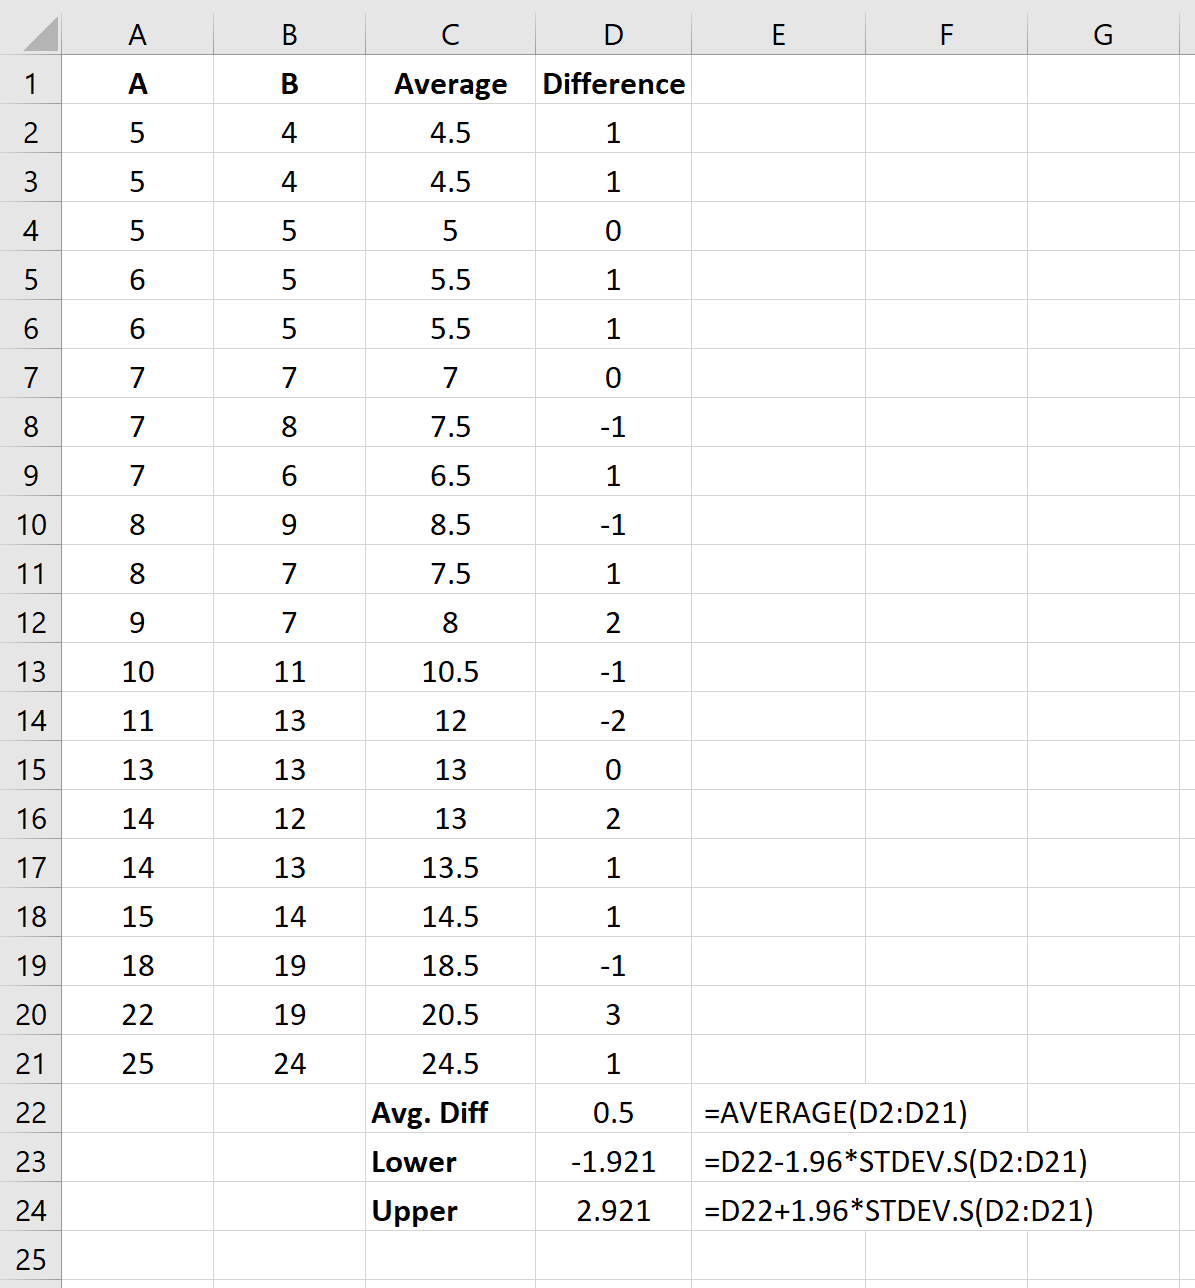
Le biais moyen (désigné statistiquement par d̄) incarne l’estimation ponctuelle de l’erreur systématique globale prévalant entre les deux modalités d’évaluation. Il représente le décalage moyen permanent d’une méthode par rapport à l’autre sur l’ensemble de la population examinée. D’un point de vue formel, il est défini comme la moyenne arithmétique des n différences individuelles calculées :
d̄ = (1 / n) * ∑ (Ai – Bi)
Dans l’interface d’Excel, l’extraction de ce paramètre central s’opère par l’invocation de la fonction statistique standard MOYENNE appliquée à la série des différences individuelles (colonne E). Si le tableau d’expérimentation s’étend de la ligne 2 à la ligne 101 (correspondant à 100 observations), l’utilisateur formule l’instruction :
=MOYENNE(E2:E101)
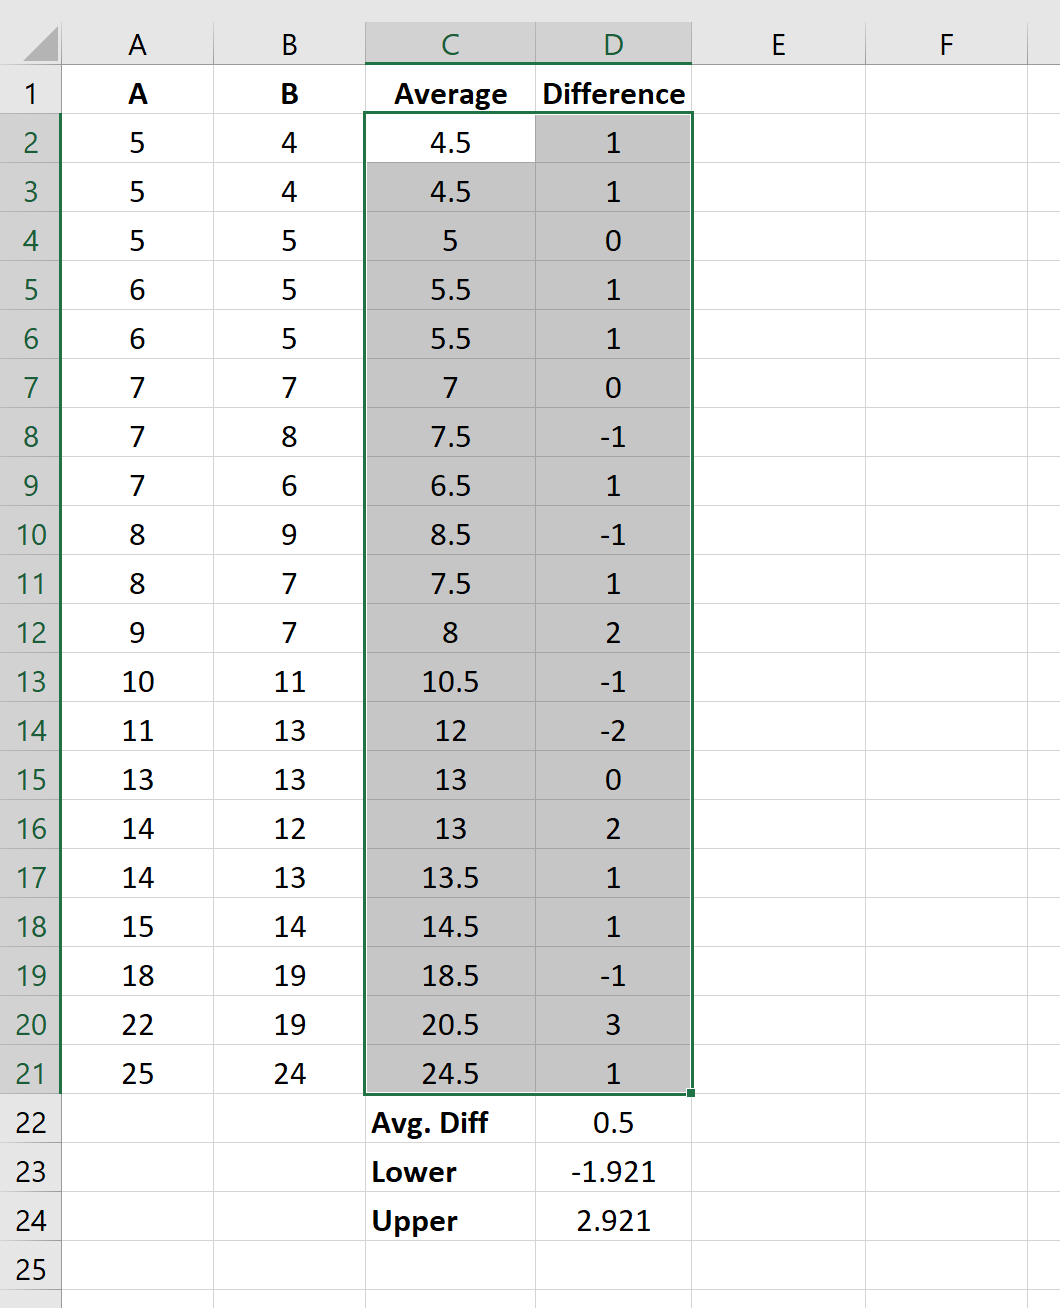
L’interprétation de la valeur résultante est immédiate. Un biais moyen numériquement nul (ou statistiquement indiscernable de zéro) atteste de l’absence totale de déviation systématique entre les deux systèmes d’acquisition. À l’inverse, un biais moyen substantiellement positif indique que l’instrument A produit globalement des valeurs supérieures à l’instrument B, tandis qu’un biais négatif formalise une sous-estimation systématique globale du mesurande par le premier instrument vis-à-vis du second.
5.2 Test d’hypothèse sur la significativité du biais moyen
L’identification d’une différence moyenne non nulle sur un échantillon expérimental pose la question de son authenticité populationnelle : ce biais reflète-t-il une divergence systématique réelle des instruments ou découle-t-il des seules fluctuations d’échantillonnage stochastiques ? Pour trancher cette interrogation inférentielle, il est préconisé d’exécuter un test t de Student pour échantillons appariés, sous l’hypothèse nulle stipulant que la différence moyenne théorique delta est strictement égale à zéro (H0 : delta = 0 versus H1 : delta ≠ 0).
Excel dispose d’une fonction analytique intégrée particulièrement directe pour extraire la probabilité critique (p-valeur) bilatérale associée à cette confrontation statistique. Dans une cellule dédiée de synthèse, l’utilisateur insère la formulation suivante :
=TEST.T(B2:B101; C2:C101; 2; 1)
Dans cette configuration de commande :
le premier argument B2:B101 désigne la série des mesures de l’instrument A ;
le second argument C2:C101 identifie les observations appariées de l’instrument B ;
le troisième argument, paramétré sur la valeur 2, spécifie un test bilatéral ;
le quatrième argument, fixé sur la valeur 1, configure l’algorithme pour exécuter un test apparié (mesures répétées intra-sujet).
Si la valeur p résultante est inférieure au seuil alpha conventionnel de 0,05, l’hypothèse nulle est réfutée : le biais systématique observé est qualifié de statistiquement significatif. Néanmoins, il importe de rappeler avec force que la significativité statistique n’implique aucunement une pertinence clinique. Avec un échantillon de grande taille (par exemple plusieurs centaines d’individus), un biais microscopique de 0,1 unité sans aucune implication pratique pourra présenter une p-valeur hautement significative (p < 0,001). C’est pourquoi l’interprétation doit toujours confronter la magnitude absolue du biais aux seuils de tolérance médicale préétablis.
5.3 Affichage et fixation des paramètres dans la feuille de calcul
Pour assurer la fluidité de la programmation sous Excel et éviter la dispersion des constantes statistiques lors de la conception du graphique, il est impératif d’isoler l’ensemble des descripteurs globaux au sein d’une zone matricielle de référence (un « bloc récapitulatif des constantes »). Ce bloc sera judicieusement disposé sur les colonnes adjacentes ou dans un tableau supérieur dédié.
Ce tableau récapitulatif contiendra les cellules désignées pour accueillir :
l’effectif total n via la commande =NB(E2:E101) ;
le biais moyen d̄ via la commande =MOYENNE(E2:E101) ;
l’écart-type des différences s via la commande =ECARTYPE.STANDARD(E2:E101) ;
la valeur p du test t apparié.
Afin de pouvoir projeter graphiquement les lignes horizontales représentant ces paramètres directeurs sur le repère de dispersion, il sera nécessaire d’injecter la valeur scalaire du biais de manière répétée le long de chaque ligne d’observation. Pour verrouiller la référence lors de la recopie incrémentale, l’ancrage absolu par l’insertion du symbole dollar ($) s’avère indispensable. Ainsi, si la cellule calculant le biais global est positionnée en $H$2, la colonne générée pour le tracé comportera la formule =$H$2 dupliquée sur toute la hauteur des lignes actives de données.
6. Détermination de la variance, de l’écart-type et des limites d’agrément à 95 %
6.1 Calcul de l’écart-type des différences
Si le biais moyen caractérise l’emplacement central de la distribution des désaccords, l’erreur aléatoire de mesure s’exprime au travers de la dispersion de ces différences autour de leur espérance empirique. La métrique fondamentale pour quantifier cette variabilité intra-sujet résiduelle est l’écart-type de l’échantillon des différences, noté sd (ou SD).
Sur le plan computationnel, l’expérimentateur doit veiller rigoureusement au choix de la primitive statistique au sein d’Excel. Il convient d’appliquer la fonction ECARTYPE.STANDARD (ou ECARTYPE dans les versions antérieures d’Excel) et d’exclure formellement la commande ECARTYPE.PEARSON (ou ECARTYPEP). La fonction ECARTYPE.STANDARD intègre au dénominateur la correction de Bessel par les degrés de liberté (n – 1), garantissant l’obtention d’un estimateur sans biais de la variance populationnelle :
sd = √ [ (1 / (n – 1)) * ∑ ( (Ai – Bi) – d̄ )² ]
Dans la feuille de calcul, la syntaxe opérationnelle s’écrit :
=ECARTYPE.STANDARD(E2:E101)
Cet écart-type constitue le pivot fondamental de la méthode : plus l’amplitude de sd est restreinte, plus la fidélité comparative entre les deux dispositifs est élevée, conditionnant directement l’étroitesse de l’intervalle de dispersion dans lequel s’inscriront les futures observations.
6.2 Formulation mathématique des limites d’agrément conventionnelles
Sous le postulat vérifié que les différences intra-sujets suivent une distribution normale ou quasi normale, les propriétés de la loi gaussienne stipulent qu’approximativement 95,45 % des écarts individuels de la population d’origine se distribuent dans un rayon de deux écarts-types de part et d’autre de la moyenne. Par convention internationale fixée par Bland et Altman, le coefficient d’élargissement retenu est de 1,96 (correspondant exactement au quantile bilatéral d’ordre 97,5 % de la distribution normale centrée réduite standard Z).
Les Limites d’Agrément à 95 % (communément abrégées LoA pour « Limits of Agreement ») sont formellement calculées selon les relations suivantes :
Limite d’Agrément Supérieure (ULA) = d̄ + (1,96 * sd)
Limite d’Agrément Inférieure (LLA) = d̄ – (1,96 * sd)
Ces deux bornes paramétriques définissent le corridor d’agrément au sein duquel se situeront, pour 95 % des sujets d’une cohorte clinique comparable, les divergences constatées entre une évaluation par l’instrument A et une évaluation par l’instrument B. L’écartement total entre la borne supérieure et la borne inférieure (représentant une amplitude de 3,92 écarts-types) synthétise l’incertitude métrologique maximale globale inhérente au remplacement d’une technique par l’autre.
6.3 Automatisation des calculs dans le tableau Excel
Pour matérialiser ces concepts dans la structure algorithmique d’Excel, l’utilisateur insère les calculs correspondants au sein du tableau des constantes statistiques préalablement configuré. Supposons que le biais moyen d̄ soit ancré dans la cellule H2 et que l’écart-type sd réside en H3 :
dans la cellule H4 (dédiée à l’ULA), l’opérateur saisit la commande : =H2+(1,96*H3) ;
dans la cellule H5 (dédiée à la LLA), il programme l’expression : =H2-(1,96*H3).
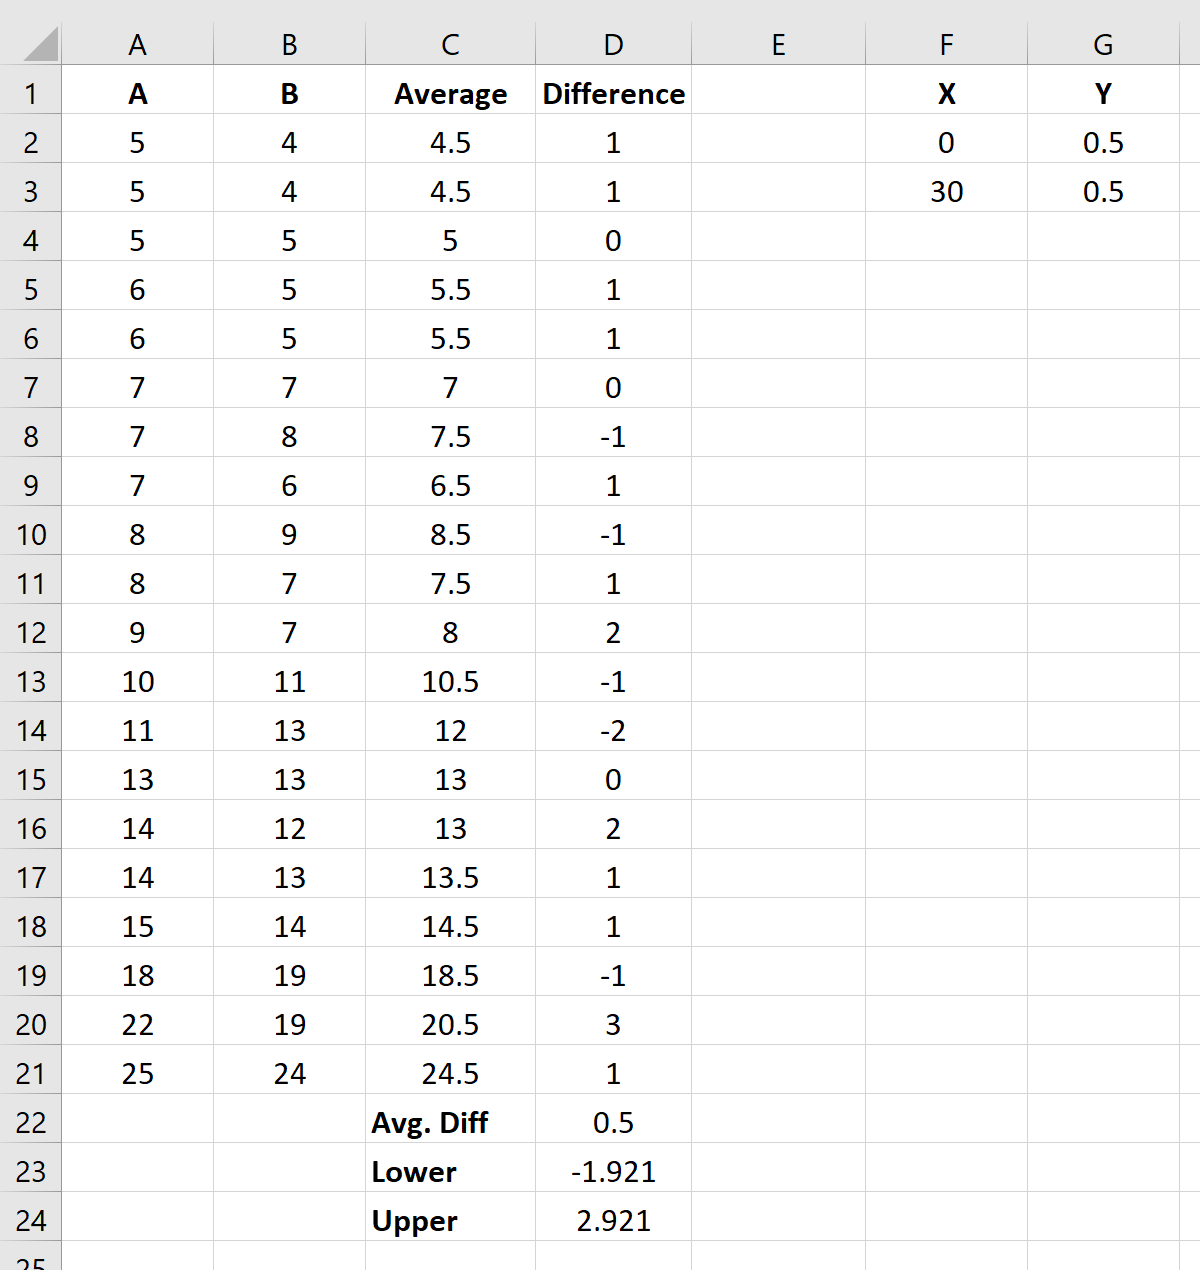
Afin de préparer l’infrastructure nécessaire à l’affichage dynamique sous forme de tracés horizontaux sur le graphique cartésien, il est hautement avantageux de générer trois nouvelles colonnes au sein du tableau principal de données (colonnes F, G et H) :
la colonne F (« Ligne_Biais ») intègre la formule =$H$2 dupliquée sur toute la longueur ;
la colonne G (« Ligne_ULA ») accueille l’instruction =$H$4 dupliquée de manière identique ;
la colonne H (« Ligne_LLA ») reçoit la syntaxe =$H$5, propagée jusqu’à la dernière observation.
Cette duplication en apparence redondante offre l’immense intérêt de corréler chaque point d’abscisse à une valeur d’ordonnée fixe et continue, autorisant l’affichage automatisé et fluide de lignes statistiques de référence via l’outil de création de graphiques combinés d’Excel.
7. Construction étape par étape du nuage de points dans Excel
7.1 Sélection des plages de données et insertion du graphique
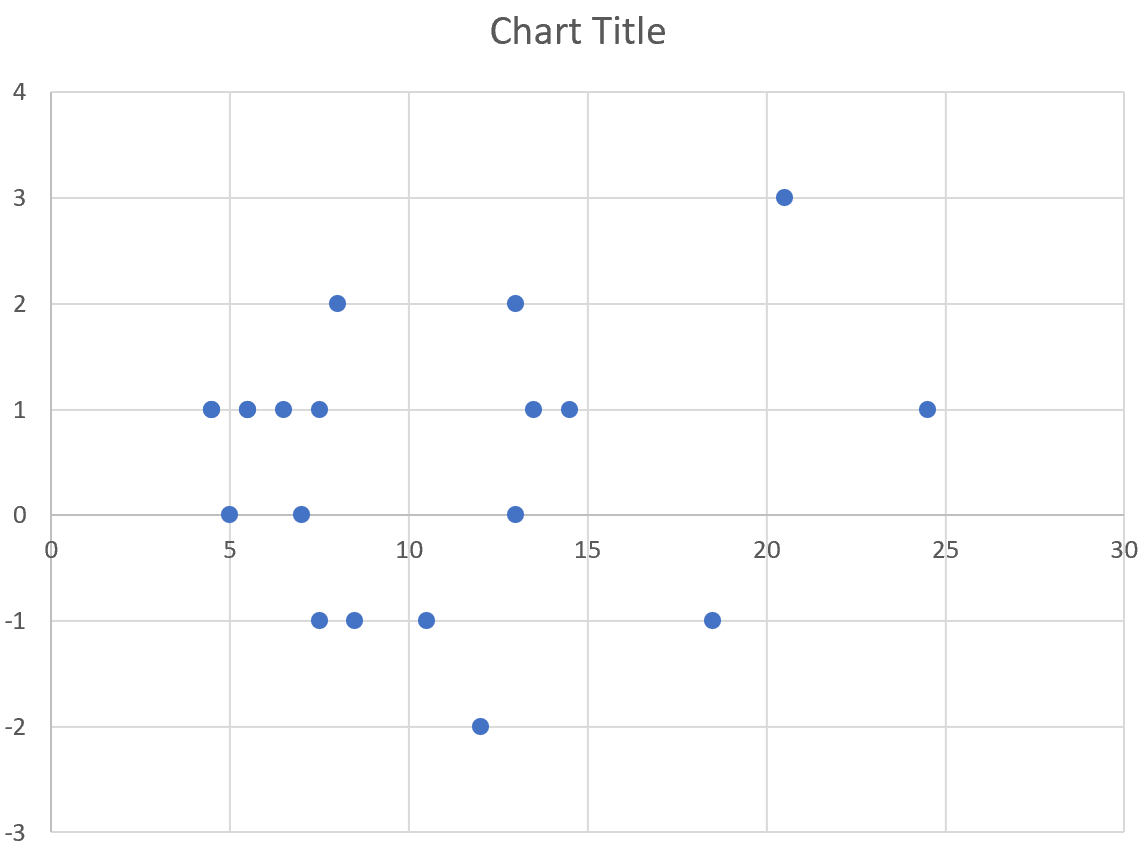
La génération initiale du tracé géométrique exige la sélection précise des deux vecteurs directeurs. L’utilisateur doit impérativement sélectionner de façon simultanée mais disjointe la colonne des moyennes individuelles (axe horizontal X) et la colonne des différences individuelles (axe vertical Y). Pour ce faire, il convient de surligner la plage des moyennes (par exemple D2:D101), puis, tout en maintenant la touche Ctrl (ou Cmd sur Mac) enfoncée, de sélectionner la plage homologue des différences (E2:E101).
Une fois cette double sélection effective, il convient de naviguer vers le ruban supérieur d’Excel, de cliquer sur l’onglet Insertion, puis, dans le groupe Graphiques, de choisir formellement la typologie Nuage de points (XY). Il est capital de sélectionner le sous-type Nuage de points avec marqueurs uniquement (sans aucune ligne de raccordement droite ou lissée entre les observations). L’insertion génère immédiatement un tracé matriciel brut au centre de la feuille active.
Pour préserver un espace de travail ergonomique et favoriser une précision maximale lors du paramétrage typographique, il est fortement recommandé de détacher le graphique de la matrice de données. L’utilisateur clique avec le bouton droit sur la zone de traçage, sélectionne Déplacer le graphique…, puis opte pour l’option Nouvelle feuille, en assignant à cet onglet le libellé « Graphique_Bland_Altman ». Cette disposition plein écran maximise la clarté visuelle et garantit un contrôle optimal des éléments géométriques.
7.2 Configuration géométrique des axes cartésiens
Le tracé brut généré par les automatismes d’Excel présente invariablement une configuration typographique non adaptée aux standards académiques internationaux. Le reparamétrage commence par la gestion des axes. L’utilisateur sélectionne l’axe horizontal (axe des abscisses X), effectue un clic droit pour ouvrir le volet Format de l’axe, et ajuste les limites minimale et maximale afin d’éliminer les marges d’affichage superflues. Les bornes doivent encadrer harmonieusement l’étendue réelle des moyennes calculées.
L’axe vertical (axe des ordonnées Y, représentant les différences) requiert une vigilance particulière. Par définition, le point zéro (absence totale de désaccord) doit constituer l’ancrage de référence mental de la lecture. Il est donc fondamental de paramétrer les valeurs minimale et maximale de l’axe vertical de manière à ce qu’elles soient symétriques par rapport au biais moyen ou qu’elles intègrent confortablement les limites d’agrément calculées ainsi qu’une marge de sécurité visuelle. Par exemple, si l’ULA culmine à +8 et la LLA à -12, un axe s’étendant de -15 à +15 assure une vision équilibrée de l’amplitude globale de dispersion.
Dans les options d’axe sous Excel, il convient également d’ajuster le positionnement de l’intersection de l’axe horizontal. Par défaut, Excel fait souvent croiser l’axe X à la valeur minimale de l’axe Y, reléguant l’axe au bas du graphique, ce qui est généralement préférable pour éviter que les graduations numériques ne viennent couper la trajectoire des points centraux. Les unités principales de graduation doivent être fixées manuellement sur des valeurs rondes et cohérentes (par exemple par paliers de 2, de 5 ou de 10) pour bannir les fractions décimales illisibles générées automatiquement par l’algorithme d’interpolation d’Excel.
7.3 Personnalisation stylistique des marqueurs de données
L’esthétique des marqueurs doit répondre aux critères de sobriété et de rigueur exigés par les comités de lecture scientifique. Par défaut, Excel génère des marqueurs volumineux de couleur unie qui masquent la superposition d’observations denses. Il convient de sélectionner la série de points, d’activer le volet Mettre en forme la série de données, puis d’accéder aux options de Remplissage et contour des marqueurs.
La typologie optimale consiste à sélectionner une forme circulaire standard (cercle plein), à réduire son diamètre à une dimension comprise entre 3 et 5 points selon la densité de l’échantillon, et à paramétrer un remplissage semi-transparent (transparence calibrée entre 40 % et 60 %). Cette transparence progressive génère un assombrissement proportionnel au niveau des coordonnées où plusieurs observations appariées se superposent étroitement, fournissant ainsi une lecture quasi probabiliste de la densité de répartition locale.
Enfin, le contour des marqueurs peut être configuré avec un liseré fin d’un gris foncé ou d’un bleu nuit contrasté. Il convient de désactiver totalement les effets d’ombre portée, les bordures tridimensionnelles ou les biseaux, qui constituent des éléments parasites (« chart junk ») préjudiciables à la lisibilité sémiologique. Le quadrillage arrière-plan peut être allégé en supprimant le quadrillage vertical secondaire et en atténuant le quadrillage horizontal majeur sous forme d’une ligne grise discrète en pointillés.
8. Intégration et mise en forme des lignes de référence statistiques
8.1 Technique d’ajout des séries pour le biais et les limites
Pour conférer au nuage de points sa pleine dimension analytique de Bland-Altman, il est indispensable de surimprimer les trois repères horizontaux fondamentaux : la ligne de biais moyen d̄, la limite d’agrément supérieure ULA et la limite d’agrément inférieure LLA. La méthode la plus robuste et la plus dynamique sous Excel repose sur l’injection des colonnes constantes préalablement construites (colonnes F, G, H) sous forme de séries additionnelles au sein du graphique XY existant.
Pour exécuter cette intégration, l’utilisateur fait un clic droit dans la zone de traçage et clique sur Sélectionner des données…. Dans la boîte de dialogue contextuelle, sous la section Entrées de légende (Série), il actionne le bouton Ajouter :
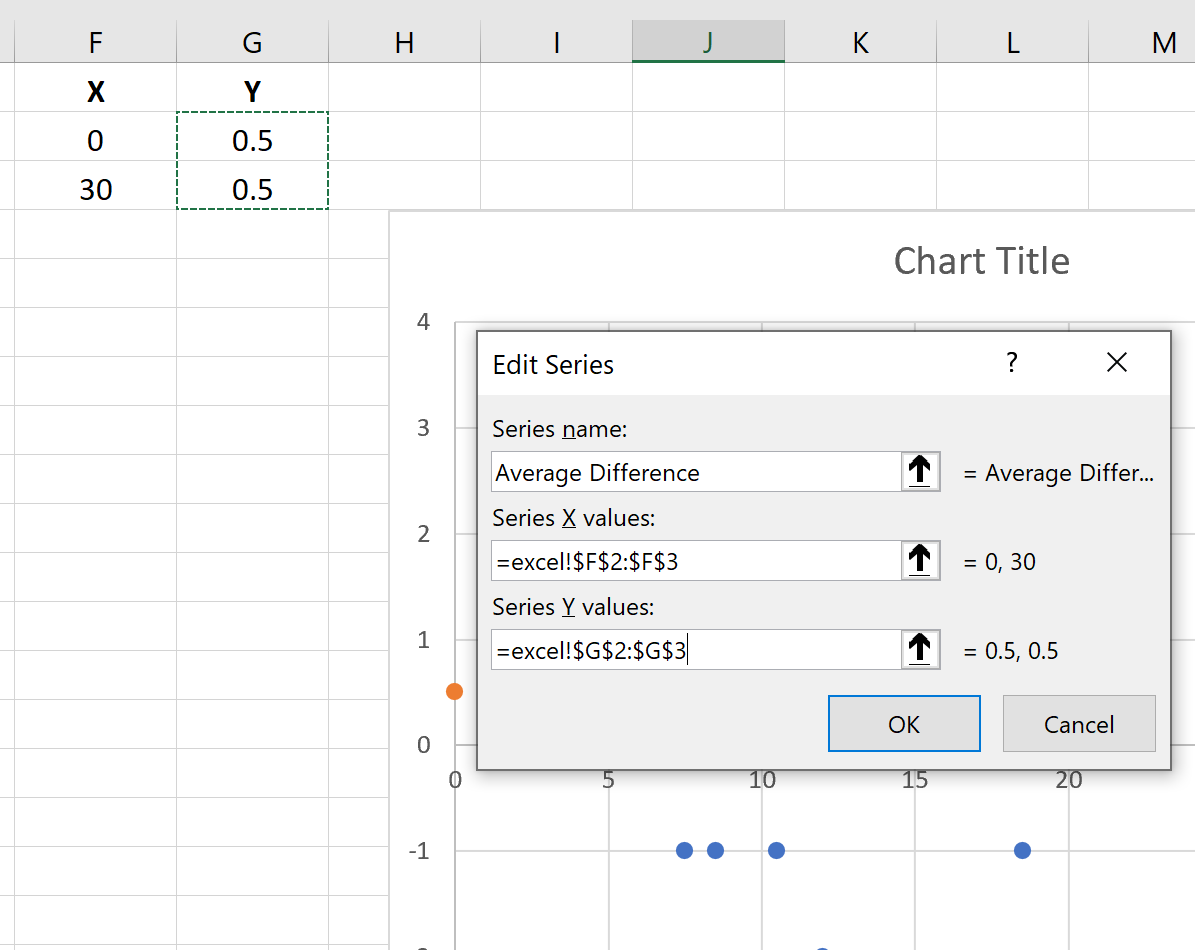
pour la première série (Biais Moyen) : dans le champ « Nom de la série », sélectionner la cellule d’en-tête correspondante ; dans le champ « Valeurs de la série X », pointer vers l’intégralité de la plage des moyennes individuelles (D2:D101) ; dans le champ « Valeurs de la série Y », sélectionner la colonne de biais constant (F2:F101) ;
l’opération est réitérée à l’identique pour l’ULA en affectant la plage G2:G101 en ordonnée ;
la procédure est répétée une troisième fois pour la LLA en pointant vers la plage H2:H101.
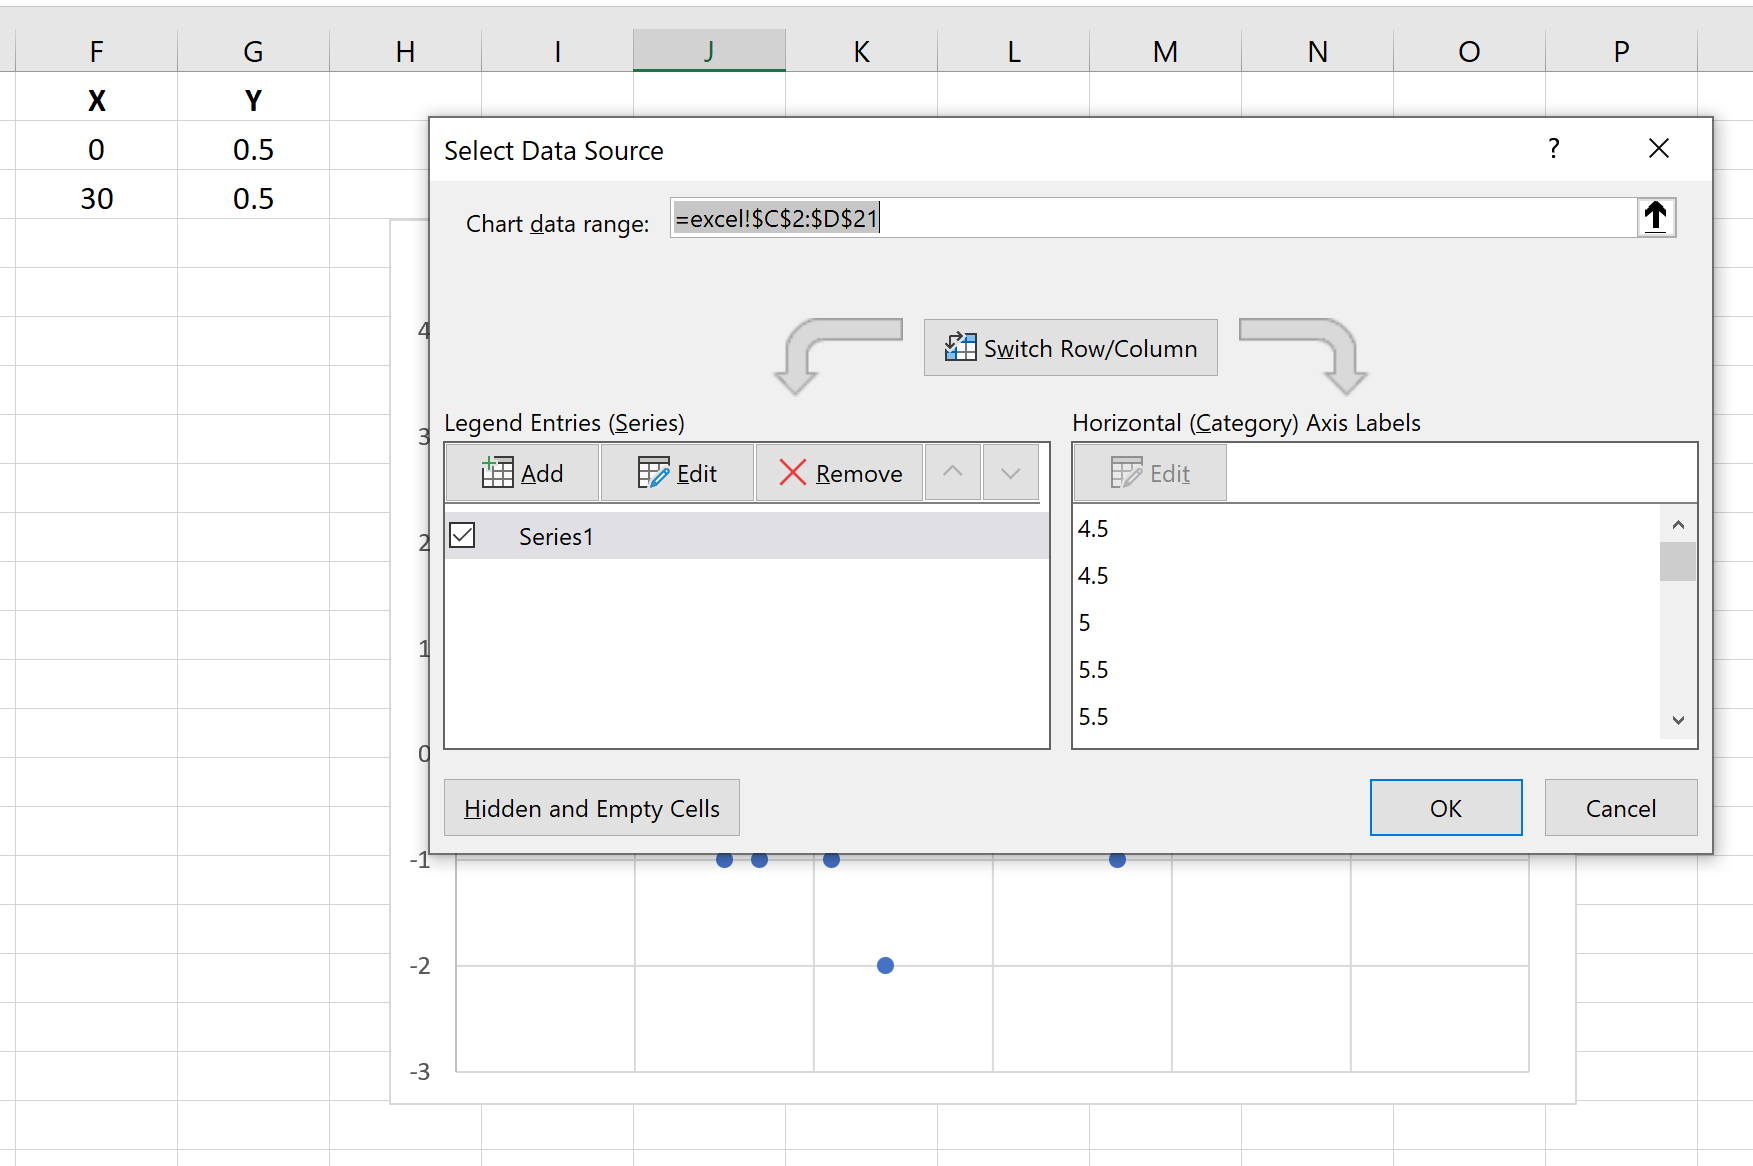
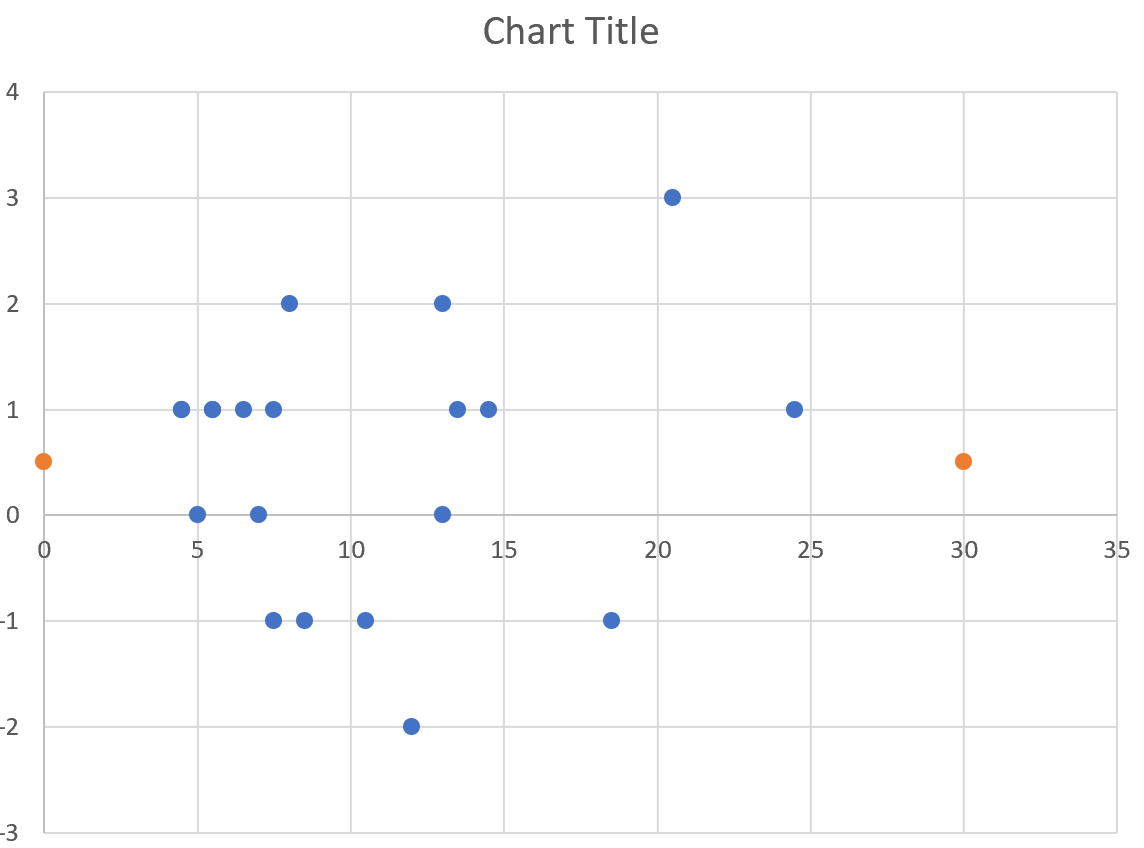
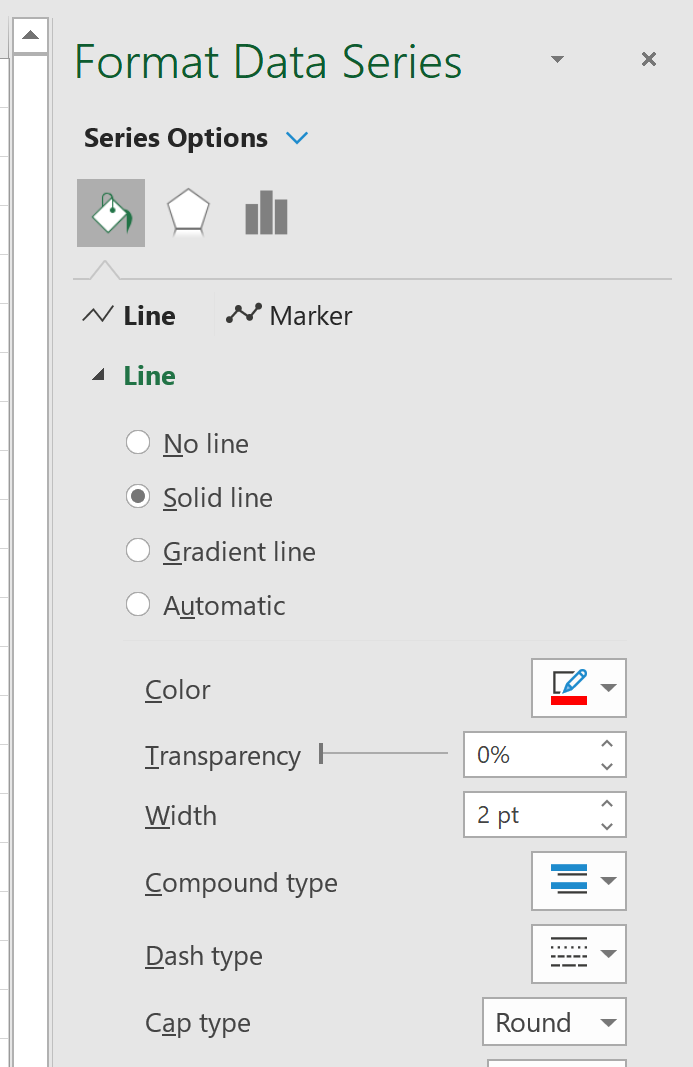
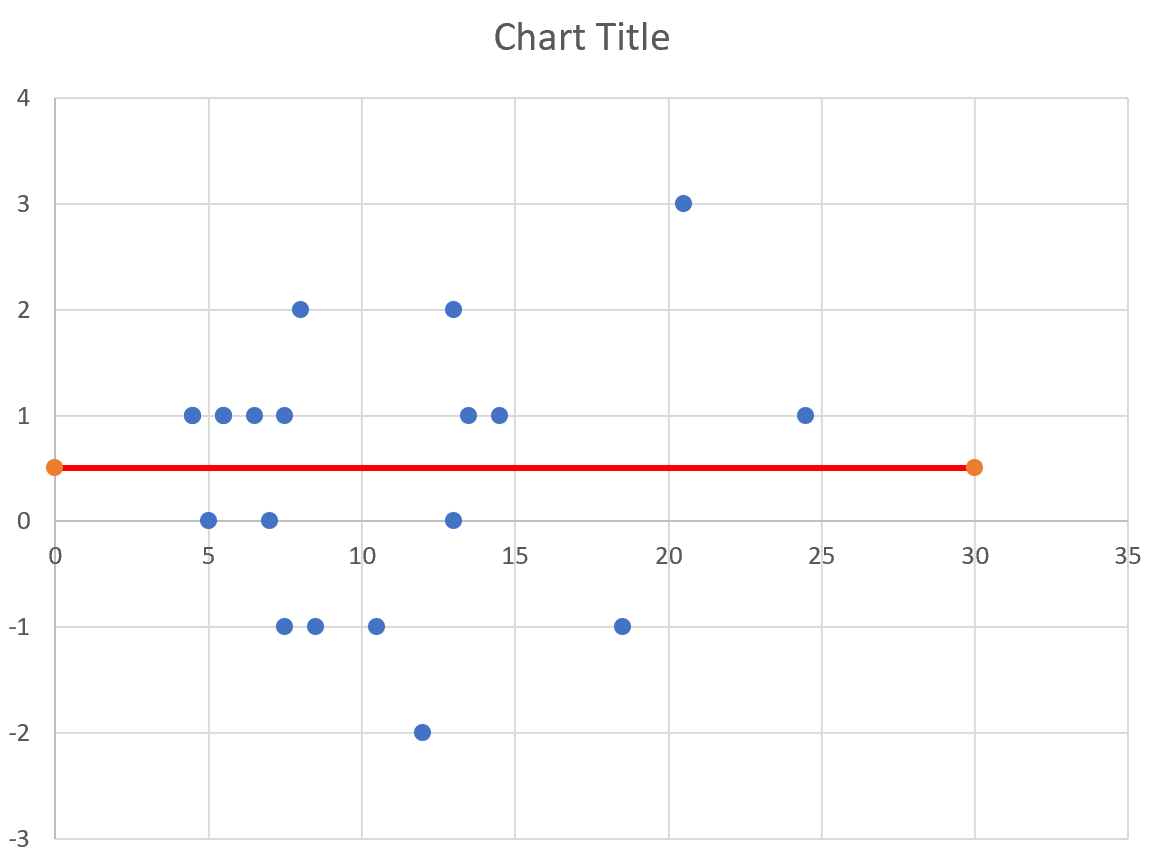
À ce stade, les nouvelles données apparaissent sous forme de points horizontaux denses. Pour transformer ces points en lignes d’ingénierie continues, il suffit de sélectionner chaque nouvelle série sur le tracé, d’ouvrir le volet de mise en forme, de configurer le type de marqueur sur Aucun, et d’activer l’option Ligne continue. Cette manipulation trace instantanément des droites géométriques rigoureusement horizontales couvrant l’amplitude intégrale de la distribution empirique.
8.2 Alternative par l’utilisation de barres d’erreur personnalisées
Une alternative technique élégante, évitant de dupliquer des colonnes entières de données scalaires au sein de la feuille de calcul, repose sur l’exploitation des barres d’erreur bidirectionnelles appliquées à un point virtuel fixe. Cette méthode s’avère particulièrement prisée par les concepteurs avancés de tableaux de bord statistiques automatisés.
Elle consiste à créer un tableau auxiliaire compact comportant trois points discrets, dont les ordonnées sont respectivement fixées sur d̄, ULA et LLA, et dont l’abscisse X correspond au centre géométrique exact de l’axe horizontal ((Xmin + Xmax) / 2). En ajoutant cette série réduite au graphique, l’utilisateur supprime la barre d’erreur verticale associée et configure la barre d’erreur horizontale en mode bidirectionnel sans empattement (« Sans extrémité »). L’amplitude de l’erreur positive et négative est alors paramétrée manuellement sur une distance fixe égale à la demi-largeur de l’axe cartésien.
Bien que cette méthodologie réduise l’empreinte mémoire de la feuille de calcul, elle présente le désavantage de nécessiter un recalcul dynamique des longueurs d’erreur en cas d’adjonction de nouvelles données étendant la plage des abscisses. La méthode des séries pleines décrite en 8.1 demeure donc la plus recommandable pour garantir une pérennité absolue des liaisons algorithmiques.
8.3 Codification visuelle et étiquetage standardisé
L’esthétique des lignes de référence doit impérativement respecter les conventions sémiotiques admises par la communauté biomédicale internationale afin d’assurer une hiérarchisation perceptive univoque. La codification standard s’établit comme suit :
la ligne centrale du biais systématique doit être représentée par une ligne continue, d’épaisseur moyenne (généralement 1,5 pt), habillée d’une teinte contrastée sobre (bleu marine, noir pur ou bordeaux profond) ;
les deux lignes de limites d’agrément (ULA et LLA) doivent impérativement être formatées en trait interrompu (pointillés longs ou tirets moyens), d’une épaisseur légèrement plus fine (1 pt à 1,25 pt), dans une tonalité grise anthracite ou rouge neutre pour signifier graphiquement le seuil critique de tolérance ;
une ligne zéro discrète (différence = 0) peut être ajoutée en trait continu très fin (0,75 pt) si le biais moyen s’écarte substantiellement de l’origine, afin de matérialiser visuellement la déviation de l’accord idéal.
Pour parachever l’élégance de la figure, l’adjonction d’étiquettes de données textuelles directes est grandement préférable à une légende déportée complexe. L’utilisateur peut insérer une zone de texte ou activer une étiquette sur l’extrémité droite de chaque ligne pour y inscrire explicitement les valeurs numériques arrondies :
« +1.96 SD (ULA) : +4.32 » ;
« Biais Moyen : -0.85 » ;
« -1.96 SD (LLA) : -6.02 ».
Ces mentions textuelles permettent au lecteur d’appréhender instantanément les bornes de tolérance sans devoir extrapoler visuellement les valeurs le long de l’axe vertical des ordonnées.
9. Interprétation statistique et clinique des résultats du graphique
9.1 Évaluation de la dispersion et du respect de l’intervalle à 95 %
L’exploitation analytique du graphique de Bland-Altman finalisé débute par une vérification rigoureuse de la validité distributionnelle interne du modèle. L’investigateur doit procéder à un dénombrement exhaustif des observations s’échappant au-delà du corridor circonscrit par l’ULA et la LLA. Conformément aux lois probabilistes d’une loi normale, approximativement 5 % des points expérimentaux doivent théoriquement se situer en dehors des limites d’agrément à 95 %.
Par exemple, sur un échantillon rigoureux de 100 sujets appariés, la présence de 4 à 6 observations externes demeure parfaitement compatible avec la distribution sous-jacente postulée. Si, en revanche, plus de 8 à 10 % des points sont projetés au-delà des limites, le postulat de normalité des résidus est potentiellement violé, ou la variance d’erreur est artificiellement accrue par des sous-populations hétérogènes. Dans ce cas, une évaluation formelle de la normalité des différences par un test de Shapiro-Wilk ou de Kolmogorov-Smirnov s’avère indispensable avant de valider l’inférence.
L’analyse qualitative des points atypiques (outliers) situés hors limites fournit également des indications métrologiques fondamentales. L’expérimentateur doit remonter aux identifiants des sujets concernés pour examiner si ces désaccords marqués sont corrélés à des artefacts physiologiques particuliers (fréquence cardiaque extrême, présence d’arythmie lors d’une mesure tensionnelle, interférence médicamenteuse) ou à des défaillances opératoires documentées. Cette autopsie des cas discordants participe directement à la fiabilisation des protocoles d’utilisation clinique du dispositif évalué.
9.2 Critères d’acceptabilité clinique a priori versus a posteriori
L’écueil méthodologique le plus grave dans l’utilisation du graphique de Bland-Altman consiste à conclure automatiquement à la validité d’une méthode au seul motif que 95 % des points s’inscrivent à l’intérieur des limites calculées. Il s’agit là d’une tautologie statistique : par définition algorithmique, les limites d’agrément sont calibrées pour englober environ 95 % de l’échantillon d’ajustement, quelle que soit la magnitude de l’imprécision des instruments.
Le jugement portant sur l’interchangeabilité de deux méthodes d’évaluation relève exclusivement d’un arbitrage clinique et fonctionnel, et non d’une sentence statistique abstraite. Les investigateurs doivent impérativement fixer, au sein du protocole expérimental préalable à l’acquisition des données, des marges de tolérance maximales tolérables (souvent notées -delta et +delta). Ces bornes a priori correspondent à la divergence maximale au-delà de laquelle l’erreur de mesure induirait un risque de classification diagnostique erronée ou un changement inadapté dans la prise en charge d’un patient.
La règle décisionnelle s’énonce alors avec limpidité : l’interchangeabilité n’est scientifiquement attestée que si et seulement si l’ensemble de l’intervalle d’agrément calculé empiriquement [LLA ; ULA] se trouve intégralement circonscrit à l’intérieur de l’intervalle d’acceptabilité clinique prédéfini [-delta ; +delta]. Dès lors que l’une des bornes empiriques outrepasse ces limites de sécurité médicale, la nouvelle méthode doit être déclarée non interchangeable, nonobstant la force éventuelle du coefficient de corrélation de Pearson ou la significativité du test t.
9.3 Évaluation de l’indépendance de la différence par rapport à la grandeur
Une lecture experte du graphique exige d’examiner la morphologie globale du nuage de dispersion pour vérifier le postulat fondamental d’homoscédasticité : l’erreur de mesure doit être parfaitement indépendante du niveau réel du paramètre mesuré. Cet alignement idéal se matérialise graphiquement par une répartition aléatoire, symétrique et homogène des points le long de l’axe horizontal des moyennes, évoquant une « bande rectiligne parallèle » aux droites statistiques de référence.
L’examinateur doit traquer avec acuité toute dérive structurelle :
une trajectoire ascendante ou descendante des résidus, trahissant un biais proportionnel où l’instrument surévalue les magnitudes faibles et sous-évalue les valeurs élevées (ou réciproquement) ;
une disposition incurvée parabolique, révélant une réponse instrumentale non linéaire sur certaines plages dynamiques du capteur ;
un élargissement progressif de la variabilité (aspect en cône ou en éventail), signifiant que la variance de l’erreur croît de manière proportionnelle à la magnitude de la grandeur mesurée.
La confirmation visuelle de l’absence de telles tendances atteste de la stabilité de l’accord métrologique sur l’ensemble du domaine d’exploration physiologique ou psychométrique étudié, validant l’utilisation d’un estimateur unique et global du biais et de ses limites d’agrément.
10. Détection des biais proportionnels, hétéroscédasticité et transformations mathématiques
10.1 Diagnostic d’un biais proportionnel par régression linéaire
Lorsque la dispersion des différences entre deux instruments s’oriente selon une trajectoire oblique le long de l’axe des moyennes, l’analyste fait face à un biais proportionnel. Dans cette configuration, le biais systématique n’est plus une constante additive fixe, mais une fonction dépendante de l’intensité de la grandeur mesurée. L’évaluation rigoureuse de cette anomalie sous Excel passe par l’adjonction d’une droite de régression linéaire ordinaire directement sur le nuage de points de Bland-Altman.
Pour implémenter cette analyse diagnostique, l’utilisateur sélectionne la série des marqueurs de dispersion, effectue un clic droit et choisit Ajouter une courbe de tendance…. Dans le volet de paramétrage latéral, il opte pour une tendance Linéaire et coche impérativement les deux options situées au bas du menu : Afficher l’équation sur le graphique et Afficher le coefficient de détermination (R²) sur le graphique.
L’équation affichée s’exprime sous la forme conventionnelle y = β₁x + β₀, où y représente la différence (A – B) et x la moyenne individuelle. Pour confirmer statistiquement si la pente β₁ s’écarte significativement de zéro, l’utilisateur peut mobiliser l’utilitaire d’analyse de données d’Excel (onglet Données > Analyse de données > Régression) ou employer les fonctions natives matricielles :
Pente : =PENTE(E2:E101; D2:D101)
Ordonnée à l’origine : =ORDONNEE.ORIGINE(E2:E101; D2:D101)
Si la probabilité critique associée à la pente s’avère inférieure à 0,05, l’existence d’un biais proportionnel est mathématiquement validée. Les limites d’agrément fixes traditionnelles (lignes droites horizontales) deviennent alors caduques et mathématiquement erronées, car elles sous-estiment l’erreur aux extrémités de l’échelle et la surestiment au centre. Des limites d’agrément obliques dépendantes de la régression doivent alors être tracées.
10.2 Traitement de l’hétéroscédasticité et variabilité croissante
L’hétéroscédasticité constitue l’une des violations les plus courantes des postulats de Bland-Altman dans les bio-essais et les dosages pharmacologiques. Elle se manifeste visuellement par une forme en entonnoir (« funnel shape »), où la dispersion verticale des différences est très étroite pour les faibles valeurs moyennes et s’élargit substantiellement au fur et à mesure que l’on progresse vers des concentrations ou des mesures élevées.
Cette configuration distributionnelle induit un biais d’estimation majeur si l’analyste persiste à appliquer la formule conventionnelle d̄ ± 1,96 * sd. Dans ce scénario, l’écart-type global sd représente une moyenne composite artificielle de la variance : les limites d’agrément horizontales en résultant seront indûment trop larges pour les mesures basses (alarmant inutilement l’observateur sur la fiabilité du système dans cette zone) et dramatiquement trop étroites pour les valeurs hautes (occultant de graves discordances réelles aux fortes magnitudes).
Face à une hétéroscédasticité patente, le modèle classique fondé sur les différences brutes doit être formellement révoqué. Deux stratégies correctives s’offrent alors au statisticien sous Excel : la formulation des écarts en pourcentage relatif de la moyenne (telle qu’esquissée au chapitre 4.3), ou, plus rigoureusement, le recours à une transformation mathématique logarithmique préalable des données individuelles brutes.
10.3 Application de transformations logarithmiques dans Excel
La transformation logarithmique constitue la panacée méthodologique lorsque la variance d’erreur et le biais s’avèrent proportionnels à la magnitude de la grandeur mesurée. Sur le plan de la théorie mathématique, la soustraction de deux logarithmes correspond rigoureusement au logarithme de leur ratio :
ln(A) – ln(B) = ln(A / B)
Ce formalisme permet de convertir une variabilité multiplicative en un système additif stable, stabilisant ainsi la variance sur l’ensemble de l’échelle et restaurant la normalité des écarts résiduels.
La procédure opérationnelle sous Excel se déroule selon les étapes successives suivantes :
générer deux nouvelles colonnes de données brutes transformées (colonnes I et J) en appliquant la fonction de logarithme népérien : en I2, saisir =LN(B2), et en J2, insérer =LN(C2) ;
calculer la colonne des moyennes des logarithmes en K2 : =(I2+J2)/2 ;
calculer la colonne des différences des logarithmes en L2 : =I2-J2 ;
extraire sur cette colonne L le biais moyen logarithmique d̄log et l’écart-type logarithmique slog via les fonctions MOYENNE et ECARTYPE.STANDARD ;
calculer les limites d’agrément logarithmiques : ULAlog = d̄log + 1,96 * slog et LLAlog = d̄log - 1,96 * slog.
L’étape finale, capitale pour la restituabilité clinique, consiste à réexprimer ces estimations dans l’échelle d’origine en appliquant la fonction exponentielle EXP() d’Excel aux constantes calculées. La valeur EXP(d̄log) fournit le ratio moyen systématique entre les instruments (par exemple, 1,05 indique que l’instrument A produit en moyenne des lectures correspondant à 105 % de celles de l’instrument B). De même, EXP(ULAlog) et EXP(LLAlog) délimitent l’intervalle dans lequel s’inscrivent 95 % des ratios de mesure individuels (par exemple, un intervalle d’agrément de [0,92 ; 1,18] atteste que les mesures de la nouvelle méthode fluctuent entre -8 % et +18 % par rapport à la méthode standard).
11. Calcul des intervalles de confiance pour le biais et les limites d’agrément
11.1 Importance théorique de l’incertitude d’échantillonnage
L’un des apports statistiques les plus fondamentaux de Bland et Altman, trop fréquemment négligé dans les exploitations logicielles superficielles, concerne la quantification de l’incertitude d’échantillonnage associée aux paramètres d’agrément estimés. Il importe d’établir une distinction théorique absolue entre les limites d’agrément à 95 % et les intervalles de confiance (généralement calculés au degré de confiance de 95 %) encadrant ces mêmes limites.
Les limites d’agrément caractérisent la variabilité biologique et métrologique inter-instruments au sein de l’échantillon d’observation (intervalle de tolérance statistique). En revanche, les intervalles de confiance quantifient l’erreur d’échantillonnage résultant du fait que l’analyse est conduite sur un échantillon fini de taille n issu d’une population parente infinie. Si l’on réitérait l’expérimentation sur une autre cohorte de même dimension, le biais moyen et les limites d’agrément calculés fluctueraient inévitablement.
Les recommandations méthodologiques internationales contemporaines (notamment les directives de l’American Psychological Association et les normes biomédicales STARD/GRRAS) prohibent formellement la publication de limites d’agrément ponctuelles dépourvues de leurs intervalles de confiance à 95 %. L’omission de ces intervalles confère une fausse impression de certitude déterministe aux seuils calculés, masquant la vulnérabilité statistique induite par des échantillons restreints.
11.2 Formules mathématiques de l’erreur type du biais et des limites
L’estimation des intervalles de confiance exige la dérivation préalable des erreurs types (notées SE, pour « Standard Error ») associées à chaque estimateur ponctuel. En notant sd l’écart-type de l’échantillon des différences et n la taille effective de la cohorte appariée :
L’erreur type du biais systématique moyen d̄ correspond à l’erreur type classique de la moyenne :
SE(d̄) = sd / √n
La dérivation de l’erreur type des limites d’agrément (ULA et LLA) est plus complexe, car ces bornes combinent deux sources distinctes de variance stochastique : l’incertitude pesant sur l’estimation de la moyenne et l’incertitude affectant l’estimation de l’écart-type. Bland et Altman ont établi que la variance asymptotique de ces limites équivaut approximativement à (1/n) + (1,96² / (2(n - 1))) * sd², ce qui converge, pour un seuil à 95 %, vers l’approximation fonctionnelle standard :
SE(LoA) = √ [ (3 * sd²) / n ] = sd * √ (3 / n) ≈ 1,732 * (sd / √n)
L’intervalle de confiance à 95 % (IC 95 %) pour chaque paramètre est ensuite construit en pondérant cette erreur type par la valeur critique bilatérale issue de la loi de Student t configurée à n - 1 degrés de liberté :
IC 95 % du Biais = d̄ ± [ t(0,05 ; n-1) * SE(d̄) ]
IC 95 % de l’ULA = ULA ± [ t(0,05 ; n-1) * SE(LoA) ]
IC 95 % de la LLA = LLA ± [ t(0,05 ; n-1) * SE(LoA) ]
11.3 Mise en œuvre des zones de confiance sur Excel
L’opérationnalisation de ces formulations mathématiques au sein du tableau de bord Excel s’effectue avec une remarquable efficacité algorithmique grâce aux fonctions statistiques intégrées :
pour extraire la valeur critique de Student t à 95 % pour n – 1 degrés de liberté, en supposant que la taille de l’échantillon n réside dans la cellule H1, l’utilisateur insère la commande : =LOI.STUDENT.INVERSE.N(0,05; H1-1) (prenant la valeur absolue du fractile bilatéral) ;
l’erreur type du biais est calculée dans une cellule adjacente via : =H3/RACINE(H1) (où H3 héberge sd) ;
l’erreur type commune des limites d’agrément est encodée par la formule : =RACINE((3*(H3^2))/H1) ou =H3*RACINE(3/H1).
Les bornes inférieures et supérieures de chaque intervalle de confiance sont alors extraites par simple soustraction et addition du produit de la valeur critique t par l’erreur type idoine. Pour restituer ces zones d’incertitude sur le tracé de Bland-Altman sans surcharger illisiblement l’espace graphique, deux approches sont envisageables sous Excel :
l’adjonction de barres d’erreur verticales fines appliquées aux lignes de référence horizontales aux extrémités du tracé ;
ou, pour une esthétique de niveau professionnel supérieur, l’insertion de zones ombrées semi-transparentes encadrant chaque ligne directrice en recourant à des graphiques combinés de type « Aires empilées » superposés au repère cartésien.
La présentation tabulaire de ces résultats au sein du manuscrit scientifique doit scrupuleusement mentionner les estimations sous la forme canonique : Biais = -0,85 (IC 95 %: -1,32 à -0,38) ; ULA = +4,32 (IC 95 %: +3,50 à +5,14) ; LLA = -6,02 (IC 95 %: -6,84 à -5,20).
12. Erreurs courantes, validation psychométrique et bonnes pratiques de publication
12.1 Pièges fréquents dans la conception sous Excel et leur remédiation
La littérature médicale et psychométrique regorge de représentations de Bland-Altman erronées découlant de fautes de manipulation sous Excel. Le piège le plus universellement constaté réside dans l’utilisation exclusive des données de l’un des deux instruments (le plus souvent l’instrument de référence A) sur l’axe horizontal des abscisses X, en lieu et place de la moyenne non pondérée ((A + B) / 2).
Bland et Altman ont formellement démontré que positionner la méthode de référence seule en abscisse induit un artefact statistique pernicieux : du fait de l’erreur aléatoire présente sur cette mesure de référence, une corrélation spurieuse négative artificielle s’établit mécaniquement entre la différence (A – B) et la valeur de A. Cette distorsion engendre l’illusion graphique d’un biais proportionnel (une pente oblique descendante artificielle) là où les instruments ne présentent qu’une imprécision symétrique non corrélée. La seule exception légitime admise par la théorie survient lorsque la méthode de référence est dénuée de toute erreur stochastique (véritable étalon de mesure physique absolu), condition quasiment inexistante en physiologie humaine.
Une seconde bévue algorithmique classique concerne la confusion entre la fonction ECARTYPE.PEARSON (variance de la population finie divisée par N) et ECARTYPE.STANDARD (estimateur sans biais divisé par n – 1). Bien que la divergence numérique s’estompe sur des cohortes massives, elle altère significativement la calibration des limites d’agrément sur les échantillons cliniques intermédiaires.
Enfin, la distorsion des proportions d’affichage géométrique constitue une faute sémiotique fréquente. En étirant démesurément l’axe horizontal tout en comprimant l’axe vertical, un utilisateur peut faire paraître visuellement négligeable une dispersion pourtant catastrophique en pratique clinique. Il convient d’adopter un ratio d’aspect équilibré et de veiller à ce que l’amplitude graphique des axes reflète loyalement les proportions physiologiques en jeu.
12.2 Considérations particulières pour les mesures répétées
L’analyse standard de Bland-Altman exposée jusqu’ici postule l’indépendance statistique stricte de chaque paire de mesures, ce qui implique qu’un sujet donné ne contribue qu’à une seule ligne d’observation dans la matrice de données. Or, en recherche translationnelle, il est très fréquent d’effectuer des mesures répétées sur les mêmes participants (par exemple, acquisition du débit cardiaque à 5 reprises au cours d’une épreuve d’effort chez 20 volontaires, générant 100 points de mesure).
L’injection directe de ces 100 paires d’observations dans la formule conventionnelle viole gravement le postulat d’indépendance des observations. Les erreurs intra-sujets étant autocorrélées, la variance globale calculée combine artificiellement la variabilité métrologique inter-méthodes et la variabilité biologique intra-individuelle des sujets. Cette confusion computationnelle conduit à une sous-estimation systématique des erreurs types et à une estimation totalement faussée des limites d’agrément.
Pour traiter adéquatement les mesures répétées, deux cas de figure se dessinent conformément aux développements méthodologiques publiés par Bland et Altman en 2007 :
si la grandeur mesurée reste stationnaire (mesures répétées de calibration stable), il est possible de calculer au préalable la moyenne des mesures pour chaque instrument par sujet, puis d’exécuter le graphique sur ces moyennes individuelles assainies, en ajustant les formules de variance par analyse de variance (ANOVA) à deux facteurs ;
si le paramètre physiologique fluctue dans le temps chez un même individu, il est impératif de décomposer la variance totale des différences en composantes de variance intra-sujet et inter-sujets via un modèle linéaire à effets mixtes. Les calculs manuels sous Excel devenant alors fastidieux, il est conseillé de procéder à l’extraction des composantes de variance via un progiciel spécialisé (R ou SAS) avant de réinjecter les limites consolidées pour le rendu visuel final dans Excel.
12.3 Normes de présentation académique selon les directives scientifiques
La publication d’un graphique de Bland-Altman au sein d’une revue à comité de lecture international impose la conformité aux directives formelles de reporting, telles que la grille de contrôle GRRAS (Guidelines for Reporting Reliability and Agreement Studies). Ces normes stipulent qu’une figure de Bland-Altman ne doit jamais être présentée de manière isolée sans une légende descriptive exhaustive et hautement contextualisée.
La légende accompagnant l’illustration finale doit impérativement préciser :
la taille effective de la cohorte analysée (n) et le nombre total d’observations appariées ;
la définition univoque des axes, en explicitant le sens algébrique exact de la soustraction (par exemple : « Axe vertical : différence mesurée en mmHg [Sphygmomanomètre électronique B – Manomètre à mercure de référence A] ») ;
les valeurs chiffrées exactes du biais moyen constaté et des deux limites d’agrément, assorties systématiquement de leurs intervalles de confiance à 95 % respectifs ;
les unités de mesure physiques appliquées ;
le rappel des marges de tolérance d’équivalence clinique acceptables prédéterminées dans le protocole de recherche.
Enfin, sur le plan de la production infographique, les graphiques générés sous Excel doivent faire l’objet d’une exportation vectorielle haute résolution. L’insertion directe de captures d’écran matricielles floues (au format JPEG basse définition) est formellement proscrite dans l’édition académique. Il convient d’exporter le graphique Excel directement au format vectoriel (PDF vectorisé ou copie vers Microsoft Word conservant le format de dessin vectoriel EMF/SVG), garantissant une netteté typographique absolue et une rastérisation parfaite lors de l’impression définitive à 300 ou 600 DPI.
Références
Altman, D. G., & Bland, J. M. (1983). Measurement in medicine: The analysis of method comparison studies. The Statistician, 32(3), 307–317. https://doi.org/10.2307/2987937
Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
Bland, J. M., & Altman, D. G. (2007). Agreement between methods of measurement with multiple observations per individual. Journal of Biopharmaceutical Statistics, 17(4), 571–582. https://doi.org/10.1080/10543400701329422
Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/BM.2015.015
Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Silcocks, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96–106. https://doi.org/10.1016/j.jclinepi.2010.03.002
Ludbrook, J. (2010). Confidence in Altman-Bland plots: A critical review of the method of Altman and Bland for assessing agreement between continuous measurements. Clinical and Experimental Pharmacology and Physiology, 37(2), 143–149. https://doi.org/10.1111/j.1440-1681.2009.05288.x