
La synthèse quantitative des données probantes constitue le pivot central de la médecine fondée sur les preuves et de la recherche contemporaine en psychologie. Alors que la prolifération des publications scientifiques rend l’appréhension globale d’un champ d’étude de plus en plus ardue, la méta-analyse offre un cadre mathématique et conceptuel rigoureux permettant d’agréger des résultats disparates, voire contradictoires. Dans ce dispositif méthodologique, le forest plot — historiquement et familièrement désigné sous le terme de blobbogramme — ne se résume pas à une simple modalité d’illustration graphique. Il représente l’épicentre sémiotique où convergent les estimations ponctuelles individuelles, l’incertitude stochastique propre à chaque échantillon, l’hétérogénéité statistique inter-études et l’effet global synthétisé. Sans cette représentation visuelle standardisée, la complexité multidimensionnelle des modèles méta-analytiques demeurerait inaccessible aux cliniciens, aux comités d’éthique et aux décideurs publics.
Le langage de programmation statistique R s’est imposé, au cours des deux dernières décennies, comme la référence computationnelle incontournable pour la conduite de méta-analyses exhaustives et reproductibles. Contrairement aux interfaces logicielles propriétaires fermées dont les fonctionnalités graphiques sont fréquemment rigides ou obsolètes, l’écosystème R combine une puissance d’estimation mathématique avancée avec une flexibilité visuelle absolue. De la modélisation à effets aléatoires par maximum de vraisemblance restreinte jusqu’à la composition typographique vectorielle de niveau éditorial, R permet d’orchestrer chaque étape du pipeline analytique avec une traçabilité scientifique parfaite, conforme aux plus hauts standards de la science ouverte.
Ce guide exhaustif a pour ambition d’accompagner les chercheurs, psychométriciens, statisticiens et étudiants avancés dans la maîtrise intégrale de la conception de forest plots sous R. En adoptant une perspective résolument ancrée dans les exigences de la psychologie quantitative et des sciences biomédicales, nous explorerons successivement les soubassements théoriques de ces représentations, la structuration irréprochable des matrices de données, les implémentations comparées via les moteurs graphiques de base, les extensions de la grammaire des graphiques avec ggplot2, ainsi que l’utilisation experte des packages spécialisés de premier plan tels que metafor, meta et forestplot. Chaque concept statistique sera disséqué afin de transformer le tracé graphique en un instrument d’inférence robuste, d’évaluation diagnostique des biais et de communication académique irréprochable.
1. Fondements conceptuels du forest plot dans la méta-analyse psychologique
1.1 Définition et morphologie du blobbogramme
L’émergence du forest plot trouve ses racines dans les travaux pionniers d’évaluation des essais cliniques au cours des années 1970 et 1980, période durant laquelle des méthodologistes comme Richard Peto et ses collègues cherchaient un moyen systématique de juxtaposer visuellement les résultats d’essais thérapeutiques indépendants. Initialement baptisé « blobbogramme » en raison des masses ou symboles rectangulaires matérialisant chaque étude, le graphique a progressivement été institutionnalisé sous l’appellation de forest plot, en référence métaphorique à la forêt que l’on observe enfin plutôt que de s’arrêter à la singularité de chaque arbre isolé. Au sein de la recherche contemporaine, ce graphique condense en une surface bidimensionnelle restreinte l’intégralité du raisonnement inférentiel méta-analytique, servant de pivot interprétatif pour quiconque souhaite évaluer la cohérence d’un corpus de littérature scientifique.
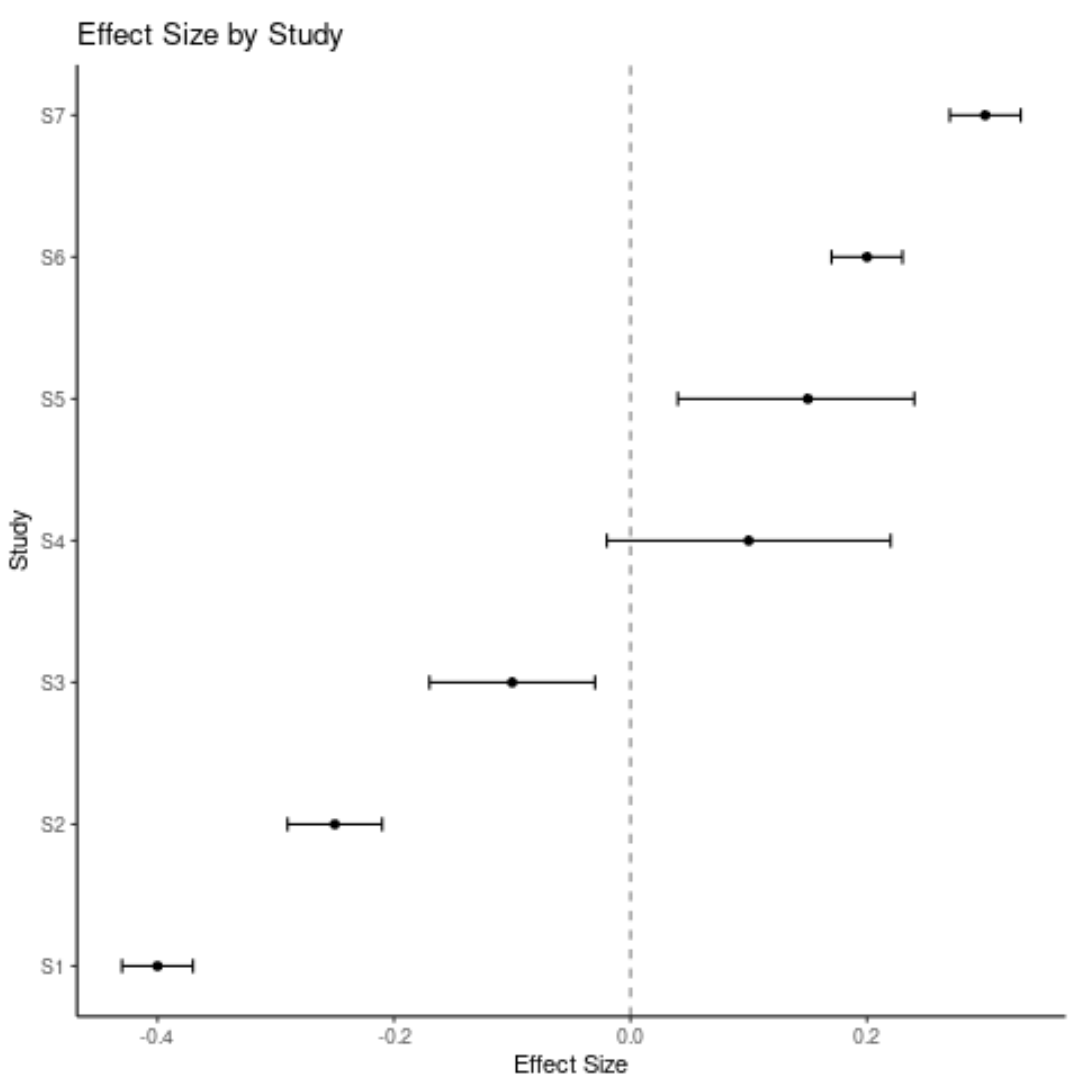
Sur le plan anatomique, un forest plot conventionnel est structuré autour de deux axes cardinaux aux fonctions asymétriques. L’ordonnée, purement catégorielle et discrète, liste les études sélectionnées selon un ordre motivé méthodologiquement — typiquement chronologique, alphabétique ou hiérarchisé selon l’amplitude de l’effet ou le poids statistique accordé. L’abscisse, quant à elle, porte une échelle continue étalonnée selon la grandeur d’effet sélectionnée (différence moyenne standardisée, rapport de cotes, coefficient de corrélation transformé). Chaque étude individuelle est visuellement décomposée en une estimation ponctuelle centrale, incarnée par un point ou un carré plein, flanquée d’un segment horizontal dont les bornes figurent les limites de l’intervalle de confiance, le plus couramment calibré au seuil de 95 %. La surface du marqueur central n’est jamais aléatoire : elle est proportionnelle au poids de l’étude dans le calcul du modèle d’agrégation, reflétant ainsi de manière tactile et immédiate la précision informationnelle de chaque cohorte.
Le point culminant de cette géométrie analytique réside dans le polygone sommateur, universellement stylisé sous la forme d’un losange ou diamant de synthèse. Situé à la base du graphique, ce losange synthétise l’effet global estimé par le modèle méta-analytique. La localisation du sommet vertical supérieur et inférieur du losange indique la valeur moyenne pondérée de l’effet, tandis que sa largeur transversale, s’étirant de sa pointe gauche à sa pointe droite, matérialise l’intervalle de confiance associé à cette estimation globale. Une lecture experte ne saurait négliger l’alignement de ce losange avec la ligne d’absence d’effet, également appelée ligne de nullité. Tracée verticalement à travers toute la hauteur du graphique, cette référence fondamentale intercepte la valeur zéro pour les grandeurs d’effet additives (telles que les différences de moyennes ou les coefficients de régression) et la valeur un pour les grandeurs multiplicatives (comme les rapports de cotes ou les risques relatifs). Tout chevauchement entre les pointes latérales du losange et cette ligne verticale signale immédiatement une absence de significativité statistique conventionnelle au seuil alpha fixé.
1.2 Métriques et grandeurs d’effet courantes en psychologie
La psychologie scientifique et les neurosciences cognitives se heurtent de manière chronique à une hétérogénéité intrinsèque de leurs instruments de mesure. Deux chercheurs mesurant l’efficacité d’une psychothérapie cognitivo-comportementale sur la dépression mobiliseront rarement les mêmes inventaires psychométriques : l’un privilégiera l’inventaire de dépression de Beck (BDI-II), tandis que l’autre emploiera l’échelle de dépression de Hamilton (HAM-D). Face à cette pluralité d’échelles de mesure continues, le forest plot requiert le recours à des différences moyennes standardisées. Le d de Cohen constitue la métrique fondamentale, calculée en divisant la différence des moyennes brutes entre le groupe expérimental et le groupe contrôle par l’écart-type combiné. Toutefois, le d de Cohen présente un biais d’optimisme avéré lorsque les effectifs d’échantillon sont réduits (inférieurs à vingt participants par groupe). Les méthodologistes lui substituent dès lors systématiquement le g de Hedges, qui incorpore un facteur correctif calculé à partir des degrés de liberté, garantissant une estimation non biaisée de la taille d’effet dans les échantillons restreints.
Lorsque la recherche psychologique adopte une posture clinique ou épidémiologique — évaluant par exemple la rémission complète d’un trouble anxieux ou l’abandon thérapeutique binaire —, les variables d’intérêt deviennent dichotomiques. Les métriques de prédilection sont alors le rapport de cotes (odds ratio, OR) et le risque relatif (RR). Ces indices possèdent des propriétés algébriques asymétriques contraignantes : ils sont bornés à zéro pour les effets protecteurs et tendent vers l’infini pour les effets délétères, la valeur neutre étant ancrée à un. Dans la construction d’un forest plot rigoureux, il est mathématiquement impératif de modéliser et de positionner ces ratios sur une échelle logarithmique (log-odds ratios), rétablissant ainsi une symétrie parfaite autour de zéro. La variance d’échantillonnage asymptotique associée au logarithme naturel du rapport de cotes est alors calculée selon la formule de Woolf, avant d’être rétro-transformée sous forme exponentielle lors de l’étiquetage final des axes pour préserver l’intelligibilité clinique.
Dans le domaine de la psychologie différentielle, organisationnelle et de la personnalité, l’objectif est fréquemment d’agréger des associations bivariées. Les coefficients de corrélation linéaire de Pearson (r) constituent des grandeurs d’effet standardisées de fait. Néanmoins, leur distribution d’échantillonnage s’écarte substantiellement de la normalité à mesure que la valeur absolue de la corrélation approche l’unité. Pour contourner cette violation des hypothèses sous-jacentes à la méta-analyse, les analystes appliquent la transformation r-to-z de Fisher, calculée via l’argument tangente hyperbolique réciproque. Cette transformation confère à la métrique une variance théorique indépendante du coefficient de corrélation sous-jacent, condition sine qua non pour un calcul rigoureux des poids statistiques inversement proportionnels à la variance. Une fois la méta-analyse modélisée et représentée graphiquement sous l’échelle z, les estimations peuvent être converties à nouveau vers l’échelle r originale sur les axes textuels du forest plot afin d’en faciliter l’interprétation substantielle.
1.3 Rôle diagnostique et communicationnel en recherche quantitative
Loin de constituer un simple artifice d’affichage passif à destination des relecteurs, le forest plot remplit une fonction diagnostique prépondérante dans l’évaluation de la validité interne d’une méta-analyse. À l’examen d’un tracé graphique, un méthodologiste aguerri identifie en quelques secondes l’intensité de l’hétérogénéité inter-études. Si les intervalles de confiance des différentes cohortes se chevauchent largement le long d’une bande verticale commune, l’hypothèse d’une homogénéité sous-jacente — selon laquelle chaque essai mesure une même réalité statistique sous réserve de fluctuations d’échantillonnage aléatoires — gagne en plausibilité. À l’inverse, si des études aux intervalles étroits occupent des régions disjointes de l’espace géométrique, le graphique signale avec force l’inadéquation d’un modèle à effets fixes et impose l’exploration d’un modèle à effets aléatoires ainsi que la recherche de modérateurs systématiques.
Le forest plot permet également la détection immédiate de valeurs aberrantes ou d’études démesurément influentes. Une étude dotée d’une taille d’échantillon monumentale se matérialisera par un carré de taille prépondérante et un intervalle d’une finesse chirurgicale. Si ce point s’écarte radicalement du faisceau des autres investigations, il est aisé de déduire graphiquement la distorsion qu’il exerce sur le losange de synthèse global. Le tracé sert ainsi d’alarme visuelle, incitant le statisticien à déclencher des diagnostics d’influence formels (distance de Cook, DFBETAS, résidus de Pearson standardisés) pour vérifier la robustesse de l’estimation agrégée.
Sur le plan des standards de publication, l’intégration d’un forest plot est devenue une exigence inconditionnelle des lignes directrices internationales telles que les déclarations PRISMA (Preferred Reporting Items for Systematic Reviews and Meta-Analyses) et les normes méthodologiques MARS (Meta-Analysis Reporting Standards) édictées par l’American Psychological Association (APA). Ces directives imposent une transparence absolue quant aux données numériques individuelles ayant alimenté la synthèse. En matérialisant conjointement le nom des auteurs, l’année, la taille de l’échantillon, la valeur précise de la taille d’effet, son intervalle de confiance et son poids mathématique, le forest plot s’érige en garant ultime de la reproductibilité scientifique, prévenant l’opacité analytique et autorisant la vérification indépendante par les pairs.
2. Configuration de l’environnement de calcul R et dépendances logicielles
2.1 Écosystème R dédié aux méta-analyses
L’architecture modulaire du Comprehensive R Archive Network (CRAN) héberge plusieurs dizaines de paquets dédiés à la recherche méta-analytique, mais trois bibliothèques principales dominent sans conteste la pratique méthodologique contemporaine : metafor, meta et forestplot, auxquelles s’ajoute l’incontournable moteur graphique ggplot2. Le paquet metafor, développé et continuellement enrichi par Wolfgang Viechtbauer, représente le standard de référence mondial pour la modélisation statistique avancée. Doté d’une flexibilité mathématique sans équivalent, il permet d’ajuster des modèles méta-analytiques linéaires généraux, multivariés, multiniveaux et de méta-régression complexe, tout en offrant une fonction dédiée particulièrement polyvalente pour la génération de tracés graphiques haute définition.
En parallèle, le paquet meta, élaboré par Guido Schwarzer, propose une surcouche algorithmique hautement intuitive qui reproduit fidèlement la philosophie analytique et les gabarits visuels popularisés par la collaboration Cochrane et le logiciel Review Manager (RevMan). Il excelle par sa capacité à automatiser les tâches routinières de transformation de données brutes (médianes, proportions, tableaux de contingence) en métriques adaptées. Enfin, pour les chercheurs dont la priorité absolue réside dans le contrôle esthétique et typographique au pixel près, la bibliothèque forestplot (conçue par Max Gordon) offre une approche matricielle découplée de tout moteur d’inférence sous-jacent, autorisant une mise en page d’une précision chirurgicale pour les publications biomédicales les plus exigeantes.
L’installation de ces bibliothèques depuis le CRAN s’effectue via les procédures de déploiement standardisées du système. Toutefois, l’environnement R présente fréquemment des frictions liées aux conflits d’espaces de noms. Par exemple, la fonction générique d’assignation ou de tracé peut être masquée lorsqu’on charge simultanément plusieurs paquets manipulant des structures de données similaires. Il est vivement conseillé d’adopter des règles de programmation défensive en appelant explicitement les fonctions capitales par leur préfixe de double deux-points, garantissant ainsi l’intégrité fonctionnelle des scripts lors d’exécutions automatisées ou de recompilations périodiques dans RStudio.
2.2 Structuration optimale du projet et gestion des versions
La recherche moderne exige une reproductibilité computationnelle stricte. Concevoir un script isolé au sein d’un répertoire désorganisé constitue une violation majeure des bonnes pratiques de recherche quantitative. Il convient de formaliser chaque projet méta-analytique sous la forme d’un projet structuré (format d’extension de projet propre à RStudio) respectant une arborescence compartimentée. Les dossiers primaires doivent impérativement scinder les données sources non modifiées, les routines de manipulation de données, les scripts d’analyse statistique inférentielle et le répertoire d’exportation des sorties graphiques à haute résolution. Cette isolation garantit qu’aucune manipulation accidentelle ne viendra corrompre les métadonnées primaires issues de la double extraction de la littérature.
Pour assurer la pérennité de l’environnement logiciel au fil des ans, le recours à un système de gestion de dépendances déterministe tel que le paquet renv est impératif. Les packages de méta-analyse évoluent fréquemment ; une mise à jour d’un algorithme d’optimisation ou un remaniement des paramètres par défaut d’une fonction graphique peut modifier subtilement l’épaisseur d’un losange ou la méthode d’estimation de la variance entre études tau carré. Le recours à renv génère un fichier de verrouillage décrivant rigoureusement la version exacte de chaque paquet installé et ses dépendances sous-jacentes. Pour des exigences de traçabilité encore plus rigides, notamment dans le cadre de consortiums de recherche multicentriques internationaux, l’encapsulation de l’environnement complet au sein d’un conteneur Docker constitue le standard ultime garantissant la réplicabilité à l’identique, quel que soit le système d’exploitation hôte.
3. Préparation et structuration rigoureuse des données méta-analytiques
3.1 Variables indispensables pour la construction du tracé
La viabilité d’un forest plot repose sur la structure matricielle de la table de données initiale. Chaque ligne doit incarner une unité d’analyse univoque — typiquement une étude indépendante ou un sous-bras expérimental distinct au sein d’une étude multivariée. Pour bâtir un graphique conforme aux normes professionnelles, la table de données doit obligatoirement encapsuler deux catégories d’informations : les variables de caractérisation bibliographique et méthodologique, et les variables numériques quantifiant l’effet et son incertitude stochastique.
Les variables qualitatives fondamentales comprennent l’identifiant textuel de l’étude (canoniquement formulé sous la forme Nom de l’Auteur Principal suivi de l’année de parution, par exemple Smith et al., 2021), la taille de l’échantillon globale ou décomposée par bras expérimental (effectif du groupe traité versus effectif du groupe témoin), ainsi que les éventuels modérateurs catégoriels (nature de l’intervention, sous-type de pathologie, tranche d’âge des participants). Du côté numérique, le tableau doit héberger au minimum l’estimation ponctuelle de la taille d’effet calculée et, selon le pipeline envisagé, soit son erreur-type asymptotique, soit les limites inférieure et supérieure directes de l’intervalle de confiance calculé au seuil de 95 %. Il est fondamental de veiller au typage strict des colonnes : les étiquettes textuelles doivent impérativement être formatées en chaînes de caractères ou en facteurs ordonnés, tandis que les valeurs métriques doivent être préservées sous forme de nombres réels en virgule flottante, débarrassés de tout symbole parasite (comme le signe de pourcentage ou les espaces insécables) fréquemment importés depuis des logiciels de bureautique.
3.2 Création programmatique d’un jeu de données synthétique
Afin d’illustrer la matérialisation concrète d’un tracé graphique sans dépendre de données propriétaires, nous pouvons conceptualiser la structure d’un essai clinique randomisé multicentrique évaluant l’efficacité d’une thérapie basée sur la pleine conscience face à un groupe témoin sur la réduction des scores d’anxiété. Le jeu de données se conçoit sous la forme d’un conteneur tabulaire moderne (tibble ou data.frame) intégrant dix investigations distinctes réparties sur une décennie.
Pour chaque observation, nous déclarons le nom de l’investigateur, l’année, l’effectif respectif de chaque cohorte, ainsi que la grandeur d’effet exprimée en g de Hedges. Les estimations ponctuelles oscillent typiquement dans ce contexte clinique entre 0.15 et 0.85 unité d’écart-type, reflétant des bénéfices faibles à modérés. L’erreur-type associée est mathématiquement dérivée de la taille d’échantillon de chaque cohorte, selon l’approximation asymptotique conventionnelle où la variance est inversement proportionnelle aux effectifs combinés. Les bornes inférieures et supérieures d’intervalles de confiance à 95 % sont ensuite générées de manière déterministe en soustrayant et en additionnant le produit de l’erreur-type par la valeur critique de la loi normale centrée réduite (1.95996). Cette cohérence arithmétique rigide prévient tout risque de discordance entre l’étendue visuelle des barres d’erreur et les tests statistiques subséquents.
3.3 Importation et nettoyage de données externes
Dans la pratique scientifique réelle, les données proviennent d’extractions bibliographiques colligées au sein de tableurs de type CSV, de classeurs Microsoft Excel ou de fichiers propriétaires issus de suites logicielles comme IBM SPSS ou Stata. L’importation de ces sources hétérogènes dans l’espace de travail R doit s’effectuer à l’aide de lecteurs optimisés capables de préserver scrupuleusement le typage des champs. Il est particulièrement crucial de surveiller l’encodage des caractères (l’encodage UTF-8 devant être universellement imposé) pour éviter que les accents des patronymes des auteurs francophones ou européens ne soient dégradés lors du rendu final.
Le nettoyage algorithmique impose une vérification drastique des valeurs manquantes. Un forest plot ne tolère aucune valeur indéterminée dans les coordonnées de points d’estimation ou de bornes d’intervalles : une seule lacune numérique résultera en une étude absente ou en une rupture d’affichage de l’axe vertical. Par ailleurs, la question du tri raisonné des données constitue une étape de communication fondamentale. Afficher des études dans un désordre aléatoire complique inutilement le repérage cognitif du lecteur. Il est fortement préconisé de restructurer explicitement le jeu de données en ordonnant les études soit de manière chronologique stricte (afin d’observer une éventuelle décrue temporelle des tailles d’effet due au déclin d’intérêt ou au raffinement méthodologique), soit selon l’ampleur de la précision statistique (tri ascendant selon l’erreur-type), ce qui positionne les essais les plus massifs et fiables au sommet du tracé.
4. Création d’un forest plot rudimentaire avec le moteur graphique de base de R
4.1 Implémentation pas à pas avec plot() et points()
Bien que l’esthétique contemporaine privilégie souvent des architectures graphiques plus récentes, la maîtrise du système graphique standard intégré au cœur du langage R demeure une compétence analytique précieuse. Ce système, fondé sur le modèle du « pinceau et de la toile », offre une vitesse d’exécution inégalée et ne requiert aucune dépendance externe, garantissant une stabilité absolue du code sur plusieurs décennies. La construction d’un forest plot au moyen de ce moteur impose une démarche procédurale minutieuse où chaque élément géométrique est déposé séquentiellement sur le canevas.
La première phase consiste à initialiser un cadre de tracé vierge via la fonction d’affichage fondamentale. L’analyste doit paramétrer les limites spatiales des axes : l’axe horizontal doit englober l’ensemble des bornes inférieures et supérieures d’intervalles de confiance du corpus avec une marge de sécurité visuelle, tandis que l’axe vertical est calibré sur une échelle entière discrète s’étalant de un au nombre total d’études sélectionnées, plus quelques unités supplémentaires dédiées au losange de synthèse et aux annotations d’en-tête. En inhibant le tracé des axes par défaut et en masquant les annotations automatiques, on obtient un espace blanc prêt à être structuré. Par la suite, la fonction d’adjonction de points positionne les estimations ponctuelles aux coordonnées respectives formées par l’effet observé en abscisse et le numéro d’ordre de l’étude en ordonnée. Les segments figurant les intervalles de confiance sont alors étirés à l’aide de primitives de tracé de segments horizontaux reliant la borne inférieure à la borne supérieure pour chaque rangée ordinale.
Le tracé de la ligne verticale de nullité est opéré au moyen de la fonction d’adjonction de lignes de référence, en spécifiant une ordonnée à l’origine de zéro (ou un pour les rapports de cotes). L’analyste paramètre généralement cette droite sous une typologie en tirets discrets ou en pointillés grisés afin d’assurer son repérage sans pour autant surcharger l’intensité visuelle du premier plan. Enfin, les estimations globales peuvent être matérialisées manuellement par des polygones fermés à quatre sommets dessinant le losange sommateur à la base du graphique.
4.2 Ajout d’étiquettes textuelles et ajustement des marges
L’écueil prépondérant lors de l’usage du système graphique de base réside dans l’étranglement typographique des étiquettes d’études. Par défaut, les paramètres graphiques globaux allouent une marge latérale gauche très restreinte, calibrée pour des graduations numériques brèves plutôt que pour des descriptions d’études étendues. Il est donc indispensable d’intervenir en amont sur le vecteur de configuration des marges, traditionnellement désigné par le paramètre global d’ajustement des marges dans l’environnement R. Il convient d’augmenter substantiellement la valeur de la marge gauche pour autoriser le déploiement d’intitulés complets sans coupure textuelle.
L’inscription des libellés nominatifs et des années s’opère ensuite via la primitive d’inscription textuelle ou par une personnalisation de l’axe vertical. En appliquant une justification textuelle à droite et en alignant chaque étiquette sur son niveau ordinal correspondant, les noms des investigateurs se calent avec une régularité typographique parfaite immédiatement à gauche de l’espace de tracé. De la même manière, il est possible d’utiliser la marge latérale droite pour afficher les valeurs numériques brutes des intervalles de confiance sous forme textuelle, complétant ainsi l’information géométrique. Malgré sa remarquable légèreté, cette approche manuelle révèle vite ses limites intrinsèques : tout ajustement dimensionnel de la fenêtre graphique requiert un recalalcul fastidieux des décalages textuels, et l’automatisation de la mise à l’échelle des surfaces de carrés s’avère inutilement complexe face aux solutions modernes dédiées.
5. Conception d’un forest plot élégant et robuste avec ggplot2
5.1 Grammaire graphique appliquée aux représentations d’intervalles
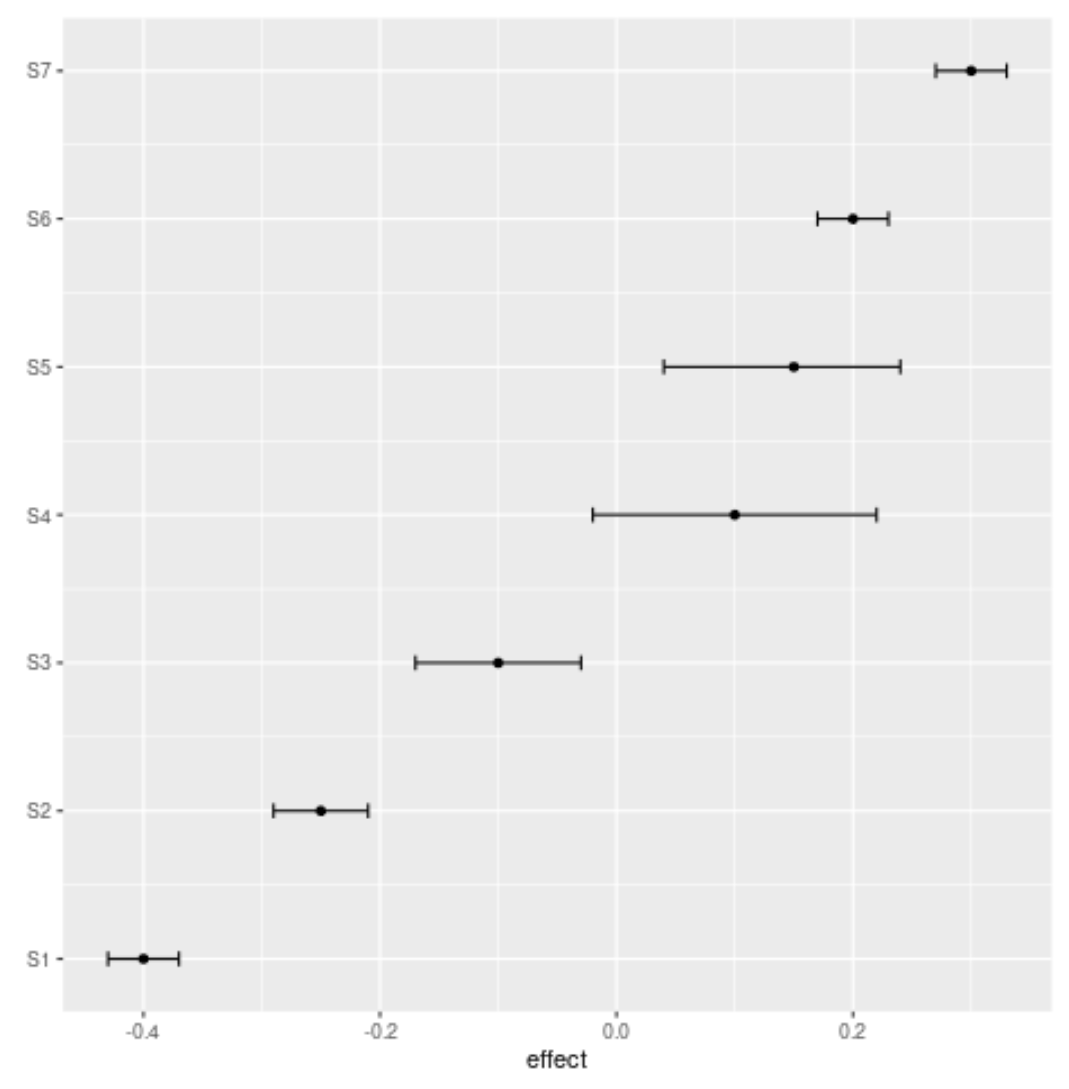
Fondé sur les principes théoriques de la grammaire des graphiques théorisés par Leland Wilkinson et matérialisés dans le langage R par Hadley Wickham, le package ggplot2 offre une approche déclarative extraordinairement puissante pour la représentation visuelle des données méta-analytiques. Au lieu de tracer empiriquement des segments sur un canevas pixelisé, l’analyste associe les colonnes de son tableau de données à des propriétés esthétiques géométriques abstraites. Pour un forest plot, la structure repose fondamentalement sur l’appariement des identifiants d’études avec l’axe spatial vertical, de la taille d’effet avec l’axe horizontal, et des variables d’intervalles avec des bornes d’étirement géométrique.
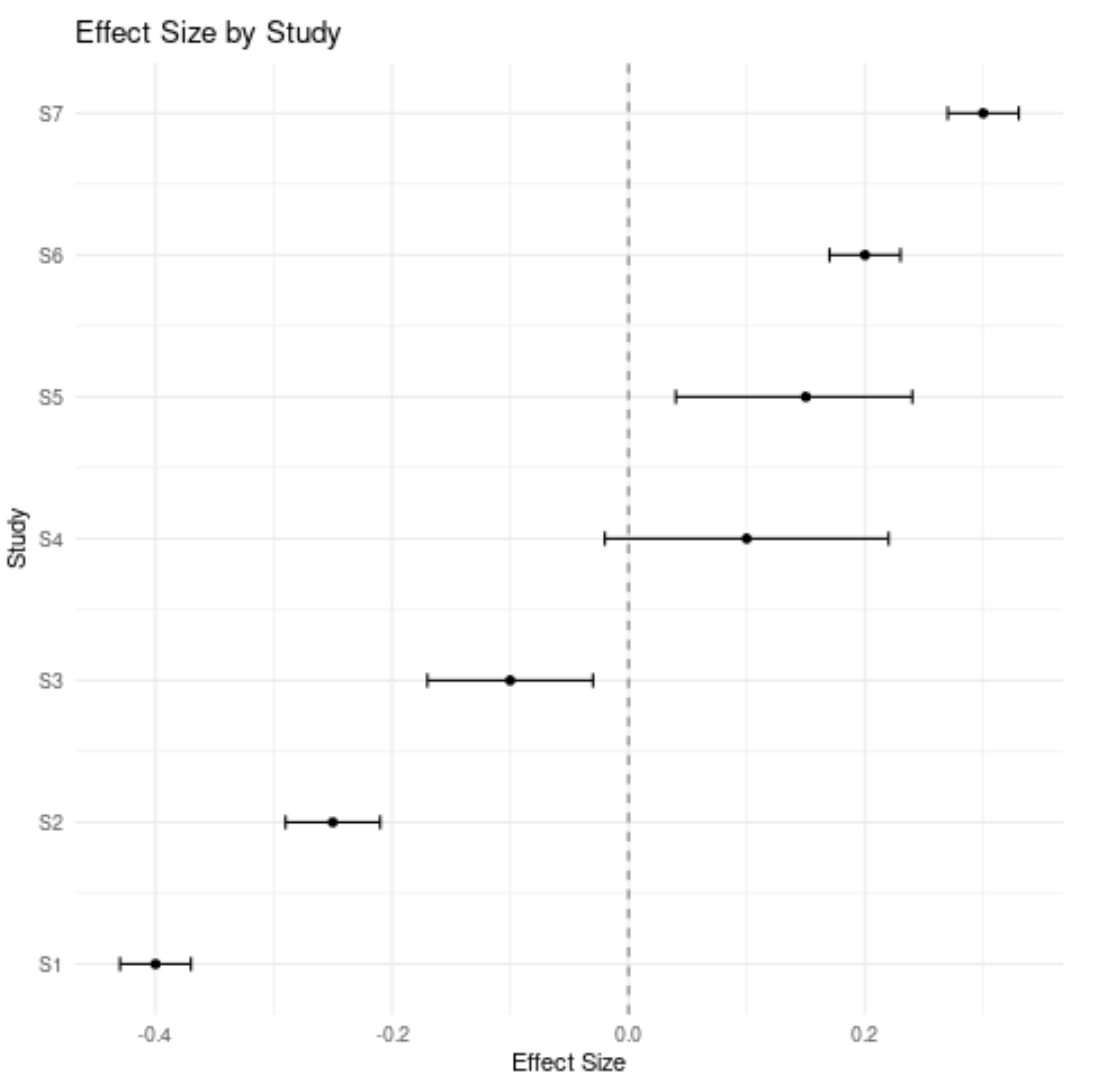
L’implémentation opérationnelle s’articule autour de deux couches géométriques fondamentales : la fonction de projection de points et la géométrie dédiée aux barres d’erreurs horizontales. Cette dernière relie harmonieusement les bornes minimale et maximale sans nécessiter de boucle computationnelle explicite. L’analyste peut moduler l’épaisseur de ces barres ainsi que la présence éventuelle de petites barres transversales terminales, bien que l’esthétique contemporaine tende à privilégier l’absence de crochets afin de réduire le bruit graphique inutile (ce qu’Edward Tufte qualifie de ratio encre-données optimal). L’insertion de la droite verticale d’absence d’effet se fait de façon élégante via une couche géométrique verticale dédiée, positionnée à zéro avec un motif de ligne en tirets.
Un avantage majeur de la grammaire graphique réside dans la modulation dynamique de la taille des marqueurs centraux. En associant la propriété de surface des points à une variable de pondération statistique (telle que l’inverse de la variance d’échantillonnage ou la taille d’effectif totale de la cohorte), ggplot2 redimensionne automatiquement les surfaces des symboles selon une fonction d’échelle rigoureuse. Cela élimine tout risque d’erreur de distorsion optique, les surfaces demeurant strictement proportionnelles au poids d’information apporté par chaque échantillon.
5.2 Stylisation et adéquation aux standards académiques
L’esthétique standard par défaut de ggplot2 — reconnaissable à son arrière-plan gris tramé de lignes blanches — s’avère inadaptée aux publications savantes de haut rang. L’analyste doit assainir visuellement le canevas en lui appliquant des thèmes épurés, tels que le thème classique ou le thème minimaliste. Ces gabarits suppriment les quadrillages superflus et restaurent des axes noirs nets et contrastés, conformes aux chartes éditoriales les plus rigides.
La typographie joue un rôle déterminant dans la lisibilité d’un forest plot destiné à l’impression ou à la diffusion sur écran haute résolution. Les éléments textuels doivent faire l’objet d’un calibrage hiérarchique au sein de la fonction de configuration du thème : les noms des auteurs nécessitent un corps de texte neutre et lisible, tandis que les en-têtes d’axes requièrent une mise en gras légère. Les graduations de l’axe des abscisses doivent être espacées régulièrement, évitant tout chevauchement d’intervalles numériques.
Un atout distinctif majeur de ggplot2 réside dans sa capacité native à déployer une visualisation partitionnée par facettes. Lorsque la méta-analyse intègre des sous-domaines théoriques ou des classes méthodologiques contrastées (par exemple, interventions en milieu scolaire versus interventions hospitalières), la fonction de décomposition par facettes permet de scinder instantanément le forest plot en plusieurs panneaux verticaux juxtaposés. Chaque sous-domaine dispose de son propre alignement d’études, tout en partageant une échelle horizontale commune, offrant ainsi une comparaison visuelle immédiate des profils d’efficacité sans exiger l’assemblage manuel fastidieux de graphiques multiples.
5.3 Insertion de données tabulaires dans la zone graphique
L’un des défis historiques majeurs rencontrés lors de l’utilisation de ggplot2 pour la composition de forest plots concerne l’alignement précis de données tabulaires numériques (effectifs, tailles d’effets numériques, pourcentages de poids) directement à côté du tracé spatial. Dans les revues médicales majeures comme The Lancet ou le New England Journal of Medicine, le forest plot n’est pas une simple figure géométrique isolée : c’est un tableau hybride où les colonnes textuelles de gauche et de droite encadrent harmonieusement la zone graphique centrale.
Pour atteindre cette perfection structurelle au sein de l’univers ggplot2, la méthodologie la plus élégante consiste à recourir à des extensions d’assemblage modulaire telles que patchwork ou cowplot. Le principe opérationnel consiste à bâtir deux ou trois objets graphiques distincts partageant exactement la même ordonnée discrète : un panneau purement textuel à gauche alignant les auteurs et les caractéristiques d’échantillon, le panneau central contenant les estimations et leurs intervalles de confiance, et un panneau textuel à droite récapitulant les estimations numériques exactes et leurs intervalles numériques chiffrés. En combinant ces objets à l’aide d’opérateurs arithmétiques de mise en page horizontale et en contraignant les marges verticales à zéro, les lignes s’alignent avec une exactitude mathématique parfaite.
Cette technique modulaire assure une maintenance informatique idéale : si de nouvelles études sont incluses lors de la mise à jour de la revue systématique, l’ensemble des panneaux s’actualise de manière synchrone sans décalage typographique résiduel, garantissant une pérennité totale de la chaîne de traitement graphique.
6. Utilisation experte du package metafor pour la méta-analyse formelle
6.1 Ajustement du modèle méta-analytique avec rma()
Le package metafor constitue le moteur d’inférence statistique par excellence en méta-analyse. Avant de pouvoir générer la moindre projection visuelle, le chercheur doit obligatoirement ajuster un modèle mathématique sous-jacent à l’aide de la fonction centrale d’analyse méta-analytique rma(). Cette étape préliminaire conditionne la validité des poids statistiques et la morphologie du losange de synthèse qui apparaîtra sur le graphique final. Le choix épistémologique fondamental s’articule autour de la dichotomie entre le modèle à effets fixes et le modèle à effets aléatoires.
En psychologie et en sciences comportementales, le modèle à effets fixes est presque universellement rejeté au profit du modèle à effets aléatoires. Le modèle à effets fixes postule qu’il existe une unique taille d’effet véritable, immuable, commune à l’ensemble des études, et que les variations observées découlent exclusivement de l’erreur d’échantillonnage aléatoire au sein de chaque cohorte. Cette hypothèse est manifestement irréaliste compte tenu de l’hétérogénéité des populations cliniques, des variantes thérapeutiques et des formats d’administration. Le modèle à effets aléatoires assume au contraire que la véritable taille d’effet varie elle-même d’une étude à l’autre selon une distribution normale de variance tau carré. Pour estimer cette variance inter-études résiduelle, l’estimateur du maximum de vraisemblance restreinte (REML, Restricted Maximum Likelihood) est généralement prescrit comme le standard le plus équilibré et robuste, surpassant les propriétés asymptotiques traditionnelles de la méthode des moments de DerSimonian et Laird.
L’exécution de la modélisation sous metafor calcule de manière automatisée la matrice des poids accordés à chaque étude, ces poids étant égaux à l’inverse de la somme de la variance d’échantillonnage intra-étude et de la variance inter-études estimée tau carré. En extrayant simultanément les indicateurs statistiques d’hétérogénéité globale — à savoir la statistique Q de Cochran, l’indice d’incohérence I carré et l’écart-type inter-études tau —, le modèle synthétise toute la matière mathématique qui viendra nourrir et légitimer le forest plot.
6.2 Génération automatique avec la fonction forest.rma()
Une fois l’objet de modélisation convenablement ajusté et validé, la génération du forest plot est initiée par l’appel de la méthode forest() appliquée directement à l’objet résultant. Contrairement aux approches séquentielles manuelles, cette fonction interprète nativement l’architecture interne du modèle pour automatiser la disposition graphique des estimations ponctuelles, la calibration proportionnelle des carrés de pondération et le positionnement du losange de synthèse à la base de l’axe.
La force de forest.rma() réside dans sa grande polyvalence de paramétrage. Par défaut, la fonction calcule automatiquement l’emprise des axes pour que l’intégralité des intervalles de confiance soit visualisée sans coupure de tracé. Sur le flanc droit de la figure, le logiciel intègre une colonne textuelle affichant la taille d’effet numérique et son intervalle de confiance au seuil défini. L’utilisateur garde la mainmise sur le formatage : il peut choisir d’ordonner les lignes en fonction de la grandeur d’effet estimée, contraindre les bornes des axes numériques, ou spécifier la position exacte des annotations descriptives.
Lorsque la méta-analyse modélise des grandeurs multiplicatives telles que des rapports de cotes ou des risques relatifs, la manipulation de l’échelle d’affichage devient primordiale. La fonction intègre un argument permettant d’appliquer une transformation exponentielle aux estimations tout en préservant une graduation logarithmique pour l’axe géométrique horizontal. De la sorte, la symétrie conceptuelle est préservée visuellement — un rapport de cotes de 0.50 se trouve positionné à égale distance de la ligne d’absence d’effet qu’un rapport de cotes de 2.00 —, tout en évitant au lecteur la gymnastique cognitive complexe liée au déchiffrage direct des valeurs log-transformées.
6.3 Paramétrage visuel avancé sous metafor
Pour hisser le rendu standard d’un tracé vers les normes d’une publication savante de premier ordre, l’analyste doit exploiter les nombreux paramètres cosmétiques et structurels offerts par la bibliothèque de Wolfgang Viechtbauer. L’ajustement du calibrage des symboles permet de moduler la sensibilité de variation des carrés d’études afin que les petites cohortes ne disparaissent pas sous forme de points invisibles et que les cohortes massives ne saturent pas l’espace visuel. La personnalisation de la palette chromatique autorise une distinction nette : le losange de synthèse peut être habillé d’une nuance contrastée et bordé d’un liséré sombre, conférant une assise visuelle immédiate au résultat combiné.
L’enrichissement informatif s’opère par l’insertion d’en-têtes de colonnes clairs au sommet du tracé. À l’aide de l’argument d’en-tête ou de commandes textuelles complémentaires, l’analyste positionne des libellés rigoureux spécifiant la nature des cohortes, la métrique employée et la teneur de la ligne de base. De même, des indications textuelles latérales peuvent être adossées aux deux extrémités de l’axe horizontal pour expliciter sans ambiguïté le sens clinique du bénéfice (par exemple en faisant figurer les mentions explicites « En faveur du traitement actif » sur la gauche et « En faveur du groupe témoin » sur la droite).
Enfin, la base du forest plot peut être complétée par des annotations méthodologiques denses restituant précisément la statistique de test globale, la valeur p associée, ainsi que les indices d’hétérogénéité chiffrés (tau carré, son erreur-type, et le pourcentage I carré accompagné de son intervalle de confiance). Cette mise en page unifiée assure que la figure se suffit à elle-même, satisfaisant ainsi aux exigences fondamentales de lecture autonome prescrites par les éditeurs scientifiques.
7. Approche alternative avec le package meta : simplicité et automatisation
7.1 Modélisation via metagen() et metabin()
Pour les praticiens de santé, les épidémiologistes et les chercheurs en sciences comportementales recherchant une transition fluide depuis les routines de la collaboration Cochrane, le package meta constitue une alternative d’une remarquable efficacité computationnelle. Son architecture repose sur des fonctions spécialisées conçues pour ingérer directement des typologies de données brutes spécifiques sans exiger de l’utilisateur qu’il procède manuellement aux calculs préliminaires des tailles d’effets et de leurs variances d’échantillonnage asymptotiques.
Pour les données continues issues d’essais psychométriques, la fonction metagen() offre un cadre générique universel acceptant directement les estimations ponctuelles et leurs erreurs-types. Si les données disponibles se résument aux moyennes brutes, écarts-types et tailles d’échantillons de deux cohortes comparées, la fonction metacont() calcule directement le d de Cohen, le g de Hedges ou la différence moyenne non standardisée, tout en sélectionnant automatiquement la formule de mise en commun des variances la plus adaptée. Pour les issues catégorielles binaires, la fonction metabin() permet de renseigner les quatre cases classiques du tableau de contingence (événements observés et effectifs totaux dans le bras interventionnel versus le bras témoin) pour calculer instantanément les risques relatifs, rapports de cotes ou différences de risques.
Le package meta intègre nativement des raffinements méthodologiques d’une importance capitale pour la pratique clinique, notamment la méthode d’ajustement de Hartung-Knapp pour les modèles à effets aléatoires. Cette correction statistique, fondée sur une distribution d’échantillonnage en t de Student plutôt que sur la loi normale asymptotique, ajuste de façon appropriée l’erreur-type de l’effet global combiné lorsque le nombre total d’études incluses est restreint (moins de vingt études). Elle prévient ainsi l’inflation artificielle de taux de faux positifs (erreurs de type I) qui affecte fréquemment les méta-analyses conventionnelles en psychologie.
7.2 Personnalisation via forest.meta()
La génération graphique au sein du paquet meta s’effectue via l’appel de la méthode spécialisée forest.meta(). Cette fonction se distingue immédiatement par la richesse de ses profils d’affichage prédéfinis. D’une simple instruction d’assignation stylistique, l’analyste peut ordonner au système d’adopter le gabarit standardisé RevMan de la collaboration Cochrane, l’esthétique épurée du Journal of the American Medical Association (JAMA), ou des dispositions conventionnelles inspirées des publications de la société savante d’épidémiologie.
L’une des fonctionnalités les plus séduisantes de forest.meta() réside dans sa capacité à afficher simultanément sur le même tracé les estimations découlant du modèle à effets fixes et celles issues du modèle à effets aléatoires. Deux losanges distincts viennent alors s’empiler à la base du canevas graphique, accompagnés de leurs pondérations respectives dans les colonnes textuelles. Cette double présentation offre un diagnostic de sensibilité visuel instantané : une divergence substantielle entre la position du losange à effets fixes et celle du losange à effets aléatoires trahit l’existence d’un effet lié à la petite taille des échantillons, suggérant la présence d’études restreintes rapportant des effets disproportionnés.
La flexibilité tabulaire de cette bibliothèque se manifeste également par la sélection intuitive des métadonnées intégrées en marge du tracé. L’utilisateur peut ajouter ou soustraire en quelques arguments des colonnes rapportant les effectifs par groupe, le poids relatif individuel en pourcentage, la valeur de la statistique p d’hétérogénéité, ou les résultats d’analyses d’interaction entre sous-groupes, le tout restant parfaitement aligné sans qu’aucune intervention typographique de bas niveau ne soit nécessaire.
8. Mise en page complexe et publication-ready avec le package forestplot
8.1 Architecture et logique matricielle du package forestplot
Lorsque les exigences de mise en page franchissent le cap des besoins éditoriaux hautement spécifiques — par exemple lors de la soumission de rapports volumineux destinés à des revues biomédicales majeures imposant des maquettes très strictes —, le package forestplot s’avère être la solution la plus modulable. Contrairement à metafor ou meta, cette bibliothèque ne réalise aucune opération d’inférence statistique interne. Elle adopte une logique purement matricielle : l’analyste lui transmet d’une part une matrice de texte contenant l’ensemble des libellés typographiques, et d’autre part des vecteurs ou matrices numériques décrivant rigoureusement les coordonnées des estimations ponctuelles et des intervalles de confiance.
Cette dissociation totale entre calcul statistique et mise en forme graphique confère une liberté architecturale sans équivalent. La matrice textuelle permet d’entrecouper les rangées d’études par des lignes d’intertitres, des en-têtes méthodologiques ou des sous-totaux cliniques d’une manière totalement asymétrique. Pour les lignes qui ne correspondent pas à des données empiriques (comme les en-têtes de colonnes ou les lignes blanches d’aération), il suffit d’assigner des valeurs manquantes dans les matrices de coordonnées numériques : la fonction sautera simplement le tracé géométrique pour ces rangées, tout en rendant le texte associé avec un alignement chirurgical.
Cette logique matricielle permet de concevoir une hiérarchie visuelle d’une remarquable limpidité. Le chercheur structure son tracé en articulant une en-tête typographique formalisée, un corpus d’études stratifiées, des sous-estimations intermédiaires, et enfin le résultat global sommateur, le tout étant rendu en une seule passe graphique cohérente et déterministe.
8.2 Personnalisation typographique et éléments graphiques avancés
Le contrôle esthétique offert par forestplot se déploie à travers une palette étendue de paramètres d’habillage visuel. L’utilisateur peut substituer aux traditionnels marqueurs rectangulaires d’autres formes géométriques telles que des cercles, des losanges ou des contours transparents personnalisés. La modulation de l’opacité et de la saturation des couleurs assure une superposition optimale lorsque des marqueurs multiples viennent à se croiser dans des zones de forte concentration de données.
Pour optimiser le guidage du regard le long des lignes de données tabulaires denses, le paquet intègre un dispositif d’habillage alterné (zebra striping). Ce procédé consiste à appliquer une trame de fond grisée très pâle sur une rangée sur deux, facilitant ainsi la lecture horizontale pour l’œil qui navigue entre le nom de l’étude à gauche, sa représentation géométrique centrale et ses valeurs chiffrées à droite. Ce raffinement de design d’information s’avère particulièrement salvateur lors de la composition de synthèses quantitatives intégrant plusieurs dizaines de cohortes distinctes.
Sur le plan de la typographie, chaque ligne peut être configurée de manière indépendante à l’aide de structures de style dédiées. Il est élémentaire de stipuler que les en-têtes de colonnes soient rendus en caractères gras sans empattement, que les études individuelles adoptent un corps de texte standard neutre, que les modérateurs de groupes soient stylisés en petites capitales et que la ligne de synthèse finale apparaisse dans une graisse accentuée. Ce degré de finition typographique garantit que le rendu généré est directement publiable, sans nécessiter la moindre retouche dans des logiciels d’édition vectorielle externes.
8.3 Gestion des méta-analyses multi-bras et modèles multivariés
La recherche contemporaine en psychothérapie se caractérise fréquemment par des plans expérimentaux dits « multi-bras », au sein desquels un même protocole compare plusieurs variantes actives d’intervention face à un groupe témoin commun (par exemple : thérapie d’acceptation et d’engagement versus thérapie comportementale dialectique versus liste d’attente). Intégrer naïvement ces comparaisons comme si elles constituaient des études totalement indépendantes constitue une violation grave de l’indépendance statistique des données, aboutissant à une double comptabilisation trompeuse des effectifs du groupe contrôle et à une sous-estimation artificielle des erreurs-types globales.
Le package forestplot excelle dans la représentation conjointe de ces structures multivariées complexes grâce à sa gestion matricielle multidimensionnelle des estimations ponctuelles. Plutôt que de fournir un vecteur unidimensionnel pour les moyennes, l’analyste transmet une matrice où chaque colonne correspond à un type de modalité d’intervention active. Sur le plan visuel, la fonction trace pour chaque rangée ordinale un faisceau de marqueurs colorés différenciés, chacun étant flanqué de son propre intervalle de confiance horizontal et doté de son propre symbole distinctif.
Une légende claire et élégante vient automatiquement expliciter la taxonomie chromatique adoptée. Cette faculté de juxtaposition permet au lecteur d’apprécier d’un seul coup d’œil l’efficacité comparative de multiples approches thérapeutiques testées au sein d’un même échantillon de référence, préservant ainsi l’intégrité de la structure expérimentale tout en contournant les pièges d’une présentation éclatée qui masquerait les interdépendances sous-jacentes du plan expérimental.
9. Visualisation de l’hétérogénéité et stratification par analyses de sous-groupes
9.1 Représentation graphique de l’hétérogénéité statistique
L’interprétation clinique d’un résultat méta-analytique ne saurait se limiter à la contemplation béate d’une valeur moyenne combinée hautement significative. Une moyenne n’a de sens scientifique que si l’on mesure rigoureusement le degré de dispersion des effets qu’elle prétend résumer. Au sein d’un forest plot, l’évaluation de l’hétérogénéité statistique repose classiquement sur l’affichage d’indices scalaires standardisés : la statistique Q de Cochran, le paramètre tau carré (variance des véritables tailles d’effets entre populations) et surtout le ratio I carré. Formalisé par Julian Higgins et Simon Thompson, le I carré quantifie le pourcentage de variabilité totale observé entre les études qui relève d’une hétérogénéité réelle plutôt que du simple aléa d’échantillonnage.
Cependant, une méprise fréquente et préjudiciable au sein de la littérature psychologique consiste à confondre l’intervalle de confiance à 95 % de l’effet moyen avec la distribution probable des effets dans de futures cohortes. L’intervalle de confiance reflète uniquement la précision stochastique de l’estimation du paramètre moyen central. Pour évaluer la dispersion réelle des effets thérapeutiques dans des conditions cliniques réelles, les méthodologistes recommandent impérativement le calcul et la figuration de l’intervalle de prédiction à 95 % (prediction interval).
Sur le plan géométrique, l’intervalle de prédiction peut être représenté directement sur le forest plot sous la forme d’un rectangle ou d’une barre horizontale étirée encadrant le losange sommateur, ou sous la forme d’un losange secondaire élargi aux pointes estompées. Alors que l’intervalle de confiance peut s’avérer extrêmement étroit lorsque l’échantillon cumulé atteint des milliers de participants, l’intervalle de prédiction intègre pleinement la variance tau carré. Il n’est pas rare de visualiser un traitement dont l’intervalle de confiance moyen indique un effet thérapeutique indéniable (par exemple g = 0.40, IC à 95 % : [0.30 ; 0.50]), mais dont l’intervalle de prédiction s’étire de -0.15 à +0.95. Cette matérialisation graphique est salutaire : elle rappelle aux cliniciens qu’en raison de l’hétérogénéité contextuelle, l’application de cette intervention dans un nouveau cadre de soin spécifique comporte une probabilité réelle d’inefficacité, voire d’aggravation clinique.
9.2 Structuration visuelle des analyses de sous-groupes
Face à une hétérogénéité substantielle révélée par l’indice I carré, la démarche scientifique commande d’explorer les modérateurs cliniques et méthodologiques susceptibles de rendre compte de cette dispersion. L’analyse de sous-groupes constitue l’outil analytique de prédilection, consistant à partitionner le corpus d’études selon une variable catégorielle a priori (par exemple, sévérité clinique des participants classée en légère, modérée ou sévère ; ou modalité de prise en charge en présentiel versus thérapie numérisée distancielle).
Dans un forest plot structuré par sous-groupes, le canevas est fragmenté en sections ordonnées verticalement, chacune étant chapeautée par un libellé de catégorie distinct. À l’intérieur de chaque compartiment figurent les études correspondantes, suivies immédiatement d’un losange intermédiaire de synthèse matérialisant l’effet combiné propre à ce sous-groupe (subtotal diamond). Cette stratification visuelle autorise une comparaison ergonomique immédiate : le regard parcourt verticalement les losanges de sous-groupes pour déceler d’éventuels décalages d’amplitude majeurs.
Il est fondamental d’adosser à cette visualisation le test statistique d’hétérogénéité entre sous-groupes, matérialisé par une statistique Q inter-groupes et sa valeur p correspondante. Les fonctions graphiques expertes permettent d’inscrire ces métriques d’interaction directement au bas de chaque section. Cette rigueur prévient les dérives interprétatives consistant à déclarer deux sous-groupes divergents simplement parce que l’un franchit le seuil classique de significativité p < 0.05 et pas l’autre — une erreur logique particulièrement répandue que la visualisation conjointe des intervalles de confiance de sous-groupes permet d’éviter.
9.3 Gestion visuelle des résultats de méta-régression
Lorsque la variable modératrice d’intérêt est continue — telle que la dose thérapeutique moyenne délivrée en milligrammes, la durée totale de l’intervention en semaines, ou l’année médiane de réalisation des essais —, la discrétisation arbitraire en sous-groupes présente des faiblesses statistiques majeures (perte de puissance, risque de faux positifs). La démarche recommandée consiste à recourir à la méta-régression, laquelle ajuste une droite d’association pondérée reliant la taille d’effet mesurée aux valeurs du modérateur continu.
Comment restituer de telles informations au sein d’un forest plot ? L’approche graphique préconisée consiste à réordonner l’axe vertical des études individuelles en fonction de la valeur ascendante exacte de la variable continue modératrice, plutôt que d’adopter un classement alphabétique insignifiant. En accompagnant les identifiants d’études d’une colonne textuelle renseignant précisément la valeur observée du modérateur, le lecteur peut déceler une éventuelle dérive visuelle progressive des estimations ponctuelles de la gauche vers la droite à mesure qu’on parcourt le graphique de haut en bas.
Toutefois, pour une démonstration irréfutable, le forest plot ainsi ordonné doit être idéalement couplé dans la publication avec un bubble plot de méta-régression. Dans ce dernier, l’axe horizontal représente la variable continue continue, l’axe vertical porte la taille d’effet observée, chaque cercle est dimensionné selon la pondération analytique de l’étude, et une droite de régression centrale bordée de son enveloppe de confiance à 95 % vient formaliser la pente prédictive. Cette synergie visuelle démontre avec force l’impact du modérateur sur la résorption de la variance tau carré initiale.
10. Conformité aux normes de publication scientifique et style APA 7
10.1 Exigences formelles de l’American Psychological Association (APA)
La publication d’une méta-analyse au sein des revues affiliées à l’APA ou adoptant son référentiel stylistique (septième édition) impose une soumission rigoureuse à des standards graphiques et typographiques hautement codifiés. Les figures ne doivent jamais comporter de titres massifs gravés directement dans le bitmap supérieur de l’image ; le titre d’une figure doit être reporté à l’extérieur de la zone de tracé, configuré dans une police en gras, suivi d’un sous-titre bref en italique décrivant le contenu représenté (par exemple : Figure 1. Forest Plot des Tailles d’Effet Thérapeutiques sur l’Anxiété Généralisée).
Le formatage des symboles mathématiques et statistiques au sein des colonnes textuelles du tracé obéit à des conventions intangibles. Toutes les lettres latines désignant des grandeurs scalaires statistiques doivent être typographiées en italique : c’est le cas du d de Cohen, du g de Hedges, de la statistique p, de la valeur z, du ratio Q, ou encore de la notation des degrés de liberté ddl. À l’inverse, les lettres grecques, telles que tau au carré, demeurent impérativement en romain droit standard. Les pourcentages d’hétérogénéité, à l’instar de l’indice I², doivent afficher leur exposant numérique dans un format supérieur net.
Dans la typographie francophone rigoureuse, la virgule constitue le séparateur décimal officiel, bien que l’usage de revues anglophones impose le point décimal. Quelle que soit la langue de soumission, la cohérence du nombre de décimales affichées doit être absolue (généralement deux décimales pour les tailles d’effets et leurs intervalles, trois décimales pour les valeurs de probabilité p exactes). Enfin, chaque figure doit comporter sous son cadre une note générale descriptive initiée par le mot Note en italique, explicitant l’intégralité des acronymes employés, la nature du modèle ajusté (modèle à effets aléatoires par maximum de vraisemblance restreinte), et la convention adoptée pour l’étirement des barres d’incertitude.
10.2 Accessibilité visuelle et contrastes chromatiques
La communication scientifique contemporaine accorde une place prépondérante à l’accessibilité universelle de l’information graphique. Les figures complexes doivent être conçues de manière à être pleinement intelligibles pour les individus présentant des déficiences de la vision des couleurs (dyschromatopsies telles que la deutéranopie ou la protanopie, touchant une part significative de la population mondiale). Les palettes contrastées simplistes fondées sur l’opposition binaire du vert et du rouge pour signifier les effets bénéfiques et néfastes doivent être définitivement bannies des protocoles de publication.
L’utilisation de palettes scientifiques perceptuellement uniformes — telles que les échelles viridis, plasma, ou les sélections issues du projet ColorBrewer — est fortement recommandée lorsque la couleur sert de vecteur de différenciation catégorielle. Ces cartographies chromatiques garantissent une gradation lumineuse monotone et continue qui préserve la différenciation des éléments géométriques, y compris lorsque le graphique est reproduit sur une imprimante monochrome noir et blanc pour une lecture papier conventionnelle.
La finesse des éléments de tracé doit également faire l’objet d’un dimensionnement calculé. Dans un contexte éditorial où les figures sont fréquemment réduites à l’échelle d’une simple colonne d’article de presse académique (soit une largeur standard d’environ 8.5 centimètres), une épaisseur de trait trop ténue deviendra invisible à l’impression, tandis qu’un corps de texte inférieur à 7 ou 8 points deviendra illisible sans loupe optique. L’analyste doit impérativement paramétrer des épaisseurs de segments suffisantes et préserver un espace négatif adéquat entre chaque rangée ordinale pour éviter toute sensation de saturation visuelle.
11. Diagnostic des biais et couplage avec d’autres représentations analytiques
11.1 Mise en regard avec le funnel plot (graphique en entonnoir)
Un forest plot, aussi esthétiquement parfait soit-il, ne saurait refléter que les études qui ont effectivement été portées à la connaissance de la communauté scientifique. La méta-analyse est structurellement menacée par le biais de publication — cette tendance délétère qui conduit les études aux résultats statistiquement significatifs et d’ampleur spectaculaire à être soumises et publiées plus promptement que les recherches rapportant des résultats nuls ou défavorables. Le funnel plot (graphique en entonnoir) constitue l’outil diagnostique cardinal permettant d’investiguer visuellement cette distorsion systématique.
Le couplage sémiotique entre un forest plot et un funnel plot repose sur une lecture croisée de la précision statistique. Dans un funnel plot, l’axe vertical mesure la précision de l’échantillon (exprimée par l’inverse de l’erreur-type ou par la taille de l’effectif) tandis que l’axe horizontal rapporte la taille d’effet observée. En l’absence de biais, le nuage de points affecte une forme d’entonnoir symétrique et inversé, se resserrant harmonieusement autour de la moyenne au sommet de l’axe vertical. Lorsqu’un biais de publication ou un effet lié aux petits échantillons est à l’œuvre, on observe un creux caractéristique dans la base inférieure du graphique, révélant la disparition suspecte d’études de petite taille rapportant des effets nuls ou négatifs.
En juxtaposant le forest plot à côté d’un contour-enhanced funnel plot (graphique en entonnoir rehaussé de contours de significativité), l’analyste peut identifier sur le forest plot quelles sont précisément les études de faible envergure qui occupent des positions extrêmes et déterminer si leur exclusion statistique ou leur ajustement via des méthodes correctives (comme la procédure de trim-and-fill de Duval et Tweedie) modifie la position du losange de synthèse global.
11.2 Analyse de sensibilité et méthode du ‘leave-one-out’
La crédibilité clinique d’un résultat agrégé repose sur sa stabilité face aux variations de composition du corpus bibliographique. Une synthèse peut paraître hautement concluante en raison de la présence fortuite d’un essai méthodologiquement défaillant ou doté d’une taille d’échantillon colossale tirant artificiellement la moyenne vers le seuil de significativité. Pour diagnostiquer cette vulnérabilité, la technique de l’omission systématique d’une étude — universellement désignée sous le terme d’analyse leave-one-out — est incontournable.
Cette approche computationnelle consiste à réajuster le modèle méta-analytique complet autant de fois qu’il y a d’études incluses, en omettant à chaque itération séquentielle une étude unique. Les résultats de cette procédure peuvent être restitués de manière magistrale sous la forme d’un forest plot d’influence dédié. Sur ce tracé spécialisé, chaque ligne n’indique plus la taille d’effet brute d’un essai individuel, mais bien le nouvel effet combiné recalculé après l’exclusion de l’étude mentionnée sur la rangée considérée.
L’examen de ce graphique d’analyse de sensibilité permet de poser un verdict d’une remarquable limpidité visuelle. Si l’ensemble des losanges ou points résultants demeurent alignés le long d’une trajectoire verticale stable sans franchir la ligne d’absence d’effet, l’analyste atteste formellement de la robustesse intrinsèque de sa conclusion. Si, à l’inverse, l’omission d’une étude particulière fait glisser le résultat combiné vers une valeur statistiquement non significative, la figure met en lumière la fragilité fondamentale de la synthèse, imposant une prudence interprétative majeure au sein de la discussion du manuscrit.
12. Reproductibilité, automatisation et exportation haute résolution
12.1 Exportation vectorielle et matricielle aux normes éditoriales
L’ultime écueil du chercheur consiste à dégrader un travail graphique remarquable par une procédure d’exportation numérique inadaptée. Une capture d’écran sommaire ou une sauvegarde dans un format de compression destructif (tel que le format JPEG standard) génère des artefacts de compression irréversibles et un flou typographique rédhibitoire qui contraindra l’éditeur à rejeter la figure lors de l’examen technique du manuscrit.
Pour préserver une netteté absolue à tout niveau d’agrandissement géométrique, le recours aux formats d’exportation vectoriels est impératif. Le format PDF vectoriel constitue la référence universelle acceptée par l’ensemble des presses universitaires et des consortiums éditoriaux. Dans un fichier vectoriel, les points, lignes, losanges et caractères textuels ne sont pas enregistrés sous la forme d’une grille finie de pixels colorés, mais sous forme d’instructions mathématiques de tracé géométrique. Le document peut être agrandi indéfiniment sans la moindre perte de définition. Les formats EPS (Encapsulated PostScript) et SVG (Scalable Vector Graphics) offrent des garanties comparables pour les environnements de publication numériques modernes.
Lorsque les exigences éditoriales imposent formellement un format matriciel (raster), le format TIFF (Tagged Image File Format) sans compression destructive avec une résolution minimale calibrée entre 300 et 600 points par pouce (DPI) est requis. Sous R, la génération de ces sorties lourdes doit s’opérer via des moteurs graphiques modernes de haute performance, à l’instar du package ragg, capable de restituer les transparences, les ligatures typographiques et les antialiasing d’une manière bien plus fidèle et propre que les périphériques graphiques natifs des systèmes d’exploitation anciens. L’analyste veille à calibrer précisément la largeur et la hauteur en centimètres ou en pouces au sein de l’instruction d’exportation, garantissant un ratio proportionnel optimal dès la compilation du script.
12.2 Automatisation dans les rapports dynamiques Quarto et R Markdown
L’intégration de la programmation lettrée (literate programming) au cœur du processus de rédaction académique représente la pierre angulaire de la science reproductible moderne. Les environnements tels que Quarto et R Markdown permettent de fusionner harmonieusement le corps du texte académique rédigé en prose scientifique avec les blocs d’instructions computationnelles R au sein d’un document source unique hautement structuré.
Dans ce paradigme de travail, le forest plot n’est plus un fichier image statique importé manuellement par glisser-déposer dans un traitement de texte. Il est généré dynamiquement lors de la compilation du manuscrit à partir des données sources brutes. L’analyste configure minutieusement les options d’exécution du bloc de calcul dédié : les paramètres de largeur et de hauteur de figure contrôlent l’emprise spatiale du tracé, l’ajustement de la résolution DPI assure la qualité du rendu matriciel intermédiaire, et les options d’alignement centrent harmonieusement le canevas au milieu de la mise en page.
Cette automatisation confère une agilité méthodologique sans égale. Si un examinateur critique requiert l’inclusion d’une étude récemment parue ou impose la réévaluation d’une taille d’effet selon une autre méthode d’imputation des données manquantes, il suffit à l’auteur d’actualiser la matrice de données et de relancer la compilation globale du document Quarto. En quelques secondes, le modèle est réajusté, les pondérations sont recalculées, le forest plot est retracé à neuf avec une précision millimétrique, et l’intégralité des références textuelles et numériques associées au sein de l’article se trouve actualisée de façon totalement synchrone, écartant tout risque d’erreur humaine de retranscription.
12.3 Synthèse des erreurs fréquentes et bonnes pratiques de codage
Au terme de ce parcours approfondi de conception, il apparaît utile de formaliser une synthèse diagnostique des erreurs méthodologiques et de programmation récurrentes qui pénalisent la réalisation de forest plots dans la pratique scientifique :
- Inversion dramatique des bornes d’intervalles de confiance : Une inversion inadvertante entre les variables de borne minimale et de borne maximale produit un tracé géométrique absurde où les segments se replient sur eux-mêmes ou génèrent des erreurs d’exécution d’affichage. Une vérification d’intégrité conditionnelle au sein du script prévient cette défaillance.
- Linéarisation inappropriée des grandeurs d’effet multiplicatives : Tracer des rapports de cotes ou des risques relatifs sur une échelle linéaire sans conversion logarithmique préalable aboutit à une asymétrie trompeuse favorisant visuellement les effets de risque par rapport aux effets protecteurs. L’axe géométrique doit impérativement adopter un espacement logarithmique tout en affichant des étiquettes rétro-converties en échelle exponentielle.
- Troncature typographique des identifiants d’études : Négliger la calibration des marges graphiques latérales conduit inévitablement à l’amputation des noms d’auteurs composés ou des dates de parution, dégradant la valeur documentaire de la figure.
- Discordance flagrante entre colonnes textuelles et représentations géométriques : Lors d’assemblages graphiques manuels ou sous ggplot2, un tri asynchrone appliqué à la table de données centrale sans réorganisation simultanée de la table des étiquettes provoque un glissement fatal : les coordonnées géométriques d’une étude se retrouvent étiquetées avec le nom d’une autre. L’usage de jointures relationnelles déterministes élimine totalement ce péril.
- Absence injustifiable de l’intervalle de prédiction : Omettre de mentionner l’intervalle de prédiction dans un contexte de forte hétérogénéité statistique prive le clinicien d’une information vitale sur l’incertitude réelle applicable aux futures prises en charge de patients réels.
Avant d’apposer son visa définitif sur une méta-analyse et de procéder à l’envoi de son manuscrit vers les comités de lecture scientifiques, l’analyste quantitative se doit de vérifier méthodiquement chacun de ces critères au moyen d’une check-list de contrôle rigoureuse. C’est à ce prix d’exigence computationnelle, mathématique et typographique que le forest plot sous R acquiert sa pleine légitimité : celle d’un instrument d’élucidation scientifique infaillible, synthétisant le passé de la recherche pour éclairer les décisions futures.
Références
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2021). Introduction to meta-analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119558378
- Higgins, J. P. T., & Thompson, S. G. (2002). Quantifying heterogeneity in a meta-analysis. Statistics in Medicine, 21(11), 1539–1558. https://doi.org/10.1002/sim.1186
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., & Welch, V. A. (Eds.). (2019). Cochrane handbook for systematic reviews of interventions (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119536604
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., … Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
- Schwarzer, G., Carpenter, J. R., & Rücker, G. (2015). Meta-analysis with R. Springer. https://doi.org/10.1007/978-3-319-21416-0
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0