
L’analyse exploratoire des données constitue le socle épistémologique sur lequel repose toute investigation quantitative rigoureuse en sciences du comportement et en neuropsychologie clinique. Lorsqu’un chercheur ou un praticien recueille des scores psychométriques issus d’évaluations standardisées, la tentation première consiste fréquemment à condenser immédiatement ces observations sous la forme de métriques synthétiques d’aplatissement, de tendance centrale et de dispersion, à l’instar de la moyenne arithmétique et de l’écart-type. Toutefois, cette démarche prématurée oblitère la structure fine de la distribution sous-jacente, masquant d’éventuelles sous-populations cliniques, des discontinuités métriques ou des valeurs résiduelles aberrantes qui constituent souvent le cœur même de la découverte scientifique.
Face aux représentations graphiques conventionnelles telles que l’histogramme de fréquences ou le diagramme en boîte à moustaches, le diagramme tige et feuilles occupe une place singulière et irremplaçable dans l’arsenal méthodologique. Conçu pour allier la rigueur du tableau numérique à l’immédiateté perceptive du tracé géométrique, cet outil permet de cartographier l’intégralité d’un échantillon sans détruire la valeur textuelle ou numérique de chaque observation individuelle. Dans les cohortes de taille modeste, courantes lors de protocoles cliniques expérimentaux ou d’études de cas multiples en neuropsychologie, cette technique s’avère nettement supérieure aux représentations probabilistes lissées, dont les algorithmes d’agrégation introduisent un biais de découpage arbitraire.
Bien que le tableur Microsoft Excel ne propose aucun graphique natif dédié au diagramme tige et feuilles au sein de sa galerie standardisée de visualisations, il est tout à fait possible d’en concevoir une implémentation exacte, dynamique et robuste. En exploitant la puissance du moteur de calcul matriciel, l’imbrication judicieuse des fonctions textuelles et statistiques, ou encore les technologies d’agrégation modernes telles que Power Query et les tableaux dynamiques sous Microsoft 365, l’expérimentateur peut ériger un dispositif d’analyse visuelle entièrement paramétrable. Ce guide exhaustif expose la théorie sous-jacente, la méthodologie de préparation des données et les algorithmes de transcription nécessaires pour concevoir, automatiser et interpréter professionnellement un diagramme tige et feuilles au sein de l’environnement Excel.
1. Fondements théoriques du diagramme tige et feuilles dans l’analyse de données psychologiques
1.1 Origine et utilité exploratoire selon John Tukey
L’apparition du diagramme tige et feuilles (ou stem-and-leaf display) s’inscrit au cœur de la révolution de l’analyse exploratoire des données formalisée par le statisticien américain John Wilder Tukey à la fin des années 1970. Rejetant la subordination exclusive des données empiriques aux tests d’hypothèses confirmatoires a priori, Tukey plaidait pour une observation minutieuse, non biaisée et descriptive des structures numériques brutes. Dans les disciplines comportementales, où la variabilité interindividuelle et les fluctuations d’échantillonnage sont particulièrement prégnantes, cette approche offre une perspective herméneutique nouvelle, autorisant les données à révéler spontanément leur morphologie avant l’application de tout modèle probabiliste contraint.
L’atout méthodologique cardinal du diagramme tige et feuilles réside dans son refus intransigeant de l’entropie informationnelle. Alors qu’un histogramme traditionnel procède par agglomération des données dans des intervalles de classe fermés — substituant une surface géométrique muette à la valeur unitaire de chaque score —, le procédé inventé par Tukey préserve intégralement l’identité de chaque donnée observée. Chaque participant conserve son score textuellement visible à l’intérieur de la forme globale. Il devient ainsi possible d’opérer une inspection bidirectionnelle constante : une vision macroscopique révélant l’allure générale de la densité de probabilité, conjointe à une vision microscopique autorisant la lecture directe de n’importe quel élément sans devoir recourir à la table source.
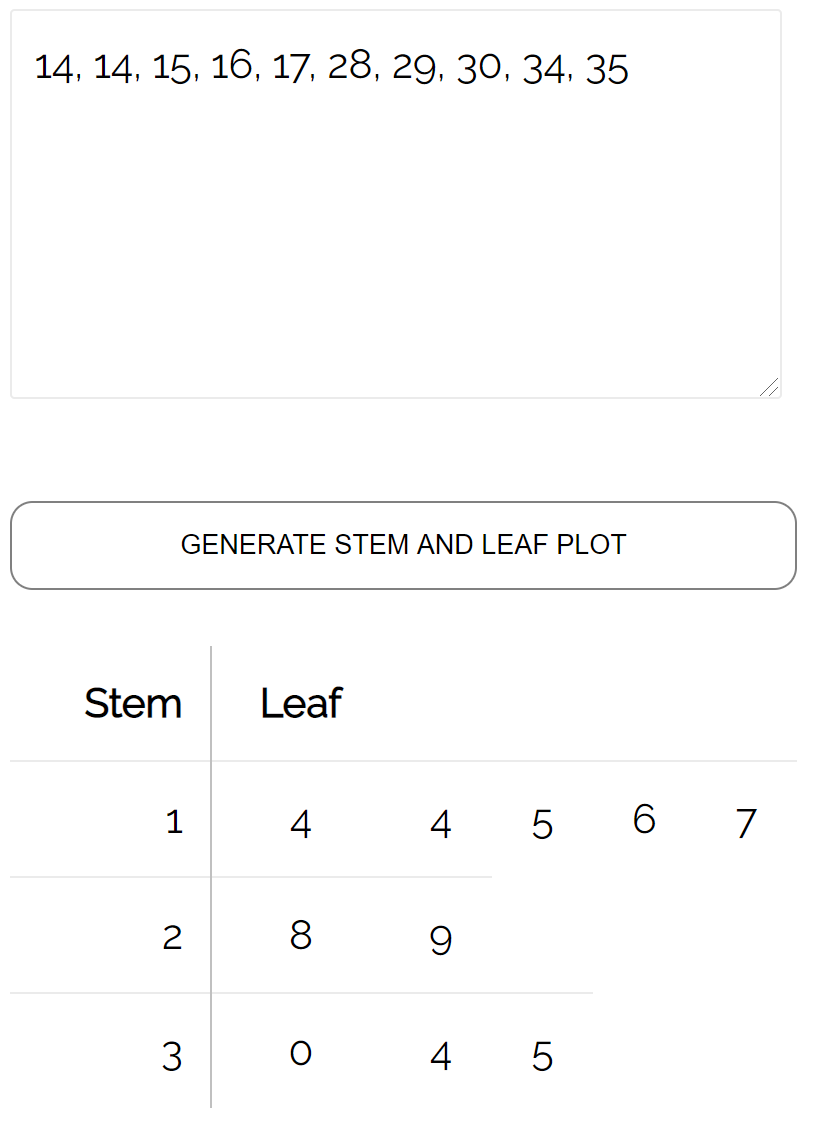
Cette dualité sémiotique confère à l’outil une pertinence singulière lors de l’évaluation de protocoles cliniques ou neuropsychologiques impliquant de petits échantillons. Lorsque le nombre de sujets oscille entre vingt et quatre-vingts individus — une situation ubiquitaire lors de l’étude de pathologies rares, de lésions cérébrales spécifiques ou d’essais psychopharmaceutiques de phase pilote —, les estimateurs de densité à noyau et les histogrammes classiques se révèlent hautement instables et dépendants du choix de l’origine ou de la largeur des intervalles de classe. Le diagramme tige et feuilles contourne ces écueils en offrant une représentation discrète, vérifiable et exempte d’artefacts d’interpolation.
1.2 Anatomie structurelle : tiges, feuilles et unités d’échelle
D’un point de vue structural, le diagramme tige et feuilles organise la partition logique de chaque observation numérique en deux constituants hiérarchiques distincts : la tige et la feuille. Mathématiquement, la tige représente la composante de poids fort du nombre, assimilable à une classe ordinale ou à un intervalle semi-ouvert régulier. Elle est formée par les chiffres directeurs de la mesure, lesquels définissent l’axe vertical ordonné le long duquel s’articulera la visualisation. La feuille, quant à elle, représente la sous-unité métrique immédiatement consécutive, c’est-à-dire le chiffre de poids faible qui parachève l’observation brute.
La validité sémiotique de l’ensemble repose impérativement sur la présence explicite d’une clé de lecture, souvent dénommée clé d’échelle ou légende de transcodage. Sans cette clé, une association visuelle associant une tige égale à 5 et une feuille égale à 2 demeure fondamentalement polysémique : elle pourrait indifféremment matérialiser la valeur 52, le nombre 5,2, la fraction décimale 0,52, ou encore une latence temporelle de 520 millisecondes. En explicitant rigoureusement l’ordre de grandeur décimal et l’unité de mesure retenue, l’expérimentateur ancre l’interprétation dans un référentiel spatial et métrique dépourvu de toute ambiguïté sémiologique.
Cette organisation spatiale est particulièrement adaptée aux scores psychométriques continus ou discrets qui affichent une variance modérée. Qu’il s’agisse de quotients de développement, de scores totaux issus d’inventaires de personnalité comme le NEO-PI-R, de temps de réaction exprimés en centièmes de seconde ou de nombres d’erreurs commises lors d’une tâche d’attention soutenue, la partition tige-feuille isole naturellement les variations globales intergroupes (les tiges) des fluctuations idiosyncrasiques intraspécifiques (les feuilles). L’observateur bénéficie dès lors d’une cartographie hiérarchique immédiate des données psychologiques recueillies.
1.3 Pertinence méthodologique pour la détection d’anomalies cliniques
Dans le contexte strict de l’évaluation psychométrique et du diagnostic clinique, le recours au diagramme tige et feuilles remplit une fonction heuristique essentielle : celle de sentinelle méthodologique. L’observation directe de l’alignement des chiffres permet de détecter instantanément les valeurs aberrantes (outliers), qu’elles résultent d’erreurs de saisie matérielle ou qu’elles traduisent une atypie neurofonctionnelle authentique chez un patient donné. La séparation spatiale manifeste d’une feuille isolée, reléguée à plusieurs tiges de distance du groupement principal, constitue une alerte perceptive immédiate bien plus incisive que l’analyse d’un simple tableau de nombres bruts.
Au-delà des scores atypiques extrêmes, ce dispositif excelle dans la mise en exergue de la multimodalité distributionnelle. Alors que le calcul aveugle d’une moyenne et d’un écart-type postule implicitement l’existence d’une distribution unimodale approximativement symétrique, le diagramme tige et feuilles met en relief la présence de plusieurs foyers de densité au sein d’une même population testée. L’émergence de deux sommets distincts le long de l’axe des tiges attire l’attention sur une fragmentation potentielle de l’échantillon, suggérant l’existence de sous-groupes cliniques différenciés, par exemple des répondeurs versus des non-répondeurs à une psychothérapie brève ou des profils cognitifs distincts dissimulés sous un diagnostic syndromique homogène.
Enfin, l’examen morphologique rendu possible par l’approche de Tukey constitue un prérequis indispensable avant l’engagement de toute procédure inférentielle paramétrique standard. L’évaluation visuelle de la symétrie, de l’étalement des queues de distribution et de la continuité des données permet au chercheur de statuer en toute connaissance de cause sur l’opportunité d’appliquer des analyses de variance (ANOVA) ou des régressions linéaires, ou d’opter prudemment pour des modélisations non paramétriques plus robustes, telles que le test des rangs signés de Wilcoxon ou le test de Mann-Whitney.
2. Préparation et structuration rigoureuse du jeu de données dans Excel
2.1 Organisation tabulaire et nettoyage des observations
L’implémentation opérationnelle d’un diagramme tige et feuilles au sein d’une feuille de calcul informatisée requiert une hygiène métrique irréprochable en amont de toute saisie de formule. Au sens strict des principes du tidy data popularisés dans le traitement de données scientifiques, chaque variable psychologique doit occuper une colonne dédiée unique, et chaque observation individuelle doit correspondre à une ligne indépendante. L’organisation tabulaire commence donc par l’établissement d’une matrice primaire où les mesures brutes d’une seule variable continue sont colligées dans une plage verticale exclusive, délimitée avec clarté au sein de l’espace de calcul.
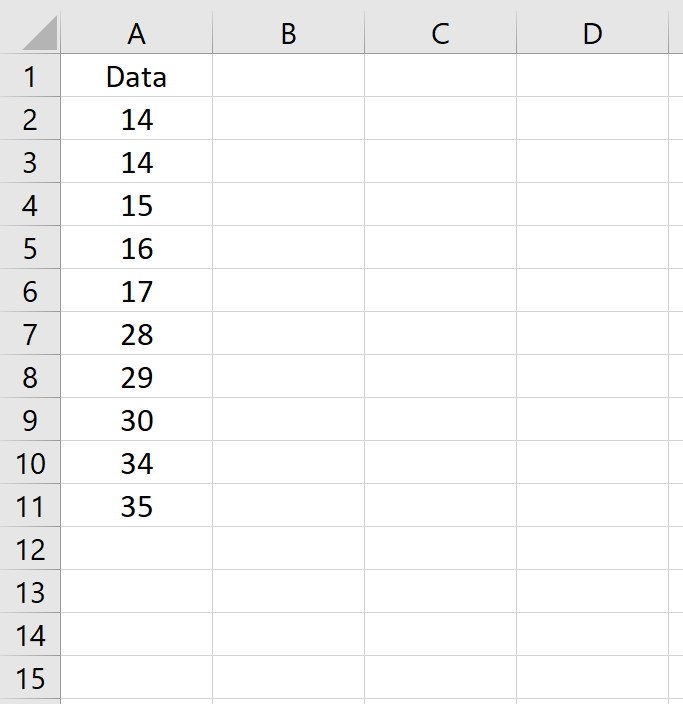
L’intégrité métrique de cette colonne source doit être soumise à une vérification systématique. Les erreurs de typage représentent l’une des sources d’anomalies les plus pernicieuses dans Microsoft Excel : des valeurs numériques involontairement formatées en tant que chaînes textuelles — souvent signalées par un indicateur triangulaire vert ou un alignement horizontal erratique à gauche de la cellule — bloqueraient l’exécution correcte des fonctions de dénombrement conditionnel. Il convient d’appliquer explicitement un format numérique uniforme à l’ensemble de la colonne d’étude, tout en procédant à l’élimination rigoureuse des doublons accidentels résultant d’une double transcription de questionnaires d’évaluation.
En accord avec les prescriptions méthodologiques de l’American Psychological Association (APA), le traitement des données manquantes doit obéir à une taxonomie stricte préalablement définie dans le plan d’analyse. Dans le contexte de l’élaboration d’un diagramme tige et feuilles, les cellules exemptes de données ne doivent en aucun cas être codées par la valeur numérique zéro, sous peine de corrompre dramatiquement la structure distributionnelle en insérant artificiellement des feuilles nulles au niveau de la tige initiale. Les valeurs absentes doivent soit être totalement isolées et exclues du vecteur de calcul, soit faire l’objet de codes textuels spécifiques non pris en compte par les algorithmes statistiques. Parallèlement, l’anonymisation rigoureuse de chaque observation via l’attribution d’un identifiant alphanumérique unique préserve l’intégrité déontologique du protocole de recherche.
2.2 Tri et inspection préliminaire des distributions brutes
Bien que les algorithmes de calcul que nous déploierons dans les sections subséquentes soient conçus pour opérer de manière totalement dynamique sur des vecteurs non ordonnés, l’application d’un tri croissant préliminaire à la colonne de données représente une bonne pratique analytique. Ce tri méthodique simplifie considérablement la phase d’audit visuel et de contrôle qualité, en permettant au concepteur de vérifier instantanément la conformité des valeurs limites et de cartographier la densité approximative des observations le long de la série ordonnée.
Pour exécuter cette opération sans compromettre les relations structurelles au sein d’une base de données psychologiques multivariée, il est impératif d’utiliser la fonctionnalité d’extension du tri aux colonnes contiguës sous l’onglet Données d’Excel. Si la colonne est analysée de manière isolée, un simple tri croissant suffit pour placer l’observation la plus basse au sommet de la plage et l’observation la plus élevée à sa terminaison inférieure. Ce déploiement séquentiel permet également de mobiliser immédiatement les filtres automatiques pour détecter d’éventuelles incohérences d’encodage, comme l’apparition accidentelle d’espaces insécables ou de virgules flottantes inopportunes.
Cette inspection initiale s’accompagne d’une normalisation visuelle des décimales superflues. Dans de multiples instruments neuropsychologiques, tels que l’évaluation des temps de réaction informatisés, les logiciels d’expérimentation génèrent des grandeurs chronométriques dotées d’une précision millimétrique à six ou sept décimales. Une telle résolution s’avère non seulement inutile sur le plan théorique mais destructrice pour la construction du diagramme tige et feuilles. Il s’avère par conséquent fondamental d’uniformiser la précision décimale requise par le protocole clinique, soit par des fonctions de troncature arithmétique, soit par l’application d’un masque de format d’affichage standardisé.
3. Détermination mathématique des paramètres d’échelle : minimum, maximum et étendue
3.1 Extraction des bornes extrêmes via les fonctions natives
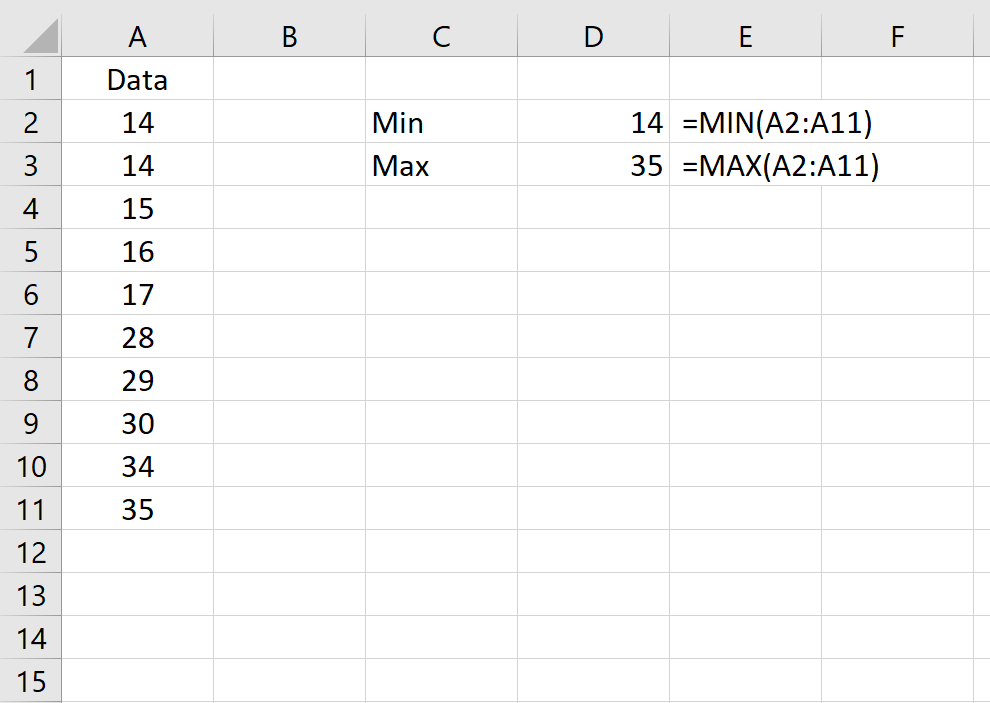
La conception architecturale du diagramme tige et feuilles impose la connaissance préalable et exacte des limites spatiales au sein desquelles se déploie la série quantitative. Pour ce faire, l’utilisateur met à contribution les fonctions d’agrégation d’Excel dans une zone de contrôle métrique annexe. L’identification du plancher distributionnel est réalisée au moyen de la fonction MIN, formulée sous la syntaxe analytique suivante :
=MIN(Plage_Donnees)
Réciproquement, la détection du plafond métrique de l’échantillon s’opère par l’adjonction de la fonction MAX, selon l’expression canonique :
=MAX(Plage_Donnees)
L’étendue globale de la distribution, paramètre fondamental qui conditionnera la hauteur totale du diagramme, résulte immédiatement de la soustraction arithmétique de la cellule plancher à la cellule plafond. Cette relation se formalise par la formule directe :
=MAX(Plage_Donnees) – MIN(Plage_Donnees)
Cette phase d’évaluation des extrema dépasse la simple commodité géométrique : elle constitue un observatoire clinique privilégié pour surveiller d’éventuels effets d’échelle pervers. Dans les inventaires d’anxiété ou les batteries de tests neuropsychologiques d’évaluation des démences comme le Mini-Mental State Examination, les données empiriques sont fréquemment confrontées à des effets de plancher (une accumulation massive d’individus obtenant le score minimal en raison d’une insensibilité du test aux variations subcliniques) ou à des effets de plafond (une saturation au score maximal traduisant une épreuve trop élémentaire pour différencier les sujets sains des cas limites). L’identification conjointe du minimum et du maximum informe le statisticien sur la probabilité de survenue de tels écueils méthodologiques.
3.2 Découpage de l’intervalle de classe et choix de la résolution
Une fois les bornes établies, le chercheur doit résoudre l’arbitrage fondamental du choix de l’incrément des tiges. L’objectif consiste à calibrer le nombre total de tiges de manière à refléter fidèlement la texture de la distribution sans verser dans l’un des deux travers symétriques de la visualisation de données : la sur-agrégation et la sur-dispersion. Une sur-agrégation — se traduisant par un nombre de tiges restreint à deux ou trois niveaux — compresserait les feuilles de manière excessive, réintroduisant la perte d’information que le diagramme cherche précisément à proscrire. À l’inverse, une sur-dispersion — caractérisée par une démultiplication démesurée des tiges étalées sur des dizaines de lignes vides — pulvériserait la cohérence visuelle, rendant illisible toute perception d’une tendance centrale.
Pour guider ce choix de manière empirique et reproductible, il est pertinent d’adapter la règle formalisée par Herbert Sturges pour le calcul des classes dans un histogramme. Selon cette règle adaptée, le nombre optimal de tiges théoriques, noté k, peut être approché par l’expression logismique :
k = 1 + log2(N)
où N représente l’effectif total de l’échantillon validé. Dans un contexte de recherche clinique impliquant généralement entre trente et cent participants, le nombre idéal de tiges oscille fonctionnellement entre six et douze unités. Cette densité offre une perspective spatiale optimale sur l’écran d’un tableur.
Lorsque les données empiriques comportent des décimales multiples, une décision d’ingénierie mathématique s’impose. Si l’on évalue des indices d’efficience intellectuelle échelonnés de 85,2 à 128,7, l’expérimentateur peut décréter que la partie entière constituera la tige (les dizaines) et la première décimale la feuille, après avoir multiplié l’ensemble des scores par dix, ou plus simplement en scindant les dizaines pour les tiges et les unités pour les feuilles, les fractions décimales étant préalablement arrondies à l’entier le plus proche. Le choix de cette résolution métrique doit être irrévocablement documenté dans le cartouche d’explication textuelle du graphique.
4. Définition et construction manuelle de l’armature des tiges
4.1 Création séquentielle de la colonne des tiges
L’armature du diagramme tige et feuilles repose sur l’implantation verticale ordonnée des valeurs de tiges le long d’une colonne dédiée, positionnée stratégiquement à gauche de la zone de réception textuelle des feuilles. En s’appuyant sur le calcul préalable du minimum et du maximum, l’expérimentateur inscrit la valeur de la tige initiale correspondant au premier chiffre significatif du plancher distributionnel. Par exemple, au sein d’une distribution de scores variant de 42 à 89 où la dizaine sert d’unité de classe, la série séquentielle s’amorce impérativement par la tige 4.
L’exigence théorique primordiale lors de cette phase de déploiement séquentiel réside dans le maintien absolu de la continuité numérique. Il est méthodologiquement prohibé d’omettre une tige sous le prétexte qu’aucune observation de l’échantillon ne viendrait s’y rattacher. Si aucune mesure ne se situe dans l’intervalle des soixante (tige 6), la tige 6 doit impérativement figurer dans l’armature verticale, vide de toute feuille adjacente. L’omission d’une tige romprait l’isomorphisme spatial du graphique en comprimant fictivement la distance métrique séparant la tige 5 de la tige 7, ce qui détruirait l’intégrité de la représentation topologique.
Pour fiabiliser l’implantation de cette série sans encourir le risque d’une omission manuelle, l’utilisateur a recours à la technique d’incrémentation arithmétique via la poignée de recopie d’Excel ou à la fonction native SEQUENCE pour les environnements plus récents. La signification sémiotique d’une tige demeurée vide est d’une portée clinique considérable : elle matérialise graphiquement un hiatus distributionnel, signalant une rupture nette de la continuité phénotypique au sein de la cohorte évaluée et alertant l’expérimentateur sur une potentielle dichotomisation de ses variables latentes.
4.2 Configuration des variantes de tiges divisées pour données denses
Lorsque l’échantillon sous examen présente une forte compacité ou une faible variance autour d’une valeur modale très marquée, l’armature séquentielle standard à tige unique par dizaine peut générer une accumulation démesurée de feuilles sur une seule ligne. Ce phénomène de saturation horizontale dégrade la lisibilité de la visualisation. Pour contourner cette limite technique, Tukey a formulé le concept de tiges répétées ou tiges divisées (split stems), une variante analytique permettant de dédoubler ou de quintupler la résolution d’un même niveau ordinal.
Dans le cas d’une division binaire, chaque tige numérique est dupliquée sur deux lignes successives de la feuille de calcul. La première ligne, conventionnellement affectée d’un astérisque ou d’un symbole distinctif dans la documentation méthodologique, accueille exclusivement les feuilles de poids faible comprises entre les chiffres 0 et 4. La seconde occurrence de la même tige est réservée aux feuilles de poids fort s’étendant de 5 à 9. Cette partition binaire double instantanément la hauteur du diagramme et décompresse les distributions excessivement condensées, restituant ainsi les subtilités morphologiques internes de l’échantillon.
Pour les distributions psychométriques présentant une concentration encore plus aiguë, il est envisageable de déployer une division quintuple, au sein de laquelle chaque unité de tige est déclinée sur cinq lignes consécutives. La première accueille les chiffres 0 et 1, la seconde les chiffres 2 et 3, la troisième les chiffres 4 et 5, la quatrième les chiffres 6 et 7, et la cinquième les chiffres 8 et 9. La structuration de ces étiquettes dans l’interface d’Excel impose alors une gestion rigoureuse des labels textuels afin que le moteur de calcul puisse faire correspondre exactement les sous-intervalles métriques adéquats lors de l’exécution des formules d’agrégation.
5. Algorithmes de calcul matriciel et textuel pour l’extraction de la première ligne de feuilles
5.1 Analyse déconstructive de la formule matricielle standard
En l’absence de module graphique dédié au diagramme tige et feuilles dans la bibliothèque standard d’Excel, l’architecture computationnelle de la visualisation doit être entièrement programmée à l’aide d’une synthèse algorithmique de fonctions textuelles et logiques. Le problème technique se pose en ces termes : comment transformer un vecteur numérique désordonné situé dans une plage source en une chaîne de caractères textuels ordonnés au sein d’une unique cellule de destination, en regroupant les unités associées à une dizaine spécifique ? La solution repose sur l’articulation de la fonction de répétition de texte REPT et de la fonction de dénombrement conditionnel NB.SI.
La fonction REPT d’Excel requiert deux arguments fondamentaux : la chaîne de texte à reproduire et le nombre de réitérations souhaité. En fixant comme texte un chiffre invariant (par exemple « 0 »), il devient possible de moduler sa fréquence d’apparition en soumettant le second argument à un comptage probabiliste fondé sur NB.SI. Dès lors, si l’on cherche à déterminer le nombre de fois où le score 40 apparaît dans la cohorte pour la tige 4, la fonction s’écrit formellement :
=REPT(« 0 »; NB.SI(Plage_Donnees; 40))
Cette mécanique arithmétique élémentaire s’applique de manière similaire aux scores de 41 à 49, où chaque chiffre de 0 à 9 est testé séquentiellement.
Pour formaliser la scission matricielle entre la composante tige et la composante feuille sans devoir coder en dur l’ensemble des scores composites, les fonctions d’extraction arithmétique MOD et ENT sont mobilisées. La fonction ENT, qui extrait la partie entière d’une division par dix, identifie sans faille la valeur de la tige, tandis que l’opérateur modulo MOD, calculé en base dix, isole strictement la fraction résiduelle unitaire correspondant à la feuille. L’imbrication de ces opérateurs textuels et arithmétiques garantit une décomposition numérique rigoureuse, indépendante de la longueur de la cohorte d’origine.
5.2 Syntaxe analytique détaillée de la formule d’agrégation
Pour rendre le système parfaitement opérationnel, l’expérimentateur assemble la formule exhaustive d’agrégation au sein de la cellule adjacente à la première tige de son armature, par exemple en cellule C2 si la tige est positionnée en B2. La formulation implique la concaténation systématique, au moyen de l’opérateur perluète (&), des dix requêtes conditionnelles balayant exhaustivement l’espace discret des chiffres de 0 à 9. La structure textuelle s’énonce comme suit :
=REPT(« 0 »; NB.SI($A$2:$A$101; B2*10+0)) & REPT(« 1 »; NB.SI($A$2:$A$101; B2*10+1)) & REPT(« 2 »; NB.SI($A$2:$A$101; B2*10+2)) & REPT(« 3 »; NB.SI($A$2:$A$101; B2*10+3)) & REPT(« 4 »; NB.SI($A$2:$A$101; B2*10+4)) & REPT(« 5 »; NB.SI($A$2:$A$101; B2*10+5)) & REPT(« 6 »; NB.SI($A$2:$A$101; B2*10+6)) & REPT(« 7 »; NB.SI($A$2:$A$101; B2*10+7)) & REPT(« 8 »; NB.SI($A$2:$A$101; B2*10+8)) & REPT(« 9 »; NB.SI($A$2:$A$101; B2*10+9))
Dans cette architecture formelle, l’adressage absolu de la matrice source, matérialisé par l’adjonction systématique des symboles de dollar ($A$2:$A$101), s’avère absolument impératif. Ce verrouillage cartographique empêche toute dérive de la plage de référence lors de la propagation ultérieure de l’algorithme vers le bas de la feuille. En revanche, l’adresse de la cellule B2 demeure en référence relative sans dollar sur son index de ligne, de sorte que l’évaluation dynamique de la tige s’adapte automatiquement à chaque palier vertical de la structure.
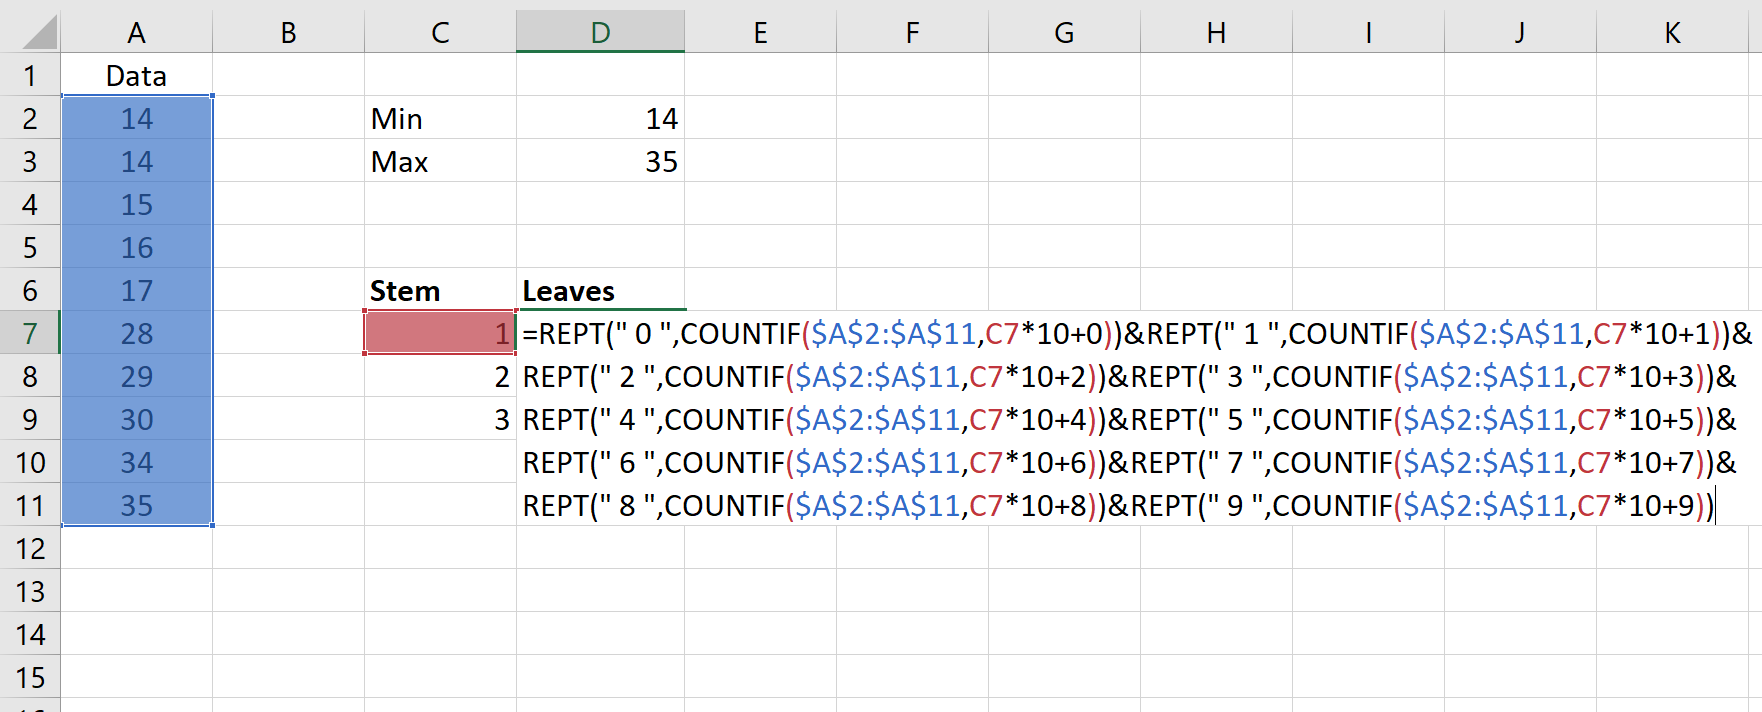
Dès la validation de cette équation matricielle textuelle au clavier, le moteur d’évaluation d’Excel agrège instantanément l’ensemble des observations correspondant à la tige ciblée sous la forme d’un ruban numérique continu. Si la cohorte comporte un sujet ayant obtenu un score de 42, deux participants affichant un score de 45 et un profil mesuré à 48, la cellule générera la chaîne textuelle continue « 2558 ». Le statisticien procède alors à un audit de conformité immédiat en comparant ce résultat préliminaire aux enregistrements bruts triés de sa colonne d’audit pour certifier l’absence totale de décalage opératoire.
6. Automatisation, propagation et fiabilisation sur l’ensemble de l’échantillon
6.1 Étirement vertical de la formule et gestion dynamique
La viabilité ergonomique du dispositif repose sur sa capacité à se propager instantanément sur l’ensemble du canevas des tiges sans exiger la moindre ressaisie manuelle. En sélectionnant la cellule C2 abritant la formule canonique validée, l’utilisateur saisit la poignée de recopie située dans le coin inférieur droit de l’encadrement actif et étire la formule verticalement jusqu’à recouvrir la rangée correspondant à la tige terminale de la série. Le recours au double-clic rapide sur cette même poignée de recopie permet également d’exécuter une expansion automatique vers le bas, conditionnée par la présence contiguë des données dans la colonne des tiges.
Au terme de cette propagation, l’expérimentateur doit engager une procédure de vérification métrologique globale afin de prémunir son étude contre toute perte silencieuse de données. L’instrument privilégié de cet audit est la fonction de comptage textuel NBCAR (ou LEN dans les éditions anglophones), laquelle calcule le nombre exact de caractères constitutifs d’une chaîne de texte. En implantant dans une colonne adjacente la fonction :
=NBCAR(C2)
puis en étendant cette mesure sur toute la colonne des feuilles, on obtient le dénombrement précis des observations répertoriées pour chaque niveau de tige.
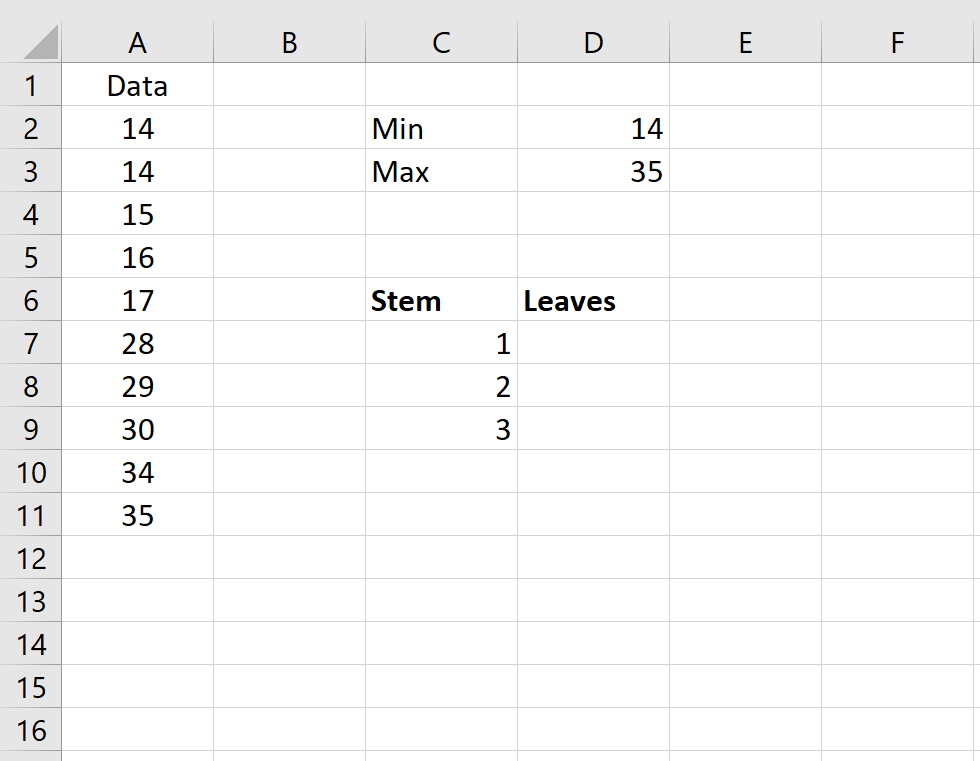
L’étape finale de fiabilisation consiste à sommer l’intégralité des sorties de la fonction NBCAR à l’aide de l’opérateur standard SOMME. La valeur scalaire résultante doit impérativement coïncider avec l’effectif N total de l’échantillon nettoyé, déterminé indépendamment via la fonction NB appliquée directement sur la plage des observations brutes initiales ($A$2:$A$101). Toute divergence numérique entre ces deux valeurs trahirait immanquablement soit la présence de données résiduelles situées en dehors des bornes d’armature des tiges (effet d’exclusion silencieuse), soit un dysfonctionnement de troncature ou d’arrondi au niveau de l’algorithme d’identification des feuilles.
6.2 Conversion en tableau structuré Excel pour actualisation dynamique
Pour élever ce modèle au niveau des standards professionnels du génie logiciel appliqué à la recherche, il est vivement recommandé de convertir la plage de données brutes d’origine en un Tableau Structuré Excel officiel (raccourci clavier Ctrl+L ou Ctrl+T sous l’environnement Windows). Cette opération transforme la plage matricielle inerte en un objet de données relationnel nommé (par exemple « TableauScores »), doté de propriétés computationnelles dynamiques.
Sous cette configuration avancée, les formules de dénombrement abandonnent les coordonnées absolues cryptiques de type $A$2:$A$101 pour adopter la notation des références structurées :
TableauScores[ScoresNeuropsy]
L’intérêt méthodologique majeur de cette structuration réside dans la réactivité dynamique absolue du diagramme. Dès lors qu’un nouveau participant est inclus dans l’essai clinique ou qu’une série de données d’un sujet exclu est expurgée de la table, le tableau structuré se redimensionne de manière entièrement autonome. Les formules dépendantes de la colonne calculée adaptent instantanément leurs bornes de sommation, et le diagramme tige et feuilles s’ajuste en temps réel sans nécessiter la moindre intervention humaine sur le code matriciel textuel.
Cette robustesse computationnelle s’avère particulièrement précieuse lors des réplications expérimentales successives ou dans le cadre de protocoles thérapeutiques longitudinaux. Les cliniciens peuvent enrichir la base de données au fil de l’admission séquentielle des patients, tout en observant en continu la déformation plastique du diagramme tige et feuilles, qui traduit de manière visuelle et immédiate l’impact de chaque nouvelle observation sur la morphologie générale de la distribution.
7. Méthodes modernes alternatives via les fonctions de texte dynamique (Office 365)
7.1 Construction optimisée avec JOINDRE.TEXTE et FILTRE
L’avènement des moteurs de calcul matriciel dynamique au sein de Microsoft 365 et des versions récentes d’Excel permet de concevoir des alternatives architecturales bien plus concises que la longue chaîne de fonctions REPT concaténées. L’introduction de fonctions novatrices d’agrégation et de tri vectoriel en mémoire vive autorise la génération directe des feuilles par manipulation fonctionnelle de flux textuels, sans devoir tester itérativement les chiffres de 0 à 9 au sein de multiples sous-formules redondantes.
Le pivot de cette démarche moderne est la fonction JOINDRE.TEXTE, qui fusionne un vecteur dynamique d’éléments textuels en un ruban unique en utilisant un délimiteur spécifié, tout en offrant la possibilité formelle d’ignorer les cellules vides. En combinant judicieusement cette fonction avec le filtrage vectoriel opéré par FILTRE et le tri matriciel sous-jacent issu de la fonction TRIER, l’expérimentateur peut condenser l’ensemble du traitement d’une tige en une ligne d’une remarquable pureté mathématique :
=JOINDRE.TEXTE(« »; VRAI; TRIER(MOD(FILTRE(TableauScores[Scores]; ENT(TableauScores[Scores]/10)=B2; « »); 10)))
Cette formule exécute simultanément quatre opérations d’analyse de données fondamentales : elle extrait via FILTRE l’ensemble des scores bruts dont la division entière par dix correspond rigoureusement à la valeur de la tige B2 ; elle isole la feuille métrique résiduelle en appliquant l’opérateur modulo dix (MOD) sur l’ensemble de ce sous-ensemble filtré ; elle classe immédiatement ces unités dans l’ordre croissant canonique grâce à TRIER ; enfin, JOINDRE.TEXTE agglomère instantanément l’ensemble de ces chiffres au sein d’une chaîne unifiée, compacte et sans espace intercalaire. Cette syntaxe moderne élimine tout risque d’erreur lié à la ressaisie de formules à répétition et optimise l’empreinte mémoire du classeur de recherche.
7.2 Génération semi-automatique via Power Query
Pour les chercheurs confrontés à des méga-bases de données de santé ou souhaitant automatiser entièrement le flux d’ingestion et de restitution sans saisir la moindre formule sur la feuille de calcul, l’environnement Power Query (moteur ETL intégré nativement à Excel) constitue une plateforme de choix. L’intégralité du processus de partitionnement et de restructuration graphique peut être réalisée au sein d’un pipeline reproductible et auditable, garantissant une étanchéité méthodologique totale entre les données sources et la couche de visualisation.
Le flux de traitement sous Power Query s’amorce par l’importation de la table de scores bruts via l’onglet Données, puis l’exécution de séquences de transformations analytiques :
* Ajout d’une colonne de division entière : création de la variable Tige via l’opération arithmétique de division entière par 10 appliquée à la métrique brute.
* Ajout d’une colonne de modulo : génération de la variable Feuille en appliquant l’opérateur d’extraction du reste modulo 10 à la même métrique.
* Conversion typologique : typage explicite de la colonne Feuille en format texte pur pour préparer la phase d’agrégation concaténée.
* Tri séquentiel ascendant : application d’un tri croissant sur les deux colonnes (Tige puis Feuille) pour assurer l’ordonnancement interne strict.
* Regroupement de lignes : exécution de la commande Regrouper par selon la variable Tige, en utilisant une opération personnalisée de concaténation de texte formulée en code Power Query M :
Text.Combine([Feuille], « »)
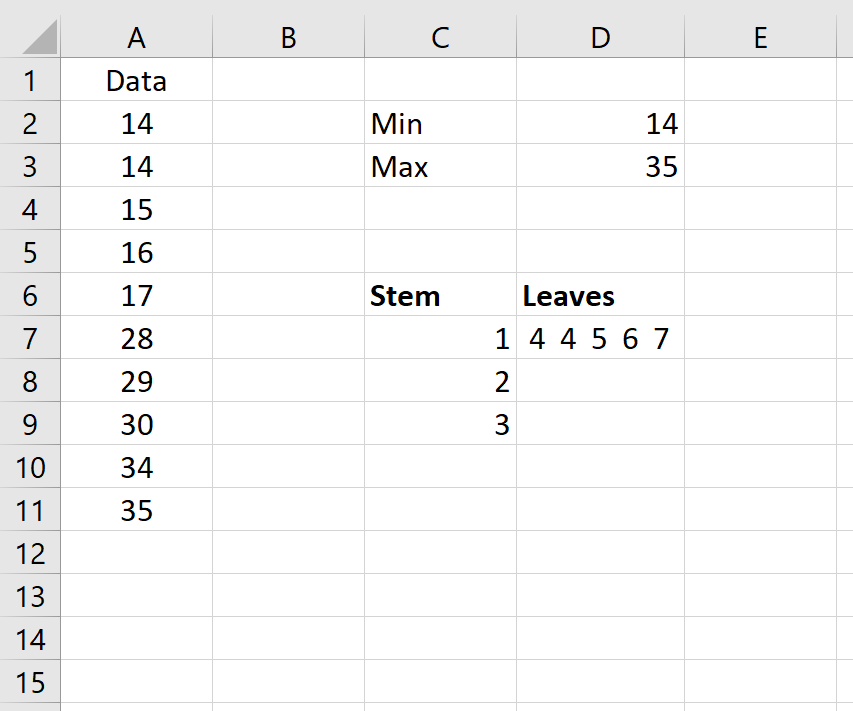
Une fois ce modèle de transformation validé, la requête Power Query est chargée directement dans la feuille de calcul sous la forme d’une table d’analyse définitive. L’expérimentateur bénéficie ainsi d’un diagramme tige et feuilles intégralement stabilisé, qu’il est possible de rafraîchir d’un simple clic droit dès lors que de nouvelles données sources sont injectées dans le système, le tout sans avoir mobilisé la moindre macro VBA ni fragilisé l’intégrité du classeur expérimental.
8. Élaboration d’un diagramme tige et feuilles bilatéral pour comparaisons intergroupes
8.1 Architecture comparative : condition contrôle versus condition expérimentale
En psychologie expérimentale, en neuropsychologie et en psychiatrie biologique, l’objectif fondamental de la recherche réside quasi systématiquement dans la comparaison des performances de deux groupes indépendants (cohorte contrôle versus cohorte pathologique) ou d’un même échantillon évalué dans deux conditions temporelles distinctes (protocole pré-test versus post-test après remédiation cognitive). Dans cette perspective comparatiste, le diagramme tige et feuilles bilatéral — souvent désigné sous l’anglicisme back-to-back stem-and-leaf plot — constitue un dispositif d’exploration graphique d’une élégance et d’une puissance diagnostique inégalées.
L’armature spatiale de ce diagramme repose sur une distribution trifide : une unique colonne centrale abrite l’échelle verticale des tiges, partagée par les deux distributions. De part et d’autre de cet axe médian se déploient symétriquement les feuilles : à gauche s’étendent horizontalement les feuilles issues du groupe contrôle (ou condition de base), tandis qu’à droite se développent les feuilles appartenant au groupe expérimental (ou condition post-thérapeutique). Cette disposition en miroir offre une lecture comparative immédiate des dispersions respectives, de l’étalement des variances et des décalages éventuels des tendances centrales le long d’une échelle métrique strictement partagée.
Une telle confrontation visuelle prend tout son sens lors de l’évaluation de latences chronométriques d’inhibition dans des tâches de type Stroop ou Go/No-Go. Si une thérapie pharmacologique parvient à normaliser la vitesse de traitement de patients cérébrolésés, le diagramme bilatéral illustrera de façon spectaculaire cette translation fonctionnelle : la distribution des feuilles du groupe clinique s’alignera progressivement sur la morphologie affichée par le groupe sain, matérialisant instantanément l’efficacité de la prise en charge sans faire abstraction de la réalité numérique individuelle des patients répondeurs.
8.2 Inversion algorithmique de la chaîne de texte gauche
La mise en œuvre technique d’un diagramme bilatéral au sein d’Excel recèle une contrainte sémiotique et mathématique complexe : l’exigence d’inversion directionnelle du flux textuel pour l’aile gauche du graphique. Alors que les feuilles du groupe expérimental positionnées à droite de la tige centrale se lisent conventionnellement de gauche à droite selon un ordre croissant (la valeur la plus proche de la tige représentant le chiffre d’unités le plus faible, soit 0, 1, 2…), les feuilles de l’aile gauche doivent impérativement s’ordonner dans le sens inverse. La lecture se faisant horizontalement en s’éloignant de la tige centrale vers la périphérie gauche, la feuille la plus basse (0) doit être immédiatement adjacente à la frontière médiane, tandis que les valeurs élevées (8, 9) doivent être repoussées vers l’extrémité distale gauche.
Pour générer cette inversion du flux au sein des cellules de l’aile gauche, la formule standard employée pour l’aile droite ne peut être reproduite sans altération. Si l’on applique l’algorithme REPT concaténé, l’expérimentateur doit inverser délibérément l’ordre syntaxique de formulation, en commençant son agrégation par le chiffre 9 et en la concluant par le chiffre 0 :
=REPT(« 9 »; NB.SI(GroupeControle; Tige*10+9)) & REPT(« 8 »; NB.SI(GroupeControle; Tige*10+8)) & … & REPT(« 0 »; NB.SI(GroupeControle; Tige*10+0))
Dans les versions modernes d’Excel exploitant les fonctions matricielles dynamiques, cette inversion de chaîne peut être automatisée en appliquant la fonction TRIER avec un coefficient de tri décroissant (-1) sur le vecteur vectoriel extrait, contraignant l’algorithme à renvoyer les sous-unités numériques selon une trajectoire rigoureusement inversée.
Enfin, l’harmonie perceptive du dispositif requiert un calage typographique spécifique. Les cellules composant l’aile gauche du diagramme bilatéral doivent impérativement faire l’objet d’un alignement horizontal forcé à droite au sein de la barre d’outils d’alignement d’Excel. À l’opposé, les cellules de l’aile droite adoptent un alignement standard à gauche, tandis que la colonne centrale accueillant les tiges est centrée horizontalement. Cette disposition typographique garantit que les deux ensembles de feuilles s’adossent parfaitement contre la frontière délimitant l’axe central des tiges, produisant une lecture visuelle bilatérale ergonomique conforme aux exigences de publication scientifique.
9. Esthétique typographique, mise en forme conditionnelle et standardisation académique
9.1 Sélection typographique et calibration des espacements
L’erreur la plus dévastatrice — et pourtant la plus fréquemment commise lors de la génération artisanale d’un diagramme tige et feuilles dans un tableur grand public — concerne l’indifférence à l’égard de la police de caractères employée. Dans les polices typographiques dites proportionnelles qui peuplent par défaut les logiciels modernes (telles que Calibri, Aptos, Arial ou Times New Roman), la largeur géométrique d’un caractère varie substantiellement selon sa morphologie intrinsèque : le chiffre « 1 » occupe un espace horizontal nettement inférieur à celui alloué au chiffre « 8 » ou « 0 ».
Cette variabilité de largeur induit une distorsion métrique fatale pour la validité du diagramme. Dès lors qu’une série de cinq chiffres « 1 » occupe une longueur physique totale moindre qu’un alignement de trois chiffres « 8 », l’œil de l’observateur perçoit une densité de distribution faussée : une classe de scores hautement peuplée peut sembler graphiquement plus étroite qu’une classe faiblement dotée mais constituée de chiffres larges. Cet artéfact optique détruit le postulat fondamental de Tukey, qui stipule que la longueur spatiale de l’agrégat textuel doit être rigoureusement proportionnelle à la fréquence statistique qu’il incarne.
Pour neutraliser rigoureusement cette distorsion visuelle, l’emploi exclusif d’une police de caractères à chasse fixe (monospaced font) s’impose comme une obligation méthodologique absolue. Des typographies académiques telles que Consolas, Courier New, Lucida Console ou DejaVu Sans Mono garantissent que chaque caractère numérique, chaque glyphe et chaque espace intercalaire occupent exactement la même largeur physique sur l’axe horizontal. L’isomorphisme entre la longueur géométrique de la ligne textuelle et la fréquence statistique observée est ainsi parfaitement préservé, hissant le rendu final au niveau d’exactitude requis par les publications internationales à comité de lecture.
9.2 Bordures, séparateurs visuels et légende selon les normes de publication
La lisibilité globale du diagramme repose sur l’intégration d’un réseau épuré de démarcations visuelles, conforme aux exigences de clarté stylistique préconisées par le manuel de publication de l’APA. La colonne verticale abritant l’armature des tiges doit être distinctement isolée des blocs de feuilles contigus par l’application d’une bordure verticale continue d’épaisseur moyenne. Si le diagramme est unilatéral, cette bordure s’applique sur la lisière droite de la colonne des tiges ; s’il s’agit d’un modèle bilatéral, des bordures verticales doivent border les deux côtés de la tige centrale pour former un couloir d’ancrage visuel net et stable. Les quadrillages horizontaux internes des cellules doivent être estompés ou entièrement désactivés afin de conférer au graphique l’apparence d’une figure statistique professionnelle plutôt que celle d’une grille comptable brute.
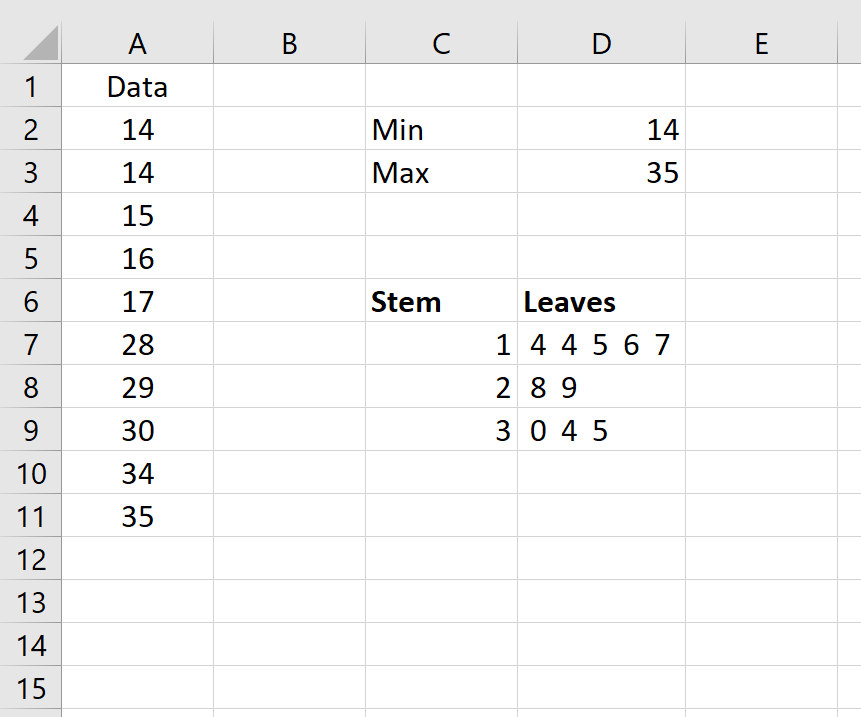
L’élément structurel déterminant qui parachève l’édifice est le cartouche explicatif de métadonnées, conventionnellement positionné sous la figure ou intégré en en-tête dans une zone de texte dédiée. Ce cartouche doit obligatoirement expliciter la clé de décodage par une formule standardisée exempte d’ambiguïté, formulée selon les canons suivants :
Tige | Feuille ; Clé : 5 | 2 = 52 unités métriques (N = 84)
Ce cartouche précise formellement l’unité métrologique adoptée (par exemple des millisecondes, des scores bruts à une échelle d’anxiété ou des pourcentages de réussite), ainsi que la taille exacte de l’échantillon N après épuration.
Dans les configurations avancées destinées à l’évaluation diagnostique, le chercheur peut également mobiliser la puissance de la mise en forme conditionnelle d’Excel pour introduire des signaux visuels subtils. L’application d’un léger ombrage en niveau de gris sur les tiges correspondant aux zones de déviance clinique standardisée (par exemple les scores chutant au-delà de deux écarts-types en dessous de la moyenne normative, traduisant un déficit pathologique sévère) permet d’attirer immédiatement l’attention du clinicien sur les strates de risque, sans jamais surcharger la figure par des polychromies agressives proscrites par les revues académiques.
10. Interprétation statistique et psychologique avancée de la morphologie obtenue
10.1 Évaluation de l’asymétrie et de l’aplatissement
Une fois déployé et typographiquement calibré au sein d’Excel, le diagramme tige et feuilles cesse d’être une simple compilation technique pour devenir un instrument d’inférence visuelle d’une remarquable subtilité. L’observateur avisé procède en premier lieu à l’évaluation morphologique de la symétrie de la distribution, transposant sur le plan visuel les concepts formels de coefficient d’asymétrie de Fisher-Pearson (Skewness). Une distribution symétrique idéale se matérialise par un renflement médian régulier de feuilles au niveau des tiges centrales, flanqué d’un effilement bilatéral progressif et homogène vers les tiges extrêmes supérieures et inférieures.
À l’inverse, l’identification d’une asymétrie positive (ou étalement vers la droite dans un système cartésien conventionnel) se signale sur le diagramme vertical par une concentration massive de feuilles denses au sommet de l’échelle des tiges (les scores faibles), couplée à une traîne résiduelle étirée vers le bas, vers les tiges de haute valeur numérique. Ce profil est typique de l’étude des temps de réaction ou des échelles d’anxiété au sein d’une population saine, où la majorité des individus affichent des latences comprimées ou une absence de symptômes, tandis qu’une minorité étire la distribution vers des scores élevés. Réciproquement, une asymétrie négative se manifeste par une masse de feuilles agglomérées sur les tiges inférieures (scores élevés) et une queue pointant vers le sommet (scores faibles), configuration symptomatique des épreuves cognitives simples présentant un effet d’apprentissage massif.
Parallèlement, le diagramme fournit un diagnostic perceptif instantané du degré d’aplatissement distributionnel (Kurtosis). Une configuration leptocurtique se révèle par une tige centrale hyper-dense débordant horizontalement de manière disproportionnée, entourée de tiges adjacentes quasi désertes et de queues relativement chargées, alertant sur un phénomène d’hypo-variabilité centrale couplé à une probabilité accrue de scores extrêmes. En contrepoint, une morphologie platicurtique présentera un profil rectangulaire et uniforme, sans pic central discernable, indiquant une dispersion homogène des scores psychométriques. Ce double diagnostic morphologique offre une assise empirique solide pour guider le choix entre statistiques paramétriques et tests de substitution non paramétriques.
10.2 Identification des sous-groupes latents et des scores sentinelles
L’un des apports cliniques les plus décisifs du diagramme tige et feuilles réside dans sa capacité singulière à dévoiler la présence de sous-groupes latents dissimulés sous l’illusion statistique d’une moyenne unique. Dans le champ de la psychopathologie expérimentale et des neurosciences comportementales, il n’est pas rare qu’un groupe de patients diagnostiqués de manière homogène sous l’étiquette de « trouble dépressif majeur » ou de « trouble du spectre de l’autisme » réagisse de manière hautement divergente à un paradigme expérimental standard. Alors qu’un histogramme standard pourrait lisser ces aspérités en choisissant des classes trop larges, le diagramme tige et feuilles fait éclater visuellement cette hétérogénéité sous la forme d’une configuration multimodale.
L’apparition de deux protubérances distinctes de feuilles séparées par une ou plusieurs tiges totalement dénuées d’observations constitue la signature graphique irréfutable d’une distribution bimodale. Sur le plan psychologique, ce pattern invite le chercheur à abandonner l’hypothèse d’une population monolitique pour interroger l’existence de variables modératrices sous-jacentes : résistance pharmacologique sélective, dissociation fonctionnelle cognitive ou existence d’un endophénotype biologique spécifique distinguant les répondeurs thérapeutiques des individus réfractaires. Le diagramme isole spatialement ces deux foyers et permet au clinicien de remonter instantanément aux identifiants individuels des participants formant chaque agrégat.
Enfin, l’observation des tiges périphériques favorise l’identification et la contextualisation clinique des « scores sentinelles ». Un patient dont le score se matérialise par une feuille isolée à l’extrémité distale d’une tige déconnectée du reste de la cohorte ne doit pas être mécaniquement éliminé comme un simple résidu statistique indésirable. L’expérimentateur, guidé par la visibilité intégrale de la valeur brute au sein de la figure, peut immédiatement confronter ce score atypique aux carnets d’observations qualitatives du laboratoire : s’agissait-il d’un moment de décrochage attentionnel documenté lors de la passation, d’une crise de panique intercurrente, ou au contraire de l’expression pure d’un profil neuroatypique exceptionnel méritant une étude de cas neuropsychologique approfondie ? C’est dans ce dialogue fécond entre métrologie quantitative et herméneutique clinique que le diagramme tige et feuilles démontre sa supériorité épistémologique.
11. Diagnostic et résolution des anomalies techniques courantes dans Excel
11.1 Gestion des nombres décimaux, négatifs et de grande amplitude
L’ingénierie d’un diagramme tige et feuilles sous Excel peut être confrontée à des configurations numériques complexes qui désynchronisent les algorithmes standards si elles ne font pas l’objet d’un traitement préalable spécifique. La première de ces difficultés concerne la gestion des nombres affectés du signe négatif, une situation courante lors du traitement de scores différentiels (contrastes post-thérapeutiques normalisés) ou de scores factoriels standardisés de type scores Z.
Le problème réside dans l’existence mathématique et textuelle du palier ambigu désigné sous le terme de « zéro négatif » (-0). Alors que le moteur arithmétique d’Excel assimile la valeur -0 à la valeur +0, la sémiotique du diagramme de Tukey exige de distinguer une classe de tiges regroupant les fractions négatives comprises entre -0,9 et -0,1 d’une classe de tiges accueillant les fractions positives étalées de 0,0 à 0,9. Pour surmonter cette aporie au sein du tableur, l’expérimentateur doit substituer aux entiers numériques purs des étiquettes textuelles rigoureuses pour l’armature des tiges (par exemple « -0 » et « +0 »), tout en conditionnant les fonctions NB.SI ou FILTRE à l’aide d’un double test logique discriminé par le signe opératoire :
=ET(Scores >= -0.9; Scores < 0)
La seconde anomalie découle de la manipulation de scores psychométriques de grande amplitude ou caractérisés par une fraction décimale de haute précision. Si l'on évalue des potentiels évoqués cognitifs mesurés en microvolts avec des grandeurs telles que 0,0042 V ou 0,0089 V, la formulation directe conduirait à un effondrement des fonctions de modulo. Il convient d'appliquer en amont une normalisation mathématique par multiplication ou division à l'aide d'une puissance de dix invariante, de manière à transposer temporairement les mesures brutes dans un espace d'entiers naturels manipulables par les fonctions REPT et MOD. Une fois la transposition achevée, l'échelle originale est expressément rétablie au niveau du cartouche de la clé de lecture (par exemple : Tige | Feuille ; Clé : 4 | 2 = 0,0042 V).
Enfin, la prudence s'impose face aux effets d'arrondis asymétriques susceptibles d'introduire des distorsions insidieuses dans le dénombrement des feuilles. L'application aveugle d'un formatage visuel de cellules réduisant les décimales apparentes n'altère en rien la grandeur réelle stockée en mémoire par le processeur d'Excel. Si la cellule contient 45,999, elle affichera visuellement "46" tout en étant évaluée sous la valeur 45 par la fonction ENT, provoquant un décalage opératoire discordant entre l'inspection visuelle et l'extraction algorithmique. Pour immuniser le système contre ce biais, l'usage des fonctions d'arrondi explicite telles que ARRONDI ou ARRONDI.INF doit être systématiquement intégré en amont de la séparation tige-feuille.
11.2 Résolution des erreurs de formules et conflits linguistiques
Le partage international de classeurs Excel de recherche et la manipulation de jeux de données psychométriques multivariés s’accompagnent souvent d’alertes logicielles et de blocages syntaxiques qu’il convient de savoir diagnostiquer et neutraliser méthodiquement. L’une des pierres d’achoppement les plus universelles découle des conflits linguistiques liés aux séparateurs d’arguments au sein des formules mathématiques.
Dans l’environnement francophone et européen continental d’Excel, le séparateur syntaxique d’arguments est conventionnellement le point-virgule (;), tandis que la virgule (,) est réservée à la notation de la décimale arithmétique. À l’inverse, les éditions anglophones adoptent la virgule comme séparateur de paramètres et le point comme séparateur décimal. L’importation d’une formule matricielle rédigée pour une interface anglo-saxonne au sein d’une installation locale générera instantanément un message d’erreur bloquant ou produira le code d’erreur textuel générique #NOM?. Le chercheur veillera donc à scrupuleusement conformer sa syntaxe à la localisation linguistique active de son système d’exploitation.
Un autre dysfonctionnement critique se manifeste sous la forme de l’erreur #VALEUR!, signalant l’impossibilité pour le processeur de calcul d’exécuter une opération mathématique en raison de l’incompatibilité de type d’une ou plusieurs cellules cibles. Dans 95 % des cas d’ingénierie du diagramme tige et feuilles, cette défaillance trahit la présence accidentelle de données stockées sous un format texte invisible au sein de la colonne source des scores bruts. La présence d’un espace insécable, généré lors de l’exportation depuis un logiciel de passation neuropsychologique en ligne, interdit toute opération arithmétique de type B2*10+1. Ce blocage se résout par l’application conjointe des fonctions PURGE et CNUM sur l’ensemble de la colonne d’origine, convertissant définitivement les pseudo-chaînes textuelles en scalaires numériques purs :
=CNUM(EPURAGE(SUPPRESPACE(A2)))
Enfin, l’apparition de l’erreur #REF! atteste d’une rupture irrémédiable de l’adressage cartographique au sein de la feuille de calcul. Elle survient typiquement lorsqu’un expérimentateur supprime physiquement la colonne hébergeant les scores bruts ou écrase les cellules sources par un collage de valeurs destructeur. L’adoption rigoureuse des Tableaux Structurés documentée à la section 6.2 permet d’éradiquer définitivement ce type de dérive référentielle, en garantissant la pérennité structurelle des calculs quelle que soit l’ampleur des réorganisations tabulaires opérées sur le classeur de données.
12. Intégration du diagramme dans le flux de production scientifique et comparaison logicielle
12.1 Exportation vectorielle et insertion dans un manuscrit scientifique
La finalité ultime d’une démarche d’analyse de données psychologiques réside dans la diffusion publique des résultats au sein de thèses de doctorat, de mémoires cliniques ou d’articles soumis à l’évaluation par les pairs dans des revues internationales. Une fois le diagramme tige et feuilles finalisé au sein d’Excel, son extraction vers les logiciels de traitement de texte académiques (Microsoft Word, LibreOffice Writer) ou les systèmes de composition typographique spécialisés (LaTeX) obéit à des protocoles de capture stricts visant à préserver sa perfection géométrique.
La méthode la plus robuste pour intégrer le rendu dans un document Word consiste à sélectionner rigoureusement l’ensemble de la plage cellulaire constitutive du diagramme (englobant la légende, l’armature des tiges, la frontière de séparation et les rubans de feuilles) puis à exécuter la commande Copier comme image sous le menu d’édition d’Excel. En optant pour le format de capture « Tel qu’à l’écran » et le sous-type vectoriel ou métafichier amélioré (EMF), l’expérimentateur garantit une restitution graphique d’une netteté absolue, exempte de toute pixellisation lors de l’impression sur presse universitaire ou de l’affichage sur écran haute densité Retina.
Dans le cas d’un manuscrit composé sous l’environnement LaTeX, le chercheur peut alternativement exporter la table au format tabulaire textuel pur ou compiler une figure via le package dédié pgfplots. Quelle que soit la modalité technique retenue, la préservation scrupuleuse de la police à chasse fixe (monospaced) demeure impérative. La rédaction de la note de bas de figure doit rigoureusement se conformer aux préconisations typographiques du manuel de style de l’APA (7e édition) :
Figure 1. Diagramme tige et feuilles des temps de réaction auditifs (en ms) dans la condition d’inhibition motrice (N = 65). Tige = centaines et dizaines ; Feuilles = unités. Données épurées exemptes de correction d’arrondi.
12.2 Mise en perspective critique : Excel face aux packages spécialisés (R, SPSS, Python)
Au terme de cet itinéraire d’ingénierie méthodologique, une évaluation critique s’impose quant à la légitimité d’Excel face aux logiciels statistiques dédiés à l’analyse de données expérimentales. Le tableau comparatif suivant synthétise les propriétés ergonomiques, analytiques et opérationnelles des différents environnements d’ingénierie disponibles pour le statisticien et le psychologue :
L’environnement Microsoft Excel brille avant tout par son accessibilité démocratique universelle et l’extraordinaire plasticité de son interface visuelle. Pour l’enseignant-chercheur formant des étudiants de licence en sciences humaines, pour le praticien clinicien exerçant en cabinet ou à l’hôpital sans accès aux licences académiques onéreuses, ou pour l’investigateur souhaitant interagir tactilement avec son jeu de données, la conception manuelle ou semi-automatisée d’un diagramme tige et feuilles sous Excel représente une démarche pédagogique et pratique d’une efficacité inégalée. Elle démystifie le traitement de données en rendant transparente chaque étape de la scission arithmétique et de l’agrégation textuelle.
Néanmoins, les limites computationnelles de cette approche émergent dès lors que les protocoles expérimentaux basculent dans le paradigme du Big Data ou de l’évaluation neuropsychologique massive en ligne. Face à des cohortes regroupant plusieurs milliers d’observations, l’exécution d’une fonction R native telle que :
stem(DonneesNeuropsy, scale = 2)
ou l’appel de la bibliothèque spécialisée stemgraphic sous un environnement Python s’exécutent en une fraction de seconde tout en calibrant algorithmiquement la résolution optimale des tiges sans requérir la moindre conception architecturale manuelle. De même, les progiciels dédiés tels qu’IBM SPSS Statistics génèrent ces sorties graphiques par de simples clics dans les menus d’exploration descriptive, bien que le format de sortie visuel y demeure souvent figé et graphiquement désuet.
En synthèse, la maîtrise de la conception d’un diagramme tige et feuilles sous Microsoft Excel constitue une compétence méthodologique à haute valeur ajoutée. Loin d’être un simple palliatif technique à l’absence de module graphique standard, cette démarche incarne une synthèse féconde entre rigueur métrologique exploratoire, compréhension algorithmique des structures textuelles et souci aigu de l’esthétique scientifique. Elle rappelle avec force que l’analyse des données psychologiques, bien avant d’être une procédure d’inférence aveugle confiée à des boîtes noires logicielles, demeure un acte intellectuel d’observation attentive où la forme visuelle magnifie et préserve la texture authentique des comportements mesurés.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Brillinger, D. R. (2002). John W. Tukey: His life and professional contributions. The Annals of Statistics, 30(6), 1535-1575. https://doi.org/10.1214/aos/1043351251
Emerson, J. D., & Hoaglin, D. C. (1983). Stem-and-leaf displays. In D. C. Hoaglin, F. Mosteller, & J. W. Tukey (Eds.), Understanding robust and exploratory data analysis (pp. 7-30). John Wiley & Sons.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Velleman, P. F., & Hoaglin, D. C. (1981). Applications, basics, and computing of exploratory data analysis. Duxbury Press.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0