
L’investigation empirique au sein des sciences du comportement et de la psychologie contemporaine repose fondamentalement sur la capacité du chercheur à dégager du sens à partir de données observationnelles, expérimentales ou psychométriques. Lorsque les phénomènes étudiés s’expriment sous forme de variables catégorielles ou qualitatives — qu’il s’agisse de diagnostics nosographiques, d’orientations d’attachement, de profils de personnalité discrets ou de réponses à des échelles d’évaluation ordinales —, les méthodes quantitatives continues classiques perdent de leur pertinence immédiate. C’est dans ce contexte méthodologique précis que l’analyse bivariée par tableau de contingence s’impose comme un outil incontournable pour cartographier la structure des relations mutuelles entre différentes modalités comportementales.
Le tableau de contingence, souvent désigné sous l’appellation de tabulation croisée ou tableau à double entrée, constitue la pierre angulaire de l’analyse distributionnelle conjointe. En synthétisant le dénombrement conjoint des observations à travers les strates de deux ou plusieurs facteurs discrets, il permet de révéler des régularités empiriques, des dépendances probabilistes ainsi que d’éventuelles divergences par rapport aux postulats théoriques d’indépendance. La maîtrise de sa formalisation mathématique et de son interprétation clinique représente un jalon essentiel dans la formation de tout praticien ou chercheur désireux d’étayer ses inférences sur une rigueur descriptive irréprochable.
Bien que les logiciels spécialisés tels que IBM SPSS Statistics, R ou Python occupent une place de choix dans l’analyse de données avancée, le tableur Microsoft Excel demeure l’environnement informatique le plus universellement déployé, accessible et flexible pour l’organisation préliminaire, la manipulation interactive et la modélisation descriptive des données de recherche. Ce guide encyclopédique se propose d’explorer de manière exhaustive l’ensemble du cycle de conception, de configuration statistique, d’optimisation ergonomique et de valorisation académique d’un tableau de contingence au sein d’Excel, en reliant scrupuleusement la manipulation logicielle aux fondements théoriques de l’évaluation psychologique et aux normes éditoriales de l’American Psychological Association (APA).
1. Introduction aux tableaux de contingence dans la recherche en psychologie
1.1 Définition et fondements épistémologiques du tableau croisé
D’un point de vue épistémologique et méthodologique, le tableau de contingence se définit comme une matrice mathématique bi-dimensionnelle organisée en lignes et en colonnes, conçue pour classer et dénombrer les unités d’observation — en l’occurrence les sujets humains ou les participants à un protocole — selon au moins deux critères de classification qualitatifs simultanés. Introduit historiquement par les pionniers de la biométrie et de la statistique inférentielle, notamment Karl Pearson au tout début du XXe siècle, ce dispositif tabulaire répond au besoin fondamental de dépasser la simple statistique univariée pour appréhender les interactions latentes ou manifestes existant au sein d’un couple de variables discrètes. Contrairement à une approche purement linéaire ou corrélationnelle qui exige des métriques d’intervalle ou de rapport, la tabulation croisée permet de préserver l’intégrité morphologique des construits qualitatifs sans forcer arbitrairement une quantification numérique artificielle.
Dans l’écosystème des sciences du comportement, où les objets d’étude s’incarnent fréquemment sous des formes catégorielles (par exemple, la présence ou l’absence d’une symptomatologie dépressive, l’orientation motivationnelle intrinsèque versus extrinsèque, ou encore le type d’intervention psychologique administrée), le tableau à double entrée agit comme un révélateur des contingences de l’environnement psychique et social. Il traduit la fréquence à laquelle deux événements discrets se manifestent de concert au sein d’une population définie, matérialisant ainsi la notion de distribution de fréquences conjointes. Cette analyse descriptive forme le socle indispensable sur lequel reposent l’inférence non paramétrique et la vérification des hypothèses nulles d’indépendance stochastique.
Il convient d’établir une distinction formelle entre le tableau de contingence, le tableau de fréquences simples et la matrice de corrélation. Le tableau de fréquences simples est strictement univarié : il recense la dispersion des effectifs d’un unique facteur, détaillant les fréquences absolues et relatives pour chaque modalité isolée. En revanche, le tableau de contingence croise simultanément deux dimensions catégorielles distinctes, générant un espace de croisement où chaque cellule correspond à l’intersection logique d’une modalité de la variable en ligne et d’une modalité de la variable en colonne. Enfin, la matrice de corrélation s’applique prioritairement à des variables quantitatives continues et présente les coefficients de covariance standardisée (comme le r de Pearson), décrivant la force et la direction d’une relation linéaire, là où le tableau de contingence examine la répartition d’effectifs dénombrés au sein de cases discrètes.
1.2 Utilité de la tabulation croisée dans l’évaluation psychologique
L’évaluation psychologique et clinique moderne repose de façon prépondérante sur des méthodologies d’observation standardisées, des questionnaires d’auto-évaluation et des inventaires psychométriques dont les résultats sont fréquemment traduits en catégories diagnostiques, en classes de sévérité ou en typologies comportementales. La tabulation croisée constitue un instrument d’exploration empirique privilégié pour documenter l’interdépendance de ces classifications. Par exemple, lorsqu’un chercheur souhaite vérifier si l’adhésion thérapeutique (bonne vs médiocre) est modulée par le style d’attachement prédominant (sécure, anxieux, évitant ou désorganisé), le tableau de contingence permet d’observer directement la manière dont les participants se répartissent à travers cette topographie relationnelle.
Par ailleurs, cette approche est couramment mobilisée dans les phases de validation psychométrique d’instruments diagnostiques. La confrontation des scores catégorisés d’un nouvel outil d’évaluation clinique avec un étalon-or diagnostique préexistant s’opère canoniquement par l’intermédiaire d’une table croisée deux par deux. Cette configuration permet de déduire des indices cruciaux tels que la sensibilité, la spécificité, la valeur prédictive positive et la valeur prédictive négative. L’analyse des divergences observées au sein des cellules hors-diagonale offre un éclairage clinique déterminant sur la nature des erreurs de classification — faux positifs et faux négatifs —, contribuant directement au raffinement des seuils décisionnels de l’instrument.
Sur le plan méthodologique, la tabulation croisée permet également de détecter des profils comportementaux distincts et des phénomènes de sous-groupes au sein d’échantillons cliniques ou non cliniques hétérogènes. Avant de s’engager dans des modélisations logistiques multinomiales ou des analyses de classes latentes particulièrement complexes, le statisticien des sciences humaines utilise le tableau croisé pour apprécier visuellement la plausibilité de ses hypothèses exploratoires. Enfin, ce format structurel prépare de manière optimale les jeux de données bruts en vue des procédures d’inférence non paramétrique, en condensant l’information dispersée au niveau des participants en un agencement compact d’effectifs observés directement exploitable par les algorithmes de test statistique.
1.3 Place du logiciel Excel dans le flux d’analyse de données
Dans l’arsenal technologique contemporain dévolu aux sciences humaines et sociales, le logiciel Microsoft Excel occupe une place singulière, caractérisée par une omniprésence institutionnelle et une courbe d’apprentissage particulièrement douce. Contrairement aux environnements de calcul statistique avancés tels que le progiciel SPSS Statistics, le langage fonctionnel R ou les bibliothèques spécialisées en Python (telles que Pandas et SciPy), Excel est nativement présent sur la quasi-totalité des postes de travail académiques, hospitaliers et institutionnels. Cette standardisation élimine les barrières d’accès financières et logistiques, garantissant une portabilité immédiate des fichiers entre collaborateurs pluridisciplinaires.
Sur le plan comparatif, si des logiciels comme R et Python offrent une puissance de programmation algorithmique inégalée et une reproductibilité scripturale absolue via des environnements dédiés, ils exigent un investissement technique substantiel souvent dissuasif pour les cliniciens et étudiants engagés dans des recherches appliquées de première ligne. SPSS, bien qu’ergonomique grâce à ses boîtes de dialogue standardisées, souffre d’un modèle économique onéreux et d’une certaine rigidité dans la mise en page interactive des synthèses tabulaires. Excel comble précisément ce fossé méthodologique en offrant une interface matricielle intuitive, hautement visuelle et instantanément réactive, idéale pour la phase exploratoire initiale où le chercheur a besoin de manipuler, filtrer, pivoter et observer ses données brutes sans latence d’exécution.
Le rôle pivot d’Excel réside principalement dans sa capacité à opérer une passerelle fluide entre la collecte de terrain — souvent réalisée via des plateformes d’enquête en ligne générant des formats de feuilles de calcul tabulaires — et les étapes d’analyse statistique inférentielle formelle. Les fonctionnalités d’agrégation dynamique d’Excel, notamment les tableaux croisés dynamiques, permettent de restructurer des milliers de lignes de réponses individuelles en matrices de contingence rigoureuses en quelques clics. Cette agilité descriptive n’exclut en rien la rigueur mathématique, Excel intégrant nativement des fonctions probabilistes de pointe permettant d’exécuter des tests d’indépendance robustes et de vérifier les conditions de validité des données avant toute dissémination scientifique.
2. Cadre théorique : Variables qualitatives et distribution conjointe
2.1 Typologie des variables analysées : Nominal et ordinal
L’analyse rigoureuse d’un tableau de contingence exige une maîtrise conceptuelle approfondie de la nature des variables sous-jacentes. Selon la taxonomie classique formulée par le psychophysicien Stanley Smith Stevens en 1946, les échelles de mesure se subdivisent en quatre niveaux hiérarchiques fondamentaux : nominal, ordinal, d’intervalle et de rapport. La tabulation croisée s’applique prioritairement aux deux premiers échelons, regroupés sous la dénomination commune de variables qualitatives ou catégorielles, dont les propriétés métriques conditionnent strictement les opérations mathématiques autorisées.
Les variables à échelle nominale désignent des entités conceptuelles composées de catégories qualitatives qualitées de modalités, qui ne possèdent aucun ordre hiérarchique, séquentiel ou quantitatif intrinsèque. La seule relation logique admissible entre deux observations mesurées sur une échelle nominale est l’équivalence ou la non-équivalence (identité ou différence). Dans le champ de la psychopathologie et de la psychologie différentielle, les exemples abondent : la catégorisation diagnostique selon les critères du Manuel diagnostique et statistique des troubles mentaux (par exemple : Trouble anxieux généralisé, Trouble dépressif majeur, Trouble obsessionnel-compulsif), l’appartenance à un groupe de traitement (groupe expérimental versus groupe témoin sous placebo), ou encore la dominance hémisphérique cérébrale.
À l’inverse, l’échelle ordinale introduit une relation d’ordre, de gradation ou de rang entre les différentes modalités, sans pour autant que la distance mathématique séparant deux rangs consécutifs puisse être postulée comme constante ou égale. En évaluation clinique, les échelles de type Likert (allant de « Pas du tout d’accord » à « Tout à fait d’accord »), les stades de développement cognitif selon l’approche piagétienne, ou encore le niveau de gravité d’une affection psychiatrique (léger, modéré, sévère) constituent des variables ordinales exemplaires. Quel que soit le niveau de mesure, une exigence axiomatique s’impose : les modalités doivent impérativement être mutuellement exclusives (un individu ne peut appartenir simultanément qu’à une seule modalité d’une variable donnée) et collectivement exhaustives (l’ensemble des modalités doit couvrir toutes les occurrences possibles observées dans la cohorte étudiée).
2.2 Concept de distribution de fréquences conjointes
Dès lors que deux variables qualitatives sont observées conjointement sur un même échantillon de participants, l’espace probabiliste se structure sous la forme d’une distribution conjointe. Formellement, si l’on désigne par X une variable qualitative comportant r modalités distinctes (notées x1, x2, …, xr) et par Y une seconde variable qualitative comportant c modalités (notées y1, y2, …, yc), l’intersection de chaque modalité xi avec chaque modalité yj engendre une cellule élémentaire au sein de la matrice croisée. Le nombre d’observations se trouvant simultanément caractérisées par la modalité xi et la modalité yj est qualifié d’effectif observé conjoint, conventionnellement noté nij.
La structure globale du tableau de contingence s’articule autour de ces effectifs conjoints nij et de leurs agrégations marginales. En sommant les effectifs d’une ligne donnée sur l’ensemble des colonnes, on obtient l’effectif marginal de ligne, noté ni. (ou ni+), qui représente le nombre total de participants présentant la modalité xi de la variable X, indépendamment de leurs réponses sur la variable Y. Réciproquement, la sommation des effectifs d’une colonne donnée sur l’ensemble des lignes définit l’effectif marginal de colonne, noté n.j (ou n+j), correspondant à l’effectif total d’individus partageant la modalité yj de la variable Y. L’ensemble de ces distributions unidimensionnelles projetées sur les marges du tableau constitue les distributions marginales.
Enfin, la sommation globale de l’ensemble des effectifs conjoints nij, qui équivaut rigoureusement à la somme de tous les effectifs marginaux de lignes ou à la somme de tous les effectifs marginaux de colonnes, détermine l’effectif total de l’échantillon, universellement désigné par la lettre N (ou n). La validité théorique et la représentativité clinique d’une telle distribution reposent sur des contraintes d’échantillonnage drastiques : la taille N doit être suffisamment substantielle et résulter d’une méthode d’échantillonnage aléatoire ou probabiliste contrôlée, afin d’éviter les biais de sélection qui déformeraient artificiellement les fréquences observées dans les sous-cellules de la matrice.
2.3 Hypothèse d’indépendance statistique entre construits
L’enjeu inférentiel majeur associé à la manipulation d’un tableau de contingence réside dans la vérification empirique de l’hypothèse d’indépendance stochastique entre deux construits psychologiques. En théorie des probabilités appliquées, deux événements A et B sont dits indépendants si et seulement si la probabilité de survenue conjointe de ces deux événements est rigoureusement égale au produit de leurs probabilités marginales respectives : P(A ∩ B) = P(A) × P(B). Transposée à l’architecture d’un tableau croisé, cette loi stipule que sous l’hypothèse nulle (notée H0) de stricte indépendance entre les variables X et Y, la proportion attendue d’individus dans chaque cellule nij ne doit dépendre que de la prévalence globale des modalités marginales correspondantes au sein de la population.
Cette formalisation permet de dériver une grandeur mathématique primordiale : l’effectif théorique, ou effectif attendu sous hypothèse d’indépendance, conventionnellement désigné par le symbole Eij (pour Expected frequency, ou mij). Pour chaque cellule située à l’intersection de la ligne i et de la colonne j, l’effectif théorique se calcule selon la formule analytique universelle :
Eij = (ni. × n.j) / N
où ni. représente le total marginal de la ligne i, n.j le total marginal de la colonne j, et N l’effectif total de l’échantillon. Cet effectif attendu reflète exactement ce que le hasard pur produirait comme répartition conjointe si aucune attraction, répulsion, influence causale ou association fonctionnelle n’existait entre les deux facteurs étudiés au sein de la cohorte.
L’analyse descriptive d’un tableau de contingence implique donc une comparaison méticuleuse, cellule par cellule, entre les effectifs empiriques réellement observés (nij) et les effectifs théoriques calculés sous l’hypothèse nulle (Eij). Tout écart substantiel entre ces deux valeurs — qu’il s’agisse d’une sur-représentation (nij > Eij) ou d’une sous-représentation (nij < Eij) — constitue l’indice empirique fondamental d’une rupture de l’indépendance statistique. Cette confrontation quantitative entre le réel observé et le théorique attendu préfigure l’application formelle des statistiques de test d’inférence bivariée.
3. Structuration et préparation des données psychologiques sous Excel
3.1 Organisation tabulaire conforme au modèle d’analyse relationnelle
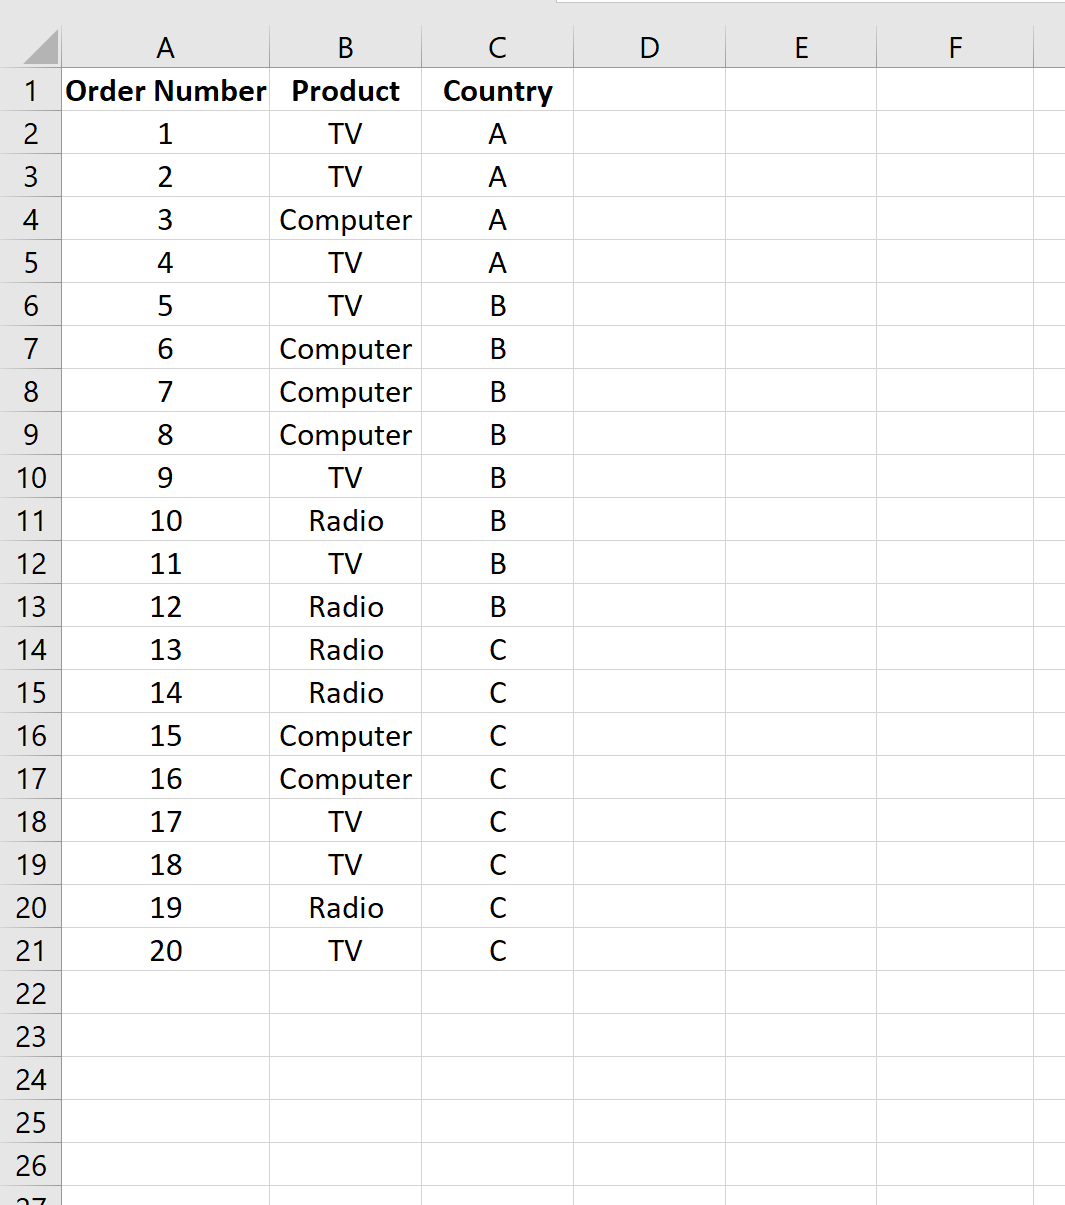
L’édification d’un tableau de contingence sans faille sous Microsoft Excel dépend de manière critique de l’architecture structurelle de la base de données source. Trop souvent, les expérimentateurs débutants commettent l’erreur méthodologique de saisir leurs données directement sous un format pré-agrégé ou sous forme de matrices disloquées. Pour garantir une interopérabilité logicielle totale et exploiter pleinement les moteurs d’agrégation d’Excel, les données brutes doivent impérativement respecter le paradigme formel du modèle relationnel en colonnes, communément qualifié de format tabulaire propre ou données normalisées (« tidy data »).
Ce principe architectural impose une règle immuable : chaque ligne de la feuille de calcul doit correspondre à une unique unité d’observation élémentaire — dans le cadre de la psychologie, un unique participant identifié par un code alphanumérique anonymisé —, et chaque colonne doit représenter une variable d’intérêt opérationnelle singulière. Aucune fusion de cellules, aucun en-tête double, aucun sous-total intercalaire ne doit venir rompre la continuité verticale de la matrice de données. La première ligne du tableau est exclusivement dédiée aux étiquettes de colonnes, lesquelles doivent être rédigées de manière concise, explicite et dénuée de caractères spéciaux problématiques pour les scripts informatiques.
Dans les protocoles cliniques ou comportementaux impliquant le recueil d’informations personnelles hautement sensibles, la conformité éthique et légale (notamment vis-à-vis du Règlement Général sur la Protection des Données ou des recommandations déontologiques de l’APA) impose l’anonymisation systématique de la matrice. L’identifiant nominatif des sujets doit être substitué par une variable d’indexation neutre et unique, telle que « ID_001 », « ID_002 », etc. Cette standardisation garantit l’intégrité de la traçabilité sans compromettre la confidentialité, tout en fournissant au logiciel Excel un identifiant vectoriel stable indispensable pour le décompte unitaire lors des agrégations dynamiques ultérieures.
3.2 Nettoyage préliminaire et détection des valeurs manquantes
Avant d’engager la moindre opération de synthèse tabulaire, une procédure rigoureuse d’audit et d’assainissement de la matrice de données doit être déployée. En recherche psychologique, les biais de saisie humaine constituent la source principale de distorsion statistique : une coquille typographique (comme la saisie involontaire de « Controle » au lieu de « Contrôle », ou l’adjonction d’un espace insécable invisible en fin de chaîne de caractères) conduira inévitablement Excel à traiter ces variantes comme des modalités qualitatives mutuellement exclusives, fragmentant artificiellement les effectifs observés.
Pour neutraliser ce risque, le chercheur doit activer les filtres automatiques d’Excel sur l’ensemble de la plage de données. En déroulant le menu de filtrage associé à chaque variable qualitative, il devient aisé d’inspecter visuellement la liste exhaustive des catégories uniques détectées par le logiciel. Toute occurrence redondante résultant d’une divergence orthographique, d’une variation de casse (majuscules/minuscules) ou d’une erreur de frappe doit être harmonisée à l’aide de la fonctionnalité « Rechercher et remplacer » ou via des formules de nettoyage de texte. Parallèlement, la mise en œuvre de règles de validation des données (via l’onglet Données > Validation des données) permet de restreindre formellement les saisies futures à une liste prédéfinie de modalités autorisées.
La gestion des valeurs manquantes (données omises lors du remplissage d’un questionnaire, abandons de protocole ou réponses inexploitables) nécessite également une prise de décision méthodologique éclairée. En aucun cas une cellule manquante ne doit être laissée avec une valeur textuelle équivoque comme « N/A » ou le chiffre « 999 » sans un traitement spécifique, car ces artifices pourraient altérer les calculs d’effectifs. Selon le paradigme d’analyse retenu — exclusion par liste (analyse des cas complets) ou imputation de données catégorielles par des techniques probabilistes —, le statisticien doit nettoyer sa feuille de calcul de manière à ce que les cellules correspondant à des observations absentes soient traitées de façon explicite et transparente, garantissant ainsi que le dénominateur de chaque calcul de proportion reflète rigoureusement l’échantillon valide.
3.3 Conversion de la matrice de données en tableau structuré Excel
Une étape technique déterminante, fréquemment négligée dans les flux de travail empiriques traditionnels, consiste à formaliser la plage de données brutes sous la forme d’un Tableau Structuré Excel officiel. Par défaut, les utilisateurs travaillent sur des plages de cellules statiques définies par des coordonnées matricielles fixes (par exemple, la plage A1:G151). Cette configuration présente une fragilité opérationnelle majeure : si de nouveaux participants sont inclus ultérieurement ou si des lignes sont insérées, les outils d’analyse pointant vers cette plage ne s’ajusteront pas de manière dynamique, générant des risques considérables d’omission d’observations.
Pour convertir une simple plage de données en un tableau structuré hautement résilient, l’expérimentateur sélectionne n’importe quelle cellule active au sein de sa matrice de recueil, puis accède au ruban supérieur pour cliquer sur la commande « Insérer un tableau », ou applique directement le raccourci clavier universel Ctrl+L (ou Ctrl+T selon les versions linguistiques du système d’exploitation). Une boîte de dialogue surgit alors pour confirmer la délimitation géographique de la plage et s’assurer que la case à cocher « Mon tableau comporte des en-têtes » est dûment validée.
Cette formalisation confère immédiatement des propriétés informatiques avancées au jeu de données :
- La gestion dynamique de l’espace matriciel : tout ajout subséquent de nouveaux cas cliniques en bas de tableau entraîne une extension automatique et transparente des limites de la base.
- La nomenclature structurée : le chercheur peut renommer son tableau via l’onglet contextuel « Création de tableau », en lui attribuant une appellation académique standardisée telle que « Table_Donnees_Cliniques ».
- La simplification syntaxique : les futures formules statistiques pourront faire référence directement aux noms de variables (ex. : Table_Donnees_Cliniques[Diagnostic]) plutôt qu’à des coordonnées matricielles rigides et propices aux erreurs d’adressage.
4. Création pas à pas du tableau de contingence via les Tableaux Croisés Dynamiques
4.1 Initialisation de l’assistant de tableau croisé dynamique
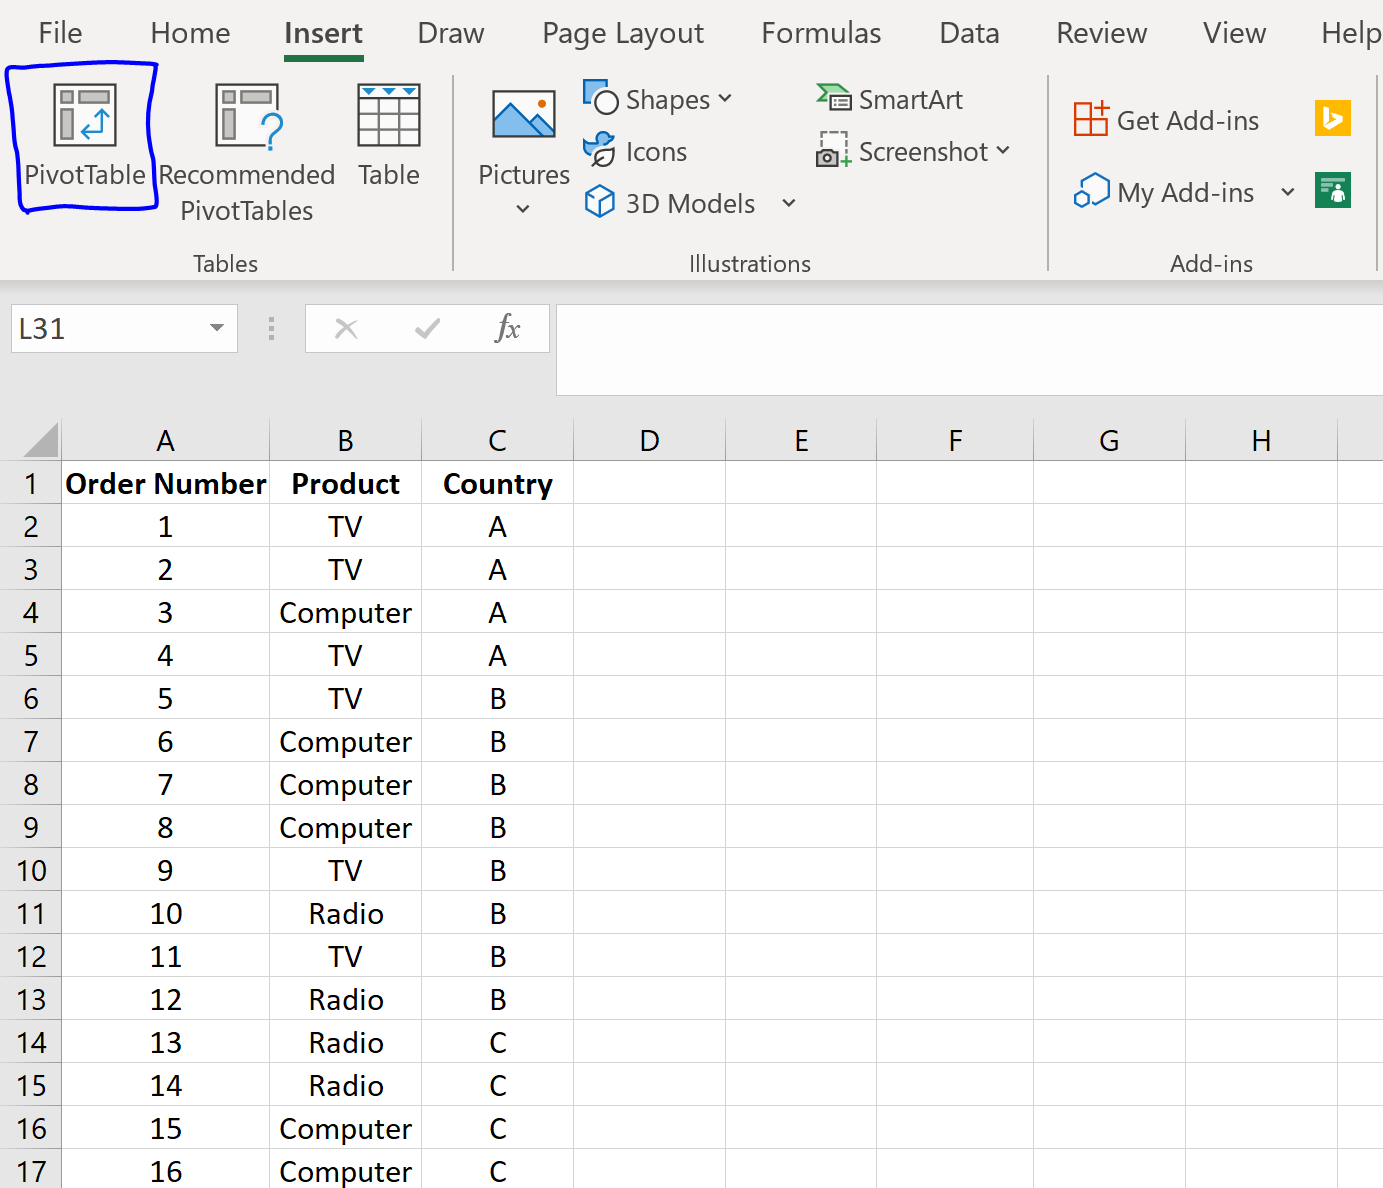
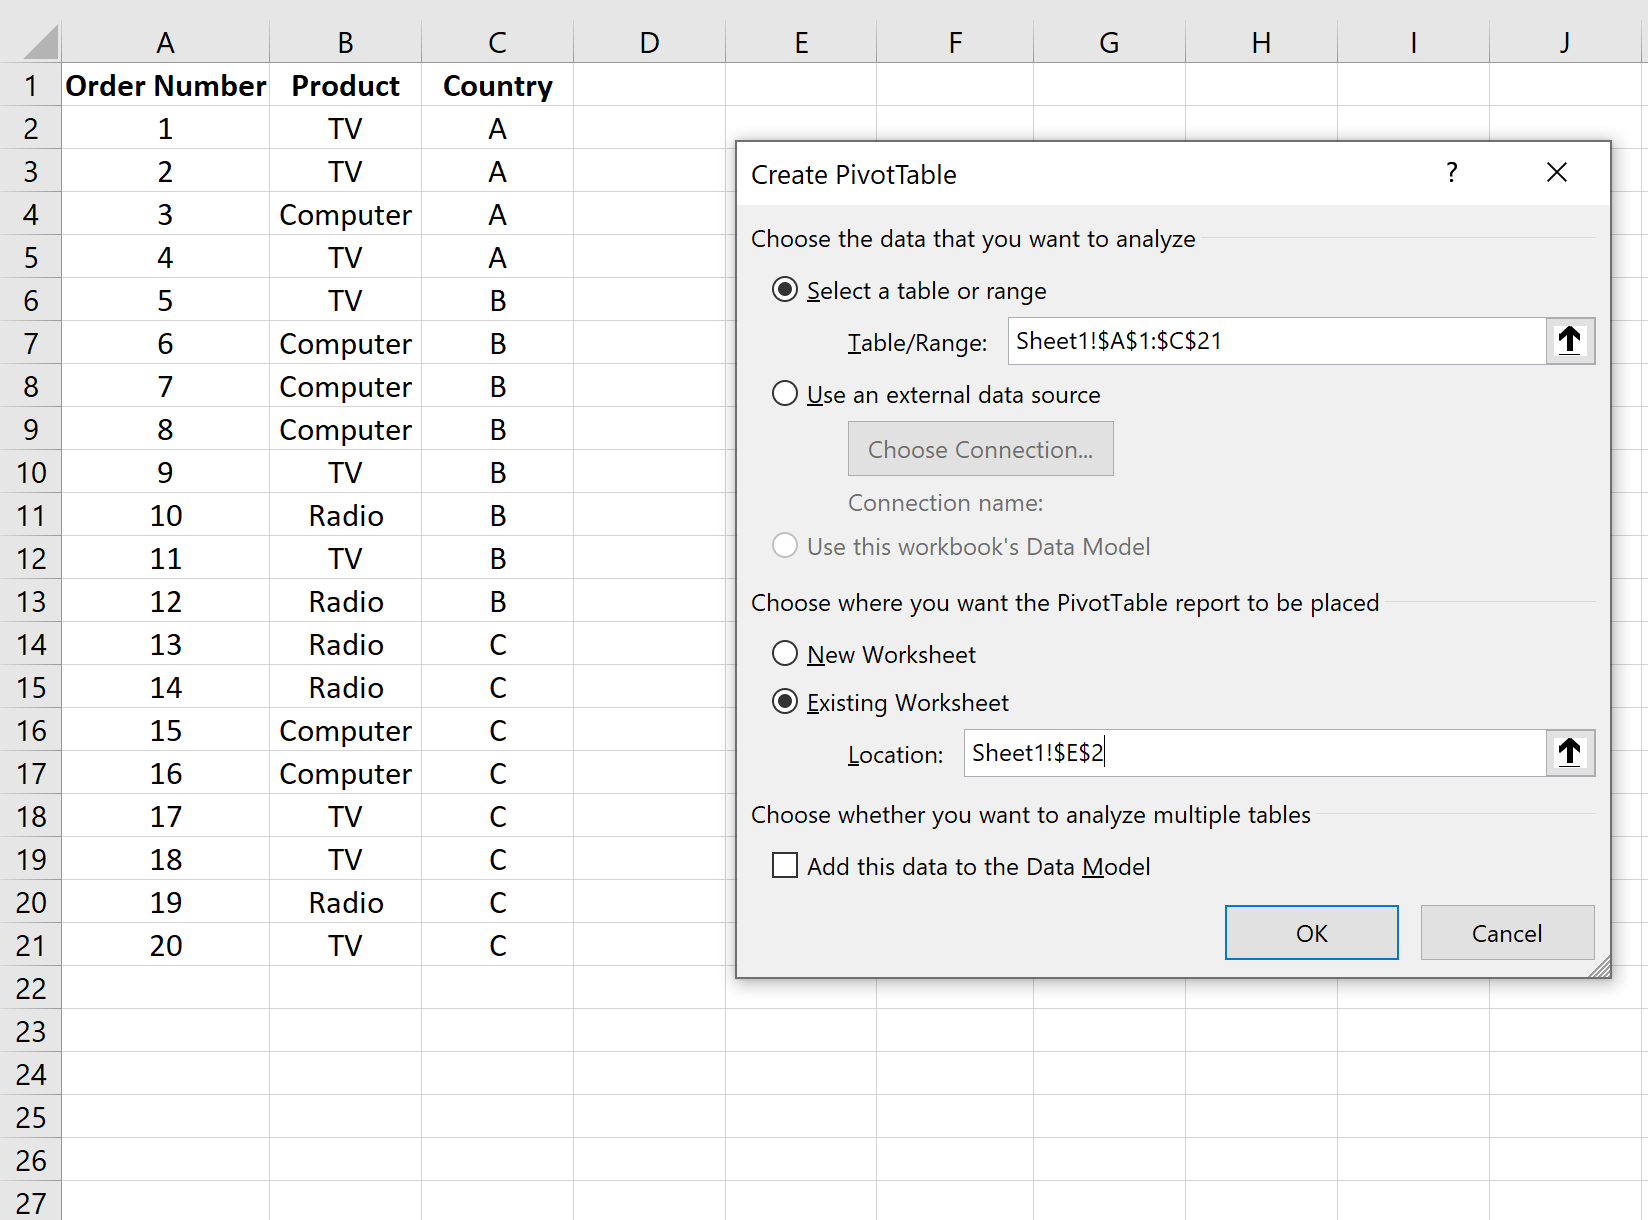
L’instrument le plus sophistiqué, rapide et robuste pour générer un tableau de contingence au sein de l’environnement Excel est indubitablement le Tableau Croisé Dynamique (TCD). Conçu initialement pour la fouille de données d’entreprise, ce moteur d’agrégation multidimensionnelle répond parfaitement aux exigences de l’analyse bivariée en psychologie expérimentale et clinique. Pour initier le processus, l’utilisateur positionne son curseur dans une cellule quelconque de son tableau structuré préalablement nommé, puis sélectionne le ruban « Insertion » situé dans la barre de menus supérieure d’Excel, avant de cliquer avec autorité sur l’icône « Tableau croisé dynamique ».
Une interface modale de configuration s’affiche instantanément. Excel pré-remplit automatiquement le champ « Sélectionnez un tableau ou une plage » en insérant le nom du tableau structuré source, garantissant ainsi que l’ensemble des données valides sera indexé par le moteur d’agrégation. Le chercheur est ensuite invité à opérer un choix stratégique concernant l’emplacement d’ancrage de la future table de contingence : il est fortement recommandé sur le plan méthodologique de sélectionner l’option « Nouvelle feuille de calcul ». Cette dissociation spatiale entre les données brutes sources et les matrices de synthèse statistique préserve la propreté de l’espace de travail et minimise tout risque d’altération accidentelle des enregistrements primaires.
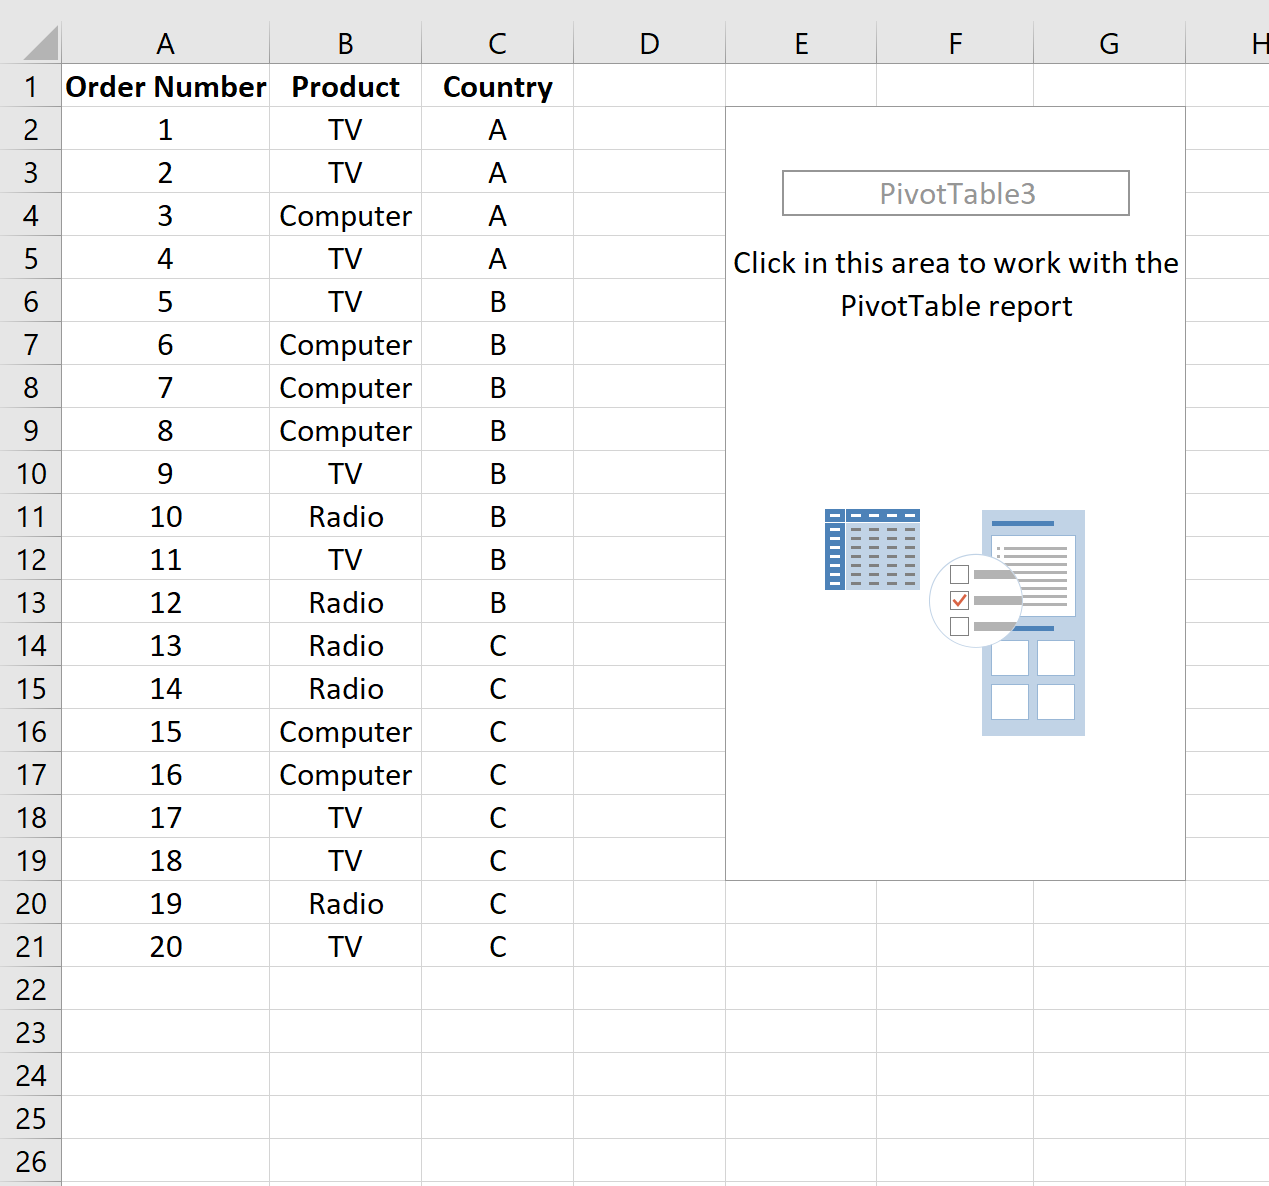
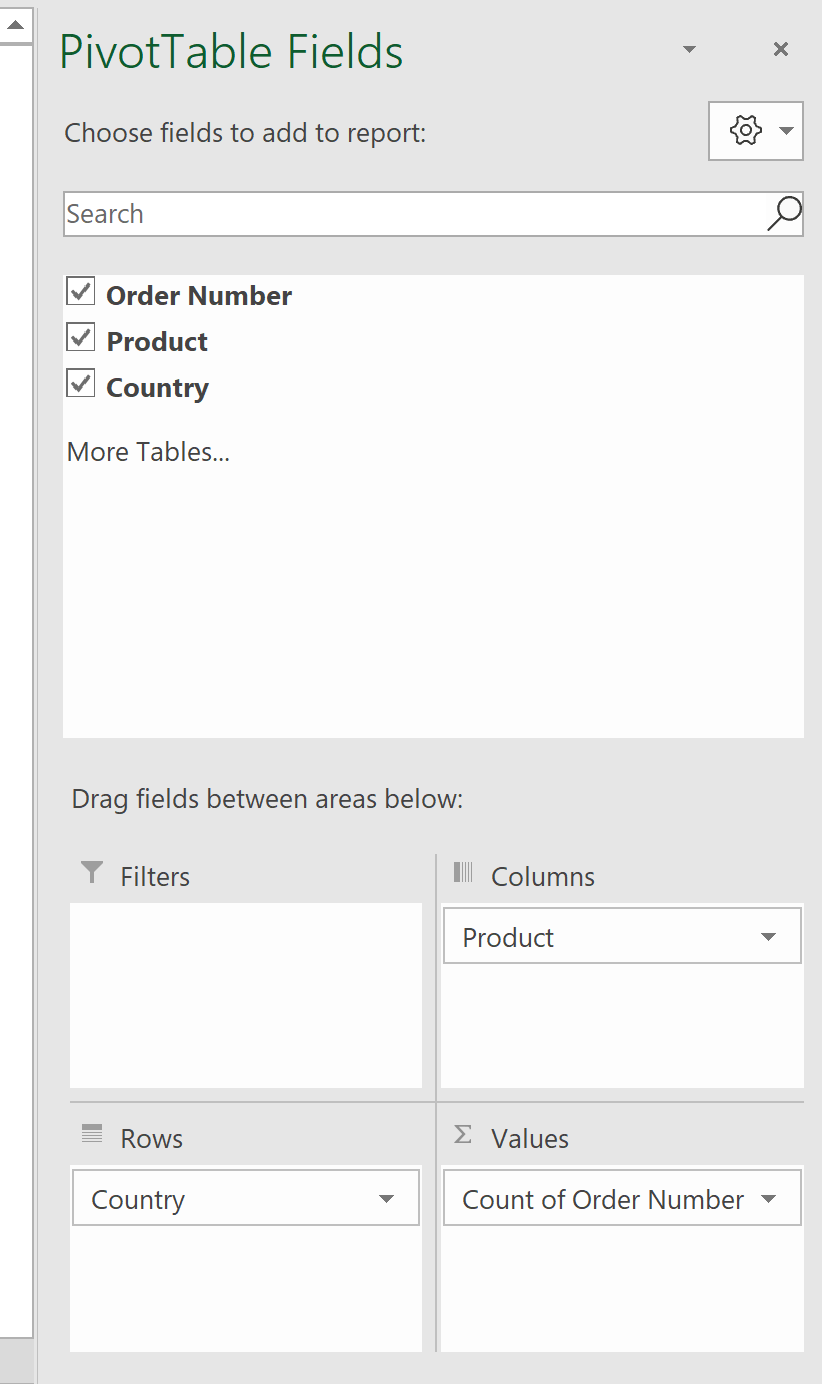
Dès la confirmation par validation sur « OK », Excel déploie une nouvelle feuille de calcul présentant une disposition tripartite ergonomique : à gauche, une zone matricielle vierge matérialisant l’emplacement réservé pour le tableau de synthèse ; à droite, le panneau latéral interactif intitulé « Champs de tableau croisé dynamique ». Ce dernier expose l’ensemble des variables catégorielles et quantitatives issues du jeu de données source, surplombant une interface organisationnelle quadrante constituée de quatre réceptacles fonctionnels : Filtres, Colonnes, Lignes et Valeurs. C’est à travers la manipulation de ces quatre quadrants que s’ordonne la mécanique matricielle du tableau de contingence.
4.2 Affectation des dimensions aux lignes et aux colonnes
La structuration conceptuelle de la table de contingence dépend rigoureusement de la disposition spatiale assignée aux variables au sein des zones « Lignes » et « Colonnes » du panneau latéral. En méthodologie de la recherche expérimentale et quasi-expérimentale, une convention épistémologique largement partagée préconise de positionner la variable indépendante (VI) — celle qui est présumée exercer une influence causale, prédictive ou temporelle, comme le protocole thérapeutique administré ou le facteur environnemental — dans la zone des lignes, et de placer la variable dépendante (VD) ou variable critère — telle que la réponse clinique, le diagnostic subséquent ou le statut comportemental — dans la zone des colonnes.
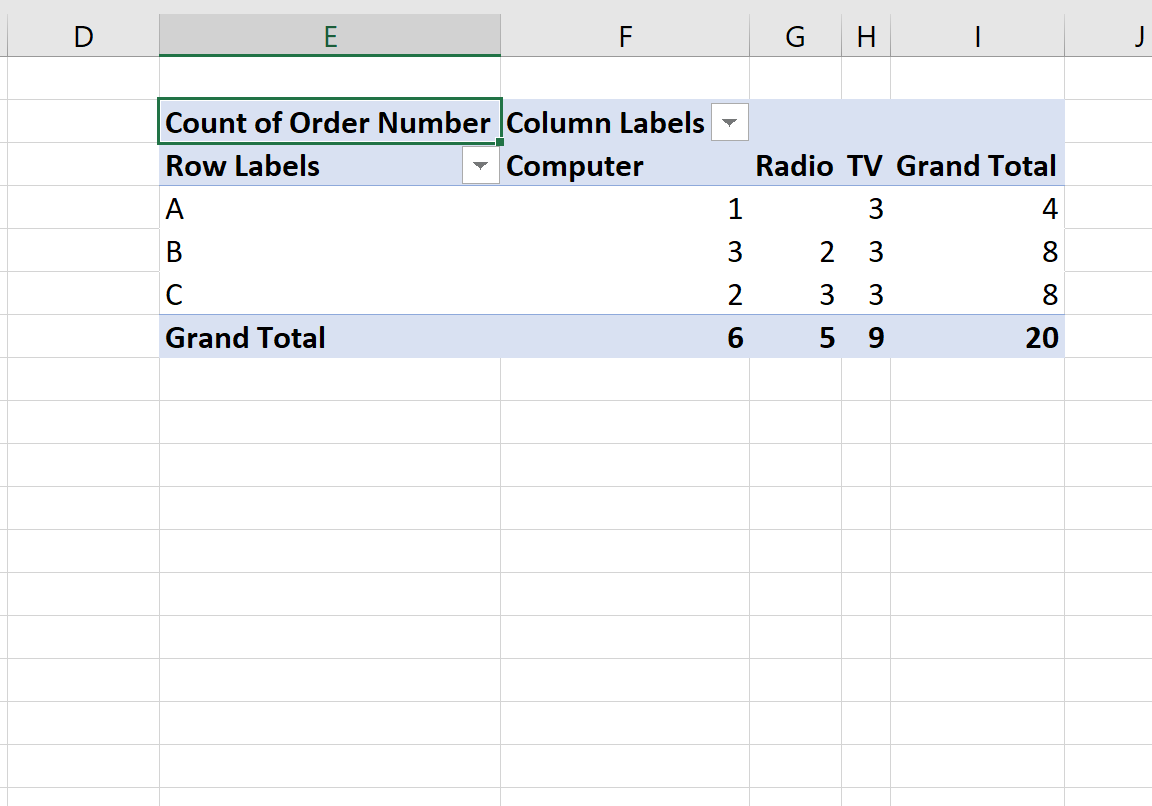
Pour concrétiser cette organisation, l’expérimentateur effectue une opération de glisser-déposer de la variable indépendante depuis la liste supérieure des champs vers le quadrant inférieur « Lignes ». Visuellement, chaque modalité discrète de ce premier facteur vient alors occuper une ligne horizontale unique dans la table de contingence naissante, complétée automatiquement par une ligne finale dédiée au « Total général » marginal. Dans un second temps, le chercheur fait glisser la variable dépendante vers le quadrant « Colonnes ». Les modalités de cette deuxième variable se déploient alors horizontalement pour former les différentes colonnes de la matrice, couronnées par une colonne terminale consacrée au cumul marginal horizontal.
Cette disposition n’est pas purement arbitraire ; elle optimise substantiellement la lisibilité cognitive des facteurs psychologiques lors de la restitution des résultats. En alignant les groupes d’exposition ou de traitement le long de l’axe vertical, l’esprit humain compare plus intuitivement les profils de réponses qui se déroulent de gauche à droite sur l’axe horizontal. Néanmoins, si l’une des deux variables qualitatives comporte un nombre significativement plus élevé de modalités que l’autre, des impératifs d’ergonomie visuelle peuvent justifier d’attribuer la dimension la plus dense aux lignes, afin d’éviter un étirement horizontal démesuré de la feuille de calcul qui obligerait à un défilement inconfortable lors de la lecture.
4.3 Sélection de la métrique d’agrégation dans la zone des valeurs
Une fois l’armature matricielle délimitée par l’intersection des lignes et des colonnes, il est impératif d’alimenter les cellules de croisement par une métrique d’agrégation reflétant fidèlement le dénombrement des participants. Cette opération s’effectue en déplaçant un champ approprié dans le quatrième quadrant de l’interface : la zone « Valeurs ». Le choix de la variable utilisée pour opérer ce comptage revêt une importance technique primordiale pour éviter toute dénaturation des effectifs réels de la recherche.
La pratique recommandée consiste à faire glisser dans la zone « Valeurs » la variable d’identification unique des participants (par exemple « ID_Participant » ou « Code_Sujet »). Dès son insertion dans ce quadrant, le moteur de calcul d’Excel génère instantanément au croisement de chaque ligne et de chaque colonne le décompte des occurrences répondant simultanément aux critères conjoints correspondants. La matrice s’anime immédiatement, révélant la distribution des fréquences observées dans la cohorte d’étude.
Cependant, une vigilance méthodologique immédiate s’impose à cette étape précise. Excel applique par défaut des règles d’heuristique automatique pour déterminer la fonction d’agrégation : si le champ inséré dans la zone des valeurs contient des données alphanumériques textuelles, le logiciel sélectionne par défaut l’opération « Nombre » (ce qui correspond précisément au dénombrement souhaité). En revanche, si le champ identifiant a été encodé sous forme de nombres entiers continus (par exemple 1, 2, 3, etc.), Excel appliquera très fréquemment et de manière automatique l’opération arithmétique « Somme ». Dans cette malencontreuse éventualité, les cellules du tableau n’afficheraient pas le nombre d’individus, mais la somme arithmétique aberrante de leurs numéros de matricule, invalidant totalement la table de contingence. Le chercheur doit donc inspecter immédiatement l’étiquette affichée dans le quadrant des valeurs pour s’assurer qu’elle stipule explicitement « Nombre de… » et non « Somme de… ».
5. Configuration rigoureuse des paramètres de champs de valeurs
5.1 Transition de l’agrégation de ‘Somme’ vers ‘Nombre’
Dans l’hypothèse où le moteur d’Excel a malencontreusement assigné l’agrégation « Somme » à la variable insérée dans le quadrant des valeurs, ou lorsque l’expérimentateur a utilisé par inadvertance une variable numérique d’évaluation clinique pour opérer le comptage, une rectification technique immédiate est obligatoire. Cette manipulation s’opère directement depuis le panneau latéral de gestion du Tableau Croisé Dynamique, sans qu’il soit nécessaire de reconstruire l’ensemble de la structure matricielle.
Le chercheur effectue un clic gauche sur le champ présent dans la zone « Valeurs », ce qui déclenche l’apparition d’un menu contextuel déroulant. Il convient alors de cliquer sur la commande terminale intitulée « Paramètres des champs de valeurs… ». Cette action ouvre une boîte de dialogue exhaustive scindée en deux onglets principaux : « Synthétiser les valeurs par » et « Afficher les valeurs ». Dans le premier onglet, Excel dresse la liste exhaustive de l’ensemble des opérateurs mathématiques d’agrégation disponibles : Somme, Nombre, Moyenne, Max, Min, Produit, Écart-type, etc.
Pour établir une tabulation de contingence conforme aux axiomes de la statistique bivariée non paramétrique, le chercheur sélectionne expressément la fonction « Nombre » (ou « Nb » selon les déclinaisons linguistiques du logiciel). En validant cette sélection par un clic sur « OK », le tableau croisé dynamique réactualise instantanément l’intégralité de sa matrice interne : chaque cellule de croisement reflète désormais scrupuleusement l’effectif discret unitaire nij, c’est-à-dire le nombre absolu d’observations individuelles associées à la combinaison bivariée correspondante.
5.2 Gestion des cellules vides et des effectifs nuls
L’un des écueils majeurs de la restitution tabulaire brute sous Excel réside dans sa manière native de représenter les intersections catégorielles dépourvues de la moindre observation. Lorsqu’aucun participant de la cohorte ne présente simultanément la modalité de ligne xi et la modalité de colonne yj, le moteur du tableau croisé dynamique génère par défaut une case totalement vide au sein de la matrice. En statistique descriptive et en psychométrie, cette absence de valeur textuelle ou numérique constitue une anomalie visuelle et conceptuelle préjudiciable, susceptible d’induire le lecteur en erreur en suggérant une donnée manquante involontaire plutôt qu’un décompte d’effectif rigoureusement nul (nij = 0).
Pour remédier à cette lacune ergonomique et garantir une rigueur descriptive irréprochable, il est nécessaire de configurer globalement les options d’affichage du Tableau Croisé Dynamique. Pour ce faire, le praticien effectue un clic droit sur n’importe quelle cellule du tableau croisé, puis sélectionne la commande « Options du tableau croisé dynamique… » dans le menu contextuel. Au sein de la fenêtre de paramétrage qui s’ouvre, dans l’onglet intitulé « Disposition et mise en forme », se trouve une option stratégique dénommée « Pour les cellules vides, afficher : ».
Il convient de cocher cette case et de saisir explicitement le chiffre arithmétique 0 dans le champ de saisie adjacent. Dès la validation par le bouton « OK », Excel remplace instantanément l’ensemble des vides structurels de la matrice par des zéros numériques standards. Sur le plan méthodologique, cette explicitation des effectifs nuls revêt une importance capitale : elle permet d’identifier sans ambiguïté les cellules structurellement ou empiriquement vides, dont la présence impose de sévères restrictions lors de l’application ultérieure des tests d’indépendance asymptotiques du Chi-deux.
5.3 Formatage typographique et ergonomie visuelle des effectifs
La crédibilité académique d’un rapport de recherche en psychologie dépend également de la clarté et de l’uniformité du traitement typographique appliqué aux visualisations tabulaires. Une table de contingence présentant des alignements incohérents, des en-têtes ésotériques ou des polices disparates compromet la transmission optimale de l’information scientifique. Excel offre une suite d’outils de formatage permettant de transformer une extraction brute en une restitution formelle haut de gamme.
En premier lieu, le formatage des données numériques doit être standardisé. Bien que les effectifs observés soient intrinsèquement des nombres entiers naturels sans décimales, il est impératif d’appliquer un format numérique explicite pour neutraliser toute anomalie d’affichage. En retournant dans la boîte de dialogue « Paramètres des champs de valeurs », l’utilisateur clique sur le bouton « Format de nombre » situé en bas à gauche de la fenêtre, sélectionne la catégorie « Nombre », fixe le nombre de décimales à 0, et veille à ne pas cocher le séparateur de milliers si les cohortes ne dépassent pas quatre chiffres. De surcroît, les effectifs au sein des cellules doivent être rigoureusement centrés horizontalement pour équilibrer la composition visuelle de la matrice.
En second lieu, les étiquettes générées automatiquement par le moteur d’Excel — telles que « Étiquettes de lignes », « Étiquettes de colonnes » ou « Nombre de ID » — manquent cruellement de précision conceptuelle et violent les critères de communication scientifique. Le chercheur doit procéder à leur renommage explicite. En cliquant directement sur ces cellules d’en-tête, il est aisé d’écrire des désignations académiques rigoureuses correspondant aux construits opérationnels évalués (par exemple « Condition Expérimentale » à la place d' »Étiquettes de lignes », et « Statut Diagnostique à 6 Mois » en lieu et place d' »Étiquettes de colonnes »). Ce raffinement terminologique garantit une autonomie sémantique complète au tableau de contingence.
6. Calcul des distributions relatives : Pourcentages de lignes, colonnes et globaux
6.1 Conversion des effectifs bruts en pourcentages du total global
Bien que le dénombrement des effectifs bruts absolus (nij) fournisse la cartographie primaire des données collectées, l’interprétation comparative des fréquences devient rapidement ardue lorsque les effectifs marginaux sont asymétriques ou lorsque le chercheur désire appréhender le poids relatif de chaque cellule dans l’écosystème global de la cohorte. Le tableau croisé dynamique d’Excel recèle une puissance analytique remarquable grâce à son moteur de calcul de proportions relatives automatisé, accessible dans l’onglet « Afficher les valeurs » des paramètres de champs.
Pour convertir les effectifs bruts en pourcentages du total général, l’analyste accède aux « Paramètres des champs de valeurs », sélectionne le second onglet intitulé « Afficher les valeurs », et remplace le paramétrage par défaut « Aucun calcul » par l’option hautement heuristique « % du total général ». Dans cette configuration, chaque cellule de la matrice exprime désormais la probabilité conjointe empirique estimée, calculée rigoureusement selon la formule mathématique :
Pij = nij / N × 100
La sommation intégrale de l’ensemble des cellules internes de la table équivaut alors rigoureusement à 100 %, tout comme la somme des pourcentages marginaux de lignes et de colonnes. Cette métrique globale est particulièrement utile en épidémiologie psychiatrique et en psychologie de la santé pour quantifier la prévalence relative absolue d’une co-occurrence pathologique ou comportementale au sein de l’échantillon global de participants investigués.
6.2 Analyse des profils-lignes : Pourcentages du total de la ligne
Dans l’immense majorité des protocoles expérimentaux ou quasi-expérimentaux en sciences du comportement, l’interrogation scientifique ne porte pas sur la part globale d’une cellule dans la cohorte totale, mais sur la manière dont la distribution de la variable dépendante varie *conditionnellement* à chaque groupe ou traitement. C’est ici qu’intervient l’analyse des profils-lignes, accessible en configurant l’option « % du total de la ligne » dans l’onglet d’affichage des valeurs.
Sous cette modalité algorithmique, Excel transforme chaque effectif brut conjoint nij en une proportion conditionnelle calculée en rapportant cet effectif à la marge de sa propre ligne :
P(Y = yj | X = xi) = (nij / ni.) × 100
Dans cette disposition géométrique, le total marginal situé à l’extrémité droite de chaque ligne horizontale affiche invariablement la valeur de 100,0 %. Ce paramétrage permet d’évaluer avec une acuité maximale l’efficacité différentielle d’interventions thérapeutiques :
- En comparant directement la ligne correspondant au « Groupe Thérapie Cognitive » à celle du « Groupe Liste d’Attente », le clinicien observe instantanément le taux de rémission interne propre à chaque condition.
- Les disparités quantitatives entre les distributions relatives de chaque ligne matérialisent visuellement la force de l’effet produit par la variable indépendante sur les modalités de réponse clinique.
6.3 Analyse des profils-colonnes : Pourcentages du total de la colonne
À l’inverse symétrique des profils-lignes, l’analyse des profils-colonnes s’impose lorsque la démarche épistémologique du chercheur s’oriente vers des protocoles rétrospectifs de type cas-témoins, fréquents en neuropsychologie clinique ou en psychopathologie développementale. Pour activer cette perspective, le praticien sélectionne l’option « % du total de la colonne » au sein du menu contextuel de calcul des valeurs du tableau croisé dynamique.
Mathématiquement, le logiciel exécute l’opération de standardisation verticale en divisant chaque effectif cellulaire par le total marginal de sa colonne de rattachement :
P(X = xi | Y = yj) = (nij / n.j) × 100
Au terme de cette transformation, la ligne terminale « Total général » affiche un score unitaire de 100,0 % sous chaque colonne. Cette modélisation permet de décomposer la morphologie rétrospective d’un état psychologique ou pathologique donné : parmi l’ensemble des patients présentant un profil diagnostique sévère à l’âge adulte (colonne dédiée), quelle est la proportion respective de sujets ayant subi des traumatismes développementaux précoces par rapport à ceux n’en ayant pas rapporté ? Il s’agit d’une évaluation directe de la composition conditionnelle interne des groupes d’aboutissement.
Une rigueur conceptuelle inébranlable s’avère indispensable pour ne jamais confondre l’analyse des profils-lignes et celle des profils-colonnes. L’inversion de ces deux perspectives conditionnelles constitue l’un des sophismes méthodologiques les plus destructeurs de l’évaluation scientifique (analogue au sophisme du procureur en probabilités conditionnelles). Le chercheur doit systématiquement s’interroger sur l’orientation de son inférence causale avant de figer le mode de restitution de ses pourcentages dans son rapport de recherche.
7. Méthode alternative : Construction manuelle par formules matricielles et conditionnelles
7.1 Extraction des modalités uniques et conception du cadre statique
Bien que les Tableaux Croisés Dynamiques offrent une puissance et une réactivité incomparables, certains contextes de recherche exigent une maîtrise algorithmique absolue et une intégration déterministe au sein de feuilles de calcul complexes. Dans de tels cas, la construction manuelle d’un tableau de contingence à l’aide de formules conditionnelles et matricielles natives constitue une alternative méthodologique d’une valeur inestimable. Cette approche élimine toute dépendance envers le cache dynamique d’Excel et garantit un recalcul instantané à la moindre modification d’une cellule source.
La première phase de cette méthodologie repose sur la cartographie des modalités catégorielles distinctes. Dans les versions modernes d’Excel (disposant du moteur de calcul matriciel dynamique), le chercheur peut mobiliser la fonction d’agrégation UNIQUE. En écrivant sur une nouvelle feuille la syntaxe suivante :
=UNIQUE(Table_Donnees_Cliniques[Condition])
Excel extrait instantanément et sans doublon la liste exhaustive des modalités de la variable en ligne sous la forme d’un vecteur vertical étendu. De même, pour les en-têtes de colonnes, la combinaison de la fonction TRANSPOSE et de UNIQUE :
=TRANSPOSE(UNIQUE(Table_Donnees_Cliniques[Remission]))
permet de déployer dynamiquement les modalités du second facteur le long d’un vecteur horizontal continu.
L’avantage prépondérant de cette structure matricielle réside dans son immunité totale face aux manipulations accidentelles de l’interface graphique : le cadre tabulaire est formellement encré dans la géométrie spatiale de la feuille de calcul. L’inconvénient corrélatif tient à l’exigence d’une rigueur absolue dans l’écriture des formules de renvoi, toute erreur de syntaxe ou de délimitation de plage se répercutant silencieusement sur l’ensemble de la distribution empirique.
7.2 Implémentation de la fonction NB.SI.ENS pour les effectifs conjoints
L’élément moteur de la construction manuelle d’un tableau de contingence repose sur la fonction conditionnelle multicritère NB.SI.ENS (ou COUNTIFS dans les versions anglophones du tableur). Cette fonction probabiliste permet de dénombrer les lignes d’un tableau source qui satisfont simultanément à un ensemble arbitraire de prédicats logiques indépendants.
La syntaxe canonique de la fonction s’articule ainsi :
=NB.SI.ENS(plage_critères1; critère1; plage_critères2; critère2)
Pour implémenter cette fonction dans le cadre d’un croisement bivarié, l’expérimentateur insère dans la première cellule d’intersection (par exemple la cellule C5) la formule articulée suivante :
=NB.SI.ENS(Table_Donnees_Cliniques[Groupe]; $B5; Table_Donnees_Cliniques[Reponse]; C$4)
L’attention mathématique du chercheur doit impérativement se focaliser sur l’usage méticuleux des références semi-absolues (le caractère d’ancrage dollar $). Dans l’exemple illustré, l’ancrage$B5 verrouille strictement la colonne B tout en laissant la ligne glisser verticalement, permettant à la formule d’interroger systématiquement la modalité de la variable indépendante située à gauche. Réciproquement, la référence C$4 verrouille la ligne 4 tout en permettant une incrémentation horizontale sur les colonnes, ciblant en permanence la modalité correspondante de la variable dépendante.
Une fois cette formule initiale solidement vérifiée dans la cellule supérieure gauche, il suffit de l’étirer horizontalement et verticalement sur l’ensemble de la grille matricielle. Par cette mécanique élégante, Excel popule de manière totalement autonome et transparente l’intégralité des cellules de contingence conjoints nij, chaque calcul reflétant de façon dynamique l’état exact des enregistrements hébergés dans la base de données source.
7.3 Calcul dynamique des totaux marginaux par la fonction SOMME
Une table de contingence confectionnée manuellement ne saurait être achevée sans l’adjonction de ses marges arithmétiques, indispensables pour apprécier les distributions marginales et vérifier la cohérence interne de la matrice. L’expérimentateur délimite donc une colonne terminale à droite intitulée « Total Ligne » et une ligne terminale en bas baptisée « Total Colonne ».
Au niveau de chaque ligne de modalité, la sommation des effectifs observés s’effectue au moyen de la formule classique SOMME appliquée à la plage horizontale contiguë correspondante :
=SOMME(C5:E5)
De manière symétrique, au pied de chaque colonne, la formule SOMME consolide l’ensemble des effectifs verticaux :
=SOMME(C5:C7)
Enfin, la cellule géométrique située au confluent de la marge des lignes et de la marge des colonnes — le coin inférieur droit de la table — reçoit le calcul du Grand Total N.
À cette intersection cruciale, une bonne pratique de contrôle méthodologique consiste à implémenter un test d’intégrité logique via la fonction SI, afin de certifier que la somme des marges horizontales est strictement égale à la somme des marges verticales :
=SI(SOMME(F5:F7)=SOMME(C8:E8); SOMME(F5:F7); "ERREUR DE MARGE")
Cette précaution algorithmique garantit au chercheur qu’aucune cellule n’a été corrompue, omise ou altérée lors de l’incrémentation manuelle des plages conditionnelles, assurant une fiabilité arithmétique équivalente à celle des moteurs précompilés d’Excel.
8. Représentation graphique du tableau de contingence sous Excel
8.1 Diagrammes en barres groupées pour la comparaison des effectifs bruts
La transcription graphique d’une table de contingence constitue une phase décisive du processus d’analyse des données, favorisant l’appréhension intuitive et immédiate des patterns comportementaux par la communauté scientifique. Lorsque l’objectif premier est de communiquer les volumes discrets absolus au sein de chaque intersection catégorielle, le diagramme en barres groupées (ou histogramme groupé) représente le vecteur sémiologique le plus performant.
Pour édifier ce visuel, le chercheur sélectionne l’ensemble des cellules internes du tableau de contingence comprenant les modalités et leurs effectifs bruts respectifs — en veillant scrupuleusement à exclure les marges de totaux généraux pour ne pas écraser l’échelle verticale —, puis clique sur Insertion > Graphiques > Histogramme 2D groupé. Dans cette configuration, chaque modalité de la variable indépendante en ligne forme un agrégat spatial distinct sur l’axe des abscisses, au sein duquel se dressent autant de colonnes colorées qu’il existe de modalités de la variable dépendante.
La rigueur académique impose d’épurer drastiquement la composition visuelle afin d’éliminer le « bruit graphique » inutile (qualifié de « chartjunk » par Edward Tufte) :
- Suppression du quadrillage secondaire dense et des effets d’ombrage ou de relief tridimensionnel non scientifiques.
- Intégration d’étiquettes de données numériques explicites positionnées au sommet de chaque barre pour renseigner l’effectif exact sans ambiguïté.
- Adjonction d’une légende chromatique claire et contrastée identifiant les modalités sans obliger le regard à d’incessants allers-retours cognitifs.
8.2 Graphiques à barres empilées 100 % pour l’analyse des profils relatifs
Si la comparaison des volumes bruts est utile, la restitution des profils distributionnels relatifs conditionnels — particulièrement dans le cadre d’études comparatives à groupes inégaux — trouve son incarnation graphique par excellence dans l’histogramme empilé 100 %. Ce dispositif visuel normalise l’ensemble des barres verticales à une hauteur constante rigoureusement fixée à 100 %, chaque colonne représentant une modalité de la variable indépendante découpée proportionnellement selon les fréquences de la variable dépendante.
L’application de ce graphique à partir de la table de pourcentages en lignes met immédiatement en exergue les disparités structurelles entre groupes. Si deux conditions thérapeutiques présentent une efficacité clinique identique, les segments de rémission au sein de leurs barres respectives afficheront des hauteurs visuelles strictement superposables. Toute divergence sensible dans la hauteur relative d’un segment chromatique particulier apporte la preuve visuelle directe d’un effet modérateur ou différentiel du traitement investigué.
Dans la perspective des standards d’accessibilité visuelle universelle et des critères de publication des revues à comité de lecture, le choix de la palette chromatique doit faire l’objet d’une attention scrupuleuse. Il convient de bannir les associations rouge-vert problématiques pour les personnes présentant un daltonisme, au profit de dégradés monochromatiques texturés ou de palettes divergentes perceptuellement uniformes (telles que les échelles Viridis ou ColorBrewer). Cette rigueur graphique garantit une lisibilité irréprochable, y compris lors d’impressions documentaires en niveaux de gris.
8.3 Liaison dynamique et actualisation automatique des visuels
L’un des avantages magistraux de l’écosystème Microsoft Excel réside dans l’interconnexion dynamique unissant les données sources, le tableau de contingence et les représentations graphiques dérivées. En exploitant les Graphiques Croisés Dynamiques (connectés nativement au Tableau Croisé Dynamique), toute altération des filtres ou des options d’agrégation se répercute instantanément sur l’espace graphique sans intervention manuelle corrective.
Pour pousser plus avant la finesse exploratoire de ses données de recherche, le psychologue peut insérer des « Segments » (ou slicers) interactifs via l’onglet Analyse du tableau croisé dynamique. Ces modules d’interface tactile permettent de filtrer la table de contingence et son graphique synchrone selon une troisième variable modératrice ou de contrôle (par exemple : le genre des participants, ou la tranche d’âge). D’un simple clic sur un bouton de segment, la table recalcule instantanément la contingence bivariée pour le sous-échantillon désigné, offrant un outil d’inspection clinique multidimensionnelle d’une souplesse inégalée.
Cette synchronisation algorithmique continue assure la parfaite reproductibilité interne du rapport. Lors de l’incorporation de nouvelles cohortes de sujets au sein du tableau structuré initial, une simple commande « Actualiser tout » (accessible par le raccourci clavier Ctrl+Alt+F5) recalcule instantanément la table de contingence sous-jacente et réajuste immédiatement l’échelle et les proportions du graphique croisé dynamique, garantissant l’intégrité pérenne de la production scientifique.
9. Inférence statistique bivariée : Du tableau croisé au test d’indépendance du Chi-deux
9.1 Génération de la table des effectifs théoriques sous hypothèse nulle
L’examen descriptif d’un tableau de contingence ne constitue que le préambule de la démarche scientifique : il convient désormais de déterminer si la relation d’interdépendance apparente observée entre les deux variables catégorielles est statistiquement significative, ou si elle peut être raisonnablement imputée aux simples fluctuations de l’échantillonnage aléatoire. Cette démarche inférentielle s’incarne universellement dans le test d’indépendance du Chi-deux (χ²) de Pearson.
Le point de départ algorithmique de ce test exige la construction d’une matrice parallèle à la table de contingence : la table des effectifs théoriques ou attendus (Eij). Pour implémenter cette matrice sous Excel, l’expérimentateur duplique l’armature de son tableau de contingence sur une zone vierge de sa feuille de calcul. En désignant les coordonnées des marges du tableau d’effectifs observés réels, le calcul de l’effectif attendu pour la première cellule s’exécute selon la formule formelle :
=(Total_Ligne_1 * Total_Colonne_1) / Grand_Total
En utilisant judicieusement les ancrages de formules sous Excel (par exemple : =($F5 * C$8) / $F$8), le chercheur peut étirer cette formule matricielle sur l’ensemble des cellules de la table théorique. Chaque case reflète désormais la fréquence précise qui devrait s’y trouver si l’hypothèse nulle H0 d’indépendance parfaite était rigoureusement vraie dans la population d’origine.
Cette phase permet de procéder à la vérification impérative des postulats mathématiques d’application de Cochran (1954) pour la validité du Chi-deux :
- Aucun effectif théorique cellulaire ne doit être strictement inférieur à 1 (Eij ≥ 1 pour toute cellule).
- Pas plus de 20 % de l’ensemble des cellules théoriques de la matrice ne doivent présenter un effectif attendu inférieur à 5 (Eij < 5).
Si ces critères probabilistes fondamentaux se trouvaient violés en raison d’un échantillon trop exigu ou d’un découpage catégoriel excessif, le test standard de Pearson perdrait de sa validité asymptotique, imposant des alternatives correctives rigoureuses.
9.2 Calcul de la p-value avec la fonction TEST.CHI2 d’Excel
Une fois les deux matrices pleinement constituées — la plage des effectifs réels observés (nij) et la plage homologue des effectifs théoriques attendus (Eij) —, Excel propose une fonction statistique d’une remarquable concision pour extraire la probabilité critique exacte associée au test d’indépendance : la fonction TEST.CHI2 (ou CHISQ.TEST en version internationale).
La syntaxe de cette fonction s’exprime sous la forme suivante :
=TEST.CHI2(plage_réelle; plage_théorique)
Il est fondamental de souligner que les plages d’arguments spécifiées dans cette fonction doivent impérativement englober exclusivement les cellules internes des effectifs, à l’exclusion totale des lignes et colonnes consacrées aux totaux marginaux. Dès sa validation, la fonction retourne instantanément la probabilité critique asymptotique p (la p-value).
L’évaluation statistique s’opère selon les canons traditionnels de la décision bivariée :
- Si la p-value ainsi calculée est strictement inférieure au seuil de significativité conventionnel alpha préétabli (généralement α = 0,05 ou α = 0,01), le chercheur rejette formellement l’hypothèse nulle H0 d’indépendance au profit de l’hypothèse alternative H1 d’une association statistiquement significative entre les construits psychologiques.
- Si la p-value est supérieure ou égale à ce seuil alpha, l’hypothèse nulle d’indépendance ne peut être rejetée, concluant à l’absence de preuve statistique quant à une interaction entre les facteurs.
Il importe toutefois de garder à l’esprit les limites computationnelles d’Excel : pour les tables de contingence d’ordre 2×2 à faibles effectifs, la fonction TEST.CHI2 ne procède pas à la correction de continuité de Yates de manière native, ni ne substitue automatiquement le calcul au test exact de Fisher. L’expérimentateur doit donc conserver une conscience méthodologique aiguë des conditions de validité de l’algorithme sous-jacent.
9.3 Quantification de la taille d’effet : V de Cramér et Phi
En psychologie moderne, sous l’impulsion résolue des directives éditoriales de l’American Psychological Association, la simple déclaration d’une significativité statistique (p < 0,05) est considérée comme insuffisante pour caractériser scientifiquement un phénomène. En effet, la p-value dépend de manière démesurée de la taille N de l’échantillon : un échantillon colossal permettra d’obtenir une p-value minuscule pour une association clinique totalement dérisoire dans la réalité pratique. Il est donc indispensable d’accompagner systématiquement le test du Chi-deux d’un indicateur standardisé de taille d’effet.
Pour les tables de contingence d’ordre 2×2, la métrique canonique est le coefficient Phi (φ). Pour les matrices plus larges de dimensions r × c (lignes × colonnes), la mesure universelle est le V de Cramér. Ce coefficient varie rigoureusement dans l’intervalle standardisé de 0 à 1, où 0 traduit une absence totale d’association et 1 une dépendance stochastique déterministe parfaite entre les catégories.
Le calcul du V de Cramér sous Excel s’opère aisément en recombinant les métriques déjà extraites. La formule théorique s’énonce :
V = Racine carrée [ χ² / (N × min(r – 1, c – 1)) ]
Dans la mesure où Excel calcule directement la p-value mais ne renvoie pas explicitement la statistique brute du χ², l’analyste peut recalculer cette dernière par inversion probabiliste via la fonction LOI.CHI2.INVERSE :
χ² = LOI.CHI2.INVERSE(p_value; degrés_de_liberté)
où les degrés de liberté sont égaux à (r – 1) × (c – 1). Ensuite, l’expérimentateur applique la formule du V de Cramér dans une cellule dédiée :
=RACINE(valeur_chi2 / (Grand_Total * MIN(nb_lignes - 1; nb_colonnes - 1)))
L’interprétation de la magnitude psychologique de l’effet s’appuie canoniquement sur les seuils heuristiques formulés par Jacob Cohen (1988). Pour une table comportant 1 degré de liberté marginal (cas d’une matrice 2×2), un V d’environ 0,10 reflète un effet de faible ampleur ; une valeur oscillant autour de 0,30 caractérise un effet moyen ; enfin, un coefficient excédant 0,50 témoigne d’un effet puissant, attestant d’une association clinique ou comportementale majeure entre les deux construits investigués.
10. Formalisation et restitution académique selon les normes de l’APA (7e édition)
10.1 Directives structurelles et esthétiques de l’APA pour les tableaux
La transcription d’une table de contingence depuis la feuille de calcul Excel vers le manuscrit académique final (qu’il s’agisse d’une thèse de doctorat ou d’un article soumis à une revue scientifique internationale) doit impérativement se conformer aux normes typographiques rigoureuses édictées par l’APA (Publication Manual of the APA, 7e édition). La structure d’un tableau APA se distingue radicalement de l’esthétique par défaut générée par les tableurs grand public.
La prescription esthétique cardinale de l’APA réside dans l’interdiction formelle de tout quadrillage vertical interne. Une table conforme aux normes académiques ne comporte strictement aucune ligne verticale séparative. L’architecture tabulaire repose exclusivement sur un jeu minimal de trois bordures horizontales principales continues :
- Une première ligne horizontale délimitant le haut du tableau, placée immédiatement sous le bloc de titre.
- Une seconde ligne horizontale insérée immédiatement sous les en-têtes de colonnes, isolant les étiquettes descriptives du corps des données numériques.
- Une troisième et ultime bordure horizontale située sous la dernière ligne d’enregistrements empiriques (généralement la ligne des totaux généraux), scellant le corps matriciel avant l’espace réservé aux notes de bas de tableau.
En outre, l’ensemble du tableau doit adopter une police typographique unifiée et sobre (telle que Times New Roman 12 pt ou Calibri 11 pt), avec un interligne simple ou 1,5 au sein de la matrice. Le tableau est initié par une désignation numérique séquentielle en gras (ex. : Tableau 1), sautée d’une ligne pour accueillir le titre thématique, rédigé en italique avec majuscule à chaque mot substantiel, court et parfaitement explicatif (ex. : Répartition des Rémissions Cliniques selon la Modalité Thérapeutique). Les effectifs entiers sont alignés au centre de leurs colonnes respectives, tandis que les pourcentages éventuels voient leurs virgules décimales rigoureusement alignées verticalement.
10.2 Rédaction des notes explicatives de bas de tableau
Sous la troisième ligne horizontale terminale du tableau s’étend l’espace critique dévolu aux notes de bas de page académiques. Selon le cadre normatif de l’APA 7, les notes tabulaires se déclinent en trois strates conceptuelles distinctes et hiérarchisées : les notes générales, les notes spécifiques et les notes de probabilité.
La Note générale s’ouvre par le terme italicisé « Note. » suivi d’un point typographique. Elle a pour vocation de fournir toutes les clés de décodage indispensables à la pleine autonomie compréhensive du tableau : explicitation de l’échantillon total (N = 150) et des effectifs sous-groupaux (n), définition exhaustive des abréviations psychométriques ou cliniques utilisées (ex. : TCC = Thérapie Cognitivo-Comportementale), et précision sur la nature des grandeurs affichées (par exemple : « Les valeurs entre parenthèses correspondent aux pourcentages calculés sur le total de la ligne. »).
Les Notes spécifiques, signalées par des lettres minuscules placées en exposant (a, b, c), renvoient à des colonnes, des lignes ou des cellules individuelles nécessitant un éclaircissement ciblé, tel qu’un ajustement méthodologique particulier appliqué à un sous-groupe expérimental.
Enfin, les Notes de probabilité documentent les niveaux de significativité statistique inférentielle au moyen du système traditionnel d’astérisques superposés, systématiquement explicité :
* p < ,05. ** p < ,01. *** p < ,001.
L’ensemble de ces annotations concourt à l’idéal méthodologique d’auto-suffisance de la présentation des résultats prôné par la communauté scientifique internationale.
10.3 Intégration narrative des résultats du tableau dans le corps du texte
L’incorporation textuelle des résultats issus de la table de contingence ne doit en aucun cas consister en une paraphrase redondante et intégrale de chacune des cellules numériques de la matrice. Le corps du manuscrit a pour finalité d’orienter l’attention du lecteur vers les tendances dominantes, les ruptures distributionnelles remarquables et la réponse directe apportée aux hypothèses de recherche initialement formulées.
L’appel au tableau au sein du texte doit être explicite et proscrire toute formule d’orientation spatiale floue telle que « le tableau ci-dessous » ou « la table ci-dessus ». L’auteur utilise impérativement le numéro d’indexation normé : « Comme l’illustre le Tableau 1, la proportion de rémission varie significativement… » La mention textuelle s’accompagne de l’énoncé canonique et standardisé des statistiques inférentielles associées, rapportant successivement le symbole statistique en italique, les degrés de liberté entre parenthèses, la valeur de la statistique de test observée, le seuil de probabilité p-value, et l’indice standardisé de taille d’effet.
Voici l’archétype exemplaire d’un paragraphe de résultats rédigé selon les standards éditoriaux les plus rigoureux de l’APA 7 :
« Une analyse par tableau de contingence croisant le type d’intervention thérapeutique et le statut clinique post-traitement a été conduite sur l’ensemble de la cohorte (voir Tableau 1). Les résultats révèlent une dépendance statistiquement significative entre la modalité de prise en charge et l’issue thérapeutique, χ²(2, N = 150) = 14,82, p < ,001, V = 0,31. L’examen des profils-lignes indique un taux de rémission substantiellement supérieur au sein du groupe soumis au protocole de Thérapie Cognitivo-Comportementale (62,0 %) en comparaison du groupe sous Pleine Conscience (44,0 %) et de la condition témoin sur liste d’attente (24,0 %). La magnitude de cette association correspond à une taille d’effet modérée selon les critères de Cohen, corroborant l’hypothèse d’une supériorité clinique de l’intervention ciblée. »
11. Résolution des anomalies techniques et erreurs fréquentes sous Excel
11.1 Problèmes de typage des variables et espaces insécables
L’analyse bivariée sous Microsoft Excel se heurte fréquemment à des désordres invisibles à l’œil nu lors de la compilation des données primaires. La pathologie informatique la plus pernicieuse concerne la présence d’espaces typographiques superflus ou d’espaces insécables (code ASCII 160) insérés insidieusement en début ou en fin de chaîne de caractères lors de l’exportation des données depuis des formulaires web ou des plateformes d’évaluation psychologique en ligne.
Aux yeux du moteur d’analyse relationnelle d’Excel, la chaîne de texte "Anxieux" et la chaîne "Anxieux " (avec un espace terminal) représentent deux entités ontologiques totalement dissemblables. En conséquence, le tableau de contingence créera automatiquement deux lignes distinctes pour ce même construit clinique, fragmentant les effectifs réels et ruinant l’inférence statistique. Pour assainir la matrice, l’utilisateur doit insérer une colonne temporaire et appliquer la fonction combinée de nettoyage de texte suivante :
=SUPPRESPACE(EPURAGE(A2))
La fonction EPURAGE élimine l’intégralité des caractères non imprimables du système, tandis que SUPPRESPACE supprime les espaces excédentaires en début et fin de mot, ne conservant que l’espacement unitaire régulier. Les résultats nettoyés sont ensuite recollés « en valeurs » sur la colonne originelle.
Un autre désordre récurrent relève du conflit de typage de données entre texte et numérique. Si des codes de modalité ont été saisis sous forme de chiffres (ex. : 1 pour « Homme », 2 pour « Femme »), il arrive fréquemment qu’une fraction de la colonne soit stockée au format « Texte » et une autre fraction au format « Nombre ». Cette dualité engendre une scission aberrante des catégories au sein de la table dynamique. L’application de la commande « Convertir » (ruban Données > Convertir) permet de réaligner l’ensemble de la colonne sur un type de données rigoureusement homogène.
11.2 Décalages d’actualisation du Tableau Croisé Dynamique
Une incompréhension structurelle majeure observée chez les utilisateurs occasionnels d’Excel concerne le fonctionnement intrinsèque de la mémoire tampon (le cache) des Tableaux Croisés Dynamiques. Contrairement aux formules matricielles classiques qui recalculent leurs sorties en temps réel à chaque pression sur la touche Entrée, le Tableau Croisé Dynamique isole ses calculs au sein d’une structure intermédiaire statique pour préserver les ressources mémoire du processeur.
En conséquence directe, si un chercheur modifie un diagnostic, rectifie une erreur de saisie ou intègre dix nouveaux participants au sein de son tableau structuré de base, ces altérations demeurent rigoureusement invisibles dans la table de contingence déjà déployée. Ce silence informatique est la cause de nombreuses erreurs de reporting dans les laboratoires. L’actualisation doit être explicitement sollicitée par l’expérimentateur, soit par un clic droit sur le TCD suivi de « Actualiser », soit par l’action conjointe des touches Alt+F5.
Pour immuniser définitivement le protocole contre les risques d’omission d’actualisation, il est hautement judicieux de configurer les propriétés automatisées du tableau croisé :
- Accéder aux « Options du tableau croisé dynamique ».
- Sélectionner l’onglet intitulé « Données ».
- Cocher impérativement l’instruction « Actualiser les données lors de l’ouverture du fichier ».
Cette configuration garantit que toute réouverture ultérieure du classeur de recherche prendra immédiatement en compte l’état le plus exhaustif et abouti de la base clinique.
11.3 Gestion des violations de conditions d’application statistique
L’une des dérives méthodologiques les plus sévères lors de l’analyse bivariée de tableaux de contingence réside dans l’application aveugle du test du Chi-deux sans contrôle préalable des effectifs théoriques cellulaires. Lorsque la matrice croise des variables comportant de multiples modalités (par exemple une table 4 × 5) sur un échantillon clinique restreint, il est quasi-systématique que la règle de Cochran soit violée, affichant une multitude de cellules théoriques Eij inférieures au seuil critique de 5.
Face à une telle violation des postulats asymptotiques, plusieurs conduites d’ajustement méthodologique s’offrent au statisticien sous Excel :
- Le regroupement raisonné de modalités : cette stratégie consiste à agréger conceptuellement et cliniquement des catégories adjacentes ou sous-représentées. Par exemple, fusionner les modalités « Dépression modérée » et « Dépression sévère » en une modalité générique « Dépression caractérisée ». Cette opération s’exécute directement dans le Tableau Croisé Dynamique en sélectionnant les deux intitulés de lignes, en effectuant un clic droit, puis en cliquant sur « Grouper ». Cela diminue les dimensions de la matrice tout en renflouant les effectifs par cellule.
- La bifurcation vers des tests exacts : si le regroupement de catégories s’avère théoriquement indéfendable ou dénature l’objet d’étude, le chercheur doit renoncer au test asymptotique du Chi-deux. Pour une table 2×2, le recours au Test Exact de Fisher s’impose alors de manière absolue. Dans la mesure où Excel ne dispose pas d’une fonction native directe pour calculer le test de Fisher sur de grands factoriels sans formules matricielles complexes, l’exportation des effectifs du tableau de contingence vers des environnements spécialisés (comme le package stats sous R via la commande
fisher.test()) constitue la démarche de rigueur scientifique recommandée.
12. Étude de cas empirique : Analyse d’un protocole en psychologie comportementale
12.1 Présentation du jeu de données expérimental simulé
Afin de concrétiser l’ensemble de ces préceptes théoriques, méthodologiques et techniques au sein d’un cas pratique intégral, nous déployons une recherche empirique simulée issue du champ de la psychologie clinique et des thérapies comportementales. Soit une cohorte de N = 150 participants adultes présentant un diagnostic formel de Trouble Anxieux Généralisé (TAG), recrutés dans le cadre d’un essai clinique randomisé et contrôlé (ECR). Le protocole vise à évaluer l’efficacité différentielle de deux approches psychothérapeutiques distinctes par rapport à une condition d’attente passive.
Le devis expérimental s’articule autour de deux variables qualitatives clés :
- La variable indépendante (VI, nominale à 3 modalités) : « Protocole_Therapeutique », comprenant :
- TCC : Thérapie Cognitivo-Comportementale standardisée (n = 50).
- Mindfulness : Programme de Réduction du Stress Basée sur la Pleine Conscience (MBSR, n = 50).
- Controle : Condition témoin avec liste d’attente sans intervention active (n = 50).
- La variable dépendante (VD, nominale binaire à 2 modalités) : « Statut_Clinique » évalué à 6 mois post-intervention au moyen d’un entretien diagnostique standardisé :
- Rémission : Absence des critères diagnostiques du TAG et amélioration fonctionnelle majeure.
- Non-Rémission : Persistance de la sévérité clinique sous le seuil d’amélioration requis.
L’interrogation scientifique fondamentale se formule ainsi : existe-t-il une dépendance statistique significative entre la condition thérapeutique administrée aux patients et la probabilité d’obtenir une rémission clinique à 6 mois ?
12.2 Exécution intégrale du traitement dans Excel
L’expérimentateur importe la matrice brute de 150 lignes sous Excel et la structure immédiatement en Tableau Structuré nommé « Table_Essai_TAG ». Par l’intermédiaire du ruban Insertion > Tableau croisé dynamique, la table de synthèse est instanciée sur une nouvelle feuille de calcul.
La configuration s’exécute selon les étapes méthodologiques canoniques :
- Glisser la variable « Protocole_Therapeutique » dans la zone Lignes.
- Glisser la variable « Statut_Clinique » dans la zone Colonnes.
- Glisser l’identifiant « ID_Patient » dans la zone Valeurs, et s’assurer scrupuleusement que l’agrégation est fixée sur Nombre.
Le tableau de contingence des effectifs observés nij ainsi généré révèle la dispersion brute suivante :
- Condition TCC : 31 rémissions et 19 non-rémissions (Total ligne = 50).
- Condition Mindfulness : 22 rémissions et 28 non-rémissions (Total ligne = 50).
- Condition Contrôle : 12 rémissions et 38 non-rémissions (Total ligne = 50).
- Marges des colonnes : Total Rémission = 65 ; Total Non-Rémission = 85 ; Grand Total N = 150.
- Effectif théorique pour chaque cellule de la colonne Rémission : (50 × 65) / 150 = 21,67.
- Effectif théorique pour chaque cellule de la colonne Non-Rémission : (50 × 85) / 150 = 28,33.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Microsoft Corporation. (2023). Créer un tableau croisé dynamique pour analyser des données de feuille de calcul. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/créer-un-tableau-croisé-dynamique
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604
Dans un second tableau dynamique homologue paramétré sur « % du total de la ligne », le chercheur extrait immédiatement les profils relatifs : le taux de rémission conditionnel atteint 62,0 % pour la TCC, 44,0 % pour la Pleine Conscience, et chute à 24,0 % dans le groupe témoin.
L’analyste implémente ensuite la table des effectifs théoriques Eij sous l’hypothèse nulle d’indépendance en appliquant la formule matricielle (ni. × n.j) / N :
L’inspection des effectifs théoriques atteste de la parfaite validité des postulats de Cochran : l’intégralité des cellules théoriques excède largement le seuil minimal de 5 (le minimum absolu étant de 21,67).
L’application de la fonction =TEST.CHI2(C5:D7; C12:D14) renvoie une valeur de probabilité critique remarquable : p = 0,000605. Le recalcul de la statistique du Chi-deux par la fonction =LOI.CHI2.INVERSE(0,000605; 2) établit la statistique de test à χ² = 14,82 (pour (3-1) × (2-1) = 2 degrés de liberté). Enfin, le calcul du V de Cramér via l’algorithme =RACINE(14,82 / (150 * 1)) quantifie la taille d’effet standardisée à V = 0,314.
12.3 Rapport complet et interprétation neuropsychologique finale
La synthèse des résultats est ensuite formalisée selon l’intégralité des critères éditoriaux et visuels de l’APA 7e édition, prête à être intégrée au sein du manuscrit scientifique définitif.
Tableau 1
Distribution des Effectifs Observés et Taux de Rémission Clinique selon la Condition Thérapeutique (N = 150)
Bordure supérieure continue :
———————————————————————————————————
Condition Thérapeutique | Rémission n (%) | Non-Rémission n (%) | Total n (%)
———————————————————————————————————
TCC | 31 (62,0 %) | 19 (38,0 %) | 50 (100 %)
Pleine Conscience | 22 (44,0 %) | 28 (56,0 %) | 50 (100 %)
Contrôle (Liste d’Attente) | 12 (24,0 %) | 38 (76,0 %) | 50 (100 %)
———————————————————————————————————
Total Général | 65 (43,3 %) | 85 (56,7 %) | 150 (100 %)
———————————————————————————————————
Note. TCC = Thérapie Cognitivo-Comportementale. Les pourcentages entre parenthèses correspondent aux profils-lignes (% calculé sur l’effectif total de chaque condition thérapeutique).
*** p < ,001.
Sur le plan de l’interprétation neuropsychologique et comportementale, ces résultats démontrent de façon statistiquement indiscutable que le devenir clinique des patients atteints de Trouble Anxieux Généralisé n’est pas indépendant du type d’intervention reçue (χ² = 14,82, ddl = 2, p < ,001). L’intensité de la relation, objectivée par un V de Cramér de 0,31, atteste d’une taille d’effet moyenne à forte selon les critères de Cohen, soulignant que cette dissociation statistique possède une pertinence clinique tangible.
L’analyse des profils conditionnels démontre une supériorité marquée de la TCC, dont le taux de rémission (62,0 %) excède de plus de 2,5 fois celui observé dans la condition témoin (24,0 %). Bien que la Pleine Conscience induise un taux de rémission intermédiaire appréciable (44,0 %), la TCC demeure la modalité la plus résolutive pour restructurer les distorsions cognitives et désamorcer les boucles d’inquiétudes dysfonctionnelles caractéristiques du TAG. Cette analyse bivariée exemplaire illustre comment, à partir d’un recueil brut minutieusement organisé dans Excel, le clinicien-chercheur parvient à extraire une démonstration empirique d’une limpidité méthodologique totale, immédiatement diffusable au sein de la communauté scientifique internationale.