
L’exploration visuelle des distributions statistiques constitue le socle fondamental de toute démarche empirique rigoureuse. Au sein des sciences économiques, biomédicales, sociologiques et comportementales, appréhender la forme géométrique d’une variable quantitative conditionne la validité des inférences subséquentes. L’histogramme, introduit dans sa formalisation moderne par le statisticien Karl Pearson à la fin du dix-neuvième siècle, demeure l’instrument graphique privilégié pour synthétiser la distribution d’une variable continue ou discrète. Loin de constituer une simple juxtaposition de rectangles verticaux, il matérialise l’estimation non paramétrique d’une fonction de densité de probabilité sous-jacente, révélant des propriétés morphologiques critiques telles que l’asymétrie, l’aplatissement, la multimodalité ou l’émergence d’observations atypiques.
Dans l’écosystème des logiciels d’analyse de données, le logiciel Stata s’est imposé comme une référence incontournable en matière d’économétrie appliquée et d’épidémiologie quantitative. Doté d’un moteur graphique puissant et modulaire, il offre un éventail complet de commandes permettant de transcender les représentations par défaut pour aboutir à des figures de qualité publication, conformes aux exigences éditoriales les plus strictes. La commande intégrée dédiée aux histogrammes allie une flexibilité algorithmique remarquable à une syntaxe scriptée hautement reproductible. Cependant, maîtriser cet outil requiert une compréhension fine de ses mécanismes sous-jacents, allant des règles de partitionnement de l’espace numérique jusqu’à l’ajustement micrométrique des composantes visuelles.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, analystes et étudiants avancés dans la maîtrise intégrale de la conception, de la personnalisation et de l’interprétation des histogrammes sous Stata. À travers un parcours méthodologique structuré débutant par les assises théoriques et progressant vers les configurations graphiques avancées, cet article décortique chaque paramètre syntaxique, met en lumière les pièges d’interprétation les plus fréquents et illustre les meilleures pratiques de programmation au sein de fichiers de commandes reproductibles.
1. Introduction aux histogrammes dans Stata et fondements théoriques
Avant d’aborder les lignes de commande dans Stata, il s’avère indispensable d’asseoir les fondements conceptuels qui gouvernent la modélisation graphique par histogramme. En tant que pont entre la théorie mathématique des probabilités et l’échantillonnage empirique, l’histogramme synthétise une masse considérable d’informations numériques au sein d’une géométrie spatiale bidimensionnelle intuitive mais exigeante.
1.1 Définition et utilité de l’histogramme en analyse de données
Un histogramme est une représentation graphique surfacique de la distribution de fréquences d’une variable quantitative, qu’elle soit continue ou discrète. Contrairement au diagramme en barres classique réservé aux variables qualitatives nominales, l’histogramme repose sur le découpage de l’intervalle des valeurs observées en sous-intervalles contigus mutuellement exclusifs, désignés sous le terme de classes ou de casiers (en anglais, bins). Au-dessus de chaque intervalle, un rectangle est érigé de telle manière que sa surface soit directement proportionnelle à la fréquence relative ou absolue des observations appartenant à cette tranche de valeurs.
Cette géométrie permet une visualisation empirique immédiate des trois propriétés cardinales d’une série statistique : sa tendance centrale (médiane, moyenne, mode), sa dispersion (étendue, intervalle interquartile, variance) et sa morphologie distributionnelle globale. L’observateur avisé peut déceler instantanément le degré d’asymétrie statistique (skewness), distinguant une queue de distribution étirée vers la droite (asymétrie positive) d’une queue étirée vers la gauche (asymétrie négative). De même, l’aplatissement (kurtosis) se manifeste par le caractère pointu ou aplati de la cloche, révélant la propension de l’échantillon à générer des événements extrêmes par rapport à une loi de distribution normale.
Enfin, l’histogramme joue un rôle de sentinelle dans la détection visuelle préliminaire des valeurs aberrantes (outliers) et des discontinuités distributionnelles. Une barre isolée à l’extrémité du tracé graphique signale immédiatement la présence d’une observation suspecte ou d’une erreur de saisie, tandis qu’un creux inattendu au centre d’une distribution unimodale théorique peut révéler une censure statistique, un effet de seuil administratif ou un biais d’échantillonnage substantiel nécessitant des investigations approfondies.
1.2 Pertinence de l’histogramme dans la recherche empirique et comportementale
Dans le protocole de recherche quantitative, la phase d’analyse exploratoire conditionne l’ensemble des choix méthodologiques ultérieurs. L’une des justifications majeures de l’emploi de l’histogramme réside dans l’évaluation empirique de l’hypothèse de normalité univariée. De nombreux estimateurs canoniques, tels que la régression linéaire par les moindres carrés ordinaires (MCO), le test t de Student pour échantillons indépendants ou l’analyse de variance univariée (ANOVA), s’appuient sur l’hypothèse que les termes résiduels ou les variables sous-jacentes suivent approximativement une loi gaussienne. L’examen attentif de l’histogramme prévient l’application mécanique de ces tests lorsque les données présentent une asymétrie prononcée ou une forte leptocurticité.
Dans les sciences comportementales, la psychométrie et les neurosciences cognitives, les métriques mesurées se heurtent fréquemment à des contraintes structurelles. C’est typiquement le cas de l’analyse des temps de réponse ou des temps de réaction, dont la distribution empirique est notoirement asymétrique positive, modélisable par des lois ex-gaussiennes ou log-normales. De même, les instruments d’évaluation psychométrique construits à partir d’échelles de Likert agrégées manifestent fréquemment des planchers ou des plafonds artificiels. La visualisation sous forme d’histogramme rend compte de cette réalité méthodologique, évitant aux analystes de tirer des conclusions erronées sur la variabilité des traits latents.
Il convient toutefois de souligner que l’histogramme s’inscrit dans une démarche triangulée. Il ne saurait se substituer totalement à la boîte à moustaches (boxplot) de Tukey, laquelle synthétise plus rigoureusement les quartiles et identifie les valeurs extrêmes selon des critères formalisés, ni au tracé quantile-quantile (Q-Q plot), outil de référence pour juger de l’adéquation à une loi théorique aux extrémités de la distribution. En combinant la lisibilité intuitive de l’histogramme avec la précision du tracé quantile-quantile, le chercheur garantit une communication scientifique irréprochable des structures de ses données avant toute tentative de modélisation prédictive ou causale.
1.3 Aperçu de la commande hist et architecture graphique de Stata
L’environnement logiciel Stata propose une architecture graphique puissante, unifiée et modulaire désignée sous le nom de système graphique twoway. Au sein de cette armature logicielle, la commande histogram (que l’on peut abréger de façon parfaitement valide sous la forme concise hist) opère comme une directive autonome de haut niveau, tout en étant interopérable avec l’ensemble des options et sous-commandes de la famille graphique générale de Stata.
Stata permet d’aborder la génération graphique selon deux modalités contrastées : l’interface utilisateur interactive (GUI) pilotée par des menus déroulants et des boîtes de dialogue, ou la syntaxe scriptée exécutée directement via la ligne de commande ou consignée dans un fichier de scripts nommé do-file. Si l’interface interactive constitue un vecteur d’apprentissage commode pour les néophytes, l’approche scriptée s’impose impérativement dans le cadre de la recherche scientifique. L’intégration de la commande histogram au sein d’un do-file garantit la traçabilité intégrale de la chaîne de traitement, assure la réplicabilité exacte des représentations graphiques et autorise l’automatisation de la production visuelle sur des séries temporelles ou des panels longitudinaux.
Les versions récentes de Stata (notamment Stata 16, 17 et 18) ont enrichi le moteur graphique d’améliorations ergonomiques majeures, incluant une gestion vectorielle native, le support de formats contemporains comme le SVG, une gestion chromatique optimisée pour le daltonisme et une gestion accrue de la transparence alpha. La commande hist tire pleinement parti de ces évolutions pour transformer des esquisses exploratoires primaires en figures de synthèse publiables dans les revues académiques internationales les plus exigeantes.
2. Préparation de l’environnement de travail et exploration du jeu de données
Toute analyse graphique rigoureuse débute par une mise en place méticuleuse de l’environnement de travail et un examen exhaustif des propriétés numériques du jeu de données. La maîtrise des commandes fondamentales de vérification évite de formuler des interprétations visuelles erronées issues de corruptions de données ou de valeurs manquantes occultées.
2.1 Chargement et initialisation des données d’exemple
Afin d’assurer une parfaite reproductibilité des exemples développés tout au long de ce guide, nous utiliserons le jeu de données d’entraînement officiel auto.dta distribué par le consortium StataCorp via Stata Press. Cette table compile diverses caractéristiques techniques, dimensions physiques et métriques économiques de soixante-quatorze modèles d’automobiles commercialisés aux États-Unis en 1978. Sa structure variée, combinant variables strictement continues, variables de dénombrement discrètes et facteurs catégoriels, en fait un support idéal d’expérimentation pédagogique.
Pour charger ce jeu de données directement en mémoire active depuis les serveurs officiels, il suffit d’exécuter l’instruction suivante dans la fenêtre de commande ou au sein d’un do-file :
use http://www.stata-press.com/data/r13/auto, clear
L’argument clear indique formellement au logiciel de réinitialiser la mémoire vive en purgeant toute table préalablement chargée, prévenant ainsi les messages d’interruption. Une fois les données résidant en mémoire, il est impératif de définir le répertoire de travail dans lequel les exportations graphiques ultérieures viendront s’enregistrer. Cette configuration s’effectue au moyen de la commande cd (pour change directory), en spécifiant le chemin d’accès absolu ou relatif propre à votre système d’exploitation :
cd « C:/Projets/Recherche/Graphiques_Stata »
Pour contrôler l’intégrité de la structure tabulaire, la commande describe fournit un aperçu concis du nombre total d’observations (N = 74), du nombre de variables (k = 12), des types de stockage informatique (float, int, byte, string) ainsi que des étiquettes associées (variable labels). Cette vérification confirme que les grandeurs métriques d’intérêt sont convenablement codées sous forme numérique et non comme des chaînes de caractères littérales.
2.2 Inspection préliminaire des variables quantitatives
Générer un histogramme sans connaître préalablement les moments empiriques de la variable cible constitue une lacune méthodologique sérieuse. L’examen des grandeurs scalaires permet d’anticiper les limites des axes, de jauger l’étendue globale et de concevoir judicieusement le découpage en classes. La commande canonique pour extraire ces paramètres statistiques est summarize (abrégée couramment en sum) :
summarize length
Cette instruction renvoie instantanément l’effectif valide, la moyenne empirique, l’écart-type ainsi que les bornes minimale et maximale de la variable length, qui consigne la longueur physique des véhicules exprimée en pouces. Pour obtenir une décomposition statistique plus profonde, incluant les quantiles spécifiques, la variance ainsi que les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis), on adjoint l’option detail :
summarize length, detail
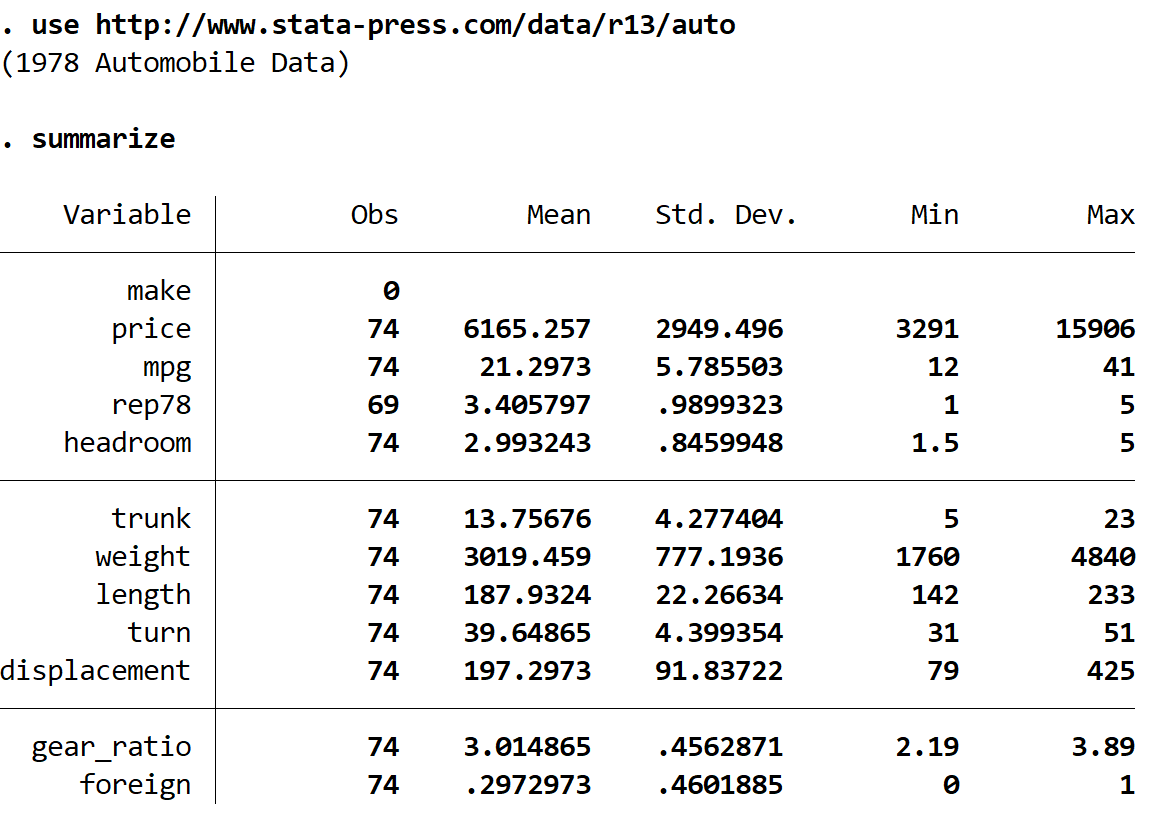
L’affichage généré par cette instruction permet de vérifier l’écart entre la médiane (cinquantième percentile) et la moyenne arithmétique. Une divergence notable entre ces deux indicateurs renseigne sur l’asymétrie de la distribution. De surcroît, cette étape autorise la détection précoce des valeurs manquantes. Dans Stata, les valeurs manquantes pour les variables numériques sont encodées par un point typographique (system missing value, noté .) ou par des codes étendus allant de .a à .z. Il convient d’être vigilant : bien que la commande d’histogramme exclue par défaut les valeurs manquantes de l’estimation de densité, un codage erroné de valeurs non renseignées sous forme de nombres extrêmes (comme 999 ou -99) distordrait irrémédiablement l’échelle de l’histogramme, écrasant la quasi-totalité des observations au sein d’une unique barre microscopique.
Parmi les grandeurs continues présentes dans la table auto.dta, la variable length présente une dynamique distributionnelle fluide, exempte de discontinuités excessives, ce qui la rend éminemment appropriée pour illustrer la construction de notre premier histogramme élémentaire.
3. Création d’un histogramme élémentaire avec la commande hist
Une fois les données appréhendées sur le plan statistique, la mise en œuvre de la commande graphique élémentaire permet d’obtenir en une fraction de seconde une cartographie visuelle de la variable étudiée. L’observation critique du résultat généré par défaut dévoile la logique algorithmique et mathématique qui régit l’affichage graphique de Stata.
3.1 Syntaxe de base et comportement par défaut du logiciel
La commande minimale permettant de produire un histogramme dans Stata se résume à l’invocation du verbe d’action suivi du nom de la variable d’intérêt, sans qu’aucune option subsidiaire ne soit requise :
hist length
Dès l’exécution de cette directive, Stata déclenche l’ouverture de sa fenêtre graphique principale (intitulée Graph) et dessine un histogramme vectoriel monochrome ou coloré selon le schéma d’affichage actif de votre session. L’observation immédiate de cette figure par défaut surprend fréquemment les utilisateurs habitués à d’autres logiciels généralistes ou tableurs de bureau : l’axe vertical (ordonnée) n’affiche ni un décompte brut du nombre de voitures, ni une proportion en pourcentage, mais une métrique continue intitulée Density (densité).
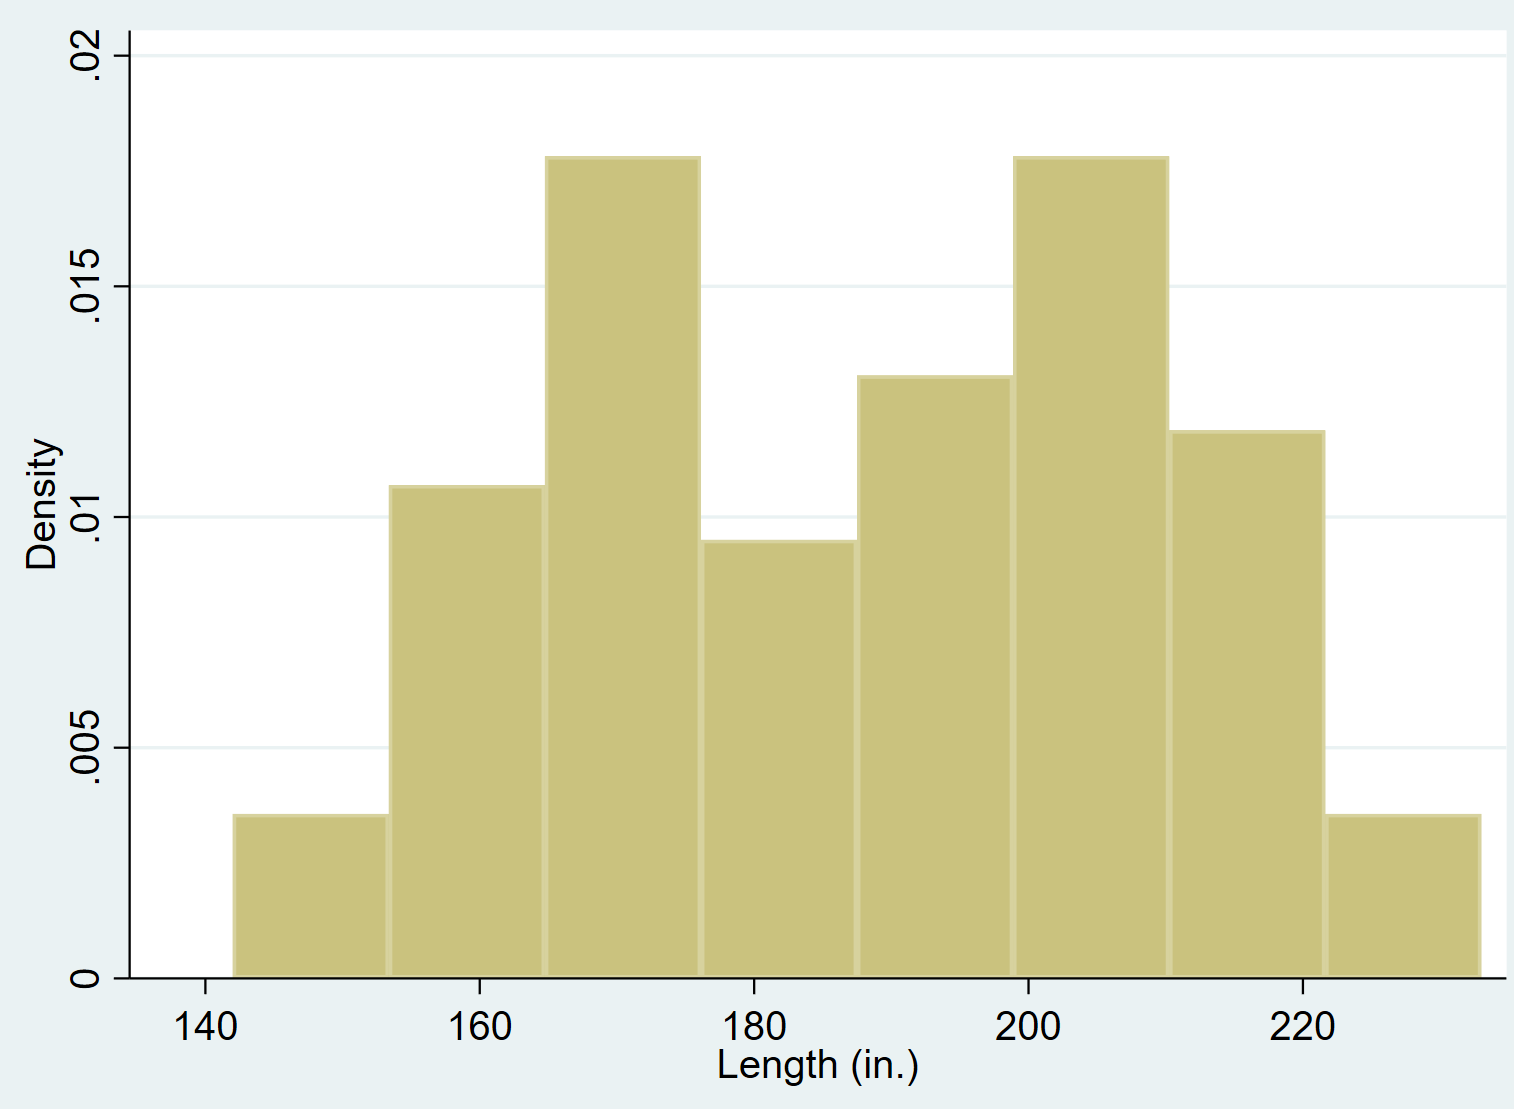
Cette configuration par défaut découle d’un parti pris théorique fondamental adopté par StataCorp. L’histogramme y est conçu avant tout comme un estimateur probabiliste continu de la fonction de densité de masse. Dans cette représentation géométrique, ce n’est pas la hauteur des barres qui reflète la probabilité, mais leur surface (produit de la largeur de l’intervalle par la hauteur de la densité). Par conséquent, la somme mathématique intégrale des aires de l’ensemble des rectangles composant l’histogramme est rigoureusement égale à l’unité (1,00). Cette normalisation permet une comparaison directe et cohérente entre des échantillons de tailles divergentes ou vis-à-vis d’une fonction de densité théorique continue (telle que la loi normale).
3.2 Calcul interne de la discrétisation par Stata
Lorsque l’utilisateur ne spécifie aucun découpage manuel, Stata exécute en coulisses un calcul algorithmique standardisé afin de déterminer le nombre d’intervalles (bins) et la largeur de classe (width). Le logiciel détermine l’étendue globale de l’échantillon, définie par la différence arithmétique entre la valeur maximale et la valeur minimale observées, puis applique une règle heuristique fondée sur la racine cubique de la taille de l’échantillon ou une variante de la règle de Sturges pour fixer la discrétisation initiale.
Dans la fenêtre des résultats de Stata, le système consigne explicitement les paramètres issus de cette phase de calcul : il indique le nombre de classes retenues (par exemple, 8 ou 10 classes selon la variable), la largeur géométrique de chaque casier, ainsi que la valeur d’ancrage plancher correspondant au point de départ de la première classe. Cette transparence permet au praticien de comprendre avec précision comment l’espace numérique a été partitionné.
Toutefois, ce mécanisme d’affectation automatisée révèle ses limites structurelles lorsque l’échantillon s’écarte des canons de la symétrie unimodale. En présence de distributions multimodales complexes ou de variables marquées par des concentrations massives de zéros (phénomènes de zero-inflation), l’algorithme par défaut tend à surlisser ou à hacher artificiellement des pics critiques. D’où la nécessité impérieuse de maîtriser le calibrage explicite des options de mise à l’échelle et de découpage.
4. Paramétrage de l’axe vertical : Fréquences, pourcentages et fractions
Si la densité de probabilité satisfait aux canons de la statistique théorique, les impératifs de la restitution de recherche ou de la vulgarisation scientifique exigent régulièrement des métriques d’ordonnée plus intuitives. Stata propose trois options canoniques permettant de transmuter l’axe vertical en unités arithmétiques palpables : les fréquences absolues, les pourcentages relatifs et les fractions unitaires.
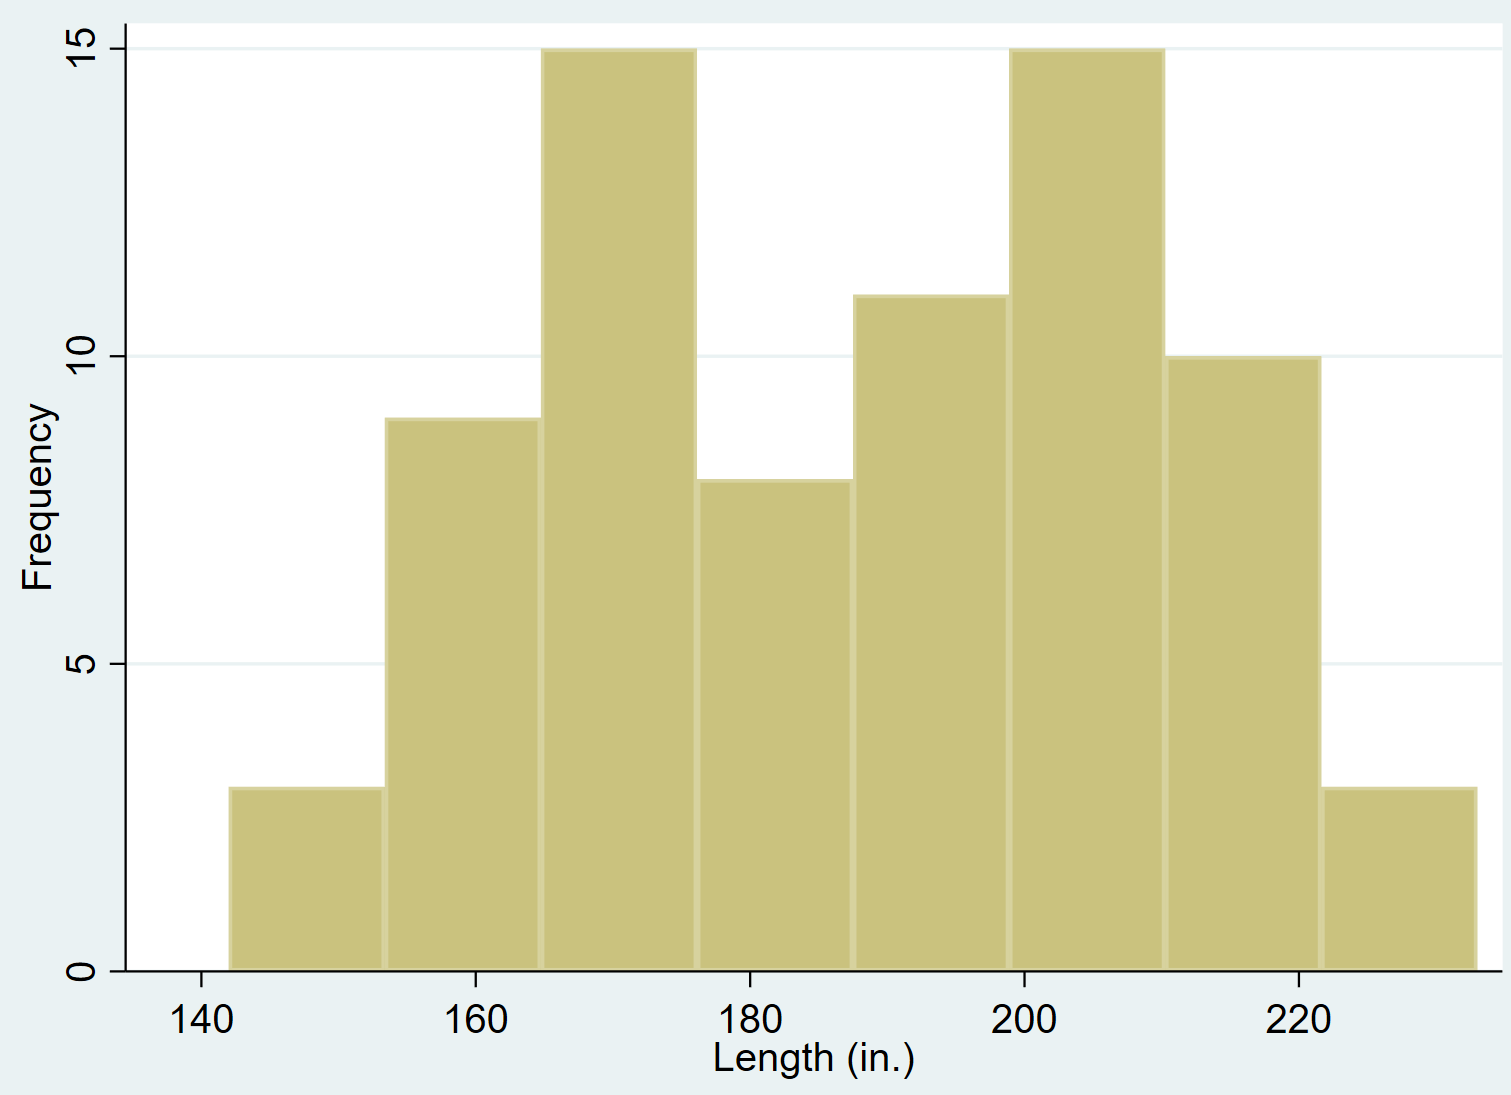
4.1 Affichage des effectifs réels avec l’option freq
L’adjonction de l’option freq (abréviation standard de frequency) modifie l’axe des ordonnées pour afficher le décompte brut des observations répertoriées au sein de chaque classe. La syntaxe s’écrit comme suit, l’option étant introduite après une virgule :
hist length, freq
Cette représentation confère une lisibilité pragmatique immédiate. Le lecteur peut quantifier directement les occurrences physiques : il lit sans détour qu’il existe, par exemple, précisément 12 véhicules mesurant entre 190 et 200 pouces au sein de la cohorte étudiée. Cette métrique d’effectifs bruts s’avère particulièrement précieuse lors des revues de contrôle de qualité des données, dans les contextes cliniques où les effectifs de patients dans certaines catégories critiques doivent être connus de manière absolue, ou pour satisfaire aux normes éditoriales de revues médicales requérant la mention explicite du nombre d’événements observés.
4.2 Normalisation relative via les pourcentages avec l’option percent
Dans de nombreuses publications en sciences sociales et en gestion, l’effectif brut présente un intérêt moindre comparé à la proportion relative que chaque groupe représente au sein de l’échantillon global. L’option percent convertit l’axe vertical en pourcentages standardisés gradués de 0 à 100 % :
hist length, percent
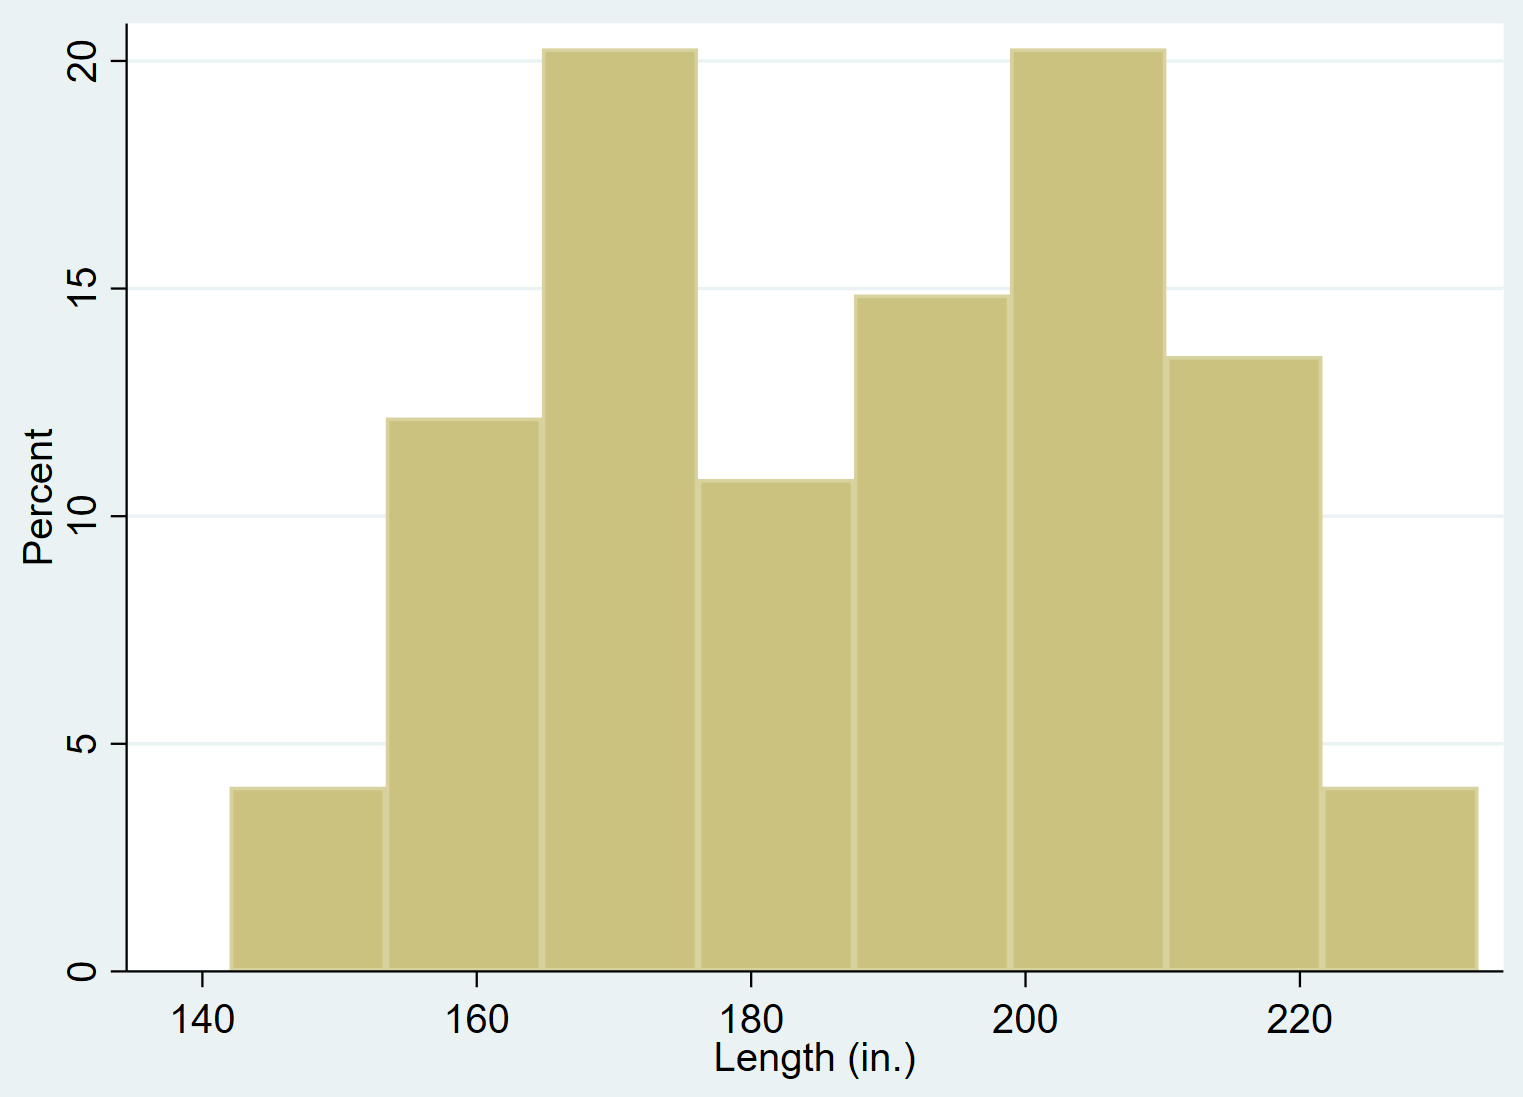
En recourant à cette normalisation en pourcentage, la somme des hauteurs de l’ensemble des rectangles équivaut rigoureusement à 100 % (à condition que les barres possèdent une largeur uniforme standardisée). Ce mode d’affichage facilite l’appropriation des données par un public non spécialisé et autorise une comparaison mentale immédiate avec d’autres enquêtes ou cohortes de dimension hétérogène. Par exemple, observer que 25 % du parc automobile américain de 1978 se situe dans la classe centrale de longueur fournit un repère d’interprétation invariant, que l’échantillon comprenne 74 ou 100 000 véhicules.
4.3 Représentation probabiliste par fractions avec l’option fraction
À mi-chemin entre la fréquence brute et le pourcentage, l’option fraction restreint l’échelle de l’axe vertical à l’intervalle unitaire fermé compris entre 0 et 1 :
hist length, fraction
Cette approche s’aligne formellement sur la théorie des probabilités appliquées aux variables aléatoires discrètes, où la somme totale des probabilités empiriques vaut exactement un. Elle présente une valeur méthodologique indéniable dans le champ de la modélisation statistique avancée, de la théorie de la décision et de l’économétrie bayésienne, où les hauteurs des barres s’interprètent directement comme des probabilités empiriques a posteriori attribuées à chaque intervalle de l’espace d’état.
Il importe toutefois de ne pas confondre mathématiquement l’histogramme en fraction avec l’histogramme en densité. Dans l’option fraction, c’est la somme arithmétique des hauteurs des barres qui vaut un (chaque hauteur représentant le ratio nk / N). Dans l’histogramme par défaut en density, c’est l’aire totale des barres qui est unitaire, la hauteur de chaque casier étant égale à (nk / N) divisé par la largeur de la classe correspondante. Cette nuance conceptuelle fondamentale doit être gardée à l’esprit lors de l’interprétation des ordonnées de densités supérieures à un, qui troublent fréquemment les analystes débutants.
5. Maîtrise de la discrétisation : Gestion des classes et des intervalles
Le choix de la discrétisation spatiale représente le défi technique majeur lors de la création d’un histogramme. Un découpage inapproprié peut masquer des structures sous-jacentes majeures ou, à l’inverse, générer des artefacts morphologiques dépourvus de tout fondement empirique. Stata confère au statisticien un contrôle total sur ce processus via trois paramètres directeurs : le nombre de classes, leur largeur métrique et leur point d’ancrage initial.
5.1 Définition explicite du nombre de classes avec bin()
L’argument bin() permet d’imposer souverainement le nombre total de rectangles verticaux qui composeront le tracé sur toute l’étendue de la variable. Sa syntaxe s’illustre par l’instruction suivante :
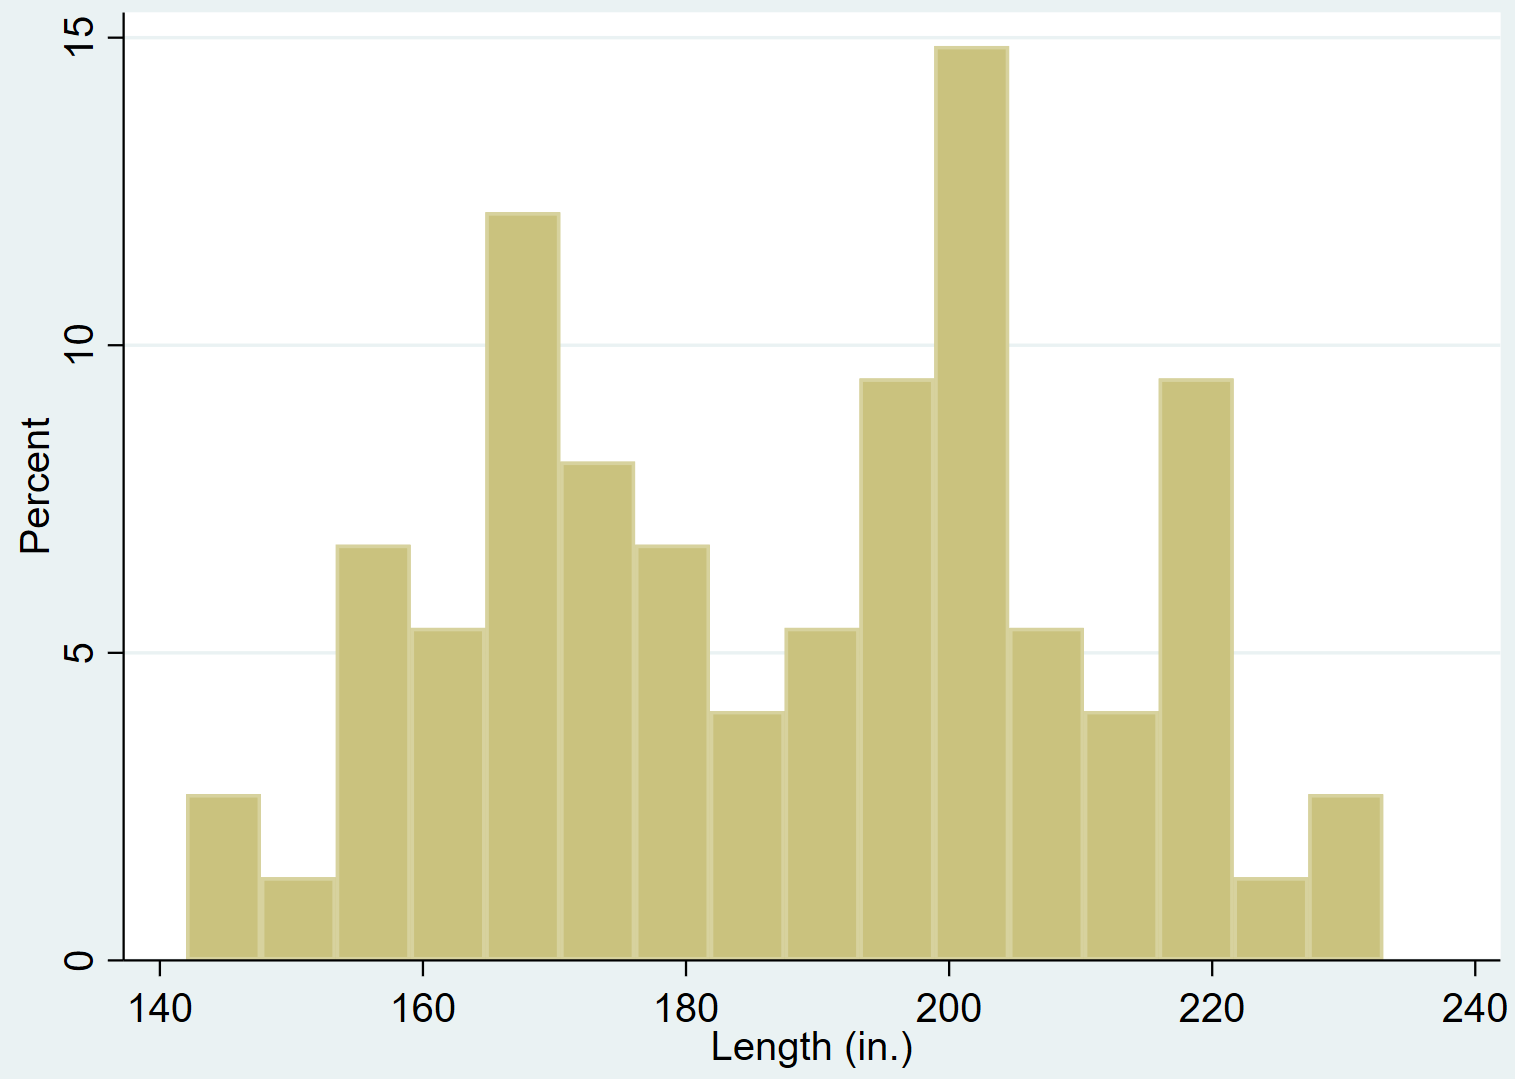
hist length, bin(15)
Le choix de cette valeur numérique engage la responsabilité méthodologique du chercheur face au dilemme classique du compromis biais-variance. Si l’on retient un nombre démesuré de classes (par exemple, bin(50) sur un échantillon modeste de 74 individus), le tracé souffre d’un phénomène de sous-lissage (undersmoothing). Les barres deviennent étroites, disjointes, parsemées de vides aléatoires, et le lecteur peine à appréhender la forme générale de la loi sous-jacente en raison de la variance d’échantillonnage excessive.
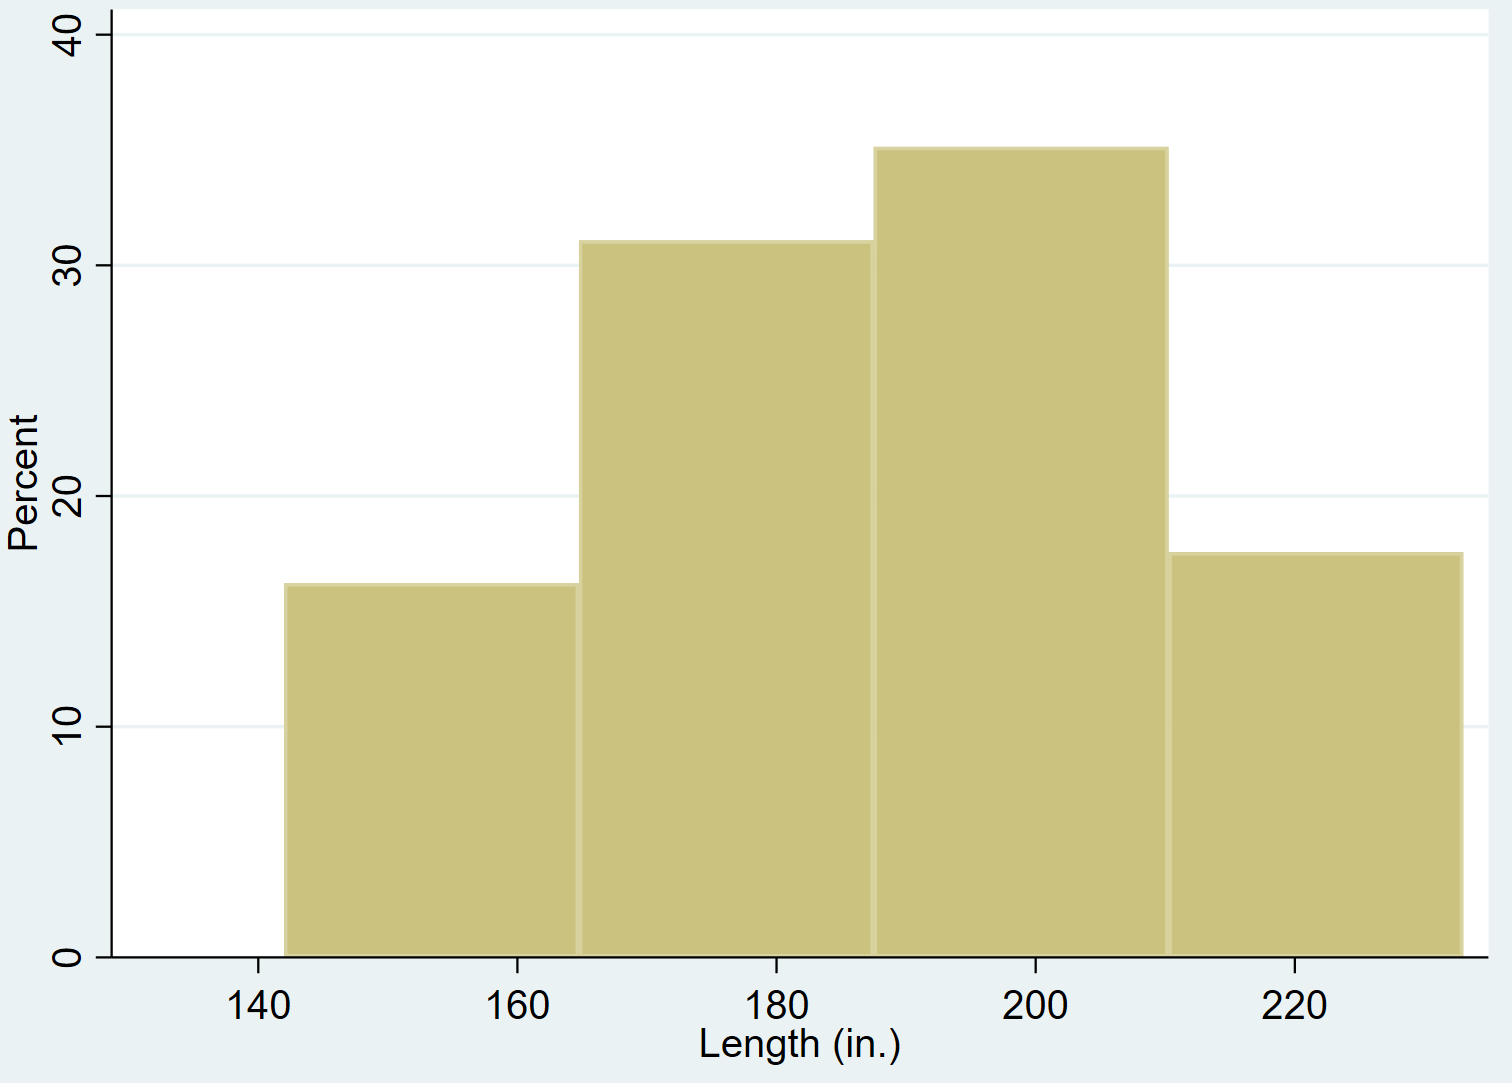
Inversement, l’assignation d’un nombre trop restreint de classes (par exemple, bin(4)) engendre un surlissage dévastateur (oversmoothing). La compression des données efface les caractéristiques morphologiques critiques telles que l’asymétrie modérée ou l’existence de deux modes distincts, assimilant abusivement la distribution à un bloc uniforme sans relief.
Pour fixer ce paramètre de manière rigoureuse, il est recommandé de s’appuyer sur des fondements théoriques éprouvés :
- La règle de Sturges : k = 1 + log2(N), adaptée aux distributions normales d’ampleur modérée (N inférieur à 200).
- La règle de Scott : basée sur la variance de l’échantillon, préconisant une largeur optimale de h = 3.49 * s * N-1/3.
- La règle de Freedman-Diaconis : particulièrement robuste aux valeurs aberrantes car fondée sur l’écart interquartile (IQR), fixant la largeur optimale à h = 2 * IQR * N-1/3.
5.2 Spécification rigoureuse de la largeur d’intervalle avec width()
Plutôt que d’agir sur le nombre final de compartiments, il s’avère souvent plus naturel et scientifiquement plus pertinent de fixer la largeur métrique des classes au moyen de l’option width(). Cette démarche permet d’aligner le découpage sur des grandeurs signifiantes et familières au sein de la discipline de recherche :
hist length, width(5)
Dans cet exemple, chaque rectangle couvrira exactement un intervalle d’une largeur de 5 pouces. Si l’on étudiait des salaires mensuels, on pourrait choisir width(500) pour agréger les rémunérations par tranches de 500 euros ; pour des âges démographiques, width(5) ou width(10) permettrait de matérialiser les quinquennats ou décennies de vie. Ce contrôle métrique élimine l’arbitraire des largeurs fractionnaires découlant de l’application aveugle de l’option bin(), qui aboutit souvent à des tranches aux bornes peu lisibles (par exemple, des intervalles de 4,732 unités). De surcroît, fixer la largeur de classe s’avère indispensable lorsque l’on procède à des comparaisons diachroniques ou multi-groupes, afin de maintenir une échelle d’analyse strictement uniforme d’un graphique à l’autre.
5.3 Calage du point d’origine des classes avec start()
L’option start() constitue le troisième levier régulateur de la discrétisation. Elle dicte formellement la borne inférieure de la première classe. Par défaut, Stata positionne généralement cette origine sur la valeur minimale empirique observée dans le jeu de données, ce qui peut engendrer des frontières de casiers arbitraires et asymétriques par rapport aux seuils théoriques réels. En combinant start() avec width(), le statisticien maîtrise intégralement la grille de discrétisation :
hist length, width(10) start(140)
Cette combinaison ordonne à Stata de faire débuter le premier casier à la valeur exacte de 140 pouces et d’ériger des casiers contigus de 10 pouces (140 à 150, 150 à 160, etc.). Ce calibrage s’avère capital pour positionner un seuil clinique signifiant (comme un indice de masse corporelle de 25 ou 30 en médecine), une frontière réglementaire (comme le salaire minimum en économie du travail) ou un zéro d’échelle absolu. Des études méthodologiques ont démontré que le simple décalage du point de départ sans altération de la largeur de classe peut modifier radicalement la perception de l’asymétrie ou faire disparaître un mode visuel secondaire. L’association méthodique des arguments width() et start() neutralise ces artefacts et confère une parfaite robustesse à la figure.
6. Superposition de modèles théoriques et de densités empiriques
L’examen isolé d’un histogramme laisse souvent planer un doute sur le degré réel de conformité des données vis-à-vis d’une référence théorique. Pour lever cette incertitude sans multiplier inutilement les graphiques distincts, Stata autorise la superposition élégante de distributions paramétriques étalonnées ou d’estimations non paramétriques lissées directement sur les barres de l’échantillon.
6.1 Superposition d’une courbe normale gaussienne avec l’option normal
La commande graphique intègre une option directe dénommée normal qui calcule et plaque sur l’histogramme la courbe théorique de Gauss correspondant aux paramètres de l’échantillon :
hist length, normal
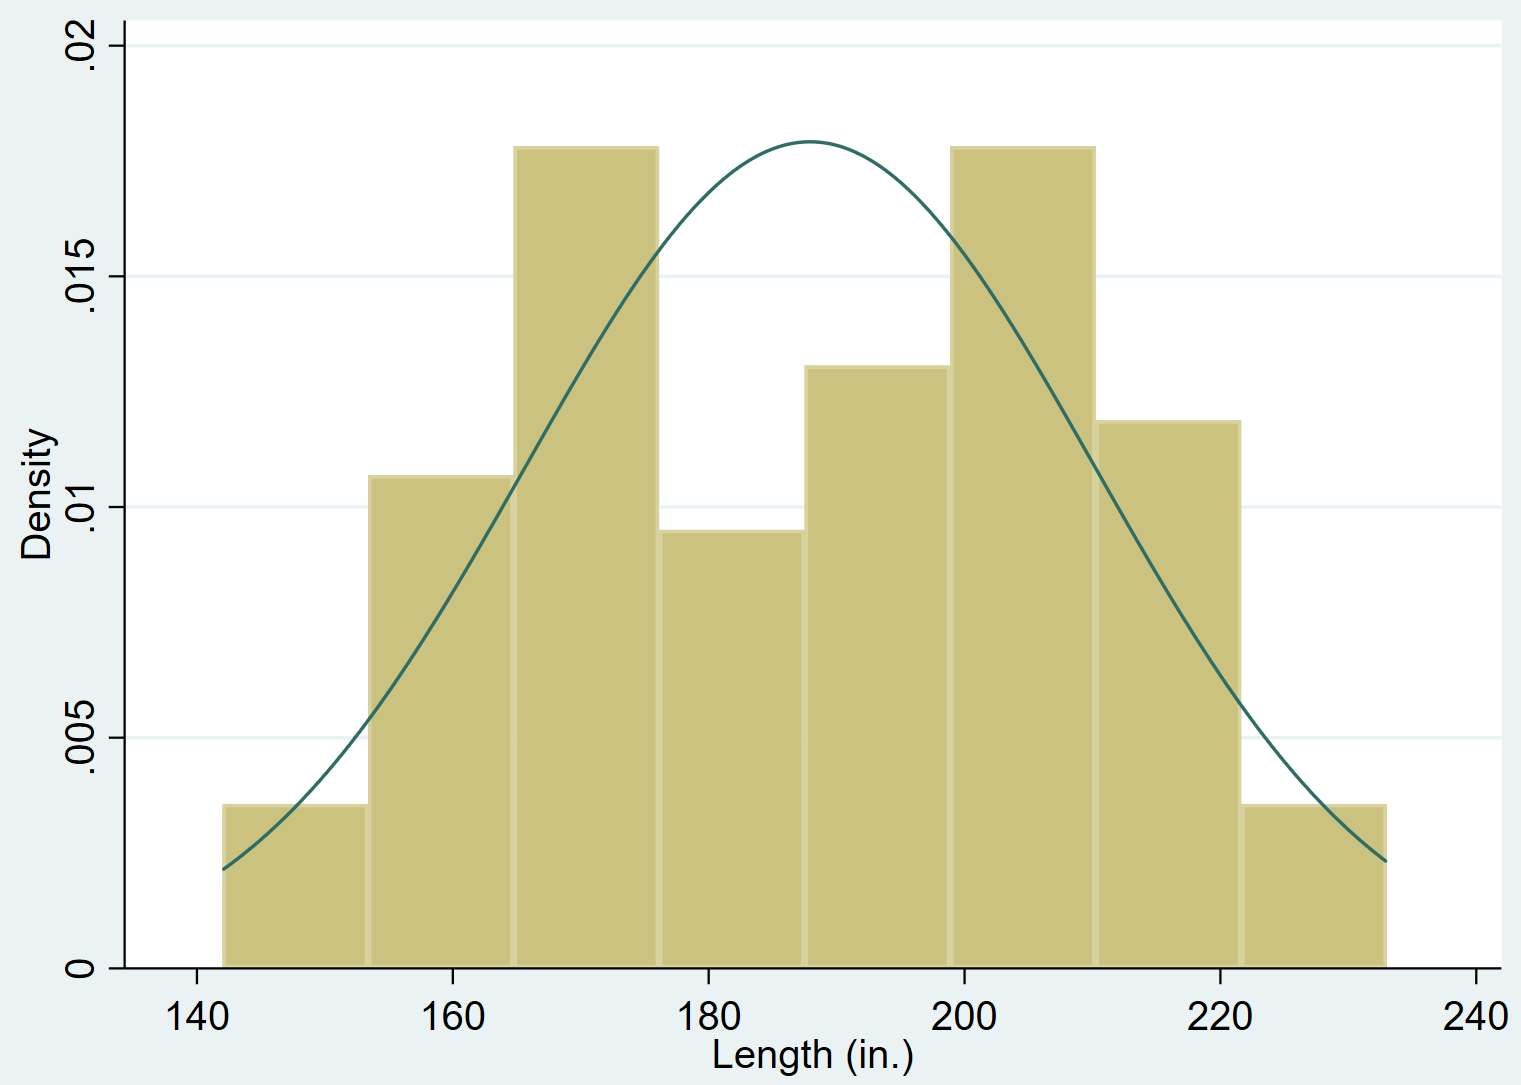
Sur le plan mathématique, Stata estime au préalable la moyenne empirique (mu) et l’écart-type non biaisé (sigma) de la variable sélectionnée. Il génère ensuite la fonction de densité gaussienne correspondante sur l’intervalle observable et trace cette cloche idéale par-dessus les rectangles de l’histogramme. L’utilisateur peut ainsi immédiatement apprécier la concordance entre les données réelles et le modèle théorique : les barres débordent-elles de la courbe au centre (leptocurticité) ? Les queues de distribution s’écourtent-elles prématurément par rapport à la courbe continue ?
Il est possible de personnaliser l’apparence de cette cloche théorique grâce au sous-argument normopts(). Par exemple, pour épaissir la courbe et lui conférer une teinte rouge contrastée, on écrira :
hist length, normal normopts(lcolor(red) lwidth(medthick))
Cette distinction chromatique permet de guider immédiatement le regard du relecteur vers les déviations structurelles par rapport à la normalité standard.
6.2 Estimation non paramétrique de la densité à noyau avec kdensity
Si la courbe normale impose une structure paramétrique rigide souvent irréaliste sur des distributions asymétriques, l’option kdensity offre une alternative séduisante en traçant un lissage non paramétrique par estimation de densité par noyau (Kernel Density Estimation) :
hist length, kdensity
L’estimateur à noyau calcule la densité locale en faisant glisser une fonction de pondération géométrique (le noyau, ou kernel, par défaut celui d’Epanechnikov dans Stata) sur l’ensemble du continuum numérique. Cette approche produit une enveloppe continue souple qui épouse fidèlement la forme réelle de la distribution empirique sans présumer de sa conformité à une loi particulière. L’analyste peut ajuster la précision de ce lissage au sein de l’option kdenopts() en modulant la largeur de fenêtre (bandwidth) ou le type de noyau (par exemple gaussien, triangulaire ou rectangulaire) :
hist length, kdensity kdenopts(kernel(gaussian) bwidth(4) lcolor(navy))
L’intégration simultanée des options normal et kdensity au sein d’une unique ligne de commande constitue un outil diagnostique redoutable :
hist length, normal normopts(lcolor(cranberry) lpattern(dash)) kdensity kdenopts(lcolor(navy) lwidth(thick))
Cette confrontation graphique met directement aux prises la référence théorique gaussienne (en pointillé rouge) et la trajectoire empirique lissée des données réelles (en bleu foncé soutenu), exposant sans ambiguïté les anomalies morphologiques de la distribution.
7. Personnalisation visuelle et esthétique des barres
La valeur communicative d’un graphique scientifique réside dans sa clarté visuelle et sa sobriété formelle. Les options graphiques par défaut de Stata, bien que fonctionnelles, nécessitent souvent des ajustements pour répondre aux chartes typographiques des maisons d’édition ou pour optimiser la transmission de l’information sans générer de bruits perceptifs parasites.
7.1 Gestion des couleurs de remplissage avec fcolor()
Le contrôle chromatique du corps des barres s’opère via l’option fcolor() (ou color de remplissage, pour fill color). Stata reconnaît une vaste nomenclature de teintes prédéfinies issues de la palette standard : teintes unies basiques (navy, maroon, forest_green, dkorange), teintes atténuées (sand, stone, slate) ou nuances en niveaux de gris (gs0 pour le noir profond jusqu’à gs16 pour le blanc absolu). Par exemple :
hist length, fcolor(sand)
Pour les chercheurs soumis à des chartes institutionnelles ou désirant exploiter des espaces chromatiques spécifiques, Stata autorise la spécification directe des coordonnées Rouge-Vert-Bleu (RVB) au sein de chaînes textuelles :
hist length, fcolor(« 41 128 185 »)
De surcroît, les versions modernes de Stata prennent en charge l’intensité et l’opacité alpha au moyen de la syntaxe par pourcentage : fcolor(navy%60) appliquera la couleur bleu marine avec une transparence de 60 %, une fonctionnalité particulièrement utile lorsque des densités ou des courbes d’ajustement sont superposées aux rectangles.
7.2 Ajustement des bordures et contours avec lcolor() et lwidth()
L’un des défauts récurrents des histogrammes par défaut réside dans la confusion visuelle qui peut survenir lorsque des barres adjacentes partagent une teinte monochrome identique sans délimitation nette de leurs arêtes. L’option lcolor() (line color) permet de tracer un contour périmétrique net autour de chaque rectangle, renforçant considérablement la lisibilité structurelle du tracé :
hist length, fcolor(ltblue) lcolor(navy)
Pour parfaire ce dessin, l’option lwidth() calibre avec précision l’épaisseur du trait de contour. Stata propose une gradation normalisée allant de none (aucun contour) à vthin, thin, medium, medthick, thick, vthick. Dans la grande majorité des manuscrits destinés à l’impression en niveaux de gris, une combinaison telle que fcolor(gs12) lcolor(black) lwidth(thin) garantit un rendu professionnel impeccable, restituant des barres gris clair parfaitement circonscrites par un liseré noir d’une netteté absolue.
Enfin, l’option lpattern() permet d’altérer le style du tracé géométrique (solid, dash, dot, dash_dot). Bien que rarement sollicitée sur les contours de barres d’histogrammes, elle trouve tout son sens lorsqu’il s’agit de distinguer des catégories superposées dans des publications purement monochromes.
7.3 Contrôle de l’espacement et du relief des barres
Par définition mathématique, les barres d’un histogramme représentant une variable continue doivent être rigoureusement contiguës : aucun espace vide ne doit s’intercaler entre elles, sauf si la fréquence d’une classe intermédiaire est strictement nulle. Cependant, pour des considérations purement esthétiques ou lors du traitement de variables pseudo-continues, certains praticiens introduisent un interstice artificiel à l’aide de l’option gap() :
hist length, gap(10)
L’argument numérique correspond au pourcentage de réduction de la largeur de la barre, dégageant un vide d’air entre chaque colonne. Il convient toutefois de manier cette option avec une grande retenue méthodologique. Introduire du vide entre des classes continues tend à brouiller la frontière sémiologique séparant l’histogramme continu du diagramme en barres catégoriel (bar chart), risquant d’induire le lecteur en erreur sur la nature de la variable. Conformément aux principes de conception d’Edward Tufte proscrivant les fioritures non informatives (chartjunk), l’analyste rigoureux privilégiera des rectangles contigus soulignés par un contraste adéquat de bordure plutôt qu’un espacement factice.
8. Configuration rigoureuse des axes, échelles et graduations
L’infrastructure graphique de Stata permet une modulation micrométrique des axes cartésiens. Un histogramme dont les graduations sont trop serrées, illisibles ou mal proportionnées compromet la communication des données empiriques. Le paramétrage des axes X et Y doit obéir à des critères d’exactitude mathématique et de sobriété visuelle.
8.1 Personnalisation complète de l’axe des abscisses (X)
L’axe horizontal supporte les valeurs quantitatives de la variable représentée. L’option maîtresse pour moduler ses échelons est xlabel(). Elle accepte une liste explicite de valeurs numériques ou une séquence arithmétique codée selon le formalisme début(pas)fin :
hist length, xlabel(140(20)240)
Cette directive positionne les repères d’échelle de vingt en vingt unités, de 140 à 240 pouces, purgeant l’axe des étiquettes redondantes ou fractionnaires disgracieuses. Stata autorise également le formatage direct des nombres affichés au moyen de codes de formatage C-like intégrés, tels que xlabel(140(20)240, format(%9.0f)) pour bannir les décimales superflues.
L’intitulé de l’axe s’administre souverainement avec l’option xtitle(), qui écrase l’étiquette par défaut issue du dictionnaire de données :
hist length, xtitle(« Longueur hors-tout du véhicule (en pouces) »)
Il est impératif d’inclure systématiquement l’unité de mesure entre parenthèses dans le corps du titre d’axe. Par ailleurs, pour étendre la portée visuelle de l’abscisse au-delà des valeurs observées ou au contraire la resserrer sur un segment d’intérêt sans filtrer les données statistiques, on emploiera l’option xscale(range(120 260)).
8.2 Optimisation de l’axe des ordonnées (Y)
De la même façon, l’axe vertical régulant les fréquences, pourcentages ou densités requiert une configuration rigoureuse via l’option ylabel(). Un bon graphique doit comporter un nombre équilibré de lignes de repère pour permettre une estimation quantitative aisée sans saturer l’espace de lecture :
hist length, percent ylabel(0(5)30, grid) ytitle(« Proportion relative au sein du parc (%) »)
L’argument grid contraint Stata à tracer des lignes de quadrillage horizontal léger à chaque cran de graduation spécifié, guidant l’œil de l’observateur depuis le sommet des barres jusqu’à l’échelle d’ordonnée sans ambiguïté. Le titre de l’ordonnée, rédigé via ytitle(), doit impérativement préciser la métrique de transformation employée (fréquence absolue, pourcentage de l’échantillon ou densité de probabilité).
Dans les cas particuliers où l’histogramme présente une asymétrie monumentale (par exemple des distributions de revenus ou de patrimoines où quelques milliardaires côtoient une masse immense d’individus aux revenus modestes), le recours à des transformations logarithmiques ou à des modulations d’échelles non linéaires via yscale(log) peut être envisagé. Néanmoins, sur un histogramme de densités continues, la transformation directe de la variable sous-jacente en amont par la commande generate log_var = ln(var) s’avère conceptuellement beaucoup plus propre et plus facile à interpréter qu’une distorsion de l’axe des ordonnées.
9. Histogrammes comparatifs et conditionnement par sous-groupes
Dans la recherche empirique, la comparaison entre groupes d’observations (par exemple entre groupes de traitement et groupes témoins, ou entre cohortes nationales et étrangères) constitue une opération centrale. Stata propose une architecture remarquable de partitionnement graphique permettant d’aligner des distributions conditionnelles sans rompre l’homogénéité des échelles.
9.1 Génération de panneaux multiples à l’aide de l’option by()
L’option by() permet de décomposer l’échantillon global en sous-ensembles mutuellement exclusifs selon les modalités d’une variable catégorielle, puis de générer autant d’histogrammes individuels juxtaposés au sein d’une même planche visuelle. Considérons la variable binaire foreign, codant l’origine de production du véhicule (0 = Américain, 1 = Étranger) :
hist length, percent by(foreign)
À l’exécution, Stata divise la fenêtre graphique en deux panneaux distincts portant chacun le sous-titre de la catégorie correspondante. Le point crucial réside dans le fait que Stata harmonise par défaut les échelles d’abscisse et d’ordonnée entre tous les sous-graphiques. Cette symétrie d’échelle est indispensable sur le plan méthodologique : elle interdit les illusions d’optique découlant de repères d’axes asynchrones et permet d’observer instantanément que les véhicules étrangers présentent une médiane de longueur nettement inférieure et une dispersion plus resserrée que leurs homologues de fabrication américaine.
Si l’on désire forcer des échelles libres et indépendantes (une pratique généralement déconseillée lors des comparaisons directes), les sous-options by(foreign, yrescale xrescale) peuvent être invoquées.
9.2 Organisation spatiale et disposition des sous-graphiques
Lorsque la variable de stratification comprend de nombreuses modalités (par exemple quatre zones géographiques ou cinq tranches d’âge), l’organisation spatiale des panneaux conditionne l’ergonomie globale du document. Le contrôle de la géométrie de la matrice graphique s’effectue via les arguments rows() ou cols() placés à l’intérieur du bloc d’options by() :
hist length, percent by(foreign, cols(1) rows(2))
En empilant les deux graphiques verticalement l’un au-dessus de l’autre (une colonne, deux lignes), on aligne rigoureusement l’axe horizontal commun des longueurs. Cette disposition est la plus efficace pour comparer des distributions de variables continues, car l’œil humain compare les déplacements latéraux avec une précision cognitive largement supérieure à celle mobilisée lors de balayages en diagonale ou entre panneaux distants.
Pour offrir une vue synoptique complète, Stata propose d’intégrer au tableau comparatif un panneau récapitulatif englobant l’échantillon global consolidé au moyen de l’option total :
hist length, percent by(foreign, total cols(3))
Dans cette configuration, trois panneaux s’alignent horizontalement : la distribution du sous-groupe domestique, celle du sous-groupe étranger, et enfin l’histogramme d’ensemble de l’ensemble des observations. Toutes les annotations globales communes (titres généraux, notes de bas de figure) s’administrent au sein de la clause byopts(), garantissant une intégration typographique harmonieuse sans répétitions intempestives des textes sur chaque panneau.
10. Traitement des variables discrètes et des échelles ordinales
Bien que l’histogramme soit originellement pensé pour des variables continues réelles, son application à des variables discrètes (telles que des comptes entiers, des nombres d’enfants ou des scores psychométriques agrégés de Likert) est fréquente. Sans précautions syntaxiques spécifiques, le moteur graphique applique des coupures fractionnaires arbitraires totalement inadaptées à la structure discontinue des données.
10.1 Application de l’option discrete pour données catégorisées
Pour signifier formellement à Stata que la variable quantitative ne prend que des valeurs entières isolées, il est impératif d’adjoindre l’option discrete :
hist rep78, discrete percent
La variable rep78 consigne l’indice de réparation des automobiles sur une échelle discrète de notation ordinale allant de 1 (très mauvais) à 5 (excellent). L’application de l’option discrete transforme immédiatement le comportement interne du compilateur graphique :
- Chaque rectangle est automatiquement centré exactement sur chaque modalité entière observée (1, 2, 3, 4 et 5).
- La largeur de chaque barre est standardisée sur une unité métrique exacte (width = 1), éliminant les intervalles continus artificiels (comme 1,5 à 2,5).
- Les frontières de classes cessent de morceler les entiers, restituant une lecture parfaite de la distribution de probabilité discrète.
Omettre l’instruction discrete sur de telles données aboutirait à une figure confuse, où des barres regrouperaient de façon bancale plusieurs catégories entières sous une largeur continue calculée par l’algorithme par défaut.
10.2 Alignement des étiquettes textuelles et des modalités qualitatives
Dans les bases de données professionnelles sous Stata, les variables discrètes et ordinales sont fréquemment enrichies d’étiquettes textuelles de valeurs (value labels) associant un libellé compréhensible à chaque code numérique sous-jacent. Lorsqu’on trace un histogramme discret, Stata reporte spontanément ces libellés textuels sous les graduations de l’axe des abscisses.
Toutefois, si les libellés sont volumineux, ils risquent de se chevaucher ou d’entrer en collision géométrique. L’arbitrage s’effectue via l’option d’orientation typographique au sein de xlabel() :
hist rep78, discrete percent xlabel(1 « Très faible » 2 « Faible » 3 « Moyen » 4 « Bon » 5 « Excellent », angle(45))
L’argument angle(45) opère une rotation spatiale des chaînes de caractères à 45 degrés, dégageant l’axe tout en préservant une lisibilité complète. De plus, il convient de distinguer avec netteté l’histogramme discret de la commande standard graph bar. Alors que graph bar est un graphique conceptuellement dédié aux variables qualitatives nominales sans notion d’intervalle métrique intrinsèque, hist, discrete conserve la métrique sous-jacente de la variable sur l’axe des abscisses : si une valeur entière intermédiaire ne possède aucune observation (par exemple si aucune voiture n’était notée 4), l’histogramme discret laissera un espace vide précis à l’emplacement géométrique du 4, signalant cette absence au lecteur. Le diagramme en barres classique, lui, accolerait simplement le 3 et le 5 en masquant ce vide informatif.
11. Habillage éditorial, titrage et schémas graphiques
La publication scientifique obéit à des normes de présentation rigides. Un graphique dépourvu de métadonnées descriptives ou affublé d’une apparence brute ne saurait satisfaire aux exigences des pairs. Stata intègre une panoplie complète de commandes d’annotation textuelle et de thèmes visuels généraux pour hisser les figures aux standards éditoriaux internationaux, notamment ceux de l’American Psychological Association (APA).
11.1 Titrage scientifique, sous-titres et notes de bas de figure
L’ornementation textuelle d’un histogramme repose sur une hiérarchie tripartite d’instructions : title() pour l’énoncé du thème principal, subtitle() pour spécifier les conditions de restriction ou d’analyse, et note() pour inscrire les mentions méthodologiques, les sources documentaires ou la taille de l’échantillon actif :
hist length, percent width(10) start(140) title(« Distribution de la longueur des automobiles »)
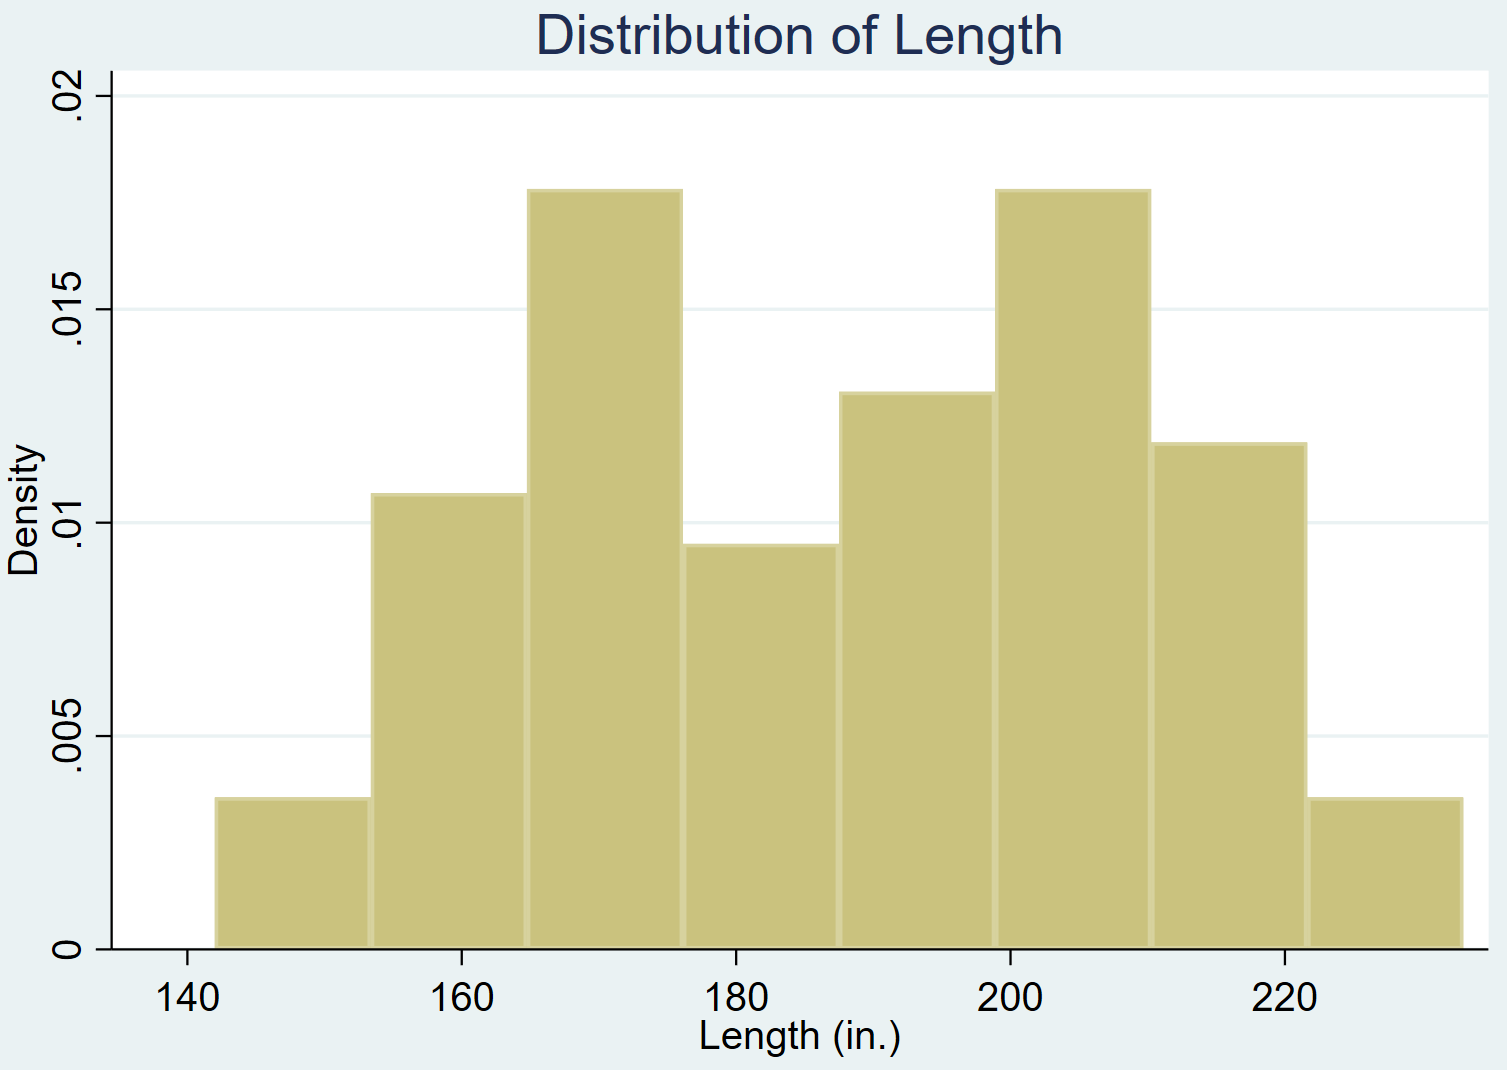
Pour enrichir la mise en contexte de la figure et préciser les contours spécifiques de l’étude, l’analyste peut adjoindre un sous-titre informatif :
hist length, percent width(10) start(140) title(« Distribution de la longueur des automobiles ») subtitle(« Échantillon de l’industrie automobile américaine, année modèle 1978 »)
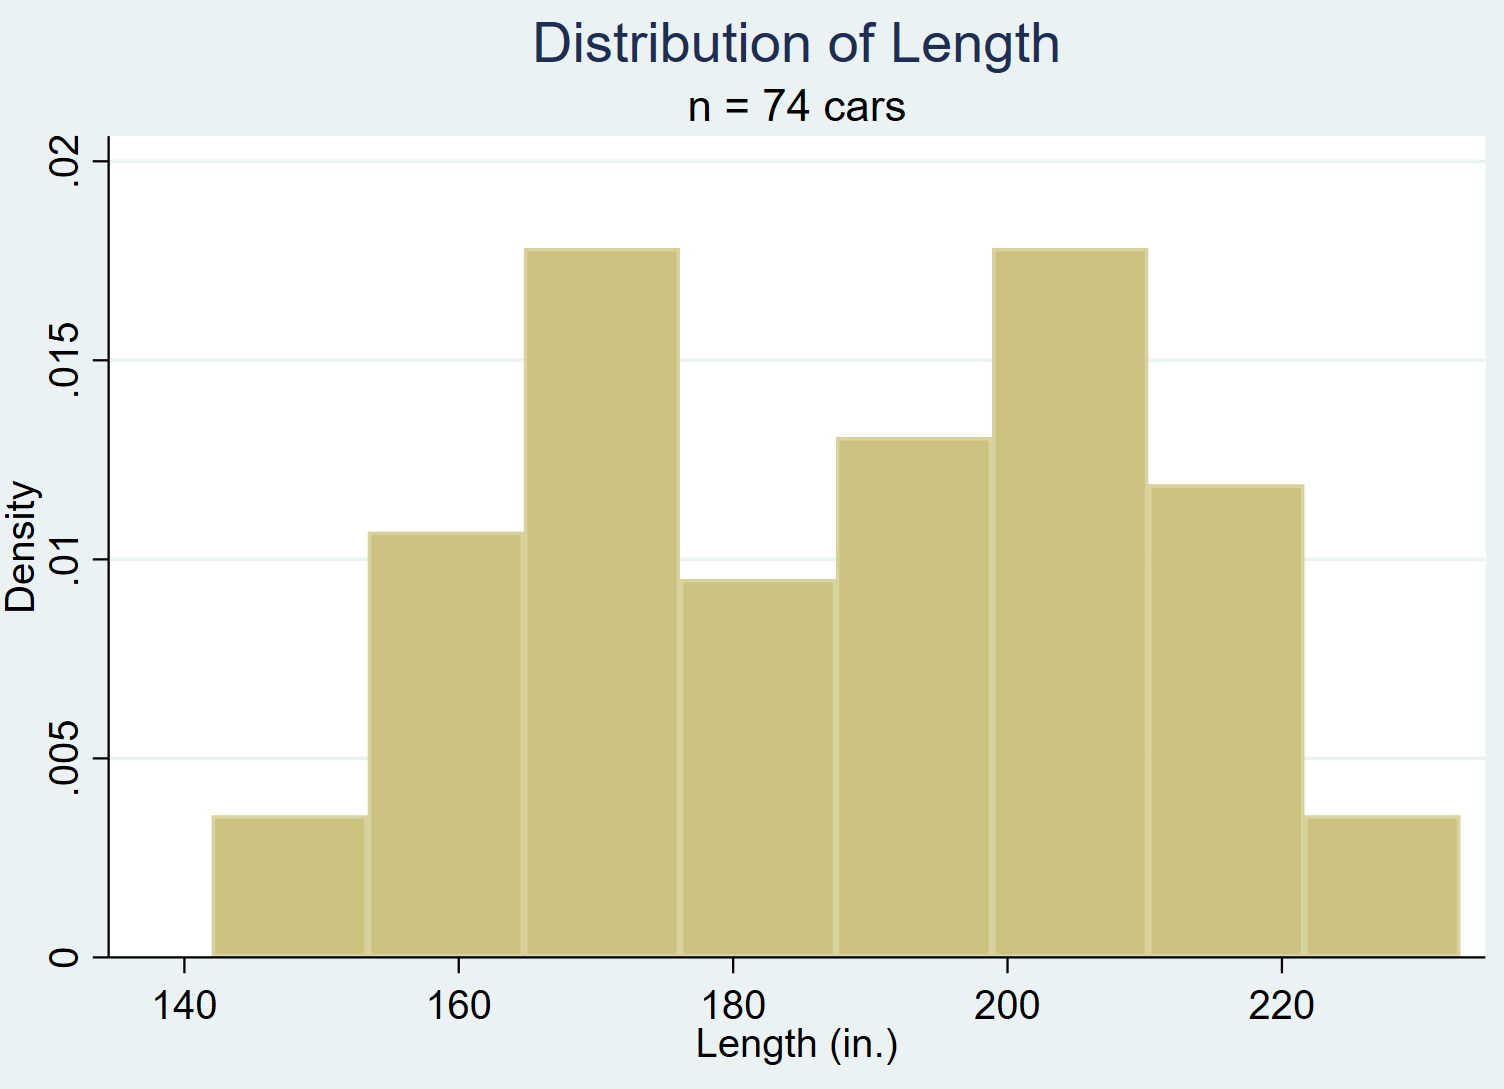
Enfin, la rigueur académique impose d’intégrer une note méthodologique explicitant le volume de données traité et la source empirique mobilisée :
hist length, percent width(10) start(140) title(« Distribution de la longueur des automobiles ») subtitle(« Échantillon de l’industrie automobile américaine, année modèle 1978 ») note(« Source : U.S. Department of Transportation. Échantillon complet N = 74 véhicules. »)
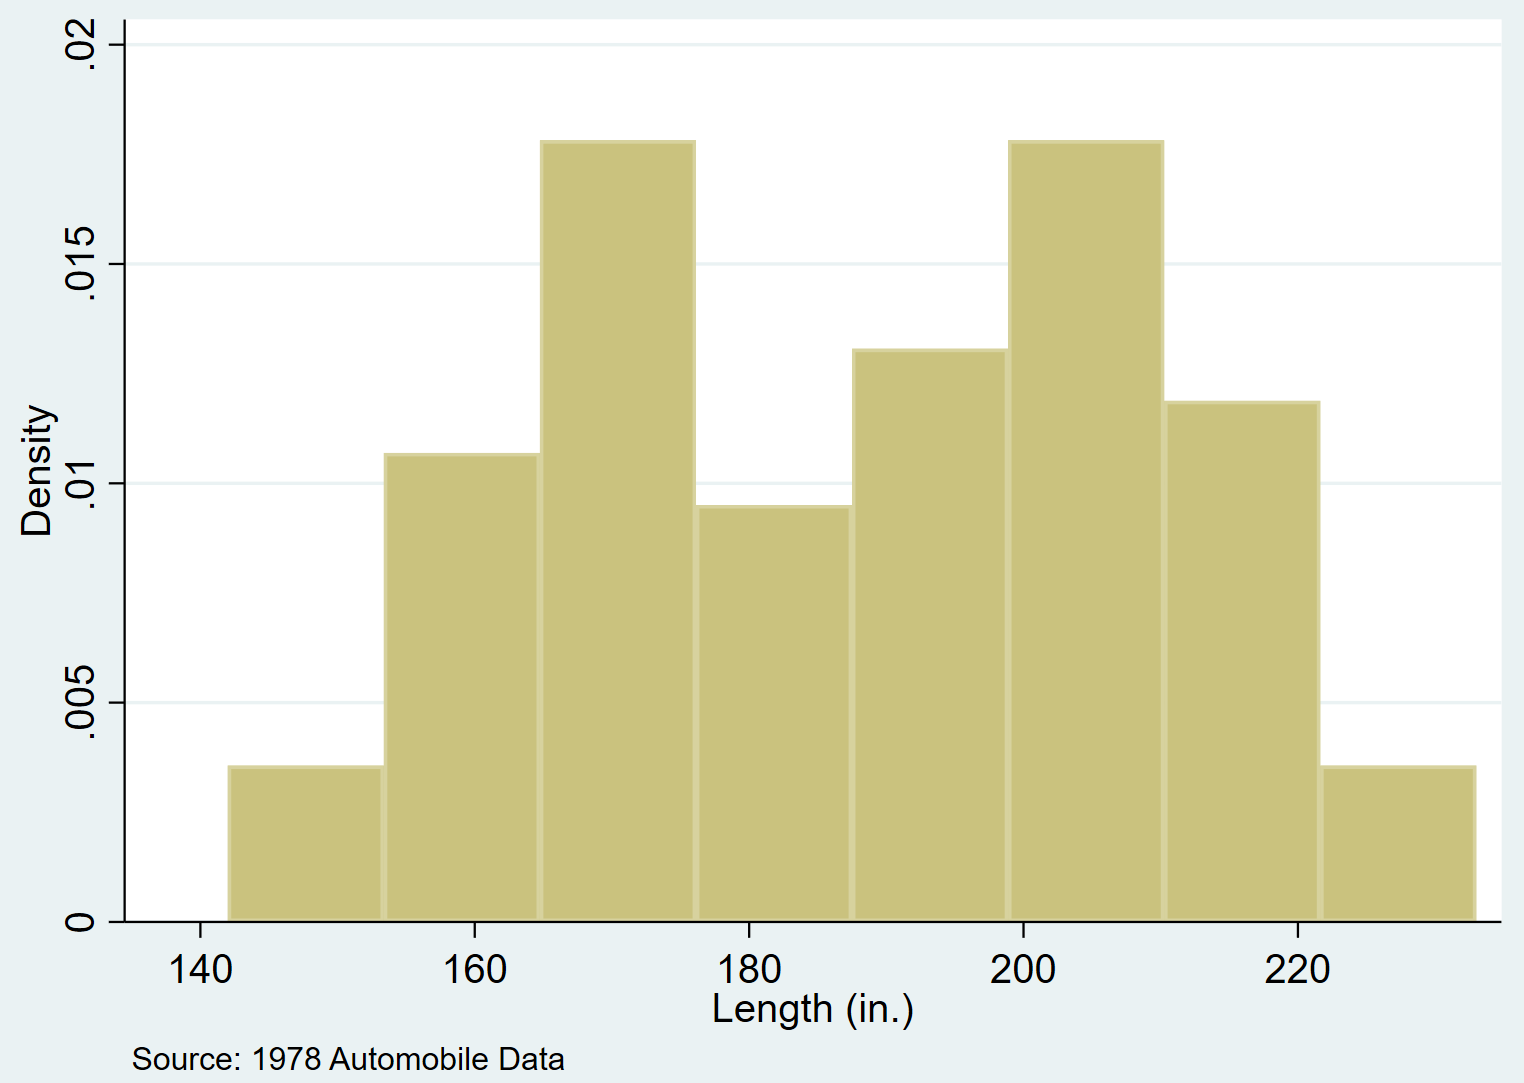
Conformément aux préconisations stylistiques du manuel de publication de l’APA (7e édition), les titres de figures doivent être concis, explicites et exempts d’abréviations non standardisées. Les notes de bas de graphique doivent mentionner systématiquement les unités physiques, les seuils de discrétisation appliqués, la signification des éventuelles courbes théoriques superposées et la taille précise de l’échantillon valide (N).
11.2 Application des thèmes visuels avec scheme()
Le rendu par défaut de Stata (historiquement gouverné par le schéma s2color et plus récemment par stcolor) arbore un arrière-plan teinté de bleu-gris ou des encadrements souvent proscrits par les maquettistes d’éditions universitaires, qui exigent un fond blanc pur et des tracés en niveaux de gris pour l’impression papier. Pour altérer l’apparence globale d’un graphique sans multiplier les micro-commandes individuelles, on fait appel aux schémas globaux (schemes).
L’adoption d’un thème monochrome optimisé pour l’impression se formalise de façon temporaire via l’option graphique scheme() :
hist length, percent scheme(s1mono)
Le thème s1mono élimine les fonds d’écran colorés au profit d’un blanc limpide, bascule les bordures et textes en noir d’imprimerie pur et adapte le contraste des barres en une trame de gris élégante. Si le chercheur désire appliquer ce standard à l’ensemble de sa session de travail pour unifier toutes ses productions visuelles, il exécutera préalablement en amont de son script la directive globale :
set scheme s1mono, permanently
Il existe également au sein de la communauté des utilisateurs de Stata d’excellents thèmes tiers développés pour répliquer le style visuel de grandes publications scientifiques ou de revues économiques. Citons notamment les suites cleanplots (développée par Trenton Mize) ou plotplain (développée par Daniel Bischof), installables via le protocole standard SSC (ssc install cleanplots) et reconnues pour leur conformité rigoureuse aux règles de la mise en page statistique moderne.
11.3 Exportation haute définition pour les revues scientifiques
La génération d’une figure dans la fenêtre interactive de Stata ne constitue que l’avant-dernière étape du processus. L’intégration dans un manuscrit Word ou un document de composition LaTeX exige une extraction sous des formats de fichiers appropriés, exempte de compression destructive.
La commande officielle dédiée à cet enregistrement est graph export. Elle s’exécute immédiatement après la commande de tracé, en ciblant le graphique actuellement présent au premier plan de la mémoire active :
hist length, percent fcolor(gs12) lcolor(black) lwidth(thin)
graph export « figure_distribution_longueur.pdf », as(pdf) replace
Le choix du format de fichier doit être dicté par le support de destination final :
- PDF (Portable Document Format) et EPS (Encapsulated PostScript) : ces formats vectoriels constituent l’étalon-or absolu pour la typographie professionnelle et l’intégration dans LaTeX. Ils conservent une résolution infinie : quelle que soit l’ampleur du zoom d’agrandissement lors de l’impression, les arêtes des barres et les courbes gaussiennes superposées ne subiront jamais aucune pixellisation.
- TIFF (Tagged Image File Format) : format matriciel très fréquemment exigé par les éditeurs de revues médicales et biologiques pour les épreuves finales. Dans ce cas, il est impératif de configurer la résolution minimale à 300 ou 600 points par pouce (dots per inch) : graph export « figure.tif », as(tif) width(2400) height(1800) replace.
- PNG et SVG : le format PNG représente le meilleur compromis matriciel sans perte pour les présentations orales (PowerPoint, Beamer) et les rapports électroniques web, tandis que le SVG offre une solution vectorielle native pour les plateformes interactives.
En inscrivant systématiquement la commande graph export immédiatement sous la commande de génération de l’histogramme dans vos do-files, vous sécurisez totalement le flux de production documentaire de votre projet de recherche.
12. Diagnostic des anomalies de distribution et dépannage technique
Même avec une syntaxe formellement impeccable, l’analyste peut se heurter à des représentations déconcertantes générées par des anomalies de données, ou à des interruptions de calcul causées par des maladresses syntaxiques. Savoir diagnostiquer ces dysfonctionnements et résoudre les messages d’erreur de Stata est une compétence méthodologique indispensable.
12.1 Identification des artefacts et diagnostics distributionnels
La morphologie d’un histogramme peut dissimuler des artefacts de mesure qu’il convient de savoir interpréter avant de valider une orientation analytique :
- Effets de plancher et de plafond : lorsqu’une barre vertigineuse émerge au niveau de la borne minimale ou maximale admissible d’une échelle (par exemple un score de 0 sur un test cognitif ou le score maximal de 100), cette anomalie signale que l’instrument de mesure est incapable de discriminer les variations en dehors de son domaine de calibration. La distribution réelle sous-jacente est tronquée ou censurée, ce qui impose d’abandonner la régression linéaire ordinaire au profit de modèles de type Tobit ou de régressions censurées.
- Mélange de sous-populations masqué : la présence de deux sommets distincts (distribution bimodale) trahit généralement la coexistence au sein d’une même cohorte de deux sous-groupes structurellement dissemblables qui ont été agrégés par inadvertance (par exemple, la distribution de la masse corporelle combinant hommes et femmes, ou celle des salaires mêlant ouvriers et cadres supérieurs). Le recours à l’histogramme conditionné par groupe via l’option by() permet immédiatement d’isoler ces composantes.
- Instabilité due au paramètre de calage : si une modification minime de l’argument start() altère profondément la localisation des modes ou fait surgir des lacunes inexpliquées, l’histogramme est en proie à une instabilité de discrétisation. Dans cette situation, l’estimation non paramétrique par noyau de densité (kdensity) doit être systématiquement consultée en arbitre de vérité pour vérifier la robustesse du profil empirique.
Il est en outre fortement recommandé de corroborer l’observation visuelle de l’histogramme par des tests statistiques formels de normalité : l’exécution des commandes sktest length (test d’asymétrie et de kurtosis de D’Agostino-Pearson) et swilk length (test d’adéquation de Shapiro-Wilk) fournira une valeur de p-value confirmant ou infirmant le diagnostic posé à partir de la figure.
12.2 Erreurs de syntaxe courantes et solutions d’optimisation
L’interaction avec l’interpréteur de commandes de Stata peut se heurter à plusieurs écueils récurrents qu’il est aisé de désamorcer une fois leurs causes comprises :
- Erreur de type de variable : « type mismatch » ou « variable may not be a string » : Cette interruption (erreur r(109) ou r(108)) se déclenche lorsque la variable spécifiée dans l’instruction d’histogramme est encodée comme une chaîne de caractères (string), même si elle n’affiche que des chiffres à l’écran. La solution consiste à convertir préalablement la variable en format numérique réel via l’instruction destring nom_variable, replace ou au moyen de la commande de codage catégoriel encode nom_variable, gen(nouvelle_var).
- Conflits d’options mutuellement exclusives : Tenter de combiner au sein de la même ligne de commande des options dimensionnelles contradictoires (telles que hist length, freq percent ou encore hist length, bin(10) width(5)) provoque un blocage immédiat de Stata. Vous devez choisir une seule métrique d’axe d’ordonnée et un seul mode directeur de discrétisation de classe.
- Ralentissement sur très grandes bases de données : Si votre jeu de données compte plusieurs dizaines de millions d’observations (comme des fichiers de recensements nationaux ou des bases de facturation hospitalière massives), le tracé d’un histogramme peut consommer un temps de calcul et des ressources mémoire considérables. L’optimisation consiste à exploiter une clause conditionnelle aléatoire pour réaliser le graphique exploratoire sur un sous-échantillon parfaitement représentatif sans altérer la distribution statistique globale : hist length if runiform() < 0.05, percent.
- Modularité dans les do-files : Pour maintenir un code graphique pérenne et aisé à mettre à jour au fil des révisions d’un article, segmentez vos options à l’aide de macro-variables locales (locals) ou utilisez le délimiteur de fin de ligne triple barre oblique (///) pour ventiler clairement une syntaxe volumineuse sur plusieurs lignes de script :
local options_titre title(« Distribution globale ») subtitle(« Données 1978 »)
local options_style fcolor(sand) lcolor(black) lwidth(thin)
hist length, percent width(10) start(140) ///
`options_titre’ ///
`options_style’ ///
scheme(s1mono)
Cette rigueur d’ingénierie logicielle garantit une maintenance sans friction, une modularité maximale et une reproductibilité absolue de vos analyses visuelles tout au long du cycle de vie de vos travaux de recherche.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bischof, D. (2014). New graphic schemes for Stata: plotplain and plottig. The Stata Journal, 14(4), 747–759. https://doi.org/10.1177/1536867X1401400403
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Mitchell, M. N. (2012). A Visual Guide to Stata Graphics (3rd ed.). Stata Press.
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall. https://doi.org/10.1201/9781315140919
- StataCorp. (2023). Stata Graphics Reference Manual: Release 18. StataCorp LLC. https://www.stata.com/manuals/g.pdf
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.