
Dans l’arsenal des méthodes quantitatives appliquées aux sciences humaines, la modélisation statistique des interrelations entre variables constitue le socle sur lequel reposent l’évaluation psychologique, la validation d’instruments de mesure et la recherche expérimentale. Alors que les praticiens et chercheurs débutants se tournent intuitivement vers les coefficients de corrélation standardisés pour évaluer l’intensité des liens bivariés, la covariance demeure l’entité fondamentale non standardisée qui capture à la fois la direction de la covariation et l’amplitude de la dispersion propre à chaque dimension observée. La maîtrise de la matrice de covariance s’avère indispensable pour quiconque souhaite explorer les structures latentes sous-jacentes à des comportements, des traits de personnalité ou des compétences cognitives complexes.
Le logiciel IBM SPSS Statistics, référence incontournable au sein des laboratoires universitaires et des centres de recherche clinique, propose plusieurs voies méthodologiques pour générer, manipuler et exporter cette matrice essentielle. Bien que l’interface graphique mette fréquemment l’accent sur les matrices de corrélation de Pearson dans ses menus de base, l’extraction rigoureuse d’une matrice de variance-covariance requiert des paramétrages précis et une compréhension approfondie des options algorithmiques. Ce guide méthodologique exhaustif détaille pas à pas l’ensemble des procédures techniques, des fondements algébriques et des considérations psychométriques indispensables pour exploiter pleinement la matrice de covariance sous SPSS.
De la préparation rigoureuse des données psychométriques brutes à l’intégration des matrices de covariance dans des analyses multivariées avancées telles que la modélisation par équations structurelles ou l’analyse factorielle confirmatoire, cet ouvrage examine en détail chaque étape du processus analytique. En s’appuyant sur des bases conceptuelles solides et des applications concrètes, ce document offre une ressource de référence tant pour les étudiants en doctorat que pour les chercheurs chevronnés désireux de garantir la reproductibilité, l’exactitude mathématique et la conformité aux normes scientifiques les plus exigeantes.
1. Introduction théorique à la covariance et à son utilité en psychométrie
1.1 Définition statistique et conceptuelle de la covariance
La covariance constitue la mesure statistique fondamentale de la variabilité conjointe observée entre deux variables aléatoires quantitatives continues. D’un point de vue conceptuel, elle quantifie le degré auquel deux grandeurs numériques fluctuent de concert autour de leurs espérances mathématiques respectives. Lorsque deux variables exhibent une covariance non nulle, cela indique que les écarts individuels par rapport à la moyenne observée sur la première variable ont tendance à être systématiquement associés à des écarts de même sens ou de sens opposé sur la seconde variable. Cette mesure résume ainsi l’existence d’une dépendance linéaire entre deux séries de données sans toutefois restreindre son résultat dans un intervalle borné prédéfini.
La direction de cette dépendance linéaire est formellement traduite par le signe algébrique de la covariance. Une valeur positive indique une relation proportionnelle directe : les individus obtenant des scores supérieurs à la moyenne sur la variable initiale tendent également à manifester des scores supérieurs à la moyenne sur la variable dépendante ou associée. À l’inverse, une covariance négative témoigne d’une covariation inverse, où les performances élevées sur une épreuve s’associent statistiquement à des scores déficitaires ou inférieurs sur la seconde dimension. Lorsque les variables varient de manière totalement indépendante, la somme des produits croisés tend théoriquement vers zéro, révélant une absence d’association linéaire systématique au sein de la population étudiée.
Il est impératif d’établir une distinction épistémologique stricte entre l’observation d’une association non standardisée et l’inférence d’un lien causal. En psychométrie et en sciences du comportement, une covariance élevée entre deux mesures empiriques ne prouve nullement l’existence d’un effet causal direct entre les construits psychologiques sous-jacents. La covariation constatée peut être le produit de mécanismes confondants, de rétroactions dynamiques ou de l’influence non observée d’un trait latent commun. L’utilité fondamentale de la covariance réside plutôt dans sa capacité à préserver les échelles de variabilité originales des scores observés, permettant ainsi aux chercheurs de modéliser des systèmes complexes de variables indicatrices sans en dénaturer l’hétérogénéité métrique initiale.
1.2 Différence fondamentale entre covariance et corrélation de Pearson
La distinction majeure entre la covariance et le coefficient de corrélation linéaire de Pearson réside dans la dépendance absolue de la première aux unités de mesure empiriques des échelles utilisées. La covariance est une statistique dimensionnelle dont l’unité correspond exactement au produit des unités des deux variables analysées (par exemple, des points au carré, des millisecondes-points ou des centimètres-kilogrammes). Par conséquent, si un chercheur modifie arbitrairement l’échelle de notation d’un test psychométrique en multipliant les scores par une constante scalaire, la covariance entre ce test et d’autres épreuves sera mécaniquement multipliée par cette même constante, altérant drastiquement son amplitude brute sans pour autant modifier la nature statistique de la relation bivariée.
À l’opposé, la corrélation de Pearson constitue une version standardisée de la covariance. Elle s’obtient en divisant la covariance bivariée par le produit des écarts-types marginaux des deux variables considérées. Ce processus de standardisation élimine purement et simplement toute dimensionnalité, contraignant le coefficient résultant à osciller rigoureusement à l’intérieur d’un continuum fermé compris entre -1 et +1. Cette propriété sans dimension octroie à la corrélation une lisibilité immédiate quant à la force relative de l’association, indépendamment des systèmes de cotation adoptés par les concepteurs des tests psychologiques.
Le choix entre covariance brute et corrélation dépend étroitement des objectifs de modélisation poursuivis. Dans le cadre d’analyses exploratoires élémentaires ou lors de la communication de résultats descriptifs, la corrélation est privilégiée en raison de sa comparabilité directe entre des échelles psychologiques hétérogènes (par exemple, la comparaison entre un score de dépression mesuré sur une échelle de Likert de 0 à 60 et un temps de réaction chronométré en millisecondes). En revanche, pour les modélisations statistiques avancées, telles que l’analyse factorielle confirmatoire ou l’estimation de modèles à équations structurelles, la covariance brute est obligatoire. Elle conserve l’information critique relative à la dispersion réelle des scores, information qui s’avère indispensable pour comparer des groupes au moyen de tests d’invariance métrique ou pour évaluer la validité incrémentale d’un ensemble d’instruments.
1.3 Importance de la matrice de covariance dans la recherche psychologique
Au sein de la recherche psychologique moderne, la matrice de variance-covariance représente l’élément empirique central sur lequel repose l’évaluation psychométrique de la fidélité des épreuves standardisées. L’estimation de la cohérence interne, traditionnellement appréhendée à travers l’alpha de Cronbach ou l’oméga de McDonald, découle directement de la sommation des éléments diagonaux (les variances individuelles des items) et des éléments hors-diagonale (les covariances inter-items). Sans une matrice de covariance correctement estimée, l’évaluation précise de la part de variance attribuable au score vrai par rapport à la variance d’erreur de mesure devient mathématiquement irréalisable.
Dans le domaine de l’analyse factorielle confirmatoire (AFC), la matrice de covariance observée constitue la donnée empirique brute fondamentale que le modèle théorique tente de reproduire. Les algorithmes d’estimation cherchent à minimiser la divergence mathématique entre cette matrice de covariance observée et la matrice de covariance implicite ou théorique générée par les paramètres du modèle structural. La qualité d’ajustement du modèle théorique à la réalité empirique est directement fonction de la congruence entre ces deux matrices. Si la matrice de covariance empirique est tronquée ou mal conditionnée, l’ensemble du processus de validation de construit s’en trouve compromis.
Enfin, la matrice de covariance est le préalable incontournable à la vérification de l’invariance de mesure à travers des populations distinctes (par exemple, entre sexes, tranches d’âge ou groupes cliniques). Pour démontrer qu’un test évalue les mêmes attributs psychologiques avec une précision équivalente chez différents segments de la population, il est indispensable de comparer directement les structures de covariance non standardisées. La covariance offre ainsi une lentille analytique rigoureuse pour garantir que les différences observées entre les groupes reflètent de véritables variations dans le trait latent et non de simples artefacts de mise à l’échelle.
2. Fondements mathématiques de la matrice de covariance
2.1 Formulation algébrique de la covariance d’échantillon
L’estimation empirique de la covariance entre deux variables quantitatives distinctes, conventionnellement notées $X$ et $Y$, repose sur une formulation algébrique précise régie par les principes de l’échantillonnage statistique. Pour un ensemble d’observations appariées comprenant $n$ individus, la covariance d’échantillon, notée $s_{xy}$ ou $\text{Cov}(X, Y)$, est formellement définie par l’équation mathématique suivante :
$$\text{Cov}(X, Y) = \frac{\sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})}{n – 1}$$
Dans cette expression, $x_i$ et $y_i$ représentent respectivement les scores bruts observés pour le $i$-ème sujet sur chaque variable, tandis que $\bar{x}$ et $\bar{y}$ symbolisent les moyennes arithmétiques correspondantes calculées au sein de l’échantillon d’étude. Le numérateur correspond au produit croisé des écarts à la moyenne, cumulant ainsi les déviations conjointes de chaque participant.
Une distinction conceptuelle majeure doit être soulignée entre la formule théorique de la population et l’estimateur d’échantillon. Dans le cas d’une population finie exhaustive de taille $N$, le dénominateur de la formule est égal à $N$. Cependant, dès lors que le statisticien travaille sur un échantillon extrait d’une population parente, la division par $n$ engendre un biais systématique par sous-estimation de la variance et de la covariance réelles. L’introduction du dénominateur $n – 1$, correspondant aux degrés de liberté résiduels après estimation des deux moyennes empiriques, constitue la correction de Bessel. Cette correction garantit que l’estimateur résultant est mathématiquement sans biais, convergeant asymptotiquement vers le paramètre populationnel inconnu à mesure que la taille de l’échantillon s’accroît.
Par ailleurs, la covariance jouit de propriétés algébriques notables, au premier rang desquelles figure la symétrie absolue : $\text{Cov}(X, Y) = \text{Cov}(Y, X)$. Cette propriété découle directement de la commutativité de la multiplication appliquée aux produits des écarts $(x_i – \bar{x})(y_i – \bar{y}) = (y_i – \bar{y})(x_i – \bar{x})$. De plus, lorsque l’on calcule la covariance d’une variable avec elle-même, la formule devient :
$$\text{Cov}(X, X) = \frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n – 1} = s_x^2$$
La covariance d’une variable avec elle-même est donc strictement équivalente à la variance d’échantillon de cette variable.
2.2 Structure géométrique et propriétés de la matrice de variance-covariance
Lorsqu’un protocole expérimental psychologique examine simultanément un vecteur de $p$ variables quantitatives, l’ensemble des relations bivariées et des dispersions univariées est synthétisé sous la forme d’une matrice carrée d’ordre $p \times p$, désignée sous le nom de matrice de variance-covariance ou matrice de dispersion, généralement notée $\mathbf{\Sigma}$ (dans la population) ou $\mathbf{S}$ (dans l’échantillon). La structure canonique de cette matrice se présente comme suit :
$$\mathbf{S} = \begin{\bmatrix} s_1^2 &a\mp; s_{12} &a\mp; \cdots &a\mp; s_{1p} s_{21} &a\mp; s_2^2 &a\mp; \cdots &a\mp; s_{2p} \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots s_{p1} &a\mp; s_{p2} &a\mp; \cdots &a\mp; s_p^2 \end{\bmatrix}$$
Les éléments situés le long de la diagonale principale de la matrice ($s_j^2$ pour $j in {1, dots, p}$) représentent exclusivement les variances univariées d’échantillon pour chacune des variables mesurées. Ces valeurs sont rigoureusement non négatives et capturent la dispersion absolue des scores autour de leurs moyennes respectives. En revanche, les éléments situés hors de la diagonale principale ($s_{jk}$ où $j \neq k$) incarnent les covariances bivariées entre les paires de variables respectives.
En vertu de la propriété de commutativité exposée précédemment, $s_{jk} = s_{kj}$ pour toute paire d’indices. Par conséquent, la matrice $\mathbf{S}$ est rigoureusement symétrique par rapport à sa diagonale principale, ce qui implique que la matrice est égale à sa transposée : $\mathbf{S} = \mathbf{S}’$.
D’un point de vue géométrique et matriciel, une propriété fondamentale de toute matrice de covariance empirique valide est d’être semi-définie positive, et dans la pratique des échantillons non singuliers, définie positive. Algébriquement, une matrice symétrique $\mathbf{S}$ est dite définie positive si, pour tout vecteur non nul $\mathbf{z} in \mathbb{R}^p$, la forme quadratique associée satisfait la condition :
$$\mathbf{z}’ \mathbf{S} \mathbf{z} > 0$$
Cette contrainte géométrique garantit que la variance de toute combinaison linéaire possible des variables d’origine demeure strictement positive. Elle implique que l’ensemble des valeurs propres de la matrice sont strictement supérieures à zéro et que le déterminant de la matrice est strictement positif ($det(\mathbf{S}) > 0$). Cette propriété est indispensable pour inverser la matrice dans le cadre de calculs statistiques multivariés.
2.3 Lien formel avec la somme des carrés et des produits croisés (SPCP)
L’architecture algorithmique interne mise en œuvre au sein d’IBM SPSS Statistics pour dériver les covariances repose sur la manipulation d’une matrice intermédiaire dénommée matrice des sommes des carrés et des produits croisés (communément abrégée en SPCP ou matrice SSCP pour Sum of Squares and Cross-Products). Si l’on formalise les données empiriques sous la forme d’une matrice centrée $\mathbf{X}_c$ d’ordre $n \times p$, où chaque colonne représente une variable dont on a soustrait la moyenne d’échantillon, la matrice SPCP se calcule par le produit matriciel suivant :
$$\mathbf{SPCP} = \mathbf{X}_c’ \mathbf{X}_c$$
Le terme diagonal de cette matrice SPCP correspond à la somme des carrés des écarts à la moyenne ($\text{SCE}$) pour une variable donnée :
$$\text{SCE}_X = \sum_{i=1}^{n} (x_i – \bar{x})^2$$
Tandis que les éléments hors-diagonale correspondent à la somme des produits croisés des écarts ($\text{SPCE}$) :
$$\text{SPCE}_{XY} = \sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})$$
La conversion mathématique directe de la matrice SPCP vers la matrice de covariance sans biais s’effectue par l’application d’un scalaire d’ajustement représentant l’inverse des degrés de liberté résiduels :
$$\mathbf{S} = \frac{1}{n – 1} \mathbf{SPCP}$$
Cette décomposition illustre pourquoi SPSS affiche souvent de manière groupée les sommes des carrés, les produits croisés et les covariances dans ses sorties statistiques : la covariance n’est autre que le produit croisé standardisé par l’effectif d’échantillon ajusté.
3. Préparation et structuration des données psychologiques dans SPSS
3.1 Configuration des variables dans la Vue des variables
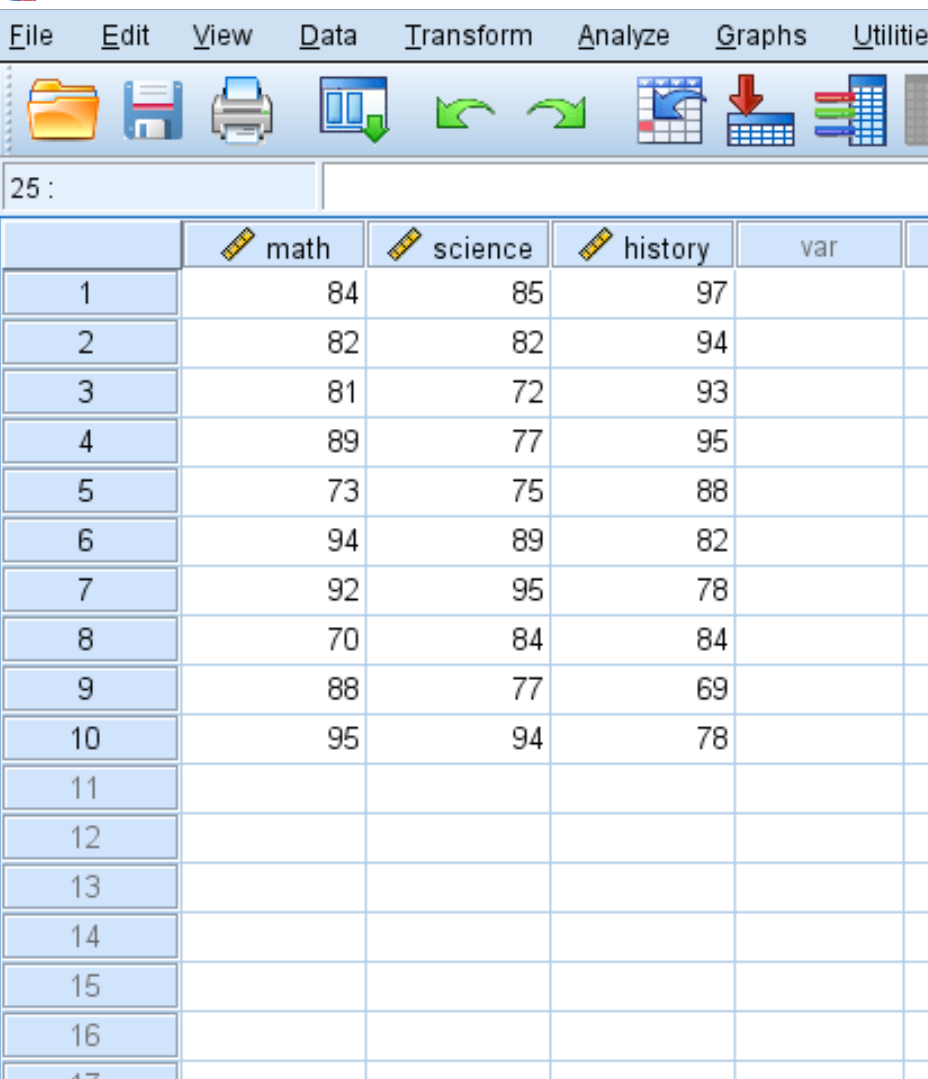
Avant de procéder au moindre calcul matriciel dans IBM SPSS Statistics, une configuration méticuleuse de la « Vue des variables » s’avère indispensable pour éviter toute erreur de calcul ou d’assignation logique. Chaque variable psychologique destinée à être intégrée dans la matrice de covariance doit impérativement être configurée avec le type « Numérique » (Numeric). Les variables malencontreusement codées en format « Chaîne » (String), même si elles ne contiennent que des chiffres, sont purement et simplement exclues des procédures d’analyse bivariée et multivariée par les routines sous-jacentes du logiciel.
Dans la colonne « Mesure » (Measure), l’analyste doit expressément assigner le statut « Échelle » (Scale) à toutes les dimensions continues (scores de tests, indices psychométriques, temps de réponse, échelles d’attitudes de type Likert traitées comme quasi-intervallaires). L’attribution adéquate de ce niveau de mesure permet à SPSS d’activer sans restriction l’ensemble des modules d’analyse paramétrique.
Il est recommandé d’attribuer des étiquettes de variables claires et explicites dans la colonne « Libellé » (Label). En l’absence d’étiquettes, SPSS utilise les identifiants techniques courts (colonne « Nom »), ce qui peut introduire des confusions lors de la manipulation de batteries de tests comprenant des dizaines d’épreuves aux intitulés abrégés. Enfin, la gestion des « Valeurs manquantes » (Missing Values) requiert une rigueur absolue : l’analyste doit déclarer explicitement les codes numériques affectés aux données non recueillies (par exemple, -99, 999 ou 99) afin qu’ils ne soient pas incorporés par erreur en tant que scores réels lors du calcul des écarts à la moyenne.
3.2 Vérification des postulats statistiques préalables
L’estimation exacte et l’interprétation pertinente d’une matrice de variance-covariance reposent sur plusieurs postulats distributionnels que le chercheur se doit d’auditer avec minutie. Le premier postulat concerne la normalité univariée et multivariée des distributions observées. Bien que le calcul de la covariance d’échantillon soit techniquement faisable sur des données asymétriques ou kurtotiques, la présence de distorsions sévères compromet l’efficacité des estimateurs sans biais et invalide les inférences fondées sur la loi normale multidimensionnelle.
Pour évaluer la normalité univariée, les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) doivent être examinés au moyen de la procédure Analyse > Statistiques descriptives > Explorer. Des valeurs standardisées oscillant au-delà de l’intervalle $[-2, +2]$ signalent des écarts marqués à la normalité nécessitant une vigilance particulière.
Le second postulat indispensable concerne la linéarité des associations bivariées. La covariance quantifie uniquement la composante linéaire de la variabilité conjointe. Si la relation fonctionnelle unissant deux construits psychologiques s’avère non linéaire (comme une courbe en U inversé décrivant la loi de Yerkes-Dodson reliant l’anxiété à la performance motrice), la covariance d’échantillon sous-estimera dramatiquement l’intensité réelle de l’association statistique, pouvant même afficher une valeur proche de zéro en présence d’une interdépendance parfaite mais curvilinéaire. L’inspection préalable de diagrammes de dispersion matriciels (Graphes > Générateur de graphiques ou Anciennes boîtes de dialogue > Dispersion/Points > Matrice de dispersion) offre un moyen visuel efficace pour s’assurer de l’adéquation de l’hypothèse de linéarité avant d’exécuter les routines matricielles.
Enfin, le dépistage des valeurs aberrantes univariées et multivariées s’avère crucial. En raison de la présence du terme quadratique $(x_i – \bar{x})(y_i – \bar{y})$ dans le numérateur de la covariance, une seule observation aberrante située aux extrémités conjointes de l’espace multivarié peut distordre de manière disproportionnée le signe et l’amplitude de la covariance estimée. Le recours à la distance de Mahalanobis, calculable via la procédure de régression linéaire, permet d’identifier et d’isoler les profils multivariés atypiques dont l’influence indue menace la stabilité de la matrice.
3.3 Gestion des données manquantes en psychologie expérimentale
Les protocoles de recherche en sciences sociales sont fréquemment confrontés au problème des observations incomplètes, qu’il s’agisse d’omissions involontaires de participants ou de défections en cours d’évaluation longitudinale. Face à des données manquantes, le choix de la méthode d’exclusion au sein d’IBM SPSS influe directement sur les propriétés structurelles de la matrice de covariance résultante. Les deux approches classiques intégrées dans les boîtes de dialogue sont la suppression par liste (listwise) et la suppression par paire (pairwise).
L’exclusion par liste (listwise deletion) restreint le calcul de l’ensemble des variances et covariances au seul sous-échantillon d’individus présentant des réponses complètes sur la totalité des variables intégrées dans l’analyse. Cette méthode garantit formellement que tous les éléments matriciels sont calculés sur une base d’observation rigoureusement identique ($n$ constant), assurant ainsi que la matrice de covariance résultante est mathématiquement consistante et définie semi-positive. Toutefois, elle présente l’inconvénient d’une perte substantielle de puissance statistique si les omissions sont dispersées à travers de nombreux participants.
À l’inverse, l’exclusion par paire (pairwise deletion) calcule chaque variance et chaque covariance séparément en exploitant toutes les observations disponibles pour la paire de variables concernée. L’effectif effectif $n_{jk}$ varie alors d’une cellule à l’autre de la matrice. Si cette approche permet d’optimiser le volume d’informations exploitées, elle introduit un danger méthodologique majeur : la disparité des bases d’échantillonnage entre cellules peut briser la cohérence mathématique interne de la matrice. Il en résulte fréquemment des matrices dites « non définies positives », caractérisées par des déterminants négatifs ou nuls, qui provoquent l’échec immédiat des procédures d’analyse factorielle ou d’équations structurelles ultérieures.
Pour prévenir ces écueils, le recours aux techniques modernes d’imputation multiple, disponibles via le module dédié Analyse > Imputation multiple de SPSS, constitue la recommandation méthodologique préférentielle. En générant plusieurs jeux de données complets fondés sur des modèles d’imputation stochastique, cette méthode préserve l’intégrité matricielle tout en modélisant fidèlement l’incertitude liée aux valeurs absentes.
4. Procédure standard sous SPSS : Analyse des corrélations bivariées
4.1 Navigation au sein de l’interface utilisateur de SPSS
L’approche la plus accessible et directe pour générer une matrice de variance-covariance dans IBM SPSS Statistics repose sur le détournement maîtrisé de la procédure conventionnelle d’analyse des corrélations. En dépit de son appellation orientée vers les coefficients sans dimension, ce module dissimule sous ses paramètres avancés un algorithme complet de calcul des produits croisés et des covariances brutes non standardisées.
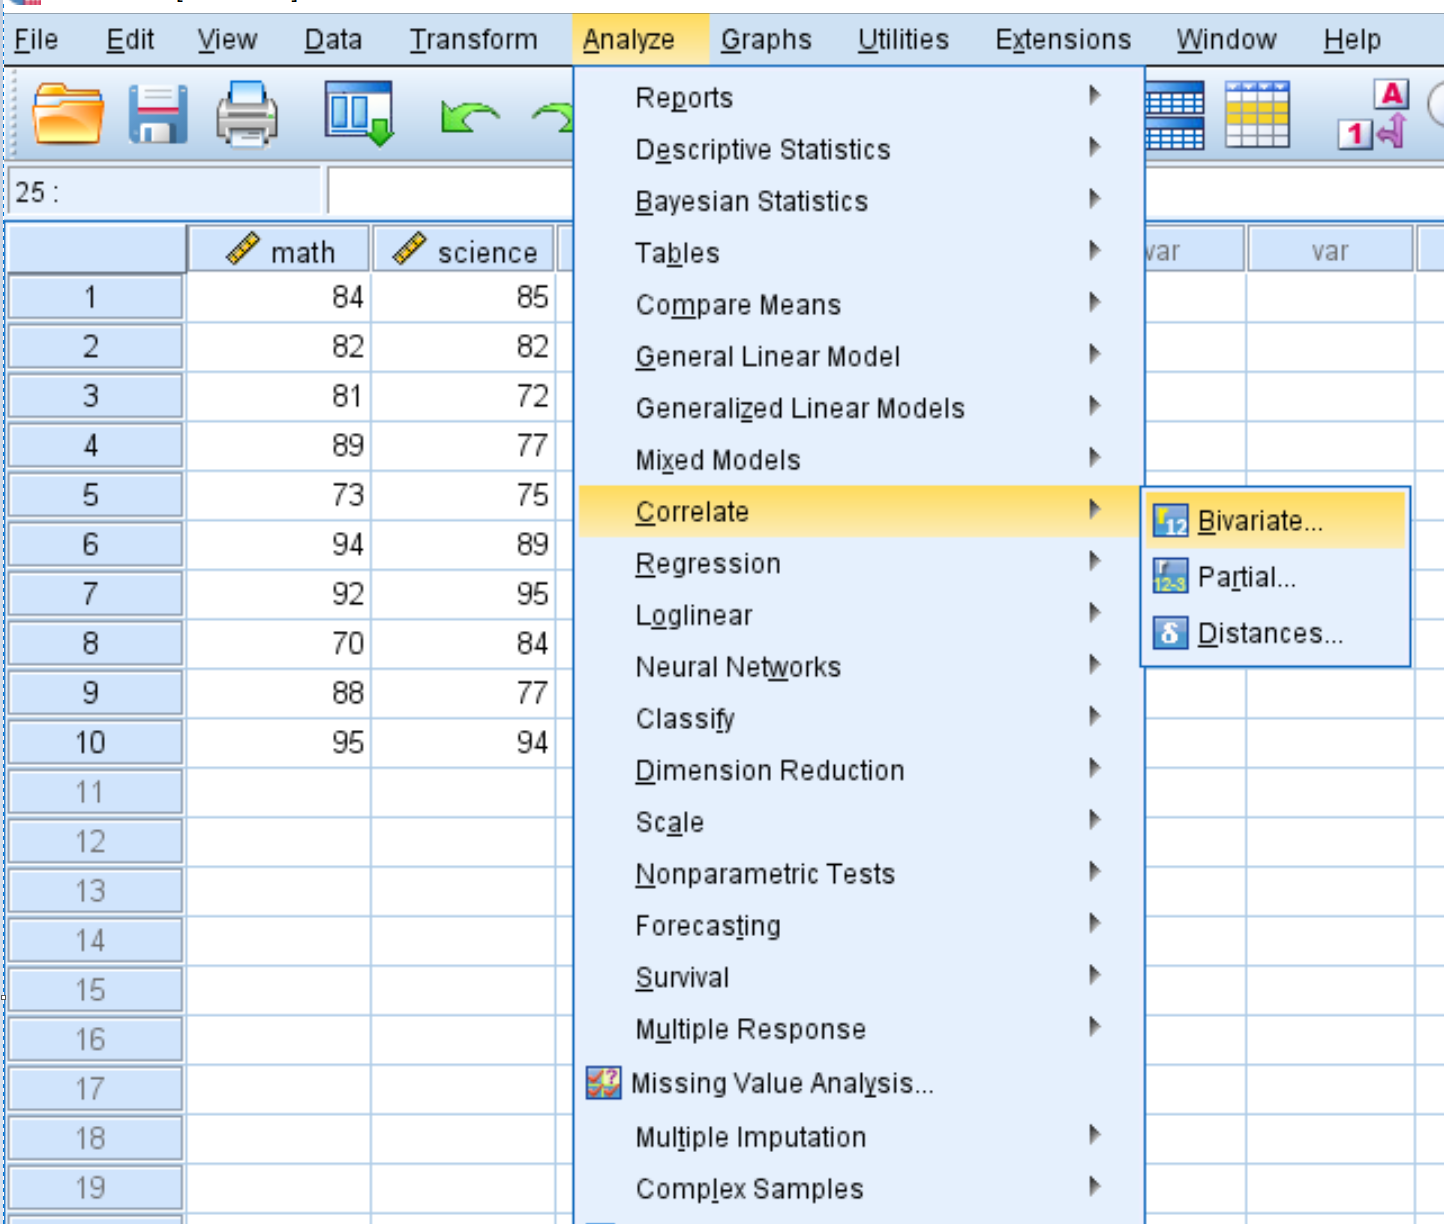
L’accès à cette fonctionnalité s’effectue via le ruban supérieur de l’application en suivant le cheminement hiérarchique suivant : Analyse > Corrélation > Bivariée… (dans la version anglaise : Analyze > Correlate > Bivariate…). L’activation de cette commande ouvre la boîte de dialogue principale dédiée aux corrélations bivariées.
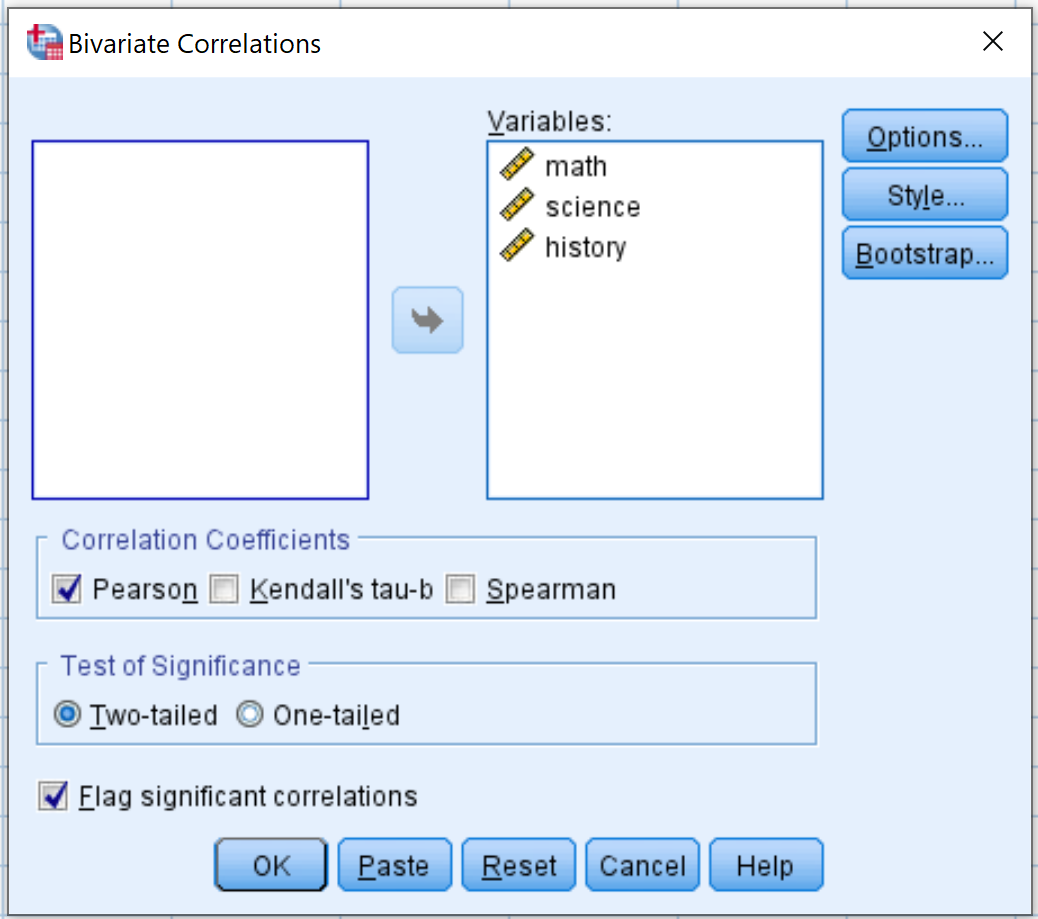
Au sein de cette interface, le panneau de gauche liste l’intégralité des variables déclarées dans le fichier actif. L’utilisateur doit identifier et sélectionner les variables quantitatives continues qu’il désire inclure dans l’analyse matricielle, puis les transférer vers le panneau de droite intitulé « Variables » au moyen du bouton de transfert central fléché. Par défaut, SPSS coche la case correspondant au coefficient de « Pearson » dans la section relative aux coefficients de corrélation, ainsi que le test de significativité « Bilatéral » (Two-tailed). Pour extraire les covariances, l’utilisateur ne doit pas valider immédiatement la boîte de dialogue, mais se diriger vers les options de paramétrage secondaire.
4.2 Configuration des options pour l’extraction de la covariance
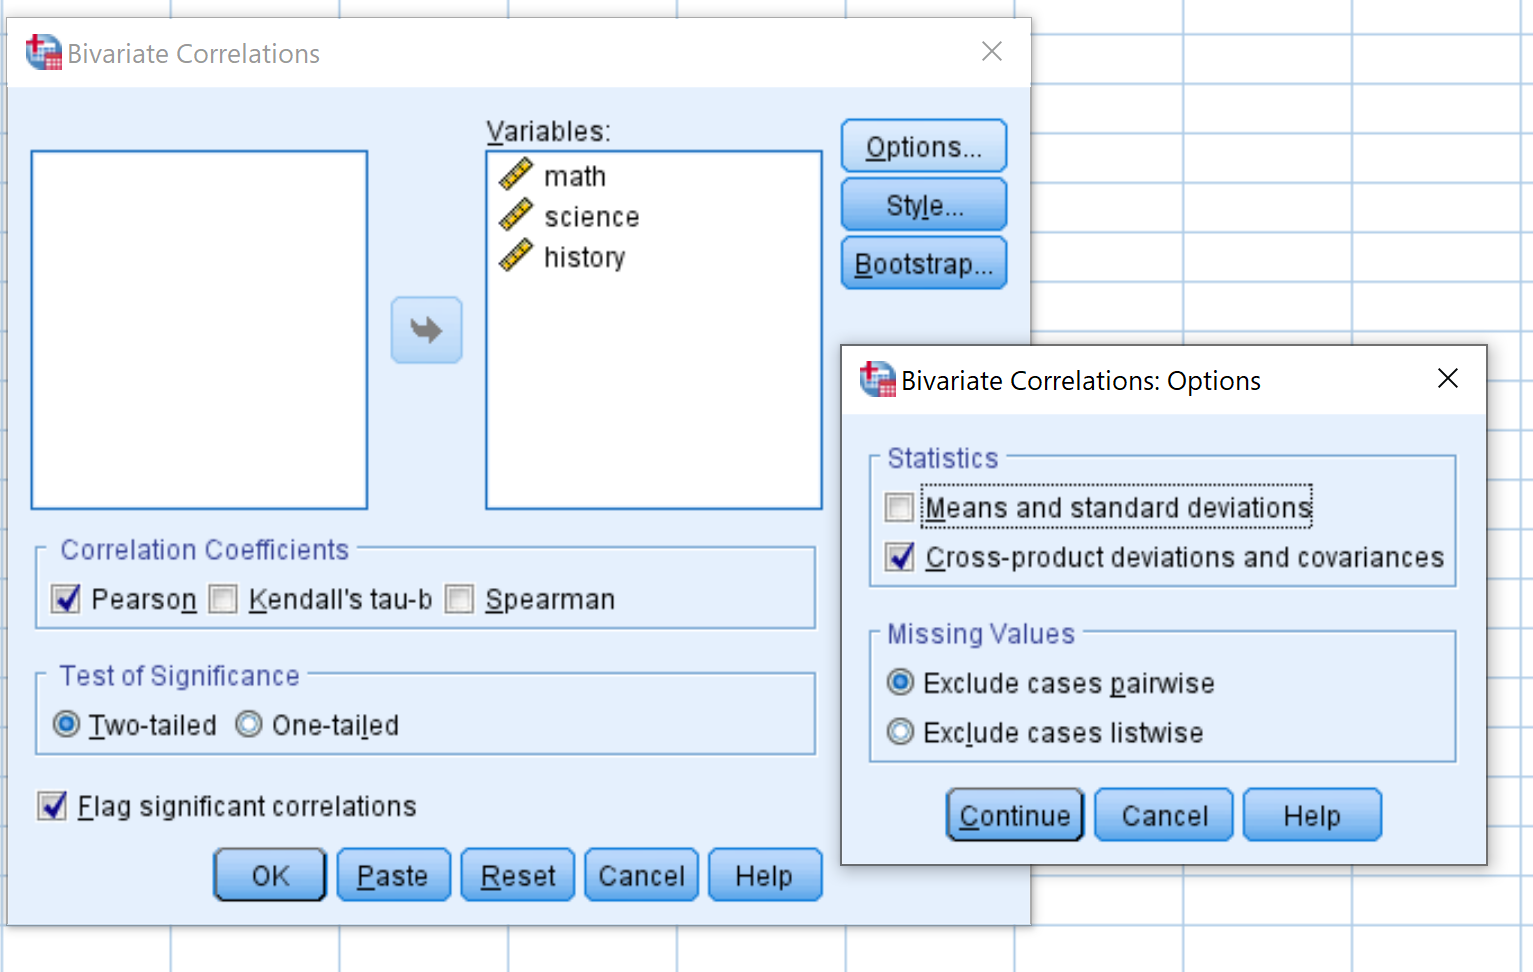
L’étape charnière permettant d’ordonner à SPSS d’afficher la matrice de covariance réside dans l’activation du bouton « Options… », positionné sur le flanc droit de la boîte de dialogue principale. Un clic sur ce bouton provoque l’ouverture d’une fenêtre de configuration subsidiaire intitulée « Corrélations bivariées : Options ».
À l’intérieur de cette sous-fenêtre, la section supérieure nommée « Statistiques » propose plusieurs cases à cocher. L’analyste doit impérativement activer la seconde case, libellée « Écarts et covariances des produits croisés » (dans l’édition anglaise du logiciel : Cross-product deviations and covariances). Cette option donne l’instruction au moteur de calcul statistique d’extraire la somme des produits croisés des écarts à la moyenne ainsi que les covariances sans biais associées pour chaque cellule bivariée.
Dans la section inférieure de cette même fenêtre, intitulée « Valeurs manquantes », l’utilisateur doit arbitrer scrupuleusement entre les deux modes de traitement décrits précédemment : « Exclure les observations par liste » (Exclude cases listwise) ou « Exclure les observations par analyse » (Exclude cases pairwise). Comme stipulé antérieurement, afin de garantir la cohérence mathématique de la matrice globale et d’assurer sa stricte définition positive, il est vivement recommandé de cocher l’option par liste, particulièrement si la matrice est destinée à alimenter ultérieurement des calculs d’analyse multivariée.
Une fois ces paramètres méthodologiques rigoureusement assignés, l’utilisateur valide la configuration en cliquant sur le bouton « Poursuivre » (Continue). À ce stade, plutôt que de presser le bouton « OK » pour une exécution immédiate, il est méthodologiquement recommandé d’appuyer sur le bouton « Coller » (Paste) afin de générer la trace écrite de l’opération au sein d’une fenêtre de syntaxe SPSS.
4.3 Automatisation via la syntaxe de commande SPSS (Command Syntax)
L’utilisation de la syntaxe de commande SPSS représente le standard méthodologique d’excellence en recherche quantitative, assurant la transparence intégrale, l’auditabilité et la reproductibilité computationnelle parfaite des traitements appliqués aux données. La procédure de corrélation bivariée configurée pour l’extraction de covariance se formalise au travers de l’instruction canonique suivante :
CORRELATIONS
/VARIABLES=Item1 Item2 Item3 Item4
/PRINT=TWOTAIL NOSIG
/STATISTICS=XPROD
/MISSING=LISTWISE.
L’examen minutieux des sous-ordres qui composent cette syntaxe éclaire le fonctionnement du moteur statistique d’IBM SPSS :
- Le mot-clé /VARIABLES spécifie nominativement la liste ordonnée des variables quantitatives entrant dans le calcul de la matrice. Les variables doivent être séparées par un espace ou indiquées par la notation abrégée
Item1 TO Item4lorsque les colonnes sont consécutives dans le fichier. - Le sous-ordre /STATISTICS=XPROD constitue l’instruction maîtresse : c’est cette déclaration explicite qui ordonne l’impression des écarts des produits croisés et des covariances bivariées. Sans ce sous-ordre, SPSS restreint sa sortie aux stricts coefficients de Pearson.
- Le paramètre /MISSING=LISTWISE verrouille le filtrage des données incomplètes en appliquant une élimination globale par liste, écartant tout risque d’incohérence inter-cellules induit par une exclusion par paire. Si l’analyste désirait expressément un traitement par paire, il substituerait cette commande par
/MISSING=PAIRWISE. - L’argument optionnel
NOSIGadjoint à la ligne/PRINTpermet d’alléger la table de sortie en occultant les niveaux de significativité statistique ($p$-values) associés aux corrélations, évitant ainsi de surcharger visuellement la matrice de résultats.
L’exécution de cette syntaxe s’opère en sélectionnant le bloc de texte au sein de l’éditeur de syntaxe et en cliquant sur l’icône de flèche verte (« Exécuter la sélection ») ou via le raccourci clavier standard Ctrl+R (sur Windows) ou Cmd+R (sur macOS).
5. Méthodes alternatives pour extraire la matrice de covariance dans SPSS
5.1 Extraction par la procédure de réduction des dimensions (Analyse factorielle)
Au-delà du module standard des corrélations, IBM SPSS Statistics offre une voie alternative particulièrement élégante pour générer et manipuler des matrices de covariance au travers de son module de réduction dimensionnelle. Cette méthode s’avère particulièrement féconde lorsqu’un chercheur souhaite comparer de manière synoptique les propriétés statistiques de la matrice de corrélation et celles de la matrice de covariance sur un même corpus de variables psychométriques.
Le protocole de navigation pour accéder à cette interface s’établit via Analyse > Réduction des dimensions > Analyse factorielle… (Analyze > Dimension Reduction > Factor…). Après avoir transféré les variables quantitatives continues d’intérêt dans le volet « Variables », l’utilisateur clique sur le bouton « Descriptifs… » (Descriptives). Au sein de la boîte de dialogue secondaire qui s’affiche, dans la section intitulée « Matrice de corrélation », il convient de cocher l’option « Coefficients » ainsi que l’option « Significativité ».
Toutefois, la spécification déterminante se situe au niveau du bouton « Extraction… ». Dans la sous-fenêtre d’extraction, l’interface propose une option intitulée « Analyser » comprenant deux boutons radio distincts : « Matrice de corrélation » et « Matrice de covariance ». En sélectionnant expressément le bouton radio « Matrice de covariance », le chercheur force l’ensemble de l’algorithme d’extraction (qu’il s’agisse de l’analyse en composantes principales ou du maximum de vraisemblance) à opérer directement sur les données non standardisées. Bien que l’objectif premier soit la réduction factorielle, le tableau intermédiaire généré dans la visionneuse de résultats présente la matrice de covariance initiale complète utilisée pour amorcer les factorisations, fournissant ainsi une table de référence rigoureusement formatée.
5.2 Utilisation de la syntaxe matricielle SPSS (MATRIX / END MATRIX)
Pour les méthodologistes et analystes de données avancés requérant un contrôle absolu sur les opérations algébriques, IBM SPSS Statistics intègre un sous-système de calcul matriciel programmable complet dénommé processeur MATRIX. Ce langage matriciel permet d’exécuter des calculs en algèbre linéaire directement sur les matrices de données, s’affranchissant totalement des contraintes des boîtes de dialogue classiques et des tableaux préformatés de la visionneuse.
L’extraction d’une matrice de variance-covariance via cet environnement programmable s’effectue en ouvrant un document de syntaxe vierge et en saisissant un bloc d’instructions encadré par les commandes maîtresses MATRIX et END MATRIX :
MATRIX.
GET X /VARIABLES=Item1 Item2 Item3 Item4 /MISSING=OMIT.
COMPUTE N = NROW(X).
COMPUTE ONE = MAKE(N, 1, 1).
COMPUTE XC = X – (ONE * CSUM(X)) / N.
COMPUTE COV = (T(XC) * XC) / (N – 1).
PRINT COV /TITLE= »Matrice de Variance-Covariance d’Echantillon Sans Biais ».
END MATRIX.
Dans ce programme, la fonction GET lit les données brutes des variables spécifiées et les charge sous forme d’une matrice mathématique $\mathbf{X}$ en omettant les observations incomplètes. La routine calcule l’effectif effectif $n$ via NROW(X), puis génère une matrice centrée $\mathbf{X}_c$ (notée XC) en soustrayant de chaque score brut la moyenne de sa colonne respective. L’opération matricielle (T(XC) * XC) / (N - 1) calcule le produit de la matrice transposée $\mathbf{X}_c’$ par $\mathbf{X}_c$, divisé par $n – 1$. L’instruction PRINT COV affiche immédiatement dans la console de sortie la matrice carrée résultante avec une précision décimale maximale, exempte de tout artifice de mise en page encombrant.
5.3 Génération via la régression linéaire multiple
Une confusion conceptuelle récurrente en analyse multivariée doit être impérativement levée concernant l’extraction de matrices de covariance par le truchement de la modélisation de régression linéaire. Lorsque l’analyste explore le menu Analyse > Régression > Linéaire…, la boîte de dialogue secondaire « Statistiques… » présente une case à cocher intitulée « Matrice de covariance » (Covariance matrix).
Il est capital de comprendre que cette option ne génère pas la matrice de covariance des variables observées ($X$ et $Y$), mais produit la matrice de variance-covariance asymptotique des coefficients de régression estimés (les coefficients $\hat{\beta}_j$). Dans cette matrice de dimension $(k + 1) \times (k + 1)$ (où $k$ est le nombre de régresseurs plus la constante), la diagonale principale contient les variances d’échantillonnage de chaque coefficient de régression, c’est-à-dire les carrés de leurs erreurs types respectives ($\text{SE}_{\hat{\beta}}^2$). Les éléments hors-diagonale quantifient les covariances d’échantillonnage entre les estimateurs, traduisant le degré auquel la surévaluation stochastique d’un paramètre $\beta_j$ s’associe à la sous-évaluation ou surévaluation d’un autre coefficient $\beta_m$.
Bien que cette matrice soit hautement précieuse pour diagnostiquer la multicolinéarité sévère ou pour conduire des tests de Wald sur des restrictions linéaires complexes, elle ne saurait en aucun cas être substituée à la matrice de covariance des données psychométriques brutes. Les chercheurs doivent donc veiller à ne pas confondre la dispersion des données empiriques et la dispersion d’échantillonnage des paramètres de régression.
6. Anatomie et décomposition du tableau de sortie SPSS
6.1 Comprendre les sections du tableau ‘Corrélations’
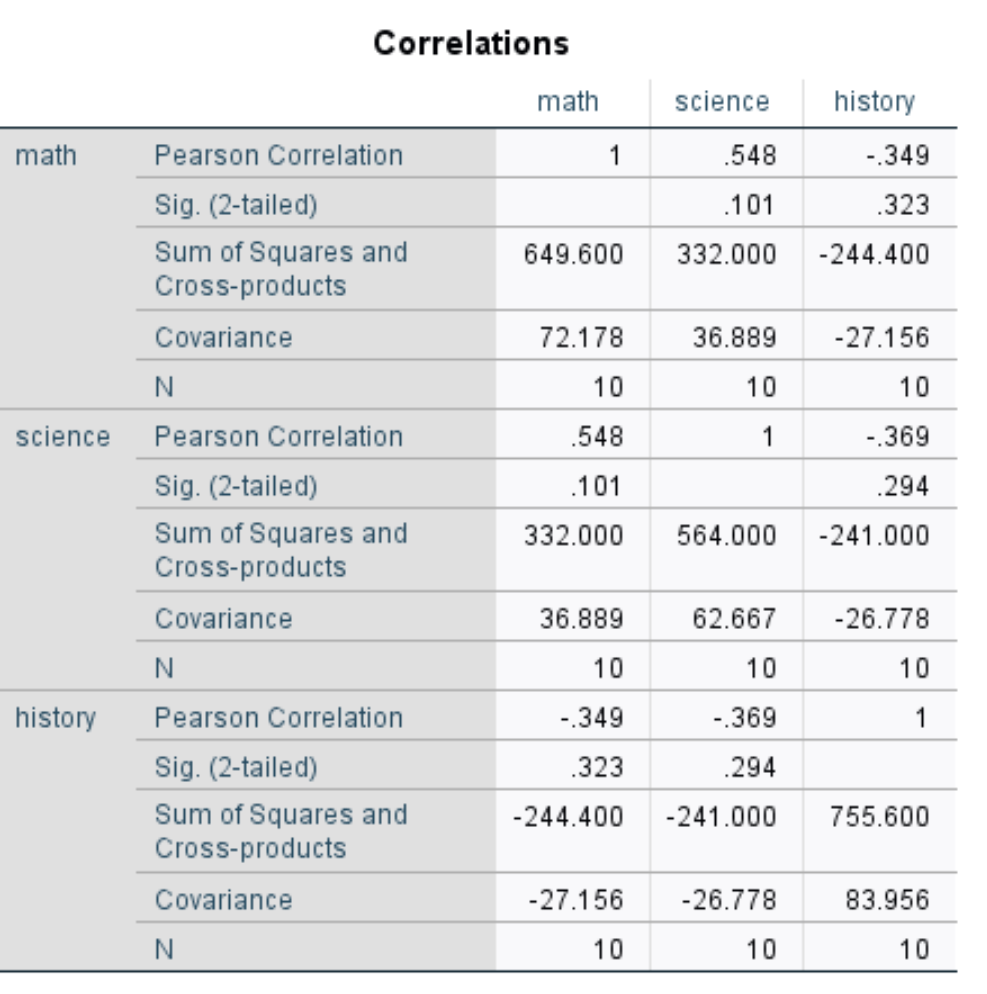
L’exécution de la procédure bivariée configurée avec le sous-ordre /STATISTICS=XPROD produit dans la visionneuse de résultats d’IBM SPSS Statistics un tableau unique intitulé « Corrélations » (Correlations). Malgré son intitulé standard, ce tableau multidimensionnel condense une quantité substantielle d’informations statistiques au sein de chaque intersection de ligne et de colonne. Pour chaque paire de variables analysée, SPSS segmente la cellule en plusieurs strates distinctes empilées verticalement.
La première strate renseigne le classique coefficient de « Corrélation de Pearson » ($r$), qui mesure la dépendance linéaire standardisée bornée entre -1 et +1. Juste en dessous figure la ligne « Sig. (bilatérale) », qui indique la probabilité asymptotique critique ($p$-value) associée au test de nullité de la corrélation dans la population parentale. Lorsque les options de produits croisés ont été sollicitées, deux lignes fondamentales s’intercalent au sein de cette décomposition :
- La ligne « Somme des carrés et des produits croisés » (Sum of Squares and Cross-products) : pour les intersections diagonales (une variable confrontée à elle-même), cette valeur indique la somme des carrés des écarts à la moyenne ($\text{SCE} = \sum (x_i – \bar{x})^2$). Pour les intersections hors-diagonale, elle fournit la somme des produits croisés des écarts conjointes ($\text{SPCE} = \sum (x_i – \bar{x})(y_i – \bar{y})$).
- La ligne « Covariance » : cette valeur statistique correspond précisément à l’estimation sans biais de la dispersion conjointe non standardisée, résultat direct de la division de la ligne précédente par ses degrés de liberté ($n – 1$).
- La ligne finale « N » : elle récapitule l’effectif exact de l’échantillon d’individus ayant contribué au calcul statistique spécifique de la cellule considérée.
6.2 Vérification manuelle des calculs fournis par SPSS
Afin de valider rigoureusement les calculs opérés par la routine computationnelle de SPSS et d’en maîtriser l’architecture numérique, il est formateur de procéder à la vérification arithmétique manuelle des éléments imprimés dans la table de sortie. Considérons, à titre d’illustration méthodologique, une cellule de corrélation bivariée liant un test de mémoire de travail ($X$) et un test de raisonnement fluide ($Y$), administrés à une cohorte de $n = 150$ participants sans aucune donnée manquante.
Dans la sortie SPSS relative à cette cellule bivariée spécifique, le logiciel imprime à la ligne « Somme des carrés et des produits croisés » une valeur numérique de $1432{,}850$, accompagnée d’un effectif $N = 150$. Conformément aux principes de l’estimation d’échantillon sans biais, les degrés de liberté associés à cette estimation bivariée sont définis par $df = n – 1 = 150 – 1 = 149$. Pour dériver manuellement la covariance empirique, il suffit d’effectuer la division du produit croisé par les degrés de liberté résiduels :
$$\text{Cov}(X, Y) = \frac{1432{,}850}{149} \approx 9{,}61644$$
En inspectant la ligne immédiatement inférieure intitulée « Covariance » dans la cellule de l’output SPSS, on constate que le logiciel affiche précisément la valeur arrondie de $9{,}616$. De même, si l’on examine la cellule située sur la diagonale principale pour la seule variable $X$, affichant une somme des carrés de $2150{,}400$, le rapport $2150{,}400 / 149$ génère une covariance d’une variable avec elle-même égale à $14{,}432$, ce qui correspond mathématiquement à la variance d’échantillon $s_x^2$.
Les légères divergences perceptibles entre un recalcul manuel externe et l’output final résultent exclusivement des troncatures d’affichage à trois décimales configurées par défaut dans le tableau pivot de SPSS. Le moteur interne réalise quant à lui ses calculs en double précision (norme IEEE 754 à 64 bits), garantissant une rigueur arithmétique totale.
6.3 Reconnaissance de la symétrie matricielle dans l’output
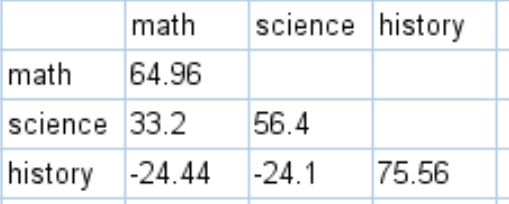
L’observation attentive du tableau global des corrélations met en exergue la symétrie axiale inhérente à la structure mathématique de la covariance. Le tableau généré par SPSS prend la forme d’une matrice carrée où chaque variable apparaît simultanément en tête de colonne et en en-tête de ligne. Si l’analyste trace mentalement une ligne oblique reliant le coin supérieur gauche au coin inférieur droit — matérialisant la diagonale principale des variances univariées —, il observe une identité parfaite entre les cellules symétriques.
Ainsi, la cellule croisant la variable 1 en ligne avec la variable 2 en colonne présente des valeurs de produits croisés, de covariance, de corrélation et de significativité rigoureusement identiques à la cellule croisant la variable 2 en ligne avec la variable 1 en colonne. Cette redondance est une conséquence directe de la commutativité du produit scalaire des vecteurs centrés :
$$\text{Cov}(X_j, X_k) = \text{Cov}(X_k, X_j)$$
Pour la rédaction des rapports de recherche scientifique, cette dualité symétrique rend superflue la publication intégrale des deux triangles matriciels. La convention méthodologique préconise quasi-systématiquement de ne retranscrire que le triangle inférieur de la matrice (c’est-à-dire l’ensemble des éléments situés strictement sous la diagonale principale), allégeant substantiellement la charge cognitive de lecture tout en préservant l’exhaustivité des informations statistiques collectées.
7. Interprétation statistique et psychométrique des covariances
7.1 Interprétation du signe et du sens de la relation
L’analyse substantielle d’une matrice de variance-covariance débute invariablement par l’examen minutieux de la polarité algébrique des coefficients non diagonaux. Le signe de la covariance informe directement sur la trajectoire synchronisée des variations interindividuelles au sein de la population échantillonnée. Une covariance positive entre deux dimensions psychologiques révèle une congruence développementale ou fonctionnelle : les participants manifestant un niveau supérieur sur le premier attribut tendent de manière consistante à extérioriser des scores élevés sur le second construit.
Dans le domaine de la neuropsychologie, une covariance positive systématique entre des scores obtenus à des tests de flexibilité cognitive, de fluence verbale et d’inhibition comportementale illustre l’action d’un facteur général d’efficacité exécutive. À l’inverse, l’émergence d’une covariance négative traduit une opposition fonctionnelle ou un compromis comportemental (trade-off). Par exemple, dans une épreuve d’attention soutenue chronométrée, une covariance négative prononcée entre la rapidité moyenne d’exécution motrice et le taux global d’erreurs commises matérialise le classique compromis vitesse-précision.
Lorsque la covariance bivariée oscille dans des valeurs infinitésimales proches de zéro, elle traduit une orthogonalité statistique, signifiant que la connaissance des déviations individuelles sur le premier domaine n’offre aucun pouvoir prédictif linéaire sur le comportement manifesté lors du second test. Cependant, l’analyste clinique doit demeurer particulièrement prudent : une covariance nulle signale l’absence de relation linéaire, mais ne permet pas de conclure à l’indépendance stochastique totale si des relations complexes d’ordre supérieur ou non linéaires existent entre les variables.
7.2 Dépendance d’échelle et défi de l’ampleur absolue
L’un des défis majeurs posés par l’interprétation directe des valeurs d’une matrice de covariance découle de leur dépendance métrique absolue à l’égard des échelles de cotation adoptées par les concepteurs des tests psychométriques. Contrairement aux coefficients de corrélation ou aux indices d’ampleur d’effet standardisés (d de Cohen), l’amplitude numérique brute d’une covariance ne véhicule en elle-même aucune indication universelle sur la force de la relation.
À titre d’exemple, supposons une covariance bivariée estimée à $150{,}2$ entre une échelle de dépression et une échelle d’anxiété. À première vue, ce chiffre d’apparence volumineuse pourrait suggérer une association d’une vigueur exceptionnelle. Toutefois, si l’échelle de dépression est cotée sur un intervalle de score allant de 0 à 500 (avec un écart-type empirique $s_x = 45$) et que l’inventaire d’anxiété s’étend de 0 à 300 (avec un écart-type $s_y = 35$), cette covariance brute de $150{,}2$ correspond en réalité à un coefficient de corrélation linéaire standardisé modeste :
$$r = \frac{150{,}2}{45 \times 35} = \frac{150{,}2}{1575} \approx 0{,}095$$
Cette association linéaire est statistiquement négligeable en dépit d’une covariance brute chiffrée à plus de cent unités.
Inversement, deux micro-indices de performance cognitive mesurés sur des échelles de Likert très resserrées allant de 1 à 5 points (avec des écarts-types de l’ordre de $0{,}60$) peuvent afficher une covariance brute d’apparence dérisoire de $0{,}30$. Or, cette modeste valeur dissimule une interdépendance linéaire substantielle :
$$r = \frac{0{,}30}{0{,}60 \times 0{,}60} = \frac{0{,}30}{0{,}36} \approx 0{,}833$$
Ce résultat illustre un lien bivarié extrêmement fort. Il est donc formellement prohibé d’évaluer la robustesse ou l’importance clinique d’une relation à la seule lecture nominale de la magnitude de sa covariance brute sans la contextualiser immédiatement à l’aune des variances marginales des instruments considérés.
7.3 Passage analytique de la covariance à la corrélation
Pour surmonter l’opacité métrique des covariances brutes lors des étapes d’exploration descriptive des données, le chercheur doit maîtriser la conversion analytique bidirectionnelle unissant la matrice de covariance à la matrice de corrélation. La dérivation du coefficient de corrélation linéaire de Pearson à partir des données brutes de dispersion s’opère par l’application formelle de l’équation standardisée :
$$r_{xy} = \frac{\text{Cov}(X, Y)}{\sqrt{s_x^2} \cdot \sqrt{s_y^2}} = \frac{s_{xy}}{s_x s_y}$$
Cette conversion se réalise directement à partir des informations extraites du tableau multidimensionnel généré par SPSS. Il suffit d’extraire la valeur de la covariance bivariée positionnée à l’intersection des deux variables, puis de la diviser par la racine carrée du produit des deux variances respectives situées sur la diagonale principale du même tableau. Sur le plan matriciel, cette transformation s’exprime sous une forme synthétique élégante :
$$\mathbf{R} = \mathbf{D}^{-1/2} \mathbf{S} \mathbf{D}^{-1/2}$$
Dans cette formulation, $\mathbf{S}$ symbolise la matrice de variance-covariance d’échantillon, $\mathbf{D} = \text{diag}(\mathbf{S})$ représente une matrice diagonale contenant exclusivement les variances univariées ($s_j^2$) sur sa diagonale principale (tous ses autres éléments étant nuls), et $\mathbf{D}^{-1/2}$ désigne la matrice diagonale inverse des écarts-types ($1/s_j$). Le produit matriciel résultant $\mathbf{R}$ constitue la matrice de corrélation standardisée exempte d’unités métriques.
8. Diagnostic des anomalies et gestion des erreurs fréquentes
8.1 Le problème des matrices non définies positives
L’une des anomalies statistiques les plus critiques rencontrées lors du traitement des matrices de covariance dans IBM SPSS ou lors de leur exportation vers des logiciels de modélisation structurale réside dans l’apparition d’une matrice « non définie positive » (non-positive definite matrix). Sur le plan mathématique, cette pathologie matricielle signifie que la matrice possède un déterminant négatif ou nul ($det(\mathbf{S}) le 0$) ou qu’au moins une de ses valeurs propres (eigenvalues) est négative. Cette situation viole le postulat fondamental selon lequel la variance de toute combinaison linéaire de variables doit être strictement positive.
L’origine méthodologique la plus fréquente de ce dysfonctionnement réside dans l’utilisation imprudente de la suppression par paire des valeurs manquantes (pairwise deletion). Lorsque les effectifs effectifs $n_{jk}$ oscillent de manière hétérogène d’une cellule à l’autre en raison de patrons de données manquantes non aléatoires, les covariances résultantes peuvent devenir mutuellement incompatibles sur le plan géométrique, brisant l’espace euclidien des données. Une autre cause fréquente est l’introduction simultanée de variables dont certaines sont des combinaisons linéaires exactes d’autres (dépendance linéaire parfaite), ce qui engendre une singularité absolue.
Les conséquences de cette anomalie sont bloquantes : impossibilité mathématique d’inverser la matrice ($\mathbf{S}^{-1}$ n’existe pas), avortement des analyses factorielles confirmatoires et génération d’erreurs fatales sous les logiciels de modélisation par équations structurelles tels qu’IBM SPSS Amos. Pour pallier cette anomalie sous SPSS, le chercheur doit réestimer sa matrice en imposant impérativement une élimination rigoureuse par liste (listwise), ou recourir à des algorithmes d’imputation multiple pour restaurer la cohérence géométrique interne des données observées.
8.2 Multicolinéarité et singularité entre construits psychologiques
La multicolinéarité sévère et la singularité constituent deux autres écueils majeurs susceptibles d’altérer la validité de la matrice de covariance. La singularité désigne une configuration limite où une variable observée est mathématiquement redondante, pouvant être prédite à $100%$ par une combinaison linéaire exacte d’autres variables de la batterie. La multicolinéarité décrit quant à elle un état où deux ou plusieurs variables sont extrêmement corrélées ($r > 0{,}90$ ou covariance disproportionnellement proche du produit direct de leurs écarts-types), révélant qu’elles mesurent exactement le même attribut psychologique sans apporter de variance résiduelle propre.
Pour diagnostiquer précocement la singularité ou la quasi-colinéarité au sein d’une matrice de variance-covariance sous SPSS, l’analyste peut inspecter le déterminant matriciel. Dans la procédure d’analyse factorielle, l’activation de l’option « Déterminant » dans la fenêtre des descriptifs permet d’extraire cette valeur scalaire. Un déterminant excessivement bas (par exemple $det(\mathbf{S}) < 0{,}00001$) alerte sur une quasi-singularité imminente qui déstabilisera l'inversion de la matrice et gonflera considérablement la variance des estimateurs.
Les solutions correctives nécessitent des décisions théoriques éclairées : l’analyste doit identifier les items ou sous-tests psychologiques redondants et procéder soit à la suppression pure et simple de l’un des indicateurs colinéaires, soit à leur agrégation computationnelle par sommation ou calcul de moyenne afin de créer un score composite unique et robuste.
8.3 Erreurs d’échantillonnage et instabilité des estimations
L’estimation sans biais de la variance-covariance n’immunise nullement les coefficients contre la vulnérabilité intrinsèque liée aux erreurs d’échantillonnage, tout particulièrement lorsque les protocoles de recherche reposent sur des cohortes d’effectif restreint ($n < 30$ ou $n < 50$ sujets). En vertu de la loi des grands nombres, la stabilité stochastique des covariances d'échantillon converge vers la matrice de population à mesure que la taille de l'échantillon s'accroît, mais fluctue dramatiquement dans les petits échantillons.
Dans un échantillon de petite taille, l’erreur type d’une covariance d’échantillon est substantiellement plus élevée que celle d’une corrélation standardisée, exposant l’analyste à un élargissement considérable des intervalles de confiance associés aux éléments de la matrice. Une covariation observée dans un petit échantillon clinique peut ainsi paraître positive et élevée par pur aléa d’échantillonnage, tout en étant non significative au sein de la population cible.
En psychométrie expérimentale et lors de l’administration de batteries cognitives, les recommandations méthodologiques préconisent d’atteindre un ratio minimal de 10 à 20 observations par paramètre matriciel à estimer. Si une batterie comporte $p = 10$ variables, la matrice de variance-covariance contient $p(p + 1) / 2 = 10 \times 11 / 2 = 55$ paramètres non redondants indépendants (10 variances et 45 covariances). Une modélisation matricielle robuste exigera par conséquent un effectif d’échantillon minimal d’au moins 200 à 300 participants pour prévenir l’instabilité asymptotique et garantir la réplicabilité des résultats empiriques.
9. La matrice de covariance dans les analyses multivariées avancées
9.1 Modélisation par équations structurelles (SEM) et IBM SPSS Amos
La modélisation par équations structurelles (Structural Equation Modeling ou SEM), couramment exécutée via des environnements dédiés tels qu’IBM SPSS Amos, représente le domaine d’élection au sein duquel la matrice de variance-covariance empirique prend toute sa valeur opératoire. Contrairement aux approches de régression traditionnelles qui traitent les observations cas par cas, les logiciels de SEM opèrent quasi-exclusivement sur la matrice de covariance résumée des variables observables en guise de donnée d’entrée fondamentale.
Le principe fondamental de la SEM consiste à confronter la matrice de covariance empirique observée ($\mathbf{S}$) à une matrice de covariance théorique implicite, notée $\mathbf{\Sigma}(boldsymbol{\theta})$, générée par les équations linéaires régissant les relations entre traits latents et indicateurs manifestes. Les algorithmes d’estimation itérative, au premier rang desquels figure le maximum de vraisemblance (ML), cherchent à ajuster les paramètres libres du vecteur $boldsymbol{\theta}$ de manière à minimiser la fonction de discordance matricielle $F_{\text{ML}}$ :
$$F_{\text{ML}} = ln|\mathbf{\Sigma}(boldsymbol{\theta})| – ln|\mathbf{S}| + \text{tr}(\mathbf{S}\mathbf{\Sigma}(boldsymbol{\theta})^{-1}) – p$$
L’utilisation de la matrice de covariance brute plutôt que de la matrice de corrélation s’avère ici incontournable pour plusieurs raisons méthodologiques cruciales. D’une part, l’emploi de corrélations standardisées peut générer des estimations sévèrement biaisées des erreurs types des paramètres structuraux et fausser la valeur du test d’adéquation globale du Chi-deux ($\chi^2$). D’autre part, seule la matrice de covariance permet de tester rigoureusement l’invariance métrique à travers des groupes multiples en préservant l’information relative à l’hétérogénéité des dispersions entre populations.
9.2 Analyse de profil et MANOVA
Dans le cadre de l’analyse de variance multivariée (MANOVA) et des analyses de profils comportementaux, la matrice de variance-covariance constitue le centre névralgique de l’évaluation des contrastes multivariés. La MANOVA généralise l’analyse univariée en testant l’égalité simultanée des centroïdes de moyennes sur un ensemble de $p$ variables dépendantes à travers plusieurs cohortes expérimentales. Cependant, la validité des statistiques de décision multivariées usuelles (Trace de Pillai, Lambda de Wilks, Trace de Hotelling-Lawley) est subordonnée au respect rigoureux d’un postulat géométrique fondamental : l’homoscédasticité multivariée.
Ce postulat stipule que les matrices de variance-covariance intra-groupes calculées au sein de chaque groupe expérimental doivent être théoriquement homogènes et mutuellement interchangeables :
$$\mathbf{\Sigma}_1 = \mathbf{\Sigma}_2 = dots = \mathbf{\Sigma}_k$$
Sous IBM SPSS Statistics, la vérification formelle de cette équivalence s’opère au moyen du test M de Box (accessible via le menu Analyse > Modèle linéaire général > Multivarié > Options > Tests d’homogénéité). Le test M de Box évalue l’hypothèse nulle d’égalité des matrices de covariance en calculant une statistique dérivée du rapport des déterminants des matrices individuelles et de la matrice de covariance regroupée (pooled covariance matrix).
Une violation flagrante de ce postulat (signalée par une valeur critique $p < 0{,}001$), combinée à des effectifs de groupes déséquilibrés, distord sévèrement le taux d'erreur de première espèce ($\alpha$) et impose à l'expérimentateur l'usage exclusif de la trace de Pillai, plus robuste, ou le recours à des modélisations semi-paramétriques alternatives.
9.3 Analyse en composantes principales basée sur la covariance
L’analyse en composantes principales (ACP) propose deux approches distinctes selon que la réduction dimensionnelle s’effectue à partir de la matrice de corrélation ou de la matrice de variance-covariance non standardisée. Dans IBM SPSS, cette dichotomie conceptuelle se paramètre directement au sein de la boîte de dialogue d’extraction factorielle évoquée précédemment.
Lorsque l’ACP est conduite sur la base de la matrice de covariance, la décomposition spectrale s’applique à la matrice $\mathbf{S}$ :
$$\mathbf{S} = \mathbf{V} \mathbf{\Lambda} \mathbf{V}’$$
Dans cette expression, $\mathbf{\Lambda}$ est la matrice diagonale des valeurs propres ordonnées et $\mathbf{V}$ désigne la matrice des vecteurs propres orthogonaux. Dans ce cadre, la somme totale de la variance à extraire correspond rigoureusement à la trace de la matrice de covariance, c’est-à-dire la somme des variances empiriques des variables d’origine :
$$\text{Variance Totale} = \text{tr}(\mathbf{S}) = \sum_{j=1}^{p} s_j^2$$
Cette approche non standardisée préserve fidèlement la hiérarchie naturelle de variabilité des épreuves. Une variable psychologique manifestant une dispersion substantielle exercera une influence prépondérante dans la détermination des premières composantes principales, tandis qu’une variable à variance restreinte ne pèsera que marginalement dans la solution factorielle finale.
Cette méthodologie est hautement recommandée en psychométrie lorsque l’ensemble des instruments administrés partage rigoureusement la même unité de cotation physique ou métrique (par exemple, une batterie de sous-épreuves chronométrées mesurées uniformément en millisecondes). En revanche, lorsque les épreuves utilisent des formats de cotation hétérogènes (combinant temps de réaction, pourcentages d’erreurs et échelles de Likert), l’ACP basée sur la covariance s’avère inappropriée car les épreuves affichant les amplitudes numériques les plus élevées masqueraient artificiellement les autres dimensions, imposant dans ce cas l’usage d’une ACP fondée sur la matrice de corrélation.
10. Exportation, conversion et manipulation matricielle avancée
10.1 Exportation de la matrice SPSS vers d’autres logiciels scientifiques
La recherche psychométrique moderne s’inscrit dans un écosystème méthodologique diversifié au sein duquel le statisticien est fréquemment amené à transférer ses structures matricielles calculées sous SPSS vers d’autres environnements logiciels de pointe, tels que les packages spécialisés du logiciel open-source R (notamment lavaan pour les équations structurelles ou psych pour les métriques psychométriques avancées), ou vers des tableurs matriciels de type Microsoft Excel.
Pour exporter une matrice de variance-covariance affichée dans la visionneuse de sorties d’IBM SPSS vers Microsoft Excel, la manipulation la plus directe repose sur l’exploitation des tableaux pivots dynamiques. L’analyste effectue un double-clic sur le tableau « Corrélations » afin d’activer le mode d’édition interactif. En réalisant un clic droit sur la table, il sélectionne l’option « Exporter… » ou réalise un simple copier-coller spécial au format texte enrichi ou tableau HTML directement dans le tableur. Une fois dans le tableur, un nettoyage par filtrage conditionnel permet de supprimer les lignes excédentaires de corrélations de Pearson, de significativité et d’effectifs pour ne conserver que la grille carrée pure des covariances numériques.
Pour une intégration fluide sous l’environnement R, le chercheur peut exporter les données sous forme de fichier tabulaire délimité (format CSV) ou utiliser directement le package foreign ou haven pour lire les fichiers systèmes SPSS. Dans R, la conversion d’une table carrée importée en un objet formel de classe matrix s’effectue instantanément au moyen de l’instruction cov_mat <- as.matrix(donnees), permettant ensuite d’alimenter directement la fonction sem() de lavaan via l’argument sample.cov = cov_mat et sample.nobs = 150, garantissant ainsi une réplication parfaite des modèles multivariés sans avoir à manipuler à nouveau l’ensemble des observations brutes.
10.2 Utilisation de la commande DISCRIMINANT ou FACTOR pour écrire une matrice
Une fonctionnalité méconnue mais extrêmement puissante d’IBM SPSS Statistics réside dans sa capacité programmatique à générer directement sur le disque dur un fichier de données natif au format .sav configuré spécifiquement comme un fichier matriciel normalisé. Cette opération s’affranchit totalement du copier-coller manuel et élimine tout risque d’erreur de saisie humaine en automatisant l’enregistrement de la matrice via la syntaxe de commande.
Cette génération s’opère au moyen du sous-ordre MATRIX OUT disponible au sein de plusieurs procédures multivariées, notamment la commande FACTOR ou la commande DISCRIMINANT. Illustrons la syntaxe au travers de la procédure d’analyse factorielle :
FACTOR
/VARIABLES Item1 Item2 Item3 Item4
/METHOD=CORRELATION
/MATRIX OUT(COV = ‘C:ProjetsMatrice_Covariance.sav’).
L’exécution de cette directive crée un fichier de données SPSS dédié dont la structure interne respecte un schéma matriciel standardisé strict. Ce fichier incorpore deux colonnes méta-analytiques réservées fondamentales :
- La variable textuelle ROWTYPE_ : elle identifie la nature statistique de la ligne correspondante au sein du tableau. Le fichier comportera des lignes portant l’étiquette
'MEAN'(renseignant les moyennes empiriques de chaque variable), des lignes libellées'STDDEV'(les écarts-types marginaux), des lignes'N'(les effectifs d’échantillonnage) et une série de lignes indexées par'COV'représentant les rangées successives de la matrice de covariance. - La variable textuelle VARNAME_ : elle spécifie le nom de la variable correspondant à la covariance croisée pour la ligne considérée.
Ce fichier matriciel standardisé peut être rouvert ultérieurement dans SPSS et injecté comme base empirique d’entrée dans d’autres procédures analytiques via la commande symétrique /MATRIX IN(...), contournant ainsi le recalcul coûteux sur les fichiers de données primaires volumineux.
10.3 Standardisation a priori des données dans SPSS
Sur le plan méthodologique, il est particulièrement instructif d’appréhender le lien opératoire existant entre la standardisation préalable des variables et l’estimation de leur matrice de covariance. La transformation standardisée (ou centrage-réduction) consiste à convertir les scores bruts d’un individu en scores $Z$, dont la moyenne théorique d’échantillon est rigoureusement égale à 0 et dont la variance est contrainte à 1, selon la transformation algébrique individuelle :
$$z_{ij} = \frac{x_{ij} – \bar{x}_j}{s_j}$$
Sous IBM SPSS Statistics, cette transformation s’automatise via le menu Analyse > Statistiques descriptives > Descriptifs…. Dans la boîte de dialogue principale, après avoir sélectionné l’ensemble des variables psychométriques à traiter, il suffit de cocher la case d’option située en bas à gauche de l’interface, libellée « Enregistrer les valeurs standardisées dans des variables » (Save standardized values as variables). SPSS génère alors immédiatement au sein du fichier de données actif une série de nouvelles colonnes préfixées par la lettre $Z$ (par exemple, ZItem1, ZItem2, etc.).
Si l’analyste exécute ensuite la procédure de calcul de covariance (vue à la Section 4) sur ces nouvelles variables standardisées, la matrice de variance-covariance résultante possédera des propriétés remarquables :
- Chaque élément diagonal, correspondant à la variance d’un score standardisé, sera exactement égal à $1{,}000$ : $\text{Var}(Z_j) = s_{z_j}^2 = 1$.
- Chaque élément hors-diagonale sera rigoureusement identique au coefficient de corrélation linéaire de Pearson d’origine : $\text{Cov}(Z_j, Z_k) = r_{jk}$.
Cette démonstration pratique permet de valider le postulat selon lequel la matrice de corrélation de Pearson n’est autre que le cas particulier de la matrice de variance-covariance calculée sur des données préalablement centrées et réduites.
11. Normes de présentation APA (7e édition) pour la matrice de covariance
11.1 Règles de mise en page typographique d’un tableau matriciel
La diffusion publique et la publication académique des structures matricielles de dispersion sont régies par des normes typographiques et éditoriales strictes édictées par l’American Psychological Association (APA, 7e édition). L’objectif premier de cette normalisation est d’épurer au maximum la présentation visuelle pour faciliter l’assimilation cognitive des corrélations empiriques sans aucune surcharge décorative superflue.
Selon les canons de l’APA, un tableau présentant une matrice de dispersion doit obéir aux principes formels suivants :
- Numérotation et titrage : Le tableau doit comporter un identifiant explicite en gras (par exemple, Tableau 1), positionné sur sa propre ligne et aligné à gauche. Juste en dessous, le titre descriptif du tableau doit figurer en italique, avec une mise en majuscule de la première lettre des mots principaux (ex. : Matrice de Variance-Covariance et Statistiques Descriptives pour les Épreuves Cognitives).
- Suppression des quadrillages : Les bordures verticales sont formellement bannies de toute mise en page APA. Le tableau ne doit comporter que trois lignes horizontales principales tracées sur toute sa largeur : une ligne sous le titre pour ouvrir l’en-tête de colonnes, une ligne sous l’en-tête pour isoler le corps des données, et une ligne finale de fermeture à la base du tableau avant les notes de bas de page.
- Format triangulaire : En raison de la symétrie absolue de la matrice démontrée au chapitre 6, les normes APA prohibent l’impression de la matrice complète en double miroir. Seul le triangle inférieur doit être renseigné, tandis que l’ensemble des cellules du triangle supérieur demeurent strictement vierges de tout chiffre ou caractère.
- Alignement décimal : L’ensemble des coefficients numériques de dispersion doivent être rigoureusement alignés verticalement sur la virgule (ou le point décimal) au sein de leurs colonnes respectives, avec une précision uniforme généralement fixée à deux ou trois décimales après la virgule.
- Intégration des paramètres marginaux : La convention méthodologique impose d’insérer en tête de tableau, immédiatement après la désignation textuelle des variables en ligne, deux colonnes introductives dédiées à la moyenne empirique ($M$) et à l’écart-type ($SD$). Les colonnes indicées suivantes numérotées de 1 à $p$ hébergent ensuite les éléments de la matrice proprement dite.
11.2 Rédaction textuelle et contextualisation dans la section Résultats
L’insertion d’un tableau matriciel au sein d’une thèse ou d’un manuscrit scientifique ne dispense en aucun cas le chercheur d’une contextualisation narrative précise intégrée dans le corps de la section « Résultats ». Le texte ne doit pas répéter fastidieusement l’ensemble des chiffres du tableau, mais guider le lecteur vers les tendances dominantes, les patrons de covariation singuliers et les implications méthodologiques saillantes.
La prose scientifique doit impérativement préciser la taille de l’échantillon analysé ($N$), la technique retenue pour le traitement des valeurs absentes (par exemple, suppression par liste) et indiquer sans ambiguïté la nature des valeurs imprimées dans le tableau (précisant si la diagonale abrite les variances univariées ou si celles-ci sont remplacées par des coefficients de fidélité tels que l’alpha de Cronbach). Une attention particulière doit être portée à la mise en garde contre la surinterprétation brute des covariances non standardisées : le chercheur veillera toujours à discuter de l’ampleur des relations en reliant conjointement les covariances observées aux écarts-types marginaux correspondants.
Une formulation académique standard s’articulera ainsi : « Les variances et covariances d’échantillon associées aux trois dimensions de la batterie mnésique ont été estimées sur l’échantillon complet ($N = 150$) selon une procédure d’exclusion par liste (voir Tableau 1). Comme attendu, la mémoire de travail manifeste une covariance conjointe positive substantielle avec le raisonnement abstrait ($s_{12} = 9{,}62$), reflétant l’interdépendance fonctionnelle des processus de contrôle exécutif rapportée dans la littérature. »
11.3 Éthique, transparence et partage des données matricielles
Dans le sillage des initiatives contemporaines en faveur de la science ouverte (Open Science) et face aux impératifs de reproductibilité computationnelle qui animent la communauté psychologique internationale, la publication et le partage systématique des matrices de covariance constituent un impératif éthique et méthodologique majeur. En effet, dans de nombreuses situations où le partage des données individuelles brutes (fichiers microdonnées) se heurte à des contraintes de confidentialité médicale ou au respect du Règlement Général sur la Protection des Données (RGPD), la matrice de variance-covariance représente le niveau d’agrégation statistique idéal.
D’une part, une matrice de covariance résumée anonymise totalement les sujets individuels : il est mathématiquement impossible de reconstituer l’identité ou les scores singuliers d’un patient à partir de la seule matrice de dispersion globale d’un groupe. D’autre part, la communication intégrale de cette matrice, accompagnée des vecteurs de moyennes ($M$) et de la taille de l’échantillon ($N$), offre à la communauté scientifique l’ensemble des données nécessaires pour répliquer intégralement la totalité des analyses factorielles, régressions linéaires ou modélisations structurelles publiées par les auteurs.
De surcroît, le dépôt de ces matrices au sein de répertoires publics pérennes (tels que l’Open Science Framework ou Zenodo) alimente directement les recherches méta-analytiques futures, notamment la méta-analyse par modélisation structurelle (TSSEM pour Two-Stage Structural Equation Modeling), permettant de synthétiser les matrices de multiples laboratoires à l’échelle planétaire.
12. Étude de cas pratique : Batterie d’évaluations cognitives sous SPSS
12.1 Présentation du protocole expérimental et du jeu de données
Pour ancrer l’ensemble des préceptes théoriques et des manipulations algorithmiques exposés jusqu’ici au sein d’une application clinique concrète, considérons une étude expérimentale menée auprès d’une cohorte de $N = 150$ étudiants de premier cycle en psychologie. Le protocole d’évaluation neuropsychologique visait à cartographier les interconnexions structurelles unissant trois composantes centrales de l’architecture cognitive humaine au moyen d’épreuves standardisées :
- Variable 1 : Mémoire de travail (MDT) — Évaluée au moyen d’une tâche informatisée d’empan de lecture complexe (Reading Span Task). Le score opérationnel correspond au nombre total d’items textuels correctement rappelés sous interférence concurrente (échelle continue brute s’étendant de 0 à 60 points).
- Variable 2 : Raisonnement fluide (RAIS) — Mesuré via une version abrégée du test des Matrices Progressives de Raven. Le score représente le nombre total de matrices visuo-spatiales correctement complétées en temps limité (score brut oscillant de 0 à 30 points).
- Variable 3 : Vitesse de traitement (VIT) — Appréhendée par un test de comparaison rapide de symboles graphiques. Le score correspond au volume de patterns perceptifs correctement identifiés en 90 secondes (score brut variant théoriquement de 0 à 100 points).
Toutes les épreuves ont été administrées individuellement dans des conditions de passation rigoureusement contrôlées en laboratoire. Le jeu de données a été préalablement audité : aucune observation aberrante n’a été détectée et les distributions respectent les critères usuels de quasi-normalité univariée et de linéarité bivariée.
12.2 Mise en œuvre intégrale de la procédure dans SPSS
La mise en œuvre computationnelle de l’extraction de la matrice de covariance pour cette batterie cognitive suit rigoureusement la méthodologie standard exposée au Chapitre 4. Au sein de la fenêtre de données de SPSS contenant les trois colonnes MDT, RAIS et VIT, l’analyste ouvre l’éditeur de syntaxe et formule le script de traitement dédié :
CORRELATIONS
/VARIABLES=MDT RAIS VIT
/PRINT=TWOTAIL NOSIG
/STATISTICS=XPROD
/MISSING=LISTWISE.
Après exécution de ce script, la visionneuse de sorties d’IBM SPSS génère le tableau unifié des corrélations. En ciblant spécifiquement les lignes relatives aux « Covariances » et en recombinant les éléments selon la structure géométrique canonique, nous extrayons la matrice de variance-covariance empirique d’échantillon $\mathbf{S}$ d’ordre $3 \times 3$ suivante :
$$\mathbf{S} = \begin{\bmatrix} 14{,}432 &a\mp; 9{,}616 &a\mp; 18{,}245 9{,}616 &a\mp; 11{,}225 &a\mp; 14{,}830 18{,}245 &a\mp; 14{,}830 &a\mp; 68{,}550 \end{\bmatrix}$$
L’observation détaillée de cette matrice révèle immédiatement les grandeurs caractéristiques de chaque sous-épreuve cognitive :
- Les éléments diagonaux fournissent les variances univariées d’échantillon : $s_{\text{MDT}}^2 = 14{,}432$ (impliquant un écart-type $s_{\text{MDT}} \approx 3{,}799$), $s_{\text{RAIS}}^2 = 11{,}225$ ($s_{\text{RAIS}} \approx 3{,}350$), et $s_{\text{VIT}}^2 = 68{,}550$ ($s_{\text{VIT}} \approx 8{,}279$). On constate l’importante dispersion brute de la vitesse de traitement en lien avec son échelle de cotation plus étendue.
- Les éléments symétriques hors-diagonale livrent les covariances conjointes : la covariance entre la mémoire de travail et le raisonnement fluide s’établit à $s_{12} = 9{,}616$, celle entre la mémoire de travail et la vitesse de traitement atteint $s_{13} = 18{,}245$, et celle unissant le raisonnement fluide à la vitesse se chiffre à $s_{23} = 14{,}830$.
12.3 Synthèse interprétative et conclusions psychométriques de l’étude
L’étape conclusive consiste à procéder à l’interprétation substantielle de cette matrice de dispersion au regard des théories de l’architecture cognitive et à illustrer l’opération de standardisation menant aux corrélations métriques. Toutes les covariances estimées sont résolument positives, ce qui démontre la présence constante du phénomène de « manifold positif » théorisé originellement par Charles Spearman : les individus performants sur une dimension de traitement cognitif tendent indubitablement à surclasser leurs pairs sur les autres dimensions mentales de la batterie.
Néanmoins, si l’on compare naïvement les covariances brutes, la covariance reliant la mémoire de travail à la vitesse de traitement ($s_{13} = 18{,}245$) apparaît nettement plus volumineuse que celle reliant la mémoire de travail au raisonnement fluide ($s_{12} = 9{,}616$). Pour déterminer si cette disparité numérique reflète une interdépendance fonctionnelle réellement plus puissante ou si elle n’est que le pur artefact de l’étalement de l’échelle de mesure de la vitesse, appliquons le calcul de corrélation standardisée dérivé au Chapitre 7.3 :
Pour le couple Mémoire de Travail – Raisonnement :
$$r_{\text{MDT, RAIS}} = \frac{9{,}616}{\sqrt{14{,}432} \times \sqrt{11{,}225}} = \frac{9{,}616}{3{,}799 \times 3{,}350} = \frac{9{,}616}{12{,}727} \approx 0{,}756$$
Pour le couple Mémoire de Travail – Vitesse :
$$r_{\text{MDT, VIT}} = \frac{18{,}245}{\sqrt{14{,}432} \times \sqrt{68{,}550}} = \frac{18{,}245}{3{,}799 \times 8{,}279} = \frac{18{,}245}{31{,}452} \approx 0{,}580$$
Cette conversion dissipe immédiatement l’illusion métrique : la relation fonctionnelle la plus vigoureuse unit en réalité la mémoire de travail au raisonnement abstrait ($r = 0{,}756$, signalant une association cognitive majeure), tandis que l’association unissant la mémoire à la vitesse est substantiellement plus modérée ($r = 0{,}580$), en dépit d’une covariance brute deux fois supérieure. Cet exemple empirique confirme de manière saisissante la nécessité absolue pour le chercheur de maîtriser la double lecture des matrices de covariance et de corrélation au sein de ses travaux d’évaluation psychologique et neuropsychologique sous IBM SPSS Statistics.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bollen, K. A. (1989). Structural equations with latent variables. John Wiley & Sons. https://doi.org/10.1002/9781118619179
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- IBM Corporation. (2021). IBM SPSS Statistics 28 algorithms. IBM Corporation. https://www.ibm.com/support/pages/ibm-spss-statistics-28-documentation
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.