
Dans le champ de l’analyse multivariée contemporaine, l’exploration des interdépendances linéaires entre multiples dimensions constitue le socle fondamental sur lequel reposent la modélisation prédictive, la psychométrie quantitative et l’économétrie appliquée. La matrice de covariance se présente comme une entité algébrique indispensable, synthétisant à la fois la dispersion individuelle de chaque variable observée et la dynamique conjointe caractérisant les paires d’attributs au sein d’un échantillon ou d’une population parente. Dès lors que l’analyste dépasse le cadre restreint des analyses univariées pour appréhender la complexité des systèmes de mesure multidimensionnels, la maîtrise de cette structure matricielle devient un impératif méthodologique incontournable.
Bien que des environnements de calcul spécialisés tels que The R Project for Statistical Computing ou Python dominent traditionnellement le traitement de données à large échelle, les tableurs modernes, et plus particulièrement Google Sheets, ont acquis des capacités de calcul matriciel et de programmation dynamique d’une remarquable puissance. L’accessibilité universelle de cet outil collaboratif en ligne permet désormais aux chercheurs, analystes décisionnels et ingénieurs de concevoir, auditer et manipuler des matrices de covariance complexes sans quitter l’interface native de leur fureteur web. Cette démocratisation logicielle exige toutefois une rigueur méthodologique sans faille afin de prémunir le praticien contre les biais d’échantillonnage, les anomalies de calcul vectoriel ou les erreurs d’interprétation causale.
Le présent traité propose une exploration exhaustive, didactique et hautement technique de la création, du déploiement et de l’interprétation d’une matrice de covariance au sein de Google Sheets. Depuis l’ancrage épistémologique et les fondements de la statistique bivariée jusqu’aux routines automatisées en Google Apps Script, en passant par l’algèbre matricielle dynamique via les formules de projection scalaire, chaque jalon méthodologique fait l’objet d’une analyse minutieuse. Ce guide vise à doter le praticien d’un cadre opératoire reproductible garantissant une fidélité absolue à l’égard des normes académiques internationales les plus strictes.
1. Fondements théoriques de la covariance dans l’analyse de données
1.1 Définition conceptuelle de la covariance bivariée
La covariance bivariée représente l’expression quantitative de la variabilité conjointe observée entre deux variables aléatoires distinctes. D’un point de vue géométrique et statistique, elle mesure la propension des observations empiriques d’un système bivarié à s’écarter de leurs espérances mathématiques respectives dans une direction concordante ou discordante. Lorsque deux métriques fluctuent de concert, c’est-à-dire qu’une observation supérieure à la moyenne arithmétique de la première variable s’accompagne systématiquement d’une observation excédant la moyenne de la seconde, le produit de leurs déviations respectives génère une valeur résiduelle positive. À l’inverse, l’antagonisme dimensionnel engendre des produits d’écarts de signe négatif, traduisant une oscillation opposée des scores collectés.
Il est impératif d’établir une distinction épistémologique fondamentale entre la dépendance statistique globale et la covariance linéaire. La covariance constitue une mesure strictement circonscrite à la détection de tendances monotones linéaires au sein du plan euclidien. Deux distributions de données peuvent manifester une dépendance stochastique ou fonctionnelle déterministe absolue, de nature quadratique, exponentielle ou sinusoïdale, tout en présentant une covariance parfaitement nulle. Ce phénomène découle de la compensation arithmétique systématique des déviations positives et négatives autour du centre de gravité bivarié. Par conséquent, une covariance nulle n’indique en aucun cas l’indépendance statistique au sens probabiliste strict, mais simplement l’absence de composante linéaire dominante orientant la distribution.
Dans l’évaluation empirique des construits psychologiques et psychométriques, la covariance occupe une fonction névralgique pour établir la validité de construit et la validité concourante. Lorsqu’un instrument psychométrique évalue, par exemple, les dimensions corrélées de l’affectivité négative et de l’évitement comportemental, la covariance bivariée documente la dynamique structurelle sous-jacente unissant ces manifestations phénoménologiques. Elle permet de vérifier si les variations interindividuelles constatées sur une échelle d’évaluation continue partagent une variance commune avec des variables physiologiques ou comportementales externes, constituant ainsi le premier jalon de toute modélisation dimensionnelle de l’esprit humain.
1.2 Formulation mathématique : populationnelle vs échantillonnale
La formalisation mathématique de la covariance impose une différenciation conceptuelle majeure entre le paramètre populationnel et son estimateur d’échantillon. Lorsque l’analyste dispose de l’intégralité du corpus d’observations composant la population d’intérêt, notée $N$, la covariance populationnelle théorique, traditionnellement désignée par la lettre grecque $\sigma_{XY}$, est formalisée par l’espérance mathématique du produit des déviations centrées :
$\sigma_{XY} = \frac{1}{N} \sum_{i=1}^{N} (X_i – \mu_X)(Y_i – \mu_Y)$
Dans cette expression, $\mu_X$ et $\mu_Y$ figurent les espérances mathématiques réelles (moyennes populationnelles) de chaque dimension respective. Le dénominateur $N$ reflète la nature exhaustive du dénombrement, dans la mesure où aucune extrapolation inductive n’est requise.
À l’inverse, dans l’écrasante majorité des protocoles de recherche en sciences humaines, sociales ou biologiques, le chercheur opère sur un échantillon probabiliste restreint extrait d’une population inaccessible dans sa totalité. L’utilisation brute de la formule populationnelle sur des données échantillonnales induit un biais systématique par sous-estimation de la dispersion conjointe réelle, car la moyenne de l’échantillon est elle-même estimée à partir des mêmes observations et minimise mécaniquement les résidus quadratiques. Pour obtenir un estimateur non biaisé de la covariance, la statistique inférentielle recourt à la correction de Bessel, en substituant au dénominateur la taille d’échantillon brute $n$ par les degrés de liberté résiduels, à savoir $n – 1$ :
$$s_{XY} = \text{Cov}(X, Y) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})$$
Cette décomposition du produit des écarts à la moyenne arithmétique met en lumière l’impact prépondérant de la taille d’échantillon sur la précision et l’asymptotique de l’estimateur. Lorsque $n$ croît vers l’infini, la différence entre $n$ et $n – 1$ devient marginale, stabilisant l’erreur standard de l’estimation. Cependant, sur des échantillons restreints, l’omission de cette correction produit des distorsions mathématiques cumulatives majeures lors de l’intégration subséquente de la covariance dans des équations structurelles ou des algorithmes de réduction dimensionnelle.
1.3 Covariance et variance : interrelations conceptuelles
La variance univariée et la covariance bivariée ne constituent pas deux entités statistiques distinctes, mais représentent les manifestations fonctionnelles d’un même opérateur sous des conditions d’application spécifiques. En examinant le cas où une variable aléatoire $X$ est appariée à elle-même, la formule de la covariance échantillonnale devient :
$$\text{Cov}(X, X) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})(X_i – \bar{X}) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})^2 = s_X^2$$
Cette équivalence algébrique démontre formellement que la variance univariée n’est rien d’autre que l’autocovariance d’une distribution. Ce résultat théorique est crucial pour l’architecture des structures matricielles, puisqu’il garantit que l’ensemble des métriques de dispersion univariées et bivariées d’un système de données peuvent être unifiées sous une syntaxe algorithmique universelle.
L’opérateur de covariance possède des propriétés formelles d’additivité et de bilinéarité qui sous-tendent l’ensemble des théorèmes de la théorie classique des tests psychométriques et du modèle linéaire général. Pour des variables aléatoires $X$, $Y$, $Z$ et des scalaires constants $a$ et $b$, la bilinéarité s’énonce selon les règles suivantes :
- $\text{Cov}(aX, bY) = ab \cdot \text{Cov}(X, Y)$
- $\text{Cov}(X + Z, Y) = \text{Cov}(X, Y) + \text{Cov}(Z, Y)$
- $\text{Var}(X \pm Y) = \text{Var}(X) + \text{Var}(Y) \pm 2\text{Cov}(X, Y)$
Ces propriétés illustrent le rôle central de la dispersion dans la géométrie de la distribution bivariée. La covariance pondère directement l’expansion ou la contraction de la variance totale d’une somme linéaire de variables. Si deux sous-échelles d’un test présentent une covariance positive élevée, la variance de leur score composite sera considérablement supérieure à la simple somme arithmétique de leurs variances intrinsèques, illustrant la manière dont la covariance capture et amplifie l’information partagée au sein des construits mesurés.
2. Structure et propriétés algébriques d’une matrice de covariance
2.1 Architecture matricielle carrée et dimensionnalité
Lorsque le protocole de recherche implique la collecte conjointe de $p$ variables quantitatives continues mesurées auprès d’un même ensemble d’unités statistiques, l’exhaustivité de leurs relations linéaires ne peut être représentée par une suite linéaire de scalaires isolés. Elle exige une organisation au sein d’une structure spatiale formalisée appelée matrice de variance-covariance, classiquement désignée par la lettre grecque majuscule Sigma ($boldsymbol{\Sigma}$) pour la population, ou par la lettre latine $\mathbf{S}$ pour l’échantillon. Cette structure adopte invariablement la configuration d’un tableau carré d’ordre $p \times p$, où la cardinalité des lignes équivaut strictement à celle des colonnes.
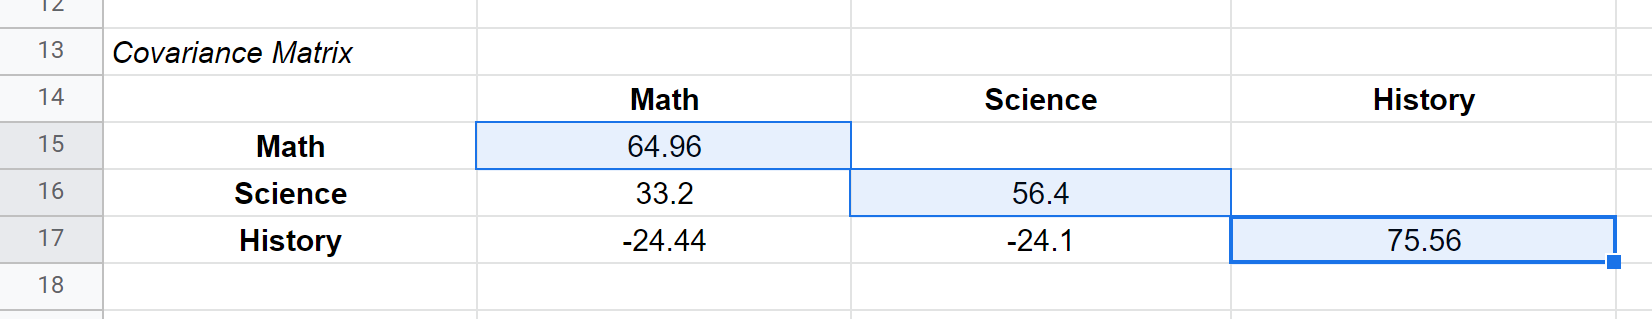
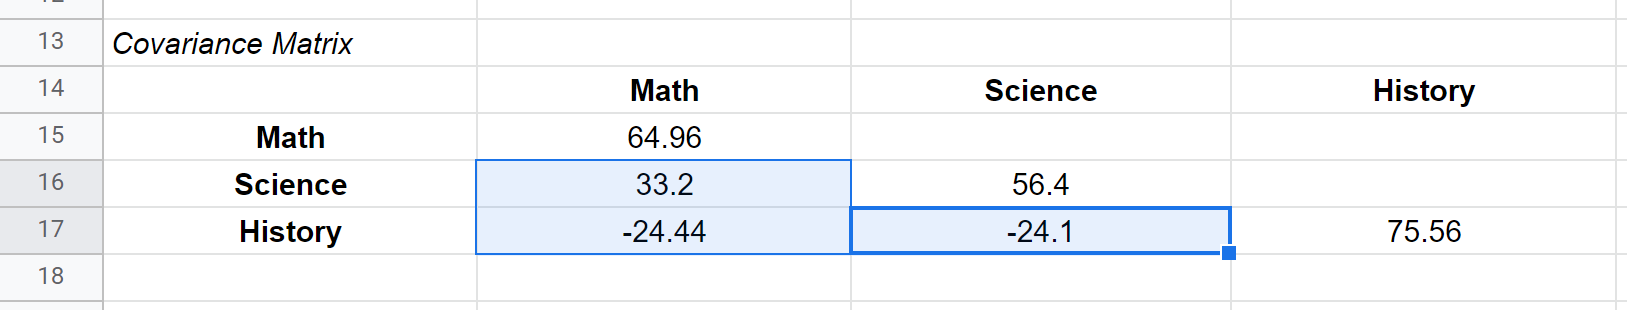
L’architecture matricielle établit une correspondance univoque et rigoureuse entre chaque ligne $i$ et chaque colonne $j$ avec les attributs empiriques étudiés. Chaque cellule individuelle de la matrice est indexée par ses coordonnées scalaires $(i, j)$, désignant l’élément $s_{ij}$ qui exprime la covariance entre la $i$-ème variable et la $j$-ème variable du système de mesure. Si l’on évalue par exemple cinq dimensions de la personnalité selon le modèle en cinq facteurs, la matrice présentera une géométrie $5 \times 5$, renfermant exactement 25 coefficients distincts qui condensent l’intégralité du comportement bivarié de l’espace psychologique modélisé.
Sur le plan formel, la disposition générale de cette matrice de dispersion s’écrit comme suit :
$$\mathbf{S} = \begin{\bmatrix} s_{11} &a\mp; s_{12} &a\mp; \cdots &a\mp; s_{1p} s_{21} &a\mp; s_{22} &a\mp; \cdots &a\mp; s_{2p} \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots s_{p1} &a\mp; s_{p2} &a\mp; \cdots &a\mp; s_{pp} \end{\bmatrix} = \begin{\bmatrix} s_1^2 &a\mp; s_{12} &a\mp; \cdots &a\mp; s_{1p} s_{21} &a\mp; s_2^2 &a\mp; \cdots &a\mp; s_{2p} \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots s_{p1} &a\mp; s_{p2} &a\mp; \cdots &a\mp; s_p^2 \end{\bmatrix}$$
Cette indexation bidimensionnelle forme la base de manipulation algorithmique requise par les moteurs de calcul matriciel modernes, permettant d’exécuter des transformations linéaires, des inversions ou des projections vectorielles avec une efficience computationnelle optimale.
2.2 Diagonale principale : les variances des variables
La diagonale principale d’une matrice de covariance regroupe l’ensemble des éléments $s_{ij}$ pour lesquels les indices de ligne et de colonne sont rigoureusement identiques, soit la série des composantes scalaires où $i = j$. En vertu des propriétés théoriques établies précédemment démontrant l’identité entre l’autocovariance et la variance univariée, cette trajectoire diagonale concentre l’intégralité de l’information relative à la dispersion univariée de chacune des $p$ variables observées. Ainsi, le premier élément $s_{11}$ consigne la variance de la variable 1, l’élément central $s_{22}$ consigne celle de la variable 2, et ainsi de suite jusqu’à l’élément terminal $s_{pp}$.
Dans les applications psychométriques concrètes, l’interprétation des valeurs logées sur la diagonale principale nécessite une vigilance particulière quant aux échelles de mesure adoptées. Si un chercheur évalue l’anxiété au moyen d’un score continu variant de 0 à 100 et le niveau de cortisol salivaire mesuré en nanomoles par litre, les variances respectives différeront de plusieurs ordres de grandeur sous le simple effet des unités physiques employées. Contrairement à la matrice de corrélation où la diagonale principale est normalisée et invariablement unitaire, la matrice de covariance brute conserve l’intégralité de l’hétérogénéité d’échelle originale des indicateurs.
Cette absence de standardisation préalable engendre une disparité prononcée des amplitudes numériques diagonales. Cette disparité n’indique nullement qu’une variable à forte variance posséderait une force d’influence conceptuelle supérieure à une variable présentant une dispersion restreinte. Elle traduit simplement la sensibilité de l’indicateur à son unité de quantification métrologique. Cette spécificité impose à l’analyste de surveiller rigoureusement l’homogénéité dimensionnelle lors de la comparaison inter-items sous Google Sheets.
2.3 Symétrie et éléments hors-diagonale
Les cellules positionnées en dehors de la diagonale principale, où $i \neq j$, représentent les covariances conjointes liant des paires de variables distinctes. La caractéristique algébrique la plus saillante de cette région matricielle réside dans sa symétrie axiale absolue par rapport à la diagonale principale. Du fait de la commutativité de la multiplication au sein de l’opérateur d’espérance mathématique, l’ordre des facteurs n’altère aucunement le résultat numérique du produit des déviations :
$$\text{Cov}(X, Y) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y}) = \frac{1}{n – 1} \sum_{i=1}^{n} (Y_i – \bar{Y})(X_i – \bar{X}) = \text{Cov}(Y, X)$$
Cette égalité universelle implique que pour toute matrice de covariance, la transposée de la matrice équivaut strictement à la matrice elle-même, propriété désignée formellement par l’équation matricielle $\mathbf{S} = \mathbf{S}^T$. Par conséquent, l’élément situé à la deuxième ligne et à la première colonne ($s_{21}$) possède une valeur mathématique strictement identique à l’élément de la première ligne et de la deuxième colonne ($s_{12}$). La matrice se scinde ainsi en deux compartiments parfaitement spéculaires : le triangle inférieur et le triangle supérieur.
L’analyse empirique de ces éléments hors-diagonale s’articule autour de trois trajectoires directionnelles :
- Une covariance positive ($s_{ij} > 0$) : Les variables manifestent une co-variation convergente ; une élévation au-dessus de la moyenne sur le construit $i$ s’accompagne tendanciellement d’une augmentation au-dessus de la moyenne sur le construit $j$.
- Une covariance négative ($s_{ij} < 0$) : Les construits s’inscrivent dans une relation inverse ou antagoniste ; les valeurs élevées sur la variable $i$ s’associent systématiquement à des valeurs déficitaires sur la variable $j$.
- Une covariance nulle ($s_{ij} = 0$) : Les deux attributs mesurés ne présentent aucune interdépendance linéaire décelable au sein de l’échantillon d’analyse.
2.4 Propriété de semi-définition positive
Au-delà de sa symétrie géométrique, toute matrice de covariance empirique ou théorique valide doit satisfaire une exigence mathématique fondamentale issue de l’algèbre bilinéaire : la condition de semi-définition positive, fréquemment qualifiée de définition positive lorsque la matrice est de rang plein. Algébriquement, une matrice symétrique réelle $\mathbf{S}$ d’ordre $p \times p$ est dite semi-définie positive si, pour tout vecteur colonne non nul $\mathbf{z} in \mathbb{R}^p$, la forme quadratique résultante est systématiquement supérieure ou égale à zéro :
$$\mathbf{z}^T \mathbf{S} \mathbf{z} ge 0$$
La démonstration statistique de cette propriété repose sur le fait que la quantité $\mathbf{z}^T \mathbf{S} \mathbf{z}$ représente conceptuellement la variance d’une combinaison linéaire des variables initiales définie par le vecteur de pondération $\mathbf{z}$. Puisqu’une variance représente une somme de carrés divisée par un scalaire positif, elle ne peut mathématiquement jamais adopter une valeur négative. Cette contrainte impose que toutes les valeurs propres de la matrice soient rigoureusement non négatives ($\lambda_k ge 0$ pour tout $k in {1, dots, p}$). Si l’une des valeurs propres s’avérait strictement négative, cela équivaudrait à postuler l’existence d’une combinaison linéaire de mesures dont la dispersion serait négative, ce qui constitue une impossibilité statistique absolue.
Dans la pratique analytique sur Google Sheets, des violations empiriques de cette propriété de semi-définition positive peuvent émerger sous l’effet de données manquantes traitées par suppression par paires (pairwise deletion), ou en raison de discordances typographiques majeures au sein de sous-ensembles d’enregistrements. Une matrice qui n’est pas semi-définie positive interdit formellement toute analyse multivariée avancée ultérieure, rendant impossible son inversion matricielle ou la convergence des algorithmes de factorisation structurelle.
3. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
3.1 Organisation tabulaire conforme aux standards d’analyse
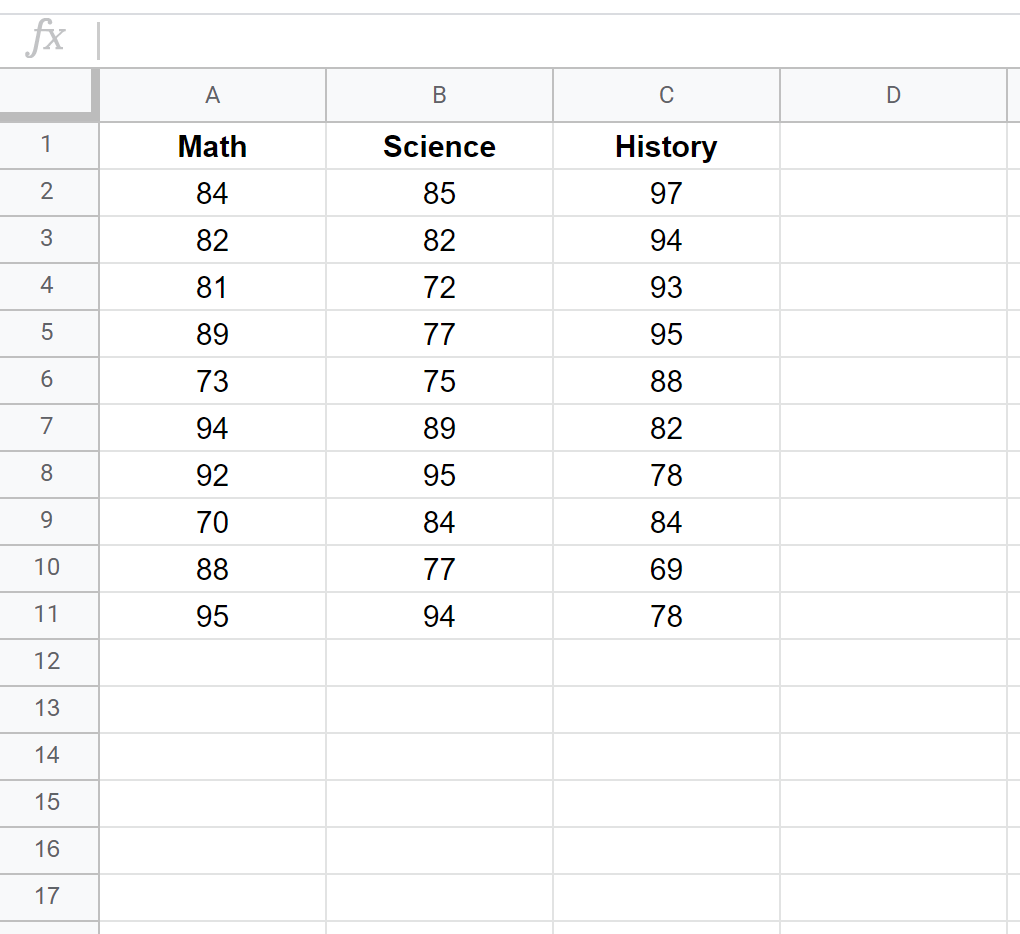
L’exactitude des calculs matriciels exécutés au sein de Google Sheets repose prioritairement sur la géométrie structurelle des tables d’entrée brutes. L’architecture tabulaire doit impérativement se conformer au principe des données standardisées ou tidy data, formalisé dans les sciences des données modernes. Selon cette convention, chaque observation empirique individuelle (sujet d’étude, participant psychométrique, unité économique ou moment temporel) doit occuper une et une seule ligne horizontale continue, sans la moindre discontinuité spatiale.
Réciproquement, chaque variable quantitative continue ou ordinale (score à un item, mesure biologique, temps de réaction en millisecondes) doit être exclusivement logée sur une colonne verticale distincte. L’analyste réservera impérativement la première ligne du classeur (ligne 1) à l’inscription des métadonnées d’identification, à savoir des en-têtes textuels explicites, synthétiques et dépourvus de caractères spéciaux ambigus (tels que Score_Anxiete, Temps_Reaction ou Item_01). Tout fractionnement du tableau par des lignes d’intertitres, des totaux intermédiaires ou des regroupements visuels de cellules doit être proscrit, sous peine d’injecter des incohérences typographiques destructrices dans les arguments des formules matricielles.
3.2 Nettoyage et validation de l’intégrité des données
Préalablement à tout traitement algorithmique sous Google Sheets, la matrice de données brutes doit faire l’objet d’un protocole d’audit et d’assainissement systématique. Les fonctions de covariance natives opèrent une manipulation stochastique sensible aux données incomplètes et aux valeurs aberrantes. La présence de cellules vides ou de chaînes de texte au sein d’une plage censée consigner des valeurs numériques peut altérer considérablement le décompte des degrés de liberté ou engendrer des exclusions asymétriques selon le type de formule déployé.
Pour auditer l’intégrité des données, il est recommandé de mettre en œuvre des fonctions logiques de validation :
- L’instruction
=EST.NUM(plage)couplée à un formatage conditionnel permet de repérer instantanément les cellules dont le contenu a été stocké par inadvertance sous format texte. - L’utilisation de la règle
=NB.VIDE(plage)permet d’évaluer avec précision l’ampleur de la non-réponse ou des valeurs manquantes. - Le dépistage des valeurs extrêmes ou erreurs d’encodage (par exemple, un score de 999 saisi sur une échelle de Likert bornée à 7) est réalisé par l’inspection des bornes descriptives au moyen des fonctions
=MAX(plage)et=MIN(plage).
Toute anomalie métrologique non rectifiée faussera artificiellement les moyennes empiriques, déformera l’amplitude des résidus quadratiques et corrompra la fidélité de l’intégralité du calcul matriciel.
3.3 Définition de plages nommées pour une lisibilité accrue
La saisie manuelle de coordonnées alphanumériques de type Feuille1!$B$2:$B$150 au sein de formules matricielles complexes constitue une source récurrente d’erreurs d’inattention, particulièrement lorsque la dimensionnalité du système s’étend sur des dizaines de colonnes. Google Sheets intègre un moteur de gestion de plages nommées accessible via le menu Données > Plages nommées, qui optimise substantiellement la lisibilité et l’auditabilité du classeur.
L’attribution de désignations nominales claires et standardisées permet de manipuler les vecteurs de variables sous une sémantique directe. En désignant, par exemple, la plage B2:B101 par le terme Var_Extraversion et la plage C2:C101 par Var_Neuroticisme, la syntaxe de calcul d’une covariance gagne une clarté immédiate. Lors de l’écriture ultérieure d’équations multivariées imbriquées, l’usage de plages nommées limite les glissements accidentels d’indices lors du déplacement de formules et simplifie le débogage conceptuel pour tout évaluateur externe, tout en facilitant la reproductibilité des analyses.
4. Fonctions statistiques natives de Google Sheets pour la covariance
4.1 La fonction COVAR : syntaxe et comportement par défaut
Au sein de la bibliothèque de calcul de Google Sheets, la fonction COVAR représente l’instruction historique consacrée à l’évaluation bivariée. Sa syntaxe opératoire élémentaire se déploie selon le modèle classique =COVAR(plage_y; plage_x), requérant deux arguments obligatoires correspondant aux deux séries d’observations quantitatives à confronter. Bien que l’inversion théorique de l’ordre des plages n’altère pas la valeur du produit scalaire en vertu du principe de commutativité, le respect scrupuleux de l’ordre spécifié par l’interface constitue une bonne pratique pour préserver l’alignement logique des séries de données.
Sur le plan algorithmique interne, la fonction COVAR adopte un comportement spécifique lorsqu’elle rencontre des cellules contenant des valeurs non numériques (chaînes textuelles, booléens ou cellules laissées vacantes). Ces éléments sont automatiquement écartés du calcul par le moteur d’évaluation. Néanmoins, la limitation la plus critique de la fonction COVAR réside dans sa décision computationnelle d’implémenter par défaut la formule de la covariance populationnelle, divisant systématiquement la somme des produits des écarts par l’effectif brut $N$ sans appliquer le moindre ajustement de degrés de liberté.
Ce choix historique, conservé pour des impératifs d’interopérabilité descendante avec les premières suites bureautiques tabulaires, rend l’utilisation de COVAR inadéquate et scientifiquement inappropriée dans la quasi-totalité des contextes de recherche académique. Tout analyste ignorant cette particularité interne s’expose à sous-estimer la covariance réelle existant au sein de sa population d’intérêt, en injectant une statistique biaisée dans ses rapports finaux.
4.2 Arbitrage entre COVARIANCE.P et COVARIANCE.S
Conformément aux directives internationales de standardisation statistique promues par l’ISO et les grands consortiums logiciels, Google Sheets met à disposition deux fonctions modernes dont l’intitulé dissipe toute ambiguïté inférentielle : COVARIANCE.P et COVARIANCE.S. L’analyste est ainsi tenu d’exercer un arbitrage conscient et méthodologiquement fondé entre ces deux protocoles d’évaluation en fonction du statut épistémique de son corpus de données.
La fonction COVARIANCE.P(plage_donnees_1; plage_donnees_2) est strictement dédiée à l’analyse de populations exhaustives. Sa formule interne applique le diviseur $N$ et ne tolère aucune extrapolation probabiliste. Son usage s’avère pertinent dans des situations bien précises, telles que l’analyse du recensement complet des employés d’une entreprise fermée ou le traitement d’une population biologique confinée sans ambition d’inférence universelle. Dans ce cas, les valeurs observées constituent l’ensemble du domaine de référence et aucune correction d’échantillonnage n’est requise.
À l’opposé, la fonction COVARIANCE.S(plage_donnees_1; plage_donnees_2) intègre impérativement la correction de Bessel par le diviseur $n – 1$. Le suffixe « .S » dérive de l’anglais Sample, confirmant sa destination explicite pour l’étude d’échantillons représentatifs. Dans tous les protocoles expérimentaux, les enquêtes par sondage, les essais cliniques ou les calibrations d’échelles d’évaluation, COVARIANCE.S s’impose comme l’unique formule méthodologiquement recevable. Le recours non averti à la version populationnelle en recherche empirique expose l’analyste au risque d’une inférence faussée, particulièrement dommageable lorsque l’effectif $n$ demeure modeste.
4.3 Fonctions de variance complémentaires : VAR.S et VAR.P
Pour assurer la complétion ordonnée de la diagonale principale d’une matrice de dispersion sans redonder inutilement les calculs bivariés sur des variables identiques, le praticien doit mobiliser les fonctions de variance univariée associées. À l’instar du diptyque de la covariance, Google Sheets structure ses outils de dispersion autour des fonctions VAR.P pour la variance populationnelle et VAR.S pour la variance échantillonnale sans biais.
Il existe une correspondance algorithmique absolue entre le résultat retourné par l’instruction univariée VAR.S(plage_X) et celui produit par l’évaluation bivariée réflexive COVARIANCE.S(plage_X; plage_X). Les moteurs de calcul de Google Sheets traitent ces deux formulations avec une précision arithmétique rigoureusement identique. Dès lors, le choix entre l’une ou l’autre de ces approches pour alimenter la diagonale matricielle relève de la lisibilité computationnelle et de l’économie cognitive de la feuille de calcul.
L’utilisation concertée de COVARIANCE.S pour les intersections hors-diagonale et de VAR.S pour les éléments diagonaux garantit une cohérence interne parfaite à la matrice finale. Cette harmonie méthodologique assure que chaque composante de la matrice obéit rigoureusement au même ajustement par le dénominateur $n – 1$, prévenant tout déphasage mathématique destructeur entre les estimations de dispersion individuelle et les mesures de co-variation bivariée.
5. Méthode pas à pas : Construction manuelle cellule par cellule
5.1 Configuration spatiale du tableau de destination
La mise en place méthodique d’une matrice de covariance sous Google Sheets débute par l’aménagement d’une zone de travail dédiée au sein de la feuille de calcul, distincte de la table de données primaires. Il est fortement conseillé de déployer cette matrice sur un onglet indépendant, par exemple nommé Matrice_Covariance, afin d’éviter tout écrasement accidentel et de faciliter la mise en forme de restitution analytique.
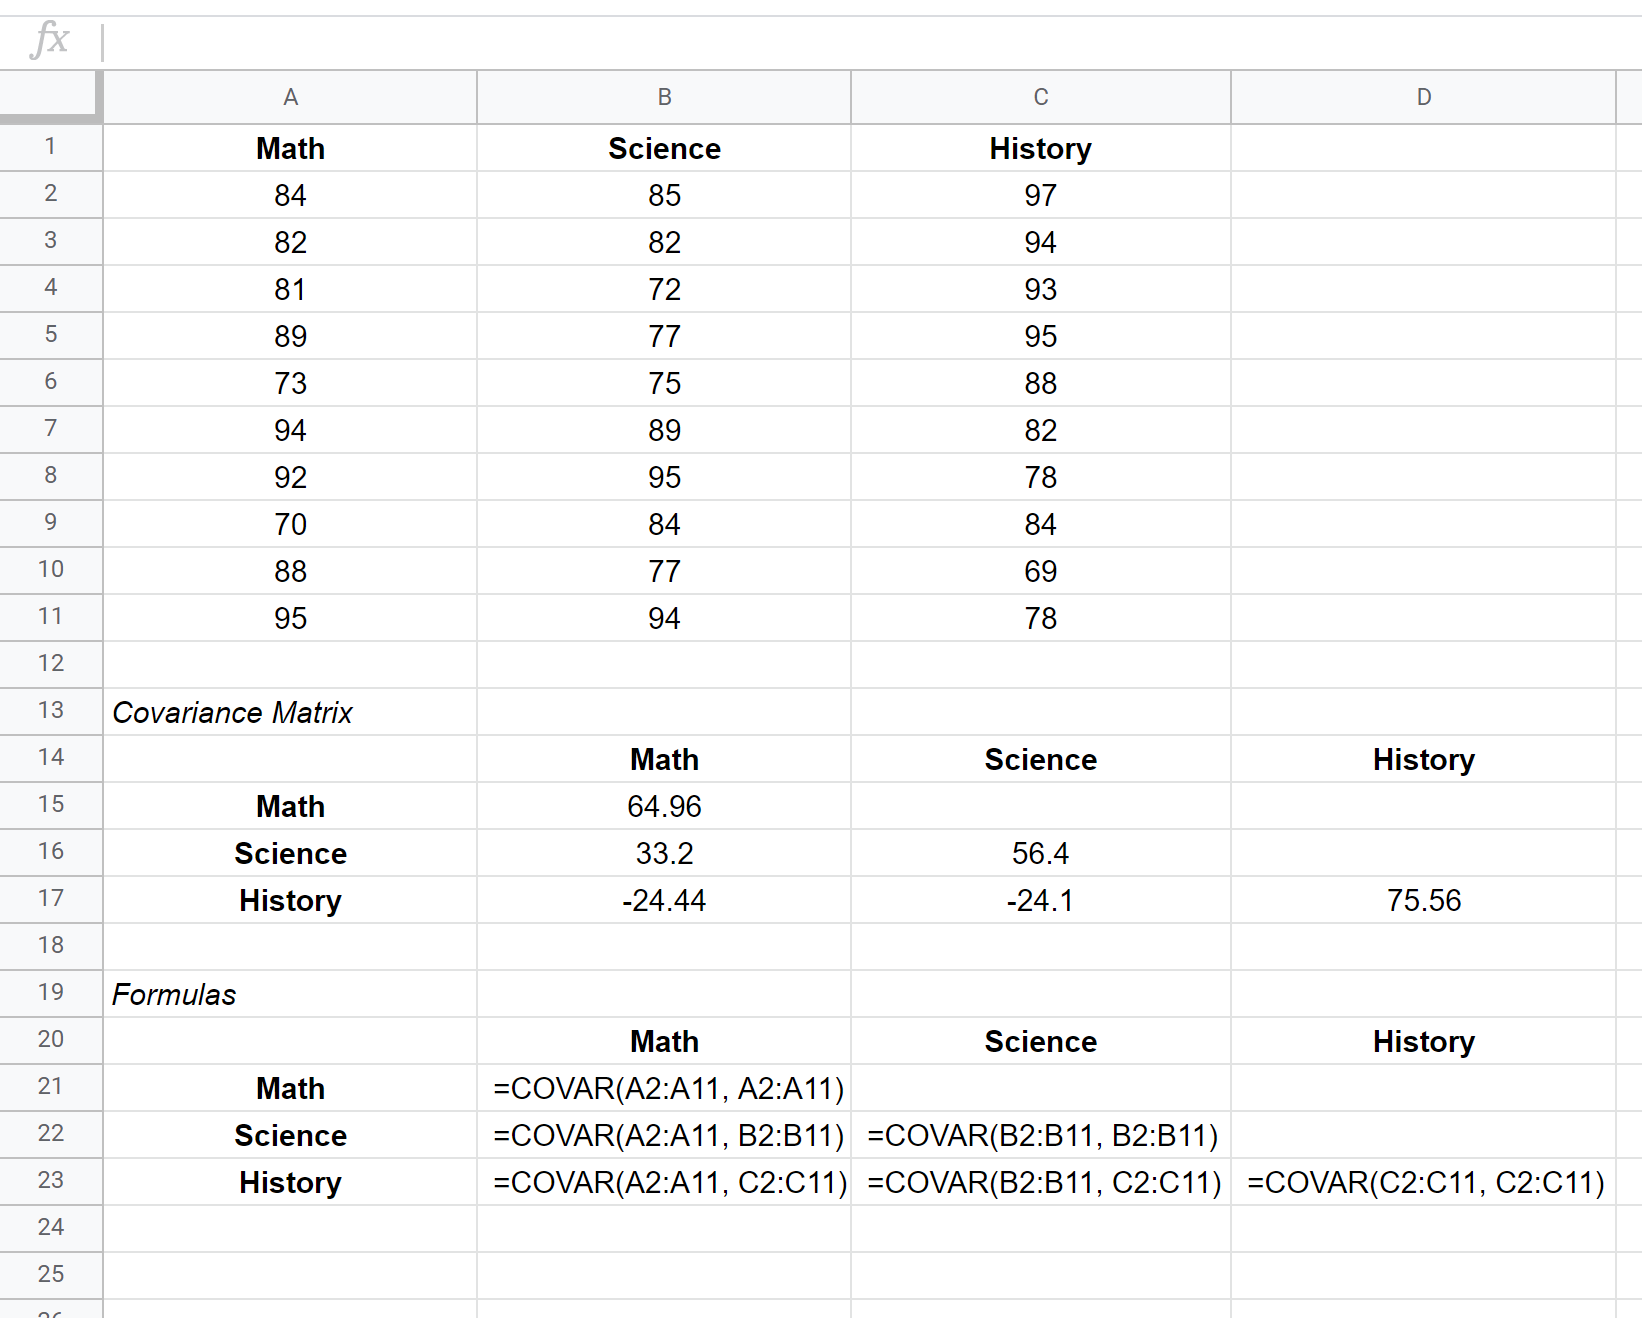
L’analyste configure un espace carré de dimension $p \times p$. Si le jeu de données évalue quatre variables (notées $A$, $B$, $C$, $D$), la structure matricielle occupera une grille de quatre lignes sur quatre colonnes. L’étape inaugurale impose de reporter de manière parfaitement symétrique les libellés de variables :
- Sur l’axe horizontal, en disposant les en-têtes dans les cellules d’en-tête de colonnes (par exemple de
B1àE1). - Sur l’axe vertical, en reproduisant ces intitulés dans les cellules d’en-tête de lignes (par exemple de
A2àA5).
L’application d’un traitement visuel spécifique — typographie contrastée, bordures nettes et arrière-plan subtilement teinté pour les en-têtes — permet d’isoler visuellement les métadonnées de l’espace numérique interne réservé aux coefficients de covariance, structurant l’espace avant l’insertion des formules.
5.2 Implémentation ciblée des variances sur la diagonale
Une fois le cadre matriciel dressé, la phase opératoire initiale consiste à renseigner la diagonale principale, reliant l’angle supérieur gauche à l’angle inférieur droit de la matrice carrée. Dans notre configuration modèle, ces cellules correspondent aux intersections d’identités : B2 pour la variable $A$, C3 pour la variable $B$, D4 pour la variable $C$, et E5 pour la variable $D$.
Dans la première cellule diagonale B2, l’analyste saisit l’instruction :
=VAR.S(Donnees!B$2:B$101)
Cette formule appelle la dispersion de la variable $A$ consignée sur la feuille source. Il procède ensuite de manière séquentielle pour les cellules diagonales adjacentes en faisant pointer la formule sur les colonnes sources correspondantes (VAR.S(Donnees!C$2:C$101) en C3, etc.).
Pour auditer la validité de la saisie, l’analyste peut implémenter temporairement dans une cellule de vérification la syntaxe équivalente =COVARIANCE.S(Donnees!B$2:B$101; Donnees!B$2:B$101). La concordance numérique absolue entre les deux valeurs confirme l’exactitude de l’implémentation. Une fois cette opération finalisée le long de la diagonale, la composante de dispersion univariée du système est intégralement verrouillée.
5.3 Calcul et duplication symétrique des covariances hors diagonale
Le renseignement des cellules situées hors de la diagonale exige une méthodologie rigoureuse pour garantir le respect de la symétrie axiale tout en réduisant l’effort d’encodage. L’analyste se focalise d’abord sur la complétion du triangle supérieur de la matrice, correspondant aux cellules positionnées au-dessus et à droite de la diagonale de variance.
Dans la cellule C2, qui matérialise l’interaction entre la variable $A$ (ligne 2) et la variable $B$ (colonne C), l’opérateur inscrit la formule de calcul bivariée :
=COVARIANCE.S(Donnees!$B$2:$B$101; Donnees!$C$2:$C$101)
Ce calcul fournit le coefficient de covariance reliant les deux séries de mesures. L’analyste poursuit cette démarche pour la cellule D2 (liant $A$ et $C$) et E2 (liant $A$ et $D$), puis descend à la ligne suivante pour renseigner la cellule D3 (liant $B$ et $C$) et E3 (liant $B$ et $D$), pour finir par la cellule E4 (liant $C$ et $D$).
Pour renseigner le triangle inférieur de manière optimale et prévenir tout risque d’incohérence, la technique la plus sûre repose sur le principe du miroir référentiel. Plutôt que de réécrire manuellement des formules COVARIANCE.S inversées au sein des cellules du triangle inférieur, l’analyste tire profit de l’égalité formelle $\mathbf{S} = \mathbf{S}^T$ en insérant de simples formules de renvoi d’égalité :
- Dans la cellule
B3, il saisit=C2 - Dans la cellule
B4, il saisit=D2 - Dans la cellule
B5, il saisit=E2 - Dans la cellule
C4, il saisit=D3 - Dans la cellule
C5, il saisit=E3 - Dans la cellule
D5, il saisit=E4
Cette approche garantit une symétrie axiale parfaite et allège la charge de calcul du tableur, tout en supprimant le risque d’erreurs d’encodage lors de la duplication des plages sources.
5.4 Verrouillage par références absolues et relatives
Lorsque le nombre de variables dépasse quelques unités, la saisie individuelle cellule par cellule devient laborieuse et propice aux fautes d’inattention. La rationalisation de la construction matricielle repose sur l’utilisation stratégique des symboles de verrouillage par le dollar ($) pour maîtriser les références absolues, relatives et mixtes au sein de Google Sheets.
Dans un schéma semi-automatisé où les données sources sont disposées dans un tableau ordonné, il est possible d’exploiter la fonction DECALER ou INDEX combinée aux coordonnées des lignes et colonnes de destination pour propager dynamiquement les calculs. L’emploi adéquat de références mixtes, comme $B2 ou B$2, s’avère déterminant si l’analyste transpose une structure de données.
Pour vérifier l’intégrité des liaisons après étirement ou duplication de formules, il est indispensable de procéder à un audit des dépendances. Google Sheets permet d’afficher l’intégralité des formules actives à l’écran via le raccourci clavier Ctrl + ` (ou via le menu Affichage > Afficher > Formules). Cette visualisation panoramique révèle immédiatement les ruptures d’incrémentation ou les dérives de plages vectorielles, garantissant une construction robuste et exempte de biais de positionnement.
6. Méthode semi-automatisée : Utilisation des formules matricielles dynamiques
6.1 Centrage préliminaire des variables par rapport à la moyenne
L’approche matricielle par blocs permet d’accélérer considérablement le traitement en s’affranchissant de l’encodage cellule par cellule. Sur le plan de l’algèbre linéaire, la covariance n’est rien d’autre que le produit interne de deux vecteurs préalablement centrés sur leur moyenne arithmétique respective. La première étape de cette méthode globale consiste donc à générer une matrice intermédiaire de données centrées, notée $\mathbf{X}_c$, de même dimensionnalité $n \times p$ que le tableau empirique source.
Pour concrétiser cette transformation vectorielle sans étirer manuellement de formules sur des milliers de lignes, Google Sheets propose la fonction ARRAYFORMULA. Supposons que nos observations s’étendent de B2 à E101 au sein de la feuille Donnees. Dans une nouvelle feuille technique intitulée Donnees_Centrees, l’analyste positionne son curseur en cellule B2 et inscrit l’instruction matricielle dynamique suivante :
=ARRAYFORMULA(Donnees!B2:E101 - MOYENNE(Donnees!B2:E101))
Attention toutefois : la syntaxe standard MOYENNE(B2:E101) calculerait une moyenne globale scalaire unique pour l’ensemble du rectangle de données, ce qui fausserait le centrage par colonne. Pour soustraire à chaque colonne sa propre moyenne marginale spécifique, il convient d’associer les fonctions BYCOL et LAMBDA :
=BYCOL(Donnees!B2:E101; LAMBDA(colonne; colonne - MOYENNE(colonne)))
Cette expression calcule la moyenne vectorielle de chaque colonne individuelle et la soustrait instantanément à chacune des observations de cette même colonne. Elle génère ainsi d’un seul tenant l’ensemble des déviations centrées $(X_i – \bar{X})$, posant les bases de la projection matricielle subséquente.
6.2 Calcul de la matrice des produits croisés via MMULT et TRANSPOSE
Une fois la matrice des scores centrés $\mathbf{X}_c$ établie, la théorie de l’algèbre matricielle énonce que la somme de l’ensemble des carrés et des produits croisés des déviations s’obtient par la multiplication de la transposée de la matrice centrée par la matrice centrée elle-même :
$$\mathbf{S}_{\text{produits}} = \mathbf{X}_c^T \mathbf{X}_c$$
Le produit matriciel d’une matrice de dimension $p \times n$ (la transposée $\mathbf{X}_c^T$) par une matrice de dimension $n \times p$ ($\mathbf{X}_c$) produit mathématiquement une matrice carrée de dimension $p \times p$, dont chaque cellule $(i, j)$ correspond rigoureusement à la somme brute $\sum (X_i – \bar{X})(Y_i – \bar{Y})$.
Google Sheets dispose précisément des opérateurs natifs permettant de transcrire cette identité mathématique en une seule formule compacte : la fonction TRANSPOSE pour inverser les dimensions spatiales de la matrice de données, et la fonction MMULT (équivalent fonctionnel de PRODMAT dans certaines localisations linguistiques) pour exécuter la multiplication matricielle :
=MMULT(TRANSPOSE(Donnees_Centrees!B2:E101); Donnees_Centrees!B2:E101)
Cette formule unique projette instantanément dans la feuille de calcul la matrice carrée complète des produits croisés et des sommes de carrés, condensant l’intégralité des relations bivariées de l’échantillon sans exiger la moindre boucle manuelle.
6.3 Mise à l’échelle finale par division scalaire
La matrice de dispersion obtenue à l’issue de l’étape précédente condense les sommes des produits des écarts, mais n’intègre pas encore la normalisation par les degrés de liberté requise pour satisfaire la définition de la covariance échantillonnale non biaisée. Il convient donc de diviser l’ensemble de ces coefficients scalaires par le facteur d’ajustement de Bessel, à savoir la taille d’échantillon diminuée d’une unité ($n – 1$).
L’opération de division scalaire peut être fusionnée directement dans l’instruction de projection matricielle initiale. En intégrant la fonction de décompte d’effectif NB sur l’une des colonnes de données pour dériver dynamiquement la quantité $n – 1$, l’équation maîtresse synthétisant l’intégralité de la matrice de covariance s’écrit :
=ARRAYFORMULA(MMULT(TRANSPOSE(BYCOL(Donnees!B2:E101; LAMBDA(col; col - MOYENNE(col)))); BYCOL(Donnees!B2:E101; LAMBDA(col; col - MOYENNE(col)))) / (NB(Donnees!B2:B101) - 1))
Cette formule génère en un temps de calcul minimal la totalité de la matrice de covariance ordonnée : les variances univariées s’installent sur la diagonale principale tandis que les covariances symétriques peuplent les éléments hors-diagonale. Au-delà de son élégance mathématique, cette technique dynamique élimine tout risque d’erreur humaine liée à la recopie manuelle et s’actualise instantanément dès lors que de nouvelles données viennent enrichir les colonnes sources.
7. Automatisation via Google Apps Script pour les analyses volumineuses
7.1 Initialisation de l’environnement de script intégré
Lorsque les configurations expérimentales manipulent des centaines de dimensions continues ou des dizaines de milliers d’enregistrements, la multiplication des fonctions de feuilles de calcul peut saturer la mémoire vive allouée au navigateur et dégrader la fluidité de l’interface. Pour contourner cette limite technique, Google Sheets intègre un environnement de développement scriptural fondé sur le standard JavaScript moderne : Google Apps Script. Cette interface offre un accès programmatique direct au modèle objet du document via l’API SpreadsheetApp.
L’accès à cet environnement s’opère par le menu supérieur du tableur via Extensions > Apps Script. L’analyste se trouve alors immergé dans un environnement de développement intégré (IDE) hébergé sur le cloud de Google, lui permettant de concevoir des modules d’extension statistiques et de développer des fonctions personnalisées réutilisables (User Defined Functions). L’extraction des données sources s’effectue de façon matricielle par un appel unique à la méthode getValues() sur l’objet de plage ciblé, ce qui rapatrie l’ensemble du tableau dans un tableau bidimensionnel JavaScript en mémoire vive, maximisant l’efficience d’exécution algorithmique.
7.2 Développement de l’algorithme de calcul matriciel
Le script d’évaluation doit traduire rigoureusement la logique combinatoire de la covariance échantillonnale en exploitant des boucles itératives optimisées. L’architecture algorithmique s’articule autour de trois phases successives :
- Le calcul préalable des moyennes arithmétiques de chaque colonne par balayage vertical des données.
- L’initialisation d’un tableau carré de dimension $p \times p$ destiné à recueillir les coefficients résultants.
- L’exécution d’une double boucle itérative imbriquée afin de calculer les covariances par paires selon la correction de Bessel.
Pour des raisons d’optimisation computationnelle, l’algorithme ne calcule que les éléments situés sur la diagonale et au sein du triangle supérieur, puis réplique instantanément chaque valeur dans la case spéculaire correspondante du triangle inférieur :
/**
 * Calcule la matrice de covariance echantillonnale non biaisee.
 *
 * @param {Array<Array<number>>} data Plage de donnees numeriques (lignes = sujets, cols = variables).
 * @return {Array<Array<number>>} Matrice de variance-covariance p x p.
 * @customfunction
 */
function MATRICE_COVARIANCE(data) {
  // Verification de l'integrite structurelle des donnees
  if (!data || data.length < 2) {
    throw new Error("L'echantillon doit comporter au moins deux observations.");
  }

  var n = data.length;
  var p = data[0].length;

  // Etape 1 : Calcul vectoriel des moyennes arithmetiques
  var means = new Array(p).fill(0);
  for (var j = 0; j < p; j++) {
    var sum = 0;
    var count = 0;
    for (var i = 0; i < n; i++) {
      var val = Number(data[i][j]);
      if (!isNaN(val)) {
        sum += val;
        count++;
      }
    }
    if (count < 2) {
      throw new Error("Donnees numeriques insuffisantes pour la colonne " + (j + 1));
    }
    means[j] = sum / count;
  }

  // Etape 2 : Initialisation de la matrice carree de sortie
  var covMatrix = [];
  for (var r = 0; r < p; r++) {
    covMatrix[r] = new Array(p).fill(0);
  }

  // Etape 3 : Calcul des covariances par paires avec symetrie axiale
  for (var j1 = 0; j1 < p; j1++) {
    for (var j2 = j1; j2 < p; j2++) {
      var crossProductSum = 0;
      for (var i = 0; i < n; i++) {
        var dev1 = Number(data[i][j1]) - means[j1];
        var dev2 = Number(data[i][j2]) - means[j2];
        crossProductSum += dev1 * dev2;
      }
      var cov = crossProductSum / (n - 1);
      covMatrix[j1][j2] = cov;
      covMatrix[j2][j1] = cov; // Application de la propriete symetrique
    }
  }

  return covMatrix;
}
7.3 Déploiement d’une fonction personnalisée réutilisable
L’intégration de la documentation formalisée au standard JSDoc au-dessus de la fonction — notamment l’indicateur syntaxique @customfunction — permet à Google Sheets d’indexer ce script directement au sein de sa bibliothèque de calcul native. Dès l’enregistrement du projet via l’icône de disquette ou le raccourci Ctrl + S, la fonction devient immédiatement accessible au sein des cellules de la feuille de calcul, enrichie du module d’autocomplétion contextuelle et d’assistance documentaire intégrée.
Pour déployer la matrice, l’utilisateur sélectionne simplement la cellule supérieure gauche de son tableau de destination et saisit la formule personnalisée comme une fonction native ordinaire :
=MATRICE_COVARIANCE(Donnees!B2:E101)
Le moteur d’exécution de Google Sheets invoque alors le script sur les serveurs distants, compile les tableaux d’écart et déverse instantanément l’intégralité de la matrice de covariance de taille $p \times p$ sur la feuille. Cette technique assure une évolutivité dimensionnelle remarquable, permettant d’actualiser une matrice de plusieurs dizaines de variables en une fraction de seconde tout en allégeant considérablement le fichier de travail.
8. Interprétation statistique approfondie de la matrice obtenue
8.1 Analyse de la magnitude et du signe des coefficients
L’exploitation analytique de la matrice de covariance exige une décomposition minutieuse des métriques obtenues, en dissociant rigoureusement l’orientation du signal de son amplitude brute. Le signe algébrique associé à chaque coefficient hors-diagonale ($s_{ij}$) renseigne directement sur la nature directionnelle de l’association linéaire : un signe positif caractérise une co-variation synergique, tandis qu’un signe négatif documente une relation de compensation ou d’opposition fonctionnelle entre les construits.
Cependant, l’interprétation de la magnitude numérique absolue d’une covariance brute requiert une prudence méthodologique majeure. Contrairement au coefficient de corrélation, la valeur scalaire de la covariance est directement tributaire des unités de mesure physiques ou psychométriques assignées aux variables étudiées. Si une variable quantifie le revenu salarial annuel exprimé en centimes d’euros et qu’une autre mesure l’âge chronologique en années, la covariance brute pourra atteindre des magnitudes vertigineuses de plusieurs millions sans que cela n’implique une proximité structurelle étroite entre ces deux phénomènes.
Une covariance élevée peut simplement traduire la présence d’une variance univariée colossale sur l’une des variables sous-jacentes. L’amplitude brute de la covariance ne constitue donc jamais un étalon d’évaluation universel de la force de liaison. Pour isoler la proximité conceptuelle réelle d’un couple de variables en faisant abstraction des unités d’échelle, il est indispensable de rapporter systématiquement la covariance aux écarts-types individuels respectifs par une opération de standardisation.
8.2 Diagnostic de colinéarité et singularité matricielle
La matrice de covariance constitue un instrument diagnostique essentiel pour détecter les situations de multicolinéarité sévère ou de singularité matricielle susceptible de compromettre les modélisations économétriques et factorielles ultérieures. Une multicolinéarité quasi-parfaite survient lorsqu’une variable empirique se trouve être une combinaison linéaire quasi-identique d’une ou plusieurs autres dimensions déjà présentes dans le modèle d’observation.
Sur le plan matriciel, cette situation se traduit par une matrice mal conditionnée, dont le déterminant s’approche dangereusement de zéro ($det(\mathbf{S}) \approx 0$). Si deux colonnes de variables partagent une redondance informationnelle quasi-totale, les lignes correspondantes au sein de la matrice de dispersion deviennent interdépendantes, réduisant le rang effectif de la structure sous sa dimension nominale $p$. La conséquence immédiate d’une telle singularité est l’impossibilité algorithmique d’inverser la matrice de covariance (l’opération $\mathbf{S}^{-1}$ devenant indéterminée).
Dans Google Sheets, l’évaluation de cette intégrité matricielle peut être conduite en calculant le déterminant de la matrice de covariance via la fonction native DETERMINDETERMAT (ou MDETERM) appliquée au bloc de cellules de la matrice :
=DETERMAT(B2:E5)
L’obtention d’une valeur de déterminant excessivement proche de zéro ($< 10^{-5}$) constitue une alerte méthodologique majeure, imposant à l'analyste de supprimer ou d'agréger les variables redondantes avant d'engager des modélisations structurelles avancées.
8.3 Rapprochement avec les hypothèses de recherche empiriques
L’ultime étape d’évaluation de la matrice réside dans la confrontation empirique de la structure de dispersion observée avec les hypothèses de recherche théoriques préalablement formulées. Dans le cadre de l’évaluation d’échelles de mesure ou de questionnaires psychométriques, la matrice de covariance constitue le miroir quantitatif des attendus conceptuels du modèle de mesure.
Si des items ont été rédigés pour saturer un même facteur sous-jacent, par exemple les symptômes somatiques de la dépression, ils doivent obligatoirement exhiber des covariances intra-dimensionnelles positives et substantiellement homogènes. L’observation inattendue d’un coefficient négatif ou d’une valeur négligeable entre deux items censés mesurer un même construit signale immanquablement une anomalie méthodologique. Il peut s’agir :
- D’un item rédigé sous forme inversée qui n’a pas fait l’objet d’un recodage préalable dans la feuille de données brutes.
- D’une ambiguïté sémantique majeure dans l’énoncé de la question provoquant des réponses discordantes selon les sous-groupes de répondants.
- D’une instabilité métrologique propre à l’échantillon sollicité.
L’analyse attentive de la matrice de dispersion permet d’assainir les outils de collecte avant toute publication scientifique ou généralisation empirique.
9. Conversion de la matrice de covariance en matrice de corrélation
9.1 Fondement mathématique de la standardisation de Pearson
Si la matrice de covariance capture l’intégralité de l’information brute relative aux échelles d’origine, son absence de standardisation restreint la comparaison immédiate de la force des liaisons unissant différents couples de variables. Pour pallier cette contrainte d’interprétation sans altérer la topologie des relations observées, l’analyste transforme la matrice de covariance en matrice de corrélation linéaire de Bravais-Pearson. Cette transformation consiste à diviser chaque covariance par le produit des écarts-types des deux variables impliquées :
$$r_{XY} = \frac{\text{Cov}(X, Y)}{\sigma_X \sigma_Y} = \frac{s_{XY}}{\sqrt{s_X^2} \sqrt{s_Y^2}} = \frac{s_{ij}}{\sqrt{s_{ii} \cdot s_{jj}}}$$
Cette opération arithmétique de normalisation élimine intégralement l’impact dimensionnel des unités de mesure. Le coefficient résultant $r$ est strictement contraint à évoluer au sein de l’intervalle fermé $[-1; +1]$. Les valeurs extrêmes $+1$ et $-1$ signent respectivement une relation linéaire fonctionnelle positive ou négative absolue, tandis que la valeur $0$ reflète l’orthogonalité ou l’absence totale de co-variation linéaire entre les attributs mesurés.
9.2 Implémentation automatisée dans une feuille miroir
La dérivation d’une matrice de corrélation à partir d’une matrice de covariance préalablement construite s’exécute de manière élégante au sein d’une seconde feuille de calcul miroir. Cette approche par liaison dynamique garantit que toute modification affectant les données originales se répercutera instantanément sur les deux niveaux d’analyse statistique.
Considérons que la matrice de covariance $4 \times 4$ soit établie dans la plage Matrice_Cov!B2:E5. Dans une nouvelle feuille nommée Matrice_Correlation, l’analyste duplique les en-têtes de colonnes et de lignes aux mêmes coordonnées, puis formule la règle de standardisation dans la cellule B2 :
=Matrice_Cov!B2 / (RACINE(Matrice_Cov!$B$2) * RACINE(Matrice_Cov!B$2))
Pour permettre une duplication automatisée sur l’ensemble de la grille via l’étirement de la poignée de recopie, il convient d’exprimer dynamiquement les coordonnées des variances diagonales au moyen d’indices d’accès absolus et relatifs. L’analyste exploitera avantageusement la fonction INDEX pour extraire les termes diagonaux associés aux coordonnées courantes de la cellule :
=Matrice_Cov!B2 / (RACINE(INDEX(Matrice_Cov!$B$2:$E$5; LIGNE(B2)-1; LIGNE(B2)-1)) * RACINE(INDEX(Matrice_Cov!$B$2:$E$5; COLONNE(B2)-1; COLONNE(B2)-1)))
La validation formelle de l’exactitude du tableau obtenu s’appuie sur une règle structurelle immuable : chaque cellule située le long de la diagonale principale de la matrice de corrélation ($r_{ii}$) doit afficher rigoureusement la valeur numérique 1,00, matérialisant la corrélation parfaite d’une variable avec elle-même.
9.3 Critères méthodologiques de choix entre covariance et corrélation
L’arbitrage entre l’exploitation d’une matrice de covariance et celle d’une matrice de corrélation ne constitue pas une simple préférence cosmétique, mais engage des conséquences méthodologiques profondes dans le choix des estimateurs multivariés subséquents :
- La matrice de covariance s’impose impérativement comme le format d’entrée obligatoire lors de la modélisation par équations structurelles (SEM), de l’analyse factorielle confirmatoire (CFA) et des analyses de régression multi-niveaux. Les algorithmes d’estimation par le maximum de vraisemblance (ML) requièrent l’information non standardisée relative à la dispersion brute afin d’estimer correctement les erreurs de mesure, les variances résiduelles et les poids de régression non standardisés ($\beta$ bruts). Une analyse factorielle menée à partir d’une matrice de corrélation peut biaiser l’estimation des erreurs standard et altérer les indices de qualité d’ajustement global du modèle (comme le Chi-deux de Cochran).
- La matrice de corrélation est préconisée lors de l’exécution d’analyses en composantes principales exploratoires (ACP) portant sur des batteries d’indicateurs hétérogènes dont les échelles métriques ne sont pas superposables (par exemple en confrontant l’âge en années, la pression artérielle en millimètres de mercure et des taux hormonaux en picogrammes par millilitre). La standardisation préalable garantit alors que la première composante principale extraite ne soit pas artificiellement dominée par la seule variable présentant la plus forte variance numérique brute.
10. Mise en forme visuelle et présentation académique des résultats
10.1 Application d’une mise en forme conditionnelle par échelle de couleurs
L’exploration visuelle d’une matrice volumineuse peut s’avérer fastidieuse lorsque l’œil doit parcourir des blocs denses de nombres décimaux. L’application d’un gradient de couleurs dynamique via le menu Format > Mise en forme conditionnelle de Google Sheets transforme la grille numérique en une cartographie thermique (heatmap) permettant d’identifier instantanément les axes de co-variation privilégiés.
Pour optimiser la lisibilité du tableau, il est recommandé de paramétrer une échelle chromatique divergente tricolore :
- La valeur médiane est ancrée au point zéro (
0,00) et associée à une teinte parfaitement neutre (blanc ou gris très clair). - Les valeurs positives supérieures sont associées à un dégradé de teintes douces, tel qu’un bleu profond dont la saturation augmente avec l’intensité de la covariance.
- Les valeurs négatives sont représentées par un dégradé de tonalités chaudes, allant de l’ambre au rouge atténué.
Une vigilance particulière s’impose néanmoins si la mise en forme conditionnelle est appliquée directement sur la matrice de covariance brute : l’amplitude des variances diagonales étant substantiellement plus élevée que celle des covariances hors-diagonale, elles risquent de saturer l’échelle chromatique et de masquer les variations subtiles entre couples de variables. Pour contourner cet écueil, l’analyste prendra soin d’exclure les cellules diagonales de la plage soumise au formatage conditionnel, ou privilégiera l’application de ce gradient sur la matrice de corrélation associée.
10.2 Normalisation typographique et règles de précision numérique
La lisibilité formelle d’un tableau statistique requiert une uniformisation rigoureuse du format d’affichage numérique. Au sein de Google Sheets, l’analyste sélectionnera l’ensemble des cellules de données et définira un format décimal personnalisé via Format > Nombre > Deux décimales ou Trois décimales. Dans les publications académiques internationales respectant les normes de l’American Psychological Association (APA 7th edition), les coefficients de covariance sont conventionnellement rapportés avec deux ou trois décimales de précision constante (ex. 14,52 ou 0,385).
De surcroît, la parité spéculaire absolue des coefficients situés de part et d’autre de la diagonale principale induit une redondance visuelle qui surcharge inutilement l’espace de lecture. Pour alléger la restitution cognitive lors d’une diffusion académique, l’analyste peut opter pour le masquage esthétique du triangle supérieur :
- En appliquant une règle de formatage conditionnel personnalisée configurant la couleur du texte sur la même teinte que l’arrière-plan de la cellule lorsque l’indice de colonne est strictement supérieur à l’indice de ligne (
=COLONNE() > LIGNE()). - En éliminant purement et simplement les formules résidant au sein de ce triangle supérieur pour n’afficher que le triangle inférieur et la diagonale principale.
Cette mise en page standardisée focalise l’attention du réviseur sur les seules estimations uniques du système relationnel.
10.3 Exportation et intégration dans des rapports scientifiques
L’intégration pérenne d’une matrice de covariance conçue sous Google Sheets vers un document de restitution scientifique rédigé sous Google Docs, Microsoft Word ou LaTeX exige une rigueur méthodique afin de préserver l’alignement des colonnes et la précision des métadonnées structurelles. L’exportation brute par copier-coller standard peut introduire des décalages d’espacement ou tronquer les chiffres décimaux.
La méthode la plus robuste repose sur une liaison dynamique via l’option Coller et lier au tableur offerte au sein de l’environnement Google Workspace. Cette modalité permet de maintenir une liaison active entre le rapport textuel et le tableur d’analyse : toute révision ultérieure du jeu de données source ou correction d’une cellule erronée actualisera automatiquement le tableau incorporé dans le rapport écrit d’un simple clic.
Chaque matrice de covariance intégrée dans un rapport de recherche doit systématiquement être accompagnée d’une note de bas de tableau formalisée. Cette notice méthodologique doit stipuler sans ambiguïté la nature de l’estimateur mobilisé (estimateur échantillonnal sans biais utilisant le diviseur $n – 1$), la taille d’échantillon totale effective ayant servi aux calculs, et renseigner explicitement sur la méthode adoptée pour gérer d’éventuelles observations incomplètes. Enfin, la préservation d’une copie horodatée et archivée du classeur Google Sheets source participe de la conformité aux exigences contemporaines de reproductibilité scientifique et de science ouverte.
11. Diagnostics, erreurs fréquentes et stratégies de dépannage
11.1 Résolution des erreurs de formule Google Sheets (#DIV/0!, #VALUE!, #N/A)
La modélisation matricielle sous tableur expose régulièrement l’analyste à l’apparition inopinée d’erreurs d’exécution bloquantes. L’identification méthodique des causes sous-jacentes à chaque code d’erreur conditionne la fiabilité du travail d’audit statistique.
Le message d’erreur #DIV/0! survient systématiquement lors de l’appel de la fonction COVARIANCE.S ou VAR.S dès lors que la plage d’analyse ne comporte qu’une seule et unique observation numérique exploitable ($n = 1$). Dans ce contexte, l’application de la correction de Bessel impose une division par zéro ($n – 1 = 0$), ce qui est arithmétiquement impossible. La résolution de ce problème impose de vérifier que les plages sources ciblent bien l’ensemble des lignes d’observations disponibles et que d’éventuelles valeurs n’ont pas été accidentellement purgées.
L’erreur #VALEUR! (ou #VALUE!) traduit généralement une incompatibilité typologique dans le flux d’instructions. Elle émerge fréquemment lorsque des cellules censées contenir des données continues renferment des caractères invisibles, des espaces insécables issus d’un import de base de données externe ou des formulations textuelles incompatibles avec l’opérateur d’espérance mathématique. L’exécution de la fonction EPURAGE ou SUPPRESPACE combinée à CNUM permet de restaurer l’intégrité numérique des cellules corrompues.
Enfin, le code #N/A émerge principalement lors de l’usage des formules matricielles dynamiques de type MMULT lorsque les dimensions vectorielles sont incompatibles pour la multiplication interne (par exemple si le nombre de colonnes de la première matrice ne correspond pas rigoureusement au nombre de lignes de la seconde). L’audit des dimensions spatiales des plages renseignées en arguments résout systématiquement cette discordance.
11.2 Divergences de dimensions et défauts d’alignement
Une anomalie fréquente lors de la construction manuelle de matrices de covariance concerne le désalignement des longueurs vectorielles soumises à la comparaison bivariée. Les fonctions COVARIANCE.S(plage_1; plage_2) et COVARIANCE.P(plage_1; plage_2) exigent impérativement que les deux arguments présentent une extension dimensionnelle rigoureusement équivalente. La déclaration d’une plage B2:B101 confrontée à une plage C2:C100 déclenche un arrêt immédiat du moteur de calcul assorti d’une alerte structurelle.
Ces divergences d’alignement sont fréquemment introduites de façon involontaire par la manipulation de filtres interactifs ou par le masquage temporaire de lignes sur la feuille de données brutes. Contrairement à certaines fonctions de base de données relationnelles, les fonctions statistiques matricielles de Google Sheets continuent d’évaluer les cellules invisibles dissimulées par un filtre standard, ce qui peut engendrer des décalages d’indices majeurs si l’analyste tente d’exclure manuellement des sous-groupes statistiques.
Pour prémunir le modèle contre tout risque de désynchronisation de paires d’observations, il est vivement recommandé d’encapsuler la sélection des données brutes dans des fonctions de filtrage dynamique en amont, telles que FILTER(plage_source; condition), garantissant que les vecteurs comparés conservent systématiquement une parité de longueur parfaite.
11.3 Pièges méthodologiques liés à l’interprétation causale
Au-delà des aspects purement calculatoires, la manipulation des matrices de covariance expose l’analyste à des dérives interprétatives dommageables sur le plan épistémologique. L’axiome fondamental selon lequel covariance n’implique en aucun cas causalité directe doit être constamment réaffirmé lors de la restitution des résultats. Une covariance positive marquée entre deux indicateurs peut résulter entièrement de l’action non contrôlée d’une variable de confusion tierce influençant simultanément les deux attributs observés.
Le risque interprétatif culmine lors de la survenue du paradoxe de Simpson. Ce phénomène statistique majeur se manifeste lorsqu’une covariance globale évaluée sur l’ensemble d’une population d’analyse présente un signe donné (par exemple positif), alors que cette même covariance s’avère systématiquement nulle ou de signe rigoureusement opposé (négatif) lorsqu’elle est calculée séparément au sein de chacun des sous-groupes constitutifs de la population. Une telle distorsion émerge dès lors que l’échantillon agrège des cohortes hétérogènes réparties de façon déséquilibrée sur les variables d’intérêt.
Le chercheur doit donc s’interdire toute conclusion causale univoque déduite de la simple inspection d’une cellule de covariance. L’inférence causale valide repose impérativement sur des devis expérimentaux randomisés, le contrôle stochastique des variables confusionnelles ou l’estimation de modèles causaux structuraux instrumentés.
12. Applications pratiques en modélisation statistique avancée
12.1 Préparation pour la modélisation par équations structurelles (SEM)
L’utilité méthodologique d’une matrice de covariance conçue sous Google Sheets prend toute son ampleur lorsqu’elle sert de tremplin d’entrée vers les environnements avancés de modélisation par équations structurelles (SEM) ou d’analyse factorielle confirmatoire (CFA), tels que le paquet lavaan sous R ou le logiciel Mplus. La majorité de ces architectures logicielles n’exigent pas le téléversement des micro-données brutes individuelles : elles peuvent estimer l’intégralité des paramètres d’un modèle structurel complexe en se nourrissant exclusivement de la matrice de covariance ordonnée et de la taille de l’échantillon $n$.
Dans ce flux de travail interopérable, l’analyste utilise Google Sheets pour nettoyer les variables, consolider la matrice de dispersion échantillonnale sans biais ($\mathbf{S}$) et auditer sa cohérence algébrique. Il vérifie l’absence de valeurs aberrantes et la positivité stricte des variances diagonales avant d’exporter la matrice sous forme de fichier texte délimité (CSV). Dans lavaan, cette matrice est directement injectée via des commandes dédiées :
# Importation de la matrice de covariance construite dans Google Sheets
cov_matrix <- lavaan::getCov(nom_fichier_ou_vecteur, names = c("X1", "X2", "X3", "X4"))

# Ajustement du modele de mesure confirmatoire
fit <- lavaan::cfa(modele_syntaxique, sample.cov = cov_matrix, sample.nobs = 100)
L’estimation par le maximum de vraisemblance compare ensuite cette matrice de covariance observée $\mathbf{S}$ à la matrice de covariance implicite ou reproduite par le modèle théorique, désignée par $boldsymbol{\Sigma}(boldsymbol{\theta})$. La minimisation de l’écart géométrique unissant ces deux structures matricielles permet d’évaluer la qualité de l’adéquation conceptuelle de la théorie aux faits observés.
12.2 Lien avec l’Analyse en Composantes Principales (ACP)
La matrice de covariance constitue le support mathématique fondamental sur lequel s’exécute la décomposition spectrale au cœur de l’Analyse en Composantes Principales (ACP). Lorsqu’une ACP est réalisée sur des données brutes non standardisées mais centrées, l’algorithme consiste très exactement à opérer la diagonalisation de la matrice de covariance $\mathbf{S}$. Cette procédure factorielle résout l’équation aux valeurs propres et vecteurs propres :
$$\mathbf{S} \mathbf{v}_k = \lambda_k \mathbf{v}_k$$
Dans cette formulation, chaque scalaire $\lambda_k$ représente une valeur propre associée au vecteur propre orthogonal $\mathbf{v}_k$. La somme algébrique de l’ensemble des valeurs propres équivaut strictement à la trace de la matrice de covariance initiale, c’est-à-dire à la somme arithmétique de toutes les variances univariées logées sur la diagonale principale :
$$\sum_{k=1}^{p} \lambda_k = \text{Trace}(\mathbf{S}) = \sum_{i=1}^{p} s_{ii}$$
Chaque axe factoriel extrait capte une fraction de l’inertie globale proportionnelle à sa valeur propre associée. Comprendre la matrice de dispersion permet à l’analyste de mesurer comment les interdépendances linéaires résumées dans Google Sheets conditionnent directement la capacité de l’ACP à comprimer l’espace dimensionnel en un sous-ensemble restreint d’axes orthogonaux synthétiques.
12.3 Calcul de la fiabilité d’échelle et cohérence interne
Une application opérationnelle immédiate de la matrice de covariance au sein de Google Sheets concerne l’évaluation de la cohérence interne d’instruments de mesure multidimensionnels, formalisée par l’incontournable coefficient Alpha de Cronbach. La théorie classique des tests psychométriques démontre que l’estimation de la fidélité d’une échelle composite composée de $k$ items peut être directement dérivée des propriétés de sommation interne de sa matrice de dispersion.
L’équation de l’Alpha de Cronbach s’énonce selon la formule canonique :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^{k} \sigma_i^2}{\sigma_X^2} \right)$$
En examinant attentivement cette formule, l’analyste constate que tous les termes requis figurent déjà au sein de sa matrice de covariance établie sous Google Sheets :
- La quantité $\sum \sigma_i^2$ représente la somme arithmétique des variances individuelles des items, ce qui correspond exactement à la trace de la matrice de covariance (la somme des cellules de la diagonale principale).
- La variance du score composite global $\sigma_X^2$ équivaut à la somme globale absolue de l’intégralité des éléments constitutifs de la matrice (englobant la totalité des variances diagonales et l’ensemble des covariances hors-diagonale).
Dans Google Sheets, l’analyste peut automatiser le diagnostic de fidélité de son instrument psychométrique en écrivant une formule unique qui puise ses paramètres directement dans la matrice de covariance préalablement générée dans la plage B2:F6 :
=(COLONNES(B2:F6) / (COLONNES(B2:F6) - 1)) * (1 - (SOMME(SI(LIGNE(B2:F6) = COLONNE(B2:F6); B2:F6; 0)) / SOMME(B2:F6)))
Cette implémentation consolide la passerelle entre l’algèbre matricielle pure et l’évaluation psychométrique appliquée, transformant le tableur en un laboratoire d’analyse complet, rigoureux et autonome.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Bollen, K. A. (1989). Structural equations with latent variables. John Wiley & Sons. https://doi.org/10.1002/9781118619179
Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
Jöreskog, K. G. (1970). A general method for analysis of covariance structures. Biometrika, 57(2), 239–251. https://doi.org/10.1093/biomet/57.2.239
Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). The Guilford Press.
Pearson, K. (1895). VII. Mathematical contributions to the theory of evolution.—III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10