
L’essor des applications infonuagiques a profondément transformé la manière dont les organisations manipulent, agrègent et diffusent les données chiffrées. Au cœur de cette révolution collaborative, le tableur en ligne de Google s’est imposé comme un standard de productivité incontournable dans les écosystèmes professionnels, administratifs et académiques. Toutefois, à mesure que les projets gagnent en envergure, les documents tabulaires tendent à croître de manière exponentielle, accumulant des dizaines de feuilles de calcul au sein d’un même classeur. Cette prolifération d’onglets soulève un défi ergonomique majeur : la saturation informationnelle et la dégradation de la navigabilité, susceptibles d’entraver significativement l’efficacité opérationnelle des utilisateurs.
Pour pallier cette complexité structurelle, la mise en place d’une architecture relationnelle intra-classeur devient un impératif méthodologique. Savoir relier de manière fluide, pérenne et intuitive un onglet source à un onglet cible ne relève pas du simple confort visuel, mais constitue une véritable stratégie d’ingénierie de l’information. En tirant parti des hyperliens internes, les concepteurs de modèles financiers, de tableaux de bord opérationnels et de répertoires de recherche peuvent transformer un ensemble touffu de données brutes en un système applicatif interactif, doté de tables des matières intelligentes, de menus contextuels et de parcours de consultation optimisés.
Le présent traité propose une exploration exhaustive des mécanismes régissant la création, la personnalisation et la gestion des hyperliens inter-onglets dans Google Sheets. De l’anatomie fondamentale des identifiants universels de grille jusqu’aux automatisations programmatiques élaborées via Google Apps Script, cette analyse décortique chaque dimension technique et méthodologique nécessaire à la construction de classeurs modernes, portables et ergonomiques.
1. Introduction aux dynamiques de navigation inter-feuilles dans Google Sheets
1.1 Fondements structurels de l’architecture d’un classeur multi-onglets
L’architecture d’un classeur multi-onglets repose sur une logique d’arborescence et de hiérarchisation stricte. Dans tout projet d’envergure, le regroupement indiscriminé de jeux de données hétérogènes sur une surface de calcul unique conduit inévitablement à un encombrement visuel préjudiciable et à des risques accrus de corruption des formules. Pour contourner cet écueil, les praticiens adoptent une modélisation modulaire : chaque feuille de calcul est dévolue à une fonction analytique précise, qu’il s’agisse de l’ingestion de données brutes, de l’élaboration de tables de concordance, de la modélisation statistique ou de la restitution visuelle sous forme de tableaux de bord exécutifs.
Cette décomposition fonctionnelle s’inspire directement des principes directeurs de la conception des bases de données relationnelles, dans lesquelles l’isolation des entités garantit l’intégrité structurelle du système global. Dès lors que les données sont ventilées sur une pluralité d’onglets, la clarté conceptuelle s’accroît considérablement, mais cette dispersion physique exige un contrepoids organisationnel immédiat. Sans un vecteur de liaison cohérent, le classeur risque de devenir un dédale impénétrable où l’utilisateur perd la vue synoptique indispensable à une prise de décision éclairée.
La modularité tabulaire nécessite donc l’instauration d’un protocole rigoureux de communication entre les feuilles. Il ne s’agit pas seulement de lier des cellules par des formules arithmétiques de référence croisée, mais de structurer un véritable parcours utilisateur à travers des éléments de pointage direct. Cette disposition permet de concevoir des classeurs à plusieurs niveaux de lecture, où l’intervenant occasionnel peut consulter une synthèse sans être distrait par les strates techniques intermédiaires hébergées sur des onglets sous-jacents.
1.2 Avantages ergonomiques et organisationnels des liaisons internes
L’intégration délibérée d’hyperliens internes apporte une valeur ergonomique substantielle en minimisant la charge cognitive de l’utilisateur final. Lorsqu’un classeur comporte un volume important d’onglets, le recours exclusif à la barre horizontale de défilement située au bas de l’interface Google Sheets s’avère particulièrement inefficace. Les actions répétées de recherche visuelle génèrent des micro-frictions temporelles qui, accumulées à l’échelle d’une organisation, dégradent la productivité globale et augmentent la probabilité d’erreurs de manipulation.
L’établissement d’une matrice de liens hypertextes transforme radicalement cette dynamique en introduisant le paradigme du saut contextuel instantané. Un collaborateur consultant un chiffre agrégé au sein d’une synthèse financière peut, d’un simple clic, être redirigé avec précision vers l’onglet documentant les hypothèses de calcul ou les transactions unitaires d’origine. Ce comportement fluide renforce la transparence des modèles et accélère considérablement les phases d’audit et de validation documentaire.
En outre, l’accessibilité pour les tiers non initiés à la topologie du fichier s’en trouve grandement facilitée. Un auditeur, un gestionnaire ou un cadre dirigeant dispose rarement du temps nécessaire pour assimiler les conventions de dénomination internes d’un classeur volumineux. La mise à disposition d’un système de renvois interactifs et explicites offre une expérience proche de celle d’une application logicielle dédiée, guidant l’utilisateur de manière prévisible et sécurisée à travers les différents compartiments de l’information décisionnelle.
1.3 Typologie comparative des approches de maillage interne
Pour mailler efficacement les feuilles de calcul, Google Sheets propose un spectre méthodologique diversifié, s’étendant du paramétrage purement déclaratif dans l’interface utilisateur jusqu’à la compilation programmatique à l’aide de scripts dédiés. La méthode la plus accessible repose sur l’interface graphique native du logiciel, permettant d’associer un lien hypertexte à une cellule ou à une plage textuelle via les menus contextuels standards. Cette approche présente l’avantage de la rapidité d’exécution pour des besoins ponctuels et n’exige aucune maîtrise syntaxique avancée.
À l’inverse, l’approche fonctionnelle mobilisant la formule HYPERLINK (ou son équivalent francophone LIEN_HYPERTEXTE) introduit une dimension algorithmique supérieure. En intégrant l’adresse de destination sous forme d’argument textuel ou de variable dynamique, le concepteur peut paramétrer, concaténer et automatiser la génération des liens selon des critères logiques prédéfinis. Cette méthode s’avère indispensable dès lors qu’il convient de gérer de larges volumes de liens ou d’indexer dynamiquement des structures tabulaires évolutives.
Enfin, à la frontière entre ingénierie de données et développement applicatif, l’automatisation via Google Apps Script représente le niveau ultime de sophistication. Par le biais d’instructions écrites en langage JavaScript, cette méthode permet d’interroger directement l’interface de programmation du classeur pour recenser en temps réel l’ensemble des feuilles créées, en extraire les propriétés intrinsèques et générer de manière autonome des tables des matières exhaustives sans intervention manuelle. Le choix entre ces paradigmes découle directement de la taille du projet, de son cycle de vie et du niveau d’expertise des mainteneurs du document.
2. Analyse technique de la structure d’une URL Google Sheets et du paramètre GID
2.1 Décomposition de l’adresse canonique d’un classeur Google Drive
Pour maîtriser pleinement la redirection hypertexte au sein de l’environnement infonuagique de Google, il est fondamental de comprendre l’architecture formelle d’une adresse URL (Uniform Resource Locator) canonique. Chaque fichier hébergé sur les serveurs de l’infrastructure Google Drive répond à une norme syntaxique stricte conçue pour garantir l’adressage univoque des ressources. Une URL standard de classeur adopte invariablement la structure de base suivante : le protocole sécurisé HTTPS, le nom d’hôte docs.google.com, suivi du chemin applicatif /spreadsheets/d/, prolongé par une séquence alphanumérique de grande longueur constituant l’identifiant universel unique du document, et conclu par des segments de contexte opérationnel.
Cet identifiant de classeur, composé généralement de quarante-quatre caractères sensibles à la casse, agit comme une clé primaire globale à l’échelle du système distribué de Google. Il discrimine formellement un classeur donné parmi l’ensemble des milliards de documents stockés mondialement. À la suite de cet identifiant unique se trouve le segment de routage interne, traditionnellement matérialisé par le terme /edit, signalant que le document est actuellement ouvert dans son interface de manipulation dynamique par un utilisateur disposant des autorisations appropriées.
Toutefois, s’arrêter à ce niveau d’observation ne permet d’adresser que le classeur dans sa globalité sans cibler une composante interne spécifique. Le protocole HTTP intègre à cet effet le mécanisme d’ancrage textuel, introduit par le caractère dièse (#). Dans l’écosystème de Google Sheets, la portion d’URL située à droite du dièse ne conditionne pas la requête adressée au serveur web distant, mais instruit le client local (le navigateur web) sur le sous-composant structurel vers lequel le focus de l’application doit être instantanément dirigé.
2.2 Rôle sémantique et fonctionnement de l’identifiant de grille (GID)
Au cœur du fragment d’ancrage se trouve la variable technique désignée sous l’acronyme GID, qui signifie formellement Grid Identifier ou identifiant de grille. Dans la grammaire des paramètres d’URL de Google Sheets, cette variable s’exprime sous la forme normalisée #gid=X, où la variable X représente un entier non signé. Le GID est l’empreinte digitale absolue d’un onglet au sein d’un classeur donné : il assure la dissociation logique des feuilles de calcul partageant une même enveloppe documentaire.
Une convention historique notable régit l’attribution de ces identifiants. Lors de la création ex nihilo d’un nouveau classeur Google Sheets, la première feuille générée par défaut reçoit conventionnellement la valeur zéro, se traduisant dans la barre d’adresse par la mention #gid=0. Cet onglet maître initial constitue la référence racine du document lors de sa phase d’initialisation. En revanche, dès lors qu’un utilisateur clique sur le bouton d’adjonction d’une nouvelle feuille, le moteur interne de Google n’incrémente pas de manière séquentielle cet identifiant.
Au contraire, Google Sheets génère de manière pseudo-aléatoire un nombre entier long, pouvant comporter de six à dix chiffres, afin d’assigner une signature singulière au nouvel onglet (par exemple, #gid=1847294827). Ce choix d’implémentation algorithmique vise à prévenir les collisions d’identifiants lors d’opérations simultanées en mode multi-utilisateurs et garantit que même si un onglet est supprimé puis récréé avec une dénomination identique, sa nouvelle incarnation disposera d’un GID distinct, protégeant ainsi l’intégrité relationnelle du document face aux ambiguïtés d’adressage.
2.3 Méthodologie d’extraction et de validation de l’identifiant GID
L’extraction rigoureuse du paramètre GID conditionne la fiabilité de toute stratégie de liaison hypertexte interne. Pour isoler manuellement cet identifiant sans altérer la cohérence des cibles de redirection, la méthodologie préconisée débute par l’ouverture du classeur au sein d’un navigateur contemporain conforme aux standards web modernes. L’opérateur doit impérativement s’assurer que le document a achevé l’ensemble de ses requêtes asynchrones de synchronisation avant de procéder à l’identification.
La démarche impose de cliquer distinctement sur l’onglet de destination dans la barre inférieure du tableur afin de le rendre actif. À cet instant précis, l’application exécute un script côté client qui actualise la valeur du fragment d’ancrage affichée dans la barre d’adresse du navigateur. L’analyste doit observer la terminaison de la chaîne d’URL pour y repérer la mention explicite du dièse immédiatement suivi du terme gid= et de sa charge utile numérique.
La phase de validation consiste à copier méticuleusement l’intégralité de ce fragment sans omettre le moindre caractère numérique ni y incorporer d’espaces parasites qui corrompraient l’évaluation syntaxique future. Une technique d’audit élémentaire pour vérifier l’exactitude de la chaîne extraite consiste à ouvrir un nouvel onglet de navigation, à y coller l’adresse intégrale incluant le paramètre GID, puis à valider l’accès : le navigateur doit immédiatement afficher le document en positionnant d’emblée la sélection visuelle sur la feuille correspondant au GID analysé, validant ainsi la viabilité du marqueur.
3. Mise en œuvre fondamentale via la fonction HYPERLINK et l’URL complète
3.1 Syntaxe formelle et spécifications d’arguments de HYPERLINK
La fonction HYPERLINK (transposable sous le libellé LIEN_HYPERTEXTE dans les configurations régionales francophones) constitue le mécanisme canonique de création programmatique de liaisons textuelles dans Google Sheets. Définie au sein de la bibliothèque standard des fonctions de tableur, sa signature syntaxique obéit à une formalisation binaire stricte : HYPERLINK(url; [libellé]). L’évaluation de cette fonction produit un objet cliquable directement intégré au flux de la cellule, capable de déclencher une commande de navigation externe ou interne.
Le premier paramètre, impératif, représente l’URL cible de la redirection. Ce paramètre doit nécessairement être formulé sous la forme d’une chaîne de caractères délimitée par des guillemets droits doubles anglo-saxons (« ), ou provenir d’une évaluation dynamique renvoyant une chaîne textuelle conforme. L’omission de ces délimiteurs lors de la saisie littérale d’une adresse constitue l’une des erreurs de syntaxe les plus fréquentes, provoquant une interruption immédiate du moteur d’évaluation matérialisée par l’erreur #NOM? (NAME?).
Le second argument, désigné sous le terme de libellé ou texte d’ancrage, demeure techniquement optionnel selon la spécification de la fonction. Lorsqu’il est délibérément omis par le concepteur, la fonction adopte un comportement de repli par défaut en affichant l’intégralité brute de la chaîne d’URL fournie en premier argument. Toutefois, dans le cadre d’une architecture documentaire soignée, il est hautement recommandé de renseigner systématiquement cet argument afin de présenter à l’utilisateur un texte descriptif, ergonomique et contextuel, évitant ainsi la pollution visuelle générée par de longues chaînes de caractères techniques.
3.2 Protocole étape par étape pour relier deux onglets distincts
L’application méthodique de la fonction HYPERLINK pour interconnecter deux feuilles de calcul s’articule autour d’un protocole opérationnel en trois phases interdépendantes. La première étape consiste à préparer le réceptacle de navigation au sein de l’onglet émetteur, communément nommé onglet source. Le concepteur sélectionne la cellule idoine – par exemple la cellule B4 d’une feuille récapitulative – et engage la saisie en inscrivant le symbole d’égalité conventionnel (=) suivi de l’opérateur fonctionnel HYPERLINK et de la parenthèse ouvrante.
La seconde phase requiert l’extraction de la cible documentaire. L’opérateur navigue vers l’onglet de destination, observe le rafraîchissement dynamique du fragment d’ancrage dans la barre de localisation de son navigateur, et copie l’adresse URL absolue dans sa totalité, incluant le préfixe de domaine, l’identifiant du document et la séquence terminale #gid=X. Il convient ensuite de revenir sur l’onglet source pour injecter cette chaîne textuelle entre guillemets doubles au sein du premier argument de la formule en cours de rédaction.
La phase finale parachève la commande par l’adjonction du séparateur d’arguments approprié – le point-virgule (;) étant la norme universelle au sein des configurations utilisant la virgule comme séparateur décimal – avant de formaliser le libellé d’affichage. À titre d’illustration, l’instruction définitive prendra la forme rigoureuse suivante : =HYPERLINK("https://docs.google.com/spreadsheets/d/1BxiMVs0XRA5nFMdKvBdBZjgmUUqptlbs74OgvE2upms/edit#gid=1548762934"; "Consulter le Registre Analytique"). La fermeture de la parenthèse et la validation par la touche Entrée finalisent l’ancrage.
3.3 Validation expérimentale du saut de contexte interactif
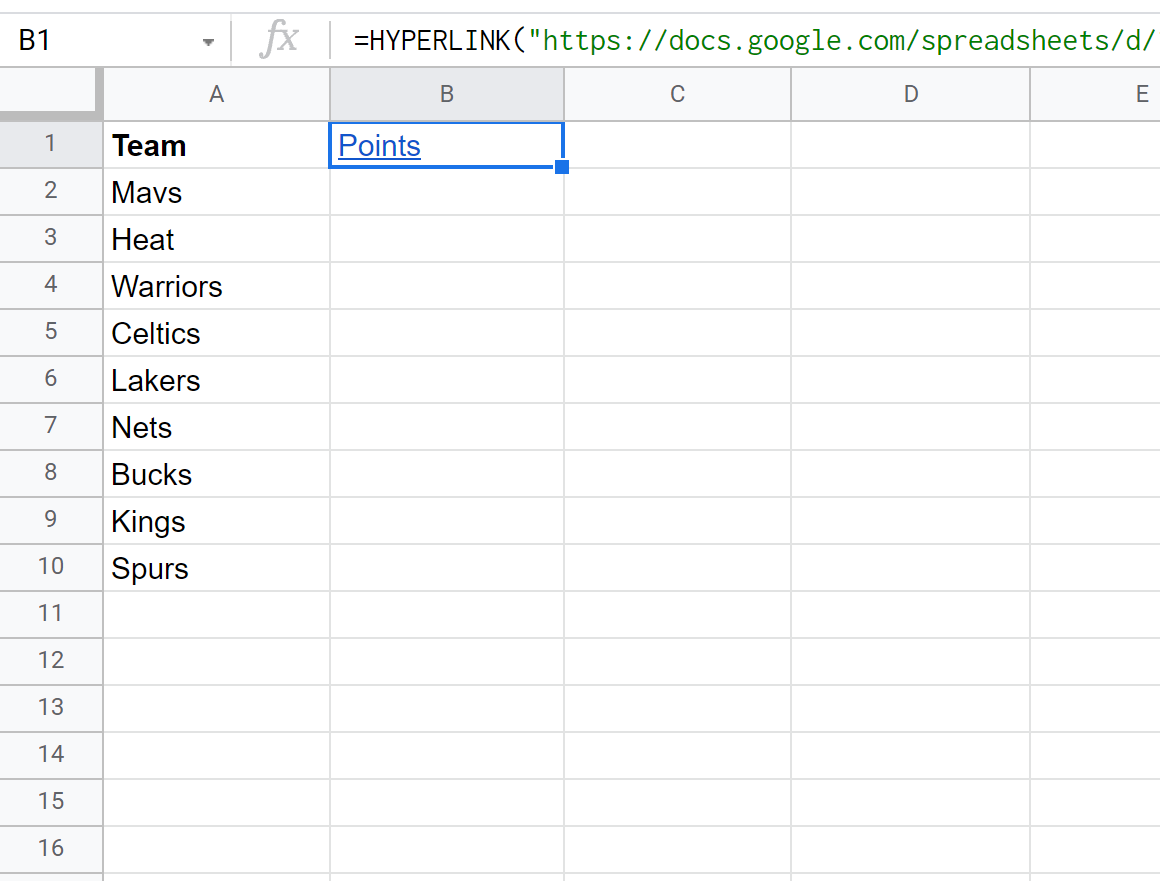
Une fois la formule consolidée au sein de la matrice de calcul, il est indispensable de soumettre l’infrastructure à une série d’épreuves de validation fonctionnelle. L’observateur constatera immédiatement la mutation typographique de la cellule hôte : Google Sheets applique par défaut une coloration bleue standardisée doublée d’un soulignement graphique continu, signalant visuellement la présence d’un hyperlien actif selon les conventions sémiotiques universelles du World Wide Web.
Lors du survol cursoriel de la cellule par la souris, l’interface déclenche l’apparition d’une infobulle flottante contextuelle (un pop-up de prévisualisation) affichant le titre de la ressource, un aperçu du libellé et une icône interactive d’accès direct. L’exécution d’un clic sur cette commande interactive opère le basculement vers l’onglet ciblé. Un comportement technique crucial doit être consigné ici : contrairement à une redirection vers un domaine externe, le saut de contexte inter-onglets opéré au sein d’un même classeur s’exécute sans rechargement complet de la page HTML.
Le moteur d’application monopage (Single Page Application) de Google Sheets intercepte l’événement de navigation, modifie instantanément l’état interne de la mémoire du navigateur et redessine en quelques millisecondes la grille de calcul correspondant au GID convoqué. L’absence de réinitialisation du DOM (Document Object Model) et de requêtes réseau lourdes garantit une réactivité optimale, assurant une expérience utilisateur d’une remarquable fluidité lors du passage d’une vue de données à une autre.
4. Méthode alternative sans formule : L’insertion native par l’interface graphique
4.1 Accès aux commandes de contextualisation de cellule
Bien que la formalisation par fonctions mathématiques et textuelles offre des perspectives d’automatisation incomparables, Google Sheets propose une modalité alternative hautement rationalisée s’appuyant intégralement sur l’interface graphique utilisateur (GUI). Cette voie s’avère particulièrement propice à l’édification rapide de classeurs statiques ou à l’usage des utilisateurs souhaitant s’émanciper des contraintes syntaxiques inhérentes à la manipulation des guillemets et des points-virgules.
Pour engager cette procédure manuelle, l’utilisateur dispose de plusieurs voies d’accès ergonomiques standardisées. La méthode la plus expéditive consiste à positionner le pointeur sur la cellule d’ancrage désirée et à solliciter le raccourci clavier universel de création d’hyperlien, soit la combinaison Ctrl + K sous les environnements Windows et ChromeOS, ou Commande + K sous le système macOS. Cet ordre clavier ouvre instantanément une boîte de dialogue flottante d’édition de liaison.
Alternativement, l’opérateur peut mobiliser le menu textuel supérieur en déployant l’arborescence Insérer, puis en sélectionnant la commande spécifique intitulée Lien. Enfin, les adeptes de la manipulation à la souris peuvent simplement effectuer un clic droit sur la cellule ou la plage de cellules sélectionnée pour faire apparaître le menu contextuel principal, au sein duquel figure la mention explicite Insérer un lien. Quelle que soit la trajectoire empruntée, l’interface présente une boîte modale dédiée à la configuration de la redirection.
4.2 Configuration du sélecteur Feuilles et plages nommées
La force singulière du dispositif natif réside dans sa capacité à abstraire entièrement la complexité des adresses URL et des identifiants GID. Lorsque la boîte modale de configuration s’ouvre, le système propose par défaut un champ de saisie textuel pour l’URL, mais déploie également sous ce dernier une option arborescente essentielle intitulée Feuilles et plages nommées (ou Sheets and named ranges dans la version anglophone du service).
En déployant cette commande par un clic gauche, l’utilisateur découvre une liste exhaustive et synchronisée en temps réel de l’intégralité des onglets physiquement présents au sein du document. Le système procède à une lecture introspective du classeur pour restituer textuellement les noms réels des feuilles de calcul. L’opérateur n’a plus qu’à cliquer directement sur l’entité de destination souhaitée sans jamais avoir besoin de consulter ou de copier la moindre chaîne alphanumérique dans la barre d’adresse de son navigateur.
Cette boîte de dialogue permet concomitamment de définir ou de modifier le texte visible de la cellule par l’intermédiaire du champ supérieur intitulé Texte. Si ce champ est laissé vide au préalable, le nom officiel de l’onglet sélectionné y est automatiquement transposé par commodité. Dès que l’utilisateur valide l’opération en appuyant sur le bouton Appliquer, Google Sheets génère en sous-main la liaison matricielle interne, encapsulant la logique d’ancrage au cœur des métadonnées de la cellule sélectionnée.
4.3 Avantages comparatifs et limites de l’insertion manuelle
L’arbitrage entre l’insertion graphique native et l’utilisation de la fonction matricielle requiert une analyse lucide de leurs vertus et contraintes respectives. Le principal avantage de la méthode native réside dans son extraordinaire robustesse face aux variations ergonomiques mineures. En particulier, si un collaborateur décide de modifier ultérieurement le nom lexical d’un onglet cible, la liaison établie par l’interface graphique conserve son efficacité fonctionnelle sans exiger la moindre retouche manuelle, car Google Sheets lie le composant à l’objet feuille interne plutôt qu’à une chaîne textuelle arbitraire.
Toutefois, cette commodité apparente se heurte à des limites architecturales flagrantes dès lors que l’on bascule dans une logique d’échelle ou de maintenance industrielle. L’insertion par clic souris est une opération purement atomique et manuelle. Il est rigoureusement impossible d’étendre par incrémentation automatique (à l’aide de la poignée de recopie) une série de liens natifs pour adresser séquentiellement une cinquantaine d’onglets consécutifs.
De plus, cette méthode ne tolère aucune forme de conditionnement logique. Il est impossible de faire varier la destination d’un lien natif en fonction du résultat d’un test booléen ou de la saisie d’un paramètre dans une liste déroulante tierce. Par conséquent, si l’approche manuelle demeure parfaitement indiquée pour concevoir la page d’accueil pérenne d’un classeur d’entreprise restreint, elle s’avère inopérante pour édifier des matrices dynamiques, des index automatisés ou des tables relationnelles soumises à de fréquentes mutations structurelles.
5. Étude de cas empirique : Structuration d’une base de données de statistiques sportives
5.1 Architecture initiale du classeur et segmentation thématique
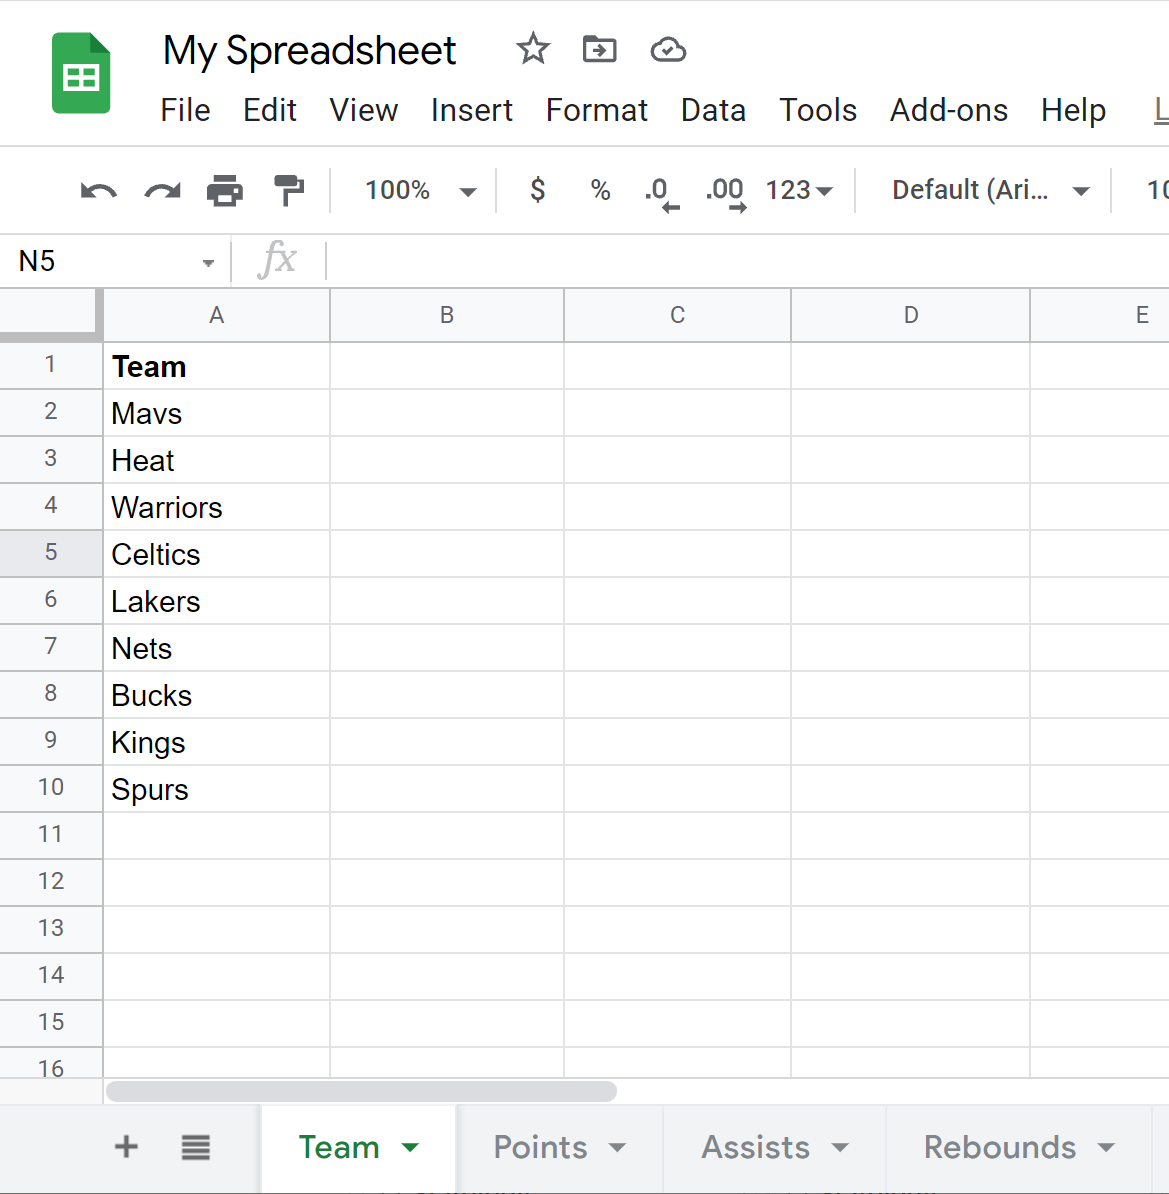
Afin de matérialiser ces concepts théoriques dans un contexte opérationnel concret, nous allons déployer une étude de cas empirique dédiée à la modélisation statistique des performances d’une franchise de basket-ball professionnel. La structure documentaire générale du classeur d’analyse a été scindée en quatre feuilles indépendantes répondant au principe de modularité précédemment évoqué.
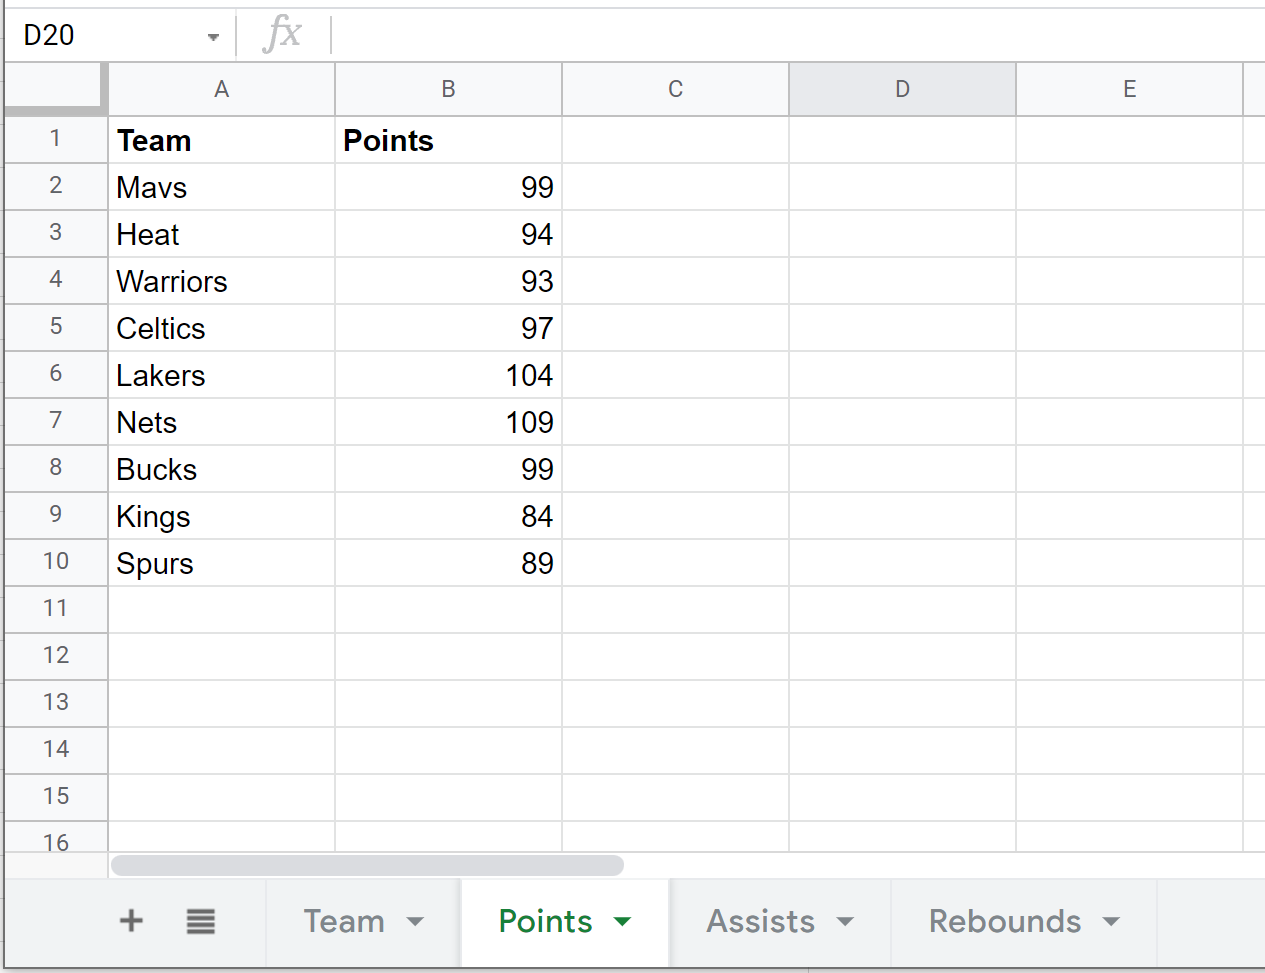
La première feuille, baptisée formellement Équipe, remplit la fonction de tableau de bord exécutif et d’onglet d’accueil général. Elle regroupe les métriques globales de la franchise, les indicateurs d’efficacité collective et les identités des joueurs inscrits sur la feuille de match. Les trois onglets subordonnés hébergent respectivement la granularité analytique détaillée par segment de jeu : la feuille Points compile l’historique des tirs primés et des pourcentages de réussite ; l’onglet Passes enregistre le ratio d’assistance par rapport aux pertes de balles ; enfin, la feuille Rebonds consigne les volumes offensifs et défensifs sous les paniers.
La cartographie de navigation souhaitée impose la création d’un portail relationnel bidirectionnel irréprochable. Depuis l’onglet central Équipe, tout dirigeant ou entraîneur adjoint doit pouvoir plonger instantanément dans l’une des trois dimensions analytiques spécialisées sans avoir à chercher manuellement les onglets situés au bas de l’écran. Réciproquement, chaque feuille analytique spécialisée doit obligatoirement proposer un point de sortie ergonomique immédiat pour rapatrier le regard vers la synthèse principale.
5.2 Implémentation ciblée d’un lien vers la feuille des Points
La matérialisation du premier vecteur de communication cible la feuille Points. Dans le scénario observé, l’ingénieur de données se positionne au préalable sur l’onglet Points afin d’en scruter les paramètres de navigation système. La barre d’adresse du fureteur web affiche une terminaison explicite révélant le marqueur d’ancrage suivant : #gid=788433911. Ce code numérique constitue la cible universelle intangible de notre saut contextuel.
De retour sur l’onglet maître Équipe, le concepteur réserve la cellule B2 pour accueillir le lien d’accès thématique. Il engage alors la saisie rigoureuse de la formule d’interconnexion en formulant : =HYPERLINK("https://docs.google.com/spreadsheets/d/1vHk6Gj_z7ZkEw8p9T_ExampleTokenProd0912/edit#gid=788433911"; "Explorer les Statistiques de Tirs (Points)"). Dès validation, la cellule prend vie et affiche le libellé signifiant.
Le contrôle qualité consiste ensuite à valider que le libellé textuel explicite parfaitement la nature de l’information sous-jacente sans générer d’ambiguïté pour le lecteur. Le texte ne doit pas se contenter d’un sommaire « Cliquez ici », formulation universellement réprouvée par les normes d’accessibilité numérique du W3C, mais doit au contraire renseigner précisément sur la nature analytique du document vers lequel l’intervenant s’apprête à être projeté.
5.3 Systématisation des liaisons vers les onglets Passes et Rebonds
La suite du déploiement repose sur une réplication systématique et méthodique de la structure d’adressage aux deux segments restants. En basculant sur l’onglet Passes, l’administrateur relève l’identifiant spécifique généré par le moteur de Google, documenté par exemple sous la séquence #gid=1903472015. Au sein de la cellule B3 de l’onglet central, l’opérateur consigne la fonction corrélée : =HYPERLINK("https://docs.google.com/spreadsheets/d/1vHk6Gj_z7ZkEw8p9T_ExampleTokenProd0912/edit#gid=1903472015"; "Visualiser la Distribution des Passes Décisives").
Le même protocole opératoire est scrupuleusement réitéré pour l’onglet Rebonds, associé pour l’exemple au marqueur #gid=456128793, et inséré au sein de la cellule B4 par l’instruction : =HYPERLINK("https://docs.google.com/spreadsheets/d/1vHk6Gj_z7ZkEw8p9T_ExampleTokenProd0912/edit#gid=456128793"; "Consulter le Rendement aux Rebonds"). L’alignement typographique, la hauteur de ligne et l’harmonisation visuelle des bordures de la plage B2:B4 concourent à former un bloc d’orientation homogène identifiable au premier regard.
Enfin, pour parachever le cycle ergonomique, la boucle de retour vers l’origine est mise en place. Sur chacun des trois onglets périphériques, la cellule isolée A1 est systématiquement dédiée à la réorientation vers la synthèse. L’identifiant #gid=0 caractérisant la feuille originelle Équipe, la formule =HYPERLINK("https://docs.google.com/spreadsheets/d/1vHk6Gj_z7ZkEw8p9T_ExampleTokenProd0912/edit#gid=0"; "← Retour au Tableau de Bord Équipe") est instanciée sur chaque feuille fille, assurant ainsi une navigabilité bilatérale complète et hautement professionnelle.
6. Conception d’hyperliens à références relatives et portabilité des classeurs
6.1 La problématique de rupture des liens absolus lors de la duplication
L’utilisation de liens hypertextes codés sous forme d’adresses URL complètes et absolues (incluant le protocole, le domaine et la clé unique du document) recèle un piège technique redoutable, souvent ignoré des concepteurs non avertis : l’altération structurelle de la portabilité lors des processus de duplication. Dans la vie courante des entreprises, un classeur de référence agit fréquemment en tant que modèle étalon (ou template). Chaque mois ou chaque trimestre, les gestionnaires procèdent à l’opération de duplication standardisée via la commande Fichier > Créer une copie.
Lors de cette duplication intégrale, le système de Google Drive alloue instantanément un nouvel identifiant alphanumérique unique au fichier clone nouvellement créé. Cependant, le contenu textuel et logique interne des cellules dupliquées ne subit aucune métamorphose automatique. En conséquence dramatique, l’ensemble des formules HYPERLINK contenant des URL absolues conserve rigoureusement l’identifiant du document originel de référence !
Dès lors, lorsqu’un collaborateur manipule la copie du classeur (par exemple, le budget prévisionnel de l’exercice 2026) et clique sur un lien hypertexte interne destiné à naviguer vers un onglet sous-jacent, le navigateur web ne le bascule pas au sein du fichier en cours de consultation, mais ouvre un nouvel onglet pointant pernicieusement vers le fichier d’origine archivé (le modèle 2025). Cette anomalie structurelle perturbe gravement le flux de travail, désoriente l’utilisateur et peut déboucher sur des risques majeurs de corruption de données historiques modifiées par inadvertance.
6.2 Utilisation de fragments d’ancrage internes relatifs
Pour s’affranchir définitivement de cette dépendance mortifère à l’identifiant de document et conférer une totale portabilité aux modèles créés, les architectes de classeurs exploitent une caractéristique avancée mais méconnue de la fonction HYPERLINK : le recours exclusif aux fragments d’ancrage relatifs. Au lieu de renseigner une adresse web absolue exhaustive, le premier paramètre de la formule est tronqué pour ne conserver strictement que la directive d’ancrage local débutant par le caractère dièse.
La syntaxe canonique relative s’exprime ainsi sous une forme épurée : =HYPERLINK("#gid=1847294827"; "Accéder aux Données Détaillées"). Dépourvue de toute mention du protocole HTTPS et de tout identifiant d’origine, cette formule instruit le moteur de calcul du client sur le fait que la cible de navigation réside expressément au sein de la page hôte actuelle.
Le moteur d’exécution web de Google Sheets traite cette référence relative de manière purement locale. Lors de la sollicitation de l’hyperlien, le navigateur modifie l’état du fragment d’URL du document actif sans jamais tenter d’effectuer une requête vers un classeur tiers. Ainsi, quelle que soit la dénomination du document, quel que soit son emplacement au sein des dossiers partagés de Google Drive et quel que soit le nombre de duplications successives opérées au fil des années, le lien demeure perpétuellement actif, robuste et circonscrit au classeur qui l’héberge.
6.3 Stratégies d’isolation pour environnements de production collaboratifs
Le déploiement industriel de modèles tabulaires au sein d’environnements corporatifs exige des protocoles rigoureux de validation de l’isolation contextuelle. Avant toute mise à disposition officielle d’un modèle matriciel à destination d’un collectif d’utilisateurs, une procédure de test unitaire doit obligatoirement être planifiée par l’équipe d’ingénierie des données.
Cette phase de recette technique implique de cloner le document pilote dans un répertoire bac à sable (ou sandbox). L’évaluateur doit alors auditer l’ensemble des cellules vectrices de navigation en s’assurant qu’aucun identifiant résiduel ne persiste dans la structure interne des liens. Une technique d’audit expéditive consiste à employer l’outil d’investigation textuelle globale du tableur (la combinaison Ctrl + H ou Édition > Rechercher et remplacer) en recherchant la chaîne de caractères docs.google.com dans l’ensemble des formules du classeur. Dans un modèle totalement étanche et portable, cette recherche textuelle doit obligatoirement renvoyer un résultat nul.
Enfin, la gouvernance des systèmes de production impose d’inscrire cette règle de standardisation dans la charte de développement interne de l’entreprise. En bannissant formellement l’incorporation d’adresses absolues pour les navigations inter-feuilles au profit strict de la syntaxe relative abrégée #gid=X, les organisations éliminent à la racine les risques de divulgation involontaire d’informations et les bris de liens récurrents consécutifs aux archivages réguliers de documents d’exploitation.
7. Ciblage granulaire : Lier directement une cellule ou une plage spécifique dans un autre onglet
7.1 Extension du paramètre de requête pour adresser des cellules uniques
L’optimisation des flux décisionnels impose fréquemment une précision spatiale supérieure à la simple redirection vers la vue globale d’un onglet. Dans des feuilles de calcul comptant plusieurs milliers de lignes et des dizaines de colonnes, contraindre l’utilisateur à parcourir manuellement la matrice après avoir atterri sur l’onglet de destination engendre une friction ergonomique inacceptable. Il s’avère donc essentiel de maîtriser la technique du ciblage granulaire, consistant à projeter le focus directement sur une coordonnée cellulaire déterminée.
Pour parvenir à ce résultat, la syntaxe de l’ancre d’URL doit être complétée par un paramètre secondaire formalisant la plage matricielle cible. Ce paramètre s’articule directement au GID par l’intermédiaire du séparateur de requête classique, l’éperluette (&), suivi de l’instruction range=. La chaîne syntaxique complète adopte ainsi la structure normalisée suivante : #gid=X&range=Coordonnée.
À titre d’illustration, si un rapport financier de synthèse doit renvoyer formellement l’analyste vers le calcul exact de la marge opérationnelle hébergé dans la cellule spécifique F84 d’un onglet secondaire doté de l’identifiant #gid=912834765, l’instruction relative définitive s’articulera comme suit : =HYPERLINK("#gid=912834765&range=F84"; "Consulter la Marge Brute en Cellule F84"). Lors de l’activation de ce lien, l’application exécute un double saut fonctionnel : elle affiche instantanément l’onglet requis tout en provoquant un défilement automatique (scrolling) jusqu’à positionner la bordure de sélection active précisément autour de la cellule F84, garantissant une concentration immédiate de l’attention visuelle.
7.2 Intégration opérationnelle des plages de données nommées
Bien que l’indexation matricielle explicite (par exemple range=A1 ou range=B12:E30) fonctionne avec une rigueur absolue, elle souffre d’une vulnérabilité intrinsèque majeure : l’instabilité dimensionnelle de la grille. Si un opérateur insère de nouvelles lignes intercalaires ou déplace des blocs de données au sein de la feuille réceptrice, la coordonnée statique codée en dur dans l’hyperlien demeurera figée (pointant toujours vers F84), alors même que la valeur métier recherchée a mécaniquement glissé vers la cellule F95, créant une inadéquation fonctionnelle majeure.
Pour immuniser le modèle face à ces dérives structurelles, la méthodologie préconisée réside dans l’utilisation exclusive des plages nommées (ou Named Ranges). Au lieu de cibler une coordonnée alphanumérique éphémère, le concepteur attribue un identifiant sémantique pérenne à la zone de données via le menu Données > Plages nommées (par exemple en assignant le nom Total_Marge_Nette à la cellule correspondante). L’interface de calcul gère dès lors automatiquement le suivi spatial de cette plage, quelle que soit l’ampleur des insertions ou suppressions futures de colonnes.
L’intégration de cette plage au cœur du paramètre de liaison s’opère en substituant le libellé sémantique aux coordonnées cartésiennes dans l’argument de plage : =HYPERLINK("#gid=912834765&range=Total_Marge_Nette"; "Accéder au Total Définitif"). De surcroît, le sélecteur natif évoqué au chapitre 4 indexe automatiquement l’ensemble des plages nommées du classeur dans son arborescence visuelle, permettant une sélection ergonomique en un clic sans risque de décalage de coordonnées à l’avenir.
7.3 Applications avancées aux tables de concordance et glossaires
L’application la plus noble du ciblage granulaire réside dans l’élaboration de structures documentaires interactives complexes, telles que les glossaires techniques, les dictionnaires de variables métier ou les tables de concordance comptables. Dans les classeurs d’audit d’envergure internationale, la prolifération d’acronymes financiers complexes et de ratios réglementaires impose souvent la consultation récurrente de définitions méthodologiques.
En instanciant un glossaire exhaustif au sein d’un onglet spécialisé où chaque ligne correspond à un concept précis pourvu de son propre ancrage granulaire, il devient possible d’émailler les tableaux de bord opérationnels de discrets renvois sémantiques. Chaque intitulé de colonne complexe au sein d’un tableau peut ainsi intégrer une formule de pointage ultra-ciblée dirigeant immédiatement l’auditeur vers la ligne précise documentant la formule mathématique et le fondement juridique de l’agrégat observé.
Cette rigueur de conception transforme un simple tableur passif en un véritable système expert auto-documenté. Les utilisateurs tiers n’ont plus à naviguer à l’aveugle dans des notices extérieures rédigées sous format PDF : l’accès à la connaissance technique s’opère de manière contextuelle, granulaire et immédiate, garantissant une conformité accrue des interprétations analytiques et valorisant substantiellement le capital informationnel de l’organisation.
8. Automatisation et calcul dynamique des hyperliens par concaténation de formules
8.1 Assemblage textuel de l’URL via les opérateurs de chaîne
Dans les architectures de données avancées, la saisie statique d’URL au sein de chaque formule individuelle constitue une démarche inefficace et anachronique. Dès lors qu’un classeur doit générer des dizaines, voire des centaines de liaisons inter-onglets dépendant de variables mouvantes, la mise en œuvre de techniques de concaténation de chaînes de caractères devient impérative. Cette approche repose sur l’assemblage dynamique de fragments textuels invariants et de paramètres variables au moyen de l’opérateur perluète (&) ou de la fonction CONCATENER.
Le principe fondamental consiste à isoler les segments pérennes de la syntaxe au sein d’un modèle algorithmique. L’opérateur de concaténation permet de fusionner la racine d’ancrage local ("#gid=") avec une valeur numérique de GID hébergée dans une cellule tierce ou issue d’un calcul intermédiaire. L’assemblage s’exprime alors selon le schéma formel : =HYPERLINK("#gid=" & B5; "Naviguer vers l'Onglet"), où la cellule B5 délivre dynamiquement l’entier numérique nécessaire à la résolution de la cible.
Cette modularisation textuelle simplifie drastiquement la maintenance préventive du système. Si la logique de routage doit être amendée ou si des paramètres additionnels doivent être injectés à grande échelle (comme la directive de centrage de plage &range=), la modification s’opère au niveau de la formule matricielle globale sans exiger l’ouverture fastidieuse de chaque cellule individuelle, réduisant ainsi drastiquement la dette technique au sein des modèles d’exploitation.
8.2 Couplage fonctionnel avec RECHERCHEV et INDEX/EQUIV
Le potentiel de l’adressage dynamique atteint sa pleine mesure lorsqu’il est synchronisé avec les puissantes fonctions de recherche matricielle que sont RECHERCHEV (VLOOKUP) et le tandem de référence INDEX/EQUIV (INDEX/MATCH). Ce dispositif nécessite la création préalable, sur une feuille de métadonnées discrète ou masquée, d’une table technique faisant office d’annuaire de routage interne. Cette table associe, sur chaque ligne, le libellé usuel d’un onglet, son GID effectif et sa plage d’atterrissage préconisée.
Supposons qu’une cellule de contrôle héberge un menu déroulant permettant à l’analyste de sélectionner une division de l’entreprise parmi une liste prédéfinie (par exemple « Division_Europe », « Division_Asie », « Division_Ameriques »). La formule de navigation hypertexte située dans la cellule adjacente doit s’adapter instantanément au choix formulé par l’opérateur pour proposer un lien menant directement à l’onglet analytique de la région sollicitée.
La formule met alors en œuvre une recherche d’équivalence dynamique pour extraire le bon GID à la volée : =HYPERLINK("#gid=" & RECHERCHEV(A1; Table_Routage; 2; FAUX); "Accéder au Bilan Régional"). Dès que l’utilisateur modifie la sélection au sein du menu déroulant A1, la fonction RECHERCHEV réévalue la correspondance, extrait le GID spécifique à la filiale sélectionnée et reconstruit en temps réel l’hyperlien actif sans aucune latence perceptible, offrant une interactivité comparable à celle d’une interface logicielle professionnelle.
8.3 Création d’index automatisés à l’aide de formules matricielles
Pour les gestionnaires confrontés à l’administration de registres monumentaux s’étendant sur un très grand nombre de feuilles, la génération unitaire de chaque hyperlien demeure un écueil chronophage. L’utilisation conjointe de la fonction matricielle ARRAYFORMULA permet de s’affranchir de cette contrainte en automatisant l’injection séquentielle d’une liste intégrale d’hyperliens sur une colonne entière à partir d’une source unique d’instructions.
En couplant une plage verticale de données techniques (contenant les identifiants GID sur la plage E2:E50) avec une plage homologue de libellés textuels (plage F2:F50), une instruction matricielle unique positionnée en tête de colonne peut générer instantanément l’intégralité du bloc interactif. La structure syntaxique s’établit ainsi : =ARRAYFORMULA(SI(ESTVIDE(E2:E50); ""; HYPERLINK("#gid=" & E2:E50; F2:F50))).
Cette approche d’ingénierie avancée procure une évolutivité sans précédent. Tout nouvel enregistrement advenu au sein de la table technique alimente instantanément la liste de navigation sans que l’opérateur n’ait à copier-coller manuellement des formules le long de la feuille. En préservant la matrice de calcul de toute altération manuelle, cette méthodologie renforce considérablement la fiabilité des classeurs complexes soumis à de volumineux flux de données entrants.
9. Architecture d’un système de navigation professionnel (Table des matières et menus)
9.1 Principes directeurs de l’agencement visuel d’une feuille sommaire
L’ordonnancement d’un classeur d’entreprise de calibre professionnel ne saurait reposer sur une simple accumulation de liens bruts disposés de manière anarchique. L’élaboration d’une feuille sommaire – couramment baptisée Accueil, Index ou Cockpit – requiert une réflexion approfondie sur l’architecture de l’information et les principes d’expérience utilisateur (ergonomie des interfaces de travail). Cette feuille d’accueil assume le rôle de portail d’aiguillage cardinal pour l’ensemble des parties prenantes du classeur.
La première règle d’agencement impose l’épuration visuelle : la grille de calcul par défaut doit souvent être masquée (via le menu Affichage > Afficher > Quadrillage) au profit de cartes thématiques, de blocs contrastés et de typographies soigneusement hiérarchisées. Les sections fonctionnelles doivent être regroupées par silos logiques (par exemple : Paramètres Système, Données Opérationnelles, Analyses Financières, Synthèses Décisionnelles) plutôt que de suivre l’ordre purement chronologique de création des onglets.
Chaque point d’accès interactif au sein de cette table des matières professionnelle doit associer un hyperlien explicite, un sous-titre contextualisant le périmètre analytique couvert par l’onglet cible et l’indication formelle de la personne ou du département responsable de la mise à jour des données. Cette cartographie globale élimine les interrogations chronophages des nouveaux collaborateurs et confère au classeur une dimension d’application web autonome hautement qualitative.
9.2 Implémentation d’une barre de navigation récurrente sur chaque onglet
L’un des écueils ergonomiques les plus prégnants réside dans le phénomène d’« enclavement informationnel », où un utilisateur navigue vers un onglet technique profond mais se trouve dans l’incapacité de repartir aisément vers d’autres espaces analytiques sans devoir mobiliser à nouveau les onglets inférieurs de Google Sheets. La réponse architecturale à cette problématique réside dans l’instanciation systématique d’une barre de navigation récurrente (ou bandeau supérieur universel) sur chaque feuille du classeur.
Pour matérialiser ce composant fonctionnel, les deux ou trois premières lignes de chaque feuille de calcul sont réservées et neutralisées. Un remplissage chromatique sobre mais distinctif est appliqué sur ce bandeau, qui accueille une série standardisée de renvois cardinaux : le lien de rapatriement vers l’Index principal, des accès directs aux trois ou quatre onglets les plus sollicités de la section, ainsi qu’une liaison vers le glossaire méthodologique.
Pour assurer la pérennité de ce repère visuel lors de la consultation de volumineux jeux de données, il est rigoureusement impératif de figer ces lignes supérieures en appliquant la directive d’ancrage via le menu Affichage > Figer > 1 ligne (ou 2 lignes). De la sorte, même si l’analyste fait défiler l’écran sur plusieurs centaines d’enregistrements vers le bas, la barre de navigation demeure en permanence visible au sommet de la fenêtre d’affichage, offrant une capacité de réorientation spatiale immédiate en toute circonstance.
9.3 Utilisation d’éléments visuels et de boutons cliquables décoratifs
Pour dépasser l’aspect austère des hyperliens textuels conventionnels, l’environnement Google Sheets offre la faculté d’associer des ancrages de navigation à des composants graphiques flottants, simulant l’apparence et le comportement de véritables boutons d’interface logicielle. Cette technique apporte une affordance visuelle supérieure, incitant naturellement l’opérateur à l’interaction grâce à des représentations tridimensionnelles, des ombrages ou des icônes explicites.
La mise en œuvre s’effectue en sollicitant le module de dessin vectoriel intégré accessible par le menu Insérer > Dessin. L’opérateur conçoit une forme géométrique stylisée (un rectangle à coins arrondis doté d’une couleur d’accentuation corporative, par exemple), y insère un libellé textuel explicite enrichi d’un glyphe de direction (tel que « Voir le Tableau de Bord → »), puis enregistre le dessin pour le déposer sur la grille de calcul hôte.
Toutefois, une vigilance architecturale s’impose concernant le rattachement de la cible. Contrairement aux cellules textuelles natives qui supportent indifféremment des URL absolues ou des fragments relatifs #gid=X, les objets graphiques et dessins intégrés requièrent fréquemment l’assignation d’une adresse URL absolue via leur menu contextuel à trois points (option Attribuer un lien) ou l’attribution d’un script d’aiguillage. L’impact sur la portabilité en cas de duplication de classeur doit donc être impérativement soupesé avant de généraliser l’usage d’objets flottants au détriment de cellules matricielles classiques.
10. Automatisation avancée des hyperliens par l’environnement Google Apps Script
10.1 Interrogation de l’arbre d’objets du tableur via JavaScript
Lorsque la structure documentaire d’un classeur s’élève à plusieurs dizaines ou centaines d’onglets soumis à des créations et suppressions quotidiennes, la maintenance manuelle des liaisons inter-feuilles s’avère intenable sur le plan organisationnel. C’est à cette frontière que l’environnement de développement intégré Google Apps Script déploie toute sa puissance. En s’appuyant sur un moteur JavaScript exécuté directement sur les infrastructures infonuagiques de Google, Apps Script permet d’interagir nativement avec l’arborescence structurelle du tableur via l’interface applicative SpreadsheetApp.
L’accès programmatique au modèle d’objets du document s’initie par l’invocation de la méthode SpreadsheetApp.getActiveSpreadsheet(). À partir de cette instance matricielle maîtresse, le moteur scriptaire peut solliciter la collection intégrale des feuilles composant le classeur via la commande getSheets(). Cette instruction renvoie un tableau indicé (array) regroupant la totalité des entités feuille présentes, sans exiger de connaître préalablement leur dénomination textuelle.
En itérant séquentiellement sur ce tableau au moyen d’une boucle algorithmique, le script peut interroger les propriétés intrinsèques de chaque feuille en exécutant les méthodes getName() pour le nom lexical d’affichage et getSheetId() pour l’identifiant numérique universel GID. L’accès à ces deux descripteurs offre les matériaux bruts nécessaires à l’assemblage programmatique d’hyperliens sans la moindre intervention humaine.
10.2 Script de génération automatique et actualisable d’une table des matières
L’illustration canonique de cette automatisation logicielle réside dans la compilation d’une routine générant de manière dynamique une table des matières exhaustive au sein d’une feuille pilote. L’algorithme se charge de purger l’index préexistant pour éviter toute pollution informationnelle résiduelle, puis de reconstituer ligne par ligne l’annuaire complet de l’ensemble des onglets actifs.
La logique applicative sous-jacente s’articule comme suit : le script isole l’onglet dédié à l’accueil, puis parcourt méthodiquement chaque feuille du classeur. Si la feuille scannée correspond à la feuille d’accueil elle-même ou à un onglet technique expressément masqué, la routine l’ignore via une clause d’exclusion conditionnelle. Pour toute autre feuille valide, le programme extrait le nom textuel et le GID, puis assemble la syntaxe relative de liaison sous la forme "#gid=" + sheetId.
Le code injecte ensuite au moyen de la commande setFormula() l’expression formelle =HYPERLINK("#gid=" + id + '"; "' + nom + '") au sein des cellules consécutives de la colonne de restitution. En quelques fractions de seconde, une table des matières complète, parfaitement ordonnancée, cliquable et rigoureusement immunisée contre les erreurs de frappe se trouve matérialisée sur la feuille d’accueil, garantissant une intégrité documentaire sans faille.
10.3 Déclencheurs événementiels pour la maintenance de l’intégrité du classeur
Pour conférer une autonomie absolue au système documentaire, l’exécution du script ne doit pas reposer sur le déclenchement volontaire et aléatoire d’un utilisateur depuis l’éditeur de code. L’environnement Apps Script met à disposition une infrastructure robuste de déclencheurs événementiels (ou triggers) capables d’intercepter les mutations fonctionnelles du classeur en temps réel.
L’événement canonique le plus pertinent dans cette perspective d’ingénierie est le déclencheur réservé onOpen(). En inscrivant la routine de rafraîchissement au cœur de cette fonction standardisée, Google Sheets ordonne l’exécution immédiate et silencieuse du script d’indexation dès qu’un utilisateur quelconque, quel que soit son fuseau horaire ou son niveau de permission, ouvre le classeur dans son interface de navigation. La table des matières est ainsi instantanément reconstruite sur la base de la topologie physique exacte du fichier au moment de son ouverture.
Pour les systèmes hautement critiques où des feuilles sont injectées ou supprimées au cours de la session de travail, il est également envisageable d’associer un déclencheur d’altération structurelle (onEdit ou déclencheur installable onChange) capable d’auditer les variations du nombre d’onglets. Cette surveillance active prémunit l’organisation contre la persistance d’hyperliens orphelins pointant vers des onglets récemment détruits et assure une synchronisation parfaite et continue du système de navigation.
11. Audit, diagnostic et résolution des anomalies de liaison inter-onglets
11.1 Symptômes et causes de redirection erronée vers la feuille par défaut
Lors de l’exploitation quotidienne de classeurs collaboratifs denses, les utilisateurs se heurtent parfois à une anomalie comportementale déroutante : en sollicitant un hyperlien censé pointer vers une feuille analytique déterminée, l’interface bascule inévitablement vers le tout premier onglet du classeur (la feuille d’origine correspondant à gid=0), ignorant totalement l’instruction contextuelle théorique. Ce phénomène traduit systématiquement un mécanisme de repli (fallback) exécuté par le moteur web face à une adresse malformée.
La cause fondamentale de cette défaillance réside presque invariablement dans une altération typographique du fragment d’ancrage. Si la chaîne textuelle comporte une coquille au sein du mot-clé (par exemple #gide= ou #grid= au lieu de #gid=), ou si la chaîne numérique du GID a été tronquée d’un ou plusieurs chiffres lors d’une opération de copier-coller manuelle, le parseur d’URL de Google Sheets ne parvient pas à réconcilier l’identifiant réclamé avec la table d’objets locale.
Face à cet identifiant inconnu ou corrompu, l’application choisit par défaut de ne pas générer de page d’erreur bloquante (type Erreur 404), mais réoriente préventivement l’utilisateur vers la racine documentaire du classeur, c’est-à-dire l’onglet maître initial. Pour résoudre cette anomalie, l’auditeur doit procéder à un contrôle méticuleux de la formule au moyen de la barre d’édition supérieure pour restaurer scrupuleusement la validité de l’expression #gid=X en la confrontant à la lecture directe de l’onglet cible actif.
11.2 Conséquences fonctionnelles du renommage et du déplacement d’onglets
Une incompréhension récurrente concerne les répercussions de la modification du libellé visible d’un onglet sur les liaisons préexistantes. Dans l’écosystème technique de Google Sheets, l’identifiant GID est une clé primaire immuable : il est attribué lors de l’instanciation de la feuille et ne subit strictement aucune modification algorithmique si l’utilisateur renomme l’onglet, change sa couleur d’accentuation ou réorganise son positionnement séquentiel en le déplaçant vers la droite ou la gauche de la barre de défilement.
Par conséquent, tout hyperlien fondé sur le GID continuera de fonctionner avec une précision irréprochable vers la feuille souhaitée, même si celle-ci passe du libellé « Synthèse_T1 » à « Archives_Historiques_2024 ». Toutefois, cette résilience purement mécanique engendre un risque corollaire d’ordre sémantique : la désynchronisation cognitive. Si la formule de liaison a été instanciée avec un deuxième argument textuel statique (=HYPERLINK("#gid=123"; "Synthèse_T1")), le texte de la cellule continuera d’afficher l’ancienne appellation alors même que l’onglet porte désormais un nom radicalement divergent.
Pour prévenir cette dérive où la signalétique de surface ne reflète plus l’état de l’infrastructure sous-jacente, il est indispensable de planifier une procédure d’harmonisation post-restructuration. Le recours à des formules matricielles dynamiques indexées sur une table de correspondance centrale (telle qu’exposée au chapitre 8) ou l’usage de scripts de maintenance garantit que tout renommage lexical d’un onglet se répercute instantanément sur l’ensemble des libellés visuels du classeur.
11.3 Gestion des permissions de partage et contextes multi-comptes
La dimension infonuagique et collaborative de Google Sheets implique une confrontation permanente avec la gestion des droits d’accès (modèle d’autorisations Google Drive) et les sessions utilisateurs multiples. Une anomalie fréquente survient lorsqu’un intervenant externe clique sur un hyperlien interne absolu et se trouve confronté à un écran de refus d’accès l’enjoignant de solliciter une permission administrateur.
Ce blocage se produit quasi systématiquement dans les environnements corporatifs où les utilisateurs possèdent simultanément un compte personnel grand public (@gmail.com) et un compte professionnel d’organisation (Google Workspace). Lorsqu’une URL absolue est sollicitée, le navigateur peut initier la requête sous l’identité du profil de session actif par défaut dans le fureteur, qui n’est pas nécessairement le compte bénéficiant des droits d’accès au document d’entreprise cible.
L’utilisation des fragments d’ancrage strictement relatifs (#gid=X) résout souverainement cette pathologie d’authentification. Le saut de contexte s’exécutant intégralement à l’intérieur de la session applicative déjà ouverte et validée par l’utilisateur, aucun arbitrage d’identité multi-comptes n’est convoqué par le navigateur. De surcroît, le concepteur doit garder à l’esprit que la protection de plages de cellules ou le masquage d’onglets (via la commande Masquer la feuille) n’empêche pas l’exécution technique d’un hyperlien vers ce GID : l’accès sera techniquement possible si les autorisations de lecture du document le permettent, exigeant une rigueur absolue dans la politique de ségrégation des données confidentielles.
12. Normes académiques, bonnes pratiques et pérennité des systèmes tabulaires
12.1 Conventions de nomenclature et documentation des dépendances
L’ingénierie des données tabulaires requiert la même rigueur déontologique et méthodologique que le développement logiciel professionnel. Dans un classeur complexe destiné à traverser les années et à être partagé entre de multiples analystes, l’absence de charte formelle de nomenclature conduit à une rapide dégradation de la maintenabilité. L’établissement de conventions de nommage univoques pour les onglets, les cellules de navigation et les plages matricielles constitue le premier rempart contre l’entropie documentaire.
Il est vivement préconisé de bannir des dénominations d’onglets les caractères spéciaux, les lettres accentuées et les espaces multiples, qui constituent autant de vecteurs de corruption potentiels lors des résolutions syntaxiques d’URL ou des extractions scriptaires. L’adoption du formalisme en casse de chameau (camelCase, ex : ventesTrimestreUn) ou de la séparation par tiret de soulignement (snake_case, ex : analyse_marge_brute) assure une excellente lisibilité technique et humaine.
Concomitamment, la tenue d’un onglet spécifiquement dédié aux métadonnées documentaires s’avère indispensable. Cette feuille de documentation doit recenser la typologie du classeur, la cartographie des dépendances relationnelles entre les onglets, le dictionnaire des plages nommées ainsi que l’historique formalisé des versions majeures du fichier. Une telle gouvernance assure la continuité opérationnelle du système en permettant à tout nouvel arrivant d’appréhender immédiatement la logique du réseau d’hyperliens sans nécessiter une transmission orale chronophage.
12.2 Préservation de la performance et sobriété des formules de renvoi
Bien que la fonction HYPERLINK soit remarquablement optimisée sur le plan algorithmique, sa prolifération anarchique au sein de très volumineuses bases de données peut induire des dégradations de performances notables. Dans les classeurs excédant plusieurs dizaines de milliers de lignes, l’instanciation de milliers de formules HYPERLINK individuelles surcharge inutilement l’arbre d’évaluation des dépendances du moteur de calcul de Google Sheets, ralentissant les temps de recalcul général lors de l’actualisation des données brutes.
La règle d’or pour préserver une vélocité optimale consiste à appliquer le principe de sobriété architecturale. Les hyperliens de navigation ne doivent pas être dispersés de manière redondante au sein de chaque enregistrement transactionnel d’une table brute, mais doivent être confinés avec discernement aux zones de pilotage stratégique, aux tables des matières, aux bandeaux d’onglets et aux cellules récapitulatives de synthèse.
De surcroît, les concepteurs doivent veiller à arbitrer judicieusement entre automatisation dynamique et ancrage direct. Si un ensemble de données est devenu purement historique et figé, il est parfaitement contre-productif de maintenir des formules de renvoi dépendantes d’imbrications lourdes de fonctions RECHERCHEV ou INDEX/EQUIV. Le gel ponctuel de ces formules sous forme de valeurs statiques (via la commande Copier > Collage spécial > Valeurs uniquement) déleste instantanément la mémoire vive allouée par le navigateur et garantit la réactivité pérenne de l’application web.
12.3 Synthèse critique et matrice décisionnelle pour la navigation tabulaire
Au terme de cette étude approfondie des mécanismes de navigation inter-feuilles dans Google Sheets, il convient de synthétiser les critères décisionnels présidant au choix de chaque méthode d’implémentation. Chaque approche technique recèle un profil d’adéquation singulier, gouverné par la complexité du classeur, son volume, sa fréquence de réplication et le niveau de technicité des équipes appelées à en assurer l’exploitation quotidienne.
Le tableau analytique ci-dessous dresse une comparaison systématique des quatre grandes méthodologies étudiées au long de cet ouvrage :
- Liaison native par l’interface graphique (Ctrl + K) :
- Complexité de mise en œuvre : Nulle (accessible à tout profil).
- Résilience au renommage d’onglet : Totale (liaison liée à l’objet interne).
- Portabilité lors de la duplication : Absolue (aucun identifiant absolu injecté).
- Potentiel d’automatisation : Nul (purement unitaire et manuel).
- Usage recommandé : Petits classeurs stables, maquettes rapides, pages de garde statiques.
- Formule HYPERLINK avec URL absolue :
- Complexité de mise en œuvre : Faible (copier-coller de l’URL du navigateur).
- Résilience au renommage d’onglet : Mécanique sur le saut, nulle sur le libellé affiché.
- Portabilité lors de la duplication : Très critique (rupture systématique pointant vers le fichier d’origine).
- Potentiel d’automatisation : Modéré (concaténation possible).
- Usage recommandé : À proscrire formellement au sein de classeurs modèles voués à être dupliqués.
- Formule HYPERLINK avec ancre relative (#gid=X) :
- Complexité de mise en œuvre : Modérée (exige l’extraction chirurgicale du paramètre GID).
- Résilience au renommage d’onglet : Mécanique sur le saut, paramétrable sur le texte.
- Portabilité lors de la duplication : Totale (l’ancre reste circonscrite au fichier actif).
- Potentiel d’automatisation : Exceptionnel (concaténation dynamique, RECHERCHEV, ARRAYFORMULA).
- Usage recommandé : Modèles d’entreprise industriels, classeurs analytiques complexes, tableaux de bord évolutifs.
- Automatisation via Google Apps Script :
- Complexité de mise en œuvre : Élevée (compétences requises en programmation JavaScript).
- Résilience au renommage d’onglet : Absolue (synchronisation dynamique programmatique).
- Portabilité lors de la duplication : Totale si le script est lié au conteneur (container-bound).
- Potentiel d’automatisation : Illimité (génération autonome d’index au déclenchement d’événements).
- Usage recommandé : Architectures monumentales d’entreprise, catalogues automatisés, classeurs gérés par scripts d’intégration continue.
En définitive, la maîtrise aboutie des liaisons inter-onglets transforme radicalement l’interaction avec les données massives. En concevant des classeurs rigoureusement maillés, portables et intuitifs, les analystes s’émancipent des limites inhérentes à la linéarité tabulaire pour bâtir de véritables outils d’aide à la décision efficients, pérennes et hautement collaboratifs.
Références
Berners-Lee, T., Fielding, R., & Masinter, L. (2005). Uniform Resource Identifier (URI): Generic Syntax (RFC 3986). Internet Engineering Task Force. https://doi.org/10.17487/RFC3986
Google. (2024). Fonction LIEN_HYPERTEXTE. Centre d’aide Google Docs. Consulté le 15 mai 2024, à l’adresse https://support.google.com/docs/answer/3093313?hl=fr
Google Workspace Developers. (2024). Class SpreadsheetApp – Google Apps Script Reference. Google Developers. Consulté le 15 mai 2024, à l’adresse https://developers.google.com/apps-script/reference/spreadsheet/spreadsheet-app
International Organization for Standardization. (2019). Ergonomie de l’interaction homme-système — Partie 210: Conception centrée sur l’opérateur humain pour les systèmes interactifs (ISO Standard n° 9241-210:2019). https://www.iso.org/standard/77520.html
World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/