
L’exploration des données quantitatives constitue une étape charnière de la démarche empirique en psychologie et en neurosciences computationnelles. Face à la complexité intrinsèque des mesures psychométriques, cognitives ou comportementales, le chercheur ne peut se contenter d’un examen superficiel fondé uniquement sur des moyennes et des écarts-types. Ces statistiques paramétriques classiques, bien qu’informatives, présentent une vulnérabilité reconnue face aux déviations de la normalité, aux distributions asymétriques et aux contaminations par des données aberrantes. Dès lors, le recours à des représentations visuelles robustes s’impose afin de cartographier fidèlement l’architecture sous-jacente des distributions observées avant toute modélisation inférentielle.
La boîte à moustaches, conçue à l’origine par le statisticien John Tukey sous l’appellation de box-and-whisker plot, s’est imposée comme l’un des dispositifs graphiques les plus denses et les plus rigoureux de l’analyse exploratoire des données. Capable de synthétiser la tendance centrale, la dispersion non paramétrique, l’asymétrie distributionnelle ainsi que les valeurs singulières au sein d’une même figure unifiée, elle transcende les limitations des traditionnels diagrammes en barres qui occultent la variabilité réelle des observations. Dans l’écosystème d’analyse logicielle, IBM SPSS Statistics offre un environnement polyvalent pour générer, affiner et interpréter ces représentations visuelles avec une précision méthodologique répondant aux standards universitaires les plus exigeants.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, cliniciens et étudiants avancés dans l’art de créer, de décoder et de valoriser les boîtes à moustaches sous SPSS. De la formalisation théorique du résumé à cinq nombres jusqu’à la mise en conformité graphique selon les normes de publication de l’American Psychological Association (APA 7e édition), chaque étape est déclinée à travers le prisme de la rigueur psychométrique. En articulant manipulation procédurale, syntaxe de commande reproductible et diagnostics cliniques approfondis, cet article fournit les clés indispensables pour transformer vos visualisations de données en véritables outils d’inférence et de découverte scientifique.
1. Introduction aux boîtes à moustaches dans le cadre de la recherche en psychologie
1.1 Utilité méthodologique de la boîte à moustaches dans les sciences du comportement
Dans le champ des sciences comportementales, les variables mesurées se caractérisent fréquemment par une forte variabilité interindividuelle et une vulnérabilité marquée aux biais d’échantillonnage. Qu’il s’agisse de scores d’inventaires de dépression, d’échelles d’anxiété-trait ou de temps de réaction mesurés en millisecondes lors de tâches d’inhibition cognitive, les données psychologiques s’écartent régulièrement du modèle théorique de la distribution normale de Gauss-Laplace. Dans ce contexte, l’utilisation aveugle d’indicateurs paramétriques expose le chercheur à des conclusions erronées, en masquant des phénomènes de troncature ou des concentrations asymétriques d’observations.
La boîte à moustaches répond à cette contrainte en offrant une lecture directe et non paramétrique de la dispersion et de l’asymétrie. Contrairement aux diagrammes en barres classiques qui réduisent l’information à une moyenne ponctuée d’un intervalle d’erreur souvent mal interprété, le boxplot expose simultanément la médiane et l’écart interquartile. Cette transparence s’avère déterminante lors de la phase préliminaire d’inspection des données, car elle permet de statuer visuellement sur la légitimité des postulats requis par les tests d’hypothèses classiques, tels que le test t de Student ou l’analyse de variance (ANOVA). L’évaluation visuelle de la forme des distributions guide ainsi le chercheur vers le maintien d’une approche paramétrique ou, à l’inverse, vers l’adoption de modèles linéaires généralisés ou de tests non paramétriques de type Mann-Whitney et Kruskal-Wallis.
Pour les variables issues d’échelles d’évaluation clinique standardisées (telles que le BDI-II, le STAI ou les sous-tests de l’échelle d’intelligence de Wechsler), la boîte à moustaches offre une granularité diagnostique incomparable. Elle permet de situer instantanément le profil distributionnel d’une cohorte clinique par rapport aux normes théoriques ou à un groupe contrôle sain, révélant la présence d’hétérogénéités sous-jacentes au sein d’un même échantillon de patients.
1.2 Composantes fondamentales de la visualisation selon John Tukey
L’acte de naissance de la boîte à moustaches remonte aux travaux pionniers de John Wilder Tukey dans les années 1970, formalisés dans son ouvrage séminal consacré à l’analyse exploratoire des données (Exploratory Data Analysis). Tukey postulait que les statistiques devaient permettre aux données de révéler spontanément leurs régularités et leurs singularités avant toute imposition d’un modèle probabiliste contraignant. C’est dans cet esprit d’heuristique visuelle que le schéma en boîte a été conçu comme un condensé géométrique du comportement d’un jeu de données.
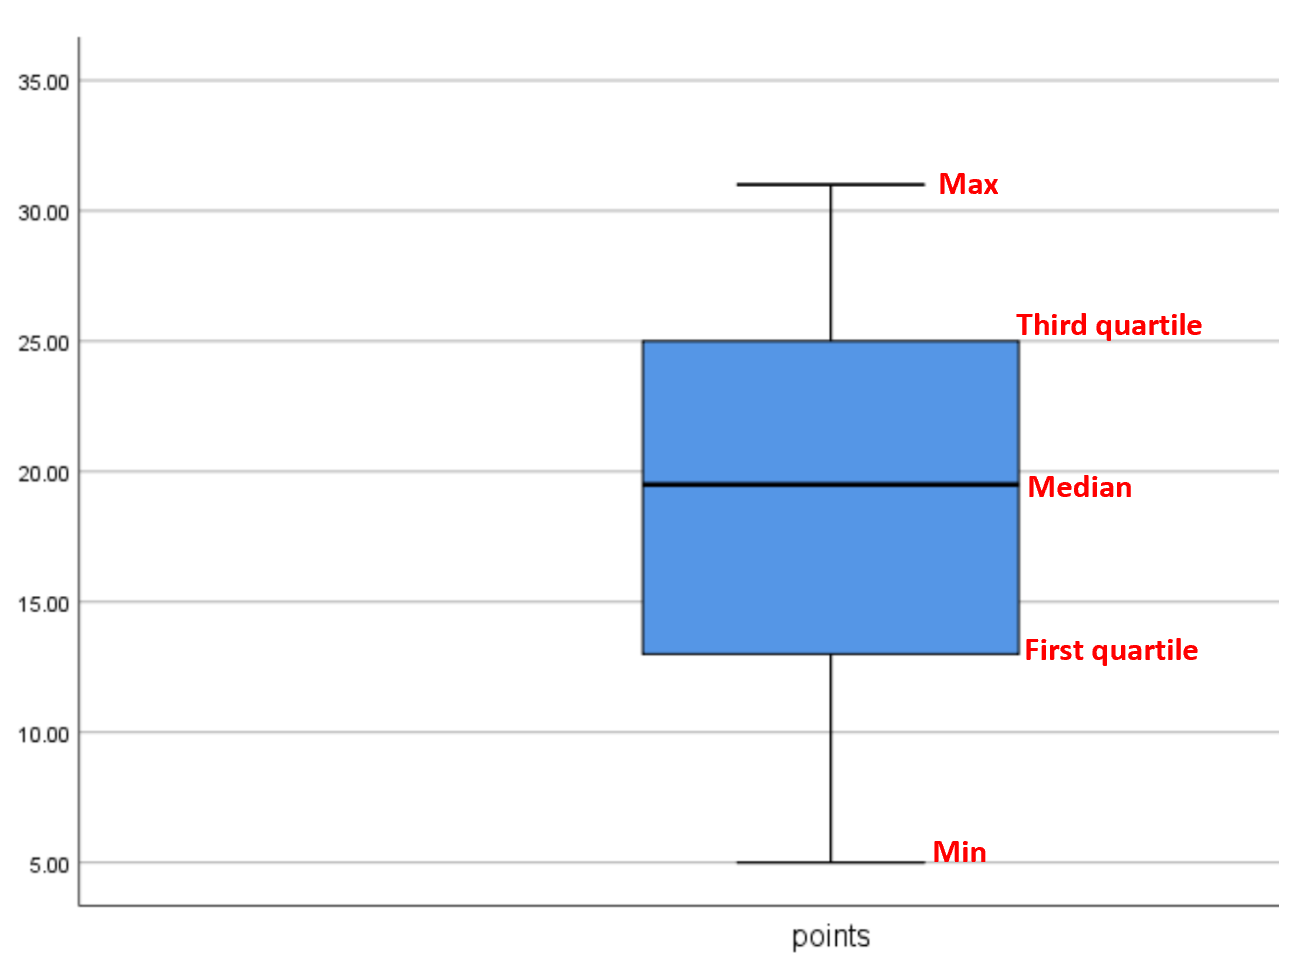
La structure classique repose sur un rectangle central (la « boîte »), dont les limites inférieures et supérieures sont rigoureusement calquées sur le premier quartile (25e percentile) et le troisième quartile (75e percentile). L’espace délimité par cette boîte représente ainsi précisément l’étendue interquartile (EIQ ou IQR), encapsulant les 50 % intermédiaires de la population étudiée. Au cœur de ce polygone, une ligne transversale marque l’emplacement de la médiane (50e percentile), servant d’ancrage à la tendance centrale non paramétrique.
De part et d’autre de cette boîte centrale émergent des segments rectilignes, communément appelés « moustaches » (whiskers). Selon la formulation standardisée adoptée par Tukey et intégrée par défaut dans SPSS, ces moustaches ne s’étendent pas nécessairement jusqu’aux valeurs absolues minimales et maximales de la série. Elles sont bornées par les « valeurs adjacentes », définies mathématiquement comme les observations les plus extrêmes situées à l’intérieur d’une zone délimitée par une fois et demie l’étendue interquartile au-delà des charnières. Tout point de donnée transgressant ces barrières virtuelles est isolé individuellement au-delà des moustaches, ce qui prévient la déformation artificielle du tracé par des artefacts de mesure.
1.3 Objectifs pédagogiques et démarche d’analyse sous SPSS
L’appropriation de la boîte à moustaches dans le logiciel IBM SPSS Statistics exige bien plus que la simple exécution mécanique de menus déroulants. L’objectif pédagogique fondamental consiste à articuler une compréhension conceptuelle des indicateurs mathématiques représentés avec la maîtrise technique des multiples voies d’exécution proposées par le logiciel. L’utilisateur doit être en mesure de choisir de façon optimale entre la procédure exploratoire automatisée, le générateur interactif de graphiques et l’écriture directe de syntaxe de commande.
La démarche analytique structurée implique d’abord une inspection critique de la distribution globale, suivie de la vérification rigoureuse des déviations par rapport au centre et aux seuils de dispersion. L’analyste doit apprendre à décoder les indicateurs graphiques comme des signaux d’alerte méthodologiques : une médiane écrasée contre un quartile signale un biais métrologique ou une sélection d’échantillon asymétrique, tandis qu’une moustache unilatéralement étirée met en lumière une queue de distribution prononcée. Cette démarche doit systématiquement déboucher sur une prise de décision éclairée quant au traitement des données et à leur restitution formelle.
Enfin, la finalité de cette démarche réside dans la communication scientifique. Un graphique statistique produit dans un cadre académique ne se contente pas d’être lisible à l’écran : il doit répondre à des critères stricts de clarté, de sobriété et de standardisation typographique, tels que prescrits par les manuels de style internationaux. Savoir transformer une sortie brute générée par le Viewer de SPSS en une figure éditable prête pour la soumission dans une revue scientifique à comité de lecture représente la compétence culminante de ce parcours méthodologique.
2. Fondements statistiques : Le résumé à cinq nombres et la distribution des données
2.1 Le résumé à cinq nombres (Five-Number Summary)
La boîte à moustaches constitue la traduction graphique intégrale d’un puissant ensemble de statistiques d’ordre connu sous le nom de « résumé à cinq nombres » (Five-Number Summary). Ce dispositif synthétique s’affranchit des contraintes distributionnelles en décrivant la structure quantitative d’une variable au moyen de cinq repères positionnels fondamentaux : le minimum non aberrant, le premier quartile (Q1), la médiane (Q2), le troisième quartile (Q3) et le maximum non aberrant.
Le premier quartile, ou 25e percentile, marque le seuil en deçà duquel se situe exactement un quart des observations classées par ordre croissant. Sur le plan psychométrique, il délimite les scores caractérisant les participants présentant les niveaux d’intensité les plus faibles sur le trait évalué. La médiane, ou second quartile (50e percentile), sépare la distribution en deux moitiés équiprobables. Contrairement à la moyenne arithmétique, elle n’est pas pondérée par la magnitude numérique des extrêmes, ce qui lui confère une robustesse absolue face aux distributions lourdement étirées.
Le troisième quartile, ou 75e percentile, établit la frontière au-dessus de laquelle se trouvent les 25 % d’individus obtenant les scores les plus élevés. Les deux valeurs extrêmes non aberrantes, délimitant l’extrémité des moustaches, représentent respectivement la plus petite et la plus grande observation du jeu de données qui ne satisfont pas aux critères formels de déviance statistique. Ce quintet de valeurs fournit une cartographie non paramétrique complète de l’étendue, du tassement et de la polarité des observations, sans rien présumer de la linéarité ou de la normalité de la variable sous-jacente.
2.2 L’écart interquartile (IQR) et la sensibilité aux distributions asymétriques
L’écart interquartile, désigné couramment par l’acronyme anglais IQR (Interquartile Range) ou EIQ en français, constitue le paramètre de dispersion central de l’approche non paramétrique. Mathématiquement, il correspond à la différence arithmétique stricte entre le troisième et le premier quartile (IQR = Q3 – Q1). En éliminant par construction les 25 % inférieurs et les 25 % supérieurs de la distribution ordonnée, l’IQR neutralise l’impact des variations marginales pour se focaliser sur l’intervalle dans lequel se concentrent les 50 % centraux des données.
La supériorité méthodologique de l’IQR sur la variance et l’écart-type apparaît avec évidence dès lors qu’une variable présente une asymétrie marquée (skewness). Dans les études de temps de réaction cognitive, par exemple, où les réponses physiologiques planchers côtoient des ralentissements attentionnels massifs, l’écart-type est systématiquement gonflé vers le haut par les quelques temps de latence très longs. Ce phénomène donne l’illusion d’une imprécision de mesure généralisée. L’IQR, quant à lui, demeure stable face à ces fluctuations périphériques, préservant une estimation fidèle de la variabilité typique du comportement étudié.
L’analyse visuelle de l’écart interquartile permet un diagnostic immédiat de la nature de l’asymétrie. Dans le cas d’une asymétrie positive (étalement vers la droite, fréquent pour les variables de consommation de substances ou d’affects négatifs en population générale), la médiane se retrouve collée à la base inférieure de la boîte, tandis que la partie supérieure du rectangle et la moustache du haut s’allongent considérablement. À l’inverse, une asymétrie négative (étalement vers la gauche, caractéristique des épreuves cognitives simples présentant un effet d’apprentissage massif) se traduit par une médiane collée au sommet de la boîte et une moustache inférieure anormalement développée.
2.3 Positionnement relatif de la moyenne et de la médiane
L’une des stratégies analytiques les plus fécondes lors de l’inspection d’une boîte à moustaches consiste à confronter mentalement ou graphiquement la position de la médiane à celle de la moyenne arithmétique. Bien que le boxplot standard de Tukey ne trace par défaut que la médiane, de nombreuses options sous SPSS permettent de projeter la moyenne au sein de la boîte sous la forme d’un marqueur distinct (souvent une croix ou un losange). Le décalage observable entre ces deux paramètres fournit un indice direct de la déviation paramétrique de la distribution.
Dans une distribution strictement symétrique et mésocurtique, représentative d’une loi normale parfaite, la moyenne arithmétique et la médiane coïncident rigoureusement au centre exact de la boîte interquartile. Dès que la distribution s’étire en direction d’une queue de distribution épaisse (heavy tail), la moyenne est irrésistiblement tractée dans le sens des valeurs extrêmes sous l’effet de leur poids arithmétique cumulé, alors que la médiane conserve sa position ordinale stable. Un écart substantiel entre ces deux métriques atteste sans ambiguïté d’une rupture du postulat de symétrie, remettant formellement en question l’adéquation des statistiques fondées sur les moindres carrés.
En outre, l’aplatissement de la distribution (kurtosis) influe directement sur la morphologie globale du graphique. Une distribution leptocurtique, caractérisée par un pic aigu et des queues épaisses, engendre une boîte interquartile extrêmement étroite et compacte, flanquée de moustaches courtes d’où s’échappent de multiples observations isolées. Inversement, une distribution platycurtique se manifeste par un étalement important du rectangle central occupant la majeure partie de l’intervalle entre les valeurs extrêmes, signalant une dispersion uniforme des scores sans concentration privilégiée autour du centre.
3. Préparation et structuration des données psychométriques dans SPSS
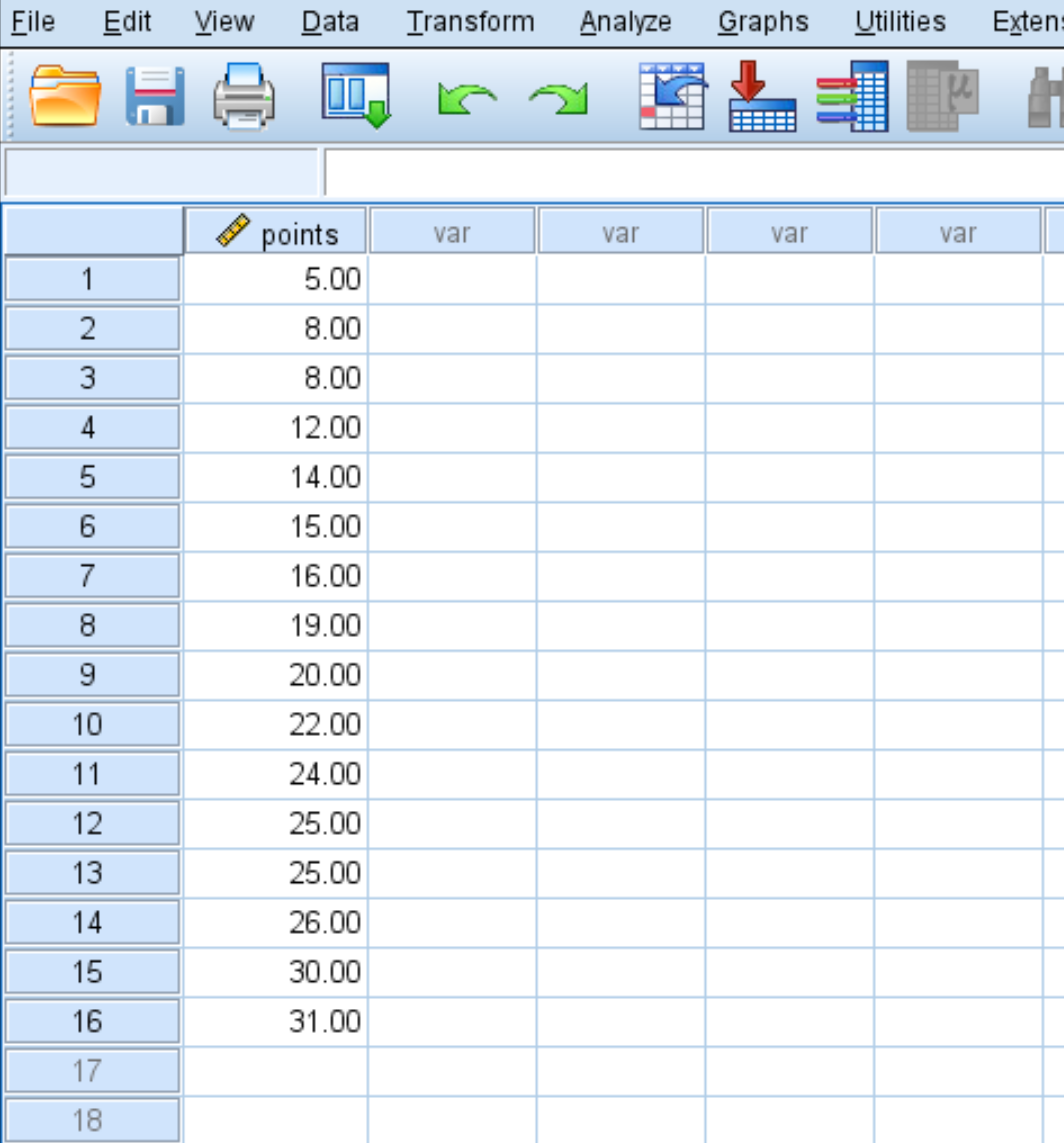
3.1 Configuration des variables dans l’éditeur de données SPSS
Avant d’engager toute procédure de tracé graphique dans SPSS, une configuration minutieuse du dictionnaire de données dans l’onglet « Affichage des variables » (Variable View) est indispensable. Le moteur graphique de SPSS s’appuie étroitement sur les métadonnées déclarées pour déterminer les options d’agrégation, les échelles des axes et les algorithmes de calcul applicables. Négliger cette étape expose le chercheur à des sorties tronquées, à des erreurs de labellisation ou à des catégorisations erronées.
Chaque variable continue destinée à faire l’objet d’un boxplot doit impérativement être paramétrée avec le niveau de mesure « Échelle » (Scale) dans la colonne « Mesure ». L’attribution d’un niveau incorrect, tel que « Nominal » ou « Ordinal », peut restreindre les fonctionnalités disponibles dans le Générateur de graphiques ou fausser l’interprétation des percentiles. Parallèlement, il convient de renseigner soigneusement la colonne « Libellé » (Variable Label). C’est ce libellé textuel étendu, et non le nom brut et abrégé de la variable, qui sera automatiquement importé par le moteur de rendu graphique pour annoter l’axe des ordonnées, garantissant l’intelligibilité immédiate des sorties.
Pour les variables indépendantes destinées à scinder les représentations en sous-groupes (variables catégorielles telles que les conditions expérimentales, les sous-types diagnostiques ou les paliers d’âge), la configuration de la colonne « Valeurs » (Values) s’avère tout aussi cruciale. Chaque code numérique entier doit être explicitement apparié à son étiquette sémantique (par exemple : 1 = « Témoins sains », 2 = « Trouble dépressif caractérisé », 3 = « Trouble bipolaire en rémission »). Ces étiquettes textuelles structureront automatiquement l’axe des abscisses ou les clés de légende, éliminant les risques de confusion analytique lors de l’examen des résultats comparatifs.
3.2 Gestion préalable des valeurs manquantes (Missing Values)
Le traitement des omissions de réponse et des données non recueillies constitue une problématique récurrente en psychologie expérimentale et clinique. SPSS distingue conceptuellement deux types d’omissions : les valeurs manquantes définies par le système (System-Missing, matérialisées par un point dans la grille de données) résultant d’absences physiques d’enregistrement, et les valeurs manquantes déclarées par l’utilisateur (User-Missing), codées arbitrairement par des chiffres conventionnels tels que 999 ou -99 pour signifier un refus de répondre, un abandon ou une panne instrumentale.
L’omission de déclarer rigoureusement ces codes numériques dans la colonne « Manquant » (Missing) de l’affichage des variables constitue une source majeure de dénaturation des boîtes à moustaches. Si la valeur 999 n’est pas formellement identifiée comme manquante par le système, SPSS la traitera comme une valeur quantitative réelle sur l’axe continu. Il en résultera un écrasement complet de la boîte interquartile au fond du graphique et l’apparition de moustaches aberrantes, rendant toute interprétation clinique rigoureusement impossible.
De surcroît, le mode d’exclusion des données manquantes doit être anticipé lors des analyses multivariées ou factorielles. Selon que l’on retient l’exclusion observation par observation (listwise) ou variable par variable (pairwise), la taille effective de l’échantillon fluctue, ce qui altère mécaniquement le rang des observations et, par conséquent, la valeur exacte des percentiles Q1, Q2 et Q3. Une vérification attentive des effectifs valides dans le tableau récapitulatif initial généré par SPSS s’impose donc systématiquement avant d’extraire des conclusions de la géométrie de la boîte.
3.3 Exemple pratique : Données de scores d’anxiété et de temps de réaction
Afin d’ancrer les développements procéduraux dans la réalité de la recherche expérimentale, considérons un protocole de recherche simulé portant sur l’impact d’une tâche d’induction de stress cognitif chez des adultes jeunes. Le jeu de données comprend un échantillon de N = 120 participants, répartis aléatoirement en deux conditions expérimentales : un groupe expérimental soumis au Trier Social Stress Test (TSST) et un groupe témoin réalisant une tâche d’attention neutre sans évaluation sociale.
Le protocole collige deux variables dépendantes quantitatives continues de natures distributionnelles contrastées. La première correspond au score obtenu à l’inventaire d’anxiété situationnelle de Spielberger (STAI-Y1, variable d’échelle continue bornée théoriquement entre 20 et 80 points), dont la distribution tend à être modérément asymétrique en fonction du niveau d’exposition au stresseur. La seconde variable enregistre le temps de réaction médian (TR, exprimé en millisecondes) lors d’une tâche ultérieure de détection de cibles sous interférence attentionnelle de type tâche de Stroop, variable typiquement caractérisée par une forte asymétrie positive et l’émergence régulière de valeurs extrêmes.
La structure factorielle de cet échantillon est matérialisée dans SPSS par une variable nominale binaire « Condition_Stress » (codée 0 = « Témoin », 1 = « Stress expérimental »), complétée par une variable de stratification ordinale « Profil_Anxiete_Trait » (codée 1 = « Bas », 2 = « Modéré », 3 = « Sévère ») issue d’une passation préliminaire du STAI-Y2. Cette organisation matricielle permettra d’illustrer la construction successive de boîtes simples, de boîtes comparatives inter-groupes et de représentations factorielles croisées.
4. Création d’une boîte à moustache simple via la procédure « Explorer »
4.1 Navigation au sein du menu Statistiques descriptives
Au sein de l’environnement SPSS, la commande « Explorer » (Explore) représente sans doute la voie la plus rigoureuse et la plus complète pour générer des boîtes à moustaches univariées. Conçue initialement pour implémenter fidèlement les préceptes de l’analyse exploratoire des données de Tukey, cette procédure surpasse largement les options de traçage élémentaires intégrées dans les menus de fréquences ou de descriptifs standards. Elle couple en effet le rendu graphique à une batterie d’indicateurs numériques de forme et de robustesse de premier ordre.
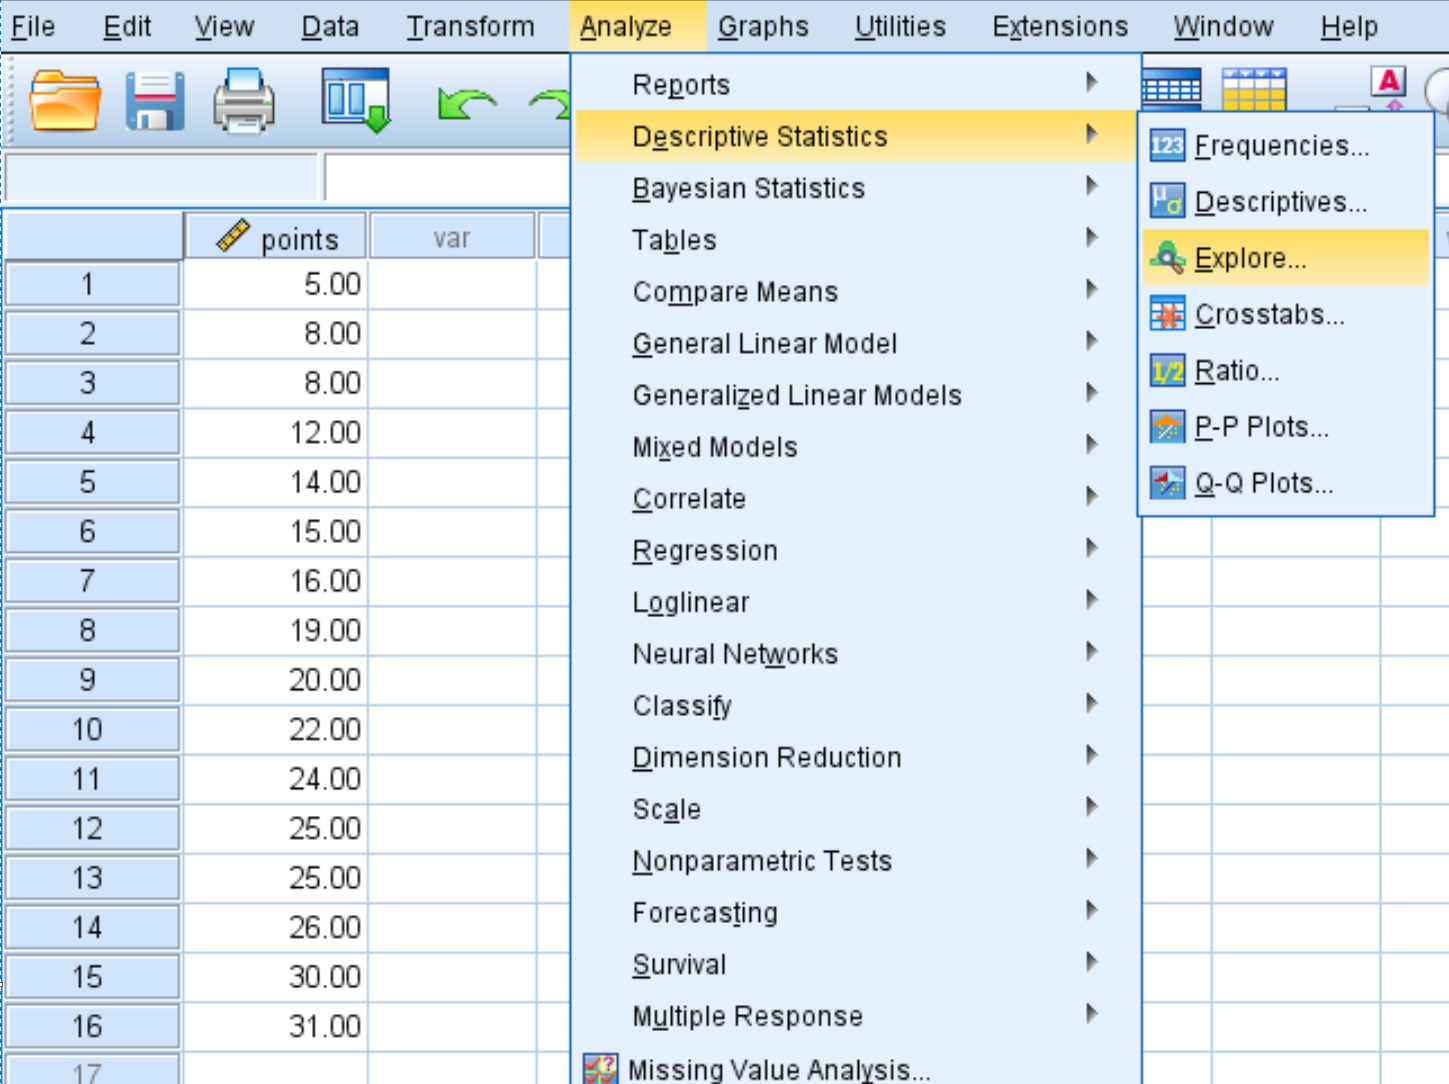
Pour accéder à cette fonctionnalité, l’utilisateur doit dérouler l’arborescence principale du logiciel : cliquez sur le menu Analyse (Analyze), positionnez le curseur sur la sous-catégorie Statistiques descriptives (Descriptive Statistics), puis sélectionnez l’instruction Explorer (Explore). Cette action déclenche l’ouverture de la boîte de dialogue principale correspondante, laquelle orchestre l’ensemble des calculs paramétriques et non paramétriques ainsi que le rendu visuel associé.
L’atout méthodologique déterminant de cette commande réside dans sa capacité à produire, en un passage unique, une documentation statistique exhaustive de la variable cible : estimation de la moyenne robuste à 5 % de troncation (5% Trimmed Mean), intervalle de confiance à 95 %, écart interquartile exact, indices d’asymétrie (skewness) et d’aplatissement (kurtosis) assortis de leurs erreurs-types respectives, tout en affichant la distribution sous forme graphique.
4.2 Attribution des champs dans la boîte de dialogue Explorer
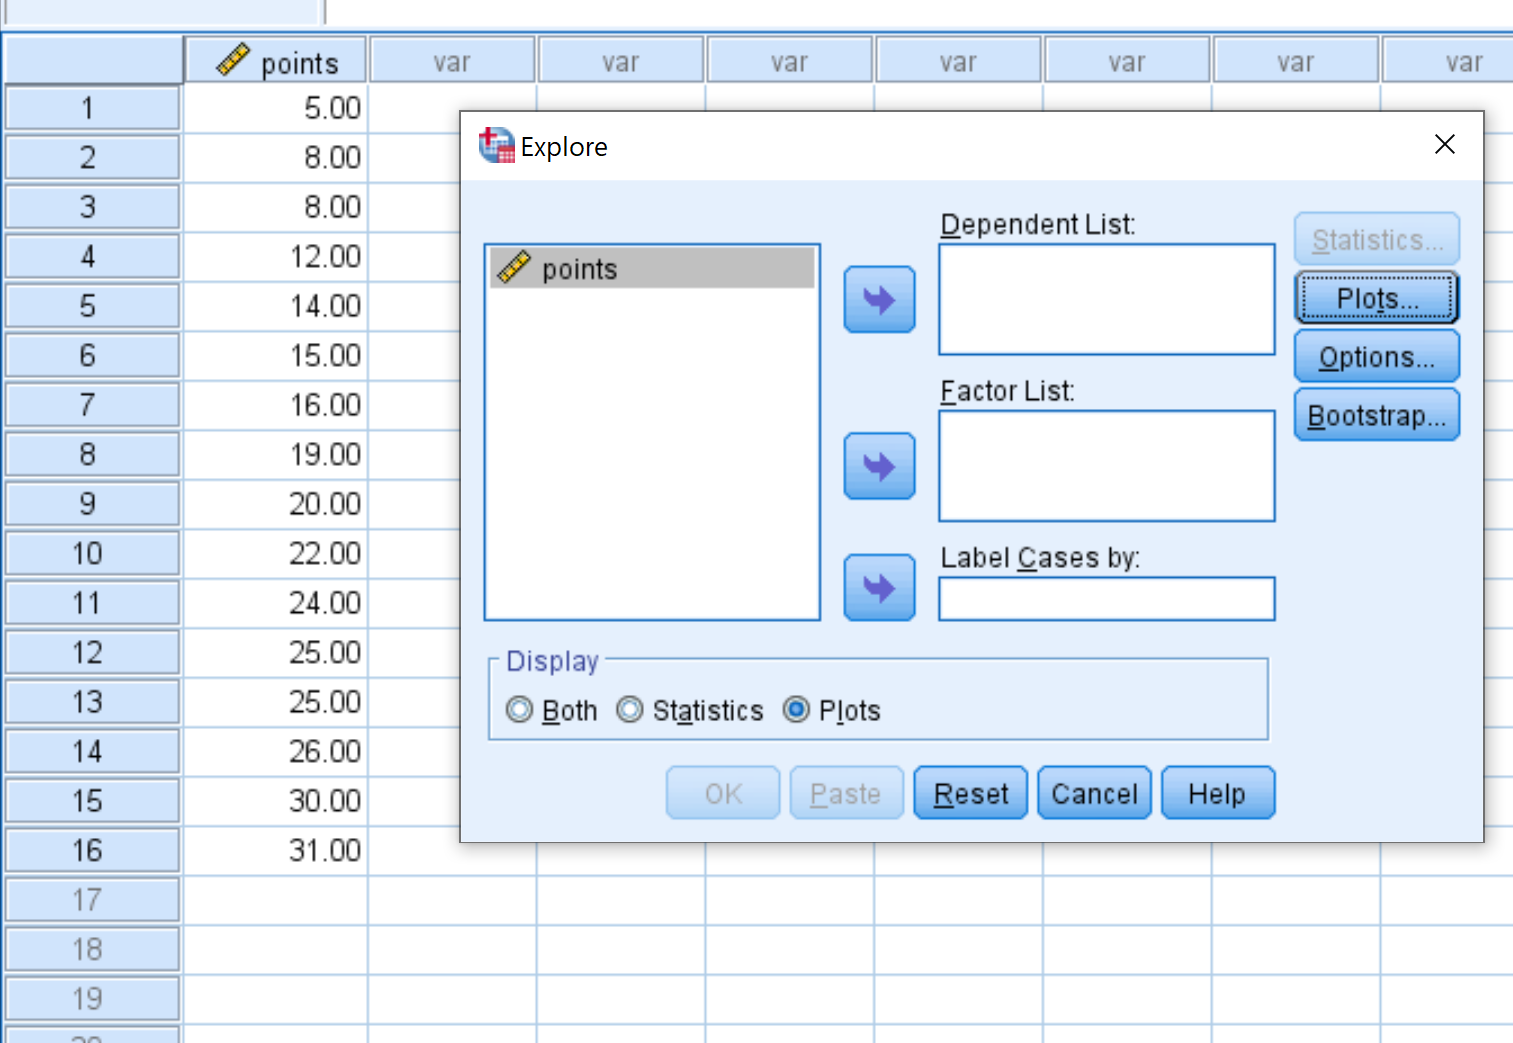
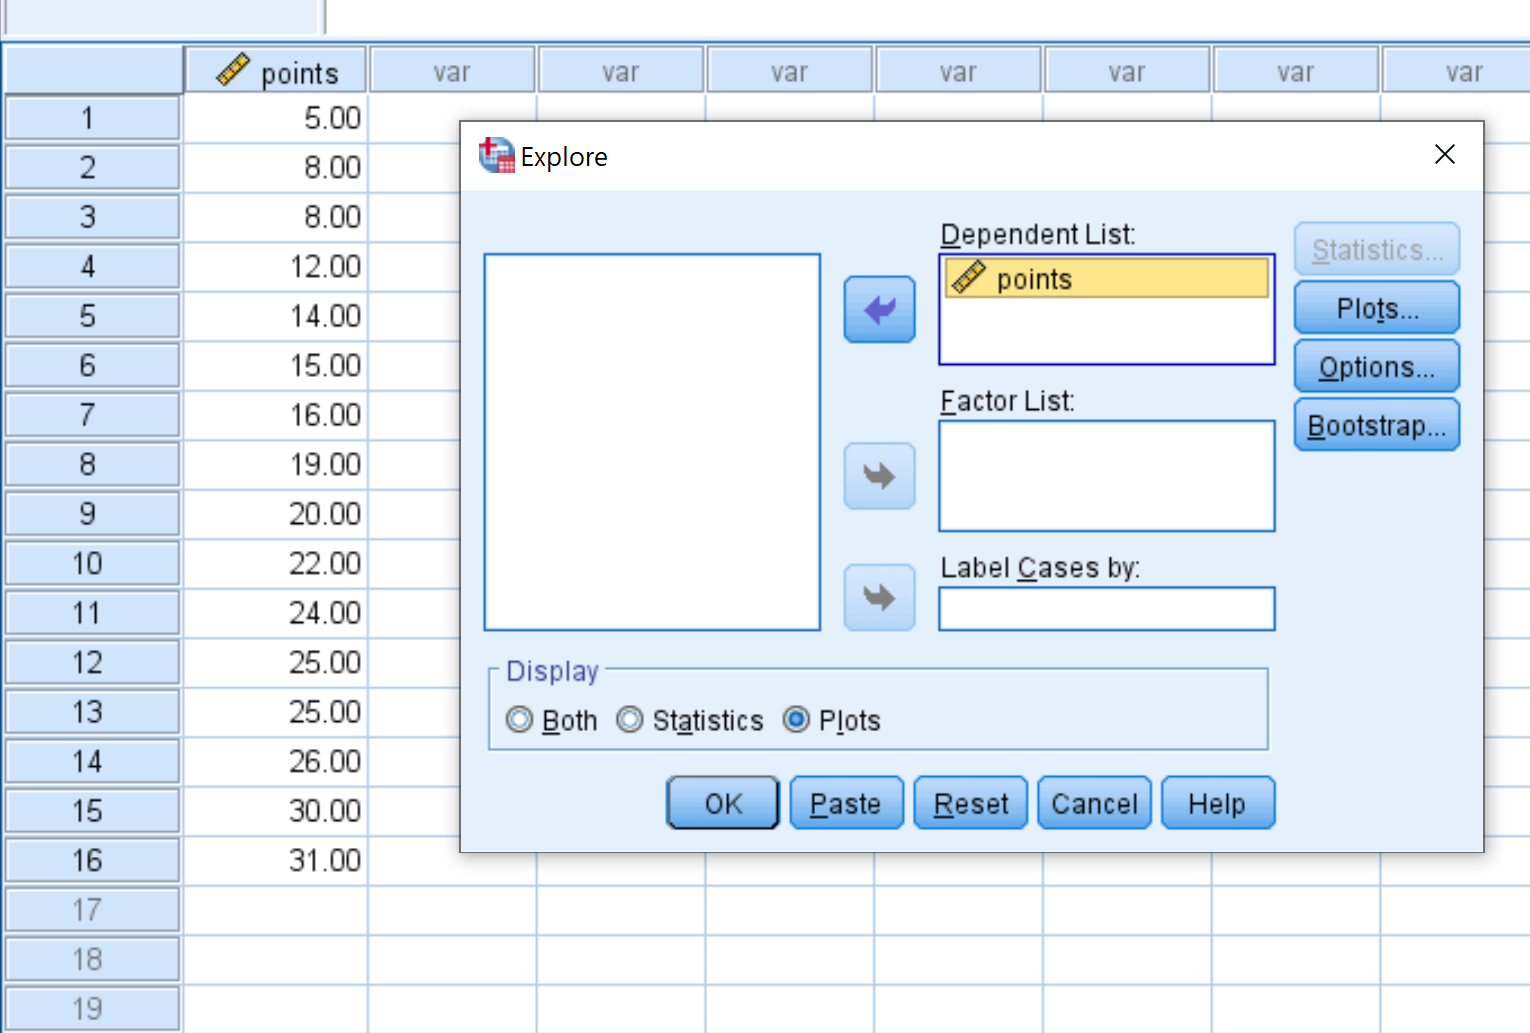
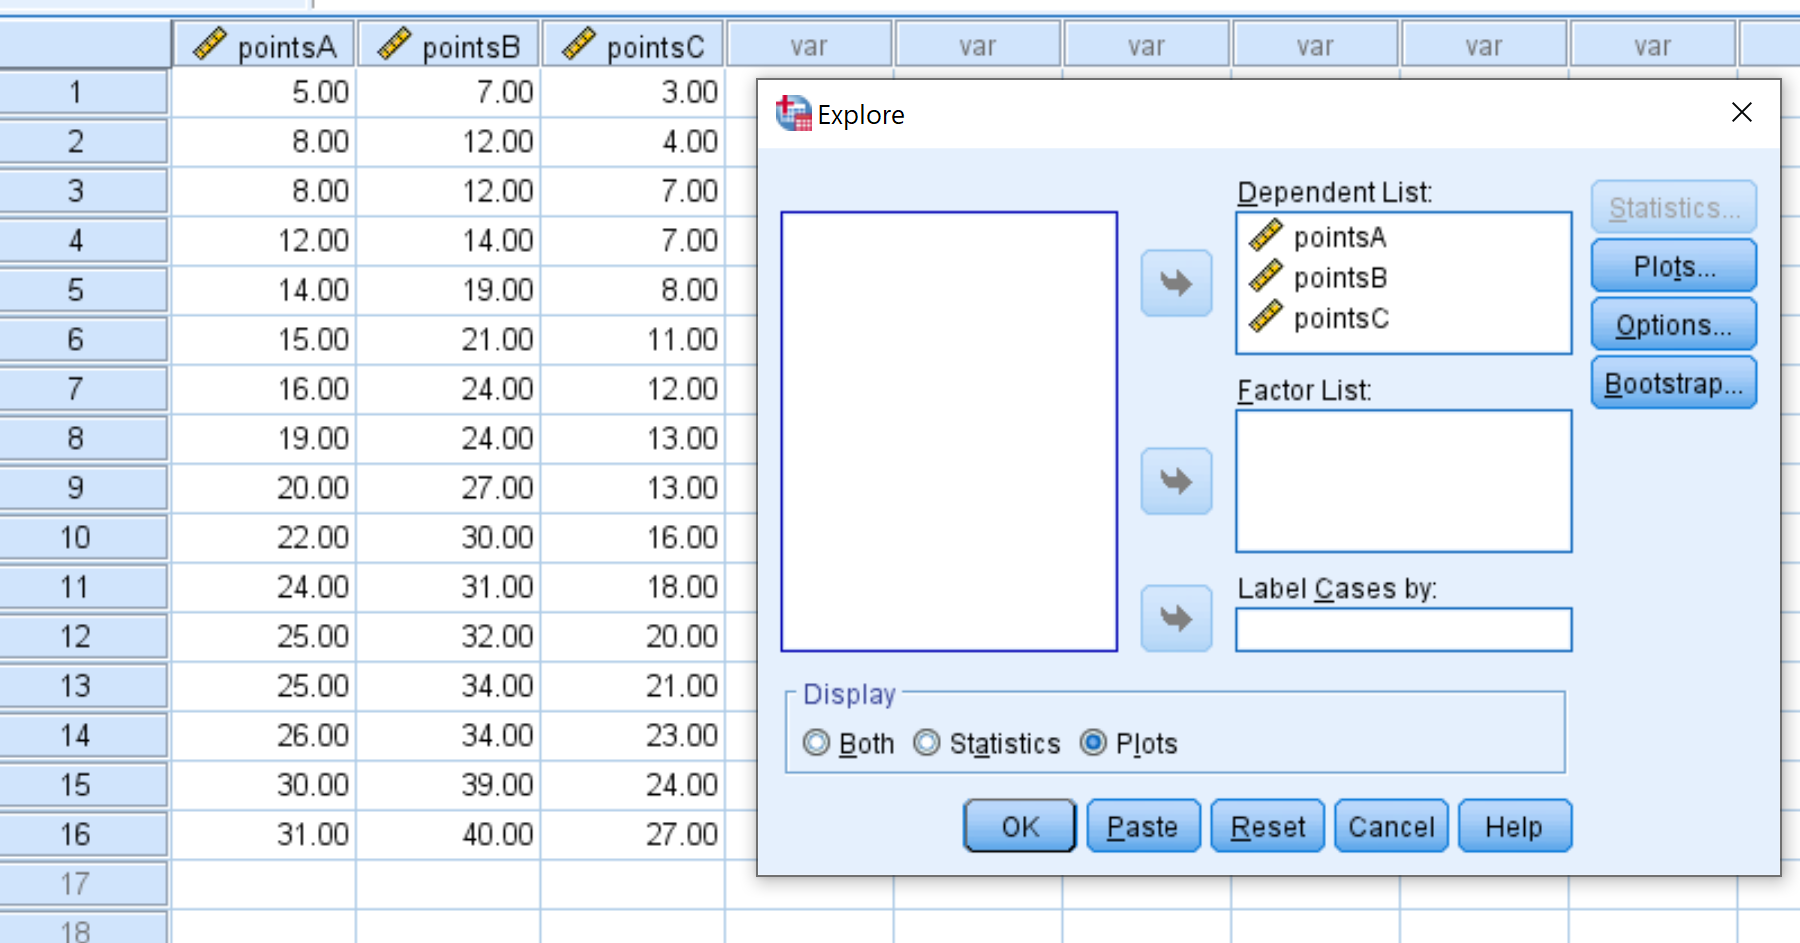
L’interface de la commande Explorer présente une structure ergonomique claire mais rigide. Dans la partie gauche figure la liste complète des variables disponibles dans le jeu de données actif. Pour générer un boxplot univarié global (par exemple, sur la distribution générale du temps de réaction de tous les sujets de l’étude), il convient de sélectionner la variable continue cible « Temps_Reaction_ms » et de la faire glisser, via la flèche directionnelle centrale, dans le champ supérieur intitulé Liste des variables dépendantes (Dependent List).
À ce stade, si l’objectif se cantonne à l’inspection descriptive globale de l’échantillon sans distinction de groupes, le champ inférieur Liste des facteurs (Factor List) doit demeurer vide. Dans le quadrant inférieur droit nommé Affichage (Display), l’utilisateur dispose de trois boutons radio alternatifs : « Les deux » (Both), « Statistiques » (Statistics) ou « Tracés » (Plots). Pour une exploration clinique complète, le maintien de la sélection par défaut « Les deux » est vivement recommandé, afin de confronter immédiatement les repères graphiques aux valeurs chiffrées correspondantes.
Il est impératif d’ajuster ensuite les paramètres graphiques en cliquant sur le bouton Tracés (Plots…) situé dans la marge supérieure droite de la boîte de dialogue. Dans la fenêtre secondaire qui s’ouvre, le groupe d’options intitulé Boîtes à moustaches (Boxplots) propose de cocher « Niveaux des facteurs ensemble » (Factor levels together) ou « Dépendants ensemble » (Dependents together). Pour optimiser le diagnostic, cochez également la case Graphiques de normalité avec tests (Normality plots with tests). Cette dernière commande intégrera dans la sortie le test formel de normalité de Shapiro-Wilk ainsi que les tracés quantile-quantile (Q-Q plots), fournissant un étayage analytique déterminant pour interpréter le boxplot.
4.3 Exécution et vérification de la sortie initiale dans le Viewer
Après validation des options sélectionnées en cliquant sur le bouton Poursuivre (Continue), puis sur OK dans la fenêtre principale, SPSS envoie les instructions au processeur de calcul et bascule automatiquement l’affichage vers la fenêtre des résultats (SPSS Viewer). Le document de sortie s’enrichit d’une séquence hiérarchisée de sections qu’il convient de contrôler chronologiquement avec un œil critique.
La première table générée, intitulée Récapitulatif du traitement des observations (Case Processing Summary), constitue le filtre de sécurité de l’analyste. Elle détaille le nombre absolu et le pourcentage de cas valides pris en compte dans le tracé, ainsi que le volume précis des données rejetées pour cause de valeurs manquantes. La confirmation d’un taux de validité conforme aux prévisions expérimentales garantit que le calcul des percentiles repose bien sur l’intégralité de l’échantillon ciblé.
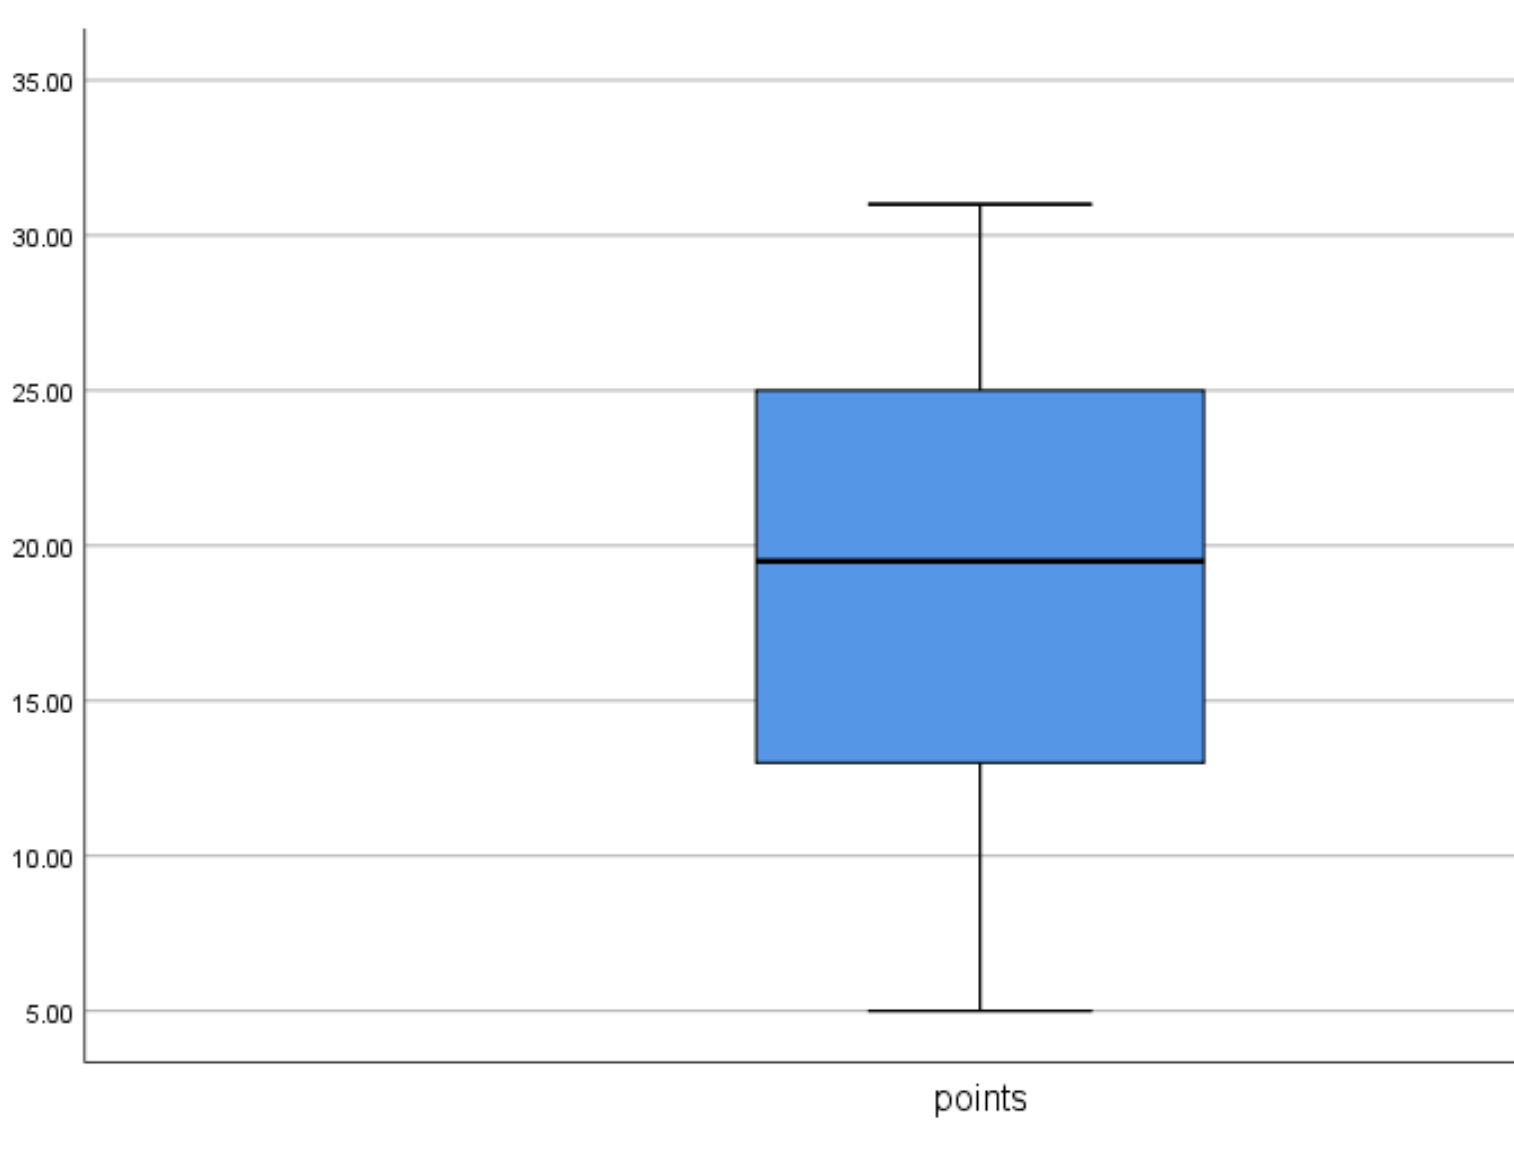
En faisant défiler le Viewer au-delà du tableau des statistiques descriptives étendues, la boîte à moustaches univariée apparaît sur le plan de travail. L’axe des ordonnées affiche l’échelle métrique de la variable continue, graduée selon un intervalle arithmétique régulier calculé par le moteur logiciel. L’utilisateur doit immédiatement inspecter les limites de cet axe pour s’assurer qu’aucune distorsion d’échelle n’est venue compresser la boîte de façon anormale, attestant d’une configuration géométrique conforme aux propriétés du signal psychométrique mesuré.
5. Création de boîtes à moustaches comparatives par groupe
5.1 Utilisation de la liste des facteurs (Factor List)
L’immense majorité des plans de recherche en psychologie clinique, cognitive ou sociale repose sur la comparaison systématique de groupes d’individus soumis à des conditions expérimentales contrastées ou présentant des caractéristiques nosographiques différentielles. La projection conjointe de boîtes à moustaches juxtaposées sur un axe d’ordonnée partagé constitue à cet égard l’un des moyens les plus puissants pour apprécier d’un coup d’œil l’ampleur d’un effet expérimental et l’hétérogénéité des réactions individuelles.
Pour mettre en œuvre cette configuration comparative via la procédure Explorer, la variable quantitative continue (par exemple, le score d’anxiété « Score_STAI ») est de nouveau assignée à la Liste des variables dépendantes. La distinction opératoire réside dans l’exploitation conjointe du champ Liste des facteurs (Factor List), au sein duquel l’utilisateur doit insérer la variable catégorielle de regroupement, telle que « Condition_Stress ». En procédant ainsi, SPSS n’opère plus une agrégation aveugle de toutes les données, mais segmente mathématiquement la distribution globale en sous-échantillons distincts.
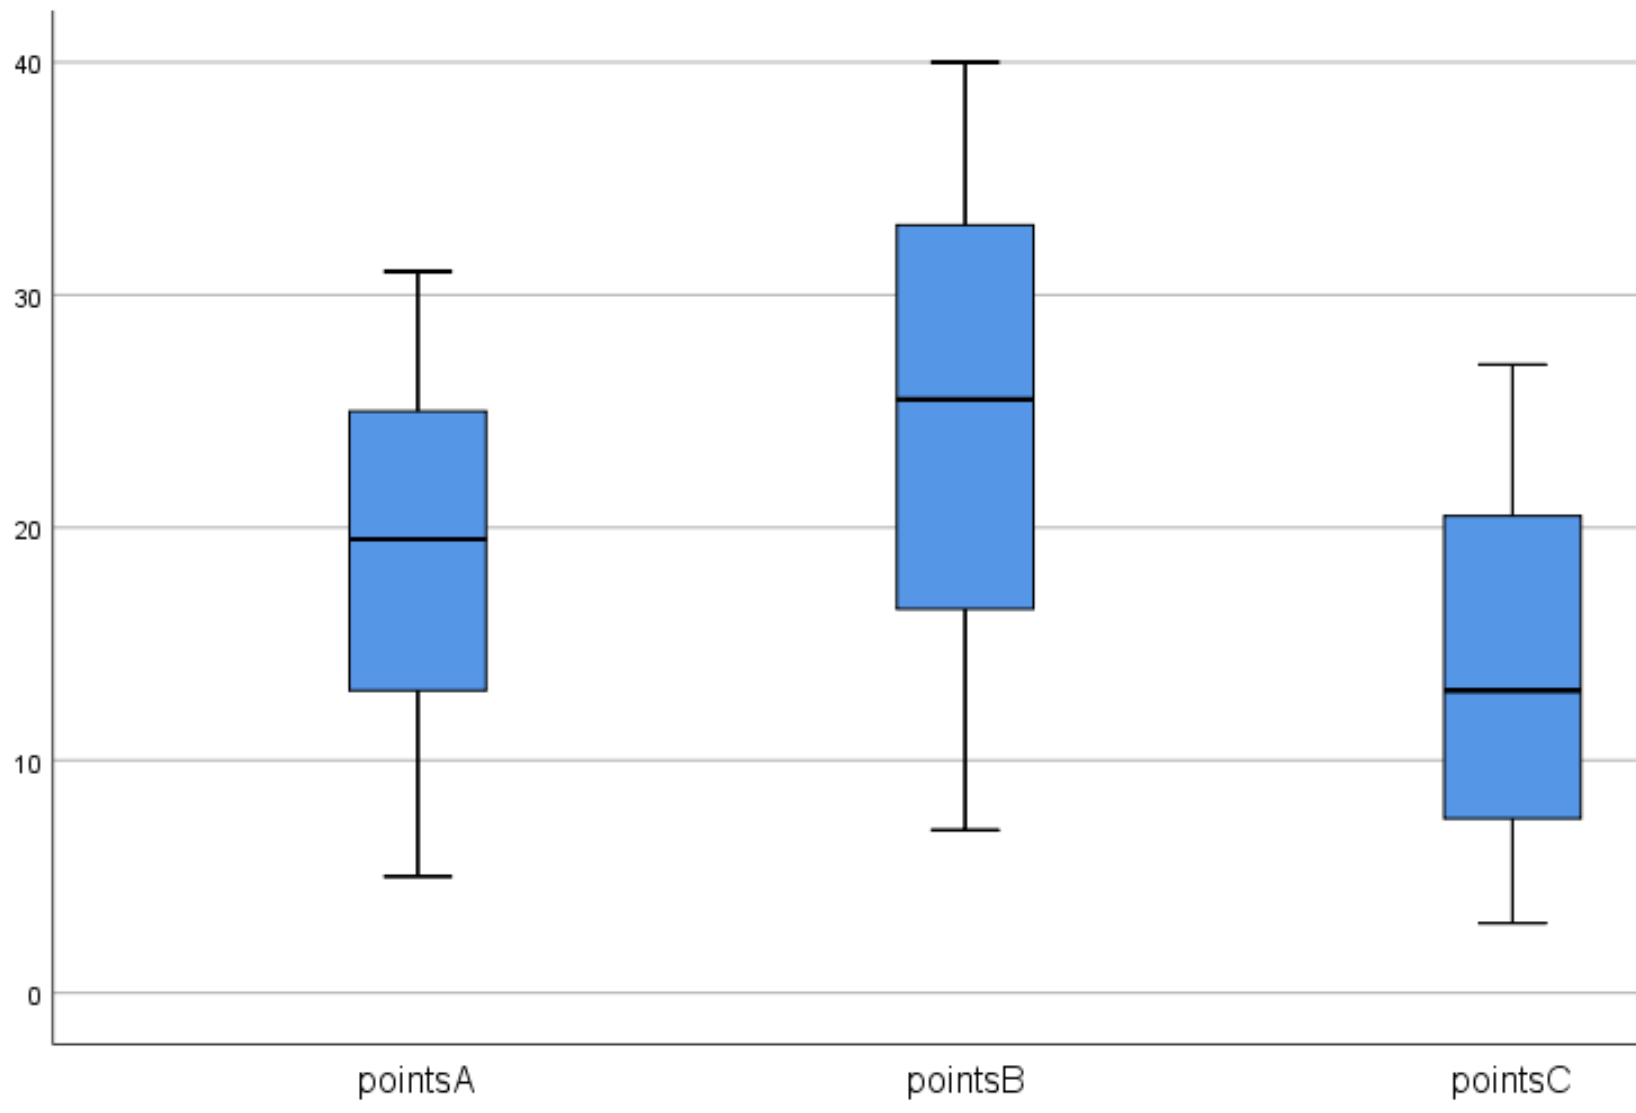
Le Viewer génère alors une figure unique comportant autant de boîtes à moustaches parallèles qu’il existe de modalités exhaustives définies dans la variable de facteur (dans notre exemple : une boîte dédiée au groupe « Témoin » et une boîte dédiée au groupe « Stress expérimental »). Cette juxtaposition horizontale immédiate permet une évaluation comparative directe des médianes, de l’étendue des boîtes centrales et de la dispersion des queues de distribution, simplifiant considérablement le travail d’inférence préliminaire.
5.2 Configuration des tracés en fonction de la structure expérimentale
Lorsque le dispositif méthodologique intègre plusieurs variables dépendantes (par exemple, l’évaluation conjointe de l’anxiété subjective et du temps de réaction) ou fait intervenir une hiérarchie factorielle à plusieurs niveaux, le paramétrage des tracés dans la boîte de dialogue Explorer doit être ajusté en conséquence via le sous-menu Tracés.
L’option Niveaux des facteurs ensemble (Factor levels together) constitue le choix par excellence pour évaluer un effet de groupe univarié : elle regroupe sur un graphique unique les différentes catégories définies par le facteur pour la variable dépendante étudiée. Cette disposition optimise la comparaison de la dispersion inter-groupes, fonctionnant comme un proxy visuel des postulats d’homoscédasticité requis pour les tests de comparaison de moyennes. Si l’amplitude verticale des boîtes interquartiles présente un rapport de un à trois entre les groupes, l’analyste est immédiatement alerté d’un risque élevé d’hétérogénéité des variances.
À l’inverse, l’option Dépendants ensemble (Dependents together) trouve son utilité lorsque le chercheur transfère simultanément plusieurs variables dépendantes partageant rigoureusement la même unité métrique (comme différentes sous-échelles d’un même questionnaire standardisé) sans spécifier de facteur de partition. SPSS aligne alors côte à côte les boîtes relatives à chaque sous-échelle, autorisant un diagnostic comparatif immédiat du profil psychométrique moyen de l’ensemble de l’échantillon d’étude.
5.3 Comparaison de mesures répétées au sein d’un même échantillon
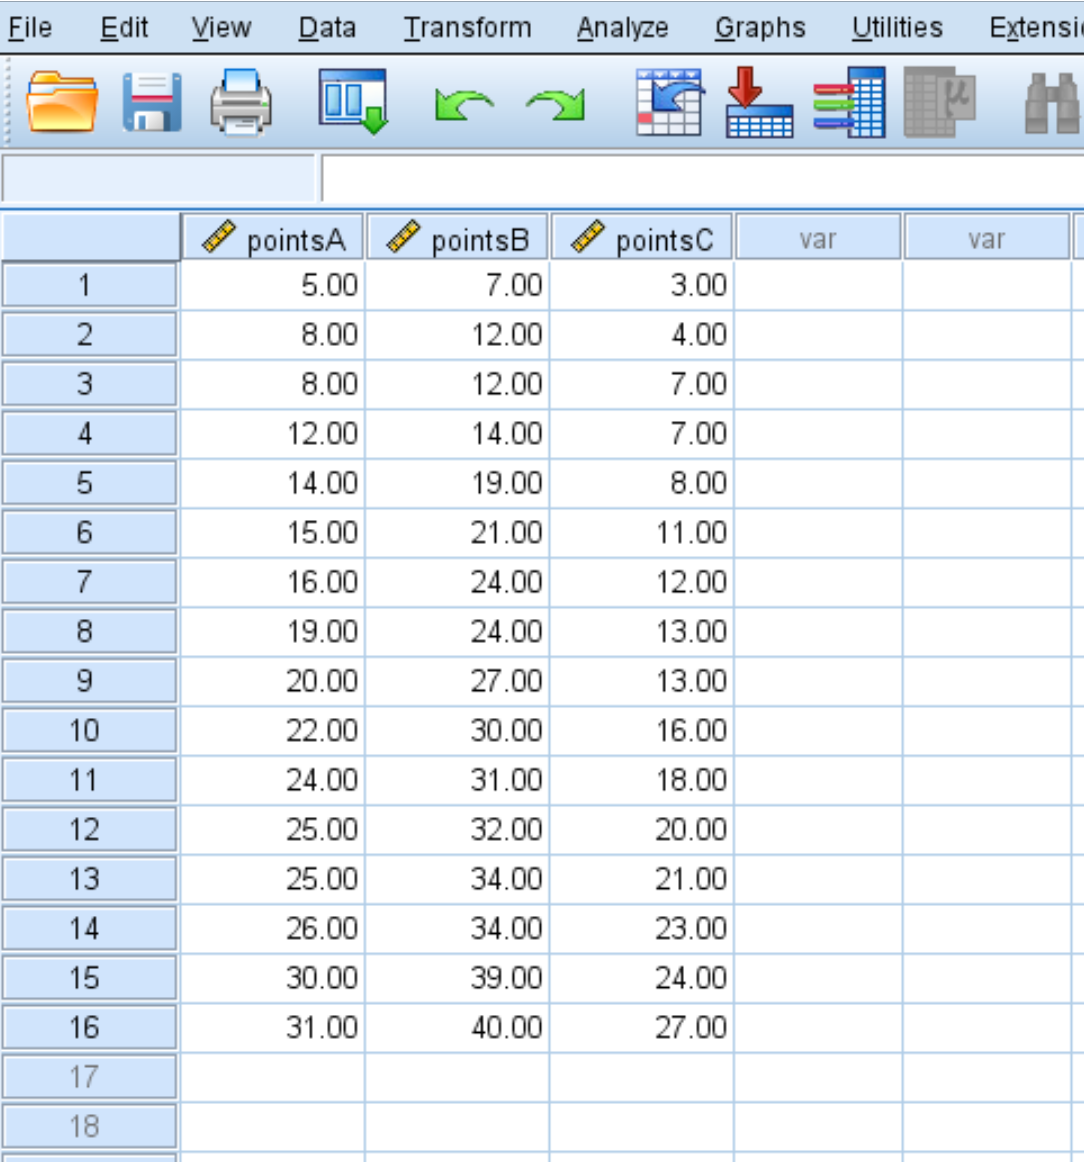
L’investigation clinique recourt fréquemment à des devis longitudinaux ou à des protocoles intra-sujets à mesures répétées, dans lesquels chaque individu est évalué à de multiples reprises dans le temps (par exemple : « Anxiete_PreTest », « Anxiete_PostTest », « Anxiete_Suivi_3Mois »). La transposition graphique de cette architecture temporelle sous SPSS requiert une attention méthodologique particulière liée au formatage matriciel des données.
Sous SPSS, les mesures répétées sont classiquement saisies dans un format dit « large » (Wide format), où chaque temps de mesure occupe une colonne séparée pour une même ligne représentant un sujet unique. Si l’on applique directement la procédure Explorer en injectant ces trois colonnes dans la « Liste des variables dépendantes » sans variable de facteur, le logiciel juxtapose les trois boîtes à moustaches chronologiques sur un même panneau. Cela permet d’observer l’évolution temporelle de la médiane et de la variabilité interindividuelle à travers les phases thérapeutiques.
Néanmoins, une précaution théorique critique s’impose lors du décodage de ce type de visualisation : les boîtes à moustaches indépendantes juxtaposées masquent intrinsèquement la corrélation intra-sujet qui unit les mesures répétées d’un même individu. Le déplacement de la médiane d’un temps à l’autre reflète fidèlement la tendance collective du groupe, mais le graphique ne permet pas de discerner si les trajectoires individuelles sont homogènes ou si certains sous-groupes de patients évoluent à contre-courant. L’analyste gardera à l’esprit que la boîte à moustaches traite ici les occasions de mesure comme des coupes transversales successives.
6. Utilisation du Générateur de graphiques (Chart Builder) pour les boîtes à moustaches
6.1 Accès et paramétrage dans la galerie de graphiques
Si la procédure Explorer séduit par sa richesse statistique automatisée, le Générateur de graphiques (Chart Builder) d’IBM SPSS offre un contrôle esthétique, fonctionnel et architectural nettement supérieur sur la composition visuelle. Reposant sur le puissant moteur sous-jacent Graphics Production Language (GPL), ce module interactif permet d’échafauder des figures complexes hautement personnalisées, répondant directement aux exigences typographiques des publications scientifiques.
L’accès s’opère via la barre de menus supérieure en sélectionnant Graphiques (Graphs), puis Générateur de graphiques (Chart Builder…). Une boîte d’alerte méthodologique rappelle fréquemment la nécessité de renseigner correctement le niveau de mesure des variables, rappel fondamental dont dépend l’activation des fonctionnalités du générateur. Une fois l’espace de travail affiché, l’utilisateur sélectionne l’onglet Galerie (Gallery) dans la partie inférieure, puis clique sur la famille typologique Boîte à moustaches (Boxplot).
La galerie expose plusieurs déclinaisons fondamentales : la « Boîte à moustaches 1-D » (tracé univarié), la « Boîte à moustaches simple » (pour comparer plusieurs sous-groupes selon un facteur nominal unique), et la « Boîte à moustaches groupée » (Clustered Boxplot, pour modéliser des plans factoriels croisés). Pour initier la construction, il suffit d’effectuer un glisser-déposer de l’icône choisie vers la grande zone d’aperçu dynamique du canevas supérieur, initialisant ainsi les zones réceptrices d’axes.
6.2 Sous-groupes et variables de regroupement supplémentaires
L’environnement du Générateur de graphiques révèle toute sa puissance lors de la modélisation de plans factoriels complexes à deux facteurs croisés (plans de type ANOVA 2×2 ou 2×3). Pour cartographier, par exemple, l’interaction potentielle entre la condition d’induction de stress et le profil d’anxiété-trait des individus, la sélection de la boîte à moustaches groupée s’avère optimale.
Après avoir glissé la variable continue « Score_STAI » sur l’axe vertical (axe Y) et la variable « Condition_Stress » sur l’axe horizontal (axe X), une zone réceptrice additionnelle intitulée « Définir les groupes/la couleur » (Cluster on X: set color) s’illumine dans le coin supérieur droit du canevas. Il suffit d’y déposer la seconde variable indépendante, « Profil_Anxiete_Trait ». SPSS génère alors immédiatement un aperçu structurel où chaque niveau du facteur X est subdivisé en grappes de boîtes différenciées par des textures ou des teintes de gris contrastées, accompagnées de leur légende d’attribution.
De plus, l’onglet latéral Propriétés des éléments (Element Properties) permet de piloter rigoureusement l’ordre d’affichage des catégories nominales. Le chercheur peut y réorganiser logiquement la disposition des groupes (par exemple, placer systématiquement le groupe témoin en première position de gauche) ou exclure temporairement une modalité non pertinente sans devoir altérer la matrice de données brutes, préservant ainsi l’intégrité de la structure source.
6.3 Personnalisation dynamique et prévisualisation
La zone de prévisualisation du Générateur de graphiques n’est pas une simple illustration statique : elle réagit dynamiquement aux modifications paramétriques ordonnées dans la boîte de contrôle latérale. En sélectionnant l’élément « Boîte à moustaches 1 » dans la liste des propriétés, l’analyste accède à des réglages morphologiques précis, tels que la modification de la largeur relative des boîtes (Box width), permettant d’ajuster l’encombrement graphique selon le nombre de sous-groupes comparés.
Ce menu autorise également le paramétrage immédiat de l’échelle de mesure sur l’axe des ordonnées. En cliquant sur le bouton « Axe Y (Boîte1) », l’utilisateur peut désactiver le calibrage automatique des bornes pour imposer des valeurs minimales et maximales ancrées sur la réalité théorique de l’instrument de mesure (par exemple, forcer l’axe à débuter au zéro absolu ou au score plancher de 20 pour une échelle psychométrique, évitant ainsi d’exagérer visuellement des fluctuations inter-groupes mineures).
Enfin, le Générateur intègre la possibilité de sauvegarder l’intégralité de la configuration stylistique sous la forme d’un fichier modèle SPSS Chart Template (portant l’extension .sgt). Cette disposition méthodologique s’avère particulièrement précieuse pour les laboratoires de recherche désireux de standardiser l’apparence de leurs productions scientifiques : un gabarit graphique validé une fois peut être appliqué rétrospectivement et automatiquement à l’ensemble des graphiques ultérieurs de la cohorte expérimentale.
7. Génération de boîtes à moustaches via la syntaxe SPSS
7.1 Syntaxe de la commande EXAMINE
Dans une perspective de science ouverte et de rigueur méthodologique, l’exploitation exclusive de l’interface graphique pilotée par la souris présente des vulnérabilités documentées : manque de traçabilité, risques de manipulations erronées non documentées et lenteur opérationnelle lors du traitement d’échantillons massifs. La maîtrise de la programmation en syntaxe de commande SPSS constitue le garant absolu de la reproductibilité des analyses exploratoires.
Le pilotage textuel de la procédure Explorer s’effectue au moyen de la commande EXAMINE. Pour reproduire par script l’exploration univariée de la variable continue de temps de réaction en fonction des niveaux de la condition de stress, l’instruction de base s’articule comme suit dans une fenêtre de syntaxe dédiée :
EXAMINE VARIABLES = Temps_Reaction_ms BY Condition_Stress
/PLOT BOXPLOT STEMLEAF
/COMPARE GROUPS
/STATISTICS DESCRIPTIVES
/CINTERVAL 95
/MISSING LISTWISE
/NOTOTAL.
La clause /PLOT BOXPLOT ordonne explicitement l’affichage des boîtes à moustaches factorielles, tandis que le paramètre /NOTOTAL supprime l’affichage superfétatoire du groupe agrégé consolidé, recentrant la sortie sur le contraste bilatéral entre les groupes expérimentaux. L’utilisateur désireux de générer ces analyses par script peut concevoir ses instructions de zéro ou cliquer systématiquement sur le bouton Coller (Paste) disponible dans chaque boîte de dialogue SPSS, ce qui transfère instantanément les ordres configurés vers l’éditeur de syntaxe.
7.2 Génération avancée avec la commande GGRAPH et GPL
Pour exploiter les potentialités visuelles maximales de SPSS et concevoir des figures vectorielles sophistiquées, la commande GGRAPH, couplée au métalangage déclaratif GPL (Graphics Production Language), représente l’outil programmatique de référence. Cette syntaxe découple la préparation statistique des données de la définition géométrique des objets graphiques, offrant une flexibilité typographique inégalée.
Une séquence GPL dédiée à l’élaboration d’une boîte à moustaches comparative robuste adopte une architecture modulaire standardisée :
GGRAPH
/GRAPHDATASET NAME= »graphdataset » VARIABLES=Condition_Stress Temps_Reaction_ms MISSING=LISTWISE REPORTMISSING=NO
/GRAPHSPEC SOURCE=INLINE.
BEGIN GPL
SOURCE: s=userSource(id(« graphdataset »))
DATA: Condition_Stress=col(value(« Condition_Stress »), unit.category())
DATA: Temps_Reaction_ms=col(value(« Temps_Reaction_ms »))
DATA: id=col(value(« $CASENUM »), unit.category())
GUIDE: axis(dim(1), label(« Condition Expérimentale »))
GUIDE: axis(dim(2), label(« Temps de Réaction (ms) »))
ELEMENT: schema(position(bin.percentile(Condition_Stress*Temps_Reaction_ms)), label(id))
END GPL.
L’élément fonctionnel central réside dans l’instruction ELEMENT: schema(), où la fonction schema désigne précisément la boîte à moustaches selon la nomenclature formelle de GPL. L’adjonction de la fonction d’étiquetage label(id) ordonne au moteur de cartographier explicitement le numéro d’enregistrement de l’observation adjacente à tout point aberrant détecté, simplifiant considérablement le travail d’identification médico-légale des singularités cliniques.
7.3 Avantages de la programmation en syntaxe pour la recherche reproductible
L’intégration de la programmation par syntaxe au cœur de la routine du chercheur en sciences humaines répond aux exigences déontologiques contemporaines de transparence méthodologique. L’enregistrement rigoureux des scripts dans un fichier de syntaxe (.sps) constitue un journal d’audit infalsifiable de toutes les décisions prises au cours de l’analyse : traitement des valeurs manquantes, découpage des facteurs, sélection des variables et paramètres graphiques appliqués.
Au-delà de la conformité aux standards de reproductibilité, l’automatisation programmatique décuple l’efficacité opérationnelle face à des devis d’évaluation psychométrique exhaustifs. L’analyse simultanée de multiples dimensions issues d’inventaires de personnalité (tels que les 30 facettes du NEO-PI-3) nécessiterait des dizaines de manipulations fastidieuses et répétées à la souris via l’interface graphique. Par script, il suffit de formuler une boucle itérative ou de renseigner l’ensemble de la liste des variables dans l’instruction EXAMINE pour exécuter en quelques secondes le tracé de plusieurs dizaines de figures parfaitement homogènes.
Enfin, cette approche immunise l’analyste contre les erreurs humaines inhérentes à la fatigue cognitive : une boîte cochée par inadvertance, une échelle mal redéfinie ou une variable confondue lors d’une session de clics successifs peuvent introduire des biais silencieux dans le traitement des sorties. La syntaxe garantit qu’un protocole validé s’exécutera de façon immuable, quel que soit le moment de l’analyse ou la version de la plateforme SPSS utilisée.
8. Interprétation statistique détaillée des composantes du graphique
8.1 Décodage de la boîte centrale et de la ligne médiane
L’évaluation rigoureuse d’une boîte à moustaches débute systématiquement par l’analyse géométrique du rectangle central, qui concentre les indicateurs majeurs de tendance centrale et de dispersion de la sous-population investiguée. La ligne transversale représentant la médiane doit être appréhendée comme le point d’équilibre non paramétrique : 50 % des participants obtiennent un score situé en dessous de ce repère, et 50 % un score situé au-dessus. Sa position absolue sur l’axe des ordonnées fournit une indication clinique immédiate de l’amplitude globale de la réponse du groupe.
La hauteur physique de la boîte, correspondant à l’écart interquartile (Q3 – Q1), traduit fidèlement le degré d’homogénéité ou d’hétérogénéité des 50 % intermédiaires de l’échantillon. Une boîte extrêmement courte et tassée reflète une forte consistance interindividuelle, signifiant que la moitié des sujets observés présentent des scores hautement convergents autour de la médiane. À l’inverse, une boîte haute témoigne d’une dispersion substantielle des réponses, suggérant que le groupe évalué réagit de façon disparate au construit mesuré, ce qui doit inciter le clinicien à rechercher des variables modératrices sous-jacentes.
L’asymétrie interne de la boîte constitue le troisième indice diagnostique fondamental. La médiane ne scinde pas obligatoirement le rectangle en deux parties égales. Si elle se positionne de façon excentrée, nettement rapprochée du plancher de la boîte (Q1), cela démontre que les observations de la moitié centrale sont denses et ramassées dans les bas scores, tandis qu’elles s’étirent de façon plus diffuse vers le troisième quartile, matérialisant une asymétrie positive locale au cœur même de la distribution.
8.2 Analyse des moustaches et de l’étendue des données
Les moustaches qui s’étendent de part et d’autre de la boîte centrale délimitent le domaine de variabilité des observations considérées comme non contaminées par des processus d’altération statistique. L’algorithme standard implémenté dans SPSS détermine la longueur maximale théorique d’une moustache en multipliant l’écart interquartile par une constante fixe de 1,5, puis en ajoutant cette marge au quartile supérieur (Q3 + 1,5*IQR) ou en la soustrayant du quartile inférieur (Q1 – 1,5*IQR).
Toutefois, une nuance algorithmique fondamentale distingue la boîte de Tukey telle que rendue par SPSS : l’extrémité de la moustache ne s’arrête pas arbitrairement à cette borne calculée, mais s’ancre exactement sur la valeur de la donnée empirique la plus extrême qui demeure à l’intérieur de cet intervalle de tolérance (la valeur adjacente). Dès lors, la longueur effective des moustaches supérieure et inférieure dépend étroitement de la structure concrète des données recueillies et présente très rarement une égalité géométrique parfaite.
Une dissymétrie marquée entre la longueur de la moustache supérieure et celle de la moustache inférieure constitue un marqueur visuel direct de non-normalité. Si la moustache supérieure s’allonge sur plusieurs unités d’échelle tandis que la moustache inférieure apparaît quasiment inexistante, la distribution est affectée d’une forte asymétrie positive avec un étalement de la queue supérieure. Cette observation visuelle disqualifie d’emblée l’hypothèse d’une loi de distribution symétrique gaussienne, rendant hautement suspecte l’utilisation de tests statistiques fondés sur la présomption de normalité stricte.
8.3 Comparaisons inter-groupes et inférences visuelles
La comparaison juxtaposée de plusieurs boîtes à moustaches au sein d’une même figure invite naturellement l’analyste à formuler des inférences comparatives sur l’efficacité relative d’un traitement ou la singularité d’un profil nosologique. Pour mener cet examen avec rigueur sans céder aux illusions perceptives, certains repères géométriques empiriques méritent d’être formalisés.
Une règle heuristique classique stipule que si la ligne médiane d’un groupe expérimental se situe entièrement en dehors du rectangle central (EIQ) d’un groupe témoin, la probabilité d’une différence statistiquement significative entre les deux populations au seuil conventionnel alpha = 0,05 est particulièrement élevée. À l’inverse, un chevauchement substantiel des deux boîtes centrales, avec des médianes logées à des niveaux d’ordonnées équivalents, laisse présager l’absence d’effet clinique ou expérimental majeur du traitement administré.
Cependant, le chercheur doit se garder rigoureusement d’ériger ces indices visuels en verdicts inférentiels définitifs. La boîte à moustaches reflète des distributions d’échantillons bruts et non des distributions d’échantillonnage de la moyenne ou de la médiane : elle ne tient pas compte directement de la puissance statistique tributaire de la taille globale de l’échantillon (N). Un chevauchement modéré de boîtes peut demeurer hautement significatif sur un très grand échantillon (N = 10 000), tout comme une disjonction visuelle apparente peut s’avérer statistiquement non significative sur une petite cohorte de 10 patients en raison d’une erreur-type élevée. L’interprétation visuelle constitue une étape exploratoire indispensable, mais ne saurait se substituer au test d’hypothèse formel.
9. Détection et gestion des valeurs aberrantes et extrêmes dans SPSS
9.1 Distinction entre valeurs aberrantes (Outliers) et valeurs extrêmes (Extreme Values)
L’un des apports majeurs de la boîte à moustaches réside dans son protocole formalisé et transparent de signalement des données discordantes. Alors que d’autres progiciels statistiques agrègent indistinctement l’ensemble des points au sein de moustaches fondées sur les percentiles 5 et 95, SPSS applique rigoureusement la taxonomie bipartite proposée par John Tukey, scindant les données atypiques en « valeurs aberrantes » (outliers) et « valeurs extrêmes » (extreme values).
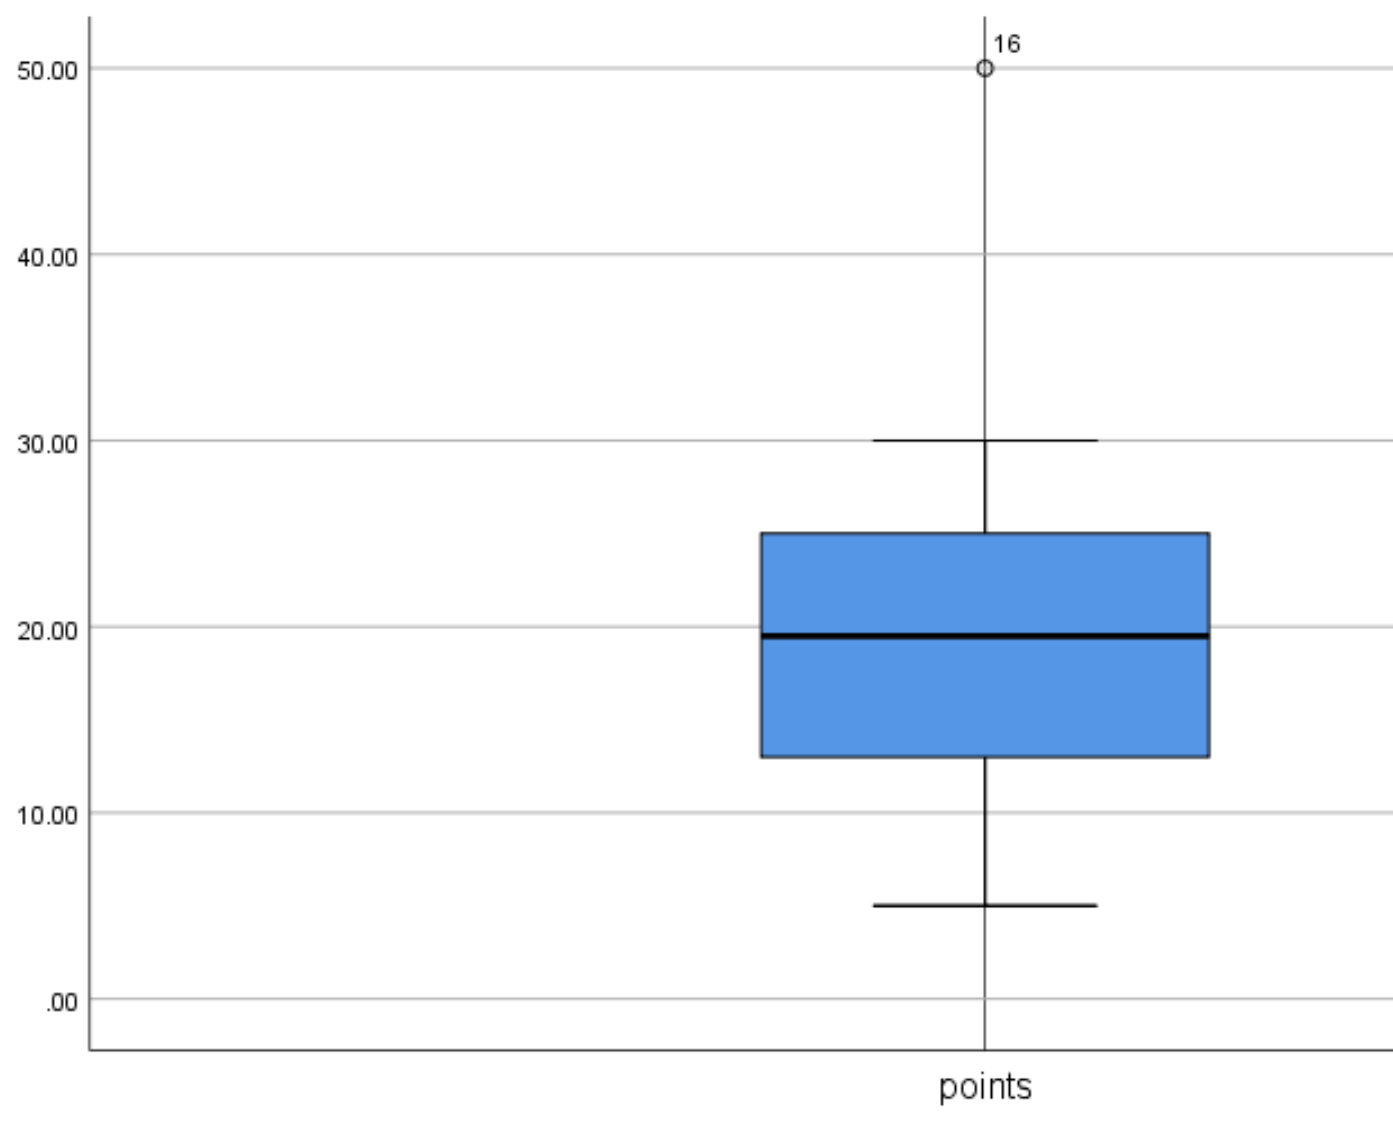
Sont classées comme valeurs aberrantes modérées (Outliers) toutes les observations dont la magnitude se situe au-delà des clôtures intérieures (c’est-à-dire entre 1,5 fois l’IQR et 3 fois l’IQR au-dessus de Q3 ou en dessous de Q1). Sur le tracé graphique de SPSS, ces données sont matérialisées de façon standardisée par de petits cercles (o). Ces points traduisent une déviation inhabituelle par rapport au corps de la distribution, sans que l’on puisse statuer d’emblée sur leur caractère pathologique ou artefactuel.
Sont formellement désignées comme valeurs extrêmes (Extreme values) les observations qui transgressent la clôture extérieure, en se positionnant à plus de 3 fois l’étendue interquartile (3*IQR) au-delà des charnières de la boîte. SPSS identifie ces déviations critiques sur le graphique au moyen d’un symbole distinctif en forme d’astérisque (*). Dans le cadre d’un protocole expérimental standard, la présence d’une valeur extrême atteste d’une rupture distributionnelle massive qui altère substantiellement les estimations paramétriques et impose des mesures correctives immédiates.
9.2 Identification et traçabilité des observations problématiques
La force opératoire de l’algorithme graphique de SPSS repose sur l’attribution systématique d’une étiquette numérique adjacente à chaque cercle ou astérisque projeté sur le canevas. Ce chiffre ne représente pas la valeur numérique prise par la mesure, mais correspond au numéro exact de la ligne d’enregistrement (Case Number) du participant concerné dans la matrice de données active. Cette traçabilité directe élimine toute incertitude lors de la phase d’audit médico-légal des données.
Conjointement au rendu graphique, la procédure Explorer génère un tableau synthétique intitulé Observations extrêmes (Extreme Values Table). Ce relevé dresse l’inventaire nominatif des cinq valeurs empiriques les plus élevées et des cinq valeurs les plus basses pour la variable investiguée, en consignant pour chacune le numéro de sujet, le code d’identification textuel le cas échéant et la valeur chiffrée absolue enregistrée. Cette double documentation autorise un recoupement immédiat entre la géométrie visuelle du boxplot et les valeurs quantitatives réelles.
Il est en outre possible, dans les options avancées d’Explorer, d’affecter une variable textuelle personnalisée (telle que l’identifiant clinique anonymisé du patient « Code_Patient ») dans le champ intitulé Étiqueter les observations par (Label Cases by). Dès lors, le Viewer de SPSS ne placera plus de simples numéros de lignes arbitraires à côté des astérisques et cercles d’aberration, mais affichera explicitement les codes patients, simplifiant la transmission des données de pharmacovigilance ou le retour aux dossiers cliniques d’origine.
9.3 Stratégies méthodologiques face aux données aberrantes en psychologie
La découverte d’observations isolées au-delà des moustaches place l’analyste face à un arbitrage méthodologique délicat. Dans les sciences comportementales, l’exclusion arbitraire et silencieuse des données discordantes constitue une faute scientifique caractérisée. Toute intervention curative sur la matrice de données doit être adossée à une typologie étiologique rigoureuse et consignée de façon transparente dans les rapports de recherche.
On distingue classiquement trois sources étiologiques principales :
- L’erreur de saisie ou de transcription matérielle : un score de 77 saisi accidentellement sous la forme 777 sur une échelle bornée à 80. La vérification du protocole papier original ou du journal informatique de recueil brut permet la correction factuelle immédiate de la coquille.
- L’artefact instrumental ou le non-respect du protocole : un participant qui interrompt une tâche de temps de réaction informatisée pour répondre au téléphone, générant une latence de 45 000 ms. Dès lors que la déviance résulte d’une violation documentée des conditions d’expérimentation, l’exclusion de l’observation est scientifiquement légitime et doit être déclarée.
- La variabilité clinique réelle et valide : un patient présentant une symptomatologie clinique exceptionnellement floride ou des aptitudes cognitives hors normes. Cette donnée, bien qu’aberrante au sens mathématique de Tukey, reflète fidèlement la réalité phénoménologique de l’échantillon clinique et ne doit en aucun cas être supprimée aveuglément pour complaire à un postulat de normalité.
Face à des données authentiques mais hautement perturbatrices pour les modèles paramétriques, plusieurs solutions alternatives s’offrent au chercheur : appliquer une transformation mathématique continue (logarithmique, racine carrée ou inverse) afin de comprimer l’étalement de la queue de distribution, recourir à la winsorisation (technique consistant à ramener la valeur aberrante au seuil percentile le plus proche non discordant), ou abandonner les modèles linéaires classiques au profit de méthodes d’estimation robustes ou de tests de rangs non paramétriques.
10. Personnalisation esthétique et mise en forme académique (Normes APA) dans SPSS
10.1 Utilisation de l’Éditeur de graphiques (Chart Editor)
Les rendus bruts générés dans la fenêtre d’affichage de SPSS souffrent traditionnellement d’une lourdeur stylistique peu compatible avec les standards esthétiques contemporains : arrière-plans grèges sombres, quadrillages omniprésents, polices typographiques mal proportionnées et saturations chromatiques excessives. L’appropriation de l’Éditeur de graphiques (Chart Editor) de SPSS est une étape essentielle pour convertir un schéma brut en une figure scientifique raffinée.
Pour activer ce module d’édition interactif, il suffit d’effectuer un double-clic directement sur le graphique cible au sein du Viewer de SPSS. La figure s’isole immédiatement dans une fenêtre d’édition dédiée, libérant une riche barre d’outils et ouvrant l’accès au volet d’ajustement structurel Propriétés (activable par le raccourci Ctrl+T ou par double-clic sur n’importe quel composant de l’image).
Depuis cet espace, chaque élément géométrique devient individuellement manipulable. Un double-clic sur le rectangle d’une boîte donne accès à l’onglet « Remplissage et bordure » (Fill & Border), permettant de remplacer les couleurs vives par défaut par des teintes de gris neutres ou un remplissage blanc pur délimité par un trait de contour noir fin. De même, un simple clic sur les lignes de quadrillage horizontal et vertical permet d’ordonner leur suppression définitive, allégeant immédiatement la charge visuelle de la représentation.
10.2 Conformité avec les normes de publication APA (7e édition)
La 7e édition du manuel de publication de l’American Psychological Association (APA) édicte des règles particulièrement rigoureuses concernant l’architecture typographique et l’économie visuelle des figures scientifiques. La conformité académique exige l’application scrupuleuse de plusieurs ajustements stylistiques fondamentaux sous SPSS :
- Élimination du titre interne au graphique : SPSS génère souvent un en-tête par défaut au sommet de la figure. Selon l’APA, aucun titre ne doit figurer dans le cadre graphique lui-même. Le numéro de figure (en gras) et son titre descriptif (en italique) sont impérativement positionnés au-dessus de l’image au sein du document de traitement de texte.
- Sobriété des axes et des graduations : Les axes horizontal et vertical doivent apparaître sous la forme de traits pleins noirs d’épaisseur régulière (généralement 1 ou 1,5 point), exempts de toute ligne de grille d’arrière-plan. Les graduations (ticks) doivent être orientées vers l’extérieur ou supprimées si elles encombrent inutilement les catégories.
- Étiquetage métrologique précis : Chaque axe doit être assorti d’une désignation conceptuelle explicite, suivie impérativement de l’unité de mesure entre parenthèses, par exemple : Temps de réaction (en millisecondes) ou Score total d’anxiété (points). Les abréviations de variables codées de type « TR_MS » ou « STAI_TOT » sont formellement prohibées dans une publication officielle.
- Uniformisation typographique : L’ensemble des textes de la figure (libellés d’axes, valeurs de graduations, légendes) doit être harmonisé dans une police de caractères standard sans empattement (sans-serif), telle qu’Arial, Calibri ou Helvetica, en conservant une taille strictement comprise entre 8 et 12 points pour préserver une parfaite lisibilité après réduction photographique.
10.3 Exportation haute résolution pour les revues scientifiques
L’obtention d’une boîte à moustaches scientifiquement irréprochable et esthétiquement normée s’avère vaine si le processus d’exportation altère sa netteté optique. Les revues scientifiques imposent des seuils de résolution minimaux stricts pour les éléments graphiques : généralement 300 à 600 DPI (points par pouce) pour les demi-teintes et jusqu’à 1200 DPI pour les dessins au trait au format d’impression final.
Pour exporter une figure depuis le Viewer de SPSS sans dégradation matricielle, effectuez un clic droit sur le graphique édité, puis sélectionnez l’instruction Exporter… (Export…). Dans la boîte de dialogue d’exportation, il convient de modifier le menu déroulant Type d’objet pour choisir un format d’image vectorielle tel que l’EPS (Encapsulated PostScript) ou le PDF vectoriel. Les formats vectoriels offrent l’avantage déterminant d’une résolution théoriquement infinie : le tracé géométrique de la boîte, des moustaches et des symboles d’aberration ne subit aucune pixellisation, quelle que soit l’échelle d’agrandissement appliquée par l’éditeur de la revue.
Si la soumission exige un format matriciel (rasterisé), le format TIFF (.tif) non compressé ou avec compression LZW constitue le choix de référence. Dans les options avancées d’exportation TIFF, l’utilisateur veillera à configurer manuellement la résolution de sortie sur un minimum absolu de 300 DPI (voire 600 DPI pour les schémas en noir et blanc). Il importe également de veiller au verrouillage strict des proportions d’aspect (Lock aspect ratio) afin d’éviter que le rectangle de la boîte à moustaches ne soit accidentellement étiré ou comprimé sur l’un de ses axes lors de l’enregistrement numérique.
11. Diagnostics cliniques et psychologiques avancés à partir des boîtes à moustaches
11.1 Évaluation visuelle de l’homoscédasticité pour l’ANOVA
Au-delà de sa fonction de description descriptive, la boîte à moustaches se révèle être un instrument diagnostique de choix pour sonder les postulats sous-jacents aux modèles linéaires généraux. L’analyse de variance classique (ANOVA univariée ou factorielle) repose de manière critique sur l’hypothèse d’homogénéité des variances intra-groupes, couramment désignée sous le terme d’homoscédasticité. Une rupture substantielle de cette condition compromet la précision du ratio F de Fisher-Snedecor et gonfle de façon incontrôlée le taux d’erreur de première espèce (rejet indu de l’hypothèse nulle).
La juxtaposition de boîtes à moustaches pour chaque niveau du facteur expérimental fournit un diagnostic préliminaire direct de la validité de ce postulat. Étant donné que la hauteur physique du rectangle central matérialise l’écart interquartile (IQR), l’analyste peut comparer visuellement l’amplitude de dispersion des 50 % intermédiaires de chaque groupe. Si la boîte la plus haute présente une hauteur supérieure à 1,5 ou 2 fois celle de la boîte la plus courte, l’analyste se trouve face à un signal manifeste d’hétéroscédasticité.
Cette inspection visuelle doit être mise en perspective avec les résultats formels du test d’égalité des variances d’erreur de Levene. Néanmoins, le test de Levene est réputé pour sa sensibilité excessive dans les grands échantillons (où d’infimes écarts sans conséquence pratique deviennent statistiquement significatifs) et pour son manque de puissance dans les cohortes restreintes. L’observation de la hauteur des boîtes à moustaches fournit un contrepoids clinique pragmatique. En cas d’hétérogénéité structurelle constatée à la fois sur le graphique et sur les indices numériques, le chercheur devra immédiatement délaisser l’ANOVA paramétrique standard au profit de modèles robustes qui ne postulent pas l’égalité des variances, tels que l’ANOVA de Welch ou la correction de Brown-Forsythe.
11.2 Détection des effets de plancher (Floor) et de plafond (Ceiling)
L’administration d’instruments de mesure psychométriques ou de batteries d’évaluation neuropsychologique se heurte régulièrement à des phénomènes de troncature d’échelle, connus sous les vocables d’effets de plancher (floor effects) et de plafond (ceiling effects). Ces distorsions méthodologiques surviennent lorsqu’une épreuve présente un niveau de difficulté inadapté à l’échantillon investigué, conduisant une proportion disproportionnée d’individus à saturer la note minimale ou maximale possible.
La boîte à moustaches agit comme un révélateur graphique immédiat de ces pathologies de mesure :
- Diagnostic d’un effet de plancher : Le bord inférieur de la boîte (Q1) ainsi que la ligne médiane se retrouvent littéralement écrasés contre la ligne de base du zéro ou la limite théorique basse de l’instrument. La moustache inférieure disparaît entièrement, tandis que la moustache supérieure s’étire démesurément vers les valeurs élevées, ponctuée de valeurs aberrantes ascendantes. Cette morphologie indique qu’une fraction massive de participants ne peut être discriminée, l’outil s’avérant trop ardu ou le seuil de détection clinique inopérant.
- Diagnostic d’un effet de plafond : Le troisième quartile (Q3) et la ligne médiane se collent au sommet de l’axe métrique, neutralisant la moustache supérieure. La boîte apparaît tronquée à son faîte, avec une moustache descendante allongée. Ce profil signale que la tâche proposée s’avère trop facile pour la cohorte étudiée, masquant d’éventuelles différences interindividuelles subtiles parmi les sujets les plus performants.
La détection graphique de tels profils tronqués interdit formellement l’utilisation de statistiques linéaires ordinaires. Elle impose un recadrage méthodologique profond : recours à des modèles de régression censurée (modèles de type Tobit), recodage ordinal de la variable ou révision intégrale des outils d’évaluation psychométrique lors de protocoles futurs.
11.3 Visualisation de profils de sous-groupes diagnostiques
Dans la recherche nosographique et translationnelle, la boîte à moustaches éclaire l’hétérogénéité interne de catégories cliniques complexes. Une catégorie diagnostique consolidée (par exemple, le syndrome de stress post-traumatique ou le trouble déficit de l’attention avec hyperactivité) dissimule fréquemment des profils de réponse hétérogènes, articulés autour d’endophénotypes distincts qui se fondent silencieusement dans les statistiques d’agrégation globale.
L’inspection minutieuse d’une boîte comparative entre un groupe contrôle et un groupe clinique révèle souvent une asymétrie interne paradoxale. Une boîte anormalement allongée chez les patients, flanquée d’un écart interquartile trois fois plus vaste que celui des témoins et d’une médiane décalée par rapport au centre géométrique, trahit la coexistence de deux sous-groupes physiologiques réactifs distincts : une fraction de patients dits « répondeurs » dont la distribution s’apparente à la normale, et une fraction de patients dits « non répondeurs » formant un bloc secondaire distant.
Bien que la boîte à moustaches standard ne permette pas d’objectiver directement la bimodalité interne d’une distribution continue (car elle résume les données par des percentiles sans en tracer la densité continue point par point), elle fonctionne comme un puissant signal d’alarme. L’observation d’une boîte démesurément étirée sans valeurs aberrantes individualisées au-delà des moustaches doit immédiatement inciter le chercheur à coupler son exploration avec un estimateur de densité par noyau (Kernel Density Estimation) ou un graphique en violon (Violin Plot), afin de débusquer les éventuels sous-groupes latents dissimulés sous la boîte.
12. Résolution des problèmes courants et bonnes pratiques méthodologiques
12.1 Erreurs fréquentes lors de la génération sous SPSS
L’utilisation pratique du moteur de visualisation de SPSS confronte fréquemment l’utilisateur à des comportements graphiques déconcertants, qui résultent le plus souvent d’erreurs de paramétrage matriciel ou d’ambiguïtés de codage dans l’interface de commande. Savoir diagnostiquer ces blocages fait partie intégrante de l’expertise méthodologique de l’analyste.
L’anomalie la plus courante se manifeste par des moustaches totalement invisibles ou écrasées contre les charnières de la boîte, alors même que les données sous-jacentes semblent continues. Ce problème découle quasi systématiquement d’une mauvaise déclaration du niveau de mesure dans le dictionnaire des variables : si une variable continue quantitative a été étiquetée par inadvertance comme « Nominale », le Générateur de graphiques applique des algorithmes de regroupement catégoriels discrets, ce qui altère le calcul continu des clôtures de Tukey.
Une seconde défaillance récurrente réside dans la superposition illisible des étiquettes d’aberration lorsque plusieurs points extrêmes se concentrent sur des valeurs très proches dans le Viewer. L’activation de l’Éditeur de graphiques permet de résoudre ce désagrément : en sélectionnant les marqueurs d’aberration dans l’onglet des propriétés, l’utilisateur peut désactiver les libellés redondants, ajuster la taille typographique ou imposer un décalage horizontal dynamique des annotations textuelles pour prévenir le chevauchement des numéros d’observation.
Enfin, la présence de boîtes uniques déconnectées et morcelées dans des panneaux séparés au lieu d’une comparaison unifiée provient d’une erreur d’assignation dans le Générateur de graphiques. Si l’on glisse la variable de regroupement dans la zone des « Lignes » ou des « Colonnes » (qui créent des facettes multipanels disjointes) au lieu de l’assigner à l’Axe X ou au canal de « Regroupement par couleur », SPSS fractionne artificiellement la visualisation en autant de fenêtres indépendantes, brisant la perspective comparative d’ensemble.
12.2 Limites inhérentes aux boîtes à moustaches et solutions complémentaires
En dépit de leur supériorité méthodologique avérée sur les diagrammes en barres classiques, les boîtes à moustaches présentent des limitations intrinsèques que tout chercheur rigoureux doit garder à l’esprit lors de l’interprétation de ses résultats.
La limite majeure réside dans l’incapacité structurelle du boxplot à discriminer la multimodalité. Une distribution unimodale parfaitement normale, une distribution uniformément plate en plateau, et une distribution bimodalement scindée en deux bosses prononcées peuvent théoriquement produire exactement la même boîte à moustaches (mêmes quartiles Q1, Q2, Q3 et mêmes valeurs adjacentes). La boîte interquartile comble les espaces vides et lisse les creux de densité, masquant des configurations sous-jacentes d’intérêt clinique majeur.
Par ailleurs, la boîte à moustaches standard occulte totalement la taille effective de l’échantillon (N). Une boîte construite sur 15 patients présente la même apparence géométrique générale qu’une boîte calculée sur 15 000 sujets, alors que la stabilité stochastique des estimations de percentiles est radicalement dissemblable. Cette absence d’indication de l’effectif peut induire une impression trompeuse de précision sur de très petits échantillons.
Pour contourner ces écueils géométriques, l’approche méthodologique contemporaine préconise d’enrichir la boîte à moustaches de couches d’information complémentaires. Il est fortement recommandé d’adjoindre en surimpression le nuage des observations individuelles brutes légèrement dispersées latéralement de façon aléatoire (Jittered Data Points). Cette technique permet de visualiser simultanément la structure globale par percentiles (la boîte de Tukey) et la distribution réelle de chaque point de mesure, dévoilant sans ambiguïté les concentrations multimodales ou les zones de vacuité d’échantillonnage.
12.3 Check-list méthodologique pour le chercheur en sciences sociales
Avant d’intégrer une boîte à moustaches dans un manuscrit académique, une thèse d’université ou un rapport de diagnostic clinique, l’analyste veillera à valider rigoureusement la check-list méthodologique récapitulative suivante :
- Vérification du niveau de métadonnées : La variable cible est-elle rigoureusement configurée en mode « Échelle » (Scale) dans l’éditeur de variables de SPSS ?
- Déclaration des valeurs manquantes : Les codes d’omission (999, -99, etc.) sont-ils formellement déclarés comme manquants pour éviter de contaminer le calcul des percentiles ?
- Audit des étiquettes factorielles : Toutes les catégories de regroupement sur l’axe des abscisses sont-elles annotées au moyen de libellés sémantiques complets et explicites, éliminant tout code numérique brut ?
- Traçabilité des données d’aberration : Chaque observation isolée au-delà des moustaches (cercles et astérisques) a-t-elle été formellement identifiée par son numéro d’enregistrement et examinée dans le dossier brut avant toute décision de maintien ou d’éviction ?
- Justification scientifique des retraits : Si des valeurs aberrantes ont été retirées de l’analyse, cette suppression est-elle méthodologiquement étayée et consignée en toute transparence dans la section méthodologique du manuscrit ?
- Conformité typographique aux normes APA 7 : La figure est-elle totalement épurée de ses grilles d’arrière-plan, de ses titres internes automatiques et de ses colorations vives inutiles, au profit d’un contraste sobre et d’une typographie sans empattement calibrée ?
- Haute résolution vectorielle : L’exportation finale a-t-elle été effectuée dans un format vectoriel (PDF, EPS) ou dans une résolution matricielle minimale de 300 à 600 DPI au format TIFF ?
En observant systématiquement ces prérequis méthodologiques et techniques, le chercheur en psychologie et en sciences du comportement confère à ses analyses exploratoires une robustesse, une reproductibilité et une élégance visuelle répondant aux plus hauts standards de la communication scientifique contemporaine.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (2000). Understanding robust and exploratory data analysis. John Wiley & Sons.
IBM Corporation. (2021). IBM SPSS Statistics 28 Brief Guide. IBM Corporation. https://www.ibm.com/docs/en/spss-statistics
McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12-16. https://doi.org/10.1080/00031305.1978.10479236
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wickham, H., & Stryjewski, L. (2011). 40 years of boxplots (Technical Report). Had.co.nz. http://vita.had.co.nz/papers/boxplots.pdf
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0