
L’analyse exploratoire des données quantitatives constitue le socle épistémologique sur lequel repose l’ensemble de l’inférence statistique contemporaine. Dans les disciplines empiriques telles que la psychologie cognitive, la neuropsychologie et les sciences du comportement, la simple réduction des observations à des métriques ponctuelles de tendance centrale et de dispersion — telles que la moyenne arithmétique et l’écart-type — s’avère fréquemment insuffisante, voire trompeuse. La morphologie sous-jacente des distributions, la présence d’asymétries subtiles, l’émergence de profils bimodaux ou encore l’empattement inhabituel des queues de distribution recèlent des informations théoriques capitales sur la nature des processus cognitifs ou cliniques sous-jacents. Dès lors, la visualisation graphique directe et non paramétrique de la densité empirique s’impose comme une démarche analytique fondamentale avant toute modélisation probabiliste formelle.
Parmi les représentations visuelles disponibles dans l’environnement statistique The R Project for Statistical Computing, l’histogramme demeure l’outil d’investigation le plus classique et le plus puissant pour sonder la distribution d’une variable continue. Toutefois, lorsque l’investigation méthodologique exige la confrontation directe de deux cohortes d’individus, de deux conditions expérimentales contrastées ou de deux vagues d’évaluation temporelle, la représentation isolée et séquentielle de chaque sous-groupe entrave la détection des disparités subtiles. La juxtaposition côte à côte force l’œil à effectuer des saccades perceptives complexes, diluant la précision des jugements comparatifs sur les zones de recouvrement et d’incongruence.
La fusion géométrique de deux distributions continues au sein d’un repère cartésien unique, par le truchement d’un histogramme bivarié superposé, offre une réponse visuelle optimale à ce défi analytique. Cette approche permet de cartographier instantanément la distance entre les centres de gravité, l’hétérogénéité des dispersions et la compacité des intersections distributionnelles. Néanmoins, l’obtention d’un rendu graphique rigoureux, lisible et conforme aux standards de diffusion académique exige la maîtrise d’un ensemble de paramètres techniques stricts : gestion fine de la transparence chromatique, synchronisation absolue des coupures d’intervalles, calcul prédictif des limites d’axes et contrôle de la densité. Ce guide exhaustif expose les fondements théoriques, les mécanismes algorithmiques et les implémentations computationnelles nécessaires à la création d’histogrammes comparatifs de haute volée sous R.
1. Introduction à la visualisation bivariée des distributions continues dans R
1.1 Pertinence épistémologique de la comparaison distributionnelle en psychométrie
Dans l’arsenal méthodologique de la psychométrie et de la biométrie, l’évaluation de construits latents — qu’il s’agisse de l’intelligence fluide, de la sévérité d’un épisode dépressif ou de la latence de traitement sensoriel — aboutit invariablement à la production de scores numériques continus ou pseudo-continus. L’habitude historique consistant à synthétiser ces mesures par le binôme moyenne-variance relève d’une simplification issue d’une vision strictement gaussienne du monde. Or, les données empiriques réelles violent régulièrement cette idéalisation. L’analyse exclusive des moyennes occulte systématiquement des phénomènes structurants : un même indice moyen peut masquer deux distributions radicalement dissemblables, l’une unimodale symétrique et l’autre scindée en deux sous-populations cliniques distinctes.
L’observation simultanée de deux distributions au moyen d’outils visuels calibrés offre une perspective heuristique irremplaçable. Elle permet aux chercheurs d’évaluer visuellement les écarts de symétrie, l’intensité de la variabilité interindividuelle et le degré d’adhésion aux postulats mathématiques prérequis aux tests d’hypothèses inférentiels classiques, comme le test t de Student ou l’analyse de variance univariée (ANOVA). Cette inspection préliminaire préserve l’analyste des pièges inhérents aux tests de significativité aveugles, qui demeurent vulnérables aux distorsions morphologiques.
En outre, la localisation géographique immédiate des valeurs extrêmes ou atypiques (les outliers) et l’estimation de l’aire de chevauchement empirique procurent une intuition directe de la taille d’effet écologique de l’intervention étudiée. L’étendue de cette zone d’intersection informe directement sur la discriminabilité pratique des deux cohortes : une faible intersection reflète une dissociation claire des profils phénotypiques ou comportementaux. R s’est imposé mondialement comme l’écosystème de prédilection pour ce type d’exploration, grâce à son architecture logicielle orientée vers la recherche reproductible et la manipulation matricielle haute fidélité.
1.2 Principes fondamentaux de l’histogramme bivarié superposé
Le concept d’histogramme superposé repose sur l’ancrage spatial de deux séries de données distinctes le long d’un axe horizontal commun (l’axe des abscisses), partageant une échelle de mesure rigoureusement unifiée. Les fréquences d’occurrence — ou, plus rigoureusement, les densités de probabilité associées — sont alors projetées verticalement sur l’axe des ordonnées sous la forme de barres contiguës. La difficulté première de ce paradigme réside dans le problème de l’occlusion visuelle : si l’on superpose deux corps opaques sur un même espace géométrique bidimensionnel, la couche supérieure masque inévitablement la couche inférieure, oblitérant l’information quantitative sous-jacente.
Pour contourner cet obstacle perceptif sans recourir à un étalement tridimensionnel — souvent néfaste pour l’exactitude de la lecture métrique —, la superposition transparente émerge comme la solution sémiologique la plus élégante. Le principe consiste à combiner deux encres virtuelles translucides qui, lorsqu’elles se rencontrent dans une zone commune d’occupation spatiale, synthétisent une troisième teinte hybride par mélange chromatique optique. Le lecteur perçoit ainsi sans effort cognitif la zone propre au premier groupe, la zone propre au second groupe, et la surface mitoyenne où les deux distributions coexistent.
Il est impératif d’opérer une distinction méthodologique rigoureuse selon la nature du plan expérimental sous-jacent. La comparaison visuelle peut impliquer deux groupes d’individus totalement indépendants (par exemple, un groupe témoin confronté à un groupe expérimental) ou deux mesures quantitatives répétées sur les mêmes sujets (mesures appariées pré- et post-traitement). Dans ce dernier cas, l’histogramme bivarié renseigne sur l’évolution globale de la distribution de la cohorte, mais fait abstraction des trajectoires individuelles intra-sujets, ce qui suppose une prudence interprétative adéquate quant à la dynamique temporelle du changement.
1.3 Cadre technique : le moteur graphique de base de R versus les extensions
L’environnement R propose historiquement deux grands paradigmes pour la synthèse graphique des données quantitatives : le système graphique de base (souvent désigné sous l’appellation base R graphics) structuré autour du package interne graphics, et le paradigme déclaratif moderne incarné par la bibliothèque ggplot2, issue de l’écosystème du tidyverse. Le moteur graphique de base de R, conçu dès les origines par Ross Ihaka et Robert Gentleman, repose sur un modèle d’affichage séquentiel calqué sur la métaphore de la toile de peintre (painter’s canvas model).
Dans ce modèle procédural élémentaire, chaque commande graphique projette des éléments visuels (axes, étiquettes, barres, polygones) sur un support d’affichage récepteur. L’argument graphique add = TRUE constitue la clef de voûte technique permettant de suspendre la réinitialisation automatique du canevas et d’autoriser l’application de couches supplémentaires directement sur l’image en cours de composition. Cette approche offre une transparence opérationnelle totale, une rapidité de rendu computationnel inégalée pour de très grands volumes de données et une absence absolue de dépendances logicielles externes, garantissant une pérennité d’exécution sur le très long terme.
Le présent protocole méthodologique se concentre en profondeur sur l’exploitation experte de ce moteur natif de R. En maîtrisant les mécanismes fondamentaux de bas niveau de la fonction hist(), l’analyste acquiert une compréhension intime des primitives graphiques, des systèmes de coordonnées locales et du contrôle matriciel des couleurs, compétences qui s’avèrent transférables et complémentaires à la maîtrise ultérieure de syntaxes déclaratives plus abstraites. L’objectif consiste à transformer un appel procédural basique en une figure vectorielle de qualité éditoriale, publiable directement dans les revues internationales les plus exigeantes.
2. Fondements mathématiques et statistiques de l’histogramme comparatif
2.1 Discrétisation des variables et sélection des intervalles de classe (bins)
D’un point de vue mathématique formel, un histogramme n’est pas une simple juxtaposition de diagrammes en bâtons, mais une méthode non paramétrique d’estimation de la fonction de densité de probabilité $f(x)$ d’une variable aléatoire continue $X$. Soit un échantillon d’observations indépendantes et identiquement distribuées $x_1, x_2, dots, x_n$ défini sur un support réel borné $[a, b]$. La construction de l’histogramme requiert une partition rigoureuse de cet intervalle en $k$ sous-intervalles disjoints et contigus, désignés sous le terme d’intervalles de classe ou bins, délimités par une séquence ordonnée de coupures ${t_0, t_1, dots, t_k}$ où $t_0 = a$ et $t_k = b$.
La largeur d’un intervalle de classe élémentaire $j$ est formulée par $h_j = t_j – t_{j-1}$. Lorsque les intervalles possèdent tous la même largeur uniforme $h$, le choix de ce paramètre scalaire unique $h$ conditionne l’arbitrage fondamental entre le biais statistique et la variance de l’estimation. Si $h$ est excessivement grand, l’histogramme souffre d’un phénomène de sur-lissage (oversmoothing), effaçant les singularités morphologiques cruciales de la population d’origine. Inversement, une valeur de $h$ démesurément faible induit un sous-lissage (undersmoothing), saturant la représentation visuelle de variations stochastiques purement aléatoires propres à l’échantillon prélevé.
Trois formulations algorithmiques majeures régissent historiquement le calcul automatique de $k$ et de $h$ dans les logiciels de calcul numérique :
- La règle de Sturges : Formule classique basée sur l’approximation binomiale de la loi normale, formulée par $k = 1 + \lceil \log_2(n) \rceil$. Bien qu’elle constitue l’option par défaut historique dans R, elle sous-estime drastiquement le nombre de classes optimal lorsque $n > 200$ ou lorsque les distributions dévient sensiblement de la normalité.
- La règle de Scott : Optimisée pour minimiser l’erreur quadratique moyenne intégrée (MISE) sous l’hypothèse gaussienne, définissant la largeur idéale par $h = 3.49 \cdot \hat{\sigma} \cdot n^{-1/3}$, où $\hat{\sigma}$ représente l’écart-type d’échantillon.
- La règle de Freedman-Diaconis : Nettement plus robuste aux asymétries et à la présence de valeurs extrêmes, cette formulation substitue l’écart-type par l’écart interquartile (IQR) selon l’équation $h = 2 \cdot \text{IQR}(X) \cdot n^{-1/3}$.
Dans le cadre d’un histogramme comparant deux séries distinctes, une contrainte méthodologique absolue s’impose : les deux variables doivent impérativement partager le même vecteur de coupures ${t_j}$. L’application indépendante d’algorithmes de discrétisation automatisés sur chaque groupe aboutit quasi systématiquement à des largeurs de classe divergentes et à des décalages d’intervalles, induisant des artefacts de perception cognitive qui annihilent la validité de la comparaison distributionnelle.
2.2 Mesures de fréquence : effectifs absolus versus densités de probabilité
L’utilisation brute des effectifs observés (les fréquences absolues $n_j$) sur l’axe des ordonnées constitue une erreur analytique récurrente lorsqu’on compare deux échantillons de tailles inégales ($N_1 \neq N_2$). Dans une telle configuration, le groupe bénéficiant de l’échantillon le plus pléthorique dominera visuellement l’espace cartésien par des hauteurs de barres disproportionnées, masquant potentiellement le fait que la probabilité relative d’observer une plage de scores donnée est rigoureusement identique dans les deux cohortes.
Pour rétablir une équité géométrique et probabiliste irréprochable, l’analyste doit procéder à une normalisation surfacique en convertissant les fréquences absolues en densités de probabilité. L’estimateur de densité associé à la $j$-ième classe est défini rigoureusement par la relation mathématique :
$$\hat{f}(x) = \frac{n_j}{N \cdot h_j} \quad \text{pour tout } x in [t_{j-1}, t_j[$$
où $n_j$ représente l’effectif de la classe, $N$ la taille globale de l’échantillon considéré, et $h_j$ la largeur du sous-intervalle. Cette formulation confère à l’histogramme normalisé une propriété fondamentale : l’aire totale couverte par l’ensemble des rectangles sous la courbe polygonale est strictement égale à l’unité ($\int \hat{f}(x) dx = 1$).
Dès lors que cette normalisation est effective pour les deux séries de données, l’aire géométrique définie par l’intersection visuelle des deux histogrammes prend une signification probabiliste directe. Elle correspond à l’intégrale du minimum des deux fonctions de densité empiriques, quantifiant mathématiquement le coefficient de recouvrement (overlapping coefficient, OVL). Cette grandeur non paramétrique reflète directement la proportion d’individus des deux populations partageant des scores indistinguables, offrant un complément quantitatif d’une valeur inestimable aux indicateurs statistiques standards.
2.3 Sensibilité aux caractéristiques morphologiques des distributions
L’histogramme bivarié agit comme un révélateur des quatre premiers moments statistiques d’une distribution, permettant une appréciation conjointe et immédiate des singularités structurelles de chaque groupe d’étude :
- Le moment d’ordre 1 (Tendance centrale) : Le décalage spatial des sommets ou des centres de masse le long de l’axe des abscisses traduit visuellement l’écart entre les moyennes empiriques ($\bar{X}_1$ et $\bar{X}_2$) ou les médianes respectives.
- Le moment d’ordre 2 (Dispersion) : L’étalement horizontal comparatif des bases des histogrammes renseigne directement sur l’hétéroscédasticité des données. Un groupe présentant une variance accrue se manifestera par une base élargie et une hauteur de crête amoindrie, conformément au principe de conservation de la masse unitaire en mode densité.
- Le moment d’ordre 3 (Asymétrie ou Skewness) : L’allongement différentiel d’une traînée latérale vers la droite (asymétrie positive) ou vers la gauche (asymétrie négative) permet de déceler la présence de planchers ou de plafonds de mesure, fréquents dans les inventaires psychopathologiques.
- Le moment d’ordre 4 (Aplatissement ou Kurtosis) : La comparaison visuelle de la concentration centrale des observations autour du mode (leptocurticité) par rapport à des profils plus aplatis aux queues épaisses (platycurticité) apporte des éclairages cruciaux sur la susceptibilité des groupes à produire des scores extrêmes imprévus.
Au-delà de ces moments classiques, la morphologie globale met en lumière des configurations impossibles à résumer par de simples paramètres numériques, notamment la multimodalité. La découverte d’une distribution bimodale dans une cohorte clinique censée être homogène signale immanquablement l’existence de sous-groupes nosographiques latents, motivant une stratification ultérieure de l’échantillon ou l’application de modèles de mélanges gaussiens (mixture models).
3. Préparation de l’environnement R et simulation de jeux de données
3.1 Configuration de la session de travail et reproductibilité scientifique
La production d’analyses scientifiques rigoureuses exige un contrôle méticuleux de l’environnement computationnel d’exécution afin de satisfaire aux impératifs internationaux de reproductibilité méthodologique. Dans le langage R, chaque session de travail hérite d’un état interne propre, incluant l’historique des paramètres graphiques configurés et l’état d’initialisation du générateur congruentiel de nombres pseudo-aléatoires.
Avant de procéder à la génération des données et à la composition visuelle, il convient de réinitialiser l’état global du système. L’effacement des variables résidentes en mémoire via l’instruction rm(list = ls()) assure qu’aucune contamination croisée ne résulte de calculs antérieurs. De même, la commande graphics.off() permet de fermer tous les périphériques graphiques précédemment ouverts, restaurant les marges et les agencements matriciels d’origine définis par la fonction par().
Pour permettre à tout chercheur d’obtenir au bit près les mêmes visualisations, le générateur de nombres pseudo-aléatoires doit être ancré de manière déterministe via la fonction set.seed(), en utilisant un nombre entier arbitraire comme graine de réplication (par exemple, set.seed(2024)). Il est également recommandé de consigner formellement les métadonnées de la session analytique en appelant sessionInfo() dans les scripts sources, documentant ainsi la version exacte de R et l’architecture du système d’exploitation hôte.
3.2 Génération de distributions gaussiennes contrastées via rnorm()
Afin d’illustrer la syntaxe d’implémentation sur un cas d’école parfaitement contrôlé, nous procédons à la modélisation mathématique de deux cohortes d’observations issues de deux processus stochastiques gaussiens indépendants. La fonction native rnorm() de R offre un générateur d’échantillons aléatoires optimisé, utilisant par défaut l’algorithme d’inversion de Box-Muller ou la méthode de Ziggurat selon la configuration du compilateur.
Nous définissons un effectif d’échantillonnage représentatif fixé à $N = 1000$ observations par condition expérimentale, procurant une stabilité asymptotique suffisante pour limiter le bruit d’échantillonnage lors de l’estimation de densité. La première série de données, représentative d’une condition de référence ou de contrôle, est paramétrée selon une loi normale standardisée centrée sur $\mu_1 = 0.60$ avec un écart-type restreint $\sigma_1 = 0.10$. La seconde série, incarnant une condition clinique ou expérimentale, est générée à partir d’une loi normale centrée sur $\mu_2 = 0.40$, partageant le même écart-type $\sigma_2 = 0.10$.
Dans un script d’analyse formel, l’exécution s’articule comme suit :
- Définition de la taille d’échantillon :
n_obs <- 1000 - Génération du vecteur contrôle :
groupe_controle <- rnorm(n = n_obs, mean = 0.60, sd = 0.10) - Génération du vecteur expérimental :
groupe_exp <- rnorm(n = n_obs, mean = 0.40, sd = 0.10)
Une validation descriptive systématique s’effectue ensuite par le biais des fonctions summary() et sd() appliquées sur chaque objet. Cette inspection garantit que les moyennes empiriques convergent étroitement vers les espérances théoriques programmées (respectivement $0.60$ et $0.40$) et que les étendues de variation restent conformes aux attentes statistiques (les données s’inscrivant théoriquement à $\pm 3\sigma$, soit approximativement entre $0.10$ et $0.90$).
3.3 Contextualisation psychologique des variables simulées
L’ancrage des exercices computationnels dans des cadres d’application concrets est indispensable pour guider les décisions de mise en forme graphique ultérieures. Les deux variables synthétisées peuvent modéliser fidèlement des indices psychométriques standardisés ou des marqueurs chronométriques issus de protocoles de neuropsychologie cognitive. Par exemple, ces valeurs peuvent être interprétées comme des temps de réaction moyens lors d’une tâche de discrimination visuo-spatiale chronométrée, normalisés sur une échelle proportionnelle comprise entre zéro et une seconde.
Alternativement, ces vecteurs peuvent symboliser l’évolution de scores de détresse psychologique évalués à l’aide d’une échelle clinique validée (telle que l’inventaire d’anxiété de Beck ou l’échelle DASS-21), rééchelonnée linéairement dans l’intervalle $[0 ; 1]$. Dans ce paradigme évaluatif, la variable groupe_controle (centrée sur $0.60$) traduirait le niveau d’anxiété basal mesuré avant l’initiation d’un programme de psychothérapie cognitive basée sur la pleine conscience, tandis que la variable groupe_exp (centrée sur $0.40$) refléterait l’abaissement significatif de cette charge affective à la suite de l’intervention clinique.
L’analogie clinique fournit des repères essentiels pour déterminer l’emplacement judicieux des légendes explicatives, la nature des libellés d’axes et la pertinence de l’alignement des intervalles de discrétisation. Elle rappelle également à l’analyste que la zone de superposition géométrique entre les deux histogrammes quantifie le taux d’individus dont le niveau de détresse post-thérapeutique demeure statistiquement indissociable du profil prétraitement, révélant la proportion de non-répondeurs thérapeutiques.
4. La syntaxe élémentaire avec la fonction hist() et l’argument add
4.1 Génération du premier histogramme de référence
Le moteur graphique natif de R initialise un nouveau repère orthogonal chaque fois qu’une fonction de traçage de haut niveau est invoquée sans spécification contraire. La fonction fondamentale hist() fait partie de ces primitives graphiques majeures. Lorsqu’elle reçoit un vecteur de valeurs numériques en premier argument, elle effectue simultanément deux opérations distinctes : le calcul en mémoire de la distribution statistique (partition des valeurs, comptage des effectifs par classe) et la projection optique des rectangles sur le périphérique graphique courant.
Dans sa forme la plus rudimentaire, l’affichage de la cohorte expérimentale s’amorce par l’instruction :
hist(groupe_exp, col = "red")
À cet instant, le système cartésien évalue l’étendue des données du vecteur groupe_exp et calcule automatiquement les bornes minimales et maximales des axes des abscisses et des ordonnées. Des marges de réserve périphériques standards (généralement fixées à 4 % au-delà des extrêmes de la partition) sont injectées par le moteur de rendu. Les graduations numériques, les encoches de repère (ticks), le titre général et les étiquettes par défaut sont instantanément figés au sein de la mémoire tampon de la fenêtre graphique.
Ce premier tracé définit de manière immuable l’échelle métrique absolue du graphique. Dès que cette toile est imprimée, toute commande ultérieure venant s’y greffer sera contrainte par les frontières spatiales établies lors de cette passe inaugurale. Il est donc crucial de noter que si la seconde distribution possède une emprise spatiale plus vaste ou des pics d’effectifs plus prononcés, elle se heurtera aux bornes préétablies par ce premier histogramme.
4.2 Superposition de la seconde variable par le paramètre add=TRUE
Pour briser le comportement par défaut de R consistant à effacer automatiquement le canevas existant avant d’afficher un nouveau graphique de haut niveau, les concepteurs du système graphics ont pourvu la fonction hist() d’un paramètre booléen fondamental : l’argument add. Lorsque ce commutateur logique est explicitement assigné à la valeur TRUE (sa valeur nominale étant FALSE), la fonction suspend toute routine d’initialisation matricielle et projette les barres de fréquence directement par-dessus le tracé préexistant.
L’implémentation naïve de cette superposition s’écrit de la manière suivante :
hist(groupe_controle, col = "blue", add = TRUE)
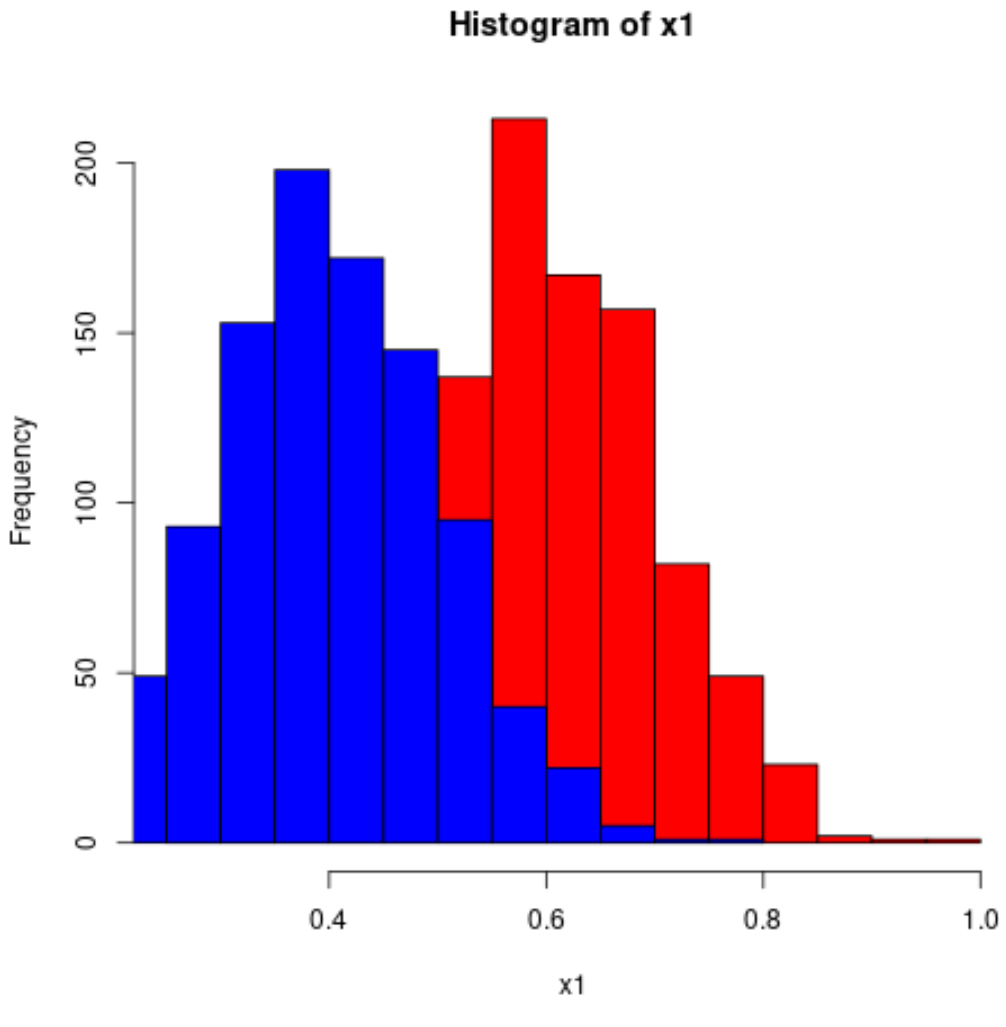
Le moteur calcule alors les classes du second vecteur (groupe_controle) et dessine les rectangles correspondants avec une couleur de remplissage bleue opaque. L’ordre d’exécution séquentielle régit l’empilement physique des pixels à l’écran : les éléments invoqués en second viennent peindre et recouvrir les couches géométriques créées en premier plan. Le résultat immédiat est l’oblitération pure et simple de l’information sous-jacente partout où les barres bleues s’élèvent au-dessus ou devant les barres rouges tracées lors de l’étape précédente.
4.3 Diagnostic des limitations de l’approche élémentaire
L’analyse critique du rendu visuel obtenu par cet enchaînement rudimentaire met en exergue trois défaillances méthodologiques rédhibitoires qui disqualifient immédiatement cette figure pour un usage scientifique professionnel :
- L’occlusion optique totale : L’utilisation d’identifiants de couleurs opaques (comme les constantes textuelles
"red"et"blue") empêche toute lecture des surfaces masquées. Les parties de l’histogramme rouge dissimulées derrière l’histogramme bleu deviennent strictement invisibles, annulant la possibilité d’apprécier la forme réelle de la première distribution dans la zone de chevauchement. - La troncature d’axes asymétrique : Les limites d’axes horizontales (
xlim) et verticales (ylim) ayant été calibrées exclusivement sur la base des données du vecteurgroupe_exp, toute valeur du vecteurgroupe_controlequi déborderait vers la droite ou qui s’élèverait à une altitude supérieure à la crête maximale du premier groupe est impitoyablement amputée du rendu visuel, sans qu’aucun message d’erreur explicite ne soit notifié dans la console R. - L’incohérence des coupures d’intervalles (bins) : R ayant exécuté l’algorithme de discrétisation de Sturges de manière indépendante sur chaque cohorte, les points de démarcation des colonnes ne sont pas alignés. Des barres de largeurs ou de phases décalées s’entrecroisent de manière chaotique, créant des illusions d’optique parasites.
Ces imperfections démontrent sans équivoque que la simple juxtaposition séquentielle via add = TRUE ne saurait constituer une solution méthodologique pérenne sans l’adjonction de paramètres de contrôle avancés.
5. Maîtrise de la transparence optique par la fonction rgb()
5.1 Fondements chromatiques de l’espace RVB et canal de transparence alpha
Pour résoudre le défi de l’occlusion spatiale, la physique de la couleur assistée par ordinateur propose le recours à la composition alpha (alpha blending). Dans l’espace colorimétrique Rouge-Vert-Bleu (RVB), une couleur perçue sur un affichage numérique est classiquement définie par un triplet vectoriel $[R, V, B]$ représentant les intensités respectives des composantes spectrales primaires.
Le canal alpha, formalisé à l’origine par les chercheurs Edwin Catmull et Alvy Ray Smith au début des années 1970, introduit une quatrième dimension scalaire normalisée $\alpha in [0, 1]$, quantifiant le coefficient d’opacité de la surface peinte. Une valeur $\alpha = 1$ désigne un matériau parfaitement opaque qui réfléchit ou absorbe toute radiation sans rien laisser filtrer de la couche inférieure, tandis qu’une valeur $\alpha = 0$ confère à la matière une translucidité intégrale, la rendant optiquement imperceptible.
Dans l’environnement R, les chaînes de caractères nommées classiques (à l’instar de "red", "darkgreen" ou "lightblue") renvoient vers une palette préétablie dépourvue de flexibilité sur le paramètre alpha. La primitive native rgb() contourne cette limitation structurelle en autorisant la manipulation programmatique directe des quatre canaux. Sa signature mathématique s’énonce selon :
rgb(red, green, blue, alpha, maxColorValue = 1)
où les quatre premiers arguments scalaires acceptent des valeurs numériques continues échelonnées de $0$ à $1$ (lorsque le diviseur maximal est calé sur l’unité).
5.2 Implémentation d’une translucidité équilibrée (alpha = 0.2 à 0.5)
Le paramétrage du degré de translucidité ne relève pas d’une simple fantaisie esthétique, mais procède d’un calibrage psychophysique rigoureux. Si le canal alpha est configuré à un niveau excessivement faible (par exemple $\alpha < 0.10$), les barres de fréquence deviennent quasi spectrales, se fondant dans la couleur de fond du canevas et rendant difficile la discrimination de la silhouette globale de l’histogramme. Inversement, un coefficient alpha trop élevé ($\alpha > 0.60$) réintroduit l’écueil de l’occlusion partielle, saturant les canaux récepteurs de l’observateur.
Dans la pratique académique, la plage optimale de lisibilité s’établit entre $\alpha = 0.20$ et $\alpha = 0.50$, avec un point d’équilibre particulièrement fonctionnel calé à $0.30$. Ce niveau assure une transmission lumineuse de 70 % à travers chaque couche graphique, autorisant une vision sans distorsion des plans arrière-plans.
Nous procédons ainsi à l’instanciation de deux variables chromatiques expertes au sein de l’environnement R :
- Couleur expérimentale translucide (teinte rouge chaude) :
coul_exp <- rgb(red = 1, green = 0, blue = 0, alpha = 0.3) - Couleur contrôle translucide (teinte bleue froide) :
coul_ctrl <- rgb(red = 0, green = 0, blue = 1, alpha = 0.3)
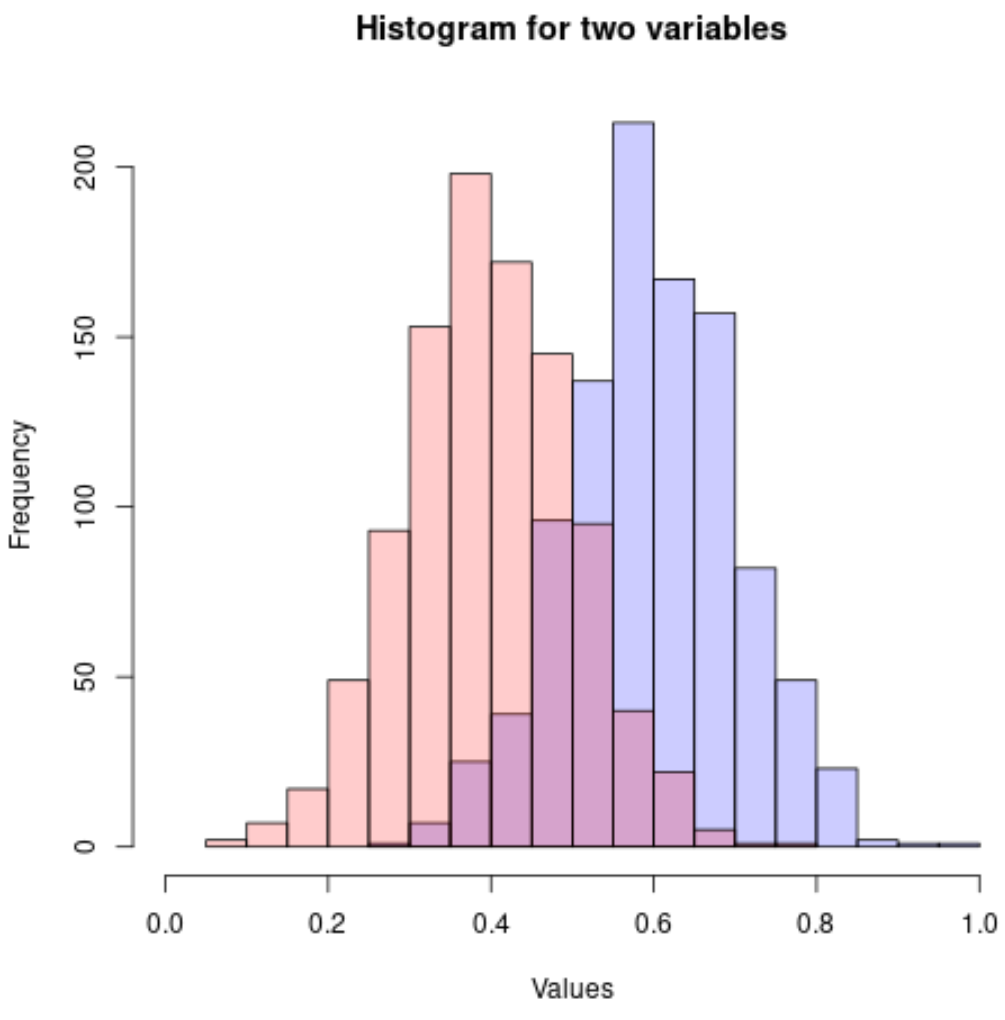
L’injection directe de ces descripteurs vectoriels au sein de l’argument col des appels successifs de la fonction hist() transforme radicalement le comportement de rendu du moteur graphique : les barres tracées en second plan ne détruisent plus les pixels du premier plan, mais s’agrègent avec eux par fusion optique soustractive.
5.3 Analyse chromatique de la zone d’intersection géométrique
L’interaction physique de deux couches transparentes obéit à la loi classique de l’interpolation linéaire de composition alpha (opération over). Lorsqu’une barre bleue translucide ($\alpha_2 = 0.3$) recouvre une barre rouge translucide ($\alpha_1 = 0.3$) posée sur un arrière-plan blanc neutre, le moteur de tramage graphique de R calcule une couleur synthétique résultante au prorata des coefficients de transmission de chaque couche.
Sur le plan perceptif, ce métissage spectral donne naissance à une troisième couleur distincte : une nuance pourpre ou violacée hautement identifiable. L’émergence optique de cette teinte pourpre délimite instantanément pour le lecteur la surface exacte de cohabitation géométrique des deux distributions. L’observateur visualise ainsi simultanément trois entités territoriales distinctes :
- La zone rouge unilatérale : portion de l’espace empirique occupée exclusivement par la cohorte expérimentale (faibles scores de latence ou d’anxiété) ;
- La zone bleue unilatérale : domaine morphologique sous l’apanage strict de la cohorte témoin (scores élevés) ;
- La zone violette centrale : espace d’intersection probabiliste partagé, traduisant le recouvrement direct des observations empiriques des deux populations.
Sur le plan de l’inclusivité scientifique et de l’ergonomie visuelle, le choix d’un couple rouge-bleu requiert une attention particulière. Pour les évaluateurs ou lecteurs atteints de dyschromatopsies congénitales (particulièrement de deutéranopie ou de protanopie, affectant jusqu’à 8 % de la population masculine), le contraste rouge-vert doit être impérativement proscrit. Le binôme chromatique rouge/bleu ou vermillon/bleu de cobalt garantit une excellente préservation de l’accessibilité visuelle, car le canal bleu est préservé chez l’immense majorité des sujets daltoniens.
6. Harmonisation rigoureuse des échelles géométriques (xlim et ylim)
6.1 Le piège de la troncature des limites d’axes lors du second tracé
Le moteur graphique sous-jacent de base R fonctionne selon un principe de rigidité spatiale après l’exécution de la première commande de haut niveau. Dès que le premier histogramme a achevé sa routine d’affichage, le système verrouille définitivement la matrice de transformation affinitaire qui convertit les coordonnées du monde utilisateur (les unités réelles des scores continus et des fréquences) en coordonnées d’affichage physiques du périphérique (les pixels ou points typographiques).
Si la seconde variable injectée via l’argument add = TRUE possède des caractéristiques de distribution plus larges — par exemple des valeurs s’étirant jusqu’à $0.95$ alors que la première variable plafonnait à $0.70$ —, les barres correspondantes sont purement et simplement amputées par le cadre graphique. Le système ne redimensionne jamais rétroactivement l’axe horizontal. De même, si le mode du second échantillon culmine à un effectif de $250$ individus par classe alors que le premier appel avait configuré un plafond vertical $y_{\max}$ à $180$, les barres supérieures du second groupe seront décapitées à la frontière physique supérieure du graphique.
Cette mutilation géométrique, souvent discrète si l’on ne scrute pas avec rigueur les données matricielles brutes, conduit l’analyste à des conclusions empiriques erronées en faussant son appréciation de la variance et de la kurtosis du second groupe. Il est donc méthodologiquement impératif de pré-calculer explicitement les dimensions maximales nécessaires pour englober la totalité des deux jeux de données avant d’émettre le moindre appel graphique.
6.2 Calcul dynamique et paramétrage explicite de l’argument xlim
Pour assurer une intégration horizontale sans faille, le chercheur doit calculer de façon algorithmique les bornes extrêmes absolues réunissant les deux cohortes. Le langage R propose la fonction native range(), laquelle extrait le minimum et le maximum stricts au sein d’un vecteur ou d’une concaténation de structures.
Le calcul s’orchestre dynamiquement selon l’instruction suivante :
limites_x <- range(c(groupe_exp, groupe_controle))
Cette commande fusionne virtuellement les deux séries en un ensemble unifié de $2000$ points et en isole les deux extrêmes. Dans un contexte psychométrique où les métriques s’ancrent sur des échelles fixes et théoriquement bornées par construction — comme un score standardisé calibré sur $[0 ; 1]$ —, il est encore plus rigoureux de neutraliser la dépendance aux aléas d’échantillonnage en fixant explicitement les limites aux frontières du construit théorique :
limites_x <- c(0, 1)
Le vecteur à deux éléments résultant doit ensuite être systématiquement passé en paramètre à l’argument xlim lors de l’appel du premier histogramme :
hist(groupe_exp, xlim = limites_x, ...)
En inscrivant cette contrainte dimensionnelle dès l’amorce du tracé, l’espace horizontal initialisé sera dimensionné pour accueillir sans troncature l’intégralité de la seconde distribution, garantissant l’intégrité de la géométrie comparative.
6.3 Normalisation verticale et paramétrage explicite de l’argument ylim
La neutralisation du risque de décapitation verticale des barres de fréquence relève d’une logique algorithmique similaire, mais requiert une étape intermédiaire de simulation computationnelle. Étant donné que les hauteurs de crêtes dépendent directement du découpage en classes qui sera appliqué, il est impossible de déduire le maximum de l’axe des ordonnées par une simple analyse des extrema des données brutes.
La stratégie optimale consiste à exploiter une fonctionnalité méconnue mais extrêmement puissante de la fonction hist() : l’argument plot = FALSE. Cet argument ordonne à la routine de calcul d’exécuter l’intégralité de la discrétisation et de la comptabilisation des fréquences sans projeter le moindre élément sur l’écran, en retournant une structure d’objet complexe de classe formelle histogram.
Le protocole algorithmique s’articule comme suit :
- Calcul hors-écran du premier profil :
h1 <- hist(groupe_exp, breaks = coupures_communes, plot = FALSE) - Calcul hors-écran du second profil :
h2 <- hist(groupe_controle, breaks = coupures_communes, plot = FALSE) - Extraction conjointe du pic d’effectif ou de densité maximal :
max_y <- max(c(h1$counts, h2$counts))(oumax(c(h1$density, h2$density))si le tracé utilise les densités) - Calcul d’une marge de sécurité verticale (majoration de 15 à 20 % pour dégager l’espace nécessaire à l’implantation ultérieure de la boîte de légende) :
limites_y <- c(0, max_y * 1.20)
En assignant formellement ce vecteur limites_y à l’argument ylim du premier histogramme tracé, la totalité de la hauteur cartésienne est verrouillée à une altitude suffisante pour prévenir tout écrêtage du second histogramme superposé.
6.4 Synchronisation des largeurs de classes par le paramètre breaks
Le dernier écueil géométrique majeur — et le plus insidieux sur le plan statistique — concerne la discordance des coupures de discrétisation. Si l’on omet de spécifier manuellement les bornes de classes, R appliquera indépendamment l’algorithme de partition sur chaque groupe, ce qui générera fatalement des classes d’étendues ou de décalages asynchrones.
Pour éliminer toute aberration visuelle, l’analyste doit construire une grille de découpage unique et partagée, qui s’étend sur la totalité du domaine couvert par les deux distributions. Cette grille est synthétisée à l’aide de la fonction génératrice de séquences régulières seq() :
coupures_communes <- seq(from = limites_x[1], to = limites_x[2], by = 0.025)
Cette commande engendre un vecteur ordonné d’intervalles constants de largeur $h = 0.025$ couvrant uniformément le continuum d’évaluation de $0$ à $1$. Ce vecteur unifié doit ensuite être injecté impérativement dans l’argument breaks de l’ensemble des appels graphiques successifs :
hist(groupe_exp, breaks = coupures_communes, ...)hist(groupe_controle, breaks = coupures_communes, add = TRUE, ...)
Cette synchronisation algorithmique assure que chaque colonne de la distribution expérimentale s’aligne au millimètre près sur la colonne correspondante de la distribution de contrôle. Les rectangles fusionnent alors selon une géométrie cartésienne irréprochable, supprimant tout déphasage visuel artificiel et autorisant une lecture directe des variations morphologiques.
7. Typographie académique, titrage et étiquetage standardisé
7.1 Rédaction scientifique des étiquettes d’axes (xlab et ylab)
Dans la communication scientifique de haut niveau, le formalisme et la rigueur typographique des étiquettes périphériques constituent le reflet direct de la précision méthodologique globale de l’étude. Par défaut, le moteur graphique de R génère des libellés mécaniques automatisés qui reprennent textuellement les noms des objets informatiques passés en argument (par exemple groupe_exp pour l’abscisse et Frequency pour l’ordonnée). Ces dénominations brutes doivent impérativement être proscrites lors de la préparation d’un manuscrit scientifique.
L’axe des abscisses (argument xlab) doit expliciter la nature sémantique exacte du construit mesuré, en mentionnant systématiquement entre parenthèses ou entre crochets l’unité physique ou psychométrique retenue :
xlab = "Score de latence sensorielle standardisé (en secondes)"
Concernant l’axe des ordonnées (argument ylab), une précision formelle absolue est requise quant à la métrique représentée. S’il s’agit d’un comptage discret, le terme « Fréquence absolue » ou « Effectif observé » s’impose. Si l’histogramme a fait l’objet d’une normalisation unitaire (via freq = FALSE), le terme « Densité de probabilité empirique » doit être substitué sans équivoque, afin de prévenir tout contresens interprétatif de la part des relecteurs.
La lisibilité textuelle peut être modulée à l’aide des paramètres de contrôle micro-typographique natifs de R :
cex.lab = 1.15: majore de 15 % la taille des étiquettes d’axes par rapport à l’échelle nominale ;font.lab = 2: impose une typographie en caractères gras pour maximiser le contraste visuel ;cex.axis = 0.95: calibre discrètement l’échelle de corps des graduations chiffrées des axes.
7.2 Structuration du titre principal et du sous-titre méthodologique
La politique éditoriale des revues affiliées à l’American Psychological Association (APA) ou à l’IEEE impose des conventions précises quant à l’agencement des titres de figures. Selon les normes internationales en vigueur (style APA 7ème édition), les figures destinées à la publication formelle ne doivent généralement pas arborer un bandeau de titre massif centré à l’intérieur du cadre graphique. Le contenu informationnel est traditionnellement déporté à l’extérieur de la planche, au sein d’une légende textuelle sous-jacente formalisée (numérotée sous la forme Figure 1. Titre de la figure…).
Toutefois, dans le cadre de communications orales lors de congrès scientifiques, de supports de séminaires ou de rapports techniques d’étape, la présence d’un titre principal intégré (argument main) et d’un sous-titre contextuel (argument sub) est recommandée pour permettre une auto-suffisance documentaire du graphique. La formulation du titre principal doit condenser la nature synthétique de la comparaison sans verbosité inutile :
main = "Comparaison distributionnelle des latences attentionnelles"
L’argument sub peut être astucieusement exploité pour documenter les caractéristiques d’échantillonnage de bas niveau sans alourdir le corps du texte principal :
sub = "Taille d'échantillon totale N = 2000 (n_1 = 1000, n_2 = 1000) ; pas d'échantillonnage h = 0.025"
Il est également possible d’ajuster l’alignement typographique horizontal du titre via le paramètre adj : une valeur adj = 0 ancre élégamment le texte à l’extrémité gauche du cadre cartésien, conformément aux tendances esthétiques de la visualisation de données moderne.
7.3 Esthétique générale des axes et des marges graphiques
L’apparence globale du graphique peut être raffinée pour satisfaire aux canons contemporains du design d’information statistique. Par défaut, le moteur graphique de base de R imprime les valeurs numériques des graduations de l’axe vertical parallèlement à la ligne de l’axe, contraignant le lecteur à incliner la tête à 90 degrés pour déchiffrer les chiffres de l’axe des ordonnées. L’activation du paramètre graphique universel las = 1 (inclus au sein de la fonction globale par() ou passé directement dans hist()) aligne horizontalement l’ensemble des graduations numériques numériques des deux axes, abolissant cette gymnastique posturale.
De plus, l’encadrement rectangulaire standard (l’enclos périphérique noir complet) enferme visuellement les distributions de manière souvent superflue. L’application de l’argument bty = "l" (pour box type: L-shape) épure le canevas en ne conservant que l’axe des abscisses et l’axe des ordonnées, matérialisant un angle droit parfait qui allège considérablement la charge cognitive du tracé.
Enfin, le calibrage géométrique des marges périphériques de la fenêtre de rendu s’ajuste rigoureusement en amont au moyen de la commande par(mar = c(5, 5, 4, 2) + 0.1). Ce vecteur à quatre dimensions alloue un espace suffisant pour les étiquettes en bas (marge 1) et à gauche (marge 2), tout en resserrant les espacements superflus en haut (marge 3) et à droite (marge 4), optimisant ainsi la surface utile dédiée à la projection des rectangles empiriques.
8. Conception et positionnement de la légende explicative
8.1 Syntaxe fondamentale de la fonction legend()
La projection simultanée de multiples séries continues sur un même canevas perd l’intégralité de sa valeur pédagogique et méthodologique en l’absence d’un ancrage sémantique univoque. La fonction native legend() constitue l’outil dédié au déploiement de boîtes explicatives vectorielles au sein de l’environnement graphique de base de R. Contrairement aux systèmes déclaratifs automatisés, la programmation procédurale de legend() exige une instanciation explicite après la finalisation des couches distributionnelles.
Le positionnement spatial de la légende peut s’effectuer au moyen de coordonnées cartésiennes absolues $(x, y)$ ou, de manière beaucoup plus résiliente et adaptative, par l’intermédiaire de mots-clés d’ancrage topologique préconfigurés tels que "topright" (coin supérieur droit), "topleft" (coin supérieur gauche) ou "top" (centre supérieur). Pour notre exemple comparatif où la distribution expérimentale se concentre à gauche et la distribution de contrôle à droite, l’ancrage supérieur central ou supérieur gauche s’impose pour éviter toute interférence physique avec les sommets des rectangles.
L’appel fondamental s’articule comme suit :
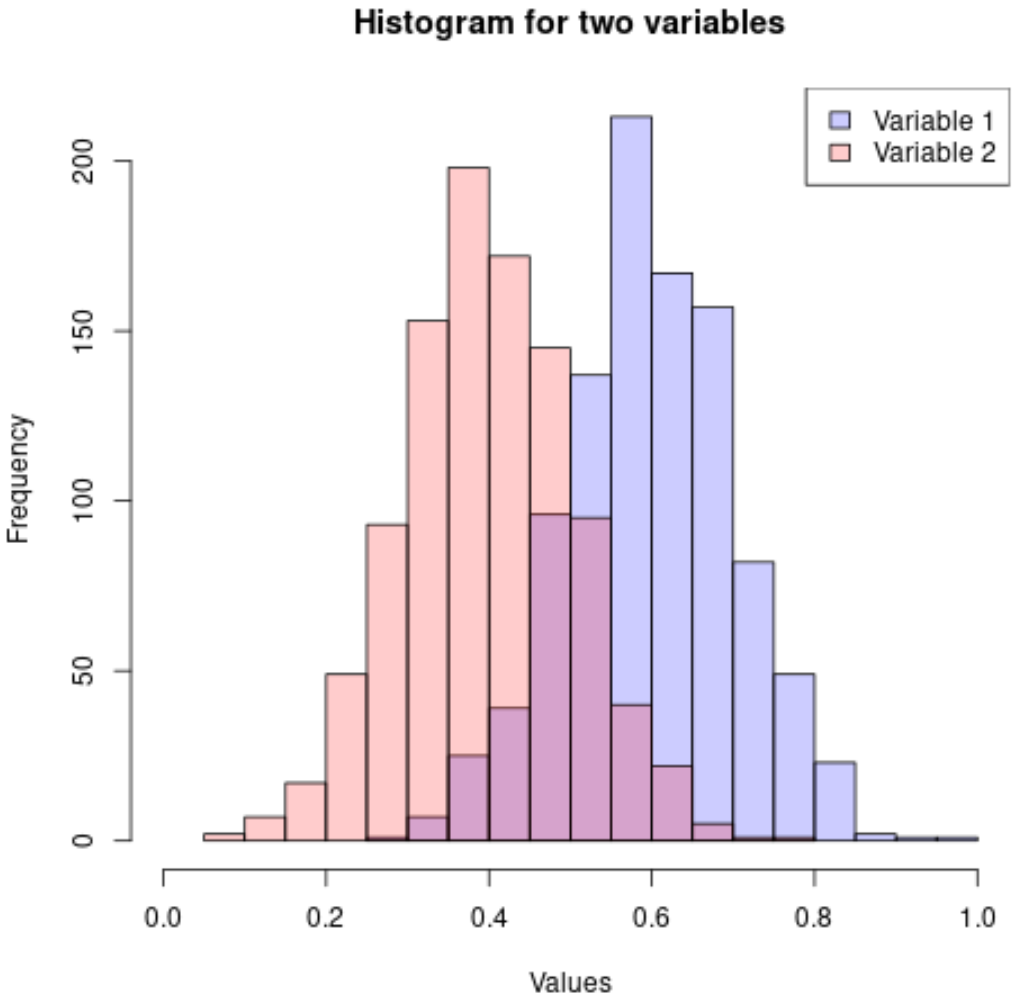
legend("topright", legend = c("Condition Expérimentale", "Condition Contrôle"), fill = c(coul_exp, coul_ctrl), bty = "o", cex = 0.9)
Le paramètre vectoriel legend associe textuellement chaque label à son identité clinique ou expérimentale formelle. L’argument crucial fill reçoit le vecteur des couleurs de remplissage. Une vigilance technique absolue s’impose ici : il est indispensable de passer à fill les descripteurs intégrant exactement la même formulation de transparence calculée via rgb() que celle utilisée dans les appels hist(). L’utilisation par mégarde de teintes opaques dans la boîte de légende induirait une discordance chromatique flagrante entre la légende et les barres tracées à l’écran.
8.2 Représentation de la zone de recouvrement au sein de la légende
Bien que la codification bipartite classique (rouge versus bleu) suffise pour des lecteurs familiers de l’analyse visuelle, la rigueur sémiotique incite à expliciter formellement la signification de la troisième teinte hybride résultant de la synthèse soustractive dans la zone de chevauchement. De nombreux évaluateurs scientifiques non formés à la lecture des histogrammes à canaux alpha peuvent s’interroger sur l’identité de cette composante violacée.
Une solution élégante consiste à intégrer une troisième entrée explicative au sein de la légende. Le défi réside alors dans la détermination computationnelle de la nuance résultante exacte. Sous un arrière-plan blanc standard ($\text{RGB} = [1, 1, 1]$), la combinaison séquentielle de deux couches translucides d’opacité $\alpha_1 = 0.3$ et $\alpha_2 = 0.3$ peut être modélisée mathématiquement pour calculer la réflectance spectrale finale.
Dans un script d’affichage avancé, cette nuance mixte peut être simulée par superposition ou approchée par un vecteur chromatique intermédiaire dédié :
coul_inter <- rgb(red = 0.5, green = 0, blue = 0.5, alpha = 0.5)
La signature de la légende s’élargit alors de la façon suivante :
- Étiquettes :
legend = c("Condition Expérimentale", "Condition Contrôle", "Zone de chevauchement") - Couleurs de remplissage :
fill = c(coul_exp, coul_ctrl, coul_inter)
Cette exhaustivité graphique élimine toute ambiguïté sémiologique et renforce la clarté pédagogique du document soumis à l’évaluation par les pairs.
8.3 Optimisation géométrique et prévention des chevauchements d’éléments
L’un des écueils majeurs lors de l’intégration d’une boîte de légende concerne le masquage physique accidentel des données empiriques. Si la boîte de légende est disproportionnée ou positionnée de manière imprévoyante, ses contours opaques peuvent recouvrir les crêtes supérieures de l’histogramme, anéantissant précisément l’effort de transparence déployé sur les barres de fréquence.
Pour prévenir cette nuisance spatiale, plusieurs paramètres de réglage fin doivent être méticuleusement articulés :
- Le facteur d’échelle textuelle (
cex) : L’assignation d’une valeur comprise entrecex = 0.80etcex = 0.90réduit proportionnellement la taille de la boîte et des caractères sans nuire à l’intelligibilité de la typographie. - La neutralisation du cadre de bordure (
bty) : L’instructionbty = "n"supprime totalement le rectangle d’encadrement périphérique et le fond opaque de la boîte de légende. Les étiquettes et les carrés colorés flottent alors harmonieusement dans l’espace vierge du canevas, ce qui allège considérablement la composition graphique. - L’ajustement préventif de l’axe vertical (
ylim) : Comme exposé à la section 6.3, l’incorporation d’une réserve altimétrique de 20 % au sommet de l’axe $y$ est la technique la plus pérenne pour libérer un sanctuaire géométrique stérile au sein duquel la boîte de légende peut s’épanouir sans jamais heurter la moindre barre distributionnelle.
9. Histogrammes en densité de probabilité et intégration de courbes de lissage
9.1 Bascule vers les fréquences relatives via l’argument freq=FALSE
Lorsque le dispositif expérimental compare deux cohortes caractérisées par des volumétries d’échantillonnage divergentes — cas omniprésent en psychopathologie comparée où le groupe clinique est structurellement plus restreint que le groupe témoin —, la projection des effectifs absolus fausse la comparaison optique. La bascule vers une mesure de fréquence relative continue devient une nécessité mathématique absolue.
Au sein de la fonction hist(), ce basculement est orchestré par l’activation du paramètre logique freq = FALSE (ou son équivalent formel prob = TRUE). Sous ce mode opératoire, le moteur de calcul révise la formule d’affectation verticale : au lieu d’imprimer la valeur brute de comptage $n_j$, il divise cette grandeur par l’effectif total $N$ du groupe et par la largeur d’intervalle $h_j$.
La conséquence mathématique immédiate est l’ajustement de l’axe des ordonnées sur une échelle de densité de probabilité continue. Il est impératif de souligner auprès des analystes que les valeurs inscrites le long de l’axe vertical peuvent dès lors dépasser la valeur $1.0$ sans violer les axiomes de Kolmogorov de la théorie des probabilités. La densité n’est pas une probabilité ponctuelle, mais un taux de probabilité par unité d’abscisse ; seule l’aire sous-jacente — résultant de la multiplication de la hauteur par la largeur de classe — est bornée par l’unité.
Lors de cette bascule en mode densité, le recalcul des limites verticales via la fonction hist(..., plot = FALSE) doit impérativement extraire le vecteur d’attributs $density et non plus $counts, sous peine de dimensionner l’axe des ordonnées sur des échelles numériques totalement inadaptées.
9.2 Calcul et superposition des courbes d’estimation de densité par noyau (KDE)
L’estimation non paramétrique par la méthode des histogrammes présente intrinsèquement une discontinuité géométrique en gradins, tributaire du positionnement des coupures d’intervalles. Pour compléter cette modélisation discrète par une courbe continue lissée, la technique de l’estimation de densité par noyau (Kernel Density Estimation, KDE) constitue le standard international de référence.
L’estimateur continu de Parzen-Rosenblatt est formalisé par :
$$\hat{f}_h(x) = \frac{1}{n h} \sum_{i=1}^{n} K\left(\frac{x – x_i}{h}\right)$$
où $K(\cdot)$ est une fonction de pondération symétrique unitaire (le noyau gaussien dans l’immense majorité des applications) et $h$ représente la largeur de bande (bandwidth), qui régule la souplesse du lissage.
Dans l’environnement R, le calcul de cette trajectoire s’exécute nativement via la primitive density(), et sa projection par-dessus l’histogramme de densité existant s’effectue au moyen de la fonction de bas niveau lines() :
- Calcul du profil de densité expérimental :
dens_exp <- density(groupe_exp, bw = "SJ") - Calcul du profil de densité témoin :
dens_ctrl <- density(groupe_controle, bw = "SJ") - Superposition de la première ligne continue :
lines(dens_exp, col = "darkred", lwd = 2.5, lty = 1) - Superposition de la seconde ligne continue :
lines(dens_ctrl, col = "darkblue", lwd = 2.5, lty = 2)
L’option bw = "SJ" ordonne l’application de l’algorithme de sélection de largeur de bande de Sheather et Jones, très supérieur à la règle empirique de Silverman en présence de structures distributionnelles complexes. La différenciation stylistique — associant un trait plein épais (lty = 1, lwd = 2.5) à la courbe expérimentale et un trait discontinu (lty = 2, lwd = 2.5) à la courbe de contrôle — garantit une discrimination visuelle parfaite, même en cas de reproduction ultérieure du manuscrit en niveaux de gris monochromes.
9.3 Représentation des estimateurs paramétriques théoriques
Une démarche méthodologique complémentaire particulièrement instructive consiste à confronter la distribution empirique observée non pas seulement à son lissage empirique par noyau, mais au modèle mathématique théorique postulé a priori (par exemple, la loi normale de Laplace-Gauss). Cette confrontation visuelle fait office d’outil diagnostique pour évaluer la conformité des résidus avant d’appliquer des modèles linéaires généraux ou des régressions paramétriques.
La génération de cette trajectoire théorique mobilise la fonction dnorm(), alimentée rigoureusement par les paramètres empiriques de moyenne et d’écart-type estimés sur l’échantillon :
- Échantillonnage horizontal d’un continuum très dense :
axe_abscisses <- seq(min(limites_x), max(limites_x), length.out = 500) - Calcul des ordonnées théoriques normales de la condition expérimentale :
y_theorique_exp <- dnorm(axe_abscisses, mean = mean(groupe_exp), sd = sd(groupe_exp)) - Projection de la courbe théorique sur le canevas :
lines(axe_abscisses, y_theorique_exp, col = "black", lwd = 1.5, lty = 3)
L’interaction conjointe de ces trois strates graphiques complémentaires — les barres translucides de l’histogramme discret, la ligne ondulée de l’estimateur par noyau non paramétrique et la cloche symétrique du modèle théorique gaussien — procure une profondeur diagnostique inégalée. L’analyste discerne d’un simple coup d’œil les zones d’asymétrie locale où les observations empiriques divergent de la trajectoire mathématique formelle.
10. Approche alternative contemporaine : Réalisation d’histogrammes bivariés avec ggplot2
10.1 Structuration préalable des données au format long (Tidy Data)
Tandis que le système graphique de base de R traite avec aisance des vecteurs indépendants isolés résidant en mémoire (format matriciel large ou structures désolidarisées), le paradigme contemporain incarné par ggplot2 repose sur les principes formels de la grammaire des graphiques de Leland Wilkinson et l’architecture des données ordonnées (tidy data) théorisée par Hadley Wickham.
Dans ce modèle conceptuel, un ensemble de données ne doit pas être représenté par de multiples vecteurs dispersés, mais par une table rectangulaire unitaire (un data.frame ou un tibble) satisfaisant à trois axiomes fondamentaux :
- Chaque variable correspond à une colonne unique ;
- Chaque observation élémentaire correspond à une ligne unique ;
- Chaque type d’unité observationnelle forme une table distincte.
Dès lors, pour tracer un histogramme bivarié sous ggplot2, la première étape méthodologique implique la restructuration des deux vecteurs groupe_exp et groupe_controle en un unique tableau à structure longue. Cette transformation s’implémente au moyen des fonctions de manipulation de données modernes de R :
donnees_longues <- data.frame(

  Score = c(groupe_exp, groupe_controle),

  Condition = factor(rep(c("Expérimentale", "Contrôle"), each = n_obs))

)
La colonne Score concentre ainsi l’ensemble des $2000$ valeurs métriques continues, tandis que la colonne factorielle Condition agit comme une étiquette catégorielle définissant l’appartenance de chaque ligne à son sous-groupe expérimental respectif.
10.2 Construction de la géométrie geom_histogram() sous ggplot2
Une fois cette architecture tabulaire consolidée, l’élaboration de l’histogramme superposé s’exprime selon une syntaxe déclarative fluide. Contrairement à la logique procédurale pas-à-pas de base R, ggplot2 associe abstraitement des variables de données à des propriétés visuelles (les correspondances esthétiques ou aesthetic mappings), puis empile des couches géométriques de manière déclarative.
Le script d’implémentation standard prend la forme suivante :
library(ggplot2)

ggplot(donnees_longues, aes(x = Score, fill = Condition)) +

  geom_histogram(aes(y = after_stat(density)),

                 position = "identity",

                 alpha = 0.35,

                 binwidth = 0.025,

                 color = "white") +

  scale_fill_manual(values = c("Expérimentale" = "red", "Contrôle" = "blue")) +

  labs(title = "Comparaison distributionnelle des latences attentionnelles",

       x = "Score de latence standardisé (sec)",

       y = "Densité de probabilité empirique") +

  theme_classic()
Dans ce bloc d’instructions, le commutateur géométrique position = "identity" joue un rôle déterminant : par défaut, geom_histogram() empile verticalement les barres des différentes catégories (position = "stack"), ce qui altère la lecture de la distribution du second groupe dont la base ne repose plus sur l’axe zéro. L’instruction position = "identity" force l’ancrage direct de toutes les classes sur le plancher cartésien horizontal, autorisant la superposition transparente. La fonction after_stat(density) assure la normalisation automatique unitaire, tandis que theme_classic() purge le canevas de tout quadrillage superflu pour se conformer au style sobre de l’APA.
10.3 Comparaison critique entre la méthode base R et la grammaire ggplot2
L’arbitrage entre l’emploi du moteur natif graphics et la bibliothèque ggplot2 soulève des considérations techniques et pragmatiques dont l’analyste doit avoir pleinement conscience :
- Gestion de la légende et des dimensions :
ggplot2excelle par son automatisation intégrale. Les échellesxlimetylimsont ajustées de manière algorithmique globale sans risque d’amputation, et la boîte de légende est générée sans intervention manuelle de calcul spatial. Dansbase R, chaque coordonnée et chaque marge doivent être définies explicitement par le chercheur. - Dépendances logicielles et reproductibilité à long terme :
base Rne requiert aucun package externe, garantissant une stabilité de compilation séculaire et une immunité totale face aux ruptures d’API. À l’inverse, l’usage deggplot2introduit un arbre complexe de dépendances (commerlang,tibble,vctrs) qui peuvent évoluer au fil des versions. - Vélocité et charge computationnelle : Pour la manipulation d’échantillons massifs (de l’ordre de plusieurs dizaines de millions d’observations), le tracé séquentiel de
base Roffre des performances d’exécution nettement supérieures et une consommation de mémoire vive résidente réduite, s’affranchissant du surcoût de restructuration au format long. - Contrôle chirurgical des primitives graphiques :
base Rautorise l’injection directe d’instructions géométriques de bas niveau (polygones, textes ancrés, flèches directrices) n’importe où sur la matrice d’affichage sans avoir à contourner le cadre rigide d’une grammaire déclarative.
En synthèse, la maîtrise conjointe des deux approches dote l’analyste d’une polyvalence complète : ggplot2 pour la vitesse de prototypage dans les flux d’analyses tidy standards, et base R pour la pérennité algorithmique, la production de scripts autonomes légers et le contrôle absolu de chaque pixel projeté.
11. Pièges analytiques fréquents et stratégies de débogage
11.1 Incohérence de l’ordre d’affichage et suppression visuelle accidentelle
La composition graphique sous base R étant tributaire de l’ordre séquentiel d’exécution des lignes de code, une interversion dans la chronologie des appels peut dégrader substantiellement le rendu visuel. Si la distribution dont la dispersion est la plus restreinte et le pic d’altitude le plus vertigineux est tracée en second plan avec une opacité mal dosée, elle peut noyer les barres plus étalées du premier groupe.
Une stratégie éprouvée consiste à tracer systématiquement en premier plan la distribution qui possède la variance la plus ample (la base la plus étalée) ou les effectifs les plus dispersés, permettant au second groupe plus concentré de venir s’inscrire au cœur de l’arène graphique. Par ailleurs, il arrive fréquemment qu’à la suite d’appels multiples de hist(..., add = TRUE), la netteté des axes cartésiens et des graduations soit partiellement dégradée par le dessin des rectangles adjacents.
Pour restaurer une netteté géométrique absolue, il est hautement recommandé d’exécuter la fonction box() en clôture de routine graphique :
box(bty = "l", lwd = 1.2)
Cette instruction simple rafraîchit la matrice vectorielle des axes orthogonalement positionnés au premier plan, redessinant des lignes d’axes parfaitement affûtées par-dessus les éventuels débordements de barres de fréquence.
11.2 Mauvaise gestion des valeurs manquantes (NA) et anomalies de troncature
Dans les jeux de données observationnelles réels, la présence de valeurs non attribuées (marquées sous l’identifiant NA pour Not Available) représente une source fréquente de dysfonctionnements silencieux. Par défaut, la primitive hist() évacue automatiquement les valeurs NA lors de la phase de discrétisation, mais signale parfois un avertissement selon la typologie des arguments fournis.
L’impact des valeurs manquantes devient particulièrement pernicieux lors des phases de pré-calcul géométrique automatisé. Si l’on applique la fonction range(c(x1, x2)) sur des vecteurs hébergeant ne serait-ce qu’une seule valeur manquante, la fonction retournera inéluctablement le vecteur c(NA, NA). L’injection subséquente de cet objet au sein de l’argument xlim provoquera le crash immédiat de la routine graphique avec le message d’erreur explicite : need finite ‘xlim’ values.
Pour immuniser les scripts d’analyse contre ce biais structurel, l’analyste doit formellement assainir les vecteurs préalablement au tracé :
- Éradication rigoureuse des valeurs manquantes :
v1_propre <- na.omit(groupe_exp)v2_propre <- na.omit(groupe_controle) - Alternativement, sécurisation de l’extraction des limites par le commutateur universel :
limites_x <- range(c(groupe_exp, groupe_controle), na.rm = TRUE)
Ce protocole défensif assure que les calculs d’intervalles et d’échelles reposent exclusivement sur des réels finis et valides.
11.3 Interprétation fallacieuse induite par un mauvais choix de classes
Le piège statistique le plus redoutable réside dans la manipulation involontaire de la morphologie perçue via un mauvais calibrage du paramètre de largeur de classe (bin width). Un découpage excessivement granulaire découpe artificiellement une distribution continue sous la forme d’une succession chaotique de pics isolés entrecoupés de vides d’effectifs nuls, simulant une instabilité stochastique ou une multimodalité fictive qui n’a aucune réalité dans la population parente.
Inversement, le sur-lissage causé par un nombre d’intervalles excessivement faible (par exemple 4 ou 5 classes sur l’ensemble du domaine) compresse l’information quantitative de manière outrancière. Ce phénomène peut occulter totalement un écart significatif de variance entre les deux cohortes ou masquer une asymétrie clinique essentielle, conférant artificiellement une silhouette gaussienne banale à une distribution profondément asymétrique.
Pour garantir la robustesse scientifique de la visualisation, l’analyste doit appliquer un protocole de validation croisée :
- Calculer la largeur de classe selon la formulation rigoureuse de Freedman-Diaconis appliquée conjointement aux deux cohortes : $h = 2 \cdot \overline{\text{IQR}} \cdot N_{\text{total}}^{-1/3}$ ;
- Générer visuellement trois variantes de test (l’une avec le pas théorique $h$, l’une avec un pas $0.5 \cdot h$, et l’une avec un pas $1.5 \cdot h$) ;
- S’assurer que les inférences visuelles tirées sur le chevauchement, l’asymétrie et les écarts de tendance centrale demeurent parfaitement stables d’une variante à l’autre.
12. Protocoles d’exportation haute fidélité pour publication académique
12.1 Sauvegarde matricielle et vectorielle de haute précision
La composition d’un graphique irréprochable au sein de la fenêtre de visualisation interactive de RStudio ou de la console R ne préjuge en rien de sa qualité de restitution finale sur une page imprimée ou un document électronique structuré. L’analyste doit impérativement maîtriser les mécanismes de redirection vers les périphériques graphiques autonomes du système.
Deux familles technologiques de formats d’exportation se disputent les exigences éditoriales :
- Les formats vectoriels purs (PDF, SVG) : À privilégier systématiquement pour les publications académiques. Ces formats n’enregistrent pas une grille figée de pixels, mais codent géométriquement chaque ligne, rectangle, caractère typographique et valeur de transparence sous forme d’équations vectorielles mathématiques. Le rendu conserve une netteté infinie, indépendamment du niveau de zoom appliqué par le lecteur. L’exportation s’orchestre via la primitive native
pdf():
pdf("Figure1_Comparaison_Histogrammes.pdf", width = 8, height = 6, pointsize = 11)
… exécution des commandes d’affichage hist(), lines(), legend() …
dev.off() - Les formats matriciels rasterisés haute résolution (TIFF, PNG) : Fréquemment réclamés par les comités éditoriaux de revues biomédicales pour l’impression finale sur presse. Dans ce cas, une résolution spatiale minimale de 300 à 600 DPI (Dots Per Inch) est formellement exigée pour éradiquer tout phénomène d’aliasing ou de pixellisation des bordures. L’implémentation requiert le paramétrage rigoureux de la fonction
png()outiff():
png("Figure1_Haute_Resolution.png", width = 18, height = 13, units = "cm", res = 300)
… exécution des commandes d’affichage …
dev.off()
Il est impératif de souligner l’obligation structurelle de clôturer l’enregistrement par l’appel formel dev.off(). Cette instruction force le système d’exploitation à vider les mémoires tampons d’écriture, à écrire les tables vectorielles de fin de fichier et à libérer le descripteur de fichier verrouillé sur le disque dur.
12.2 Conformité avec les normes éditoriales de psychologie (style APA 7)
L’adaptation d’une figure aux directives du manuel de publication de l’APA (7ème édition) impose un ensemble d’arbitrages stylistiques exigeants visant à maximiser la sobriété cognitive du support graphique :
- Sobriété des polices typographiques : L’APA préconise expressément l’emploi exclusif de polices de caractères sans empattement (sans-serif) telles qu’Arial, Helvetica ou Calibri, pour leur lisibilité optimale sur écran et papier. Dans R, ces familles peuvent être invoquées globalement via le paramètre
family = "sans"au sein depar(). - Traitement des contrastes monochromes : Bien que la diffusion numérique autorise la polychromie complète, une proportion significative de lecteurs continue d’imprimer les articles sur des dispositifs d’impression laser monochromes. L’analyste averti vérifie la résilience de son histogramme superposé une fois converti en niveaux de gris. Si nécessaire, les surfaces unicolores translucides peuvent être enrichies par des motifs de hachures géométriques différentiels grâce à l’argument natif
densityetanglede la fonctionhist()(par exemple, des hachures orientées à 45 degrés pour le groupe 1 et à 135 degrés pour le groupe 2). - Désengorgement de la planche graphique : Les notes techniques décrivant la significativité statistique ($p$-values, indices de d de Cohen, intervalles de confiance à 95 %) doivent être évacuées du cœur du canevas pour être consignées méthodiquement au sein de la légende textuelle extérieure normalisée qui accompagne la planche dans le manuscrit définitif.
12.3 Encapsulation du code dans une fonction R réutilisable et pérenne
L’aboutissement de toute démarche de programmation statistique scientifique réside dans l’abstraction et l’encapsulation algorithmique. Plutôt que de recopier manuellement des dizaines de lignes de code procédural à chaque nouveau projet, il est particulièrement vertueux de consigner cette machinerie méthodologique au sein d’une fonction R générique, hautement paramétrable et réutilisable au sein de pipelines de traitement ouverts.
Voici l’architecture formelle d’une fonction dédiée, synthétisant l’ensemble des préceptes techniques développés tout au long de ce protocole :
plot_dual_histogram <- function(var1, var2,

                                nom_var1 = "Groupe 1", nom_var2 = "Groupe 2",

                                coul1_rgb = c(1, 0, 0), coul2_rgb = c(0, 0, 1),

                                alpha_val = 0.35, largeur_classe = NULL,

                                mode_densite = TRUE, lab_x = "Score standardisé",

                                titre_general = "", tracer_noyau = TRUE) {
# 1. Assainissement des vecteurs
v1 <- na.omit(as.numeric(var1))
v2 <- na.omit(as.numeric(var2))
# 2. Harmonisation des bornes horizontales
lim_x <- range(c(v1, v2))
etendue <- lim_x[2] - lim_x[1]
lim_x[1] <- lim_x[1] - (etendue * 0.05)
lim_x[2] <- lim_x[2] + (etendue * 0.05)
# 3. Synchronisation algorithmique des coupures
if (is.null(largeur_classe)) {
h_fd <- 2 * mean(c(IQR(v1), IQR(v2))) * (length(v1) + length(v2))^(-1/3)
largeur_classe <- ifelse(h_fd > 0, h_fd, etendue / 30)
}
coupures <- seq(lim_x[1], lim_x[2] + largeur_classe, by = largeur_classe)
# 4. Pré-calcul des fréquences pour dimensionnement vertical
h1 <- hist(v1, breaks = coupures, plot = FALSE)
h2 <- hist(v2, breaks = coupures, plot = FALSE)
if (mode_densite) {
y_max_base <- max(c(h1$density, h2$density))
if (tracer_noyau) {
d1 <- density(v1, bw = "SJ")
d2 <- density(v2, bw = "SJ")
y_max_base <- max(c(y_max_base, d1$y, d2$y))
}
lab_y <- "Densité de probabilité"
} else {
y_max_base <- max(c(h1$counts, h2$counts))
lab_y <- "Fréquence absolue"
}
lim_y <- c(0, y_max_base * 1.25)
# 5. Instanciation des couleurs translucides
c1 <- rgb(coul1_rgb[1], coul1_rgb[2], coul1_rgb[3], alpha = alpha_val)
c2 <- rgb(coul2_rgb[1], coul2_rgb[2], coul2_rgb[3], alpha = alpha_val)
c1_bord <- rgb(coul1_rgb[1], coul1_rgb[2], coul1_rgb[3], alpha = min(1, alpha_val + 0.3))
c2_bord <- rgb(coul2_rgb[1], coul2_rgb[2], coul2_rgb[3], alpha = min(1, alpha_val + 0.3))
# 6. Exécution graphique séquentielle
hist(v1, breaks = coupures, freq = !mode_densite, col = c1, border = c1_bord,
xlim = lim_x, ylim = lim_y, xlab = lab_x, ylab = lab_y,
main = titre_general, las = 1, bty = "l", cex.lab = 1.1, cex.axis = 0.95)
hist(v2, breaks = coupures, freq = !mode_densite, col = c2, border = c2_bord,
add = TRUE)
# 7. Tracé optionnel des densités par noyau
if (mode_densite && tracer_noyau) {
lines(d1, col = rgb(coul1_rgb[1] * 0.7, coul1_rgb[2] * 0.7, coul1_rgb[3] * 0.7), lwd = 2.2)
lines(d2, col = rgb(coul2_rgb[1] * 0.7, coul2_rgb[2] * 0.7, coul2_rgb[3] * 0.7), lwd = 2.2, lty = 2)
}
# 8. Rendu de la légende
legend("topright", legend = c(nom_var1, nom_var2), fill = c(c1, c2),
border = c(c1_bord, c2_bord), bty = "n", cex = 0.9)
# 9. Ré-affirmation du cadre
box(bty = "l", lwd = 1.2)
}
Cette fonction générique synthétise en un ensemble autonome l’ensemble des bonnes pratiques documentées : détection dynamique d’intervalles optimaux selon Freedman-Diaconis, calcul anticipé d’échelles globales unifiées, fusion optique par composition alpha, estimation non paramétrique par noyau de Sheather-Jones et typographie épurée conforme aux canons internationaux. L’analyste dispose dès lors d’un composant méthodologique robuste, entièrement pérenne et déployable en une seule ligne d’instruction dans l’ensemble de ses futurs protocoles de recherche quantitative.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299-314. https://doi.org/10.1080/10618600.1996.10474713
- Murrell, P. (2018). R graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429447273
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
- Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683-690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall. https://doi.org/10.1007/978-1-4899-3324-9
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0