
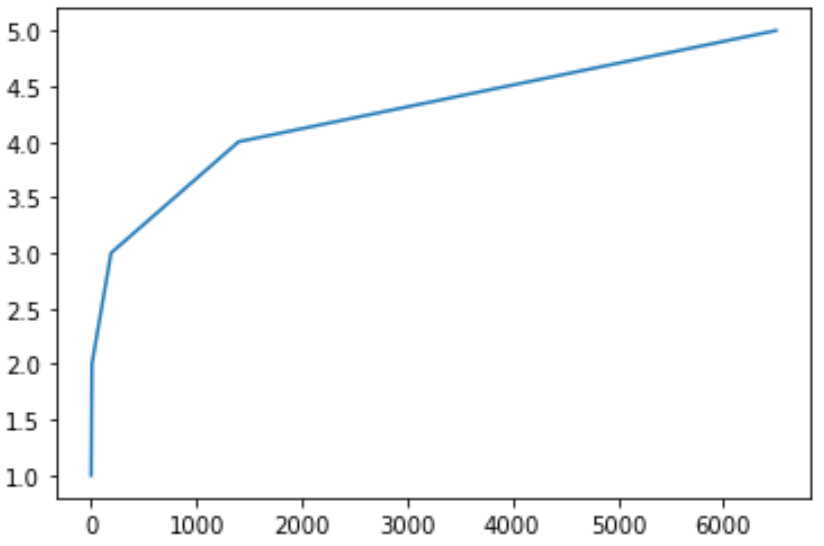
La représentation visuelle de données quantitatives complexes constitue une composante déterminante de la démarche scientifique moderne. Dans de multiples disciplines allant de l’astrophysique à la biologie computationnelle, en passant par l’économétrie financière et le traitement du signal, les chercheurs et analystes sont confrontés à des distributions statistiques caractérisées par une dispersion extrême. Lorsque les observations s’étendent sur plusieurs ordres de grandeur, l’utilisation traditionnelle d’un repère cartésien linéaire engendre une compression sévère des valeurs les plus modestes au profit exclusif des amplitudes maximales. Cette asymétrie de projection compromet la détection de dynamiques structurelles sous-jacentes, masquant des régimes de transition cruciaux ou des lois fondamentales d’invariance d’échelle.
Pour surmonter ces écueils géométriques et cognitifs, la transformation logarithmique des axes de coordonnées s’impose comme une méthodologie analytique incontournable. En substituant aux intervalles arithmétiques constants des rapports géométriques proportionnels, l’échelle logarithmique reconfigure la métrique spatiale du graphique. Ce changement de paradigme perceptif permet non seulement d’embrasser simultanément l’infiniment petit et le macroscopique au sein d’un même espace de visualisation, mais également de convertir des comportements fonctionnels complexes, tels que les croissances exponentielles ou les relations en loi de puissance, en formes géométriques affines immédiatement quantifiables à l’œil nu.
Au sein de l’écosystème open-source dédié au calcul scientifique en langage Python, la bibliothèque Matplotlib s’érige en standard de référence pour l’élaboration de figures destinées à la communication scientifique de haut niveau. Grâce à son moteur graphique hautement configurable et son architecture modulaire, Matplotlib offre une panoplie exhaustive d’outils dédiés à la manipulation des échelles logarithmiques. Cet article propose une exploration approfondie et rigoureuse des mécanismes fondamentaux, des fonctions spécialisées et des meilleures pratiques typographiques permettant d’exploiter pleinement la puissance des échelles non linéaires avec Matplotlib, garantissant ainsi une exactitude mathématique irréprochable et une lisibilité éditoriale optimale.
1. Introduction aux échelles logarithmiques dans la visualisation de données avec Matplotlib
1.1 Fondements mathématiques et intérêt analytique de la transformation logarithmique
La transformation logarithmique repose sur une opération mathématique élémentaire mais aux propriétés analytiques profondes. En appliquant la fonction logarithme, définie comme l’opération réciproque de l’exponentiation, à une variable strictement positive, nous opérons une contraction non linéaire de l’espace métrique. Les écarts mesurés le long de l’axe ne traduisent plus des différences absolues, régies par l’addition, mais des variations relatives, gouvernées par la multiplication. Dans un repère à échelle linéaire, la distance séparant 1 de 10 équivaut rigoureusement à celle séparant 100 de 109. À l’inverse, au sein d’une échelle logarithmique, l’intervalle spatial séparant 1 de 10 est identique à celui reliant 10 à 100 ou 1 000 à 10 000, matérialisant visuellement une progression par décades constantes.
Cette propriété de compression dynamique s’avère particulièrement puissante pour linéariser les relations non linéaires gouvernant les phénomènes physiques et sociaux. Lorsqu’une variable dépendante suit une trajectoire exponentielle en fonction du temps, l’application d’un logarithme à cette grandeur convertit la courbe ascendante en une droite affine dont le coefficient directeur reflète directement le taux de croissance instantané. De manière analogue, les phénomènes régis par des lois de puissance voient leurs distributions se redresser en droites parfaites dès lors que l’on applique une double transformation logarithmique. L’évaluation empirique des modèles théoriques s’en trouve grandement facilitée, car l’œil humain et les estimateurs statistiques de régression linéaire évaluent l’alignement de points avec une acuité nettement supérieure à celle requise pour caractériser des courbures asymptotiques complexes.
Au-delà de la linéarisation structurelle, l’ajustement logarithmique remplit une fonction essentielle de régularisation visuelle face aux distributions statistiques hautement asymétriques. Dans les jeux de données exhibant une longue traîne, à l’instar des répartitions de revenus, des densités de population ou des fréquences de connexion aux serveurs de données, une poignée d’observations massives relègue 99 % de l’échantillon dans une zone marginale et illisible au voisinage immédiat de l’origine. La transformation logarithmique redistribue les observations de manière homogène sur l’ensemble du support graphique, restaurant la visibilité des microstructures internes sans recourir à un découpage artificiel ou à une censure préjudiciable des valeurs extrêmes.
1.2 Présentation de la bibliothèque Matplotlib et de son architecture de tracés
Développée initialement par John D. Hunter pour reproduire les capacités graphiques de MATLAB au sein de l’environnement Python, la bibliothèque Matplotlib a évolué pour devenir la colonne vertébrale de la visualisation scientifique contemporaine. Son architecture interne s’articule autour de couches conceptuelles bien délimitées, séparant rigoureusement la définition des données, leur transformation géométrique et leur rendu sur le support de sortie. Au sommet de cette hiérarchie se trouve l’interface procédurale pyplot, conçue pour orchestrer des modifications d’état rapides et intuitives à travers des commandes globales successives.
En profondeur, le moteur de Matplotlib s’appuie sur une structure orientée objet articulée autour des concepts de Figure, qui encapsule l’intégralité de la zone de dessin, et d’Axes, qui matérialise le système de coordonnées bidimensionnel ou tridimensionnel recevant les données. Chaque objet Axes héberge des instances d’Axis distinctes pour l’abscisse et l’ordonnée. Ces dernières intègrent les moteurs de projection, communément appelés échelles (scales), chargés d’intercepter les coordonnées brutes des vecteurs numériques pour leur appliquer les transformations mathématiques appropriées avant le rendu final par le moteur graphique (backend). Cette conception modulaire garantit que le changement d’échelle s’effectue au niveau de la projection spatiale elle-même, préservant l’intégrité numérique absolue des données sous-jacentes.
L’une des forces majeures de Matplotlib réside dans son interopérabilité native avec les bibliothèques fondamentales du calcul matriciel telles que NumPy et Pandas. Les vecteurs de nombres flottants, les séries temporelles et les tableaux multidimensionnels sont ingérés sans duplication mémoire inutile, permettant le traitement fluide de volumes massifs d’observations. Les routines de calcul exploitent les vecteurs optimisés en langage C sous-jacents, assurant une transformation logarithmique quasi instantanée, compatible avec les impératifs de la recherche quantitative et de l’exploration de données à grande échelle.
1.3 Cas d’usage méthodologiques en analyse expérimentale et quantitative
L’adoption raisonnée d’une échelle logarithmique ne relève pas d’une simple coquetterie esthétique, mais procède d’une exigence méthodologique stricte imposée par la nature des processus étudiés. En cinétique chimique et en pharmacodynamie, par exemple, la décroissance des concentrations réactives ou l’élimination métabolique d’un principe actif obéissent fréquemment à des équations différentielles linéaires d’ordre un. L’analyse de ces cinétiques de relaxation temporelle sur des durées s’étendant de la milliseconde à plusieurs dizaines d’heures exige une projection semi-logarithmique afin de dissocier les phases rapides d’équilibrage initial des régimes lents de diffusion terminale.
Dans le champ des sciences cognitives et de la psychophysique, la formalisation des perceptions sensorielles face aux stimulations externes obéit rigoureusement à la loi historique de Weber-Fechner. Cette loi stipule que la sensation ressentie varie comme le logarithme de l’intensité du stimulus physique appliqué, qu’il s’agisse de l’intensité acoustique en décibels, de la brillance lumineuse en photométrie ou de la perception tactile des pressions mécaniques. La transcription graphique des courbes de réponse psychophysique impose par conséquent l’usage d’abscisses logarithmiques pour refléter fidèlement le paysage perceptif du sujet expérimental, établissant une correspondance directe entre l’espace visuel du tracé et l’expérience phénoménologique mesurée.
Enfin, l’étude des systèmes complexes, des graphes de communication et de la linguistique quantitative se heurte inévitablement à l’émergence de lois d’invariance d’échelle, illustrées par la célèbre loi de Zipf ou les distributions de degrés des réseaux sans échelle. Qu’il s’agisse de mesurer la connectivité des routeurs d’Internet, la récurrence des termes au sein d’un vaste corpus textuel ou la distribution de Pareto caractérisant les transactions sur les marchés financiers, les histogrammes et densités de probabilité requièrent impérativement un affichage doublement logarithmique. Sans cette projection symétrique, les régularités structurelles gouvernant ces phénomènes critiques demeureraient totalement indiscernables sous l’accumulation des données médianes.
2. Configuration de l’environnement de travail et principes fondamentaux de Matplotlib
2.1 Importation des modules nécessaires et gestion de l’environnement
L’amorce d’un projet de visualisation rigoureux en Python requiert l’établissement d’un environnement computationnel stable, prévisible et parfaitement reproductible. Selon les conventions canoniques adoptées par la communauté académique internationale, l’interface pyplot de Matplotlib s’importe sous le pseudonyme standard plt, tandis que la bibliothèque numérique NumPy est systématiquement désignée par le préfixe np. Cette standardisation syntaxique facilite grandement la relecture par les pairs et garantit la portabilité du code source entre différents environnements d’exécution, qu’il s’agisse de scripts autonomes ou de carnets interactifs.
Pour conférer aux visualisations une qualité conforme aux exigences éditoriales des revues internationales, il est vivement préconisé d’ajuster en amont les paramètres globaux via le dictionnaire matplotlib.rcParams. Ce mécanisme de configuration centralisé permet de fixer l’ensemble des attributs typographiques, la résolution par défaut, la taille géométrique des canevas et les caractéristiques de tracé des graduations sans saturer le flux logique des instructions graphiques individuelles. Il est particulièrement opportun d’y définir une taille de police lisible, d’activer le moteur mathématique pour le rendu des symboles grecs ou des puissances, et de contraindre l’épaisseur des traits de repère pour éviter tout effet de flou visuel lors de l’intégration dans des documents finaux.
La reproductibilité computationnelle exige également une traçabilité rigoureuse des versions logicielles employées. Les mécanismes de gestion des échelles logarithmiques ayant connu des raffinements notables au fil des itérations successives de Matplotlib — notamment dans la gestion des étiquettes mathématiques et la tolérance aux bornes extrêmes —, la mention explicite des numéros de version dans les métadonnées de l’analyse constitue une garantie contre les disparités d’affichage susceptibles d’émerger lors du déploiement sur des infrastructures distribuées ou des systèmes d’exploitation hétérogènes.
2.2 Comparaison entre l’interface fonctionnelle pyplot et l’approche orientée objet
L’architecture de Matplotlib expose deux paradigmes de développement distincts, souvent sources de confusion pour les praticiens. Le premier, désigné sous le terme d’interface fonctionnelle ou procédurale basée sur l’état, repose sur l’appel direct de fonctions issues de l’espace de noms plt. Ce paradigme, hérité de la philosophie de programmation séquentielle, applique des modifications implicites à la figure ou à l’axe actuellement actif en mémoire système. Bien qu’extrêmement séduisante pour des manipulations exploratoires préliminaires ou des tracés ponctuels à la console, cette approche révèle ses limites intrinsèques dès lors que la complexité structurelle du graphique s’accroît.
Le second paradigme, plébiscité par les développeurs chevronnés et la documentation de référence, repose sur une approche résolument orientée objet. En instanciant explicitement le couple de conteneurs via la primitive fig, ax = plt.subplots(), l’utilisateur obtient des références directes et immuables vers la figure globale et l’objet de gestion des axes. Chaque opération de modification graphique devient alors un appel de méthode ciblé sur l’instance ax correspondante. Cette formulation élimine toute ambiguïté relative à l’identification du tracé ciblé, simplifie la gestion concurrente de multiples panneaux et assure une modularité absolue du code source.
Dans le contexte précis des échelles logarithmiques, la manipulation directe de l’objet Axes offre une granularité de contrôle inégalée. Elle permet de dissocier chronologiquement l’injection des données brutes de la transformation topologique du repère, d’ajuster indépendamment les localisateurs de graduations et d’injecter des formateurs typographiques spécifiques. Pour tout travail académique visant la publication formelle ou l’intégration au sein de pipelines de production industrielle, l’adoption de l’architecture orientée objet constitue un prérequis incontournable pour maintenir la robustesse du système d’affichage.
2.3 Préparation rigoureuse des données numériques
L’opération mathématique du logarithme impose une contrainte arithmétique fondamentale et incontournable : son domaine de définition analytique est strictement restreint à l’ensemble des réels positifs non nuls. Toute tentative de passage au logarithme d’une valeur nulle ou strictement négative se heurte à une indétermination mathématique majeure, aboutissant à une divergence vers l’infini négatif ou à la génération de nombres complexes non représentables sur une droite réelle standard. Par conséquent, l’ingénierie préliminaire des données constitue une phase critique avant toute sollicitation des modules graphiques.
Lorsque les jeux d’observations empiriques proviennent d’instruments de mesure bruités ou de relevés météorologiques, il est fréquent que des valeurs nulles accidentelles ou des dérives instrumentales légèrement négatives viennent corrompre le signal principal. Il incombe à l’analyste de procéder à un nettoyage systématique par filtrage vectoriel, en exploitant les masques booléens de NumPy pour exclure explicitement les éléments n’appartenant pas à l’intervalle ouvert concerné. Alternativement, selon la nature du protocole expérimental, l’application contrôlée d’une constante de décalage infinitésimale (offset) peut être envisagée, à la condition expresse que cette manipulation soit méthodologiquement documentée et n’introduise aucun biais artificiel dans l’estimation des puissances relatives.
Par ailleurs, la structuration des vecteurs de données doit anticiper l’étendue effective des décades à couvrir. Une série s’étalant sur dix ordres de grandeur génère des gradients géométriques considérables qui, mal anticipés, peuvent conduire à des phénomènes de troncature périphérique où les points situés aux limites extrêmes du domaine sont partiellement masqués par le cadre du tracé. Une inspection préalable des extremums numériques et l’application d’un tri ordonné le long de l’axe directeur garantissent une injection stable des données dans le moteur de rendu, évitant les instabilités d’interpolation ou les discontinuités de tracé non conformes à la physique sous-jacente.
3. Utilisation de plt.semilogx() pour l’échelle logarithmique sur l’axe des abscisses
3.1 Mécanisme interne et syntaxe formelle de semilogx()
La fonction matplotlib.pyplot.semilogx() représente l’une des passerelles fonctionnelles les plus directes pour instaurer une asymétrie d’échelle au sein d’un repère cartésien. Sa signature formelle accepte l’ensemble des arguments positionnels et nominatifs traditionnellement alloués à la méthode générique de tracé de lignes, tout en incorporant des paramètres spécialisés dédiés à la manipulation de la projection horizontale. L’exécution de cette directive informe le système graphique que l’axe des abscisses doit subir une transformation logarithmique immédiate, tandis que l’axe des ordonnées demeure sous le régime d’une échelle affine uniforme standard.
Sous le capot, l’appel à cette fonction active une séquence interne qui substitue au moteur de projection linéaire standard une instance de classe spécialisée chargée d’intercepter chaque coordonnée $X$ pour calculer son image logarithmique. Ce mécanisme ne modifie aucunement les valeurs stockées dans vos vecteurs NumPy originaux, garantissant que les infobulles, les opérations de sélection interactive ou les routines d’exportation de coordonnées conservent les grandeurs physiques initiales. La compression spatiale s’opère exclusivement lors de l’application de la matrice de transformation affine projetant les coordonnées de l’espace utilisateur vers l’espace de la fenêtre de rendu (device space).
Cette approche fonctionnelle s’avère particulièrement adaptée aux scripts d’analyse rapide où la vitesse de prototypage prime sur la modularité architecturale. Elle permet, en une unique instruction compacte, d’ajuster simultanément le tracé des courbes et la métrique sous-jacente sans nécessiter d’appels ultérieurs de reconfiguration. Les arguments de personnalisation chromatique, de motifs de pointillés ou de marqueurs géométriques s’y appliquent avec une transparence totale, assurant une continuité stylistique parfaite vis-à-vis des habitudes de codage acquises sur les tracés linéaires élémentaires.
3.2 Implémentation pas-à-pas sur une série de données à croissance rapide en X
Pour apprécier concrètement l’apport de semilogx(), considérons l’étude de la réponse fréquentielle d’un filtre électronique passe-bas ou la résistance mécanique d’un matériau composite soumis à des cycles de contrainte oscillant entre l’unité et plusieurs centaines de milliers d’unités de fréquence. Dans une telle configuration, la variable indépendante subit une expansion spectaculaire sur cinq ou six décades, tandis que la variable dépendante, telle que l’atténuation en amplitude, fluctue dans une plage numérique resserrée et continue.
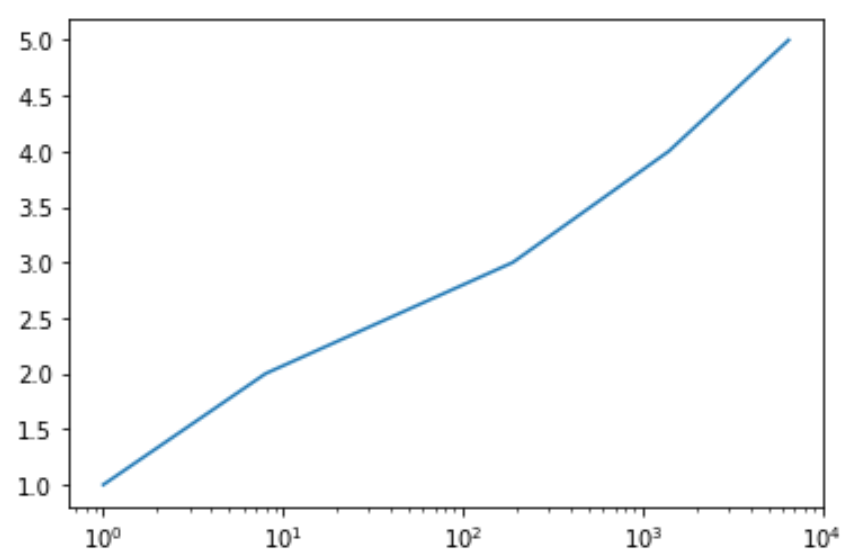
Si l’on injecte ces données dans un graphique conventionnel à double échelle linéaire, l’observateur se heurte à une catastrophe sémiotique : l’immense majorité des points expérimentaux correspondant aux basses et moyennes fréquences se trouve écrasée de manière indistinguable contre l’axe vertical d’origine. La totalité de l’espace visuel horizontal se voit monopolisée par la dernière décade de mesure, donnant l’illusion trompeuse d’un comportement quasi statique sur 90 % du spectre observé. Ce phénomène d’oblitération graphique interdit toute évaluation critique de la bande passante ou de la fréquence de coupure du système étudié.
L’application rigoureuse de la méthode semilogx() résout instantanément cette pathologie géométrique. Le vecteur horizontal se déploie désormais selon une métrique où chaque décade — de 1 à 10, de 10 à 100, de 100 à 1 000, et au-delà — occupe une largeur physique strictement identique sur le support de visualisation. Les subtiles inflexions du signal aux faibles valeurs de l’abscisse apparaissent avec une clarté cristalline, permettant de caractériser simultanément la stabilité du plateau initial et la décroissance asymptotique ultérieure avec une précision géométrique irréprochable.
3.3 Ajustement des graduations et lisibilité de l’abscisse
L’instauration d’une projection logarithmique sur l’axe horizontal modifie en profondeur la disposition et la fréquence spatiale des repères visuels. Par défaut, Matplotlib configure l’abscisse de façon à positionner des graduations majeures sur chaque puissance entière de la base choisie, complétées par des graduations mineures intermédiaires réparties de façon décroissante le long de chaque intervalle décadaire. Cette géométrie singulière reflète l’espacement naturel des entiers naturels au travers du prisme logarithmique, créant ce rythme visuel caractéristique où les repères se resserrent progressivement à l’approche de la décade suivante.
Une vigilance particulière doit être accordée à la densité typographique de ces étiquettes le long de l’axe $X$. Si la plage dynamique couverte s’étend sur une dizaine d’ordres de grandeur, la multiplication des mentions textuelles peut générer un chevauchement disgracieux susceptible de rendre la lecture ardue, particulièrement dans le format restreint d’une colonne d’article scientifique. Il convient alors d’ajuster les espacements d’affichage pour n’afficher textuellement que les décades paires ou les ordres de grandeur stratégiques, tout en maintenant les petits tirets mineurs pour conserver le guidage visuel de l’œil.
En complément, l’insertion de lignes indicatrices verticales, projetées depuis les graduations majeures à travers l’intégralité du champ de tracé, participe grandement à l’intelligibilité de la figure. En reliant directement les points remarquables de la courbe aux valeurs correspondantes sur l’échelle des abscisses, ces lignes de repère permettent à l’analyste d’évaluer instantanément les grandeurs critiques sans subir les distorsions de parallaxe inhérentes à la lecture d’axes non linéaires sur des canevas de grandes dimensions.
4. Utilisation de plt.semilogy() pour l’échelle logarithmique sur l’axe des ordonnées
4.1 Syntaxe formelle et fonctionnement de semilogy()
Symétrique de la fonction précédente, matplotlib.pyplot.semilogy() applique une transformation logarithmique sur l’axe vertical tout en conservant une géométrie strictement linéaire sur l’axe horizontal. Cette configuration représente sans conteste l’agencement le plus fréquemment sollicité en analyse quantitative, trouvant son utilité fondamentale dans le suivi des grandeurs sujettes à des amplifications explosives ou à des amortissements drastiques en fonction d’un paramètre uniforme, typiquement le temps ou la distance spatiale.
D’un point de vue programmatique, semilogy() hérite de l’ensemble des capacités d’affichage de son homologue horizontal. Elle procède à l’évaluation systématique des composantes du vecteur vertical afin d’établir les bornes d’affichage minimales et maximales en puissances de dix. L’algorithme interne de calibres vérifie que la valeur la plus petite du vecteur ordonné ne viole pas la stricte condition de positivité requise pour l’évaluation du logarithme. Dans l’éventualité où une borne inférieure nulle ou négative serait détectée, le système émet un avertissement d’exécution et ajuste arbitrairement la coupure basse à une fraction résiduelle de la valeur positive minimale observée.
L’intérêt conceptuel majeur de cet agencement réside dans sa capacité à conférer une lisibilité immédiate aux processus stationnaires en termes de taux de variation. Tout système physique ou biologique dont la dérivée première temporelle est proportionnelle à son amplitude instantanée voit sa signature graphique transformée en une droite rigoureuse. L’inclinaison de cette droite fournit à l’analyste une mesure géométrique instantanée de la constante de temps propre du phénomène, éliminant les biais d’appréciation subjective générés par l’envolée exponentielle sur repère cartésien linéaire.
4.2 Démonstration expérimentale sur des données de progression exponentielle
L’utilité analytique de semilogy() se manifeste de manière éclatante lors de la modélisation des cinétiques de prolifération microbienne en microbiologie ou de la transmission d’une épidémie au sein d’une population naïve. Imaginons un jeu de données documentant le dénombrement quotidien d’agents pathogènes sur un intervalle de trois semaines. Dans la phase initiale d’expansion non contrainte, la dynamique suit rigoureusement un modèle malthusien régi par une équation de la forme $N(t) = N_0 \cdot e^{\lambda t}$.
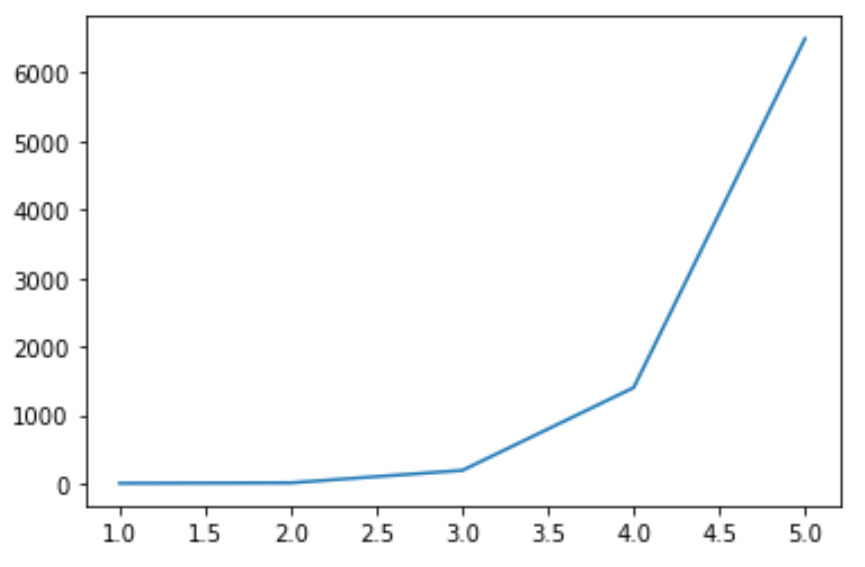
En projetant cette série temporelle dans un espace linéaire ordinaire, la progression semble imperceptible durant les quinze premiers jours, le nombre d’unités demeurant visuellement collé à la ligne de base du zéro. Soudainement, la courbe s’infléchit de façon spectaculaire et s’élève de manière quasi verticale sur les cinq derniers jours, monopolisant l’attention visuelle sur la fin de la période de mesure. Cette représentation induit une perception biaisée chez l’observateur non averti, qui aura tendance à interpréter l’inflexion visuelle comme une accélération brutale et tardive du phénomène, alors que le taux de réplication relatif $lambda$ demeurait pourtant rigoureusement constant depuis l’origine de l’expérience.
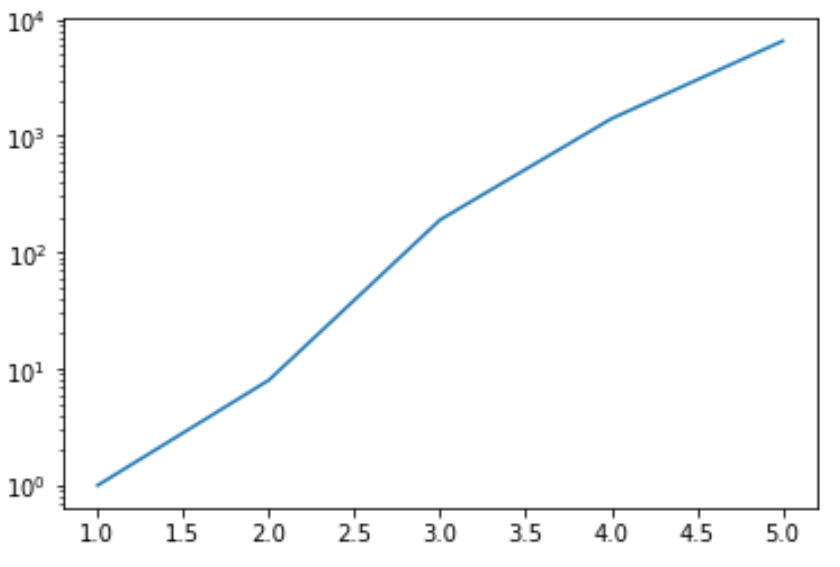
L’application de semilogy() rétablit l’exactitude de l’interprétation scientifique. La courbe de progression se déploie sous la forme d’une ligne droite d’une régularité absolue. La pente géométrique de ce tracé sur l’écran incarne directement la valeur du paramètre $lambda$. Tout changement de régime — qu’il s’agisse d’un ralentissement de la prolifération consécutif à l’épuisement des nutriments ou d’une accélération liée à une mutation — se traduit immédiatement par une brisure de la ligne droite, aisément identifiable par un simple contrôle visuel, sans nécessiter d’ajustement non linéaire complexe en amont.
4.3 Comparaison visuelle entre tracé standard et tracé semi-logarithmique vertical
Pour documenter rigoureusement l’impact épistémologique de ce choix de visualisation, la mise en miroir d’un affichage linéaire et d’un affichage semi-logarithmique constitue une démarche didactique d’une grande valeur pédagogique. Sur un repère standard, les variations d’ordre de grandeur modeste sont anéanties. Si une série expérimentale comprend simultanément des oscillations d’amplitude 0,1 à basse énergie et des pics d’amplitude 1 000 à haute énergie, les fluctuations de faible intensité se trouvent réduites à une épaisseur de trait indifférenciée, interdisant toute vérification empirique d’hypothèses d’oscillations secondaires.
En contrepoint, l’ordonnée logarithmique déploie un pouvoir de discrimination homogène sur l’ensemble de la fenêtre d’observation. Une fluctuation d’un facteur 2 affectant une valeur de base de 0,1 produit une translation verticale rigoureusement équivalente à celle générée par un facteur 2 appliqué à une valeur de 500. Cette égalité de traitement spatial assure une transparence analytique intégrale : le lecteur perçoit avec la même fidélité les comportements asymptotiques aux basses énergies et la dynamique des maxima absolus.
Cette restauration de la visibilité sur les faibles amplitudes ne s’opère pas au détriment de l’intelligibilité globale. Au contraire, elle permet de contextualiser les erreurs expérimentales. Dans de nombreuses mesures instrumentales, le bruit de mesure est homoscédastique en termes relatifs (proportionnel au signal mesuré) plutôt qu’en termes absolus. L’échelle semi-logarithmique verticalise alors ces barres d’incertitude relative en leur conférant une longueur visuelle constante sur l’axe vertical, simplifiant considérablement l’analyse de conformité statistique des modèles ajustés.
5. Représentation en double échelle logarithmique avec plt.loglog()
5.1 Propriétés analytiques du tracé log-log et lois de puissance
La mobilisation d’une échelle logarithmique simultanée sur l’abscisse et sur l’ordonnée, rendue possible par la fonction matplotlib.pyplot.loglog(), constitue l’outil analytique par excellence pour sonder les systèmes physiques régis par des lois de puissance. De nombreuses régularités universelles de la nature s’expriment sous la forme générale $Y = a \cdot X^k$, où l’exposant $k$ gouverne la réponse structurelle du système et $a$ représente une constante de proportionnalité dimensionnelle. Ce formalisme englobe des lois fondamentales telles que la gravitation universelle, la loi de Stefan-Boltzmann en thermodynamique ou les régimes de turbulence de Kolmogorov en mécanique des fluides.
En appliquant le logarithme aux deux membres de cette équation différentielle ou algébrique, la relation mathématique se métamorphose selon l’identité fondamentale :
$$\log(Y) = k \cdot \log(X) + \log(a)$$
Sur le plan géométrique, cette transformation projette l’ensemble des couples $(X, Y)$ dans un repère affine où la coordonnée transformée $log(Y)$ dépend linéairement de la coordonnée transformée $log(X)$. Par conséquent, au sein d’une projection doublement logarithmique, toute loi de puissance, quelle que soit la complexité de son exposant réel, se manifeste sous la forme visuelle d’une droite parfaite.
L’intérêt méthodologique de cette propriété est considérable. L’identification d’une droite dans un tracé log-log fournit une preuve heuristique immédiate de l’existence d’une invariance d’échelle caractérisant le phénomène étudié. L’exposant $k$, qui définit la classe d’universalité du système, n’est autre que la pente de cette droite géométrique. Ainsi, une droite de pente négative égale à -2 signale instantanément une décroissance en carré inverse, tandis qu’une pente fractionnaire positive telle que 0,5 ou 1,5 oriente immédiatement le physicien vers des processus de transport diffusif ou des couplages géométriques fractals.
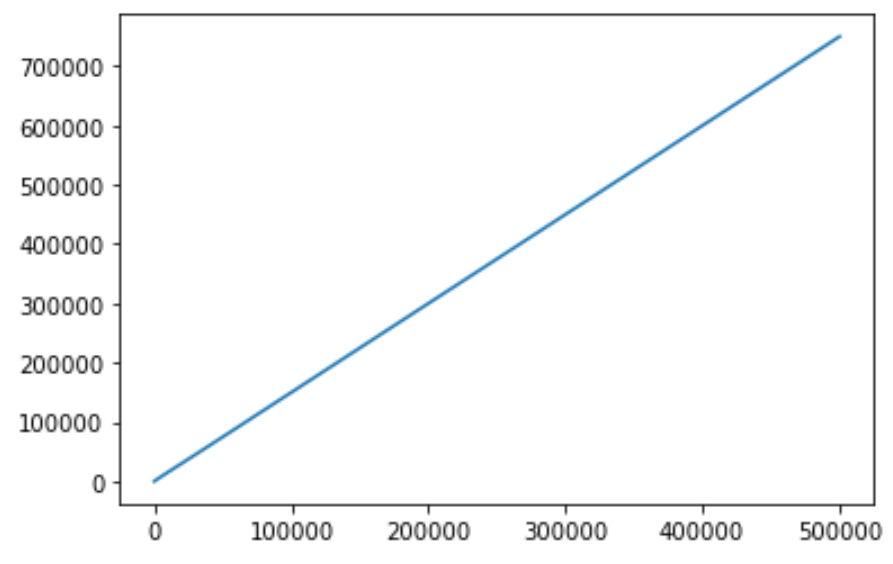
5.2 Implémentation pratique de loglog() sur données bidimensionnelles
La mise en œuvre computationnelle de cette double transformation s’effectue avec une remarquable simplicité grâce à la fonction loglog() de Matplotlib. Cette commande unifiée se charge d’instancier simultanément les mécanismes de projection logarithmique sur les deux axes orthogonaux, évitant à l’utilisateur d’avoir à déclarer séquentiellement la reconfiguration de chaque composante dimensionnelle. Elle accepte en entrée les coordonnées scalaires ou matricielles des points expérimentaux et synchronise le redimensionnement dynamique du canevas pour englober l’ensemble des décades couvertes par les deux variables.
Lors de la manipulation de jeux de données expérimentaux bruités, l’usage de loglog() gagne à être combiné à la superposition de courbes théoriques de référence. Il est d’usage d’injecter conjointement le nuage de points issu des mesures empiriques, souvent stylisé sous forme de marqueurs discrets sans trait de liaison, et la trajectoire pronostiquée par le modèle mathématique, représentée par un trait continu ou en tiretés d’une teinte contrastée. Cette cohabitation visuelle permet une vérification immédiate de la validité du modèle sur l’ensemble de la plage d’observation, les écarts structurels se manifestant sous la forme de déviations systématiques par rapport à la rectitude attendue.
Il convient de souligner que loglog() prend en charge nativement le recalcul des limites géométriques via les méthodes d’ajustement automatique du cadrage. Néanmoins, pour préserver une composition visuelle équilibrée et prévenir tout tassement périphérique, il demeure hautement conseillé de fixer manuellement des limites englobant des décades entières. L’arrondissement des bornes minimales et maximales à la puissance de dix immédiatement inférieure ou supérieure garantit une respiration graphique optimale et permet aux grilles de coordonnées de se déployer de manière harmonieuse sur l’ensemble de la figure.
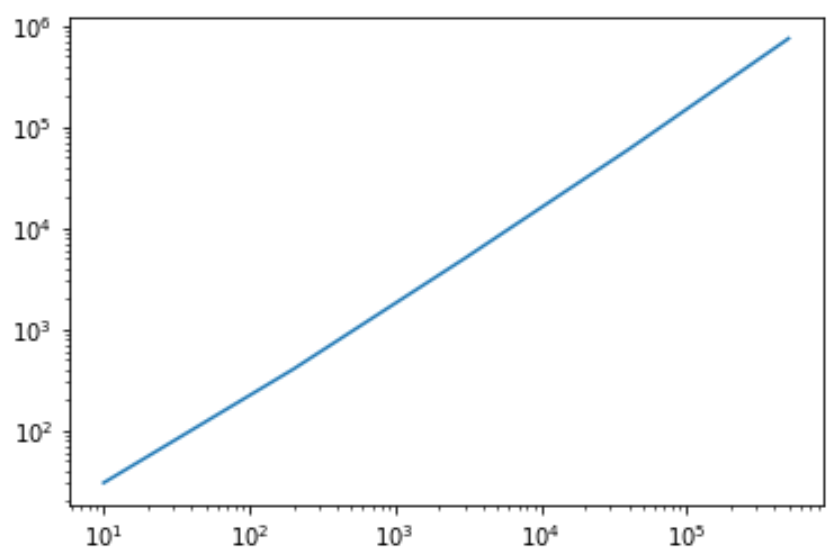
5.3 Interprétation graphique des pentes dans un plan doublement logarithmique
Si la rectitude d’une trajectoire sur un repère log-log atteste formellement d’une loi de puissance, la déduction visuelle directe de la valeur de l’exposant requiert une vigilance méthodologique extrême. Dans un système de rendu graphique conventionnel, les dimensions physiques allouées à une décade sur l’axe horizontal ne coïncident pas nécessairement avec les dimensions physiques allouées à une décade sur l’axe vertical. En raison de l’étirement potentiel du canevas ou des ratios de fenêtrage rectangulaires par défaut, un angle visuel de 45 degrés ne correspond que rarement à une pente mathématique unitaire ($k = 1$).
Pour neutraliser ce piège cognitif et autoriser une lecture géométrique directe des exposants à l’aide d’un simple rapporteur ou par estimation oculaire, il est impératif d’ajuster le rapport d’aspect de la projection graphique. Cet alignement métrique s’obtient en imposant une contrainte d’égalité stricte entre les graduations spatiales des deux axes, assurant qu’un centimètre de longueur d’affichage sur l’abscisse représente rigoureusement le même nombre de décades qu’un centimètre sur l’ordonnée. Une fois cette contrainte satisfaite, les pentes relatives deviennent comparables d’une figure à l’autre et les inclinaisons géométriques retrouvent leur signification physique immédiate.
De surcroît, le plan doublement logarithmique constitue un puissant détecteur de ruptures de symétrie et de transitions de phase. Dans les études thermodynamiques ou les dynamiques de défaillance des réseaux complexes, il est fréquent qu’un système suive une loi d’échelle spécifique sur un sous-ensemble de son domaine d’existence, avant de basculer vers un exposant critique distinct au-delà d’un certain seuil opérationnel. Ce basculement se manifeste dans le repère log-log par une discontinuité angulaire marquée entre deux segments rectilignes consécutifs. La localisation précise du point d’inflexion permet d’identifier expérimentalement la valeur de la grandeur critique déclenchant la transition de régime au sein du système physique.
6. Approche orientée objet : Méthodes ax.set_xscale() et ax.set_yscale()
6.1 Découplage conceptuel de l’instanciation des tracés et du paramétrage des axes
Bien que les fonctions fonctionnelles telles que semilogx(), semilogy() ou loglog() soient pratiques pour des opérations de scriptage immédiat, elles induisent une liaison étroite entre le moment où la donnée est injectée et celui où la topologie de l’axe est définie. L’approche orientée objet recommandée pour les réalisations professionnelles et académiques repose au contraire sur une stricte dissociation architecturale entre l’opération de dessin géométrique et la configuration métrique du conteneur d’affichage.
En amorçant la figure par une instanciation méthodique du type fig, ax = plt.subplots(), l’utilisateur acquiert une maîtrise totale sur le cycle de vie du rendu graphique. Dans ce cadre de travail, les tracés sont effectués en première intention à l’aide des méthodes génériques d’affichage, telles que ax.plot() pour les lignes continues ou ax.scatter() pour les nuages de dispersion, sans qu’il soit nécessaire d’anticiper la nature linéaire ou non linéaire de l’échelle à ce stade de l’exécution. Les données sont ingérées dans leur pureté algébrique, préservant l’orthogonalité du code source.
Ce découplage fonctionnel apporte une flexibilité considérable dans l’élaboration de bibliothèques d’analyse ou de modules graphiques réutilisables. Une fonction logicielle de visualisation peut ainsi se concentrer exclusivement sur l’ingestion des séries numériques et le paramétrage des styles de lignes, laissant le soin aux modules applicatifs supérieurs de décider, a posteriori et selon la dispersion réelle des données récoltées, de commuter les axes vers une projection logarithmique ou de maintenir une échelle linéaire classique. Cette isolation des responsabilités conceptuelles garantit une maintenabilité et une testabilité optimales du code.
6.2 Paramétrage explicite avec set_xscale(‘log’) et set_yscale(‘log’)
La bascule explicite vers une échelle logarithmique au sein du paradigme orienté objet s’opère par l’invocation ciblée des méthodes ax.set_xscale('log') pour la dimension horizontale et ax.set_yscale('log') pour la dimension verticale. Ces méthodes reçoivent une chaîne de caractères normalisée spécifiant l’algorithme d’échelle à engager, tout en acceptant un éventail complet d’arguments nommés destinés à paramétrer finement la transformation géométrique appliquée.
L’intérêt majeur de ces méthodes explicites réside dans leur capacité à recevoir des arguments de réglage avancés lors du même appel fonctionnel. C’est à ce niveau qu’il est possible de stipuler la base mathématique de la projection ou de définir les comportements d’écrêtage face aux valeurs non positives à l’aide de paramètres dédiés. Cette syntaxe explicite rend le code auto-documenté : tout lecteur ou relecteur comprend instantanément la transformation structurelle imposée à l’axe, sans avoir à inférer le comportement du système à partir d’un appel implicite ou d’une fonction procédurale globale.
Par ailleurs, cette approche autorise la reconfiguration dynamique et réversible de l’espace graphique au sein d’une même session de travail interactive. Dans des contextes de traitement analytique pas à pas, il devient aisé de basculer alternativement un axe d’un régime linéaire à un régime logarithmique pour vérifier visuellement une hypothèse statistique, puis de restaurer la métrique d’origine à l’aide d’un simple appel à ax.set_yscale('linear'), le tout sans altérer les propriétés de style, les étiquettes de légende ou les configurations de couleurs préalablement associées à l’objet Axes.
6.3 Gestion des graphiques complexes à axes multiples
L’exploitation de l’architecture orientée objet devient absolument indispensable dès lors que l’on aborde la conception de graphiques composites associant plusieurs systèmes d’axes au sein d’un même cadre visuel. Le cas emblématique est représenté par les figures à axes jumeaux (twin axes), où une même variable en abscisse contrôle deux grandeurs dépendantes aux dynamiques dimensionnelles radicalement divergentes, projetées respectivement sur le côté gauche et le côté droit du tracé.
En mobilisant la méthode ax.twinx(), Matplotlib engendre un second conteneur d’axes qui partage strictement la métrique horizontale du conteneur parent, tout en disposant d’un axe vertical totalement indépendant superposé géométriquement au premier. Grâce à l’approche orientée objet, il devient parfaitement légitime et aisé de configurer l’axe vertical primaire selon une échelle linéaire standard pour suivre une grandeur thermique modérée, tout en appliquant la méthode ax_twin.set_yscale('log') sur l’axe vertical secondaire pour tracer l’évolution d’une pression gazeuse s’envolant sur quatre décades.
Une telle cohabitation exige toutefois une discipline méthodologique rigoureuse. L’analyste doit veiller à désactiver l’affichage des grilles secondaires ou à les synchroniser précisément pour éviter qu’une superposition chaotique de lignes de repère horizontales ne rende la figure indéchiffrable. De même, l’harmonisation chromatique entre les courbes tracées et la typographie des étiquettes d’axes respectives s’avère indispensable pour guider l’œil du lecteur sans ambiguïté vers l’échelle de lecture appropriée, évitant ainsi toute confusion entre la trajectoire linéaire et la progression logarithmique conjointe.
7. Personnalisation des bases logarithmiques : Base 10, Base 2 et Base naturelle
7.1 Modification de la base logarithmique de projection
Bien que la base décimale (base 10) constitue le standard de facto dans l’immense majorité des applications d’ingénierie et de physique générale en raison de son adéquation immédiate avec le système de numération usuel, elle ne possède aucun monopole conceptuel. Selon la structure intime du modèle mathématique ou la physique du processus étudié, l’emploi de bases alternatives s’avère fréquemment bien plus pertinent et éclairant sur le plan analytique.
Matplotlib permet de redéfinir la base de la projection logarithmique avec une simplicité exemplaire. Au sein de la méthode ax.set_yscale('log') ou de son pendant horizontal, il suffit de renseigner l’argument dédié, désigné sous le paramètre base dans les versions récentes de la bibliothèque (ou historiquement basey et basex). L’affectation d’une valeur scalaire positive supérieure à l’unité redéfinit instantanément l’intégralité du moteur de projection : les intervalles d’espacement constants sur le canevas ne matérialiseront plus des multiplications par 10, mais des progressions proportionnelles à la base choisie.
Le choix de cette base n’altère pas la nature affine intrinsèque des linéarisations de courbes, mais il modifie radicalement l’implantation et la fréquence des graduations graphiques. L’adoption d’une base inadéquate peut générer soit une surpopulation de repères si la base est trop resserrée face à une dispersion immense, soit à l’inverse une absence quasi totale de graduations si une base excessivement large est appliquée à un jeu de données n’embrassant qu’une dynamique modérée. La base doit impérativement faire écho à la granularité naturelle du phénomène exploré.
7.2 Tracés en base 2 pour les dynamiques de dédoublement et informatiques
Le recours à la base binaire (base 2) s’impose comme une évidence méthodologique dans l’ensemble des disciplines associées à l’informatique théorique, à la théorie de l’information et à l’analyse de complexité algorithmique. Les structures de données hiérarchiques, telles que les arbres binaires de recherche ou les protocoles de division pour régner (divide and conquer), voient leur allocation de mémoire et leur temps de calcul progresser selon des puissances entières de deux. De même, la fameuse loi de Moore, caractérisant la densification des transistors sur les circuits intégrés, repose fondamentalement sur un rythme de dédoublement temporel régulier.
En configurant l’axe avec l’instruction explicite ax.set_yscale('log', base=2), l’espacement visuel entre 2, 4, 8, 16, 32, 64 et 128 devient géométriquement équidistant. Cette distribution spatiale met immédiatement en valeur le comportement d’un algorithme : un coût temporel qui double à chaque incrémentation de la taille de l’entrée se manifestera par une droite dont la pente s’interprète directement en termes de cycles d’horloge par duplication. L’observateur n’a plus à opérer mentalement des conversions arbitraires vers des décades décimales non naturelles pour apprécier la cadence d’expansion du système.
Sur le plan typographique, il est alors d’usage de coupler cette échelle en base deux à un formateur d’étiquettes spécialisé capable de transcrire les valeurs sous la forme compacte et élégante $2^k$, voire en unités normalisées telles que les kibioctets (Kio) ou les mébioctets (Mio) pour le stockage mémoire. Cette cohérence formelle entre la métrique du repère, la disposition des repères visuels et les unités de mesure informatiques renforce substantiellement la clarté argumentative des publications scientifiques spécialisées.
7.3 Tracés en base népérienne pour les modèles différentiels continus
Dans le domaine des mathématiques pures, de la physique théorique et de la cinétique des réacteurs continus, la constante fondamentale d’Euler ($e \approx 2,71828$) constitue la base la plus élégante et la plus féconde sur le plan formel. Les équations différentielles régissant la relaxation d’un circuit oscillant, la décroissance radioactive des isotopes instables ou la diffusion thermique s’expriment intrinsèquement sous la forme d’exponentielles népériennes $e^{-t/\tau}$, où $tau$ incarne la constante de temps ou la durée de vie moyenne du système.
L’implémentation d’une échelle logarithmique naturelle dans Matplotlib s’effectue aisément en alimentant l’argument de base avec la constante d’Euler fournie par NumPy, via la syntaxe ax.set_yscale('log', base=np.e). Cette configuration aligne la métrique spatiale sur le coefficient d’atténuation continu du processus physique. Une décroissance de la grandeur mesurée d’un facteur $1/e$ correspond alors très exactement à une distance unitaire sur l’axe vertical du tracé, permettant une lecture géométrique instantanée des taux d’amortissement sans interférence du facteur de conversion artificiel inhérent au passage par la base dix.
Bien que particulièrement rigoureuse pour les spécialistes du domaine, l’utilisation de la base népérienne réclame un soin attentif dans l’étiquetage textuel des axes. La plupart des lecteurs n’ayant pas une intuition spatiale aiguë des puissances successives de $e$ (qui progressent approximativement selon 2,71, 7,38, 20,08, 54,59…), il est vivement conseillé de styliser les libellés sous la forme symbolique $e^1, e^2, e^3$ ou d’accompagner les repères d’annotations explicites pour prévenir toute ambiguïté de lecture chez un lectorat interdisciplinaire.
8. Gestion fine des graduations et du formatage des étiquettes (Tick Locators et Formatters)
8.1 Contrôle des graduations majeures et mineures avec LogLocator
L’esthétique et la pertinence fonctionnelle d’un graphique logarithmique reposent en grande partie sur l’ordonnancement rigoureux de ses graduations. Pour administrer cette distribution spatiale, le module matplotlib.ticker met à disposition des classes dédiées, au premier rang desquelles figure LogLocator. Ce mécanisme algorithmique a pour charge de calculer dynamiquement la position optimale des tirets de repère (ticks) le long de l’axe, en s’adaptant continuellement aux limites de cadrage imposées et à l’espace physique disponible sur la figure.
Le contrôle précis s’opère en associant des instances distinctes de LogLocator aux graduations majeures et aux graduations mineures de l’axe considéré. Pour un axe en base 10 conventionnel, les graduations majeures sont typiquement assignées aux puissances entières de dix. Pour les graduations mineures, le localisateur peut être paramétré pour injecter des repères intermédiaires situés aux multiples entiers de la décade (soit 2, 3, 4, 5, 6, 7, 8 et 9 fois la puissance de base). Cette configuration fine s’effectue au moyen des méthodes ax.yaxis.set_major_locator() et ax.yaxis.set_minor_locator().
Une problématique récurrente réside dans la gestion de la densité des graduations lorsque l’échelle embrasse une très vaste plage dynamique, excédant par exemple dix décades. Dans ce cas de figure, l’affichage systématique de l’ensemble des graduations mineures génère une bande d’encre noire opaque et illisible le long de l’axe. En ajustant le paramètre de sous-échantillonnage (subs) au sein du constructeur de LogLocator, l’analyste peut contraindre le localisateur à n’afficher que les repères mineurs stratégiques (par exemple uniquement le repère médian correspondant au chiffre 5) ou à supprimer intégralement les sous-graduations pour les plages les plus étendues, restaurant ainsi la respiration visuelle de l’ensemble.
8.2 Formatage typographique des étiquettes avec LogFormatter
Le positionnement géométrique des repères ne résout pas à lui seul la question de leur identification textuelle. Par défaut, Matplotlib fait appel à des formateurs génériques qui peuvent parfois convertir les puissances de dix en nombres flottants expansifs (tels que 0.00001 ou 1000000.0), rompant avec les usages académiques et encombrant lourdement les marges de la figure. Pour conférer à la publication une allure professionnelle impeccable, l’activation d’un formateur spécialisé tel que LogFormatterMathtext s’avère indispensable.
Ce formateur met à profit le moteur de rendu mathématique interne de Matplotlib pour transcrire automatiquement chaque graduation majeure sous la notation scientifique canonique $10^k$, où $k$ est un exposant entier formaté avec élégance. Cette notation présente le double avantage d’occuper un encombrement typographique minimal et d’éliminer toute ambiguïté sur le nombre de zéros significatifs, particulièrement pour les ordres de grandeur infinitésimaux ou astronomiques. L’assignation de ce composant s’effectue via l’instruction ax.yaxis.set_major_formatter(LogFormatterMathtext()).
En outre, il est possible de personnaliser finement la politique d’étiquetage des graduations mineures. Bien que les règles de mise en page préconisent généralement de laisser les graduations mineures exemptes d’étiquettes textuelles pour préserver la lisibilité de la figure, certaines situations analytiques requièrent la mention explicite de points de repère intermédiaires remarquables (par exemple 2 et 5 au sein de chaque décade). Les options de configuration avancées de LogFormatter permettent de piloter cette granularité textuelle sans altérer l’ordonnancement mathématique des repères.
8.3 Configuration des grilles logarithmiques pour une lisibilité accrue
L’estimation quantitative des coordonnées d’un point à l’intérieur d’un repère logarithmique présente une difficulté cognitive notable pour l’œil humain, en raison du resserrement spatial continu des intervalles à l’intérieur de chaque décade. L’implantation d’un réseau de lignes de guidage (grille) constitue par conséquent une assistance visuelle majeure pour permettre au lecteur d’interpoler mentalement la valeur d’une observation avec un niveau d’incertitude minimal.
Pour exploiter pleinement le potentiel de la grille, son activation doit coordonner harmonieusement les réseaux majeur et mineur à travers l’instruction ax.grid(True, which='both'). Toutefois, l’application uniforme d’un même style de trait à l’ensemble du quadrillage aboutirait à une surcharge graphique désastreuse (effet de moiré). La bonne pratique éditoriale consiste à instaurer une hiérarchie visuelle stricte : la grille majeure, correspondant aux décades entières, s’habille d’un trait plein ou légèrement tireté d’une opacité modérée, tandis que la grille mineure se compose de pointillés très discrets, déclinés dans une teinte grise neutre et estompée.
Cette différenciation typographique permet à l’observateur d’identifier instantanément les frontières d’ordres de grandeur majeurs grâce aux lignes directrices principales, tout en conservant la capacité d’apprécier la progression non linéaire interne grâce à l’espacement resserré des pointillés secondaires. Ce soin apporté au maillage spatial transforme un graphique potentiellement hermétique en un instrument de mesure visuelle d’une remarquable précision analytique.
9. Traitement des valeurs nulles, négatives et étendues spécifiques (Symlog et Logit)
9.1 Limites arithmétiques du logarithme standard face aux zéros et aux réels négatifs
L’écueil mathématique le plus déstabilisant lors de l’application d’une échelle logarithmique standard réside dans son incompatibilité absolue avec les valeurs nulles et les nombres réels négatifs. Sur le plan de l’analyse fonctionnelle, la limite du logarithme en base quelconque lorsque sa variable tend vers zéro par valeurs positives diverge vers $-\infty$, tandis que la fonction n’est tout simplement pas définie sur le demi-plan des réels strictement négatifs au sein du corps des nombres réels.
Face à cette impossibilité géométrique, le moteur de projection de Matplotlib réagit par défaut en filtrant purement et simplement les points expérimentaux problématiques. Si une série de mesures contient des zéros ou des valeurs négatives consécutives à des fluctuations de bruit de fond, ces données sont invisibilisées sur le rendu final, et le système émet un avertissement d’exécution (UserWarning). Ce comportement par défaut engendre un péril méthodologique majeur : l’omission non sollicitée d’une fraction des observations peut conduire l’analyste à des interprétations statistiques erronées, en masquant par exemple des états de repos absolu ou des inversions de polarité au sein du système étudié.
Par ailleurs, toute tentative de forcer manuellement une limite d’axe incluant zéro (par exemple via ax.set_ylim(bottom=0)) au sein d’une échelle logarithmique conventionnelle déclenche une correction automatique d’urgence du système, qui réajustera arbitrairement la borne inférieure à une valeur arbitraire non nulle. Il est donc fondamental de ne jamais chercher à représenter des zéros parfaits sur une échelle logarithmique standard et de mobiliser des approches topologiques alternatives conçues pour surmonter cette discontinuité.
9.2 Mise en œuvre de l’échelle symétrique symlog
Pour répondre au défi posé par les données embrassant des amplitudes massives tout en traversant la valeur zéro ou en s’étendant dans le domaine des nombres négatifs, Matplotlib intègre une échelle spécialisée remarquable : l’échelle logarithmique symétrique, désignée sous le terme de symlog. Cette échelle hybride réalise un compromis géométrique ingénieux en scindant l’espace de projection en deux régimes continus distincts : une zone centrale régie par une métrique linéaire standard englobant le zéro, bordée de part et d’autre par des zones logarithmiques déployées sur les domaines positifs et négatifs.
La configuration de cette transformation s’opère via la méthode ax.set_yscale('symlog'), laquelle nécessite impérativement le paramétrage judicieux de l’argument linthresh. Ce paramètre, abréviation de seuil de linéarité (linear threshold), définit la demi-largeur de l’intervalle centré sur l’origine $[-linthresh, +linthresh]$ à l’intérieur duquel la projection se comporte de manière purement linéaire. Dès lors qu’une valeur franchit cette frontière dans le sens positif ou négatif, la transformation bascule de manière continue vers une échelle logarithmique. Le paramètre d’échelle linscale permet en outre d’ajuster la proportion spatiale occupée par ce couloir linéaire sur le canevas par rapport à la décade logarithmique adjacente.
L’utilisation de symlog s’avère particulièrement providentielle en électromagnétisme, en dynamique des fluides ou en microéconomie pour représenter des bilans de flux, des potentiels oscillants ou des profits et pertes industriels. Elle autorise la visualisation concomitante de déviations négatives majeures de plusieurs millions d’unités, d’un comportement quasi stationnaire au voisinage immédiat de zéro, et de pics d’expansion positifs astronomiques, le tout sur un tracé unique parfaitement continu et dépourvu de rupture d’affichage.
9.3 Utilisation de l’échelle logit pour les proportions et probabilités
Un autre cas de figure méthodologique singulier concerne la visualisation de variables quantitatives intrinsèquement bornées sur l’intervalle ouvert $]0, 1[$, telles que des probabilités d’occurrence, des fractions molaires, des scores de classification d’apprentissage automatique ou des taux de conversion. Lorsque ces proportions se rapprochent très étroitement des limites absolues 0 ou 1, les échelles linéaires et logarithmiques classiques se révèlent inadaptées pour discriminer les variations marginales extrêmes.
Pour ces contextes probabilistes, Matplotlib implémente l’échelle logit, accessible via la directive ax.set_yscale('logit'). Fondée sur la fonction quantile de la régression logistique, cette transformation projette une proportion $p$ selon la relation mathématique :
$$\text{logit}(p) = \log\left(\frac{p}{1 – p}\right)$$
Cette transformation produit une décompression symétrique et spectaculaire aux deux extrémités de l’intervalle : les valeurs proches de zéro sont étirées vers l’infini négatif de manière quasi logarithmique, tandis que les valeurs proches de l’unité sont simultanément étirées vers l’infini positif selon une géométrie inversement symétrique. Seul le point médian $p = 0,5$ conserve une pente linéaire locale.
L’apport méthodologique de l’échelle logit est capital pour l’évaluation des systèmes à très haute fiabilité ou l’analyse des événements rares. Elle permet d’apprécier avec une acuité géométrique identique la différence séparant un taux de pureté de 0,99 d’un taux de 0,999, et la différence séparant un taux d’erreur de 0,01 d’un taux de 0,001. Les deux régimes asymptotiques extrêmes se trouvent ainsi placés sur un pied d’égalité visuel, prévenant l’écrasement périphérique typique des représentations en pourcentages standards.
10. Intégration d’échelles logarithmiques dans des sous-figures multiples
10.1 Création de grilles comparatives coordonnées
Dans le cadre de l’élaboration de synthèses scientifiques destinées à la publication, il est fréquent qu’un jeu de données complexe gagne à être présenté simultanément sous différentes perspectives métriques. La mise en regard, au sein d’une figure multi-panneaux unique, d’une projection linéaire conventionnelle et d’une projection logarithmique constitue un puissant ressort démonstratif pour expliciter l’impact structurel d’une transformation d’échelle sur la compréhension des mécanismes physiques observés.
La génération de telles compositions s’articule aisément autour de la méthode fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5)). Dans cette configuration, le premier conteneur ax1 peut être dédié à l’affichage des données brutes selon une métrique cartésienne standard, tandis que le second conteneur ax2 reçoit la même collection de données couplée à une transformation ax2.set_yscale('log'). Cette juxtaposition directe permet au lecteur d’apprécier la magnitude macroscopique globale sur le premier panneau tout en examinant la finesse des régimes transitoires et des lois de décroissance sur le panneau adjacent.
Pour garantir une présentation éditoriale irréprochable, l’optimisation des espacements entre les sous-graphiques s’avère primordiale. Les libellés d’axes logarithmiques, intégrant des puissances de dix ou des notations scientifiques en exposant, occupent généralement un gabarit horizontal supérieur à celui de simples nombres entiers. L’activation des gestionnaires de mise en page automatique tels que plt.tight_layout() ou, de préférence dans les versions récentes, l’option constrained_layout=True lors de l’instanciation de la figure, élimine tout risque de chevauchement entre les étiquettes de graduation du panneau gauche et le titre ou l’axe du panneau droit.
10.2 Partage d’axes logarithmiques entre sous-graphiques
Lorsque la structure de l’expérience implique la comparaison de plusieurs séries de données similaires réparties à travers une matrice de panneaux graphiques — par exemple la réponse spectrale de différents capteurs disposés en grille 2×2 —, l’harmonisation absolue des systèmes de projection s’impose comme une condition sine qua non de rigueur scientifique. L’observateur doit pouvoir comparer la hauteur ou l’inclinaison des courbes d’un panneau à l’autre sans que son jugement soit faussé par des calibres locaux divergents.
Matplotlib répond à cette exigence méthodologique au moyen des arguments sharex=True et sharey=True intégrés à la primitive plt.subplots(). Lorsqu’un axe est converti vers une échelle logarithmique sur l’un des panneaux d’un ensemble lié, l’intégralité des sous-graphiques de la colonne ou de la ligne correspondante hérite instantanément et automatiquement de cette métrique non linéaire. Les bornes d’affichage se synchronisent en temps réel : tout zoom ou translation opéré sur l’un des panneaux se répercute de manière parfaitement synchrone sur l’ensemble de la grille de visualisation.
Ce partage structurel engendre un bénéfice esthétique et cognitif substantiel. Le moteur graphique supprime automatiquement les étiquettes de graduation et les libellés redondants sur les panneaux intérieurs de la grille, ne les conservant que sur la périphérie externe de la composition globale. Cette épuration visuelle allège drastiquement la charge mentale de l’observateur, focalisant l’attention sur les écarts relatifs entre les systèmes expérimentaux plutôt que sur le déchiffrage d’axes répétés inutilement.
10.3 Uniformisation des limites et des styles de tracés
L’exploitation de sous-figures partagées exige une discipline typographique rigoureuse dans la fixation des limites de cadrage et le traitement des styles. Si le partage automatique d’axe n’est pas activé pour des impératifs d’affichage sélectif, il incombe au chercheur d’appliquer manuellement des bornes strictement identiques au moyen des méthodes ax.set_ylim() sur l’ensemble des axes verticaux logarithmiques composant la mosaïque. L’incohérence des bornes extrêmes entre panneaux adjacents constitue l’une des erreurs les plus dommageables en communication scientifique, susceptible d’induire le lecteur en erreur quant à l’importance relative des amplitudes mesurées.
De même, la cohérence stylistique doit être préservée d’un panneau à l’autre avec une rigueur absolue. Une série expérimentale identifiée par une teinte spécifique, une épaisseur de trait donnée ou un motif de marqueur singulier sur le premier sous-graphique doit impérativement conserver ces caractéristiques exactes à travers l’ensemble des figures de la publication. L’utilisation d’une légende commune centralisée, déportée à l’extérieur des panneaux de tracé (par exemple en bandeau supérieur ou inférieur) au moyen de la méthode fig.legend(), renforce l’unité sémiotique de l’ensemble.
Enfin, l’homogénéisation des grilles de lecture à travers les différents sous-graphiques garantit une lecture transversale fluide. Si une grille fine majeure et mineure est déployée sur le premier panneau logarithmique, une trame identique doit s’étendre sur les panneaux suivants. Cette régularité crée un étalonnage visuel stable dans l’esprit du lecteur, transformant la collection de sous-figures en un véritable tableau de bord analytique rigoureux et harmonieux.
11. Diagnostic des anomalies récurrentes et écueils méthodologiques
11.1 Interprétation et résolution des avertissements de calcul
La mise en œuvre pratique des échelles logarithmiques confronte régulièrement l’analyste à des messages d’avertissement émis par le noyau de calcul lors de l’exécution du tracé. Le plus emblématique d’entre eux demeure sans conteste l’avertissement :
UserWarning: Data has no positive values, and therefore cannot be log-scaled.
Ce message d’alerte signale que le vecteur numérique fourni à la méthode de projection ne contient aucune observation strictement supérieure à zéro, rendant matériellement impossible l’évaluation du logarithme sur le domaine des nombres réels. Dans cette situation extrême, Matplotlib bascule d’autorité vers une échelle factice comprise par défaut entre $10^{-1}$ et $10^0$, laissant le canevas totalement vierge de toute donnée.
Pour prévenir cette défaillance, une stratégie défensive d’ingénierie des données s’impose systématiquement en amont du tracé. L’application d’un contrôle d’intégrité numérique préalable, fondé sur l’utilisation de masques conditionnels NumPy, permet d’intercepter les vecteurs non conformes avant leur injection graphique. L’extraction systématique des composantes strictement positives via des opérations de masquage vectoriel garantit que le moteur graphique n’ingère que des valeurs valides sur le plan analytique. Si cette opération réduit la longueur du vecteur, il convient d’en avertir explicitement le lecteur ou de basculer de manière programmatique vers l’échelle symétrique symlog documentée précédemment.
Un autre avertissement fréquent concerne les instabilités induites par des limites d’axes mal initialisées (Invalid limit for log scale). Ce phénomène survient généralement lorsqu’un utilisateur assigne par mégarde une valeur nulle ou négative à l’un des paramètres de cadrage dans set_ylim() ou set_xlim(). La méthode rigoureuse consiste à toujours extraire les bornes dynamiquement à partir des données valides, en appliquant les fonctions np.nanmin() et np.nanmax() restreintes aux éléments positifs de la distribution.
11.2 Prévention des artefacts de tracé et d’interpolation
L’association d’une échelle logarithmique à des techniques de traitement numérique de lissage ou d’interpolation de signaux recèle des pièges subtils pouvant corrompre gravement la fidélité de la représentation scientifique. Une erreur méthodologique répandue consiste à procéder à une interpolation continue (telle qu’une interpolation par splines cubiques) sur les données brutes dans l’espace euclidien linéaire, pour ensuite projeter la courbe résultante sur un axe logarithmique.
Cette chronologie d’opérations engendre des artefacts d’oscillation désastreux. Une fonction spline cubique ajustée dans un repère linéaire tentera de minimiser les courbures sous une métrique arithmétique. Lorsqu’une telle courbe est projetée dans un espace logarithmique, les oscillations résiduelles autour des petites valeurs s’amplifient de manière démesurée, produisant des courbures fictives, des ondulations sans réalité physique, voire des plongées accidentelles vers des valeurs négatives qui interrompent brutalement le tracé de la ligne continue. La règle absolue en la matière exige que toute opération d’interpolation ou de lissage soit exécutée au sein de l’espace transformé : l’algorithme doit interpoler le logarithme de la variable en fonction du logarithme de l’abscisse, avant de renvoyer le résultat au moteur de visualisation.
La même rigueur s’applique à la gestion des barres d’erreur expérimentales via la fonction ax.errorbar(). Dans un repère linéaire, une marge d’incertitude symétrique $\pm \Delta Y$ se traduit par des moustaches de longueurs égales de part et d’autre du point central. Sur une échelle logarithmique, cette symétrie physique devient une asymétrie géométrique absolue : l’intervalle inférieur $[Y – \Delta Y, Y]$ occupe un espace graphique considérablement plus vaste que l’intervalle supérieur $[Y, Y + \Delta Y]$. Si l’amplitude du bruit expérimental $\Delta Y$ est supérieure ou égale à la valeur centrale $Y$, la borne inférieure de la barre d’erreur plonge dans le domaine négatif et ne peut être représentée. L’analyste doit impérativement configurer le paramètre de borne minimale de Matplotlib pour écrêter ces segments ou exprimer les incertitudes sous forme de facteurs multiplicatifs géométriques.
11.3 Pièges cognitifs et risque de mauvaise interprétation chez le lecteur
Au-delà des contraintes purement techniques et informatiques, l’emploi des échelles logarithmiques soulève des enjeux cognitifs et éthiques de premier ordre dans la transmission de l’information quantitative. Le cerveau humain possède une prédisposition naturelle et intuitive à interpréter l’espace physique de manière linéaire : nous assimilons spontanément une distance géométrique deux fois plus longue à une quantité physique deux fois plus importante. Dès lors qu’une figure brise ce contrat implicite, le risque de mauvaise interprétation par un lecteur distrait augmente de façon critique.
Le piège le plus pernicieux réside dans l’illusion visuelle d’amortissement ou de modération qu’impose le logarithme aux dynamiques explosives. Sur un axe vertical logarithmique, une courbe représentant une propagation pandémique ou une dette financière souveraine prend l’apparence d’une progression linéaire tranquille ou d’un plateau stabilisé, masquant le fait sous-jacent que chaque incrément vertical d’égale longueur représente en réalité une multiplication par 10 ou par 100 de la quantité absolue. Des décideurs publics ou des pairs non spécialistes peuvent ainsi sous-estimer dramatiquement la criticité d’un phénomène exponentiel en se fiant à la fausse modération visuelle du tracé.
Pour déjouer ces biais de perception, la responsabilité éditoriale de l’auteur implique une pédagogie visuelle intransigeante. Il est impératif d’inclure explicitement la mention de l’échelle non linéaire directement dans le libellé de l’axe (par exemple en stipulant explicitement Concentration molaire (échelle log, mol/L)) ainsi que dans la légende descriptive de la figure. L’ajout d’annotations textuelles directes pointant les jalons quantitatifs clés ou l’adjonction de la grille mineure resserrée — qui rappelle constamment à l’œil la nature compressive de l’espace métrique — constituent des remparts indispensables contre toute lecture superficielle ou fallacieuse des résultats publiés.
12. Directives académiques pour la publication et l’exportation des figures
12.1 Exportation vectorielle et matricielle haute fidélité
L’aboutissement de toute démarche de visualisation scientifique réside dans la phase critique d’exportation de la figure vers des fichiers exploitables par les comités de rédaction des revues internationales. Une figure préparée avec la plus haute rigueur conceptuelle perd l’essentiel de son impact persuasif si son rendu final souffre d’artéfacts de pixellisation ou d’une pixellisation grossière de ses graduations fines.
Pour préserver l’infinie netteté des tracés logarithmiques, le recours aux formats graphiques vectoriels constitue la recommandation académique cardinale. Les extensions telles que le PDF (Portable Document Format), le SVG (Scalable Vector Graphics) ou l’EPS (Encapsulated PostScript) encodent les courbes, les grilles et les glyphes typographiques sous la forme d’instructions géométriques immuables, garantissant une résolution théoriquement infinie, indépendante du facteur de zoom appliqué lors de la mise en page de l’article imprimé. L’exportation s’opère au moyen de l’instruction canonique plt.savefig('nom_fichier.pdf', format='pdf').
Dans l’éventualité où les directives éditoriales exigeraient impérativement la remise d’images matricielles (pixels), notamment sous forme de fichiers TIFF ou PNG haute fidélité, il est indispensable de forcer la densité d’échantillonnage spatiale à une valeur conforme aux standards de l’imprimerie professionnelle. L’adjonction du paramètre dpi=300 (points par pouce), voire dpi=600 pour les tracés d’art au trait monochrome, assure que les tirets de repère mineurs et les exposants scientifiques conserveront une acuité cristalline. Enfin, l’utilisation systématique du paramètre bbox_inches='tight' permet de rogner automatiquement les marges superflues et garantit qu’aucune étiquette périphérique ne soit tronquée lors de l’enregistrement final.
12.2 Conformité typographique et standardisation des unités
L’intégration d’un graphique au sein d’une communication académique de haut rang impose une harmonie esthétique globale entre la figure et le corps de texte du document hôte. Les disparités typographiques — telles qu’un texte rédigé en police avec empattement (serif) côtoyant des graphiques conçus en polices bâtons (sans-serif) discordantes — altèrent la perception de qualité professionnelle du travail scientifique.
Matplotlib permet d’atteindre une perfection typographique absolue grâce à l’activation de son moteur de composition LaTeX natif. En configurant l’instruction globale plt.rcParams['text.usetex'] = True, le système délègue l’intégralité du rendu des textes et des formules mathématiques à la distribution LaTeX installée sur la machine hôte. Les étiquettes d’axes logarithmiques adoptent alors les fontes exactes du document final (par exemple Computer Modern ou Times), et les expressions quantitatives bénéficient de la rigueur du moteur d’alignement mathématique international, assurant une conformité parfaite dans la transcription des exposants et des variables physiques.
La formulation des libellés d’axes doit également se conformer strictement aux normes du Système International d’Unités (SI) et aux directives de l’Union Internationale de Chimie Pure et Appliquée (IUPAC). Les grandeurs physiques et leurs unités respectives doivent être présentées selon une convention normalisée, privilégiant la notation fractionnaire (par exemple $T / \text{K}$ ou $P / 10^5,\text{Pa}$) ou l’encapsulation standardisée des unités entre crochets. Cette rigueur formelle élimine toute ambiguïté sur la nature de la valeur représentée et garantit l’universalité de la lecture transculturelle.
12.3 Synthèse comparative des fonctions et matrice de décision
Pour conclure cette analyse méthodologique approfondie, il est utile d’ordonner les différentes approches techniques explorées au sein d’une synthèse comparative, destinée à guider le praticien vers la solution algorithmique la plus efficiente en fonction de la nature structurelle de son jeu de données. Le tableau ci-dessous dresse une taxonomie raisonnée des méthodes disponibles dans Matplotlib, mettant en balance leurs champs d’application préférentiels, leurs atouts conceptuels et leurs limites intrinsèques.
| Méthode Matplotlib | Axe(s) transformé(s) | Modèle physique sous-jacent | Tolérance aux valeurs nulles/négatives | Paradigme recommandé |
|---|---|---|---|---|
semilogx() |
Abscisse ($X$) uniquement | Réponse fréquentielle, loi de Weber-Fechner | Non ($X > 0$ impératif) | Scripting fonctionnel rapide |
semilogy() |
Ordonnée ($Y$) uniquement | Croissance/décroissance exponentielle, cinétique | Non ($Y > 0$ impératif) | Scripting fonctionnel rapide |
loglog() |
Abscisse et Ordonnée ($X$ et $Y$) | Lois de puissance, fractales, lois de Zipf/Pareto | Non ($X > 0$ et $Y > 0$ impératifs) | Scripting fonctionnel rapide |
ax.set_xscale('log') / ax.set_yscale('log') |
Configuration sélective et découplée | Universel (exponentiel, puissance, base variable) | Non (requiert filtrage préalable) | Orienté objet professionnel |
ax.set_yscale('symlog') |
Unitaire ou bilatéral | Flux bidirectionnels, dynamiques avec zéros réels | Oui (zone linéaire autour de zéro via linthresh) |
Orienté objet professionnel |
ax.set_yscale('logit') |
Unitaire ou bilatéral | Probabilités, proportions sur $]0, 1[$, taux de survie | Strictement borné sur $]0, 1[$ | Orienté objet professionnel |
La règle décisionnelle fondamentale guidant le choix de l’échelle d’affichage peut ainsi se résumer selon une logique arborescente rigoureuse. L’analyste doit en premier lieu évaluer la distribution statistique et le domaine de positivité des données brutes. Si la série traverse l’origine en présentant des états stationnaires ou des valeurs négatives fondamentales, la mobilisation exclusive de l’échelle symétrique symlog s’impose sans équivoque.
Dans l’hypothèse où les grandeurs sont strictement positives, l’analyse du modèle théorique sous-jacent doit piloter l’allocation dimensionnelle. Si la dynamique suggère une proportionnalité relative sur une seule des coordonnées (croissance démographique, temps de réponse impulsionnel), un tracé semi-logarithmique ciblé (semilogy pour un taux dépendant, semilogx pour une stimulation sensorielle) offre le cadre de linéarisation idéal. En revanche, dès lors que le processus met en jeu une invariance d’échelle ou un couplage multiplicatif bilatéral, le recours à la projection doublement logarithmique loglog ou son équivalent orienté objet constitue la seule voie rigoureuse permettant de mettre au jour les exposants critiques gouvernant l’architecture du système.
En observant ces principes fondamentaux et en maîtrisant les subtilités d’ordonnancement des localisateurs de graduations et des formateurs typographiques, l’utilisateur de Matplotlib dispose d’un instrument analytique d’une souveraine précision. La visualisation cesse alors d’être une simple illustration passive pour devenir un vecteur actif de découverte scientifique et une garantie indiscutable de la reproductibilité des analyses quantitatives.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Caswell, T. A., Droettboom, M., Lee, A., de Andrade, E. S., Hoffmann, T. Hunter, J., Firing, E., Stansby, D., Klymak, J., Varoquaux, N., Nielsen, J. H., Root, B., May, R., Dale, D., Lee, K., Seppänen, J. K., McDougall, D., Straw, A., Hobson, P., … & Matplotlib development team. (2023). Matplotlib: Visualization with Python (Version 3.8.0) [Software]. Zenodo. https://doi.org/10.5281/zenodo.8340442
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Rougier, N. P., Droettboom, M., & Bourne, P. E. (2014). Ten simple rules for better figures. PLOS Computational Biology, 10(9), e1003833. https://doi.org/10.1371/journal.pcbi.1003833