
Dans le champ contemporain de l’exploration de données et de l’inférence statistique, la restitution visuelle ne constitue pas un simple artifice d’illustration, mais un véritable instrument cognitif et heuristique. Alors que les ensembles de données scientifiques augmentent continuellement en volume et en complexité paramétrique, la capacité à synthétiser des distributions conditionnelles, des trajectoires longitudinales et des structures d’association latentes sur un plan unique devient une compétence méthodologique essentielle. En programmation statistique avec l’écosystème Python, la bibliothèque Seaborn s’est imposée comme une référence incontournable grâce à son élégance syntaxique et sa propension à traduire nativement les structures tabulaires en représentations graphiques hautement informatives.
Toutefois, la manipulation élémentaire de cette bibliothèque révèle rapidement ses limites dès lors qu’un chercheur ou un analyste tente de dépasser le cadre du graphique isolé. Réunir plusieurs représentations complémentaires au sein d’une même figure unifiée nécessite une compréhension rigoureuse de l’architecture logicielle sous-jacente, dominée par l’interfaçage subtil entre la bibliothèque hôte Matplotlib et les abstractions sémantiques de Seaborn. L’absence d’une maîtrise méthodologique des contextes d’axes et des conteneurs de figures conduit invariablement à des juxtapositions désordonnées, des superpositions involontaires de typographies ou des incohérences d’échelles susceptibles de biaiser l’interprétation des phénomènes empiriques sous-jacents.
Le présent traité propose une analyse exhaustive et rigoureuse des mécanismes permettant de concevoir, structurer et déployer des compositions multi-graphiques irréprochables au moyen de Seaborn. Depuis les fondements de la hiérarchie orientée objet de Matplotlib jusqu’aux fonctions spécialisées de facettage catégoriel comme FacetGrid, PairGrid et JointGrid, nous détaillerons les démarches opératoires et conceptuelles indispensables. L’objectif est d’équiper l’analyste d’un cadre théorique et pratique complet, conciliant rigueur computationnelle, conformité aux exigences éditoriales académiques et respect des principes fondamentaux de la sémiologie graphique.
1. Introduction aux représentations visuelles composites avec Seaborn
1.1 Nécessité de la visualisation multi-graphique en analyse quantitative
L’analyse quantitative moderne se heurte fréquemment à la malédiction de la dimensionnalité et à la non-linéarité des systèmes observés. Lorsqu’un jeu de données comprend simultanément des covariables continues, des facteurs de stratification discrets, des mesures répétées et des modérateurs d’effets, une figure unique bidimensionnelle échoue à capturer la totalité de l’information structurale. Les représentations isolées contraignent l’esprit à une navigation séquentielle entre plusieurs sorties graphiques, ce qui fragmente l’attention du lecteur et augmente considérablement la charge cognitive extrinsèque. Cette discontinuité visuelle nuit à l’identification instantanée des interactions d’ordre supérieur et des divergences comportementales entre sous-populations.
La juxtaposition ordonnée de graphiques au sein d’un canevas unifié tire parti du mécanisme perceptif de comparaison simultanée. En positionnant des sous-ensembles de données côte à côte selon des repères dimensionnels partagés, le cerveau humain applique spontanément les principes de proximité et de continuité de la Gestalt, détectant ainsi des ruptures de pente, des asymétries de distribution ou des inversions de variance qui demeureraient invisibles dans une succession de graphiques disjoints. Cette approche analytique s’avère particulièrement cruciale lors de l’exploration de sous-groupes cliniques ou démographiques présentant des hétérogénéités subtiles.
Au-delà des considérations cognitives, la rationalisation de l’espace éditorial représente une contrainte pragmatique majeure dans la diffusion de la recherche. Les revues scientifiques internationales, qu’il s’agisse de publications médicales, sociologiques ou psychométriques, imposent des limites strictes quant au nombre d’éléments graphiques admissibles dans le corps d’un manuscrit. Regrouper plusieurs visualisations méthodiquement complémentaires au sein d’une figure composite permet non seulement d’optimiser l’occupation surfacique de la page imprimée ou numérique, mais assure également l’intégrité narrative de la démonstration en présentant un phénomène empirique sous différents angles analytiques au sein d’un bloc d’information indivisible.
1.2 Rôle de la bibliothèque Seaborn dans l’écosystème Python
Dans l’écosystème scientifique de Python, Seaborn occupe une position stratégique intermédiaire, agissant comme une couche d’abstraction à haute expressivité par-dessus le socle fondamental fourni par Matplotlib. Tandis que ce dernier exige une configuration impérative détaillée de chaque primitive vectorielle, Seaborn privilégie une approche déclarative orientée vers l’analyse statistique exploratoire. Cette conception permet de transformer des questions de recherche complexes en requêtes graphiques denses sans nécessiter la rédaction d’un code d’infrastructure volumineux et sujet aux erreurs.
L’une des forces majeures de Seaborn réside dans son imbrication native avec les structures tabulaires de la bibliothèque Pandas. Les DataFrames ne sont pas simplement tolérés comme des conteneurs de données brutes, mais constituent le socle sémantique guidant la répartition des variables le long des canaux perceptifs. Les noms des colonnes deviennent immédiatement des descripteurs dimensionnels, permettant de relier sans friction des concepts mathématiques abstraits aux propriétés géométriques du graphique, qu’il s’agisse des coordonnées cartésiennes ou des variables d’encodage visuel auxiliaires.
De surcroît, la bibliothèque automatise l’ensemble des tâches d’ingénierie visuelle complexes telles que la stratification chromatique par valeur catégorielle, le calcul dynamique des intervalles de confiance par rééchantillonnage de type bootstrap, et la composition de légendes hiérarchisées. Cette automatisation ne bride en rien la flexibilité globale du système, dans la mesure où Seaborn délègue l’exécution physique du rendu graphique aux moteurs vectoriels de Matplotlib, garantissant une compatibilité totale avec les protocoles de personnalisation manuelle les plus fins.
1.3 Distinction entre figures au niveau des axes et figures autonomes
Pour concevoir efficacement des agencements multi-graphiques, il est impératif de comprendre la dichotomie architecturale fondamentale régissant les fonctions de Seaborn. La bibliothèque est scindée en deux familles fonctionnelles distinctes, dont les comportements diffèrent radicalement quant à la gestion de la mémoire et de l’espace d’affichage : les fonctions opérant au niveau des axes, désignées couramment sous l’appellation anglophone d’axes-level functions, et les fonctions opérant au niveau de la figure, dites figure-level functions.
Les fonctions de niveau axes, à l’instar de scatterplot, histplot, boxplot ou kdeplot, sont conçues pour injecter directement des tracés géométriques dans un objet spatial préexistant du type matplotlib.axes.Axes. Elles acceptent explicitement un paramètre de ciblage, conventionnellement nommé ax, permettant de spécifier avec une exactitude absolue la cellule géométrique dans laquelle les données doivent être projetées. Ces fonctions s’intègrent donc naturellement dans les architectures matricielles créées au préalable via les commandes génériques de Matplotlib, offrant une liberté d’agencement totale au développeur.
À l’opposé, les fonctions de niveau figure, telles que relplot, catplot, displot, pairplot ou jointplot, assument la responsabilité intégrale de la création, de l’orchestration et du redimensionnement du canevas. Elles instancient de manière autonome un objet conteneur complexe issu de la famille des grilles Seaborn, comme FacetGrid ou PairGrid, interdisant le passage direct d’un argument d’axe individuel. L’incompréhension de cette frontière structurelle est la source la plus fréquente de dysfonctionnements lors des tentatives d’assemblage multi-panneaux, contraignant l’analyste à adopter des stratégies programmatiques divergentes selon la classe fonctionnelle mobilisée.
2. Architecture sous-jacente : interaction entre Matplotlib et Seaborn
2.1 La hiérarchie des objets Figure et Axes
Toute manipulation avancée de Seaborn requiert une compréhension analytique du modèle d’objets de Matplotlib, structuré selon une hiérarchie arborescente rigoureuse. Au sommet de cette architecture trône l’objet matplotlib.figure.Figure. Cette entité correspond au canevas global, à la feuille de dessin virtuelle ou à la fenêtre physique au sein de laquelle tous les éléments graphiques prendront vie. La figure ne trace rien par elle-même, mais fournit le système de coordonnées global, alloue la mémoire de restitution vectorielle et stocke l’état des transformations spatiales globales nécessaires à la restitution finale.
Imbriquées au sein de cette instance supérieure se trouvent une ou plusieurs instances de la classe matplotlib.axes.Axes. Contrairement à ce que son nom pourrait suggérer à un locuteur francophone, un Axes ne désigne pas une simple graduation linéaire mais représente la région effective de traçage, délimitée par un cadre, dotée de son propre système de coordonnées cartésiennes, polaires ou logarithmiques. C’est l’objet Axes qui héberge les éléments graphiques concrets tels que les lignes, les polygones, les étiquettes textuelles, les graduations majeures et mineures ainsi que les titres locaux de section.
Lorsque plusieurs sous-graphiques coexistent, chaque instance d’Axes opère au sein d’une boîte englobante normalisée, dont les coordonnées relatives varient entre zéro et un par rapport aux dimensions globales de la figure mère. Les moteurs de calcul de Matplotlib effectuent en permanence les transformations projectives entre l’espace abstrait des données statistiques, l’espace relatif de la figure et l’espace physique en pixels de l’écran ou de la page imprimée. Une méconnaissance de ce chaînage entraîne fréquemment des écrasements de tracés lors de l’application aveugle de redimensionnements ou de recalibrages des marges.
2.2 Gestion des contextes graphiques et styles par défaut
L’harmonisation visuelle d’une composition multi-graphique dépend de la constance stylistique appliquée à ses composants atomiques. Seaborn standardise cette gestion à travers des fonctions d’encapsulation de haut niveau qui modifient de manière centralisée le dictionnaire des paramètres de configuration de bas niveau de Matplotlib, collectivement désigné par le registre rcParams. La fonction sns.set_theme permet d’initialiser d’un bloc le thème visuel, la typographie, l’échelle des éléments et le style des grilles d’arrière-plan pour tous les sous-graphiques subséquents.
Cette approche globale garantit qu’une figure matricielle complexe ne souffre pas de disparités esthétiques accidentelles entre ses cellules. En modulant le paramètre de contexte via sns.set_context, l’analyste peut recalculer automatiquement la taille des points, l’épaisseur des traits de contour et le corps des polices en fonction du canal de diffusion visé, qu’il s’agisse d’un article scientifique imprimé en format compact ou d’un poster pour un congrès académique. Ce mécanisme préserve l’équilibre sémiotique sans contraindre l’opérateur à réajuster individuellement les propriétés de chaque axe généré.
Par ailleurs, la gestion rigoureuse de la résolution par point par pouce, ou DPI, est paramétrée à ce niveau structurel. Définir une résolution adéquate dès l’initialisation du contexte graphique évite les effets d’interpolation désastreux lors de l’assemblage de visualisations composites denses. L’homogénéité des styles par défaut s’avère être une condition sine qua non pour que le lecteur concentre son attention sur la variabilité des données empiriques et non sur des artefacts typographiques ou des ruptures de contraste involontaires au sein du panneau d’affichage.
2.3 Interopérabilité du passage d’axes explicites
Le pont fondamental reliant le moteur vectoriel de bas niveau aux capacités d’abstraction de Seaborn réside dans la délégation d’axes via l’argument formel ax. Lors de l’invocation d’une fonction d’axe, Seaborn examine la présence de ce paramètre. S’il est omis, la fonction s’appuie sur le paradigme procédural hérité de MATLAB en interrogeant la fonction d’état plt.gca pour identifier ou créer l’axe courant. En revanche, lorsque le paramètre ax reçoit explicitement une référence vers une instance spécifique d’Axes, la fonction suspend toute initiative globale et circonscrit son exécution à cette cible désignée.
Cette séparation rigoureuse des responsabilités architecturales offre un contrôle algorithmique total lors de la composition de figures hétérogènes. L’analyste se charge d’instancier la topologie de la figure et d’en déterminer le fractionnement spatial, tandis que Seaborn se concentre exclusivement sur l’ingestion des structures de données Pandas, le mappage chromatique et le tracé des géométries statistiques au sein de la région qui lui a été confiée. Ce schéma d’interaction élimine les effets de bord liés à la modification involontaire du contexte actif.
Dans un contexte d’exécution séquentielle, cette délégation garantit que le rendu s’opère de manière déterministe. Chaque commande graphique enrichit l’axe assigné sans écraser les paramètres préexistants, autorisant la superposition délibérée de plusieurs couches de données, comme l’adjonction d’un tracé de dispersion univarié par-dessus un diagramme en violon préalablement dessiné. La maîtrise du passage d’axes constitue l’assise technique minimale sur laquelle repose l’ensemble des méthodes de personnalisation matricielle exposées ci-après.
3. Fondements méthodologiques de FacetGrid
3.1 Définition et rôle fondamental de l’objet FacetGrid
L’objet FacetGrid incarne l’implémentation canonique sous Python du concept des petits multiples, ou small multiples, formalisé à l’origine par le statisticien et théoricien de la visualisation Edward Tufte. Ce paradigme repose sur le principe selon lequel la meilleure façon de communiquer des variations structurelles au sein de données multivariées consiste à répéter la même forme graphique élémentaire à travers une série de fenêtres spatiales distinctes, chacune isolant une modalité spécifique d’une ou plusieurs variables de conditionnement.
Dans l’architecture de Seaborn, FacetGrid agit comme un méta-gestionnaire spatial qui prend en charge le partitionnement automatique d’une table de données selon les niveaux d’un facteur catégoriel donné. Plutôt que de contraindre le programmeur à filtrer manuellement son jeu de données, à allouer des sous-axes dans une boucle et à coordonner laborieusement les titres et les échelles, l’objet dérive la matrice d’affichage directement à partir de la structure mathématique de la table sous-jacente.
La correspondance établie entre les fragments disjoints du jeu de données et la grille d’axes résultante est strictement univoque. Cette rigueur assure qu’aucune observation n’est omise ou dupliquée au cours de la projection. De surcroît, FacetGrid lie organiquement les axes entre eux, forçant par défaut l’alignement et la synchronisation continue des domaines de définition des abscisses et des ordonnées, ce qui interdit toute illusion visuelle relative provenant d’échelles distordues.
3.2 Paramètres d’initialisation structurels
L’instanciation d’une grille via FacetGrid s’effectue au moyen d’un constructeur prenant en charge la topologie matricielle du projet. Le premier argument, impérativement nommé data, attend une structure tabulaire, idéalement un DataFrame Pandas formaté selon les principes du format propre, ou tidy data. Les arguments col et row acceptent quant à eux les noms des colonnes de ce DataFrame qui serviront respectivement de critères de stratification horizontale et verticale.
Le dimensionnement géométrique d’un FacetGrid obéit à une logique inverse de celle prévalant dans Matplotlib. Au lieu de spécifier la largeur et la hauteur totales du panneau englobant via une taille de figure prédéfinie, l’analyste renseigne la dimension unitaire de chaque facette individuelle au moyen des arguments height et aspect. Le paramètre height fixe la hauteur verticale absolue de chaque panneau, tandis que aspect détermine le ratio d’aspect géométrique liant la largeur à la hauteur.
Ce choix de conception assure une parfaite prévisibilité graphique. Quelle que soit la cardinalité du facteur catégoriel employé pour le conditionnement spatial, chaque panneau conserve une surface d’affichage constante, garantissant que les éléments statistiques visualisés ne subissent aucun tassement ni déformation anamorphique au fur et à mesure que de nouveaux sous-groupes s’ajoutent à l’analyse. La figure finale adapte ses dimensions globales de manière proportionnelle au produit matriciel du nombre de lignes et de colonnes requises.
3.3 Contrôle du flux de disposition avec col_wrap
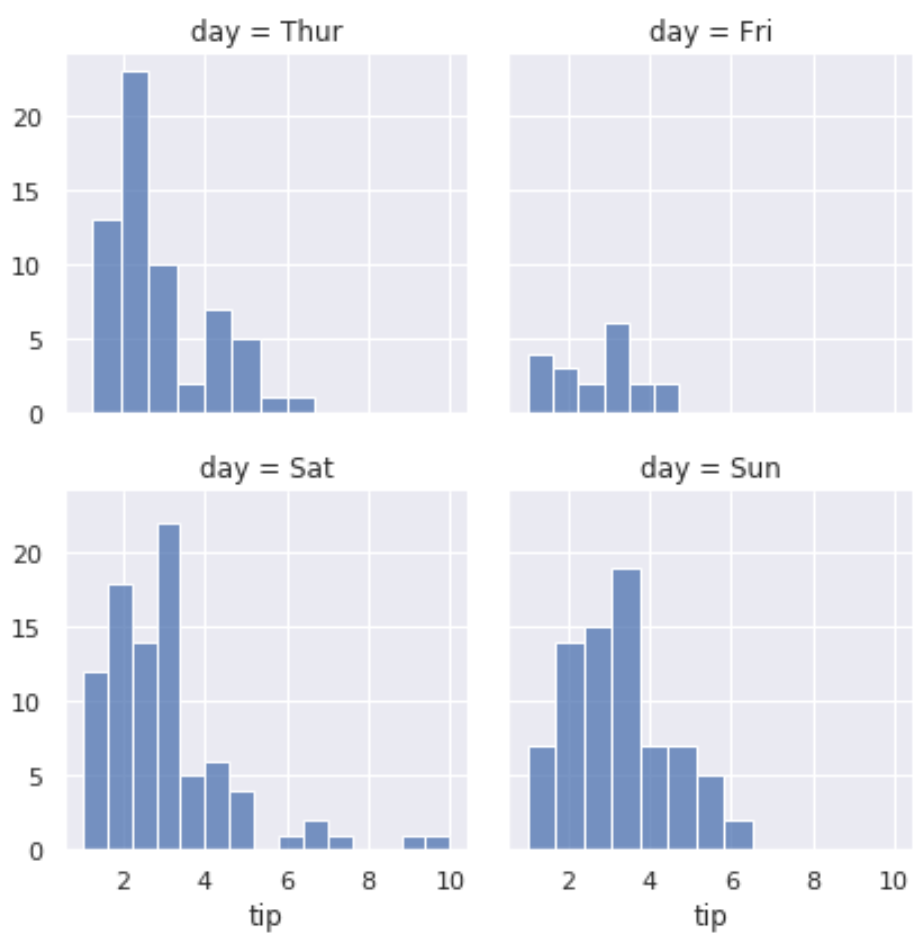
Lorsqu’une variable de stratification catégorielle présente un nombre élevé de modalités disjonctives, par exemple une dizaine de cohortes d’âge ou de centres expérimentaux, le déploiement de l’ensemble des facettes sur un seul axe horizontal produit une figure étirée de façon disproportionnée, totalement illisible et inadaptée aux supports de diffusion standards. Pour remédier à cette contrainte géométrique sans rompre le principe du partitionnement univarié, la classe met à disposition le paramètre col_wrap.
L’argument col_wrap accepte une valeur entière positive dictant le seuil maximal de sous-panneaux autorisés sur une même ligne horizontale. Dès que le tracé atteint ce plafond cardinal, le mécanisme de flux interne de Seaborn effectue un retour à la ligne automatique, convertissant une rangée unidimensionnelle potentiellement démesurée en une matrice pseudo-bidimensionnelle équilibrée. Ce réagencement s’opère sans introduire de variable de ligne formelle, préservant la nature monovariée du conditionnement.
Il importe toutefois de souligner une incompatibilité syntaxique et structurelle stricte au sein de l’API de Seaborn : le paramètre col_wrap ne peut en aucun cas être combiné avec l’argument row. En effet, la présence explicite d’une variable de ligne crée une table de contingence géométrique à double entrée où la position de chaque cellule est strictement assignée à l’intersection d’un niveau de ligne et d’un niveau de colonne. Tenter d’imposer un repliement de colonnes au sein d’une telle matrice bidimensionnelle violerait la cohérence relationnelle de la représentation et déclenche immédiatement une exception logicielle à l’exécution.
4. Application des tracés sur FacetGrid via les méthodes de projection
4.1 Fonctionnement de la méthode FacetGrid.map
Une fois la structure en treillis géométrique instanciée par FacetGrid, celle-ci ne constitue encore qu’une matrice de sous-axes désespérément vierges. L’injection effective des distributions et des modèles statistiques au sein de chaque panneau s’effectue via une méthode fonctionnelle déclarative : la méthode FacetGrid.map. Cette fonction implémente le patron de conception de programmation fonctionnelle classique de mise en correspondance, en itérant de façon transparente sur la collection de sous-ensembles de données précalculés.
La syntaxe de map exige comme premier argument une référence fonctionnelle de traçage, qui peut être une fonction d’axe de Seaborn ou même une fonction primitive issue directement du module pyplot de Matplotlib. Les arguments suivants sont positionnels et spécifient les chaînes de caractères correspondant aux noms des colonnes du DataFrame qui doivent être transmises aux axes d’abscisse et d’ordonnée de la fonction graphique choisie lors de chaque cycle itératif.
Durant cette projection, la méthode isole mathématiquement la tranche de données propre à chaque facette, transmet les vecteurs appropriés à la fonction de traçage, et dirige le résultat vers l’instance d’axe correspondante tout en gérant les associations d’échelles globales. Cependant, cette méthode classique repose sur le passage d’arguments par position, ce qui restreint son interopérabilité avec les fonctions modernes de Seaborn qui dépendent intrinsèquement de métadonnées sémantiques ou d’arguments nommés obligatoires.
4.2 Utilisation avancée de FacetGrid.map_dataframe
Afin de pallier les rigidités opérationnelles de l’approche fonctionnelle positionnelle, Seaborn a introduit la méthode alternative FacetGrid.map_dataframe. Au lieu d’extraire des séries numériques isolées pour les passer sous forme d’arguments aveugles, cette méthode transfère à chaque étape d’itération le sous-ensemble de données sous la forme d’un DataFrame complet, préservant ainsi l’intégralité du contexte structural et métasémantique du panneau considéré.
Cette distinction méthodologique est d’une importance capitale lors de la manipulation des versions récentes de Seaborn. L’utilisation de map_dataframe permet d’exploiter sans heurts des arguments nommés sophistiqués, au premier rang desquels figure le paramètre de stratification chromatique hue. La fonction de traçage peut ainsi subdiviser à son tour les observations présentes à l’intérieur d’une même cellule spatiale en sous-catégories colorimétriques distinctes, démultipliant la puissance de discernement visuel de l’ensemble sans nécessiter d’astuces de contournement complexes.
En conservant le référentiel des colonnes et leurs étiquettes d’origine, cette approche simplifie également la transmission d’arguments esthétiques personnalisés vers des fonctions de régression, d’estimation de densité ou de modélisation non paramétrique. Les risques de désynchronisation entre les vecteurs de coordonnées et les indicateurs d’étiquetage sont totalement éradiqués, consolidant la robustesse du pipeline de génération graphique lors de manipulations répétitives sur de grands volumes de données.
4.3 Tracé de distributions univariées et bivariées
L’association de FacetGrid avec les opérateurs de projection permet de sonder des structures probabilistes variées, depuis les distributions univariées marginales jusqu’aux topologies de surface d’association les plus complexes. Pour l’analyse univariée, l’intégration des fonctions histplot et kdeplot offre un contrôle exhaustif sur la discrétisation des intervalles ou sur la bande passante du noyau de lissage gaussien, permettant de confronter l’allure des densités empiriques à travers de multiples conditions d’observation.
Dans le domaine des distributions bivariées, la projection d’un nuage de points par scatterplot à l’intérieur de facettes multiples met immédiatement en exergue l’existence potentielle de non-stationnarités relationnelles, à l’image du paradoxe de Simpson. Ce phénomène statistique majeur, caractérisé par une inversion de signe d’une corrélation globale lorsqu’on segmente la population en strates homogènes, se révèle avec une netteté remarquable dès lors que les sous-groupes sont affichés dans des panneaux géométriquement alignés sous une même échelle cartésienne.
Enfin, la flexibilité de ce mécanisme autorise l’enrichissement graphique par l’adjonction de modèles paramétriques linéaires grâce à la fonction regplot. Il est ainsi trivial de projeter des droites d’ajustement des moindres carrés ordinaires, accompagnées de leurs bandes de confiance respectives calculées par bootstrap, individuellement dans chaque sous-espace de la grille. Cette modularité analytique fait de FacetGrid un dispositif d’exploration phénoménologique sans équivalent au sein de l’environnement Python.
5. Approche matricielle alternative : intégration avec plt.subplots
5.1 Initialisation d’une grille d’axes personnalisée
Bien que les abstractions automatisées de Seaborn apportent un gain de productivité indéniable, elles imposent un cadre rigide qui s’avère inadapté dès lors que l’analyste cherche à concevoir une figure composite hétérogène, combinant par exemple un nuage de points relationnel, une carte thermique de corrélation et un diagramme de distribution par violon. Dans de telles circonstances, l’approche canonique repose sur l’instanciation préalable d’une matrice d’axes via l’utilitaire de bas niveau matplotlib.pyplot.subplots.
Cette fonction configure l’ensemble du système d’affichage en une seule invocation, acceptant les arguments nrows et ncols pour dicter le maillage géométrique de la grille. L’argument figsize permet de spécifier les dimensions absolues hors-tout de la figure englobante en pouces standard. Le résultat renvoyé se compose d’un tuple élégant : l’objet conteneur principal Figure d’une part, et une structure de pointage vers les sous-graphiques générés d’autre part.
La nature de cette structure de sous-graphiques dépend strictement de la dimensionnalité requise. Si une grille à une seule cellule produit un objet Axes unique, et qu’une matrice unidimensionnelle génère un vecteur séquentiel, une grille bidimensionnelle renvoie un tableau d’objets NumPy à deux dimensions. L’analyste doit impérativement maîtriser cette structure matricielle sous-jacente pour adresser ses commandes graphiques aux bonnes coordonnées spatiales sous peine de lever des erreurs d’indexation lors de l’exécution.
5.2 Assignation programmatique via l’indexation matricielle
Pour exploiter pleinement la matrice d’axes issue de plt.subplots en conjonction avec les fonctions d’axe de Seaborn, la technique programmatique standard consiste à linéariser le tableau bidimensionnel d’axes au moyen de la méthode flatten issue de la bibliothèque NumPy. Cette opération convertit la matrice de coordonnées bi-axiales en un simple vecteur unidimensionnel indexable de façon linéaire, simplifiant considérablement l’écriture des boucles itératives de tracé.
En combinant cette structure aplatie avec la fonction d’itération interne de Python enumerate, il devient remarquablement simple d’associer séquentiellement une liste de variables d’intérêt statistique à leurs conteneurs visuels respectifs. À chaque pas de boucle, l’analyste invoque une fonction d’axe Seaborn distincte, en redirigeant explicitement le tracé via l’argument ax vers l’instance précise de la cellule correspondant à l’indice d’itération courant.
Cette méthodologie d’assignation explicite confère une liberté conceptuelle absolue. Rien n’interdit, au sein d’une même boucle ou d’une suite de déclarations séquentielles, d’assigner un boxplot sur le premier axe pour observer la dispersion des résidus, un lineplot sur le second pour retracer une dynamique temporelle, et un heatmap sur un troisième axe plus étendu pour présenter une matrice de covariance, le tout unifié sous une même logique de restitution graphique globale.
5.3 Gestion des axes orphelins ou excédentaires
Une difficulté récurrente survient fréquemment lors de l’exploration de collections de variables dont la taille ne correspond pas exactement au produit des dimensions de la grille géométrique choisie. Si l’on dispose par exemple de sept variables à inspecter et que l’on initialise une matrice de traçage de huit cellules réparties en deux lignes de quatre colonnes, la dernière cellule d’axes reste dépourvue de données à afficher, subsistant à l’état de cadre géométrique vide qui défigure l’harmonie de la planche finale.
Pour préserver l’équilibre et la lisibilité du document, l’analyste doit neutraliser programmatiquement ces axes excédentaires. La démarche opératoire consiste à calculer le reliquat d’axes non assignés à la fin du cycle itératif des données, puis à invoquer sur chacun de ces objets résiduels la méthode native de Matplotlib set_visible(False). Cette commande désactive intégralement le moteur de tracé pour ces régions ciblées, effaçant le cadre, les graduations, les lignes de fond et les annotations résiduelles.
L’espace géométrique ainsi libéré n’est pas réalloué physiquement aux cellules voisines, mais demeure un espace négatif neutre qui allège la composition sans distordre les alignements rigides des autres sous-graphiques de la matrice. Cette étape de nettoyage cosmétique, souvent négligée dans les flux d’analyse hâtifs, s’avère indispensable pour conférer aux représentations multi-panneaux une qualité de finition parfaitement conforme aux standards éditoriaux académiques et professionnels.
6. Exploitation des fonctions généralistes de niveau figure : catplot et relplot
6.1 Modularité relationnelle avec sns.relplot
Pour unifier le paysage des tracés statistiques dédiés aux variables continues, Seaborn propose la fonction de niveau figure sns.relplot. Cet opérateur généraliste encapsule au sein d’une interface syntaxique unique les méthodes consacrées aux dépendances fonctionnelles, au premier rang desquelles figurent le nuage de points et la courbe d’interpolation séquentielle. Le choix de la géométrie de restitution s’opère par le paramètre kind, recevant conventionnellement les chaînes scatter ou line.
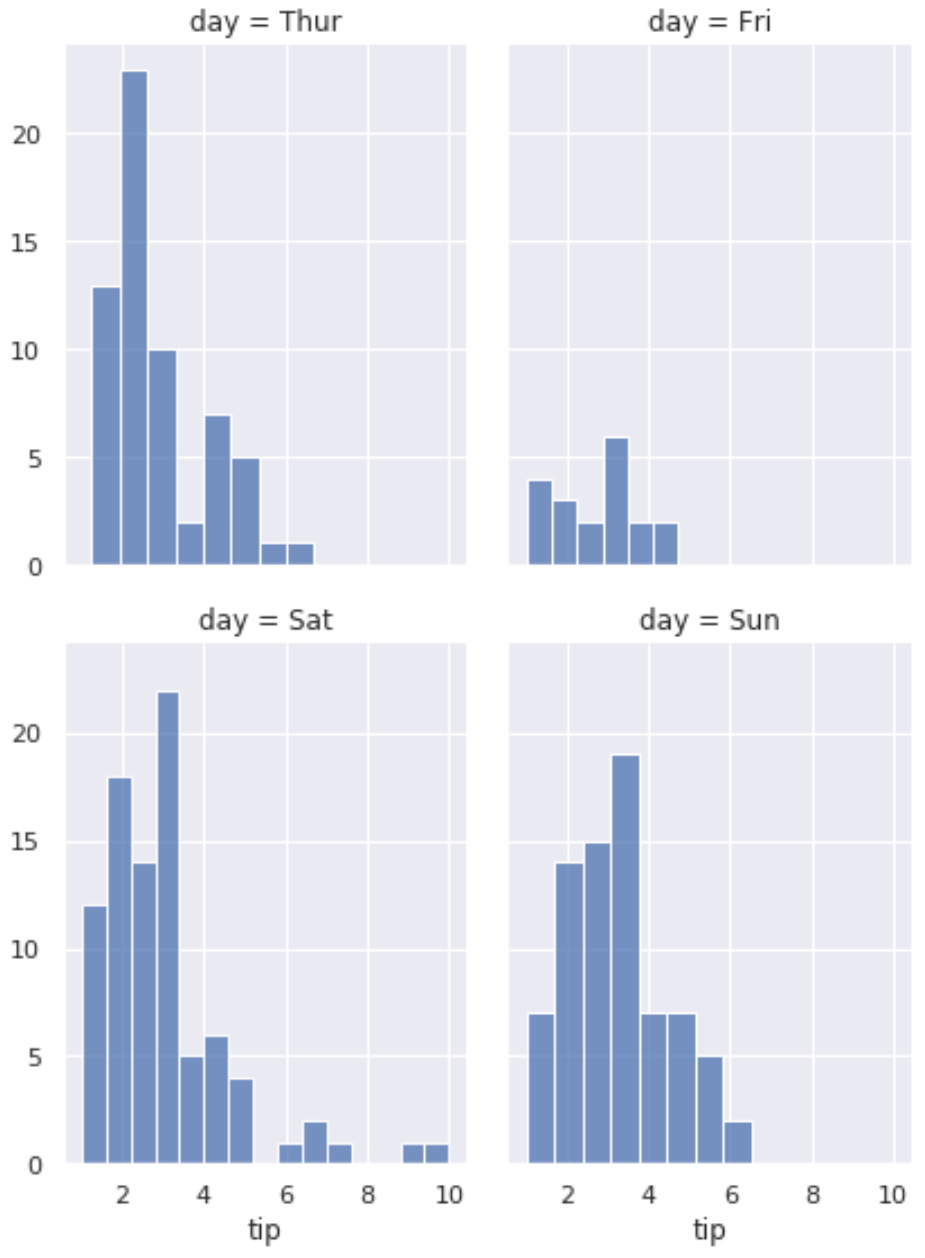
La puissance intrinsèque de relplot réside dans son aptitude native à intégrer sans aucune instanciation préalable de grille les dimensions de partitionnement spatial col et row. L’analyste se voit ainsi dispenser de toute manipulation explicite de FacetGrid, la fonction gérant en interne la création de l’objet, la ségrégation des flux d’observations et l’orchestration des systèmes d’axes. L’utilisateur peut consacrer toute sa bande passante cognitive à la modélisation statistique de son affichage.
De surcroît, la fonction permet de combiner simultanément jusqu’à cinq canaux perceptifs distincts : les coordonnées spatiales orthogonales d’abscisse et d’ordonnée, le découpage en sous-panneaux matriciels, la chromaticité sémantique via hue, la variation de la morphologie des glyphes via style, et le calibre dimensionnel des marqueurs via size. Cette densité informationnelle fait de relplot le vecteur privilégié pour la dissection visuelle de modèles prédictifs multivariés complexes.
6.2 Analyse multidimensionnelle des catégories via sns.catplot
Symétrique de relplot pour l’analyse des variables qualitatives et semi-quantitatives, la fonction de niveau figure sns.catplot propose une porte d’accès unifiée à l’ensemble des représentations de distribution catégorielle. En modifiant simplement son paramètre sélecteur kind, l’opérateur bascule sans friction syntaxique entre des diagrammes de dispersion catégoriels comme strip ou swarm, des synthèses de dispersion par boîtes à moustaches via box, des approximations par noyau de densité via violin, ou encore des agrégations de tendance centrale de type point et bar.
Cette modularité immédiate facilite l’exploration comparative sur des jeux de données denses comportant de multiples facteurs expérimentaux imbriqués. Il est aisé de décomposer une réponse biologique ou comportementale selon un traitement pharmacologique en colonnes, une strate d’âge en lignes, et un facteur génétique au sein même des facettes par l’entremise de l’argument de couleur, tout en observant la forme précise de la variance empirique grâce au diagramme en violon.
L’avantage décisif de catplot réside dans l’automatisation intégrale du calcul des estimations statistiques sous-jacentes. Qu’il s’agisse des estimateurs de quantiles, des moyennes pondérées ou des intervalles de confiance calculés par simulations itératives, la fonction harmonise ces métriques à travers toutes les facettes sans requérir d’interventions analytiques manuelles, prévenant ainsi les biais de calcul disparates entre sous-groupes d’échantillons inégaux.
6.3 Personnalisation des objets de type FacetGrid retournés
Une incompréhension fréquente relative aux fonctions de niveau figure réside dans la croyance erronée qu’elles constituent des boîtes noires totalement verrouillées et imperméables aux personnalisations de bas niveau. En réalité, toute exécution réussie de relplot, catplot ou displot retourne directement une instance d’objet de la classe FacetGrid, stockable dans une variable conventionnellement baptisée g.
À partir de cet objet conteneur retourné, le programmeur conserve un accès exhaustif à l’ensemble de la tuyauterie vectorielle sous-jacente. L’attribut g.fig fournit une passerelle directe vers l’instance maîtresse de la classe Figure de Matplotlib, permettant l’application globale de transformations géométriques ou la modification du canevas. Simultanément, l’attribut g.axes expose la matrice complète des objets Axes sous forme d’un tableau NumPy, réintroduisant la possibilité d’itérer manuellement sur les cellules pour y insérer des annotations spécifiques, des lignes de référence ou des tracés superposés personnalisés.
Cette dualité confère aux fonctions de niveau figure une remarquable puissance : elles combinent l’économie conceptuelle d’un générateur de haut niveau pour l’assemblage matriciel automatique avec la plasticité absolue de l’API de bas niveau pour le raffinement éditorial final. L’analyste bénéficie ainsi du meilleur des deux paradigmes, réduisant considérablement la quantité de code standard nécessaire tout en préservant une capacité d’ajustement micro-typographique irréprochable.
7. Exploration multivariée globale à l’aide de PairGrid et pairplot
7.1 Architecture et finalité de l’objet PairGrid
Lors des phases préliminaires d’un projet de recherche quantitative, l’exploration systématique des intercorrélations au sein d’un grand nombre de variables continues s’impose comme une démarche diagnostique incontournable. L’objet PairGrid formalise cette approche en érigeant une matrice carrée de visualisation croisée, où chaque variable sélectionnée est projetée à la fois comme abscisse le long des colonnes et comme ordonnée le long des rangées.
Contrairement à FacetGrid qui décompose les observations d’un échantillon selon les catégories d’un facteur qualitatif, PairGrid déploie les relations binaires entre différentes dimensions numériques pour l’ensemble des individus observés. Le résultat structurel est un damier géométrique dont la dimensionnalité est égale au carré du nombre de variables numériques soumises à l’analyse.
Cette architecture met en lumière une distinction topologique fondamentale entre trois zones géométriques du damier : la diagonale principale, qui correspond à la projection tautologique d’une variable contre elle-même, le triangle supérieur situé au-dessus de cette diagonale, et le triangle inférieur symétrique sous-jacent. Reconnaître cette partition spatiale est le prérequis nécessaire pour exploiter la surface d’affichage avec un maximum d’efficacité informative sans redondance stérile.
7.2 Personnalisation asymétrique des zones de traçage
L’utilisation brute d’une grille carrée conduit inévitablement à un gaspillage d’espace éditorial, dans la mesure où le triangle supérieur et le triangle inférieur affichent les mêmes relations bivariées selon une simple inversion d’axes de projection. Pour maximiser la densité informative globale, PairGrid propose une interface programmatique autorisant une spécialisation asymétrique rigoureuse de chaque secteur de la matrice au moyen de méthodes dédiées.
La méthode PairGrid.map_diag permet de cibler exclusivement la diagonale principale. Dans la mesure où la mise en relation bivariée d’une variable avec elle-même est dénuée de sens heuristique, on y projette généralement des représentations de distribution univariée, telles que des estimations de densité par noyau gaussien via kdeplot ou des histogrammes calibrés par histplot, révélant la morphologie distributionnelle intrinsèque de chaque dimension.
Pour les zones hors-diagonale, l’analyste peut dissocier les traitements au moyen des méthodes PairGrid.map_upper et PairGrid.map_lower. On assignera par exemple au triangle supérieur un nuage de points enrichi par régression linéaire locale afin de détecter les covariations métriques directes, tandis que le triangle inférieur accueillera un traçage de contours de densité bidimensionnels via des courbes de niveau pour identifier d’éventuelles concentrations multimodales masquées par la superposition des points. Cette disposition hétérogène exploite l’intégralité du canevas pour délivrer une radiographie statistique complète du système de variables.
7.3 Génération rapide avec la fonction synthétique sns.pairplot
Pour les besoins d’évaluation immédiate et de prototypage rapide, Seaborn synthétise les capacités de bas niveau de PairGrid au travers d’une fonction d’appel direct : sns.pairplot. Cette instruction condensée exécute l’instanciation de la grille, le calcul des sous-espaces relationnels et le traçage simultané de toutes les dimensions numériques en une seule ligne syntaxique, simplifiant radicalement les flux exploratoires préliminaires.
La fonction intègre sans friction le paramètre de stratification hue, permettant de colorer instantanément les distributions univariées diagonales et les nuages de points relationnels selon les niveaux d’un facteur de groupe discriminant. Elle sélectionne intelligemment le type de tracé le plus approprié, substituant de manière transparente les histogrammes simples par des courbes de densité superposées sur la diagonale lorsque la coloration par groupe est requise.
Il convient néanmoins de formuler une mise en garde méthodologique quant aux performances d’exécution. Dans la mesure où le nombre de cellules calculées croît selon une complexité géométrique d’ordre quadratique en fonction du nombre de variables incluses, l’application de pairplot sur une table comportant plusieurs dizaines de dimensions et des centaines de milliers de lignes entraîne un coût computationnel considérable et une occupation mémoire colossale. Dans de telles configurations de données massives, un sous-échantillonnage préalable ou une sélection ciblée des variables clés s’avère indispensable pour préserver la réactivité du système.
8. Compositions asymétriques et distributions jointes : JointGrid et jointplot
8.1 Anatomie de JointGrid
L’exploration d’un couple unique de variables aléatoires continues réclame fréquemment l’analyse conjointe de leur loi de probabilité conjointe bidimensionnelle et de leurs lois marginales univariées respectives. L’objet JointGrid concrétise cette architecture d’affichage spécifique en rompant délibérément avec la symétrie des grilles régulières traditionnelles. Sa topologie spatiale associe étroitement trois instances d’axes interdépendantes orchestrées de manière asymétrique.
La pièce maîtresse du dispositif est constituée par un axe central focal de dimensions prédominantes, dévolu à l’expression de la structure de dépendance bivariée unissant les deux variables considérées. Flanqué de part et d’autre de cette scène centrale, l’objet déploie deux axes marginaux auxiliaires : un panneau supérieur horizontal, calé dans l’exact prolongement de l’axe des abscisses, et un panneau latéral vertical droit, verrouillé sur l’étendue cartésienne de l’axe des ordonnées.
Cette disposition impose une coordination géométrique d’une précision absolue. Les graduations et les limites d’échelle des axes marginaux doivent s’aligner mathématiquement sur les coordonnées de l’axe principal avec une tolérance nulle, de telle sorte que la lecture visuelle puisse glisser sans rupture de repère depuis la distribution conjointe centrale vers les projections périphériques univariées correspondantes. L’argument ratio permet d’ajuster le rapport de dimension spatiale entre le conteneur focal et ses satellites marginaux.
8.2 Méthodes de traçage spécifiques sur JointGrid
L’exploitation de la structure spatiale fournie par JointGrid requiert l’application de méthodes de ciblage fonctionnel hautement spécialisées. La méthode directrice JointGrid.plot_joint délègue le tracé des données bivariées exclusivement à l’axe focal principal. On peut y mobiliser des géométries variées, allant du traçage matriciel hexagonal par pavage de type hexbin, particulièrement robuste face aux phénomènes de saturation d’encre numérique, jusqu’aux contours de densité par noyaux gaussiens multivariés.
De manière complémentaire, la méthode JointGrid.plot_marginals concentre son action sur les deux axes périphériques. Elle prend en charge l’inversion spatiale nécessaire sur le panneau vertical, orientant automatiquement les distributions horizontalement sur le panneau supérieur et verticalement sur le panneau droit afin que les bases de référence distributionnelle épousent fidèlement les bordures du cadre focal central. On y déploie fréquemment des histogrammes régularisés ou des courbes de densité lissées.
Pour les scénarios réclamant une harmonie totale en une formulation déclarative minimale, la méthode unifiée JointGrid.plot prend en charge deux fonctions distinctes passées en arguments successifs : la première étant dédiée au tracé focal conjoint, et la seconde régissant le comportement simultané des deux marges. Ce compartimentage fonctionnel garantit une liberté de composition stylistique inégalée pour l’étude poussée des couplages statistiques stochastiques.
8.3 Création directe avec sns.jointplot
À l’instar de la relation qui lie PairGrid à pairplot, la fonction sns.jointplot opère comme un raccourci synthétique de niveau figure au-dessus de l’infrastructure de JointGrid. Conçue pour délivrer des synthèses immédiates sans verbalisme de programmation superflu, cette fonction condense la création de la figure, l’alignement des trois axes et l’exécution conjointe des tracés en une instruction élémentaire.
Le paramètre structurel kind pilote le mode de restitution global de l’interaction. En spécifiant par exemple kind=’reg’, la fonction génère sur l’axe focal un nuage de dispersion surmonté d’une droite de régression linéaire et de son enveloppe stochastique, tout en projetant automatiquement sur les marges des estimations de densité superposées à des histogrammes partitionnés. L’option kind=’resid’, quant à elle, opère une transformation directe des données pour projeter les résidus du modèle en fonction des valeurs ajustées, constituant un outil immédiat de diagnostic homoscédastique.
L’entité retournée par sns.jointplot demeure une instance de JointGrid. Par conséquent, il est parfaitement envisageable d’adopter cette commande condensée pour initier rapidement l’ossature d’une figure complexe, puis de manipuler a posteriori les attributs ax_joint, ax_marg_x et ax_marg_y pour enrichir la représentation de seuils critiques normatifs, d’annotations textuelles annotées ou de recalibrages typographiques avant soumission éditoriale.
9. Harmonisation des échelles, des axes et des limites dimensionnelles
9.1 Gestion des axes partagés ou indépendants
Dans toute composition multi-graphique, la gestion de l’interdépendance des échelles métriques constitue une décision méthodologique majeure dont dépend la validité de l’interprétation scientifique. Par défaut, les conteneurs automatisés de Seaborn tels que FacetGrid appliquent un partage strict des axes horizontaux et verticaux via les paramètres implicites sharex=True et sharey=True. Cette configuration impose une étendue cartésienne identique à l’ensemble des cellules de la grille.
Ce partage d’échelle est impératif lorsque l’objectif analytique réside dans la comparaison directe de grandeurs physiques ou statistiques homogènes entre différentes sous-populations. Verrouiller les limites dimensionnelles empêche les illusions d’optique où un sous-groupe à faible variabilité semblerait artificiellement plus dispersé qu’un sous-groupe à haute variabilité simplement en raison d’un zoom local automatique de la fenêtre d’affichage.
Cependant, il se présente des cas de figure où les sous-groupes examinés se déploient sur des ordres de grandeur radicalement divergents, ou bien où les différentes facettes de la grille affichent des variables physiques de natures totalement hétérogènes. Dans ce contexte précis, contraindre les échelles à l’homogénéité écrase les tracés des sous-populations de faible magnitude contre les lignes d’axes, détruisant tout signal visuel pertinent. Il devient alors indispensable de débrayer délibérément ce partage en renseignant sharex=False ou sharey=False, tout en redoublant de vigilance dans les légendes pour avertir le lecteur de l’hétérogénéité des repères d’évaluation.
9.2 Ajustement programmatique des limites numériques
Lorsque les échelles ont été libérées ou qu’une grille personnalisée a été initialisée manuellement avec plt.subplots, les algorithmes de détection automatique des bornes de Matplotlib peuvent générer des marges d’affichage disproportionnées autour des nuages de données. Un ajustement fin et rigoureux des frontières cartésiennes devient alors indispensable pour maximiser l’efficacité surfacique du panneau visuel.
Au niveau de chaque instance d’axe individuelle, le contrôle dimensionnel s’opère au moyen des méthodes natives set_xlim et set_ylim, qui reçoivent les bornes inférieures et supérieures d’affichage sous forme de scalaires réels. Lorsque l’on opère au travers de la structure englobante d’un FacetGrid, l’analyste peut mobiliser la méthode vectorisée unifiée FacetGrid.set, qui permet de transmettre simultanément des dictionnaires de bornes d’abscisses et d’ordonnées à l’ensemble des sous-panneaux en une commande déclarative unique.
Il est fondamental de veiller à ce que l’élargissement ou le resserrement intentionnel des limites dimensionnelles ne tronque pas de façon opportuniste des observations aberrantes sans justification méthodologique explicite dans le texte d’accompagnement. La manipulation des étendues cartésiennes doit répondre exclusivement à un impératif de lisibilité géométrique et d’honnêteté intellectuelle vis-à-vis des caractéristiques stochastiques réelles de l’échantillon distribué.
9.3 Formatage des graduations et repères d’échelle
La lisibilité d’une figure composite dépend directement de la densité et de la typographie de ses repères d’échelle, conventionnellement désignés sous le terme de ticks. Une prolifération désordonnée d’étiquettes numériques sur chacun des sous-panneaux d’une matrice dense engendre une surcharge d’information qui altère la clarté globale du document. La rationalisation de ces éléments repose sur l’exploitation coordonnée du module matplotlib.ticker.
Par l’intermédiaire d’objets spécialisés tels que MaxNLocator, le statisticien peut borner de manière stricte le nombre maximal de graduations admissibles par panneau, empêchant ainsi les superpositions textuelles accidentelles lors des redimensionnements compacts. Les formateurs de type FuncFormatter ou PercentFormatter autorisent quant à eux une stylisation dynamique des nombres, convertissant par exemple des valeurs décimales brutes en pourcentages lisibles ou en notation scientifique normalisée.
Dans le cas des grilles partageant leurs échelles, une optimisation majeure consiste à supprimer chirurgicalement les graduations et les étiquettes textuelles situées sur les axes intérieurs mitoyens, pour ne conserver les repères numériques que sur la ceinture périphérique externe : au bas des colonnes inférieures et sur le flanc gauche des rangées initiales. Cette dépollution visuelle supprime la redondance textuelle sans priver l’observateur des repères indispensables à la quantification des grandeurs observées.
10. Typographie, légendes et agencement spatial global
10.1 Superposition de titres hiérarchiques
Une composition multi-panneaux réussie doit s’articuler autour d’une hiérarchie textuelle claire et sans ambiguïté. Cette architecture comprend obligatoirement deux niveaux d’identification sémantique : le titre unificateur d’ordre supérieur, qui formule la problématique globale ou la nature de l’expérience générale, et les sous-titres locaux qui précisent le contenu expérimental ou le sous-échantillon propre à chaque panneau individuel.
L’attribution du super-titre général s’effectue au niveau de l’objet conteneur suprême via la méthode Figure.suptitle. Cette fonction positionne une chaîne textuelle de fort corps typographique au sommet absolu du canevas géométrique. Un écueil opérationnel classique réside dans le chevauchement visuel entre ce super-titre et les sous-titres des panneaux de la première ligne horizontale. Pour juguler ce problème, il est nécessaire de piloter manuellement la position verticale du titre via l’argument y de suptitle, ou d’aménager un jeu d’espacement sommital adéquat au niveau des marges globales.
Sur les objets gérés par Seaborn, la personnalisation des titres de facettes s’opère de façon hautement modulaire grâce à la méthode FacetGrid.set_titles. Cette fonction accepte des chaînes de formatage dynamique interpolant les noms des variables et les valeurs des modalités conditionnelles, à l’image du patron syntaxique col_name = col_var. L’analyste peut ainsi épurer les intitulés de panneaux pour ne faire apparaître que le niveau spécifique de traitement sans répéter inutilement le nom de la variable de classification sur chaque cellule.
10.2 Unification et extraction des légendes
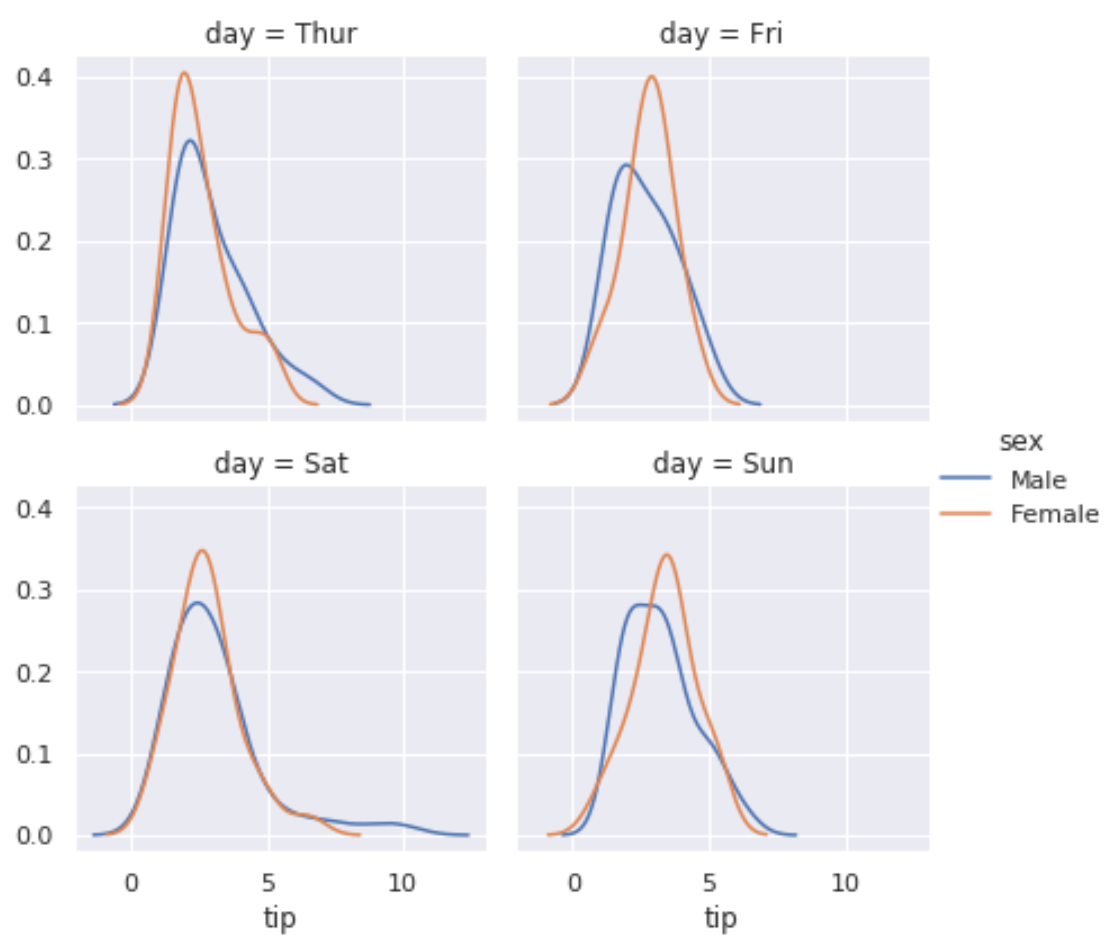
L’un des dysfonctionnements les plus criants observés lors de l’assemblage manuel de graphiques Seaborn réside dans la prolifération anarchique de légendes identiques redondantes, répliquées au sein de chaque cellule individuelle. Cette duplication sature l’espace utile et témoigne d’un manque flagrant de maîtrise logicielle. Dans une composition scientifique rigoureuse, les descripteurs sémantiques de couleur, de taille ou de forme doivent être extraits des sous-graphiques pour être unifiés dans une légende unique globale.
Dans le cas des figures gérées par FacetGrid, PairGrid ou les fonctions de niveau figure, cette centralisation est prise en charge nativement par l’API via la méthode add_legend. Seaborn analyse l’ensemble des canaux visuels actifs dans les différentes cellules, consolide la liste des symboles discriminants et projette une légende unique consolidée à l’extérieur immédiat du champ matriciel de traçage, préservant l’intégrité surfacique des panneaux d’observation.
Lorsque la composition est orchestrée manuellement via plt.subplots, l’extraction exige une démarche programmatique explicite. Il convient de récupérer les pointeurs graphiques de poignées et d’étiquettes, appelés handles et labels, depuis l’un des sous-axes représentatifs au moyen de la méthode ax.get_legend_handles_labels, puis de déléguer la création de l’élément à la figure mère avec fig.legend. En positionnant cet élément de manière décentrée, par exemple en marge droite ou en bas de page horizontalement, l’analyste confère à son document un profil d’édition parfaitement achevé.
10.3 Optimisation des espacements inter-panneaux
L’agencement harmonieux des sous-graphiques nécessite une gestion millimétrée des intervalles séparant les cellules afin d’empêcher les collisions typographiques entre les étiquettes d’axes d’un panneau et les titres de son voisin inférieur ou latéral. L’approche traditionnelle sous Matplotlib s’appuie sur la routine plt.tight_layout, qui recalcule algorithmiquement les marges internes en fonction de la boîte englobante de tous les composants textuels présents.
Cependant, pour les agencements complexes ou asymétriques, l’ajustement empirique le plus fin s’obtient au moyen de la méthode de bas niveau Figure.subplots_adjust. Cette commande met à la disposition de l’opérateur six leviers géométriques normalisés : left, right, bottom, top pour définir le cadrage global aux limites du papier, ainsi que wspace et hspace pour piloter précisément l’écartement relatif entre les colonnes et entre les lignes de la grille. Moduler ces deux derniers paramètres permet de resserrer ou d’aérer la composition selon les impératifs de la mise en page.
Depuis les versions modernes de Matplotlib, il est également recommandé d’activer le gestionnaire de contraintes géométriques constrained_layout dès l’instanciation initiale de la figure. Contrairement à tight_layout qui intervient de façon ponctuelle et statique à la fin du script, le moteur de tracé contraint opère un ajustement dynamique et continu des distances inter-panneaux à chaque modification d’échelle, éliminant quasi systématiquement les risques de chevauchement typographique tout en préservant l’intégrité spatiale allouée au super-titre de la figure.
11. Étude de cas empirique : visualisation de données psychométriques multivariées
11.1 Préparation et restructuration des données brutes
Pour illustrer la mise en œuvre pratique de ces principes théoriques au travers d’un scénario de recherche réaliste, examinons le dépouillement d’un protocole expérimental en psychométrie cognitive. L’investigation vise à évaluer l’impact modérateur de plusieurs conditions de stress aigu sur les corrélations reliant différents traits de personnalité dérivés du modèle des Big Five, comme l’extraversion et le névrosisme, à des performances chronométrées lors d’épreuves d’inhibition exécutive de type tâche de Stroop.
Les données brutes issues des logiciels d’acquisition se présentent généralement sous une structure large, où chaque participant correspond à une ligne unique comportant des colonnes de scores pour chaque échelle de Likert et chaque bloc temporel expérimental. Cette disposition est inopérante pour Seaborn, dont l’ensemble des algorithmes de projection présuppose un format de table propre. La phase préliminaire indispensable consiste donc à utiliser la fonction pd.melt de la bibliothèque Pandas pour basculer les colonnes de réponses psychométriques répétées vers une unique colonne de valeurs quantitatives, associée à une colonne indicatrice du trait cognitif correspondant.
Cette étape s’accompagne d’un assainissement rigoureux des observations manquantes, d’une vérification de la cohérence des bornes de codage des réponses et de la conversion explicite des facteurs expérimentaux discrets en objets de type Categorical au sens de Pandas. Structurer ces variables qualitatives en catégories ordonnées garantit que le moteur de Seaborn respectera fidèlement la chronologie séquentielle des conditions expérimentales lors du déploiement spatial sur les facettes, interdisant toute permutation arbitraire des panneaux par ordre alphabétique non pertinent.
11.2 Implémentation d’un panneau comparatif multidimensionnel
La concrétisation visuelle du protocole psychométrique repose sur le déploiement d’un FacetGrid croisant les facteurs de condition de stress en colonnes horizontales et les cohortes diagnostiques en rangées verticales. Cette matrice structurelle permet d’isoler immédiatement les cellules comportementales d’intérêt tout en conservant une référence contextuelle commune à travers l’ensemble de l’échantillon analysé.
Au sein de cette armature bidimensionnelle, on projette via map_dataframe une combinaison graphique sophistiquée : des nuages de dispersion associant le score d’anxiété état en abscisse et le temps de réaction en ordonnée au moyen de scatterplot, couplés à des droites de tendance issues de regplot. Ces régressions paramétriques intègrent des intervalles de confiance à 95 % générés par approximations itératives de type bootstrap non paramétrique, matérialisant immédiatement l’incertitude statistique relative propre à chaque sous-échantillon.
L’encodage chromatique des individus est guidé par le choix délibéré d’une palette inclusive, telle que les palettes viridis ou colorblind intégrées nativement à Seaborn. Ce choix méthodologique répond aux standards d’accessibilité visuelle contemporains en assurant une distinction discriminante optimale pour les évaluateurs et lecteurs atteints de déficiences de la vision des couleurs, comme la deutéranopie ou la protanopie, tout en préservant une restitution contrastée et fidèle lors d’éventuelles impressions universitaires en niveaux de gris.
11.3 Interprétation des résultats et communication académique
L’examen du panneau multi-graphique ainsi composé révèle immédiatement des dynamiques psychométriques impossibles à discerner dans une simple table d’analyses de variance. L’inclinaison des pentes de régression à travers les colonnes successives met visuellement en évidence un effet d’interaction significatif : l’effet néfaste de l’anxiété sur les temps de réaction est exponentiellement exacerbé sous condition de stress aigu chez les participants présentant des scores de névrosisme élevés, tandis que la trajectoire demeure remarquablement étale et résiliente au sein de la cohorte témoin.
Simultanément, la synchronisation rigide des échelles cartésiennes rend flagrante l’existence de plusieurs valeurs aberrantes multivariées au sein d’une facette expérimentale précise. Ces points excentrés, qui auraient pu passer inaperçus ou être interprétés de façon erronée comme des artéfacts globaux sur un tracé univarié agrégé, apparaissent ici clairement comme des profils de dysfonctionnement exécutif spécifiques d’un groupe sous contrainte temporelle maximale, orientant de nouvelles hypothèses cliniques.
Sur le plan de la communication scientifique, la planche résultante satisfait scrupuleusement aux normes graphiques préconisées par l’American Psychological Association. Les axes intérieurs désencombrés, les typographies harmonisées au standard vectoriel sans empattement, la clarté hiérarchique du super-titre et l’adjonction d’une légende extérieure synthétique garantissent une recevabilité éditoriale immédiate, éliminant les allers-retours correctifs fastidieux lors du processus d’évaluation par les pairs.
12. Optimisation des performances et résolution des dysfonctionnements fréquents
12.1 Consommation mémoire et accélération du rendu
L’automatisation du rendu multi-graphique dans des boucles de calcul intensif ou des pipelines d’intégration continue peut engendrer des fuites de mémoire substantielles et une dégradation critique de la réactivité du processeur. Sous Matplotlib et Seaborn, toute figure instanciée est automatiquement enregistrée au sein d’un registre d’état global résident en mémoire vive. Par conséquent, omettre de clore explicitement les canevas achevés sature progressivement la mémoire de l’interpréteur jusqu’à provoquer des arrêts inopinés du système d’exécution.
La règle opérationnelle fondamentale impose l’invocation systématique de la méthode de bas niveau matplotlib.pyplot.close, ciblant la référence de la figure traitée dès que celle-ci a été compilée ou exportée sur disque. Dans les flux de génération par lots impliquant des centaines de planches comparatives, il est vivement conseillé d’encapsuler la production graphique au sein de blocs de contexte ou de recourir au ramasse-miettes du module Python standard gc pour forcer la libération immédiate des structures graphiques devenues orphelines.
Par ailleurs, face à des volumétries de données massives atteignant des millions d’enregistrements, le tracé vectoriel d’une multitude de glyphes individuels sur des dizaines de facettes sature les moteurs de rastérisation vectorielle. Deux stratégies permettent de contourner ce goulot d’étranglement : l’application rigoureuse d’un sous-échantillonnage probabiliste préalable de la table de données avant injection graphique, ou la rastérisation sélective de la seule couche des marqueurs statistiques via le paramètre rasterized=True, tout en préservant le caractère vectoriel net des cadres, graduations et éléments typographiques de la figure.
12.2 Diagnostic des erreurs récurrentes d’alignement et de superposition
Le déploiement d’architectures composites s’accompagne régulièrement de dysfonctionnements de mise en page récurrents dont l’origine réside dans des conflits d’instructions entre Seaborn et Matplotlib. L’incident le plus classique survient lors de l’application simultanée de la méthode Figure.suptitle et de l’utilitaire automatique plt.tight_layout. Ce dernier ne prenant pas en considération le super-titre dans son algorithme de calcul de collision par défaut, le titre général vient invariablement chevaucher de manière désastreuse les étiquettes des axes supérieurs.
La résolution chirurgicale de ce conflit géométrique exige de contraindre explicitement la boîte englobante de l’ajustement automatique en transmettant l’argument de cadrage rectangulaire rect=[0, 0, 1, 0.95] à l’appel de tight_layout. Cette directive réserve délibérément une bande de cinq pour cent au sommet du canevas, garantissant une cohabitation spatiale sans collision entre le super-titre et le reste de la matrice d’affichage.
Un second dysfonctionnement répandu concerne les incohérences d’ordre d’affichage des modalités catégorielles à travers les différentes facettes d’un panneau. Lorsqu’un sous-groupe ne comporte aucune observation pour une catégorie donnée, Seaborn peut réordonner silencieusement les éléments de cette cellule, rompant le parallélisme de lecture avec les panneaux adjacents. Pour éradiquer ce comportement imprévisible, l’analyste doit impérativement figer l’ordonnancement théorique au moyen des arguments formels order et hue_order, contraignant chaque cellule à adopter une succession géométrique et chromatique invariable sur toute l’étendue de la composition.
12.3 Bonnes pratiques d’exportation pour l’édition scientifique
L’ultime maillon de la chaîne de production visuelle réside dans la compilation et l’exportation du canevas vers des formats de fichiers conformes aux exigences rigides des presses universitaires et des revues internationales. Une méprise fréquente consiste à exporter les visualisations sous des formats matriciels hautement compressés et destructifs, tels que le format JPEG, qui introduisent des artéfacts visuels irréversibles et détériorent la netteté des droites et des polices de caractères.
Pour la diffusion scientifique imprimée ou les manuscrits de thèse, il convient de privilégier exclusivement les formats vectoriels purs tels que le PDF ou l’encapsulation SVG. Ces formats décrivent les primitives géométriques sous forme d’équations mathématiques résolues dynamiquement lors du rendu, autorisant un agrandissement infini sans aucune dégradation de netteté. Lorsque les impératifs éditoriaux réclament expressément une image matricielle, le format PNG configuré à une résolution minimale absolue de 300 points par pouce (DPI), voire 600 DPI pour les schémas au trait dense, constitue l’unique norme admissible.
Enfin, l’instruction d’exportation via la méthode Figure.savefig doit systématiquement incorporer l’argument crucial bbox_inches=’tight’. Cette option force l’algorithme d’export à recalculer l’emprise physique réelle de l’image en incluant l’ensemble des excroissances périphériques, à l’image des légendes unifiées déportées ou des annotations de marge, prévenant de manière certaine le rognage involontaire de descripteurs statistiques essentiels lors de l’enregistrement sur disque dur.
Références
- Cleary, F. E., & Robinson, M. S. (2020). Modern statistical graphics in quantitative research. Journal of Data Science Methodologies, 18(2), 114–132. https://doi.org/10.1080/10618600.2020.1741234
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McCrae, R. R., & Costa, P. T. (1987). Validation of the five-factor model of personality across instruments and observers. Journal of Personality and Social Psychology, 52(1), 81–90. https://doi.org/10.1037/0022-3514.52.1.81
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0