
La restitution visuelle des trajectoires temporelles et des dynamiques continues constitue l’un des piliers méthodologiques de l’exploration de données empiriques contemporaine. Dans les sciences biomédicales, l’épidémiologie, l’économétrie ou la sociologie quantitative, les chercheurs sont constamment confrontés à la nécessité de traduire des flux séquentiels d’observations en synthèses visuelles immédiatement intelligibles, sans sacrifier l’intégrité analytique des mesures. Le graphique linéaire, par sa capacité intrinsèque à matérialiser la continuité sous-jacente de phénomènes ordonnés, s’impose comme l’outil paradigmatique de cette transition entre la matrice numérique brute et l’inférence cognitive. Au sein du progiciel SAS (Statistical Analysis System), la mise en œuvre de ces représentations s’est profondément transformée au cours des deux dernières décennies, évoluant d’une syntaxe graphique procédurale rigide vers un modèle déclaratif moderne et polyvalent.
Historiquement dominé par le module SAS/GRAPH et son instruction GPLOT, le paysage du traitement graphique sous SAS a été radicalement métamorphosé par l’avènement du système ODS Graphics et de la procédure PROC SGPLOT. Cette dernière fournit un cadre unifié, robuste et remarquablement expressif, articulé autour d’une logique en couches successives. Grâce à l’instruction SERIES, les statisticiens disposent d’un instrument d’une précision chirurgicale pour configurer, moduler et enrichir des tracés longitudinaux. Qu’il s’agisse de documenter la cinétique d’un biomarqueur sérique au cours d’un essai randomisé contrôlé, de cartographier la volatilité d’indices macroéconomiques ou d’identifier des points de rupture au sein de séries chronologiques industrielles, la maîtrise de cette procédure s’avère indispensable pour tout praticien de la donnée soucieux de rigueur méthodologique.
Le présent traité propose une analyse exhaustive des mécanismes conceptuels, syntaxiques et esthétiques présidant à la création de graphiques linéaires sous SAS. À travers un parcours didactique rigoureux, chaque étape du développement graphique sera disséquée, depuis la restructuration matricielle des tables d’entrée jusqu’à l’exportation vectorielle conforme aux protocoles les plus stricts de l’édition scientifique internationale. En explorant successivement les tracés univariés, les stratifications multigroupes, les doubles échelles ordonnées, ainsi que l’adjonction de mesures de variabilité probabiliste, ce manuel fournit les clés théoriques et appliquées permettant de transformer des jeux de données complexes en représentations visuelles de haute précision éditoriale.
1. Introduction aux représentations graphiques longitudinales dans SAS
1.1 Importance de la visualisation séquentielle en analyse de données
L’exploration visuelle de séquences ordonnées répond à une exigence épistémologique fondamentale : permettre au chercheur d’appréhender la structure dynamique interne d’un phénomène avant toute formalisation stochastique formelle. Dans le cadre de l’analyse des séries temporelles, des processus stochastiques ou des études de cohortes à mesures répétées, le tracé linéaire remplit une fonction heuristique irremplaçable. Il permet d’identifier sans délai la présence d’une composante tendancielle globale, qu’elle soit linéaire, exponentielle ou asymptotique, tout en révélant les oscillations périodiques, les instabilités saisonnières et les ruptures structurelles soudaines consécutives à un événement exogène ou à une intervention thérapeutique ciblée.
La perception visuelle humaine possède des propriétés cognitives remarquables pour détecter la covariance spatio-temporelle et les discontinuités topologiques. En reliant par des segments continus des points d’observation discrets disposés le long d’un continuum temporel, le graphique linéaire postule implicitement une hypothèse de continuité du phénomène sous-jacent entre deux jalons métriques. Cette extrapolation visuelle, lorsqu’elle est méthodologiquement fondée, facilite la comparaison intuitive entre les trajectoires prévues par des modèles théoriques et la dispersion effective des réalisations empiriques.
Il existe une profonde complémentarité entre la modélisation statistique inférentielle — telle que les modèles linéaires mixtes, les régressions à coefficients variables ou les processus autorégressifs intégrés — et la visualisation séquentielle. Alors que les tests d’hypothèses et les tables de paramètres quantifient avec rigueur l’amplitude des effets et leur significativité statistique, ils échouent souvent à illustrer la cinétique fine d’un profil individuel ou l’émergence d’effets de seuil locaux. La visualisation longitudinale opère ainsi comme un garde-fou méthodologique contre les pièges de l’agrégation aveugle et les conclusions erronées tirées de moyennes globales trompeuses.
1.2 Rôle de PROC SGPLOT dans l’écosystème ODS Graphics
La transition de l’ancienne suite SAS/GRAPH vers le système contemporain ODS Graphics (Output Delivery System) représente une avancée majeure dans l’histoire logicielle de SAS Institute. Les anciennes procédures, à l’instar de PROC GPLOT, contraignaient les analystes à manipuler des déclarations globales lourdes (instructions SYMBOL, AXIS, LEGEND) dont la persistance en mémoire entraînait de fréquents effets de bord. L’émergence des procédures statistiques graphiques, incarnées au premier chef par PROC SGPLOT, a instauré un paradigme déclaratif hautement standardisé, modulaire et totalement découplé de la gestion bas niveau des pilotes d’affichage d’ancienne génération.
Au cœur de l’écosystème ODS Graphics, PROC SGPLOT interagit directement avec les moteurs de rendu analytiques du système. Cette architecture permet de générer des sorties graphiques dont la résolution typographique, l’étalonnage colorimétrique et l’équilibrage des marges s’ajustent automatiquement en fonction des destinations de sortie sélectionnées (HTML, PDF, RTF ou documents vectoriels). Les styles ODS intégrés — tels que HTMLBlue, Journal ou Statistical — garantissent une homogénéité formelle remarquable, répondant d’emblée aux chartes graphiques des éditeurs scientifiques internationaux et des instances réglementaires sanitaires comme la Food and Drug Administration (FDA) ou l’Agence Européenne des Médicaments (EMA).
En outre, la compacité syntaxique de PROC SGPLOT n’obère en rien son potentiel de personnalisation avancée. L’instruction permet de composer des figures stratifiées complexes en superposant des primitives graphiques indépendantes à l’intérieur d’un canevas cartésien unique. Cette modularité libère l’utilisateur de la programmation fastidieuse de coordonnées absolues : le compilateur graphique interne optimise dynamiquement la gestion des collisions d’étiquettes, le calibrage des intervalles d’axes et l’implantation contextuelle des clés de légende.
1.3 Distinction conceptuelle entre nuages de points et diagrammes linéaires
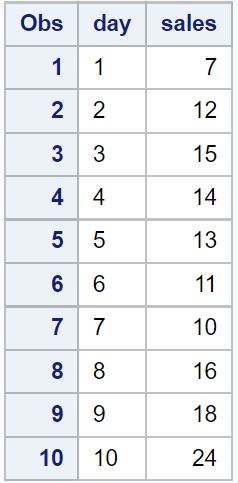
La distinction opérée entre un nuage de points généré par l’instruction SCATTER et une courbe séquentielle produite par l’instruction SERIES relève de choix épistémologiques et sémiologiques cruciaux. Le diagramme de dispersion (scatter plot) traite chaque observation comme un couple de coordonnées numériques autonomes, sans préjuger d’un quelconque ordonnancement directionnel reliant les points les uns aux autres. Il est l’instrument de prédilection pour évaluer la corrélation brute, la densité bivariée ou la partition hétérogène de données transversales indépendantes et identiquement distribuées.
À l’inverse, l’instruction SERIES matérialise une connexion orientée d’un sommet à un autre, instaurant une relation d’ordre strict le long de l’abscisse. Ce tracé linéaire postule l’existence d’une dépendance structurelle ou d’un flux sous-jacent : le point d’indice t est méthodologiquement lié au point d’indice t+1 par le passage du temps ou par la progression monotone d’une variable métrique d’exposition. Tracer une ligne entre deux observations n’est donc pas une simple coquetterie esthétique, mais une déclaration explicite sur la nature interpolable du processus étudié.
Par conséquent, employer une instruction SERIES sur des données non ordonnées ou sur des variables catégorielles nominales constitue une faute méthodologique majeure, susceptible de suggérer des tendances fictives là où ne résident que des contrastes discrets. Le recours conjoint aux instructions SCATTER et SERIES au sein d’un même bloc de code offre toutefois une synthèse analytique féconde : il permet de rendre visibles simultanément les mesures empiriques observées (via les marqueurs discrets) et la cinétique de raccordement théorique ou séquentiel qui les unifie.
2. Fondements syntaxiques de PROC SGPLOT et de l’instruction SERIES
2.1 Architecture générale de la procédure PROC SGPLOT
L’architecture fondamentale de PROC SGPLOT repose sur une syntaxe compacte et modulaire, pensée selon le concept de superposition en couches (layers). L’invocation de la procédure débute impérativement par la spécification du jeu de données source au moyen de l’option DATA=, pointant vers une table SAS temporaire de la bibliothèque WORK ou une table permanente résidant dans une librairie dédiée. Cette liaison univoque assure que toutes les instructions graphiques subséquentes s’abreuvent à la même source relationnelle de variables.
À l’intérieur du bloc encadré par PROC SGPLOT et le terminateur canonique RUN;, le programmeur empile séquentiellement les déclarations graphiques. Chaque instruction interne correspond à un type de tracé élémentaire : diagrammes en barres (VBAR, HBAR), nuages de points (SCATTER), histogrammes (HISTOGRAM) ou courbes continues (SERIES). L’ordre d’écriture de ces instructions détermine leur profondeur de superposition (ordre Z) sur le canevas final, la première instruction rédigée étant dessinée à l’arrière-plan, tandis que les instructions ultérieures viennent se greffer au premier plan.
Cette structure s’achève par l’instruction QUIT; ou RUN;, qui déclenche la compilation syntaxique, l’exécution des calculs d’échelle sous-jacents et l’injection du rendu final dans le flux ODS actif. L’absence de points-virgules intermédiaires ou la confusion entre options de procédure et options d’instructions spécifiques figurent parmi les anomalies syntaxiques les plus couramment rencontrées par les néophytes, d’où la nécessité d’une rigueur absolue dans la délimitation des blocs logiques.
2.2 Paramétrage obligatoire de l’instruction SERIES
Au sein de l’arsenal syntaxique de PROC SGPLOT, l’instruction SERIES nécessite une déclaration minimale de deux arguments obligatoires assignant respectivement les dimensions horizontales et verticales du plan cartésien. L’argument X= définit la variable indépendante qui structurera l’abscisse. Il s’agit le plus fréquemment d’une grandeur temporelle (dates SAS, heures, numéros de cycle expérimental ou intervalles de suivi) ou d’une échelle de concentration métrique strictement ordonnée.
L’argument Y= désigne, quant à lui, la variable dépendante ou réponse quantitative dont on désire cartographier la trajectoire. Cette variable doit impérativement être de nature numérique continue. Le compilateur graphique relie les points définis par les coordonnées (X, Y) au moyen de segments rectilignes, suivant l’ordre physique d’apparition des lignes dans la table de données sous-jacente, sauf paramétrage spécifique contraire. Ainsi, la déclaration syntaxique élémentaire s’énonce sous la forme prototypique :
proc sgplot data=bibliotheque.source;

    series x=temps y=mesure;

run;
Une précondition méthodologique absolue réside dans le tri préalable des données. Si les observations ne sont pas rigoureusement agencées selon l’ordre croissant de la variable assignée à X=, la trajectoire linéaire subira des allers-retours désordonnés, traçant une toile de segments entrecroisés illisible, improprement qualifiée de « tracé en zigzag » ou « pelote de fil ». L’application systématique d’une étape PROC SORT en amont de toute invocation de l’instruction SERIES constitue par conséquent une règle de programmation non négociable.
2.3 Gestion de l’environnement d’exécution graphique ODS
L’environnement dans lequel s’exécute PROC SGPLOT est gouverné par l’instruction globale ODS GRAPHICS, qui agit comme le chef d’orchestre des paramètres matériels et géométriques de la production visuelle. Avant d’exécuter la procédure proprement dite, il est d’usage d’initialiser ou de réinitialiser cet environnement afin d’éviter la persistance d’options résiduelles héritées d’exécutions antérieures. La commande ODS GRAPHICS ON; garantit l’activation pleine et entière du moteur vectoriel moderne de SAS.
Parmi les commutateurs majeurs de l’instruction ODS GRAPHICS figurent les dimensions spatiales explicites de la zone de traçage. Les options WIDTH= et HEIGHT= permettent d’imposer des contraintes dimensionnelles précises, mesurées en centimètres (cm), millimètres (mm), pouces (in) ou pixels (px), neutralisant ainsi les redimensionnements dynamiques imprévisibles liés aux écrans utilisateurs. Par exemple, la commande ODS GRAPHICS / WIDTH=16cm HEIGHT=10cm IMAGENAME="Figure1" RESET=INDEX; standardise le ratio d’aspect selon les critères des formats éditoriaux de type demi-page.
Un autre attribut critique réside dans la gestion de la netteté et de l’anticrénelage (antialiasing). Grâce à l’option ANTIALIAS=ON et ANTIALIASMAX=, le moteur ODS Graphics applique des algorithmes d’interpolation sous-pixel aux segments de droite et aux glyphes typographiques, lissant les aspérités d’escalier inhérentes aux affichages matriciels basse résolution. Ce paramétrage soigné en amont de la procédure assure une restitution visuelle d’une pureté cristalline, indispensable pour les présentations professionnelles et les revues à fort facteur d’impact.
3. Création d’un graphique linéaire univarié simple
3.1 Préparation et structuration d’un jeu de données expérimental
Pour illustrer les principes fondamentaux du tracé linéaire univarié, nous modélisons une étude pharmacocinétique simplifiée mesurant l’évolution de la concentration plasmatique d’un principe actif chez un sujet sain au fil des heures suivant l’administration per os. La structuration de ce jeu de données requiert une étape DATA claire, associant des valeurs temporelles discrètes à une série continue de concentrations calculées en microgrammes par millilitre.
L’étape DATA SAS se déploie via la commande INPUT suivie de l’instruction DATALINES (ou CARDS), permettant d’injecter directement la matrice empirique au sein du flux de code :
data work.pharmacocinetique;

    input Temps_Heures Concentration_ug_ml;

    datalines;

0.0  0.00

0.5  2.15

1.0  5.80

1.5  8.90

2.0  9.45

3.0  7.60

4.0  5.20

6.0  2.85

8.0  1.40

12.0 0.35

16.0 0.08

24.0 0.01

;

run;
Une bonne pratique de validation méthodologique impose de s’assurer de l’intégrité de la table résultante avant toute tentative de modélisation visuelle. L’exécution de la procédure PROC PRINT DATA=work.pharmacocinetique; RUN; permet de contrôler l’absence de valeurs aberrantes, de troncatures inopinées ou de valeurs manquantes non désirées au sein des colonnes numériques.
3.2 Génération de la courbe de base sans options secondaires
La génération du tracé minimal s’opère par l’invocation directe de PROC SGPLOT, en assignant Temps_Heures à l’abscisse et Concentration_ug_ml à l’ordonnée, sans enrichissement stylistique accessoire :
proc sgplot data=work.pharmacocinetique;

    series x=Temps_Heures y=Concentration_ug_ml;

run;
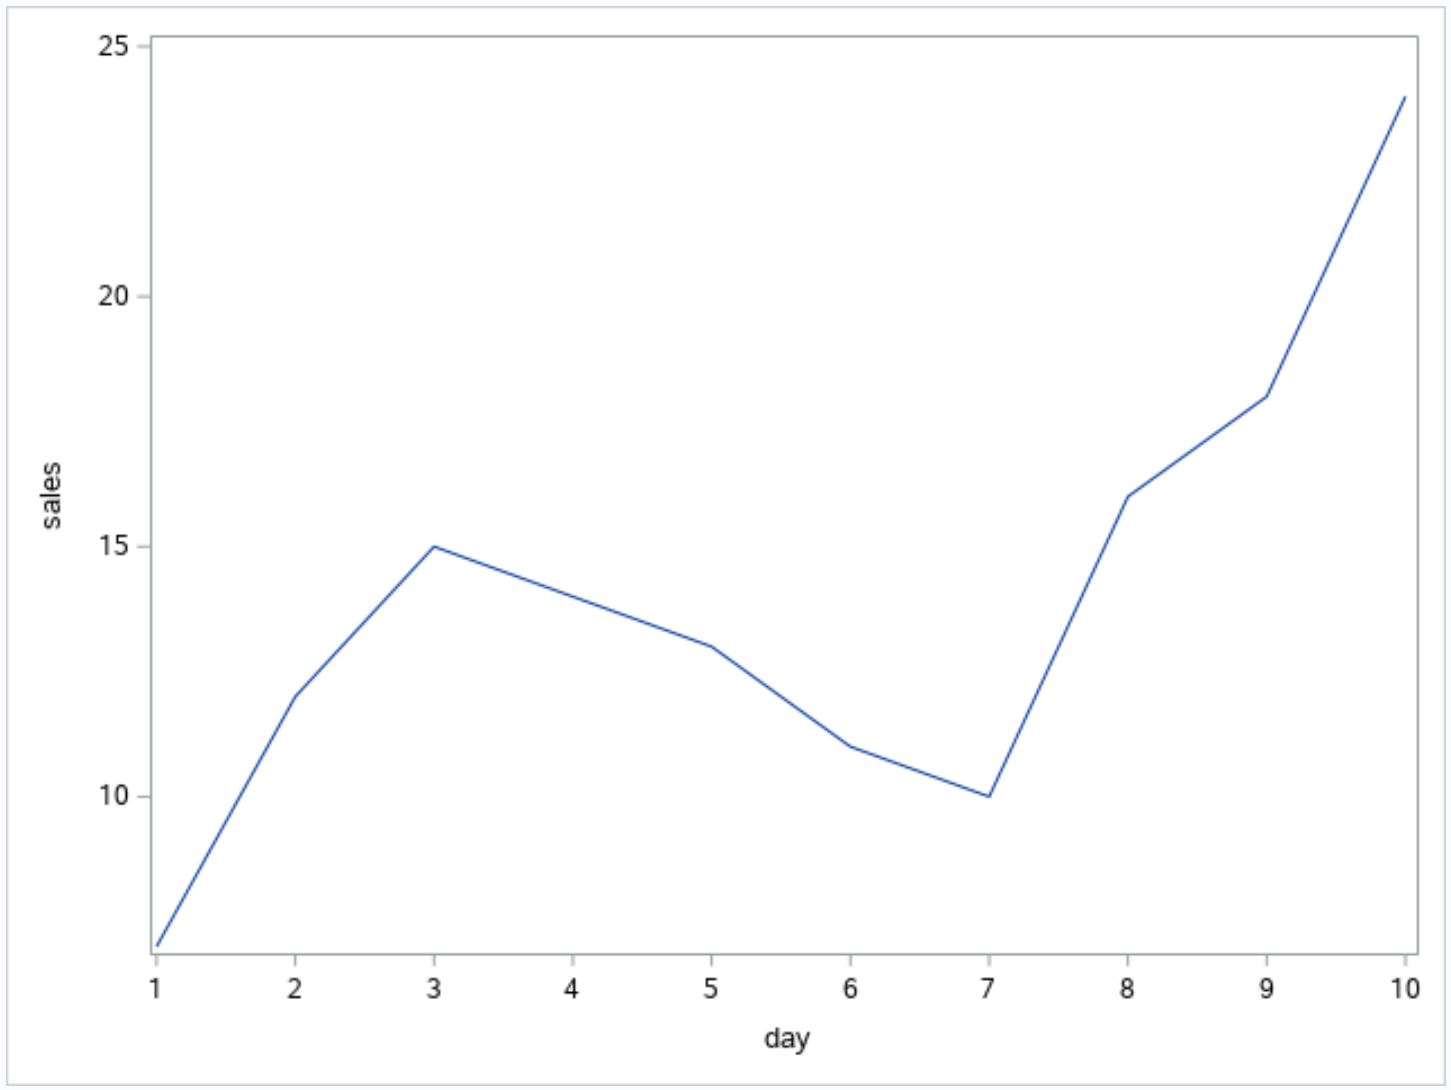
À l’exécution de cette requête, le moteur graphique de SAS prend en charge de façon totalement autonome le calibrage initial. Il scrute la distribution des valeurs numériques pour déterminer les bornes optimales des axes, calcule le pas d’incrémentation le plus lisible, applique la palette chromatique par défaut du style ODS en vigueur (typiquement un bleu corporate soutenu pour le style HTMLBlue) et dimensionne la ligne selon une épaisseur standard d’un pixel et demi.
Bien que cette configuration basique offre une visibilité instantanée sur la cinétique du composé — révélant une phase d’absorption rapide culminant vers la deuxième heure, suivie d’une élimination biexponentielle —, sa sobriété confine à l’austérité. Les libellés d’axes sont directement dérivés des noms physiques des variables, sans unités formelles, et l’absence d’indication ponctuelle sur les moments exacts de prélèvement laisse le lecteur dans l’incertitude quant à la densité réelle de l’échantillonnage expérimental.
3.3 Interprétation des éléments graphiques fondamentaux
L’observation critique de ce graphique primaire met en lumière la mécanique algorithmique de SAS. Sur l’axe des abscisses, le moteur a automatiquement généré des graduations régulières espacées de cinq heures, adaptées à l’intervalle d’observation global allant de 0 à 24 heures. Sur l’axe des ordonnées, la graduation s’étend naturellement de 0 à 10 microgrammes par millilitre, absorbant la valeur maximale observée (9,45 ug/ml) tout en offrant une marge de respiration visuelle au sommet du tracé.
Les coordonnées cartésiennes de chaque point du tableau sont converties en pixels d’affichage selon une transformation affine linéaire rigoureuse. Chaque segment relie deux paires successives de coordonnées spatiales par le plus court chemin euclidien. Toutefois, cette interpolation linéaire brute entre des points distants (par exemple entre la 16e et la 24e heure) masque l’éventuelle convexité réelle de la cinétique biologique durant cet intervalle.
L’analyse de ces conventions par défaut démontre que, si PROC SGPLOT produit immédiatement des figures scientifiquement cohérentes, l’intervention experte de l’analyste demeure incontournable pour transmuter un simple tracé exploratoire en un support de communication conforme aux normes de publication académique les plus strictes.
4. Personnalisation avancée de l’apparence de la ligne
4.1 Modification des attributs chromatiques et géométriques
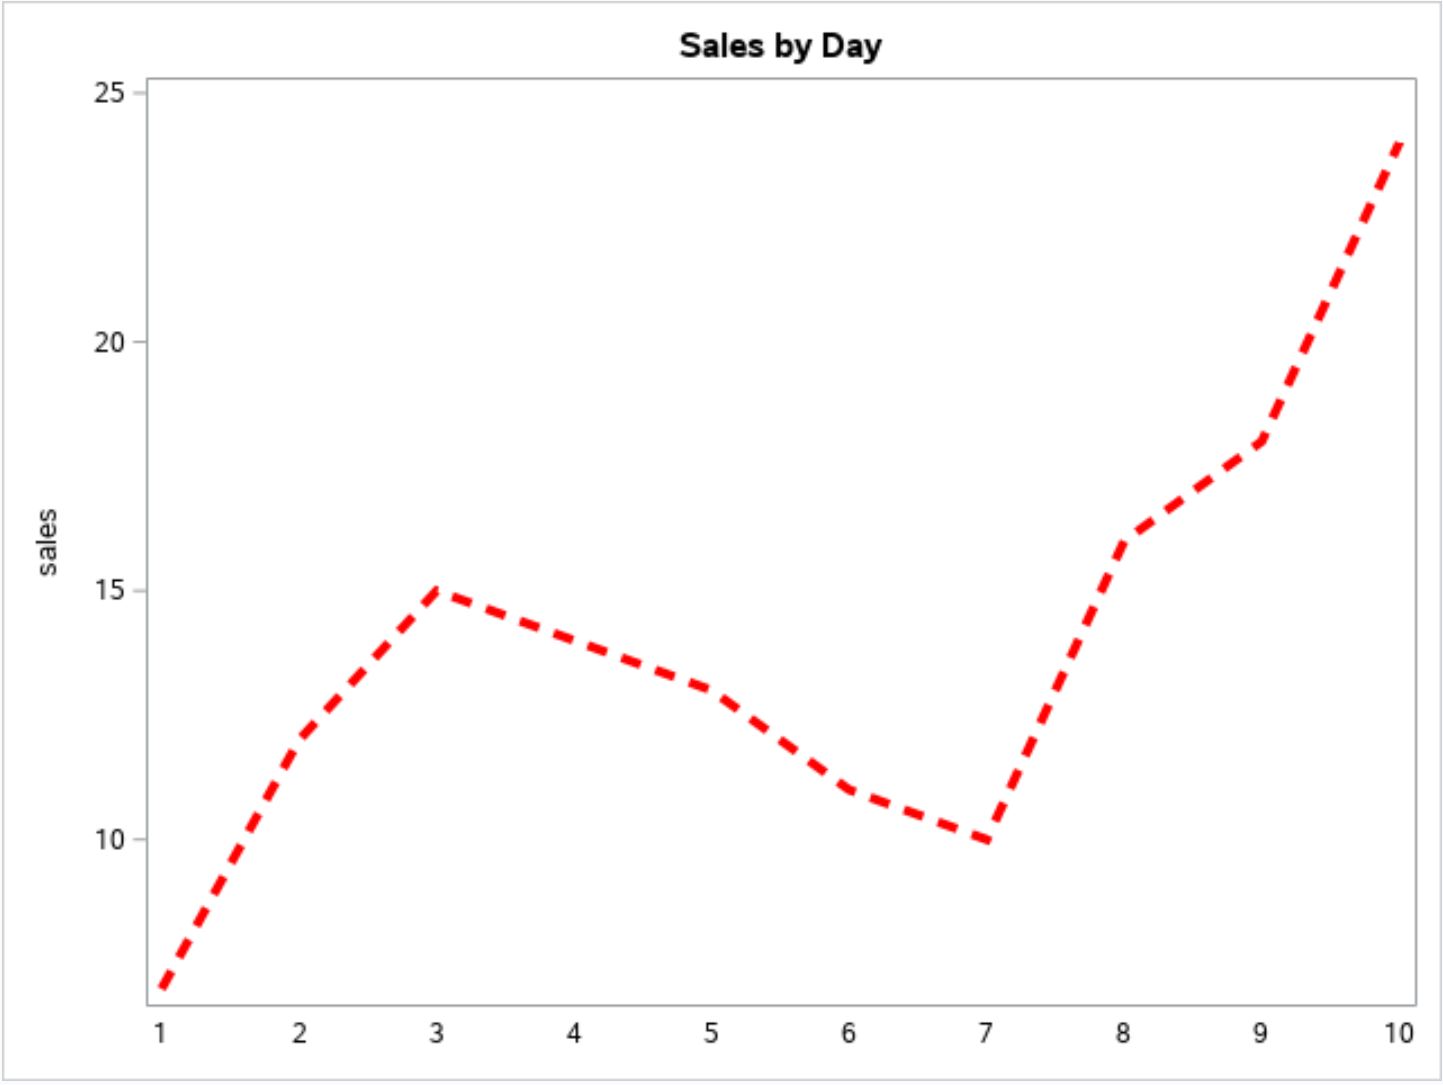
L’esthétique visuelle d’un tracé linéaire sous PROC SGPLOT ne relève pas de la superficialité cosmétique, mais conditionne directement l’efficacité de la transmission de l’information. L’option pivot pour moduler l’aspect de la courbe est l’argument composite LINEATTRS=(...), inséré directement après la barre oblique délimitant les options au sein de l’instruction SERIES. Cet argument centralise le contrôle de la couleur, de l’épaisseur géométrique et du motif structurel du trait.
Le paramètre COLOR= permet de spécifier l’identité chromatique du tracé en s’appuyant soit sur la nomenclature normalisée des couleurs SAS (telles que CX1B4F72, Navy, ForestGreen, DarkRed), soit sur l’utilisation directe du codage hexadécimal universel au format RVB (précédé de la chaîne CX sous SAS, comme COLOR=CX2C3E50). Le choix d’une teinte doit répondre à des critères d’ergonomie cognitive : les teintes froides et sombres renforcent l’impression d’autorité et de précision factuelle, tandis que les teintes saturées vives permettent de détacher une série critique au sein d’un faisceau de courbes témoins.
Simultanément, l’argument THICKNESS= quantifie la masse graphique de la ligne. Exprimé en pixels (par exemple THICKNESS=2PX ou 3PX) ou en points d’édition typographique (THICKNESS=1.5PT), ce paramètre doit être ajusté en fonction de la résolution finale visée et du nombre de séries superposées. Un trait d’une épaisseur de 2.5 points procure une présence visuelle remarquable pour une courbe isolée, empêchant son effacement lors de la conversion matricielle ou de l’impression sur support physique.
4.2 Sélection des motifs de ligne pour l’impression scientifique
Dans le champ de l’édition scientifique internationale, la dépendance exclusive à la couleur pour discriminer des trajectoires constitue une entorse reconnue aux principes d’accessibilité universelle et pénalise l’impression en niveaux de gris (monochrome). L’argument PATTERN= au sein de LINEATTRS= apporte une solution méthodologique pérenne en introduisant des variations morphologiques structurées sur le tracé.
SAS met à disposition un riche répertoire de motifs codifiés sous forme nominale ou numérique. Les motifs primaires comprennent :
- SOLID (ou motif 1) : Ligne continue uniforme, réservée conventionnellement aux cohortes de contrôle, aux moyennes globales ou aux séries empiriques de référence.
- DASH (ou motif 2) : Ligne en tiretés réguliers, idéale pour figurer des trajectoires alternatives, des prédictions prospectives ou des interventions spécifiques.
- DOT (ou motif 8) : Ligne en pointillés serrés, couramment employée pour les bornes d’intervalles statistiques ou les projections hypothétiques.
- DASHDOT, SHORTDASH ou LONGDASH : Combinaisons élaborées permettant d’étendre la différenciation visuelle jusqu’à plus de dix profils identifiables sans ambiguïté.
L’utilisation de ces motifs renforce la ségrégation visuelle des données : l’œil humain repère instantanément la discontinuité rythmique d’un trait hachuré face à un trait plein, autorisant une double sémiotisation (couleur ET texture) qui neutralise tout risque de méprise, y compris pour les lecteurs présentant des déficiences de la vision des couleurs (daltonisme).
4.3 Intégration de marqueurs sur les points d’observation
L’une des limitations majeures de l’instruction SERIES élémentaire réside dans l’invisibilité des coordonnées réelles d’échantillonnage : une longue ligne droite peut tout aussi bien relier deux points très distants que dissimuler des dizaines de mesures intermédiaires alignées. L’activation de l’option MARKERS force l’apparition d’un glyphe géométrique à chaque coordonnée exacte présente dans le jeu de données.
Pour gouverner la morphologie de ces symboles, l’instruction s’enrichit de l’argument MARKERATTRS=(...). Ce dernier permet de configurer le symbole (SYMBOL=CIRCLEFILLED, TRIANGLEFILLED, SQUARE, STAR), la taille (SIZE=7PX) et la couleur spécifique des repères. Il devient ainsi envisageable de dissocier chromatiquement la ligne et ses marqueurs pour produire un contraste analytique sophistiqué :
proc sgplot data=work.pharmacocinetique;

    series x=Temps_Heures y=Concentration_ug_ml /

        lineattrs=(color=CX1A5276 thickness=2 pattern=solid)

        markers

        markerattrs=(color=CXB03A2E symbol=CircleFilled size=8px);

run;
Cette symbiose entre tracé continu et marqueurs discrets offre le plus haut degré d’intelligibilité scientifique : le lecteur perçoit simultanément la cinétique globale du modèle interpolé et la rigueur d’échantillonnage du protocole expérimental.
5. Configuration rigoureuse des axes cartésiens (XAXIS et YAXIS)
5.1 Contrôle des étiquettes, lignes de base et graduations
Les axes d’un graphique constituent le cadre métrique sur lequel repose l’ensemble de l’interprétation quantitative. Par défaut, SAS génère des axes fonctionnels mais fréquemment surchargés d’éléments graphiques accessoires qui polluent l’espace visuel (bruit visuel selon les préceptes de la sémiologie graphique d’Edward Tufte). Les instructions complémentaires XAXIS et YAXIS permettent de discipliner rigoureusement chaque facette du cadre de coordonnées.
L’option DISPLAY=(...) permet une suppression sélective des composants jugés superflus. La syntaxe DISPLAY=(NOLINE NOTICKS) permet, par exemple, d’éliminer le trait de bordure externe et les petits ergots de graduation pour ne préserver que les valeurs numériques étalonnées et le titre descriptif de l’axe. À l’inverse, l’ajout du mot-clé GRID au sein de l’instruction YAXIS projette un quadrillage horizontal discret à travers la zone de tracé, facilitant grandement la lecture et l’estimation visuelle des valeurs d’ordonnées par le lecteur.
La personnalisation du libellé de l’axe s’exécute via l’argument LABEL=, qui accepte des chaînes de caractères enrichies incluant la casse typographique exacte et les unités de mesure conventionnelles entre parenthèses. L’argument LABELATTRS=(...) permet en outre de spécifier la police, la taille et la graisse typographique du titre, tandis que VALUEATTRS=(...) s’applique aux nombres jalonnant les repères d’échelle, garantissant ainsi une harmonie textuelle complète avec le corps du manuscrit.
5.2 Définition explicite des échelles et des intervalles
L’algorithme de calcul automatique des échelles de SAS tend à minimiser l’espace vide, ce qui peut involontairement tronquer l’axe des ordonnées au-dessus de zéro ou étendre les abscisses au-delà des limites logiques de l’observation empirique. Pour maîtriser strictement le repère cartésien, les options MIN= et MAX= imposent des bornes physiques infranchissables au moteur graphique.
De surcroît, l’option VALUES=(début TO fin BY incrément) offre un contrôle absolu sur le pas de graduation de l’axe. Par exemple, l’instruction xaxis values=(0 to 24 by 2); contraint SAS à insérer un repère toutes les deux heures régulières, neutralisant les choix algorithmiques arbitraires. Pour les cinétiques d’ordre exponentiel ou les données présentant une forte asymétrie positive (telles que les titres d’anticorps ou les niveaux d’expression génique), l’adjonction de l’option TYPE=LOG couplée à LOGBASE=10 transforme l’axe linéaire en échelle logarithmique normalisée, restituant avec fidélité les dynamiques relatives sur plusieurs ordres de grandeur.
Cette maîtrise de l’amplitude scalaire est fondamentale pour prévenir toute manipulation visuelle involontaire. Fixer délibérément l’origine d’un axe vertical à zéro évite de dramatiser des fluctuations mineures, respectant ainsi le principe fondamental de proportionnalité graphique requis par les communautés académiques internationales.
5.3 Formatage des variables d’axes numériques et calendaires
Lorsque la variable portée en abscisse est une date calendaire ou un horodatage continu (timestamp), SAS exploite sa structure interne de stockage (nombre de jours écoulés depuis le 1er janvier 1960) pour effectuer ses calculs de distance. Sans directive explicite, ces nombres bruts peuvent s’afficher de façon incompréhensible pour le destinataire final. L’instruction FORMAT variable format. au sein de la procédure permet de traduire instantanément ces scalaires en mentions calendaires explicites (ex. DATE9., MONYY7. ou YYMMDD10.).
Cependant, l’utilisation de dates longues entraîne régulièrement des collisions horizontales entre les étiquettes de graduation le long de l’abscisse. L’instruction XAXIS intègre une option extrêmement sophistiquée pour pallier ce désagrément : le paramètre FITPOLICY=. Ce régulateur d’affichage accepte diverses stratégies dynamiques :
FITPOLICY=ROTATE: Applique une rotation angulaire systématique (généralement à 45 degrés) aux étiquettes d’abscisses, maintenant leur lisibilité intégrale dans un encombrement horizontal réduit.FITPOLICY=STAGGER: Déploie les étiquettes en quinconce sur deux lignes alternées, décongestionnant la ligne d’axe.FITPOLICY=THIN: Supprime algorithmiquement une graduation sur deux ou sur trois lorsque la densité textuelle menace la lisibilité globale.
En combinant un formatage temporel rigoureux à une politique d’adaptation spatiale optimale, l’analyste confère à son graphique une finition professionnelle irréprochable, exempte de tout chevauchement typographique disgracieux.
6. Graphiques linéaires à courbes multiples avec la commande GROUP=
6.1 Organisation des données au format long (Tidy Data)
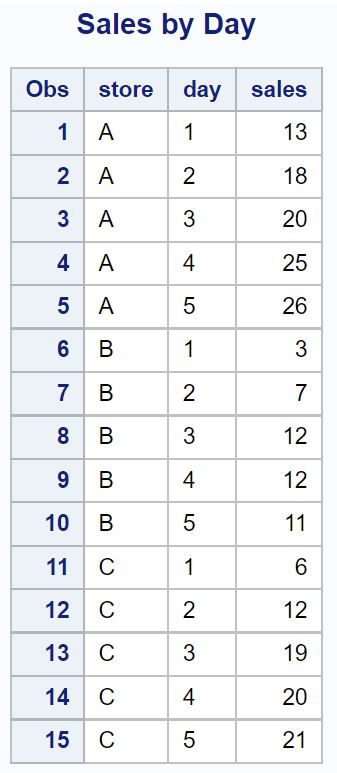
Dans les applications analytiques réelles, la comparaison longitudinale de plusieurs groupes — tels qu’un bras thérapeutique sous placebo opposé à deux cohortes sous molécules actives — constitue la règle. Pour exploiter pleinement la puissance de PROC SGPLOT sans multiplier le code inutilement, il est indispensable d’adopter une organisation tabulaire conforme aux principes des données ordonnées (Tidy Data), également dénommée « format long ».
Dans ce paradigme architectural, chaque ligne physique de la table SAS représente une mesure unique et contient au minimum trois variables :
- Une variable d’ordonnancement séquentiel (ex.
Semaine). - Une variable catégorielle d’appartenance à une strate (ex.
Groupe_Traitement). - Une variable de réponse numérique (ex.
Score_Clinique).
Si les données sources se présentent sous un format large (où chaque cohorte ou temps de mesure occupe une colonne dédiée), il est impératif d’opérer une transposition matricielle préalable à l’aide de la procédure PROC TRANSPOSE. Cette étape reconfigure le tableau en une structure verticale normalisée, seule géométrie autorisant l’utilisation native de l’option de regroupement factoriel sous PROC SGPLOT.
6.2 Implémentation de l’option GROUP= au sein de l’instruction SERIES
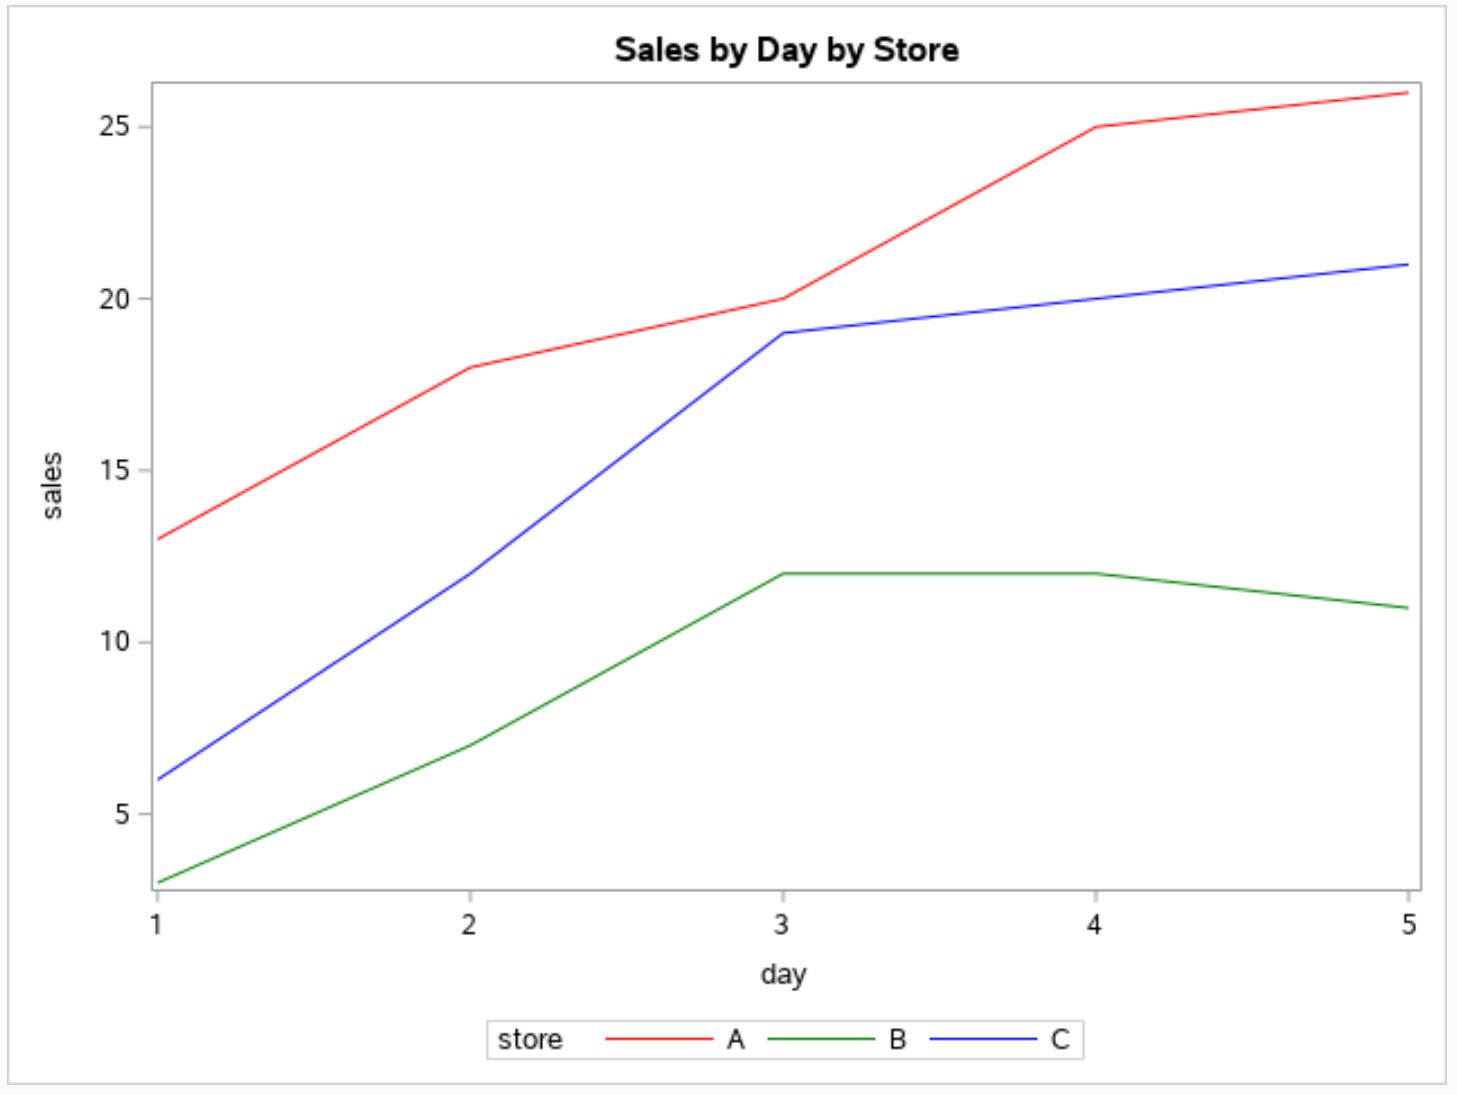
Dès lors que la structure longue est validée, le traçage simultané des différentes trajectoires se réalise avec une remarquable économie de moyens syntaxiques grâce à l’option GROUP= adjointe à l’instruction SERIES. SAS va segmenter de façon transparente le flux de données en autant de sous-ensembles qu’il existe de modalités distinctes dans la variable catégorielle, générant une ligne spécifique pour chaque classe identifiée :
proc sgplot data=work.essai_clinique;

    series x=Semaine y=Score_Clinique / group=Groupe_Traitement

        markers

        lineattrs=(thickness=2);

    xaxis values=(0 to 24 by 4) label="Durée de suivi (Semaines)";

    yaxis grid label="Score moyen de sévérité symptomatique";

run;
Le moteur ODS Graphics applique alors automatiquement le schéma de discrimination stylistique défini par le modèle de style actif. Chaque strate hérite d’une nuance chromatique distincte (ex. bleu marine, bordeaux, vert olive) et d’un symbole de marqueur spécifique (cercle, carré, losange), préservant une cohérence visuelle parfaite sans qu’aucune déclaration manuelle complexe ne soit requise.
Cette approche garantit une évolutivité totale du programme SAS : si une quatrième modalité vient ultérieurement enrichir la table de données, le code demeure inchangé et intègre instantanément la nouvelle trajectoire dans la représentation finale, en lui attribuant les propriétés stylistiques idoines.
6.3 Gestion et personnalisation de la légende générée
L’introduction de l’option GROUP= déclenche la création automatique d’une légende contextuelle identifiant les correspondances entre les modalités factorielles et leurs signatures graphiques. Si cette légende par défaut se positionne traditionnellement au bas du graphique dans un cartouche horizontal, son agencement précis peut être finement sculpté au moyen de l’instruction dédiée KEYLEGEND.
L’instruction KEYLEGEND prend place à l’intérieur du bloc PROC SGPLOT et accepte une multitude d’arguments de configuration spatiale. L’argument POSITION= permet de relocaliser la clé explicative dans les angles du graphique (TOPRIGHT, BOTTOMLEFT) ou à l’extérieur immédiat de la zone cartésienne (RIGHT, BOTTOM). L’option ACROSS= contraint le nombre de colonnes textuelles : une valeur de ACROSS=1 force ainsi un empilement vertical rigoureux des catégories, idéal lors d’une implantation en marge droite.
Il est également possible d’enlever le filet d’encadrement en précisant NOBORDER, d’ajuster la taille des caractères typographiques via VALUEATTRS=(...) et de modifier le titre de la légende avec TITLE="Bras d'étude :". Une légende méticuleusement calibrée et dégagée des tracés de données fluidifie l’appréhension du message scientifique et supprime les allers-retours oculaires laborieux.
7. Superposition de séries multiples indépendantes sans variable de groupe
7.1 Multiplication des instructions SERIES au sein d’un même bloc SGPLOT
Bien que le recours aux données au format long combinées à l’option GROUP= constitue le modèle standard pour les comparaisons inter-groupes, il existe des configurations analytiques où les variables à confronter représentent des grandeurs métriques distinctes mesurées au sein d’une même unité expérimentale et stockées en colonnes parallèles (format large). Dans cette situation, la superposition graphique s’effectue en empilant délibérément plusieurs instructions SERIES successives au sein d’un bloc unique de PROC SGPLOT.
Chaque ligne d’instruction relie alors l’abscisse commune à une variable de réponse singulière :
proc sgplot data=work.surveillance_meteo;

    series x=Date_Mesure y=Temperature_Moyenne / name="serie_temp";

    series x=Date_Mesure y=Point_De_Rosee / name="serie_rosee";

run;
Cette approche par accumulation d’instructions directes s’avère particulièrement pertinente lorsqu’on souhaite confronter des métriques partageant la même échelle physique mais incarnant des concepts distincts, ou lorsque l’on désire projeter sur un même espace la trajectoire brute d’une variable et son lissage mathématique prédictif calculé en amont.
7.2 Harmonisation des attributs visuels individuels
L’écueil inhérent à la multiplication déconnectée des instructions SERIES réside dans le risque d’hétérogénéité stylistique ou, à l’opposé, d’une monotonie chromatique totale si le programmeur ne prend pas en main la stylisation explicite de chaque courbe. L’affectation individualisée de l’argument LINEATTRS= sur chaque ligne de commande devient indispensable pour instituer une hiérarchie visuelle explicite.
On attribuera, par exemple, un trait continu épais de teinte sombre à la série représentant la métrique cible principale, tandis que les variables secondaires ou les seuils environnementaux recevront un trait plus fin, teinté d’une nuance neutre (comme un gris ardoise CX7F8C8D) et doté d’un motif discontinu (PATTERN=DASH). Cette différenciation volontaire guide immédiatement le regard du lecteur vers l’objet scientifique central de la démonstration.
De plus, pour rattacher ces différentes séries à une légende unifiée, l’analyste exploitera l’option NAME="identifiant" couplée à LABEL="Description" sur chaque instruction SERIES. L’instruction terminale KEYLEGEND "serie_temp" "serie_rosee" / NOBORDER; fusionnera alors ces identifiants au sein d’un répertoire sémantique irréprochable.
7.3 Application à l’analyse de cohortes cliniques
Un cas d’usage paradigmatique de cette architecture en couches indépendantes réside dans la comparaison entre les moyennes observées au sein d’une cohorte de patients et une courbe normative de référence issue de tables de standardisation nationales ou de modèles mathématiques théoriques.
Dans ce cadre clinique, l’instruction primaire dessine la trajectoire empirique des patients, enrichie de ses marqueurs discrets d’évaluation périodique, tandis que la seconde instruction trace la trajectoire théorique sous la forme d’un profil lisse et continu, dépourvu de tout marqueur ponctuel. Cette dissociation formelle élimine tout quiproquo : le lecteur saisit instantanément que la courbe continue matérialise une équation déterministe ou une référence externe de santé publique, tandis que les points reliés représentent les données empiriques réelles sous observation.
Cette technique permet d’éviter l’écueil de la surcharge cognitive. En calibrant judicieusement les épaisseurs et les contrastes de luminosité, le didacticien parvient à faire coexister jusqu’à quatre séries analytiques simultanées sans que le canevas ne sombre dans une saturation graphique illisible.
8. Implémentation d’un axe vertical secondaire (Y2AXIS)
8.1 Fondements méthodologiques du double axe ordonné
L’intégration d’un axe vertical secondaire à droite du graphique (nommé axe Y2 sous SAS) répond au défi posé par la juxtaposition de deux grandeurs physiques dépendantes de la même échelle d’abscisse mais s’exprimant dans des unités de mesure incommensurables, ou présentant des ordres de grandeur radicalement disjoints. C’est le cas, par exemple, lors de la mise en relation conjointe de la pression artérielle systolique (exprimée en millimètres de mercure, avec des valeurs oscillant entre 100 et 180) et du taux d’enzymes hépatiques ou d’une fraction d’éjection ventriculaire (exprimée en pourcentage, comprise entre 30 et 70 %).
D’un point de vue épistémologique, l’usage du double axe des ordonnées exige une prudence méthodologique extrême. Un mauvais calibrage des échelles respectives peut induire des illusions optiques de co-variation, d’intersection fallacieuse ou d’amplification disproportionnée d’un effet biologique marginal. L’analyste se doit de justifier formellement la pertinence clinique ou physique de leur rapprochement visuel et de documenter scrupuleusement la dissociation des grandeurs mesurées.
La règle d’or d’une telle représentation réside dans l’intelligibilité absolue du couplage : le lecteur doit identifier sans le moindre effort cognitif quelle courbe se rattache à l’axe vertical primaire gauche (YAXIS) et quelle courbe est gouvernée par l’axe secondaire droit (Y2AXIS).
8.2 Syntaxe de l’assignation à l’axe secondaire Y2
Sous la procédure PROC SGPLOT, le basculement d’une série vers l’axe vertical secondaire s’opère de manière directe et concise grâce au commutateur Y2AXIS accolé à l’instruction SERIES concernée :
proc sgplot data=work.suivi_biologique;

    series x=Mois y=Pression_Arterielle /

        lineattrs=(color=CXC0392B thickness=2)

        name="serie_pa" label="Pression Artérielle (mmHg)";
series x=Mois y=Fraction_Ejection / y2axis
lineattrs=(color=CX2980B9 thickness=2 pattern=dash)
name="serie_fe" label="Fraction d'Éjection (%)";
yaxis label="Pression Artérielle Systolique (mmHg)"
labelattrs=(color=CXC0392B) valueattrs=(color=CXC0392B);
y2axis label="Fraction d'Éjection Ventriculaire Gauche (%)"
labelattrs=(color=CX2980B9) valueattrs=(color=CX2980B9);
xaxis values=(1 to 12 by 1) label="Mois de traitement";
keylegend "serie_pa" "serie_fe" / position=bottom noborder;
run;
Comme le met en exergue ce script, l’harmonie sémiotique est poussée jusqu’à l’application rigoureuse d’un codage couleur croisé : le texte et les repères numériques de l’axe vertical gauche adoptent le rouge bordeaux (CXC0392B) de la courbe de pression artérielle, tandis que l’axe droit et ses valeurs s’habillent du bleu cobalt (CX2980B9) gouvernant la trajectoire de la fraction d’éjection. Ce renforcement chromatique prévient toute confusion de lecture.
8.3 Résolution des conflits de superposition et de lisibilité
L’introduction simultanée de YAXIS et de Y2AXIS soulève immédiatement un problème esthétique et perceptif majeur : celui du quadrillage horizontal (GRID). Si l’on active aveuglément le quadrillage sur les deux axes simultanément, le graphique se retrouve lacéré par deux réseaux de lignes horizontales désynchronisées, créant un brouillage optique intolérable.
La doctrine d’excellence consiste à n’activer le quadrillage que sur l’axe vertical primaire gauche (yaxis grid;), tout en désactivant formellement celui de l’axe secondaire (y2axis nogrid;). Il est même vivement préconisé d’ajuster mathématiquement les bornes et incréments des deux échelles (via les options MIN=, MAX= et VALUES=) de manière à ce que les repères cardinaux coïncident visuellement sur les mêmes hauteurs horizontales, préservant ainsi une pureté géométrique globale.
Enfin, les titres d’axes doivent être suffisamment détaillés pour expliciter formellement la dimension métrologique employée. Les abréviations cryptiques sont proscrites pour s’assurer que le lecteur comprenne instantanément la polarité de chaque coordonnée.
9. Enrichissement contextuel : Annotations, repères et titres
9.1 Hiérarchisation textuelle avec TITLE et FOOTNOTE
Une figure scientifique ne saurait se suffire d’un tracé graphique nu : elle doit être intégrée dans une hiérarchie informationnelle explicite permettant son autonomie interprétative. Les instructions globales du système SAS TITLE et FOOTNOTE constituent le premier niveau d’encadrement éditorial du document visuel.
Le système SAS permet d’empiler jusqu’à dix niveaux de titres (TITLE1 à TITLE10) et de notes de bas de figure (FOOTNOTE1 à FOOTNOTE10). Il est fortement recommandé d’adopter une hiérarchie stricte :
TITLE1énonce l’objet général de l’analyse en des termes clairs et formels.TITLE2précise le périmètre méthodologique, la cohorte analysée ou la stratification temporelle mise en œuvre.FOOTNOTE1stipule la source institutionnelle des données ou le progiciel ayant réalisé le traitement statistique.FOOTNOTE2renseigne sur la taille effective de l’échantillon (ex. N = 1 248), la signification des seuils d’erreur et les éventuelles conventions de rejet des valeurs aberrantes.
Une pratique incontournable réside dans la réinitialisation systématique de ces instructions globales. Puisque les déclarations TITLE conservent leur valeur en mémoire pour toutes les procédures ultérieures, il convient d’insérer l’instruction TITLE; FOOTNOTE; à la suite immédiate de la commande RUN; de PROC SGPLOT afin de réinitialiser la table des titres et d’éviter des projections textuelles indésirables sur les sorties ultérieures.
9.2 Insertion de lignes de référence analytiques avec REFLINE
L’évaluation visuelle d’une trajectoire gagne considérablement en pertinence lorsqu’elle est mise en regard de seuils normatifs, d’objectifs thérapeutiques ou d’événements temporels cardinaux. L’instruction REFLINE remplit précisément cet office en projetant des droites de repérage cartésiennes orthogonales sur le graphique.
L’instruction permet de tracer des lignes horizontales (en ciblant des valeurs de l’axe vertical) ou verticales (en pointant des repères d’abscisse). Elle s’enrichit d’une multitude d’options de contextualisation :
proc sgplot data=work.suivi_glycemie;

    series x=Semaine y=HbA1c / lineattrs=(color=CX2C3E50 thickness=2);

    refline 7.0 / axis=y lineattrs=(color=CXE74C3C pattern=dash thickness=1.5)

                  label="Seuil d'intervention (7,0 %)"

                  labelpos=auto labelattrs=(color=CXE74C3C weight=bold);

    refline 12 / axis=x lineattrs=(color=CX7F8C8D pattern=dot)

                 label="Initiation du traitement bitherapique"

                 labelpos=top;

run;
L’option LINEATTRS= garantit que ces lignes d’étalonnage demeurent discrètes (souvent stylisées par des motifs discontinus de type DASHDOT ou SHORTDASH) afin de ne pas concurrencer le tracé des données effectives. L’option LABELPOS= permet d’ancrer le libellé explicatif à l’emplacement le plus opportun, prévenant les chevauchements avec la trajectoire empirique.
9.3 Intégration d’annotations textuelles directes
Pour parachever l’autonomie interprétative d’une figure sans obliger le lecteur à chercher des statistiques clés dans le corps de l’article, l’instruction INSET permet d’incruster un cartouche d’information textuelle directement à l’intérieur de l’espace de tracé.
Contrairement aux titres et notes qui résident en périphérie du canevas, l’encadré INSET occupe une position géographique déterminée par l’option POSITION= (telle que TOPLEFT, TOPRIGHT, BOTTOMRIGHT). Cet encadré peut agréger des chaînes textuelles libres, le rappel des p-valeurs issues d’une analyse de variance pour mesures répétées, ou des synthèses d’ajustement global (comme un coefficient de détermination R² ou un critère d’information d’Akaike AIC).
Le paramétrage des attributs de boîte (BORDER, OPAQUE, FILLATTRS=(COLOR=white)) permet de créer un îlot de lisibilité immaculé au sein d’une zone où la dispersion des points pourrait perturber la typographie, atteignant ainsi une clarté didactique optimale.
10. Représentation de la variabilité : Bandes de dispersion et d’erreur
10.1 Superposition de l’instruction BAND avec l’instruction SERIES
Dans toute démarche scientifique rigoureuse, la trajectoire d’une moyenne empirique n’a de sens que si elle s’accompagne de l’expression tangible de son incertitude stochastique ou de sa variabilité interindividuelle. Présenter une simple ligne reliant des moyennes temporelles sans figurer l’erreur type ou l’intervalle de confiance constitue un déficit méthodologique préjudiciable. L’instruction BAND sous PROC SGPLOT répond magistralement à cet impératif en matérialisant une enveloppe polygonale le long du continuum horizontal.
La mise en œuvre requiert la spécification formelle d’une variable pour l’axe d’abscisse (X=), ainsi que de deux colonnes numériques délimitant respectivement le plancher et le plafond de l’enveloppe de dispersion via les arguments LOWER= et UPPER=. Une attention capitale doit être accordée à l’ordre syntaxique des déclarations dans le code :
proc sgplot data=work.resultats_modelises;

    band x=Temps lower=IC_Inferieur upper=IC_Superieur /

        fillattrs=(color=CXA9CCE3) transparency=0.5;

    series x=Temps y=Moyenne_Estimee /

        lineattrs=(color=CX1B4F72 thickness=2);

run;
L’instruction BAND doit impérativement précéder l’instruction SERIES. En vertu de la logique d’empilement en couches de SAS, la surface polygonale est ainsi projetée en arrière-plan, laissant la courbe de la moyenne se dessiner avec une netteté totale au premier plan, exempte de tout masquage visuel.
10.2 Réglage de l’opacité et des textures de remplissage
L’usage de surfaces opaques au sein d’un espace cartésien présente le risque majeur d’occulter les éléments graphiques sous-jacents, en particulier le quadrillage d’axe ou d’éventuelles séries secondaires concurrentes. L’option TRANSPARENCY= constitue le levier technique incontournable pour conférer une semi-transparence élégante et fonctionnelle à la bande d’erreur.
Ce paramètre accepte un scalaire compris rigoureusement entre 0 (opacité intégrale par défaut) et 1 (transparence totale, rendant la couche invisible). Une valeur étalonnée entre 0.4 et 0.6 s’avère optimale dans la quasi-totalité des configurations cliniques. Elle permet de percevoir avec une douceur chromatique saisissante le halo d’incertitude entourant la trajectoire principale, tout en laissant transparaître les repères matriciels de l’arrière-plan.
Par ailleurs, pour les publications scientifiques imprimées sous des contraintes strictes de noir et blanc, le paramètre FILLPATTERN= offre la possibilité de substituer à la couleur unie des hachures diagonales fines (ex. L1, R1), assurant une différentiation graphique infalsifiable même lors de photocopies de basse qualité.
10.3 Préparation préalable des métriques de dispersion
L’utilisation fluide de l’instruction BAND présuppose une rigoureuse préparation des données en amont. En règle générale, la table empirique brute ne contient que les observations individuelles de chaque sujet à chaque visite. Il est donc nécessaire de mobiliser au préalable des procédures de réduction statistique telles que PROC MEANS ou PROC SUMMARY pour extraire les paramètres d’agrégation nécessaires.
Le code SAS d’agrégation classique s’articule comme suit :
proc sort data=work.sujets_bruts;

    by Visite;

run;
proc means data=work.sujets_bruts noprint;
by Visite;
var Score_Efficacite;
output out=work.stats_agregees
mean=Moyenne
stderr=Erreur_Type
lclm=IC_Inf_95
uclm=IC_Sup_95;
run;
Cette étape génère une table concise où chaque visite calendaire est documentée par la moyenne d’échantillon et les bornes théoriques de l’intervalle de confiance calculées sur la base de la loi de Student. C’est cette table agrégée qui sert d’intrant direct à PROC SGPLOT, assurant une parfaite fidélité entre la modélisation mathématique du risque et sa transcription graphique.
11. Diagnostic des anomalies de rendu et pièges fréquents
11.1 Problématique des tracés en dents de scie et désordre séquentiel
L’anomalie la plus spectaculaire et pourtant la plus courante rencontrée lors de la programmation de l’instruction SERIES est l’apparition de segments désordonnés s’entrecroisant dans un chaos géométrique absolu, couramment qualifié de phénomène en « dents de scie » ou en « toile d’araignée ». Ce désordre visuel ne procède pas d’un dysfonctionnement logiciel, mais de la nature même du tracé de ligne vectorielle.
Le compilateur graphique de SAS ne lit pas l’abscisse de manière vectorielle globale avant d’ordonner son tracé : il suit docilement l’ordre physique des observations tel qu’il se présente dans la table d’entrée. Si un enregistrement correspondant au temps T=4 est physiquement positionné après un enregistrement à T=8, le traceur virtuel opère un mouvement rétrograde en arrière pour relier les deux points, fracturant irrémédiablement la continuité séquentielle du tracé.
Le remède méthodologique est invariable : il impose l’application systématique et rigoureuse d’une étape de tri préalable au moyen de PROC SORT, en indexant la table sur les identifiants de strate (si l’option GROUP= est mobilisée) ainsi que sur la variable chronologique d’abscisse :
proc sort data=work.donnees_longitudinales;

    by Groupe Temps;

run;
Cette directive simple rétablit l’ordonnancement univoque indispensable à la génération d’un flux linéaire continu et cohérent.
11.2 Gestion des données manquantes et discontinuités de tracé
Dans les études observationnelles ou les essais cliniques prolongés, l’incomplétude des recueils d’information génère inévitablement des cellules manquantes (représentées par un point d’ordonnée . sous SAS). Le comportement par défaut de l’instruction SERIES face à une donnée manquante consiste à interrompre brutalement le tracé : un trou visuel apparaît entre la mesure valide précédente et la mesure valide subséquente.
Ce comportement peut être délibérément modulé grâce à des options spécifiques. Si l’on souhaite matérialiser formellement la rupture sans masquer l’absence de recueil, l’option BREAK force l’interruption des segments, soulignant ainsi la présence de données lacunaires. Si, au contraire, une imputation linéaire par interpolation directe entre les points observés disponibles est méthodologiquement acceptable, le programmeur peut traiter la table par une procédure d’interpolation amont (comme PROC EXPAND sous SAS/ETS).
Il convient néanmoins de proscrire formellement l’interpolation graphique silencieuse lorsqu’elle masque des pertes de suivi massives susceptibles de biaiser l’analyse de survie ou l’évaluation clinique. La transparence éditoriale exige de documenter les points manquants, soit par une note de bas de page explicite, soit par l’apposition d’un repère discret matérialisant l’attrition de la cohorte.
11.3 Dépannage des chevauchements d’étiquettes et conflits de formats
Un autre désagrément récurrent réside dans la compression ou l’illisibilité des graduations horizontales lorsque l’amplitude temporelle s’étale sur des centaines d’itérations journalières. Lorsque le moteur graphique tente d’inscrire l’intégralité des dates, les chaînes textuelles se superposent, formant un bloc d’encre compact et indéchiffrable.
Le diagnostic de ces anomalies repose sur l’examen attentif du journal d’exécution (SAS Log). Des avertissements formels tels que WARNING: The label for axis could not be fully displayed ou NOTE: Some tick values were dropped due to lack of space signalent immédiatement que la politique d’étiquetage par défaut s’avère défaillante. Pour neutraliser ce conflit, l’activation des options de contrôle spatial dans XAXIS (notamment FITPOLICY=THIN ou FITPOLICY=ROTATE) combinée à l’espacement délibéré des graduations via l’option VALUES= s’impose de façon catégorique.
Enfin, il arrive fréquemment que des dates stockées sous forme de chaînes de caractères alphanumériques (format caractère) soient assignées par erreur à l’argument X=. Le système traite alors chaque valeur comme une modalité nominale discrète et équidistante, détruisant tout étalonnage proportionnel du temps écoulé. La conversion préalable de ces variables en véritables dates numériques SAS au moyen de la fonction INPUT(chaine, DATE9.) résout instantanément cette altération métrologique.
12. Exportation haute résolution et standards de publication
12.1 Configuration des formats vectoriels et matriciels
L’aboutissement du processus de génération graphique réside dans la matérialisation d’un fichier numérique exporté répondant sans compromis aux exigences des imprimeurs scientifiques et des comités éditoriaux internationaux. L’époque où les captures d’écran basse résolution étaient tolérées est définitivement révolue : la soumission d’articles académiques exige des fichiers d’une résolution native minimale de 300 à 600 DPI (points par pouce) pour les formats matriciels, ou l’emploi de formats vectoriels scalaires.
L’instruction ODS GRAPHICS couplée aux destinations d’exportation spécifiques pilote cette machinerie avec une extrême finesse. Pour une fidélité géométrique infinie, indépendante du facteur de zoom, les formats vectoriels PDF ou SVG sont vivement privilégiés :
ods _all_ close;

ods listing gpath="C:PublicationsFigures" image_dpi=300;

ods graphics on / imagefmt=tiff imagename="Fig1_Cinétique" width=18cm height=12cm reset=index;
proc sgplot data=work.resultats_definitifs;
series x=Semaine y=Moyenne / lineattrs=(thickness=2);
run;
ods listing close;
ods html; /* Réactivation de l'environnement standard */
Dans cet extrait de code, la redirection vers la destination ODS LISTING permet d’imposer un format TIFF non destructif sans compression avec un étalonnage à 300 DPI, satisfaisant ainsi aux critères de production les plus sévères de l’industrie biomédicale.
12.2 Alignement sur les normes de présentation scientifique (style APA)
Les canons de la mise en forme scientifique, tels que codifiés par l’American Psychological Association (style APA) ou le Comité International des Rédacteurs de Revues Médicales (ICMJE), imposent une esthétique épurée, rigoureuse et totalement exempte d’artifices ornementaux inutiles. Sous SAS, cette sobriété s’obtient par la neutralisation des styles colorés par défaut au profit du modèle Journal ou Statistical.
Pour mettre un tracé linéaire en conformité stricte avec les normes APA :
- L’arrière-plan du graphique et les bordures extérieures doivent être totalement blancs, dénués de tout ombrage ou teinte de fond colorée.
- La palette graphique doit être convertie en une échelle de gris rigoureuse ou en un contraste noir absolu.
- Le quadrillage d’arrière-plan doit être éliminé ou réduit à une trame d’une extrême discrétion.
- Les polices typographiques doivent impérativement s’orienter vers des familles sans empattement universelles (telles qu’Arial, Helvetica ou Calibri) pour préserver une lisibilité maximale à petite échelle.
L’instruction suivante illustre cette purification formelle :
ods graphics on / style=Journal;

proc sgplot data=work.etude_apa noborder;

    series x=Temps y=Reponse / group=Groupe

        lineattrs=(thickness=1.5)

        markers;

    xaxis display=(noline noticks) label="Temps expérimental (Jours)"

          labelattrs=(family="Arial" size=10pt weight=bold);

    yaxis display=(noline noticks) label="Performance moyenne"

          labelattrs=(family="Arial" size=10pt weight=bold);

    keylegend / noborder position=topright valueattrs=(family="Arial" size=9pt);

run;
L’application rigoureuse de ce modèle assure une intégration harmonieuse au sein de n’importe quel manuscrit académique sans exiger de retouche manuelle sous des logiciels graphiques tiers.
12.3 Automatisation et reproductibilité via les macros SAS
L’excellence opérationnelle en analyse de données repose sur l’automatisation et la reproductibilité absolue des chaînes de production graphique. Lorsque le statisticien doit générer des tracés longitudinaux standardisés pour plusieurs dizaines de biomarqueurs, de strates pathologiques ou de territoires géographiques, la duplication manuelle de blocs PROC SGPLOT devient une source majeure d’erreurs et d’inefficacité.
L’encapsulation de l’architecture graphique au sein du langage macro de SAS permet de paramétrer intégralement la production séquentielle de figures. En concevant une macro-commande acceptant des variables dynamiques, l’analyste crée un patron analytique pérenne :
%macro GenererTraceLineaire(JeuDonnees=, VarX=, VarY=, Groupe=, TitreGraph=, FichierSortie=);

    ods listing gpath="C:ProjetsRapports" image_dpi=300;

    ods graphics on / imagename="&FichierSortie" imagefmt=png width=16cm height=10cm reset=index;
proc sort data=&JeuDonnees out=work._tmp_plot;
by &Groupe &VarX;
run;
proc sgplot data=work._tmp_plot noborder;
title "&TitreGraph";
series x=&VarX y=&VarY / group=&Groupe lineattrs=(thickness=2) markers;
xaxis grid;
yaxis grid;
keylegend / position=bottom noborder;
run;
title;
ods listing close;
%mend GenererTraceLineaire;
Grâce à cette abstraction modulaire, un appel unique d’une seule ligne tel que :
%GenererTraceLineaire(JeuDonnees=work.pharmacocinetique, VarX=Temps_Heures, VarY=Concentration_ug_ml, Groupe=Bras, TitreGraph=Cinétique comparée, FichierSortie=Fig_PK_Final);
suffit à ordonner les données, calibrer l’environnement matriciel haute résolution, compiler la figure et l’exporter de façon standardisée, concrétisant ainsi l’alliance parfaite entre rigueur méthodologique, puissance analytique et reproductibilité scientifique intégrale.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Heath, D. (2014). SAS Programming for Enterprise Analyst: An Introduction to ODS Graphics. SAS Institute Inc.
- Kuhfeld, W. F. (2010). Statistical Graphics in SAS: An Introduction to the Graph Template Language and the Statistical Graphics Procedures. SAS Institute Inc.
- Matange, S. (2013). Getting Started with the Graph Template Language in SAS: Examples, Tips, and Techniques for Creating Custom Graphs. SAS Institute Inc.
- SAS Institute Inc. (2021). SAS/GRAPH: Statistical Graphics Procedures Guide, Sixth Edition. SAS Institute Inc. https://documentation.sas.com
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10