
Dans le champ de la recherche contemporaine en psychologie, en neurosciences cognitives et en sciences du comportement, l’exploration rigoureuse des distributions empiriques constitue le socle fondamental sur lequel reposent la validation des hypothèses et l’intégrité de l’inférence statistique. Les variables psychologiques continues — qu’il s’agisse de latences motrices, de temps de réponse cognitifs, de scores composites issus d’inventaires cliniques ou d’indices psychophysiologiques — présentent rarement les caractéristiques idéalisées de la loi normale théorique. Trop souvent, les chercheurs ont recours de manière réflexe à des représentations discrétisées rudimentaires, à l’instar des histogrammes conventionnels, ou s’en remettent exclusivement à des résumés paramétriques réducteurs tels que la moyenne et l’écart-type, masquant ainsi des caractéristiques distributionnelles pourtant déterminantes pour la compréhension des processus sous-jacents.
L’estimation de la densité par noyau (communément désignée sous l’acronyme anglophone KDE pour Kernel Density Estimation) représente une avancée méthodologique majeure pour surmonter ces contraintes. En tant qu’approche d’estimation non paramétrique, cette méthode mathématique permet de reconstruire de manière continue et lisse la fonction de densité de probabilité sous-jacente d’une variable aléatoire, sans imposer d’a priori arbitraire quant à la famille paramétrique dont elle est issue. Dans l’environnement informatique R, plateforme de référence internationale pour le calcul statistique et la science des données, la mise en œuvre de ces techniques bénéficie d’une flexibilité algorithmique et graphique sans équivalent, allant des fonctions natives du moteur de base jusqu’aux grammaires visuelles hautement élaborées de l’écosystème graphique moderne.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, psychométriciens, biostatisticiens et analystes de données à travers l’ensemble des étapes conceptuelles, mathématiques et informatiques requises pour générer, optimiser et interpréter des graphiques de densité de noyau dans R. À travers un parcours didactique rigoureux, nous explorerons les fondements théoriques de l’estimateur de Rosenblatt-Parzen, l’impact déterminant des fonctions de noyau et du paramètre de lissage, les techniques d’enrichissement esthétique et comparatif, ainsi que la transposition de ces concepts à des études de cas cliniques concrètes, tout en adhérant scrupuleusement aux standards éditoriaux les plus exigeants de la communauté scientifique.
1. Introduction à l’estimation de la densité par noyau en psychométrie et statistiques
L’analyse des distributions continues constitue une étape préalable indispensable à toute modélisation statistique avancée. Avant d’engager des modélisations linéaires, des analyses factorielles ou des tests d’hypothèses inférentiels, le chercheur doit impérativement appréhender la géométrie intrinsèque de ses données empiriques afin de détecter d’éventuelles violations de postulats statistiques ou de déceler des structures latentes.
1.1 Définition et principes fondamentaux de l’estimation de densité par noyau
L’estimation de densité par noyau est une procédure statistique non paramétrique conçue pour estimer la fonction de densité de probabilité inconnue d’une population à partir d’un ensemble fini d’observations empiriques. Contrairement aux approches paramétriques classiques qui postulent a priori que les données dérivent d’une distribution théorique prédéfinie — telle qu’une distribution normale, log-normale ou de Weibull — et qui se restreignent à l’estimation de ses paramètres fondamentaux (l’espérance et la variance, par exemple), l’estimateur par noyau n’impose aucune contrainte rigide quant à la morphologie globale de la courbe. Cette méthode confère aux données la primauté absolue dans la détermination de leur propre forme distributionnelle, offrant ainsi une fidélité d’observation particulièrement précieuse face à des phénomènes psychologiques complexes.
L’un des avantages majeurs de cette méthode réside dans la transition d’une représentation discrète et segmentée vers une courbe mathématiquement continue et différentiable. Cette continuité garantit que chaque point de l’espace de la variable se voit attribuer une cote de densité relative, évitant ainsi les ruptures visuelles et conceptuelles imposées par les frontières de classes arbitraires. D’un point de vue méthodologique, cette continuité s’avère indispensable pour analyser des construits psychologiques et comportementaux mesurés sur des continuums théoriques, tels que l’intensité des affects, les indices de réactivité électrodermale ou les scores factoriels latents issus de modèles d’équations structurelles. L’estimation non paramétrique permet de révéler des asymétries fines, des queues de distribution épaisses ou des plateaux centraux que les approximations paramétriques auraient inévitablement effacés.
1.2 Comparaison critique entre histogrammes et courbes de densité
Bien que l’histogramme demeure la technique d’exploration visuelle la plus fréquemment enseignée et employée, il souffre d’imperfections méthodologiques structurelles qui limitent drastiquement sa portée analytique. Le principal écueil de l’histogramme réside dans sa dépendance aiguë et conjointe envers deux paramètres arbitraires : le nombre total de classes (ou leur largeur) et l’origine de départ du découpage sur l’axe des abscisses. Une modification marginale de l’origine de la première classe, maintenant une largeur constante, peut radicalement transformer l’aspect visuel de l’histogramme, faisant apparaître ou disparaître des pics fictifs et conduisant le chercheur à des conclusions erronées quant à l’unimodalité ou la multimodalité de son échantillon.
À l’inverse, l’estimation de la densité par noyau élimine complètement la problématique du point d’origine en positionnant une fonction de pondération continue — le noyau — sur chaque point empirique individuel. La courbe finale résulte de la sommation algébrique de ces composantes élémentaires, assurant une régularité et une cohérence géométrique exemplaires. De surcroît, dans le cadre d’échantillons psychologiques de taille modeste ou intermédiaire (par exemple, des cohortes cliniques de 40 à 100 participants), les histogrammes ont tendance à générer un profil visuel en marches d’escalier excessivement heurté, où le bruit d’échantillonnage domine le signal théorique. Le lissage par noyau préserve les propriétés distributionnelles sous-jacentes sans noyer l’information empirique dans des artéfacts d’intervalles discrets.
1.3 Cas d’usage spécifiques en sciences psychologiques et cognitives
L’utilité pratique de l’estimation de la densité par noyau s’illustre avec acuité dans l’étude de la chronométrie mentale et de la dynamique cognitive. L’analyse des temps de réaction dans des tâches de discrimination perceptive ou de flexibilité attentionnelle produit universellement des distributions fortement asymétriques à droite, classiquement décrites par des modèles ex-gaussiens. La modélisation par noyau permet d’isoler précisément la composante motrice rapide (le pic initial de densité) de la queue exponentielle tardive reflétant les défaillances attentionnelles transitoires, sans contraindre le chercheur à un ajustement paramétrique rigide si les hypothèses de normalité locale sont violées.
Un autre cas d’usage fondamental concerne l’évaluation de la multimodalité dans les échelles d’évaluation clinique et les questionnaires de personnalité. Lorsqu’un inventaire psychométrique administré à une cohorte hétérogène présente deux modes distincts dans sa courbe de densité, cette géométrie signale la coexistence de sous-populations fonctionnellement divergentes au sein d’un même échantillon. Par exemple, dans une étude évaluant des scores de dépression au moyen d’un questionnaire standardisé, l’apparition d’un pic secondaire dans les valeurs élevées de l’échelle met immédiatement en lumière l’existence d’un sous-groupe cliniquement symptomatique. Ce diagnostic morphologique, immédiatement visible grâce au graphique de densité, guide les décisions de stratification méthodologique et de classification diagnostique.
2. Fondements mathématiques et algorithmiques du lissage par noyau
Pour exploiter de manière éclairée les fonctionnalités graphiques de R et ajuster judicieusement les hyperparamètres de lissage, il est impératif de maîtriser l’armature formelle qui sous-tend l’estimation non paramétrique univariée.
2.1 Formulation mathématique de l’estimateur de Rosenblatt-Parzen
L’estimateur de densité par noyau, formalisé de manière indépendante par Murray Rosenblatt en 1956 et Emanuel Parzen en 1962, constitue une généralisation continue de l’histogramme de fréquences. Soit un échantillon de variables aléatoires indépendantes et identiquement distribuées, noté X_1, X_2, …, X_n, issu d’une population régie par une fonction de densité de probabilité inconnue f(x). L’estimateur de Rosenblatt-Parzen de cette fonction au point réel x est formellement défini par l’expression mathématique suivante :
f_chap(x) = (1 / (n * h)) * Somme_{i=1}^n K((x – X_i) / h)
Dans cette formulation canonique, la variable n désigne la taille totale de l’échantillon empirique, le terme K(u) représente la fonction de noyau unitaire choisie, et le scalaire positif h correspond à la largeur de bande (communément appelée bandwidth ou paramètre de lissage). L’équation révèle que la densité estimée en tout point x équivaut à la moyenne arithmétique d’une collection d’impulsions de probabilité individuelles, centrées sur chaque observation empirique X_i et mises à l’échelle spatiale par le paramètre h. Sur le plan des propriétés asymptotiques, sous réserve de la régularité locale de la fonction cible et d’un contrôle rigoureux de la décroissance de h lorsque n tend vers l’infini, cet estimateur jouit d’une convergence en probabilité robuste et d’une consistance statistique démontrée, garantissant la fiabilité des inférences à grande échelle.
2.2 Rôle et propriétés formelles de la fonction de noyau
La fonction de noyau K(u) joue le rôle fondamental d’opérateur de pondération locale dans le calcul de la densité. Pour préserver les axiomes probabilistes fondamentaux de Kolmogorov, le noyau doit obligatoirement satisfaire à des conditions mathématiques strictes. D’une part, il doit être non négatif pour toute valeur réelle de u, garantissant que la densité résultante ne produise jamais de valeurs de probabilité négatives. D’autre part, son intégrale sur l’ensemble de l’axe réel doit impérativement être égale à l’unité, assurant ainsi que l’intégrale de la fonction de densité estimée f_chap(x) totalise exactement 1 sur son domaine de définition. Enfin, le noyau doit être une fonction paire et symétrique autour de zéro, éliminant tout biais directionnel dans l’attribution du poids aux observations environnantes.
La littérature statistique répertorie plusieurs familles canoniques de noyaux, chacune présentant des profils géométriques et des propriétés d’efficacité distincts :
- Le noyau Gaussien : Défini par la fonction de densité de la loi normale standard, K(u) = (1 / racine(2 * pi)) * exp(-0.5 * u^2). Il dispose d’un support infini et confère une régularité différentiable d’ordre infini à la courbe finale.
- Le noyau d’Épanechnikov : Défini par l’expression parabolique K(u) = 0.75 * (1 – u^2) pour toute valeur absolue de u inférieure ou égale à 1, et zéro au-delà. Il s’agit d’un noyau à support compact qui possède la propriété remarquable d’être optimal au sens de la minimisation de l’erreur quadratique moyenne asymptotique.
- Le noyau rectangulaire (ou uniforme) : Défini par K(u) = 0.5 pour la valeur absolue de u inférieure ou égale à 1, générant une attribution de poids binaire sans décroissance progressive.
- Le noyau triangulaire : Caractérisé par une décroissance linéaire sous la forme K(u) = 1 – valeur_absolue(u) pour un argument borné par 1.
- Le noyau bi-poids (biweight ou quartic) : Défini par K(u) = (15 / 16) * (1 – u^2)^2 sur le domaine [-1, 1], offrant un compromis harmonieux entre courbure douce et support strictement borné.
2.3 Le paramètre de lissage : compromis biais-variance
Bien que le choix formel de la fonction de noyau K(u) influence légèrement l’esthétique générale de la courbe, l’exactitude et la fidélité géométrique de l’estimation dépendent de manière écrasante de la sélection du paramètre de lissage h. La largeur de bande opère comme un régulateur d’échelle spatiale : elle détermine l’étendue de la zone d’influence de chaque observation empirique sur l’axe des abscisses. La recherche de la valeur idéale de h confronte inévitablement le chercheur au dilemme classique du compromis entre le biais et la variance en apprentissage statistique.
Si la largeur de bande attribuée est excessivement faible (phénomène de sous-lissage ou undersmoothing), la variance de l’estimateur explose. Chaque donnée individuelle engendre un pic pointu et isolé, fragmentant la courbe de densité globale en une succession d’ondulations chaotiques. Le graphique reflète alors le bruit stochastique propre à l’échantillon plutôt que la dynamique fondamentale de la population parente. À l’opposé, si la largeur de bande est fixée à un niveau disproportionné (phénomène de sur-lissage ou oversmoothing), c’est le biais qui devient prohibitif. L’intégration d’un voisinage trop vaste aplanit systématiquement les caractéristiques de relief de la distribution : les pics modaux s’affaissent dramatiquement, les vallées inter-modales sont colmatées, et la variance globale de la courbe est artificiellement surestimée. La formalisation mathématique de ce compromis passe traditionnellement par la minimisation de l’Erreur Quadratique Moyenne Intégrée (MISE pour Mean Integrated Squared Error), qui décompose le risque quadratique total en la somme intégrée du carré du biais et de la variance de l’estimateur.
3. Configuration de l’environnement R et préparation des données
Une démarche empirique exemplaire débute par une standardisation rigoureuse de l’environnement de calcul au sein de la console R, couplée à un protocole systématique de nettoyage et d’assurance qualité des variables psychométriques cibles.
3.1 Initialisation de la session et gestion des dépendances
L’estimation élémentaire de la densité de noyau présente l’avantage considérable d’être nativement intégrée dans les versions fondamentales de R à travers le sous-système stats, dispensant initialement le praticien de l’installation de modules tiers pour les opérations courantes. Il convient néanmoins de s’assurer que la session de travail repose sur une version moderne de l’interpréteur R (version 4.1.0 ou ultérieure) afin de garantir la compatibilité des moteurs graphiques vectoriels et la stabilité des algorithmes d’optimisation numérique.
Dans le cadre d’un pipeline d’analyse universitaire complet, il est toutefois judicieux de charger un socle d’extensions spécialisées destinées à la manipulation de tables de données volumineuses et au rendu graphique avancé. L’adjonction de bibliothèques telles que ggplot2 pour la modélisation graphique déclarative, dplyr pour les opérations de transformation de données, et scales pour le formatage précis des cotes de densité et des axes dimensionnels garantit une flexibilité d’analyse optimale lors des phases ultérieures du traitement expérimental.
3.2 Prétraitement et nettoyage des variables psychologiques continues
L’exécution de la fonction d’estimation de noyau requiert une vigilance particulière quant à l’intégrité du vecteur numérique fourni. Dans les protocoles de recherche clinique et comportementale, les bases de données contiennent fréquemment des valeurs manquantes résultant d’abandons de protocole, d’omissions volontaires ou de défaillances instrumentales. L’algorithme standard d’estimation de densité dans R interrompt son exécution par défaut en présence d’une valeur NA unique. Dès lors, le chercheur doit expressément spécifier le paramètre d’exclusion systématique na.rm = TRUE ou opérer une purge préalable ciblée, tout en consignant rigoureusement l’ampleur de cette réduction d’échantillon dans son cahier de laboratoire numérique.
Parallèlement, la détection des observations extrêmes ou aberrantes constitue une précaution méthodologique critique. Contrairement aux estimateurs paramétriques rigides (tels que la moyenne empirique), la densité de noyau ne subit pas d’effondrement global en présence d’un outlier éloigné, mais ce dernier crée invariablement une « bosse » artificielle et trompeuse dans la queue extrême de la distribution. L’inspection des quantiles empiriques extrêmes et l’évaluation de l’asymétrie de distribution (skewness) permettent d’arbitrer rationnellement entre la conservation de ces données comme expressions légitimes de variabilité biologique ou leur exclusion documentée au profit de la robustesse analytique.
3.3 Génération de jeux de données reproductibles pour l’expérimentation
Afin de concrétiser les développements techniques de cet ouvrage par des applications pratiques immédiatement vérifiables, nous instaurons une procédure de génération synthétique de données simulant des scénarios psychométriques réalistes. La reproductibilité computationnelle absolue de nos exemples est garantie par l’assignation formelle d’une graine pseudo-aléatoire au moyen de l’instruction set.seed().
Nous modélisons deux vecteurs de scores distincts. Le premier figure une distribution unimodale normale standardisée (représentant les performances d’un groupe contrôle à une tâche de mémoire de travail, centrée sur une moyenne de 100 avec un écart-type de 15). Le second vecteur synthétise une distribution bivariée ou bimodalement perturbée, simulant une population clinique au sein de laquelle coexistent un cluster de patients répondeurs et un sous-groupe réfractaire au traitement psychopharmacologique. Ces vecteurs serviront de matériaux de référence tout au long des démonstrations de codage qui vont suivre.
4. Méthode 1 : Construction d’un graphique de densité élémentaire avec density() et plot()
Le système graphique originel de R (communément appelé R Base Graphics) demeure l’un des outils les plus puissants, véloces et didactiques pour générer des courbes de densité de niveau professionnel sans introduire de couches de dépendances logicielles complexes.
4.1 Calcul de l’objet de densité avec la fonction density()
L’élaboration d’un graphique de densité sous R de base s’articule impérativement en deux phases disjointes : une étape d’évaluation mathématique suivie d’une étape de projection visuelle. L’estimation s’effectue via l’appel à la fonction analytique density(), laquelle accepte en argument principal le vecteur numérique de données continues. L’objet résultant relève formellement de la classe S3 density et encapsule l’ensemble des coordonnées géométriques nécessaires à la reconstruction de la courbe.
L’interrogation interne de cet objet révèle une structure composée de sept éléments fondamentaux. Les composantes vectorielles x et y, qui comptent par défaut 512 points également espacés (ce nombre pouvant être modulé via le paramètre n), constituent la grille de coordonnées cartésiennes de la distribution lissée. Le vecteur x définit les abscisses balayant le domaine d’étendue des données, tandis que le vecteur y fournit la hauteur de densité de probabilité associée en chaque point d’évaluation. L’objet consigne également la largeur de bande effectivement calculée (bw), le noyau employé (kernel), ainsi que la taille de l’échantillon valide exploité, autorisant des analyses quantitatives rétrospectives approfondies.
4.2 Génération graphique avec la fonction générique plot()
Une fois l’objet de classe density instancié dans l’environnement de calcul, la fonction générique polymorphique plot() prend le relais pour traduire les coordonnées mathématiques en une figure géométrique bidimensionnelle. Un appel élémentaire sous la forme plot(density(vecteur_donnees)) génère instantanément un affichage de base. Toutefois, les standards éditoriaux académiques imposent une configuration fine des attributs esthétiques et descriptifs du graphique.
L’enrichissement visuel du tracé s’obtient par l’exploitation des paramètres graphiques universels de R. Le paramètre main permet d’assigner un titre conceptuel explicite à la figure, tandis que xlab et ylab définissent respectivement les libellés scientifiques normalisés des axes horizontal et vertical (par exemple, « Score standardisé (QI) » en abscisse et « Densité de probabilité relative » en ordonnée). De surcroît, la modulation de l’épaisseur du trait via le paramètre lwd (typiquement fixé entre 2 et 3 pour une clarté optimale à l’impression), le choix du motif de ligne par lty (continu, pointillé, tireté) et la sélection de la nuance chromatique par l’argument col permettent d’élever la figure aux exigences des publications scientifiques contemporaines.
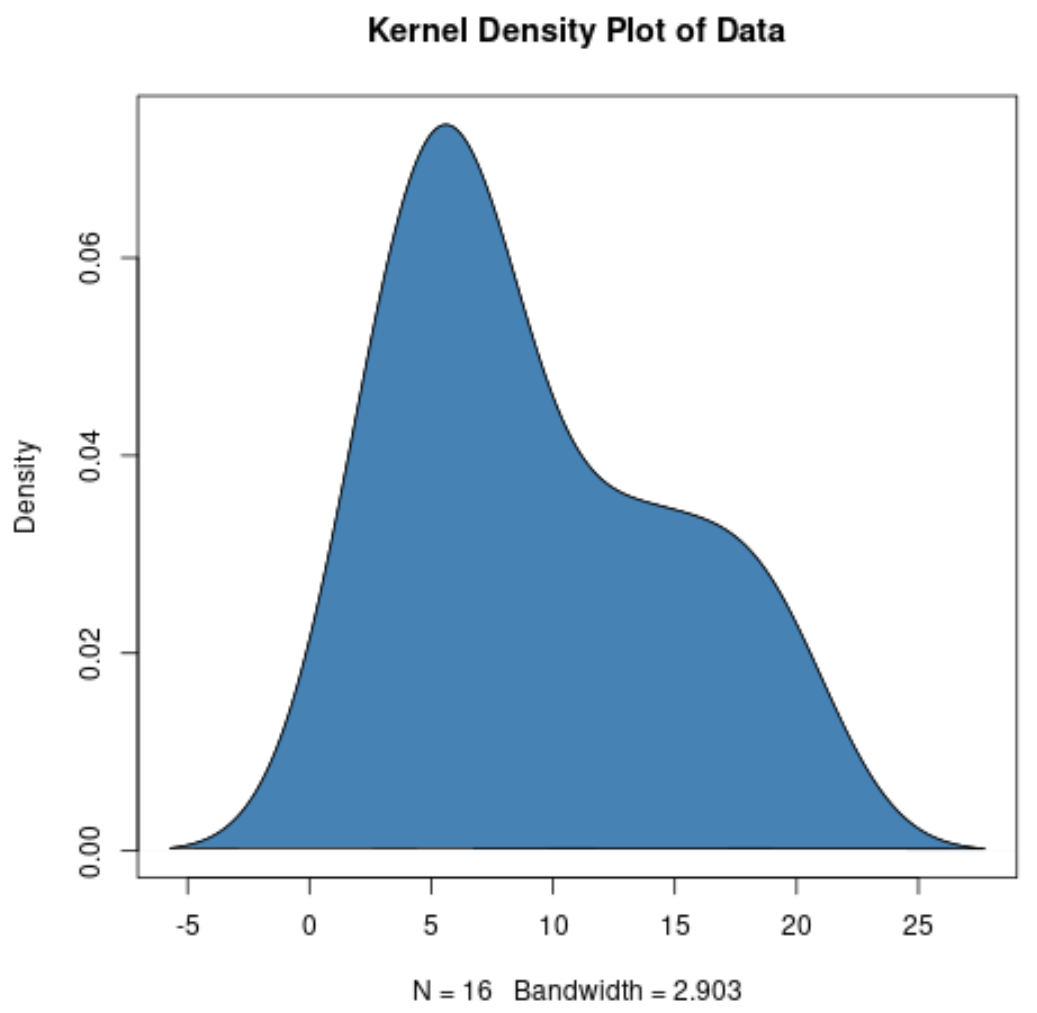
4.3 Interprétation des métriques de sortie sur les données empiriques
L’évaluation critique du graphique produit nécessite une compréhension rigoureuse de la nature des unités affichées sur l’axe des ordonnées. Il est fréquent que des chercheurs non statisticiens commettent l’erreur d’assimiler la valeur de l’axe vertical à une probabilité brute (en s’inquiétant, par exemple, de voir des valeurs dépasser l’unité ou en interprétant une hauteur de 0.04 comme une probabilité de 4 %). Il convient de réaffirmer avec force que l’ordonnée représente une cote de densité, c’est-à-dire une probabilité par unité de mesure sur l’axe des abscisses.
L’inspection du graphique permet d’identifier visuellement le mode empirique principal, correspondant au maximum global de la fonction de densité, repérable à l’abscisse où y atteint son apogée. La confrontation de ce sommet graphique avec la moyenne et la médiane arithmétiques de l’échantillon apporte un éclairage immédiat sur la symétrie de la distribution : un mode significativement décalé vers la gauche par rapport à la moyenne témoigne sans équivoque d’une asymétrie positive marquée, révélant une accumulation de cas chez les scores bas accompagnée d’une dispersion prolongée vers les scores extrêmes élevés.
5. Méthode 2 : Amélioration visuelle et remplissage avec polygon()
Si la simple courbe filaire générée par plot() suffit à la vérification technique rapide, la communication visuelle de haut niveau requiert un traitement géométrique plus élaboré, matérialisant l’aire d’intégration sous la courbe au moyen d’un polygone continu coloré.
5.1 Mécanisme de construction géométrique avec polygon()
L’adjonction d’un remplissage sous une courbe de densité repose sur la fonction géométrique de bas niveau polygon(). Cette primitive graphique opère en reliant séquentiellement une suite ordonnée de coordonnées cartésiennes bidimensionnelles pour former une surface fermée, dont l’intérieur est ensuite balayé par une teinte uniforme ou une trame directionnelle. Pour appliquer cette logique à une estimation de densité, il ne suffit pas de lui fournir les coordonnées brutes x et y de l’objet calculé, car la base de la courbe resterait ouverte, provoquant une distorsion visuelle indésirable.
Le protocole technique rigoureux impose de « fermer » géométriquement la trajectoire en ancrant artificiellement les extrémités gauche et droite de la courbe sur l’axe horizontal d’ordonnée nulle (y = 0). Concrètement, le vecteur des abscisses passé à polygon() doit agréger la valeur minimale du domaine, l’ensemble des coordonnées x de l’objet de densité, puis la valeur maximale du domaine. En miroir exact, le vecteur des ordonnées doit débuter par un point d’ordonnée zéro, incorporer l’ensemble des densités estimées y, et s’achever par une remise à zéro formelle. L’appel coordonné de polygon(c(min(x), x, max(x)), c(0, y, 0), ...) génère ainsi une nappe polygonale étanche, fermée à sa base, conférant une présence sculpturale immédiate à la distribution.
5.2 Gestion des couleurs et de la transparence chromatique
L’impact cognitif et la lisibilité d’un graphique de densité sont intimement corrélés au choix chromatique de l’analyste. Le recours à des aplats de couleurs primaires opaques et saturées (tels que le rouge vif ou le bleu pur sans atténuation) génère une fatigue visuelle pénalisante et obère toute possibilité de superposition analytique. Il est impératif de privilégier des palettes chromatiques harmonieuses, scientifiquement validées pour leur perceptibilité universelle, y compris par des personnes présentant des déficiences de la vision des couleurs (dyschromatopsies).
La maîtrise de la transparence alpha constitue ici l’instrument technique décisif. Dans l’écosystème R base, la translucidité d’une teinte s’ajuste élégamment via la fonction adjustcolor() ou par l’assignation explicite d’un canal alpha dans l’opérateur rgb(). Par exemple, la transformation d’une teinte bleu cobalt par l’application d’un coefficient alpha.f = 0.35 permet de conférer au polygone une présence visuelle équilibrée, soulignant l’enveloppe distributionnelle sans masquer la grille de fond ni les éléments d’annotation textuelle situés dans le plan arrière.
5.3 Personnalisation avancée de l’esthétique du graphique
Pour hisser le rendu graphique aux standards des périodiques internationaux d’excellence, il convient de dépouiller le canevas de ses scories visuelles par défaut. Cela commence par la suppression du cadre périphérique rectangulaire conventionnel (via l’instruction bty = "n" ou bty = "l" dans l’appel initial), éliminant ainsi les bordures superflues qui alourdissent inutilement la composition globale selon les principes d’optimisation du ratio encre-données théorisés par Edward Tufte.
Par la suite, l’adjonction de lignes de repère discrètes au moyen de la primitive grid(), paramétrée avec des teintes grises douces et des styles pointillés (lty = 3, col = "gray85"), structure l’espace sans saturer le regard. Enfin, l’introduction ciblée d’annotations contextuelles à l’aide des fonctions text() et arrows() permet de documenter directement sur la figure des jalons statistiques ou cliniques névralgiques — tels que le report précis d’un seuil de significativité clinique sur l’échelle des abscisses, enrichi d’une flèche directionnelle élégante pointant vers la zone critique de la queue distributionnelle.
6. Méthode 3 : Superposition et comparaison de distributions multiples
Dans la quasi-totalité des dispositifs expérimentaux en psychologie et en médecine comportementale, l’interrogation scientifique ne porte pas sur un groupe unique isolé, mais sur la comparaison distributionnelle entre deux ou plusieurs conditions expérimentales (contrôle versus traitement, témoins versus pathologiques, pré-test versus post-test).
6.1 Harmonisation des échelles avec xlim et ylim
La superposition séquentielle de multiples courbes de densité au sein d’un même repère cartésien sous R base constitue un écueil fréquent pour les chercheurs inexpérimentés. Par défaut, le moteur graphique dimensionne les bornes des axes X et Y exclusivement à partir du premier objet graphique tracé. Par conséquent, si la seconde distribution présente un étalement horizontal plus large ou un pic modal de densité substantiellement plus élevé que la première, cette seconde courbe se trouvera irrémédiablement tronquée aux frontières du graphique, annihilant la validité de la comparaison visuelle.
La résolution rigoureuse de cette contrainte nécessite une phase de calibrage dynamique préalable. L’analyste doit impérativement calculer en amont les deux objets de densité indépendants, puis déterminer les bornes globales extrêmes pour chacun des deux axes au moyen des fonctions vectorielles range() ou du doublet c(min(...), max(...)). Concrètement, la borne maximale de l’axe des ordonnées doit être définie par ylim = c(0, max(c(densite1$y, densite2$y))), tandis que l’amplitude horizontale doit couvrir simultanément xlim = range(c(densite1$x, densite2$x)). L’injection explicite de ces paramètres globaux dans l’appel initial de plot() garantit une matrice d’accueil parfaitement dimensionnée pour recevoir l’intégralité des tracés superposés.
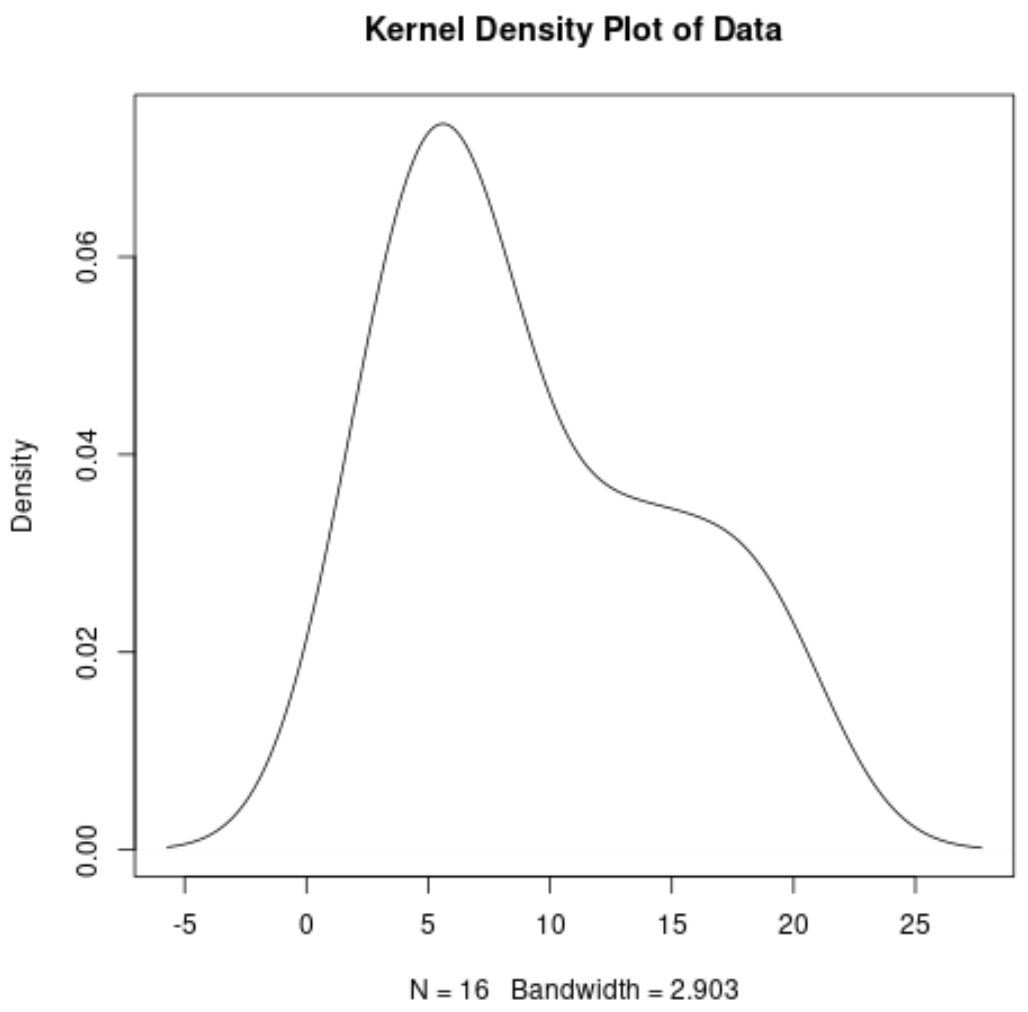
6.2 Superposition séquentielle via lines() et polygon()
Dès lors que le cadre graphique est convenablement calibré par un premier appel graphique, l’empilement des couches comparatives s’opère sans régénérer de nouvelle fenêtre, en mobilisant la fonction d’adjonction linéaire lines() ou son pendant surfacique polygon(). L’approche la plus efficiente pour comparer deux conditions (par exemple, un groupe exposé à un protocole de remédiation cognitive versus un groupe placé sur liste d’attente) consiste à dessiner la première courbe avec un niveau de translucidité maîtrisé, puis à projeter immédiatement la seconde densité par-dessus la première.
L’utilisation combinée de couleurs distinctes à tonalité complémentaire (telles qu’une nuance cyan et une teinte ambrée) associées à un paramètre de transparence alpha équilibré (typiquement 0.4) permet de matérialiser optiquement l’aire de chevauchement distributionnel. La zone d’intersection prend visuellement une teinte hybride issue de la fusion soustractive des deux canaux chromatiques, conférant une appréciation immédiate et intuitive de la distance qui sépare les deux populations. L’analyste discerne d’un coup d’œil si l’effet de l’intervention clinique se traduit par une simple translation spatiale de la moyenne ou par une transformation structurelle plus profonde de la dispersion et de l’asymétrie du groupe traité.
6.3 Conception d’une légende scientifique rigoureuse
Un graphique comparatif multivarié est dépourvu de valeur scientifique exploitable s’il ne s’accompagne pas d’une légende descriptive univoque, structurée et auto-suffisante. La fonction legend() permet de positionner avec une précision millimétrique cet élément d’information cardinal au sein du repère cartésien. Le choix de l’emplacement peut s’effectuer par coordonnées spatiales directes ou par des mots-clés sémantiques universels tels que "topright", "topleft" ou "bottomright", sélectionnés impérativement de manière à occuper les zones vierges de données pour ne masquer aucune portion de courbe.
Pour assurer une conformité totale avec les règles de publication scientifique, la légende doit synthétiser avec une rigueur absolue la codification employée : elle doit juxtaposer les intitulés textuels explicites des groupes, les nuances de couleur respectives des polygones (paramètre fill) ainsi que les styles de lignes des bordures (paramètre border ou lty). Par ailleurs, l’inclusion systématique de la taille effective de chaque sous-échantillon (sous la forme canonique n = 45) au sein des étiquettes textuelles de la légende renforce l’intégrité de la figure en rappelant d’emblée au lecteur le niveau d’assise statistique sous-jacent à chacune des trajectoires dessinées.
7. Exploration et sélection de la fonction de noyau (Kernel)
Le paramétrage du noyau constitue le mécanisme fondamental par lequel l’influence de chaque observation empirique est pondérée et diffusée spatialement sur son voisinage numérique.
7.1 Paramétrage de l’argument kernel dans la fonction density()
L’environnement R se distingue par une prise en charge exceptionnellement vaste de familles mathématiques de noyaux. Au sein de la fonction native density(), la sélection de l’opérateur morphologique s’opère au moyen de l’argument textuel kernel. Par défaut, l’interpréteur applique le noyau gaussien (kernel = "gaussian"). L’utilisateur dispose néanmoins d’une collection d’alternatives formalisées, mobilisables d’un simple paramétrage : "epanechnikov", "rectangular", "triangular", "biweight", "cosine" ou encore "optcosine".
L’expérimentation comparée consistant à appliquer simultanément ces différentes variantes à une distribution empirique identique démontre un principe statistique récurrent : l’impact du choix de la fonction de noyau sur l’allure générale de la densité estimée est relativement mineur, particulièrement lorsque la taille de l’échantillon devient substantielle. Les noyaux à discontinuité angulaire, tels que le noyau rectangulaire, impriment une micro-rugosité perceptible le long de la ligne de fuite, alors que les noyaux d’Épanechnikov ou de Gauss génèrent des trajectoires d’une élégante continuité. Cependant, la localisation spatiale des pics de densité et l’estimation de l’étalement global de la distribution demeurent largement invariants d’un noyau à l’autre, consolidant l’idée que le choix de l’équation du noyau n’est pas le facteur de variabilité principal de l’inférence non paramétrique.
7.2 Analyse mathématique du support des fonctions de noyau
La distinction conceptuelle la plus profonde entre les familles de noyaux réside dans la géométrie de leur support mathématique, c’est-à-dire l’ensemble des points du domaine pour lesquels la fonction prend des valeurs strictement non nulles. Les noyaux dits « à support compact » — au premier rang desquels figurent le noyau d’Épanechnikov et le noyau biweight — possèdent une étendue strictement délimitée au segment [-1, 1] une fois standardisés par la largeur de bande. En conséquence, une observation empirique X_i n’exerce aucune influence au-delà d’une distance spatiale égale à h. Cette propriété garantit une excellente parcimonie computationnelle et une absence totale de contamination probabiliste à longue distance.
À l’inverse, le noyau gaussien possède un support infini s’étendant sur l’intégralité de l’axe des nombres réels, de moins l’infini à plus l’infini. Même si la décroissance exponentielle confère un poids négligeable aux points distants de plus de trois ou quatre largeurs de bande, le noyau gaussien diffuse mathématiquement une fraction infinitésimale de densité sur l’ensemble du continuum. Ce comportement engendre le problème bien documenté de la fuite de bordure (boundary leakage), particulièrement critique dans les protocoles psychométriques exploitant des échelles strictement bornées, comme les échelles de Likert de 1 à 7 ou les pourcentages de réussite. L’emploi d’un noyau à support infini sur de telles variables produit inévitablement l’apparition de densités théoriquement impossibles en deçà du minimum absolu ou au-delà du plafond de l’échelle, obligeant le chercheur à des corrections spécifiques.
7.3 Critères de sélection dans les protocoles de recherche en psychologie
Face à ce panel d’options, quelle posture méthodologique le chercheur en sciences du comportement doit-il adopter ? D’un point de vue purement statistique et théorique, le noyau d’Épanechnikov est rigoureusement prouvé comme étant l’estimateur le plus efficace, au sens où il minimise la perte d’information quantifiée par l’erreur quadratique moyenne intégrée asymptotique (AMISE). Son efficacité relative est conventionnellement établie comme le mètre étalon de référence (100 %), face auquel le noyau gaussien affiche une efficacité relative d’environ 95.1 % et le noyau rectangulaire s’effondre aux alentours de 93 %.
Néanmoins, dans la pratique de la communication académique et de la psychométrie appliquée, le noyau gaussien s’est imposé comme la norme consensuelle prépondérante au sein des revues scientifiques de premier plan. Ce plébiscite pragmatique découle de ses propriétés de régularité infinie : le noyau de Gauss produit des courbes totalement dépourvues d’aspérités angulaires, mathématiquement dérivables à tous les ordres, ce qui facilite grandement l’identification de points d’inflexion pour le repérage précis des modes locaux. Sauf contrainte technique spécifique requérant un confinement compact du support, la recommandation académique standard consiste donc à conserver le noyau gaussien par défaut, tout en consignant explicitement ce choix dans la section méthodologique du manuscrit afin d’en garantir la parfaite transparence opérationnelle.
8. Optimisation critique de la largeur de bande (Bandwidth)
Si la forme du noyau demeure un élément d’importance secondaire, le paramétrage de la largeur de bande (bandwidth) représente le cœur battant de l’estimation de densité, régulant de façon déterminante l’équilibre délicat entre sous-estimation des détails réels et sur-interprétation du bruit aléatoire.
8.1 Règles empiriques classiques de sélection de bande passante
Afin de décharger l’analyste de l’assignation purement subjective d’une valeur numérique arbitraire, les statisticiens ont formalisé des heuristiques analytiques automatisées visant à approximer la largeur de bande idéale en fonction de la taille de l’échantillon et de sa dispersion empirique. Dans R, l’option par défaut implémentée dans la fonction density() est la règle empirique de Silverman modifiée, désignée par le mot-clé bw = "nrd0". Cette formule classique est définie par l’équation suivante :
h_nrd0 = 0.9 * min(s, IQR / 1.34) * n^(-1/5)
Dans cette expression, s correspond à l’écart-type de l’échantillon, IQR désigne l’écart interquartile empirique, et n représente le volume de l’effectif valide. L’introduction de l’écart interquartile confère une précieuse robustesse face aux données aberrantes potentielles. Une variante très proche, paramétrable via bw = "nrd", substitue le facteur multiplicatif 0.9 par le coefficient théorique de Scott (1.06). Bien que ces règles empiriques soient remarquablement efficaces et computationnellement instantanées sur des données unimodales se rapprochant de la normalité, elles révèlent des défaillances dramatiques dès lors que l’échantillon s’écarte de cette hypothèse de base. En particulier, face à des distributions bimodales ou multimodales caractéristiques de populations hétérogènes, ces heuristiques naïves ont tendance à imposer un sur-lissage pénalisant, colmatant purement et simplement le creux inter-modal et masquant la présence de sous-groupes cliniques majeurs.
8.2 Algorithmes de sélection automatisée par validation croisée et plug-in
Pour s’affranchir de la dépendance aveugle à l’hypothèse de normalité sous-jacente des règles de Silverman, la théorie statistique moderne préconise le recours à des algorithmes d’optimisation basés sur les données, disponibles nativement dans R. La méthode contemporaine la plus recommandée en statistique appliquée est sans conteste l’algorithme dit « plug-in » de Sheather et Jones (1991), activable dans density() par l’argument bw = "sj" (ou déclinable via la fonction spécialisée bw.SJ()).
L’approche de Sheather et Jones résout l’estimation de la rugosité de la dérivée seconde de la fonction de densité inconnue par un système itératif complexe, sans présupposer une géométrie unimodale normale. Elle s’impose de façon consensuelle comme la référence méthodologique la plus robuste, capable de préserver fidèlement les creux inter-modaux tout en filtrant le bruit d’échantillonnage marginal. D’autres approches alternatives existent au sein de l’interpréteur R, telles que la validation croisée par moindres carrés non biaisée (bw = "ucv") ou la validation croisée biaisée (bw = "bcv"). Cependant, la validation croisée non biaisée présente une forte instabilité stochastique sur des échantillons de taille modeste, produisant parfois des valeurs de largeur de bande anormalement sous-dimensionnées qui fragmentent artificiellement la courbe.
8.3 Ajustement manuel contextuel via l’argument adjust
Bien que les sélectionneurs algorithmiques automatisés tels que la méthode de Sheather-Jones constituent un point de départ objectif rigoureux, l’analyse exploratoire des données psychologiques justifie fréquemment une modulation raisonnée de la résolution de lissage sous la supervision du chercheur. La fonction density() offre un mécanisme d’ajustement particulièrement élégant grâce à l’argument proportionnel adjust.
Ce paramètre agit comme un opérateur multiplicateur scalaire appliqué à la largeur de bande fondamentale préalablement calculée :
- L’assignation de
adjust = 1conserve intacte la valeur calculée par l’algorithme sélectionné (comportement standard du système). - L’affectation d’une valeur inférieure à l’unité, telle que
adjust = 0.5, divise par deux la largeur de bande effective. Cette configuration déploie une acuité graphique accrue, révélant des micro-structures, des discontinuités de réponse ou des clusters de granularité fine dans les scores de performance psychologique. - Inversement, l’assignation d’une valeur majorée, comme
adjust = 1.8, accroît de 80 % le lissage de base, favorisant une lecture globale et épurée de la macro-tendance de la distribution en gommant les artefacts locaux induits par les fluctuations d’échantillonnage de faible ampleur.
9. Approche moderne : Graphiques de densité avec l’écosystème ggplot2
Si la syntaxe de base de R excelle pour les visualisations directes et le prototypage rapide, l’écosystème moderne fondé sur la grammaire des graphiques de Leland Wilkinson et implémenté par la bibliothèque ggplot2 transcende la visualisation des densités en offrant une modularité déclarative et une cohérence esthétique incomparables.
9.1 Construction de base avec geom_density()
La transition vers la philosophie ggplot2 s’opère par l’abandon des primitives de dessin séquentielles au profit d’une cartographie esthétique (aesthetic mapping) unifiée liant formellement les colonnes d’un tableau de données (data.frame ou tibble) aux composantes dimensionnelles et colorimétriques de la scène graphique. La projection d’une courbe de densité repose sur la couche géométrique dédiée geom_density().
L’implémentation élémentaire requiert l’assignation de la variable continue au sein du bloc aes(x = score), laissant la bibliothèque calculer automatiquement en arrière-plan la statistique de densité associée (notée de manière interne after_stat(density)). La personnalisation des attributs statiques s’effectue directement dans le corps de geom_density() : l’épaisseur du contour se pilote via linewidth = 1, sa coloration par color = "navy", et la texture de remplissage sous-jacente par fill = "skyblue", pondérée de façon indispensable par un facteur de transparence tel que alpha = 0.4. L’alignement sur les exigences de présentation formelle de l’American Psychological Association (APA 7e édition) est ensuite trivialement atteint par l’adjonction de la couche de thème préconfigurée theme_classic(), complétée d’ajustements typographiques dans theme().
9.2 Comparaisons multi-groupes avancées et facettage
L’immense valeur différentielle de ggplot2 se révèle pleinement lorsqu’il s’agit d’articuler la comparaison de distributions entre de multiples conditions expérimentales ou strates démographiques. Au lieu de programmer manuellement le calibrage des fenêtres et l’empilement itératif des lignes comme l’impose R base, il suffit de renseigner la variable catégorielle de regroupement au niveau de la cartographie esthétique, par exemple en formulant aes(x = score, fill = condition, color = condition). Le moteur graphique orchestre automatiquement le calcul des densités distinctes, la séparation des couches, l’application harmonieuse des palettes de couleurs et l’assemblage complet de la légende descriptive sans aucune intervention manuelle.
Lorsque le protocole intègre un plan factoriel complexe impliquant plusieurs variables indépendantes croisées (par exemple, Genre [Féminin / Masculin] x Diagnostic [Témoin / Trouble anxieux / Dépression majeure]), la superposition brute de l’ensemble des courbes engendre inévitablement une surcharge visuelle illisible. ggplot2 résout cette complexité avec une aisance remarquable grâce à son système de facettage (small multiples), concrétisé par les fonctions facet_wrap() ou facet_grid(). Ce mécanisme scinde instantanément la toile en une matrice ordonnée de sous-graphiques autonomes partageant des échelles strictement calibrées, permettant au regard d’effectuer des comparaisons morphologiques croisées d’une pureté analytique exemplaire.
9.3 Graphiques hybrides : Raincloud plots et ggridges
L’estimation de densité, bien que puissante, présente le défaut intrinsèque d’effacer la visibilité directe des points empiriques réels au profit d’un lissage continu synthétique. Pour pallier cette lacune épistémique, la visualisation scientifique contemporaine plébiscite désormais des topologies graphiques hybrides, au premier rang desquelles trônent les célèbres Raincloud plots (graphiques en nuages de pluie). Cette configuration innovante fusionne sur un même plan dimensionnel une demi-courbe de densité représentant la distribution générale (le « nuage »), un diagramme en boîte à moustaches schématisant les indicateurs de position et de dispersion (la médiane et l’intervalle interquartile), et un tapis de dispersion jitterisé figurant chaque observation individuelle sous forme de gouttelette de pluie.
Une autre alternative d’une grande puissance esthétique et analytique réside dans l’exploitation des visualisations en crêtes (ridge plots) rendues accessibles par l’extension spécialisée ggridges et sa couche geom_density_ridges(). Cette technique empile verticalement le long d’un axe nominal les courbes de densité partiellement décalées dans l’espace, évoquant la silhouette d’une chaîne montagneuse. Elle offre une clarté incomparable pour visualiser des suivis longitudinaux de scores psychométriques à travers de nombreuses vagues temporelles successives ou pour hiérarchiser une multitude de sous-échelles d’un inventaire de personnalité sans jamais encombrer l’espace graphique.
10. Étude de cas empirique : Application aux scores d’anxiété et de dépression
Afin d’illustrer la pertinence clinique et la puissance diagnostique de l’estimation de densité de noyau, nous développons à présent une analyse empirique complète et contextualisée, portant sur la cohorte d’une étude d’intervention en psychologie de la santé.
10.1 Présentation du jeu de données cliniques simulé
Notre scénario d’étude évalue l’impact d’une exposition prolongée à un stress psychosocial aigu sur les manifestations de comorbidité anxio-dépressive. Nous concevons une population expérimentale synthétique totalisant 400 participants adultes (200 individus alloués au groupe contrôle préservé et 200 individus composant le groupe expérimental exposé au stresseur). Les scores continus sont évalués au moyen de deux échelles psychométriques étalonnées de référence internationale : le questionnaire d’anxiété généralisée GAD-7 (Generalized Anxiety Disorder-7) et l’inventaire de dépression PHQ-9 (Patient Health Questionnaire-9).
Sur le plan des propriétés métriques simulées, les participants du groupe témoin présentent une distribution unimodale asymétrique positive tout à fait typique d’une population saine, caractérisée par une forte concentration des cotes dans les bas niveaux de l’échelle (moyenne aux alentours de 4 points, dispersion resserrée). À l’opposé, le groupe exposé au stress est délibérément modélisé sous la forme d’un mélange de lois gaussiennes : une fraction résiliente (environ 65 % de l’effectif) maintient des scores d’anxiété modérés, tandis qu’une sous-population vulnérable (35 %) présente une rupture fonctionnelle aiguë, matérialisée par un second mode de haute intensité clinique culminant au-delà de 14 points sur le GAD-7. Ce profil bimodal reflète fidèlement la réalité de la réponse adaptative humaine, où l’hétérogénéité psychologique réfute l’hypothèse d’une réponse translationnelle uniforme.
10.2 Implémentation pas à pas de l’analyse comparative de densité
L’implémentation de la procédure analytique sous R s’articule méthodiquement en débutant par le calcul isolé des fonctions de densité conditionnelles via la fonction density(), en instruisant l’algorithme d’optimisation de Sheather et Jones (bw = "sj") pour garantir la préservation sans compromis de la structure bimodale suspectée. Les cotes d’anxiété de chaque bras expérimental sont soumises à cet estimateur, extrayant avec une extrême précision les coordonnées cartésiennes de part et d’autre.
Dans un second temps, le canevas de base de R est déployé en verrouillant les limites dimensionnelles globales pour neutraliser tout écueil de rognage : l’abscisse est circonscrite entre 0 et 21 (l’intervalle théorique strict du GAD-7), tandis que l’ordonnée est calibrée sur la crête maximale identifiée entre les deux conditions. Le groupe témoin est matérialisé par un polygone ombré d’un bleu marine feutré translucide. Par superposition immédiate, la distribution du groupe soumis au stresseur est intégrée en utilisant une teinte vermillon semi-transparente. Une démarcation verticale pointillée est ensuite apposée à l’abscisse 10, matérialisant le seuil de significativité clinique conventionnel validé en épidémiologie psychiatrique pour orienter le patient vers un protocole thérapeutique spécialisé.
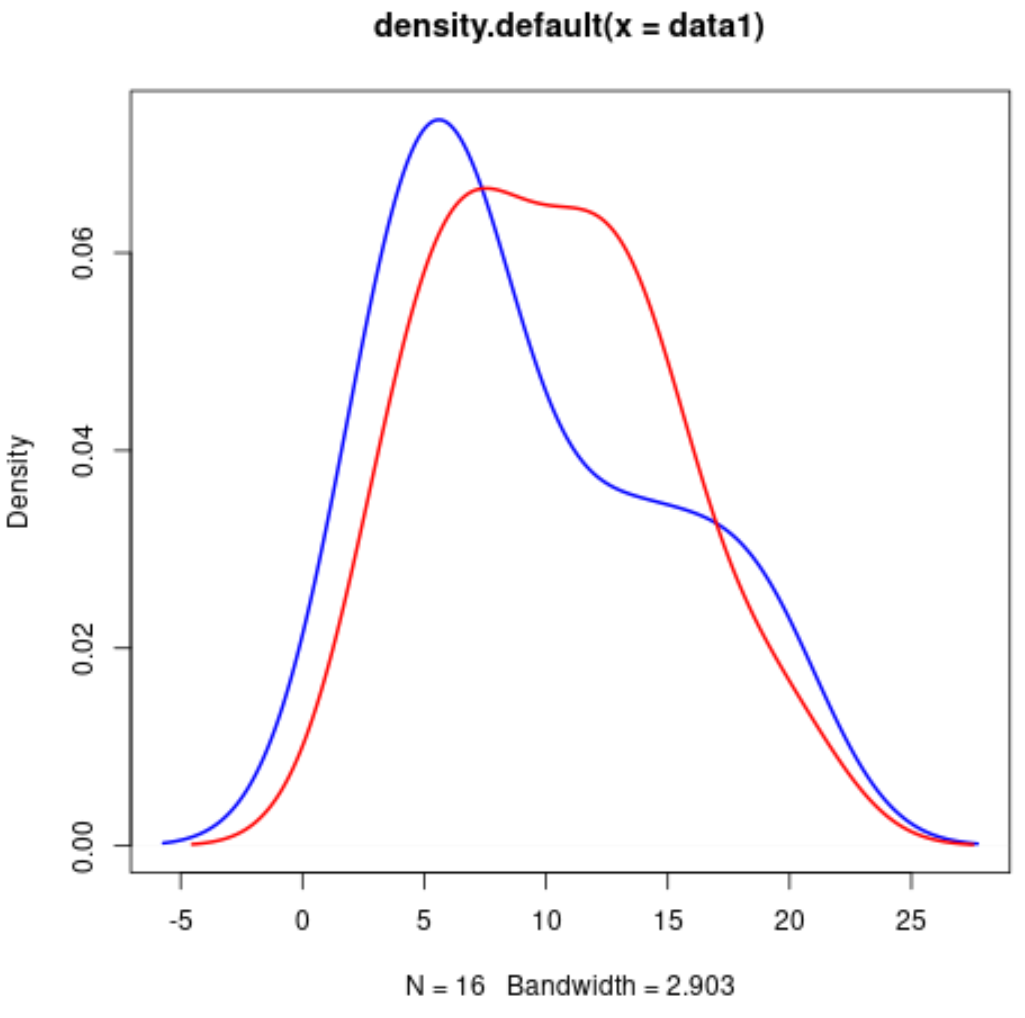
10.3 Interprétation substantive des résultats psychométriques
La contemplation de la figure de densité finale déploie une richesse d’enseignements substantiels qui pulvérise les interprétations sommaires issues des statistiques paramétriques réductrices. Si l’analyste s’était borné à pratiquer un classique test t de Student comparant les moyennes des deux groupes, il aurait certes conclu à un effet statistiquement significatif de l’exposition au stress, objectivé par une augmentation moyenne globale de 4.8 points sur l’échelle. Cependant, ce résultat brut aurait totalement masqué la réalité clinique sous-jacente en accréditant l’illusion trompeuse que l’ensemble des individus exposés au stresseur avaient subi une détérioration anxieuse homogène.
Le graphique de densité par noyau révèle avec une acuité visuelle incontestable la fracture interne du groupe exposé. La courbe met en exergue l’émergence d’une seconde bosse majeure située au-delà du seuil critique de 10 points, isolant un cluster distinct de patients en situation de détresse sévère, tandis que le premier mode demeure remarquablement ancré dans des valeurs infracliniques très proches de la cohorte témoin. Sur le plan de la prise de décision médicale et de l’allocation des ressources en santé mentale, cette découverte guide vers la recherche ciblée de biomarqueurs de vulnérabilité ou de déterminants psychologiques protecteurs (comme le soutien social perçu ou le coping centré sur le problème), démontrant que la densité de noyau transcende le statut de simple outil d’illustration pour devenir un instrument heuristique de premier ordre dans la découverte scientifique.
11. Diagnostics, limites et pièges courants de l’estimation de densité
L’estimation non paramétrique de la densité ne saurait être assimilée à une panacée méthodologique exempte de contraintes. Elle comporte des écueils structurels que tout chercheur rigoureux doit savoir diagnostiquer et contourner.
11.1 Le biais de frontière pour les variables strictement positives ou bornées
L’un des désordres méthodologiques les plus insidieux et récurrents de l’estimation de densité réside dans le phénomène de distorsion aux bornes, techniquement qualifié de biais de frontière (boundary bias). Les noyaux symétriques conventionnels, au premier rang desquels le noyau gaussien, étendent mécaniquement leur pondération de part et d’autre de chaque point empirique. Dès lors, lorsqu’une variable psychologique ou comportementale est assujettie à une barrière physique, temporelle ou institutionnelle infranchissable — telle que les temps de réaction moteurs qui ne peuvent mathématiquement jamais descendre en deçà de zéro milliseconde — le noyau diffuse indûment une fraction de sa masse de probabilité au-delà de la frontière interdite.
Cette fuite géométrique génère deux conséquences préjudiciables : d’une part, la courbe suggère l’existence de cotes intrinsèquement impossibles (comme des temps de réponse négatifs), ruinant la crédibilité du graphique ; d’autre part, par conservation de l’aire sous-jacente égale à 1, la fonction de densité sous-estime systématiquement la hauteur réelle de la distribution à proximité immédiate de la borne critique. Pour juguler ce biais sous R, l’approche la plus élégante consiste à opérer une transformation mathématique continue de la variable (par exemple, une transformation logarithmique népérienne ou une fonction logit pour les proportions bornées sur l’intervalle [0, 1]), à estimer la densité sur l’espace transformé non contraint, puis à procéder au rapatriement sur l’échelle originelle par multiplication par le jacobien de la transformation inverse. Des extensions R dédiées, telles que bde (Bounded Density Estimation) ou evmix, proposent également des noyaux asymétriques adaptés (noyaux bêta ou gamma) qui résolvent nativement ce problème d’étanchéité.
11.2 Artefacts causés par une taille d’échantillon insuffisante
Un principe fondamental de l’inférence non paramétrique énonce que l’estimateur de Rosenblatt-Parzen converge asymptotiquement vers la densité théorique cible à une vitesse substantiellement plus lente que les estimateurs paramétriques standards. Alors que l’estimation d’une moyenne ou d’une variance converge à un taux proportionnel à l’inverse de la racine carrée de n (soit n^(-1/2)), l’erreur de l’estimateur de densité régresse au rythme décéléré de n^(-2/5) sous un paramétrage optimal de la largeur de bande.
En conséquence directe, lorsque l’estimation de densité est exécutée sur des cohortes réduites (typiquement des échantillons de recherche translationnelle ou des études de cas cliniques rassemblant moins de 25 à 30 observations), l’instabilité stochastique devient majeure. Les algorithmes d’optimisation automatisés réagissent excessivement à l’espacement aléatoire qui sépare des points clairsemés, produisant des oscillations de surface, des bosses fictives ou des dépressions locales dépourvues de toute réalité biologique ou comportementale. Le chercheur s’expose alors au risque mortel de la sur-interprétation en formulant des hypothèses cliniques élaborées pour expliquer des micro-modes qui ne sont en vérité que de simples résonances du bruit d’échantillonnage. En deçà d’un effectif d’au moins 50 à 100 observations continues, l’usage des courbes de densité lissées doit impérativement s’accompagner de la visualisation brute des points individuels et être interprété avec une circonspection méthodologique absolue.
11.3 Mauvaise interprétation de la hauteur de la densité vs la probabilité
Il est de la responsabilité déontologique de l’analyste de veiller à ce que les représentations graphiques qu’il communique ne génèrent pas d’illusions cognitives chez les cliniciens ou les décideurs non mathématiciens. Le piège le plus universellement constaté réside dans la confusion intellectuelle entre cote de densité et probabilité ponctuelle. Face à une variable continue, la probabilité exacte associée à un point infinitésimal isolé P(X = x) est mathématiquement égale à zéro.
De surcroît, dès lors qu’une variable psychologique continue possède une variance très faible et se trouve resserrée sur une micro-plage d’abscisses (par exemple, des temps de réaction mesurés en secondes fractionnaires comprises entre 0.15 et 0.25 s), la valeur de la fonction de densité de probabilité en son sommet peut aisément atteindre des hauteurs vertigineuses de 15, 20 ou même 50, sans qu’aucune anomalie statistique ne soit commise. La condition axiomatique d’intégration stipule que c’est la surface totale sous la courbe qui doit équivaloir à 1, et non la coordonnée maximale de l’axe vertical. Pour extraire la probabilité effective qu’un participant présente un score situé dans un intervalle clinique donné [a, b], il est nécessaire de calculer l’intégrale définie de la fonction estimée entre ces deux bornes, opération réalisée numériquement sous R au moyen de la fonction integrate() appliquée à une fonction d’approximation construite via approxfun(density(x)).
12. Bonnes pratiques académiques et standardisation pour la publication
L’aboutissement d’une recherche empirique repose sur la transposition scrupuleuse des productions graphiques aux exigences formelles des revues internationales dotées d’un comité de lecture exigeant.
12.1 Directives de conformité aux normes APA (7e édition)
Le manuel de publication de l’American Psychological Association (APA 7e édition) régit la mise en forme de la majorité des revues savantes en psychologie, en psychiatrie et en sciences comportementales. La conformité à cette norme impose une discipline visuelle rigoureuse qui proscrit catégoriquement les fioritures décoratives, les effets d’ombre portées, les arrière-plans colorés ou les bordures de cadrage omnidirectionnelles superflues.
Sur le plan typographique, les polices de caractères incorporées au sein des graphiques (titres, libellés des axes, chiffres d’échelles) doivent appartenir de façon homogène à des familles sans empattement (sans-serif) d’une neutralité exemplaire, telles qu’Arial, Calibri ou Helvetica, tout en préservant une taille de corps comprise entre 8 et 12 points pour assurer une réduction homothétique sans perte de lisibilité. L’axe des ordonnées doit impérativement comporter la mention standardisée « Densité de probabilité » (ou simplement « Densité »), tandis que l’axe horizontal doit expliciter le nom complet du construit évalué, accompagné entre parenthèses de son unité métrique ou de l’acronyme officiel de l’instrument validé. Les notes de figure positionnées sous le graphique doivent, avec une méticulosité absolue, expliciter la nature de la fonction de noyau appliquée (ex. : « Lissage par noyau gaussien ») ainsi que la valeur exacte de la largeur de bande utilisée (ex. : « bande passante ajustée par l’algorithme de Sheather-Jones, h = 1.42 »), offrant aux évaluateurs les moyens techniques de vérifier l’adéquation de la calibration statistique.
12.2 Exportation haute résolution pour les revues à comité de lecture
Une défaillance classique dans le processus de soumission éditoriale réside dans l’exportation de figures sous des formats matriciels comprimés et dégradés (comme les fichiers JPEG ou PNG basse définition), dont laPixellisation grossière déprécie instantanément la valeur du manuscrit lors du processus d’évaluation par les pairs. Les maisons d’édition académiques de premier rang (Elsevier, Springer-Nature, Wiley, APA Press) exigent formellement des documents graphiques conformes à des critères industriels d’impression stricts.
Deux voies d’exportation d’excellence doivent être privilégiées au sein de R :
- Les formats vectoriels purs (PDF, EPS, SVG) : Générés nativement via les périphériques d’impression virtuels
pdf(file = "figure1.pdf", width = 7, height = 5)ou par l’instruction moderneggsave(filename = "figure1.svg", device = "svg"). Le format vectoriel encode la trajectoire sous forme d’équations géométriques scalables, garantissant une résolution infinie et un rendu typographique parfait, quel que soit le taux d’agrandissement opéré par l’imprimeur. - Les formats matriciels non compressés à haute résolution (TIFF) : Lorsqu’un format matriciel est formellement exigé pour des raisons de composition éditoriale, l’exportation doit impérativement être paramétrée à une densité spatiale minimale de 300 à 600 points par pouce (DPI) en mobilisant le périphérique dédié :
tiff(filename = "figure1.tif", width = 2100, height = 1500, res = 300, compression = "lzw"). La compression sans perte LZW préserve l’intégrité intégrale des contours fins et des nuances de transparence alpha préalablement programmées.
12.3 Reproductibilité scientifique et partage du code source
À l’ère de la crise de la reproductibilité et de l’avènement des principes de la science ouverte (Open Science Framework), la publication d’un graphique scientifique ne peut plus être dissociée de la traçabilité absolue des calculs computationnels qui l’ont engendré. Un graphique de densité, reposant sur des arbitrages méthodologiques déterminants (sélection du noyau, choix de la bande passante, traitement des frontières, exclusion de données manquantes), doit être intégralement reproductible par n’importe quel chercheur indépendant à partir du jeu de données brutes d’origine.
Cette exigence déontologique s’opérationnalise magistralement par l’intégration du script d’analyse au sein d’environnements de programmation lettrée et reproductible tels que Quarto ou R Markdown. Ces outils conjuguent dans un document unique le code source exécutable R, les descriptions discursives théoriques et les sorties graphiques dynamiques. Le script de génération doit consigner explicitement la fixation initiale de la graine pseudo-aléatoire (set.seed()), l’archivage formel de la session informatique incluant le numéro de version de R et de l’ensemble des modules graphiques activés (via l’instruction fondamentale sessionInfo()), et être mis à disposition de la communauté savante sur des plateformes d’archivage public pérennes telles que Zenodo ou GitHub. Cette rigueur méthodologique garantit que la représentation graphique s’élève du simple statut d’image illustrative à celui d’un argument scientifique probant, vérifiable et durablement inscrit dans le patrimoine de la recherche contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Epanechnikov, V. A. (1969). Non-parametric estimation of a multivariate probability density. Theory of Probability & Its Applications, 14(1), 153–158. https://doi.org/10.1137/1114019
- Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Rosenblatt, M. (1956). Remarks on some nonparametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190
- Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683–690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0