
La communication visuelle des résultats quantitatifs constitue un pilier fondamental de la recherche empirique moderne. Dans les sciences biomédicales, les sciences du comportement, l’économétrie et l’ingénierie des données, la capacité à synthétiser des relations multivariées complexes conditionne la transparence, la reproductibilité et l’impact persuasif des publications scientifiques. Au cœur de cette démarche sémiotique, la boîte à outils graphique offerte par l’environnement statistique R, et plus particulièrement par la bibliothèque ggplot2 conçue par Hadley Wickham d’après la grammaire des graphiques de Leland Wilkinson, s’est imposée comme le standard de référence mondial pour l’exploration et la restitution visuelle de données empiriques.
Toutefois, la simple génération de figures isolées s’avère rapidement insuffisante lorsqu’il s’agit de confronter des dynamiques distributionnelles complexes, de comparer des groupes expérimentaux selon plusieurs angles d’observation ou d’évaluer conjointement des variables dépendantes mesurées sur des échelles hétérogènes. Si la superposition de couches géométriques au sein d’un même repère cartésien représente le réflexe analytique élémentaire, cette technique atteint des limites perceptuelles critiques dès lors que la densité de points, la multiplicité des tracés ou l’enchevêtrement des distributions engendrent une surcharge cognitive préjudiciable à la lisibilité. Dès lors, l’agencement ordonné de graphiques juxtaposés ou multi-panneaux émerge non seulement comme une nécessité esthétique, mais surtout comme un impératif méthodologique d’inférence visuelle.
Ce guide exhaustif a pour vocation d’explorer l’ensemble des mécanismes théoriques et pratiques permettant de juxtaposer, d’aligner et de composer des figures côte à côte avec une précision éditoriale rigoureuse. En parcourant les solutions algorithmiques contemporaines, depuis le paradigme algébrique novateur de l’extension patchwork jusqu’aux outils historiques éprouvés tels que cowplot et gridExtra, sans omettre les articulations avec le facettage natif, cet ouvrage détaille chaque étape nécessaire à la conception de figures composites répondant aux normes de publication les plus strictes, notamment celles de l’American Psychological Association.
1. Introduction à la visualisation juxtaposée avec ggplot2 dans la recherche empirique
1.1 Pertinence méthodologique de la comparaison graphique directe
L’architecture cognitive humaine traite l’information visuelle à travers des processus pré-attentionnels optimisés pour la détection spatiale, la reconnaissance des formes et l’évaluation des contrastes relatifs. Dans le cadre de l’analyse de données expérimentales, contraindre le lecteur à alterner mentalement entre plusieurs pages ou sections textuelles pour confronter deux distributions distinctes s’accompagne d’une déperdition mnésique substantielle. Les travaux pionniers de William Cleveland et Robert McGill sur la perception graphique ont démontré avec rigueur que la comparaison de grandeurs alignées le long d’une échelle commune présente le degré d’erreur d’estimation le plus faible chez l’observateur humain, comparativement au décodage d’angles, de volumes ou de saturations chromatiques.
La juxtaposition rigoureuse de figures indépendantes permet d’établir une ligne de base perceptive stable. Par exemple, la confrontation d’un groupe contrôle et d’un groupe expérimental gagne immensément à présenter, au sein d’un même champ visuel immédiat, les caractéristiques d’asymétrie, d’aplatissement et de valeurs aberrantes de leurs distributions respectives. Cette disposition spatiale simultanée évite les distorsions interprétatives générées par des comparaisons successives asynchrones, tout en stimulant la détection immédiate des violations de postulats statistiques fondamentaux, tels que l’homoscédasticité ou la normalité des résidus.
Enfin, l’évaluation conjointe de métriques complémentaires requiert fréquemment une organisation juxtaposée. L’observation isolée d’un indice de tendance centrale, tel que la moyenne arithmétique ou la médiane, dissimule fréquemment des phénomènes critiques d’hétérogénéité sous-jacente ou de bimodalité. En plaçant côte à côte une représentation synthétique des quantiles et une estimation non paramétrique de la densité de probabilité, le chercheur offre une vision holistique du phénomène étudié. Cette complémentarité instrumentale garantit que l’interprétation des données ne repose pas sur une réduction unilatérale du signal empirique, mais sur une appréhension équilibrée de sa localisation et de sa dispersion.
1.2 Limites de la superposition unique et besoin d’agencements multi-panneaux
La superposition aveugle de primitives géométriques au sein d’un canevas cartésien unique constitue l’un des écueils les plus récurrents de la datavisualisation contemporaine. Lorsque l’analyste superpose des nuages de points denses appartenant à plusieurs cohortes, la saturation spatiale engendre un phénomène d’occlusion visuelle, désigné sous le terme d’overplotting. Même en modulant les degrés d’opacité ou en introduisant un tremblement stochastique, la lisibilité se dégrade inéluctablement, empêchant l’identification des discontinuités locales et des regroupements marginaux propres à chaque sous-population.
Le problème devient conceptuellement insoluble lorsque l’analyse porte sur des variables dépendantes dotées d’unités de mesure incommensurables. Recourir à des artifices de visualisation tels que les doubles axes des ordonnées superposés avec des échelles disjointes est unanimement condamné par les experts en sémiologie graphique. En effet, de telles constructions trompeuses suggèrent artificiellement des croisements de courbes, des synchronicités d’amplitude ou des relations causales qui dépendent uniquement de l’ajustement arbitraire des facteurs d’échelle choisis par l’auteur. L’unique échappatoire méthodologique conforme à l’éthique scientifique réside dans la séparation physique des tracés en panneaux contigus, dotés chacun de son propre système d’axes précisément dimensionné.
Enfin, les exigences formelles des revues à comité de lecture imposent une densité informationnelle optimale sans compromettre l’élégance typographique. Une figure composite multi-panneaux permet d’articuler un récit démonstratif complet au sein d’un espace délimité, respectant les contraintes strictes des gabarits éditoriaux en simple ou double colonne. Cette structuration globale condense l’argumentation empirique en une unité visuelle autonome, facilitant grandement la mission d’évaluation des pairs et renforçant la clarté pédagogique du manuscrit final.
1.3 Panorama des solutions disponibles au sein de l’écosystème du Tidyverse
Face à la nécessité de dissocier les informations visuelles, l’environnement R propose une variété d’outils conceptuellement distincts qu’il convient de classifier rigoureusement. La première solution, native à l’architecture de ggplot2, réside dans le mécanisme de facettage implémenté via les fonctions de structuration spatiale conditionnelle. Le facettage décompose un jeu de données unique en sous-ensembles matriciels homogènes à travers une formule reliant une ou plusieurs variables catégorielles. Bien que performant pour analyser des sous-groupes d’une même structure tabulaire, il demeure structurellement inopérant lorsqu’il s’agit de combiner des graphiques reposant sur des géométries radicalement dissemblables, des données issues de sources disparates ou des configurations d’axes incompatibles.
Pour surmonter cette restriction, la communauté des développeurs de R a conçu des bibliothèques dédiées à l’assemblage de graphiques autonomes. Historiquement, l’extension gridExtra, s’appuyant directement sur le moteur graphique de bas niveau grid, a constitué la première réponse robuste en fournissant des fonctions capables de ranger des objets graphiques au sein de tables d’affichage rectangulaires. Néanmoins, l’absence de communication bidirectionnelle entre les objets combinés et les métriques de mise en page entraînait fréquemment des désalignements fâcheux des axes lorsque les étiquettes textuelles présentaient des longueurs asymétriques.
Ultérieurement, la bibliothèque cowplot a apporté des améliorations majeures en matière d’alignement physique des panneaux et de conformité aux standards éditoriaux académiques. Plus récemment, l’émergence du package patchwork, développé par Thomas Lin Pedersen, a révolutionné ce domaine en introduisant un paradigme déclaratif basé sur des opérateurs arithmétiques intuitifs. Ce package transforme des objets graphiques complets en véritables opérandes d’une algèbre spatiale, harmonisant automatiquement les alignements d’axes, la fusion des légendes et la numérotation hiérarchique des sous-figures avec un niveau d’abstraction jusqu’alors inégalé.
2. Configuration de l’environnement R et installation des extensions requises
2.1 Installation et chargement rigoureux des dépendances logicielles
La mise en place d’un flux de travail reproductible débute impérativement par une gestion rigoureuse de l’environnement d’exécution logiciel. Dans le cadre de l’écosystème R, la pérennité computationnelle d’un script d’analyse visuelle dépend de l’adéquation entre les versions du moteur R de base et celles des bibliothèques tierces compilées sur le poste de travail. L’installation des outils nécessaires à la composition graphique s’effectue au moyen de la commande usuelle d’interrogation du réseau officiel du Comprehensive R Archive Network, ciblant conjointement le cœur graphique et son extension de composition modulaire.
Il est vivement recommandé, dans une perspective d’ingénierie logicielle saine, de s’assurer de la compatibilité des versions installées. L’évolution rapide des dépendances internes du système rlang et des moteurs graphiques sous-jacents peut parfois provoquer des comportements divergents lors de l’évaluation paresseuse des expressions graphiques. L’incorporation d’outils d’isolation de paquets, tels que le gestionnaire d’environnements virtuels renv, offre à ce titre une garantie substantielle pour geler l’état précis des dépendances mobilisées lors de la production des figures destinées à la publication.
L’initialisation formelle du script scientifique doit comporter l’appel explicite des bibliothèques nécessaires via l’instruction de chargement standardisée. Cette démarche permet d’enregistrer dans l’espace de noms de la session les méthodes S3 surchargées qui gouvernent le comportement arithmétique des objets graphiques. C’est précisément l’activation préalable de ces mécanismes qui confère aux objets de classe spécifique la capacité d’interagir entre eux sans nécessiter de conversion fastidieuse préalable en structures de bas niveau.
2.2 Préparation et structuration des données d’analyse
L’efficacité opérationnelle de ggplot2 repose entièrement sur le respect scrupuleux des principes des données ordonnées ou tidy data, formalisés par Hadley Wickham. Selon ce cadre théorique, chaque variable mesurée doit constituer une colonne distincte, chaque unité observationnelle doit former une ligne unique, et chaque type d’unité observationnelle doit être consigné au sein d’une table dédiée. Toute déviation par rapport à cette norme tabulaire compromet l’expressivité déclarative de la grammaire graphique et impose des manipulations intermédiaires coûteuses.
Afin de concrétiser les architectures de test présentées dans ce guide, le jeu de données classique issu des travaux morphologiques sur le genre Iris représente un support pédagogique et empirique idéal. Collecté par Edgar Anderson et popularisé par Ronald Fisher, ce corpus comprend des mensurations biométriques précises concernant la longueur et la largeur des sépales et des pétales chez trois espèces botaniques distinctes. Cette structure offre un équilibre parfait entre prédicteurs continus multivariés et catégorisation factorielle discrète.
Avant d’engager la moindre commande visuelle, une phase préliminaire de contrôle de la structure des données s’avère indispensable. Il convient de s’assurer que les variables catégorielles sont explicitement modélisées sous la forme de facteurs dûment ordonnés ou étiquetés, évitant ainsi que les variables discrètes ne soient traitées par inadvertance comme de simples vecteurs de chaînes de caractères. De surcroît, la vérification des échelles de mesure et l’éventuelle imputation ou exclusion motivée des observations manquantes garantissent que le rendu graphique ultérieur ne souffrira d’aucun artéfact computationnel non documenté.
3. Fondements théoriques de la composition graphique avec patchwork
3.1 La syntaxe algébrique appliquée aux objets graphiques
L’originalité conceptuelle majeure de l’extension patchwork réside dans la transposition de l’arithmétique élémentaire au domaine de la géométrie de mise en page. Au lieu de contraindre le programmeur à invoquer des fonctions d’agencement imbriquées assorties de listes infinies de paramètres géométriques, l’extension surcharge les opérateurs binaires standard de l’interpréteur R. Cette élégance syntaxique permet de traiter des figures entières comme de simples grandeurs algébriques réceptives aux lois de composition spatiale.
Dans ce modèle formel, l’opérateur d’addition assume le rôle d’un concaténateur horizontal. Lorsque deux entités graphiques sont associées par cet opérateur, le moteur d’évaluation interprète la relation comme l’instruction explicite de créer un agencement linéaire bidimensionnel où les composants visuels occupent des colonnes adjacentes de proportions équivalentes. Inversement, l’opérateur de division arithmétique se voit assigner la fonction sémantique de la superposition verticale, ordonnant les tracés selon une séquence d’étages étagés le long de la dimension orthogonale.
Sous cette couche d’abstraction épurée s’opère une conversion dynamique particulièrement complexe. Chaque graphique individuel, initialement encapsulé dans une structure de données décrivant ses composantes analytiques, est traduit lors de l’assemblage en un arbre d’arborescence graphique fondé sur des objets de classe grob (graphical objects) gérés par une table d’agencement gtable. Le package patchwork agit alors comme un compilateur de layout qui calcule les dimensions relatives minimales, synchronise les boîtes englobantes et résout les contraintes topologiques de manière transparente pour l’utilisateur final.
3.2 Philosophie de conception et séparation des responsabilités
La puissance méthodologique de cette approche découle d’un principe fondamental de génie logiciel : la séparation stricte des responsabilités. Dans les flux de travail traditionnels de bas niveau, l’analyste devait souvent modifier les marges individuelles d’un graphique, tronquer ses étiquettes ou dissimuler manuellement sa légende en prévision de son intégration dans une figure combinée. Cette imbrication des paramètres de tracé et des paramètres de mise en page nuisait gravement à la modularité et à la réutilisabilité du code source.
Avec le paradigme moderne, chaque panneau conserve son intégrité esthétique, son système de coordonnées et sa spécification thématique de manière totalement autonome. Le graphique univarié ou bivarié est conçu, débogué et optimisé isolément, sans qu’aucune considération relative à son voisin spatial immédiat ne vienne parasiter sa définition géométrique. C’est exclusivement au stade ultime de l’assemblage que la topologie spatiale globale intervient, appliquant des directives de composition macroscopiques à l’ensemble du composite formé.
Cette distinction conceptuelle élimine radicalement le besoin d’interagir directement avec la complexité aride des viewports du système graphique de base de R. L’utilisateur est affranchi des calculs trigonométriques et des conversions d’unités physiques (millimètres, pouces ou coordonnées normalisées de périphérique), déléguant l’intégralité de l’arbitrage géométrique à une couche d’optimisation intelligente capable de préserver le ratio d’aspect critique des données visualisées.
4. Création pas à pas de deux graphiques côte à côte avec patchwork
4.1 Définition séquentielle du premier graphique : le diagramme en boîte
Afin de concrétiser la démarche expérimentale, débutons par la conception d’un premier artefact graphique dédié à l’évaluation comparative des distributions marginales. Le diagramme en boîte de Tukey constitue un choix méthodologique d’une redoutable efficacité pour synthétiser les caractéristiques non paramétriques d’une variable continue subdivisée selon les modalités d’un facteur discret. Il cartographie simultanément la médiane, la dispersion interquartile et l’étendue des valeurs considérées comme non aberrantes selon le critère standard de Tukey.
Dans notre architecture de démonstration, nous choisissons d’explorer la variabilité de la longueur des sépales à travers les trois catégories taxonomiques du jeu de données botanique. La cartographie esthétique associe la variable d’espèce à l’axe des abscisses ainsi qu’à la palette de remplissage intérieur, tandis que la mesure biométrique s’inscrit le long de l’axe des ordonnées. L’introduction d’un paramètre d’opacité judicieusement calibré au niveau de la couche géométrique permet de conserver une lisibilité optimale tout en préparant la cohérence stylistique avec les panneaux subséquents.
Le raffinement de ce premier composant impose une attention rigoureuse aux conventions d’étiquetage typographique. L’adjonction de désignations explicites d’axes, pourvues de leurs unités métriques respectives, et l’application d’un thème visuel épuré dénué d’éléments ornementaux superflus constituent le socle de ce premier panneau. Cette structure complète n’est pas envoyée immédiatement vers le périphérique de rendu, mais rigoureusement assignée à une variable d’objet dédiée au sein de la session de travail R.
4.2 Définition séquentielle du second graphique : la courbe de densité
Le second artefact graphique est spécifiquement élaboré pour apporter un éclairage distributionnel complémentaire sur la même métrique continue, en s’affranchissant toutefois de la discrétisation spatiale propre aux boîtes à moustaches. L’estimation de densité par noyau de lissage gaussien permet de visualiser la forme continue de la fonction de densité de probabilité empirique sous-jacente, révélant sans ambiguïté la présence éventuelle de modélisations multimodales ou d’asymétries subtiles que le diagramme en boîte tend structurellement à masquer.
Pour concevoir cette figure, la mesure biométrique continue est assignée à l’axe horizontal, tandis que l’axe vertical capture mathématiquement la densité estimée par l’algorithme de fenêtrage. La différenciation des populations botaniques s’opère par l’attribution de teintes distinctes aux surfaces sous les courbes. À ce stade, la modulation de la transparence prend une importance méthodologique critique : un coefficient d’opacité modéré s’avère indispensable pour observer distinctement les zones géométriques de chevauchement inter-groupes.
Tout comme lors de l’étape précédente, la cohérence chromatique globale doit être strictement maintenue en employant les mêmes correspondances factorielles que celles adoptées dans le premier graphique. De surcroît, l’application des directives thématiques uniformisées garantit que la tonalité des lignes de repère et la typographie des axes s’harmonisent en tout point. Ce second objet analytique est ensuite stocké sous un nom de variable distinct, prêt pour l’opération d’assemblage spatial.
4.3 Combinaison horizontale élémentaire et rendu graphique
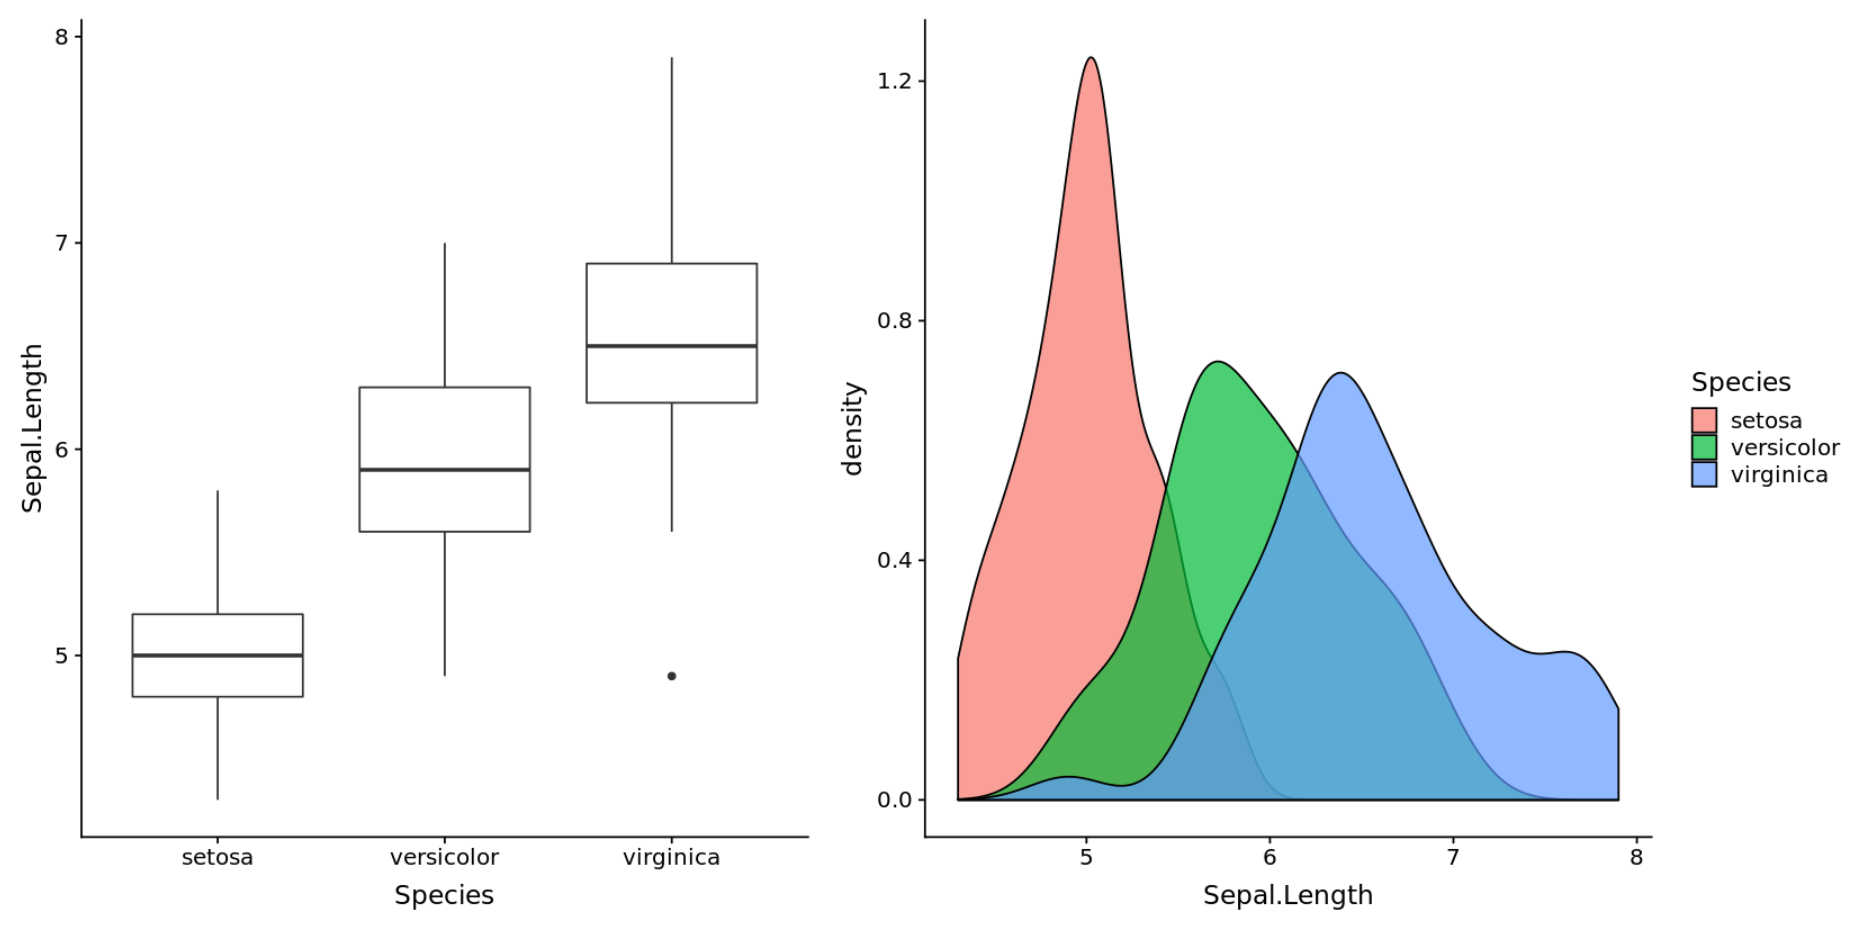
Une fois les deux représentations graphiques encapsulées dans leurs variables respectives au sein de l’environnement de calcul, la phase d’agrégation peut intervenir. Dans le cadre théorique du package patchwork, la commande nécessaire pour juxtaposer ces deux panneaux sur un axe strictement horizontal atteint une concision expressive maximale : elle consiste simplement à relier le premier identifiant graphique au second à l’aide de l’opérateur d’addition canonique.
Lors de l’évaluation de cette ligne d’instruction, le compilateur interne analyse la structure des deux objets et instancie automatiquement une grille d’affichage composée d’une rangée unique scindée en deux colonnes d’égale amplitude spatiale. Contrairement aux approches rustiques d’affichage partagé, le mécanisme compense instantanément les divergences dimensionnelles potentielles induites par les libellés de texte afin que les zones effectives de traçage occupent rigoureusement une superficie identique sur le périphérique de sortie.
La vérification empirique du rendu au sein de la fenêtre graphique permet de constater la parfaite harmonisation structurelle de l’ensemble. Les deux graphiques coexistent désormais en une entité unifiée, offrant au lecteur la possibilité d’effectuer une translation visuelle directe entre le diagramme de Tukey à gauche et les fonctions de densité à droite. Cette configuration binaire élémentaire pose les bases opératoires sur lesquelles des structures spatiales d’une complexité nettement plus élevée peuvent être édifiées.
5. Extension multidimensionnelle : aligner trois graphiques ou plus horizontalement
5.1 Intégration d’un nuage de points pour révéler les corrélations bivariées
L’approfondissement du protocole d’analyse empirique exige fréquemment l’introduction d’un troisième panneau destiné à élucider la structure de covariance reliant la variable étudiée à un second prédicteur quantitatif. Alors que les deux premiers graphiques documentaient la dynamique marginale univariée d’une seule dimension biométrique, l’adjonction d’un nuage de points permet d’examiner les relations bivariées conditionnelles et de détecter visuellement d’éventuels phénomènes d’interaction ou de corrélation intra-classe.
La construction de ce troisième panneau repose sur l’instanciation d’une géométrie de points projetant sur le plan cartésien la longueur des sépales en fonction de leur largeur respective. La ségrégation chromatique des observations individuelles s’aligne fidèlement sur la classification taxonomique préétablie, assurant une parfaite lisibilité sémiotique à travers les différents modules graphiques. L’insertion optionnelle d’une droite d’ajustement linéaire calculée par les moindres carrés ordinaires au sein de chaque sous-groupe enrichit la figure d’une estimation paramétrique immédiate des gradients de corrélation.
Sur le plan de l’architecture du code, ce graphique bivarié est intégralement paramétré selon les mêmes exigences de sobriété stylistique que ses prédécesseurs. L’assignation de sa structure finale à un troisième identifiant d’objet graphique parachève la constitution de la triade expérimentale, ouvrant la voie à une composition sérielle élargie sur le plan horizontal.
5.2 Assemblage linéaire ternaire et préservation de la lisibilité
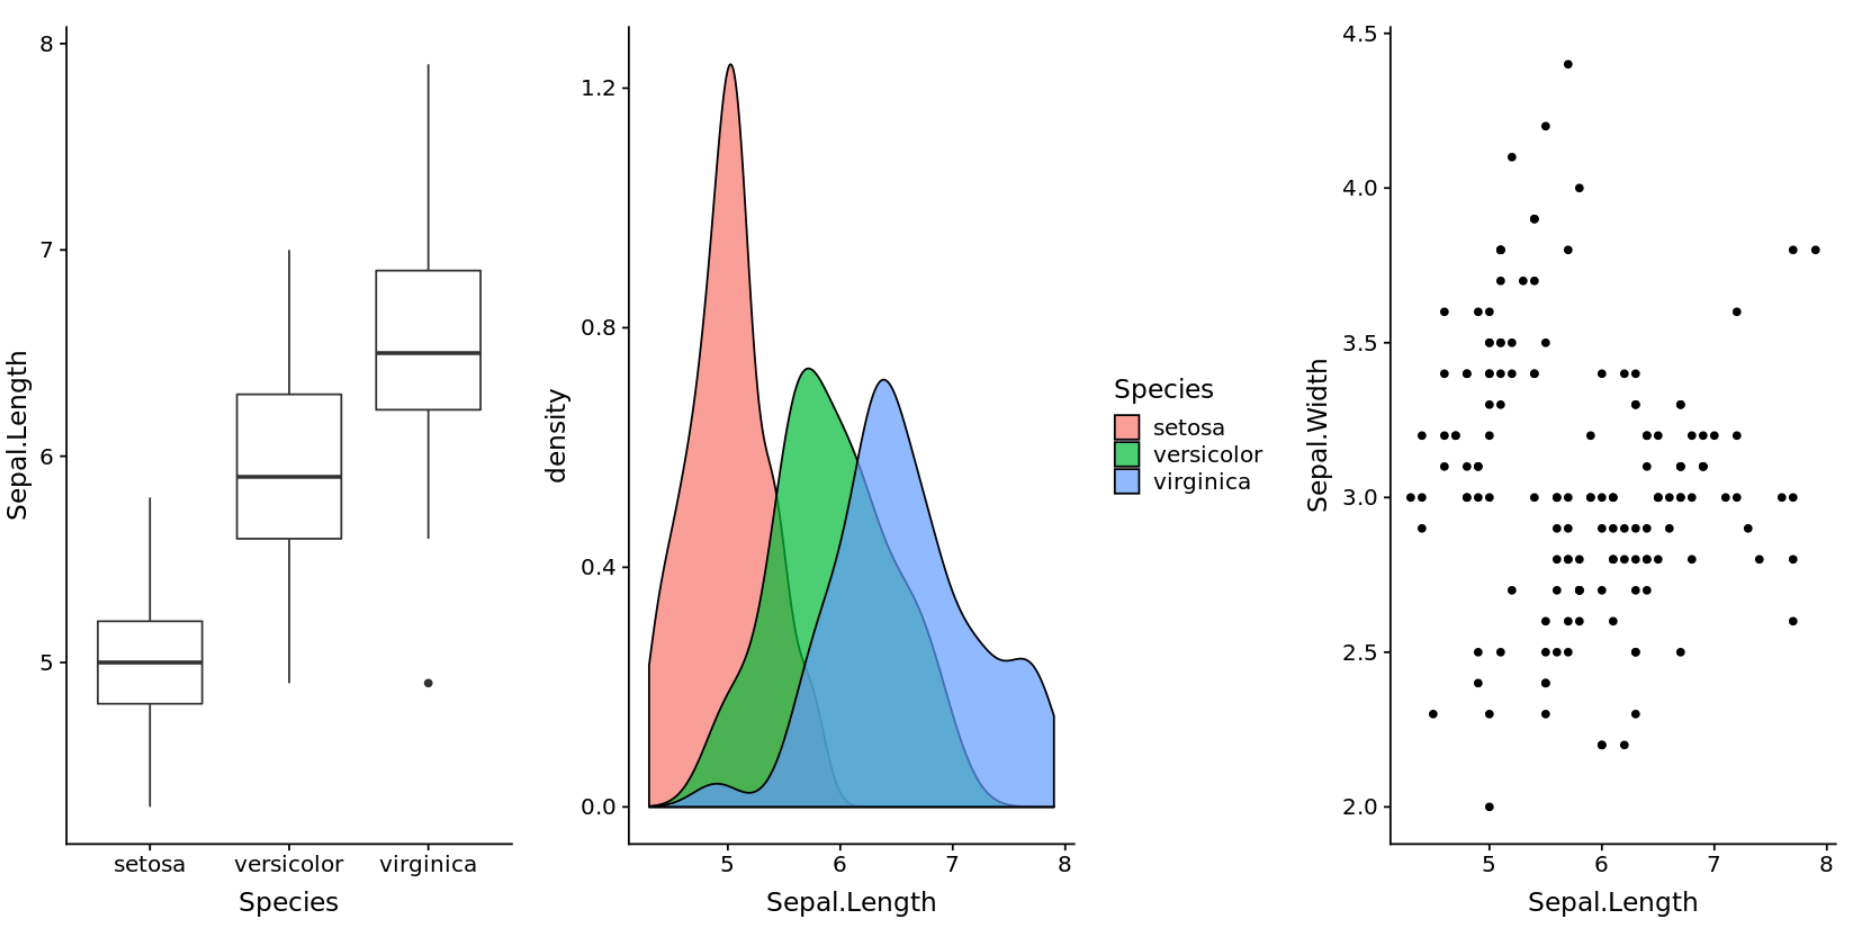
L’extension de la chaîne combinatoire s’opère par une simple itération de l’opération d’addition, formalisée par la séquence reliant successivement les trois variables graphiques distinctes. Cette écriture intuitive génère immédiatement un agencement tri-panneaux au sein duquel chaque figure se voit allouer par défaut un tiers exact de la largeur totale disponible dans la fenêtre d’affichage.
Néanmoins, la juxtaposition linéaire de trois figures distinctes sur une même ligne horizontale introduit des contraintes ergonomiques considérables qu’il convient d’anticiper méthodologiquement. À mesure que le nombre de subdivisions transversales s’accroît, la largeur dévolue à chaque panneau individuel subit une contraction proportionnelle. Si les dimensions physiques globales du support d’affichage demeurent invariables, ce phénomène de compression spatiale risque d’engendrer un chevauchement des étiquettes textuelles au niveau de l’axe des abscisses, ou une déformation outrancière de l’angle visuel des nuages de points.
Pour prévenir cette dégradation qualitative, l’analyste doit ajuster avec minutie le ratio d’aspect global de la figure finale. Cet arbitrage impose d’augmenter substantiellement la largeur absolue du conteneur de rendu lors de l’exportation, ou de procéder à une réduction homothétique calibrée de la taille de base des polices de caractères au sein des paramètres thématiques généraux, évitant ainsi tout encombrement textuel préjudiciable à l’élégance du manuscrit.
5.3 Paramétrage précis du nombre de colonnes via plot_layout
Bien que le comportement automatique de l’opérateur d’addition tende à distribuer les figures sur une ligne unique lorsque la place le permet, il s’avère indispensable d’exercer un contrôle déterministe sur cette disposition spatiale au moyen de la fonction d’agencement dédiée, désignée sous le nom explicite de plot_layout. Cette directive structurelle s’ajoute à la suite de la séquence additive pour spécifier les contraintes géométriques régissant la matrice d’affichage.
La fixation délibérée du paramètre assignant le nombre de colonnes à la valeur exacte de trois garantit de manière immuable que les graphiques demeureront alignés côte à côte, prévenant tout saut de ligne involontaire lors du redimensionnement de la fenêtre graphique ou lors de la compilation sur des écrans dotés de résolutions disparates. Par ailleurs, la fonction offre la possibilité d’ajuster les proportions relatives des différents panneaux grâce à un vecteur d’amplitudes pondérées assigné à l’argument des largeurs, rompant si nécessaire avec l’homogénéité stricte des dimensions par défaut.
Cette flexibilité s’avère particulièrement précieuse lorsqu’un panneau complexe, tel qu’un nuage de points enrichi de multiples annotations d’inférence statistique, requiert un espace visuel supérieur à celui d’une boîte à moustaches relativement dépouillée. L’analyste peut ainsi allouer, par exemple, des coefficients proportionnels distincts aux colonnes successives, adaptant dynamiquement l’espace alloué au degré de charge informationnelle de chaque sous-composant de la figure de recherche.
6. Gestion de l’agencement spatial : opérateurs d’empilement et de juxtaposition combinés
6.1 Usage combiné des opérateurs de division et de parenthésage
L’exploration visuelle avancée requiert couramment de dépasser la simple organisation unidimensionnelle en ligne pour concevoir des figures composites hiérarchisées à double niveau d’observation. L’écosystème patchwork excelle précisément dans cette tâche grâce à l’articulation conjointe de la division arithmétique et du parenthésage mathématique conventionnel. Tout comme dans l’algèbre scalaire, l’usage des parenthèses au sein de l’expression graphique permet de regrouper des sous-arbres visuels et d’imposer un ordre de priorité d’évaluation géométrique rigoureux.
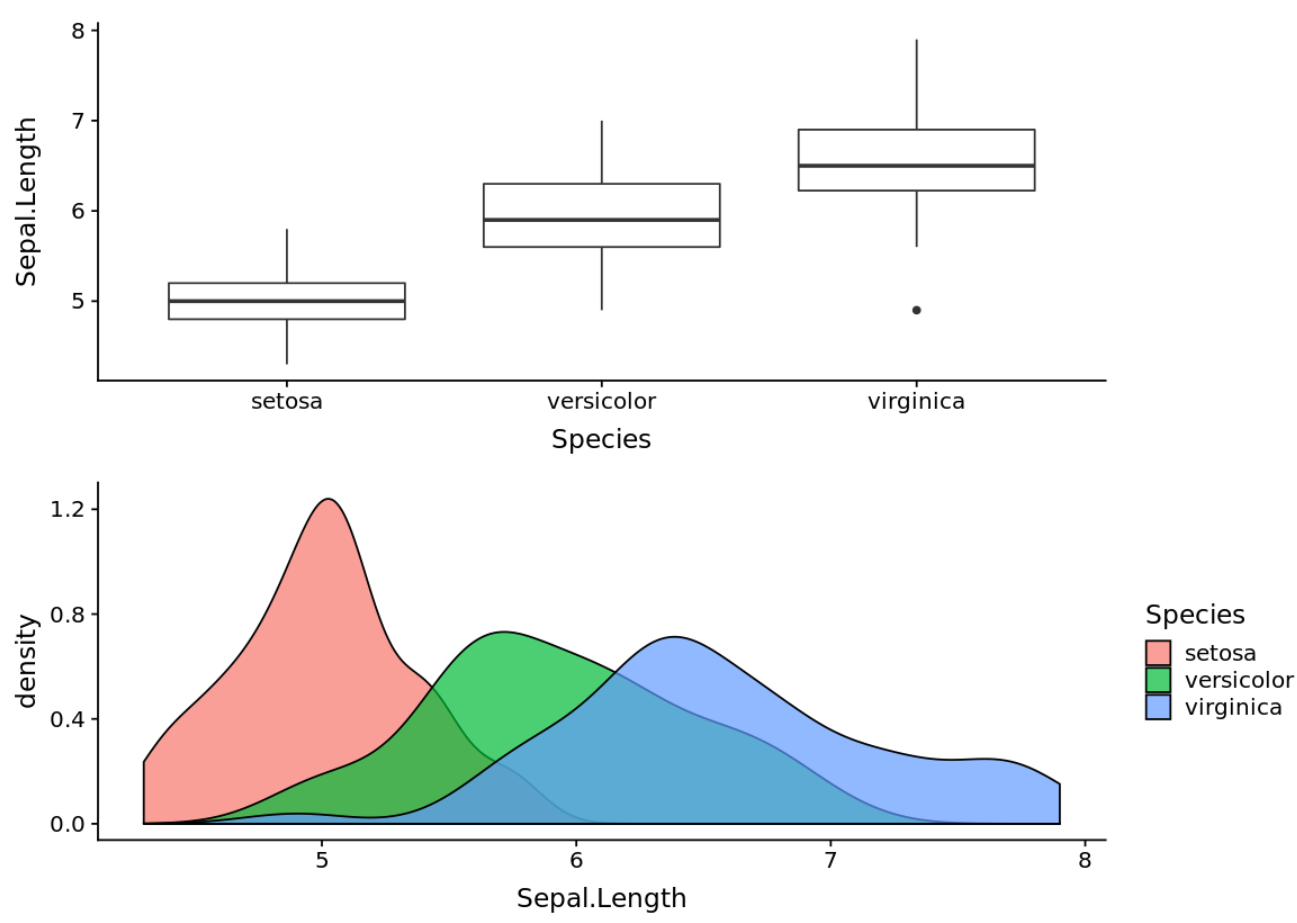
En formulant une expression où deux graphiques élémentaires sont conjoints par l’opérateur d’addition au sein d’une parenthèse, puis placés au-dessus d’un troisième graphique au moyen de l’opérateur de division, l’analyste instaure une asymétrie spatiale délibérée. Cette topologie confère au panneau inférieur l’intégralité de la largeur basale de la composition, tandis que les deux panneaux supérieurs se partagent équitablement l’espace supérieur en une disposition juxtaposée standard.
Une telle organisation visuelle s’avère méthodologiquement particulièrement judicieuse pour mettre en exergue une figure récapitulative majeure ou une série chronologique étendue sur toute la largeur de lecture, tout en offrant en amont deux panneaux analytiques détaillés scrutant des distributions marginales spécifiques. Le parenthésage garantit que chaque sous-bloc spatial préserve son alignement interne sans que les disparités dimensionnelles entre les étages ne viennent déformer l’harmonie globale du tracé.
6.2 Création de matrices de disposition personnalisées
Pour les configurations éditoriales d’une complexité extrême qui défient les capacités de composition offertes par la seule imbrication d’opérateurs binaires élémentaires, patchwork met à disposition un mécanisme de modélisation spatiale textuelle d’une remarquable puissance. Cette approche repose sur la définition d’une chaîne de caractères stylisée décrivant explicitement l’occupation matricielle de chaque élément au moyen d’un système de coordonnées textuelles.
Dans ce modèle déclaratif, l’utilisateur dresse une représentation textuelle symbolique sous la forme d’un tableau de lettres où chaque caractère alphabétique correspond à l’identifiant d’un tracé graphique particulier. L’analyste peut ainsi définir des structures asymétriques élaborées où un graphique s’étend sur plusieurs lignes et colonnes contiguës, tandis que d’autres modules occupent des alvéoles périphériques réduites. L’incorporation du symbole dièse au sein de la matrice textuelle permet en outre de matérialiser des zones vides délibérées, créant ainsi des respirations spatiales indispensables pour équilibrer la dynamique de composition.
Cette matrice visuelle est ensuite fournie en argument direct à la fonction d’agencement global via le paramètre dédié au design spatial. Cette technique de spécification cartographique découple intégralement la séquence de création des objets graphiques de leur affectation topologique spatiale finale, autorisant des expérimentations de mise en page sophistiquées sans exiger la moindre restructuration des couches de données sous-jacentes.
6.3 Contrôle des marges internes et de l’espacement inter-panneaux
L’optimisation de l’ergonomie visuelle d’une figure composite exige une gestion millimétrée des espaces interstitiels séparant les différents panneaux adjacents. Par défaut, le moteur graphique de ggplot2 applique des marges périphériques standardisées autour de chaque tracé. Lorsque plusieurs graphiques sont regroupés côte à côte, l’accumulation de ces marges de réserve peut engendrer des intervalles visuels exagérément larges, fractionnant artificiellement l’attention du lecteur et diluant la force de frappe analytique du composite.
Le contrôle de cet espacement inter-panneaux s’opère par l’ajustement du paramètre des marges de tracé au sein de la fonction d’orchestration thématique de ggplot2. En modulant avec discernement les vecteurs dimensionnels déterminant les dégagements supérieur, droit, inférieur et gauche au niveau de chaque composant individuel, l’analyste peut comprimer les zones de vide inutiles et rapprocher les cadres physiques de traçage de manière à favoriser une transition oculaire fluide.
Cette démarche d’épuration spatiale s’inscrit en droite ligne des principes théoriques édictés par Edward Tufte concernant le ratio données-encre (data-ink ratio). Selon cette doctrine sémiologique fondamentale, chaque unité de surface graphique non investie dans la transmission directe d’un signal empirique informatif doit être interrogée, minimisée ou bannie. L’harmonisation rigoureuse des marges résiduelles entre graphiques adjacents permet d’atteindre une densité d’information maximale tout en conférant à la planche finale une apparence harmonieuse propre aux meilleures publications académiques.
7. Harmonisation des axes, échelles et légendes partagées
7.1 Uniformisation des limites d’axes pour des comparaisons non biaisées
L’écueil méthodologique le plus insidieux guettant la visualisation juxtaposée réside dans la disparité d’étalonnage des axes de mesure. Lorsque deux graphiques disposés côte à côte évaluent la même dimension empirique à travers deux contextes expérimentaux distincts, l’algorithme d’optimisation par défaut de ggplot2 calibre automatiquement les bornes d’ordonnées ou d’abscisses sur l’intervalle strict des valeurs observables au sein de chaque sous-échantillon respectif. Il en résulte couramment des échelles visuellement discordantes bien que morphologiquement semblables.
Une telle asymétrie d’étalonnage constitue une source majeure d’illusion cognitive pour le lecteur scientifique. En effet, deux grandeurs visuellement identiques à l’écran peuvent masquer un écart de grandeur d’un ordre de magnitude substantiel si l’observateur omet de lire minutieusement les graduations numériques de chaque axe. De même, une variabilité résiduelle insignifiante dans un groupe contrôle peut apparaître artificiellement surdimensionnée par rapport à une variance massive dans le groupe expérimental, faussant radicalement l’inférence visuelle préliminaire.
Pour éliminer définitivement ce biais d’interprétation, la synchronisation stricte des bornes d’axes s’impose comme une obligation méthodologique absolue. L’application explicite du système de coordonnées cartésiennes bornées, via la fonction coordonnée cartésienne en lui spécifiant des limites rigoureusement identiques pour tous les panneaux concernés, garantit une comparabilité visuelle univoque. Cette standardisation spatiale assure que chaque unité géométrique mesurable à l’écran correspond rigoureusement à la même quantité physique sur l’ensemble des panneaux constitutifs de la figure composite.
7.2 Consolidation et déduplication des légendes
Lorsque plusieurs graphiques juxtaposés emploient une nomenclature catégorielle identique pour guider la coloration des géométries, le comportement par défaut de l’interpréteur génère une légende redondante à droite de chaque panneau individuel. Cette duplication itérative encombre inutilement l’espace visuel global, compresse de manière asymétrique les largeurs de traçage effectives et confère à la publication une impression d’inachèvement technique préjudiciable à la crédibilité de la communication.
Le package patchwork résout cette difficulté sémiotique majeure avec une remarquable élégance grâce à l’argument de mutualisation des guides d’étiquetage intégré à la fonction de mise en page. En instruisant explicitement le gestionnaire d’agencement de collecter les légendes, le moteur examine l’ensemble des panneaux constitutifs, identifie les échelles esthétiques strictement congruentes, supprime instantanément les doublons superflus et isole une instance unique de la légende partagée au sein de la périphérie globale de la composition.
L’analyste dispose par la suite de la faculté de relocaliser cette légende unifiée selon les impératifs morphologiques de sa planche visuelle. Que ce guide soit positionné à droite, relégué dans la partie inférieure sous la forme d’un bandeau horizontal épuré, ou stratégiquement intégré dans une alvéole laissée vacante par l’agencement matriciel, cette consolidation structurelle assainit considérablement la présentation, focalisant l’attention de l’observateur sur les seules distributions comparées.
7.3 Alignement physique rigoureux des zones de tracé
L’un des défis les plus redoutables de l’assemblage graphique multivarié concerne l’alignement mécanique rigoureux des repères de coordonnées. Dans un flux de travail non spécialisé, la largeur occupée par les graduations et les intitulés d’axes textuels varie fréquemment d’un graphique à son voisin immédiat en fonction du nombre de caractères typographiques requis pour représenter les chiffres ou les étiquettes de catégories. Par conséquent, les cadres internes des zones de données subissent des décalages latéraux parasites qui brisent l’alignement visuel horizontal.
Ce décalage physique est particulièrement dommageable lorsque l’observateur cherche à projeter une ligne de référence imaginaire d’un panneau à l’autre pour apprécier l’évolution d’une métrique sous différents modes d’agrégation. L’œil humain étant d’une sensibilité extrême aux ruptures de collinéarité, la moindre discontinuité spatiale altère la fluidité de la lecture transversale et peut induire en erreur l’estimation des parallélismes de tendances.
L’architecture interne de patchwork neutralise ce problème structurel de manière totalement native. En s’appuyant sur les capacités de résolution de contraintes dimensionnelles des tables graphiques, l’extension recalcule dynamiquement les marges internes de chaque objet afin que les bordures délimitant les canevas de données effectifs soient rigoureusement alignées sur le plan vertical et horizontal. Même en présence de textes d’ordonnées d’amplitudes très disparates, la planéité des repères est mathématiquement préservée sans intervention manuelle requise de la part du chercheur.
8. Annotation académique et étiquetage standardisé des panneaux
8.1 Numérotation automatique des sous-figures selon les normes éditoriales
Les conventions régissant la publication d’articles scientifiques au sein de revues à comité de lecture imposent une identification univoque de chaque panneau constitutif d’une figure composite. Les normes rédactionnelles universelles, à l’instar des protocoles éditoriaux des maisons d’édition académiques majeures, prescrivent de référencer individuellement les sous-figures au moyen de caractères alphabétiques majuscules ou minuscules placés au sommet de chaque tracé, permettant au corps de texte de renvoyer avec une exactitude irréprochable vers des sous-ensembles méthodologiques ciblés.
Pour répondre à cette contrainte de rigueur sans imposer une pénible surcharge d’annotations manuelles susceptibles d’engendrer des décalages typographiques, patchwork propose la fonction déclarative plot_annotation pourvue du paramètre de hiérarchisation des étiquettes de panneaux. Cette fonction analyse automatiquement la topologie spatiale du composite et insère séquentiellement les marqueurs d’identification requis au sommet de chaque figure, respectant strictement l’ordre naturel de balayage visuel de gauche à droite et de haut en bas.
L’utilisateur conserve un contrôle absolu sur le style de cette nomenclature indicatrice. Il est aisé de sélectionner une numérotation par lettres majuscules latines, par minuscules, par chiffres arabes ou par numéraux romains, tout en personnalisant les séparateurs contextuels, qu’il s’agisse de parenthèses fermantes, de crochets ou de points d’exclamation typographiques. Cette automatisation rigoureuse supprime tout risque de désynchronisation des renvois bibliographiques lors des révisions structurelles ultérieures de l’article de recherche.
8.2 Ajout de titres globaux, sous-titres et notes de bas de figure
Une figure composite ne saurait se résumer à une simple collection de graphiques disparates ; elle forme une entité rhétorique unifiée qui exige une contextualisation globale de premier ordre. Alors que les étiquettes thématiques individuelles décrivent les caractéristiques techniques immédiates de chaque panneau, l’ensemble de la planche scientifique bénéficie grandement de l’adjonction d’un chapeau explicatif centralisant l’objectif épistémique de l’investigation empirique.
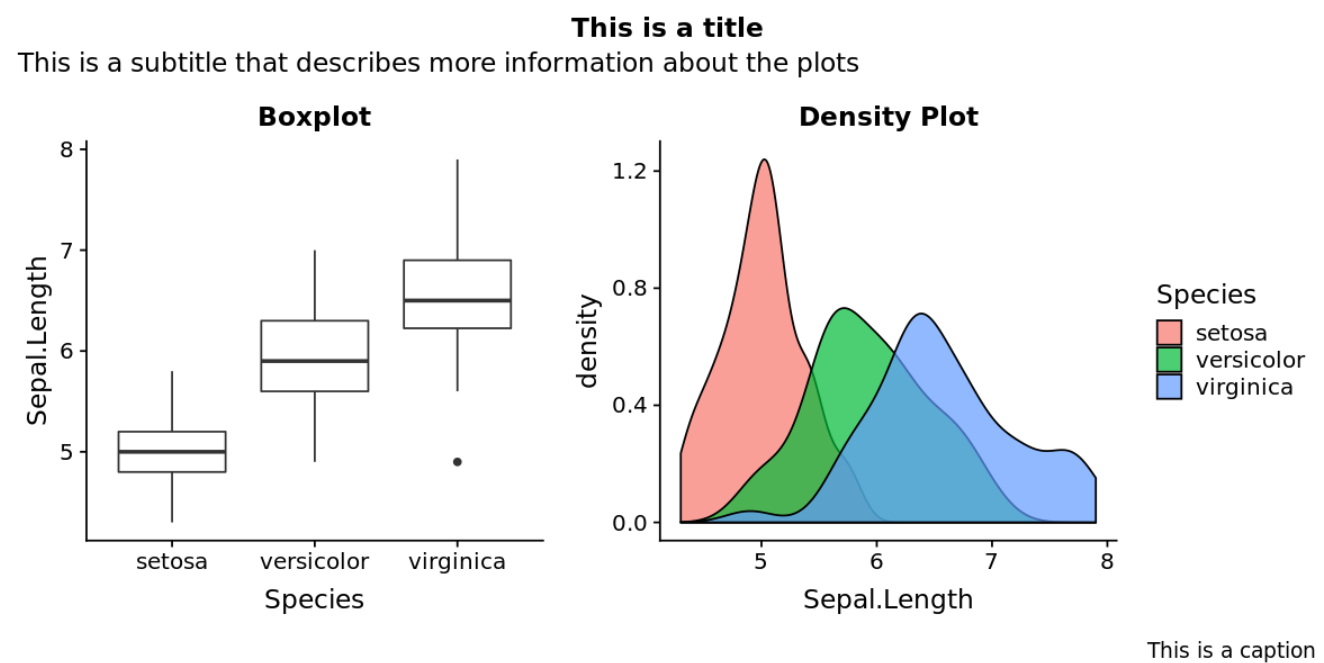
La commande d’annotation globale permet d’incorporer avec fluidité un titre d’ensemble surplombant l’ensemble des panneaux disposés côte à côte, immédiatement complété par un sous-titre méthodologique explicitant, par exemple, la nature de la cohorte d’analyse, la taille de l’échantillon total ou le plan factoriel mobilisé. Cette hiérarchisation permet au lecteur de contextualiser instantanément l’architecture empirique sans devoir se référer continuellement au corps de texte principal de l’article.
De surcroît, l’insertion d’une légende ou note descriptive en bas de figure (caption) constitue le réceptacle privilégié pour consigner les informations d’inférence statistique indispensables à la transparence scientifique. C’est en ce lieu normalisé que l’analyste consigne les seuils de significativité retenus, la signification exacte des barres d’erreur (écart-type, erreur standard de la moyenne ou intervalle de confiance bootstrapé à quatre-vingt-quinze pour cent) ainsi que les conventions abréviatives mobilisées, assurant une autonomie informative complète à la figure de publication.
8.3 Typographie et personnalisation avancée des étiquettes
L’harmonisation typographique entre la production graphique et la charte graphique de la publication finale conditionne le professionnalisme esthétique du manuscrit. Des étiquettes de panneaux rendues dans une fonte discordante ou des contrastes de graisses inadaptés nuisent à l’unité visuelle globale de l’œuvre scientifique. Il apparaît donc indispensable de pouvoir réguler finement chaque attribut formel des balises spatiales créées par le gestionnaire de composition.
Cette customisation avancée s’effectue par l’intermédiaire de la surcharge des éléments textuels de thème appliquée au sein de la fonction d’annotation globale. L’élément de marquage de tracé, gouverné par la syntaxe standardisée de modification d’éléments textuels, autorise la reconfiguration précise de la famille de polices de caractères, du corps typographique exprimé en points typographiques, de la couleur et de la graisse de chaque identifiant alphabétique de sous-figure.
L’analyste dispose en outre d’une maîtrise géométrique sur le positionnement physique des étiquettes par rapport aux boîtes englobantes des données. Qu’il soit jugé préférable d’ancrer les lettres indicatrices à l’extérieur immédiat de la marge supérieure gauche des tracés pour un alignement strict avec les marges du document, ou de les loger à l’intérieur même du quadrant supérieur du cadre de coordonnées afin de compacter la hauteur totale de la figure, ces ajustements millimétrés parachèvent la préparation de figures prêtes pour la composition finale d’un ouvrage ou d’un périodique académique de premier plan.
9. Approches alternatives : utilisation de gridExtra et de cowplot
9.1 Mise en page par grille avec gridExtra::grid.arrange
Avant l’avènement du paradigme déclaratif moderne, la bibliothèque gridExtra, orchestrée autour de sa fonction emblématique de disposition de grille, a longtemps constitué l’épine dorsale de la mise en page multi-graphiques dans l’écosystème R. S’interfaçant directement avec les structures arborescentes de la bibliothèque de base grid, cet outil permet de collecter une liste hétéroclite d’objets graphiques et de les contraindre à s’agencer au sein d’une matrice régulière définie par un nombre déterminé de rangées et de colonnes.
L’avantage cardinal de cette approche historique réside dans sa compatibilité universelle. Tout objet graphique convertible en entité de type grob, qu’il procède de ggplot2, du moteur graphique de base de R ou d’autres bibliothèques spécialisées, peut être assimilé et disposé par cette fonction de grille. Cette polyvalence s’avère particulièrement utile pour les utilisateurs opérant sur des chaînes de traitement héritées où coexistent plusieurs dialectes de visualisation distincts.
Néanmoins, la méthode présente une déficience structurelle majeure qui motive aujourd’hui son abandon progressif au profit de solutions plus modernes : l’absence d’alignement intelligent et adaptatif des repères de coordonnées. Lorsque deux graphiques disposés côte à côte possèdent des échelles de graduations de largeurs inégales ou des légendes disjointes, la fonction répartit aveuglément les cellules de la grille sans compenser les asymétries textuelles internes. Il en résulte un décalage vertical et horizontal flagrant des cadres de tracé qui compromet irrémédiablement la rigueur de l’inférence visuelle directe.
9.2 Combinaison précise et publication-ready avec cowplot::plot_grid
Face aux insuffisances criantes de la disposition par grille brute, la bibliothèque cowplot, élaborée par le biologiste computationnel Claus O. Wilke, a marqué une étape fondamentale vers l’atteinte d’une rigueur éditoriale irréprochable. Sa fonction directrice d’agencement matriciel a été expressément programmée pour pallier les problèmes d’alignement géométrique en intégrant un algorithme dédié à l’égalisation automatique des boîtes d’axes selon les dimensions horizontale et verticale.
L’extension cowplot se distingue par sa facilité à générer immédiatement des étiquettes de panneaux normalisées pour les périodiques savants. Grâce à un simple argument d’étiquetage automatique, la fonction génère des lettres indicatrices parfaitement calibrées au sommet de chaque sous-figure, respectant les ratios d’espacement des publications académiques de premier rang. De surcroît, la bibliothèque intègre un thème visuel épuré signature qui élimine systématiquement le quadrillage d’arrière-plan et les bordures épaisses pour magnifier le ratio données-encre théorisé par Edward Tufte.
Cependant, en dépit de ses qualités géométriques indéniables, cowplot requiert une syntaxe procédurale plus verbeuse lorsqu’il s’agit de construire des agencements complexes non réguliers ou d’extraire une légende partagée. La manipulation exige fréquemment d’invoquer des sous-fonctions dédiées pour isoler manuellement le bloc de légende, avant de le réinjecter comme un objet graphique indépendant au sein d’une grille composite secondaire, ce qui alourdit considérablement l’architecture des scripts d’analyse.
9.3 Critères comparatifs pour orienter le choix de la méthode
L’arbitrage raisonné entre ces trois environnements technologiques concurrents doit s’opérer en fonction des exigences de flexibilité syntaxique, de robustesse typologique et de maintenabilité à long terme du code source. Le tableau fonctionnel ci-dessous met en lumière les caractéristiques discriminantes régissant ces différentes approches de la composition graphique en R :
- patchwork : Syntaxe algébrique native intuitive, alignement automatique parfait de tous les axes, mutualisation native et déduplication directe des légendes partagées, gestion intégrée des annotations globales et des sous-titres, standard recommandé pour tout projet moderne basé exclusivement sur ggplot2.
- cowplot : Syntaxe fonctionnelle intermédiaire, alignement bidirectionnel rigoureux des tracés, intégration native de thèmes minimalistes conformes aux revues biologiques, gestion manuelle de l’extraction et du placement des légendes, choix idéal pour s’interfacer avec des dessins vectoriels complémentaires de bas niveau.
- gridExtra : Approche historique impérative basée sur des matrices rigides, aucun alignement adaptatif automatique des canevas internes, compatibilité universelle avec l’ensemble des objets graphiques de base de R, à réserver aux architectures logicielles patrimoniales ou hétérogènes.
Au regard des critères contemporains d’ingénierie logicielle et de lisibilité du code, la suprématie pratique de patchwork s’avère indiscutable pour la quasi-totalité des flux de travail contemporains reposant sur le paradigme du Tidyverse. Sa concision syntaxique exceptionnelle et sa résolution transparente des contraintes topologiques complexes en font l’outil d’élection incontournable pour tout chercheur ou analyste de données.
10. Comparaison avec le facettage natif : quand choisir les sous-graphiques autonomes
10.1 Fonctionnalités et cas d’usage de facet_wrap et facet_grid
L’infrastructure native de ggplot2 intègre un dispositif d’affichage démultiplié exceptionnellement puissant à travers les opérateurs de facettage en enveloppe et de facettage en grille. Ces primitives structurelles permettent de segmenter un jeu de données en sous-échantillons homogènes régis par les niveaux factoriels d’une ou plusieurs variables catégorielles, et de reproduire automatiquement le même motif géométrique au sein d’une matrice de sous-panneaux synchronisés.
Le facettage présente des atouts incomparables pour l’analyse de données homogènes. Les échelles de mesure des abscisses et des ordonnées sont mutuellement partagées et synchronisées par défaut avec une exactitude mathématique absolue, prévenant tout risque de désalignement d’unités. De surcroît, une seule instruction succincte suffit pour générer des dizaines de représentations comparatives selon une formule conditionnelle, conférant une rentabilité programmatique maximale à la démarche d’exploration multivariée.
Toutefois, ce mécanisme repose sur un postulat architectural rigide : l’intégralité des données visualisées au sein de l’ensemble des facettes doit obligatoirement provenir d’une table unique structurée selon les principes stricts du format long. Dès lors que l’analyste cherche à briser cette uniformité géométrique ou à introduire des variations esthétiques divergentes d’une facette à l’autre, le facettage natif heurte une frontière conceptuelle infranchissable qui requiert le recours à des graphiques autonomes.
10.2 Scénarios méthodologiques exigeant des graphiques indépendants côte à côte
La première circonstance méthodologique imposant l’agencement de graphiques indépendants survient lors de la nécessaire cohabitation de primitives géométriques fondamentalement hétérogènes. Lorsqu’un protocole expérimental requiert d’adosser un diagramme en boîte synthétisant des distributions quantiles à un nuage de points modélisant une corrélation bivariée, le facettage s’avère inapplicable puisque les règles de projection spatiale des deux représentations diffèrent intrinsèquement par nature.
Le second scénario récurrent concerne l’exploitation de jeux de données dotés de structures ou d’origines distinctes. Il est fréquent, dans le cadre d’un rapport de recherche exhaustif, de devoir juxtaposer des données micro-économiques individuelles issues d’un sondage transversal et des séries macro-économiques agrégées collectées à l’échelle nationale. Forcer la fusion de ces structures tabulaires discordantes au sein d’un tableau long unique relèverait d’un contorsionnisme algorithmique injustifié et source d’erreurs d’agrégation massives.
Enfin, la personnalisation asymétrique avancée des espaces de représentation justifie pleinement l’assemblage autonome. L’application d’un système de coordonnées polaires ou cartésiennes inversées sur un volet particulier, la mise en œuvre de palettes chromatiques spécifiques conditionnées par la nature théorique des variables représentées ou l’ajout d’annotations textuelles d’inférence statistique complexes dans un seul quadrant constituent autant de configurations stylistiques qu’un panneau unitaire gère avec une liberté totale, affranchi des contraintes d’uniformité imposées par le facettage natif.
10.3 Approche hybride : imbrication de facettes dans une disposition patchwork
Loin de constituer deux alternatives mutuellement exclusives, le facettage natif et la composition par patchwork s’associent harmonieusement pour donner naissance à des architectures visuelles hybrides d’une formidable complexité démonstrative. Rien n’interdit, dans la logique déclarative des objets graphiques, d’encapsuler un graphique préalablement facetté au sein d’une variable autonome, puis de l’insérer comme un opérande élémentaire dans une équation de composition globale.
Cette méthodologie d’imbrication modulaire se révèle particulièrement féconde dans les protocoles expérimentaux multifactoriels. Un chercheur peut ainsi concevoir un premier panneau horizontal divisé en sous-facettes pour comparer le comportement de sous-groupes expérimentaux au fil du temps, tout en lui adjoignant sur le flanc droit un graphique autonome non facetté illustrant l’estimation globale de l’amplitude de l’effet d’intervention via une méta-analyse ou un diagramme en forêt (forest plot).
Cette approche symbiotique conjugue les bénéfices du partage déterministe d’échelles au sein du sous-ensemble facetté avec la liberté topologique offerte par la sur-couche d’agencement spatial. L’analyste accède ainsi à un niveau de composition éditoriale sur mesure, capable d’épouser avec une fidélité chirurgicale les articulations logiques les plus complexes d’une démonstration scientifique empirique.
11. Adaptation aux standards de publication scientifique et psychologique
11.1 Conformité avec les exigences graphiques du style APA (7e édition)
Les normes méthodologiques et stylistiques édictées par l’American Psychological Association au sein de leur septième édition constituent une référence incontournable pour l’ensemble des sciences humaines, médicales et comportementales. En matière de présentation des figures empiriques, ces normes imposent un principe d’épuration esthétique poussé à l’extrême : proscription des grilles de fond encombrantes, bannissement des ombrages tridimensionnels dénués de valeur sémiotique et élimination stricte des bordures superflues entourant le tracé.
La réalisation de figures juxtaposées conformes à ce standard requiert l’application d’un thème visuel minimaliste exempt de tout quadrillage secondaire non informatif. L’intégration de la directive de thème épuré de ggplot2 ou des préréglages esthétiques de cowplot jette les bases de cette conformité en nettoyant instantanément le fond du canevas pour ne préserver que les seuls axes de référence indispensables au repérage des coordonnées.
Sur le plan de l’architecture textuelle, le style APA impose une hiérarchie typographique hautement ritualisée. Le numéro formel de la figure doit s’afficher en caractères gras au sommet de la composition, suivi immédiatement à la ligne suivante d’un titre de figure rédigé en italique décrivant avec concision l’objet de l’expérience. Les sous-panneaux juxtaposés sont alors signalés par des lettres cursives minuscules ou majuscules harmonisées, tandis qu’une note descriptive détaillée en petits caractères au bas du composite documente l’ensemble des conventions métriques et statistiques mobilisées.
11.2 Accessibilité visuelle et perceptibilité des contrastes
L’éthique de la recherche empirique contemporaine accorde une place centrale à l’accessibilité universelle de l’information scientifique. Une fraction substantielle du lectorat académique présente des déficiences congénitales de la vision chromatique, particulièrement sous la forme de daltonismes affectant la discrimination des longueurs d’onde rouges et vertes (deutéranopie et protanopie). Concevoir une figure composite dont l’interprétation repose exclusivement sur un contraste rouge-vert constitue un écueil méthodologique disqualifiant qui exclut une portion notable des évaluateurs et des pairs.
Pour garantir une robustesse perceptive universelle, l’analyste doit impérativement recourir à des palettes de couleurs perceptuellement uniformes, à l’instar des échelles de la famille viridis. Ces palettes chromatiques sont mathématiquement étalonnées pour que la progression perçue de la luminosité corresponde linéairement à la variation de la métrique sous-jacente, assurant une préservation irréprochable du gradient informatif tant en vision trichromatique normale qu’en cas de daltonisme sévère, ou même lors d’une restitution en niveaux de gris purs.
De surcroît, le principe fondamental de la redondance d’encodage visuel doit être systématiquement appliqué lors de la juxtaposition de panneaux. Il est méthodologiquement impératif de ne jamais confier la ségrégation des cohortes à la seule dimension chromatique : l’adjonction conjointe de formes géométriques discriminantes pour les points, de types de pointillés contrastés pour les lignes d’ajustement ou de motifs de remplissage différentiels garantit que la figure demeure intégralement intelligible même si elle fait l’objet d’une impression monochrome dégradée sur support papier standard.
12. Bonnes pratiques d’exportation haute résolution et reproductibilité computationnelle
12.1 Sauvegarde vectorielle et matricielle avec ggsave
L’aboutissement du processus de composition graphique réside dans la phase critique d’exportation vers un support de stockage numérique destiné à la soumission éditoriale. Une figure d’une rigueur analytique irréprochable perd toute sa force démonstrative si elle subit une détérioration de son acuité visuelle consécutive à une compression matricielle inadéquate ou à une pixellisation grossière des contours géométriques lors de son impression finale.
La commande de sauvegarde universelle offerte par ggplot2 via la fonction ggsave interagit de façon transparente avec les compositions issues de l’extension patchwork. En fournissant l’identifiant de la composition finale à cette routine de restitution, le moteur procède à une compilation de l’arbre graphique selon les paramètres physiques exacts spécifiés par l’utilisateur. Le choix du format de fichier doit alors être dicté par les exigences techniques de l’éditeur scientifique.
Pour une qualité de restitution optimale, les formats vectoriels tels que le Portable Document Format (PDF) ou le Scalable Vector Graphics (SVG) doivent être priorisés sans réserve. Ces protocoles stockent les tracés, les marqueurs et les caractères typographiques sous forme d’instructions géométriques paramétriques pures, garantissant une netteté absolue à n’importe quel niveau d’agrandissement sans altération de résolution. Lorsqu’un format matriciel est impérativement requis par le système de soumission de la revue, comme le TIFF ou le PNG haute fidélité, l’analyste veillera à calibrer rigoureusement la résolution spatiale entre un minimum absolu de 300 à 600 points par pouce (DPI), tout en explicitant les dimensions physiques en centimètres ou en pouces afin d’assurer une proportionnalité parfaite des éléments de texte.
12.2 Automatisation et inclusion dans des rapports reproductibles
Dans la perspective contemporaine de la science ouverte et de la vérification computationnelle, l’élaboration de visualisations ne doit jamais être dissociée du flux de traitement des données brutes. L’archivage de figures sous forme de captures d’écran manuelles ou de manipulations manuelles dans des logiciels de retouche d’images graphiques tiers constitue une faute méthodologique grave qui anéantit toute reproductibilité des analyses scientifiques.
L’intégration des compositions graphiques au sein de systèmes d’édition dynamique de documents tels que Quarto ou R Markdown incarne le sommet de la rigueur méthodologique moderne. En encapsulant le code de chargement, de modélisation géométrique et d’assemblage spatial au sein de blocs de code programmatiques autonomes, le chercheur garantit que toute mise à jour ultérieure du jeu de données expérimental réactualisera instantanément la totalité des panneaux juxtaposés sans nécessiter la moindre intervention manuelle d’ajustement esthétique.
Cette automatisation rigoureuse offre en outre un contrôle millimétré sur le comportement de mise en page dans le document cible grâce aux options de configuration de blocs, permettant d’aligner les figures composites au centre de la page, d’ajuster leur occupation relative par rapport à la largeur du texte imprimé et de synchroniser les métadonnées pour la génération automatisée des tables des matières visuelles. La figure scientifique s’affirme alors non plus comme une illustration statique éphémère, mais comme un produit computationnel certifié, pérenne et rigoureusement reproductible au service de l’avancement du savoir collectif.
Références
- Anderson, E. (1936). The species problem in Iris. Annals of the Missouri Botanical Garden, 23(3), 457–509. https://doi.org/10.2307/2394164
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Pedersen, T. L. (2020). patchwork: The Composer of Plots. R package version 1.1.1. https://CRAN.R-project.org/package=patchwork
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media.
- Wilke, C. O. (2020). cowplot: Streamlined Plot Theme and Plot Annotations for ‘ggplot2’. R package version 1.1.1. https://CRAN.R-project.org/package=cowplot
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer.