
Dans le paysage contemporain des sciences du comportement, de la psychologie cognitive et des neurosciences computationnelles, la communication visuelle des données empiriques constitue un pivot épistémologique fondamental. Longtemps dominée par des représentations synthétiques agrégées — au premier rang desquelles trônent les diagrammes en barres affublés d’intervalles d’erreur souvent mal interprétés —, l’analyse exploratoire des données subit depuis deux décennies une mutation paradigmatique majeure. Sous l’impulsion du mouvement pour la science ouverte et la reproductibilité des résultats expérimentaux, la communauté scientifique exige désormais une transparence accrue qui expose la structure intime des distributions sans masquer l’hétérogénéité sous-jacente des cohortes de participants.
Le graphique à points, ou dot plot, s’inscrit au cœur de cette exigence éthique et méthodologique. En matérialisant chaque observation individuelle par un marqueur discret le long d’un continuum d’évaluation, il réconcilie la concision visuelle d’un indicateur de fréquence avec la richesse granulaire des scores bruts. Or, si des environnements de programmation statistique tels que le langage R ou les bibliothèques Python permettent d’engendrer ces visualisations au prix de lignes de script parfois rébarbatives, de nombreux laboratoires de recherche et praticiens cliniques s’appuient quotidiennement sur des solutions de tableurs collaboratifs en ligne pour la saisie et le traitement préliminaire de leurs protocoles expérimentaux.
L’environnement Google Sheets s’est imposé comme un vecteur de travail synchrone incontournable au sein des équipes universitaires distribuées géographiquement. Pourtant, l’application ne propose pas d’option native directement intitulée « graphique à points de distribution » dans sa palette d’outils conventionnels. Ce guide magistral a pour dessein d’exposer la méthode la plus accessible, robuste et universelle permettant de contourner cette restriction logicielle apparente. En mobilisant l’architecture sous-jacente des nuages de points cartésiens couplée à une modélisation spatiale rigoureuse, nous détaillerons pas à pas la transformation des données, la configuration paramétrique des repères, l’épuration sémiotique du canevas selon les normes internationales de l’American Psychological Association, et l’automatisation algorithmique du processus.
1. Fondements conceptuels du graphique à points dans l’analyse de données psychologiques
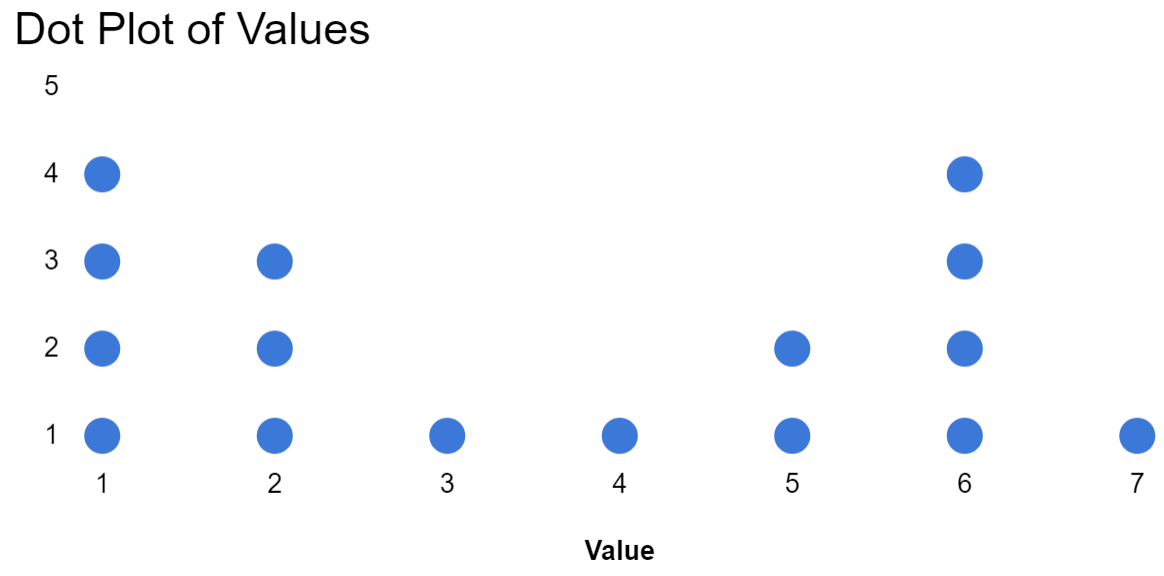
1.1 Définition et morphologie du graphique à points (dot plot)
La formalisation statistique moderne du graphique à points trouve ses racines fondamentales dans les travaux séminaux du statisticien américain William S. Cleveland durant les années 1980 et au début des années 1990. Conçu initialement pour pallier la lourdeur cognitive et la faible densité informative des diagrammes à barres standardisés, le dot plot se définit comme une transposition visuelle scalaire dans laquelle des symboles discrets — le plus souvent de nature circulaire — sont agencés sur un axe quantitatif ou ordinal pour refléter précisément la position de chaque observation empirique.
D’un point de vue morphologique, le tracé se caractérise par l’empilement vertical ordonné de marqueurs identiques lorsque plusieurs observations partagent une coordonnée numérique identique le long de l’axe de mesure horizontal. Cette technique d’accumulation séquentielle confère au graphique la silhouette intuitive d’un histogramme de fréquences, tout en préservant l’individualité de chaque unité expérimentale. L’observateur n’est ainsi jamais confronté à un agrégat opaque, mais à une constellation structurée où la hauteur d’une pile correspond strictement au cardinal de la classe d’équivalence considérée.
Il importe de distinguer formellement cette construction d’un nuage de points bidimensionnel classique. Dans un diagramme de dispersion traditionnel, deux variables quantitatives continues sont confrontées pour évaluer leur covariance au sein d’un espace orthogonal à deux dimensions réelles. À l’inverse, le graphique à points appliqué à la distribution de fréquences utilise l’ordonnée non pas comme une variable empirique mesurée, mais comme un artifice d’agencement spatial traduisant le décompte cumulé des répétitions scalaires. Cette distinction conceptuelle est primordiale pour comprendre la manipulation matricielle requise au sein des tableurs grand public.
1.2 Pertinence méthodologique en sciences cognitives et psychologie expérimentale
Dans le domaine des sciences cognitives et de la neuropsychologie clinique, la taille des échantillons étudiés demeure fréquemment restreinte en raison de la rareté des profils pathologiques, de la complexité des paradigmes d’imagerie cérébrale ou des contraintes inhérentes aux études longitudinales. Dans des cohortes oscillant couramment entre dix et soixante sujets, l’application de métriques de synthèse telles que la moyenne arithmétique assortie de l’écart-type peut induire en erreur de manière substantielle. En effet, un estimateur de tendance centrale dissimule aisément la présence de valeurs extrêmes ou aberrantes qui, dans de petits échantillons, altèrent artificiellement la significativité statistique des tests d’hypothèse.
Le graphique à points offre une parade méthodologique remarquable en autorisant une appréciation directe de la forme distributionnelle sans aucune perte d’information métrologique. Le chercheur peut instantanément déceler une distribution bimodale — révélant potentiellement deux sous-populations cliniques distinctes adoptant des stratégies de résolution cognitive divergentes — là où un histogramme classique masquerait cette dichotomie sous un choix malavisé de largeur de classe. De surcroît, l’étalement horizontal et la densité des regroupements permettent de repérer d’un coup d’œil les phénomènes d’asymétrie positive ou négative le long de l’échelle d’évaluation psychométrique.
Enfin, la conservation scrupuleuse des scores individuels garantit la traçabilité des données du laboratoire jusqu’à la publication finale. Les examinateurs et les pairs peuvent, à la simple lecture du document visuel, extraire la totalité des observations numériques ayant servi à étayer l’argumentaire scientifique. Cette transparence s’aligne rigoureusement sur les recommandations actuelles visant à restaurer la reproductibilité méthodologique dans les sciences de l’esprit, où la surinterprétation d’effets ténus a trop souvent été favorisée par des visualisations agrégatives opaques.
1.3 Avantages opérationnels de la solution Google Sheets pour les chercheurs
Le recours à la suite logicielle infonuagique Google Sheets s’est largement démocratisé au détriment des tableurs propriétaires statiques pour des raisons fonctionnelles évidentes. Dans le contexte de laboratoires de recherche multicentriques ou d’équipes pédagogiques universitaires encadrant des travaux d’étudiants, l’accessibilité multiplateforme et la synchronisation en temps réel constituent des atouts majeurs. L’ensemble des collaborateurs d’un protocole expérimental peut insérer, valider ou corriger des séries de mesures simultanément depuis des terminaux hétérogènes sans jamais risquer de divergences de versions ou de corruptions de fichiers locaux.
Sur le plan opérationnel de l’acquisition de données, Google Sheets permet l’établissement de liaisons directes avec des formulaires de passation en ligne ou des scripts d’automatisation via Google Apps Script. Au fur et à mesure que les sujets expérimentaux complètent une batterie de tests psychométriques, les rangées de données brutes s’incrémentent dans la feuille de calcul de manière dynamique. Un graphique à points convenablement configuré reflétera instantanément l’évolution de la distribution de l’échantillon, offrant aux investigateurs une modalité de contrôle continu de la collecte sans nécessiter de réimportation laborieuse vers un logiciel de traitement tiers.
Par ailleurs, cette méthodologie réduit considérablement le fossé technique séparant la phase de recueil empirique de la phase de dissémination scientifique. Trop souvent, l’utilisation de logiciels statistiques complexes génère un goulet d’étranglement temporel pour les cliniciens et les étudiants peu aguerris à la programmation en ligne de commande. Maîtriser la confection d’une figure épurée et statistiquement impeccable au sein même du réceptacle de saisie initiale assure un gain d’efficience substantiel et autorise la rédaction préliminaire de rapports de recherche sans rupture logistique.
2. Configuration préalable de la feuille de calcul et saisie des données brutes
2.1 Organisation initiale du tableau de contingence ou de fréquences
L’amorce de toute visualisation scientifique exige une rigueur absolue quant à l’ordonnancement structural des données brutes au sein de la grille matricielle. Lorsque l’investigateur recueille des observations psychométriques discrètes — qu’il s’agisse de scores à une échelle de dépression, du nombre d’erreurs commises lors d’une tâche de mémoire de travail ou de temps de réaction arrondis —, deux approches fondamentales de saisie s’opposent : la saisie individuelle séquentielle et le tableau de contingence préalablement condensé.
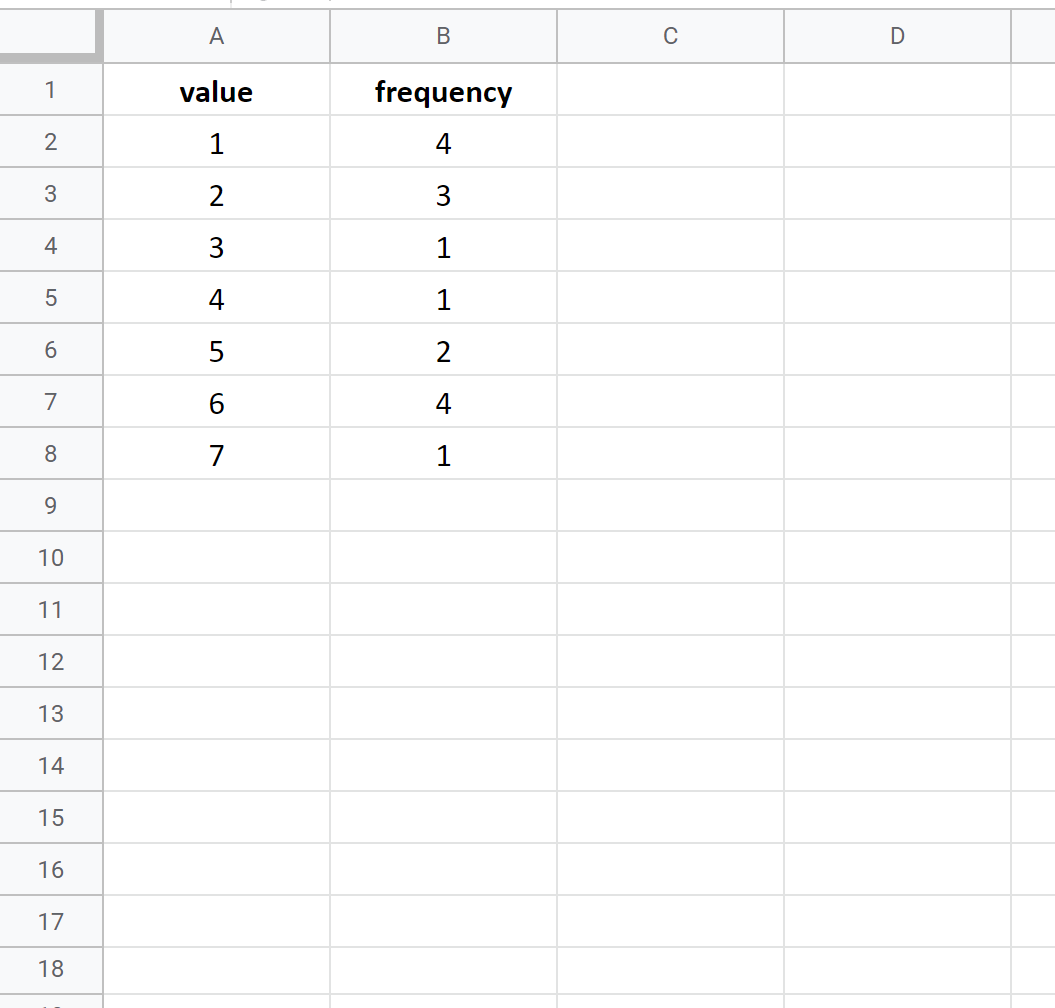
Dans l’éventualité où les données se présentent sous la forme d’un tableau de contingence synthétique, la feuille de calcul doit héberger deux colonnes prioritaires. La première colonne, que l’on nommera conventionnellement la variable d’intérêt ou le score empirique, répertorie de façon strictement croissante l’ensemble des valeurs uniques observées ou théoriquement admissibles de l’échelle. La seconde colonne juxtapose à chaque modalité son effectif absolu, c’est-à-dire la fréquence d’apparition de ce score spécifique au sein du groupe étudié. Il est impératif de s’assurer que chaque valeur n’apparaisse qu’une seule fois dans cette nomenclature d’inventaire.
D’un point de vue informatique, la vérification de l’intégrité typologique des cellules revêt une importance capitale. Le moteur de calcul de Google Sheets traite les chaînes textuelles et les entités numériques selon des logiques dissemblables qui, si elles sont confondues, paralysent le fonctionnement ultérieur du traceur de nuages de points. Toutes les cellules englobant les valeurs d’évaluation et les décomptes doivent être rigoureusement typées au format numérique standard. Il convient d’exclure formellement tout ajout de préfixes textuels, d’espaces typographiques ou d’annotations explicatives au sein même des cellules destinées au traitement mathématique.
2.2 Contrôle de qualité et nettoyage des données expérimentales
Le prétraitement des séries expérimentales impose une phase d’audit exhaustif visant à éradiquer les artefacts d’encodage susceptibles de fausser la projection visuelle. L’un des écueils les plus fréquents découle de l’hétérogénéité des séparateurs décimaux, notamment lorsque des données sont collectées à partir de postes informatiques configurés sous des paramètres régionaux divergents (virgule française contre point anglo-saxon). Une valeur comportant un séparateur non reconnu par la localisation active de la feuille sera convertie en chaîne de caractères, s’alignant par défaut sur le bord gauche de la cellule, ce qui l’exclura automatiquement de l’algorithme de tracé continu.
De même, les espaces insécables ou résiduels résultant de copier-coller depuis des plateformes de passation web doivent être traqués et neutralisés. L’utilisation de fonctions de purge textuelle s’avère alors judicieuse pour assainir les champs de saisie. En matière de valeurs manquantes, la déontologie expérimentale requiert une politique d’arbitrage explicite : les cellules laissées vacantes par l’abandon d’un sujet ou un échec d’enregistrement ne doivent en aucun cas être remplies par la valeur zéro, ce qui biaiserait lourdement la distribution, mais doivent être proprement isolées ou soustraites de l’espace de calcul selon les critères d’exclusion définis dans le protocole de recherche.
Cette discipline s’inscrit dans les préceptes méthodologiques du concept de « tidy data » formalisé par Hadley Wickham. Chaque variable doit occuper une colonne dédiée, chaque observation doit constituer une rangée exclusive, et chaque type d’unité d’observation doit former une table indépendante. Le respect rigide de cette grammaire des données dès la phase de saisie dans le tableur constitue la meilleure assurance contre les déconvenues techniques lors des phases ultérieures d’interpolation et de paramétrage graphique.
2.3 Conception de l’architecture de la feuille pour isoler les étapes d’analyse
Une bonne pratique en sciences des données consiste à cloisonner hermétiquement la matrice des données originales non transformées et les zones de calcul dévolues à la mise en forme graphique. Fusionner les colonnes de saisie clinique et les colonnes techniques de positionnement spatial au sein d’un même espace visuel génère une pollution cognitive inutile et accroît considérablement le risque de corruption accidentelle des données lors des manipulations routinières.
Il est vivement préconisé de scinder le classeur en deux onglets opérationnels distincts, ou à tout le moins de séparer physiquement la feuille de travail en deux quadrants clairement balisés. Le premier quadrant recevra les données brutes issues des cahiers d’observation ou des fichiers de journalisation machine. Le second quadrant, baptisé « Moteur Graphique » ou « Transformation de Cleveland », hébergera les formules d’expansion matricielle et les vecteurs de coordonnées cartésiennes indispensables à l’élaboration du tracé.
Pour parachever cette architecture défensive, l’expérimentateur attribuera des entêtes explicites et standardisés à chaque colonne (par exemple, Score_Psychometrique et Index_Vertical_Y). Il est également hautement conseillé de verrouiller l’accès aux plages calculées via les paramètres de protection de Google Sheets. Ce procédé garantit qu’un utilisateur consultant le classeur partagé ne pourra pas altérer par inadvertance les fonctions matricielles complexes qui alimentent la représentation visuelle, préservant ainsi l’intégrité de la figure tout au long du cycle de vie du projet.
3. Restructuration des données : transformation impérative vers le format long
3.1 Nécessité algorithmique du format long pour l’empilement vertical
Pour comprendre la nécessité absolue d’une restructuration matricielle préalable, il convient de se pencher sur les mécanismes internes du moteur de rendu graphique de Google Sheets. Contrairement à des progiciels spécialisés dotés d’un opérateur natif d’empilement de points (tel que geom_dotplot dans la grammaire des graphiques de R), le tableur de Google ne dispose d’aucun algorithme automatique capable de calculer à la volée la collision spatiale de points partageant une même valeur d’abscisse pour les empiler élégamment le long de l’axe vertical.
Si l’on injectait directement une liste de scores bruts dans un nuage de points unidimensionnel sans artifice d’ordonnée, l’ensemble des marqueurs correspondant à une même valeur se superposeraient exactement sur un unique point géométrique le long de la ligne de base. L’œil humain ne percevrait alors aucune différence entre un score obtenu par un seul participant et un score partagé par quarante individus, annihilant totalement la vocation informative du tracé. Dès lors, il devient impératif de synthétiser une ordonnée artificielle qui attribuera à chaque occurrence successive d’une même valeur un échelon d’altitude distinct.
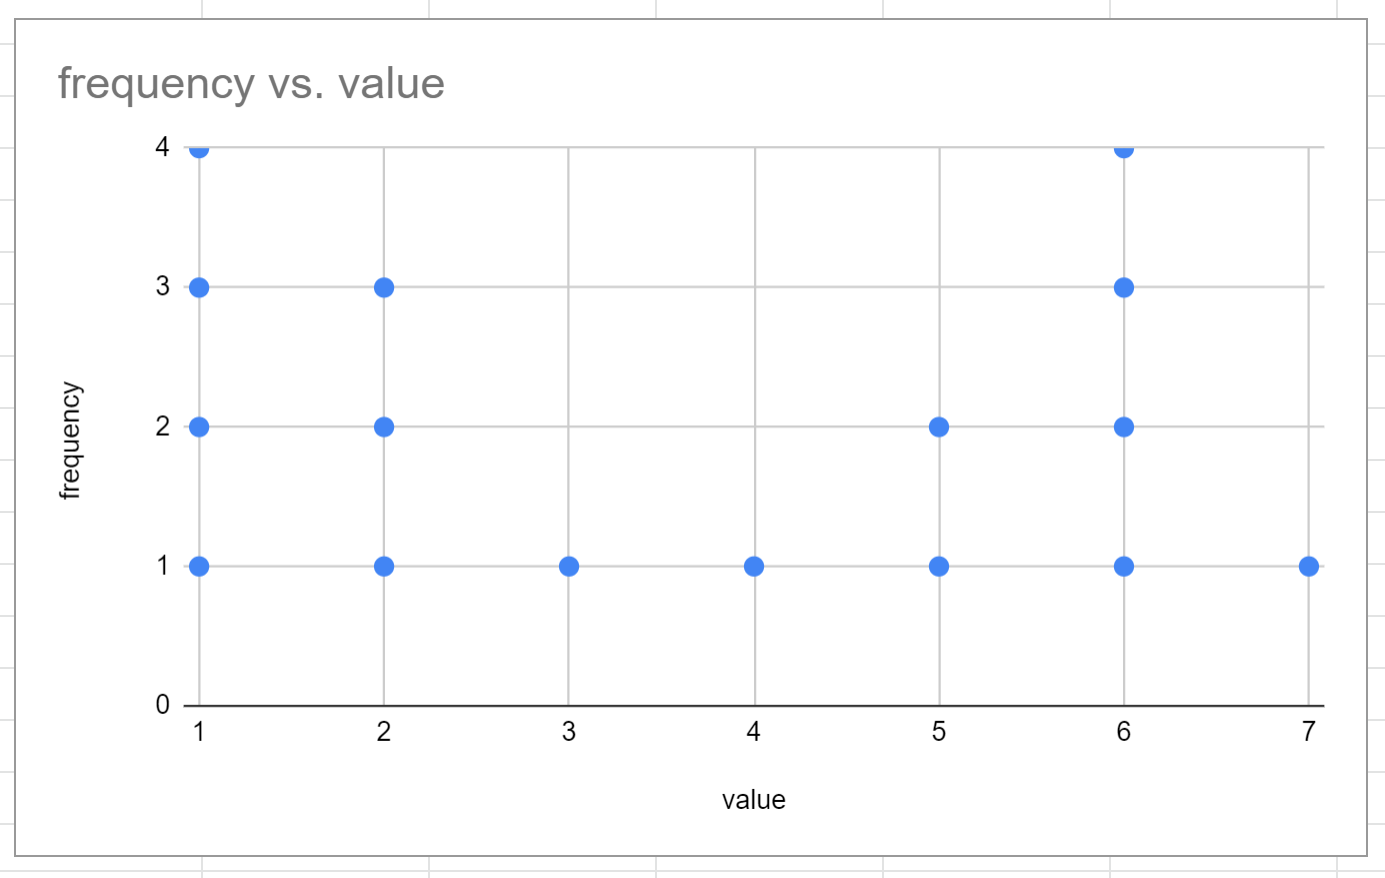
Cette approche implique une conversion systématique vers ce que la statistique informatique nomme le format long. Chaque marqueur élémentaire doit être caractérisé dans le tableau par une paire de coordonnées cartésiennes strictes (X, Y). L’abscisse X correspond scrupuleusement au score mesuré chez l’individu, tandis que l’ordonnée Y reçoit un indice scalaire incrémental entier : 1 pour le premier participant ayant obtenu ce score, 2 pour le deuxième participant affichant la même performance, et ainsi de suite jusqu’à l’effectif maximal k observé pour cette modalité.
3.2 Technique manuelle de dégroupement pour échantillons restreints
Pour des jeux de données de taille modeste — n’excédant pas quelques dizaines d’observations —, la mise en œuvre d’une technique de décomposition manuelle s’avère souvent la démarche la plus transparente et la plus rapide à appréhender sur le plan didactique. Considérons un échantillon où la distribution de fréquences indique que le score 12 a été obtenu par 3 sujets, le score 13 par 5 sujets et le score 14 par 2 sujets. Le dégroupement consiste à expliciter manuellement la trajectoire d’empilement point par point.
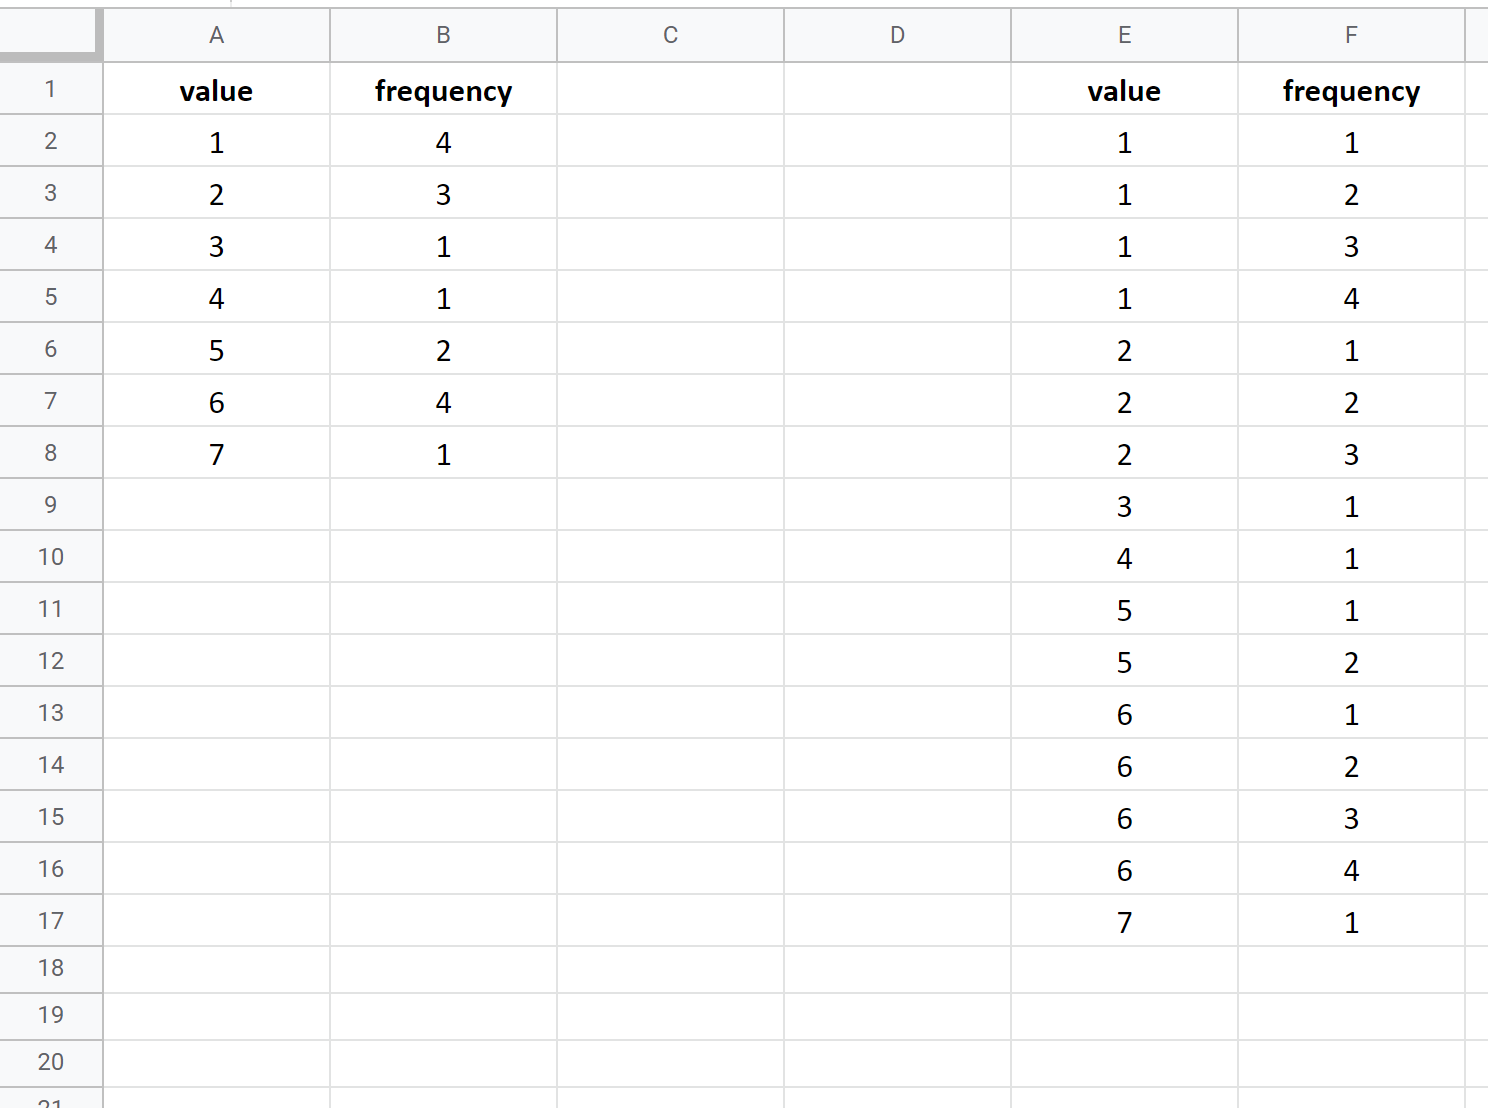
L’expérimentateur initialise deux colonnes cibles vierges, respectivement intitulées Axe_X_Score et Axe_Y_Niveau. Pour le score 12 présentant une fréquence de 3, il inscrira dans la première colonne la séquence 12, 12, 12 sur trois lignes consécutives. Dans la colonne adjacente, il attribuera à ces trois lignes les coordonnées d’empilement 1, puis 2, puis 3. La même logique est immédiatement réitérée pour le score 13 : inscription de la valeur 13 sur cinq lignes successives, appariée aux valeurs verticales 1, 2, 3, 4 et 5 dans la colonne secondaire.
Cette phase requiert une vigilance absolue quant au contrôle de la cardinalité globale de l’échantillon expansé. La somme arithmétique des fréquences renseignées dans le tableau d’origine doit correspondre au nombre total de lignes occupées par les nouvelles coordonnées cartésiennes. Une divergence numérique à ce stade traduirait une omission ou une duplication illégitime d’observation, corrompant de facto la représentativité de la distribution avant même le tracé du premier pixel.
3.3 Validation de la structure matricielle avant génération graphique
Avant d’activer le module d’insertion graphique, un examen approfondi de la structure tabulaire finale s’impose afin d’éviter les erreurs d’interprétation du moteur d’analyse de Google Sheets. Les deux colonnes générées doivent former un bloc contigu et ininterrompu d’informations. Aucune ligne blanche, aucune cellule isolée contenant une annotation textuelle ou aucun artefact de calcul intermédiaire ne doit s’immiscer au sein de cette plage de données cibles.
L’expérimentateur s’assurera également que l’ordonnée d’empilement ne comporte pas de valeurs nulles ou négatives lors de cette initialisation : le niveau de base conventionnel d’une pile commence rigoureusement à l’unité 1. Si une valeur de l’échelle d’évaluation n’a été sélectionnée par aucun participant dans l’échantillon expérimental, elle ne doit générer aucune ligne dans cette matrice expansée, la vacuité de son effectif étant traduite spatialement par l’absence pure et simple de marqueur sur l’axe des abscisses lors de la projection graphique.
Enfin, la vérification de la concordance des bornes constitue le dernier garde-fou. Le rang maximal présent dans la colonne d’altitude Y doit refléter avec exactitude le mode de la distribution, c’est-à-dire la fréquence la plus élevée parmi toutes les modalités du spectre expérimental. Une fois cette validation géométrique et comptable achevée, la matrice de coordonnées (X, Y) est déclarée opérationnelle pour subir la phase d’encapsulation graphique au sein du tableur.
4. Génération initiale du graphique et sélection du moteur de tracé
4.1 Sélection de la plage de données et insertion de l’objet graphique
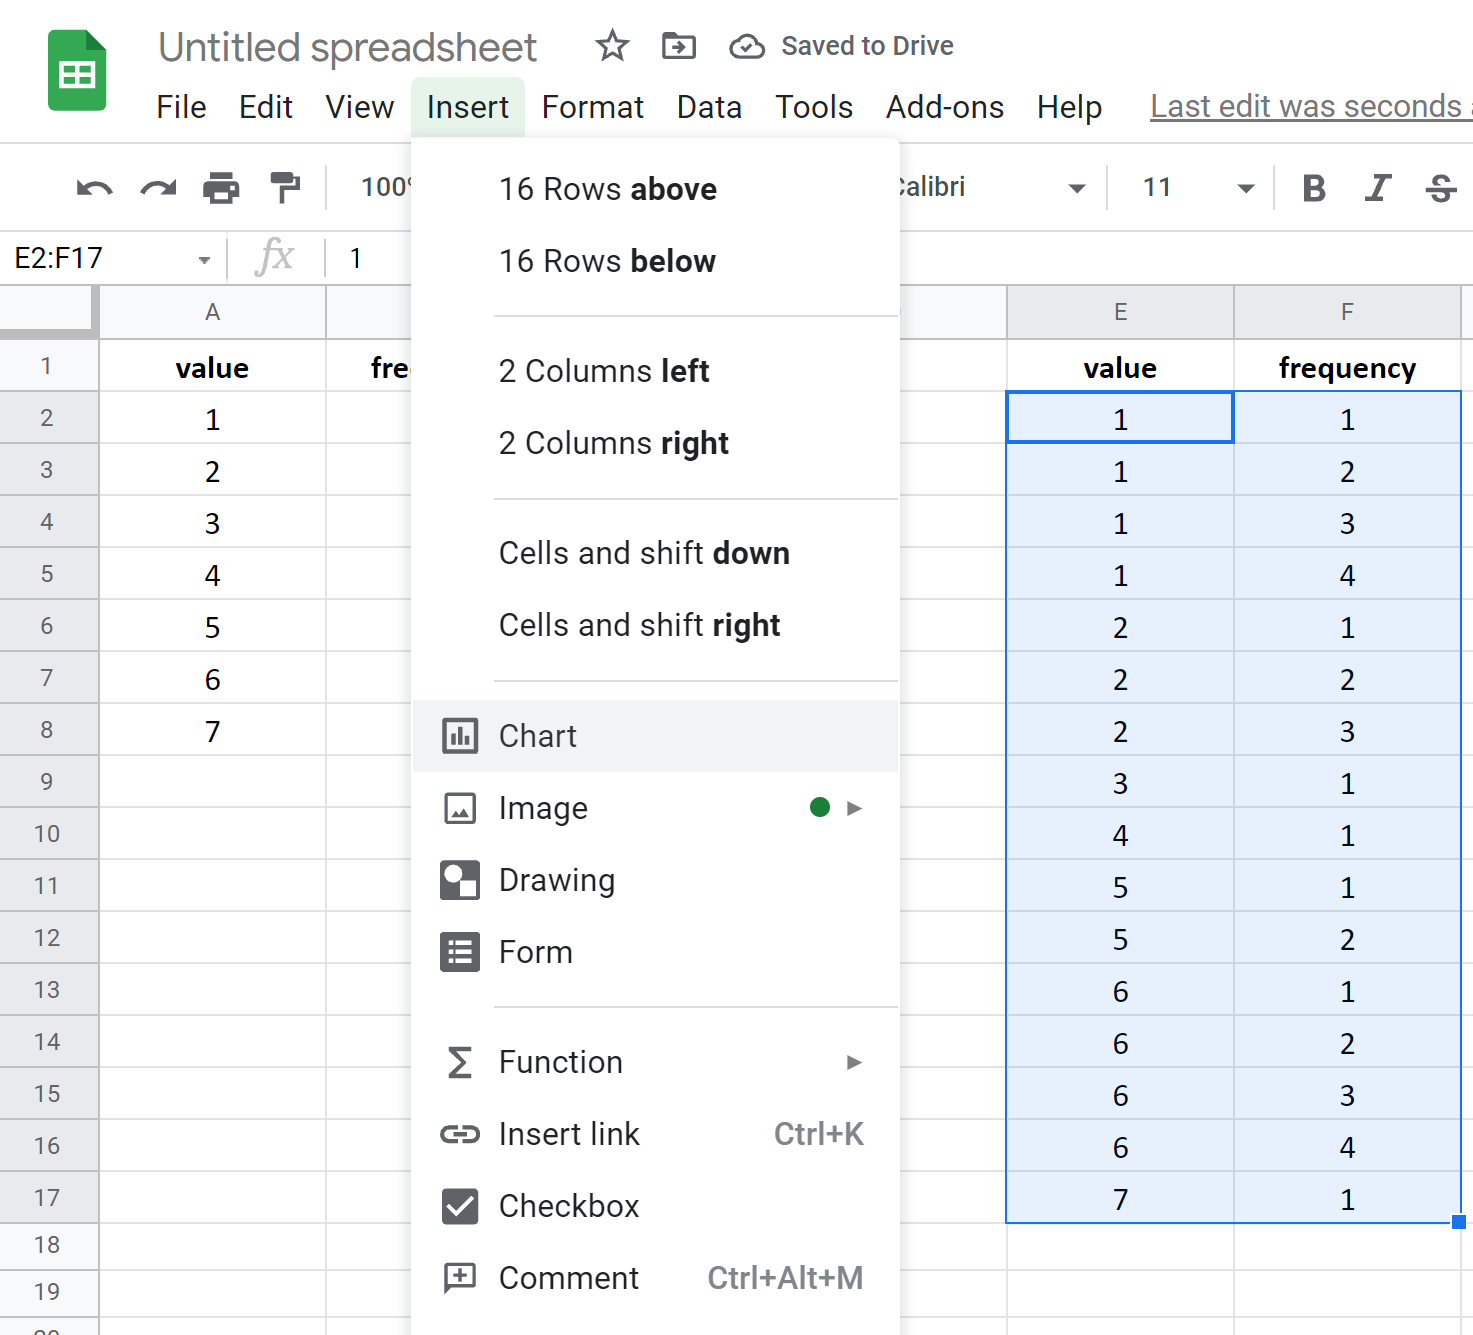
Le déclenchement du rendu visuel s’opère par la mise en surbrillance rigoureuse du bloc de coordonnées préalablement consolidé. À l’aide du curseur de la souris ou par l’intermédiaire des raccourcis de sélection matricielle, l’utilisateur sélectionne l’intégralité des cellules de la plage délimitée par les deux colonnes (Axe X et Axe Y), en prenant grand soin d’incorporer dès la première ligne les étiquettes descriptives des entêtes de colonnes. Cette inclusion permettra à l’application d’inférer automatiquement la sémantique des variables lors du paramétrage initial.
La commande d’insertion s’effectue ensuite par le biais de la barre d’outils supérieure de Google Sheets, en déroulant le menu contextuel Insertion, puis en sélectionnant l’option Graphique. Alternativement, l’icône représentative d’un histogramme présente dans la barre d’outils rapide produit un résultat rigoureusement équivalent. À cet instant précis, l’algorithme heuristique de Google Sheets analyse la structure dimensionnelle des données sélectionnées et génère de façon probabiliste un modèle graphique préconçu au centre de la feuille de calcul active.
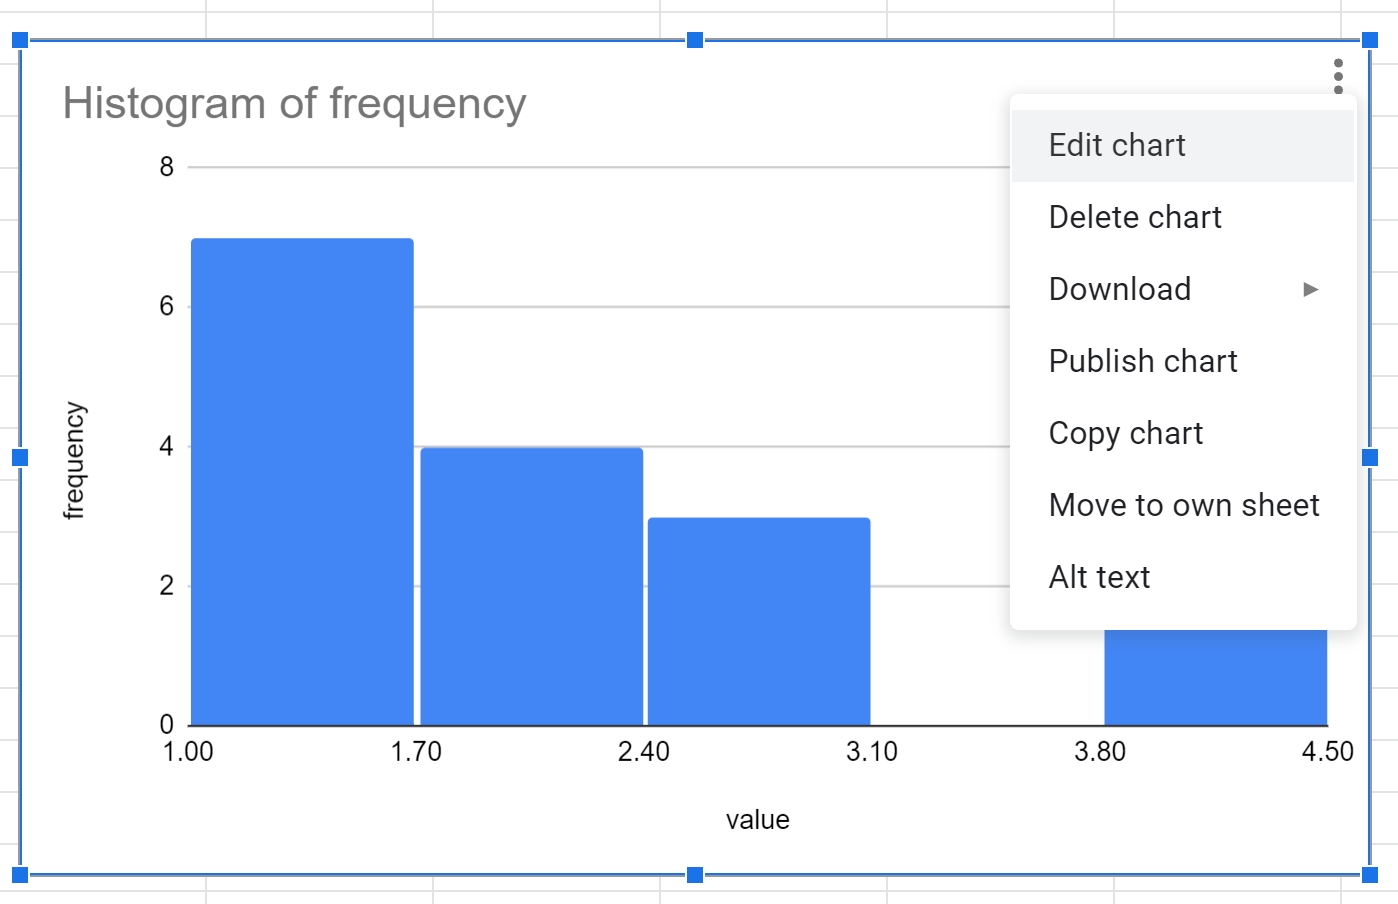
Dans la majorité des cas de figure, le moteur interne propose par défaut un diagramme à barres verticales, un tracé de lignes brisées ou un histogramme aggloméré. Cette réaction est parfaitement normale : le tableur interprète conventionnellement deux colonnes numériques contiguës comme une séquence chronologique ou une série de catégories nécessitant une comparaison de volumes. Il importe de ne pas se laisser désarçonner par cet affichage initial chaotique et de basculer immédiatement vers l’éditeur de personnalisation logicielle.
4.2 Bascule vers le type de tracé adéquat via l’éditeur de graphiques
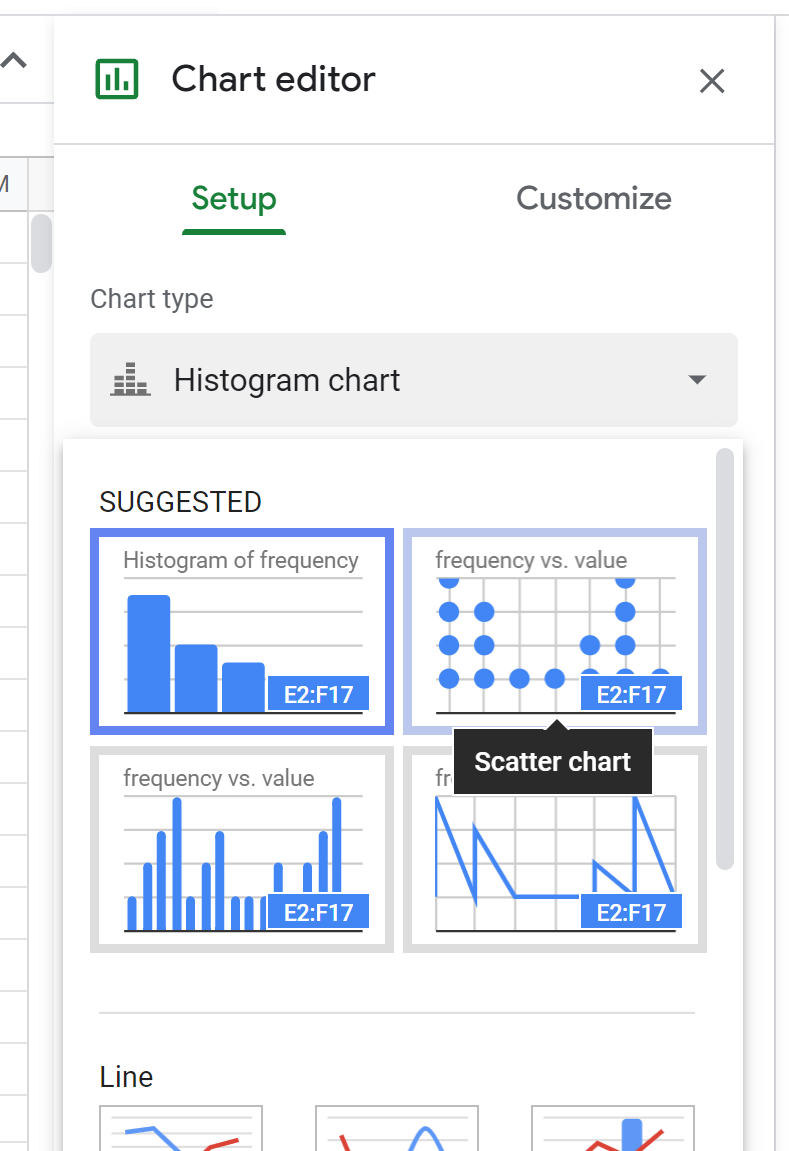
Dès l’insertion de l’objet visuel, un volet latéral intitulé Éditeur de graphiques se déploie automatiquement sur la bordure droite de l’interface utilisateur. Si ce panneau venait à se fermer inopportunément, il suffirait d’opérer un double-clic sur le corps du graphique ou de cliquer sur les trois points verticaux logés dans l’angle supérieur droit du conteneur visuel pour sélectionner la commande Modifier le graphique. Cet éditeur se compose de deux volets directeurs : Configuration et Personnaliser.
L’utilisateur doit concentrer son attention sur l’onglet Configuration. En activant le menu déroulant placé sous l’instruction Type de graphique, l’interface dévoile une taxonomie étendue de modèles de représentation : courbes, surfaces, barres, secteurs, cartes géographiques et diagrammes de dispersion. Pour implémenter la méthode la plus simple et la plus exacte du graphique à points, il est impératif de faire défiler cette arborescence jusqu’à la section intitulée Nuage de points (souvent identifiée en langue anglaise sous le vocable Scatter chart) et de valider ce choix.
Ce basculement modifie radicalement le principe de restitution géométrique sous-jacent. Au lieu de considérer les données comme des catégories discrètes juxtaposées de manière arbitraire, le moteur graphique affecte désormais à chaque enregistrement un emplacement précis au sein d’un plan cartésien régi par des échelles continues. La forme globale du tracé commence dès lors à émerger : les observations individuelles s’alignent le long de l’axe des abscisses tout en s’élevant verticalement selon les indices précalculés.
4.3 Affectation correcte des séries et de l’axe des abscisses
L’une des sources d’anomalies les plus pernicieuses réside dans l’inversion involontaire des dimensions opérée automatiquement par l’analyseur syntaxique du tableur. Il est absolument primordial de vérifier scrupuleusement l’affectation respective des axes dans le panneau de configuration. La variable d’évaluation psychologique (notre score clinique ou comportemental) doit impérativement figurer dans le champ dédié à l’Axe X. Si l’éditeur y a positionné la colonne des rangs verticaux, il convient de modifier cette attribution en cliquant sur le sélecteur de plage correspondant.
Corrélativement, la section dénommée Série doit accueillir exclusivement la colonne hébergeant les indices d’empilement vertical (l’ordonnée Y). Si des séries superflues se sont greffées automatiquement lors de l’insertion — ce qui arrive fréquemment lorsque la sélection initiale incluait des colonnes annexes —, l’utilisateur doit impérativement les purger en cliquant sur le menu contextuel à trois points situé en regard de chaque série parasite et en sélectionnant la commande Supprimer.
Enfin, l’expérimentateur veillera à inspecter l’état des cases à cocher situées au bas de l’onglet Configuration. Les options intitulées Inverser les lignes et les colonnes ou Combiner les plages doivent impérativement demeurer désactivées. En revanche, l’option Utiliser la ligne 1 comme en-têtes doit être formellement validée afin que les libellés conceptuels des variables soient reconnus en tant que métadonnées descriptives et ne soient pas incorporés de manière erratique sous forme de coordonnées numériques au sein du repère orthogonal.
5. Calibrage mathématique des axes pour un alignement vertical rigoureux
5.1 Configuration des bornes d’échelle sur l’axe vertical (Y)
Bien que le nuage de points soit désormais déployé, la géométrie du graphique présente à ce stade un défaut structural majeur : par défaut, Google Sheets applique un algorithme d’ajustement dynamique (auto-scaling) qui dilate ou comprime les marges périmétriques pour faire occuper à la figure l’intégralité du conteneur. Cette mise à l’échelle automatique génère souvent un décalage visuel déroutant, plaçant la première rangée de points trop près ou trop loin de la ligne horizontale de référence.
Pour rectifier cette anomalie de perspective, l’utilisateur doit migrer vers l’onglet Personnaliser de l’éditeur de graphiques, puis déployer la rubrique intitulée Axe vertical. Au sein de ce menu se trouvent deux paramètres critiques : Valeur minimale et Valeur maximale. Ces champs ne doivent sous aucun prétexte être abandonnés à l’automatisation logicielle. Pour garantir une assise visuelle stable et équilibrée, il est scientifiquement recommandé de fixer la valeur minimale à un seuil délibérément calibré, tel que 0,75 ou 0,80.
Cette subtilité de calibrage empêche le premier point de la pile (dont l’ordonnée est 1) d’entrer en collision graphique directe avec la ligne d’axe horizontale, tout en évitant un vide spatial démesuré sous la distribution. Concernant la valeur maximale, elle doit être fixée manuellement à un entier légèrement supérieur à la fréquence modale de l’échantillon (par exemple, si la pile la plus haute culmine à 8 observations, fixer la borne supérieure à 8,5 ou 9). Cet encadrement rigide garantit que les proportions des piles traduisent fidèlement les rapports de force numériques sans distorsion d’échelle.
5.2 Harmonisation des pas d’incrémentation et intervalles scalaires
L’intelligibilité d’un graphique à points repose sur l’équidistance absolue séparant chaque marqueur successif le long d’une même colonne verticale. Si les graduations de l’axe vertical sont configurées selon des intervalles arbitraires (par exemple des fractions décimales comme 1,5 ou 2,3 générées par l’interpolation par défaut du logiciel), la sémiotique visuelle du décompte discret est lourdement compromise. L’œil humain doit être en mesure d’associer intuitivement une unité de hauteur géométrique à une unité d’observation physique.
Pour harmoniser cette graduation, toujours dans l’onglet Personnaliser, l’expérimentateur accèdera à la section dédiée aux Quadrillages et graduations, en veillant à sélectionner l’Axe vertical dans le sélecteur contextuel supérieur. Il conviendra de basculer le mode de calcul des espacements de la position « Automatique » vers la position « Nombre de lignes de quadrillage » ou d’ajuster le « Pas majeur ». Le pas doit être impérativement configuré sur une valeur entière stricte de 1.
Ce réglage oblige le moteur de rendu à caler ses repères théoriques exactement sur les nombres entiers caractérisant nos occurrences d’empilement (1, 2, 3, 4…). Bien que ces graduations verticales soient ultimement vouées à être dissimulées lors de la phase d’épuration esthétique, ce calibrage sous-jacent contraint la matrice de projection à respecter une proportionnalité orthonormée stricte. Aucun point ne subira dès lors d’étirement élastique en fonction de la taille de redimensionnement de la fenêtre du navigateur.
5.3 Paramétrage de l’axe horizontal (X) selon la nature de la variable psychologique
Le traitement métrologique de l’axe des abscisses réclame une attention toute particulière, dictée par la nature fondamentale de l’instrument de mesure psychologique employé. S’agit-il d’une échelle ordinale de type Likert en 5 ou 7 points, d’un score de sévérité symptomatique borné entre 0 et 30, ou d’une mesure chronométrique discrétisée ? L’axe horizontal doit impérativement refléter l’espace des possibles théorique de l’épreuve expérimentale et non se limiter paresseusement aux seules valeurs fortuites récoltées dans le sous-échantillon actif.
Dans l’onglet Personnaliser, sous la sous-section Axe horizontal, l’utilisateur configurera délibérément la Valeur minimale et la Valeur maximale. Par exemple, si l’on évalue des performances à une épreuve cognitive graduée de 0 à 10, le minimum doit être fixé à 0 (ou -0,5 pour aérer les bords extrêmes) et le maximum à 10 (ou 10,5), quand bien même aucun participant n’aurait obtenu la note minimale ou maximale. Cette précaution épistémologique prévient le lecteur contre l’illusion d’une distribution tronquée et permet de contextualiser immédiatement la dispersion observée au regard de l’échelle totale.
Simultanément, dans la section Quadrillages et graduations dédiée à l’Axe horizontal, il importe de fixer le pas d’incrémentation principal pour qu’il coïncide rigoureusement avec les unités naturelles de l’instrument d’évaluation. Pour une échelle de Likert, le pas sera invariablement réglé à 1 afin que chaque échelon (1, 2, 3, 4, 5) héberge sa graduation maîtresse. L’alignement spatial des piles de points au-dessus de ces repères cardinaux doit être millimétrique, assurant ainsi une lecture sans ambiguïté de l’affectation catégorielle de chaque marqueur.
6. Élimination des artefacts graphiques et dépouillement visuel
6.1 Suppression des composantes superflues de l’axe vertical
L’un des postulats théoriques majeurs de la sémiologie graphique, vigoureusement défendu par Edward Tufte sous l’appellation du ratio encre-données (data-ink ratio), postule que tout élément graphique ne véhiculant pas une information nouvelle ou indispensable doit être impitoyablement proscrit. Dans le cas précis d’un graphique à points de distribution univariée, l’axe vertical présente un statut singulier : il constitue un guide de construction purement auxiliaire, dont la matérialisation explicite surcharge inutilement l’espace visuel.
En effet, la hauteur cumulée d’une pile de points porte en elle-même l’information quantitative de l’effectif : nul n’a besoin de se reporter à un axe chiffré à gauche pour comprendre qu’une colonne comptant quatre disques empilés contient précisément quatre observations. Conserver des valeurs chiffrées (1, 2, 3, 4) le long de l’ordonnée engendre une confusion chez le lecteur novice, qui pourrait interpréter ces chiffres comme une seconde variable expérimentale mesurée plutôt que comme un simple compteur de fréquence.
Pour épurer ce segment, l’expérimentateur se rendra dans la rubrique Axe vertical de l’éditeur graphique. Il conviendra de supprimer purement et simplement le titre de l’axe s’il a été renseigné. Ensuite, sous l’option relative au formatage des étiquettes d’axe, il convient de modifier la couleur de police pour lui assigner la valeur Aucune ou de basculer la taille de la police sur un mode invisible. Enfin, la ligne d’axe elle-même doit être désactivée en sélectionnant une bordure transparente ou une couleur identique au fond du canevas, faisant ainsi disparaître tout vestige de l’échafaudage technique.
6.2 Gestion méthodique des lignes de quadrillage majeures et mineures
Les grilles matricielles automatiques déployées par les tableurs constituent l’un des artefacts visuels les plus invasifs de la visualisation contemporaine. Les lignes de quadrillage horizontales, en particulier, traversent les piles de points de part en part, introduisant un parasitage optique qui découpe artificiellement les marqueurs circulaires et détériore la clarté perceptive globale préconisée par les théories de la Gestalt.
Dans la section Quadrillages et graduations, l’utilisateur prendra soin de désactiver l’affichage des lignes de quadrillage majeures et mineures pour l’Axe vertical. En décochant ces options, le fond du graphique est instantanément libéré de ses striations horizontales superflues, permettant aux colonnes de points de s’ériger sur un canevas immaculé. Cette opération confère immédiatement à la production graphique un rendu professionnel digne des standards de l’édition scientifique.
Concernant l’Axe horizontal, une nuance opérationnelle peut être envisagée. Si le nombre de modalités sur l’échelle est important et que la lecture nécessite un ancrage visuel précis pour distinguer deux scores contigus (par exemple pour différencier nettement la colonne 17 de la colonne 18), des lignes directrices verticales très légères peuvent être tolérées. Néanmoins, si elles sont maintenues, leur contraste doit être drastiquement diminué : il conviendra de leur assigner une teinte gris clair à très faible saturation (code hexadécimal de type #E0E0E0), transformant le quadrillage en un repère subliminal discret plutôt qu’en un obstacle perceptif prépondérant.
6.3 Épuration de la zone de légende et des bordures de cadre
Dans le cadre de l’analyse distributionnelle d’un échantillon univarié, la présence d’une légende indiquant la dénomination de la série représente une redondance graphique absolue. Le lecteur observant une constellation de points homogènes n’a que faire d’un encadré excentré lui précisant que la pastille circulaire symbolise la « Série 1 ». Cette zone annexe encombre la composition, réduit la surface utile allouée au tracé principal et force le regard à des allers-retours cognitifs inutiles.
Pour éliminer cet artefact, il suffit de naviguer vers la section Légende de l’onglet Personnaliser de l’éditeur de Google Sheets. Dans le menu déroulant déterminant la position spatiale du bloc de légende, l’utilisateur sélectionnera l’option Aucune. Le graphique se redéploie instantanément pour occuper l’intégralité de la largeur disponible dans son conteneur, améliorant substantiellement la lisibilité de la dispersion horizontale des scores comportementaux.
Enfin, la question de la délimitation externe de l’objet graphique doit être traitée avec sobriété. Par défaut, Google Sheets applique fréquemment un contour rectangulaire sombre autour de la zone de tracé ainsi qu’une bordure extérieure au canevas global. Dans la rubrique Style de graphique, l’expérimentateur fixera la Couleur de la bordure du graphique sur Aucune. Cette démarche garantit une intégration fluide du graphique lors de son incorporation ultérieure dans un traitement de texte académique, empêchant l’apparition de rectangles inélégants rompant la continuité typographique du manuscrit final.
7. Optimisation esthétique et stylisation sémiotique conforme aux standards APA
7.1 Dimensionnement et colorimétrie des marqueurs circulaires
L’optimisation des marqueurs visuels constitue l’étape où la rigueur géométrique fusionne avec la sémiotique de la perception. Dans le volet Personnaliser, sous la section Série, l’expérimentateur accède aux paramètres morphologiques des points. Deux variables dimensionnelles exercent une influence prépondérante sur la qualité de restitution : la taille du point (exprimée en pixels) et son coefficient d’opacité chromatique.
Le calibrage du diamètre des cercles dépend étroitement de la densité de l’échantillon et de la résolution d’exportation envisagée. Pour des cohortes modérées (N compris entre 20 et 50 sujets), un diamètre étalonné à 7 px ou 10 px confère une lisibilité optimale. Si les marqueurs sont calibrés de manière trop étriquée, la distribution perd son impact visuel et apparaît famélique ; à l’inverse, un calibrage hypertrophié (au-delà de 14 px) risque de provoquer des chevauchements latéraux indésirables entre des colonnes de scores pourtant contiguës sur l’axe des abscisses.
Sur le plan colorimétrique, il convient d’adhérer impérativement aux principes de conception universelle accessibles aux individus présentant des déficiences de la vision des couleurs (daltonisme, deutéranopie). Les teintes criardes ou hautement saturées doivent être proscrites au profit d’un bleu acier profond, d’un ardoise sobre ou d’un noir classique à haut contraste. L’application d’une opacité réglée à 80 % ou 85 % constitue une astuce technique remarquable : elle confère une translucidité subtile aux cercles, rendant immédiatement décelable toute collision millimétrique ou toute superposition accidentelle de coordonnées qui serait passée inaperçue avec des marqueurs totalement opaques.
7.2 Définition typographique des étiquettes d’axes et du titre
La typographie d’une figure scientifique ne doit rien céder à la fantaisie décorative. Les conventions éditoriales internationales préconisent l’usage exclusif de polices de caractères linéaires sans empattement (sans-serif), reconnues pour leur lisibilité exceptionnelle sur écran comme sur support papier imprimé. Google Sheets intègre nativement des fontes respectant ces critères, telles que Roboto, Arial ou Helvetica. L’utilisateur veillera à unifier la police de l’ensemble des composantes textuelles du graphique sous une unique famille typographique.
L’étiquette de l’axe horizontal (Axe X) réclame un libellé irréprochable sur le plan métrologique. Elle ne doit pas se contenter d’abréviations cryptiques issues du protocole de codage du laboratoire. Il convient de stipuler explicitement le construit psychologique mesuré, suivi impérativement de son unité de mesure ou de la désignation de l’inventaire psychométrique entre parenthèses — par exemple : Temps d’inhibition cognitive (millisecondes) ou Score total à l’inventaire de dépression de Beck (BDI-II). La taille de ce libellé sera calibrée à 12 ou 14 points pour assurer une hiérarchie visuelle équilibrée.
Quant à la titraille interne au graphique, la rigueur académique commande souvent de la neutraliser au profit de légendes externes insérées directement dans le corps de texte du manuscrit. Si un titre doit néanmoins figurer temporairement sur la maquette de travail, il sera formulé de façon descriptive et laconique, sans emphase narrative, en adoptant une graisse semi-forte et une taille calibrée à 14 ou 16 points, disposé de manière centrée ou aligné sur le bord gauche du tracé.
7.3 Harmonisation globale selon les prescriptions du manuel de l’APA (7e édition)
La publication dans les périodiques affiliés à l’American Psychological Association (APA) soumet l’iconographie à un cahier des charges d’une rigueur inflexible, codifié dans la 7e édition du manuel officiel de style. L’harmonie générale du graphique à points doit se conformer point par point à cette doctrine sémiotique. Le précepte cardinal repose sur l’éradication systématique de tout artifice visuel tridimensionnel, de tout dégradé d’ombrage ou de tout effet de texture décorative assimilable à ce que Tufte qualifie de « chartjunk ».
Dans l’écosystème de l’APA, une figure monochrome ou exploitant des dégradés de gris méthodiquement contrastés est traditionnellement privilégiée, garantissant que l’information demeure parfaitement décodable lors d’une impression photocopiée en noir et blanc haute résolution. Si la couleur est tolérée dans les formats de publication électronique en accès libre, elle doit maintenir un ratio de contraste minimal de 4.5:1 par rapport au fond blanc immaculé de la page.
De plus, la disposition hiérarchique standardisée prescrit que le graphique soit couronné non pas d’un titre interne expansif, mais d’un numéro d’identification en gras (ex. Figure 1), immédiatement suivi d’un titre concis en italique placé à la ligne inférieure. Sous le corps du tracé s’insère obligatoirement une section typographique débutant par la mention Note. en italique, explicitant la signification de chaque point (ex. Chaque cercle représente le score individuel d’un participant ; les piles verticales indiquent la fréquence des scores identiques), assurant l’autonomie sémantique complète de la figure vis-à-vis du texte principal.
8. Automatisation du format long par l’usage des formules matricielles avancées
8.1 Limites de la manipulation manuelle face aux volumétries scientifiques
Si le dégroupement manuel explicité à la section 3 s’avère irremplaçable pour assimiler les fondements de la méthode cartésienne, il révèle d’évidentes limites opérationnelles dès lors que le protocole de recherche s’élargit à des cohortes de moyenne ou grande envergure. Répéter artisanalement des dizaines de fois la même valeur numérique dans une cellule et lui assigner un compteur vertical unitaire représente une tâche rébarbative, chronophage et hautement vulnérable aux erreurs d’inattention humaine.
Un simple décalage de ligne ou une omission de transcription au sein d’une pile altère instantanément la géométrie de la distribution et fausse la représentation de la fréquence modale. Plus critique encore, cette approche artisanale s’avère intrinsèquement statique : si de nouveaux participants sont inclus dans l’étude au cours des semaines d’expérimentation, l’investigateur se voit contraint de reconstruire manuellement l’intégralité de sa plage matricielle de transformation.
Pour conférer à la feuille de calcul une réactivité dynamique et une robustesse professionnelle, il devient indispensable d’automatiser l’émergence des coordonnées d’empilement par le truchement de formules matricielles natives de Google Sheets. Ces fonctions algorithmiques permettent de transformer instantanément une liste brute d’observations individuelles en un ensemble coordonné prêt pour le tracé, sans la moindre intervention manuelle répétitive.
8.2 Déploiement combiné des fonctions REDUCE, SEQUENCE et SPLIT
Pour les utilisateurs manipulant des tableaux de contingence déjà agrégés (comportant une colonne de scores uniques et une colonne de fréquences associées), Google Sheets dispose d’une panoplie de fonctions matricielles contemporaines capables d’opérer l’expansion en format long de manière totalement algorithmique. La combinaison moderne des fonctions matricielles permet de répliquer chaque modalité de score exactement le nombre de fois prescrit par sa fréquence, tout en générant simultanément la séquence arithmétique d’altitude.
Sur le plan conceptuel, l’architecture d’une telle automatisation s’articule autour de la duplication textuelle et de l’éclatement matriciel. En utilisant conjointement la fonction matricielle REPT pour réitérer chaque score séparé par un délimiteur arbitraire au prorata de son effectif numérique, puis en fractionnant la chaîne résultante au moyen de la fonction SPLIT, le tableur génère instantanément la colonne d’abscisses expansée. Pour générer les ordonnées d’empilement correspondantes, l’imbrication dynamique de la fonction SEQUENCE permet d’injecter des séries séquentielles de 1 à k pour chaque groupe de répétition.
Cette algèbre tabulaire dynamique transforme radicalement le flux de travail au sein du laboratoire. Dès l’instant où un technicien ou un chercheur ajuste la valeur d’une fréquence dans le tableau récapitulatif initial, la colonne matricielle sous-jacente s’auto-exécute et se redimensionne en temps réel, provoquant la mise à jour visuelle instantanée du graphique à points sans nécessiter la moindre retouche manuelle du périmètre de sélection des données.
8.3 Génération de l’ordonnée d’empilement à partir de listes de données brutes
Dans la pratique courante de la collecte de données en psychologie, le jeu de données se présente presque toujours sous la forme la plus brute qui soit : une unique colonne continue énumérant les scores individuels des sujets dans l’ordre chronologique de leur passation expérimentale (par exemple, la plage de cellules s’étendant de A2 à A60). Dans cette configuration prépondérante, la tâche d’automatisation ne consiste pas à dupliquer des scores, mais à calculer à la volée le rang d’occurrence instantané de chaque valeur.
La solution mathématique la plus élégante et universelle repose sur le déploiement contextuel de la fonction de décompte conditionnel NB.SI (ou COUNTIF selon les paramètres linguistiques du tableur). En insérant dans la colonne adjacente B (en B2) une formule calculant le nombre d’apparitions de la valeur A2 dans la plage dynamique s’étendant du sommet de la colonne jusqu’à la ligne active (au moyen d’un verrouillage d’ancrage absolu de la première borne sous la forme NB.SI($A$2:A2; A2)), le tableur affecte automatiquement à chaque score son altitude exacte.
Ainsi, la toute première fois qu’un score — par exemple 15 — est rencontré dans la colonne A, la formule retourne la valeur scalaire 1. Si dix lignes plus bas, un autre sujet obtient à son tour le score 15, la formule dynamique inspecte la plage antérieure, détecte l’existence d’une première occurrence et renvoie automatiquement le rang 2. Cette méthode, facilement étirable sur l’ensemble de la série ou encapsulable dans une matrice ARRAYFORMULA, résout définitivement l’assignation des ordonnées sans altérer l’ordonnancement original des sujets au sein du registre d’expérimentation.
9. Comparaison méthodologique : graphique à points versus histogrammes et boîtes à moustaches
9.1 Confrontation critique avec l’histogramme classique
L’histogramme demeure traditionnellement l’outil par défaut enseigné dans les cursus d’introduction à la statistique pour visualiser des distributions continues. Cependant, son application routinière soulève de profondes réserves méthodologiques dès lors qu’il s’agit d’analyser des variables psychométriques discrètes sur des échantillons de taille restreinte à modérée. Le principal talon d’Achille de l’histogramme réside dans le caractère arbitraire du choix de la largeur des intervalles (les fameux bins) et du point d’ancrage de leur origine.
Une même série expérimentale de 40 participants peut revêtir une morphologie unimodale symétrique ou au contraire exhiber une fausse asymétrie multimodale selon que l’analyste décide d’agréger les données par pas de 2, de 3 ou de 5 unités. Cette sensibilité paramétrique introduit un degré de subjectivité périlleux dans l’interprétation clinique. De surcroît, l’histogramme dissout irrémédiablement l’individualité des observations au profit de barres de surface opaques, empêchant tout contrôle de l’exactitude des valeurs réelles constituant chaque classe.
Le graphique à points balaie radicalement ces distorsions heuristiques. En éliminant tout partitionnement arbitraire en classes artificielles, il présente la distribution dans sa granularité originelle la plus pure. L’observateur visualise directement l’espace métrique réel séparant les observations. La détection des discontinuités, des lacunes distributionnelles (gaps) et des regroupements spontanés s’opère avec une netteté sans égale, inaccessible à la volumétrie grossière des blocs d’un histogramme standard.
9.2 Mise en regard avec le boxplot (boîte à moustaches)
Popularisée par John Tukey dans le cadre de l’analyse exploratoire des données, la boîte à moustaches (boxplot) constitue un modèle synthétique d’une redoutable efficacité pour résumer les paramètres d’ordre d’une distribution : médiane, quartiles et valeurs aberrantes potentielles. Néanmoins, sa puissance de synthèse s’accompagne d’un risque d’aveuglement distributionnel majeur que de nombreux méthodologistes dénoncent régulièrement dans la littérature scientifique.
Le défaut rédhibitoire du boxplot réside dans son incapacité structurelle à différencier des morphologies de distribution fondamentalement divergentes. Une distribution parfaitement homogène unimodale, une distribution en cloche classique et une distribution profondément bimodale séparant deux groupes d’individus totalement distincts peuvent engendrer des boîtes à moustaches rigoureusement identiques si leurs quartiles coïncident par hasard mathématique. Se fier exclusivement au boxplot expose l’expérimentateur au risque de manquer l’émergence d’une sous-population clinique atypique.
En juxtaposant ou en substituant le graphique à points au boxplot, le chercheur s’immunise contre cette cécité interprétative. Chaque marqueur élémentaire témoignant de son statut réel au sein de la distribution, la bimodalité ou les singularités morphologiques sautent immédiatement aux yeux sans la moindre ambiguïté. Pour des publications de haut niveau, il est d’ailleurs fréquent de voir superposée à un graphique à points une discrète marque centrale identifiant la médiane empirique, conjuguant ainsi la force indicielle de la statistique non paramétrique avec l’honnêteté descriptive du tracé de Cleveland.
9.3 Critères de décision pour le choix de la figure dans les publications scientifiques
Le choix raisonné du type de représentation iconographique doit découler d’un arbitrage méthodologique strict, fondé sur la taille de l’échantillon empirique (N) et la nature métrologique des variables considérées. Le tableau suivant synthétise les critères de décision directeurs guidant l’arbitrage entre graphique à points, histogramme et boîte à moustaches au sein des publications de recherche empirique :
- Échantillons restreints (N < 30) : Le graphique à points s’impose comme le standard méthodologique absolu. L’usage d’histogrammes ou de boîtes à moustaches sur de tels effectifs est scientifiquement proscrit, les estimations de densité de probabilité ou de quartiles étant hautement instables et sujettes à des fluctuations d’échantillonnage majeures.
- Échantillons modérés (30 ≤ N ≤ 100) : Le graphique à points conserve une supériorité éclatante pour toutes les variables psychométriques discrètes (échelles d’attitudes, scores d’inventaires cliniques, décomptes d’erreurs). Il permet de visualiser conjointement la tendance centrale et la fidélité de chaque observation individuelle.
- Échantillons massifs (N > 150 ou 200) : Le graphique à points commence à atteindre ses limites de lisibilité spatiale en raison du risque d’encombrement massif et d’écrasement des colonnes. Dans ce contexte, l’histogramme de fréquences fines ou les estimateurs de densité par noyau (violin plots) redeviennent préférables pour apprécier la forme asymptotique de la distribution.
Par ailleurs, la nature discrète versus continue de la mesure pèse lourdement dans la balance. Pour toute mesure continue intrinsèquement dotée d’une infinité théorique de décimales (telle que l’activité électrodermale continue ou des latences de potentiels évoqués en microvolts), un arrondi ou un découpage discret préalable est impératif pour rendre possible l’empilement caractéristique du graphique à points sous peine de n’observer qu’une succession de points isolés de hauteur 1.
10. Dépannage et résolution des anomalies courantes sous Google Sheets
10.1 Problèmes de superposition indésirable ou d’écrasement horizontal
L’une des anomalies les plus frustrantes fréquemment rencontrées par les utilisateurs de Google Sheets se manifeste sous la forme d’un alignement chaotique où l’ensemble des points d’une même coordonnée théorique se chevauchent de manière anarchique ou s’agglutinent sur une frange latérale étroite du conteneur. Cette distorsion provient presque invariablement d’une mauvaise interprétation de la nature scalaire de l’axe horizontal par le moteur de rendu.
Si la colonne assignée à l’Axe X a été encodée au format texte ou si une cellule isolée contient un caractère alphabétique erratique, Google Sheets bascule l’axe horizontal en modalité catégorielle ordinale. Au lieu d’étalonner les abscisses selon une échelle métrique continue et proportionnelle, le logiciel attribue à chaque ligne un emplacement catégoriel discret équidistant, détruisant instantanément la logique d’alignement vertical des piles de points.
Pour remédier définitivement à ce dysfonctionnement, l’utilisateur doit d’abord s’assurer que toutes les cellules de la plage source sont formellement configurées au format Format > Nombre > Nombre. Ensuite, au sein de l’onglet Configuration de l’éditeur graphique, il convient de vérifier que l’option intitulée Traiter les étiquettes comme du texte est scrupuleusement désactivée. L’axe horizontal réintégrera immédiatement son comportement cartésien continu, restituant l’alignement vertical impeccable des différentes observations.
10.2 Décalage asymétrique de la première rangée de points
Un autre désagrément visuel récurrent réside dans l’impression désagréable que le premier niveau d’empilement (correspondant à l’ordonnée Y = 1) est soit partiellement tronqué par la bordure inférieure du graphique, soit suspendu de manière disproportionnée au-dessus de la ligne d’axe horizontale. Ce phénomène découle directement de l’attribution mécanique d’une valeur minimale égale à zéro sur l’axe vertical.
Lorsque la borne inférieure de l’axe Y est fixée à 0, l’intervalle séparant l’origine (0) du premier point (1) est égal à une unité métrique complète, alors que l’intervalle séparant le premier point du deuxième point (2) est également d’une unité. Visuellement, ce vide d’une unité entière sous la base des colonnes crée une sensation de flottement géométrique préjudiciable à la perception unitaire de la pile de distribution.
La résolution de cette asymétrie spatiale requiert un réglage chirurgical de la borne minimale de l’axe vertical au sein du panneau Personnaliser > Axe vertical. En substituant la valeur 0 par un seuil fractionnaire précisément calculé — idéalement compris entre 0,5 et 0,75 —, l’utilisateur réduit le vide spatial inférieur. Le marqueur de niveau 1 vient dès lors se positionner à une distance harmonieuse de la ligne horizontale d’abscisse, offrant une perception de contact stable comparable aux barres ancrées d’un histogramme standard.
10.3 Disparition des points extrêmes lors du redimensionnement de la fenêtre
Il arrive occasionnellement qu’en redimensionnant le conteneur du graphique sur la feuille de calcul ou lors de l’exportation d’une prévisualisation d’impression, les marqueurs situés aux bornes périphériques extrêmes — particulièrement le point le plus élevé de la pile modale ou les scores situés aux extrémités gauche et droite — apparaissent tronqués en demi-cercle ou disparaissent purement et simplement du champ de vision.
Ce phénomène d’écrêtage est imputable à la gestion logicielle automatique des marges internes du canevas de tracé. Lorsque le diamètre des points (ex. 10 px) dépasse la marge résiduelle allouée entre la coordonnée cartésienne centrale du point et la limite stricte de la zone d’affichage, le moteur graphique applique un rognage matriciel impitoyable sur les pixels débordants.
Pour neutraliser ce comportement préjudiciable, l’expérimentateur doit manuellement desserrer les contraintes de bornes dans les paramètres de personnalisation des axes. Si le score empirique le plus élevé est de 20, fixer manuellement le maximum de l’axe horizontal à 20,5 ou 21 réintroduit une marge de sécurité spatiale suffisante pour que le cercle périphérique s’affiche dans son intégrité sphérique complète. La même politique de surdimensionnement marginal de 0,5 unité doit être appliquée au maximum de l’axe vertical pour préserver le sommet des plus hautes colonnes.
11. Applications pratiques en neuropsychologie et sciences du comportement
11.1 Illustration empirique : distribution des temps de réaction discrets
Afin de concrétiser l’application de cette méthode au sein d’un protocole expérimental réel, considérons une recherche en neuropsychologie cognitive investiguant le coût attentionnel de l’inhibition motrice au travers d’une épreuve informatisée d’interférence verbale de type tâche de Stroop. Les participants sont soumis à une condition incongruente où la couleur de l’encre ne coïncide pas avec le signifiant lexical du mot affiché. La variable dépendante retenue réside dans l’allongement de la latence de réponse motrice, discrétisée par intervalles de 10 millisecondes.
Dans cette configuration, l’application d’un graphique à points permet de mettre en lumière la signature distributionnelle prototypique des processus attentionnels humains : une traîne asymétrique positive prononcée (positive skewness). Alors que le corps dense des participants s’agrège de manière compacte entre 120 et 180 millisecondes de délai d’interférence, la projection visuelle des points individuels révèle immédiatement la présence de trois participants atypiques affichant des latences supérieures à 320 millisecondes.
L’observation granulaire de cette distribution sur Google Sheets autorise l’équipe de recherche à engager une discussion diagnostique immédiate : ces latences extrêmes reflètent-elles des épisodes authentiques d’échec d’inhibition préfrontale ou découlent-elles de lapses attentionnels transitoires liés à la fatigue expérimentale ? Cette opportunité d’inspection visuelle détaillée s’avère infiniment plus stimulante intellectuellement qu’une simple moyenne agrégée de groupe qui diluerait ces profils déviants sous une variance trompeuse.
11.2 Visualisation de scores à des échelles psychométriques d’anxiété
Le deuxième champ d’application paradigmatique concerne l’évaluation psychométrique standardisée au moyen d’auto-questionnaires dimensionnels au sein d’une cohorte clinique de psychiatrie adulte. Considérons le protocole d’administration de l’échelle d’anxiété généralisée à 7 items (GAD-7), dont le score total varie sur un continuum théorique borné entre 0 et 21 points, chaque niveau d’atteinte étant sanctionné par des seuils catégoriels conventionnels de sévérité (faible, modérée, sévère).
La modélisation de cette cohorte au moyen d’un graphique à points permet d’examiner avec une clarté remarquable la distribution des participants au regard des seuils diagnostiques cardinaux de l’instrument. En calibrant rigoureusement l’axe horizontal de 0 à 21, la figure expose sans ambiguïté les concentrations massives de patients gravitant autour des bornes de passage à l’anxiété cliniquement significative (scores de 10 et 15).
De surcroît, le graphique permet de diagnostiquer instantanément de potentiels effets de plancher (une accumulation anormale de points sur la coordonnée 0) ou de plafond (une saturation de points sur la coordonnée 21) au sein de la cohorte évaluée. Ces phénomènes d’asymétrie de bornes, capitaux pour juger de la validité de l’outil dans cet échantillon spécifique, sont perceptibles d’un coup d’œil sur le graphique de Cleveland, guidant les cliniciens dans l’orientation de leurs prises en charge psychothérapeutiques individualisées.
11.3 Comparaison visuelle multi-groupes par superposition de séries discrètes
Bien que le graphique à points soit fondamentalement une visualisation univariée, il est tout à fait envisageable d’étendre sa portée méthodologique à la comparaison de deux groupes expérimentaux contrastés — par exemple, un groupe témoin sain apparié à un groupe expérimental souffrant de lésions cérébrales focales — au sein d’une même feuille de calcul Google Sheets.
Pour accomplir cette prouesse sans complexifier outre mesure le montage cartésien, l’expérimentateur scinde son tableau de coordonnées en attribuant une colonne d’ordonnées distincte pour chaque sous-groupe : la colonne B héberge les altitudes d’empilement du groupe témoin, tandis que la colonne C accueille celles du groupe clinique. Dans l’éditeur graphique, ces deux colonnes sont configurées en tant que deux Séries indépendantes associées au même Axe X d’évaluation.
L’attribution de codes chromatiques contrastés (par exemple des disques bleu nuit pour les sujets témoins et des disques ambrés pour les patients) permet une lecture immédiate du degré de recouvrement distributionnel des deux populations. L’observateur évalue visuellement la séparation des distributions sans qu’il soit nécessaire d’invoquer prématurément un test paramétrique d’inférence (tel qu’un test t de Student), favorisant ainsi une appréhension intuitive de l’amplitude de l’effet clinique réel avant toute démarche probabiliste formelle.
12. Synthèse méthodologique, réplicabilité et exportation académique
12.1 Protocole d’exportation vectorielle haute définition
L’aboutissement de la démarche graphique réside dans l’extraction de l’objet visuel depuis l’environnement Google Sheets vers le manuscrit académique final, sans concéder la moindre altération de netteté typographique ou géométrique. De nombreux auteurs commettent l’erreur fatale de réaliser une banale capture d’écran de leur interface de travail, aboutissant à des illustrations tramées, pixelisées et rigoureusement inacceptables pour les exigences de publication internationale.
Google Sheets dispose d’une fonction native d’exportation de qualité professionnelle. En cliquant sur le menu contextuel à trois points situé dans le coin supérieur du canevas graphique, l’utilisateur sélectionne la commande Télécharger, puis choisit impérativement l’option Document PDF (.pdf) ou Image vectorielle modifiable (.svg). Contrairement aux formats matriciels compressés (tels que PNG ou JPEG), les formats vectoriels garantissent que les cercles et les caractères textuels conservent une résolution infinie, quelle que soit l’échelle d’agrandissement appliquée lors de la mise en page finale.
Si la revue scientifique de destination exige expressément un fichier image à points au format TIFF ou PNG haute résolution, le fichier PDF vectoriel téléchargé pourra être converti ultérieurement via un logiciel graphique spécialisé ou un utilitaire de traitement d’images dédié en configurant la résolution de rastérisation à une densité minimale de 300 à 600 DPI (points par pouce). Cette précaution garantit une pureté d’impression irréprochable et témoigne du professionnalisme méticuleux de l’équipe de recherche.
12.2 Archivage et reproductibilité de la feuille de calcul
Conformément aux directives de la science ouverte et aux principes méthodologiques FAIR (Facile à trouver, Accessible, Interopérable, Réutilisable), la feuille de calcul ayant servi à générer la figure doit être documentée de manière à ce que n’importe quel chercheur indépendant puisse répliquer l’intégralité du processus visuel à partir des données brutes.
L’investigateur prendra soin de consigner un cartouche textuel au sein d’un onglet annexe de la feuille de calcul, détaillant les versions des formules employées, la date d’extraction des données et le glossaire des variables comportementales. Les formules complexes de restructuration matricielle devront être explicitées par des notes de cellule pédagogiques afin que des tiers non spécialistes puissent en saisir la logique algorithmique sans ambiguïté.
Une fois purgé de toute information d’identification personnelle (en stricte conformité avec le Règlement Général sur la Protection des Données et les comités d’éthique de la recherche biomédicale), le classeur Google Sheets peut être exporté et pérennisé sous un format ouvert (tel que .ods ou .csv annoté) sur des répertoires de données académiques certifiés, à l’instar de l’Open Science Framework (OSF) ou de dépôts institutionnels universitaires, favorisant ainsi la transparence et la collégialité de l’effort scientifique.
12.3 Recommandations finales pour la communication scientifique
Le graphique à points de distribution constitue bien plus qu’une simple alternative esthétique aux diagrammes conventionnels : il incarne une véritable profession de foi épistémologique en faveur de la fidélité métrologique et de la clarté explicative. En délaissant les boîtes opaques et les barres synthétiques d’antan pour cette constellation ordonnée de points discrets, l’expérimentateur affirme sa volonté de ne rien soustraire au regard critique de la communauté savante.
Il demeure primordial de toujours accompagner le graphique à points d’un appareil critique rigoureux dans le texte du rapport scientifique. Préciser systématiquement les paramètres d’échantillonnage, la métrique exacte sous-jacente, et veiller à ce que l’interprétation discursive s’aligne fidèlement sur ce que la géométrie de la distribution révèle — sans surinterpréter d’infimes regroupements locaux comme des régularités universelles —, garantit une intégrité analytique sans faille.
En maîtrisant la méthode ici détaillée sur Google Sheets, praticiens, cliniciens, étudiants et chercheurs confirmés disposent d’un levier d’action puissant et universellement accessible pour hisser leurs restitutions empiriques au niveau des standards internationaux les plus rigoureux, unifiant la démocratisation des outils collaboratifs infonuagiques et l’excellence académique la plus intransigeante.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1984). Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging. The American Statistician, 38(4), 270–280. https://doi.org/10.2307/2683401
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Kroenke, K., Spitzer, R. L., Williams, J. B., Monahan, P. O., & Löwe, B. (2007). Anxiety disorders in primary care: prevalence, impairment, comorbidity, and detection. Annals of Internal Medicine, 146(5), 317–325. https://doi.org/10.7326/0003-4819-146-5-200703060-00004
- Spitzer, R. L., Kroenke, K., Williams, J. B., & Löwe, B. (2006). A brief measure for assessing generalized anxiety disorder: The GAD-7. Archives of Internal Medicine, 166(10), 1092–1097. https://doi.org/10.1001/archinte.166.10.1092
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276–283. https://doi.org/10.2307/2686111
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0