
Dans le champ contemporain de l’analyse quantitative et des sciences du comportement, la représentation visuelle des données empiriques constitue une étape charnière qui transcende la simple illustration esthétique. Longtemps cantonnés à des résumés statistiques sommaires tels que la moyenne arithmétique et l’écart-type, souvent illustrés par des diagrammes en barres ou des boîtes à moustaches opaques, les chercheurs en psychologie et en neurosciences cognitives font face à une exigence accrue de transparence méthodologique. Cette évolution s’inscrit au cœur de la crise de la reproductibilité, incitant la communauté scientifique à privilégier des formes graphiques capables d’exposer l’intégralité de la structure distributionnelle sans dissimuler les singularités sous-jacentes. À cet égard, le graphique à points empilés, communément désigné sous le terme anglo-saxon de stacked dot plot, s’impose comme une modalité de restitution particulièrement vertueuse, réconciliant la lisibilité macroscopique des fréquences avec la préservation absolue de l’individualité de chaque observation.
Le langage de programmation statistique R, reconnu internationalement comme la référence pour l’analyse computationnelle et la création graphique scientifique, offre un écosystème remarquable pour concevoir des visualisations à la fois rigoureuses et modulables. Que ce soit au moyen du moteur graphique natif via des fonctions historiques comme stripchart, ou par l’intermédiaire de la grammaire des graphiques structurée au sein du paquet ggplot2 avec la couche dédiée geom_dotplot, R permet d’orchestrer une discrétisation spatiale fine des distributions uni- et multivariées. La maîtrise de ces outils techniques permet aux analystes d’aborder des corpus de données complexes en évitant les écueils conventionnels de l’agrégation prématurée et de la perte d’information statistique.
Le présent traité méthodologique propose une exploration exhaustive, théorique et opérationnelle, de la construction des graphiques à points empilés au sein de l’environnement R. Conçu spécifiquement pour répondre aux exigences des protocoles de recherche expérimentale en psychologie, ce guide détaille l’ensemble des concepts mathématiques, sémiotiques et computationnels nécessaires à la génération de visualisations conformes aux standards éditoriaux les plus rigoureux, notamment ceux de l’American Psychological Association (APA). De la formalisation de la perception visuelle selon les préceptes de Cleveland et McGill jusqu’à la manipulation fine des paramètres d’empilement algorithmique, en passant par le traitement des artefacts de sur-traçage et l’intégration de métriques de tendance centrale robustes, ce document constitue un manuel complet pour tout chercheur désireux d’élever la qualité analytique de ses productions scientifiques.
1. Introduction aux graphiques à points empilés dans l’analyse quantitative
1.1 Définition et morphologie du graphique à points empilés
Le graphique à points empilés est une représentation géométrique univariée qui projette un ensemble d’observations discrètes ou discrétisées le long d’un axe dimensionnel unique, tout en empilant verticalement ou orthogonalement les unités statistiques qui partagent une valeur identique ou comprise dans un même intervalle métrique. Formalisé initialement dans les travaux séminaux de Leland Wilkinson sur la grammaire graphique, ce dispositif visuel combine la simplicité de lecture d’un axe linéaire avec la puissance analytique d’une distribution de fréquences. Contrairement à un simple nuage de points unidimensionnel où la superposition directe engendre une perte critique de discernement, le graphique à points empilés applique un algorithme de décalage régulier qui préserve la visibilité de chaque élément constitutif de l’échantillon.
D’un point de vue morphologique, le stacked dot plot se distingue fondamentalement de l’histogramme classique. Alors que l’histogramme substitue aux données brutes des rectangles continus dont l’aire correspond à une densité ou une fréquence relative agrégée, le tracé à points empilés conserve chaque observation sous la forme d’un glyphe géométrique distinct, généralement un disque plein ou évidé. De même, il surpasse le diagramme en bandes traditionnel (strip chart brut) en substituant au chevauchement aléatoire ou au bruit artificiel (jittering) une structure déterministe et ordonnée. Cette organisation permet à l’observateur d’opérer simultanément un décodage qualitatif de la morphologie distributionnelle et un dénombrement cardinal précis des effectifs au sein de chaque classe métrique.
Cette morphologie s’avère particulièrement éclairante lors de l’examen de variables issues de dispositifs de mesure comportementale. Dans les situations où les valeurs observées se concentrent sur un nombre restreint de points de données entiers, le graphique empilé agit comme une matérialisation directe de la fonction de masse empirique. L’observateur n’a plus besoin d’interpoler mentalement des hauteurs de barres continues par rapport à un axe vertical abstrait ; il apprécie directement la masse de données par la sommation physique des symboles empilés, conférant à cette figure une clarté cognitive inégalée pour l’analyse des fréquences discrètes.
1.2 Applications empiriques dans la recherche en psychologie
Dans le domaine des sciences psychologiques, les applications du graphique à points empilés couvrent un large spectre méthodologique, s’étendant de la psychologie cognitive expérimentale à la neuropsychologie clinique. Un cas d’usage prééminent réside dans l’analyse des scores de latence et des temps de réaction recueillis sur de petits échantillons de participants. Lors d’expérimentations factorielles impliquant des tâches de détection visuelle, de rotation mentale ou de paradigme de Stroop sur des cohortes réduites (par exemple, n compris entre 15 et 40 sujets par condition), l’agrégation de la latence au sein d’une moyenne occulte fréquemment l’existence d’asymétries positives marquées ou de distributions bimodales témoignant de stratégies attentionnelles divergentes. Le tracé empilé rend ces dynamiques immédiatement perceptibles.
De surcroît, le graphique à points empilés constitue l’outil de prédilection pour l’investigation des mesures psychométriques discrètes, telles que les inventaires de personnalité ou les échelles de dépression et d’anxiété fondées sur des échelles de Likert à 5 ou 7 points. Dans ces configurations d’échantillonnage, les scores composites totaux manifestent une granularité discrète inhérente à leur sommation mathématique. La visualisation par empilement évite l’illusion d’une fausse continuité métrique que suggèrent souvent les courbes de densité lissées, tout en fournissant une perspective exhaustive sur la répartition exacte des participants le long des échelons de sévérité clinique.
Enfin, cette modalité graphique excelle dans l’identification sans ambiguïté des effets de plancher et de plafond au sein des instruments d’évaluation cognitive ou d’apprentissage. Dans l’étude des populations gériatriques ou pédiatriques, il est fréquent qu’un test de mémoire ou de flexibilité mentale produise une accumulation massive de scores minimaux ou parfaits. Tandis qu’un diagramme en boîte standard tronque ou dissimule la morphologie exacte de cette saturation sous la forme d’un trait de médiane collé au bord du quartile, le graphique à points empilés déploie une tour verticale proéminente à l’extrémité de l’échelle, signalant sans équivoque la limitation psychométrique de l’outil et renforçant la transparence méthodologique des protocoles à effectif contraint.
1.3 Avantages comparatifs par rapport aux représentations classiques
La supériorité épistémologique du graphique à points empilés sur les représentations graphiques traditionnelles se manifeste avec éclat lorsqu’on le confronte aux boîtes à moustaches de Tukey. Bien que les boîtes à moustaches constituent un standard indiscutable pour condenser les paramètres d’ordre (médiane, écart interquartile, valeurs aberrantes théoriques), elles opèrent une simplification dramatique qui dissimule la véritable géométrie des données sous-jacentes. Une distribution unimodale symétrique, une distribution bimodale en selle de cheval et une distribution uniforme peuvent engendrer des diagrammes de boîte rigoureusement superposables. Le graphique à points empilés neutralise ce risque en restituant l’intégralité du profil distributionnel sans aucun filtre réducteur.
De façon encore plus critique, le tracé à points empilés permet d’extirper la recherche en psychologie du dogme délétère des diagrammes en barres flanqués d’une barre d’erreur, souvent dénoncés sous le qualificatif de dynamite plots. Ces figures conventionnelles, largement répandues dans la littérature du siècle dernier, constituent une source majeure de désinformation visuelle : la hauteur de la barre crée une asymétrie perceptive injustifiée en accordant une présence visuelle substantielle à la zone comprise entre zéro et la moyenne, tout en masquant complètement la variance intra-groupe, l’asymétrie de la distribution et l’influence des valeurs extrêmes. Les points empilés évitent cet écueil en matérialisant exclusivement les points d’ancrage empiriques réels.
Sur le plan de la communication scientifique et pédagogique, la clarté intuitive des points empilés facilite la transmission des résultats cliniques à des publics hétérogènes, incluant des praticiens de terrain ou des comités d’éthique non spécialistes de l’économétrie. En conformité absolue avec les directives du mouvement de la science ouverte (Open Science Framework) et les principes de données FAIR (Faciles à trouver, Accessibles, Interopérables, Réutilisables), ce mode de restitution garantit que le lecteur visualise les micro-données exactes à partir desquelles les inférences statistiques et les conclusions théoriques ont été élaborées.
2. Fondements théoriques et pertinence méthodologique en psychologie
2.1 Principes de perception visuelle et théorie de Cleveland-McGill
L’efficacité analytique du graphique à points empilés s’enracine profondément dans les lois fondamentales de la psychophysique et de la sémiologie graphique, formalisées notamment par William S. Cleveland et Robert McGill dans leur théorie paradigmatique des tâches de perception graphique élémentaire. Selon cette hiérarchie empiriquement validée, l’évaluation visuelle de la position d’un élément le long d’une échelle graduée commune se classe au sommet absolu de la précision cognitive humaine, surpassant nettement l’estimation des longueurs, des orientations angulaires, des surfaces bidimensionnelles ou des saturations chromatiques. En alignant l’ensemble des observations sur un même axe métrique continu ou discret, le graphique à points empilés mobilise cet opérateur cognitif optimal.
Cette conformité aux mécanismes perceptifs primaires induit une réduction drastique de la charge cognitive extrinsèque imposée au lecteur du manuscrit de recherche. Lorsque l’analyste contemple une courbe d’estimation de la densité par noyau, le cortex visuel doit intégrer une fonction différentielle continue pour appréhender la probabilité d’occurrence, ce qui nécessite une médiation mathématique complexe sujette à des distorsions d’interprétation. En revanche, dans le cas du tracé à points empilés, la hauteur d’une colonne de disques correspond directement à un comptage d’événements discrets, permettant une quantification immédiate et pré-attentionnelle de la fréquence locale.
En outre, l’évaluation de la symétrie, de l’aplatissement (kurtosis) et de l’asymétrie (skewness) s’effectue sans abstraction délibérée. Le profil global formé par l’enveloppe des empilements de points reproduit fidèlement la silhouette de la fonction de masse sans requérir l’ajustement paramétrique d’un modèle sous-jacent. Ainsi, l’observateur détecte intuitivement les déviations par rapport à la normalité gaussienne, ce qui oriente de manière préventive le diagnostic des postulats distributionnels préalables aux modélisations inférentielles.
2.2 Le problème de la perte d’information dans les grands résumés statistiques
L’histoire de la psychométrie contemporaine est émaillée de conclusions erronées découlant de l’utilisation non critique de la moyenne arithmétique et de la déviation standard pour résumer des données phénotypiques ou psychopathologiques asymétriques. Dans les populations cliniques souffrant de troubles psychiatriques majeurs, les scores aux inventaires diagnostiques exhibent fréquemment des queues de distribution extrêmement étirées, entrecoupées de ruptures de continuité ou de vides empiriques que des paramètres de position globale sont incapables d’encoder. Le recours au graphique à points empilés permet de pallier ces défaillances de modélisation en exposant sans fard la texture discontinue du phénomène mesuré.
Considérons le paradoxe classique du quartet d’Anscombe ou le Datasaurus Dozen : des jeux de données aux propriétés descriptives identiques (moyennes et variances concordantes au centième près) peuvent provenir de structures distributionnelles radicalement dissemblables. Dans une cohorte expérimentale où l’intervention psychologique produit un effet scindé — améliorant spectaculairement un sous-groupe de patients tout en détériorant l’état d’un autre —, l’analyse exclusive de la moyenne postulera une absence d’effet thérapeutique (effet nul global). Le tracé empilé révèle immédiatement la ségrégation de l’échantillon en deux grappes disjointes, incitant le chercheur à investiguer des variables modératrices sous-jacentes.
Cette transparence visuelle agit en synergie directe avec l’application des statistiques non paramétriques (tests de Wilcoxon-Mann-Whitney, tests de Kruskal-Wallis) ou des modèles linéaires généralisés à distribution non normale. Avant même d’exécuter un test d’hypothèse, le chercheur dispose d’une cartographie fidèle de l’espacement ordinal et des rangs réels de chaque individu statistique, ce qui prémunit la démarche empirique contre les faux négatifs induits par un non-respect insidieux des hypothèses de modélisation classique.
2.3 Adéquation selon la taille d’échantillon
L’opportunité méthodologique de déployer un graphique à points empilés est étroitement tributaire de la taille de l’échantillon (n) disponible pour l’investigation. Cette représentation délivre son rendement diagnostique maximal pour des cohortes de taille petite à modérée, typiquement bornées entre n = 15 et n = 150 observations par condition expérimentale. Au sein de cet intervalle de puissance statistique, chaque observation préserve une existence spatiale bien différenciée sur la toile graphique, et le lecteur peut aisément dénombrer ou suivre individuellement les trajectoires des sujets à travers les différentes strates de la variable dépendante.
Lorsque la volumétrie d’échantillonnage s’élève au-delà de seuils critiques (par exemple, n > 250 ou plusieurs milliers d’observations issues de cohortes épidémiologiques massives), le graphique à points empilés subit le phénomène d’occlusion visuelle et de saturation dimensionnelle (overplotting). Les colonnes de points tendent alors à dépasser les limites physiques du cadre graphique, contraignant l’analyste à réduire dramatiquement la taille des glyphes au point d’en faire des poussières graphiques indistinctes, ce qui anéantit le bénéfice même de la discrétisation individuelle.
Dans de tels contextes de volumétrie massive, la transition vers des modèles de représentation continue ou semi-continue devient une nécessité sémiotique. Le chercheur devra alors basculer avec discernement vers des estimateurs de densité à noyau (kernel density plots), des diagrammes en violon complets ou des histogrammes lissés avec ajustement fin de la bande passante. Le graphique à points empilés doit ainsi être conçu comme un instrument chirurgical de haute précision dédié à la petite et moyenne métrologie, domaine d’excellence prépondérant des protocoles expérimentaux contrôlés en laboratoire de psychologie.
3. Préparation de l’environnement de travail et structuration des données sous R
3.1 Configuration des bibliothèques et reproductibilité
L’édification d’un pipeline de visualisation robuste et reproductible sous R requiert une initialisation méthodique de l’environnement de calcul. La première prescription consiste à verrouiller l’aléa généré par les générateurs pseudo-aléatoires lors des simulations ou des opérations de sous-échantillonnage, garantissant ainsi que les figures générées demeurent rigoureusement identiques au pixel près lors des exécutions ultérieures. L’attribution d’un germe numérique constant par l’instruction set.seed(42) (ou tout autre entier prédéfini) doit systématiquement ouvrir la séquence de script.
Dans un second temps, le chargement sélectif des extensions logicielles appropriées assure l’accès aux fonctions avancées de gestion des structures vectorielles et de modélisation graphique. Si le moteur de base R ne nécessite aucune importation externe pour exécuter les instructions natives telles que stripchart, la création de visualisations modernes articulées autour de la grammaire graphique commande l’activation du paquet ggplot2. Dans le cadre de flux de travail exhaustifs, l’incorporation de l’écosystème tidyverse (englobant dplyr pour le remaniement des données et tibble pour l’encadrement tabulaire) s’avère hautement préconisée.
Enfin, la vérification de la compatibilité des versions de R et des paquets graphiques constitue un impératif méthodologique incontournable. Les modifications apportées périodiquement au moteur de rendu graphique vectoriel ou aux algorithmes de partitionnement de ggplot2 peuvent engendrer des variations subtiles dans le calcul des empilements ou la gestion des marges de graduation. La documentation rigoureuse de la session via l’appel récurrent à l’instruction sessionInfo() garantit la traçabilité des conditions logicielles nécessaires à la régénération pérenne des artefacts graphiques.
3.2 Simulation d’un jeu de données psychométriques contrôlé
Afin d’illustrer la construction pas-à-pas des graphiques à points empilés avec une pertinence clinique réaliste, nous procédons à la génération d’un ensemble de données synthétiques simulant l’administration d’une échelle psychométrique d’évaluation de la dépression, inspirée des propriétés quantitatives de l’inventaire de dépression de Beck (BDI-II). Dans ce scénario expérimental, nous nous proposons de comparer l’efficacité de deux protocoles thérapeutiques : une Thérapie Cognitive et Comportementale (TCC) structurée face à une condition de Contrôle sur Liste d’Attente (CLA), administrées à une cohorte de 60 patients (30 participants par modalité d’intervention).
Le jeu de données est programmé pour refléter les scores totaux discrets obtenus post-traitement, lesquels s’échelonnent conventionnellement de 0 à 63 points entiers. Pour modéliser la condition de contrôle, nous employons un échantillonnage discret tiré d’une distribution unimodale asymétrique centrée autour d’une sévérité modérée (moyenne estimée autour de 26 points, écart-type de 6), synthétisé via la commande sample() avec remise appliquée à une grille probabiliste tronquée. Inversement, la condition expérimentale TCC est configurée pour exhiber une amélioration clinique sensible, se traduisant par un glissement distributionnel vers des scores réduits (moyenne approximative de 12 points) et l’émergence d’un amas marqué au voisinage des valeurs minimales de rémission.
Ces données individuelles sont ensuite combinées dans une structure tabulaire rectangulaire standardisée de type data.frame ou tibble. Cet arrangement associe à chaque observation un identifiant numérique unique (Participant_ID), une variable nominale identifiant la modalité d’intervention (Groupe), et la mesure quantitative discrète correspondante (Score_Depression). Cette structure matricielle constitue le socle indispensable sur lequel les moteurs graphiques de base et avancés appliqueront leurs algorithmes de projection géométrique.
3.3 Validation du formatage des variables
Préalablement à tout acte de rendu visuel, une inspection diagnostique scrupuleuse de la structure interne du jeu de données doit être conduite. L’omission fréquente de la conversion des variables nominales en objets de type factor dans l’espace R constitue l’une des sources majeures d’échec d’empilement ou de désordre taxinomique sur les axes. La variable catégorielle inter-sujets doit être formellement instruite comme un facteur ordonné ou non au moyen de la primitive factor(), en explicitant scrupuleusement les niveaux (levels) et les étiquettes textuelles (labels) afin de garantir une disposition harmonieuse des groupes le long de l’axe structural.
En parallèle, la vérification de l’intégrité métrique de la variable dépendante s’impose. Si le vecteur de scores présente des encodages sous format textuel ou sous forme de réels imprécis induits par des erreurs d’importation de fichiers externes (séparateurs décimaux erronés), le moteur graphique échouera à calculer les fréquences discrètes exactes nécessaires à l’empilement déterministe. Le recours systématique à la fonction de vérification logique is.numeric() ou à l’inspection globale via str() permet d’écarter toute altération de la nature dimensionnelle des scores psychométriques.
L’exploration préliminaire se clôture par le calcul des résumés d’effectifs à l’aide de l’outil table() et des métriques descriptives transversales avec summary(). Cette tabulation préliminaire offre un double bénéfice : elle certifie l’absence totale de valeurs manquantes (NA) insidieuses susceptibles de corrompre les calculs d’alignement spatial, et elle fournit à l’analyste un étalon arithmétique absolu des fréquences d’empilement attendues sur la toile graphique finale, autorisant un contrôle qualité rigoureux du rendu algorithmique.
4. Méthode 1 : Construction d’un graphique à points empilés avec les fonctions de base (stripchart)
4.1 Syntaxe fondamentale et mécanisme d’empilement
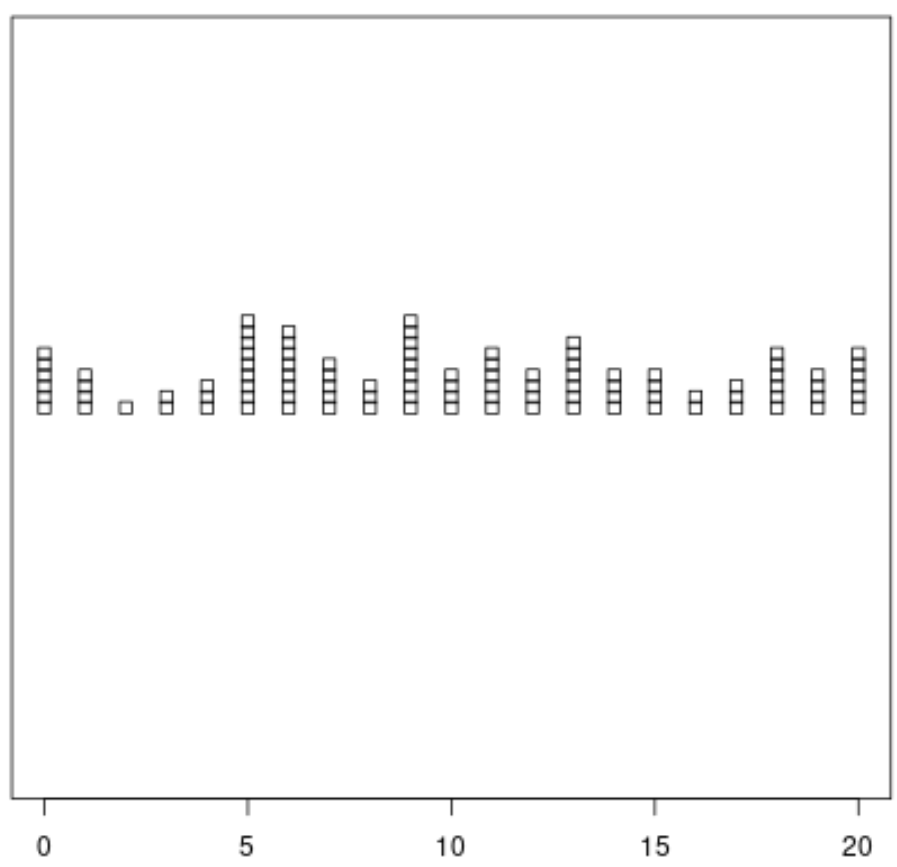
L’environnement natif de R renferme, au sein de sa bibliothèque standard graphics, une commande historique remarquablement agile pour tracer des distributions univariées sans dépendre de paquets tiers : la fonction stripchart(). Dans son implémentation brute, cette procédure génère une simple droite le long de laquelle les valeurs sont juxtaposées. Toutefois, l’activation spécifique du paramètre formel method = « stack » transforme radicalement le comportement interne du moteur graphique en enclenchant l’algorithme d’agrégation verticale déterministe qui fonde le principe du graphique à points empilés.
Le fonctionnement mécanique de cet empilement repose sur une analyse séquentielle du vecteur de données numériques fourni en entrée. Lorsque deux ou plusieurs occurrences présentent une valeur strictement équivalente (ou tombent sous le seuil d’indiscernabilité fixé par la résolution graphique active), le système calcule une coordonnée de décalage orthogonal incrémentale. Au lieu de sur-imprimer le glyphe au même emplacement bidimensionnel, il élève chaque observation subséquente d’un incrément constant le long de l’axe perpendiculaire, érigeant ainsi progressivement une tour de symboles proportionnelle à l’effectif observé.
L’application directe de cette commande sur un vecteur brut (par exemple, les scores des patients du groupe TCC) engendre immédiatement une silhouette distributionnelle dépouillée. Les échelles et les marges graphiques natives s’adaptent de façon automatique à l’étendue numérique du vecteur d’entrée pour l’axe principal, tandis que l’axe secondaire d’empilement est ajusté pour héberger la hauteur de la colonne la plus élevée sans déborder du cadre périphérique standard calculé par les paramètres par défaut du périphérique graphique actif.
4.2 Orientation spatiale et disposition des axes
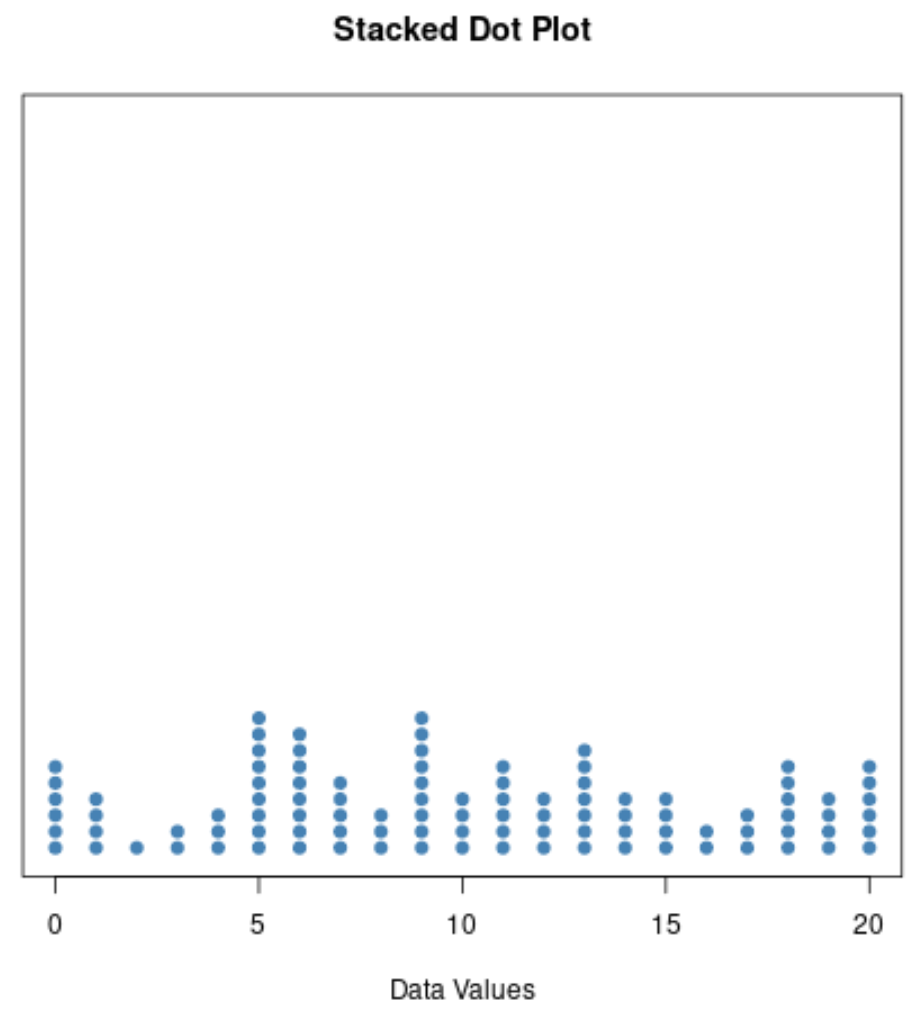
Par configuration initiale, l’instruction stripchart() déploie son tracé de façon horizontale : l’axe primaire supportant la graduation des valeurs de mesure s’étend sur l’abscisse (axe horizontal x), tandis que les tours d’empilement s’érigent verticalement le long de l’ordonnée (axe y). Cette disposition horizontale s’avère particulièrement naturelle pour la conceptualisation de scores psychométriques perçus comme des continus scalaires s’étalant de la gauche vers la droite, mimant ainsi la progression temporelle ou l’aggravation dimensionnelle d’un symptôme clinique.
Néanmoins, dans de nombreuses configurations de comparaison expérimentale où l’on souhaite juxtaposer plusieurs cohortes côte à côte, l’orientation verticale devient structurellement supérieure. Le basculement spatial s’opère sans friction au moyen de l’argument logique vertical = TRUE. Dans ce mode inversé, l’axe métrique des ordonnées accueille les scores de la variable dépendante, tandis que les empilements de données se projettent horizontalement vers la droite à partir d’une ligne d’ancrage définie. Cette géométrie verticale s’aligne fidèlement sur la tradition des diagrammes en boîte et des distributions d’indices de performance cognitive.
L’ergonomie générale du tracé commande par ailleurs un calibrage explicite des limites dimensionnelles afin de ménager un espace visuel respirant autour des extrêmes de distribution. L’utilisation délibérée des arguments vectoriels xlim et ylim permet de circonscrire précisément la fenêtre d’observation. Par exemple, forcer l’étendue horizontale entre 0 et 60 pour une échelle clinique bornée structurellement entre ces deux valeurs empêche l’algorithme d’ajuster arbitrairement le cadre aux bornes étroites de l’échantillon observé, assurant ainsi une comparabilité visuelle authentique entre différents sous-échantillons d’études.
4.3 Gestion du décalage et alignement de la ligne de base
L’un des leviers de contrôle les plus précis au sein de la fonction stripchart() réside dans la manipulation des arguments spatiaux at et offset. Le paramètre scalaire ou vectoriel at détermine la coordonnée géographique exacte sur l’axe orthogonal où s’établit la ligne de base (le plancher) sur lequel reposera le premier point de chaque colonne empilée. Dans le cadre d’un tracé univarié unique, cette ligne d’ancrage est fréquemment positionnée sur la valeur unitaire 1, mais elle peut être réassignée sur toute autre coordonnée afin de coordonner l’insertion du tracé au sein d’un agencement graphique composite complexe à multiples compartiments.
Le paramètre offset, quant à lui, gouverne l’espacement inter-points relatif appliqué lors de chaque superposition verticale d’une observation supplémentaire. Exprimé sous la forme d’une fraction de la taille de police ou de cellule graphique de base, un décalage calibré par défaut à 1/3 (environ 0,33) produit généralement un empilement contigu où les cercles se touchent de façon tangentielle. Si la géométrie des symboles choisis engendre des frictions visuelles ou un empiètement partiel excessif détériorant la lisibilité, l’analyste a toute latitude pour moduler cette constante avec finesse (par exemple en assignant offset = 0.5 ou offset = 0.8).
Cette modulation micro-métrique de l’alignement est cruciale pour prévenir les collisions graphiques disgracieuses lors de la représentation simultanée de plusieurs sous-groupes sur un même canevas. En fractionnant judicieusement les ancrages vectoriels at = c(1, 2) pour deux conditions distinctes et en ajustant le coefficient offset pour que la hauteur cumulée des piles ne vienne jamais empiéter sur le territoire de la cohorte voisine, l’analyste compose un document visuel d’une netteté parfaite, dépourvu de tout chevauchement non contrôlé.
5. Personnalisation avancée du graphique stripchart dans l’environnement R de base
5.1 Attribution des symboles et sélecteurs de forme
Le raffinement formel d’un tracé à points empilés réalisé sous le moteur de base R exige une sélection rigoureuse de la typologie des glyphes géométriques employés pour représenter les observations. Cette opération est régie par l’argument canonique pch (plotting character), qui accepte une vaste gamme de codes numériques entiers correspondant à des topologies universelles. Dans les publications psychologiques académiques, la pratique conventionnelle privilégie très nettement l’usage de disques circulaires fermés (obtenus via pch = 16 ou pch = 19), lesquels offrent une visibilité optimale et une saturation spatiale homogène au sein de la colonne empilée.
Alternativement, le recours à des cercles ouverts ou évidés (accessible via pch = 1 ou la forme composite bordée pch = 21) s’avère particulièrement judicieux dans les contextes où la densité locale des scores engendre une contiguïté extrême. La forme pch = 21 présente un avantage méthodologique supérieur en autorisant une différentiation conjointe de la bordure périphérique (paramétrée par l’argument col) et du remplissage interne (gouverné par l’argument bg), permettant ainsi de maintenir une démarcation visuelle irréprochable même si deux glyphes voisins viennent accidentellement à se frôler de quelques pixels.
L’échelle physique individuelle de ces marqueurs se module quant à elle par l’entremise de l’argument de dilatation scalaire cex (character expansion). Par défaut initialisé à la valeur 1, ce coefficient peut être contracté avec souplesse (par exemple cex = 0.7 ou cex = 0.8) lorsque le nombre total d’observations croît, évitant ainsi que les piles de points ne prennent l’aspect d’un bloc uniforme et monolithique. À l’inverse, pour des séries très restreintes (n < 20), une élévation modérée à cex = 1.2 renforce la présence visuelle et confère à chaque mesure son plein poids indicatif.
5.2 Application des palettes chromatiques et transparence
L’application raisonnée de la couleur au sein d’une figure scientifique répond à une stricte exigence de clarification sémantique et non à des considérations purement ornementales. Dans le moteur graphique de base R, l’incorporation de teintes professionnelles unies s’opère via des chaînes de caractères hexadécimales standardisées (telles que le bleu académique « #2B4C7E » ou le bordeaux sobre « #7E2B3D ») ou par le truchement de la table des noms de couleurs internes via la fonction native colors(). Le respect des préceptes de publication scientifique commande de bannir les teintes primaires saturées au profit d’un nuancier atténué favorisant le repos oculaire.
L’un des apports majeurs à la sémiologie graphique moderne consiste en l’intégration systématique d’un canal alpha de semi-transparence. Dans le système graphique de base, cette fonctionnalité s’active avec une grande élégance mathématique au moyen de la fonction intégrée adjustcolor(). En soumettant une couleur de base à un facteur d’opacité modulé (par exemple adjustcolor(« #2B4C7E », alpha.f = 0.6)), l’analyste confère aux disques une perméabilité lumineuse salutaire :
- Les points conservent leur démarcation individuelle lors de l’empilement régulier.
- En cas d’imperfections de discrétisation ou de légers chevauchements limites, l’intensification de la saturation chromatique signale instantanément la multiplicité sous-jacente sans opacité trompeuse.
- L’harmonie globale du tracé s’aligne fidèlement sur les chartes éditoriales les plus strictes de la psychologie empirique.
Dans les contextes d’analyse multigroupes, l’attribution d’un vecteur de couleurs conditionnel — indexé sur les niveaux du facteur expérimental — permet de discriminer instantanément les distributions respectives sans altérer la cohérence globale du système de coordonnées unifié.
5.3 Habillage complet selon les critères de publication
Pour hisser une figure générée par stripchart() au niveau de conformité exigé par les revues à comité de lecture, l’habillage marginal périphérique doit être méticuleusement reconstruit. Les éléments textuels par défaut du moteur de base R manquent souvent de la typographie soignée et de la hiérarchisation nécessaires aux publications savantes. L’analyste doit dès lors enrichir l’instruction de base avec des déclarations explicites des libellés fondamentaux au moyen des arguments xlab (titre de l’axe des abscisses, incluant obligatoirement les unités de mesure), ylab (titre de l’ordonnée) et main (titre structurel du graphique).
L’ergonomie avancée préconise fréquemment de désactiver le cadre par défaut rectangulaire intégral — souvent perçu comme visuellement oppressant et redondant — en assignant frame.plot = FALSE ou bty = « n », pour ensuite reconstruire manuellement des axes épurés à l’aide de la primitive axis(). Cette décomposition permet un contrôle absolu sur l’espacement des coches métriques (ticks), l’orientation des chiffres numériques (via le paramètre d’alignement textuel las = 1 pour assurer une lecture horizontale systématique) et la distance séparatrice entre le texte et la ligne d’axe.
Enfin, l’adjonction subtile de repères structurants vient parfaire l’édifice visuel. L’insertion d’une grille de fond discrète au moyen de la commande grid(nx = NA, ny = NULL, col = « gray90 », lty = « dotted ») offre un soutien précieux pour guider l’œil sans rivaliser avec les données réelles, tandis que l’appel conclusif à la fonction box(bty = « l ») dépose une bordure classique en équerre (axe inférieur et axe gauche uniquement), consacrant ainsi un artefact graphique d’une sobriété clinique irréprochable.
6. Méthode 2 : Implémentation moderne avec ggplot2 et geom_dotplot
6.1 Architecture fondamentale du tracé sous ggplot2
L’essor fulgurant de la bibliothèque logicielle ggplot2 a profondément transformé la production graphique en science quantitative en introduisant un paradigme formel hérité de la théorie sémiotique de Leland Wilkinson : la grammaire des graphiques. Au sein de cette architecture logicielle, un graphique n’est plus une simple toile matricielle sur laquelle sont projetés des symboles isolés, mais une superposition ordonnée de couches sémantiques combinant une source de données rectangulaire, un système de coordonnées géométriques, un mappage esthétique liant variables et dimensions perceptives, et un objet géométrique chargé de matérialiser les enregistrements.
La transcription du concept de point empilé au sein de cet environnement s’incarne dans la couche spécialisée geom_dotplot(). L’initialisation du processus s’articule autour de l’appel cardinal à la fonction ggplot(), au sein duquel le tableau de données empirique est fourni en argument principal, conjointement à la spécification du mappage structurel via l’opérateur esthétique aes() (généralement en liant l’abscisse au score quantitatif d’intérêt dans une configuration univariée simple : aes(x = Score_Depression)). C’est sur ce canevas sémantique que vient s’agréger, par l’opérateur arithmétique d’addition +, la géométrie geom_dotplot().
Contrairement aux fonctions primitives de base, geom_dotplot() ne se borne pas à tracer des glyphes statiques : elle met en œuvre un algorithme statistique interne de compartimentage et d’optimisation de densité préalable au tracé. Le moteur calcule de manière dynamique la répartition des observations le long du continuum métrique, alloue chaque enregistrement à un réceptacle spatial précis et calcule l’élévation nécessaire pour empiler les symboles de façon équidistante et harmonieuse, délivrant un contrôle dimensionnel sans égal dans le paysage logiciel scientifique.
6.2 Maîtrise de la largeur de classe (binwidth)
Au cœur du mécanisme opérationnel de geom_dotplot() siège un paramètre mathématique d’une sensibilité critique absolue : la largeur de classe, formalisée par l’argument numérique binwidth. Ce paramètre détermine l’empan de l’intervalle le long duquel les observations sont réputées suffisamment proches pour être agrégées au sein d’une même pile verticale. Si l’utilisateur omet de déclarer explicitement cette valeur, ggplot2 émet un avertissement méthodologique et applique une heuristique automatique (souvent calibrée sur un trentième de l’étendue globale) qui s’avère fréquemment inappropriée pour les données psychométriques.
Dans le cadre de variables intrinsèquement discrètes, telles que des scores composites d’échelles de Likert ou des dénombrements d’erreurs commises lors d’une tâche de laboratoire, la rigueur méthodologique impose de fixer rigoureusement binwidth = 1. Cette décision garantit que seules les observations partageant une valeur strictement identique seront superposées au sein d’un même empilement, préservant ainsi la pureté cardinale de la distribution. Toute déviation arbitraire par rapport à cette valeur unitaire altère la fidélité de l’observation empirique.
Les conséquences d’un mauvais calibrage du binwidth sont majeures sur le plan sémiotique :
- Un sur-lissage (induit par un binwidth trop large) fusionne artificiellement des scores adjacents mais distincts au sein d’une tour d’empilement unique, masquant la granularité réelle du phénomène et générant des modes fallacieux.
- Un sous-lissage (résultant d’une valeur trop exiguë sur une variable quasi-continue) fragmente la distribution en une multitude de piles infinitésimales composées d’un seul point isolé, privant le graphique de tout pouvoir d’évocation morphologique globale.
6.3 Méthodes de compartimentage et alignement géométrique
Le second pivot algorithmique de geom_dotplot() réside dans le choix de la méthode de compartimentage statistique, gouvernée par le paramètre method. Deux philosophies calculatoires s’affrontent ici : l’algorithme par défaut method = « dotdensity » et la méthode alternative déterministe method = « histodot ». L’algorithme de densité de points calcule des compartiments dont la largeur s’adapte de manière dynamique en fonction de la densité locale, garantissant que le diamètre maximal d’un point ne dépasse jamais le binwidth tout en maintenant une proximité étroite avec la valeur exacte de chaque donnée individuelle.
Pour les chercheurs exigeant une régularité spatiale stricte similaire à celle d’un histogramme parfait, l’activation de method = « histodot » s’impose. Dans ce mode d’opération, les bornes de compartimentage sont fixées de façon rigide le long d’une grille mathématique régulière et équidistante à l’avance. Chaque observation est assignée de manière immuable au centre de son compartiment respectif, conférant aux colonnes d’empilement un alignement vertical absolument parfait, parfaitement perpendiculaire à l’axe des abscisses, ce qui facilite grandement la comparaison visuelle directe des hauteurs entre colonnes voisines.
Enfin, la morphologie globale du graphique dépend crucialement de l’argument d’orientation de l’élévation, stackdir. Ce paramètre accepte quatre valeurs distinctes :
- « up » : oriente l’empilement exclusivement vers le haut à partir de la ligne de flottaison (configuration asymétrique standard).
- « down » : inverse la direction pour projeter la masse de données vers le bas.
- « center » : scinde symétriquement l’élévation de part et d’autre d’un axe médian, engendrant une forme fuselée reminiscent d’un diagramme en violon à granularité discrète.
- « centerwhole » : réalise un centrage symétrique strict tout en contraignant l’algorithme à conserver les symboles entiers sans décalage fractionnaire d’alignement.
7. Paramétrage fin des attributs géométriques et esthétiques avec geom_dotplot
7.1 Gestion conjointe de la bordure et du remplissage
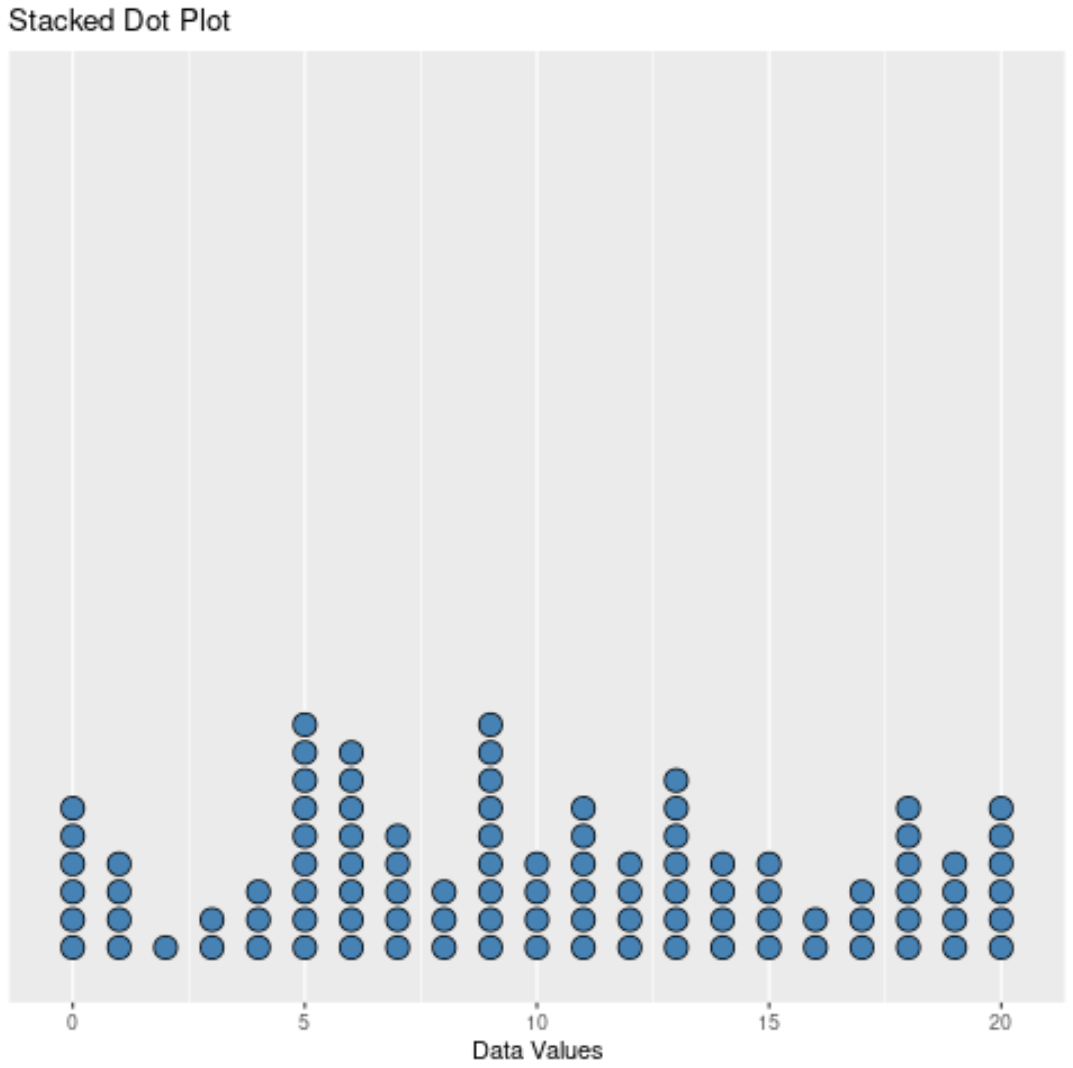
La puissance sémiotique de ggplot2 réside dans sa capacité à dissocier rigoureusement les différentes propriétés matérielles d’un objet graphique. Au sein de geom_dotplot(), cette distinction prend une importance cardinale à travers la séparation opérationnelle des arguments fill (couleur du corps interne du glyphe) et colour (teinte du contour périphérique vectoriel). Cette dissociation permet d’échapper au rendu monochrome plat et indifférencié en dotant chaque point d’une assise géométrique nettement circonscrite.
L’application d’un contour périphérique sombre (par exemple colour = « #1A1A1A » ou un gris anthracite profond colour = « gray20 ») couplée à un remplissage interne chromatique doux ou pastel confère à l’empilement une délimitation spatiale sans faille. Même lorsque les disques se touchent ou s’entremêlent légèrement aux confins de densités élevées, la frontière vectorielle extérieure garantit que l’œil humain conserve la faculté d’isoler et de dénombrer mentalement chaque unité statistique sans ambiguïté sémiotique.
Cette maîtrise de la frontière est consolidée par le réglage méticuleux de l’épaisseur de ligne via le paramètre stroke. En abaissant cette valeur à des dimensions subtiles (par exemple stroke = 0.4 ou stroke = 0.5, comparativement à la valeur unitaire standard souvent trop lourde), l’analyste préserve la finesse du rendu et évite que les lignes de contour n’empiètent sur la surface de remplissage, garantissant que la surface utile de chaque symbole reflète fidèlement sa véritable proportion spatiale.
7.2 Dimensionnement relatif et mise à l’échelle des points
L’une des difficultés récurrentes rencontrées par les utilisateurs de geom_dotplot() réside dans l’interaction complexe entre la largeur de compartimentage binwidth et l’argument de mise à l’échelle relative des symboles, formalisé par dotsize. Alors que binwidth définit la partition métrique de l’axe structural, dotsize agit comme un coefficient multiplicateur appliqué au diamètre physique des disques. Si ce paramètre est laissé à sa valeur par défaut unitaire alors que la distribution présente une forte concentration locale, les colonnes peuvent s’élever au-delà des frontières supérieures du tracé.
L’optimisation ergonomique requiert une harmonisation mathématique de ces deux variables. Si une classe particulièrement dense menace d’être tronquée ou de déborder de la zone de traçage, l’abaissement concerté de dotsize (par exemple à dotsize = 0.7 ou dotsize = 0.8) contracte le volume physique des cercles sans altérer l’espacement fondamental des compartiments. Ce micro-ajustement permet de stabiliser l’enveloppe globale de la distribution tout en restaurant un interstice respirant salutaire entre les différentes sphères empilées.
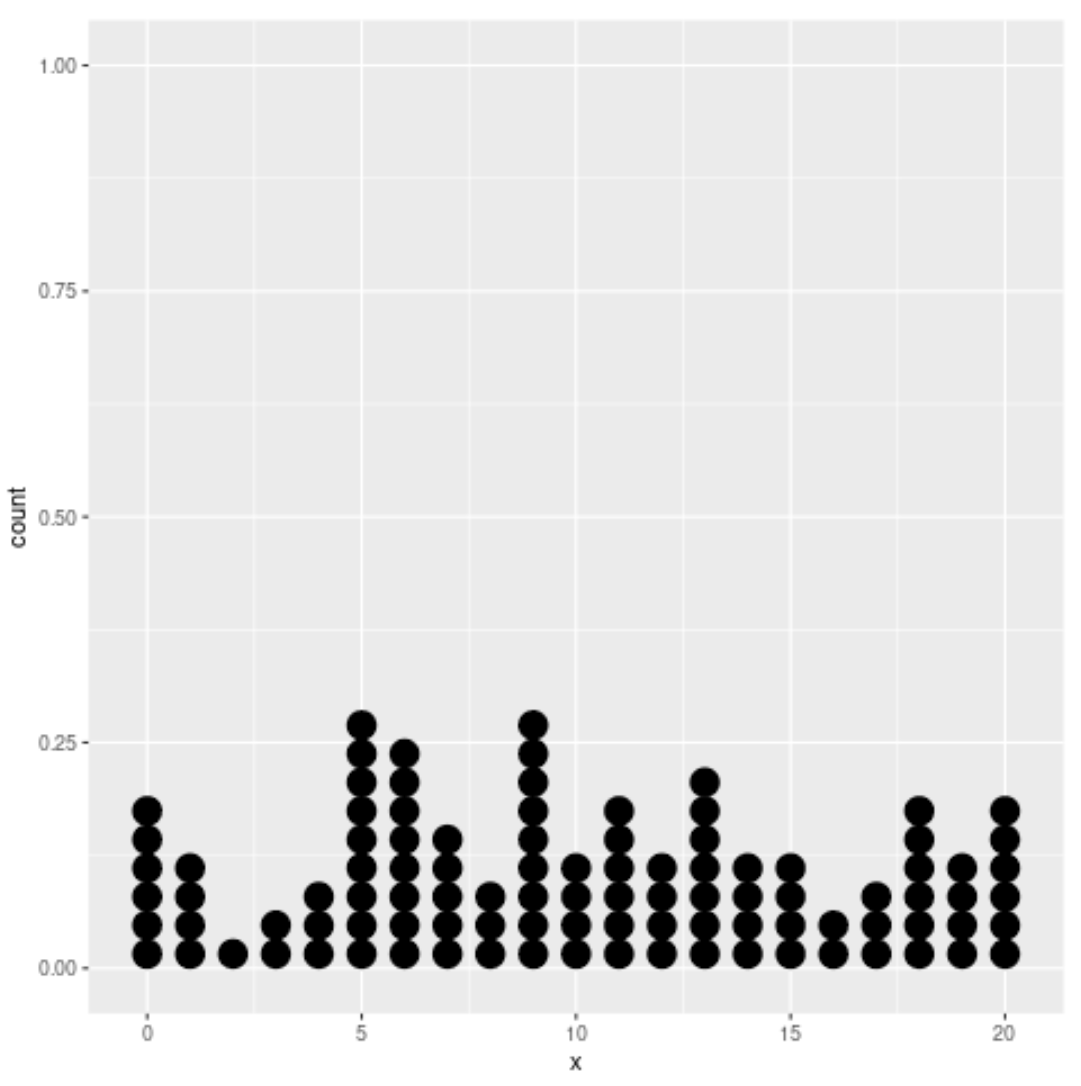
Parallèlement, une anomalie conceptuelle majeure propre à l’implémentation de geom_dotplot() doit être impérativement résolue : l’apparition par défaut sur l’axe des ordonnées d’une graduation numérique arbitraire s’étendant de 0 à 1 (ou des fractions décimales de densité) qui ne correspond en rien à un comptage cardinal intelligible pour le lecteur. La rigueur méthodologique impose de neutraliser cette graduation trompeuse au sein de la chaîne de commandes en insérant la directive explicite scale_y_continuous(NULL, breaks = NULL), purgeant ainsi la figure de toute pollution informationnelle.
7.3 Structuration du thème selon le style des revues académiques
L’obtention d’une figure publiable exige l’éradication systématique du thème par défaut de ggplot2 (le fameux fond gris cuadrillé theme_grey()), perçu par la communauté scientifique internationale comme un marqueur de travail inachevé ou amateur. L’intégration de thèmes épurés natifs tels que theme_classic() ou theme_minimal() constitue le socle indispensable pour instituer une esthétique académique conforme aux directives des sociétés savantes.
Au-delà de l’application d’un modèle prédéfini, l’analyste doit mobiliser la fonction theme() pour affiner la hiérarchie typographique et supprimer les éléments décoratifs superflus. La conformité aux normes scientifiques requiert l’éradication des lignes de grille majeures et mineures sur l’axe orthogonal à la distribution de données (puisque l’axe d’élévation ne supporte plus de graduation numérique absolue), concentrant l’intégralité de l’attention perceptive du lecteur sur la seule silhouette morphologique des empilements de données :
Les ajustements thématiques préconisés englobent :
- L’uniformisation de la police vectorielle (généralement une fonte de type sans-serif comme Arial, Helvetica ou Liberation Sans).
- Le calibrage précis de la taille des caractères (titres d’axes fixés entre 11 et 12 points, graduations numériques à 10 points).
- L’attribution d’une coloration neutre (noir pur « #000000 » ou gris très sombre « #222222 ») à la ligne de base d’abscisse et à ses coches métriques associées.
8. Comparaison multigroupes et facettage pour les devis expérimentaux
8.1 Mappage de facteurs qualitatifs inter-sujets
Dans la quasi-totalité des protocoles de recherche en psychologie, l’investigation ne se cantonne pas à l’observation d’un échantillon univarié isolé, mais vise à évaluer des contrastes théoriques entre différentes conditions expérimentales ou cohortes cliniques. Sous ggplot2, cette extension multigroupes s’opère avec une remarquable fluidité structurelle en intégrant une variable nominale inter-sujets au sein de la déclaration esthétique globale : la variable dépendante continue ou discrète est alors assignée à l’axe des ordonnées (aes(y = Score_Depression)), tandis que le facteur de groupement catégoriel est projeté le long de l’abscisse (aes(x = Groupe)).
Pour maximiser la ségrégation visuelle des distributions, l’incorporation de la dimension de remplissage chromatique dépendant du facteur (aes(fill = Groupe)) déploie automatiquement un code couleur contrasté différenciant les cohortes. Dans cette géométrie bidimensionnelle, geom_dotplot() doit être explicitement configuré pour empiler les points le long de l’axe vertical en déclarant l’argument binaxis = « y ». Dès lors, le moteur calcule les compartiments statistiques indépendamment le long de la coordonnée des ordonnées pour chaque groupe de façon ségréguée.
L’analyste veillera scrupuleusement à l’accessibilité chromatique des palettes mobilisées. Le recours aux palettes scientifiques universellement reconnues, telles que les nuanciers développés par ColorBrewer ou la palette viridis (spécifiquement sa variante cividis ou plasma), assure une discernabilité optimale pour les personnes présentant des déficiences de la vision des couleurs (daltonisme, deutéranopie) tout en garantissant un rendu contrasté et intelligible en cas d’impression en niveaux de gris au sein de revues physiques.
8.2 Empilement et positionnement relatif des sous-groupes
Lorsqu’un devis factoriel intègre une imbrication de multiples facteurs (par exemple un plan d’expérience croisant deux modalités de traitement thérapeutique avec deux strates de genre ou de sévérité clinique initiale), la disposition géométrique des points empilés au sein de chaque niveau principal impose des arbitrages sémiotiques précis. Deux stratégies spatiales majeures s’offrent à l’analyste sous ggplot2 : l’empilement conjoint au sein d’une colonne partagée via stackgroups = TRUE, ou l’esquive parallèle latérale au moyen de position = position_dodge().
L’utilisation de stackgroups = TRUE instruit le moteur de superposer les observations des différents sous-groupes directement les unes au-dessus des autres au sein du même compartiment métrique, en attribuant une teinte distincte à chaque sous-échantillon. Cette approche s’avère particulièrement puissante lorsque le chercheur désire communiquer la composition sous-jacente d’une distribution globale globale sans fractionner l’enveloppe distributionnelle générale.
À l’inverse, l’application d’un décalage latéral contrôlé via l’opérateur d’esquive spatiale (position = position_dodge(width = 0.8)) scinde physiquement les sous-groupes en deux colonnes d’empilement parallèles positionnées côte à côte au sein de chaque modalité principale. Cette seconde approche est méthodologiquement supérieure pour l’évaluation des interactions factorielles simples : elle permet au chercheur et au lecteur de comparer immédiatement et sans ambiguïté les hauteurs, les dispersions et les médianes locales respectives des deux sous-populations au sein de chaque condition du traitement.
8.3 Décomposition en facettes avec facet_wrap() et facet_grid()
Lorsque la complexité du devis expérimental s’accroît par l’adjonction de variables modératrices additionnelles (telles que des tranches d’âge, des centres hospitaliers de recrutement ou des temps de mesure longitudinaux pré/post-test), la superposition de multiples sous-groupes sur un même espace de coordonnées engendre une saturation perceptive contre-productive. La solution architecturale d’excellence réside alors dans le recours au facettage (small multiples), concrétisé sous ggplot2 par les fonctions facet_wrap() et facet_grid().
L’adjonction d’une couche telle que facet_wrap(~ Tranche_Age) segmente le jeu de données en une matrice ordonnée de sous-graphiques autonomes partageant des échelles strictement identiques. Ce compartimentage spatial présente des vertus analytiques déterminantes :
- Il élimine tout risque de collision géométrique entre les points empilés issus de cohortes structurellement divergentes.
- Il permet une inspection visuelle directe de la stabilité de l’effet thérapeutique à travers les différentes strates de la variable modératrice.
- Il maintient une rigueur d’alignement absolu entre les panneaux matriciels successifs.
Dans ce contexte de facettage, il est crucial de préserver l’invariance métrique en maintenant le paramètre par défaut scales = « fixed ». L’activation inconsidérée de scales = « free » (qui ajuste dynamiquement les limites d’axes à l’étendue locale de chaque facette) induirait une illusion perceptive délétère en attribuant des dimensions physiques identiques à des empilements aux effectifs ou aux amplitudes pourtant disparates, violant ainsi les principes élémentaires de la perception visuelle de Cleveland-McGill.
9. Intégration d’indicateurs de tendance centrale et de dispersion
9.1 Superposition de la moyenne et de l’intervalle de confiance
Bien que le graphique à points empilés se suffise à lui-même pour retranscrire la masse empirique brute des données, l’inférence scientifique en psychologie exige fréquemment l’intégration synthétique d’indicateurs de tendance centrale et d’estimations de l’incertitude d’échantillonnage. L’enrichissement d’un geom_dotplot() par une synthèse paramétrique s’exécute avec une remarquable élégance sous ggplot2 au moyen de la couche analytique stat_summary().
La formulation conventionnelle implique la projection d’un marqueur ponctuel figurant la moyenne arithmétique de l’échantillon, flanqué d’un segment d’erreur illustrant l’intervalle de confiance à 95 % calculé par rééchantillonnage non paramétrique (bootstrapping). Cette intégration s’opère en instruisant stat_summary(fun.data = mean_cl_boot, geom = « pointrange », colour = « black », size = 0.8). En exploitant les algorithmes robustes de bootstrap issus de la bibliothèque Hmisc, cette technique s’affranchit des postulats de normalité stricte pour quantifier l’incertitude inférentielle.
Pour prévenir toute collision ou confusion perceptive entre les disques empilés représentant les observations individuelles et le marqueur de la moyenne de synthèse, il convient d’opérer une dissociation sémiotique rigoureuse :
- Assigner au point de synthèse une forme géométrique radicalement différente (par exemple un losange shape = 18 ou une croix épaisse).
- Adopter un dimensionnement substantiel démarquant clairement le paramètre inférentiel des micro-données environnantes.
- Utiliser un décalage spatial latéral contrôlé pour que la barre d’intervalle de confiance s’érige à côté de la colonne empilée et non en surimpression directe.
9.2 Combinaison avec des médianes et écarts interquartiles
Face à des scores psychométriques présentant une asymétrie distributionnelle prononcée ou une nature ordinale marquée, l’usage de la moyenne arithmétique devient théoriquement contestable. La déférence envers la réalité mathématique commande alors de substituer aux métriques paramétriques des indicateurs d’ordre non paramétriques, incarnés par la médiane et l’écart interquartile (EIQ, représentant le 25e et le 75e percentile de la distribution).
Cette intégration peut être accomplie de manière épurée en déployant des segments horizontaux discrets venant s’imbriquer au cœur des empilements de points. L’analyste peut mobiliser stat_summary() avec des fonctions personnalisées calculant le premier, le deuxième et le troisième quartile, ou superposer de façon semi-transparente une boîte à moustaches squelettique et très étroite (geom_boxplot(width = 0.15, alpha = 0.3, outlier.shape = NA)). La neutralisation des valeurs aberrantes de la boîte à moustaches via outlier.shape = NA est un impératif méthodologique strict pour éviter que ces points extrêmes ne soient dessinés deux fois sur la même figure.
Cette symbiose graphique entre le tracé à points empilés et les repères interquartiles matérialise l’équilibre parfait entre condensation statistique et exhaustivité granulaire. Le lecteur dispose instantanément de la lecture des bornes au sein desquelles se concentrent les 50 % centraux de la population étudiée, tout en conservant la capacité de vérifier si cette enveloppe interquartile englobe une masse homogène continue ou dissimule une lacune empirique bimodale au voisinage de la valeur médiane.
9.3 Cohabitation graphique avec des tracés de densité continus
L’une des innovations graphiques contemporaines les plus fécondes en psychologie quantitative réside dans le développement des figures en nuage de pluie (raincloud plots), popularisées notamment par Micah Allen et ses collaborateurs. Ce paradigme visuel fusionne, au sein d’une composition unifiée, une estimation de densité continue lisse (la « goutte » ou le nuage), une boîte à moustaches récapitulative condensée, et l’ensemble exhaustif des points de données individuels (la « pluie »), positionnés sous forme empilée ou légèrement dispersée.
L’implémentation de cette modalité avancée au moyen de geom_dotplot() exige une orchestration spatiale asymétrique millimétrée. En mobilisant des bibliothèques d’extension spécialisées comme ggdist, l’analyste peut projeter sur le flanc supérieur ou droit d’un axe une demi-courbe de densité lissée (stat_halfeye()), tandis que la couche geom_dotplot() est instruite avec stackdir = « down » ou décalée latéralement pour venir se déployer sur le flanc opposé sans jamais croiser l’espace du violon continu.
Cette cohabitation offre une perspective analytique totale : la courbe supérieure informe l’observateur sur le modèle théorique sous-jacent de distribution continue probable au sein de la population générale parente, tandis que l’empilement inférieur de points rappelle sans équivoque la taille finie de l’échantillon collecté, ses irrégularités d’échantillonnage locales et sa nature discrète intrinsèque. Cette confrontation féconde entre modèle et données brutes incarne l’idéal de rigueur promu par la métrologie cognitive contemporaine.
10. Gestion des jeux de données complexes et optimisation visuelle (Overplotting et Binwidth)
10.1 Résolution des conflits de chevauchement sur grands effectifs
Bien que le graphique à points empilés manifeste des vertus exemplaires sur des effectifs modérés, l’élévation graduelle de la puissance statistique et du nombre d’observations (n > 100 à 200 par groupe) engendre inéluctablement des conflits spatiaux d’empilement. Le risque majeur réside dans l’expansion verticale effrénée des piles, conduisant les sommets des colonnes les plus denses à franchir le cadre physique de la fenêtre graphique ou à envahir l’espace alloué aux catégories contiguës, anéantissant ainsi l’intégrité sémiotique de la figure.
Pour juguler cette dérive sans renoncer au principe des points empilés, plusieurs leviers de micro-agrégation algorithmique doivent être actionnés. Le premier mécanisme consiste à ajuster le paramètre formel binpositions au sein de geom_dotplot(). Par défaut assigné à « bygroup », le basculement vers binpositions = « all » force l’algorithme à standardiser la grille de calcul de position sur l’intégralité du jeu de données consolidé, garantissant que l’échelle d’empilement demeure rigoureusement comparable et mathématiquement stable d’un panneau à l’autre.
Si la saturation dimensionnelle persiste en dépit de la contraction de dotsize, une alternative méthodologique transitoire consiste à introduire une dispersion déterministe ou un quasi-empilement régulé, tel que proposé par le paquet spécialisé ggbeeswarm via sa géométrie geom_quasirandom(). Ce dispositif simule la logique du point empilé en déployant les observations le long d’un profil de densité de violon tout en préservant une répulsion spatiale mutuelle rigoureuse entre disques voisins, prévenant toute collision sans imposer l’orthogonalité stricte d’une grille de compartiments discrets.
10.2 Étalonnage mathématique du binwidth pour variables non entières
Dans de nombreuses disciplines psychologiques, les variables dépendantes investiguées ne se présentent pas sous la forme d’entiers discrets élémentaires, mais sous l’aspect de variables quantitatives continues ou de scores composites continus découlant d’analyses factorielles confirmatoires, d’extractions en composantes principales ou de moyennes dimensionnelles fractionnaires. Dans ces configurations complexes, l’assignation intuitive d’un binwidth unitaire perd toute pertinence mathématique et l’analyste doit impérativement étalonner ce paramètre sur des fondements statistiques éprouvés.
Une démarche rigoureuse consiste à dériver la largeur optimale du compartiment d’empilement à partir des formulations classiques d’estimation de bande passante non paramétrique, au premier rang desquelles figure la règle de Freedman-Diaconis. Cette formulation théorique fonde le calcul de la largeur optimale h sur la relation mathématique liant l’écart interquartile (EIQ) à la racine cubique de l’effectif d’échantillon total :
h = 2 × EIQ / (n^(1/3))
L’implémentation de ce calcul au sein du script R préalable à l’appel de geom_dotplot(binwidth = h) garantit que l’agrégation spatiale des points ne procède pas d’un choix visuel arbitraire ou opportuniste, mais reflète fidèlement les propriétés stochastiques intrinsèques de la série statistique.
Cette précaution mathématique élimine le risque majeur d’artéfacts de granularité : un seuil de compartimentage trop étroitement paramétré sur une variable continue engendre une dispersion chaotique où chaque point constitue sa propre colonne, privant l’observateur de toute perception de la masse distributionnelle. À l’inverse, un seuil trop généreux induit une illusion d’attraction gravitationnelle artificielle en regroupant des participants ayant des caractéristiques psychologiques divergentes sous la même étiquette visuelle d’amas.
10.3 Interactivité exploratoire préliminaire
Préalablement à la fixation définitive d’un tracé destiné à l’impression statique, l’exploration interactive des amas de données apporte une plus-value inestimable pour le diagnostic clinique et la détection d’observations atypiques (outliers). L’environnement R autorise une métamorphose instantanée d’un objet graphique statique généré sous ggplot2 en une application vectorielle dynamique par l’intermédiaire de la passerelle logicielle plotly.
L’encapsulation de l’objet graphique dans la commande unitaire ggplotly() dote immédiatement chaque point empilé d’une sensibilité événementielle au survol du curseur informatique (tooltip). L’analyste peut dès lors associer, via l’esthétique textuelle auxiliaire de ggplot2 (aes(text = paste(« Sujet: », Participant_ID, « <br>Âge: », Age))), une fiche d’identité diagnostique exhaustive à chaque observation individuelle.
Cette fonctionnalité s’avère particulièrement précieuse lors de l’investigation des points situés aux extrémités supérieures des empilements : en survolant un disque isolé au sommet d’une pile clinique déviante, le clinicien identifie en une fraction de seconde l’identifiant matriciel du patient, son historique anamnestique et ses comorbidités éventuelles, sans devoir exécuter des requêtes de filtrage matriciel fastidieuses au sein de sa console d’analyse.
11. Diagnostic, pièges statistiques et erreurs courantes d’interprétation
11.1 Confusion entre fréquence d’échantillon et échelle de l’axe vertical
L’un des écueils conceptuels les plus pernicieux documentés dans la littérature méthodologique liée à geom_dotplot() réside dans l’interprétation erronée de l’échelle affichée le long de l’axe vertical. Lorsqu’un tracé à points empilés est généré avec l’axe métrique de la variable positionné en abscisse (x), ggplot2 génère sur l’axe des ordonnées (y) une échelle normalisée de densité d’empilement qui s’étend conventionnellement de 0 à 1 (ou des valeurs décimales associées au calcul interne de count normalisé).
Cette graduation technique induit une confusion systématique chez les relecteurs et éditeurs de revues scientifiques : une part substantielle de lecteurs néophytes interprète spontanément ces valeurs décimales comme des probabilités cumulées ou, pire encore, suppose que la hauteur d’une pile de 10 points atteignant le repère 0,8 correspond à un effectif cardinal de 0,8 sujet, ce qui n’a aucun sens mathématique. Pour pallier ce paradoxe sémiotique, il est impératif :
- Soit de supprimer purement et simplement toute graduation sur cet axe secondaire via scale_y_continuous(NULL, breaks = NULL), en explicitant dans la note de légende que la hauteur des colonnes est strictement proportionnelle au dénombrement unitaire des individus.
- Soit de reprogrammer le mappage interne de l’élévation pour restituer un comptage absolu rigoureux au moyen de la syntaxe d’évaluation retardée aes(y = after_stat(count)), garantissant que les graduations affichées correspondent rigoureusement aux entiers cardinaux de l’échantillon.
11.2 Artefacts visuels induits par le choix des algorithmes de binning
Le traitement algorithmique appliqué par les moteurs graphiques pour agglomérer les points comporte une composante discrétionnaire qui n’est pas sans danger pour la fidélité de l’interprétation théorique. L’utilisation non contrôlée de l’algorithme par défaut dotdensity peut induire des altérations morphologiques insidieuses de la distribution. Cet algorithme ajustant dynamiquement le positionnement du centre de chaque amas en fonction de la proximité séquentielle des données, il arrive que deux jeux de données aux structures ordonnées distinctes produisent des silhouettes visuelles excessivement similaires du fait du glissement continu des compartiments.
De surcroît, le choix d’un binwidth disproportionné peut créer de toutes pièces des modes artificiels (des pics fictifs) là où la population parente réelle ne manifeste qu’une distribution plane et régulière. Lorsqu’une grappe de points est artificiellement fusionnée au sein d’une pile unique par un algorithme trop intégrateur, le chercheur court le risque de théoriser l’existence d’un sous-type psychopathologique distinct qui ne constitue en réalité qu’un pur artéfact de calcul graphique.
Pour conjurer ces erreurs diagnostiques graves, le protocole de validation méthodologique impose de conduire une vérification croisée de l’allure distributionnelle. L’analyste doit systématiquement confronter la silhouette obtenue sous geom_dotplot() avec un histogramme fin non paramétré et avec la fonction de répartition empirique cumulative (obtenue via stat_ecdf()). Ce n’est qu’à la condition d’une convergence morphologique absolue entre ces différents prismes géométriques que les amas de points empilés peuvent être légitimement interprétés comme l’expression d’un phénomène psychologique authentique.
11.3 Distorsion des proportions relatives dans les devis déséquilibrés
L’évaluation comparative de groupes expérimentaux au moyen de graphiques à points empilés devient particulièrement délicate lorsque les effectifs d’échantillonnage s’avèrent substantiellement asymétriques (par exemple, un groupe témoin comprenant n = 120 participants confronté à un groupe clinique rare de n = 20 patients). Dans cette configuration de devis expérimental hautement déséquilibré, la transcription graphique brute sans mise en perspective d’échelle induit des biais cognitifs majeurs lors de l’évaluation de la variance et de l’homoscédasticité.
D’une part, la colonne la plus dense du grand groupe projettera une tour imposante dominant visuellement l’ensemble de la composition, tandis que les observations du petit échantillon sembleront éparpillées et négligeables, incitant l’observateur à sous-estimer intuitivement la dispersion réelle de la pathologie rare. D’autre part, si l’analyste active sans précaution des mécanismes de normalisation de surface (où la hauteur maximale de chaque groupe est artificiellement forcée à correspondre à une dimension unitaire identique), il dénature gravement la réalité des effectifs en attribuant à un point unique du petit groupe une surface physique et un poids visuel six fois supérieurs à ceux d’un point du groupe majoritaire.
La neutralisation de ce piège méthodologique repose sur une transparence sémiotique sans compromis :
- Conserver rigoureusement un diamètre physique de point strictement identique pour tous les sous-groupes comparés (invariance absolue de dotsize).
- Consigner explicitement les effectifs précis de chaque cohorte (n exact) au sein des étiquettes des axes catégoriels (par exemple, « Contrôle (n = 120) » vs « Clinique (n = 20) »).
- Expliciter dans la légende accompagnatrice la nature asymétrique du schéma d’échantillonnage pour prémunir les évaluateurs contre des jugements erronés sur l’homogénéité des variances intra-groupes.
12. Exportation de haute qualité et reproductibilité selon les normes académiques (APA)
12.1 Conformité stricte aux exigences graphiques du manuel APA (7e édition)
La publication d’artefacts graphiques au sein des revues affiliées à l’American Psychological Association (APA 7e édition) ou des organes éditoriaux majeurs en neurosciences est régie par un corpus normatif d’une rigueur absolue. Contrairement aux pratiques informelles du web, une figure scientifique académique doit se conformer à une architecture normalisée tripartite : le numéro d’ordre de la figure en caractères gras au sommet (par exemple, Figure 1), suivi d’un titre bref et informatif rédigé en italique sur une ligne distincte, et clos par une note de bas de figure (Note.) détaillant exhaustivement l’interprétation des symboles, abréviations et barres d’erreur.
Sur le plan typographique et géométrique, les critères de l’APA proscrivent formellement l’utilisation d’effets tridimensionnels, d’ombrages artificiels ou de perspectives décoratives susceptibles de déformer l’évaluation des grandeurs. Les polices de caractères autorisées doivent appartenir à des familles sans-serif hautement lisibles (telles que Arial, Calibri ou Helvetica), calibrées entre 8 et 14 points selon le niveau de hiérarchie informationnelle. Les contrastes de luminance entre les glyphes empilés et le fond blanc immaculé doivent respecter les standards internationaux d’accessibilité visuelle.
Enfin, la note de figure sous-jacente doit impérativement expliciter le sens de la granularité observée : elle doit mentionner sans omission que chaque disque plein symbolise une observation individuelle unique, stipuler la largeur de compartimentage (binwidth) sélectionnée pour l’agrégation, et définir rigoureusement la signification mathématique de tout indice de tendance centrale superposé (en spécifiant explicitement s’il s’agit d’une moyenne accompagnée d’un intervalle de confiance à 95 % par bootstrap ou d’une médiane flanquée de l’écart interquartile).
12.2 Techniques de rendu et exportation vectorielle avec ggsave()
La préservation intégrale de la netteté chirurgicale d’un tracé à points empilés lors du processus d’édition et d’impression professionnelle commande l’abandon absolu des formats matriciels compressés destructeurs (tels que le JPEG conventionnel). L’exportation finale d’un graphique élaboré sous ggplot2 doit être exécutée au moyen de la fonction spécialisée ggsave(), en ciblant prioritairement des formats de description géométrique vectorielle tels que le PDF (Portable Document Format), l’EPS (Encapsulated PostScript) ou le format SVG.
Le recours aux formats vectoriels garantit que chaque point empilé est encodé sous forme d’une primitive mathématique indépendante de toute résolution en pixels : la figure peut ainsi faire l’objet d’agrandissements typographiques illimités lors de la composition des épreuves d’imprimerie sans jamais souffrir de pixellisation ou de dégradation de contour. La syntaxe opérationnelle implique la spécification rigoureuse des dimensions physiques réelles en centimètres ou en pouces (par exemple, ggsave(« figure1_apa.pdf », width = 16, height = 10, units = « cm », device = cairo_pdf)), où l’appel au pilote vectoriel cairo_pdf assure une gestion irréprochable de l’incorporation des fontes typographiques et de la transparence alpha.
Dans les circonstances où l’éditeur scientifique exige formellement la fourniture de fichiers matriciels (notamment pour les formats d’archivage TIFF ou PNG haute résolution), le paramétrage de la densité d’échantillonnage par pouce constitue la variable déterminante. L’argument de résolution doit être formellement verrouillé à un niveau minimal de 300 DPI pour les documents en demi-teintes chromatiques, et préférentiellement calibré à 600 ou 1200 DPI pour les tracés en noir et blanc stricts au trait (line art), garantissant une netteté de contour équivalente aux standards de la gravure typographique traditionnelle.
12.3 Génération de scripts autonomes pour la reproductibilité computationnelle
L’aboutissement ultime de la démarche méthodologique réside dans l’assurance d’une reproductibilité computationnelle parfaite de l’ensemble du pipeline graphique. Dans l’esprit des principes de la recherche ouverte et reproductible, la génération d’une figure empirique ne doit jamais résulter d’une suite de manipulations manuelles dans des interfaces logicielles opaques, mais doit être entièrement encapsulée dans un script R autonome, autodocumenté et exécutable de bout en bout sans intervention humaine discrétionnaire.
Pour institutionnaliser cette reproductibilité pérenne, la structuration du code source doit adopter une conception modulaire :
- Création de fonctions personnalisées paramétrables recevant le jeu de données brut et restituant directement l’objet graphique compilé.
- Intégration d’assertions conditionnelles préalables vérifiant l’absence de valeurs aberrantes ou manquantes.
- Documentation méticuleuse de chaque étape du pipeline via des commentaires structurés.
L’intégration de ces scripts graphiques au sein de documents dynamiques informatisés, tels que les environnements R Markdown ou les carnets d’édition scientifique contemporains développés sous Quarto, consacre la fusion parfaite entre le texte discursif de l’article scientifique, le code computationnel d’analyse et les artefacts graphiques résultants. Lors de chaque recompilation du manuscrit de recherche, l’intégralité des graphiques à points empilés est régénérée dynamiquement à partir des micro-données certifiées les plus récentes, éliminant tout risque d’erreur humaine d’archivage et garantissant à la communauté scientifique une transparence méthodologique absolue.
Références
Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, Article 63. https://doi.org/10.12688/wellcomeopenres.15191.1
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276-281. https://doi.org/10.1080/00031305.1999.10474474
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0