
Dans le champ contemporain de l’analyse décisionnelle et de l’ingénierie des processus, la surcharge informationnelle constitue une entrave majeure à l’efficacité opérationnelle. Face à des volumétries de données massives et hétérogènes, les gestionnaires, ingénieurs et chercheurs sont continuellement confrontés à l’impératif de hiérarchiser les dysfonctionnements, les coûts ou les anomalies afin d’optimiser l’allocation de ressources structurellement limitées. C’est au cœur de cette tension méthodologique que s’impose le diagramme de Pareto, un dispositif sémiotique et quantitatif remarquable, hybridant la discrétisation catégorielle d’un histogramme ordonné et la continuité probabiliste d’une fonction de répartition empirique.
L’avènement des suites logicielles en nuage, au premier rang desquelles figure Google Sheets, a démocratisé la modélisation statistique avancée au sein des organisations décentralisées. Toutefois, l’apparente simplicité d’un tableur dissimule fréquemment des approximations conceptuelles et graphiques délétères. L’élaboration d’un graphique de Pareto scientifiquement rigoureux et visuellement irréprochable ne saurait résulter d’un simple automatisme applicatif ; elle requiert une discipline mathématique, une préparation rigoureuse de la structure de données et une maîtrise approfondie des mécanismes d’indexation, de double étalonnage et de dynamisation matricielle.
Ce guide exhaustif a pour vocation d’articuler les soubassements épistémologiques du principe de Pareto avec les protocoles techniques les plus avancés de Google Sheets. À travers un parcours algorithmique et analytique jalonné de considérations ergonomiques, sémiologiques et statistiques, nous détaillerons l’intégralité du cycle de vie de cette visualisation : de la taxonomie primaire des données brutes à la gouvernance collaborative du classeur, en passant par le calcul matriciel des cumuls et l’étalonnage millimétrique de l’axe secondaire. L’objectif ultime est d’armer l’analyste d’un cadre reproductible, robuste et conforme aux standards académiques internationaux les plus exigeants.
1. Fondements théoriques et épistémologiques du principe de Pareto
1.1 Genèse sociologique et économique de la distribution de Pareto
L’ancrage théorique du principe d’asymétrie remonte aux travaux séminaux de l’économiste et sociologue italien Vilfredo Pareto à la fin du XIXe siècle. Dans son Cours d’économie politique (1896), Pareto met en évidence une régularité empirique frappante dans la distribution des revenus au sein de la société italienne : environ 80 % des terres et des richesses nationales sont concentrées entre les mains de 20 % de la population. Cette observation initiale, modélisée sous la forme d’une loi de puissance mathématique caractérisée par une queue lourde, a posé les jalons de l’analyse des distributions asymétriques où la densité de probabilité décroît de manière polynomiale plutôt que gaussienne.
Il a fallu attendre le milieu du XXe siècle pour que l’ingénieur et théoricien de la gestion de la qualité Joseph Moses Juran généralise cette distribution empirique aux sciences de l’ingénieur et au management industriel. Juran formalise l’adage sous l’appellation canonique de « principe de Pareto » ou « règle des 80/20 », introduisant une dichotomie conceptuelle fondamentale : la séparation formelle entre les « quelques éléments vitaux » (vital few) et la « masse triviale » ou les « nombreux éléments utiles » (trivial many ou useful many). Ce glissement épistémologique a transformé une observation sociologique descriptive en un outil normatif de décision, affirmant que dans tout système complexe, une fraction minime des causes produit la majorité écrasante des effets.
La pertinence méthodologique de cette modélisation statistique dans l’analyse des phénomènes asymétriques contemporains demeure absolue. Qu’il s’agisse de l’analyse des non-conformités de fabrication, de la concentration du chiffre d’affaires par segment de clientèle ou des vulnérabilités dans le code source d’un logiciel, les jeux de données réels dérogent très fréquemment à la distribution normale symétrique en cloche. La reconnaissance de cette asymétrie structurelle prévient l’erreur d’une gestion uniforme et impose l’adoption d’un paradigme analytique focalisé sur la disparité d’impact, légitimant ainsi la conception d’outils visuels spécifiquement dédiés à cette mise en relief.
1.2 Structure sémiotique et visuelle du diagramme de Pareto
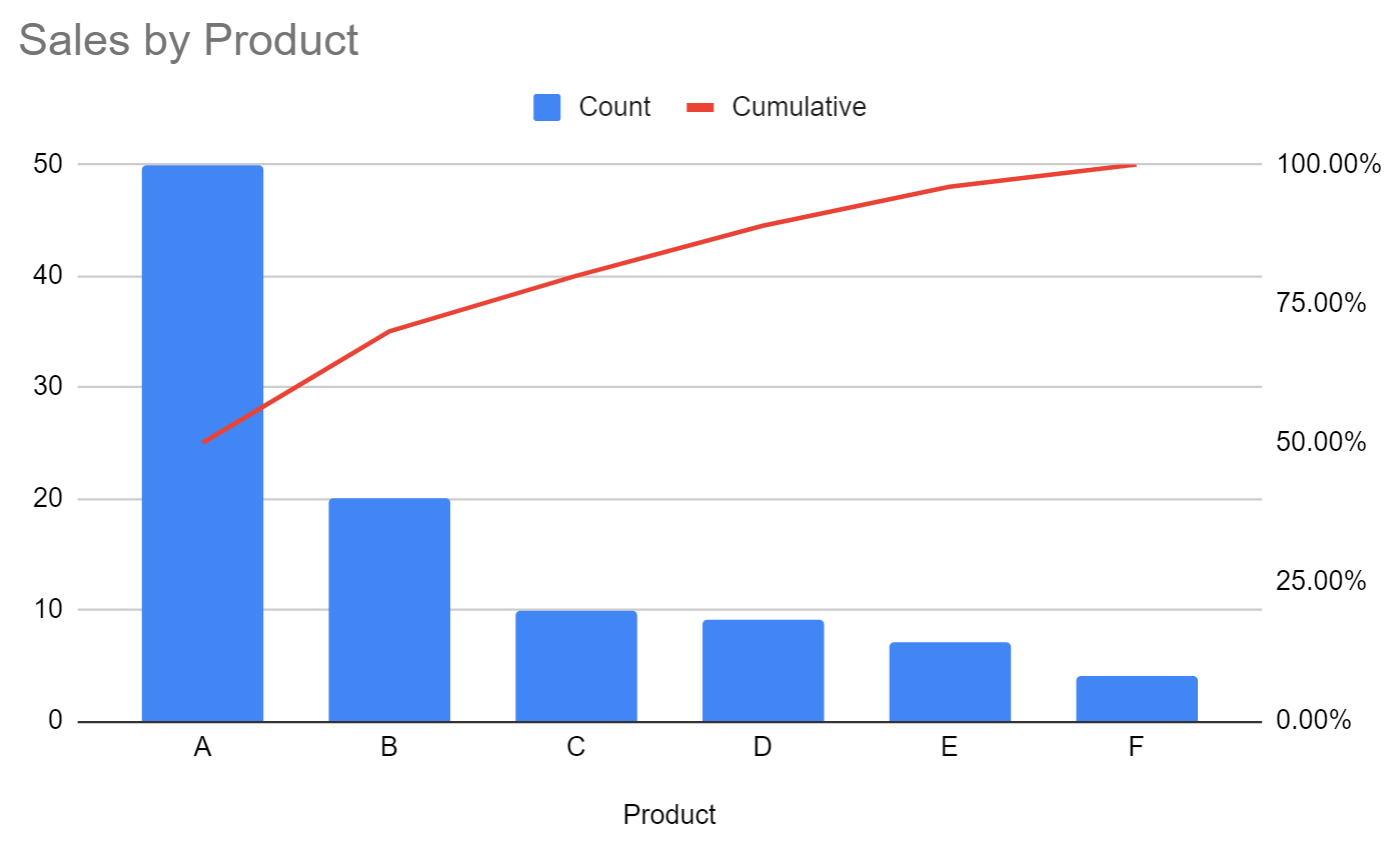
Sur le plan sémiotique, le diagramme de Pareto opère une synthèse remarquable entre deux modes distincts de représentation graphique de l’information : le registre discret et le registre continu. L’histogramme sous-jacent utilise la dimension spatiale de la hauteur des barres pour représenter les fréquences absolues ou relatives observées au sein de catégories nominales mutuellement exclusives. Cette composante discrète interpelle le système perceptif primaire en matérialisant immédiatement l’ordre de grandeur de chaque modalité, les barres étant impérativement agencées de gauche à droite selon un ordre d’amplitude strictement décroissant.
À cette représentation discrète s’adjoint une courbe polygonale, assimilable à l’ogive de Galton, figurant la fonction de répartition cumulative empirique. Projetée sur un axe vertical secondaire calibré de 0 % à 100 %, cette ligne brisée continue illustre l’accumulation progressive de l’impact causé par l’adjonction successive des catégories. L’axe primaire de gauche quantifie ainsi le volume unitaire mesuré (coûts en devises, nombre de rebuts, durée d’arrêt de ligne en minutes), tandis que l’axe secondaire de droite confère une métrique adimensionnelle normalisée permettant d’apprécier la saturation globale du phénomène étudié.
Le point névralgique de la lecture sémiotique réside dans l’interprétation cognitive de la rupture de pente (le « coude » de la courbe). Lorsque la courbe cumulative amorce une décélération sensible de son taux de croissance marginal, elle signale visuellement la transition critique entre la zone des causes majeures et celle de la longue traîne résiduelle. Cette inflexion géométrique offre aux observateurs une frontière décisionnelle claire, objectivant le seuil à partir duquel l’effort analytique ou correctif supplémentaire produira un rendement marginal décroissant.
1.3 Implications cognitives et décisionnelles en psychologie du travail
L’utilité managériale et académique du diagramme de Pareto s’éclaire au prisme des sciences cognitives et de la théorie de la charge cognitive développée par John Sweller. Confronté à des tableaux matriciels bruts comptant des dizaines de lignes de données multidimensionnelles, l’esprit humain subit une saturation rapide de sa mémoire de travail. Le diagramme de Pareto agit comme un puissant artefact cognitif externe, procédant à un regroupement préalable (chunking) et à un ordonnancement pré-attentif des données qui soulagent les facultés de traitement de l’analyste.
De surcroît, le recours à une visualisation normée atténue drastiquement deux biais cognitifs ubiquitaires dans les processus d’arbitrage : le biais de disponibilité et le biais d’ancrage. En l’absence d’une quantification rigoureuse et ordonnée, les décideurs ont tendance à surévaluer les dysfonctionnements récents, hautement médiatisés ou émotionnellement saillants au détriment de pannes récurrentes mais discrètes dont le coût cumulé est pourtant destructeur. Le diagramme de Pareto neutralise cette subjectivité en confrontant les représentations mentales individuelles à la rigueur mathématique des volumes mesurés.
Enfin, dans une perspective de dynamique des groupes et de management collaboratif, la clarté synthétique du diagramme de Pareto maximise l’alignement stratégique. En matérialisant visuellement l’écart écrasant d’impact entre les modalités de classe A et la longue traîne, l’outil réduit les frictions discursives lors des réunions de crise ou des revues de projet. Il cristallise un consensus immédiat autour des priorités vitales, facilitant l’allocation consensuelle des budgets d’intervention et l’adhésion collective aux feuilles de route opérationnelles.
2. Préparation méthodologique de l’environnement Google Sheets
2.1 Configuration des paramètres régionaux et syntaxiques
Avant d’initier la moindre manipulation de données au sein de Google Sheets, un paramétrage scrupuleux de l’environnement s’avère indispensable. L’analyste doit impérativement configurer les paramètres régionaux du classeur via le menu Fichier > Paramètres. Cette étape est hautement stratégique, car elle régit la nature du séparateur décimal (virgule dans l’espace francophone, point dans l’espace anglo-saxon) ainsi que le délimiteur syntaxique des arguments au sein des fonctions mathématiques (point-virgule versus virgule).
Une divergence entre l’encodage des données sources et les paramètres régionaux de la feuille de calcul provoque des erreurs d’interprétation silencieuses mais catastrophiques : des valeurs numériques contenant des points peuvent être coercées de manière arbitraire en chaînes textuelles non calculables, faussant irrémédiablement le moteur de calcul. Il convient d’assurer une parfaite cohérence entre la localisation déclarée et le standard de formatage employé lors des imports de données brutes.
Parallèlement, la normalisation des encodages de caractères (privilégier systématiquement l’UTF-8) prévient la corruption des caractères accentués au sein des libellés de catégories. L’harmonisation des fuseaux horaires et des métadonnées de la feuille garantit quant à elle la synchronisation temporelle précise des observations, une précaution capitale dans le cadre d’analyses de séries chronologiques ou d’audits qualité traçables.
2.2 Conception de la matrice de données selon les principes du Tidy Data
La fiabilité de l’analyse dépend intrinsèquement de l’architecture structurelle de la matrice de données sous-jacente. L’analyste se doit d’appliquer les préceptes du Tidy Data théorisés par Hadley Wickham. Ce paradigme repose sur trois postulats stricts : chaque variable forme une colonne distincte, chaque observation correspond à une ligne unique, et chaque cellule contient une unité d’information atomique.
Il est formellement prohibé d’introduire des cellules fusionnées (merged cells) au sein de la plage de calcul ou de modélisation. La fusion altère la topologie matricielle du tableur, induit des discontinuités dans l’adressage direct des cellules et paralyse le bon fonctionnement des formules matricielles et des moteurs de rendu graphique. Les en-têtes doivent être cantonnés à une seule ligne continue, dénuée de sauts de ligne typographiques désordonnés.
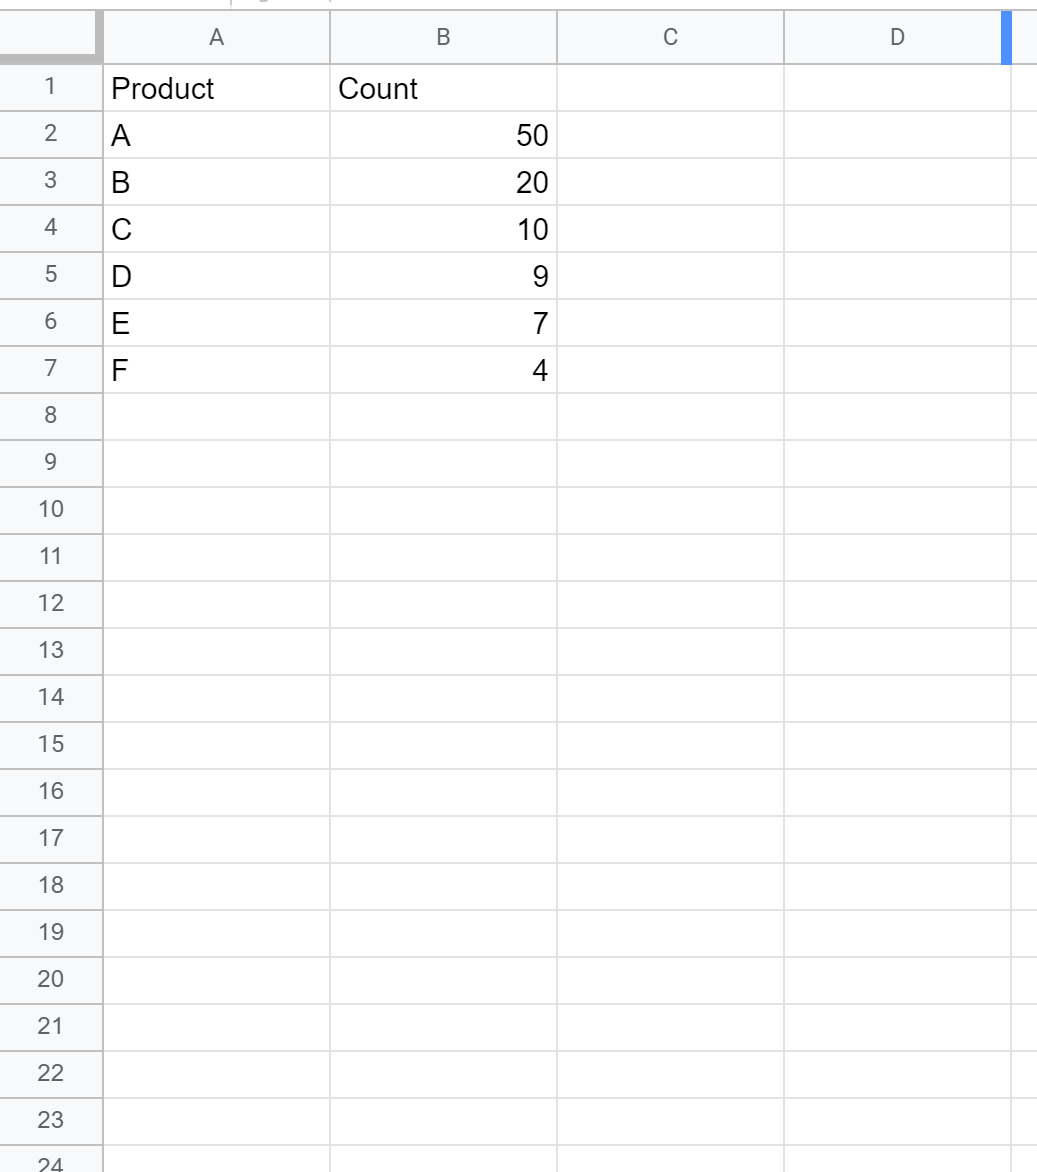
Le typage des colonnes doit être rigide : la première colonne héberge des chaînes nominales invariables représentant les catégories causales, tandis que la seconde colonne accueille exclusivement des valeurs scalaires numériques pures représentant les occurrences ou les coûts. Les valeurs manquantes ou indéterminées ne doivent jamais être laissées vides si elles dénotent une absence de défaillance ; elles doivent être imputées de la valeur zéro (0) ou faire l’objet d’un filtrage explicite en amont afin de prévenir toute rupture de chaîne algorithmique.
2.3 Gouvernance et auditabilité du classeur d’analyse
Pour conférer une valeur probante et institutionnelle à l’analyse, le classeur Google Sheets doit être structuré comme un instrument auditable et pérenne. Cette gouvernance débute par le cloisonnement des espaces : il est recommandé d’instituer une séparation physique entre la feuille des données sources brutes (immuable), la feuille de transformation/modélisation analytique, et la feuille de restitution hébergeant le tableau de bord final et son graphique de Pareto.
Il est impératif d’ériger un dictionnaire de données synthétique, hébergé sur un onglet dédié, documentant de manière exhaustive chaque variable : libellé exact, définition opérationnelle, unité de mesure, formule de calcul associée et règles d’agrégation appliquées. Ce dictionnaire prévient les ambiguïtés sémantiques entre contributeurs et fluidifie les audits ultérieurs.
Enfin, le verrouillage préventif des plages critiques (via Données > Feuilles et plages protégées) évite toute modification involontaire des formules matricielles de cumul par des utilisateurs tiers. L’analyste doit consigner la traçabilité des données primaires en renseignant la provenance des enregistrements (identifiant d’extraction de l’ERP, horodatage de la requête SQL d’origine, nom de l’auditeur) dans une cellule de métadonnées dédiée, garantissant ainsi l’intégrité de la chaîne de preuve.
3. Étape 1 : Structuration et saisie rigoureuse des données primaires
3.1 Établissement des catégories d’analyse et de taxonomie
L’élaboration d’un diagramme de Pareto exige au préalable une taxonomie descriptive robuste. Les catégories délimitées doivent impérativement respecter le principe logique MECE (Mutually Exclusive, Collectively Exhaustive, soit mutuellement exclusives et collectivement exhaustives). Chaque occurrence observée, chaque réclamation client ou chaque défaut matériel doit pouvoir être assigné à une catégorie unique sans ambiguïté classificatoire, sans recoupement sémantique avec une autre modalité, et sans omission dans le spectre des événements possibles.
Lorsque la variété taxonomique est excessive, l’analyste se trouve confronté à une démultiplication de catégories marginales ne totalisant chacune qu’une fraction infime du phénomène global. La pratique analytique commande de regrouper ces occurrences sporadiques sous une étiquette résiduelle standardisée, communément intitulée « Divers », « Autres » ou « Non spécifié ». Cette modalité synthétique doit faire l’objet d’une attention vigilante : si son poids relatif excède 10 % à 15 % du total mesuré, cela traduit une défaillance taxonomique sous-jacente nécessitant une réévaluation qualitative des définitions de causes.
La normalisation syntaxique des étiquettes en colonne A s’avère critique. L’insertion involontaire d’espaces insécables, de doubles espaces ou de variations mineures de casse (majuscule/minuscule) engendre des scissions catégorielles artificielles lors des traitements d’agrégation. L’application préventive de la fonction de nettoyage =TRIM(PROPER(A2)) ou =SUPPRESPACE(NOMPROPRE(A2)) garantit l’homogénéité textuelle absolue de la nomenclature employée.
3.2 Enregistrement et vérification des fréquences absolues
Les grandeurs quantitatives associées à chaque catégorie doivent être consignées au sein de la colonne B. Selon la problématique investiguée, cette mesure peut consister en une fréquence d’apparition (dénombrement cardinal d’occurrences d’un événement) ou en une grandeur continue pondérée (coût financier des réparations, durée d’indisponibilité machine, heures-hommes consommées). L’analyste privilégiera toujours la grandeur qui reflète le plus fidèlement le préjudice réel du système : cent pannes mineures coûtant dix euros chacune ne sauraient éclipser une panne unique immobilisant l’usine pour un million d’euros.
L’intégrité des données saisies requiert un protocole de vérification formel. L’analyste mettra en place une colonne de test temporaire recourant à la fonction =ISNUMBER(B2) (ou =ESTNUM(B2)) pour certifier que chaque cellule contient un entier ou un flottant légitime et non un résidu textuel. Simultanément, une règle d’assertion logique =B2>=0 doit être imposée : le principe de Pareto s’applique exclusivement à des grandeurs positives ou nulles, les valeurs négatives rendant conceptuellement caduque la monotonie croissante de la courbe cumulative.
Il convient également d’établir la taille globale de la cohorte d’échantillonnage par la sommation totale de la colonne B au moyen de la formule =SUM(B2:B) (ou =SOMME(B2:B)). Cette sommation constitue le dénominateur de référence indispensable aux calculs ultérieurs et valide la représentativité statistique du corpus analysé au regard du seuil minimal d’échantillonnage requis par les théorèmes fondamentaux de la statistique.
3.3 Procédure impérative de tri décroissant préalable
Le tri décroissant rigoureux des fréquences constitue la condition sine qua non algorithmique de validité du diagramme de Pareto. Contrairement à d’autres formats de visualisation où l’ordre des abscisses peut être alphabétique ou temporel, le diagramme de Pareto impose que la première barre de gauche présente l’amplitude la plus élevée, suivie de barres successivement décroissantes jusqu’à l’extrémité droite du graphique.
Pour opérer ce classement, deux méthodologies coexistent au sein de Google Sheets. La méthode directe consiste à sélectionner l’intégralité de la plage matricielle (A2:B), puis à accéder au menu Données > Trier une plage > Options avancées de tri de plage, en désignant la colonne B avec un ordre de tri décroissant (Z à A ou 9 à 0). Bien qu’efficace pour des analyses ponctuelles, cette approche statique modifie l’ordonnancement originel de la matrice source.
Dans un contexte d’ingénierie de données avancée, la préservation de l’immutabilité des données brutes prévaut. Il est alors nettement préférable de construire un tableau miroir dynamique en utilisant la fonction matricielle =SORT(A2:B; 2; FALSE) (ou =TRIER(A2:B; 2; FAUX)). Cette formulation génère automatiquement une réplique parfaitement ordonnée de la base sans altérer la feuille source. Une absence de tri altère la trajectoire de la ligne cumulative : au lieu de présenter une courbure concave caractéristique à concavité tournée vers le bas marquant la saturation, la courbe prendrait une allure chaotique ou sigmoïdale, annihilant toute lisibilité sémiotique.
4. Étape 2 : Modélisation algorithmique des fréquences cumulées
4.1 Formulation mathématique de la somme progressive
L’élaboration de la fonction de répartition cumulative empirique requiert la modélisation mathématique du cumul progressif des parts relatives. Pour chaque rang catégoriel $k$ variant de 1 à $N$, la fréquence cumulative $C_k$ s’exprime formellement comme le ratio de la somme partielle des fréquences observées jusqu’à ce rang sur la somme globale de l’échantillon :
$$C_k = \frac{\sum_{i=1}^{k} f_i}{\sum_{j=1}^{N} f_j}$$
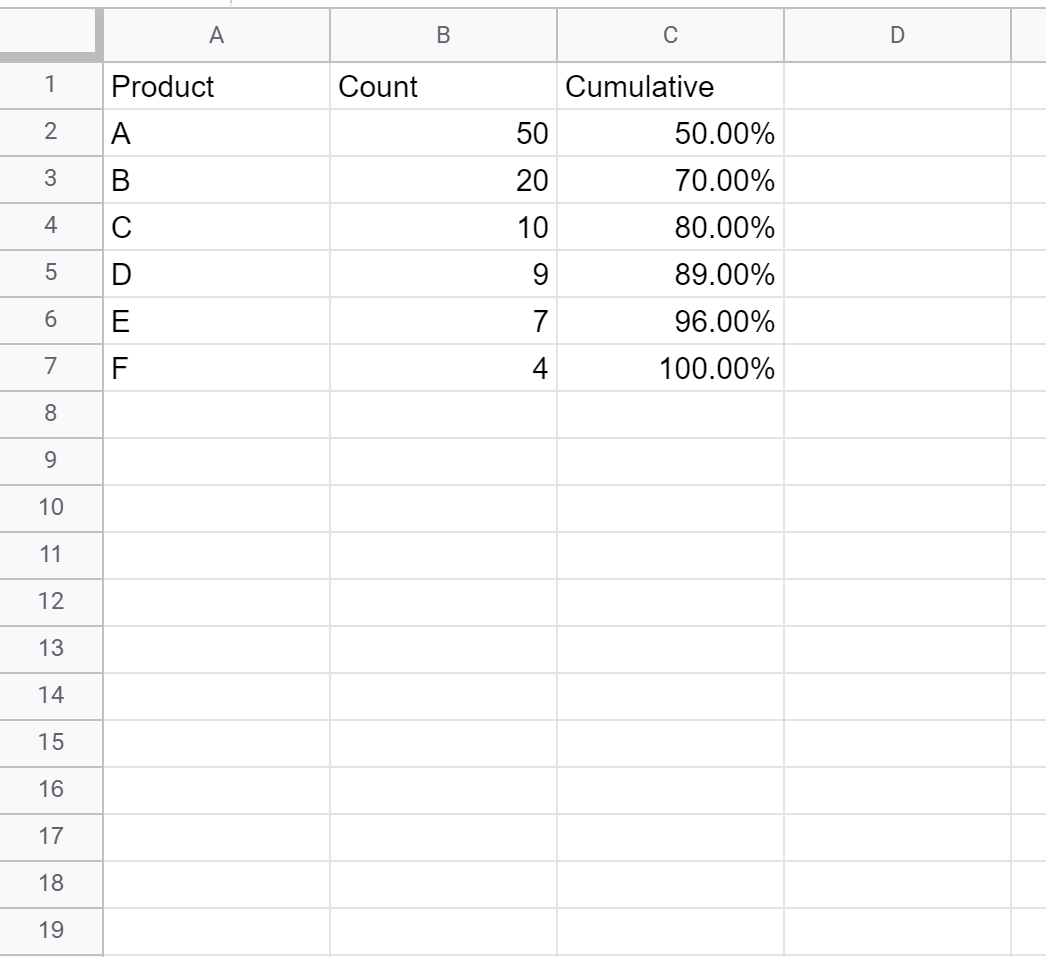
Au sein de la syntaxe de Google Sheets, cette modélisation s’articule par une combinaison magistrale de références relatives et de références absolues. Dans la première cellule de la colonne C (cellule C2), l’analyste saisit la formule suivante : =SUM($B$2:B2)/SUM($B$2:$B$15) (dans l’hypothèse où le tableau s’étend jusqu’à la ligne 15). L’usage des symboles dollar ($) joue ici un rôle mécanique décisif : le terme $B$2 ancre rigidement le point de départ de la sommation au sommet de la série numérique, tandis que le terme B2, laissé totalement relatif, se décale dynamiquement au fur et à mesure que la formule est incrémentée vers le bas.
Le dénominateur SUM($B$2:$B$15) est intégralement verrouillé par un double ancrage absolu pour maintenir le diviseur invariant sur l’ensemble des itérations verticales. Lorsque l’analyste étire la poignée de recopie jusqu’à la rangée finale, la formule de la rangée $k$ devient =SUM($B$2:Bk)/SUM($B$2:$B$N), réalisant l’agrégation continue requise avec une parfaite exactitude arithmétique.
4.2 Typage et formatage rigoureux du pourcentage cumulé
Une fois la formule propagée le long de la colonne C, le résultat par défaut renvoyé par le moteur de calcul se présente sous la forme de nombres décimaux compris dans l’intervalle [0 ; 1]. Afin d’assurer une lisibilité optimale et d’alimenter correctement les futures échelles du graphique, il convient d’appliquer explicitement un formatage de pourcentage. Cette opération s’effectue via le menu Format > Nombre > Pourcentage, ou par un clic direct sur l’icône « % » de la barre d’outils contextuelle.
Une précision minimale de deux décimales (ex. : 34,57 %) doit être configurée afin de détecter d’éventuelles subtilités d’accumulation entre des catégories de magnitudes proches. L’analyste procède alors à un contrôle de cohérence incontournable : la valeur de la dernière ligne active doit impérativement afficher 100,00 %. Toute divergence par rapport à cette valeur terminale dénonce immédiatement une corruption dans les plages référencées ou l’omission d’une portion des données lors du calcul de la sommation globale.
Sur le plan computationnel, l’analyste veillera à se prémunir contre les potentielles divisions par zéro générées lorsque le dénominateur est nul (par exemple lors de l’initialisation d’un classeur vierge). L’encapsulation de la formule au sein d’une clause conditionnelle de sécurité, telle que =IF(SUM($B$2:$B$N)=0; 0; SUM($B$2:B2)/SUM($B$2:$B$N)), confère une robustesse professionnelle à la structure logicielle.
4.3 Alternative dynamique via les formules matricielles (ARRAYFORMULA)
Bien que l’étirement manuel d’une formule relative demeure une pratique courante, elle présente une vulnérabilité opérationnelle majeure : lors de l’insertion ultérieure de nouvelles lignes ou de la modification de la volumétrie des données, les formules ne se propagent pas automatiquement, provoquant des ruptures de calcul. L’ingénierie avancée sous Google Sheets privilégie l’usage de formules matricielles autonomes.
L’implémentation de la fonction ARRAYFORMULA associée à des calculs itératifs permet de générer l’intégralité du vecteur cumulé en inscrivant une expression unique dans l’en-tête de la colonne C. Dans les versions modernes de Google Sheets, l’introduction de la fonction d’accumulation d’ordre supérieur SCAN offre la solution la plus élégante et computationnellement optimisée :
=LET(donnees; B2:B15; total; SUM(donnees); SCAN(0; donnees; LAMBDA(cumul; val; cumul + val)) / total)
Cette syntaxe alloue dynamiquement la mémoire nécessaire sans dupliquer des formules identiques sur des milliers de cellules. Elle garantit l’immutabilité du modèle de calcul : un utilisateur tiers ne peut pas corrompre involontairement une formule intermédiaire en écrasant une cellule médiane. Le temps d’exécution s’en trouve allégé, conférant au classeur une réactivité maximale, particulièrement lors de calculs matriciels complexes appliqués à de grands volumes de données.
5. Étape 3 : Instanciation et initialisation du graphique combiné
5.1 Sélection exhaustive de la plage matricielle
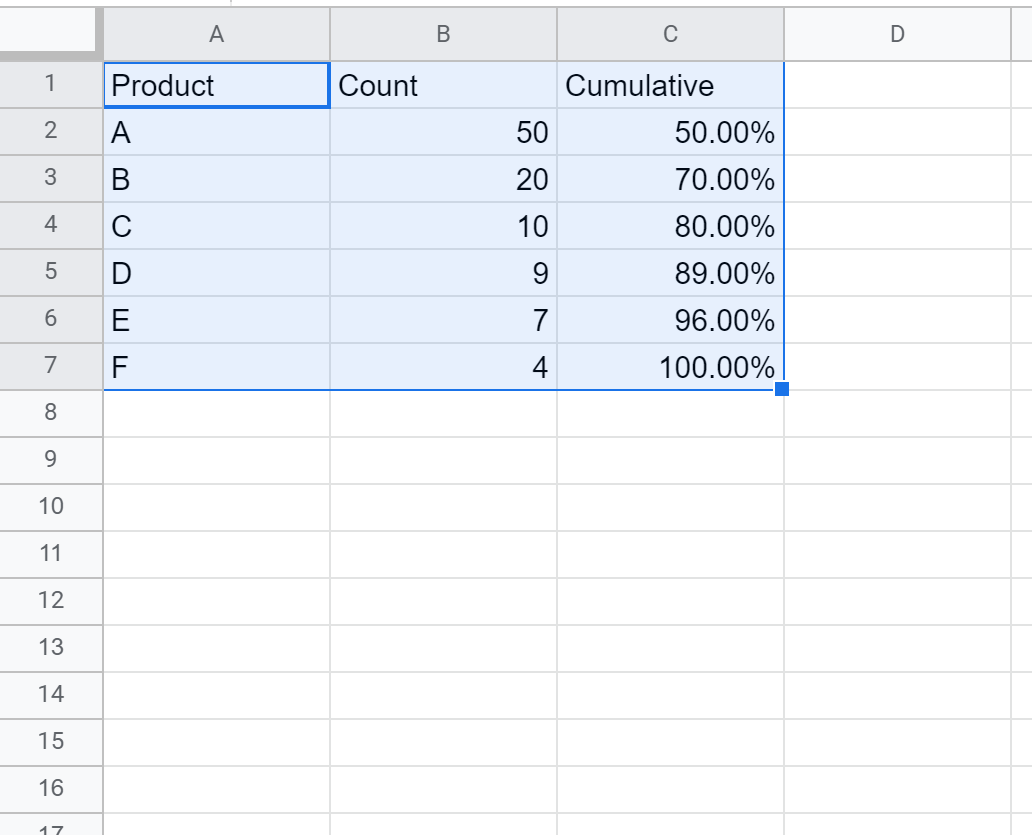
L’instanciation correcte du graphique de Pareto repose sur une sélection rigoureuse de la plage matricielle source. L’analyste doit sélectionner simultanément les trois colonnes constitutives du modèle : la colonne A (catégories nominales), la colonne B (fréquences absolues ordonnées) et la colonne C (pourcentages cumulés calculés). La sélection doit impérativement inclure la ligne 1, correspondant aux libellés d’en-têtes de colonnes (ex. : « Causes », « Nombre d’incidents », « Cumul relatif »).
Une erreur méthodologique classique consiste à intégrer dans cette sélection la ligne réservée au « Total général ». Une telle inclusion induit une distorsion catastrophique du tracé : le total, représentant par définition 100 % du volume, se matérialise sous la forme d’une barre colossale écrasant visuellement toutes les catégories individuelles, et projette la courbe cumulative au-delà des limites logiques du modèle. La ligne de total doit impérativement être exclue de la plage matricielle source du graphique.
Pour garantir la rapidité et la fiabilité de la sélection sans dérapage du curseur, il est recommandé d’utiliser les raccourcis de navigation clavier. En se positionnant sur la cellule A1, la combinaison Ctrl + Maj + Flèche Bas suivie de Ctrl + Maj + Flèche Droite (ou Cmd + Shift sur macOS) permet de capturer l’exacte empreinte matricielle avec une précision chirurgicale.
5.2 Sélection du type de graphique adapté dans l’éditeur
La matrice étant activement surlignée, l’utilisateur sollicite la création du composant graphique en naviguant vers le menu principal : Insertion > Graphique. Le panneau latéral intitulé « Éditeur de graphiques » se déploie alors automatiquement sur le flanc droit de l’interface de travail. Par défaut, le moteur heuristique de Google Sheets tente d’inférer la structure des données, proposant fréquemment un diagramme à barres empilées ou un histogramme simple inadéquat.
L’analyste doit immédiatement se rendre dans l’onglet « Configuration » de l’éditeur. Dans le menu déroulant « Type de graphique », il est capital de faire défiler les options jusqu’à la section « Graphique en courbes » ou « Graphiques combinés », et de sélectionner explicitement le Graphique combiné (Combo Chart). Ce gabarit particulier est le seul capable d’héberger nativement au sein d’une aire de traçage unique des séries de données répondant à des typologies de rendu divergentes (colonnes juxtaposées à des tracés linéaires).
Il convient ensuite de vérifier les paramètres fondamentaux de l’onglet Configuration :
- La case « Utiliser la ligne 1 comme en-têtes » doit être impérativement cochée afin que les libellés soient extraits et injectés automatiquement dans la légende.
- La case « Utiliser la colonne A comme libellés » doit être cochée pour mapper les dénominations nominales sur l’axe horizontal (X).
Cette démarche permet d’éviter l’écueil fréquent d’une catégorie alphabétique traitée à tort comme une série quantitative indépendante.
5.3 Diagnostic visuel de la configuration par défaut
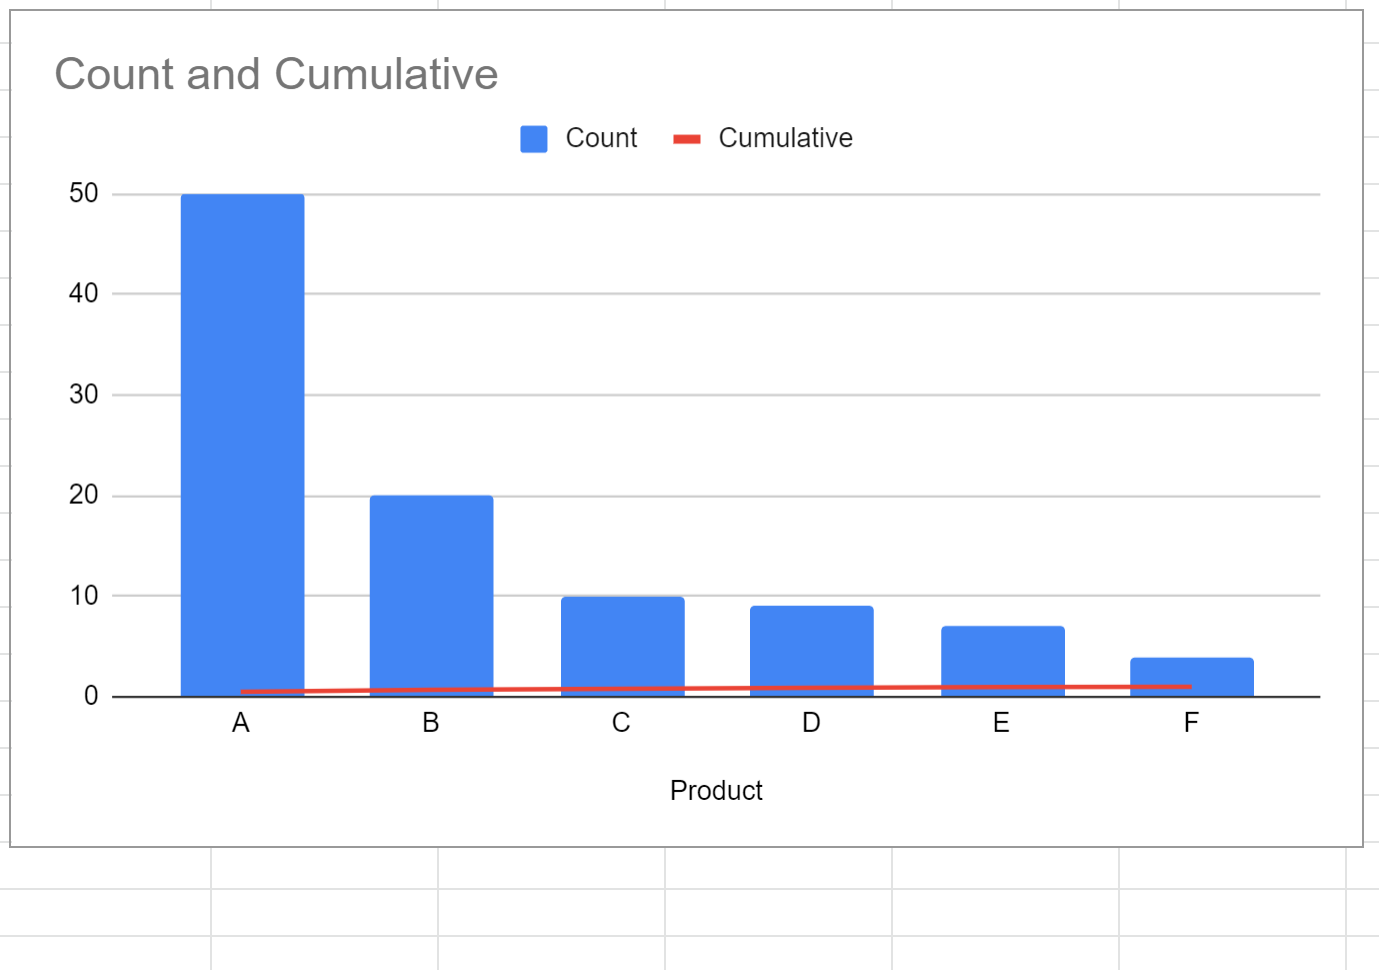
À ce stade de la procédure, l’artefact graphique généré sur la feuille présente un aspect déconcertant pour l’œil non averti. Les deux séries numériques (les fréquences absolues de la colonne B et les pourcentages cumulés de la colonne C) sont matérialisées sous la forme de barres verticales parallèles, projetées sur une échelle commune unique : l’axe vertical de gauche.
Ce choix de rendu initial génère une anomalie géométrique majeure : les valeurs cumulées oscillant strictement entre 0 et 1 (dans leur représentation scalaire sous-jacente), elles se trouvent aplaties sur la ligne de base du graphique si les fréquences de la colonne B s’élèvent à des centaines ou des milliers d’unités. La série cumulative devient un ensemble de barres imperceptibles, collées au plancher des abscisses.
L’analyste ne doit nullement s’alarmer de cette configuration préliminaire dysfonctionnelle. Il s’agit du comportement nominal de l’algorithme de rendu, qui ne possède pas la capacité prédictive d’inférer la nécessité d’un découplage métrique d’axe sans instructions déclaratives explicites. L’étape consécutive vise précisément à corriger cette topologie par l’activation et la configuration d’un axe vertical secondaire.
6. Étape 4 : Configuration experte de l’axe vertical secondaire
6.1 Dissociation et affectation de la série cumulative
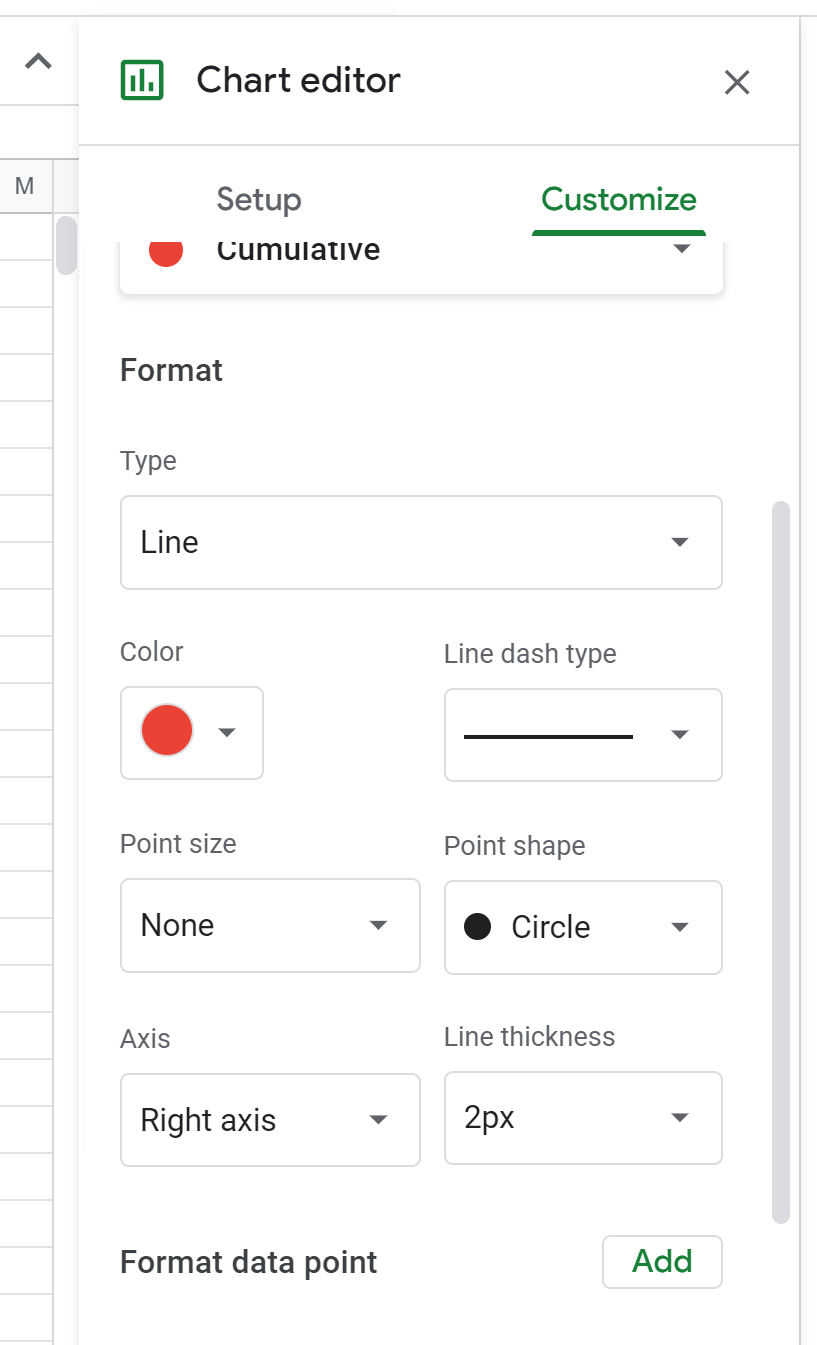
La métamorphose du graphique combiné brut en un véritable diagramme de Pareto s’opère dans l’onglet « Personnaliser » de l’éditeur de graphiques. L’opérateur clique sur l’arborescence déroulante intitulée Séries. Dans le sélecteur contextuel de séries, qui affiche par défaut l’état « Appliquer à toutes les séries », l’analyste sélectionne de manière ciblée la série dédiée aux fréquences cumulées (désignée par l’intitulé de la colonne C, par exemple « Pourcentage cumulé »).
Dès lors que la cible est isolée, deux modifications structurelles fondamentales doivent être appliquées :
- Le paramètre « Type » doit être basculé de « Colonnes » vers Ligne. Cette opération scinde sémiotiquement les représentations, associant la modalité causale discrète aux barres et l’accumulation continue à une trajectoire linéaire.
- Le paramètre critique « Axe », qui est originellement positionné sur « Axe de gauche », doit être impérativement réassigné sur l’Axe de droite.
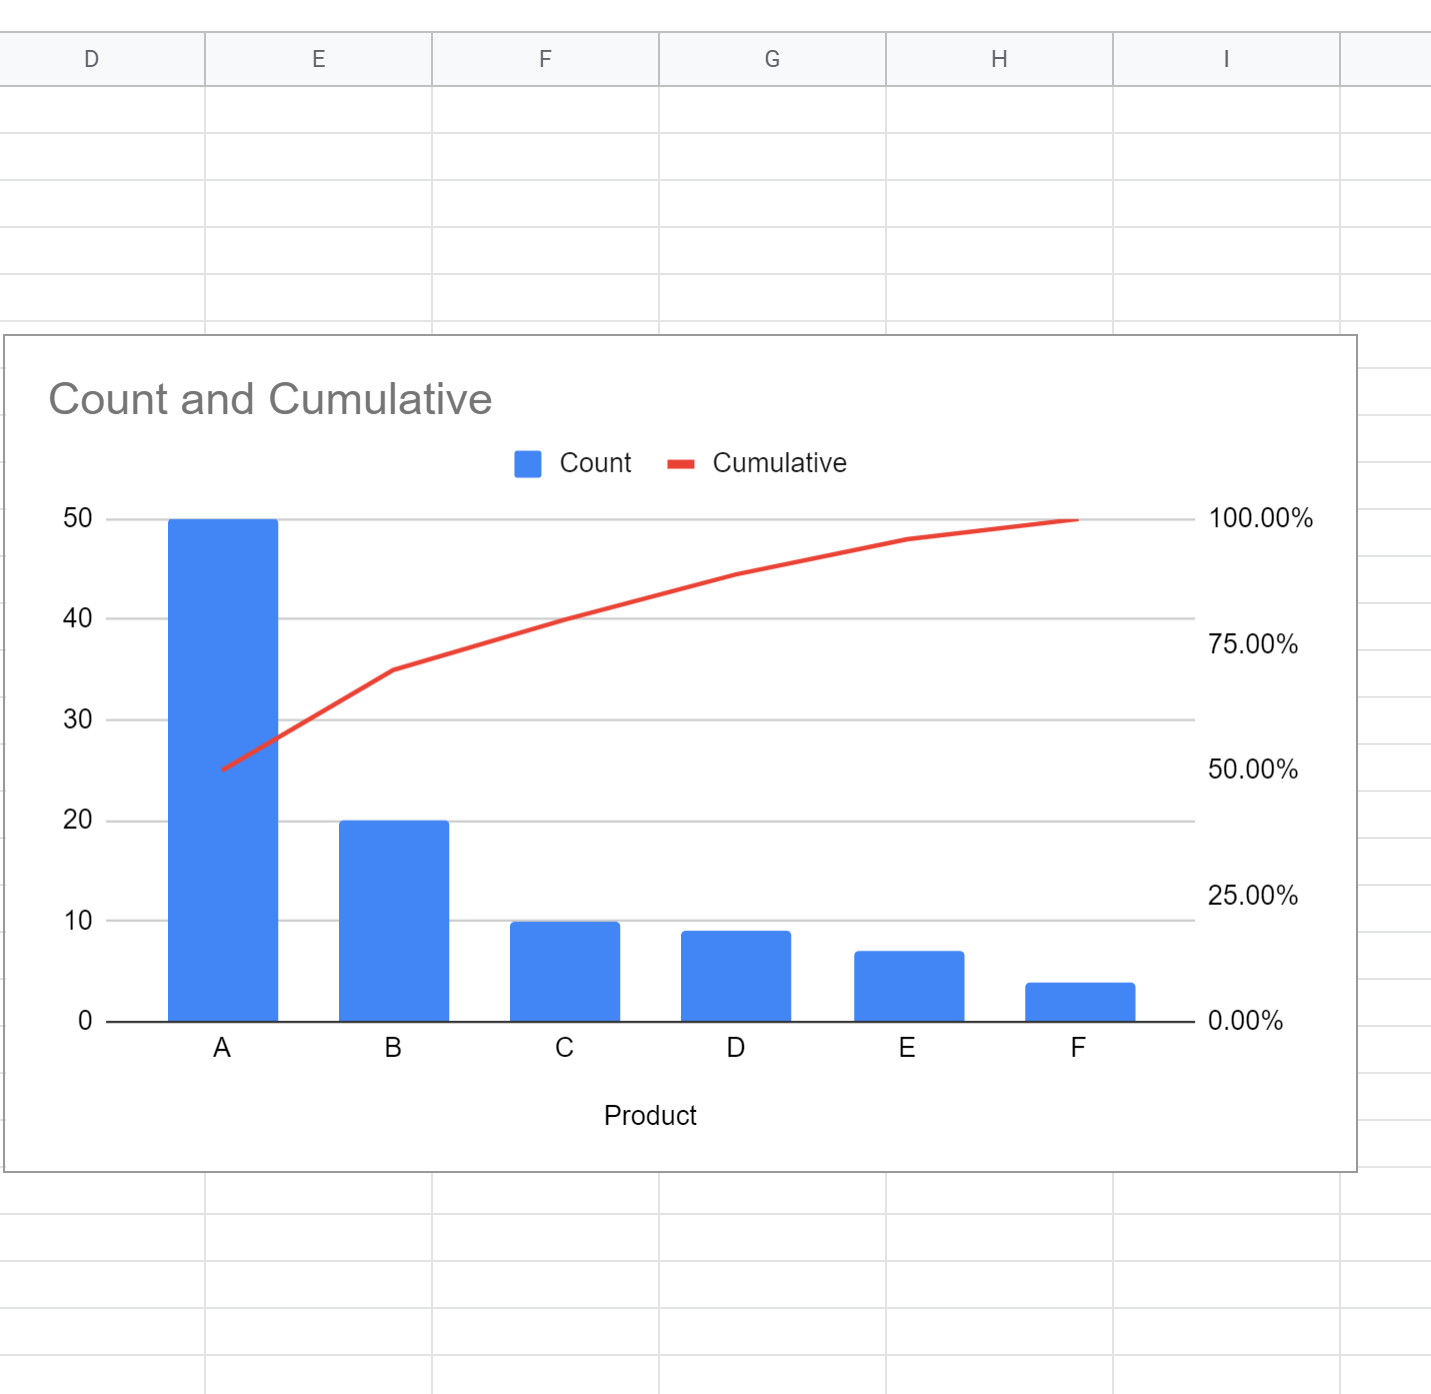
Cette réassignation vectorielle libère immédiatement la courbe cumulative de l’attraction gravitationnelle de l’échelle unitaire des fréquences. Un second axe vertical s’affiche instantanément sur le flanc droit de la zone de traçage, et la ligne brisée s’élève pour survoler l’histogramme, décrivant la courbure ascendante caractéristique recherchée.
6.2 Étalonnage mathématique et verrouillage des bornes d’axe
Bien que l’axe secondaire soit activé, son étalonnage par défaut par le moteur de Google Sheets constitue une source d’erreurs statistiques considérables. Le logiciel procède en effet à un ajustement dynamique d’échelle flottante (auto-scaling) : il borne généralement la valeur supérieure au sommet exact de la série observée (ex. : 100 %) ou, pire, ajuste arbitrairement l’échelle jusqu’à 110 % ou 120 % pour ménager un espacement graphique marginal.
Cette variabilité automatique est méthodologiquement proscrite. L’observateur a besoin d’un ancrage absolu pour évaluer mentalement le point d’inflexion des 80 %. Pour instaurer ce verrouillage mathématique, l’analyste déploie l’arborescence Axe vertical droit au sein du volet « Personnaliser ». Il convient alors de renseigner manuellement les bornes de graduation :
- La Valeur minimale doit être impérativement fixée à 0 (ou 0,00). Une origine flottante tronquant l’axe à la baisse constituerait un artefact trompeur, violant les règles fondamentales de l’intégrité visuelle des données.
- La Valeur maximale doit être rigidement verrouillée à 1 (si les données sous-jacentes sont décimales) ou à 100 (selon le mode d’encodage du formatage de cellule de la feuille). L’objectif absolu est que le sommet physique de l’axe coïncide rigoureusement avec la saturation complète du système (100 %).
Le fait de figer la valeur plafond à 100 % garantit que la courbe cumulative atteindra l’angle supérieur droit de la boîte de traçage sur la dernière modalité, matérialisant visuellement la complétude du phénomène analysé.
6.3 Harmonisation des repères de graduation
L’excellence graphique d’un tableau de bord de niveau institutionnel requiert une harmonisation visuelle entre les graduations de l’axe primaire (gauche) et celles de l’axe secondaire (droit). Lorsque les lignes de grille horizontales ne coïncident pas, le graphique génère une interférence visuelle et cognitive néfaste, rendant la lecture confuse et pénible.
Dans la section Quadrillage et graduations de l’éditeur de graphiques, l’analyste sélectionne l’axe vertical droit et paramètre un pas de graduation majeur fixe. Pour un axe gradué de 0 % à 100 %, l’intervalle optimal de discrétisation s’établit à 0,20 (soit 20 %). Cette configuration engendre cinq subdivisions régulières : 0 %, 20 %, 40 %, 60 %, 80 % et 100 %, faisant émerger de manière saillante et naturelle le seuil canonique des 80 %.
Il convient ensuite de veiller à ce que l’axe primaire gauche présente un nombre d’intervalles majeurs identique afin que les lignes de grille horizontales grises traversent l’aire de traçage de part en part en s’alignant sur les graduations de droite. Cette harmonisation structurelle renforce la lisibilité globale et élimine les illusions d’optique découlant de repères asynchrones.
7. Stylisation avancée et conformité aux standards de visualisation
7.1 Optimisation de la chromaticité selon les principes de Gestalt
La colorimétrie d’un graphique analytique ne saurait répondre à des considérations purement ornementales ; elle doit être subordonnée aux principes de la psychologie de la perception visuelle (théorie de la Gestalt). L’objectif est d’orchestrer la hiérarchie visuelle pour guider l’attention de l’analyste vers les zones de friction critique sans générer de fatigue oculaire.
Pour les barres d’histogramme de l’axe primaire, représentant la distribution catégorielle, il est hautement recommandé d’adopter une teinte sobre, froide et modérément désaturée, telle qu’un bleu ardoise, un gris anthracite ou un bleu pétrole feutré. Cette modération chromatique confère une assise stable au graphique tout en évitant l’effet de saturation visuelle propre aux palettes bariolées générées par défaut.
À l’inverse, la trajectoire cumulative de l’axe secondaire réclame une tonalité contrastée et affirmée pour faire ressortir la courbure globale. Un rouge brique profond, un pourpre chaud ou un ambre contrasté permettent de dissocier instantanément le flux continu du socle discret. L’épaisseur du trait linéaire doit être calibrée à 2 ou 3 points de pixel (px), accompagnée d’un dimensionnement discret des points de données nodaux (cercles de 4 ou 7 px), afin de matérialiser clairement les intersections catégorielles tout en prévenant les occultations visuelles mutuelles.
7.2 Intégration d’une ligne de seuil critique à 80 %
Afin de parachever la force probante du diagramme de Pareto, la mise en évidence formelle de la ligne de coupure conventionnelle des 80 % est une méthode hautement éprouvée. Bien que Google Sheets ne propose pas d’outil natif direct permettant d’injecter une constante analytique dans un graphique combiné sans modifier la structure des données, l’analyste chevronné contourne cette limite par une élégante technique d’ingénierie matricielle.
Dans la matrice de données, une quatrième colonne (colonne D) est insérée sous l’en-tête « Seuil 80 % ». Chaque cellule active de cette colonne reçoit la valeur constante 0,80 (formatée en 80,00 %). Lors de l’extension de la plage source du graphique pour inclure la colonne D (plage A1:D15), une troisième série est créée.
Dans l’onglet « Personnaliser > Séries », cette série de seuil est paramétrée avec les attributs suivants :
- Type de rendu : Ligne.
- Attribution d’axe : Axe de droite.
- Couleur : gris neutre ou vermillon atténué.
- Style de tiret : Tirets pointillés (dashed line).
- Épaisseur : 1 ou 2 px, dépourvue de points de données nodaux.
Cette construction projette une ligne horizontale rigoureuse traversant le graphique à la hauteur exacte des 80 %. Le point géométrique où la courbe cumulative franchit cette ligne de flottaison isole visuellement et immédiatement les modalités vitales de la classe A.
7.3 Configuration rigoureuse des étiquettes et légendes
L’étiquetage typographique conditionne l’autonomie documentaire du diagramme. Tout graphique destiné à être présenté à un comité de direction ou intégré dans un rapport de recherche doit pouvoir être interprété sans le recours à un commentaire verbal explicatif. Cette rigueur commence par la formulation du titre principal, qui doit énoncer une thèse ou circonscrire l’objet de recherche (ex. : « Distribution des anomalies logicielles et concentration des défaillances critiques (T3 2024) » plutôt qu’un laconique « Pareto Graph »).
Les titres d’axes doivent faire l’objet d’une déclaration explicite :
- Axe horizontal (X) : Typologie causale / Modalités de défaillance.
- Axe vertical gauche (Y1) : Fréquence brute des occurrences (Unités) ou Impact financier (€).
- Axe vertical droit (Y2) : Pourcentage cumulé du phénomène total (%).
La légende doit être déportée préférentiellement au sommet (Top) ou en pied de graphique (Bottom), hors de la zone de traçage dynamique, pour maximiser l’espace alloué au rendu des données. L’application d’étiquettes de données chiffrées au sommet des colonnes doit être mise en œuvre avec parcimonie : si le nombre de barres excède sept ou huit items, l’affichage systématique de valeurs textuelles sature l’espace. L’analyste se limitera dans ce cas à annoter uniquement les trois premières barres vitales pour maintenir la clarté sémiotique de l’ensemble.
8. Automatisation et dynamisation du graphique face aux flux de données
8.1 Utilisation des plages ouvertes pour l’ingestion continue
Dans un écosystème d’entreprise moderne, les données ne sont pas statiques ; elles s’enrichissent au rythme des transactions, des tickets d’assistance ou des enregistrements de contrôle qualité. Un graphique de Pareto dont les plages sont bornées de manière rigide (ex. : A2:D15) devient obsolète dès lors que de nouvelles observations s’insèrent au-delà de la ligne 15. Pour pérenniser l’architecture sans maintenance manuelle récurrente, il est indispensable de configurer des plages matricielles ouvertes.
La syntaxe de Google Sheets permet de désigner des colonnes entières sans spécifier d’indice de fin, par la notation A2:C. Cependant, l’inclusion directe de plages infinies dans le moteur de rendu d’un graphique combiné présente un risque majeur : le système tente d’interpréter les centaines de lignes résiduelles vides situées au bas de la feuille, générant des espaces vides béants à droite de l’histogramme ou des déformations de la courbe cumulative.
Pour immuniser le flux de calcul contre cette distorsion, l’analyste fait transiter les données brutes à travers une table de traitement intermédiaire filtrée. L’application de la fonction =FILTER(A2:C; A2:A <> "") garantit que seules les lignes porteuses d’une modalité nominale effective sont transmises à la matrice de calcul du graphique de Pareto, excluant dynamiquement les vides et automatisant l’ajustement morphologique de la visualisation lors de chaque saisie nouvelle.
8.2 Construction d’une architecture recalculée par QUERY
Le nec plus ultra de l’ingénierie sous Google Sheets réside dans l’utilisation conjointe de la fonction QUERY, qui intègre les instructions déclaratives du langage SQL directement au cœur du tableur. Dans de nombreux scénarios opérationnels, les données brutes proviennent d’un journal transactionnel d’incidents non agrégé où chaque ligne représente un ticket d’anomalie unitaire, sans tri préalable ni regroupement.
La fonction QUERY permet d’opérer la taxonomie, le dénombrement sommatoire et le tri décroissant en une seule formule unifiée :
=QUERY(DonneesBrutes!A2:B; "SELECT A, COUNT(B) WHERE A IS NOT NULL GROUP BY A ORDER BY COUNT(B) DESC LABEL COUNT(B) 'Volume d''incidents'")
Cette expression réalise les tâches suivantes :
- Elle filtre automatiquement les entrées nulles ou vierges.
- Elle regroupe les occurrences sous leurs dénominations respectives.
- Elle calcule le volume agrégé de chaque catégorie.
- Elle applique le tri d’amplitude strictement décroissante indispensable au principe de Pareto.
À partir de cette table calculée dynamiquement, l’analyste n’a plus qu’à adjoindre la colonne de cumul algorithmique vue précédemment. Dès lors, le diagramme de Pareto devient entièrement auto-réactif : toute modification, adjonction ou suppression effectuée dans le journal d’origine réactualise instantanément l’agrégation, réordonne les barres et recalcule la courbe cumulative en temps réel sans intervention humaine.
8.3 Validation des données et contrôles d’intégrité programmés
L’automatisation d’un classeur analytique amplifie le risque de propagation d’erreurs en cascade si des mécanismes de verrouillage préventif ne sont pas déployés. Afin de garantir l’immunité structurelle de la chaîne de données, l’analyste mettra en place des contrôles de validation des données stricts (via Données > Règles de validation des données) sur les colonnes d’ingestion primaire.
Une liste fermée de critères de défaillance doit être imposée au moyen d’un menu déroulant standardisé alimenté par le dictionnaire de données. Cette restriction prévient les variantes typographiques (« Panne Électrique » versus « panne electrique ») qui feraient imploser l’agrégation de la fonction QUERY en créant des catégories fantômes distinctes, diluant ainsi le poids relatif des facteurs majeurs.
En parallèle, l’analyste instaurera un bloc d’alertes conditionnelles au sommet du tableau de bord. Au moyen d’une cellule de contrôle booléenne contenant la formule =IF(ROUND(MAX(C2:C); 4)=1; "CONFORME"; "ERREUR ARITHMÉTIQUE"), le gestionnaire vérifie en un coup d’œil l’intégrité du cumul. L’application d’un format conditionnel teignant cette cellule en vert émeraude ou en pourpre écarlate informe immédiatement l’opérateur de la validité mathématique du graphique avant toute exploitation décisionnelle.
9. Analyse critique et interprétation statistique des résultats
9.1 Localisation du point de bascule et segmentation ABC
L’exploitation analytique du diagramme de Pareto achevé consiste à délimiter rationnellement les zones de criticité opérationnelle au moyen de la méthode de classification ABC, dérivée des théories de gestion des stocks de General Electric. Cette segmentation subdivise l’abscisse du graphique en trois compartiments distincts :
- Zone A (Les facteurs vitaux) : Comprise entre le point d’origine et le point d’inflexion où la courbe cumulative atteint environ 70 % à 80 %. Cette zone ne concentre généralement que 15 % à 20 % de l’éventail des causes recensées. C’est sur ce segment étroit que doit être concentrée l’intégralité des budgets de correction, d’automatisation ou d’audit prioritaire, chaque action corrective y produisant un rendement marginal maximal.
- Zone B (Les facteurs intermédiaires) : Elle couvre typiquement les causes situées entre 80 % et 95 % du cumul d’impact. Elle correspond à des anomalies d’importance modérée qui feront l’objet d’interventions programmées dans un second temps, lorsque la classe A sera stabilisée.
- Zone C (La longue traîne des facteurs triviaux) : Englobant le segment résiduel de 95 % à 100 %, elle rassemble une multitude de défaillances rares ou dispersées. La rationalité économique et managériale commande formellement d’éviter tout sur-investissement sur ces causes : le coût d’éradication de ces événements marginaux excède presque systématiquement le préjudice direct subi par l’organisation.
9.2 Mise en garde contre les biais d’interprétation causale
Le diagramme de Pareto est un instrument purement descriptif et non prédictif ou téléologique ; son déploiement exige une vigilance méthodologique pour écarter des biais d’interprétation qui mèneraient à des actions inopérantes. Le premier piège réside dans le paralogisme classique confondant corrélation empirique et causalité substantielle (Cum hoc ergo propter hoc). Ce n’est pas parce qu’un symptôme particulier présente la fréquence la plus élevée qu’il constitue le moteur causal primaire du dysfonctionnement systémique.
Le second danger majeur relève de la négligence des événements extrêmes à faible fréquence mais à impact catastrophique, théorisés par Nassim Nicholas Taleb sous le concept de « cygne noir » (Black Swan). Par sa structure même, le diagramme de Pareto relègue les événements très peu fréquents dans la masse résiduelle de la classe C. Si une défaillance n’est survenue qu’une seule fois dans l’année, mais qu’elle a provoqué l’explosion d’une chaudière ou une perte humaine, la modélisation standard par dénombrement d’occurrences la dissimulera dans la longue traîne, incitant à tort le management à l’ignorer. D’où l’impératif absolu de toujours pondérer le classement par la sévérité monétaire ou sécuritaire plutôt que par le seul volume d’occurrences brutes.
Enfin, l’analyste prendra en considération la dimension temporelle de l’échantillonnage. Une instabilité saisonnière ou une dérive conjoncturelle peut masquer l’émergence rapide d’un problème neuf. Le croisement systématique du diagramme de Pareto avec des cartes de contrôle chronologiques de Shewhart et des diagrammes de causes à effet d’Ishikawa (méthode des 5M) prévient l’isolement analytique et assure un diagnostic en profondeur des causes racines.
9.3 Évaluation de la sensibilité statistique du modèle
L’allure de la courbe cumulative d’un diagramme de Pareto est sensible aux choix taxinomiques initiaux. L’analyste doit pratiquer une analyse de sensibilité pour évaluer la robustesse de ses conclusions. Le premier facteur de variabilité réside dans le niveau d’agrégation des catégories (grain des données). Si l’on sur-découpe artificiellement une cause majeure en cinq sous-catégories pointues, on disperse son volume global ; les cinq segments s’affaissent individuellement dans le classement, induisant une dilution trompeuse de la loi des 80/20.
Inversement, le regroupement paresseux d’occurrences hétérogènes au sein d’une catégorie parapluie disproportionnée (ex. : « Erreurs matérielles diverses ») gonfle artificiellement la première barre du graphique, offrant l’illusion trompeuse d’un levier d’action unique alors que les leviers sous-jacents sont fragmentés et incompatibles. La stabilité du modèle de Pareto s’évalue en faisant varier légèrement les frontières taxonomiques : si les 20 % des catégories vitales demeurent structurellement constants malgré les variations de granularité, l’inférence décisionnelle peut être qualifiée de robuste.
La taille de l’échantillon conditionne également la significativité statistique de la courbure. Sur un échantillon trop étriqué (moins de 30 à 50 observations), la variance d’échantillonnage est trop élevée pour autoriser une segmentation ABC définitive. L’analyste doit attester d’une profondeur d’historique suffisante avant d’engager des plans de transformation structurels fondés sur cette visualisation.
10. Résolution des dysfonctionnements et anomalies techniques courantes
10.1 Correction des anomalies d’échelle et d’inversion d’axes
Un dysfonctionnement technique fréquemment observé lors de la manipulation de l’éditeur de Google Sheets réside dans le plafonnement aberrant de l’axe secondaire à des valeurs irréalistes, telles que 10 000 % ou 100 000 %. Ce phénomène survient lorsque l’utilisateur encode manuellement les bornes de graduation dans le volet « Axe vertical droit » en écrivant le chiffre 100 alors que les données de la colonne source sont déjà formatées avec le type Pourcentage natif de Google Sheets.
Dans l’architecture interne du tableur, le format pourcentage applique un facteur multiplicatif visuel par cent : le nombre décimal réel stocké est 1. Dès lors, si l’analyste renseigne la valeur 100 comme plafond d’un axe formaté en pourcentage, le moteur interprète cette saisie comme 10 000 % (100 x 100 %), comprimant la courbe cumulative tout en bas du graphique. La rectification est immédiate : il convient de saisir strictement le scalaire 1 (ou 1,00) dans la case « Valeur maximale » pour réaligner le plafond à l’exactitude des 100,00 %.
Une autre anomalie visuelle réside dans l’inversion involontaire des affectations de séries, où les barres s’ancrent sur l’axe droit et la ligne sur l’axe gauche. Pour restaurer l’ordre canonique, l’analyste doit se rendre dans Personnaliser > Séries, sélectionner successivement chaque série et réassigner formellement les fréquences brutes à l’axe gauche et les pourcentages à l’axe droit. Si les étiquettes horizontales se chevauchent de façon illisible le long de l’axe X, l’analyste activera l’option d’inclinaison angulaire (30°, 60° ou 90°) dans le volet Axe horizontal afin de fluidifier la typographie.
10.2 Dépannage des ruptures de calcul dans les plages dynamiques
L’affichage soudain des messages d’erreur #DIV/0! ou #REF! dans la colonne de cumul paralyse immédiatement le tracé du graphique de Pareto. L’erreur #DIV/0! apparaît généralement lors de l’application de formules matricielles ouvertes sur des plages où la sommation globale retourne zéro (en l’absence provisoire d’enregistrements). Elle se résout définitivement par l’encapsulation de la formule de cumul dans une fonction préventive : =IFERROR(formule; 0) ou =SI.ERREUR(formule; 0).
L’erreur #REF!, pour sa part, trahit généralement une rupture de continuité référentielle consécutive à la suppression physique brutale d’une ligne ou d’une colonne servant d’ancrage absolu (typiquement la cellule $B$2). Pour éviter cette vulnérabilité, il est recommandé de substituer l’adressage direct par la fonction INDEX, par exemple INDEX(B:B; 2), qui ne subit pas d’invalidation lors des restructurations de la grille de saisie.
Enfin, lors de l’insertion de lignes de données médianes dans un tableau semi-automatisé, les formules à incrément glissant SUM($B$2:B2) peuvent subir des décalages d’indices majeurs, sautant la nouvelle ligne ou comptabilisant deux fois une même cellule. L’adoption définitive des architectures matricielles décrites en section 4.3 (à base de SCAN ou de QUERY) élimine structurellement ces risques d’anomalies computationnelles en centralisant la logique algorithmique dans une cellule unique maîtresse.
10.3 Réparation des comportements graphiques inattendus de Google Sheets
Il arrive parfois que la courbe cumulative disparaisse purement et simplement de l’aire de traçage, bien que sa présence soit déclarée dans la légende du graphique. Cette anomalie résulte presque toujours d’une coercition textuelle involontaire : si les cellules de la colonne C ont été accidentellement typées en « Texte brut » (souvent lors d’un copier-coller depuis une source web externe), Google Sheets refuse d’interpoler des coordonnées géométriques à partir de caractères alphabétiques.
La restauration du composant s’opère en sélectionnant la colonne C, puis en forçant le format via Format > Nombre > Pourcentage. Si la ligne ne réapparaît pas instantanément, il suffit de cocher puis décocher l’option « Traiter les étiquettes comme du texte » au sein de l’onglet Configuration de l’éditeur de graphiques pour forcer le rafraîchissement du moteur de rendu.
Dans les configurations comportant un volume très élevé de catégories nominales (plus de 30 barres), Google Sheets a tendance à omettre unilatéralement un certain nombre de libellés sur l’axe des abscisses pour éviter les collisions visuelles, désynchronisant l’interprétation des barres de droite. Pour contrer ce bridage algorithmique, l’analyste doit modifier le paramètre du nombre d’éléments affichés dans les options avancées de l’axe horizontal, ou opérer un regroupement plus vigoureux des catégories résiduelles sous l’étiquette « Divers », restituant au diagramme sa mission d’épuration visuelle sélective.
11. Études de cas appliquées : Du management opérationnel aux sciences humaines
11.1 Application à la gestion de la qualité et réduction des défaillances
Pour illustrer la mise en œuvre pratique de cette méthodologie, considérons une usine d’injection plastique automobile confrontée à un taux de rebut inacceptable de 8,4 % sur sa chaîne de production de tableaux de bord. Au cours d’un trimestre d’audit rigoureux, 12 450 pièces défectueuses ont été collectées et soumises à une inspection de métrologie industrielle. La nomenclature taxonomique a identifié dix causes de défaillance distinctes : rayures de surface, bavures thermiques, retassures d’injection, déformations géométriques, bulles d’air emprisonnées, craquelures structurales, décoloration pigmentaire, inclusions de corps étrangers, voile de surface et dimensions hors tolérance.
La structuration matricielle des données au sein de Google Sheets et l’application du calcul de cumul progressif ont généré la modélisation chiffrée suivante :
- Bavures thermiques : 5 620 pièces (45,14 % du total) | Cumul : 45,14 %
- Retassures d’injection : 3 480 pièces (27,95 % du total) | Cumul : 73,09 %
- Bulles d’air emprisonnées : 1 120 pièces (9,00 % du total) | Cumul : 82,09 %
- Rayures de surface : 650 pièces (5,22 % du total) | Cumul : 87,31 %
- Déformations géométriques : 480 pièces (3,86 % du total) | Cumul : 91,17 %
- Dimensions hors tolérance : 390 pièces (3,13 % du total) | Cumul : 94,30 %
- Craquelures structurales : 280 pièces (2,25 % du total) | Cumul : 96,55 %
- Décoloration pigmentaire : 210 pièces (1,69 % du total) | Cumul : 98,24 %
- Inclusions étrangères : 130 pièces (1,04 % du total) | Cumul : 99,28 %
- Voile de surface : 90 pièces (0,72 % du total) | Cumul : 100,00 %
L’instanciation du diagramme de Pareto met en évidence une rupture de pente spectaculaire dès la troisième modalité. L’observation empirique confirme la loi de puissance : les deux premières défaillances (bavures thermiques et retassures) concentrent à elles seules 73,09 % du volume global de rebuts de l’usine, et l’adjonction des bulles d’air franchit le seuil critique avec 82,09 %. Ce constat a conduit le comité de direction à suspendre les projets d’amélioration périphérique pour focaliser l’ensemble des ressources d’ingénierie sur le réglage thermique des presses et le calibrage de la pression de maintien. L’éradication ciblée de ces deux défaillances dominantes a réduit le taux global de rebut à 2,3 % en trois mois, dégageant une économie annuelle brute de 480 000 euros pour un investissement matériel minime.
11.2 Application à l’ergonomie cognitive et à la recherche utilisateur (UX)
Le champ de l’ingénierie logicielle et de la recherche utilisateur (UX) offre un terrain d’application particulièrement fécond pour le principe de Pareto. Considérons la refonte d’une plateforme transactionnelle de commerce en ligne dont le taux d’abandon de panier au stade final d’encaissement atteignait un niveau anormalement élevé de 68 %. Une cohorte de 2 500 sessions utilisateur interrompues a été minutieusement décortiquée à l’aide d’enregistrements télémétriques et d’entretiens qualitatifs standardisés afin d’établir la taxonomie des points de friction cognitifs.
Huit irritants ergonomiques majeurs ont été isolés et quantifiés dans Google Sheets :
- Imposition de créer un compte utilisateur préalable (au lieu d’un achat invité) : 1 150 abandons (46,00 %).
- Frais de livraison découverts tardivement à la dernière étape : 675 abandons (27,00 %).
- Refus inexpliqué de certains protocoles de paiement électronique : 280 abandons (11,20 %).
- Interface de saisie du numéro de carte bancaire rigide et rejetant les espaces : 175 abandons (7,00 %).
- Navigation ambiguë entre les étapes de validation : 95 abandons (3,80 %).
- Lenteur de chargement de la page de récapitulatif (> 4 secondes) : 65 abandons (2,60 %).
- Absence de badges de sécurité perçus comme rassurants : 40 abandons (1,60 %).
- Champs de formulaire facultatifs inutilement intrusifs : 20 abandons (0,80 %).
Le tracé du diagramme de Pareto a agi comme un puissant débloqueur d’arbitrage managérial au sein de l’équipe produit. Alors que les développeurs réclamaient une refonte intégrale de l’architecture technique des serveurs pour réduire les millisecondes de latence (action relevant de la classe C n’expliquant que 2,6 % des pertes), le graphique a démontré mathématiquement que les deux premiers irritants représentaient à eux seuls 73,00 % des abandons totaux. L’introduction immédiate d’un mode de commande « invité » sans création de compte et l’affichage transparent des frais logistiques dès la fiche produit ont permis de récupérer instantanément 41 % des ventes égarées, maximisant le retour sur investissement du sprint d’ingénierie.
11.3 Application à la psychologie des organisations et à la gestion du temps
Les sciences humaines et la psychologie du travail mobilisent également le diagramme de Pareto pour analyser la distribution de la charge mentale et l’épuisement professionnel (burnout) des cadres dirigeants au sein d’environnements hyperconnectés. Une étude ergonomique longitudinale menée auprès de quarante directeurs fonctionnels a documenté l’intégralité des interruptions de tâches subies au cours d’une période d’observation cumulée de 1 200 heures de travail effectif.
L’analyse catégorielle a comptabilisé 4 380 micro-ruptures attentionnelles, réparties selon la classification taxonomique suivante :
- Notifications instantanées de messagerie collaborative (Slack, Teams) : 1 920 interruptions (43,84 %).
- Courriels électroniques non sollicités appelant une lecture urgente : 1 280 interruptions (29,22 %).
- Sollicitations orales spontanées de collaborateurs sans rendez-vous : 510 interruptions (11,64 %).
- Appels téléphoniques directs sur mobile professionnel : 290 interruptions (6,62 %).
- Réunions de travail imprévues convoquées le jour même : 180 interruptions (4,11 %).
- Problèmes logistiques matériels (imprimantes, accès réseau, visioconférence) : 110 interruptions (2,51 %).
- Alertes de calendrier pour tâches différées : 60 interruptions (1,37 %).
- Parasitage sonore ambiant en espace ouvert de travail : 30 interruptions (0,69 %).
La projection de ces grandeurs sur un diagramme de Pareto révèle une concentration dramatique : les notifications de messagerie et les courriels constituent les « facteurs vitaux » de la classe A, cumulant à eux deux 73,06 % de la dispersion attentionnelle globale. Les interventions d’ergonomie organisationnelle ne se sont donc pas égarées dans des mesures anecdotiques comme l’insonorisation acoustique des bureaux (classe C, 0,69 %), mais ont ciblé le protocole numérique structurel : désactivation unilatérale des notifications push, instauration de plages horaires asynchrones de déconnexion obligatoire et regroupement des consultations d’e-mails à deux créneaux journaliers fixes. L’évaluation longitudinale a enregistré une chute de 62 % des marqueurs de stress physiologique perçu et une augmentation de 45 % du temps consacré aux travaux de fond stratégiques à haute valeur cognitive ajoutée.
12. Protocole de pérennisation, gouvernance et diffusion académique
12.1 Exportation vectorielle et insertion dans des publications scientifiques
L’aboutissement d’une recherche empirique ou d’un rapport de diagnostic industriel exige une diffusion graphique répondant aux plus hauts standards éditoriaux internationaux. Une erreur fréquente consiste à capturer le graphique de Google Sheets au moyen d’un outil de capture d’écran matricielle (format PNG ou JPEG basse définition). Ce procédé introduit une pixellisation destructive des polices de caractères et une dégradation du tracé des lignes cumulatives lors de l’impression sur papier couché ou de la consultation sur écrans à très haute densité de pixels (écrans Retina).
Pour préserver l’intégrité visuelle du diagramme, l’analyste doit impérativement solliciter l’exportation vectorielle native de Google Sheets. Cette action s’exécute en cliquant sur le menu vertical contextuel à trois points situé dans l’angle supérieur droit du cadre du graphique, puis en sélectionnant Télécharger > Document PDF (.pdf) ou Télécharger > Graphique vectoriel adaptatif (.svg).
Le format SVG (Scalable Vector Graphics) préserve l’intégralité des primitives géométriques : les barres de fréquence, la trajectoire de la courbe et chaque caractère typographique des étiquettes restent des objets mathématiques indépendants, garantissant un rendu d’une netteté parfaite à n’importe quel coefficient d’agrandissement typographique. Ce standard vectoriel permet en outre une retouche esthétique avancée au sein de logiciels de mise en page professionnels (tels qu’Adobe Illustrator ou Inkscape) pour ajuster l’épaisseur des contours et assurer une conformité rigoureuse avec les directives stylistiques des revues académiques à comité de lecture (normes APA 7e édition).
12.2 Stratégies de partage collaboratif et protection des formules
La puissance intrinsèque de Google Sheets réside dans son architecture infonuagique nativement collaborative. Cependant, cette ouverture constitue une source de vulnérabilité lorsque plusieurs intervenants interagissent simultanément sur un classeur critique. La gouvernance du fichier commande d’appliquer une politique stricte de contrôle d’accès basée sur le principe du moindre privilège.
L’accès aux tiers non techniciens doit être borné au statut de « Lecteur » ou de « Commentateur », empêchant toute modification intempestive de la disposition des colonnes. Si des collaborateurs doivent impérativement saisir de nouvelles observations, l’analyste cloisonnera strictement l’espace : la feuille de saisie primaire reste accessible en écriture, tandis que la feuille de modélisation mathématique et la feuille du tableau de bord graphique sont intégralement verrouillées via Données > Feuilles et plages protégées.
L’analyste configure des permissions d’édition exclusives sur les plages hébergeant les formules de cumul progressif et les matrices QUERY, interdisant à tout autre utilisateur de les altérer. L’exploitation rigoureuse de l’Historique des versions (accessible via Fichier > Historique des versions > Afficher l’historique des versions) offre un filet de sécurité institutionnel : chaque modification est horodatée et nominativement tracée, autorisant une restauration instantanée d’un état antérieur intègre en cas de corruption accidentelle.
12.3 Synthèse des étapes critiques et liste de contrôle finale
Pour clore ce protocole méthodologique, l’analyste procédera à un audit systématique de conformité avant toute officialisation ou publication de son diagramme de Pareto. Cette vérification s’articule autour d’une grille de contrôle rigoureuse en douze points d’assertion :
- 1. Taxonomie MECE : Les catégories nominales de la colonne A sont-elles strictement mutuellement exclusives et collectivement exhaustives ?
- 2. Épuration typographique : La nomenclature a-t-elle été purgée de ses espaces parasites et variations de casse via des fonctions de nettoyage textuel ?
- 3. Positivité des grandeurs : L’intégralité des valeurs quantitatives de la colonne B est-elle strictement positive ou nulle ?
- 4. Ordonnancement préalable : Les données sont-elles triées selon un ordre d’amplitude strictement décroissant de gauche à droite ?
- 5. Immutabilité des sources : Le tri a-t-il été implémenté au moyen d’une fonction dynamique (
SORTouQUERY) préservant l’intégrité des enregistrements bruts ? - 6. Continuité algorithmique : La formule de cumul emploie-t-elle convenablement l’ancrage semi-absolu (
$B$2:B2) ou une formule matricielle autonome (SCAN) ? - 7. Convergence terminale : Le pourcentage cumulé de la rangée finale atteint-il rigoureusement la valeur de 100,00 % ?
- 8. Exclusion du total : La ligne de sommation générale a-t-elle été formellement exclue de la plage matricielle alimentant le graphique ?
- 9. Découplage de la série : La série cumulative est-elle dissociée sous forme de tracé linéaire ancré sur l’axe vertical secondaire de droite ?
- 10. Verrouillage des bornes : L’axe vertical secondaire droit est-il rigidement borné entre les valeurs scalaires 0 et 1 (0 % et 100 %) ?
- 11. Hiérarchie chromatique : Les barres discrètes présentent-elles une chromaticité sobre et contrastée par rapport à la courbe continue, conformément aux règles de Gestalt ?
- 12. Autonomie sémiotique : Les titres du graphique et des trois axes (X, Y1, Y2) sont-ils explicitement déclarés avec leurs unités de mesure respectives ?
La validation méthodique de l’ensemble de ces critères atteste de la parfaite robustesse technique, arithmétique et sémiologique du travail d’analyse. Ainsi architecturé au sein de Google Sheets, le diagramme de Pareto transcende le simple statut d’illustration graphique pour s’ériger en un véritable instrument d’aide à la décision stratégique, alliant la précision de la modélisation probabiliste à la clarté de la communication managériale contemporaine.
Références
Juran, J. M. (1951). Quality control handbook (1re éd.). McGraw-Hill.
Juran, J. M. (1975). The non-Pareto principle; mea culpa. Quality Progress, 8(5), 8-9.
Pareto, V. (1896). Cours d’économie politique. F. Rouge / F. Pichon.
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer. https://doi.org/10.1007/0-387-28695-0