
L’évaluation rigoureuse de la concordance entre deux instruments de mesure quantitative constitue un jalon fondamental de la recherche clinique, biomédicale et psychométrique contemporaine. Lorsqu’un investigateur souhaite introduire une nouvelle technique d’évaluation, qu’il s’agisse d’un biomarqueur digital, d’une échelle psychométrique abrégée ou d’un capteur télémétrique innovant, la question primordiale n’est pas simplement d’établir si le nouvel outil est corrélé avec la méthode de référence établie, mais bien de déterminer si les deux modalités peuvent être employées de manière interchangeable sans compromettre la précision du diagnostic ou la validité des conclusions empiriques. Pendant plusieurs décennies, la pratique courante a consisté à s’appuyer sur des coefficients de corrélation linéaire conventionnels, masquant ainsi des écarts systématiques préjudiciables et induisant en erreur des générations entières de chercheurs.
Face à cette carence méthodologique majeure, les statisticiens britanniques John Martin Bland et Douglas G. Altman ont proposé, au milieu des années 1980, une approche graphique et paramétrique novatrice qui a profondément révolutionné la métrologie appliquée. En substituant à l’analyse de régression classique une modélisation directe des différences individuelles en fonction des magnitudes moyennes des mesures, la méthode de Bland-Altman permet d’isoler explicitement le biais systématique moyen et d’établir des intervalles de tolérance empiriques, universellement désignés sous le terme de limites d’agrément à quatre-vingt-quinze pour cent. Cette méthodologie offre une translucidité visuelle sans précédent, permettant d’identifier immédiatement les biais constants, les hétéroscédasticités structurelles ainsi que la présence pernicieuse de biais proportionnels au fil du continuum de mesure.
L’environnement logiciel et statistique R s’affirme aujourd’hui comme le véhicule analytique d’excellence pour concevoir, personnaliser et interpréter ces représentations avec une minutie scientifique irréprochable. Ce guide exhaustif a pour vocation d’exposer de manière systématique, pas à pas et dans toute son étendue théorique et pratique, le processus complet d’implémentation du graphique de Bland-Altman dans R. En parcourant les soubassements épistémologiques de la concordance, la structuration programmatique des structures de données appariées, le calcul des estimateurs d’accord et l’élaboration de graphiques vectoriels publiables conformes aux normes académiques internationales, ce tutoriel fournira aux cliniciens, psychométriciens et scientifiques des données les repères techniques nécessaires pour valider l’interchangeabilité de leurs dispositifs d’évaluation.
1. Introduction aux fondements théoriques du graphique de Bland-Altman
1.1 Genèse et utilité méthodologique de l’approche Bland-Altman
La validation instrumentale a longtemps souffert de l’absence de conventions méthodologiques adaptées à l’exigence de comparabilité stricte. L’acte fondateur de la méthode moderne remonte à la parution, dans la prestigieuse revue médicale The Lancet en 1986, de l’article séminal de John Martin Bland et Douglas G. Altman intitulé « Statistical methods for assessing agreement between two methods of clinical measurement ». Les auteurs y formulaient une critique dévastatrice des pratiques de l’époque, qui consistaient à évaluer la validité d’un nouvel appareil de mesure en calculant simplement son coefficient de corrélation avec une méthode établie. Cette publication, devenue l’une des plus citées de l’histoire de la littérature scientifique mondiale, visait à formaliser l’évaluation de l’interchangeabilité, c’est-à-dire la possibilité clinique ou expérimentale de remplacer une méthode par une autre sans altérer la classification des individus ni fausser le suivi longitudinal des patients.
En sciences appliquées, la comparaison de deux instruments mesurant une même grandeur continue nécessite une distinction conceptuelle fondamentale entre la validité de construit et la reproductibilité des scores bruts. Alors que la validité de construit examine si un instrument appréhende adéquatement le concept latent qu’il prétend mesurer par rapport à un réseau nomologique, l’analyse de concordance s’attache à la stricte interchangeabilité métrologique. Deux méthodes peuvent mesurer exactement le même concept tout en présentant un étalonnage différent qui engendre un décalage systématique inacceptable en pratique médicale ou psychologique. L’approche de Bland et Altman repose sur un principe d’une grande élégance : au lieu de confronter les mesures dans un espace cartésien conventionnel où les deux méthodes sont arbitrairement désignées comme variables dépendante et indépendante, elle examine les fluctuations des écarts intra-individuels au regard de la magnitude moyenne de la grandeur évaluée.
Cette perspective déplace l’interrogation métrologique depuis la prédiction vers la quantification de l’erreur absolue. Elle part de l’axiome selon lequel la véritable valeur sous-jacente mesurée demeure inconnue dans la majorité des contextes biomédicaux, la meilleure approximation accessible étant par conséquent la moyenne arithmétique des scores délivrés par les deux dispositifs pour chaque sujet. L’utilité méthodologique de Bland-Altman s’articule ainsi autour de la décomposition analytique de la divergence globale en deux composantes fondamentales : le biais moyen, qui renseigne sur l’erreur systématique unilatérale, et la dispersion des résidus autour de ce biais, qui documente l’amplitude de l’erreur aléatoire inhérente au processus de mesurage.
1.2 Limites du coefficient de corrélation de Pearson dans l’évaluation de la concordance
L’utilisation persistante du coefficient de corrélation produit-moment de Pearson dans les protocoles de comparaison d’instruments constitue l’une des erreurs méthodologiques les plus insidieuses et récurrentes de la littérature scientifique. La corrélation linéaire mesure exclusivement la force et la direction d’une association linéaire entre deux variables statistiques, sans jamais évaluer leur accord absolu. Un coefficient de Pearson proche de l’unité indique simplement que les observations s’alignent le long d’une droite de régression quelconque, mais il est totalement aveugle au fait que cette droite puisse être très éloignée de la droite d’identité parfaite d’équation y = x.
Cette déficience se manifeste de manière flagrante à travers l’incapacité structurelle de Pearson à détecter les biais systématiques, qu’ils soient constants ou proportionnels. Considérons une situation expérimentale où un nouvel instrument d’évaluation psychométrique attribue systématiquement à chaque sujet une valeur égale au double de celle fournie par l’instrument étalon, augmentée d’une constante de dix unités. Dans une telle configuration, la corrélation de Pearson atteindra la valeur parfaite de 1,00, témoignant d’une liaison linéaire absolue. Pourtant, la divergence entre les deux instruments est substantielle et conduirait, en situation diagnostique clinique, à des orientations thérapeutiques erronées en raison de la discordance absolue des scores attribués aux mêmes individus.
Par ailleurs, le coefficient de corrélation de Pearson présente une sensibilité trompeuse à l’étendue de l’échantillonnage et à la dispersion globale des mesures au sein de la cohorte étudiée. Lorsque l’échantillon analysé présente une très large hétérogénéité naturelle, la variance inter-sujets gonfle artificiellement la valeur du coefficient r, masquant une imprécision de mesure locale pourtant inacceptable pour l’évaluation clinique individualisée. Inversement, au sein d’un échantillon homogène où la variance vraie est restreinte, le coefficient de corrélation peut chuter drastiquement alors même que les deux instruments affichent une concordance absolue remarquable. C’est pourquoi seule une analyse directe des résidus appariés, émancipée de la variance inter-sujets, permet d’établir objectivement la proximité métrologique réelle de deux systèmes d’évaluation.
1.3 Applications en psychométrie et sciences comportementales
Bien que le graphique de Bland-Altman ait été originellement conçu pour l’évaluation d’appareils biomédicaux continus comme les sphygmomanomètres ou les spiromètres, sa transposition au champ de la psychométrie et des sciences comportementales s’est révélée particulièrement féconde. Dans l’univers de l’évaluation psychologique, les chercheurs sont fréquemment confrontés au défi d’harmoniser des inventaires de personnalité, des grilles d’hétéro-évaluation psychiatrique ou des questionnaires d’auto-évaluation de la symptomatologie anxio-dépressive. La quantification de l’interchangeabilité devient alors cruciale lorsqu’une structure hospitalière ou un laboratoire de recherche envisage de substituer une version informatisée ou auto-administrée sur smartphone à un entretien semi-structuré conventionnel administré par un clinicien.
La validation croisée des outils digitaux émergents constitue un autre terrain privilégié pour le formalisme de Bland-Altman. L’essor fulgurant des technologies d’évaluation écologique momentanée et des dispositifs vestimentaires mesurant en continu l’activité motrice, la variabilité de la fréquence cardiaque ou les cycles veille-sommeil nécessite une confrontation méthodique avec les protocoles étalons de laboratoire, telle la polysomnographie. Le recours à Bland-Altman permet de déterminer si l’algorithme commercial intégré au capteur grand public sous-estime systématiquement la durée totale du sommeil paradoxal ou si sa marge d’erreur individuelle reste contenue dans des limites cliniquement tolérables pour la recherche épidémiologique.
Enfin, l’analyse de la fidélité inter-évaluateurs sur des continuums comportementaux bénéficie grandement de cette modélisation. Dans l’observation codifiée des interactions parents-enfants ou le dépistage standardisé des troubles du spectre de l’autisme, l’accord entre juges indépendants ne saurait se contenter d’un simple coefficient kappa de Cohen ou d’une corrélation intra-classe, qui résument l’accord en un indice scalaire unique. L’inspection d’un graphique de Bland-Altman révèle si un évaluateur manifeste une propension systématique à la sévérité par rapport à un autre, ou si la divergence entre les juges s’accentue dramatiquement lorsque l’intensité symptomatique du patient se situe dans les zones extrêmes de l’échelle clinique.
2. Préparation de l’environnement de travail dans R
2.1 Configuration de l’environnement R et RStudio
L’implémentation rigoureuse d’une chaîne d’analyse statistique dans le logiciel R exige une préparation méticuleuse de la session de travail afin de garantir l’intégrité et la reproductibilité des calculs. Avant toute manipulation, il convient de s’assurer que la version installée de l’environnement R est récente, de préférence supérieure à la version 4.0.0, afin de prévenir les incompatibilités de gestion des chaînes de caractères devenues des facteurs de données non désirés. Sous l’environnement de développement intégré RStudio, la vérification s’effectue simplement en consultant la console d’accueil ou en interrogeant la fonction de version intégrée au système.
La configuration de la locale linguistique mérite une attention particulière dans les contextes académiques francophones. Par défaut, R s’aligne sur les spécifications régionales du système d’exploitation, ce qui peut conduire à l’usage non souhaité de virgules en guise de séparateurs décimaux au lieu du point standardisé en syntaxe de programmation anglo-saxonne. L’exécution de la commande de paramétrage de l’environnement linguistique via les options de localisation permet d’éviter les dysfonctionnements silencieux lors de la conversion des données textuelles en valeurs numériques flottantes. De même, l’organisation spatiale du projet doit être établie dès l’initialisation en définissant un répertoire de travail dédié à l’aide de la commande d’assignation du dossier de travail ou, de façon bien plus recommandée, par la création d’un projet RStudio autonome, ce qui garantit la gestion de chemins d’accès relatifs indépendants de la machine hôte.
Enfin, les bonnes pratiques de programmation statistique proscrivent formellement la préservation des objets d’une session antérieure dans l’espace de travail global. L’activation de l’option interdisant la restauration automatique de l’espace de travail lors du démarrage de RStudio évite la pollution des environnements par des variables résiduelles. Il est salutaire d’initialiser tout script analytique par la vidange explicite de la mémoire de travail via l’invocation de la fonction de nettoyage des objets globaux, suivie du déclenchement du ramasse-miettes de R pour réallouer les ressources mémoires de façon optimale.
2.2 Présentation et installation des bibliothèques logicielles requises
Bien que le système de base de R dispose d’outils matriciels et graphiques suffisants pour élaborer manuellement un diagramme de concordance, l’adoption de bibliothèques logicielles spécialisées enrichit considérablement la puissance d’investigation et la qualité esthétique des représentations. Trois composantes majeures de l’écosystème open-source doivent être mobilisées : le métapaquet de manipulation et d’harmonisation de données tidyverse, le moteur de visualisation déclarative ggplot2, et la bibliothèque analytique dédiée BlandAltmanLeh.
Le méta-ensemble tidyverse, et plus spécifiquement son module dplyr, fournit une grammaire d’une clarté inégalée pour la manipulation des structures de données. L’utilisation d’opérateurs de chaînage séquentiel permet de transformer les vecteurs bruts, de calculer les métriques de dispersion intra-individuelle et de restructurer les tableaux de données avec une lisibilité conceptuelle exemplaire. Concomitamment, la bibliothèque ggplot2, articulée autour de la sémantique formelle de la « grammaire des graphiques » conceptualisée par Leland Wilkinson, offre un contrôle typographique, chromatique et géométrique absolu, indispensable pour satisfaire aux exigences drastiques des comités de lecture des revues scientifiques de premier plan.
Le package spécialisé BlandAltmanLeh, développé par Bernhard Lehnert et mis à disposition sur le réseau d’archives CRAN, vient parachever cet environnement technique. Ce module propose des algorithmes optimisés pour calculer de façon native les estimations ponctuelles du biais, les limites de dispersion à 95 % ainsi que leurs intervalles de confiance respectifs. L’installation de ces bibliothèques s’effectue au moyen de la commande standard d’installation des packages depuis les serveurs officiels du CRAN, après quoi leur chargement dans la mémoire active de la session R est opéré au sommet du script via les directives de liaison de bibliothèques correspondantes.
2.3 Principes de reproductibilité et gestion de session
La crédibilité d’une recherche méthodologique en psychométrie repose sur l’impératif catégorique de la reproductibilité computationnelle. Afin qu’un tiers ou qu’un réviseur méthodologique puisse régénérer à l’identique l’ensemble des graphiques, des estimations tabulaires et des intervalles d’incertitude présentés dans une publication, le script d’analyse doit être auto-suffisant et immunisé contre les sources d’aléa non contrôlées. Dès lors que des procédures d’échantillonnage, des simulations de Monte-Carlo ou des techniques de rééchantillonnage par réinjection bootstrap sont envisagées, la fixation rigide d’une graine de randomisation via la fonction de paramétrage de la graine aléatoire de R devient indispensable.
Au-delà de la graine aléatoire, la documentation pérenne de l’architecture logicielle s’impose comme une règle fondamentale de la science ouverte. Les versions respectives des modules installés évoluant au fil du temps, certaines fonctions peuvent voir leur syntaxe modifiée ou leurs comportements par défaut altérés lors de mises à jour subséquentes. Il est donc recommandé d’enregistrer les métadonnées de la session de calcul en consignant la sortie textuelle générée par l’instruction d’information de session de R à la fin du flux analytique. Cette précaution permet d’archiver la version précise du système d’exploitation, l’architecture du processeur ainsi que les numéros de version exacts de chaque package invoqué.
Enfin, la traçabilité des scripts d’analyse gagne à être formalisée au travers de fichiers de type programmation lettrée comme R Markdown ou Quarto. Cette approche entrelace harmonieusement la prose explicative académique, les directives de code exécutables et le rendu visuel vectoriel dans un unique document source. La recherche reproductible n’est ainsi plus une simple aspiration théorique, mais une réalité opérationnelle où chaque point matérialisé sur le graphique de concordance peut être instantanément tracé jusqu’à sa source tabulaire d’origine.
3. Étape 1 – Structuration et importation des données appariées
3.1 Création programmatique du jeu de données illustratif
Pour illustrer concrètement la démarche sans dépendre de fichiers externes soumis à des restrictions de confidentialité clinique, nous allons générer de manière programmatique un jeu de données expérimental hautement réaliste. Imaginons une étude psychométrique menée auprès de vingt participants adultes, visant à comparer une échelle d’évaluation de la symptomatologie dépressive validée de longue date (désignée comme Instrument A, ou méthode étalon administrée par un psychiatre) et une nouvelle application numérique d’auto-évaluation sur tablette tactile (désignée comme Instrument B, ou méthode expérimentale évaluée).
Pour construire ce jeu de données, nous initialisons deux vecteurs de scores continus mesurés sur les mêmes vingt sujets. L’instrument A génère une série de valeurs continues reflétant l’hétérogénéité des états cliniques au sein de la cohorte, s’étalant par exemple de dix à quarante-cinq points. L’instrument B, bien que fortement corrélé à l’instrument A, contient à la fois une erreur systématique d’étalonnage et une dispersion aléatoire individuelle. Nous concevons ces deux vecteurs sous forme de séquences numériques précises au sein de l’interpréteur R, puis nous les agrégeons au sein d’une structure rectangulaire de type tableau de données (data frame) en y adjoignant un identifiant unique pour chaque participant.
Le choix d’un effectif de vingt observations appariées présente une justification pédagogique et empirique majeure. Bien qu’une taille d’échantillon plus vaste soit requise dans un protocole d’agrément à visée d’autorisation réglementaire, un échantillon restreint de vingt cas permet au chercheur de suivre manuellement chaque calcul, de contrôler l’intégrité de chaque soustraction et d’apprécier visuellement l’impact des variations individuelles sur les lignes de référence. Cette granularité facilite l’assimilation conceptuelle avant le passage à des cohortes épidémiologiques comportant des centaines ou des milliers de paires d’observations.
3.2 Inspection et validation de l’intégrité du data frame
Une fois le tableau de données constitué, une phase incontournable de vérification diagnostique s’ouvre. L’investigateur doit s’assurer que les structures sous-jacentes sont conformes aux prérequis computationnels de R. L’utilisation conjointe des fonctions de visualisation des premières lignes d’un tableau et d’inspection de sa structure interne permet de valider que les colonnes relatives à l’instrument A et à l’instrument B sont formellement reconnues comme des variables numériques quantitatives continues et non comme des vecteurs de chaînes de caractères ou des facteurs catégoriels.
La détection d’éventuelles données manquantes représente l’étape suivante du contrôle de qualité. Le protocole de Bland-Altman reposant strictement sur une comparaison par paires intra-individuelles, la présence d’une valeur manquante sur l’un des deux instruments invalide immédiatement l’observation correspondante pour l’estimation de l’accord. L’application de fonctions logiques de détection des données absentes permet de certifier que le tableau de données ne souffre d’aucun vide d’enregistrement. En cas de valeurs non renseignées, le chercheur devra arbitrer entre la suppression par liste complète de l’observation appariée ou le recours à des méthodologies d’imputation multiple appropriées.
Enfin, l’examen des statistiques descriptives fondamentales offre une première intuition métrologique des distributions en présence. L’évaluation des moyennes arithmétiques, des écarts-types, des médianes et des étendues interquartiles pour chacun des deux instruments permet de déceler d’emblée d’éventuelles asymétries de distribution prononcées ou la présence de points extrêmes résultant d’erreurs de saisie cléricale. Cet audit initial garantit la robustesse de l’analyse subséquente en évitant de propager des artéfacts dans les calculs d’agrément.
3.3 Gestion des formats de données larges versus longs
L’organisation architecturale des tableaux de données constitue une pierre d’achoppement fréquente pour les utilisateurs de R abordant l’analyse de concordance. En statistique computationnelle, on distingue classiquement deux paradigmes de structuration tabulaire : le format large et le format long. Dans le format large, chaque unité expérimentale (le patient) occupe exactement une seule ligne horizontale, et chaque instrument de mesure est assigné à une colonne distincte. Dans le format long, chaque mesure individuelle correspond à une ligne indépendante, les colonnes étant réservées à l’identifiant du sujet, au nom de l’instrument employé et à la valeur numérique recueillie.
L’analyse de Bland-Altman repose par définition sur une architecture au format large. La dérivation des différences algébriques et des moyennes intra-sujets exige une synchronisation matricielle directe, où l’indice de ligne désigne sans ambiguïté le même participant pour les deux variables instrumentales. Cependant, de nombreux entrepôts de données cliniques ou d’enregistrements issus de bases relationnelles SQL exportent nativement les données sous format long. Il est donc fondamental de maîtriser les fonctions de restructuration tabulaire, notamment celles offertes par le package tidyr avec ses instructions de pivotement vers le format large ou vers le format long.
La conversion rigoureuse d’un format long vers un format large requiert une vérification attentive de l’absence de doublons au sein du couple identifiant-instrument. Si un même sujet a été mesuré à plusieurs reprises par le même instrument sans horodatage différencié, l’algorithme de pivotement ne pourra pas résoudre l’assignation cellulaire sans agrégation indésirable. Une fois le pivotement opéré et l’alignement sujet par sujet validé, le tableau de données se trouve dans la disposition canonique nécessaire pour aborder les calculs arithmétiques des écarts et des magnitudes.
4. Étape 2 – Calcul des paramètres fondamentaux : moyennes et différences
4.1 Algorithme de calcul des moyennes inter-instruments
Le premier paramètre géométrique structurant le graphique de Bland-Altman est positionné sur l’axe des abscisses (axe horizontal) et correspond à la moyenne arithmétique des deux instruments pour chaque unité observationnelle. Sur le plan formel, si nous désignons par A_i la mesure obtenue sur le sujet i par le premier instrument et par B_i la mesure recueillie sur ce même sujet par le second instrument, la coordonnée horizontale X_i de l’observation est définie par la demi-somme des deux valeurs, soit X_i = (A_i + B_i) / 2.
L’implémentation de ce calcul au sein de R s’effectue avec une efficacité vectorielle remarquable. Plutôt que d’avoir recours à une boucle itérative impérative, lente et sujette aux erreurs d’indiçage, le moteur arithmétique de R permet d’effectuer l’opération d’addition et de division vectorielle directement sur les colonnes du tableau de données. La création d’une nouvelle variable au moyen de l’opérateur de mutation de dplyr ou par assignation directe dans le data frame enrichit immédiatement la table analytique sans surcharge computationnelle notable.
La justification théorique sous-jacente au choix de la moyenne comme variable d’abscisse mérite d’être explicitée avec insistance. Dans la pratique clinique courante, la « vraie valeur » de la grandeur mesurée demeure une entité théorique inaccessible, car aucun instrument métrologique n’est rigoureusement exempt d’erreur expérimentale. Utiliser l’une des deux méthodes comme référence sur l’axe horizontal, comme cela se pratiquait autrefois en portant par exemple l’instrument étalon en abscisse et la méthode candidate en ordonnée, introduit un biais mathématique connu sous le nom de régression vers la moyenne et crée une dépendance artificielle entre les résidus et la variable de contrôle. En moyennant les deux mesures imparfaites, on obtient l’estimateur sans biais le plus efficient de la magnitude véritable sous-jacente.
4.2 Dérivation des différences intra-sujets et orientation des soustractions
Le second paramètre géométrique, destiné à être projeté sur l’axe des ordonnées (axe vertical), réside dans la différence algébrique calculée pour chaque individu entre les deux instruments de mesure. Cette grandeur différentielle, notée D_i pour l’observation i, s’exprime mathématiquement sous la forme élémentaire D_i = A_i – B_i. Ce différentiel individuel capture l’ampleur exacte de la divergence instrumentale propre à chaque sujet et servira de base à l’ensemble des inférences statistiques de l’accord.
L’orientation de la soustraction revêt une importance conceptuelle et pratique déterminante que le chercheur ne doit jamais traiter à la légère. Le choix de soustraire l’instrument B de l’instrument A (A – B) ou, à l’inverse, l’instrument A de l’instrument B (B – A) ne modifie certes pas la valeur absolue des écarts ni l’amplitude de la dispersion, mais il inverse intégralement le signe algébrique du biais moyen résultant. Par convention établie dans la communauté scientifique internationale, on privilégie la formule « Méthode Testée moins Méthode de Référence » (ou l’inverse de manière strictement documentée), afin qu’une valeur positive reflète sans ambiguïté une surestimation par le nouvel instrument, tandis qu’une valeur négative dénote une sous-estimation systématique.
Il incombe donc à l’analyste de documenter explicitement dans ses rapports et sur les libellés de ses représentations graphiques l’ordre précis de l’opération mathématique adoptée. L’omission de cette précision élémentaire dans les légendes figure parmi les sources les plus courantes de confusion et de mésinterprétation dans la littérature médicale, empêchant les praticiens de discerner quel appareil surévalue ou sous-évalue la grandeur pathologique suivie.
4.3 Intégration des variables dérivées dans l’objet de données
Après avoir formulé les équations de la moyenne et de la différence, il convient de les intégrer de façon permanente et harmonieuse au sein de l’objet de données principal dans l’environnement R. Cette intégration s’opère élégamment via le paradigme fonctionnel, en créant simultanément deux nouvelles colonnes dédiées, classiquement baptisées « moyenne » et « difference ».
Le contrôle de conformité dimensionnelle constitue l’action de clôture de cette phase de dérivation. L’analyste doit vérifier que le tableau résultant conserve un nombre d’enregistrements strictement égal à l’effectif originel de vingt sujets et que les calculs vectoriels n’ont pas introduit d’anomalies de type valeurs non numériques ou indéterminées. L’appel à la fonction d’affichage récapitulatif du tableau enrichi permet de vérifier visuellement sur les premiers cas la parfaite concordance entre les opérations mentales arithmétiques et les valeurs numériques stockées en mémoire.
Ce tableau de données complété constitue désormais la matrice analytique universelle à partir de laquelle tous les estimateurs du modèle de Bland-Altman vont être extraits. La conservation de cette structure rectangulaire unifiée simplifiera ultérieurement le passage des données aux moteurs graphiques, qu’il s’agisse des fonctions canoniques du système de base ou des fonctions géométriques avancées de ggplot2.
5. Étape 3 – Estimation statistique du biais moyen et des limites d’agrément
5.1 Quantification du biais moyen (Mean Difference)
Le biais moyen représente le barycentre empirique de l’écart systématique existant entre les deux modalités d’évaluation. Sur le plan statistique, il correspond à l’espérance mathématique des différences individuelles et s’estime par la simple moyenne arithmétique des résidus D_i sur l’échantillon des N sujets analysés. Si l’on désigne le biais moyen par la lettre D barrée, il s’exprime formellement par la somme de toutes les différences D_i divisée par l’effectif N.
L’interprétation de la valeur numérique de ce biais moyen doit être menée avec rigueur. Une estimation ponctuelle strictement égale à zéro est une chimère statistique en contexte empirique ; le biais sera donc presque invariablement positif ou négatif. Un biais positif indique que le premier instrument fournit, en moyenne générale, des évaluations numériques supérieures à celles du second, alors qu’un biais négatif signale le phénomène réciproque. La question fondamentale est de déterminer si cette divergence observée s’écarte de façon statistiquement significative de la valeur théorique zéro, ce qui dénoterait l’existence d’une erreur systématique d’étalonnage non imputable aux simples fluctuations de l’échantillonnage aléatoire.
Pour statuer sur cette significativité statistique, l’analyste procède à un test de Student pour échantillon unique appliqué sur le vecteur des différences, en posant pour hypothèse nulle que la moyenne de la population est égale à zéro. Bien que ce test apporte une réponse probabiliste sur l’existence du biais, le chercheur clinicien ne doit jamais confondre significativité statistique et pertinence clinique. Un biais de quelques dixièmes de points sur une échelle d’évaluation psychologique peut s’avérer hautement significatif sur le plan statistique au sein d’un très large échantillon tout en demeurant parfaitement négligeable et dénué d’impact pour la décision diagnostique au chevet du patient.
5.2 Dérivation de l’écart-type et calcul des limites d’agrément à 95 %
La quantification du biais systématique ne saurait être suffisante pour statuer sur la concordance, car deux instruments peuvent présenter un biais moyen rigoureusement nul tout en manifestant une dispersion erratique et chaotique d’un individu à l’autre. Il est donc indispensable d’évaluer la variabilité des différences individuelles autour de ce biais moyen, ce qui s’opère par le calcul de l’écart-type des différences, classiquement désigné par le symbole s_d. Cet écart-type se calcule au moyen de la racine carrée de la variance empirique corrigée des écarts D_i par rapport au biais moyen.
À partir du biais moyen et de cet écart-type s_d, Bland et Altman ont formalisé le concept fondamental des « limites d’agrément » (Limits of Agreement, ou LoA). Sous le postulat théorique selon lequel les différences intra-individuelles suivent une distribution gaussienne (normale), environ 95 % des écarts observés entre les deux instruments dans la population générale sont attendus à l’intérieur d’un intervalle défini par le biais moyen majoré et minoré de 1,96 fois l’écart-type des différences. La limite d’agrément supérieure s’établit ainsi à la valeur du biais moyen augmentée de 1,96 * s_d, tandis que la limite d’agrément inférieure s’établit au biais moyen diminué de 1,96 * s_d.
La signification métrologique de ces limites d’agrément est d’une clarté absolue pour le praticien : elles délimitent l’enveloppe de dispersion à l’intérieur de laquelle se situeront la quasi-totalité des discordances entre les deux méthodes pour un individu donné sélectionné au hasard. Si les valeurs numériques bornant ces limites d’agrément excèdent l’amplitude de l’erreur maximale tolérée définie a priori par les normes cliniques ou psychométriques du domaine, les deux instruments ne pourront en aucun cas être considérés comme cliniquement interchangeables, nonobstant la perfection de leur éventuelle corrélation de Pearson.
5.3 Formulation des intervalles de confiance pour le biais et les limites
Une bévue méthodologique fréquente dans l’analyse de concordance consiste à traiter le biais moyen et les limites d’agrément calculés sur un échantillon comme s’il s’agissait de constantes immuables de la population générale. En réalité, ces estimateurs sont eux-mêmes tributaires de l’erreur d’échantillonnage et sont entachés d’une incertitude stochastique directement liée à la taille N de l’échantillon recruté. Afin d’inscrire la démarche dans les canons de l’inférence statistique moderne, il est impératif d’adjoindre à chacune de ces estimations son intervalle de confiance à 95 % respectif.
L’erreur-type du biais moyen se calcule de façon classique en divisant l’écart-type des différences s_d par la racine carrée de l’effectif N. L’intervalle de confiance à 95 % du biais moyen s’obtient alors en multipliant cette erreur-type par le quantile approprié de la distribution de Student à N – 1 degrés de liberté. Pour ce qui concerne les limites d’agrément supérieure et inférieure, leur variance d’échantillonnage est substantiellement plus élevée, car elle combine à la fois l’incertitude liée à l’estimation de la moyenne et celle afférente à l’estimation de la variance. Bland et Altman ont démontré que l’erreur-type d’une limite d’agrément peut être approximée avec précision par la racine carrée du produit de trois divisé par N, le tout multiplié par l’écart-type s_d.
L’adjonction de ces intervalles de confiance confère une profondeur analytique irremplaçable à l’interprétation. Ils révèlent en effet au chercheur la marge de plausibilité statistique réelle de ses frontières d’accord. Dans une cohorte à effectif restreint, la borne supérieure de l’intervalle de confiance de la limite haute peut s’étendre bien au-delà de la valeur ponctuelle observée, incitant l’investigateur à une extrême prudence clinique avant de conclure définitivement à la parfaite interchangeabilité des instruments évalués.
6. Étape 4 – Construction pas à pas avec le système graphique de base (Base R)
6.1 Génération du nuage de points initial avec la fonction plot()
L’environnement natif de R, souvent désigné sous l’appellation de « Base R », dispose d’un moteur de traçage matriciel robuste, rapide et remarquablement adapté à l’exécution de représentations exploratoires sans nécessiter le chargement de dépendances externes. L’élaboration d’un graphique de Bland-Altman au sein de ce système débute par l’invocation de la fonction générique d’affichage bidimensionnel de R, en assignant explicitement le vecteur des moyennes individuelles sur le premier argument (axe X) et le vecteur des différences calculées sur le second argument (axe Y).
Pour assurer la lisibilité immédiate du nuage de points, une attention soignée doit être portée au choix des paramètres morphologiques des symboles graphiques. Par défaut, le moteur graphique trace de simples cercles creux qui peuvent se chevaucher de façon confuse lorsque deux observations présentent des coordonnées proches. L’emploi d’un paramètre de forme plein, combiné à un redimensionnement adéquat de l’échelle des symboles et à l’application d’une nuance chromatique adoucie comme un bleu acier ou un gris anthracite sombre, favorise la discrimination visuelle des points individuels.
Le paramétrage des limites d’affichage des axes d’abscisse et d’ordonnée représente un ajustement technique fondamental. Par défaut, la fonction d’affichage calcule les étendues géométriques pour englober strictement les valeurs minimale et maximale du nuage de points. Or, dans un graphique de Bland-Altman, les lignes horizontales correspondant aux limites d’agrément supérieure et inférieure s’étendent bien souvent au-delà des valeurs individuelles observées. Il est donc indispensable d’élargir manuellement l’amplitude de l’axe vertical au moyen de l’argument de bornage des ordonnées, sous peine de voir les lignes de référence critiques tronquées ou repoussées hors du champ visible du canevas graphique.
6.2 Superposition des lignes de référence horizontales
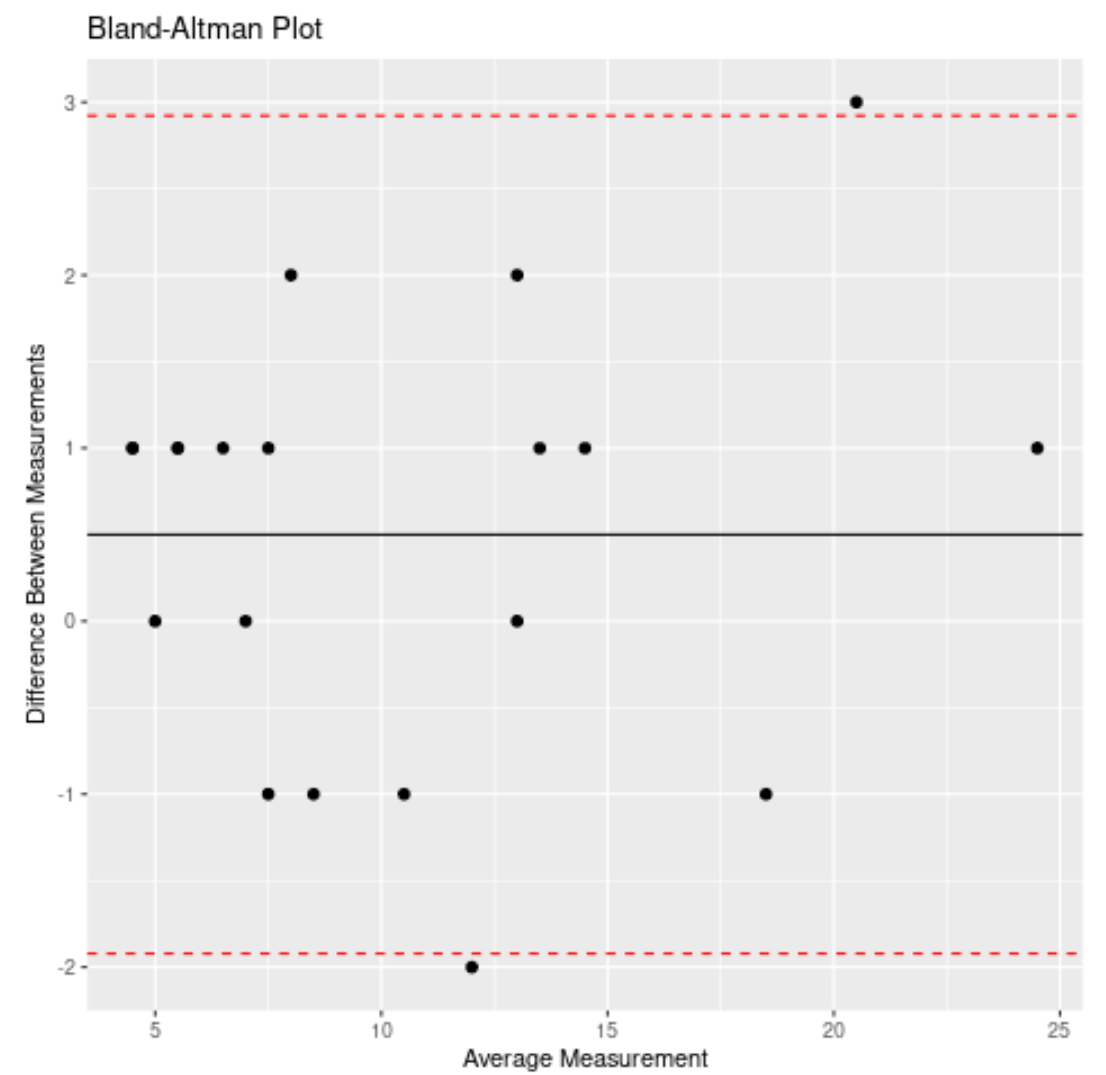
Une fois le semis de points appariés positionné sur le plan de coordonnées, le cœur conceptuel de la méthode de Bland-Altman s’incarne par l’adjonction des repères d’accord horizontaux. Dans le système graphique de base de R, cette opération s’exécute séquentiellement grâce à l’instruction de superposition de droites géométriques, configurée pour tracer des droites horizontales aux ordonnées spécifiques précédemment dérivées.
La première ligne tracée matérialise le biais systématique moyen. On lui confère généralement une apparence pleine, matérialisée par un trait d’épaisseur accentuée et une couleur contrastée, traditionnellement un bleu profond ou un noir absolu. Cette ligne horizontale scinde visuellement l’espace d’observation en deux hémi-plans : tout point émergeant au-dessus traduit une supériorité ponctuelle de la méthode testée chez le sujet concerné, tandis que tout point situé en dessous témoigne d’une supériorité de l’instrument étalon.
Dans un second temps, l’investigateur projette les deux lignes parallèles discontinues figurant respectivement la limite d’agrément supérieure et la limite d’agrément inférieure, situées à plus ou moins 1,96 écart-type du biais moyen. On privilégie pour ces tracés un style de ligne hachuré ou pointillé, associé à une tonalité d’alerte telle qu’un rouge carmin. Enfin, l’insertion facultative d’une fine ligne en pointillé fin positionnée exactement à l’ordonnée zéro offre un repère visuel immédiat pour juger du centrage de la distribution par rapport à l’idéal théorique d’absence absolue de biais métrologique.
6.3 Personnalisation des axes, des étiquettes et des annotations textuelles
Un graphique destiné à une diffusion académique ou clinique ne saurait se contenter des libellés cryptiques assignés par défaut par les noms de variables internes au script R. L’analyste se doit de reconfigurer rigoureusement les intitulés d’axes en exploitant les arguments textuels dédiés de la commande graphique. L’axe des abscisses doit spécifier sans équivoque la formule de la grandeur évaluée sous la forme « Moyenne des deux méthodes [(Méthode A + Méthode B) / 2] », tandis que l’axe des ordonnées doit énoncer l’ordre de la différence algébrique, formulée par exemple comme « Différence entre méthodes [Méthode A – Méthode B] ».
L’enrichissement informatif du tracé s’accomplit par l’apposition directe d’étiquettes textuelles au droit des lignes de référence horizontales. L’instruction textuelle de base de R permet d’imprimer des chaînes de caractères à des coordonnées spatiales précises du canevas. En exploitant les coordonnées d’extrémité de l’axe des abscisses et les valeurs exactes des ordonnées correspondant au biais et aux limites, on imprime les valeurs numériques arrondies des estimateurs, précédées d’acronymes explicites tels que « Biais moyen », « Limite Supérieure » et « Limite Inférieure ».
Enfin, l’optimisation des espacements marginaux autour du canevas s’opère préalablement au traçage via la fonction de paramétrage global de l’environnement graphique. L’ajustement du vecteur des marges internes évite que les étiquettes textuelles positionnées en périphérie ne soient rognées par la bordure extérieure de la fenêtre de rendu. Cette rigueur typographique méticuleuse confère au rendu généré en R de base un niveau de finition esthétique pleinement compatible avec les critères éditoriaux des traités scientifiques.
7. Étape 5 – Construction avancée et élégante avec ggplot2
7.1 Définition de la structure géométrique et esthétique de base
Bien que le système graphique natif de R soit d’une redoutable efficacité algorithmique, la bibliothèque ggplot2 s’impose désormais comme le standard de référence pour la production de figures scientifiques publiables. Fondée sur la formalisation rigoureuse de la grammaire des graphiques, ggplot2 envisage chaque représentation visuelle comme une superposition modulaire de couches fonctionnelles comprenant des données sources, des associations esthétiques cartographiant les variables sur des propriétés visuelles, et des objets géométriques dédiés.
L’initialisation du graphique de Bland-Altman sous ggplot2 commence par la fonction d’instanciation principale, au sein de laquelle on spécifie le tableau de données enrichi préalablement créé ainsi que le bloc d’associations esthétiques de base. Ce dernier assigne formellement la colonne représentative de la moyenne individuelle sur l’axe des abscisses et la colonne des différences sur l’axe des ordonnées. Cette étape fondamentale établit l’ancrage cartésien sur lequel viendront s’agréger l’ensemble des modules d’affichage subséquents.
La première couche géométrique concrète matérialise le nuage d’observations individuelles au travers de la commande d’affichage ponctuel geom_point(). Pour transcender le classicisme visuel et résoudre les écueils potentiels liés à la superposition de données coïncidentes, l’analyste introduit un coefficient de transparence alpha ainsi qu’un dimensionnement minutieux des glyphes. L’adjonction d’une couleur d’accentuation sobre et élégante assure une perception visuelle optimale des distributions locales, conférant immédiatement au graphique une facture esthétique contemporaine et hautement professionnelle.
7.2 Intégration dynamique des lignes de moyenne et des bornes d’agrément
L’expression de la structure paramétrique de l’accord dans ggplot2 s’articule par l’empilement de couches horizontales dynamiques grâce à l’instruction géométrique geom_hline(). Cette fonction permet de projeter des lignes horizontales traversant l’intégralité du repère sans dépendre de coordonnées d’abscisses fixes, garantissant ainsi un ajustement automatique parfait même en cas de redimensionnement ultérieur de la figure.
L’architecture standardisée d’un tracé de Bland-Altman conforme aux exigences éditoriales implique l’insertion de trois lignes fondamentales. La ligne médiane, fixée à l’ordonnée du biais moyen, est traditionnellement typographiée sous la forme d’un trait plein ou d’un trait à tirets longs d’épaisseur modérée, arborant une teinte neutre et sombre. À ses côtés, les lignes matérialisant les limites d’agrément supérieure et inférieure sont introduites à leurs ordonnées respectives au moyen d’un tracé discontinu de type tireté ou pointillé fin, souvent souligné par une couleur contrastée permettant de repérer instantanément l’enveloppe de dispersion attendue à 95 %.
Une sophistication graphique majeure offerte par ggplot2 réside dans la possibilité de superposer des zones d’incertitude ombrées pour matérialiser visuellement les intervalles de confiance des estimateurs. En mobilisant l’opérateur géométrique de remplissage rectangulaire ou de ruban d’incertitude, l’investigateur peut insérer un discret voile translucide encadrant le biais moyen et chacune des deux bornes d’accord. Cette figuration graphique des intervalles de confiance prévient les jugements péremptoires en rappelant continuellement à l’observateur la variabilité statistique inhérente à la taille de l’échantillon analysé.
7.3 Formatage typographique, thèmes éditoriaux et palette académique
La transition d’une ébauche graphique exploratoire vers une figure publiable dans une revue à fort facteur d’impact repose sur le raffinement des composantes stylistiques non liées aux données brutes. Par défaut, ggplot2 applique un arrière-plan quadrillé grisâtre qui, bien que fonctionnel pour l’analyse à l’écran, est universellement proscrit dans les publications imprimées ou électroniques des presses universitaires. L’application d’un thème épuré, tel que theme_classic() ou theme_minimal(), permet d’éliminer immédiatement ces artéfacts visuels encombrants au profit d’un canevas blanc immaculé rehaussé de fines bordures coordonnées.
La personnalisation de la typographie constitue le second levier d’optimisation éditoriale. Au sein de la couche de modification des attributs de thème, le chercheur ajuste harmonieusement la taille, la graisse et la police de caractères des titres d’axes, des graduations numériques et des annotations textuelles. Les libellés d’axes sont rédigés avec une précision chirurgicale, explicitant systématiquement les unités de mesure employées sur les instruments comparés. L’intégration directe d’étiquettes de texte calibrées à l’aide de geom_text() ou du package spécialisé ggrepel assure un affichage net et lisible des valeurs numériques sans risque de chevauchement sur les données expérimentales.
Enfin, l’exportation physique du graphique vectoriel est régie par la fonction ggsave(), qui constitue le joyau de la chaîne de production graphique de ggplot2. Cette fonction autorise un contrôle millimétrique des dimensions spatiales de l’image (largeur, hauteur en centimètres ou en pouces) et permet d’exporter directement le canevas vers des formats vectoriels non destructifs tels que le PDF ou l’EPS, garantissant une netteté absolue quelle que soit l’échelle d’impression. Pour les revues exigeant des formats matriciels, la spécification d’une résolution minimale de 300 à 600 points par pouce (DPI) au format TIFF ou PNG assure une restitution parfaite des détails microscopiques.
8. Étape 6 – Utilisation des packages dédiés à l’analyse de Bland-Altman
8.1 Automatisation du tracé via le package BlandAltmanLeh
Bien que la construction manuelle pas à pas au moyen de ggplot2 offre une liberté artistique et architecturale incomparable, l’utilisation de bibliothèques logicielles spécifiquement dédiées à la concordance permet d’accélérer considérablement le flux de travail analytique en éliminant les tâches répétitives de dérivation manuelle. Au sein de cet écosystème spécialisé, le package BlandAltmanLeh figure parmi les solutions les plus élégantes et rigoureuses développées pour R.
La bibliothèque BlandAltmanLeh met à la disposition de l’utilisateur la fonction de haut niveau bland.altman.plot(), qui prend directement en entrée les deux vecteurs numériques appariés sans exiger la transformation préalable de la table de données ni le calcul explicite des moyennes et des différences. En une ligne de commande concise, cette routine exécute la totalité de la chaîne analytique : elle extrait le biais moyen, estime l’écart-type résiduel, calcule les limites d’agrément supérieure et inférieure à 95 %, et projette instantanément le graphique correspondant sur la fenêtre de visualisation active.
L’un des atouts déterminants de ce package réside dans son interopérabilité native avec le moteur graphique de ggplot2. Par l’ajustement d’un simple argument logique au sein de la fonction d’appel, l’utilisateur peut contraindre la commande à ne pas utiliser le moteur graphique matriciel de base, mais à renvoyer un véritable objet graphique conforme aux spécifications de ggplot2. Cette fonctionnalité hybride offre le compromis parfait : elle automatise intégralement la dérivation statistique des paramètres tout en conservant la modularité de ggplot2, permettant à l’analyste de surcharger ensuite l’objet renvoyé par l’adjonction de couches thématiques personnalisées ou de palettes de couleurs spécifiques.
8.2 Extraction programmatique des statistiques sous-jacentes
L’analyse métrologique moderne ne se limite pas à la contemplation passive d’une figure géométrique ; elle requiert impérativement la consignation des valeurs scalaires exactes au sein de tableaux récapitulatifs normalisés destinés aux sections textuelles des publications académiques. Le package BlandAltmanLeh répond magistralement à cette exigence par l’intermédiaire de sa fonction analytique sous-jacente bland.altman.stats().
Contrairement à la fonction d’affichage visuel, bland.altman.stats() n’engendre aucun rendu graphique mais retourne une structure d’objet complexe de type liste contenant la totalité des grandeurs numériques dérivées du protocole d’agrément. L’interrogation de cette liste permet d’extraire programmatique les vecteurs individuels des moyennes et des différences, la valeur scalaire du biais moyen, l’écart-type résiduel, ainsi que les valeurs numériques exactes des limites d’agrément supérieure et inférieure. Plus fondamentalement encore, l’objet compile directement les bornes des intervalles de confiance à 95 % associés au biais ainsi qu’à chacune des deux limites de dispersion.
L’accessibilité programmatique directe de ces statistiques s’avère providentielle pour la rédaction automatisée de rapports biomédicaux au sein d’environnements de programmation lettrée tels que Quarto ou R Markdown. L’analyste peut insérer dynamiquement les valeurs numériques calculées au cœur même des paragraphes narratifs de son manuscrit, éliminant définitivement les erreurs humaines de recopie ou d’arrondi typographique qui polluent traditionnellement la transcription manuelle des sorties statistiques.
8.3 Comparaison méthodologique entre scripts manuels et bibliothèques automatisées
Face à la dualité entre script fait sur mesure et automatisation logicielle, l’analyste statisticien doit opérer un arbitrage méthodologique éclairé en fonction de la complexité intrinsèque de son devis de recherche. Les deux approches ne s’excluent pas mutuellement, mais répondent à des phases distinctes de la démarche d’investigation psychométrique et clinique.
Le recours à un script entièrement manuel élaboré autour de dplyr et ggplot2 procure une flexibilité architecturale absolue. Il permet d’adapter instantanément le formalisme graphique à des situations atypiques que les packages automatisés ne prennent généralement pas en charge : incorporation d’intervalles de confiance asymétriques issus d’un bootstrap non paramétrique, traçage de limites d’agrément courbes en présence d’hétéroscédasticité fonctionnelle, ou coloration sélective des observations en fonction de covariables catégorielles secondaires comme le sexe ou la classe d’âge des sujets. Ce contrôle microscopique total justifie pleinement l’investissement temporel consenti pour coder manuellement chaque étape de l’algorithme.
À l’inverse, l’exploitation de packages spécialisés tels que BlandAltmanLeh ou son homologue mcr offre un gain de temps inestimable lors des phases exploratoires et standardise le flux de calcul selon des normes algorithmiques rigoureusement auditées et testées unitairement par la communauté scientifique internationale. Pour des études d’interchangeabilité simples reposant sur des mesures indépendantes et conformes aux postulats gaussiens, la compacité syntaxique des packages dédiés réduit drastiquement le risque d’introduire des bogues de programmation dans le code d’analyse, garantissant une efficacité opérationnelle maximale.
9. Vérification des postulats statistiques sous-jacents
9.1 Test de normalité de la distribution des différences
L’échafaudage mathématique qui sous-tend la validité des limites d’agrément à 95 % formulées par Bland et Altman repose sur une hypothèse distributionnelle fondamentale : la normalité de la distribution des différences intra-individuelles. Il convient de souligner avec force une confusion théorique pernicieuse régulièrement commise par les praticiens : la méthode de Bland-Altman n’exige nullement que les mesures brutes de l’instrument A ou de l’instrument B suivent individuellement une loi normale, mais requiert exclusivement que les différences algébriques (A – B) se distribuent selon une courbe en cloche gaussienne autour de leur moyenne.
La vérification de cette hypothèse nécessite la mise en œuvre d’une démarche diagnostique croisant inspection graphique visuelle et tests formels d’ajustement. Sur le plan visuel, la modélisation d’un diagramme quantile-quantile de Gauss (Q-Q plot) à l’aide des instructions natives ou des couches géométriques de ggplot2 permet d’examiner l’alignement des résidus observés sur la droite théorique de normalité. Des déviations prononcées aux extrémités de la distribution trahissent la présence de queues de distribution épaisses ou d’une asymétrie marquée, invalidant la couverture théorique standardisée des limites.
Ce diagnostic visuel gagne à être corroboré par le test d’ajustement de Shapiro-Wilk, particulièrement puissant et adapté aux effectifs d’échantillons de taille modeste à modérée. L’application de la fonction shapiro.test() sur le vecteur des différences calcule le coefficient W et sa p-value associée. Si cette dernière s’avère inférieure au seuil conventionnel de cinq pour cent, l’hypothèse nulle de normalité doit être formellement rejetée. Dans cette conjoncture défavorable, l’utilisation aveugle du multiplicateur 1,96 devient caduque, car l’enveloppe paramétrique ne garantira plus la capture de 95 % des observations futures, imposant alors le recours à des approches alternatives non paramétriques.
9.2 Détection de l’hétéroscédasticité et dépendance moyenne-différence
Le second postulat critique inhérent au modèle standard de Bland-Altman postule l’homoscédasticité de la dispersion des erreurs, c’est-à-dire la constance absolue de la variance des différences sur l’ensemble de l’éventail de mesure. En d’autres termes, l’amplitude de la divergence entre les deux instruments ne doit être tributaire ni du niveau d’élévation de la magnitude mesurée, ni de l’intensité du score moyen du sujet.
L’examen visuel attentif de la géométrie du nuage de points constitue le premier outil de détection de l’hétéroscédasticité. Une configuration pathologique classique se manifeste sous la forme d’un « entonnoir » ou d’un cône d’expansion, où les points se regroupent étroitement autour du biais moyen pour les faibles valeurs de l’abscisse, puis divergent de façon spectaculaire et évasée à mesure que la moyenne inter-instruments s’accroît. Une telle structure visuelle indique sans ambiguïté que la variabilité de la mesure est proportionnelle à la magnitude du signal biologique ou psychologique évalué.
Sur le plan quantitatif, cette dépendance structurelle peut être rigoureusement modélisée en ajustant une régression linéaire simple reliant la variable des différences à celle des moyennes au moyen de la fonction de modélisation linéaire lm(). L’obtention d’un coefficient de pente statistiquement distinct de zéro confirme l’existence d’un biais proportionnel formel. Si la pente est significativement positive ou négative, l’hypothèse d’un biais constant unilatéral s’effondre, signifiant que l’instrument testé surestime ou sous-estime la grandeur selon des intensités variables tout au long de l’échelle clinique. Des limites d’agrément horizontales traditionnelles s’avèrent alors trompeuses et méthodologiquement inappropriées.
9.3 Identification et traitement raisonné des valeurs aberrantes
La présence d’observations extrêmes ou aberrantes (outliers) au sein d’un échantillon apparié peut fausser drastiquement les conclusions d’une étude d’agrément. En raison de la sensibilité bien documentée de la moyenne arithmétique et de l’écart-type aux valeurs isolées, un unique point anormalement distant du centre de gravité peut décaler artificiellement la ligne de biais moyen et gonfler de façon disproportionnée l’écart-type des résidus, élargissant artificiellement les limites d’agrément au point de faire conclure à tort à une non-interchangeabilité des dispositifs.
L’identification de ces observations atypiques repose sur des métriques diagnostiques rigoureuses. Au sein du graphique de Bland-Altman, tout point s’aventurant au-delà des limites d’agrément à 95 % constitue théoriquement un sujet de préoccupation, bien que la définition même de ces bornes implique statistiquement qu’environ cinq pour cent des observations saines puissent franchir ce seuil sans que cela traduise une aberration expérimentale. L’investigateur doit donc examiner plus spécifiquement les points excédant un écartement de trois écarts-types par rapport au biais moyen, ou explorer les résidus standardisés et les distances de Cook issus de la modélisation linéaire.
Le traitement de ces données atypiques exige une probité scientifique exemplaire. L’élimination pure et simple d’un point au seul motif qu’il compromet l’accord recherché constitue une dérive méthodologique inacceptable. Le chercheur doit d’abord vérifier si l’anomalie ne provient pas d’une erreur matérielle de saisie, d’un dysfonctionnement matériel de l’instrument ou d’une non-conformité manifeste au protocole de recueil. Si l’observation reflète une mesure authentique et biologiquement plausible, elle doit être conservée au sein de l’échantillon, et faire l’objet d’une analyse de sensibilité comparant les résultats statistiques obtenus avec et sans l’observation litigieuse.
10. Approches alternatives en cas de non-respect des hypothèses statistiques
10.1 Transformations logarithmiques des variables brutes
Lorsque la vérification des postulats statistiques met en évidence une hétéroscédasticité manifeste, marquée par une dispersion des écarts proportionnelle à la grandeur moyenne mesurée, la transformation mathématique des échelles brutes offre un recours particulièrement élégant. Dans les sciences biomédicales et comportementales, où de nombreuses grandeurs physiques ou physiologiques obéissent à des distributions log-normales, l’application d’une transformation par logarithme népérien sur les deux séries de mesures brutes en amont de toute soustraction permet très fréquemment de restaurer l’homoscédasticité et la normalité des résidus.
La mise en œuvre de cette stratégie sous R s’opère en calculant le logarithme de chaque instrument à l’aide de la fonction log(), puis en dérivant les moyennes et les différences sur ces variables transformées. Les calculs statistiques standards de Bland-Altman sont ensuite appliqués rigoureusement sur ces grandeurs logarithmiques pour obtenir le biais transformé ainsi que les limites associées. Sur cette échelle, la différence entre deux logarithmes équivaut mathématiquement au logarithme du ratio des deux mesures, convertissant l’analyse des écarts absolus en une évaluation des variations relatives.
L’étape cruciale réside dans la rétro-transformation finale des estimateurs statistiques vers l’échelle d’interprétation originale au moyen de la fonction exponentielle exp(). En prenant l’exponentielle du biais moyen calculé sur les logs, l’analyste obtient le ratio moyen des scores entre les deux instruments. De même, les exponentielles des limites d’agrément inférieure et supérieure fournissent les bornes de tolérance du ratio de mesure à 95 %. Ainsi, affirmer que l’intervalle de concordance transformé s’établit entre 0,92 et 1,08 signifie de façon très intuitive que les mesures fournies par le nouvel instrument fluctuent entre une sous-estimation maximale de huit pour cent et une surestimation maximale de huit pour cent par rapport à la méthode étalon.
10.2 Analyse non paramétrique des limites d’agrément
Dans l’éventualité où la distribution des différences intra-sujets refuse d’adopter une silhouette gaussienne malgré les tentatives de transformation mathématique, et que des asymétries persistantes demeurent, l’hypothèse paramétrique articulée autour du facteur multiplicateur 1,96 doit être définitivement abandonnée. L’analyste se tourne alors vers l’approche non paramétrique des limites d’agrément, expressément préconisée par Bland et Altman dans leurs travaux ultérieurs.
L’estimation non paramétrique consiste à renoncer à l’emploi de l’écart-type et à dériver directement les frontières d’accord à partir des percentiles empiriques de la distribution des différences observées. La limite inférieure d’agrément se définit alors empiriquement comme le 2,5e centile de la série des résidus, tandis que la limite supérieure correspond au 97,5e centile, la médiane empirique se substituant à la moyenne arithmétique pour quantifier la tendance centrale du biais systématique. Dans R, l’obtention de ces bornes s’effectue instantanément via l’invocation de la fonction de calcul des quantiles empiriques quantile(), configurée avec les probabilités adéquates.
Toutefois, l’estimation robuste de percentiles extrêmes requiert une taille d’échantillon substantielle, généralement supérieure à une centaine d’observations. Pour des cohortes plus réduites, la mise en œuvre d’un rééchantillonnage par bootstrap non paramétrique au travers de la bibliothèque boot de R constitue l’approche méthodologique la plus rigoureuse. En générant plusieurs milliers de réplicats bootstrap de l’échantillon original, le chercheur peut dériver des intervalles de confiance précis autour de ces quantiles empiriques, sans s’appuyer sur aucun postulat de normalité distributionnelle préalable.
10.3 Modélisation par régression pour le biais proportionnel
Il advient fréquemment que la discordance entre deux dispositifs ne se résume pas à un simple décalage parallèle constant, mais obéisse à un biais proportionnel avéré : l’écart s’élargit ou se restreint de manière systématique au fur et à mesure que l’on progresse sur l’échelle des valeurs. Dans une telle conjoncture, projeter des limites d’agrément horizontales d’ordonnée fixe constitue une aberration méthodologique qui sous-estime l’erreur pour les valeurs élevées tout en la surestimant pour les faibles valeurs.
Pour remédier à cette anomalie, Bland et Altman ont formalisé une extension par modélisation linéaire des résidus. La méthode consiste à ajuster une droite de régression linéaire prédisant la différence D_i en fonction de la moyenne X_i. La droite d’ajustement modélise la trajectoire fonctionnelle du biais moyen, qui n’est plus une constante scalaire mais une fonction affine continue. Parallèlement, l’écart-type des résidus de cette régression est extrait pour calculer des limites d’agrément dynamiques, qui se matérialisent sous la forme de deux droites parallèles (ou obliques divergentes en cas de variabilité croissante) encadrant la droite de régression centrale à une distance de plus ou moins 1,96 fois l’écart-type résiduel.
L’implémentation de cette procédure sophistiquée dans R conjugue la modélisation paramétrique via la fonction lm() et la projection visuelle de limites dépendantes au sein de ggplot2. En générant un vecteur de prédiction sur l’ensemble du domaine des abscisses et en lui adjoignant les marges d’erreur résiduelles, l’analyste parvient à tracer des lignes d’accord obliques qui épousent fidèlement la dérive proportionnelle des instruments. Ce raffinement méthodologique permet de préserver l’utilité clinique du graphique même lorsque le modèle standard classique d’agrément constant est invalidé par les données empiriques.
11. Interprétation psychométrique et prise de décision clinique
11.1 Définition a priori des marges d’équivalence clinique ou conceptuelle
L’erreur la plus fondamentale et la plus dommageable commise dans l’exploitation du graphique de Bland-Altman réside dans la tentation de confier à l’algorithme statistique le soin de décider si l’accord observé est « satisfaisant » ou « insuffisant ». La méthode de Bland-Altman est un outil strictement descriptif et estimatif : elle quantifie la magnitude du biais et délimite l’étendue de l’erreur empirique à 95 %, mais elle est par nature incapable de porter un jugement de valeur sur l’acceptabilité opérationnelle de ces résultats. Cette évaluation relève exclusivement d’un arbitrage contextuel, clinique ou psychométrique, obligatoirement fixé a priori par l’investigateur avant le recueil des premières données.
Cette distinction primordiale sépare la significativité statistique de la pertinence clinique. La définition des marges d’équivalence admissibles doit résulter d’une analyse substantielle des conséquences pratiques d’une erreur d’évaluation sur le sujet. En psychométrie clinique, l’analyste se réfère fréquemment au concept d’erreur standard de mesure (Standard Error of Measurement, ou SEM) ou à la différence minimale cliniquement importante (Minimal Clinically Important Difference, ou MCID). Si l’on sait pertinemment qu’une variation de cinq points sur une échelle d’évaluation de la dépression n’induit aucune modification du diagnostic catégoriel ni de la stratégie pharmacologique prescrite, un intervalle d’agrément borné entre moins quatre et plus quatre points sera jugé hautement acceptable.
La formulation préalable de ces critères de tolérance dans le protocole de recherche prévient les biais de confirmation a posteriori, où l’investigateur serait tenté d’adapter sa tolérance clinique à la largeur des limites empiriques observées pour complaire à ses hypothèses de travail. L’inclusion formelle de ces frontières d’équivalence sous forme de lignes horizontales supplémentaires sur le graphique de Bland-Altman permet de confronter directement l’enveloppe de dispersion statistique aux seuils d’inacceptabilité clinique définis par les comités de consensus.
11.2 Critères d’interchangeabilité de deux instruments de mesure
Une fois les marges d’équivalence clinique rigoureusement ancrées, le processus décisionnel relatif à l’interchangeabilité des deux méthodes d’évaluation peut être mené à son terme de façon formelle et transparente. La règle de décision s’articule autour d’un principe géométrique et statistique limpide : deux instruments de mesure ne peuvent être proclamés interchangeables que si et seulement si l’intégralité de l’intervalle couvert par les limites d’agrément à 95 % (idéalement enrichies de leurs intervalles de confiance d’échantillonnage) s’inscrit rigoureusement à l’intérieur de la zone de tolérance clinique définie a priori.
L’application de ce critère conduit typiquement à l’un des trois scénarios diagnostiques suivants :
- Interchangeabilité parfaite et inconditionnelle : Le biais moyen est proche de zéro et les limites d’agrément supérieure et inférieure se situent très confortablement à l’intérieur des marges de tolérance clinique. Les praticiens peuvent employer indifféremment l’un ou l’autre instrument sans ajustement d’échelle ni risque diagnostique.
- Interchangeabilité conditionnelle ou biais d’étalonnage réparable : L’étendue de dispersion (l’écart-type résiduel) est très étroite et compatible avec les exigences de précision, mais le biais moyen est statistiquement et cliniquement non nul. Les deux instruments ne sont pas interchangeables dans leur état brut, mais ils peuvent le devenir moyennant l’application d’un facteur de correction constant simple compensant l’erreur d’étalonnage systématique.
- Divergence et non-interchangeabilité formelle : Les limites d’agrément débordent amplement des seuils d’acceptabilité clinique, ou la présence d’un biais proportionnel majeur rend les écarts imprévisibles selon le niveau d’intensité de la grandeur. Les méthodes doivent être impérativement déclarées non interchangeables, proscrivant le remplacement de la méthode de référence par l’outil expérimental dans la pratique professionnelle.
Cette démarche de décision structurée confère à la recherche méthodologique une portée translationnelle immédiate. Elle évite la commercialisation ou le déploiement hâtif de solutions d’évaluation technologiques ou d’applications mobiles qui, sous couvert d’une séduisante corrélation statistique linéaire, introduiraient un niveau d’aléa préjudiciable au dépistage précoce des pathologies ou à l’objectivation des progrès thérapeutiques.
11.3 Directives de communication scientifique des résultats
La présentation des résultats issus d’une analyse de Bland-Altman au sein d’un manuscrit soumis à une revue académique à comité de lecture doit obéir à des standards rédactionnels rigoureux afin de garantir la transparence et l’auditabilité des conclusions. Les normes préconisées par les directives internationales, à l’instar des déclarations STARD pour les études de précision diagnostique ou des critères de l’American Psychological Association (APA), proscrivent les déclarations vagues ou isolées.
Sur le plan textuel et tabulaire, la communication formelle doit comporter l’énoncé exhaustif de six paramètres métrologiques obligatoires : la taille précise de l’échantillon apparié (N), le biais systématique moyen accompagné de son intervalle de confiance à 95 %, l’écart-type empirique des différences, la valeur numérique exacte de la limite d’agrément inférieure assortie de son intervalle d’incertitude à 95 %, la valeur numérique exacte de la limite d’agrément supérieure avec son propre intervalle d’incertitude, et enfin l’amplitude explicite de la marge de tolérance clinique définie a priori. Un tableau récapitulatif structuré synthétise ces métriques avec un arrondi typographique cohérent avec la sensibilité des instruments.
La rédaction de la discussion doit quant à elle faire preuve d’une nuance épistémologique exemplaire. L’investigateur veillera à expliciter les implications pratiques des limites d’agrément en formulant des assertions concrètes adaptées aux cliniciens de terrain, par exemple : « Les résultats démontrent que pour 95 % des évaluations individuelles, la méthode d’auto-évaluation sur tablette fournit une estimation se situant entre 3,2 points en dessous et 4,8 points au-dessus du score psychiatrique étalon. Considérant que la marge d’erreur admissible prédéfinie avait été fixée à plus ou moins 6 points, les deux modalités d’évaluation peuvent être légitimement considérées comme interchangeables pour le dépistage de masse dans les cohortes universitaires. »
12. Synthèse, pièges méthodologiques et bonnes pratiques
12.1 Erreurs récurrentes de modélisation et d’interprétation dans R
L’implémentation pratique de l’analyse de Bland-Altman au moyen de scripts R recèle plusieurs chausse-trapes statistiques et informatiques contre lesquelles le chercheur doit se prémunir avec la plus haute vigilance. La première méprise, remarquablement commune chez les analystes débutants, consiste à confondre la droite de régression linéaire conventionnelle et les lignes horizontales de Bland-Altman, allant parfois jusqu’à ajuster un modèle de régression de type A sur B en tentant d’interpréter le coefficient d’accord à travers la pente de régression.
Une seconde erreur computationnelle dévastatrice concerne l’inversion involontaire des colonnes lors du calcul des différences au sein d’équipes multi-analystes. Si un premier collaborateur calcule les écarts sous la forme A – B tandis qu’un second structure un code miroir sous la forme B – A, les représentations graphiques afficheront des biais de polarités opposées, ouvrant la voie à des contresens majeurs dans les conclusions relatives à la direction de la surestimation. Une vérification unitaire systématique de la conformité du code d’assignation au moyen d’assertions logiques permet de juguler instantanément ce péril.
Enfin, l’omission totale de la vérification de la normalité des différences figure au premier rang des manquements éditoriaux. De nombreux utilisateurs se contentent de tracer aveuglément les lignes horizontales calculées via l’expression standardisée de Bland-Altman sans s’être préalablement assurés par un test de Shapiro-Wilk ou un diagramme quantile-quantile que la distribution sous-jacente tolérait l’application du multiplicateur 1,96. La publication de graphiques affichant des limites paramétriques sur des distributions asymétriques tronquées engendre une désinformation scientifique insidieuse qu’un environnement analytique rigoureux comme R permet pourtant d’éviter sans effort.
12.2 Check-list méthodologique pour une analyse de concordance rigoureuse
Afin de structurer le flux d’investigation et de prémunir les chercheurs contre toute négligence procédurale, le tableau méthodologique suivant récapitule les contrôles séquentiels obligatoires à exécuter avant de statuer définitivement sur l’interchangeabilité de deux méthodes d’évaluation dans l’environnement R :
- Phase Préparatoire : Définition explicite a priori de la marge de tolérance ou d’équivalence clinique admissible (delta maximal toléré). Vérification de l’indépendance stricte des observations entre les sujets de la cohorte.
- Phase de Validation des Données : Alignement rigoureux des mesures appariées au sein d’une structure en format large (wide data frame). Audit exhaustif de l’intégrité numérique et détection des données absentes ou mal codées.
- Phase de Dérivation Statistique : Calcul unifié des moyennes (A + B)/2 et des différences orientées (A – B). Quantification du biais systématique moyen, de son écart-type résiduel et des limites d’agrément supérieure et inférieure.
- Phase de Vérification des Hypothèses : Test formel d’ajustement à la loi normale pour les différences (test de Shapiro-Wilk et Q-Q plot). Détection de l’hétéroscédasticité ou d’un biais proportionnel par régression de la différence sur la moyenne. Identification et traitement raisonné des observations atypiques marginales.
- Phase de Rendu Graphique : Traçage conforme aux standards typographiques via ggplot2, incluant la ligne de biais moyen, les limites d’agrément à 95 %, les étiquettes numériques arrondies, les intervalles de confiance respectifs et les libellés scientifiques complets des axes.
- Phase Inférentielle et Décisionnelle : Confrontation formelle des limites d’agrément à 95 % empiriques avec les marges de tolérance clinique prédéfinies avant de formuler toute conclusion d’interchangeabilité.
12.3 Extensions analytiques : mesures répétées et évaluateurs multiples
Le modèle standardisé de Bland-Altman détaillé tout au long de ce guide a été formulé pour le cas de figure canonique où chaque individu fait l’objet d’une mesure unique et synchrone par chacun des deux instruments. Cependant, les protocoles expérimentaux contemporains en psychométrie et physiologie clinique s’orientent de plus en plus fréquemment vers des devis longitudinaux ou des architectures multi-niveaux impliquant des mesures répétées dans le temps ou l’intervention d’évaluateurs multiples.
L’application naïve du formalisme standard sur des données comportant des répétitions par sujet constitue une faute statistique sévère : la multiplicité des observations intra-individuelles viole frontalement le postulat fondamental d’indépendance des résidus et comprime artificiellement la variance d’échantillonnage, conduisant à des limites d’agrément trompeusement étroites. Pour contourner cet écueil, Bland et Altman ont élaboré en 2007 des formulations adaptées articulées autour de l’analyse de variance à deux facteurs et des modèles à effets mixtes. Sous R, ces architectures s’implémentent magistralement via la bibliothèque lme4, qui permet de décomposer rigoureusement la variance résiduelle totale entre la variabilité intra-sujet et la variabilité inter-sujets.
De même, lorsque le protocole vise à évaluer la concordance non plus entre deux instruments exclusifs mais entre une pluralité d’évaluateurs ou d’observateurs simultanés (trois juges ou davantage), le graphique bidimensionnel classique de Bland-Altman doit être complété par l’estimation de coefficients de corrélation intra-classe (Intraclass Correlation Coefficient, ou ICC) appropriés, notamment les modèles à deux facteurs à effets aléatoires évaluant l’accord absolu (ICC type 2,1 selon la classification de Shrout et Fleiss). Ces prolongements analytiques témoignent de la vitalité théorique de la métrologie de l’accord, dont la maîtrise technique dans l’environnement R représente un atout méthodologique inestimable pour tout chercheur aspirant à l’excellence scientifique.
Références
Altman, D. G., & Bland, J. M. (1983). Measurement in medicine: The analysis of method comparison studies. The Statistician, 32(3), 307–317. https://doi.org/10.2307/2987937
Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
Bland, J. M., & Altman, D. G. (2007). Agreement between methods of measurement with multiple observations per individual. Journal of Biopharmaceutical Statistics, 17(4), 571–582. https://doi.org/10.1080/10543400701329422
Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/BM.2015.015
Lehnert, B. (2015). BlandAltmanLeh: Plots (Slightly Extended) Bland-Altman Plots (R package version 0.3.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=BlandAltmanLeh
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0