
Dans le champ contemporain de l’analyse quantitative et de la communication scientifique, la restitution visuelle des données constitue un vecteur fondamental de l’intelligibilité des résultats. Alors que la volumétrie des informations empiriques collectées ne cesse de croître dans les organisations académiques, médicales et industrielles, la capacité à synthétiser des relations bivariées ou multivariées complexes conditionne directement la validité des conclusions formulées par les chercheurs et les analystes. Au cœur de cet écosystème de représentation graphique, le diagramme à barres doubles — fréquemment désigné sous le terme technique de graphique à colonnes groupées ou à barres juxtaposées — occupe une place de premier plan. Il offre un dispositif sémiotique d’une rare efficacité pour confronter deux distributions distinctes au travers d’une même typologie de variables catégorielles.
L’adoption généralisée de suites logicielles en mode infonuagique (*cloud computing*), au premier rang desquelles figure Google Sheets, a profondément transformé les pratiques d’édimétrie et de visualisation de données. Bien loin de se cantonner à un simple rôle de tableur bureautique, cet outil intègre désormais des moteurs de rendu graphique sophistiqués, couplés à des algorithmes de détection de structure capables d’automatiser des flux de travail analytiques poussés. Toutefois, la production d’une figure rigoureuse, exempte de biais de perception et conforme aux standards internationaux de publication scientifique, ne saurait reposer sur la seule automatisation logicielle. Elle exige une maîtrise théorique approfondie des postulats de la sémiologie graphique, une préparation scrupuleuse de la matrice de données sous-jacente et un calibrage minutieux des paramètres géométriques et chromatiques de la restitution.
Le présent guide méthodologique et pratique propose une déconstruction exhaustive du processus de conception d’un graphique à barres doubles au sein de l’environnement Google Sheets. Destiné aux chercheurs, analystes de données, statisticiens et professionnels soucieux de rigueur méthodologique, cet ouvrage traite aussi bien des soubassements épistémologiques régissant la comparaison visuelle de grandeurs que des protocoles techniques pas-à-pas requis pour exploiter l’intégralité du potentiel fonctionnel de la plateforme. De la normalisation des variables sources à l’exportation vectorielle haute définition, en passant par l’intégration d’intervalles de confiance, l’automatisation via des fonctions matricielles et l’alignement sur les normes de publication internationales, chaque étape est explicitée avec une précision systématique afin de transformer vos données tabulaires brutes en instruments de communication visuelle irréprochables.
1. Fondements méthodologiques et intérêt du graphique à barres doubles
1.1 Définition et structure sémiotique du graphique à barres doubles
Le graphique à barres doubles constitue un système de transcription visuelle fondé sur la projection orthogonale de grandeurs numériques le long d’un système de coordonnées cartésiennes. Son principe fondamental réside dans la juxtaposition spatiale immédiate de deux séries de données quantitatives pour chaque modalité discrète d’une variable nominale ou ordinale commune, positionnée sur l’axe de référence. Dans le cadre théorique de la sémiologie graphique développé originellement par Jacques Bertin dans son œuvre fondatrice Sémiologie Graphique, la longueur ou la hauteur d’une barre constitue une variable visuelle d’élévation, reconnue pour être la plus précisément décodée par le système perceptif humain. En assignant deux barres contiguës à un même point d’ancrage catégoriel, le graphique crée une unité perceptive locale permettant une double lecture sémiotique : une lecture intra-catégorielle instantanée évaluant l’écart absolu ou relatif entre les deux conditions observées, et une lecture inter-catégorielle transversale retraçant l’évolution du phénomène à travers les différentes strates de l’échantillon.
D’un point de vue structural, il convient d’opérer une différenciation conceptuelle stricte entre le diagramme en colonnes groupées, dont le développement s’opère sur un plan vertical le long de l’axe des ordonnées, et le diagramme à barres horizontales groupées, qui projette les mesures de gauche à droite sur l’axe des abscisses. Si ces deux représentations partagent une architecture mathématique isomorphe, leur impact cognitif diverge selon la typologie et le libellé des modalités. Le déploiement horizontal s’avère particulièrement préconisé lorsque les dénominations textuelles des catégories présentent une longueur taxonomique importante, évitant ainsi les distorsions de lecture induites par une inclinaison artificielle du texte. Inversement, le déploiement vertical mobilise une métaphore spatiale universelle associant la verticalité ascendante à l’accroissement quantitatif, renforçant l’intuitivité du traitement analytique.
Le rôle cognitif de la proximité spatiale s’enracine directement dans les postulats de la psychologie de la forme (théorie de la Gestalt). En réduisant la distance euclidienne entre les deux stimuli visuels représentant les groupes sous étude, le concepteur du graphique diminue drastiquement la trajectoire des saccades oculaires requises pour comparer les grandeurs. Cette économie de mouvements oculaires atténue la charge imposée à la mémoire de travail visuo-spatiale du lecteur. Au lieu de retenir mentalement une valeur observée à une extrémité du graphique pour aller la confronter à une valeur située en un point distant, le cerveau effectue une comparaison différentielle différentiée quasi-instantanée par alignement de contours. Dans les sciences sociales et comportementales, où les différences d’amplitudes entre groupes sont souvent subtiles et requièrent une discrimination fine, cette contiguïté spatiale maximise la sensibilité de l’observateur aux variations intergroupes significatives.
1.2 Applications de la visualisation comparative en recherche empirique
En recherche empirique, l’administration d’un protocole expérimental nécessite l’usage d’outils visuels capables d’illustrer sans ambiguïté les effets d’interaction et les contrastes statistiques élémentaires. L’une des applications paradigmatiques du graphique à barres doubles réside dans la restitution des scores psychométriques recueillis lors de protocoles pré-test et post-test appliqués à des cohortes distinctes. Dans une telle configuration, l’axe catégoriel énumère les différentes dimensions cognitives ou socio-affectives évaluées (par exemple : mémoire de travail, flexibilité cognitive, régulation émotionnelle), tandis que les deux barres juxtaposées matérialisent l’état initial avant intervention et le niveau de performance stabilisé consécutif au protocole thérapeutique ou pédagogique. La juxtaposition permet d’apprécier d’un seul coup d’œil non seulement l’amplitude du progrès accompli au sein de chaque dimension, mais également d’identifier les domaines réfractaires à l’intervention.
De manière corollaire, le paradigme méthodologique opposant un groupe contrôle non soumis à la manipulation expérimentale à un groupe expérimental trouve dans le graphique à barres doubles un support de communication privilégié. Qu’il s’agisse de mesurer des temps de réaction en millisecondes, des taux d’erreur, des concentrations sériques de biomarqueurs ou des scores de satisfaction au travail, la projection bilatérale des moyennes permet au lecteur de valider visuellement l’efficacité de la condition testée par rapport au niveau de référence. Ce type de figure permet en outre d’observer si l’effet expérimental se maintient de manière homogène à travers diverses sous-populations catégorielles (classes d’âge, strates socio-économiques, catégories nosographiques), facilitant la détection visuelle d’interactions statistiques modératrices avant même la lecture des tables d’analyses de variance (ANOVA).
L’observation longitudinale discrète sur des pas de temps séquentiels constitue un autre champ d’application prépondérant. Dans le suivi des métriques organisationnelles ou épidémiologiques, les données sont fréquemment agrégées par périodes temporelles fixes (semestres, trimestres, cohortes annuelles). L’intégration de deux séries parallèles — telles que les taux d’incidence d’une pathologie observés dans deux régions géographiques distinctes ou les volumes de rétention d’utilisateurs selon deux modes d’onboarding — permet de tracer visuellement la dynamique comparative sans recourir à des courbes continues qui suggéreraient à tort une collecte ininterrompue. Enfin, en synthétisant deux flux d’informations quantitatives au sein d’un format géométrique épuré, le graphique à barres doubles opère une réduction substantielle de la charge cognitive extrinsèque, permettant au chercheur de focaliser ses ressources attentionnelles sur l’interprétation théorique des données multivariées.
1.3 Critères de pertinence statistique face à d’autres représentations
Le choix d’un graphique à barres doubles doit résulter d’un arbitrage méthodologique fondé sur la nature des variables et les objectifs inférentiels de l’étude, excluant tout opportunisme esthétique. Confronté au diagramme à barres empilées (*stacked bar chart*), le graphique à barres doubles démontre une supériorité absolue dès lors que l’objectif premier réside dans la comparaison directe et non équivoque des grandeurs de chaque sous-groupe. Dans une barre empilée, seul le segment reposant directement sur la ligne de base bénéficie d’un ancrage à zéro commun ; le segment supérieur, quant à lui, flotte au-dessus du premier, ce qui contraint l’œil humain à estimer une longueur sans repère d’alignement fixe. Cette instabilité de la référence spatiale induit des erreurs systématiques de jugement perceptif chez le lecteur, particulièrement lorsque les variations relatives sont faibles. Le graphique groupé, en fournissant une ligne de flottaison nulle partagée à l’intégralité des barres, préserve l’intégrité de la mesure comparative absolue.
Néanmoins, la rigueur statistique impose de reconnaître les limites intrinsèques du graphique à barres face à d’autres formalismes de restitution visuelle, notamment les nuages de points (*scatter plots*) ou les diagrammes de dispersion avec boîte à moustaches (*box plots*). Lorsque l’échantillon d’analyse repose sur une distribution continue présentant une forte asymétrie, une multimodalité ou des valeurs extrêmes substantielles, la barre pleine tend à masquer l’hétérogénéité sous-jacente en réduisant l’information à une simple moyenne ponctuelle. Dans un tel contexte, le diagramme à barres doubles ne doit être retenu que si les postulats de normalité sont raisonnablement vérifiés ou s’il est formellement complété par des indicateurs de dispersion rigoureux, tels que des barres d’écart type ou des intervalles de confiance à 95 %.
Sur le plan de la théorie de la mesure formulée par Stanley Smith Stevens, le diagramme à barres doubles exige le respect strict des caractéristiques inhérentes aux échelles d’intervalles et de proportions (échelles de ratio). Étant donné que la perception visuelle de la grandeur repose sur le rapport proportionnel des longueurs des barres, l’utilisation de ce format sur des variables purement ordinales (comme des échelles de Likert non normalisées) peut induire le lecteur en erreur en suggérant faussement que la distance quantitative séparant deux modalités subjectives est rigoureusement identique. Lorsque les données respectent les critères des échelles de ratio — où le zéro possède une signification physique ou conceptuelle absolue — le diagramme à barres doubles déploie toute sa puissance probatoire en garantissant une correspondance parfaite entre la magnitude géométrique dessinée et la réalité empirique mesurée.
2. Structuration préalable et préparation rigoureuse de la matrice de données
2.1 Organisation tabulaire conforme aux normes de traitement
L’efficacité algorithmique du générateur de figures de Google Sheets dépend de la conformité structurelle du jeu de données matriciel. Pour que le moteur interprète sans ambiguïté les dimensions analytiques, la feuille de calcul doit respecter rigoureusement les principes des données ordonnées (*tidy data*), théorisés notamment par Hadley Wickham. Cette organisation impose une disposition dans laquelle la première colonne (colonne A) est réservée à la variable indépendante catégorielle. C’est au sein de cette colonne matricielle que doivent figurer l’ensemble des modalités nominales ou temporelles qui jalonneront l’axe de référence. Chaque ligne individuelle doit représenter une unité d’observation catégorielle unique et exclusive, éliminant toute redondance sémantique susceptible de fragmenter l’affichage du futur axe des abscisses.
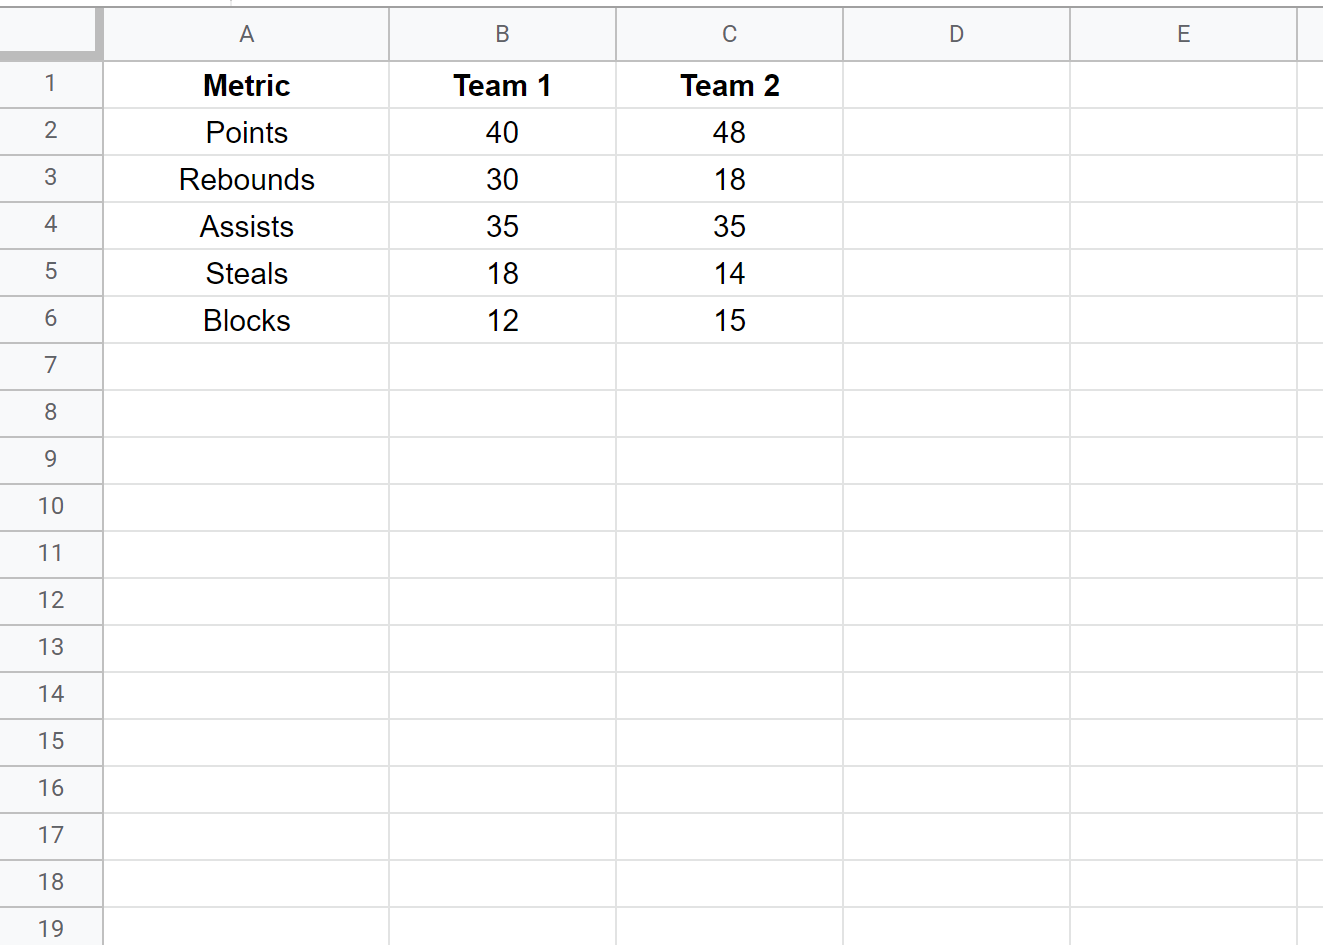
Les colonnes immédiatement adjacentes (colonnes B et C) doivent être dédiées de manière univoque aux variables dépendantes ou aux deux cohortes soumises à la comparaison (par exemple : « Groupe Témoin » en colonne B et « Groupe Expérimental » en colonne C). Cette contiguïté vectorielle est indispensable pour que le traceur automatique de Google Sheets assigne nativement ces séries comme des éléments comparatifs couplés. L’introduction de colonnes vides intermédiaires, souvent employée à tort pour des motifs d’aération esthétique du tableur, rompt la contiguïté de la plage matricielle et conduit fréquemment le parseur de Google Sheets à interpréter les données comme des sous-ensembles indépendants ou non dimensionnels, faussant la détection initiale du type de diagramme.
La formalisation de la première ligne d’en-tête (ligne 1) constitue une condition primordiale pour l’automatisation ultérieure de la légende. Les cellules A1, B1 et C1 doivent contenir des étiquettes textuelles concises, dénuées de formules complexes ou de retours à la ligne intempestifs. Le texte inscrit en B1 et C1 sera directement extrait par le moteur graphique pour générer les libellés de la légende interactive. Il convient donc de proscrire les codes cryptiques de bases de données (tels que « var_q01_g1 ») au profit d’intitulés scientifiquement précis et auto-porteurs (tels que « Traitement A » et « Traitement B »). L’application d’un formatage visuel distinct aux en-têtes (comme la mise en gras ou le centrage) facilite en outre la délimitation algorithmique des métadonnées par l’intelligence contextuelle du tableur.
2.2 Nettoyage, normalisation et vérification des variables
Avant d’initier la commande de création graphique, une étape d’audit qualitatif et de nettoyage des cellules numériques s’avère indispensable. L’un des écueils techniques les plus récurrents réside dans la présence involontaire de valeurs textuelles parasites dissimulées au sein des colonnes de données quantitatives. La présence d’espaces insécables, de chaînes vides résiduelles, d’abréviations textuelles d’absence de données (comme « N/A », « non renseigné » ou « null » sans syntaxe de fonction) force Google Sheets à requalifier l’intégralité ou une partie de la colonne en format texte. Lorsque cette mutation typologique survient, le traceur refuse d’affecter une échelle métrique continue aux barres correspondantes, ce qui se traduit visuellement par l’omission pure et simple de la barre concernée ou par son écrasement à une valeur nulle fictive.
Le traitement des données brutes nécessite fréquemment une étape d’agrégation statistique préalable au tracé. Le graphique à barres doubles n’a pas vocation à compiler des micro-observations individuelles directes ; il projette des indicateurs de tendance centrale stabilisés. Il appartient ainsi à l’opérateur de construire une table récapitulative intermédiaire à l’aide de formules conditionnelles rigoureuses. Les fonctions telles que MOYENNE.SI.ENS, MEDIANE ou les requêtes matricielles complexes doivent être mobilisées pour calculer les estimations centrales relatives à chaque modalité catégorielle. Lors de l’arbitrage entre moyenne arithmétique et médiane, le chercheur devra vérifier l’asymétrie de distribution de ses données sources afin de choisir la mesure la plus fidèle à la distribution réelle.
Enfin, l’homogénéité des unités de mesure entre les deux séries constitue un prérequis mathématique incontournable. Il est conceptuellement inadmissible de juxtaposer au sein d’un même groupe de barres une série exprimée en pourcentages normalisés et une autre exprimée en scores bruts continus s’étalant sur plusieurs ordres de grandeur. Cette hétérogénéité d’échelles produirait l’annihilation visuelle de la série de moindre amplitude, privant l’utilisateur de toute capacité comparative. Le tableau ci-dessous explicite la structure matricielle canonique requise avant toute tentative d’insertion graphique dans le tableur :
| Dimension d’Évaluation (Col. A) | Cohorte Contrôle (Col. B) | Cohorte Expérimentale (Col. C) |
|---|---|---|
| Attention Visuelle | 64,2 | 78,9 |
| Mémoire Spatiale | 52,1 | 61,4 |
| Vitesse Motrice | 45,8 | 44,2 |
| Inhibition Cognitive | 58,3 | 72,1 |
2.3 Configuration des plages d’analyse dans Google Sheets
Une fois la table synthétique élaborée et vérifiée, la délimitation technique de la plage d’analyse doit être effectuée avec précision. La sélection doit intégrer impérativement la cellule supérieure gauche contenant l’intitulé de la dimension catégorielle (typiquement la cellule A1) jusqu’à la cellule inférieure droite hébergeant la dernière valeur numérique de la seconde série (par exemple la cellule C5 dans le cadre d’un tableau à quatre modalités). La sélection manuelle peut s’opérer au curseur ou, de manière plus rigoureuse pour les jeux de données volumineux, via les raccourcis clavier de sélection vectorielle (combinaison des touches Contrôle, Majuscule et touches directionnelles sous Windows/Linux, ou Commande, Majuscule et flèches sous macOS). Cette démarche prévient l’oubli de cellules marginales souvent causé par un balayage imprécis de la souris.
Pour les infrastructures de données destinées à des actualisations récurrentes ou intégrées au sein de tableaux de bord automatisés, le recours aux plages nommées (*named ranges*) représente une bonne pratique organisationnelle de premier ordre. En accédant au menu Données puis en sélectionnant l’entrée Plages nommées, l’analyste peut attribuer un identifiant sémantique univoque (tel que Matrice_Comparaison_Cognitive) à l’intervalle A1:C5. Cette encapsulation structurelle offre l’avantage de pérenniser la référence des données sources. En cas d’adjonction ultérieure de nouvelles lignes catégorielles, la modification des coordonnées au sein du gestionnaire de plages nommées actualise automatiquement l’ensemble des figures et des formules dépendantes, éliminant les risques de rupture de liaison graphique.
Le contrôle préalable des données aberrantes (*outliers*) s’impose également lors de cette phase de configuration spatiale. Une valeur aberrante non corrigée — résultant par exemple d’une erreur d’encodage ou de conversion typographique (comme l’omission d’une virgule décimale transformant un score de 7,8 en 78) — va provoquer une dilatation artificielle de l’échelle des ordonnées lors de la génération automatique. Cette distorsion comprime l’ensemble des autres barres vers la ligne de base, réduisant à néant le pouvoir résolutif du graphique. L’application temporaire d’une règle de mise en forme conditionnelle signalant les valeurs excédant un intervalle d’écarts-types prédéterminé permet d’intercepter ces anomalies numériques en amont du tracé.
3. Procédure d’insertion du graphique dans Google Sheets
3.1 Sélection des données sources et exécution de la commande
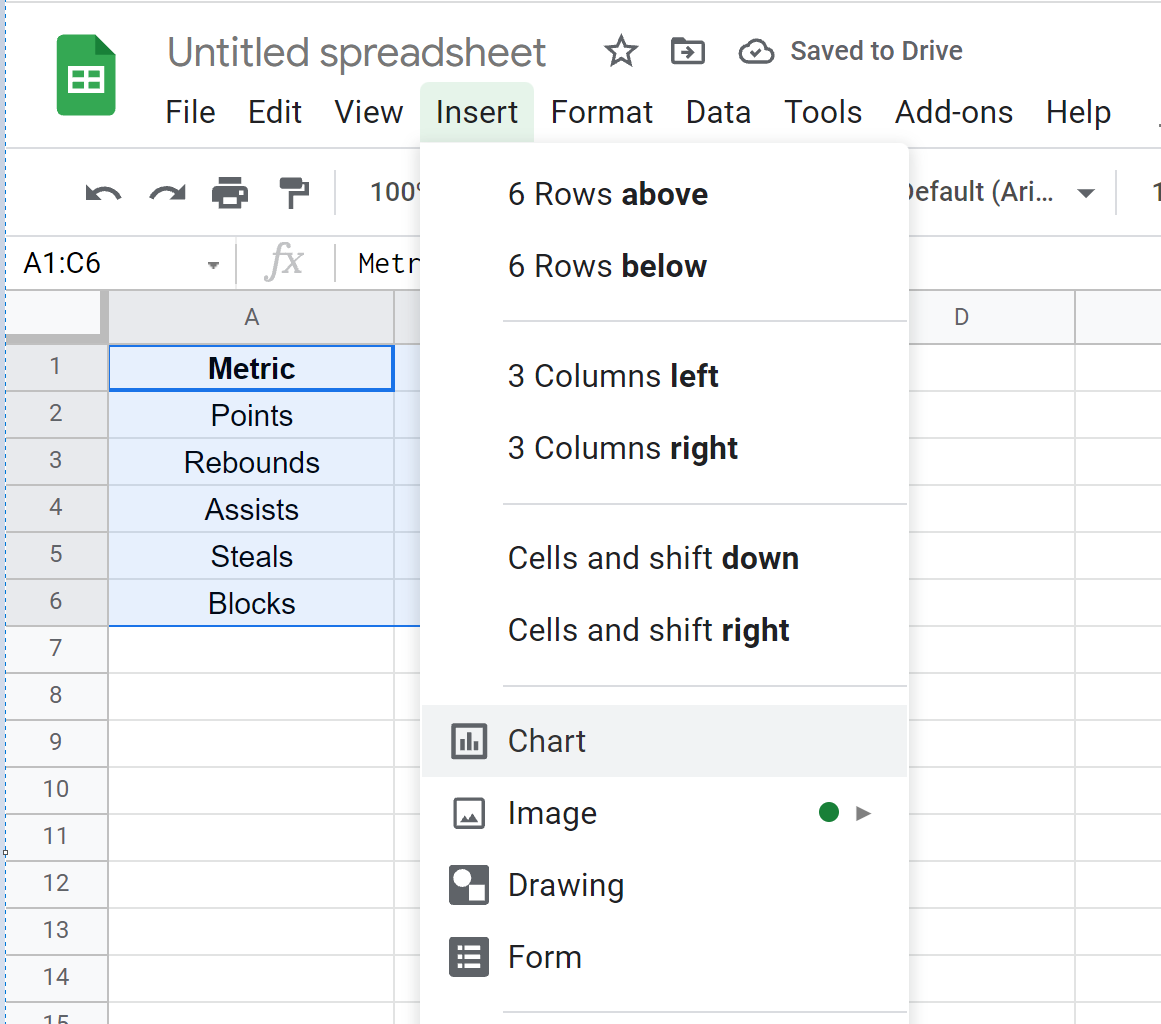
L’initialisation de la création graphique dans l’interface Google Sheets requiert une rigueur d’exécution méthodique afin d’éviter que l’interpréteur d’intelligence artificielle du tableur ne produise une disposition inadaptée aux objectifs de recherche. L’utilisateur doit s’assurer que la surbrillance de la matrice de données est active et couvre l’intégralité du périmètre tabulaire, en-têtes nominatifs inclus. Toute sélection partielle — par exemple, omettre la colonne catégorielle pour ne surligner que les deux colonnes de données numériques — priverait l’algorithme de son référentiel sémantique et forcerait le logiciel à substituer les modalités textuelles par des indices numériques ordinaux arbitraires (1, 2, 3…), dégradant immédiatement la valeur informative du document.
Une fois le bloc cellulaire scrupuleusement circonscrit, l’utilisateur active la routine de génération visuelle. Deux voies ergonomiques sont offertes par l’environnement : le déploiement du menu supérieur via le clic sur l’onglet Insertion, suivi de la sélection de l’élément Graphique, ou l’utilisation directe du pictogramme dédié représentant un graphique à colonnes miniatures positionné au sein de la barre d’outils contextuelle. L’exécution de cette commande provoque l’instanciation immédiate d’un canevas vectoriel dynamique flottant au-dessus de la grille des cellules, accompagné du déploiement simultané du panneau latéral de configuration.
Lors de cette injection inaugurale, l’algorithme heuristique de Google Sheets analyse la composition dimensionnelle de la matrice sélectionnée. Dans la majorité des cas impliquant une colonne de texte adjacente à deux colonnes numériques, le système identifie la nature comparative de la structure et propose d’emblée un diagramme en colonnes. Cependant, cette sélection automatisée n’est pas infaillible : selon la distribution des valeurs ou l’éventuelle interprétation numérique des dates en colonne A, le moteur peut arbitrairement basculer vers une courbe linéaire continue ou un diagramme circulaire non pertinent. Il appartient donc à l’opérateur de ne jamais considérer le premier rendu visuel comme définitif et d’engager immédiatement la procédure de calibration paramétrique.
3.2 Exploration de l’Éditeur de graphiques intégré
Le panneau latéral droit, intitulé formellement Éditeur de graphiques, centralise l’intégralité des commandes de contrôle géométrique, relationnel et stylistique du visuel. Il est articulé autour d’une dichotomie fonctionnelle fondamentale matérialisée par deux onglets maîtres : l’onglet Configurer et l’onglet Personnaliser. Le premier onglet régit l’architecture analytique de la figure : il définit la typologie de visualisation exploitée, la plage de coordonnées sources, l’affectation du vecteur matriciel désigné pour l’axe des abscisses et la liaison des séries de données quantitatives assignées à l’axe des ordonnées. C’est à ce niveau que se noue l’intégrité structurelle du graphique à barres doubles.
L’onglet Personnaliser, pour sa part, gouverne l’ensemble des composantes esthétiques, sémiotiques et typographiques du rendu final. Cet onglet est découpé en plusieurs sous-sections repliables hautement hiérarchisées : Style de graphique, Titres des graphiques et des axes, Séries, Légende, Axe horizontal, Axe vertical et Quadrillage et graduations. La maîtrise de ces sous-menus est indispensable pour transformer une ébauche logicielle générique en une figure de qualité publication, répondant aux standards esthétiques et aux exigences typographiques des comités de lecture scientifique internationaux.
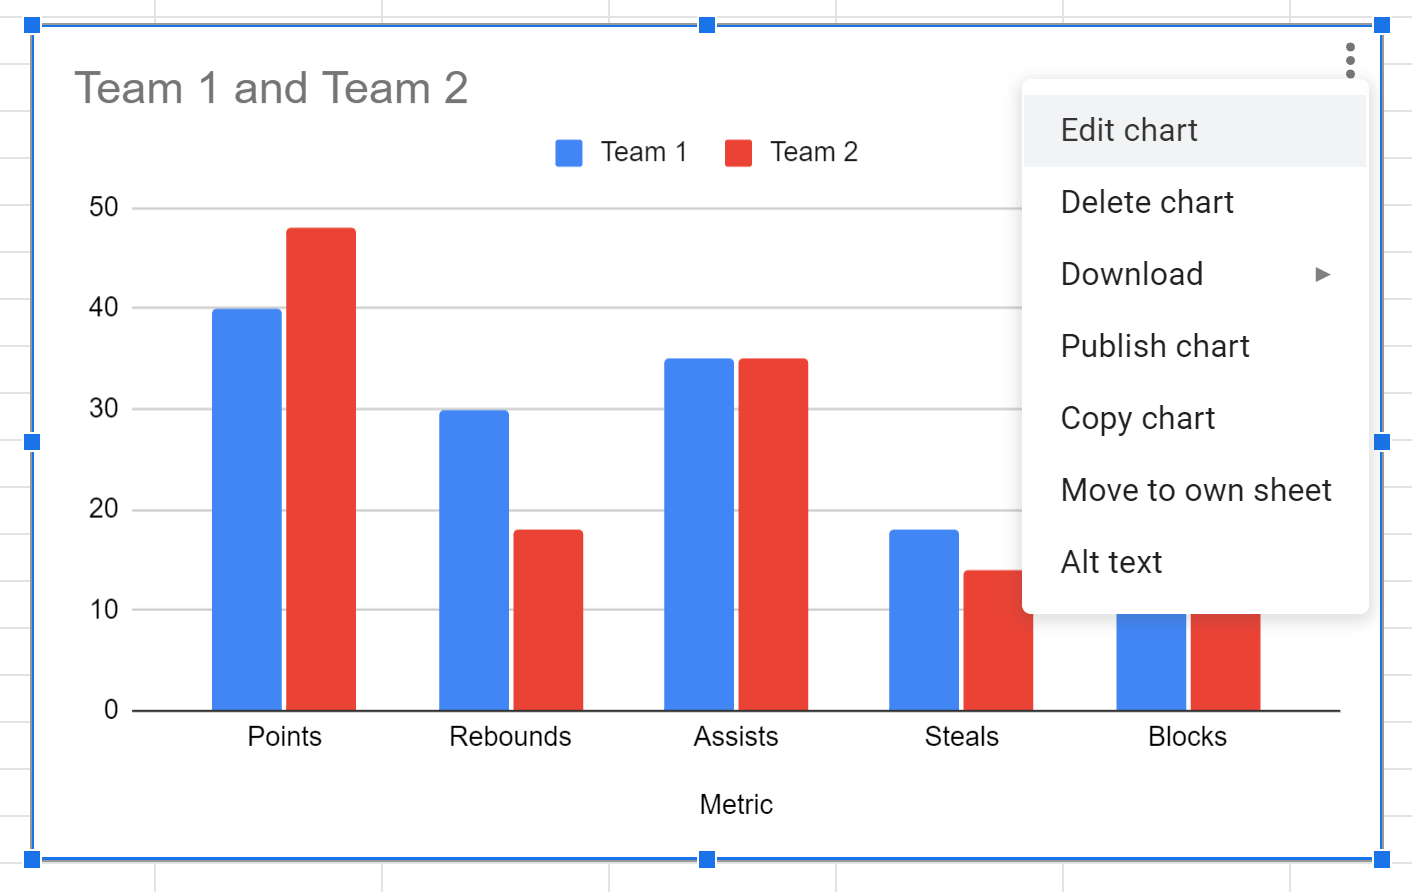
Dans l’éventualité où l’opérateur cliquerait en dehors du canevas graphique au cours de sa session de travail, provoquant la fermeture involontaire du panneau latéral, la réactivation de l’Éditeur de graphiques s’opère de manière intuitive mais requiert le respect d’une manipulation précise. Un double-clic consécutif appliqué directement sur la surface du graphique restaure instantanément l’interface latérale. Alternativement, le passage du curseur sur le coin supérieur droit de l’objet graphique révèle une icône contextuelle constituée de trois points verticaux superposés. Un clic sur cet élément déploie un menu déroulant opérationnel au sein duquel figure la commande Modifier le graphique, restituant l’accès plein et entier aux paramètres structurels et cosmétiques.
3.3 Résolution des erreurs d’insertion initiale
Au cours de la phase initiale d’insertion, plusieurs désynchronisations structurelles courantes peuvent altérer la topologie de la figure. L’anomalie la plus fréquemment documentée réside dans la transposition erronée des axes et des séries. Ce phénomène survient lorsque l’interpréteur de Google Sheets inverse involontairement la logique des dimensions tabulaires, regroupant les données par colonne plutôt que par ligne catégorielle. Pour corriger cette distorsion, l’utilisateur doit inspecter minutieusement le bas de l’onglet Configurer et agir sur les cases à cocher contextuelles : Inverser les lignes et les colonnes, Utiliser la ligne 1 comme en-têtes et Utiliser la colonne A comme libellés. L’activation ou la désactivation de ces bascules relationnelles restaure immédiatement la hiérarchie matricielle adéquate.
Une autre distorsion opérationnelle classique concerne l’omission accidentelle de points d’observation consécutive à une sélection initiale tronquée de la plage de cellules. Si une nouvelle modalité a été adjointe dans la feuille de calcul postérieurement à l’insertion du graphique, il n’est nullement nécessaire de détruire la figure pour en réinstancier une nouvelle. Il suffit de cliquer sur le champ Plage de données situé au sommet de l’onglet Configurer, puis d’ajuster textuellement la référence matricielle (par exemple en étendant A1:C5 vers A1:C9) ou de cliquer sur le pictogramme de grille matricielle pour effectuer une nouvelle délimitation dynamique sur la grille sous-jacente.
Il importe de souligner la réactivité bidirectionnelle native caractérisant l’environnement Google Sheets : le canevas graphique fonctionne sous un paradigme de liaison de données réactive continue. Toute rectification typographique, réévaluation numérique ou élimination d’une valeur textuelle parasite au sein des cellules sources de la grille se répercute en temps réel sur la géométrie des barres sans nécessiter la moindre commande d’actualisation manuelle. Cette synchronisation continue garantit une cohérence absolue entre la réalité arithmétique de la base de données et l’artefact visuel projeté, facilitant les ajustements itératifs lors des séances de nettoyage préliminaire.
4. Configuration du type de diagramme et des séries de données
4.1 Sélection du format de colonnes ou de barres groupées
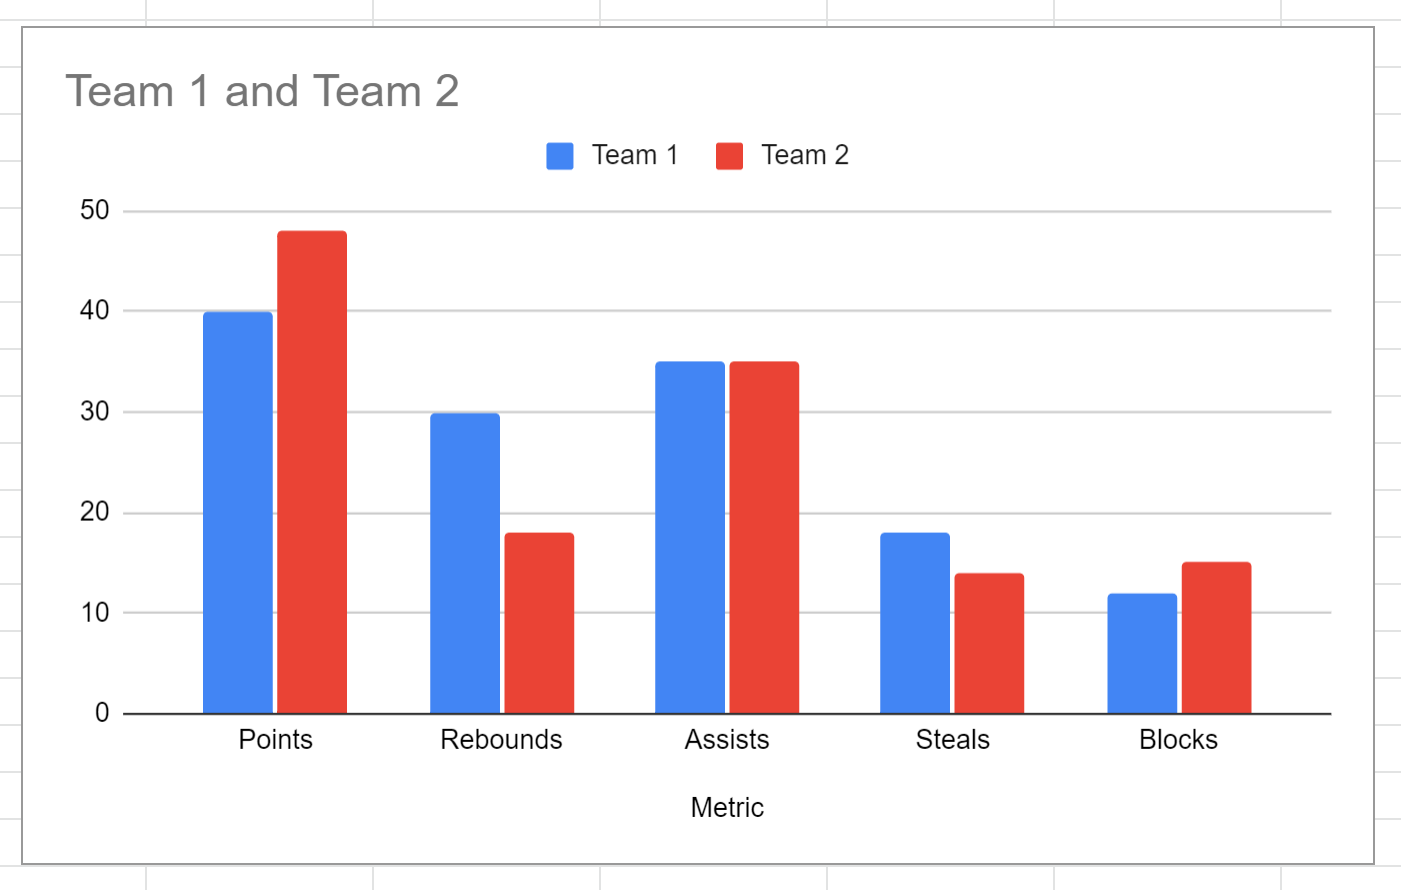
La transcription géométrique exacte de la relation bivariée exige la sélection formelle du gabarit de tracé approprié au sein du catalogue visuel de Google Sheets. Dans l’onglet Configurer, le premier champ déployable intitulé Type de graphique donne accès à une taxonomie diversifiée d’objets graphiques répartis par familles conceptuelles. Pour élaborer un graphique à barres doubles vertical standard, l’opérateur doit impérativement sélectionner le modèle intitulé Graphique à colonnes (qui correspond, selon la nomenclature internationale, au *grouped column chart*). Dans ce mode, chaque modalité catégorielle se voit assigner un segment d’abscisse sur lequel s’érigent côte à côte deux colonnes verticales indépendantes dont la hauteur traduit l’amplitude des séries respectives.
Le choix alternatif réside dans le modèle Graphique à barres, qui transpose la projection sur un plan horizontal. Ce format géométrique devient hautement recommandé d’un point de vue ergonomique dès lors que la variable catégorielle comporte un nombre substantiel de modalités (typiquement au-delà de huit ou dix catégories) ou lorsque les intitulés textuels s’avèrent excessivement longs. La projection horizontale offre une ligne de lecture naturelle de gauche à droite, épargnant au lecteur la torsion du cou ou la gymnastique oculaire imposée par des étiquettes verticales tassées. Le chercheur doit évaluer la charge spatiale de son graphique pour arbitrer méthodologiquement entre verticalité et horizontalité.
Il est impératif, au cours de cette sélection, de proscrire catégoriquement les modèles intitulés Graphique à colonnes empilées ou Graphique à colonnes empilées à 100 %. Bien que séduisants pour illustrer la composition d’un tout ou des rapports de proportionnalité partiels, ces gabarits empilés annihilent la capacité de comparaison absolue des grandeurs intermédiaires. Comme évoqué précédemment, la seconde série se trouvant perchée sur la crête de la première sans point d’ancrage bas invariant, toute évaluation visuelle fine de la différence d’amplitude entre les deux groupes devient cognitivement compromise. Le mode groupé non empilé demeure l’unique formalisme garantissant l’ancrage isométrique de chaque barre sur la ligne de référence commune.
4.2 Affectation des axes catégoriels et des séries comparatives
Une fois le format de colonnes groupées validé, l’agencement relationnel des variables requiert une vérification rigoureuse dans la section inférieure de l’onglet Configurer. Le champ dédié à l’Axe X (ou axe horizontal) doit être explicitement rattaché au vecteur contenant les descripteurs qualificatifs, c’est-à-dire la colonne A. Si l’interpréteur a capturé de manière erronée une série numérique pour occuper cette fonction d’axe de base, l’utilisateur doit cliquer sur le sélecteur contextuel de l’axe horizontal, purger l’assignation invalide et désigner la plage vectorielle correspondant à la dimension catégorielle authentique.
Immédiatement en dessous de la configuration de l’axe X se trouve le compartiment critique intitulé Séries. Pour qu’un graphique à barres doubles opère de manière nominale, ce conteneur doit lister exactement deux entrées distinctes, reflétant fidèlement les colonnes quantitatives B et C. Si une seule série s’y trouve référencée par suite d’une détection automatique défaillante, l’analyste clique sur l’intitulé Ajouter une série, puis pointe manuellement vers la colonne matricielle délaissée. Chaque série doit afficher en en-tête le libellé de sa cohorte respective (par exemple, « Groupe Contrôle » et « Groupe Expérimental »), attestant de l’association correcte des vecteurs de données.
Dans certaines configurations expérimentales spécifiques, la perspective d’analyse nécessite d’inverser le paradigme de groupement : plutôt que de comparer les deux cohortes modalité par modalité, le chercheur peut souhaiter visualiser les modalités groupées par cohorte globale. Cette réorganisation topologique s’effectue sans restructurer manuellement la feuille source, par la simple activation de la commande Inverser les lignes et les colonnes. Cette opération effectue une rotation matricielle instantanée, recalculant le positionnement relatif des barres et redéfinissant la dynamique comparative sans altérer la cohérence sous-jacente des données primaires.
4.3 Gestion des cohortes et catégories manquantes
L’occurrence de cellules dépourvues de valeur au sein de la matrice tabulaire introduit un facteur de perturbation visuelle que l’analyste doit traiter conformément aux principes de l’intégrité scientifique. Dans Google Sheets, une cellule vide au sein d’une série numérique peut être interprétée de deux manières divergentes : soit comme une valeur zéro absolue, soit comme une donnée absente (*null* ou *missing*). Par défaut, le moteur graphique tend à omettre la barre correspondante, créant une asymétrie flagrante où un groupe de barres ne présente qu’une unique colonne solitaire au lieu du doublet attendu.
Si la vacuité de la cellule résulte d’une mesure effective attestant d’une quantité strictement nulle, l’opérateur doit impérativement encoder le chiffre 0 au sein de la cellule source. Cette démarche force le tableur à réserver l’emplacement spatial de la barre sur l’axe catégoriel, manifestant visuellement une colonne de hauteur nulle. À l’inverse, si la cellule découle d’une perte d’observation ou d’une non-collecte empirique, il convient de s’assurer que l’omission visuelle de la barre ne brise pas l’équidistance géométrique du tracé. L’absence d’une mesure ne doit jamais conduire à un rapprochement artificiel des catégories adjacentes, sous peine de déformer l’échelle nominale sous-jacente.
Pour garantir le parallélisme visuel et la comparabilité des groupes, chaque modalité présente sur l’axe de référence doit conserver une largeur d’ancrage constante, que les barres associées soient présentes ou partiellement absentes. L’observateur doit être en mesure d’apprécier la structure équilibrée du protocole d’observation. Si une modalité catégorielle souffre de lacunes observationnelles symétriques au sein des deux séries, il est méthodologiquement préférable d’exclure temporairement cette modalité de la plage de données plutôt que de générer un intervalle vide qui interrompt la continuité rythmique du diagramme.
5. Paramétrage mathématique et calibrage de l’axe des ordonnées
5.1 Définition des bornes d’échelle et ancrage du zéro
Le paramétrage de l’axe vertical (axe des ordonnées, ou axe Y) constitue le pivot éthique et mathématique de toute représentation graphique quantitative. En vertu des principes de la sémiologie graphique, la hauteur d’une barre physique est proportionnelle à la magnitude de la valeur numérique qu’elle prétend matérialiser. En conséquence, il existe un impératif méthodologique catégorique, rappelé avec force par Darrell Huff dans son classique How to Lie with Statistics : l’axe vertical d’un diagramme à barres doit impérativement être ancré à la valeur zéro. L’interruption de l’axe ou sa troncature artificielle au voisinage du plancher des données constitue l’une des techniques de désinformation visuelle les plus délétères de l’analyse quantitative.
Pour verrouiller rigoureusement cet ancrage dans Google Sheets, l’opérateur doit basculer sur l’onglet Personnaliser, déployer la section Axe vertical, et localiser les champs textuels dédiés aux valeurs Min et Max. La valeur minimale doit être formellement fixée à 0, interdisant ainsi à l’algorithme d’ajuster automatiquement le bas de l’axe au niveau de la plus petite observation de la série (ce qui aurait pour effet néfaste d’exagérer visuellement des disparités marginales entre les groupes). Parallèlement, la borne maximale doit être judicieusement calibrée légèrement au-dessus de la valeur la plus élevée de l’échantillon, prévenant l’écrasement de la barre la plus haute contre le cadre supérieur de la figure, tout en évitant un plafonnement excessif qui comprimerait l’ensemble du profil graphique.
L’impact psychologique de l’amplification artificielle des écarts visuels ne doit jamais être sous-estimé. Lorsqu’un analyste tronque l’axe d’un graphique à barres pour débuter une échelle à la valeur 50 afin d’illustrer une variation entre deux groupes mesurés à 52 et 58, la barre du second groupe apparaît visuellement quatre fois plus imposante que celle du premier, suggérant fallacieusement une multiplication par quatre de la grandeur observée, alors que la variation relative réelle n’est que de l’ordre de 11,5 %. Une telle pratique altère la perception rationnelle du lecteur et disqualifie la crédibilité scientifique du rapport d’analyse. Le maintien inconditionnel de l’ancrage à zéro préserve l’isomorphisme entre la métrique empirique et la géométrie perceptive.
5.2 Graduation, intervalles et échelle logarithmique
La lisibilité métrologique du graphique repose sur un étalonnage rigoureux des lignes de quadrillage et des incréments d’échelle. Au sein du sous-menu Quadrillage et graduations de l’onglet Personnaliser, Google Sheets permet d’affiner la granularité des repères visuels. L’opérateur doit privilégier une graduation principale régulière, segmentant l’axe en intervalles réguliers et intuitifs (par incréments de 5, 10, 20, 50 ou 100 unités, selon l’ordre de grandeur du phénomène). L’activation d’un nombre excessif de lignes de quadrillage secondaires surcharge l’espace de lecture et s’oppose au principe d’économie visuelle ; une trame aérée de quatre à six lignes horizontales principales suffit largement à guider l’extrapolation visuelle sans encombrer le champ perceptif.
L’opportunité d’une transformation logarithmique de l’axe vertical doit faire l’objet d’un examen statistique approfondi. Accessible via la case à cocher Échelle logarithmique dans la configuration de l’axe vertical, cette transformation mathématique compresse les écarts proportionnels d’ordres de grandeur élevés. Bien qu’elle soit fréquemment mobilisée dans les disciplines épidémiologiques ou financières pour modéliser des cinétiques de prolifération exponentielle ou des distributions à queue lourde, son application sur un graphique à barres s’avère hautement délicate. En altérant la relation de proportionnalité directe entre la hauteur de la barre et la mesure absolue, l’échelle logarithmique détruit la lecture intuitive des surfaces. Son emploi doit être restreint aux cas où les valeurs comparées s’étendent sur plusieurs décades scalaires (par exemple, confronter des grandeurs de 10, 1 000 et 100 000 au sein du même tracé), et doit obligatoirement être explicitement signalée dans le corps du titre ou de la légende explicative.
L’harmonisation des incréments d’échelle avec la variabilité intrinsèque des données constitue un critère d’excellence méthodologique. Le pas de graduation retenu sur l’axe vertical doit présenter un ordre de grandeur cohérent avec les écarts-types observés au sein des cohortes. Si les barres d’erreur associées aux moyennes s’étendent sur une amplitude typique de cinq unités, retenir des graduations principales espacées de cinquante unités masquerait l’appréciation visuelle de la significativité des contrastes. L’étalonnage optimal assure un équilibre entre la résolution analytique des écarts et la fluidité visuelle globale du plan de traçage.
5.3 Formatage typographique et notation des unités
La précision de lecture d’une figure dépend de l’explicitation typographique des unités appliquées le long de l’axe des ordonnées. Les conventions typographiques francophones requièrent une vigilance particulière dans le traitement des séparateurs de grands nombres et des décimales. Conformément aux normes métrologiques internationales du Bureau International des Poids et Mesures (BIPM), la virgule constitue le séparateur décimal canonique en langue française, tandis que les milliers sont isolés par des espaces insécables fins et non par des points. Google Sheets respecte ces conventions dès lors que les paramètres régionaux de la feuille de calcul sont correctement configurés sur un pays francophone (Paramètres de la feuille de calcul > Langue > France ou Canada).
L’insertion explicite de l’unité de mesure au sein de l’intitulé formel de l’axe vertical s’avère indispensable pour conférer une autonomie sémantique complète au graphique. Au lieu d’un libellé vague tel que « Performance », l’opérateur renseignera scrupuleusement « Performance moyenne (temps de réponse en ms) » ou « Taux de complétion (%) ». Cette précaution élimine tout doute quant à la dimension physique ou psychométrique mesurée. Si les grandeurs sont normalisées ou pondérées par une transformation mathématique spécifique (par exemple des scores Z ou des indices base 100), cette nature relative doit être rigoureusement consignée dans le libellé de l’axe.
L’orientation angulaire des étiquettes numériques d’axe constitue un autre facteur ergonomique déterminant. Les valeurs associées aux graduations verticales doivent impérativement demeurer positionnées à l’horizontale. Une orientation oblique ou verticale des chiffres contraint le lecteur à un effort de déchiffrage contre-productif. En ce qui concerne l’axe horizontal, si la longueur des intitulés textuels provoque un chevauchement des étiquettes de catégories, Google Sheets propose, au sein du sous-menu Axe horizontal, un ajustement de l’inclinaison des libellés (à 30°, 45° ou 90°). Il convient néanmoins d’épuiser d’abord les solutions de concision textuelle ou d’envisager la bascule vers un diagramme à barres horizontales avant de recourir à une inclinaison typographique à 90°, réputée pour dégrader la rapidité de lecture.
6. Personnalisation esthétique et contraste chromatique des séries
6.1 Attribution des palettes de couleurs selon les règles de lisibilité
La sélection chromatique des deux séries de barres constitue un acte de conception sémiotique qui transcende largement les considérations purement décoratives. L’attribution des couleurs doit satisfaire à des exigences de contraste d’intensité lumineuse et de séparation chromatique permettant une différenciation visuelle immédiate, tout en assurant l’accessibilité universelle de la figure. L’une des faiblesses des palettes automatisées générées par défaut par les logiciels bureautiques réside dans leur recours fréquent à des contrastes binaires non universels, tels que l’opposition conventionnelle entre le vert et le rouge, particulièrement dommageable pour les individus présentant des déficits de la vision des couleurs (daltonisme).
Pour concevoir un graphique respectueux des normes d’accessibilité universelle préconisées par le Consortium W3C (WCAG), il est recommandé d’adopter des palettes chromatiques expressément calibrées pour être résilientes à la protanopie, à la deutéranopie et à la tritanopie. Des répertoires méthodologiques standardisés, à l’image des travaux pionniers de Cynthia Brewer avec l’outil ColorBrewer, démontrent la supériorité de combinaisons reposant sur le contraste bleu/orange ou bleu-vert/pourpre. Ces couples de couleurs préservent une séparabilité perceptuelle nette, y compris sous des conditions de simulation de daltonisme complet ou lors d’une impression monochrome.
Il importe également d’éviter les déséquilibres perceptuels induits par une asymétrie de saillance chromatique arbitraire. Si l’une des séries est teintée d’une couleur chaude et hautement saturée (comme un rouge cramoisi vibrant) tandis que la série conjointe se voit assigner une nuance pastel froide et désaturée (comme un bleu ciel délavé), l’œil de l’observateur va spontanément surpondérer l’importance de la première série, en lui attribuant inconsciemment une priorité cognitive ou un statut d’alerte non justifié par les données empiriques. Sauf dans les cas méthodologiques explicites où le chercheur entend volontairement mettre en lumière un groupe anomalique par rapport à une norme de contrôle, les deux séries comparées doivent exhiber des saturations et des valeurs lumineuses comparables afin de préserver la neutralité exploratoire de l’observateur.
6.2 Ajustement de l’opacité, des bordures et du remplissage
Dans l’onglet Personnaliser, sous la section Séries, Google Sheets met à la disposition de l’utilisateur des options avancées permettant de moduler l’aspect surfacique des colonnes. Le paramètre Opacité du remplissage permet d’atténuer la densité optique des aplats de couleur. L’abaissement de cette valeur vers un pourcentage situé entre 70 % et 85 % permet d’alléger le poids visuel global de la composition, facilitant la lecture en arrière-plan des lignes de quadrillage principales tout en conférant un rendu moderne et soigné au visuel. Cette aération chromatique est particulièrement vertueuse lorsque le graphique comporte un nombre élevé de catégories.
L’adjonction d’une bordure contrastée constitue un raffinement technique précieux pour délimiter les contours géométriques des barres sans alourdir le dessin. En configurant la Couleur de la bordure de la ligne sur une teinte légèrement plus sombre que le remplissage interne (ou sur un gris anthracite discret), l’analyste garantit la netteté des arêtes géométriques. Ce contourage net s’avère particulièrement efficace pour préserver la distinction entre deux barres juxtaposées lorsque celles-ci présentent des hauteurs très proches ou lorsque la figure est visualisée sur des moniteurs d’ordinateurs présentant un mauvais calibrage de contraste ou un rétroéclairage déficient.
L’espacement interne et externe régit la respiration spatiale de la scène graphique. Bien que l’interface standard de Google Sheets automatise en grande partie la largeur des colonnes, le concepteur doit veiller à ce que l’intervalle séparant deux groupes catégoriels distincts soit sensiblement supérieur à l’interstice existant entre les deux barres jumelées d’une même modalité. Le respect de ce différentiel d’espacement est dicté par la loi de proximité de la Gestalt : si la distance séparant deux barres de groupes distincts devient équivalente ou inférieure à l’espace séparant les barres du doublet, l’œil de l’observateur tend à regrouper mentalement des séries divergentes, provoquant une désorientation cognitive immédiate.
6.3 Conformité avec les chartes graphiques académiques
La préparation d’une figure destinée à l’insertion dans un mémoire de thèse, une monographie scientifique ou une revue internationale à comité de lecture impose une mise en conformité stricte avec les exigences éditoriales académiques, au premier rang desquelles figurent les prescriptions du manuel de style de l’American Psychological Association (APA 7e édition). Ces standards valorisent l’extrême sobriété et le dépouillement ornemental. Les artefacts décoratifs superflus — fréquemment qualifiés de « chartjunk » par Edward Tufte dans ses traités fondateurs — doivent être impitoyablement éradiqués de l’espace de traçage.
Dans cette perspective, l’usage des effets de perspective tridimensionnelle (3D), bien que disponible sous forme de case à cocher dans Google Sheets, doit être formellement prohibé dans tout travail à prétention scientifique. La projection 3D introduit une distorsion parallaxe systématique des arêtes supérieures des barres : l’œil humain devient incapable de déterminer avec certitude si la valeur exacte est alignée avec la face avant de la colonne, avec son plan supérieur ou avec la paroi arrière de perspective. De surcroît, les faces latérales génèrent des contrastes d’ombrage arbitraires qui annihilent la précision métrologique de la lecture visuelle.
Pour les contextes d’impression matérielle où la reproduction en quadrichromie n’est pas garantie, l’adaptation de la palette en niveaux de gris (*greyscale*) constitue une étape méthodologique fondamentale. L’analyste doit attribuer à la première cohorte une teinte de gris anthracite dense (par exemple à 70 % d’opacité noire) et à la seconde série un gris clair texturé ou un remplissage blanc cerclé d’un trait noir net. Ce contraste d’amplitude lumineuse garantit que le document demeurera parfaitement décodable après photocopie ou numérisation noir et blanc, préservant la longévité et la transférabilité empirique des travaux scientifiques publiés.
7. Intégration rigoureuse des titres, sous-titres et légendes
7.1 Rédaction scientifique du titre et des axes selon le style académique
L’appareil textuel encapsulant le diagramme à barres doubles ne doit comporter aucune ambiguïté taxonomique. Au sein de la section Titres des graphiques et des axes de l’onglet Personnaliser, la rédaction du titre principal doit s’affranchir des formules génériques et anecdotiques telles que « Comparaison des résultats » ou « Graphique du groupe A et B ». Dans une tradition d’écriture académique rigoureuse, l’intitulé formel d’une figure doit encapsuler la relation fonctionnelle entre la variable dépendante mesurée et les facteurs indépendants manipulés ou observés (par exemple : « Comparaison différentielle de la latence de traitement mnésique (ms) en fonction de la tranche d’âge et de la condition d’interférence »).
L’utilisation judicieuse du sous-titre de graphique permet de délester le titre principal de détails contextuels méthodologiques indispensables, mais dont l’accumulation alourdirait la titraille principale. Ce champ secondaire doit être exploité pour préciser la volumétrie globale de l’échantillon analysé (mentionnant le format conventionnel $N = dots$ ou $n = dots$), la nature des scores projetés (moyennes arithmétiques pondérées versus médianes) ou la date et le contexte spatio-temporel de la collecte empirique. Cette pratique offre au lecteur une compréhension autonome immédiate du cadre d’échantillonnage sans qu’il ne soit contraint de traquer ces métadonnées au sein des paragraphes du manuscrit textuel.
La nomenclature des axes doit également bannir tout jargon logiciel ou abréviation ésotérique non explicitée. Le libellé de l’axe horizontal doit désigner précisément la dimension catégorielle sous-jacente (par exemple : « Modalités de remédiation cognitive »), tandis que l’axe vertical doit impérativement rappeler l’unité arithmétique exploitée. Sur le plan typographique, une hiérarchie stricte doit être respectée : le titre principal doit adopter un corps de police substantiel (typiquement 14 ou 16 points en graisse semi-forte ou forte), tandis que les sous-titres et les intitulés d’axes doivent être dimensionnés à des échelles typographiques secondaires (11 à 12 points), conservant une unité stylistique avec la police textuelle employée dans le document hébergeur.
7.2 Positionnement et calibrage de la légende
La légende constitue la clef de voûte sémiotique permettant d’associer la pigmentation chromatique des barres à la cohorte empirique qu’elle incarne. Dans Google Sheets, la gestion de cet élément s’opère dans la section Légende de l’onglet Personnaliser. L’arbitrage de son positionnement spatial exerce un impact substantiel sur l’ergonomie de lecture. La plateforme propose cinq localisations standards : Aucun, Haut, Bas, Gauche, Droite ou Intérieur.
L’implantation de la légende au sommet de la zone de traçage (*Haut*) ou immédiatement à la droite de celle-ci (*Droite*) représente la solution la plus fonctionnelle dans la vaste majorité des configurations. La disposition au sommet présente l’avantage majeur d’initier le champ de balayage visuel : le lecteur identifie la correspondance chromatique avant même de plonger dans le tracé métrique, réduisant le besoin de réajustement cognitif ultérieur. Le positionnement à droite s’avère particulièrement opportun lorsque le graphique à barres doubles présente une orientation horizontale, accompagnant la progression latérale du tracé géométrique.
Une règle méthodologique essentielle réside dans l’harmonisation absolue de l’ordre séquentiel d’apparition des séries au sein de la légende avec l’ordonnancement spatial des barres physiques au sein de chaque groupe catégoriel. Si, au sein d’une modalité, la barre de gauche représente le « Groupe Témoin » et celle de droite le « Groupe Expérimental », la légende doit rigoureusement répertorier l’élément « Groupe Témoin » en première position et « Groupe Expérimental » en seconde position. Toute inversion dans cette séquence perturbe les réflexes d’association perceptive du lecteur et induit des risques substantiels d’erreur d’interprétation lors de la confrontation rapide des grandeurs.
7.3 Gestion des notes de bas de graphique et métadonnées
Bien que l’éditeur natif de Google Sheets ne possède pas de champ expressément étiqueté comme « Note de figure » au sens des manuels de publication de l’APA, l’intégration de métadonnées au pied de l’artefact graphique s’avère indispensable pour satisfaire aux exigences de reproductibilité de la science ouverte. Cette intégration peut être accomplie par l’adjonction méthodique d’une boîte de texte ancrée au canevas graphique ou par la rédaction soignée d’une légende textuelle sous-jacente intégrée dans l’outil d’édition documentaire hôte (Google Docs, Microsoft Word ou LaTeX).
Cette note descriptive inférieure remplit trois fonctions épistémiques majeures. En premier lieu, elle doit expliciter sans équivoque la signification de l’ensemble des acronymes ou abréviations taxonomiques figurant sur l’axe catégoriel. En second lieu, elle doit stipuler la nature de l’incertitude statistique projetée sur la figure, précisant formellement : « Les barres d’erreur représentent les erreurs types de la moyenne (SEM) » ou « Les barres d’erreur matérialisent les intervalles de confiance à 95 % ». L’omission de cette mention vide les barres de dispersion de toute valeur analytique opérante.
Enfin, la note de bas de graphique doit documenter les seuils de significativité statistique associés aux contrastes intergroupes majeurs. L’utilisation conventionnelle d’astérisques de significativité au-dessus des groupes de barres (par exemple $*p < 0,05$ ; $**p < 0,01$ ; $***p < 0,001$) doit obligatoirement trouver son décodage explicatif complet au sein de cet encart terminal. C'est à ce prix de rigueur et d'exhaustivité contextuelle que la figure accède à un statut de preuve documentaire autonome et scientifiquement irréfutable.
8. Affichage des étiquettes de données et annotations de précision
8.1 Activation et positionnement des valeurs quantitatives
L’intégration des étiquettes de données directes (*data labels*) permet de transcender l’une des limites intrinsèques du diagramme à barres conventionnel : l’imprécision inhérente à l’extrapolation visuelle d’une hauteur de barre vers un axe des ordonnées distant. En affichant la valeur numérique exacte au contact direct de chaque colonne, le concepteur du graphique dispense le lecteur d’un tracé mental horizontal fastidieux, éliminant les incertitudes d’estimation dues aux effets de parallaxe. Dans Google Sheets, cette fonctionnalité est activable individuellement pour chaque série dans le sous-menu Séries de l’onglet Personnaliser, en cochant la commande Libellés de données.
Le positionnement géométrique de ces étiquettes constitue une variable de clarté fondamentale. Google Sheets offre plusieurs options de placement : Centre, Base intérieure, Extrémité intérieure et Extrémité extérieure. Pour un graphique à barres doubles, la disposition en Extrémité extérieure (au sommet immédiat de la colonne) est généralement privilégiée car elle n’interfère pas avec la masse colorée de la barre et signale nettement le niveau culminant de la mesure. Toutefois, lorsque l’échelle verticale a été calibrée au plus près de la valeur maximale, les étiquettes positionnées à l’extrémité extérieure peuvent entrer en collision avec la bordure supérieure de la zone de traçage. Dans ce cas de figure précis, l’arbitrage en faveur de l’Extrémité intérieure (juste en dessous du sommet de la colonne) s’avère hautement judicieux.
Un enjeu ergonomique critique réside dans la prévention du chevauchement d’étiquettes lorsque deux barres contiguës présentent des amplitudes quasi-identiques. La contiguïté spatiale des colonnes peut amener deux blocs textuels numériques à fusionner partiellement, devenant illisibles. Dans une telle conjoncture, l’opérateur peut opter pour une réduction raisonnée de la taille de police des étiquettes ou faire le choix méthodologique de n’activer les libellés directs que sur une unique série d’intérêt spécifique, en laissant la série de référence se lire le long de l’axe vertical usuel.
8.2 Personnalisation du formatage numérique des étiquettes
L’affichage des valeurs numériques directes impose un strict respect des règles métrologiques relatives aux chiffres significatifs. L’une des dérives les plus fréquentes lors de l’exportation de données de tableur réside dans l’affichage d’un chapelet désordonné de décimales flottantes (par exemple, afficher « 45,782914 % » au-dessus d’une barre), traduisant une illusion d’hyper-précision dénuée de sens physique au regard de la précision expérimentale réelle de l’instrumentation de mesure. Le niveau de précision affiché dans le graphique doit être en parfaite harmonie avec le formatage appliqué aux cellules sources de la grille.
Google Sheets synchronise directement le format des étiquettes de données sur le format numérique des cellules associées. Pour arrondir uniformément les libellés à une unique décimale ou à l’entier le plus proche, l’analyste doit opérer directement sur les colonnes sources B et C via la barre d’outils principale, en mobilisant les icônes Réduire le nombre de décimales ou Augmenter le nombre de décimales. L’uniformisation de ce paramètre sur l’ensemble de la table source épure instantanément le graphique, offrant une cadence visuelle homogène et professionnelle le long des couronnes de colonnes.
La lisibilité chromatique des étiquettes requiert également un paramétrage contrasté en fonction du choix de placement opéré. Lorsque les étiquettes sont inscrites en Extrémité intérieure ou au Centre d’une barre arborant une couleur sombre et dense, l’utilisation de la typographie noire par défaut engendre un déficit de contraste patent, rendant la lecture pénible. Dans le panneau de configuration de la série, la modification de la couleur de police des libellés (en optant par exemple pour un blanc pur ou un jaune pâle hautement contrasté) permet de garantir une visibilité optimale conforme aux préconisations d’ergonomie visuelle.
8.3 Ajout d’annotations qualitatives spécifiques
Au-delà de la transcription mécanique des données numériques, une figure scientifique gagne une valeur analytique substantielle lorsqu’elle intègre des repères qualitatifs permettant d’orienter l’interprétation de l’observateur vers des seuils critiques. Dans l’écosystème Google Sheets, l’introduction de lignes de seuil horizontales (matérialisant par exemple un seuil clinique de pathologie, un niveau normatif national ou un standard réglementaire d’acceptabilité) ne dispose pas d’un outil d’insertion automatisé direct au sein du modèle à barres. L’analyste rigoureux contourne cette limite technique par l’adjonction d’une série tierce calculée au sein de la matrice source, paramétrée sous forme de ligne continue via le type de graphique combiné (*combo chart*).
L’utilisation d’annotations textuelles ponctuelles permet de documenter visuellement des divergences ou des mutations d’effets notables au sein d’une modalité particulière (telle qu’une rupture statistique hautement significative observée sous la condition la plus sévère). Ces repères textuels peuvent être intégrés via la fonctionnalité d’annotations graphiques de Google Sheets en insérant une colonne dédiée au format « Libellé contextuel » ou par l’application de formes vectorielles superposées avant publication finale.
Il importe toutefois de maintenir une vigilance constante pour éviter le piège de la surcharge informationnelle. La vertu cardinale d’un graphique à barres doubles demeure sa concision géométrique immédiate. L’accumulation effrénée de flèches indicatrices, de bulles de commentaires, de valeurs absolues superposées et d’astérisques d’évaluation peut rapidement saturer le champ visuel du lecteur, aboutissant à une détérioration globale de la lisibilité de la figure. L’analyste doit procéder à des arbitrages éditoriaux stricts, réservant les annotations directes aux seules ruptures structurelles majeures et renvoyant les nuances analytiques secondaires vers le texte accompagnateur du rapport.
9. Intégration d’indicateurs de dispersion et de barres d’erreur
9.1 Fondements de l’incorporation de la variabilité statistique
Dans la littérature scientifique contemporaine, la restitution exclusive de mesures de tendance centrale (moyennes arithmétiques) au sein d’un graphique comparatif sans mention explicite de la dispersion sous-jacente est considérée comme une anomalie méthodologique rédhibitoire. Une moyenne isolée de son contexte distributionnel dissimule l’hétérogénéité des observations empiriques, empêchant le lecteur d’estimer si la différence géométrique observée entre deux barres traduit une séparation robuste des distributions ou un artefact stochastique imputable à quelques observations marginales. L’incorporation formelle de barres d’erreur constitue l’instrument fondamental permettant de réintroduire visuellement la dimension de l’incertitude épistémique.
Sur le plan conceptuel, l’analyste doit opérer une distinction épistémologique stricte entre les trois principaux indicateurs d’incertitude usuellement projetés sous forme de barres d’erreur : l’écart type ($SD$, pour *Standard Deviation*), l’erreur type de la moyenne ($SEM$, pour *Standard Error of the Mean*) et l’intervalle de confiance ($CI$, généralement fixé au seuil de 95 %). L’écart type documente la variabilité intrinsèque des données individuelles autour de la moyenne au sein de l’échantillon observé ; il s’agit d’une métrique strictement descriptive. L’erreur type de la moyenne, inversement, quantifie la précision avec laquelle la moyenne d’échantillon estime la moyenne théorique de la population parente, incorporant l’effet stabilisateur de la taille de l’échantillon par division par la racine carrée de l’effectif ($SEM = SD / \sqrt{n}$).
L’intervalle de confiance à 95 % déploie une signification explicitement inférentielle : il borne l’espace paramétrique qui, sous répétition infinie du protocole expérimental dans des conditions identiques, contiendrait la vraie moyenne de la population dans 95 % des cas. L’impact de ce choix sur la validité interne des inférences du lecteur est considérable : des barres représentant l’écart type apparaîtront substantiellement plus déployées que des barres illustrant l’erreur type sur un échantillon étendu. Il est donc éthiquement obligatoire de ne jamais laisser le lecteur deviner la nature de la dispersion affichée et de consigner formellement cette définition au sein de la légende textuelle du graphique.
9.2 Configuration des barres d’erreur dans Google Sheets
L’implémentation pratique des barres d’erreur dans l’environnement Google Sheets s’effectue au sein de l’onglet Personnaliser, sous la rubrique Séries. L’opérateur commence par sélectionner la série spécifique à laquelle l’indicateur doit être appliqué (par exemple le « Groupe Contrôle »), puis coche la case d’option formelle intitulée Barres d’erreur. L’interface déploie immédiatement deux menus déroulants de configuration : le sélecteur de mode de calcul et le champ de saisie de la valeur quantitative.
Google Sheets propose trois méthodologies paramétriques d’assignation des barres d’erreur : Pourcentage, Constante et Écart type. Le mode Pourcentage assigne une barre dont la demi-amplitude équivaut à une proportion arbitraire fixe de la hauteur de la barre (par exemple 10 %), un automatisme dénué de fondement statistique rigoureux dans la vaste majorité des protocoles expérimentaux. Le mode Constante applique une marge métrique absolue uniforme à l’ensemble des modalités, utile uniquement si une marge d’erreur instrumentale fixe a été mesurée en amont. Le mode Écart type calcule automatiquement une valeur de dispersion globale à partir des observations constitutives de la série.
Il importe toutefois de souligner une limitation technique substantielle inhérente au moteur graphique natif de Google Sheets : le logiciel applique une marge d’erreur uniforme à l’intégralité des modalités d’une même série lorsqu’il est configuré via l’interface standard, ne permettant pas d’assigner nativement des barres d’erreur hétérogènes calculées ligne par ligne pour chaque cellule de manière directe dans les graphiques standards sans passer par des scripts Google Apps ou des tables dérivées spécifiques. Pour surmonter cette restriction lors de publications hautement exigeantes où chaque moyenne catégorielle présente son propre écart type empirique calculé, les chercheurs avancés configurent des séries complémentaires spécifiques ou recourent à des bibliothèques de programmation dédiées telles que Matplotlib ou ggplot2 après extraction tabulaire.
9.3 Interprétation visuelle du chevauchement des intervalles
La confrontation visuelle de barres d’erreur juxtaposées au sein d’un graphique à barres doubles donne fréquemment lieu à des raccourcis inférentiels erronés de la part des analystes et des lecteurs profanes. Il existe une heuristique largement répandue stipulant que si les barres d’erreur associées à deux groupes se chevauchent le long de l’axe vertical, la différence observée est non statistiquement significative, tandis que l’absence de chevauchement garantirait une divergence significative au seuil conventionnel de $p < 0,05$. Cette déduction intuitive est statistiquement inexacte et dangereuse sur le plan méthodologique.
Les études empiriques en cognition statistique, notamment les travaux conduits par Sarah Belia et ses collaborateurs (2005) ainsi que les synthèses de Geoff Cumming et Sue Finch (2005), ont rigoureusement démontré que le non-chevauchement de barres basées sur l’erreur standard ($SEM$) constitue un critère excessivement conservateur : deux moyennes dont les barres d’erreur standard ne se chevauchent pas sont en réalité souvent significativement différentes à des seuils bien plus stricts que $p = 0,05$ (typiquement $p < 0,01$ pour des échantillons de taille modérée). Inversement, lorsque les barres figurent des intervalles de confiance à 95 %, un léger chevauchement d'environ un quart ou un tiers de la longueur des bras d'erreur demeure parfaitement compatible avec une différence statistiquement significative au seuil classique de 5 %.
En conséquence, l’observateur averti doit traiter l’inspection visuelle des barres d’erreur comme une appréciation exploratoire de l’incertitude et de la stabilité distributionnelle, et non comme un substitut expéditif aux tests d’hypothèses formels. Le graphique à barres doubles ne dispense en aucun cas de l’exécution et de la restitution méthodique de tests statistiques adaptés (tels que le test $t$ de Student pour échantillons indépendants ou appariés, ou les modèles linéaires d’analyse de variance multivariée). La figure visuelle et le tableau inférentiel numérique forment un tandem complémentaire et indissociable au sein de tout rapport de recherche rigoureux.
10. Techniques dynamiques et automatisation avancée dans Google Sheets
10.1 Liaison avec des fonctions matricielles et calculées
L’un des atouts déterminants de Google Sheets pour l’ingénierie des données réside dans sa capacité à alimenter dynamiquement les visualisations graphiques à partir de moteurs de requêtes matricielles élaborés. Plutôt que de pointer le graphique vers une table de saisie statique figée — vulnérable aux erreurs d’actualisation manuelle — l’analyste peut générer une table intermédiaire autonome entièrement automatisée via la fonction maîtresse QUERY. En mobilisant une syntaxe déclarative inspirée du langage SQL standard, la formule extrait, filtre et agrège en direct les observations hébergées dans un onglet brut récepteur :
=QUERY(Donnees_Brutes!A1:D500; "SELECT A, AVG(B), AVG(C) WHERE A IS NOT NULL GROUP BY A ORDER BY A")
Cette approche architecturale garantit que tout enregistrement advenu au sein de la table de données brutes est instantanément agrégé par moyenne mathématique, la table intermédiaire étant recalculée sans intervention humaine et répercutée de façon transparente sur la hauteur des barres du graphique couplé. Dans des scénarios requérant des filtrages combinatoires conditionnels plus souples, l’exploitation conjointe des fonctions FILTER, UNIQUE et SORT permet d’isoler automatiquement des sous-cohortes répondant à des critères expérimentaux stricts, conférant une résilience opérationnelle totale au système de restitution.
La fonction TRANSPOSE offre également une flexibilité structurelle considérable lors de la phase d’alignement géométrique. Il arrive fréquemment que des bases de données administratives ou des interfaces d’exportation d’instruments de laboratoire livrent des jeux d’enregistrements orientés de manière orthogonale aux attentes de Google Sheets (les modalités catégorielles s’étalant le long des colonnes horizontales plutôt qu’en lignes verticales). En encapsulant la plage source au sein d’une instruction telle que =TRANSPOSE(Extraction_Brute!A1:Z3), l’opérateur effectue un basculement matriciel instantané à 90 degrés, rétablissant la disposition verticale canonique indispensable au tracé sans devoir reconstruire laborieusement la structure tabulaire primaire.
10.2 Intégration de contrôles interactifs et menus déroulants
La transformation d’un graphique à barres doubles statique en un outil analytique interactif s’opère avec une grande fluidité au sein de Google Sheets grâce aux mécanismes de validation de données. L’analyste peut concevoir une cellule de pilotage supérieure dotée d’une liste déroulante (accessible via Données > Validation des données > Liste d’éléments) permettant à l’utilisateur final de sélectionner une sous-population d’intérêt, une zone géographique ou une année d’observation spécifique (par exemple : « Cohorte 2022 », « Cohorte 2023 », « Tous »).
La matrice alimentant le graphique à barres doubles est alors asservie à cette cellule de contrôle contextuelle par l’intermédiaire de fonctions de recherche et de sélection dynamique telles que RECHERCHEV, INDEX / EQUIV ou des clauses conditionnelles imbriquées. Dès lors que l’observateur sélectionne une modalité au sein du menu déroulant, les vecteurs numériques de la table intermédiaire se mettent immédiatement à jour, provoquant une métamorphose instantanée et fluide des hauteurs de barres sur le graphique couplé, sans nécessiter la moindre duplication de figures sur la feuille de travail.
Une alternative visuelle particulièrement ergonomique réside dans le déploiement des Segments (*Slicers*), accessibles via le menu Données > Ajouter un segment. Cet objet interactif flottant permet d’appliquer des filtres transversaux sur l’ensemble des données d’un tableau de bord. En manipulant les boutons du segment pour isoler instantanément une modalité factorielle (comme le niveau d’instruction ou le genre des participants), le graphique à barres doubles recalcule en direct les distributions comparées des deux séries pour la sous-fraction sélectionnée, combinant la puissance de l’exploration interactive à l’élégance de la visualisation comparative.
10.3 Gestion des grands volumes de catégories
Lorsque la variable indépendante distribuée le long de l’axe catégoriel présente une cardinalité élevée — dépassant typiquement dix à quinze modalités distinctes —, le diagramme à barres doubles vertical subit une dégradation géométrique sévère. Les barres individuelles se rétrécissent considérablement pour s’adapter à la largeur disponible, les espacements inter-groupes s’amenuisent et les étiquettes textuelles entrent en collision ou adoptent une inclinaison verticale illisible. L’analyste doit alors déployer des stratégies de restructuration pour préserver l’utilité cognitive de son visuel.
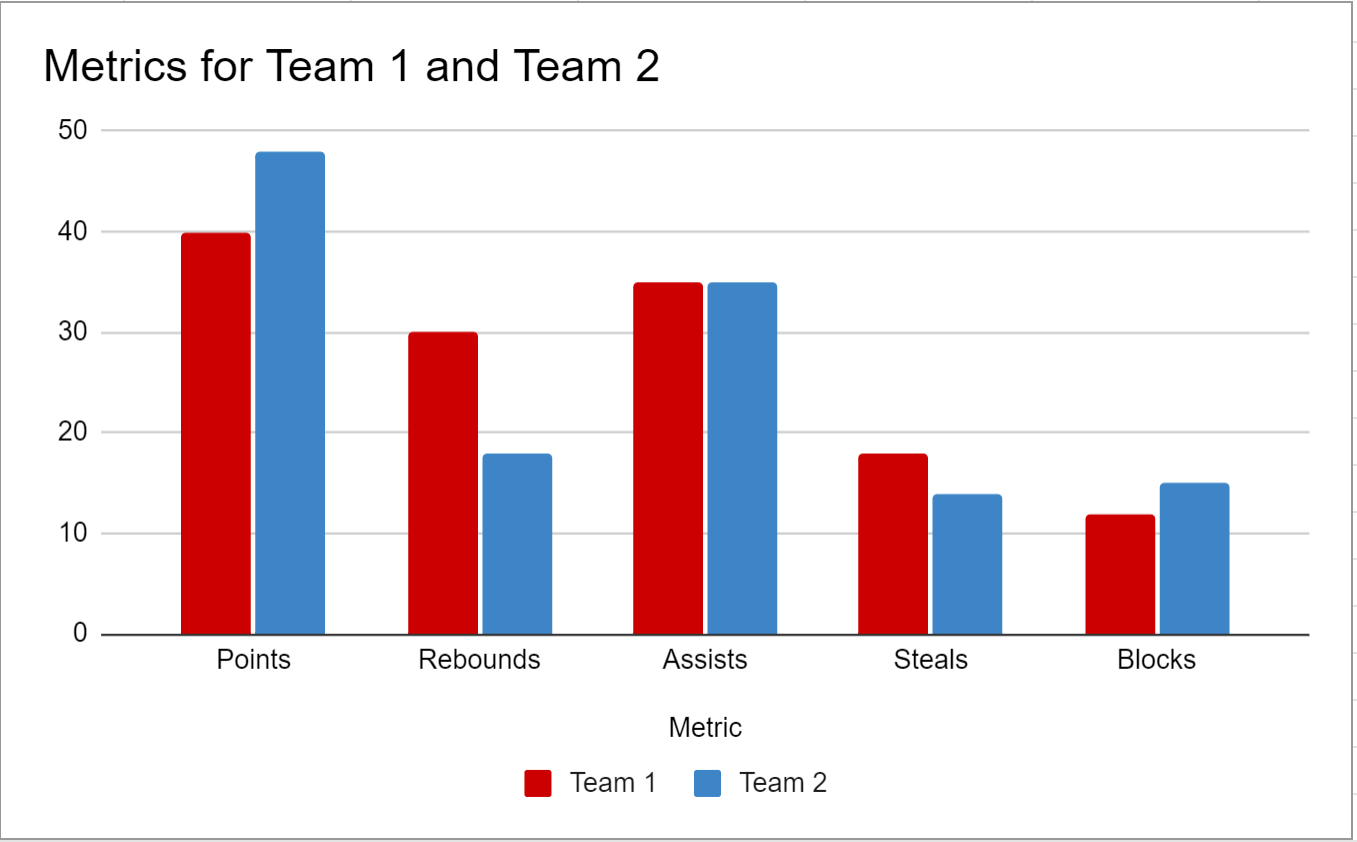
La première stratégie repose sur l’agrégation statistique des modalités secondaires au sein d’une catégorie résiduelle générique conventionnellement libellée « Autres ». En exploitant des fonctions conditionnelles de tri décroissant, l’analyste isole les six ou huit catégories exhibant les magnitudes quantitatives les plus substantielles, tandis que l’ensemble des modalités de faible poids est sommé ou moyenné au sein de cette catégorie d’appoint terminale. Cette condensation mathématique élimine le bruit visuel et recentre l’attention du lecteur sur les segments prépondérants de l’échantillon empirique.
Une seconde approche, particulièrement adaptée aux restitutions professionnelles denses, consiste à exploiter les Vues filtrées (*Filter views*). Contrairement à un filtrage global qui altère la visibilité des données pour l’ensemble des utilisateurs connectés simultanément à la feuille collaborative, la vue filtrée permet à un observateur d’isoler une portion spécifique de la matrice sans perturber le travail de ses pairs. Couplée à un redimensionnement dynamique de la plage de données du graphique, cette technique permet d’examiner successivement plusieurs tranches catégorielles sans dégrader la résolution spatiale du canevas.
11. Pièges analytiques, biais cognitifs et optimisation visuelle
11.1 Distorsions optiques et manipulations involontaires
La conception d’un graphique n’est jamais un acte neutre : des altérations géométriques d’apparence bénigne peuvent modifier radicalement les inférences déduites par l’observateur, introduisant des biais cognitifs majeurs. Au premier rang de ces pièges figure la manipulation du ratio d’aspect (*aspect ratio*), c’est-à-dire le rapport géométrique entre la hauteur et la largeur de la zone de traçage. Si un analyste étire démesurément la fenêtre graphique verticalement, la pente visuelle séparant deux barres juxtaposées paraît vertigineuse, exacerbant artificiellement l’écart psychologique entre les deux groupes. Inversement, un écrasement horizontal excessif comprime les contrastes de hauteur, donnant l’impression trompeuse que les deux cohortes sont rigoureusement identiques.
Pour neutraliser cette distorsion de perception, le statisticien William S. Cleveland a formulé le principe méthodologique fondamental de l’inclinaison à 45 degrés (*banking to 45 degrees*). Bien que formulé initialement pour les courbes de séries temporelles, ce principe s’étend conceptuellement à la visualisation en barres : le ratio d’aspect du graphique doit être calibré pour que les contrastes relatifs moyens se déploient selon des diagonales perceptuelles modérées, évitant tant la verticalisation dramatique que l’aplatissement anesthésiant. La zone de traçage doit maintenir des proportions équilibrées, usuellement calquées sur un rapport largeur/hauteur compris entre 1,4:1 et 1,6:1 (proche du ratio d’or de la tradition typographique classique).
Un autre biais réside dans l’illusion optique induite par les contrastes simultanés de clarté. Deux barres de dimensions physiques rigoureusement identiques paraîtront de hauteurs différentes si l’une est teintée d’une couleur excessivement sombre posée sur un fond pâle et l’autre d’une nuance pastel flottant à proximité d’une bordure épaisse. Le cerveau humain ne traite pas la géométrie de manière purement isolée de son environnement chromatique ; il intègre l’ensemble de la scène optique. Une symétrie de saturation et de contraste entre les deux séries demeure la seule garantie méthodologique contre ces illusions visuelles incontrôlées.
11.2 Principes de la Gestalt appliqués au diagramme à barres doubles
L’optimisation ergonomique d’un diagramme à barres doubles trouve son fondement théorique dans les lois de l’organisation perceptive identifiées par la psychologie de la Gestalt. La première loi fondamentale est la loi de proximité : les stimuli visuels spatialement proches les uns des autres sont spontanément agrégés au sein d’une entité cognitive unifiée. Dans notre cas de figure, cela impose impérativement que la distance séparant la barre du Groupe 1 et la barre du Groupe 2 au sein de la modalité « A » soit drastiquement inférieure à la distance séparant le bloc de la modalité « A » de celui de la modalité « B ». Le non-respect de ce gradient spatial détruit la perception des doublets et pousse l’observateur à comparer par erreur des barres de modalités différentes.
La seconde loi d’application impérieuse est la loi de similarité : les éléments visuels partageant des caractéristiques géométriques ou chromatiques communes sont automatiquement perçus comme appartenant à une même classe fonctionnelle. Cela prescrit une constance chromatique absolue et intangible d’une série le long de l’ensemble de l’axe catégoriel. Si la cohorte expérimentale est teintée en bleu profond pour la première modalité, elle doit conserver ce même bleu profond sur l’intégralité des modalités subséquentes. Modifier la couleur d’une série d’une modalité à l’autre sous prétexte de diversifier l’esthétique brise la loi de similarité et anéantit la capacité du cerveau à tracer la trajectoire comparative globale de la cohorte.
Enfin, l’optimisation doit répondre au principe cardinal d’économie graphique formalisé par Edward Tufte sous le concept de ratio encre/données (*data-ink ratio*). Selon ce postulat méthodologique, la proportion d’encre (ou de pixels actifs à l’écran) consacrée à la restitution authentique de l’information empirique doit tendre vers l’unité. Tout élément décoratif n’apportant aucune plus-value analytique directe — arrière-plans texturés, bordures d’encadrement épaisses, quadrillages de fond saturés, effets d’ombres portées sous les barres — constitue du « bruit graphique » qui dilue la concentration cognitive. L’analyste doit éliminer impitoyablement ces fioritures pour ne préserver que la pureté expressive des barres géométriques, des graduations indispensables et de l’appareil textuel descriptif.
11.3 Grille d’évaluation critique avant publication
Avant d’extraire une figure d’un tableur pour l’intégrer au sein d’un manuscrit soumis à publication ou d’un rapport exécutif à fort enjeu décisionnel, l’exécution d’un audit de conformité méthodique permet de prévenir la diffusion d’artefacts défectueux. La grille d’évaluation ci-dessous formalise les points de contrôle critiques que tout analyste rigoureux se doit de passer en revue :
| Dimension d’Audit | Critère de Conformité Méthodologique | Statut de Validation |
|---|---|---|
| Ancrage Mathématique | L’axe vertical est-il impérativement initialisé à la valeur zéro absolue, sans troncature artificielle masquée ? | Obligatoire |
| Cohérence Métrologique | La hauteur géométrique de chaque barre correspond-elle scrupuleusement à la valeur tabulée dans la grille source ? | Obligatoire |
| Accessibilité Chromatique | La palette de couleurs retenue préserve-t-elle le contraste chez les personnes atteintes de déficits de perception des couleurs ? | Obligatoire |
| Autonomie Sémantique | Le titre, le sous-titre et les unités d’axe permettent-ils de comprendre la figure sans lire le corps de texte connexe ? | Recommandé |
| Dispersion et Incertitude | La variabilité statistique est-elle matérialisée par des barres d’erreur explicitement définies dans la légende textuelle ? | Obligatoire |
| Sobriété Géométrique | L’ensemble des artefacts tridimensionnels (3D) et des ombrages ornementaux superflus ont-ils été totalement purgés ? | Obligatoire |
Ce protocole systématique de vérification garantit l’alignement de la production graphique sur les plus hautes exigences de rigueur épistémique. Une figure franchissant avec succès l’ensemble de ces points de contrôle accède au statut de document de preuve autonome, capable de soutenir un examen critique contradictoire lors des phases d’évaluation par les pairs ou de revue de direction.
12. Exportation, intégration éditoriale et mise en conformité académique
12.1 Protocoles d’exportation haute fidélité
La transmission éditoriale d’un visuel conçu dans Google Sheets requiert la sélection méthodique d’un format d’encapsulation numérique garantissant l’absence de dégradation de la résolution lors des phases de mise en page pré-presse. L’extraction de la figure s’opère via le menu contextuel à trois points verticaux positionné dans l’angle supérieur de l’objet graphique, en pointant sur la sous-commande Télécharger. Le logiciel déploie alors trois options de sérialisation de fichier : Document PDF (.pdf), Image PNG (.png) et Graphique vectoriel évolutif (.svg).
Pour toute destination éditoriale professionnelle, d’impression académique ou de compilation typographique via des moteurs de rendu vectoriel (comme LaTeX), le téléchargement au format SVG (Scalable Vector Graphics) représente le standard d’excellence absolu. Contrairement aux images matricielles basées sur des pixels fixes, le fichier vectoriel SVG code mathématiquement l’ensemble des primitives géométriques (rectangles, tracés de ligne, glyphes typographiques). Cette caractéristique confère à la figure une capacité de mise à l’échelle infinie, sans aucun phénomène d’aliasing, de flou de contour ou de pixellisation, garantissant une netteté microscopique des arêtes lors de l’impression sur presse haute résolution (1 200 à 2 400 DPI).
L’exportation en format matriciel PNG doit être réservée aux supports de diffusion purement écran (publications sur blog spécialisé, tableaux de bord intranet ou présentations en ligne). Si ce format est retenu pour des documents imprimés, l’opérateur doit veiller à dimensionner préalablement le canevas de traçage au sein de la feuille Google Sheets à une taille géométrique substantielle avant de lancer la commande de téléchargement, contraignant le moteur de rasterisation du tableur à générer une matrice de pixels suffisamment dense pour approcher le seuil critique d’impression standardisé de 300 DPI.
12.2 Liaison dynamique avec Google Docs et Google Slides
L’un des avantages les plus puissants de l’écosystème infonuagique de Google réside dans l’interopérabilité applicative continue reliant le tableur aux logiciels de traitement de texte (Google Docs) et de présentation multimédia (Google Slides). Lors du transfert d’un graphique à barres doubles vers un manuscrit ou un diaporama, l’analyste effectue un copier-coller conventionnel (ou recourt au menu Insertion > Graphique > À partir de Sheets). Une boîte de dialogue contextuelle propose alors une alternative stratégique décisive : Associer au tableur (*Link to spreadsheet*) ou Coller sans association.
L’activation de l’option d’association dynamique établit une liaison logicielle vivante entre le document récepteur et la feuille matricielle source. Si, postérieurement à l’insertion de la figure dans un manuscrit de quatre-vingts pages rédigé sous Google Docs, le statisticien est amené à corriger une erreur d’encodage, à ajouter des données complémentaires ou à ajuster la saturation d’une couleur au sein du tableur d’origine, le document textuel ne requiert aucune réinsertion manuelle. Une commande interactive discrète intitulée Mettre à jour apparaît instantanément au sommet de l’objet graphique au sein de Google Docs ; un simple clic rafraîchit le tracé, synchronisant parfaitement le manuscrit avec la dernière révision certifiée des données.
Cette architecture dynamique exige toutefois une discipline organisationnelle rigoureuse en matière de gestion des droits d’accès et de pérennité des structures de répertoires infonuagiques sur Google Drive. La suppression involontaire de la feuille de calcul source, sa relocalisation au sein d’un répertoire partagé inaccessible aux collaborateurs ou la modification arbitraire des plages nommées peut induire une rupture irrémédiable de la liaison de données. Dans un contexte de publication d’équipe, il est recommandé de confiner la matrice source et le document texte au sein d’un même espace de stockage partagé (*Shared Drive*) administré sous gouvernance institutionnelle centralisée.
12.3 Conformité aux exigences des manuels de style scientifiques
L’insertion d’une figure au sein d’un article soumis aux protocoles de diffusion de l’American Psychological Association (APA 7e édition) obéit à un agencement structurel canonique hautement formalisé. Contrairement aux pratiques de mise en page publicitaires où le titre est fréquemment gravé à l’intérieur de la zone de traçage, les normes APA exigent que l’artefact graphique soit scindé en quatre composantes séquentielles distinctes, ordonnées selon une stricte verticalité :
- Numéro de la figure : Inscrit en première ligne, en caractères droits et en graisse grasse (ex. : Figure 1), aligné à gauche.
- Titre de la figure : Positionné sur la ligne immédiatement inférieure, à simple interligne, rédigé en italique sans graisse (ex. : Comparaison des scores moyens de mémoire de travail selon l’âge et la cohorte d’entraînement), adoptant une casse de titre standardisée (*Title Case* en anglais, casse de phrase usuelle en français avec majuscule initiale).
- Corps visuel du graphique : Le canevas géométrique à barres doubles proprement dit, épuré de tout titre interne supérieur afin de proscrire toute redondance textuelle avec le titre officiel.
- Note de bas de figure : Positionnée sous la figure, initiée par le terme Note. en italique suivi d’un point. Cette section consigne les définitions des abréviations, la nature exacte des barres d’erreur (ex. : Les barres d’erreur représentent les intervalles de confiance à 95 %.) et les seuils de significativité des tests statistiques associés.
Enfin, l’inscription de la recherche dans le paradigme de la science ouverte (*Open Science Framework*) requiert la mise à disposition pérenne des données brutes et des routines analytiques associées au graphique. Lors de la publication du manuscrit, il est hautement recommandé d’adosser à la figure un identifiant pérenne (tel qu’un DOI attribué par un dépôt institutionnel comme Zenodo ou OSF) renvoyant directement vers la feuille Google Sheets source hébergeant la matrice tabulaire intégrale. Ce protocole garantit la reproductibilité totale des analyses, offrant à la communauté scientifique la faculté d’auditer la chaîne de traitement depuis la cellule source jusqu’à l’artefact visuel définitif.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand error bars and confidence intervals. Psychological Methods, 10(4), 389–398. https://doi.org/10.1037/1082-989X.10.4.389
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Brewer, C. A. (2003). ColorBrewer 2.0: Color Advice for Cartography. Pennsylvania State University. https://colorbrewer2.org/
- Cairo, A. (2016). The Truthful Art: Data, Charts, and Maps for Communication. New Riders.
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Google. (2024). Types de graphiques dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/190718
- Huff, D. (1954). How to Lie with Statistics. W. W. Norton & Company.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/