
L’analyse des données quantitatives contemporaines en sciences humaines et comportementales confronte continuellement le chercheur à la complexité des dynamiques multivariées. Longtemps restreinte à une exploration séquentielle et fragmentée des relations bivariées, la pratique statistique s’est transformée sous l’impulsion de paradigmes visuels capables de saisir simultanément la structure globale et les singularités locales des jeux de données. Dans cet arsenal méthodologique, la matrice de nuages de points — universellement désignée sous le terme anglophone de pairs plot ou scatterplot matrix — constitue un instrument d’une remarquable puissance heuristique. Elle offre un panorama synoptique immédiat sur l’ensemble des intersections bivariées d’un espace multidimensionnel, révélant avec une clarté sans égale ce que les résumés numériques condensés tendent inévitablement à dissimuler.
Dans l’écosystème du langage R, la mise en œuvre de ces visualisations bénéficie d’une flexibilité architecturale hors du commun. Du moteur graphique de base aux extensions avancées portées par la grammaire des graphiques ou par des paquets hautement spécialisés en psychométrie, R permet de transcender la simple juxtaposition de tracés cartésiens pour forger de véritables tableaux de bord analytiques intégrés. Ces matrices graphiques combinent distributions univariées, ajustements non paramétriques, modélisations linéaires, coefficients de corrélation modulés et détections d’hétérogénéités sous-jacentes au sein d’une composition spatiale cohérente et hautement informative.
Le présent traité propose une exploration exhaustive de la conception, de la personnalisation et du décodage herméneutique des matrices de dispersion dans R, en portant une attention toute particulière aux contraintes conceptuelles et empiriques des sciences du comportement. À travers un itinéraire articulant rigueur épistémologique, maîtrise algorithmique et profondeur interprétative, ce guide détaille l’intégralité du cycle de vie de la visualisation multivariée, depuis le prétraitement des échelles psychométriques jusqu’à la restitution finale selon les canons typographiques les plus exigeants de la recherche académique internationale.
1. Fondements épistémologiques et utilité des pairs plots en sciences du comportement
1.1 Définition et rôle de la matrice de nuages de points dans l’analyse exploratoire
La matrice de nuages de points s’inscrit au cœur de la révolution de l’Analyse Exploratoire des Données (Exploratory Data Analysis), initiée et théorisée par le statisticien John Tukey au cours des années 1970. Rejetant la subordination exclusive des données empiriques aux seuls tests d’hypothèses confirmatoires a priori, Tukey a démontré la nécessité épistémologique d’accorder une primauté à la fouille visuelle des structures intrinsèques. La matrice de dispersion opérationnalise ce principe en déployant un agencement géométrique matriciel où chaque cellule positionnée à l’intersection d’une ligne et d’une colonne projette la dispersion conjointe d’un couple de variables. L’observateur n’est plus contraint d’itérer laborieusement à travers une infinité de graphiques isolés : il embrasse d’un seul regard l’intégralité de l’espace relationnel de son échantillon.
Dans le domaine empirique des sciences du comportement, cette saisie simultanée des dimensions bivariées est indispensable. Contrairement aux sciences dures où les variables physiques sont souvent isolables en laboratoire, les construits psychologiques — tels que l’affectivité négative, le traitement de l’information ou les traits de personnalité — interagissent au sein d’un maillage systémique dense. L’avantage fondamental de la visualisation simultanée réside dans sa capacité à préserver l’intégrité contextuelle de chaque variable tout en cartographiant ses résonances mutuelles avec l’ensemble du système étudié.
Il existe une divergence fonctionnelle majeure entre une matrice de covariance numérique et son homologue graphique. Une matrice de covariance ou de corrélation condense la relation entre deux variables en un scalaire unique, postulant implicitement la linéarité et l’homoscédasticité du phénomène. En revanche, l’inspection graphique ne postule aucun modèle préconçu : elle donne à voir la morphologie brute des observations, débusquant les courbures insidieuses, les concentrations marginales asymétriques et les ruptures de continuité que la réduction arithmétique neutralise irrémédiablement.
1.2 Applications empiriques spécifiques aux variables psychologiques
L’exploration des dimensions psychométriques sous-jacentes d’un instrument d’évaluation constitue le premier terrain d’élection du pairs plot. Lors du développement ou de la validation transculturelle d’un inventaire clinique ou d’un test d’aptitude, le chercheur doit examiner comment les scores composites des sous-échelles s’organisent mutuellement. Une matrice de nuages de points permet de vérifier instantanément si les facettes théoriquement affiliées à un même construit de second ordre convergent géométriquement sous la forme d’un continuum dense et régulier, ou si certaines composantes présentent une dispersion diffuse trahissant un manque de fidélité ou une saturation factorielle ambiguë.
Le dépistage précoce des colinéarités excessives entre facettes cognitives et affectives s’avère tout aussi crucial. En psychologie différentielle, la redondance conceptuelle entre deux construits est un péril récurrent : lorsque deux échelles mesurent des manifestations quasi interchangeables d’un même état interne, le nuage de points s’effondre en un alignement rectiligne extrêmement comprimé. Le repérage précoce de cet état de quasi-singularité épargne au modélisateur des difficultés ultérieures d’instabilité numérique lors des régressions multivariées.
De surcroît, le pairs plot sert de filtre diagnostique impératif avant l’engagement de méthodologies lourdes telles que la modélisation par équations structurelles (SEM). Ces architectures statistiques reposent généralement sur l’hypothèse de normalité multivariée et sur la régularité des covariations. L’inspection visuelle révèle immédiatement les non-linéarités sous-jacentes, telles que les interactions en U inversé fréquemment observées entre le niveau d’éveil physiologique (arousal) et les performances exécutives, conformément à la loi classique de Yerkes-Dodson, prévenant ainsi les erreurs de spécification structurelle.
1.3 Cadre comparatif entre inspection tabulaire et projection graphique
L’illusion de complétude offerte par un tableau de coefficients de corrélation constitue l’un des pièges cognitifs les plus tenaces de la méthodologie quantitative. L’esprit humain, confronté à une grille de décimales comprises entre -1 et +1, applique spontanément une heuristique de linéarité et d’homogénéité. Si un tableau indique un coefficient r de Pearson égal à 0,72 entre deux mesures psychologiques, l’analyste infère inconsciemment l’existence d’une relation proportionnelle harmonieuse le long de toute l’étendue de l’échantillon. Or, cette valeur scalaire peut masquer une réalité géométrique radicalement différente.
Cette vulnérabilité a été immortalisée par Francis Anscombe à travers son célèbre quartet statistique. Dans ce paradoxe démonstratif, quatre jeux de données artificiels partagent des propriétés descriptives univariées et un coefficient de corrélation rigoureusement identiques, mais présentent des morphologies géométriques antinomiques : une relation linéaire classique, une relation parfaitement quadratique, une droite linéaire parasitée par un point aberrant désaxé, et une distribution stationnaire verticalisée par un unique point de levier. Transposé aux sciences du comportement, le quartet d’Anscombe rappelle qu’une corrélation substantielle peut découler artificiellement d’un sous-groupe atypique ou, à l’inverse, qu’une corrélation nulle peut résulter d’une magnifique relation curvilinéaire symétrique.
La projection graphique apporte ainsi une composante géométrique irremplaçable qui assied la robustesse des inférences préliminaires. Elle immunise le psychologue contre la réification hâtive des indices numériques et préserve la traçabilité des comportements marginaux. Le tracé visuel ne supplante pas l’analyse quantitative formelle : il en constitue le garde-fou indispensable, conditionnant l’interprétation légitime de tout modèle statistique ultérieur.
2. Préparation de l’environnement R et gestion des structures de données psychométriques
2.1 Configuration des bibliothèques logicielles et reproductibilité
La mise en œuvre d’un protocole d’analyse visuelle rigoureux sous R débute impérativement par l’établissement d’un environnement computationnel scrupuleusement maîtrisé. La science ouverte et la reproductibilité des résultats exigent que chaque étape de transformation des données et de production graphique puisse être réexécutée à l’identique par des tiers. Dans cette optique, l’ancrage de la séquence pseudo-aléatoire via l’instruction set.seed revêt une importance capitale dès lors que des procédures de rééchantillonnage, d’imputation ou de simulation interviennent dans le flux de traitement.
L’écosystème logiciel mobilisé dans le cadre de cette monographie articule quatre piliers complémentaires. En premier lieu, le socle graphique fourni par le paquetage de base (base R) offre des fonctions natives d’une vélocité et d’une robustesse incomparables pour l’esquisse matricielle. En second lieu, la bibliothèque psych, développée par William Revelle, s’impose comme la référence incontournable pour l’analyse psychométrique et différentielle, proposant des déclinaisons hautement perfectionnées de matrices de dispersion. En troisième lieu, la bibliothèque GGally étend la célèbre grammaire des graphiques de ggplot2 à l’espace multidimensionnel. Enfin, le méta-paquetage tidyverse unifie les opérations de manipulation et de restructuration tabulaire.
L’intégration de ces bibliothèques au sein de documents computationnels dynamiques pilotés par Quarto ou R Markdown assure une traçabilité totale entre le code source, les métadonnées environnementales et les rendus visuels haute fidélité, éliminant ainsi toute rupture de continuité numérique entre l’analyse brute et le manuscrit académique.
2.2 Nettoyage et structuration d’un jeu de données psychologiques
L’application directe d’un pairs plot à un tableau de données brutes sans phase d’assainissement préalable conduit invariablement à des visualisations dégradées, voire méthodologiquement trompeuses. La problématique centrale réside dans le traitement des observations manquantes, omniprésentes dans les protocoles d’évaluation psychologique. Il convient de discriminer la nature du mécanisme sous-jacent selon la taxonomie de Rubin : données manquantes complètement au hasard (MCAR), manquant au hasard (MAR), ou manquant de façon non aléatoire (MNAR). L’élimination par liste (listwise deletion) opérée par défaut par de nombreuses fonctions graphiques peut drastiquement réduire la taille effective de l’échantillon et introduire des biais de sélection critiques si le mécanisme est de type MAR ou MNAR.
Par ailleurs, la typologie des variables psychométriques requiert un étalonnage conceptuel préalable. Les chercheurs manipulent fréquemment des scores agrégés continus issus d’échelles standardisées aux côtés d’items discrets mesurés sur des échelles de Likert ordinales en cinq ou sept points. Confondre sans précaution ces deux métriques au sein d’une même matrice graphique engendre une superposition massive de points le long des coordonnées discrètes, annihilant toute lisibilité géométrique.
La structuration préparatoire doit également inclure l’éviction méthodique des identifiants alphanumériques anonymisés, des variables d’horodatage et des méta-données administratives qui viendraient saturer inutilement la matrice de dispersion par des axes dénués de toute signification substantive. Les scores bruts inversés doivent être recodés en amont pour assurer une directionnalité théorique univoque à travers l’ensemble des panneaux.
2.3 Simulation d’une cohorte comportementale multidimensionnelle
Afin de manipuler les concepts géométriques et psychométriques sur une base empirique contrôlée mais réaliste, la construction d’un jeu de données synthétique s’avère particulièrement éclairante. Considérons une cohorte comportementale de mille individus évalués sur trois dimensions psychopathologiques majeures : l’anxiété généralisée, la symptomatologie dépressive et la réactivité au stress perçu. Ces construits présentent dans la population générale une comorbidité substantielle qu’il convient de modéliser avec précision.
La simulation d’un tel système multivarié repose sur l’injection délibérée d’une matrice de variance-covariance cible, paramétrant des corrélations modérées à fortes entre l’anxiété et la dépression, tout en introduisant une rupture délibérée d’homoscédasticité : à mesure que le niveau de stress perçu s’accroît, l’hétérogénéité des manifestations dépressives augmente de façon exponentielle, reflétant les phénomènes bien connus de décompensation adaptative face à l’adversité chronique. De surcroît, un sous-groupe clinique minoritaire peut être implanté pour simuler une structure bivariée bimodale.
Avant d’engager la projection matricielle de cette cohorte synthétique, un contrôle descriptif univarié élémentaire s’impose. L’examen des moyennes, des écarts-types, ainsi que des indices d’asymétrie (skewness) et d’aplatissement (kurtosis) permet de vérifier que les métriques simulées oscillent dans des intervalles plausibles au regard de la nosographie clinique standard, préparant le terrain pour une exploration matricielle éclairante.
3. Syntaxe fondamentale et exécution de la fonction native pairs()
3.1 Paramétrage élémentaire de pairs() sur un data frame complet
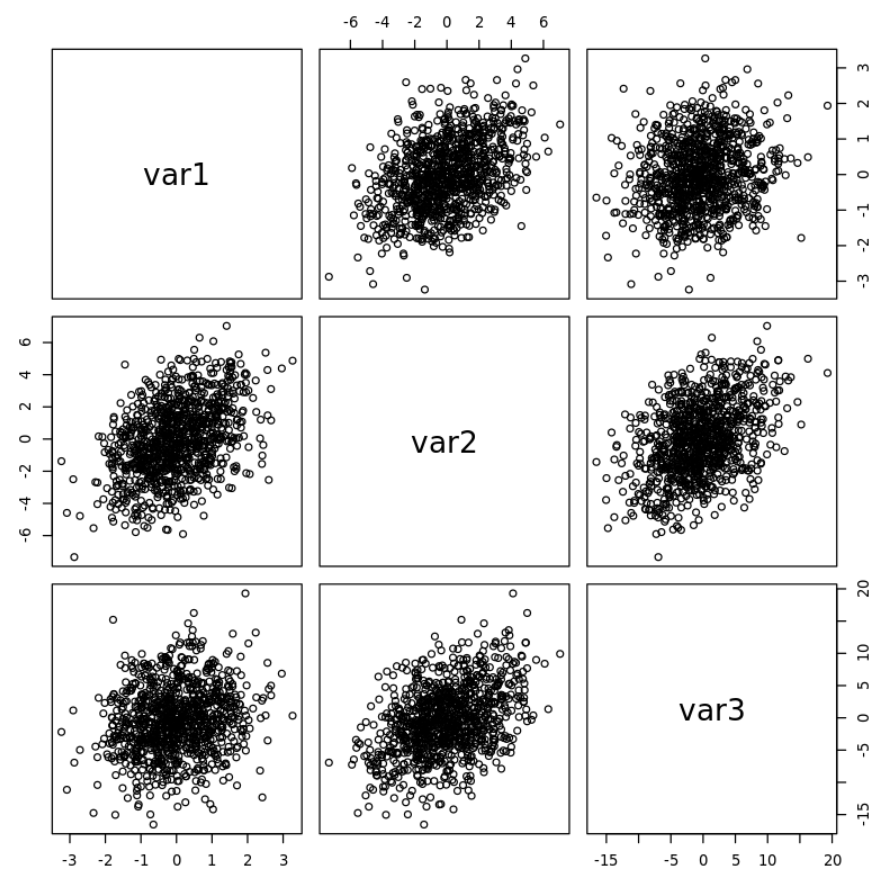
Le langage R intègre nativement, au sein de son moteur graphique historique, la fonction générale pairs(). Conçue pour une efficacité opérationnelle maximale, cette instruction accepte en entrée directe un tableau de données rectangulaire de type data frame ou une matrice numérique. Dans sa syntaxe la plus élémentaire, l’invocation pairs(x) instancie immédiatement une grille cartésienne n x n, où n correspond au nombre total de colonnes numériques incluses dans l’objet transmis. L’interpréteur R procède de manière autonome au balayage des vecteurs constitutifs, éliminant implicitement les colonnes textuelles ou les facteurs non convertibles.
Néanmoins, l’évaluation automatique présente des limites lorsqu’un tableau contient un grand nombre de variables hétérogènes. La formulation explicite par l’opérateur de formule constitue alors la méthode la plus élégante et la plus sûre sur le plan méthodologique. En déclarant une formule sans variable dépendante, où les construits d’intérêt sont agrégés par des opérateurs d’addition, le chercheur sélectionne avec une précision chirurgicale les axes soumis à la confrontation géométrique. Cette approche évite le calcul fastidieux de sous-ensembles matriciels préalables et documente explicitement l’intention analytique au sein même du flux de code.
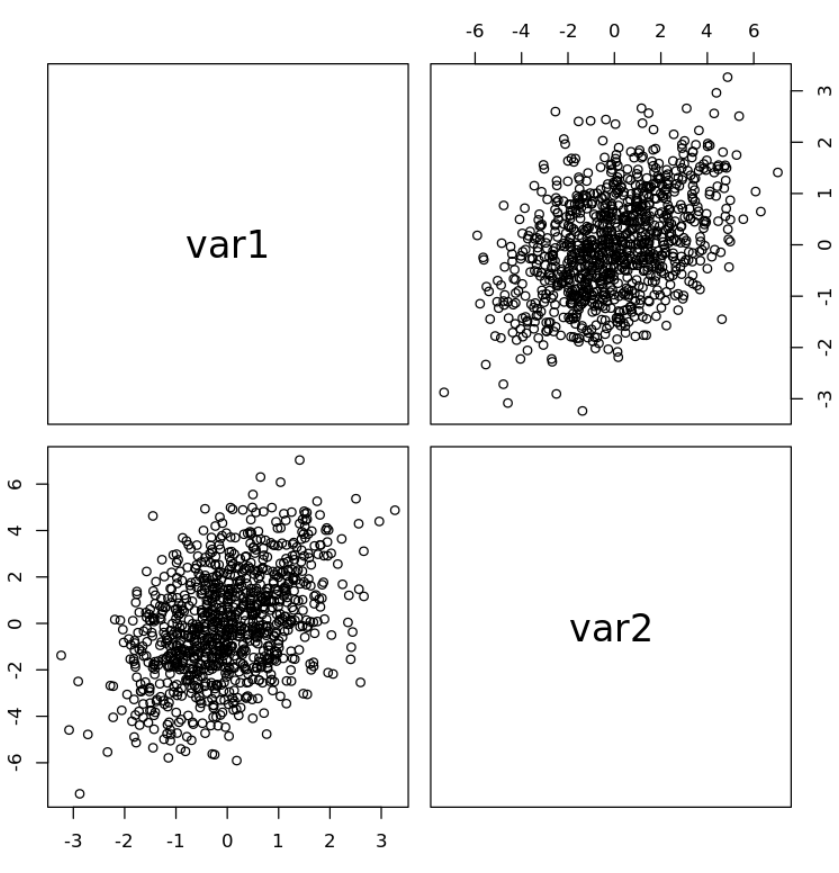
Le comportement par défaut de l’interpréteur génère une disposition symétrique dans laquelle les étiquettes des variables trônent sur la diagonale principale descendante, tandis que chaque cellule hors diagonale accueille un nuage de points sans fard, borné par les valeurs minimales et maximales observées pour les deux variables correspondantes.
3.2 Contrôle des arguments d’annotation et de style
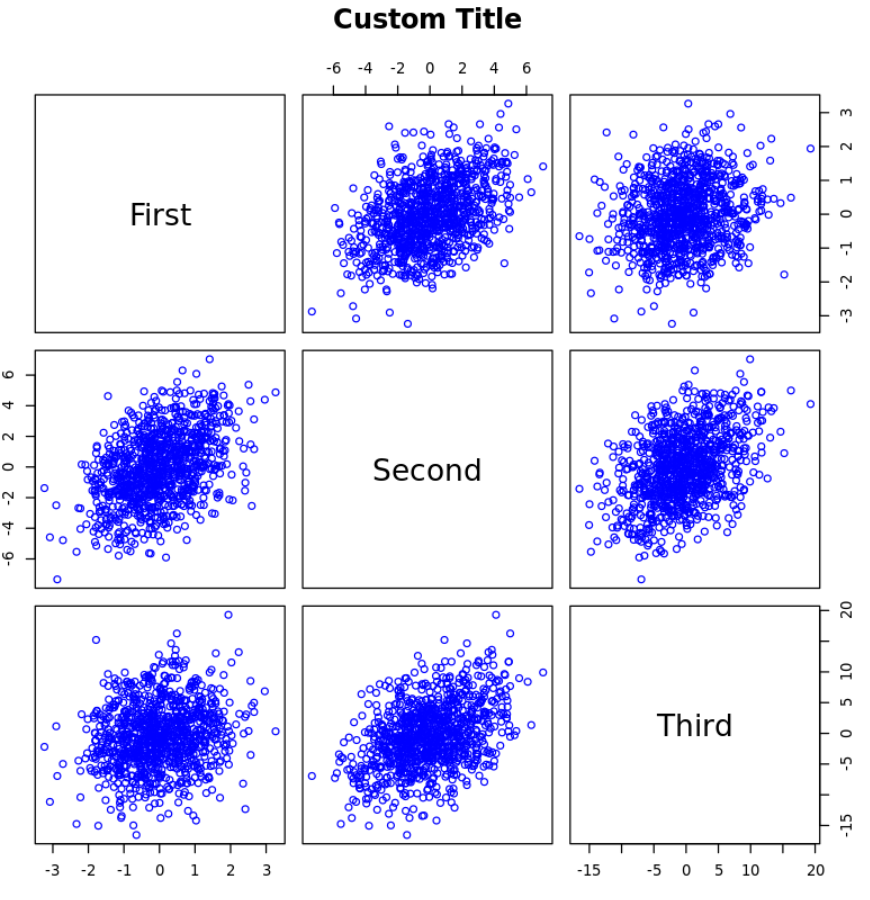
L’élévation d’un graphique brut au statut de document de travail scientifiquement exploitable requiert un calibrage soigné de ses attributs d’habillage textuel. L’argument principal de titrage (main) permet d’ancrer le contexte conceptuel de l’analyse, complété le cas échéant par un sous-titre (sub) explicitant les spécificités de la cohorte ou du protocole expérimental. Les étiquettes textuelles assignées à la diagonale peuvent être redéfinies exhaustivement via l’argument labels, offrant la possibilité de substituer aux noms abrégés des colonnes de données des dénominations psychométriques complètes et formellement irréprochables.
La lisibilité de la matrice dépend étroitement de la dimension typographique des caractères. Dans une matrice comportant de nombreuses variables, les étiquettes diagonales peuvent entrer en collision avec les bordures internes des cellules. Le paramètre cex.labels permet d’ajuster proportionnellement le facteur d’échelle textuel, garantissant un espacement aéré et une netteté de lecture optimale. De façon analogue, le paramètre font.labels permet de moduler la graisse typographique pour hiérarchiser visuellement les titres.
La question du contrôle des échelles d’axes s’avère particulièrement délicate. Par défaut, pairs() calibre individuellement les étendues cartésiennes de chaque cellule sur les minima et maxima locaux des variables appariées. Si cette autonomie maximise l’occupation de l’espace graphique de chaque sous-fenêtre, elle peut induire l’évaluateur en erreur lors de la comparaison d’échelles censées partager une métrique commune. Les arguments xlim et ylim permettent, lorsque cela est théoriquement pertinent, d’unifier les bornes dimensionnelles sur un intervalle standardisé commun.
3.3 Gestion des symboles graphiques et des couleurs
Dans un nuage de points dense, le choix de la géométrie du glyphe d’observation exerce une influence directe sur la détectabilité des structures de dispersion. Le paramètre graphique pch (plotting character) régit la forme des points tracés. L’utilisation du glyphe par défaut, un cercle ouvert de dimension standard, devient rapidement inopérante lorsque les observations se comptent par centaines, générant des amas opaques indéchiffrables. L’adoption d’un point plein miniature ou d’un symbole circulaire doté d’un fin contour permet de préserver la discernabilité des coordonnées individuelles.
La mitigation du phénomène d’occultation réciproque — désigné sous le terme de chevauchement ou overplotting — franchit un palier qualitatif déterminant grâce à l’incorporation de la transparence via le canal alpha. En exploitant la fonction rgb() pour définir la teinte globale au moyen de composantes spectrales rouge-vert-bleu complétées par une valeur d’opacité fractionnaire, chaque observation devient partiellement translucide. Dès lors, la saturation chromatique qui émerge sur le graphique matérialise fidèlement la densité locale des données : les zones de forte concentration révèlent un foyer intensément coloré, tandis que les trajectoires marginales conservent une pâleur vaporeuse.
L’unification de l’identité graphique à travers le paramètre col parachève cette mise en forme. En évitant les contrastes chromatiques criards au profit d’une palette sobre et continue, le chercheur dirige l’attention cognitive de l’observateur vers la dispersion des scores plutôt que vers des artefacts de rendu visuel.
4. Protocole de lecture et décodage analytique de la matrice de nuages de points
4.1 Anatomie structurelle : diagonale, triangle supérieur et triangle inférieur
L’analyse méthodique d’un pairs plot impose une compréhension géométrique sans faille de son architecture matricielle. La diagonale principale, qui s’étend du coin supérieur gauche au coin inférieur droit, constitue l’axe de référence univarié du dispositif. Chaque case diagonale représente une variable isolée et sert de pivot cartésien pour l’ensemble des cellules alignées sur son plan horizontal et son plan vertical. Il convient de retenir une règle de correspondance fondamentale : pour toute cellule située à l’intersection de la ligne i et de la colonne j, la variable i est assignée à l’axe des ordonnées (axe vertical Y), tandis que la variable j régit l’axe des abscisses (axe horizontal X).
Cette organisation engendre une propriété mathématique immédiate : une symétrie miroir stricte entre le triangle supérieur (au-dessus de la diagonale) et le triangle inférieur (en dessous de la diagonale). La cellule positionnée en ligne j et colonne i projette rigoureusement les mêmes données empiriques que la cellule i-j, à ceci près que les axes cartésiens ont subi une permutation orthogonale complète. Ce qui était ordonnée devient abscisse, et réciproquement.
Cette redondance bidirectionnelle n’est pas un gaspillage d’espace graphique ; elle offre une flexibilité cognitive précieuse. Selon le postulat causal ou temporel sous-jacent, le chercheur peut préférer lire une relation en concevant une variable comme prédictrice (en X) ou comme critère (en Y). De plus, comme nous le verrons ultérieurement, cette dualité offre l’opportunité structurelle de dédier chaque triangle à des représentations informatives distinctes et complémentaires.
4.2 Identification visuelle des patrons relationnels
Le premier niveau de décodage analytique concerne la morphologie des associations bivariées. Une relation linéaire classique se matérialise sous la forme d’un ellipsoïde de dispersion plus ou moins étiré. Une pente orientée positivement du quadrant sud-ouest vers le quadrant nord-est dénote une covariation directe : des niveaux élevés sur le premier construit accompagnent des valeurs proportionnellement élevées sur le second, configuration typique de l’association entre affect négatif et rumination mentale. Inversement, une orientation descendante nord-ouest vers sud-est signale une association inverse. Un nuage parfaitement circulaire ou orthogonal traduit l’indépendance linéaire des variables.
Cependant, la véritable supériorité de la matrice graphique réside dans l’identification instantanée des courbures non linéaires. Les trajectoires en cloche, paraboliques ou exponentielles se détachent avec une netteté remarquable. Par exemple, l’exploration conjointe d’un indice de stress perçu et d’un score d’efficience mnésique peut révéler un patron quadratique dans lequel les performances s’accroissent jusqu’à un seuil de tension modéré avant de s’effondrer dramatiquement, patron qu’un coefficient scalaire traditionnel échouerait à synthétiser.
Les données psychométriques sont en outre perpétuellement exposées aux effets de seuil, d’accumulation plancher et de saturation plafond. Un effet de plancher massif se traduit par un écrasement brutal d’une multitude d’observations le long de la bordure inférieure ou gauche d’une cellule, formant une ligne continue dense d’où s’échappe un faisceau de dispersion asymétrique. Ces singularités géométriques alertent immédiatement le méthodologiste sur l’inadéquation de la sensibilité métrologique du test pour les fractions extrêmes de l’échantillon.
4.3 Repérage précoce de l’hétéroscédasticité et des sous-populations
L’homoscédasticité — postulat selon lequel la variance des erreurs conditionnelles demeure invariante sur l’ensemble de l’espace prédictif — s’évalue graphiquement par la régularité du diamètre transversal du nuage de points le long de sa trajectoire directrice. L’hétéroscédasticité se dévoile graphiquement par des morphologies en mégaphone ou en éventail : le nuage de points, extrêmement compact à une extrémité de l’axe, s’évase progressivement vers l’autre extrémité. En clinique psychologique, ce phénomène illustre fréquemment la perte de régulation homéostatique : chez les individus à bas niveau de vulnérabilité, les scores d’impulsivité sont uniformément contenus, tandis qu’aux scores élevés d’inhibition altérée, l’hétérogénéité des comportements devient gigantesque.
L’observation d’un pairs plot permet également de diagnostiquer l’existence de sous-populations masquées au sein de la cohorte générale. Si l’échantillon est composé d’entités nosologiques hétérogènes ou de profils neuro-développementaux distincts non identifiés a priori, le nuage ne prend pas la forme d’un ellipsoïde continu mais se scinde en îlots distincts ou en trajectoires bimodales divergentes. Deux grappes nettement disjointes signalent une segmentation structurelle qui invalide d’emblée toute modélisation linéaire globale non stratifiée.
Enfin, l’appréciation globale de la compacité de l’ellipse fournit une estimation intuitive de la variance résiduelle du système. Plus l’enveloppe extérieure des points s’approche de la circularité diffuse, plus le système bivarié est gouverné par des sources de variance non partagées ou par des erreurs de mesure substantielles, fixant ainsi des limites réalistes aux attentes explicatives des futurs modèles.
5. Personnalisation avancée de pairs() via les fonctions de panneau (panel functions)
5.1 Exploitation du paramètre panel.smooth et ajustements de régression
La puissance d’extension de la fonction pairs() réside dans son architecture modulaire articulée autour des fonctions de panneau (panel functions). Plutôt que de contraindre l’utilisateur à un affichage stéréotypé, le moteur graphique de base délègue le dessin du contenu de chaque cellule à des sous-fonctions dédiées. L’argument panel.smooth constitue l’illustration la plus accessible de cette modularité. En remplaçant la fonction de tracé brute par cette fonction préconfigurée, l’interpréteur superpose automatiquement à chaque nuage de points une courbe de lissage non paramétrique de type LOESS (Locally Estimated Scatterplot Smoothing).
L’ajustement LOESS procède par régressions pondérées locales sur des voisinages restreints d’observations, ce qui permet à la courbe de serpenter fidèlement au cœur du nuage sans être assujettie à une contrainte de linéarité rigide. Le degré de lissage — contrôlé par la largeur de la fenêtre glissante — s’avère déterminant : une paramétrisation judicieuse élimine le bruit haute fréquence tout en révélant avec une probité exemplaire les inflexions, les zones d’asymptote et les ruptures d’allure au sein des trajectoires psychologiques.
Pour le modélisateur désireux d’évaluer la pertinence d’une approximation par les moindres carrés ordinaires, il est extrêmement aisé d’écrire une fonction de panneau personnalisée. En encapsulant les primitives d’affichage standard associées à l’instruction abline appliquée à un modèle linéaire univarié instancié à la volée, le graphique se dote de droites de régression paramétriques rectilignes, permettant de confronter immédiatement la courbure LOESS à la rigidité de l’hypothèse linéaire.
5.2 Intégration d’histogrammes et d’estimateurs de densité sur la diagonale
Dans sa configuration native, la diagonale principale d’une matrice de nuages de points se borne à afficher le libellé textuel des variables, ce qui représente une sous-exploitation manifeste de l’espace graphique disponible. Grâce au paramètre diag.panel, le chercheur peut transformer ces réceptacles textuels en fenêtres d’exploration univariée de haute volée. L’implémentation classique documentée dans les manuels de référence de R consiste à concevoir une fonction panel.hist capable d’intercepter la variable vectorielle active et de projeter son histogramme de fréquences au sein même de la cellule diagonale.
Cette approche univariée diagonale gagne une valeur analytique considérable lorsqu’elle superpose à l’histogramme discret une estimation de densité de noyau gaussienne (kernel density estimation). Tandis que le découpage en classes de l’histogramme peut dépendre du choix de l’origine et de la largeur des intervalles, la courbe de densité continue trace le profil morphologique fluide de la distribution marginale sous-jacente.
L’interprétation conjointe de la diagonale et des cellules bivariées engendre une synergie herméneutique remarquable. L’observateur visualise instantanément si une asymétrie marquée observée sur un axe marginal est la cause directe de l’étirement unilatéral du nuage bivarié adjacent. Il repère si les distributions multimodales diagonales correspondent à la scission spatiale des nuages de points périphériques, réalisant ainsi une synthèse immédiate entre les propriétés distributionnelles intrinsèques des échelles et leurs interactions systémiques.
5.3 Affichage dynamique des coefficients de corrélation dans le triangle supérieur
Puisque le triangle inférieur et le triangle supérieur véhiculent une information bidimensionnelle symétrique, il est particulièrement judicieux d’exploiter cette redondance pour diversifier les modes de représentation. Une convention méthodologique consiste à allouer le triangle inférieur à la géométrie pure des nuages de points complétés de leurs courbes de lissage, et à consacrer intégralement le triangle supérieur à l’évaluation quantitative des métriques d’association via le paramètre upper.panel.
La conception d’une fonction panel.cor personnalisée permet d’atteindre un haut degré de sophistication analytique. Au lieu d’imprimer une chaîne de caractères textuelle monochrome uniforme, cette fonction calcule dynamiquement le coefficient de corrélation de Pearson, de Spearman ou de Kendall entre les deux vecteurs mis en présence. Elle module ensuite proportionnellement la taille de police d’écriture du texte affiché en fonction directe de l’amplitude absolue du coefficient calculé : une corrélation frôlant l’unité s’affichera dans un corps imposant captant immédiatement le regard, tandis qu’une corrélation négligeable sera inscrite dans une échelle minuscule et discrète.
De surcroît, cette fonction de panneau peut exécuter un test inférentiel d’hypothèse nulle (cor.test) et adjoindre au texte les astérisques de significativité statistique conventionnels selon les paliers d’usage en psychologie empirique. Le triangle supérieur se métamorphose ainsi en un tableau de corrélation interactif et hiérarchisé, offrant simultanément l’estimation ponctuelle, la puissance heuristique de sa magnitude relative et le verdict du seuil de décision probabiliste.
6. L’approche psychométrique dédiée : Utilisation du paquetage psych et de pairs.panels()
6.1 Architecture et fonctionnalités de la fonction pairs.panels()
Conscient des contraintes techniques inhérentes à l’écriture manuelle répétitive de fonctions de panneau dans le moteur de base de R, William Revelle a consolidé l’ensemble de ces besoins méthodologiques au sein de la fonction emblématique pairs.panels(), pièce maîtresse du paquetage psych. Véritable standard de fait dans la littérature psychologique internationale, cette procédure synthétise nativement, en un appel d’instruction unique, une quantité colossale d’informations statistiques intégrées.
L’agencement architectural de pairs.panels() déploie d’emblée une distribution optimale de l’espace : la diagonale accueille des histogrammes surmontés de tracés de densité continus, le triangle supérieur compile les coefficients de corrélation pondérés par leur amplitude typographique, et le triangle inférieur met en scène les observations brutes escortées de courbes LOESS locales et de droites de régression. Cependant, l’innovation la plus remarquable réside dans l’intégration systématique d’ellipses de corrélation lissées autour des nuages de dispersion.
Ces ellipses de dispersion — contrôlées par le paramètre ellipses — fournissent une schématisation géométrique de l’inertie bivariée. Orientées selon l’axe principal du nuage de points, leur aplatissement est directement proportionnel à la magnitude de la corrélation : une corrélation parfaite génère un segment linéaire aplati, tandis qu’une absence totale de relation produit un cercle parfait. L’ellipse permet ainsi de saisir l’intensité et le sens de l’association sans que le regard ne soit perturbé par le bruit aléatoire des coordonnées individuelles.
6.2 Sélection des métriques d’association adaptées aux échelles psychologiques
L’un des atouts prééminents de l’outil pairs.panels() réside dans sa souplesse d’adaptation aux spécificités de mesure des construits psychologiques. La statistique paramétrique classique s’effondre lorsque les données s’écartent drastiquement de la normalité univariée ou bivariée, ou lorsqu’elles présentent des distributions hautement asymétriques consécutives à des seuils cliniques sévères. Par une simple altération du paramètre method, l’analyste peut substituer au calcul de Pearson l’évaluation non paramétrique des rangs de Spearman ou le coefficient tau de Kendall, robustes face aux étirements monotones et aux anomalies de distribution.
Pour les psychométriciens opérant sur des items individuels d’échelles de personnalité ou de questionnaires d’attitude, le postulat de continuité est conceptuellement caduc. Le paquetage psych excelle dans la prise en charge des corrélations polychoriques (pour les variables ordinales à plus de deux modalités ordonnées) et tétrachoriques (pour les items dichotomiques de type vrai/faux ou réussite/échec). pairs.panels() permet d’intégrer ces métriques d’association latente qui modélisent la corrélation théorique qui prévaudrait si les variables sous-jacentes étaient mesurées sur un continuum gaussien ininterrompu.
De plus, des fonctionnalités d’estimation robuste permettent de minimiser l’impact délétère des valeurs résiduelles extrêmes sur les indicateurs de tendance centrale matricielle. Les médianes peuvent être projetées à la place des moyennes marginales, assurant un ancrage descriptif hautement résilient face aux artefacts d’échantillonnage.
6.3 Segmentation par groupes diagnostiques ou démographiques
L’investigation clinique et différentielle requiert perpétuellement la comparaison de sous-groupes d’individus, qu’il s’agisse de contraster une cohorte de patients présentant un trouble anxieux généralisé avec un groupe contrôle sain, ou d’explorer les variations structurelles selon le sexe biologique ou la tranche d’âge. pairs.panels() apporte une réponse graphique d’une élégance méthodologique rare grâce à son paramètre d’arrière-plan bg.
En assignant à ce paramètre un facteur catégoriel vectorisé couplé à une palette de contrastes chromatiques distincts, les points individuels se colorent instantanément selon leur affiliation d’appartenance. Mieux encore, la fonction est capable de segmenter les ellipses de dispersion par strate : au lieu de tracer une enveloppe globale indifférenciée, elle projette sur le même panneau les ellipses de concentration distinctes associées à chaque sous-cohorte.
Cette superposition révèle des phénomènes psychologiques d’une importance capitale, tels que les divergences structurelles de covariance entre cohortes. Il devient immédiatement visible si la relation entre réactivité émotionnelle et contrôle exécutif conserve la même orientation et la même intensité dans le groupe clinique et dans le groupe contrôle, ou si une inversion d’axe apparaît. De même, ce partitionnement graphique constitue un outil de dépistage visuel d’une efficacité redoutable pour détecter le paradoxe de Simpson, dans lequel une association positive apparente au niveau de la population globale masque en réalité des relations rigoureusement négatives au sein de chacun des sous-groupes constitutifs.
7. Visualisation multivariée moderne avec GGally::ggpairs dans le tidyverse
7.1 Fondations théoriques de ggpairs et grammaire des graphiques
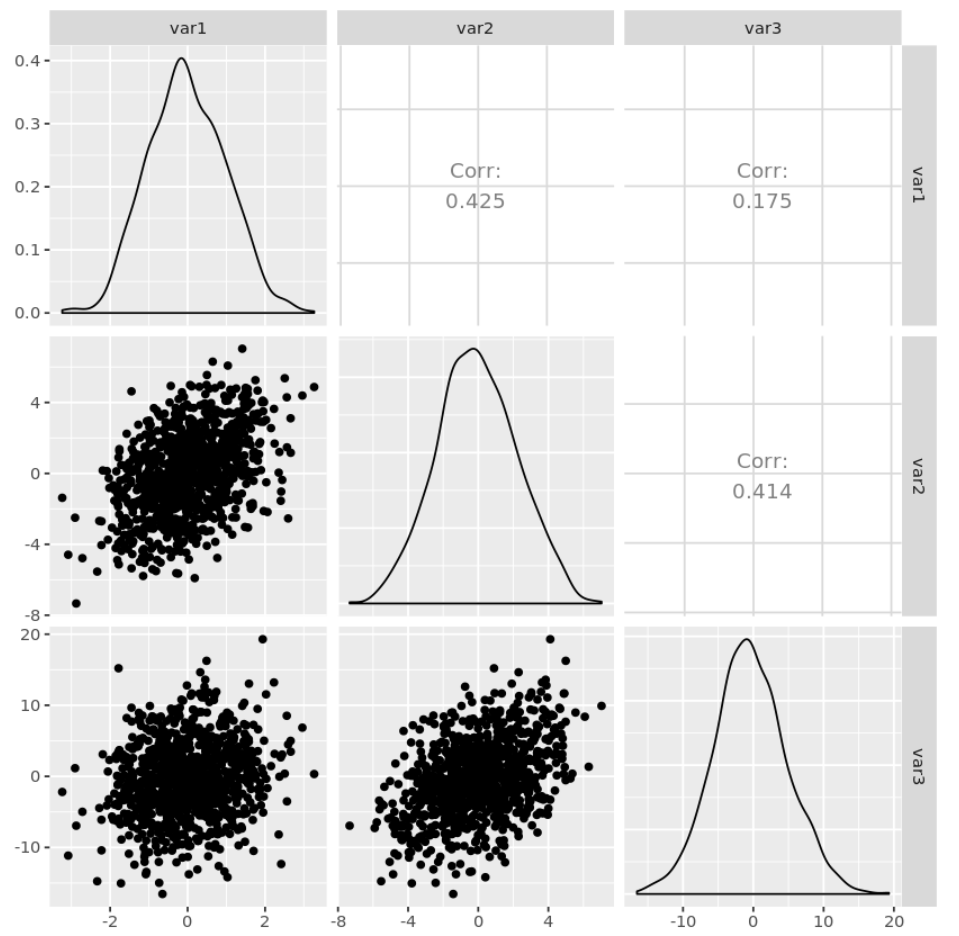
Bien que les fonctions issues du moteur de base et du paquetage psych fassent preuve d’une robustesse éprouvée, leur architecture demeure tributaire du modèle impératif historique de R. L’émergence du méta-paquetage tidyverse et de la formalisation de la grammaire des graphiques par Leland Wilkinson — magistralement implémentée par Hadley Wickham dans ggplot2 — a profondément redéfini les standards de la visualisation scientifique. Le paquetage GGally accomplit la translation de cette philosophie vers les matrices de dispersion grâce à sa fonction maîtresse ggpairs().
L’apport conceptuel déterminant de ggpairs() réside dans son traitement unifié et polymorphique des données hétérogènes. Dans un protocole comportemental complexe, le chercheur ne manipule que rarement un ensemble exclusivement composé de variables numériques continues. Les tableaux intègrent conjointement des facteurs binaires (par exemple, la présence ou l’absence d’un antécédent clinique), des classifications polytomiques (telles que des catégories diagnostiques) et des scores dimensionnels continus. Alors que les fonctions graphiques conventionnelles échouent ou tronquent arbitrairement ces mélanges, ggpairs() évalue dynamiquement la nature de chaque paire de variables et instancie automatiquement la géométrie visuelle théoriquement appropriée.
Cette approche s’articule de façon transparente avec les pipelines de transformation de données pilotés par dplyr. La sélection préalable de sous-ensembles, le filtrage de conditions expérimentales ou l’enrichissement par mutation vectorielle s’enchaînent naturellement en amont de l’instruction de projection graphique sans exiger la moindre restructuration matricielle fastidieuse.
7.2 Configuration des sections : upper, lower et diag
La puissance d’adaptation de ggpairs() se manifeste dans la flexibilité paramétrique de ses trois macro-sections cardinales : upper (le triangle supérieur), lower (le triangle inférieur) et diag (la diagonale univariée). Chaque section est configurée via une structure de listes précisant les géométries assignées à chaque croisement typologique : continu avec continu, continu avec catégoriel, ou catégoriel avec catégoriel.
À l’intersection de deux variables continues, l’utilisateur conserve la liberté de substituer aux nuages traditionnels des estimations de densité bivariée par courbes de niveau, des grilles de corrélation lissées ou des espaces vierges intentionnels. Pour les intersections hybrides combinant un axe continu et une variable catégorielle, ggpairs() déploie une richesse analytique remarquable : le panneau génère automatiquement des diagrammes en boîte (boxplots), des diagrammes en violon visualisant l’estimation de densité de chaque modalité, ou des histogrammes segmentés superposés, illustrant instantanément les variations de moyenne et d’étalement entre les strates comportementales.
Lorsque deux variables catégorielles se croisent au sein de la matrice, ggpairs() délaisse les nuages de dispersion sans objet pour orchestrer des diagrammes à barres empilées, proportionnelles ou juxtaposées. L’observateur décode ainsi en un instant les dépendances de fréquences, les proportions relatives et les déséquilibres d’échantillonnage entre classes nominales, réalisant une unification totale de l’analyse exploratoire univariée et multivariée sur un canvas unique.
7.3 Esthétique avancée et factorisation chromatique
L’application du formalisme de la grammaire des graphiques transparaît avec éclat dans l’usage du mapping esthétique global. L’injection de l’instruction mapping = aes(color = groupe) déclenche une cascade de modifications visuelles concertées à travers l’ensemble des panneaux de la matrice. Chaque modalité du facteur spécifié se voit attribuer une empreinte chromatique harmonisée qui se répercute de façon cohérente : les courbes de densité univariées de la diagonale se dédoublent pour chaque sous-cohorte, les nuages de points du triangle inférieur se teintent selon les affiliations d’appartenance avec ajustement de droites de régression spécifiques par couleur, et les boîtes à moustaches hybrides adoptent un remplissage différencié.
L’optimisation éditoriale de ce rendu implique une gestion rigoureuse de l’accessibilité visuelle. L’adjonction de palettes chromatiques perceptuellement uniformes et compatibles avec les différentes formes de dyschromatopsies — au premier rang desquelles trône l’échelle Viridis — garantit une transmission sans distorsion de l’information graphique, que le support soit consulté sur écran haute définition ou imprimé en niveaux de gris au sein d’une revue spécialisée.
Enfin, l’adhésion aux canons graphiques contemporains s’opère par l’application des thèmes modulaires de ggplot2. L’adjonction d’un thème épuré tel que theme_minimal() ou theme_bw() expurge le graphique des fonds grisâtres encombrants, affine la grille des coordonnées cartésiennes et allège la typographie des axes, hissant instantanément la matrice multivariée au niveau d’exigence requis pour une soumission académique internationale.
8. Adaptation méthodologique aux variables discrètes et échelles de Likert
8.1 Le problème fondamental de la superposition exacte (Overplotting)
L’application naïve des techniques de dispersion cartésienne aux données psychométriques brutes se heurte à une aporie géométrique majeure résultant de la nature même des instruments de mesure. La quasi-totalité des inventaires d’auto-évaluation en psychologie — qu’il s’agisse d’échelles de stress perçu, de questionnaires d’estime de soi ou d’épreuves d’anxiété situationnelle — colligent les réponses des participants sous la forme d’échelles ordinales discrètes bornées, comportant le plus souvent entre quatre et sept ancrages numériques entiers.
Lorsque deux variables de cette nature sont projetées au sein d’un nuage de points standard, les coordonnées cartésiennes possibles sont rigoureusement limitées à un nombre fini de nœuds d’intersection géométrique sur un quadrillage rigide. Par exemple, le croisement de deux échelles de Likert en cinq points ne génère qu’un ensemble discret de vingt-cinq coordonnées théoriques possibles. Dès lors que la taille de l’échantillon comprend plusieurs centaines de participants, des dizaines, voire des centaines d’individus partageant des scores identiques viennent se superposer exactement sur les mêmes pixels.
Cette superposition exacte (overplotting) engendre une perte colossale d’information diagnostique. Deux cellules présentant une apparence graphique quasi identique sur le papier peuvent héberger des réalités distributionnelles opposées : l’une peut ne contenir que trois observations isolées par croisement, tandis que l’autre concentre la quasi-totalité de l’échantillon en un point névralgique sans que l’observateur ne puisse en prendre conscience. Ce biais perceptif déforme dramatiquement l’évaluation intuitive des corrélations et dissimule totalement l’asymétrie réelle des comportements.
8.2 Techniques de bruitage aléatoire contrôlé (Jittering)
La réponse computationnelle classique pour neutraliser l’occultation géométrique sur des variables discrètes réside dans l’injection d’une dispersion stochastique minimale, opération universellement désignée sous le néologisme de bruitage aléatoire ou jittering. Le principe algorithmique consiste à adjoindre à chaque coordonnée discrète entière un décalage aléatoire uniforme ou gaussien infinitésimal d’amplitude strictement circonscrite.
Dans l’environnement graphique natif de base R, cette manœuvre s’opère grâce à la fonction jitter(). En modulant précautionneusement l’argument factor de cette primitive au sein des coordonnées passées à la matrice, les points individuels s’émancipent de leur alignement artificiel strict pour former de petites nébuleuses de dispersion localisées autour des ancrages entiers théoriques. L’épaisseur et la densité chromatique de chaque constellation deviennent alors immédiatement représentatives du volume d’observations sous-jacent.
Au sein de l’écosystème GGally et ggplot2, cette opération est élégamment prise en charge par l’incorporation de la géométrie geom_jitter au niveau de la définition des panneaux inférieurs. Le chercheur doit veiller avec une rigueur méthodologique absolue à ne pas saturer l’amplitude de dispersion aléatoire : un facteur de bruit excessif déborderait sur les catégories adjacentes, créant une illusion fallacieuse de continuité et corrompant l’intégrité de la structure ordinale du test.
8.3 Alternatives géométriques : diagrammes en tournesol et cartes de chaleur
Si le bruitage aléatoire apporte un soulagement visuel incontestable pour les cohortes de taille modeste, il révèle ses limites dès lors que l’échantillon atteint des proportions épidémiologiques massives. Dans de telles conditions, le chevauchement réapparaît au sein même des îlots bruités. Deux alternatives méthodologiques majeures s’offrent alors au visualisateur de données quantitatives.
La première technique, historiquement théorisée pour la représentation des points dupliqués, est le diagramme en tournesol (sunflower plot). Dans cette géométrie, chaque coordonnée unique n’accueille qu’un point central d’où rayonnent de multiples petits segments rectilignes — les « pétales » — dont le nombre dénomètre rigoureusement la fréquence exacte des observations coïncidentes en ce lieu de l’espace. Un point isolé signale une réponse unique, tandis qu’un tournesol arborant vingt pétales condense la convergence de vingt participants distincts, réconciliant ainsi précision arithmétique et lisibilité cartésienne.
La seconde approche repose sur le compartimentage spatial régulier et la projection par cartes de chaleur. L’espace bivarié est partitionné en une mosaïque de compartiments géométriques, le plus souvent hexagonaux (hexagonal binning). Le nombre d’individus capturés à l’intérieur de chaque alvéole détermine l’intensité de sa coloration thermique. Cette méthode élimine totalement la notion de point individuel au profit d’un gradient de densité surfacique continue, fournissant une cartographie d’une netteté souveraine pour l’analyse des grands inventaires psychologiques nationaux regroupant des dizaines de milliers de répondants.
9. Dépistage des violations de postulats statistiques et détection des cas aberrants
9.1 Diagnostic visuel de la normalité bivariée
L’estimation des coefficients de corrélation linéaire de Pearson et la plupart des procédures de modélisation causale reposent sur le postulat théorique de la normalité multivariée de l’échantillon. Si la normalité de chaque distribution marginale univariée constitue une condition nécessaire, elle n’est en aucun cas une condition suffisante pour garantir la normalité bivariée conjointe. L’inspection géométrique des cellules d’un pairs plot constitue le test diagnostique de premier niveau le plus rapide et le plus intuitif à la disposition du praticien.
Sur le plan morphologique, une distribution normale bivariée canonique se manifeste géométriquement sous la forme d’un ellipsoïde concentrique régulier dont la densité volumique décroît de manière harmonieuse et symétrique depuis le barycentre vers la périphérie. Les courbes de niveau de densité bivariée associées doivent dessiner des ellipses parfaites, régulières et strictement homothétiques. Toute déformation asymétrique — telle qu’une allure piriforme (en forme de poire) ou une concentration décentrée vers un quadrant particulier — atteste d’une violation substantielle du postulat de normalité conjointe.
Les conséquences inférentielles de ces anomalies géométriques sont majeures. L’existence d’asymétries bivariées prononcées corrompt la validité des intervalles de confiance paramétriques et majore exponentiellement les risques d’erreur de Type I ou de Type II lors des tests de significativité statistique, imposant le basculement immédiat vers des méthodes d’estimation robustes ou des procédures de rééchantillonnage par bootstrap.
9.2 Dépistage des observations aberrantes univariées et multivariées
La manipulation de matrices de dispersion met en lumière une distinction fondamentale de la statistique spatiale : la discrimination entre valeurs extrêmes univariées et observations aberrantes proprement multivariées. Une observation peut afficher des valeurs parfaitement banales et centrales lorsqu’elle est examinée isolément sur chaque échelle marginale, tout en constituant une aberration phénoménale par l’incongruité de son positionnement bivarié conjoint.
Considérons, à titre d’illustration psychologique, l’évaluation conjointe de la sévérité d’un traumatisme et du niveau d’adaptation résiliente. Une valeur moyenne sur l’échelle de traumatisme et une valeur moyenne sur l’échelle d’adaptation ne génèrent aucun signal d’alerte lors de l’inspection descriptive univariée. En revanche, si ces deux construits sont presque parfaitement anticorrélés dans la population générale, un individu présentant simultanément un score maximal de traumatisme et un score maximal d’adaptation s’isolera dramatiquement dans un angle désert du nuage de points.
Ces observations isolées correspondent visuellement à des points situés à une distance de Mahalanobis disproportionnée du centre de gravité du nuage. Leur détection précoce est indispensable car ces cas possèdent un potentiel d’effet de levier (leverage) gigantesque : en agissant comme des points d’ancrage décentrés, ils sont capables de faire basculer la trajectoire d’une droite de régression des moindres carrés ou d’engendrer une corrélation substantielle totalement fictive. Le pairs plot permet d’isoler graphiquement ces coordonnées pour en examiner l’authenticité clinique ou procédurale avant toute décision d’exclusion ou de traitement spécialisé.
9.3 Détection de la multicolinéarité sévère
La multicolinéarité représente l’une des menaces les plus pernicieuses pour la stabilité et l’interprétabilité des modèles de régression multiple, de médiation ou d’équations structurelles. Elle survient lorsque deux ou plusieurs variables explicatives partagent une fraction de variance quasi identique, conduisant à une quasi-singularité de la matrice de covariance. Sur le plan algorithmique, cette pathologie entraîne une explosion des erreurs-types des coefficients de régression, rendant les estimations erratiques, hypersensibles aux moindres fluctuations de l’échantillon et parfois d’un signe inverse à la réalité empirique.
Dans un pairs plot, la multicolinéarité sévère se dévoile par une géométrie sans équivoque : l’ellipse de dispersion bivariée s’effondre totalement sur elle-même pour se réduire à un segment linéaire quasi unidimensionnel d’une extrême minceur. Les points individuels ne présentent plus aucun flottement transversal par rapport à l’axe directeur. La détection visuelle d’un tel écrasement entre deux sous-échelles d’un même inventaire psychologique trahit l’existence d’une redondance conceptuelle aiguë.
Cette mise en évidence graphique incite le chercheur à prendre des décisions structurelles assainissantes en amont de toute modélisation causale : fusion des deux instruments en un score composite unique, suppression de l’échelle redondante par arbitrage théorique, ou extraction d’un score factoriel commun via une analyse factorielle confirmatoire.
10. Étude de cas appliquée : Évaluation des cinq facteurs de personnalité (Big Five)
10.1 Présentation du corpus empirique et importation des données
Afin de concrétiser l’ensemble des préceptes théoriques exposés au sein d’une démonstration empirique intégrale, nous mobilisons le modèle taxonomique de référence de la psychologie différentielle : le modèle des Cinq Grands facteurs de personnalité (Big Five), articulé autour des dimensions d’Ouverture à l’expérience, de Conscienciosité, d’Extraversion, d’Agréabilité et de Névrosisme (paradigme OCEAN). Ce modèle postule l’universalité de ces cinq traits latents pour capturer l’architecture fondamentale de la variabilité phénotypique humaine.
Le corpus de données exploité est issu du jeu de données bfi, gracieusement intégré au paquetage psych de R. Cet échantillon recueille les réponses standardisées de 2 800 participants à 25 items d’auto-évaluation dérivés de la banque internationale d’items de personnalité (IPIP), chaque trait étant quantifié par cinq énoncés étalonnés sur une échelle ordinale en six points. Le tableau inclut également des informations signalétiques précieuses, notamment le sexe biologique des répondants et leur niveau d’éducation formelle.
Le protocole initial d’ingénierie des données consiste à agréger les items constitutifs de chaque dimension après inversion scrupuleuse des formulations négatives, produisant cinq scores factoriels continus bornés. Un filtre d’imputation ou de nettoyage préliminaire élimine les profils incomplets afin de stabiliser la structure de l’échantillon, avant de procéder à l’alignement typologique des vecteurs de données.
10.2 Construction incrémentale d’un pairs plot de niveau publication
L’élaboration du dispositif graphique académique s’articule par étapes successives au sein de l’environnement GGally, garantissant un contrôle millimétré de chaque strate sémiotique. La sélection se focalise sur les cinq scores dimensionnels de personnalité, auxquels est adjointe la variable binaire de stratification du genre biologique. Cette démarche incrémentale permet de construire un objet graphique répondant aux critères éditoriaux les plus rigoureux.
La première strate configure le partitionnement chromatique par l’assignation de la variable de genre au paramètre mapping global, assurant une distinction fluide entre les profils masculins et féminins à travers l’ensemble des modules. La deuxième strate calibre la section diagonale pour afficher des courbes d’estimation de densité de noyau gaussienne partiellement transparentes, autorisant la comparaison directe de la morphologie distributionnelle des deux genres pour chacun des traits. La troisième strate déploie sur le triangle inférieur les nuages de points bruités escortés de leurs droites de régression linéaires respectives et de leurs bandes d’intervalle de confiance à 95 %.
La quatrième strate habille le triangle supérieur par des modules numériques ggally_cor, paramétrés pour afficher les coefficients de corrélation de Pearson décomposés par strate de genre, complétés par l’évaluation du différentiel d’association global. Enfin, la typographie générale est épurée par la greffe du thème theme_bw(), associée à une réduction calibrée de l’interlignage textuel et des marges marginales, optimisant ainsi la lisibilité de la figure en prévision de son insertion dans une maquette typographique de revue internationale.
10.3 Interprétation substantive des associations psychologiques révélées
Le décodage du graphique finalisé met en lumière des configurations substantives d’un profond intérêt théorique pour la psychologie différentielle. Le premier constat saillant réside dans l’observation de l’orthogonalité presque parfaite entre la dimension d’Ouverture à l’expérience et le facteur de Conscienciosité. Le nuage de points bivarié correspondant adopte une silhouette remarquablement circulaire, confirmée par un coefficient de corrélation oscillant autour de zéro. Cette configuration géométrique apporte une preuve empirique éclatante de la validité divergente de ces deux construits : la propension à la curiosité intellectuelle et à l’exploration non conventionnelle opère en totale indépendance de la rigueur organisationnelle et de la persévérance auto-disciplinée de l’individu.
À l’inverse, une association négative robuste et statistiquement hautement significative se détache entre le Névrosisme et l’Extraversion. L’ellipse de dispersion s’étire selon une pente descendante homogène : les individus présentant une réactivité émotionnelle exacerbée et une forte propension à l’affliction anxieuse manifestent systématiquement des scores d’affirmation sociale et d’énergie grégaire plus étouffés. La régularité de cette ellipse témoigne de la cohérence de ce phénomène sur l’ensemble de l’étendue de l’échantillon.
Enfin, l’examen comparatif des sous-cohortes de genre révèle des nuances fascinantes : si la pente des régressions demeure rigoureusement parallèle entre hommes et femmes sur la plupart des intersections factorielles — attestant d’une invariance de mesure structurelle réjouissante —, les distributions marginales de la diagonale matérialisent un léger décalage latéral de la moyenne sur l’échelle de Névrosisme et d’Agréabilité, documentant avec une probité exemplaire les variations d’étalonnage différentiel bien documentées dans la littérature psychologique contemporaine.
11. Défis de dimensionnalité, limitations cognitives et pièges méthodologiques
11.1 Le fléau de la dimensionnalité graphique (High-Dimensional Data)
En dépit de sa remarquable puissance d’exploration, le pairs plot se heurte à une frontière géométrique et cognitive infranchissable désignée sous l’expression de fléau de la dimensionnalité graphique. Le nombre total de sous-panneaux générés par une matrice de dimension k croît selon une progression polynomiale stricte égale à k au carré. Dès lors qu’une étude psychologique ambitionne de scruter simultanément un inventaire clinique comportant vingt ou trente facettes distinctes, l’espace d’affichage se décompose en une grille vertigineuse de 400 à 900 cellules microscopiques.
Dans un tel scénario, chaque cellule bivariée individuelle se trouve compressée à des dimensions physiques infinitésimales. Les étiquettes textuelles deviennent illisibles, les glyphes individuels fusionnent en amas indéchiffrables et l’observateur perd toute capacité à distinguer les courbures géométriques ou les hétéroscédasticités locales. La matrice graphique cesse d’être un instrument de discernement heuristique pour se muer en une mosaïque opaque saturant les capacités de traitement visuel de l’esprit humain.
Face à cette limite intrinsèque, la seule parade méthodologique réside dans le partitionnement thématique raisonné. Le chercheur doit renoncer au fantasme de l’exhaustivité panoptique globale pour décomposer son protocole en sous-matrices modulaires conceptuellement cohérentes : confronter séparément le bloc des aptitudes cognitives, le bloc des régulations affectives, et le bloc des indicateurs sociodémographiques, rétablissant ainsi un équilibre viable entre exhaustivité et lisibilité perceptuelle.
11.2 Biais d’interprétation et découverte fortuite d’associations (p-hacking visuel)
L’immersion dans une vaste matrice de dispersion bivariée expose le chercheur à un piège épistémologique pernicieux : l’illusion de découverte fortuite consécutive au problème des comparaisons multiples, que l’on pourrait qualifier de p-hacking visuel ou de paréidolie statistique. Lorsque l’œil parcourt des dizaines de cellules simultanément, le système visuel humain, hautement optimisé pour la détection de formes signifiantes dans le bruit aléatoire, tend spontanément à focaliser son attention sur les alignements singuliers, les amas atypiques ou les courbures esquissées au détriment des motifs de dispersion aléatoires.
Si la matrice présente cent sous-graphiques indépendants, les lois élémentaires de la probabilité dictent qu’environ cinq d’entre eux afficheront, par simple fluctuation d’échantillonnage stochastique, une association apparente formellement significative au seuil alpha conventionnel de 5 %. Interpréter rétrospectivement ces artefacts comme des découvertes théoriques majeures relève de l’erreur méthodologique la plus pure. Le sur-lissage des courbes non paramétriques accentue encore ce péril en forgeant des ondulations sinueuses à partir de légères concentrations accidentelles de points.
Pour immuniser la pratique scientifique contre cette dérive exploratoire, la rigueur exige que tout patron structural découvert fortuitement au sein d’une matrice non guidée par une hypothèse a priori soit impérativement consigné comme une conjecture exploratoire préliminaire. Cette dernière doit faire l’objet d’une validation confirmatoire indépendante sur un nouvel échantillon de réplication croisée avant de pouvoir prétendre au statut de résultat scientifique établi.
11.3 Alternatives analytiques pour les très grands espaces de variables
Lorsque la complexité dimensionnelle d’un recueil de données prohibe l’usage direct du pairs plot, le chercheur doit recourir à des instruments de synthèse visuelle alternatifs capables d’opérer une réduction d’information préliminaire. La première alternative réside dans l’usage de corrélogrammes ordonnés (ordered correlation plots). En renonçant à la projection individuelle des nuages de dispersion pour ne conserver que la codification chromatique des coefficients scalaires au sein d’une matrice thermique (heatmap), et en réorganisant dynamiquement l’ordre des variables par des algorithmes de partitionnement hiérarchique (hierarchical clustering), les blocs de covariation homogènes émergent instantanément à l’échelle globale.
Une seconde approche s’appuie sur la réduction dimensionnelle géométrique préalable via l’Analyse en Composantes Principales (ACP) ou, dans un cadre non linéaire, via des plongements stochastiques tels que le t-SNE ou l’UMAP. Les individus et les variables sont alors projetés au sein d’un espace orthogonal réduit en deux ou trois dimensions capturant la majeure partie de l’inertie du système, permettant d’identifier la topologie relationnelle fondamentale avant de zoomer ultérieurement sur des paires de variables sélectionnées.
Enfin, la psychométrie computationnelle contemporaine privilégie de plus en plus l’approche en réseaux psychométriques (network psychometrics), magnifiquement implémentée dans R par des bibliothèques telles que qgraph ou bootnet. Dans ce paradigme, les variables deviennent les nœuds d’un graphe topologique interconnectés par des arêtes dont l’épaisseur et la couleur traduisent l’intensité des corrélations partielles régularisées (via des pénalisations de type LASSO). Cette modélisation élimine les associations bivariées fallacieuses induites par des causes communes et offre une lisibilité structurelle inégalée pour l’exploration de dizaines d’items psychologiques conjoints.
12. Bonnes pratiques académiques, normes APA et intégration reproductible
12.1 Conformité avec les directives de publication de l’APA (7e édition)
L’intégration d’une matrice de nuages de points au sein d’un manuscrit soumis aux exigences éditoriales de l’American Psychological Association (APA, 7e édition) impose le respect rigoureux de normes formelles de clarté, d’accessibilité et de sobriété typographique. Les directives académiques proscrivent formellement les ornementations graphiques superflues (chartjunk), les arrière-plans colorés non signifiants et les effets de volume en trois dimensions qui altèrent l’estimation visuelle des proportions géométriques.
La typographie incorporée au sein des panneaux — qu’il s’agisse des libellés d’axes, des graduations cartésiennes ou des coefficients numériques — doit afficher une police d’écriture universelle et sans empattement (telle qu’Arial ou Helvetica), calibrée de sorte que les plus petits caractères conservent une lisibilité absolue après réduction à la largeur standard d’une colonne de texte imprimé. Les abréviations des construits doivent être unifiées et rigoureusement définies au sein du corps du texte.
La légende d’une figure APA doit être rédigée avec un soin exceptionnel. Elle ne se contente pas d’intituler le graphique : elle doit former un ensemble autonome et intelligible par lui-même sans que le lecteur n’ait à compulser le texte principal. Elle doit expliciter la signification de chaque élément sémiotique utilisé : la signification des courbes de lissage (en précisant l’algorithme LOESS et sa portée), la méthode d’estimation des corrélations (par exemple, Pearson avec intervalles de confiance à 95 %), la signification géométrique des ellipses de dispersion, ainsi que les niveaux de significativité statistique associés aux astérisques de décision.
12.2 Exportation vectorielle haute définition depuis R
L’un des écueils techniques les plus récurrents lors de la phase de publication réside dans la dégradation qualitative des figures lors de leur exportation depuis l’interpréteur R. La capture directe d’une matrice graphique par des captures d’écran matricielles ou par des formats de compression destructifs à basse résolution (tels que le format JPEG standard) génère une pixellisation désastreuse des tracés et une imprécision dramatique des petits points de dispersion.
La rigueur académique commande de privilégier systématiquement des dispositifs d’exportation vectorielle natifs via les instructions dédiées de l’environnement R. L’appel préalable à la fonction pdf(), cairo_ps() ou svg() permet d’inscrire l’intégralité du rendu géométrique sous la forme d’équations mathématiques scalables. Les points, les segments de régression et les glyphes typographiques conservent ainsi une netteté absolue quel que soit le facteur d’agrandissement opéré par l’imprimeur ou par le lecteur de documents électroniques.
Lorsqu’un format matriciel est formellement exigé par l’éditeur pour des raisons techniques, l’analyste doit employer la primitive png() en spécifiant impérativement une résolution graphique minimale de 300 points par pouce (DPI), voire 600 DPI pour les matrices à haute densité de micro-symboles. De surcroît, le ratio d’aspect (largeur divisée par hauteur) doit être calibré avec une exactitude scrupuleuse pour garantir la perfecta régularité carrée des cellules bivariées internes, prévenant toute distorsion visuelle de l’obliquité des pentes de corrélation.
12.3 Intégration dynamique dans des rapports Quarto et R Markdown
L’aboutissement de la démarche méthodologique moderne s’incarne dans l’automatisation complète de la chaîne de production graphique au moyen de la programmation lettrée intégrée sous Quarto ou R Markdown. En enchâssant le code de génération de la matrice de nuages de points au sein de blocs d’instructions exécutables (code chunks), le chercheur élimine définitivement les manipulations manuelles d’exportation et de réinsertion d’images, sources inépuisables d’erreurs d’attribution ou de désynchronisation entre les données recalculées et les figures finales.
La configuration de ces blocs de calculs permet d’ajuster finement les métadonnées de restitution par des options déclaratives précises. Les paramètres fig.width et fig.height définissent les dimensions physiques effectives de la matrice, tandis que fig.cap injecte dynamiquement la légende formelle aux normes APA. L’activation de la mise en cache (cache = TRUE) optimise le temps de compilation du document en évitant le recalcul intégral des modèles d’estimation non paramétriques lors de simples révisions rédactionnelles textuelles.
Cette intégration dynamique garantit une traçabilité totale au service de la transparence scientifique. Tout évaluateur ou lecteur accédant au dépôt public de la recherche (par exemple via l’Open Science Framework ou GitHub) peut cloner le projet et réexécuter l’intégralité du code source pour régénérer à l’identique, depuis les vecteurs bruts jusqu’à la composition matricielle polychrome, l’exacte figure illustrant l’article. La matrice de nuages de points cesse alors d’être une simple illustration statique pour s’ériger en un acte computationnel certifiable, asseyant de façon inébranlable la robustesse et la pérennité des inférences psychologiques produites.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829-836. https://doi.org/10.1080/01621459.1979.10481038
- Epskamp, S., Cramer, A. O., Waldorp, L. J., Schmittmann, V. D., & Borsboom, D. (2012). qgraph: Network visualizations of relationships in psychometric data. Journal of Statistical Software, 48(4), 1-18. https://doi.org/10.18637/jss.v048.i04
- Friendly, M. (2002). Corrgrams: Exploratory displays for correlation matrices. The American Statistician, 56(4), 316-324. https://doi.org/10.1198/000313002533
- Goldberg, L. R. (1992). The development of markers for the Big-Five factor structure. Psychological Assessment, 4(1), 26-42. https://doi.org/10.1037/1040-3590.4.1.26
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research. Northwestern University. https://cran.r-project.org/package=psych
- Schloerke, B., Cook, D., Larmarange, J., Briatte, F., Marbach, M., Thoen, E., Elberg, A., & Crowley, J. (2021). GGally: Extension to ‘ggplot2’. https://cran.r-project.org/package=GGally
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0