
L’évaluation rigoureuse des instruments de mesure constitue l’un des piliers épistémologiques et méthodologiques des sciences comportementales, de la psychopathologie clinique et de la neuropsychologie moderne. Lorsqu’un chercheur ou un praticien déploie un questionnaire psychométrique, une échelle d’évaluation symptomatique ou un biomarqueur cognitif, la question fondamentale de la validité critériée et du pouvoir de discrimination de l’outil se pose inévitablement : dans quelle mesure cet instrument parvient-il à distinguer avec précision les individus porteurs d’une condition clinique spécifique des sujets indemnes ? Face à la complexité des manifestations psychiques, qui s’échelonnent le plus souvent sur un continuum dimensionnel plutôt que sous forme de catégories discrètes étanches, l’analyse par la courbe ROC (Receiver Operating Characteristic) s’est imposée comme le standard statistique de référence pour modéliser et optimiser la décision diagnostique binaire.
Le logiciel IBM SPSS Statistics met à la disposition des analystes un environnement d’analyse ROC extrêmement robuste, facilitant la transition entre la collecte des données quantitatives brutes et la formulation de recommandations diagnostiques opérationnelles. Néanmoins, la simplicité apparente des boîtes de dialogue et la génération automatisée des graphiques dissimulent souvent des subtilités statistiques substantielles. Une exploitation inadéquate des paramètres par défaut, une mauvaise compréhension des compromis inhérents à la matrice de confusion ou une méconnaissance de la relation liant la sensibilité à la spécificité peuvent conduire à des seuils cliniques inadaptés, entraînant des erreurs systématiques de sous-diagnostic ou de sur-diagnostic aux répercussions éthiques et thérapeutiques majeures.
Ce guide propose une analyse exhaustive, méthodique et résolument ancrée dans les standards de la recherche académique pour maîtriser la construction, l’analyse inférentielle et l’interprétation clinique des courbes ROC sous SPSS. En examinant successivement les fondations théoriques issues de la détection du signal, les spécifications techniques du logiciel, l’évaluation de l’aire sous la courbe, l’extraction algorithmique des seuils optimaux et la rédaction conforme aux exigences de l’American Psychological Association (APA), ce document vise à fournir aux chercheurs, cliniciens et étudiants de cycle supérieur les compétences requises pour transformer des données psychométriques en décisions diagnostiques probantes et reproductibles.
1. Introduction aux courbes ROC et fondements théoriques en psychologie
1.1 Historique et transfert méthodologique vers les sciences comportementales
L’histoire de la courbe ROC trouve sa source au cœur des bouleversements technologiques de la Seconde Guerre mondiale, plus précisément dans le développement et l’optimisation des systèmes de détection radar britanniques et américains. Les opérateurs radar militaires étaient alors confrontés à un défi perceptif critique : distinguer les échos électromagnétiques émis par des aéronefs ennemis de ceux induits par des perturbations environnementales aléatoires, telles que des bancs de brouillard, des nuées d’oiseaux ou le bruit thermique des appareils de réception. Ce problème de décision en univers incertain a stimulé la formulation de la théorie de la détection du signal (Signal Detection Theory) développée initialement par des mathématiciens et des ingénieurs comme Peterson, Birdsall et Fox au début des années 1950. L’objectif était de quantifier mathématiquement la capacité d’un récepteur à extraire un signal signifiant noyé dans un bruit de fond indésirable, tout en isolant la sensibilité propre du détecteur par rapport aux biais décisionnels de l’opérateur humain.
Le transfert conceptuel de ce formalisme d’ingénierie vers les sciences humaines et cognitives s’est opéré par l’intermédiaire de la psychophysique expérimentale durant les années 1960, principalement sous l’impulsion des travaux séminaux de David Green et John Swets. Les psychologues expérimentalistes cherchaient depuis longtemps à résoudre un artefact méthodologique majeur de la mesure sensorielle : lorsqu’un participant affirme percevoir un stimulus visuel ou auditif de faible intensité, cette réponse reflète-t-elle une réelle acuité sensorielle ou simplement une propension psychologique libérale à répondre positivement dans le doute ? La théorie de la détection du signal a apporté une solution théorique élégante en décomposant mathématiquement la performance en deux composantes indépendantes : le paramètre de sensibilité discriminative (noté d’) et le critère de réponse ou biais décisionnel (noté c ou bêta). La courbe ROC s’est matérialisée comme la trace graphique intégrale de cette sensibilité à travers l’ensemble des critères de réponse imaginables.
Au fil des décennies suivantes, ce paradigme expérimental a progressivement migré vers la psychopathologie, la psychométrie clinique et l’évaluation diagnostique en médecine comportementale. Les cliniciens ont pris conscience que le dépistage d’une pathologie psychologique complexe, telle que l’épisode dépressif caractérisé, le trouble du spectre de l’autisme ou le déclin neurocognitif précoce, obéit aux mêmes postulats formels que la détection d’un écho radar. Le score continu issu d’un inventaire clinique constitue le signal latent, qui fluctue au gré de la sévérité symptomatique mais demeure contaminé par le bruit de mesure psychométrique et l’hétérogénéité individuelle. L’analyse ROC contemporaine s’est ainsi métamorphosée en un instrument indispensable pour évaluer les performances globales des échelles d’évaluation, indépendamment des variations arbitraires des seuils de coupure adoptés par les praticiens.
1.2 Définition conceptuelle de la courbe ROC (Receiver Operating Characteristic)
Sur le plan géométrique et conceptuel, la courbe ROC se définit comme une représentation bidimensionnelle continue de la performance d’un classifieur binaire à mesure que son seuil de décision varie d’une extrémité à l’autre de son spectre de valeurs. Contrairement aux approches diagnostiques traditionnelles qui réduisent prématurément un instrument continu à une décision dichotome unique via un cut-off préétabli, l’approche ROC cartographie l’ensemble des scénarios de décision envisageables. Chaque point de la courbe correspond à un seuil particulier appliqué à l’échelle continue, visualisant simultanément la proportion de succès diagnostiques et la proportion correspondante d’erreurs d’identification induites par ce même seuil.
L’espace cartésien dans lequel se déploie la courbe est standardisé à l’intérieur d’un carré unitaire dont les deux dimensions varient rigoureusement de 0 à 1 (ou de 0 % à 100 %). L’axe vertical des ordonnées (axe Y) héberge le taux de vrais positifs, rigoureusement équivalent à la sensibilité clinique de l’instrument. Cet axe reflète la probabilité qu’un sujet véritablement atteint de la pathologie selon le critère diagnostique de référence obtienne un score égal ou supérieur au seuil sélectionné, étant ainsi correctement identifié comme cas positif. Plus la trajectoire de la courbe s’élève rapidement vers le haut de l’axe Y pour de faibles valeurs d’abscisse, plus l’instrument démontre une aptitude précoce à capturer les individus pathologiques sans nécessiter un relâchement excessif du critère de sévérité.
L’axe horizontal des abscisses (axe X) figure quant à lui le taux de faux positifs, qui correspond mathématiquement au complémentaire de la spécificité diagnostique, soit la quantité (1 – spécificité). Cette dimension représente la probabilité qu’un individu cliniquement indemne obtienne par erreur un résultat au-dessus du seuil critique et se trouve classé à tort comme positif. La construction de la courbe ROC impose une relation monotone croissante : lorsque le seuil décisionnel s’abaisse pour devenir plus permissif et englober davantage de sujets malades (accroissant la sensibilité le long de l’axe Y), il incorpore inéluctablement une proportion grandissante de faux positifs (faisant progresser la trajectoire vers la droite de l’axe X). L’efficacité discriminante d’un test se matérialise donc visuellement par l’ampleur de la convexité de la courbe en direction du sommet supérieur gauche de l’espace graphique, point idéal où la sensibilité atteint 1,0 sans générer aucun faux positif.
1.3 Pertinence dans la recherche clinique et psychologique
L’intégration de la méthodologie ROC dans la recherche clinique et psychologique moderne répond à trois impératifs scientifiques majeurs : la validation formelle des instruments de mesure, l’objectivation des seuils cliniques décisionnels et la comparaison rigoureuse de paradigmes concurrents. En matière de validation psychométrique, l’analyse ROC offre une évaluation directe de la validité de critère concomitante ou prédictive. Lors du développement d’une nouvelle échelle d’évaluation de la symptomatologie dépressive ou d’un test cognitif de dépistage de la maladie d’Alzheimer, prouver la cohérence interne ou la structure factorielle de l’outil ne suffit pas ; il est impératif d’attester de son pouvoir de séparation effectif entre les groupes cliniques et les populations témoins au sein d’environnements cliniques écologiquement représentatifs.
Le deuxième apport fondamental réside dans la sélection rationnelle et transparente des valeurs seuils (cut-off points). Dans la pratique psychologique quotidienne, les décisions d’orientation diagnostique, d’admission à un protocole thérapeutique spécialisé ou d’aménagement pédagogique reposent fréquemment sur une binarisation incontournable. Or, historiquement, ces valeurs de coupure étaient souvent assignées de manière purement empirique, par convention d’experts ou par référence aux percentiles d’un échantillon normatif, sans réelle évaluation des conséquences épidémiologiques de ces choix. La courbe ROC permet de sortir de cette subjectivité en modélisant explicitement la balance coût-bénéfice propre à chaque seuil, offrant ainsi au chercheur et au praticien la possibilité de choisir un point de coupure calibré précisément selon les priorités du milieu d’application (privilégiant par exemple la sensibilité pour le dépistage à large échelle ou la spécificité pour la confirmation diagnostique de pathologies fortement stigmatisantes).
Enfin, l’analyse ROC constitue l’armature méthodologique idéale pour comparer empiriquement la validité discriminante relative de plusieurs échelles concurrentes administrées à une même cohorte de patients. En projetant sur un même repère graphique les performances diagnostiques d’un auto-questionnaire ultra-bref en cinq items par rapport à un inventaire clinique standardisé comprenant quarante questions, le chercheur peut évaluer de manière non biaisée si l’instrument allégé conserve une efficacité discriminatoire équivalente à l’outil étendu. Cette comparabilité s’avère particulièrement précieuse dans un contexte de rationalisation du temps clinique, où l’optimisation des ressources de santé mentale exige des outils diagnostiques à la fois économiquement viables, peu chronophages et statistiquement rigoureux.
2. Fondements statistiques : Sensibilité, spécificité et matrice de confusion
2.1 Structure et composantes de la matrice de confusion binaire
L’échafaudage statistique sur lequel repose l’intégralité de l’analyse ROC est constitué par la matrice de confusion binaire, également dénommée tableau de contingence 2×2. Cette structure croise l’état clinique réel du participant—déterminé par un standard diagnostique reconnu comme absolu ou de référence—avec l’état prédit par l’instrument psychométrique à l’étude pour une valeur seuil donnée. La confrontation de ces deux variables dichotomiques génère quatre catégories exclusives de sujets, qui représentent la totalité de l’espace des événements diagnostiques au sein de la cohorte analysée.
Le premier quadrant héberge les Vrais Positifs (VP), c’est-à-dire les individus présentant formellement l’affection recherchée et dont le score au test psychométrique atteint ou excède le seuil de décision, confirmant la pertinence clinique de l’alerte. Le second quadrant correspond aux Faux Négatifs (FN), représentant les sujets effectivement malades mais dont le score s’est situé sous le seuil critique ; ces individus constituent les cas manqués par le test, une situation particulièrement redoutable en psychopathologie lorsque sont en jeu des conduites suicidaires, des épisodes psychotiques débutants ou des démences à leur stade initial. Le troisième quadrant accueille les Faux Positifs (FP), soit les participants indemnes de tout trouble selon l’étalon de référence mais faussement désignés comme pathologiques par l’outil psychométrique, induisant potentiellement de la détresse psychologique, des examens invasifs superflus ou une stigmatisation diagnostique inopportune. Enfin, le quatrième quadrant rassemble les Vrais Négatifs (VN), englobant les individus asymptomatiques que le test identifie adéquatement comme sains en leur attribuant un score inférieur au seuil critique.
Bien que la sensibilité et la spécificité découlent exclusivement de la distribution de ces quatre valeurs fondamentales, la dynamique globale d’un programme de dépistage dépend lourdement de la prévalence sous-jacente de l’affection dans la population source. La prévalence clinique modifie profondément le ratio entre les effectifs réels de sujets malades et sains intégrés dans la matrice de contingence. Si une pathologie présente une prévalence extrêmement faible, même une minime proportion de faux positifs peut submerger numériquement le total des vrais positifs, modifiant substantiellement la certitude associée à un résultat positif dans l’exercice clinique quotidien.
2.2 Sensibilité et spécificité : formulation mathématique et complémentarité
La formalisation mathématique de la sensibilité diagnostique (Se) exprime une probabilité conditionnelle : il s’agit de la probabilité d’observer un résultat d’évaluation positif (T+) sachant que l’individu est réellement atteint de l’affection cible (M+). Sur le plan opératoire, elle s’obtient par la division du nombre de vrais positifs par la somme intégrale des individus malades présents dans l’échantillon :
Sensibilité = VP / (VP + FN) = P(T+ | M+)
Une sensibilité élevée traduit donc l’aptitude d’une échelle à exclure efficacement un diagnostic lorsqu’elle s’avère négative. Selon l’adage mnémotechnique anglo-saxon SnNOut (High Sensitivity, Negative test rules Out), un test ultra-sensible rendu négatif garantit avec un très haut niveau de certitude que le patient est exempt du trouble, car le nombre de faux négatifs (FN) est marginal.
À l’inverse, la spécificité diagnostique (Sp) quantifie la probabilité conditionnelle qu’un test psychométrique fournisse un résultat strictement négatif (T-) sachant que l’individu est réellement exempt du trouble ciblé (M-). Son calcul s’opère en divisant l’effectif des vrais négatifs par l’ensemble des sujets sains de la cohorte étudiée :
Spécificité = VN / (VN + FP) = P(T- | M-)
Une spécificité élevée confère à l’instrument une remarquable valeur de confirmation selon le principe SpPIn (High Specificity, Positive test rules In). Un résultat positif issu d’une échelle hautement spécifique apporte une quasi-certitude quant à l’existence du trouble, le volume de faux positifs (FP) étant statistiquement comprimé au minimum.
La relation opérationnelle liant sensibilité et spécificité s’articule autour d’un arbitrage inéluctable et structurel : toute tentative clinique visant à maximiser la sensibilité d’une échelle d’évaluation continue implique un abaissement de son seuil critique, ce qui réduit mécaniquement la spécificité en exposant un plus grand nombre d’individus sains au risque d’être faussement catalogués comme pathologiques. Inversement, relever le seuil décisionnel pour protéger la spécificité et éviter les fausses alarmes détériore inévitablement la sensibilité, abandonnant des patients réellement atteints dans la catégorie silencieuse des faux négatifs. L’analyse par courbe ROC transcende cette opposition dialectique en objectivant visuellement ce compromis pour chaque graduation de l’échelle d’évaluation étudiée.
2.3 Distinction entre performances intrinsèques et valeurs prédictives
L’une des confusions les plus tenaces en psychométrie appliquée et en épidémiologie clinique réside dans l’assimilation hâtive de la sensibilité et de la spécificité aux valeurs prédictives positive et négative. Sur le plan formel, la sensibilité et la spécificité représentent des caractéristiques opératoires intrinsèques du test diagnostique. Dans la mesure où leurs dénominateurs respectifs isolent séparément les malades réels (VP + FN) et les non-malades réels (VN + FP), ces deux métriques demeurent mathématiquement indépendantes de la prévalence du trouble au sein de la population examinée. Que l’échelle d’évaluation soit testée dans un service psychiatrique d’urgence où la dépression prévaut à 60 % ou au sein d’une université où elle touche 8 % des étudiants, la sensibilité et la spécificité intrinsèques demeurent théoriquement stables, sous réserve d’invariance de mesure psychométrique.
En revanche, dans l’exercice clinique concret, le psychologue ou le psychiatre se trouve confronté à la trajectoire probabiliste inverse : face à un patient obtenant un score positif au test, quelle est la probabilité réelle que cette personne soit effectivement malade ? Cette interrogation est mesurée par la Valeur Prédictive Positive (VPP), formalisée comme suit :
VPP = VP / (VP + FP) = P(M+ | T+)
Symétriquement, la Valeur Prédictive Négative (VPN) quantifie la probabilité que le patient soit effectivement indemne de toute pathologie dès lors que son score au test ressort sous la barre critique :
VPN = VN / (VN + FN) = P(M- | T-)
Contrairement aux paramètres intrinsèques, les valeurs prédictives dépendent lourdement de la prévalence du trouble, comme le formalise le théorème de Bayes. Dans un contexte de dépistage en population générale où la prévalence d’une pathologie est modeste, même une échelle psychologique dotée d’une spécificité respectable de 90 % générera un volume absolu de faux positifs supérieur à celui des vrais positifs, conduisant à une VPP paradoxalement dégradée. C’est précisément l’invariance théorique de la sensibilité et du taux de faux positifs face à la prévalence qui confère à la courbe ROC son statut méthodologique d’étalon universel : elle fournit une mesure objective du pouvoir de discrimination de l’outil psychométrique, totalement affranchie des aléas d’échantillonnage et des fluctuations épidémiologiques de la condition clinique sous investigation.
3. Lien entre la régression logistique binaire et la courbe ROC
3.1 Modélisation logistique et génération des probabilités prédites
L’évaluation de la performance diagnostique ne se limite pas à l’analyse bivariée d’une échelle psychométrique unique face à un critère clinique. Dans la recherche étiologique et translationnelle contemporaine, les cliniciens mobilisent fréquemment la régression logistique binaire afin d’estimer la probabilité d’une maladie en intégrant simultanément de multiples covariables continues et catégorielles (par exemple, des scores d’anxiété, des marqueurs d’impulsivité, des antécédents familiaux et des données sociodémographiques). Dans ce cadre multivarié, le modèle logistique applique une transformation dite logit—correspondant au logarithme népérien du rapport des cotes (log-odds)—afin de linéariser la relation entre les prédicteurs exogènes et la variable dépendante binaire :
logit(p) = ln(p / (1 – p)) = β₀ + β₁X₁ + β₂X₂ + … + βₖXₖ
À partir des coefficients estimés par la méthode du maximum de vraisemblance, le modèle restitue pour chaque individu de l’échantillon une probabilité prédite d’appartenance au groupe cible (comprise entre 0,0 et 1,0). IBM SPSS Statistics offre la possibilité d’enregistrer automatiquement ces probabilités prédites au sein du fichier de données actif via la sous-commande Save > Probabilities lors du paramétrage de la régression logistique. Cette nouvelle variable générée capture l’ensemble de l’information multivariée et synthétise la sévérité du risque diagnostique sous la forme d’un score de propension continu hautement raffiné.
La jonction méthodologique directe entre la modélisation logistique et la courbe ROC s’établit précisément à ce niveau : cette variable de probabilités prédites peut être immédiatement réinjectée dans le module ROC de SPSS comme variable de test. Au lieu d’évaluer le pouvoir de séparation d’un instrument psychométrique isolé, la courbe ROC issue d’une régression logistique synthétise graphiquement la capacité globale de l’ensemble de la batterie clinique modélisée à distinguer les cas avérés des témoins. Cette synergie statistique transcende les approches descriptives conventionnelles en évaluant l’apport combiné de prédicteurs hétérogènes au sein d’un formalisme d’optimisation prédictive rigoureusement unifié.
3.2 Évaluation de la calibration versus discrimination
Lorsqu’un chercheur évalue un modèle diagnostique prédictif, il doit impérativement distinguer deux dimensions complémentaires mais conceptuellement étanches de la validation statistique : la discrimination et la calibration. La discrimination réfère à l’aptitude intrinsèque du modèle à ordonner correctement les participants en fonction de leur niveau de risque effectif, assurant qu’un patient atteint de la pathologie reçoive systématiquement un score prédictif plus élevé qu’un individu sain. L’analyse par courbe ROC et son indicateur synthétique, l’aire sous la courbe (AUC), quantifient exclusivement cette dimension discriminante. Une courbe ROC irréprochable signifie que l’outil classe idéalement les participants selon leur gravité clinique relative, sans préjuger de l’exactitude absolue des probabilités numériques estimées.
À l’opposé, la calibration évalue l’adéquation exacte entre les probabilités prédites par le modèle mathématique et les proportions de cas observées dans la cohorte d’étude. Dans SPSS, cette propriété est classiquement examinée à l’aide du test d’adéquation de Hosmer-Lemeshow. Ce test partitionne l’échantillon en déciles de risque théorique et compare statistiquement les effectifs observés aux effectifs modélisés par la régression. Un modèle peut faire preuve d’une excellente discrimination (avec une AUC de 0,88 sur sa courbe ROC) tout en souffrant d’une médiocre calibration s’il sous-estime ou surestime systématiquement la probabilité réelle de la maladie à l’échelle individuelle (par exemple en assignant une probabilité moyenne de 20 % à des groupes affichant empiriquement 40 % d’infections réelles).
La courbe ROC agit ainsi comme un complément indispensable aux métriques de pseudo-R² classiquement rapportées dans les sorties de régression logistique de SPSS, telles que les coefficients de Cox & Snell ou de Nagelkerke. Tandis que ces pseudo-coefficients expriment la proportion globale de déviance expliquée par l’ensemble des prédicteurs, ils demeurent réputés pour leur variabilité contingente et leur sensibilité aux fluctuations des distributions d’échantillonnage. L’AUC issue de la courbe ROC fournit une métrique de discrimination standardisée, intuitive et dotée d’une signification clinique immédiate, permettant de juger sans équivoque si l’incorporation de nouvelles échelles psychométriques accroît concrètement la séparation clinique des groupes diagnostiques.
3.3 Justification de l’approche ROC pour les prédicteurs continus
L’utilisation préférentielle de l’approche ROC face à des prédicteurs continus se justifie fondamentalement par le dépassement d’un écueil méthodologique classique inhérent aux sorties standard des régressions logistiques : le recours systématique à un seuil arbitraire de probabilité fixé par défaut à p = 0,50. Lorsqu’un statisticien exécute une commande de régression logistique dans SPSS sans paramétrage avancé, le tableau de classification binaire généré classe mécaniquement tout sujet dont la probabilité estimée dépasse 0,50 dans le groupe positif, et tout sujet en dessous dans le groupe négatif. Or, ce seuil de 0,50 ne possède aucune justification clinique ou théorique générale en psychopathologie ; il constitue une convention algorithmique purement symétrique.
Dans la recherche en santé mentale et en psychiatrie expérimentale, les échantillons présentent fréquemment des distributions fortement asymétriques, la proportion de patients souffrant d’un trouble rare (tel qu’un premier épisode psychotique ou une tentative de suicide) oscillant fréquemment entre 3 % et 15 % au sein des cohortes de recrutement initial. Dans un tel contexte de prévalence asymétrique, assigner un seuil rigide à 0,50 conduit fréquemment le modèle logistique à classer la totalité des sujets dans la catégorie majoritaire saine, affichant un taux global de reclassement apparemment flatteur (ex. 92 % de bonnes classifications globales) tout en présentant une sensibilité nulle (0 % de malades identifiés). L’investigateur peu vigilant conclut alors erronément à l’inefficacité clinique de ses prédicteurs psychométriques.
L’analyse par courbe ROC permet de transcender intégralement ce piège interprétatif en s’affranchissant de toute coupure préalable. Elle parcourt de façon continue l’éventail des scores possibles générés par le prédicteur, modélisant la dynamique des taux de vrais et de faux positifs à travers l’ensemble du spectre distributionnel. Ce traitement garantit une évaluation équitable et objective de la valeur informative de l’échelle, permettant d’identifier a posteriori un seuil empirique adapté aux impératifs réels de la décision clinique, quelle que soit la sévérité du déséquilibre initial entre les groupes diagnostiques.
4. Préparation et organisation des données psychométriques dans SPSS
4.1 Structuration et codage des variables d’intérêt
Avant d’initier la commande de tracé d’une courbe ROC dans IBM SPSS Statistics, une rigueur absolue s’impose quant à l’architecture du tableau de données et au codage des attributs de variables sous la vue des variables (Variable View). Le module d’analyse ROC de SPSS requiert impérativement deux variables distinctes pour opérer : une variable d’état (State Variable) et au moins une variable de test (Test Variable). Tout manquement dans la spécification de leurs types ou de leurs valeurs numériques faussera irrémédiablement les calculs ou produira des sorties mathématiquement aberrantes.
La variable d’état incarne la présence ou l’absence effective de l’entité clinique recherchée et doit être impérativement structurée sous une forme dichotomique binaire. Il est fortement recommandé d’adopter le standard international de codage binaire : 0 pour l’absence formelle de la pathologie (sujet témoin ou sain) et 1 pour la présence avérée du trouble (cas clinique confirmé). Il est impératif d’assigner des libellés de valeurs explicites dans SPSS (ex. Valeur 0 = « Témoin indemne », Valeur 1 = « Épisode dépressif caractérisé ») et de déclarer la variable comme nominale ou ordinale. Une gestion rigoureuse des données manquantes doit être opérée à cette étape : les cas présentant des valeurs inconnues sur la variable d’état doivent être codés en valeurs manquantes système (System-Missing) ou déclarés en valeurs manquantes de l’utilisateur (User-Defined Missing) pour être exclus des estimations de contingence.
La variable de test, quant à elle, héberge le score quantitatif continu ou semi-continu fourni par l’échelle psychométrique, le questionnaire auto-rapporté ou le biomarqueur évalué. Bien que l’algorithme de calcul de la courbe ROC tolère des variables ordinales (telles que des scores d’échelles de Likert sommateurs), il s’exécute avec une précision maximale lorsque les données proviennent d’une métrique d’échelle d’intervalles (mesure Scale dans SPSS). L’analyste doit vérifier l’intégrité de cette colonne de scores, s’assurer de l’absence de chaînes de caractères textuelles intempestives et certifier que l’ensemble des scores a été calculé après imputation ou traitement préalable des items manquants selon les règles préconisées par les auteurs de l’instrument psychométrique.
4.2 Établissement du critère de référence (Gold Standard)
La validité scientifique de l’analyse ROC repose sur un postulat méthodologique strict : la certitude diagnostique conférée par la variable d’état doit approcher autant que possible la vérité absolue. En recherche clinique, ce critère de référence est universellement qualifié d’étalon-or ou Gold Standard. Pour un trouble psychiatrique ou un profil psychopathologique, cet étalon ne saurait consister en une simple impression clinique non formalisée ou en une autre échelle auto-rapportée approximative. Il doit s’agir d’une démarche diagnostique exhaustive et hautement validée, telle qu’une entrevue clinique semi-structurée standardisée administrée par des professionnels chevronnés—par exemple la SCID (Structured Clinical Interview for DSM) ou la MINI (Mini-International Neuropsychiatric Interview)—aboutissant à une assignation formelle selon les critères nosographiques en vigueur.
L’un des écueils méthodologiques les plus fréquents en psychopathologie quantitative réside dans le phénomène de contamination du critère, couramment désigné sous le terme d’incorporation de biais (incorporation bias). Ce biais survient lorsque l’échelle psychométrique que le chercheur tente d’évaluer fait elle-même partie des éléments constitutifs utilisés par les cliniciens pour établir le diagnostic de référence. Si, par exemple, le score au questionnaire de dépistage de la dépression à l’étude est mis à la disposition des psychiatres experts chargés d’attribuer le diagnostic SCID servant d’étalon-or, les performances discriminantes de l’outil ressortiront massivement et artificiellement surestimées. L’indépendance stricte entre le processus d’évaluation du test et l’assignation du statut diagnostique final constitue le gage absolu de la neutralité de l’analyse.
Il est par conséquent primordial de documenter méticuleusement dans le protocole de recherche la chronologie et l’aveuglement méthodologique des mesures. Idéalement, l’évaluation par l’échelle de test psychométrique et l’administration de l’entrevue diagnostique de référence doivent être réalisées dans un intervalle temporel très resserré pour éviter toute fluctuation de l’état thymique ou psychique sous-jacent, tout en garantissant un double aveugle absolu : le clinicien conduisant l’entrevue diagnostique étalon ne doit avoir aucunement connaissance du score recueilli à l’échelle de test, et l’évaluateur administrant l’outil psychométrique doit ignorer totalement l’assignation clinique du sujet.
4.3 Audit des postulats préalables et nettoyage de l’échantillon
L’exécution de la procédure ROC sous SPSS requiert un audit statistique préalable de la qualité distributionnelle de la base de données. Bien que l’algorithme non paramétrique par défaut de la courbe ROC ne postule pas une normalité univariée stricte des scores au sein de chaque groupe clinique, l’analyse descriptive préalable des distributions via la commande Analyser > Statistiques descriptives > Explorer (Analyze > Descriptive Statistics > Explore) demeure essentielle. Cette démarche permet d’isoler d’éventuelles valeurs aberrantes extrêmes (outliers) consécutives à des erreurs de saisie ou à des biais de complétion, dont la présence altérerait la délimitation des bornes de seuil et déformerait les coordonnées de la courbe.
L’investigateur doit également calculer la puissance statistique requise pour garantir que l’échantillon réuni confère une stabilité suffisante à l’estimation de l’aire sous la courbe (AUC). Contrairement aux tests d’hypothèses comparatifs traditionnels (tels que le test t de Student), la précision d’une analyse ROC est conditionnée par l’effectif du groupe clinique le plus restreint. Si une étude intègre 500 témoins sains mais seulement 12 patients atteints du trouble clinique ciblé, l’erreur type asymptotique associée à l’AUC sera dominée par la variance du petit sous-groupe pathologique, élargissant drastiquement l’intervalle de confiance et rendant fragile la détermination des seuils optimaux. Des formules dédiées, telles que celles dérivées des travaux de Hanley et McNeil, permettent de dimensionner a priori le nombre minimal de cas positifs et de cas négatifs requis pour rejeter l’hypothèse nulle avec une puissance statistique appropriée (classiquement fixée à 80 % ou 90 %).
Enfin, l’exploration des données doit porter sur la présence éventuelle de covariables modératrices de la discrimination. Des variables sociodémographiques majeures telles que l’âge, le genre biologique ou le niveau d’instruction académique peuvent moduler drastiquement la distribution des scores continus à une échelle psychométrique ou cognitive, sans que cette variation ne soit corrélée à la pathologie elle-même. Si des distributions différentielles notables apparaissent entre les sous-groupes démographiques, le chercheur devra envisager une stratification a priori de l’échantillon avant de lancer la procédure ROC sous SPSS, garantissant que les seuils diagnostiques qui seront ultimement dégagés soient équitables et pertinents pour chaque strate de la population clinique.
5. Procédure pas-à-pas pour générer une courbe ROC dans SPSS
5.1 Accès au module et configuration de la boîte de dialogue
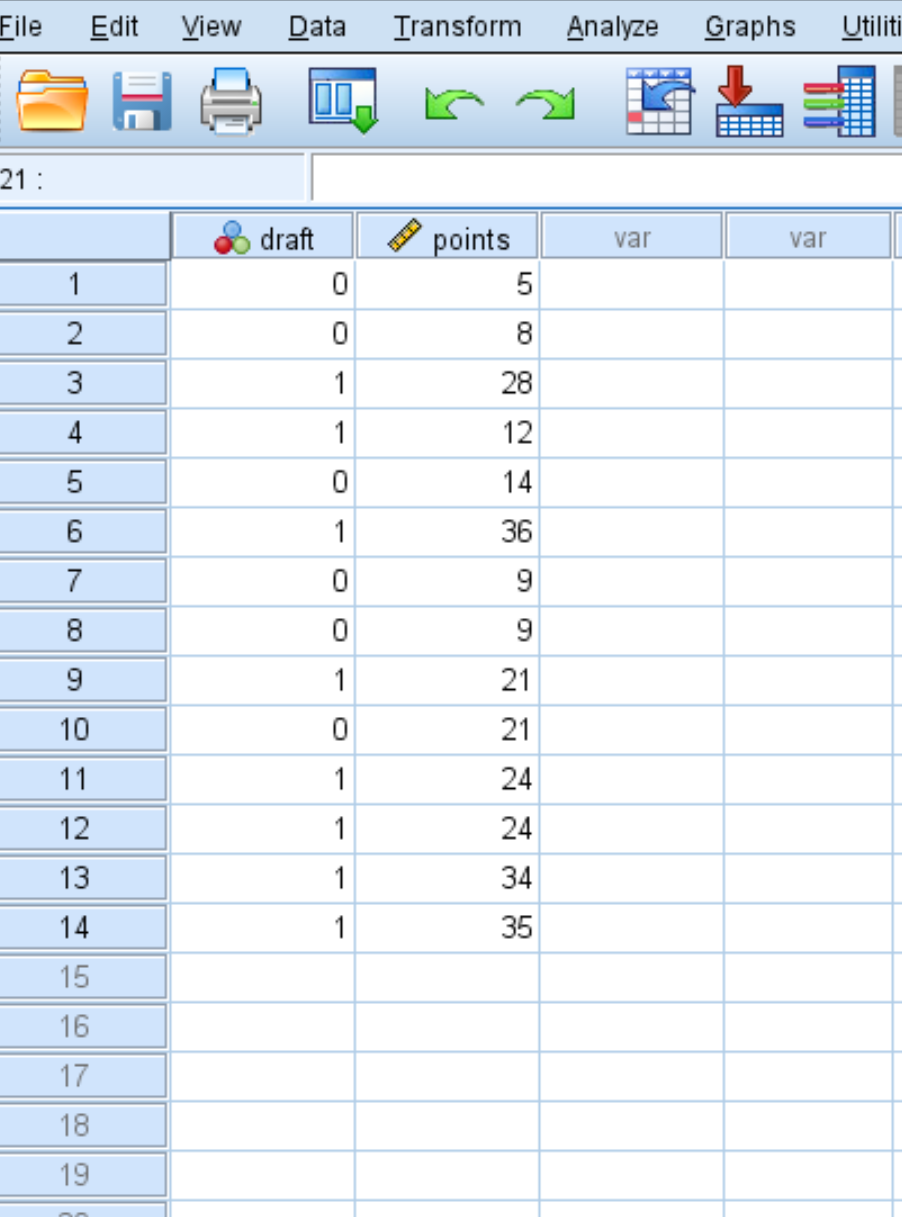
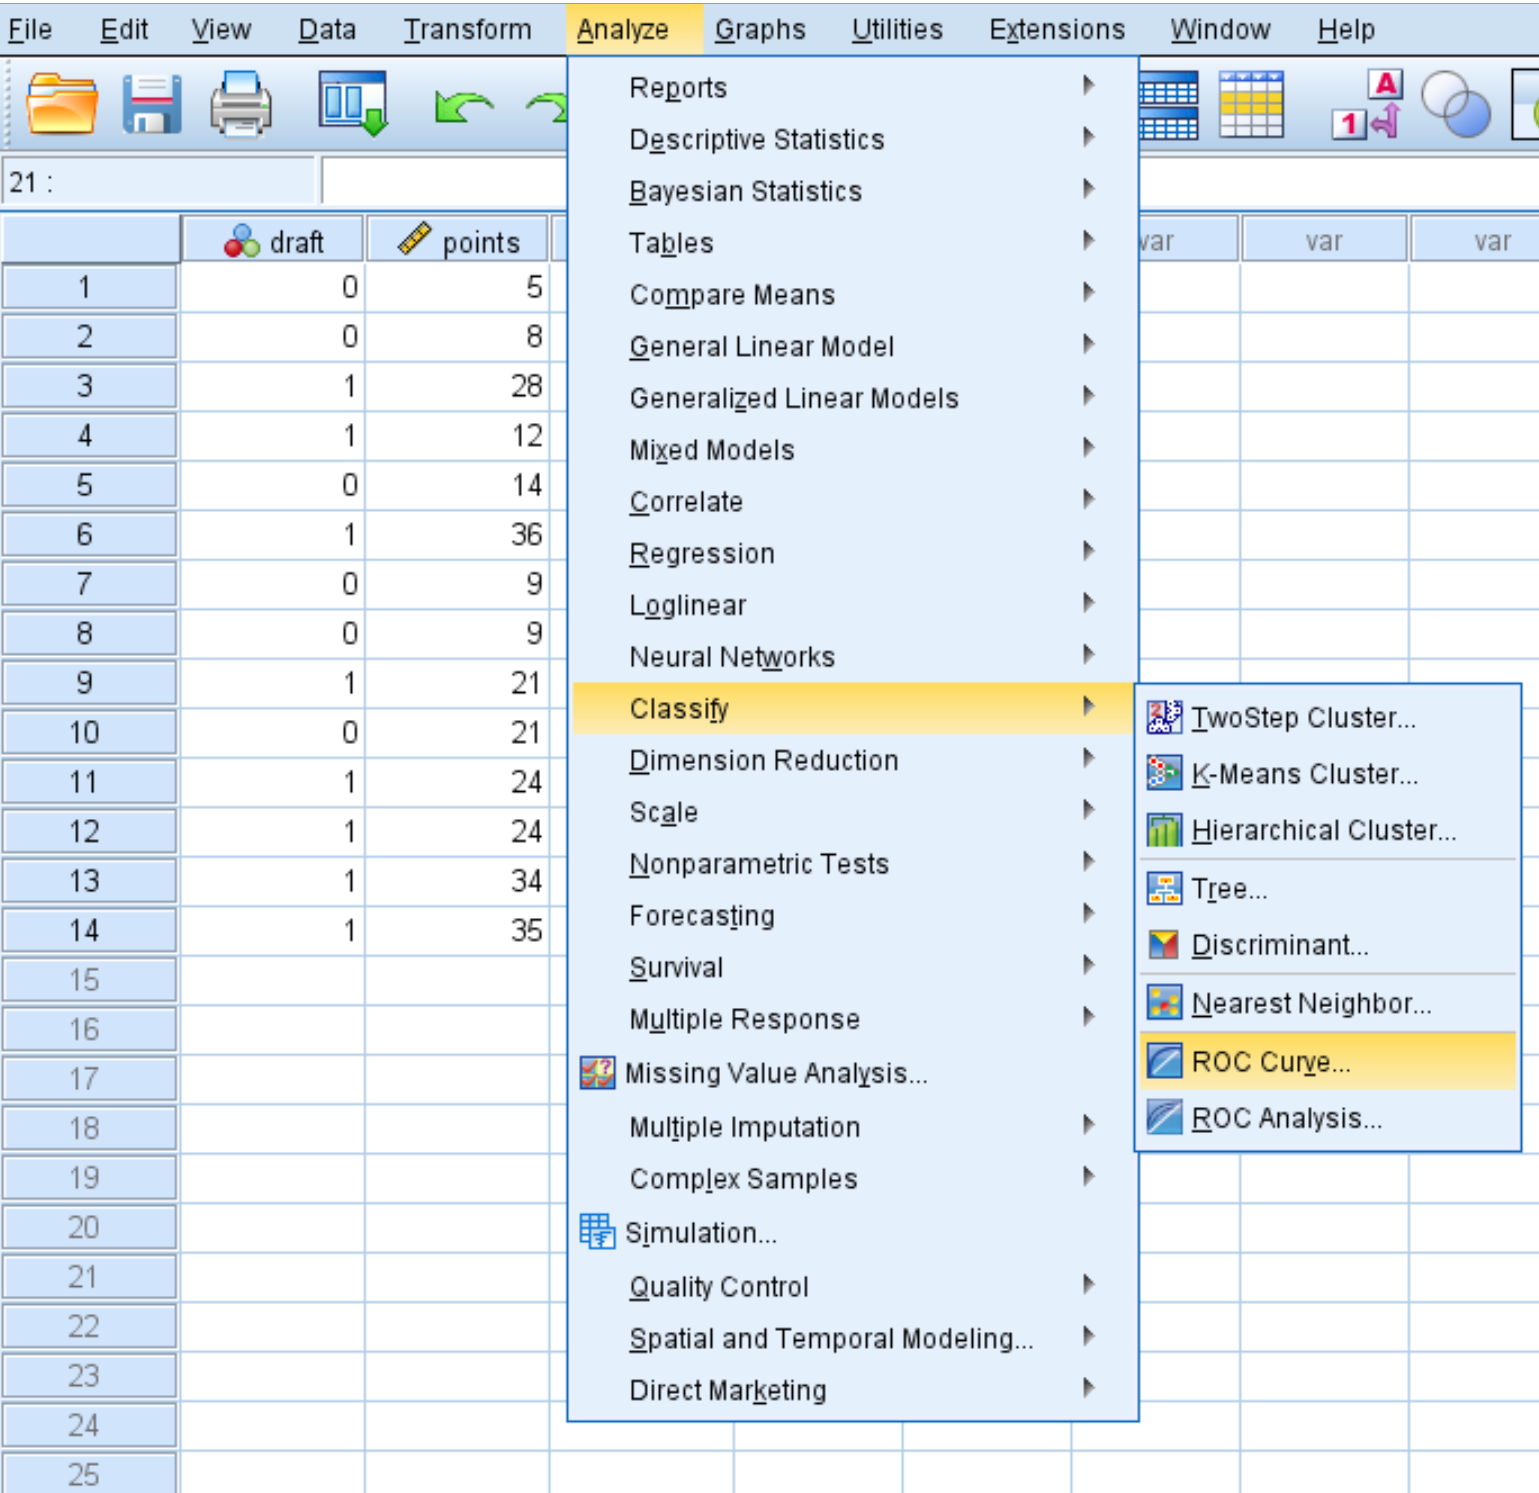
Pour amorcer l’exécution statistique de la courbe ROC au sein de l’environnement graphique d’IBM SPSS Statistics, le chercheur emprunte le menu déroulant supérieur en naviguant à travers le chemin suivant : Analyser > Classifier > Courbe ROC (dans l’interface en langue anglaise : Analyze > Classify > ROC Curve). Cette action déclenche l’ouverture instantanée de la boîte de dialogue principale dédiée au paramétrage du modèle diagnostique, structurée autour de zones de transfert de variables spécifiques et de commandes de sélection d’options de sortie.
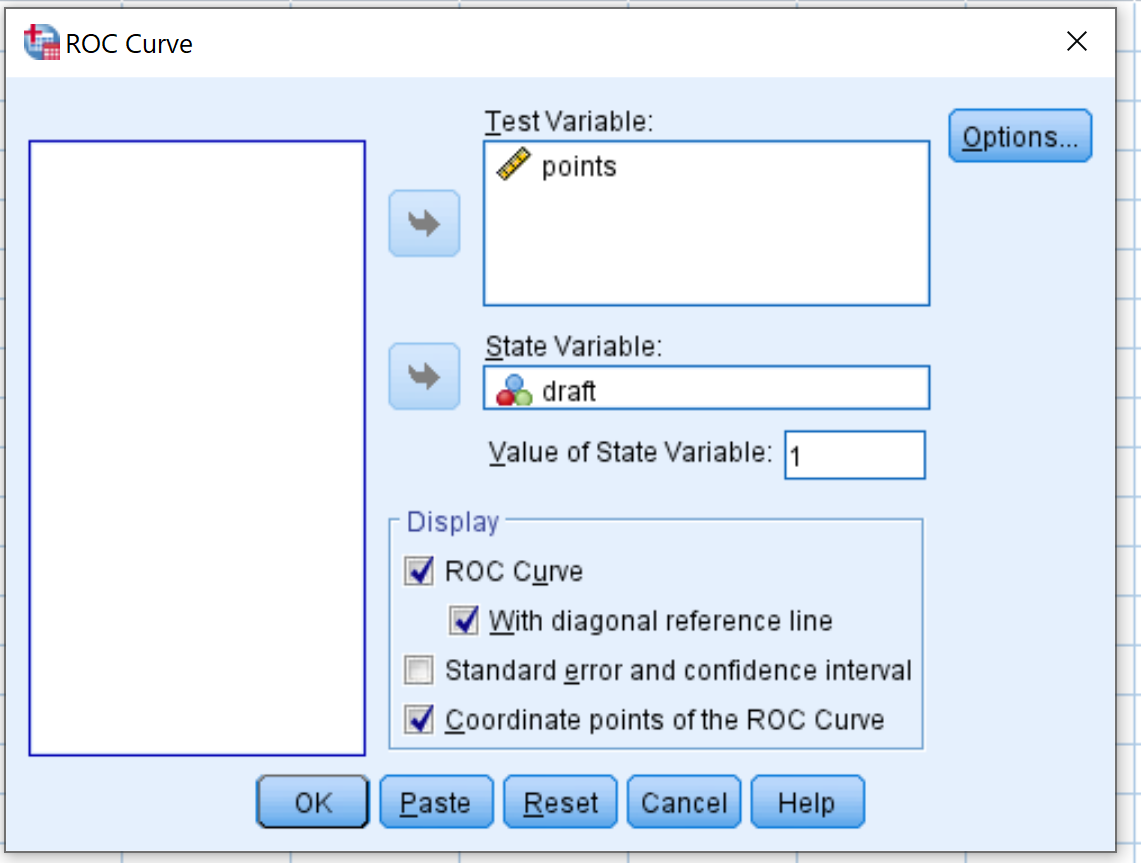
La première opération technique réside dans l’assignation des variables. Dans la liste des colonnes disponibles à gauche de la boîte de dialogue, l’analyste sélectionne la ou les variables quantitatives continues mesurées (par exemple, le score total à un inventaire d’anxiété ou la probabilité prédite issue d’un modèle logistique préalable) et les transfère par la flèche directionnelle centrale vers le champ intitulé Variable(s) de test (Test Variable). Il convient de souligner que SPSS permet l’insertion simultanée de multiples variables de test au sein de ce champ, autorisant ainsi la confrontation conjointe et la projection superposée de plusieurs échelles psychométriques concurrentes au sein d’une seule exécution logicielle.
La seconde manœuvre, fondamentale, consiste à désigner la variable binaire de vérité clinique dans le champ Variable d’état (State Variable). Dès que cette variable est transférée, le champ subsidiaire Valeur de la variable d’état (Value of State Variable) s’active obligatoirement. C’est ici que l’utilisateur doit inscrire la valeur numérique exacte encodée dans son fichier de données pour spécifier l’appartenance au groupe pathologique cible (par convention méthodologique, le chiffre 1). Omettre de remplir cette case ou inscrire la valeur du groupe témoin (0) inverserait complètement les calculs sous-jacents, produisant un tracé symétrique inversé et générant des métriques fallacieuses.
5.2 Paramétrage des options de sortie graphiques et tabulaires
Une fois les variables insérées, le chercheur doit configurer avec minutie la section inférieure de la boîte de dialogue, intitulée Affichage (Display), qui regroupe quatre cases à cocher déterminantes pour la richesse analytique des résultats fournis par SPSS. Par défaut, certaines de ces options fondamentales demeurent décochées, ce qui priverait l’analyste des données nécessaires à la calibration clinique fine des instruments psychométriques.
La première case, Courbe ROC (ROC Curve), doit être maintenue activée afin d’obtenir la représentation graphique des trajectoires de sensibilité et de faux positifs. Il est vivement conseillé d’activer systématiquement la sous-option associée intitulée Avec ligne de référence diagonale (With diagonal reference line). Cette commande ordonne au moteur de rendu graphique d’imprimer la bissectrice à 45 degrés joignant le point d’origine (0,0) au sommet diagonal (1,1), fournissant le repère visuel indispensable du hasard pur contre lequel la performance de l’échelle d’évaluation sera immédiatement confrontée.
La deuxième case critique s’intitule Erreur standard et intervalle de confiance (Standard error and confidence interval). Son activation enclenche l’évaluation inférentielle de l’aire sous la courbe (AUC), ordonnant à SPSS de calculer l’erreur type asymptotique sous les hypothèses paramétrique et non paramétrique, la p-valeur de signification bilatérale et les bornes de l’intervalle de confiance à 95 %. Enfin, la troisième case, dont l’omission constitue une erreur clinique fréquente, est Coordonnées de la courbe ROC (Coordinate points of the ROC Curve). L’activation de cette case impose au logiciel de générer une table récapitulative exhaustive listant chaque seuil de score observable, assorti de sa sensibilité exacte et de son taux correspondant de faux positifs (1 – spécificité), matrice quantitative incontournable pour l’extraction computationnelle du point de coupure optimal.
5.3 Utilisation de la syntaxe SPSS pour assurer la reproductibilité
Bien que l’environnement graphique par fenêtres soit intuitif, les standards contemporains de la recherche ouverte et de la reproductibilité méthodologique (Open Science) exigent des psychologues et biostatisticiens qu’ils conservent une trace scripturale inaltérable de leurs manipulations analytiques. Dans la boîte de dialogue de configuration de la courbe ROC, au lieu de cliquer immédiatement sur le bouton OK, l’utilisateur gagne à presser le bouton Coller (Paste). Cette action transfère l’instruction computationnelle formalisée directement dans la fenêtre de l’éditeur de syntaxe de SPSS.
L’instruction syntaxique standard exécutée par le logiciel s’articule autour de la commande maîtresse ROC, secondée par une arborescence de sous-commandes strictes délimitées par des barres obliques. L’architecture de la commande se déploie selon le formalisme suivant :
ROC variable_score BY variable_etat (1)

/PLOT=CURVE(REFERENCE)

/PRINT=SE COORDINATES

/CRITERIA=CUTOFF(INCLUDE) TESTPOS(LARGE) CI(95) DISTRIBUTION(FREE).
La sous-commande /CRITERIA recèle des leviers de contrôle analytique puissants. L’argument TESTPOS(LARGE) indique explicitement au compilateur statistique qu’un score numériquement plus élevé à la variable de test dénote une probabilité supérieure de présenter l’état clinique pathologique (ce qui représente le cas de figure canonique pour la vaste majorité des inventaires psychopathologiques). Si l’outil évalué fonctionne à l’inverse (par exemple un test de fluidité verbale ou un inventaire d’estime de soi où un score abaissé signale le dysfonctionnement cognitif ou thymique), il suffit de modifier cet argument en TESTPOS(SMALL) dans la syntaxe. L’argument DISTRIBUTION(FREE) commande l’estimation non paramétrique de l’erreur type, assurant la robustesse des inférences face aux violations de normalité, tandis que CI(95) verrouille le niveau de confiance souhaité. La sauvegarde de ce fichier scriptural (.sps) permet de relancer l’analyse instantanément sur de futures cohortes de réplication tout en garantissant un audit transparent des analyses.
6. Interprétation graphique de la courbe ROC générée par SPSS
6.1 Compréhension de la trajectoire de la courbe
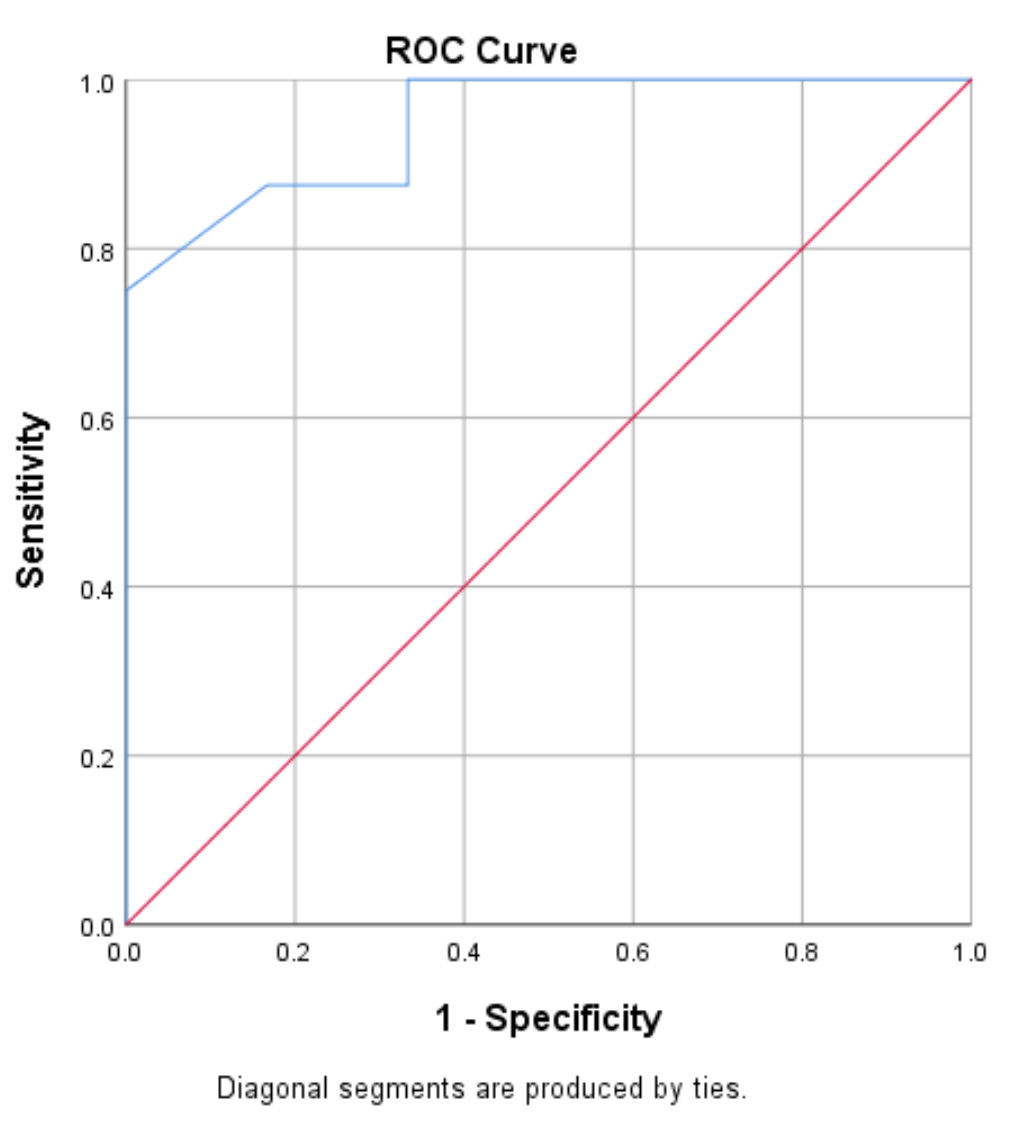
L’inspection du graphique généré dans le visualiseur de sorties (SPSS Output Viewer) constitue la première étape analytique pour apprécier l’efficacité discriminante globale d’un instrument psychométrique. L’espace d’affichage se structure sous la forme d’un plan cartésien carré, borné à gauche par la valeur 0,0 et à droite par 1,0 sur l’axe horizontal (représentant le taux de faux positifs ou 1 – spécificité), et gradué identiquement de 0,0 à 1,0 sur l’axe vertical (figurant le taux de vrais positifs ou sensibilité). La bissectrice diagonale joignant l’angle inférieur gauche (0,0) au sommet supérieur droit (1,0) matérialise la ligne théorique de non-discrimination ou ligne de chance.
La signification géométrique de cette droite diagonale à 45 degrés est fondamentale : elle incarne la trajectoire qu’emprunterait un dispositif d’évaluation dont le pouvoir de séparation diagnostique serait rigoureusement équivalent au hasard pur, comparable à un tirage à pile ou face pour attribuer le statut de malade à un individu. En tout point de cette diagonale, le taux de vrais positifs est exactement égal au taux de faux positifs. Par conséquent, une échelle d’évaluation dont la courbe s’entrelace avec cette ligne diagonale ou s’en écarte de manière marginale ne possède aucune valeur sélective sur le plan clinique, classant les participants sans aucune concordance avec leur pathologie réelle.
À l’inverse, un instrument psychométrique démontrant une haute validité critériée se signale visuellement par une trajectoire qui s’élève de manière abrupte dès l’origine des abscisses, longeant verticalement l’axe de gauche pour s’infléchir ensuite vigoureusement vers le sommet supérieur gauche de l’espace graphique (les coordonnées idéales [0, 1]). Cette forte convexité traduit la capacité de l’outil à capter une proportion massive de sujets véritablement malades (sensibilité très élevée) alors même que le taux de faux positifs est maintenu à des niveaux très réduits. Plus la cambrure de la courbe est prononcée vers cet angle supérieur gauche, plus l’espace surfacique sous-jacent s’élargit, confirmant un pouvoir de discrimination clinique substantiel.
6.2 Visualisation du sens de la relation entre le score et l’état
L’interprétation visuelle de la courbe ROC requiert une vigilance absolue quant au sens de la relation liant l’ampleur numérique du score au statut clinique réel. Dans la configuration psychopathologique standard, les questionnaires sont construits de façon à ce que la sévérité clinique s’exprime par une augmentation quantitative des scores : plus un participant accumule des points sur une échelle telle que l’inventaire de dépression de Beck ou l’échelle d’anxiété de Hamilton, plus la charge symptomatique s’alourdit. Dans ce schéma conventionnel, la courbe ROC s’incurve naturellement dans le triangle supérieur gauche de l’espace graphique, naviguant au-dessus de la diagonale de référence.
Cependant, de nombreuses disciplines psychologiques déploient des paradigmes de mesure fondés sur une relation directionnelle rigoureusement inversée. C’est typiquement le cas de la neuropsychologie clinique et de la psychométrie cognitive : dans des épreuves d’évaluation des fonctions exécutives, de mémoire épisodique ou de dépistage global de la démence (comme le Mini-Mental State Examination – MMSE ou le MoCA), une performance abaissée constitue le marqueur du déficit neurocognitif. De même, en psychologie sociale ou clinique de la santé, des réserves psychologiques protectrices telles que l’estime de soi, l’optimisme dispositionnel ou le soutien social perçu s’expriment par des scores faibles chez les individus vulnérables ou cliniquement déprimés.
Si l’analyste omet d’informer SPSS de cette directionnalité inversée (en maintenant le paramètre par défaut TESTPOS(LARGE)), le tracé de la courbe va paradoxalement plonger dans le triangle inférieur droit du graphique, cheminant en dessous de la ligne diagonale de référence. Cette position sous-diagonale ne signifie nullement que l’instrument cognitif est défaillant ou privé de valeur discriminante, mais simplement que le sens de la relation empirique est diamétralement opposé aux suppositions du compilateur algorithmique. Pour corriger instantanément cette configuration graphique, l’utilisateur doit réexécuter la commande en inversant la polarité du test via la sélection de l’option adéquate dans SPSS, convertissant la trajectoire en une courbe convexe conventionnelle orientée vers le sommet supérieur gauche.
6.3 Analyse morphologique des irrégularités graphiques
L’observation attentive de la morphologie de la courbe tracée par SPSS renseigne l’investigateur sur plusieurs caractéristiques distributionnelles propres à l’échantillon d’étude et à l’instrument psychométrique évalué. Dans un contexte idéal théorique impliquant une population infinie et une variable de test rigoureusement continue mesurée avec une précision infinitésimale, la courbe ROC adopte un profil parfaitement lissé et curviligne. Cependant, sur des données observationnelles concrètes collectées au sein de cohortes cliniques, le visualiseur de SPSS restitue un tracé empirique non paramétrique qui procède par paliers discrets, adoptant une allure caractéristique en marches d’escalier.
Cette structure étagée est le reflet direct de la granularité des scores de l’échelle et de la taille de l’échantillon analysé. Chaque marche horizontale ou verticale correspond à une transition entre deux scores distincts observés dans la série de données. Lorsqu’une cohorte comporte un volume restreint de patients pathologiques (par exemple, 20 sujets au sein du groupe cible), l’identification d’un seul cas positif supplémentaire le long de l’abscisse induit une élévation verticale brusque de 1/20e (soit un bond de 0,05 ou 5 % de sensibilité). Dès lors, un graphique marqué par de larges marches anguleuses signale un manque de puissance statistique et une taille d’échantillon limitée, invitant à la réserve quant à la généralisabilité des points de cassure observés.
Par ailleurs, l’apparition de plateaux horizontaux prolongés ou de lignes verticales droites d’amplitude anormale au sein du tracé graphique doit attirer l’attention de l’analyste. Un long segment horizontal indique qu’une variation substantielle du seuil de coupure augmente significativement le taux de faux positifs (dilatant l’axe X) sans parvenir à capturer le moindre vrai positif additionnel (l’axe Y stagnant à niveau constant). Cela traduit l’existence de zones de plafonnement psychométrique où l’échelle perd momentanément tout pouvoir de résolution pour départager les cas pathologiques des témoins sains, un indice diagnostique qui mérite d’être examiné lors de la révision formelle de l’instrument.
7. Analyse approfondie de l’aire sous la courbe (AUC / ASC) et inférence
7.1 Interprétation quantitative de la valeur de l’AUC
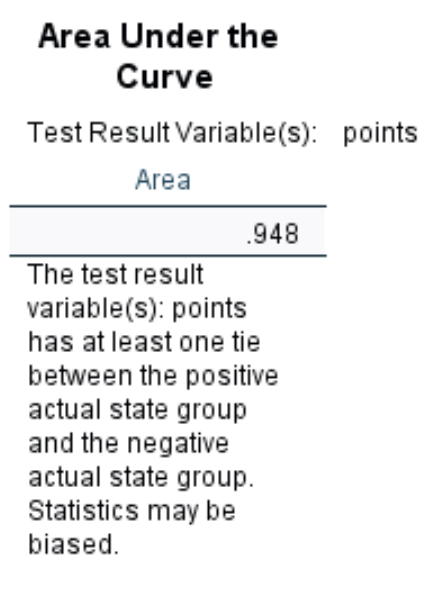
Si la courbe ROC offre une illustration visuelle remarquable de la dynamique diagnostique, son exploitation quantitative et sa modélisation inférentielle s’articulent autour d’une mesure synthétique maîtresse : l’Aire sous la Courbe (désignée par l’acronyme universel AUC pour Area Under the Curve, ou parfois ASC en littérature francophone). L’AUC quantifie l’intégrale de la fonction définie par la trajectoire ROC sur l’intervalle unitaire de variation des faux positifs [0, 1]. En vertu de cette normalisation spatiale, l’AUC s’exprime obligatoirement par une valeur numérique sans dimension comprise entre 0,0 et 1,0.
Sur le plan probabiliste, l’AUC possède une signification concrète extrêmement puissante : elle représente la probabilité exacte qu’un individu sélectionné aléatoirement au sein du groupe clinique pathologique obtienne un score au test psychométrique supérieur à celui d’un participant tiré au sort dans la population témoin saine. Ainsi, afficher une AUC de 0,85 signifie concrètement que si un clinicien met en présence une paire de sujets appariés composée d’un patient déprimé et d’un sujet asymptomatique, l’inventaire psychométrique évalué attribuera un score de sévérité plus élevé au patient déprimé dans très exactement 85 % des occurrences expérimentales.
Afin de structurer le jugement clinique et l’évaluation psychométrique, la littérature biomédicale et méthodologique de référence (notamment issue des classifications proposées par Swets ainsi que par Hosmer et Lemeshow) a codifié une grille d’interprétation consensuelle de l’ampleur de l’AUC :
- AUC = 0,50 : Discrimination rigoureusement nulle. L’instrument est équivalent à une conjecture aléatoire, totalement dénué d’utilité sélective.
- 0,50 < AUC < 0,70 : Discrimination médiocre ou faible. Bien que le test puisse afficher un lien statistique significatif en grand échantillon, son pouvoir de séparation individuel demeure trop ténu pour étayer une décision clinique recevable.
- 0,70 ≤ AUC < 0,80 : Discrimination acceptable. L’instrument commence à posséder une consistance suffisante pour des actions de pré-dépistage en population générale, mais génère une marge d’erreur substantielle.
- 0,80 ≤ AUC < 0,90 : Discrimination excellente. L’outil psychométrique sépare adéquatement les sous-populations cliniques et s’avère hautement fiable pour orienter le diagnostic différentiel spécialisé.
- AUC ≥ 0,90 : Discrimination exceptionnelle à quasi-parfaite. L’instrument garantit une séparation optimale des distributions cliniques, un niveau rarement observé en santé mentale hors du recours à des batteries d’évaluation exhaustives.
Dans l’éventualité où le tableau de sortie d’IBM SPSS Statistics restituerait une AUC substantiellement inférieure à 0,50 (par exemple 0,18), l’investigateur doit immédiatement reconnaître le symptôme d’une polarité inversée des scores (telle qu’évoquée en section 6.2). L’outil psychométrique ne présente pas une défaillance discriminatoire, mais une trajectoire négative non spécifiée au logiciel ; l’AUC corrigée s’obtient alors instantanément par le calcul complémentaire (1 – AUC observée, soit 1 – 0,18 = 0,82).
7.2 Estimation non paramétrique et calcul de l’erreur standard
L’évaluation statistique de l’AUC sous IBM SPSS Statistics ne procède pas d’une simple géométrie descriptive, mais mobilise un appareillage inférentiel sophistiqué fondé sur l’équivalence fondamentale mise en lumière par Hanley et McNeil (1982) : l’aire empirique non paramétrique sous la courbe ROC est rigoureusement identique sur le plan mathématique à la statistique de concordance U du test de Mann-Whitney (également connu sous l’appellation de test de la somme des rangs de Wilcoxon). Cette découverte théorique majeure autorise l’estimation de l’AUC sans nécessiter de postulat contraignant quant à la normalité des distributions sous-jacentes du test psychométrique.
Le calcul algorithmique de l’aire s’opère selon la méthode trapézoïdale non paramétrique (Wilcoxon-Mann-Whitney), intégrant les sommes de rangs attribuées aux cas cliniques au sein de la série globale unifiée. Parallèlement, SPSS procède à l’estimation de l’erreur standard asymptotique (notée Std. Error dans le tableau de sortie). Pour ce faire, le logiciel utilise par défaut l’algorithme proposé par Hanley et McNeil, qui calcule la variance d’échantillonnage théorique de l’AUC à partir des effectifs respectifs des groupes malades (n₁) et sains (n₂), ainsi que de la valeur estimée de l’AUC elle-même et de paramètres de corrélation de rang interne (Q₁ et Q₂) :
Var(AUC) = [AUC(1 – AUC) + (n₁ – 1)(Q₁ – AUC²) + (n₂ – 1)(Q₂ – AUC²)] / (n₁ × n₂)
À partir de cette erreur type, SPSS formule et évalue le test de l’hypothèse nulle statistique formelle stipulant que l’AUC observée en population générale est rigoureusement égale à 0,50 (ce qui signifierait l’absence intégrale de pouvoir discriminant au-delà du hasard pur) :
H₀ : AUC = 0,50 versus H₁ : AUC ≠ 0,50
Le tableau de sortie de SPSS restitue la colonne Signification asymptotique (Asymptotic Sig.), qui consigne la p-valeur bilatérale associée au test de Wald dérivé (Z = (AUC – 0,5) / Erreur Type). Un rejet de l’hypothèse nulle au seuil conventionnel alpha = 0,05 (p < 0,05) certifie que l’instrument psychométrique sépare les groupes d’une manière statistiquement distincte du hasard pur. Néanmoins, le chercheur doit se garder de considérer une significativité statistique comme une preuve automatique de pertinence diagnostique : au sein d’une cohorte clinique très volumineuse intégrant des milliers de participants, une AUC particulièrement modeste de 0,57 obtiendra une valeur p hautement significative (p < 0,001) en dépit d’une inutilité clinique manifeste.
7.3 Intervalles de confiance à 95 % et rigueur inférentielle
L’évaluation rigoureuse de la validité critériée d’une échelle diagnostique impose d’aller au-delà de l’estimation ponctuelle de l’AUC en examinant attentivement l’Intervalle de Confiance à 95 % asymptotique (noté Asymptotic 95% Confidence Interval dans SPSS), délimité par une borne inférieure (Lower Bound) et une borne supérieure (Upper Bound). Cet encadrement stochastique modélise la marge de fluctuation attendue de la performance du test si l’expérimentation diagnostique était répétée sur une infinité d’échantillons cliniques indépendants extraits de la même population cible.
Le premier impératif inférentiel réside dans l’examen critique de la borne inférieure de cet intervalle de confiance. Même si l’estimation ponctuelle de l’AUC semble encourageante (par exemple 0,72) et que la valeur p s’avère inférieure au seuil alpha conventionnel, si la borne inférieure de l’intervalle de confiance vient flirter avec la valeur critique de 0,50 ou l’inclut (par exemple IC à 95 % [0,49 ; 0,85]), le chercheur ne peut affirmer avec une certitude statistique standard que le test dépasse le hasard pur. Une telle situation reflète presque systématiquement un manque criant de puissance statistique attribuable à un effectif restreint au sein de l’un des sous-groupes diagnostiques analysés.
De surcroît, l’amplitude absolue de l’intervalle de confiance (calculée comme la différence arithmétique entre la borne supérieure et la borne inférieure) offre une lecture directe de la précision de la mesure psychométrique. Un intervalle très étroit (ex. IC à 95 % [0,86 ; 0,91]) garantit une estimation robuste et une reproductibilité élevée du pouvoir discriminant de l’échelle à travers différentes cohortes. En revanche, un intervalle excessivement dilaté (ex. IC à 95 % [0,62 ; 0,89]) témoigne d’une grande instabilité distributionnelle, imposant la plus grande réserve quant à l’extrapolation de seuils cliniques précis et nécessitant le recrutement de participants additionnels pour fiabiliser la décision diagnostique.
8. Identification et sélection des seuils optimaux (Cut-off Points)
8.1 Exploitation de la table des coordonnées de la courbe dans SPSS
L’analyse de l’AUC confirme si l’instrument psychométrique possède ou non la capacité de discriminer les groupes cliniques, mais elle ne dit pas encore à quel endroit précis de l’échelle le praticien doit placer la frontière diagnostique pour prendre une décision thérapeutique. C’est ici qu’intervient la table des coordonnées de la courbe générée par SPSS (intitulée Coordinates of the Curve). Ce tableau volumineux et détaillé représente la transcription numérique intégrale de chaque nœud du tracé géométrique.
La première colonne de cette table, intitulée Seuil de coupure positif (Positive if Greater Than or Equal To), énumère une suite continue de valeurs seuils potentielles. Il est capital de comprendre la logique algorithmique de SPSS à cet égard : le logiciel ne reporte pas simplement les scores bruts observables, mais calcule systématiquement la moyenne arithmétique située à mi-chemin entre deux scores observés consécutifs dans la base de données. Ainsi, si les scores bruts successifs de patients au sein d’une échelle sont de 14 et 15 points, SPSS affichera un seuil de coupure positionné à 14,50 points. L’analyste interprète ce seuil continu sous une forme clinique discrète immédiate : assigner un cut-off à 14,50 signifie dans la pratique que tout patient obtenant un score brut supérieur ou égal à 15 est classifié dans la catégorie clinique positive.
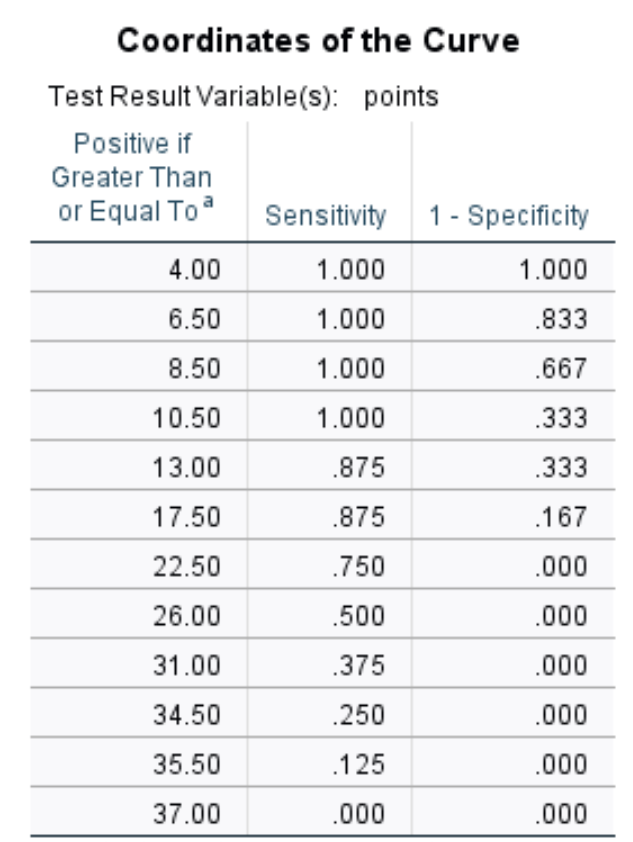
Les colonnes adjacentes fournissent respectivement la Sensibilité exacte et le taux de faux positifs, intitulé sous SPSS 1 – Spécificité, attachés à chacun de ces seuils de score successifs. La lecture conjointe de ces colonnes permet d’observer concrètement la dynamique d’arbitrage (trade-off) : au sommet de la table, les seuils très bas s’accompagnent d’une sensibilité unitaire (1,000) mais d’une spécificité désastreuse (1 – spécificité approchant 1,000). Au fil de la descente vers les seuils élevés, la spécificité s’améliore progressivement (1 – spécificité tendant vers 0,000) au détriment direct de la sensibilité qui s’étiole. Pour exploiter cette matrice volumineuse et identifier rationnellement le point d’équilibre optimal, l’analyste procède fréquemment à l’exportation de cette table vers un tableur ou mobilise une syntaxe dédiée afin d’appliquer des critères mathématiques formels.
8.2 Calcul et application de l’indice de Youden (J)
Parmi les critères algorithmiques développés pour isoler le seuil de coupure optimal d’une échelle diagnostique, l’indice de Youden (noté J), formulé initialement par le biostatisticien W.J. Youden en 1950, demeure le standard méthodologique le plus largement sollicité en psychopathologie et en médecine clinique. Cet indice formalise l’optimisation conjointe et simultanée des deux composantes fondamentales de la matrice de confusion, sans assigner a priori de pondération asymétrique à l’une ou l’autre. L’équation formelle de la statistique J se définit comme suit :
J = Sensibilité + Spécificité – 1
Dans la mesure où la table des coordonnées de SPSS fournit la colonne (1 – Spécificité), le calcul computationnel se simplifie sous la forme arithmétique directe :
J = Sensibilité – (1 – Spécificité)
L’indice de Youden oscille sur une échelle variant théoriquement de -1 à +1, bien que seules les valeurs positives supérieures à 0 présentent un sens clinique. Un test dénué de tout pouvoir discriminant (situé le long de la diagonale de référence où sensibilité = 1 – spécificité) génère un indice de Youden de 0, tandis qu’un test parfait (sensibilité de 1,0 et spécificité de 1,0) atteint la valeur maximale de 1,0.
Sur le plan géométrique, l’indice de Youden maximal (J_max) correspond rigoureusement au point de la trajectoire ROC qui se situe à la plus grande distance verticale perpendiculaire par rapport à la bissectrice de référence à 45 degrés. En important les colonnes de la table des coordonnées de SPSS dans Microsoft Excel ou en programmant une brève routine dans SPSS Syntax, l’analyste crée une nouvelle colonne calculant Sensibilité - [1 - Spécificité] pour chaque ligne. Le seuil de score associé à la valeur la plus élevée de cette différence constitue le seuil optimal de Youden. Ce point de coupure représente l’exact barycentre opérationnel où l’instrument psychométrique maximise son efficacité diagnostique globale en réduisant au strict minimum arithmétique la somme conjointe des faux positifs et des faux négatifs.
8.3 Critères alternatifs basés sur les conséquences cliniques
Si l’indice de Youden s’avère idéal sur le plan purement mathématique, son application aveugle en recherche psychologique peut soulever des dilemmes déontologiques et cliniques majeurs. L’indice de Youden postule implicitement deux axiomes épidémiologiques souvent contestables sur le terrain : il présume d’une part que la prévalence du trouble est d’exactement 50 %, et d’autre part qu’un résultat faux négatif entraîne des conséquences humaines et sanitaires d’une gravité parfaitement équivalente à celles d’un résultat faux positif. Or, dans la réalité clinique quotidienne, ces deux postulats sont rarement vérifiés.
Considérons l’évaluation du risque suicidaire imminent ou le dépistage d’une pathologie neurodégénérative précoce : commettre une erreur de type faux négatif (laisser repartir un patient suicidaire sans intervention hospitalière sous prétexte que son score au test est inférieur au seuil) engendre des répercussions létales irréparables. En revanche, générer un faux positif (orienter un patient en crise passagère vers un examen psychiatrique approfondi où l’absence de plan létal sera rapidement documentée) induit un coût logistique et un stress transitoire, mais préserve la vie humaine. Dans un tel paradigme d’urgence vitale, l’analyste délaisse l’indice de Youden standard au profit d’un seuil asymétrique calibré sur une exigence de sensibilité minimale inviolable (par exemple, sélectionner impérativement dans la table SPSS le seuil garantissant au moins 95 % ou 98 % de sensibilité), acceptant sciemment une dégradation de la spécificité pour comprimer le risque de faux négatifs.
À l’inverse, dans le cas d’affections chroniques pour lesquelles un diagnostic clinique erroné expose le sujet à une pharmacothérapie lourde aux effets indésirables majeurs, ou lorsque le dépistage vise l’inclusion dans des protocoles de neurochirurgie expérimentale hautement invasifs, c’est la protection de la spécificité qui devient l’impératif éthique cardinal. L’investigateur privilégiera alors un cut-off garantissant une spécificité supérieure à 90 % ou 95 % pour écarter tout risque de fausse identification positive.
Un autre critère géométrique fréquemment utilisé est celui de la distance euclidienne minimale au point idéal (0, 1), noté d. Ce critère calcule la distance séparant chaque point de la courbe de l’angle supérieur gauche parfait :
d = √[ (1 – Sensibilité)² + (1 – Spécificité)² ]
Le seuil minimisant cette fonction quadratique identifie la coordonnée la plus proche du profil idéal, offrant une alternative élégante à l’indice de Youden, particulièrement lorsque la courbe présente des asymétries morphologiques marquées.
9. Évaluation comparative de multiples prédicteurs et modèles sous SPSS
9.1 Superposition de plusieurs échelles sur un même graphique
L’un des avantages les plus remarquables du module ROC d’IBM SPSS Statistics réside dans sa capacité à traiter simultanément plusieurs variables quantitatives continues face à une variable d’état unique. Cette fonctionnalité s’avère particulièrement utile dans les projets de recherche translationnelle visant à benchmarker ou comparer directement la pertinence de plusieurs échelles psychométriques administrées à une même cohorte de recherche (par exemple, comparer l’efficacité diagnostique conjointe du Beck Depression Inventory (BDI-II), du Hamilton Depression Rating Scale (HDRS) et du Patient Health Questionnaire (PHQ-9)).
Pour exécuter cette confrontation multi-prédicteurs, l’analyste sélectionne l’ensemble des variables de test candidates et les glisse collectivement au sein du champ Variable(s) de test dans la boîte de dialogue principale de la courbe ROC. Lors de l’exécution, le moteur graphique de SPSS compile et projette sur un plan cartésien unique les différentes trajectoires ROC, en leur attribuant des codes chromatiques ou des motifs de tracé distincts. Cette mise en regard graphique permet une première évaluation visuelle synthétique : la courbe qui domine structurellement les autres en se maintenant systématiquement plus proche de l’angle supérieur gauche manifeste une supériorité diagnostique à travers la quasi-totalité de l’éventail des seuils cliniques.
Parallèlement au tracé superposé, SPSS génère un tableau récapitulatif unifié de l’aire sous la courbe (Area Under the Curve) présentant une synthèse tabulaire comparative. Chaque prédicteur y dispose de sa propre estimation ponctuelle d’AUC, de son erreur standard dédiée, de sa p-valeur de rejet de l’hypothèse nulle et de son intervalle de confiance à 95 %. Cette sortie intégrée permet au chercheur d’apprécier d’un simple regard la hiérarchie métrologique des instruments étudiés.
9.2 Comparaison statistique de deux AUC dépendantes
L’observation d’un écart arithmétique entre les AUC de deux échelles psychométriques concurrentes au sein du tableau descriptif de SPSS (par exemple une AUC de 0,84 pour l’échelle A contre 0,78 pour l’échelle B) ne permet pas de conclure formellement à la supériorité statistique de la première. Dans la mesure où les deux instruments ont été administrés aux mêmes sujets cliniques de la cohorte, les estimations des deux AUC ne sont pas indépendantes : elles sont intrinsèquement corrélées et appariées. Pour tester si la différence observée entre ces deux grandeurs est statistiquement significative, il est obligatoire de recourir à un test d’hypothèse pour échantillons appariés, dont le standard méthodologique international est le test non paramétrique de DeLong (DeLong et al., 1988).
À ce niveau de l’analyse, l’investigateur doit faire face à une limitation historique du module de base de la commande ROC sous SPSS : le logiciel génère bien les estimations ponctuelles et les intervalles de chaque prédicteur individuel, mais il n’exécute pas par défaut le calcul de la matrice de covariance requise pour comparer statistiquement deux AUC corrélées au sein d’un tableau comparatif formel. Pour contourner cette limite intrinsèque sans quitter l’écosystème logiciel SPSS, plusieurs solutions techniques rigoureuses sont à la disposition du statisticien :
- L’intégration de la macro de DeLong : Il est possible d’importer et d’exécuter un script matriciel SPSS (syntaxe utilisant le processeur
MATRIX ... END MATRIX) codant explicitement l’algorithme de DeLong pour échantillons dépendants, produisant la statistique Z et la p-valeur exacte de la différence d’AUC. - Le recours à l’extension R ou Python pour SPSS : Grâce au menu d’extensions d’IBM SPSS (Integration Plug-in for R), les chercheurs peuvent exécuter directement le paquet hautement certifié
pROCau départ de la syntaxe SPSS pour automatiser les tests de DeLong ou de bootstrap appariés. - La modélisation par régression logistique comparative : L’analyste ajuste deux modèles de régression logistique emboîtés (le premier modèle intégrant uniquement l’échelle A, le second combinant les échelles A et B) et compare la déviance globale via le test du rapport de vraisemblance (Likelihood Ratio Test).
Le recours à ces méthodes prévient la surinterprétation des écarts marginaux de performance entre outils psychométriques et garantit une justification statistique rigoureuse avant de recommander l’adoption d’un instrument plutôt qu’un autre.
9.3 Validation incrémentielle de biomarqueurs et scores composites
L’une des frontières les plus actives de la recherche clinique moderne concerne la validation incrémentielle : un nouveau biomarqueur (génétique, neuro-imagerie, marqueur salivaire de cortisol) ou une nouvelle échelle psychométrique sophistiquée apportent-ils une valeur ajoutée discriminante statistiquement significative par rapport aux outils d’évaluation clinique et sociodémographique existants ? L’analyse ROC multivariée constitue l’instrument d’évaluation préférentiel pour tester cette question fondamentale de l’utilité clinique marginale.
La démarche méthodologique procède par modélisation séquentielle emboîtée. Le chercheur ajuste dans un premier temps un modèle de régression logistique binaire standard (Modèle 1) regroupant les prédicteurs cliniques de routine (tels que l’âge du sujet, le niveau de sévérité initial et un questionnaire court de dépistage). Les probabilités prédites issues de ce premier modèle sont sauvegardées et injectées dans la procédure ROC de SPSS, fournissant l’AUC de référence (notée AUC_base). Dans un second temps, le chercheur estime un modèle enrichi (Modèle 2) qui incorpore l’ensemble des prédicteurs précédents ainsi que le nouveau biomarqueur candidat. Les nouvelles probabilités prédites sont également soumises à l’analyse ROC sous SPSS pour dégager une seconde aire (notée AUC_enrichie).
Le gain incrémentiel apporté par le nouveau marqueur se matérialise par le différentiel d’aire sous la courbe :
ΔAUC = AUC_enrichie – AUC_base
Une augmentation statistiquement significative de cette aire confirme la pertinence diagnostique du nouveau biomarqueur. Néanmoins, l’investigateur doit impérativement se prémunir contre le risque de surapprentissage ou surajustement statistique (overfitting). En intégrant un nombre excessif de prédicteurs au sein d’un modèle logistique évalué sur le même échantillon, le modèle a tendance à modéliser le bruit aléatoire propre à la cohorte, ce qui produit une AUC artificiellement gonflée qui s’effondrerait lors de l’application à de nouveaux patients. L’implémentation de procédures de validation croisée (par exemple la validation croisée en k-blocs ou le rééchantillonnage par bootstrap) est indispensable pour attester de la robustesse externe du gain incrémentiel avant toute dissémination clinique.
10. Diagnostic psychologique : Application clinique détaillée à partir d’un cas pratique
10.1 Présentation du cas clinique d’étude
Afin d’ancrer de manière pragmatique l’ensemble des concepts théoriques développés jusqu’ici, examinons un cas pratique issu d’une étude d’épidémiologie clinique universitaire. Une équipe de psychologues cliniciens attachée à un service universitaire de santé mentale souhaite implémenter un protocole d’orientation diagnostique pour le dépistage de l’Épisode Dépressif Caractérisé (EDC) chez les étudiants de premier cycle. Face aux contraintes de temps des consultations de première ligne, l’équipe cherche à comparer la performance discriminante de deux échelles psychométriques majeures et à déterminer le cut-off optimal à appliquer.
L’échantillon d’étude réunit N = 320 étudiants ayant consenti à participer à une évaluation psychiatrique approfondie. Le critère diagnostique de référence (l’étalon-or) repose sur l’administration de l’entrevue diagnostique standardisée MINI (Mini-International Neuropsychiatric Interview) conduite en aveugle par des psychiatres universitaires chevronnés. Les résultats sont enregistrés dans la variable d’état binaire intitulée Diagnostic_MINI, rigoureusement codée 0 = Absent (n = 248 étudiants indemnes) et 1 = Présent (n = 72 étudiants remplissant formellement l’ensemble des critères nosographiques d’un épisode dépressif caractérisé, soit une prévalence d’échantillon de 22,5 %).
Chaque participant a préalablement complété deux auto-questionnaires validés : l’inventaire de dépression de Beck révisé (variable continue Score_BDIII, variant théoriquement de 0 à 63 points) et l’échelle Patient Health Questionnaire en neuf items (variable continue Score_PHQ9, variant théoriquement de 0 à 27 points). Les données brutes ont été vérifiées, nettoyées de toute valeur aberrante et structurées sous SPSS pour exécuter une analyse ROC comparative multivariée pas-à-pas.
10.2 Exécution logicielle et sortie des résultats SPSS
Pour exécuter l’analyse sous IBM SPSS Statistics, le protocole suivant est paramétré dans la boîte de dialogue de la courbe ROC :
- Transfert concomitant des variables
Score_BDIIIetScore_PHQ9dans la zone Variable(s) de test. - Assignation de
Diagnostic_MINIdans le champ Variable d’état, avec spécification explicite de la valeur 1 comme événement cible positif. - Activation des options d’affichage : Courbe ROC (avec ligne diagonale), Erreur standard et intervalle de confiance, et Coordonnées de la courbe ROC.
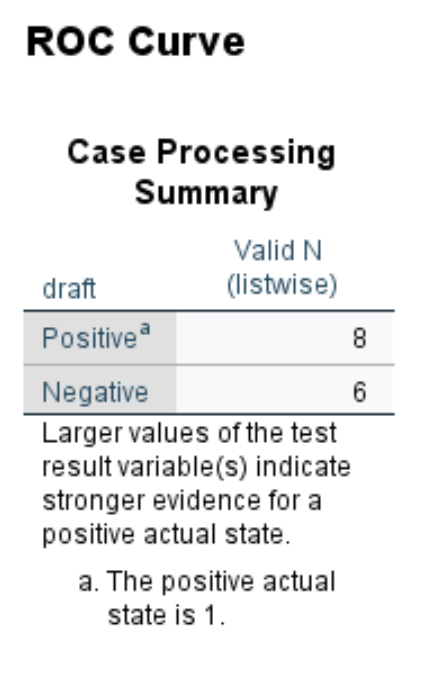
L’exécution de la syntaxe génère les sorties graphiques et tabulaires reproduites synthétiquement ci-dessous. Le visualiseur présente d’abord le tableau récapitulatif des effectifs valides, confirmant le traitement complet de 72 cas positifs réels et 248 cas négatifs réels, sans aucune exclusion liée à des valeurs manquantes.
Sur le plan graphique, les deux courbes ROC se déploient amplement dans le triangle supérieur gauche, bien au-dessus de la ligne diagonale de chance à 45 degrés, signalant d’emblée une remarquable aptitude discriminante pour les deux instruments psychométriques. Néanmoins, la courbe matérialisant le score BDI-II enveloppe presque intégralement celle du PHQ-9, démontrant visuellement une convexité supérieure.
L’examen du tableau quantitatif Aire sous la courbe (Area Under the Curve) fournit les métriques inférentielles de référence :
- Pour le BDI-II : L’aire sous la courbe estimée s’élève à AUC = 0,894 (Erreur standard asymptotique = 0,021 ; Signification asymptotique p < 0,001 ; Intervalle de confiance asymptotique à 95 % : [0,853 ; 0,935]).
- Pour le PHQ-9 : L’aire sous la courbe ressort à AUC = 0,841 (Erreur standard asymptotique = 0,026 ; Signification asymptotique p < 0,001 ; Intervalle de confiance asymptotique à 95 % : [0,789 ; 0,892]).
Ces données attestent que les deux instruments démontrent un pouvoir de séparation diagnostique statistiquement très significatif face au diagnostic psychiatrique MINI de référence. Conformément à la grille d’interprétation méthodologique standard, le PHQ-9 présente une discrimination « excellente » (AUC comprise entre 0,80 et 0,90), tandis que le BDI-II approche les confins d’une discrimination « exceptionnelle » avec une AUC de près de 0,90.
10.3 Résolution décisionnelle et choix du cut-off en contexte universitaire
Pour déterminer le seuil opérationnel à adopter dans le centre de santé universitaire, l’équipe examine la table des coordonnées de la courbe issue de la sortie SPSS pour l’inventaire BDI-II. L’objectif est d’extraire la valeur de score brute qui optimise le dépistage des étudiants en souffrance psychique sans surcharger de manière intenable les capacités de consultation de l’équipe clinique.
L’extraction des coordonnées pour les seuils intermédiaires du BDI-II restitue la matrice computationnelle suivante :
- Seuil SPSS à 13,50 points (équivalent à un score brut BDI-II ≥ 14) : Sensibilité = 0,917 ; 1 – Spécificité = 0,226 (soit une spécificité de 0,774). L’indice de Youden s’établit à : J = 0,917 + 0,774 – 1 = 0,691.
- Seuil SPSS à 15,50 points (équivalent à un score brut BDI-II ≥ 16) : Sensibilité = 0,861 ; 1 – Spécificité = 0,141 (soit une spécificité de 0,859). L’indice de Youden atteint : J = 0,861 + 0,859 – 1 = 0,720.
- Seuil SPSS à 17,50 points (équivalent à un score brut BDI-II ≥ 18) : Sensibilité = 0,778 ; 1 – Spécificité = 0,085 (soit une spécificité de 0,915). L’indice de Youden redescend à : J = 0,778 + 0,915 – 1 = 0,693.
L’application formelle de l’algorithme d’optimisation de Youden désigne sans ambiguïté le seuil brut BDI-II ≥ 16 comme le cut-off mathématiquement optimal (J_max = 0,720). À ce niveau de coupure, l’instrument capture 86,1 % des étudiants véritablement dépressifs tout en conservant une spécificité respectable de 85,9 % chez les sujets indemnes.
Cependant, l’analyse contextuelle de la santé publique universitaire enrichit cette décision : si le centre de consultation utilise le BDI-II non pas comme outil de confirmation définitive mais comme premier filtre de dépistage systématique en ligne invitant les étudiants à risque à un entretien d’évaluation gratuit, l’équipe peut décider d’abaisser délibérément le seuil clinique au score BDI-II ≥ 14. Ce choix stratégique privilégie la sensibilité (91,7 %), réduisant drastiquement le nombre d’étudiants dépressifs ignorés (taux de faux négatifs comprimé à seulement 8,3 %), tout en tolérant un volume acceptable de faux positifs (22,6 %) qui seront rapidement réorientés à l’issue de l’entretien clinique initial. Cette mise en œuvre illustre la manière dont l’analyse ROC sous SPSS articule la modélisation mathématique et l’éthique de la décision en santé mentale.
11. Erreurs courantes, limites méthodologiques et biais d’interprétation
11.1 Mauvaise définition de la valeur d’état positive
Parmi les anomalies analytiques les plus régulièrement observées lors de l’apprentissage de la modélisation ROC sous SPSS, l’erreur de paramétrage de la valeur d’état positive figure au premier rang des confusions techniques. Comme documenté dans la section 5.1, le champ Valeur de la variable d’état exige de l’utilisateur qu’il stipule explicitement le code numérique correspondant à l’événement clinique que le test est censé prédire. Une inversion inopinée—consistant par exemple à renseigner le chiffre 0 (qui code pour le statut de témoin sain dans le fichier de données) au lieu de 1—entraîne un basculement complet de la matrice de confusion algorithmique.
Dans une telle configuration, SPSS considère que la condition positive d’intérêt est l’état de santé, et évalue l’aptitude de l’échelle à détecter les sujets sains par des scores élevés de pathologie. Graphiquement, la courbe ROC s’affaisse immédiatement sous la bissectrice de référence à 45 degrés, décrivant une trajectoire inversée dans le triangle inférieur droit. L’aire sous la courbe (AUC) plonge quant à elle sous le seuil critique de 0,50 (restituant typiquement une valeur telle que 0,11 pour l’exemple précédent du BDI-II), tout en affichant paradoxalement une p-valeur hautement significative.
Cette issue statistique ne signale aucun dysfonctionnement psychométrique intrinsèque de l’échelle d’évaluation, mais reflète purement une anomalie d’attribution sémantique. L’investigateur doit immédiatement corriger le paramétrage dans la boîte de dialogue ou modifier la sous-commande syntaxique BY variable_etat (1) afin de rétablir la bonne polarité, ce qui replace immédiatement la trajectoire dans sa géométrie standard au-dessus de la diagonale.
11.2 Biais d’échantillonnage et spectre diagnostique (Spectrum Bias)
Sur le plan méthodologique, la menace la plus insidieuse pesant sur la validité externe d’une analyse ROC est constituée par le biais d’échantillonnage lié au spectre diagnostique, universellement désigné sous le terme de Spectrum Bias. Cette dérive survient lorsque le chercheur évalue un instrument psychométrique en comparant une cohorte de patients atteints de formes sévères et prototypiques de la pathologie (par exemple, des patients hospitalisés pour un épisode dépressif majeur mélancolique résistant) à un groupe de témoins sains recrutés au sein d’une population exempte de tout antécédent (témoins dits « hyper-normaux »).
Une telle dichotomisation artificielle isole les deux extrémités du spectre clinique, éliminant les cas frontières, les formes comorbides, les présentations d’intensité légère à modérée et les participants manifestant une détresse psychologique générale non spécifique. L’exécution de la procédure ROC sous SPSS au sein d’une telle cohorte bimodale artificielle aboutira mécaniquement à une aire sous la courbe spectaculaire (dépassant fréquemment 0,95) et à une séparation presque parfaite des scores. L’investigateur peu averti conclura avec un optimisme déplacé à l’excellence diagnostique de son questionnaire.
Néanmoins, dès lors que cet instrument est déployé sur un terrain clinique écologique (comme un cabinet de médecine générale ou un service d’accueil en santé mentale), les performances s’effondrent brutalement. Confronté à une population hétérogène où se côtoient des troubles de l’adaptation, des pathologies anxieuses intriquées et des manifestations dépressives subcliniques, le test génère une profusion d’erreurs de classification et de faux positifs. Pour garantir la solidité et l’invariance diagnostique d’une courbe ROC, il est impératif d’échantillonner des cohortes cliniques continues et représentatives du spectre complet des présentations symptomatiques rencontrées dans la pratique de soins quotidienne.
11.3 Confusion entre discrimination, calibration et pertinence clinique
Une erreur épistémologique répandue chez les chercheurs et praticiens formés à la méthode ROC réside dans la surestimation systématique de la portée de l’AUC, conçue à tort comme un indicateur universel et autosuffisant de l’utilité clinique d’un test. Il est indispensable de réaffirmer qu’une AUC élevée ne garantit qu’une seule et unique propriété statistique : la capacité de discrimination, c’est-à-dire l’aptitude de l’instrument à ordonner les paires d’individus selon leur degré relatif de pathologie.
Une échelle psychométrique peut afficher une discrimination excellente (AUC = 0,88) tout en s’avérant totalement défaillante sur le plan de la calibration probabiliste ou inadaptée aux exigences concrètes du déploiement en santé publique. Comme détaillé dans la section 2.3, la performance d’un test dépend de la prévalence du trouble au sein de la population où il est administré. Un instrument diagnostique doté d’une AUC remarquable et d’un cut-off affichant 90 % de sensibilité et 90 % de spécificité conduira à des résultats cliniquement problématiques s’il est appliqué à une affection psychiatrique rare dont la prévalence en population générale s’établit à 1 %. Dans ce scénario épidémiologique concret, la Valeur Prédictive Positive (VPP) ne dépassera guère 8,3 % : plus de neuf personnes identifiées comme positives sur dix seront en réalité de faux positifs, imposant un fardeau diagnostique et anxieux inacceptable.
Pour dépasser ces limites inhérentes à l’approche ROC classique, la recherche translationnelle s’oriente aujourd’hui vers des paradigmes décisionnels complémentaires, tels que l’analyse des courbes de décision (Decision Curve Analysis – DCA) développée initialement par Andrew Vickers. La DCA quantifie le bénéfice net clinique (Net Benefit) apporté par l’adoption d’un modèle diagnostique à travers différents seuils de préférence décisionnelle, en intégrant explicitement les préjudices comparés des faux positifs et des faux négatifs. L’analyse par courbe ROC sous SPSS constitue le socle exploratoire incontournable de la discrimination psychométrique, mais elle doit s’articuler avec les paramètres de prévalence et les impératifs d’utilité clinique pour orienter avec discernement la prise de décision en santé mentale.
12. Rédaction académique et communication des résultats selon les normes de l’APA
12.1 Règles stylistiques et typographiques selon la 7e édition de l’APA
La restitution écrite des résultats d’une analyse ROC au sein d’un manuscrit soumis à une revue scientifique affiliée aux normes de l’American Psychological Association (APA 7e édition) exige une rigueur typographique et stylistique stricte. Les symboles statistiques alphabétiques latins doivent être systématiquement composés en caractères italiques (notamment p pour la valeur de signification, N pour l’échantillon total, n pour les sous-effectifs de groupe, d pour la taille d’effet ou la distance, et Z pour la statistique de test). En revanche, les abréviations composées de plusieurs lettres ou acronymes usuels, à l’image de AUC (ou ASC), IC (pour Intervalle de Confiance) ou VPP/VPN, demeurent rigoureusement composées en caractères romains droits.
La rédaction de la section des résultats doit formuler explicitement l’ensemble des métriques inférentielles générées par SPSS : la valeur ponctuelle de l’aire sous la courbe, l’erreur type, les bornes exactes de l’intervalle de confiance à 95 %, ainsi que la valeur p précise (il convient de privilégier des valeurs exactes telles que p = ,003 plutôt que des inégalités génériques, sauf si la valeur descend sous le seuil d’arrondi logiciel standard auquel cas la notation normalisée devient p < ,001). Conformément aux normes typographiques de l’APA pour les nombres compris mathématiquement entre 0 et 1 (qui ne peuvent jamais excéder l’unité unitaire, comme les proportions, corrélations et probabilités), le zéro initial placé avant la virgule ou le point décimal doit être omis en langue anglaise (ex. p < .001, AUC = .89), tandis que l’usage académique francophone tolère l’insertion du zéro décimal (ex. p < 0,001 ; AUC = 0,89).
Voici un gabarit d’intégration textuelle académique formelle pour un résultat statistiquement significatif :
« Une analyse par courbe ROC a été conduite sous IBM SPSS Statistics pour évaluer le pouvoir discriminant de l’inventaire BDI-II dans l’identification des épisodes dépressifs caractérisés validés par le MINI. L’aire sous la courbe s’est avérée statistiquement significative et d’un niveau d’efficacité excellent, AUC = 0,894, Erreur Type = 0,021, p < 0,001, IC à 95 % [0,853 ; 0,935]. L’optimisation conjointe via l’indice de Youden maximal (J = 0,720) a permis d’isoler un seuil diagnostique optimal situé à BDI-II ≥ 16, conférant une sensibilité de 86,1 % et une spécificité de 85,9 %. »
À l’opposé, dans l’éventualité d’un résultat non significatif où l’outil psychométrique échoue à discriminer la pathologie, la formulation textuelle standard s’énonce comme suit :
« L’analyse par courbe ROC n’a pas permis de mettre en évidence un pouvoir de discrimination statistiquement significatif pour l’échelle cognitive évaluée, AUC = 0,542, Erreur Type = 0,048, p = ,384, IC à 95 % [0,448 ; 0,636]. La borne inférieure de l’intervalle de confiance englobant le seuil de chance de 0,50, l’instrument ne permet pas d’ordonner de manière recevable les participants selon leur état clinique de référence. »
12.2 Conception et exportation de figures conformes aux exigences d’édition
Le graphique généré par défaut dans le visualiseur de sorties d’IBM SPSS Statistics ne remplit pas immédiatement les exigences graphiques rigoureuses imposées par les périodiques scientifiques internationaux de rang A. Le fond grisé par défaut, la présence de quadrillages denses (gridlines), l’épaisseur parfois insuffisante des lignes de tracé et la taille réduite des polices de caractères nuisent à la lisibilité et imposent une étape de post-traitement dans l’éditeur de graphiques de SPSS (accessible par un double-clic direct sur la figure).
Pour mettre le graphique en conformité avec les standards esthétiques de l’APA :
- Suppression du fond et du quadrillage : Il convient d’éliminer la couleur d’arrière-plan afin d’obtenir un fond blanc pur neutre, et de désactiver les lignes de grille horizontales et verticales qui encombrent l’espace visuel.
- Personnalisation des tracés : La courbe ROC de l’instrument évalué doit être configurée avec un trait plein d’une épaisseur substantielle (au moins 1,5 à 2 points), de couleur noire ou contrastée. La ligne diagonale de référence à 45 degrés doit impérativement être formatée sous la forme d’un trait discontinu (tirets ou pointillés) d’épaisseur plus fine, permettant une distinction visuelle immédiate entre les données empiriques et le repère théorique de chance.
- Standardisation typographique : Les intitulés des axes X et Y doivent être réécrits de façon limpide (Axe Y : Sensibilité ; Axe X : 1 – Spécificité), en adoptant une police sans empattement universelle (comme Arial ou Helvetica) d’une taille garantissant la lisibilité lors d’une réduction de format (taille 10 à 12 points minimum).
- Gestion des légendes : En cas de comparaison multi-prédicteurs, la légende explicative doit être positionnée à l’intérieur de l’espace graphique (par exemple dans le coin inférieur droit libre) ou sous la figure, en évitant tout chevauchement avec les courbes expérimentales.
Lors de l’exportation finale depuis SPSS (accessible par clic droit > Exporter ou via le menu fichier), le chercheur doit proscrire les formats de compression avec perte d’information (tels que le JPEG à basse résolution). Les standards d’édition exigent des formats matriciels haute résolution à compression sans perte (TIFF à 300 ou 600 DPI minimum) ou, idéalement, des formats vectoriels préservant une netteté absolue quelle que soit l’échelle d’agrandissement (formats PDF, EPS ou EMF). Cette rigueur technique garantit une restitution visuelle optimale lors de la publication définitive de l’article de recherche.
12.3 Tableaux récapitulatifs des seuils diagnostiques
Lorsque la portée d’une recherche clinique implique l’orientation des praticiens vers le choix de valeurs de coupure différenciées selon les contextes de soins, la simple mention textuelle du seuil optimal de Youden s’avère insuffisante. Les normes de l’APA préconisent l’agencement d’un tableau synthétique exhaustif rassemblant l’éventail des seuils pertinents et consignant l’ensemble des métriques de classification dérivées, permettant au lecteur de sélectionner le compromis clinique répondant à ses propres contraintes opérationnelles.
Un tableau APA rigoureux se conforme à des directives de mise en page strictes : il ne comporte aucune bordure verticale, limitant son cloisonnement à trois bordures horizontales horizontales maîtresses (une sous le titre de tableau, une délimitant la ligne d’en-tête des colonnes, et une fermant le corps du tableau au-dessus des notes de bas de page). L’alignement numérique doit être standardisé sur la droite ou centré sur la virgule décimale.
Le tableau ci-dessous illustre l’agencement normalisé d’un récapitulatif des performances diagnostiques du BDI-II extrait d’une analyse ROC :
| Seuil brut (BDI-II) | Sensibilité [IC 95 %] | Spécificité [IC 95 %] | VPP (%) | VPN (%) | Indice de Youden (J) |
|---|---|---|---|---|---|
| ≥ 12 | 0,958 [0,883 ; 0,991] | 0,681 [0,620 ; 0,739] | 46,6 | 98,3 | 0,639 |
| ≥ 14 | 0,917 [0,827 ; 0,969] | 0,774 [0,717 ; 0,824] | 54,1 | 97,0 | 0,691 |
| ≥ 16 * | 0,861 [0,759 ; 0,931] | 0,859 [0,809 ; 0,899] | 64,0 | 95,5 | 0,720 |
| ≥ 18 | 0,778 [0,665 ; 0,867] | 0,915 [0,873 ; 0,947] | 72,7 | 93,4 | 0,693 |
| ≥ 20 | 0,681 [0,560 ; 0,786] | 0,952 [0,917 ; 0,975] | 80,3 | 91,1 | 0,633 |
Note. N = 320 participants (72 cas confirmés par le MINI, 248 témoins indemnes). BDI-II = Beck Depression Inventory-II ; VPP = Valeur Prédictive Positive ; VPN = Valeur Prédictive Négative ; IC 95 % = Intervalle de confiance exact binomial à 95 %. L’indice de Youden est calculé selon la formule J = Sensibilité + Spécificité – 1. L’astérisque (*) identifie le seuil de coupure optimal identifié par l’indice de Youden maximal.
L’insertion de telles tables normalisées, associant des intervalles de confiance aux paramètres ponctuels et détaillant rigoureusement la méthodologie de sélection, confère à la recherche publiée une transparence métrologique absolue, permettant à la communauté scientifique et aux cliniciens de terrain d’exploiter les conclusions empiriques avec une fiabilité optimale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation. https://www.pearsonassessments.com
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- IBM Corporation. (2021). IBM SPSS Statistics 28 Brief Guide. IBM Corp. https://www.ibm.com/docs/en/spss-statistics
- Kroenke, K., Spitzer, R. L., & Williams, J. B. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J. C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- Sheehan, D. V., Lecrubier, Y., Sheehan, K. H., Amorim, P., Janavs, J., Weiller, E., Hergueta, T., Baker, R., & Dunbar, G. C. (1998). The Mini-International Neuropsychiatric Interview (M.I.N.I.): The development and validation of a structured diagnostic psychiatric interview for DSM-IV and ICD-10. Journal of Clinical Psychiatry, 59(Suppl 20), 22–33. https://pubmed.ncbi.nlm.nih.gov/9881538/
- Swets, J. A. (1988). Measuring the accuracy of diagnostic systems. Science, 240(4857), 1285–1293. https://doi.org/10.1126/science.3287615
- Vickers, A. J., & Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565–574. https://doi.org/10.1177/0272989X06295361
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32–35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.CO;2-3″>https://doi.org/10.1002/1097-0142(1950)3:1<32::AID-CNCR2820030106>3.0.CO;2-3
- Zweig, M. H., & Campbell, G. (1993). Receiver-operating characteristic (ROC) plots: A fundamental evaluation tool in clinical medicine. Clinical Chemistry, 39(4), 561–577. https://doi.org/10.1093/clinchem/39.4.561