
Dans le paysage contemporain de l’analyse de données et de la statistique inférentielle, la tentation est grande de se tourner immédiatement vers des modélisations complexes, des algorithmes d’apprentissage automatique ou des représentations graphiques hautement synthétiques. Pourtant, l’essence d’une investigation scientifique rigoureuse repose d’abord et avant tout sur une prise de contact directe, intime et sans distorsion avec la matière empirique brute. L’analyse exploratoire des données, conceptualisée pour pallier les écueils d’une dépendance aveugle aux métriques réductrices que sont la moyenne ou l’écart-type, a mis en lumière des outils d’une puissance insoupçonnée. Parmi ces dispositifs sémiotiques et numériques, le diagramme tige-et-feuille (ou stem-and-leaf display) occupe une place singulière, alliant l’évidence visuelle d’un histogramme à la conservation intégrale de chaque point d’observation individuel.
Lorsque la recherche scientifique exige non plus seulement l’analyse d’un groupe isolé, mais la confrontation directe et synoptique de deux distributions indépendantes ou appariées, le diagramme tige-et-feuille dos-à-dos (ou bilatéral) s’impose comme une méthodologie d’une exceptionnelle pertinence. En partageant un tronc central unique sur lequel viennent s’adosser de part et d’autre les feuilles représentatives de deux cohortes distinctes, cette représentation semi-graphique permet d’observer simultanément les variations de forme, les décalages de tendance centrale, les contrastes de dispersion et l’émergence d’éventuelles valeurs aberrantes. Que ce soit en psychologie cognitive, en neuropsychologie clinique, en épidémiologie ou en sciences de l’éducation, le tracé bilatéral offre une granularité analytique que les boîtes à moustaches ou les diagrammes à barres échouent souvent à restituer avec autant de fidélité.
Ce guide exhaustif a pour vocation d’exposer de manière magistrale et pratique les fondements théoriques, les protocoles opératoires de construction manuelle, les ajustements structurels avancés et les modalités d’interprétation critique du diagramme tige-et-feuille dos-à-dos. En abordant pas à pas les contraintes typographiques, les raffinements mathématiques de scission des tiges, ainsi que les scripts d’automatisation sous les environnements de calcul statistique modernes, cet ouvrage de référence accompagnera les chercheurs, analystes et étudiants exigeants vers une maîtrise parfaite de cet outil fondamental de la statistique exploratoire.
1. Fondements théoriques du diagramme tige-et-feuille simple
1.1 Origine historique et principes de l’analyse exploratoire des données
L’émergence du diagramme tige-et-feuille s’inscrit au cœur d’une véritable révolution épistémologique menée durant la seconde moitié du vingtième siècle par le statisticien américain John Wilder Tukey. Dans son ouvrage pionnier paru en 1977, intitulé Exploratory Data Analysis, Tukey s’est insurgé contre l’hégémonie quasi exclusive de la statistique confirmatoire, laquelle postule a priori des modèles probabilistes rigides et contraint l’expérimentateur à tester des hypothèses formelles avant même d’avoir inspecté la morphologie intrinsèque de ses mesures. Pour Tukey, l’analyste doit avant tout se comporter en détective : il doit observer la texture des faits numériques bruts, débusquer les régularités inattendues, traquer les anomalies distributionnelles et laisser les données révéler leur structure propre avant de leur imposer le carcan d’une loi de probabilité paramétrique.
La philosophie de l’analyse exploratoire des données (AED) repose sur le refus catégorique de sacrifier la granularité des données sur l’autel de la synthèse abstraite. Dans les approches traditionnelles, le passage immédiat au calcul d’estimateurs synthétiques — tels que la moyenne arithmétique de Gauss ou la variance de Pearson — tend à oblitérer des caractéristiques fondamentales : la présence d’une seconde bosse traduisant une sous-population non détectée, un étalement asymétrique sévère, ou encore l’existence d’artefacts d’échantillonnage dissimulés dans les queues de distribution. Le diagramme tige-et-feuille est né de cette volonté de préserver l’intégrité numérique absolue de chaque observation au sein même d’un artefact spatial visuel, réconciliant le chiffre brut avec l’appréhension gestaltiste de la forme.
Dans l’histoire des représentations graphiques, le dispositif de Tukey constitue une synthèse remarquable entre les tableaux ordonnés de distribution de fréquences popularisés dès le dix-neuvième siècle par des précurseurs tels qu’Arthur Bowley et les histogrammes continus introduits par Karl Pearson. Là où l’imprimerie et le calcul manuel imposaient autrefois un arbitrage coûteux entre le tableau de chiffres indigeste et le graphique géométrique anonyme, Tukey a démontré qu’en utilisant le chiffre typographique lui-même comme unité de mesure géométrique et spatiale, l’analyste pouvait générer instantanément un histogramme textuel sans rien perdre du contenu informationnel d’origine. Cette économie de moyens et cette densité sémiotique exceptionnelle ont conféré au tracé tige-et-feuille une longévité académique remarquable.
1.2 Anatomie structurelle : définition de la tige et de la feuille
D’un point de vue architectural, le diagramme tige-et-feuille repose sur une règle de segmentation arithmétique élémentaire mais d’une rigueur absolue : la scission positionnelle de chaque valeur quantitative observée en deux entités modulaires distinctes, baptisées respectivement « tige » (stem) et « feuille » (leaf). Cette décomposition s’opère selon un principe de séparation décimale ou positionnelle où la tige recueille les composantes d’ordre supérieur (les chiffres de poids fort), tandis que la feuille est constituée du chiffre immédiatement consécutif d’ordre inférieur (le premier chiffre de poids faible significatif), les éventuelles décimales résiduelles étant tronquées ou arrondies selon un protocole strictement défini.
La tige assume un rôle éminemment structurel et topologique : elle matérialise une classe d’intervalles ordonnés, réguliers et consécutifs le long d’un axe vertical de référence. Chaque valeur de tige symbolise le seuil d’une classe d’équivalence dont l’amplitude est invariablement déterminée par une puissance entière de dix (le plus souvent des dizaines, des centaines ou des unités entières). À l’opposé, la feuille conserve la métrique individuelle : elle représente l’écart résiduel spécifique de chaque observation à l’intérieur de l’intervalle délimité par sa tige. Dès lors, chaque donnée n’est plus représentée par une barre anonyme ou un point abstrait, mais par sa propre valeur numérique résiduelle, ancrée horizontalement à sa tige d’appartenance.
Le fonctionnement cognitif et géométrique du diagramme repose sur un postulat d’isomorphisme spatial strict : chaque chiffre composant une feuille doit impérativement occuper une cellule d’espacement uniforme le long de l’axe horizontal. Cette contrainte impose l’usage systématique de polices à espacement fixe (chasse fixe ou polices à espacement constant) où la largeur d’un zéro est strictement identique à celle d’un un, d’un huit ou d’un espace blanc. Grâce à cette égalité de largeur textuelle, la longueur géométrique totale d’une ligne de feuilles devient rigoureusement proportionnelle au nombre d’observations tombant dans cette tranche d’intervalles. Le dispositif transforme ainsi de manière transparente un agencement typographique en une véritable mesure géométrique de densité de probabilité empirique.
1.3 Avantages métriques par rapport aux histogrammes traditionnels
Bien que l’histogramme classique demeure l’une des figures les plus couramment employées dans les publications empiriques, il souffre d’une tare méthodologique majeure : la perte irréversible de l’information quantique élémentaire. Lorsqu’une série d’observations continues est agrégée au sein de classes de largeur arbitraire (les fameux bins), les valeurs individuelles sont définitivement effacées au profit d’une surface rectangulaire globale. Il devient dès lors rigoureusement impossible, à la simple lecture du graphique, de reconstituer les scores exacts, de détecter des regroupements suspects au sein d’une même classe, ou d’isoler une valeur aberrante nichée au fond d’un rectangle d’apparence anodine.
À l’inverse, le diagramme tige-et-feuille conserve l’intégralité du jeu de données brut sous une forme immédiatement récupérable. Un relecteur ou un évaluateur scientifique confronté à un tel diagramme peut, sans recourir au fichier informatique initial, relire une par une chaque observation numérique, vérifier les calculs d’estimateurs, ou recalculer des statistiques alternatives. Cette traçabilité absolue garantit une transparence scientifique maximale. En outre, la juxtaposition des feuilles réelles permet de discerner des phénomènes de granularité fine — tels que des effets de report d’arrondi ou des préférences pour certains chiffres pairs ou impairs lors de la passation de tests — qui demeurent totalement invisibles sur les représentations lissées traditionnelles.
Sur le plan opérationnel, le diagramme tige-et-feuille facilite un dénombrement manuel direct d’une efficacité redoutable pour les échantillons de petite à moyenne taille (généralement entre vingt et trois cents unités d’observation). Les feuilles étant systématiquement consignées selon un ordre croissant le long de chaque ligne, l’ensemble du jeu de données se retrouve pré-trié de facto. La recherche de la médiane, des quartiles, des déciles, du minimum et du maximum devient une simple opération d’arpentage séquentiel de rang, éliminant tout recours obligatoire aux formules de calcul automatisées. Cette immédiateté cognitive confère à l’outil une puissance pédagogique et diagnostique inégalée pour l’analyste soucieux de contrôler manuellement la vraisemblance de ses distributions empiriques.
2. Concept et spécificités du diagramme tige-et-feuille dos-à-dos
2.1 Définition de l’approche comparative bilatérale
Le diagramme tige-et-feuille dos-à-dos — désigné dans la littérature anglophone sous les vocables de back-to-back stem-and-leaf display ou comparative stem-and-leaf plot — constitue l’extension bivariée naturelle du dispositif univarié de John Tukey. Alors que le tracé simple se limite à l’exploration descriptive d’une cohorte isolée, la configuration dos-à-dos répond à un impératif central de la démarche expérimentale : la comparaison directe, sans intermédiaire et sans artifice, de deux distributions de données mesurées sur une métrique rigoureusement identique. Il s’agit d’une tentative méthodique pour juxtaposer deux réalités empiriques au sein d’un même espace géométrique unifié.
Le principe fondamental de cette architecture réside dans la symétrie bilatérale articulée autour d’une colonne centrale unique. Plutôt que de contraindre le chercheur à faire naviguer son regard d’un graphique à un autre — démarche notoirement faussée par les disparités d’échelles, les décalages d’axes ou les effets d’illusion d’optique inhérents aux graphiques séparés —, le diagramme dos-à-dos contraint les deux jeux de données à s’affronter sur le même champ spatial. Les observations du premier groupe se déploient horizontalement vers la gauche, tandis que les observations du second groupe s’étendent symétriquement vers la droite, toutes deux solidement ancrées sur un même référentiel vertical partagé.
Cette mise en regard directe permet une analyse différentielle d’une acuité exceptionnelle. Le moindre glissement de tendance centrale, l’élargissement asymétrique d’une queue de distribution ou la polarisation exclusive de valeurs aberrantes au sein d’une seule condition sautent immédiatement aux yeux de l’observateur. La confrontation n’est plus médiatisée par des valeurs moyennes abstraites assorties d’intervalles de confiance parfois trompeurs lorsque les conditions d’homos遊asticité ou de normalité sont violées ; elle s’exprime dans la matérialité concrète de deux masses typographiques dont la densité relative est directement observable et mesurable.
2.2 Architecture centrale : le tronc commun partagé
L’élément structurel déterminant du diagramme dos-à-dos est incontestablement son tronc commun central, matérialisé par une colonne verticale unique contenant les valeurs ordonnées des tiges. Ce tronc sert d’ancrage absolu et garantit que les deux populations étudiées sont évaluées à travers le même prisme de quantification. Il est formellement délimité sur le plan visuel par deux lignes de séparation verticales (des barres verticales continues ou des traits d’alignement stricts) qui isolent la colonne centrale des tiges des deux couloirs d’expansion latéraux réservés aux feuilles.
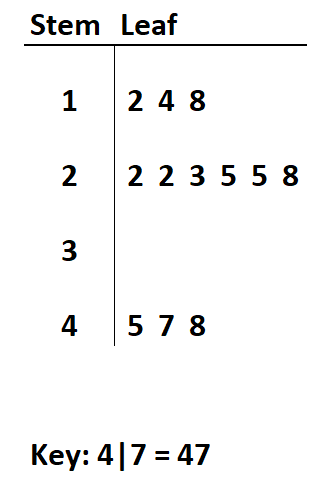
De part et d’autre de cette colonne vertébrale, l’expansion des feuilles obéit à une divergence directionnelle opposée mais géométriquement isomorphe. Sur le flanc droit du diagramme, les feuilles du groupe B se déploient dans le sens de lecture typographique conventionnel, c’est-à-dire de la gauche vers la droite en s’éloignant du tronc. Sur le flanc gauche, réservé au groupe A, les feuilles se déploient dans une direction centrifuge inverse, progressant de la droite vers la gauche à mesure que l’on s’écarte du tronc central. Cette symétrie en miroir assure que la proximité physique avec le tronc central représente systématiquement les valeurs de feuilles les plus faibles pour chaque tige donnée, garantissant ainsi la comparabilité spatiale des deux versants.
Il est impératif, pour préserver la validité de l’échelle d’intervalle, que la colonne centrale des tiges soit absolument continue, sans la moindre rupture de séquence. Même si l’un des groupes — voire les deux simultanément — ne présente aucune observation empirique pour un intervalle donné, la tige correspondante doit impérativement figurer sur le tronc central. L’omission délibérée d’une tige vide dans le but d’économiser de l’espace typographique constituerait une faute méthodologique grave, assimilable à la troncature frauduleuse de l’axe d’un graphique de coordonnées cartésiennes, car elle comprimerait artificiellement les distances géométriques et fausserait irrémédiablement l’appréciation des dispersions et des écarts entre les deux groupes.
2.3 Pertinence méthodologique en recherche psychologique et comportementale
Dans le domaine des sciences psychologiques, comportementales et neuropsychologiques, les données recueillies présentent très fréquemment des propriétés distributionnelles rétives aux idéalisations des statistiques paramétriques classiques : asymétries prononcées des temps de réaction, effets de plancher ou de plafond sur les scores d’échelles d’auto-évaluation, distributions bimodales reflétant la coexistence d’individus symptomatiques et asymptomatiques, ou encore échantillons d’effectifs restreints interdisant le recours serein au théorème central limite. C’est dans ce contexte méthodologique spécifique que le diagramme tige-et-feuille dos-à-dos déploie sa pertinence maximale.
Lors de protocoles expérimentaux comparant un groupe clinique à un groupe témoin sain — par exemple, dans l’évaluation de scores de dépression mesurés via l’échelle de Beck ou d’indices de mémoire épisodique —, le tracé bilatéral offre une lecture diagnostique instantanée. Il permet au clinicien-chercheur de vérifier si la différence statistique observée lors d’un test inférentiel résulte d’un déplacement homogène de l’ensemble des participants du groupe clinique ou si elle est artificiellement tirée vers le haut par une poignée de patients ultra-sévères isolés dans la queue supérieure de distribution. Cette différenciation qualitative entre glissement structural et influence résiduelle d’outliers est au cœur de la validité de construit en psychométrie.
De même, dans les protocoles longitudinaux pré-test et post-test à mesures répétées, le diagramme dos-à-dos offre un moyen élégant de confronter les états distributionnels d’une même cohorte avant et après l’administration d’une intervention thérapeutique ou d’un programme d’entraînement cognitif. Il permet d’apprécier immédiatement les gains différentiels : observe-t-on une réduction de la variance intra-groupe après traitement, traduisant une efficacité généralisée à tous les sujets, ou constate-t-on au contraire une scission de la population en répondeurs et non-répondeurs ? Enfin, la consultation visuelle directe du tracé fournit une base de décision rationnelle et argumentée pour choisir en toute rigueur entre l’application d’un test paramétrique de Student et celle d’une alternative robuste non paramétrique comme le test de Wilcoxon-Mann-Whitney.
3. Préparation et organisation rigoureuse des données bivariées
3.1 Sélection et appariement des distributions d’échantillons
L’élaboration d’un diagramme tige-et-feuille dos-à-dos exige une discipline préparatoire sans faille. La première condition méthodologique sine qua non réside dans la vérification scrupuleuse de l’homogénéité métrique des deux distributions. Les deux séries numériques confrontées doivent impérativement mesurer la même variable opérationnelle, exprimée rigoureusement dans la même unité de mesure physique ou psychométrique. Tenter d’adosser des scores de latence mesurés en millisecondes à des temps mesurés en secondes sans conversion d’échelle préalable, ou comparer des pourcentages de réussite à des scores bruts non normalisés priverait le tronc commun de toute signification logique et conduirait à un contresens interprétatif absolu.
La question des effectifs d’échantillons respectifs constitue un autre enjeu critique. Bien que le diagramme tige-et-feuille dos-à-dos fonctionne parfaitement avec des échantillons de tailles différentes — par exemple un groupe contrôle de quarante individus confronté à un groupe expérimental de soixante sujets —, l’analyste doit garder à l’esprit que la longueur brute des lignes horizontales reflète des effectifs absolus et non des densités relatives. Dès lors, lorsque le ratio d’effectifs entre les deux groupes devient disproportionné (par exemple un ratio supérieur à un contre trois ou un contre quatre), la lecture visuelle directe des densités de probabilité peut être biaisée au détriment du plus petit groupe. L’analyste doit impérativement consigner de manière ostensible les tailles exactes des échantillons dans l’en-tête du diagramme afin de guider le jugement critique du lecteur.
Enfin, la nature expérimentale du design doit être clairement clarifiée dès cette étape préparatoire. S’agit-il de deux groupes totalement indépendants (conception inter-sujets) ou des scores mesurés sur les mêmes sujets à deux moments temporels différents ou sous deux conditions manipulées distinctes (conception intra-sujets) ? Si la structure visuelle du tracé dos-à-dos s’adapte admirablement aux deux configurations, sa vocation première demeure la comparaison globale des profils distributionnels. Pour des échantillons appariés, l’analyste consciencieux veillera à compléter l’exploration par un tracé tige-et-feuille univarié des scores différentiels individuels (post-test moins pré-test) afin d’isoler la variance intra-sujet avec une précision complémentaire.
3.2 Tri séquentiel préliminaire et vérification d’exhaustivité
Il est matériellement et conceptuellement impossible de concevoir un diagramme tige-et-feuille rigoureux à partir d’un ensemble de données désordonné. L’inscription directe de valeurs au fil de l’eau, telle qu’elle pouvait être tolérée dans des ébauches exploratoires sur le terrain, débouche quasi inévitablement sur des erreurs d’ordonnancement des feuilles au sein des tiges, compromettant la recherche ultérieure des quantiles et dégradant la lisibilité du tracé. Par conséquent, la règle fondamentale impose un tri préalable complet et exhaustif par ordre croissant (du plus petit au plus grand score) de chacune des deux listes de données brutes, de manière totalement indépendante.
Ce travail de tri préliminaire doit s’accompagner d’une procédure formelle de réconciliation d’effectifs. Pour chaque cohorte, le chercheur doit calculer la somme des occurrences identifiées et s’assurer que ce décompte manuel ou semi-automatisé coïncide rigoureusement avec le nombre d’observations répertoriées dans le protocole de recueil d’origine. Une seule valeur égarée lors de la phase de transcription manuelle modifie la parité du jeu de données, déplace la médiane et fausse le rang de tous les quantiles subséquents. Une attention toute particulière doit être accordée aux doublons et aux scores répétés : chaque occurrence d’un score identique doit posséder sa propre feuille sur le tracé. Si la valeur 42 apparaît sept fois dans un échantillon, le chiffre 2 devra être consigné exactement sept fois sur la ligne de la tige 4.
Une bonne pratique préparatoire consiste à consigner les données triées dans un tableau synoptique à deux colonnes distinctes, en annotant au préalable pour chaque valeur la décomposition opérée : l’identification explicite de la tige candidate et du chiffre retenu pour la feuille. Ce pointage systématique élimine les risques d’hésitation cognitive au moment du dessin ou de la saisie textuelle finale, garantissant que l’effort de l’analyste se concentrera exclusivement sur l’exactitude de l’espacement spatial et la symétrie de la mise en page.
3.3 Traitement des échelles de mesure et des valeurs décimales
L’adaptation du diagramme tige-et-feuille à des données continues présentant plusieurs décimales ou, à l’inverse, à des grandeurs s’étalant sur des milliers ou des millions d’unités, impose l’application d’un facteur de normalisation ou d’une échelle multiplicatrice par puissance de dix. Par définition mathématique, la feuille ne peut et ne doit comporter qu’un seul chiffre typographique unitaire (compris strictement entre 0 et 9). Il est formellement prohibé d’accoler deux chiffres à l’intérieur d’une même feuille (comme écrire « 15 » pour représenter 115 sur une tige de 100), car cela détruirait immédiatement l’isomorphisme spatial qui régit la représentativité physique de la densité de données.
Pour des données continues composées de nombres réels décimaux (par exemple des concentrations hormonales oscillant entre 1,23 et 8,97 ng/ml), l’analyste doit choisir la résolution adéquate. Si la tige représente l’entier (de 1 à 8), la feuille doit représenter le premier chiffre après la virgule (les dixièmes). Qu’advient-il dès lors du chiffre des centièmes ? Deux approches techniques s’affrontent ici : l’arrondi classique au plus proche ou le tronquage pur et simple. Selon les directives rigoureuses de Tukey, le tronquage à la décimale désirée (élimination pure et simple des chiffres d’ordre inférieur) est fréquemment privilégié en phase exploratoire pour des raisons de vitesse de calcul et de préservation de l’intervalle semi-ouvert inférieur. Toutefois, dans les publications académiques actuelles, l’arrondi arithmétique standard (au chiffre le plus proche, avec règle de report sur le chiffre pair le plus proche pour les terminaisons en 5) est largement toléré, à la condition expresse de documenter explicitement ce choix dans les métadonnées du graphique.
Inversement, si les données mesurées concernent des scores très élevés, par exemple des temps d’attention sélective variant entre 1 200 et 4 500 millisecondes, le facteur d’échelle doit être défini de manière à ce que la feuille représente les centaines, la tige incarnant les milliers. Une observation de 3 240 ms sera donc consignée avec une tige de 3 et une feuille de 2 (arrondie à la centaine la plus proche), et la légende explicative stipulera clairement que la tige représente les unités de milliers (x 1 000) et la feuille les unités de centaines (x 100). La cohérence de cette normalisation doit demeurer absolue et intangible sur l’intégralité du graphique et pour les deux cohortes étudiées simultanément.
4. Guide pas-à-pas : Construction manuelle du diagramme dos-à-dos
4.1 Étape 1 : Détermination et alignement de la colonne centrale des tiges
Le tracé d’un diagramme tige-et-feuille dos-à-dos débute impérativement par la prospection globale des valeurs extrêmes de l’ensemble combiné des deux échantillons. Le statisticien doit identifier sans ambiguïté le minimum absolu (la valeur la plus basse observée sur l’ensemble des deux groupes) et le maximum absolu (la valeur la plus haute observée sur l’ensemble des deux groupes). Cette identification initiale permet d’établir l’étendue totale conjointe des données et de circonscrire sans omission l’éventail complet des tiges requises pour structurer l’axe vertical.
Une fois cette plage définie, on procède à l’inscription verticale ordonnée des tiges dans la colonne centrale. La convention graphique dominante préconise d’inscrire la tige de plus faible valeur numérique tout en haut de la colonne, et de faire croître les tiges vers le bas, imitant ainsi l’ordre naturel d’un tableau d’intervalles descendant. Toutefois, dans certains contextes d’ingénierie ou de physique où l’on souhaite assimiler l’axe vertical à l’axe des ordonnées d’un plan cartésien, une orientation ascendante (plus petit en bas, plus grand en haut) peut être adoptée. Quelle que soit l’orientation retenue, elle doit être appliquée avec une constance rigoureuse et ne jamais être inversée en cours de route.
Une fois les chiffres des tiges calligraphiés ou saisis verticalement, on trace de part et d’autre deux lignes verticales franches et continues. Ces deux délimitations linéaires ont pour fonction de matérialiser les frontières infranchissables du « tronc » partagé. La largeur allouée à la colonne centrale doit être suffisante pour accueillir confortablement les chiffres des tiges — y compris les nombres négatifs avec leur signe moins ou les tiges à deux ou trois chiffres —, tout en maintenant un espacement textuel uniforme qui évite toute interférence visuelle avec les feuilles adjacentes.
4.2 Étape 2 : Projection des feuilles du groupe de gauche (lecture inversée)
Le traitement du versant gauche constitue la zone de vulnérabilité technique la plus fréquente pour les néophytes. Par convention internationale immuable, le groupe positionné sur le flanc gauche — appelons-le Groupe A ou Condition Contrôle — doit voir ses feuilles se déployer de manière centrifuge, c’est-à-dire en s’éloignant physiquement du tronc central vers la gauche de la page ou de l’écran. Cette règle implique une direction d’ordonnancement strictement opposée au sens de lecture occidental traditionnel.
Très concrètement, pour une tige donnée, la feuille possédant la valeur numérique la plus basse doit être impérativement inscrite immédiatement à gauche de la ligne verticale centrale de délimitation. Les feuilles de valeurs progressivement supérieures viennent ensuite s’agréger vers la gauche, s’étalant au fur et à mesure dans l’espace disponible. Si pour la tige 5, le groupe de gauche comporte les valeurs 50, 52, 53 et 58, la disposition visuelle à partir du tronc s’écrira successivement : 8, puis 3, puis 2, puis 0 immédiatement collé à la barre. Vue dans le sens conventionnel de lecture de gauche à droite, la ligne apparaît donc comme « 8 3 2 0 | 5 », mais son décodage conceptuel s’opère toujours depuis la colonne centrale vers l’extérieur : la valeur minimale (0) est la plus proche de la tige, et la plus élevée (8) en est la plus éloignée.
Le respect de la largeur unitaire de chaque caractère revêt ici une dimension cruciale. Chaque chiffre consigné sur le flanc gauche doit s’inscrire dans une colonne textuelle imaginaire rigoureusement alignée verticalement avec les chiffres des lignes supérieures et inférieures. Aucun décalage ne doit être toléré. Si une ligne comporte quatre feuilles et que la ligne sous-jacente en comporte deux, le chiffre le plus externe de la première ligne doit dépasser spatialement de deux largeurs exactes de caractère par rapport à la seconde. C’est exclusivement à cette condition que la surface de l’empreinte typographique résiduelle reflète honnêtement la densité probabiliste sous-jacente.
4.3 Étape 3 : Projection des feuilles du groupe de droite (lecture standard)
Le remplissage du flanc droit du diagramme tige-et-feuille dos-à-dos — traditionnellement dévolu au Groupe B ou à la Condition Expérimentale — présente une plus grande familiarité opératoire pour l’opérateur, puisqu’il s’exécute selon le sens de lecture naturel de gauche à droite. Toutefois, il exige la même méticulosité dans le calage géométrique et l’ordonnancement séquentiel que le flanc opposé.
Pour chaque tige du tronc vertical, l’analyste se positionne immédiatement à droite de la seconde ligne verticale délimitant le tronc. La feuille associée à la valeur la plus basse pour cette tige est inscrite dans la première case disponible immédiatement contiguë à la ligne de séparation. Les feuilles correspondant aux observations d’amplitude croissante sont ensuite reportées successivement vers la droite, chacune occupant un emplacement de largeur strictement constante. Si pour la tige 5, le groupe de droite contient les scores 51, 54, 54 et 59, l’écriture se traduira directement par la séquence ordonnée : la tige 5, la barre verticale, puis les chiffres 1, 4, 4 et 9 s’étendant paisiblement vers la marge droite.
La superposition verticale des rangées de feuilles sur le versant droit doit faire l’objet d’un ajustement micrométrique rigoureux. Le chercheur doit veiller à ce que la première feuille de droite se trouve à la même distance géométrique de la barre verticale que celle qui sépare la première feuille de gauche de sa propre barre. De surcroît, le pas spatial séparant deux colonnes successives de feuilles de droite doit être strictement égal au pas spatial employé pour les colonnes de gauche. Ce parallélisme métrique bilatéral garantit qu’une ligne de sept feuilles à droite possédera une longueur millimétrique rigoureusement identique à une ligne de sept feuilles à gauche, rendant les deux profils morphologiques directement comparables d’un simple coup d’œil synoptique.
4.4 Étape 4 : Rédaction indispensable de la clé de lecture
Un diagramme tige-et-feuille dépourvu d’une clé de lecture explicite et sans équivoque est méthodologiquement invalide et scientifiquement inutilisable. En effet, dans la mesure où le tracé décompose des grandeurs numériques sans exhiber directement les virgules décimales ni les puissances de dix multiplicatrices, un ensemble de chiffres tels que « 2 | 4 | 7 » peut tout aussi bien signifier que les valeurs mesurées sont 42 et 47, 4,2 et 4,7, ou encore 420 et 470. La clé de lecture a pour fonction première de lever cette ambiguïté sémiotique en fixant définitivement l’interprétation mathématique des caractères.
Dans le cas spécifique de la configuration bilatérale dos-à-dos, la clé de lecture (souvent appelée « légende ») doit impérativement être formulée sous une structure tripartite symétrique, illustrant simultanément le mécanisme de décodage pour les deux flancs du diagramme. Une formulation académique canonique s’énonce classiquement sous la forme suivante :
- Clé de lecture générale : Feuille de gauche | Tige | Feuille de droite.
- Exemple d’illustration : 3 | 7 | 8 signifie un score de 73 pour le Groupe A et un score de 78 pour le Groupe B.
- Précision métrique de l’unité : Indication explicite de la grandeur physique ou psychométrique mesurée (par exemple : unité = millisecondes, ou tige = dizaines de points, feuille = unités de points).
En complément immédiat de cette équation de décodage, l’en-tête du diagramme doit afficher clairement les métadonnées expérimentales associées à chaque cohorte. Ces métadonnées comprennent l’intitulé formel de chaque groupe (par exemple « Sujets Amnésiques » à gauche contre « Témoins Appariés » à droite), ainsi que leurs effectifs réels respectifs notés conventionnellement n₁ et n₂. L’inclusion visible de ces effectifs prévient les erreurs de jugement perceptuel qui pourraient naître de la confrontation visuelle de deux séries dont les tailles d’échantillons diffèrent sensiblement.
5. Exemple pratique appliqué : Comparaison de deux cohortes d’évaluation
5.1 Présentation du scénario empirique et des séries brutes
Afin d’ancrer de manière pragmatique les directives théoriques exposées précédemment, considérons un protocole de recherche quasi-expérimental issu du champ de la psychologie de la santé et des neurosciences comportementales. Une équipe de chercheurs s’intéresse à l’efficacité d’une intervention de réduction du stress basée sur la pleine conscience (programme MBSR) destinée à des cadres d’entreprise soumis à une charge cognitive chronique. Le protocole implique deux cohortes d’adultes : un Groupe Contrôle sans intervention (Groupe A, comprenant 25 participants) et un Groupe Expérimental ayant complété les huit semaines du cycle thérapeutique (Groupe B, comprenant 25 participants).
À l’issue des huit semaines de suivi, l’ensemble des participants complète l’Inventaire d’Anxiété et de Stress Perçu (IASP), un instrument psychométrique standardisé dont le score composite s’échelonne sur une échelle théorique continue allant de 10 (sérénité absolue) à 90 points (détresse psychologique extrême). Les mesures brutes recueillies sont présentées ci-dessous, préalablement ordonnées par ordre strictement croissant pour chaque groupe afin de satisfaire aux exigences méthodologiques de préparation :
- Groupe Contrôle (A) [n = 25] : 34, 38, 41, 45, 47, 48, 50, 52, 53, 55, 56, 58, 59, 61, 62, 63, 65, 66, 68, 70, 72, 74, 77, 81, 85.
- Groupe MBSR (B) [n = 25] : 18, 22, 24, 25, 27, 29, 31, 32, 33, 35, 36, 38, 40, 42, 43, 44, 46, 48, 51, 53, 54, 57, 60, 64, 69.
L’inspection des séries ordonnées révèle une variabilité interindividuelle marquée. Dans le Groupe Contrôle, les scores s’étalent d’un minimum de 34 à un maximum de 85 points. Dans le Groupe MBSR, les valeurs s’échelonnent d’un minimum remarquable de 18 points jusqu’à un plafond de 69 points. L’analyste se trouve face à une étendue globale conjointe débutant à 18 et culminant à 85, ce qui délimite un champ d’exploration de près de soixante-huit unités d’écart.
5.2 Modélisation pas-à-pas du diagramme dos-à-dos
L’étendue totale des données (de 18 à 85 points) dicte immédiatement le découpage en tiges : la dizaine s’impose comme l’unité structurelle naturelle de tige, tandis que l’unité élémentaire constituera la feuille. Le tronc central partagé doit par conséquent intégrer l’ensemble continu des tiges allant de 1 (représentant l’intervalle [10-19]) jusqu’à 8 (représentant l’intervalle [80-89]). Notons avec attention que même si le Groupe Contrôle ne possède aucun participant affichant un score dans les dizaines (10-19) ni dans les vingtaines (20-29), ces tiges doivent impérativement demeurer ouvertes sur le tronc commun pour refléter fidèlement l’amplitude des mesures du Groupe Expérimental.
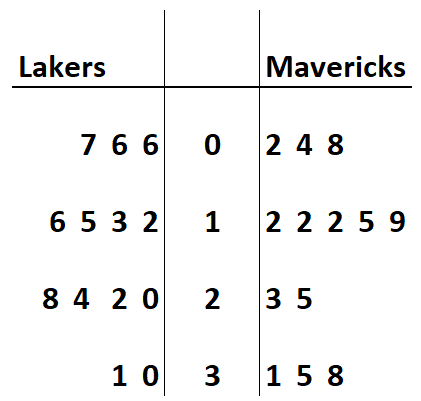
Procédons à l’inscription descriptive ligne par ligne du diagramme tige-et-feuille dos-à-dos finalisé. Sur le versant gauche (Groupe A, Contrôle), pour la tige 1 et la tige 2, le couloir demeure vierge de toute feuille. Pour la tige 3, les valeurs 34 et 38 sont projetées vers la gauche : le chiffre 4 est apposé contre la tige centrale, précédé vers la marge gauche par le chiffre 8 (séquence visuelle : 8 4). Pour la tige 4, les feuilles 41, 45, 47 et 48 s’écrivent vers la gauche selon l’ordre centrifuge : 8 7 5 1. Cette logique se poursuit sur l’ensemble de l’axe vertical, générant la distribution exacte des observations.
Sur le versant droit (Groupe B, MBSR), le déploiement s’opère selon l’axe naturel. La tige 1 reçoit l’unique feuille 8 (pour le score 18). La tige 2 reçoit consécutivement les feuilles 2, 4, 5, 7 et 9 (reflétant les scores 22, 24, 25, 27, 29). La tige 3 accueille six feuilles parfaitement alignées : 1, 2, 3, 5, 6, 8. Le processus se prolonge jusqu’à la tige 6 (scores 60, 64, 69) tandis que les tiges 7 et 8 demeurent intégralement désertes sur ce versant. La clé de lecture est solennellement annexée au pied de la composition : « Clé : 4 | 3 | 1 équivaut à un score de 34 pour le Groupe Contrôle et à un score de 31 pour le Groupe MBSR (unités de points entiers IASP). »
5.3 Première lecture exploratoire et comparaison descriptive
La restitution géométrique des deux masses textuelles produit un effet de révélation immédiate que la seule lecture des chiffres en colonnes ne permettait pas de saisir avec autant de force. Un coup d’œil synoptique sur l’artefact achevé met en évidence un décalage spatial massif et spectaculaire entre les deux cohortes d’évaluation. La masse centrale du Groupe MBSR est nettement concentrée sur le tiers supérieur du graphique (tiges 2, 3 et 4), tandis que la silhouette du Groupe Contrôle se trouve lourdement affaissée vers le bas (tiges 5, 6 et 7).
Ce déplacement vertical de la densité visuelle correspond très précisément à une différence sensible de tendance centrale en faveur de l’hypothèse d’efficacité de l’intervention de réduction du stress. Chez les participants ayant suivi le programme de pleine conscience, le centre de gravité de la distribution gravite autour de la tige 3 (médiane à 40 points), alors que chez les sujets témoins n’ayant reçu aucun accompagnement, le centre de gravité bascule sur la tige 5 (médiane à 59 points), matérialisant un écart d’environ dix-neuf points sur l’échelle clinique.
Au-delà de la seule tendance centrale, la confrontation visuelle des deux silhouettes apporte un éclairage crucial sur la forme même des distributions. Le Groupe Contrôle exhibe une distribution relativement symétrique, quasi-mésokurtique, solidement campée entre 40 et 75 points, avec deux scores isolés dans la tige 8 qui tirent légèrement la queue vers les extrêmes hauts. Le Groupe MBSR, quant à lui, manifeste un profil modérément asymétrique positif (étalement vers les scores plus élevés), caractérisé par un agrégat dense de scores extrêmement bas (cinq participants sous la barre des 30 points) et une extinction progressive de l’effectif au fur et à mesure que l’on progresse vers les tiges supérieures. Cette observation qualitative confirme que l’intervention a non seulement abaissé le niveau moyen d’anxiété, mais qu’elle a également permis à un sous-groupe important de participants de franchir un seuil d’apaisement particulièrement marqué.
6. Techniques avancées de scission et d’ajustement des tiges
6.1 Méthode des tiges scindées en deux parties (demi-tiges)
Dans certaines configurations d’échantillonnage, l’application de la règle standard d’une tige par décade aboutit à un échec graphique cuisant : la totalité ou l’écrasante majorité des observations empiriques se retrouve agglomérée sur seulement deux ou trois tiges consécutives. Une telle concentration transforme les lignes de feuilles en rubans horizontaux interminables et disproportionnés, tout en masquant l’allure précise de la courbe sous-jacente. Pour surmonter cet écueil et accroître la résolution verticale du diagramme, John Tukey a forgé la méthode rigoureuse des « tiges scindées » (split stems).
La première déclinaison de cette approche consiste à diviser chaque intervalle de tige en deux sous-classes d’amplitude égale de cinq unités numériques, désignées sous le terme de demi-tiges. La première tige reçoit conventionnellement les feuilles dites « basses », c’est-à-dire les chiffres élémentaires compris entre 0 et 4 inclus. La seconde tige, portant la même valeur numérique d’ordre supérieur mais souvent assortie d’un symbole distinctif (par exemple une astérisque ou la lettre « h » pour high, ou plus simplement la répétition stricte du chiffre de la tige), reçoit les feuilles dites « hautes », à savoir les chiffres compris entre 5 et 9 inclus.
Cette division par deux doit impérativement s’appliquer avec une cohérence symétrique absolue sur l’ensemble de l’axe vertical du tronc central partagé. Il est rigoureusement proscrit de scinder une tige très peuplée tout en laissant les tiges adjacentes non scindées. Si la décision de doubler le nombre de tiges est actée, chaque tige sans exception — de la valeur minimale absolue à la valeur maximale — doit être dupliquée en deux occurrences verticales successives. Sur le versant gauche comme sur le versant droit, les feuilles sont alors ventilées selon cette règle de dichotomie unitaire, restituant immédiatement un profil granulaire d’une finesse deux fois supérieure qui fait réapparaître des variations de courbure jusqu’alors totalement étouffées.
6.2 Division par cinq (quintiles de tige)
Lorsque la taille des échantillons croît substantiellement — par exemple lorsque l’on approche des deux ou trois cents individus par cohorte — ou que la variance de l’échantillon est exceptionnellement resserrée autour d’un plateau étroit, la subdivision en deux demi-tiges s’avère encore insuffisante pour dissiper la saturation typographique. La méthodologie exploratoire offre alors un raffinement ultime : la décomposition quintésimale, ou division de chaque tige en cinq sous-intervalles contigus d’exactement deux unités d’amplitude chacun.
Dans ce système hautement normalisé, chaque valeur de tige est répétée cinq fois consécutivement le long de la colonne verticale centrale. Tukey a instauré une codification textuelle universelle pour étiqueter ces cinq sous-classes sans ambiguïté :
- La première occurrence reçoit les feuilles * (astérisque) ou étiquette numérique [0-1] : feuilles 0 et 1.
- La deuxième occurrence reçoit la lettre t (pour two / three) : feuilles 2 et 3.
- La troisième occurrence reçoit la lettre f (pour four / five) : feuilles 4 et 5.
- La quatrième occurrence reçoit la lettre s (pour six / seven) : feuilles 6 et 7.
- La cinquième occurrence reçoit le point . ou la lettre e (pour eight / nine) : feuilles 8 et 9.
L’attribution des feuilles sur les flancs bilatéraux s’opère dès lors avec une précision quasi-chirurgicale. Pour une tige de base 6, une feuille 62 sera obligatoirement orientée sur la ligne « 6t », tandis qu’une feuille 67 trouvera son ancrage sur la ligne « 6s ». Cette expansion quintésimale permet d’obtenir un tracé d’une fluidité morphologique comparable à celle d’un histogramme haute résolution ou d’un estimateur de densité par noyau (Kernel Density Estimation), tout en conservant scrupuleusement la traçabilité intégrale de chaque chiffre individuel. Cette technique exige toutefois une discipline d’alignement spatial irréprochable sous peine de générer une dispersion textuelle difficilement appréhendable par le lecteur.
6.3 Tronquage versus arrondissement des grands nombres
La manipulation de grands nombres ou de séries continues étendues pose le problème technique récurrent de la réduction de dimensionnalité : comment ramener une mesure complexe à la dyade fonctionnelle « tige unique + feuille unitaire » sans trahir la fidélité mathématique des données ? Ce dilemme oppose deux stratégies de réduction algorithmique dont les implications doivent être clairement maîtrisées : l’arrondi mathématique standard et le tronquage positionnel.
L’arrondi classique (vers le chiffre pair le plus proche pour les valeurs équidistantes) possède la propriété statistique théorique de minimiser le biais systématique sur l’estimation de la moyenne globale de la cohorte. Toutefois, il introduit une distorsion locale dans le diagramme tige-et-feuille : une valeur de 49,8 qui est arrondie à 50 va voir sa feuille migrer de la tige 4 vers la tige 5. Dans certaines situations d’analyse exploratoire fine, ce franchissement artificiel de seuil d’intervalle peut modifier la perception visuelle des frontières de distribution ou simuler l’existence d’une observation supérieure là où il n’y avait en réalité qu’une valeur s’approchant de la borne.
Le tronquage pur et simple (qui consiste à supprimer purement et simplement les décimales excédentaires sans ajustement de report) constitue l’approche historiquement privilégiée par John Tukey. Dans cette optique, 49,8 devient 49 (tige 4, feuille 9) et 49,1 devient également 49. L’avantage déterminant réside dans le fait que l’appartenance à la tige correspond rigoureusement à l’intervalle semi-ouvert inférieur [40, 50[, sans aucune contamination croisée. Le coût mathématique en est un léger biais négatif systématique d’une demi-unité sur l’ensemble de la distribution. En pratique moderne, le choix entre ces deux techniques est laissé à l’appréciation du chercheur, mais la rigueur académique impose que ce choix soit formellement mentionné dans les notes explicatives accompagnant le tracé dos-à-dos.
7. Détection et traitement des valeurs aberrantes (outliers)
7.1 Repérage visuel et critère de Tukey sur le diagramme dos-à-dos
L’un des apports les plus féconds de l’analyse exploratoire réside dans sa capacité à révéler les singularités que les résumés numériques globaux lissent et dissimulent. Sur un diagramme tige-et-feuille dos-à-dos, le repérage visuel d’une valeur aberrante (ou donnée atypique) est d’une simplicité désarmante : il se manifeste par la présence d’une ou plusieurs feuilles émergeant sur une tige isolée à l’extrémité supérieure ou inférieure de la colonne, séparée du reste du corpus distributionnel par une succession ininterrompue de tiges entièrement vides.
Pour dépasser l’impression visuelle purement subjective et doter l’investigation d’un fondement mathématique incontestable, Tukey a formalisé la fameuse règle des clôtures interquartiles (interquartile fences). Cette méthode non paramétrique, particulièrement robuste face aux anomalies, utilise l’écart interquartile (noté IQR, égal à la différence entre le troisième quartile Q₃ et le premier quartile Q₁) pour borner la distribution légitime :
- Clôture intérieure inférieure : Q₁ – 1,5 × IQR
- Clôture intérieure supérieure : Q₃ + 1,5 × IQR
- Clôture extérieure inférieure : Q₁ – 3,0 × IQR
- Clôture extérieure supérieure : Q₃ + 3,0 × IQR
Toute observation comprise entre les clôtures intérieures et extérieures est qualifiée de « valeur atypique modérée » (ou valeur suspecte), tandis que tout point de donnée franchissant les clôtures extérieures est catégorisé sans appel comme « valeur atypique extrême ». Sur le diagramme dos-à-dos, le comptage direct des feuilles permet de localiser Q₁ et Q₃ en un instant, d’exécuter mentalement ou manuellement cette arithmétique simple, et d’identifier immédiatement si une feuille périphérique dépasse ces barrières critiques sur l’un ou l’autre des deux versants.
7.2 Gestion spatiale des valeurs extrêmes isolées
L’existence d’une valeur extrême prodigieusement distante pose un problème architectural redoutable lors du tracé du tronc central. Imaginons une distribution dont le gros des scores se situe entre 20 et 55, mais comportant un participant ayant obtenu le score exceptionnel de 142. Si l’analyste s’astreignait à respecter la règle de continuité absolue du tronc sans adaptation, il serait contraint d’inscrire consécutivement les tiges 6, 7, 8, 9, 10, 11, 12 et 13 sous forme de lignes intégralement vierges de feuilles. Cette pratique engendrerait un allongement spatial démesuré et artificiel du tracé, dilatant inutilement l’espace graphique au détriment de l’analyse du corps principal des données.
Pour résoudre cette tension structurelle sans trahir l’exigence de probité métrique, Tukey a formulé une convention de notation d’une grande élégance : la substitution des tiges distantes par des lignes spéciales d’extrêmes isolés, couramment désignées sous les mentions d’en-tête « HI » (pour High, valeurs excessivement élevées) et « LO » (pour Low, valeurs excessivement basses). Les tiges régulières continues sont alors interrompues dès la dernière tige peuplée respectant les clôtures intérieures, et la ligne « HI » ou « LO » recueille directement le score intégral non scindé de l’observation atypique.
Dans la configuration bilatérale dos-à-dos, cette notation s’adapte avec une remarquable clarté. La ligne « HI » est apposée au bas du graphique (ou en haut selon l’orientation choisie). Si l’observation extrême appartient au groupe de gauche, la valeur intégrale (ex. : « 142 ») est inscrite dans le couloir gauche de la ligne HI, tandis que le couloir droit demeure vide. Inversement, si une valeur extrêmement basse affecte le groupe de droite, elle est consignée dans le couloir droit de la ligne LO. Cette approche permet de préserver l’échelle fine et compacte du tronc commun pour la confrontation des masses centrales, tout en signalant de manière éclatante la présence et la magnitude exacte des anomalies périphériques.
7.3 Implications diagnostiques en sciences du comportement
L’identification de valeurs aberrantes sur un diagramme tige-et-feuille dos-à-dos ne doit jamais être considérée comme une simple étape technique d’épuration algorithmique ; elle constitue en réalité un acte diagnostique majeur dans la recherche scientifique. En psychologie cognitive, en neuropsychologie et dans les sciences médicales, une observation atypique n’est que rarement un simple « bruit » négligeable. Elle véhicule une information déterminante sur le fonctionnement individuel ou sur la validité du protocole de recueil.
L’analyste doit d’abord opérer la distinction cruciale entre les anomalies instrumentales et la variabilité biologique ou comportementale réelle. Une valeur invraisemblable peut résulter d’une erreur de saisie typographique (inversion de chiffres), d’une défaillance d’horloge logicielle lors du recueil de temps de réaction, ou d’une incompréhension flagrante des consignes par un sujet expérimental. La conservation intégrale des chiffres sur le diagramme dos-à-dos permet bien souvent de déceler immédiatement l’erreur typographique : une observation de « 92 » apparaissant sur une échelle psychométrique rigoureusement bornée à 60 points saute aux yeux comme une saisie erronée qu’un histogramme aurait agrégée sans avertissement.
Lorsque la valeur aberrante s’avère authentique, sa distribution asymétrique entre les deux versants du tracé dos-à-dos devient une source d’hypothèses heuristiques puissantes. La présence exclusive de trois valeurs sur-performantes dans la queue supérieure du groupe soumis à un nouvel entraînement cognitif peut signaler l’existence d’une sous-population d’individus à haut potentiel intellectuel réagissant de manière spectaculaire au paradigme, là où les participants standard ne manifestent qu’un gain marginal. Conclure à l’élimination systématique de ces sujets au seul motif qu’ils violent le postulat de normalité statistique constituerait une grave erreur épistémologique, privant le chercheur de la découverte d’un biomarqueur ou d’une variable modératrice essentielle.
8. Analyse comparative des distributions : Forme, centre et dispersion
8.1 Évaluation de la forme distributionnelle et de la symétrie
L’observation globale d’un diagramme tige-et-feuille dos-à-dos mobilise la perception visuelle de la forme géométrique pour conduire une véritable analyse morphologique comparée. Trois dimensions structurales dominent cette analyse : la symétrie, la modalité et l’aplatissement (ou kurtosis). L’observateur examine en premier lieu l’équilibre pondéral de chaque versant par rapport à son propre centre de masse.
Une distribution est dite symétrique lorsque les feuilles se distribuent de manière équilibrée de part et d’autre d’une tige médiane dominante, dessinant une silhouette en cloche caractéristique. À l’opposé, une asymétrie positive (ou étalement vers la droite dans le plan cartésien traditionnel) se matérialise sur le diagramme vertical par une longue queue de feuilles s’étirant vers les tiges de valeurs élevées (vers le bas de la colonne si les tiges croissent vers le bas), la majorité de la masse se condensant sur les petites tiges initiales. Inversement, une asymétrie négative se traduit par un étalement prononcé vers les petites tiges (vers le haut), avec une condensation sur les valeurs fortes. La juxtaposition bilatérale permet de détecter immédiatement si une intervention expérimentale a induit une rupture de symétrie, transformant par exemple une distribution normale de base en une distribution tronquée par un effet de plafond.
Le diagnostic de la modalité constitue une autre supériorité éclatante du tracé dos-à-dos. Une distribution unimodale ne présente qu’une seule tige (ou une paire de tiges adjacentes) exhibant une longueur de feuilles maximale. L’émergence d’une bimodalité — deux tiges très denses séparées par une ou deux tiges nettement dépeuplées — constitue un signal d’alarme scientifique majeur. Elle révèle de manière quasi irréfutable que la cohorte analysée n’est pas homogène, mais qu’elle abrite en réalité deux sous-populations distinctes régies par des mécanismes psychologiques ou physiologiques différenciés (par exemple des sujets porteurs d’un allèle génétique spécifique opposés aux non-porteurs au sein d’un même groupe clinique). De telles bifurcations morphologiques demeurent fréquemment invisibles sur des boîtes à moustaches conventionnelles.
8.2 Localisation spatiale des indices de tendance centrale
La recherche et la confrontation des indices de tendance centrale s’effectuent sur le diagramme dos-à-dos avec une élégance mathématique directe, fondée sur le simple comptage de rang ordinal. Contrairement aux approches computationnelles opaques, l’analyste localise la médiane (notée M ou Q₂) en arpentant physiquement le réseau des feuilles ordonnées de chaque côté du tronc.
Pour un échantillon de taille n, le rang de la médiane est rigoureusement déterminé par la formule classique :
Rang de la médiane = (n + 1) / 2
Si la taille n est impaire, la médiane correspond précisément à la feuille occupant ce rang central exact en comptant depuis la valeur la plus faible. Si n est pair, la médiane se situe à l’équidistance des deux observations occupant les rangs n / 2 et (n / 2) + 1. Sur le diagramme dos-à-dos, cette recherche s’exécute de manière symétrique et indépendante : l’analyste dénombre les feuilles à gauche à partir de la valeur la plus basse jusqu’à isoler physiquement la feuille médiane du groupe A, puis répète l’opération à droite pour le groupe B. Le décalage spatial vertical séparant ces deux ancrages donne une mesure tangible et immédiate de l’amplitude de l’effet d’expérimentation.
En complément de la médiane robuste, la confrontation visuelle de la forme permet d’anticiper intuitivement la position relative de la moyenne arithmétique. En présence d’une asymétrie prononcée, la moyenne est inexorablement attirée vers la queue de la distribution par l’effet de levier des valeurs distantes. L’observateur averti sait ainsi que si le flanc gauche présente une longue queue descendante, la moyenne du groupe A sera substantiellement supérieure à sa médiane. Cette estimation visuelle des divergences centre-médiane offre un garde-fou décisif contre les interprétations abusives fondées aveuglément sur le test t de Student en l’absence de normalité avérée.
8.3 Mesure et comparaison de la dispersion inter-groupes
L’inspection comparative ne saurait se limiter à la seule tendance centrale ; l’évaluation de la dispersion constitue le troisième pilier indissociable de l’analyse distributionnelle. Deux groupes peuvent en effet présenter des médianes rigoureusement superposables sur la même tige centrale tout en exhibant des architectures de variabilité radicalement dissemblables, phénomène porteur d’une signification scientifique de premier ordre.
La première métrique de dispersion, immédiatement accessible sur le diagramme dos-à-dos, est l’étendue globale (Range), calculée en retranchant la feuille minimale de la feuille maximale pour chaque cohorte. Bien que très intuitive, l’étendue présente l’inconvénient d’être hypersensible aux valeurs aberrantes isolées. L’analyste se tournera donc préférentiellement vers l’écart interquartile (IQR), qui capture l’étendue occupée par les cinquante pour cent centraux des observations. De la même manière que pour la médiane, les premier et troisième quartiles (Q₁ et Q₃) sont pointés par simple arpentage de rang le long des feuilles ordonnées :
- Premier quartile (Q₁) : valeur de rang 0,25 × (n + 1) décomptée depuis le minimum.
- Troisième quartile (Q₃) : valeur de rang 0,75 × (n + 1) décomptée depuis le minimum.
- Écart interquartile (IQR) : Q₃ – Q₁ matérialisé par la distance verticale séparant ces deux repères.
Sur le plan géométrique, l’écart interquartile se visualise instantanément par la hauteur verticale du bloc compact de feuilles encadrant la médiane. Si le couloir central du groupe A condense 50 % de ses données sur une travée de deux tiges seulement alors que le groupe B étale ses 50 % centraux sur six tiges successives, l’hétérogénéité des variances (hétéroscédasticité) est démontrée de visu. Cette constatation visuelle directe avertit immédiatement le biostatisticien que l’application de tests paramétriques standard fondés sur l’hypothèse de variances égales devra être abandonnée au profit de corrections robustes, telles que le test t de Welch.
9. Applications concrètes dans la recherche psychologique et cognitive
9.1 Analyses pré-test versus post-test au sein d’un même groupe
Dans l’arsenal méthodologique des essais cliniques et des études interventionnelles en sciences cognitives, l’analyse des designs pré-test versus post-test représente un domaine d’élection pour le diagramme tige-et-feuille dos-à-dos. Imaginons un essai évaluant l’impact d’une remédiation informatisée de la mémoire de travail chez des patients victimes d’un accident vasculaire cérébral. Le flanc gauche du diagramme recueille les scores d’empan mnésique avant la prise en charge (pré-test), tandis que le flanc droit compile les performances de ces mêmes patients au terme des douze semaines d’entraînement intensif (post-test).
Cette mise en miroir permet de documenter instantanément la dynamique plastique du processus rééducatif. Au-delà de l’élévation globale attendue de la performance, le tracé bilatéral répond à des interrogations cliniques fondamentales : assiste-t-on à un resserrement de la variabilité interindividuelle — ce qui indiquerait que l’entraînement a principalement bénéficié aux sujets les plus lourdement déficitaires en comblant leur retard initial —, ou assiste-t-on au contraire à un étirement spectaculaire vers le haut de la distribution ?
De surcroît, le diagramme dos-à-dos autorise l’identification visuelle immédiate des « non-répondeurs » thérapeutiques. Si la tige la plus basse du versant pré-test (par exemple la tige 2, reflétant un empan très altéré de deux items) présente trois feuilles, et que l’on constate avec consternation que le versant post-test exhibe toujours deux feuilles ancrées sur cette même tige résiduelle, le clinicien identifie en un éclair la persistance d’un noyau réfractaire. Cette révélation qualitative immédiate guide les analyses secondaires visant à corréler cette absence de gain à des lésions neuroanatomiques spécifiques identifiées en neuro-imagerie.
9.2 Confrontation groupe clinique versus groupe témoin
La recherche diagnostique et neuropsychologique repose traditionnellement sur la comparaison entre des cohortes de patients atteints d’une affection neurologique ou psychiatrique (par exemple la maladie d’Alzheimer au stade prodromal, les troubles du spectre de l’autisme ou la schizophrénie) et des groupes témoins appariés sur l’âge, le genre et le niveau d’études socio-économique. Le diagramme tige-et-feuille dos-à-dos constitue dans ce cadre une interface de restitution privilégiée entre le laboratoire de recherche et la pratique clinique de terrain.
Lors de l’exploration d’un test de flexibilité mentale tel que le Trail Making Test (partie B), où la métrique analysée est le temps requis pour exécuter une alternance de chiffres et de lettres, la distribution des temps chez les sujets témoins est habituellement compacte et centrée sur des durées courtes. En revanche, la distribution des patients présentant un syndrome dysexécutif frontal affiche une dispersion majeure et un étalement asymétrique hautement pathologique. Le tracé bilatéral rend compte avec une netteté saisissante de ce que les biostatisticiens nomment la zone de chevauchement distributionnel (distributional overlap).
En observant précisément la zone de transition le long du tronc central, le clinicien peut fixer des valeurs seuils (cut-off scores) d’une grande pertinence diagnostique. Il perçoit exactement combien de patients échappent au profil pathologique pour se fondre dans la distribution normale, et inversement, quel pourcentage de sujets sains réalise des scores faussement positifs. Cette appréhension granulaire est inestimable pour calibrer la sensibilité et la spécificité clinique d’un nouvel instrument psychométrique sans s’enfermer prématurément dans des abstractions mathématiques complexes.
9.3 Analyse des temps de réaction et chronométrie mentale
La chronométrie mentale constitue l’un des piliers méthodologiques historiques de la psychologie expérimentale. L’enregistrement des temps de réaction (TR) lors de tâches d’attention sélective, de décision lexicale ou de compatibilité spatiale (effet Simon, tâche de Stroop) génère des distributions dont les propriétés physiques sont universellement reconnues : une borne inférieure physiologique infranchissable (environ 150 à 200 millisecondes correspondant au temps de conduction sensorielle et motrice), un pic modal dense très rapidement atteint, et une longue queue asymétrique vers les temps longs résultant des fluctuations attentionnelles occasionnelles.
La confrontation de deux conditions expérimentales au sein d’un paradigme de chronométrie mentale — par exemple une condition « neutre » versus une condition « conflictuelle » générant une interférence cognitive — trouve dans le diagramme tige-et-feuille dos-à-dos une plateforme d’analyse d’une efficacité chirurgicale. En paramétrant les tiges sur les centaines de millisecondes (tiges 2, 3, 4, 5, 6, 7…) et les feuilles sur les dizaines, l’expérimentateur observe directement la signature chronométrique du conflit cognitif.
Ce tracé met en lumière avec une clarté remarquable si le ralentissement moyen induit par la condition de conflit découle d’un glissement additif uniforme de l’ensemble du processus de traitement perceptivo-moteur (translation pure de la distribution vers le bas sans déformation morphologique) ou s’il traduit une déstabilisation stochastique du contrôle exécutif (allongement disproportionné de la queue supérieure sans modification du temps d’amorce minimale). De surcroît, le diagramme permet de détecter en une fraction de seconde d’éventuels temps ultra-courts suspects (anticipations motrices illégitimes situées sous le seuil physiologique des 180 ms) et de les isoler pour exclusion motivée avant les analyses inférentielles définitives.
10. Implémentation computationnelle : Automatisation avec R et Python
10.1 Génération de diagrammes dos-à-dos avec l’environnement R
Bien que l’exécution manuelle du diagramme tige-et-feuille conserve une vertu pédagogique et heuristique indéniable, le traitement rigoureux de jeux de données volumineux au sein de laboratoires modernes exige une automatisation algorithmique exempte de toute faille typographique. L’environnement d’ingénierie statistique R, référence mondiale incontestée pour la recherche empirique, dispose d’outils dédiés d’une grande maturité pour générer nativement des tracés tige-et-feuille bilatéraux impeccables.
La bibliothèque spécialisée la plus renommée pour cet usage est incontestablement le paquet aplpack (conçu initialement par Peter Wolf pour l’implémentation moderne des méthodes de Tukey). Ce paquet fournit la fonction spécialisée stem.leaf.backback(), spécialement architecturée pour l’analyse bivariée bilatérale. L’appel de cette fonction prend en argument direct les deux vecteurs numériques indépendants représentant les deux cohortes à confronter. La fonction calcule automatiquement l’amplitude commune optimale, aligne le tronc central partagé, applique par défaut la règle des demi-tiges si la densité l’exige, et génère en sortie console un tracé d’une précision typographique absolue.
L’environnement R offre en outre un paramétrage fin des constantes de scission. L’argument m permet de contraindre manuellement le nombre de parties en lesquelles chaque tige doit être divisée (1 pour une tige par décade, 2 pour des demi-tiges, 5 pour une division quintésimale). L’argument depths = TRUE ajoute dans les marges latérales externes les décomptes cumulés de profondeurs d’observations depuis les deux extrémités jusqu’à la tige médiane, fournissant ainsi une lecture instantanée du rang des quartiles. Cette intégration scriptée permet d’incorporer directement l’analyse exploratoire semi-graphique au sein de rapports reproductibles dynamiques générés via R Markdown ou Quarto.
10.2 Développement et personnalisation sous Python
Au sein de l’écosystème de programmation scientifique Python, de plus en plus prépondérant en science des données et en neuro-imagerie computationnelle, la bibliothèque standard d’analyse statistique ne comporte pas nativement de fonction équivalente prête à l’emploi. Il revient dès lors à l’analyste de mobiliser les bibliothèques fondamentales telles que Pandas pour la structuration des séries de données et de concevoir des fonctions de rendu personnalisées garantissant l’isomorphisme spatial requis.
Une implémentation computationnelle rigoureuse sous Python repose sur la création d’une classe d’ingénierie procédant en plusieurs temps algorithmiques. Dans un premier temps, les données contenues dans une structure matricielle (DataFrame) sont filtrées pour éliminer les valeurs non disponibles, puis triées de manière vectorielle. L’algorithme extrait la partie entière du quotient par la puissance de dix retenue pour délimiter les tiges, et calcule le modulo correspondant pour isoler le chiffre unitaire constitutif de la feuille. Deux dictionnaires ordonnés sont ainsi générés en mémoire vive, stockant les listes ordonnées de feuilles associées à chaque tige commune pour les deux groupes.
Pour le rendu graphique, deux stratégies techniques s’offrent au développeur. La première consiste à générer un flux textuel strictement formaté via les mécanismes d’alignement de chaînes de caractères (méthodes de formatage de chaînes avec spécificateurs d’espacement strict), en inversant programmatiquement la chaîne des feuilles du groupe de gauche pour imposer la lecture centrifuge. La seconde approche, plus visuelle et adaptée aux publications modernes, exploite la bibliothèque matplotlib pour créer un canevas graphique vectoriel où chaque chiffre typographique est dessiné sous forme d’objet texte individuel positionné à des coordonnées cartésiennes strictement équidistantes, contournant définitivement les problèmes d’incompatibilité de polices de caractères.
10.3 Contraintes et adaptations pour les publications académiques
L’intégration d’un diagramme tige-et-feuille dos-à-dos au sein d’un manuscrit soumis à une revue scientifique à comité de lecture (répondant aux normes éditoriales de l’American Psychological Association ou d’éditeurs tels qu’Elsevier ou Springer) impose des précautions typographiques et matérielles impératives. Le premier écueil réside dans le choix de la police de caractères utilisée pour le corps du graphique.
L’utilisation de polices proportionnelles standard couramment employées dans le traitement de texte académique (telles que Times New Roman, Calibri ou Arial) est formellement destructrice pour un diagramme semi-graphique. Dans ces polices, la lettre « 1 » ou le chiffre « 1 » occupe une largeur physique sur la page substantiellement inférieure à celle du chiffre « 8 » ou « 0 ». Par conséquent, une ligne comportant dix fois le chiffre « 1 » paraîtra visuellement beaucoup plus courte qu’une ligne comportant huit fois le chiffre « 8 », détruisant purement et simplement l’isomorphisme géométrique entre la longueur de la rangée et la fréquence statistique des données. L’analyste doit impérativement exiger le recours exclusif à une police à chasse fixe (monospace) — telle que Courier New, Consolas ou DejaVu Sans Mono — où chaque caractère alphanumérique et chaque espace blanc occupent une cellule rectangulaire rigoureusement identique.
Pour les auteurs composant leurs manuscrits sous le système de composition typographique LaTeX, le diagramme doit être encapsulé au sein d’un environnement textuel non formaté ou d’un bloc dédié, en veillant à désactiver la césure automatique des mots et en verrouillant les marges latérales pour éviter tout retour à la ligne prématuré qui briserait la continuité d’une longue rangée de feuilles. Lorsque les directives de la revue exigent la fourniture de figures sous format vectoriel autonome (PDF vectoriel ou EPS), il est hautement recommandé de convertir le tracé textuel en figure graphique vectorielle nette, garantissant une netteté absolue de résolution indépendamment du facteur de zoom ou du processus de photocomposition de l’imprimeur.
11. Erreurs méthodologiques fréquentes et comment les éviter
11.1 L’inversion directionnelle des feuilles sur le versant gauche
Parmi l’ensemble des dérives procédurales identifiées dans la littérature académique et estudiantine, l’inversion directionnelle des feuilles sur le versant gauche du diagramme dos-à-dos représente l’erreur la plus prévalente et la plus dommageable. Conditionné par des décennies d’automatismes cognitifs d’écriture et de lecture linéaire de gauche à droite, le rédacteur non averti a une tendance spontanée quasi irrépressible à inscrire les feuilles du groupe de gauche en débutant depuis la marge extérieure gauche pour progresser vers la colonne centrale des tiges.
Cette faute d’ordonnancement détruit instantanément la logique architecturale de tout le système bilatéral. En effet, si l’on écrit de gauche à droite sur le flanc gauche, la feuille la plus faible de l’intervalle se retrouve reléguée à la périphérie externe la plus lointaine, tandis que la feuille la plus élevée vient se coller contre la colonne centrale des tiges. Il en résulte une rupture sémiotique fatidique : la proximité physique avec le tronc n’a plus la même signification mathématique selon que le regard se porte sur le versant gauche (où elle représenterait les scores élevés) ou sur le versant droit (où elle représente les scores faibles). Toute lecture synoptique comparative de la densité se trouve irrémédiablement faussée.
Pour immuniser définitivement le praticien contre cette dérive, une règle mnémotechnique fondamentale doit être intériorisée : le principe du déploiement centrifuge universel. L’analyste doit concevoir le tronc central partagé comme le niveau de base absolu (l’altitude zéro) à partir duquel la matière numérique s’écoule symétriquement vers l’extérieur. Que l’on regarde vers l’ouest ou vers l’est, le chiffre le plus modeste doit toujours être immédiatement adjacent à la tige d’ancrage, et les grandeurs croissantes doivent invariablement s’éloigner vers l’horizon marginal. Tout tracé violant ce principe doit être rejeté sans compromis.
11.2 Omission des tiges intermédiaires sans données
Une seconde erreur méthodologique insidieuse consiste à omettre délibérément, lors du tracé vertical du tronc central, les tiges intermédiaires pour lesquelles aucun des deux groupes ne possède d’observation empirique. Cette pratique procède le plus souvent d’un réflexe d’optimisation spatiale mal compris : l’opérateur constate un vide empirique entre, par exemple, la tige 4 et la tige 8, et décide unilatéralement d’accoler directement la ligne 8 sous la ligne 4 afin d’économiser quelques centimètres de papier ou de hauteur d’écran.
Cette suppression transforme clandestinement une échelle d’intervalles continus en une simple échelle ordinale discontinue, commettant un biais analytique inacceptable. L’omission des tiges vides contracte artificiellement l’espace physique qui sépare le corps principal de la distribution d’une observation distante. Ce qui était en réalité une valeur aberrante extrême, isolée à trente unités de distance dans un désert statistique, se retrouve soudainement représentée comme si elle était contiguë aux données centrales. La perception visuelle de la dispersion s’en trouve dramatiquement compressée et l’appréciation de la variance est totalement annihilée.
La doctrine méthodologique de l’analyse exploratoire des données ne tolère aucune exception sur ce point : l’axe vertical des tiges est continu, immuable et équidistant, de la valeur minimale observée jusqu’à la valeur maximale observée. Même si dix tiges consécutives ne recueillent pas la moindre feuille sur aucun des deux versants, ces dix tiges doivent figurer sobrement et explicitement dans la colonne centrale, matérialisant par leur vide textuel même la réalité objective du fossé empirique qui sépare les observations.
11.3 Défauts d’espacement et utilisation de polices proportionnelles
Comme souligné dans les considérations matérielles préalables, l’erreur consistant à rédiger ou imprimer un diagramme tige-et-feuille à l’aide d’une typographie à espacement variable ou proportionnel constitue un véritable contresens technique. Dans une typographie standard de traitement de texte, la largeur géométrique allouée à chaque caractère dépend de la morphologie de la lettre ou du chiffre : un « i » ou un « 1 » est extrêmement étroit, tandis qu’un « m » ou un « 8 » est large et massif.
Les répercussions de ce choix typographique erroné sur la validité scientifique du tracé sont dévastatrices. Imaginons une ligne du groupe A comportant douze fois la feuille « 1 » (associée par exemple au score répétitif de 31 points) et une ligne du groupe B comportant neuf fois la feuille « 8 » (associée au score de 38 points). Sous une police proportionnelle défaillante, la rangée de neuf « 8 » s’étirera sur une distance physique nettement plus longue que la rangée des douze « 1 ». L’observateur examinant la figure en déduira immédiatement, sur la base de sa perception gestaltiste de la longueur des barres, que la condition B est plus densément peuplée que la condition A sur cette tranche d’intervalles, parvenant à une conclusion diamétralement opposée à la vérité arithmétique sous-jacente.
Pour prévenir cette déformation de perspective, la règle méthodologique est absolue : aucun diagramme tige-et-feuille dos-à-dos ne doit être diffusé sans un contrôle rigoureux de l’égalité absolue de la largeur des cellules typographiques. La grille spatiale sous-jacente doit former un damier parfait où chaque caractère alphanumérique s’inscrit dans un quadrilatère aux dimensions invariables, préservant la stricte proportionnalité entre métrique spatiale et densité de fréquence.
11.4 Absence ou ambiguïté de la double légende
Enfin, une proportion alarmante de diagrammes tige-et-feuille insérés dans des rapports d’étape ou des mémoires universitaires souffre de l’absence totale ou de la formulation ambiguë de leur clé explicative. L’auteur d’un document commet fréquemment l’erreur égocentrique de présupposer que le système de scission décimale qu’il a appliqué de manière implicite coulera de source pour n’importe quel lecteur extérieur.
Rien n’est plus trompeur. Soit une ligne d’apparence anodine telle que « 4 | 6 | 9 ». Sans légende explicite, comment le relecteur peut-il déterminer s’il s’agit d’une observation clinique mesurant des quotients intellectuels (46 pour A, 49 pour B), des dosages d’anticorps sanguins exprimés en dizaines de milligrammes (0,46 contre 0,49 mg/L), ou des temps de parcours d’athlètes chronométrés en centaines de secondes (460 contre 490 s) ? Cette indétermination paralyse toute tentative d’évaluation critique de la portée scientifique des résultats.
Sur le diagramme dos-à-dos, cette exigence de clarté est dédoublée. La clé ne doit pas seulement expliciter la valeur de la feuille et de la tige, elle doit modéliser la syntaxe de lecture pour les deux sens d’exploration. Une clé incomplète qui n’illustrerait que le flanc droit (« 6 | 9 = 69 ») laisserait planer un doute insidieux sur la méthode de lecture appliquée au flanc gauche par un lecteur peu familier des conventions d’inversion centrifuge de Tukey. L’analyste se conformera donc toujours au modèle canonique exhaustif : « 4 | 6 | 9 correspond à 64 points pour le Groupe A et à 69 points pour le Groupe B (unités entières de mesure) ».
12. Synthèse comparative : Tige-et-feuille dos-à-dos versus autres visualisations
12.1 Confrontation directe avec les boîtes à moustaches comparatives (Boxplots)
La boîte à moustaches (ou boxplot), également popularisée par John Tukey dans le cadre de l’analyse exploratoire des données, partage avec le diagramme tige-et-feuille dos-à-dos une vocation comparatiste évidente. Elle résume une distribution à travers cinq nombres cardinaux : le minimum, le premier quartile, la médiane, le troisième quartile et le maximum (auxquels s’ajoute l’identification normalisée des valeurs atypiques au-delà des moustaches). Cependant, le niveau de granularité et les propriétés sémiotiques de ces deux artefacts diffèrent substantiellement.
La supériorité éclatante du diagramme tige-et-feuille dos-à-dos réside dans sa totale transparence vis-à-vis de la forme interne réelle de la distribution. Une boîte à moustaches est, par construction géométrique, incapable de révéler une bimodalité ou un creux central au sein de la boîte interquartile : deux groupes présentant exactement les mêmes valeurs de médiane, de Q₁ et de Q₃ généreront des boîtes à moustaches parfaitement identiques, alors même que l’un des groupes peut présenter une distribution normale unie et compacte tandis que l’autre est constitué de deux cohortes hautement polarisées séparées par un vide statistique complet. Le diagramme tige-et-feuille dévoile immédiatement cette supercherie en exposant le vide des feuilles centrales.
En contrepartie, la boîte à moustaches comparative reprend l’avantage opérationnel dès lors que le protocole expérimental implique la confrontation simultanée de plus de deux groupes (par exemple la comparaison de cinq doses d’une molécule pharmacologique ou de six classes scolaires différentes). Dans cette situation polyadique, la structure géométrique bilatérale du diagramme dos-à-dos devient inapplicable, ce dernier étant structurellement limité par sa symétrie en miroir à deux versants exclusifs. Dès lors, le chercheur avisé adoptera une démarche de complémentarité synergique : il utilisera les boîtes à moustaches juxtaposées pour balayer l’ensemble des conditions expérimentales multiples, puis déploiera le diagramme tige-et-feuille dos-à-dos pour radiographier en profondeur les contrastes critiques opposant deux sous-ensembles cibles d’intérêt majeur.
12.2 Confrontation avec les histogrammes juxtaposés et superposés
L’histogramme demeure la figure statistique la plus instinctivement mobilisée par les praticiens pour visualiser la dispersion d’une variable continue. Toutefois, lorsqu’il s’agit d’exécuter une comparaison bivariée directe entre deux séries de données, l’histogramme classique se heurte à des contraintes de lisibilité graphique particulièrement épineuses que l’architecture dos-à-dos permet de contourner avec une formidable aisance.
Lorsque deux histogrammes sont présentés sur des figures séparées superposées l’une au-dessus de l’autre, l’œil de l’observateur doit effectuer des micro-mouvements saccadiques verticaux permanents pour tenter d’estimer si les barres de telle classe de valeurs s’alignent précisément avec celles du graphique sous-jacent. Si les auteurs tentent de superposer les deux distributions au sein d’un graphique unique à barres entremêlées ou translucides, le résultat visuel sombre rapidement dans une illisibilité chromatique notoire, où la superposition des teintes de gris ou des hachures crée des illusions de relief parasites. Les « pyramides des âges » ou histogrammes en miroir résolvent partiellement ce problème, mais demeurent tributaires d’un écueil fondamental : la sensibilité extrême au choix de la largeur des classes (le binwidth).
Il est en effet mathématiquement démontré qu’en modifiant simplement le point d’origine ou la largeur des intervalles d’un histogramme, on peut radicalement métamorphoser l’apparence visuelle d’une distribution, faisant apparaître ou disparaître des bosses au gré des regroupements arbitraires de points. Le diagramme tige-et-feuille dos-à-dos élimine ce risque de manipulation ou d’artefact visuel : la largeur des classes est fixée par le système décimal objectif, le tronc central est strictly identique et partagé pour les deux cohortes, et chaque observation individuelle conserve sa signature numérique explicite au sein du graphique.
12.3 Grille d’aide à la décision pour le choix de la méthode graphique
Afin de guider l’investigateur scientifique dans l’arbitrage rationnel entre les différentes solutions graphiques offertes par la sémiologie statistique, le tableau synthétique de décision ci-dessous articule les critères d’éligibilité, les plages de validité métrique et les limites respectives de chaque méthodologie en fonction des contraintes de l’échantillonnage et des objectifs de la recherche :
- Diagramme tige-et-feuille dos-à-dos :
- Taille optimale d’échantillon : Échantillons de petite à moyenne taille, idéalement compris entre 20 et 150 observations par cohorte (jusqu’à 300 avec scission fine des tiges).
- Nombre de cohortes confrontables : Exactement deux groupes (confrontation bivariée exclusive).
- Degré de fidélité informationnelle : Absolu (zéro perte de données brutes, préservation intégrale des valeurs et de leur localisation ordinale exacte).
- Objectifs majeurs : Analyse exploratoire minutieuse, détection des anomalies, identification des bimodalités masquées, validation manuelle des postulats paramétriques, restitution pédagogique et clinique transparente.
- Contre-indications majeures : Échantillons massifs (n > 500 par groupe engendrant un débordement textuel illisible) et variables catégorielles non ordinales.
- Boîtes à moustaches comparatives (Boxplots) :
- Taille optimale d’échantillon : Valide pour toute taille d’échantillon dès n > 15, exceptionnellement robuste pour les grands volumes de données (n > 10 000).
- Nombre de cohortes confrontables : Théoriquement illimité (comparaison synoptique aisée de 3 à plus de 20 groupes contigus sur un même axe).
- Degré de fidélité informationnelle : Synthétique et réducteur (les données sont condensées en cinq estimateurs de position, masquant totalement les sous-structures internes).
- Objectifs majeurs : Balayage macroscopique rapide, comparaison de multiples niveaux de facteurs dans des designs factoriels complexes, détection standardisée d’outliers selon la règle d’écart interquartile.
- Contre-indications majeures : Échantillons minuscules (n < 10) où les quartiles perdent toute significativité, et recherche d’effets de granularité fine ou de multimodalité.
- Histogrammes en miroir / Diagrammes de densité en violon :
- Taille optimale d’échantillon : Échantillons volumineux à très volumineux (n > 200 jusqu’aux mégadonnées du Big Data).
- Nombre de cohortes confrontables : Principalement deux groupes en miroir bilatéral, ou superposition limitée de deux à trois courbes de densité lissées.
- Degré de fidélité informationnelle : Intermédiaire à probabiliste (agrégation en bandes d’amplitudes ou lissage mathématique continu par noyau gaussien).
- Objectifs majeurs : Modélisation continue de variables d’intérêt en population générale, publication esthétique pour de larges audiences académiques, visualisation de distributions d’apprentissage profond.
- Contre-indications majeures : Petits échantillons où les courbes de densité par noyau simulent des bosses artificielles fantômes et où le choix du pas d’intervalle dénature totalement la vérité empirique du recueil.
En dernière analyse, le diagramme tige-et-feuille dos-à-dos apparaît comme un monument d’équilibre méthodologique au sein du paysage de la statistique moderne. Loin d’être une simple curiosité historique reléguée aux manuels d’initiation, il incarne dans sa matérialité textuelle la quintessence même de l’esprit critique scientifique : le refus du compromis réducteur, le respect méticuleux de chaque observation empirique recueillie, et la quête d’une clarté visuelle sans artifice au service exclusif de la rigueur de la découverte.
Références
- Bowley, A. L. (1901). Elements of Statistics. P. S. King & Son.
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Emerson, J. D., & Hoaglin, D. C. (1983). Stem-and-leaf displays. In D. C. Hoaglin, F. Mosteller, & J. W. Tukey (Eds.), Understanding Robust and Exploratory Data Analysis (pp. 7–32). John Wiley & Sons.
- Friendly, M. (2008). The golden age of statistical graphics. Statistical Science, 23(4), 502–535. https://doi.org/10.1214/08-STS268
- National Institute of Standards and Technology. (2012). Stem-and-Leaf Plot. NIST/SEMATECH e-Handbook of Statistical Methods. https://www.itl.nist.gov/div898/handbook/eda/section3/stemleaf.htm
- Tukey, J. W. (1972). Some graphic and semigraphic displays. In T. A. Bancroft (Ed.), Statistical Papers in Honor of George W. Snedecor (pp. 293–316). Iowa State University Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Velleman, P. F., & Hoaglin, D. C. (1981). Applications, Basics, and Computing of Exploratory Data Analysis. Duxbury Press.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wolf, P. (2019). aplpack: Another Plot Package (Functions for Drawing Stem-and-Leaf Plots, Bagplots, Faces, and Other Specialized Graphics). R package version 1.3.3. https://cran.r-project.org/package=aplpack