
L’analyse quantitative en sciences sociales, en économie comportementale et en psychométrie repose fondamentalement sur la modélisation statistique de phénomènes complexes. Dans ce contexte, les chercheurs sont constamment confrontés à la nécessité d’intégrer des informations qualitatives au sein de formalismes mathématiques conçus initialement pour traiter des grandeurs continues. Qu’il s’agisse d’évaluer l’impact d’une appartenance catégorielle, d’un statut socio-économique, d’un protocole d’intervention psychologique ou d’une affiliation nosographique, la conversion rigoureuse de ces attributs discrets en variables numériques exploitables constitue une étape fondamentale de la préparation des données.
La variable muette, fréquemment désignée sous l’anglicisme dummy variable ou sous l’appellation méthodologique d’indicateur binaire, s’érige en pierre angulaire de cette passerelle épistémologique. En attribuant de manière déterministe les valeurs discrètes 0 et 1 pour marquer l’absence ou la présence d’un attribut qualitatif spécifique, l’analyste transforme un espace nominal non métrique en un ensemble de dimensions vectorielles intégrables dans le modèle linéaire généralisé. Cette transformation n’est pas une simple commodité programmatique ; elle engage la cohérence géométrique de l’espace des prédicteurs et conditionne directement l’identifiabilité mathématique des paramètres estimés.
Ce manuel exhaustif propose une exploration approfondie, à la fois théorique, mathématique et computationnelle, de la création et de la manipulation des variables muettes dans l’environnement statistique R. En parcourant les mécanismes sous-jacents de l’algèbre matricielle, les fonctions primitives du langage de base, les modules d’automatisation modernes et les flux de travail intégrés dans le paradigme Tidyverse, ce guide offre une feuille de route détaillée pour les praticiens de la recherche empirique soucieux d’allier rigueur méthodologique et reproductibilité algorithmique.
1. Introduction théorique et épistémologique aux variables muettes en psychométrie
1.1 Définition formelle et utilité des variables indicatrices en modélisation
Dans l’architecture du modèle linéaire général, la variable muette se formalise comme une fonction indicatrice vectorielle. Mathématiquement, pour un ensemble d’observations indicées par $i in {1, dots, n}$, une variable muette $D_{i}$ associée à une modalité spécifique $A$ d’une variable qualitative prend la valeur 1 si l’unité statistique $i$ possède la caractéristique $A$, et 0 dans le cas contraire. Cette binarisation stricte permet de projeter une information d’ordre qualitatif, dénuée de propriétés arithmétiques intrinsèques, dans un espace vectoriel euclidien où les opérations de somme, de produit scalaire et de projection orthogonale deviennent légitimes.
L’utilité première de ce dispositif réside dans la quantification de construits discrets au sein de structures paramétriques. En psychométrie et en sciences du comportement, de nombreuses variables fondamentales se manifestent sous une forme catégorielle : le statut diagnostique d’un patient selon les classifications du Manuel diagnostique et statistique des troubles mentaux (DSM-5), le type d’attachement dans le cadre des relations interpersonnelles, ou encore le groupe d’assignation expérimentale dans les essais randomisés contrôlés. Intégrer de telles dimensions sans les dénaturer exige un cadre formel préservant leur nature discrète tout en autorisant le calcul de différentiels moyens, de pentes conditionnelles et d’effets d’interaction ajustés sur d’autres covariables continues.
La distinction épistémologique entre les types d’échelles de mesure, conceptualisée historiquement par Stanley Smith Stevens, prend ici tout son sens. Les variables continues possèdent une unité de mesure constante et un continuum infini de valeurs potentielles, tandis que les variables ordinales ordonnent les observations sans garantir l’égalité des intervalles sous-jacents. En revanche, les variables nominales polytomiques segmentent la population en classes qualitatives exhaustives et mutuellement exclusives, sans aucune hiérarchie naturelle ou ordonnancement géométrique. L’usage des variables indicatrices permet ainsi de traiter les échelles nominales sans imposer arbitrairement une relation d’ordre fallacieuse qui viendrait biaiser de manière substantielle l’estimation des moindres carrés ordinaires.
1.2 La transition des échelles qualitatives vers les représentations numériques
L’écueil méthodologique le plus sévère lors de la manipulation de variables nominales réside dans l’assignation de codes numériques arbitraires traités ultérieurement comme des grandeurs scalaires continues. Attribuer les valeurs 1, 2 et 3 respectivement aux modalités « Célibataire », « Marié » et « Divorcé », puis insérer directement cette variable codée dans une équation de régression linéaire sous-tend l’hypothèse absurde que l’état d’être divorcé correspond au triple de l’état de célibataire, ou que la « distance psychologique ou sociologique » séparant un individu marié d’un individu célibataire équivaut rigoureusement à celle séparant un individu divorcé d’un individu marié. Une telle dérive viole les postulats de mesure fondamentale et vicie irrémédiablement l’interprétation des estimateurs.
La méthode de codage par variables muettes résout élégamment ce problème en substituant à l’axe unidimensionnel arbitraire un hyperespace multidimensionnel constitué d’autant d’axes orthogonaux que la variable qualitative compte de degrés de liberté informatifs. Ce processus préserve rigoureusement la structure topologique et géométrique des données. Aucun espacement quantitatif n’est postulé entre les catégories ; chaque modalité est représentée par une coordonnée discrète sur un axe binaire qui lui est propre, éliminant tout artefact d’équidistance.
Dans la formulation matricielle standard de la régression linéaire générale, définie par l’équation classique $Y = X\beta + \varepsilon$, où $Y$ désigne le vecteur des réponses de dimension $(n \times 1)$, $X$ la matrice de conception (ou design matrix) de dimension $(n \times p)$, $\beta$ le vecteur des coefficients directeurs à estimer, et $varepsilon$ le vecteur des perturbations aléatoires, les prédicteurs qualitatifs binarisés s’intègrent comme des colonnes de zéros et de uns. Cette formalisation matricielle garantit que les produits matriciels fondamentaux, notamment la matrice des covariances des régresseurs $X’X$, conservent des propriétés analytiques transparentes et permettent une interprétation géométrique directe en termes de contrastes moyens entre sous-populations.
1.3 Objectifs du tutoriel et contexte computationnel dans l’écosystème R
Le langage de programmation et environnement statistique R constitue historiquement un vecteur d’excellence pour le traitement rigoureux des données catégorielles grâce à sa structure primitive dédiée : le type factor. Conçu dès l’origine par les laboratoires Bell pour le langage S puis réimplémenté dans R, le facteur permet d’encapsuler la sémantique statistique des variables qualitatives en distinguant formellement les étiquettes textuelles humaines (les modalités ou levels) de leur représentation interne sous forme d’entiers pointant vers une table de contrastes prédéfinie. Cette architecture logicielle confère à R une supériorité notable sur d’autres langages à vocation générale dans l’automatisation de l’analyse linéaire.
Toutefois, la manipulation explicite des variables muettes demeure indispensable pour une pluralité de cas d’usage avancés. D’une part, certains algorithmes d’apprentissage automatique supervisé, tels que les forêts aléatoires optimisées, les réseaux de neurones profonds ou les modèles de régression régularisée (Lasso, Ridge, ElasticNet via des bibliothèques spécialisées comme glmnet), exigent impérativement des matrices numériques homogènes en entrée et ne prennent pas en charge nativement les structures de facteurs. D’autre part, dans un dessein pédagogique, de contrôle méthodologique ou de reporting psychométrique, la décomposition manuelle d’une modalité permet de mieux maîtriser l’architecture des équations structurelles estimées.
Ce guide pas à pas a pour vocation de démystifier ces processus computationnels à travers un prisme empirique centré sur les sciences humaines. Nous examinerons successivement l’approche vectorielle primitive avec les fonctions de base, la dérivation matricielle via la commande native model.matrix(), l’automatisation performante au moyen de bibliothèques spécialisées à haut débit telles que fastDummies, et enfin l’intégration harmonieuse dans les pipelines modernes de modélisation prédictive avec tidymodels et son module de pré-traitement recipes. Chaque section sera étayée par des considérations relatives à la théorie de la mesure et à la robustesse statistique des conclusions inférentielles.
2. Fondements mathématiques et la règle de k – 1 variables
2.1 Le piège des variables muettes (Dummy Variable Trap) et la colinéarité parfaite
La conversion d’une variable qualitative comprenant $k$ modalités distinctes soulève immédiatement une contrainte algébrique stricte connue sous la dénomination de « piège des variables muettes » (Dummy Variable Trap). Si un analyste tente de modéliser une variable catégorielle en créant simultanément $k$ variables indicatrices et qu’il insère l’ensemble de ces $k$ vecteurs dans une équation de régression linéaire comportant une constante d’origine (l’intercept $\beta_0$), il engendre mécaniquement une situation de colinéarité parfaite, ou dépendance linéaire exacte.
Considérons en effet le vecteur unité $J = (1, 1, dots, 1)’$ associé à la constante du modèle. Par définition, chaque observation $i$ appartient à une et une seule modalité parmi les $k$ catégories possibles du régresseur qualitatif (principe d’exhaustivité et d’exclusion mutuelle). Par conséquent, pour chaque ligne de la matrice de données, la somme arithmétique des $k$ variables muettes associées s’écrit de manière déterministe :
$$\sum_{j=1}^{k} D_{i,j} = D_{i,1} + D_{i,2} + dots + D_{i,k} = 1$$
Cette relation d’égalité montre que le vecteur unitaire de l’intercept est exactement égal à la somme vectorielle des $k$ variables muettes créées. Les colonnes correspondantes de la matrice de conception $X$ ne sont plus linéairement indépendantes ; le rang de la matrice $X$ devient strictement inférieur à son nombre de colonnes ($p$). Il en résulte directement que la matrice symétrique semi-définie positive $X’X$, indispensable à l’obtention des estimateurs par la méthode des moindres carrés ordinaires, devient une matrice singulière dont le déterminant est nul ($det(X’X) = 0$).
Puisque la matrice $X’X$ n’est pas inversible, la formule fermée classique des estimateurs des moindres carrés ordinaires :
$$\hat{\beta} = (X’X)^{-1} X’Y$$
se trouve confrontée à une impossibilité algorithmique absolue. Le système d’équations normales admet une infinité de solutions équivalentes, rendant l’identification des paramètres structurellement impossible. Sur le plan computationnel, les logiciels statistiques non avertis renvoient une erreur d’inversion matricielle ou attribuent des valeurs de type NA (non disponible) aux coefficients surnuméraires en raison de l’écrasement des valeurs singulières lors de la décomposition numérique QR.
2.2 La formalisation de la modalité de référence (Baseline Category)
Pour restaurer le plein rang de la matrice d’expérience $X$ et lever l’indétermination mathématique du système, il est impératif d’imposer une contrainte d’identification. La méthode la plus courante et la plus intuitive consiste à omettre délibérément l’un des vecteurs indicatifs de la spécification de la régression. Cette règle fondamentale énonce que pour une variable qualitative possédant $k$ niveaux discrets, exactement $k – 1$ variables muettes doivent être introduites dans le modèle en présence d’une constante libre.
La modalité dont le vecteur indicatif est écarté de la matrice de régression est désignée sous les vocables de « modalité de référence », « catégorie de base » ou « niveau témoin » (baseline category ou reference level). Sur le plan statistique, cette soustraction vectorielle confère à la constante du modèle $\beta_0$ une signification primordiale : elle capture l’espérance mathématique conditionnelle de la variable dépendante $Y$ pour le sous-groupe d’individus appartenant à cette modalité de référence, lorsque toutes les autres covariables continues du modèle sont fixées à zéro.
La sélection rationnelle de cette catégorie de référence ne modifie en rien la qualité globale de l’ajustement du modèle, mesurée par la somme des carrés des résidus ou le coefficient de détermination $R^2$, mais elle détermine l’architecture comparative de tous les paramètres de pente estimés. Les coefficients associés aux $k – 1$ variables muettes conservées dans le modèle quantifient les écarts moyens ou différentiels marginaux observés entre chaque groupe respectif et la catégorie de base choisie. Dès lors, le choix de ce niveau doit s’appuyer sur des fondements théoriques rigoureux : s’agira-t-il d’un groupe contrôle clinique, de la modalité statistiquement modale de l’échantillon, ou d’une condition expérimentale neutre ? La clarté de la communication scientifique dépend intimement de cette décision opératoire.
2.3 Application au cas concret : statut matrimonial et prédiction du revenu
Afin d’ancrer ces concepts dans une démarche analytique concrète, considérons une investigation psychologique et socio-économique s’intéressant à l’impact des trajectoires de vie conjugale sur le bien-être matériel d’une cohorte d’actifs. La variable qualitative étudiée concerne le statut matrimonial, noté conventionnellement marital_status, et comporte initialement trois modalités discrètes et exhaustives :
- Célibataire (individus n’ayant jamais contracté d’union légale) ;
- Marié (individus vivant sous le régime légal du mariage ou de l’union civile) ;
- Divorcé (individus ayant vécu une dissolution légale d’union).
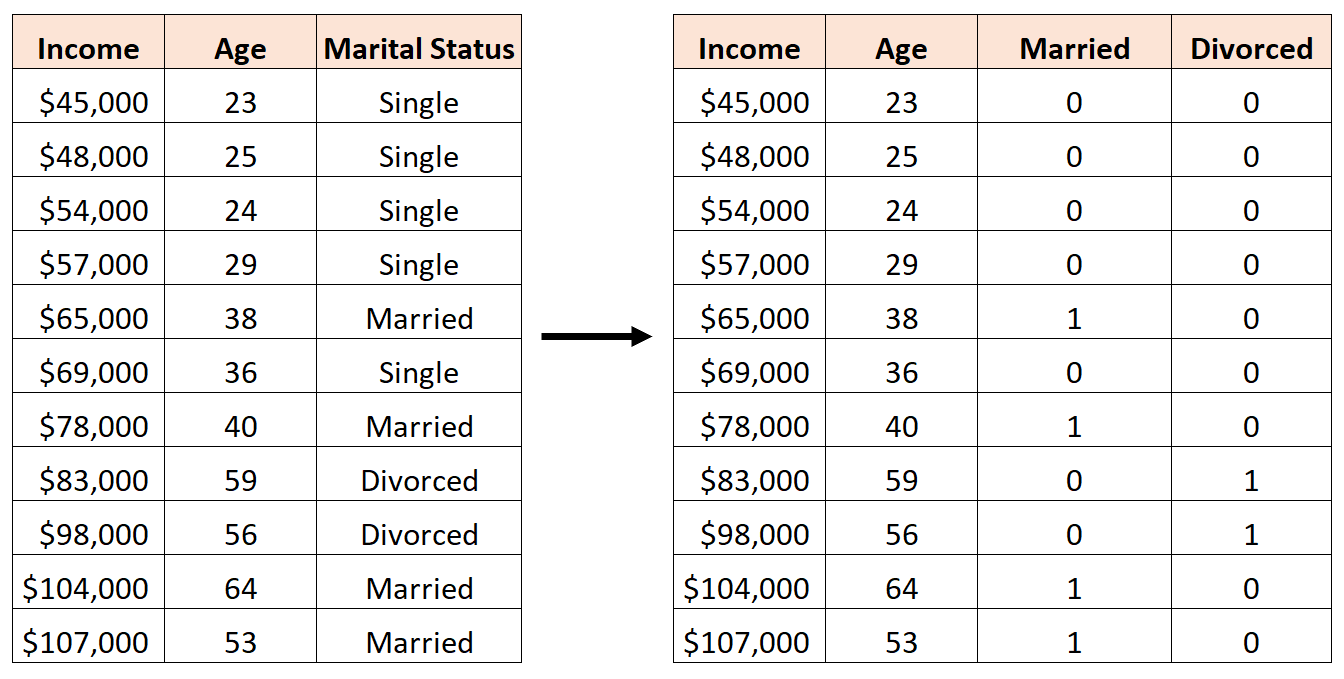
Le nombre total de modalités s’élève à $k = 3$. En application stricte du théorème fondamental de décomposition matricielle, le nombre d’indicateurs binaires requis pour modéliser cette variable dans une régression dotée d’une ordonnée à l’origine est de $k – 1 = 3 – 1 = 2$. Désignons arbitrairement la modalité « Célibataire » comme niveau de référence théorique. Il convient alors de construire deux variables indicatrices, notées respectivement $D_{\text{Marié}}$ et $D_{\text{Divorcé}}$.
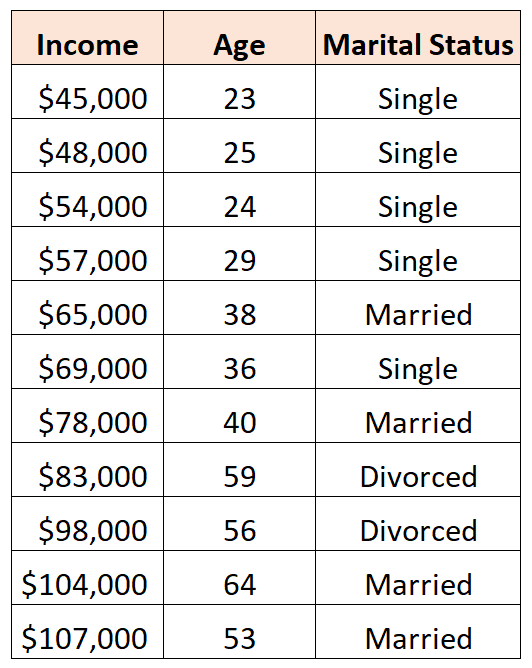
L’espace vectoriel d’entrée pour chaque sujet statistique $i$ se décline selon le codage binaire formel suivant :
- Si l’individu $i$ est Célibataire : $D_{i, \text{Marié}} = 0$ et $D_{i, \text{Divorcé}} = 0$. Le profil numérique associé correspond au doublet $(0, 0)$.
- Si l’individu $i$ est Marié : $D_{i, \text{Marié}} = 1$ et $D_{i, \text{Divorcé}} = 0$. Le profil numérique associé correspond au doublet $(1, 0)$.
- Si l’individu $i$ est Divorcé : $D_{i, \text{Marié}} = 0$ et $D_{i, \text{Divorcé}} = 1$. Le profil numérique associé correspond au doublet $(0, 1)$.
L’équation théorique de prédiction du revenu annuel $Y_i$ ajustée sur l’âge $X_{i, \text{Âge}}$ prend la forme linéaire suivante :
$$Y_i = \beta_0 + \beta_1 X_{i, \text{Âge}} + \beta_2 D_{i, \text{Marié}} + \beta_3 D_{i, \text{Divorcé}} + \varepsilon_i$$
Dans ce cadre analytique, le coefficient $\beta_2$ mesure la différence espérée de revenu entre un individu marié et un individu célibataire ayant strictement le même âge chronologique. De même, $\beta_3$ reflète la divergence structurelle de revenu entre un individu divorcé et un célibataire à âge constant. L’absence de redondance colinéaire est mathématiquement garantie puisque le doublet $(0, 0)$ assure la distinction et la solvabilité de la catégorie de référence sans introduire de troisième colonne unitaire compétitive avec $\beta_0$.
3. Étape 1 : Préparation de l’environnement de travail et création du jeu de données
3.1 Initialisation de la session et bonnes pratiques de reproductibilité
Toute démarche d’investigation quantitative rigoureuse débute par une configuration standardisée de la session de calcul sous R. La reproductibilité computationnelle implique de garantir que les résultats obtenus sur une station de travail puissent être répliqués à l’identique, au bit près, sur tout autre environnement informatique, indépendamment des spécificités du système d’exploitation sous-jacent. Cette exigence impose la fixation formelle de l’aléa généré lors des processus stochastiques de simulation.
L’initialisation de l’espace de travail s’opère en purgeant la mémoire vive des objets résiduels à l’aide de l’instruction rm(list = ls()) et en forçant l’utilisation d’encodages de caractères universels tels que l’UTF-8 via les options globales de la session. Parallèlement, l’attribution d’une graine déterministe au générateur congruentiel de nombres pseudo-aléatoires s’effectue au moyen de la fonction native set.seed(). Le choix de la valeur entière passée en argument est arbitraire sur le plan théorique, mais sa permanence garantit la constance des réalisations d’échantillonnage aléatoire :
La commande s’écrit formellement sous la syntaxe standardisée :
set.seed(12345)
L’environnement doit être configuré pour documenter systématiquement la version de R exploitée ainsi que l’état des modules chargés en invoquant la fonction sessionInfo() au terme du script. Ce protocole immunise le chercheur contre les modifications comportementales mineures susceptibles d’intervenir lors des mises à jour incrémentales des extensions logicielles.
3.2 Génération programmatique du data frame empirique
Afin de contextualiser nos manipulations sur des bases empiriques réalistes, générons un ensemble de données psychologiques et économiques synthétique comprenant $n = 1000$ observations individuelles. Nous échantillonnerons trois variables représentatives : le statut matrimonial (variable qualitative nominale polytomique), l’âge (variable quantitative continue exprimée en années révolues) et le revenu annuel brut (variable continue exprimée en unités monétaires standardisées).
Pour émuler la distribution démographique observée dans les enquêtes sociométriques réelles, définissons des proportions inégales pour les trois modalités d’état civil : 45 % de célibataires, 40 % d’individus mariés et 15 % d’individus divorcés. La génération stochastique du vecteur de statut matrimonial s’articule autour de la fonction vectorisée sample() en autorisant le tirage avec remise :
statut <- sample(c("Célibataire", "Marié", "Divorcé"), size = 1000, replace = TRUE, prob = c(0.45, 0.40, 0.15))
L’âge des participants est ensuite généré selon une distribution uniforme discrète ou continue s’étendant de 22 à 65 ans via runif(1000, min = 22, max = 65). Enfin, pour insuffler un réalisme psychométrique au modèle, la variable dépendante de revenu est construite comme une fonction déterministe de l’âge et du statut marital, à laquelle s’adjoint un terme de perturbation gaussien homoscédastique d’écart-type résiduel constant :
bruit <- rnorm(1000, mean = 0, sd = 4500)
revenu <- 18000 + (650 * age) + ifelse(statut == "Marié", 8000, 0) + ifelse(statut == "Divorcé", -2500, 0) + bruit
L’assemblage matriciel prend la forme d’un objet de classe data.frame conventionnel regroupant ces séries ordonnées :
donnees_etude <- data.frame(revenu = round(revenu, 2), age = round(age, 1), statut_matrimonial = statut, stringsAsFactors = FALSE)
L’interrogation immédiate de la structure de l’objet via str(donnees_etude) et l’affichage des premières lignes par head(donnees_etude) valident la conformité des types primitifs : deux vecteurs numériques à double précision et un vecteur de chaînes de caractères de type character.
3.3 Audit exploratoire des distributions et des modalités qualitatives
Avant d’engager toute transformation matricielle, la déontologie de l’analyste de données commande d’effectuer une inspection statistique rigoureuse des fréquences observées. Le comptage des occurrences d’une variable nominale permet de s’assurer de l’absence de modalités quasi-vides (ou sparse categories), lesquelles sont susceptibles de provoquer de fortes instabilités lors de l’estimation de l’erreur-type des coefficients de régression.
Dans l’environnement de base de R, la distribution d’une variable qualitative s’examine à l’aide de la commande table(), complétée par la fonction prop.table() pour l’évaluation des fréquences relatives. L’instruction combinée :
prop.table(table(donnees_etude$statut_matrimonial)) * 100
permet de certifier que les proportions observées dans l’échantillon synthétique convergent de manière satisfaisante vers les probabilités d’affectation théoriques configurées à l’étape précédente. L’apparition inopinée de catégories sous-représentées (par exemple, moins de 5 % des observations totales) contraindrait le statisticien à envisager un regroupement de modalités afin de garantir la convergence asymptotique des estimateurs.
Enfin, un premier diagnostic bivarié croisant le statut matrimonial et la distribution continue du revenu est mené par le calcul des espérances conditionnelles à l’aide de la fonction d’agrégation vectorisée tapply() :
tapply(donnees_etude$reve\nu, donnees_etude$statut_matrimonial, summary)
Cette commande permet d’obtenir un tableau récapitulatif des indicateurs de tendance centrale (médiane, moyenne arithmétique) et de dispersion (écarts interquartiles) pour chaque strate conjugale, corroborant ainsi l’existence empirique des écarts différentiels que les variables muettes auront pour vocation formelle d’isoler dans les étapes analytiques ultérieures.
4. Étape 2 : Méthode manuelle avec les fonctions de base de R
4.1 Utilisation de la fonction conditionnelle ifelse()
L’approche la plus élémentaire et pédagogique pour concevoir des variables muettes en dehors de tout cadre automatisé repose sur l’emploi de structures conditionnelles vectorisées natives. La fonction ifelse() de R évalue un test logique scalaire appliqué à chaque élément d’un vecteur et renvoie une valeur spécifique selon que le prédicat booléen s’avère vrai (TRUE) ou faux (FALSE).
Pour notre jeu de données comportant les modalités « Célibataire », « Marié » et « Divorcé », et en maintenant notre décision méthodologique d’ériger les célibataires en modalité de référence omise, nous devons implémenter manuellement deux nouvelles colonnes indicatrices. La syntaxe computationnelle se déploie de la manière suivante :
donnees_etude$statut_marie <- ifelse(donnees_etude$statut_matrimonial == "Marié", 1, 0)
donnees_etude$statut_divorce <- ifelse(donnees_etude$statut_matrimonial == "Divorcé", 1, 0)
Ce mécanisme garantit une transparence absolue dans l’affectation binaire. Si un individu présente la modalité « Marié », la variable statut_marie reçoit la valeur 1 tandis que statut_divorce se voit assigner la valeur 0. Si un individu est « Divorcé », les assignations s’inversent de façon symétrique. Crucialement, pour tout sujet présentant l’attribut « Célibataire », les deux conditions logiques échouent successivement, attribuant un 0 dans les deux colonnes créées. Le groupe de référence se trouve ainsi implicitement codé par le profil vectoriel conjoint $(0, 0)$, satisfaisant à la perfection la condition nécessaire pour contourner le piège de la colinéarité parfaite.
Bien que d’une clarté conceptuelle indiscutable pour des jeux de données d’envergure modeste, cette méthode présente l’inconvénient d’un coût de développement linéaire : pour une variable nominale à vingt modalités, l’analyste serait astreint à déclarer dix-neuf lignes de code redondantes, augmentant proportionnellement le risque d’erreurs typographiques ou d’incohérences de nommage.
4.2 Alternative par conversion logique directe en entiers
Une alternative élégante et nettement supérieure en termes d’efficience computationnelle consiste à exploiter la coercition de type sous-jacente du langage R. En effet, dans le modèle de calcul de R, un vecteur booléen (de type logical) composé exclusivement de constantes TRUE et FALSE peut être converti de manière déterministe en un vecteur numérique entier sans recourir à la lourdeur d’une fonction conditionnelle d’embranchement telle que ifelse().
L’évaluation logique directe d’une égalité stricte génère un vecteur booléen en mémoire. En enveloppant cette comparaison logique dans la fonction primitive de coercition as.integer() ou as.numeric(), le système convertit automatiquement les valeurs de vérité TRUE en l’entier 1, et les valeurs de fausseté FALSE en l’entier 0. La syntaxe optimisée s’écrit ainsi :
donnees_etude$statut_marie <- as.integer(donnees_etude$statut_matrimonial == "Marié")
donnees_etude$statut_divorce <- as.integer(donnees_etude$statut_matrimonial == "Divorcé")
Cette approche présente un avantage déterminant lors du traitement de très larges bases de données psychologiques ou épidémiologiques comportant des centaines de milliers d’observations. Alors que la fonction ifelse() effectue des vérifications d’attributs et des duplications d’objets intermédiaires coûteuses en cycles processeur, la coercition directe via as.integer() opère par une modification quasi-instantanée du pointeur de type C interne de R, réduisant considérablement l’empreinte mémoire et le temps d’exécution global.
4.3 Contrôle de conformité de la nouvelle matrice de données
Toute manipulation manuelle de données nécessite une étape formelle de validation croisée. Il est impératif de vérifier que les nouvelles colonnes indicatrices reproduisent sans altération l’information portée par la variable qualitative originale et qu’aucun glissement d’indice ou aucune valeur manquante fortuite n’a été introduite au cours du processus de conversion.
L’outil le plus rigoureux pour attester de cette conformité structurelle demeure la table de contingence bivariée. En croisant la variable textuelle initiale avec chacune des variables muettes dérivées, l’analyste doit observer une séparation disjonctive sans ambiguïté. L’exécution de la commande suivante :
table(donnees_etude$statut_matrimonial, donnees_etude$statut_marie)
doit faire apparaître une matrice de contingence de dimension $(3 \times 2)$ où la modalité « Marié » est strictement concentrée dans la colonne 1, tandis que les lignes « Célibataire » et « Divorcé » présentent exclusivement des effectifs au sein de la colonne 0. Une inspection symétrique doit être réalisée sur la variable statut_divorce.
De surcroît, la vérification de l’absence de chevauchement contradictoire entre les deux indicateurs s’opère par le test de tabulation croisée conjointe :
table(donnees_etude$statut_marie, donnees_etude$statut_divorce)
Le quadrant supérieur droit correspondant à la cellule $(1, 1)$ — c’est-à-dire l’hypothèse absurde où un individu serait simultanément codé comme marié et divorcé — doit afficher un effectif rigoureusement nul. L’observation d’un total de zéro dans cette cellule, couplée au fait que l’effectif de la cellule $(0, 0)$ concorde exactement avec le nombre de célibataires dénombrés dans l’échantillon brut, confirme la validité logique de la matrice enrichie.
5. Étape 3 : Méthode matricielle native via model.matrix()
5.1 Compréhension du mécanisme interne de codage par contrastes de R
Sous son apparente simplicité, l’écosystème R recèle une machinerie analytique sophistiquée pour la gestion des données catégorielles. Lorsque des modèles linéaires sont formulés à l’aide de l’opérateur symbolique ~, le moteur d’évaluation n’exige pas que l’analyste ait préalablement éclaté ses variables qualitatives en colonnes muettes indépendantes. Si la variable est formellement déclarée comme un facteur (factor), R applique un système interne d’assignation de contrastes mathématiques.
La transformation d’un vecteur de chaînes en facteur s’effectue par l’instruction :
donnees_etude$statut_matrimonial <- as.factor(donnees_etude$statut_matrimonial)
Dès lors, l’objet acquiert un attribut structurel déterminant nommé levels. Par défaut, R ordonne les modalités selon l’ordre lexicographique standard (alphabétique). Dans notre cas d’étude, l’ordre résultant devient irrémédiablement : 1. « Célibataire », 2. « Divorcé », 3. « Marié ». Par défaut, les modèles paramétriques dans R exploitent le système de contrastes de traitement, matérialisé par la fonction sous-jacente contr.treatment().
Ce schéma de codage désigne automatiquement le premier niveau alphabétique comme modalité de base. Pour chaque niveau subséquent, R crée une variable indicatrice implicite qui est comparée à cette référence. La fonction d’inspection des contrastes :
contrasts(donnees_etude$statut_matrimonial)
révèle explicitement la matrice de conception sous-jacente, affichant une ligne pour chaque niveau et une colonne pour chaque degré de liberté paramétré. Si ce comportement par défaut est souvent commode, l’ordre purement alphabétique peut s’avérer néfaste s’il promeut comme groupe témoin une modalité marginale ou dénuée de sens théorique.
5.2 Génération de la matrice d’expérience avec model.matrix()
Pour les utilisateurs souhaitant extraire l’exacte matrice numérique exploitée en coulisses par les algorithmes d’estimation linéaire, R met à disposition la fonction universelle model.matrix(). Cette primitive prend pour arguments une formule symbolique spécifiant les relations entre les prédicteurs et le data frame hôte, et renvoie la matrice de conception complète, prête pour le calcul matriciel pur.
Pour générer l’espace des variables muettes avec prise en compte automatique d’un intercept, la syntaxe canonique s’énonce comme suit :
matrice_conception <- model.matrix(~ statut_matrimonial, data = donnees_etude)
L’inspection des dimensions via dim(matrice_conception) atteste de la présence d’une matrice de dimensions $(1000 \times 3)$. L’instruction head(matrice_conception) permet de constater que la première colonne est uniformément constituée de 1 (l’intercept symbolisé par (Intercept)), la deuxième colonne est nommée statut_matrimonialDivorcé et la troisième statut_matrimonialMarié. Conformément à la théorie, la modalité « Célibataire » a été absorbée dans la constante d’origine.
Si l’analyste requiert l’ensemble exhaustif des $k$ variables muettes sans omission préalable — par exemple pour nourrir un modèle de régression pénalisée de type Ridge ou un classifieur bayésien sans intercept explicite —, il convient d’altérer la formule en soustrayant formellement l’unité :
matrice_disjonctive <- model.matrix(~ statut_matrimonial - 1, data = donnees_etude)
L’opérateur - 1 supprime la génération de la colonne vectorielle unitaire, forçant ainsi model.matrix() à produire les trois indicateurs binaires disjoints pour chaque observation, correspondant à un codage disjonctif complet.
5.3 Avantages algorithmiques de l’approche matricielle
L’utilisation de la fonction model.matrix() transcende largement la simple génération cosmétique de colonnes binaires. Sur le plan de la robustesse computationnelle, cette fonction encapsule une gestion particulièrement rigoureuse des données manquantes. En association avec les options d’environnement globales de gestion des valeurs manquantes, telles que na.action = na.pass ou na.action = na.omit, elle permet de calibrer précisément le comportement de l’algorithme face aux lacunes d’échantillonnage.
Par ailleurs, cette fonction résout de manière transparente les problématiques de cohérence typologique. Si une modalité présente dans les attributs d’un facteur ne se trouve pas représentée au sein d’un sous-échantillon particulier (un phénomène fréquent lors de validations croisées par découpage de plis $k$-fold), model.matrix() maintient la structure dimensionnelle globale dictée par la définition originelle du facteur, évitant ainsi l’apparition d’erreurs d’incompatibilité de dimensions (dimension mismatch) lors du calcul des produits matriciels de prédiction sur des jeux de données d’évaluation.
Enfin, cette approche s’interface de façon optimale avec les architectures de programmation mathématique de bas niveau. La matrice produite est directement assimilable par des bibliothèques d’algèbre linéaire haute performance écrites en FORTRAN ou en C++, telles que BLAS (Basic Linear Algebra Subprograms) et LAPACK, garantissant des décompositions spectrales et des inversions de Cholesky à la vitesse d’exécution maximale permise par le matériel.
6. Étape 4 : Automatisation avec le package fastDummies
6.1 Installation, chargement et principes de l’extension fastDummies
Tandis que les fonctions fondamentales de R suffisent pour des manipulations académiques ponctuelles, les projets d’analyse de données massives nécessitent des solutions hautement automatisées, capables de traiter des dizaines de colonnes qualitatives simultanément au sein de structures tabulaires sans altérer l’intégrité des autres covariables. Le package fastDummies, développé spécifiquement pour combler cette lacune opérationnelle, s’est imposé comme une référence incontournable de l’écosystème CRAN.
L’installation de l’extension s’effectue par la procédure classique de gestionnaire de paquets :
install.packages("fastDummies")
library(fastDummies)
La philosophie de fastDummies repose sur un traitement non destructif et vectorisé en profondeur. Contrairement aux méthodes manuelles qui imposent une assignation itérative colonne par colonne, ou à model.matrix() qui renvoie une matrice brute déconnectée des variables d’origine n’ayant pas fait partie de la formule, la fonction phare dummy_cols() opère directement sur un data.frame ou un tibble. Elle identifie de manière autonome les colonnes de type texte ou facteur, génère les variables muettes correspondantes et les agrège harmonieusement au jeu de données initial tout en conservant intactes les variables continues adjacentes.
6.2 Paramétrage fin de l’encodage disjonctif complet
La puissance du package réside dans la finesse et l’exhaustivité de ses arguments de paramétrage, qui permettent d’ajuster l’encodage exactement aux contraintes théoriques de la modélisation à entreprendre. Pour illustrer son exécution, appliquons dummy_cols() à notre table synthétique :
donnees_encodees <- dummy_cols(donnees_etude, select_columns = "statut_matrimonial", remove_first_dummy = TRUE, remove_selected_columns = FALSE)
Examinons la portée des arguments mobilisés :
select_columns: Permet de désigner explicitement le sous-ensemble de variables qualitatives à vectoriser. Si l’argument est omis, la fonction scanne l’intégralité du data frame et convertit automatiquement toutes les colonnes de nature catégorielle.remove_first_dummy = TRUE: Cet argument est capital. Il instruit la fonction de retrancher systématiquement la première modalité ordonnée rencontrée pour chaque variable traitée. Ce mécanisme garantit l’exclusion mécanique de la première indicatrice et prémunit instantanément l’analyste contre le piège de la colinéarité parfaite dans le cadre d’un modèle avec ordonnée à l’origine.remove_selected_columns = FALSE: Détermine si la colonne nominale source doit être purgée de la table résultante ou conservée à des fins de documentation ou de comparaison visuelle.
Une variante stratégique de haute importance réside dans l’exploitation du paramètre remove_most_frequent_dummy = TRUE. En substituant ce paramètre à remove_first_dummy, la fonction identifie algorithmiquement la modalité qui rassemble la plus grande fréquence empirique au sein de l’échantillon et l’assigne automatiquement comme catégorie de référence. Cette pratique méthodologique est particulièrement recommandée en statistique inférentielle, car choisir le groupe le plus populeux comme référence maximise la stabilité asymptotique de l’intercept et réduit au minimum l’erreur-type des contrastes différentiels associés aux autres modalités.
De surcroît, fastDummies excelle dans le traitement des observations incomplètes via l’argument dummy_na = TRUE. Lorsque cette option est activée, la présence de valeurs manquantes (NA) au sein d’une variable catégorielle ne provoque pas l’échec de la transformation : la fonction crée une colonne dédiée explicitement à l’absence de donnée (par exemple statut_matrimonial_NA), permettant ainsi d’isoler et de tester directement le pattern de non-réponse au sein de la modélisation sans recourir à une imputation préalable.
6.3 Évaluation comparative des performances et de la lisibilité du code
Sur le plan de l’ingénierie logicielle, fastDummies a été optimisé pour surpasser les boucles classiques grâce à une implémentation sous-jacente exploitant la bibliothèque ultra-rapide data.table. Lors d’analyses appliquées sur de vastes bases de données psychologiques issues d’enquêtes en ligne à l’échelle nationale (comportant souvent $N > 100,000$ sujets et plusieurs dizaines de variables sociodémographiques polytomiques), le gain en temps d’exécution par rapport à des approches manuelles fondées sur ifelse() est de plusieurs ordres de grandeur.
Outre sa supériorité computationnelle, l’extension standardise rigoureusement le nommage des attributs générés. Les colonnes produites adoptent une convention de nomenclature prévisible et propre, concaténant le nom originel de la variable, un caractère de séparation configurable (par défaut le tiret du bas _), et l’intitulé de la modalité spécifique (par exemple statut_matrimonial_Marié). Cette standardisation élimine tout risque de confusion lexicale dans les scripts d’analyse automatisés et prévient les erreurs de syntaxe lors de la transmission des objets matriciels aux étapes ultérieures de restitution graphique ou tabulaire.
7. Étape 5 : L’approche moderne avec le Tidyverse et le package recipes
7.1 Architecture du pré-traitement dans l’écosystème Tidymodels
Dans le paradigme contemporain de la science des données sous R, l’écosystème tidymodels — conçu comme le pendant formel de modélisation du célèbre tidyverse — promeut une séparation conceptuelle rigoureuse entre la phase de spécification mathématique des transformations (le pré-traitement) et l’ajustement effectif des algorithmes prédictifs. Au cœur de cette philosophie se trouve le package recipes, qui traite la préparation des données à l’instar d’une recette culinaire standardisée, séquentielle et hautement reproductible.
L’avantage épistémologique fondamental de cette démarche en psychométrie et en apprentissage machine réside dans la neutralisation stricte de ce que la littérature nomme la « fuite de données » (data leakage). Dans une procédure de validation méthodologique valide (telle que la validation croisée par stratification ou l’isolation d’un échantillon de test hold-out), aucune information issue du jeu de données de test ne doit s’immiscer dans la phase de calibrage des paramètres de transformation. L’architecture de recipes garantit qu’une transformation appliquée aux données d’apprentissage soit apprise sur ce sous-échantillon d’entraînement exclusif, puis fidèlement projetée sur les données de test sans recalcul rétroactif.
L’initialisation d’une telle structure requiert l’installation et le chargement du métapaquet unifié :
install.packages("tidymodels")
library(tidymodels)
La formulation de la recette commence par l’instanciation de l’objet de base via la commande recipe(), associant la variable cible à modéliser et les covariables explicatives candidates :
recette_base <- recipe(revenu ~ age + statut_matrimonial, data = donnees_etude)
7.2 Implémentation de l’étape de binarisation via step_dummy()
Une fois l’architecture relationnelle définie dans la recette, l’analyste y adjoint séquentiellement les étapes de transformation désirées à l’aide de verbes normalisés préfixés par step_. La conversion des variables catégorielles en variables muettes s’articule autour de l’instruction step_dummy().
Pour convertir le statut matrimonial tout en évitant la redondance linéaire, l’instruction s’intègre harmonieusement dans un pipeline mobilisant l’opérateur de tuyau (pipe) classique |> ou %>% :
recette_transformee <- recette_base |>
step_dummy(all_nominal_predictors(), one_hot = FALSE)
L’analyse détaillée des instructions révèle l’élégance de cette formulation :
all_nominal_predictors(): Il s’agit d’un sélecteur contextuel (selector function) qui scanne dynamiquement l’ensemble des prédicteurs et identifie automatiquement ceux correspondant à des échelles nominales ou factorielles, sans exiger leur énumération exhaustive par l’utilisateur.one_hot = FALSE: Ce paramètre régit l’alternative entre le codage indicatif classique et le codage disjonctif complet dit one-hot. En fixantone_hot = FALSE, la fonction génère rigoureusement $k – 1$ variables muettes pour chaque facteur, réservant la première modalité comme catégorie de référence sous-jacente. Si le chercheur affectait la valeurTRUEà cette option, $k$ indicateurs binaires seraient produits, ce qui serait désirable pour des modèles pénalisés sans intercept ou certains réseaux de neurones, mais proscrit pour un modèle de régression linéaire classique fondé sur l’inversion de la matrice $X’X$.
L’exécution matérielle de cette recette conceptuelle se décompose en deux phases distinctes : le calibrage (prep()) et l’application (bake()) :
recette_preparee <- prep(recette_transformee, training = donnees_etude)
donnees_finales <- bake(recette_preparee, new_data = NULL)
L’argument new_data = NULL indique au moteur de calcul d’extraire la matrice des données d’entraînement ayant servi au calibrage, désormais enrichie des colonnes binarisées et délestée de la variable textuelle primitive.
7.3 Avantages de la modularité Tidymodels pour l’évaluation empirique
L’intégration de la création des variables muettes au sein du framework tidymodels offre des garanties d’une valeur inestimable pour les protocoles expérimentaux hautement exigeants. Dans le cadre d’un rééchantillonnage par bootstrap ou d’une validation croisée à 10 plis (10-fold cross-validation), l’encapsulation de step_dummy() dans un objet de type workflow() garantit que si une modalité catégorielle rare venait à disparaître aléatoirement d’un pli d’entraînement spécifique, le modèle n’échouerait pas et ne subirait aucune corruption structurelle.
De plus, cette modularité autorise un chaînage fonctionnel sophistiqué impossible avec les méthodes basiques. Il devient aisé de positionner en amont de step_dummy() une étape d’imputation k-NN (step_impute_knn()) pour traiter les valeurs manquantes, ou de regroupement des modalités infimes via step_other(), puis d’enchaîner en aval par une standardisation des variables continues résultantes à l’aide de step_normalize(). L’ensemble de ce flux s’applique de manière déterministe et identique sur les cohortes de réplication, conférant à la recherche psychométrique une traçabilité analytique irréprochable conforme aux standards contemporains de la science ouverte.
8. Gestion et modification stratégique de la modalité de référence
8.1 Manipulation des niveaux de facteurs avec relevel()
Comme nous l’avons théorisé, le choix de la modalité omise conditionne l’interprétation mathématique de l’ordonnée à l’origine et la substance sémantique de tous les paramètres de pente calculés. L’ordre alphabétique assigné par défaut par R constitue une commodité lexicale dépourvue de pertinence substantive. Dès lors, le chercheur doit être capable de piloter délibérément la structure hiérarchique du facteur sous-jacent.
La commande native la plus directe pour reconfigurer la modalité de référence d’un facteur sans altérer la distribution empirique des données s’avère être la fonction relevel(). Supposons que, dans le cadre de notre modélisation sur le revenu, nous refusions le choix de « Célibataire » comme modalité de base et souhaitions instituer la modalité « Marié » comme niveau de référence théorique :
donnees_etude$statut_matrimonial <- relevel(as.factor(donnees_etude$statut_matrimonial), ref = "Marié")
L’exécution subséquente de la fonction d’interrogation levels(donnees_etude$statut_matrimonial) permet de constater la mutation structurelle opérée : le niveau « Marié » figure dorénavant en position indicielle numéro 1, reléguant les autres modalités aux échelons postérieurs. Tout appel ultérieur à model.matrix(), lm() ou dummy_cols(..., remove_first_dummy = TRUE) déduira automatiquement que la modalité « Marié » est désormais la base de référence omise, adaptant immédiatement la matrice d’expérience sans nécessiter de recodage laborieux des colonnes.
8.2 Réorganisation avancée des modalités avec le package forcats
Pour des réorganisations catégorielles plus complexes impliquant de multiples facteurs polytomiques, l’extension spécialisée forcats (intégrée nativement dans l’écosystème tidyverse) déploie un ensemble d’outils analytiques d’une puissance inégalée. Parmi ses fonctions maîtresses, citons :
fct_relevel(): Permet de repositionner arbitrairement plusieurs niveaux à des rangs séquentiels spécifiques, par exemple en écrivant :
fct_relevel(statut_matrimonial, "Marié", "Divorcé", "Célibataire").fct_infreq(): Réordonne dynamiquement l’ensemble des modalités du facteur selon leur fréquence d’apparition empirique décroissante dans l’échantillon. Cette commande s’avère particulièrement judicieuse pour satisfaire de manière programmatique au principe méthodologique consistant à ériger la modalité dominante en catégorie de référence :
donnees_etude$statut_matrimonial <- fct_infreq(donnees_etude$statut_matrimonial).fct_lump(): Permet de compacter intelligemment les modalités résiduelles à effectifs infinitésimaux au sein d’une méta-catégorie unique standardisée (généralement désignée par l’étiquette « Other »). En fixant par exemple un seuil d’exclusion proportionnel (argumentprop = 0.05), l’analyste assainit la variable qualitative avant son étape de binarisation, évitant ainsi la génération de colonnes muettes dégénérées saturées de zéros.
L’utilisation combinée de ces instructions garantit une préparation élégante, limpide et reproductible des attributs factoriels, préparant de manière idéale le terrain pour les étapes d’estimation inférentielle.
8.3 Critères méthodologiques du choix de la catégorie de base
La désignation de la catégorie de base ne doit jamais être abandonnée à la contingence informatique ou à la commodité du tri alphabétique. En psychologie empirique, en psychiatrie translationnelle et en sociologie quantitative, cette décision doit découler d’un alignement parfait entre les postulats théoriques de l’investigation et les propriétés métriques de l’échantillon recueilli.
Trois heuristiques fondamentales doivent guider ce choix méthodologique :
- Le critère du groupe contrôle ou normatif : Dans les dispositifs quasi-expérimentaux ou d’évaluation clinique, la catégorie de base doit systématiquement être attribuée au groupe témoin, non exposé à l’intervention, ou à la cohorte d’individus sains (dits neurotypiques ou indemnes de pathologie). Cette configuration permet d’interpréter immédiatement la constante comme le niveau moyen de l’état de référence psychologique, et chaque coefficient de pente muet comme la taille brute de l’effet différentiel induit par les diverses variantes de la condition expérimentale ou nosologique.
- Le critère de robustesse distributionnelle : Il est formellement déconseillé de retenir comme modalité de base une catégorie marginale caractérisée par un très faible effectif d’échantillonnage. En effet, l’erreur-type de la constante $\beta_0$ dépend directement de la taille de l’échantillon du groupe de base. Si ce groupe est restreint, la variance de l’intercept explose, ce qui dégrade par transitivité la précision stochastique et la puissance statistique du test de Student pour l’ensemble des coefficients associés aux variables muettes. Sélectionner la modalité statistiquement modale maximise la fiabilité globale des inférences.
- Le critère d’interprétabilité et de parcimonie scientifique : Lorsque la variable nominale possède une modalité conventionnellement acceptée comme le standard culturel, historique ou clinique dominant, son assignation comme point d’ancrage favorise la communicabilité des résultats au sein de la communauté des pairs et facilite les méta-analyses futures en évitant les conversions arithmétiques fastidieuses de contrastes inversés.
9. Ajustement du modèle de régression linéaire avec les variables muettes
9.1 Spécification de l’équation de régression sous lm()
Afin de valider empiriquement nos développements théoriques, procédons à l’ajustement formel du modèle de régression linéaire prédisant le revenu des individus en fonction de leur âge continu et de leur statut matrimonial qualitatif. R met à notre disposition deux voies syntaxiques distinctes mais mathématiquement équivalentes, qu’il convient de comparer de front.
La première voie s’appuie sur l’introduction directe des variables muettes manuelles binarisées que nous avons construites à l’Étape 2, en laissant « Célibataire » implicitement absorbé dans l’intercept :
modele_manuel <- lm(revenu ~ age + statut_marie + statut_divorce, data = donnees_etude)
La seconde voie exploite l’intelligence factorielle native de R en injectant directement la variable catégorielle factorisée sous sa forme synthétique globale, préalablement réordonnée avec « Célibataire » comme modalité initiale de base :
modele_factoriel <- lm(revenu ~ age + statut_matrimonial, data = donnees_etude)
L’exécution de ces deux régressions illustre la perfection computationnelle du système. L’appel à la fonction d’extraction des paramètres estimés coef(modele_manuel) et coef(modele_factoriel) révèle une identité numérique absolue jusqu’à la dernière décimale pour tous les paramètres communs : la valeur de l’intercept, le coefficient de régression attaché à l’âge, et les pentes différentielles affectées respectivement au statut de marié et au statut de divorcé sont strictement indiscernables. Cette équivalence démontre sans ambiguïté que l’opérateur symbolique ~ procède en coulisses à l’exacte transformation matricielle que nous avons explicitée manuellement.
9.2 Lecture rigoureuse du tableau récapitulatif des résultats
L’interrogation analytique du modèle s’opère canoniquement par l’invocation de la fonction summary(modele_factoriel), laquelle déploie un ensemble de statistiques inférentielles fondamentales qu’il convient d’examiner avec minutie. Le tableau des coefficients structure les estimations sous la forme canonique de quatre colonnes normalisées :
Estimate: La valeur ponctuelle des coefficients du modèle calculée par la méthode des moindres carrés ordinaires. L’intercept s’établit aux alentours de 18 000 unités monétaires, la pente de l’âge avoisine les 650 unités, tandis que le termestatut_matrimonialMariéaffiche une valeur positive proche de +8 000 et le termestatut_matrimonialDivorcéune valeur négative avoisinant -2 500, reproduisant fidèlement les paramètres théoriques injectés lors de notre simulation initiale.Std. Error: L’écart-type d’échantillonnage de chaque estimateur, calculé comme la racine carrée des éléments diagonaux de la matrice de covariance des coefficients $\sigma^2 (X’X)^{-1}$. Cette grandeur quantifie l’incertitude stochastique entourant l’estimation ponctuelle du paramètre.t value: La statistique empirique du test de Student, obtenue par le ratio rigoureux entre l’estimation ponctuelle et son erreur-type ($t = \hat{\beta}_j / SE(\hat{\beta}_j)$). Elle teste l’hypothèse nulle d’absence d’effet résiduel ($H_0 : \beta_j = 0$).Pr(>|t|): La valeur $p$ (ou p-value asymptotique) bilatérale associée. Une valeur inférieure aux seuils critiques usuels ($\alpha = 0{,}05$, $0{,}01$ ou $0{,}001$) conduit au rejet péremptoire de l’hypothèse nulle en faveur de l’existence d’une disparité systématique de revenu imputable à la modalité considérée comparativement au groupe témoin.
Enfin, le bas du tableau renseigne sur la qualité globale de l’ajustement : l’erreur standard résiduelle (Residual standard error), le coefficient de détermination multiple $R^2$, sa version ajustée prenant en compte le nombre de degrés de liberté résiduels ($n – p$), et la statistique de Fisher globale ($F$-statistic) évaluant la significativité conjointe de l’ensemble des régresseurs du modèle.
9.3 Diagnostic de la matrice de variances-covariances des estimateurs
Une dimension fréquemment occultée dans la pratique statistique réside dans le fait que, si les variables muettes générées sont orthogonalement indépendantes dans le cas de plans d’expérience parfaitement balancés, leurs estimateurs de coefficients de pente $\hat{\beta}$ ne sont jamais stochastiquement indépendants dans les données observationnelles. L’extraction de la matrice de variance-covariance des coefficients au moyen de la fonction vcov() permet de visualiser cette interdépendance :
matrice_vcov <- vcov(modele_factoriel)
L’examen des termes hors-diagonaux (les covariances $\text{Cov}(\hat{\beta}_j, \hat{\beta}_k)$) révèle que la covariance entre le coefficient différentiel des individus mariés et celui des individus divorcés n’est pas nulle. Elle est systématiquement positive dès lors que le modèle comporte un intercept commun. Cela s’explique par le fait que tout aléa d’échantillonnage venant déplacer l’estimation de l’ordonnée à l’origine (qui correspond au groupe des célibataires) va induire un ajustement mécanique et simultané des deux pentes différentielles calculées par rapport à ce même point d’ancrage.
La corrélation formelle entre deux estimateurs de pentes muettes peut être extraite via la fonction cov2cor(vcov(modele_factoriel)). La surveillance de ces grandeurs est capitale : si un déséquilibre sévère frappe la répartition des effectifs ou si une colinéarité résiduelle s’installe avec d’autres covariables continues, cette covariance croisée peut s’accroître dramatiquement, gonflant artificiellement les erreurs-types et fragilisant la reproductibilité des inférences psychométriques.
10. Interprétation statistique et psychologique des coefficients estimés
10.1 Sens statistique de la constante (intercept)
L’ordonnée à l’origine $\hat{\beta}_0$ d’une équation de régression incorporant des variables muettes fait l’objet d’erreurs d’interprétation récurrentes dans la littérature empirique. Mathématiquement, la constante correspond à l’espérance conditionnelle de la variable expliquée lorsque l’ensemble des prédicteurs du modèle s’annule strictement :
$$\mathbb{E}[Y mid X_{\text{Âge}} = 0, D_{\text{Marié}} = 0, D_{\text{Divorcé}} = 0] = \hat{\beta}_0$$
Dans notre contexte, $D_{\text{Marié}} = 0$ et $D_{\text{Divorcé}} = 0$ désignent sans ambiguïté un individu appartenant au groupe de référence, à savoir un Célibataire. Cependant, affirmer que l’intercept représente le revenu attendu d’un célibataire est une approximation méthodologique dangereuse : il s’agit en réalité du revenu d’un célibataire âgé de zéro an, une situation dénuée de sens dans une cohorte de travailleurs adultes !
Pour restaurer une intelligibilité substantielle à la constante sans modifier les pentes ni le coefficient $R^2$, il est vivement recommandé d’appliquer un centrage sur la moyenne empirique de la variable continue âge :
donnees_etude$age_centre <- donnees_etude$age - mean(donnees_etude$age)
modele_centre <- lm(revenu ~ age_centre + statut_matrimonial, data = donnees_etude)
Dans cette nouvelle paramétrisation, l’intercept $\hat{\beta}_0$ devient immédiatement traduisible sur le plan psychologique et sociologique : il représente rigoureusement le revenu moyen prédit pour un individu célibataire présentant l’âge moyen exact de la population échantillonnée (environ 43 ans). Cette pratique de centrage offre une base de référence solide pour la discussion clinique et scientifique des grandeurs d’échelle absolue.
10.2 Interprétation des coefficients différentiels de pente
Les coefficients numériques adossés aux variables indicatrices ne constituent pas des moyennes de groupes isolées, mais des paramètres différentiels marginaux, ou contrastes simples. Considérons la formalisation mathématique de l’espérance conditionnelle du revenu pour chaque strate conjugale à un niveau d’âge fixé $X_0$ :
- Pour un individu Célibataire : $\mathbb{E}[Y mid X_0, \text{Célibataire}] = \beta_0 + \beta_1 X_0$
- Pour un individu Marié : $\mathbb{E}[Y mid X_0, \text{Marié}] = \beta_0 + \beta_1 X_0 + \beta_2$
- Pour un individu Divorcé : $\mathbb{E}[Y mid X_0, \text{Divorcé}] = \beta_0 + \beta_1 X_0 + \beta_3$
En effectuant la soustraction algébrique rigoureuse entre l’espérance du groupe des individus mariés et celle des célibataires, les termes $\beta_0$ et $\beta_1 X_0$ s’annulent parfaitement :
$$\mathbb{E}[Y mid X_0, \text{Marié}] – \mathbb{E}[Y mid X_0, \text{Célibataire}] = \beta_2$$
Le coefficient $\hat{\beta}_2$ (environ +8 000 dans notre simulation) s’interprète donc ainsi : À âge strictement identique, les individus mariés perçoivent en moyenne 8 000 unités monétaires de revenu de plus que les individus célibataires. De même, $\hat{\beta}_3$ (environ -2 500) indique qu’à âge constant, les individus divorcés enregistrent un différentiel de revenu négatif de 2 500 unités comparativement aux célibataires de l’échantillon. L’indépendance de ces écarts conditionnellement à l’âge découle de l’hypothèse de parallélisme propre au modèle linéaire additif standard.
10.3 Comparaison directe entre deux modalités non référentes
Une lacune classique de l’analyse linéaire consiste à omettre de comparer entre elles les modalités représentées par les variables muettes. La table fournie par summary() confronte systématiquement chaque niveau à la référence omise (Marié vs Célibataire, Divorcé vs Célibataire), mais ne teste aucunement l’hypothèse nulle d’égalité entre les deux modalités actives (Marié vs Divorcé).
Mathématiquement, le différentiel moyen entre individus mariés et individus divorcés s’exprime par la différence de leurs coefficients respectifs :
$$\Delta_{\text{Marié – Divorcé}} = \beta_2 – \beta_3$$
Pour déterminer si cet écart (environ $8000 – (-2500) = 10500$) est statistiquement significatif au sens de l’inférence formelle, il est rigoureusement erroné de comparer simplement le chevauchement de leurs intervalles de confiance respectifs. La variance de cette différence linéaire combine les variances individuelles et la covariance croisée extraites de la matrice $\text{vcov}$ :
$$\text{Var}(\hat{\beta}_2 – \hat{\beta}_3) = \text{Var}(\hat{\beta}_2) + \text{Var}(\hat{\beta}_3) – 2\text{Cov}(\hat{\beta}_2, \hat{\beta}_3)$$
Plutôt que de recalculer manuellement cette statistique sous l’approximation d’un test de Wald, la méthodologie contemporaine préconise l’utilisation de bibliothèques spécialisées dans l’analyse des contrastes post-hoc et des moyennes marginales estimées, telles que emmeans ou multcomp :
library(emmeans)
moyennes_ajustees <- emmeans(modele_factoriel, "statut_matrimonial")
pairs(moyennes_ajustees, adjust = "tukey")
La commande pairs() exécute l’ensemble exhaustif des comparaisons par paires entre les modalités du facteur, ajuste rigoureusement les degrés de liberté ainsi que les seuils d’erreur globale de type I via la procédure de correction de Tukey, et renvoie les estimations d’écarts exacts accompagnées de leurs erreurs-types réelles et de leurs valeurs $p$ corrigées. Les conclusions psychométriques peuvent dès lors être énoncées avec une validité statistique optimale.
11. Cas avancés : Interactions, variables ordinales et multicollinéarité
11.1 Modélisation des effets d’interaction modérateurs
L’hypothèse d’additivité stricte posée par le modèle linéaire initial postule que l’effet de l’âge sur le revenu est invariant quel que soit l’état civil de l’individu, ce qui se traduit géométriquement par des droites de régression parfaitement parallèles dans le plan bidimensionnel. Or, en psychologie différentielle et en économie du travail, les transitions de vie conjugale interagissent fréquemment avec les trajectoires de carrière, modulant la pente de progression salariale au fil de l’avancée en âge.
Pour modéliser mathématiquement ce phénomène d’hétérogénéité des pentes (ou effet de modération), il convient de construire des termes d’interaction croisant les variables muettes et la covariable continue. Dans la syntaxe matricielle de R, l’opérateur * génère automatiquement à la fois les effets principaux et les termes de produits croisés :
modele_interaction <- lm(revenu ~ age_centre * statut_matrimonial, data = donnees_etude)
Le développement algébrique du prédicteur linéaire s’écrit formellement :
$$Y_i = \beta_0 + \beta_1 X_{\text{Âge}} + \beta_2 D_{\text{Marié}} + \beta_3 D_{\text{Divorcé}} + \beta_4 (X_{\text{Âge}} \times D_{\text{Marié}}) + \beta_5 (X_{\text{Âge}} \times D_{\text{Divorcé}}) + \varepsilon_i$$
Dans cette architecture avancée :
- $\beta_1$ représente le taux de variation marginal du revenu par année d’âge chez les Célibataires exclusivement (car lorsque $D_{\text{Marié}} = 0$ et $D_{\text{Divorcé}} = 0$, les termes d’interaction disparaissent).
- $\beta_4$ quantifie le différentiel d’accélération salariale annuelle entre les individus mariés et les célibataires. La pente effective pour le sous-groupe des mariés devient $(\beta_1 + \beta_4)$. Un test de Student significatif sur $\beta_4$ rejette formellement l’hypothèse de pentes parallèles, confirmant la présence d’un effet modérateur du statut marital sur la rentabilité économique de l’expérience professionnelle.
11.2 Variables qualitatives ordonnées : contrastes polynomiaux versus binarisation
Une confusion fréquente chez les analystes débutants concerne le traitement des variables qualitatives ordonnées (telles que les échelles de Likert mesurant le bien-être, ou les niveaux de qualification hiérarchisés : Baccalauréat, Licence, Master, Doctorat). Lorsqu’un facteur est explicitement converti en facteur ordonné à l’aide de l’instruction ordered(variable), le moteur interne de R adopte un comportement algorithmique profondément différent : il ne déploie plus les contrastes de traitement indicatifs classiques, mais calcule des contrastes polynomiaux orthogonaux (marqués par les extensions linéaires .L, quadratiques .Q, cubiques .C, etc.).
Bien que mathématiquement élégants pour déceler des tendances de courbure sur des espaces métriques sous-jacents, les contrastes polynomiaux s’avèrent notoirement inintelligibles lorsqu’il s’agit de communiquer des résultats en psychométrie appliquée. Dans de nombreuses situations méthodologiques, il est infiniment plus judicieux de refuser ce comportement par défaut et de forcer l’usage de variables muettes standard pour les échelles ordinales, via la commande explicite :
contrasts(echelle_ordonnee) <- contr.treatment(niveaux)
Une alternative de modélisation hautement raffinée consiste à recourir au codage par seuils cumulatifs ou codage de paliers successifs (reverse Helmert ou successive difference coding via le package spécialisé MASS). Contrairement au codage muet simple où chaque niveau est comparé à la base initiale, le codage par paliers évalue l’impact marginal du passage incrémental d’un niveau ordonné au niveau immédiatement supérieur (par exemple, le gain spécifique conféré par l’obtention d’un Master comparativement au niveau Licence), offrant une lecture phénoménologique d’une pertinence remarquable pour les théories du développement psychologique et cognitif.
11.3 Surveillance rigoureuse du facteur d’inflation de la variance (VIF)
L’introduction d’un ensemble de variables muettes, en particulier lorsqu’elles sont couplées à des termes d’interaction croisés, majore considérablement le risque de multicolinéarité quasi-parfaite au sein de la matrice $X’X$. Si la dépendance linéaire stricte est théoriquement conjurée par la règle des $k-1$ variables, une corrélation empirique élevée entre prédicteurs est susceptible de faire enfler artificiellement les erreurs-types des estimateurs, rendant les coefficients instables et hautement sensibles à des fluctuations d’échantillonnage infinitésimales.
Pour diagnostiquer rigoureusement ce phénomène en présence de variables catégorielle polytomiques, l’indicateur standard est le facteur d’inflation de la variance (VIF). Toutefois, pour une variable qualitative régie par plusieurs variables muettes conjointes formant un seul bloc conceptuel à plusieurs degrés de liberté ($k – 1$), le calcul du VIF univarié traditionnel devient trompeur. Il convient impérativement de mobiliser le facteur d’inflation de la variance généralisé (GVIF, ou Generalized Variance Inflation Factor), théorisé par Fox et Monette, implémenté dans le package réputé car :
library(car)
vif(modele_factoriel)
La fonction renvoie une métrique standardisée notée :
$$\text{GVIF}^{\frac{1}{2 \times \text{df}}}$$
où $\text{df}$ correspond aux degrés de liberté associés au régresseur (soit $k – 1$ pour le facteur). Cette normalisation permet de comparer directement la magnitude de l’inflation de variance entre des variables continues unidimensionnelles et des variables qualitatives polytomiques complexes. La règle heuristique méthodologique prescrit d’examiner avec une vigilance critique toute valeur ajustée supérieure au seuil critique de 2 ou 2,5 (ce qui équivaut approximativement à un VIF conventionnel supérieur à 5 ou 10), signalant une instabilité numérique requiring soit une réduction du nombre de modalités par coalescence, soit le recours à des estimateurs régularisés de type Ridge.
12. Synthèse pratique, erreurs fréquentes et guide décisionnel
12.1 Inventaire des erreurs classiques rencontrées par les analystes
L’expérience de l’enseignement méthodologique et de la révision d’articles scientifiques met en exergue une récurrence d’erreurs systématiques commises lors de la création et du traitement des variables indicatrices sous R. L’analyste rigoureux veillera à identifier et proscrire les dérives suivantes :
- Le piège de la colinéarité non géré : Tenter d’injecter manuellement $k$ variables muettes issues de
dummy_cols(..., remove_first_dummy = FALSE)dans un appel àlm()avec intercept. Bien que l’algorithme robuste de décomposition QR de R protège l’utilisateur en supprimant automatiquement la dernière colonne avec la mentionaliasedouNA, cette neutralisation silencieuse témoigne d’un manque de maîtrise conceptuelle du design matriciel et peut masquer de sévères problèmes de spécification dans des modèles non linéaires plus fragiles (tels que les modèles mixtes ou logistiques multinomiaux). - La corruption d’échantillonnage prédictif : Utiliser des variables muettes manuelles pour entraîner un modèle, puis tenter d’appliquer la fonction
predict()sur de nouvelles données sans s’assurer que les niveaux de référence et l’exact agencement des colonnes soient rigoureusement congruents. Ce risque est intégralement éliminé par l’usage des facteurs natifs ou des recettesrecipes. - L’inversion involontaire du schéma de contrastes : Oublier que la modification des options globales de la session de R via
options(contrasts = c("contr.sum", "contr.poly"))altère irrémédiablement le comportement delm()à l’échelle du système entier, transformant le codage par traitement en un codage par somme (où chaque niveau est comparé non pas à une référence, mais à la moyenne globale non pondérée de l’ensemble des modalités). - L’assimilation abusive de l’absence à zéro lors de données manquantes : Dans les codages manuels fondés sur des tests logiques mal formulés, assigner la valeur 0 à un individu présentant la valeur manquante
NAsur la variable qualitative source, le requalifiant insidieusement en membre du groupe de base.
12.2 Arbre de décision pour choisir la méthode idoine dans R
Face à la pluralité des paradigmes computationnels exposés tout au long de ce manuel, quel cadre algorithmique le praticien doit-il privilégier au sein de ses travaux d’analyse ? Le protocole décisionnel suivant permet d’orienter rationnellement ce choix :
- Cadre 1 : Modélisation inférentielle classique et psychométrie standard (Régression linéaire, ANOVA factorielle, ANCOVA sous
lm()ouglm()).
Choix recommandé : L’approche factorielle native de R (as.factor(),relevel(),forcats).
Justification : C’est la méthode la plus sûre, la plus parcimonieuse et la mieux intégrée avec les packages de post-estimation tels queemmeans. Elle protège de manière intrinsèque contre la multicolinéarité et conserve la sémantique originelle des construits qualitatifs. - Cadre 2 : Manipulation tabulaire exploratoire et reporting descriptif direct (Génération rapide de profils pour visualisations univariées ou transferts vers d’autres formats de fichiers).
Choix recommandé : L’extension fastDummies (dummy_cols()).
Justification : Sa vitesse d’exécution, sa syntaxe claire et ses arguments explicites (remove_most_frequent_dummy,dummy_na) en font l’outil parfait pour produire des tableaux explicites sans perturber les pipelines de manipulation de données tabulaires ordinaires. - Cadre 3 : Modélisation prédictive avancée, Apprentissage machine et Psychométrie computationnelle (Régression Lasso, XGBoost, Réseaux neuronaux sous
tidymodels).
Choix recommandé : L’architecture recipes (step_dummy()au sein d’unworkflow).
Justification : C’est l’unique méthodologie garantissant une étanchéité méthodologique absolue contre le data leakage lors du rééchantillonnage croisé, capable d’orchestrer des pré-traitements multidimensionnels hautement reproductibles sur des jeux de données d’évaluation externes.
12.3 Check-list finale de validation pour les rapports académiques
Avant d’intégrer les estimations issues d’un modèle incorporant des variables muettes au sein d’un manuscrit soumis pour publication scientifique (aux normes de l’American Psychological Association – APA 7th edition), le chercheur est invité à auditer ses livrables à l’aune de la grille d’auto-évaluation méthodologique suivante :
- [ ] Explicitation de la modalité de base : La catégorie de référence omise est-elle explicitement et sans ambiguïté mentionnée dans le corps de texte de la section méthodologique et dans les notes de bas de tableaux de régression ?
- [ ] Justification théorique du choix témoin : Le statut de la modalité de base repose-t-il sur un argumentaire scientifique recevable (groupe contrôle, niveau normatif prévalent) et non sur un artefact d’ordre alphabétique incontrôlé ?
- [ ] Centrage des variables d’ajustement continues : Les covariables d’ancrage (telles que l’âge ou les scores psychométriques de base) ont-elles été centrées sur la moyenne afin de conférer à la constante du modèle une signification immédiatement interprétable ?
- [ ] Vérification de l’homoscédasticité par strate : La dispersion résiduelle a-t-elle été vérifiée pour chaque groupe muet individuel (à l’aide du test de Breusch-Pagan ou d’un examen des résidus studentisés vs valeurs prédites) afin de s’assurer que l’erreur type des contrastes ne soit pas biaisée par une variance résiduelle hétérogène ?
- [ ] Précision du libellé des indicateurs : Les en-têtes de colonnes et de lignes dans les tableaux de résultats évitent-ils les abréviations cryptiques générées par le compilateur (par exemple, remplacer
statut_matrimonialMariépar l’intitulé formel : « Statut marital : Marié (Réf. Célibataire) ») ? - [ ] Correction des comparaisons multiples : Si l’article s’aventure à discuter les contrastes existant entre des modalités actives non référentes, une correction statistique rigoureuse des seuils d’erreur globale de type I (procédure de Tukey, Holm ou Benjamini-Hochberg) a-t-elle été scrupuleusement appliquée et documentée ?
En respectant scrupuleusement l’ensemble de ces préceptes théoriques, algébriques et computationnels, l’analyste de données s’assure que ses travaux de modélisation sous R répondent aux critères les plus élevés de la rigueur quantitative contemporaine, transformant la contrainte technique de la binarisation indicatrice en un levier d’élucidation scientifique particulièrement puissant.
Références
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Fox, J., & Monette, G. (1992). Generalized collinearity diagnostics. Journal of the American Statistical Association, 87(417), 178-183. https://doi.org/10.1080/01621459.1992.10475190
- Greene, W. H. (2018). Econometric Analysis (8th ed.). Pearson.
- Kaplan, J. (2020). fastDummies: Fast Creation of Dummy (Binary) Columns and Rows from Categorical Variables (R package version 1.6.3). CRAN. https://cran.r-project.org/package=fastDummies
- Kuhn, M., & Silge, J. (2022). Tidy Modeling with R. O’Reilly Media. https://www.tmwr.org/
- Kuhn, M., & Wickham, H. (2023). recipes: Preprocessing and Feature Engineering Steps for Modeling (R package version 1.0.8). CRAN. https://cran.r-project.org/package=recipes
- Lenth, R. V. (2023). emmeans: Estimated Marginal Means, aka Least-Squares Means (R package version 1.8.9). CRAN. https://cran.r-project.org/package=emmeans
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach (7th ed.). Cengage Learning.