
La modélisation de la variabilité humaine et des phénomènes naturels constitue l’un des piliers méthodologiques des sciences contemporaines. Au sein de cet édifice quantitatif, la distribution normale, communément désignée sous le nom de courbe en cloche ou courbe de Gauss, occupe une place prépondérante. Qu’il s’agisse d’évaluer les aptitudes cognitives générales, d’étalonner un inventaire clinique de la personnalité ou de quantifier des dispersions biométriques, cette loi de probabilité continue offre un cadre théorique d’une élégance et d’une robustesse inégalées. La compréhension de ses fondements analytiques s’avère indispensable pour quiconque souhaite interpréter fidèlement des scores standardisés, situer un individu au sein d’une population de référence ou tester des hypothèses inférentielles rigoureuses.
Pourtant, la transposition de ces concepts mathématiques abstraits vers des outils opérationnels du quotidien représente fréquemment un obstacle technique pour les praticiens, les chercheurs et les étudiants. Bien que des environnements statistiques spécialisés comme The R Project for Statistical Computing ou IBM SPSS Statistics intègrent des modules automatisés pour générer de telles représentations, Microsoft Excel demeure la plateforme universelle la plus accessible au sein des laboratoires, des cliniques psychologiques et des services de ressources humaines. Maîtriser la construction dynamique d’une courbe en cloche sous Excel ne constitue pas une simple prouesse graphique, mais une véritable démarche d’appropriation statistique, transformant un tableau de nombres statiques en un instrument sémiotique clair, communicable et reproductible.
Ce guide exhaustif a été conçu pour détailler l’intégralité des étapes nécessaires à l’élaboration d’une courbe normale paramétrée sous Microsoft Excel, depuis les axiomes fondamentaux du calcul des probabilités jusqu’à l’optimisation esthétique conforme aux standards académiques internationaux. En articulant théorie psychométrique, formalisation algébrique et manipulation logicielle avancée, cet article propose une méthodologie pas à pas accompagnée d’un modèle opérationnel. Vous découvrirez comment structurer vos données, exploiter les fonctions de densité, manipuler les scores réduits et concevoir une visualisation dynamique d’une fidélité mathématique absolue, capable de s’adapter automatiquement à vos paramètres empiriques.
1. Fondements théoriques de la courbe en cloche et applications psychométriques
1.1 Origine statistique et propriétés de la distribution normale
L’histoire de la distribution normale s’inscrit au cœur de l’évolution du calcul des probabilités et de la théorie des erreurs. Initialement esquissée par Abraham de Moivre au XVIIIe siècle dans ses travaux sur l’approximation de la loi binomiale, elle a été formellement conceptualisée et développée par Carl Friedrich Gauss dans ses recherches sur l’astronomie et la mécanique céleste, ainsi que par Pierre-Simon de Laplace à travers la démonstration du théorème central limite. Ce théorème constitue la clé de voûte de l’inférence moderne : il stipule que la somme d’un grand nombre de variables aléatoires indépendantes et de même loi de distribution converge asymptotiquement vers une distribution normale, indépendamment de la forme de la loi sous-jacente initiale. Ce principe mathématique fondamental explique pourquoi tant de grandeurs physiques, physiologiques et comportementales épousent spontanément cette morphologie caractéristique.
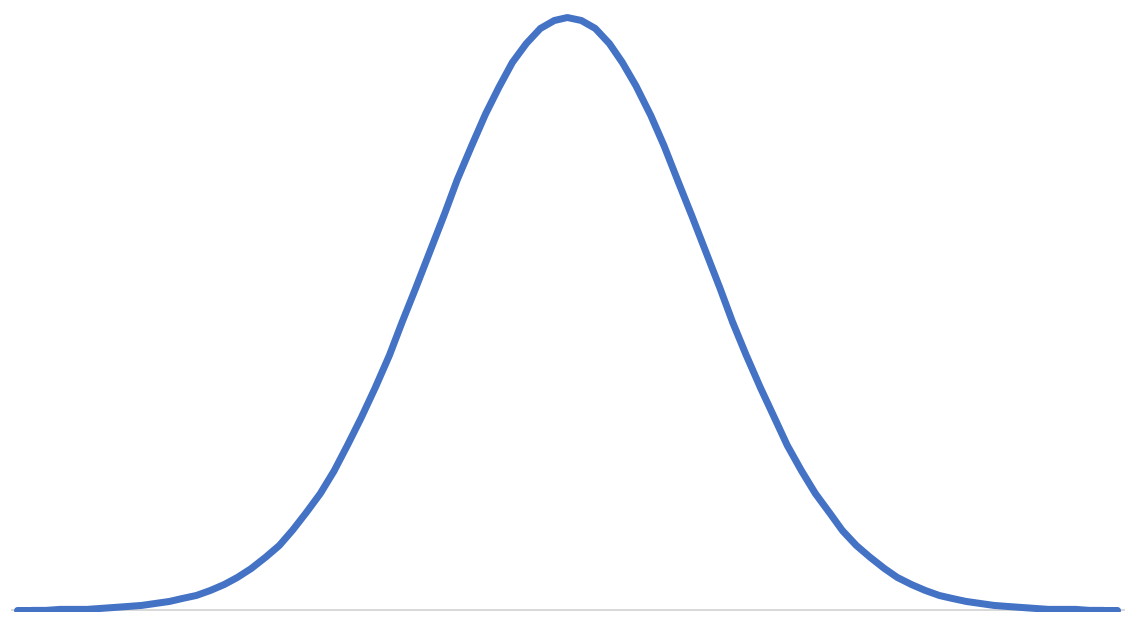
Sur le plan géométrique et structural, la distribution de Gauss-Laplace présente des propriétés d’une grande rigueur formelle. Il s’agit d’une fonction continue définie sur l’ensemble des nombres réels, caractérisée par une symétrie axiale parfaite autour de son centre. Cette symétrie engendre une conséquence majeure pour l’analyse descriptive : la moyenne arithmétique, la médiane et le mode sont rigoureusement confondus au même point d’inflexion central. La courbe est strictement unimodale, présentant un sommet unique qui correspond au point de densité maximale. De part et d’autre de cette valeur centrale, les ailes de la distribution s’étendent de manière asymptotique vers l’axe des abscisses, tendant vers zéro sans jamais l’intercepter, illustrant le principe selon lequel toute valeur réelle possède une probabilité d’occurrence théorique non nulle, bien qu’infinitésimale aux extrémités.
Une autre caractéristique essentielle réside dans la règle empirique dite « 68-95-99,7 », déduite de l’intégration de la fonction de densité de probabilité. Dans toute distribution gaussienne parfaite, précisément 68,27 % de l’aire totale sous la courbe se trouve confinée dans l’intervalle compris entre un écart-type en deçà et un écart-type au-delà de la moyenne arithmétique. Si l’on élargit l’intervalle à deux écarts-types de part et d’autre du centre, la proportion atteint 95,45 % de l’espace probabiliste global. Enfin, un empan de trois écarts-types englobe 99,73 % des observations possibles. Cette prévisibilité mathématique confère à la distribution normale un pouvoir normatif considérable, permettant de transformer instantanément une distance algébrique en un rang probabiliste universellement intelligible.
1.2 Pertinence de la courbe de Gauss en sciences psychologiques
Dans le domaine des sciences psychologiques, de la psychométrie et de la neuropsychologie, la courbe en cloche sert de paradigme central pour la modélisation des traits latents et des aptitudes cognitives. La mesure de l’intelligence générale, telle qu’opérée par les échelles composites d’intelligence de Wechsler (American Psychological Association), repose intégralement sur le postulat d’une distribution normale du Quotient Intellectuel (QI) au sein de la population générale. En fixant arbitrairement la moyenne théorique à 100 et l’écart-type à 15, les psychométristes utilisent les propriétés gaussiennes pour convertir des scores bruts hétérogènes en indices comparables, délimitant avec précision les seuils de déficience intellectuelle ou de haut potentiel cognitif.
Cette logique d’étalonnage s’étend de manière analogue aux inventaires standardisés de la personnalité, tels que le MMPI (Minnesota Multiphasic Personality Inventory) ou le modèle à cinq facteurs opérationnalisé dans le NEO-PI. Dans ces contextes diagnostiques, les réponses d’un individu sont agrégées sous forme de dimensions continues où la normalité statistique est assimilée à une zone de fonctionnement adaptatif moyen, tandis que les déviations positives ou négatives marquées signalent des configurations comportementales atypiques ou potentiellement pathologiques. L’évaluation psychométrique ne mesure pas une grandeur physique directe, mais infère une position relative au moyen de scores étalonnés qui prennent tout leur sens clinique à travers le prisme de la courbe de Gauss.
Il convient néanmoins de souligner les limites épistémologiques et méthodologiques inhérentes à l’application aveugle de ce postulat. Les distributions empiriques observées dans la pratique clinique s’écartent fréquemment de l’idéal théorique en raison de biais d’échantillonnage, d’effets de plancher ou de plafond inhérents aux épreuves, ou encore d’asymétries structurelles propres à certains construits psychopathologiques comme la dépression majeure ou l’anxiété phobique. Poser l’hypothèse de normalité requiert toujours une vérification rigoureuse préalable. Lorsque cette normalité est raisonnablement vérifiée ou conventionnellement imposée par des transformations mathématiques adéquates, la courbe en cloche devient l’instrument diagnostique le plus puissant dont dispose le praticien pour objectiver ses conclusions cliniques.
1.3 Rôle d’Excel dans la modélisation statistique appliquée
L’utilisation d’environnements de programmation statistique tels que R, Python ou SAS est traditionnellement valorisée dans la recherche universitaire de pointe. Néanmoins, leur barrière d’apprentissage syntaxique et leur manque d’interactivité visuelle directe limitent leur déploiement opérationnel auprès des praticiens de terrain, des conseillers d’orientation ou des cliniciens hospitaliers. Microsoft Excel s’impose alors comme une passerelle d’une efficacité remarquable, démocratisant le traitement analytique et la restitution visuelle des données psychométriques. Grâce à son moteur de calcul en temps réel et à ses modules graphiques modulables, le tableur permet de manipuler les concepts probabilistes sans abstraction superflue.
La valeur ajoutée d’Excel réside principalement dans sa capacité à offrir une visualisation dynamique et paramétrée des distributions normales. Contrairement aux figures statiques extraites de manuels ou d’articles scientifiques, une feuille de calcul conçue avec rigueur permet de modifier instantanément les constantes descriptives fondamentales pour observer immédiatement leurs répercussions sur l’aplatissement de la courbe, l’écartement des ailes ou la position relative d’un sujet clinique. Cette réactivité en fait un outil pédagogique hors pair pour l’enseignement de la biométrie et de la psychométrie, mais également un outil de diagnostic ergonomique pour la génération de profils psychologiques individualisés intégrables dans des bilans écrits.
L’objectif de ce tutoriel est de vous guider méthodologiquement pas à pas dans la conception d’un modèle Excel pérenne, robuste et esthétiquement irréprochable. En évitant les raccourcis approximatifs qui consistent à tracer un simple histogramme lissé artificiellement, nous allons construire de manière analytique la véritable fonction de densité de Gauss. Ce modèle permettra d’obtenir une courbe en cloche vectorielle continue, ajustable à n’importe quelle échelle de mesure psychologique, dotée d’axes gradués précis et de repères visuels normalisés répondant aux exigences éditoriales des plus grandes revues scientifiques.
2. Paramètres mathématiques essentiels et fonctions Excel dédiées
2.1 Définition formelle de la moyenne et de l’écart-type
Pour paramétrer une distribution normale de façon univoque, deux grandeurs statistiques fondamentales sont requises : un paramètre de position et un paramètre de dispersion. Le paramètre de position est la moyenne arithmétique de la population, traditionnellement symbolisée par la lettre grecque mu (μ). Sur le plan psychométrique, μ matérialise le centre de gravité de la mesure, le niveau d’intensité typique ou attendu pour un échantillon normatif représentatif. Dans l’espace géométrique de la courbe, la moyenne détermine l’emplacement précis de l’axe vertical de symétrie et localise le point sommital où la concentration des observations est théoriquement la plus dense.
Le paramètre de dispersion est l’écart-type, universellement désigné par la lettre grecque sigma (σ). L’écart-type mesure la variabilité moyenne des scores individuels par rapport à la moyenne centrale. En termes mathématiques, il correspond à la racine carrée de la variance. Sur le plan graphique, σ dicte la morphologie globale de la cloche : il contrôle son étalement horizontal et sa hauteur verticale relative. Un écart-type faible produit une distribution leptokurtique, caractérisée par un pic aigu et des flancs abrupts traduisant une grande homogénéité intra-groupe. À l’inverse, un écart-type élevé engendre une courbe platykurtique, aplatie et étirée, révélatrice d’une importante hétérogénéité des compétences ou des traits mesurés.
Il est fondamental de comprendre l’interaction géométrique intime qui lie la moyenne et l’écart-type. Les points d’inflexion de la courbe en cloche — c’est-à-dire les coordonnées précises où la concavité s’inverse pour passer d’une courbure orientée vers le bas à une courbure orientée vers le haut — sont situés exactement aux abscisses μ – σ et μ + σ. La distance séparant ces deux points d’inflexion équivaut rigoureusement au double de l’écart-type. Ainsi, la manipulation de ces deux simples scalaires sous Excel permet de modéliser avec une exactitude mathématique totale n’importe quel étalonnage psychométrique, qu’il s’agisse de micro-variations biométriques ou de macro-échelles d’évaluation comportementale.
2.2 La fonction de densité de probabilité (PDF)
La représentation graphique de la courbe en cloche repose sur le tracé de la fonction de densité de probabilité continue, couramment désignée par l’acronyme PDF (Probability Density Function). L’expression analytique de cette fonction pour une variable aléatoire continue X suivant une loi normale d’espérance μ et d’écart-type σ s’exprime par la relation suivante :
f(x) = (1 / (σ √(2π))) × exp(- (x – μ)² / (2σ²))
Dans cette équation, la constante d’Euler (e ≈ 2,71828) et le nombre pi (π ≈ 3,14159) jouent un rôle structurel fondamental. L’ordonnée f(x) ne représente pas une probabilité discrète ponctuelle — puisque la probabilité pour une variable continue d’adopter une valeur infiniment précise est formellement égale à zéro —, mais une densité relative. L’aire délimitée sous cette fonction entre deux bornes quelconques correspond rigoureusement à l’intégrale définie de la fonction, matérialisant la probabilité exacte que la variable aléatoire prenne une valeur comprise dans cet intervalle. L’aire totale sous l’ensemble de la courbe est rigoureusement égale à 1.
Dans Microsoft Excel, le calcul manuel de cette équation complexe est heureusement évité grâce à l’implémentation de la fonction native LOI.NORMALE.N (ou NORM.DIST dans les versions anglophones du logiciel). Cette fonction requiert quatre arguments spécifiques : la valeur d’abscisse x, l’espérance moyenne, la dispersion ecart_type, et un argument logique déterminant le mode de restitution. Pour tracer la courbe de densité en cloche, le quatrième paramètre doit impérativement être configuré à FAUX (ou 0). L’utilisation de cette valeur booléenne force Excel à renvoyer la valeur de la densité de probabilité non cumulée f(x). Si l’utilisateur commettait l’erreur d’inscrire VRAI, la fonction renverrait la fonction de répartition cumulée, générant non point une courbe en cloche symétrique, mais une courbe sigmoïde monotone croissante représentant les percentiles cumulés de 0 à 1.
2.3 Standardisation et variable centrée réduite (score z)
Afin de manipuler des grandeurs psychométriques issues d’échelles disparates au sein d’un même cadre visuel cohérent, le recours à la standardisation est indispensable. L’opération de centrage et de réduction transforme une variable brute x en une variable standardisée universelle, traditionnellement nommée score z ou cote z. L’algorithme mathématique sous-jacent est défini par l’expression :
z = (x – μ) / σ
Le score z exprime la distance algébrique séparant un score brut individuel de la moyenne normative de son groupe de référence, cette distance étant quantifiée en unités d’écarts-types. Un score z de 0 indique une performance parfaitement conforme à la moyenne arithmétique. Un score z positif signale un positionnement supérieur à la moyenne, tandis qu’un score z négatif reflète une performance inférieure. En vertu des lois de transformation linéaire, la distribution des scores z possède systématiquement une moyenne égale à 0 et un écart-type égal à 1, ce qui constitue la loi normale centrée réduite N(0, 1).
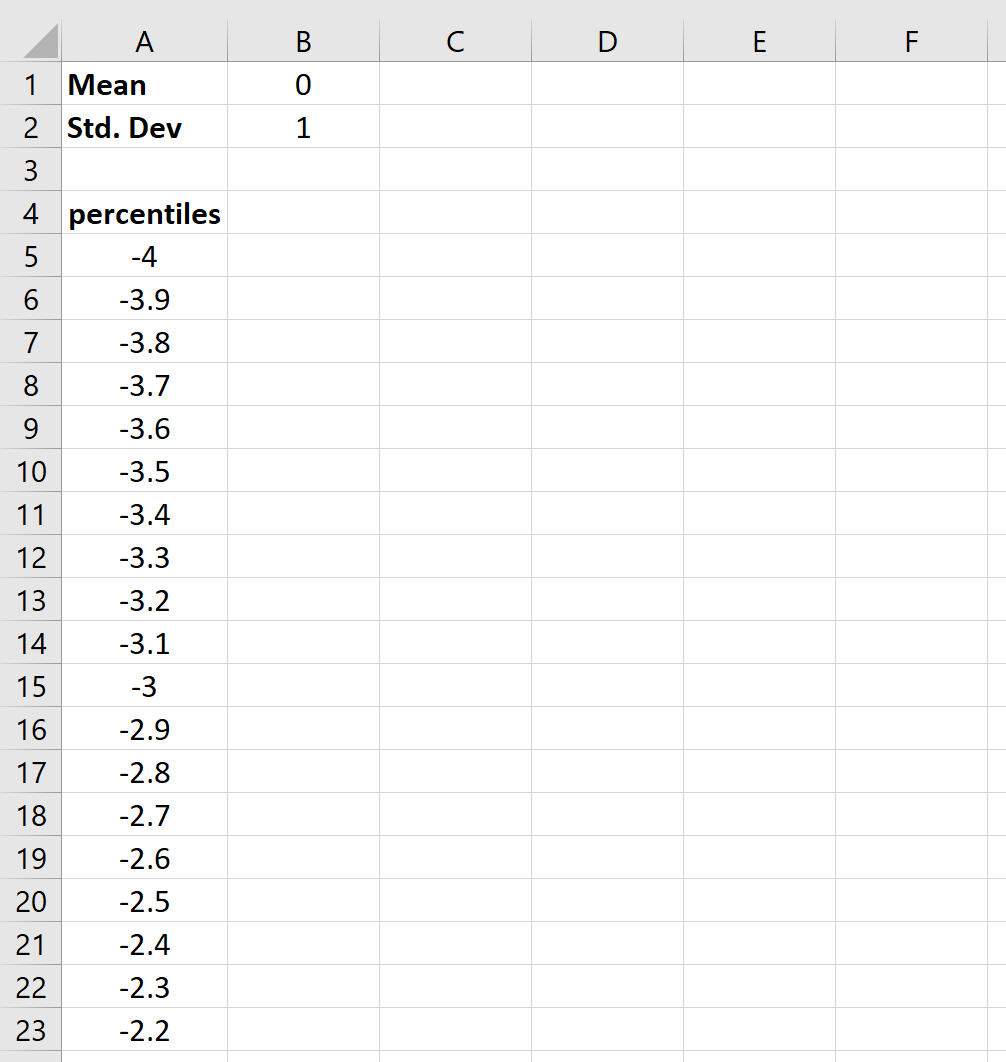
Dans le cadre de la construction graphique sous Excel, l’établissement d’une plage d’échantillonnage s’étendant formellement de z = -4 à z = +4 représente la norme de référence. Cette amplitude de 8 écarts-types couvre la quasi-totalité du spectre empiriquement concevable, englobant plus de 99,99 % de la population théorique. Les percentiles correspondants s’articulent harmonieusement autour de cette échelle standard : le score z = 0 coïncide rigoureusement avec le 50e percentile, le score z = -1 correspond approximativement au 16e percentile, et le score z = +1 au 84e percentile. La standardisation constitue ainsi l’armature logique indispensable pour bâtir une feuille de calcul automatisée et universellement transposable.
3. Configuration préalable de la feuille de calcul Excel
3.1 Architecture et ergonomie du tableau de bord statistique
L’intégrité et la lisibilité d’un modèle statistique reposent sur une organisation spatiale rigoureuse de la feuille de calcul. Construire un modèle pérenne nécessite d’abandonner toute disposition désordonnée au profit d’un agencement modulaire respectant les principes d’architecture de données professionnelles. Une feuille d’analyse statistique doit être scindée en trois blocs fonctionnels distincts : le bloc des paramètres d’entrée (les variables indépendantes saisies par l’utilisateur), le bloc des calculs séquentiels (le moteur dynamique inaccessible aux modifications accidentelles) et le bloc de restitution graphique (l’espace de visualisation finale).
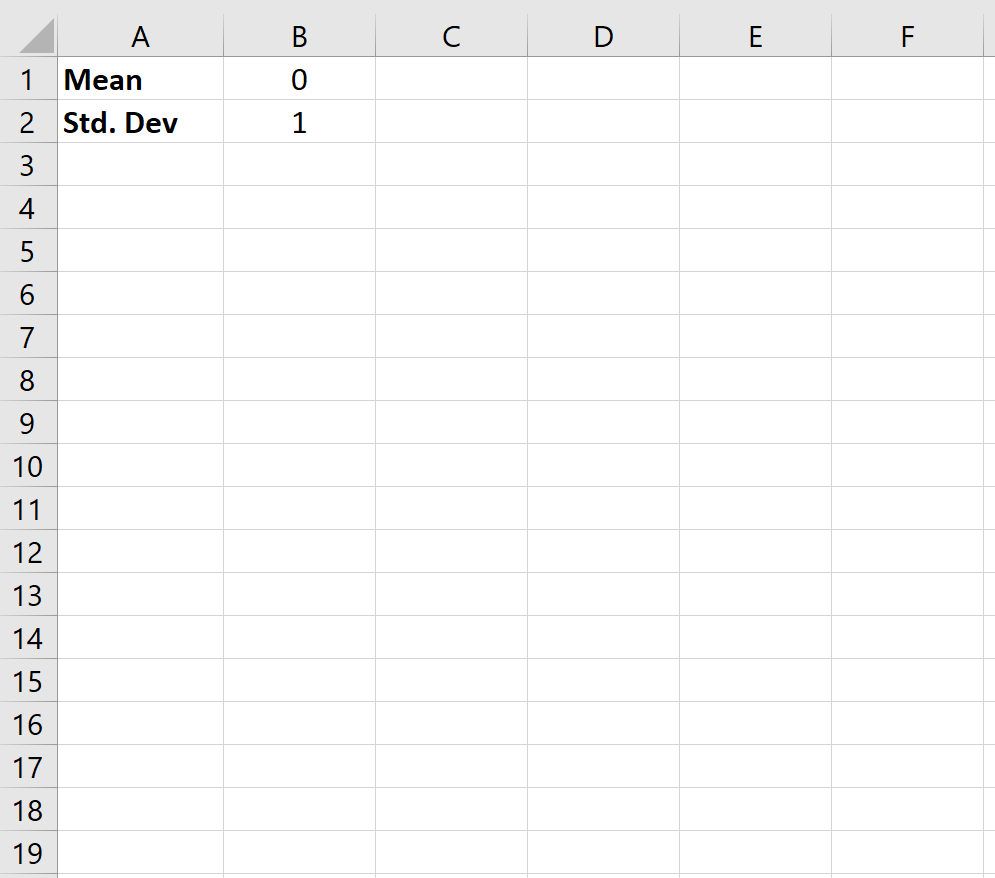
Il est recommandé de consacrer les premières lignes de la feuille (colonnes A et B) à l’encart des paramètres généraux, mis en exergue par des bordures nettes et une typographie sobre. Cette zone accueille les variables fondamentales que sont la moyenne observée et l’écart-type associé, ainsi que des indicateurs descriptifs complémentaires tels que la taille de l’échantillon ou l’intitulé de la sous-épreuve psychométrique évaluée. En isolant ces valeurs critiques en amont, l’utilisateur s’assure qu’aucune constante numérique ne sera injectée en dur au sein des formules de calcul situées en aval, garantissant ainsi l’entière flexibilité de l’outil.
Les colonnes adjacentes (par exemple de la colonne D à la colonne G) doivent héberger le tableau de calcul matriciel dynamique. Chaque colonne se voit attribuer un rôle univoque : la séquence des scores z, les valeurs brutes correspondantes, les valeurs de densité de probabilité calculées, et les étiquettes textuelles de l’axe des abscisses. Cet agencement linéaire facilite l’audit de la feuille, limite le risque d’erreurs référentielles et simplifie grandement la sélection des plages de données lors de la configuration avancée du graphique.
3.2 Étape 1 : Définition des cellules pour la moyenne et l’écart-type
La première phase opérationnelle consiste à attribuer des emplacements fixes aux paramètres fondamentaux de la distribution normale. Dans une feuille Excel vierge, positionnez-vous en cellule A1 et saisissez le libellé Moyenne (µ). En cellule A2, saisissez Écart-type (σ). Les cellules adjacentes B1 et B2 serviront respectivement de conteneurs pour les valeurs numériques associées. À titre d’initialisation, vous pouvez consigner la valeur 100 en B1 et la valeur 15 en B2, correspondant aux propriétés d’un indice composite d’intelligence de Wechsler.
Pour optimiser la lisibilité des formules ultérieures et prévenir les fautes de frappe, il est vivement préconisé d’utiliser le Gestionnaire de noms d’Excel. Sélectionnez la cellule B1, puis rendez-vous dans l’onglet Formules du ruban supérieur et cliquez sur Définir un nom. Attribuez à cette cellule le nom symbolique Moyenne. Répétez la même opération pour la cellule B2 en lui assignant l’étiquette EcartType. Grâce à cette convention de nommage, les formules complexes injectées dans les colonnes de calcul gagneront une clarté sémantique immédiate, substituant des variables explicites aux références de cellules opaques.
Il importe également de mettre en place une validation minimale de ces cellules pour sécuriser l’intégrité fonctionnelle du modèle. Dans les calculs de densité gaussienne, l’écart-type apparaît au dénominateur de l’exposant ainsi que dans le coefficient multiplicateur de l’inverse. L’introduction accidentelle d’une valeur nulle ou négative en cellule B2 générerait instantanément une cascade d’erreurs de division par zéro (#DIV/0!) ou de valeurs arithmétiques invalides (#NOMBRE!). Il est donc judicieux d’appliquer une règle de validation de données (onglet Données > Validation des données) contraignant la cellule B2 à n’accepter que des nombres décimaux strictement supérieurs à zéro.
3.3 Gestion des références absolues et relatives
L’écriture rigoureuse de formules sous Excel exige une maîtrise parfaite des modes d’adressage cellulaire. Si vous choisissez de ne pas utiliser le Gestionnaire de noms mentionné précédemment, la distinction entre références relatives et références absolues devient déterminante pour la viabilité de votre feuille de calcul. Lors de la saisie d’une formule mathématique destinée à être propagée verticalement sur plusieurs dizaines de lignes, toute référence à la moyenne (B1) ou à l’écart-type (B2) doit impérativement être verrouillée sous forme absolue au moyen du symbole dollar : $B$1 et $B$2.
L’omission de ce verrouillage syntaxique constitue l’erreur la plus fréquente chez les praticiens non spécialistes. En étirant vers le bas une formule contenant une référence relative non protégée (telle que B1), Excel incrémente automatiquement l’indice de ligne au fil de la propagation : la ligne suivante appellera indûment B2, puis B3, pointant ainsi vers des cellules vides ou incohérentes. Ce glissement d’adressage détruit instantanément la mécanique de calcul et fausse l’intégralité des valeurs de densité générées.
Parallèlement, les variables indépendantes locales — telles que la valeur courante du score z ou du score brut calculée spécifiquement pour une ligne donnée — doivent conserver leur statut de références relatives (par exemple D5 ou E5). Cette juxtaposition calculée entre références absolues (paramètres de population invariants) et références relatives (points de pas séquentiels) garantit que chaque ligne opérera une évaluation spécifique de la fonction de densité tout en demeurant fidèlement ancrée aux paramètres centraux de votre modèle.
4. Génération de l’axe des scores standardisés (Scores z)
4.1 Étape 2 : Construction de la séquence de -4 à +4
La morphologie continue de la courbe normale requiert un tracé graphique reposant sur un nombre suffisant de points de calcul pour éviter tout aspect brisé ou anguleux. Bien que l’outil de lissage graphique d’Excel puisse gommer artificiellement certaines discontinuités, la précision scientifique impose de calculer un maillage numérique fin. La plage idéale de variation standardisée s’étend de -4,0 à +4,0 écarts-types, et l’adoption d’un pas d’incrémentation régulier de 0,1 unité fournit exactement le compromis optimal entre fluidité visuelle et compacité du tableau de bord.
Dans la colonne D de votre feuille de calcul, inscrivez en cellule D4 le titre de colonne Score z. Positionnez-vous en cellule D5 et saisissez la borne inférieure du domaine d’échantillonnage : -4 (ou -4,0). Pour générer la séquence complète sans saisie manuelle laborieuse, sélectionnez la cellule D5, accédez à l’onglet Accueil du ruban, cliquez sur l’icône Remplir dans la section Édition, puis sélectionnez la commande Série….
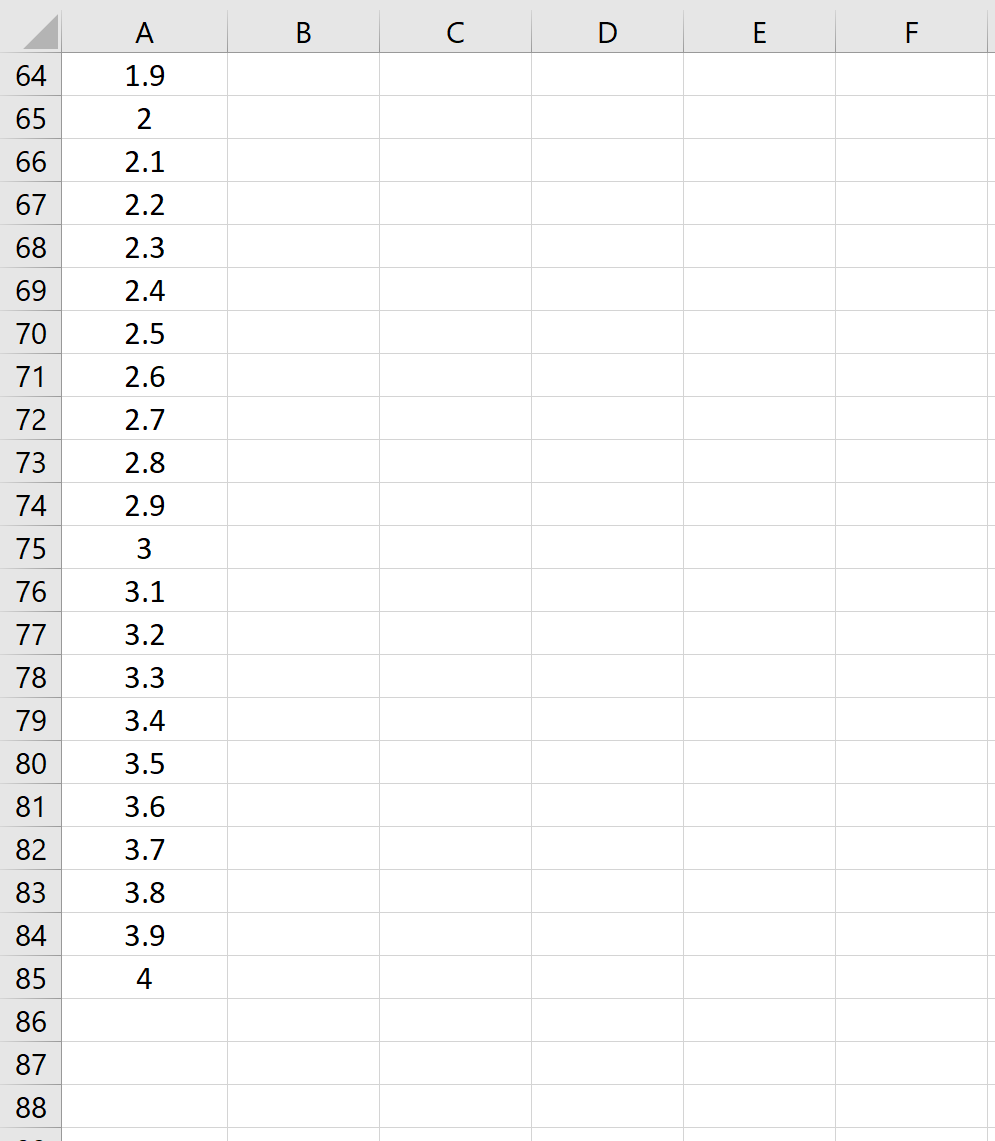
Dans la boîte de dialogue contextuelle, activez l’option Colonnes, configurez le type sur Linéaire, fixez la Valeur du pas à 0,1, et spécifiez la Dernière valeur à 4. En validant par OK, Excel injecte instantanément une succession rigoureuse de 81 coordonnées débutant à -4,0 en D5 et culminant à +4,0 en D85. Cette série de 81 points constitue l’ossature numérique fondamentale sur laquelle s’échafauderont toutes les transformations algébriques ultérieures de votre courbe.
4.2 Justification méthodologique de l’amplitude [-4σ ; +4σ]
Le choix délibéré d’encadrer la distribution dans un intervalle strict de [-4σ ; +4σ] ne relève pas d’un arbitraire esthétique, mais procède d’une analyse probabiliste précise des intégrales de la loi normale. En vertu de la fonction d’erreur de Gauss, la proportion de la distribution contenue dans l’intervalle compris entre -3σ et +3σ atteint 99,7300 %. Bien que cet intervalle classique soit fréquemment utilisé dans les représentations simplifiées, il omet un reliquat de 0,27 % de la population théorique, ce qui provoque des coupures abruptes des ailes de la courbe aux extrémités de l’axe graphique.
En élargissant l’horizon d’évaluation à quatre écarts-types de part et d’autre de la moyenne, l’intégrale couvre exactement 99,9936 % de l’aire sous la courbe. Le reliquat résiduel d’observations situées au-delà de ces frontières n’excède pas 0,0064 %, soit une occurrence théorique inférieure à 1 individu sur 15 000. Ce niveau de complétude permet d’obtenir des ailes graphiques qui convergent de manière fluide et quasi imperceptible vers le niveau zéro de l’axe horizontal, éliminant tout effet de troncature visuelle indésirable.
De surcroît, cette étendue prend tout son sens dans les applications cliniques et neuropsychologiques de pointe. Le diagnostic de troubles neurodéveloppementaux profonds ou, à l’inverse, l’identification de profils intellectuels exceptionnels requiert l’examen précis de scores se situant au-delà du troisième écart-type. En calibrant votre chiffrier sur un spectre de 8 écarts-types au total, vous offrez à votre modèle la capacité de représenter fidèlement ces cas extrêmes sans nécessiter d’ajustements structurels ultérieurs.
5. Calcul des valeurs brutes de la variable psychologique
5.1 Étape 3 : Conversion des scores z en échelle de mesure réelle
L’échelle des scores z constitue l’armature statistique universelle, mais les restitutions cliniques et les bilans de recherche exigent l’affichage des métriques propres aux instruments d’évaluation employés. L’étape suivante consiste à convertir chaque valeur de score z standardisé de la colonne D en son équivalent brut sur l’échelle continue d’intérêt. Cette opération s’effectue par l’inversion algébrique de la formule de standardisation :
x = μ + (z × σ)
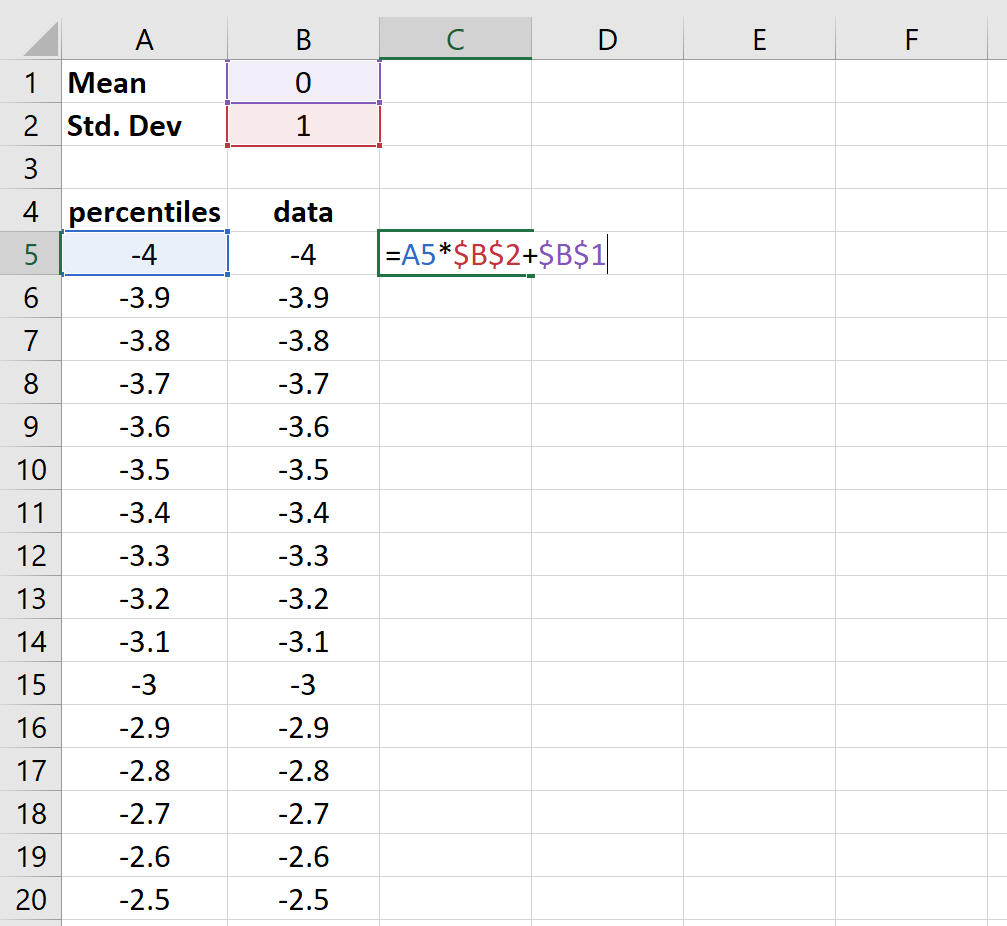
Positionnez-vous dans la colonne E de votre feuille de calcul. Attribuez à la cellule E4 le titre Valeur Brute (x). Dans la cellule sous-jacente E5, introduisez la formule arithmétique dynamique faisant référence aux paramètres définis à l’étape 1 et au score z de la ligne courante :
=$B$1+(D5*$B$2) (ou =Moyenne+(D5*EcartType) si vous avez appliqué le nommage de cellules).
Validez la formule, puis propagez-la verticalement jusqu’au terme du tableau en double-cliquant sur la poignée de recopie (le petit carré situé à l’angle inférieur droit de la cellule sélectionnée) ou en étirant la sélection jusqu’à la cellule E85. Excel recalcule instantanément les 81 points d’évaluation. Pour un modèle initialisé avec une moyenne de 100 et un écart-type de 15, vous constaterez que la cellule E5 (associée à z = -4) affiche la valeur 40, que la cellule centrale E45 (associée à z = 0) affiche rigoureusement 100, et que la borne supérieure en E85 (associée à z = +4) culmine à 160.
5.2 Adaptation aux métriques psychométriques courantes
L’extrême puissance de cette architecture réside dans sa neutralité métrologique : en modifiant simplement les deux cellules de paramètres fondamentaux ($B$1 et $B$2), l’ensemble de la colonne E s’ajuste instantanément à n’importe quel système de cotation psychométrique sans exiger la moindre retouche des formules matricielles. Le tableau ci-dessous illustre la transposition directe des paramètres pour les trois étalonnages les plus fréquemment mobilisés dans l’évaluation psychologique et pédagogique :
- Échelles composites de Wechsler (QI standard) : μ = 100, σ = 15. L’étendue de la colonne E balaie le continuum allant de 40 à 160 points, couvrant les profils allant de la déficience intellectuelle sévère au très haut potentiel cognitif.
- Notes T (T-Scores, fréquentes dans le MMPI et l’évaluation de la personnalité) : μ = 50, σ = 10. La colonne E présentera alors une progression linéaire allant de 10 à 90 points, la zone d’alerte clinique débutant conventionnellement au-delà du seuil de 65 ou 70 (z ≥ +1,5 ou +2).
- Échelle Sten (Standard Ten, très répandue en psychologie du travail et orientation) : μ = 5,5, σ = 2,0. L’échantillonnage s’étendra de -2,5 à 13,5, bornant les profils comportementaux en dix classes standards normalisées.
Cette flexibilité algorithmique garantit que le graphique en cloche adossé à ces colonnes reflétera avec une exactitude mathématique rigoureuse les grandeurs physiques ou psychométriques réelles propres à votre spécialité, évitant ainsi les erreurs d’approximation visuelle lors de la communication de vos résultats à des tiers ou dans des publications institutionnelles.
6. Calcul de la fonction de densité de probabilité (PDF)
6.1 Étape 4 : Implémentation de la fonction LOI.NORMALE.N
La génération des coordonnées verticales (ordonnées Y) de notre future courbe en cloche exige l’application de la fonction de densité de probabilité normale à chacune des valeurs calculées précédemment. C’est ici qu’intervient la fonction statistique dédiée d’Excel, conçue pour résoudre instantanément l’équation exponentielle différentielle de Gauss.
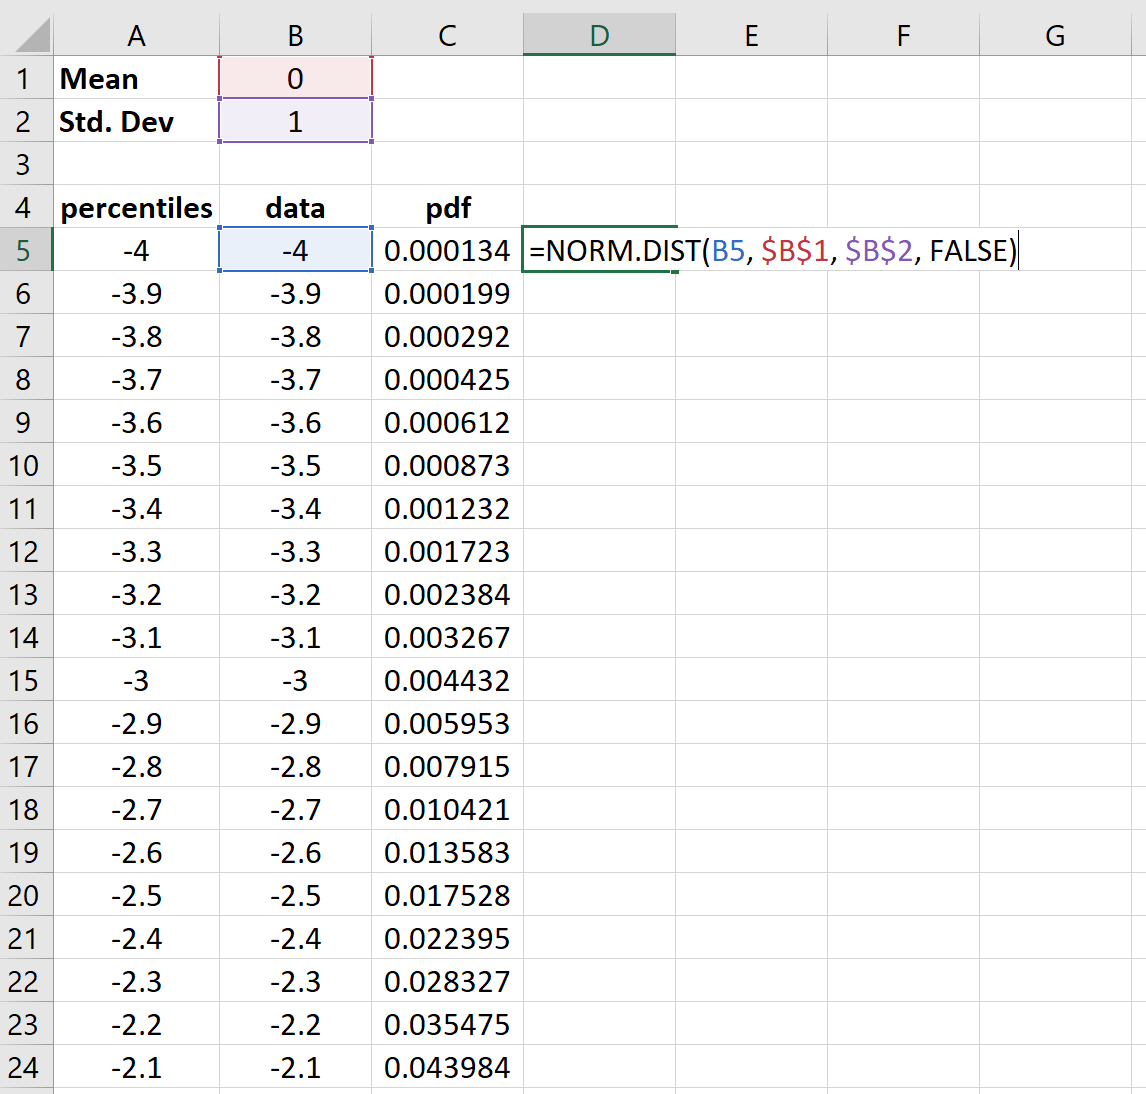
Positionnez-vous dans la colonne F et nommez la cellule F4 Densité (PDF). Dans la cellule F5, vous devez saisir la fonction normalisée d’Excel en lui fournissant la valeur brute de la variable continue, la moyenne d’étalonnage, l’écart-type de référence, et la commande booléenne désactivant le calcul cumulé :
=LOI.NORMALE.N(E5; $B$1; $B$2; FAUX)
Si vous exploitez une version anglophone de Microsoft Excel, la formulation syntaxique équivalente s’écrit =NORM.DIST(E5, $B$1, $B$2, FALSE). Il convient de souligner qu’une alternative méthodologiquement équivalente consiste à calculer la densité directement à partir des scores z de la colonne D, au moyen de la formule =LOI.NORMALE.STANDARD.N(D5; FAUX) divisée par l’écart-type pour respecter l’échelle de mesure des ordonnées. Néanmoins, l’appel direct à LOI.NORMALE.N adossé à la colonne des valeurs brutes offre une traçabilité plus intuitive et prévient les confusions conceptuelles.
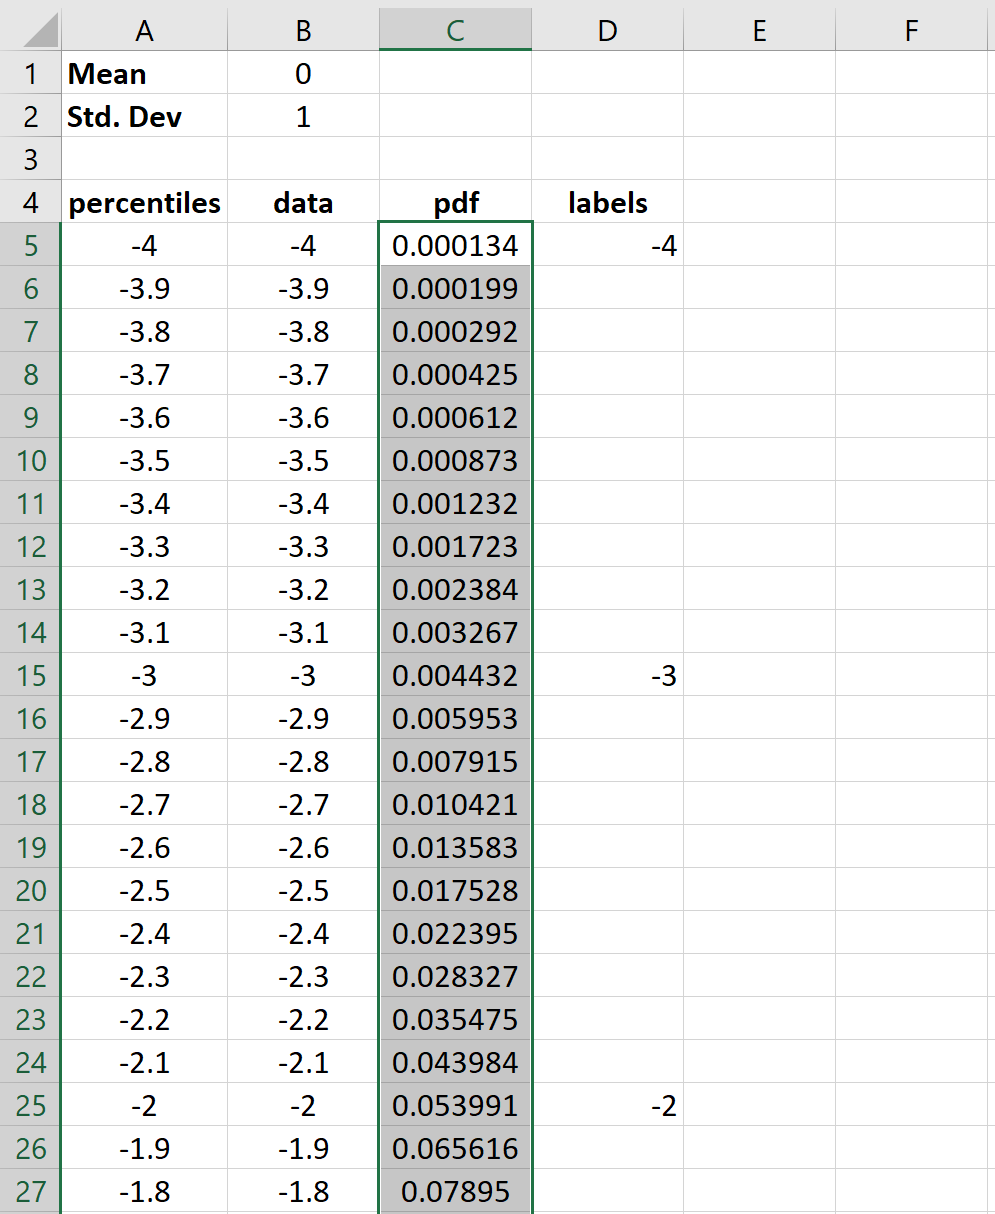
Étirez cette formule jusqu’à la cellule F85. Vous observerez une séquence de nombres décimaux extrêmement réduits aux extrémités (de l’ordre de 0,000008 en F5 pour un écart-type de 15), qui croissent de manière exponentielle au fur et à mesure que l’abscisse se rapproche du centre de la distribution, pour culminer précisément au sommet en cellule F45 (qui correspond à x = μ = 100). La valeur maximale théorique d’une densité normale pour σ = 15 s’établit rigoureusement à 1 / (15 × √(2π)) ≈ 0,026596, fournissant un repère de vérification immédiat pour contrôler l’exactitude de vos calculs.
6.2 Validation de l’intégrité numérique des densités obtenues
Avant d’engager la phase de construction graphique, un contrôle qualité des valeurs numériques générées s’avère indispensable afin d’éviter la propagation d’incohérences structurelles. Deux critères arithmétiques fondamentaux permettent d’attester de la validité de votre série de données : l’analyse de symétrie équidistante et le test de l’asymptote terminale.
Le contrôle de symétrie repose sur la propriété théorique f(μ – c) = f(μ + c), où c représente n’importe quelle déviation scalaire par rapport au centre. Dans votre tableau, comparez la densité calculée à z = -1 (cellule F35, x = 85) avec celle obtenue à z = +1 (cellule F55, x = 115). Les deux valeurs doivent présenter une égalité mathématique absolue jusqu’à la dixième décimale (approximativement 0,016131 pour σ = 15). De même, confrontez les valeurs à z = -2 et z = +2. Toute dissymétrie observée trahirait une erreur d’adressage cellulaire dans vos formules ou un décalage accidentel lors de l’incrémentation des scores z.
Le dépannage des messages d’erreur courants constitue la seconde étape de cette vérification. Si votre colonne F affiche l’erreur #VALEUR!, inspectez le formatage de vos cellules d’entrée en B1 et B2 : elles doivent contenir des nombres purs et non des chaînes textuelles (attention à l’utilisation du point typographique au lieu de la virgule décimale selon les paramètres régionaux de votre système d’exploitation). Si l’erreur #NOMBRE! surgit, assurez-vous que l’écart-type n’a pas été fixé par inadvertance à une valeur négative ou nulle. Une fois cette validation effectuée, vos séries de données offrent une base solide pour la conception graphique.
7. Création des étiquettes personnalisées de l’axe horizontal
7.1 Étape 5 : Conception des étiquettes réservées aux centiles entiers
Une courbe statistique destinée à une communication scientifique ou clinique doit concilier rigueur mathématique et lisibilité ergonomique. Si vous générez un graphique en injectant directement l’intégralité des 81 valeurs brutes de la colonne E sur l’axe des abscisses, l’axe deviendra immédiatement illisible : 81 nombres s’écraseront mutuellement le long d’une bande horizontale étroite, créant une surcharge cognitive préjudiciable.
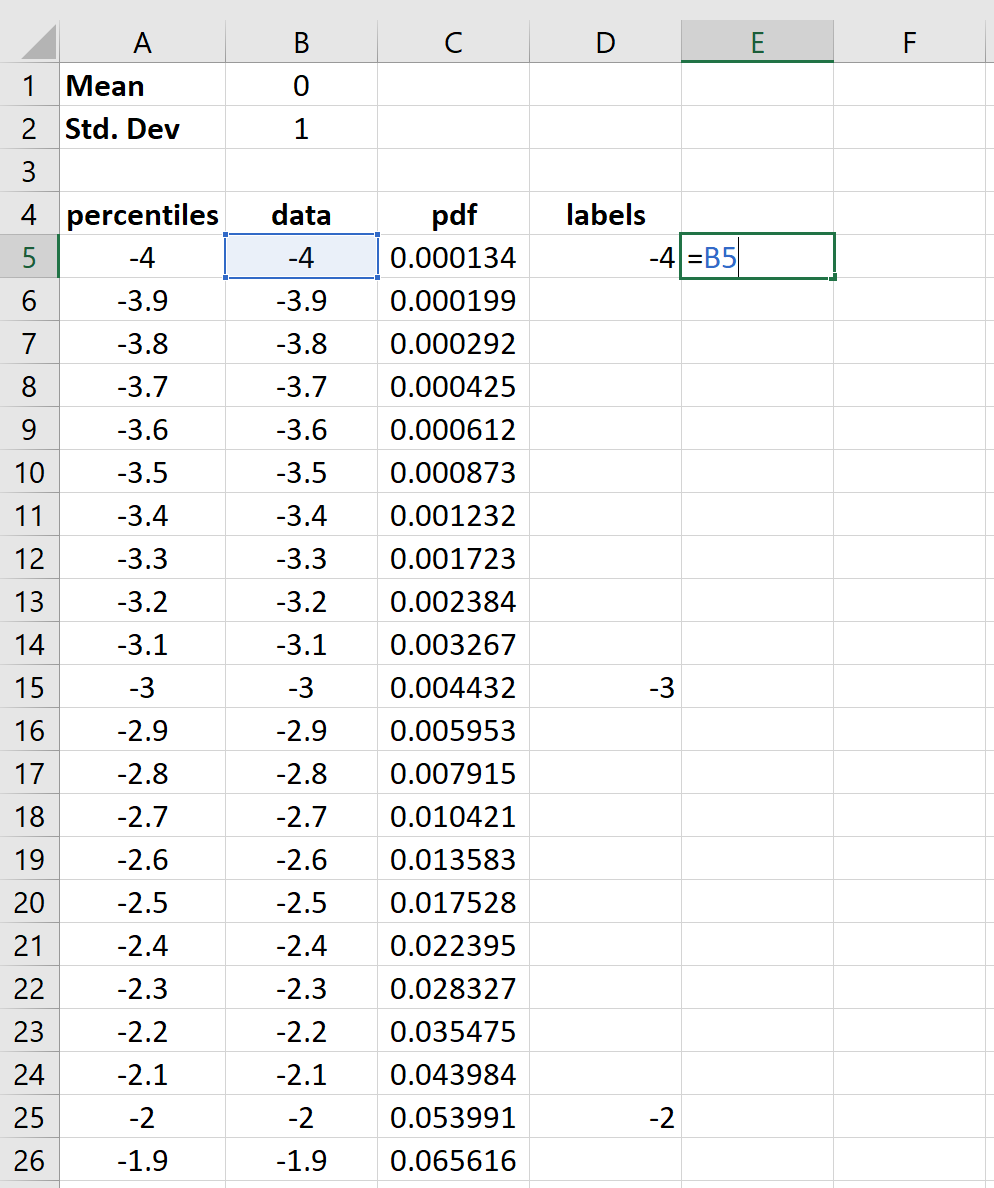
Pour contourner cet écueil graphique propre au moteur d’Excel, la solution consiste à concevoir une colonne dédiée aux étiquettes filtrées. Cette colonne n’affichera de valeur numérique que pour les points d’ancrage méthodologiquement remarquables — à savoir les multiples entiers de l’écart-type correspondant aux scores z entiers : -4, -3, -2, -1, 0, 1, 2, 3 et 4 — tout en laissant un vide formel pour les 72 points d’interpolation intermédiaires nécessaires à la courbure.
Désignez la cellule G4 par l’intitulé Étiquettes Axe. Dans la cellule G5, introduisez la formulation logique conditionnelle suivante :
=SI(MOD(D5; 1)=0; ARRONDI(E5; 0); "")
Cette formule examine la coordonnée z présente en D5. La fonction MOD(D5; 1) calcule le reste de la division du score z par 1. Si ce reste est nul, cela signifie que la coordonnée est un entier strict (-4, -3, etc.). La fonction SI renvoie alors la valeur brute correspondante issue de la cellule E5 (ici arrondie à l’entier le plus proche par précaution typographique). Si le score z comporte des décimales (-3,9 ; -3,8 ; etc.), la condition n’est pas remplie et la formule renvoie une chaîne vide figurée par les doubles guillemets "".
7.2 Harmonisation des formats d’affichage
Étirez la formule conditionnelle de la cellule G5 jusqu’à la cellule G85. Vous remarquerez que la colonne G présente désormais un aspect visuel aéré : seules 9 cellules sur les 81 contiennent une valeur affichée, tandis que les cellules intermédiaires semblent entièrement transparentes. Il s’agit précisément du comportement souhaité pour configurer ultérieurement l’axe horizontal sans surcharger le regard.
Il est nécessaire de clarifier un point technique subtil concernant la gestion des chaînes vides sous Excel. Bien que la cellule contienne une chaîne textuelle nulle "", Excel la traite comme un texte vide et non comme un zéro arithmétique. Si l’on avait programmé la formule conditionnelle pour renvoyer le nombre 0 au lieu de guillemets vides, le graphique tracerait une succession d’étiquettes parasites « 0 » sur l’ensemble du ruban horizontal, détruisant la cohérence de l’affichage.
Selon l’outil psychologique étalonné, vous pouvez adapter la commande d’arrondi au sein de la fonction conditionnelle. Pour les échelles composites de QI ou les T-scores, un arrondi à l’entier strict (ARRONDI(E5; 0)) garantit une lisibilité maximale (ex. : 55, 70, 85, 100, 115, 130, 145). Pour des métriques plus fines comme les scores Sten, les échelles standardisées de Wechsler pour les sous-tests (Moyenne 10, Écart-type 3) ou des mesures biométriques, modifiez le second argument pour afficher une ou deux décimales (ex. : ARRONDI(E5; 1)), préservant ainsi le niveau de granularité pertinent pour le diagnostic.
8. Génération graphique pas à pas de la courbe sous Excel
8.1 Étape 6 : Insertion du graphique de base à partir des données de densité
Une fois les quatre colonnes numériques parfaitement calibrées et vérifiées, la génération de la représentation visuelle peut débuter. Contrairement à une intuition fréquente, il ne faut pas sélectionner l’intégralité du tableau de données pour insérer le tracé. La démarche correcte consiste à cibler initialement la seule composante verticale du phénomène, à savoir la densité de probabilité.
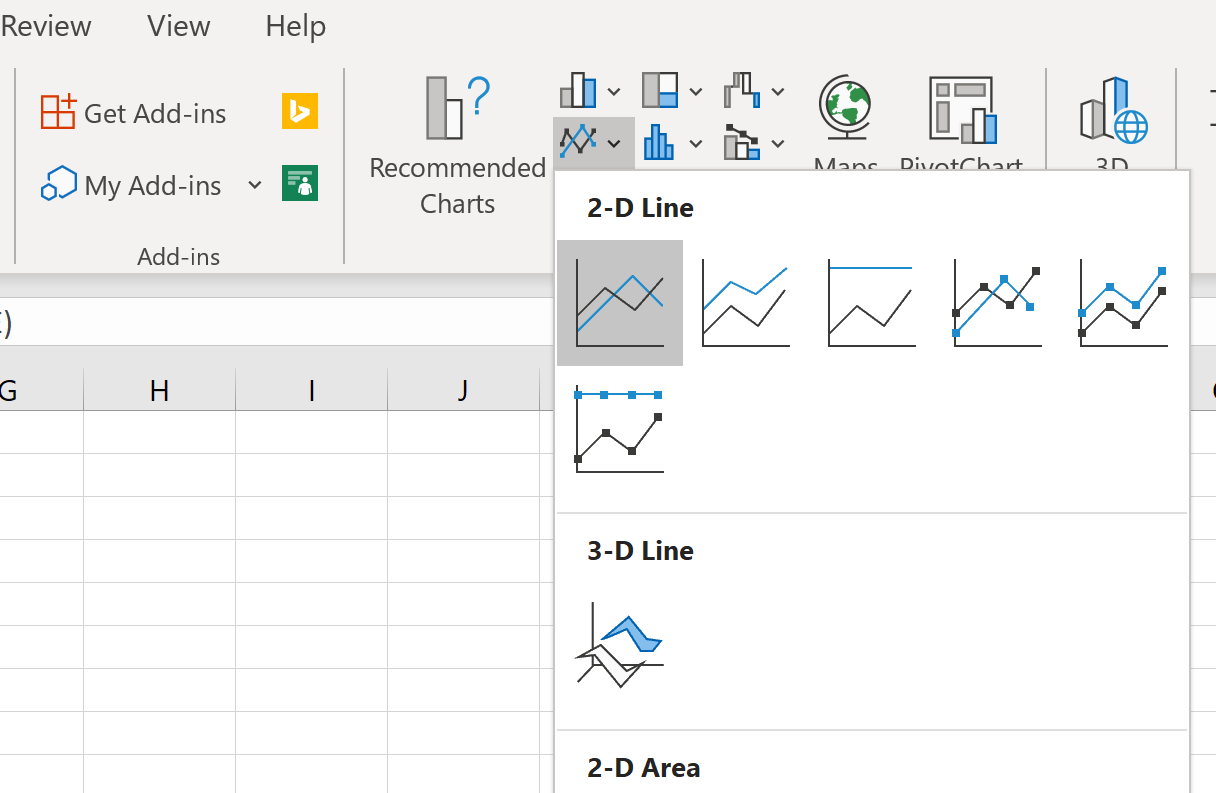
Sélectionnez avec précision la plage des ordonnées calculées, s’étendant de la cellule F5 à la cellule F85. Rendez-vous dans le ruban supérieur d’Excel et cliquez sur l’onglet Insertion. Dans la section dédiée aux Graphiques, cliquez sur le menu déroulant Insérer un graphique en courbes et sélectionnez le sous-type élémentaire intitulé Ligne 2D (courbe simple sans marqueurs de données).
Excel déploie instantanément sur votre feuille de calcul un canevas graphique représentant une courbe en cloche parfaitement continue et symétrique. À ce stade du processus, examinez avec attention la morphologie obtenue : elle possède déjà les caractéristiques esthétiques de la loi de Gauss. Cependant, l’examen de l’axe horizontal révèle une anomalie critique : l’axe des abscisses est numéroté de façon arbitraire de 1 à 81. Ces chiffres ne traduisent nullement vos scores psychologiques, mais reflètent simplement l’indice séquentiel des lignes au sein de la plage sélectionnée. Il est donc indispensable de reprogrammer cet axe.
8.2 Étape 7 : Modification et étalonnage des étiquettes de l’axe horizontal
L’opération d’attribution des véritables valeurs d’échelle requiert l’accès au module de gestion des sources du graphique. Effectuez un clic droit directement dans la zone de traçage du graphique nouvellement créé et choisissez l’option Sélectionner des données… au sein du menu contextuel. Une boîte de dialogue modale s’ouvre, subdivisée en deux volets principaux : les Entrées de légende (Série) sur la gauche et les Étiquettes de l’axe horizontal (abscisse) sur la droite.
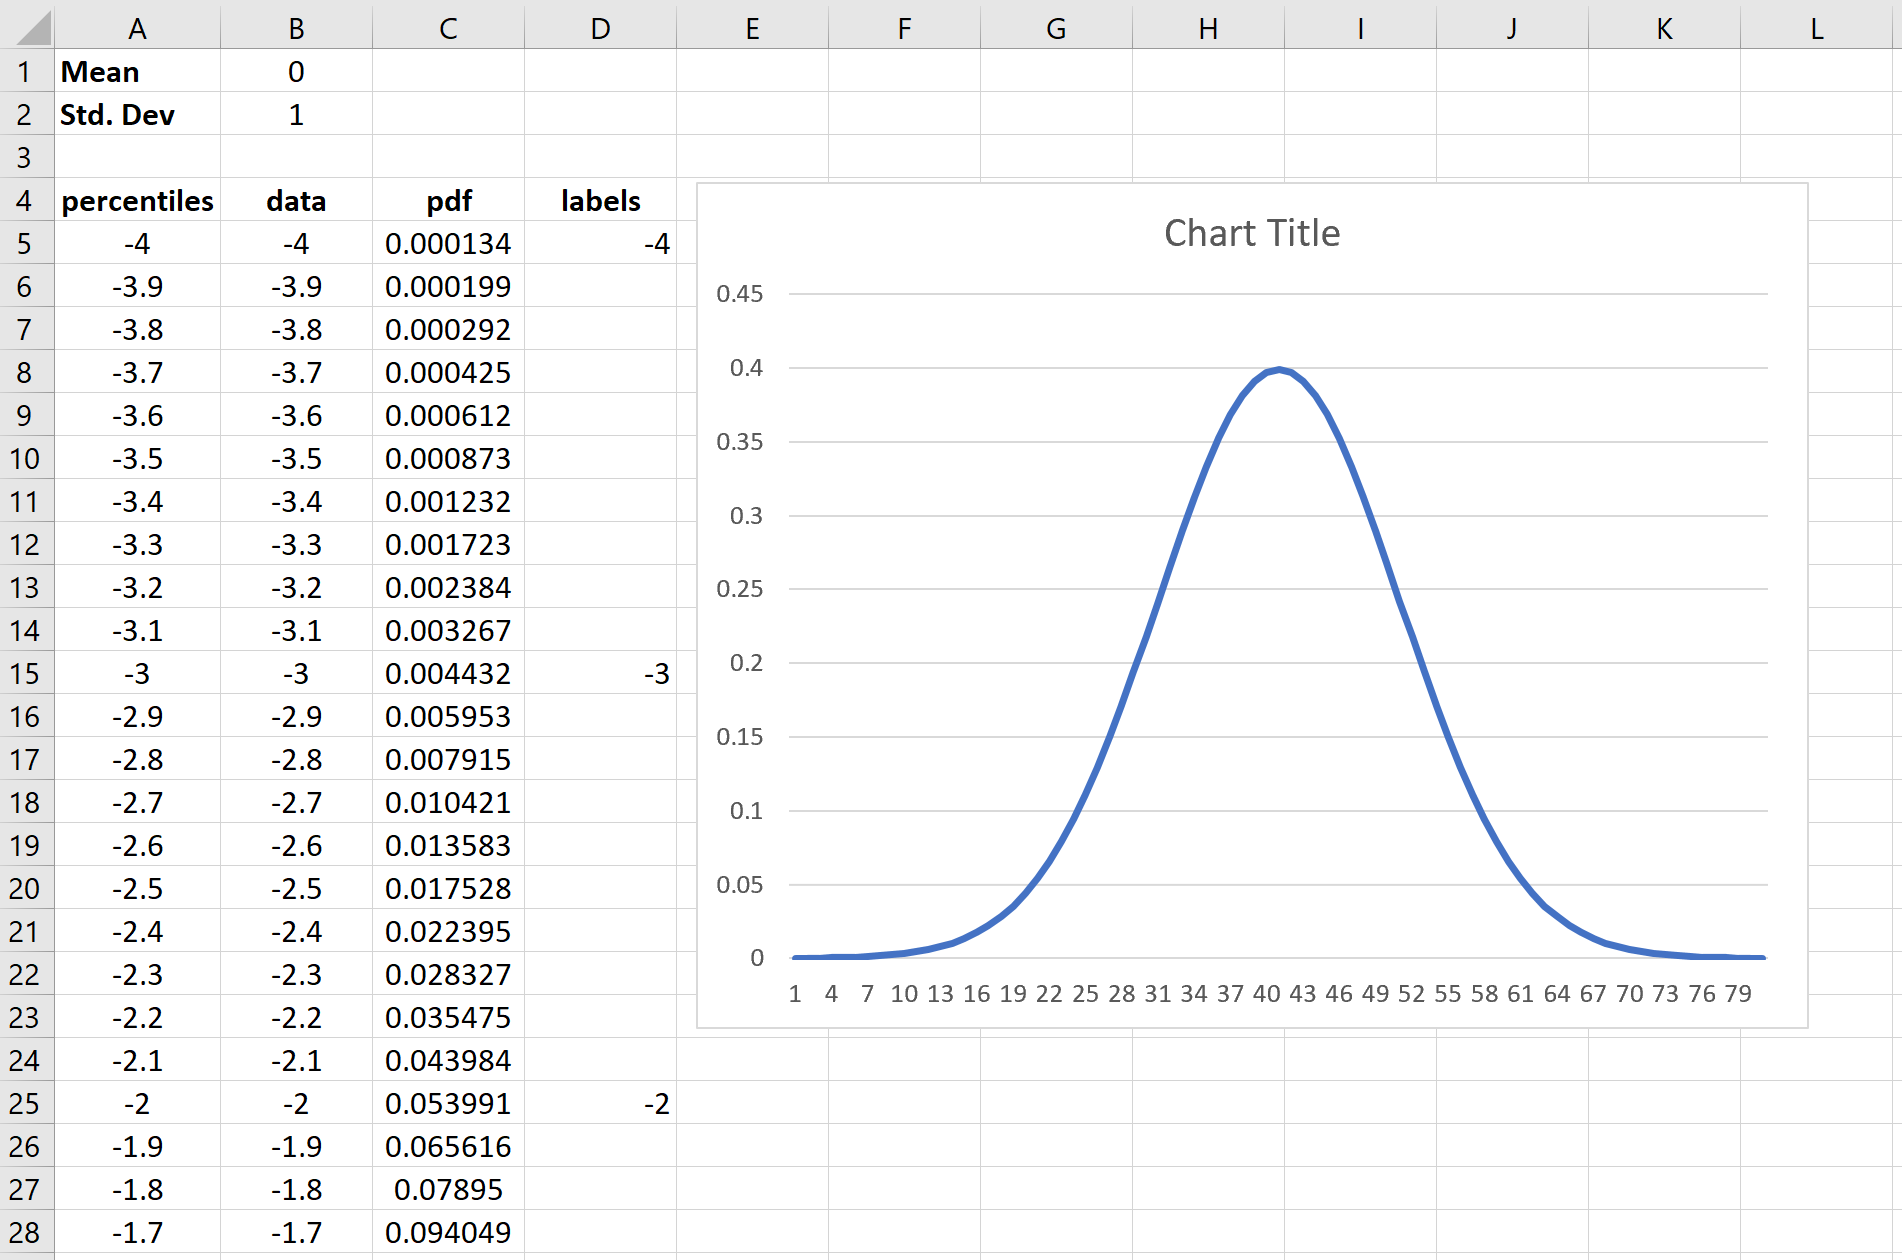
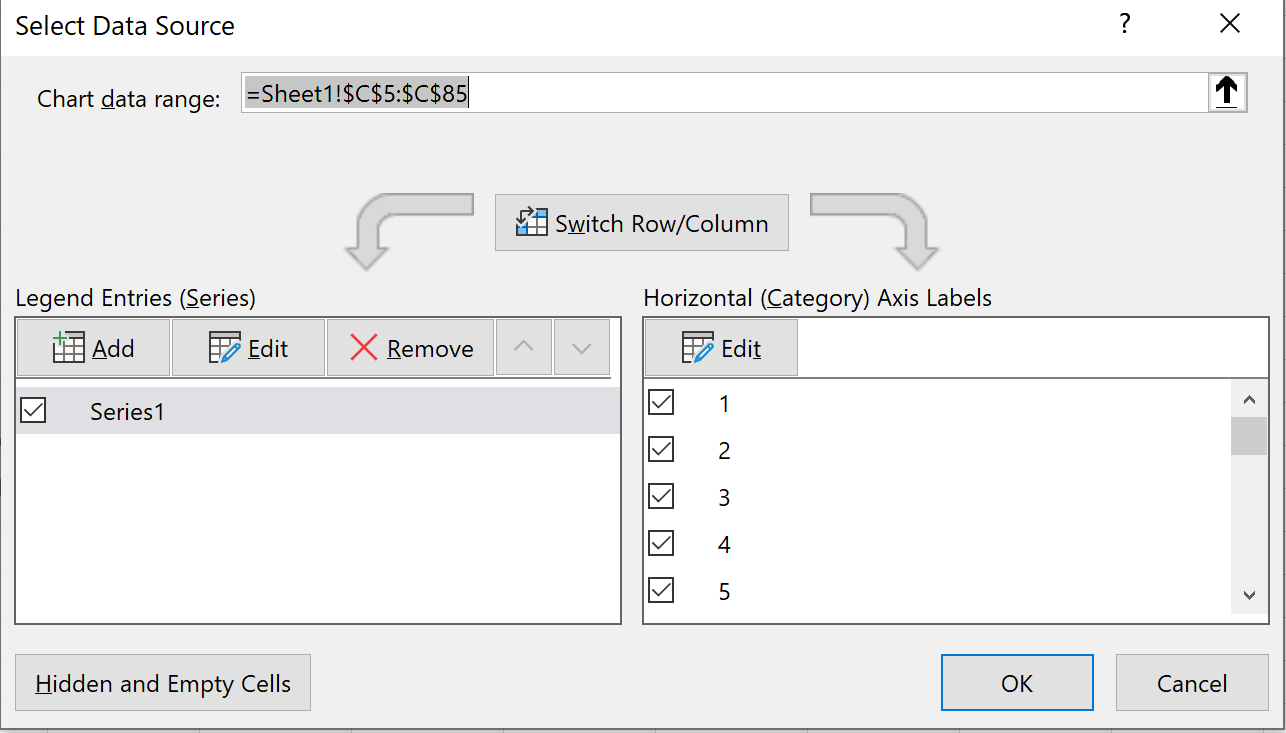
Portez votre attention sur le volet droit intitulé Étiquettes de l’axe horizontal (abscisse) et cliquez sur le bouton Modifier. Une petite invite contextuelle sollicite alors la Plage d’étiquettes des axes. Cliquez sur l’icône de sélection et surlignez rigoureusement la plage contenant vos étiquettes conditionnelles élaborées à l’étape 5, à savoir le domaine cellulaire G5:G85. Validez par OK dans l’invite, puis confirmez une seconde fois par OK dans la boîte de dialogue principale.
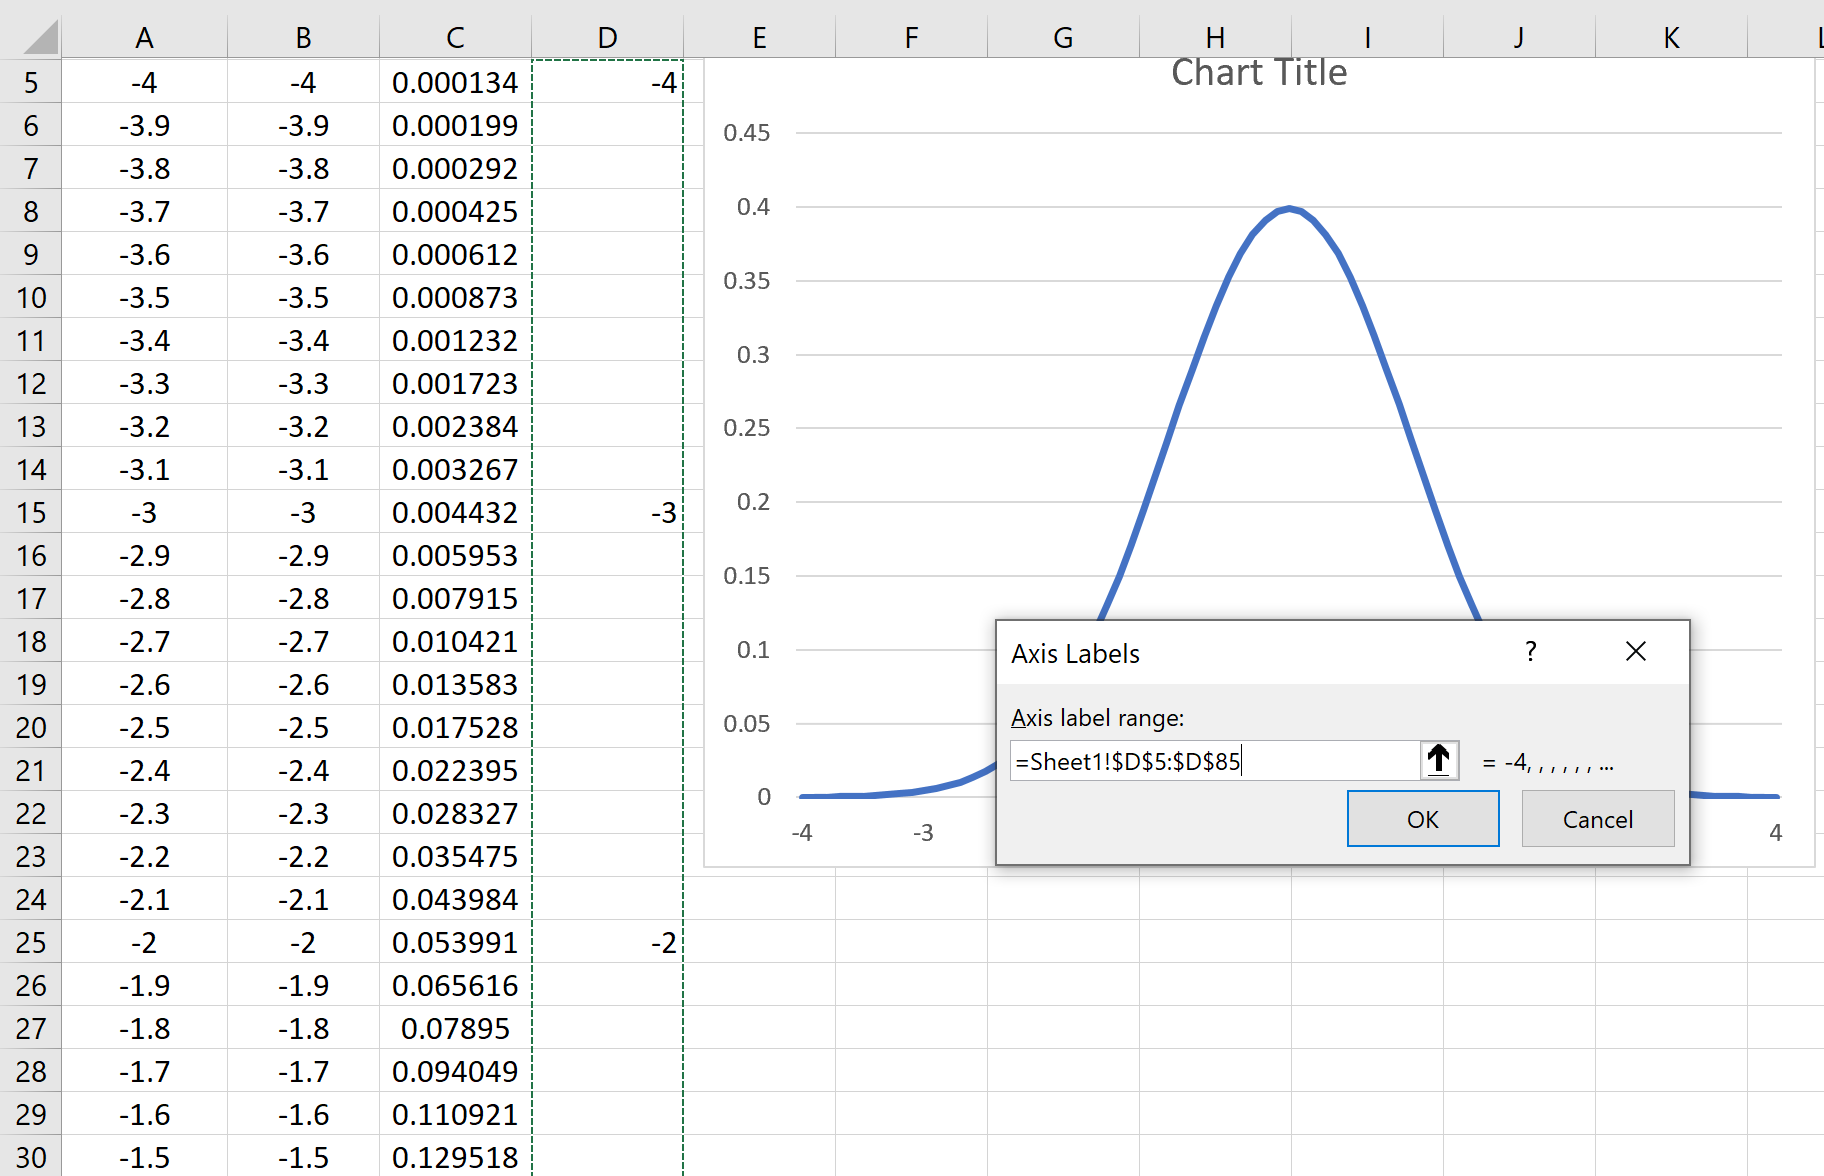
En observant le graphique actualisé, la transformation s’opère : la numérotation arbitraire de 1 à 81 a disparu au profit d’un axe aéré où n’apparaissent que les 9 repères cardinaux calculés (par exemple 40, 55, 70, 85, 100, 115, 130, 145 et 160). Grâce au filtrage conditionnel instauré par notre formule SI, les points intermédiaires ne génèrent aucun texte superflu, assurant un alignement typographique parfait entre les graduations visibles et les déviations standard théoriques sous la courbe.
8.3 Alternative méthodologique : Le nuage de points avec courbe lissée
Il existe une variante technique estimable pour générer une courbe en cloche sous Excel : l’utilisation d’un Graphique en nuage de points (XY) avec lignes lissées. Dans cette configuration, au lieu d’utiliser un graphique de type Ligne adossé à une colonne d’étiquettes textuelles, vous sélectionnez conjointement deux plages de données : la colonne des valeurs brutes E5:E85 pour les coordonnées X, et la colonne des densités F5:F85 pour les coordonnées Y.
L’avantage cardinal du nuage de points réside dans le traitement de l’axe horizontal comme un véritable axe numérique continu à échelle d’intervalle, et non comme une succession de catégories discrètes. Excel calcule alors de manière autonome la répartition proportionnelle des graduations et gère automatiquement l’espacement physique entre les points. Cette approche élimine l’obligation de concevoir la colonne d’étiquettes conditionnelles (étape 5), puisque l’axe gère nativement les pas d’incrémentation numériques.
Néanmoins, le nuage de points présente une contrainte sémiotique : il ne permet pas de contraindre facilement l’axe horizontal à afficher exclusivement les multiples de l’écart-type sans imposer des réglages manuels stricts des unités principales dans les options d’axe. Si votre écart-type est un nombre inhabituel (par exemple σ = 6,8), l’axe numérique générera des graduations arbitraires (ex. : 40, 50, 60, 70) qui ne coïncideront pas avec les frontières d’écarts-types (μ ± 1σ, μ ± 2σ). L’approche par graphique en courbes avec étiquettes filtrées (méthode 8.1 – 8.2) demeure donc la plus élégante pour restituer visuellement les zones psychométriques normées.
9. Personnalisation esthétique et optimisation sémiotique
9.1 Stylisation de la courbe selon les normes de publication académique
La restitution graphique brute produite par défaut par les tableurs contemporains souffre souvent d’une surabondance d’artifices visuels qui encombrent la transmission de l’information statistique. Les recommandations de Edward Tufte sur l’intégrité sémiotique stipulent que le ratio données/encre doit être maximisé : tout pixel qui ne véhicule pas une information quantitative directe doit être épuré ou neutralisé. Pour satisfaire aux exigences éditoriales des revues scientifiques internationales (normes APA 7e édition), une refonte stylistique s’impose.
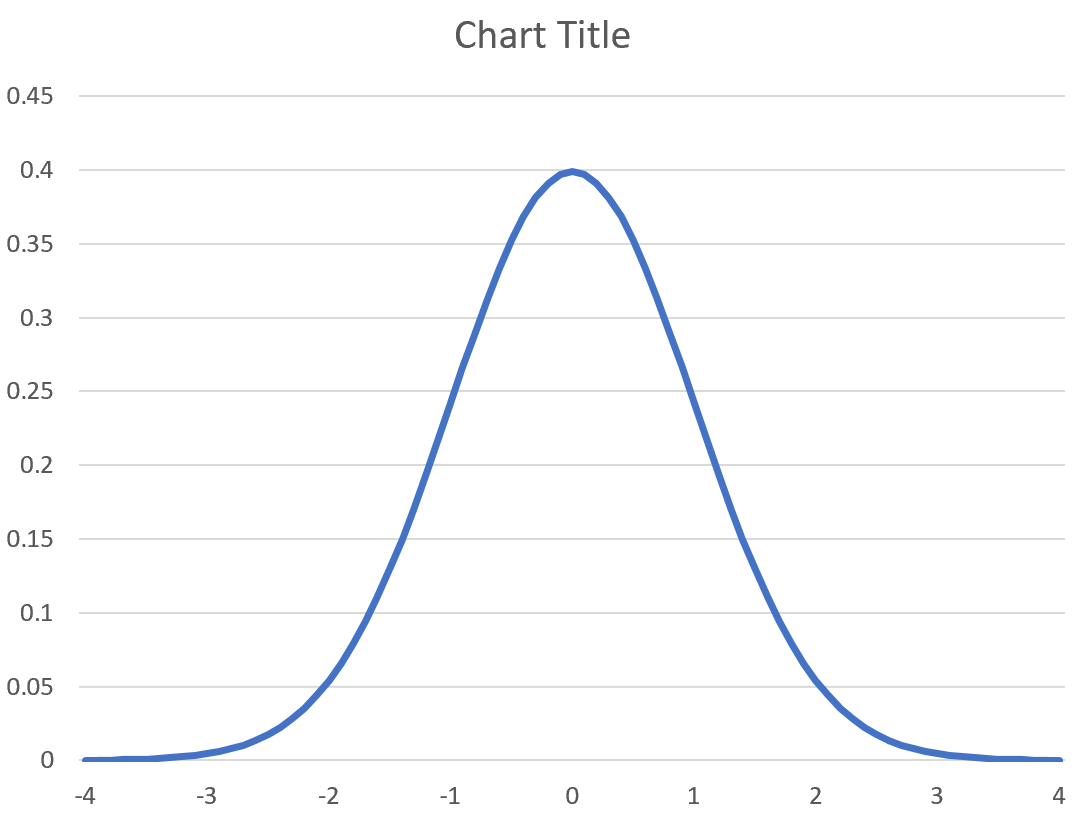
Commencez par supprimer sans hésitation le quadrillage horizontal majeur. Sélectionnez l’une des lignes de grille traversant le graphique et appuyez sur la touche Suppr de votre clavier. Ce décapage visuel focalise instantanément l’attention de l’observateur sur la dynamique de courbure et la pureté morphologique de la fonction gaussienne. De même, sélectionnez la légende automatique (intitulée par défaut « Série1 ») et supprimez-la, son apport explicatif étant totalement superflu dans le contexte d’une distribution univariée.
Formatez ensuite le tracé de la courbe lui-même. Effectuez un double-clic sur la ligne graphique pour ouvrir le volet latéral Format de la série de données. Dans l’onglet Remplissage et ligne (figuré par un pot de peinture), choisissez une ligne continue de teinte sombre et sobre — tel qu’un bleu nuit institutionnel, un gris anthracite ou un noir pur. Ajustez la largeur du trait à une valeur comprise entre 2 pt et 2,5 pt pour lui conférer une présence graphique marquée sans alourdir le contour. Assurez-vous que l’option de ligne lissée soit désactivée si votre échantillonnage comporte 81 points, la densité de notre maillage assurant déjà une fluidité géométrique naturelle exempte d’artéfacts de calcul.
9.2 Délimitation des zones d’écart-type et ombrage contextuel
Dans un rapport psychométrique professionnel ou une publication neuropsychologique, le pouvoir explicatif d’une courbe de Gauss est démultiplié lorsqu’elle matérialise visuellement les intervalles de référence cliniques. L’ombrage de zones stratégiques sous la courbe — par exemple l’intervalle d’efficience normale compris entre -1σ et +1σ, ou les zones critiques situées au-delà de deux écarts-types — transforme une simple fonction mathématique en un puissant instrument diagnostique immédiatement interprétable par un lecteur profane.
Pour implémenter cette segmentation visuelle sous Excel, la méthode la plus propre consiste à recourir à la superposition d’un graphique en aires. Dans votre chiffrier, créez une colonne additionnelle intitulée Aire Normale. À l’aide d’une instruction conditionnelle du type =SI(ET(D5>=-1; D5<=1); F5; 0), vous isolez les ordonnées de densité cantonnées entre les bornes standardisées -1 et +1. En intégrant cette nouvelle série au sein du graphique et en lui affectant le type Aire 2D, Excel colore instantanément l’espace sous-jacent à la courbe sur cet intervalle spécifique.
Appliquez à cette zone ombrée un remplissage uni doté d’une transparence de 60 % à 70 %, en optant pour une nuance pastel douce (un bleu ciel atténué ou un vert sauge). Cette transparence évite d’écraser la lecture de l’axe des abscisses tout en guidant immédiatement le regard vers la plage qui rassemble théoriquement 68,27 % de la population générale. De la même façon, les zones d’extrême sévérité pathologique ou de surdouance intellectuelle (z > +2 et z < -2) peuvent faire l’objet de colonnes dédiées associées à un ombrage ambré ou rouge très pâle, concrétisant sans ambiguïté les seuils de rupture diagnostique.
9.3 Ajout d’éléments textuels et légendes explicatives
L’autonomie sémiotique d’une figure dépend de la précision de ses annotations textuelles. Une figure scientifique doit pouvoir être comprise sans qu’il soit nécessaire de lire le corps du texte qui l’accompagne. La première composante textuelle fondamentale est le titre dynamique du graphique. Au lieu de saisir un libellé figé, associez le titre du graphique à une formule de concaténation située dans une cellule de votre chiffrier. Par exemple, en cellule A10, programmez la formule suivante :
="Distribution Théorique de Gauss (N = "&B3&" ; µ = "&B1&" ; σ = "&B2&")"
Cliquez ensuite sur le titre de votre graphique, saisissez le signe égal = dans la barre de formule supérieure d’Excel, puis cliquez sur votre cellule de concaténation A10 avant de valider par Entrée. Désormais, toute modification de la moyenne ou de l’écart-type au sein de vos cellules d’entrée sera répercutée en temps réel au sommet de votre figure, assurant une parfaite synchronisation entre vos paramètres descriptifs et la restitution visuelle.
Complétez l’agencement sémiotique en insérant des zones de texte flottantes au-dessus de la courbe pour renseigner les pourcentages théoriques de population délimités par les déviations standard : insérez l’annotation 34,1 % de part et d’autre de la moyenne centrale, 13,6 % au sein des intervalles [-2σ ; -1σ] et [+1σ ; +2σ], puis 2,1 % aux ailes extrêmes. Enfin, intégrez une note de bas de graphique renseignant l’outil psychométrique utilisé, la date de publication de l’étalonnage et le seuil d’erreur standard de mesure (SEM), conformément aux recommandations formelles de la pratique psychométrique moderne.
10. Exemple pratique appliqué : Étalonnage d’un test psychométrique
10.1 Présentation du cas clinique : Échelle d’anxiété cognitive
Pour démontrer l’opérationnalité directe de notre démarche méthodologique, considérons une situation concrète issue de la psychologie clinique et de la santé. Une équipe de chercheurs a développé une épreuve d’évaluation dimensionnelle intitulée Échelle d’Anxiété Cognitive Généralisée (EACG), administrée auprès d’une cohorte représentative de 1 200 adultes âgés de 25 à 45 ans afin d’établir les barèmes de référence nationaux. Cette échelle psychométrique génère un score quantitatif continu borné théoriquement de 15 à 75 points.
L’exploration analytique des données d’étalonnage atteste d’une remarquable conformité à la loi de Gauss, sans asymétrie marquée ni aplatissement anormal. Les indices de tendance centrale et de dispersion recueillis sur cet échantillon normatif s’établissent rigoureusement comme suit :
- Moyenne arithmétique de référence (μ) : 45,2 points bruts.
- Écart-type de référence (σ) : 6,8 points bruts.
- Taille de la cohorte d’étalonnage (N) : 1 200 participants.
L’objectif clinique assigné consiste à bâtir la courbe en cloche paramétrée de cette nouvelle échelle sous Microsoft Excel afin de créer un gabarit visuel permanent. Ce support graphique servira de grille d’évaluation dynamique au sein d’une unité de thérapie cognitive et comportementale pour positionner les nouveaux patients consultants, évaluer la sévérité relative de leurs manifestations anxieuses et objectiver l’efficacité de la prise en charge thérapeutique par l’observation des déplacements sur la courbe après traitement.
10.2 Exécution intégrale sous Excel de l’exemple concret
Pour concrétiser cet étalonnage au sein du modèle conçu dans les chapitres précédents, la procédure d’actualisation s’effectue en quelques clics :
Accédez à la zone des paramètres d’entrée de votre feuille de calcul. Remplacez l’ancienne moyenne par 45,2 dans la cellule B1, puis saisissez l’écart-type empirique 6,8 dans la cellule B2. À cet instant précis, la dynamique du chiffrier opère de manière entièrement automatique :
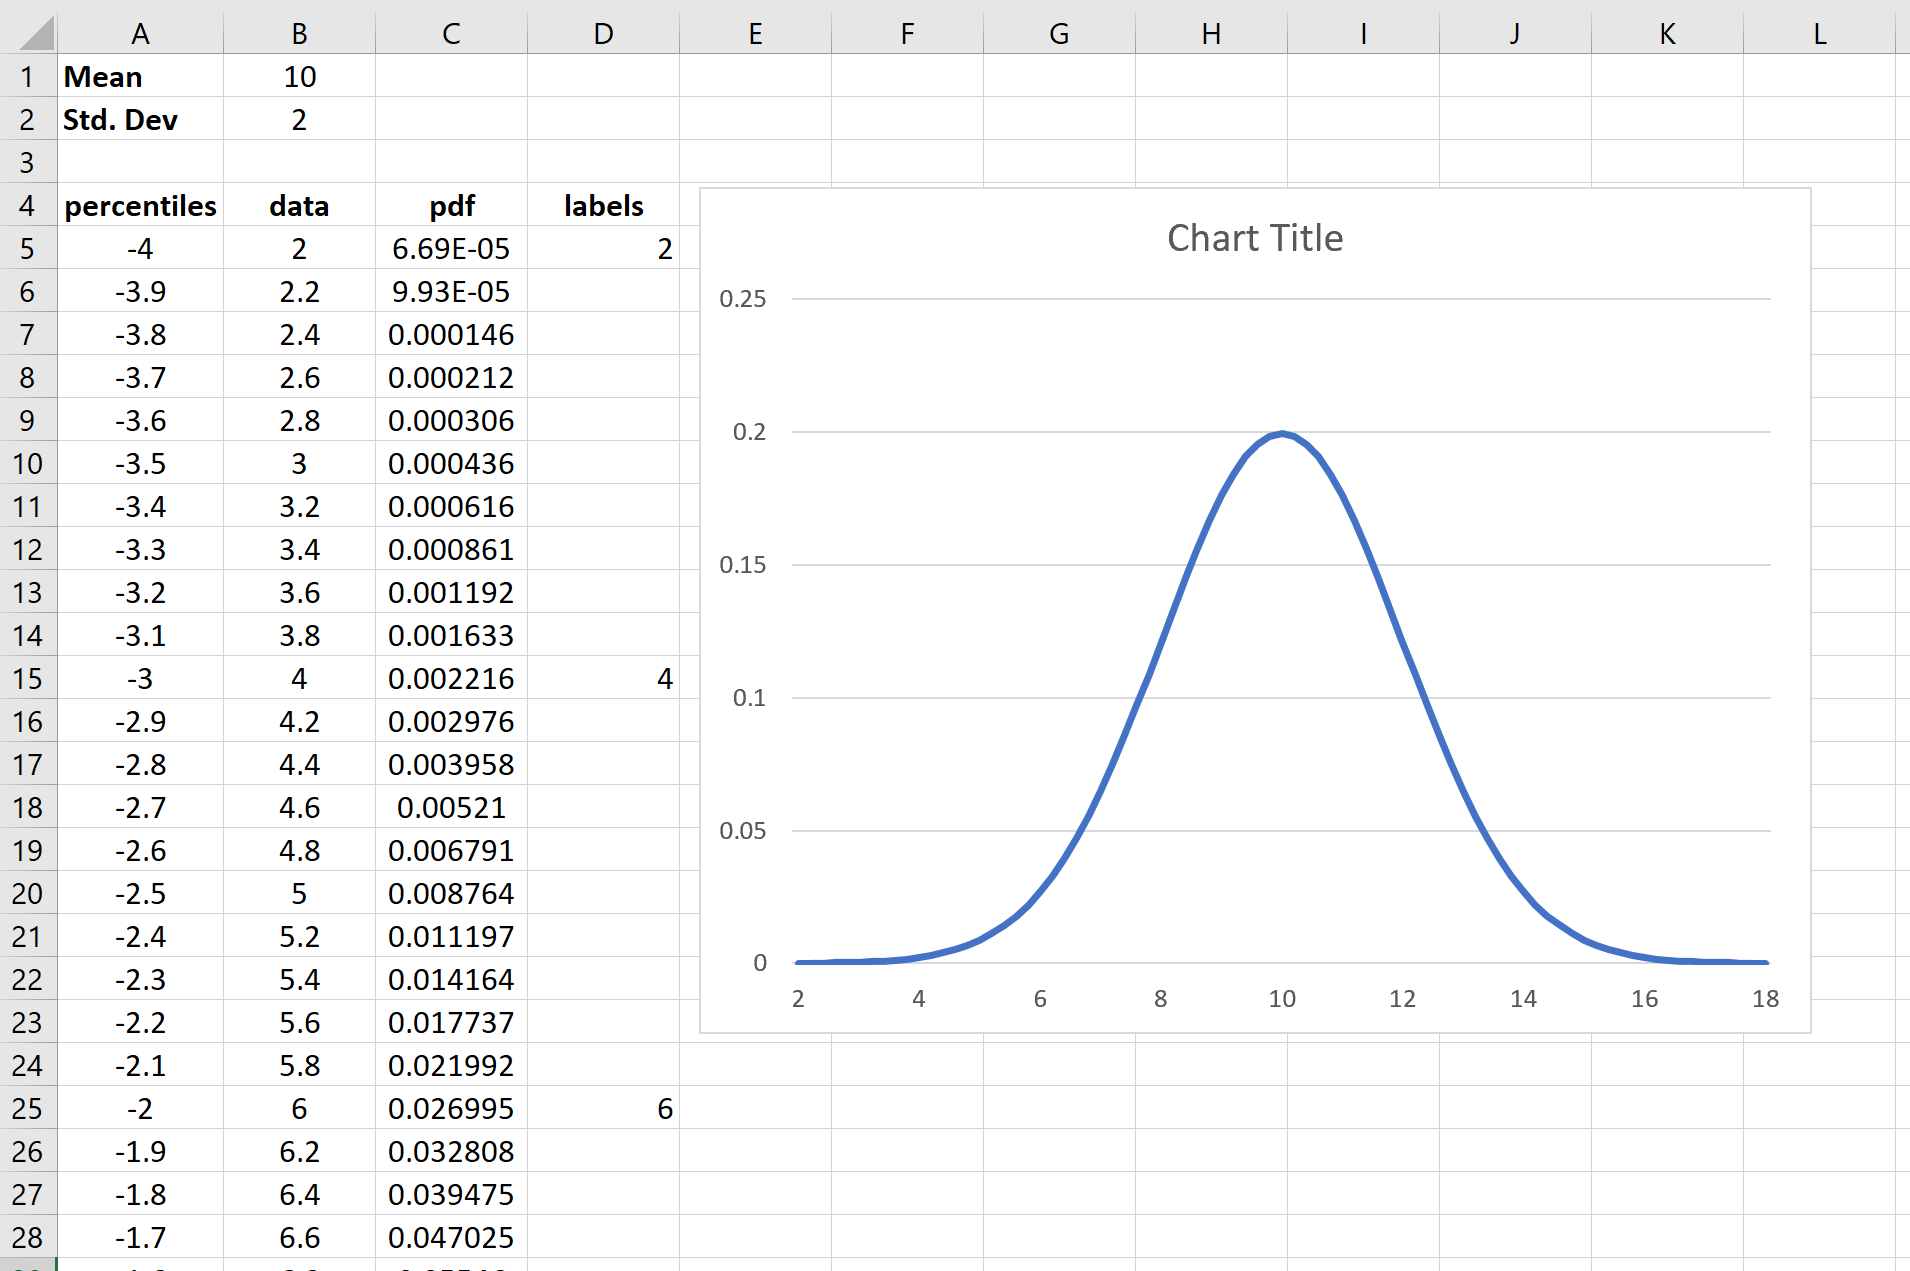
Dans la colonne E, la conversion des 81 points standardisés recalcule instantanément les scores bruts propres à l’EACG. La valeur plancher à -4 écarts-types (cellule E5) s’établit désormais à 45,2 + (-4 × 6,8) = 18,0. La valeur centrale (cellule E45, z = 0) affiche rigoureusement la moyenne empirique de 45,2. La valeur plafond à +4 écarts-types (cellule E85) atteint 45,2 + (4 × 6,8) = 72,4. L’amplitude calculée de 18 à 72,4 s’inscrit en adéquation parfaite avec les bornes théoriques de l’inventaire psychologique (15 à 75 points).
Dans la colonne G des étiquettes filtrées de l’axe horizontal, seules émergent les valeurs de rupture correspondant aux écarts-types entiers arrondis à la première décimale : 18,0 ; 24,8 ; 31,6 ; 38,4 ; 45,2 ; 52,0 ; 58,8 ; 65,6 ; 72,4. Le graphique se met à jour simultanément : l’abscisse affiche ces repères exacts, la cloche conserve sa symétrie parfaite et les zones ombrées d’écart-type s’adaptent instantanément aux nouvelles réalités métrologiques de l’échelle d’anxiété, sans exiger la moindre modification de la géométrie du graphique.
10.3 Interprétation diagnostique guidée par le graphique
Visualisons à présent l’application diagnostique concrète de cette courbe paramétrée à travers l’étude d’un cas individuel. Un patient adulte se présente en consultation d’évaluation avec un score brut de 60 points à l’EACG. Le praticien souhaite traduire instantanément cette performance en positionnement probabiliste pour éclairer sa décision clinique.
Le calcul algébrique direct du score standardisé donne : z = (60 – 45,2) / 6,8 = 14,8 / 6,8 ≈ +2,18. En observant le graphique d’étalonnage affiché à l’écran, le clinicien repère immédiatement que le score de 60 se situe au-delà du seuil critique de +2 écarts-types (fixé à 58,8 points sur l’axe des abscisses). Le patient bascule sans ambiguïté dans la zone d’extrême atypicité supérieure de la distribution.
En mobilisant les fonctions cumulées d’Excel ou les tables de la loi normale, le praticien détermine que la valeur z = +2,18 correspond précisément au 98,5e percentile (LOI.NORMALE.STANDARD.N(2,18; VRAI) ≈ 0,9854). Cela signifie formellement que 98,5 % de la population adulte normative présente des manifestations d’anxiété cognitive d’une intensité inférieure à celle manifestée par le patient, et que seuls 1,5 % des individus affichent des scores équivalents ou supérieurs. L’immédiateté visuelle offerte par la courbe en cloche Excel permet d’intégrer cette figure dans le compte-rendu d’évaluation du patient, matérialisant de manière transparente et rassurante la justification diagnostique d’une prise en charge psychothérapeutique ciblée.
11. Structure et exploitation du modèle Excel téléchargeable
11.1 Architecture logicielle du modèle fourni
Afin de garantir un déploiement professionnel immédiat sans exiger une reconstruction intégrale manuelle, un modèle de classeur Excel paramétré et sécurisé a été élaboré selon les standards ergonomiques les plus stricts. Ce modèle s’articule autour de trois feuilles interconnectées, conçues pour préserver l’intégrité de la logique statistique tout en offrant un confort d’utilisation maximal :
- Feuille 1 : Notice méthodologique et Guide d’usage : Cet onglet récapitule les fondements théoriques de la loi normale, détaille les définitions formelles des construits statistiques manipulés et propose un glossaire complet des métriques psychométriques implémentées. Il intègre un journal des versions et une documentation des fonctions mobilisées pour garantir la conformité scientifique des travaux.
- Feuille 2 : Calculateur matriciel dynamique : Ce module central héberge le moteur algorithmique du chiffrier. Il contient les cellules d’injection des paramètres fondamentaux ainsi que le tableau des 81 lignes de calcul séquentielles (scores z, valeurs brutes, densités de probabilité et étiquettes conditionnelles). Pour prévenir toute manipulation erronée susceptible d’altérer les équations, les colonnes matricielles font l’objet d’un verrouillage d’intégrité sans mot de passe, laissant exclusivement accessibles les deux cellules d’entrée de la moyenne et de l’écart-type.
- Feuille 3 : Graphique d’étalonnage standardisé : Cet onglet offre un espace de visualisation épuré, isolé de toute pollution tabulaire. La courbe de Gauss s’y déploie dans une résolution optimale, adossée à son titre dynamique, ses zones d’écart-type ombrées et ses axes normalisés, configurée pour un affichage plein écran ou une impression instantanée au format paysage.
Ce classeur intègre également un menu déroulant préconfiguré reposant sur une validation de données contextuelle. L’utilisateur peut ainsi choisir en un clic entre des profils d’évaluation prédéfinis (par exemple « QI Wechsler (100, 15) », « T-Score (50, 10) », « Sten (5.5, 2) », « Note standard (10, 3) ») ou opter pour le mode « Métrique personnalisée », offrant une adaptabilité immédiate aux exigences de chaque protocole expérimental ou clinique.
11.2 Guide d’injection de données personnalisées
L’exploitation opérationnelle du modèle téléchargé se caractérise par une remarquable simplicité d’exécution. Pour projeter vos propres corpus d’évaluation psychométrique ou biométrique au sein du canevas graphique, suivez simplement les directives suivantes :
Ouvrez le classeur et positionnez-vous sur l’onglet Calculateur dynamique. Rendez-vous dans la cellule B1 et saisissez la moyenne arithmétique issue de votre échantillon ou du manuel de votre instrument de mesure. Déplacez-vous en cellule B2 et introduisez l’écart-type correspondant. Si vous disposez de l’effectif global de votre échantillon normatif, vous pouvez renseigner la cellule B3 pour enrichir automatiquement le titre dynamique du graphique.
Dès la validation de ces saisies par la touche Entrée, le moteur de recalcul multithread d’Excel actualise instantanément les 81 lignes de coordonnées et répercute ces transformations sur la figure vectorielle de l’onglet Graphique standardisé. Si vous souhaitez comparer visuellement deux cohortes distinctes (par exemple un groupe témoin et un groupe clinique), il vous suffit de dupliquer la feuille de calcul via un clic droit sur l’onglet concerné (commande Déplacer ou copier… en cochant Créer une copie), puis d’injecter les paramètres de la seconde population au sein de la nouvelle feuille pour générer un profil comparatif indépendant en quelques fractions de seconde.
11.3 Exportation haute définition pour rapports et mémoires
L’insertion d’une figure statistique dans un mémoire de recherche, une thèse de doctorat ou un compte-rendu psychologique clinique exige une qualité de rendu irréprochable, exempte de pixellisation ou de déformations typographiques. Trop souvent, les praticiens procèdent par captures d’écran approximatives qui dégradent la netteté des courbes et confèrent un aspect négligé au document final.
Pour garantir un rendu typographique et graphique de niveau publication, il est vivement conseillé d’utiliser les formats vectoriels intégrés. Sélectionnez le graphique dans Excel d’un clic gauche sur sa bordure extérieure, puis exécutez la commande de copie standard (Ctrl + C). Basculez dans Microsoft Word ou PowerPoint, puis ouvrez le menu contextuel de collage (ou cliquez sur la flèche sous le bouton Coller dans le ruban) et sélectionnez l’option Image (métafichier amélioré) ou Coller avec liaison de données.
Le collage en tant que métafichier amélioré (EMF) transforme la figure Excel en un objet vectoriel pur : les traits de la courbe, les graduations d’axe et les polices de caractères sont restitués sous forme d’instructions géométriques scalaires et non de matrice de pixels. Vous pouvez ainsi agrandir ou réduire la figure à l’échelle d’une pleine page sans la moindre perte de netteté, assurant une parfaite conformité avec les critères esthétiques des normes de publication de l’American Psychological Association (APA 7th edition).
12. Diagnostic des erreurs fréquentes et rigueur méthodologique
12.1 Erreurs techniques courantes lors du paramétrage Excel
L’élaboration d’un modèle statistique sous Excel expose le praticien à des chausse-trappes logicielles classiques qu’une veille méthodologique rigoureuse permet d’identifier et de corriger rapidement. Le tableau suivant consigne les dysfonctionnements les plus fréquemment observés lors de la construction d’une courbe en cloche, leurs causes logiques sous-jacentes et les protocoles de résolution associés :
- Inversion de la moyenne et de l’écart-type : Une permutation involontaire des arguments au sein de la fonction
LOI.NORMALE.N(x; ecart_type; moyenne; FAUX)produit une morphologie aberrante, le pic de densité étant déporté à l’abscisse correspondant à la valeur de la dispersion. Rappel syntaxique immuable : l’argument de position (moyenne) précède toujours l’argument d’échelle (écart-type). - Sélection du mode cumulatif (VRAI au lieu de FAUX) : L’inscription du booléen
VRAIen quatrième argument de la fonction de densité génère une courbe sigmoïde ascendante matérialisant la fonction de répartition. Si votre tracé ne forme pas une cloche symétrique mais une marche en S plafonnant à 1,0, corrigez impérativement le paramètre enFAUX. - Distorsion de l’axe horizontal par décalage d’index : L’apparition de nombres entiers de 1 à 81 sur l’axe des abscisses indique que la plage des étiquettes d’axe horizontal n’a pas été formellement liée à la colonne des étiquettes filtrées (étape 8.2). Retournez dans la boîte de dialogue Sélectionner des données pour réassigner la plage G5:G85.
- Apparition d’étiquettes parasites « 0 » sur l’axe : Si votre axe affiche une cascade de zéros entre les graduations principales, votre formule conditionnelle a renvoyé la valeur numérique
0au lieu de la chaîne de texte vide"". Rectifiez la formule de l’étape 7.1 en insérant des guillemets vides stricts.
12.2 Biais d’interprétation et limites statistiques en psychologie
Au-delà de la maîtrise technique de l’outil informatique, la responsabilité éthique et scientifique du praticien réside dans sa lucidité quant aux limites de l’inférence gaussienne. La commodité mathématique de la courbe en cloche engendre parfois ce que l’épistémologie critique qualifie d’« illusion de la normalité absolue » : la propension à imposer un gabarit gaussien sur des construits humains qui ne s’y conforment pas dans la réalité empirique.
Avant d’interpréter un score à l’aide d’une courbe en cloche paramétrée, la vérification formelle des postulats de distribution s’impose impérativement. L’examen des coefficients d’asymétrie (Skewness) et d’aplatissement (Kurtosis) constitue le préalable minimal. Un coefficient d’asymétrie s’écartant sensiblement de zéro indique que la distribution réelle penche d’un côté, invalidant la symétrie axiale du modèle. Des tests d’adéquation probabiliste plus rigoureux — tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov corrigé par Lilliefors — doivent être mobilisés sur les données brutes avant d’entériner la pertinence d’un étalonnage gaussien.
Imposer arbitrairement une distribution normale sur des variables psychopathologiques fortement asymétriques (par exemple des échelles mesurant l’idéation suicidaire ou les conduites addictives, où l’immense majorité des sujets sains obtient un score de zéro) constitue une faute méthodologique majeure. De même, la présence de distributions bimodales — révélatrices de l’hétérogénéité sous-jacente de deux sous-populations distinctes au sein de l’échantillon — ne peut être fidèlement appréhendée par une unique courbe de Gauss. La rigueur impose d’adapter l’outil statistique à la réalité empirique, et non de contraindre la réalité humaine à se plier aux canons esthétiques d’un modèle théorique idéalisé.
12.3 Bonnes pratiques pour la reproductibilité et la pérennité des calculs
Pour clore ce cycle méthodologique, l’adoption de standards de documentation stricts garantit la pérennité de vos feuilles de calcul au sein de votre laboratoire ou de votre cabinet clinique. La reproductibilité computationnelle repose sur la transparence intégrale des formules et la documentation contextuelle des outils employés.
Prenez soin de documenter systématiquement au sein de votre fichier la version linguistique d’Excel sous laquelle le modèle a été élaboré. Bien que les versions récentes d’Excel assurent une traduction dynamique transparente des fonctions statistiques lors de l’ouverture de classeurs entre différentes localisations (par exemple la conversion automatique de LOI.NORMALE.N en NORM.DIST lors du passage d’un environnement francophone à un système anglophone), l’utilisation de séparateurs de liste (le point-virgule ; sous les configurations régionales européennes francophones contre la virgule , sous les configurations américaines) peut occasionner des erreurs de syntaxe lors de copier-coller manuels de formules.
Enfin, privilégiez toujours la sauvegarde de vos gabarits sous des formats ouverts et standardisés. Bien que le format natif .xlsx garantisse une compatibilité universelle avec les suites bureautiques contemporaines telles que LibreOffice Calc ou Google Sheets, réalisez des vérifications de rendu lorsque vous migrez vos modèles d’une plateforme logicielle à une autre, certaines fonctions graphiques avancées d’Excel — comme l’ajustement fin des étiquettes ou les transparences d’aires superposées — pouvant subir des altérations de mise en page. En appliquant cette discipline de contrôle qualité, votre modèle de courbe en cloche s’imposera comme un instrument d’évaluation et de valorisation scientifique d’une précision et d’une pérennité sans faille.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Microsoft Corporation. (2023). Fonction LOI.NORMALE.N. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/office/loi-normale-n-fonction-loi-normale-n-4ba27a00-50d4-4735-8664-927318357f8d
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.