
Dans le champ de l’analyse exploratoire des données quantitatives et de la psychométrie appliquée, la représentation graphique des distributions constitue une étape pivotale qui conditionne tant l’appréhension intuitive des phénomènes sous-jacents que la validité des conclusions inférentielles subséquentes. La boîte à moustaches, formalisée à l’origine par le statisticien américain John Tukey sous la dénomination de box-and-whisker plot, s’est imposée depuis plusieurs décennies comme le standard méthodologique par excellence pour résumer la dispersion, la tendance centrale et les asymétries d’une variable continue sans formuler d’hypothèses distributionnelles restrictives quant à sa normalité paramétrique.
Néanmoins, si la tradition pédagogique et graphique tend à représenter ces diagrammes selon une orientation verticale canonique, la pratique scientifique moderne met en lumière les avantages métrologiques et perceptifs considérables de l’orientation horizontale. Ce changement d’axe cartésien, loin de relever d’une simple coquetterie esthétique, répond à des impératifs ergonomiques stricts : il optimise le confort visuel, autorise l’affichage sans distorsion d’étiquettes textuelles complexes inhérentes aux inventaires psychologiques et s’aligne fidèlement sur les sens naturels de lecture des représentations ordinales. Dans l’écosystème du langage statistique R, la mise en œuvre de telles visualisations horizontales requiert une compréhension fine tant des mécanismes du moteur graphique natif que de la grammaire déclarative propre au paquet ggplot2.
Le présent guide a pour vocation de décomposer de manière exhaustive l’ensemble des fondements théoriques, des processus algorithmiques et des arbitrages techniques régissant la construction de boîtes à moustaches horizontales sous R. En adoptant une approche rigoureuse axée sur la reproductibilité scientifique et les normes éditoriales académiques internationales, nous explorerons comment passer d’une simple commande exploratoire univariée à des visualisations multivariées hautement calibrées, prêtes pour l’évaluation par les pairs au sein des revues scientifiques les plus exigeantes.
1. Fondements théoriques et pertinence statistique de la boîte à moustaches horizontale
1.1 Structure conceptuelle du résumé à cinq nombres de Tukey
La puissance analytique de la boîte à moustaches repose fondamentalement sur la théorie du résumé à cinq nombres formalisée par John W. Tukey en 1977. Ce dispositif statistique non paramétrique est conçu pour condenser les caractéristiques distributionnelles essentielles d’une série de données sans imposer les postulats de symétrie ou de normalité souvent violés dans les données comportementales réelles. Les cinq métriques fondamentales incluent le minimum de l’échantillon, le premier quartile ($Q_1$ ou 25e percentile), la médiane ($Q_2$ ou 50e percentile), le troisième quartile ($Q_3$ ou 75e percentile) et le maximum de la distribution. Contrairement aux approches basées sur le couple moyenne arithmétique et variance, ces quantiles possèdent une propriété de résistance remarquable, signifiant que la valeur de la médiane et la dispersion interquartile demeurent inchangées même face à une contamination importante de l’échantillon par des valeurs discordantes ou des erreurs de mesure ponctuelles.
L’élément central du dispositif, le corps de la boîte, circonscrit l’écart interquartile (noté $IQR$, pour Interquartile Range), défini mathématiquement comme la différence arithmétique entre le troisième et le premier quartile ($IQR = Q_3 – Q_1$). Cet intervalle intègre exactement les cinquante pour cent centraux des observations empiriques, constituant un indicateur de variabilité intrinsèque insensible aux variations des queues de distribution. L’asymétrie de la distribution se manifeste visuellement de façon immédiate par le décentrage de la ligne médiane à l’intérieur de la boîte : un positionnement plus proche de la charnière inférieure signale une asymétrie positive (étalement vers les valeurs élevées), tandis qu’un ancrage à proximité de la charnière supérieure indique une asymétrie négative.
Les moustaches s’étendent de part et d’autre de la boîte selon un algorithme déterministe standardisé. Par défaut dans la majorité des implémentations computationnelles, elles ne rejoignent pas nécessairement les valeurs minimales et maximales absolues, mais s’arrêtent à la valeur observée la plus extrême située à l’intérieur d’une clôture de sécurité calculée comme $1,5 \times IQR$ en deçà de $Q_1$ et au-delà de $Q_3$. Toute observation franchissant ces frontières méthodologiques est catégorisée formellement comme une valeur aberrante (outlier) et représentée par un glyphe individuel disjoint. Cette règle heuristique, bien que conventionnelle, correspond pour une loi normale sous-jacente à une couverture théorique d’approximativement 99,3 % des données, garantissant ainsi qu’un point isolé signalé hors des moustaches présente une probabilité très faible d’être issu du processus générateur standard sans perturbation singulière.
1.2 Justification ergonomique et cognitive de l’orientation horizontale
Le basculement de la boîte à moustaches depuis l’axe vertical classique vers un axe horizontal relève d’une décision ergonomique motivée par les principes de la théorie de la charge cognitive de John Sweller et la sémiologie graphique conceptualisée par Jacques Bertin. Dans un boxplot vertical conventionnel, l’axe des ordonnées est dévolu à la métrique continue, tandis que l’axe des abscisses accueille les différentes modalités factorielles. Dès lors que l’expérimentateur manipule des variables indépendantes composées de nombreuses catégories ou caractérisées par des libellés textuels étendus (par exemple, les noms de facettes de personnalité selon le modèle à cinq facteurs ou des diagnostics psychiatriques complexes), les étiquettes de l’axe horizontal entrent inévitablement en collision typographique, contraignant le concepteur à des expédients insatisfaisants tels que l’inclinaison des polices à 45 ou 90 degrés ou la troncature lexicale arbitraire.
L’attribution de la dimension horizontale à la variable numérique quantitative résout immédiatement cette congestion spatiale. L’axe vertical, désormais dévolu aux niveaux catégoriels, autorise un alignement typographique naturel de gauche à droite sans aucune restriction sur la longueur des chaînes de caractères. Cette disposition préserve la fluidité du balayage oculaire occidental, qui s’effectue horizontalement et de haut en bas, minimisant la fatigue visuelle du relecteur et accélérant le décodage sémantique des conditions expérimentales. En outre, la comparaison d’un grand nombre de groupes (dépassant fréquemment dix ou quinze cohortes dans les études épidémiologiques) devient nettement plus lisible sous une forme de liste étagée verticalement.
Sur le plan de l’intégration dans l’édition académique, le format horizontal s’insère avec une élégance naturelle dans les gabarits éditoriaux stricts, en particulier les présentations en double colonne standardisées des publications de l’American Psychological Association (APA). Un graphique étalé le long de l’axe des abscisses occupe rationnellement la largeur d’une colonne simple (environ 8,5 centimètres) ou d’une pleine page (environ 17 centimètres) tout en conservant une échelle proportionnelle favorable pour l’axe continu, empêchant les moustaches de paraître artificiellement comprimées ou hypertrophiées comme c’est couramment le cas dans les figures verticales insérées sous des contraintes de hauteur limitées.
1.3 Applications empiriques spécifiques en recherche psychologique
En psychologie expérimentale et cognitive, la structure distributionnelle des données s’écarte quasi systématiquement du modèle gaussien idéalisé. L’étude emblématique des temps de réaction (TR) dans les paradigmes d’amorçage ou de détection visuelle illustre parfaitement cet impératif métrologique. Les latences motrices et décisionnelles suivent en effet des lois de distribution ex-gaussiennes ou log-normales, caractérisées par une asymétrie droite prononcée où quelques essais particulièrement longs étirent artificiellement la moyenne arithmétique. Une boîte à moustaches horizontale matérialise instantanément ce décalage structurel, permettant au chercheur de distinguer d’un seul coup d’œil le traitement modal des stimuli de l’accumulation atypique de temps de décision anormalement lents.
Dans le domaine de la psychométrie différentielle et de la psychologie clinique, l’évaluation des instruments de mesure standardisés (tels que l’inventaire de dépression de Beck ou l’échelle d’anxiété STAI) requiert la comparaison rigoureuse de scores composites entre diverses cohortes pathologiques et témoins sains. La boîte à moustaches horizontale facilite la détection des effets plancher ou plafond, fréquemment observés au sein des populations normatives où la majeure partie des répondants endosse un score minimal ou nul. La visualisation de la compression de la boîte contre la borne inférieure de l’instrument fournit une indication diagnostique capitale sur le pouvoir discriminant de l’échelle dans les tranches inférieures de sévérité clinique.
Enfin, dans le cadre de la vérification des postulats statistiques préalablement à la conduite d’analyses inférentielles paramétriques (telles que les modèles linéaires généraux ou l’analyse de variance factorielle), l’examen d’un ensemble de boîtes à moustaches horizontales constitue une procédure exploratoire bien supérieure au simple test formel d’homoscédasticité de Levene. La similitude visuelle des longueurs d’écarts interquartiles à travers les groupes permet de statuer sur l’homogénéité des variances avec un niveau de robustesse épargné par la sensibilité excessive des tests d’hypothèse formels face aux larges effectifs.
2. Configuration de l’environnement de travail et préparation des données psychométriques
2.1 Chargement et gestion des bibliothèques nécessaires
La reproductibilité computationnelle d’un flux de travail analytique sous R débute impérativement par une gestion rigoureuse de l’environnement logiciel et de l’espace de noms des paquets. Bien que les fonctionnalités natives de base de R permettent de produire des graphiques fonctionnels sans faire appel à des dépendances externes, le standard méthodologique contemporain s’appuie largement sur l’écosystème tidyverse, complété par des bibliothèques dédiées à la mise en page académique. Il convient d’initialiser la session en chargeant explicitement les modules statistiques et graphiques requis au sommet du script.
Le paquet ggplot2 constitue le composant névralgique de notre chaîne de traitement pour la génération des graphiques déclaratifs, tandis que dplyr et tidyr assurent les manipulations relationnelles et structurelles sur les matrices de données. Pour la conformité avec les conventions de publication scientifiques, l’adjonction de bibliothèques telles que ggpubr ou cowplot est fortement recommandée afin de bénéficier de thèmes typographiques épurés et de fonctions d’assemblage multi-panneaux sophistiquées. L’adjonction du paquet forcats permet quant à elle une manipulation fluide des structures factorielles catégorielles, indispensable pour le réordonnancement algorithmique des axes graphiques.
Afin de garantir que les simulations aléatoires intégrées dans la génération de jeux d’échantillonnage demeurent strictement reproductibles d’une machine à l’autre, il est primordial de fixer la graine du générateur pseudo-aléatoire du système. La commande set.seed(42), combinée à une configuration explicite des options générales de la session (notamment l’évitement de la conversion implicite des chaînes textuelles en facteurs désuète ou la gestion fine des avertissements d’écrasement de méthodes), scelle l’architecture logicielle dans un état déterministe propice à la validation scientifique.
2.2 Structuration et nettoyage d’un jeu de données expérimental
La grammaire des graphiques sous R exige impérativement que les données soient organisées sous la forme d’un tableau rectangulaire au format long (tidy data). Dans cette morphologie relationnelle, chaque ligne correspond rigoureusement à une observation unitaire (par exemple, la passation d’un test par un participant donné à un temps spécifique), chaque colonne incarne une variable mesurée ou manipulée, et chaque cellule abrite une valeur atomique unique. Or, la collecte psychologique primaire via des plateformes d’expérimentation en ligne génère fréquemment des formats larges où les scores répétés ou les différentes sous-échelles d’un inventaire sont étalés sur de multiples colonnes contiguës.
Le passage méthodologique d’une structure large à une structure longue s’opère couramment à l’aide de la fonction pivot_longer() issue du paquet tidyr. Parallèlement à cette transformation géométrique, un typage strict des colonnes doit être opéré au sein de l’environnement de programmation. Les identifiants des participants doivent être convertis en vecteurs de caractères ou facteurs non ordonnés, tandis que les conditions expérimentales (par exemple, « Contrôle », « Entraînement cognitif », « Pharmacothérapie ») doivent recevoir un statut explicite de facteur (factor). Si les conditions possèdent une progression intrinsèque, comme des niveaux de dosage ou des stades de développement, la définition d’un facteur ordonné (ordered) est formellement requise pour guider ultérieurement le tracé graphique.
Le traitement des données manquantes (valeurs NA) constitue un enjeu analytique majeur. L’exclusion aveugle de lignes entières peut biaiser gravement la représentativité de l’échantillon. Il est recommandé de quantifier précisément l’incidence du patron d’absence (aléatoire ou systématique) et d’appliquer, selon la justification méthodologique adoptée, un filtrage localisé ou des procédures d’imputation multiple avant d’injecter la matrice nettoyée dans les fonctions de traçage de boîtes à moustaches.
2.3 Audit exploratoire préliminaire des distributions
Préalablement à toute démarche d’esthétique graphique, une auscultation numérique systématique des variables d’intérêt s’impose afin de détecter d’éventuelles anomalies d’encodage et d’anticiper le comportement des quantiles. Cet audit implique le calcul segmenté des statistiques descriptives fondamentales pour chaque groupe d’échantillonnage : effectif valide ($n$), médiane, moyenne arithmétique, écart-type, écart interquartile empirique, ainsi que les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Cette décomposition chiffrée prévient les erreurs d’interprétation visuelle en fournissant un étalon quantitatif rigoureux.
L’examen de l’équilibre des effectifs entre les différents bras factoriels constitue également une composante indispensable de l’audit. La présence de groupes substantiellement déséquilibrés (par exemple, un groupe témoin de cent cinquante sujets confronté à un sous-groupe clinique de douze patients) modifie radicalement la précision de l’estimation des quantiles extrêmes, induisant une variabilité accrue de l’étendue des moustaches purement imputable à la taille de l’échantillon plutôt qu’à une divergence physiologique intrinsèque. Cet audit conduit naturellement à documenter les métadonnées de l’expérience, incluant les bornes minimales et maximales théoriques des échelles psychométriques utilisées (par exemple, une échelle de Likert bornée entre 1 et 7), ce qui évitera de contraindre artificiellement les fenêtres d’affichage lors de la modélisation sous R.
3. Construction d’une boîte à moustaches horizontale univariée avec R de base
3.1 Syntaxe fondamentale et manipulation de l’argument horizontal
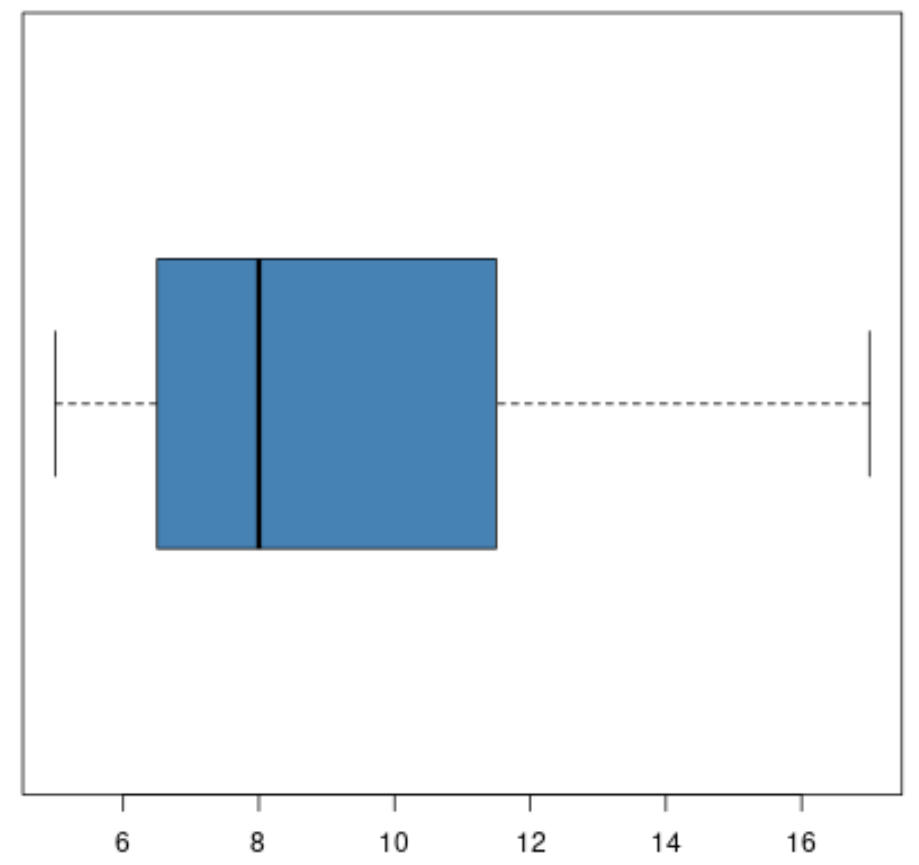
L’environnement graphique de base de R (fourni nativement par le moteur graphics) offre une voie d’accès directe, légère et hautement optimisée pour tracer des distributions univariées sans dépendances algorithmiques complexes. La fonction cardinale dédiée à cette tâche est boxplot(). Lorsqu’elle est appliquée à un simple vecteur numérique continu, cette routine calcule en arrière-plan la statistique à cinq nombres de Tukey et produit par défaut une boîte à moustaches disposée verticalement le long de l’ordonnée cartésienne.
Pour faire basculer l’orientation spatiale de la géométrie selon le plan horizontal, il suffit de manipuler le paramètre logique horizontal en lui assignant la valeur TRUE. Dès lors, le moteur graphique permute la projection : l’axe des abscisses (X) héberge l’échelle de mesure continue de la variable psychométrique, tandis que l’axe des ordonnées (Y) ne présente qu’une seule position unitaire centrée, généralement dénuée d’étiquetage factoriel significatif dans ce contexte univarié. Le tracé génère instantanément la barre médiane épaisse, les bordures du rectangle interquartile, les deux moustaches terminées par des barres d’arrêt, et, le cas échéant, les points isolés correspondant aux observations empiriques transgressant le seuil de 1,5 fois l’écart interquartile.
Cette approche univariée simple s’avère particulièrement utile lors des phases d’inspection initiale des données (data screening), au cours desquelles l’analyste cherche à repérer d’éventuelles erreurs de saisie d’un coup d’œil, comme un score psychométrique encodé à 999 au lieu de 9, sans devoir composer une instruction graphique déclarative élaborée.
3.2 Personnalisation élémentaire des axes et étiquettes
L’esthétique brute générée par l’appel canonique de boxplot() nécessite systématiquement une personnalisation contextuelle pour atteindre un niveau de clarté suffisant pour la communication scientifique. La dénomination des axes et l’attribution de titres informatifs s’effectuent au moyen d’arguments explicites intégrés à l’appel de fonction. Le paramètre main reçoit une chaîne de caractères définissant le titre principal du graphique, tandis que sub permet de renseigner un éventuel sous-titre méthodologique explicitant par exemple la taille de la cohorte analysée.
Dans la configuration horizontale, le libellé de l’axe quantitatif continu doit être formellement renseigné via l’argument xlab, et non pas ylab, car la métrique numérique réside désormais sur l’abscisse. L’argument ylab peut quant à lui être purement neutralisé par une chaîne vide (ylab = "") afin d’éviter la génération d’un libellé inutile sur l’axe vertical qui ne comporterait aucun niveau catégoriel dans une analyse univariée. L’argument booléen axes = TRUE, actif par défaut, peut être modulé pour redessiner des axes personnalisés via des fonctions complémentaires si des graduations fines non conventionnelles sont requises.
Par ailleurs, pour empêcher le moteur graphique de couper visuellement les moustaches ou de masquer partiellement les valeurs aberrantes périphériques en raison d’un calcul d’emprise spatiale trop étroit, il est recommandé de borner manuellement l’axe des abscisses via l’argument xlim. La spécification d’un vecteur numérique à deux éléments (par exemple, xlim = c(0, 100)) garantit que l’ensemble du spectre théorique de l’instrument psychométrique demeure visible, prévenant ainsi les illusions perceptives d’écrasement ou de dispersion excessive.
3.3 Gestion de la largeur de la boîte et des proportions visuelles
Dans un dispositif graphique horizontal univarié, la boîte à moustaches a naturellement tendance à occuper une hauteur visuelle excessive par rapport à l’espace vertical disponible, générant une impression d’épaisseur disproportionnée qui nuit à l’élégance de la figure. Ce comportement géométrique est gouverné par le paramètre boxwex (abréviation de box width expansion), dont la valeur par défaut est fixée à 0,8. En abaissant cette valeur à une fraction plus modeste (telle que boxwex = 0.3 ou 0.4), l’épaisseur relative de la boîte se trouve réduite, offrant une allure plus effilée et sophistiquée au diagramme.
Les proportions globales perçues dépendent intimement du ratio hauteur-largeur du périphérique graphique d’affichage lui-même (la fenêtre active sous RStudio ou les dimensions déclarées lors de l’ouverture d’un périphérique d’enregistrement tel que png() ou pdf()). L’attribution d’une hauteur physique modeste (par exemple 3 à 4 pouces) combinée à une largeur d’affichage plus généreuse (6 à 8 pouces) produit un ratio d’aspect idéal pour l’orientation horizontale, magnifiant la dynamique des étalements le long de l’abscisse tout en conservant une discrétion typographique sur l’axe vertical.
L’optimisation de cette silhouette univariée est particulièrement adaptée aux supports de communication condensés, tels que les diapositives de présentation orale lors de conférences internationales ou les figures insérées dans les résumés graphiques (graphical abstracts) exigés par de nombreuses maisons d’édition contemporaines, où chaque millimètre carré d’espace visuel doit concourir à la transmission univoque de l’information quantitative.
4. Boîtes à moustaches horizontales multivariées par groupes avec R de base
4.1 Utilisation de la syntaxe de formule statistique
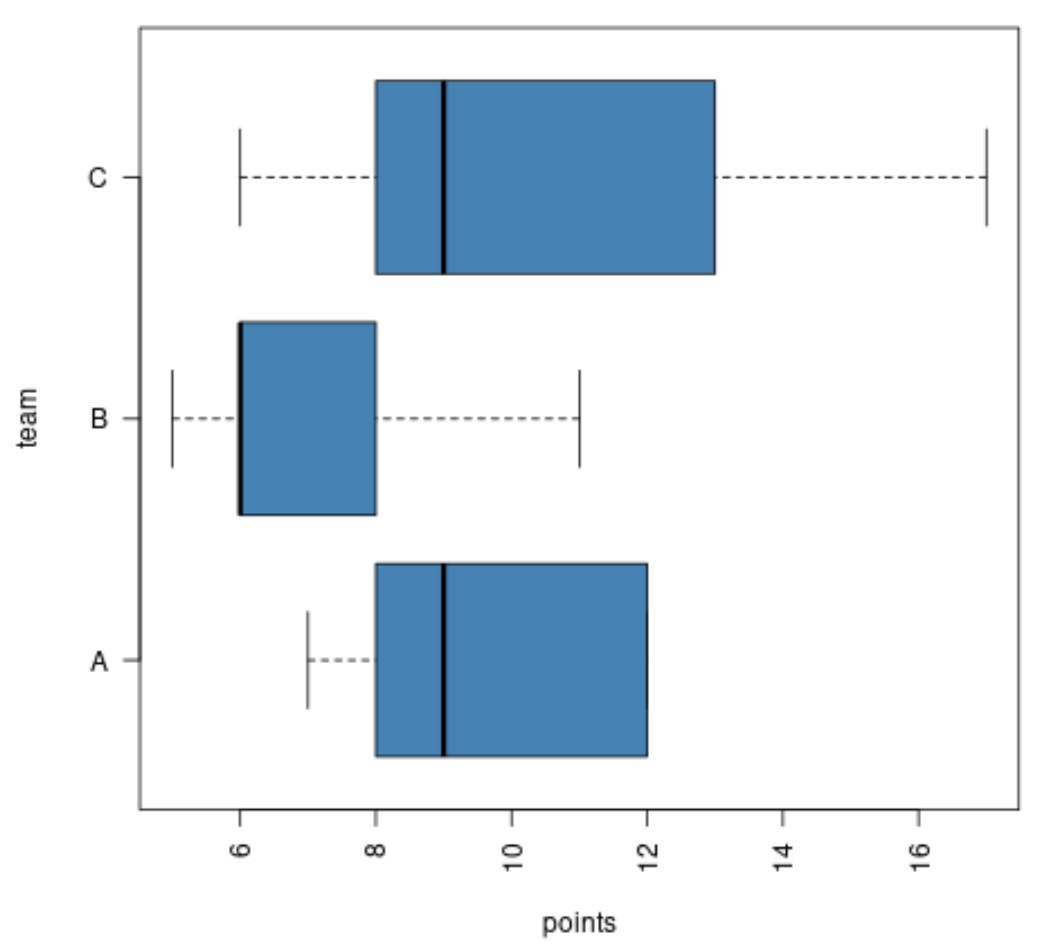
L’intérêt comparatif de la boîte à moustaches se manifeste pleinement lors de l’évaluation simultanée de plusieurs populations ou conditions de recherche. Dans le système graphique de base de R, cette modélisation s’articule élégamment autour de la syntaxe de formule statistique introduite historiquement par le langage S. La relation s’exprime sous la forme symbolique reponse ~ predicteur, où le terme de gauche désigne le vecteur continu dépendant et le terme de droite représente la variable de groupement catégorielle (généralement convertie en facteur).
Lors de l’application conjointe de cette formule et de l’instruction horizontal = TRUE dans la commande boxplot(reponse ~ groupe, data = mon_dataframe, horizontal = TRUE), R réorganise immédiatement le système d’axes cartésiens : les différentes modalités du facteur sont projetées séquentiellement de haut en bas le long de l’axe vertical Y, tandis que l’axe horizontal X transcrit l’étendue continue de la variable réponse. L’argument explicite data sécurise l’évaluation environnementale en contraignant la fonction à résoudre les symboles de variables à l’intérieur du cadre de données spécifié, évitant ainsi la pollution accidentelle par des vecteurs dispersés dans l’espace de travail global.
Cette approche permet une confrontation directe et instantanée des structures distributionnelles entre groupes d’échantillonnage. L’alignement parallèle des boîtes horizontales simplifie considérablement l’évaluation visuelle de la séparation des médianes relatives, du recouvrement mutuel des corps interquartiles et des disparités potentielles de variabilité entre cohortes, délivrant une synthèse exploratoire préalable indispensable aux protocoles d’analyse de variance ou de régression linéaire robuste.
4.2 Orientation et disposition des étiquettes factorielles
L’un des obstacles ergonomiques récurrents lors du traçage de multiples catégories réside dans l’orientation du texte matérialisant le nom des groupes sur l’axe vertical. Par défaut dans le système graphique de base de R, les étiquettes des axes sont souvent orientées parallèlement à la ligne de l’axe, ce qui force une rotation verticale non naturelle des noms de groupes le long de l’ordonnée Y, complexifiant la lecture pour l’observateur.
La résolution de cette limitation typographique s’effectue via le paramètre graphique global las (pour label style). En spécifiant formellement las = 1 à l’intérieur de l’appel de boxplot() ou au sein de la fonction de configuration générale par(), l’utilisateur force l’ensemble des étiquettes textuelles à se maintenir strictement à l’horizontale, quel que soit l’axe auquel elles sont rattachées. Cette modification engendre toutefois un risque technique corollaire : si les libellés de groupes s’avèrent étendus, ils risquent d’être tronqués par le bord gauche de la fenêtre d’affichage.
Pour neutraliser ce risque de troncature lexicale, il est impératif d’ajuster préalablement les marges graphiques via la commande par(mar = c(bas, gauche, haut, droite)). L’accroissement stratégique de la deuxième composante de ce vecteur numérique (la marge gauche, fixée par défaut à 4,1 lignes de texte) vers une amplitude de 8 à 12 lignes permet de réserver un corridor spatial amplement suffisant pour l’épanouissement complet des chaînes textuelles descriptives les plus longues, préservant ainsi l’intégrité de la communication scientifique.
4.3 Implémentation de facteurs croisés et sous-groupes
La recherche psychologique examine fréquemment des plans expérimentaux factoriels impliquant le croisement de multiples variables indépendantes (par exemple, un plan d’interaction factorielle 2×2 croisant le statut clinique d’un patient et son assignation à une modalité de traitement cognitif ou pharmacologique). La syntaxe de formule de R de base absorbe avec aisance cette complexification structurelle par l’emploi de l’opérateur d’interaction ou de croisement, formulé sous la forme reponse ~ facteurA * facteurB ou reponse ~ facteurA : facteurB.
Lors de l’évaluation graphique, le système génère automatiquement une boîte à moustaches horizontale distincte pour chaque cellule de conception résultant de la combinatoire factorielle. Les étiquettes textuelles générées sur l’axe vertical concatènent alors les libellés des sous-groupes correspondants (séparés par un point, comme « Témoin.Placebo », « Clinique.Placebo », etc.). Cette spatialisation permet d’évaluer directement l’existence d’effets simples ou d’interactions croisées : si l’écartement des médianes entre les niveaux du facteur B varie radicalement selon le niveau considéré du facteur A, l’effet d’interaction saute aux yeux sans nécessiter l’attente des résultats inférentiels numériques.
Il convient néanmoins de souligner une limite ergonomique intrinsèque au système de base : dès lors que le nombre de combinaisons factorielles dépasse six ou huit modalités croisées, la lisibilité globale de l’axe vertical peut s’altérer en raison de l’absence de regroupement hiérarchique visuel ou d’espacement modulaire entre sous-familles de conditions, ouvrant la voie à la supériorité structurelle de la grammaire des graphiques développée ultérieurement par les outils modernes.
5. Personnalisation graphique avancée dans le système de base R
5.1 Harmonisation chromatique et palettes scientifiques
L’attribution de teintes chromatiques au sein du système graphique de base transcende la simple dimension ornementale : elle remplit une fonction sémiologique précise en encodant visuellement l’appartenance factorielle ou le statut d’une condition d’étude. Le paramètre col accepte un vecteur de chaînes de caractères représentant des codes hexadécimaux ou des noms de couleurs standardisées sous R. Si un vecteur de couleurs est fourni avec une longueur égale au nombre de groupes projetés sur l’axe vertical, chaque boîte à moustaches reçoit une coloration individualisée différenciatrice.
Il est vivement préconisé d’abandonner les couleurs primaires saturées saturant historiquement les exemples rudimentaires (tels que le rouge vif ou le vert pur), au profit de palettes scientifiquement validées conçues pour offrir une uniformité perceptive rigoureuse et une accessibilité intégrale pour les personnes présentant des déficiences de la vision des couleurs (daltonisme, deutéranopie). Les palettes dérivées du projet RColorBrewer (par exemple les séries douces Set2 ou Pastel1) ou les gammes perceptuellement continues de la bibliothèque viridis (disponible nativement dans les versions récentes de R via la fonction hcl.colors()) répondent idéalement à ce cahier des charges académique.
En outre, l’intégration d’un canal alpha de transparence au sein des définitions de couleurs (au format hexadécimal à huit caractères de type #RRGGBBAA) permet d’alléger l’impact visuel des grandes masses rectangulaires. Cette translucidité offre l’avantage fonctionnel d’atténuer la lourdeur globale de la figure et de favoriser la superposition harmonieuse ultérieure d’autres couches d’annotations géométriques ou de points statistiques au premier plan.
5.2 Ajustement fin des éléments géométriques de la boîte
Le moteur graphics de base offre une granularité de contrôle remarquable sur chacun des sous-éléments structuraux constituant l’architecture géométrique de la boîte à moustaches. Le paramètre medcol gouverne la teinte chromatique de la ligne médiane centrale, tandis que medlwd module son épaisseur physique en pixels typographiques, autorisant la mise en exergue de cet indicateur central par un trait nettement plus affirmé que le reste du tracé. Symétriquement, les arguments whisklty, whiskcol et boxcol permettent de spécifier respectivement le type de trait (plein, pointillé, tireté), la couleur des moustaches et la teinte du contour extérieur de la boîte rectangulaire.
Un raffinement graphique hautement informatif consiste à exploiter l’argument logique notch = TRUE. Cette commande instruit R d’entailler les parois latérales de la boîte au voisinage immédiat de la ligne médiane. La profondeur et l’amplitude de cette encoche (notch) matérialisent un intervalle de confiance approché autour de la médiane, calculé selon la formule empirique de McGill, Tukey et Larsen :
$$\text{Médiane} \pm 1,58 \times \frac{IQR}{\sqrt{n}}$$
Sur le plan de l’inférence visuelle rapide, cette géométrie permet au lecteur de tester informellement l’hypothèse nulle d’égalité des médianes : si les encoches de deux boîtes horizontales contiguës ne se chevauchent aucunement sur l’axe continu des abscisses, il est possible d’en déduire avec une confiance avoisinant 95 % que les deux médianes de population diffèrent significativement. Enfin, le paramètre staplewex contrôle l’amplitude des barres transversales d’arrêt aux extrémités des moustaches ; une valeur fixée à zéro supprime purement et simplement ces barres terminales pour un rendu minimaliste très contemporain.
5.3 Enrichissement contextuel par légendes et repères statistiques
Une figure scientifique ne peut être considérée comme achevée sans la présence de repères d’ancrage contextuels facilitant son interprétation directe par la communauté des pairs. L’une des opérations fondamentales consiste à projeter une ligne de repère marquant un seuil normatif, un niveau de base pré-expérimental ou la moyenne globale de l’échantillon unifié. Dans un canevas horizontal, cette matérialisation s’accomplit par l’appel de la fonction abline(v = seuil, lty = 2, col = "grey50"), qui trace une droite perpendiculaire à l’axe des abscisses à la coordonnée continue indiquée, sans interférer avec les graduations catégorielles de l’axe vertical.
L’adjonction de texte explicatif contextualisé ou l’impression des valeurs numériques exactes des médianes au-dessus ou à l’intérieur de chaque boîte s’opère via la fonction vectorielle text(). Étant donné que l’axe vertical Y correspond sous-jacemment à une échelle numérique ordonnée discrète (où le premier groupe correspond à la position $Y = 1$, le second à $Y = 2$, et ainsi de suite), il est aisé de positionner des chaînes textuelles en fournissant un vecteur de coordonnées cartésiennes précises sous la forme text(x = valeurs_medianes, y = 1:nombre_groupes, labels = etiquettes).
Enfin, si une structuration chromatique complexe a été mise en œuvre pour encoder des sous-familles conceptuelles, l’insertion d’une légende explicative s’effectue au moyen de la fonction legend(). En exploitant des mots-clés d’ancrage ergonomiques comme "topright" ou "bottomright", couplés aux paramètres d’apparence de bordure (bty = "n" pour un affichage sans boîte encadrante superflue), l’analyste parfait la lisibilité sémiologique du graphique avant son intégration dans le rapport d’étude.
6. Création de boîtes à moustaches horizontales avec ggplot2
6.1 Paradigme de la grammaire des graphiques appliqué au boxplot
Le passage au paquet ggplot2, conçu par Hadley Wickham sur la base des concepts formels introduits par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics, marque une rupture épistémologique profonde avec le modèle impératif de R de base. Dans ce paradigme déclaratif, une visualisation n’est plus construite par une succession d’instructions graphiques directes appliquées séquentiellement à une toile passive, mais par l’assemblage modulaire et cumulatif de couches sémantiques distinctes comprenant des données sources, des associations esthétiques cartographiant les variables sur des axes ou canaux perceptifs, des objets géométriques et des transformations statistiques sous-jacentes.
L’implémentation d’une boîte à moustaches s’incarne au sein de cette grammaire par la fonction géométrique dédiée geom_boxplot(). En arrière-plan, cette couche géométrique déclenche automatiquement l’évaluation de la transformation statistique associée nommée stat_boxplot. C’est ce processeur statistique invisible qui procède à l’extraction ordonnée des résumés de Tukey, calculant pour chaque groupement factoriel identifié la médiane, les charnières inférieure et supérieure, l’écart interquartile et la liste exhaustive des vecteurs d’observations tombant au-delà des barrières de clôture.
Cette distinction conceptuelle confère une reproductibilité et une robustesse remarquables au système. L’analyste ne manipule jamais manuellement les coordonnées physiques d’un rectangle ou la découpe spatiale d’une ligne : il déclare formellement que la variable dépendante continue doit être matérialisée sous la forme d’un objet boxplot distribué le long d’une échelle factorielle spécifique, ggplot2 se chargeant de calibrer les espaces, les largeurs et les alignements d’une manière géométriquement parfaite et adaptative.
6.2 Approche moderne : assignation directe des variables aux axes x et y
Pendant de nombreuses années, la grammaire interne de ggplot2 imposait une contrainte stricte de verticalité unidirectionnelle : l’esthétique x devait obligatoirement recevoir la variable discrète de catégorisation, tandis que l’esthétique y était exclusivement réservée à la variable continue quantitative. Depuis l’avènement majeur de la version 3.3.0 de ggplot2, le moteur graphique a bénéficié d’une refonte architecturale intégrant le support bidirectionnel des géométries orientées. Cette modernisation algorithmique a rendu obsolète la gymnastique mentale consistant à concevoir d’abord un graphique vertical pour ensuite le renverser spatialement.
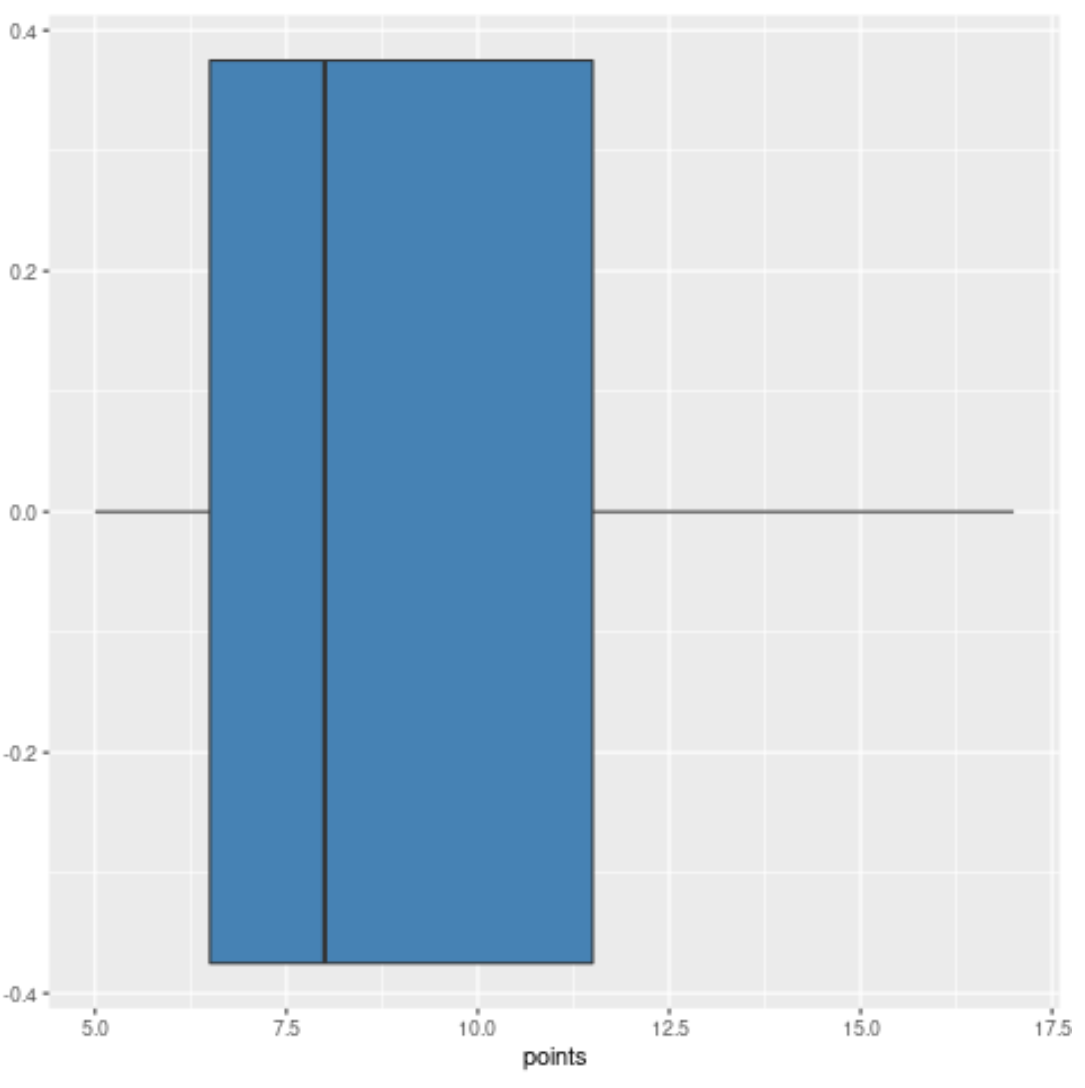
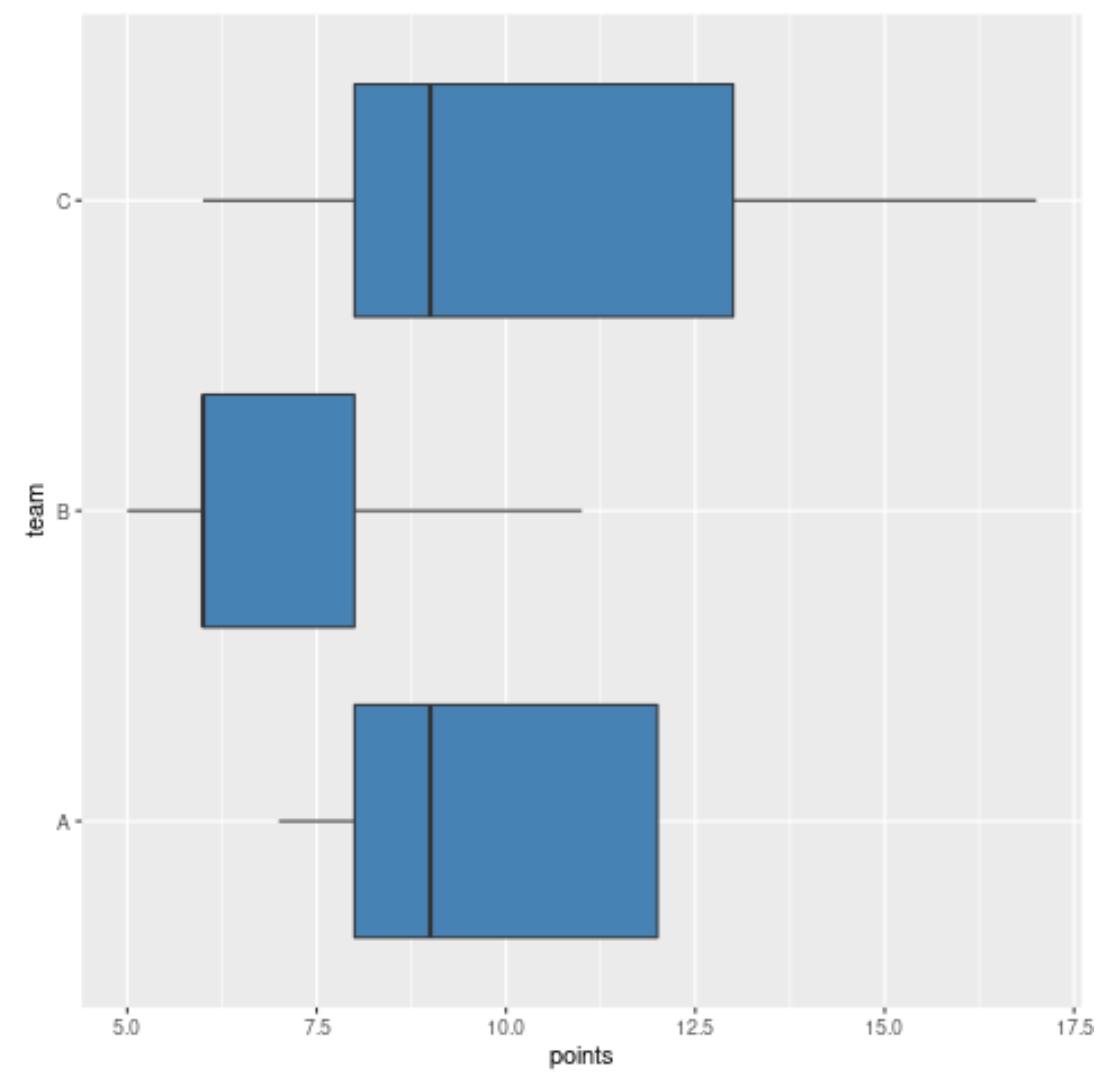
Désormais, pour générer une boîte à moustaches horizontale native sous ggplot2, la syntaxe déclarative directe s’exprime avec une limpidité exemplaire en associant simplement la métrique numérique continue à l’abscisse (x) et la variable factorielle catégorielle à l’ordonnée (y) au sein de la fonction d’association esthétique aes() :
ggplot(data = mon_dataframe, mapping = aes(x = score_continu, y = condition_factorielle)) + geom_boxplot()
Cette approche moderne simplifie considérablement la maintenance du code informatique et l’ajout de couches graphiques additionnelles. Toutes les fonctions d’échelle et de formatage s’appliquent intuitivement sur l’axe qui porte réellement la métrique physique : ainsi, la commande scale_x_continuous() pilote directement la graduation, les étiquettes et les limites de l’axe quantitatif horizontal, tandis que scale_y_discrete() gouverne l’apparence des niveaux catégoriels étagés verticalement, éliminant tout décalage cognitif lors de la rédaction des scripts.
6.3 Approche historique : inversion cartésienne via coord_flip()
En dépit de la suprématie syntaxique de l’approche moderne par assignation directe, il demeure capital pour tout chercheur ou praticien de la donnée de maîtriser la méthodologie historique reposant sur la fonction d’inversion cartésienne coord_flip(). En effet, une vaste part de la littérature méthodologique publiée au cours de la décennie écoulée, ainsi que d’innombrables banques de scripts institutionnelles pérennes, ont été architecturées selon ce mécanisme d’inversion de coordonnées.
Le principe fondamental de coord_flip() consiste à stipuler la construction géométrique selon le patron vertical historique (en assignant la variable factorielle à x et la variable quantitative à y), puis à intercaler en toute fin de chaîne de composition une instruction forçant la matrice de projection cartésienne à permuter ses deux dimensions spatiales à l’affichage. Bien que le rendu graphique final d’une telle figure apparaisse strictement identique à l’œil nu à celui issu de l’approche moderne, cette méthode engendre une dissonance cognitive notable lors du paramétrage des fonctions annexes.
En effet, sous coord_flip(), toute modification de l’axe quantitatif horizontal doit paradoxalement continuer à être formulée via des fonctions ciblant formellement l’axe Y, telles que scale_y_continuous() ou des ajustements thématiques de type axis.text.y qui affectent en réalité les graduations textuelles projetées à l’abscisse de la figure finale. Si cette technique demeure pleinement fonctionnelle pour préserver la rétrocompatibilité des anciens scripts académiques, il est formellement recommandé de basculer vers l’assignation directe lors de l’initiation de tout nouveau protocole de recherche scientifique.
7. Structuration multivariée et facettage horizontal sous ggplot2
7.1 Gestion des facteurs multiples avec l’esthétique de remplissage
L’exploration des données psychologiques implique régulièrement l’analyse conjointe d’un prédicteur principal et d’un facteur modérateur ou d’appariement démographique (par exemple, la comparaison de scores d’épuisement professionnel à travers divers corps de métier, stratifiés selon le genre ou la tranche d’âge des répondants). Dans la grammaire de ggplot2, la représentation simultanée de ces dimensions sans éclatement de la figure s’accomplit par l’association esthétique du second facteur au canal chromatique de remplissage via l’argument aes(fill = variable_secondaire).
Lorsque cette esthétique est injectée dans une structure horizontale, geom_boxplot() active automatiquement son mécanisme d’esquive spatiale (dodging). Pour chaque modalité factorielle disposée sur l’axe vertical, le moteur produit autant de boîtes à moustaches horizontales parallèles qu’il existe de niveaux dans la variable de remplissage, chacune recevant une couleur distinctive et étant légèrement décalée le long de l’axe vertical pour éviter tout recouvrement géométrique. La gestion fine de cet espacement relatif s’opère au moyen du paramètre position = position_dodge(width = 0.8), qui garantit que l’alignement mutuel des boîtes demeure rigoureusement symétrique et lisible.
La génération de la légende explicative associée aux teintes de remplissage est prise en charge de manière totalement automatisée par le moteur graphique. Cette légende peut ensuite faire l’objet de raffinements typographiques substantiels, incluant le renommage de son en-tête via labs(fill = "Modulateur") et le réordonnancement explicite de ses composantes pour refléter fidèlement la progression théorique postulée dans le modèle d’analyse.
7.2 Décomposition en sous-graphiques par facettage horizontal
Lorsqu’une analyse factorielle intègre un nombre trop élevé de combinaisons croisées, l’accumulation de boîtes esquivées au sein d’un espace graphique unitaire finit par saturer l’espace perceptif, engendrant un encombrement visuel contre-productif. Pour résoudre cette complexité sans sacrifier l’exhaustivité de l’information, ggplot2 propose une implémentation native du principe des petits multiples formalisé par Edward Tufte, désignée sous le terme technique de facettage (faceting).
L’instruction facet_wrap(~ variable_tiers, ncol = 1) permet de découper dynamiquement la matrice de données globale en une série de sous-graphiques autonomes disposés en empilement vertical ou en panneaux juxtaposés. Dans le cadre de boîtes à moustaches horizontales, l’alignement des facettes en une colonne unique partageant strictement le même axe des abscisses continu offre une puissance comparative inestimable : l’œil humain peut faire glisser son attention le long d’une verticale imaginaire pour confronter instantanément la position relative des distributions entre différents contextes expérimentaux indépendants.
L’utilisation de la variante matricielle facet_grid(facteur_ligne ~ facteur_colonne) autorise quant à elle un partitionnement bidimensionnel croisé d’une rigueur absolue. Il est généralement conseillé de maintenir les échelles d’axes coordonnées et fixes (via le paramètre par défaut scales = "fixed") afin de ne pas induire le lecteur en erreur en modifiant subrepticement l’emprise métrique d’un panneau à l’autre, préservant ainsi l’intégrité de la comparaison quantitative.
7.3 Ordonnancement raisonné des catégories selon des métriques cibles
L’un des défauts les plus préjudiciables à la clarté d’une figure réside dans le classement purement arbitraire ou alphabétique des catégories le long de l’axe vertical. Présenter des cohortes cliniques ou des spécialités professionnelles par ordre alphabétique force le lecteur à des allers-retours cognitifs laborieux pour identifier quelle condition présente la médiane la plus élevée ou la dispersion la plus étroite, créant une entropie visuelle inutile.
Une visualisation scientifique de haut niveau exige un ordonnancement raisonné, guidé par la statistique sous-jacente. Grâce aux fonctions utilitaires du paquet forcats (intégrateur majeur du tidyverse), il est particulièrement aisé de réordonner dynamiquement les niveaux d’un facteur en fonction d’un résumé statistique de la variable continue. La fonction fct_reorder(facteur_categoriel, variable_continue, .fun = median) réorganise de manière ascendante ou descendante la succession des groupes sur l’axe vertical en se fondant directement sur la valeur calculée de leur médiane empirique respective.
Appliquée à un diagramme horizontal, cette métamorphose ordinale transforme radicalement l’efficacité de la transmission : les boîtes s’échelonnent selon une cascade harmonieuse et logique, délivrant instantanément la hiérarchie des performances ou des intensités symptomatiques à travers les populations étudiées. Cette technique permet de révéler des tendances globales, des ruptures de pente ou des regroupements typologiques invisibles sous un classement alphabétique passif.
8. Esthétique avancée et mise en conformité avec les normes APA sous ggplot2
8.1 Élimination des artefacts graphiques et application de thèmes épurés
L’apparence par défaut de ggplot2, caractérisée par un fond d’écran grisâtre maillé de lignes de quadrillage blanches (le thème theme_grey()), bien qu’innovante sur le plan de la compensation perceptive générale, demeure formellement rejetée par la quasi-totalité des manuels éditoriaux académiques, au premier rang desquels figurent les normes de l’APA. La publication dans des revues internationales de premier rang exige une épuration visuelle drastique éliminant tout artefact susceptible de parasiter la perception des données pures.
La substitution du thème natif par des déclinaisons standardisées sobres s’opère directement par l’adjonction de couches thématiques préconfigurées telles que theme_classic() ou theme_bw(). Le thème classique présente l’avantage considérable de reproduire fidèlement l’aspect des tracés manuels traditionnels : un arrière-plan blanc immaculé, une suppression intégrale des grilles de carroyage internes superflues, et la matérialisation de lignes d’axes noires nettes bordant uniquement la partie inférieure et gauche du plan graphique.
Pour parfaire cette standardisation au sein d’un laboratoire ou pour assurer une cohérence visuelle stricte à travers tous les chapitres d’une thèse doctorale, il est hautement recommandé de construire une fonction thématique personnalisée. En surchargeant la fonction theme(), l’analyste peut verrouiller des paramètres millimétrés régissant l’épaisseur des traits d’axes (axis.line = element_line(linewidth = 0.5, color = "black")), la longueur des graduations (axis.ticks.length = unit(0.2, "cm")) et la suppression complète des lignes mineures d’arrière-plan, aboutissant à une signature graphique épurée et irréprochable.
8.2 Typographie et calibrage textuel pour les manuscrits scientifiques
L’excellence d’une figure scientifique tient pour une large part à sa discipline typographique. Les recommandations éditoriales de l’APA stipulent que l’ensemble des éléments textuels composant une figure (titres, libellés d’axes, annotations, valeurs de légende) doit adopter une police de caractères homogène avec empattement (telle que Times New Roman) ou sans empattement (telle qu’Arial, Helvetica ou Calibri), couramment utilisée au sein du corps du texte principal du manuscrit.
Sous ggplot2, l’harmonisation de la famille de polices s’effectue globalement via l’argument base_family intégré au thème d’arrière-plan (par exemple, theme_classic(base_family = "Times New Roman")). Parallèlement, un calibrage hiérarchique rigoureux de la taille des corps de texte doit être appliqué pour garantir une lisibilité optimale après réduction typographique à l’impression :
- Titres des axes (axis.title) : calibrés généralement à une taille de 10 à 12 points typographiques avec une graisse moyenne ou semi-forte pour asseoir la nature des dimensions mesurées.
- Étiquettes des graduations (axis.text) : maintenues entre 8 et 9 points pour offrir une discrétion absolue qui ne dispute pas la primauté perceptive aux objets géométriques centraux.
- Titres de sections et métadonnées de légendes : alignés à des échelles équivalentes garantissant l’équilibre architectural global du canevas visuel.
De surcroît, la rédaction des étiquettes scientifiques requiert couramment l’insertion de symboles statistiques normalisés ou d’expressions mathématiques complexes (tels que la lettre grecque bêta $\beta$, un indice $d$ de Cohen ou un exposant carré). Cette précision sémiotique est prise en charge de façon transparente par ggplot2 grâce à la fonction expression() intégrée aux commandes labs(), permettant de générer des notations mathématiques typographiquement impeccables directement incorporées aux axes cartésiens.
8.3 Application de palettes de couleurs académiques et monochromatiques
Bien que la publication électronique contemporaine lève progressivement les barrières tarifaires historiques associées à l’impression en couleur, la conception de figures scientifiques doit impérativement préserver un principe de double lisibilité : le graphique doit demeurer parfaitement intelligible et contrasté, qu’il soit visualisé sur un écran haute définition en couleurs ou photocopié en niveaux de gris purs sur un support papier basse résolution.
Pour répondre à ce prérequis, les échelles monochromatiques fondées sur des dégradés de gris calibrés constituent un standard de robustesse inaltérable. La fonction scale_fill_grey(start = 0.4, end = 0.9) permet d’attribuer aux différents niveaux factoriels des teintes de gris régulièrement espacées, suffisamment claires pour ne pas masquer la ligne médiane noire centrale, mais assez différenciées pour être distinguées sans équivoque.
Si la couleur est retenue pour des raisons d’expressivité sémantique, l’usage des palettes de l’échelle viridis via scale_fill_viridis_d(option = "mako", begin = 0.2, end = 0.8) constitue la recommandation méthodologique de référence. Conçues sur la base de principes psychophysiques stricts, ces échelles garantissent que la luminance croît de façon strictement monotone le long de l’axe factoriel, assurant une préservation absolue des contrastes perçus tant par les lecteurs daltoniens que lors d’une conversion brutale du document final en mode noir et blanc.
9. Détection, caractérisation et gestion visuelle des valeurs aberrantes
9.1 Paramétrage algorithmique des critères d’identification des outliers
Dans la théorie classique de l’analyse exploratoire des données, l’identification formelle d’une observation comme point aberrant (outlier) n’implique nullement son élimination automatique du fichier d’analyse : elle signale avant tout au chercheur une anomalie computationnelle, une hétérogénéité d’échantillonnage insoupçonnée ou une singularité clinique digne d’investigation. L’algorithme standard implémenté tant dans R de base que sous geom_boxplot() s’appuie sur un seuil multiplicateur conventionnel fixé à 1,5 fois l’écart interquartile au-delà des charnières quantiles.
Il est possible de moduler algorithmiquement cette sensibilité de détection par le biais du paramètre numérique coef (dans le système graphique de base) ou via l’argument équivalent de transformation statistique dans ggplot2. En élevant ce coefficient multiplicateur à la valeur 3,0, l’analyste reconfigure le seuil géométrique pour masquer les déviations modérées et ne matérialiser visuellement que les valeurs aberrantes dites « extrêmes » ou sévères selon la taxonomie originelle de Tukey. Ce filtrage visuel permet de ne pas surcharger la figure par des points isolés dans les très grands échantillons où la détection d’outliers légers constitue une certitude purement mathématique inhérente à la taille de la cohorte.
D’un point de vue méthodologique, il est impératif que le choix du coefficient retenu soit formellement consigné dans la légende descriptive de la figure soumise pour publication. Toute altération du seuil par défaut non signalée expose le manuscrit à des critiques justifiées lors du processus d’expertise par les pairs, en modifiant arbitrairement l’étendue apparente des moustaches et la perception de la dispersion naturelle du phénomène biologique ou comportemental observé.
9.2 Personnalisation stylistique des points aberrants
Par défaut au sein de geom_boxplot(), les valeurs aberrantes sont représentées sous la forme de disques noirs pleins de petite dimension. Cette signature géométrique peut s’avérer sous-optimale lorsque le nombre d’observations déviantes est élevé, risquant de créer des conglomérats massifs illisibles, ou au contraire d’induire une confusion visuelle avec d’autres couches de points superposées.
La personnalisation de ces glyphes individuels s’opère via un ensemble d’arguments dédiés intégrés à l’appel de geom_boxplot() :
outlier.shape: permet de modifier le glyphe géométrique en adoptant par exemple des cercles évidés (code 21) ou des croix distinctives évitant la saturation d’encre.outlier.size: ajuste le diamètre physique des points pour moduler leur impact visuel sans altérer la clarté des moustaches contiguës.outlier.alpha: introduit un niveau de transparence précieux pour déceler les superpositions exactes d’observations multiples partageant le même score discontinu.outlier.coloretoutlier.fill: permettent d’attribuer une teinte chromatique spécifique (telle qu’un rouge carmin subtil) afin de guider délibérément l’attention du lecteur vers ces individus atypiques.
Un piège technique capital doit être formellement souligné : lorsque l’analyste décide de superposer un nuage de points bruts (par exemple via geom_jitter()) sur sa boîte à moustaches horizontale, il est indispensable de neutraliser le tracé des points aberrants par défaut de la boîte en spécifiant impérativement outlier.shape = NA. Omettre cette précaution engendre une duplication systématique des valeurs aberrantes, qui sont alors dessinées deux fois à l’écran : une première fois comme composante géométrique de la boîte, et une seconde fois comme élément du nuage dispersé, faussant lourdement la perception visuelle de la densité d’échantillonnage locale.
9.3 Étiquetage textuel individuel des observations divergentes
Au-delà de la simple localisation géométrique des valeurs aberrantes sur l’axe continu horizontal, il s’avère particulièrement fécond en recherche idiographique ou clinique d’identifier nommément les participants ou les unités expérimentales correspondant à ces profils extrêmes. L’identification textuelle directe évite à l’expérimentateur des allers-retours fastidieux entre la figure graphique et la table de données brutes.
Cette individualisation programmatique requiert d’isoler dans un premier temps les coordonnées des points franchissant les clôtures de Tukey via une étape de filtrage algorithmique avec dplyr, en calculant les seuils par groupe factoriel à l’aide de commandes groupées. Une fois la sous-matrice des participants atypiques extraite, l’application du paquet d’extension ggrepel constitue la solution méthodologique optimale. Grâce à la fonction geom_text_repel() configurée pour une géométrie horizontale, le système projette automatiquement les identifiants textuels (tels que les numéros d’anonymisation des patients ou les libellés de sous-échelles) en les écartant intelligemment du centre des points par des algorithmes d’attraction-répulsion physiques pour prévenir toute superposition textuelle.
Cette approche hybride associe la rigueur globale du résumé distributionnel à la finesse de l’analyse de cas particuliers, permettant par exemple de constater immédiatement qu’une observation dissidente persistante sur plusieurs échelles psychométriques croisées correspond systématiquement au même sujet pathologique, guidant ainsi des investigations qualitatives ciblées sur son dossier clinique.
10. Superposition de couches de données : combiner boîtes horizontales et distributions brutes
10.1 Intégration de nuages de points avec dispersion aléatoire
En dépit de sa robustesse incontestable, la boîte à moustaches souffre d’une faiblesse inhérente : elle condense drastiquement l’information et masque la taille réelle de l’échantillon sous-jacent. Une boîte représentant quinze participants présente rigoureusement la même surface géométrique qu’une boîte issue d’un échantillon de quinze mille sujets si leurs quantiles coïncident par hasard. Cette opacité structurelle entre en contradiction directe avec les exigences modernes de transparence des données (open science).
Pour restaurer cette dimension essentielle, la pratique contemporaine préconise la superposition d’un nuage de points individuels bruts par-dessus la structure de la boîte à moustaches. L’adjonction de la couche geom_jitter() assure une dispersion stochastique contrôlée des observations. Dans une orientation horizontale, il est impératif de contraindre rigoureusement cette gigue aléatoire : la dispersion doit s’exercer exclusivement le long de l’axe vertical Y (via le paramètre height = 0.2) pour étaler harmonieusement les points au sein de chaque bande catégorielle, tout en interdisant formellement toute dispersion sur l’axe horizontal X (width = 0) afin de ne pas altérer la position métrique exacte du score observé.
En couplant cette dispersion orthogonale à une opacité modérée (alpha = 0.3 à 0.5), l’analyste produit une visualisation combinée d’une honnêteté scientifique totale : les cinquante pour cent centraux des données demeurent encadrés par la géométrie rigide du résumé de Tukey, tandis que la texture granuleuse des points sous-jacents dévoile instantanément les grappes d’individus, les zones de vacuité d’échantillonnage et l’effectif effectif assigné à chaque condition.
10.2 Construction de graphiques en nuage de pluie horizontaux
Pour pousser encore plus loin la fidélité de la représentation distributionnelle, la communauté des bio-statisticiens et des neuroscientifiques a formalisé le concept des graphiques en nuage de pluie (raincloud plots), popularisés par Micah Allen et ses collaborateurs. Ces figures composites articulent harmonieusement trois niveaux d’information imbriqués : une boîte à moustaches étroite indiquant les quantiles essentiels, un nuage de points individuels figurant les données brutes, et une demi-courbe de densité lissée (ressemblant à un nuage étiré) restituant la morphologie continue de la distribution.
Dans l’écosystème R, la construction d’un graphique en nuage de pluie horizontal est grandement facilitée par l’extension spécialisée ggdist. L’assemblage s’effectue en décalant spatialement les différentes géométries le long de l’ordonnée verticale Y pour éviter qu’elles ne se parasitent mutuellement. La fonction stat_halfeye() projette la demi-densité lissée sur la moitié supérieure du couloir factoriel, tandis qu’une boîte à moustaches miniaturisée (geom_boxplot(width = 0.15)) s’installe au centre, surmontant une couche de points bruts dispersés disposée dans la tranche inférieure.
Cette association révèle de manière spectaculaire les caractéristiques morphologiques que la boîte à moustaches standard est structurellement incapable d’exposer, au premier rang desquelles figure la bimodalité. Une distribution présentant deux sommets distincts (par exemple, deux sous-populations réagissant différemment à une thérapie expérimentale) produira sous une boîte classique un rectangle interquartile faussement uniforme avec une médiane médiane sans relief, tandis que le graphique en nuage de pluie horizontal dévoilera instantanément ce creux central et cette scission populationnelle.
10.3 Ajout d’indicateurs paramétriques complémentaires
Dans les rapports de recherche contemporains, les comités de lecture réclament fréquemment la mention conjointe des estimateurs ordinaux non paramétriques (médiane, IQR) et des indices paramétriques classiques (moyenne arithmétique, intervalle de confiance à 95 %), afin de permettre aux lecteurs de faire le lien avec les tableaux numériques d’analyses d’inférence linéaire traditionnelles. Il est tout à fait possible d’intégrer élégamment ces métriques supplémentaires directement au sein de la boîte à moustaches horizontale.
La commande déclarative stat_summary() de ggplot2 offre l’infrastructure analytique nécessaire pour accomplir ce croisement sans modifier la structure des données sources. En spécifiant la transformation fun = mean et en sollicitant une forme géométrique distinctive (par exemple, un losange plein via geom = "point", shape = 18, size = 3, color = "darkred"), la moyenne empirique de chaque groupe se matérialise directement au sein du corps de la boîte à son exacte coordonnée horizontale.
La confrontation immédiate de la position spatiale de la ligne médiane noire et du losange rouge de la moyenne offre un éclairage clinique d’une puissance saisissante : tout écartement physique perceptible entre ces deux indicateurs de tendance centrale matérialise sans ambiguïté l’impact gravitationnel de l’asymétrie distributionnelle ou l’influence démesurée d’une valeur aberrante isolée sur l’estimation de la moyenne. L’insertion d’une barre d’erreur matérialisant l’intervalle de confiance paramétrique superposée à la boîte permet de clore l’argumentation empirique en réconciliant visuellement les deux traditions statistiques.
11. Exportation haute résolution et intégration dans la chaîne de publication
11.1 Paramétrage des formats vectoriels et matriciels
La dernière étape du flux de travail graphique consiste à extraire la figure construite sous R pour l’incorporer dans le manuscrit scientifique destiné à la soumission. Cette transition nécessite une maîtrise technique des spécifications imposées par les éditeurs internationaux quant aux formats de fichiers, aux dimensions physiques réelles et aux densités d’échantillonnage de pixels. La fonction cardinale dédiée à cette opération sous ggplot2 est ggsave().
Le choix fondamental repose sur l’arbitrage entre formats vectoriels et formats matriciels (ou raster) :
- Formats vectoriels (PDF, EPS, SVG) : ils conservent chaque tracé géométrique et chaque glyphe typographique sous la forme d’équations mathématiques pures. Ils doivent être privilégiés de manière quasi systématique pour les publications scientifiques car ils autorisent un agrandissement infini sans aucune dégradation de netteté ni effet de crénelage (aliasing), assurant une reproduction d’une perfection absolue lors de la composition typographique finale par l’éditeur.
- Formats matriciels (TIFF, PNG) : requis lorsque des revues imposent le dépôt d’images consolidées. Pour un diagramme horizontal, il convient d’exiger impérativement une résolution spatiale minimale de 300 à 600 points par pouce (DPI) en configurant l’argument
dpi = 300au sein deggsave(), tout en définissant explicitement les dimensions physiques métriques (par exemple,width = 17, height = 10, units = "cm") pour correspondre fidèlement à la grille de composition de la revue ciblée.
11.2 Intégration dynamique dans les flux R Markdown et Quarto
L’essor fulgurant des systèmes de publication computationnelle reproductible, à l’instar de R Markdown et de son successeur universel Quarto, a profondément transformé les pratiques de rédaction académique. Plutôt que d’exporter manuellement des fichiers statiques pour les insérer laborieusement dans un traitement de texte propriétaire, le chercheur contemporain encapsule directement son code R de traçage de boîte à moustaches horizontale à l’intérieur de blocs de code dynamiques (code chunks) disséminés dans le texte source de son manuscrit.
Le calibrage ergonomique du rendu visuel au sein du document compilé final s’opère par le biais des options de bloc d’instructions intégrées aux en-têtes. Pour une boîte à moustaches horizontale, il est préconisé de configurer spécifiquement un ratio largeur-hauteur étalé via les métadonnées de bloc :
#| fig-width: 7
#| fig-height: 4
#| fig-cap: "Distribution des scores psychométriques à travers les conditions expérimentales."
#| fig-align: "center"
Cette mécanisation garantit une reproductibilité scientifique absolue : si une correction ultérieure survient dans le jeu de données primaires ou si des participants supplémentaires complètent le protocole empirique, une simple réexécution du script de compilation recalcule l’intégralité des quantiles et régénère instantanément la figure au sein du document de publication final, éliminant tout risque d’erreur de copier-coller humain ou d’incohérence entre les données chiffrées citées dans le texte et les représentations graphiques associées.
11.3 Post-traitement et contrôle qualité des figures
Préalablement à l’expédition formelle d’une soumission éditoriale, une procédure de vérification qualité doit être méticuleusement exécutée sur le fichier graphique produit. L’un des écueils techniques les plus insidieux concerne l’incorporation matérielle des polices de caractères (font embedding) au sein des fichiers vectoriels de type PDF ou EPS. Si les polices exploitées lors du tracé ne sont pas scellées à l’intérieur du fichier d’échange, les serveurs typographiques de l’imprimeur ou de la plateforme d’évaluation risquent de leur substituer des fontes génériques non adaptées, induisant des chevauchements catastrophiques d’étiquettes textuelles sur l’axe vertical.
L’application du paquet extrafont combinée à l’instruction embed_fonts() permet de neutraliser définitivement ce péril technique en forçant l’ancrage binaire des tracés de caractères au cœur du document PDF produit. Parallèlement, une attention rigoureuse doit être portée à l’espace colorimétrique retenu : si les navigateurs et moniteurs fonctionnent nativement sous l’espace RVB (Rouge, Vert, Bleu), les rotatives d’impression physique requièrent une conversion vers l’espace soustractif CMJN (Cyan, Magenta, Jaune, Noir). La vérification de la stabilité chromatique lors du basculement d’un profil à l’autre prévient les dérives de contraste involontaires.
Enfin, l’archivage pérenne du code source de la visualisation constitue le dernier maillon de cette chaîne éthique. Déposer le script complet de traçage graphique sur un référentiel public ouvert (tel que l’Open Science Framework (OSF) ou GitHub) adossé à un identifiant d’objet numérique pérenne (DOI) garantit que la figure demeure auditable, reproductible et réutilisable par l’ensemble de la communauté scientifique internationale pour les générations à venir.
12. Pièges fréquents, erreurs d’interprétation et solutions algorithmiques
12.1 Biais d’interprétation liés à la taille des échantillons
L’une des dérives d’interprétation les plus pernicieuses en science quantitative consiste à accorder un niveau de confiance identique à des boîtes à moustaches issues d’échantillons aux effectifs radicalement dissemblables. En raison de sa structure purement proportionnelle basée sur des pourcentages fixes d’observations (charnières à 25 % et 75 %), une boîte construite sur un micro-échantillon de dix participants présentera une silhouette graphique tout aussi stable et rassurante qu’une boîte issue d’un groupe comprenant mille observations. Or, l’erreur-type de la médiane et la variabilité d’échantillonnage des quantiles extrêmes explosent mathématiquement lorsque l’effectif s’étiole.
Pour remédier visuellement à cette asymétrie de puissance statistique sans quitter l’environnement de la boîte à moustaches horizontale, une solution élégante consiste à exploiter l’argument logique varwidth = TRUE, disponible tant sous le système de base que dans geom_boxplot(). Dès lors que ce paramètre est activé, R recalcule la largeur relative de chaque boîte (c’est-à-dire son épaisseur sur l’axe vertical dans notre orientation horizontale) de manière strictement proportionnelle à la racine carrée de l’effectif effectif du groupe ($ sqrt{n} $).
Sous cette géométrie proportionnelle, une condition expérimentale massivement documentée arborera une boîte épaisse et majestueuse affirmant sa solidité inférentielle, tandis qu’une cohorte clinique restreinte verra son rectangle se contracter en un ruban effilé signalant immédiatement à l’observateur la précarité métrologique de ses estimations. En complément systématique, il demeure impératif d’intégrer explicitement la taille réelle de l’échantillon entre parenthèses directement au sein de chaque libellé factoriel le long de l’axe vertical (par exemple, « Groupe Témoin (n = 120) » versus « Syndrome Atypique (n = 8) »).
12.2 Confusions syntaxiques récurrentes et débogage dans R
L’apprentissage et la mise en œuvre des boîtes à moustaches horizontales sous R s’accompagnent inévitablement de heurts syntaxiques documentés qui peuvent désarçonner l’analyste débutant ou chevronné. Le premier piège classique sous le système de base R concerne l’inversion par inadvertance des termes de la formule statistique : formuler boxplot(groupe ~ score, horizontal = TRUE) au lieu de boxplot(score ~ groupe, horizontal = TRUE) tente de contraindre le moteur à traiter une variable catégorielle comme une métrique continue, générant des messages d’erreur obscurs ou un canevas graphique totalement illisible.
Un second écueil omniprésent dans le système graphique de base concerne le blocage computationnel bien connu sous le libellé « Error in plot.new() : figure margins too large ». Cette erreur survient généralement lorsque l’analyste a accru la marge gauche de manière excessive via par(mar = ...) pour loger ses étiquettes horizontales, au sein d’une fenêtre d’affichage physique dont l’espace total est trop restreint. La résolution de ce problème impose de redimensionner manuellement le panneau de visualisation ou de réajuster les marges globales avec discernement.
Sous ggplot2, la confusion la plus fréquente provient de la collision historique entre coord_flip() et les fonctions d’échelle continue. Si l’analyste tente de modifier les limites de l’axe quantitatif désormais affiché horizontalement en déclarant un scale_x_continuous(limits = c(0, 100)) alors qu’il a employé coord_flip(), le compilateur appliquera la troncature à l’axe catégoriel sous-jacent, provoquant l’effacement mystérieux de l’intégralité des données géométriques. L’adoption résolue de l’assignation directe moderne (aes(x = score, y = groupe)) évite définitivement ces conflits d’héritage d’axes et garantit un débogage fluide et logique.
12.3 Considérations éthiques et honnêteté visuelle en psychologie
La puissance rhétorique d’un graphique confère à son concepteur une responsabilité éthique considérable dans la chaîne de transmission du savoir scientifique. Une manipulation inadéquate des paramètres géométriques d’une boîte à moustaches horizontale peut aisément induire en erreur l’évaluation par les pairs ou le grand public en distordant la réalité des effets empiriques observés, participant insidieusement à la crise de reproductibilité qui traverse les sciences comportementales.
Le piège éthique le plus critique concerne la troncature arbitraire de l’axe continu des abscisses. En contraignant l’échelle de mesure à un segment microscopique centré exclusivement autour des médianes observées (par exemple, en restreignant la vue entre les scores 45 et 55 pour une échelle psychométrique standard s’étendant en réalité de 0 à 100), l’expérimentateur hypertrophie artificiellement des micro-décalages d’échantillonnage totalement dénués de pertinence clinique, transformant une variation aléatoire négligeable en un gouffre apparent. La déontologie méthodologique exige que l’axe horizontal balaye l’étendue théorique complète de l’instrument de mesure, ou, à défaut, justifie formellement la sélection du segment affiché.
Pour assurer une transparence visuelle irréprochable avant toute validation finale, le chercheur doit soumettre sa figure à une check-list de contrôle rigoureuse :
- Les étiquettes textuelles de l’axe vertical sont-elles disposées strictement à l’horizontale et lisibles sans rotation de la tête ?
- Le seuil de détermination des valeurs aberrantes est-il explicité et scientifiquement justifié ?
- La taille de l’échantillon de chaque cohorte est-elle rendue manifeste par la texture des données ou documentée numériquement ?
- Les palettes de couleurs sélectionnées garantissent-elles un contraste parfait pour les personnes daltoniennes et à l’impression en niveaux de gris ?
- Le script informatique complet garantit-il la reproduction exacte de la géométrie au bit près à partir du fichier de données brut ?
En respectant scrupuleusement ces impératifs métrologiques, ergonomiques et déontologiques, la boîte à moustaches horizontale cesse d’être un simple dessin conventionnel pour s’élever au rang d’instrument d’investigation et de démonstration scientifique de premier ordre, alliant la puissance de synthèse non paramétrique de John Tukey à l’élégance de la communication contemporaine.
Références
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: a multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of Box Plots. The American Statistician, 32(1), 12-16. https://doi.org/10.2307/2683468
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0