
L’analyse exploratoire des données quantitatives constitue le socle fondamental de toute démarche empirique rigoureuse, particulièrement au sein des sciences humaines, de la psychologie cognitive et des sciences comportementales. Face à des distributions empiriques complexes, souvent caractérisées par des asymétries prononcées, des artéfacts de mesure ou des scores extrêmes, les chercheurs se heurtent rapidement aux limites inhérentes aux résumés statistiques paramétriques classiques. La boîte à moustaches, conceptualisée par le statisticien américain John Tukey, s’impose dès lors comme un instrument d’investigation visuelle irremplaçable, offrant une synthèse ordinale robuste de la dispersion, de la tendance centrale et des singularités distributionnelles d’une série de mesures.
Pourtant, la transposition de ce standard graphique universel au sein des outils contemporains de traitement collaboratif de données soulève des défis d’ordre technique singuliers. L’écosystème Google Sheets, bien qu’omniprésent dans les laboratoires de recherche, les départements universitaires et les cellules d’évaluation clinique en raison de ses fonctionnalités de synchronisation en temps réel, ne propose pas de moteur de génération directe d’un diagramme de Tukey conforme aux canons de la publication scientifique. Pour contourner cette lacune architecturale, les analystes de données doivent mobiliser une démarche ingénieuse consistant à détourner le graphique financier en chandeliers japonais (candlestick chart) afin d’émuler fidèlement la boîte interquartile et ses extensions ordinales.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, statisticiens, psychologues et étudiants avancés dans l’élaboration méthodologique, le calcul algorithmique et l’optimisation graphique d’une boîte à moustaches dans Google Sheets. De la formalisation mathématique du résumé à cinq nombres à la mise en conformité visuelle avec les normes éditoriales de l’American Psychological Association (APA), ce manuel didactique détaille chaque étape opératoire pour transformer des matrices de données brutes en visualisations analytiques d’une précision irréprochable.
1. Fondements théoriques de la boîte à moustaches en psychologie et sciences quantitatives
1.1 Définition épistémologique et utilité du diagramme de Tukey
La boîte à moustaches, traditionnellement désignée dans la littérature anglo-saxonne sous le vocable de box-and-whisker plot, a été introduite formellement en 1977 par John Wilder Tukey dans son ouvrage fondateur intitulé Exploratory Data Analysis. S’inscrivant en rupture avec une tradition statistique quasi exclusivement inférentielle et paramétrique, Tukey plaidait pour une approche exploratoire préalable, postulant que les chercheurs doivent examiner la physionomie intrinsèque de leurs observations avant d’échafauder des hypothèses probabilistes rigides. Le diagramme de Tukey est ainsi né d’une volonté de condenser graphiquement les propriétés structurales d’un échantillon continu au moyen de repères d’ordre insensibles aux déformations extrêmes.
Dans le domaine des sciences psychologiques, où les échelles d’évaluation psychométrique (telles que les échelles de Likert à intervalles supposés égaux) et les chronométries cognitives génèrent quasi systématiquement des distributions asymétriques, la boîte à moustaches s’avère d’une pertinence épistémologique capitale. L’analyse des temps de réaction lors d’une tâche de Stroop ou d’un paradigme d’amorçage sémantique, par exemple, révèle invariablement un étalement asymétrique vers la droite, causé par des latences motrices incompressibles associées à des épisodes occasionnels d’inattention du sujet expérimental. Face à de tels profils, la boîte à moustaches préserve l’intégrité descriptive du phénomène en évitant l’écueil du lissage trompeur inhérent aux représentations gaussiennes.
Sur le plan de l’utilité clinique et psychométrique, le diagramme permet en outre d’objectiver immédiatement l’amplitude de la variabilité interindividuelle et intra-individuelle. Il fournit une cartographie directe de la zone de densité médiane, tout en délimitant de manière explicite les фронtières au-delà desquelles un score cesse d’appartenir à la variabilité physiologique normale pour être suspecté d’aberration technique ou de déviation pathologique. Cette dualité entre condensation de masse et individualisation des marges fait du diagramme de Tukey un pivot incontournable de l’investigation quantitative contemporaine.
1.2 Comparaison entre représentations paramétriques et non paramétriques
La distinction épistémologique majeure entre les approches paramétriques et non paramétriques réside dans le degré de dépendance vis-à-vis des postulats distributionnels. Les indicateurs paramétriques fondamentaux, à savoir la moyenne arithmétique et l’écart-type, reposent sur l’hypothèse implicite d’une distribution sous-jacente symétrique, idéalement mésocurtique et assimilable à la loi normale de Laplace-Gauss. Dès lors qu’une distribution présente une contamination par des valeurs extrêmes ou manifeste une bimodalité latente, la moyenne est irrémédiablement déportée dans la direction de la queue de distribution, tandis que l’écart-type s’accroît artificiellement sous l’effet de l’élévation au carré des déviations individuelles.
À l’inverse, l’approche non paramétrique incarnée par la boîte à moustaches substitue à ces paramètres sensibles des estimateurs de position d’une exceptionnelle robustesse : la médiane empirique et l’écart interquartile (Interquartile Range ou IQR). La médiane correspond au cinquantième centile ordinal, séparant formellement l’effectif en deux moitiés équiprobables, sans égard pour la magnitude relative des valeurs périphériques. L’écart interquartile, quant à lui, quantifie la dispersion des cinquante pour cent médians de la distribution, circonscrivant l’hétérogénéité centrale sans subir la déformation que provoquerait un score isolé aberrant résultant d’une défaillance instrumentale.
Sur le plan de la communication scientifique, la complémentarité graphique s’avère essentielle. Alors que l’histogramme dépend étroitement du choix arbitraire de la largeur des classes de fréquence et que le diagramme de dispersion (scatterplot) devient rapidement illisible lorsqu’il est saturé par des milliers d’observations superposées, la boîte à moustaches synthétise la forme globale avec une remarquable économie d’encre graphique. Elle permet d’embrasser d’un seul regard la dispersion, le centrage et la symétrie de cohortes entières, facilitant les comparaisons d’échelles multiples sans obliger le lecteur à scruter des matrices numériques exhaustives.
1.3 Spécificités techniques de l’écosystème Google Sheets
Bien que Google Sheets soit devenu un environnement de prédilection pour la gestion de bases de données distribuées et la mise en œuvre de protocoles collaboratifs entre laboratoires distants, son moteur de visualisation natif présente une particularité historique qui surprend souvent les chercheurs habitués à des progiciels spécialisés comme R, SPSS ou Jamovi. Contrairement à ces derniers, Google Sheets ne dispose pas, au sein de son menu de sélection standard, d’un modèle de « diagramme en boîte » généré automatiquement à partir d’une simple colonne de données continues brutes sans agrégation préalable.
Cette carence fonctionnelle contraint l’utilisateur à une démarche d’ingénierie statistique : le recours détourné au graphique en chandeliers (candlestick chart). Originellement conçu pour l’analyse financière des marchés boursiers afin de visualiser les cours d’ouverture, de clôture, les planchers et les plafonds d’un actif financier sur une unité de temps donnée, ce format visuel présente des propriétés géométriques strictement identiques à celles requises pour dessiner un diagramme de Tukey. La boîte centrale du chandelier correspond à l’intervalle interquartile, tandis que les mèches verticales supérieure et inférieure figurent fidèlement les moustaches de la distribution statistique.
Ce détournement technique, loin d’être un obstacle rédhibitoire, confère en réalité une grande flexibilité méthodologique. Il impose au chercheur de maîtriser la chaîne algorithmique complète menant des données primaires aux estimateurs de position. En outre, la synchronisation infonuagique native de Google Sheets autorise une actualisation dynamique et instantanée des représentations graphiques : chaque nouvelle passation d’un questionnaire en ligne via Google Forms ou chaque ajout de sujet expérimental recalcule automatiquement les paramètres statistiques et réajuste la morphologie des chandeliers, garantissant une surveillance continue de l’intégrité des protocoles de recherche.
2. Anatomie statistique du résumé à cinq nombres (Five-Number Summary)
2.1 Le minimum et le maximum statistiques
L’édification d’une boîte à moustaches repose structurellement sur le concept mathématique du résumé à cinq nombres, formalisé pour capturer l’essentiel d’une distribution sans formuler d’hypothèse a priori sur sa loi de probabilité. Les deux premières bornes de ce résumé sont constituées par les valeurs extrêmes empiriques : le minimum absolu et le maximum absolu observés dans la série de données. Le minimum représente l’observation ayant le rang ordinal le plus bas, tandis que le maximum matérialise l’observation de rang le plus élevé au sein de l’espace d’échantillonnage examiné.
Il importe toutefois de distinguer conceptuellement les extremums empiriques bruts des bornes théoriques définies par Tukey pour la troncature des moustaches. Dans la conception canonique du diagramme de Tukey, les moustaches ne s’étirent pas systématiquement jusqu’aux minima et maxima absolus de la série, mais s’arrêtent à la dernière observation située à l’intérieur d’un intervalle protecteur déterminé par une barrière mathématique égale à une fois et demie l’écart interquartile (1,5 IQR). Tout point excédant cette barrière est alors considéré comme une observation disjointe et représenté sous forme de point distinct. Dans l’implémentation financière simplifiée sous Google Sheets, la tentation est grande de faire correspondre les extrémités des moustaches au minimum et au maximum réels, ce qui exige de la part du statisticien une vigilance accrue quant à la nature des valeurs ainsi matérialisées.
Au sein d’un protocole d’expérimentation psychologique, le repérage de ces valeurs extrêmes constitue un filtre de contrôle de qualité essentiel. Un minimum ou un maximum absurde trahit instantanément une coquille d’encodage matériel, comme l’inversion de chiffres au clavier (par exemple, un score de 99 sur une échelle étalonnée de 1 à 9), ou encore une violation manifeste du protocole par un participant (tel qu’un temps de réponse de 15 millisecondes, physiologiquement impossible pour une tâche de discrimination visuelle complexe).
2.2 Les quartiles (Q1 et Q3) et la dispersion centrale
Le premier quartile, noté usuellement Q1 ou 25e centile, correspond à la valeur ordinale sous laquelle se situent exactement 25 % des observations les plus basses de l’échantillon ordonné, laissant 75 % de l’effectif au-dessus d’elle. À l’opposé symétrique de la distribution, le troisième quartile, noté Q3 ou 75e centile, représente la valeur sous laquelle se concentrent 75 % des observations, les 25 % restants se déployant vers les valeurs supérieures. Ces deux indicateurs de position délimitent avec précision les contours de la « boîte » centrale du diagramme de Tukey.
L’écart interquartile, calculé par la différence arithmétique simple entre le troisième et le premier quartile (formule : IQR = Q3 – Q1), constitue la métrique fondamentale de dispersion non paramétrique. Contrairement à l’écart-type ou à la variance, dont les calculs intègrent la totalité des déviations quadratiques par rapport au centre arithmétique, l’IQR neutralise l’impact des 25 % d’observations les plus basses et des 25 % les plus hautes. Il se concentre exclusivement sur le demi-échantillon central, ce qui en fait un estimateur possédant un point de rupture (breakdown point) élevé : il peut supporter jusqu’à 25 % de valeurs arbitrairement corrompues à chaque extrémité sans que sa mesure fondamentale de l’éparpillement central ne subisse de dénaturation.
Visualiser l’IQR sous la forme d’un rectangle géométrique permet d’appréhender immédiatement la densité empirique des scores. Une boîte compacte et resserrée témoigne d’une forte homogénéité des réponses chez la majorité des sujets, tandis qu’une boîte particulièrement allongée signale une divergence prononcée des comportements ou des traits psychologiques mesurés, même au sein du noyau central de la cohorte évaluée.
2.3 La médiane empirique comme point d’ancrage central
La médiane empirique, ou second quartile (notée indifféremment Q2 ou Med), constitue le pivot géométrique et statistique du résumé à cinq nombres. Elle correspond à la valeur de la variable qui partage formellement l’effectif ordonné en deux sous-groupes d’égale proportion : cinquante pour cent des participants obtiennent un résultat inférieur ou égal à cette valeur, et cinquante pour cent obtiennent un résultat supérieur ou égal. En tant que paramètre de tendance centrale fondé sur le rang, la médiane ne dépend aucunement des valeurs numériques marginales, mais uniquement du dénombrement des observations positionnées de part et d’autre de son seuil.
Cette propriété mathématique confère à la médiane une résistance quasi absolue face aux biais méthodologiques fréquents en psychométrie, tels que les effets de plafond ou de plancher. Si plusieurs sujets dépressifs obtiennent le score maximal absolu sur une échelle clinique de Beck, ce regroupement artificiel perturbera gravement la moyenne arithmétique globale en la tirant vers le haut, alors que la médiane demeurera insensible à la saturation métrique de cette extrémité. Elle continue de refléter fidèlement le profil du participant médian représentatif de l’échantillon clinique.
L’analyse du positionnement spatial de la médiane au sein de la boîte interquartile constitue l’un des diagnostics visuels les plus puissants offerts par le diagramme. Si la médiane est rigoureusement équidistante de Q1 et de Q3, la distribution des 50 % de scores centraux est réputée parfaitement symétrique. En revanche, si la médiane se colle contre le plancher de Q1, la distribution manifeste une asymétrie positive (étalement vers la droite) ; si elle se rapproche intimement de Q3, elle démontre une asymétrie négative (étalement vers la gauche), fournissant un indice qualitatif direct sur la courbure de la fonction de masse empirique.
3. Préparation et structuration rigoureuse des données brutes dans Google Sheets
3.1 Nettoyage préliminaire et typologie des variables
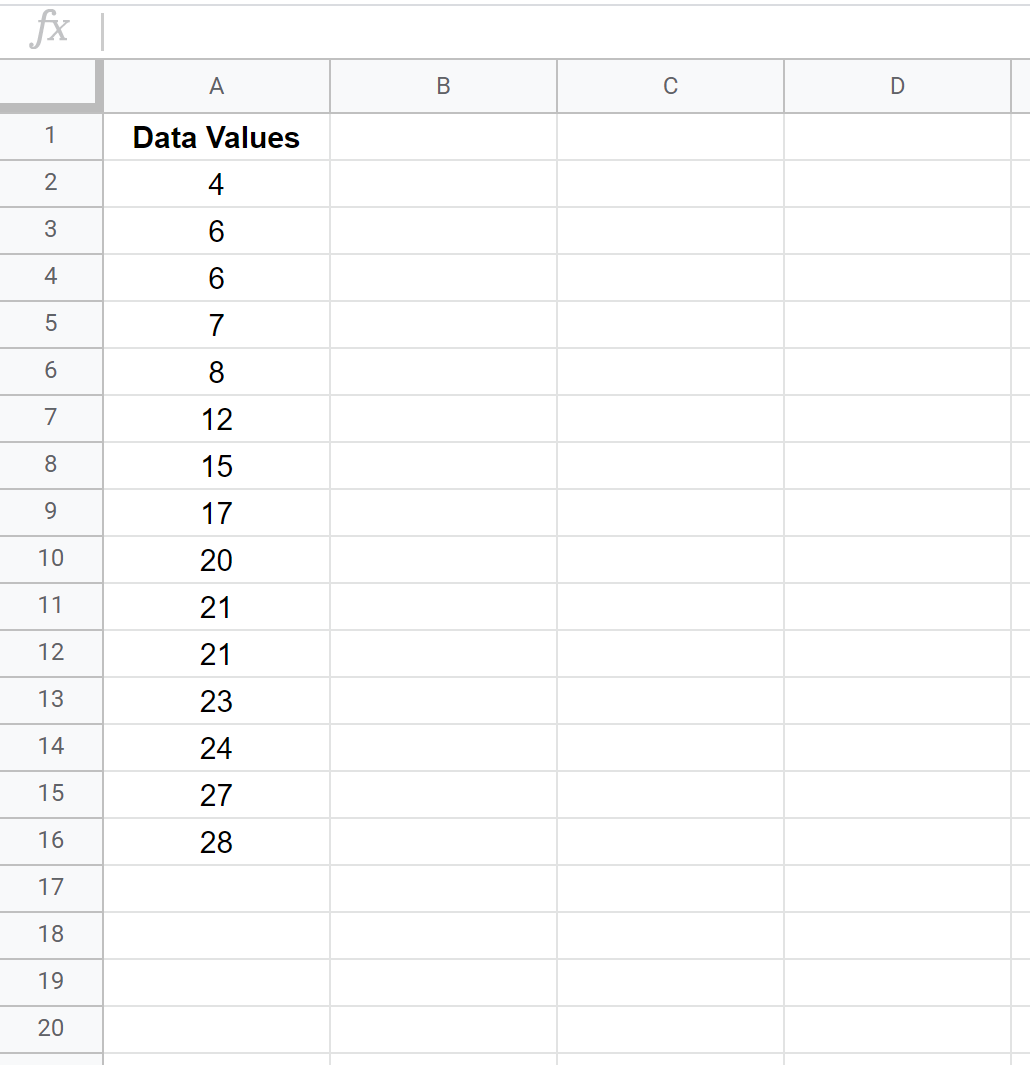
La viabilité de toute modélisation graphique sous Google Sheets dépend impérativement de la pureté formelle de la table matricielle d’origine. Avant d’engager le moindre calcul algorithmique, l’expérimentateur doit soumettre sa base de données brutes à une inspection rigoureuse destinée à repérer les artéfacts de saisie. Dans les classeurs issus de passations expérimentales en ligne ou d’extractions logicielles, il est courant que certaines cellules censées accueillir des scalaires numériques soient enregistrées sous forme de chaînes de texte, souvent à cause d’espaces invisibles insérés par inadvertance ou de l’utilisation erronée de caractères typographiques alphabétiques.
Le traitement des données manquantes (missing data) doit être orchestré selon des principes méthodologiques explicites. Dans le contexte de l’analyse exploratoire, une cellule laissée totalement vide est généralement ignorée par les fonctions statistiques d’agrégation de Google Sheets, ce qui constitue le comportement par défaut le plus sain. Toutefois, l’insertion accidentelle de codes textuels tels que « NA », « null », « non-réponse » ou la convention informatique désuète « 999 » viendra gravement vicier le calcul des rangs quartilaires ou engendrera des erreurs d’incompatibilité de type au sein des fonctions mathématiques.
Il est préconisé d’attribuer des intitulés de colonnes normalisés, dépourvus de caractères accentués complexes ou de symboles diacritiques susceptibles de perturber les liaisons dynamiques. Pour une étude portant sur l’efficacité comparée de thérapies cognitives, des étiquettes telles que Groupe_Controle, Therapie_Standard et Therapie_Innovante permettent d’isoler sans ambiguïté les vecteurs de scores continus qui feront l’objet des estimations quantitatives ultérieures.
3.2 Disposition matricielle requise pour le graphique en chandeliers
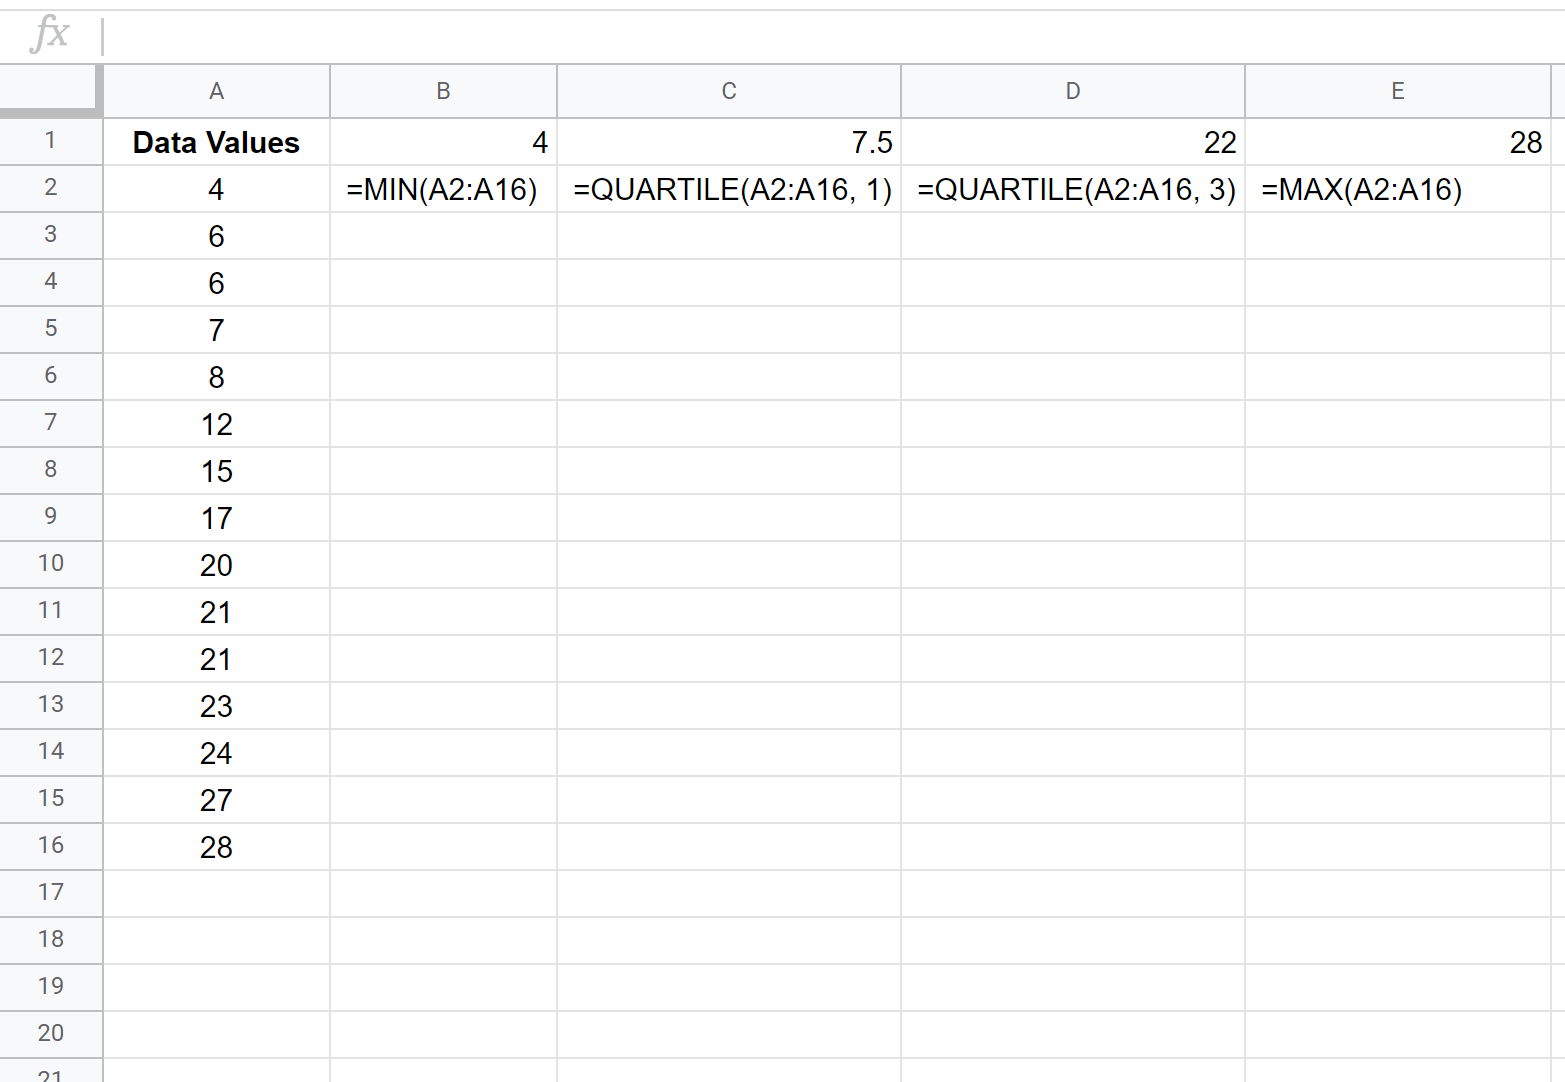
L’implémentation du graphique en chandeliers pour émuler une boîte à moustaches dans Google Sheets requiert une disposition matricielle extrêmement stricte. Contrairement aux visualisations univariées classiques qui opèrent directement sur une colonne verticale d’observations individuelles non agrégées, le moteur de rendu du graphique en chandeliers exige un tableau synthétique contenant obligatoirement cinq colonnes de données disposées dans un ordre séquentiel invariant.
Cette topologie contrainte s’organise selon la séquence linéaire suivante :
- Colonne 1 : Identifiant de catégorie (variable qualitative nominale définissant les groupes expérimentaux ou les conditions d’évaluation).
- Colonne 2 : Borne inférieure / Minimum (correspondant au cours le plus bas dans le modèle boursier, qui matérialisera l’extrémité de la moustache inférieure).
- Colonne 3 : Premier quartile (Q1) (assimilé au cours d’ouverture financière, qui délimite la frontière inférieure du corps de la boîte).
- Colonne 4 : Troisième quartile (Q3) (assimilé au cours de clôture financière, qui délimite la frontière supérieure du corps de la boîte).
- Colonne 5 : Borne supérieure / Maximum (correspondant au cours le plus haut dans le modèle financier, qui matérialisera l’extrémité de la moustache supérieure).
Toute inversion dans cet agencement séquentiel corrompt irrémédiablement le tracé géométrique du graphique. Si l’utilisateur permute par mégarde la position de Q1 et de Q3, Google Sheets interprétera le différentiel comme une régression baissière et modifiera la couleur de remplissage du corps de la boîte selon les paramètres financiers par défaut, annihilant la standardisation sémiotique de la boîte de Tukey.
3.3 Validation de la structure tabulaire
Afin de garantir la pérennité de la feuille de calcul lors de l’adjonction future de nouvelles cohortes de sujets, il est vivement recommandé d’appliquer des règles de validation des données à l’ensemble des plages matricielles. La fonctionnalité native de validation de Google Sheets (accessible via le menu Données > Validation des données) permet de contraindre les entrées manuelles à des intervalles numériques strictement bornés, empêchant l’apparition de valeurs négatives impossibles pour des échelles d’anxiété ou des temps de réaction qui doivent demeurer strictement positifs.
Une précaution ergonomique additionnelle consiste à figer systématiquement les lignes d’en-tête (via Affichage > Figer > 1 ligne). Lorsque les cohortes d’expérimentation intègrent plusieurs centaines de participants s’étirant sur de longues colonnes, cette fixation préserve la lisibilité immédiate de la structure relationnelle entre les données sources brutes et le tableau de synthèse dévolu au tracé graphique.
Enfin, l’expérimentateur vérifiera l’alignement typographique des valeurs au sein des cellules : les données numériques valides sont automatiquement alignées à droite par Google Sheets. La persistance d’un alignement spontané à gauche dans une cellule statistique doit agir comme un signal d’alerte visuel immédiat, révélant qu’une valeur est interprétée par le tableur comme un texte littéral et qu’elle sera, de facto, exclue du calcul des quartiles.
4. Calcul algorithmique des paramètres statistiques via les formules Google Sheets
4.1 Extraction des valeurs minimale et maximale
L’extraction dynamique des bornes absolues d’un ensemble de mesures quantitatives s’effectue au moyen des fonctions mathématiques natives élémentaires de Google Sheets. Pour déterminer la limite inférieure de la distribution d’une variable expérimentale stockée dans la plage B2:B101, la syntaxe canonique à mobiliser est la suivante :
=MIN(B2:B101)
Réciproquement, l’identification du plafond de distribution s’opère par l’invocation de la fonction réciproque :
=MAX(B2:B101)
L’intérêt capital de formuler ces calculs par voie algorithmique réside dans leur réactivité dynamique face à toute altération de la base primaire. Si une nouvelle mesure d’un participant est ultérieurement corrigée ou insérée dans la plage couverte, les valeurs minimales et maximales du tableau récapitulatif s’ajustent instantanément, sans qu’aucune manipulation humaine supplémentaire ne soit exigée. Pour prévenir les erreurs lors de l’adjonction de données sur des colonnes de taille indéterminée, il est parfaitement loisible d’utiliser des plages ouvertes telles que B2:B, Google Sheets ignorant spontanément les cellules vides subséquentes.
Toutefois, comme souligné dans l’analyse de l’anatomie de Tukey, si le chercheur souhaite borner ses moustaches non pas aux valeurs brutes extrêmes, mais aux limites protectrices conventionnelles de 1,5 fois l’IQR pour neutraliser visuellement les valeurs suspectes, ces cellules ne contiendront pas un simple MIN ou MAX, mais des formules imbriquées conditionnelles complexes que nous expliciterons dans les sections consacrées au traitement des données aberrantes.
4.2 Calcul précis des quartiles avec les variantes QUARTILE
Le traitement des percentiles au sein de Google Sheets nécessite une vigilance épistémologique aiguë en raison de la présence de plusieurs formulations logiques pour la fonction quartile. Historiquement, le tableur proposait la fonction standard QUARTILE, calquée sur les algorithmes initiaux de Microsoft Excel. Cependant, les versions contemporaines offrent deux implémentations mathématiquement distinctes : QUARTILE.INC et QUARTILE.EXC.
La distinction mathématique fondamentale repose sur le mode d’inclusion ou d’exclusion des percentiles extrêmes (0 et 1) :
- QUARTILE.INC (Inclusif) : Calcule les quartiles en postulant que l’intervalle de percentiles s’étend de 0 à 1 inclus. Le percentile d’ordre k s’obtient par interpolation linéaire entre les rangs ordonnés selon la formule
Rang = 1 + k * (N - 1). C’est l’algorithme traditionnel standard utilisé dans la majorité des sciences sociales et comportementales. - QUARTILE.EXC (Exclusif) : Exclut les percentiles 0 et 1 absolus de l’évaluation, positionnant l’intervalle de percentile entre
1 / (N + 1)etN / (N + 1), avec une formule de rang établie àRang = k * (N + 1). Cette variante est privilégiée par certains statisticiens théoriciens pour des échantillons issus de distributions continues infinies, mais elle échoue fréquemment si l’échantillon est trop restreint (en retournant une erreur#NUM!).
Pour demeurer en stricte adéquation avec les conventions de Tukey et les recommandations de publication académique, il est vivement préconisé d’utiliser expressément la variante inclusive. Pour extraire le premier quartile (Q1) et le troisième quartile (Q3) de notre plage de scores psychométriques B2:B101, nous saisirons respectivement :
=QUARTILE.INC(B2:B101; 1)
=QUARTILE.INC(B2:B101; 3)
Le second argument spécifie le rang ordinal du quartile sollicité (1 pour le 25e centile, 3 pour le 75e centile). La fonction applique une interpolation linéaire entre les scores réels si le rang calculé n’aboutit pas à un entier naturel strict, garantissant ainsi une continuité métrique parfaite de la boîte interquartile.
4.3 Calcul de la médiane et de l’écart interquartile
La tendance centrale non paramétrique doit impérativement être consignée dans le tableau de calculs préparatoires, quand bien même le graphique en chandeliers présente des limitations structurelles quant à son affichage direct. L’extraction de la valeur médiane s’effectue avec la fonction dédiée :
=MEDIANE(B2:B101)
Il est à noter que l’instruction alternative =QUARTILE.INC(B2:B101; 2) renvoie un résultat rigoureusement équivalent, la médiane n’étant autre que le deuxième quartile de la série ordonnée.
La quantification formelle de l’écart interquartile s’opère par une soustraction arithmétique élémentaire au sein d’une cellule dérivée. Si la valeur de Q1 a été calculée en cellule D2 et celle de Q3 en cellule E2, la formule s’établira sobrement comme :
=E2 - D2
Cette mesure de l’IQR ne sera pas injectée de manière brute dans l’une des cinq colonnes dévolues au tracé du chandelier (puisque le chandelier attend les positions absolues des quartiles et non la différence relative), mais elle servira de constante numérique fondamentale pour établir le diagnostic de symétrie de la distribution, calculer les seuils de Tukey pour l’identification des scores atypiques, et documenter le tableau d’accompagnement méthodologique indispensable à tout rapport empirique publiable.
5. La méthode du graphique en chandeliers comme boîte à moustaches alternative
5.1 Principe de transposition financière au contexte statistique
Pour contourner l’inexistence d’un objet graphique spécifiquement intitulé « Boîte à moustaches » au sein de la bibliothèque native de Google Sheets, l’analyste procède à une translation conceptuelle féconde en détournant les conventions du graphique boursier en chandeliers. Dans le monde du courtage et de l’analyse technique des marchés, une « bougie » (candlestick) vise à matérialiser en une silhouette unique les fluctuations d’un titre financier au cours d’une séance de négociation. Elle se compose d’un corps central rectangulaire et de deux extensions linéaires verticales dénommées « mèches » ou « ombres ».
La correspondance biunivoque entre les paramètres du marché financier et les indicateurs ordinaux du diagramme de Tukey s’établit avec une élégance structurelle totale :
- Le cours le plus bas (Low) correspond rigoureusement à la borne inférieure (minimum statistique ou extrémité de la moustache basse).
- Le cours d’ouverture (Open) est assigné au premier quartile (Q1), matérialisant l’arête basse du corps de la boîte interquartile.
- Le cours de clôture (Close) est assigné au troisième quartile (Q3), matérialisant l’arête haute du corps de la boîte interquartile.
- Le cours le plus haut (High) correspond rigoureusement à la borne supérieure (maximum statistique ou extrémité de la moustache haute).
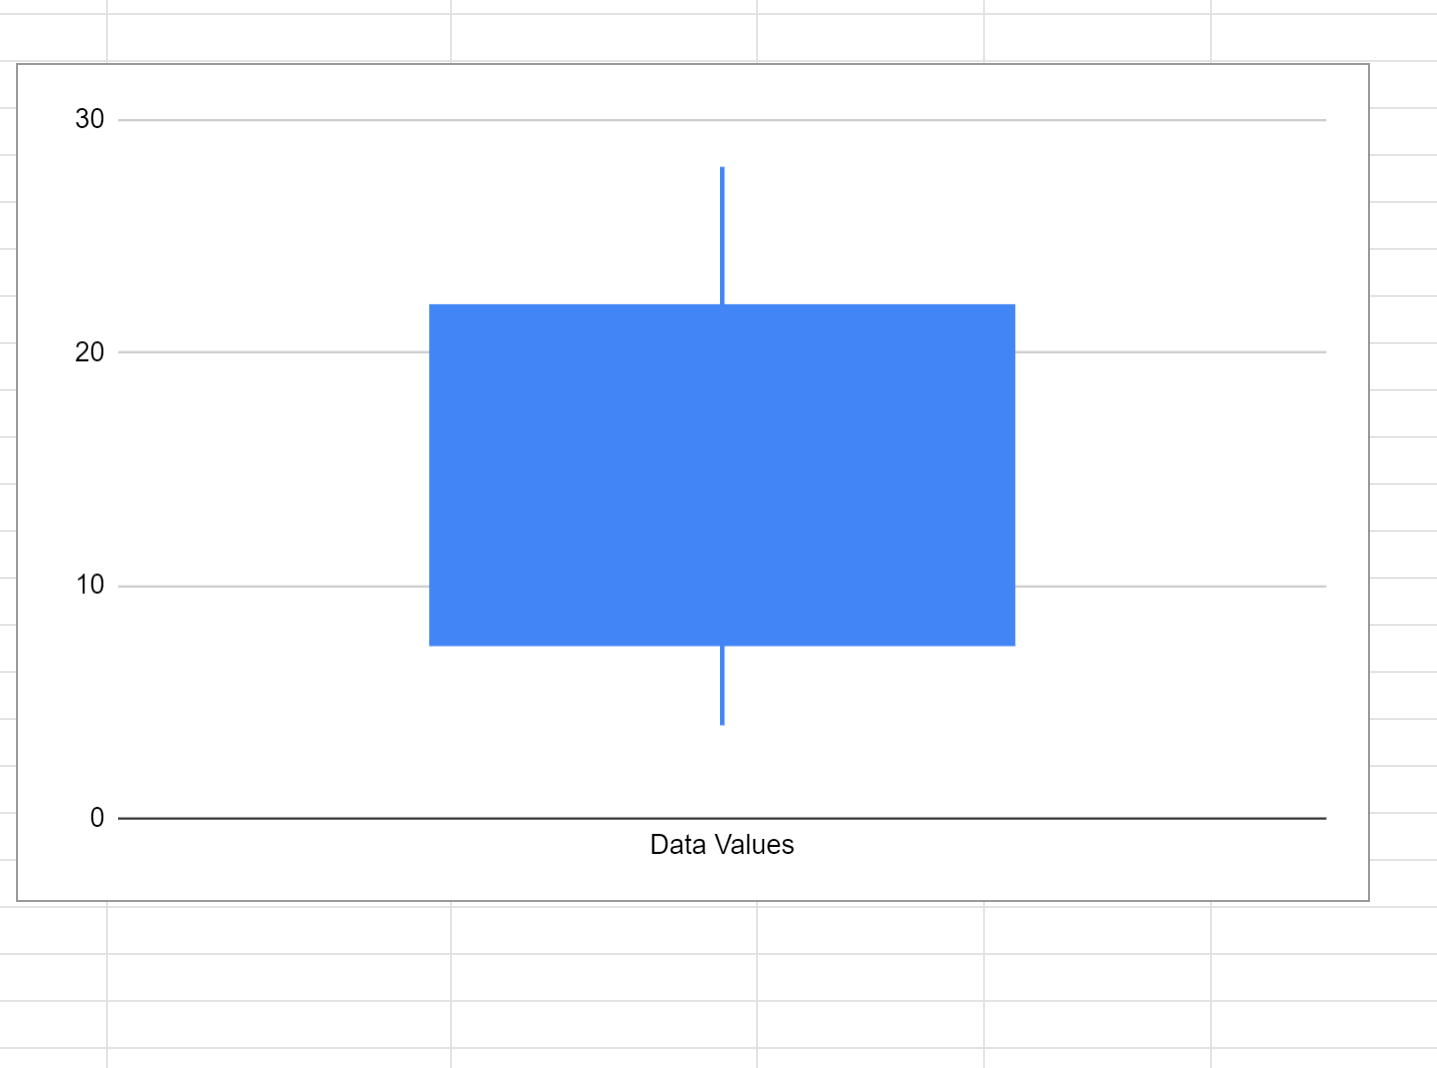
Par ce mécanisme d’équivalence géométrique, Google Sheets trace un parallélépipède dont la hauteur délimite très exactement la dispersion des 50 % d’observations centrales (l’écart interquartile), tandis que les segments filiformes verticaux s’étendent de part et d’autre pour rejoindre les valeurs extrêmes de l’échantillon. L’analyste obtient ainsi une simulation géométrique immaculée du diagramme de Tukey sans avoir eu besoin d’écrire une seule ligne de code complexe.
5.2 La question spécifique de l’affichage de la médiane
Cette émulation financière présente cependant une contrainte méthodologique majeure qu’aucun chercheur quantitatif ne saurait éluder : le chandelier japonais standard est structurellement conçu pour afficher quatre métriques (Bas, Ouverture, Clôture, Haut), et ne possède aucun mécanisme interne pour tracer un trait horizontal intermédiaire à l’intérieur du corps de la bougie afin de représenter la médiane empirique (Q2). Dans la modélisation financière, un tel niveau intermédiaire n’a pas de raison d’être, le corps étant simplement rempli ou évidé selon que la séance est haussière (Clôture > Ouverture) ou baissière.
Cette omission visuelle de la médiane constitue une régression par rapport aux canons stricts du diagramme de Tukey classique, dans lequel la médiane joue un rôle diagnostique fondamental pour évaluer la symétrie distributionnelle. Si l’objectif du graphique est purement exploratoire ou destiné à un rapport interne de screening de données, cette absence peut être tolérée en reportant la valeur numérique de la médiane dans le texte ou au sein d’un tableau récapitulatif adossé à la figure.
Pour des publications académiques formelles, les chercheurs recourent fréquemment à des stratégies palliatives. La première consiste à superposer, par voie de post-production vectorielle ou via un graphique combiné complexe à séries multiples, un point ou un tiret horizontal matérialisant précisément la coordonnée de la médiane. Une seconde alternative méthodologique implique d’annoter directement la valeur numérique de la médiane au-dessus de la boîte à l’aide des étiquettes de données, compensant ainsi la carence de la barre interne par une précision typographique accrue.
5.3 Alternative via les extensions ou scripts Google Apps Script
Pour les contextes où l’absence de la barre médiane s’avère rédhibitoire vis-à-vis des exigences d’un comité de lecture ou des standards éditoriaux de l’APA, la communauté des développeurs et statisticiens a conçu des alternatives programmatiques performantes exploitant le moteur Google Apps Script. En s’appuyant sur l’environnement JavaScript sous-jacent de Google Workspace, il est possible de scripter la génération d’un objet graphique personnalisé conforme à 100 % aux cinq barres standard de Tukey.
L’écriture d’un script personnalisé permet de faire appel à la bibliothèque externe Google Charts intégrée, laquelle intègre un type de graphique spécifiquement étiqueté BoxPlot au sein de ses composants de rendu HTML/SVG avancés. Le script peut extraire les données matricielles brutes, calculer en interne les cinq nombres (y compris la médiane exacte et les seuils d’aberration), et injecter dans une page web autonome ou un tableau de bord Google Sheets un diagramme vectoriel incorporant le trait médian et l’affichage individualisé des valeurs aberrantes sous forme de disques isolés.
Il existe également sur le Google Workspace Marketplace des modules complémentaires (add-ons) préconfigurés dédiés à l’analyse statistique avancée. Toutefois, ces extensions tierces introduisent souvent des dépendances logicielles externes, des problématiques potentielles de confidentialité des données médicales ou psychologiques hautement sensibles, et requièrent parfois des abonnements payants. L’arbitrage rationnel incite donc la plupart des chercheurs universitaires à privilégier l’émulation native par chandelier pour l’exploration fluide, et le recours à un script interne documenté lorsque la rigueur formelle de publication l’impose strictement.
6. Guide pas-à-pas : Génération de la boîte à moustaches dans Google Sheets
6.1 Sélection des plages de données et insertion de l’objet graphique
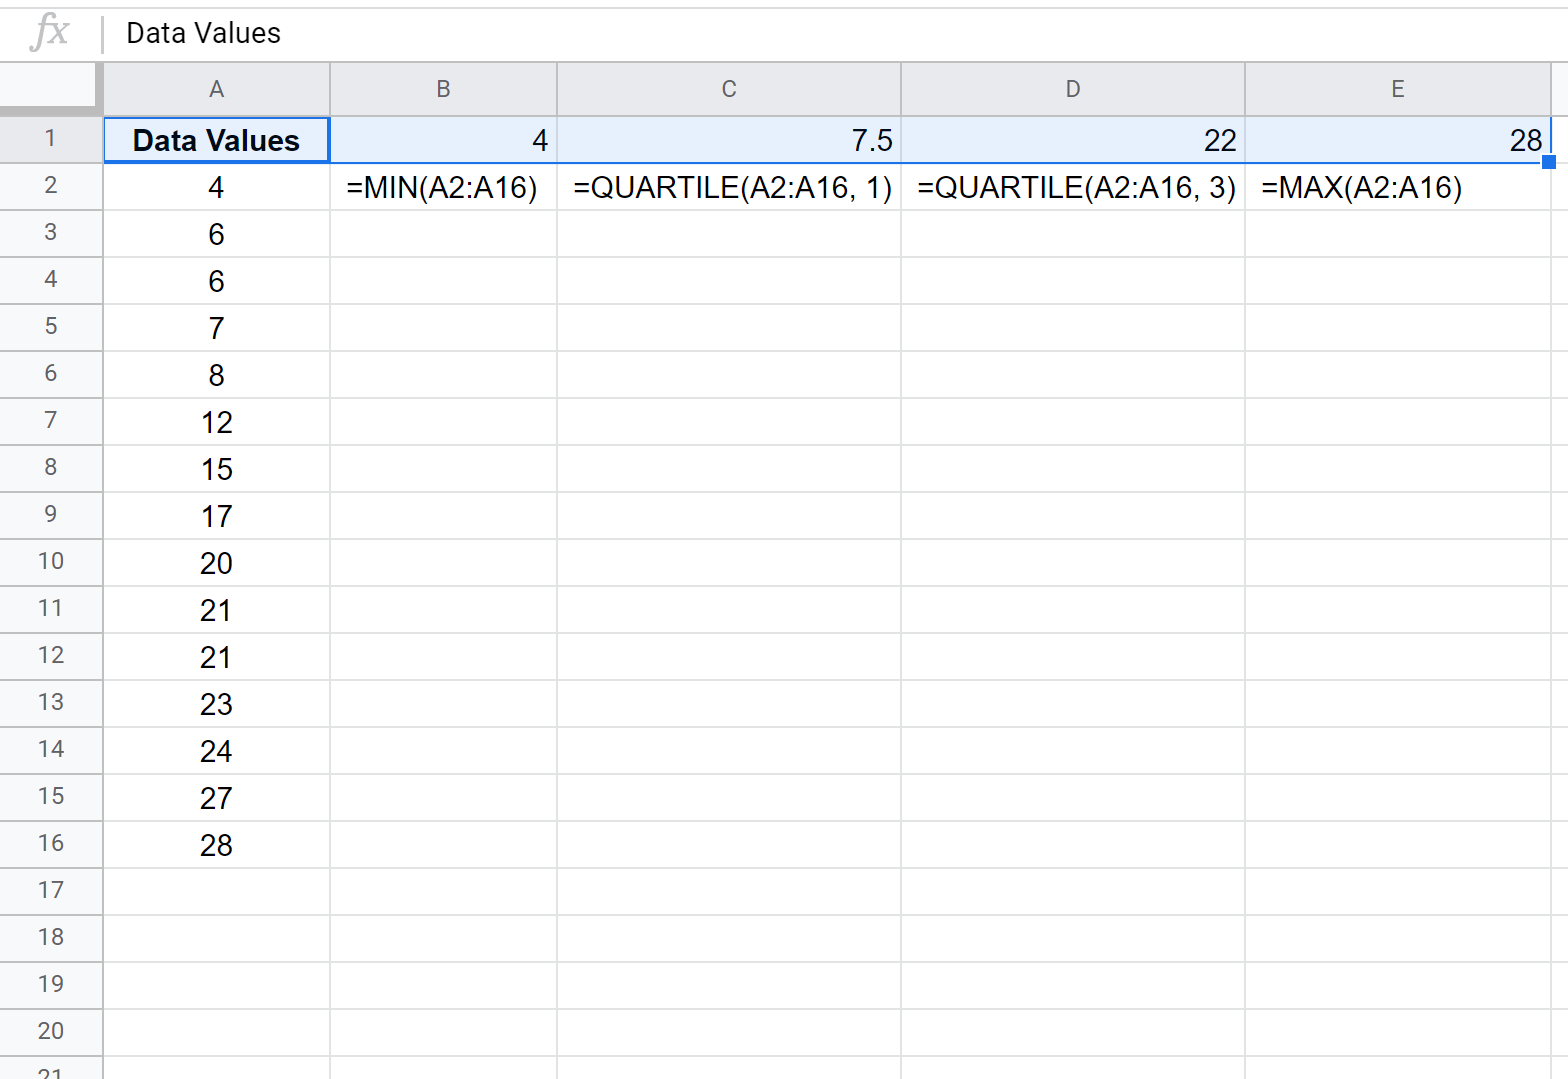
Pour matérialiser la boîte à moustaches dans votre feuille de calcul, la première étape opératoire requiert une sélection rigoureuse de la plage tabulaire préalablement construite. Positionnez le curseur de la souris sur la cellule supérieure gauche de votre tableau de synthèse (incluant impérativement les libellés d’en-tête, par exemple la cellule A1), maintenez le bouton enfoncé et étirez la zone de surbrillance jusqu’à la cellule inférieure droite contenant le maximum de votre dernier groupe expérimental (par exemple E4 si vous comparez trois cohortes).
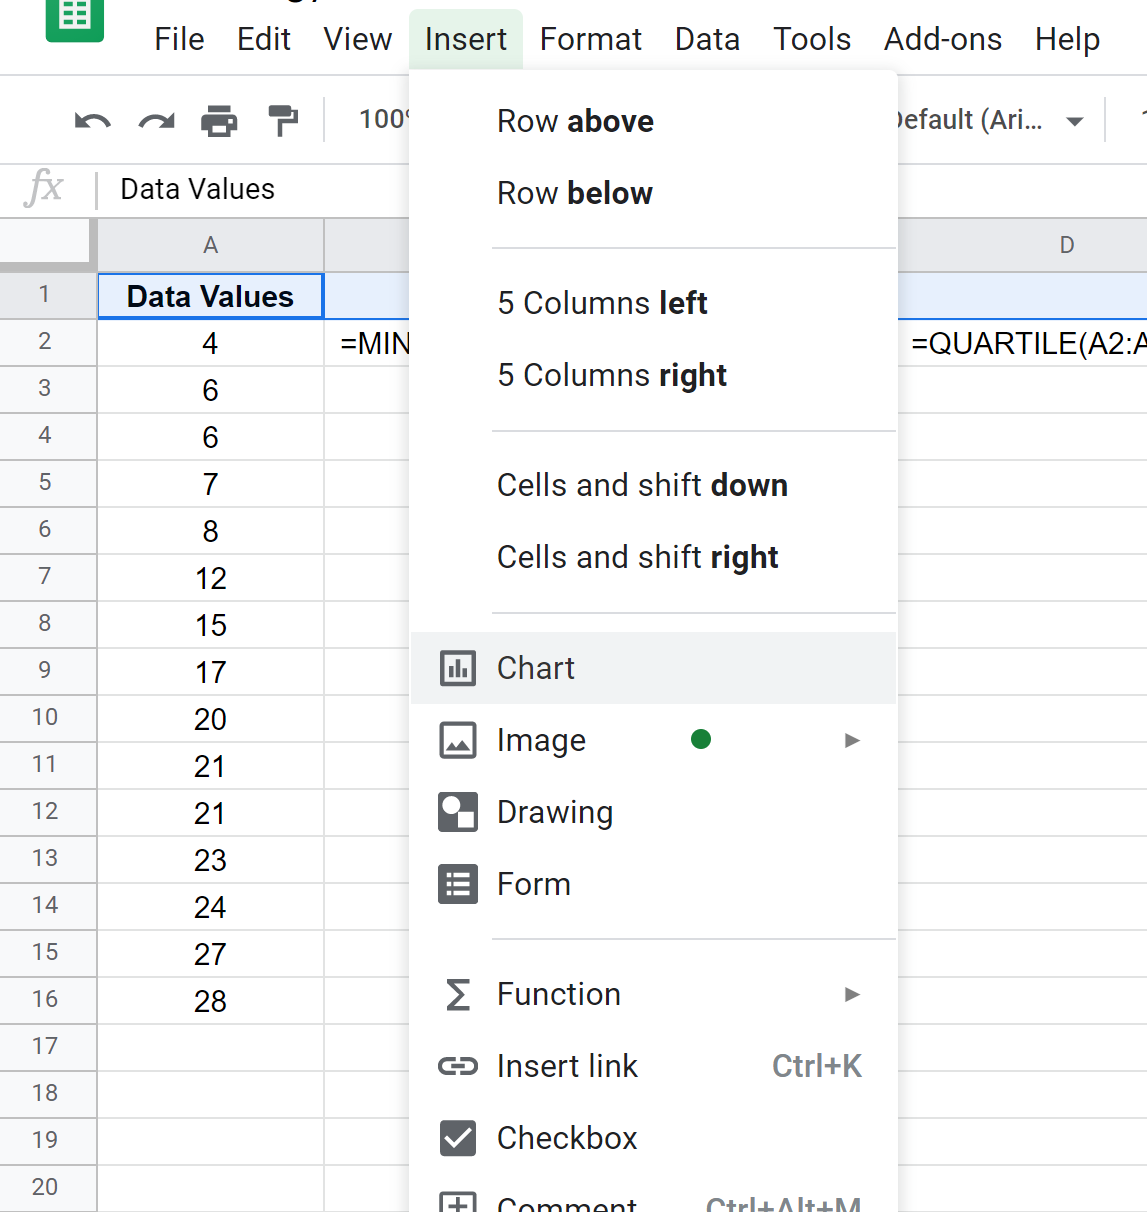
Une fois la matrice récapitulative sélectionnée, naviguez dans la barre d’outils supérieure de Google Sheets et cliquez sur le menu contextuel Insertion, puis sélectionnez l’option Graphique. Alternativement, vous pouvez cliquer directement sur l’icône représentant un histogramme stylisé située dans la barre d’outils d’accès rapide. À cet instant précis, Google Sheets déploie un volet latéral sur la droite de l’écran intitulé « Éditeur de graphiques » et insère un objet visuel par défaut au centre de la feuille de travail active.
Par défaut, l’intelligence contextuelle de Google Sheets tend souvent à générer un graphique en colonnes empilées ou un histogramme groupé, car il interprète les colonnes de chiffres comme des séries indépendantes. Il ne faut pas s’inquiéter de cette restitution visuelle initiale incohérente : l’ajustement structurel s’opère dans le sous-onglet de configuration de l’éditeur.
6.2 Configuration du type de graphique dans l’éditeur
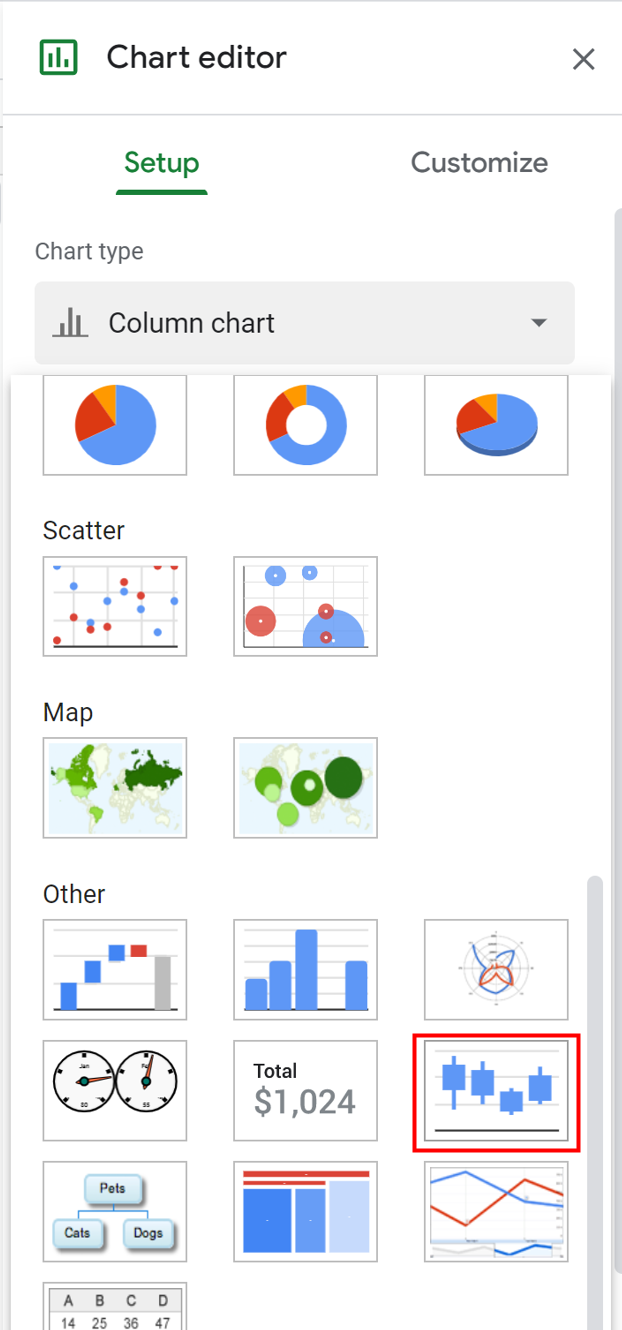
Au sein de l’Éditeur de graphiques situé dans la partie droite de votre interface, assurez-vous d’activer l’onglet Configurer. Cliquez sur le menu déroulant intitulé Type de graphique. Faites défiler la liste exhaustive des modèles visuels vers le bas, dépassez les sections réservées aux graphiques en courbes, en secteurs et en barres, jusqu’à atteindre la section intitulée Autres. Repérez et sélectionnez le pictogramme représentant quatre chandeliers financiers, formellement libellé Graphique en chandeliers.
Dès la sélection de ce modèle, l’interface de l’éditeur réorganise ses champs de mappage de données. Vous devez vérifier méticuleusement que chaque colonne correspond avec exactitude aux assignations mathématiques de votre distribution :
- Le champ Axe X doit pointer vers votre colonne d’identifiants qualitatifs (ex.
Condition_Experimentale). - Le champ Bas (Low) doit impérativement être alimenté par la colonne des Minima.
- Le champ Ouvrir (Open) doit être mappé avec la colonne du Premier Quartile (Q1).
- Le champ Fermer (Close) doit être assigné à la colonne du Troisième Quartile (Q3).
- Le champ Haut (High) doit recevoir la série des Maxima.
Assurez-vous également que les options Utiliser la ligne 1 comme en-têtes et Utiliser la colonne A comme libellés sont expressément cochées. Si la structure d’agencement semble inversée, veillez à décocher l’option Intervertir les lignes et les colonnes, sans quoi Google Sheets tenterait d’interpréter chaque point statistique comme une catégorie temporelle autonome.
6.3 Résolution immédiate des anomalies de génération
Lors de cette phase d’instanciation graphique, plusieurs erreurs d’affichage récurrentes peuvent survenir. L’anomalie la plus communément rencontrée réside dans l’apparition de bougies creuses ou colorées de façon asymétrique d’un groupe à l’autre. Dans la sémiologie financière de Google Sheets, si la valeur de « Fermeture » (Q3) est supérieure à la valeur d’« Ouverture » (Q1), le chandelier est considéré comme positif (souvent blanc ou vert). Si, suite à une faute de frappe ou une formule erronée, Q1 s’avère supérieur à Q3, le chandelier apparaît en plein sombre (rouge ou noir). Si vous observez une disparité de remplissage entre vos groupes d’étude, examinez immédiatement vos formules : une inversion arithmétique entre vos colonnes de quartiles en est systématiquement la cause.
Un autre dysfonctionnement fréquent prend la forme d’un graphique totalement vierge accompagné du message d’erreur laconique : « Données insuffisantes pour tracer le graphique ». Cette alerte se produit quasi systématiquement lorsque la plage de données définie dans l’éditeur englobe des cellules textuelles inattendues au sein des plages quantitatives, ou si l’ordre des colonnes a été perturbé lors de la sélection initiale. Vérifiez que votre plage ne contient que des scalaires numériques purs dans les colonnes 2 à 5.
Enfin, si les chandeliers apparaissent écrasés contre l’axe horizontal, formant de minces bandes imperceptibles, le problème provient d’une distorsion d’échelle verticale induite par la présence d’une valeur zéro artificielle ou d’un résidu métrique lointain. La résolution de ce déséquilibre visuel exige un recalibrage manuel des bornes de l’axe des ordonnées, manipulation détaillée dans la section suivante.
7. Personnalisation visuelle et mise en conformité avec les standards académiques
7.1 Épuration graphique selon les normes de publication APA
Les normes éditoriales de l’American Psychological Association (notamment formalisées dans le manuel APA 7th edition) imposent une sobriété visuelle exemplaire pour toute figuration de données statistiques. L’objectif cardinal est de maximiser le ratio « encre/données » théorisé par Edward Tufte, en éliminant impitoyablement tout artifice ornemental superflu (le fameux chartjunk) qui n’apporte aucune information empirique utile au déchiffrage cognitif du lecteur.
Pour épurer le graphique sous Google Sheets, basculez dans l’onglet Personnaliser de l’Éditeur de graphiques. Rendez-vous dans la section Quadrillage et graduations. Désactivez intégralement le Quadrillage principal et le Quadrillage secondaire sur l’axe vertical comme sur l’axe horizontal. Les fonds striés de lignes grises créent une interférence optique majeure qui réduit l’acuité avec laquelle l’œil humain compare les longueurs relatives des moustaches de Tukey.
Dans la section Style de graphique, appliquez un arrière-plan rigoureusement blanc pur (#FFFFFF) et supprimez la bordure externe du graphique en sélectionnant la couleur « Aucun » pour le contour. Bannissez formellement toute tentative d’application d’effets tridimensionnels (option 3D nativement proposée mais scientifiquement proscrite), car les projections en perspective altèrent géométriquement la perception des hauteurs de quartiles et falsifient la lecture quantitative des données.
En matière typographique, harmonisez l’ensemble des textes du graphique (titres, étiquettes d’axes, annotations numériques) en adoptant une police unique sans empattement hautement lisible, telle qu’Arial, Helvetica ou Calibri, ou une police avec empattement standardisée si votre manuscrit est rédigé sous Times New Roman. Veillez à ce que la taille de police minimale ne descende jamais en deçà de 10 points pour préserver une lisibilité parfaite lors des réductions d’échelle à l’impression.
7.2 Configuration rigoureuse des axes et de l’échelle
Le paramétrage des axes constitue le garant de l’honnêteté intellectuelle de la représentation graphique. Dans le volet Personnaliser, accédez au sous-menu Axe vertical. Par défaut, Google Sheets ajuste l’échelle de façon dynamique en fixant l’origine au zéro absolu, ce qui peut avoir pour effet de tasser dramatiquement les boîtes au sommet du cadran si votre échelle d’évaluation psychologique s’étend, par exemple, de 80 à 140 points de quotient intellectuel.
Pour restituer la pleine granularité de la dispersion sans pour autant induire d’illusion d’optique grossissante, fixez manuellement la Valeur minimale et la Valeur maximale de l’axe vertical légèrement en deçà et au-delà des bornes réelles observables de votre protocole expérimental. Si vos temps de réaction oscillent entre 350 et 850 millisecondes, calibrez l’axe vertical sur un intervalle strict de 300 à 900 ms. Précisez systématiquement l’unité de mesure au sein du titre de l’axe vertical (ex. « Temps de réaction latente (ms) » ou « Score d’anxiété standardisé (z-score) »).
Concernant l’Axe horizontal, veillez à ce que les libellés textuels des groupes expérimentaux ne soient jamais tronqués ou inclinés de façon oblique à 45 degrés si l’espace le permet. Une orientation horizontale stricte facilite la lecture séquentielle sans solliciter d’effort postural de la part de l’évaluateur. Si les intitulés de vos conditions expérimentales s’avèrent trop longs (ex. « Condition d’exposition à un stimulus acoustique aversif continu »), remplacez-les par des acronymes standardisés (ex. « CE-SAAC ») dont la signification détaillée sera explicitée dans la légende textuelle de la figure.
7.3 Ajout de titres informatifs et de légendes explicatives
L’académisme scientifique exige qu’une figure graphique soit conceptuellement autosuffisante : un chercheur doit être en mesure de décrypter l’intégralité du résultat représenté sans être contraint de se plonger dans le corps textuel de l’article pour identifier la nature des axes ou des échantillons examinés. Dans la section Titres du graphique et des axes, formulez un titre principal synthétique, précis et dénué d’emphase journalistique.
Le titre doit formaliser de manière explicite la relation sous étude, la variable dépendante mesurée et les groupes comparés (par exemple : « Distribution des scores d’anxiété préopératoire (STAI-Y) en fonction du protocole de relaxation préopératoire »). Il est fortement recommandé d’intégrer un sous-titre apportant une précision méthodologique capitale sur l’échantillonnage, notamment l’effectif global et la cohorte concernée (ex. « Échantillon clinique adulte randomisé, N = 120 »).
Une note de bas de graphique doit impérativement accompagner le diagramme lorsqu’il est exporté pour un manuscrit de recherche. Cette note textuelle (placée immédiatement sous la figure) doit lever toute ambiguïté quant à l’anatomie choisie pour les moustaches :
« Note : Le corps de la boîte représente l’écart interquartile (Q1-Q3) ; les moustaches verticales délimitent les scores minimaux et maximaux observés au sein de chaque condition expérimentale. »
Cette précision technique est indispensable pour dissiper tout quiproquo avec un diagramme d’erreur classique matérialisant des erreurs-types ou des intervalles de confiance à 95 %.
8. Détection, modélisation et gestion des valeurs aberrantes (Outliers)
8.1 Formalisation mathématique du critère de Tukey
L’un des apports méthodologiques les plus remarquables de John Tukey à la statistique exploratoire réside dans sa formulation objective et probabiliste du repérage des observations singulières, désignées dans la littérature sous le terme d’outliers ou valeurs aberrantes. Contrairement aux approches intuitives ou subjectives qui consistent à écarter arbitrairement un point « qui semble trop éloigné », Tukey a formalisé un critère arithmétique strict fondé sur l’étirement relatif de l’écart interquartile.
Pour toute distribution continue, Tukey définit deux seuils critiques nommés « barrières » ou « clôtures » (fences) :
- Barrière intérieure inférieure :
Q1 - (1,5 * IQR) - Barrière intérieure supérieure :
Q3 + (1,5 * IQR)
Toute observation empirique qui se positionne au-delà de ces barrières intérieures est qualifiée de valeur aberrante modérée. Sur le plan théorique, si la distribution sous-jacente suit parfaitement une loi normale, la probabilité qu’une observation franchisse spontanément ce seuil par simple fluctuation d’échantillonnage n’est que d’environ 0,7 % (soit approximativement une observation sur 140). Lorsque la distance excède trois fois l’écart interquartile (Q1 - 3 * IQR ou Q3 + 3 * IQR), la donnée est étiquetée comme valeur aberrante extrême, sa survenue spontanée sous l’hypothèse de normalité devenant statistiquement infinitésimale (environ un cas sur un million).
8.2 Implémentation d’une colonne de détection conditionnelle
Pour systématiser l’identification de ces observations atypiques au sein d’une feuille de calcul Google Sheets, il est particulièrement élégant de construire une colonne logique dédiée à côté de vos données brutes. Supposons que vos mesures d’anxiété soient consignées dans la colonne B (de B2 à B101), et que vous ayez consigné la valeur calculée de Q1 en cellule $F$2 et celle de Q3 en cellule $G$2. L’écart interquartile s’obtient alors par ($G$2 - $F$2).
Dans la colonne C, adjacente à la première observation, nous pouvons injecter une formule logique exploitant les fonctions combinées SI et OU :
=SI(OU(B2 < ($F$2 - 1,5 * ($G$2 - $F$2)); B2 > ($G$2 + 1,5 * ($G$2 - $F$2))); "ABERRANTE"; "CONFORME")
En étirant cette formulation conditionnelle sur l’ensemble de la plage d’expérimentation, Google Sheets étiquette instantanément et sans ambiguïté chaque observation individuelle. Pour décupler l’efficacité du contrôle qualité visuel, appliquez une règle de Mise en forme conditionnelle sur la colonne des données brutes : configurez un formatage automatique colorant la cellule en rouge pâle dès lors que la cellule adjacente affiche la chaîne textuelle « ABERRANTE ».
Sur le plan méthodologique, la mise en évidence d’une valeur aberrante ne confère aucunement une légitimité automatique à sa suppression pure et simple de la base de données de recherche. Le chercheur doit mener une enquête épistémologique : s’agit-il d’une erreur de codage manifeste, d’une défaillance matérielle d’un capteur physiologique, ou d’une véritable singularité psychologique d’un participant qui reflète la variabilité authentique de la population générale ? L’exclusion aveugle de données valides constitue une pratique de recherche discutable (Questionable Research Practice) qui vicie artificiellement la variance empirique.
8.3 Représentation visuelle des valeurs aberrantes dans Google Sheets
C’est ici que se manifeste la limite structurelle la plus préjudiciable du graphique en chandeliers utilisé comme ersatz de boîte à moustaches. Dans le chandelier standard, la mèche supérieure s’étire nécessairement jusqu’au sommet de la série assignée au paramètre « Haut » (High). Si vous laissez le maximum absolu dans cette colonne, la mèche absorbera visuellement la valeur aberrante, donnant l’impression trompeuse d’une queue de distribution étirée mais continue, sans individualiser le point singulier disjoint préconisé par Tukey.
Pour surmonter cet obstacle technique tout en restant dans l’environnement Google Sheets, l’analyste rigoureux emploie une technique de dissociation statistique :
- Dans le tableau récapitulatif servant à tracer le chandelier, remplacez le calcul du
MAXpar la valeur de la plus haute observation non aberrante (c’est-à-dire le maximum des valeurs situées sous la barrièreQ3 + 1,5 * IQR). Faites de même pour le paramètre « Bas » en retenant la plus basse observation non aberrante. Les moustaches du chandelier représenteront ainsi fidèlement les bornes de Tukey classiques. - Pour matérialiser visuellement les scores atypiques rejetés au-delà des moustaches, créez une série de données additionnelle configurée sous la forme d’un nuage de points superposé au graphique principal. Chaque point aberrant sera ainsi figuré sous la forme d’un cercle ou d’une croix isolée flottant au-dessus ou en dessous des mèches du chandelier.
Si la complexité de cette superposition graphique s’avère trop lourde à administrer dans Google Sheets pour un rapport exploratoire rapide, le chercheur a le devoir d’accompagner impérativement sa figure d’une note de bas de page exhaustive répertoriant explicitement l’identifiant des sujets aberrants, leur valeur numérique exacte, et la décision statistique prise à leur égard (maintien ou exclusion des tests inférentiels ultérieurs).
9. Comparaison intergroupes : Conception de boîtes à moustaches multiples
9.1 Organisation des données pour protocoles factoriels
L’immense majorité des devis de recherche en sciences quantitatives ne se limite pas à l’analyse univariée d’une cohorte isolée, mais implique la comparaison structurelle de multiples groupes d’individus soumis à des manipulations expérimentales distinctes ou répartis selon des variables d’assignation démographiques ou cliniques. Pour exécuter une comparaison intergroupes rigoureuse sous Google Sheets, l’organisation matricielle des résumés à cinq nombres doit être scrupuleusement agencée de manière séquentielle.
La structuration matricielle impose une disposition ligne par ligne, où chaque ligne de synthèse représente un niveau de la variable indépendante inter-sujets. Considérons un protocole factoriel évaluant les effets de trois posologies d’une molécule nootropique sur la mémoire de travail (Placebo, Dose Faible, Dose Forte) combinées au facteur Sexe (Femmes, Hommes). Le tableau préparatoire dans Google Sheets prendra la forme d’une table à 6 lignes statistiques et 5 colonnes de paramètres :
- Ligne 1 : En-têtes (
Groupe,Minimum,Q1,Q3,Maximum) - Ligne 2 : Placebo_Femmes
- Ligne 3 : Placebo_Hommes
- Ligne 4 : Faible_Femmes
- Ligne 5 : Faible_Hommes
- Ligne 6 : Forte_Femmes
- Ligne 7 : Forte_Hommes
Dans le cas d’un protocole intra-sujets (mesures répétées longitudinales de type Pré-test versus Post-test sur un groupe unique), la même rigueur tabulaire s’applique : chaque condition temporelle constitue une ligne distincte au sein de la matrice récapitulative, permettant au moteur de chandeliers d’aligner les boîtes chronologiques le long d’une échelle horizontale partagée.
9.2 Homogénéisation visuelle des échelles intergroupes
L’un des pièges méthodologiques les plus pernicieux lors de la comparaison intergroupes réside dans la fragmentation visuelle ou l’incohérence d’échelle. Dans Google Sheets, il est impératif que l’ensemble des conditions expérimentales comparées soit intégré au sein d’un unique objet graphique partageant le même axe vertical d’ordonnées. Générer des graphiques séparés pour chaque groupe expérimental constitue une grave erreur ergonomique, car le redimensionnement automatique propre à chaque fenêtre graphique masque les différences réelles de niveau moyen ou de variance.
Pour assurer une ségrégation cognitive immédiate entre les cohortes lors de la lecture d’un protocole factoriel complexe, l’analyste peut moduler l’espacement et la différenciation chromatique. Bien que l’éditeur de chandeliers de Google Sheets n’offre pas une palette de personnalisation couleur aussi fine boîte par boîte que des logiciels de programmation statistique purs, il est possible d’ajuster la densité des chandeliers en calibrant la largeur des colonnes dans le menu Personnaliser > Chandelier.
Veillez à ce que l’axe horizontal soit dimensionné avec suffisamment d’ampleur pour éviter tout chevauchement typographique des libellés de groupes. Si l’espace s’avère restreint, utilisez une nomenclature codifiée normalisée (ex. « Ctrl-T0 », « Ctrl-T1 », « Exp-T0 », « Exp-T1 ») dont la matrice de décodage sera systématiquement formalisée dans la légende méthodologique d’accompagnement.
9.3 Évaluation comparative directe de la variance et de l’asymétrie
L’affichage juxtaposé de boîtes à moustaches multiples transcende la simple présentation descriptive : il autorise un diagnostic visuel direct des postulats statistiques fondamentaux nécessaires à l’inférence ultérieure. La première propriété constatable d’un coup d’œil est l’homoscédasticité (l’homogénéité des variances entre les groupes), qui constitue le postulat d’application cardinal des analyses de variance (ANOVA) et des tests t de Student.
Sur le plan géométrique, l’homoscédasticité se traduit par une hauteur rigoureusement comparable des corps de boîtes (IQR) et une amplitude similaire de la portée des moustaches sur l’ensemble des chandeliers juxtaposés. Si l’observateur constate qu’un groupe expérimental présente une boîte trois fois plus haute que le groupe témoin, l’hypothèse de variance constante est manifestement violée (hétéroscédasticité). Cette observation précoce oriente immédiatement le statisticien vers des corrections appropriées (telles que le test de Welch) ou vers des modèles statistiques non paramétriques (test de Kruskal-Wallis).
De surcroît, la comparaison intergroupes révèle instantanément les effets de traitement structurels. Un décalage spatial franc de l’ensemble du corps d’un chandelier par rapport à un autre, sans chevauchement des boîtes centrales, témoigne d’une taille d’effet substantielle provoquée par l’intervention expérimentale. Enfin, si un groupe manifeste une asymétrie marquée (médiane plaquée contre une extrémité de la boîte) alors que les autres présentent une parfaite symétrie centrale, cette discordance morphologique alerte sur une réaction différentielle des sujets au traitement, invitant à rechercher d’éventuels sous-groupes de répondeurs au sein de la cohorte.
10. Interprétation statistique et psychologique avancée des diagrammes
10.1 Diagnostic de la forme de la distribution
L’interprétation clinique ou comportementale d’une boîte à moustaches exige une lecture sémiotique raffinée de ses proportions spatiales. La configuration géométrique du diagramme offre un diagnostic visuel immédiat de la symétrie ou de l’asymétrie (skewness) de la distribution empirique :
- Distribution symétrique (mésocurtique / normale) : La médiane empirique se positionne au centre géométrique exact de la boîte interquartile (distance
Q2 - Q1égale à la distanceQ3 - Q2). Parallèlement, les moustaches supérieure et inférieure arborent une longueur rigoureusement identique, traduisant une décroissance homogène des fréquences de part et d’autre du centre de gravité. - Asymétrie positive (étalement vers la droite / vers les valeurs hautes) : La médiane se trouve comprimée vers la base de la boîte, à proximité immédiate de Q1. Le rectangle supérieur (entre la médiane et Q3) est nettement plus allongé que le rectangle inférieur, et la moustache supérieure présente une envergure substantiellement plus vaste que la moustache inférieure. Ce profil est emblématique des temps de réaction chronométriques, des seuils de détection sensorielle ou des échelles de consommation de substances addictives.
- Asymétrie négative (étalement vers la gauche / vers les valeurs basses) : La médiane est accolée au sommet de la boîte, contre Q3. C’est ici le rectangle inférieur et la moustache basse qui s’étirent de façon disproportionnée. Ce schéma est couramment observé lors d’épreuves cognitives faciles révélant un effet de plafond massif, où la vaste majorité des participants frôle la note maximale d’évaluation.
Cette lecture morphologique permet au psychométricien de juger instantanément de l’adéquation d’un instrument de mesure : un test psychologique censé discriminer les individus sur l’ensemble d’un continuum d’aptitude ne devrait jamais produire de distributions fortement asymétriques au sein d’une population saine standard.
10.2 Inférence statistique préliminaire basée sur le chevauchement
Bien que la boîte à moustaches soit formellement un outil descriptif et exploratoire, elle fournit une base d’inférence visuelle intuitive précieuse pour anticiper le résultat des tests d’hypothèses formels. Une règle heuristique couramment enseignée stipule que si les boîtes interquartiles de deux groupes expérimentaux indépendants ne présentent aucun chevauchement vertical (c’est-à-dire que le premier quartile du groupe supérieur est strictement supérieur au troisième quartile du groupe inférieur), il existe une probabilité extrêmement élevée que la différence intergroupe atteigne le seuil conventionnel de significativité statistique (p < .05).
Il importe toutefois de dissiper une confusion théorique fréquente chez les apprentis chercheurs : un chevauchement des boîtes de Tukey n’est pas équivalent à un chevauchement d’intervalles de confiance (IC à 95 %). L’intervalle interquartile capture la dispersion de 50 % des observations individuelles brutes de l’échantillon, tandis que l’intervalle de confiance encadre la précision de l’estimateur de la moyenne de la population, qui dépend intimement de la racine carrée de la taille de l’échantillon (N). Par conséquent, même si deux boîtes à moustaches se chevauchent modérément, un test d’hypothèse inférentiel (test t ou ANOVA) peut parfaitement s’avérer hautement significatif si la taille de l’échantillon analysé est suffisamment conséquente pour conférer une grande puissance statistique au protocole.
La boîte à moustaches doit donc être appréhendée comme un guide d’exploration pré-analytique. Elle permet au chercheur d’orienter sereinement ses choix de modélisation mathématique : si les distributions sont symétriques et homoscédastiques, l’analyse paramétrique classique conserve toute sa validité ; si les boîtes trahissent de fortes asymétries et des variances discordantes, l’orientation vers des tests de rangs non paramétriques (Wilcoxon-Mann-Whitney) ou des méthodes de rééchantillonnage (bootstrap) s’impose de manière impérieuse.
10.3 Mises en garde méthodologiques quant aux fausses interprétations
En dépit de son extraordinaire puissance synthétique, le diagramme de Tukey recèle des pièges d’interprétation méthodologiques que tout analyste quantitatif chevronné se doit de garder à l’esprit. L’angle mort le plus critique réside dans l’incapacité structurelle de la boîte à moustaches à déceler la bimodalité ou la multimodalité d’une distribution de données. Une distribution bimodale symétrique (par exemple, un groupe composé de deux sous-populations distinctes présentant des modes séparés mais équidistants) générera exactement la même boîte à moustaches qu’une distribution unimodale parfaitement gaussienne.
Pour parer à cette illusion de régularité, il est indispensable de ne jamais considérer la boîte à moustaches comme un substitut absolu à l’histogramme de fréquences ou au tracé d’estimation de densité par noyau (Kernel Density Estimation). En phase de diagnostic initial, associer une boîte à moustaches à un graphique de violon (violin plot) ou à un nuage de points individuel (strip plot) garantit qu’aucun creux de densité latent n’est occulté par la simplification ordinale du résumé à cinq nombres.
Une seconde dérive interprétative réside dans l’illusion de précision sur des échantillons d’effectifs squelettiques. Générer une boîte à moustaches sur une série de moins de 10 ou 15 observations n’a aucun sens statistique : le calcul des quartiles sur de si petits échantillons repose sur des extrapolations ordonales instables, et la boîte renvoie une fausse impression de régularité robuste. En dessous de ce seuil numérique minimal, la seule figuration honnête et scientifiquement recommandable demeure la représentation intégrale et brute de chaque observation individuelle sous la forme d’un graphique de dispersion transparent.
11. Dépannage méthodologique et résolution des erreurs courantes
11.1 Gestion des messages d’erreur et des graphiques vides
L’exploitation de Google Sheets pour générer des visualisations techniques complexes se heurte fréquemment à des messages d’anomalie logicielle déroutants. Le phénomène le plus classique est le traçage d’un canevas blanc totalement vide à l’emplacement du graphique, souvent couplé au message « Impossible de tracer le graphique pour les données sélectionnées ». Cette panne découle presque invariablement d’une contamination de la plage de calcul par des caractères non numériques.
Pour remédier à cette situation, inspectez immédiatement la plage tabulaire de synthèse. La présence d’une seule cellule affichant un code d’erreur statistique tel que #VALEUR!, #DIV/0! ou #NUM! au sein de vos colonnes de résumés bloque instantanément l’intégralité du moteur de rendu des chandeliers. L’erreur #NUM! survient généralement lors de l’emploi imprudent de la fonction QUARTILE.EXC sur un échantillon trop restreint où le rang calculé excède les bornes autorisées de l’algorithme exclusif. La substitution immédiate par QUARTILE.INC résout systématiquement cette anomalie algorithmique.
Une autre source d’inhibition graphique résulte d’un conflit lors de la sélection des axes dans l’éditeur. Si le tableur tente obstinément de lire vos données horizontalement au lieu de les interpréter verticalement, ouvrez l’éditeur de graphique, naviguez dans l’onglet Configurer, et vérifiez l’état de la case à cocher Intervertir les lignes et les colonnes. Forcer la bascule de ce commutateur restaure généralement la verticalité des chandeliers financiers.
11.2 Problèmes de formatage des données chiffrées
Dans un contexte de collaboration internationale ou lors de l’importation de fichiers .csv générés par des instruments psychophysiologiques paramétrés en langue anglaise, la gestion des séparateurs décimaux constitue une source intarissable de corruption des calculs. Le monde francophone utilise historiquement la virgule comme délimiteur décimal (ex. 12,54), tandis que les standards computationnels anglo-saxons mobilisent le point décimal (ex. 12.54).
Si vous collez des données chiffrées formatées avec des points au sein d’une feuille Google Sheets dont les paramètres régionaux sont configurés sur la France ou la Belgique, le tableur sera incapable d’interpréter ces chaînes comme des scalaires arithmétiques : il les convertira silencieusement en chaînes de texte brut. Dès lors, vos formules MIN, MAX ou QUARTILE renverront la valeur 0 ou ignoreront purement et simplement ces observations, générant des chandeliers complètement tronqués.
Pour résoudre structurellement ce dysfonctionnement, deux approches sont envisageables :
- Accéder aux paramètres de la feuille de calcul via Fichier > Paramètres, et modifier le paramètre régional en sélectionnant Royaume-Uni ou États-Unis, harmonisant ainsi le moteur de calcul avec vos données d’extraction anglophones.
- Si vous préférez maintenir la régionalisation francophone, utilisez la fonction native Édition > Rechercher et remplacer pour substituer globalement tous les points décimaux par des virgules décimales sur votre colonne de données primaires avant de relancer les algorithmes quartilaires.
11.3 Distorsions visuelles involontaires
L’honnêteté de la transmission scientifique exige d’éviter toute distorsion géométrique induite par un dimensionnement arbitraire de l’objet graphique au sein de la grille du tableur. Par défaut, l’utilisateur a la possibilité d’étirer librement la fenêtre graphique à l’aide des poignées de redimensionnement de la souris. Un étirement horizontal excessif compresse artificiellement la hauteur des chandeliers, minimisant visuellement la variance apparente des groupes expérimentaux. À l’inverse, un étirement vertical disproportionné amplifie dramatiquement les plus infimes déviations d’échelles, donnant une impression de divergence colossale là où les écarts réels sont statistiquement négligeables.
Il est préconisé de respecter un ratio d’aspect géométrique standardisé (idéalement proche du ratio d’or 4:3 ou du format panoramique équilibré 16:9) et de calibrer l’axe vertical des ordonnées de telle manière que l’intervalle interquartile global occupe approximativement le tiers central de la hauteur totale du cadran. Cette proportion géométrique prévient toute lecture biaisée et préserve l’intégrité perceptive de l’évaluateur.
Prenez également garde à la troncature aveugle des moustaches causée par une borne maximale d’axe vertical configurée trop bas. Si votre maximum empirique atteint 98 points et que vous fixez manuellement le plafond de l’axe à 90 pour zoomer sur la boîte, Google Sheets ne tronquera pas simplement la ligne : il peut purement et simplement refuser de dessiner le chandelier concerné ou couper la mèche de manière invisible, induisant le lecteur en erreur sur l’étendue réelle de la variabilité extrême observée au laboratoire.
12. Exportation, intégration aux rapports de recherche et reproductibilité
12.1 Exportation vectorielle et matricielle haute résolution
Une fois votre boîte à moustaches parfaitement configurée, épurée selon les normes académiques et vérifiée sur le plan statistique, se pose la question cruciale de son extraction hors de l’écosystème Google Sheets en vue de son insertion au sein d’un manuscrit de recherche soumis pour publication ou d’un mémoire universitaire. Pour garantir une qualité typographique irréprochable, le choix du format d’exportation revêt une dimension stratégique.
Cliquez sur l’icône matérialisée par trois points verticaux située dans le coin supérieur droit de votre graphique pour faire apparaître le menu des options d’objet. Déroulez le sous-menu Télécharger. Google Sheets met à disposition trois formats d’exportation :
- Document PDF (.pdf) : Format vectoriel universel à privilégier absolument si votre rapport est composé sous des systèmes de composition professionnels tels que LaTeX. Le tracé vectoriel préserve une netteté absolue, les lignes des chandeliers et les polices de caractères conservant une précision infinie sans aucune pixellisation, quelle que soit la mise à l’échelle appliquée par l’éditeur.
- Graphismes vectoriels adaptables (.svg) : Format vectoriel ouvert idéal si vous devez procéder à une post-production graphique sous un logiciel d’illustration vectorielle spécialisé (tel qu’Adobe Illustrator ou Inkscape), par exemple pour insérer manuellement le trait horizontal de la médiane ou ajouter des accolades d’acuité statistique (* p < .05).
- Image PNG (.png) : Format matriciel standard recommandé pour les logiciels de traitement de texte courants comme Microsoft Word ou LibreOffice Writer. Assurez-vous d’agrandir substantiellement la fenêtre du graphique dans Google Sheets avant de lancer l’exportation PNG afin d’obtenir une matrice de pixels d’une densité résolutive suffisante (idéalement supérieure à 300 DPI à l’impression).
Si vous rédigez votre manuscrit directement au sein de l’environnement infonuagique Google Docs ou concevez une présentation sous Google Slides, ne passez pas par une exportation statique de fichiers intermédiaires. Utilisez la commande native Insertion > Graphique > À partir de Sheets. Cette passerelle technique préserve un lien dynamique permanent : toute correction apportée ultérieurement à votre feuille de données brutes affichera un bouton interactif « Mettre à jour » dans votre manuscrit Google Docs, actualisant instantanément la figure sans exiger de nouvelle manipulation d’importation.
12.2 Rédaction scientifique des légendes selon les standards académiques
L’intégration d’une figure au sein d’un article scientifique soumis aux comités de lecture des revues internationales de psychologie ou de neurosciences comportementales ne tolère aucune approximation dans la formalisation de sa légende textuelle. Selon les préceptes de l’APA 7th edition, la légende se structure en trois éléments séquentiels rigoureusement ordonnés : le numéro formel de la figure en gras (ex. Figure 1), le titre descriptif de la figure en italique, suivi du paragraphe explicatif technique.
Voici un modèle rédactionnel académique parfait pour documenter une boîte à moustaches générée via la méthode développée dans ce guide :
Figure 1
Distribution des latences de réponse motrice lors de la tâche d’attention soutenue en fonction de la condition de privation de sommeil
Note. Le rectangle central délimite l’écart interquartile (25e centile inférieur, 75e centile supérieur). Les moustaches verticales délimitent les scores minimaux et maximaux empiriques observés au sein de chaque cohorte expérimentale. Les paramètres statistiques de position ont été estimés via l’algorithme inclusif QUARTILE.INC au sein de l’environnement Google Sheets. L’échantillon comprend N = 45 participants par condition (Cohorte totale N = 135). * p < .05, ** p < .01.
Il est impératif de stipuler explicitement la nature de l’algorithme d’interpolation quartilaire mobilisé lorsque des progiciels de tableurs sont employés, car les légères variations d’estimation d’un logiciel à l’autre (notamment entre SAS, SPSS, R type 7 et les fonctions Excel/Sheets) peuvent modifier marginalement les coordonnées des percentiles sur des cohortes de taille modeste.
12.3 Archivage des feuilles de calcul et science ouverte
Dans le sillage du mouvement planétaire pour la science ouverte (Open Science) et la crise de réplicabilité qui a profondément interrogé les méthodologies en sciences humaines et biomédicales, les revues savantes exigent de plus en plus fréquemment la mise à disposition publique des données sources brutes et des protocoles computationnels ayant servi à l’élaboration des figures et des synthèses quantitatives.
Pour ériger votre feuille de calcul Google Sheets en artefact de recherche scientifiquement reproductible, plusieurs démarches déontologiques s’imposent :
- Anonymisation stricte : Purgez méticuleusement votre base de toute donnée à caractère personnel identifiable (noms, dates de naissance précises, adresses IP d’étudiants ou de patients) pour vous conformer aux exigences éthiques et aux réglementations légales sur la protection des données (RGPD).
- Feuille de métadonnées (Codebook / ReadMe) : Insérez un premier onglet autonome au sein de votre classeur faisant office de dictionnaire des variables. Détaillez-y la signification exacte de chaque colonne, les unités métriques utilisées, les codes assignés aux conditions factorielles et la formulation algorithmique des paramètres calculés.
- Dépôt sur une plateforme pérenne : Ne vous contentez pas de partager un simple lien d’accès Google Drive, dont l’adresse URL ou les droits d’accès peuvent être altérés au fil des ans. Exportez votre classeur finalisé et déposez-le au sein d’un entrepôt de données de recherche certifié doté d’un identifiant pérenne (DOI), tel que l’Open Science Framework (OSF), Zenodo ou Dataverse.
En adoptant ces standards méthodologiques et computationnels d’excellence, vous garantissez que vos visualisations par boîtes à moustaches sous Google Sheets ne constituent pas de simples illustrations éphémères, mais de véritables instruments d’analyse quantitative rigoureux, transparents, immédiatement vérifiables et pérennes au bénéfice de l’ensemble de la communauté scientifique internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Brillinger, D. R. (2002). John W. Tukey’s work on thinking about thoughts. Annals of Statistics, 30(6), 1595-1615. https://doi.org/10.1214/aos/1043351250
- Friendly, M. (2008). A brief history of data visualization. In C. Chen, W. Härdle, & A. Unwin (Eds.), Handbook of Data Visualization (pp. 15-56). Springer. https://doi.org/10.1007/978-3-540-33037-0_2
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12-16. https://doi.org/10.1080/00031305.1978.10479236
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H., & Stryjewski, L. (2011). 40 years of boxplots. Technical Report, Hadley Wickham. https://vita.had.co.nz/papers/boxplots.pdf
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0