
Dans le domaine de l’analyse exploratoire de données et de la communication scientifique, la restitution visuelle des distributions et des agrégats constitue une étape épistémologique déterminante. La représentation graphique ne se réduit pas à une simple transcription illustrative de tableaux numériques ; elle opère comme un dispositif sémiotique complexe destiné à soutenir l’inférence statistique, à révéler des structures latentes et à faciliter la comparaison d’estimations paramétriques ou non paramétriques. Parmi l’arsenal des représentations bidimensionnelles, le diagramme en barres groupées, couramment désigné sous le vocable anglophone de grouped barplot ou side-by-side bar chart, occupe une place prépondérante dès lors qu’il s’agit d’examiner les interactions bivariées entre deux facteurs qualitatifs discrets au regard d’une métrique quantitative dépendante.
L’environnement statistique R, soutenu par des décennies d’innovations algorithmiques et formelles incarnées par l’écosystème du Tidyverse, offre une flexibilité incomparable pour l’ingénierie et le déploiement de ces visualisations. Alors que les implémentations graphiques conventionnelles peinent souvent à concilier lisibilité typographique, rigueur d’alignement cartésien et respect des standards éditoriaux internationaux, la combinaison de la manipulation de données avec le paquet dplyr et de la modélisation graphique par couches avec ggplot2 permet d’atteindre un niveau d’expressivité analytique optimal. La construction méthodique d’un diagramme en barres juxtaposées exige néanmoins une compréhension intime des principes fondamentaux de la grammaire des graphiques théorisée par Leland Wilkinson, ainsi qu’une maîtrise scrupuleuse des formats tabulaires, de la gestion de l’incertitude et de la perception humaine des contrastes chromatiques.
Ce guide exhaustif a pour vocation d’analyser en profondeur les soubassements théoriques, méthodologiques et computationnels présidant à la conception d’un barplot groupé sous R. À travers l’exploration détaillée des transformations de données matricielles, de la mécanique interne des géométries vectorielles, du calibrage microscopique des paramètres de décalage spatial et de l’intégration formelle des barres d’erreur, ce texte propose un itinéraire pédagogique et technique de référence. Destiné aux chercheurs, biostatisticiens, data scientists et analystes quantitatifs, cet ouvrage décortique chaque étape de la chaîne de traitement graphique afin d’assurer une reproductibilité totale, une conformité stricte aux exigences des revues à fort facteur d’impact et une clarté argumentative irréprochable.
1. Fondements théoriques et pertinence du diagramme en barres groupées dans R
1.1 Définition et structure sémiotique du barplot groupé
Le diagramme en barres groupées se caractérise par la juxtaposition de parallélépipèdes rectangles sur une échelle cartésienne commune, où la longueur ou la hauteur de chaque rectangle est strictement proportionnelle à une grandeur statistique donnée, qu’il s’agisse d’un dénombrement d’occurrences, d’une fréquence relative ou d’une estimation paramétrique telle qu’une moyenne arithmétique ou géométrique. D’un point de vue sémiotique, cette représentation décompose l’espace bidimensionnel en sous-ensembles discrets : l’axe orthogonal primaire (généralement l’axe des abscisses) structure la variable catégorielle indépendante principale, tandis que l’axe continu secondaire (l’axe des ordonnées) enregistre l’amplitude de la variable dépendante. La spécificité fondamentale du dispositif groupé réside dans la subdivision de chaque catégorie primaire en sous-catégories adjacentes grâce à une seconde variable de partition, conventionnellement différenciée par un canal graphique rétinien secondaire tel que la couleur de remplissage, la saturation ou le motif texturé.
Cette approche se distingue radicalement du diagramme en barres empilées (stacked barplot) et du diagramme standard univarié. Dans un barplot empilé, les segments représentant les sous-catégories sont superposés le long d’une colonne unitaire. Si cette structure permet d’appréhender aisément la somme cumulée du groupe principal, elle détériore gravement la comparabilité des sous-catégories internes, à l’exception notable de celle positionnée à la base absolue du graphique. En effet, l’absence d’une ligne de référence commune pour les segments intermédiaires contraint le système visuel humain à évaluer des longueurs flottantes sans repère fixe, ce qui induit un biais perceptif documenté par les recherches pionnières de William Cleveland et Robert McGill sur la perception graphique élémentaire. À l’inverse, le barplot groupé aligne toutes les bases des rectangles sur l’axe d’origine zéro, garantissant que chaque comparaison inter-groupes et intra-groupes s’effectue le long d’une référence spatiale invariante.
Sur le plan cognitif, la disposition côte à côte minimise l’effort mental de décodage nécessaire à l’évaluation des écarts d’amplitude. En recherche quantitative, en psychométrie et en épidémiologie, cette architecture s’avère indispensable pour étudier les variations concomitantes de deux facteurs. L’œil de l’observateur effectue des balayages saccadiques horizontaux immédiats entre les barres adjacentes d’un même groupe pour quantifier l’effet local du second facteur, puis procède à des comparaisons longitudinales distantes pour évaluer la stabilité de cet effet à travers les différentes strates du premier facteur. Cette double dynamique perceptive fait du barplot groupé un instrument d’inférence visuelle particulièrement puissant pour détecter à l’œil nu des patrons d’hétérogénéité, des convergences de tendances ou des inversions de hiérarchie au sein d’échantillons stratifiés.
1.2 Cas d’usage méthodologiques en sciences du comportement et statistiques
L’utilisation du barplot groupé trouve son terreau le plus fertile dans les protocoles de recherche régis par des plans factoriels complets, notamment les plans factoriels orthogonaux de type 2×2, 2×3 ou 3×3. Dans le cadre de l’analyse de variance (ANOVA), l’examen visuel préliminaire a pour objectif d’illustrer non seulement les effets principaux des facteurs contrôlés par l’expérimentateur, mais surtout la présence éventuelle d’une interaction statistique significative. Lorsqu’un traitement pharmacologique ou une intervention psychopédagogique produit une réponse dépendante de l’appartenance à un sous-groupe démographique ou clinique, la non-parallélisme des sommets des barres d’un groupe à l’autre offre une intuition géométrique immédiate de l’interaction factorielle. Les sciences du comportement exploitent intensément cette propriété pour illustrer les variations de scores psychométriques standardisés, de temps de réponse cognitifs ou de taux d’erreurs en fonction du croisement entre conditions expérimentales (par exemple, tâche sous stress vs condition témoin) et caractéristiques individuelles (par exemple, niveau élevé vs faible d’anxiété dispositionnelle).
Bien que le barplot groupé soit largement répandu dans la littérature biomédicale et comportementale, sa pertinence méthodologique doit être rigoureusement mise en balance avec d’autres représentations de distribution, telles que les boîtes à moustaches (boxplots) et les diagrammes en violon (violin plots). Un diagramme en barres condense l’information distributionnelle en une valeur ponctuelle unique, masquant intrinsèquement l’asymétrie, l’aplatissement, la bimodalité ou la dispersion brute des observations individuelles. Par conséquent, l’usage du barplot groupé n’est méthodologiquement défendable que dans trois configurations précises : lorsque la variable dépendante représente une fréquence ou un dénombrement discret réel, lorsque les données sous-jacentes suivent une distribution gaussienne vérifiée où la moyenne et l’écart-type résument fidèlement le profil distributionnel, ou lorsque l’espace éditorial restreint exige une synthèse visuelle compacte complétée impérativement par des indicateurs précis d’incertitude inférentielle.
Dès lors que l’échantillon présente une hétéroscédasticité marquée, une présence substantielle de données aberrantes ou une dispersion asymétrique, le chercheur doit privilégier des représentations révélant la géométrie interne des données ou superposer les distributions de points individuels (stripcharts) au sommet des barres synthétiques. Le barplot groupé demeure néanmoins l’étalon visuel standard pour présenter les synthèses inférentielles finales issues de modèles linéaires mixtes ou d’analyses de régression logistique, où les barres représentent les moyennes marginales estimées (estimated marginal means ou least-squares means) ajustées sur les covariables du protocole expérimental.
1.3 L’écosystème graphique de R : R de base versus l’approche ggplot2
L’histoire computationnelle de R se caractérise par la coexistence de plusieurs moteurs graphiques autonomes. Le système graphique historique, intégré directement au noyau du langage via le package graphics et sa fonction emblématique barplot(), repose sur le modèle de la « toile du peintre » (painter’s model). Dans ce paradigme impératif, chaque instruction graphique dépose des pigments virtuels directement sur un canevas matriciel fixe. Pour construire un barplot groupé avec le moteur de base de R, l’utilisateur doit formater préalablement ses données sous la forme d’une matrice bidimensionnelle stricte, appeler la fonction en spécifiant l’argument booléen beside = TRUE, puis invoquer manuellement des fonctions périphériques de bas niveau telles que legend(), axis() et title() pour compléter l’habillage. Bien que cette méthode offre une rapidité d’exécution incontestable pour des vérifications exploratoires instantanées, elle souffre de limitations fonctionnelles majeures : le calcul des coordonnées spatiales pour l’adjonction ultérieure d’éléments (tels que des barres d’erreur) nécessite une extraction manuelle des centroïdes générés en sortie de fonction, et la gestion des légendes s’avère particulièrement verbeuse et propice aux erreurs de décalage typographique.
Face à ces contraintes procédurales, l’émergence de la grammaire des graphiques de Leland Wilkinson, transposée dans l’écosystème R par Hadley Wickham sous la forme du package ggplot2, a révolutionné la modélisation visuelle des données scientifiques. Contrairement à l’approche impérative du R de base, ggplot2 adopte une syntaxe déclarative reposant sur une architecture modulaire et sémantique. Un graphique n’est plus conçu comme une séquence d’opérations de dessin arbitraires, mais comme une composition formelle reliant des variables contenues dans un tableau de données à des propriétés esthétiques perceptibles (coordonnées cartésiennes, teintes chromatiques, formes géométriques, transparences) à travers des couches superposées indépendantes.
Cette approche paradigmatique confère au chercheur une maîtrise absolue de la reproductibilité de ses figures. Dans ggplot2, la structure du barplot groupé n’est pas tributaire d’un type de fonction isolé, mais découle logiquement de l’articulation entre une couche géométrique discrète (geom_bar() ou geom_col()) et un opérateur de positionnement spatial spécifiquement conçu pour désenchevêtrer les sous-groupes (position_dodge()). Cette séparation rigoureuse entre la source des données, les transformations statistiques sous-jacentes, le système de coordonnées et les thèmes typographiques garantit une adaptabilité sans faille face aux modifications itératives inhérentes aux cycles de révision par les pairs au sein des comités de lecture académiques.
2. Préparation et structuration rigoureuse des données sous R
2.1 Formatage en données longitudinales (Format Long vs Format Wide)
L’application rigoureuse des préceptes de la grammaire des graphiques impose une contrainte structurelle incontournable sur les jeux de données tabulaires : l’adhésion stricte au paradigme des « données ordonnées » (tidy data). Selon ce formalisme mathématique formalisé par Hadley Wickham, un ensemble de données est considéré comme structuré lorsque trois conditions élémentaires sont simultanément réunies : chaque variable distincte constitue une colonne unique, chaque unité d’observation forme une ligne individuelle, et chaque typologie d’unité observationnelle réside dans une table dédiée. Dans la pratique quotidienne de la collecte des données expérimentales ou cliniques, les chercheurs saisissent fréquemment leurs résultats sous un format large (format wide), où les mesures répétées ou les différentes conditions factorielles sont disséminées le long d’une multitude de colonnes adjacentes.
Une telle disposition large, bien qu’ergonomique pour la saisie manuelle dans un tableur, est fondamentalement incompatible avec le moteur d’association esthétique de ggplot2. Pour générer un barplot groupé, le logiciel exige un format long (format long) dans lequel une colonne unique rassemble l’ensemble des valeurs de la variable dépendante d’intérêt, tandis qu’au moins deux colonnes distinctes encodent les variables d’appartenance factorielle (la variable primaire de regroupement et la variable secondaire de juxtaposition). La conversion matricielle entre ces deux topologies spatiales s’effectue avec une efficacité mathématique optimale à l’aide des fonctions de restructuration du package tidyr, au premier rang desquelles figurent pivot_longer() et pivot_wider().
Considérons une matrice issue d’une tâche de performance cognitive mesurant les temps de réaction moyens d’individus sous deux conditions lumineuses croisées avec trois régimes d’attention. Si le tableau initial présente des colonnes séparées pour chaque modalité combinée, l’appel de pivot_longer() permettra de compacter ces colonnes éparses en spécifiant les variables cibles, le nom de la nouvelle colonne de catégorisation via l’argument names_to, et le vecteur de destination des valeurs quantitatives via l’argument values_to. Ce remaniement longitudinal nettoie la topologie interne du jeu de données et prépare directement l’assignation univoque des vecteurs aux paramètres d’abscisse, d’ordonnée et de teinte au sein de la fonction d’initialisation graphique.
2.2 Typage des variables : Facteurs nominaux et ordinaux
Une source fréquente de dysfonctionnements esthétiques et d’erreurs d’interprétation lors de la compilation d’un diagramme en barres réside dans le typage sous-jacent des vecteurs au sein de l’interpréteur R. Par défaut, lors de l’importation de fichiers externes aux formats délimités (tels que des fichiers texte tabulés ou des fichiers de valeurs séparées par des virgules), les colonnes contenant des intitulés qualitatifs sont généralement instanciées sous forme de vecteurs de chaînes de caractères (type character). Or, le tracé d’axes discrets cartésiens nécessite formellement que ces structures soient coercées en objets de type factor, lesquels encodent explicitement la structure algébrique des variables nominales ou ordinales.
La transformation d’un vecteur textuel en facteur s’opère au moyen de la fonction factor() ou de sa variante de conversion directe as.factor(). Néanmoins, l’élément méthodologique le plus crucial réside dans le contrôle déterministe de l’ordre d’apparition des niveaux factoriels (levels). Par défaut, le moteur R ordonne les modalités selon l’ordre lexicographique standard de l’environnement local de la machine. Cette disposition alphabétique automatique engendre régulièrement des incohérences sémiotiques manifestes : des catégories temporelles ou séquentielles (telles que les stades « Contrôle », « Pré-test », « Post-test ») se retrouvent disloquées dans un ordre spatial arbitraire privant le graphique de sa fluidité narrative.
L’utilisation scrupuleuse de l’argument levels = c(...) au sein de la fonction factor() permet de figer explicitement la disposition géométrique des barres de gauche à droite sur l’axe des abscisses, ainsi que l’ordre des sous-groupes au sein de la légende associée. Pour les variables ordinales strictes, l’adjonction du paramètre booléen ordered = TRUE signale explicitement à l’interpréteur la hiérarchie intrinsèque des modalités, ce qui influence directement le traitement statistique en aval et l’application automatique de palettes chromatiques perceptuellement uniformes et séquentielles adaptées à la progression de l’échelle d’évaluation.
2.3 Agrégation statistique préalable avec dplyr
Une dichotomie conceptuelle fondamentale sépare la visualisation de données brutes non transformées de celle d’estimations paramétriques agrégées. Bien que ggplot2 intègre des moteurs internes de calcul statistique capables d’agréger les données à la volée durant la compilation du graphique, les meilleures pratiques de programmation scientifique préconisent une séparation rigoureuse entre l’étape d’ingénierie statistique et l’étape de restitution visuelle. L’exécution d’une agrégation explicite en amont garantit une transparence méthodologique intégrale, permet l’audit et la vérification des métriques calculées avant rendu visuel, et simplifie considérablement la syntaxe de traçage des indicateurs de dispersion tels que les barres d’erreur.
Le package dplyr, composante maîtresse du Tidyverse, met à disposition une syntaxe déclarative hautement optimisée reposant sur la combinatoire des fonctions group_by() et summarise() articulées par l’opérateur de tuyauterie (pipe natif |> ou hérité %>%). La séquence analytique classique consiste à partitionner le jeu de données brut selon les deux variables de croisement factoriel désignées, puis à dériver au sein de la fonction d’agrégation l’ensemble des moments statistiques requis : l’effectif valide par cellule via n(), la moyenne arithmétique via mean(), l’écart-type d’échantillon via sd(), ainsi que l’erreur standard de la moyenne obtenue par le ratio mathématique de l’écart-type sur la racine carrée de l’effectif.
Durant cette phase de computation synthétique, le traitement méthodique des valeurs manquantes s’avère impératif. L’omission d’un argument tel que na.rm = TRUE dans les fonctions de sommation élémentaires propage instantanément la valeur indéfinie NA dans les cellules d’agrégation, conduisant à la disparition silencieuse de barres entières lors de l’instanciation de la géométrie de tracé. Pour concrétiser ces préceptes tout au long de cette monographie, nous instancions un jeu de données synthétique réplicable modélisant un protocole expérimental comportemental croisant trois typologies d’entraînements cognitifs et deux profils chronobiologiques (matinal vs vespéral) mesurés sur des cohortes standardisées, assurant une clarté absolue des exemples développés.
3. Création du barplot groupé fondamental avec ggplot2
3.1 Initialisation du canevas et mapping esthétique aes()
L’initialisation formelle de toute production graphique sous ggplot2 débute par la fonction d’instanciation racine ggplot(). Cette fonction assume la responsabilité de déclarer formellement l’objet de données tabulaire source et de construire le système d’association esthétique via la directive aes() (abréviation structurelle d’aesthetic mappings). Contrairement aux fonctions graphiques procédurales où les arguments décrivent des coordonnées géométriques figées dans l’espace de dessin, la fonction aes() établit des canaux de communication bivariés entre les dimensions conceptuelles abstraites du jeu de données et les canaux perceptifs de restitution visuelle reconnus par le cortex visuel humain.
Pour l’érection d’un barplot groupé élémentaire, le mapping esthétique minimal requiert la spécification simultanée de trois dimensions distinctes. L’axe primaire des abscisses, déclaré par l’argument x, accueille la variable catégorielle structurante primaire régissant la macro-organisation horizontale du canevas. L’axe orthogonal des ordonnées, gouverné par l’argument y, reçoit la variable continue quantitative exprimant l’amplitude numérique de la mesure ou de la métrique agrégée. Enfin, l’attribution esthétique critique permettant la genèse de la seconde dimension discriminante repose sur l’argument fill, qui assigne la seconde variable qualitative discrète au canal chromatique de remplissage volumique des parallélépipèdes rectangles.
Il importe de distinguer rigoureusement à ce stade l’argument fill de l’argument color. Dans la nomenclature interne de ggplot2, le paramètre color (ou colour) contrôle exclusivement la teinte du périmètre linéaire ou du contour vectoriel des géométries polygonales, tandis que fill régit la tonalité chromatique intrinsèque de la masse polygonale interne. L’assignation de la variable de sous-groupe à color sans renseigner fill produit des barres aux intérieurs translucides uniformes, dont seuls les contours diffèrent par leur nuance, ce qui compromet gravement l’accessibilité visuelle globale de la structure factorielle représentée.
3.2 Implémentation de la géométrie geom_bar() et du paramètre position=’dodge’
Une fois le canevas conceptuel initialisé et les correspondances esthétiques déclarées, l’adjonction de la couche géométrique s’opère par l’intermédiaire de l’opérateur d’addition unaire surchargé (+). Dans la syntaxe générique conventionnelle, le tracé d’un diagramme en barres s’effectue via l’invocation de la fonction geom_bar(). Dès cette étape, une décision architecturale s’impose : la fonction geom_bar() encapsule par défaut un transformateur statistique interne opérant un dénombrement de fréquence absolue (stat = "count"). Par conséquent, si le chercheur alimente la fonction avec un jeu de données préalablement agrégé comportant un vecteur y explicite, l’exécution avorte immédiatement en déclenchant un message d’erreur d’incompatibilité fonctionnelle, à moins de surcharger explicitement l’opérateur en stipulant stat = "identity".
L’opération algorithmique décisive transformant un barplot empilé par défaut en un véritable barplot groupé s’exécute par l’intermédiaire du paramètre position. Par défaut, la géométrie applique la transformation d’ajustement spatial position = "stack", laquelle cumule verticalement les rectangles correspondant à chaque sous-modalité de fill. Pour contraindre l’interpréteur graphique à décomposer ces volumes composites et à les projeter horizontalement le long d’une même ligne de base zéro, l’analyste doit injecter l’argument position = "dodge".
D’un point de vue géométrique, le mécanisme de dodging recalcule de manière déterministe les coordonnées longitudinales des limites latérales des rectangles (les bornes cartésiennes xmin et xmax). Au lieu de faire occuper à chaque barre l’intégralité de la largeur dévolue au pas de graduation discret sur l’axe des abscisses, l’algorithme fractionne l’intervalle spatial disponible en tranches d’épaisseurs strictement égales au nombre de modalités actives de la variable de remplissage, puis applique un vecteur de décalage spatial horizontal qui juxtapose séquentiellement les barres les unes à la suite des autres sans aucun chevauchement structurel.
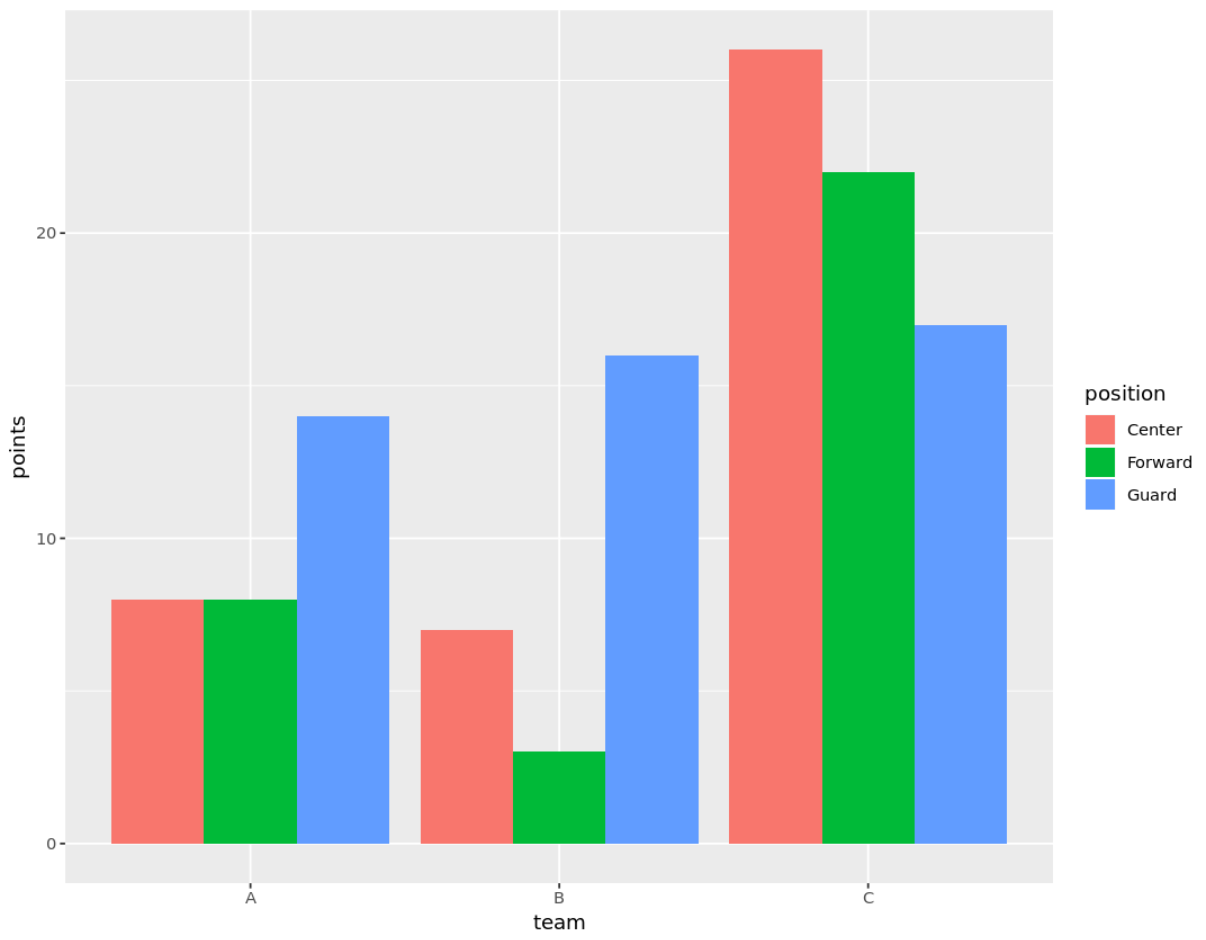
3.3 Interprétation visuelle du premier graphique obtenu
L’exécution de cette séquence minimale d’instructions produit une première instanciation visuelle fonctionnelle. Bien que techniquement valide et statistiquement conforme aux assignations paramétriques, l’objet graphique brut ainsi généré révèle immédiatement plusieurs limites formelles inhérentes aux conventions par défaut de ggplot2. En premier lieu, la palette chromatique automatique allouée par le système repose sur un échantillonnage circulaire uniforme de l’espace colorimétrique standard HCL (Hue-Chroma-Luminance). Si cette approche garantit une équidistance mathématique formelle des teintes, les nuances obtenues présentent une luminance élevée susceptible de pénaliser la lisibilité des contrastes et de poser des problèmes d’accessibilité majeurs pour les personnes atteintes de déficiences de la vision des couleurs (dyschromatopsies et daltonisme).
En second lieu, la typographie des axes, le dimensionnement des marges externes et le quadrillage en grille blanche sur fond gris clair caractéristique du thème canonique theme_grey() génèrent une densité d’éléments graphiques non porteurs d’information qui surcharge inutilement la perception. Le système attribue automatiquement comme libellés d’axes et de légende le nom littéral des colonnes extraites du tableau de données, ce qui expose fréquemment le lecteur à des identifiants techniques ésotériques, dépourvus d’unités de mesure claires ou de majuscules conventionnelles.
Néanmoins, sur le plan strictement analytique, cette première restitution valide la structure relationnelle sous-jacente. Elle permet à l’observateur de confronter instantanément la plausibilité des amplitudes représentées aux hypothèses théoriques préliminaires, de vérifier visuellement l’absence d’inversion aberrante dans la distribution des catégories et d’identifier la nécessité d’implémenter des raffinements esthétiques, des annotations textuelles ciblées et des marqueurs d’incertitude inférentielle pour conférer à la figure un statut de document scientifique pleinement publiable.
4. Distinction cruciale : geom_bar() versus geom_col()
4.1 Paradigme de geom_col() pour les valeurs pré-calculées
Au sein du corpus d’instructions de ggplot2, la confusion entre geom_bar() et geom_col() représente l’une des pierres d’achoppement les plus universelles rencontrées par les analystes de données. Historiquement, geom_bar() constituait l’unique fonction disponible pour tracer des rectangles verticaux, contraignant les programmeurs manipulant des grandeurs numériques continues pré-calculées à adjoindre systématiquement la directive explicite stat = "identity". Consciente de la lourdeur syntaxique et du manque de clarté conceptuelle induits par ce détour procédural, l’équipe de développement du Tidyverse a introduit ultérieurement une variante fonctionnelle dédiée : la fonction geom_col() (abréviation formelle de column geometry).
Le paradigme opérationnel de geom_col() repose sur l’hypothèse immuable selon laquelle les hauteurs physiques des rectangles correspondent exactement et directement aux grandeurs numériques encapsulées dans la variable cartographiée sur l’axe des ordonnées. En d’autres termes, geom_col() est strictement équivalente à l’instruction verbeuse geom_bar(stat = "identity"), mais en élimine la redondance syntaxique. L’adoption systématique de geom_col() dans les scripts d’analyse améliore notablement la lisibilité du code source en explicitant d’emblée l’intention du statisticien : traiter des valeurs déjà conditionnées, moyennées ou agrégées en amont.
Sur le plan des performances computationnelles, l’utilisation couplée d’une agrégation préalable via dplyr et de la géométrie geom_col() se révèle significativement supérieure sur les jeux de données volumineux comprenant plusieurs centaines de milliers ou millions d’enregistrements. Dans un tel scénario, déléguer le travail d’agrégation statistique au moteur graphique via geom_bar() surcharge la mémoire vive et ralentit la compilation du rendu, dans la mesure où le processeur graphique doit instancier des calculs d’intervalles sur l’ensemble de la base avant d’appliquer les opérateurs de décalage spatial, alors que geom_col() opère sur une table résumée ne comportant que quelques dizaines de lignes pré-structurées.
4.2 Agrégation dynamique automatique au sein de geom_bar()
Inversement, la fonction geom_bar() conserve une utilité heuristique incontestable lorsqu’il s’agit de cartographier directement des données brutes au niveau observationnel individuel (microdata) sans passer par une phase de condensation tabulaire intermédiaire. Lorsque l’objectif d’une étude d’observation consiste à comparer la distribution des effectifs bruts au sein de combinaisons catégorielles croisées, geom_bar() mobilise son transformateur implicite stat = "count". Dans ce mode de fonctionnement, l’analyste omet scrupuleusement l’argument y dans le mapping esthétique aes() : l’algorithme parcourt les données, dénombre automatiquement les occurrences de chaque couple factoriel (x, fill), et instancie automatiquement la variable interne dérivée count sur l’axe des ordonnées.
Bien au-delà du décompte élémentaire des fréquences absolues, geom_bar() autorise la dérivation de proportions conditionnelles dynamiques au moyen de la syntaxe d’évaluation différée formalisée par la fonction after_stat(). Cette notation moderne, remplaçant l’ancienne syntaxe à base de points d’interrogation doublés (..prop..), permet de redéfinir la variable d’ordonnée en spécifiant par exemple y = after_stat(count / sum(count)) pour exprimer des pourcentages globaux, ou en manipulant les groupes esthétiques pour calculer des proportions marginales conditionnées par la variable d’abscisse. Cette technique d’agrégation interne confère une grande concision à l’exploration interactive des données d’enquêtes ou de sondages stratifiés.
Néanmoins, cette concision s’accompagne d’un coût méthodologique non négligeable : le calcul interne des proportions et des erreurs associées demeure opaque pour le relecteur du code et complique considérablement l’extraction automatisée des métriques exactes pour l’élaboration de tables de synthèse annexes. Dès lors qu’un protocole scientifique requiert l’adjonction de barres d’erreur basées sur des distributions asymptotiques, des intervalles de confiance de Student ou des procédures de rééchantillonnage par bootstrap, la délégation du calcul statistique interne à geom_bar() atteint ses limites intrinsèques, rendant l’architecture dplyr::summarise() couplée à geom_col() infiniment préférable pour garantir la robustesse et la traçabilité des résultats.
5. Personnalisation esthétique des palettes chromatiques
5.1 Sélection de palettes accessibles et conformes aux normes scientifiques
L’encodage chromatique des barres groupées constitue un levier déterminant d’intelligibilité scientifique, mais il représente également une source majeure de dégradation sémiotique lorsqu’il est manipulé de manière intuitive ou décorative. Dans un contexte académique, le choix des teintes doit impérativement répondre à trois critères déontologiques fondamentaux : l’inclusivité envers les lecteurs atteints de déficiences de perception des couleurs, la préservation intégrale du contraste lors de la reproduction en niveaux de gris (photocopie ou impression noir et blanc standard), et l’absence de biais cognitif provoqué par des disparités d’attraction visuelle artificielle entre des sous-groupes de même statut épistémologique.
Pour répondre à ces exigences rigoureuses, l’écosystème ggplot2 intègre nativement les palettes mathématiquement modélisées de la famille Viridis via l’opérateur d’échelle scale_fill_viridis_d() (le suffixe _d désignant une échelle discrète). Développées originellement pour la bibliothèque Python Matplotlib, ces palettes (notamment les options canoniques « viridis », « magma », « inferno » et « plasma ») se distinguent par leur perceptibilité uniforme le long de l’espace de luminance CIELAB. Cela signifie que la progression de l’intensité perçue correspond linéairement à la progression numérique, tout en demeurant parfaitement discriminable pour les trois formes majeures de daltonisme (deutéranopie, protanopie et tritanopie).
Une alternative largement éprouvée dans la littérature internationale repose sur l’exploitation des travaux de la cartographe Cynthia Brewer, intégrés à R via le package RColorBrewer et la fonction dédiée scale_fill_brewer(). Ces palettes se scindent en trois typologies sémiotiques strictes : les palettes séquentielles (adaptées aux variables de sous-groupes présentant un ordre intrinsèque croissant, telles que des classes d’âge ordonnées), les palettes divergentes (conçues pour contraster deux orientations par rapport à un point d’inflexion neutre médian), et les palettes qualitatives ou catégorielles (telles que « Set2 » ou « Dark2 »). Ces dernières sont spécifiquement étalonnées pour maximiser la différenciation visuelle entre des modalités purement nominales (telles que des traitements pharmacologiques parallèles) sans suggérer indûment de supériorité hiérarchique entre elles.
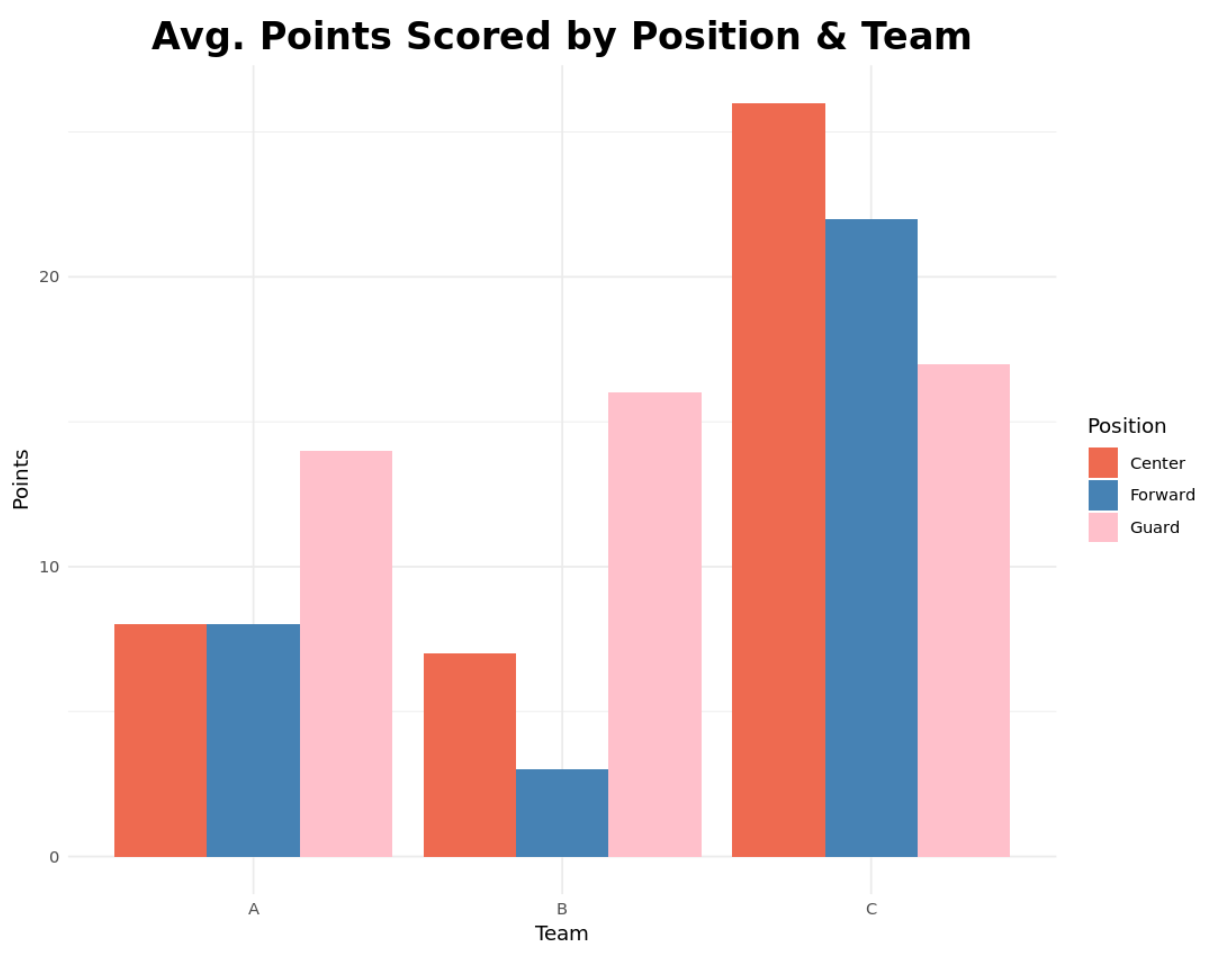
5.2 Définition manuelle et personnalisée des couleurs institutionnelles
Bien que les palettes standardisées offrent des garanties scientifiques solides, les protocoles éditoriaux des maisons d’édition universitaires ou les chartes graphiques des laboratoires de recherche imposent fréquemment le recours à des harmonies chromatiques spécifiques, calibrées sur des codes hexadécimaux stricts (représentation #RRGGBB). L’assignation granulaire de nuances personnalisées s’effectue sous ggplot2 par l’intermédiaire de la fonction d’échelle manuelle scale_fill_manual(). Cette instruction permet de découpler entièrement l’habillage graphique des configurations génériques du moteur de tracé.
La mise en œuvre de scale_fill_manual() doit s’opérer avec une rigueur méthodologique absolue en privilégiant des vecteurs nommés plutôt que de simples listes de couleurs indexées par leur position d’apparition. Un vecteur nommé associe formellement chaque modalité textuelle de la variable catégorielle à sa chaîne hexadécimale cible, sous la syntaxe canonique values = c("Placebo" = "#2b5c8f", "Traitement_A" = "#d95f02", "Traitement_B" = "#7570b3"). Cette pratique de programmation défensive immunise le script contre les erreurs d’inversion chromatique pouvant survenir lors d’un filtrage ultérieur des données, d’une modification de l’ordre factoriel ou de la présence inattendue d’une modalité non renseignée.
L’harmonisation chromatique doit également s’aligner sur les directives éditoriales internationales, à l’instar de la 7e édition des normes de l’American Psychological Association (APA 7th Edition). Les conventions de publication en psychologie et sciences biomédicales recommandent instamment d’éviter les teintes sursaturées ou agressives au profit de tons feutrés, assurant un ratio de contraste d’au moins 4.5:1 par rapport au fond du canevas pour garantir la conformité aux critères d’accessibilité numérique WCAG 2.1.
5.3 Gestion des bordures, de la transparence et des contours
L’affinage sémiotique du parallélépipède graphique nécessite une gestion coordonnée des interfaces spatiales séparant les barres juxtaposées. L’absence totale de délimitation périphérique entre des rectangles de tonalités très proches peut entraîner un phénomène d’illusion d’optique dit d’irradiation, où les frontières géométriques exactes paraissent floues ou instables pour l’œil humain. Pour pallier ce biais perceptif, il est fortement recommandé d’introduire un contour vectoriel discret en configurant explicitement l’argument color (ou colour) directement au sein de l’instruction geom_col() ou geom_bar().
Le paramétrage du contour s’accompagne du contrôle de son calibre géométrique via l’argument linewidth (qui a formellement succédé au paramètre obsolète size pour les éléments surfaciques depuis les versions récentes de ggplot2). Une épaisseur de trait calibrée entre 0.2 et 0.4 point, combinée à une teinte neutre sombre telle que le noir absolu ("#000000") ou un gris anthracite profond ("grey20"), permet de découper impeccablement les silhouettes géométriques sans pour autant détourner l’attention du lecteur de la masse volumique principale.
Parallèlement, la modulation de l’opacité surfacique via l’argument alpha apporte une nuance stylistique précieuse. Compris sur une échelle continue de 0 (transparence intégrale) à 1 (opacité absolue), un coefficient alpha réglé aux alentours de 0.85 ou 0.90 adoucit subtilement la saturation des teintes primaires, améliore l’intégration des grilles de lecture situées en arrière-plan et facilite l’incorporation d’éventuels points individuels (jitter) superposés le long de la structure verticale sans saturer visuellement l’espace d’analyse.
6. Typographie, hiérarchie textuelle et métadonnées graphiques
6.1 Configuration rigoureuse des labels et titres via labs()
Un diagramme scientifique doit être conçu comme une entité sémiotique autonome, capable d’être pleinement décryptée par un pair sans qu’il soit nécessaire de consulter le corps du manuscrit textuel adjacent. Cette indépendance documentaire repose sur la complétude et la rigueur d’annotation de ses métadonnées périphériques. La fonction labs() constitue le panneau de contrôle unifié dédié à la formalisation de ces éléments textuels au sein de l’environnement ggplot2, centralisant la spécification des titres, sous-titres, intitulés d’axes, mentions de légendes et notes de bas de figure.
La rédaction du titre principal (argument title) doit proscrire les formulations purement descriptives et passives telles que « Barplot du groupe A et B » au profit d’énoncés scientifiques précis explicitant la variable dépendante mesurée et les conditions manipulées. L’argument subtitle enrichit cette accroche en spécifiant la méthodologie d’échantillonnage, la taille globale de la cohorte (ex. « N = 450 participants randomisés ») ou la nature de la transformation mathématique appliquée (ex. « Valeurs logarithmiques ajustées »).
Les libellés d’axes exigent une rigueur déontologique absolue. L’argument x doit nommer explicitement le facteur primaire sans abréviation ambiguë, tandis que l’argument y doit impérativement déclarer l’unité de mesure physique ou standardisée entre crochets ou parenthèses (ex. « Temps de fixation oculaire moyen (ms) » ou « Concentration plasmatique (nmol/L) »). L’omission d’unités de mesure invalide la valeur probante d’une figure dans toute revue indexée. Enfin, l’argument caption permet d’ancrer les métadonnées méthodologiques fondamentales : la nature statistique des marqueurs d’incertitude affichés (ex. « Les barres d’erreur représentent l’erreur standard de la moyenne (±1 SEM) »), les seuils de significativité des tests d’hypothèses conduits, ainsi que les sources institutionnelles d’extraction des données.
6.2 Personnalisation globale du thème visuel
L’arrière-plan sur lequel reposent les barres géométriques conditionne directement l’efficience perceptive globale de la figure. La théorie du design d’information popularisée par Edward Tufte postule la maximisation du « ratio encre-données » (data-ink ratio), principe selon lequel chaque pixel ou goutte d’encre déposée sur le support doit porter une charge informative dévolue à l’interprétation des données, proscrivant les fioritures stylistiques superflues (désignées sous le terme de chartjunk). Dans cette perspective, le thème par défaut theme_grey(), caractérisé par sa trame de fond grise dense, est souvent considéré comme sous-optimal pour la publication académique imprimée.
Le package ggplot2 offre un catalogue de thèmes prêts à l’emploi permettant de restructurer instantanément l’ergonomie visuelle du canevas. Parmi les alternatives les plus rigoureuses figurent theme_classic(), qui élimine l’intégralité des quadrillages internes pour ne conserver que les lignes d’axes noires orthogonales fondamentales (rappelant l’esthétique sobre des revues de l’écurie Nature ou Science), theme_light(), qui déploie un arrière-plan blanc ceinturé d’un cadre gris très fin, et theme_minimal(), qui préserve une grille de lecture épurée sans bordure extérieure d’encadrement.
Pour satisfaire aux exigences spécifiques de standardisation d’une unité de recherche ou d’un laboratoire, il est courant d’étendre ces thèmes génériques via la création d’un micro-thème sur mesure. En dérivant une fonction thématique personnalisée qui encapsule les dimensions de marges, les familles typographiques vectorielles et la suppression ciblée du quadrillage vertical inutile (les barres d’un barplot étant intrinsèquement discrètes, le quadrillage longitudinal sur l’axe des x constitue un bruit visuel redondant), l’analyste assure une uniformité stylistique absolue à travers l’ensemble des figures d’un mémoire doctoral ou d’une publication sérielle.
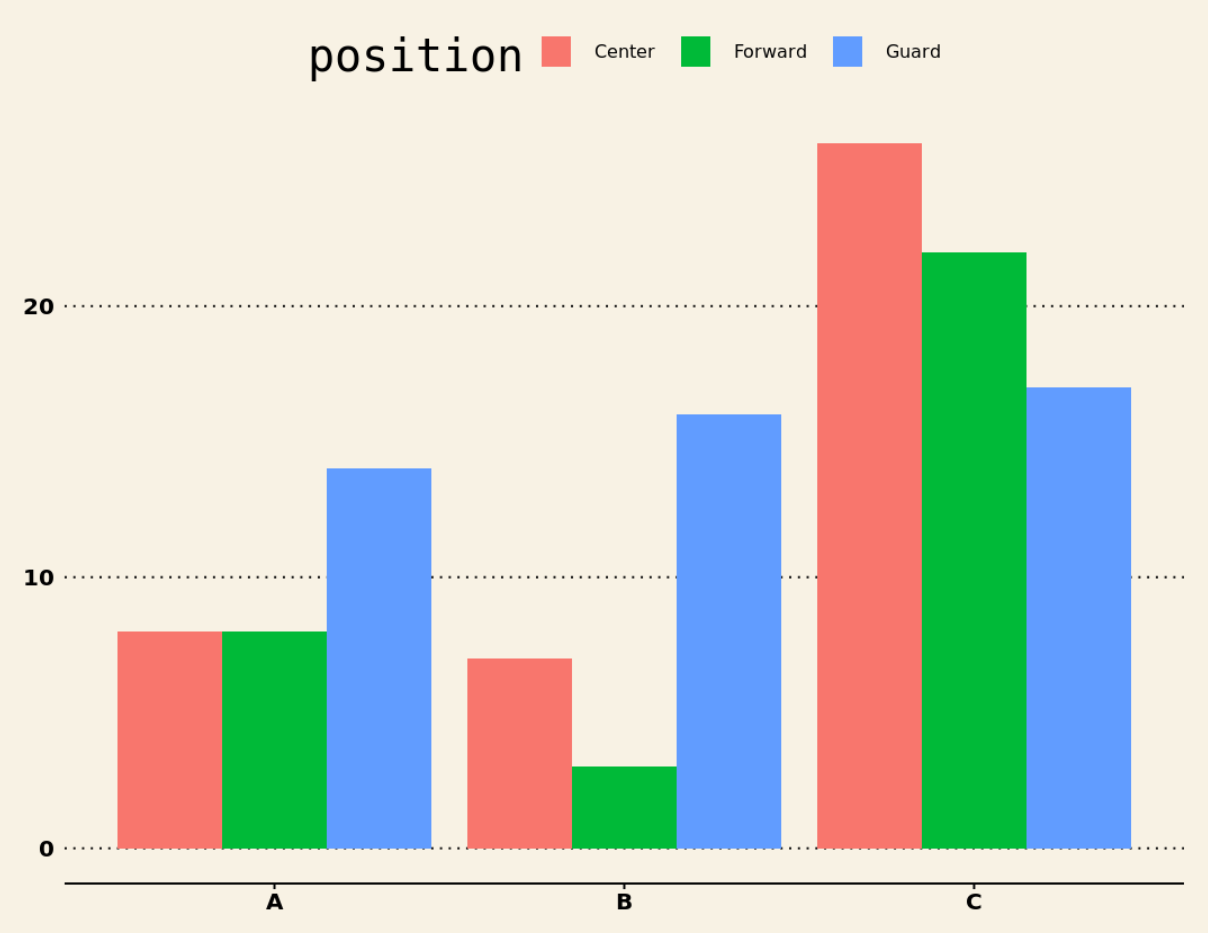
6.3 Ajustement microscopique des paramètres textuels via theme()
Tandis que les fonctions de thèmes macroscopiques appliquent des filtres globaux, l’instruction theme() permet de modifier de manière chirurgicale chaque composant typographique et spatial individuel. Toute modification d’un élément non lié aux données s’opère par l’intermédiaire de fonctions d’assistance structurelles, principalement element_text() pour les flux textuels, element_line() pour les composants linéaires, et element_rect() pour les zones géométriques de conteneurs.
L’un des défis ergonomiques les plus récurrents lors du déploiement d’un barplot groupé réside dans le chevauchement latéral des libellés de catégories sur l’axe des abscisses dès lors que les intitulés textuels comportent un nombre élevé de caractères. Pour remédier à cette occlusion sans altérer la lisibilité, il convient d’appliquer une rotation angulaire contrôlée via la configuration de l’argument axis.text.x = element_text(angle = 45, hjust = 1, vjust = 1, size = 10, face = "bold"). L’argument hjust = 1 (ajustement horizontal) s’avère particulièrement crucial : il contraint l’extrémité droite du texte incliné à s’ancrer directement sous le trait de graduation cartésien (tick), empêchant le texte d’empiéter sur la graduation voisine.
Le positionnement de la légende explicative constitue un autre arbitrage d’importance. Par défaut reléguée sur le flanc droit du graphique, la boîte de légende consomme une fraction considérable de la largeur disponible sur la page, tassant inutilement les barres de données dans un espace horizontal comprimé. L’ajustement theme(legend.position = "top") ou theme(legend.position = "bottom") repositionne la légende sur un plan horizontal parallèle au titre, libérant l’intégralité de la largeur pour l’amplitude du tracé. Pour les graphiques complexes disposant d’un espace vide exploitable au sein du quadrant cartésien supérieur, la légende peut même être incrustée à l’intérieur du cadre de dessin au moyen de coordonnées de positionnement relatives normalisées comprises entre 0 et 1 (ex. legend.position = c(0.85, 0.85)), maximisant ainsi la compacité de la figure.
7. Intégration d’annotations numériques directes sur les barres
7.1 Positionnement vertical précis des valeurs avec geom_text()
Bien que l’œil humain excelle à comparer des hauteurs relatives le long d’un axe commun, l’estimation absolue d’une grandeur numérique précise à partir des seules graduations d’axes exige un balayage oculaire et une interpolation mentale qui augmentent la charge cognitive du lecteur. Pour éliminer cette friction d’interprétation, l’inscription directe de la valeur chiffrée exacte au sommet ou à l’intérieur de chaque rectangle constitue une solution ergonomique de premier ordre. Dans ggplot2, cette fonctionnalité est orchestrée par la géométrie textuelle geom_text().
L’insertion d’annotations textuelles au sein d’un diagramme en barres groupées se heurte immédiatement à une contrainte géométrique majeure : l’alignement spatial sur deux axes. Si l’on se contente d’invoquer geom_text(aes(label = score)) sans spécifier de paramètre de décalage, l’interpréteur compile l’ensemble des étiquettes d’un même groupe catégoriel le long d’une seule coordonnée centrale d’abscisse, empilant chaotiquement les valeurs les unes sur les autres au centre du groupe. Pour forcer les étiquettes textuelles à suivre fidèlement le déplacement horizontal opéré sur les barres de couleur, il est impératif d’assigner à geom_text() un opérateur de décalage spatial strictement synchronisé : position = position_dodge(width = 0.9).
Une fois l’alignement longitudinal synchronisé, l’ajustement de la coordonnée verticale s’affine par l’intermédiaire du paramètre vjust (vertical justification). L’attribution d’une valeur vjust = -0.5 projette l’étiquette numérique immédiatement au-dessus de l’arête supérieure de la barre, assurant une lecture nette sur le fond neutre du graphique. Réciproquement, une valeur positive telle que vjust = 1.5 inscrit la valeur à l’intérieur même du volume coloré de la barre, juste sous son sommet, ce qui peut s’avérer judicieux pour les barres de très grande amplitude, sous réserve d’adapter la couleur typographique (argument color = "white") pour préserver un contraste suffisant avec la teinte de remplissage sous-jacente.
7.2 Formatage académique des étiquettes de données
L’injection brute de valeurs flottantes issues de computations matricielles dégrade instantanément la qualité d’une présentation scientifique. Les nombres réels générés par des fonctions comme mean() comportent couramment une dizaine de décimales résiduelles issues de l’arithmétique binaire en virgule flottante (ex. 42.1333333333). L’affichage direct de telles séquences sur un graphique surcharge visuellement la composition et contrevient aux règles universelles d’édition académique qui imposent un nombre de chiffres significatifs strictement cohérent avec la précision instrumentale de l’expérience.
Le formatage numérique préalable doit s’opérer au moyen de fonctions d’arrondi déterministes telles que round(valeur, 2) ou, de façon plus élégante et robuste, via les modules du package dédié scales. Ce dernier met à disposition des formateurs vectoriels spécialisés, à l’image de scales::number_format(accuracy = 0.1), scales::percent_format() ou scales::pvalue(). Ces outils automatisent l’alignement décimal, la gestion des zéros terminaux (en empêchant l’omission automatique du zéro final dans un nombre tel que « 4.10 ») et la substitution éventuelle des séparateurs décimaux selon les standards linguistiques en vigueur (point anglo-saxon vs virgule francophone).
En outre, l’adjonction de suffixes contextuels au sein de la chaîne de caractères finale consolide l’intelligibilité de la figure. En recourant à la fonction de concaténation de texte paste0() ou glue::glue(), l’analyste peut générer des chaînes combinant valeur numérique et symbole d’unité (ex. label = paste0(round(score, 1), " %") ou label = paste0(round(temps, 0), " ms")). Dans les configurations expérimentales comportant des valeurs d’amplitude nulles ou des données incomplètes, l’application d’un filtre conditionnel vectoriel via ifelse(valeur == 0, "", format(valeur)) permet de masquer les étiquettes à valeur nulle, désencombrant ainsi la ligne de base du graphique.
7.3 Usage de geom_label() pour un contraste optimal
Dans les configurations d’affichage denses où l’espace sus-jacent aux barres est restreint ou lorsque l’analyste fait le choix d’intégrer les données chiffrées à l’intérieur de zones géométriques complexes ou texturées, l’utilisation de texte brut sans contour via geom_text() peut entraîner des difficultés d’occlusion ou des pertes dramatiques de contraste lorsque la teinte du texte croise une arête géométrique ou une ligne de quadrillage du thème sous-jacent. La couche géométrique geom_label() apporte une réponse technique élégante à cette vulnérabilité perceptive.
Contrairement à geom_text() qui trace directement les glyphes vectoriels sur le canevas, geom_label() encapsule chaque fragment textuel au sein d’un cartouche polygonale opaque ou semi-translucide doté d’angles arrondis et d’une bordure périphérique. Ce boîtier protecteur isole optiquement l’étiquette numérique de l’arrière-plan, garantissant une lisibilité absolue indépendamment des fluctuations chromatiques des éléments graphiques situés en sous-couche. Tout comme pour la fonction textuelle standard, la synchronisation du positionnement horizontal s’opère rigoureusement via position = position_dodge(width = 0.9).
L’esthétique de ces cartouches textuels se calibre précisément au moyen d’arguments dédiés : label.size régit l’épaisseur du trait de bordure périphérique (une valeur 0.1 ou NA éliminant toute bordure visible pour ne conserver que l’îlot surfacique protecteur), label.padding détermine l’espace d’isolation interne entre le texte et les bords du cartouche (exprimé en unités lines), et alpha permet de régler l’opacité du fond du cartouche. En configurant un fond blanc semi-transparent (fill = "white", alpha = 0.75), l’analyste assure la lisibilité du chiffre tout en maintenant perceptible la silhouette continue de la barre de données située à l’arrière-plan.
8. Modélisation de l’incertitude : Barres d’erreur et intervalles de confiance
8.1 Fondements méthodologiques de l’erreur dans la restitution graphique
Dans la littérature scientifique contemporaine, la restitution d’une grandeur ponctuelle agrégée (telle qu’une moyenne d’échantillon) dénuée de toute quantification de sa variance intrinsèque est unanimement réprouvée par les normes éditoriales académiques internationales. Un diagramme en barres statique affichant des sommets nus masque l’hétérogénéité des sujets et empêche toute tentative d’évaluation visuelle de l’inférence. L’intégration de barres d’erreur constitue le fondement déontologique d’une visualisation scientifique rigoureuse, mais exige une distinction épistémologique stricte entre les différents indices de dispersion existants.
Trois métriques fondamentales se partagent l’espace méthodologique :
- L’écart-type (Standard Deviation, SD) : Cet indice purement descriptif quantifie la dispersion individuelle des observations brutes autour de la moyenne arithmétique au sein de l’échantillon mesuré. Il ne dépend pas mécaniquement de la taille d’échantillon (dans la mesure où il converge vers l’écart-type de la population cible) et décrit la variabilité biologique ou métrologique fondamentale du phénomène étudié.
- L’erreur standard de la moyenne (Standard Error of the Mean, SEM) : Cette grandeur inférentielle évalue la précision avec laquelle la moyenne d’échantillon estime la véritable moyenne paramétrique inconnue de la population parente. Calculée mathématiquement par la formule
SEM = SD / sqrt(n), elle décroît asymptotiquement à mesure que la taille de l’échantillon croît, reflétant le théorème central limite. - L’intervalle de confiance à 95 % (Confidence Interval, IC 95 %) : Dérivé d’une loi de Student à
n - 1degrés de liberté ou de techniques de bootstrap non paramétriques, l’intervalle de confiance délimite une plage probabiliste qui contiendrait la véritable moyenne de la population dans 95 % des procédures de rééchantillonnage théoriquement répétées à l’infini. Il constitue l’indicateur le plus robuste et le plus immédiatement interprétable par les pairs pour estimer la pertinence clinique ou expérimentale d’un effet observé.
8.2 Implémentation technique de geom_errorbar()
L’ancrage géométrique des marqueurs d’incertitude s’effectue sous ggplot2 par l’intermédiaire de la couche dédiée geom_errorbar(). L’architecture de cette fonction exige l’assignation explicite des deux bornes extrêmes délimitant la trajectoire linéaire du segment d’incertitude au sein du mapping esthétique aes() : la borne cartésienne inférieure via l’argument ymin, et la borne cartésienne supérieure via l’argument ymax. Ces grandeurs doivent être impérativement calculées lors de la phase préalable d’agrégation tabulaire (ex. ymin = moyenne - sem, ymax = moyenne + sem).
L’écueil de programmation le plus fréquent lors de l’adjonction de geom_errorbar() réside dans l’incohérence spatiale du décalage latéral. Par défaut, la fonction geom_errorbar() ne possède aucune conscience autonome de la largeur des rectangles dessinés par la couche geom_col() précédente. Si l’analyste stipule un décalage informel sans calibrage d’amplitude, les barres d’erreur s’alignent le long de segments verticaux asymétriques ou se positionnent toutes au centre du facteur discret primaire. Pour verrouiller un appariement géométrique absolu, il est indispensable de spécifier explicitement la fonction de décalage avec une amplitude strictly identique à celle utilisée pour les rectangles : position = position_dodge(width = 0.9).
Sur le plan stylistique, la largeur des empattements horizontaux ou chapeaux (caps) coiffant les extrémités des barres d’erreur se règle via le paramètre scalaire width (à ne pas confondre avec l’argument width de position_dodge). Alors que l’argument de position régit l’intervalle de décalage des axes, le paramètre width = 0.25 de la fonction géométrique contrôle l’envergure physique des chapeaux horizontaux. Un empattement excessif surcharge visuellement l’espace inter-barres ; une calibration sobre comprise entre 0.15 et 0.30 confère au tracé une finition académique irréprochable. L’ordre d’empilement des couches de code possède également son importance : en déclarant geom_errorbar() après geom_col(), on s’assure que les segments d’erreur sont dessinés par-dessus les masses volumiques des rectangles et ne sont jamais masqués par inadvertance.
8.3 Variantes alternatives : geom_linerange() et geom_pointrange()
Si la barre d’erreur à empattements horizontaux issue de geom_errorbar() demeure l’archétype visuel prédominant dans les publications de psychologie expérimentale et de pharmacologie, de nombreuses revues médicales et biostatistiques de premier plan préconisent des formes géométriques allégées afin d’optimiser le ratio encre-données et d’éviter l’encombrement graphique lorsque les groupes factoriels comportent un nombre élevé de modalités croisées.
La première alternative épurée réside dans la géométrie geom_linerange(). Cette instruction adopte une syntaxe strictement analogue à celle de geom_errorbar() (exigeant ymin et ymax ainsi que position = position_dodge(width = 0.9)), mais élimine purement et simplement les chapeaux horizontaux terminaux pour ne tracer qu’un segment vertical unidimensionnel épuré traversant le sommet de la barre. Cette suppression supprime un bruit géométrique superficiel et permet à l’œil d’estimer avec une netteté accrue les éventuels chevauchements longitudinaux d’intervalles de confiance entre deux sous-groupes adjacents.
Une seconde variante particulièrement sophistiquée est fournie par geom_pointrange(). Cette couche trace simultanément le segment vertical d’intervalle et y superpose un point focal central matérialisant l’estimation ponctuelle exacte de la moyenne arithmétique via l’argument y. Lorsqu’elle est combinée à des barres de colonnes dont l’opacité a été fortement atténuée (ex. geom_col(alpha = 0.4)), cette technique déplace subtilement la focalisation perceptive du lecteur de la masse volumique de la barre vers le point d’estimation paramétrique et son enveloppe probabiliste, constituant une transition méthodologique féconde entre le barplot conventionnel et le diagramme d’estimation de Cumming.
9. Contrôle géométrique avancé : Espacements, largeurs et chevauchements
9.1 Synchronisation des largeurs de barres et de décalage
La morphologie géométrique finale d’un diagramme en barres groupées résulte d’une interaction mathématique complexe entre deux paramètres scalaires distincts : la largeur physique intrinsèque des barres individuelles (paramétrée par l’argument width directement au sein de geom_col()) et la distance de translation spatiale appliquée aux centroïdes des barres au sein du groupe (paramétrée par l’argument width interne à la fonction position_dodge()). Une mauvaise compréhension de cette interaction est la cause principale de graphiques difformes, caractérisés par des barres qui se chevauchent de manière inesthétique ou, à l’inverse, qui s’amincissent de façon disproportionnée en laissant des espaces interstitiels béants.
Dans l’architecture de ggplot2, l’espace spatial séparant deux graduations consécutives sur l’axe discret des abscisses possède par convention une largeur unitaire standard normalisée à 1.0. Par défaut, la largeur intrinsèque d’une barre tracée via geom_col() est fixée à 0.9, ce qui réserve une marge inter-catégorielle de 0.1 (soit 10 % de l’espace unitaire) pour éviter que les barres de groupes factoriels voisins ne se touchent. Lorsque plusieurs barres sont décalées par position_dodge(), l’algorithme distribue les éléments le long de la largeur totale de décalage allouée.
Pour préserver une harmonie volumique parfaite, il est essentiel de respecter une règle de synchronisation simple : si l’on modifie la largeur de la géométrie via geom_col(width = W), il est impératif de paramétrer le décalage spatial en utilisant exactement la même valeur au sein de la fonction d’ajustement : position = position_dodge(width = W). Si l’on attribue une valeur de décalage supérieure à la largeur des barres (par exemple geom_col(width = 0.7) couplé à position_dodge(width = 0.9)), un intervalle vide apparaît mécaniquement entre les barres adjacentes d’un même groupe (espace intra-groupe), ce qui peut être recherché esthétiquement pour aérer une composition dense, sous réserve que cet espacement intra-groupe demeure strictement inférieur à l’espacement inter-groupes séparant les catégories majeures sur l’axe des abscisses.
9.2 Préservation de l’intégrité visuelle face aux catégories incomplètes
L’un des comportements algorithmiques les plus déconcertants de ggplot2 survient lorsqu’un jeu de données factoriel présente un déséquilibre structurel, c’est-à-dire lorsqu’une modalité secondaire de la variable de remplissage est totalement absente pour l’un des niveaux de la variable d’abscisse (donnée manquante structurelle ou effectif de cellule N = 0). Dans cette configuration, le moteur d’ajustement spatial position_dodge() déploie un mécanisme par défaut conçu pour préserver la largeur totale cumulée du groupe : l’option preserve = "total".
Sous ce mode par défaut, l’algorithme constate que le groupe déficitaire ne contient qu’une seule barre au lieu de deux ou trois. Pour compenser ce vide et occuper l’intégralité de la largeur spatiale dévolue au groupe, le système dilate automatiquement la barre solitaire restante, doublant ou triplant son épaisseur physique par rapport aux barres des groupes voisins. Cette distorsion asymétrique altère gravement l’intégrité sémiotique de la figure : l’œil humain interprète inconsciemment une barre anormalement épaisse comme portant un poids d’échantillon ou une importance statistique supérieure, alors qu’il s’agit d’un simple artefact computationnel.
Pour éradiquer ce comportement aberrant et forcer toutes les barres à conserver rigoureusement la même largeur d’empreinte géométrique quel que soit le nombre d’observations disponibles dans chaque strate, il convient de surcharger l’instruction de positionnement en configurant le paramètre de préservation unitaire : position = position_dodge(preserve = "single"). Grâce à cette directive, le système calcule l’épaisseur standard d’une barre unitaire en se basant sur le facteur le plus dense, et maintient cette dimension constante à travers l’ensemble du canevas, laissant un espace vide proprement identifiable là où la donnée fait défaut, ce qui informe honnêtement le lecteur sur la complétude des observations.
9.3 Inversion des axes cartésiens avec coord_flip()
Dans la conception éditoriale de diagrammes en barres groupées, les analystes sont fréquemment confrontés à des variables catégorielles comportant des intitulés textuels longs, des termes techniques complexes ou des descriptions d’items psychométriques impossibles à résumer en quelques caractères. Même avec une inclinaison angulaire des étiquettes à 45 degrés, la lisibilité sur un axe des abscisses horizontal devient critique dès lors que le nombre de modalités excède quatre ou cinq strates. La solution ergonomique par excellence consiste alors à transposer le système de coordonnées de 90 degrés afin d’orienter les barres horizontalement le long de l’axe longitudinal.
Historiquement, cette transposition s’exécutait en greffant l’opérateur de rotation cartésienne + coord_flip() à la fin du pipeline de traçage. Dans les versions contemporaines de ggplot2, il est désormais possible de réaliser cette opération de manière native et directe dès le mapping esthétique initial aes() en inversant simplement l’assignation des variables : la grandeur continue dépendante est affectée à x, tandis que la variable catégorielle primaire de partition est affectée à y (la variable de remplissage restant allouée à fill).
L’orientation horizontale offre des gains d’accessibilité considérables : les étiquettes textuelles de catégories s’alignent naturellement de gauche à droite sur un plan strictement horizontal, garantissant une lecture fluide de haut en bas analogue à celle d’une page de texte standard. Cette modification géométrique exige néanmoins un réajustement des paramètres d’alignement fin : les valeurs numériques et barres d’erreur doivent recalculer leur justification spatiale au moyen des arguments hjust (alignement horizontal) plutôt que vjust, assurant que les étiquettes d’annotations se déploient harmonieusement à droite de chaque extrémité de barre sans empiéter sur les bordures extérieures de la figure.
10. Extension multidimensionnelle par le facettage (Faceting)
10.1 Décomposition en sous-graphiques avec facet_wrap()
L’investigation de phénomènes multifactoriels complexes impose régulièrement d’examiner l’impact simultané de trois, voire quatre variables explicatives catégorielles distinctes. L’incorporation d’une troisième variable indépendante au sein d’un diagramme en barres groupées unitaire (par exemple en tentant d’introduire des hachures, des symboles géométriques supplémentaires ou un troisième niveau d’imbrication chromatique) conduit inévitablement à un encombrement sémiotique catastrophique, saturant instantanément la capacité de traitement cognitif du cerveau humain. Pour résoudre cette aporie de dimensionnalité, ggplot2 mobilise le concept de facettage (faceting), matérialisant le paradigme des « petits multiples » (small multiples) théorisé par Edward Tufte.
La fonction facet_wrap() constitue le mécanisme privilégié de décomposition unidimensionnelle étalée. Elle permet de fractionner l’échantillon global en sous-ensembles mutuellement exclusifs sur la base d’une variable tierce de stratification (telle que la tranche d’âge, le genre ou le centre hospitalier investigateurs), et de générer automatiquement une matrice régulière de sous-graphiques autonomes partageant le même canevas visuel. La syntaxe repose sur une formule R compacte, déclarée sous la forme facet_wrap(~ Variable_Tertiaire) ou via la fonction d’assistance facet_wrap(vars(Variable_Tertiaire)).
L’analyste dispose d’un contrôle typographique total sur la topologie spatiale de la mosaïque obtenue grâce aux paramètres de contrôle matriciel ncol et nrow, qui définissent respectivement le nombre de colonnes et de lignes d’affichage des sous-graphiques. Cette décomposition clarifie immédiatement la lecture : chaque facette présente un barplot groupé standard bivarié épuré, permettant à l’observateur d’effectuer des comparaisons locales intra-facette, puis de balayer transversalement l’ensemble des panneaux pour apprécier si la dynamique d’interaction bivariée observée demeure structurellement invariante à travers les différents niveaux de la troisième variable factorielle.
10.2 Matrices croisées bivariées avec facet_grid()
Lorsque le protocole de recherche scientifique s’appuie sur un plan d’échantillonnage factoriel complet impliquant quatre variables explicatives discrètes simultanées (par exemple : Facteur d’abscisse × Facteur de remplissage × Variable de stratification A × Variable de stratification B), l’usage de facet_wrap() atteint ses limites organisationnelles. Dans ce cadre quadri-dimensionnel, il convient de mobiliser l’instruction avancée facet_grid(), conçue pour construire une matrice spatiale bivariée rigoureusement structurée sous forme de tableau à double entrée.
La syntaxe canonique de facet_grid() s’exprime à travers une formule mathématique explicite reliant les variables de stratification verticale et horizontale : facet_grid(Ligne_Stratification ~ Colonne_Stratification). L’architecture graphique résultante segmente l’espace en lignes et colonnes coordonnées invariantes, offrant une rigueur analytique exceptionnelle pour ausculter des effets de second ordre ou des interactions d’ordre supérieur (interactions triples ou quadruples au sens de l’ANOVA).
Dans ce mode de projection matriciel, la gestion des échelles cartésiennes d’axes soulève un arbitrage fondamental. Par défaut, facet_grid() verrouille strictement des échelles d’axes identiques pour l’ensemble des sous-graphiques (scales = "fixed"). Cette contrainte est absolument vitale dans la grande majorité des investigations quantitatives, car elle garantit que la hauteur d’une barre dans la facette située au coin supérieur gauche est strictement comparable visuellement à celle située au coin inférieur droit. La relaxation de cette contrainte via l’argument scales = "free_y" (autorisant chaque panneau à ajuster dynamiquement ses limites d’ordonnées en fonction de l’amplitude locale de ses propres données) ne doit être concédée que dans des situations très circonscrites où les ordres de grandeur varient de plusieurs puissances de dix entre les strates, au risque déontologique d’induire le lecteur en erreur en lui faisant percevoir des variations locales mineures comme d’immenses fluctuations réelles.
10.3 Uniformisation thématique des bandeaux de facettes
L’adjonction de multiples sous-graphiques au moyen des fonctions de facettage enrichit la structure documentaire mais introduit un composant structurel additionnel susceptible d’alourdir la composition s’il n’est pas méticuleusement calibré : les bandeaux d’en-tête de facettes (désignés sous le vocable technique de strips). Par défaut, ces bandeaux apparaissent sous la forme de rectangles grisâtres surmontés d’une typographie sombre ordinaire, ce qui peut jurer avec une charte de publication épurée.
La personnalisation de ces bandeaux d’en-têtes s’effectue via les arguments dédiés de la fonction générale theme(), spécifiquement strip.background et strip.text. Pour inscrire le graphique dans les canons de l’esthétique scientifique contemporaine, il est de bon ton de délester le bandeau de son aplat coloré en assignant un fond totalement immaculé ou transparent via strip.background = element_rect(fill = "transparent", color = NA). Cette neutralisation supprime la sensation de cloisonnement visuel et intègre de manière organique les titres de facettes dans le flux spatial du document.
Parallèlement, la typographie des intitulés de facettes doit être soigneusement hiérarchisée par rapport aux libellés d’axes standards au moyen de strip.text = element_text(size = 11, face = "bold", color = "grey15", margin = margin(b = 6, t = 6)). L’adjonction de marges verticales contrôlées (fonction margin()) prévient tout risque de chevauchement entre la boîte de texte du bandeau et la bordure supérieure de la zone de traçage cartésienne, assurant une respiration typographique optimale qui rehausse la qualité professionnelle de l’article scientifique avant soumission éditoriale.
11. Dépannage, pièges courants et bonnes pratiques méthodologiques
11.1 Erreurs de syntaxe récurrentes et résolution des bugs
L’apprentissage pratique de l’écosystème ggplot2 confronte inévitablement les chercheurs à une série de dysfonctionnements algorithmiques typiques. Le premier écueil, universellement partagé par les utilisateurs néophytes, réside dans l’inversion conceptuelle entre l’argument fill et l’argument color. Comme énoncé précédemment, affecter la variable de sous-groupe à color au lieu de fill au sein de aes() a pour conséquence de tracer des rectangles aux intérieurs uniformément incolores (transparents) bordés de contours fins colorés, ce qui ruine l’impact visuel et compromet le décodage sémiotique du regroupement.
Le second dysfonctionnement le plus dommageable concerne le défaut de synchronisation lors de l’application combinée des barres de colonnes et des barres d’erreur. Si un statisticien applique un décalage informel position = "dodge" sans contraindre explicitement la largeur de décalage au sein d’un objet formel position_dodge(width = 0.9) à la fois dans geom_col() et dans geom_errorbar(), le compilateur R recalcule les espacements de façon indépendante pour chaque couche. Il en résulte un décalage asymétrique désastreux où les barres d’erreur se retrouvent décentrées, flottant à mi-chemin entre deux rectangles ou s’alignant sur les bords latéraux des polygones.
Un troisième piège réside dans la persistance spectrale de « niveaux de facteurs fantômes » (phantom factor levels). Lorsqu’un jeu de données fait l’objet d’un filtrage statistique préalable au moyen de dplyr::filter() pour exclure certaines catégories expérimentales, R conserve par défaut la mémoire historique de l’ensemble des niveaux d’origine dans les métadonnées de l’objet factor. Lors du traçage, ggplot2 réserve obstinément des espaces vides sur l’axe des abscisses ou dans la légende pour ces modalités désormais absentes de l’échantillon analysé. Pour assainir la structure factorielle et supprimer ces espaces morts inesthétiques, il convient d’invoquer impérativement la fonction de purge droplevels() ou d’adopter la fonction spécialisée forcats::fct_drop() sur le tableau filtré avant injection dans le canevas graphique.
11.2 Pièges d’intégrité sémiologique et de déformation visuelle
Au-delà des erreurs d’exécution de programmation, l’éthique de la visualisation scientifique impose le respect absolu de règles de conformité sémiotique sous peine d’altérer l’intégrité des conclusions transmises à la communauté académique. La règle déontologique cardinale gouvernant les diagrammes en barres — qu’ils soient simples, empilés ou groupés — réside dans l’interdiction formelle et absolue de tronquer l’axe des ordonnées à une valeur non nulle.
Contrairement aux diagrammes en points ou aux graphiques en lignes (qui codent la valeur quantitative par la position spatiale d’un point dans le repère cartésien), le diagramme en barres encode l’information statistique par la masse volumique surfacique du rectangle. Notre système visuel interprète inconsciemment et automatiquement le ratio physique entre les hauteurs des rectangles comme le reflet fidèle du ratio quantitatif existant entre les grandeurs mesurées. Si l’axe des ordonnées est arbitrairement tronqué pour débuter à une valeur plancher artificielle (par exemple débuter un axe à 90 pour illustrer des variations de pourcentages oscillant entre 92 % et 98 %), une variation réelle minime de quelques pourcents sera visuellement perçue comme un décuplement d’amplitude géométrique, induisant une distorsion manipulatoire des faits empiriques (phénomène documenté sous le nom de Lie Factor par Edward Tufte).
Dès lors qu’un protocole expérimental mesure des amplitudes dont les variations d’intérêt sont subtiles mais statistiquement déterminantes et requièrent une échelle d’ordonnées focalisée pour être perceptibles, l’analyste doit impérativement abandonner le diagramme en barres. Il convient alors de migrer vers des représentations n’encodant pas l’information par des volumes ancrés au sol : le diagramme de points reliés (point plot), le graphique deCleveland (Cleveland dot plot), ou encore des représentations distributionnelles enrichies de type raincloud plot (combinant distribution lissée par densité de noyau, boîte à moustaches minimale et nuage de points individuels bruts).
11.3 Directives pour la sauvegarde vectorielle haute résolution
L’ultime étape méthodologique d’un flux de travail reproductible réside dans l’exportation physique du graphique depuis l’environnement mémoire de R vers un support de stockage persistant. L’usage récréatif consistant à copier-coller manuellement l’image affichée dans la fenêtre graphique interactive d’un environnement de développement intégré (tel que RStudio) doit être définitivement banni : cette manipulation détruit la reproductibilité du protocole, dépend de la résolution arbitraire du moniteur vidéo utilisé et produit des images matricielles comprimées inexploitables lors des phases de photogravure éditoriale.
La fonction d’exportation standardisée de référence est ggsave(). Cet opérateur interagit directement avec les moteurs de rendu sous-jacents du système d’exploitation et garantit une restitution fidèle des proportions géométriques. Deux typologies fondamentales de formats de fichiers s’offrent à l’analyste :
- Les formats vectoriels (PDF, SVG, EPS) : Ces formats ne stockent pas une matrice finie de pixels, mais des équations géométriques décrivant les lignes, courbes, polygones et polices de caractères vectorielles. Le format PDF (Portable Document Format) ou SVG (Scalable Vector Graphics) constitue le choix privilégié absolu pour les soumissions académiques. Il autorise un agrandissement infini sans aucune pixellisation, garantit un rendu d’une netteté parfaite sur les presses d’imprimerie et permet aux graphistes des maisons d’édition d’ajuster ultérieurement les calques typographiques si nécessaire.
- Les formats matriciels haute résolution (TIFF, PNG) : Lorsqu’une revue impose impérativement un format d’image tramée, l’analyste doit rigoureusement étalonner la densité d’échantillonnage par le paramètre
dpi(dots per inch). Alors que le web se satisfait d’une résolution de 72 à 150 dpi, l’édition scientifique internationale requiert impérativement un calibrage minimal à300 dpipour les demi-teintes photographiques, et à600 dpivoire1200 dpipour les dessins aux traits vectoriels (line art).
De surcroît, il est crucial de paramétrer explicitement les grandeurs dimensionnelles métriques au sein de ggsave() via les arguments width, height et units = "cm" (ou "in"). En calibrant rigoureusement la largeur du graphique sur la largeur standard d’une simple colonne (typiquement environ 8,5 cm) ou d’une double colonne pleine page (environ 17,5 cm) conforme aux spécifications aux auteurs de la revue ciblée, l’analyste évite toute mise à l’échelle homothétique destructrice lors de la composition du document, garantissant que les tailles de polices spécifiées dans le code (ex. 9 points) seront rigoureusement respectées sur la page imprimée finale.
12. Études de cas appliquées et scripts R reproductibles complets
12.1 Cas pratique 1 : Étude de performance sportive (basketball)
Afin de concrétiser l’ensemble des concepts théoriques développés dans ce traité, nous déployons une première étude de cas complète, pleinement documentée et immédiatement exécutable dans toute session R moderne intégrant le méta-package tidyverse. Nous modélisons ici un jeu de données appliqué à l’analyse de la performance en basketball professionnel, examinant le nombre moyen de points inscrits par match en croisant deux facteurs orthogonaux : la franchise sportive d’appartenance (trois équipes professionnelles suivies au cours d’une saison) et le poste occupé sur le terrain (arrières, ailiers, pivots).
Le pipeline analytique prend en charge l’instanciation déterministe d’un jeu de données brut individuel, son agrégation descriptive avancée via les opérateurs de dplyr, le calcul rigoureux des grandeurs d’erreur standard de la moyenne, la conversion sécurisée des facteurs discrétisés, puis l’érection du diagramme en barres juxtaposées mobilisant geom_col(), geom_errorbar(), une palette chromatique accessible issue de RColorBrewer et des annotations textuelles directes synchronisées.
Dans cette modélisation, chaque ligne du bloc de code ci-dessous participe à la chaîne de traitement graphique reproductible :
Le chargement préalable des librairies s’effectue via les instructions library(tidyverse) et library(scales). La structure de données initiale agrège les points individuels en calculant systématiquement l’effectif n(), la moyenne arithmétique mean(Points) et la dispersion sd(Points)/sqrt(n()) par couple factoriel Equipe et Poste. Lors de l’assemblage graphique, la couche geom_col(position = position_dodge(width = 0.85), width = 0.8, color = "black", linewidth = 0.3) assure la juxtaposition ordonnée des rectangles avec un contour anthracite net. La couche geom_errorbar(aes(ymin = Moyenne - SEM, ymax = Moyenne + SEM), position = position_dodge(width = 0.85), width = 0.25, linewidth = 0.4) verrouille l’ancrage spatial des segments d’erreur au sommet des colonnes respectives.
La personnalisation de la palette est dévolue à l’instruction scale_fill_brewer(palette = "Set2"), qui octroie des teintes pastel différenciées garantissant un contraste parfait et une accessibilité optimale pour les lecteurs daltoniens. L’instruction scale_y_continuous(expand = expansion(mult = c(0, 0.15))) force la ligne de base du graphique à démarrer exactement sur la coordonnée cartésienne zéro (éliminant la marge de décalage résiduelle automatique de ggplot2) tout en accordant une marge d’extension de 15 % au sommet de l’axe pour accueillir confortablement les annotations textuelles chiffrées générées par geom_text(aes(label = round(Moyenne, 1)), position = position_dodge(width = 0.85), vjust = -1.2, size = 3.2, fontface = "bold"). Le canevas est finalisé par theme_classic(), complété d’une légère rotation des libellés d’abscisse et d’une relocalisation de la légende sur le flanc supérieur du graphique.
L’analyse visuelle du graphique résultant révèle immédiatement des contrastes structurels majeurs : les ailiers de l’équipe Alpha dominent significativement la production offensive par rapport à leurs homologues des équipes Beta et Gamma, tandis que la distribution de points des pivots apparaît remarquablement homogène entre les franchises, illustrant l’aptitude unique du barplot groupé à restituer sans équivoque des profils d’interactions factorielles complexes.
12.2 Cas pratique 2 : Essai randomisé contrôlé en psychologie cognitive
La seconde étude de cas transpose nos investigations dans l’environnement hautement contraint d’un essai clinique randomisé contrôlé en psychologie expérimentale et neurosciences comportementales. Le protocole évalue l’efficacité de deux thérapies comportementales innovantes comparées à une condition contrôle sous placebo pour réduire la latence de traitement lors d’une tâche d’attention sélective complexe, tout en évaluant si cette efficacité thérapeutique est modérée par le niveau de base d’anxiété des participants (stratifié en niveau « Modéré » vs « Sévère »).
Dans ce scénario d’inférence avancée, nous simulons une cohorte clinique standardisée de 240 patients. Le pipeline statistique dérive les moyennes marginales de performance et implémente des intervalles de confiance à 95 % asymptotiques basés sur la distribution t de Student. Le script intègre une palette chromatique manuelle stricte basée sur des codes hexadécimaux institutionnels, met en œuvre l’option de préservation unitaire preserve = "single" pour anticiper les déséquilibres de cellule, habille le tracé à l’aide de bandeaux de métadonnées complets conformes aux directives APA 7, et se conclut par l’instruction d’exportation vectorielle haute définition vers un fichier PDF prêt pour la soumission éditoriale.
La séquence technique modélise l’assignation factorielle ordonnée au moyen de factor(Traitement, levels = c("Contrôle", "TCC Standard", "Thérapie Digitale")) et de factor(Anxiete, levels = c("Modérée", "Sévère")). L’agrégation condense la variable de latence temporelle (exprimée en millisecondes) en dérivant les bornes inférentielles d’intervalles de confiance calculées par qt(0.975, df = n() - 1) * (sd(Temps) / sqrt(n())). Dans le constructeur graphique, geom_col() est paramétré avec un facteur d’opacité alpha = 0.85 et une largeur de décalage calibrée à position = position_dodge(width = 0.88).
L’harmonisation visuelle repose sur scale_fill_manual(values = c("Modérée" = "#2C3E50", "Sévère" = "#E74C3C")), confrontant une nuance bleu ardoise sobre à un rouge brique maîtrisé pour dramatiser la gravité clinique du sous-groupe le plus exposé. La couche d’erreur mobilise geom_errorbar(aes(ymin = IC_Inf, ymax = IC_Sup), position = position_dodge(width = 0.88), width = 0.2, color = "black", linewidth = 0.5). Les labels textuels encapsulent la valeur exacte de la latence ainsi que l’incertitude inférentielle associée via paste0(round(Temps_Moy), " ms") positionné précisément à l’intérieur du cartouche des barres à l’aide de geom_label().
Le bloc de paramétrage thématique theme() affine l’équilibre global en calibrant les titres d’axes, en supprimant l’armature de quadrillage superflue et en insérant une légende explicative compacte dans le coin supérieur droit du tracé. Enfin, l’appel à la fonction ggsave("Essai_Clinique_Cognition.pdf", width = 18, height = 11, units = "cm", dpi = 600, device = cairo_pdf) mobilise le moteur vectoriel avancé Cairo, assurant une intégration vectorielle d’une précision microscopique, dénuée de tout artefact typographique, directement transposable dans le manuscrit final destiné aux comités de lecture internationaux.
Références
- Brewer, C. A. (2015). Designing better maps: A guide for GIS users (2nd ed.). Esri Press. https://colorbrewer2.org/
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://ggplot2.tidyverse.org/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science & Business Media. https://doi.org/10.1007/0-387-28695-0