
Dans le champ de l’ingénierie des données, de l’économétrie et de la gestion moderne des systèmes d’information, le tableur Microsoft Excel demeure une plateforme fondamentale d’agrégation, de transformation et d’investigation analytique. Néanmoins, la fiabilité opérationnelle et la validité inférentielle de tout modèle décisionnel reposent sur un postulat critique : la pureté et l’intégrité du corpus de données sous-jacent. L’apparition d’enregistrements dupliqués — qu’elle découle de transferts asynchrones entre bases relationnelles, d’erreurs humaines lors de la saisie manuelle ou de concaténations défectueuses issues de progiciels de gestion intégrés — constitue l’une des anomalies structurelles les plus préjudiciables à la modélisation statistique.
La quantification précise des doublons ne se résume pas à une opération cosmétique de nettoyage de surface. Elle représente une composante essentielle de l’assurance qualité des données, conditionnant directement l’exactitude des calculs de dispersion, la calibration des coefficients de régression et la véracité des métriques de reporting financier. Selon les directives établies par le support technique de Microsoft et les standards internationaux de gestion de l’information, identifier et quantifier les redondances matricielles sans corrompre les enregistrements sources requiert une maîtrise rigoureuse de l’arsenal fonctionnel d’Excel.
Cet article examine l’ensemble des protocoles méthodologiques et algorithmiques permettant de dénombrer les doublons au sein de Microsoft Excel. De l’évaluation scalaire univariée au moyen de la fonction standard NB.SI jusqu’aux architectures de traitement par moteur Power Query et aux procédures matricielles vectorisées sous Visual Basic for Applications (VBA), ce guide exhaustif offre une décomposition théorique et opérationnelle des meilleures pratiques de l’audit de données.
1. Fondements théoriques et définition des données redondantes dans Excel
1.1 Définition analytique du doublon dans les structures matricielles
D’un point de vue strictement formel, une matrice de données tabulaires se compose d’un ensemble ordonné de vecteurs lignes représentant des observations individuelles et de vecteurs colonnes formalisant des variables dimensionnelles ou quantitatives. Dans ce paradigme, une ambiguïté conceptuelle récurrente concerne la distinction entre une valeur redondante partielle et une observation strictement identique. Une redondance partielle survient lorsqu’une entité présente une identité partagée sur un sous-ensemble restreint d’attributs — par exemple, un même numéro de client apparaissant dans plusieurs transactions distinctes — tandis qu’une observation strictement identique correspond à un vecteur ligne complet dont chaque scalaire constitutif est rigoureusement superposable à un autre vecteur du même espace matriciel.
L’impact de la redondance non contrôlée sur les analyses statistiques descriptives et inférentielles est délétère. Dans les calculs d’agrégation élémentaire, la présence d’occurrences parasites fausse les estimateurs de tendance centrale en déplaçant artificiellement la moyenne arithmétique vers les clusters surreprésentés. Au niveau des mesures de variabilité, l’introduction de doublons contracte ou dilate de façon illégitime la variance empirique, introduisant un biais systématique qui invalide la distribution normale sous-jacente requise pour les tests d’hypothèses, tels que le test t de Student ou les analyses de variance factorielles. Un coefficient de détermination issu d’une régression linéaire exécutée sur une base contenant des redondances résiduelles verra sa robustesse mathématique compromise par l’inflation artificielle des degrés de liberté.
La typologie des données concernées complexifie davantage cette analyse. Les chaînes textuelles sont particulièrement vulnérables aux décalages morphologiques subtils, aux variations de casse ou aux espacements parasites qui échappent aux filtres superficiels. Les valeurs numériques subissent quant à elles les aléas de la précision en virgule flottante inhérente aux architectures de calcul d’Excel, basée sur le standard binaire IEEE 754. Enfin, les formats temporels représentent un vecteur de confusion critique : dans le moteur d’Excel, une date n’est qu’un nombre séquentiel entier incrémenté depuis le 1er janvier 1900, auquel s’adjoint une fraction décimale matérialisant l’horodatage précis. Une divergence microscopique de quelques secondes entre deux horodatages produit deux valeurs sous-jacentes distinctes, transformant un doublon fonctionnel en deux entités mathématiquement disjointes lors de l’évaluation.
1.2 Enjeux de l’intégrité des données dans les protocoles d’investigation
L’intégrité des données constitue la clé de voûte de toute démarche scientifique, clinique ou financière. Dans le cadre de protocoles d’investigation clinique ou d’échantillonnages expérimentaux, l’intrusion d’enregistrements dupliqués génère des biais de sélection substantiels. Si un sujet expérimental se retrouve comptabilisé deux fois dans une cohorte médicale à la suite d’un dysfonctionnement d’interopérabilité entre les systèmes de dossiers patients informatisés, les taux de prévalence calculés ainsi que les estimations du risque relatif sont invalidés. De tels écarts méthodologiques compromettent l’homogénéité des groupes d’intervention et de contrôle, conduisant à des erreurs de type I (faux positifs) ou de type II (faux négatifs) potentiellement lourdes de conséquences éthiques et scientifiques.
Il apparaît impératif d’établir une démarcation claire entre l’élimination définitive d’un doublon et son dénombrement quantitatif préalable. Si l’action réflexe de l’analyste inexpérimenté consiste souvent à appliquer la commande native de suppression des doublons, cette approche destructive s’avère méthodologiquement hasardeuse. La suppression irréversible efface les traces de l’anomalie d’origine, masquant des défaillances structurelles dans la chaîne de transmission des données. À l’inverse, le simple comptage quantitatif préserve l’intégrité contextuelle de la base de données brute, permettant de quantifier le degré de corruption du jeu de données sans altérer la topologie matricielle d’origine.
La préservation de la traçabilité des enregistrements bruts lors de l’audit s’inscrit au cœur des exigences réglementaires modernes, telles que les normes émises par l’Organisation internationale de normalisation (notamment la norme ISO 9001 sur le management de la qualité) ou les cadres d’intégrité numérique édictés par l’Agence européenne des médicaments. Un protocole d’audit irréprochable exige que chaque modification apportée à un corpus fasse l’objet d’une documentation systématique. Dénombrer précisément les occurrences permet d’établir des métadonnées de contrôle, offrant aux auditeurs la possibilité de reproduire le cheminement analytique depuis l’état initial altéré jusqu’à la base nettoyée et validée.
2. Comptage élémentaire des occurrences individuelles avec la fonction NB.SI
2.1 Syntaxe fondamentale et référence absolue
Dans l’environnement de calcul francophone d’Excel, la fonction NB.SI représente l’instruction scalaire fondamentale pour évaluer la fréquence d’apparition d’un critère prédéterminé au sein d’une plage matricielle unidimensionnelle. Sa signature algorithmique s’énonce sous la forme explicite =NB.SI(Plage; Critère), où l’argument Plage délimite le vecteur source des données à examiner et l’argument Critère spécifie la condition logique ou la valeur scalaire de référence déterminant l’incrémentation du compteur d’occurrences.
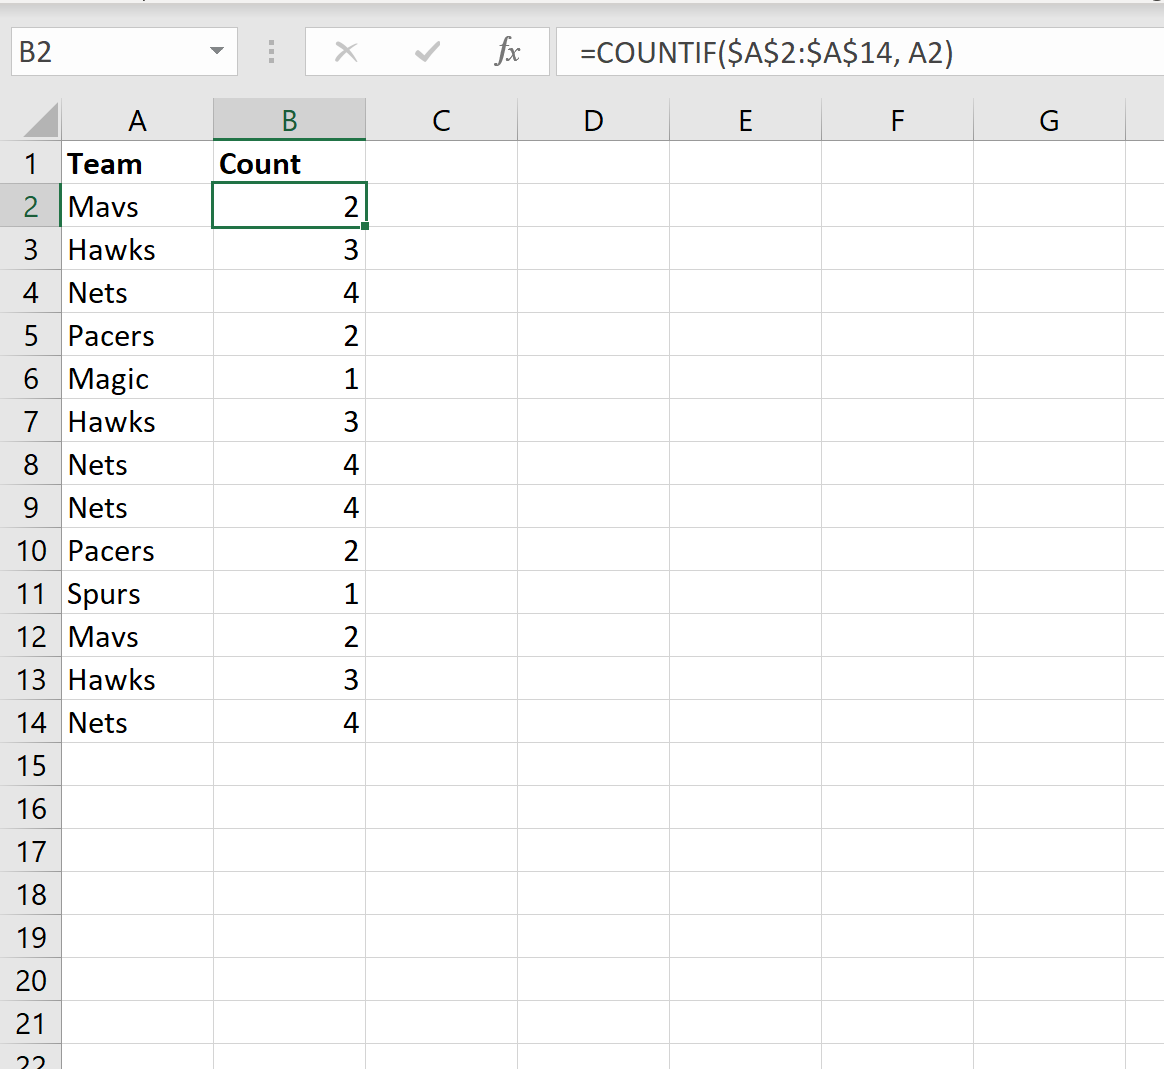
L’utilisation judicieuse de cette fonction repose sur la maîtrise des types d’adressage de cellules. Pour que l’évaluation demeure cohérente lorsqu’une formule est répliquée verticalement sur plusieurs centaines ou milliers de lignes, il est impératif de figer la plage d’analyse au moyen de références absolues, signalées par le symbole dollar encadrant les coordonnées matricielles. Considérons un registre univarié contenant des identifiants d’inventaire situés entre la cellule A2 et la cellule A14. Si la formule est inscrite dans la colonne adjacente en B2 selon la syntaxe =NB.SI($A$2:$A$14; A2), la plage de recherche demeure strictement ancrée sur les coordonnées géographiques fixes de la collection, tandis que l’argument relatif A2 s’incrémente de manière fluide lors de l’étirement vers le bas (devenant A3, A4, etc.).
Cette distinction est fondamentale : l’omission des ancrages absolus transformerait l’instruction en =NB.SI(A2:A14; A2), ce qui entraînerait un glissement progressif de la fenêtre d’investigation vers le bas de la feuille de calcul lors de la recopie. En cellule B5, par exemple, la plage analysée deviendrait A5:A17, tronquant arbitrairement les observations situées en amont et produisant des résultats mathématiquement erronés. Le strict respect du verrouillage absolu garantit que chaque entité est systématiquement confrontée à l’intégralité du corpus univarié.
2.2 Interprétation quantitative du vecteur de sortie
L’exécution de la formule =NB.SI($A$2:$A$14; A2) génère un vecteur numérique de même dimension que la plage d’origine, fournissant pour chaque observation sa cardinalité d’apparition globale. L’interprétation analytique de ce vecteur s’articule autour de seuils numériques précis. Une observation dont le résultat d’évaluation produit une valeur unitaire égale à 1 est formellement qualifiée de valeur unique ou isolée. Cette occurrence n’apparaît qu’une seule et unique fois dans l’ensemble de la distribution étudiée, attestant de son absence de redondance au sein du référentiel sélectionné.
Dès lors que la valeur renvoyée est supérieure ou égale à 2, l’élément est caractérisé comme appartenant à une classe d’équivalence dupliquée. Un coefficient 2 indique que l’observation est présente en double exemplaire dans la base ; une valeur scalaire 5 signale une récurrence quintuple. Cette quantification scalaire transcende le simple constat binaire de présence ou d’absence, conférant à l’analyste une mesure exacte de la sévérité de la redondance pour chaque entité spécifique.
Pour fluidifier la lecture analytique de ces vecteurs de sortie dans des environnements décisionnels partagés, il est d’usage d’adjoindre des formats de restitution personnalisés ou des masques d’affichage explicites. Par l’intermédiaire de fonctions conditionnelles combinées ou de masquages typographiques, l’analyste peut convertir ces scalaires bruts en étiquettes sémantiques telles que « Observation Unique » pour la valeur 1 et « Entrée Répétée (n) » pour les valeurs supérieures. Une telle formalisation facilite l’intégration ultérieure de ces données dans des filtres automatiques sans obliger les tiers à interpréter manuellement les décomptes bruts.
2.3 Limites intrinsèques de la fonction NB.SI standard
Bien que d’une accessibilité remarquable pour les opérations quotidiennes, la fonction NB.SI souffre de limitations computationnelles et structurelles strictes qui restreignent son utilisation dans le cadre du traitement de mégadonnées. Sur le plan de la complexité algorithmique temporelle, l’application itérative de la formule NB.SI sur chaque ligne d’une colonne de taille importante génère une charge de calcul de complexité quadratique, notée mathématiquement en notation grand O comme étant d’ordre O(n²). Dans une feuille de calcul excédant cent mille lignes, le moteur de calcul d’Excel est contraint d’effectuer jusqu’à dix milliards d’évaluations scalaires, ce qui entraîne une dégradation spectaculaire de la réactivité de l’application, voire le blocage du thread de calcul principal.
Une seconde faille réside dans le traitement des chaînes textuelles longues. Les fonctions de la famille NB.SI ne sont pas programmées pour évaluer correctement des chaînes de caractères dont la longueur excède le seuil critique de 255 caractères typographiques. Lorsqu’une cellule contient un bloc textuel dépassant cette taille limite — situation fréquente lors de l’analyse de journaux d’événements réseau, de requêtes SQL ou de descriptions médicales standardisées —, la fonction génère fréquemment l’erreur fatale #VALEUR! ou tronque arbitrairement l’évaluation, produisant un faux négatif silencieux extrêmement préjudiciable pour l’intégrité de l’audit.
Enfin, la fonction NB.SI applique une interprétation contextuelle agressive des caractères dits génériques (wildcards), tels que l’astérisque (*), le point d’interrogation (?) ou le tilde (~). Si les données brutes contiennent des codes industriels, des identifiants chimiques ou des expressions techniques intégrant ces symboles littéraux sans échappement préalable par un tilde, le moteur d’évaluation les interprète comme des opérateurs logiques de substitution plutôt que comme des caractères stricts. Par conséquent, des chaînes distinctes telles que « PROD*A » et « PROD-A » peuvent être comptabilisées à tort comme des occurrences identiques, faussant totalement le résultat du dénombrement.
3. Dénombrement cumulatif séquentiel pour l’identification de l’ordre d’apparition
3.1 Mécanisme de la plage expansive semi-bloquée
Le dénombrement global par NB.SI fournit la fréquence totale d’une observation mais demeure incapable de différencier son instance originale de ses répliques ultérieures. Pour pallier cette lacune fonctionnelle et reconstruire la chronologie interne des enregistrements, il est nécessaire de déployer une formule reposant sur le mécanisme d’une plage expansive semi-bloquée. Cette formulation élégante repose sur l’alternance méthodique entre une référence absolue sur l’origine du vecteur et une référence relative sur sa borne terminale : =NB.SI($A$2:A2; A2).
Le fonctionnement de cette référence mixte lors de l’étirement vertical le long de la colonne B mérite une décomposition mécanique détaillée. Lorsque la formule réside en B2, la plage scrutée se limite strictement à l’intervalle $A$2:A2, évaluant le contenu de A2. Lors du glissement en cellule B3, la référence supérieure figée demeure invariante en $A$2, mais la borne inférieure relative se dilate automatiquement pour embrasser la coordonnée A3, devenant ainsi $A$2:A3. Cette expansion incrémentielle se poursuit de façon continue jusqu’à la terminaison de la série d’observations.
Ce comportement dynamique confère au vecteur de sortie une propriété mathématique discriminante essentielle : il génère un compteur de récidive séquentiel ordonné. La première apparition chronologique d’une valeur dans la lecture descendante de la feuille se solde inévitablement par l’obtention d’un scalaire égal à 1, étant donné qu’à cet instant précis du balayage, aucun antécédent n’a encore été rencontré dans la sous-matrice supérieure. En revanche, toute réapparition ultérieure de la même valeur produit une valeur strictement incrémentée : 2 pour la seconde occurrence, 3 pour la troisième, et ainsi de suite. Ce dispositif permet de segmenter instantanément l’échantillon entre points d’ancrage initiaux et répétitions parasites subséquentes.
3.2 Construction d’indicateurs booléens d’exclusion
L’exploitation pratique de ce décompte cumulatif séquentiel s’articule principalement autour de la génération d’indicateurs logiques ou de marqueurs de contrôle conditionnels. En encapsulant la formule incrémentielle au sein d’une instruction conditionnelle binaire standard, l’auditeur de données est en mesure d’automatiser le tri fonctionnel : =SI(NB.SI($A$2:A2; A2)=1; « Original »; « Doublon »). Cette écriture attribue sans équivoque le statut d’enregistrement maître à la première instance détectée, tout en fléchant impérativement les répétitions suivantes vers une catégorie d’exclusion systématique.
Cette approche présente un avantage analytique considérable : la construction d’un index de purge conditionnelle préservant le premier signal sans altérer la structure physique de la feuille de calcul. Contrairement aux outils natifs de déduplication qui éliminent physiquement les lignes de la table et empêchent tout contrôle rétrospectif contradictoire, l’adjonction de cet indicateur booléen conserve l’intégralité du matériel empirique dans son état originel d’acquisition.
L’analyste dispose dès lors de la liberté opérationnelle d’appliquer un filtre automatique standard sur la colonne d’audit pour isoler les doublons surnuméraires à des fins d’inspection qualitative, de calculer la proportion relative d’anomalies par rapport au corpus total, ou d’exporter temporairement le sous-ensemble épuré vers une destination analytique tierce. Cette méthodologie garantit une traçabilité totale et réversible, indispensable dans les environnements soumis à des audits de conformité stricts.
4. Identification et dénombrement des doublons multicritères avec NB.SI.ENS
4.1 Extension multivariée pour enregistrements complexes
Dans la majorité des architectures de bases de données réelles, la redondance ne s’évalue que très rarement à l’échelle d’une variable univariée isolée. Un nom de famille identique ou une date de transaction partagée ne caractérisent pas en soi une répétition anormale. L’identification rigoureuse d’un doublon structurel exige alors l’analyse simultanée de multiples champs d’attributs au sein de chaque enregistrement matriciel. Pour traiter ces dépendances croisées, l’environnement Excel propose la fonction multicritère NB.SI.ENS, conçue pour opérer des intersections logiques ET sur plusieurs plages dimensionnelles distinctes.
La formalisation générique de cette instruction s’exprime selon la séquence suivante : =NB.SI.ENS(Plage1; Critère1; Plage2; Critère2; …; PlageN; CritèreN). Chaque condition ajoutée restreint l’espace des solutions, la fonction n’incrémentant son compteur scalaire que pour les observations qui satisfont rigoureusement et simultanément l’ensemble des contraintes vectorielles imposées. Considérons une base d’enregistrements hospitaliers comprenant en colonne A le nom patronymique, en colonne B le prénom du patient et en colonne C sa date de naissance complète. L’expression permettant de dénombrer la récurrence exacte d’un même individu s’écrit formellement : =NB.SI.ENS($A$2:$A$500; A2; $B$2:$B$500; B2; $C$2:$C$500; C2).
Cette logique d’intersection multidimensionnelle offre une granularité d’investigation indispensable pour démasquer les quasi-doublons ou les enregistrements partagés complexes. Elle permet de s’assurer qu’une coïncidence nominative entre deux individus distincts n’est pas qualifiée à tort de redondance, protégeant ainsi l’analyse contre les faux positifs qui détruiraient la validité des études démographiques ou épidémiologiques.
4.2 Optimisation des performances sur bases multidimensionnelles
Si la fonction NB.SI.ENS se révèle puissante, sa transposition aveugle sur des volumes matriciels denses pose d’importants défis d’optimisation computationnelle. L’évaluation simultanée de plusieurs critères vectoriels étend considérablement le nombre d’opérations élémentaires exécutées par le processeur. Chaque condition supplémentaire multiplie les cycles d’accès à la mémoire cache pour vérifier l’alignement des index matriciels, ce qui induit une latence substantielle sur des classeurs hébergeant plusieurs dizaines de milliers de lignes.
Pour contourner ce goulot d’étranglement algorithmique sans sacrifier la rigueur de l’évaluation multicritère, une technique consiste à recourir à une colonne d’indirection calculée via la concaténation de chaînes textuelles. En créant en amont une clé primaire composite artificielle au sein d’une colonne technique — par le biais d’une formule du type =A2& »| »&B2& »| »&C2, intégrant judicieusement un caractère séparateur non ambigu —, l’analyste synthétise l’espace multidimensionnel en un vecteur univarié unique. Dès lors, le dénombrement n’exige plus qu’une simple fonction NB.SI scalaire standard appliquée sur cette clé synthétique, ce qui allège considérablement la charge de traitement globale du moteur de calcul.
Il demeure toutefois crucial d’insister sur une condition structurelle inviolable lors de l’usage de NB.SI.ENS : la stricte concordance dimensionnelle des plages d’investigation. L’ensemble des arguments de plage vectorielle transmis à la fonction doivent obligatoirement posséder des dimensions identiques (même hauteur de début et de fin de ligne, et même orientation). Tout désalignement dimensionnel — par exemple en associant une plage $A$2:$A$500 à une plage $B$2:$B$499 — se solde par le déclenchement immédiat d’une erreur d’incompatibilité de dimension matricielle #VALEUR!, bloquant l’ensemble de la chaîne de traitement décisionnelle.
5. Calcul de la cardinalité globale des valeurs uniques et sans doublon
5.1 Modélisation mathématique par inversion des fréquences
Au-delà de l’identification locale des doublons ligne par ligne, l’une des problématiques fondamentales de la théorie de l’information consiste à déterminer le cardinal distinct global d’une distribution matricielle, c’est-à-dire le nombre précis d’entités uniques sous-jacentes abstraction faite de leurs répétitions. Historiquement, avant l’avènement des fonctionnalités de propagation matricielle dynamique, les ingénieurs de données ont formalisé une solution élégante basée sur la théorie de la sommation par pondération inverse des fréquences absolues.
Le principe mathématique sous-jacent est d’une remarquable simplicité axiomatique : si un élément spécifique apparaît avec une fréquence empirique notée k au sein d’une collection, chacune de ses occurrences physiques contribue pour une fraction égale à exactement 1/k à la somme totale de cette classe d’équivalence. Dès lors, en sommant l’ensemble de ces fractions unitaires sur l’ensemble de la distribution, la contribution cumulative de cette entité redondante est rigoureusement égale à :
$$\sum_{i=1}^{k} \frac{1}{k} = k \times \frac{1}{k} = 1$$
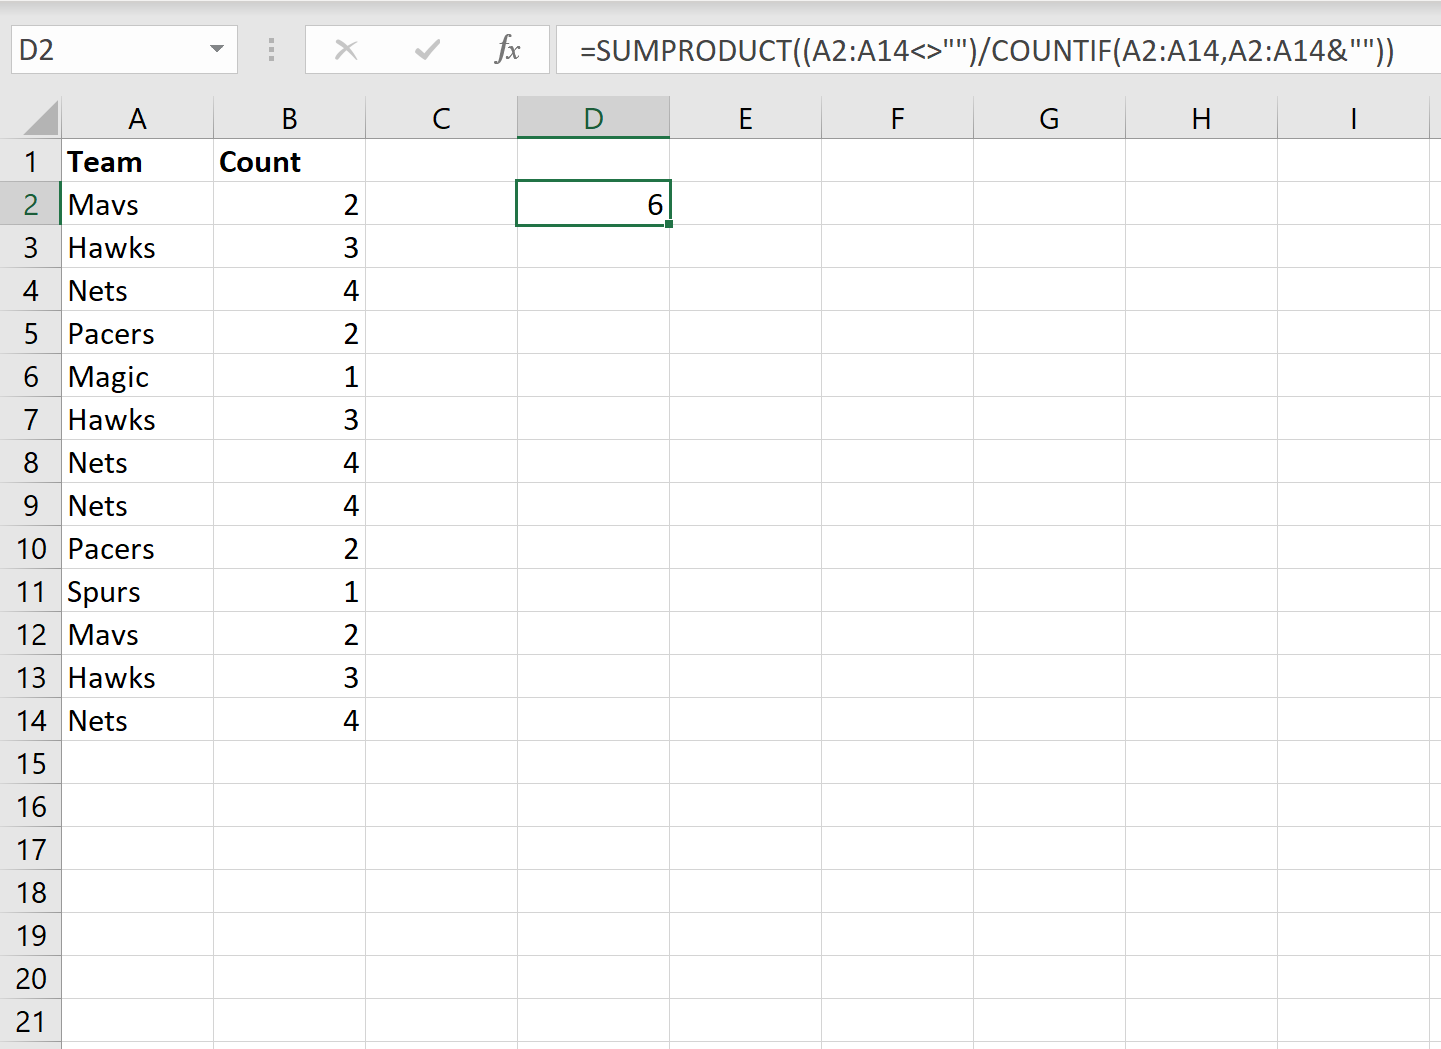
Transposée dans le formalisme des formules de calcul Excel, cette modélisation théorique donne naissance à l’expression matricielle classique : =SOMME(1/NB.SI(A2:A14; A2:A14)). Dans cette configuration, le second argument de la fonction NB.SI n’est pas un scalaire isolé mais la matrice de données elle-même, forçant la fonction à calculer un vecteur de fréquences complet. La division scalaire 1/NB.SI convertit instantanément ce vecteur de fréquences en un vecteur de poids harmoniques qui, une fois consolidé par la fonction SOMME, fournit la cardinalité exacte des valeurs distinctes contenues dans l’échantillon.
Néanmoins, cette formulation mathématique élégante présente une vulnérabilité critique face à l’incomplétude structurelle des données : le risque de division par zéro. Si la plage examinée héberge ne serait-ce qu’une seule cellule vide ou non initialisée, l’évaluation de NB.SI pour cette entrée manquante retourne la valeur 0. L’opération fractionnaire subséquente 1/0 provoque l’interruption du processus par la génération de l’erreur mathématique #DIV/0!, neutralisant l’intégralité du calcul sur l’ensemble de la feuille de calcul.
5.2 Formulation robuste avec SOMMEPROD pour tableaux denses
Pour neutraliser le risque de division par zéro tout en s’affranchir de la validation manuelle complexe par les touches Ctrl+Maj+Entrée inhérente aux formules matricielles classiques pré-modernes, la pratique recommandée s’est orientée vers l’usage de la fonction SOMMEPROD combinée à une technique de neutralisation vectorielle par concaténation de chaînes nulles. Cette instruction avancée s’articule sous la syntaxe canonique suivante :
=SOMMEPROD((A2:A14″ »)/NB.SI(A2:A14; A2:A14& » »))
La robustesse de ce montage repose sur deux barrières mathématiques et logiques hautement sophistiquées. En premier lieu, l’expression (A2:A14″ ») agit comme un filtre logique univarié qui génère un vecteur booléen constitué de VRAI pour les cellules renseignées et de FAUX pour les cellules dépourvues de contenu. Dans le cadre de l’arithmétique interne de la fonction SOMMEPROD, ces valeurs booléennes sont implicitement coercées en scalaires binaires 1 et 0 lors des opérations arithmétiques, annulant ainsi mécaniquement la contribution de toute cellule vide au numérateur.
En second lieu, l’adjonction de l’opérateur de concaténation associé à une chaîne de caractères vide à la fin du critère — formulé par A2:A14& » » — empêche la fonction NB.SI de renvoyer une fréquence nulle face à une cellule vacante. En forçant la conversion interne des cellules vides en chaînes de texte vides de longueur zéro, NB.SI évalue ces occurrences résiduelles et renvoie au dénominateur le décompte total des cellules vides présentes dans la plage au lieu de la valeur 0. Dès lors, pour toute cellule vide, la fraction évaluée se formalise sous la forme 0/m (où m représente le nombre de cellules vides), ce qui donne rigoureusement 0 et élimine définitivement toute possibilité d’interruption par une erreur #DIV/0!.
Cette approche robuste garantit une stabilité algorithmique totale sur des tableaux denses contenant des lacunes d’échantillonnage ou des champs optionnels non renseignés. De plus, la fonction SOMMEPROD gérant nativement le traitement matriciel vectorisé sans nécessiter d’instructions de compilation spécifiques de la part de l’utilisateur, elle réduit drastiquement les risques d’invalidation du calcul lors des manipulations courantes du classeur par des opérateurs tiers.
6. Exploitation des fonctions matricielles dynamiques modernes
6.1 Extraction et comptage instantané avec UNIQUE et LIGNES
L’introduction du moteur de calcul matriciel dynamique au sein des versions récentes de Microsoft 365 et des éditions contemporaines d’Excel a constitué un changement de paradigme fondamental dans la manipulation des structures de données. Auparavant contraints par des formules imbriquées complexes et rigides, les analystes disposent désormais d’opérateurs vectoriels natifs capables de propager leurs résultats de manière fluide sur les plages adjacentes. L’instruction pivot de cette révolution est la fonction UNIQUE, conçue pour isoler sans effort l’ensemble des observations distinctes d’un ensemble matriciel.
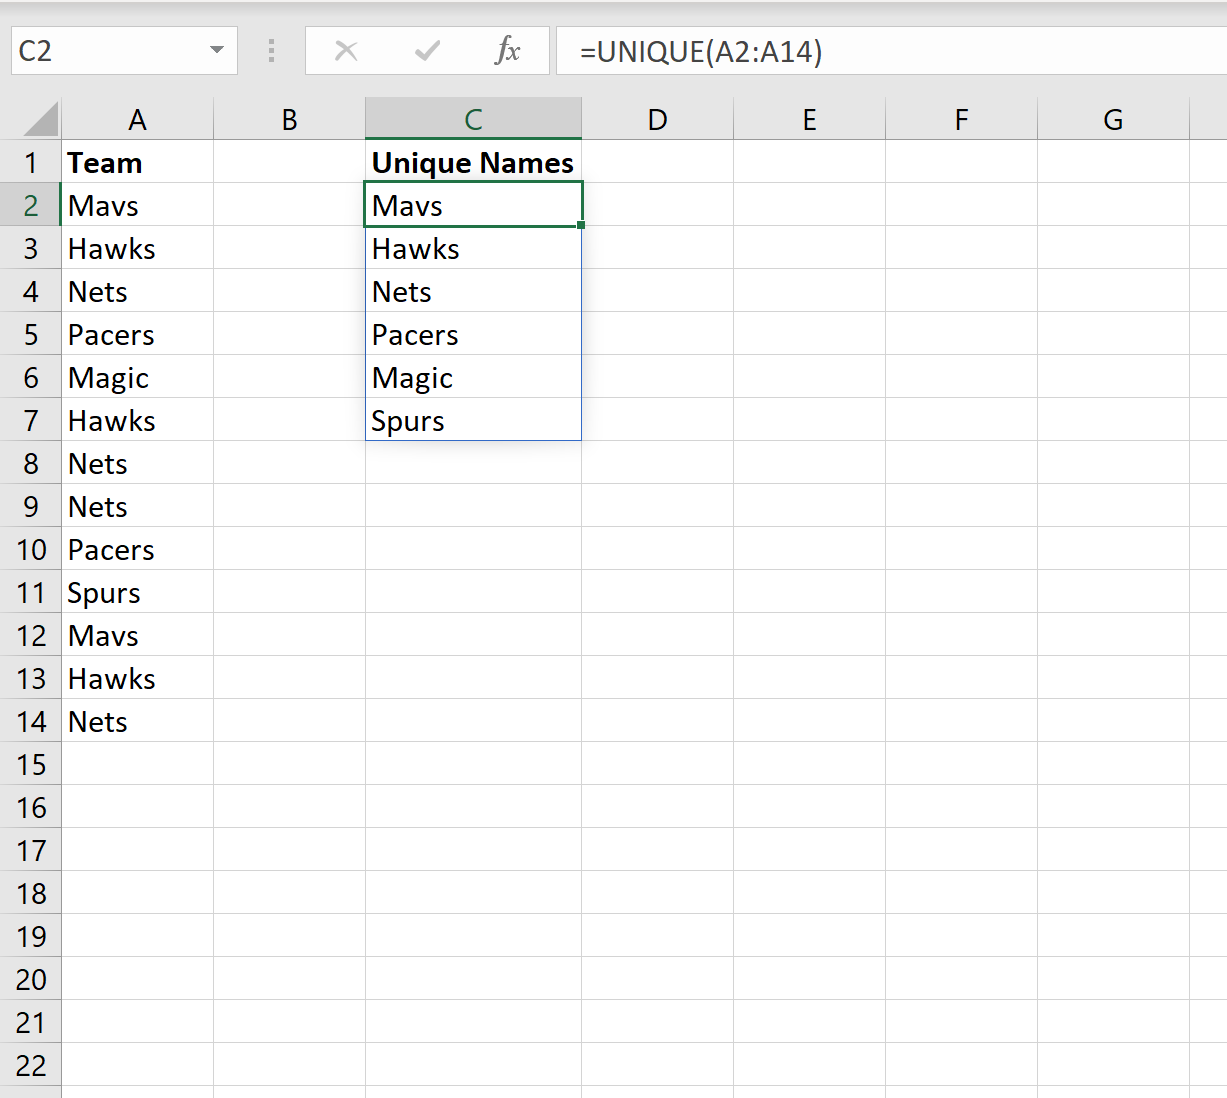
L’application brute de la formule =UNIQUE(A2:A14) dans une cellule cible a pour effet d’instancier un vecteur étendu (plage de débordement) contenant une copie épurée de la source, où chaque modalité n’est représentée qu’une seule et unique fois. Si cette fonction modifie profondément l’extraction visuelle, son association synergique avec la fonction de métadonnées géométriques LIGNES transforme le processus de dénombrement global en une opération algorithmiquement directe et élégante : =LIGNES(UNIQUE(A2:A14)).
Dans cette architecture moderne, l’opérateur UNIQUE prend en charge la réduction dimensionnelle de la matrice en mémoire vive, tandis que l’opérateur LIGNES évalue instantanément la cardinalité verticale du tableau résultant. Cette approche élimine le recours aux divisions harmoniques lourdes et résout les problèmes de complexité quadratique associés aux anciennes fonctions. La consommation de ressources mémoire est optimisée et l’expression gagne en lisibilité sémantique, facilitant la maintenance et l’audit du code fonctionnel par des équipes d’analystes pluridisciplinaires.
6.2 Filtrage exclusif des éléments strictement dupliqués
La puissance du moteur matriciel dynamique ne se borne pas à l’extraction des valeurs uniques globales ; elle permet également de cibler et d’extraire les éléments spécifiquement corrompus par la redondance. La fonction UNIQUE intègre dans sa signature complète un troisième argument optionnel booléen hautement spécialisé : =UNIQUE(matrice; [par_colonne]; [exactement_une_fois]). En valorisant ce dernier paramètre à VRAI, la fonction inverse son filtre traditionnel et extrait exclusivement les éléments qui ne disposent d’aucun doublon dans la série originelle.
Toutefois, dans le cadre d’un audit de conformité de données, l’objectif fondamental consiste généralement à isoler non pas les éléments singuliers, mais précisément la liste restrictive des observations récurrentes qui polluent le corpus d’investigation. Pour matérialiser ce rapport d’audit automatisé sans écrire la moindre ligne de code macroscopique, l’analyste conjugue la fonction de filtrage vectoriel FILTRE avec la fonction matricielle NB.SI et l’opérateur de réduction UNIQUE au sein d’une formule composite de haut niveau :
=UNIQUE(FILTRE(A2:A14; NB.SI(A2:A14; A2:A14)>1))
Cette expression opère en trois temps logiques successifs. Premièrement, le vecteur d’évaluation interne NB.SI(A2:A14; A2:A14)>1 génère un masque logique booléen qui identifie chaque cellule de la plage dont la fréquence est strictement supérieure à l’unité. Deuxièmement, la fonction FILTRE utilise ce masque pour élaguer la distribution et ne retenir que les observations en situation de redondance. Troisièmement, la fonction englobante UNIQUE consolide ces éléments dupliqués filtrés afin de ne restituer chaque anomalie qu’une seule fois dans la liste d’audit finale. Le résultat génère une nomenclature instantanée, dynamique et auto-actualisable de l’ensemble des doublons du jeu de données source.
7. Mise en évidence visuelle et audit interactif par mise en forme conditionnelle
7.1 Application des règles graphiques intégrées
L’exploration visuelle constitue une phase précoce incontournable de tout diagnostic d’intégrité de données. Microsoft Excel intègre nativement, au sein de son module de mise en forme conditionnelle, un sous-système de détection automatisée permettant de modifier instantanément la signature chromatique des cellules en fonction de leur statut d’unicité ou de redondance. Accessible via le cheminement de commande Accueil > Mise en forme conditionnelle > Règles de mise en surbrillance des cellules > Valeurs en double, cet outil applique une couche de présentation dynamique sans altérer la valeur sous-jacente des enregistrements.
L’interface offre à l’analyste le choix binaire de formater soit les valeurs dupliquées (l’ensemble des occurrences dont la fréquence est supérieure ou égale à 2), soit, à l’inverse, les valeurs strictement uniques de l’échantillon. Cette méthode fournit un retour visuel immédiat, particulièrement appréciable lors de la présentation synthétique d’un jeu de données à des parties prenantes non techniciennes ou lors de phases de contrôle qualité préliminaires sur des registres de petite dimension.
Néanmoins, la dépendance exclusive envers ces règles graphiques natives présente des contraintes sévères qu’un auditeur méthodique se doit de mesurer. Sur les bases de données volumineuses excédant plusieurs dizaines de milliers de lignes, le moteur de rendu graphique d’Excel subit des pénalités d’affichage considérables, l’évaluation de la mise en forme s’exécutant sur le thread d’interface graphique principal. De surcroît, cette approche visuelle se révèle incapable de hiérarchiser les redondances : une cellule présente en double exemplaire reçoit exactement la même coloration d’alerte qu’une valeur répétée mille fois, masquant la structure distributive réelle des erreurs.
7.2 Règles personnalisées basées sur des formules analytiques
Pour dépasser les restrictions d’expressivité des règles prédéfinies et concevoir un dispositif d’audit interactif plus informatif, il est recommandé de substituer aux styles automatiques des règles personnalisées fondées sur des expressions logiques formelles. En accédant au gestionnaire de règles de mise en forme conditionnelle et en sélectionnant la modalité Utiliser une formule pour déterminer pour quelles cellules le format sera appliqué, l’ingénieur de données bénéficie d’une liberté algorithmique totale.
La règle fondamentale pour signaler les cellules dupliquées consiste à renseigner une formule basée sur la fonction NB.SI verrouillée sur sa plage mais relative sur son point d’origine, par exemple : =NB.SI($A$2:$A$100; A2)>1. Cette écriture ordonne au moteur de styles de calculer la fréquence globale de chaque cellule et d’appliquer le format graphique retenu uniquement si le décompte dépasse l’unité. Il devient dès lors aisé de mettre en place une coloration hiérarchique étagée — un code couleur de type « carte thermique » — en configurant plusieurs règles concurrentes dotées d’ordres de priorité séquentiels :
- Règle de sévérité critique (Rouge carmin) : =NB.SI($A$2:$A$100; A2)>=5
- Règle d’anomalie modérée (Orange ambré) : =NB.SI($A$2:$A$100; A2)>=3
- Règle de duplication élémentaire (Jaune pâle) : =NB.SI($A$2:$A$100; A2)=2
Ce protocole de diagnostic visuel rapide permet aux réviseurs d’évaluer d’un simple coup d’œil non seulement la présence d’anomalies de saisie, mais également leur niveau de criticité au sein du modèle opérationnel. L’utilisation d’une référence cumulative de type =NB.SI($A$2:A2; A2)>1 permet de ne colorer que les répliques parasites, laissant la première occurrence dans son formatage standard. Cela réduit la saturation visuelle et met en évidence les lignes superflues à cibler pour les opérations d’épuration.
8. Agrégation et synthèse de fréquence via les tableaux croisés dynamiques
8.1 Paramétrage architectural du tableau croisé dynamique
Lorsque le volume des observations atteint des échelles dimensionnelles où le recalcul de formules scalaires commence à dégrader la réactivité du classeur, le tableau croisé dynamique (TCD) s’impose comme une alternative architecturale majeure. Conçu spécifiquement pour le traitement analytique en mémoire vive (OLAP), le moteur interne de pivotement d’Excel agrège les tables de données avec une efficacité computationnelle nettement supérieure à celle des fonctions standard de feuille de calcul.
Pour construire une matrice de diagnostic des redondances au moyen d’un tableau croisé dynamique, l’analyste sélectionne la table de données cible et déploie un canevas de pivotement sur une nouvelle feuille de calcul. L’opération architecturale s’effectue en glissant la variable nominative ou l’identifiant technique à auditer simultanément dans deux sections fonctionnelles de l’interface de conception : dans la zone des Lignes (pour structurer la consolidation unitaire des modalités distinctes) et dans la zone des Valeurs (pour initialiser le calcul de fréquence).
Par défaut, si la variable sélectionnée est de nature textuelle, Excel lui applique la fonction d’agrégation Nombre, qui calcule la cardinalité physique d’apparition de la clé dans chaque sous-groupe. Si la colonne est typée comme numérique, le tableur applique par défaut une fonction d’agrégation Somme ; il est alors impératif d’intervenir manuellement dans les paramètres du champ de valeurs pour modifier cette mesure en Nombre. Une fois la table d’agrégation générée, l’analyste procède à un tri décroissant sur la colonne des effectifs calculés. Cette disposition place immédiatement les doublons les plus critiques au sommet de la hiérarchie visuelle, mettant en lumière les anomalies les plus sévères du jeu de données.
8.2 Filtrage contextuel des récurrences supérieures à l’unité
La restitution exhaustive de toutes les modalités distinctes au sein du tableau croisé dynamique n’étant pas nécessaire lorsque seul l’audit des anomalies est recherché, il convient de restreindre l’affichage aux seules occurrences multiples. Cette opération s’effectue au moyen de l’application d’un filtre contextuel numérique avancé. En cliquant sur le menu déroulant du champ des étiquettes de lignes, l’opérateur sélectionne Filtres s’appliquant aux valeurs > Supérieur à… et fixe le seuil critique d’exclusion à la valeur scalaire 1.
Cette action élague instantanément le rapport de synthèse de toutes les observations singulières conformes, ne laissant subsister dans la structure pivotée que les éléments dont la multiplicité indique une redondance avérée. Pour les architectures de données plus avancées intégrant le Modèle de données d’Excel (adossé au moteur tabulaire Power Pivot), il devient même possible de calculer un dénombrement distinct natif au travers du langage DAX (Data Analysis Expressions), offrant une granularité analytique supplémentaire.
L’avantage opérationnel déterminant du tableau croisé dynamique réside dans sa réactualisation asynchrone maîtrisée. Alors que les formules analytiques traditionnelles s’exécutent de façon continue à chaque interaction physique avec la feuille de calcul — consommant inutilement des cycles processeur précieux —, le tableau croisé dynamique maintient une image statique en mémoire jusqu’à ce qu’un ordre de rafraîchissement soit formellement émis. Cette caractéristique en fait l’outil de prédilection pour l’investigation des grandes bases d’enregistrements transactionnels, alliant fluidité d’utilisation et puissance de traitement statistique.
9. Audit structurel et dépouillement à grande échelle avec Power Query
9.1 Importation et préparation du flux de données
Dans les contextes d’entreprise où la manipulation des données s’inscrit dans des processus de production récurrents et automatisés, les mécanismes fondés sur les formules de calcul classiques montrent rapidement leurs limites en matière de gouvernance et de reproductibilité. L’utilisation du moteur ETL (Extract, Transform, Load) intégré d’Excel, incarné par la technologie Power Query, représente la méthodologie la plus pérenne pour conduire un audit structurel des redondances. Fonctionnant sur la base du langage fonctionnel M, Power Query permet d’appliquer une suite d’opérations d’ingénierie des données rigoureuses et totalement auditables.
Le processus débute par l’ingestion de la matrice source dans l’environnement Power Query via la commande Données > Obtenir des données > À partir d’un tableau/d’une plage. Dès son initialisation, le moteur applique une étape d’évaluation typologique sur l’ensemble des colonnes. Cette normalisation préalable des types de données (conversion explicite en types Texte, Entier 64 bits, Date/Heure) est fondamentale pour prémunir l’analyse contre les faux négatifs. Par exemple, deux valeurs visuellement identiques mais dont l’une est stockée sous forme textuelle et l’autre sous forme d’entier numérique ne sauraient être agrégées sans cette conversion d’alignement préalable.
La force architecturale de cette approche réside dans la préservation absolue de la table source. Contrairement aux modifications destructives susceptibles d’altérer la grille de calcul Excel, Power Query opère dans un bac à sable mémoire hermétique. Chaque étape de nettoyage et de contrôle est séquentiellement enregistrée sous la forme d’une instruction fonctionnelle M immuable, préservant l’intégrité de la source tout en consignant l’historique complet des transformations à des fins de contrôle interne.
9.2 Mise en œuvre des transformations de regroupement
Une fois le schéma relationnel stabilisé et typé, l’identification algorithmique des doublons s’articule autour de l’instruction native Regrouper par (Group By), située dans l’onglet Accueil ou Transformer de l’éditeur de requêtes. Cette commande permet de définir une clé d’agrégation dimensionnelle univariée ou composite (multicritère) et d’appliquer une opération de réduction sur le reste des enregistrements.
Dans la boîte de dialogue de paramétrage du regroupement, l’analyste sélectionne la ou les colonnes d’identification constituant la signature du doublon potentiel. Il configure ensuite une nouvelle colonne d’agrégation — communément baptisée Frequence_Occurrence — en lui assignant l’opération d’évaluation Compter les lignes. Pour des investigations plus exhaustives requérant la conservation des attributs secondaires de chaque transaction, l’opérateur peut parallèlement adjoindre une seconde mesure de regroupement appliquant l’opération Toutes les lignes, ce qui encapsule les enregistrements sources correspondants dans des sous-tables imbriquées de type table interne.
Le code M généré par cette manipulation s’exprime selon une syntaxe déclarative formelle :
Table.Group(EtapePrecedente, {« Identifiant_Client »}, {{« Nombre_Occurrences », each Table.RowCount(_), Int64.Type}})
À l’issue de cette opération, la table résultante affiche chaque modalité distincte associée à son cardinal d’apparition. L’analyste applique alors un filtre relationnel descendant en configurant la condition [Nombre_Occurrences] > 1. Cette transformation isole instantanément le sous-ensemble structurel des redondances, éliminant sans ambiguïté les observations non problématiques du pipeline de traitement.
9.3 Injection du rapport d’anomalies dans le classeur de travail
La finalisation de l’investigation sous Power Query réside dans l’exportation contrôlée du rapport de redondance vers l’environnement classeur de travail standard. L’analyste dispose de deux modes fondamentaux de restitution via l’option Fermer et charger dans… : l’injection physique sous la forme d’un tableau structuré autonome au sein d’une nouvelle feuille de calcul dédiée, ou la création d’une simple Connexion uniquement couplée à l’intégration éventuelle dans le Modèle de données.
Le choix d’une feuille d’audit distincte permet d’isoler la nomenclature des erreurs au sein d’un espace de travail clairement identifié, séparé de la base de production courante. Le bénéfice méthodologique réside dans l’automatisation intégrale du processus d’audit : lors de l’intégration de nouveaux relevés ou de mises à jour périodiques de la table source, un simple clic sur le bouton Actualiser tout déclenche la réexécution séquentielle de l’ensemble des étapes de transformation M compilées, régénérant instantanément le registre des anomalies sans nécessiter la moindre intervention de réécriture fonctionnelle.
En matière de performances computationnelles, le moteur d’exécution de Power Query surpasse nettement l’évaluation matricielle de formules de feuille de calcul sur des volumes supérieurs à un demi-million d’enregistrements. Grâce à son traitement par flux optimisé en langage compilé C++ sous-jacent et à sa gestion économe des structures d’indexation, Power Query prévient les blocages d’interface graphique et les dépassements de mémoire vive qui surviennent couramment lors de l’usage massif de fonctions volatiles ou matricielles traditionnelles.
10. Résolution des pièges typographiques et normalisation textuelle préalable
10.1 Neutralisation des espaces invisibles et caractères non imprimables
Dans la pratique courante du traitement de données, un pourcentage élevé de faux négatifs — c’est-à-dire d’enregistrements fonctionnellement dupliqués mais considérés comme disjoints par les algorithmes de recherche — trouve son origine dans des corruptions typographiques invisibles à l’œil nu. Parmi ces anomalies, les espaces superflus en début ou fin de chaîne textuelle ainsi que les caractères de contrôle non imprimables représentent les écueils les plus fréquents lors des imports de fichiers CSV, d’extractions web ou de dumps de bases relationnelles legacy.
La standardisation pré-analytique requiert le déploiement d’une chaîne de nettoyage combinant plusieurs fonctions textuelles spécialisées. La fonction élémentaire SUPPRESPACE supprime les espaces initiaux, les espaces terminaux et réduit les séquences d’espaces internes consécutifs à un intervalle simple standard. Cependant, cette fonction s’avère totalement inopérante face au caractère d’espace insécable, codifié sous la valeur décimale 160 au sein de la table ASCII (ou en encodage HTML), très fréquemment rencontré dans les flux issus d’applications web ou de progiciels européens. Pour neutraliser ce caractère spécifique, il est impératif d’intégrer une opération de substitution explicite.
La formule de normalisation complète d’une cellule textuelle brute s’articule selon l’architecture suivante :
=SUPPRESPACE(EPURAGE(SUBSTITUE(A2; CAR(160); » « )))
Dans cette expression, la fonction SUBSTITUE commence par convertir chaque occurrence du caractère ASCII 160 en un espace standard standardisé de code 32. La fonction EPURAGE intervient ensuite pour éliminer l’ensemble des 32 premiers caractères non imprimables de la table ASCII 7 bits (tels que les sauts de ligne, les tabulations et les retours chariot). Enfin, la fonction SUPPRESPACE procède à l’élagage final des espaces redondants. La génération d’une colonne technique assainie appliquant cette formule en amont des calculs de dénombrement garantit la totale comparabilité des chaînes et supprime les biais d’invisibilité typographique.
10.2 Prise en compte ou exclusion de la casse typographique
Un autre angle mort majeur de l’évaluation standard sous Excel réside dans la gestion de la casse typographique (différenciation entre lettres majuscules et lettres minuscules). Par conception interne, les fonctions d’interrogation courantes du tableur telles que NB.SI, NB.SI.ENS ou RECHERCHEV sont intrinsèquement insensibles à la casse. Pour ces fonctions, les chaînes de caractères « PARIS », « Paris » et « paris » sont traitées comme des entités strictement identiques, renvoyant un décompte agrégé indifférencié.
Si cette insensibilité contextuelle s’avère souvent avantageuse pour gommer les incohérences de saisie humaine, elle devient profondément préjudiciable dans des contextes techniques exigeant une stricte fidélité binaire, tels que l’audit de clés de hachage cryptographique, de mots de passe temporaires, d’identifiants sensibles ou de codes industriels normalisés. Pour contourner cette limite et instaurer un dénombrement sensible à la casse, l’analyste doit mobiliser la fonction EXACT, qui procède à une comparaison bit à bit stricte de deux chaînes textuelles et renvoie un résultat booléen exclusif.
Puisque la fonction EXACT ne compare nativement que deux éléments scalaires à la fois, son extrapolation matricielle pour le dénombrement global exige son imbrication au sein d’une fonction d’agrégation vectorielle comme SOMMEPROD :
=SOMMEPROD(–EXACT($A$2:$A$100; A2))
Le double opérateur unaire négatif (–) applique une coercition arithmétique transformant les résultats logiques VRAI et FAUX issus de la fonction EXACT en scalaires numériques correspondants 1 et 0. La fonction SOMMEPROD procède ensuite à la sommation unitaire de ce vecteur binaire. Cette formulation garantit qu’une chaîne telle que « ID-Alpha » ne sera pas comptabilisée comme un doublon de « ID-ALPHA », préservant ainsi la rigueur d’investigation exigée par les protocoles techniques les plus pointus.
11. Programmation procédurale Visual Basic for Applications (VBA) pour routines automatisées
11.1 Algorithme de comptage par dictionnaire de données (Scripting.Dictionary)
Pour les ingénieurs système et auditeurs confrontés à des classeurs massifs dont la structure exclut l’usage de Power Query ou l’insertion de colonnes de formules intermédiaires, le recours au langage procédural Visual Basic for Applications (VBA) offre une alternative d’une grande efficacité. Si une double boucle imbriquée classique en VBA souffre des mêmes tares de lenteur quadratique O(n²) que les fonctions de feuille mal configurées, l’instanciation en mémoire vive d’un objet de table de hachage via la bibliothèque Scripting.Dictionary permet d’abaisser la complexité algorithmique globale à un ordre linéaire O(n).
L’algorithme de hachage stocke chaque valeur sous la forme d’une clé textuelle unique associée à une charge utile numérique faisant office de compteur de fréquence. Le balayage séquentiel de la matrice ne s’effectue dès lors qu’en une seule passe : pour chaque cellule lue, l’algorithme interroge le dictionnaire via la méthode native Exists. Si la clé n’est pas encore présente, elle est initialisée avec la valeur 1 ; dans le cas contraire, son compteur associé est incrémenté d’une unité.
La procédure s’articule selon la séquence conceptuelle suivante :
- Extraction intégrale de la plage de cellules cibles dans un tableau matriciel Variant en mémoire vive pour minimiser les accès lents au modèle d’objet Excel (COM).
- Instanciation tardive de l’objet dictionnaire : Set dict = CreateObject(« Scripting.Dictionary »).
- Configuration du mode de comparaison textuelle selon le niveau d’exigence (binaire ou textuel) via la propriété CompareMode.
- Itération séquentielle sur la dimension verticale du tableau en mémoire avec incrémentation conditionnelle de la clé.
- Restitution directe du vecteur de dénombrement calculé dans une matrice de sortie réinjectée d’un seul bloc sur la feuille de calcul.
Ce protocole de traitement en mémoire vive garantit des temps d’exécution fulgurants, réduisant à quelques fractions de seconde l’audit complet de jeux de données comportant plusieurs centaines de milliers d’enregistrements, là où des formules de feuille de calcul conventionnelles provoqueraient des latences prolongées.
11.2 Création d’une fonction personnalisée (UDF)
Au-delà des procédures autonomes par macro-commandes de traitement par lot, l’environnement VBA autorise l’extension de la bibliothèque fonctionnelle native d’Excel au travers de la conception de fonctions définies par l’utilisateur (User-Defined Functions ou UDF). Cette modalité permet d’encapsuler la complexité de l’audit de doublons au sein d’une formule réutilisable directement dans la grille de calcul, sous une syntaxe épurée telle que =COMPTER_DOUBLONS(Plage; Valeur).
La structure formelle de cette fonction personnalisée s’implémente au sein d’un module standard selon les règles d’ingénierie logicielle suivantes :
Function COMPTER_DOUBLONS(ByVal PlageSource As Range, ByVal ValeurCible As Range, Optional ByVal RespecterCasse As Boolean = False) As Long
À l’intérieur de la routine, une gestion rigoureuse des exceptions et des états limites est mise en œuvre. La fonction vérifie préalablement que les références transmises ne pointent pas vers des cellules générant des erreurs internes, que la plage d’investigation n’est pas totalement vide et que les types de données sous-jacents peuvent faire l’objet d’une comparaison logique stable. En intégrant un argument optionnel booléen pilotant la sensibilité à la casse, l’UDF offre une adaptabilité analytique supérieure aux fonctions natives du tableur.
Néanmoins, le déploiement de ces fonctions personnalisées en environnement professionnel requiert une vigilance particulière sur le plan de la gouvernance informatique. L’usage de macros impose l’enregistrement des classeurs sous des extensions spécifiques autorisant le code exécutable (.xlsm ou .xlsb), ce qui peut déclencher des alertes de sécurité lors des échanges par messagerie ou entrer en conflit avec les politiques de restriction d’exécution de code imposées par les directions des systèmes d’information. De surcroît, les fonctions personnalisées UDF écrites en VBA ne bénéficient pas nativement de l’accélération multithread du moteur de calcul interne d’Excel, un facteur à considérer lors de leur dimensionnement sur de très larges volumes.
12. Synthèse comparative et arbre décisionnel pour l’environnement de production
12.1 Matrice d’évaluation des performances computationnelles
Le choix d’une méthodologie d’identification et de dénombrement des doublons ne saurait être laissé au hasard ou relever d’une simple préférence personnelle ; il doit découler d’un arbitrage technique rigoureux prenant en considération les dimensions quantitatives du corpus, les exigences de réactualisation opérationnelle et le niveau de technicité des utilisateurs finaux du modèle. Le tableau analytique suivant synthétise les propriétés comparées des différentes approches explorées :
| Méthodologie | Complexité Algorithmique | Volumétrie Optimale | Sensibilité à la Casse | Mode d’Actualisation | Impact Mémoire / CPU |
|---|---|---|---|---|---|
| NB.SI standard | Quadratique O(n²) | < 10 000 lignes | Non | Dynamique (Calcul standard) | Élevé sur grand volume |
| NB.SI expansif ($A$2:A2) | Quadratique O(n²) | < 10 000 lignes | Non | Dynamique (Calcul standard) | Très élevé sur grand volume |
| SOMMEPROD & EXACT | Quadratique O(n²) | < 5 000 lignes | Oui | Dynamique (Calcul matriciel) | Critique sur grand volume |
| UNIQUE & LIGNES (DYN) | Quasi-linéaire O(n log n) | < 200 000 lignes | Non | Dynamique native | Optimisé (Multi-thread) |
| Tableau Croisé Dynamique | Quasi-linéaire O(n log n) | > 500 000 lignes | Non (Sauf Data Model) | Asynchrone (Sur commande) | Très faible (Hébergé RAM) |
| Power Query (M) | Linéaire O(n) | Illimitée (Mégadonnées) | Oui (Nativement) | Asynchrone (Sur commande) | Très optimisé (Hors-grille) |
| VBA (Scripting.Dictionary) | Linéaire O(n) | > 500 000 lignes | Configurable | Procédural (Événementiel) | Négligeable (Passe unique) |
L’analyse de cette matrice met en lumière des lignes de rupture technologiques nettes. Pour les petits volumes de traitement (< 10 000 enregistrements), les formules de feuille de calcul (NB.SI, fonctions matricielles dynamiques) demeurent les plus indiquées en raison de leur réactivité instantanée et de leur transparence visuelle directe. Dès que la volumétrie dépasse le seuil critique des 50 000 observations, l’utilisation de formules scalaires répliquées doit être proscrite au profit des tableaux croisés dynamiques ou des requêtes Power Query, sous peine d’engendrer des temps de latence préjudiciables à la productivité des utilisateurs.
12.2 Protocole normalisé pour l’assurance qualité des classeurs d’analyse
Afin de prémunir les organisations contre les défaillances décisionnelles induites par des données corrompues, tout classeur d’analyse d’envergure doit être soumis à un protocole standardisé d’assurance qualité en cinq phases séquentielles immuables :
Phase 1 : Ingestion et assainissement morphologique préliminaire. Dès l’intégration des flux de données brutes, appliquer systématiquement les procédures d’élagage des caractères invisibles et des espaces insécables via l’expression combinée =SUPPRESPACE(EPURAGE(SUBSTITUE(…))). Cette étape écarte à la source plus de 90 % des anomalies de non-concordance typographique.
Phase 2 : Profilage de fréquence et marquage non destructif. Déployer une colonne d’audit technique adossée à une formule de dénombrement cumulatif =NB.SI($A$2:A2; A2) ou concevoir une synthèse d’évaluation via un tableau croisé dynamique. L’objectif exclusif de cette phase est de chiffrer l’incidence globale du taux de duplication sans altérer l’intégrité matricielle du corpus initial.
Phase 3 : Validation des dépendances croisées multidimensionnelles. Si les données comportent plusieurs attributs d’identification interdépendants, valider l’intégrité multicritère au moyen d’instructions NB.SI.ENS ou par l’intermédiaire d’une clé de hachage concaténée temporaire, afin de séparer les doublons fonctionnels stricts des simples homonymies contextuelles.
Phase 4 : Isolation et documentation des exceptions d’audit. Extraire systématiquement la sous-matrice des anomalies vers un onglet de reporting dédié au moyen de la fonction matricielle dynamique FILTRE ou d’une branche de dérivation sous Power Query. Cet inventaire contradictoire doit être soumis à la validation métier des gestionnaires de données avant toute intervention correctrice définitive.
Phase 5 : Traçabilité et pérennisation des métadonnées. Documenter de manière explicite au sein d’une feuille de garde ou d’un registre de métadonnées l’ensemble des règles fonctionnelles, seuils de tolérance et formules mis en œuvre. Dans les environnements soumis à des cadres réglementaires rigoureux, cette documentation assure la reproductibilité intégrale de la chaîne de traitement et confère aux analyses une opposabilité juridique et méthodologique totale.
Références
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- International Organization for Standardization. (2015). Quality management systems — Requirements (ISO Standard No. 9001:2015). https://www.iso.org/standard/62085.html
- Microsoft Corporation. (2024). Fonction NB.SI – Support technique Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/nb-si-fonction-nb-si-e2cfa09c-e08e-4916-b830-4e39db82338d
- Microsoft Corporation. (2024). Fonction UNIQUE – Support technique Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/fonction-unique-c5ab87fd-30a3-4ce9-9d1a-40204fb85e1e
- Perez, E. (2021). Data Analysis with Microsoft Excel: Advanced Formulas and Functions. O’Reilly Media.
- Pulpit, M. (2020). Mastering Power Query in Power BI and Excel. Packt Publishing.
- Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (Office 2021 and Microsoft 365) (7th ed.). Microsoft Press.