
Dans l’écosystème de l’ingénierie des données et de l’analyse statistique avancée, la manipulation des données brutes ne représente que la première étape d’un cycle analytique rigoureux. Pour qu’une information chiffrée ou textuelle conserve sa pertinence à travers le temps et au sein d’équipes pluridisciplinaires, elle doit être contextualisée par des métadonnées solides et normées. L’environnement SAS (Statistical Analysis System), reconnu historiquement pour sa robustesse dans le traitement des données cliniques, financières et sociologiques, intègre une architecture spécifique où la séparation entre la structure physique de la table et sa description sémantique occupe une place centrale. L’attribution d’étiquettes de variables, couramment désignée sous le terme d’étiquetage ou de labellisation, constitue l’un des piliers méthodologiques fondamentaux garantissant la traçabilité et l’intelligibilité des variables quantitatives et qualitatives.
L’absence d’étiquetage systématique expose les analystes, biostatisticiens et chercheurs à des risques majeurs d’erreur d’interprétation, en particulier lorsque les jeux de données comportent des centaines, voire des milliers de colonnes désignées par des codes mnémoniques obscurs ou des acronymes abrégés. Qu’il s’agisse de dissocier des scores composites dans une batterie de tests psychométriques ou de caractériser des biomarqueurs au sein d’une cohorte épidémiologique, l’instruction dédiée à la gestion des libellés permet d’associer à chaque variable un texte explicatif complet sans enfreindre les règles strictes régissant la nomenclature syntaxique des colonnes.
Ce guide méthodologique exhaustif explore de manière approfondie les principes, syntaxes et applications pratiques liés à l’attribution, la modification et l’exploitation des étiquettes de variables dans le système SAS. En articulant les concepts théoriques de la structure des fichiers de données avec des exemples opérationnels, ce document propose un parcours complet allant de l’utilisation fondamentale de l’instruction dans l’étape DATA jusqu’à l’automatisation par macro-programmation et l’interopérabilité avec d’autres environnements statistiques, offrant ainsi une référence complète pour la gestion des métadonnées analytiques.
1. Introduction aux métadonnées et à l’étiquetage des variables dans SAS
1.1 Définition et rôle des étiquettes dans l’architecture SAS
Au sein de l’environnement SAS, une table de données (ou fichier de type SAS7BDAT) se décompose physiquement et conceptuellement en deux composantes fondamentales : la partie contenant les données brutes (enregistrées sous forme d’observations et de variables au sein du vecteur de données) et la partie descriptrice (communément appelée descriptor portion). C’est précisément dans cette section descriptrice que sont consignées les métadonnées de la table. Ces métadonnées englobent la date de création du fichier, le moteur d’accès utilisé, le nombre d’observations, mais surtout les attributs intrinsèques de chaque variable, à savoir son nom, son type (numérique ou caractère), sa longueur en octets, son format d’affichage, son informat de lecture et, de manière déterminante, son étiquette descriptive (attribut LABEL).
Il existe une différenciation fondamentale entre le nom technique de la variable et son étiquette descriptive. Le nom de la variable est un identifiant technique strictement encadré par les règles syntaxiques de SAS : il ne peut pas comporter d’espaces, doit respecter des limites précises de longueur et ne tolère aucun caractère diacritique ou ponctuation complexe. En revanche, l’étiquette descriptive constitue une passerelle sémantique entre le système informatique et l’esprit de l’analyste. Elle permet de documenter sans ambiguïté la teneur exacte de la mesure réalisée, intégrant des espaces, des lettres accentuées et des symboles textuels. Cette distinction permet aux moteurs de calcul de manipuler des identifiants compacts et normalisés tout en fournissant aux utilisateurs des libellés intelligibles lors de la génération des états statistiques.
Les bénéfices de cette structuration se manifestent principalement au niveau de la restitution des analyses. Dans les sorties produites par les procédures d’analyse et les modules graphiques tels que les composants ODS Graphics, les noms de variables peuvent être automatiquement substitués par leurs étiquettes respectives. Les tableaux récapitulatifs, les graphiques de dispersion ou les diagrammes en barres s’en trouvent immédiatement clarifiés, éliminant la nécessité de retouches manuelles a posteriori. De surcroît, dans le cadre de la documentation à long terme des jeux de données d’enquête ou des bases de registres administratifs, l’étiquetage intégré à la table garantit que la signification des variables demeure accessible même si le cahier d’observation ou le dictionnaire de données physique externe venait à être dissocié du fichier électronique.
1.2 L’importance documentaire en recherche quantitative et psychométrie
Dans les disciplines quantitatives telles que la psychométrie, l’épidémiologie comportementale et les sciences sociales empiriques, les protocoles de collecte de données reposent fréquemment sur des questionnaires standardisés générant des dizaines d’items codés sous des formes hautement synthétiques. Des désignations telles que Q1_A, BDI_04 ou STAI_T12 constituent des conventions de codage fonctionnelles pour la saisie et les scripts de programmation, mais elles s’avèrent totalement opaques lors des phases de relecture, de modélisation statistique ou d’audit scientifique. Sans métadonnées associées, le risque de méprise dans l’interprétation des échelles psychologiques augmente de manière exponentielle, particulièrement lorsqu’un instrument comporte des items directs et des items inversés mesurant une même dimension latente.
L’étiquetage des variables permet d’inscrire le texte intégral ou la teneur opérationnelle de la question posée directement au cœur de l’attribut de métadonnées de la variable SAS. Ainsi, un item étiqueté avec précision prévient les erreurs méthodologiques graves, telles que l’omission d’une inversion de score avant le calcul d’un coefficient alpha de Cronbach ou l’assignation erronée d’une modalité de réponse lors de l’estimation d’un modèle d’équations structurelles. L’analyste peut vérifier en un coup d’œil si la variable manipulée correspond au score brut, au score standardisé ou à une probabilité prédite.
Au-delà de la prévention des erreurs d’analyse, l’incorporation systématique des étiquettes répond aux exigences contemporaines de la science ouverte et de la reproductibilité scientifique. Les organismes subventionnaires et les comités d’éthique exigent de plus en plus fréquemment que les données de recherche soient déposées dans des entrepôts sécurisés conformément aux principes FAIR (Facile à trouver, Accessible, Interopérable, Réutilisable). Un jeu de données SAS pourvu d’étiquettes exhaustives constitue un ensemble auto-documenté. Tout chercheur secondaire exploitant la base dans le futur est en mesure de comprendre immédiatement la structure des données sans avoir à déchiffrer des centaines de lignes de code préparatoire, assurant ainsi une pérennité optimale du capital scientifique collecté.
1.3 Distinction conceptuelle entre nom, format et étiquette de variable
Pour maîtriser pleinement la gestion des données sous SAS, il est impératif d’établir une démarcation conceptuelle nette entre trois attributs majeurs : le nom de la variable, son format d’affichage et son étiquette. Chacun de ces éléments remplit une fonction technique distincte dans le cycle de vie du vecteur de données et ne saurait être confondu avec les autres sous peine d’engendrer des erreurs de programmation ou des représentations erronées des sorties tabulaires.
Le nom de la variable (variable name) répond à des contraintes syntaxiques rigides. Selon les options du système (notamment l’option VALIDVARNAME), un nom SAS standard ne doit pas dépasser 32 caractères dans les versions modernes, doit impérativement débuter par une lettre alphabétique ou un trait de soulignement (underscore) et ne peut contenir que des caractères alphanumériques sans aucun espace ni caractère accentué. Ce nom est la clé d’indexation primaire utilisée par le compilateur SAS pour adresser les zones mémoires au sein du vecteur de données de programme (Program Data Vector ou PDV) lors de l’exécution de l’étape DATA.
Le format, quant à lui, est une directive de conversion qui régit la manière dont les valeurs internes de la variable sont traduites lors de leur affichage ou de leur restitution graphique. Par exemple, un format n’altère pas la valeur numérique sous-jacente d’une variable (par exemple, le nombre 1 ou 2), mais commande à SAS d’imprimer la chaîne « Homme » ou « Femme » sur les rapports. Les formats servent donc à transformer les valeurs individuelles des observations. À l’opposé, l’étiquette (attribut LABEL) qualifie la variable dans sa globalité conceptuelle et non ses modalités de réponse. L’étiquette est une annotation sémantique descriptive rattachée à la colonne entière, décrivant la nature de la mesure (par exemple, « Sexe biologique assigné à la naissance »). Une gestion rigoureuse des données sous SAS implique donc l’utilisation conjointe de ces trois piliers : un nom technique concis, une étiquette descriptive explicite et un format adapté pour les modalités de réponse catégorielles.
2. Fondements syntaxiques de l’instruction LABEL dans l’étape DATA
2.1 Syntaxe générale et règles de déclaration
L’attribution pérenne d’une étiquette descriptive à une variable s’effectue traditionnellement au cours de la phase de compilation et d’exécution d’une étape DATA à l’aide de l’instruction déclarative LABEL. La syntaxe canonique de cette instruction repose sur une structure simple mais soumise à des règles formelles d’écriture. Le mot-clé réservé LABEL est suivi du nom de la variable cible, d’un signe d’égalité, puis de la chaîne de caractères constituant le libellé textuel délimité par des guillemets, l’ensemble se terminant obligatoirement par un point-virgule.
Sur le plan de la délimitation des chaînes de caractères, SAS autorise l’usage indifférent des guillemets simples (apostrophes droites) ou des guillemets doubles. Cependant, le choix du délimiteur influe directement sur le comportement du macro-processeur SAS. Si le libellé contient des références à des macro-variables devant être résolues au moment de la compilation (par exemple, l’inclusion dynamique d’une année d’enquête via une macro-variable), l’emploi des guillemets doubles est strictement requis. À l’inverse, si l’étiquette contient du texte littéral simple, les guillemets simples suffisent amplement, prévenant toute tentative de résolution intempestive du macro-compilateur face à des symboles spécifiques.
Le positionnement de l’instruction LABEL au sein de l’étape DATA répond à une logique déclarative. Bien qu’elle puisse être insérée à n’importe quel endroit du bloc d’instructions de l’étape DATA, l’étiquette est prise en compte dès la phase de compilation lors de l’établissement du dictionnaire interne de la table en cours de génération. Il est néanmoins recommandé, selon les normes de programmation structurée, de regrouper toutes les déclarations d’attributs (LABEL, FORMAT, INFORMAT, LENGTH) en tête ou en fin de l’étape DATA, juste après les instructions de lecture des données (telles que SET, MERGE ou INPUT), garantissant ainsi une lisibilité optimale du code source pour la maintenance logicielle.
2.2 Attribution simultanée d’étiquettes à des variables multiples
Dans les applications réelles de traitement de données, les tables comportent rarement une variable unique nécessitant une annotation. Pour optimiser le code et éviter la répétition fastidieuse du mot-clé LABEL pour chaque colonne, le compilateur SAS permet de déclarer en série une multiplicité d’assignations au sein d’une seule et même instruction LABEL. Cette faculté simplifie considérablement la maintenance des scripts de préparation de données volumineuses.
La syntaxe de déclaration multiple s’articule en énumérant les paires composées du nom de la variable, du signe d’égalité et de la chaîne de texte correspondante, sans insérer de point-virgule entre chaque élément. Un unique point-virgule est apposé à la toute fin de l’énumération pour signifier au compilateur la clôture de l’instruction. L’oubli de cette règle fondamentale et l’insertion prématurée d’un point-virgule au milieu d’une série provoquent immédiatement des erreurs de syntaxe, SAS interprétant alors la variable suivante comme une nouvelle instruction orpheline non reconnue.
La lisibilité et la mise en page du code SAS revêtent ici une importance critique. Pour faciliter la relecture par les pairs et l’audit du code lors des processus d’assurance qualité, il est hautement préconisé d’adopter une indentation verticale rigoureuse. Chaque variable et son étiquette associée doivent être disposées sur une ligne dédiée, avec un alignement soigné des signes d’égalité. Cette discipline rédactionnelle permet non seulement d’identifier instantanément les variables encore non documentées, mais elle prévient également les erreurs courantes de fermeture de guillemets qui peuvent survenir lors de la saisie de longues listes de métadonnées.
2.3 Gestion des caractères spéciaux, apostrophes et contraintes de longueur
L’utilisation de la langue française dans les métadonnées descriptives introduit des spécificités typographiques, notamment l’usage récurrent des apostrophes élisives et des lettres accentuées. La gestion de l’apostrophe textuelle constitue un piège classique pour le programmeur SAS. Lorsque le libellé textuel est encapsulé dans des guillemets simples et qu’il contient une apostrophe (par exemple dans l’expression de l’âge d’un sujet), le compilateur interprète cette apostrophe interne comme la marque de fin de la chaîne littérale, ce qui corrompt la suite de l’analyse syntaxique. Pour neutraliser cette interprétation, la règle de base impose de dédoubler l’apostrophe interne sans insérer d’espace ou, plus élégamment, de délimiter l’intégralité de l’étiquette par des guillemets doubles.
Concernant les limites structurelles, la longueur maximale admissible pour une étiquette de variable dans les versions modernes de SAS (SAS 9.4 et versions ultérieures de la plateforme SAS Viya) est fixée à 256 octets. Il convient de souligner que cette limite s’exprime en octets et non en nombre strict de caractères. Dans un environnement configuré avec un encodage multi-octets comme l’UTF-8, un caractère accentué ou un glyphe particulier peut occuper entre deux et quatre octets en mémoire. Par conséquent, une étiquette rédigée en français comportant de nombreux accents peut atteindre la limite maximale de saturation plus rapidement qu’une étiquette rédigée en anglais standard sur un seul octet par caractère (codage ASCII ou LATIN1).
La maîtrise de l’encodage des caractères (notamment le passage de WLATIN1 à UTF-8) est devenue incontournable dans les architectures de recherche contemporaines. Lors de la migration d’une table d’une instance serveur à une autre, des phénomènes de troncature ou de transcodage erroné (garbled characters ou mojibake) peuvent survenir si l’environnement d’exécution n’est pas harmonisé. Les gestionnaires de bases de données doivent s’assurer que la longueur déclarée des étiquettes réserve une marge de sécurité suffisante pour éviter que les derniers mots d’une question de sondage ou d’une description clinique ne soient brutalement tronqués lors de la compilation.
3. Analyse pas à pas de l’exemple fondamental
3.1 Création du jeu de données brut sans étiquettes et limites associées
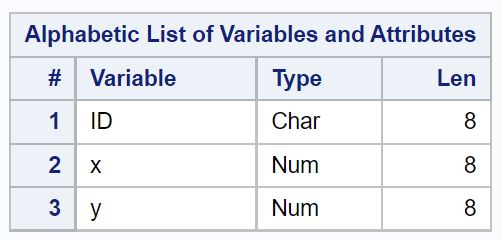
Afin de comprendre l’utilité pratique de la démarche d’étiquetage, considérons l’examen d’un cas d’école emblématique illustrant le traitement de métriques sportives ou de recherche comportementale. Dans de nombreuses situations initiales de collecte, les données sont importées ou saisies sous une forme brute minimale, où les colonnes sont désignées par des identifiants génériques. Imaginons une étape DATA élémentaire créant une table de travail comportant trois variables nommées respectivement ID, x et y, renseignées par des instructions de lecture en ligne avec l’instruction CARDS ou DATALINES.
Dans ce scénario non documenté, la variable ID reçoit des chaînes identifiant des équipes ou des unités d’échantillonnage, la variable x enregistre des nombres entiers représentant par exemple le nombre de points marqués, et la variable y enregistre des valeurs numériques correspondant aux rebonds captés. Bien que le moteur de calcul SAS exécute sans aucune difficulté les opérations mathématiques sur les colonnes x et y, le jeu de données résultant souffre d’un déficit cognitif évident. Aucune indication interne ne permet de déterminer si x réfère à des points, à des fautes commises, à des pourcentages de réussite ou à un temps de jeu.
Cette ambiguïté engendre des risques majeurs d’erreurs méthodologiques. Si un statisticien tiers est chargé d’effectuer des régressions linéaires ou des tests de comparaisons de moyennes sur cette table sans disposer du script originel ou d’un cahier de codage indépendant, le risque d’intervertir les prédicteurs x et y dans l’équation d’estimation est particulièrement élevé. De plus, toute sortie générée par une procédure descriptive telle que PROC PRINT ou PROC MEANS n’affichera que les lettres laconiques x et y en en-têtes de colonnes, produisant des rapports dénués de toute intelligibilité immédiate pour les décideurs ou les examinateurs de l’étude.
3.2 Implémentation technique de l’instruction LABEL dans le bloc DATA
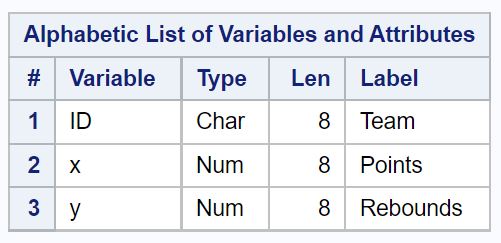
Pour remédier définitivement à ce manque de clarté, l’introduction de l’instruction LABEL au sein même de l’étape DATA permet d’associer immédiatement des métadonnées explicites aux trois identifiants. Lors de la construction de la table, le programmeur insère l’instruction déclarative appropriée, en assignant à la variable ID l’étiquette ‘Team’ (Équipe), à la variable x l’étiquette ‘Points’ et à la variable y l’étiquette ‘Rebounds’ (Rebonds). La syntaxe intégrée au code source s’écrit de manière fluide au sein du bloc d’instructions de l’étape DATA.
D’un point de vue mécanique, lors de la phase de compilation de l’étape DATA, le superviseur SAS initialise le vecteur de données de programme (PDV) et réserve les emplacements de stockage nécessaires dans la section d’en-tête de la table de sortie. Lorsque le compilateur rencontre l’instruction LABEL, il inscrit immédiatement ces chaînes descriptives dans la table des symboles du descripteur de fichier. Aucune instruction machine n’est exécutée au niveau des enregistrements individuels lors de cette étape : l’association est purement structurelle et s’effectue à coût computationnel quasi nul, indépendamment du nombre de lignes de données traitées.
La validation du bon déroulement de cette opération requiert une inspection minutieuse du journal SAS (SAS Log). Lors de l’exécution, le journal confirme la lecture des lignes d’observations et la création de la table cible dans la bibliothèque de travail (WORK) ou permanente. L’absence de messages d’avertissement (WARNING) ou d’erreurs (ERROR) atteste que l’instruction déclarative a été convenablement analysée et que les longueurs des étiquettes n’ont enfreint aucune règle de syntaxe. La table de données ainsi constituée est désormais auto-documentée.
3.3 Comparaison de l’interprétabilité avant et après labellisation
L’impact pratique de cette intervention minimale sur le code source se révèle de façon spectaculaire dès lors que l’on compare les sorties d’analyse générées avant et après l’application de la labellisation. Initialement, la consultation des données brutes confronte l’analyste à un tableau rectangulaire où les colonnes ID, x et y obligent le lecteur à une gymnastique mnémotechnique constante pour se remémorer la métrique sous-jacente. L’accès à l’information requiert une charge cognitive inutile et expose le projet à des incompréhensions lors des réunions d’équipe.
Une fois les étiquettes intégrées, toute procédure analytique configurée pour exploiter les libellés substitue les identifiants techniques par les descripteurs sémantiques. Dans le cas présent, les colonnes se présentent distinctement sous les titres « Team », « Points » et « Rebounds ». Les moyennes calculées ne portent plus sur un indice y désincarné, mais attestent clairement de la moyenne des rebonds captés par formation sportive. L’interprétation devient instantanée, non équivoque et directement transférable vers des supports de diffusion scientifique.
Pour les analystes secondaires et les auditeurs de données, cette transition marque le passage d’une structure brute instable à une table d’analyse professionnelle conforme aux meilleures pratiques de l’industrie. La traçabilité de la mesure est définitivement scellée au niveau de l’infrastructure de données. Même si le jeu de données est réutilisé des années plus tard dans le cadre d’une méta-analyse ou d’une revue systématique, la signification des paramètres de base demeure inaltérée et directement accessible au sein de l’environnement d’interrogation SAS.
4. Inspection et validation des métadonnées via la procédure PROC CONTENTS
4.1 Exécution et analyse de la sortie standard de PROC CONTENTS
La validation de l’attribution correcte des étiquettes constitue une phase d’assurance qualité incontournable dans tout pipeline de programmation statistique. Sous SAS, la procédure de référence pour auditer la structure interne et les métadonnées d’une table sans en lire nécessairement toutes les observations individuelles est la procédure CONTENTS (PROC CONTENTS). Cette procédure système extrait et restitue sous une forme normalisée l’intégralité du descripteur de table conservé dans l’en-tête du fichier .sas7bdat.
L’exécution de la procédure s’opère par l’invocation simple de l’instruction proc contents data=nom_de_la_table; run;. La sortie générée par le système se segmente en plusieurs sections analytiques hautement informatives. La première section synthétise les attributs globaux du jeu de données : nom de la table, bibliothèque d’appartenance, type de moteur de stockage, date et heure de création, date de dernière modification, nombre exact d’observations enregistrées, nombre total de variables et type d’encodage des caractères (par exemple utf-8 ou latin1).
La seconde section majeure fournit la liste structurée des variables de la table. Par défaut, SAS présente cette liste dans un ordre strictement alphabétique selon les noms des variables, ce qui permet de localiser rapidement une mesure au sein d’une table comportant plusieurs centaines de colonnes. C’est dans ce tableau d’inventaire détaillé que figurent les propriétés physiques de chaque colonne : son type de données (numérique ou caractère), sa taille de stockage en mémoire (en octets), sa position d’alignement relatif au sein du vecteur de données et ses attributs de présentation visuelle.
4.2 Localisation et interprétation de la colonne Label
Au sein du tableau récapitulatif généré par PROC CONTENTS, une colonne spécifique intitulée expressément « Label » (ou « Étiquette de la variable » dans les environnements SAS francisés) est systématiquement réservée à l’affichage des métadonnées textuelles. Si une variable n’a fait l’objet d’aucun étiquetage préalable, la cellule correspondante demeure strictement vierge. En revanche, dès lors qu’une instruction LABEL a été convenablement compilée, le texte descriptif s’y trouve intégralement reporté en regard du nom technique de la variable.
L’examen minutieux de cette colonne permet de certifier l’adéquation parfaite entre la variable cible et son libellé sémantique. L’auditeur de données peut y vérifier que les noms de variables n’ont pas subi de décalage accidentel lors de déclarations en série au sein de l’étape DATA. C’est également à cet endroit précis que l’on détecte les éventuels dysfonctionnements liés à une troncature textuelle involontaire : si une étiquette excède la longueur maximale autorisée ou si une erreur d’encodage a altéré le décompte des octets, la fin du libellé apparaîtra tronquée dans le rapport de la procédure.
De même, l’inspection de la colonne Label permet d’identifier immédiatement les erreurs de syntaxe subtiles qui n’auraient pas nécessairement bloqué la compilation, telles que la présence de guillemets superflus, d’espaces doubles indésirables ou de caractères de ponctuation mal placés. La confirmation visuelle dans la sortie de PROC CONTENTS scelle la phase d’audit unitaire, autorisant l’intégration de la table de données dans les processus analytiques subséquents en toute confiance méthodologique.
4.3 Options avancées de PROC CONTENTS pour le contrôle qualité
Pour dépasser l’inspection visuelle manuelle et instaurer des contrôles qualité automatisés et exhaustifs, la procédure CONTENTS offre plusieurs options avancées et mécanismes d’exportation programmatique. L’une des options les plus couramment sollicitées est l’option VARNUM, adjointe à l’instruction d’appel sous la forme proc contents data=nom_de_la_table varnum; run;. Cette directive commande à SAS d’ajouter à la suite de la liste alphabétique un second inventaire des variables, ordonné cette fois selon leur ordre physique de création dans la table (numéro de position logique). Cette vue est précieuse pour vérifier la cohérence logique de questionnaires administrés de façon séquentielle.
De surcroît, la puissance de PROC CONTENTS s’exprime pleinement dans sa capacité à déverser l’intégralité de la partie descriptrice directement dans une nouvelle table de données SAS à des fins d’analyse programmatique. Cette opération s’effectue via l’argument out= au sein de l’instruction PROC CONTENTS (par exemple, proc contents data=table_source out=dictionnaire noprint; run;). L’argument noprint permet d’inhiber la génération des rapports à l’écran, ce qui accélère considérablement les traitements dans les environnements de production automatisés.
La table SAS ainsi générée, nommée ici dictionnaire, contient une observation par variable de la table source et des colonnes réservées telles que NAME (le nom de la variable) et LABEL (l’étiquette de la variable). Dès lors, le biostatisticien peut concevoir une étape DATA conditionnelle simple pour identifier automatiquement toute variable dont l’étiquette est manquante (clause de filtrage if missing(label)). Cette approche permet d’ériger des barrières de sécurité informatique au sein de pipelines de validation : le script peut ainsi interrompre automatiquement le traitement d’une étude clinique si le taux de couverture des étiquettes de variables n’atteint pas le seuil contractuel de 100 %.
5. Étiquetage permanent versus étiquetage temporaire dans SAS
5.1 Persistance des attributs avec l’étape DATA
La distinction entre la persistance à long terme et l’assignation éphémère constitue un concept cardinal de l’architecture de données sous SAS. Lorsqu’une instruction LABEL est invoquée au sein d’une étape DATA qui écrit une table physique sur disque, l’attribution possède un caractère définitif et permanent. L’étiquette s’ancre directement au niveau du descripteur binaire du fichier hébergé dans le répertoire associé à la bibliothèque cible (que ce soit une bibliothèque utilisateur ou la bibliothèque temporaire de session).
Cette permanence garantit une robustesse documentaire absolue. Lorsque la table est ultérieurement manipulée par des procédures d’infrastructure système — telles que le tri via la procédure SORT, la réplication via la procédure COPY, ou la constitution d’index physiques —, l’intégrité de la section descriptrice est rigoureusement préservée. Les variables conservent leurs étiquettes associées sans qu’il soit jamais nécessaire de réitérer l’instruction déclarative dans les scripts ultérieurs. Cette pérennité constitue le socle indispensable au travail collaboratif, permettant à différents membres d’une unité de biostatistique de se partager des tables de données entièrement contextualisées.
Il importe toutefois de souligner que si une étape DATA ultérieure lit la table existante (via l’instruction SET) pour générer une nouvelle table dérivée, les étiquettes sont automatiquement héritées par défaut. Cependant, si le programmeur redéclare une nouvelle instruction LABEL au sein de cette nouvelle étape DATA pour une variable préexistante, l’ancienne étiquette est purement et simplement écrasée et remplacée par la nouvelle métadonnée dans la table de destination, offrant ainsi une flexibilité totale d’ajustement sans risque de corrompre la table mère source d’origine.
5.2 Attribution temporaire d’étiquettes au sein d’une procédure analytique
À l’opposé de la démarche de labellisation permanente au sein de l’étape DATA, SAS offre la possibilité technique d’appliquer des étiquettes de façon purement éphémère ou temporaire à l’intérieur d’un bloc de procédure statistique spécifique (tel que PROC PRINT, PROC FREQ, PROC MEANS ou PROC REPORT). Cette faculté s’exécute en insérant l’instruction déclarative LABEL directement entre l’instruction PROC d’ouverture et l’instruction RUN de clôture de la procédure ciblée.
Dans ce contexte procédural, la portée de l’instruction LABEL est strictement circonscrite à la durée d’exécution de la procédure en cours. Les moteurs de traitement internes appliquent les étiquettes déclarées uniquement pour le calcul des sorties et la génération des tables de résultats visibles par l’utilisateur. Dès que l’instruction RUN est exécutée et que le contrôle revient à l’environnement global SAS, ces étiquettes temporaires disparaissent totalement de la mémoire vive. La table de données d’origine sous-jacente, stockée sur disque, ne subit rigoureusement aucune modification de son descripteur de fichier.
Sur le plan de la hiérarchie de traitement, une étiquette déclarée temporairement au sein d’une procédure statistique bénéficie d’une priorité absolue sur toute étiquette permanente préalablement stockée dans la table de données. Si une variable possède déjà une étiquette pérenne mais qu’une instruction locale LABEL est formulée dans la procédure, SAS masque temporairement le libellé permanent au profit du libellé local le temps de générer le rapport. Cette spécificité offre une souplesse méthodologique exceptionnelle : elle permet d’adapter le vocabulaire ou la langue d’un rapport pour un auditoire particulier sans avoir à altérer l’intégrité de la base de référence.
5.3 Arbitrage méthodologique selon les phases du cycle de données
La décision d’opter pour un étiquetage permanent au niveau de l’étape DATA ou pour un étiquetage temporaire au sein des blocs de procédures dépend étroitement de la maturité du jeu de données et de la phase d’avancement au sein du cycle de vie analytique. Une gouvernance rigoureuse des données impose des choix méthodologiques clairs afin de prévenir la prolifération de versions discordantes d’un même indicateur.
Durant les phases initiales d’ingestion, d’assainissement et de structuration des données (data cleaning et data preparation), la règle absolue est d’implémenter un étiquetage permanent et exhaustif au cœur des étapes DATA maîtresses. Ces tables fondamentales, souvent archivées comme sources uniques de vérité (gold standard), doivent contenir la description sémantique canonique de chaque mesure. C’est à ce stade que l’on documente les variables conformément aux protocoles cliniques ou aux guides de codage des enquêtes, assurant une fondation pérenne pour l’ensemble des analyses ultérieures du projet.
Inversement, le recours aux étiquettes temporaires dans les procédures de restitution trouve toute sa justification lors des phases terminales de valorisation, de diffusion et de publication des résultats. Il est fréquent qu’un même indicateur doive être présenté sous des intitulés légèrement divergents selon le public visé : une désignation technique rigoureuse pour un rapport d’audit méthodologique interne, et une formulation synthétique vulgarisée pour une publication institutionnelle ou un tableau de bord destiné à des gestionnaires non scientifiques. L’utilisation d’étiquettes locales évite la duplication inutile de tables lourdes sur disque dur et prévient les conflits d’appellation entre versions successives de scripts d’analyse.
6. Utilisation des étiquettes dans les procédures de reporting et de statistiques descriptives
6.1 Optimisation des sorties tabulaires avec PROC PRINT et l’option LABEL
La procédure PRINT (PROC PRINT) représente l’outil fondamental de restitution séquentielle et d’exploration directe des observations dans l’écosystème SAS. Toutefois, le comportement par défaut de PROC PRINT présente une particularité historique essentielle : même si les variables d’une table possèdent des étiquettes permanentes parfaitement enregistrées dans leur partie descriptrice, la procédure continue d’afficher les noms techniques des variables en en-têtes de colonnes, sauf instruction explicite contraire de l’analyste.
Pour forcer la procédure PRINT à exploiter pleinement les métadonnées descriptives, le programmeur doit impérativement activer l’option LABEL directement dans l’en-tête de la commande, sous la forme proc print data=nom_de_la_table label; run;. L’adjonction de ce mot-clé commande au moteur de restitution de substituer les noms abrégés des colonnes par leurs libellés textuels complets. Les tableaux générés gagnent instantanément en clarté, permettant une lecture fluide des observations individuelles sans nécessiter le recours à une légende annexe.
L’optimisation des sorties avec PROC PRINT prend tout son sens lors de la confection d’annexes pour des rapports cliniques ou des mémoires universitaires. En combinant l’option LABEL avec des instructions de contrôle telles que ID (pour ancrer l’identifiant du sujet sur la gauche du tableau) ou VAR (pour restreindre l’affichage à un sous-ensemble déterminé de mesures étiquetées), l’analyste produit des états de listing d’une grande élégance typographique. Le formatage des cellules s’adapte automatiquement à la largeur des étiquettes descriptives, garantissant une mise en page harmonieuse prête pour l’exportation vers des documents de traitement de texte.
6.2 Clarté des tableaux de contingence avec PROC FREQ
Dans l’analyse des variables qualitatives et des distributions catégorielles, la procédure FREQ (PROC FREQ) constitue la clé de voûte du calcul des fréquences simples et des tableaux de contingence croisés. Contrairement à la procédure PRINT, PROC FREQ adopte par défaut un comportement orienté vers la valorisation des métadonnées : dès lors qu’une variable fait l’objet d’un étiquetage, son étiquette est automatiquement mobilisée pour titrer les sections de fréquences univariées et pour désigner les dimensions de lignes et de colonnes dans les tables de tri croisé.
Cette intégration native des étiquettes transforme radicalement l’intelligibilité des tableaux d’association statistique. Dans une analyse épidémiologique portant sur des déterminants socio-démographiques, un tableau croisé opposant deux variables initialement nommées STAT_SOC et RECID_MAL présentera explicitement pour le lecteur les en-têtes « Statut socio-économique du foyer » et « Récidive de la pathologie à 12 mois ». Les profils de répartition et les pourcentages marginaux s’interprètent sans risque de confusion sémantique, facilitant la détection visuelle d’associations entre modalités et l’analyse des tests d’indépendance du Chi-deux associés.
Il demeure néanmoins des circonstances analytiques où l’affichage de longues étiquettes textuelles perturbe la compacité d’un tableau croisé complexe comportant de nombreuses strates. Dans cette situation, le système SAS prévoit la possibilité de désactiver l’usage des étiquettes en invoquant l’option globale de procédure NOLABEL (sous la forme proc freq data=nom_de_la_table nolabel; run;). Cette commande oblige la procédure à basculer vers un affichage restreint aux seuls noms techniques de variables, restaurant la compacité dimensionnelle nécessaire pour l’analyse visuelle rapide de très grands tableaux de contingence.
6.3 Présentation des métriques quantitatives avec PROC MEANS
La synthèse des distributions continues (moyennes, écarts-types, médianes, quartiles et étendues) est traditionnellement dévolue à la procédure MEANS (PROC MEANS). Cette procédure intègre nativement une colonne spécifiquement dévolue à la restitution des étiquettes dans son rapport tabulaire standard. Dans la sortie par défaut, chaque ligne d’indicateurs statistiques est flanquée à la fois du nom de la variable d’analyse et de son étiquette descriptive associée, offrant ainsi une lecture à double niveau technique et fonctionnel.
Cette caractéristique s’avère particulièrement déterminante dans le traitement des échelles psychométriques composites comportant de multiples sous-dimensions. Lorsqu’une batterie de tests évalue simultanément des facettes cognitives distinctes (par exemple l’anxiété somatique, l’anxiété cognitive et l’évitement comportemental), l’affichage exclusif des noms synthétiques de variables (tels que ANX_SOM, ANX_COG, EVT_COMP) peut prêter à confusion lors de revues rapides. La présence conjointe des étiquettes garantit que les métriques de tendance centrale et de dispersion sont sans ambiguïté attribuées à leurs sous-construits théoriques respectifs.
Par ailleurs, l’interaction entre les étiquettes de variables sous PROC MEANS et le système de diffusion des sorties ODS (Output Delivery System) offre des perspectives avancées pour la publication scientifique. Lorsque les résultats de PROC MEANS sont redirigés vers des destinations ODS telles que HTML, PDF ou RTF (Microsoft Word), les étiquettes sont automatiquement converties en en-têtes de tableaux stylisés. L’analyste s’affranchit ainsi de toute retouche manuelle fastidieuse des en-têtes dans des logiciels tiers, préservant la chaîne de valeur de la reproductibilité analytique de bout en bout.
7. Modification et suppression des étiquettes avec PROC DATASETS
7.1 Efficience computationnelle de PROC DATASETS pour les grands jeux de données
Dans le domaine du traitement de mégadonnées (Big Data), telles que les bases médico-administratives hospitalières ou les cohortes épidémiologiques massives rassemblant plusieurs millions d’enregistrements, la modification des métadonnées pose un défi de performance informatique majeur. Si un programmeur choisit d’actualiser une étiquette de variable en faisant transiter sa table par une étape DATA standard avec l’instruction SET, SAS est contraint de relire l’intégralité physique des données depuis le disque dur, de recalculer le vecteur de données d’un bout à l’autre et de réécrire chaque observation sur disque dans un nouveau fichier physique.
Cette approche par étape DATA se révèle extrêmement dispendieuse en temps processeur (CPU) et en opérations d’entrée-sortie (I/O), saturant inutilement les disques de stockage temporaires pour une simple correction textuelle. Pour contourner cette inefficience structurelle, l’architecture SAS intègre la procédure DATASETS (PROC DATASETS). Cette procédure système opère une action directe et chirurgicale au niveau de la section descriptrice (l’en-tête du fichier .sas7bdat), sans effectuer aucune lecture ni réécriture de la partie contenant les observations de données.
Grâce à cette manipulation directe in situ, la modification ou l’ajout d’une étiquette descriptive sur une table pesant plusieurs dizaines de gigaoctets s’exécute de façon quasi instantanée, ne nécessitant que quelques millisecondes d’accès disque. L’importance de ce choix algorithmique devient critique dans les pipelines industriels de données et les environnements de serveurs partagés où la préservation des ressources computationnelles constitue un impératif d’exploitation quotidien.
7.2 Syntaxe de révision d’étiquettes existantes
L’implémentation pratique de la révision d’étiquettes via la procédure DATASETS requiert une articulation syntaxique spécifique reposant sur des sous-instructions imbriquées. L’appel initial invoque la procédure en spécifiant la bibliothèque hôte (par exemple proc datasets library=work nolist;, l’option nolist inhibant l’affichage verbeux du catalogue). On cible ensuite la table à modifier au moyen de l’instruction MODIFY, suivie de l’instruction déclarative LABEL spécifiant les ajustements textuels à opérer.
Cette syntaxe permet de cibler de manière sélective une variable unique sans affecter le reste de la table, ni altérer les autres étiquettes, formats ou index existants. Une fois la clause LABEL formulée, l’exécution s’opère immédiatement dès l’émission de l’instruction RUN, et l’instruction QUIT permet de clore proprement la session interactive de la procédure DATASETS. La structure générale de ce bloc d’instructions s’établit selon une logique modulaire d’une grande rigueur.
Un atout majeur de cette méthode réside dans la possibilité de contrôler instantanément la prise en compte des modifications. En intégrant la sous-commande CONTENTS immédiatement après la révision au sein de la même session PROC DATASETS, le système génère un aperçu actualisé de la partie descriptrice. L’analyste obtient la confirmation immédiate que la nouvelle étiquette descriptive a bien remplacé l’ancienne formulation dans l’en-tête de la table sans qu’aucun octet d’observation n’ait été déplacé sur le système de fichiers.
7.3 Suppression ciblée ou totale des métadonnées de libellé
Bien que l’enrichissement documentaire soit la norme en gestion de données, certains contextes analytiques ou réglementaires spécifiques exigent la purge, ciblée ou intégrale, des métadonnées textuelles associées aux variables. C’est notamment le cas lors de protocoles de double insu stricts ou lors de procédures d’anonymisation et de pseudonymisation destinées à des tiers, au sein desquelles les libellés de questions d’enquête pourraient contenir des éléments indirects d’identification ou des indications orientant les analystes évaluateurs.
Sous la procédure DATASETS, la technique pour neutraliser une étiquette sans supprimer la variable elle-même consiste à lui assigner une chaîne de caractères strictement vide. Cette déclaration s’effectue en écrivant le nom de la variable suivi du signe d’égalité et de deux guillemets accolés sans aucun espace (par exemple label x = »;). Lors de la validation, le gestionnaire de métadonnées de SAS efface l’entrée correspondante dans le dictionnaire interne du descripteur, réinitialisant la colonne Label de cette variable à un état vierge.
L’impact de cette neutralisation se manifeste immédiatement dans toutes les procédures de restitution subséquentes exploitant les étiquettes. Les procédures telles que PROC PRINT (avec option LABEL) ou PROC FREQ, ne trouvant plus de chaîne descriptive dans l’en-tête de la table, basculent automatiquement et par défaut sur l’affichage du nom technique brut de la variable. Cette méthode permet ainsi de dé-documenter sélectivement des tables de données sensibles avant leur exportation hors de l’infrastructure de recherche sécurisée.
8. Application méthodologique aux données psychométriques et comportementales
8.1 Étiquetage des items individuels d’échelles de Likert
Dans la recherche comportementale, les protocoles d’évaluation empirique mobilisent massivement des questionnaires composés d’échelles de type Likert (par exemple à 5 ou 7 points d’ancrage allant de « Pas du tout d’accord » à « Tout à fait d’accord »). Dans les fichiers de données brutes, ces instruments sont le plus souvent découpés en colonnes désignées par le sigle de l’inventaire flanqué du numéro séquentiel de l’item (par exemple BDI_01 à BDI_21 pour l’Inventaire de Dépression de Beck, ou NEO_01 à NEO_60 pour les versions abrégées du Big Five).
L’étiquetage des variables constitue ici le moyen idéal d’intégrer le libellé textuel intégral de la question au sein même de la métadonnée SAS. Au lieu de manipuler un identifiant abstrait BDI_09, la variable se voit assigner l’étiquette descriptive complète documentant la propension aux idées suicidaires ou au découragement. Cette pratique élimine les allers-retours fastidieux entre l’écran d’analyse statistique et le manuel imprimé du test, permettant à l’analyste de conduire ses modélisations en comprenant instantanément la substance psychologique sous-jacente.
De surcroît, une convention méthodologique fondamentale dans la gestion des échelles de Likert consiste à signaler explicitement dans l’étiquette le sens de cotation de l’item, en particulier pour les items inversés (reverse-scored items). En préfixant ou en suffixant l’étiquette par une mention explicite telle que « [INV] », le chercheur documente visuellement que la question mesure le pôle opposé du construit latent. Lors des phases ultérieures d’évaluation de la cohérence interne (alpha de Cronbach) ou d’analyse factorielle confirmatoire, ce marquage s’avère un rempart décisif contre l’oubli de recodage préalable des polarités d’items.
8.2 Documentation des scores composites et des sous-dimensions
Au-delà de la mesure au niveau des items élémentaires, les analyses quantitatives en sciences sociales et biomédicales reposent sur l’agrégation de ces réponses sous forme de scores composites, de scores factoriels issus d’analyses en composantes principales, ou de scores seuils standardisés. Ces variables calculées font l’objet d’étapes de transformation successives par des opérateurs arithmétiques au sein de l’étape DATA, générant de nouvelles colonnes dont le nom synthétique ne rend pas toujours compte de la complexité du calcul sous-jacent.
L’attribution rigoureuse d’étiquettes descriptives sur ces scores dérivés permet de consigner des éléments documentaires cruciaux pour les auditeurs et réviseurs d’articles scientifiques. Une étiquette exemplaire ne se limite pas à mentionner le nom de la sous-échelle ; elle indique la méthode d’agrégation retenue (somme brute pondérée, moyenne des items valides, standardisation en score Z ou score T) ainsi que la version normative de référence (par exemple : « Score composite Extraversion – Somme brute standardisée – Normes adultes 2020 »).
Cette exhaustivité documentaire au sein de l’attribut LABEL garantit la traçabilité intégrale de la chaîne de traitement statistique. Si un modèle de régression multivarié met en évidence un effet significatif d’un score composite sur une variable d’intérêt clinique, l’analyste peut immédiatement certifier, à la seule lecture des métadonnées de la table de résultats, quelle définition opérationnelle exacte du construit psychologique a produit cet effet, écartant ainsi toute ambiguïté lors de la rédaction de la section méthodologique du manuscrit scientifique.
8.3 Gestion des identifiants et des variables de protocoles longitudinaux
Les plans d’expérience à mesures répétées et les études de cohortes longitudinales introduisent une complexité additionnelle liée à la dimension temporelle de l’échantillonnage. Dans de tels dispositifs de recherche, les mêmes instruments de mesure sont administrés aux mêmes participants à plusieurs points temporels successifs (par exemple au départ de l’étude ou pré-test T0, à la fin du traitement ou post-test T1, et lors de sessions de suivi à moyen et long termes T2 et T3).
Dans une table organisée au format large (wide format), où chaque ligne correspond à un sujet unique et où les temps de mesure successifs sont disposés en colonnes distinctes, l’attribution d’étiquettes claires constitue le seul moyen de différencier avec certitude les différentes vagues d’observation. L’étiquette de chaque variable doit formellement incorporer l’ancrage temporel précis, la fenêtre d’évaluation clinique et, le cas échéant, le bras d’assignation interventionnelle (bras expérimental versus groupe témoin sous placebo).
De même, pour les variables d’identification des participants, qui font l’objet d’obligations strictes de confidentialité et de protection des données de santé à caractère personnel (en conformité avec le Règlement Général sur la Protection des Données ou RGPD), l’étiquetage permet de documenter le niveau de sécurisation de l’identifiant. Une étiquette descriptive telle que « Identifiant unique pseudonymisé du participant – Clé de hachage niveau 2 » informe l’analyste de la nature dérivée de la variable d’identification, garantissant le respect des protocoles de gouvernance éthique tout en maintenant une documentation technique irréprochable.
9. Automatisation de l’étiquetage par les macros SAS et scripts dynamiques
9.1 Développement d’une macro pour l’application d’un dictionnaire externe
Dans les environnements d’analyse à grande échelle où les questionnaires comportent des centaines d’items, la saisie manuelle d’instructions LABEL au sein de l’étape DATA devient contre-productive, source d’erreurs typographiques et difficilement maintenable. La solution d’ingénierie consiste à externaliser la gestion des métadonnées dans un dictionnaire de données autonome, matérialisé par un fichier tableur ou un fichier de texte délimité (CSV), comportant a minima deux colonnes normalisées : le nom physique de la variable (var_name) et son libellé descriptif exhaustif (var_label).
L’automatisation du processus repose sur l’exploitation du macro-langage SAS et de la procédure SQL (PROC SQL) pour ingérer dynamiquement ce dictionnaire externe et le métamorphoser en une suite d’instructions d’étiquetage exécutables. Après avoir importé le fichier CSV de métadonnées dans une table de travail temporaire, PROC SQL permet de concaténer l’ensemble des paires de variables et d’étiquettes en une seule et unique macro-variable globale via la clause SELECT … INTO :macro_var SEPARATED BY ‘ ‘.
Une fois cette macro-variable peuplée de la chaîne d’assignations multiples, elle est simplement appelée au sein de l’étape DATA de traitement principal sous la forme synthétique label ¯o_var.;. Lors de la phase de prétraitement, le macro-processeur SAS résout la référence et substitue la macro-variable par des centaines d’instructions d’étiquetage formatées sans qu’aucune ligne de code manuel supplémentaire n’ait été saisie. Cette séparation stricte entre le dictionnaire sémantique et la logique de calcul algorithmique représente un standard d’excellence dans le développement logiciel appliqué aux statistiques.
9.2 Macro-programmation pour séries de variables standardisées
Il est fréquent en recherche quantitative de devoir traiter des blocs entiers de variables indicées issues d’une même matrice de questions ou d’un protocole d’observation unifié (par exemple une série de trente questions d’évaluation de la satisfaction client nommées SAT_1 jusqu’à SAT_30). Rédiger individuellement trente lignes d’étiquetage quasi identiques présente une redondance évidente qu’il est aisé d’éliminer au moyen d’une boucle itérative de macro-programmation.
La conception d’une macro paramétrée exploitant la directive %DO permet de générer à la volée les instructions d’étiquetage pour toute la séquence numérique. La macro prend en paramètres d’entrée le préfixe de la variable, le libellé conceptuel de base, ainsi que les indices de début et de fin de la série. À chaque itération de la boucle, le macro-compilateur concatène le nom de la variable indicée avec la chaîne de caractères descriptive correspondante, ajustant dynamiquement le numéro de l’item dans le corps du texte de l’étiquette.
Cette approche dynamique présente l’avantage considérable de garantir une uniformité typographique et sémantique parfaite sur l’ensemble de la série de variables. De plus, si l’intitulé conceptuel global de la section vient à être révisé par le comité scientifique du projet, une seule modification de la chaîne de paramètres dans l’appel de la macro suffit à régénérer instantanément l’intégralité du jeu d’étiquettes sur la table finale, optimisant radicalement les délais de maintenance logicielle.
9.3 Validation automatisée de la conformité du dictionnaire
L’automatisation de l’étiquetage ne saurait être complète sans la mise en œuvre d’un dispositif algorithmique de validation et de contrôle qualité, garantissant que la réalité des tables de données créées reflète scrupuleusement les exigences du dictionnaire de métadonnées de référence. Dans les centres de gestion de données cliniques (CDISC), la validation de la conformité des tables constitue une obligation réglementaire impérative soumise à des audits stricts.
Ce contrôle automatisé s’élabore en programmant une comparaison ensembliste entre la table des métadonnées extraite de la base de production via PROC CONTENTS OUT=… et la table de référence issue du dictionnaire de données officiel. À l’aide d’une étape de fusion (MERGE) ou d’une requête relationnelle PROC SQL avec jointure externe, le script identifie instantanément deux catégories d’anomalies critiques : les variables présentes dans la base de données mais totalement dépourvues d’étiquettes, et les variables dont l’étiquette réelle s’écarte du texte réglementaire validé dans le protocole d’étude.
Si des discordances sont détectées lors de ce rapprochement algorithmique, le script est configuré pour émettre des messages personnalisés d’avertissement ou d’erreur critique dans le journal d’exécution (via l’instruction macro %PUT %STR(ERROR: …)), voire pour interrompre l’exécution générale du pipeline d’analyse. Cette architecture d’assurance qualité logicielle certifie que seules des données rigoureusement étiquetées et conformes aux dictionnaires approuvés sont transmises aux biostatisticiens pour les analyses d’efficacité finales.
10. Bonnes pratiques de gouvernance des métadonnées et conventions rédactionnelles
10.1 Clarté sémantique et neutralité descriptive
L’attribution d’étiquettes de variables ne doit jamais être considérée comme un acte technique anodin, mais bien comme un exercice de rédaction scientifique rigoureusement normé. Une étiquette médiocre ou ambiguë engendre autant de confusion chez l’analyste que l’absence totale de métadonnée. Par conséquent, l’élaboration des étiquettes descriptives doit impérativement respecter des principes cardinaux de clarté sémantique, de neutralité et de précision terminologique.
Il est impératif d’éviter tout jargon temporaire, abréviation cryptique non standardisée ou acronyme propre à un opérateur de saisie. Les termes choisis doivent refléter la nomenclature officielle et reconnue dans la littérature scientifique du domaine concerné. Une étiquette optimale se structure de manière hiérarchique et informative en précisant successivement trois composantes clés : le concept théorique mesuré, l’unité de mesure physique ou l’échelle d’évaluation sous-jacente, et le contexte ou la condition d’administration du test (par exemple : « Fréquence cardiaque au repos – Battements par minute – Position assise »).
La neutralité descriptive impose par ailleurs de consigner dans l’étiquette ce que la variable mesure objectivement et non l’hypothèse de recherche que le chercheur espère vérifier. La description doit demeurer purement factuelle. Ainsi, plutôt que d’étiqueter une variable « Amélioration de l’anxiété sous thérapie », la neutralité méthodologique exige d’inscrire « Différence absolue du score STAI entre T0 et T1 (T1 – T0) », garantissant ainsi que l’orientation mathématique de la soustraction et l’interprétation clinique restent incontestables pour tout réévaluateur indépendant.
10.2 Gestion de la concision et contraintes d’affichage graphique
Si la richesse documentaire est une vertu, la prolixité excessive constitue un écueil technique majeur lors de l’exploitation visuelle des données sous SAS. Bien que le système autorise jusqu’à 256 octets par étiquette, l’insertion de descriptions kilométriques pose de sévères difficultés de mise en page dès lors que les données sont injectées dans les procédures graphiques du module ODS Graphics, telles que PROC SGPLOT, PROC SGPANEL ou PROC SGSCATTER.
Dans un graphique de dispersion ou un diagramme en boîtes à moustaches généré par PROC SGPLOT, l’étiquette de la variable est automatiquement mobilisée pour légender les axes horizontal et vertical. Si l’étiquette comporte une phrase excessivement longue, le moteur de rendu graphique se voit contraint de tronquer le texte avec des points de suspension, de réduire la taille de la police à un seuil illisible ou de rogner la zone utile du graphique pour loger les métadonnées. L’analyste doit donc rechercher l’équilibre optimal entre exhaustivité documentaire et concision typographique.
Pour concilier ces exigences contradictoires, il est recommandé d’adopter des stratégies rédactionnelles normalisées au sein de l’équipe de recherche. L’utilisation d’abréviations universellement admises dans la discipline (par exemple « sd » pour déviation standard, « nb » pour nombre, « temp. » pour température) permet de concentrer l’information critique en un nombre réduit de caractères. De surcroît, le recours occasionnel à des étiquettes locales au sein des procédures graphiques permet d’adapter la longueur du titre de l’axe spécifiquement à la résolution de l’image finale sans altérer l’étiquette maîtresse plus longue stockée dans la table pérenne.
10.3 Standardisation institutionnelle pour les projets multicentriques
Dans les projets de grande envergure mobilisant des consortiums de recherche multicentriques ou des réseaux d’institutions hospitalières internationales, l’harmonisation des pratiques de programmation SAS constitue un facteur critique de réussite. En l’absence d’une gouvernance centralisée des métadonnées, chaque équipe locale a tendance à développer ses propres conventions d’étiquetage, aboutissant à une hétérogénéité préjudiciable lors de la consolidation finale des bases de données consolidées.
La mise en place d’un Guide de Style et de Gouvernance des Métadonnées s’impose dès l’initiation du projet. Ce document directeur définit les normes impératives que tous les analystes du réseau doivent respecter : règles de casse (majuscules/minuscules), positionnement systématique des unités de mesure entre crochets ou parenthèses, politique d’encodage des caractères (imposant l’UTF-8 de façon universelle) et formats d’abréviation autorisés. Cette standardisation garantit une cohérence esthétique et sémantique parfaite sur l’ensemble des livrables analytiques du consortium.
Ce guide institutionnel doit également formaliser la gestion du cycle de vie et du versionnage des étiquettes. Lorsqu’un instrument d’évaluation psychologique fait l’objet d’une révision mineure de formulation en cours d’étude, la politique de gouvernance dicte si l’étiquette doit être mise à jour en incrémentant un numéro de version ou si une nouvelle variable distincte doit être créée. L’adhésion rigoureuse à ces normes harmonise le niveau d’excellence opérationnelle entre analystes seniors et programmeurs juniors, facilitant la mutualisation des composants de code et l’auditabilité globale du système d’information de recherche.
11. Diagnostic et résolution des erreurs courantes liées aux étiquettes
11.1 Résolution des erreurs de guillemets et apostrophes non échappées
Parmi les incidents de programmation les plus récurrents recensés lors de la compilation des étapes DATA, les erreurs d’inadéquation de guillemets lors de l’affectation d’étiquettes figurent au premier rang. Le symptôme classique se manifeste par un journal SAS saturé de messages d’erreurs en cascade signalant une instruction non terminée (unclosed quote), un comportement erratique du compilateur ignorant des dizaines de lignes de code subséquentes, et l’échec pur et simple de la génération de la table de sortie.
Cette défaillance provient quasi systématiquement de la présence d’une apostrophe typographique française non échappée au sein d’une chaîne elle-même délimitée par des guillemets simples (par exemple dans l’expression erronée de l’étiquette du niveau d’éducation). Le compilateur SAS interprète la première apostrophe rencontrée comme la borne terminale de la chaîne textuelle, traitant les mots suivants comme des instructions SAS inconnues, tandis que le véritable guillemet fermant reste orphelin, maintenant le compilateur dans un état de lecture littérale indéfinie.
Le diagnostic s’opère par l’examen visuel du journal : une couleur anormale de coloration syntaxique dans l’éditeur étendu ou la présence du message système « WARNING: The quoted string currently being processed has become more than 262 characters long » constituent des indicateurs infaillibles de cette erreur. La remédiation immédiate consiste à appliquer systématiquement la méthode de l’encapsulation par guillemets doubles lorsque le libellé contient des apostrophes, ou à dédoubler strictement chaque apostrophe textuelle interne. La mise en œuvre de cette discipline syntaxique restaure instantanément l’intégrité de la compilation de l’étape DATA.
11.2 Omission ou écrasement inattendu lors des opérations de fusion (MERGE)
Un autre défi méthodologique majeur concerne la transmission et la préservation des étiquettes lors des opérations d’appariement et de fusion de tables de données via l’instruction MERGE au sein de l’étape DATA. Lorsque deux tables indépendantes contenant une variable portant le même nom physique mais pourvue d’étiquettes descriptives divergentes sont fusionnées, le comportement d’héritage des métadonnées sous SAS obéit à des règles strictes de priorité qu’il est indispensable de maîtriser.
La règle d’écrasement de SAS stipule que la valeur des attributs de la variable issue de la table positionnée la plus à droite (c’est-à-dire lue en dernier lieu dans la liste de l’instruction MERGE) prévaut et écrase les attributs homologues des tables mentionnées en amont. Par conséquent, si la première table contenait une étiquette hautement documentée pour une variable de stratification et que la seconde table ne contient pour cette même variable qu’une étiquette abrégée ou vide, c’est cette dernière formulation dégradée qui subsistera dans la table issue de la fusion.
Pour prévenir cette déperdition accidentelle de capital documentaire, il est impératif d’adopter des stratégies de programmation défensives. L’analyste consciencieux prendra soin de vérifier en amont l’harmonisation des descripteurs des tables sources via PROC CONTENTS. Si nécessaire, il positionnera intentionnellement une instruction déclarative LABEL explicite à la fin du bloc d’instructions de l’étape DATA de fusion, réassignant formellement l’étiquette normative définitive et neutralisant ainsi tout écrasement intempestif survenu lors du passage des flux d’enregistrements.
11.3 Absence d’affichage des étiquettes dans les résultats générés
Une source fréquente d’incompréhension chez les analystes débutants réside dans le constat que, bien que les étiquettes de variables aient été scrupuleusement renseignées au sein de l’étape DATA et validées par PROC CONTENTS, les rapports générés par certaines procédures statistiques continuent d’afficher obstinément les noms de variables techniques abrégés. Cette situation ne relève pas d’une corruption de la table, mais découle de l’état des options globales du système d’exploitation SAS régissant l’affichage.
Le système SAS possède une option d’environnement générale nommée LABEL (et son pendant inverse NOLABEL). Si, à la suite d’un script d’initialisation ou d’un paramétrage spécifique de la session utilisateur, l’option globale est positionnée sur NOLABEL, SAS inhibe systématiquement l’affichage de toutes les étiquettes de variables sur l’ensemble des procédures d’analyse de la session, indépendamment de la présence physique de ces attributs dans les descripteurs de fichiers. Pour restaurer l’affichage généralisé des métadonnées, il convient d’exécuter l’instruction globale options label; au tout début du script de travail.
Par ailleurs, comme examiné précédemment pour la procédure PRINT, certaines procédures spécifiques exigent l’activation explicite d’une option locale au sein de l’instruction procédurale elle-même pour déclencher le rendu des libellés. Il importe également de distinguer le comportement des destinations du système ODS : alors que les sorties au format texte classique (dites sorties Listing) peuvent masquer les étiquettes en l’absence d’options dédiées, les destinations graphiques modernes (ODS HTML5, ODS PDF) exploitent par défaut les étiquettes pour enrichir les en-têtes structurés de documents, à condition toutefois que l’option système générale soit bien activée.
12. Exportation et interopérabilité des jeux de données SAS étiquetés
12.1 Transfert des étiquettes vers d’autres progiciels statistiques (SPSS, R, Stata)
Dans les environnements de recherche modernes et les consortiums scientifiques pluridisciplinaires, les flux de travail analytiques ne se cantonnent que rarement à un écosystème logiciel unique. Les données préparées et assainies sous SAS sont fréquemment exportées vers d’autres plateformes d’analyse statistique spécialisées telles que R, Stata ou IBM SPSS Statistics. La préservation de l’intégrité des étiquettes de variables lors de ces transferts trans-logiciels constitue un impératif fondamental d’interopérabilité.
Lors de l’utilisation de la procédure d’exportation native PROC EXPORT pour transcoder une table SAS vers le format natif de SPSS (.sav) ou de Stata (.dta), le moteur de conversion SAS (ou les modules SAS/ACCESS associés) effectue une translation automatique des attributs de métadonnées. L’attribut LABEL du fichier SAS7BDAT est directement converti en variable label au sens de la structure de données cible. Cependant, des précautions doivent être observées quant aux contraintes de longueur maximale autorisées par les logiciels récepteurs : Stata, par exemple, a longtemps restreint les étiquettes de variables à 80 octets, ce qui pouvait occasionner des troncatures sévères si les étiquettes SAS initiales approchaient la limite de 256 octets.
Dans l’écosystème R, la lecture directe des tables SAS7BDAT s’effectue couramment au moyen du package spécialisé haven (faisant partie intégrante de la suite tidyverse). Ce package lit nativement la section descriptrice du fichier binaire SAS et convertit fidèlement chaque étiquette de variable en un attribut d’objet R nommé label rattaché à chaque colonne du tibble ou data frame. L’analyste R peut interroger cette métadonnée par des fonctions dédiées (telles que attr(donnees$variable, « label »)), assurant une continuité documentaire parfaite sans rupture sémantique lors du changement d’environnement informatique.
12.2 Exportation vers des formats délimités et gestion des dictionnaires de codes
En dépit des avantages des formats binaires propriétaires, le partage universel de données ouvertes ou le dépôt légal dans des archives publiques impose très fréquemment la conversion des tables dans des formats textuels ouverts et pérennes, au premier rang desquels figure le format de valeurs séparées par des virgules (CSV) ou par des tabulations (TXT). Cependant, la structure physique d’un fichier CSV présente une limitation conceptuelle majeure : il s’agit d’un format rectangulaire strictement plat, totalement dépourvu de mécanisme standardisé pour encapsuler une partie descriptrice de métadonnées.
Lorsqu’une table SAS étiquetée est exportée en CSV via PROC EXPORT standard, la première ligne du fichier généré ne contient par défaut que les noms techniques abrégés des variables, et l’intégralité du capital documentaire constitué par les étiquettes descriptives est purement et simplement perdu lors de l’opération. Pour contourner cette lacune d’infrastructure, l’analyste SAS dispose de deux approches méthodologiques complémentaires pour garantir la pérennité documentaire des données ainsi diffusées.
La première stratégie consiste à générer concomitamment un livre de codes autonome (codebook ou dictionnaire de données) accompagnant le fichier CSV. Ce dictionnaire est extrait de la partie descriptrice de la table source au moyen de la procédure CONTENTS combinée avec une redirection ODS ou une sortie tabulaire, documentant exhaustivement la correspondance entre le nom physique de la colonne, son type, sa longueur et son étiquette textuelle complète. La seconde stratégie, plus avancée sur le plan technique, consiste à employer des scripts personnalisés sous étape DATA pour inscrire intentionnellement dans le fichier CSV deux lignes d’en-tête distinctes : la première ligne consignant les noms de variables techniques pour les parsers informatiques, et la seconde ligne reportant textuellement l’ensemble des étiquettes de variables pour les utilisateurs humains.
12.3 Archivage patrimonial et principes FAIR des données de recherche
L’archivage pérenne des données quantitatives répond désormais aux normes internationales strictes édictées par les principes FAIR, qui visent à rendre les actifs numériques faciles à trouver (Findable), accessibles (Accessible), interopérables (Interoperable) et réutilisables (Reusable). Dans cette perspective d’intendance patrimoniale des données de recherche, la présence d’étiquettes de variables explicites et exhaustives ne constitue plus une simple commodité de mise en page, mais bien une exigence déontologique et méthodologique centrale conditionnant la validité des dépôts institutionnels.
Lorsqu’un jeu de données issu d’un essai clinique ou d’une vaste enquête de santé publique est déposé au sein d’entrepôts de données certifiés, il est destiné à être réexaminé et réanalysé plusieurs décennies après sa collecte initiale, bien souvent après la cessation d’activité des chercheurs ayant conçu le protocole expérimental initial. Si les variables de la base ne reposent que sur des mnémoniques internes ou des abréviations de laboratoire orphelines, la table de données devient scientifiquement stérile et inexploitable pour la communauté scientifique, réduisant à néant l’investissement financier et humain consenti lors de l’étude.
En inscrivant de manière indélébile le contexte expérimental, la question d’évaluation psychométrique ou l’unité de mesure biologique au cœur même de l’attribut LABEL de la table SAS, le chercheur confère à ses données une autonomie sémantique complète. Cette rigueur de documentation assure que les analyses secondaires futures, les méta-analyses sur données individuelles et les audits de réplication méthodologique pourront être exécutés avec une garantie maximale d’exactitude et de fidélité conceptuelle, pérennisant ainsi la contribution scientifique des données collectées pour les générations futures de chercheurs.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2e éd.). SAS Institute. https://support.sas.com/publishing/
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6e éd.). SAS Institute. https://www.sas.com
- Horstman, D. (2017). PROC CONTENTS: The Unsung Hero of Metadata in SAS. SAS Global Forum Proceedings. https://www.lexjansen.com
- SAS Institute Inc. (2021). SAS(R) 9.4 Language Reference: Concepts, Sixth Edition. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/base/index.html
- SAS Institute Inc. (2023). Base SAS Procedures Guide: Statistical Procedures. SAS Institute Inc. https://documentation.sas.com
- Wicklin, R. (2013). Simulating Data with SAS. SAS Institute. https://support.sas.com/publishing/
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 1-9. https://doi.org/10.1038/sdata.2016.18