
Dans le domaine du traitement de données et de l’analyse quantitative appliquée aux sciences sociales, au marketing ou à la recherche clinique, la conversion d’observations qualitatives en métriques quantifiables constitue une étape fondamentale. L’environnement logiciel de Microsoft Excel demeure, en dépit de l’émergence d’environnements de programmation dédiés tels que Python ou R, l’outil le plus universellement déployé pour structurer, nettoyer et interroger des corpus tabulaires. Néanmoins, l’apparente simplicité de la manipulation des chaînes de caractères masque une complexité algorithmique et méthodologique substantielle dès lors qu’il s’agit d’extraire la distribution fréquentielle d’un texte avec rigueur et reproductibilité.
Le dénombrement textuel ne se résume pas à l’application machinale d’un opérateur de comptage standard. Il requiert une compréhension fine de la mécanique d’évaluation logique propre au moteur de calcul d’Excel, de la distinction entre correspondances exactes, approchées et génériques, ainsi que des contraintes inhérentes à la typographie, à l’encodage binaire des caractères et à la sensibilité à la casse. Une analyse lexicométrique mal calibrée est susceptible d’induire des biais de mesure considérables, conduisant à des distorsions analytiques lors de la prise de décision stratégique ou de la publication de résultats scientifiques.
Ce guide exhaustif a pour vocation d’exposer l’ensemble des paradigmes, formules et architectures de données permettant de quantifier méthodiquement la fréquence d’unités textuelles au sein de Microsoft Excel. De l’utilisation canonique de la fonction NB.SI jusqu’aux formulations matricielles avancées exploitant la manipulation intra-cellulaire de chaînes et les fonctions dynamiques modernes, chaque section articule fondements théoriques et démonstrations opérationnelles précises, garantissant une intégrité analytique sans compromis.
1. Fondements méthodologiques du comptage textuel dans Excel
1.1 Importance de l’analyse fréquentielle des données qualitatives
La transformation de données qualitatives brutes en indicateurs quantitatifs analysables constitue un pivot méthodologique dans toute démarche empirique. Lorsqu’un analyste est confronté à des réponses issues de questionnaires ouverts, à des comptes rendus d’incidents techniques ou à des transcriptions d’entretiens semi-directifs, le premier défi réside dans la réduction de la complexité lexicale. En quantifiant l’occurrence des termes, on dégage une métrique objective permettant d’établir la prévalence d’un concept au sein d’une population statistique donnée. Cette opération permet de substituer à l’intuition interprétative une mesure formelle de la dispersion thématique, condition sine qua non pour appliquer ultérieurement des tests paramétriques ou non paramétriques.
Dans les protocoles de recherche mixte, la codification des verbatims s’appuie sur une grille de catégorisation systématique où chaque segment textuel est associé à un label normé. La fréquence d’apparition de ces labels devient l’indicateur primaire de l’intensité d’une préoccupation ou de la récurrence d’un phénomène. Par exemple, l’évaluation de la satisfaction des usagers face à une politique publique requiert de décompter avec exactitude les mentions lexicales associées à des champs sémantiques distincts tels que l’accessibilité, le délai de traitement ou la clarté informationnelle. Une telle quantification structure le corpus en matrices de contingence exploitables pour l’analyse factorielle des correspondances.
Par ailleurs, l’identification des récurrences lexicales et des patrons sémantiques dominants sert de fondement à l’évaluation de la fiabilité inter-juges. Lorsque plusieurs évaluateurs indépendants procèdent à l’annotation d’un même échantillon de texte, la concordance de leurs assignations lexicales peut être validée mathématiquement par des coefficients statistiques comme le Kappa de Cohen ou le coefficient alpha de Krippendorff. L’exactitude des calculs de fréquence textuelle sous-jacents conditionne donc directement la validité scientifique des indices d’accord inter-observateurs, garantissant que les régularités observées ne résultent pas de fluctuations aléatoires ou d’artefacts algorithmiques mal maîtrisés.
1.2 Typologie des structures textuelles au sein d’un tableur
D’un point de vue épistémologique et structurel, il est impératif de distinguer deux formes fondamentales de données textuelles au sein d’un tableur : les chaînes textuelles atomiques et les données textuelles libres. Une donnée textuelle atomique se caractérise par son indivisibilité logique dans le modèle de données : il s’agit d’une modalité de variable nominale discrète, telle qu’une région géographique, un statut marital ou un identifiant de cohorte. Dans cette configuration, la cellule entière représente une observation unique et exclusive, ce qui rend l’appariement terme à terme direct et robuste.
À l’opposé, les données textuelles libres rassemblent des phrases, des paragraphes ou des transcriptions complètes au sein d’une seule unité cellulaire. Le traitement de ces structures impose une décomposition syntaxique préalable ou le recours à des algorithmes de recherche intra-cellulaire capables d’isoler un mot-clé précis au milieu d’une séquence syntagmatique continue. L’ambiguïté inhérente à la langue naturelle — marquée par la polysémie, la flexion morphologique et l’insertion de ponctuations variées — complexifie drastiquement le dénombrement en créant des frontières de mots floues que le moteur de recherche du tableur doit interpréter fidèlement.
La validité des inférences statistiques tirées de ces deux types de corpus dépend intrinsèquement de la normalisation préalable des chaînes de caractères. Une variation mineure, telle que la présence d’une espace insécable, d’une cédille omise ou d’un pluriel irrégulier, fragmente artificiellement les fréquences d’un concept en multiples modalités concurrentes. La standardisation en amont, qu’elle relève de la lemmatisation formelle ou de l’application de masques de nettoyage textuel, constitue une exigence architecturale prévenant la sous-estimation systématique des occurrences réelles.
1.3 Architecture computationnelle d’Excel pour le traitement de texte
L’architecture interne du moteur de calcul d’Excel repose sur un système de typage strict des données, scindant les cellules en types numériques, textuels, booléens et d’erreur. Lorsqu’une chaîne de caractères est assignée à une cellule, l’interpréteur lui alloue une structure de chaîne de type BSTR ou chaîne Unicode UTF-16, dotée d’une longueur prédéfinie pouvant atteindre 32 767 caractères. La façon dont l’interpréteur évalue ces chaînes lors de l’exécution des fonctions de comparaison détermine le résultat de tout calcul fréquentiel.
Une dimension critique réside dans la localisation linguistique de l’environnement de travail. Les formules et les délimiteurs d’arguments diffèrent substantiellement entre les versions francophones et anglophones : là où la version anglaise mobilise la fonction COUNTIF et sépare ses arguments par une virgule, la version française exige la fonction NB.SI et l’usage obligatoire du point-virgule comme délimiteur syntaxique. Cette divergence s’étend également à la gestion des expressions régulières, traditionnellement absentes du moteur de formule natif classique et nécessitant des mécanismes de substitution complexes basés sur des métacaractères universels.
Enfin, le moteur standard d’Excel est nativement insensible à la casse et insensible aux variations typographiques élémentaires lors de l’usage des fonctions logiques traditionnelles. Les chaînes « Paris », « PARIS » et « paris » sont interprétées comme équivalentes par les fonctions de comptage conditionnel de base. Si cette tolérance morphologique simplifie l’agrégation de données mal saisies, elle constitue un obstacle majeur pour l’analyse précise d’acronymes, de codes génétiques ou de nomenclatures sensibles aux minuscules et majuscules, imposant le recours à des comparateurs binaires dédiés.
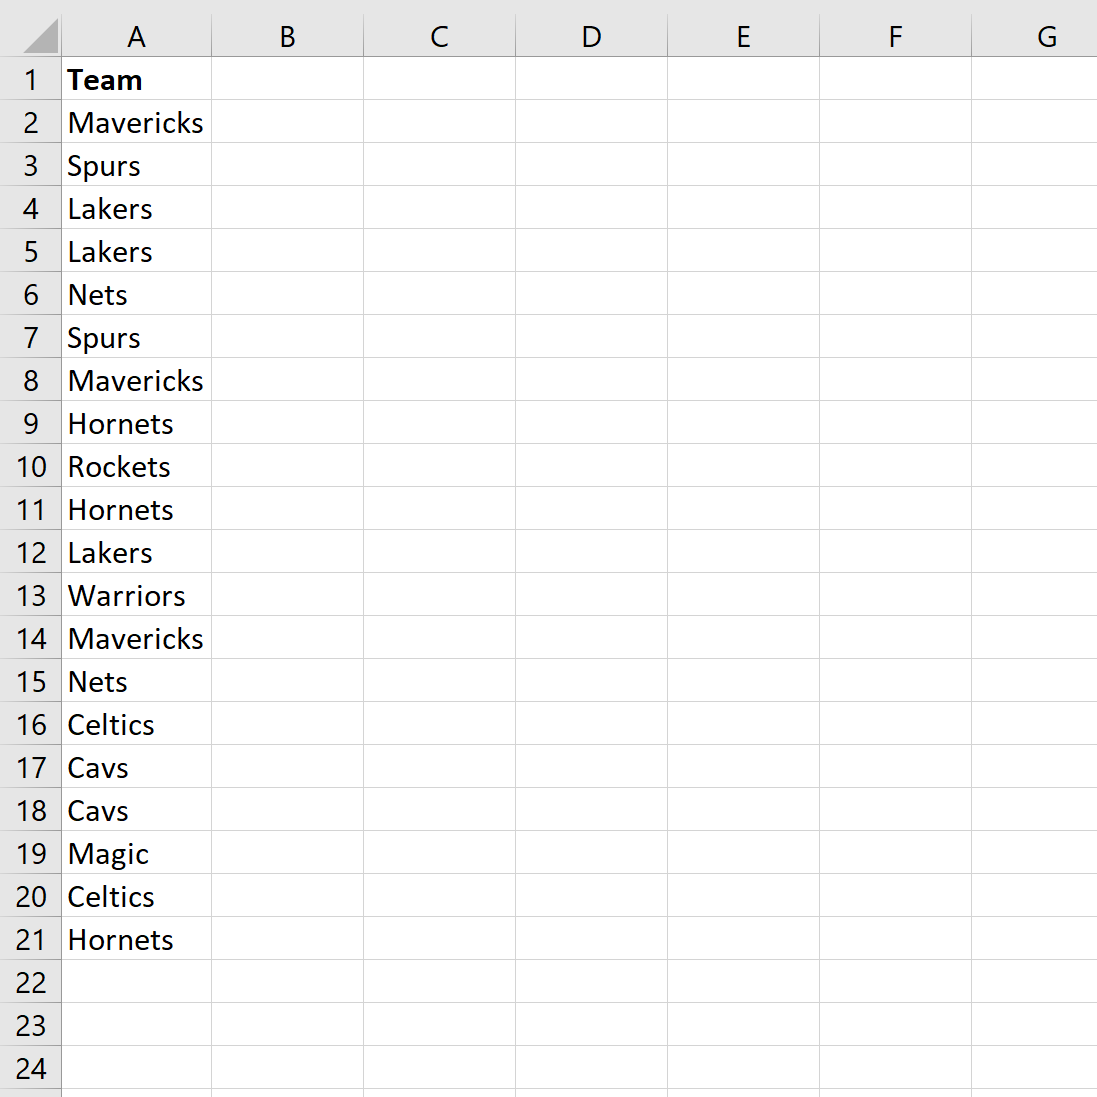
2. La fonction fondamentale NB.SI : Syntaxe et principes opérationnels
2.1 Décomposition de la syntaxe canonique de la fonction
La fonction fondamentale pour dénombrer des entités textuelles conditionnelles est la fonction NB.SI. Sa formulation canonique s’articule autour de deux arguments obligatoires et se présente sous la structure formelle :
=NB.SI(plage; critère)
L’argument plage circonscrit l’espace d’échantillonnage, c’est-à-dire l’ensemble des adresses matricielles contenant les observations à évaluer. Cette plage peut être continue (par exemple A2:A1500) ou correspondre à une colonne structurée au sein d’un tableau Excel. L’intégrité du calcul repose sur la fixité de cet intervalle lors du recopiage de formules, justifiant fréquemment l’usage de références absolues via l’opérateur dollar (par exemple $A$2:$A$1500).
L’argument critère définit la condition d’appariement que chaque cellule de la plage doit satisfaire pour être incrémentée dans le total cumulé. Ce critère peut être formulé sous la forme d’une constante littérale, d’une expression logique avec comparateur, ou d’une référence dynamique vers une cellule tierce. Lorsque le moteur d’évaluation traverse la plage, il exécute un test booléen unitaire sur chaque cellule. Chaque occurrence satisfaisant le prédicat logique génère une valeur de vérité vraie (valeur 1 au niveau binaire), et la fonction restitue la somme arithmétique de ces états positifs.
2.2 Règles d’évaluation des chaînes de caractères littérales
L’évaluation des critères textuels par la fonction NB.SI obéit à des conventions typographiques strictes. Toute constante textuelle codée explicitement au sein de la formule doit impérativement être encadrée par des guillemets doubles droits (caractère ASCII 34). L’omission de ces guillemets provoque une erreur de syntaxe immédiate (#NOM?), le moteur interprétant le texte non délimité comme une tentative d’appel à une fonction ou à une plage nommée inexistante.
Comme mentionné précédemment, la fonction applique une insensibilité totale à la casse. Ainsi, l’écriture =NB.SI(A2:A50; "FRANCE") restituera indifféremment le décompte des cellules contenant « France », « france », « FRANCE » ou même des agencements hétérogènes tels que « FrAnCe ». Cette propriété réduit considérablement l’effort de normalisation des entrées lors du traitement de questionnaires où la touche de verrouillage des majuscules a été utilisée de façon erratique par les répondants.
En revanche, la présence d’espaces invisibles constitue l’un des pièges les plus insidieux de l’argument critère. Une chaîne littérale spécifiée comme "France " (contenant une espace terminale après le mot) ne correspondra à aucune cellule contenant le mot canonique "France". Le moteur effectue une comparaison caractère par caractère en se fondant sur les codes ASCII sous-jacents ; l’espace étant un caractère plein au sens computationnel, toute divergence dans le nombre d’espaces disqualifie l’égalité booléenne sans que l’utilisateur n’en perçoive visuellement la raison à l’écran.
2.3 Références de cellules versus chaînes codées en dur
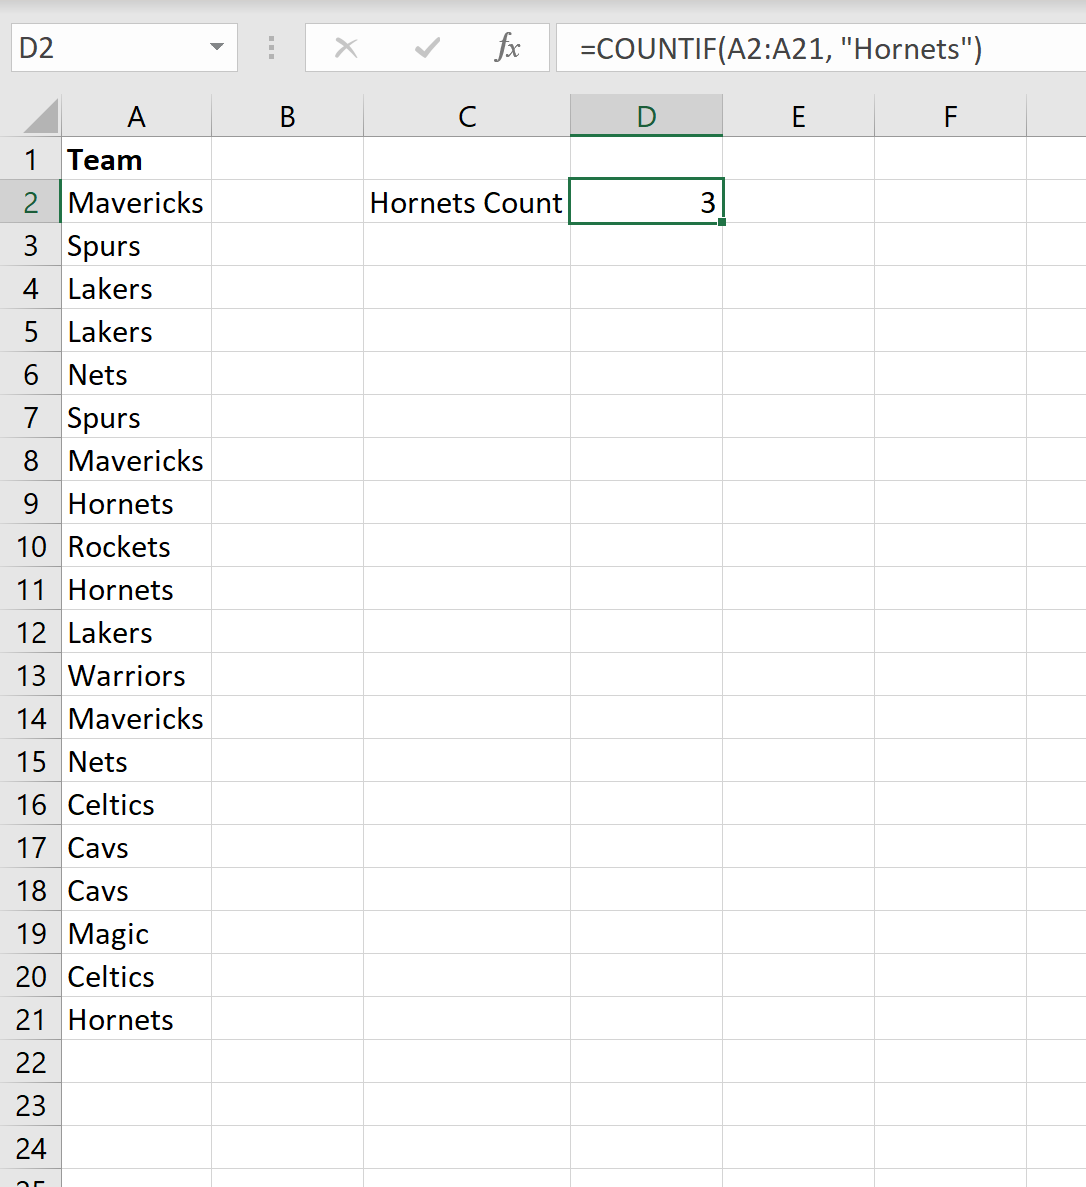
Dans une perspective de modélisation pérenne et de bonne pratique en ingénierie de données, l’incorporation de chaînes de caractères en dur au sein des formules de calcul est formellement déconseillée. Il est nettement supérieur de recourir à la paramétrisation dynamique en référençant des cellules contenant les termes à décompter. La formule prend alors la forme =NB.SI($A$2:$A$1000; D2), où D2 héberge l’étiquette ciblée.
Cette approche présente une pluralité d’avantages opérationnels et méthodologiques :
- Réduction drastique des erreurs systématiques : La modification d’un libellé dans la cellule de référence met à jour instantanément tous les décomptes associés sans exiger une inspection manuelle du code des formules.
- Facilitation de l’auditabilité : Les auditeurs et relecteurs d’un modèle peuvent valider d’un coup d’œil la cohérence des catégories d’analyse regroupées au sein d’une table d’index dédiée.
- Scalabilité et portabilité : L’étirement vertical d’une formule paramétrée le long d’une liste de catégories uniques permet de construire une distribution statistique complète en une seule opération, assurant une reproductibilité parfaite des analyses.
3. Dénombrement d’une occurrence textuelle unique et exacte
3.1 Protocole pas à pas pour un terme isolé
Pour mesurer la fréquence exacte d’une modalité nominale discrète au sein d’un échantillon, un protocole rigoureux doit être appliqué. Supposons une étude portant sur le statut contractuel d’un panel de 500 individus documenté dans la plage B2:B501. Le protocole d’extraction se déroule en quatre étapes distinctes :
En premier lieu, l’analyste isole la variable d’intérêt en s’assurant que la plage cible ne comprend ni en-têtes de colonnes, ni totaux partiels pouvant biaiser le décompte global. La formulation univariée s’établit comme suit :
=NB.SI($B$2:$B$501; "Titulaire")
En deuxième lieu, une vérification de cohérence est impérativement menée sur un échantillon témoin. Cette validation croisée s’opère couramment en appliquant un filtre automatique textuel sur la colonne B pour le critère « Titulaire », et en comparant le nombre de lignes visibles affiché dans la barre d’état d’Excel avec la valeur numérique renvoyée par la fonction.
En troisième lieu, l’analyste calcule le rapport entre la fréquence absolue obtenue et la taille globale de l’échantillon pour contextualiser l’indicateur. Si le résultat affiche 125 occurrences, la confrontation à la taille d’échantillon totale via la fonction NBVAL($B$2:$B$501) permet de déduire instantanément une prévalence empirique de 25 %, jetant les bases de l’analyse descriptive.
3.2 Analyse critique des limitations de l’appariement exact
En dépit de son efficacité sur des bases de données hautement standardisées, le protocole d’appariement exact présente des failles structurelles aiguës lorsqu’il est confronté à des données issues de saisies humaines non contraintes. La vulnérabilité première réside dans la sensibilité aux fautes d’orthographe, aux coquilles et aux permutations de lettres. Un individu ayant saisi « Tutilaire » ou « Titulaier » sera systématiquement ignoré par l’algorithme, introduisant une erreur d’attrition non aléatoire au sein du comptage.
La seconde limitation provient de la pollution invisible des données par les espaces insécables (code Unicode U+00A0 ou CAR(160) sous Excel), fréquemment générées lors de l’extraction de données à partir d’applications Web, de progiciels de gestion intégrée (ERP) ou de fichiers PDF. L’œil humain ne discerne aucune différence entre un mot suivi d’une espace standard et le même mot suivi d’une espace insécable, mais le moteur de NB.SI constate une divergence binaire absolue, aboutissant à l’exclusion pure et simple de l’enregistrement.
En conséquence, l’exploitation de l’appariement exact requiert obligatoirement un protocole de vérification d’intégrité préalable. Si ce travail de contrôle n’est pas réalisé en amont, les fréquences absolues issues de NB.SI doivent être considérées avec prudence, sous peine de sous-évaluer massivement la fréquence réelle des phénomènes étudiés.
4. Exploitation des caractères génériques pour le décompte partiel
4.1 Utilisation de l’astérisque pour les correspondances indéterminées
Lorsque le corpus analysé est constitué de données textuelles complexes ou de commentaires semi-ouverts, la correspondance stricte s’avère inopérante. Excel intègre des caractères génériques (wildcards) permettant de modéliser des motifs de recherche flexibles. Le plus puissant d’entre eux est l’astérisque (*), qui représente une séquence arbitraire de zéro, un ou plusieurs caractères consécutifs.
L’intégration de l’astérisque permet de concevoir des filtres lexicaux sophistiqués :
- Recherche d’un préfixe spécifique : Le critère
"Électr*"décompte toutes les chaînes débutant par cette racine, englobant « Électrique », « Électronique », « Électricité » ou « Électroménager ». - Recherche d’un suffixe : Le critère
"*logie"ciblera l’ensemble des termes se terminant par cette séquence, tels que « Sociologie », « Psychologie » ou « Biologie ». - Recherche d’un mot-clé en position quelconque : L’encadrement par deux astérisques
"*qualité*"permet d’incrémenter le compteur dès lors que la séquence apparaît dans la cellule, qu’elle soit isolée, placée en début de phrase ou enfouie au milieu d’un long commentaire.
L’utilisation des astérisques s’avère indispensable pour l’extraction de radicaux lexicaux au sein d’enquêtes de satisfaction. Néanmoins, l’analyste doit veiller au risque majeur de sur-comptage. Si le radical sélectionné est trop court — par exemple l’usage du motif "*car*" pour repérer les mentions d’automobiles —, l’algorithme déploiera une inclusion indésirable de cellules contenant des termes parasites tels que « placard », « encart », « carton » ou « écarter », faussant irrémédiablement la distribution statistique.
4.2 Précision structurelle avec le point d’interrogation
Tandis que l’astérisque absorbe un nombre indéfini de caractères, le point d’interrogation (?) représente strictement un et un seul caractère individuel. Cette propriété octroie un contrôle géométrique de la chaîne recherchée, ce qui la rend précieuse pour gérer les variations morphologiques mineures ou normaliser des codes alphanumériques à structure fixe.
Considérons par exemple l’analyse d’une nomenclature de produits ou de répondants où l’orthographe admet des variantes d’une seule lettre, comme le mot « licence » et sa transcription anglophone « license ». L’application du critère "licen?e" garantit l’interception des deux graphies sans ouvrir la porte à des termes dérivés indésirables d’une longueur supérieure. De même, si l’on recherche des codes d’identification normalisés à cinq caractères commençant par « FR » et finissant par « 01 », le critère "FR??01" ciblera rigoureusement les chaînes à six caractères correspondant au schéma, tout en rejetant les variations non conformes à la grille typologique.
La distinction méthodologique fondamentale réside donc dans la contrainte spatiale : l’astérisque est un opérateur de contingence textuelle large, idéal pour le repérage thématique exploratoire, tandis que le point d’interrogation est un opérateur de tolérance typographique circonscrite, indispensable à l’assainissement de données codifiées selon un protocole strict.
4.3 Neutralisation des métacaractères via le tilde
Une difficulté algorithmique survient dès lors que le texte source à quantifier intègre explicitement des symboles que le moteur d’Excel interprète par défaut comme des métacaractères, à savoir l’astérisque, le point d’interrogation ou le tilde lui-même. Si une base de données de contrôle qualité contient des annotations du type « Erreur* » ou des références d’interrogations formulées sous la forme « Conforme ? », l’usage naïf de =NB.SI(A2:A100; "Conforme ?") échouera lamentablement : le point d’interrogation sera interprété comme un substitut à n’importe quel caractère, comptabilisant ainsi « Conforme 1 » ou « Conforme A » au lieu de cibler strictement le signe de ponctuation.
Pour neutraliser cette ambiguïté computationnelle, Excel utilise le tilde (~) comme caractère d’échappement universel. Tout métacaractère précédé d’un tilde perd instantanément ses propriétés génériques pour être réévalué comme un caractère littéral strict. Ainsi, la formule appropriée pour repérer exclusivement la chaîne avec interrogation s’écrira :
=NB.SI(A2:A100; "Conforme ~?")
De même, pour décompter les cellules contenant une astérisque technique signalant par exemple un niveau de significativité statistique (p < 0.05*), il conviendra de formuler le critère sous la forme "*~**" si l’on souhaite localiser l’astérisque littérale n’importe où dans la chaîne. Enfin, pour rechercher un tilde authentique au sein d’une transcription lexicale phonétique, la duplication syntaxique s’impose sous la forme de deux tildes successifs "~~". Cette maîtrise des caractères d’échappement préserve l’intégrité de la codification face aux corpus linguistiques spécialisés.
5. Extraction automatisée et analyse de fréquences multiples avec UNIQUE et NB.SI
5.1 Génération dynamique de la nomenclature avec UNIQUE
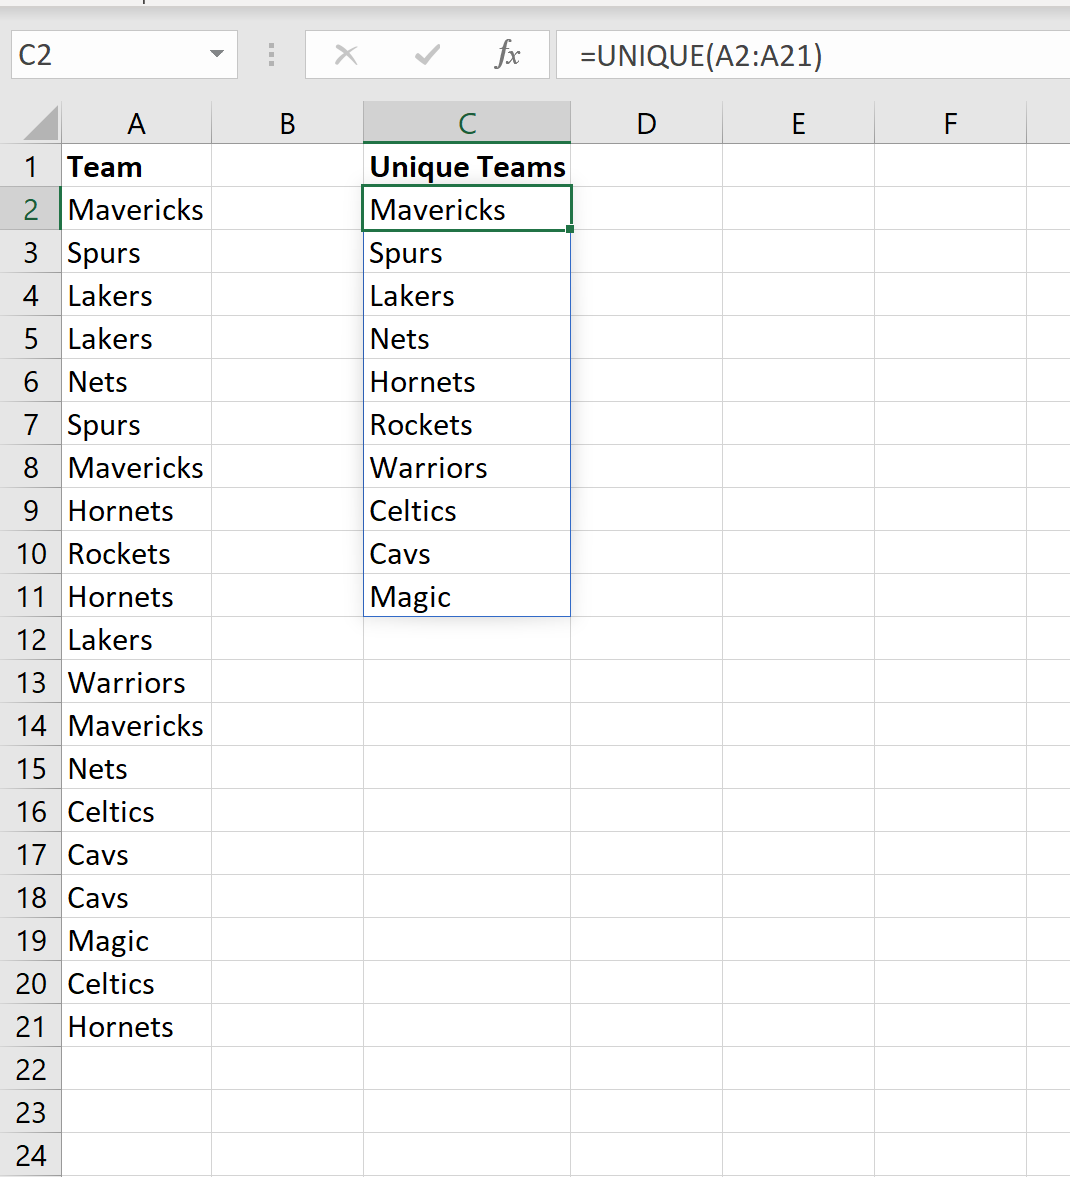
Dans les versions contemporaines de Microsoft Excel (Excel 365 et Excel 2021), l’introduction du moteur de calcul matriciel dynamique a révolutionné l’analyse de fréquence lexicale. Auparavant, l’extraction de la liste des termes distincts d’un corpus exigeait des macros complexes en VBA ou l’usage manuel de l’outil d’élimination des doublons de données. Désormais, la fonction UNIQUE permet d’isoler automatiquement et dynamiquement la nomenclature exhaustive d’un ensemble textuel.
La formulation est remarquable d’élégance :
=UNIQUE(A2:A1500)
Cette expression, saisie dans une cellule libre (par exemple en D2), génère ce que l’on qualifie d’une plage propagée (spill range). Le moteur évalue l’ensemble des valeurs textuelles contenues dans l’espace d’échantillonnage source, extrait chaque modalité distincte une seule fois, et remplit verticalement les cellules contiguës nécessaires à l’affichage des résultats. Si une nouvelle modalité textuelle est saisie ultérieurement dans la source, la nomenclature s’étend instantanément sans requérir la moindre réécriture algorithmique.
Toutefois, ce comportement de propagation exige une vigilance structurelle : si un obstacle physique — telle qu’une valeur statique ou un commentaire — obstrue la trajectoire d’expansion de la plage propagée, Excel renvoie immédiatement une erreur d’intersection bloquante de type #PROPAGATION! (ou #SPILL!). L’espace sous-jacent doit impérativement demeurer vierge de toute donnée pour garantir le déploiement normal du vecteur lexical.
5.2 Couplage de NB.SI avec l’opérateur de propagation dièse
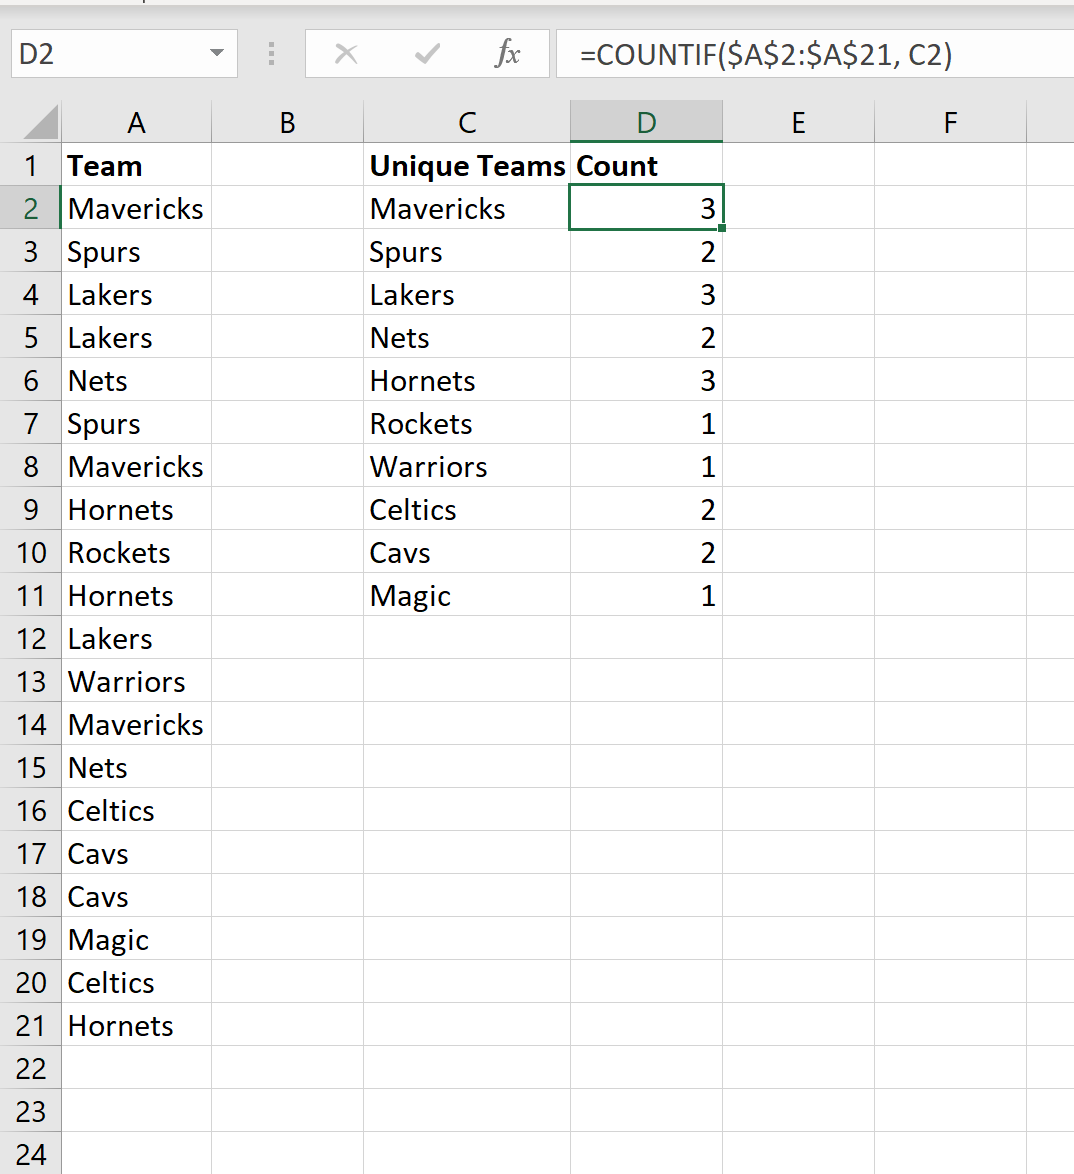
L’articulation entre l’extraction dynamique des catégories et leur dénombrement fréquentiel s’opère par la conjonction de la fonction NB.SI et de l’opérateur de propagation représenté par le symbole dièse (#). Au lieu de recopier manuellement une formule de comptage unitaire en face de chaque élément de la liste unique, l’analyste spécifie la racine de la plage propagée comme argument critère :
=NB.SI($A$2:$A$1500; D2#)
En inscrivant D2#, l’utilisateur instruit le moteur de calcul d’évaluer simultanément chaque valeur issue de la liste dynamique créée en D2. Le moteur renvoie en réponse une colonne de fréquences absolues parfaitement synchrone avec la taille de la nomenclature textuelle. Si le corpus d’origine voit apparaître de nouveaux termes ou si certaines catégories disparaissent suite à un filtrage, l’ensemble du tableau de distribution fréquentielle s’ajuste en temps réel de manière totalement autonome.
Sur le plan des performances computationnelles, cette architecture matricielle surpasse très largement les anciennes cohortes de formules recopiées manuellement sur des dizaines de milliers de lignes. Le moteur vectorise les opérations en mémoire vive, optimisant les cycles processeur et prévenant les désynchronisations accidentelles consécutives à un étirement incomplet de formules sur des jeux de données volumineux.
5.3 Tri et hiérarchisation de la distribution fréquentielle
L’exploration d’un corpus lexical impose fréquemment de classer les entités textuelles selon un ordre décroissant d’apparition, conformément aux préceptes de la loi de Zipf en linguistique computationnelle ou de la distribution de Pareto en gestion des opérations. Excel autorise l’orchestration combinée des fonctions dynamiques pour produire un tableau de fréquences ordonné directement par formule.
Considérons la construction matricielle suivante, réunissant le filtrage unique, le tri et le calcul fréquentiel :
=TRIER(CHOISIRCOLS(HSTACK(UNIQUE(A2:A1000); NB.SI(A2:A1000; UNIQUE(A2:A1000))); 1; 2); 2; -1)
Cette imbrication sophistiquée procède à une analyse complète :
- Elle extrait les catégories textuelles distinctes via
UNIQUE. - Elle calcule parallèlement la fréquence absolue associée à chaque catégorie avec
NB.SI. - Elle assemble horizontalement les deux vecteurs colonnes via
HSTACK(ouASSEMB.H). - Elle soumet l’ensemble à la fonction
TRIERen ciblant la deuxième colonne (celle des décomptes) avec un ordre descendant (valeur -1).
Le résultat génère instantanément un diagramme de distribution textuelle où les termes les plus récurrents dominent le sommet de la matrice. L’analyse des fréquences cumulées devient dès lors immédiate, autorisant l’identification des 20 % de termes concentrant 80 % de la masse lexicale du corpus examiné.
6. Filtrage multidimensionnel et critères textuels combinés avec NB.SI.ENS
6.1 Syntaxe matricielle des conditions conjonctives
Dans la recherche empirique, une variable textuelle est rarement étudiée de manière isolée. Elle s’inscrit au sein d’une matrice multivariée où sa prévalence doit être examinée à la lumière de segments démographiques, géographiques ou chronologiques. Pour réaliser ces analyses croisées sans recourir à des tables de contingence manuelles, la fonction NB.SI.ENS constitue l’instrument d’évaluation conjonctive par excellence (correspondant à l’opérateur logique ET).
Sa syntaxe générale s’organise selon une succession ordonnée de couples plage-critère :
=NB.SI.ENS(plage_critères1; critère1; [plage_critères2; critère2]; ...)
Imaginons un protocole d’évaluation de la qualité des soins hospitaliers consignant les verbatims des patients en colonne C (« Insatisfaction »), leur tranche d’âge en colonne D (« >=65 ») et le service concerné en colonne B (« Urgences »). La formule permettant d’isoler la fréquence textuelle spécifique au sein de ce sous-groupe s’exprimera ainsi :
=NB.SI.ENS($B$2:$B$1000; "Urgences"; $C$2:$C$1000; "Insatisfaction"; $D$2:$D$1000; ">=65")
Une contrainte géométrique stricte régit impérativement cette fonction : toutes les plages d’analyse mobilisées doivent posséder des dimensions identiques (même nombre de lignes et même nombre de colonnes). Toute asymétrie dimensionnelle, par exemple l’usage d’une plage B2:B1000 associée à une plage C2:C999, déclenche irrémédiablement une erreur #VALEUR!, le moteur d’Excel étant dans l’incapacité d’aligner les vecteurs d’observation lors de l’exécution du produit logique cellule à cellule.
6.2 Modélisation de critères disjonctifs avec constantes matricielles
Si la fonction NB.SI.ENS excelle dans l’évaluation des conditions conjonctives (ET), elle est structurellement incapable d’évaluer nativement des conditions disjonctives (OU) appliquées à une même variable. Par exemple, si l’on cherche à dénombrer les répondants ayant exprimé soit « Satisfait », soit « Très satisfait » au sein d’une même colonne, l’écriture consécutive de ces deux conditions dans NB.SI.ENS renverrait le chiffre zéro, aucune cellule ne pouvant héberger simultanément deux valeurs scalaires distinctes.
Pour dépasser cette limitation sans alourdir la feuille de calcul, la méthodologie préconise l’injection d’une constante matricielle au niveau de l’argument critère, encapsulée au sein d’une fonction de sommation arithmétique :
=SOMME(NB.SI($A$2:$A$500; {"Satisfait"; "Très satisfait"}))
Le fonctionnement de cette structure mérite une explication détaillée : la présence de la matrice constante délimitée par des accolades {"Satisfait"; "Très satisfait"} contraint la fonction NB.SI à s’exécuter deux fois consécutivement. Elle calcule dans un premier temps le décompte des occurrences de « Satisfait », puis dans un second temps celui de « Très satisfait », renvoyant en mémoire un vecteur de deux valeurs (par exemple {45; 62}). La fonction englobante SOMME agrège ensuite les éléments de ce vecteur pour restituer le total consolidé de 107 occurrences.
Sur le plan méthodologique, cette modélisation disjonctive suppose que les catégories soient mutuellement exclusives au sein d’une même cellule. Si la recherche s’opère par des caractères génériques (par exemple {"*bio*"; "*santé*"}) sur du texte libre, il convient de veiller au risque de double décompte : un verbatim contenant à la fois « bio » et « santé » sera additionné deux fois par la sommation vectorielle. L’analyste devra alors préférer des formulations booléennes plus avancées pour préserver l’unicité de l’observation.
6.3 Combinaison de critères textuels et d’opérateurs relationnels
L’analyse fréquentielle textuelle gagne une puissance prédictive majeure lorsqu’elle est combinée avec des variables métriques continues, telles que des scores psychométriques, des indices d’intensité ou des données temporelles. Cette articulation requiert l’association correcte des opérateurs relationnels standards (>, <, >=, <=, <>) avec les étiquettes textuelles au sein de NB.SI.ENS.
Lorsqu’un opérateur relationnel est combiné avec une cellule de référence contenant un seuil numérique, la syntaxe d’Excel impose l’usage de l’opérateur de氲concaténation esperluette (&). Supposons que l’on veuille compter le nombre de fois où le terme « Réclamation » survient dans un dossier dont le montant du litige — consigné dans la colonne E — excède un seuil dynamique placé dans la cellule G1 :
=NB.SI.ENS($A$2:$A$1000; "Réclamation"; $E$2:$E$1000; ">" & $G$1)
L’omission de l’esperluette ou le confinement de la référence cellulaire à l’intérieur des guillemets doubles (comme ">G1") conduirait le moteur à rechercher littéralement la chaîne textuelle « G1 » au lieu de considérer la valeur numérique sous-jacente hébergée dans la cellule, privant ainsi l’analyse de toute portée dynamique. Le respect rigoureux de ces règles de liaison syntaxique garantit l’intégrité des sous-ensembles extraits à des fins d’analyse inférentielle.
7. Gestion de la sensibilité à la casse et appariement binaire strict
7.1 Limites de NB.SI face aux distinctions typographiques
Comme démontré précédemment, les fonctions de la famille NB.SI et NB.SI.ENS reposent sur un modèle de comparaison insensible à la casse. Dans une écrasante majorité de cas d’usage administratifs, cette tolérance est bénéfique. En revanche, dans de multiples domaines scientifiques, la casse porte une charge sémantique autonome et discriminante :
- Génétique et bio-informatique : Les séquences de nucléotides ou les allèles dominants/récessifs se caractérisent formellement par l’alternance de majuscules et de minuscules (ex. « A » versus « a »).
- Technologies de l’information : La gestion des identifiants d’accès, des jetons d’authentification ou des hachages cryptographiques requiert un appariement binaire absolu.
- Linguistique et documentation : La distinction entre un acronyme signifiant et un nom commun homographe (par exemple « OMS » pour l’Organisation Mondiale de la Santé et « oms » comme segment textuel altéré) est fondamentale pour éviter des confusions sémantiques grossières.
Face à ces cas critiques, s’appuyer sur NB.SI produit une distorsion méthodologique par agrégation fallacieuse. Il s’avère alors indispensable de contourner les fonctions conventionnelles au profit de primitives capables d’opérer une comparaison bit-à-bit des caractères encodés.
7.2 Construction d’une formule matricielle avec EXACT et SOMMEPROD
La solution canonique pour imposer le respect scrupuleux de la casse repose sur la combinaison de la fonction EXACT et de l’opérateur matriciel SOMMEPROD. La fonction EXACT compare deux chaînes de caractères et renvoie la valeur booléenne VRAI si et seulement si les deux chaînes sont rigoureusement identiques au niveau de chaque caractère, majuscules, minuscules et accents compris ; elle renvoie FAUX dans le cas contraire.
Pour compter le nombre d’occurrences d’une chaîne sensible à la casse sur une plage donnée (par exemple A2:A500) par rapport à un critère spécifié en C2, la formule matricielle s’articule comme suit :
=SOMMEPROD(--(EXACT(C2; $A$2:$A$500)))
Le mécanisme computationnel se déploie selon la chronologie suivante :
- La fonction
EXACT(C2; $A$2:$A$500)compare la chaîne de référenceC2avec chacune des 499 cellules de la plage, générant en mémoire un vecteur booléen constitué d’une suite deVRAIet deFAUX. - L’opérateur double unaire
--(deux signes moins consécutifs) force la coercition de ces booléens en valeurs numériques binaires : chaqueVRAIest converti en 1, et chaqueFAUXest converti en 0. - La fonction SOMMEPROD, dotée nativement de la capacité à manipuler des matrices sans validation matricielle complexe (Ctrl+Maj+Entrée sur les versions historiques), effectue la somme arithmétique de ce vecteur binaire, renvoyant avec une exactitude chirurgicale le décompte des entités typographiquement conformes.
Ce protocole isole parfaitement l’occurrence « ADN » des variantes « Adn » ou « adn », préservant la validité des statistiques descriptives sur des corpus hypersensibles.
7.3 Optimisation des performances de calcul sur de grands corpus
Bien que la combinaison SOMMEPROD et EXACT offre une fidélité analytique totale, elle présente un coût computationnel non négligeable. Contrairement à NB.SI, qui bénéficie d’une optimisation interne en langage C++ par indexation rapide des valeurs scalaires, SOMMEPROD force une évaluation itérative élément par élément de l’ensemble de la plage mémoire allouée.
Lorsque le classeur intègre plusieurs dizaines de milliers d’enregistrements et que des centaines de formules de ce type sont exécutées en parallèle, des temps de latence perceptibles peuvent dégrader l’expérience utilisateur et ralentir les cycles de recalcul. Pour pallier cette contrainte sans renoncer à la rigueur de la casse, il est recommandé de mettre en œuvre une stratégie reposant sur des colonnes auxiliaires pré-calculées :
- Une colonne d’index binaire est adjointe à la base source, générant un code de hachage ou une signature insensible aux ambiguïtés via la fonction
CODE()ou une concaténation typographique dédiée. - Le comptage s’exécute ensuite sur cette variable transformée à l’aide de fonctions standards plus véloces, déchargeant ainsi le processeur d’évaluations itératives lourdes lors de chaque actualisation de la feuille.
8. Calcul des fréquences relatives et normalisation statistique
8.1 Détermination rigoureuse du dénominateur d’échantillon
L’obtention d’une fréquence absolue — c’est-à-dire le simple dénombrement du nombre de fois où une entité apparaît — ne représente que la moitié du travail analytique. Pour permettre des comparaisons rigoureuses entre corpus de tailles inégales, il est impératif de convertir ces grandeurs brutes en fréquences relatives. Cette normalisation statistique exige la détermination rigoureuse du dénominateur d’échantillon, opération moins triviale qu’il n’y paraît dans un tableur.
Le réflexe habituel consiste à mobiliser la fonction NBVAL, chargée de dénombrer l’ensemble des cellules non vides d’une plage :
=NBVAL($A$2:$A$1000)
Cependant, une faille méthodologique fréquente réside dans la présence de cellules contenant des chaînes vides (""), résultant souvent de formules conditionnelles préexistantes (par exemple SI(condition; valeur; "")). Pour le moteur d’Excel, une chaîne de longueur nulle renvoyée par une formule n’est pas une cellule vide : elle est comptabilisée par NBVAL, ce qui majore indûment le dénominateur et fausse l’ensemble des proportions calculées.
Pour surmonter cet écueil et mesurer le volume réel d’observations textuelles tangibles, il convient de soustraire les cellules vides résiduelles à l’aide de la formule :
=NBVAL($A$2:$A$1000) - NB.SI($A$2:$A$1000; "")
Le ratio de fréquence relative univariée s’établit alors formellement selon la formule suivante :
=NB.SI($A$2:$A$1000; D2) / (NBVAL($A$2:$A$1000) - NB.SI($A$2:$A$1000; ""))
Cette rigueur de calcul garantit que la base de référence reflète fidèlement la population des verbatims valides, excluant les résidus techniques du dénominateur statistique.
8.2 Conversion en pourcentages et distribution proportionnelle
Une fois le coefficient décimal obtenu, la formalisation des résultats impose sa conversion au format de pourcentage. Cette démarche doit impérativement s’effectuer via les options de mise en forme natives d’Excel (ruban Accueil > groupe Nombre > Pourcentage) et non par une multiplication manuelle par 100 au sein de la formule de calcul. L’application d’un coefficient multiplicateur artificiel altère la valeur numérique sous-jacente, compromettant les calculs ultérieurs de variances ou de covariances.
La règle d’or de la distribution proportionnelle exige par ailleurs la vérification systématique de la fermeture distributionnelle : la somme de l’ensemble des fréquences relatives associées aux modalités mutuellement exclusives doit être égale à exactement 1,000 (soit 100 %). Un écart supérieur aux arrondis de précision machine (généralement au-delà du milliardième) trahit la présence de données non captées par le protocole de comptage ou l’inclusion de doublons méthodologiques.
Dans les rapports scientifiques officiels, la gestion des arrondis décimaux doit obéir aux normes internationales de métrologie. L’usage de la fonction ARRONDI s’impose lorsque les résultats doivent être figés pour publication papier, évitant que la somme visuelle des pourcentages affichés à l’écran n’aboutisse à des totaux incongrus de 99,9 % ou 100,1 % susceptibles de susciter l’interrogation des relecteurs académiques.
8.3 Calcul des fréquences conditionnelles et pondérées
Dans de nombreux plans d’échantillonnage stratifiés ou d’enquêtes sociologiques, chaque répondant se voit assigner un coefficient de pondération visant à redresser l’échantillon par rapport aux caractéristiques démographiques réelles de la population mère. Dans ce cadre, la simple fréquence absolue textuelle perd sa pertinence, car la mention d’un mot par un individu sous-représenté doit peser davantage que la même mention émise par un individu sur-représenté.
Le calcul d’une fréquence textuelle pondérée ne peut être pris en charge par la fonction NB.SI. Il nécessite la puissance vectorielle de SOMMEPROD, croisant la variable textuelle avec la variable de pondération située dans une colonne distincte :
=SOMMEPROD(($A$2:$A$1000 = D2) * ($W$2:$W$1000)) / SOMME($W$2:$W$1000)
Dans cette architecture :
- Le premier membre
($A$2:$A$1000 = D2)isole par un vecteur booléen l’occurrence textuelle ciblée. - Le second membre
($W$2:$W$1000)multiplie chaque occurrence positive par son poids d’échantillonnage unitaire correspondant. - Le résultat cumulé est divisé par la somme des poids
SOMME($W$2:$W$1000), délivrant la fréquence relative pondérée exacte.
Cette approche permet d’estimer avec précision la prévalence réelle d’un terme au sein de la population cible, conférant aux analyses textuelles issues d’Excel un degré de rigueur conforme aux standards de l’économétrie et de la statistique publique.
9. Dénombrement textuel au moyen des tableaux croisés dynamiques
9.1 Configuration du tableau croisé dynamique pour l’agrégation textuelle
Au-delà des approches formulaires, le Tableau Croisé Dynamique (TCD) représente le composant natif le plus ergonomique et véloce pour synthétiser les distributions de données textuelles. Pour ériger une distribution fréquentielle textuelle au moyen d’un TCD, la séquence de paramétrage technique s’organise avec une précision millimétrée.
L’opérateur sélectionne la base de données source, puis déclenche l’assistant via le ruban Insertion > Tableau croisé dynamique. La variable textuelle d’intérêt doit ensuite être glissée simultanément dans deux sections fonctionnelles distinctes du panneau des champs :
- Dans la zone Lignes : cette assignation ordonne au moteur de générer la nomenclature exhaustive et sans doublon des termes présents dans le champ textuel.
- Dans la zone Valeurs : l’insertion d’une variable textuelle dans cette zone force automatiquement le TCD à adopter le mode de synthèse statistique Nombre (comptage d’occurrences). Contrairement aux variables numériques que le système tente nativement de sommer, le texte contraint le moteur à calculer le cardinal de chaque sous-ensemble.
Le principal point de friction méthodologique réside dans la gestion de la mémoire cache du tableau croisé. Les TCD ne s’ajustent pas dynamiquement en temps réel lors de la saisie de nouvelles lignes dans la source : ils exigent un rafraîchissement explicite (clic droit > Actualiser). En outre, par défaut, le cache conserve en mémoire les étiquettes textuelles qui ont été supprimées de la table source. Pour éviter que des catégories fantômes n’apparaissent dans les décomptes, il convient de configurer les Options du tableau croisé dynamique > onglet Données > Nombre d’éléments à retenir par champ sur la valeur Aucun.
9.2 Exploitation du modèle de données pour le décompte distinct
Une distinction conceptuelle majeure en analyse lexicométrique sépare le volume brut d’occurrences textuelles de la richesse ou diversité lexicale. Si l’on analyse par exemple les interactions au sein d’un forum d’entraide, dénombrer le nombre total de fois où le terme « Problème » survient mesure l’intensité de la difficulté, tandis que dénombrer le nombre d’usagers distincts ayant employé ce terme mesure l’étendue de la contagion du problème dans la communauté.
Historiquement, le calcul d’un décompte distinct au sein d’un TCD standard était impossible sans formules auxiliaires complexes. Désormais, l’intégration du moteur de modélisation relationnelle Power Pivot au sein d’Excel résout cette lacune. Lors de l’initialisation du tableau croisé, l’utilisateur doit impérativement cocher la case :
« Ajouter ces données au modèle de données »
Cette simple action active le moteur xVelocity en arrière-plan. Dès lors, en modifiant les paramètres du champ de valeurs, une nouvelle fonction de synthèse statistique apparaît à la base de la liste : le Comptage distinct (équivalent à la fonction DAX DISTINCTCOUNT). Cette métrique quantifie précisément le nombre d’entités uniques associées à chaque modalité textuelle, prévenant toute distorsion induite par des participants hyperactifs répétant compulsivement les mêmes termes dans le corpus.
9.3 Comparaison entre solutions par formules et tableaux croisés
Le choix entre l’édification d’un modèle fondé sur des formules (NB.SI, UNIQUE, SOMMEPROD) et le déploiement d’un tableau croisé dynamique dépend des impératifs analytiques et de l’architecture du projet d’analyse :
Avantages préférentiels des architectures par formules :
- Réactivité absolue : recalcul immédiat sans action manuelle dès qu’une valeur est altérée dans la base source.
- Souplesse de mise en forme : intégration transparente au sein de maquettes graphiques sur mesure et de tableaux de bord financiers ou scientifiques hautement standardisés.
- Précision algorithmique : capacité à insérer des critères sensibles à la casse ou des comptages intra-cellulaires impossible à réaliser directement dans un TCD standard sans recourir au code DAX.
Avantages préférentiels des Tableaux Croisés Dynamiques :
- Puissance de traitement : traitement ultra-rapide de plusieurs millions de lignes grâce à la compression mémoire du modèle de données.
- Exploration multidimensionnelle : manipulation fluide par glisser-déposer facilitant les regroupements hiérarchiques et la création de segments interactifs (slicers).
- Moindre risque de corruption logicielle : immunité face aux suppressions accidentelles de formules ou aux ruptures de plages propagées.
10. Nettoyage préalable et standardisation du corpus textuel
10.1 Élimination des artefacts d’espacement avec SUPPRESPACE
L’adage fondamental de la science des données « Garbage in, garbage out » s’applique avec une acuité particulière au dénombrement textuel sous Excel. L’artefact le plus pernicieux et le plus fréquemment rencontré réside dans la prolifération incontrôlée d’espaces au sein des données d’entrée. Ces espaces parasites prennent trois formes distinctes : les espaces initiales précédant le mot, les espaces terminales lui succédant, et les espaces multiples consécutives séparant deux vocables au sein d’une même phrase.
Pour éradiquer ces scories typographiques de façon industrielle, la fonction SUPPRESPACE (équivalent de la fonction anglophone TRIM) s’avère indispensable. Son action algorithmique est triple : elle supprime impitoyablement toute espace présente en tête de chaîne, purge toute espace orpheline située en queue de chaîne, et réduit tout chapelet d’espaces internes consécutives à une espace simple normalisée :
=SUPPRESPACE(A2)
L’application systématique de cette fonction — idéalement encapsulée directement à l’intérieur de la colonne de calcul ou déployée sur une colonne de nettoyage intermédiaire — prévient l’échec des appariements stricts exécutés par la suite par NB.SI. La standardisation de l’espacement constitue le prérequis absolu à toute quantification lexicale fiable.
10.2 Purge des caractères non imprimables et espaces insécables
L’intervention de SUPPRESPACE, bien qu’essentielle, demeure impuissante face à deux classes d’anomalies techniques très courantes lors d’imports de fichiers plats (CSV, TXT) ou de requêtes Web : les caractères de contrôle non imprimables et les espaces insécables. Les caractères non imprimables correspondent aux codes ASCII 0 à 31, comprenant notamment les sauts de ligne (caractère 10) et les retours chariot (caractère 13), qui corrompent la lecture des délimiteurs.
La fonction EPURAGE (ou CLEAN) est spécifiquement conçue pour éliminer ces codes de contrôle du texte :
=EPURAGE(A2)
La situation devient plus critique avec l’espace insécable, dont le code binaire est CAR(160) en encodage ANSI ou U+00A0 en Unicode standard. Cette entité typographique n’est identifiée ni par SUPPRESPACE (qui ne cible que l’espace standard de code ASCII 32), ni par EPURAGE. La présence d’une espace insécable invisible garantit l’échec de la fonction NB.SI.
Pour neutraliser définitivement ce piège, il convient d’appliquer une formule de substitution polymorphe avancée, associant la suppression des espaces insécables et le nettoyage général :
=SUPPRESPACE(EPURAGE(SUBSTITUE(A2; CAR(160); " ")))
Cette construction convertit d’abord l’espace insécable (code 160) en espace ordinaire (code 32), purge les caractères de contrôle, puis confie le texte à SUPPRESPACE qui compacte l’ensemble. Toute base textuelle soumise à ce traitement préparatoire atteint un niveau d’intégrité optimal pour le calcul fréquentiel.
10.3 Harmonisation typographique et diacritique
La variabilité morphologique de la langue française constitue un défi permanent pour l’analyste de données. Outre les questions de casse, la gestion des accents, des cédilles et des variantes orthographiques impose une homogénéisation délibérée du corpus. Si l’on souhaite procéder à une catégorisation unifiée insensible aux erreurs d’accentuation (par exemple agréger « Réponse », « Reponse » et « reponse » au sein d’une modalité unique), des transformations formelles s’imposent.
La première mesure consiste à basculer l’ensemble du corpus sous une casse homogène au moyen des fonctions MINUSCULE ou MAJUSCULE :
=MINUSCULE(A2)
La gestion de la neutralisation diacritique (désaccentuation) ne dispose pas d’opérateur natif direct au sein des formules classiques d’Excel. Elle s’obtient méthodologiquement soit par une séquence imbriquée de fonctions SUBSTITUE convertissant manuellement « é », « è », « ê » en « e », soit par l’entremise d’un script Power Query en amont, convertissant le texte selon une table de transcodage de pages de code ISO/ASCII.
Enfin, pour résorber la synonymie lexicale au sein d’une enquête (par exemple unifier « Hôpital », « Centre hospitalier », « CHU » et « Clinique » sous le méta-terme unique « Établissement de santé »), il est conseillé de bâtir une table de concordance (dictionnaire de synonymes) exploitée par la fonction RECHERCHEX avant de déclencher le décompte de fréquence sur les codes normalisés. On découple ainsi la variabilité brute de la mesure conceptuelle.
11. Formules matricielles avancées pour le comptage intra-cellulaire
11.1 Dénombrement d’un mot au sein d’une chaîne textuelle complexe
L’ensemble des procédures exposées dans les sections précédentes s’applique au dénombrement de cellules répondant à un critère. Or, une problématique fondamentale de l’analyse textuelle survient lorsqu’il s’agit de compter le nombre total d’occurrences d’un terme spécifique à l’intérieur d’une même cellule contenant un texte long, une transcription ou un paragraphe de verbatim. Une cellule peut en effet contenir le mot « client » à trois, quatre ou cinq reprises : les fonctions de type NB.SI(A2; "*client*") ne renverront jamais que la valeur 1, constatant simplement la présence du mot sans en mesurer l’intensité intra-cellulaire.
Pour accomplir cette prouesse sans recourir à du code VBA, il existe un algorithme d’ingénierie mathématique fondé sur la soustraction différentielle de longueurs de chaînes. Cet algorithme repose sur la fonction NBCAR (qui calcule le nombre de caractères d’une chaîne) et la fonction SUBSTITUE (qui remplace un terme textuel par un autre).
La logique formelle se déploie selon la formule suivante, appliquée à la cellule A2 pour le mot-clé hébergé en $D$1 :
=(NBCAR(A2) - NBCAR(SUBSTITUE(A2; $D$1; ""))) / NBCAR($D$1)
La mécanique algorithmique sous-jacente est une merveille de déduction computationnelle :
NBCAR(A2)mesure la longueur totale initiale de la cellule en nombre de caractères.SUBSTITUE(A2; $D$1; "")purge intégralement le mot cible de la cellule en le remplaçant par une chaîne vide de longueur nulle.NBCAR(SUBSTITUE(...))mesure la nouvelle longueur de la cellule amputée du mot recherché.- La soustraction de la seconde longueur à la première donne exactement le nombre total de caractères soustraits de la cellule par l’opération d’éradication.
- En divisant ce volume de caractères soustraits par la longueur unitaire intrinsèque du mot cible
NBCAR($D$1), on obtient rigoureusement le nombre précis d’apparitions de ce mot au sein de la chaîne.
Par exemple, si la cellule A2 fait 100 caractères et que l’on recherche le mot « test » (qui comporte 4 caractères), si le mot survient 3 fois, la suppression du mot abaissera la longueur à 88 caractères. Le calcul (100 - 88) / 4 = 12 / 4 = 3 occurrences est d’une infaillibilité mathématique totale.
11.2 Gestion de la sensibilité à la casse lors du comptage intra-cellulaire
L’analyste averti identifiera immédiatement une limitation structurelle dans l’usage naïf de la formule précédente : la fonction SUBSTITUE est, par essence et par conception interne sous Excel, strictement sensible à la casse. Dès lors, l’expression SUBSTITUE(A2; "client"; "") ignorera superbement les mentions orthographiées « Client », « CLIENT » ou « cLIENt », sous-estimant drastiquement le dénombrement réel des occurrences lexicales au sein du verbatim.
Pour lever cette contrainte et conférer à la mesure intra-cellulaire une neutralité morphologique totale, il convient de normaliser artificiellement la chaîne inspectée et le critère de recherche sous une casse uniforme avant d’opérer la substitution différentielle. On encapsule les variables dans la fonction MINUSCULE :
=(NBCAR(A2) - NBCAR(SUBSTITUE(MINUSCULE(A2); MINUSCULE($D$1); ""))) / NBCAR($D$1)
En convertissant simultanément le texte d’analyse et le mot-clé cible en minuscules, la fonction SUBSTITUE opère sur un terrain parfaitement homogène. Chaque occurrence du mot — quelle qu’ait été sa disposition typographique originale dans la rédaction du participant — est effacée de façon exhaustive, autorisant une détection intégrale des occurrences sémantiques au sein d’entretiens psychologiques ou de volumineux rapports d’audit.
11.3 Sommation multi-cellulaire des occurrences internes
L’étape ultime consiste à agréger cette quantification intra-cellulaire sur l’ensemble des lignes constituant le corpus textuel d’une recherche, afin d’obtenir la fréquence brute totale d’un vocable disséminé à travers des milliers de verbatims. L’association matricielle de l’algorithme différentiel avec la fonction SOMMEPROD offre une solution d’une élégance et d’une puissance redoutables :
=SOMMEPROD((NBCAR($A$2:$A$1000) - NBCAR(SUBSTITUE(MINUSCULE($A$2:$A$1000); MINUSCULE(D1); ""))) / NBCAR(D1))
Dans cette architecture avancée, le moteur d’Excel vectorise l’opération :
- Il calcule pour chacune des 999 lignes de la plage
$A$2:$A$1000la différence de longueur induite par la substitution du termeD1. - Il effectue la division vectorielle ligne à ligne par le nombre de caractères du mot recherché.
- La fonction SOMMEPROD opère la réduction arithmétique globale en sommant le vecteur résultant, délivrant en une seule cellule le volume total absolu de mentions du mot présent dans l’ensemble de la base documentaire.
Cette approche épargne à l’utilisateur la création de colonnes auxiliaires pour chaque mot de son dictionnaire thématique. Elle condense en une formule unique ce qui exigeait jadis des procédures de calcul complexes, tout en garantissant une stabilité computationnelle exemplaire lors des phases de consolidation de données qualitatives de grande ampleur.
12. Automatisation, intégrité et reproductibilité des protocoles de recherche
12.1 Structuration dynamique des données sous forme de Tableaux Excel
L’un des vecteurs d’erreur les plus répandus dans l’exploitation des formules de dénombrement réside dans l’obsolescence des plages référencées. Lorsqu’un analyste écrit =NB.SI(A2:A500; "Urgent") et que l’équipe d’enquête intègre ultérieurement 150 nouvelles observations dans les lignes 501 à 650, la formule n’intègre pas spontanément ces ajouts, générant des biais d’échantillonnage invisibles. Pour immuniser définitivement le classeur contre ce risque, il est impératif de structurer les plages de données sous la forme formelle d’un Tableau Excel (objet ListObject).
Cette conversion — actionnée via le raccourci Ctrl + L ou l’onglet Insertion > Tableau — confère à la base des propriétés structurelles remarquables :
- Extension dynamique automatique : Toute nouvelle ligne adjointe à la base est immédiatement absorbée au sein de l’objet sans aucune intervention sur les formules.
- Syntaxe des références structurées : Les références de plages statiques opaques (comme
$A$2:$A$500) sont avantageusement remplacées par des identifiants sémantiques clairs, tels queTableauEnquête[Commentaires].
La formule de comptage canonique devient dès lors :
=NB.SI(TableauEnquête[Statut]; "Validé")
Cette écriture explicite améliore drastiquement la lisibilité du modèle, facilite le transfert du classeur entre chercheurs et élimine à la racine les risques d’omission de données lors de l’ingestion de nouveaux lots expérimentaux.
12.2 Protocoles d’audit et de validation des résultats de dénombrement
L’assurance qualité d’un modèle d’analyse fréquentielle implique l’implémentation de dispositifs de contrôle interne permettant de détecter les ruptures de cohérence statistique. Tout tableau de distribution fréquentielle textuelle doit obligatoirement intégrer une cellule d’audit sommatif vérifiant que la somme des occurrences catégorielles coïncide avec le total de la population observée.
Une formule de contrôle booléen classique s’exprime par :
=SI(SOMME(E2:E50) = (NBVAL(TableauEnquête[Statut]) - NB.SI(TableauEnquête[Statut]; "")); "Cohérence validée"; "ALERTE : Données orphelines")
L’apparition d’un message d’alerte signale immédiatement qu’une ou plusieurs catégories textuelles présentes dans la source ont échappé à la table des critères (dictionnaire lexical), soit en raison d’une faute d’orthographe imprévue, soit par l’émergence d’une modalité non répertoriée. Ce filet de sécurité algorithmique garantit qu’aucune donnée résiduelle ne demeure invisible aux yeux du chercheur avant la formulation de conclusions empiriques.
Parallèlement, la documentation interne des formules au sein même du classeur — rendue aisée par la fonction FORMULETEXTE — autorise les auditeurs à inspecter l’architecture de calcul sans risque d’altérer par mégarde le code sous-jacent. L’adjonction systématique d’onglets de métadonnées explicitant les règles de codification lexicale et les versions d’Excel mobilisées constitue un prérequis d’éthique analytique indiscutable.
12.3 Archivage et reproductibilité des données de recherche
Dans la perspective de la science ouverte (Open Science) et de la conformité aux directives FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables), les classeurs Excel hébergeant des analyses fréquentielles doivent obéir à des règles de conservation garantissant leur reproductibilité computationnelle à long terme. Les environnements logiciels évoluant, une formule matricielle complexe valide sous une version donnée peut présenter des comportements divergents lors de son ouverture sur des versions antérieures ou au sein d’environnements tiers (comme LibreOffice Calc ou Google Sheets).
Pour assurer la pérennité documentaire, il est recommandé de sanctuariser les fichiers selon une architecture en couches étanches :
- La couche immuable des données brutes : Une feuille de calcul protégée en écriture hébergeant le corpus textuel originel, strictement vierge de toute formule de modification ou de nettoyage.
- La couche algorithmique de traitement : Une feuille dédiée articulant les fonctions de nettoyage (
SUPPRESPACE,EPURAGE,SUBSTITUE) et les tables de distribution fréquentielle dynamiques. - La couche d’archivage institutionnel : Une copie du classeur final où l’ensemble des formules a fait l’objet d’un figeage par conversion en valeurs statiques pures (copier > collage spécial en valeurs). Ce figeage immunise les distributions numériques finales contre toute dérive logicielle future lors du dépôt du corpus dans des entrepôts de données scientifiques institutionnels.
En conjuguant une maîtrise scrupuleuse des fonctions logiques, une standardisation textuelle méthodique et une architecture d’audit rigoureuse, l’analyste transforme Microsoft Excel en une plateforme lexicométrique robuste, capable de répondre aux standards scientifiques et professionnels les plus rigoureux.
Références
- Benesty, M. (2018). Analyse de données textuelles : De l’enquête au Web. Dunod.
- Lebart, L., Salem, A., & Bécue-Bertaut, M. (2000). Analyse statistique des données textuelles : Questions ouvertes et entretiens. Dunod.
- Microsoft Support. (2024). Fonction NB.SI – Support Microsoft. Consulté le 15 mai 2024 à l’adresse https://support.microsoft.com/fr-fr/office/fonction-nb-si-e0de10c6-f885-4e71-abb4-1f464816df34
- Microsoft Support. (2024). Fonction NB.SI.ENS – Support Microsoft. Consulté le 15 mai 2024 à l’adresse https://support.microsoft.com/fr-fr/office/fonction-nb-si-ens-dda3faf6-21a0-4b8d-8da4-4a5697625533
- Microsoft Support. (2024). Fonction UNIQUE – Support Microsoft. Consulté le 15 mai 2024 à l’adresse https://support.microsoft.com/fr-fr/office/fonction-unique-c5ab87fd-30a3-4ce9-9d1a-40204fb85e1e
- Microsoft Support. (2024). Fonction SOMMEPROD – Support Microsoft. Consulté le 15 mai 2024 à l’adresse https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-16753e75-9f68-4874-94ac-4d2145a2fd2e
- Rastier, F. (2011). La mesure et le grain : Sémantique de corpus. Honoré Champion.
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.