
Dans le paysage contemporain des sciences organisationnelles et de l’ingénierie des systèmes d’information, la manipulation de structures tabulaires constitue une activité fondamentale, bien que fréquemment sous-estimée dans sa complexité intrinsèque. Au sein des entreprises modernes, des institutions financières et des centres de recherche, la dispersion des sources de données engendre inévitablement des disparités documentaires. La confrontation de deux cohortes d’enregistrements indépendants — qu’il s’agisse de comparer un grand livre comptable avec un relevé bancaire, de rapprocher un registre des effectifs avec une base d’accès physique, ou de synchroniser deux états successifs d’un inventaire d’actifs — représente le défi classique de la réconciliation. Face à ces impératifs de conformité et d’exactitude, l’analyste se trouve confronté à l’obligation de déployer des méthodes formelles, rigoureuses et reproductibles.
L’environnement Microsoft Excel, omniprésent dans les architectures décisionnelles décentralisées, propose un arsenal de fonctions matricielles et vectorielles conçues pour répondre à ces problématiques. Parmi celles-ci, la fonction RECHERCHEV (homologue francophone de VLOOKUP) demeure le mécanisme algorithmique de référence historique pour l’appariement vertical d’entités. Pourtant, son usage dans le cadre spécifique de la détection des discordances entre deux listes soulève une série de questions méthodologiques profondes : comment transformer un outil intrinsèquement conçu pour l’extraction de données associées en un discriminant booléen capable d’isoler l’intersection, l’exclusion et la divergence ensembliste ? L’adoption d’une approche empirique et approximative expose les organisations à des risques critiques de faux négatifs et d’erreurs d’interprétation managériale.
Le présent traité propose une analyse exhaustive et systématique des fondements opératoires, syntaxiques et cognitifs de la comparaison de listes par le truchement de la fonction RECHERCHEV. En explorant la synergie logique entre RECHERCHEV et les prédicats de test d’erreur tels que ESTNA, en décortiquant les protocoles de mise en forme conditionnelle dynamique et en évaluant les limites structurelles de la fonction face aux paradigmes émergents (tels que RECHERCHEX ou Power Query), cette étude offre un cadre d’application complet, académique et opérationnel destiné à garantir une intégrité absolue lors des audits de données les plus exigeants.
1. 1. Fondements épistémologiques et enjeux de la réconciliation de données dans Excel
1.1 1.1 Problématique de l’intégrité des données tabulaires
L’intégrité des données tabulaires constitue le socle sur lequel repose toute prise de décision rationnelle au sein des organisations complexes. Dans le cadre de l’analyse computationnelle décentralisée, l’anomalie de divergence se définit formellement comme l’apparition d’une incohérence d’état ou d’existence entre deux ensembles d’enregistrements censés décrire une même réalité phénoménologique ou opérationnelle. Lorsque deux cohortes d’identifiants — qu’il s’agisse de numéros de transactions, de codes d’inventaire ou d’identifiants d’utilisateurs — sont générées par des sous-systèmes logiciels disjoints, les décalages temporels d’écriture, les pannes de transmission et les manipulations humaines asynchrones induisent inéluctablement une entropie informationnelle. Cette divergence, si elle n’est pas quantifiée avec une précision mathématique, vicie l’ensemble des modélisations décisionnelles en aval.
Face à ces divergences, l’inspection visuelle manuelle représente une vulnérabilité cognitive majeure. Les sciences cognitives ont largement documenté le phénomène de cécité d’inattention, par lequel le cortex visuel humain, confronté à des matrices denses composées de milliers de lignes monotones, compense la fatigue sensorielle en générant des illusions de continuité. L’œil humain tend spontanément à régulariser les anomalies mineures, telles qu’une faute typographique infime ou un décalage de rang, rendant l’audit manuel hautement erratique et non probabiliste. Dès lors que le volume d’enregistrements dépasse le seuil psychologique de quelques dizaines d’occurrences, le taux d’erreur humaine croît de façon exponentielle, transformant une tentative de contrôle de gestion en une source supplémentaire d’incertitude.
Il apparaît ainsi impératif de substituer à l’arbitrage visuel empirique des protocoles algorithmiques déterministes. Un processus déterministe garantit que l’évaluation de deux états de données produira rigoureusement le même résultat booléen, indépendamment de l’opérateur, du moment de l’exécution ou de la fatigue cognitive de l’observateur. La reproductibilité de l’analyse devient alors la condition sine qua non de la validité scientifique et réglementaire de l’audit. Ce déterminisme algorithmique doit impérativement appréhender une typologie tripartite des discordances : les omissions unilatérales (éléments présents au sein d’une cohorte source mais absents de la référence), les redondances matricielles (duplications parasites d’un identifiant compromettant l’unicité de la clé) et les altérations scalaires (divergences typographiques, variations lexicales ou corruptions de format).
1.2 1.2 Définition et rôle fondamental de la fonction RECHERCHEV
Introduite dès les premières itérations des tableurs électroniques pour émuler les tables d’indexation manuelles, la fonction de recherche verticale, universellement désignée sous l’acronyme RECHERCHEV dans l’écosystème francophone et VLOOKUP dans la nomenclature anglophone originale, occupe une place centrale dans la taxonomie des formules tabulaires. Son rôle primaire réside dans le balayage séquentiel de la première colonne d’un arrangement matriciel défini afin de localiser une valeur de référence, puis dans la restitution scalaire d’une information positionnée sur la même ligne au sein d’un vecteur adjacent préalablement indexé. Bien que nativement conçue pour des opérations de jointure attributaire, son utilisation détournée à des fins de diagnostic comparatif en fait la pierre angulaire de l’analyse relationnelle élémentaire sur tableur.
Le comportement d’appariement de RECHERCHEV repose sur une dichotomie fondamentale régie par son quatrième argument : la distinction entre la correspondance exacte et la correspondance approximative. Alors que la correspondance approximative s’appuie sur une hypothèse de tri préalable des données pour identifier la plus grande valeur inférieure ou égale à l’élément cherché — un mécanisme adapté aux échelles tarifaires ou aux tranches d’imposition —, la comparaison rigoureuse de deux listes impose l’usage exclusif de la correspondance exacte. Dans ce dernier mode, l’algorithme parcourt l’espace matriciel sans assomption d’ordre, recherchant une égalité binaire absolue entre la clé interrogée et les entrées du vecteur d’accueil. Toute déviation par rapport à ce postulat d’exactitude introduit un risque inacceptable d’appariement fallacieux.
Sur le plan méthodologique, RECHERCHEV constitue l’analogue fonctionnel le plus immédiat des jointures relationnelles théorisées par Edgar F. Codd dans le modèle relationnel de données, et matérialisées par l’instruction SQL JOIN. Plus précisément, l’exécution d’une formule RECHERCHEV au sein d’une colonne calculée adossée à une liste principale émule la projection sélective d’une jointure externe gauche (LEFT OUTER JOIN). La liste source joue le rôle de la table directrice, tandis que la matrice interrogée agit comme la table jointe. La présence ou l’absence d’une valeur concordante traduit ainsi directement l’état de l’association relationnelle entre les deux entités abstraites modélisées dans le classeur.
1.3 1.3 Objectifs méthodologiques de la comparaison inter-listes
L’entreprise méthodologique de confrontation de deux listes distinctes ne saurait être réduite à une simple validation cosmétique ; elle répond à des impératifs mathématiques formalisés par la théorie des ensembles. L’analyste cherche à partitionner l’univers du discours en trois sous-ensembles mutuellement exclusifs : l’intersection des deux listes (l’ensemble des éléments $A cap B$ partageant une identité commune), le complément relatif de la liste cible dans la liste source (les éléments exclusifs $A setminus B$), et le complément relatif de la liste source dans la liste cible (les éléments exclusifs $B setminus A$). L’union formelle $A cup B$ regroupe l’exhaustivité des instances documentées. L’objectif premier de la démarche algorithmique réside dans la caractérisation univoque de chaque enregistrement par rapport à ces frontières ensemblistes.
Cette classification rigoureuse permet de valider l’exhaustivité et la continuité des flux d’information lors des transitions temporelles ou systémiques. Dans un scénario de migration d’un progiciel de gestion intégré (ERP) vers une infrastructure d’infonuagique, ou lors de la clôture d’un exercice fiscal confrontant le budget prévisionnel aux dépenses réelles consolidées, l’analyste doit attester qu’aucune déperdition d’entités n’a eu lieu au cours du transfert. Le recours systématique à des formules d’appariement automatisées fournit une piste d’audit vérifiable, capable d’isoler instantanément les anomalies de migration sans dépendre d’estimations macroscopiques qui masqueraient des déséquilibres internes compensatoires.
Il convient par conséquent d’établir une taxonomie claire et standardisée des états résultant du rapprochement. Un enregistrement sera classé en état de « concordance » lorsque sa clé d’identification trouve un écho parfait et univoque dans le référentiel opposé, sans altération de ses attributs critiques. L’état d’« exclusion » qualifiera l’absence structurelle absolue d’une clé dans l’un des deux vecteurs observés. Enfin, la « divergence » désignera les cas plus complexes où, bien que l’existence de la clé soit avérée dans les deux sources, les attributs périphériques associés présentent des désaccords quantitatifs ou qualitatifs. La maîtrise de ces nuances conditionne l’architecture des formules qui seront déployées au sein du tableur.
2. 2. Analyse structurelle et syntaxique de la fonction RECHERCHEV (VLOOKUP)
2.1 2.1 Décomposition analytique des arguments de la fonction
Pour exploiter avec une rigueur chirurgicale la fonction RECHERCHEV dans des contextes d’audit complexes, il est indispensable de disséquer la signature syntaxique de cette routine native. L’expression canonique s’articule autour de quatre paramètres ordonnés : =RECHERCHEV(valeur_cherchée, table_matrice, no_index_col, [valeur_proche]). Chacun de ces arguments joue un rôle mécanique précis dans la cinématique d’exécution du moteur de calcul d’Excel. Une mauvaise interprétation de la sémantique de l’un de ces paramètres détruit irrévocablement la fiabilité de la comparaison.
Le premier paramètre, valeur_cherchée, désigne l’atome scalaire que le moteur d’évaluation va isoler et tenter de corréler avec les éléments de la matrice cible. Dans une procédure de comparaison, cet argument prend presque systématiquement la forme d’une référence relative pointant vers la première cellule de la colonne d’identifiants à auditer (par exemple, la cellule A2). La gestion rigoureuse de la relativité de cette référence est primordiale : en omettant tout symbole de dollar ($) devant le numéro de ligne, l’analyste autorise la translation automatique et cohérente de la coordonnée lors du déploiement vertical de la formule le long de l’axe longitudinal des enregistrements.
Le deuxième argument, table_matrice, circonscrit le domaine géométrique bidimensionnel au sein duquel s’opérera l’investigation algorithmique. Deux impératifs structurels absolus régissent ce paramètre : d’une part, la première colonne de ce domaine doit obligatoirement héberger les données de comparaison potentielles ; d’autre part, cette plage doit impérativement faire l’objet d’un verrouillage cartésien absolu par l’adjonction de symboles dollar (par exemple $C$2:$C$100). Sans ce verrouillage, la recopie incrémentale de la formule vers le bas entraînerait une dérive concomitante du champ d’observation, tronquant de manière asymétrique les données interrogées et générant de faux positifs d’absence sur les segments inférieurs de la liste.
Le troisième argument, no_index_col, impose la désignation d’un entier strictement positif représentant le rang structural de la colonne dont la valeur doit être restituée. Dans le contexte très particulier de la simple validation d’existence inter-listes, la matrice interrogée peut se résumer à une colonne unique, fixant ainsi cet index à 1. Enfin, le quatrième argument, valeur_proche, constitue le commutateur booléen déterminant le comportement de recherche. Il est méthodologiquement non négociable d’y injecter explicitement la valeur logique FAUX (ou son équivalent binaire 0). Cette configuration force l’interruption de toute heuristique probabiliste au profit d’un algorithme de parcours séquentiel linéaire recherchant une correspondance exacte, garantissant ainsi qu’aucune valeur approchée ne viendra polluer l’audit d’intégrité.
2.2 2.2 Sémantique des valeurs de retour et gestion de l’erreur #N/A (#N/D)
L’exécution de la fonction RECHERCHEV aboutit structurellement à une bifurcation d’états : soit la clé est localisée et le moteur renvoie la valeur de la cellule correspondante, soit la clé est absente et le moteur émet un signal d’interruption sous la forme de l’erreur #N/A (ou #N/D pour « Non Disponible » dans certaines localisations de l’environnement Microsoft Office). Loin de constituer une défaillance logicielle au sens d’un bug d’exécution, la survenue de l’erreur #N/A est un événement sémantique majeur. Elle représente la notification standardisée et mathématiquement rigoureuse de la vacuité de l’intersection pour l’élément considéré dans le domaine d’interrogation.
Il convient de distinguer avec acuité la valeur d’erreur #N/A des autres typologies d’erreurs intrinsèques du tableur. Alors que #VALEUR! signale une inadéquation de type d’opérande (comme la tentative d’appliquer un opérateur arithmétique à une chaîne de caractères) et que #REF! dénonce une rupture de continuité spatiale causée par la destruction d’une cellule cible dans le classeur, #N/A informe exclusivement sur l’état du domaine : l’élément recherché n’a pas été trouvé. Cette valeur possède ainsi un statut informatif de premier ordre dans les architectures décisionnelles. Elle constitue le marqueur ontologique de l’exclusion relative d’un enregistrement par rapport au groupe témoin.
Cependant, les propriétés intrinsèques des valeurs d’erreur dans le graphe de dépendance acyclique direct d’Excel imposent une vigilance extrême. Toute valeur d’erreur non capturée possède un caractère hautement viral : elle contamine l’ensemble des formules dépendantes qui tentent d’évaluer la cellule concernée. Une somme, une moyenne ou une concaténation englobant une cellule renvoyant #N/A échouera irrémédiablement en propageant ce code d’erreur vers la couche supérieure de présentation. Cette toxicité computationnelle rend obligatoire l’interception et la neutralisation de l’erreur à sa source au moyen d’opérateurs spécialisés de traitement logique.
2.3 2.3 Contraintes architecturales inhérentes à la conception de RECHERCHEV
En dépit de son omniprésence historique, la fonction RECHERCHEV souffre de restrictions architecturales héritées de sa conception au début des années 1980. La contrainte la plus notoire réside dans son asymétrie vectorielle unidirectionnelle. Le moteur de RECHERCHEV est structurellement incapable d’opérer un balayage de droite à gauche : la clé recherchée doit obligatoirement résider dans la colonne la plus à gauche de la plage matricielle définie en argument. Si l’identifiant de la table de référence se situe à droite des attributs de contrôle, l’analyste se trouve contraint de réorganiser spatialement ses données ou de délaisser RECHERCHEV au profit de formulations alternatives plus souples. Cette rigidité dimensionnelle restreint les schémas de conception de classeurs complexes.
Une seconde limite critique découle du comportement déterministe de RECHERCHEV face aux doublons au sein de la matrice interrogée. L’algorithme est programmé pour interrompre son balayage dès qu’il rencontre la toute première occurrence conforme à la valeur_cherchée. En conséquence, si la liste de référence comporte plusieurs lignes assignées au même identifiant, RECHERCHEV deviendra totalement aveugle aux occurrences ultérieures, ignorant les potentielles duplications aberrantes présentes plus bas dans la table. Cette caractéristique induit un biais d’évaluation si l’analyste espère détecter des violations d’unicité en utilisant cette seule primitive fonctionnelle.
Enfin, la vulnérabilité structurelle liée à l’utilisation d’un index de colonne statique et numérique (no_index_col) expose les classeurs à des risques sévères de régression applicative. Lorsqu’un opérateur insère ultérieurement une colonne intercalaire au sein de la plage table_matrice pour enrichir le modèle de données, le décalage géométrique qui en découle n’est pas répercuté automatiquement sur l’argument entier codé en dur dans la formule. Ce décrochage spatial a pour conséquence immédiate l’extraction involontaire d’une donnée divergente ou, si l’index dépasse la nouvelle largeur de la matrice, l’apparition fâcheuse de l’erreur #REF!. Cette fragilité structurelle milite pour un encadrement méthodologique strict de son emploi.
3. 3. Formulation combinatoire : Synergie entre ESTNA et RECHERCHEV
3.1 3.1 Fonctionnement logique de la fonction ESTNA (ISNA)
Afin de domestiquer la propagation des erreurs et de métamorphoser un échec de recherche en une information exploitable par les moteurs conditionnels, il est nécessaire d’associer RECHERCHEV à des fonctions de test d’état unaire. Au premier rang de celles-ci figure la fonction ESTNA (identifiée sous le nom ISNA dans la version internationale). La mission fondamentale de cette primitive logique consiste à inspecter la valeur passée en argument pour déterminer si celle-ci correspond spécifiquement au code d’interruption #N/A. Si l’argument contient ce code précis, la fonction renvoie la valeur booléenne VRAI ; dans tous les autres cas — qu’il s’agisse d’une chaîne de caractères valide, d’un nombre, d’une valeur logique ou même d’une autre typologie d’erreur —, elle renvoie invariablement FAUX.
Il est capital d’opérer une distinction rigoureuse entre la fonction ESTNA et ses homologues d’audit, à savoir ESTERREUR (ISERROR) et ESTERR (ISERR). Alors que ESTERREUR intercepte indistinctement n’importe quel code d’erreur (masquant ainsi d’éventuelles corruptions critiques telles que #REF!, #DIV/0! ou #NOM?), ESTNA opère un ciblage sélectif et exclusif sur l’état #N/A. Cette granularité est essentielle dans le cadre de la vérification de conformité de données : l’analyste ne souhaite en aucun cas qu’une erreur de syntaxe ou une référence brisée soit interprétée silencieusement comme une simple absence de l’élément dans la liste cible. En isolant exclusivement le signal #N/A, ESTNA garantit que l’infrastructure de test réagit uniquement au phénomène d’exclusion logique.
Sur le plan de l’ergonomie visuelle et computationnelle, l’adjonction de la fonction ESTNA joue un rôle d’atténuateur de bruit informationnel. Les codes d’erreur bruts du tableur génèrent une anxiété cognitive chez les utilisateurs finaux non techniciens et dégradent la lisibilité des tableaux de bord opérationnels. En transformant un événement d’échec en une valeur booléenne pure, ESTNA standardise la réponse algorithmique dans un format normalisé, directement digestible par les couches de présentation, les segments d’analyse décisionnelle et les algorithmes de filtrage dynamique.
3.2 3.2 Architecture de la formule combinée =ESTNA(RECHERCHEV(…))
La fusion fonctionnelle s’incarne dans une syntaxe devenue classique au sein des laboratoires d’analyse de données : =ESTNA(RECHERCHEV(A2,$C$2:$C$9,1,FAUX)). Cette architecture imbriquée opère une composition de fonctions au sens mathématique du terme, dans laquelle l’ensemble d’arrivée de la fonction interne RECHERCHEV devient l’ensemble de départ de la fonction externe ESTNA. L’analyse de cette formule impose de disséquer le flux de traitement de l’information, qui se déroule de l’intérieur vers l’extérieur selon une séquence d’évaluation séquentielle et rigoureuse.
Dans un premier temps, le sous-système de calcul résout l’expression RECHERCHEV(A2,$C$2:$C$9,1,FAUX). Il saisit l’identifiant situé dans la cellule source A2 et inspecte le vecteur de référence absolu $C$2:$C$9. Si la clé est trouvée, le moteur extrait la valeur correspondante (ici l’identifiant lui-même, puisque l’index est fixé à 1). Dans un second temps, cette valeur retournée est transmise au prédicat enveloppant ESTNA(...). Puisque la valeur extraite est une chaîne ou un nombre parfaitement régulier et non le code #N/A, la fonction ESTNA conclut que l’hypothèse de non-disponibilité est fausse et émet en conséquence la valeur booléenne FAUX. Ce résultat FAUX certifie ainsi de manière paradoxale mais rigoureuse que l’élément est bel et bien présent dans la liste cible.
À l’inverse, si l’identifiant présent en A2 ne trouve aucune contrepartie dans la colonne C, l’évaluation de la fonction RECHERCHEV avorte et génère le signal #N/A. La fonction ESTNA réceptionne alors ce code d’interruption exact. Reconnaissant la signature spécifique de l’absence, elle valide l’assertion logique et renvoie la valeur booléenne VRAI. L’analyste dispose ainsi d’un indicateur binaire d’une limpidité absolue : toute cellule affichant VRAI correspond mathématiquement à un élément appartenant en propre à la liste source et totalement exclu de la liste cible ($A setminus B$). Cette corrélation inverse entre l’exclusion empirique et le booléen VRAI constitue le pivot algorithmique de toute la méthodologie de réconciliation.
3.3 3.3 Variantes fonctionnelles basées sur SI et ESTNUM
Bien que le renvoi d’un statut booléen pur satisfasse pleinement les exigences de traitement informatique, la transmission de livrables à des parties prenantes managériales requiert fréquemment une contextualisation lexicale explicite. L’encapsulation de la formule au sein d’une structure conditionnelle SI (IF) permet de traduire les valeurs logiques en diagnostics sémantiques intuitifs. L’expression prend alors la forme suivante : =SI(ESTNA(RECHERCHEV(A2,$C$2:$C$9,1,FAUX)); "Absent de la liste cible"; "Concordant"). Cette formulation remplace l’aridité du booléen par un libellé clair, éliminant toute ambiguïté d’interprétation pour les auditeurs non initiés aux subtilités de la logique formelle.
Dans certains contextes de conception où l’analyste préfère raisonner sur la présence effective plutôt que sur l’absence, il est possible d’inverser la polarité de la condition par l’entremise de l’opérateur de négation unaire NON (NOT), produisant la formule =NON(ESTNA(RECHERCHEV(A2,$C$2:$C$9,1,FAUX))). Dès lors, le résultat VRAI signale directement l’existence confirmée de l’élément dans les deux cohortes, modélisant explicitement l’intersection ensembliste ($A cap B$). Une autre alternative méthodologique réside dans l’utilisation conjointe des fonctions ESTNUM (ISNUMBER) et EQUIV (MATCH), bien que l’élégance de la structure combinée avec RECHERCHEV conserve une attractivité pédagogique et opérationnelle indiscutable pour les professionnels habitués à cette syntaxe historique.
Du point de vue de l’efficience computationnelle, l’imbrication d’une fonction SI autour de ESTNA(RECHERCHEV(...)) induit une surcharge de calcul marginale mais mesurable sur des volumétries massives. Chaque niveau d’arborescence syntaxique contraint l’interpréteur de formules d’Excel à allouer des contextes d’exécution supplémentaires en mémoire vive. Néanmoins, pour des jeux de données d’échelle moyenne (compris entre quelques centaines et quelques dizaines de milliers d’enregistrements), l’impact sur le cycle d’horloge du processeur demeure totalement imperceptible, justifiant pleinement le compromis entre pureté algorithmique brute et clarté taxonomique de restitution.
4. 4. Protocole d’application pas à pas sur un cas pratique
4.1 4.1 Configuration et structuration des jeux de données d’exemple
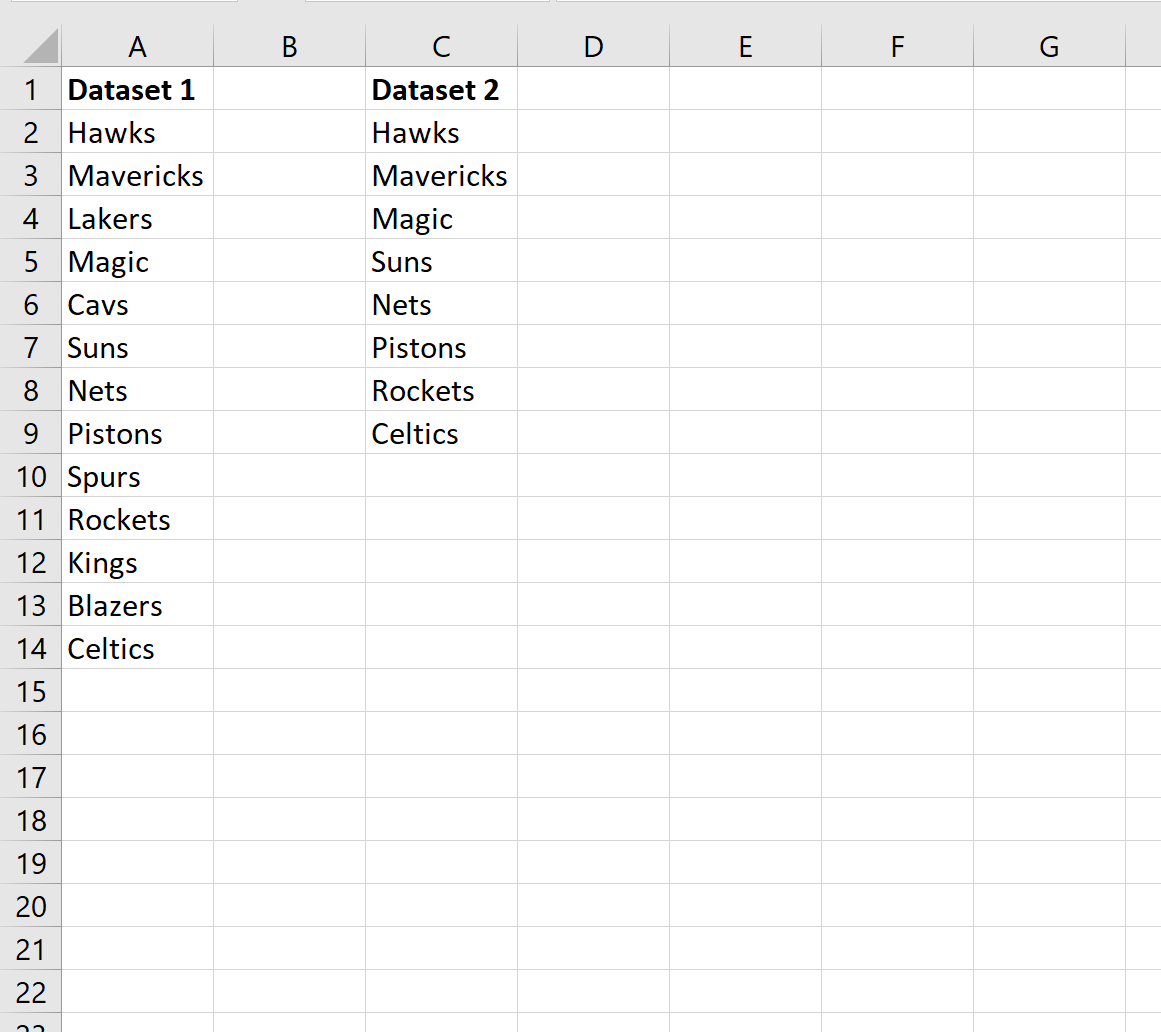
Afin d’illustrer la mise en œuvre empirique de cette ingénierie de réconciliation, considérons un cas d’école emblématique rencontré lors d’un audit de conformité d’inventaire d’équipements technologiques. Supposons deux jeux de données hétérogènes consignés sur une même feuille de calcul. D’une part, la colonne A héberge la Liste source (Dataset 1), matérialisant le parc d’actifs déclaré par le département des opérations logistiques, couvrant les lignes géométriques 2 à 9. D’autre part, la colonne C contient la Liste de référence (Dataset 2), issue directement de l’extraction des identifiants matériels scannés sur le réseau physique par les équipes de sécurité informatique au cours de la même période d’audit.
Avant d’engager la moindre saisie d’expression matricielle, une inspection préliminaire de la géométrie des données s’avère indispensable. L’analyste doit attester l’homogénéité dimensionnelle des représentations textuelles. Une incohérence fréquente provient de la présence d’espaces typographiques parasites ou de dissemblances de casse qui, bien que négligeables pour l’observateur humain, constituent des ruptures d’égalité stricte pour le moteur déterministe d’appariement. Dans notre scénario d’étude, la colonne B sera explicitement réservée comme zone d’accueil tampon — la « Colonne auxiliaire de contrôle » — destinée à héberger les formules d’investigation sans modifier les données sources.
Sur le plan de l’organisation spatiale, l’isolation physique des colonnes constitue une règle d’or pour éviter tout phénomène d’écrasement ou d’interférence accidentelle. L’insertion délibérée de colonnes vides entre les ensembles de données (telle que la colonne B séparant physiquement la liste source A de la liste cible C) prévient les erreurs de manipulation lors des opérations d’extension automatique de plages ou de tris manuels non maîtrisés. Ce compartimentage strict établit un cadre sécurisé pour l’exécution du protocole algorithmique.
4.2 4.2 Implémentation manuelle de la formule dans une colonne auxiliaire
Le protocole opératoire débute par la sélection ciblée de la cellule B2, marquant l’origine vectorielle de notre segment d’observation auxiliaire. L’analyste initie la saisie de l’instruction canonique dans la barre de formule : =ESTNA(RECHERCHEV(A2,$C$2:$C$9,1,FAUX)). Une attention méticuleuse doit être accordée au verrouillage cartésien du second argument. Alors que l’identifiant interrogé est référencé par la désignation relative A2, la matrice d’audit doit être impérativement ancrée par les coordonnées absolues $C$2:$C$9 au moyen de l’insertion manuelle des délimiteurs ou par la pression séquentielle de la touche fonctionnelle F4 lors de la capture de la plage.
Une fois la formule validée en B2 par l’actionnement de la touche Entrée, le moteur d’évaluation procède à sa résolution instantanée. Pour déployer ce prédicat algorithmique sur l’ensemble de la population statistique, l’opérateur fait usage du mécanisme de recopie incrémentale. Ce déploiement peut être accompli en positionnant le curseur sur la poignée de recopie située à l’angle inférieur droit de la cellule active (le carré d’ancrage sombre), jusqu’à métamorphose du pointeur en une croix fine, suivi soit d’un glissement directionnel manuel jusqu’à la cellule B9, soit d’une double pulsation rapide du bouton gauche de la souris. Cette dernière manœuvre déclenche l’analyse automatique de la densité des cellules adjacentes et propage la formule jusqu’à la rupture de continuité de la colonne A.
L’inspection du vecteur résultant en colonne B révèle la dynamique de l’évaluation relative : en examinant la cellule B3, l’observateur constate que l’expression s’est réajustée de manière transparente en =ESTNA(RECHERCHEV(A3,$C$2:$C$9,1,FAUX)), puis en A4 en cellule B4, tandis que la référence matricielle $C$2:$C$9 est demeurée immuable. Ce comportement structurel garantit que chaque enregistrement unitaire de la cohorte $A$ est scrupuleusement confronté à l’intégralité inaltérée de la cohorte $B$, préservant ainsi l’équité du test sur toute la profondeur de l’échantillon.
4.3 4.3 Vérification analytique et audit des concordances
L’obtention des résultats dans la colonne auxiliaire amorce la phase de validation croisée et d’audit analytique. L’analyste se doit de procéder à un échantillonnage contradictoire afin de corroborer la validité empirique des diagnostics émis par le moteur logique. Pour ce faire, il sélectionne des cellules témoins représentant distinctement les deux états booléens observés. Si la cellule B2 renvoie la mention FAUX, l’opérateur vérifie visuellement que la valeur consignée en A2 (par exemple, la référence d’équipement « PC-001 ») possède bien une entrée strictement identique au sein de la plage C2:C9. La confirmation de cette concordance valide le fonctionnement nominal de la branche de détection positive.
Corrélativement, l’isolation documentaire des éléments exclusifs constitue le cœur de cible de la mission d’audit. Lorsqu’une cellule telle que B5 affiche la valeur booléenne VRAI, cela documente mathématiquement que la clé correspondante (par exemple « SRV-099 ») n’a généré aucun écho au sein du référentiel technique de la colonne C. L’opérateur documente cette exclusion relative en annotant formellement l’écart au sein de la feuille de travail ou en appliquant un filtre automatique configuré pour restreindre temporairement l’affichage aux seules occurrences VRAI de la colonne B.
Cette démarche de vérification méthodique permet de dresser un bilan d’intégrité préliminaire. En quantifiant le ratio d’occurrences VRAI par rapport au volume total de lignes évaluées, le contrôleur établit l’indice de dérive ou de perte informationnelle caractérisant les deux cohortes. Cependant, bien que la méthode par colonne auxiliaire offre une robustesse mathématique irréprochable, elle présente l’inconvénient d’alourdir la structure physique du classeur par l’adjonction de données intermédiaires. Cette contrainte incite fréquemment à déporter cette logique booléenne vers les moteurs graphiques de mise en valeur contextuelle.
5. 5. Visualisation analytique via la mise en forme conditionnelle
5.1 5.1 Principes fondamentaux de la mise en forme conditionnelle par formule
La mise en forme conditionnelle constitue une couche d’abstraction graphique d’une puissance remarquable au sein d’Excel, permettant d’altérer dynamiquement les propriétés sémiotiques et visuelles d’une cellule (remplissage chromatique, couleur de police, bordures) en fonction de l’évaluation en temps réel d’un prédicat mathématique ou logique. Loin de se limiter aux règles préétablies d’encadrement de seuils numériques élémentaires, le module de mise en forme conditionnelle intègre un compilateur complet de formules personnalisées capable d’exécuter des algorithmes avancés en arrière-plan sans nécessiter la matérialisation d’une colonne auxiliaire de calcul au sein de la grille spatiale du classeur.
Le moteur d’évaluation de la mise en forme conditionnelle repose sur un principe d’évaluation implicite rigoureusement binaire : dès lors que l’expression fournie par l’utilisateur renvoie la valeur VRAI (ou toute valeur numérique non nulle assimilée à un état logique vrai), le gestionnaire de styles déclenche immédiatement l’application de la charte graphique configurée sur la cellule cible. Si l’expression retourne FAUX, 0 ou un code d’erreur non masqué, la mise en forme reste inactive et la cellule conserve ses attributs esthétiques standards. Cette mécanique permet de superposer un calque diagnostique transparent directement au-dessus des données d’origine.
Toutefois, la manipulation de formules au sein de l’interface de mise en forme conditionnelle exige une discipline mathématique supérieure en ce qui concerne la gestion de la relativité cartésienne. La formule injectée dans le gestionnaire de règles est systématiquement formulée du point de vue de la cellule d’ancrage primaire (généralement la cellule supérieure gauche de la zone de sélection active). Le moteur projette ensuite cette formule sur chaque cellule de la plage sélectionnée en appliquant les lois universelles de translation des références relatives, tandis que les références munies d’ancres absolues restent rigoureusement immobiles. Une confusion dans l’attribution des symboles $ dans ce moteur d’évaluation implicite fausserait l’intégralité du balayage graphique.
5.2 5.2 Déploiement rigoureux de la règle personnalisée
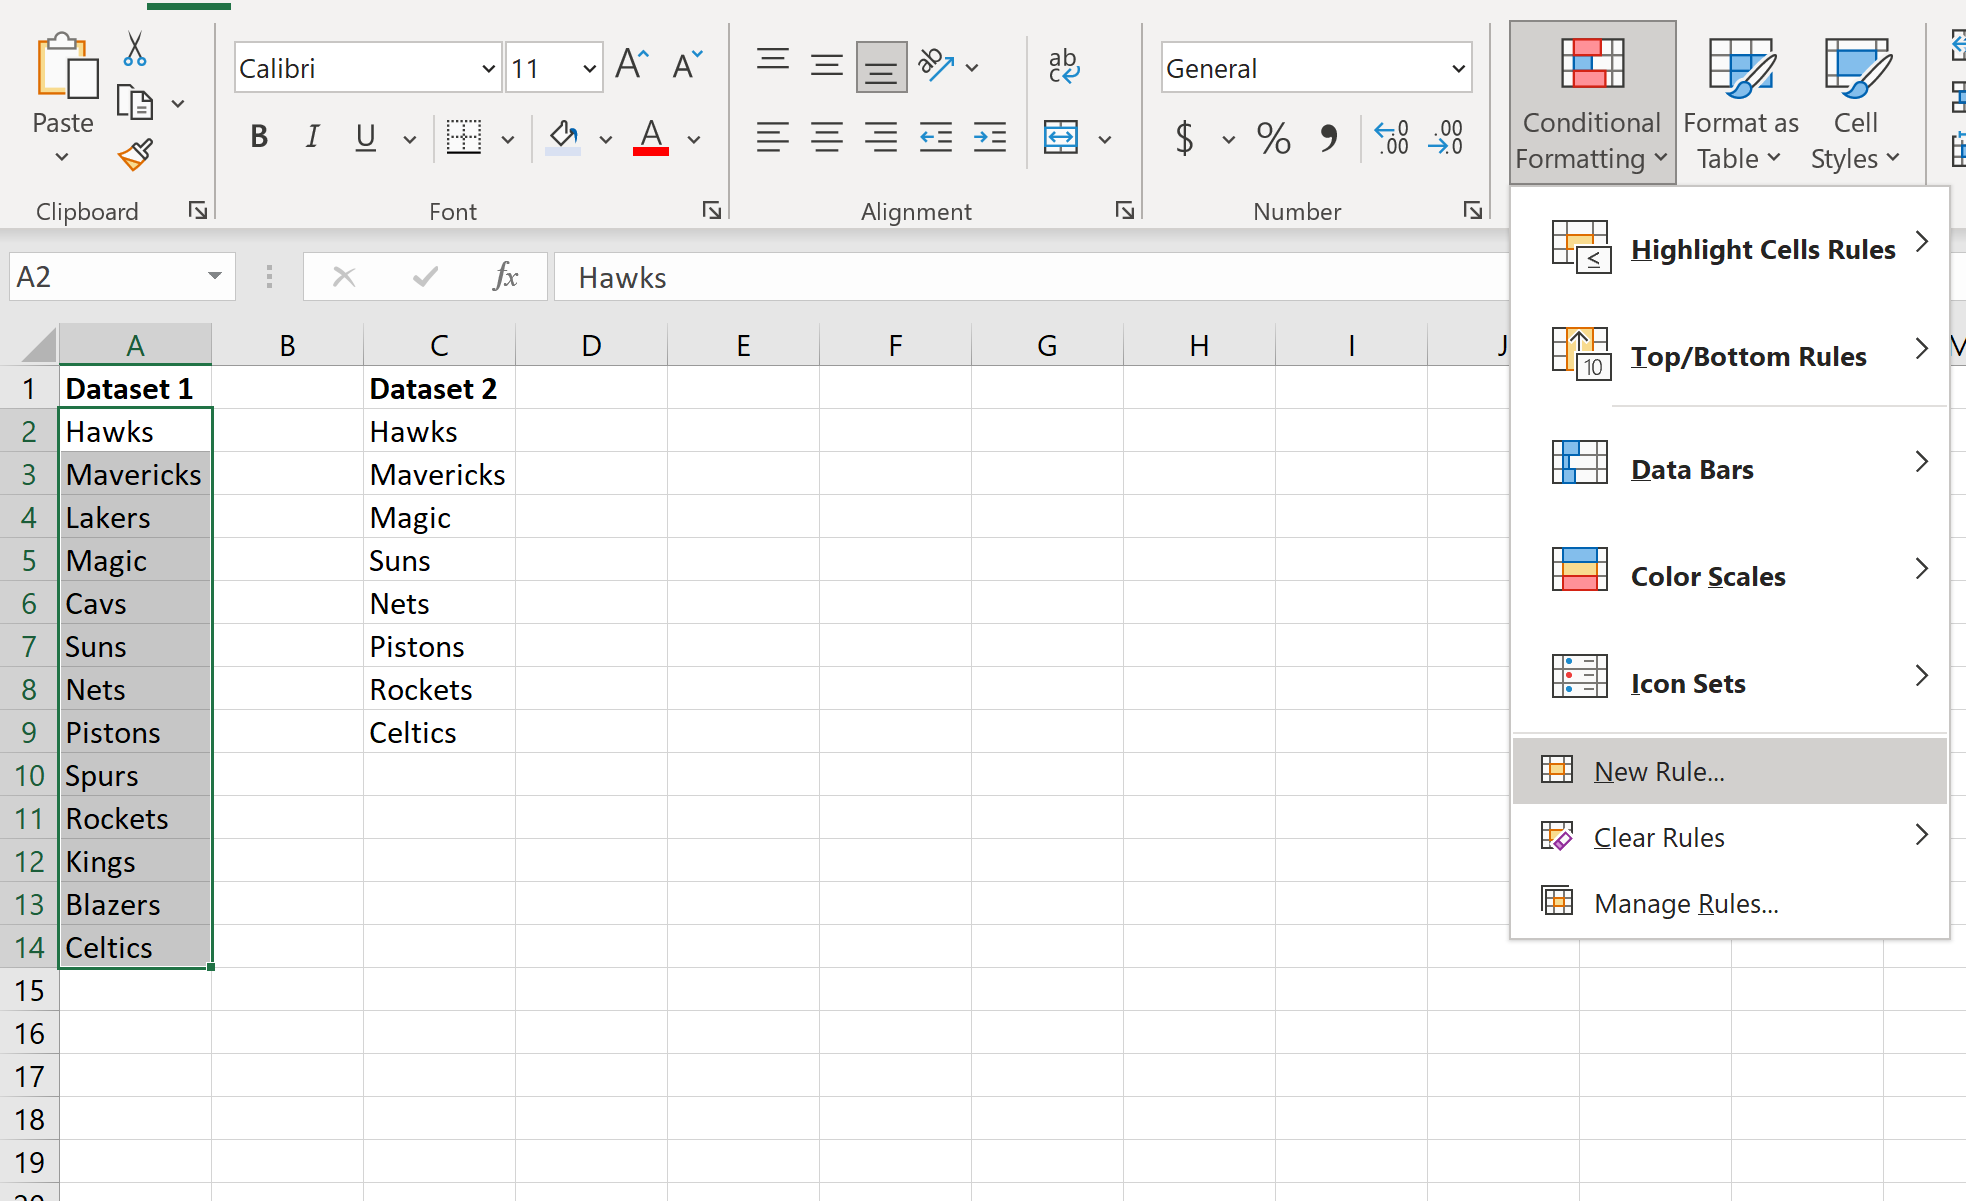
L’implémentation opérationnelle de la détection visuelle sans colonne intermédiaire impose un protocole rigoureux en quatre phases séquentielles. La première étape, dont dépend le succès absolu de la manœuvre, réside dans la pré-sélection géométrique intégrale du domaine d’application. L’analyste sélectionne à la souris ou au clavier la plage A2:A9 représentant l’ensemble de la liste source à auditer. Il est impératif de veiller à ce que la cellule A2 demeure la cellule active de cette sélection (reconnaissable à son fond blanc contrastant au sein de la zone en surbrillance dans l’interface par défaut d’Excel).
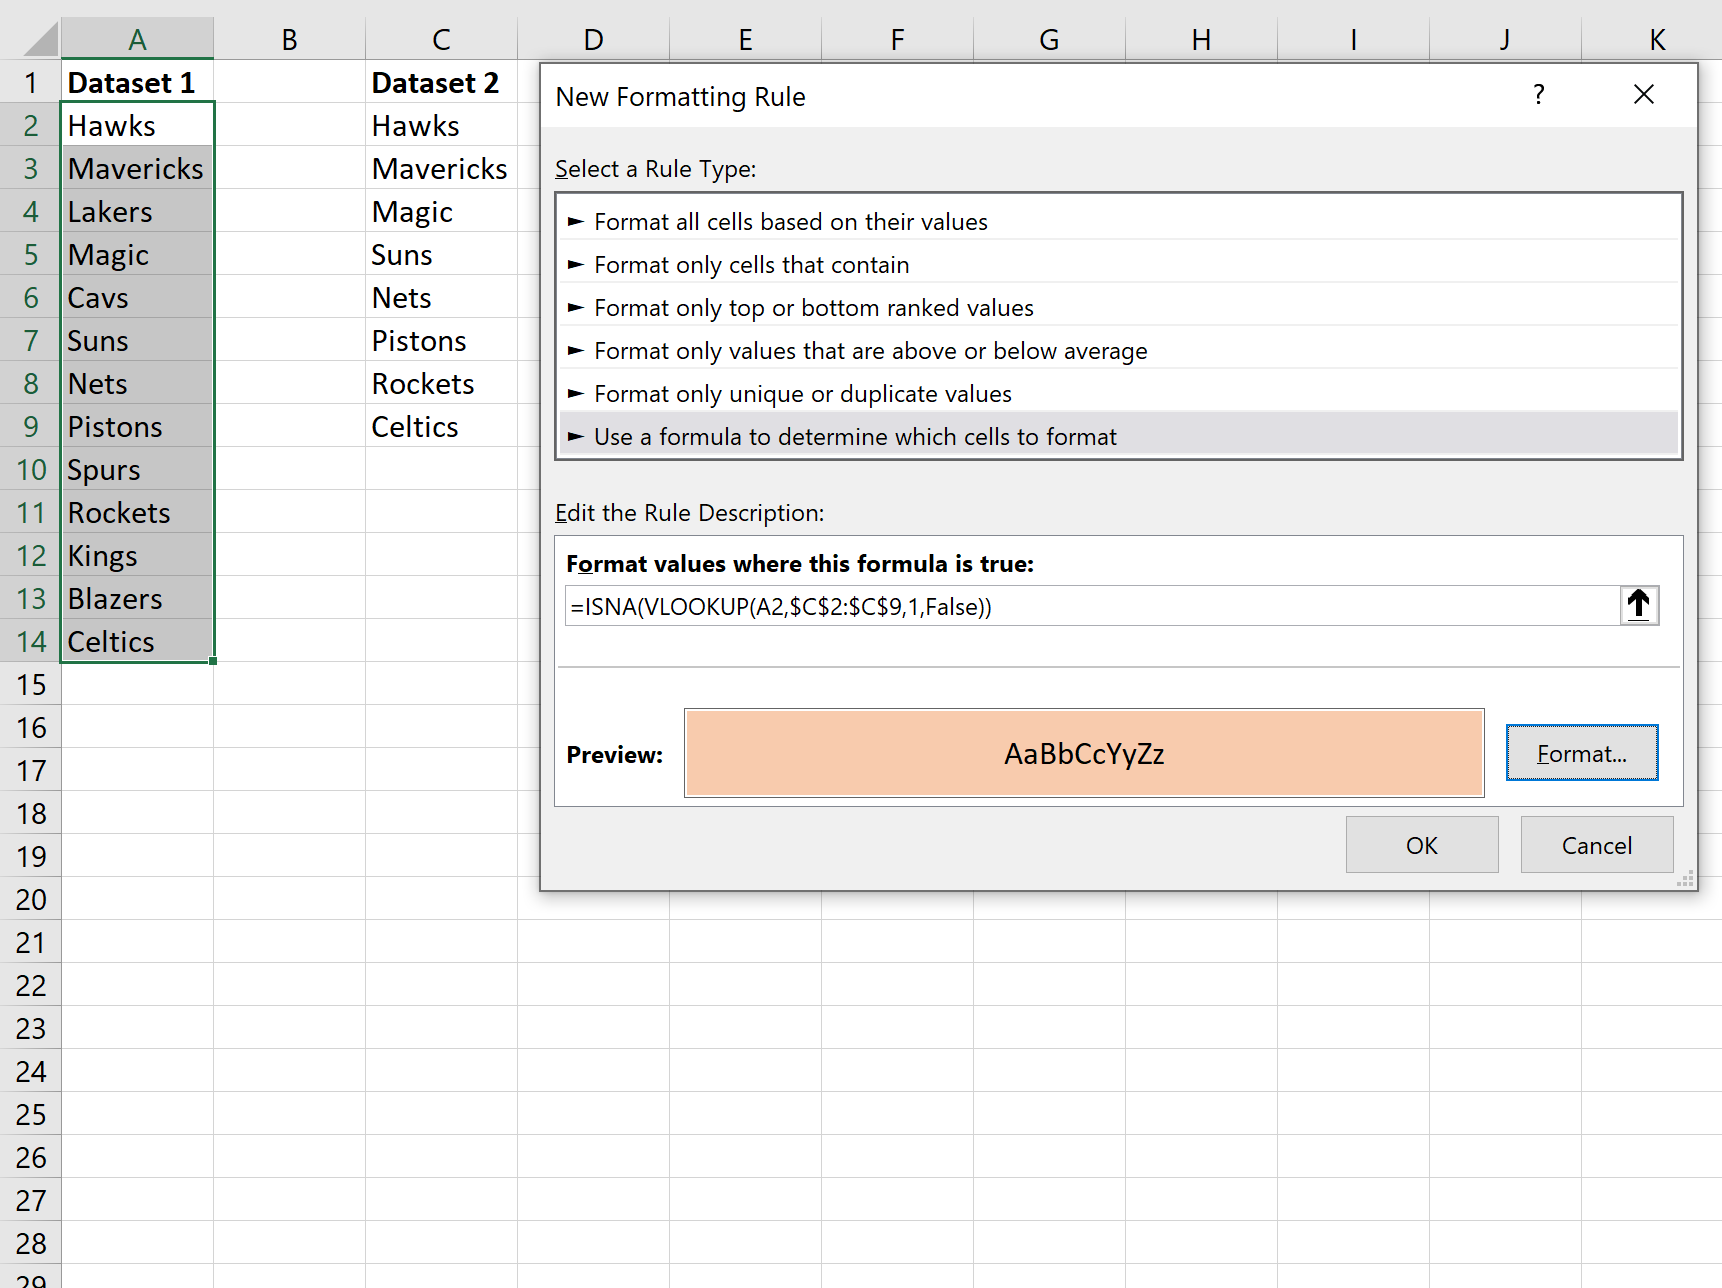
La seconde phase consiste à franchir l’arborescence des menus contextuels en accédant au ruban supérieur d’Excel : l’opérateur active l’onglet Accueil, localise le groupe fonctionnel Styles, clique sur le menu déroulant Mise en forme conditionnelle, puis sélectionne explicitement l’entrée Nouvelle règle…. Cette action ouvre une boîte de dialogue modale orchestrant les différents paradigmes de règles exploitables par le tableur.
Dans cette interface, la troisième étape requiert la sélection du sixième type de règle intitulé sans équivoque : « Utiliser une formule pour déterminer pour quelles cellules le format sera appliqué ». Cette option démasque un champ de saisie textuel linéaire conçu pour accueillir l’instruction de contrôle. L’analyste y transcrit avec une exactitude scrupuleuse la formule canonique étudiée précédemment : =ESTNA(RECHERCHEV(A2,$C$2:$C$9,1,FAUX)). La présence de la coordonnée relative A2 assure que chaque cellule de la plage sélectionnée A2:A9 sera évaluée séquentiellement par rapport au bloc immuable $C$2:$C$9.
La quatrième et dernière phase réside dans la définition de l’attribut de restitution sémiotique. L’opérateur clique sur le bouton de commande Format… situé au bas de l’interface pour configurer la réponse visuelle associée à la validation de l’état VRAI, finalisant ainsi le câblage logique de la règle d’audit.
5.3 5.3 Choix sémiotique des formats visuels et validation du résultat
Le choix des attributs graphiques ne saurait être arbitraire ; il relève d’une démarche d’ergonomie cognitive et de sémiotique visuelle rigoureuse. Dans le cadre d’un audit de divergence, l’apparition d’un élément manquant (signalée par ESTNA(...) = VRAI) correspond traditionnellement à une anomalie ou à une alerte structurelle. Il convient par conséquent de privilégier des palettes chromatiques standardisées issues de la psychologie de la perception. Un remplissage rouge pastel doux (par exemple, le code hexadécimal #FFC7CE) associé à une typographie rouge foncé (#9C0006) offre un contraste optimal garantissant une lisibilité immédiate sans saturer la vue de l’analyste lors de l’examen de jeux de données massifs.
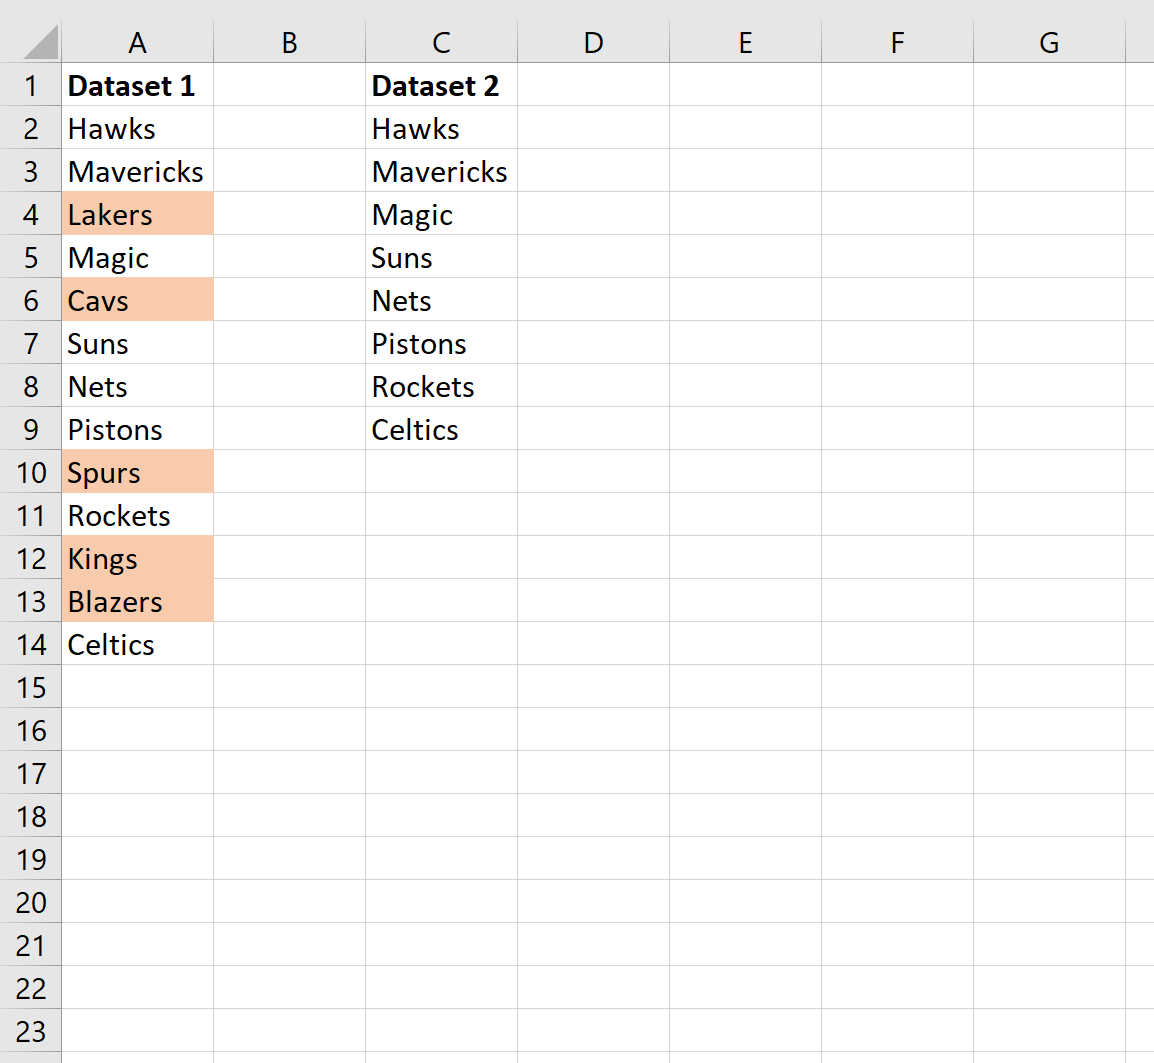
Une fois les attributs de formatage validés par le clic sur le bouton OK au sein des deux boîtes de dialogue successives, le moteur graphique compile la règle et actualise instantanément le canevas de la feuille. Les cellules de la colonne A dont les valeurs sont formellement absentes de la colonne C s’illuminent alors de la teinte rouge distinctive, tandis que les identifiants présents dans les deux colonnes conservent leur neutralité esthétique originelle. L’analyste bénéficie d’une vision synthétique instantanée de la distribution spatiale des anomalies.
Le processus se clôture impérativement par une procédure de contre-validation empirique. L’opérateur procède à un test de stress interactif : en modifiant volontairement l’une des valeurs concordantes de la liste source pour introduire un caractère arbitraire, il doit constater la coloration rouge immédiate et dynamique de la cellule modifiée. Réciproquement, l’adjonction d’un identifiant manquant au sein de la colonne C doit neutraliser instantanément la mise en surbrillance de sa contrepartie en colonne A. Cette réactivité en temps réel confirme le parfait fonctionnement du couplage entre le moteur de calcul et la couche graphique.
6. 6. Comparaison bidirectionnelle : Identification des éléments symétriques et asymétriques
6.1 6.1 Nécessité théorique du double balayage vectoriel
L’une des fautes méthodologiques les plus destructrices observées dans les pratiques d’audit d’entreprise réside dans la présomption de commutativité de la comparaison unilatérale. Interroger la présence de la liste A au sein de la liste B ne renseigne en aucune manière sur l’état d’inclusion de la liste B au sein de la liste A. En termes de logique mathématique formelle, l’opération de complémentation relative est strictement asymétrique : le sous-ensemble $A setminus B$ n’est pas équivalent au sous-ensemble $B setminus A$. Limiter son investigation à un balayage unilatéral de gauche à droite revient à ignorer délibérément l’intégralité des enregistrements potentiellement orphelins hébergés dans la seconde cohorte.
Dans le cadre d’un contrôle de conformité financière ou d’une conciliation de balances comptables, une telle asymétrie d’investigation génère un risque d’audit inacceptable. Si un analyste vérifie que toutes les factures émises par son système de facturation figurent bien sur le relevé d’encaissement bancaire mais omet de vérifier le cheminement inverse, il sera structurellement incapable d’identifier des encaissements non identifiés, des versements frauduleux ou des doublons d’enregistrement générés unilatéralement par l’établissement financier. L’exhaustivité du contrôle exige impérativement un double balayage vectoriel croisé, scannant l’espace relationnel selon ses deux trajectoires orthogonales.
Le protocole bidirectionnel complet vise ainsi à caractériser simultanément la dualité des exclusions relatives afin de reconstituer la différence symétrique $A \Delta B = (A setminus B) \cup (B setminus A)$. Cette grandeur ensembliste représente la totalité des divergences existant entre les deux sources d’information. Seul l’isolement formel de ces deux sous-groupes asymétriques permet aux gestionnaires de flux d’engager des actions de remédiation ciblées sur chacun des systèmes d’origine.
6.2 6.2 Implémentation du balayage miroir (Liste 2 vers Liste 1)
Pour concrétiser cette exigence d’investigation réciproque, l’analyste doit déployer un dispositif symétrique opérant un balayage miroir de la colonne C vers la colonne A. Si l’opérateur travaille au moyen de colonnes auxiliaires, il instanciera une nouvelle zone de calcul en colonne D. En cellule D2, la formule réciproque sera formulée comme suit : =ESTNA(RECHERCHEV(C2,$A$2:$A$9,1,FAUX)). Dans cette configuration inversée, c’est l’enregistrement C2 qui devient la clé d’interrogation mobile, tandis que la liste source $A$2:$A$9 est figée dans le rôle de matrice de référence absolue.
Dans l’hypothèse où l’analyste privilégie l’approche ergonomique par mise en forme conditionnelle directe, le protocole de déploiement miroir impose une seconde règle indépendante. L’opérateur sélectionne préalablement l’espace spatial C2:C9 hébergeant la liste de référence. En accédant à l’interface de création de règle, il saisit scrupuleusement l’expression algorithmique inverse : =ESTNA(RECHERCHEV(C2,$A$2:$A$9,1,FAUX)). La rigueur commande ici d’adopter une sémiotique chromatique différenciée pour éviter toute confusion cognitive entre les deux typologies d’orphelins.
Il est préconisé d’attribuer aux anomalies de la liste cible un code couleur contrastant mais distinct de celui appliqué à la liste source. Alors que les exclusions de A ($A setminus B$) peuvent conserver leur surbrillance rouge pastel, les exclusions de C ($B setminus A$) se verront idéalement attribuer une nuance orangée ou ambrée (telle qu’un remplissage #FED8B1 combiné à une typographie #8B4500). Cette différentiation chromatique permet à l’auditeur d’identifier d’un simple coup d’œil la directionnalité de l’asymétrie pour chaque élément discordante affiché sur l’interface de travail.
6.3 6.3 Synthèse matricielle des intersections et des divergences
Au-delà de la visualisation chromatique segmentée, les standards de gouvernance de données imposent la production d’un état récapitulatif consolidé capable de restituer une synthèse matricielle claire aux instances de direction. Pour orchestrer cette réconciliation totale sans contraindre le lecteur à décrypter des cellules éparses, il est possible d’élaborer une colonne de diagnostic catégorielle exploitant des structures logiques à embranchements multiples combinant les opérateurs SI, ET et ESTNA.
Une construction robuste consiste à implémenter, au sein d’une feuille de synthèse dédiée ou dans des colonnes adjacentes, une formule évaluant le statut relationnel de l’enregistrement par rapport aux deux axes d’existence. Par exemple, au moyen de fonctions logiques imbriquées ou d’arborescences de tests, l’analyste peut générer un diagnostic textuel unifié attribuant formellement à chaque ligne l’une des trois étiquettes normalisées : "Concordance Parfaite" (appartenance conjointe validée), "Exclusif Source A" (omission dans la cible), ou "Exclusif Cible C" (élément orphelin non déclaré à la source). Cette formalisation discrète élimine toute ambiguïté interprétative.
Ce diagnostic catégoriel sert ensuite de matrice d’alimentation pour des tableaux de bord dynamiques articulés autour de tableaux croisés dynamiques ou de graphiques de synthèse en anneau. Les décideurs peuvent ainsi appréhender immédiatement les indicateurs clés de performance (KPI) de la réconciliation : taux d’appariement global, volume absolu des discordances unilatérales et répartition proportionnelle des anomalies selon les vecteurs d’origine. La rigueur de la formule RECHERCHEV sous-jacente garantit l’infaillibilité mathématique des métriques consolidées présentées aux comités d’audit.
7. 7. Prétraitement et normalisation des données : Prérequis à l’exactitude
7.1 7.1 Résolution des divergences typographiques et invisibles
L’application d’un algorithme déterministe tel que RECHERCHEV se heurte fréquemment à ce que les ingénieurs de données désignent sous le concept d’entropie textuelle. En pratique, deux chaînes de caractères paraissant rigoureusement identiques à l’œil nu sur l’interface graphique d’Excel peuvent être fondamentalement divergentes au niveau de leur encodage binaire sous-jacent. La source de pollution la plus insidieuse réside dans la présence d’espaces typographiques superflus, situés en début de chaîne, en fin de libellé ou sous forme de doubles espaces intercalaires involontaires. Confronté à la comparaison entre "REF-100" et "REF-100 ", RECHERCHEV conclura inévitablement à un échec d’appariement et émettra un signal #N/A erroné.
Le fléau le plus pernicieux lors de l’extraction de données depuis des systèmes tiers (tels que des interfaces web ou des flux XML/JSON d’applications métier) est l’espace insécable, matérialisé par le caractère ASCII 160 (ou entité ), alors que l’espace standard correspond au code ASCII 32. La fonction classique SUPPRESPACE (TRIM), bien qu’extrêmement efficace pour purger les espaces standards initiaux et terminaux, est structurellement incapable d’intercepter ni de détruire les espaces insécables ASCII 160. Pour assainir un jeu de données contaminé, l’analyste doit déployer un protocole d’assainissement systématique combinant SUPPRESPACE, EPURAGE (CLEAN) et la substitution de code via SUBSTITUE(A2; CAR(160); "").
Concernant la sensibilité à la casse typographique (distinction entre majuscules et minuscules), il convient de souligner que RECHERCHEV est intrinsèquement insensible à la casse. Pour cette fonction, les chaînes "excel", "EXCEL" et "Excel" sont considérées comme strictement équivalentes. Si cette tolérance scalaire simplifie grandement l’appariement de fichiers commerciaux non uniformisés, elle représente une limite critique dès lors que la casse porte une signification discriminante (par exemple, dans le cas de codes d’authentification ou d’identifiants cryptographiques sensibles). Dans cette dernière hypothèse, le recours à RECHERCHEV doit être écarté au profit de formulations combinatoires exploitant la fonction EXACT.
7.2 7.2 Hétérogénéité des formats de stockage (Texte versus Nombre)
Une autre anomalie systémique perturbant les processus de comparaison réside dans l’hétérogénéité des types de données primitifs attribués aux cellules. Excel maintient une frontière d’étanchéité absolue entre un scalaire encodé sous forme de nombre binaire pur et une chaîne de caractères alphanucléiques ne comportant que des chiffres. Ainsi, la valeur numérique 1024 et la valeur textuelle "1024" sont traitées par le moteur de comparaison comme deux objets dissemblables, interdisant toute égalité logique. Si la liste source stocke un identifiant sous forme de texte tandis que la table de référence l’héberge sous forme de nombre flottant, RECHERCHEV échouera systématiquement avec un diagnostic d’absence #N/A.
Cette divergence de format est fréquente lors des consolidations multi-sources : certains extracteurs SQL génèrent des colonnes de codes postaux ou de numéros de matricule typées en chaînes pour préserver les zéros de tête, tandis que d’autres outils d’exportation convertissent silencieusement ces flux en nombres entiers. L’analyste diagnostique cette distorsion à la disposition spatiale des cellules : par défaut, Excel aligne automatiquement les nombres réels sur la bordure droite de la cellule et les chaînes textuelles sur la bordure gauche. De surcroît, les nombres stockés comme texte s’accompagnent souvent d’un marqueur d’avertissement triangulaire vert à l’angle supérieur gauche de la cellule.
Pour standardiser les jeux de données préalablement au rapprochement, plusieurs techniques de conversion unifiée peuvent être mobilisées. Pour convertir un texte numérique en nombre pur au sein d’une formule dynamique, l’analyste peut recourir à l’opérateur arithmétique unaire double négatif : --A2, ou à la fonction native CNUM (VALUE). Réciproquement, pour forcer la conversion d’un nombre en chaîne textuelle sans modifier la disposition de la feuille, l’opérateur de concaténation vide s’avère redoutable : A2 & "". Enfin, pour un assainissement statique irréversible de la grille, l’usage de la fonctionnalité Convertir de l’onglet Données permet d’uniformiser instantanément le typage d’une colonne entière.
7.3 7.3 Traitement des caractères spéciaux et métacaractères
Une subtilité technique méconnue des utilisateurs de RECHERCHEV réside dans son traitement automatique des métacaractères dits génériques (ou « wildcards »). Par conception interne, le moteur de recherche exacte d’Excel attribue aux caractères point d’interrogation (?), astérisque (*) et tilde (~) une sémantique d’expression rationnelle simplifiée. L’astérisque représente une séquence indéterminée de caractères arbitraires, le point d’interrogation émule un caractère unique quelconque, et le tilde sert de caractère d’échappement pour désactiver la fonction spéciale des deux premiers.
Ce comportement induit des dysfonctionnements majeurs lorsque les listes d’audit contiennent des identifiants techniques incorporant naturellement ces symboles, comme des masques de sous-réseau, des expressions mathématiques ou des désignations de références industrielles du type "REF*01" ou "ID?A". Si la formule recherche "REF*01", l’astérisque sera interprété comme un joker universel. L’algorithme s’arrêtera alors sur la première chaîne débutant par "REF" et se terminant par "01" (par exemple "REF-XYZ-01"), validant une fausse concordance catastrophique pour l’exactitude de l’audit.
Pour neutraliser ce risque de faux positif algorithmique, il est indispensable de neutraliser ces métacaractères avant leur injection dans RECHERCHEV. Cette opération s’accomplit en encapsulant la valeur_cherchée au sein d’une chaîne de substitution injectant le tilde d’échappement devant toute occurrence de joker. La syntaxe prend la forme complexe : SUBSTITUE(SUBSTITUE(A2; "~"; "~~"); "*"; "~*"). Enfin, lors de l’importation de fichiers externes au format CSV, l’analyste veillera à valider la conformité de l’encodage source (UTF-8 avec ou sans BOM versus ANSI Windows), faute de quoi les caractères diacritiques ou spéciaux seront corrompus en symboles indéchiffrables (mojibake), invalidant toute possibilité d’appariement déterministe.
8. 8. Diagnostic approfondi des erreurs et résolution des anomalies de calcul
8.1 8.1 Échec de correspondance inexpliqué malgré une ressemblance visuelle
L’une des situations les plus déconcertantes pour l’analyste réside dans la survenue d’une erreur #N/A face à deux chaînes de caractères qui semblent rigoureusement identiques à l’observation visuelle la plus attentive. Lorsque le moteur logique affirme la divergence là où l’humain perçoit l’équivalence, une méthodologie d’investigation médico-légale des données doit être immédiatement déployée. La première démarche d’investigation consiste à tester l’égalité binaire stricte des deux cellules suspectes au moyen de la fonction EXACT : la formulation =EXACT(A2, C5) renverra sans complaisance FAUX si le moindre écart de bit subsiste entre les deux représentations.
Pour identifier la localisation et la nature de cet écart masqué, l’audit de la longueur vectorielle au moyen de la fonction NBCAR (LEN) constitue le révélateur le plus direct. En appliquant la formule =NBCAR(A2) en parallèle de =NBCAR(C5), l’analyste met fréquemment en lumière un différentiel de longueur d’un ou deux caractères. Ce décalage confirme de manière irréfutable l’existence d’espaces invisibles résiduels, de retours chariots imbriqués (code ASCII 10 ou ASCII 13) ou de caractères de contrôle non imprimables. Une inspection séquentielle par la fonction CODE(STXT(A2; LIGNE(INDIRECT("1:" & NBCAR(A2))); 1)) permet d’extraire la table des codes ASCII unitaires composant la cellule incriminée pour en démasquer l’intrus.
Une autre source d’incompréhension provient de la confusion entre la valeur réelle sous-jacente d’une cellule et son format d’affichage contextuel. L’application d’un format de nombre personnalisé (par exemple l’affichage d’un préfixe "ID-" sur une cellule contenant en réalité l’entier pur 45) modifie l’apparence visuelle sans altérer l’identité de l’objet computationnel. Si la table de référence contient la véritable chaîne textuelle "ID-45", l’appariement avec la cellule formatée 45 échouera irrémédiablement. L’analyste doit impérativement inspecter la barre de formule d’Excel, qui affiche la réalité brute de la valeur, dénuée de tout artifice cosmétique de mise en forme.
8.2 8.2 Erreurs structurelles d’adressage et de déréférencement
En dehors des altérations de contenu, l’intégrité du calcul comparatif est régulièrement compromise par des fautes d’architecture de formules commises lors de la phase de conception. La régression la plus commune découle de l’oubli du verrouillage cartésien absolu sur la plage de recherche. Si l’analyste écrit par inadvertance =ESTNA(RECHERCHEV(A2, C2:C9, 1, FAUX)) sans adjoindre les symboles dollar $, l’étirement de la formule sur cent lignes provoquera une translation progressive de la matrice de recherche vers le bas. À la cinquantième ligne, la matrice interrogée sera C51:C58, ignorant totalement les cinquante premiers éléments de référence et générant une marée artificielle d’erreurs #N/A qualifiant d’absents des éléments pourtant bien présents au sommet de la liste.
Une autre défaillance critique s’illustre par l’apparition brutale du code d’erreur #REF! au sein de la colonne de contrôle. Ce dysfonctionnement survient quasi systématiquement à la suite d’une modification structurelle de la feuille opérée par un tiers, telle que la suppression physique de colonnes entières englobées dans la matrice d’origine. Si la colonne interrogée en colonne C est détruite, le pointeur mémoire de RECHERCHEV se trouve rompu, conduisant à l’invalidation pure et simple du graphe de calcul de la formule. La réparation de cette anomalie exige la reconstruction intégrale de la plage de référence au sein de la signature syntaxique.
Enfin, l’apparition du code d’erreur #VALEUR! trahit une anomalie fondamentale dans le paramétrage des arguments de la fonction. Ce symptôme se manifeste fréquemment lorsque l’utilisateur, par étourderie ou incompréhension conceptuelle, affecte à l’argument no_index_col une valeur entière inférieure à 1 (par exemple 0 ou un nombre négatif). Excel interdisant strictement tout déréférencement vers un index nul, il stoppe net l’évaluation et lève l’exception d’opérande non valide. L’audit scrupuleux de chaque segment argumentaire constitue l’unique rempart face à ces dérives structurelles.
8.3 8.3 Anomalies liées au mode de calcul du classeur
Il arrive que l’analyste, confronté à l’absence totale de réaction de ses formules lors de la saisie de nouvelles données ou de la modification de cellules sources, suspecte à tort une défaillance de la logique algorithmique. Dans un nombre non négligeable de cas, cette inertie apparente n’a aucun lien avec la validité de RECHERCHEV, mais résulte de la reconfiguration silencieuse du mode de calcul global du classeur Microsoft Excel. Pour préserver les ressources processeur lors de la manipulation de fichiers titanesques, de nombreux modèles macro-économiques ou financiers désactivent le recalcul automatique au profit d’un mode de calcul configuré sur Manuel.
Lorsque le mode de calcul est commuté sur Manuel, le moteur matriciel n’évalue plus les formules à la modification des antécédents : les valeurs affichées demeurent figées dans leur état antérieur, créant une désynchronisation trompeuse entre la réalité des colonnes comparées et le diagnostic affiché. L’opérateur peut attester cet état de blocage en examinant la barre d’état inférieure d’Excel, qui arbore alors la mention caractéristique « Calculer ». Le déblocage opérationnel immédiat s’obtient par l’activation de la touche système F9 (recalcul intégral du classeur actif) ou de la combinaison Maj + F9 (recalcul exclusif de la feuille de calcul active).
Pour rétablir la dynamique computationnelle pérenne, il convient de réactiver l’actualisation automatique en naviguant vers l’onglet Formules, en déployant le menu Options de calcul, et en cochant sans équivoque l’option Automatique. Par ailleurs, la présence de dépendances circulaires non résolues au sein du classeur — même localisées sur un onglet périphérique sans lien direct avec l’audit en cours — peut paralyser l’ordonnanceur de calcul séquentiel d’Excel, perturbant gravement le rafraîchissement des règles de mise en forme conditionnelle dynamiques adossées aux fonctions de recherche.
9. 9. Évaluation comparative : RECHERCHEV face aux architectures modernes
9.1 9.1 Confrontation fonctionnelle avec le couple INDEX / EQUIV
Dès la fin des années 1990, les experts avancés du tableur ont progressivement délaissé la rigidité unitaire de RECHERCHEV au profit de l’architecture découplée offerte par la combinaison des fonctions INDEX et EQUIV (INDEX/MATCH). Cette alternative repose sur une dissociation conceptuelle fondamentale entre la localisation spatiale d’une valeur au sein d’un vecteur et l’extraction de l’attribut correspondant. Dans l’optique exclusive de comparer deux listes pour tester une existence, l’usage de la fonction INDEX est même totalement superflu : la seule fonction EQUIV suffit amplement à accomplir la tâche d’audit.
Le test d’existence se formalise alors selon une syntaxe épurée : =ESTNUM(EQUIV(A2, $C$2:$C$9, 0)). La fonction EQUIV effectue un balayage unidimensionnel sur la plage de référence $C$2:$C$9. Si l’élément A2 est localisé, EQUIV renvoie un scalaire numérique représentant le rang ordinal de l’occurrence au sein du vecteur (par exemple la position 4). La fonction enveloppante ESTNUM intercepte ce chiffre et délivre immédiatement la valeur booléenne VRAI, confirmant la concordance. Si l’élément fait défaut, EQUIV produit l’erreur #N/A, qui est immédiatement transmutée par ESTNUM en un état logique FAUX.
Sur le plan des performances et de la robustesse d’ingénierie, la supériorité du couple EQUIV/ESTNUM sur RECHERCHEV est indiscutable. D’une part, EQUIV ne charge en mémoire centrale qu’un vecteur colonne unique, réduisant l’empreinte mémoire par rapport à RECHERCHEV qui exige la déclaration d’une matrice englobante. D’autre part, cette méthode est totalement immunisée contre les corruptions causées par l’insertion ou la suppression de colonnes adjacentes, puisqu’elle s’affranchit totalement de la notion fragile d’index numérique codé en dur (no_index_col). De surcroît, elle s’exécute avec une vitesse d’évaluation significativement plus véloce sur des référentiels comptant des centaines de milliers de lignes.
9.2 9.2 Avènement et supériorité de la fonction RECHERCHEX (XLOOKUP)
Introduite par Microsoft pour moderniser radicalement les capacités de manipulation tabulaire, la fonction RECHERCHEX (identifiée comme XLOOKUP dans les environnements internationaux) représente l’aboutissement méthodologique de quatre décennies d’évolution algorithmique. Conçue pour remplacer définitivement à la fois RECHERCHEV et l’assemblage INDEX/EQUIV, RECHERCHEX élimine d’emblée l’intégralité des limitations structurelles historiques grâce à une architecture orthogonale native.
La syntaxe canonique de base de RECHERCHEX s’articule autour de vecteurs disjoints : =RECHERCHEX(valeur_cherchée, tableau_recherche, tableau_renvoyé, [si_non_trouvé], [mode_recherche], [mode_correspondance]). Pour comparer deux listes, l’expression prend une allure d’une remarquable simplicité : =RECHERCHEX(A2, $C$2:$C$9, $C$2:$C$9, "ABSENT"). Cette formulation présente deux innovations majeures : d’une part, la correspondance exacte est désormais le comportement par défaut de la fonction, rendant obsolète l’injection manuelle de l’argument FAUX ; d’autre part, la gestion native des éléments non appariés via le quatrième argument si_non_trouvé supprime purement et simplement le besoin d’encapsuler la recherche au sein des fonctions ESTNA ou SIERREUR.
En outre, RECHERCHEX s’affranchit totalement de l’orientation spatiale. Elle est capable d’interroger indifféremment des colonnes situées à droite ou à gauche de la clé de référence, autorisant des comparaisons vectorielles horizontales ou inversées sans la moindre reconfiguration de la grille. Elle propose également des modes de parcours sophistiqués, tels que la recherche inversée du bas vers le haut pour extraire la dernière occurrence chronologique d’un événement. Pour toute organisation opérant sur des versions contemporaines d’Excel (Microsoft 365, Office 2021 et versions ultérieures), la migration systématique de RECHERCHEV vers RECHERCHEX constitue le standard d’ingénierie préconisé.
9.3 9.3 Exploitation des fonctions matricielles dynamiques (FILTRE, UNIQUE)
L’introduction du moteur de calcul matriciel dynamique à propagation automatique (« Dynamic Array Engine ») a bouleversé la gestion des flux de conciliation. Traditionnellement, l’analyste était contraint d’étirer une formule cellule par cellule sur toute la longueur de sa cohorte pour réaliser un audit comparatif. Désormais, l’utilisation conjointe des nouvelles primitives matricielles dynamiques telles que FILTRE (FILTER) et UNIQUE permet d’isoler l’intégralité des éléments discordants en une formule unitaire saisie dans une cellule unique, la réponse se déversant dynamiquement vers le bas.
Pour extraire instantanément la liste pure des éléments exclusifs de la cohorte source A n’apparaissant nulle part dans la référence C, une formule matricielle moderne s’exprime ainsi : =FILTRE(A2:A9; ESTNA(RECHERCHEV(A2:A9; C2:C9; 1; FAUX))). Dans cette mécanique révolutionnaire, l’argument valeur_cherchée n’est plus une référence scalaire scalaire unitaire A2, mais l’ensemble du vecteur A2:A9. Le moteur calcule l’ensemble des exclusions en mémoire tampon et projette sur la feuille uniquement les enregistrements non appariés, générant automatiquement un rapport d’audit exhaustif sans intervention humaine supplémentaire.
Toutefois, une vigilance aiguë s’impose quant à la compatibilité descendante au sein des parcs applicatifs d’entreprise. Si un classeur articulé autour de fonctions matricielles dynamiques (comme FILTRE) est ouvert sur une version patrimoniale d’Excel (telle que les éditions 2013 ou 2016), le moteur de calcul historique se révèle incapable de matérialiser les plages propagées, encapsulant les formules dans des accolades de compatibilité matricielle d’ancienne génération et renvoyant fréquemment l’erreur #NOM?. Dès lors que l’interopérabilité avec des filiales ou des prestataires équipés de versions historiques est exigée, la vénérable combinaison =ESTNA(RECHERCHEV(...)) conserve une utilité universelle incontournable.
10. 10. Approches quantitatives alternatives : L’usage de NB.SI pour la comparaison
10.1 10.1 Mécanisme algorithmique de NB.SI (COUNTIF) pour la détection
Au sein de l’arsenal classique des formules tabulaires, la fonction NB.SI (identifiée par le label international COUNTIF) propose une alternative élégante et éminemment populaire pour comparer deux listes. Cette méthode repose sur une translation méthodologique du problème : au lieu de tenter de récupérer la valeur associée à une clé d’identification pour vérifier son existence, l’analyste transforme le problème d’appariement qualitatif en un calcul de fréquence statistique univariée au sein de la population cible.
La syntaxe de la formule de détection d’absence s’énonce ainsi : =NB.SI($C$2:$C$9; A2)=0. Dans cette formulation, le premier argument spécifie la plage de scrutation absolue représentant la liste de référence, tandis que le second argument héberge le critère scalaire représenté par la clé analysée. Le moteur de calcul dénombre combien de fois la valeur A2 se manifeste physiquement dans la matrice $C$2:$C$9. En adjoignant l’opérateur de comparaison relationnelle =0, l’analyste formule un test logique limpide : si le décompte est strictement nul, la formule renvoie le booléen VRAI, signifiant l’absence totale de l’élément dans la référence opposée ($A setminus B$).
Cette approche quantitative présente l’avantage pédagogique de s’affranchir totalement de la manipulation des codes d’erreurs. Contrairement à RECHERCHEV qui exige l’usage d’une fonction tampon comme ESTNA pour neutraliser l’arrêt d’exécution sur #N/A, NB.SI génère nativement un scalaire numérique entier continu compris entre zéro et l’infini. Il en résulte des expressions syntaxiques plus compactes, hautement intuitives pour les collaborateurs néophytes, et se prêtant avec une souplesse remarquable à l’intégration directe dans les moteurs de mise en forme conditionnelle.
10.2 10.2 Comparaison de charge computationnelle : RECHERCHEV versus NB.SI
Toutefois, l’élégance syntaxique de NB.SI masque une asymétrie de performance majeure dès lors que l’analyse est déployée sur des volumétries industrielles excédant plusieurs dizaines de milliers de lignes. Sur le plan de la théorie de la complexité computationnelle, RECHERCHEV et NB.SI obéissent à des algorithmes de parcours fondamentalement divergents qui impactent directement le temps d’exécution processeur en notation grand O ($O(N)$).
La fonction RECHERCHEV opérant avec l’argument FAUX exécute une recherche séquentielle à interruption anticipée (« short-circuit evaluation »). L’algorithme balaie la colonne de référence de haut en bas et interrompt immédiatement son itération dès lors qu’il valide la première correspondance exacte rencontrée. Si l’élément cible réside au sommet de la table, le coût computationnel est unitaire ($O(1)$). En moyenne empirique, pour une population uniformément répartie, RECHERCHEV explore seulement la moitié de l’espace matriciel avant de converger vers un résultat positif.
À l’opposé, la fonction NB.SI est structurellement tenue de garantir un comptage exhaustif absolu. Par définition, elle ne peut en aucun cas interrompre sa trajectoire de balayage à la première occurrence trouvée, car son mandat algorithmique consiste à recenser la totalité des occurrences potentielles réparties sur l’ensemble de la plage. En conséquence, pour chaque cellule évaluée, NB.SI parcourt systématiquement et inconditionnellement l’intégralité des cellules de la table cible ($O(N)$). Sur une cohorte de 50 000 enregistrements confrontée à une base de 50 000 références, l’usage de NB.SI force l’exécution de 2,5 milliards d’opérations d’égalité scalaire, provoquant un gel massif du processeur là où RECHERCHEV traite l’opération en une fraction de ce temps.
10.3 10.3 Formulation par NB.SI.ENS (COUNTIFS) pour comparaisons multicritères
Malgré sa gourmandise en ressources computationnelles, la famille des fonctions de comptage conditionnel dispose d’un avantage décisif sur la fonction RECHERCHEV historique : sa capacité intrinsèque à appréhender des comparaisons multicritères sans restructuration des données sources. Lorsque la réconciliation d’intégrité ne dépend pas d’un identifiant unitaire simple mais d’une clé composite distribuée sur plusieurs attributs — par exemple le rapprochement simultané du Nom, du Prénom et de la Date de Naissance d’un collaborateur —, RECHERCHEV se révèle totalement impuissante sans l’adjonction de colonnes intermédiaires de concaténation artificielle.
La fonction NB.SI.ENS (COUNTIFS) transcende cette limite en autorisant la juxtaposition de couples de conditions vectorielles. La syntaxe d’exclusion multicritère se déploie alors avec une fluidité remarquable : =NB.SI.ENS($D$2:$D$100; A2; $E$2:$E$100; B2)=0. Dans cette formule, le système valide simultanément que la valeur A2 réside dans la colonne D et que, sur la même ligne géométrique, la valeur B2 corresponde à l’entrée de la colonne E. L’obtention d’un total cumulé égal à zéro atteste l’absence formelle de la combinaison des deux critères dans la base d’audit.
Cette faculté d’interrogation multidimensionnelle native fait de NB.SI.ENS un outil irremplaçable pour l’analyste confronté à des référentiels complexes dépourvus de clé primaire technique d’unicité (telle qu’un numéro d’identifiant universel unique ou UUID). Elle épargne la pollution esthétique et structurelle inhérente à la création de colonnes de fusion artificielles (=A2&"|"&B2), tout en conservant une lisibilité logique absolue au sein des moteurs de mise en forme conditionnelle gérant des architectures de contrôle à critères croisés.
11. 11. Scalabilité et industrialisation : Tableaux structurés et optimisation
11.1 11.1 Migration vers les Tableaux structurés Excel (ListObject)
L’une des évolutions architecturales majeures introduites dans l’environnement Excel moderne réside dans le concept de Tableaux structurés, techniquement désignés sous la nomenclature d’interface objet ListObject. Abandonner la gestion des données sur des plages cartésiennes standards au profit de tableaux structurés constitue un prérequis impératif à toute démarche d’industrialisation et d’automatisation fiable des procédures de réconciliation inter-listes.
La conversion d’une plage classique en tableau structuré s’opère par le raccourci système Ctrl + L (ou Ctrl + T) ou via le ruban Accueil > Mettre sous forme de tableau. Cette mutation altère en profondeur le paradigme de référencement cartésien : les coordonnées absolues et statiques de type $C$2:$C$9 sont instantanément remplacées par des références structurées explicites et dynamiques. L’expression algorithmique de comparaison acquiert alors une transparence sémantique proche du langage naturel : =ESTNA(RECHERCHEV([@Identifiant]; TableRef[Identifiant]; 1; FAUX)).
L’intérêt fondamental de cette architecture réside dans l’extensibilité dynamique automatique des domaines d’audit. Dès lors qu’un opérateur incorpore de nouveaux enregistrements au bas de la table TableRef, la dimension spatiale de la matrice s’ajuste instantanément en mémoire sans nécessiter la moindre retouche manuelle des formules existantes. Réciproquement, toute formule introduite sur une ligne d’une colonne calculée est immédiatement propagée sur toute la hauteur de la colonne structurée, éradiquant les risques majeurs de dérive vectorielle ou d’oubli de recopie incrémentale propres aux feuilles de calcul patrimoniales non structurées.
11.2 11.2 Optimisation des temps de réponse sur les classeurs massifs
Lorsque les volumes d’enregistrements franchissent des échelles critiques (dépassant 100 000 lignes), l’utilisation non régulée de formules volatiles et de règles de mise en forme conditionnelle peut dégrader drastiquement la réactivité du classeur, provoquant des temps de calcul insoutenables. La mise en forme conditionnelle est particulièrement énergivore : le gestionnaire graphique évalue en continu les expressions logiques dès que l’utilisateur fait défiler l’écran ou modifie une cellule quelconque dans l’espace de travail actif, surchargeant inutilement le processeur graphique et l’interpréteur de code.
Pour optimiser la performance sans sacrifier la rigueur de l’audit sur des volumétries massives, l’ingénierie tabulaire préconise de bannir la mise en forme conditionnelle par formule sur l’intégralité de la base de données. Il est infiniment plus performant de déporter le calcul logique dans une colonne auxiliaire dédiée hébergée au sein d’un tableau structuré, puis d’appliquer une règle de mise en forme conditionnelle ultra-légère basée sur la simple valeur de cellule (par exemple colorer la cellule si sa valeur textuelle est strictement égale à "Absent"). Cette séparation stricte entre le moteur de calcul et le moteur de rendu visuel accélère l’affichage d’un facteur exponentiel.
Une autre technique d’optimisation avancée réside dans l’usage du double RECHERCHEV approximatif ultra-rapide en lieu et place du RECHERCHEV exact, à condition impérative que la liste de référence soit préalablement triée par ordre alphanumérique strict. La formulation prend alors la configuration : =SI(RECHERCHEV(A2; $C$2:$C$100000; 1; VRAI)=A2; "Présent"; "Absent"). Puisque la recherche approximative s’appuie sur un algorithme de recherche dichotomique par partition binaire ($O(log N)$) plutôt que sur un balayage linéaire séquentiel ($O(N)$), le traitement de 100 000 lignes s’effectue en quelques millisecondes au lieu de plusieurs dizaines de secondes, offrant un gain de performance spectaculaire sur les machines de travail de bureau.
11.3 11.3 Transition vers Power Query pour les réconciliations massives
En dépit de leur puissance, les formules natives de feuilles de calcul atteignent un plafond d’efficacité structurel dès lors que l’analyste doit réconcilier des référentiels multi-sources hétérogènes dépassant plusieurs millions d’enregistrements ou issus de formats disparates (bases SQL, fichiers plats CSV, flux d’API web). Dans ce cadre industriel, la tentative de résoudre la comparaison par des fonctions de cellules telles que RECHERCHEV devient contre-productive. L’analyste se doit d’opérer une transition méthodologique vers le moteur d’intégration relationnelle sous-jacent d’Excel : Power Query.
Power Query déporte l’intégralité de la logique de transformation et d’audit hors de l’espace d’affichage de la grille de calcul, au sein d’un moteur de traitement vectoriel en mémoire (le langage M). Pour opérer la réconciliation entre deux listes au sein de Power Query, l’analyste importe les deux cohortes sous forme de requêtes de connexion, puis exécute une opération de Fusion de requêtes. L’interface propose alors nativement l’intégralité des jointures de la théorie ensembliste relationnelle :
- Jointure anti-gauche (Left Anti-Join) : isole instantanément l’intégralité des lignes de la première table qui ne possèdent aucune contrepartie dans la seconde table ($A setminus B$).
- Jointure anti-droite (Right Anti-Join) : extrait rigoureusement les enregistrements exclusifs de la seconde table non répertoriés dans la source initiale ($B setminus A$).
- Jointure interne (Inner Join) : matérialise l’intersection parfaite des éléments strictement communs ($A cap B$).
- Jointure externe totale (Full Outer Join) : consolide la totalité des enregistrements en documentant les absences relatives de part et d’autre.
Le déploiement de réconciliations sous Power Query offre une robustesse inégalée : le pipeline de nettoyage (suppression des espaces insécables, uniformisation de la casse, typage strict des colonnes) est entièrement encapsulé au sein d’étapes de transformation immuables et auditables. L’actualisation d’une telle conciliation ne requiert plus aucune manipulation de formules : un simple clic sur le bouton Actualiser tout réexécute l’intégralité du pipeline d’audit en arrière-plan, garantissant une pérennité absolue des processus de contrôle interne au sein de l’entreprise.
12. 12. Synthèse méthodologique et recommandations opérationnelles pour l’analyste
12.1 12.1 Arbre de décision pour le choix de la méthode d’appariement
Pour naviguer avec clairvoyance parmi les différentes approches méthodologiques présentées au long de ce traité, l’analyste de données doit disposer d’un arbre de décision rationnel guidant le choix de l’outil en fonction des contraintes de son écosystème opérationnel. Ce choix s’articule autour de trois variables clés : la version du tableur déployée sur le parc utilisateur, la volumétrie absolue des données à auditer, et la complexité structurale de la clé de comparaison.
Lorsque l’audit porte sur des jeux de données d’envergure faible à modérée (inférieure à 10 000 enregistrements) et que l’objectif est une mise en évidence visuelle immédiate pour un usage ponctuel, le déploiement de la règle de mise en forme conditionnelle =ESTNA(RECHERCHEV(A2, $C$2:$C$9, 1, FAUX)) demeure la solution la plus rapide et la plus universellement reconnue. Si la comparaison repose sur des critères composites multiples (nom et prénom disjoints), l’arbitrage bascule immédiatement vers la fonction NB.SI.ENS(...) = 0 pour contourner la rigidité univariée de RECHERCHEV sans déformer les tables d’origine.
Dès lors que l’analyste évolue sur un environnement moderne Microsoft 365, la fonction RECHERCHEV doit s’effacer au profit de RECHERCHEX ou des expressions de filtrage dynamique =FILTRE(...), qui éliminent structurellement les risques de mauvaises manipulations d’arguments. Enfin, pour tout projet récurrent à vocation réglementaire, portant sur des volumétries dépassant 50 000 lignes ou exigeant la consolidation de fichiers multiples, l’arbitrage doit être unilatéral : la construction d’un pipeline d’ingestion sous Power Query avec jointure anti-gauche représente le seul standard garantissant intégrité, scalabilité et auditabilité professionnelle.
12.2 12.2 Protocole de contrôle qualité et documentation des audits
L’élaboration d’un modèle tabulaire de comparaison destiné à être partagé avec des tiers ou audité par des régulateurs financiers exige un niveau de documentation irréprochable. L’analyste doit formellement consigner la règle algorithmique sous-jacente au sein du classeur. Cette formalisation s’accomplit par l’adjonction systématique d’un onglet de documentation (« Readme / Piste d’Audit ») explicitant le périmètre des jeux de données comparés, la date d’extraction des référentiels, la sémantique attribuée aux codes couleurs de la mise en forme conditionnelle, et la justification du choix des fonctions mobilisées.
En complément de la documentation descriptive, l’intégration de totaux de contrôle mathématiques (« Check-totals ») au sommet de la feuille constitue le rempart ultime contre les corruptions silencieuses de calcul. L’analyste mettra en place une cellule de contrôle validant l’équation ensembliste fondamentale : le nombre d’éléments total de la liste source doit être rigoureusement égal à la somme arithmétique des concordances identifiées et des exclusions détectées. Toute divergence constatée entre ces deux agrégats numériques (généralement matérialisée par une cellule d’alerte rouge affichant un écart non nul) signale instantanément une anomalie de bornage matriciel, une présence imprévue de doublons parasitaires ou une rupture dans le graphe de dépendance des formules.
Enfin, la gouvernance des données impose une politique d’archivage systématique des états sources bruts. Les colonnes A et C ayant servi à la comparaison doivent être gelées en valeur ou sauvegardées dans un répertoire sécurisé en lecture seule préalablement à toute manœuvre de remédiation opérationnelle. Cette précaution garantit qu’en cas de contestation ultérieure par les parties prenantes, l’analyste sera en mesure de rejouer le protocole algorithmique à l’identique et de démontrer mathématiquement la légitimité des discordances identifiées.
12.3 12.3 Synthèse des écueils critiques à éviter impérativement
En guise de clôture méthodologique, il est capital de réitérer la liste des trois écueils mortels qui guettent l’opérateur non averti lors de la manipulation de la fonction RECHERCHEV à des fins de comparaison :
- L’omission catastrophique de l’argument
FAUX: L’omission du quatrième paramètre de RECHERCHEV force par défaut le passage en mode de correspondance approximative. Sur une base non triée, ce comportement erratique conduit le moteur à apparier des valeurs disparates au prétexte qu’elles partagent des similitudes séquentielles, générant une quantité dramatique de faux positifs qui masqueront des disparités critiques. - Le défaut d’ancrage absolu des plages cibles : Négliger le verrouillage de la
table_matricepar des délimiteurs cartésiens$provoque une translation mécanique du périmètre d’observation lors de la recopie incrémentale, tronquant les données et induisant des diagnostics de non-concordance fallacieux sur la partie inférieure des fichiers audités. - L’illusion de concordance par conformité visuelle superficielle : Se fier aveuglément à l’apparence des chaînes affichées à l’écran sans auditer la pureté textuelle sous-jacente (espaces insécables
ASCII 160, retours à la ligne résiduels, typage masqué texte/nombre) conduit irrémédiablement à l’échec des algorithmes d’égalité binaire et vicie l’ensemble du diagnostic décisionnel.
En intégrant ces principes d’hygiène numérique, en maîtrisant les subtilités de la composition logique =ESTNA(RECHERCHEV(...)), et en sachant discerner le moment idoine pour migrer vers les architectures relationnelles modernes, l’analyste transforme un simple tableur bureautique en un véritable instrument de précision scientifique, assurant une fiabilité absolue lors de ses audits d’intégrité de données.
Références
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
- Frye, C. (2021). Microsoft Excel Step by Step (Office 2021 and Microsoft 365). Microsoft Press.
- Microsoft Support. (2023). Fonction RECHERCHEV. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fonction-recherchev-0bbc80c8-26fe-4963-8ab8-93a18ad188a1
- Microsoft Support. (2023). Fonction RECHERCHEX. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fonction-recherchex-b7fd680e-6d10-43e6-84f9-88eae8bf5929
- Microsoft Support. (2023). Utiliser la mise en forme conditionnelle pour mettre en surbrillance des informations. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/utiliser-la-mise-en-forme-conditionnelle-pour-mettre-en-surbrillance-des-informations-fed60dfa-1d3f-4e13-9ecb-f1951ff89d7f
- Simons, D. J., & Chabris, C. F. (1999). Gorillas in our midst: Sustained inattentional blindness for dynamic events. Perception, 28(9), 1059-1074. https://doi.org/10.1068/p281059
- Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (Office 2021 and Microsoft 365) (7th ed.). Microsoft Press.