
Dans le paysage contemporain des systèmes d’information d’entreprise, le tableur électronique demeure paradoxalement l’outil d’analyse décisionnelle le plus ubiquitaire et le plus vulnérable. Bien que les architectures modernes privilégient les entrepôts de données gouvernés et les solutions d’intelligence d’affaires intégrées, Microsoft Excel conserve un rôle prépondérant dans l’agrégation ad hoc, la consolidation financière, l’analyse actuarielle et le reporting opérationnel. Cette omniprésence engendre une prolifération exponentielle de versions divergentes d’un même jeu de données matriciel, souvent dispersées au gré d’échanges de courriels asynchrones, de processus manuels d’extraction-chargement ou de modifications collaboratives non orchestrées. L’identification exhaustive et rigoureuse des écarts entre deux feuilles de calcul n’est donc pas un simple artefact de confort bureautique, mais un impératif méthodologique sous-tendant la fiabilité décisionnelle et la conformité réglementaire.
L’analyse différentielle de deux états d’une grille de données met en jeu des notions fondamentales d’intégrité référentielle, de typologie des données et de logique booléenne. Lorsqu’un analyste est confronté à deux volumétries tabulaires prétendant décrire la même réalité économique ou scientifique à des instants distincts, ou issues de canaux d’ingestion concurrents, l’examen visuel non instrumenté relève d’une négligence heuristique majeure. Les erreurs d’inattention, la cécité au changement et la complexité inhérente aux structures matricielles bidimensionnelles rendent indispensable le recours à des protocoles comparatifs déterministes. Ces démarches visent à convertir une confrontation empirique sujette aux biais cognitifs en un audit logique, reproductible et documenté, capable d’isoler les micro-variations scalaires comme les bouleversements structurels globaux.
Face à la diversité des scénarios d’incohérence — allant de la modification subreptice d’une décimale de taux d’actualisation à la permutation désastreuse d’un bloc de lignes ordonnées —, l’écosystème d’Excel offre un éventail de méthodologies aux degrés de sophistication variables. De la modélisation de masques matriciels soustractifs aux jointures relationnelles avancées sous Power Query, en passant par l’automatisation impérative via Visual Basic for Applications (VBA) et les compléments d’inspection architecturale, chaque approche répond à des contraintes dimensionnelles et organisationnelles spécifiques. Le présent traité a pour vocation d’exposer de façon systématique, scientifique et exhaustive l’ensemble des concepts, des formulations mathématiques et des architectures logiques nécessaires à la détection, la qualification et la réconciliation des divergences entre feuilles de calcul Excel.
1. 1. Cadre conceptuel et enjeux de l’analyse différentielle dans les tableurs
1.1 1.1 Fondements de l’intégrité des données tabulaires
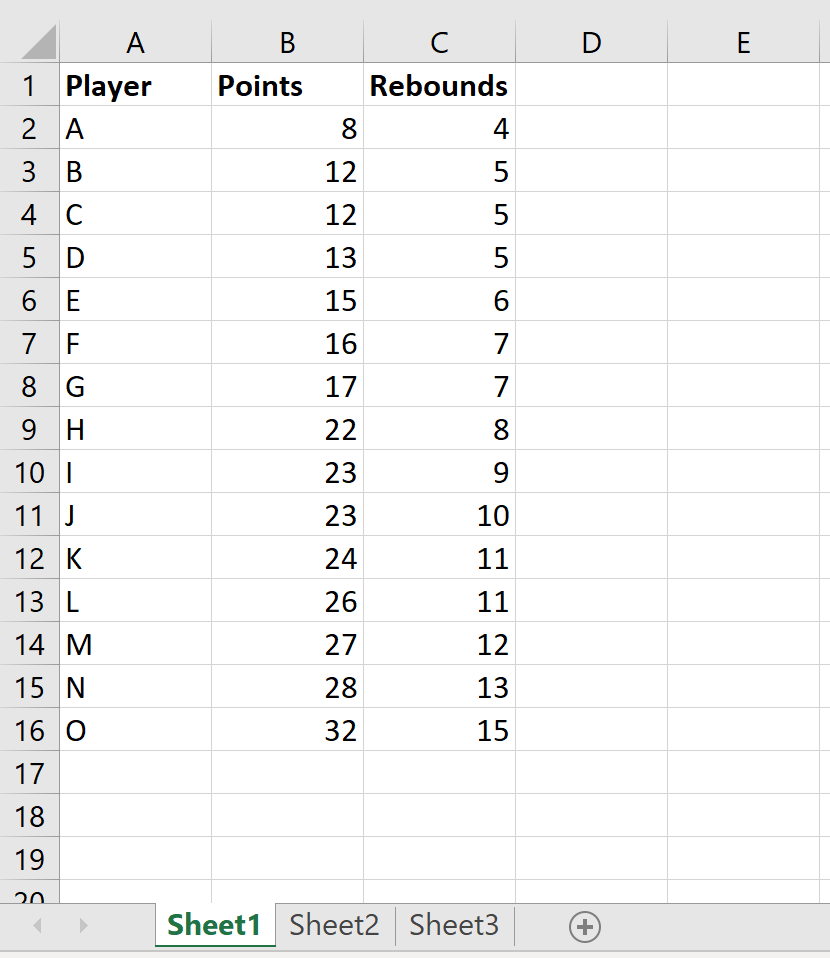
L’intégrité des données au sein d’une structure matricielle repose sur le postulat d’une concordance absolue entre la modélisation abstraite de l’information et son instanciation scalaire dans chaque cellule du tableur. Une feuille de calcul se définit formellement comme un espace euclidien discret à deux dimensions, au sein duquel chaque nœud d’intersection, ou cellule, héberge une valeur typée, une formule ou un état nul. La fidélité des enregistrements matriciels exige que deux états temporels successifs ou deux flux parallèles préservent non seulement l’identité des valeurs atomiques, mais également les relations fonctionnelles et contextuelles unissant ces éléments. Dès lors qu’un décalage émerge entre l’état attendu et l’état observé, la validité déterministe de l’ensemble du modèle se trouve compromise, transformant le tableur en une source d’incertitude systémique pour les organisations.
Les processus d’extraction, de transformation et de chargement (ETL), ainsi que les saisies manuelles non supervisées, génèrent une typologie diversifiée d’anomalies. On distingue classiquement les corruptions par troncature, résultant de limitations de formats de transfert tels que les fichiers CSV mal encodés, les anomalies de conversion d’unités ou de devises, et les altérations induites par des algorithmes d’auto-complétion agressifs. La saisie humaine introduit quant à elle des erreurs de frappe stochastiques, des permutations de chiffres consécutifs — une défaillance cognitive documentée en ergonomie cognitive —, ainsi que des écrasements accidentels de formules dynamiques par des constantes statiques. Ces dégradations imperceptibles altèrent insidieusement la cohérence interne du document sans nécessairement déclencher d’erreurs d’exécution apparentes dans le moteur de calcul.
Les répercussions décisionnelles d’une telle altération silencieuse s’avèrent considérables dans les secteurs assujettis à une stricte gouvernance, à l’instar de l’analyse financière, de la modélisation épidémiologique ou de l’ingénierie des structures. Une divergence infime logée au sein d’un paramètre d’amortissement ou d’une probabilité de défaillance peut, par percolation algorithmique dans un réseau complexe de formules interdépendantes, modifier substantiellement la valeur actuelle nette d’un portefeuille d’investissements ou invalider le dimensionnement d’un ouvrage d’art. Sur le plan heuristique, les décideurs fondent leur confiance sur l’autorité visuelle apparente de la feuille de calcul, postulant à tort que l’alignement des colonnes et la précision des décimales attestent de la vérité des propositions chiffrées. Dès lors, l’absence de vérification formelle institutionnalise le risque de modèle et expose l’entité à des sanctions d’audit ou à des pertes en capital majeures.
Il apparaît ainsi impératif d’adopter un protocole rigoureux de vérification croisée préalablement à toute décision opérationnelle ou stratégique fondée sur des données modifiées. Ce protocole ne doit pas être conçu comme une opération curative intermittente, mais comme une procédure d’assurance qualité systématique, intégrée au cycle de vie de la donnée. La vérification différentielle méthodique constitue l’ultime rempart contre la dérive entropique des modèles numériques décentralisés, garantissant que chaque mise à jour reflète exclusivement des mutations légitimes du phénomène modélisé et non des artefacts techniques parasites.
1.2 1.2 Typologie des divergences entre classeurs et feuilles
La caractérisation précise de la nature des discordances s’avère indispensable pour sélectionner la technologie comparative optimale. La première classe regroupe les divergences scalaires simples, caractérisées par une altération de la valeur brute hébergée dans une cellule dont l’adresse spatiale demeure strictement constante d’une version à l’autre. Il s’agit typiquement de la substitution d’une chaîne alphabétique par une autre, de la révision d’un coefficient quantitatif ou de la modification d’un booléen d’activation logique. Bien que conceptuellement élémentaires, ces discordances scalaires peuvent présenter des subtilités pernicieuses, notamment lorsque le type de données sous-jacent est converti à l’insu de l’observateur, par exemple lorsqu’un entier monétaire est transformé en chaîne textuelle visuellement identique mais algorithmiquement inerte face aux fonctions d’agrégation arithmétique.
La seconde catégorie englobe les disparités d’ordonnancement, de pagination et les permutations de lignes ou d’enregistrements. Dans cette configuration, les données intrinsèques demeurent rigoureusement identiques au niveau de l’entité transactionnelle, mais leur distribution séquentielle le long de l’axe vertical ou horizontal se trouve modifiée par une opération de tri intempestive, un filtrage asymétrique ou une insertion intercalaire désynchronisée. Une comparaison cellule à cellule naïve, appliquée à des matrices ayant subi une permutation de cette nature, diagnostique à tort une corruption totale de l’espace tabulaire, confondant une simple réorganisation topologique avec une destruction généralisée des valeurs réelles. Cette vulnérabilité illustre l’insuffisance des approches purement géométriques face aux données relationnelles.
Les écarts structurels constituent la troisième classe d’hétérogénéités, matérialisés par des asymétries dimensionnelles globales entre les deux référentiels. L’adjonction ou la suppression arbitraire de colonnes d’attributs, la scission de tables contiguës ou la fusion graphique de blocs de cellules induisent des ruptures de continuité référentielle. Les cellules fusionnées s’avèrent particulièrement destructrices pour l’intégrité différentielle, dans la mesure où le modèle sous-jacent d’Excel attribue la valeur consolidée à la cellule supérieure gauche tout en assignant des valeurs vides aux cellules adjacentes couvertes par la fusion visuelle. Ces déformations architecturales empêchent toute comparaison directe sans une phase préalable de réalignement et de normalisation topologique de l’espace de données.
Enfin, la quatrième classe de divergences concerne les variations de métadonnées, de formats de présentation sous-jacents et d’encodages de caractères. Un nombre réel peut afficher une conformité apparente entre deux feuilles tout en dissimulant un écart de précision machine lié au stockage binaire ou au format d’arrondi à l’affichage. De surcroît, les disparités d’encodage textuel — telles que les divergences entre UTF-8, ANSI ou Windows-1252 — génèrent des altérations cryptiques des caractères diacritiques et des symboles typographiques spéciaux. De telles discordances, souvent imperceptibles à l’œil nu lors d’un examen superficiel de la grille, compromettent radicalement l’efficacité des opérateurs de comparaison exacte et brisent l’interopérabilité computationnelle des modèles.
1.3 1.3 Démarche préparatoire et normalisation des jeux de données
Avant d’engager toute confrontation différentielle instrumentée, il est indispensable de soumettre les deux ensembles de données à une phase systématique de normalisation et d’hygiène numérique. La disparité des types de variables constitue l’obstacle préliminaire le plus fréquent : des valeurs numériques formatées comme texte dans l’un des jeux doivent être coercitivement unifiées avec les valeurs numériques réelles de l’autre sous peine d’invalider les tests d’égalité logique. Parallèlement, l’éradication des espaces parasites — qu’il s’agisse d’espaces typographiques de début ou de fin de chaîne, ou d’espaces insécables (code ASCII 160) fréquemment générés par les extracteurs web et les exports ERP — conditionne la réussite de toute opération d’appariement textuel déterministe.
L’établissement ou la désignation formelle d’une clé primaire invariable s’impose comme la pierre angulaire de l’architecture préparatoire. Lorsque les structures tabulaires sont susceptibles d’avoir fait l’objet de tris distincts ou d’insertions asynchrones, la position spatiale géométrique (numéro de ligne et de colonne) ne peut plus être mobilisée comme référentiel d’appariement fiable. L’analyste doit identifier ou fabriquer un vecteur d’indexation composite unique — composé par exemple de la concaténation standardisée d’un code d’identification d’entité, d’une date transactionnelle et d’une référence de produit — permettant de lier de manière univoque chaque enregistrement de la première feuille à son homologue exact dans la seconde, indépendamment de leurs localisations physiques respectives dans la matrice.
La gestion rigoureuse de la casse et des conventions typographiques participe de cette même exigence méthodologique. Si la langue humaine tolère des variations orthographiques mineures et considère l’égalité fondamentale entre majuscules et minuscules, les algorithmes de validation logique réagissent différemment selon la formulation des requêtes. Il convient d’arbitrer explicitement dès l’entame du projet si les distinctions typographiques doivent être qualifiées de divergences substantielles ou de simples artefacts de saisie sans incidence conceptuelle, et d’appliquer le cas échéant des filtres d’harmonisation de casse systématiques sur l’intégralité du corpus d’analyse.
Enfin, le protocole méthodologique prescrit de manière impérative l’établissement d’une sauvegarde immuable des deux sources d’information primitives avant toute instanciation comparative. L’acte de comparaison, en particulier lorsqu’il implique l’exécution de formules complexes ou de scripts d’automatisation sur site, comporte le risque latent d’altérer par mégarde les classeurs soumis à examen. La duplication des classeurs dans un répertoire protégé en écriture, complétée par le calcul optionnel d’une empreinte cryptographique (hachage SHA-256) pour attester de leur intégrité avant manipulation, garantit la traçabilité de l’audit et confère à la démarche différentielle une robustesse juridiquement opposable.
2. 2. Méthodologie d’extraction comparative par feuille matricielle dédiée
2.1 2.1 Architecture logique de la feuille de diagnostic tierce
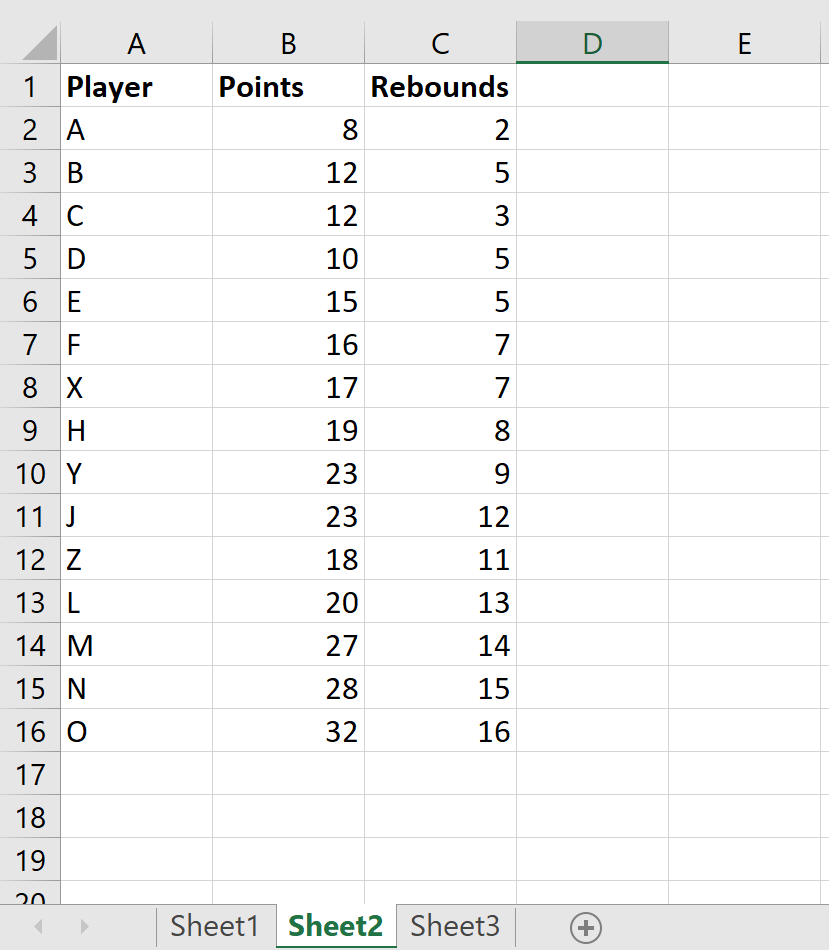
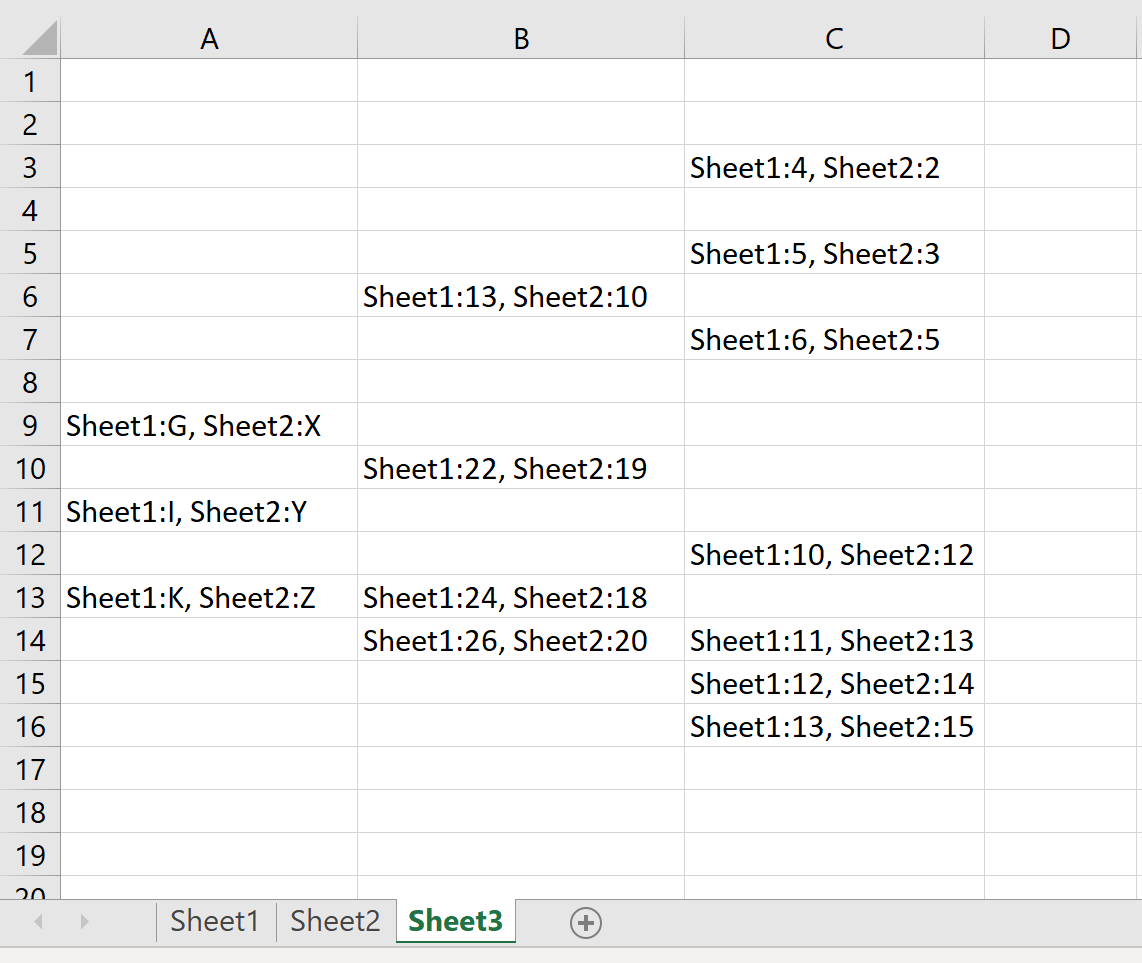
La méthodologie dite de la feuille de diagnostic tierce repose sur le principe fondamental de l’isomorphisme spatial. Elle consiste à instancier, au sein du classeur hôte ou dans un document d’audit séparé, un onglet dédié dont la topographie reproduit scrupuleusement la géométrie matricielle des feuilles soumises à examen. Si les feuilles primaires et secondaires s’étendent de la cellule A1 à la cellule Z500, la feuille de diagnostic exploitera rigoureusement la même étendue de coordonnées cartésiennes. À chaque cellule de coordonnées $(x, y)$ de la feuille d’audit correspondra une équation booléenne interrogeant simultanément la cellule $(x, y)$ du premier jeu de données et la cellule $(x, y)$ du second, établissant ainsi un modèle miroir d’observation analytique.
Le principal avantage d’une telle architecture réside dans le découplage logique absolu entre la phase de diagnostic et les données de production. En s’interdisant d’insérer des formules comparatives au sein même des onglets d’origine, l’analyste préserve scrupuleusement la virginité des tables sources, écartant tout risque de corruption de structure, de décalage accidentel de références ou de rupture des chaînes de calcul existantes. Ce confinement analytique s’avère particulièrement précieux dans le contexte de modèles de grande complexité, où l’insertion d’une simple colonne d’audit briserait les plages nommées, les tableaux structurés et les références implicites des macros préexistantes.
Sur le plan cartographique, ce canevas tiers opère une transformation sémiotique de l’espace de calcul. Au lieu d’afficher la matière informationnelle hétérogène des données sources, la feuille d’audit projette une carte binaire ou textuelle d’anomalies, matérialisant instantanément les zones de convergence et les clusters d’erreurs. Les amas de discordances sautent aux yeux de l’analyste, qu’il s’agisse d’un décalage progressif se propageant en diagonale — signalant une insertion de cellule asymétrique — ou d’une colonne entière passant au rouge, trahissant un renommage de métadonnée ou une dérive d’unité de mesure.
Toutefois, le déploiement d’une feuille matricielle miroir impose une gestion méticuleuse de l’empreinte computationnelle. Sur des volumes massifs excédant plusieurs centaines de milliers de cellules, la duplication intégrale de l’espace adressable sous forme de formules logiques peut saturer la mémoire vive allouée au moteur de calcul multithread d’Excel. Il convient dès lors de dimensionner strictement la matrice d’audit à l’aire de données réellement peuplée (la propriété UsedRange) et de privilégier des formulations arithmétiques ou logiques pures, dépourvues de fonctions volatiles susceptibles de forcer un recalcul permanent à chaque interaction utilisateur.
2.2 2.2 Implémentation de la fonction conditionnelle discriminante
L’implémentation opérationnelle de la feuille de diagnostic fait appel à la combinaison de la fonction logique SI et des références absolues ou relatives vers les classeurs et feuilles à confronter. Dans sa déclinaison la plus élémentaire, la formule positionnée en cellule A1 de la feuille tierce adopte une structure de test d’égalité scalaire. Si le contenu de la cellule d’origine est strictement identique au contenu de la cellule cible, le moteur renvoie une chaîne vide ou un marqueur de conformité ; dans le cas contraire, il déclenche une routine de restitution différentielle explicitant la nature de la divergence observée.
Pour conférer à la feuille de diagnostic une réelle valeur d’audit opérationnel, il est fortement déconseillé de se limiter à un simple indicateur booléen (VRAI/FAUX). L’analyste doit concevoir une formulation syntaxique informative capable d’afficher simultanément les deux états contradictoires au sein de la même cellule d’évaluation. La syntaxe canonique s’articule généralement ainsi :
=SI(Feuil1!A1=Feuil2!A1;"";Feuil1!A1 & " <> " & Feuil2!A1)
Cette expression produit un canevas épuré où l’absence totale de caractère signifie la conformité absolue, tandis que chaque cellule discordante affiche de manière transparente la valeur historique confrontée à la valeur révisée, séparées par un opérateur typographique d’inégalité explicite. Cette disposition accélère considérablement l’analyse causale en dispensant l’auditeur de constantes allées et venues visuelles entre les deux onglets de référence.
Il est par ailleurs pertinent d’anticiper le comportement des valeurs nulles et des cellules vides au sein de cette fonction discriminante. Dans l’écosystème Excel, une cellule vide comparée à une cellule contenant la valeur zéro peut être interprétée comme équivalente par l’opérateur standard d’égalité, dissimulant ainsi l’effacement accidentel d’un enregistrement critique. Pour neutraliser ce biais, la formule doit être enrichie par l’adjonction de la fonction ESTVIDE ou par la concaténation préalable d’une chaîne vide aux deux opérandes afin de forcer une évaluation textuelle stricte des présences effectives, garantissant une étanchéité analytique sans faille.
2.3 2.3 Extension bidimensionnelle et adressage relatif
La puissance du modèle de diagnostic matriciel réside dans sa capacité de propagation vectorielle et bidimensionnelle à partir d’une cellule d’amorce unique. Lors de la rédaction de la formule maîtresse en position initiale A1, l’analyste doit impérativement proscrire l’usage des ancrages absolus matérialisés par le symbole dollar ($). L’adressage relatif complet (par exemple Feuil1!A1 en lieu et place de Feuil1!$A$1) constitue le prérequis absolu permettant au mécanisme de translation référentielle d’Excel d’adapter dynamiquement les coordonnées lors de la recopie horizontale le long de l’axe des abscisses et verticale le long de l’axe des ordonnées.
La propagation s’opère méthodologiquement par l’exploitation de la poignée de recopie incrémentale ou par la commande de remplissage instantané vers le bas et vers la droite après sélection préalable du périmètre d’investigation. Cette opération géométrique projette instantanément l’algorithme de contrôle sur l’intégralité du rectangle matriciel défini par les données sources. Il convient toutefois de procéder à des sondages de contrôle aux quatre coins cardinaux de la plage nouvellement générée (A1, A_max, X_max_1, X_max_Y_max) afin de vérifier l’exactitude de l’ancrage spatial et de confirmer que les décalages d’onglets n’ont pas introduit de dérives directionnelles involontaires.
Un écueil récurrent lors de l’extension bidimensionnelle réside dans la disparité de dimensionnement des deux matrices sources. Si la feuille primaire comporte cinq cents lignes et que la feuille secondaire en compte cinq cent cinquante à la suite d’ajouts non concertés, une propagation bornée à la hauteur de la feuille la plus courte laissera cinquante lignes secondaires totalement hors du champ d’observation différentielle. L’auditeur doit par conséquent déterminer le maximum d’emprise spatiale entre les deux ensembles et étendre la feuille miroir jusqu’à cette limite supérieure absolue.
Au-delà de ces frontières, l’interrogation de cellules orphelines peut générer des erreurs d’adresses ou l’illusion d’une conformité artificielle. L’encadrement des formules par des routines de test dimensionnel prévenant l’apparition des erreurs de type #REF! garantit la pérennité structurelle de la matrice comparative. Lorsque le classeur comparé réside dans un fichier fermé externe, le maintien de liens dynamiques ouverts et la vérification des chemins UNC d’accès aux fichiers sources évitent la rupture de la chaîne d’évaluation computationnelle lors du partage ultérieur du classeur de diagnostic.
3. 3. Visualisation différentielle par mise en forme conditionnelle
3.1 3.1 Théorie sémiotique de l’alerte chromatique
La détection de l’erreur dans un environnement informationnel saturé relève intimement de la théorie de la charge cognitive et de l’ingénierie des interfaces visuelles. L’œil humain, confronté à une grille uniforme de valeurs alphanumériques monochromes, est incapable d’isoler rapidement des singularités microscopiques en raison du phénomène de cécité attentionnelle. La mise en forme conditionnelle intervient comme un amplificateur perceptif fondamental, exploitant les mécanismes de traitement pré-attentionnel du cortex visuel : la couleur, le contraste et la saturation s’imposent à la conscience de l’opérateur avant même que ce dernier n’engage l’effort cognitif de lecture et d’analyse sémantique du chiffre.
Toutefois, l’efficacité d’un tel système de signalétique d’alerte repose sur le choix rigoureux d’une palette chromatique non ambiguë. L’usage indiscriminé d’une sursaturation bariolée ou de nuances pastel indiscernables engendre une fatigue oculaire prématurée et accroît le risque d’erreur d’interprétation. Les standards d’ergonomie décisionnelle préconisent l’adoption de contrastes tranchés, en réservant les teintes chaudes et saturées (typiquement un remplissage rouge carmin léger avec une typographie rouge sombre) pour signaler la rupture formelle de parité, tandis que les concordances doivent demeurer dénuées de toute coloration afin de préserver la neutralité du fond visuel.
Il est par ailleurs envisageable d’introduire une graduation sémiotique de l’alerte conditionnelle en fonction de l’amplitude ou de la typologie des déviances observées. Dans le cadre de données quantitatives financières, un dégradé d’intensité chromatique peut être configuré pour différencier les variations non significatives, relevant de l’arrondi monétaire mineur, des écarts substantiels matérialisant des anomalies comptables critiques. Cette priorisation visuelle oriente l’attention de l’auditeur vers les foyers d’incohérence majeurs, optimisant ainsi l’allocation temporelle des ressources de vérification humaine.
Néanmoins, la sémiotique visuelle atteint ses limites intrinsèques face à des volumes massifs de discordances. Lorsqu’une modification structurelle amont engendre la divergence de 90 % des cellules d’une feuille, la saturation chromatique générale transforme la grille en un champ uniforme d’alertes indifférenciées, anéantissant l’effet de contraste pré-attentionnel recherché. L’analyste doit avoir conscience de ce point de bascule cognitif où la signalétique visuelle perd toute pertinence heuristique au profit d’outils statistiques globaux d’agrégation d’anomalies.
3.2 3.2 Formulation des règles conditionnelles d’inégalité
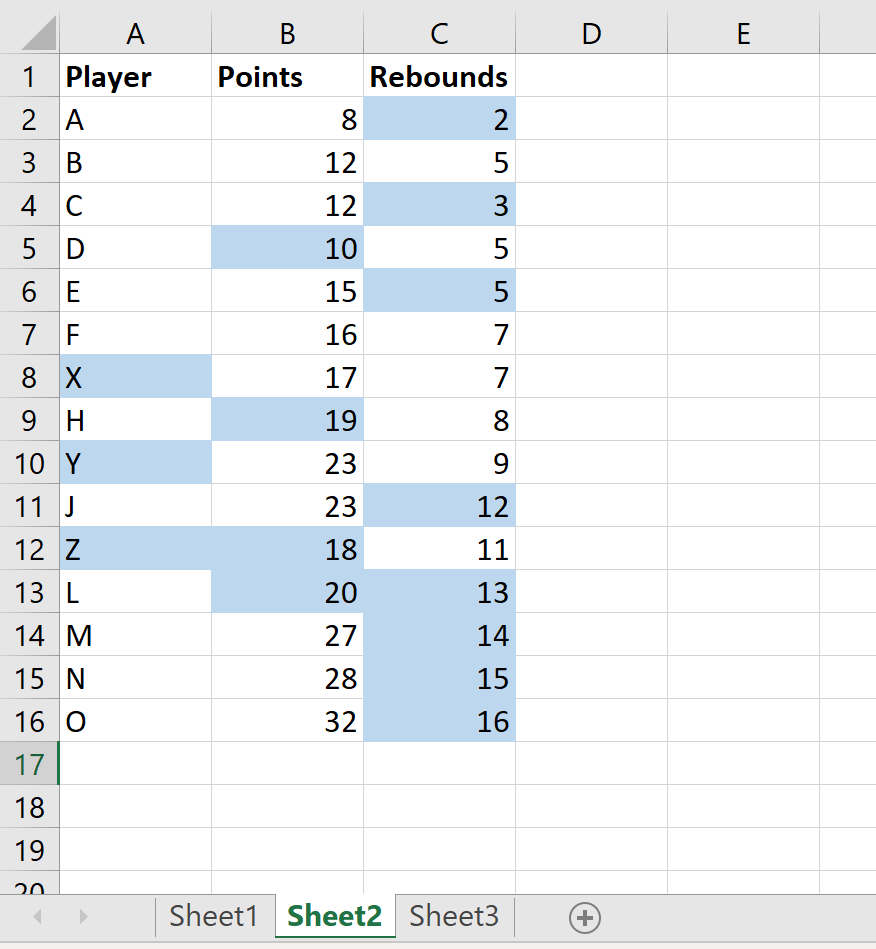
L’application d’une mise en forme conditionnelle comparative ne saurait reposer sur les modèles préprogrammés de surlignage de doublons proposés nativement dans l’interface standard d’Excel, ces derniers opérant de manière globale et aveugle au sein d’une même plage sans notion de confrontation spatiale d’un onglet à l’autre. L’analyste doit impérativement recourir à la création d’une règle personnalisée régie par une formule booléenne spécifique, capable d’évaluer dynamiquement l’état de chaque cellule active par rapport à son homologue exacte située sur la feuille concurrente.
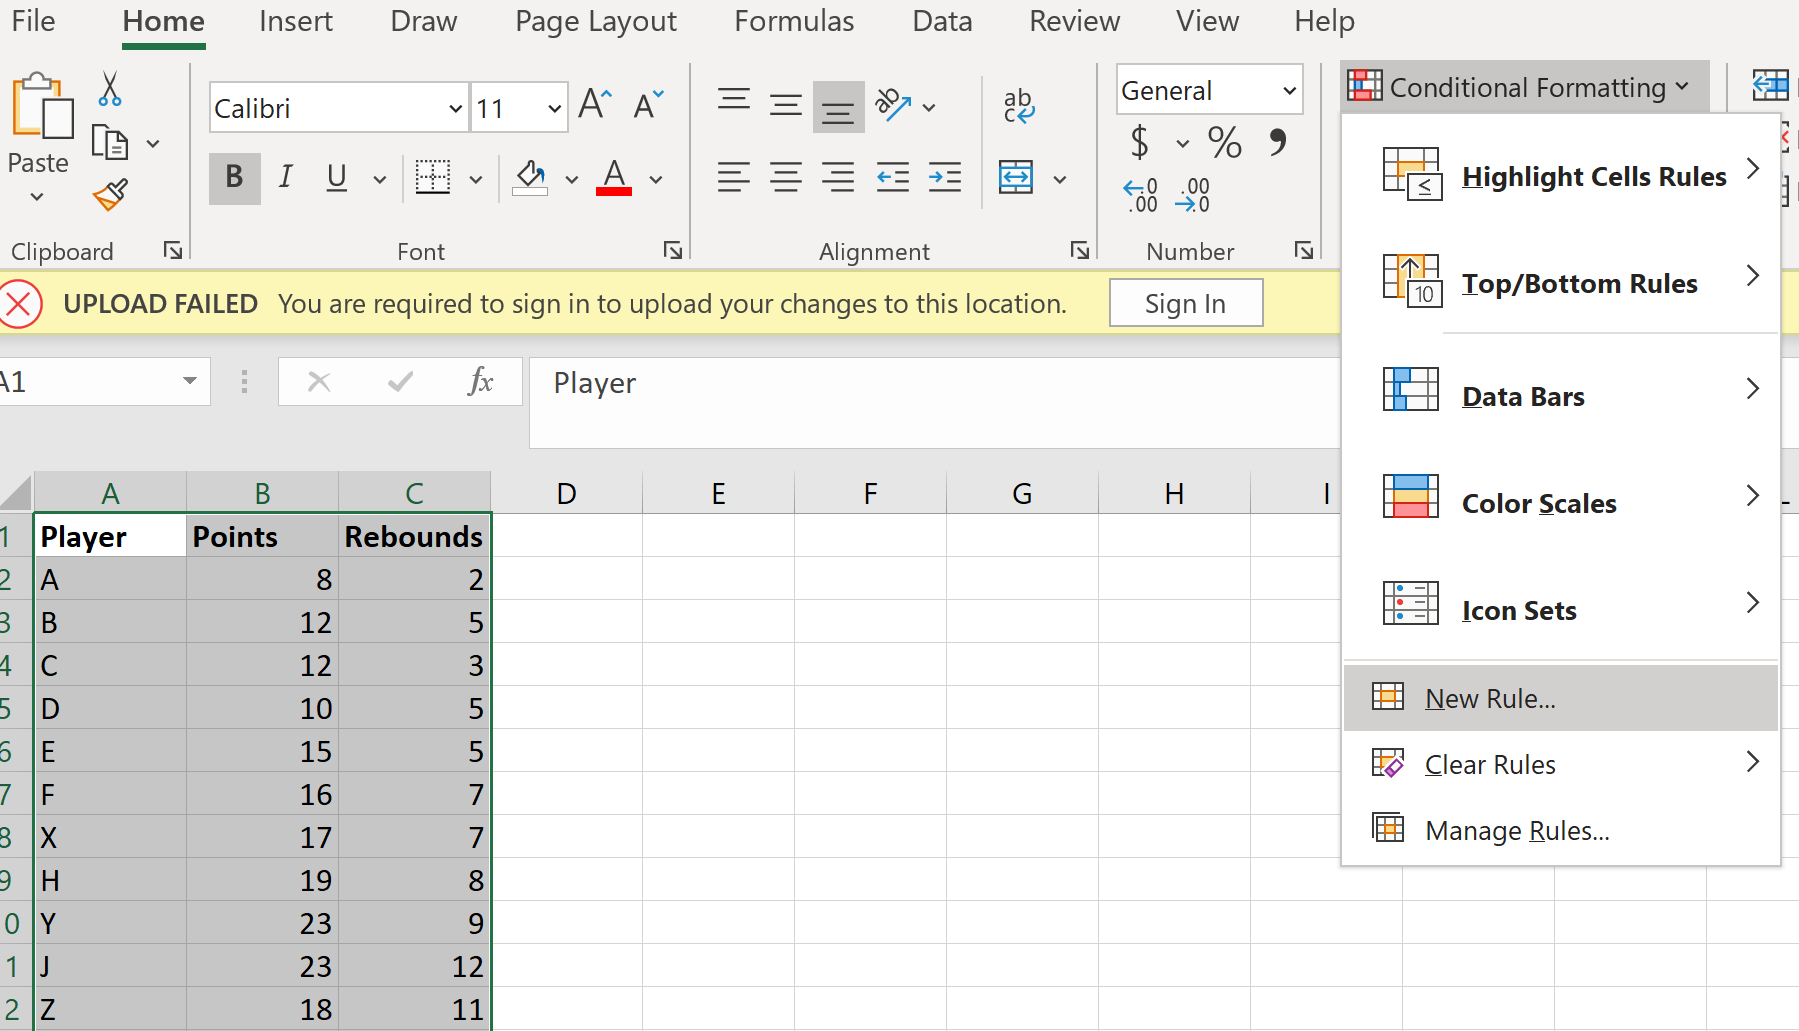
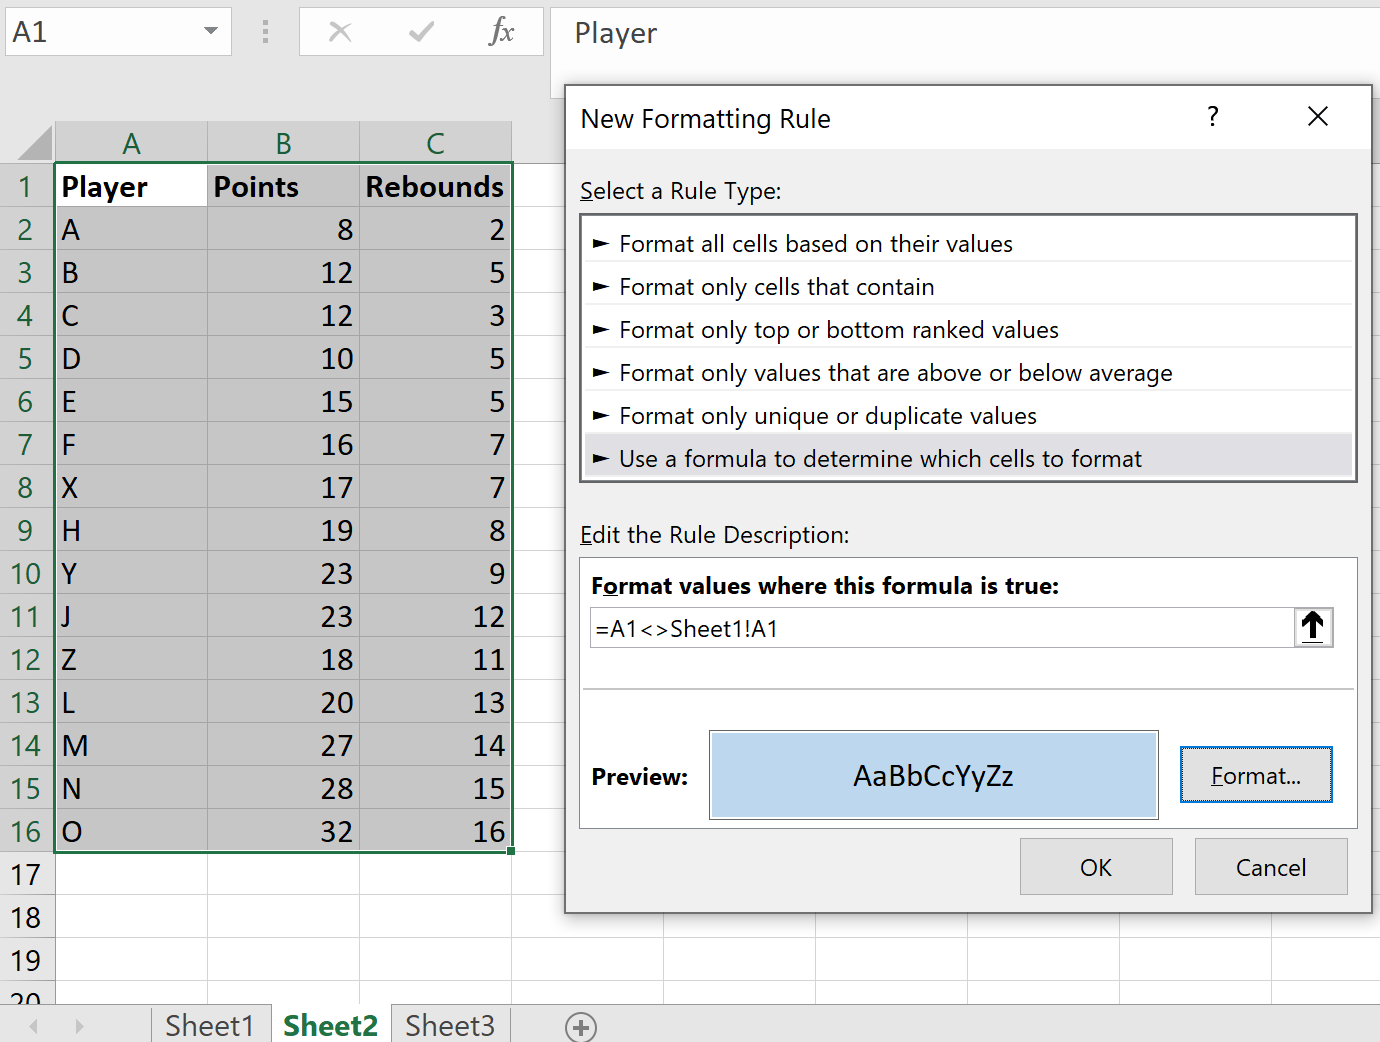
Pour mettre en œuvre cette mécanique, l’opérateur sélectionne l’intégralité de la plage d’intérêt sur la feuille de référence (par exemple de A1 à Z500 sur la Feuil1), puis accède au gestionnaire de mise en forme conditionnelle pour y instancier une règle définie par l’expression suivante :
=A1<>Feuil2!A1
La maîtrise de la notation relative dans la rédaction de cette formule d’activation booléenne s’avère absolument déterminante. L’adresse A1 doit être saisie sans le moindre caractère de verrouillage ($). Dans le modèle d’évaluation de la mise en forme conditionnelle d’Excel, la formule est évaluée pour la cellule supérieure gauche de la sélection active (ici A1), puis virtuellement translatée de manière incrémentale sur chacune des cellules couvertes par la plage d’application, garantissant ainsi que la cellule B12 sera comparée à Feuil2!B12, C45 à Feuil2!C45, et ainsi de suite de manière rigoureusement univoque.
Des règles conjointes peuvent être superposées au sein du même périmètre pour discriminer les sous-catégories d’inégalités. Une seconde règle, exploitant par exemple une fonction logique d’interrogation de vacuité telle que =ET(ESTVIDE(A1);NON(ESTVIDE(Feuil2!A1))), pourra être dotée d’une texture de remplissage distincte (comme un hachurage diagonal ou une teinte ambrée) afin d’avertir explicitement l’auditeur que l’anomalie ne réside pas dans une variation de valeur mais dans la disparition pure et simple d’un enregistrement précédemment renseigné.
3.3 3.3 Déploiement et audit du gestionnaire de règles
Une fois les règles différentielles rédigées, la pérennité du dispositif de surveillance exige un audit méticuleux de leur implémentation au sein du gestionnaire de règles de mise en forme conditionnelle. L’un des écueils structurels les plus documentés de l’environnement Excel réside dans la fragmentation anarchique des plages d’application, consécutive aux opérations récurrentes de copier-coller effectuées par les utilisateurs. Lorsqu’une portion de tableau est déplacée ou collée avec ses formats d’origine, Excel scinde automatiquement la règle globale en une myriade de sous-règles orphelines aux périmètres disjoints, dégradant catastrophiquement les performances de calcul du classeur.
L’auditeur doit donc inspecter le champ syntaxique désigné sous le libellé « S’applique à » au sein de la fenêtre modale du gestionnaire. Ce champ doit impérativement matérialiser une plage contiguë et consolidée, rédigée selon une notation absolue stricte (par exemple =$A$1:$Z$500), en éliminant toute référence morcelée issue de manipulations antérieures. De même, l’ordre de priorité hiérarchique des règles doit être contrôlé : si plusieurs conditions sont susceptibles d’interagir ou de se neutraliser mutuellement, l’activation judicieuse de la case à cocher « Interrompre si vrai » permettra de stopper l’évaluation dès la validation du premier critère critique, optimisant ainsi le thread d’affichage.
La persistance opérationnelle des styles conditionnels impose également une vigilance accrue lors de l’intégration de nouvelles données dans les feuilles sous surveillance. Si des enregistrements sont insérés au-delà des limites géométriques de la plage initialement couverte sans que les tableaux n’aient été convertis préalablement en objets structurés (ListObjects), les nouvelles lignes échapperont totalement au champ d’évaluation de la règle, créant une dangereuse zone d’ombre informationnelle où des anomalies majeures pourraient proliférer silencieusement.
Enfin, il convient de diagnostiquer les dysfonctionnements visuels découlant des processus d’évaluation asynchrone sur les grands classeurs. Dans certaines configurations matérielles ou lors de liaisons vers des classeurs distants via des disques réseau, le recalcul des règles graphiques peut accuser une latence perceptible, affichant temporairement des surlignages obsolètes. La commande manuelle de recalcul forcé de l’ensemble du classeur (via la séquence de touches Ctrl + Alt + F9) permet de purger les mémoires tampons d’affichage et de garantir que la cartographie chromatique observable correspond rigoureusement à l’état instantané des relations matricielles sous-jacentes.
4. 4. Approche par fonctions de recherche et d’appariement relationnel
4.1 4.1 Emploi comparatif des fonctions RECHERCHEV et RECHERCHEH
Lorsque les données soumises à analyse ont subi des réordonnancements, des tris hétérogènes ou des insertions de lignes intercalaires, les méthodes géométriques spatiales vues précédemment s’avèrent inopérantes. L’analyste doit alors opérer un changement de paradigme et migrer d’une comparaison de coordonnées à une comparaison par appariement relationnel. Les fonctions historiques RECHERCHEV (recherche verticale) et RECHERCHEH (recherche horizontale) incarnent la première génération de ces outils d’interrogation indexée au sein d’Excel.
Le principe fondamental consiste à désigner une colonne clé présente dans les deux feuilles — typiquement un numéro de compte, un code matricule ou un identifiant transactionnel unique — et à utiliser cette clé pour aller extraire dynamiquement la valeur correspondante dans la feuille opposée, indépendamment de sa localisation sur l’axe vertical. La syntaxe impose une rigueur absolue : le quatrième argument de la fonction, régissant la précision de la recherche, doit impérativement être configuré sur la valeur booléenne FAUX (ou 0) pour interdire toute approximation par interpolation et forcer une concordance exacte de la clé d’identification.
L’exécution de la fonction RECHERCHEV produit deux signaux distincts d’incohérence qu’il convient de ségréguer méthodiquement. D’une part, la restitution d’une valeur discordante par rapport à la cellule locale atteste d’une altération de l’attribut transporté par l’entité. D’autre part, la génération du code d’erreur #N/A (valeur non disponible) constitue un signal critique de divergence d’existence : elle informe formellement l’auditeur que la clé primaire identifiée dans la feuille source est strictement introuvable dans la table de destination. En enveloppant la formule dans des constructions telles que SI(ESTNA(RECHERCHEV(...));"Enregistrement manquant";...), on formalise un diagnostic immédiat des ruptures de complétude du jeu de données.
Néanmoins, l’architecture native de RECHERCHEV recèle des failles structurelles bien documentées qui limitent sa robustesse dans le cadre d’un audit de grande ampleur. D’un côté, la fonction exige de manière contraignante que la colonne hébergeant la clé d’identification réside impérativement dans la position la plus à gauche de la plage de recherche, interdisant toute recherche vectorielle orientée vers la gauche sans modification préalable de la structure de la table source. De l’autre, la définition de l’indice de colonne sous forme d’un entier statique codé en dur rend la comparaison extrêmement vulnérable aux insertions ou suppressions de colonnes opérées dans la table distante, un événement mineur suffisant à décaler aveuglément l’attribut interrogé et à fausser l’intégralité du diagnostic différentiel.
4.2 4.2 Robustesse structurelle du couple INDEX et EQUIV
Pour s’affranchir des limitations intrinsèques de RECHERCHEV, les concepteurs de modèles complexes privilégient historiquement le couplage fonctionnel des instructions INDEX et EQUIV. Cette association découple entièrement la mécanique de localisation spatiale de la mécanique d’extraction de valeur, offrant une modularité et une résilience structurelle incomparablement supérieures face aux aléas de restructuration tabulaire.
La fonction EQUIV intervient en première ligne pour identifier la position séquentielle absolue (le numéro de ligne) de la clé primaire recherchée au sein d’un vecteur unidimensionnel distant, sans être entravée par la disposition relative des colonnes adjacentes. Dès lors qu’une clé d’appariement est validée par EQUIV (opérant sous le mode de correspondance exacte 0), le numéro de ligne ainsi extrait est transmis en paramètre dynamique à la fonction INDEX, laquelle se charge de puiser la valeur cible dans le vecteur de retour désigné, quelle que soit son orientation ou sa distance par rapport à l’index primaire.
Cette déliaison géométrique confère une immunité totale face à l’insertion ou à la suppression inopinée de colonnes intercalaires : les références vectorielles s’ajustent dynamiquement au sein de la formule sans jamais altérer l’intégrité de la cible d’extraction. Sur le plan de la détection différentielle, la formule type s’articule ainsi :
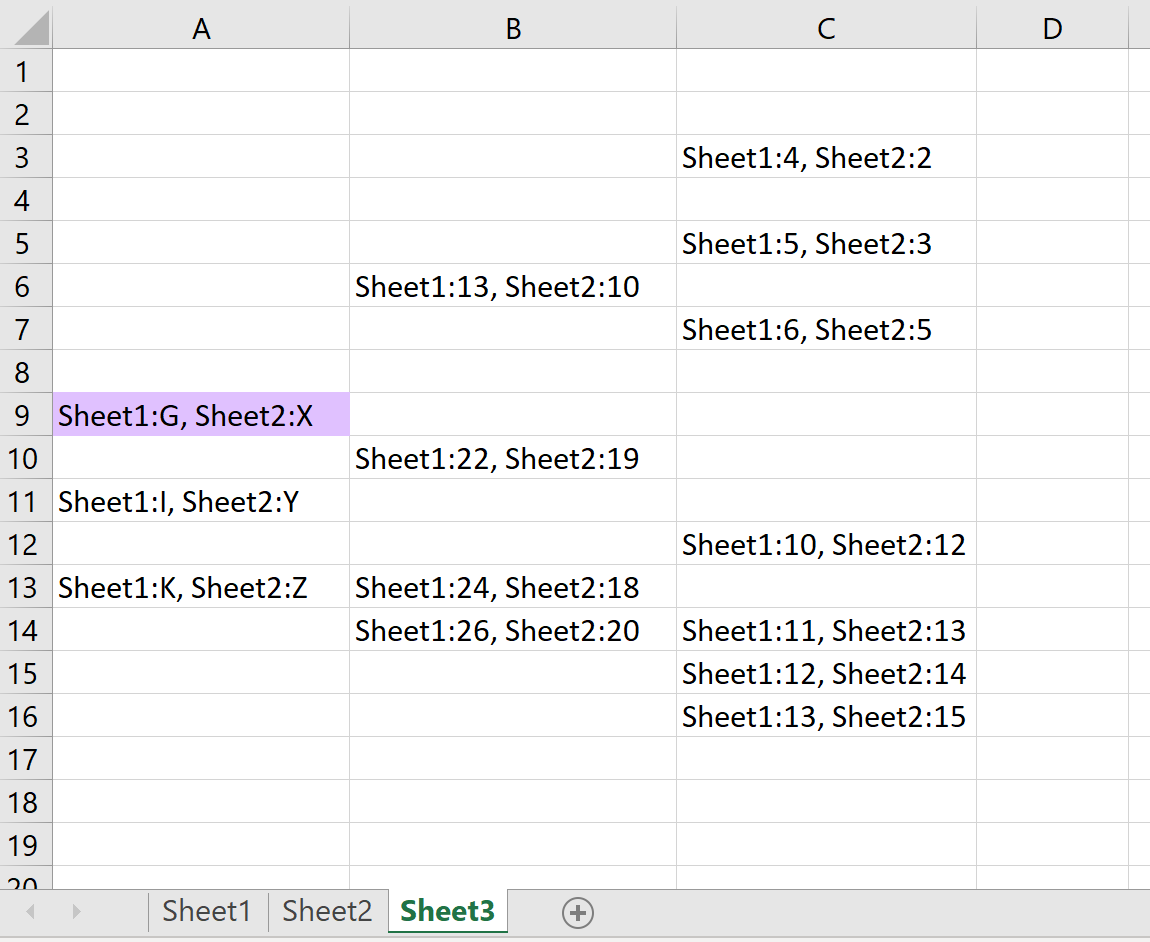
=SI(ESTNA(EQUIV(A2;Feuil2!$A$2:$A$1000;0));"Clé absente";SI(B2=INDEX(Feuil2!$B$2:$B$1000;EQUIV(A2;Feuil2!$A$2:$A$1000;0));"Conforme";"Divergence"))
Cette approche permet d’auditer séparément et avec une rigueur chirurgicale l’intégrité de présence (la ligne existe-t-elle dans le jeu cible ?) et l’intégrité d’attribut (la valeur portée par cette ligne est-elle strictement égale ?).
Sur le plan des performances computationnelles, le couple INDEX/EQUIV surpasse nettement RECHERCHEV lors du traitement de matrices volumineuses. L’optimisation algorithmique peut être poussée davantage en scindant l’évaluation : une colonne dédiée peut héberger le calcul d’indexation unique fourni par EQUIV pour chaque ligne, permettant à de multiples colonnes comparatives subséquentes de faire référence à cette coordonnée résolue sans réitérer inutilement le coût d’exploration dichotomique ou séquentielle du vecteur de clé primaire pour chaque attribut contrôlé.
4.3 4.3 Déploiement moderne via la fonction RECHERCHEX
Introduite pour moderniser et unifier les algorithmes de recoupement dans le moteur de calcul d’Excel, la fonction RECHERCHEX constitue l’état de l’art pour l’audit différentiel de jeux de données tabulaires. Éliminant les contraintes structurelles de RECHERCHEV et encapsulant la puissance d’INDEX/EQUIV en une syntaxe plus fluide, elle offre une flexibilité sans précédent dans le balayage bidirectionnel des enregistrements.
L’un des avantages conceptuels majeurs de RECHERCHEX réside dans la prise en charge native des exceptions d’absence d’appariement. Le quatrième argument de la fonction, libellé si_non_trouvé, permet d’intercepter immédiatement la non-concordance référentielle sans contraindre l’analyste à des imbrications lourdes de fonctions d’erreur de type SIERREUR ou ESTNA. Ainsi, l’expression formelle s’épure significativement :
=RECHERCHEX(A2;Feuil2!$A$2:$A$1000;Feuil2!$B$2:$B$1000;"Enregistrement orphelin";0)
Cette syntaxe garantit que l’absence d’une clé dans le référentiel secondaire génère un diagnostic textuel précis dès la première passe d’évaluation, tout en restituant l’attribut exact en cas de correspondance trouvée.
Par ailleurs, RECHERCHEX s’inscrit pleinement dans le modèle de calcul dynamique matriciel d’Excel. Elle est capable de renvoyer non pas une cellule isolée, mais une plage contiguë complète d’attributs sous forme de déversement dynamique (spill array). Cette propriété permet de comparer l’intégralité des colonnes d’une ligne d’un seul bloc par une simple instruction matricielle :
=SI(B2:Z2=RECHERCHEX(A2;Feuil2!$A$2:$A$1000;Feuil2!$B$2:$Z$1000);"OK";"Écart détecté")
L’ensemble du vecteur d’attributs de la feuille active est instantanément confronté au vecteur homologue déversé depuis la feuille distante, minimisant radicalement le nombre de formules indépendantes à maintenir et réduisant l’empreinte mémoire globale du classeur de diagnostic.
Enfin, RECHERCHEX intègre nativement des modes de recherche avancés, tels que la recherche inversée (du dernier élément vers le premier) particulièrement efficiente pour auditer des journaux d’événements chronologiques inversés, ainsi que la correspondance par caractères génériques. Cette polyvalence algorithmique autorise le traitement de scénarios de réconciliation complexes, impossibles à instrumenter au moyen des formules traditionnelles sans développement procédural additionnel.
5. 5. Algèbre relationnelle et traitement des jointures via Power Query
5.1 5.1 Modélisation de l’environnement d’ingestion ETL
Lorsque les volumes de données franchissent le seuil critique des dizaines de milliers de lignes ou que les jeux de données présentent des asymétries structurelles sévères, les formules de calcul matricielles révèlent leurs limites en matière de scalabilité et de maintenabilité. La modélisation sous l’environnement Power Query — le moteur ETL (Extract, Transform, Load) intégré au cœur d’Excel — permet d’aborder l’analyse comparative sous le prisme formel de l’algèbre relationnelle. Cette approche substitue aux micro-évaluations cellulaires des opérations ensemblistes robustes, appliquées globalement à des tables de données formellement définies.
La première phase opérationnelle consiste à connecter et ingérer les deux feuilles Excel au sein du moteur Power Query sous la forme de requêtes d’importation distinctes. Au moment de l’ingestion, une attention méthodologique extrême doit être accordée au typage strict des données. Contrairement à la grille Excel qui tolère une permissivité typologique relative dans une même colonne, Power Query impose un schéma de données rigoureux : une colonne typée en entier Int64.Type refusera toute comparaison avec une colonne homologue par inadvertance typée en chaîne textuelle type text. Cette rigueur élimine d’emblée une proportion massive de fausses disparités implicites issues de mauvaises interprétations logiques.
Un atout fondamental de ce pipeline d’audit réside dans l’immutabilité absolue des sources d’origine. Les tables sources demeurent en lecture seule stricte ; aucune formule, aucun format, aucune modification n’est injectée dans les feuilles de travail natives des utilisateurs. L’intégralité des opérations différentielles est modélisée au travers du langage relationnel formel M (Power Query Formula Language), dont chaque étape séquentielle est rigoureusement enregistrée et documentée dans le panneau des étapes appliquées, conférant au processus une reproductibilité algorithmique totale, conforme aux exigences de l’audit informatique moderne.
5.2 5.2 Exécution des jointures d’exclusion pour isoler les deltas
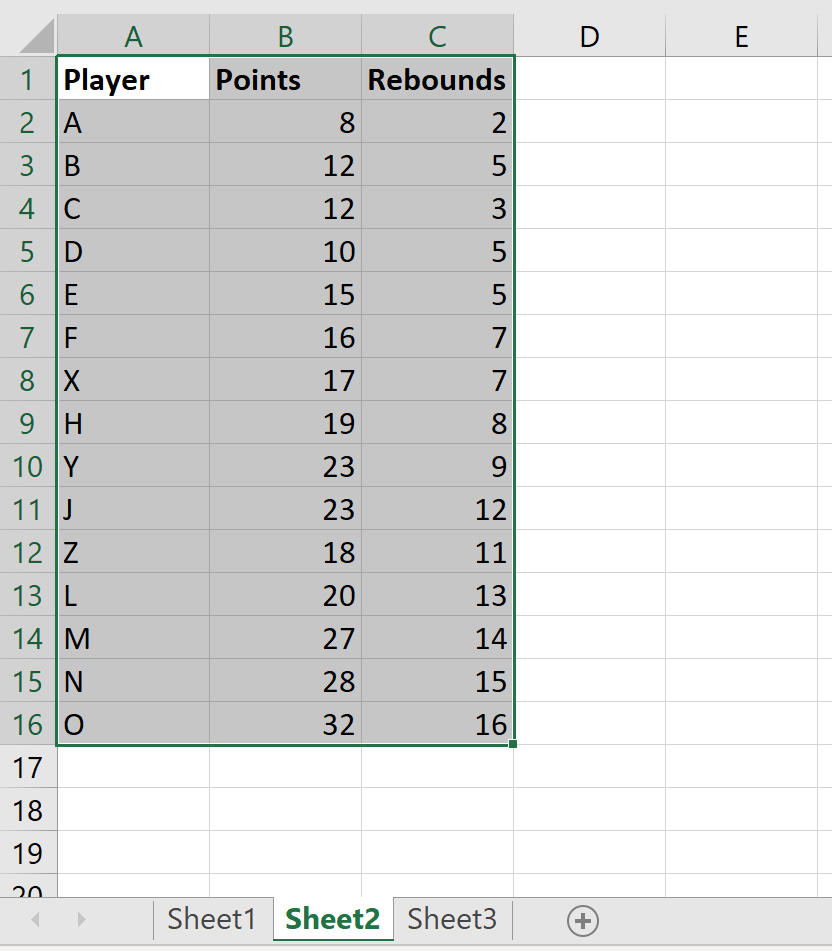
L’identification des divergences d’existence entre deux états d’un jeu de données s’exécute avec une élégance mathématique parfaite au moyen des jointures d’exclusion, également dénommées anti-jointures dans la théorie des bases de données relationnelles. La confrontation de deux tables $T_1$ et $T_2$ par fusion de requêtes permet de ségréguer instantanément les données en fonction de leur cardinalité référentielle, sans écrire la moindre ligne de code conditionnel complexe.
L’application d’une jointure Anti-Gauche (Left Anti-Join) sur la clé primaire isole exclusivement les enregistrements présents dans la table $T_1$ qui ne trouvent aucune correspondance dans la table $T_2$. Cette opération permet d’extraire, dans une table dédiée, l’intégralité des lignes qui ont été supprimées du second référentiel ou qui constituent des éléments orphelins propres à la source initiale. Symétriquement, l’exécution d’une jointure Anti-Droite (Right Anti-Join) réalise l’opération inverse : elle isole les entités présentes dans $T_2$ mais absentes de $T_1$, mettant en exergue les créations d’enregistrements secondaires ou les insertions non autorisées survenues dans le nouveau jeu de données.
Pour obtenir une vision synoptique exhaustive au sein d’un tableau de bord unique, l’analyste peut recourir à la fusion complète externe (Full Outer Join). Cette technique ensembliste conserve la totalité des lignes des deux tables, en alignant les clés concordantes et en générant des marqueurs d’absence null pour chaque absence relative. Une fois la jointure réalisée, l’expansion ciblée des colonnes d’attributs permet de juxtaposer directement chaque valeur d’origine avec sa valeur candidate, créant ainsi une structure relationnelle prête pour le calcul automatisé des deltas de valeurs au moyen d’expressions M vectorisées.
5.3 5.3 Traitement des modifications d’attributs au sein des lignes communes
Au-delà des apparitions et disparitions d’enregistrements, la détection des mutations d’attributs sur les lignes existant conjointement dans les deux référentiels constitue l’objectif central de l’audit. Ce traitement s’opère méthodiquement en exécutant une jointure interne (Inner Join) fondée sur la clé primaire univoque. Cette opération a pour effet mathématique de restreindre l’univers d’analyse à l’intersection stricte des deux ensembles, soit l’ensemble des entités partagées par les deux états de données.
Au sein de cette table d’intersection, l’auditeur procède à l’expansion des colonnes de données provenant des deux sources, en attribuant systématiquement des préfixes distinctifs (par exemple Source.Montant et Cible.Montant). L’étape suivante consiste à adjoindre des colonnes conditionnelles d’évaluation différentielle multivariée. Sous l’interface Power Query ou via une formule personnalisée en langage M, on introduit une règle booléenne transversale évaluant l’égalité simultanée de tous les attributs pairs :
Table.AddColumn(EtapePrecedente, "Est_Conforme", each [Source.Montant] = [Cible.Montant] and [Source.Statut] = [Cible.Statut])
Un simple filtre booléen configuré sur l’état false permet alors d’éliminer instantanément toutes les lignes de conformité parfaite pour n’isoler que la population exacte des enregistrements altérés. L’analyste peut enrichir cette table finale par des colonnes calculées mesurant les écarts arithmétiques absolus et relatifs pour les données quantitatives, transformant l’exercice d’audit en un rapport de variance opérationnel directement exploitable. Le résultat peut enfin être chargé vers une nouvelle feuille de calcul Excel sous forme de tableau structuré auto-rafraîchissable, garantissant que toute actualisation des données sources mettra à jour dynamiquement l’intégralité du diagnostic différentiel.
6. 6. Comparaison textuelle fine et fonctions de validation logique
6.1 6.1 Différenciation sensible à la casse via la fonction EXACT
L’une des particularités les plus insidieuses du moteur de calcul d’Excel réside dans son insensibilité native à la casse lors de l’exécution des opérateurs logiques standards. Une comparaison directe matérialisée par la formule ="PARIS"="paris" renvoie invariablement la valeur booléenne VRAI. Si cette tolérance orthographique est souvent bénéfique dans les usages bureautiques courants, elle s’avère rédhibitoire dans le cadre de vérifications d’intégrité strictes impliquant des identifiants cryptographiques, des codes de sécurité, des chaînes de nomenclature sensibles à la typographie ou des codes-barres alphanumériques structurés.
Pour neutraliser cette complaisance du moteur et forcer une analyse binaire exacte du registre de chaque caractère, l’analyste doit impérativement mobiliser la fonction EXACT. Cette fonction prend en charge deux paramètres textuels et restitue la valeur VRAI uniquement si les deux chaînes présentent un ordonnancement de caractères rigoureusement superposable, intégrant la stricte identité des minuscules, des majuscules et des éventuelles marques diacritiques. Ainsi, l’évaluation =EXACT("CodeAlpha"; "Codealpha") renvoie rigoureusement FAUX, isolant immédiatement une altération de saisie qui serait demeurée totalement invisible lors d’un test d’égalité standard.
L’intégration de la fonction EXACT au sein d’architectures conditionnelles complexes renforce considérablement la fiabilité de la détection différentielle. Elle peut être encapsulée dans des structures décisionnelles plus larges visant à orienter la sévérité du diagnostic :
=SI(EXACT(Feuil1!A1;Feuil2!A1);"Concordance stricte";SI(Feuil1!A1=Feuil2!A1;"Divergence de casse uniquement";"Divergence sémantique"))
Cette approche graduée permet aux auditeurs de trier efficacement les anomalies nécessitant une refonte immédiate des données critiques de celles relevant de simples variations cosmétiques de saisie.
6.2 6.2 Détection et neutralisation des divergences typographiques
Les divergences textuelles apparentes sont très fréquemment induites non par des mutations substantielles du texte lui-même, mais par l’introduction de micro-pollutions typographiques invisibles à l’œil nu. Parmi celles-ci figurent en première ligne les espaces insécables (code ASCII 160 en encodage Windows/ANSI ou en HTML), massivement injectées lors des extractions issues de portails web ou d’interfaces ERP modernes, là où l’utilisateur visualise ou saisit un espace standard (code ASCII 32). Une formule de comparaison basique appliquée à deux chaînes contenant respectivement ces deux types d’espaces conclura invariablement à une non-égalité, plongeant l’analyste dans la perplexité face à deux textes d’apparence strictement superposable.
Pour assainir préventivement le corpus textuel avant comparaison, il convient de conjuguer les fonctions de nettoyage natives. La fonction SUPPRESPACE éradique l’ensemble des espaces standards superflus situés en tête et en queue de chaîne de caractères, tout en réduisant les espaces multiples internes à un séparateur unique. Elle doit être couplée à la fonction EPURAGE, dont la vocation est de purger la chaîne de l’intégralité des 32 premiers caractères de contrôle non imprimables du jeu ASCII standard (tels que les sauts de ligne, retours chariot ou tabulations horizontales) :
=SUPPRESPACE(EPURAGE(SUBSTITUE(A1;CAR(160);" ")))
Cette formule prétraitante assure une homogénéisation radicale en convertissant explicitement les espaces insécables en espaces standards avant de compacter la structure textuelle.
Un test d’audit quantitatif complémentaire repose sur l’évaluation systématique de la longueur des chaînes par la fonction NBCAR. Dans de nombreux cas d’incohérence textuelle inexpliquée, l’expression =NBCAR(Feuil1!A1)=NBCAR(Feuil2!A1) met en lumière une asymétrie de longueur métrique révélant la présence de caractères invisibles résiduels. Enfin, si l’analyste souhaite délibérément neutraliser les divergences de registre typographique pour se focaliser exclusivement sur l’identité lexicale des termes, l’encapsulation des comparateurs au sein des fonctions MAJUSCULE ou MINUSCULE permet d’aplanir uniformément la casse sur l’ensemble des vecteurs analysés.
6.3 6.3 Quantification de la similarité textuelle
La validation binaire stricte (vrai ou faux) s’avère parfois trop réductrice lorsque l’analyste est confronté à des bases de données historiques lourdement dégradées par la saisie humaine manuelle, comportant des fautes d’orthographe, des inversions phonétiques ou des abréviations contextuelles fluctuantes. Dans ce contexte, une comparaison déterministe échoue systématiquement à relier des entités théoriquement identiques mais formellement altérées (par exemple « Société Générale » et « Soc. Generale »). Il devient alors indispensable d’introduire des notions de métrique de similarité textuelle, fondées sur le concept mathématique de distance d’édition (telle que la distance de Levenshtein).
Le moteur natif de calcul d’Excel ne propose pas d’algorithme de calcul de distance d’édition sous forme de fonction de feuille standard. L’analyste doit dès lors faire appel à des compléments spécialisés, tels que le module Fuzzy Lookup développé par Microsoft Research, ou basculer vers les fonctionnalités d’appariement flou intégrées aux opérations de fusion de requêtes sous Power Query. Ces algorithmes décomposent les chaînes de caractères en sous-ensembles de n-grammes et calculent des indices de similarité statistique oscillant entre 0 (divergence absolue) et 1 (identité parfaite).
Le paramétrage du seuil de tolérance (ou niveau de confiance de similarité) constitue une étape hautement délicate de cette démarche probabiliste. Un seuil configuré de manière excessivement laxiste (par exemple à 0.60) engendre un nombre massif de faux positifs, appariant arbitrairement des entités commerciales ou des patronymes totalement distincts mais partageant des structures syllabiques proches. Inversement, un seuil d’une rigueur disproportionnée (à 0.95) réintroduit le risque de faux négatifs en ignorant des altérations typographiques patentes.
Il est par conséquent impératif de souligner qu’une comparaison différentielle par appariement flou ne constitue jamais une preuve d’audit mathématiquement déterministe. Elle doit être formellement circonscrite à un statut d’outil de pré-qualification sélective, soumise à une validation humaine systématique des correspondances probables préalablement à toute réconciliation définitive ou écrasement de données dans les référentiels maîtres de l’organisation.
7. 7. Automatisation procédurale par scripts VBA et macros comparatives
7.1 7.1 Architecture d’un algorithme de balayage bidimensionnel
L’automatisation procédurale au moyen du langage Visual Basic for Applications (VBA) constitue la solution de prédilection lorsque l’audit différentiel doit être encapsulé dans un processus répétable, déployé sur des postes dépourvus de compléments avancés ou orchestré dans le cadre d’une gouvernance applicative spécifique. La conception d’une macro comparative performante repose sur une architecture d’itération imbriquée parcourant méthodiquement la grille cartésienne des cellules cibles, en matérialisant l’intersection de chaque ligne et de chaque colonne par des variables d’indexation scalaires.
Le développement rigoureux d’un tel script exige une instanciation explicite des objets de référence au travers des classes Workbook, Worksheet et Range, en proscrivant formellement l’usage d’objets implicites ou de sélections actives (telles que Select ou ActiveCell), particulièrement lentes et sources d’instabilité logicielle. L’algorithme initialise deux compteurs de boucle (ligne et colonne) dont les bornes maximales sont dynamiquement calculées par l’inspection des propriétés du tableau source, assurant ainsi une adaptation automatique à l’envergure variable des données ingérées.
Préalablement au déclenchement du moteur itératif, il est impératif d’optimiser l’environnement d’exécution de l’application Excel afin de préserver les ressources processeur et d’éviter les scintillements graphiques pénalisants. Le script doit systématiquement désactiver le rafraîchissement synchrone de l’écran par la commande Application.ScreenUpdating = False, suspendre le moteur de calcul automatique des formules via Application.Calculation = xlCalculationManual, et neutraliser la gestion des événements d’interface grâce à Application.EnableEvents = False. Cet agencement libère la totalité de la bande passante processeur au bénéfice exclusif de la logique de comparaison vectorielle.
Enfin, l’architecture algorithmique doit intégrer des mécanismes de contrôle dimensionnel préventif. Si la macro constate, dès l’initialisation, que les plages de données désignées présentent des largeurs ou des longueurs hétérogènes sans qu’aucun identifiant de pivotement ne soit spécifié, une interruption programmée accompagnée d’un message d’alerte explicite doit avertir l’utilisateur de l’incompatibilité géométrique immédiate, évitant ainsi le traitement inutile de dizaines de milliers d’itérations vouées à l’échec computationnel.
7.2 7.2 Génération automatisée d’un journal des modifications
Une macro comparative d’entreprise ne doit pas se cantonner à une modification cosmétique des feuilles sources par surlignage ponctuel ; elle doit générer une piste d’audit formalisée sous la forme d’un journal séquentiel des modifications (audit trail). Ce journal s’instancie sous la forme d’une nouvelle feuille de calcul vierge, automatiquement créée par le script, dont les en-têtes normalisés permettent de consigner exhaustivement chaque événement de divergence détecté au cours de l’analyse.
À chaque occurrence d’inégalité constatée entre la cellule source $(i, j)$ et sa contrepartie cible $(i, j)$, l’algorithme extrait et append un enregistrement structurel renseignant les coordonnées alphanumériques de la cellule (via la propriété Address), le libellé de l’en-tête de la colonne concernée, la valeur historique portée par la première feuille, la valeur candidate identifiée dans la seconde feuille, ainsi que le type de données sous-jacent. Cet enregistrement peut être complété par des métadonnées contextuelles telles que l’identifiant de l’utilisateur système ayant exécuté la macro et un horodatage précis à la seconde près, généré par la fonction Now de l’interpréteur.
Parallèlement à la génération du journal textuel, le script peut appliquer de manière sélective un surlignage chromatique directement sur les feuilles sources afin de faciliter le repérage visuel local des cellules incriminées. Cette opération s’exécute en altérant prudemment la propriété Interior.Color des cellules divergentes, tout en veillant à conserver la valeur primitive de la propriété Interior.ColorIndex initiale au sein d’une pile de variables pour autoriser une procédure ultérieure de restauration des styles visuels d’origine si l’audit l’exige.
Le script s’achève par le rétablissement systématique des paramètres applicatifs suspendus lors de la phase d’initialisation, encapsulé au sein d’un bloc de gestion d’erreurs structuré (On Error GoTo CleanupHandler). Cette précaution garantit que, même en cas de plantage impromptu ou d’interruption manuelle de l’exécution par l’utilisateur, l’interface graphique d’Excel et son moteur de recalcul ne demeurent pas figés en mode manuel, assurant la résilience opérationnelle du poste de travail.
7.3 7.3 Traitement des volumes massifs par tableaux mémoires virtuels
Si la logique séquentielle exploitant des boucles itérant directement sur les cellules du modèle objet d’Excel (par l’intermédiaire de l’objet Cells(i, j)) fonctionne de manière satisfaisante sur de petits échantillons, elle souffre d’un écueil de performance rédhibitoire dès lors que les données excèdent quelques milliers de lignes. Chaque interrogation unitaire d’une cellule via l’interface COM (Component Object Model) engendre un surcoût d’interopérabilité substantiel entre l’environnement VBA et le moteur de calcul d’Excel, conduisant à des temps d’exécution prohibitifs sur des bases d’envergure industrielle.
Pour contourner ce goulot d’étranglement matériel et démultiplier la vélocité de traitement par un facteur oscillant couramment entre cinquante et cent, le développeur chevronné recourt à la technique des tableaux mémoires virtuels (Variant Arrays). Cette approche consiste à transférer en bloc l’intégralité du contenu de la plage de données source dans une variable matricielle résidant directement dans la mémoire vive (RAM) allouée au processus :
Dim matriceSource As Variant
matriceSource = Feuille1.Range("A1:Z50000").Value2
Une opération symétrique est appliquée sur la plage concurrente pour charger matriceCible.
Dès lors, l’ensemble des opérations comparatives s’exécute exclusivement en mémoire vive, au travers de boucles itérant sur les indices scalaires du tableau à deux dimensions en mémoire pure, sans jamais solliciter le modèle d’objet graphique ni réveiller les couches applicatives d’Excel. Les millions de comparaisons booléennes élémentaires sont ainsi absorbées par le processeur en une fraction de seconde.
Les divergences détectées sont parallèlement empilées dans un tableau tampon virtuel de restitution dimensionné dynamiquement. Une fois la double boucle matricielle achevée, le script projette l’intégralité de ce tableau tampon vers la feuille de restitution du journal d’audit en une seule instruction de transfert de bloc, via l’assignation globale de la propriété Resize d’une cellule d’ancrage. Cette minimisation drastique des entrées/sorties sur la couche applicative confère à l’algorithme une performance industrielle, autorisant l’audit comparatif quasi-instantané de centaines de milliers de points de données.
8. 8. Utilisation des utilitaires natifs et compléments d’audit Excel
8.1 8.1 Exploitation de l’outil d’analyse de feuille de calcul Inquire
Consciente des risques inhérents à l’usage non supervisé des tableurs dans les contextes assujettis à de sévères contraintes de contrôle interne — à l’instar des exigences de la loi Sarbanes-Oxley aux États-Unis —, la firme Microsoft a développé un complément d’audit institutionnel dénommé Inquire, disponible au sein des éditions professionnelles et d’entreprise d’Office (Microsoft 365 ProPlus, Office Professionnel Plus). Cet outil intègre un module dédié à l’analyse différentielle avancée : l’utilitaire Spreadsheet Compare.
L’activation de ce module s’opère via les options d’Excel, dans le menu de gestion des compléments COM. Une fois activé, Spreadsheet Compare opère comme une application autonome hautement spécialisée, capable de charger simultanément deux classeurs fermés pour exécuter une décomposition différentielle exhaustive de leur contenu. Contrairement aux approches artisanales qui se limitent souvent à la comparaison des valeurs scalaires affichées, Spreadsheet Compare inspecte l’intégralité des couches de métadonnées du classeur : il cartographie distinctement les mutations de valeurs saisies, les altérations de formules de calcul, les changements de formats de cellules, les modifications de noms définis, les évolutions du code VBA sous-jacent, ainsi que les déformations structurelles des plages de données.
L’interface de diagnostic restitue une cartographie interactive sophistiquée, organisée selon une typologie de couleurs standardisée permettant d’identifier immédiatement la nature exacte de chaque écart (les valeurs modifiées apparaissent traditionnellement en vert, les formules altérées en violet, et les lignes ou colonnes insérées en jaune). L’auditeur peut filtrer sélectivement les catégories d’incohérences à visualiser, éliminant par exemple le bruit lié aux variations cosmétiques de polices pour concentrer son attention exclusivement sur la dérive des formules mathématiques de consolidation.
Enfin, Spreadsheet Compare offre la possibilité d’exporter l’intégralité du diagnostic différentiel sous la forme d’un rapport d’audit formel, imprimable ou archivable au format Excel standard. Ce document certifié consigne de manière opposable l’état des deux versions analysées, documentant avec une exactitude forensique l’auteur présumé, l’emplacement et la portée de chaque altération. Il constitue ainsi un composant pivot de toute politique rigoureuse de conformité et de contrôle périodique des risques opérationnels liés aux modèles bureautiques.
8.2 8.2 Méthode ergonomique d’affichage côte à côte synchrone
Dans les scénarios d’investigation rapide ou de vérification préliminaire portant sur des jeux de données de granularité modeste, l’analyste peut recourir à des solutions d’inspection visuelle assistée sans nécessairement mobiliser d’ingénierie algorithmique lourde. L’environnement graphique d’Excel propose à cet effet un dispositif d’affichage multi-fenêtre synchronisé, accessible au travers de l’onglet « Affichage » du ruban principal.
La commande « Afficher côte à côte » ordonne l’agencement géométrique immédiat des deux classeurs ou des deux fenêtres d’un même classeur sous la forme de panneaux verticaux ou horizontaux adjacents occupant l’intégralité du champ de vision de l’écran. L’intérêt ergonomique pivot de cette disposition réside dans l’activation conjointe du « Défilement synchrone ». Lorsque ce mode est enclenché, le mouvement d’ascenseur horizontal ou vertical opéré par l’opérateur au sein de la fenêtre maîtresse entraîne instantanément un déplacement rigoureusement proportionnel dans la fenêtre secondaire.
Cette synchronisation mécanique permet à l’auditeur d’effectuer un balayage manuel assisté, en observant l’alignement des enregistrements et en repérant visuellement les distorsions évidentes dans la continuité des séries numériques ou textuelles. Cette méthode s’avère particulièrement utile lors des réunions d’arbitrage contradictoire, permettant à deux experts de commenter conjointement les évolutions macroscopiques d’un budget ou d’un calendrier de projet sans s’enfermer dans la complexité technique de formules de réconciliation.
Il importe toutefois de souligner avec gravité les risques inhérents à une telle approche si elle est érigée en méthode d’audit définitive sur des données critiques. La vulnérabilité aux biais de fatigue cognitive, le phénomène de persistance rétinienne et l’incapacité physiologique de l’œil à détecter des altérations de faible magnitude (comme la substitution du chiffre zéro par la lettre « O » majuscule ou l’inversion d’une décimale de faible poids) excluent formellement l’inspection visuelle manuelle des standards d’audit rigoureux. Elle ne doit demeurer qu’un outil d’exploration qualitative liminaire.
8.3 8.3 Sélection des cellules non conformes par la commande Atteindre
Pour les utilisateurs recherchant une méthode rapide d’isolation d’anomalies sans saisie de formules complexes ni recours aux macros, la commande native d’audit spatial dénommée « Atteindre les cellules spécifiques » offre un raccourci opérationnel méconnu d’une remarquable efficacité. Ce mécanisme exploite les fonctionnalités de filtrage géométrique intégrées au moteur d’exploration d’Excel.
Pour mettre en œuvre cette méthode au sein d’une même feuille de calcul ou après avoir juxtaposé par collage deux plages d’évaluation contiguës au sein du même onglet, l’utilisateur sélectionne l’intégralité du bloc matriciel consolidé. En appelant la boîte de dialogue contextuelle via le raccourci clavier F5 (ou Ctrl + T), puis en activant le bouton « Cellules… », l’analyste accède à un menu d’options d’isolation parmi lesquelles figurent les sélecteurs « Différences par ligne » et « Différences par colonne ».
Lorsqu’elle est enclenchée sur une sélection matricielle comportant des lignes jumelles, l’option « Différences par ligne » (accessible directement par la combinaison de touches Ctrl + ) ordonne au moteur d’Excel de balayer instantanément chaque ligne de la sélection, de comparer chaque cellule à la cellule de référence positionnée sur la même ligne dans la première colonne de la sélection, et de désélectionner immédiatement toutes les cellules conformes. En une fraction de seconde, le curseur d’Excel se fige exclusivement sur la collection disjointe des cellules hébergeant une valeur divergente.
L’opérateur peut alors, en un clic unique sur la palette d’outils, appliquer un remplissage chromatique de contraste vif ou modifier la bordure de toutes les cellules ainsi isolées, pérennisant instantanément la cartographie visuelle des divergences. Bien que cette méthode souffre d’une limitation majeure — son incapacité totale à traiter des matrices ayant subi des réordonnancements ou des décalages d’insertion —, elle demeure l’instrument de diagnostic ponctuel le plus véloce pour contrôler la conformité de copies matricielles censées être rigoureusement isomorphes.
9. 9. Gestion des divergences structurelles et asynchronismes de données
9.1 9.1 Détection et alignement des décalages d’insertion de lignes
L’écueil méthodologique le plus destructeur rencontré dans la pratique de l’analyse comparative réside dans le phénomène de décalage en cascade provoqué par l’insertion ou la suppression asymétrique d’une ou plusieurs lignes au sein d’une matrice séquentielle. Lorsqu’une ligne isolée est intercalée à la position 15 d’un jeu de données de dix mille enregistrements sans que le second référentiel ne subisse le même ajustement, toute formule de comparaison géométrique cellule à cellule naïve diagnostiquera une rupture d’intégrité absolue sur l’intégralité des neuf mille neuf cent quatre-vingt-cinq lignes subséquentes, générant une illusion statistique d’effondrement global du modèle alors même qu’un unique décalage spatial est à l’œuvre.
Pour surmonter cette rupture de synchronicité, l’analyste doit impérativement abandonner l’hypothèse de l’alignement géométrique direct et implémenter des algorithmes d’alignement séquentiel. Ces techniques, conceptuellement analogues aux méthodes d’alignement de séquences utilisées en bio-informatique (comme les algorithmes de Needleman-Wunsch), reposent sur la détection des points d’ancrage fixes fournis par les clés primaires invariables. Le protocole méthodologique prescrit d’extraire préalablement l’ensemble des clés des deux référentiels, d’opérer une consolidation unioniste dédupliquée de ces index, et de reconstruire une trame cartographique commune intégrant des lignes fictives (ou cellules vides) aux emplacements exacts des asymétries de présence.
Cette normalisation géométrique préalable rétablit la parité séquentielle des deux matrices avant l’exécution du test différentiel de contenu. Les cellules se retrouvent à nouveau situées sur des niveaux ordonnés identiques, neutralisant l’effet de cascade destructeur. Dans les environnements manuels ne bénéficiant pas d’outils d’alignement automatique, l’auditeur peut identifier le point précis de rupture en repérant la première ligne d’erreur, puis insérer manuellement un bloc de cellules vides au sein du tableau décalé pour réaligner visuellement et algorithmiquement le continuum des données.
9.2 9.2 Validation de l’intégrité du schéma et des en-têtes
L’analyse différentielle des contenus cellulaires s’avère dépourvue de sens si l’architecture matricielle sous-jacente — le schéma de la table — a elle-même fait l’objet de mutations unilatérales non documentées. La validation de l’intégrité du schéma s’impose dès lors comme une phase pré-analytique obligatoire, consistant à vérifier formellement que les deux tables partagent un ensemble d’attributs rigoureusement superposable en nature, en quantité et en désignation.
Ce contrôle s’exécute avec une remarquable efficacité en mobilisant des formules matricielles dynamiques horizontales confrontant les vecteurs d’en-têtes positionnés sur la première ligne de chaque feuille. L’analyste peut instancier des expressions exploitant la fonction EQUIV ou NB.SI pour vérifier méthodiquement que chaque intitulé de colonne de la table d’origine existe à l’identique dans la table de destination. L’expression suivante, positionnée au-dessus de chaque en-tête d’audit :
=SI(ESTNUM(EQUIV(A1;Feuil2!$1:$1;0));"En-tête validé";"COLONNE MANQUANTE DANS LA CIBLE")
permet d’isoler instantanément les suppressions, adjonctions ou renommages intempestifs d’attributs.
Au-delà de la conformité lexicale des libellés, il convient de contrôler l’ordonnancement structurel des colonnes. Si une colonne « Prix Unitaire » a été permutée avec la colonne « Quantité en Stock » au cours d’une manipulation de restructuration, une formule de comparaison spatiale aveugle confrontera des valeurs arithmétiques hétérogènes. La mise en œuvre de requêtes d’harmonisation sous Power Query ou de formules matricielles dynamiques de transposition (telles que CHOISIRCOLS associées à TRIER) permet de réordonner automatiquement les colonnes des deux tables selon une nomenclature alphabétique standardisée préalablement au calcul des divergences scalaires.
9.3 9.3 Écarts induits par la fusion de cellules et représentations non tabulaires
Dans la pratique des organisations, de nombreuses feuilles de calcul dérivent de maquettes de reporting conçues pour l’impression ou l’esthétique visuelle, au détriment des règles élémentaires d’hygiène tabulaire. L’usage intensif de cellules fusionnées constitue la manifestation la plus critique de cette pathologie logicielle. Dans le modèle de données interne d’Excel, une plage fusionnée s’étendant par exemple de B2 à D2 n’est pas une entité composite unifiée : la valeur réelle est exclusivement stockée dans la cellule d’ancrage supérieure gauche (B2), tandis que les cellules adjacentes couvertes graphiquement (C2 et D2) sont transformées en cellules vides de valeur nulle.
Ce comportement asymétrique perturbe radicalement les algorithmes de comparaison différentielle. Si une version du rapport a fusionné des cellules pour centrer un titre de catégorie tandis que la version concurrente a répété la valeur sur chaque ligne, l’audit différentiel diagnostiquera une série d’anomalies fictives d’absence sur les cellules secondaires. De surcroît, la présence de fusions bloque l’exécution de nombreuses fonctionnalités natives, interdisant le tri relationnel, perturbant l’extension des formules matricielles et invalidant l’adressage dynamique au sein des requêtes VBA ou Power Query.
Le protocole d’assainissement impose par conséquent la défusion systématique et inconditionnelle de l’intégralité de l’espace de données avant toute démarche comparative. Cette opération doit être complétée par une routine de propagation descendante des valeurs orphelines (procédure de comblement des vides) afin de restaurer une structure tabulaire rectangulaire pure, où chaque enregistrement porte explicitement la totalité de ses attributs contextuels. Enfin, la conversion formelle des plages standard en Tableaux Excel structurés (ListObjects) permet d’éradiquer définitivement ces artefacts de mise en page en imposant une étanchéité absolue entre la structure logique des données relationnelles et leur rendu typographique superficiel.
10. 10. Traitement des écarts d’arrondi, de calcul et de métadonnées numériques
10.1 10.1 Problématique de l’arithmétique en virgule flottante
L’une des causes les plus déconcertantes de faux positifs lors de la comparaison de données numériques réside dans la mécanique interne de calcul des ordinateurs, régie par la norme internationale IEEE 754 pour l’arithmétique en virgule flottante à double précision. Les microprocesseurs modernes encodent les nombres décimaux sous forme de fractions binaires finies. Or, de nombreuses fractions décimales élémentaires de notre système quotidien (telles que $0.1$, $0.2$ ou $0.3$) ne possèdent pas de représentation binaire exacte finie et se transforment en développements périodiques infinis, analogues à la fraction $1/3$ dans le système décimal.
Il en résulte l’apparition de résidus infinitésimaux dans les derniers bits de mantisse lors des séquences d’opérations arithmétiques complexes. Ainsi, l’évaluation logique directe de l’expression =(0,1 + 0,2) = 0,3 renvoie paradoxalement la valeur FAUX au sein de nombreux moteurs d’évaluation d’Excel, la somme arithmétique binaire générant un résidu de l’ordre de $0,30000000000000004$. L’analyste confrontant une valeur issue d’une saisie statique brute ($0.3$) à une valeur homologue résultant d’une chaîne de calcul dynamique verra sa formule différentielle conclure à une rupture formelle d’égalité, alors même que les grandeurs économiques ou physiques sous-jacentes sont rigoureusement équivalentes.
Une distinction fondamentale doit par ailleurs être rappelée entre la valeur affichée à l’écran, conditionnée par le masque typographique de la cellule (le format de nombre), et la valeur réelle sous-jacente hébergée dans la mémoire vive. Une cellule formatée pour n’afficher que deux décimales présentera visuellement le nombre $12,54$, alors que sa valeur machine réelle peut être $12,5448921$. Si la cellule homologue héberge la valeur constante $12,5400000$, les deux éléments apparaîtront rigoureusement identiques à l’observateur humain, mais déclencheront une alerte d’inégalité immédiate au sein des algorithmes d’audit. La neutralisation méthodique de ces artefacts impose d’envelopper systématiquement les calculs numériques dans la fonction ARRONDI, en calant strictement le nombre de décimales résolues sur le seuil de précision physique ou financier pertinent du modèle.
10.2 10.2 Comparaison avec marge de tolérance paramétrable
Pour immuniser les modèles d’audit différentiel contre les micro-divergences arithmétiques sans altérer arbitrairement les données sous-jacentes, il est scientifiquement recommandé de substituer au test d’égalité stricte une évaluation par intervalle de confiance, fondée sur la notion de marge de tolérance paramétrable (désignée par la constante mathématique epsilon $epsilon$).
Cette approche s’implémente en recourant à la fonction de calcul de la valeur absolue ABS. La formule comparative ne se demande plus si les valeurs $A$ et $B$ sont rigoureusement identiques, mais si la distance géométrique qui les sépare est strictement inférieure à un seuil d’admissibilité prédéterminé, représentatif de la matérialité de l’écart :
=SI(ABS(Feuil1!A1 - Feuil2!A1) <= 0,001; "Conforme sous tolérance"; "Écart matériel constaté")
Dans un contexte d’audit financier ou comptable, ce seuil de tolérance absolue peut être configuré sur la plus petite unité transactionnelle monétaire légale (par exemple $0,01$ euro), absorbant ainsi l’intégralité des bruits de calcul générés par les répartitions au prorata temporis ou les applications successives de taux de taxe sur la valeur ajoutée.
Toutefois, lorsque les séries de données embrassent des ordres de grandeur hétérogènes — juxtaposant des flux de trésorerie de plusieurs milliards d’unités avec des taux unitaires microscopiques —, la tolérance absolue perd sa pertinence méthodologique. Un écart de dix euros est anecdotique sur un chiffre d’affaires d’entreprise, mais inacceptable sur le prix unitaire d’un composant de micro-électronique. L’analyste averti implémente alors une formule de tolérance relative, calculant l’écart en pourcentage de la valeur de référence :
=SI(ABS((Feuil1!A1 - Feuil2!A1) / Feuil1!A1) <= 0,0001; "Écart relatif négligeable"; "Divergence relative significative")
Cette normalisation assure une sensibilité homogène du diagnostic différentiel sur l’ensemble du spectre d’échelle des grandeurs mesurées.
10.3 10.3 Discordances temporelles et de numérotation sérielle
La dimension temporelle constitue un foyer notoire de discordances fallacieuses au sein des classeurs Excel, en raison de la complexité du modèle interne de datation logicielle. Excel ne stocke pas les dates sous la forme d’objets calendaires natifs, mais sous la forme de nombres sériels séquentiels représentant la quantité de jours écoulés depuis un instant originel conventionnel désigné comme le « jour zéro ». Or, il coexiste historiquement dans Excel deux systèmes de calendrier divergents : le système standard fondé sur le 1er janvier 1900 (prévalent sur l’environnement Windows) et le système hérité du 1er janvier 1904 (initialement conçu pour les architectures Macintosh afin de gérer les années bissextiles).
Si deux classeurs générés sur des environnements ou des paramétrages régionaux distincts confrontent des dates au travers de formules d’égalité simples, une même date calendaire (par exemple le 15 mai 2024) peut porter des valeurs de numéros de série décalées exactement de quatre ans et un jour (soit un différentiel sériel de 1462 jours), générant une invalidation généralisée de la conformité chronologique. L’auditeur doit inspecter les options avancées du classeur pour s’assurer que la case « Utiliser le calendrier 1904 » présente un état booléen rigoureusement identique sur les deux documents audités.
Par ailleurs, les exports de données temporelles provenant de systèmes distribués intègrent fréquemment des horodatages complets incluant les fractions de seconde et les fuseaux horaires (temps universel coordonné UTC), là où les tables locales ne consignent que des dates tronquées au format jour/mois/année. Puisque la fraction de journée est représentée dans Excel par la partie décimale du nombre sériel (midi correspondant à 0.5), deux cellules affichant identiquement la date du jour seront jugées inégales si l’une d’elles héberge silencieusement une composante horaire non nulle. L’application systématique de la fonction ENT pour extraire la seule composante entière du nombre sériel, combinée à l’usage des fonctions de standardisation DATEVAL et TEMPSVAL sur les flux textuels convertis, assure l’alignement formel indispensable à la réconciliation des chronologies.
11. 11. Cadre d’assurance qualité, traçabilité et documentation de l’audit
11.1 11.1 Établissement d’une piste d’audit opposable
Dans un contexte réglementaire et opérationnel gouverné par des impératifs stricts de conformité, l’audit différentiel de deux feuilles de calcul ne peut demeurer un exercice volatil confiné à la mémoire éphémère d’un opérateur. Il convient d’établir une piste d’audit opposable, c’est-à-dire un corpus documentaire complet, certifié et traçable, capable de démontrer formellement devant des auditeurs externes, des autorités de régulation ou les directions des risques la méthodologie adoptée, l’exhaustivité des tests exécutés et le traitement réservé à chaque anomalie mise au jour.
Le fondement de cette piste d’audit repose sur la formalisation préalable de critères d’admissibilité stricts : l’organisation doit définir en amont les classes d’écarts tolérés (telles que les variations de décimales inférieures au seuil de matérialité retenu) et les écarts proscrits nécessitant un arrêt immédiat de la chaîne de calcul décisionnelle. L’analyste produit des métriques de synthèse standardisées synthétisant le niveau de distorsion globale entre les deux jeux de données, notamment le taux de couverture différentielle (pourcentage de cellules examinées), le taux d’erreur brut (nombre de discordances rapporté au nombre total de points de données) et le coefficient de divergence scalaire maximal.
L’archivage sécurisé des instantanés comparatifs constitue le second pilier de cette démarche qualité. Les versions soumises à examen, accompagnées des feuilles de diagnostic matriciel, des requêtes Power Query et des journaux d’exécution de scripts VBA, doivent être consignées dans un espace de stockage sécurisé, pourvu d’un contrôle d’accès nominatif et d’une politique de rétention conforme aux normes d’archivage légal. Enfin, la piste d’audit doit consigner formellement la chaîne d’attribution des responsabilités : chaque divergence matérielle identifiée doit faire l’objet d’un ticket de suivi désignant explicitement l’analyste déclarant, l’expert métier mandaté pour statuer sur la cause de l’anomalie, et l’autorité ayant validé la régularisation définitive.
11.2 11.2 Stratégies d’arbitrage et de réconciliation des données
La découverte d’incohérences entre deux référentiels d’information pose immédiatement la question opérationnelle critique de la réconciliation : lorsqu’un écart est mis en lumière, quelle version de la donnée doit prévaloir sur l’autre ? L’arbitrage ne doit en aucun cas résulter d’une intuition subjective ou du statut hiérarchique de l’opérateur, mais découler d’un modèle de décision formel désignant de manière univoque la source de vérité canonique, concept désigné dans l’ingénierie des données sous le terme de Golden Record.
Ce modèle de décision hiérarchise les flux en fonction de leur proximité avec l’événement transactionnel primaire. Dans la majorité des architectures de gouvernance, la source de vérité canonique correspond au flux d’extraction directe de la base de données transactionnelle de production (l’ERP ou le CRM), dont les données bénéficient des verrous d’intégrité de la couche relationnelle du serveur, tandis que les modifications manuelles saisies localement sur un tableur départemental sont présumées non fiables jusqu’à validation contradictoire. Dans d’autres scénarios d’audit de révision budgétaire, c’est au contraire la feuille de calcul validée par le comité d’investissement qui constitue la référence dérogatoire légitime face aux projections théoriques antérieures.
Une fois l’autorité canonique établie, la procédure d’écrasement ou de mise à jour des valeurs erronées doit être scrupuleusement encadrée pour prévenir les cycles de régression. Il est proscrit d’altérer manuellement les cellules une à une, une telle pratique réintroduisant immédiatement des risques de fautes de saisie. La synchronisation corrective doit être opérée par des scripts de mise à jour automatisés ou des requêtes d’ingestion écrasant formellement les cellules fautives tout en consignant la trace de l’état antérieur. Idéalement, cette phase de réconciliation doit s’accompagner d’un mécanisme de retour d’information (feedback loop) vers les systèmes amont afin de corriger définitivement la faille d’ingestion ou le processus de saisie défaillant ayant initialement engendré la dissidence des jeux de données.
11.3 11.3 Automatisation des tests de non-régression tabulaires
L’assurance qualité des systèmes décisionnels fondés sur des tableurs exige que l’effort différentiel dépasse le cadre de la vérification ponctuelle pour s’inscrire dans une logique de surveillance continue. La conception de classeurs sentinelles — documents maîtres intégrant des routines de contrôle automatisées appelées à chaque ingestion de nouveaux jeux de données périodiques — permet d’ériger une barrière préventive robuste contre les dérives computationnelles et les régressions logicielles.
Ces classeurs sentinelles intègrent des blocs de validation logique s’exécutant automatiquement à l’ouverture du document ou lors du déclenchement des requêtes d’actualisation. Ils incorporent des indicateurs d’alerte visuelle (tels que des pastilles de statut rouge/vert dans les cellules d’en-tête du tableau de bord) asservis à des formules de totalisation matricielle d’écarts. Si une discordance structurelle ou une déviation d’attribut excédant les tolérances autorisées est interceptée dans le flux entrant, le classeur sentinelle bloque immédiatement la mise à jour des graphiques et des rapports exécutifs, prévenant ainsi la diffusion de chiffres corrompus auprès de la direction générale.
Cette démarche de non-régression s’avère particulièrement cruciale lors des migrations d’infrastructure logicielle, telles que le passage d’une version locale perpétuelle d’Excel vers la suite infonuagique Microsoft 365, ou lors de la modification des paramètres linguistiques et régionaux du parc informatique. Les variations subtiles de comportement du moteur de calcul matriciel dynamique (introduit avec la gestion native des déversements de formules) ou les modifications des règles de conversion de dates peuvent altérer le résultat de formules patrimoniales jusqu’alors stables. Les protocoles de validation croisée sentinelle assurent la pérennité déterministe des calculs au travers de toutes les évolutions du cycle de vie matériel et logiciel de l’entreprise.
12. 12. Guide décisionnel pour la sélection de la méthode comparative appropriée
12.1 12.1 Matrice multicritère d’évaluation des méthodes
Pour naviguer avec pertinence au sein de l’arsenal technologique exposé tout au long de cette monographie, l’analyste de données doit procéder à un arbitrage rationnel fondé sur une analyse multicritère rigoureuse. Aucune méthode ne saurait prétendre à une supériorité universelle ; l’efficacité d’une approche dépend intimement de l’adéquation entre ses caractéristiques algorithmiques et les contraintes objectives de la situation d’audit opérationnelle.
Le premier critère d’arbitrage réside dans la confrontation entre la volumétrie des données et la performance computationnelle du matériel informatique disponible. Pour des tables de dimension modeste (inférieures à 5 000 cellules), les méthodes basées sur les formules de diagnostic matricielles directes ou sur la mise en forme conditionnelle offrent une réactivité immédiate sans aucun temps de développement préparatoire. En revanche, dès lors que les données franchissent le cap des 100 000 lignes, ces approches saturent les threads du processeur et dégradent l’affichage graphique ; le recours aux pipelines optimisés de Power Query ou aux tableaux mémoires virtuels en VBA s’impose alors de manière inconditionnelle pour maintenir les cycles de traitement dans des temporalités acceptables.
Le second critère concerne le niveau d’expertise technique requis pour l’implémentation et la maintenance de la solution. Si la mise en forme conditionnelle et les fonctions de recherche élémentaires de type RECHERCHEV sont maîtrisées par une large fraction des utilisateurs bureautiques, l’algèbre relationnelle en langage M sous Power Query, la manipulation de compléments d’infrastructure comme Spreadsheet Compare ou l’architecture de macros VBA relèvent de compétences avancées. Le gestionnaire de projet doit veiller à ne pas implémenter une architecture comparative sophistiquée qui deviendrait un artefact opaque non maintenable dès lors que l’analyste concepteur quitte l’organisation.
Le troisième axe décisionnel évalue la récurrence du besoin d’audit. Une comparaison ponctuelle, réalisée dans l’urgence pour réconcilier deux fichiers de clôture comptable exceptionnelle, justifie l’emploi d’approches rapides et pragmatiques (comme les raccourcis de la commande Atteindre ou les fenêtres d’affichage synchrone côte à côte). À l’inverse, un processus de réconciliation mensuel intégrant des flux de données asynchrones récurrents exige l’investissement méthodologique initial nécessaire à la construction d’un pipeline Power Query ou d’un classeur sentinelle automatisé, amorti dès les premières itérations de production.
12.2 12.2 Arbre de décision opérationnel
Afin de structurer le choix méthodologique de manière déterministe, le parcours décisionnel suivant peut être rigoureusement déroulé par l’auditeur :
- Cas 1 : Jeux de données statiques de petite dimension (< 2 000 lignes) à structure strictement isomorphe (aucune ligne insérée, ordre identique).
- Méthode préconisée : Visualisation directe par règle de mise en forme conditionnelle (
=A1<>Feuil2!A1) ou création d’une feuille matricielle miroir avec formule informative (=SI(A1=Feuil2!A1;"";A1 & " <> " & Feuil2!A1)). - Bénéfice : Mise en œuvre instantanée, diagnostic visuel direct, charge technique nulle.
- Méthode préconisée : Visualisation directe par règle de mise en forme conditionnelle (
- Cas 2 : Jeux de données présentant des asymétries de tri, des lignes intercalées ou des suppressions, mais dotés d’une clé primaire unique fiable.
- Méthode préconisée : Emploi des fonctions d’appariement relationnel moderne
RECHERCHEX(ou coupleINDEX/EQUIVsur les anciennes versions d’Excel). - Bénéfice : Insensibilité totale aux permutations spatiales et aux insertions de lignes, distinction nette entre absence d’enregistrement et mutation d’attribut.
- Méthode préconisée : Emploi des fonctions d’appariement relationnel moderne
- Cas 3 : Volumétries massives (> 50 000 lignes), flux de données asynchrones hétérogènes, ou comparaison récurrente périodique.
- Méthode préconisée : Modélisation d’un pipeline d’ingestion et de jointures relationnelles via Power Query (Anti-jointures gauche/droite et jointure interne filtrée).
- Bénéfice : Scalabilité industrielle, immutabilité absolue des données sources, automatisation du rafraîchissement d’un simple clic, traçabilité documentée en langage M.
- Cas 4 : Processus d’entreprise hautement spécifiques nécessitant des interactions système, l’exportation de logs formatés ou l’exécution sur des postes sans droits d’administration.
- Méthode préconisée : Script procédural VBA optimisé exploitant le chargement en tableaux mémoires virtuels (Variant Arrays) et la génération d’un journal d’audit horodaté.
- Bénéfice : Vitesse d’exécution maximale en mémoire pure, autonomie complète au sein du classeur, personnalisation totale du protocole d’audit et des alertes.
- Cas 5 : Audit forensique institutionnel, conformité réglementaire stricte et révision de structures de formules de calcul.
- Méthode préconisée : Utilitaire institutionnel Spreadsheet Compare (complément Inquire).
- Bénéfice : Inspection multidimensionnelle (valeurs, métadonnées, formules, code VBA), neutralité absolue de l’audit, rapports d’audit certifiés exportables.
12.3 12.3 Recommandations de gouvernance pour l’analyste de données
Au terme de cette analyse approfondie des méthodologies comparatives, il apparaît indispensable d’énoncer un ensemble de préceptes de gouvernance applicative destinés à pérenniser l’intégrité des modèles tabulaires. L’analyse différentielle ne doit pas être appréhendée comme une panacée curative isolée, mais comme l’élément d’un écosystème global de maîtrise de la qualité logicielle bureautique.
La première règle de saine gouvernance prescrit la séparation physique absolue entre la couche de stockage des données brutes, la couche de calcul logique et la couche de présentation ou de restitution décisionnelle. Les feuilles hébergeant les données transactionnelles doivent être scrupuleusement protégées contre toute intervention humaine directe, verrouillées en écriture et maintenues dans une structure tabulaire rectangulaire standardisée, dépourvue de cellules fusionnées, d’en-têtes décoratifs ou de totaux intercalaires. L’adoption généralisée des Tableaux Excel structurés (ListObjects) constitue l’assise fondamentale garantissant la résilience de l’ensemble des requêtes aval.
La seconde recommandation proscrit formellement l’évaluation visuelle non instrumentée sur des corpus d’informations guidant des décisions opérationnelles, financières ou humaines critiques. L’analyste doit cultiver une méfiance déontologique envers l’évidence graphique d’une feuille de calcul : deux nombres paraissant conformes à l’affichage peuvent abriter des disparités masquées par les arrondis typographiques ou l’arithmétique en virgule flottante ; deux textes en apparence identiques peuvent être corrompus par des espaces insécables ou des discordances de registre typographique. L’audit déterministe par formules logiques, requêtes relationnelles ou scripts vérifiés doit s’imposer comme un réflexe méthodologique immuable.
Enfin, les équipes d’analyse décisionnelle doivent maintenir une veille technologique active et un effort de formation continue portant sur les évolutions du moteur de calcul d’Excel. L’introduction récente des tableaux dynamiques matriciels, de nouvelles fonctions vectorielles de manipulation de texte et de tableaux, ainsi que la convergence continue entre le moteur relationnel Power Query et les interfaces bureautiques redessinent en profondeur les standards méthodologiques. En maîtrisant avec rigueur cette panoplie d’instruments différentiels, l’analyste de données transforme le tableur d’un vecteur historique d’incertitude et de risque opérationnel en un instrument maîtrisé d’excellence computationnelle, d’intégrité scientifique et de rigueur décisionnelle.
Références
- Benninga, S. (2014). Financial Modeling (4th ed.). MIT Press.
- De Levie, R. (2004). Advanced Excel for Scientific Data Analysis. Oxford University Press.
- Goldwater, R., & Powell, S. G. (2005). Errors in operational spreadsheets. Journal of End User Computing, 17(3), 67-83.
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). Institute of Electrical and Electronics Engineers. https://standards.ieee.org/ieee/754/6267/
- International Organization for Standardization. (2018). Information technology — Security techniques — Hash-functions — Part 3: Dedicated hash-functions (ISO/IEC 10118-3:2018). https://www.iso.org/standard/67116.html
- Microsoft Corporation. (2023). Documentation Power Query M. Microsoft Learn. https://learn.microsoft.com/fr-fr/powerquery-m/
- Microsoft Corporation. (2023). Fonction RECHERCHEX. Support Microsoft. https://support.microsoft.com/fr-fr/office/recherchex-fonction-recherchex-b34d831a-074d-425d-aa24-977a6fceb9e7
- Microsoft Corporation. (2023). Comparer des classeurs avec l’outil Inquire Spreadsheet Compare. Support Microsoft. https://support.microsoft.com/fr-fr/office/comparer-des-classeurs-avec-l-outil-de-comparaison-de-feuilles-de-calcul-inquire-d1327752-90fd-4e48-bfc2-0b2984534892
- Panko, R. R. (2016). What we know about spreadsheet errors. Journal of End User and Organizational Development, 10(2), 15-46.
- Panko, R. R., & Aurigemma, S. (2010). Revisiting the Ogden study: How well do individuals and teams find spreadsheet errors? Proceedings of the 43rd Hawaii International Conference on System Sciences, 1-10. https://doi.org/10.1109/HICSS.2010.279
- Puls, K., & Escobar, M. (2015). M is for (Data) Monkey: A Guide to the M Language in Excel Power Query. Holy Macro! Books.
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.