
Dans l’écosystème contemporain des technologies de l’information et de l’ingénierie des données d’entreprise, la feuille de calcul demeure un instrument prépondérant pour l’analyse opérationnelle, l’arbitrage financier et la gouvernance informationnelle. Google Sheets s’est imposé comme un environnement infonuagique collaboratif de premier plan, conjuguant accessibilité ubiquitaire et puissance de calcul distribuée. Toutefois, la manipulation de volumes croissants de données hétérogènes engendre des défis méthodologiques substantiels, au premier rang desquels figure la comparaison rigoureuse de colonnes de données. Qu’il s’agisse de rapprocher des états financiers, de synchroniser des inventaires logistiques, de vérifier l’intégrité de bases de données clients ou de valider des flux d’extraction, de transformation et de chargement (ETL), la capacité à confronter deux vecteurs de données constitue une compétence analytique fondamentale.
La comparaison de colonnes ne se résume pas à l’application naïve d’un opérateur d’égalité binaire. Elle mobilise une compréhension théorique approfondie de la structure des données tabulaires, des spécificités typologiques des valeurs manipulées, ainsi que des limites computationnelles inhérentes aux moteurs de calcul sur tableur. Une divergence apparente entre deux cellules peut résulter d’une multiplicité de facteurs : discordances typographiques invisibles, disparités de formats sous-jacents, micro-variations sur nombres à virgule flottante ou désalignements spatiaux des enregistrements. À l’inverse, une apparente conformité peut masquer des ambiguïtés sémantiques pernicieuses susceptibles de compromettre la validité des modèles décisionnels. Dès lors, le praticien de la donnée doit maîtriser une taxonomie complète de techniques comparatives, allant de la confrontation horizontale positionnelle à l’analyse ensembliste vectorielle décorrélée de l’ordre d’apparition.
Ce traité exhaustif explore en profondeur l’ensemble des méthodologies, fonctions et architectures algorithmiques permettant d’effectuer des comparaisons de colonnes irréprochables au sein de Google Sheets. À travers des fondements théoriques éprouvés, des déconstructions syntaxiques minutieuses, des études de cas industrielles et des protocoles d’automatisation avancés impliquant le langage de requête Google et Google Apps Script, ce document fournit aux analystes, ingénieurs et gestionnaires les clés d’une gouvernance rigoureuse de leurs données tabulaires. L’objectif ultime est d’éradiquer les faux positifs et négatifs, d’optimiser l’efficience algorithmique des classeurs et d’instaurer des mécanismes d’audit fiables et pérennes.
1. Fondements méthodologiques de la comparaison de données tabulaires dans Google Sheets
1.1 Principes d’intégrité et préparation des ensembles de données
Préalablement à toute tentative d’évaluation comparative au sein d’un tableur, l’analyste se doit de vérifier l’intégrité fondamentale des données brutes. L’adage classique de la science informatique, stipulant que des données d’entrée corrompues génèrent inévitablement des extrants erronés, trouve dans l’environnement tabulaire une illustration particulièrement critique. Les divergences apparentes observées entre deux colonnes trouvent très fréquemment leur genèse non pas dans une réelle dissemblance sémantique des attributs métiers, mais dans une contamination typographique ou structurelle survenue lors des phases d’ingestion ou de saisie manuelle. L’évaluation de la propreté des données implique ainsi un examen systématique des distributions textuelles, des conventions d’encodage et de la normalisation morphologique des éléments à confronter.
L’harmonisation des formats constitue le deuxième pilier de cette phase préparatoire. Google Sheets applique un mécanisme de typage dynamique qui catégorise implicitement les entrées cellulaires en chaînes de caractères, valeurs numériques pures, booléens ou dates temporelles. Deux représentations visuellement identiques peuvent ainsi être traitées de manière orthogonale par le moteur logique du logiciel. Par exemple, un code d’identification stocké sous forme de chaîne textuelle ne présentera jamais d’équivalence logique stricte avec son pendant converti en valeur entière décimale. De surcroît, les formats temporels représentent une source notoire de faux négatifs : une date affichée au format européen standard peut receler une composante horaire non visible qui vicie l’évaluation d’égalité absolue avec une date calendaire pure. Une standardisation préliminaire des typages s’avère donc impérative avant toute opération d’appariement.
Enfin, la présence insidieuse d’espaces insécables (code Unicode U+00A0) et de caractères invisibles constitue l’un des pièges les plus déconcertants pour les concepteurs de modèles tabulaires. Fréquemment importés lors de copier-coller depuis des interfaces web ou des systèmes ERP hérités, ces glyphes invisibles ne sont pas systématiquement traités par les fonctions de nettoyage basiques. Le caractère d’espace standard (U+0020) et l’espace insécable possèdent des valeurs d’octets distinctes, empêchant le processeur de calcul d’établir une correspondance entre deux chaînes pourtant parfaitement indiscernables à l’œil nu. L’analyste rigoureux doit par conséquent déployer des protocoles de neutralisation de ces artefacts textuels en amont de toute confrontation formelle.
1.2 Taxonomie des typologies de comparaison tabulaire
La formulation d’une stratégie comparative exige une distinction théorique impérative entre deux paradigmes fondamentaux : la comparaison horizontale, dite ligne à ligne, et la comparaison vectorielle globale ou ensembliste. La comparaison horizontale postule une stricte concordance ordinale et spatiale entre les enregistrements des deux colonnes. Dans ce schéma, l’entité située à la coordonnée matricielle d’ordonnée i au sein du vecteur A est confrontée exclusivement à l’entité occupant la même ordonnée i au sein du vecteur B. Cette approche est principalement mobilisée lors de la vérification de flux temporels parallèles, d’audits de réplication de bases de données où les index primaires sont synchronisés, ou lors du suivi de versions consécutives d’un même rapport structuré à l’identique.
À l’opposé, la comparaison vectorielle globale s’affranchit de toute contingence positionnelle pour embrasser les principes de la théorie des ensembles. La question fondamentale ne réside plus dans l’alignement géométrique des cellules, mais dans l’appartenance d’un élément donné du vecteur source à l’ensemble cible considéré dans sa globalité. Cette approche répond à des problématiques métiers cardinales telles que le rapprochement d’inventaires d’entrepôts multiples, l’identification de clients communs au sein de fichiers de prospection hétérogènes, ou la détection de transactions bancaires orphelines. Assimiler une problématique vectorielle à un traitement ligne à ligne constitue une erreur méthodologique rédhibitoire qui engendre des diagnostics massivement faussés dès lors qu’un seul décalage ou tri asymétrique intervient dans l’un des ensembles.
Le choix de l’architecture algorithmique optimale requiert par conséquent une clarification préalable des objectifs poursuivis. Si le modèle vise à évaluer la stabilité d’un système au cours du temps à structure constante, le paradigme ligne à ligne offre une rapidité d’exécution et une lisibilité immédiate. En revanche, si la recherche porte sur l’exhaustivité, la redondance inter-systèmes ou la disjonction de nomenclatures, l’analyste doit nécessairement convoquer des outils de calcul ensembliste. Ces derniers exploitent des tables de hachage logiques, des mécanismes de projection matricielle ou des prédicats relationnels capables de sonder l’intégralité d’un espace vectoriel indépendamment de l’ordonnancement de ses composants individuels.
1.3 Rigueur des références cellulaires et adressage logique
L’implémentation de toute formule comparative dans un environnement tabulaire repose sur la maîtrise de l’adressage mémoire et de la topologie cellulaire. Google Sheets distingue fondamentalement les références relatives des références absolues et mixtes. Lors du déploiement vertical d’une formule de comparaison horizontale, l’adressage relatif (par exemple, A1=B1) constitue le standard opérationnel requis. Lors de l’étirement ou de l’expansion de la formule vers le bas, les indices de ligne s’incrémentent de manière synchrone, préservant ainsi l’alignement relatif entre les deux colonnes cibles tout au long de l’axe vertical.
Cependant, dès lors que l’on bascule vers des architectures comparatives vectorielles requérant le balayage d’une matrice fixe pour chaque élément individuel, l’opérateur dollar ($) devient le garant absolu de l’intégrité computationnelle. L’absence de verrouillage des indices de plage (par exemple en utilisant B1:B100 au lieu de $B$1:$B$100) produit un phénomène de dérive spatiale de la zone de prospection à mesure que la formule est propagée. Ce glissement mécanique élimine progressivement les premières occurrences de l’ensemble cible et incorpore des cellules vierges en queue de plage, induisant des taux d’erreur exponentiels qui demeurent souvent indétectables pour un observateur non averti.
De surcroît, la gestion de la cohérence dimensionnelle entre deux colonnes de longueurs divergentes impose une vigilance méthodologique particulière. Dans les scénarios réels d’entreprise, il est exceptionnel que deux jeux de données présentent une cardinalité strictement équivalente. La confrontation d’un vecteur de 5 000 lignes à un vecteur de 12 000 lignes génère des asymétries de traitement qui doivent être anticipées. L’analyste doit définir des frontières de calcul explicites pour éviter que les cellules vierges de la colonne la plus courte ne soient interprétées comme des valeurs nulles ou des zéros logiques lors de la confrontation avec le résidu de la colonne la plus étendue, prévenant ainsi toute distorsion de l’analyse globale.
2. Détection de l’égalité stricte entre deux colonnes ligne par ligne
2.1 Syntaxe fondamentale et implémentation de la fonction SI
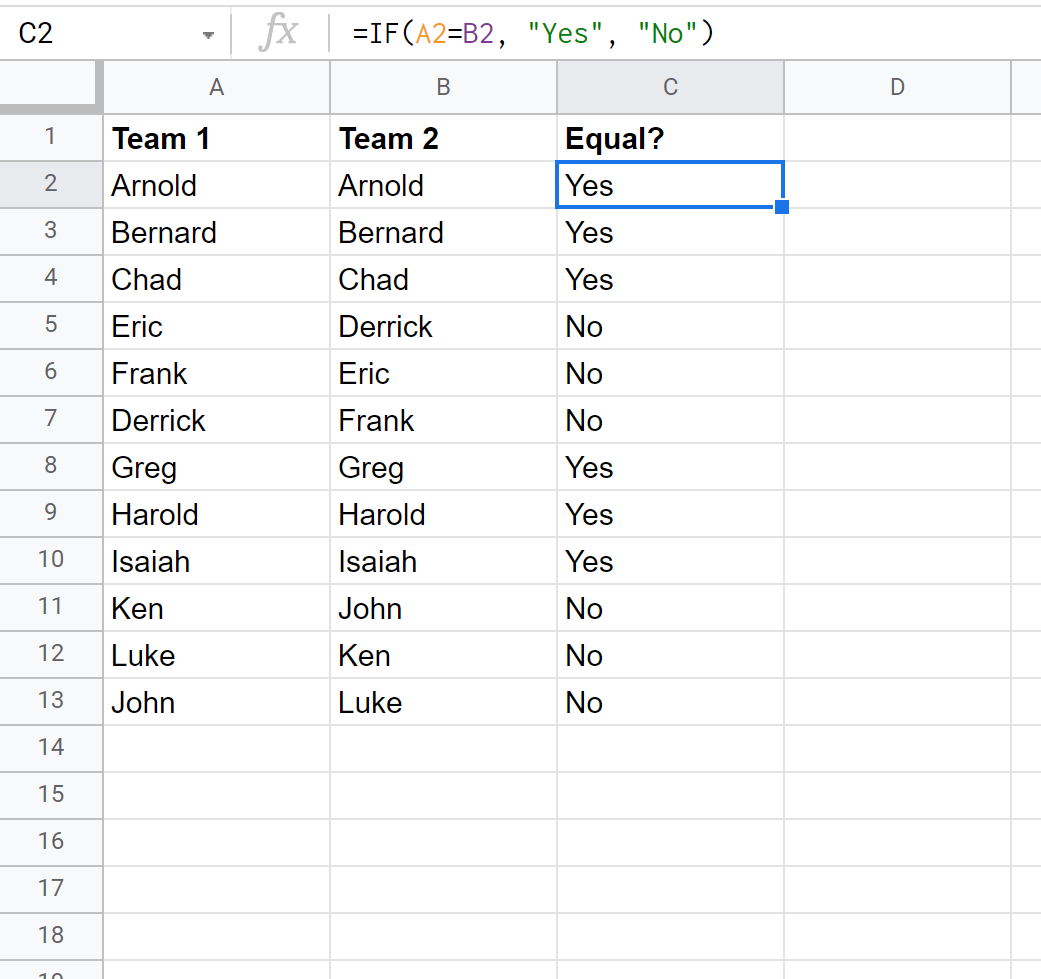
L’opération comparative la plus intuitive au sein d’un environnement de calcul tabulaire réside dans la vérification de l’identité géométrique terme à terme. La syntaxe canonique employée repose sur la conjugaison de l’opérateur d’assignation logique et de la structure conditionnelle fondamentale : =SI(A1=B1; "Oui"; "Non"). Dans cette expression, le moteur d’évaluation interne de Google Sheets procède à un test de vérité binaire sur la relation d’équivalence A1=B1. Si les deux cellules renferment des valeurs que le système juge isomorphes, la condition retourne la constante booléenne VRAI, déclenchant l’évaluation de la première branche d’expression (« Oui »). À l’inverse, toute divergence typographique, quantitative ou sémantique bascule le flux logique vers la constante FAUX, renvoyant l’étiquette d’invalidation (« Non »).
Il importe de souligner que l’opérateur d’égalité simple au sein de Google Sheets opère selon un modèle de comparaison permissive et non discriminante sur le plan typographique. Par exemple, l’expression ="EXEMPLE"="exemple" évaluera systématiquement à VRAI. Cette insensibilité native à la casse typographique constitue un avantage fonctionnel pour l’appariement général de textes administratifs, mais s’avère problématique dans le cadre de protocoles d’ingénierie logicielle ou financière où la casse véhicule une valeur sémantique distincte, telle que des codes d’authentification ou des identifiants cryptographiques. L’interprétation systématique des résultats nécessite dès lors l’adjonction d’une colonne tierce dédiée, matérialisant le statut de conformité pour chaque enregistrement.
Pour conférer à ce dispositif une rigueur analytique maximale, il convient d’exclure les libellés subjectifs au profit de codifications binaires normalisées ou de booléens stricts. La formule épurée =A1=B1 retourne directement VRAI ou FAUX sans l’intermédiation de la fonction SI. Ce format booléen natif présente une efficience computationnelle supérieure, réduit la charge mémorielle du classeur et autorise des agrégations arithmétiques ultérieures immédiates, la constante VRAI étant assimilée à la valeur 1 et FAUX à la valeur 0 lors des opérations de sommation vectorielle.
2.2 Gestion de la sensibilité à la casse avec la fonction EXACT
Lorsque le protocole de vérification exige une fidélité orthographique absolue et que la distinction entre majuscules et minuscules revêt une importance critique, l’opérateur d’égalité standard doit impérativement être proscrit au profit de la fonction EXACT. La syntaxe =EXACT(A1; B1) exécute une comparaison binaire octet par octet des chaînes textuelles contenues dans les cellules cibles. Dès lors, la moindre variation dans l’usage de la typographie majuscule se solde par le renvoi impitoyable de la valeur booléenne FAUX, éliminant tout risque de faux positif lié à la permissivité native du tableur.
Considérons à titre d’illustration l’audit de nomenclatures de pièces industrielles ou de codes produits internationaux de type SKU (Stock Keeping Unit). Dans ces nomenclatures hautement standardisées, la séquence textuelle « Ab-100 » peut désigner un sous-ensemble mécanique totalement distinct de la pièce « AB-100 ». L’application de la fonction conditionnelle standard =A1=B1 conclurait erronément à l’interchangeabilité des deux composants. En revanche, l’implémentation de la clause =SI(EXACT(A1; B1); "Conforme"; "Discordance de Casse") garantit une ségrégation rigoureuse de ces occurrences, préservant l’intégrité du système de gestion des stocks sous-jacent.
La fonction EXACT étend également son exigence formelle aux caractères diacritiques et aux accents typographiques. Une confrontation confrontant un caractère accentué à sa contrepartie non accentuée sera invariablement déclarée dissemblable. Cette étanchéité sémantique transforme EXACT en un instrument indispensable pour les auditeurs de données linguistiques, les gestionnaires de bases d’adresses nominatives et les programmeurs chargés d’assurer la cohérence des variables d’environnement entre différents systèmes applicatifs intégrés.
2.3 Nettoyage préemptif des chaînes avec SUPPRESPACE et EPURAGE
Dans la pratique professionnelle, les échecs de comparaison ligne par ligne trouvent majoritairement leur source dans la présence d’espaces parasites indésirables, insérés par inadvertance en début ou en fin de chaîne de caractères par les opérateurs humains ou les scripts d’exportation défaillants. Une cellule contenant la séquence "Paris " (comportant une espace finale) ne satisfera jamais le test d’égalité logique face à la cellule "Paris". Pour immuniser le système comparatif contre ces distorsions périphériques, l’analyste doit encapsuler les références cellulaires dans la fonction SUPPRESPACE (ou TRIM en nomenclature anglophone).
La fonction SUPPRESPACE procède à une double action assainissante : elle élague impérativement tous les espaces situés en tête et en queue de chaîne, tout en compressant les séquences d’espaces multiples contigus situés au cœur du texte pour n’en conserver qu’un spécimen unique. Cependant, cette fonction s’avère insuffisante face aux pollutions générées par des caractères non imprimables, tels que les sauts de ligne intempestifs (ASCII 10 ou 13) et les tabulations horizontales, fréquents lors de l’extraction de données depuis des formats PDF ou des tables HTML complexes. C’est ici qu’intervient la fonction complémentaire EPURAGE (CLEAN), qui neutralise systématiquement l’ensemble des 32 premiers caractères non imprimables de la table ASCII standard.
La conception d’une cellule de comparaison hautement résiliente nécessite l’imbrication synergique de ces fonctions d’assainissement préliminaire au sein de l’assertion logique. La formule optimale prend ainsi la forme suivante :
=SI(SUPPRESPACE(EPURAGE(A1))=SUPPRESPACE(EPURAGE(B1)); "Équivalence stricte"; "Anomalie")
Cette construction défensive neutralise l’intégralité des bruits structurels superficiels et focalise l’évaluation algorithmique sur le substrat informatif réel des données, réduisant de manière spectaculaire le taux de discordances infondées.
3. Évaluation des disparités d’ordre et de grandeur numérique
3.1 Formulation comparative avec les opérateurs relationnels
Lorsque la confrontation tabulaire quitte le champ de l’équivalence catégorielle pour aborder l’analyse de grandeurs quantitatives, les opérateurs relationnels d’inégalité stricte et large deviennent les instruments de prédilection de l’analyste. Google Sheets implémente l’ensemble canonique des comparateurs mathématiques : supérieur strict (>), inférieur strict (<), supérieur ou égal (>=), inférieur ou égal (<=) et disjonction stricte (<>). L’usage de ces primitives relationnelles permet d’établir des diagnostics d’évolution, de surperformance ou de sous-évaluation entre deux séries chronologiques ou deux métriques concurrentes.
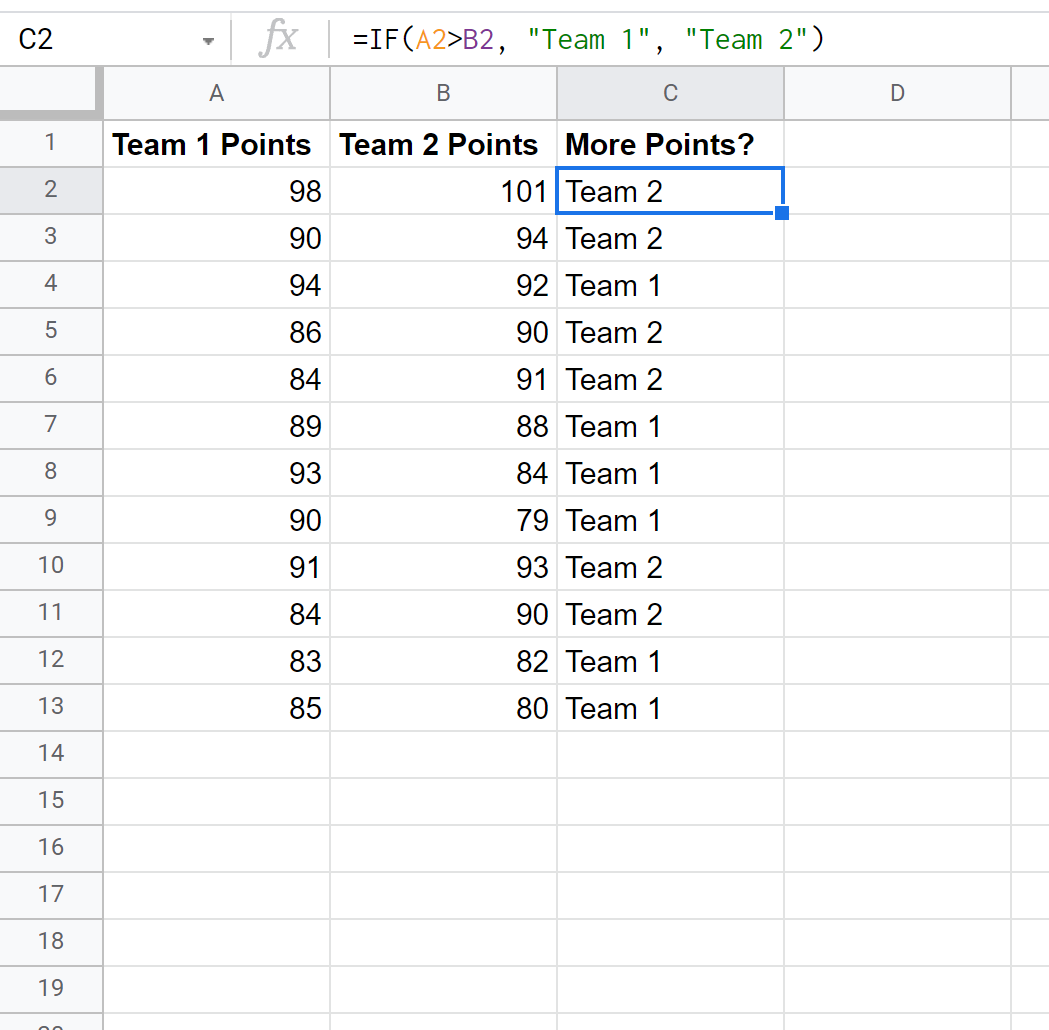
Une formulation élémentaire visant à identifier la supériorité relative s’articule sous la forme : =SI(A1>B1; "Colonne A dominante"; "Colonne B dominante"). Toutefois, cette écriture binaire souffre d’un biais d’interprétation méthodologique rédhibitoire : elle occulte totalement le cas d’équivalence parfaite. En effet, si la valeur hébergée en A1 équivaut mathématiquement à celle de B1, l’inégalité stricte A1>B1 renvoie la valeur FAUX, conduisant erronément le système à classifier cette situation d’égalité sous l’étiquette « Colonne B dominante ».
Afin de prévenir tout classement fallacieux, l’arborescence décisionnelle doit impérativement intégrer l’égalité arithmétique comme un cas d’usage distinct. La formule comparative doit dès lors adopter une structure disjonctive explicite :
=SI(A1>B1; "A > B"; SI(A1<B1; "A < B"; "A = B"))
Cette décomposition tripartite garantit l’exhaustivité logique du test en couvrant scrupuleusement les trois configurations possibles régies par la loi de trichotomie des nombres réels, assurant une modélisation mathématique sans faille de vos flux d’analyse.
3.2 Classifications ordinales multicritères par conditions imbriquées
L’approfondissement de l’analyse comparative numérique exige souvent de dépasser le simple constat d’ordre de grandeur pour établir des échelons de tolérance ou des classifications d’écart adaptées aux règles de gestion d’entreprise. Si l’imbrication historique de multiples clauses SI permet d’atteindre ce résultat, cette méthode nuit gravement à la lisibilité et à la maintenance du classeur. L’avènement de la fonction SI.CONDITIONS (ou IFS) a profondément rationalisé cette pratique en offrant une structure déclarative linéaire et séquentielle.
La fonction SI.CONDITIONS évalue une série de couples condition-valeur et retourne le résultat correspondant à la première condition testée comme vérifiée. Cette architecture s’avère particulièrement adaptée à la segmentation des variations d’un budget prévisionnel (Colonne A) confronté aux dépenses réelles constatées (Colonne B). L’analyste peut ainsi concevoir une échelle d’évaluation multicritère formalisée de la manière suivante :
=SI.CONDITIONS(A1=B1; "Conformité parfaite"; A1>B1*1,1; "Dépassement critique (>10%)"; A1>B1; "Dépassement modéré"; A1<B1; "Sous-consommation")
La hiérarchisation des conditions revêt ici une importance capitale. L’interpréteur de Google Sheets procédant à une lecture séquentielle de gauche à droite, les conditions les plus restrictives et les seuils d’écart les plus contraignants doivent impérativement précéder les conditions plus générales. L’omission de cet ordonnancement logique conduirait par exemple la condition générale A1>B1 à capturer l’ensemble des écarts positifs, rendant morte et inopérante la condition spécifique de dépassement critique pourtant définie en aval.
3.3 Quantification mathématique des écarts absolus et relatifs
L’appréciation rigoureuse d’une disparité numérique ne saurait se limiter à un constat ordinal qualitatif ; elle requiert une quantification mathématique d’une précision absolue. Deux métriques fondamentales doivent être mobilisées conjointement : la différence arithmétique simple, qui mesure l’amplitude linéaire brute de la divergence, et la variation relative en pourcentage, qui contextualise cette déviation à l’aune du volume de base de référence.
La mesure d’amplitude absolue est obtenue via l’expression élémentaire =A1-B1, fréquemment adjointe de la fonction de valeur absolue =ABS(A1-B1) lorsqu’il s’agit de quantifier la dispersion globale indépendamment du sens de l’écart. En revanche, le calcul de la dynamique relative s’exprime par le ratio mathématique =(A1-B1)/B1, formaté par la suite en affichage de pourcentage. Cette dernière opération introduit néanmoins un risque de défaillance computationnelle majeur : la division par zéro lorsque la cellule référente au dénominateur contient la valeur nulle.
Pour parer à l’interruption préjudiciable du calcul et à l’apparition des codes d’erreur inesthétiques #DIV/0! qui contaminent les tableaux récapitulatifs, l’analyste doit encapsuler systématiquement le calcul dans une structure d’interception d’anomalie au moyen de la fonction SI.ERREUR (ou IFERROR). La formulation robuste prend dès lors la forme canonique :
=SI.ERREUR((A1-B1)/B1; "Base de référence nulle")
Ce formalisme assure une continuité logique du classeur et permet d’adjoindre une explication métier intelligible là où une simple défaillance arithmétique brute aurait bloqué les chaînes de consolidation subséquentes.
4. Identification des intersections : trouver les valeurs communes aux deux colonnes
4.1 Vérification de l’existence par RECHERCHEV
L’identification de l’intersection entre deux colonnes indépendantes constitue le socle du rapprochement de données. Dans ce contexte, l’objectif consiste à déterminer si un élément figurant au sein de la colonne A trouve un ou plusieurs échos au sein de la colonne B, indépendamment de son positionnement vertical. La fonction historique RECHERCHEV (ou VLOOKUP) a longtemps constitué l’instrument exclusif pour opérer cette prospection d’existence, en exploitant sa capacité à scanner la première colonne d’une matrice cible.
La mécanique fondamentale de cette approche s’articule autour de la formule : =RECHERCHEV(A1; $B:$B; 1; FAUX). Le quatrième argument, impérativement positionné à FAUX, ordonne au moteur de recherche de n’admettre que des correspondances rigoureusement exactes, désactivant ainsi le mode de recherche par interpolation approximative réservé aux séries préalablement ordonnées. Si la valeur A1 réside au sein de la colonne B, la fonction renvoie la valeur elle-même. En cas de non-concordance, le moteur de calcul déclenche l’émission du code d’erreur #N/A (signifiant Non Applicable).
Bien que cette erreur confirme techniquement l’absence d’intersection pour l’élément analysé, elle dégrade la lisibilité opérationnelle du rapport. L’analyste averti recourt donc aux fonctions d’interception booléenne telles que ESTNA ou la combinaison NON(ESTNA()) pour métamorphoser ce comportement en un indicateur analytique limpide. La formulation achevée se configure ainsi :
=SI(ESTNA(RECHERCHEV(A1; $B:$B; 1; FAUX)); "Absent du vecteur B"; "Commun aux deux vecteurs")
Cette écriture procure un contrôle catégoriel irréprochable et convertit un comportement d’échec technique en une information métier directement exploitable pour les filtres et tableaux croisés dynamiques.
4.2 Exploitation de la fonction EQUIV pour tester l’appartenance
Bien que RECHERCHEV remplisse fonctionnellement sa mission de détection, elle n’en demeure pas moins un outil structurellement surdimensionné et computationnellement inefficace pour la pure vérification d’appartenance. Conçue initialement pour extraire des valeurs déportées sur des colonnes adjacentes, elle impose une charge mémoire supérieure à celle de la fonction spécialisée EQUIV (ou MATCH). La vocation exclusive de EQUIV réside dans le repérage de la position ordinale relative d’un élément au sein d’un vecteur unidimensionnel.
L’implémentation de la fonction EQUIV pour le test d’intersection s’exécute selon la syntaxe suivante : =EQUIV(A1; $B:$B; 0). Le paramètre 0 impose une correspondance exacte et absolue. Lorsque l’élément A1 est localisé dans la colonne B, EQUIV ne restitue pas la chaîne textuelle elle-même, mais l’indice numérique de la ligne de correspondance (par exemple, 42 si la valeur coïncide avec la quarante-deuxième cellule du vecteur B). À l’inverse, l’absence d’intersection se solde également par la génération de l’erreur #N/A.
Pour transformer cette position numérique en un prédicat binaire de conformité, il suffit d’encapsuler la recherche au sein de la fonction de validation de type ESTNUM. La formule qui en résulte représente l’un des archétypes de l’optimisation sur Google Sheets :
=SI(ESTNUM(EQUIV(A1; $B:$B; 0)); "Intersection avérée"; "Élément exclusif à A")
Cette approche surpasse RECHERCHEV tant en vitesse d’exécution lors du traitement de jeux de données massifs qu’en robustesse structurelle face aux remaniements géométriques de la feuille de calcul.
4.3 Utilisation de NB.SI pour une validation fréquentielle
Une troisième méthodologie hautement performante pour certifier l’existence d’une valeur dans un ensemble tiers consiste à sonder la fréquence d’apparition de cette valeur par le biais de la fonction NB.SI (ou COUNTIF). Cette approche s’avère particulièrement séduisante par son élégance conceptuelle et son absence intrinsèque de génération de codes d’erreur, neutralisant ainsi le besoin d’envelopper la requête dans des fonctions d’interception d’exception de type ESTNA ou SI.ERREUR.
La structure syntaxique de cette validation fréquentielle est d’une grande sobriété mathématique : =NB.SI($B:$B; A1). Le moteur computationnel parcourt la colonne cible B et calcule le nombre exact d’occurrences correspondant au critère A1. Si le décompte obtenu est strictement supérieur à zéro, l’analyste détient la preuve formelle que l’entité réside au sein de l’intersection des deux ensembles. L’exploitation conditionnelle standard s’orchestre dès lors comme suit :
=SI(NB.SI($B:$B; A1)>0; "Appartenance validée"; "Occurrence isolée")
Au-delà de la confirmation d’intersection, la fonction NB.SI délivre une information dimensionnelle précieuse : le degré de multiplicité de l’élément recherché. Alors que RECHERCHEV et EQUIV s’interrompent dès la détection de la toute première correspondance sans renseigner sur la présence d’éventuels doublons résiduels, NB.SI quantifie avec exactitude le nombre de réplications de l’élément dans la colonne cible. Cette caractéristique transforme cette fonction en un instrument de choix lors de l’audit de tables de correspondance censées respecter une contrainte d’intégrité référentielle d’unicité (relations de type un-à-un ou plusieurs-à-un).
5. Détection et extraction des valeurs divergentes et exclusives
5.1 Isolement des éléments exclusifs à une seule colonne
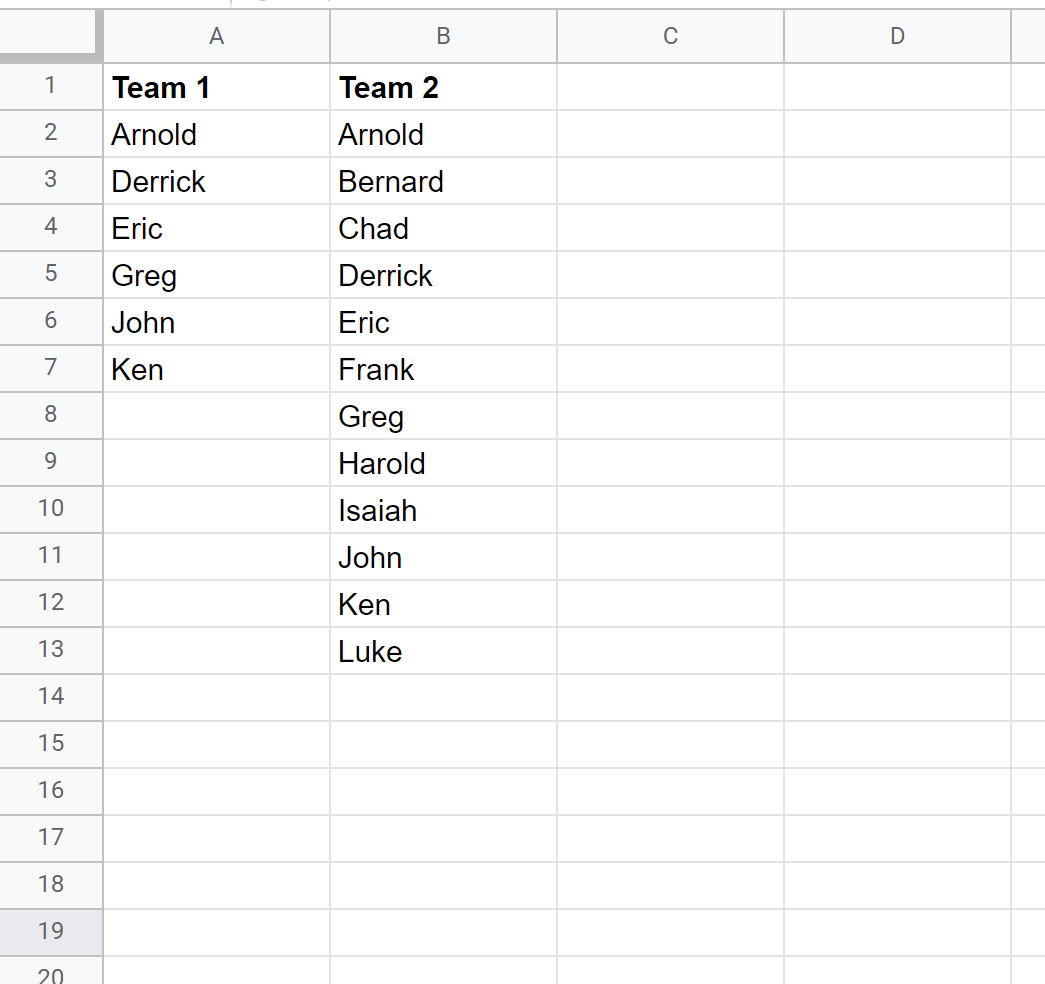
Tandis que l’identification des intersections répond au besoin de synchronisation, l’extraction des éléments exclusifs à une colonne unique constitue le pivot fondamental des opérations d’audit d’omissions documentaires et de réconciliation de bilans comptables. Du point de vue de la théorie des ensembles, cette opération correspond à la soustraction ensembliste, souvent notée A B, qui regroupe les éléments appartenant de manière unilatérale à l’ensemble A tout en étant rigoureusement absents de l’ensemble B.
Pour matérialiser cette disjonction sans recourir à des tris manuels fastidieux, Google Sheets offre la fonction matricielle dynamique FILTER. En combinant la puissance de filtrage vectoriel de FILTER avec l’évaluation d’absence délivrée par ESTNA et EQUIV, l’analyste peut générer de façon entièrement dynamique et automatisée la liste exhaustive des éléments manquants. La formule directrice s’énonce ainsi :
=FILTER(A2:A; ESTNA(EQUIV(A2:A; B2:B; 0)))
Cette construction algorithmique opère une itération interne sur l’ensemble de la plage source A2:A. Pour chaque élément individuel, elle vérifie son appartenance au vecteur B2:B. Dès lors que l’indice retourné est inexistant (générant l’état ESTNA), le prédicat logique devient VRAI, contraignant la fonction FILTER à propager la valeur correspondante dans la colonne de destination. Aucun espace vide ou artefact d’espacement n’est généré : le résultat constitue un flux vectoriel compact et auto-ajustable, se recalibrant automatiquement à chaque mise à jour des ensembles de référence.
5.2 Analyse de la différence symétrique entre ensembles
Dans un contexte d’audit exhaustif, l’analyste ne peut se contenter d’extraire la disjonction asymétrique A B. Il est indispensable de procéder à l’analyse de la différence symétrique intégrale, conventionnellement désignée par l’opérateur ensembliste A Δ B. Cette grandeur mathématique agrège l’ensemble des éléments qui appartiennent de manière exclusive soit au vecteur A, soit au vecteur B, tout en radiant rigoureusement l’intégralité des composants appartenant à leur intersection mutuelle.
Pour concrétiser cette différence symétrique au sein d’une restitution synthétique unique, les versions modernes de Google Sheets permettent d’associer des opérateurs d’empilement matriciel et des fonctions de restructuration de vecteurs telles que TOCOL et VSTACK. En consolidant les exclusions unilatérales de chaque vecteur respectif, l’architecture de la formule de synthèse s’articule comme suit :
=VSTACK(FILTER(A2:A; ESTNA(EQUIV(A2:A; B2:B; 0))); FILTER(B2:B; ESTNA(EQUIV(B2:B; A2:A; 0))))
Cette expression produit un tableau récapitulatif sans concession, exposant dans une continuité spatiale unique l’ensemble des anomalies d’appariement constatées de part et d’autre des sources d’information. Afin de distinguer l’origine respective de ces divergences, il est d’usage d’adjoindre une balise textuelle dynamique lors de l’empilement, permettant ainsi aux équipes opérationnelles d’identifier immédiatement le système d’origine défaillant et de déclencher les procédures de remédiation appropriées.
5.3 Gestion des faux doublons et des discordances invisibles
Lors de la production de rapports d’exclusions, l’émergence de faux doublons et de discordances invisibles représente un défi d’interprétation récurrent. Des enregistrements qui semblent textuellement ou numériquement indiscernables sur l’interface graphique du tableur peuvent se voir erronément classifiés au sein des listes d’anomalies exclusives. Cette pathologie des données procède quasi systématiquement de divergences d’encodage de bas niveau ou d’altérations sémantiques imperceptibles.
La première mesure corrective consiste à auditer l’unicité intrinsèque de chacun des vecteurs sources au moyen de la fonction UNIQUE. En effet, si un élément redondant est présent plusieurs fois dans la colonne A tout en étant absent de la colonne B, la formule d’exclusion conventionnelle restituera cette valeur de manière répétée au sein du rapport de divergence. L’adjonction systématique de la clause d’unicité, sous la forme =UNIQUE(FILTER(A2:A; ESTNA(EQUIV(A2:A; B2:B; 0)))), assure que chaque anomalie d’exclusion n’est documentée qu’une seule et unique fois, allégeant la charge d’investigation humaine.
La seconde étape critique repose sur l’élimination des discordances invisibles induites par des variations de micro-typographie. Cela inclut la confusion classique entre le tiret cadratin, le tiret demi-cadratin et le trait d’union standard (ASCII 45), ainsi que l’utilisation de guillemets dits courbes ou typographiques à la place des guillemets droits universels. Le recours à des listes triées de non-correspondance couplées à des analyses de fréquence de caractères permet de repérer ces micro-erreurs d’encodage et de restaurer une comparabilité rigoureuse avant l’émission des diagnostics d’exclusion définitifs.
6. Automatisation visuelle par la mise en forme conditionnelle
6.1 Mise en surbrillance des égalités et différences ligne à ligne
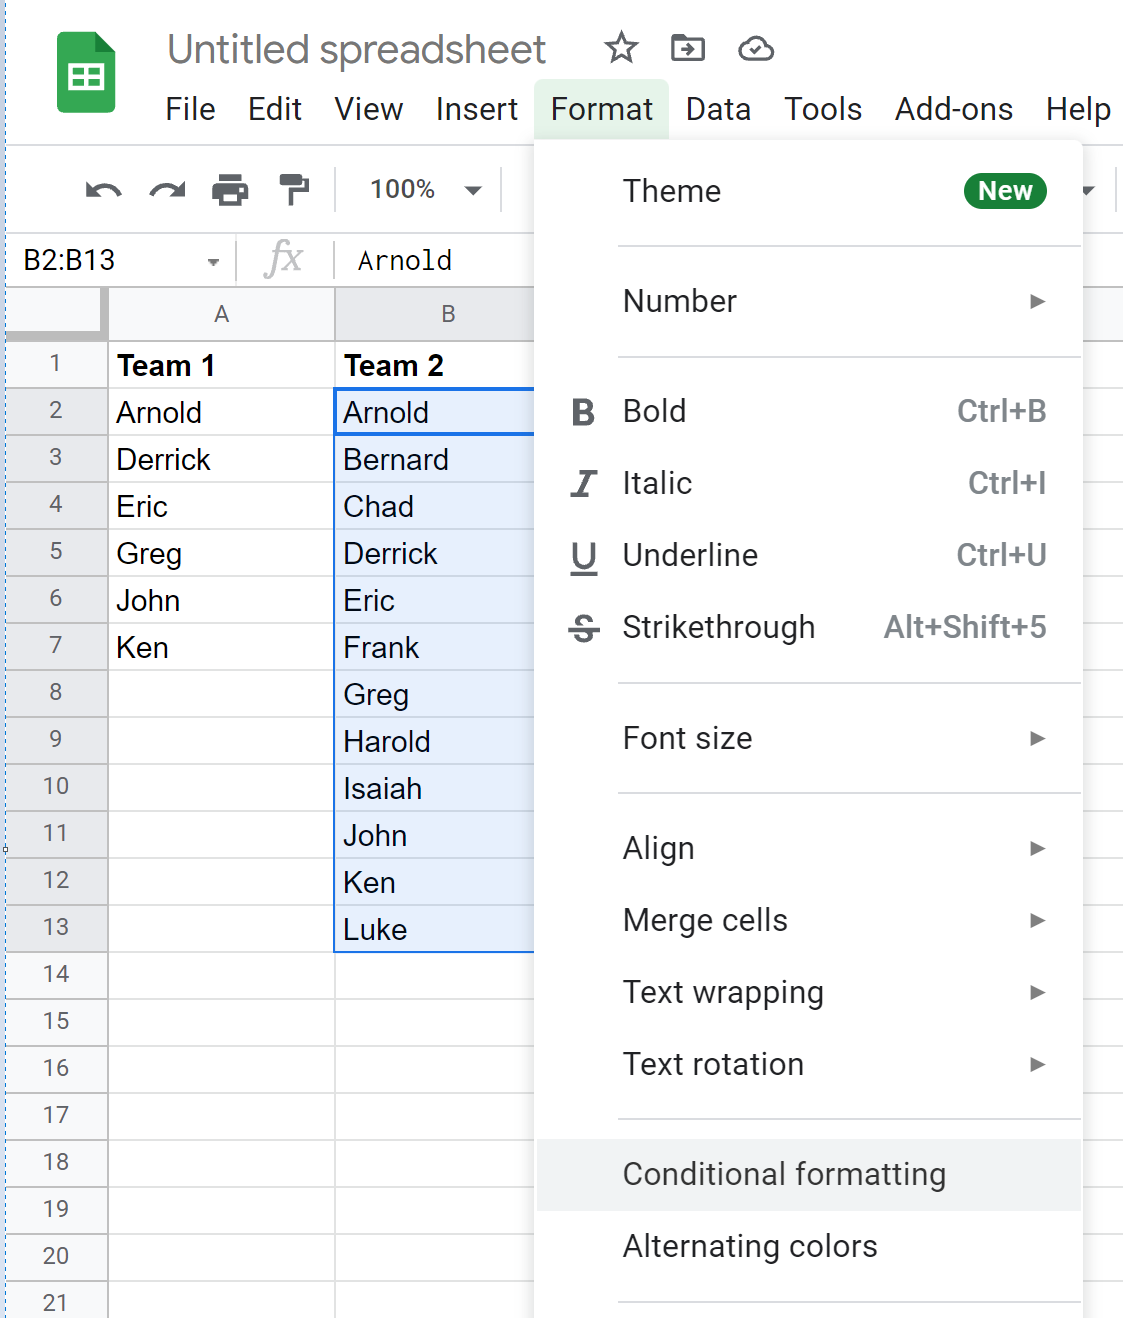
Si la génération de colonnes d’état et l’extraction de listes disjointes sont indispensables pour l’exploitation algorithmique, la restitution visuelle directe sur les données sources offre une efficience ergonomique remarquable. Le moteur de mise en forme conditionnelle de Google Sheets permet d’appliquer des couches de stylisation dynamique (changements de chromie de fond, modifications typographiques, bordures d’alerte) basées sur l’évaluation en temps réel de formules booléennes personnalisées.
Pour matérialiser les concordances strictes ligne à ligne, l’analyste définit une règle de surbrillance sur la plage bidimensionnelle A2:B100 en sélectionnant l’option « La formule personnalisée est ». La syntaxe requise s’énonce comme suit :
=$A2=$B2
Le positionnement du verrouillage absolu par le symbole dollar sur la colonne ($A et $B) conjugué au maintien de la référence relative sur l’indice de ligne (2) constitue la clé de voûte de cette configuration. Lors de l’évaluation matricielle, le moteur compare systématiquement chaque cellule de la ligne active à son homologue adjacente, assurant une illumination simultanée des deux cellules de la paire dès lors que la parité logique est vérifiée.
Symétriquement, l’identification visuelle des désalignements s’opère par l’introduction de la règle opposée : =$A2<>$B2. L’attribution d’une nuance chromatique contrastée, telle qu’un rouge carmin subtil pour les discordances et un vert sauge pour les conformités, permet à l’opérateur d’embrasser d’un seul coup d’œil l’état général de synchronisation du tableau. Cela permet d’identifier immédiatement les ruptures de séquence et les blocs d’enregistrements désynchronisés.
6.2 Coloration des correspondances globales décorrélées de l’alignement
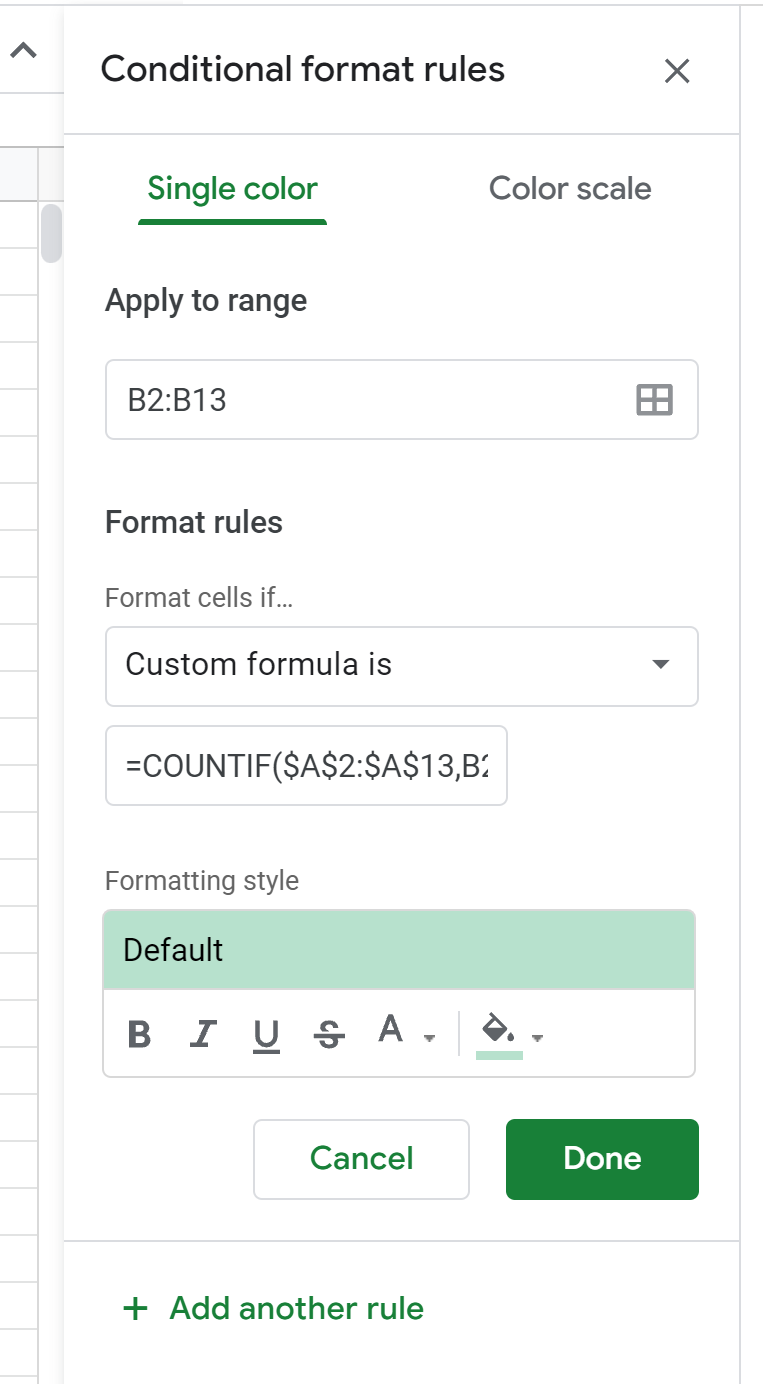
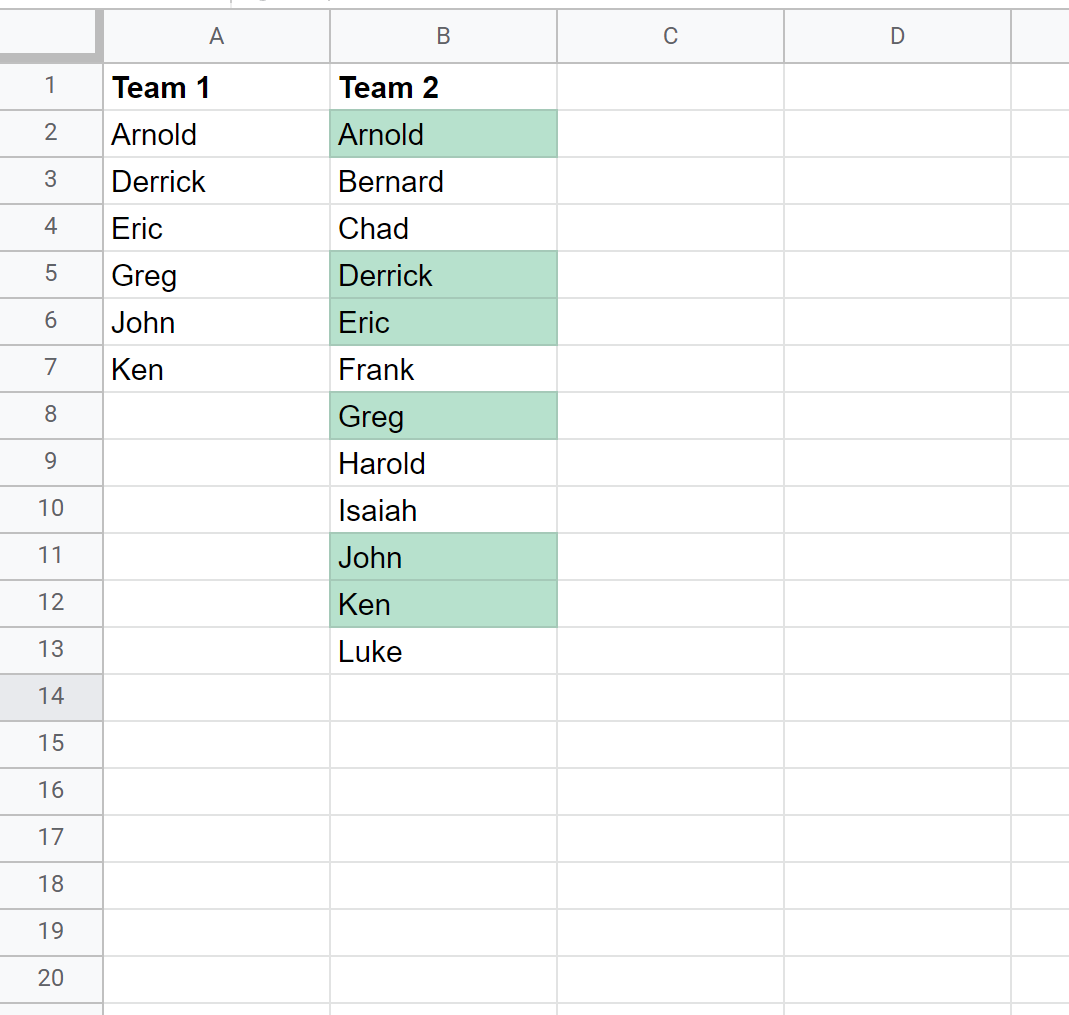
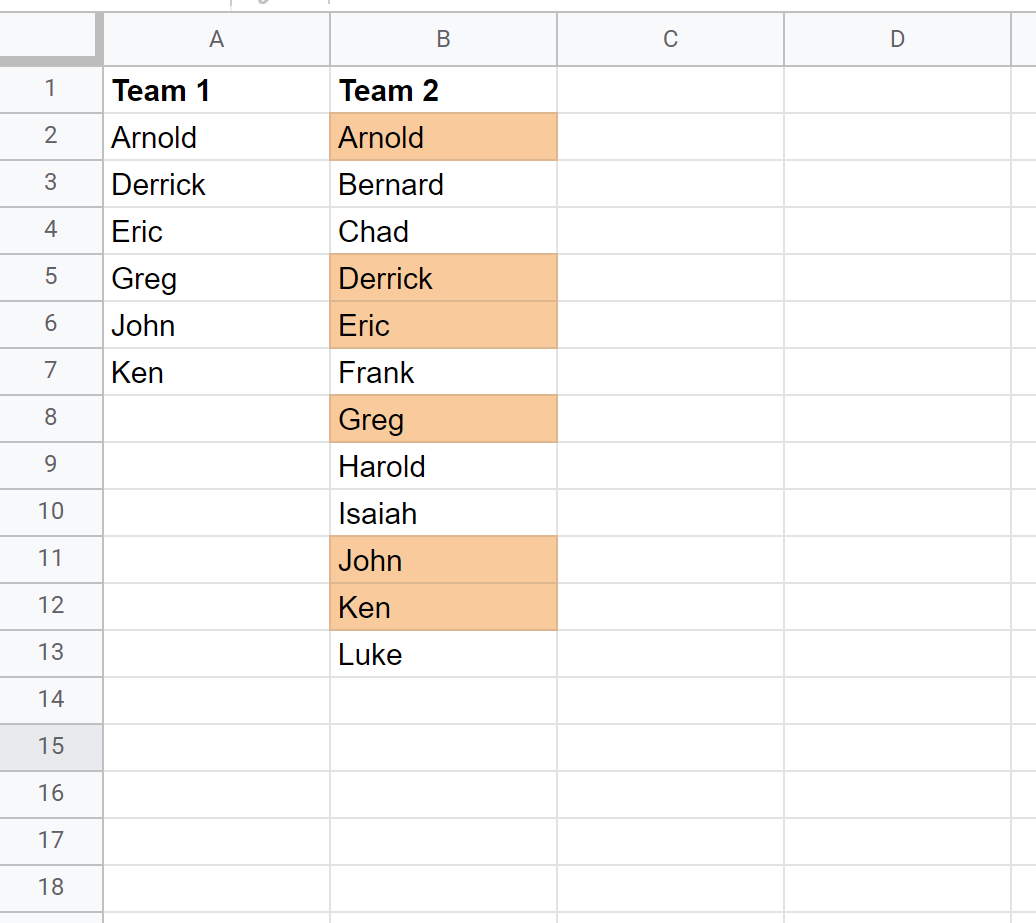
La complexité analytique s’accroît d’un degré substantiel lorsqu’il s’agit de mettre en surbrillance visuelle les éléments qui partagent une intersection globale avec une colonne partenaire, nonobstant leur positionnement horizontal respectif. Dans cette architecture, la règle conditionnelle ne doit plus confronter des cellules de coordonnées équivalentes, mais vérifier l’existence de la cellule courante sur l’ensemble du vecteur distant.
En sélectionnant la plage de données de la colonne A (par exemple A2:A100), la formule personnalisée à déployer exploite la fonction de comptage fréquentiel précédemment étudiée :
=NB.SI($B$2:$B$100; A2)>0
Dans cette configuration spécifique, la plage de recherche distante $B$2:$B$100 est obligatoirement fixée sous sa double dimension d’abscisse et d’ordonnée par le caractère $ afin d’interdire tout glissement vectoriel lors du balayage de la mise en forme. En revanche, le paramètre de critère A2 est exempt de verrouillage sur son numéro de ligne, garantissant que chaque cellule de la colonne cible interroge individuellement l’ensemble de référence avec sa propre valeur intrinsèque.
Il importe toutefois d’émettre une mise en garde méthodologique quant à l’impact sur les performances globales du classeur. Le déploiement de règles de mise en forme conditionnelle incorporant des fonctions de balayage vectoriel comme NB.SI sur des plages de données très étendues (plusieurs dizaines de milliers de lignes) contraint le navigateur client et les processeurs de Google Sheets à réévaluer des millions de combinaisons logiques à chaque frappe de clavier. Il est dès lors recommandé de cantonner ces règles visuelles avancées à des plages circonscrites ou d’en désactiver l’exécution continue lors des phases massives d’injection de données.
6.3 Signalement des données isolées et valeurs manquantes
La face complémentaire de la coloration des intersections consiste à éclairer les zones d’absence : signaler avec éclat les valeurs orphelines de la colonne A qui ne possèdent aucun correspondant dans la colonne B. L’identification visuelle instantanée de ces omissions permet d’éviter l’oubli de données critiques avant la clôture de processus opérationnels majeurs.
La formalisation de cette règle pour la plage A2:A100 repose sur la conjonction de la fonction d’absence et d’un garde-fou prévenant la coloration involontaire des cellules vides en fond de tableau :
=ET(A2<>""; ESTNA(EQUIV(A2; $B$2:$B$100; 0)))
L’introduction de la clause logique ET (ou AND) s’avère ici incontournable. En effet, en l’absence de la condition A2<>"", les cellules vierges de la colonne A seraient systématiquement évaluées par EQUIV, générant une valeur d’erreur assimilable à une absence et déclenchant la coloration erronée de milliers de cellules vides sous votre ensemble de données utile, produisant une pollution visuelle inacceptable.
Dans le domaine des métriques continues et des valorisations financières, la mise en forme conditionnelle par échelle de dégradés chromatiques apporte également une valeur sémiologique précieuse. En associant une palette thermique continue à la différence d’amplitude numérique calculée entre les deux vecteurs, l’analyste hiérarchise instantanément l’acuité des écarts sans avoir à scruter individuellement les valeurs numériques, concentrant immédiatement son attention sur les anomalies les plus déstabilisantes pour le modèle économique.
7. Formulation matricielle avancée pour comparaisons globales sans étirement
7.1 Déploiement de ARRAYFORMULA pour les comparaisons directes
L’une des limitations historiques des tableurs bureautiques traditionnels réside dans la nécessité récurrente de copier ou d’étirer physiquement une formule sur l’ensemble d’un axe vertical pour en propager le calcul. Cette servitude technique génère une maintenance laborieuse, alourdit l’empreinte mémoire du classeur et expose les organisations à des risques d’incohérence lorsque des utilisateurs omettent d’actualiser la formule sur les nouvelles lignes insérées. Google Sheets élimine radicalement ce risque structurel grâce à son moteur de calcul matriciel unifié, matérialisé par la puissante fonction ARRAYFORMULA.
L’enveloppement d’une logique comparative au sein d’une formule matricielle permet de traiter en une seule instruction atomique des vecteurs entiers de données. L’architecture fondamentale pour opérer la confrontation ligne par ligne de deux colonnes complètes prend la forme suivante :
=ARRAYFORMULA(SI(A2:A=""; ""; SI(A2:A=B2:B; "Identique"; "Différent")))
La présence du prédicat initial SI(A2:A=""; ""; ...) constitue un prérequis absolu de conception matricielle. Sans ce verrou conditionnel, l’opérateur vectoriel continuerait d’évaluer indéfiniment la relation d’équivalence sur les milliers de cellules vierges s’étendant jusqu’à la limite inférieure de la feuille de calcul. Ces cellules vides généreraient alors le résultat indésirable « Identique » (la chaîne vide étant jugée équivalente à elle-même), saturant inutilement les ressources computationnelles du document.
L’introduction d’une fonction ARRAYFORMULA transforme ainsi la première cellule de la colonne d’analyse en une matrice d’expansion dynamique (ou spill range). Aucune formule secondaire ne doit être saisie sur les lignes descendantes. Si un utilisateur tente d’altérer manuellement l’une des cellules dépendantes de cette expansion matricielle, le système neutralise instantanément la propagation et émet l’erreur explicite #REF! pour collision de contenu, protégeant l’intégrité de la chaîne logique contre toute altération accidentelle.
7.2 Traitement itératif moderne via les fonctions LAMBDA et MAP
L’introduction récente dans le moteur de Google Sheets des concepts de programmation fonctionnelle d’ordre supérieur, incarnés par l’opérateur LAMBDA et la fonction d’itération parallèle MAP, constitue une évolution technique majeure pour la comparaison de données tabulaires complexes. Alors que certaines fonctions sophistiquées résistent historiquement à la vectorisation native au sein de ARRAYFORMULA, la combinaison MAP et LAMBDA offre une flexibilité algorithmique absolue en appliquant un bloc d’instructions élémentaire à chaque n-uplet de cellules issues de vecteurs multiples.
L’implémentation de cette architecture pour la comparaison croisée de deux vecteurs s’articule selon une élégance syntaxique remarquable :
=MAP(A2:A; B2:B; LAMBDA(valA; valB; SI(OU(valA=""; valB=""); ""; SI(EXACT(valA; valB); "Conforme"; "Anomalie"))))
Dans ce modèle d’exécution, MAP prend en charge l’orchestration du parcours séquentiel des deux colonnes sources. Pour chaque ligne traversée, elle extrait la valeur issue de A et celle issue de B, puis les transmet comme arguments paramétriques nommés valA et valB au corps de la fonction anonyme LAMBDA. Cette dernière encapsule l’intégralité de la logique décisionnelle, en isolant les cas d’absence et en appliquant des fonctions sensibles à la casse comme EXACT, sans aucune contrainte de propagation matricielle conventionnelle.
L’avantage cardinal de cette formulation fonctionnelle moderne réside dans sa modularité conceptuelle et sa clarté déclarative. Les paramètres étant formellement étiquetés au sein de la signature LAMBDA, le code gagne en lisibilité opérationnelle, réduisant les risques d’erreur de ciblage cellulaire lors des phases de maintenance collaborative et facilitant l’implémentation de calculs décisionnels imbriqués d’une grande complexité.
7.3 Optimisation des temps de calcul sur de volumineux jeux de données
L’application indistincte de formules matricielles ou de copies physiques sur des bases de données volumineuses (dépassant couramment plusieurs dizaines ou centaines de milliers de lignes) pose des défis aigus de latence réseau et d’épuisement des quotas d’exécution mémoire. Chaque actualisation d’une cellule déclenche une cascade de recalculs qui, si elle est mal orchestrée, peut paralyser l’expérience utilisateur et compromettre la fluidité du travail collaboratif.
L’analyse comparative de la charge computationnelle révèle que les fonctions itératives natives optimisées (telles que ARRAYFORMULA avec des opérateurs logiques directs) affichent des temps de réponse nettement inférieurs à l’étirement individuel de milliers de formules isolées. Ce gain s’explique par la réduction substantielle de la taille de l’arbre d’analyse syntaxique maintenu par le moteur de Google Sheets. Toutefois, l’usage de MAP et de fonctions LAMBDA imbriquées, bien que structurellement plus lisibles, engendre un surcoût d’interprétation contextuelle qui peut dégrader les performances globales si l’on applique des fonctions lourdes de manipulation textuelle sur des plages indéfinies du type A:A.
Pour prévenir l’apparition de goulets d’étranglement sévères sur les classeurs de grande dimension, plusieurs règles architecturales strictes doivent être respectées :
- Proscrire impérativement les références circulaires ou semi-ouvertes illimitées (préférer explicitement
A2:A50000à l’expression génériqueA2:Alorsque la dimension maximale des flux est maîtrisée). - Séparer physiquement les données brutes des couches de comparaison au moyen d’onglets de staging dédiés, limitant ainsi la propagation involontaire des déclencheurs de recalcul automatique.
- Convertir périodiquement les résultats de comparaisons historiques statiques en valeurs brutes (via l’opération de collage spécial « Valeurs uniquement ») afin de décharger le moteur computationnel des analyses rétrospectives qui ne sont plus soumises à évolution.
8. Traitement des données textuelles imparfaites et correspondances approximatives
8.1 Normalisation textuelle avant comparaison algorithmique
Dans l’immense majorité des applications pratiques de rapprochement, les données textuelles à confronter proviennent d’environnements hétérogènes dépourvus de standards d’interopérabilité rigoureux. Noms d’entités juridiques, descriptions d’articles de catalogue ou désignations d’adresses postales sont continuellement pollués par des disparités d’accentuation, de capitalisation typographique ou de ponctuations parasites. Soumettre ces chaînes brutes à un test d’égalité stricte conduit invariablement à un taux d’échec massif des correspondances légitimes.
La normalisation préalable constitue le passage obligé d’un appariement textuel pertinent. La première étape consiste à neutraliser les divergences de casse au moyen des fonctions uniformisatrices MAJUSCULE (UPPER) ou MINUSCULE (LOWER). Dans les contextes où l’on souhaite standardiser des noms propres tout en conservant une lisibilité typographique harmonieuse, la fonction NOMPROPRE (PROPER) convertit chaque initiale de vocable en majuscule tout en basculant le reste de la séquence en minuscules régulières.
La seconde étape réside dans l’élision systématique des marques de ponctuation résiduelles et des caractères spéciaux non informatifs. La fonction SUBSTITUE constitue à cet égard une arme de précision. En combinant plusieurs instances de substitution successives, l’analyste peut dépouiller les chaînes de leurs tirets, virgules, points ou apostrophes. Par exemple, pour normaliser l’appellation d’une société commerciale avant comparaison, la structure suivante peut être adoptée :
=SUBSTITUE(SUBSTITUE(MAJUSCULE(A1); "."; ""); "-"; " ")
Ce traitement unificateur garantit que des désignations telles que « S.A.S. LOGISTIQUE » et « SAS Logistique » convergent vers un vecteur sémantique rigoureusement identique, autorisant dès lors l’établissement d’une égalité logique parfaite.
8.2 Exploitation des expressions régulières avec REGEXMATCH
Lorsque les disparités textuelles dépassent la simple présence de ponctuations statiques et qu’il convient de détecter des segments partagés au sein de structures complexes ou non prévisibles, les fonctions basées sur les expressions régulières constituent le niveau d’ingénierie supérieur. Google Sheets intègre un moteur d’évaluation basé sur la syntaxe universelle RE2, matérialisé notamment par la fonction REGEXMATCH.
La fonction REGEXMATCH évalue si une portion quelconque d’une chaîne de caractères cible satisfait un motif régulier spécifié, retournant la valeur booléenne VRAI ou FAUX. Cette approche est déterminante pour comparer deux colonnes où l’une contient des désignations complètes tandis que l’autre ne renferme que des racines identificatoires ou des radicaux de codes. Considérons l’appariement d’une colonne de libellés de relevés bancaires (colonne A) avec une table de références de factures courtes (colonne B). La confrontation directe s’avère impossible par les opérateurs conventionnels. En revanche, l’application de la syntaxe :
=REGEXMATCH(A1; "(?i)" & B1)
opère une vérification d’inclusion dynamique immédiate. L’introduction du modificateur (?i) ordonne au moteur de regex de neutraliser toute sensibilité à la casse. Dès lors que la séquence textuelle encapsulée dans la cellule B1 est localisée n’importe où au sein de la longue chaîne de la cellule A1, la correspondance est formellement déclarée valide.
De surcroît, les expressions régulières autorisent l’extraction préemptive de préfixes ou suffixes standardisés au moyen de la fonction REGEXEXTRACT ou leur élimination chirurgicale via REGEXREPLACE. Cette flexibilité permet d’isoler des numéros de séries noyés dans des commentaires textuels ou d’homogénéiser des numéros de téléphone internationaux préalablement à toute opération comparative.
8.3 Approches de l’appariement flou et similarité lexicale
En dépit de l’arsenal de normalisation textuelle et des expressions régulières, l’analyste de données se heurte inéluctablement au problème des coquilles orthographiques aléatoires, des inversions de lettres ou des approximations phonétiques introduites lors de saisies non supervisées. Les formules natives standards de Google Sheets se révèlent intrinsèquement inopérantes face à ces cas d’espèce : une différence d’un seul caractère orthographique suffit à invalider l’égalité logique la plus élémentaire.
L’adresse de cette complexité requiert le basculement vers les concepts mathématiques de l’appariement flou (ou fuzzy matching) et du calcul de distances lexicales, au premier rang desquelles trône la célèbre distance d’édition de Levenshtein. Cette métrique quantifie le nombre minimal de modifications élémentaires (insertions, suppressions ou substitutions d’un caractère unique) indispensables pour transformer une chaîne textuelle source en une chaîne cible. Le rapport entre cette distance d’édition et la longueur globale de la chaîne permet d’établir un indice de similarité lexicale normalisé s’échelonnant de 0 % (disjonction absolue) à 100 % (identité parfaite).
Puisque Google Sheets ne propose pas de primitive native calculant la distance de Levenshtein, l’analyste doit combler cette lacune par l’adjonction de modules complémentaires certifiés issus du Google Workspace Marketplace ou par la programmation d’algorithmes personnalisés via Google Apps Script. L’incorporation d’une tolérance d’appariement (par exemple, déclarer deux colonnes conformes si leur similarité lexicale excède un seuil de confiance de 85 %) permet de réconcilier des bases de données historiques massives sans exiger un assainissement manuel individuel de chaque enregistrement corrompu.
9. Exploitation de Google Query Language pour l’interrogation comparative
9.1 Architecture d’une clause QUERY pour le filtrage comparatif
Parmi l’ensemble des fonctions proposées par Google Sheets, la fonction QUERY occupe une place à part, incarnant un véritable moteur d’algèbre relationnelle embarqué. Inspirée directement de la syntaxe formelle du langage SQL (Structured Query Language) et reposant sur l’API de visualisation de Google, QUERY offre une puissance analytique sans commune mesure pour filtrer, transformer et confronter des structures de données complexes par le biais de déclarations textuelles structurées.
L’implémentation de la fonction QUERY dans un cadre comparatif présuppose une compréhension rigoureuse de sa syntaxe d’appel : =QUERY(données; chaîne_requête; [en-têtes]). Pour réaliser une extraction ciblée des sous-ensembles répondant à des critères d’inégalité ou de discordance entre deux colonnes situées sur une même table de données, l’analyste exploite la clause déclarative WHERE. Considérons une matrice de données couvrant les plages A2 à B100. L’extraction sélective de l’ensemble des lignes matérialisant une disparité quantitative s’exprime selon le formalisme suivant :
=QUERY(A2:B100; "SELECT A, B WHERE A != B"; 0)
Cette directive ordonne au processeur de requête de sonder le périmètre matriciel désigné, d’évaluer la condition de disjonction stricte A != B sur chaque tuple d’enregistrement et de projeter instantanément dans une nouvelle plage de résultats l’ensemble des paires cellulaires défaillantes. Ce traitement évite la prolifération de formules de filtrage auxiliaires et concentre l’intelligence analytique au sein d’une chaîne de commande compacte, auto-documentée et d’une remarquable élégance conceptuelle.
9.2 Jointures logiques simulées et plages virtuelles
L’un des tours de force les plus remarquables autorisés par l’écosystème Google Sheets réside dans sa capacité à instancier des matrices virtuelles en mémoire vive par l’intermédiaire des opérateurs d’accolades ({ }). Cette technique permet de restructurer, réordonner ou concaténer des plages cellulaires dispersées avant de les injecter comme source unique dans la fonction QUERY, autorisant de fait la simulation de jointures relationnelles sans exiger la migration des données vers un système de gestion de bases de données (SGBD) traditionnel.
Lorsque des plages sont regroupées à l’intérieur d’accolades avec un séparateur de point-virgule (empilement vertical) ou de barre oblique / antislash / virgule selon les paramètres régionaux (concaténation horizontale), le moteur QUERY cesse de faire référence aux colonnes par leurs lettres alphabétiques natives pour adopter le formalisme d’indexation positionnelle abstraite Col1, Col2, Col3.... Dès lors, pour simuler un rapport comparatif croisé dynamique entre deux colonnes physiquement isolées au sein d’onglets distincts, la syntaxe se déploie selon cette logique :
=QUERY({Sources_A!A2:A100 Sources_B!B2:B100}; "SELECT Col1, Col2 WHERE Col1 is not null AND Col1 != Col2"; 0)
Cette modélisation matricielle s’avère particulièrement puissante car elle permet de simuler des comportements de type INNER JOIN ou FULL OUTER JOIN en croisant des tables hétérogènes de longueurs asymétriques. L’analyste génère ainsi des rapports comparatifs synthétiques d’une intégrité mathématique totale, complètement découplés des contraintes d’alignement physique de la feuille de calcul hôte.
9.3 Agrégation statistique des divergences constatées
Au-delà de la restitution brute des éléments divergents, le moteur QUERY déploie toute son envergure analytique lors de la phase d’agrégation et de synthèse décisionnelle. Les instances de gouvernance et comités de direction n’exigent pas nécessairement la visualisation microscopique de milliers d’anomalies ligne à ligne, mais requièrent des indicateurs clés de performance (KPI) de conformité, des volumes quantitatifs ventilés et des distributions statistiques des typologies d’écarts observés.
En mobilisant conjointement les clauses d’agrégation GROUP BY et les fonctions mathématiques incorporées du langage (count, sum, avg), la fonction QUERY permet de convertir instantanément un flux de comparaison brute en un tableau de bord analytique à haute valeur ajoutée. Par exemple, si une colonne tierce C qualifie la nature de l’écart constaté entre A et B (« Erreur typographique », « Rupture de stock », « Variation tarifaire »), la commande suivante produit une consolidation multidimensionnelle immédiate :
=QUERY(A2:C100; "SELECT C, count(A), avg(A-B) WHERE A != B GROUP BY C LABEL count(A) 'Nombre d''écarts', avg(A-B) 'Écart Moyen'"; 0)
Cette requête unifiée isole les enregistrements divergents, les segmente par typologie d’anomalie métier, calcule le dénombrement précis des occurrences fautives ainsi que la moyenne arithmétique de la déviation financière observée, tout en réaffectant des étiquettes textuelles professionnelles aux en-têtes de colonnes générés. Cette concentration de puissance de calcul illustre avec éclat comment l’analyste peut transcender les mécanismes comparatifs élémentaires pour asseoir une gouvernance industrielle et automatisée de la qualité de ses actifs informationnels.
10. Automatisation programmatique via Google Apps Script
10.1 Conception d’une fonction de comparaison personnalisée (UDF)
Bien que les fonctions matricielles natives et les clauses de requête couvrent une vaste palette de cas d’usage, elles trouvent leurs limites d’exploitabilité dès lors que la logique de comparaison intègre des règles conditionnelles hautement complexes ou que les volumes de données provoquent un ralentissement du navigateur client. C’est dans ce contexte que l’environnement de développement intégré Google Apps Script (basé sur le standard moderne ECMAScript JavaScript) s’impose comme le prolongement technique indispensable de la feuille de calcul.
Le développement de fonctions personnalisées (ou User-Defined Functions, UDF) permet d’encapsuler au sein d’un algorithme compilé sur les serveurs de Google l’ensemble des protocoles comparatifs souhaités. L’architecture type d’une fonction personnalisée dédiée à la confrontation de deux colonnes requiert une conception évitant impérativement les appels itératifs de lecture cellulaire. L’instruction primordiale réside dans l’utilisation de la méthode getValues() appliquée sur la plage globale sélectionnée, chargeant l’intégralité des données en une unique opération synchrone dans un tableau bidimensionnel en mémoire vive JavaScript.
La déconstruction structurelle d’une telle fonction personnalisée s’illustre par l’implémentation suivante, destinée à comparer deux vecteurs cellulaires et à renvoyer un tableau de résultats directement vers la feuille de calcul :
La fonction prend en entrée deux arguments correspondant aux plages à comparer. Après avoir validé que les dimensions vectorielles sont cohérentes, elle procède à une boucle séquentielle en mémoire vive, appliquant des critères de normalisation textuelle rigoureux et évaluant l’équivalence sémantique. Les résultats sont accumulés dans un tableau JavaScript bidimensionnel, qui est ensuite renvoyé directement par la fonction. Ce format de restitution matriciel est automatiquement interprété par Google Sheets comme une plage dynamique qui s’étend vers le bas à partir de la cellule d’appel de la formule personnalisée.
10.2 Algorithmes de recherche par tables de hachage en JavaScript
L’atout méthodologique majeur de l’ingénierie programmatique réside dans l’optimisation de la complexité temporelle des algorithmes de comparaison ensembliste. Dans les approches basiques par formules imbriquées de type EQUIV ou dans des boucles de script naïves à deux niveaux, la comparaison d’une colonne de taille n face à une colonne de taille m s’effectue avec une complexité quadratique notée en notation grand O sous la forme O(n × m). Pour deux colonnes de 50 000 lignes chacune, cela implique potentiellement 2,5 milliards d’itérations élémentaires, conduisant inévitablement au dépassement du temps d’exécution maximal alloué par l’environnement Google Apps Script (généralement bridé à 6 minutes).
Pour contourner ce verrou algorithmique, le développeur chevronné déploie des structures de données basées sur les tables de hachage en exploitant les objets natifs JavaScript Set ou Map. En convertissant préalablement l’intégralité du vecteur distant B au sein d’une structure d’ensemble Set, le temps d’accès et d’interrogation de l’existence d’un élément bascule d’une complexité linéaire O(m) à une complexité constante d’ordre O(1). L’algorithme global de comparaison atteint dès lors une complexité linéaire optimale en O(n + m).
Grâce à cette réduction drastique du coût computationnel, la confrontation de jeux de données massifs impliquant plusieurs dizaines de milliers d’enregistrements s’exécute en une fraction de seconde. L’algorithme parcourt le vecteur source A, interroge l’objet Set via sa méthode ultra-rapide has(), et alimente immédiatement deux tableaux distincts documentant d’un côté les intersections validées et de l’autre les exclusions unilatérales. Cette efficience computationnelle garantit la stabilité et la réactivité des modèles de données d’entreprise les plus exigeants.
10.3 Génération automatique d’un rapport d’audit dans un onglet dédié
L’étape ultime de l’automatisation programmatique réside dans la délégation totale du processus de reporting au moteur de script, s’affranchissant de toute intervention manuelle de l’utilisateur final. Par l’intermédiaire des interfaces de programmation d’applications (API) de Google Apps Script, un script peut être déclenché périodiquement (via des déclencheurs temporels ou time-driven triggers) ou lors de la survenue d’événements contextuels (modification de cellules via onEdit).
Le script d’audit procède de manière autonome : il sonde les deux colonnes cibles au sein des onglets opérationnels, applique ses filtres de hachage pour discriminer les données conformes des anomalies résiduelles, puis vérifie la présence d’un onglet spécifiquement nommé « Audit_Rapprochement ». Si cet onglet est inexistant, le script l’instancie dynamiquement via la méthode insertSheet(), applique une charte graphique professionnelle préformatée (en-têtes foncés, bordures fines, largeurs de colonnes auto-ajustées par autoResizeColumns()), et y dépose l’intégralité du compte rendu analytique.
De surcroît, le script horodate précisément l’opération de réconciliation en écrivant un timestamp de clôture dans une cellule d’en-tête dédiée, assurant une traçabilité intégrale pour les départements de contrôle interne et d’audit informatique. Enfin, le système peut incorporer des alertes conditionnelles programmées : si le volume des discordances relevées franchit un seuil de tolérance métier préalablement configuré (par exemple, un taux d’omission supérieur à 2 % du volume total du vecteur), l’API MailApp.sendEmail() peut être immédiatement invoquée pour expédier une notification d’urgence aux administrateurs de la base de données, instaurant un écosystème de supervision préventive et proactive de premier plan.
11. Audit, diagnostics d’erreurs et gestion des cas limites
11.1 Résolution des conflits de typage de données
Dans l’architecture interne de Google Sheets, l’évaluation de la vérité logique est indissociable de l’intégrité typologique des entités confrontées. L’un des écueils les plus pernicieux auxquels sont confrontés les praticiens réside dans la présence de nombres stockés sous format textuel face à des valeurs purement numériques. Un chiffre « 123 » précédé d’une apostrophe ou importé d’un flux textuel CSV ne sera jamais reconnu comme équivalent au nombre décimal 123 par un test logique de type A1=B1, quand bien même leur aspect visuel dans l’interface de travail semble identique.
Pour diagnostiquer ces incompatibilités invisibles, l’analyste convoque la fonction TYPE. Cette fonction renvoie une signature entière documentant la nature réelle de la donnée sous-jacente : 1 pour un nombre pur, 2 pour une chaîne textuelle, 4 pour une expression booléenne, 16 pour un code d’erreur et 64 pour une structure matricielle. La confrontation des retours TYPE(A1) et TYPE(B1) dévoile immédiatement les éventuelles asymétries typologiques qui paralysent les chaînes de détection.
La résolution de ce conflit s’opère par l’application préventive de fonctions de coercition de type. La fonction CNUM (ou VALUE) force la conversion d’une chaîne textuelle en valeur numérique pure, sous réserve que la chaîne ne recèle pas de caractères non numériques incompatibles. Dans un cadre de modélisation mathématique directe, l’utilisation de l’opérateur double unaire (--) représente une alternative syntaxique particulièrement prisée pour son économie de calcul : en appliquant une double négation mathématique, --A1 contraint le moteur interne à métamorphoser la chaîne "123" en nombre réel 123 sans mobiliser d’appel de fonction verbeux.
11.2 Neutralisation des anomalies d’arrondi sur nombres à virgule flottante
L’exécution de calculs arithmétiques préalables sur les colonnes à confronter introduit un risque technique bien documenté dans l’ensemble des sciences informatiques modernes : les anomalies d’arrondi découlant de la représentation des nombres à virgule flottante sous la norme internationale IEEE 754. Les tableurs contemporains manipulent les nombres décimaux en arithmétique binaire à double précision, ce qui rend structurellement impossible la représentation binaire finie exacte de certaines fractions décimales pourtant banales, telles que 0,1 ou 0,2.
En conséquence de cette contrainte matérielle, des opérations arithmétiques élémentaires peuvent engendrer des micro-résidus infinitésimaux de l’ordre de 10-16. Ainsi, une cellule résultant de l’opération =0,1+0,2 peut héberger en mémoire la valeur 0,30000000000000004. Dès lors, si cette cellule est confrontée à une seconde colonne renfermant la constante brute 0,3, l’assertion d’égalité stricte A1=B1 retournera inévitablement la valeur FAUX, au grand désarroi de l’analyste financier non initié aux arcanes du calcul numérique matériel.
Pour immuniser les modèles d’analyse financière et d’ingénierie contre ces micro-dérives mathématiques, deux protocoles d’assainissement doivent être rigoureusement appliqués :
- L’encapsulation systématique des valeurs calculées au sein de la fonction ARRONDI (ou ROUND) en spécifiant le niveau de précision décimale pertinent pour le domaine métier (par exemple,
=ARRONDI(A1; 2)=ARRONDI(B1; 2)pour des transactions monétaires en centimes). - L’abandon de l’égalité stricte au profit d’un test de proximité différentielle par seuil de tolérance infinitésimal (fréquemment désigné par la lettre grecque epsilon, noté ε), formalisé sous la règle :
=ABS(A1-B1)<0,00001. Si la valeur absolue de l’écart arithmétique demeure inférieure au seuil critique retenu, les entités sont déclarées fonctionnellement équivalentes.
11.3 Traitement robuste des cellules vides et des valeurs nulles
Le comportement des cellules dépourvues de contenu constitue une source intarissable de faux diagnostics comparatifs au sein de Google Sheets. Le moteur de calcul adopte une politique d’interprétation polymorphe et asymétrique à l’égard du néant informationnel : une cellule totalement vierge est assimilée à la valeur numérique 0 lorsqu’elle est sollicitée dans le cadre d’un opérateur arithmétique d’addition ou de multiplication, mais elle équivaut à la chaîne textuelle vide "" lorsqu’elle est évaluée dans un contexte de manipulation textuelle.
Cette plasticité comportementale induit des conséquences néfastes lors des confrontations d’inégalité ou d’équivalence. Par exemple, si la cellule A1 est vierge et que la cellule B1 héberge la valeur numérique 0, l’expression relationnelle A1=B1 sera curieusement évaluée à VRAI par le moteur permissif du tableur. Ce mécanisme assimile erronément une absence totale de saisie documentaire à une mesure de performance nulle, faussant les inventaires ou les bilans opérationnels.
Pour juguler ces dérives, le concepteur du classeur doit bâtir des garde-fous logiques d’une étanchéité sans compromis. L’utilisation des fonctions de contrôle d’état ESTVIDE (ISBLANK) permet de ségréguer le statut matériel de la cellule avant tout traitement comparatif. Une formulation défensive industrielle pour l’évaluation de deux vecteurs intègre dès lors une clause d’exclusion préalable des cellules non renseignées :
=SI(OU(ESTVIDE(A1); ESTVIDE(B1)); "Cellule incomplète"; SI(A1=B1; "Égal"; "Différent"))
Cette approche garantit qu’aucune valeur par défaut ou équivalence abusive n’est extrapolée à partir du vide, conférant au modèle une intégrité d’analyse et une robustesse statistique irréprochables.
12. Synthèse décisionnelle et protocoles de validation des résultats
12.1 Matrice de sélection des méthodes selon le contexte opérationnel
Face à la profusion des approches documentées au fil de ce traité, l’ingénieur de données ou l’auditeur opérationnel se doit d’appliquer une grille de sélection méthodique, guidée par une évaluation pragmatique de trois critères directeurs : la volumétrie globale des données à traiter, le caractère statique ou continu du flux d’information, et le niveau d’expertise technique des équipes collaboratrices appelées à maintenir le document partagé.
Pour les vérifications ponctuelles et l’analyse ad hoc portant sur des jeux de données d’amplitude restreinte à modérée (inférieure à 5 000 enregistrements), la combinaison de formules élémentaires (SI, EXACT, NB.SI) enrichie d’une couche d’automatisation visuelle par mise en forme conditionnelle demeure le choix le plus rapide et le plus immédiatement appréhendable par l’ensemble des parties prenantes. L’ergonomie visuelle prime alors sur les impératifs d’optimisation computationnelle de bas niveau.
Dès lors que le volume s’étend de 5 000 à 50 000 lignes ou que les tableaux sont alimentés par des flux asynchrones continus, le recours impératif aux fonctions matricielles intégrées (ARRAYFORMULA, FILTER, MAP/LAMBDA) devient la norme technique d’excellence. Ces fonctions garantissent l’auto-expansion du calcul sans étirement manuel et préviennent les fragmentations de logique tout en maîtrisant les cycles de recalcul. Enfin, au-delà de 50 000 lignes ou dans les contextes requérant des appariements flous, des distances lexicales complexes et l’émission automatique de rapports de synthèse archivés, l’architecture doit impérativement basculer vers les scripts d’arrière-plan Google Apps Script tirant parti des structures de données en tables de hachage (Set et Map), sous peine de paralyser durablement l’environnement de calcul infonuagique.
12.2 Protocole de contrôle qualité et vérification des résultats
Le déploiement d’un dispositif de comparaison de données, aussi élégant soit-il sur le plan conceptuel, ne saurait s’affranchir d’une validation empirique préalable rigoureuse. L’analyste doit instaurer un protocole de contrôle qualité systématique pour vérifier l’exactitude des résultats produits par ses formules avant toute exploitation opérationnelle ou transmission des livrables aux instances de gouvernance.
Ce protocole repose en premier lieu sur la constitution d’un jeu de données de test calibré, intégrant délibérément l’ensemble des cas limites documentés dans ce guide :
- Paires textuelles parfaitement conformes pour valider le taux d’identification nominal.
- Paires présentant des discordances de casse typographique pour tester l’étanchéité de la fonction
EXACT. - Chaînes polluées par des espaces d’en-tête, de fin et des sauts de ligne pour valider l’efficience de
SUPPRESPACEetEPURAGE. - Nombres au format texte confrontés à des valeurs décimales pour éprouver la coercition de typage.
- Calculs décimaux infinitésimaux pour tester les mécanismes de neutralisation des anomalies d’arrondi IEEE 754.
- Lignes partiellement vides ou composées exclusivement de zéros pour évaluer les fonctions de garde-fous.
En second lieu, l’analyste applique des techniques d’échantillonnage aléatoire au sein de ses résultats de production via les fonctions de tirage au sort (ALEA ou ALEA.ENTRE.BORNES), en soumettant un échantillon représentatif d’enregistrements à une vérification manuelle scrupuleuse. Enfin, l’introduction de formules de contrôle croisé indépendantes en tête de feuille (par exemple, vérifier que la somme arithmétique des intersections uniques et des exclusions symétriques équivaut rigoureusement à la cardinalité totale de l’union des ensembles audités) constitue le verrou d’intégrité ultime garantissant l’inviolabilité des conclusions analytiques formulées.
12.3 Archivage, documentation et pérennité des modèles d’analyse
La pérennité d’un modèle de données réside autant dans sa robustesse algorithmique que dans sa capacité à être compris, audité et maintenu par des tiers en l’absence de son concepteur initial. La prolifération de formules matricielles hautement sophistiquées au sein de classeurs d’entreprise engendre souvent des phénomènes d’opacité cognitive préjudiciables à la continuité des opérations dès lors qu’un roulement d’équipe intervient.
L’analyste rigoureux consacre dès lors un soin méticuleux à la documentation interne de son travail. Google Sheets offre la possibilité d’insérer des notes et commentaires standardisés directement au sein des cellules hébergeant les formules directrices. Ces métadonnées explicatives doivent consigner la finalité métier du calcul, la signification des paramètres adoptés (notamment les seuils d’écart de tolérance ou les motifs d’expressions régulières), ainsi que la date de la dernière révision logicielle. Par ailleurs, les formules matricielles avancées exploitant LAMBDA peuvent être encapsulées et documentées de manière centralisée grâce au gestionnaire de fonctions nommées, transformant un code cryptique en un verbe métier intelligible pour l’ensemble des collaborateurs du domaine d’activité.
Enfin, pour prémunir l’architecture comparative contre toute altération accidentelle (écrasement involontaire d’une formule matricielle, suppression d’une règle de mise en forme conditionnelle, écriture sur une plage d’expansion), l’administrateur doit activer le verrouillage des plages cellulaires sensibles via l’outil « Protéger les feuilles et les plages ». En restreignant les droits de modification de ces axes de calcul aux seuls analystes autorisés tout en préservant l’accès en lecture et saisie sur les colonnes de données brutes, l’organisation s’assure que ses modèles de rapprochement continueront de délivrer des diagnostics d’une précision chirurgicale sur le long terme, consolidant ainsi la gouvernance numérique de l’ensemble de ses actifs stratégiques.
Références
- Bensimon, G. (2021). Modélisation avancée et gouvernance des feuilles de calcul en entreprise. Éditions Eyrolles.
- Google. (s. d.). Aide Google Sheets : Liste des fonctions de feuille de calcul. Centre d’aide Google Docs. Consulté le 15 mars 2024, à l’adresse https://support.google.com/docs/table/25219
- Google. (s. d.). Google Apps Script : Guides et références pour SpreadsheetApp. Google Developers. Consulté le 15 mars 2024, à l’adresse https://developers.google.com/apps-script/reference/spreadsheet
- Goldberg, D. (1991). What every computer scientist should know about floating-point arithmetic. ACM Computing Surveys (CSUR), 23(1), 5-48. https://doi.org/10.1145/103162.103163
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE Computer Society. https://doi.org/10.1109/IEEESTD.2019.8766229
- Levenshtein, V. I. (1966). Binary codes capable of correcting deletions, insertions, and reversals. Soviet Physics Doklady, 10(8), 707-710.
- Panko, R. R. (2008). What we know about spreadsheet errors. Journal of End User Computing, 10(2), 15-21. https://doi.org/10.4018/joeuc.1998040102
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.