
Dans le domaine de l’ingénierie des données et de l’analyse décisionnelle sur tableur, la maîtrise des structures conditionnelles représente une compétence charnière. L’environnement infonuagique de Google Sheets offre une flexibilité algorithmique remarquable, permettant aux analystes de transformer des données brutes en indicateurs stratégiques hautement raffinés. Au cœur de cette mécanique opératoire réside la capacité d’articuler des branchements logiques capables de réagir dynamiquement à la variabilité des données d’entrée. Si la fonction élémentaire d’aiguillage conditionnel permet de traiter des scénarios binaires simples, la réalité opérationnelle des organisations impose presque systématiquement la prise en compte de critères multiples, hétérogènes et concurrents.
L’intersection entre la logique formelle et le traitement tabulaire se matérialise avec une acuité particulière lors de la modélisation de règles de gestion disjonctives. Dans ces contextes, une décision n’est pas subordonnée à la validation cumulative de toutes les hypothèses, mais plutôt à l’observation d’au moins une condition favorable parmi un ensemble défini. L’intégration de la fonction logique OU au sein de l’instruction décisionnelle SI constitue le fondement canonique de cette approche. Cette association permet de synthétiser des arbres décisionnels complexes en expressions compactes, élégantes et maintenables, évitant ainsi le piège de la prolifération des formules redondantes et fragiles.
Le présent traité propose une exploration exhaustive, tant sur le plan théorique que pratique, de la combinaison des fonctions SI et OU dans Google Sheets. De la formalisation mathématique de l’algèbre booléenne sous-jacente jusqu’aux déploiements vectoriels avancés via les formules matricielles, cet article a pour vocation d’armer l’analyste, le contrôleur de gestion et le développeur d’une compréhension granulaire des flux d’évaluation logique. En abordant les subtilités d’optimisation computationnelle, les spécificités de la coercition de type et les architectures de débogage méthodologique, cette étude érige la manipulation des expressions disjonctives au rang de standard d’ingénierie logicielle appliquée aux feuilles de calcul.
1. Fondements théoriques de la logique booléenne dans les tableurs
1.1 Principes de l’algèbre de Boole appliquée aux feuilles de calcul
L’architecture logique de Google Sheets repose fondamentalement sur les axiomes de l’algèbre de Boole, formalisée au milieu du XIXe siècle par George Boole. Dans ce système mathématique binaire, toute proposition ne peut adopter que l’un de deux états de vérité distincts et mutuellement exclusifs : le VRAI (correspondant à l’état logique haut ou numérique 1) et le FAUX (représentant l’état logique bas ou numérique 0). Au sein d’un tableur, ces entités ne sont pas de simples chaînes de caractères arbitraires, mais des primitives booléennes fondamentales qui régissent la totalité des opérations de comparaison et d’évaluation conditionnelle. Lorsque l’on soumet un ensemble de données à un test logique, le moteur de calcul traduit instantanément l’assertion formulée en l’une de ces deux valeurs de vérité canoniques.
La disjonction logique inclusive, incarnée par l’opérateur OU, obéit à des propriétés structurelles très précises dans les systèmes algorithmiques. Contrairement à la disjonction exclusive qui exige qu’une seule proposition soit vraie à l’exclusion de toute autre, la disjonction inclusive stipule qu’une proposition composite est réputée vraie si au moins l’un de ses constituants élémentaires est vrai. Dans une table de vérité classique à deux variables propositionnelles, la sortie logique ne bascule vers l’état FAUX que dans l’unique éventualité où l’intégralité des opérandes est rigoureusement évaluée à FAUX. Dès lors qu’une variable, ou a fortiori l’ensemble des variables, présente la valeur VRAI, le résultat disjonctif global est immédiatement validé à VRAI. Cette propriété d’inclusivité confère au OU une puissance d’agrégation essentielle pour la prise de décision automatisée.
D’un point de vue structurel, il existe une scission théorique profonde entre l’évaluation d’une condition scalaire unique et la confluence de critères multiples. Une condition élémentaire se borne à mesurer l’écart géométrique ou logique entre deux points de données, par exemple en vérifiant si une cellule surpasse une constante prédéfinie. En revanche, la confluence disjonctive orchestre une synthèse de propositions multidimensionnelles, harmonisant des prédicats qui peuvent émaner de domaines de mesures ou de formats totalement disjoints. Cette mécanique formelle permet de ramener une multiplicité d’observations hétérogènes à une unité sémantique binaire exploitable par les mécanismes de routage de la feuille de calcul.
1.2 Rôle respectif des fonctions conditionnelles et des opérateurs logiques
L’interaction entre la fonction SI et la fonction OU repose sur une division fonctionnelle stricte du travail computationnel au sein de l’environnement de calcul. La fonction conditionnelle SI agit exclusivement en tant que structure d’aiguillage binaire de flux de données. Elle ne possède pas la compétence intrinsèque d’évaluer directement des combinaisons d’événements indépendants ; son mandat se limite à inspecter un prédicat unique et, selon l’état de ce dernier, à commuter le flux d’exécution vers une branche d’expression désignée comme affirmative ou vers une branche alternative qualifiée de négative. En substance, la fonction SI est un commutateur algorithmique qui attend un ordre sans participer à la délibération de la décision.
À l’inverse, la fonction OU opère comme un prédicat d’agrégation dont le rôle exclusif consiste à réduire une multiplicité d’états logiques en une seule valeur scalaire de vérité. Elle ingère une série indéfinie de propositions booléennes, applique les lois de la disjonction inclusive, et condense cette diversité en une sortie unique : VRAI ou FAUX. La fonction OU n’a aucune capacité d’action directe sur le contenu des cellules : elle est incapable d’écrire un message, d’exécuter un calcul d’appoint ou d’ordonner un affichage personnalisé. Son spectre d’intervention est strictement confiné à l’analyse logique pure et à la transmission d’un état de fait au système hôte.
C’est précisément dans la symbiose de ces deux entités que s’établit la puissance des modèles décisionnels sur tableur. La fonction OU prépare et condense la réalité empirique du modèle décisionnel en neutralisant la complexité inhérente aux conditions plurielles, tandis que la fonction SI transforme cette condensation logique en une action univoque et signifiante pour l’utilisateur. Ce couplage assure une séparation nette entre l’analyse logique (déléguée au bloc disjonctif) et l’exécution fonctionnelle (dévolue à la structure conditionnelle), garantissant ainsi une lisibilité et une robustesse architecturales optimales.
1.3 L’évaluation court-circuit et le flux d’exécution logique
Le moteur d’évaluation de Google Sheets, conçu pour gérer de volumineux classeurs analytiques, met en œuvre des mécanismes sophistiqués de calcul séquentiel des arguments. Parmi ces optimisations logiques figure le concept fondamental d’évaluation court-circuit, également désigné sous le terme de court-circuit booléen. Ce paradigme stipule que l’évaluation d’une expression logique composée s’interrompt prématurément dès lors que le résultat final de l’opération est inévitablement déterminé par les premiers opérandes analysés. Dans le cadre théorique strict d’un opérateur disjonctif, l’apparition d’un premier prédicat évalué à VRAI suffit mathématiquement à garantir que la résultante globale sera VRAI, rendant caduque toute inspection des prédicats subséquents.
Dans la mise en œuvre applicative des tableurs, bien que les fonctions standard évaluent formellement l’ensemble des arguments passés en paramètres pour valider la correction syntaxique, le chemin d’exécution conditionnel dépend lourdement de la hiérarchisation des tests. Lorsque la fonction SI inspecte son expression logique, elle court-circuite systématiquement l’exécution de la branche inutilisée. Si le bloc disjonctif retourne VRAI, seule la branche affirmative est matériellement calculée ; la branche négative est totalement ignorée par le processeur lors du cycle d’évaluation courant. Cela préserve d’importantes ressources mémoire et évite le déclenchement de calculs annexes particulièrement gourmands ou d’éventuelles erreurs de calcul contenues dans la branche écartée.
Les implications de ce mécanisme sur la charge de traitement computationnelle sont substantielles lors du traitement de jeux de données massifs. Un analyste averti concevra ses propositions disjonctives de manière stratégique : en positionnant en première position les prédicats statistiques les plus susceptibles d’être validés ou ceux réclamant le coût algorithmique le plus faible, il optimise la fluidité globale du recalcul de la feuille de calcul. Cet ordonnancement raisonné des arguments prévient les goulots d’étranglement au sein du moteur JavaScript qui orchestre l’exécution de Google Sheets côté client et côté serveur.
2. Anatomie et syntaxe fondamentale de la fonction SI (IF)
2.1 Décomposition des arguments de la fonction SI
La fonction SI constitue le fondement des structures de contrôle dans la quasi-totalité des dialectes de feuilles de calcul. Sa syntaxe universelle s’articule autour d’une structure ternaire canonique nécessitant jusqu’à trois arguments séquentiels, conventionnellement libellés comme suit : SI(expression_logique; valeur_si_vrai; [valeur_si_faux]). L’argument initial, impérativement requis, représente le cœur battant de l’instruction : il s’agit d’une assertion qui doit pouvoir être résolue sous la forme d’un booléen VRAI ou FAUX, qu’elle émane d’une comparaison directe, d’une cellule dédiée ou d’une fonction logique imbriquée telle que le OU.
Le deuxième paramètre, valeur_si_vrai, détermine avec une exactitude mathématique la réponse renvoyée par la cellule dans l’hypothèse où l’expression logique est résolue positivement. Ce paramètre peut accueillir une diversité absolue de types de données : une chaîne de caractères descriptive, une constante numérique, une référence vers une autre cellule du classeur ou même une formule analytique complexe nécessitant une exécution contextuelle. Le rôle de ce second volet est de matérialiser la conséquence opérationnelle directe de la validation des hypothèses formulées en amont.
Le troisième argument, valeur_si_faux, revêt une importance syntaxique singulière en raison de son caractère optionnel dans la déclaration formelle de la fonction, bien que son omission soit rigoureusement déconseillée dans les contextes de modélisation financière ou industrielle. Si cet argument est omis par le concepteur et que l’expression logique s’avère fausse lors du calcul, Google Sheets renvoie par défaut la valeur booléenne littérale FAUX. Ce comportement implicite peut induire des ruptures de cohérence majeures dans les chaînes de traitement ultérieures, notamment lorsqu’une colonne est censée héberger exclusivement des valeurs numériques ou des flux textuels standardisés.
2.2 Gestion des valeurs par défaut et des cellules vides
L’évaluation des arguments au sein de la fonction SI requiert une vigilance absolue quant à l’interprétation par le moteur des données nulles, non renseignées ou structurellement vides. Dans l’écosystème de Google Sheets, une cellule physique totalement vierge est dotée d’une dualité contextuelle déroutante : elle est interprétée comme le nombre 0 dans le cadre d’opérations arithmétiques ou de comparaisons d’inégalité, mais équivaut simultanément à une chaîne vide (« ») lors des manipulations textuelles. Lorsqu’une fonction SI omet intentionnellement de spécifier le troisième argument et renvoie une cellule vide, ce comportement peut polluer l’intégrité analytique du modèle en générant des ambiguïtés sémantiques.
Pour neutraliser l’apparition intempestive du booléen FAUX ou du zéro numérique résiduel lorsque la condition n’est pas satisfaite, les analystes chevronnés recourent couramment à l’injection explicite d’une chaîne vide, notée syntaxiquement sous la forme de deux guillemets droits contigus : « ». Cette pratique a pour effet immédiat de conférer à la cellule un rendu visuel immaculé, tout en garantissant que les mécanismes de mise en forme conditionnelle ou de comptage textuel puissent fonctionner sans heurts. Cependant, il convient de noter qu’une cellule contenant une chaîne vide n’est plus rigoureusement reconnue comme vide par la fonction ESTVIDE, ce qui impose une rigueur d’audit soutenue.
Le traitement des résidus numériques constitue un autre enjeu critique. Si la branche de retour alternatif d’une fonction SI est configurée pour retourner un zéro arithmétique sans masquage contextuel, ce zéro peut fausser les calculs d’agrégation en aval, notamment les moyennes arithmétiques calculées via MOYENNE qui intègrent les zéros mais ignorent les cellules véritablement vides ou textuelles. La sélection de la valeur de repli doit par conséquent faire l’objet d’un arbitrage réfléchi, dicté par la nature des fonctions d’agrégation qui consommeront les résultats de la colonne conditionnelle.
2.3 Typologie des retours et imbrications possibles
La puissance d’une structure conditionnelle ne réside pas uniquement dans sa capacité à partitionner un jeu d’enregistrements en catégories statiques, mais également dans son aptitude à générer des flux dynamiques à forte valeur ajoutée décisionnelle. En premier lieu, la fonction SI excelle dans la génération de libellés textuels explicites (« Conforme », « Audit Requis », « Éligible »). Ces alertes sémantiques constituent le socle de l’aide à la décision managériale, en permettant d’isoler instantanément les anomalies ou les opportunités stratégiques sans obliger le décideur à réinterpréter la combinatoire mathématique sous-jacente.
En second lieu, la branche affirmative ou négative de la fonction SI peut intégrer des calculs numériques dynamiques hautement circonstanciés. Au lieu de se limiter au retour d’un coefficient statique, la fonction peut héberger des opérations arithmétiques sophistiquées, appliquant par exemple des décotes progressives, des pondérations probabilistes ou des pénalités financières indexées sur l’amplitude de l’écart mesuré dans le test logique. Cette réactivité numérique confère aux classeurs financiers un niveau d’adaptabilité organique indispensable à la simulation de scénarios économiques complexes.
Enfin, la fonction SI offre un potentiel de composition architecturale virtuellement illimité grâce au mécanisme d’imbrication récursive. Bien que l’introduction de la fonction OU permette précisément de désengorger les cascades de SI trop profondes, il demeure courant d’insérer au sein des branches de retour d’autres fonctions analytiques avancées telles que RECHERCHEV, INDEX, EQUIV, ou même des sous-structures conditionnelles hiérarchisées. Cette modularité transforme la fonction SI en une véritable plaque tournante logicielle, orchestrant l’aiguillage des données vers les modules computationnels les plus opportuns.
3. Anatomie et comportement de la fonction OU (OR)
3.1 Mécanisme d’évaluation multi-arguments de la disjonction logique
La fonction OU représente l’implémentation opérationnelle directe de l’opérateur de disjonction logique dans Google Sheets. Sa syntaxe fondamentale se présente sous la forme générale : OU(expression_logique1; [expression_logique2; …]). Contrairement à de nombreux langages de programmation impératifs qui restreignent leurs opérateurs logiques de base à des structures strictement binaires exigeant le chaînage répété de l’opérateur (tel que A || B || C), Google Sheets adopte un paradigme fonctionnel n-aire extrêmement souple. La fonction est ainsi capable d’ingérer un nombre arbitraire d’arguments propositionnels distincts au sein d’une seule et même invocation parenthésée.
Le moteur d’exécution applique une règle de décision implacable lors du traitement de ces paramètres d’entrée. Dès lors qu’au moins une proposition parmi l’ensemble des arguments fournis est évaluée à l’état VRAI, la fonction OU interrompt virtuellement son incertitude et retourne la valeur globale VRAI à la cellule réceptrice. La simultanéité de la validation de plusieurs propositions n’altère en rien ce comportement : qu’il y ait un seul critère vérifié ou que l’intégralité des arguments s’avère conforme aux assertions, le statut de sortie demeure invariablement VRAI, matérialisant ainsi la nature inclusive de la disjonction.
À l’inverse, l’émission de la primitive booléenne FAUX par la fonction OU est soumise à une exigence d’invalidation exhaustive. Le système doit impérativement constater que le premier argument est faux, que le deuxième argument est faux, et ainsi de suite jusqu’au dernier élément de la liste sans la moindre exception. Cette asymétrie fondamentale fait de la fonction OU un filtre d’invalidation rigide et, paradoxalement, une passerelle d’admission permissive : il suffit d’une unique dérogation positive pour franchir avec succès le seuil logique érigé par la fonction.
3.2 Traitement des conditions multiples n-aires
L’extensibilité n-aire de la fonction OU offre une flexibilité conceptuelle majeure pour l’ingénieur de données. Dans des contextes organisationnels complexes, une décision opérationnelle dépend rarement de la simple dichotomie de deux paramètres isolés. La fonction OU permet d’agréger, sans rupture structurelle ni altération de la lisibilité, dix, vingt ou cinquante prédicats logiques indépendants. Cette extensibilité élimine le besoin de concevoir des formules alambiquées basées sur des imbrications géométriques inextricables, concentrant toute la substance délibérative au sein d’un bloc fonctionnel unique et compact.
En outre, la fonction OU fait preuve d’une agilité remarquable quant à l’origine spatiale et sémantique des propositions logiques qu’elle évalue conjointement. Il est tout à fait licite d’intégrer dans un même appel de fonction des tests portant sur des cellules contiguës, des valeurs dispersées sur des feuilles de calcul distinctes au sein du même classeur, voire des retours de fonctions de recherche matricielle externes. L’opérateur disjonctif transcende l’organisation spatiale des données pour ne s’intéresser qu’à la valeur de vérité pure résultant de chaque test individuel, créant une passerelle logique transversale entre des silos d’information hétéroclites.
Une caractéristique avancée de la fonction OU réside dans sa capacité à ingérer directement des plages vectorielles ou des arguments matriciels. Lorsqu’une plage de cellules continues, telle que A1:A10, est soumise à un critère comparatif à l’intérieur de la fonction OU, par exemple sous la forme OU(A1:A10= »Critère »), la fonction évalue la condition sur l’ensemble des éléments de la plage vectorielle. Si une seule cellule au sein de cette matrice unidimensionnelle ou bidimensionnelle satisfait l’égalité, la fonction synthétise instantanément le vecteur sous-jacent en un unique VRAI scalaire, illustrant sa formidable capacité de réduction dimensionnelle.
3.3 Comportement face aux types de données hétérogènes et aux erreurs
L’un des aspects les plus critiques de l’utilisation de la fonction OU en environnement de production concerne son comportement lorsqu’elle est confrontée à des données aberrantes, des types inattendus ou des valeurs d’erreur système. Dans Google Sheets, la présence d’une erreur d’exécution telle que #VALEUR!, #N/A, ou #DIV/0! au sein de l’un quelconque des arguments passés à la fonction OU engendre quasi systématiquement la contamination immédiate du résultat global. L’erreur se propage en cascade à travers l’opérateur disjonctif, neutralisant toute capacité de calcul logique et renvoyant l’erreur au niveau supérieur de la formule.
Parallèlement, la fonction OU applique des règles de coercition de type implicite qui méritent une attention analytique scrupuleuse. Lorsqu’un argument fourni à la fonction n’est pas un test comparatif formel mais une valeur numérique brute, Google Sheets interprète cette valeur à l’aune des conventions informatiques traditionnelles : le zéro absolu (0) est rigoureusement assimilé à la valeur logique FAUX, tandis que tout nombre réel non nul (qu’il soit positif ou négatif, entier ou fractionnaire) est irrévocablement interprété comme VRAI. En revanche, l’insertion d’une chaîne de caractères alphabétique brute qui ne peut être convertie en booléen provoquera l’interruption du calcul avec une erreur de type non concordant.
Face à ces vulnérabilités potentielles, le concepteur de modèles robustes doit impérativement déployer des stratégies préventives d’assainissement des données en amont de l’évaluation logique. Le recours préventif à des fonctions d’interception comme SIERREUR ou des prédicats d’inspection préalable tels que ESTNUM ou NON.VIDE permet d’immuniser la fonction OU contre les défaillances systémiques de la source de données. L’objectif d’une telle démarche est de garantir que chaque argument présenté au bloc disjonctif soit préalablement aseptisé, prévenant ainsi les plantages silencieux ou les interruptions de flux opérationnel.
4. La combinaison canonique : Imbriquer OU à l’intérieur de SI
4.1 Schéma conceptuel et syntaxe standard
La fusion structurelle de la fonction conditionnelle SI et de l’opérateur disjonctif OU représente l’un des idiomes algorithmiques les plus universels et les plus élégants du traitement de données sur tableur. Cette architecture repose sur un principe d’emboîtement modulaire où la fonction OU est insérée précisément à l’emplacement du premier argument de la fonction SI, venant ainsi se substituer à la traditionnelle comparaison scalaire unique. Le schéma d’implémentation standard obéit rigoureusement à la structure syntaxique suivante : =SI(OU(condition_1; condition_2; …; condition_n); valeur_si_vrai; valeur_si_faux).
Dans ce paradigme de composition, la fonction SI abdique totalement son autorité d’évaluation directe et délègue l’intégralité de l’arbitrage factuel au bloc OU subordonné. La fonction disjonctive agit comme un filtre d’instruction préliminaire : elle auditionne les multiples conditions stipulées par l’analyste, effectue la synthèse de leurs valeurs de vérité respectives conformément aux règles de l’algèbre booléenne, et transmet un scalaire binaire unique à la fonction enveloppante SI. Cette dernière n’a plus alors qu’à exécuter mécaniquement l’aiguillage vers la branche d’action idoine selon que le condensé logique reçu s’établit à VRAI ou à FAUX.
Sur le plan de l’ergonomie visuelle et de la lisibilité logicielle, cette approche unifiée procure une clarification immédiate de la structure du classeur. En substituant une disjonction compacte à une succession de branchements imbriqués tortueux, l’analyste assainit la typographie de sa feuille de calcul. L’agencement strict des parenthèses délimitatrices — veillant à ce que le bloc disjonctif soit intégralement clos par une parenthèse fermante avant la spécification des branches d’action de la fonction SI — matérialise visuellement la frontière entre la phase de test et la phase de routage opérationnel des données.
4.2 Évaluation pas à pas d’une expression conditionnelle disjonctive
Pour maîtriser parfaitement le fonctionnement de la combinaison canonique, il convient de décomposer minutieusement la chronologie des micro-opérations exécutées par le moteur de Google Sheets lors de l’évaluation d’une formule telle que =SI(OU(A2= »Prioritaire »; B2>1000); « Traitement Spécial »; « Standard »). Le traitement ne s’effectue pas de façon monolithique mais traverse trois phases algorithmiques séquentielles strictement ordonnées qui garantissent la justesse du résultat final.
La première phase correspond à la résolution interne des propositions au sein de l’antre de la fonction OU. Le processeur isole le premier prédicat A2= »Prioritaire » et compare le contenu textuel de la cellule source avec le littéral spécifié ; il attribue temporairement à cette expression locale un statut de vérité, disons FAUX. Simultanément ou séquentiellement, il analyse le second argument B2>1000 en évaluant la grandeur quantitative de la cellule numérique face au seuil arithmétique fixé ; supposons que cette valeur soit validée à VRAI. À l’issue de cette première étape de calcul élémentaire, les expressions contextuelles disparaissent pour laisser place à un ensemble d’états booléens purs : OU(FAUX; VRAI).
La deuxième phase opère la réduction scalaire de cet ensemble disjonctif. En vertu des principes de la disjonction inclusive examinés précédemment, la présence de la primitive VRAI au sein des arguments neutralise immédiatement l’impact du FAUX concomitant. La fonction OU synthétise donc la séquence et s’efface totalement du registre d’exécution en renvoyant l’entité atomique VRAI. Enfin, la troisième phase engage le commutateur SI : celle-ci reçoit l’instruction résolue SI(VRAI; « Traitement Spécial »; « Standard »). Constatant l’état positif du prédicat d’entrée, elle oriente instantanément l’exécution vers le premier paramètre de retour, inscrivant la mention « Traitement Spécial » dans la cellule cible sans jamais évaluer la branche alternative.
4.3 Bonnes pratiques de ponctuation et conventions régionales
L’implémentation opérationnelle de formules imbriquées dans Google Sheets confronte fréquemment les praticiens à des écueils de portabilité syntaxique liés aux conventions régionales et aux paramètres linguistiques du logiciel. La divergence la plus fondamentale réside dans le caractère séparateur d’arguments. Dans les configurations francophones et européennes standard — où la virgule est conventionnellement réservée à la notation des décimales arithmétiques —, le séparateur d’arguments officiel et obligatoire est le point-virgule (;). Une omission ou une utilisation erronée de la virgule à la place du point-virgule provoquera immanquablement une erreur d’analyse syntaxique (#ERREUR!), rendant la formule totalement inopérante.
Une attention tout aussi rigoureuse doit être portée à la typographie des chaînes de caractères littérales insérées au sein du bloc disjonctif ou des branches de retour conditionnel. Google Sheets exige de manière intraitable l’usage de guillemets droits doubles standard (« ) pour circonscrire toute valeur textuelle. L’utilisation malencontreuse de guillemets typographiques courbes (souvent introduits involontairement lors de transferts textuels depuis des traitements de texte ou des courriels) empêche l’analyseur lexical de reconnaître les bornes textuelles, conduisant le moteur à interpréter la saisie comme le nom d’une plage nommée inexistante, ce qui déclenche l’erreur fatale #NOM?.
Enfin, la structuration géométrique de la formule doit obéir à des règles préventives strictes pour éviter l’apparition de références circulaires pernicieuses. Lors de l’écriture d’une formule SI combinée avec un OU au sein d’une cellule donnée (par exemple en C2), il est impératif de s’assurer qu’aucun des prédicats disjonctifs ne vienne interroger directement ou indirectement la valeur de cette même cellule C2. Une boucle de rétroaction non maîtrisée plongerait le tableur dans une impasse computationnelle itérative non résolue, paralysant l’actualisation dynamique du modèle d’affaires.
5. Application pratique aux chaînes de caractères et données textuelles
5.1 Filtrage catégoriel : exemple d’appartenance régionale
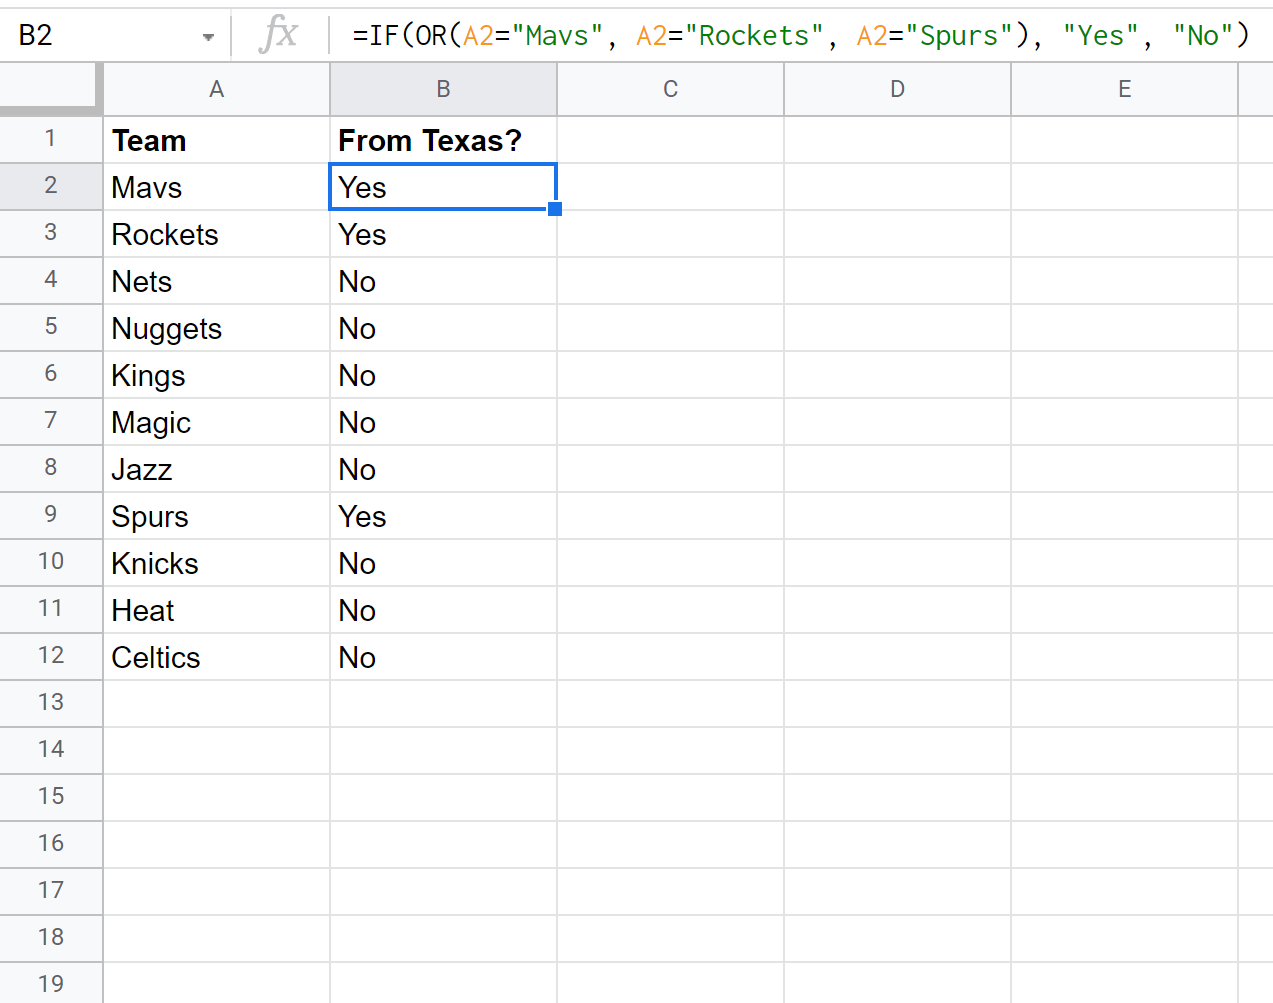
L’une des applications opérationnelles les plus courantes de la formule combinée SI et OU concerne la catégorisation d’enregistrements textuels au sein de référentiels d’entreprise hétérogènes. Considérons, à titre d’illustration empirique dans le monde de l’analyse sportive et logistique, un jeu de données répertoriant les franchises de basketball professionnelles de la NBA, où l’analyste doit déterminer de façon automatisée si une équipe donnée appartient géographiquement à l’État du Texas, afin de rationaliser des tournées promotionnelles ou des calculs de taxation interétatique.
Dans ce scénario, une franchise texane peut être identifiée sous trois appellations distinctes au sein de la colonne A : les Mavericks de Dallas (« Mavs »), les Rockets de Houston (« Rockets ») ou les Spurs de San Antonio (« Spurs »). L’implémentation de la règle de décision par la formule =SI(OU(A2= »Mavs »; A2= »Rockets »; A2= »Spurs »); « Texas »; « Autre Région ») résout cette problématique de filtrage avec une remarquable économie de moyens. Dès que la valeur textuelle logée en A2 coïncide avec l’un quelconque de ces trois descripteurs, la disjonction bascule à l’état VRAI, validant l’attribution immédiate du label territorial « Texas ».
L’avantage architectural de cette approche combinée apparaît de manière saisissante lorsqu’on la confronte à l’alternative archaïque des fonctions SI imbriquées en cascade. Pour parvenir au même résultat sans l’opérateur OU, l’analyste serait contraint de déployer une formule redondante du type =SI(A2= »Mavs »; « Texas »; SI(A2= »Rockets »; « Texas »; SI(A2= »Spurs »; « Texas »; « Autre Région »))). Cette prolifération de branchements séquentiels accroît considérablement la verbosité du code, démultiplie le risque d’erreurs de parenthésage lors de modifications ultérieures et rend l’auditabilité du modèle particulièrement laborieuse pour les relecteurs externes.
5.2 Sensibilité à la casse et gestion des espaces résiduels
L’évaluation des critères textuels par l’intermédiaire de l’opérateur d’égalité simple (=) dans Google Sheets présente une caractéristique fondamentale qu’il convient d’appréhender avec précision : l’insensibilité native à la casse typographique. Cela signifie que l’instruction comparative A2= »Mavs » sera résolue de façon strictement identique que la cellule source contienne la mention « MAVS », « mavs », ou « Mavs ». Cette tolérance intégrée facilite grandement le traitement des saisies manuelles désordonnées au sein desquelles les utilisateurs alternent arbitrairement entre majuscules et minuscules sans intention sémantique particulière.
Toutefois, cette tolérance structurelle ne s’étend en aucun cas aux caractères invisibles, et plus spécifiquement aux espaces superflus qui viennent fréquemment polluer les bases de données brutes. Une cellule contenant la séquence textuelle « Mavs » (avec une espace terminale parasite) échouera inévitablement au test d’égalité stricte face à la constante « Mavs ». Pour prémunir le bloc disjonctif contre ces faux négatifs indétectables à l’œil nu, il est vivement recommandé d’encapsuler la référence de cellule dans la fonction d’assainissement SUPPRESPACE (TRIM), formulant ainsi le test sous la forme rigoureuse : OU(SUPPRESPACE(A2)= »Mavs »; …).
Dans les cas d’usage hautement spécifiques où la différenciation entre majuscules et minuscules revêt une importance capitale (par exemple lors de l’authentification d’identifiants de sécurité ou de codes SKU d’inventaire sensibles à la casse), l’opérateur d’égalité standard devient caduc. L’analyste doit alors substituer à la simple égalité la fonction d’inspection typographique stricte EXACT, en structurant son prédicat disjonctif sous la forme : OU(EXACT(A2; « MAVS »); EXACT(A2; « Mavs »)). Cette fonction garantit une comparaison binaire rigoureuse caractère par caractère selon les tables d’encodage Unicode.
5.3 Utilisation de fonctions de recherche textuelle avec OU
La rigidité de l’égalité textuelle globale atteint ses limites lorsque le critère d’identification ne constitue qu’une composante partielle d’une chaîne plus volumineuse, comme une chaîne de commentaires de support client ou un numéro d’immatriculation complexe. Dans une telle configuration, l’analyste doit associer la fonction OU à des instruments de recherche de sous-chaînes textuelles tels que les fonctions CHERCHE ou TROUVE. Puisque ces fonctions renvoient la position numérique du segment trouvé ou génèrent une erreur d’exécution en cas d’absence, le prédicat disjonctif doit être articulé avec la fonction ESTNUM pour convertir l’indice de recherche en booléen exploitable : OU(ESTNUM(CHERCHE(« Urgent »; A2)); ESTNUM(CHERCHE(« Critique »; A2))).
Bien que cette combinaison fonctionnelle résolve efficacement la détection de mots-clés multiples au sein d’un corps textuel, elle impose une charge syntaxique lourde qui peut rapidement saturer la barre de formule. C’est à ce confluent technique précis que s’impose l’utilisation des expressions rationnelles (regex), natives dans l’environnement Google Sheets via la fonction matricielle textuelle REGEXMATCH. Cette fonction possède son propre opérateur de disjonction interne, matérialisé par la barre verticale (« | »), ce qui permet de reformuler la disjonction précédente sous la forme remarquablement sobre : =SI(REGEXMATCH(A2; « (?i)Urgent|Critique »); « Alerte »; « Normal »).
L’arbitrage entre la formulation classique SI(OU(…)) et la compacité moderne offerte par REGEXMATCH relève d’une décision d’architecture logicielle. Si la formule articulant SI et OU présente une clarté didactique indéniable pour des équipes d’analystes peu familières des grammaires formelles d’expressions régulières, le recours à REGEXMATCH optimise la maintenabilité du modèle lorsque le nombre d’alternatives textuelles s’accroît de façon exponentielle. L’ingénieur tabulaire choisira donc l’approche la plus alignée sur la maturité technique de son organisation.
6. Application pratique aux grandeurs numériques et critères d’inégalité
6.1 Définition de seuils critiques et bornes d’exclusion
L’application de la disjonction logique aux variables quantitatives intervient principalement lors de la surveillance de métriques d’exploitation, de l’audit de bilans financiers ou du contrôle de la qualité industrielle. Dans ces disciplines, la détection des anomalies repose fréquemment sur l’identification d’observations atypiques situées en dehors d’une enveloppe de tolérance opérationnelle normale. Il ne s’agit pas de vérifier l’appartenance d’une valeur à un intervalle continu (problématique qui relèverait de la conjonction logique ET), mais au contraire de repérer les franchissements de seuils extrêmes caractérisant les valeurs divergentes.
Considérons un protocole de surveillance thermique au sein d’une chaîne logistique de produits pharmaceutiques, où la température mesurée en degrés Celsius (colonne B) doit impérativement demeurer comprise entre 2°C et 8°C sous peine de dégradation irréversible des principes actifs. L’assertion désignant une anomalie de conservation correspond à un état où la température est soit strictement inférieure à la borne minimale permise, soit strictement supérieure à la borne maximale autorisée. La modélisation de cette règle d’exclusion s’opère par la formule : =SI(OU(B2<2; B2>8); « Rupture Chaîne du Froid »; « Conforme »).
D’un point de vue conceptuel et mathématique, il est primordial de distinguer avec la plus grande rigueur les intervalles ouverts des intervalles fermés lors de la définition de ces frontières critiques. Le choix délibéré entre les opérateurs d’inégalité stricte (<, >) et les opérateurs d’inégalité large (<=, >=) modifie radicalement le traitement des valeurs frontières exactes. Une ambiguïté sur ce point précis peut engendrer des déclarations de non-conformité illégitimes ou, plus grave encore, masquer des dérives opérationnelles majeures lors de l’évaluation des cas limites.
6.2 Combinaison d’opérateurs de comparaison variés
La puissance d’agrégation de la fonction OU ne se cantonne pas à l’évaluation d’un type unique de relation mathématique ; elle permet de faire cohabiter au sein d’une même clause de décision des opérateurs d’inégalité et des tests d’égalité stricte. Cette hétérogénéité des comparaisons est particulièrement sollicitée dans les systèmes de réapprovisionnement et de gestion d’inventaire automatisée. Dans ces environnements, le déclenchement d’un bon de commande d’urgence peut résulter soit de l’épuisement quantitatif du stock physique sous un seuil de sécurité, soit de l’attribution manuelle d’un statut de forçage administratif.
Imaginons un modèle logistique où la colonne B enregistre la quantité disponible en magasin, tandis que la colonne C héberge un indicateur d’obsolescence ou de priorité manuelle. La formule d’aiguillage décisionnel s’articule alors comme suit : =SI(OU(B2<=5; C2= »Rupture Imminente »); « Commander »; « Attente »). Ici, l’opérateur d’inégalité large (<=) et l’opérateur d’égalité textuelle (=) opèrent de concert sans la moindre interférence technique, prouvant la capacité de la fonction OU à fédérer des critères quantitatifs et qualitatifs sous une même égide décisionnelle.
Toutefois, lors de la manipulation d’inégalités appliquées à des valeurs numériques fractionnaires, une précaution algorithmique fondamentale s’impose concernant la représentation des nombres à virgule flottante selon le standard IEEE 754. Les tableurs modernes peuvent générer d’infimes imprécisions d’arrondi binaire lors de calculs arithmétiques intermédiaires (par exemple, une soustraction renvoyant 0,0000000000000004 au lieu de zéro). Pour éviter que ces approximations mécaniques ne faussent les tests comparatifs au sein du bloc OU, l’analyste prudent enveloppera ses grandeurs calculées dans la fonction ARRONDI avant de les soumettre aux bornes d’exclusion.
6.3 Gestion des zéros, valeurs négatives et données quantitatives absentes
Un écueil statistique classique lors de la modélisation de règles conditionnelles numériques réside dans la confusion entre l’inexistence d’une valeur et la valeur zéro. Dans Google Sheets, lorsqu’une formule évalue une cellule vierge au moyen d’un opérateur numérique tel que B2<10, la cellule non renseignée est implicitement castée en la valeur numérique 0. Par conséquent, si une ligne du classeur représente un produit qui n’a pas encore fait l’objet de relevé métrique, la condition B2<10 sera évaluée à VRAI, déclenchant un faux positif potentiellement catastrophique dans l’audit de performance.
Pour prévenir cette dérive analytique, le concepteur du classeur doit sécuriser son bloc disjonctif en introduisant des barrières de qualification préliminaires. En combinant des prédicats d’inspection structurelle, il est possible d’exiger explicitement la présence effective d’une valeur quantitative réelle avant d’autoriser l’évaluation des seuils arithmétiques. Cette fiabilisation est traditionnellement mise en œuvre via l’imbrication de la fonction ESTNUM ou par l’adjonction d’un test de non-vacuité explicite : B2<> » ».
La présence de grandeurs négatives exige une vigilance conceptuelle tout aussi affûtée. Selon la convention comptable ou physique adoptée, un nombre négatif peut représenter un déficit financier, une diminution d’inventaire ou une inversion de flux. L’analyste doit formuler ses prédicats disjonctifs en tenant compte du positionnement relatif des nombres sur l’axe des réels, sous peine de voir des valeurs négatives qualifiées d’anomalies de manière totalement contre-productive au regard des objectifs de l’audit.
7. Combinaison mixte : Évaluation conjointe de texte et de variables numériques
7.1 Modélisation d’une règle d’affaires hybride
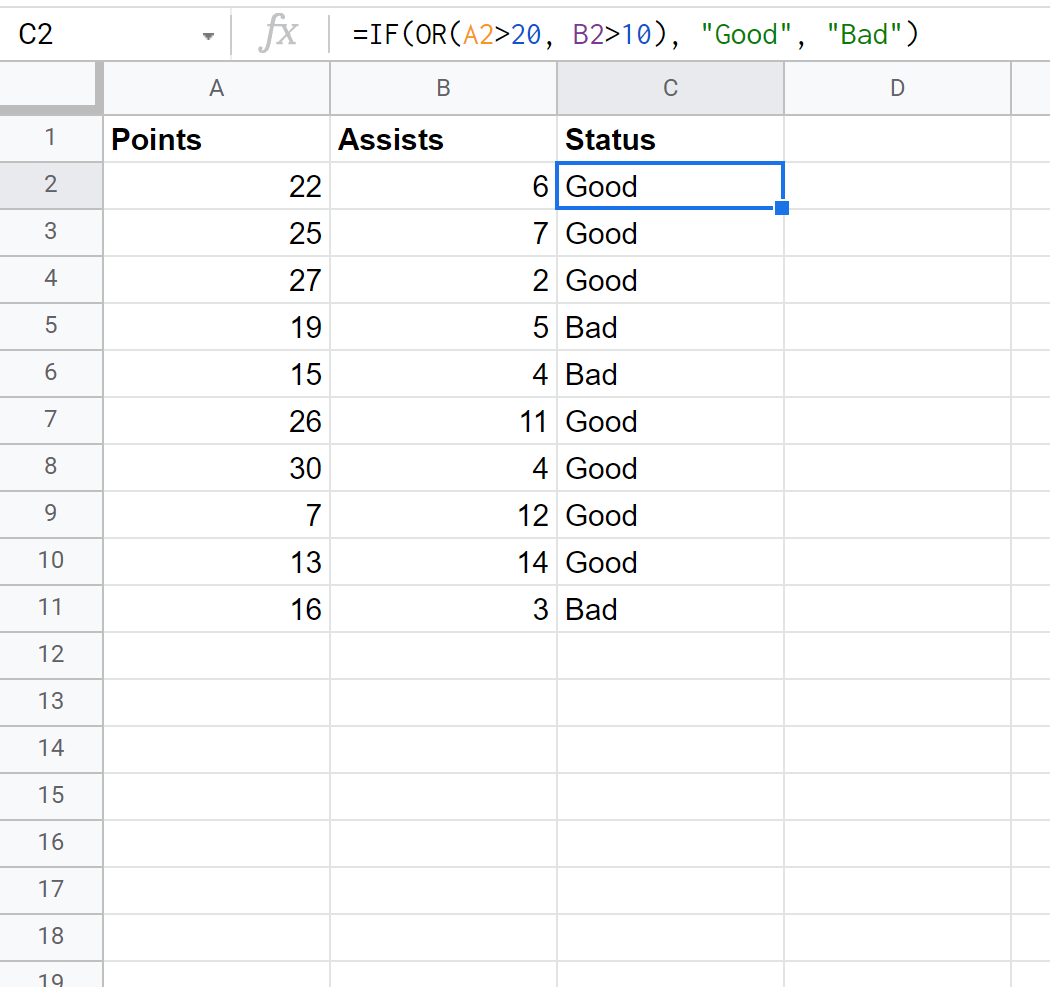
Dans les écosystèmes d’affaires contemporains, les décisions stratégiques ne s’articulent presque jamais autour d’une seule typologie de données. La réalité opérationnelle conjugue continuellement des attributs qualitatifs catégoriels (tels que la désignation commerciale d’un contrat, le rang hiérarchique d’un client ou la localisation d’un centre de profit) avec des grandeurs quantitatives continues (comme le chiffre d’affaires cumulé, l’ancienneté en mois ou le ratio de solvabilité). La structure unifiée =SI(OU(A2= »String »; B2>10); « valeur1 »; « valeur2 ») constitue la transcription formelle de ces règles d’affaires hybrides.
Considérons un scénario d’optimisation de la politique de fidélisation au sein d’une institution bancaire ou d’une plateforme de commerce électronique de premier plan. L’équipe dirigeante souhaite octroyer un traitement préférentiel haut de gamme (« Accès Conciergerie ») aux usagers qui satisfont au moins l’un des deux critères d’éligibilité suivants : soit le client a souscrit formellement au statut statutaire d’adhésion « VIP » (colonne A), soit le montant cumulé de ses transactions annuelles surpasse le seuil de 50 000 euros (colonne B). La règle de gestion trouve son incarnation directe dans la formule : =SI(OU(A2= »VIP »; B2>50000); « Accès Conciergerie »; « Accès Standard »).
L’implémentation de cette règle hybride apporte une contribution inestimable à l’efficience managériale. Elle garantit qu’un client historique disposant d’un abonnement contractuel VIP bénéficiera immédiatement des égards dus à son rang, même si ses volumes transactionnels de l’exercice en cours sont ponctuellement modestes. Simultanément, un nouvel acteur économique affichant un volume d’affaires exceptionnel sera instantanément promu au même palier d’excellence relationnelle sans être entravé par la bureaucratie d’une mise à jour de statut manuelle. Le modèle décisionnel devient ainsi à la fois inclusif, réactif et parfaitement autonome.
7.2 Cohérence des types de données au sein de la clause disjonctive
D’un point de vue de la compilation interne et de l’intégrité logicielle, la coexistence d’assertions textuelles et métriques au sein de la même enveloppe disjonctive soulève la question de la cohérence des types de données. La fonction OU de Google Sheets fait preuve sur ce terrain d’une robustesse appréciable : chaque test logique formulé au sein de ses arguments opère dans son propre espace d’évaluation hermétique. La comparaison de la chaîne textuelle en A2 n’entre jamais en collision calculatoire avec la confrontation numérique menée en B2.
Cette indépendance computationnelle n’exonère toutefois pas l’analyste d’une rigueur absolue quant à l’intégrité référentielle de son modèle de données. L’un des pièges les plus insidieux consiste en l’inversion par inadvertance des colonnes de référence lors de l’écriture ou de l’étirement transversal de la formule. Si par erreur d’indexation la formule vient à confronter un texte à un opérateur numérique (par exemple, en évaluant si le mot « VIP » est supérieur au nombre 50 000), Google Sheets résoudra la comparaison selon des règles d’arbitrage lexical implicites : toute chaîne textuelle est traditionnellement considérée par le moteur de comparaison comme supérieure à n’importe quelle valeur numérique, validant la condition de manière totalement erratique.
Pour immuniser le système contre ces dysfonctionnements sémantiques, il est crucial de s’assurer de l’homogénéité stricte de chaque prédicat individuel. Les colonnes textuelles doivent être confrontées exclusivement à des chaînes textuelles ou à des fonctions textuelles, et les colonnes numériques doivent être appariées sans exception à des grandeurs quantitatives. L’étanchéité sémantique de chaque argument est le garant incontournable de la validité du retour synthétique généré à l’attention de l’utilisateur final.
7.3 Étude de cas empirique : scoring multidimensionnel
Pour illustrer la mise en œuvre de ces principes sur un cas pratique complexe, analysons la constitution d’une cohorte d’expérimentation clinique ou d’un programme d’amorçage technologique au sein d’un incubateur d’entreprises. Dans ce protocole de qualification, une candidature est déclarée éligible au financement d’amorçage si elle remplit au moins une condition d’excellence parmi trois dimensions distinctes : appartenir à une filière stratégique prioritaire (« DeepTech »), détenir un portefeuille de brevets préalablement déposés (supérieur ou égal à 2), ou présenter une traction commerciale initiale matérialisée par un chiffre d’affaires pré-commercial supérieur à 100 000 euros.
La structure formelle de la formule conditionnelle se déploie à travers un prédicat ternaire intégrant texte et variables numériques : =SI(OU(A2= »DeepTech »; B2>=2; C2>100000); « Admis en Phase 2 »; « Rejeté »). Cette formalisation permet aux commissions de sélection de traiter instantanément des milliers de dossiers de candidature sans introduire de distorsions subjectives dans l’évaluation des dossiers. La transparence totale de la règle mathématique renforce l’équité institutionnelle du processus d’attribution des subventions.
Cependant, cette étude de cas empirique permet également de mettre en exergue les limites inhérentes au modèle disjonctif pur lors de l’extension dimensionnelle. Dès lors que l’on agrège plus de trois critères hétérogènes au sein d’une clause OU, le risque de dilution sélective s’accroît : l’éligibilité devenant extrêmement permissive, la cohorte sélectionnée peut rapidement saturer les capacités d’accueil de l’organisation. L’analyste se trouve alors confronté à la nécessité de raffiner son architecture logique, en combinant les disjonctions avec des conjonctions impératives au sein de structures logiques composites de rang supérieur.
8. Extension logique : Combinaisons avancées avec ET (AND) et SI imbriqués
8.1 Formes canoniques disjonctives : imbrication de SI, OU et ET
L’ingénierie décisionnelle avancée exige fréquemment de modéliser des réalités multifactorielles où la prise de décision dépend de la validation de blocs conditionnels distincts, dont chacun requiert la conjonction cumulative de plusieurs sous-critères. En algèbre booléenne, cette architecture est désignée sous l’appellation de forme normale disjonctive (une disjonction de conjonctions). Dans Google Sheets, cette abstraction mathématique s’opérationnalise avec une précision chirurgicale par l’imbrication de la fonction ET (AND) à l’intérieur du bloc disjonctif OU de la fonction SI.
Considérons un barème d’exonération de frais logistiques pour une plateforme de négoce international. La gratuité des frais de port est concédée sous deux scénarios alternatifs mais rigides : le client appartient au segment des grossistes (« Grossiste ») ET son volume d’achat dépasse 500 unités, OU le client relève du marché domestique (« National ») ET le montant de sa commande excède 1 500 euros. La formalisation canonique de cet arbre décisionnel s’exprime par la formule : =SI(OU(ET(A2= »Grossiste »; B2>500); ET(A2= »National »; C2>1500)); « Port Gratuit »; « Port Payant »).
La conception d’édifices logiques de ce niveau de complexité ne doit jamais être improvisée directement dans la barre de formule du tableur. La méthode recommandée par les ingénieurs système consiste à schématiser préalablement l’arbre décisionnel sur papier ou sous forme de table de vérité formalisée. Chaque chemin critique menant à une issue favorable est d’abord modélisé comme un bloc conjonctif ET distinct ; l’ensemble des branches positives est ensuite agrégé au sein du tronc disjonctif OU. Cette approche de décomposition cartésienne prévient les inversions logiques qui constituent la cause première d’échec des modèles financiers complexes.
8.2 Factorisation des structures conditionnelles répétitives
L’un des apports majeurs de la maîtrise des opérateurs logiques dans Google Sheets réside dans l’art de la factorisation structurelle. Dans de nombreuses organisations, la maintenance logicielle des classeurs est gravement entravée par l’accumulation historique de formules conditionnelles kilométriques, issues d’ajouts successifs d’arbres de SI imbriqués. Cette prolifération désordonnée engendre une explosion de la complexité cyclomatique du modèle, le rendant hautement vulnérable à la moindre modification de structure de données.
Considérons une situation d’attribution de primes de fin d’année où un collaborateur est gratifié du bonus s’il travaille dans la division commerciale, s’il a dépassé ses objectifs individuels de plus de 15 %, ou s’il justifie de dix années d’ancienneté. Rédigée par un utilisateur inexpérimenté, la formule adoptera l’allure d’une cascade redondante : =SI(A2= »Commerce »; 1000; SI(B2>0,15; 1000; SI(C2>=10; 1000; 0))). Une telle structure impose de répéter la valeur d’attribution « 1000 » à trois reprises, ce qui multiplie d’autant les risques d’erreur en cas de révision budgétaire du montant de la prime.
La factorisation disjonctive permet de condenser l’ensemble de ces occurrences en une formule épurée et saine : =SI(OU(A2= »Commerce »; B2>0,15; C2>=10); 1000; 0). La valeur d’attribution de la prime est désormais inscrite à un emplacement unique dans la logique décisionnelle. Cette réduction drastique de l’entropie de la formule simplifie la transmission intergénérationnelle du classeur entre analystes, minimise les coûts d’audit et réduit la taille globale du fichier en mémoire cache d’évaluation.
8.3 Optimisation cognitive et ergonomie des formules complexes
Lorsque la structure logique d’une formule combine plusieurs étages de fonctions SI, OU et ET, l’interface standard d’affichage linéaire de Google Sheets peut devenir un obstacle sévère à la compréhension du code. Pour pallier cette contrainte cognitive, il est impératif d’adopter des normes de présentation analogues à l’indentation de code informatique professionnel. Google Sheets permet nativement d’insérer des retours à la ligne au sein de la barre de formule en combinant les touches Ctrl + Entrée (sur Windows) ou Commande + Entrée (sur macOS).
En utilisant judicieusement cette fonctionnalité, l’analyste peut structurer visuellement sa formule complexe de manière aérée, en isolant chaque prédicat conjonctif sur une ligne distincte précédée d’espaces typographiques. Une formule disjonctive à plusieurs volets devient alors un véritable script modulaire dont chaque branche de décision saute immédiatement aux yeux lors de la sélection de la cellule. Cette ergonomie visuelle réduit substantiellement la charge cognitive requise pour analyser ou faire évoluer les règles décisionnelles.
Pour les modèles institutionnels hautement critiques où la survie de l’organisation dépend de la conformité des flux logiques, il demeure néanmoins opportun d’appliquer le principe de parcimonie cognitive. Si une formule disjonctive composite dépasse trois niveaux d’imbrication et devient difficilement appréhendable même après indentation, l’analyste avisé fractionnera son raisonnement en créant des colonnes auxiliaires d’étapes de calcul. Chaque colonne intermédiaire résoudra un sous-système logique, offrant ainsi des points de contrôle traçables et vérifiables tout au long de la chaîne d’évaluation.
9. Utilisation vectorielle : ARRAYFORMULA avec SI et l’opérateur d’addition booléenne
9.1 Les limites intrinsèques de la fonction OU dans ARRAYFORMULA
Dans l’ingénierie avancée des feuilles de calcul Google Sheets, le déploiement de formules matricielles via la fonction directrice ARRAYFORMULA représente le summum de l’efficacité opérationnelle. Cette technique permet de loger une formule unique dans la cellule d’en-tête et de propager automatiquement son exécution sur l’intégralité d’une colonne dynamique. Cependant, les praticiens se heurtent systématiquement à une impasse technique fondamentale : la fonction standard OU est totalement incompatible avec le paradigme matriciel d’ARRAYFORMULA.
Cette incompatibilité ne constitue pas un bogue logiciel mais découle de la nature mathématique intrinsèque de la fonction OU. Comme nous l’avons établi dans les fondements théoriques, la vocation d’origine de la fonction OU est d’opérer une réduction dimensionnelle : elle ingère une multiplicité d’arguments (ou une plage vectorielle continue) et les synthétise en un résultat scalaire unique. Par conséquent, lorsqu’elle est encapsulée dans ARRAYFORMULA sur une colonne telle que OU(A2:A= »Mavs »; B2:B>10), la fonction n’évalue pas la ligne 2, puis la ligne 3 de manière indépendante ; elle agrège la totalité absolue des cellules de la colonne en un seul booléen global.
Le résultat de cette agrégation globale est dramatique pour le modèle : dès qu’une seule ligne de toute la feuille de calcul satisfait à l’une des conditions, la fonction OU renvoie VRAI pour la colonne dans son intégralité. La fonction SI applique alors aveuglément la branche affirmative à chaque ligne du classeur, anéantissant toute discrimination analytique. Pour obtenir une évaluation disjonctive ligne par ligne en mode vectoriel, l’analyste est contraint de changer de paradigme et de délaisser la fonction OU au profit des opérateurs arithmétiques booléens.
9.2 Émulation du OU logique via l’addition arithmétique
La résolution élégante de ce verrou vectoriel réside dans l’exploitation formelle d’un théorème d’équivalence de l’algèbre de Boole : l’isomorphisme entre la disjonction logique inclusive et l’addition arithmétique. Dans les environnements informatiques, les valeurs de vérité sont intrinsèquement coercibles en grandeurs numériques : la valeur logique VRAI équivaut strictement à l’entier 1, tandis que la valeur logique FAUX correspond sans équivoque à l’entier 0. En additionnant arithmétiquement deux expressions comparatives, on reproduit exactement le comportement d’une table de vérité disjonctive.
Analysons la mécanique de l’opération (Condition1) + (Condition2) appliquée à une ligne donnée. Si les deux conditions sont fausses, l’opération produit l’addition arithmétique 0 + 0 = 0. Si l’une des conditions est vraie et l’autre fausse, le calcul devient 1 + 0 = 1 ou 0 + 1 = 1. Si les deux conditions sont simultanément vraies, l’expression génère la somme arithmétique 1 + 1 = 2. On constate avec émerveillement que l’expression n’est égale à 0 que dans l’unique éventualité où l’intégralité des prédicats est réfutée. Dès lors qu’au moins une condition est satisfaite, la somme résultante est strictement supérieure à zéro.
La formulation vectorielle de la disjonction s’exprime donc sous la forme canonique : ((Condition1) + (Condition2)) > 0. Intégrée au sein d’une formule matricielle complète, l’instruction prend l’allure suivante : =ARRAYFORMULA(SI(((A2:A= »Mavs ») + (B2:B>10)) > 0; « Oui »; « Non »)). Grâce à cette transcription arithmétique, ARRAYFORMULA traite les colonnes comme des vecteurs indépendants, applique l’addition ligne par ligne sur les registres vectoriels et restitue un partitionnement disjonctif parfait sur des centaines de milliers de lignes sans jamais saturer le moteur de calcul.
9.3 Déploiement dynamique à l’échelle d’une colonne entière
L’implémentation d’une formule matricielle vectorielle sur une plage ouverte (comme A2:A et B2:B) soulève immédiatement la problématique de la gestion des lignes vierges résiduelles situées au bas de la feuille de calcul. En l’absence de garde-fous structurels, ARRAYFORMULA évaluera l’ensemble des lignes vides du classeur jusqu’à la limite physique de la grille. Dans notre formule précédente, les cellules vides n’étant ni égales à « Mavs » ni supérieures à 10, l’addition produira 0, conduisant la fonction SI à inscrire la mention « Non » sur des milliers de lignes inutilisées, alourdissant inutilement le document.
Pour immuniser le modèle contre cette prolifération de calculs parasites, il est indispensable de ceinturer la formule matricielle d’un sas de vacuité protecteur. Cette sécurité est traditionnellement implémentée en introduisant un premier niveau de condition SI qui inspecte si la ligne active comporte des données significatives avant d’autoriser le déclenchement de l’évaluation disjonctive. La formule complète et professionnalisée prend alors la forme suivante :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); ; SI(((A2:A= »Mavs ») + (B2:B>10)) > 0; « Oui »; « Non »)))
Cette construction sophistiquée garantit que si la cellule source A2:A ne contient aucune information, le moteur de calcul n’affiche absolument rien (matérialisé par l’espace vide entre les deux points-virgules successifs) et court-circuite tout calcul subséquent. Le classeur ne calcule et n’affiche les résultats conditionnels disjonctifs que pour les lignes physiquement renseignées. Cette approche élimine définitivement la corvée manuelle d’étirement des formules vers le bas, garantissant que tout nouvel enregistrement saisi ou importé via une connexion API sera instantanément pris en compte par la mécanique décisionnelle.
10. Diagnostic, débogage et résolution des anomalies courantes
10.1 Typologie des erreurs syntaxiques et sémantiques
Le déploiement de formules combinant des fonctions logiques expose inévitablement les analystes à des dysfonctionnements computationnels. La première pathologie récurrente se manifeste par l’apparition de l’erreur d’exécution #VALEUR!. Ce signal d’alerte survient typiquement lors d’une inadéquation manifeste entre le type de données attendu par un opérateur de comparaison et le type réel de la donnée injectée, ou lorsqu’un argument textuel non numérique est introduit dans une opération de coercition arithmétique directe sans assainissement préalable.
La seconde anomalie courante découle d’une défaillance dans le parenthésage structurel de la formule. La fonction OU requérant l’encapsulation exhaustive de ses arguments au sein de son propre jeu de parenthèses, une erreur fréquente consiste à fermer prématurément ou tardivement cette enveloppe. Une parenthèse fermante positionnée par inadvertance après le premier argument de retour aura pour effet désastreux de basculer la valeur affirmative à l’intérieur du bloc disjonctif lui-même, perturbant l’affectation positionnelle des arguments attendus par la fonction SI hôte.
Enfin, l’erreur #NOM? signale presque invariablement une défaillance dans la reconnaissance des identifiants textuels par l’analyseur lexical de Google Sheets. Cette rupture d’interprétation trouve généralement son origine dans l’omission des guillemets droits entourant une constante textuelle (le système tentant alors de localiser une fonction personnalisée ou une plage nommée inexistante portant ce patronyme), ou dans une faute de frappe touchant les acronymes des fonctions elles-mêmes (par exemple en orthographiant « OUI » au lieu de « OU », ou « IF » dans une feuille configurée exclusivement pour le dialecte français).
10.2 Techniques de décomposition pour isoler les faux positifs et négatifs
La typologie d’anomalie la plus pernicieuse ne réside pas dans les erreurs d’exécution explicites (qui interrompent le calcul et forcent l’intervention de l’utilisateur), mais dans les erreurs silencieuses de logique interne : les faux positifs (une règle qui s’active alors qu’elle devrait être réfutée) et les faux négatifs (une condition remplie qui est pourtant ignorée par le système). Face à ces dérives invisibles, la méthodologie d’investigation exige une décomposition clinique de l’architecture de la formule incriminée.
La première technique d’audit préventif consiste à procéder à l’isolation univariée du bloc logique. L’analyste extrait temporairement l’expression disjonctive =OU(Condition1; Condition2) hors de la fonction SI et la déploie dans une colonne d’essai contiguë. En observant directement la succession brute des booléens scalaires VRAI et FAUX générés par la disjonction pure, il devient aisé de repérer à quelle ligne précise l’évaluation dévie de la trajectoire empirique attendue, sans subir l’effet masquant des valeurs de retour textuelles ou numériques paramétrées dans la fonction SI.
La seconde technique met à profit l’inspecteur contextuel de Google Sheets. Lorsque l’on surligne une section précise d’une formule au sein de la barre d’édition, l’environnement affiche une infobulle d’évaluation partielle indiquant le résultat instantané de la sous-expression sélectionnée. Cette fonctionnalité d’introspection logicielle permet d’auditer pas à pas la résolution de chaque prédicat individuel à l’intérieur du bloc disjonctif, offrant un moyen d’identifier avec certitude le critère défaillant au sein d’une expression composite.
10.3 Pièges liés aux types de données non coercibles
L’un des défis majeurs dans l’exploitation quotidienne des classeurs réside dans la non-coercibilité ou la coercition défaillante des types de données importés depuis des systèmes tiers (tels que des extractions ERP, des fichiers CSV ou des bases de données SQL). Le piège le plus universel concerne les grandeurs quantitatives stockées au format texte. Si une colonne héberge visuellement le chiffre 100 mais que ce dernier est étiqueté sous le format textuel, l’évaluation arithmétique OU(B2>50) renverra un résultat imprévisible ou faux, car la comparaison s’opérera selon des tables d’encodage de caractères alphanumériques et non selon l’ordre naturel des grandeurs réelles.
Un phénomène d’altération similaire survient avec une acuité particulière lors de la présence d’espaces insécables (dont l’encodage binaire correspond à l’octet non standard ASCII 160 ou Unicode U+00A0), fréquemment générés lors des exports web ou des formats de séparation de milliers. La fonction traditionnelle SUPPRESPACE (TRIM) de Google Sheets étant historiquement conçue pour neutraliser uniquement l’espace standard (ASCII 32), elle se révèle totalement inopérante face à un espace insécable. Cette défaillance silencieuse empêche toute égalité textuelle stricte de se réaliser, plongeant l’analyste dans une incompréhension totale face à un test pourtant visuellement irréprochable.
Pour assainir définitivement ces flux quantitatifs corrompus avant de les introduire dans le bloc décisionnel disjonctif, il convient d’appliquer des fonctions de conversion forcée. L’encapsulation des cellules métriques litigieuses au sein de la fonction CNUM (VALUE) permet d’extraire la grandeur arithmétique pure en brisant le formatage textuel parasite. De même, la substitution préventive des espaces exotiques via la fonction SUBSTITUE garantit que les chaînes soumises à l’évaluation comparative sont rigoureusement conformes aux attentes du moteur de calcul logique.
11. Optimisation des performances et clarté architecturale du modèle
11.1 Impact computationnel sur les feuilles de calcul massives
L’intégration massive de formules conditionnelles au sein de feuilles de calcul comptant des dizaines ou des centaines de milliers d’enregistrements pose avec acuité la question de l’optimisation des ressources matérielles et de la réactivité computationnelle. Google Sheets fonctionnant principalement via un moteur d’exécution hébergé sur le cloud couplé à une interface de rendu dynamique en JavaScript sur le navigateur client, chaque modification apportée à une cellule racine déclenche une cascade de recalculs automatiques susceptibles de dégrader l’expérience utilisateur.
Le choix d’implémentation entre des formules locales recopiées de manière itérative sur chaque ligne et une architecture matricielle vectorisée (via ARRAYFORMULA et addition booléenne) exerce une influence déterminante sur l’empreinte mémoire du classeur. Si les formules matricielles présentent l’avantage indéniable de centraliser le code dans une cellule unique et d’éliminer la gestion de milliers d’instances d’arbres syntaxiques distincts, elles mobilisent d’importants volumes de calcul séquentiel lors de leur actualisation initiale. Dès lors que le volume de la feuille franchit le cap des 100 000 lignes, l’évaluation de disjonctions matricielles complexes peut induire des latences perceptibles lors de la saisie.
Pour préserver une fluidité optimale sur les jeux de données volumineux, l’analyste veillera à proscrire formellement l’inclusion de fonctions volatiles au sein de ses prédicats logiques combinés SI et OU. Des fonctions telles que AUJOURDHUI(), MAINTENANT(), ALEA(), ou INDIRECT() présentent la fâcheuse propriété de forcer le recalcul systématique de l’intégralité de la formule à laquelle elles participent, et ce à chaque interaction utilisateur sur le document, quand bien même la donnée sous-jacente demeurerait strictement inchangée. L’expulsion de ces éléments vers des cellules de référence statiques dédiées permet de restaurer la vélocité native du moteur de calcul.
11.2 Lisibilité et documentation des règles logiques
La valeur opérationnelle d’une feuille de calcul ne se mesure pas exclusivement à sa sophistication algorithmique, mais tout autant à sa pérennité et à sa transmissibilité. Un classeur dont les règles d’affaires reposent sur des coordonnées spatiales opaques (telles que =SI(OU(AA12= »X »; BL12>100); …)) devient rapidement un fardeau technique pour l’organisation, inaccessible à tout relecteur externe qui n’a pas participé à la genèse du modèle.
L’un des leviers méthodologiques les plus efficaces pour remédier à cette opacité consiste à recourir systématiquement au nommage des plages de cellules. En substituant aux références de coordonnées des étiquettes sémantiques claires — par exemple en nommant la cellule B1 Seuil_Critique et la colonne A Statut_Client —, l’analyste transforme sa formule en une proposition quasi littéraire : =SI(OU(Statut_Client= »VIP »; Volume_Ventes > Seuil_Critique); « Accordé »; « Refusé »). Cette transparence narrative fluidifie considérablement les audits internes et réduit le risque de corruption logique lors des modifications architecturales.
Cette discipline de clarté doit impérativement être consolidée par une politique rigoureuse de documentation intégrée. Google Sheets offre la possibilité d’insérer des notes explicatives et des commentaires collaboratifs directement sur les cellules d’en-tête hébergeant les formules directrices. L’analyste y consignera la justification économique de la règle de gestion disjonctive, la date de la dernière révision des seuils et les hypothèses opérationnelles retenues, transformant ainsi la feuille de calcul en un actif intellectuel pérenne et documenté pour l’ensemble de l’entreprise.
11.3 Alternatives structurelles : SI.CONDITIONS (IFS) et SWITCH
Bien que la combinaison canonique SI et OU soit capable de résoudre l’immense majorité des cas de figure disjonctifs, l’ingénieur de données se doit de connaître les alternatives structurelles offertes par les versions modernes de Google Sheets, et d’en mesurer les mérites comparatifs. Au premier rang de ces alternatives figure la fonction SI.CONDITIONS (IFS), conçue pour sérialiser l’évaluation d’une suite de conditions sans avoir recours à l’imbrication manuelle de fonctions SI successives.
Toutefois, une analyse comparative rigoureuse démontre que la fonction SI.CONDITIONS ne remplace pas directement l’élégance de la disjonction OU. Pour exprimer le fait que l’un des trois critères A, B ou C entraîne le résultat R, SI.CONDITIONS contraindra souvent l’utilisateur à répéter la valeur de retour : SI.CONDITIONS(A; R; B; R; C; R), retombant ainsi dans les écueils de verbosité et de redondance que la factorisation par OU permet précisément d’éradiquer. La fonction SI.CONDITIONS s’avère en revanche supérieure lorsque différents blocs de conditions (dont certains peuvent intégrer des OU) doivent aboutir à des résultats divergents multiples.
Une autre alternative d’intérêt réside dans la fonction SWITCH, particulièrement adaptée aux scénarios où l’on teste l’égalité stricte d’une unique variable cible face à une pluralité de cas prédéfinis. Dès lors qu’il s’agit de tester si une même cellule est égale à « Option1 », « Option2 » ou « Option3 », SWITCH propose une écriture plus compacte que la combinaison SI(OU(…)). Cependant, SWITCH s’avère totalement inopérante dès qu’interviennent des inégalités mathématiques, des comparaisons de plages ou des variables d’évaluation multiples, réaffirmant ainsi la souveraineté de la structure SI combinée avec OU pour l’ensemble des logiques décisionnelles complexes et hétérogènes.
12. Synthèse méthodologique et guide décisionnel pour l’analyste
12.1 Arbre de décision pour la sélection de la structure conditionnelle idoine
Afin de guider l’analyste dans le choix de l’instrument logique le plus efficient face à une problématique d’affaires donnée, il est possible de formaliser un cadre décisionnel méthodique. Ce processus de sélection s’articule autour de trois interrogations fondamentales portant sur la typologie des prédicats, le mode d’exécution requis et le format de restitution des données. Le respect de ce cheminement intellectuel prévient les erreurs de sur-ingénierie logicielle ou, à l’inverse, l’emploi de formules inadaptées à la charge de données.
La première interrogation concerne la nature dimensionnelle des critères : les tests portent-ils sur une variable unique confrontée à des constantes discrètes, ou impliquent-ils une pluralité de grandeurs et de colonnes interconnectées ? Dans le premier scénario, des fonctions dédiées comme SWITCH ou des recherches via EQUIV peuvent suffire. En revanche, dès lors que les prédicats sont multivariables et mélangent grandeurs numériques et statuts qualitatifs, la combinaison SI et OU s’impose comme l’unique standard universellement robuste.
La seconde interrogation examine l’architecture de déploiement : la logique doit-elle être appliquée de manière isolée sur quelques cellules scalaires, ou doit-elle être projetée de façon continue et dynamique sur une colonne de données en expansion perpétuelle ? Si le traitement vectoriel dynamique à grande échelle est exigé, l’analyste doit immédiatement écarter la fonction standard OU pour se tourner vers la formulation matricielle ARRAYFORMULA fondée sur l’addition arithmétique booléenne. Ce protocole méthodique garantit l’alignement parfait entre la formule retenue et les impératifs d’évolutivité du système.
12.2 Protocole de validation préalable au déploiement en production
Le déploiement d’un modèle conditionnel en environnement de production — particulièrement lorsqu’il sous-tend des décisions financières, logistiques ou réglementaires critiques — ne saurait s’effectuer sans un protocole préalable de validation formelle. La première étape de ce protocole consiste à bâtir un jeu d’essais exhaustif (ou banc de test unitaire) conçu pour éprouver l’ensemble des branches d’exécution de l’arbre logique. Ce jeu d’épreuve doit impérativement inclure des enregistrements validant chaque condition de façon unitaire, des enregistrements cumulant la totalité des critères favorables, et des cas ne validant absolument aucun prédicat.
La deuxième étape de sécurisation repose sur le test systématique des conditions aux limites et des valeurs extrêmes. L’analyste doit introduire intentionnellement dans le jeu de test des valeurs immédiatement inférieures, égales et immédiatement supérieures aux seuils de déclenchement quantitatifs spécifiés dans le bloc disjonctif. De surcroît, l’injection délibérée de cellules vierges, de zéros arithmétiques, de chaînes textuelles vides et de caractères spéciaux permet de vérifier l’étanchéité des mécanismes de défense du modèle face aux anomalies de saisie réelles.
Enfin, la troisième étape consiste à auditer la portabilité logicielle de la feuille de calcul. Dans de nombreuses multinationales, les classeurs transitent fréquemment entre Google Sheets et d’autres tableurs propriétaires du marché tels que Microsoft Excel. L’analyste doit s’assurer que les formules logiques disjonctives implémentées reposent sur des fonctions universellement traduisibles et qu’aucun décrochage sémantique ne viendra altérer l’intégrité décisionnelle du modèle lors des exports inter-plateformes.
12.3 Perspectives d’extension vers Google Apps Script et l’automatisation
Bien que les formules natives combinant SI et OU répondent avec une remarquable efficacité à l’écrasante majorité des besoins de modélisation tabulaire, il existe un point de rupture structurel où la complexité logique justifie le basculement vers des solutions procédurales. Lorsque la clause disjonctive exige l’évaluation d’un nombre excessif de conditions interdépendantes, qu’elle réclame des appels récurrents à des bases de données externes via des protocoles réseau, ou que l’auditabilité réglementaire impose une traçabilité rigoureuse de chaque étape de calcul, l’environnement Google Apps Script s’impose comme le prolongement naturel du tableur.
Le développement de fonctions personnalisées (User Defined Functions ou UDF) basées sur JavaScript permet d’encapsuler des prédicats logiques disjonctifs d’une extrême sophistication au sein d’une signature logicielle hautement épurée dans la feuille de calcul. Cette démarche offre l’avantage inestimable de décharger la grille de calcul de sa charge cognitive en isolant la complexité algorithmique au sein d’un environnement scripté pourvu d’instructions de contrôle de flux impératives classiques, de points d’arrêt de débogage et de mécanismes robustes de gestion des exceptions.
En outre, l’automatisation par Google Apps Script permet de transcender la nature purement réactive des formules du tableur pour engager des actions procédurales concrètes. Alors qu’une fonction SI combinée avec OU se borne à afficher une valeur textuelle ou numérique au sein d’une cellule passive, un script déclenché sur modification peut inspecter la validation d’une condition disjonctive et, en réponse immédiate, générer l’envoi d’un courriel d’alerte, créer un événement dans un agenda partagé ou exporter l’enregistrement anormal vers un système externe de gestion des tickets. La maîtrise de la logique conditionnelle dans Google Sheets s’avère ainsi être la passerelle indispensable vers l’ingénierie globale de l’automatisation d’entreprise.
Références
- Boole, G. (1854). An Investigation of the Laws of Thought on Which Are Founded the Mathematical Theories of Logic and Probabilities. Walton and Maberly.
- Google. (2024). Documentation du support Google : Fonction SI. Google Help Center. https://support.google.com/docs/answer/3093339
- Google. (2024). Documentation du support Google : Fonction OU. Google Help Center. https://support.google.com/docs/answer/3093306
- Google. (2024). Documentation du support Google : Utiliser les formules matricielles (ARRAYFORMULA). Google Help Center. https://support.google.com/docs/answer/3093275
- Google Developers. (2024). Google Apps Script : Aperçu des feuilles de calcul. Google Developers Guide. https://developers.google.com/apps-script/guides/sheets
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE Computer Society. https://doi.org/10.1109/IEEESTD.2019.8766229
- Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press.
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.