
Dans l’écosystème contemporain des technologies de l’information et de l’analyse décisionnelle, les tableurs infonuagiques ont transcendé leur statut historique de simples registres comptables pour devenir de véritables moteurs computationnels décentralisés. Au cœur de cette métamorphose technologique, Google Sheets s’impose comme un environnement prédominant, alliant accessibilité collaborative en temps réel et robustesse analytique. Néanmoins, la modélisation de règles de gestion complexes exige des praticiens bien plus qu’une simple saisie linéaire de données quantitatives : elle requiert la structuration rigoureuse d’arbres de décision algorithmiques au sein desquels l’information brute est soumise à des critères d’évaluation systématiques.
Le traitement conditionnel des flux de données tabulaires repose sur un principe fondateur de l’informatique théorique : l’aptitude d’un système à modifier sa trajectoire computationnelle en fonction de la validation ou de l’invalidation d’une proposition logique. Si la fonction conditionnelle fondamentale permet d’opérer un aiguillage binaire élémentaire, son application isolée révèle rapidement des limites structurelles insurmontables dès lors que l’analyste fait face à des univers multidimensionnels où la prise de décision dépend de la convergence simultanée de plusieurs prérequis indépendants mais indissociables. C’est précisément à cette intersection logique que se matérialise l’impératif d’intégrer des opérateurs d’agrégation propositionnelle capables d’évaluer la coïncidence de multiples assertions.
L’alliance formalisée entre la fonction conditionnelle maîtresse et l’opérateur de conjonction constitue l’un des piliers de l’architecture logicielle des feuilles de calcul. En articulant harmonieusement ces deux entités mathématiques, l’utilisateur met en œuvre un modèle déterministe capable de traiter des cohortes d’enregistrements hétérogènes selon une logique stricte et sans équivoque. Ce guide encyclopédique se propose d’explorer exhaustivement la synergie opérationnelle, la mécanique interne et le champ applicatif résultant de la combinaison des fonctions SI et ET dans Google Sheets, en guidant le lecteur des abstractions algébriques initiales jusqu’aux déploiements industriels les plus avancés.
1. Fondements de la logique booléenne et des structures conditionnelles dans Google Sheets
1.1 Principes fondamentaux du traitement algorithmique des données
Le traitement algorithmique au sein d’un tableur repose sur le paradigme du calcul dirigé par les données, où chaque cellule agit comme une fonction mathématique pure prenant des entrées en dépendance et projetant une valeur de sortie déterministe. Dans ce cadre, la prise de décision conditionnelle constitue l’artifice computationnel permettant d’introduire des embranchements au sein de graphes d’évaluation par ailleurs linéaires. Sans embranchement, un classeur se limiterait à de simples transformations arithmétiques statiques, incapable de répondre aux fluctuations qualitatives et quantitatives inhérentes aux contextes opérationnels réels.
À la base de tout embranchement logique se trouve la notion de prédicat. Un prédicat est une assertion propositionnelle formulée à l’égard d’une ou plusieurs variables cellulaires, susceptible d’une évaluation binaire stricte. Ce mécanisme découle directement des principes formels énoncés par Aristote dans sa théorie du syllogisme, formalisant l’existence d’états propositionnels qui ne tolèrent aucune ambiguïté intermédiaire. Dans le moteur d’exécution de Google Sheets, l’évaluation d’un prédicat déclenche une bifurcation immédiate du flux de traitement : si la proposition est reconnue conforme à la réalité des valeurs sous-jacentes, l’algorithme poursuit sa trajectoire le long d’une branche spécifiée, tandis qu’une divergence de fait l’oriente vers un chemin computationnel alternatif.
L’évolution historique des systèmes tabulaires, depuis les premières implémentations sur VisiCalc à la fin des années 1970 jusqu’à la plateforme distribuée de Google, témoigne d’une quête permanente d’expressivité logique. L’introduction précoce de fonctions d’aiguillage a permis aux financiers, scientifiques et gestionnaires de transposer des règles de gestion textuelles complexes en suites d’instructions formelles. Aujourd’hui, Google Sheets intègre ces fonctionnalités dans un moteur de calcul hautement optimisé, capable de parser et de résoudre des millions de prédicats par seconde au moyen de structures de données arborescentes.
1.2 Le rôle central de l’algèbre de Boole dans l’analyse tabulaire
La manipulation des flux d’information dans les environnements informatiques modernes est régie par les axiomes posés au XIXe siècle par le mathématicien britannique George Boole. L’algèbre de Boole postule un univers algébrique restreint à deux entités uniques : le VRAI (généralement associé au chiffre 1 ou à l’affirmation d’une propriété) et le FAUX (associé au chiffre 0 ou à la négation de cette même propriété). Dans Google Sheets, ces états logiques constituent un type de données primitif à part entière, distinct des chaînes de caractères et des valeurs quantitatives scalaires.
Une caractéristique fondamentale du moteur d’évaluation de Google Sheets réside dans sa capacité de coercition implicite des types de données logiques. Lorsqu’un booléen est contraint de participer à une opération arithmétique élémentaire, telle qu’une addition ou une multiplication, le tableur convertit automatiquement la valeur VRAI en l’entier 1 et la valeur FAUX en l’entier 0. Inversement, au sein d’un contexte d’évaluation conditionnelle, toute valeur numérique non nulle est assimilée par défaut à un état vrai, tandis que le zéro strict correspond rigoureusement à l’état faux. Cette porosité fonctionnelle contrôlée permet d’établir des ponts mathématiques sophistiqués entre le calcul propositionnel pur et l’algèbre matricielle.
L’exigence d’une rigueur absolue dans la manipulation de ces concepts algébriques s’avère indispensable à l’intégrité des modèles de données d’entreprise. Une compréhension superficielle des propriétés de clôture, d’associativité et de distributivité inhérentes à l’algèbre booléenne conduit inévitablement à des biais de modélisation, se traduisant par des attributions erronées de primes, des classifications fiscales défectueuses ou des incohérences prévisionnelles. C’est la maîtrise formelle des états logiques qui garantit la résilience d’un système d’information tabulaire face aux cas limites et aux volumes massifs de données.
1.3 Convergence fonctionnelle entre sélection conditionnelle et conjonction
Dans la pratique de la modélisation informationnelle, les situations requérant une décision basée sur un paramètre unique sont excessivement rares. L’évaluation de l’éligibilité d’un client à une facilité de paiement, par exemple, ne dépend pas exclusivement de son volume de facturation annuel, mais également de son ancienneté contractuelle, de son historique d’impayés et de sa localisation géographique. Face à cette multiplicité de dimensions explicatives, une structure décisionnelle unaire se révèle rapidement caduque, incapable de modéliser l’intrication des contraintes réelles.
Lorsqu’un utilisateur tente de résoudre une équation décisionnelle multicritère en utilisant exclusivement la fonction conditionnelle élémentaire, il est rapidement acculé à concevoir une succession d’arbres imbriqués de manière fractale. Cette approche, bien que mathématiquement valide, engendre une complexité algorithmique exponentielle sur le plan de la lisibilité humaine et de la maintenance logicielle. Elle crée ce que les ingénieurs en logiciel qualifient couramment de « code spaghetti », où chaque embranchement additionnel dégrade la transparence opérationnelle de la feuille de calcul et multiplie les risques de régression fonctionnelle.
La conjonction logique se présente alors comme le vecteur providentiel de simplification et de puissance computationnelle. En associant la sélection conditionnelle à un opérateur d’agrégation conjonctive, il devient possible de compacter des systèmes de contraintes arbitrairement denses au sein d’une unique cellule de calcul. Le couplage structurel unifié entre la structure SI et l’opérateur ET offre la possibilité d’exprimer un nœud décisionnel robuste, dans lequel l’exécution d’une trajectoire donnée est subordonnée au respect exhaustif, simultané et indivisible d’un ensemble de critères hétérogènes.
2. Anatomie et syntaxe fondamentale de la fonction SI (IF)
2.1 Décomposition paramétrique de la fonction SI
La fonction SI représente l’instruction de contrôle de flux fondamentale intégrée à Google Sheets. Sa signature formelle obéit à une nomenclature tripartite standardisée : =SI(expression_logique; valeur_si_vrai; [valeur_si_faux]). Chacun de ces paramètres joue un rôle spécifique et ordonné dans le processus décisionnel, assurant une ségrégation étanche entre la phase d’évaluation de la condition et la phase de restitution du résultat correspondant.
Le premier argument, désigné sous le vocable d’expression_logique, constitue le moteur déterministe de la formule. Il s’agit d’une clause d’évaluation qui doit impérativement aboutir à un résultat booléen, c’est-à-dire VRAI ou FAUX, ou à une valeur numérique convertible sans équivoque selon les lois de la coercition implicite. Cet argument peut consister en une opération relationnelle basique, à l’image d’une comparaison entre deux adresses cellulaires, ou intégrer une fonction subordonnée hautement complexe capable de générer un verdict logique après une cascade de traitements matriciels préalables.
Les deuxième et troisième arguments gouvernent l’aiguillage effectif. Le paramètre valeur_si_vrai spécifie l’entité qui sera injectée dans la cellule hôte si l’expression_logique est validée par le processeur. Le troisième argument, valeur_si_faux, définit quant à lui l’alternative opérationnelle déployée dans l’éventualité où l’évaluation du prédicat échouerait. Bien que ce dernier paramètre soit syntaxiquement marqué comme facultatif par les spécifications logicielles, son omission expose le modèle de données à des comportements par défaut qui peuvent altérer la pureté des calculs subséquents.
2.2 Typologie des valeurs de retour et dynamique d’affectation
L’extrême polyvalence de la fonction SI provient de la variété des typologies de données qu’elle autorise en guise de sorties alternatives. Contrairement à des fonctions rigides qui restreignent leurs résultats à des scalaires numériques, la fonction SI est capable d’émettre des chaînes de caractères littérales, des constantes arithmétiques, des dates calendaires sérialisées, ou encore des références dynamiques pointant vers des zones périphériques de la feuille active ou de classeurs distants.
Au-delà des valeurs passives, la fonction SI se distingue par sa capacité à encapsuler des expressions dynamiques et des formules secondaires de degré supérieur dans ses branches de sortie. Ainsi, l’évaluation positive d’un prédicat peut déclencher l’exécution conditionnelle d’un calcul pondéré complexe, impliquant des fonctions de recherche matricielle telles que RECHERCHEV ou INDEX, tandis que l’évaluation négative déclenchera une procédure d’amortissement financier ou renverra une chaîne informative. Cette plasticité permet de concevoir des mécanismes de calcul sélectif qui évitent d’exécuter des formules coûteuses en ressources lorsque les préconditions fonctionnelles ne sont pas satisfaites.
La gestion du vide structurel constitue une facette méthodologique cruciale de l’affectation de valeurs. L’analyste rigoureux doit systématiquement distinguer la génération d’une chaîne textuelle nulle, formalisée syntaxiquement par l’adjonction de guillemets contigus sans espace intermédiaire (« »), de l’absence déclarée de paramètre qui induit le retour de l’état logique brut. L’assignation d’une chaîne nulle confère à la cellule une dimension de neutralité textuelle particulièrement adaptée à la mise en forme des rapports de synthèse, sans déclencher les comportements d’affichage disgracieux souvent associés aux résultats booléens bruts.
2.3 Erreurs d’implémentation et pièges syntaxiques récurrents
L’omission accidentelle du troisième argument dans la définition syntaxique de la fonction SI représente sans doute l’anomalie la plus récurrente chez les modélisateurs débutants. Si la formule =SI(A1>100; « Objectif atteint ») est exécutée alors que la cellule A1 héberge la valeur arithmétique 50, le moteur de calcul de Google Sheets ne disposera d’aucune directive explicite pour traiter la branche d’invalidité. Par conséquent, l’interpréteur générera la valeur booléenne littérale FAUX au sein de la cellule, un comportement susceptible de déstabiliser les calculs arithmétiques situés en aval qui attendent généralement une chaîne textuelle ou une valeur numérique zéro.
Un autre écueil majeur réside dans la confusion des séparateurs d’arguments, un dysfonctionnement directement corrélé à la localisation linguistique et aux paramètres régionaux du compte Google de l’utilisateur. Alors que les configurations anglo-saxonnes emploient conventionnellement la virgule pour délimiter les paramètres au sein des structures fonctionnelles, les environnements francophones et européens exploitent exclusivement le point-virgule, réservant la virgule au rôle de séparateur décimal arithmétique. L’introduction erronée d’une virgule au sein d’un classeur paramétré en français conduit inévitablement à l’apparition de l’erreur d’analyse syntaxique bloquante #ERROR! (ou #ERREUR!).
Enfin, la non-concordance des types de données lors de l’évaluation du prédicat représente une source insidieuse d’erreurs logiques silencieuses. Si une valeur quantitative est stockée par inadvertance sous forme de texte au sein de la cellule de test — situation fréquente lors de l’importation de fichiers au format CSV non standardisés —, une comparaison de type supérieur ou inférieur face à un nombre pur peut générer des résultats diamétralement opposés aux attentes mathématiques fondamentales. Dans le modèle de tri interne de Google Sheets, toute chaîne textuelle est universellement considérée comme supérieure à n’importe quelle entité numérique, faussant irrémédiablement l’expression_logique sans pour autant générer de message d’erreur explicite.
3. Mécanique opérationnelle et propriétés de la fonction ET (AND)
3.1 Table de vérité booléenne et principe d’injonction cumulative
La fonction ET matérialise l’opérateur de conjonction logique de l’algèbre classique, souvent formalisé par le symbole typographique du « v » inversé (∧) dans les traités de logique formelle. Sa vocation est d’agréger une multiplicité de conditions élémentaires indépendantes en une résultante unitaire. La syntaxe canonique sous Google Sheets se structure sous la forme =ET(expression_logique1; [expression_logique2; …]), où chaque expression subit une évaluation séquentielle rigoureuse.
La mécanique fondamentale de la fonction ET repose sur une table de vérité intraitable régie par le principe de l’injonction cumulative absolue. Pour que la fonction ET retourne la valeur logique VRAI, l’intégralité sans exception des expressions logiques soumises à ses arguments doit préalablement et individuellement être évaluée à l’état VRAI. Dès lors qu’un seul argument, parmi des dizaines voire des centaines d’assertions conjointes, bascule à l’état FAUX, la fonction globale s’effondre instantanément et renvoie l’état FAUX. Cette propriété mathématique consacre la prévalence universelle de l’élément faux dans toute conjonction d’événements logiques.
Dans les coulisses du moteur de calcul, cette mécanique est optimisée par le principe d’évaluation en court-circuit (short-circuit evaluation). Bien que le tableur doive s’assurer de la conformité globale, son optimiseur interne interrompt dans de nombreux cas le traitement analytique dès lors que la première condition d’échec est rencontrée le long de la séquence des paramètres. Cette caractéristique confère à la fonction une efficacité algorithmique notable, épargnant des cycles d’évaluation inutiles à la machine virtuelle hébergeant la session de travail de l’utilisateur.
3.2 Évaluation multicritère et scalabilité des arguments logiques
L’une des forces majeures de la fonction ET réside dans son extraordinaire scalabilité horizontale. Google Sheets permet d’adjoindre un nombre considérable d’arguments logiques au sein d’une unique enveloppe fonctionnelle, autorisant théoriquement jusqu’à plusieurs dizaines d’assertions distinctes. Cette plasticité dimensionnelle permet d’aborder des cahiers des charges opérationnels particulièrement contraignants, où la conformité d’une transaction financière exige la validation conjointe d’un plafond budgétaire, d’une date d’émission valide, d’un code analytique autorisé et d’un niveau d’accréditation managériale adéquat.
Cette scalabilité s’exprime également à travers la prise en charge d’arguments logiques de nature profondément hétérogène. Au sein d’une même instance de la fonction ET, il est parfaitement loisible d’évaluer simultanément des prédicats relationnels quantitatifs (tels que la vérification d’un solde bancaire), des égalités qualitatives portant sur des chaînes de caractères (comme l’appartenance d’un individu à un département spécifique), et des comparaisons temporelles complexes reposant sur des fonctions d’horodatage. Le moteur logique réalise une synthèse unifiée de ces différentes natures de données sans nécessiter la moindre conversion intermédiaire de la part de l’utilisateur.
De surcroît, la fonction démontre une modularité syntaxique exceptionnelle lors des phases d’évolution des règles métier de l’entreprise. Si un nouveau décret réglementaire impose soudainement l’adjonction d’une condition d’intégrité supplémentaire au sein d’un processus existant, le modélisateur n’est nullement contraint de refondre l’architecture globale de sa feuille de calcul : il lui suffit d’injecter une nouvelle expression_logique au sein du bloc ET existant, séparée par un point-virgule, préservant ainsi l’intégrité fonctionnelle de la solution préétablie.
3.3 Comportement face aux valeurs non booléennes et cellules vides
La robustesse d’une fonction analytique se mesure à sa capacité à gérer les anomalies de saisie, les absences d’information et les typologies de données inattendues. Dans le cas de la fonction ET au sein de Google Sheets, le comportement face aux cellules vides et aux valeurs non booléennes mérite une attention analytique rigoureuse afin d’éviter des interprétations fallacieuses des résultats finaux.
Lorsqu’un argument de la fonction ET pointe directement vers une cellule totalement vierge, Google Sheets n’assimile pas systématiquement cette dernière à l’état FAUX. Si la cellule vide est évaluée de manière isolée au sein d’une comparaison implicite, elle se comporte comme la valeur numérique 0. En revanche, si une cellule vide est intégrée dans un test relationnel explicite tel que A1 > 0, elle sera reconnue comme non conforme et générera l’état FAUX attendu. Il convient de souligner que si une plage cellulaire contenant des espaces vides est directement transmise à la fonction ET sans opérateur relationnel, le moteur ignorera simplement les cellules vides, concentrant son calcul conjonctif sur les seules cellules logiquement ou numériquement renseignées.
En ce qui concerne les valeurs textuelles non convertibles, le moteur adopte une posture stricte : la présence d’une chaîne de caractères brute au sein d’un argument qui attend une résolution booléenne explicite déclenchera irrémédiablement l’apparition de l’erreur typologique #VALEUR! (indiquant une incompatibilité fondamentale de type de données). L’ingénieur tabulaire doit par conséquent veiller à neutraliser préventivement toute possibilité d’injection de texte corrompu en amont des tests de conjonction, en mobilisant des techniques de typage fort ou des fonctions de vérification préalable comme ESTNUM ou ESTTEXTE.
4. Architecture d’imbrication de la formule combinée =SI(ET(…))
4.1 Modélisation structurelle de l’imbrication
L’imbrication fonctionnelle représente le mécanisme architectural par lequel le résultat d’une fonction de niveau inférieur devient l’argument direct d’une fonction de niveau supérieur. Dans le cas d’espèce, la formule combinée =SI(ET(…)) consacre la substitution intégrale du premier argument de la fonction SI (l’expression_logique) par la totalité de la structure computationnelle de la fonction ET. Cette symbiose engendre une unité décisionnelle compacte aux propriétés particulièrement élégantes.
Le flux d’information interne s’articule de manière unidirectionnelle et séquentielle. Dans un premier temps, les multiples prédicats encapsulés au sein de la fonction ET sont résolus de manière concertée. Dès que cette phase de réduction logique est achevée, la fonction ET synthétise l’ensemble des résultats sous la forme d’un booléen scalaire unique : soit VRAI, soit FAUX. Ce booléen agrégé est alors immédiatement transmis au nœud décisionnel de la fonction SI hôte, qui agit dès lors comme un simple aiguillage binaire pour diriger l’affichage vers la valeur_si_vrai ou la valeur_si_faux.
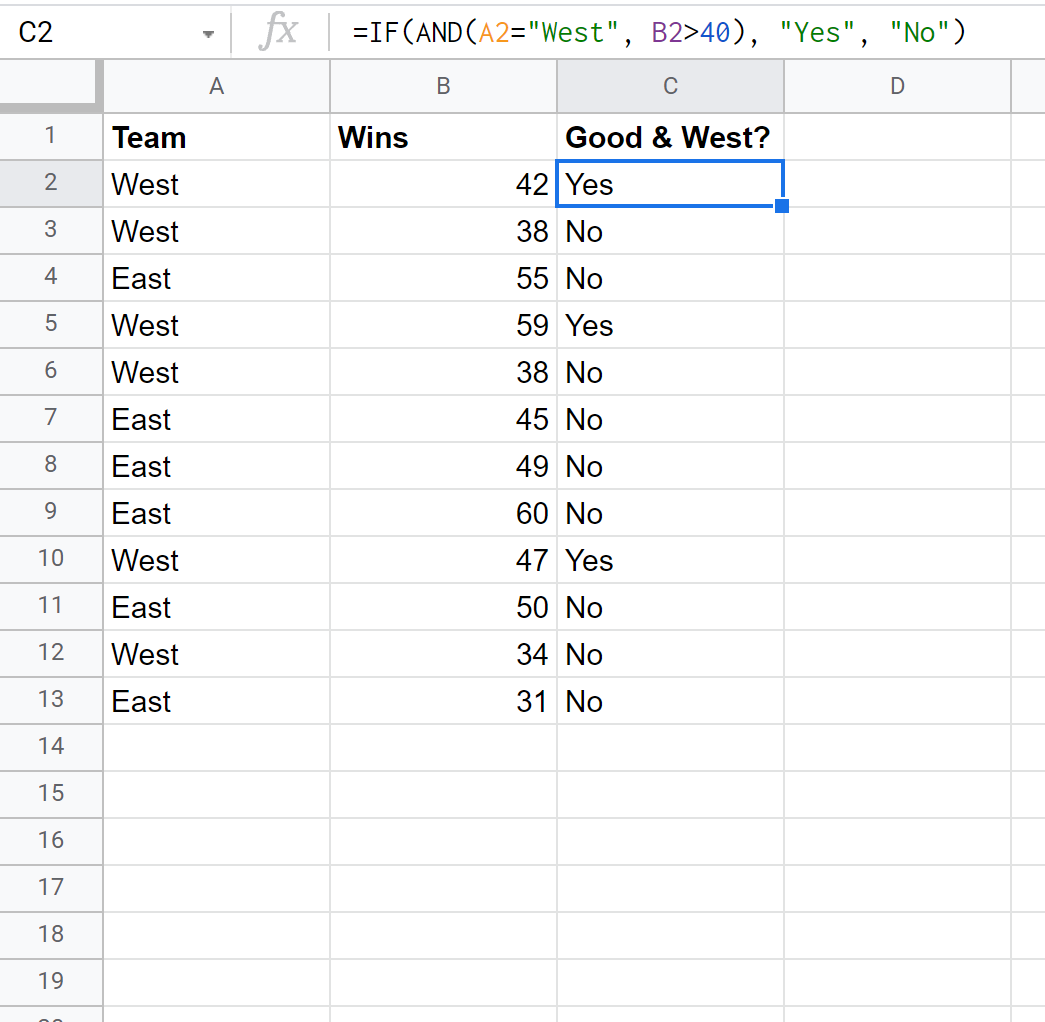
Le formalisme syntaxique canonique de cette association s’établit universellement selon l’agencement structurel suivant : =SI(ET(condition1; condition2; [conditionN]); valeur_vrai; valeur_faux). Dans cette topologie computationnelle, l’ensemble des conditions logiques est regroupé au sein d’une barrière de parenthèses spécifique appartenant à la fonction ET, évitant tout chevauchement syntaxique avec les arguments de retour conditionnels dévolus à la fonction SI maîtresse.
4.2 Ordre d’évaluation computationnelle par le moteur Google Sheets
Pour appréhender pleinement le fonctionnement de la combinaison =SI(ET(…)), il est indispensable d’examiner comment le moteur d’exécution de Google Sheets interprète la structure syntaxique d’une formule. Le parseur décompose la chaîne de caractères mathématique sous la forme d’un arbre syntaxique abstrait (AST, ou Abstract Syntax Tree). Dans cet arbre, la fonction SI occupe la racine de l’arborescence, tandis que la fonction ET et ses prédicats constitutifs forment un sous-arbre prioritaire greffé sur le nœud du premier argument.
En vertu des règles d’évaluation applicatives propres aux langages fonctionnels, le processeur résout impérativement les feuilles du sous-arbre le plus profondément imbriqué avant de pouvoir évaluer le nœud parent. Ainsi, l’ensemble des tests relationnels hébergés par la fonction ET font l’objet d’un calcul prioritaire. Tant que le sous-arbre ET n’a pas renvoyé son état booléen définitif, la fonction SI demeure dans un état d’attente d’évaluation de sa bifurcation conditionnelle. Cette précédence opérationnelle garantit qu’aucune valeur de sortie n’est résolue de façon prématurée.
Cette logique d’ordonnancement a des implications directes sur la consommation des ressources de calcul. Puisque Google Sheets garantit la non-évaluation de la branche conditionnelle délaissée (la valeur_si_faux n’est jamais calculée si l’expression_logique s’avère vraie, et vice-versa), l’imbrication =SI(ET(…)) protège le système contre des calculs périphériques superflus. La concentration des efforts algorithmiques sur le prédicat conjonctif amont permet d’optimiser l’allocation de la mémoire vive et du temps processeur, même au sein de classeurs hébergeant des dizaines de milliers d’enregistrements actifs.
4.3 Démarcation conceptuelle entre la conjonction (ET) et la disjonction (OU)
La conception d’architectures conditionnelles impose une distinction épistémologique stricte entre les principes de conjonction et de disjonction, ces deux opérateurs incarnant des philosophies de sélection diamétralement opposées. Tandis que la fonction ET incarne une logique restrictive et élitiste, la fonction OU (qui formalise l’opérateur logique de disjonction inclusive) applique une logique permissive et englobante.
L’utilisation de la structure =SI(ET(…)) s’impose souverainement lorsque l’invalidation d’une seule et unique clause disqualifie irrévocablement l’enregistrement analysé. C’est le cas par excellence de l’audit de conformité réglementaire, où un produit manufacturé doit simultanément satisfaire à des seuils thermiques, chimiques et mécaniques stricts pour obtenir son homologation. L’échec d’un seul test rend caduque l’attribution de la certification, justifiant l’application sans concession de la table de vérité conjonctive. À l’inverse, l’usage de =SI(OU(…)) se destine aux scénarios où l’accomplissement d’au moins un élément parmi plusieurs opportunités suffit à valider le passage (par exemple, bénéficier d’un tarif réduit si l’on est étudiant OU retraité).
Les conséquences méthodologiques de ce choix sur la segmentation analytique des populations de données sont fondamentales. L’opérateur ET agit comme un entonnoir qui réduit considérablement la taille de la cohorte retenue dans la branche affirmative, créant des sous-ensembles homogènes répondant à un faisceau d’indices concordants. L’opérateur OU produit la trajectoire inverse en élargissant l’entonnoir d’admission. Une confusion entre ces deux opérateurs, ou une imbrication non maîtrisée des deux paradigmes, aboutit inévitablement à des distorsions massives lors du reporting statistique final.
5. Applications pratiques avec critères qualitatifs et chaînes de caractères
5.1 Validation croisée d’attributs catégoriels
Dans l’univers professionnel du traitement de données textuelles, la validation croisée d’attributs catégoriels constitue l’un des cas d’usage les plus ubiquitaires de la formule =SI(ET(…)). Cette démarche consiste à vérifier qu’une entité observée appartient simultanément à deux classes de nomenclature distinctes mais complémentaires au sein de la base de données. L’absence d’une telle double validation rendrait impossible l’extraction de métriques segmentées fiables.
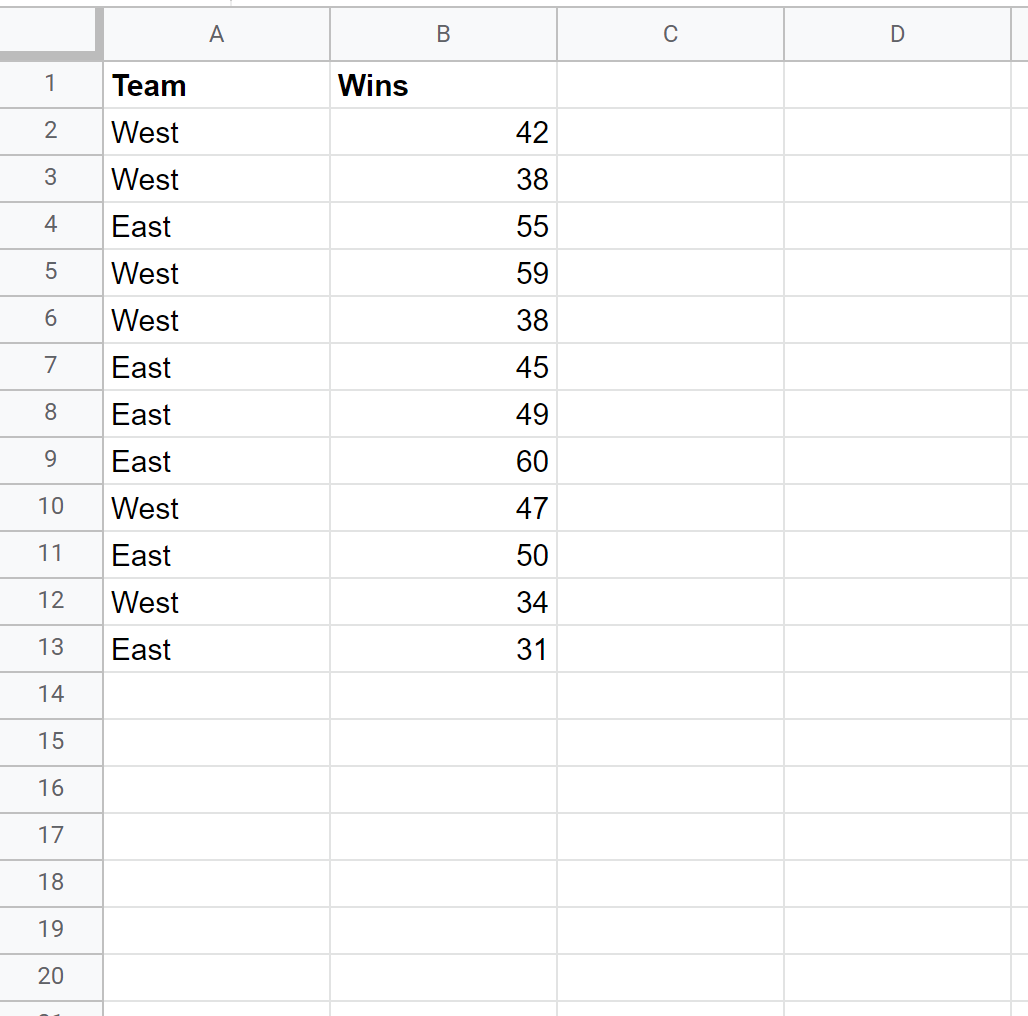
Considérons à titre d’illustration empirique la gestion opérationnelle d’une ligue sportive professionnelle ou d’un réseau commercial découpé en zones géographiques. L’analyste souhaite identifier spécifiquement les unités répondant simultanément à une localisation précise et à un statut de performance particulier. La formule s’articulera alors autour d’égalités textuelles directes :
=SI(ET(B2= »Conférence Ouest »; C2= »Qualifié »); « Prioritaire »; « Standard »)
Dans cet agencement, Google Sheets inspecte rigoureusement la cellule B2 pour s’assurer de sa conformité littérale avec le libellé « Conférence Ouest », tout en analysant concomitamment la cellule C2 pour attester de la présence du qualificatif « Qualifié ». L’attribution de la mention « Prioritaire » est subordonnée au respect irréprochable de ces deux critères textuels distincts. Si l’un des paramètres dévie, ne serait-ce que par une nuance typographique minime, la cellule d’arrivée sera invariablement créditée de la mention « Standard ».
5.2 Gestion de la sensibilité à la casse et normalisation
L’une des particularités notables des opérateurs de comparaison standard dans Google Sheets, à commencer par l’opérateur d’égalité (=), réside dans leur insensibilité native à la casse. Par défaut, pour le moteur de calcul du tableur, l’expression (« PARIS » = « paris ») renvoie invariablement la valeur logique VRAI. Si cette tolérance typographique s’avère souvent avantageuse pour absorber des incohérences mineures de saisie chez les utilisateurs finaux, elle constitue un danger critique lorsqu’il s’agit de contrôler des identifiants stricts, des codes d’authentification ou des acronymes techniques hautement sensibles.
Pour instaurer une ségrégation rigoureuse basée sur la typographie exacte au sein d’une structure conjonctive, l’analyste chevronné doit encapsuler la fonction EXACT à l’intérieur du bloc ET. La fonction EXACT opère une confrontation binaire au niveau des octets de caractères, garantissant que les minuscules et les majuscules soient traitées comme des entités structuralement incompatibles. La formulation prend alors la tournure méthodologique suivante :
=SI(ET(EXACT(A2; « PRODUCTION »); B2= »Actif »); « Accrédité »; « Rejeté »)
En parallèle de l’usage d’EXACT, la sécurisation des comparaisons qualitatives passe par un prétraitement hygiénique systématique des flux textuels entrants. L’introduction parasite d’espaces invisibles en début ou en fin de chaîne, courante lors des opérations de copier-coller depuis des applications web tierces, compromet la justesse des prédicats textuels. L’encapsulation préventive des adresses cellulaires au moyen des fonctions SUPPRESPACE (TRIM) et MINUSCULE (LOWER) permet d’assainir l’expression avant son évaluation conjonctive, garantissant ainsi l’inviolabilité du processus de validation.
5.3 Filtrage conditionnel basé sur des segments partiels de texte
L’analyse qualitative ne se limite pas à des confrontations d’égalité parfaite ; elle exige fréquemment de sonder des cellules pour détecter l’apparition de séquences sous-jacentes ou de motifs lexicaux spécifiques. L’association de la formule =SI(ET(…)) avec des fonctions de détection textuelle spécialisées décuple le pouvoir d’investigation de la feuille de calcul.
Pour vérifier qu’une cellule intègre un fragment textuel particulier tout en s’assurant qu’un critère catégoriel complémentaire est honoré, l’analyste peut mobiliser la fonction CHERCHE (SEARCH), insensible à la casse, ou la fonction TROUVE (FIND), sensible à la casse, encapsulées au sein de la fonction ESTNUM. Par exemple, pour accorder un traitement spécifique à un client dont la raison sociale contient le terme « Distribution » et dont le secteur d’activité stipule « Agroalimentaire », la formule s’énoncera ainsi :
=SI(ET(ESTNUM(CHERCHE(« Distribution »; A2)); B2= »Agroalimentaire »); « Compte Clé »; « Ordinaire »)
Pour les modélisations plus sophistiquées nécessitant la capture d’expressions régulières complexes, Google Sheets offre la puissante fonction REGEXMATCH. En insérant cette dernière au cœur du réceptacle logique ET, il devient possible d’imposer la validation simultanée d’un masque de format (tel qu’un matricule composé de trois lettres suivies de quatre chiffres) et d’un état de disponibilité logistique :
=SI(ET(REGEXMATCH(A2; « ^[A-Z]{3}-[0-9]{4}$ »); C2= »En Stock »); « Conforme »; « Non Conforme »)
Cette approche permet d’écarter toute génération inopinée d’erreurs d’exécution grâce à la nature intrinsèquement booléenne de REGEXMATCH, qui renvoie nativement VRAI ou FAUX sans nécessiter de conversion fonctionnelle intermédiaire, simplifiant d’autant la lisibilité de la formule globale.
6. Filtrage quantitatif et délimitation d’intervalles numériques
6.1 Définition d’intervalles numériques bornés
Dans la théorie des ensembles mathématiques, l’appartenance d’une variable quantitative x à un intervalle continu borné fermé noté [a, b] implique la vérification simultanée de deux propositions relationnelles distinctes : x doit être structurellement supérieur ou égal à la borne inférieure a, et x doit impérativement demeurer inférieur ou égal à la borne supérieure b. L’incapacité syntaxique fondamentale des tableurs modernes à interpréter des expressions d’inégalités composées continues (comme 10 ≤ A1 ≤ 50) fait de la combinaison =SI(ET(…)) la seule méthode canonique pour résoudre ce problème.
Pour transposer cette contrainte topologique au sein de Google Sheets, l’analyste doit impérativement décomposer l’intervalle en deux prédicats relationnels distincts coordonnés par la fonction de conjonction. La syntaxe rigoureuse s’énonce comme suit :
=SI(ET(A1>=10; A1<=50); "Dans la cible"; "Hors cible")
Cette méthodologie d’encadrement strict par double borne permet d’éliminer définitivement les chevauchements de tranches numériques dans les modèles de classification graduée, tels que les barèmes d’imposition, les tranches de tarification au volume ou les grilles de rémunération variable des forces de vente.
6.2 Combinaison asymétrique d’opérateurs relationnels
La délimitation d’intervalles quantitatifs ne s’effectue pas exclusivement sur des bornes fermées symétriques. Dans de multiples branches de l’ingénierie financière et du contrôle qualité statistique, les modèles d’attribution doivent naviguer au sein d’intervalles semi-ouverts à gauche ou à droite, impliquant l’entrelacement asymétrique d’inégalités strictes (<, >) et d’inégalités larges (≤, ≥).
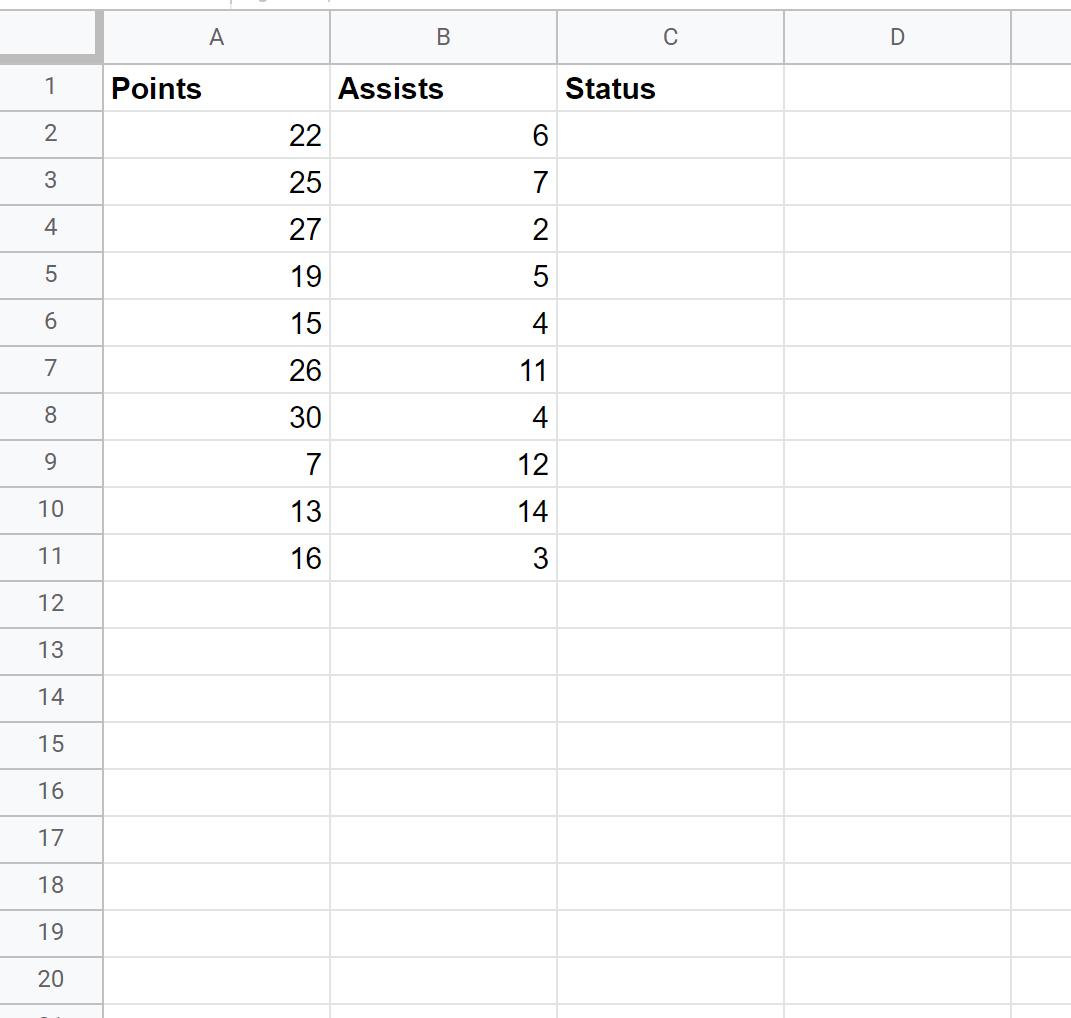
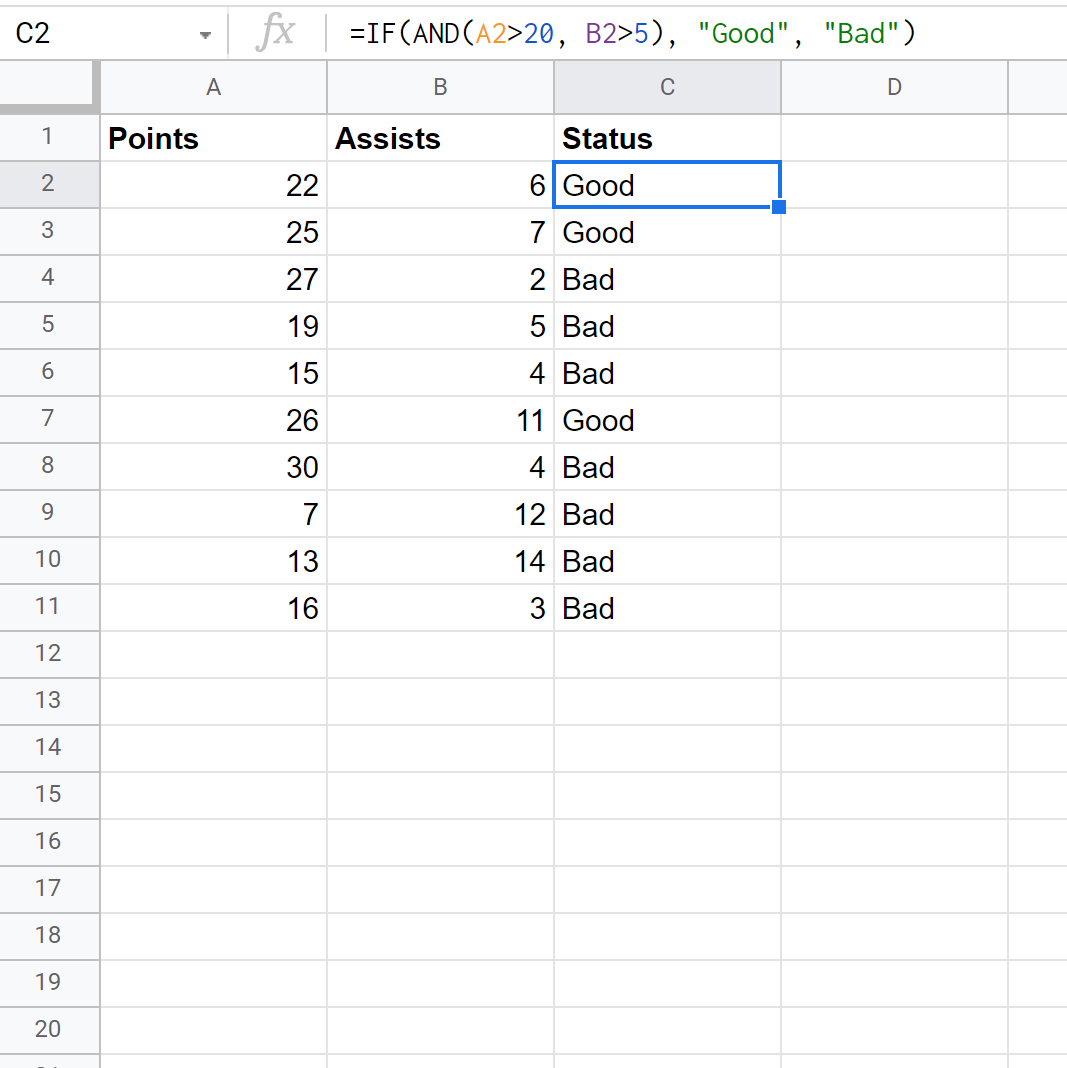
L’asymétrie relationnelle est particulièrement sollicitée lors de l’isolation d’anomalies opérationnelles ou de l’identification de profils de volatilité au sein de cours boursiers. Supposons qu’un protocole d’arbitrage exige de repérer les transactions dont le ratio d’endettement se situe strictement au-dessus de 1,5 tout en maintenant un rendement sur capitaux propres supérieur ou égal à 12 %. La modélisation prendra la structure suivante :
=SI(ET(D2>1,5; E2>=0,12); « Opportunité Confirmée »; « Surveillance »)
L’exactitude conceptuelle du choix entre une inégalité stricte et une inégalité large est d’une portée capitale : l’utilisation malencontreuse d’un opérateur supérieur ou égal (>=) en lieu et place d’un opérateur strictement supérieur (>) sur une valeur frontière peut intégrer de manière indue des milliers d’enregistrements marginaux au sein d’une catégorie privilégiée, faussant irrémédiablement l’allocation finale du capital et l’évaluation du risque financier sous-jacent.
6.3 Validation croisée multicritère : volume et performance
L’un des sommets de l’analyse décisionnelle en entreprise réside dans la validation conjointe de métriques de volume et de ratios de rentabilité unitaire. Un volume de transactions spectaculaire dépourvu d’une marge opérationnelle saine fragilise la viabilité de l’entreprise, de même qu’une marge éclatante assise sur un volume d’affaires microscopique ne génère pas la masse brute de trésorerie requise pour financer les coûts fixes organisationnels.
Considérons le barème d’attribution de gratifications commerciales de fin d’exercice au sein d’une organisation industrielle. Pour prétendre au versement d’une prime d’excellence, un collaborateur doit impérativement avoir généré un chiffre d’affaires cumulé excédant 500 000 euros ET afficher un taux d’encaissement effectif des créances d’au moins 95 %, attestant ainsi de la qualité de sa relation client :
=SI(ET(F2>500000; G2>=0,95); F2*0,05; 0)
L’élégance de cette construction réside dans sa dimension productive intégrée : au sein de la branche d’affirmation, l’algorithme ne se borne pas à restituer un label textuel stérile, mais procède immédiatement au calcul arithmétique dynamique de la commission allouée (soit 5 % du chiffre d’affaires consigné en F2). Dans l’hypothèse d’une défaillance sur l’un des deux axes stratégiques, le retour numérique est immédiatement borné à zéro, préservant ainsi la trésorerie de l’entité contre les rémunérations indues.
7. Traitement des variables temporelles et séquences de dates avec SI et ET
7.1 Cohérence des formats de date et sérialisation sous-jacente
Le traitement des variables chronologiques au sein de Google Sheets exige une compréhension sans faille des mécanismes de sérialisation sous-jacents. Pour l’interpréteur du tableur, une date n’est en aucune manière une chaîne de caractères stylisée avec des barres obliques ou des tirets, mais un nombre entier séquentiel représentant le nombre de jours écoulés depuis une origine calendaire arbitraire (établie traditionnellement au 30 décembre 1899). Ainsi, la date du 1er janvier 1900 correspond à la valeur sérielle 1, tandis qu’une date du XXIe siècle correspond à un nombre entier d’une magnitude supérieure à 45 000.
Cette réalité architecturale implique qu’une tentative de comparaison temporelle basée sur des chaînes textuelles littérales — par exemple l’assertion A1 > « 01/01/2024 » — conduit à un comportement erratique désastreux. Le moteur procède à une comparaison alphabétique lexicographique où le texte « 01/01/2024 » sera évalué arbitrairement par rapport aux autres représentations de chaînes, ignorant totalement la chronologie temporelle réelle.
Pour sécuriser de manière absolue l’évaluation conjonctive temporelle, il est impératif d’utiliser la fonction canonique DATE au sein des arguments de la fonction ET. La fonction DATE(année; mois; jour) génère de manière transparente et infaillible le numéro sériel exact attendu par le moteur de comparaison, immunisant la formule contre toute distorsion liée aux préférences régionales d’affichage :
=SI(ET(A2>=DATE(2024;1;1); A2<=DATE(2024;12;31)); "Exercice 2024"; "Autre Exercice")
7.2 Validation d’événements au sein de fenêtres temporelles précises
Dans la gestion de flux logistiques, le contrôle de conformité contractuelle ou la gestion de litiges juridiques, la capacité à valider la survenance d’événements à l’intérieur d’une fenêtre temporelle glissante ou fixée par des jalons externes est fondamentale. La formule combinée =SI(ET(…)) excelle dans la modélisation de ces contraintes de temporalité conjointe.
Examinons le processus d’audit de facturation fournisseur, dans lequel une facture ne peut être validée pour mise en paiement que si deux jalons chronologiques distincts sont corroborés : la date de réception du service doit s’inscrire dans le mois civil en cours, et la date limite de règlement contractuel doit impérativement intervenir dans un délai ultérieur d’au moins 30 jours pour préserver le besoin en fonds de roulement :
=SI(ET(B2>=DATE(2024;6;1); B2=B2+30); « Paiement Validé »; « Anomalie d’Échéance »)
Dans cette modélisation, le troisième argument du bloc ET exploite avec profit l’arithmétique des dates en ajoutant directement l’entier 30 à la date initiale de livraison située en B2. L’imbrication garantit une étanchéité administrative absolue : aucune créance ne peut franchir le sas comptable sans avoir satisfait à ces conditions de calendrier cumulatives.
7.3 Dynamisation des expressions temporelles avec AUJOURDHUI()
La fixation de bornes temporelles statiques présente l’inconvénient d’exiger une mise à jour manuelle périodique des formules de calcul. Pour doter une feuille de calcul d’une autonomie fonctionnelle permanente, il convient d’associer la structure conditionnelle conjonctive à des fonctions temporelles volatiles hautement dynamiques, au premier rang desquelles trône la fonction AUJOURDHUI (TODAY).
La fonction AUJOURDHUI renvoie quotidiennement le numéro sériel correspondant à la date courante du système hôte sans exiger d’argument. En couplant cette valeur dynamique avec des deltas arithmétiques au sein de la fonction ET, l’analyste conçoit des filtres de surveillance capables de traquer des dérives en temps réel. Prenons l’exemple d’un système de gestion de relance client chargé d’alerter le service de recouvrement dès lors qu’une créance présente un retard compris rigoureusement entre 15 et 45 jours calendaires par rapport à la date du jour :
=SI(ET(A2=(AUJOURDHUI()-45)); « Niveau de Relance 2 »; « Hors Seuil »)
Il importe toutefois de souligner l’impact opérationnel lié à la volatilité intrinsèque de la fonction AUJOURDHUI. Cette dernière étant réévaluée à chaque recalcul global de la feuille de calcul ou à l’ouverture du classeur, son utilisation sur des dizaines de milliers de lignes équipées de la syntaxe =SI(ET(…)) peut générer une consommation non négligeable de bande passante et de temps de calcul. L’ingénieur tabulaire veillera donc à modérer l’usage des fonctions volatiles au sein des architectures massives afin de maintenir une réactivité fluide du classeur.
8. Imbrications complexes et arbres de décision hiérarchiques
8.1 Chaînage séquentiel de blocs conditionnels SI(ET())
La réalité économique ne s’accommode que rarement de partitions binaires élémentaires. Souvent, la population d’enregistrements observée doit être segmentée en plusieurs strates de maturité, de risque ou de gratification. Dans un tel environnement, la structure unitaire =SI(ET(…)) se révèle insuffisante à elle seule et doit être déployée sous la forme d’une cascade conditionnelle séquentielle, communément appelée imbrication en arbre de décision.
Dans ce modèle architectural, la valeur_si_faux de la première fonction SI est colonisée par une deuxième fonction SI abritant son propre module ET d’évaluation conjonctive, laquelle peut à son tour déléguer sa sortie négative à un troisième palier conditionnel. Cette cascade logique permet d’établir une grille de tri étanche et hiérarchisée :
=SI(ET(A2>=100; B2>=90); « Rang A »; SI(ET(A2>=75; B2>=70); « Rang B »; SI(ET(A2>=50; B2>=50); « Rang C »; « Échec »)))
La conception d’un tel réseau de validation exige une discipline intellectuelle rigoureuse quant à l’ordre d’énonciation des conditions. Le moteur procédant à une lecture séquentielle de gauche à droite, les conditions les plus sélectives et les paliers les plus élevés doivent impérativement figurer en tête de formule. Si les paliers inférieurs étaient positionnés prématurément, ils captureraient l’ensemble des enregistrements performants par effet de bord, vidant instantanément de leur substance les prédicats de niveau supérieur situés en aval.
8.2 Hybridation des opérateurs logiques : imbrication conjointe de ET et de OU
Le raffinement ultime de l’analyse booléenne tabulaire s’exprime à travers l’hybridation matricielle, où des blocs conjonctifs (ET) et des blocs disjonctifs (OU) sont mutuellement entrelacés pour traduire des formes propositionnelles complexes de la théorie des ensembles. Ce type d’hybridation reproduit fidèlement la structure des règlements d’exonération fiscale ou des conditions d’octroi de subventions publiques.
Considérons un dispositif institutionnel où une entreprise industrielle n’est éligible à une prime d’innovation écologique que si elle valide d’une part un critère d’ancienneté stricte (avoir plus de 3 années d’exercice continu), et d’autre part au moins l’une des deux conditions d’impact suivantes : réduire son empreinte carbone de 20 % OU investir un minimum de 100 000 euros dans des équipements décarbonés. La transcription algorithmique de cette règle de gestion impose d’encapsuler la fonction OU directement à l’intérieur de la fonction ET :
=SI(ET(A2>3; OU(B2>=0,20; C2>=100000)); « Subvention Accordée »; « Non Éligible »)
La rigueur de cette architecture repose intégralement sur le positionnement méticuleux des parenthèses de délimitation. La fonction OU agissant comme un terme unaire au sein de la fonction ET, le résultat de sa délibération disjonctive (VRAI si l’un au moins des deux critères environnementaux est rempli) est immédiatement injecté comme un booléen classique au sein de l’injonction cumulative du ET supérieur. L’inversion des positions relatives de ET et de OU transformerait radicalement la portée légale du test, conduisant à des versements financiers non conformes aux directives initiales.
8.3 Stratégies de modularisation et documentation du code de calcul
À mesure que la complexité des formules conditionnelles imbriquées s’accroît, la lisibilité intrinsèque de l’expression mathématique s’étiole, atteignant un seuil critique où plus aucun collaborateur de l’organisation — voire le concepteur initial lui-même après quelques semaines d’inactivité sur le fichier — n’est en mesure de déchiffrer la trajectoire logique de la cellule. Pour prévenir cette obsolescence informationnelle, il est impératif d’adopter des stratégies de modularisation et de documentation normalisées.
La première stratégie consiste à exploiter pleinement les possibilités de mise en page offertes par la barre de formule de Google Sheets. En utilisant la combinaison de touches Alt+Entrée (ou Commande+Entrée sur macOS), l’utilisateur insère des retours à la ligne structurels au sein de la formule sans en altérer l’exécution. En combinant ces sauts de ligne avec une indentation visuelle au moyen d’espaces typographiques, on confère à la formule une allure proche du code informatique moderne, isolant chaque bloc =SI(ET(…)) sur sa propre ligne de développement.
La seconde stratégie repose sur le nommage explicite des plages de cellules via le gestionnaire de métadonnées de Google Sheets. La substitution de coordonnées spatiales abstraites et cryptiques (telles que F2 ou M50) par des identifiants sémantiques universels (tels que Chiffre_Affaires ou Ratio_Marge) transmute la formule en une prose de gestion immédiatement compréhensible :
=SI(ET(Chiffre_Affaires > 100000; Ratio_Marge >= 0,15); « Prime Validée »; « Rejet »)
Cette clarté lexicale simplifie considérablement les audits de conformité menés par des intervenants tiers ou les commissaires aux comptes lors de la clôture des états financiers annuels.
9. Protocoles de débogage et résolution des dysfonctionnements computationnels
9.1 Typologie et diagnostic des erreurs logiques récurrentes
Le développement de structures décisionnelles avancées dans Google Sheets expose inéluctablement le modélisateur à un faisceau de dysfonctionnements computationnels standardisés. Chacun de ces signaux d’erreur obéit à une étiologie algorithmique précise qu’il convient de savoir diagnostiquer avec célérité afin de rétablir la navigabilité du modèle de données.
L’erreur emblématique #NOM? (#NAME?) signale invariablement l’incapacité du moteur d’exécution à résoudre le nom d’une fonction invoquée. Dans le contexte de l’écriture de formules combinées, ce blocage résulte très souvent d’une faute de frappe typographique (par exemple, la saisie accidentelle de =SII(ET(…)) ou de =IF(AND(…)) au sein d’une interface configurée dans une nomenclature francophone stricte). Dès lors qu’une commande lexicale échappe au dictionnaire interne de l’application, l’évaluation est avortée instantanément au stade de l’analyse lexicale.
L’erreur #VALEUR! (#VALUE!), pour sa part, dénonce une rupture fondamentale dans la compatibilité des types d’opérandes. Si la fonction ET intègre au sein de ses prédicats une opération arithmétique cherchant à soustraire une chaîne de caractères alphabétique d’un nombre entier, l’évaluation conjonctive ne peut aboutir et contamine l’ensemble de la fonction SI hôte. Enfin, l’apparition d’un message d’erreur signalant une « référence circulaire » indique que la formule conditionnelle tente d’évaluer la valeur de la cellule au sein de laquelle elle réside physiquement, créant une boucle infinie de rétroaction que le système interrompt immédiatement par sécurité.
9.2 Gestion des valeurs manquantes et cellules non renseignées
L’un des défis les plus pernicieux dans la maintenance des classeurs partagés réside dans le traitement des enregistrements incomplets ou des cellules délibérément laissées vierges par les opérateurs de saisie. En l’absence de précautions spécifiques, la coercition implicite de Google Sheets, qui assimile fréquemment une cellule vide à la valeur numérique zéro dans les contextes arithmétiques, peut fausser dramatiquement l’intégrité d’une analyse conjonctive.
Considérons une condition visant à identifier les clients dont l’encours est inférieur à 1 000 euros ET dont l’âge est inférieur à 25 ans. Si la cellule relative à l’âge d’un client est totalement vierge, le test A1 < 25 renverra VRAI car la cellule vide sera traitée comme 0. Le système qualifiera ainsi indûment ce profil comme éligible, générant une grave distorsion d’évaluation. Pour blindé la formule contre ce phénomène, il est indispensable d’introduire des tests d’intégrité préliminaires au sein même du bloc ET en mobilisant la fonction ESTVIDE (ISBLANK) combinée à l’opérateur de négation NON (NOT), ou la fonction ESTNUM (ISNUMBER) :
=SI(ET(ESTNUM(A2); A2<1000; ESTNUM(B2); B2<25); "Éligible"; "Inéligible")
En imposant formellement que les cellules A2 et B2 contiennent des valeurs numériques tangibles avant d’autoriser la comparaison de seuil, le système neutralise le risque d’assimilation des données manquantes et préserve l’étanchéité statistique du modèle.
9.3 Méthodologie d’audit pas-à-pas et d’isolement des expressions
Lorsqu’une formule conditionnelle combinée complexe renvoie un résultat non conforme aux prévisions théoriques sans toutefois générer de message d’erreur syntaxique explicite, le recours à une méthodologie d’audit déconstructive devient impératif. La complexité inhérente aux imbrications profondes empêche en effet une appréciation globale directe de la chaîne d’évaluation.
La technique la plus efficace consiste à procéder à la scission chirurgicale de la formule en créant des colonnes de contrôle intermédiaires temporaires. L’analyste extrait l’intégralité du sous-arbre =ET(…) logé à l’intérieur de la fonction SI et l’injecte de manière isolée au sein d’une colonne adjacente. Il devient alors possible d’observer immédiatement le comportement booléen nu (VRAI ou FAUX) renvoyé par la conjonction pour l’ensemble des lignes du tableau. Si le résultat booléen brut est lui-même déficient, l’analyste scinde alors la fonction ET en autant de colonnes distinctes qu’elle compte de sous-arguments relationnels, identifiant en un coup d’œil le critère spécifique responsable du blocage logique.
Parallèlement, Google Sheets propose un outil d’aide à l’évaluation particulièrement ergonomique intégré à sa barre d’édition. En surlignant une portion précise de l’expression mathématique directement au sein du champ de saisie, une infobulle interactive contextuelle s’affiche instantanément, révélant la valeur calculée en temps réel pour le segment sélectionné. Cette technique de prévisualisation sélective permet de vérifier la résolution de chaque prédicat de façon indépendante sans devoir modifier la structure formelle de la feuille de calcul.
10. Intégration avancée avec les fonctions matricielles et la mise en forme conditionnelle
10.1 Le défi de la vectorisation : incompatibilité native de ET avec ARRAYFORMULA
L’une des étapes les plus déconcertantes pour les praticiens expérimentés de Google Sheets réside dans la tentative de vectorisation d’une structure conditionnelle conjonctive au moyen de la puissante fonction ARRAYFORMULA. Traditionnellement, ARRAYFORMULA permet d’appliquer une formule unique située dans la cellule supérieure d’un tableau à l’ensemble d’une colonne de données sans nécessiter la moindre recopie incrémentale manuelle vers le bas.
Toutefois, une tentative naïve de vectorisation formulée sous la forme =ARRAYFORMULA(SI(ET(A2:A100>10; B2:B100= »Oui »); « Valide »; « Rejet »)) aboutit à un échec conceptuel immédiat. Cet écueil trouve son origine dans la nature structurelle profonde de la fonction ET : il s’agit d’une fonction d’agrégation globale scalaire. Par essence, la fonction ET examine l’intégralité des plages matricielles qui lui sont transmises (A2:A100 et B2:B100) pour condenser l’ensemble des observations en un unique booléen global VRAI ou FAUX pour la totalité du classeur, anéantissant ainsi tout calcul itératif ligne par ligne.
Pour contourner cette barrière structurelle et vectoriser efficacement une double condition sans renoncer à la puissance d’ARRAYFORMULA, l’analyste doit transposer l’opérateur de conjonction logique en son équivalent arithmétique booleen : la multiplication. Dans l’algèbre binaire, le produit de deux booléens n’équivaut à 1 (VRAI) que si et seulement si les deux termes valent 1. Si l’un des deux prédicats s’avère faux (égal à 0), le produit algébrique s’effondre à 0 (FAUX). La formulation matricielle canonique s’établit dès lors sous la forme suivante :
=ARRAYFORMULA(SI((A2:A100>10) * (B2:B100= »Oui »); « Valide »; « Rejet »))
Cette transcription vectorielle élégante contourne l’agrégation de la fonction ET, permettant à Google Sheets d’évaluer la conjonction sur des dizaines de milliers de lignes de manière quasi instantanée avec une économie maximale de mémoire.
10.2 Dynamisation visuelle par les règles de mise en forme conditionnelle
L’extraction d’insights décisionnels à partir de volumétries de données considérables ne passe pas uniquement par l’inscription textuelle de verdicts dans des colonnes adjacentes ; elle s’exprime également avec une grande acuité par l’illumination visuelle dynamique des motifs sous-jacents. Le moteur de mise en forme conditionnelle de Google Sheets constitue le réceptacle naturel des logiques conjonctives formalisées par la fonction ET.
Pour appliquer un format stylistique distinct (tel qu’un surlignement chromatique vert émeraude ou une mise en gras typographique) aux seules entités d’un tableau respectant cumulativement deux contraintes opérationnelles, le modélisateur doit recourir à l’option « La formule personnalisée est » au sein du panneau de configuration de la mise en forme conditionnelle. Dans cette fenêtre d’encapsulation, l’usage de la fonction SI devient superflu : seule l’expression conjonctive =ET(…) doit être inscrite, le moteur de style appliquant les modifications esthétiques chaque fois que l’assertion renvoie la valeur VRAI.
La réussite de cette implantation repose sur la maîtrise rigoureuse des références d’adressage absolues et relatives (marquées par le symbole du dollar $). Si l’objectif est d’illuminer la totalité d’une ligne d’enregistrement (de la colonne A à la colonne G) dès lors que les colonnes C et D franchissent conjointement certains seuils critiques, la formule personnalisée devra verrouiller impérativement les colonnes par un dollar tout en laissant flotter librement l’index des lignes :
=ET($C2>=1000;$D2= »Validé »)
Ce verrouillage directionnel garantit que chaque cellule transversale de la ligne interroge systématiquement les cellules indicatrices C et D de sa propre rangée, assurant une homogénéité graphique impeccable de la grille de restitution visuelle.
10.3 Interopérabilité avec les fonctions de requêtage et d’agrégation
La formule combinée =SI(ET(…)) ne fonctionne pas en vase clos au sein du classeur : elle gagne à être intégrée au sein d’écosystèmes computationnels plus larges impliquant des fonctions de requêtage déclaratif ou des moteurs d’agrégation multicritères, à l’instar de QUERY, SOMME.SI.ENS (SUMIFS) ou COMPTE.SI.ENS (COUNTIFS).
Dans de multiples architectures de tableaux de bord, il est particulièrement pertinent de concevoir une « colonne de marquage décisionnel » (helper column) pilotée par une formule =SI(ET(…)). Cette colonne technique procède à la labellisation unitaire rapide des enregistrements qui satisfont à des critères conjonctifs profonds ou hautement sophistiqués, difficilement exprimables au sein de la syntaxe SQL parfois rigide de la fonction QUERY. Une fois ce statut assigné de manière granulaire, la fonction QUERY peut alors s’appuyer sur ce champ unifié pour agréger, pivoter ou filtrer les sous-ensembles de données avec une simplicité déconcertante :
=QUERY(A1:H1000; « SELECT B, SUM(E) WHERE H = ‘Prioritaire’ GROUP BY B »)
Cette approche d’hybridation structurelle soulage la fonction de requêtage d’une surcharge computationnelle inutile, tout en garantissant à l’utilisateur final une traçabilité parfaite des règles de gestion directement visible au cœur du tableau principal.
11. Analyse comparative de performance et solutions alternatives modernes
11.1 Coût computationnel et impact sur les classeurs à forte volumétrie
L’un des défis majeurs auxquels sont confrontés les architectes de bases de données sur tableur réside dans la dégradation progressive des performances de calcul au fur et à mesure que la volumétrie des enregistrements augmente. Dans Google Sheets, chaque formule =SI(ET(…)) instanciée sur une ligne individuelle représente un nœud distinct au sein du graphe de dépendances que le moteur de calcul infonuagique doit surveiller, recalculer et synchroniser.
Lorsque cette combinaison conditionnelle est déployée de façon unitaire sur des plages englobant des dizaines de milliers de lignes, la multiplication des instances fonctionnelles engendre une consommation sensible de cycles processeur et une hausse de l’occupation mémoire de la machine virtuelle sous-jacente. Ce phénomène est décuplé si l’un des arguments de la fonction ET fait appel à des calculs périphériques coûteux, tels que des recherches d’équivalence matricielle ou des vérifications d’horodatage en continu.
Pour prévenir les latences d’affichage, les freezes temporaires de navigation et les dépassements de quotas d’exécution imposés par l’infrastructure cloud de Google, les analystes doivent privilégier la rationalisation des expressions logiques. Dès que cela est possible, le recours à la vectorisation arithmétique booléenne via ARRAYFORMULA (comme explicité à la section 10.1) doit supplanter le déploiement de formules unitaires recopiées vers le bas. Une formule matricielle unique réduit considérablement l’arborescence du graphe de dépendance interne, restituant une fluidité immédiate aux classeurs volumineux.
11.2 Utilisation de la fonction SI.CONDITIONS (IFS) comme alternative structurelle
Face à la lourdeur visuelle et au risque d’erreur inhérent aux cascades d’arbres décisionnels combinant plusieurs =SI(ET(…)) imbriqués dans les branches négatives successives, Google a enrichi son moteur fonctionnel par l’introduction de la fonction SI.CONDITIONS (IFS). Cette fonction moderne réinvente l’ordonnancement conditionnel en éliminant définitivement la nécessité d’imbriquer des parenthèses de rejet successives.
La syntaxe de SI.CONDITIONS repose sur une succession linéaire de paires ordonnées d’arguments : =SI.CONDITIONS(condition1; valeur1; [condition2; valeur2; …]). Au sein de cette architecture séquentielle aplatie, la fonction ET s’intègre avec une fluidité remarquable, servant de moteur d’évaluation pour chacune des paires d’interrogation :
=SI.CONDITIONS(ET(A2>100; B2= »Oui »); « Niveau 1″; ET(A2>50; B2= »Oui »); « Niveau 2 »; VRAI; « Défaut »)
Dans ce schéma, la clause finale VRAI agit comme le réceptacle universel par défaut, équivalent à l’ultime valeur_si_faux d’une cascade classique de SI imbriqués. L’adoption de SI.CONDITIONS combinée à la fonction ET améliore considérablement la maintenabilité du modèle de calcul, facilitant la relecture et la modification ultérieure des règles métier par des équipes pluridisciplinaires.
11.3 Exploitation des fonctions FILTER et CHOISIRCOLS pour les extractions conditionnelles
L’utilisation de la combinaison =SI(ET(…)) répond avant tout à un objectif d’étiquetage inline, où chaque observation au sein d’une ligne de données doit recevoir une qualification individuelle tout en préservant l’intégrité de la structure tabulaire originelle. Toutefois, lorsque l’objectif ultime de l’analyste n’est pas d’enrichir une colonne existante, mais d’extraire sélectivement un sous-ensemble d’enregistrements répondant à plusieurs critères conjonctifs pour l’isoler sur une feuille dédiée, d’autres solutions architecturales modernes s’avèrent infiniment supérieures.
La fonction FILTER incarne l’outil par excellence pour l’extraction conditionnelle en mémoire vive. Plutôt que de recourir à une formule =SI(ET(…)) pour marquer les lignes avant de leur appliquer un tri mécanique, la fonction FILTER réalise l’ensemble de l’opération en une seule étape déclarative non destructive. Au sein de sa syntaxe, la conjonction s’exprime naturellement par la juxtaposition de virgules ou de points-virgules délimitant chaque série de contraintes :
=FILTER(A2:D100; B2:B100= »Terminé »; C2:C100>=1000)
En associant cette directive de filtrage à la fonction CHOISIRCOLS (CHOOSECOLS), le modélisateur peut restreindre la projection aux seules colonnes indispensables au reporting exécutif. Bien que ces fonctions ne remplacent pas la polyvalence inline de la formule =SI(ET(…)) pour qualifier dynamiquement une transaction dans le flux opérationnel, elles constituent l’alternative reine pour la consolidation et la restitution épurée des sous-ensembles conjonctifs.
12. Guide méthodologique pour la conception de systèmes décisionnels fiables
12.1 De l’expression du besoin métier à la formalisation booléenne
La cause fondamentale de défaillance des systèmes décisionnels tabulaires réside rarement dans l’incapacité technique à saisir une formule dans une cellule ; elle prend presque systématiquement racine en amont, lors de la traduction imparfaite de l’expression du besoin métier vers le formalisme booléen. Les langues naturelles, à l’image du français, sont truffées d’ambiguïtés sémantiques relatives aux conjonctions de coordination.
Dans le discours courant, l’usage du vocable « et » masque fréquemment une intention disjonctive sous-jacente. Lorsqu’un dirigeant d’entreprise ordonne d’accorder une remise « aux clients basés en France et en Belgique », la formulation linguistique exploite la conjonction copulative « et ». Toutefois, sur le plan formel de la théorie des ensembles, aucun client ne peut être simultanément situé en France ET en Belgique au sein de la même cellule géographique : l’intention réelle du dirigeant relève d’une disjonction inclusive (France OU Belgique). Une traduction littérale de la consigne managériale sous la forme =SI(ET(Pays= »France »; Pays= »Belgique »); Remise; 0) aboutirait à une formule structurellement stérile, incapable de renvoyer le moindre résultat positif.
Pour neutraliser ces distorsions cognitives, le concepteur de modèles de données doit obligatoirement rédiger une table de décision matricielle sur papier ou support documentaire avant de procéder au paramétrage dans le tableur. Cette formalisation préalable consiste à dresser la liste exhaustive de l’ensemble des combinaisons possibles d’états d’entrée, de leur assigner le verdict métier incontestable attendu par les parties prenantes, et de dériver ensuite la formule booléenne minimale requise pour satisfaire sans faille à cette grille d’arbitrage.
12.2 Protocoles de vérification, de validation et de test unitaire
À l’instar des protocoles d’ingénierie logicielle régissant le déploiement d’applications critiques, les formules décisionnelles majeures au sein d’une entreprise doivent faire l’objet de campagnes de tests unitaires rigoureuses avant leur mise en production opérationnelle. Un modèle financier déployé sans phase de recette formelle expose l’organisation à des préjudices patrimoniaux majeurs.
La constitution d’un jeu de données synthétique dédié (banc d’essai unitaire) représente la méthode privilégiée pour certifier la robustesse d’une formule =SI(ET(…)). Ce jeu d’essai doit être calibré pour éprouver systématiquement l’intégralité des quatre quadrants de la table de vérité :
- Un enregistrement où l’ensemble des conditions du bloc ET est incontestablement validé (cas VRAI/VRAI menant au déclenchement nominal de la valeur_si_vrai).
- Un enregistrement où la première condition est satisfaite mais la seconde est en échec (cas VRAI/FAUX validant l’étanchéité du bloc conjonctif).
- Un enregistrement où la première condition échoue tandis que la seconde est validée (cas FAUX/VRAI confirmant l’absence d’asymétrie illégitime).
- Un enregistrement où l’ensemble des critères est en situation de défaillance complète (cas FAUX/FAUX confirmant l’orientation vers la valeur_si_faux).
Ce protocole doit impérativement être complété par l’injection délibérée de cas limites critiques (edge cases) : valeurs frontières exactes sur les inégalités, cellules délibérément laissées vides, caractères accentués, ou formats textuels corrompus. C’est uniquement au terme d’une validation intégrale et sans réserve de cette matrice de tests que la formule peut être transférée au sein du classeur de production de l’entreprise.
12.3 Documentation interne et transfert de compétences au sein de l’organisation
La pérennité d’un système d’information repose fondamentalement sur sa capacité à survivre au départ ou à la réaffectation de ses concepteurs originaux. Trop souvent, des classeurs maîtres abritant des formules conditionnelles complexes se transforment en « boîtes noires » impénétrables que les équipes en place n’osent plus modifier de peur de déstabiliser l’équilibre précaire de l’infrastructure informationnelle.
Pour assurer la pérennité et l’auditabilité des formules combinant SI et ET, l’organisation doit instaurer une charte documentaire contraignante. Tout d’abord, l’insertion de métadonnées contextuelles par le biais de l’outil « Insérer une note » (ou « Insérer un commentaire ») directement rattaché à l’en-tête de la colonne décisionnelle permet de consigner l’historique de la formule : la date de sa mise en service, la version de la politique de l’entreprise dont elle transcrit les règles, le nom de l’auteur original et l’explication littérale de l’arbre logique déployé.
De surcroît, la normalisation des conventions de nommage appliquées aux plages de données et la conservation d’un glossaire sémantique centralisé garantissent que n’importe quel analyste junior sera en mesure d’auditer, de corriger ou d’enrichir l’architecture conditionnelle du classeur sans risquer d’altérer la cohérence globale des calculs. Cette démarche de transmission méthodologique transforme la feuille de calcul individuelle en un actif immatériel résilient, vecteur de gouvernance et d’efficience pérenne pour l’ensemble de l’organisation.
Références
- Boole, G. (1854). An investigation of the laws of thought on which are founded the mathematical theories of logic and probabilities. Walton and Maberly.
- Google. (s. d.). Aide Google Sheets : Fonction SI (IF). Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093364
- Google. (s. d.). Aide Google Sheets : Fonction ET (AND). Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093301
- Google. (s. d.). Aide Google Sheets : Fonction SI.CONDITIONS (IFS). Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/7014145
- Google. (s. d.). Aide Google Sheets : Fonction ARRAYFORMULA. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093275
- Google. (s. d.). Aide Google Sheets : Utiliser la mise en forme conditionnelle. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/78413
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Winston, W. L. (2021). Microsoft Excel Data Analysis and Business Modeling (7e éd.). Microsoft Press.