
Dans l’écosystème de l’analyse décisionnelle contemporaine, la structuration hiérarchique des données constitue une opération fondamentale sur laquelle reposent d’innombrables arbitrages stratégiques, financiers et opérationnels. Qu’il s’agisse d’évaluer la rentabilité relative d’investissements concurrents, d’ordonnancer des candidats lors d’un processus de recrutement hautement sélectif ou d’optimiser l’affectation de ressources logistiques limitées, la capacité à ordonner sans ambiguïté un ensemble d’entités représente une exigence analytique primordiale. Or, la réalité empirique se caractérise par une complexité multidimensionnelle irréductible qui résiste violemment aux tentatives de réduction à un indicateur unique. L’évaluation monocritère, bien que séduisante par sa simplicité de mise en œuvre, engendre inévitablement des pertes d’information critiques et se heurte de manière systématique au problème des ex aequo, paralysant ainsi le processus de décision rationnelle.
Le logiciel Microsoft Excel demeure, en dépit de l’émergence d’environnements de programmation dédiés tels que Python ou R, le vecteur d’analyse quantitative le plus répandu au sein des organisations. Toutefois, son utilisation pour des classements multicritères sophistiqués révèle fréquemment les limites méthodologiques des praticiens. Si l’outil propose des fonctions natives d’ordonnancement statistique, leur application directe sur des systèmes de variables multiples nécessite une compréhension approfondie des structures mathématiques sous-jacentes, de la théorie de la décision et de la logique booléenne matricielle. L’élaboration d’un modèle de classement robuste, capable de départager équitablement et dynamiquement des entités partageant des scores identiques sur un premier niveau d’analyse, exige une articulation rigoureuse de formules combinatoires ou l’exploitation judicieuse des nouvelles capacités de calcul matriciel dynamique.
L’objet de cette étude exhaustive est de déconstruire, formaliser et optimiser l’ensemble des méthodes permettant d’établir un classement multicritère rigoureux dans l’environnement Microsoft Excel. En explorant successivement les fondements mathématiques de l’ordre lexicographique, les mécanismes internes des fonctions statistiques classiques, la puissance combinatoire des tests conjonctifs, les techniques de pondération infinitésimale et les ruptures paradigmatiques introduites par le moteur de calcul d’Excel 365, cet article offre un guide définitif pour transformer des jeux de données complexes en hiérarchies décisionnelles fiables, pérennes et parfaitement auditables.
1. Introduction aux enjeux et fondements du classement multicritère dans Excel
1.1 Limites épistémologiques et pratiques du classement monocritère
L’illusion d’une métrique unidimensionnelle omnisciente constitue l’un des écueils épistémologiques majeurs de l’analyse de données moderne. Réduire la performance d’un collaborateur, la viabilité d’un portefeuille d’actifs ou la criticité d’un risque opérationnel à un indicateur unique procède d’une simplification réductrice qui altère profondément la validité des conclusions analytiques. Dans les systèmes complexes, les variables observées entretiennent des relations de dépendance non linéaires, de compensation ou d’antagonisme qui échappent intégralement à une mesure scalaire unique. L’évaluation monocritère postule de manière implicite que l’ensemble de la valeur d’une observation peut être capturé par un seul axe géométrique, ce qui contredit frontalement les principes élémentaires de l’analyse décisionnelle multicritère formalisée par les travaux pionniers de l’European Journal of Operational Research.
Sur le plan strictement empirique, le classement monocritère engendre une pathologie récurrente : la prolifération des ex aequo. Dès lors qu’une série statistique présente une granularité discrète, une échelle de mesure restreinte ou une concentration de valeurs autour d’un seuil critique, la probabilité que deux entités distinctes partagent exactement le même score augmente de façon exponentielle. Dans un environnement compétitif où l’allocation des récompenses, des financements ou des promotions est intrinsèquement binaire ou séquentielle, l’incapacité à départager des concurrents égaux paralyse l’action et introduit une part d’arbitraire destructrice d’efficacité. L’analyste se trouve alors contraint de recourir à des procédures manuelles d’arbitrage, annihilant l’automatisation et la reproductibilité du modèle de calcul.
Cette carence méthodologique entraîne une dégradation substantielle de l’intégrité de la prise de décision. Lorsqu’un algorithme de classement se heurte à des égalités sans disposer de règles explicites de départage, il génère des lacunes dans la séquence des rangs ou attribue des positions identiques qui occultent des variations substantielles sur d’autres dimensions critiques de la performance. Pour restaurer la pertinence du classement, il devient impératif d’intégrer des variables secondaires, voire tertiaires, qui agiront comme des discriminants d’arbitrage conditionnels. Cette approche séquentielle garantit que chaque entité se voit assigner une position ordinale univoque, reflétant fidèlement sa valeur relative globale au sein du système observé.
1.2 Typologie des critères de décision : hiérarchiques vs pondérés
Face à la nécessité de traiter plusieurs dimensions analytiques, deux paradigmes mathématiques et opérationnels distincts s’offrent au concepteur de modèles décisionnels : l’approche hiérarchique, régie par l’ordre lexicographique, et l’approche compensatoire, fondée sur l’agrégation pondérée. Le choix entre ces deux méthodologies ne relève pas d’une simple préférence technique sous Excel, mais engage une posture théorique fondamentale quant à la commensurabilité des grandeurs mesurées et à la nature des arbitrages tolérés par le décideur.
Le classement hiérarchique strict repose sur une séquence de priorités absolues et non négociables. Dans ce schéma inspiré du classement alphabétique des dictionnaires, le premier critère prévaut de manière catégorique sur l’ensemble des critères subséquents. Une variation, aussi minime soit-elle, sur le critère primaire emporte définitivement la décision, reléguant le critère secondaire au rang de variable muette. Ce dernier n’est activé par le moteur logique que dans l’éventualité exacte d’une égalité parfaite sur le critère principal. Cette structure ordinale préserve la pureté de la hiérarchie organisationnelle ou technique en interdisant toute forme de compensation : une performance exceptionnelle sur un axe secondaire ne saurait compenser un déficit sur l’axe prioritaire.
À l’opposé, l’agrégation pondérée postule la substituabilité des performances à travers le calcul d’un score composite unique. Chaque critère se voit attribuer un coefficient scalaire reflétant son importance relative, permettant à une surperformance sur une variable donnée de contrebalancer une faiblesse sur une autre. Cette modélisation impose toutefois des contraintes rigoureuses de normalisation préalable des échelles de mesure qualitatives, ordinales et continues afin d’éviter qu’une variable à forte amplitude numérique n’écrase artificiellement des métriques cruciales mais de faible magnitude. Dans Excel, l’analyste doit savoir naviguer entre ces deux logiques, en discernant avec clarté si le processus d’affaires exige une sélection impérative séquentielle ou une évaluation globale équilibrée.
1.3 Panorama des approches algorithmiques disponibles dans le tableur
L’environnement Microsoft Excel offre un spectre étendu de solutions techniques pour implémenter des classements multicritères, dont l’efficacité opérationnelle dépend intimement de l’architecture fonctionnelle sous-jacente et de la version du logiciel utilisée. Historiquement, les analystes ont dû déployer une ingéniosité remarquable pour contourner l’incapacité originelle des fonctions statistiques élémentaires à gérer nativement la multidimensionnalité. Ces approches classiques reposent sur la conjugaison synergique de fonctions d’ordonnancement univariées et de formules de comptage conditionnel multi-critères, instaurant une mécanique de correction incrémentielle particulièrement robuste.
Parallèlement, l’approche par scoring synthétique, consistant à injecter les critères secondaires sous forme de perturbations infinitésimales au sein d’un score composite calculé dans une colonne auxiliaire, a longtemps constitué la méthode de référence pour traiter d’importants volumes d’informations. Cette technique arithmétique tire parti de la rapidité du calcul scalaire élémentaire pour contourner la lourdeur des évaluations logiques imbriquées. Cependant, elle soulève des questions de précision numérique liées aux limites de la représentation des nombres en virgule flottante selon la norme IEEE 754, contraignant l’analyste à un calibrage méticuleux des ordres de grandeur.
L’introduction récente du moteur de calcul matriciel dynamique dans les versions modernes d’Excel, notamment via Microsoft 365, a profondément bouleversé ce paysage algorithmique. L’apparition de fonctions matricielles dédiées au tri et au réordonnancement sans recalcul cellulaire itératif autorise désormais des architectures de formules élégantes, déversées automatiquement sur la feuille de calcul sans duplication mécanique. Le choix de la méthode optimale requiert ainsi un arbitrage minutieux entre la volumétrie globale du classeur, les exigences d’auditabilité interne imposées par les normes de gouvernance des modèles et les contraintes d’interopérabilité technique avec des versions antérieures du tableur.
2. Fondements mathématiques et logiques de la hiérarchisation multicritère
2.1 Formalisation de l’ordre lexicographique
L’ordonnancement multicritère séquentiel puise ses fondements théoriques dans la formalisation mathématique de l’ordre lexicographique, concept issu de la théorie des ensembles et de l’algèbre générale. Considérons un ensemble fini d’observations $E = {x_1, x_2, dots, x_n}$, où chaque observation est représentée par un vecteur multidimensionnel de $m$ composantes $x_i = (c_{i,1}, c_{i,2}, dots, c_{i,m})$, chaque dimension $c_{i,k}$ correspondant à un critère d’évaluation quantitatif ordonné. La relation d’ordre lexicographique strict, notée $prec_L$, impose une hiérarchie stricte d’importance entre les indices des critères, où l’indice 1 prévaut sur l’indice 2, qui prévaut lui-même sur l’indice 3, et ainsi de suite jusqu’à l’indice terminal $m$.
Formellement, pour deux vecteurs $x_i$ et $x_j$, l’affirmation selon laquelle $x_i$ est strictement supérieur à $x_j$ selon l’ordre lexicographique ($x_i succ_L x_j$) est vérifiée s’il existe un indice $k in {1, dots, m}$ tel que pour tout entier $p c_{j,k}$. Cette définition axiomatique met en exergue le principe fondamental de non-activation des composantes secondaires : tant qu’une disparité stricte est constatée sur la composante prioritaire la plus basse, l’évaluation s’interrompt immédiatement sans jamais interroger la valeur des critères subséquents, garantissant une étanchéité absolue entre les niveaux d’arbitrage successifs.
Sur le plan des propriétés fondamentales de la théorie de l’ordre, la relation lexicographique est une relation d’ordre total dès lors que l’ensemble des composantes individuelles est lui-même totalement ordonné. Elle respecte scrupuleusement les axiomes de réflexivité (chaque élément est en relation avec lui-même), d’antisymétrie (si deux éléments se dominent mutuellement, ils sont rigoureusement identiques sur l’ensemble des composantes) et de transitivité (la domination de $x_i$ sur $x_j$ et de $x_j$ sur $x_k$ implique infailliblement la domination de $x_i$ sur $x_k$). L’application de ce cadre logique au sein d’Excel implique de transposer fidèlement cette dynamique conditionnelle sous forme d’instructions booléennes séquentielles capables de reproduire mathématiquement l’activation ciblée de la rupture d’égalité.
2.2 Modélisation de l’ajustement dynamique des rangs
Pour matérialiser l’ordre lexicographique au sein d’un tableau de calcul sans altérer l’intégrité de la structure tabulaire originelle, il convient de formaliser la mécanique d’ajustement incrémentiel de rang. Dans un système à deux dimensions constitué d’un vecteur principal $A$ et d’un vecteur secondaire $B$, le rang ordinal final d’une observation $i$, désigné par $R(i)$, peut être défini comme la somme arithmétique d’un rang brut d’origine et d’un facteur de décalage correctif induit par les relations de supériorité relative constatées sur le second axe.
Le rang brut initial, calculé exclusivement sur l’axe principal $A$, attribue une position commune à l’ensemble des entités partageant une valeur identique $A_i$. Dès lors, si un groupe de cardinalité $K$ présente la même performance sur $A$, chacune de ces entités reçoit un rang partagé $R_0$. Pour convertir cette égalité multiple en une séquence ordinale continue et bijective vers l’ensemble des entiers naturels, il est nécessaire d’introduire un opérateur d’incrémentation qui mesure la dominance locale sur le critère $B$. Ce décalage d’ajustement correspond précisément au nombre d’individus qui satisfont simultanément à deux conditions strictes : posséder une valeur identique sur l’axe principal ($A_j = A_i$) et posséder une valeur strictement supérieure sur l’axe secondaire ($B_j > B_i$).
Mathématiquement, le modèle dynamique s’écrit sous la forme analytique suivante :
R(i) = R_0(i) + |{ j ∈ {1, …, n} : A_j = A_i et B_j > B_i }|
Ce calcul de cardinalité résout élégamment le problème de la collision ordinale. L’individu du groupe d’ex aequo qui possède la valeur secondaire la plus élevée n’aura aucun concurrent vérifiant la condition de supériorité stricte ; son terme de décalage sera nul et il conservera le rang de base avantageux $R_0$. Les concurrents présentant des valeurs secondaires inférieures verront leur rang incrémenté d’autant d’unités qu’il existe d’éléments les surclassant sur ce second critère, établissant ainsi une dispersion ordinale stricte, sans trou et sans collision, tout en respectant scrupuleusement la primauté du vecteur $A$.
3. Analyse approfondie de la fonction RANG.EQ dans Excel
3.1 Syntaxe, arguments et comportement opérationnel de RANG.EQ
La fonction RANG.EQ (ou RANK.EQ dans la nomenclature anglophone du logiciel) constitue l’élément computationnel central sur lequel repose l’évaluation statistique de position univariée dans Excel. Conçue pour succéder à l’ancienne fonction RANG tout en maintenant une compatibilité ascendante stricte, cette instruction a pour vocation d’évaluer la position relative d’une valeur numérique au sein d’une série statistique de référence. Sa syntaxe canonique requiert trois arguments : RANG.EQ(nombre, référence, [ordre]), dont l’articulation logique conditionne l’exactitude du résultat mathématique obtenu.
Le premier paramètre, désigné par l’argument nombre, représente la valeur scalaire individuelle dont l’analyste cherche à déterminer le rang. Dans le cadre d’un tableau structuré, ce paramètre prend généralement la forme d’une référence de cellule relative, telle que $B2, amenée à être incrémentée le long de la série lors du déploiement vertical de la formule. Le second paramètre, référence, désigne la matrice unidimensionnelle ou le vecteur global contenant l’intégralité des observations soumises à la comparaison. Il est méthodologiquement impératif que cette plage fasse l’objet d’un verrouillage absolu par l’adjonction de symboles typographiques dollars, à l’instar de $B$2:$B$100, sous peine de voir la fenêtre d’évaluation glisser mécaniquement vers le bas et fausser de manière catastrophique l’intégrité des rangs calculés.
Le troisième argument, ordre, est un commutateur binaire facultatif qui gouverne la direction de la hiérarchisation. Si cet argument est omis ou défini sur la valeur 0 (zéro), la fonction adopte un ordonnancement décroissant par défaut, assignant le rang le plus avantageux, c’est-à-dire la valeur 1, à l’observation présentant la magnitude arithmétique maximale. Inversement, l’assignation d’une valeur non nulle, traditionnellement la valeur 1, impose un tri croissant, réservant la première position à la valeur la plus basse. Cette flexibilité de paramétrage est essentielle lorsqu’il s’agit de modéliser des critères de performance asymétriques où une grandeur plus faible est synonyme d’efficacité supérieure, comme un temps d’exécution, un coût financier ou un taux de rebut manufacturier.
3.2 Gestion native des ex aequo et limites intrinsèques de la fonction
Bien que la fonction RANG.EQ accomplisse sa tâche univariée avec une célérité remarquable, son comportement natif face aux doublons révèle une limite structurelle rédhibitoire pour l’analyse multicritère. Lorsque deux ou plusieurs cellules au sein de la plage de référence contiennent des valeurs numériques rigoureusement identiques, la fonction leur attribue systématiquement le même rang ordinal. Par convention mathématique, ce rang partagé correspond à la position la plus favorable qu’auraient occupée ces observations si elles avaient été légèrement distinguées.
Cette attribution d’indices partagés engendre une altération immédiate de la structure séquentielle du classement en générant des discontinuités ou « trous » dans la suite des entiers naturels. À titre d’illustration, si deux observations se partagent la deuxième position d’une distribution statistique, la fonction RANG.EQ leur affectera indistinctement le rang 2. Toutefois, l’observation immédiatement inférieure dans la hiérarchie ne se verra pas attribuer le rang 3, mais sera brutalement reléguée au rang 4. La cardinalité du groupe d’ex aequo est ainsi implicitement prise en compte pour décaler la suite de la distribution, mais l’égalité interne demeure non résolue.
L’incapacité structurelle fondamentale de RANG.EQ réside dans son hermétisme vectoriel : la fonction est intrinsèquement aveugle à toute dimension informationnelle externe à sa plage de référence exclusive. Elle est structurellement incapable d’interroger une seconde colonne de données pour discriminer les observations qu’elle a regroupées sous un même indice. Tenter de résoudre ce blocage en multipliant les arguments ou en imbriquant naïvement la fonction génère des erreurs de syntaxe bloquantes. L’analyste se trouve confronté à l’obligation de concevoir une couche algorithmique externe pour enrichir la fonction de base d’un mécanisme de discernement latéral.
3.3 Comparaison critique entre RANG.EQ et RANG.MOYENNE
L’environnement Microsoft Excel intègre, aux côtés de l’opérateur standard, la fonction RANG.MOYENNE (ou RANK.AVG), introduite pour répondre aux exigences spécifiques de certains protocoles statistiques non paramétriques. Une analyse critique des divergences opératoires entre ces deux fonctions s’avère indispensable pour éclairer les motifs qui justifient l’exclusion méthodique de RANG.MOYENNE dans les architectures de classement multicritère opérationnelles.
Tandis que RANG.EQ assigne la borne inférieure entière du rang partagé, RANG.MOYENNE procède à un calcul arithmétique pour déterminer le rang moyen qu’occuperaient les éléments ex aequo. Si nous reprenons l’hypothèse de deux individus en compétition pour la deuxième et la troisième position, RANG.MOYENNE effectuera le calcul fractionnaire $(2 + 3) / 2 = 2,5$ et affectera cette valeur décimale à chacune des deux observations. Si trois éléments partagent les positions 4, 5 et 6, le rang attribué sera $(4 + 5 + 6) / 3 = 5,0$. Cette propriété assure que la somme arithmétique globale de l’ensemble des rangs de la série demeure invariantement égale à la somme des entiers de 1 à $N$, soit $N(N+1)/2$, ce qui satisfait les prérequis d’élaboration de tests d’hypothèses tels que le test de Wilcoxon-Mann-Whitney.
Néanmoins, dans la perspective d’un classement de gestion, sélectif ou décisionnel, la production de valeurs fractionnaires s’avère profondément problématique. L’apparition de demi-points ou de tiers de points contredit la nature strictement discrète et ordinale d’un rang, rendant l’interprétation managériale malaisée et l’interfaçage avec des fonctions d’indexation indirecte particulièrement complexe. Plus grave encore, l’usage d’une base décimale moyenne perturbe l’application des termes d’incrémentation booléens fondés sur des nombres cardinaux entiers. C’est pourquoi seule la fonction RANG.EQ, par son ancrage sur des valeurs entières strictes correspondant aux bornes supérieures de dominance, offre l’assise mathématique indispensable à l’adjonction d’un mécanisme de correction multicritère par comptage conditionnel.
4. Mécanique et syntaxe de la fonction NB.SI.ENS pour la gestion des ex aequo
4.1 Fonctionnement logique de la conjonction multiconditionnelle
Pour dépasser l’unidimensionalité de RANG.EQ, le tableur met à la disposition de l’analyste un puissant moteur d’interrogation logique à travers la fonction NB.SI.ENS. Cette fonction statistique est spécifiquement dimensionnée pour dénombrer les enregistrements d’une base de données qui vérifient simultanément une multiplicité de critères logiques indépendants. Sa structure formelle obéit à la séquence syntaxique suivante : NB.SI.ENS(plage_critères1, critères1, [plage_critères2, critères2], …), acceptant théoriquement jusqu’à 127 couples d’évaluation.
Le comportement algorithmique interne de NB.SI.ENS repose sur l’opérateur logique d’intersection conjonctive « ET ». Pour qu’une ligne donnée soit comptabilisée dans le résultat final, elle doit impérativement satisfaire à l’intégralité des tests relationnels stipulés sur chacun des vecteurs de données parallèles. Ce fonctionnement vectoriel synchrone suppose que l’ensemble des plages d’évaluation possède rigoureusement les mêmes dimensions géométriques et la même orientation spatiale, sous peine de déclencher l’apparition immédiate d’un code d’erreur #VALEUR!.
Une particularité essentielle de la fonction réside dans la formulation textuelle de ses critères. Contrairement aux instructions arithmétiques standard, les opérateurs relationnels de comparaison tels que l’égalité, la supériorité stricte ou l’infériorité doivent être encapsulés sous forme de chaînes de caractères. Lorsqu’un critère doit intégrer la valeur dynamique d’une cellule de la ligne courante, l’analyste est tenu d’utiliser l’opérateur de concaténation typographique perluète (&) pour agréger l’opérateur logique textuel et la référence cellulaire variable, comme dans la structure syntaxique « > » & $C2. Cette spécificité impose une grande rigueur de saisie afin d’éviter que la référence ne soit interprétée de manière littérale comme une simple étiquette textuelle figée.
4.2 Formulation du critère d’égalité sur la variable principale
Dans l’architecture de résolution séquentielle d’un conflit de classement, le premier rôle assigné à NB.SI.ENS consiste à circonscrire l’analyse au seul sous-ensemble des observations qui se trouvent en situation de concurrence directe avec l’individu évalué sur la dimension primaire. Il s’agit en quelque sorte d’isoler dynamiquement le groupe des ex aequo au sein duquel l’arbitrage secondaire devra obligatoirement être exercé, sans jamais perturber les observations qui se situent au-dessus ou en dessous sur cette même dimension.
Pour formaliser cette sélection au sein de la formule, l’analyste déclare en premier argument la plage exhaustive des scores principaux, en prenant soin d’en figer les coordonnées géométriques par un adressage absolu rigoureux, par exemple $B$2:$B$100. Le critère associé à cette plage consiste en l’exacte valeur numérique présentée par l’observation courante sur cette même variable, référencée de façon relative ou semi-relative par l’instruction $B2. Dans la mesure où l’opérateur d’égalité est sous-entendu par défaut dans le moteur syntaxique d’Excel, l’écriture simplifiée $B2 est rigoureusement équivalente à l’expression explicite « = » & $B2.
Cette première condition conjonctive a pour effet direct d’éliminer instantanément du décompte toute entité présentant un score principal supérieur ou inférieur à la ligne courante. Seules les observations possédant une valeur strictement équivalente passent le filtre de cette première porte logique. Dès lors, le terrain computationnel est parfaitement préparé pour l’application du critère de départage secondaire sur une population homogène du point de vue de la performance prioritaire.
4.3 Formulation du critère de supériorité sur la variable secondaire
Une fois le périmètre des ex aequo parfaitement délimité, le second couple d’arguments de la fonction NB.SI.ENS est mobilisé pour matérialiser la relation de domination sur la variable de départage. Ce second volet logique prend pour référence la plage absolue contenant l’ensemble des scores secondaires, matérialisée par exemple par l’adressage $C$2:$C$100. L’objectif est alors de quantifier précisément combien d’observations, parmi celles qui partagent déjà la même valeur sur le critère principal, parviennent à surpasser l’observation courante sur ce critère subsidiaire.
Le critère appliqué à cette seconde plage adopte la forme contractuelle « > » & $C2, dans le cadre classique d’une métrique où la performance est corrélée positivement à la magnitude arithmétique. Cette clause ordonne au moteur de calcul de comptabiliser exclusivement les entités dont la valeur secondaire est strictement supérieure à celle de l’individu situé sur la ligne 2. L’emploi de l’inégalité stricte est ici un impératif méthodologique cardinal. Si l’analyste commettait l’erreur de substituer un opérateur d’inégalité large (« >= » & $C2), l’individu courant se comptabiliserait lui-même au sein du calcul, ce qui induirait une surévaluation systématique du terme de décalage d’au moins une unité pour l’ensemble des observations du groupe.
Le recours à la supériorité stricte garantit une propriété algébrique cruciale : pour l’observation qui surclasse l’ensemble de ses pairs ex aequo sur la dimension secondaire, le dénombrement renvoie la valeur entière zéro. En effet, nul individu ne présente une valeur strictement plus grande que la sienne dans ce sous-groupe. Ce zéro préserve le rang d’origine sans modification. Pour les entités suivantes du même groupe, le dénombrement renverra successivement les entiers 1, 2, 3, etc., générant très exactement les termes d’incrément nécessaires pour échelonner verticalement les concurrents au sein de la hiérarchie générale.
5. Modélisation pas à pas : Combinaison unifiée de RANG.EQ et NB.SI.ENS
5.1 Construction et anatomie de la formule standard
L’intégration opérationnelle des principes théoriques exposés précédemment se cristallise dans l’élaboration d’une formule composite unifiée, chef-d’œuvre de concision algorithmique et d’efficience computationnelle dans les versions classiques d’Excel. En positionnant dans la cellule de destination du rang la formule complète suivante :
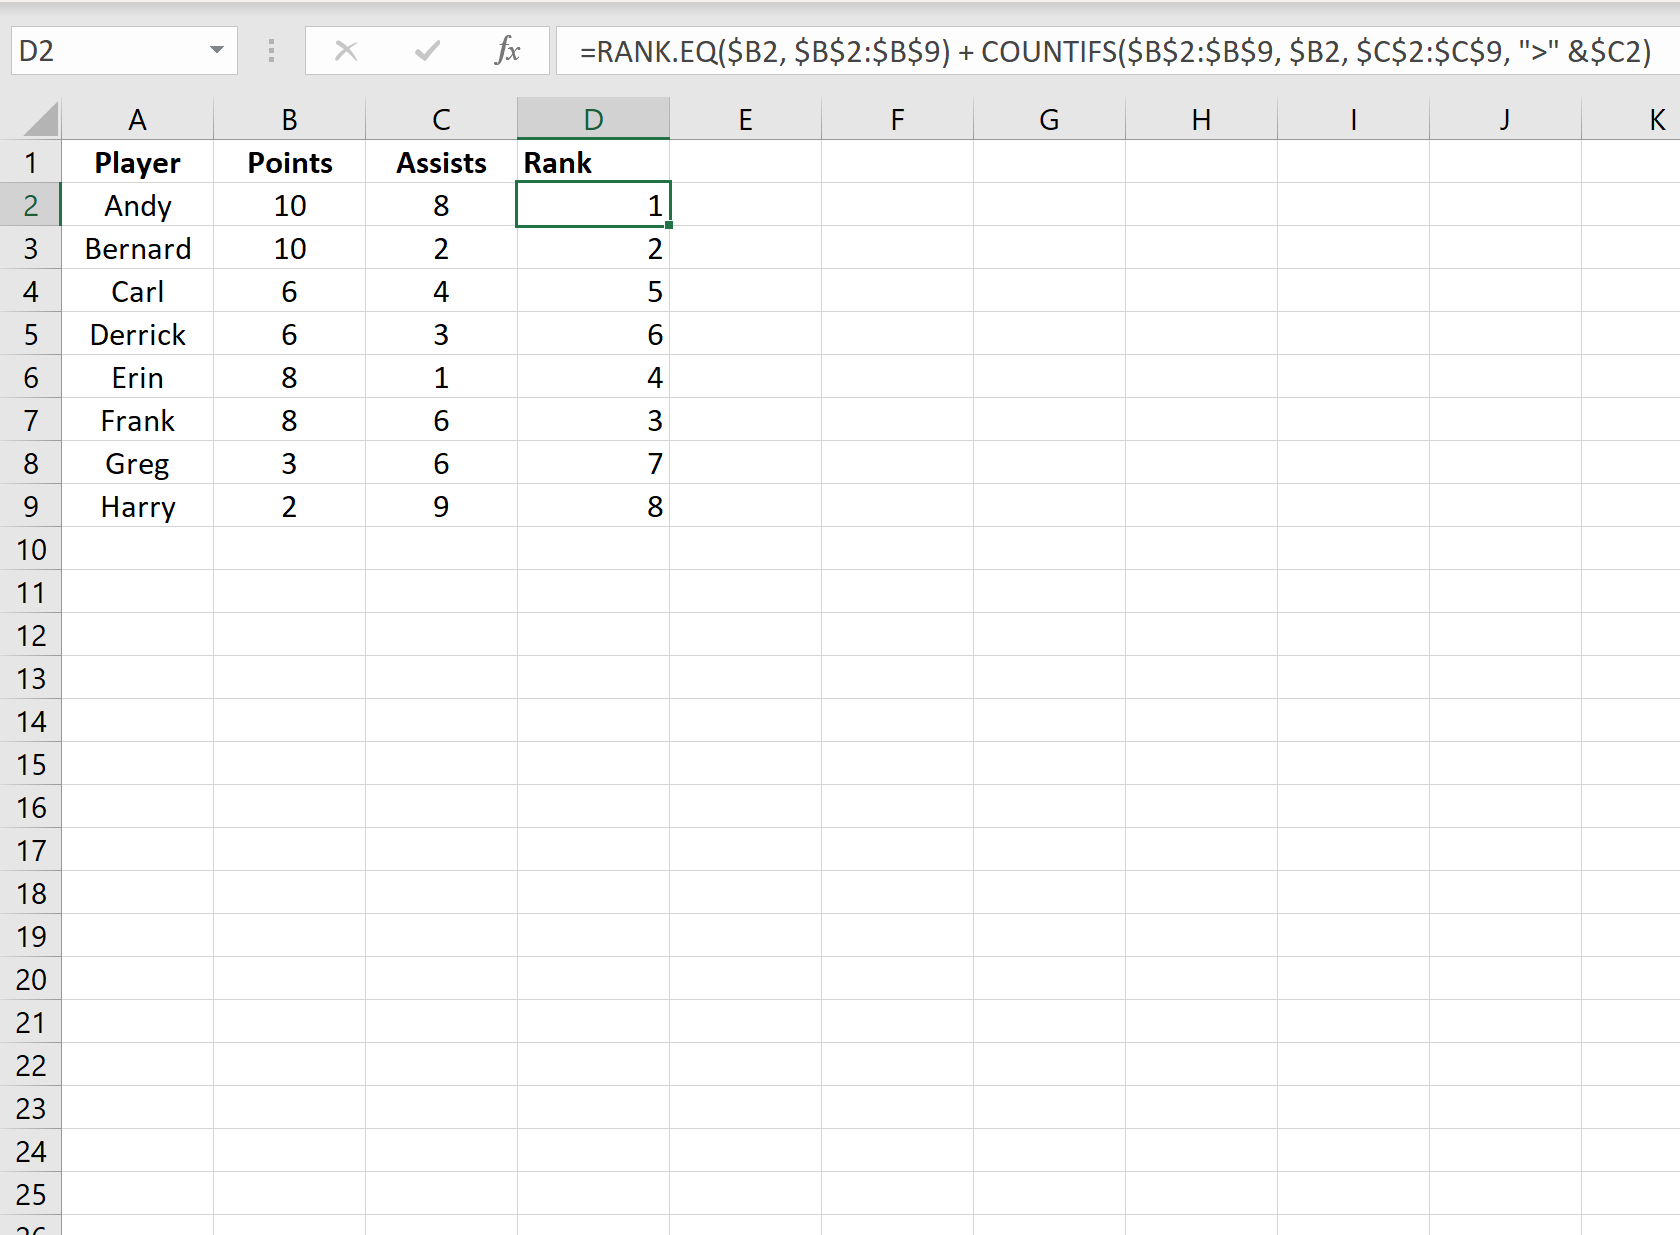
=RANG.EQ($B2;$B$2:$B$9) + NB.SI.ENS($B$2:$B$9;$B2; $C$2:$C$9; « > » & $C2)
l’analyste orchestre une séquence d’évaluation arithmétique et logique d’une élégance absolue. Pour en appréhender l’intimité opératoire, il convient de disséquer le flux de traitement séquentiel qu’exécute le processeur de calcul d’Excel lors de chaque évaluation cellulaire.
Dans un premier temps chronologique, le membre de gauche, constitué par le terme RANG.EQ($B2;$B$2:$B$9), est évalué de façon totalement autonome. Il interroge la population globale de la colonne B pour déterminer le rang d’ancrage de la ligne 2. Si l’observation est unique par son score, elle reçoit son rang définitif et le terme d’incrément de droite sera nul. Si l’observation fait partie d’un groupe d’ex aequo, elle reçoit, à l’instar de tous ses alter ego, la meilleure position théorique accessible au sein de ce cluster. Ce résultat intermédiaire constitue le socle ordinal inviolable du classement.
Dans un second temps, le moteur évalue le terme d’addition arithmétique en sollicitant le membre de droite : NB.SI.ENS($B$2:$B$9; $B2;$C$2:$C$9; « > » &$C2). Ce dernier scrute simultanément les deux dimensions pour quantifier le déficit de performance secondaire de l’observation courante par rapport à ses rivaux immédiats. Le résultat scalaire entier renvoyé par cette fonction (0 pour le meilleur, 1 pour le second, 2 pour le troisième, etc.) vient directement s’agréger au rang de base par une simple sommation arithmétique. Cette hybridation assure l’attribution d’un rang rigoureusement unique pour chaque entité, sans jamais altérer la hiérarchie globale établie par le critère dominant.
5.2 Application concrète sur un jeu de données de performance
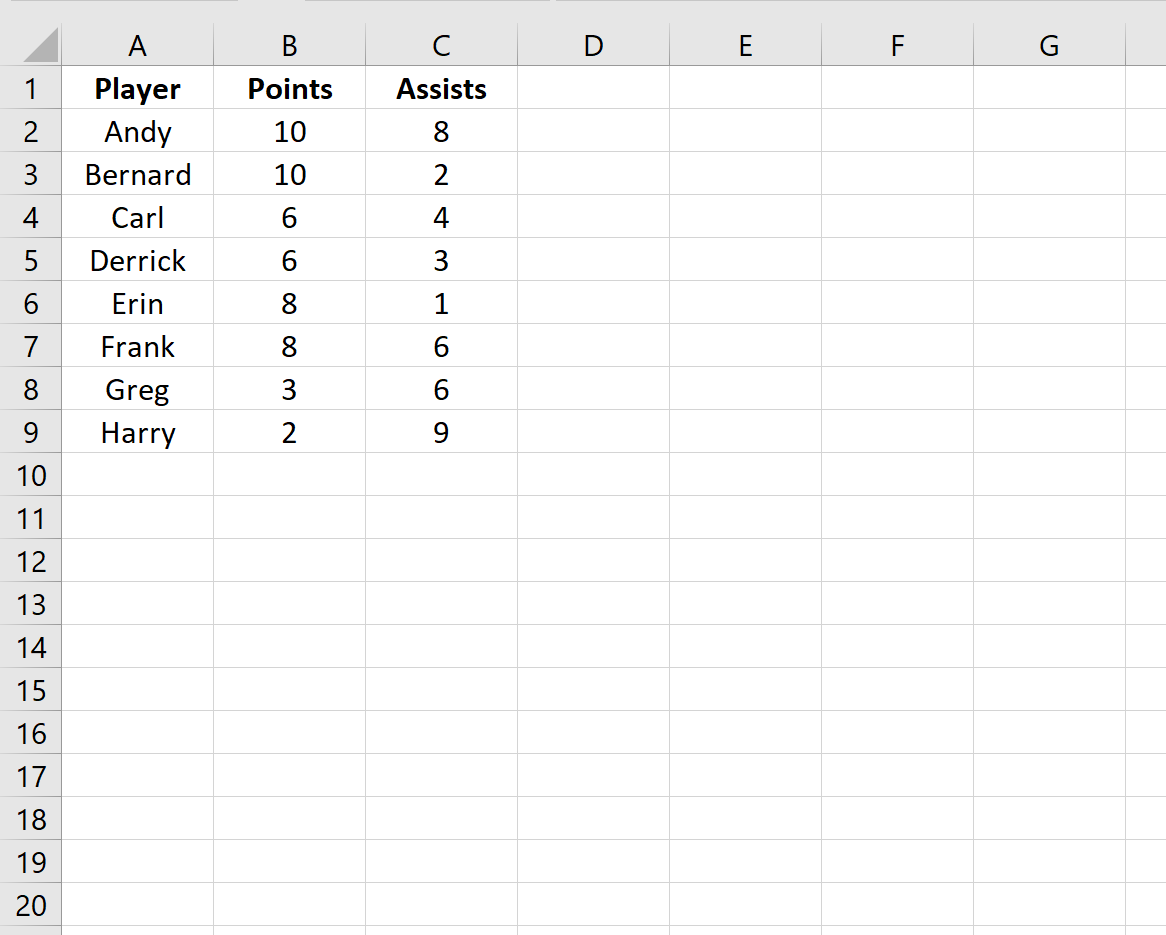
Afin de concrétiser cette mécanique opérationnelle et de dissiper toute ambiguïté théorique, considérons un jeu de données empirique extrait de l’analyse des performances d’une équipe sportive professionnelle. Ce tableau recense huit athlètes évalués sur deux variables distinctes : la quantité de points inscrits (critère principal situé en colonne B) et le total de passes décisives distribuées (critère secondaire situé en colonne C). Le tableau s’étend de la ligne 2 à la ligne 9 de la feuille de calcul.
Supposons que les enregistrements se présentent comme suit : le joueur Alexandre a inscrit 24 points et délivré 5 passes ; le joueur Bertrand a inscrit 28 points et délivré 2 passes ; le joueur Clément a inscrit 20 points et délivré 8 passes ; le joueur David a marqué 24 points et réalisé 9 passes ; le joueur Éric a obtenu 18 points et 4 passes ; le joueur Fabien a totalisé 24 points et 7 passes ; le joueur Gabriel affiche 28 points et 6 passes ; enfin, le joueur Henri présente 15 points et 10 passes.
Observons avec minutie la résolution du conflit statistique entre Alexandre, David et Fabien, qui partagent tous trois le score identique de 24 points sur le critère principal. Le traitement de la formule sur la ligne correspondant à David (24 points, 9 passes) se déroule comme suit :
- L’instruction RANG.EQ(24; $B$2:$B$9) observe que Bertrand et Gabriel (28 points) surpassent 24 points. La meilleure position disponible pour un score de 24 points est donc la 3e position. Le rang de base renvoie ainsi le scalaire 3.
- L’instruction NB.SI.ENS($B$2:$B$9; 24; $C$2:$C$9; « >9 ») recherche les joueurs qui ont marqué 24 points ET réalisé strictement plus de 9 passes décisives. Aucun athlète ne vérifiant cette condition, la fonction retourne exactement 0.
- Le rang final de David est donc $3 + 0 = 3$. Il décroche la 3e position du classement général.
Analysons immédiatement le cas de Fabien (24 points, 7 passes décisives) :
- Son rang de base calculé par RANG.EQ est invariablement égal à 3, puisqu’il a lui aussi marqué 24 points.
- La fonction NB.SI.ENS($B$2:$B$9; 24; $C$2:$C$9; « >7 ») identifie les joueurs avec 24 points et plus de 7 passes. Seul David satisfait ces deux critères simultanés (avec ses 9 passes). Le décompte logique renvoie donc le scalaire entier 1.
- Le rang final de Fabien s’établit à $3 + 1 = 4$. Il s’installe naturellement en 4e position.
Enfin, examinons la ligne d’Alexandre (24 points, 5 passes) :
- Le terme RANG.EQ renvoie toujours la valeur de base 3.
- L’expression NB.SI.ENS($B$2:$B$9; 24; $C$2:$C$9; « >5 ») dénombre les individus totalisant 24 points et plus de 5 passes. David (9 passes) et Fabien (7 passes) remplissent tous deux ces critères conjonctifs. Le résultat du dénombrement est donc égal à 2.
- Le rang consolidé d’Alexandre devient $3 + 2 = 5$. Il hérite ainsi de la 5e position.
Le groupe d’ex aequo initialement indistinct sur la base des points (rang 3 partagé) a été rigoureusement et équitablement sérialisé sur les positions 3, 4 et 5 sans créer le moindre chevauchement ni provoquer de rupture ordinale dans la suite des entiers naturels assignés au reste de la cohorte.
5.3 Règles d’adressage absolu et relatif pour la pérennité du modèle
L’intégrité opérationnelle de cette architecture combinatoire repose entièrement sur une discipline sans faille dans le maniement des modes d’adressage cellulaire sous Excel. Une compréhension erronée de la distinction entre références absolues, relatives et mixtes constitue l’origine de l’immense majorité des dysfonctionnements observés lors de la duplication des modèles de classement au sein de classeurs d’entreprise.
Le recours aux dollars d’ancrage doit obéir à une logique fonctionnelle rigide :
- Les arguments désignant des matrices d’observation globale, à savoir la plage de calcul de RANG.EQ et les plages de critères de NB.SI.ENS, doivent impérativement être configurés en références absolues complètes (ex. : $B$2:$B$9 et $C$2:$C$9). Cet ancrage total garantit que lors de la recopie incrémentale de la cellule vers le bas du tableau, la « loupe » d’observation de l’algorithme demeure rigoureusement stationnaire et embrasse en permanence la totalité de la cohorte statistique. L’oubli de ces ancrages provoquerait un glissement progressif de la plage vers le bas, faisant disparaître les premières lignes de la base de comparaison pour les observations inférieures et faussant dramatiquement l’exhaustivité du classement.
- À l’inverse, les arguments désignant la cible d’évaluation individuelle (le premier paramètre de RANG.EQ et les variables injectées après concaténation dans NB.SI.ENS) doivent impérativement comporter une liberté de mouvement sur l’axe vertical, en adoptant une syntaxe relative ou semi-relative sur la colonne (ex. : $B2 et $C2). Cette configuration autorise le curseur d’évaluation à accompagner le défilement des enregistrements au fur et à mesure que la formule est dupliquée sur les lignes subséquentes.
Lorsque le modèle est implémenté au sein d’un Tableau Structuré natif d’Excel (accessible via le raccourci Ctrl + L ou l’onglet Insertion > Tableau), la syntaxe gagne considérablement en lisibilité et en résilience structurelle. La formule s’écrit alors au moyen de références structurées explicites :
=RANG.EQ([@Points]; [Points]) + NB.SI.ENS([Points]; [@Points]; [Passes]; « > » & [@Passes])
Dans cette notation standardisée, l’arobase [@Points] indique sans ambiguïté la valeur scalaire de la ligne active, tandis que le nom de champ simple [Points] désigne l’intégralité du vecteur de données sur la colonne concernée. Outre l’élimination des risques d’erreurs de pointage manuel, cette formulation assure une propagation automatique immédiate de la formule à chaque insertion d’un nouvel enregistrement dans le tableau, garantissant l’évolutivité dynamique du modèle sans intervention manuelle de l’analyste.
6. Extension de l’algorithme à trois critères ou davantage
6.1 Complexification de la chaîne de conjonction séquentielle
Bien que la combinaison de deux critères résolve une proportion écrasante des situations d’égalité dans les jeux de données opérationnels, certains contextes analytiques à haute granularité ou soumis à des contraintes réglementaires exigeantes requièrent l’arbitrage successif de trois, quatre, voire cinq niveaux de décision séquentiels. Dès lors que deux entités présentent une similitude parfaite sur la métrique prioritaire et sur la variable de premier recours, la décision doit être transmise sans discontinuité logique à un troisième vecteur métrique.
Cette complexification ne modifie pas la nature fondamentale de l’algorithme unifié, mais impose d’étendre la chaîne de conjonction au sein de l’architecture matricielle. Le principe fondamental demeure invariant : une variable de rang $k$ ne peut être légitimement activée pour départager des concurrents que si, et seulement si, l’ensemble des variables d’ordre supérieur ($1$ à $k-1$) présentent une stricte égalité entre ces mêmes concurrents. Dans le formalisme d’Excel, cette imbrication conditionnelle se traduit par la juxtaposition d’instructions NB.SI.ENS indépendantes ou par l’adjonction de couples de conditions supplémentaires au sein d’une structure arithmétique cumulative.
Il est crucial de souligner que chaque niveau de discrimination additionnel nécessite d’intégrer dans son périmètre logique l’égalité sur tous les critères qui le précèdent. Si l’on souhaite intégrer un troisième critère représenté par le vecteur $D$, il ne suffit pas d’évaluer la condition où $D_j > D_i$ ; il est impératif d’évaluer la conjonction stricte $(B_j = B_i) \text{ ET } (C_j = C_i) \text{ ET } (D_j > D_i)$. Omettre l’égalité sur le second critère conduirait à ce qu’une observation dominée sur la variable $C$ puisse indûment pénaliser un concurrent sous le seul prétexte qu’elle posséderait un score supérieur sur la variable tertiaire $D$, ce qui violerait explicitement l’ordre lexicographique établi.
6.2 Structure matricielle de la formule à trois niveaux d’arbitrage
Pour matérialiser formellement un modèle décisionnel intégrant trois variables ordonnées de manière séquentielle et décroissante (la variable principale en colonne B, la variable secondaire en colonne C et la variable tertiaire en colonne D), l’expression mathématique et syntaxique sous Excel se déploie à travers l’addition de deux termes correcteurs distincts agrégés au rang primaire :
=RANG.EQ($B2;$B$2:$B$100) + NB.SI.ENS($B$2:$B$100;$B2; $C$2:$C$100; « > » & $C2) + NB.SI.ENS($B$2:$B$100;$B2; $C$2:$C$100; $C2;$D$2:$D$100; « > » &$D2)
L’analyse de l’anatomie computationnelle de cette formule tripartite révèle une logique rigoureuse :
- Le premier terme, RANG.EQ($B2;$B$2:$B$100), détermine le rang de base dicté exclusivement par le critère dominant de la colonne B.
- Le deuxième terme, NB.SI.ENS($B$2:$B$100; $B2;$C$2:$C$100; « > » &$C2), quantifie le décalage provoqué par la supériorité sur le critère secondaire C pour les seules observations ayant une valeur identique en B.
- Le troisième terme, NB.SI.ENS($B$2:$B$100; $B2;$C$2:$C$100;$C2; $D$2:$D$100; « > » & $D2), n’intervient que si l’égalité persiste à la fois sur la colonne B et sur la colonne C. Il examine les enregistrements qui partagent rigoureusement la valeur de B2 et la valeur de C2, et comptabilise combien d’entre eux surclassent l’observation courante sur le troisième critère situé en colonne D.
Bien que cette méthode garantisse une précision mathématique irréprochable et respecte scrupuleusement l’étanchéité des niveaux hiérarchiques, l’analyste doit être conscient du phénomène d’explosion textuelle et cognitive de la formule. À chaque nouveau critère ajouté, la syntaxe s’alourdit d’un terme supplémentaire comportant l’ensemble des égalités préalables plus la nouvelle inégalité de départage. Au-delà de trois critères, la formule devient visuellement encombrante, complexe à auditer pour des tiers non initiés et plus exposée aux erreurs typographiques de maintenance, suggérant le recours à des approches matricielles modernes ou à des structures modulaires d’étapes de calcul.
6.3 Modélisation de critères avec sens d’optimisation opposés
L’une des exigences les plus subtiles de l’ingénierie décisionnelle réside dans la gestion de systèmes multicritères dont les sens d’optimisation sont asymétriques ou opposés. Dans de nombreux scénarios réels, l’analyste cherche à maximiser un indicateur d’efficacité ou de gain tout en minimisant simultanément une variable de coût, de délai de traitement, de taux d’incident ou de volatilité de portefeuille.
L’architecture articulant RANG.EQ et NB.SI.ENS s’adapte avec une flexibilité remarquable à ces configurations hétérogènes, sous réserve d’un ajustement chirurgical des commutateurs d’ordre et des opérateurs de comparaison relationnelle. Deux configurations fondamentales se présentent classiquement dans la pratique :
Cas 1 : Maximiser le critère principal (B), puis minimiser le critère secondaire (C).
Dans cette configuration, un score élevé en B est favorable, mais en cas d’égalité, le compétiteur présentant la plus faible valeur en C doit être préféré. La formule s’établit comme suit :
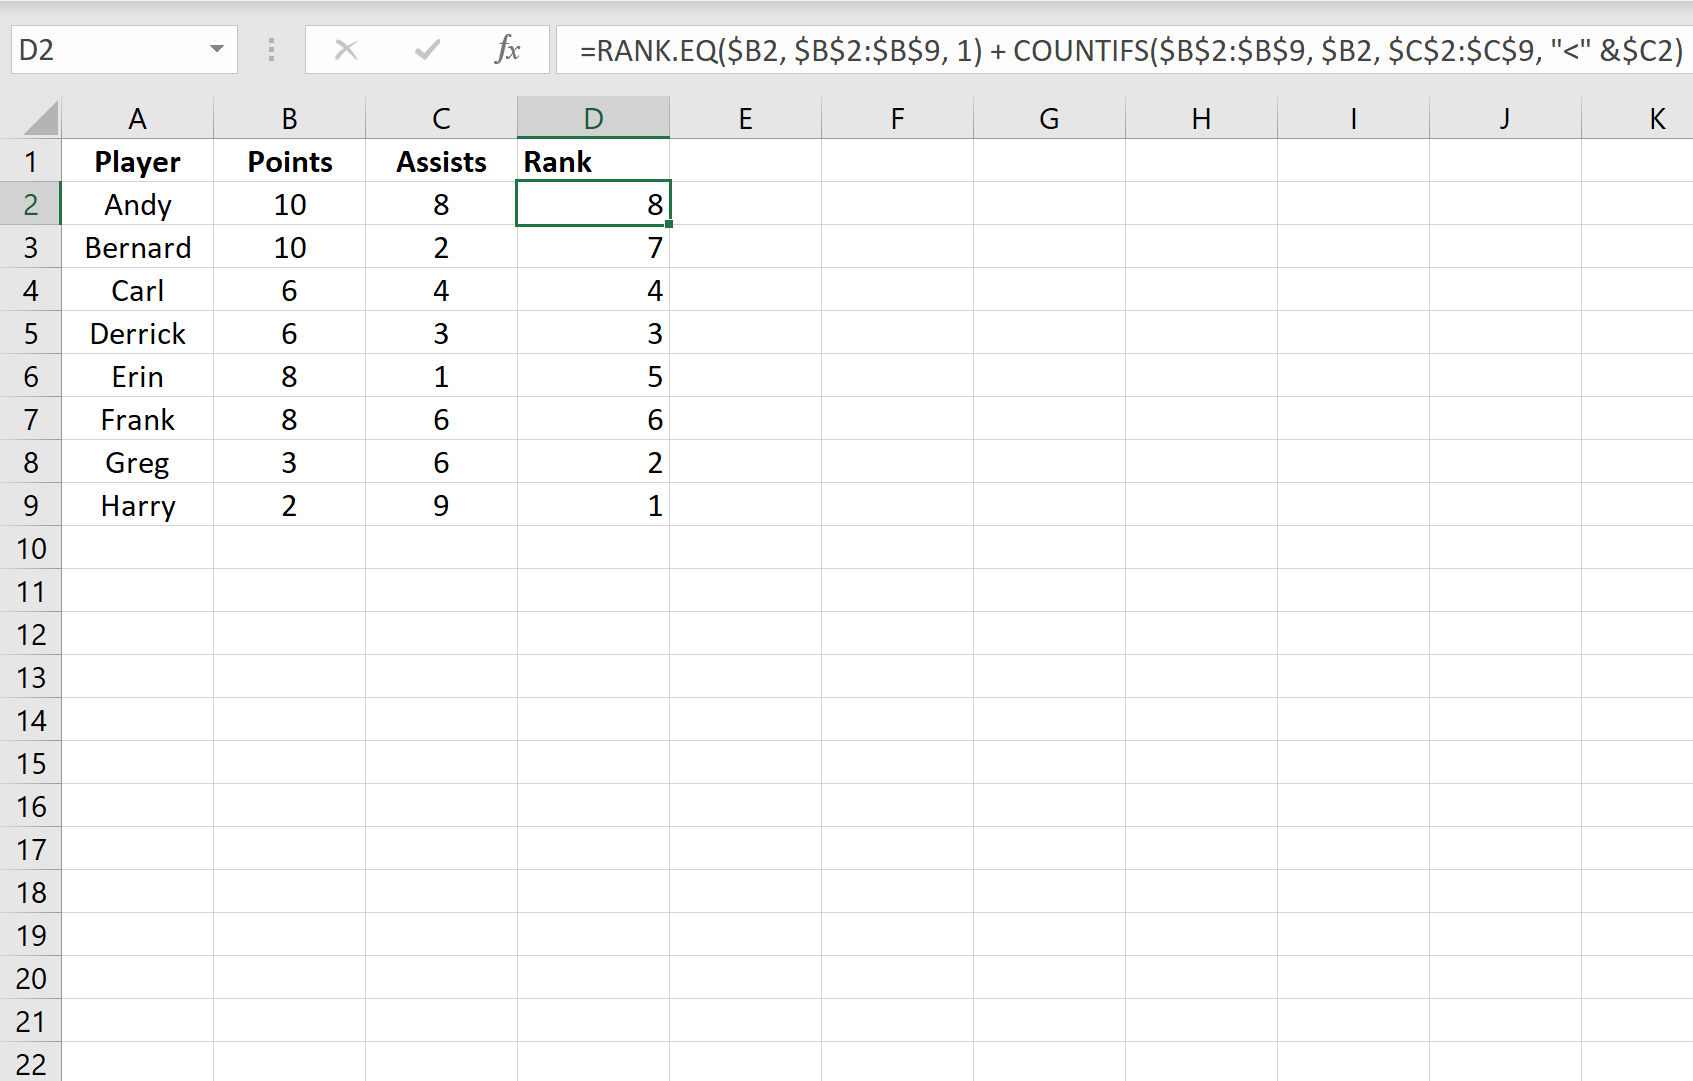
=RANG.EQ($B2;$B$2:$B$100; 0) + NB.SI.ENS($B$2:$B$100;$B2; $C$2:$C$100; « < » & $C2)
L’argument d’ordre de RANG.EQ est configuré sur 0 pour classer la colonne B par ordre décroissant (plus grand = meilleur). En revanche, le critère de comparaison sur la colonne C adopte l’opérateur d’infériorité stricte « < » & $C2. Ainsi, le terme de décalage comptabilise le nombre d’individus présentant une valeur en C plus petite que celle de l’observation courante. L’entité possédant le coût ou le délai le plus faible n’aura aucun rival avec un score plus bas ; son incrément sera nul, et elle conservera la meilleure place du sous-groupe.
Cas 2 : Minimiser le critère principal (B), puis maximiser le critère secondaire (C).
Ici, nous cherchons le score le plus bas sur le vecteur B, mais en cas d’égalité, l’entité possédant la valeur la plus haute sur le vecteur C doit l’emporter. L’agencement syntaxique s’inverse rigoureusement :
=RANG.EQ($B2;$B$2:$B$100; 1) + NB.SI.ENS($B$2:$B$100;$B2; $C$2:$C$100; « > » & $C2)
L’argument d’ordre de RANG.EQ est expressément fixé à 1 pour imposer un classement croissant sur la métrique principale B (plus petit = meilleur). Le dénombrement conditionnel sur l’axe C mobilise quant à lui l’opérateur de supériorité stricte « > » & $C2, pénalisant tout individu dominé par une valeur secondaire plus élevée. Cette symétrie d’inversion garantit la fidélité de l’ordonnancement mathématique face à n’importe quelle combinatoire de polarités décisionnelles.
7. Approches alternatives fondées sur la pondération et les scores composites
7.1 Création d’un indice composite par somme pondérée infinitésimale
Face à la complexité syntaxique des formules multiconditionnelles imbriquées, l’analyste quantitatif dispose d’une alternative conceptuelle puissante issue des mathématiques appliquées : la méthode de la perturbation infinitésimale, fréquemment désignée sous le vocable d’approche par score composite d’arbitrage. Cette technique consiste à fusionner les différents critères de décision au sein d’une métrique scalaire unique calculée dans une colonne auxiliaire, conçue spécifiquement pour qu’une fonction RANG.EQ élémentaire puisse ensuite générer un classement complet d’un seul bloc.
Le principe fondamental consiste à conserver l’intégralité de la valeur du critère prioritaire tout en lui agrégeant la valeur du critère secondaire atténuée par un facteur réducteur suffisamment infime pour qu’elle ne puisse jamais, en aucune circonstance arithmétique, franchir la plus petite variation observable sur le critère principal. Si nous notons $C_1$ le critère principal et $C_2$ le critère secondaire, le score composite ajusté $S_i$ prend la forme générique :
S_i = C_{1,i} + ε × C_{2,i}
où $varepsilon$ (epsilon) représente un coefficient scalaire d’atténuation strictement contrôlé. Pour dimensionner mathématiquement ce coefficient, il est indispensable de connaître la borne supérieure absolue du critère secondaire, notée $\max(C_2)$, ainsi que le plus petit incrément non nul observable sur le critère principal, noté $\Delta_{\min}(C_1)$. La condition formelle de non-interférence s’énonce ainsi :
ε × max(C_2) < Delta_{min}(C_1)
Par exemple, si le critère principal est un décompte de points exprimé sous la forme d’entiers naturels (dont le plus petit écart possible entre deux valeurs distinctes est $\Delta_{\min} = 1$) et que le critère secondaire est un score exprimé sur une échelle continue ne dépassant jamais la valeur théorique de 100, il suffit de choisir un coefficient $varepsilon = 0,0001$ (soit $10^{-4}$). Dans cette configuration, la contribution maximale du critère secondaire au score synthétique sera de $100 \times 0,0001 = 0,01$, valeur rigoureusement incapable de faire grimper artificiellement un individu ayant un score principal de 10 au-dessus d’un individu ayant un score de 11. En revanche, pour deux observations présentant un score principal rigoureusement égal à 10, le critère secondaire brisera l’égalité avec une précision absolue lors de l’application de RANG.EQ sur la colonne de score composite.
7.2 Normalisation préalable des variables hétérogènes
L’implémentation rigoureuse d’un modèle d’agrégation pondérée ou composite requiert une étape méthodologique préalable souvent négligée par les utilisateurs d’Excel : la standardisation ou normalisation statistique des données sources. Lorsque les critères à agréger s’expriment dans des unités de mesure disparates (par exemple des millions d’euros de chiffre d’affaires, des pourcentages de satisfaction client et des nombres de jours de retard de livraison), leurs distributions présentent des moyennes et des dispersions scalaires sans commune mesure. Sommer directement ces variables brutes, même affectées de coefficients empiriques, introduit un biais structurel majeur où la métrique à la plus forte variance numérique neutralise de facto l’influence des autres variables.
La méthode de normalisation la plus adaptée aux modèles de décision sur tableur est la transformation par mise à l’échelle Min-Max, qui projette l’ensemble des observations d’une série statistique sur un intervalle fermé borné entre 0 et 1. Pour une variable $X$, la valeur normalisée $X’_i$ se calcule par la formule élémentaire :
X’_i = (X_i – min(X)) / (max(X) – min(X))
Dans l’environnement Excel, cette normalisation s’opère aisément par une formule faisant appel aux fonctions MIN et MAX appliquées sur la plage de données, par exemple : =(B2-MIN($B$2:$B$100))/(MAX($B$2:$B$100)-MIN($B$2:$B$100)). Pour les critères dont le sens d’optimisation est inverse (critères de coût ou de risque à minimiser), la formule est inversée pour conserver une lecture cohérente où 1 représente systématiquement l’optimum et 0 la pire performance observée :
X’_i = (max(X) – X_i) / (max(X) – min(X))
Pour les jeux de données présentant une forte asymétrie de distribution ou des valeurs aberrantes extrêmes (outliers), l’analyste privilégiera la méthode de centrage-réduction issue de la statistique inférentielle, également appelée calcul du $Z$-score, formalisée par l’expression $Z_i = (X_i – \mu) / \sigma$. Dans Excel, cette métrique s’obtient élégamment au moyen de la fonction native CENTREE.REDUITE(X; moyenne; ecart_type), combinée avec les fonctions MOYENNE et ECARTYPE.STANDARD. Une fois l’ensemble des dimensions projeté dans un espace métrique adimensionnel homogène, l’application de schémas de pondération séquentiels ou compensatoires s’effectue sur des bases mathématiques saines et dénuées d’artéfacts d’échelle.
7.3 Avantages et écueils comparatifs de la méthode par score auxiliaire
Le recours à une colonne auxiliaire hébergeant un score composite présente des atouts indéniables qui expliquent sa popularité historique auprès des gestionnaires de bases de données volumineuses sous Excel. Le principal avantage réside dans son extraordinaire efficience computationnelle. Le calcul arithmétique direct d’un produit scalaire $(C_{1} \times w_1) + (C_{2} \times w_2)$ est exécuté par le processeur avec une vitesse d’horloge infiniment plus rapide que l’évaluation matricielle de fonctions logiques multiconditionnelles telles que NB.SI.ENS. Sur un classeur comportant des centaines de milliers de lignes, cette méthode garantit un rafraîchissement quasi instantané du modèle là où des formules conjonctives lourdes provoqueraient un gel perceptible du tableur.
Toutefois, cette méthodologie comporte des écueils théoriques et techniques substantiels que l’analyste doit impérativement appréhender. Le risque le plus insidieux réside dans les erreurs d’arrondi machine inhérentes à la norme IEEE 754 gouvernant le calcul en virgule flottante au sein des logiciels informatiques. Excel gère la précision numérique jusqu’à 15 chiffres significatifs. Dès lors que l’on manipule des coefficients réducteurs infinitésimaux (par exemple $10^{-12}$) appliqués à des variables comportant déjà une partie décimale étendue, le moteur de calcul peut tronquer ou altérer des décimales critiques par absorption numérique, générant des égalités ou des écarts factices qui corrompent subrepticeusement la validité du classement final.
Le second inconvénient majeur est d’ordre ergonomique et documentaire : la perte totale de lisibilité directe. Un score composite artificiel dénué de signification physique (comme un score hybride de 24,000789 points) obscurcit la lecture immédiate du tableau pour les parties prenantes opérationnelles. De plus, il requiert l’adjonction d’une colonne de calcul intermédiaire qui rompt la compacité visuelle du modèle. L’analyste se trouve ainsi confronté à un arbitrage classique en ingénierie logicielle : privilégier la performance brute et la légèreté de calcul de la perturbation infinitésimale, ou plébisciter la clarté conceptuelle, l’intégrité numérique et la traçabilité immédiate de la méthode combinée RANG.EQ + NB.SI.ENS.
8. Exploitation des fonctions matricielles dynamiques modernes dans Excel 365
8.1 Mise en œuvre de la fonction TRIERPAR pour un ordonnancement direct
L’introduction du moteur de calcul à tableaux dynamiques dans Microsoft 365 et Excel 2021 a constitué une véritable révolution architecturale, modifiant en profondeur la manipulation des structures de données hiérarchiques. Au cœur de cette transition paradigmatique se trouve la fonction TRIERPAR (ou SORTBY en anglais), conçue spécifiquement pour trier l’ensemble d’un tableau de données sur la base d’une séquence hiérarchique de critères indépendants, sans jamais requérir de formules cellulaires itératives ni altérer les données sources.
La syntaxe canonique de la fonction TRIERPAR traduit nativement la logique multicritère :
TRIERPAR(tableau; par_tableau1; ordre_tri1; [par_tableau2; ordre_tri2]; …)
Dans cette architecture, l’argument tableau désigne la matrice globale d’enregistrements que l’analyste souhaite ordonner (incluant potentiellement les étiquettes de noms et l’ensemble des colonnes de données). Les couples subséquents par_tableau / ordre_tri permettent d’énoncer la séquence exacte des règles d’arbitrage. Chaque critère d’évaluation se voit attribuer de manière explicite son vecteur de référence et son orientation ordinale propre, matérialisée par l’entier 1 pour un tri croissant ou par l’entier -1 pour un tri décroissant.
Considérons l’application de cette fonction sur notre jeu de données précédent hébergé dans la plage A2:C9 (contenant les athlètes, leurs points et leurs passes décisives). La saisie, dans une cellule vierge de destination, de la formule unifiée suivante :
=TRIERPAR(A2:C9; B2:B9; -1; C2:C9; -1)
déclenche l’ordonnancement instantané de l’ensemble de la structure matricielle. Le moteur trie d’abord l’ensemble des lignes selon les points (colonne B) du plus grand au plus petit (-1) ; puis, pour toute occurrence d’égalité parfaite constatée sur cette première composante, il mobilise automatiquement les données de passes décisives (colonne C), triées elles aussi par ordre décroissant (-1). Le résultat se déverse de manière dynamique et autonome sur la grille de calcul sous la forme d’un tableau complet parfaitement trié, sans qu’aucune formule n’ait besoin d’être étirée manuellement vers le bas.
8.2 Reconstitution matricielle d’une colonne de rang dynamique
Si la fonction TRIERPAR excelle à réordonner spatialement un jeu de données complet, de nombreux tableaux de bord analytiques imposent de conserver la disposition physique originale des enregistrements tout en adjoignant, au sein d’une colonne dédiée, le numéro de rang dynamique multicritère assigné à chaque observation. L’écosystème matriciel moderne d’Excel permet de reconstituer cette colonne d’indices de manière totalement autonome en associant harmonieusement les fonctions SEQUENCE, LIGNES, TRIERPAR et EQUIVX.
La stratégie mathématique consiste à générer virtuellement un classement ordonné des identifiants ou des lignes du tableau d’origine, puis à utiliser une fonction de recherche indicielle pour rapatrier la position séquentielle correspondant à chaque enregistrement. Supposons que les identifiants uniques des entités se trouvent dans la plage A2:A9, leurs scores principaux dans B2:B9 et leurs scores de départage dans C2:C9. La formule matricielle dynamique globale s’articule comme suit :
=EQUIVX(A2:A9; TRIERPAR(A2:A9; B2:B9; -1; C2:C9; -1); 0)
Disséminons l’élégance algorithmique de cette instruction :
- L’expression interne TRIERPAR(A2:A9; B2:B9; -1; C2:C9; -1) extrait le vecteur des identifiants de la colonne A et le réordonne intégralement dans la mémoire vive selon la logique multicritère définie (décroissante sur B, puis décroissante sur C). Cette sous-matrice virtuelle ordonne ainsi les identifiants du premier au dernier absolu.
- La fonction EQUIVX (version enrichie et hautement optimisée de la classique EQUIV) prend ensuite pour argument de recherche le vecteur d’origine non trié A2:A9. Pour chaque identifiant de la liste brute, elle recherche sa position ordinale exacte au sein du vecteur virtuel trié issu de TRIERPAR.
- L’argument 0 stipule une exigence de correspondance exacte. Dès lors, si un individu figure en première position de la liste ordonnée en mémoire, EQUIVX renvoie le scalaire 1 ; s’il apparaît en quatrième position de ce tri virtuel, la fonction renvoie le scalaire 4.
Saisie dans une unique cellule en haut de la colonne de rang, cette formule matricielle dynamique « se déverse » (phénomène de spill) instantanément sur l’ensemble de la hauteur de la plage grâce au mécanisme d’expansion automatique des formules dynamiques. Elle dote chaque enregistrement de son rang multicritère exact tout en préservant scrupuleusement l’intégrité de l’ordre d’affichage originel du classeur.
8.3 Comparaison analytique : Formules classiques versus Moteur matriciel dynamique
L’arbitrage entre l’architecture combinatoire classique (RANG.EQ + NB.SI.ENS) et l’architecture matricielle moderne (EQUIVX + TRIERPAR) représente une décision structurante pour l’ingénierie des classeurs Excel. Chacune de ces méthodologies présente des forces spécifiques et des contraintes d’environnement qu’il convient d’évaluer rigoureusement.
L’avantage prééminent du moteur matriciel dynamique réside dans sa robustesse structurelle face aux opérations d’édition de la grille. Dans l’approche classique, l’adjonction ou la suppression impromptue de lignes impose de vérifier que les formules cellulaires ont été correctement propagées ou contractées, sous peine de laisser des cellules orphelines ou désynchronisées. Avec la formule matricielle dynamique, la définition de la plage de calcul est centralisée dans une cellule unique maîtresse (la cellule d’origine du déversement). Toute modification volumétrique de la source est répercutée de façon instantanée et homogène sans aucune intervention humaine. De surcroît, la lisibilité conceptuelle de la formule matricielle est incomparablement supérieure : elle exprime directement l’intention métier (« trouver la position de chaque individu dans la liste triée par critère 1 puis critère 2 ») plutôt que de construire un artifice d’incrémentation arithmétique complexe.
Néanmoins, la formule combinée classique conserve des bastions d’application inexpugnables. Le premier est l’exigence d’interopérabilité descendante : au sein des grandes entreprises ou des administrations, de nombreux postes de travail exploitent encore des versions d’Excel perpétuelles historiques (Excel 2016, 2019 ou versions antérieures de suites bureautiques tierces). Sur ces environnements, les fonctions TRIERPAR et EQUIVX sont totalement inconnues et génèrent une erreur bloquante #NOM?. Le second atout de l’approche classique réside dans sa résilience absolue au sein des Tableaux Structurés. En effet, par conception technique, Microsoft interdit le déversement automatique de formules matricielles dynamiques à l’intérieur des colonnes d’un Tableau Structuré officiel, afin d’éviter les collisions avec le mécanisme natif d’auto-expansion de ces derniers. Dans le cadre rigide et sécurisé d’un tableau structuré d’entreprise, la formule RANG.EQ + NB.SI.ENS demeure à ce jour la solution universelle de référence.
9. Gestion des cas critiques : doublons parfaits, données manquantes et valeurs textuelles
9.1 Résolution des égalités absolues sur l’ensemble des critères
Aussi sophistiqué et étendu que soit le système de critères successifs déployé par l’analyste, il subsiste une limite stochastique incontournable : l’occurrence de doublons parfaits. Deux entités distinctes peuvent présenter des valeurs strictement identiques sur l’axe principal, sur l’axe secondaire et sur l’ensemble des axes subsidiaires intégrés au modèle. Face à ce cas de figure, l’ordre lexicographique pur s’avère structurellement impuissant à opérer une discrimination rationnelle, puisque les vecteurs d’information sous-jacents sont rigoureusement indiscernables d’un point de vue quantitatif.
Si le modèle impose l’assignation d’un rang strictement unique pour chaque ligne (par exemple dans le cadre d’un algorithme d’affectation séquentielle où aucun ex aequo final n’est toléré), il devient nécessaire d’introduire une règle de départage arbitraire mais parfaitement déterministe. La convention universelle consiste alors à utiliser l’ordre physique d’apparition dans le tableau comme critère ultime de désambiguïsation, en favorisant l’enregistrement situé le plus haut dans la feuille de calcul.
Pour implémenter cette règle au sein de la formule classique unifiée sans perturber les arbitrages multicritères préalables, l’analyste intègre un ultime terme correcteur fondé sur la fonction NB.SI ou NB.SI.ENS couplée à une plage d’adressage semi-expansible. Considérons la structure suivante :
+ NB.SI.ENS($B$2:$B2;$B2; $C$2:$C2;$C2) – 1
Remarquons la dissymétrie délibérée des dollars d’ancrage : la plage débute à la borne absolue $B$2 mais s’achève à la borne relative $B2 correspondant à la ligne courante. Ce segment de formule quantifie combien de fois la combinaison exacte de scores $(B_i, C_i)$ est déjà apparue dans le tableau, depuis le sommet de la liste jusqu’à la ligne active. Lors de la première occurrence du doublon parfait, la fonction renvoie 1 ; en soustrayant 1, l’incrément est nul, préservant la position dominante de la première entité rencontrée. Lorsque le second enregistrement rigoureusement identique est évalué quelques lignes plus bas, la plage expansée englobe désormais la première occurrence ; le décompte renvoie 2, et la soustraction de 1 génère un incrément mécanique de +1 sur le rang. Cette technique garantit mathématiquement l’unicité stricte de chaque valeur ordinale finale sans aucune exception possible.
9.2 Traitement rigoureux des cellules vides et des anomalies de type texte
L’intégrité computationnelle des modèles de classement dans Excel est fréquemment compromise par la présence de données imparfaites, corrompues ou incomplètes au sein des plages d’analyse. Des cellules laissées vierges, des valeurs nulles non renseignées ou des chaînes de caractères textuelles (telles que des mentions « Absent », « En cours », « N/A » ou de simples espaces insérés accidentellement) provoquent des comportements hautement erratiques des fonctions statistiques sous-jacentes.
La fonction RANG.EQ possède la particularité d’ignorer purement et simplement les cellules contenant du texte brut, mais elle renvoie instantanément un code d’erreur bloquant #N/A si la cellule cible évaluée (le premier argument) est elle-même textuelle ou vide. De son côté, la fonction NB.SI.ENS interprète une cellule vide comme équivalente à la valeur numérique zéro dans certaines comparaisons scalaires, mais la traite comme une absence de correspondance dans d’autres configurations, ce qui fausse insidieusement les décomptes conjonctifs sans déclencher d’alerte explicite.
Pour prémunir le modèle contre ces défaillances structurelles, il est impératif d’encapsuler la formule de classement au sein d’une structure conditionnelle préventive qui contrôle l’intégrité numérique des cellules de la ligne active avant d’autoriser l’exécution du moteur de calcul. L’utilisation conjointe des fonctions SI et ESTNUM permet d’ériger un bouclier logique infaillible :
=SI(ET(ESTNUM($B2); ESTNUM($C2)); RANG.EQ($B2;$B$2:$B$100) + NB.SI.ENS($B$2:$B$100;$B2; $C$2:$C$100; « > » & $C2); « »)
Dans cette architecture sécurisée, le moteur de calcul vérifie préalablement que la variable principale située en B2 et la variable secondaire située en C2 sont toutes deux des entités numériques valides. Si l’une des cellules est vide ou contient une mention textuelle, la fonction SI court-circuite immédiatement l’évaluation et renvoie une chaîne vide « » (ou toute étiquette prédéfinie telle que « Données incomplètes »), sanctuarisant la feuille de calcul contre la propagation d’erreurs visuelles destructrices.
9.3 Sécurisation contre les erreurs de division et d’inexistence
Au-delà des contrôles de typage cellulaire, un modèle de production doit intégrer des protocoles de tolérance aux pannes pour parer aux corruptions systémiques générées par l’introduction intempestive de codes d’erreur au sein des données sources (tels que #DIV/0! consécutif à un calcul de ratio impossible, ou #REF! résultant de la suppression accidentelle d’une colonne de dépendance). L’apparition d’un seul code d’erreur au sein de la plage de référence suffit à « empoisonner » l’intégralité du calcul vectoriel de RANG.EQ et de NB.SI.ENS, rendant l’ensemble du classement inopérant.
La fonction SIERREUR constitue le premier niveau de défense pour fiabiliser l’affichage final d’un classeur destiné à des utilisateurs finaux. En enveloppant la formule maîtresse au sein de cette instruction :
=SIERREUR(Formule_De_Classement; « Erreur d’audit »)
l’analyste empêche le plantage général de la grille de calcul et attire l’attention sur les anomalies locales à corriger. Néanmoins, l’usage de SIERREUR ne doit jamais dispenser de l’assainissement systématique des données en amont de la modélisation.
Dans les environnements analytiques d’entreprise rigoureux, l’assainissement préalable des données sources est délégué au moteur Microsoft Power Query (intégré nativement dans l’onglet Données > Obtenir des données d’Excel). Power Query permet de construire des flux d’ingestion automatisés qui typent explicitement les colonnes en nombres décimaux stricts, filtrent ou remplacent les valeurs nulles par des seuils conventionnels documentés, et éliminent les enregistrements orphelins avant même que le tableau de calcul n’ait à traiter les formules de classement. Cette séparation stricte entre la couche d’assainissement des données (ETL) et la couche d’évaluation ordinale garantit la pérennité absolue des modèles face aux variations imprévues des flux de données opérationnels.
10. Optimisation des performances et intégrité structurelle des modèles
10.1 Impact computationnel de NB.SI.ENS sur les jeux de données massifs
L’un des défis majeurs posés par l’ingénierie quantitative sous Excel réside dans la maîtrise de l’empreinte computationnelle des formules déployées sur de larges volumétries d’informations. Si la combinaison RANG.EQ + NB.SI.ENS brille par son élégance sur des tableaux comptant de quelques dizaines à quelques milliers d’enregistrements, son déploiement aveugle sur des bases de données massives (excédant 50 000 ou 100 000 lignes) peut induire une dégradation catastrophique des performances de calcul du logiciel.
Cette dégradation s’explique par l’analyse de la complexité algorithmique intrinsèque de la méthode. Pour chaque ligne individuelle du tableau, la fonction NB.SI.ENS parcourt l’intégralité des plages vectorielles de comparaison pour vérifier la conjonction des critères logiques. Si la matrice comporte $N$ enregistrements, l’évaluation complète de la colonne de rang requiert un nombre d’opérations élémentaires de comparaison proportionnel à $N \times N$, soit une complexité algorithmique temporelle quadratique notée $\mathcal{O}(N^2)$ en théorie de la complexité informatique. Sur un jeu de données de 10 000 lignes, le moteur de calcul doit ainsi procéder à près de 100 millions d’évaluations conditionnelles ; sur une table de 100 000 lignes, ce volume explose à 10 milliards d’opérations élémentaires.
Lorsque cette charge de calcul est atteinte, le moteur multithread d’Excel sature l’utilisation des processeurs, provoquant des blocages temporaires du classeur à chaque modification d’une cellule quelconque de la feuille. Pour pallier cette contrainte sans abandonner l’environnement Excel, l’analyste avisé dispose de plusieurs leviers d’optimisation :
- Basculer temporairement le mode de calcul d’Excel en mode Calcul manuel (accessible via l’onglet Formules > Options de calcul > Manuel). Les formules ne sont alors recalculées qu’à la demande explicite de l’utilisateur par l’activation de la touche F9, ce qui libère l’édition interactive des données.
- Sur les très grands volumes, renoncer à l’évaluation en direct par NB.SI.ENS au profit de la méthode arithmétique par score composite infinitésimal décrite à la section 7, dont la complexité linéaire $\mathcal{O}(N)$ ne requiert que deux passages d’évaluation et préserve la fluidité opérationnelle du tableur.
10.2 Utilisation des références de tableaux structurés
L’utilisation des Tableaux Structurés d’Excel (communément désignés sous le terme de Listes ou Tables Excel) représente le standard d’ingénierie moderne pour garantir la maintenabilité et la résilience structurelle des architectures de données complexes. En convertissant une simple plage cellulaire en un objet tableau formel, l’analyste émancipe son modèle de la rigidité des coordonnées alphanumériques au profit d’un adressage sémantique explicite.
La transcription d’un modèle multicritère en références structurées enrichit considérablement la lisibilité du code analytique pour les auditeurs et collaborateurs. Considérons la formule tripartite implémentée au sein d’une table nommée Tbl_Performance comportant les colonnes Score, Anciennete et Evaluation :
=RANG.EQ([@Score]; [Score]) + NB.SI.ENS([Score]; [@Score]; [Anciennete]; « > » & [@Anciennete]) + NB.SI.ENS([Score]; [@Score]; [Anciennete]; [@Anciennete]; [Evaluation]; « > » & [@Evaluation])
Cette formulation présente des vertus techniques déterminantes :
- L’arobase [@NomDeColonne] explicite la notion de contexte de ligne courante, éliminant définitivement les erreurs de décalage vertical consécutives à un étirement maladroit de la formule.
- L’évocation du nom de la colonne sans arobase [NomDeColonne] référence automatiquement l’intégralité de la colonne utile, sans avoir à connaître à l’avance ni à figer les numéros de ligne extrêmes (comme $B$2:$B$5000).
- Lors de l’adjonction de nouveaux enregistrements à la suite du tableau (que ce soit par saisie manuelle, collage de données ou rafraîchissement d’une requête Power Query), le tableau structuré étend automatiquement ses limites physiques et propage instantanément la formule sur les nouvelles lignes créées, tout en réajustant immédiatement le périmètre des plages d’évaluation globales sans nécessiter la moindre retouche manuelle.
10.3 Bonnes pratiques de documentation et d’auditabilité
Un modèle de classement multicritère ne saurait être qualifié de robuste s’il ne s’accompagne pas d’un dispositif rigoureux de documentation et de transparence méthodologique. Dans le cadre de la gouvernance des modèles de données et de la conformité aux normes d’audit interne (telles que les exigences relatives aux risques de modèles financiers), la responsabilité de l’analyste est engagée quant à la clarté et à la reproductibilité de ses calculs.
Pour assurer cette auditabilité, il est recommandé de sanctuariser plusieurs règles directrices d’architecture sur la feuille de calcul :
- Standardisation explicite des en-têtes de colonnes : Les intitulés des variables doivent mentionner sans équivoque leur statut hiérarchique dans le protocole de décision, par exemple : Critère 1_ChiffreAffaires [Max], Critère 2_TauxReclamation [Min], Critère 3_ScoreRSE [Max]. L’explicitation du sens d’optimisation (maximisation ou minimisation) directement dans l’en-tête prévient les erreurs de signe lors des maintenances ultérieures.
- Création d’un cartouche de paramétrage dédié : Plutôt que de coder en dur les coefficients d’ajustement ou les opérateurs relationnels au sein des formules, il est judicieux d’isoler dans une zone distincte de la feuille (ou sur un onglet de configuration spécifique) les paramètres exogènes du modèle, tels que les pondérations relatives, les seuils d’atténuation infinitésimale ou les identifiants de versions de règles métiers.
- Intégration d’un dictionnaire de données associé : Pour les modèles déployés au sein d’équipes pluridisciplinaires, un onglet dédié doit consigner la définition opérationnelle de chaque métrique, son unité de mesure, sa source d’extraction d’origine et la justification managériale de sa position dans l’ordre de priorité lexicographique établi. Cette traçabilité documentaire constitue la garantie fondamentale d’une transmission sans heurts de la propriété intellectuelle du modèle au sein de l’organisation.
11. Applications pratiques sectorielles et études de cas réels
11.1 Analyse de la performance sportive et athlétique
L’analyse statistique de la performance sportive contemporaine (sport analytics) constitue un terrain d’élection emblématique pour l’application des modèles de hiérarchisation multicritère sous Excel. Dans les ligues compétitives professionnelles (telles que le football, le basketball ou le rugby), l’évaluation des athlètes ou la constitution des classements de championnats ne peut souffrir aucune approximation et repose sur des règles de départage strictes codifiées par les instances réglementaires.
Considérons l’automatisation intégrale du tableau de classement d’une ligue de football professionnel sous Excel. Les équipes sont d’abord hiérarchisées sur la base du total de points accumulés au cours de la saison (3 points par victoire, 1 point par match nul, 0 point par défaite). En cas d’égalité arithmétique de points entre deux ou plusieurs formations, le règlement sportif impose une série séquentielle de règles d’arbitrage : la plus forte différence de buts générale (buts marqués moins buts encaissés), puis le plus grand nombre de buts marqués, puis, en cas de nouvelle parité, la différence de buts particulière établie lors des confrontations directes entre les clubs concernés.
L’implémentation de ce cahier des charges s’opère magistralement par l’extension de notre formule à trois composantes au sein d’un tableau structuré regroupant l’ensemble des clubs de la ligue. La formule compare d’abord la colonne [Points] via RANG.EQ, puis adjoint une instruction NB.SI.ENS vérifiant l’égalité de points et la supériorité sur la colonne [Diff_Buts], complétée par un second terme NB.SI.ENS examinant l’égalité simultanée sur les points et la différence de buts pour discriminer les concurrents restants sur la base de la colonne [Buts_Marques]. Ce dispositif garantit une mise à jour instantanée et dynamique de l’ordonnancement officiel de la compétition à l’issue de chaque journée de championnat, dès la saisie des scores des rencontres sportives, éliminant tout risque d’erreur humaine d’interprétation des règles de ligue.
11.2 Évaluation psychométrique et métriques de ressources humaines
Le management des ressources humaines s’appuie de manière croissante sur des processus d’évaluation quantitative standardisés pour orchestrer des campagnes de recrutement volumineuses, des plans de promotion interne ou des revues annuelles de talents (talent reviews). Dans ces contextes à forts enjeux humains et juridiques, la transparence des critères de sélection et l’équité de traitement des candidats constituent des impératifs éthiques et organisationnels absolus.
Considérons une procédure de concours hautement sélective au sein d’une organisation internationale visant à pourvoir des postes de direction stratégique. Les candidats sont évalués sur la base de trois indicateurs quantifiés : un score d’expertise technique issu d’une épreuve écrite standardisée (noté sur 100), une note d’évaluation comportementale et de leadership attribuée lors d’un centre d’évaluation (assessment center, notée sur 50) et une métrique d’ancienneté organisationnelle utile exprimée en années d’expérience pertinente. La gouvernance du concours stipule formellement que l’expertise technique constitue le prérequis éliminatoire prioritaire ; qu’en cas d’égalité sur l’épreuve technique, le leadership comportemental doit impérativement prévaloir ; et que l’ancienneté n’intervient qu’en ultime recours pour départager des candidats ayant obtenu des résultats identiques sur les deux premières dimensions.
En déployant l’algorithme multicritère standardisé au sein du classeur d’évaluation du jury, la direction des ressources humaines s’assure d’une conformité totale des résultats finaux avec les règles de sélection publiées. L’application de la formule sécurisée évite l’arbitraire d’un choix subjectif du jury en situation d’ex aequo et immunise l’organisation contre d’éventuels recours contentieux de candidats évincés. Par ailleurs, la standardisation préalable des échelles de notation permet de produire des visualisations graphiques claires illustrant la distribution spatiale des profils retenus et confirmant que chaque candidat sélectionné l’a été en stricte conformité avec la hiérarchie logique préalablement arrêtée.
11.3 Gestion de la relation client et scoring d’affaires commerciales
Dans l’univers du commerce B2B (business-to-business) et de la gestion de la relation client (CRM), l’efficacité de la force de vente dépend directement de sa capacité à prioriser quotidiennement ses actions de prospection et de négociation sur les opportunités d’affaires présentant le plus fort potentiel de conversion financière immédiate. Face à un portefeuille commercial comptant plusieurs centaines de pistes ouvertes, les directeurs commerciaux doivent disposer d’un système de hiérarchisation dynamique automatisé.
Un modèle classique de priorisation commerciale multicritère mobilise trois variables stratégiques distinctes associées à chaque opportunité d’affaires : la valeur financière brute prévisionnelle du contrat (exprimée en montants monétaires à maximiser), la probabilité de clôture estimée selon l’état d’avancement de la négociation (pourcentage à maximiser) et l’ancienneté chronologique de l’opportunité dans le pipeline commercial (nombre de jours écoulés depuis le premier contact, métrique à minimiser pour sanctionner la perte de dynamisme des cycles d’affaires trop longs).
Dans cette configuration, l’analyste commercial élabore une formule articulant maximisation et minimisation combinées. La variable prioritaire est constituée par la valeur financière nette pondérée (produit de la valeur brute par la probabilité). En cas d’égalité stricte entre plusieurs affaires sur cette métrique prévisionnelle, le premier niveau d’arbitrage privilégie l’opportunité présentant le taux de conversion brut le plus élevé (sélection par NB.SI.ENS avec opérateur « > »). Si l’égalité persiste, l’algorithme fait intervenir le critère de vélocité temporelle en pénalisant les affaires les plus anciennes au moyen d’un terme conditionnel fondé sur l’infériorité stricte « <« appliquée à la colonne d’ancienneté en jours. La force de vente dispose ainsi d’un classement ordinal actualisé chaque matin, orientant instantanément son énergie commerciale vers les dossiers générant le retour sur investissement le plus rapide et le plus certain.
12. Protocole de diagnostic, audit et débogage des anomalies de classement
12.1 Méthodologie de vérification de l’exhaustivité de la séquence ordinale
L’une des vertus cardinales de l’ingénierie logicielle appliquée au tableur réside dans l’intégration de mécanismes de contrôle de cohérence automatisés permettant de vérifier instantanément la validité mathématique d’un modèle sans nécessiter de relecture manuelle fastidieuse. Dans le cadre d’un système de classement qui se veut strict et bijectif, la distribution ordinale finale des rangs doit satisfaire à une propriété mathématique universelle : elle doit constituer une permutation exacte de la suite des entiers naturels consécutifs compris entre 1 et $N$, où $N$ désigne la cardinalité totale des entités classées.
Pour auditer l’intégrité de cette séquence ordinale, l’analyste met en place deux indicateurs de cohérence complémentaires dans une zone de contrôle dédiée du classeur :
- Le test de la somme de Gauss : Selon le théorème fondamental formalisé par le mathématicien Carl Friedrich Gauss, la somme arithmétique des $N$ premiers entiers naturels est rigoureusement égale à l’expression $S(N) = N(N + 1) / 2$. L’analyste insère ainsi une formule de contrôle comparant la somme effective de sa colonne de rangs calculés avec cette espérance théorique :
=SI(SOMME($D$2:$D$101) = (LIGNES($D$2:$D$101)*(LIGNES($D$2:$D$101)+1)/2); « Séquence Valide »; « Anomalie Détectée »)
Toute divergence numérique entre ces deux grandeurs signale infailliblement la présence d’une anomalie structurelle (telle qu’un saut d’indice ordonné ou la persistance d’un doublon non résolu). - Le contrôle de complétude par les bornes extrêmes : L’analyste s’assure conjointement que la valeur minimale de la série ordinale est rigoureusement égale à 1 (=MIN($D$2:$D$101)=1) et que la valeur maximale est rigoureusement égale à l’effectif total observé (=MAX($D$2:$D$101)=LIGNES($D$2:$D$101)).
En complément de ces vérifications algébriques, l’application d’une règle de Mise en forme conditionnelle native (via le menu Accueil > Mise en forme conditionnelle > Règles de mise en surbrillance des cellules > Valeurs en double) sur la colonne des rangs permet d’illuminer instantanément en rouge toute cellule partageant indûment son rang avec une autre, offrant un retour visuel immédiat en cas d’échec du protocole de départage.
12.2 Outils natifs d’audit de formules dans Excel
Lorsqu’une incohérence est signalée par les indicateurs de contrôle, l’analyste doit mobiliser l’arsenal des outils d’audit analytique intégrés au ruban d’Excel pour déconstruire pas à pas l’évaluation de sa formule et localiser la faille logique avec une précision chirurgicale. Les trois fonctionnalités majeures de l’onglet Formules dédiées à cette mission sont :
- L’outil « Repérer les antécédents » : En activant cette commande sur la cellule contenant la formule de rang défaillante, Excel trace un réseau de flèches graphiques bleues matérialisant l’ensemble des cellules et plages de données qui alimentent directement le calcul. Cette visualisation permet de déceler instantanément une erreur d’adressage spatial, telle qu’une plage de critères décalée d’une ligne, une colonne de dépendance pointée par erreur ou une absence de verrouillage par dollars ayant fait dériver la fenêtre d’évaluation vers le bas.
- La commande « Évaluer la formule » : Cet outil représente le débogueur d’exécution pas à pas du tableur. Il ouvre une boîte de dialogue interactive permettant d’observer la résolution séquentielle de chaque segment de la formule composite, en soulignant le prochain opérateur ou la prochaine fonction en cours d’évaluation. L’analyste peut ainsi visualiser la valeur scalaire retournée par RANG.EQ, puis observer la construction textuelle exacte du critère « > » & $C2, et vérifier enfin si le dénombrement renvoyé par NB.SI.ENS produit le scalaire attendu. Cet outil s’avère particulièrement irremplaçable pour détecter pourquoi une égalité n’a pas été identifiée comme telle (par exemple en raison d’une micro-différence décimale invisible à l’affichage standard).
- La fenêtre Espion : Pour les modèles complexes répartis sur plusieurs feuilles de calcul, l’ajout de cellules critiques à la Fenêtre Espion permet de surveiller en temps réel l’évolution des valeurs et des formules de classement lors de la modification de paramètres situés sur d’autres onglets du classeur, facilitant le diagnostic des répercussions systémiques.
12.3 Arbre de décision pour le choix de la méthode idéale
Pour conclure cette étude exhaustive et guider rationnellement l’analyste ou le consultant dans la conception de son architecture de classement, il apparaît opportun de synthétiser les recommandations sous la forme d’un arbre de décision méthodologique fondé sur les caractéristiques concrètes du projet analytique :
Dimension 1 : Environnement technique et compatibilité logicielle
Le classeur est-il exclusivement exploité au sein d’un environnement moderne Microsoft 365 ou Excel pour le Web ?
- Si OUI, et que le tri ne se fait pas dans un Tableau Structuré : Privilégier sans réserve l’approche matricielle dynamique moderne TRIERPAR pour un affichage réordonné, ou la combinaison déversée EQUIVX + TRIERPAR pour alimenter une colonne de rang dynamique autonome sans recopie de formule.
- Si NON (présence de versions Excel 2019, 2016 ou antérieures, ou déploiement impératif au sein d’un Tableau Structuré officiel) : S’orienter vers les formules déterministes classiques.
Dimension 2 : Volumétrie et complexité computationnelle
Quelle est la taille de la population statistique à hiérarchiser ?
- Inférieure à 10 000 lignes : Déployer la formule combinée standard RANG.EQ + NB.SI.ENS. Sa lisibilité analytique, son intégrité numérique absolue et son absence d’effets de bord liés à la précision en virgule flottante en font la méthode la plus robuste et auditable du marché.
- Supérieure à 50 000 lignes : Rejeter la méthode NB.SI.ENS en raison de sa complexité quadratique $\mathcal{O}(N^2)$. Déployer l’approche par somme pondérée et score composite infinitésimal via une colonne auxiliaire normalisée, traitée par un RANG.EQ unique d’une rapidité d’exécution optimale.
Dimension 3 : Exhaustivité ordinale et présence de doublons parfaits
Le processus d’affaires tolère-t-il des rangs partagés en cas d’identité totale sur l’ensemble des critères ?
- Si des ex aequo sont acceptables : S’en tenir à la formule multicritère pure.
- Si un classement strictement bijectif (sans aucun doublon d’indice de 1 à N) est exigé : Compléter la formule d’un terme correcteur de position physique via la fonction LIGNE ou une plage expansible NB.SI.ENS d’apparition séquentielle.
En observant scrupuleusement ces règles de sélection architecturale et en appliquant la rigueur syntaxique documentée tout au long de cet ouvrage, les professionnels de la donnée transforment le tableur Excel en un système d’aide à la décision hautement sophistiqué, alliant la précision mathématique la plus intransigeante à une ergonomie opérationnelle irréprochable.
Références
- Benninga, S. (2014). Financial Modeling (4e éd.). MIT Press.
- Billingsley, P. (2012). Probability and Measure (Anniversary éd.). John Wiley & Sons.
- Carlberg, C. (2014). Statistical Analysis: Microsoft Excel 2013. Que Publishing.
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). Institute of Electrical and Electronics Engineers. https://standards.ieee.org/ieee/754/6005/
- Microsoft Corporation. (2024). Documentation officielle des fonctions Excel : RANG.EQ, NB.SI.ENS et TRIERPAR. Microsoft Learn. https://learn.microsoft.com/fr-fr/office/troubleshoot/excel/excel-troubleshooting
- Roy, B. (1996). Multicriteria Methodology for Decision Aiding. Kluwer Academic Publishers.
- Triantaphyllou, E. (2000). Multi-Criteria Decision Making Methods: A Comparative Study. Springer Science+Business Media.
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.
- Winston, W. L. (2021). Microsoft Excel Data Analysis and Business Modeling (6e éd.). Microsoft Press.