
La transmission visuelle de résultats empiriques complexes repose sur un équilibre rigoureux entre précision sémiotique, lisibilité spatiale et économie cognitive. Dans l’écosystème de programmation statistique R, l’extension ggplot2, conçue par Hadley Wickham sur les fondements théoriques établis par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics, s’est imposée comme la norme de référence pour la production de figures scientifiques. Néanmoins, si la modularité de cette grammaire permet d’associer intuitivement des dimensions de données à des variables esthétiques telles que la couleur, la forme ou la taille, la disposition par défaut des éléments d’accompagnement textuel — et singulièrement celle de la légende — constitue fréquemment un écueil majeur pour la publication académique. Une légende mal positionnée altère le balayage visuel, fragmente l’attention du lecteur et gaspille une surface graphique précieuse au détriment de la résolution des observations.
Le contrôle chirurgical de l’emplacement de la légende ne relève pas d’une simple coquetterie esthétique, mais procède d’une véritable démarche méthodologique visant à maximiser le ratio données-encre théorisé par Edward Tufte. Les configurations standardisées de ggplot2 relèguent systématiquement les clés d’identification sur le flanc droit du tracé. Cette disposition latérale externe entraîne une asymétrie spatiale et impose un coût cognitif élevé lors de l’examen de visualisations denses, le regard de l’observateur devant osciller en permanence entre les grappes de données et la bordure extrême du graphique. Dès lors que l’on manipule des tracés à panneaux multiples, des séries temporelles longitudinales ou des surfaces de corrélation complexes, la capacité à relocaliser la légende — que ce soit sur les marges périphériques ou directement immergée à l’intérieur du repère cartésien — devient une compétence indispensable pour tout statisticien, bio-informaticien ou chercheur en sciences sociales.
Ce guide exhaustif a pour ambition d’explorer de manière approfondie l’ensemble des mécanismes, des fonctions et des paramètres régissant la géométrie, l’orientation, la justification et la personnalisation des légendes au sein de ggplot2. À travers une progression méthodique articulée autour d’exemples reproductibles et d’analyses théoriques pointues, nous détaillerons les syntaxes canoniques permises par le système thématique, les interactions subtiles entre les fonctions theme() et guides(), ainsi que les stratégies d’optimisation indispensables à la conformité avec les normes éditoriales internationales les plus strictes, à l’instar des recommandations de l’American Psychological Association (APA).
1. Fondements et rôle cognitif de la disposition des légendes sous ggplot2
1.1 Charge cognitive et ergonomie visuelle des graphiques statistiques
L’efficacité d’une représentation graphique scientifique se mesure à l’aune de la vitesse et de la fidélité avec lesquelles l’appareil cognitif humain décode les relations quantitatives sous-jacentes. Selon la théorie de la charge cognitive initialement formulée par John Sweller, la mémoire de travail dispose de ressources de traitement strictement limitées. Dans le cadre de la lecture d’un graphique, toute opération mentale qui ne participe pas directement à la compréhension du phénomène statistique étudié constitue une charge cognitive extrinsèque. Une légende reléguée à la périphérie d’un tracé génère ce que les psychologues de la perception nomment l’effet d’attention divisée (split-attention effect). L’observateur est contraint de mémoriser temporairement une modalité de couleur ou de forme, de détacher son regard de la zone d’intérêt focal, de repérer l’étiquette correspondante sur la marge droite, puis de réancrer son regard au sein du plan géométrique pour valider son inférence.
Ce trajet saccadique oculaire incessant allonge le temps d’accès sémantique et induit une fatigue visuelle qui altère la détection des structures globales, des discontinuités ou des valeurs aberrantes. Les principes psychophysiques régissant la perception visuelle, en particulier la loi de proximité issue de la théorie de la Gestalt, démontrent sans ambiguïté que des éléments spatiaux proches sont spontanément appréhendés comme appartenant à une même entité logique. En rapprochant la légende des données observées, ou en l’insérant dans un espace résiduel non exploité du système de coordonnées cartésiennes, le concepteur du graphique réduit drastiquement la distance euclidienne parcourue par l’œil, fluidifie la trajectoire du regard et permet une intégration pré-attentive des clés de classification catégorielle.
1.2 L’architecture du système thématique de ggplot2
Pour maîtriser la manipulation des légendes, il est indispensable de comprendre la dichotomie fondamentale sur laquelle repose le moteur de rendu de ggplot2. D’une part, la structure géométrique profonde associe les variables du tableau de données aux canaux perceptifs via l’instruction aes() et matérialise les observations au travers des couches geom_*(). D’autre part, le système thématique, gouverné par la fonction theme(), administre l’ensemble des attributs non liés aux données (non-data ink), englobant la typographie, les quadrillages, les axes et l’encadrement des légendes. Cette séparation stricte garantit une modularité absolue : la modification de l’habillage thématique ne corrompt jamais l’intégrité des transformations mathématiques sous-jacentes.
L’architecture de theme() fonctionne selon un modèle hiérarchique arborescent hérité du moteur sous-jacent de R, la bibliothèque grid. Les arguments thématiques relatifs aux guides sont organisés selon une nomenclature rigoureuse débutant par le préfixe legend.. L’évaluation de ces arguments s’effectue de manière séquentielle le long du pipeline de composition graphique relié par l’opérateur d’addition binaire +. Les propriétés cosmétiques attribuées tardivement écrasent systématiquement les paramètres définis en amont. Ainsi, lorsqu’un utilisateur applique un thème prédéfini global tel que theme_bw() ou theme_classic(), il est impératif d’injecter les instructions de personnalisation fine de la légende postérieurement à cette déclaration globale, sous peine de voir les ajustements écrasés par les valeurs par défaut dudit modèle.
1.3 Préparation des données d’expérimentation et environnement R
Afin de garantir une reproductibilité immédiate de l’ensemble des démonstrations présentées dans cet article, nous mobilisons un environnement de travail épuré et stabilisé reposant sur le cœur de la collection tidyverse. Les données exploitées pour les premières déclinaisons proviennent du jeu de données morphométriques historique collecté par Edgar Anderson et popularisé par Ronald Fisher, le célèbre jeu de données iris, intégré nativement dans la distribution de base de R. Ce jeu de données présente l’avantage pédagogique de posséder trois classes botaniques distinctes caractérisées par des gradients continus de longueurs et de largeurs de sépales et de pétales.
Pour initialiser la session d’analyse, l’environnement doit être configuré via le chargement explicite des bibliothèques nécessaires. Nous définissons un canevas graphique minimaliste qui servira d’étalon comparatif tout au long des sections subséquentes. Ce canevas met en relation la longueur des sépales (axe des abscisses) avec la largeur des sépales (axe des ordonnées), tout en modulant la pigmentation des marqueurs en fonction de l’espèce taxonomique. La syntaxe canonique de base s’établit comme suit :
library(ggplot2)
library(dplyr)
p_base <- ggplot(data = iris, aes(x = Sepal.Length, y = Sepal.Width, color = Species)) +
geom_point(size = 3, alpha = 0.85) +
labs(x = "Longueur des sépales (cm)", y = "Largeur des sépales (cm)", color = "Espèce")
Ce modèle graphique générique produit par défaut un positionnement périphérique standard. À partir de cette référence, nous allons disséquer l’ensemble des altérations syntaxiques envisageables pour restructurer la répartition spatiale de l’information.
2. Syntaxe fondamentale : la fonction theme() et l’argument legend.position
2.1 Anatomie générale de l’argument legend.position
L’argument pivot administrant la localisation spatiale de la boîte de légende est legend.position, accessible exclusivement au sein de la fonction d’enveloppe theme(). La flexibilité remarquable de cet argument réside dans sa capacité polymorphique à recevoir deux natures distinctes de paramètres en entrée : d’une part, des chaînes de caractères prédéfinies assignant des ancrages marginaux cardinaux, et d’autre part, des vecteurs numériques bidimensionnels déterminant des coordonnées proportionnelles à l’intérieur du repère cartésien.
Lorsque le paramètre reçoit une chaîne de caractères, les valeurs conventionnelles reconnues par l’interpréteur graphique sont strictement limitées à un ensemble fermé de constantes littérales : "top" (sommet), "bottom" (base), "left" (flanc gauche), "right" (flanc droit, valeur standard par défaut) et "none" (suppression intégrale du conteneur). À l’inverse, l’injection d’un vecteur numérique sous la forme c(x, y) déclenche un mode de calcul géométrique fondé sur une interpolation bilinéaire rapportée à l’espace de traçage normalisé, dont l’origine et les bornes supérieures font l’objet d’une formalisation mathématique explicite détaillée ultérieurement.
2.2 L’emplacement par défaut sous ggplot2 et ses limites
La décision architecturale initiale d’implanter la légende sur le flanc droit (legend.position = "right") trouve sa justification dans une volonté d’universalité : cet emplacement garantit que la zone rectangulaire de guidage n’entrera jamais en collision géométrique directe avec les formes tracées au sein du système cartésien, indépendamment de la dispersion ou de la variance des points de données. Toutefois, cette sécurité procédurale engendre des déséquilibres visuels manifestes qui nuisent fréquemment à la qualité éditoriale d’un manuscrit scientifique.
En premier lieu, le positionnement latéral droit consomme une part substantielle de la dimension horizontale de la page. Dans les revues académiques structurées selon une mise en page stricte à deux colonnes (à l’instar des périodiques publiés par l’IEEE, Nature Research ou Elsevier), la largeur réservée à une colonne oscille généralement entre 80 et 88 millimètres. L’amputation de 20 à 30 millimètres sur la bordure droite pour afficher des étiquettes textuelles contraint le panneau de données principal dans un rectangle étroit. Les axes numériques subissent alors un écrasement horizontal marqué, provoquant une distorsion de l’aspect visuel des pentes de régression et augmentant le risque de chevauchement typographique des étiquettes des graduations numériques (tick labels).
2.3 Cohérence syntaxique et intégration dans le flux d’analyse
Dans la chaîne d’exécution d’un script d’analyse reproductible, la rigueur structurelle est la clé de voûte de la maintenabilité du code. Il est hautement recommandé d’organiser l’appel aux calques cosmétiques dans un ordre séquentiel invariant : d’abord la déclaration des données et des correspondances esthétiques globales, puis l’adjonction des géométries mathématiques (geom_*), suivie de la configuration des échelles statistiques (scale_*), des étiquettes contextuelles (labs), du thème global préconfiguré, et enfin de la personnalisation chirurgicale des micro-éléments thématiques via theme().
Pour illustrer la gestion des priorités thématiques, considérons le fragment de code ci-dessous. Si l’appel à theme(legend.position = "bottom") était intercalé en amont de theme_minimal(), la routine interne de theme_minimal() réinitialiserait la propriété de positionnement à sa valeur par défaut, anéantissant l’ajustement demandé. L’écriture rigoureuse et pérenne s’établit selon ce schéma séquentiel :
p_ordonne <- p_base +
theme_minimal(base_size = 12) +
theme(legend.position = "bottom")
L’adoption systématique de ce canevas structurel prévient les régressions visuelles silencieuses et assure que chaque surcharge stylistique opère sur un socle typographique et spatial parfaitement stabilisé.
3. Positionnement périphérique externe : configuration sur les quatre marges
3.1 Disposition sommitale (« top ») pour optimiser les rapports verticaux
L’élévation de la boîte de légende vers la marge supérieure du tracé par l’assignation de la chaîne textuelle "top" constitue une stratégie particulièrement adaptée aux graphiques présentant une forte densité horizontale ou destinés à s’insérer dans des maquettes de documents à ratio vertical prédominant. Lorsque cette commande est exécutée, le moteur interne de ggplot2 applique une mutation automatique à la topologie de la légende : la structure passe d’un empilement vertical natif à une distribution horizontale des éléments graphiques.
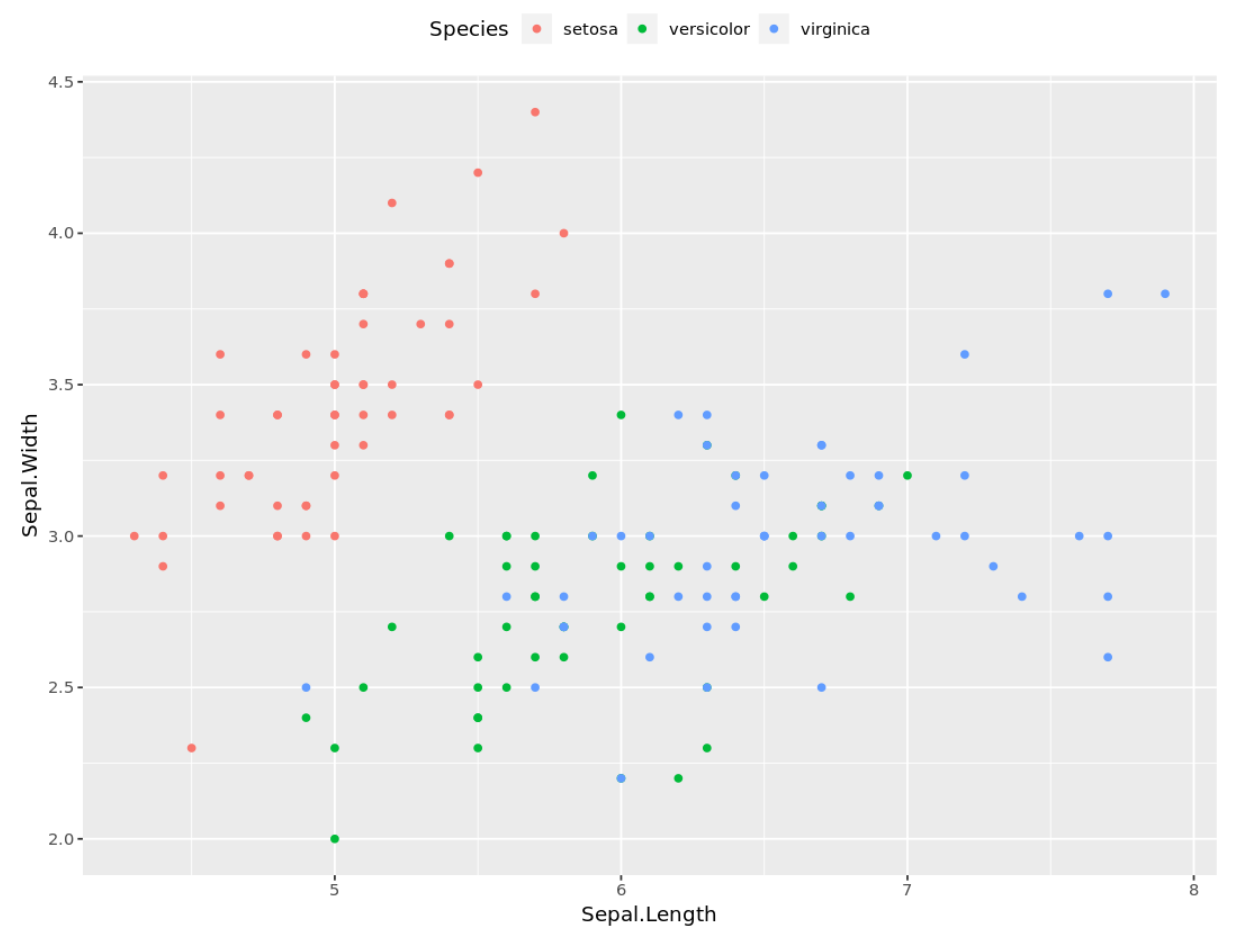
Cette transition morphologique aligne les clés d’identification de manière séquentielle de gauche à droite, sous la forme d’un ruban d’en-tête positionné immédiatement sous le titre général et les sous-titres de la figure, mais au-dessus de la ligne délimitant le panneau supérieur de données. D’un point de vue de l’ergonomie de lecture, cet agencement s’harmonise idéalement avec le mouvement oculaire naturel de balayage occidental de type « Z », tel que mis en lumière dans les recherches sur l’oculométrie menées par Colin Ware. Le lecteur appréhende d’abord l’intitulé de la figure, intègre immédiatement la nomenclature chromatique ou géométrique, puis plonge son regard dans la matrice de données avec une grille d’interprétation déjà consolidée dans sa mémoire immédiate.
Le code d’implémentation correspondant s’articule comme suit :
p_top <- p_base +
theme_bw() +
theme(legend.position = "top")
3.2 Disposition basale (« bottom ») pour les graphiques étendus
À l’opposé de la marge supérieure, le positionnement basal obtenu via la commande legend.position = "bottom" déplace l’ensemble des descripteurs sous l’axe horizontal des abscisses. Cet agencement confère au panneau de dispersion ou aux diagrammes en barres une amplitude latérale maximale, libérant intégralement les limites gauche et droite pour les visualisations nécessitant une grande finesse de lecture horizontale, à l’instar des chronogrammes boursiers ou des séries épidémiologiques étendues sur plusieurs décennies.
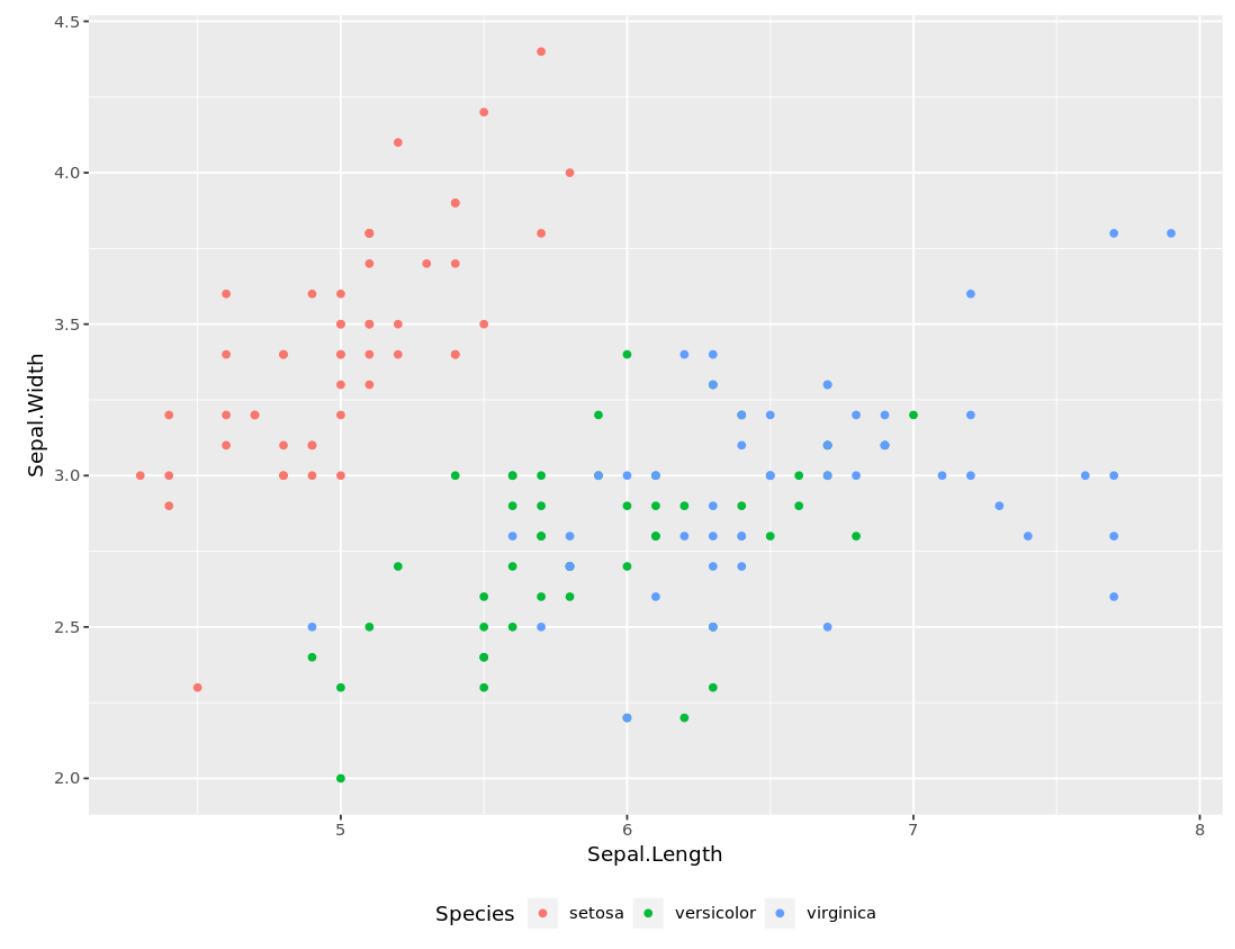
Cependant, l’introduction d’une légende basale impose une vigilance typographique accrue concernant la séparation entre les étiquettes numériques de l’axe des x, le titre général dudit axe et les composants textuels de la légende. Par défaut, la proximité spatiale de ces trois couches de texte peut créer une sensation de surcharge et induire des ambiguïtés sémantiques. Le code suivant met en œuvre cette disposition tout en consolidant l’espace vertical disponible :
p_bottom <- p_base +
theme_light() +
theme(legend.position = "bottom")
Dans ce contexte, la légende agit comme une note de bas de graphique structurante, idéale pour clore le périmètre visuel avant les mentions bibliographiques ou les notes méthodologiques de source.
3.3 Disposition latérale gauche (« left ») versus droite (« right »)
Bien que moins fréquemment exploitée dans les publications périodiques conventionnelles, l’assignation de la légende sur le flanc gauche à l’aide de l’instruction legend.position = "left" présente un intérêt méthodologique notable dans des contextes analytiques spécifiques. Positionnée à gauche, la légende intercepte le regard de l’analyste avant même que celui-ci ne pénètre dans le repère de coordonnées, inversant l’ordre traditionnel d’assimilation perceptuelle.
Le choix entre flanc gauche et flanc droit doit être dicté par la nature des échelles représentées. Lorsque l’axe vertical des ordonnées porte des étiquettes textuelles allongées — comme c’est le cas dans les diagrammes de dispersion horizontaux ou les graphiques de type forest plots recensant des études méta-analytiques —, positionner la légende à gauche peut accentuer l’éloignement physique entre le début des barres et le point zéro du tracé. En revanche, si la marge droite doit accueillir des annotations marginales, des droites de régression prolongées ou des densités de répartition (rug plots), le transfert de la légende vers le flanc gauche rétablit un équilibre esthétique global. La mise en œuvre syntaxique s’opère selon le schéma :
p_left <- p_base +
theme_classic() +
theme(legend.position = "left")
La confrontation rigoureuse de ces quatre ancrages périphériques démontre que le choix des marges n’est jamais neutre : chaque bordure redéfinit la géométrie du rectangle central et dicte une dynamique attentionnelle propre.
4. Positionnement relatif à l’intérieur du repère cartésien
4.1 Le système de coordonnées relatives normalisées c(x, y)
L’une des fonctionnalités les plus puissantes et élégantes de ggplot2 réside dans sa capacité à désancrer totalement la légende des marges extérieures pour l’implanter directement dans l’espace utile du panneau de dessin. Cette opération s’accomplit en attribuant à legend.position un vecteur numérique de longueur deux : c(x, y). Il est fondamental de souligner que ces valeurs scalaires ne correspondent aucunement aux unités physiques des données tracées sur les axes (comme les centimètres ou les milligrammes), mais s’expriment dans un système d’espace unitaire abstrait et normalisé, variant de 0 à 1.
Dans ce repère normé, le couple c(0, 0) désigne rigoureusement le coin inférieur gauche du panneau de données (l’intersection minimale des axes), tandis que le couple c(1, 1) cible l’angle supérieur droit extrême. Par extension, le centre géométrique exact du graphique est représenté par les coordonnées c(0.5, 0.5). L’avantage conceptuel de cette abstraction normalisée est considérable : la position de la légende demeure stable même si l’étendue des données d’entrée subit un filtrage statistique ou si les échelles logarithmiques transforment la dynamique des valeurs brutes. Cette approche permet de valoriser les espaces intra-graphiques sous-utilisés (souvent appelés « zones blanches » ou espaces négatifs), évitant ainsi tout gaspillage spatial sur les marges extérieures.
4.2 Insertion dans les quadrants supérieurs : angles haut-droit et haut-gauche
Dans une vaste majorité de distributions empiriques, en particulier lors de l’étude de corrélations linéaires négatives ou de distributions asymétriques, certains quadrants du repère demeurent dépourvus d’observations. L’angle supérieur droit constitue fréquemment un réceptacle de prédilection pour accueillir une légende compacte sans altérer la lecture du nuage de points.
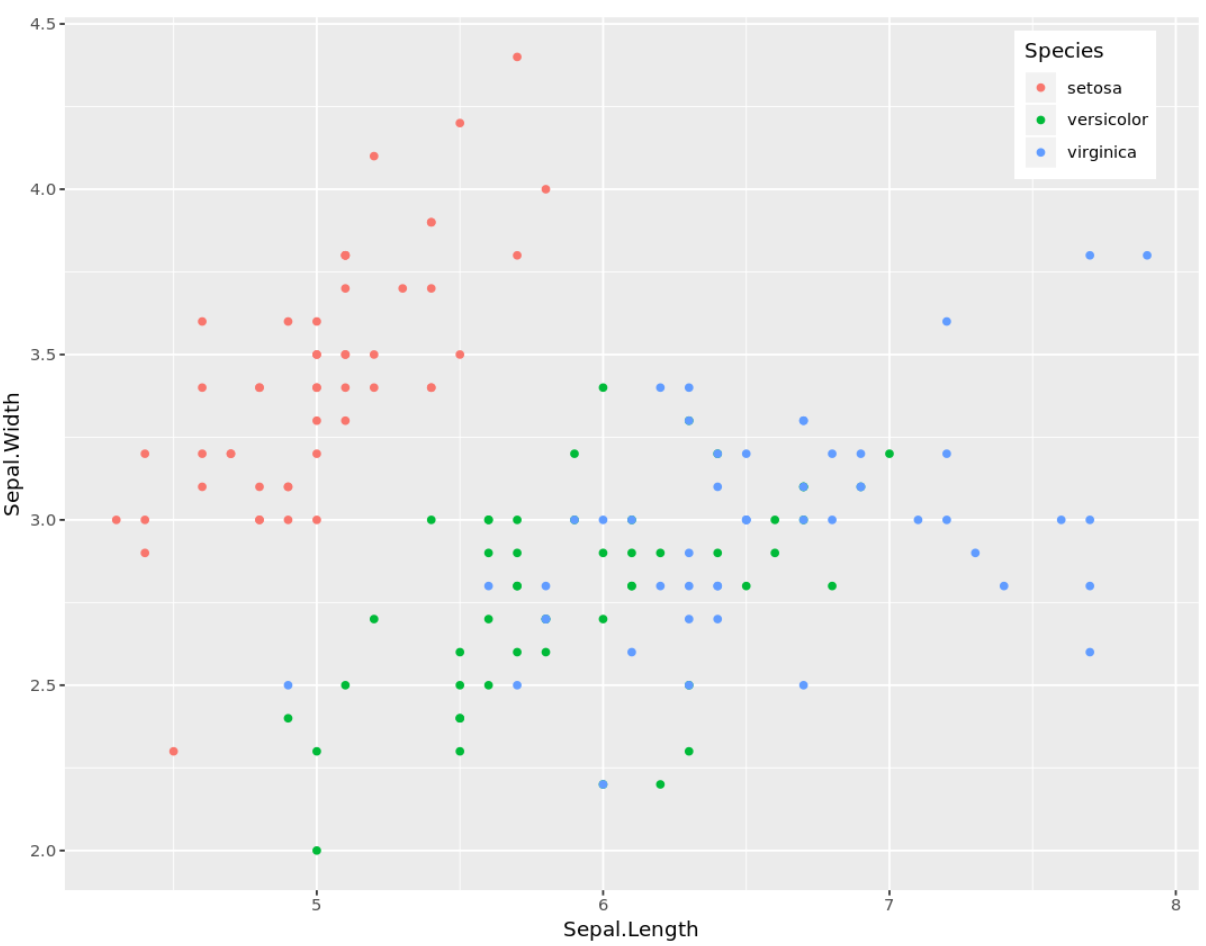
Pour implanter la boîte de guidage dans ce secteur, les coordonnées relatives doivent cibler une zone comprise entre 0.70 et 0.95 sur chaque axe. Par exemple, l’affectation du vecteur c(0.85, 0.85) positionnera la boîte dans l’angle supérieur droit. Réciproquement, dans les configurations où les valeurs de données croissent de manière exponentielle le long de la diagonale ascendante, l’angle supérieur gauche devient l’espace résiduel optimal. L’insertion s’opère alors via des coordonnées proches de c(0.15, 0.85). L’expérimentation suivante matérialise l’ancrage haut-droit au sein du nuage de données iris :
p_inset_haut_droit <- p_base +
theme_bw() +
theme(legend.position = c(0.85, 0.85))
Il convient toutefois de veiller à ce que la boîte ainsi incrustée ne masque pas de micro-agrégats de données ou des valeurs atypiques isolées situées aux frontières supérieures du nuage.
4.3 Insertion dans les quadrants inférieurs : angles bas-droit et bas-gauche
Selon une logique symétrique, les structures de données présentant des pentes positives prononcées libèrent les quadrants opposés, à savoir les secteurs bas-droit et bas-gauche. L’ancrage dans l’angle inférieur droit est fréquemment mobilisé lors de la modélisation de régressions sigmoïdales ou logistiques, où les observations s’accumulent au plafond et au plancher des bornes asymptotiques.
L’implémentation technique d’une incrustation en angle inférieur droit mobilise typiquement un couple de coordonnées de l’ordre de c(0.85, 0.15), tandis que le secteur inférieur gauche sollicite des valeurs voisines de c(0.15, 0.15). Considérons la syntaxe requise pour une disposition bas-droite :
p_inset_bas_droit <- p_base +
theme_minimal() +
theme(legend.position = c(0.85, 0.15))
Cependant, l’utilisation brute de ces coordonnées révèle rapidement une limite structurelle : par défaut, le point de référence de la légende qui est aligné sur ces coordonnées normalisées n’est autre que son propre centre de gravité géométrique. Il en résulte que des coordonnées extrêmes comme c(0.95, 0.95) ont tendance à repousser la moitié droite et la moitié supérieure de la boîte hors du champ visible du graphique. Pour pallier cette dérive d’ancrage, il devient indispensable de mobiliser conjointement le paramètre de justification géométrique.
5. Ancrage et alignement de précision avec legend.justification
5.1 Rôle et fonctionnement de l’argument legend.justification
L’argument legend.justification constitue le complément mécanique indissociable de legend.position dès lors que l’on recherche une rigueur d’alignement au millimètre près. Tandis que legend.position dicte l’emplacement géographique du point d’ancrage sur la surface du canevas, legend.justification détermine précisément quelle partie de la boîte de légende s’accroche audit point.
La métaphore de la punaise et de la carte illustre parfaitement cette dynamique : legend.position indique l’endroit exact du mur où la punaise est plantée, tandis que legend.justification précise si la punaise transperce le coin supérieur droit, le centre mathématique ou le coin inférieur gauche de la carte. Par défaut, la valeur assignée à legend.justification est "center" (ou c(0.5, 0.5)). Cette configuration standard explique pourquoi une tentative d’alignement avec legend.position = c(1, 1) conduit inévitablement à un débordement partiel de la boîte en dehors du repère : le centre de la légende étant calé sur le sommet du cadre, trois quarts de sa surface s’échappent hors de la zone de visualisation.
5.2 Calibration fine par coordonnées doubles numériques
Pour obtenir un accostage parfait des bordures de la boîte de légende le long des axes internes du graphique, la méthode la plus élégante et robuste consiste à apparier strictement les coordonnées de legend.position avec celles de legend.justification sous leur forme numérique vectorielle. Ainsi, pour sceller la boîte dans le coin supérieur droit sans le moindre millimètre de débordement extérieur ni de collision involontaire, on combinera une position à c(1, 1) avec une justification à c(1, 1) :
p_calibre_haut_droit <- p_base +
theme_bw() +
theme(
legend.position = c(0.98, 0.98),
legend.justification = c(1, 1)
)
Dans cette configuration, les valeurs 0.98 introduisent une marge de respiration visuelle infime de deux pour cent par rapport aux lignes noires des axes du cadre, garantissant que le tracé de la bordure du graphique ne fusionne pas disgracieusement avec le rectangle de la légende. Le tableau ci-dessous synthétise les couples de calibration vectorielle recommandés pour les quatre coins cardinaux internes :
| Emplacement ciblé | Coordonnées legend.position | Coordonnées legend.justification | Effet visuel obtenu |
|---|---|---|---|
| Coin supérieur droit | c(0.98, 0.98) |
c(1, 1) |
Accrochage interne fluide sous le coin nord-est du repère. |
| Coin supérieur gauche | c(0.02, 0.98) |
c(0, 1) |
Accrochage interne fluide sous le coin nord-ouest du repère. |
| Coin inférieur droit | c(0.98, 0.02) |
c(1, 0) |
Accrochage interne reposant sur le coin sud-est du repère. |
| Coin inférieur gauche | c(0.02, 0.02) |
c(0, 0) |
Accrochage interne reposant sur l’origine sud-ouest (zéro). |
5.3 Traitement des marges intérieures via legend.margin et legend.box.margin
L’insertion d’une légende au sein du panneau de données nécessite également un ajustement rigoureux des marges intérieures (padding) pour éviter que le conteneur ne prenne une extension spatiale démesurée. ggplot2 distingue deux paramètres de marge hiérarchiquement imbriqués : legend.margin, qui gouverne l’espace entourant individuellement chaque guide esthétique, et legend.box.margin, qui encadre le conteneur global englobant les multiples légendes éventuelles.
Par défaut, ces marges intègrent des zones tampons blanches relativement volumineuses qui augmentent artificiellement l’emprise de la boîte et risquent de masquer des observations sous-jacentes. L’optimisation de la compacité passe par l’utilisation conjointe de la fonction margin() pour compresser ces espaces résiduels au strict minimum typographique :
p_compacte <- p_base +
theme_bw() +
theme(
legend.position = c(0.98, 0.98),
legend.justification = c(1, 1),
legend.margin = margin(t = 2, r = 4, b = 2, l = 4, unit = "pt"),
legend.box.margin = margin(0, 0, 0, 0, unit = "pt")
)
Cette densification géométrique préserve la visibilité des données adjacentes tout en fournissant une structure d’identification immédiatement exploitable.
6. Suppression intégrale et masquage sélectif des légendes
6.1 Élimination globale par theme(legend.position = « none »)
Bien que la légende soit un vecteur fondamental d’intelligibilité, de nombreuses situations analytiques commandent sa suppression pure et simple. L’élimination intégrale de toute boîte de guidage constitue la syntaxe canonique employée dès lors que l’information catégorielle est rendue redondante par d’autres canaux sémiotiques, ou lorsqu’un étiquetage textuel direct est appliqué à même les courbes géométriques.
L’éradication globale de l’appareil de légende s’exécute de manière élégante et concise en passant la valeur textuelle "none" à l’argument legend.position. Cette opération réaffecte instantanément la totalité de l’espace marginal horizontal et vertical au panneau cartésien de données. La surface d’affichage disponible s’en trouve agrandie, ce qui optimise la résolution visuelle des points :
p_sans_legende <- p_base +
theme_classic() +
theme(legend.position = "none")
Ce procédé est tout particulièrement recommandé lorsque les données font l’objet d’une facettisation où chaque sous-groupe est déjà isolé dans un panneau individuel doté d’un en-tête explicite, rendant la légende chromatique strictement tautologique.
6.2 Masquage au niveau de la couche géométrique avec show.legend = FALSE
Dans des contextes analytiques plus nuancés, le praticien peut souhaiter conserver la légende générée par une couche géométrique tout en occultant délibérément celle produite par un calque secondaire. Cet arbitrage s’avère particulièrement utile lors de la superposition d’annotations, de nuages de dispersion enrichis d’une droite de régression globale issue de geom_smooth(), ou de l’adjonction de contours d’intervalles de confiance.
La commande globale theme(legend.position = "none") est incapable d’opérer cette distinction fine. L’instrument adapté réside dans l’argument logique show.legend = FALSE, directement implanté au sein de l’instruction géométrique concernée. Considérons l’exemple suivant, où une droite de régression linéaire est tracée au-dessus des observations botaniques d’iris. Sans intervention, ggplot2 ajouterait automatiquement une clé de légende parasite matérialisant la ligne de tendance. En appliquant show.legend = FALSE sur la couche lissante, seule l’esthétique relative à la distribution factorielle des espèces est conservée :
p_selectif <- ggplot(iris, aes(x = Sepal.Length, y = Sepal.Width)) +
geom_point(aes(color = Species), size = 3) +
geom_smooth(method = "lm", color = "black", se = FALSE, show.legend = FALSE) +
theme_minimal()
Ce mécanisme garantit que la légende finale demeure circonscrite aux seules variables taxonomiques d’intérêt expérimental, préservant la netteté interprétative du graphique.
6.3 Suppression ciblée d’une esthétique particulière via guides()
Un cas de figure complexe survient fréquemment dans les visualisations multivariées combinant simultanément plusieurs variables esthétiques distinctes, par exemple lorsqu’une variable continue régit la dimension des marqueurs (size) tandis qu’une variable qualitative module leur pigmentation (color) et qu’une troisième gouverne la géométrie de leur glyphe (shape). Dans ce contexte, ggplot2 construit autant de blocs de légende indépendants qu’il existe d’esthétiques cartographiées.
Si l’analyste souhaite occulter une seule de ces échelles tout en préservant le rendu et l’agencement spatial des autres, la fonction d’arbitrage de haut niveau guides() offre le levier d’action le plus précis. En assignant la chaîne "none" à l’argument d’esthétique cible au sein de guides(), le traceur neutralise spécifiquement la production de ce guide sans dénaturer le tracé des données :
p_multivarie <- ggplot(iris, aes(x = Sepal.Length, y = Sepal.Width, color = Species, size = Petal.Length)) +
geom_point(alpha = 0.7) +
guides(size = "none") +
theme_bw() +
theme(legend.position = "right")
Cette approche chirurgicale élimine la redondance d’un descripteur dimensionnel secondaire jugé superflu pour l’auditoire final, tout en conservant la segmentation chromatique essentielle des catégories d’espèces.
7. Contrôle de l’orientation et structure interne : legend.direction et guides
7.1 Basculement de l’orientation avec legend.direction
La disposition spatiale de la légende le long d’une bordure ou à l’intérieur du tracé ne résout pas à elle seule l’agencement interne des éléments qui la composent. L’argument legend.direction intervient pour arbitrer la linéarité du flux de présentation des symboles et de leurs étiquettes textuelles respectives. Cet argument accepte deux états d’orientation exclusifs : "vertical" et "horizontal".
Bien que ggplot2 applique de façon heuristique une orientation verticale lorsque la légende est placée à droite ou à gauche, et une orientation horizontale lorsqu’elle migre au sommet ou à la base, cette logique par défaut entre parfois en contradiction avec la morphologie intrinsèque du jeu de données. Par exemple, si une légende placée au bas du tracé comporte sept modalités aux libellés textuels très longs, une orientation horizontale stricte sur une seule ligne débordera inévitablement sur les côtés de la page. Réciproquement, pour une légende insérée à l’intérieur du repère cartésien via legend.position = c(0.85, 0.85), il est fréquent que le formatage vertical par défaut s’avère trop encombrant en hauteur. L’utilisateur peut contraindre explicitement la géométrie interne via legend.direction :
p_direction <- p_base +
theme_bw() +
theme(
legend.position = "top",
legend.direction = "vertical"
)
7.2 Structuration en lignes et colonnes avec guide_legend()
Pour dépasser les contraintes binaires de legend.direction et modeler précisément la matrice géométrique des symboles, il est indispensable de mobiliser la fonction génératrice d’échelle guide_legend(). Cette dernière autorise un partitionnement bidimensionnel arbitraire par l’intermédiaire de ses arguments cardinaux nrow (nombre de rangées horizontales) et ncol (nombre de colonnes verticales).
Considérons le cas d’une légende comportant douze catégories expérimentales disposée au sommet d’une figure. Afficher douze éléments sur une unique rangée engendre une typographie microscopique et illisible. À l’inverse, laisser les douze modalités sur une seule colonne verticale obstrue le tracé des données. La solution méthodologique optimale consiste à structurer la légende sous la forme d’un tableau équilibré de trois rangées et quatre colonnes :
p_matrice_guide <- p_base +
guides(color = guide_legend(nrow = 1, byrow = TRUE)) +
theme_bw() +
theme(legend.position = "bottom")
L’argument logique complémentaire byrow = TRUE garantit que l’incrémentation des modalités s’organise horizontalement de gauche à droite avant de descendre à la ligne suivante, préservant ainsi l’ordre alphabétique ou logique naturel dans le sens conventionnel de lecture.
7.3 Agencement de plusieurs blocs de légende avec legend.box
Dès lors qu’un graphique sollicite simultanément plusieurs dimensions esthétiques autonomes (comme color pour les groupes et shape pour les conditions de traitement), ggplot2 matérialise deux boîtes de légendes distinctes réunies au sein d’un méta-conteneur global (legend box). Le contrôle de l’empilement mutuel de ces différents conteneurs est dévolu à l’argument legend.box.
Par défaut, ces blocs multiples sont empilés selon un alignement vertical lorsque la position est latérale. Cependant, lors d’un positionnement en pied de graphique ("bottom"), cette superposition verticale crée une perte d’espace béante sous le tracé. En configurant legend.box = "horizontal", les deux blocs de légende sont réalignés côte à côte le long de l’axe horizontal. De surcroît, l’ajustement fin de la respiration entre les blocs s’effectue via legend.spacing :
p_multi_box <- ggplot(iris, aes(x = Sepal.Length, y = Sepal.Width, color = Species, shape = Species)) +
geom_point(size = 3) +
theme_bw() +
theme(
legend.position = "bottom",
legend.box = "horizontal",
legend.spacing.x = unit(1, "cm")
)
Ce niveau de modularité garantit un équilibre morphologique parfait, même face aux architectures graphiques composites les plus chargées.
8. Personnalisation esthétique du conteneur de légende
8.1 Application d’un arrière-plan opaque, transparent ou semi-transparent
L’immersion d’une légende à l’intérieur du repère cartésien normalisé pose immédiatement le problème de sa visibilité relative et de sa coexistence avec les points de données situés en arrière-plan. Si la boîte de légende possède un arrière-plan rigoureusement opaque, elle occulte irrémédiablement les données situées sous sa surface, ce qui constitue une faute méthodologique majeure pouvant masquer des grappes d’échantillons cruciales. Réciproquement, une boîte entièrement dénuée d’arrière-plan expose le texte descriptif à des collisions directes avec les données tracées, rendant les libellés totalement illisibles.
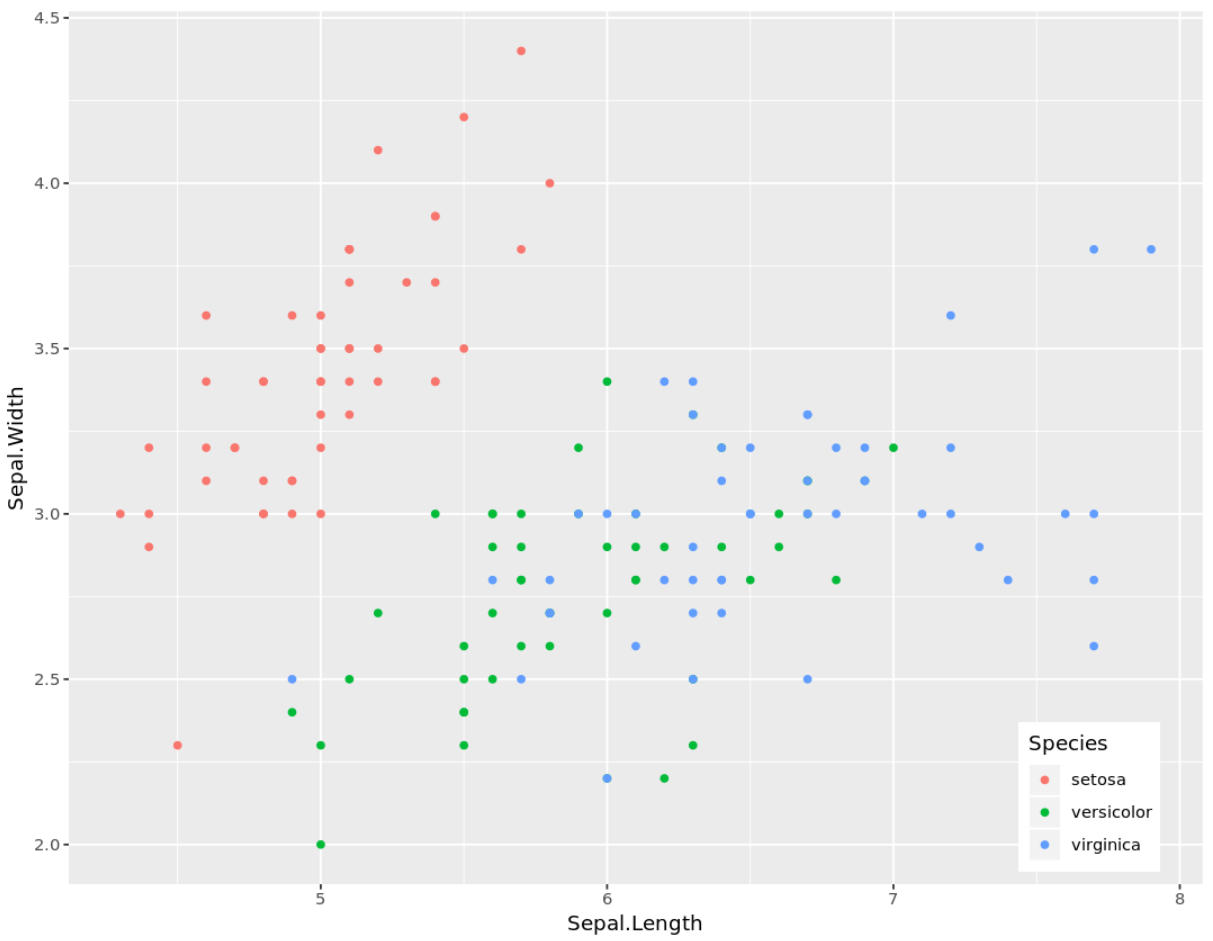
La solution d’ingénierie visuelle réside dans la modulation de l’opacité à l’aide de l’argument legend.background couplé à la fonction element_rect(). L’injection d’une composante d’opacité partielle (canal alpha) au sein de la couleur d’arrière-plan crée un voile semi-transparent idéal :
p_alpha_box <- p_base +
theme_bw() +
theme(
legend.position = c(0.85, 0.85),
legend.justification = c(1, 1),
legend.background = element_rect(fill = alpha("white", 0.75), color = NA)
)
Dans les configurations d’affichage où le secteur d’ancrage est totalement vierge de toute observation, la boîte peut être rendue entièrement translucide via l’assignation radicale legend.background = element_blank(), assurant une intégration d’une grande pureté visuelle.
8.2 Encadrement et bordures décoratives de la boîte
Pour conférer une rigueur géométrique accrue à la légende incrustée, l’adjonction d’une fine bordure périphérique permet de délimiter formellement le territoire sémantique de guidage par rapport à l’espace physique des données. L’argument element_rect() reçoit alors des paramètres explicites de couleur (color ou colour), d’épaisseur de contour (linewidth) et éventuellement de type de tracé (linetype).
Il est impératif d’adopter des valeurs de contour mesurées afin d’éviter l’écueil de la surcharge graphique. Une bordure noire épaisse attire indûment l’œil au détriment des points expérimentaux. Un filet gris discret d’une largeur de 0.3 à 0.5 point remplit parfaitement cet office sans enfreindre la sobriété stylistique requise dans les revues à comité de lecture :
p_bordure <- p_base +
theme_bw() +
theme(
legend.position = c(0.95, 0.95),
legend.justification = c(1, 1),
legend.background = element_rect(fill = "white", color = "grey60", linewidth = 0.4, linetype = "solid")
)
8.3 Personnalisation des symboles et des étiquettes textuelles
L’optimisation globale de l’interface de guidage exige un contrôle symétrique sur les dimensions internes des symboles (les clés graphiques ou legend keys) et sur la hiérarchie typographique des descripteurs textuels. L’argument legend.key, stylisé par element_rect(), permet notamment de purger l’arrière-plan grisâtre historique caractéristique du thème originel de ggplot2.
Par ailleurs, la dimension physique des échantillons graphiques se calibre au moyen de legend.key.size (ou de ses déclinaisons univariées legend.key.height et legend.key.width), tandis que la typographie du titre de légende et des libellés de catégories est régie respectivement par legend.title et legend.text, tous deux pilotés par la fonction element_text() :
p_typo_complete <- p_base +
theme_bw() +
theme(
legend.position = c(0.95, 0.05),
legend.justification = c(1, 0),
legend.key = element_blank(),
legend.key.size = unit(0.5, "cm"),
legend.title = element_text(face = "bold", size = 10, color = "black"),
legend.text = element_text(size = 9, face = "italic", color = "grey20")
)
Cette harmonisation globale garantit que chaque composant microscopique de la légende converge vers une cohérence éditoriale irréprochable.
9. Gestion des légendes dans les agencements à facettes (facet_wrap et facet_grid)
9.1 Comportement par défaut des légendes sur les panneaux partitionnés
La segmentation d’un jeu de données multidimensionnel en sous-ensembles graphiques homogènes constitue l’un des piliers méthodologiques formalisés par Edward Tufte sous l’appellation de « petits multiples » (small multiples). Sous ggplot2, ce paradigme est matérialisé par les puissantes fonctions de partitionnement spatial facet_wrap() et facet_grid(). Par construction architecturale, le système extrait automatiquement une légende unifiée et centralisée pour l’ensemble de la matrice de sous-tracés, la positionnant par défaut sur le flanc extérieur droit du canevas partitionné.
Si ce principe de mutualisation centralisée évite la duplication redondante des clés explicatives au sein de chaque panneau, il génère un déséquilibre spatial particulièrement criant sur les agencements massifs comprenant de trois à douze facettes. Le panneau global de données s’élargit considérablement, repoussant la légende à une distance physique disproportionnée des premiers sous-graphiques situés sur la colonne de gauche. Cette élongation accentue de nouveau l’effet d’attention divisée et dégrade l’efficacité de la comparaison instantanée inter-panneaux.
9.2 Incrustation de la légende dans une facette vide
Un défi esthétique et spatial récurrent apparaît lorsqu’un chercheur déploie un partitionnement via facet_wrap() sur une variable factorielle dont le nombre total de modalités ne correspond pas à un multiple exact de la grille dimensionnelle choisie (par exemple, 5 modalités réparties sur une grille de 2 lignes et 3 colonnes, ou 7 modalités sur une grille 3×3). Ce cas de figure laisse inévitablement une ou plusieurs cellules entièrement vierges d’observations dans les coins de la matrice.
Laisser un quadrant rectangulaire totalement vide au sein d’une figure destinée à une publication prestigieuse constitue un gaspillage d’espace flagrant. Bien que les versions standard de ggplot2 n’aient longtemps pas offert de mécanisme automatisé pour résoudre cette anomalie, l’introduction récente de paramètres avancés au sein de la fonction facet_wrap() (notamment via l’argument axes) couplée à des extensions spécialisées ou à un réglage millimétré de coordonnées permet désormais d’orienter la légende centrale directement dans l’enceinte de cette facette orpheline. L’astuce consiste à combiner une légende sans arrière-plan avec des coordonnées d’insertion calculées par rapport à l’emprise totale du canevas, transformant une lacune géométrique en un espace informationnel utile.
9.3 Partage et mutualisation de légendes avec patchwork et cowplot
Dans le flux d’analyse de données avancées, la production de figures composites associant des types de visualisations radicalement disparates (par exemple, la juxtaposition d’un nuage de points corrélationnel, d’un boxplot de distribution factorielle et d’un chronogramme longitudinal) dépasse le périmètre d’action du moteur natif de facet_*. Les chercheurs recourent alors à des extensions de mise en page composite de haut niveau telles que patchwork ou cowplot.
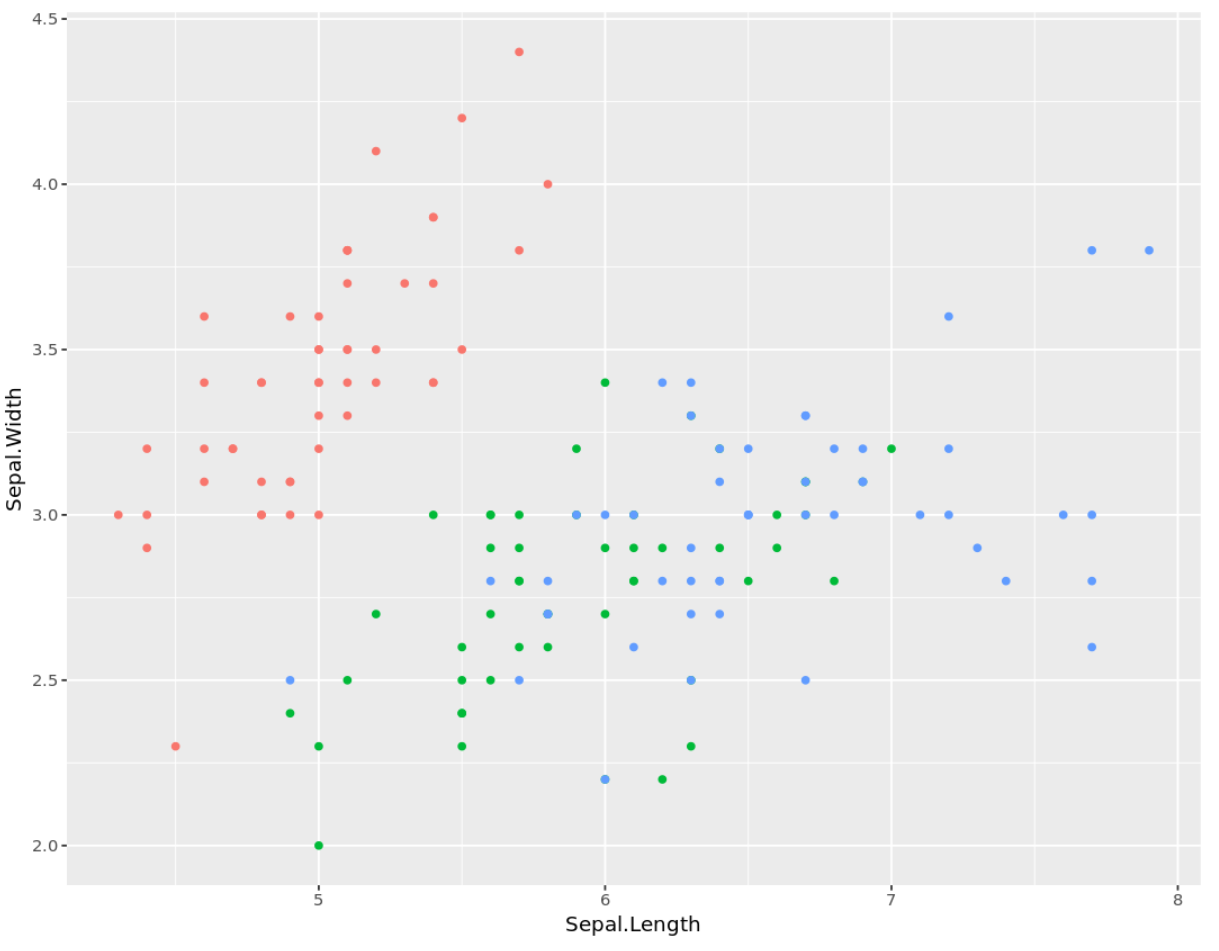
Le défi majeur de ces assemblages hétérogènes réside dans l’apparition récurrente de légendes dupliquées qui encombrent inutilement chaque panneau élémentaire. Avec patchwork, la rationalisation s’exécute avec une remarquable fluidité syntaxique au moyen de l’instruction plot_layout(guides = "collect"). Cette commande inspecte l’arbre de composition, identifie les échelles esthétiques strictement identiques, procède à l’extraction d’une légende mutualisée unique et autorise sa relocalisation stratégique au sommet ou au bas de l’ensemble de la planche composite :
library(patchwork)
p1 <- ggplot(iris, aes(x = Sepal.Length, y = Sepal.Width, color = Species)) + geom_point() + theme_minimal()
p2 <- ggplot(iris, aes(x = Species, y = Sepal.Length, fill = Species)) + geom_boxplot() + theme_minimal()
planche_composite <- (p1 + p2) +
plot_layout(guides = "collect") &
theme(legend.position = "bottom")
L’utilisation de l’opérateur d’application globale & assure que l’instruction thématique s’injecte de manière homogène sur chacun des sous-graphiques du tableau composite, conférant à la publication une cohérence stylistique absolue.
10. Cas pratiques d’application sur données comportementales et quantitatives
10.1 Nuage de points corrélationnel avec incrustation interne
Afin de démontrer l’intérêt translationnel de ces méthodologies, développons un cas pratique contextualisé issu de la psychologie différentielle et des neurosciences comportementales. Imaginons une étude modélisant le temps de réaction moyen d’individus (en millisecondes) en fonction de leur niveau de stress perçu quantifié sur une échelle psychométrique standardisée, le tout stratifié selon trois profils cliniques distincts : Sujets Témoins, Groupe Anxiété Modérée et Groupe Trouble Panique.
Pour des raisons de lisibilité dans le cadre d’une communication scientifique, nous choisissons d’incruster la légende dans l’espace vide situé dans l’angle supérieur gauche du graphique, le nuage présentant une pente corrélationnelle ascendante vers la droite. Le script R complet se structure ainsi :
set.seed(42)
n <- 150
donnees_psycho <- data.frame(
Stress = runif(n, 10, 50),
Groupe = factor(rep(c("Témoin", "Anxiété", "Panique"), each = 50))
)
donnees_psycho$TempsReaction <- 200 + 3.5 * donnees_psycho$Stress + as.numeric(donnees_psycho$Groupe) * 35 + rnorm(n, 0, 15)
p_cognitif <- ggplot(donnees_psycho, aes(x = Stress, y = TempsReaction, color = Groupe, shape = Groupe)) +
geom_point(size = 2.8, alpha = 0.8) +
scale_color_brewer(palette = "Dark2") +
labs(x = "Score de stress perçu (PST)", y = "Temps de réaction (ms)", color = "Cohorte clinique :", shape = "Cohorte clinique :") +
theme_classic(base_size = 11) +
theme(
legend.position = c(0.05, 0.95),
legend.justification = c(0, 1),
legend.background = element_rect(fill = alpha("white", 0.6), color = "grey80", linewidth = 0.3),
legend.margin = margin(4, 6, 4, 6)
)
Cette disposition met en valeur les données expérimentales tout en s’assurant qu’aucun point n’est masqué par la boîte explicative.
10.2 Histogrammes superposés et courbes de densité : positionnement en bandeau
L’analyse des formes distributionnelles continues via des courbes d’estimation de la densité par noyau (kernel density estimation) constitue un second domaine d’application critique. Lors de la superposition des densités de probabilité de deux ou trois groupes, la hauteur maximale des courbes atteint généralement son sommet dans la zone médiane de l’axe des abscisses, laissant la marge sommitale supérieure totalement dégagée.
Le positionnement de la légende sous la forme d’un bandeau sommital horizontal unifié libère l’axe des abscisses de toute compétition visuelle avec les libellés de données. La suppression délibérée des boîtes individuelles de symboles (legend.key = element_blank()) allège considérablement la figure :
p_densite <- ggplot(iris, aes(x = Sepal.Length, fill = Species)) +
geom_density(alpha = 0.45, color = "white", linewidth = 0.5) +
scale_fill_viridis_d(option = "mako", begin = 0.2, end = 0.8) +
labs(x = "Longueur des sépales (cm)", y = "Densité estimée", fill = "Taxonomie :") +
theme_minimal(base_size = 12) +
theme(
legend.position = "top",
legend.direction = "horizontal",
legend.justification = "center",
legend.title = element_text(face = "bold", size = 10),
panel.grid.minor = element_blank()
)
Cette approche garantit une intégration naturelle et fluide des descripteurs distributionnels dans la dynamique de lecture de la figure.
10.3 Graphique longitudinal de profils d’évolution avec étiquetage direct
Dans l’analyse de séries temporelles longitudinales regroupant plusieurs cohortes de patients suivis sur de multiples jalons temporels, la confrontation répétée à une légende périphérique externe dégrade sévèrement la lisibilité. L’œil humain éprouve de lourdes difficultés à associer des teintes chromatiques proches réparties sur des trajectoires linéaires qui s’entrecroisent à travers le temps.
La méthodologie graphique la plus aboutie consiste ici à combiner l’élimination totale de la légende conventionnelle via theme(legend.position = "none") avec un étiquetage textuel direct (direct labeling) positionné immédiatement à l’extrémité terminale de chaque trajectoire temporelle à l’aide de geom_text() ou de l’extension de répulsion typographique ggrepel :
donnees_suivi <- iris %>%
group_by(Species) %>%
summarise(Petal.Length = mean(Petal.Length), Petal.Width = mean(Petal.Width))
p_direct <- ggplot(iris, aes(x = Petal.Length, y = Petal.Width, color = Species)) +
geom_point(alpha = 0.3) +
geom_text(data = donnees_suivi, aes(label = Species), hjust = -0.15, fontface = "bold", size = 4.5) +
coord_cartesian(xlim = c(1, 8.5)) +
theme_classic() +
theme(legend.position = "none")
Ce paradigme supprime radicalement toute charge cognitive de décodage : le vecteur textuel fait corps avec l’observation physique, incarnant l’idéal ergonomique promu par les standards contemporains de la visualisation scientifique.
11. Exportation scientifique, redimensionnement et conformité aux normes APA
11.1 Conséquences de ggsave() sur les coordonnées relatives de position
L’une des déconvenues techniques les plus frustrantes rencontrées par les chercheurs lors de la préparation de leurs manuscrits concerne la dérive spatiale des légendes incrustées lors de l’exportation sur disque via la commande ggsave(). Un graphique dont l’ancrage interne paraît rigoureusement millimétré au sein de la fenêtre de prévisualisation interactive de l’environnement RStudio peut voir sa boîte de légende glisser hors cadre ou heurter les points de données une fois exporté dans un fichier externe au format PDF ou PNG.
Ce phénomène physique découle de la nature mathématique des coordonnées normalisées c(x, y). Ces valeurs sont relatives aux proportions dimensionnelles globales du périphérique graphique ouvert (aspect ratio). Si le ratio entre la largeur et la hauteur du tracé est modifié lors de l’appel de ggsave(filename, width = ..., height = ...), la surface relative du panneau cartésien se déforme, déplaçant le point d’ancrage calculé. La bonne pratique méthodologique impérative impose de calibrer les coordonnées de legend.position exclusivement en observant le rendu produit avec les dimensions physiques finales verrouillées dans ggsave() :
ggsave("figure_1.pdf", plot = p_calibre_haut_droit, width = 16, height = 12, units = "cm", dpi = 300)
11.2 Alignement strict sur les normes éditoriales APA (7e édition)
Les directives éditoriales fixées par la septième édition du manuel de style de l’American Psychological Association (APA 7th Edition) dictent des contraintes draconiennes pour la publication des figures quantitatives. L’APA proscrit catégoriquement les éléments décoratifs non indispensables, les quadrillages verticaux agressifs, ainsi que les encadrements rectangulaires superflus autour des légendes graphiques.
Pour se conformer rigoureusement aux normes de l’APA, une figure sous ggplot2 doit privilégier un thème sobre dépouillé de tout trait de cadrage, adosser ses étiquettes à une police sans-serif standardisée (à l’instar d’Arial ou d’Helvetica), positionner la légende de préférence sous le graphique ou incrustée sans la moindre bordure délimitante, et laisser un contraste chromatique compatible avec la reproduction en niveaux de gris. Le bloc de configuration APA se formalise typiquement de la manière suivante :
theme_apa <- function(base_size = 11) {
theme_classic(base_size = base_size) +
theme(
legend.position = "bottom",
legend.direction = "horizontal",
legend.title = element_text(face = "bold", size = base_size),
legend.text = element_text(size = base_size - 1),
legend.background = element_blank(),
legend.key = element_blank(),
axis.line = element_line(linewidth = 0.5, color = "black"),
axis.text = element_text(color = "black")
)
}
Cette matrice stylistique assure une acceptation immédiate de la silhouette graphique par les relecteurs et éditeurs techniques des périodiques internationaux les plus exigeants.
11.3 Préservation de la netteté et formats vectoriels (PDF, SVG, TIFF)
L’assurance d’une netteté parfaite des légendes à l’impression scientifique requiert un arbitrage rigoureux quant au format de compression du fichier généré. La typographie d’une légende et la minutie des glyphes géométriques (en particulier les motifs hachurés ou les petits marqueurs de dispersion) tolèrent mal la pixellisation induite par des formats matriciels mal résolus comme les formats JPEG ou PNG à 72 DPI.
Pour les soumissions de manuscrits académiques, les formats vectoriels purs tels que le PDF natif (device = cairo_pdf) ou le SVG (Scalable Vector Graphics) doivent être systématiquement privilégiés. Dans ces formats, chaque lettre de la légende et chaque contour d’icône sont encodés sous la forme d’instructions géométriques polynomiales mathématiques, autorisant un agrandissement infini sans la moindre dégradation de résolution. Lorsqu’un format matriciel est formellement exigé par l’éditeur (exigence fréquente pour la plateforme d’impression des revues de biologie cellulaire), l’exportation doit impérativement cibler le format TIFF non compressé avec une résolution calibrée à un seuil minimal de 600 voire 1200 points par pouce :
ggsave("figure_haute_resolution.tiff", plot = p_apa, width = 14, height = 10, units = "cm", dpi = 600, compression = "lzw")
12. Diagnostic des anomalies fréquentes et synthèse des meilleures pratiques
12.1 Résolution des conflits causés par l’ordre d’application des thèmes
L’anomalie de programmation la plus fréquemment constatée chez les utilisateurs de ggplot2 réside dans l’annulation involontaire de la personnalisation de leur légende par suite d’une mauvaise structuration de l’ordre d’évaluation des instructions thématiques. Un statisticien débutant écrit couramment la séquence erronée suivante :
# CODE ERRONE :
p_err <- p_base +
theme(legend.position = "bottom") +
theme_bw()
Lors de l’évaluation de cette expression, le moteur graphique applique d’abord scrupuleusement la position basale sur le canevas, mais l’instruction subséquente theme_bw() écrase instantanément l’ensemble des définitions cosmétiques préexistantes en restaurant la valeur canonique par défaut du thème noir et blanc, à savoir legend.position = "right". La règle d’or méthodique et absolue s’énonce donc comme suit : les thèmes complets prédéfinis doivent impérativement être déclarés en premier, et les surcharges spécifiques via theme() doivent clore la chaîne de commande :
# CODE CORRECT ET FONCTIONNEL :
p_valide <- p_base +
theme_bw() +
theme(legend.position = "bottom")
12.2 Dépannage des légendes tronquées ou repoussées hors cadre
Une seconde pathologie graphique fréquente se matérialise lorsque les libellés textuels des modalités de légende sont exceptionnellement longs, provoquant le tronquage des derniers caractères alphabétiques qui s’échappent hors des marges physiques de l’image. Ce défaut apparaît particulièrement lors de l’attribution de la légende à droite ou à gauche sans redimensionnement approprié des marges d’emprise globales.
Pour endiguer ce phénomène de cisaillement, deux interventions correctives complémentaires doivent être mobilisées. La première consiste à étendre la marge périphérique externe du tracé au moyen de l’argument plot.margin au sein de theme(), allouant ainsi une zone tampon confortable pour accueillir les expansions de texte. La seconde méthode fait appel à la désactivation du mécanisme de coupure géométrique au sein du système de coordonnées, via l’assignation du paramètre clip = "off" au sein de coord_cartesian() :
p_depannage <- p_base +
coord_cartesian(clip = "off") +
theme_minimal() +
theme(
plot.margin = margin(t = 15, r = 35, b = 15, l = 15, unit = "pt"),
legend.position = "right"
)
Cette précaution évite tout rognage typographique disgracieux lors du rendu raster ou vectoriel final.
12.3 Synthèse opérationnelle et liste de contrôle méthodologique
Pour clore cette analyse technique et fournir aux analystes de données un cadre de travail immédiatement mobilisable en routine professionnelle, nous présentons ci-dessous une liste de contrôle méthodologique en cinq points cardinaux à vérifier avant d’engager la validation définitive d’une figure statistique pour publication :
- Vérification de la pertinence de l’information : La présence de la légende est-elle strictement indispensable, ou peut-elle être remplacée avec profit par un étiquetage textuel direct le long des géométries ou par des titres de facettes explicites ?
- Optimisation de la trajectoire du regard : La légende est-elle implantée de manière à minimiser la distance euclidienne avec les données focales (par exemple par incrustation interne semi-transparente dans un quadrant vide), prévenant ainsi la fatigue oculaire liée à l’attention divisée ?
- Ordre immuable de composition thématique : Les réglages chirurgicaux de
legend.positionetlegend.justificationsont-ils positionnés rigoureusement en aval de toute déclaration de thème préconfiguré au sein du pipelineggplot2? - Absence absolue d’occultation de données : Si la boîte de légende est incrustée à l’intérieur du plan cartésien, son arrière-plan possède-t-il une transparence calibrée (canal alpha) ou des marges vérifiées pour garantir qu’aucune observation isolée n’est occultée ?
- Stabilité géométrique à l’exportation : L’alignement et les proportions relatives de la boîte de guidage ont-ils été inspectés visuellement sur le fichier d’exportation final généré par
ggsave()selon ses dimensions physiques réelles et son format vectoriel définitif ?
En respectant ces préceptes avec rigueur, le praticien s’assure que ses visualisations de données s’élèvent au plus haut degré de précision quantitative et d’élégance typographique exigé par la communauté scientifique internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Pedersen, T. L. (2020). patchwork: The composer of plots (R package version 1.1.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=patchwork
- Slowikowski, K. (2021). ggrepel: Automatically position non-overlapping text labels with ‘ggplot2’ (R package version 0.9.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=ggrepel
- Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The psychology of learning and motivation: Cognition in education (Vol. 55, pp. 37–76). Academic Press. https://doi.org/10.1016/B973008-01055-6.00002-8
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Ware, C. (2019). Information visualization: Perception for design (4th ed.). Morgan Kaufmann. https://doi.org/10.1016/C2017-0-02058-2
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science & Business Media. https://doi.org/10.1007/0-387-28695-0