
Dans le champ de l’analyse statistique contemporaine et du traitement computationnel de données empiriques, le prétraitement des variables numériques constitue une étape architecturale déterminante. Parmi l’arsenal des transformations linéaires à la disposition du chercheur, de l’ingénieur de données ou du biostatisticien, le centrage des données occupe une place fondamentale. Trop souvent reléguée à une simple manipulation algorithmique préliminaire, cette opération modifie substantiellement les propriétés structurales des variables au sein des modèles multivariés. En substance, centrer une variable consiste à soustraire une mesure de tendance centrale—généralement la moyenne arithmétique—de chaque observation individuelle, opérant ainsi une translation géométrique du nuage de points sans altérer sa morphologie sous-jacente.
L’environnement statistique R, reconnu mondialement pour sa puissance calculatoire et son écosystème vectorisé, offre une multitude d’approches pour accomplir cette transformation. De l’arithmétique matricielle native héritée du langage S jusqu’aux paradigmes fonctionnels modernes incarnés par le Tidyverse et l’extension data.table, le praticien dispose d’un éventail d’outils d’une flexibilité absolue. Cependant, une maîtrise imparfaite des subtilités syntaxiques, des formats de sortie ou de la gestion des données manquantes peut engendrer des anomalies silencieuses, compromises dans des chaînes de traitement complexes ou des pipelines d’apprentissage automatique. La sélection rigoureuse des fonctions appropriées s’avère donc indispensable pour garantir l’intégrité numérique et la reproductibilité des analyses.
Au-delà de la pure mécanique logicielle, la décision de centrer une variable répond à des impératifs épistémologiques et méthodologiques profonds. En psychométrie, en économétrie et dans les sciences comportementales, l’échelle absolue de mesure est souvent dépourvue d’un zéro naturel ou physiquement fondé. Le centrage octroie alors une signification tangible à l’origine mathématique, ce qui bouleverse l’interprétation des ordonnées à l’origine dans les régressions linéaires, dissipe les artefacts de multicolinéarité non essentielle dans les modèles d’interaction, et conditionne la validité des inférences dans les modélisations multiniveaux. Cet article exhaustif explore l’ensemble de ces dimensions, combinant formalisations mathématiques rigoureuses, considérations méthodologiques pointues et tutoriels algorithmiques détaillés au sein du langage R.
1. Fondements théoriques et mathématiques du centrage des données
1.1 Définition formelle et soustraction de la moyenne
Sur le plan de l’algèbre scalaire, le centrage d’un ensemble discret d’observations se formule comme une transformation affine univariée particulièrement épurée. Considérons un vecteur aléatoire réel unidimensionnel noté X, composé de n réalisations empiriques indexées de 1 à n, tel que X = (x1, x2, …, xn)T. La moyenne arithmétique de cet échantillon, notée x̄, est définie comme la somme arithmétique de toutes les valeurs divisée par le cardinal de l’échantillon. La transformation de centrage génère un nouveau vecteur Xcentré dont chaque composante xi, centré est calculée selon l’expression élémentaire : xi, centré = xi – x̄. Cette soustraction scalaire systématique réaligne le barycentre empirique de la variable directement sur la coordonnée zéro.
La propriété mathématique fondamentale découlant immédiatement de cette formulation réside dans le fait que l’espérance empirique ou la moyenne de la variable transformée devient rigoureusement et universellement nulle. En sommant l’ensemble des composantes du vecteur centré, la linéarité de l’opérateur de sommation démontre que la somme des xi équivaut exactement à n fois la moyenne x̄, annulant ainsi la sommation totale et fixant la nouvelle moyenne arithmétique à une valeur strictement égale à zéro. Cette annihilation de la constante moyenne s’effectue sans aucune déformation de la dispersion relative des données : la variance empirique, l’écart-type, ainsi que l’ensemble des moments statistiques centrés d’ordre supérieur (tels que le coefficient d’asymétrie de Pearson ou le kurtosis d’aplatissement) demeurent rigoureusement invariants. La forme probabiliste de la distribution initiale est intégralement préservée.
Il est impératif d’établir une démarcation épistémologique stricte entre le centrage simple et la standardisation (souvent qualifiée de réduction ou de transformation en score Z). Tandis que le centrage n’applique qu’une translation d’origine soustractive laissant inchangée l’unité métrique originelle, la standardisation divise en outre chaque observation centrée par l’écart-type empirique du vecteur. Par conséquent, une variable standardisée se caractérise simultanément par une moyenne nulle et une variance unitaire, perdant ainsi son échelle métrique initiale au profit d’un étalon universel sans dimension. Le centrage simple, en conservant l’unité physique ou psychométrique native de la mesure, préserve l’interprétabilité directe des variations tout en repositionnant le repère analytique.
1.2 Propriétés géométriques et vectorielles de la translation
D’un point de vue géométrique dans l’espace euclidien à n dimensions, noté ℝn, le centrage d’une variable s’interprète comme la projection orthogonale du vecteur de données X sur le sous-espace orthogonal au vecteur unitaire composé exclusivement de 1. Ce vecteur unitaire, souvent noté 1n, définit la droite vectorielle le long de laquelle s’exprime la moyenne globale des observations. Lors de l’opération de centrage, la soustraction du vecteur moyen équivaut à translater le repère cartésien global : l’origine des axes n’est plus fixée à un point arbitraire (0, 0, …, 0), mais se déplace exactement au centre de gravité ou centroïde du nuage géométrique de points formé par les observations empiriques.
Cette translation euclidienne conserve scrupuleusement les distances inter-points relatives. Pour toute paire d’observations distinctes (xi, xj), la distance euclidienne unidimensionnelle reste invariante car la différence (xi – x̄) – (xj – x̄) se simplifie trivialement en xi – xj. Dans une perspective multidimensionnelle impliquant plusieurs variables prédictrices simultanées, translater chaque dimension vers sa moyenne respective ne modifie en rien la configuration spatiale interne, la convexité de l’enveloppe des données, ni les distances de Mahalanobis mesurées entre les individus statistiques. La matrice des covariances des données centrées est rigoureusement identique à la matrice de covariance calculée sur les données brutes.
Sur le plan de l’analyse fonctionnelle et de l’estimation de densité par noyau (Kernel Density Estimation), cette translation géométrique se traduit sur un graphique bidimensionnel par un glissement horizontal uniforme de la courbe de densité de probabilité le long de l’axe des abscisses. La morphologie de la courbe, incluant son amplitude maximale, l’épaisseur de ses queues de distribution, sa multimodalité éventuelle et ses points d’inflexion, demeure parfaitement inchangée. L’axe de symétrie ou le sommet principal de la courbe se trouve simplement repositionné exactement à la verticale de l’abscisse x = 0, rendant immédiate la visualisation des densités de probabilité associées aux valeurs inférieures ou supérieures à la moyenne de l’échantillon.
1.3 Importance de la redéfinition du point d’origine
L’un des défis méthodologiques les plus aigus dans l’analyse de données empiriques réside dans l’existence fréquente d’un zéro conventionnel entièrement arbitraire, voire physiologiquement ou conceptuellement irréalisable. Dans une multitude de disciplines, les instruments de mesure attribuent des valeurs numériques à des grandeurs qui ne possèdent aucun seuil d’extinction naturelle. Par exemple, la température mesurée en degrés Celsius possède un zéro relatif défini par la transition de phase de l’eau, mais non une absence totale d’énergie thermique. De manière plus critique encore, dans les sciences humaines et médicales, des variables telles que la pression artérielle systolique, le rythme cardiaque, l’âge chronologique d’une cohorte adulte ou le quotient intellectuel ne peuvent jamais s’annuler sans entraîner la caducité théorique de l’observation.
Le centrage statistique résout cette aporie en substituant à ce zéro abstrait ou hors de portée un zéro statistique empirique doté d’une signification phénoménologique concrète. Une fois la transformation effectuée, la valeur numérique zéro cesse de représenter une absence chimérique de la propriété mesurée ; elle incarne désormais très précisément le niveau moyen observé au sein de l’échantillon d’étude ou de la population parente. Dès lors, toute coordonnée mathématique devient directement informative : une observation présentant une valeur de zéro se situe rigoureusement au cœur de la distribution typique de son groupe d’appartenance.
Cette redéfinition de l’origine structure radicalement l’évaluation des écarts individuels. Une valeur positive dénote immédiatement une déviation au-dessus de la norme empirique du groupe, dont l’amplitude quantifie exactement le surplus mesuré dans l’unité d’origine de l’instrument. Inversement, une valeur négative signale un déficit quantitatif par rapport au niveau moyen. Cette dichotomisation intuitive et symétrique autour de l’origine simplifie considérablement la communication des données complexes, stabilise la calibration d’algorithmes prédictifs et prépare le terrain mathématique pour une interprétation limpide des paramètres de modélisation paramétrique.
2. Pertinence méthodologique du centrage en sciences psychologiques
2.1 Interprétabilité des échelles psychométriques de Likert
Dans l’investigation empirique en psychologie clinique, différentielle ou sociale, la collecte des données quantitatives repose massivement sur l’administration de questionnaires psychométriques instrumentés par des échelles de Likert ordinales ou quasi-intervallaires. Typiquement, ces échelles s’échelonnent sur des gradients discrets variant de 1 (« Pas du tout d’accord ») à 5 ou 7 (« Totalement d’accord »). Dans cette configuration standard, le chiffre zéro brille par son absence absolue du spectre de réponse accessible aux participants. Si un chercheur procède à des analyses statistiques linéaires directes sur ces scores bruts ou sur leurs agrégats sommés, les fonctions mathématiques sous-jacentes intègrent implicitement la valeur zéro comme base de projection théorique, quand bien même aucun sujet n’aurait pu sélectionner un tel ancrage.
La pratique du centrage transforme radicalement la lisibilité cognitive de ces scores d’attitudes, de traits de personnalité ou d’états affectifs. En soustrayant le score moyen de l’échantillon à chaque score individuel, le zéro devient l’expression parfaite de l’attitude moyenne ou du niveau prototypique du construit au sein du groupe étudié. Par exemple, sur une mesure d’anxiété-trait issue du célèbre inventaire STAI (State-Trait Anxiety Inventory), un score centré équivalant à zéro caractérise un individu dont la propension à l’anxiété est parfaitement normative au regard de son groupe de référence. Des scores de +5 ou -5 indiquent respectivement une symptomatologie modérément supérieure ou inférieure à l’étalon moyen de l’échantillon, conservant l’unité du score d’origine sans dénaturer la métrique du test.
Cette clarification confère un avantage substantiel lors du partage des conclusions diagnostiques ou de recherche auprès de praticiens non statisticiens, de comités cliniques ou de décideurs institutionnels. Transmettre un rapport psychologique indiquant qu’un patient présente un score brut de 38 sur une échelle d’évaluation de la dépression n’offre aucun sens immédiat sans une mémorisation exhaustive des normes tabulaires de l’instrument. En revanche, rapporter un score centré de +12,4 permet à tout observateur d’appréhender instantanément que ce patient manifeste un excès de détresse psychologique très substantiel par rapport à la moyenne établie de la cohorte d’admission.
2.2 Clarification de l’ordonnée à l’origine dans la régression linéaire
L’un des apports les plus déterminants du centrage concerne la réhabilitation sémantique de l’ordonnée à l’origine—le paramètre β0—dans le cadre du modèle linéaire général. Dans une régression linéaire standard formalisée par l’équation Y = β0 + β1X + ε, le coefficient d’interception β0 représente, par définition mathématique stricte, la valeur attendue de la variable dépendante Y lorsque le prédicteur X est strictement égal à zéro. Si la variable X est une mesure continue telle que l’âge, le poids corporel, le taux de cortisol salivaire ou le niveau d’intelligence fluide, un score de X = 0 constitue une impossibilité biologique ou conceptuelle. L’ordonnée à l’origine brute devient alors une abstraction mathématique vide de sens, se situant bien souvent en dehors des limites observables du phénomène, voire prenant des valeurs négatives physiquement aberrantes.
Lorsque le chercheur procède au centrage préalable du prédicteur X, l’équation de régression se reformule comme suit : Y = β0* + β1(X – x̄) + ε. Dans cette configuration géométrique translatée, lorsque le prédicteur centré prend la valeur zéro, cela signifie que la variable brute X est rigoureusement positionnée à sa moyenne empirique x̄. Par conséquent, la nouvelle ordonnée à l’origine β0* devient immédiatement l’estimation de la valeur moyenne attendue de la variable dépendante Y pour un individu statistiquement représentatif ou moyen de l’échantillon. L’interception cesse d’être une extrapolation fantomatique pour s’ériger en un indicateur descriptif de référence primordial.
Cette propriété s’avère particulièrement précieuse lors de l’estimation de modèles comparatifs impliquant des sous-groupes démographiques ou expérimentaux distincts. En centrant les covariables continues au préalable, la comparaison des intercepts entre différents sous-groupes (par exemple via une analyse de covariance ou une régression modélisée avec des termes d’interaction catégorielle) permet d’évaluer directement les différences de niveau moyen de base entre les groupes sans risquer des distorsions induites par des écarts structurels de moyennes sur les prédicteurs continus. Le paramètre β0 acquiert ainsi une stabilité inférentielle maximale.
2.3 Réduction de la multicolinéarité structurelle dans les interactions
Dans l’investigation des hypothèses psychologiques complexes, l’analyse des effets d’interaction et de modération représente une démarche méthodologique incontournable. Les chercheurs cherchent régulièrement à déterminer si l’impact d’un prédicteur focal X sur un critère comportemental Y varie en fonction des fluctuations d’une tierce variable modératrice Z. Dans le paradigme standard de la régression par moindres carrés ordinaires, cette interrogation se traduit par l’introduction d’un terme multiplicatif modélisant le produit croisé, sous la forme X × Z. Or, lorsque les variables X et Z sont mesurées sur des échelles numériques brutes dont les moyennes diffèrent substantiellement de zéro, le produit croisé arithmétique se retrouve inévitablement et fortement corrélé avec les variables constitutives individuelles X et Z.
Ce phénomène d’intercorrélation artificielle relève de ce que la littérature statistique nomme la multicolinéarité non essentielle ou structurelle, par opposition à la multicolinéarité essentielle qui découle de véritables redondances conceptuelles entre prédicteurs au sein de la population. Cette multicolinéarité non essentielle gonfle artificiellement le facteur d’inflation de la variance (VIF) des prédicteurs de premier ordre, ce qui dilate dramatiquement leurs erreurs-types associées et dégrade la puissance statistique des tests de significativité univariés menés sur les effets principaux.
Le centrage des prédicteurs X et Z préalablement au calcul de leur produit matriciel ou scalaire offre une parade mathématique exemplaire à cette pathologie structurelle. En neutralisant les composantes moyennes avant l’opération multiplicative, la covariance artificielle entre les termes d’ordre inférieur et le terme d’interaction est drastiquement amenuisée, réduisant les VIF à des niveaux tout à fait tolérables. Si cette transformation ne modifie aucunement la valeur statistique de l’interaction globale elle-même (comme nous le théoriserons dans une section dédiée), elle stabilise formidablement l’estimation des erreurs-types des coefficients linéaires isolés et confère aux effets dits « principaux » une interprétation directe d’effets conditionnels à la moyenne du modérateur.
3. Centrage d’un vecteur élémentaire avec les fonctions de base de R
3.1 Utilisation de la soustraction arithmétique manuelle
L’approche la plus fondamentale et transparente pour centrer une série d’observations en R consiste à mobiliser les opérateurs arithmétiques de base couplés à la fonction native de calcul de moyenne. Grâce à la nature vectorisée intrinsèque du moteur de calcul de R, toute opération arithmétique appliquée entre une structure unidimensionnelle de longueur n et un scalaire de longueur 1 déclenche automatiquement le mécanisme de recyclage vectoriel. Ainsi, calculer explicitement la moyenne empirique via la fonction mean() et la soustraire directement du vecteur initial constitue l’implémentation la plus limpide et la plus dépourvue d’artéfacts de typage logiciel.
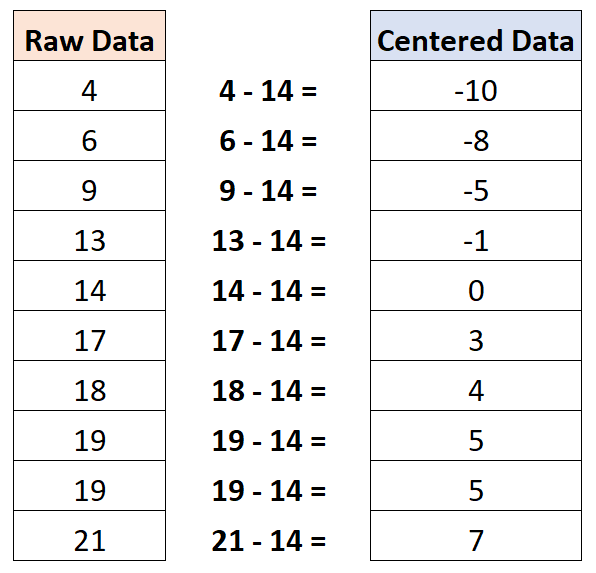
Considérons un vecteur numérique représentant, par exemple, les scores d’extraversion de cinq participants : scores <- c(12, 15, 18, 22, 28). Le calcul de la moyenne s’opère par l’instruction moyenne_scores <- mean(scores), ce qui fournit la valeur 19. Pour centrer manuellement ce vecteur, il suffit d’exécuter l’instruction arithmétique directe : scores_centres <- scores - moyenne_scores. Le résultat produit est un nouveau vecteur numérique contenant les valeurs (-7, -4, -1, 3, 9). L’opération s’est déroulée de manière purement vectorielle, chaque composante se voyant retrancher le scalaire 19 sans nécessiter l’écriture d’une boucle explicite d’itération.
Une étape méthodologique saine consiste à vérifier dans la console interactive la conformité du résultat aux théorèmes mathématiques. L’évaluation de mean(scores_centres) doit restituer une valeur numériquement équivalente à zéro (aux tolérances d’arrondi de virgule flottante près, souvent de l’ordre de 10-16). De même, l’exécution de sum(scores_centres) doit impérativement converger vers zéro. Cette transparence totale confère à l’arithmétique manuelle un attrait pédagogique indéniable : l’utilisateur conserve une maîtrise algorithmique complète, sans s’exposer aux altérations inattendues de métadonnées ou de classes d’objets fréquemment engendrées par des fonctions d’emballage plus élaborées.
3.2 Centrage vectoriel direct avec scale()
Dans la bibliothèque de base de l’environnement R (package base), la fonction canonique universellement documentée pour opérer des transformations linéaires sur des variables numériques est scale(). Conçue initialement pour automatiser le calcul complet des scores standards ou scores Z, cette fonction accepte plusieurs arguments booléens qui conditionnent son comportement opérationnel. Sa signature formelle s’articule autour des paramètres center et scale, régissant respectivement la soustraction de la tendance centrale et la division par un indice de dispersion métrique.
Par défaut, la fonction scale() est configurée avec scale(x, center = TRUE, scale = TRUE), ce qui déclenche une standardisation totale (centrage puis réduction par l’écart-type). Pour contraindre cette fonction à opérer un centrage pur sans réduction, il est rigoureusement impératif d’assigner explicitement la valeur logique FALSE au paramètre de mise à l’échelle : scores_centres <- scale(scores, center = TRUE, scale = FALSE). L’omission de cette spécification représente l’un des pièges les plus universels chez les analystes débutants, conduisant à une division inopinée par la dispersion empirique qui anéantit l’échelle d’origine des données.
L’inspection fine de l’objet produit par scale() révèle une particularité structurelle majeure : la fonction ne renvoie pas un simple vecteur atomique, mais une matrice bidimensionnelle à une seule colonne (matrice colonne de dimension n × 1). De plus, R associe automatiquement à cet objet des métadonnées d’exécution sous la forme d’attributs internes. L’attribut scaled:center consigne la valeur exacte de la moyenne empirique qui a été retranchée. Pour interroger cette métadonnée sans devoir recalculer la moyenne initiale, le statisticien peut exécuter l’instruction attr(scores_centres, "scaled:center"), récupérant ainsi immédiatement la mémoire de la transformation opérée.
3.3 Conversion des formats et gestion de la classe d’objet
La transformation d’un vecteur unidimensionnel fluide en une structure matricielle formelle par la fonction scale() engendre fréquemment des incompatibilités techniques au sein des scripts d’analyse. En R, de nombreuses fonctions analytiques ou de visualisation graphique attendent formellement un vecteur atomique sous-jacent (de type numeric ou double) et réagissent de manière imprévisible ou génèrent des avertissements d’incompatibilité de dimensions lorsqu’elles reçoivent une matrice univariée dotée d’attributs matriciels complexes.
Afin d’immuniser la chaîne de traitement statistique contre toute régression logicielle en aval, il est fortement recommandé de dépouiller l’objet de sa gangue matricielle immédiatement après l’appel à scale(). Pour convertir formellement la sortie matricielle en un vecteur atomique classique, deux fonctions utilitaires principales sont couramment convoquées : as.vector() et as.numeric(). L’instruction s’écrit alors de manière condensée et sécurisée : scores_centres <- as.vector(scale(scores, center = TRUE, scale = FALSE)). Cette conversion élimine instantanément les attributs matriciels superficiels tout en préservant scrupuleusement l’intégrité des valeurs numériques calculées.
Cette rigueur dans la gestion du typage d’objets s’avère particulièrement critique lorsqu’on réinjecte les colonnes transformées dans un conteneur de données tel qu’un data.frame ou un tibble. Conserver une colonne sous format de matrice 1D encapsulée au sein d’un data frame peut corrompre des mécanismes aussi triviaux que la sélection indiciaire par crochet simple, l’exportation vers des formats tabulaires plats (tels que le CSV) ou la sérialisation JSON. L’aplatissement explicite via as.vector() garantit une compatibilité ascendante et descendante absolue avec l’ensemble des bibliothèques de modélisation telles que stats::lm() ou les grammaires de ggplot2.
4. Fonctionnement détaillé et attributs de la fonction scale()
4.1 Analyse structurelle des attributs internes de l’objet produit
L’architecture interne de l’interpréteur R repose sur un système riche de programmation par objets où n’importe quelle structure de données élémentaire peut être enrichie d’une liste de métadonnées arbitraires qualifiées d’attributs (attributes). La fonction scale() exploite précisément ce paradigme pour consigner l’historique calculatoire de la normalisation spatiale. Lorsqu’un jeu de données numériques est passé à travers scale(), l’objet résultant se voit greffer au moins deux attributs fondamentaux selon les arguments mobilisés : l’attribut dim fixant sa morphologie matricielle, et l’attribut scaled:center mémorisant les valeurs scalaires des centres soustraits pour chaque colonne traitée.
Cette conservation programmatique de la mémoire empirique répond à un impératif méthodologique de premier ordre. Dans le cadre de protocoles d’analyse longitudinale, de déploiements d’algorithmes prédictifs en production ou de validations croisées, le statisticien est perpétuellement confronté à la nécessité d’appliquer rigoureusement la même transformation à de nouvelles cohortes d’observations sans recalculer une nouvelle moyenne sur ces dernières. En extrayant programmatiquement l’attribut via attr(resultat, "scaled:center"), le chercheur dispose d’une référence immuable qu’il peut soustraire arithmétiquement d’un nouvel échantillon indépendant, garantissant une cohérence d’ancrage absolu entre les différentes phases d’expérimentation.
Pour auditer l’ensemble des métadonnées attachées à une structure issue de scale(), la commande de diagnostic la plus exhaustive demeure str(objet) ou attributes(objet). Ces fonctions révèlent instantanément l’architecture composite de la sortie. Si le statisticien souhaite neutraliser spécifiquement ces attributs sans passer par as.vector(), l’assignation de la valeur nulle aux attributs non dimensionnels via l’instruction attr(objet, "scaled:center") <- NULL permet de nettoyer sélectivement la structure tout en conservant, le cas échéant, les dimensions matricielles globales.
4.2 Différences fondamentales selon le paramétrage des booléens
La versatilité de la fonction scale() repose sur l’orthogonalité de ses deux paramètres logiques : center et scale. La combinatoire de ces deux booléens engendre quatre régimes calculatoires radicalement distincts sur le plan de la théorie statistique, qu’il convient de formaliser avec une précision mathématique sans équivoque pour écarter tout risque de contresens analytique.
Le premier régime, center = TRUE, scale = FALSE, représente l’objet principal de cette monographie : le centrage arithmétique pur. Chaque observation se voit retrancher la moyenne arithmétique de sa variable, l’échelle métrique d’origine étant conservée à l’identique. Le deuxième régime correspond aux valeurs par défaut de R : center = TRUE, scale = TRUE. Dans cette configuration, R soustrait d’abord la moyenne empirique, puis divise chaque valeur résultante par l’écart-type d’échantillon corrigé (calculé avec n – 1 au dénominateur). L’utilisateur obtient alors une distribution standardisée universelle d’espérance nulle et d’écart-type égal à 1.
Le troisième régime, nettement plus singulier et fréquemment mécompris, survient lors de la combinaison center = FALSE, scale = TRUE. Dans cette hypothèse, aucune soustraction de moyenne n’est opérée. R calcule alors la racine carrée de la moyenne des carrés (la valeur efficace ou moyenne quadratique définie par la racine de la somme des xi2 divisée par n – 1) et divise chaque observation brute par cette quantité scalaire. Cette opération n’a strictement aucun lien avec la standardisation classique et ne doit en aucun cas être confondue avec un centrage. Enfin, la combinaison center = FALSE, scale = FALSE correspond à l’application d’un opérateur d’identité triviale, renvoyant la matrice des données sans la moindre altération mathématique.
4.3 Performances computationnelles sur les grands vecteurs numériques
Sur le plan de l’architecture informatique et de l’ingénierie logicielle, la fonction scale() ne délègue pas ses calculs à des fonctions de haut niveau interprétées au sein de la boucle d’évaluation de R. Pour garantir une vélocité maximale, le code source sous-jacent de scale.default() fait appel à des routines compilées écrites directement en langage C ou Fortran. Cette descente au niveau machine permet d’exécuter les opérations de sommation, de calcul d’écart-type et de translation en minimisant le coût de l’allocation mémoire dynamique et le traçage des pointeurs d’objets.
Toutefois, lorsqu’on confronte la fonction scale() à des volumes massifs de données (par exemple des vecteurs numériques contenant plusieurs dizaines de millions d’observations), le surcoût lié à la création des structures matricielles, à la vérification interne des arguments et à la génération des attributs de métadonnées peut devenir un facteur limitant de performance. Dans ces scénarios extrêmes d’ingénierie statistique, l’implémentation de la soustraction arithmétique manuelle vectorisée x - mean(x) surpasse fréquemment scale() en termes de vitesse pure d’exécution et d’empreinte carbone mémoire.
Ce gain d’efficience s’explique par le fait que l’expression arithmétique élémentaire évite l’instanciation de la classe matricielle intermédiaire et n’exécute qu’une seule passe en mémoire vive pour le calcul de la moyenne, suivie d’une seconde passe vectorisée optimisée par les instructions SIMD (Single Instruction, Multiple Data) des processeurs contemporains. Pour des jeux de données gigantesques où la préservation de la mémoire vive (RAM) est cruciale, la soustraction scalaire directe demeure la méthode de référence absolue pour les ingénieurs soucieux d’optimisation computationnelle.
5. Centrage de plusieurs colonnes au sein d’un data frame en R de base
5.1 Application ciblée sur un sous-ensemble de variables continues
Dans la pratique courante du traitement de données, les informations ne se présentent que très rarement sous la forme de vecteurs isolés ; elles sont quasi systématiquement structurées au sein de tableaux de données hétérogènes (data.frame). Un jeu de données typique héberge conjointement des identifiants alphanumériques, des variables catégorielles factorielles (sexe, statut clinique, groupe expérimental) et des prédicteurs continus d’échelles variées. Tenter d’appliquer aveuglément une transformation de centrage à l’intégralité d’un tel tableau provoquerait immédiatement une levée d’erreur fatale, les opérations arithmétiques étant indéfinies sur les types textuels ou facteurs.
Le statisticien opérant en R de base doit donc maîtriser les techniques d’indexation vectorielle pour cibler exclusivement les colonnes quantitatives continues. Deux stratégies prévalent : l’indexation numérique par position ordinale ou l’indexation nominative par vecteur de chaînes de caractères. Cette dernière est unanimement privilégiée pour des raisons de robustesse programmatique, l’ordre physique des colonnes pouvant fluctuer lors d’opérations d’importation ou de nettoyage préliminaire. En définissant un vecteur explicite des variables à centrer, par exemple vars_continues <- c("age", "score_anxiete", "temps_reaction"), on circonscrit formellement le périmètre d’action du traitement.
Une fois la sélection opérée, l’opération de remplacement peut s’effectuer directement au sein du data frame initial via l’opérateur d’assignation par crochets df[, vars_continues] <- scale(df[, vars_continues], center = TRUE, scale = FALSE). Toutefois, si la traçabilité intégrale de l’analyse exige de conserver simultanément les variables brutes pour des audits comparatifs ultérieurs, il est nettement plus judicieux de générer de nouvelles colonnes affublées d’un suffixe explicite, à l’instar de df[, paste0(vars_continues, "_cent")] <- scale(df[, vars_continues], center = TRUE, scale = FALSE). Cette démarche défensive prévient tout écrasement destructif irréversible de l’information primaire.
5.2 Utilisation de la famille des fonctions apply() et lapply()
Pour orchestrer le centrage multivariable sans recourir à la syntaxe matricielle de scale(), les fonctions d’ordre supérieur de la famille apply constituent l’épine dorsale de la programmation fonctionnelle en R de base. Lorsque les données quantitatives sont isolées dans un sous-tableau, la fonction apply() permet d’itérer une transformation le long d’une dimension spécifique d’une matrice ou d’un tableau bidimensionnel. En configurant le paramètre directionnel MARGIN = 2, l’utilisateur indique sans ambiguïté à R que la fonction de centrage doit être exécutée indépendamment sur chaque colonne successive.
L’expression fonctionnelle s’articule élégamment sous la forme : df_centre <- apply(df[, vars_continues], 2, function(col) col - mean(col, na.rm = TRUE)). Cette formulation a le mérite exceptionnel d’offrir une flexibilité totale quant au choix de la métrique centrale appliquée, tout en gérant explicitement les éventuelles omissions de données. Néanmoins, il convient de souligner que apply() coercit préalablement le data frame sélectionné en une matrice homogène avant d’itérer, ce qui implique une conversion uniforme de tous les types sous-jacents en format numérique flottant à double précision.
Alternativement, la fonction lapply() traite intrinsèquement le data.frame selon sa nature véritable, à savoir une liste ordonnée de vecteurs verticaux de même longueur. L’appel lapply(df[, vars_continues], function(col) col - mean(col, na.rm = TRUE)) itère la fonction anonyme sur chaque vecteur sans jamais déconstruire l’objet en matrice globale. La structure de liste résultante peut ensuite être réassemblée instantanément sous la forme d’un tableau structuré propre par l’intermédiaire de la commande enveloppante as.data.frame(). Cette méthode préserve un profil d’allocation mémoire remarquablement économe et assure une séparation étanche des calculs entre les différentes colonnes.
5.3 Mise en œuvre via une boucle itérative classique for
Bien que la communauté des développeurs R ait historiquement manifesté une certaine réticence dogmatique à l’égard des boucles itératives explicites au profit des constructions vectorisées, la boucle for demeure un paradigme d’une clarté pédagogique insurpassable pour les analystes débutants ou pour la construction de scripts séquentiels exigeant des vérifications conditionnelles granulaires à chaque étape de calcul. Dans les versions modernes de R équipées du compilateur à la volée (JIT compiler activé par défaut depuis la version 3.4), les boucles itératives bien dimensionnées offrent des vitesses d’exécution strictement comparables à leurs homologues fonctionnels.
L’écriture d’une boucle de centrage explicite s’organise autour de l’itération des noms de colonnes ou de leurs indices positionnels. L’avantage prépondérant de cette structure séquentielle réside dans la possibilité d’y encapsuler des structures conditionnelles défensives. Ainsi, le chercheur peut formuler une boucle inspectant chaque colonne d’un tableau entier, évaluant dynamiquement son type via is.numeric(), et n’appliquant la translation de centrage que si et seulement si la variable répond favorablement au test d’appartenance de classe :
Au sein du bloc de la boucle, l’instruction for(nom in names(df)) { if(is.numeric(df[[nom]])) { df[[paste0(nom, "_cent")]] <- df[[nom]] - mean(df[[nom]], na.rm = TRUE) } } réalise une modification incrémentale sur place (in-place modification). Cette approche algorithmique pas-à-pas prévient toute conversion matricielle indésirable, isole parfaitement chaque variable dans son propre espace d’évaluation et immunise le script contre les erreurs de typage global qui surviennent fréquemment lorsque des tableaux comportent des colonnes hybrides ou des formats temporels.
6. Approches modernes de centrage avec l’écosystème Tidyverse
6.1 Utilisation conjointe de mutate() et across() dans dplyr
L’émergence et la standardisation de l’écosystème Tidyverse, sous l’impulsion majeure d’Hadley Wickham, ont profondément métamorphosé les canons d’écriture du code statistique en R. Au cœur de cette révolution conceptuelle se trouve la bibliothèque dplyr, dédiée à la manipulation déclarative, lisible et grammaticale des jeux de données. Pour accomplir des transformations de variables à grande échelle, le verbe fondamental mutate() s’associe harmonieusement à la fonction de ciblage contextuel across(), instaurant une syntaxe d’une fluidité expressive incomparable.
Le paradigme contemporain s’affranchit des mécanismes d’indexation matricielle complexe pour adopter une formulation sémantique déclarative. L’enchaînement canonique s’articule par l’opérateur de composition séquentielle (le traditionnel opérateur pipe %>% ou le pipe natif de R |> introduit avec R 4.1.0). L’expression prend la forme suivante :
df_traite <- df |> mutate(across(where(is.numeric), ~ .x - mean(.x, na.rm = TRUE), .names = "{.col}_cent"))
Dans cette unique ligne de code s’expriment plusieurs concepts logiciels avancés : la fonction de sélection where(is.numeric) audite de manière entièrement autonome l’architecture du tableau pour n’isoler que les vecteurs quantitatifs ; la fonction anonyme formulée sous forme de formule lambda (~ .x - mean(.x, na.rm = TRUE)) explicite l’opération arithmétique univariée où .x représente le vecteur contextuel substitué ; enfin, le paramètre déclaratif .names orchestre dynamiquement la génération des nouvelles colonnes en adjoignant le suffixe spécifié, garantissant l’intégrité intégrale des données sources originelles.
6.2 Préservation de la typologie tibble sans attributs matriciels
L’un des bénéfices techniques les plus substantiels de l’adoption de dplyr pour le centrage des variables réside dans la préservation rigoureuse de la typologie sous-jacente des conteneurs de données modernes, à savoir les tibbles. Contrairement aux data frames traditionnels de R de base qui tolèrent parfois l’injection insidieuse de colonnes matricielles multidimensionnelles lors de l’usage imprudent de la fonction scale(), la grammaire interne de dplyr interdit par conception ces hybridations de classes qui constituent une source notoire de régressions logicielles.
En mobilisant l’arithmétique directe au sein de la fonction lambda de mutate(), le résultat produit conserve scrupuleusement la classe native du vecteur d’origine—typiquement double pour les valeurs flottantes continues ou integer converti implicitement en réels lors de la soustraction d’une moyenne non entière. L’absence absolue d’attributs matriciels parasites (tels que dim ou scaled:center) garantit que chaque colonne générée demeure un vecteur atomique univarié pur.
Cette propreté architecturale prend toute sa dimension méthodologique lorsque les jeux de données transformés sont subséquemment dirigés vers les frameworks d’apprentissage automatique ou d’estimation statistique avancée du méta-package tidymodels (comme parsnip, recipes ou workflows). Les modules de vérification de ces écosystèmes exigent une conformité typologique absolue des tables d’ingestion. Centrer par mutate() et across() évite les ruptures de pipeline et assure une interopérabilité sans faille avec l’ensemble des moteurs de modélisation prédictive contemporains.
6.3 Lisibilité du code et reproductibilité pour la recherche
À l’ère de la crise de la reproductibilité scientifique et de la généralisation des protocoles de science ouverte (Open Science), la clarté syntaxique du code source d’analyse statistique ne relève plus d’une simple coquetterie esthétique, mais s’érige en un critère déontologique fondamental. Un script rédigé selon les principes du Tidyverse Style Guide possède une structure quasi narrative qui permet à tout examinateur, évaluateur par les pairs ou statisticien auditeur d’appréhender instantanément la séquence logique des manipulations appliquées aux cohortes empiriques.
L’auto-documentation inhérente à l’écriture mutate(across(...)) explicite sans équivoque les règles d’inclusion des prédicteurs (par exemple via des sélecteurs contextuels comme starts_with("echelle_") ou contains("score")) et documente la gestion spécifique des valeurs manquantes directement au sein de la formule de transformation. Il devient dès lors totalement superflu de commenter laborieusement des blocs opaques de boucles matricielles ou des assignations d’index numériques abstraits dont la compréhension exige une reconstitution mentale pénible de l’état du tableau de données.
En standardisant les pipelines de prétraitement au sein de scripts R Markdown ou Quarto rigoureusement documentés, les chercheurs en psychologie et en neurosciences s’assurent que leurs transformations de centrage peuvent être réexécutées à l’identique d’un simple clic sur des cohortes de réplication. Cette transparence algorithmique totale favorise l’archivage pérenne des données et constitue un gage incontournable de rigueur méthodologique lors de la soumission de protocoles de recherche à des comités de lecture internationaux particulièrement vigilants sur les questions d’intégrité computationnelle.
7. Gestion des valeurs manquantes (NA) lors du centrage statistique
7.1 Propagation du poison statistique des NA dans R
Le traitement des valeurs manquantes, désignées universellement sous l’acronyme NA (Not Available) dans l’écosystème R, représente l’un des aspects les plus critiques et périlleux de l’ingénierie des données. Par conception logique rigoureuse, R adopte une philosophie de propagation stricte de l’incertitude : si une opération arithmétique ou statistique élémentaire implique une quantité inconnue, le résultat mathématique global de cette opération est lui-même fondamentalement inconnu. Par voie de conséquence directe, l’exécution de la fonction mean(x) sur un vecteur hébergeant ne serait-ce qu’une seule observation manquante renvoie inexorablement la valeur scalaire NA.
Lorsque cette caractéristique fondamentale n’est pas anticipée dans une formule de centrage manuelle ou vectorisée, les conséquences pour le jeu de données sont absolument dévastatrices. Lors de l’évaluation de l’expression x - mean(x), la moyenne non protégée valant NA, le mécanisme de recyclage arithmétique propage cette valeur manquante à l’intégralité du vecteur. En un instant, l’ensemble des données empiriques valides—fussent-elles au nombre de dizaines de milliers—se trouve intégralement écrasé et converti en un vecteur uniforme de NA. Cette contamination silencieuse, que les statisticiens qualifient métaphoriquement d’« empoisonnement par les NA », peut anéantir une analyse en chaîne si aucun mécanisme d’arrêt d’urgence n’est programmé.
Pour immuniser les calculs contre cette défaillance classique, la configuration explicite du paramètre de neutralisation des valeurs absentes est catégoriquement impérative : mean(x, na.rm = TRUE). De manière analogue, la fonction native scale() intègre par défaut une gestion implicite qui ignore les NA lors du calcul de la moyenne de centrage et de l’écart-type, propageant le statut manquant exclusivement aux positions ordinales qui étaient initialement absentes, tout en préservant le calcul exact du centre sur les cas complets. La vigilance du programmeur demeure toutefois essentielle dès lors qu’il s’affranchit des fonctions de haut niveau pour élaborer ses propres algorithmes de transformation.
7.2 Biais d’échantillonnage induit par l’exclusion des valeurs manquantes
Au-delà de la pure mécanique logicielle de l’argument na.rm = TRUE, l’omission des valeurs manquantes lors du calcul de la moyenne de centrage soulève des interrogations épistémologiques et méthodologiques profondes quant à la représentativité statistique de l’échantillon d’analyse. Dans la taxonomie canonique introduite par le statisticien Donald Rubin, les données manquantes se catégorisent selon trois mécanismes générateurs sous-jacents : les données manquant de manière complètement aléatoire (MCAR – Missing Completely at Random), les données manquant de manière aléatoire (MAR – Missing at Random) et les données manquant de manière non aléatoire (MNAR – Missing Not at Random).
Dans l’éventualité où le mécanisme générateur des données absentes s’avère non aléatoire (MNAR)—par exemple lorsque des participants souffrant d’une dépression clinique sévère ou d’un déclin cognitif marqué omettent systématiquement de renseigner les items terminaux d’un inventaire psychométrique—, la moyenne calculée uniquement sur les sujets ayant renseigné intégralement les mesures (les cas complets) se trouve structurellement biaisée. La moyenne x̄ observée sous-estime dramatiquement le véritable niveau de détresse de la population parente. Par conséquent, centrer la variable par rapport à cette moyenne optimiste déplace artificiellement l’origine statistique vers le bas, altérant la signification diagnostique de l’ensemble des scores centrés ultérieurs.
Dans une telle configuration de vulnérabilité méthodologique, les bonnes pratiques contemporaines en sciences comportementales proscrivent formellement le centrage direct fondé sur l’exclusion naïve des cas incomplets. Il est impératif de procéder préalablement à une procédure robuste d’imputation multiple par équations chaînées (par exemple via le package R mice). Le centrage des variables doit alors être calculé au sein de chaque jeu de données imputé indépendamment, avant que les estimations paramétriques finales ne soient agrégées selon les règles formelles de Rubin. Cette approche garantit la préservation de l’incertitude d’échantillonnage et prévient les distorsions systématiques induites par l’attrition sélective.
7.3 Pratiques recommandées pour les bases de données d’enquêtes psychologiques
L’administration d’enquêtes en ligne, de questionnaires d’évaluation de la personnalité ou de protocoles expérimentaux longitudinaux engendre quasi systématiquement des matrices de données parsemées d’omissions partielles. Avant d’engager toute procédure de centrage statistique à grande échelle, le chercheur rigoureux doit déployer un audit diagnostique scrupuleux pour cartographier la structure des valeurs absentes au sein de son environnement R.
Des bibliothèques spécialisées telles que naniar ou VIM permettent d’auditer visuellement et numériquement le pourcentage exact de données manquantes par colonne et par individu, ainsi que de tester formellement l’hypothèse d’amputation aléatoire via le test de Little. Une règle empirique solidement ancrée stipule que si le taux de données manquantes sur une variable excède un seuil critique (couramment fixé entre 5 % et 10 % dans les protocoles stricts), une analyse de sensibilité comparative s’impose impérativement : il convient de comparer les résultats des modèles statistiques obtenus avec un centrage calculé sur cas complets versus un centrage réalisé post-imputation multiple.
Enfin, il est absolument capital de veiller à la concordance parfaite des dénominateurs d’échantillon entre la phase de centrage et la phase de modélisation inférentielle. Si un modèle de régression ultérieur exclut automatiquement des participants par suppression de liste (listwise deletion) en raison de valeurs manquantes sur d’autres covariables du modèle, la moyenne utilisée pour centrer le prédicteur principal—si elle a été calculée préalablement sur l’échantillon total incluant ces sujets rejetés—ne correspondra plus exactement à la moyenne empirique effective de l’échantillon d’estimation du modèle. Une telle divergence, bien que numériquement minime dans les grands échantillons, peut suffire à fausser l’interprétation exacte de l’ordonnée à l’origine dans les études à effectifs réduits.
8. Centrage global versus centrage au sein des groupes en modélisation multiniveau
8.1 Grand-Mean Centering (GMC) vs Group-Mean Centering (CWC)
Lorsque les données empiriques présentent une structure hiérarchique, emboîtée ou groupée—phénomène ubiquitaire en sciences de l’éducation (élèves nichés au sein de classes scolaires), en psychologie organisationnelle (employés regroupés au sein d’équipes de travail) ou en médecine (patients suivis au sein de différents centres hospitaliers)—, la modélisation multiniveau ou hiérarchique (modèles mixtes) devient le paradigme d’analyse requis. Dans ce cadre analytique avancé, l’opération de centrage cesse d’être une simple question d’échelle pour s’ériger en un choix théorique d’une gravité épistémologique colossale : le chercheur doit arbitrer entre le centrage par rapport à la moyenne globale (Grand-Mean Centering ou GMC) et le centrage par rapport à la moyenne du groupe (Group-Mean Centering ou Centering Within Clusters, abrégé en CWC).
Le Grand-Mean Centering (GMC) consiste à soustraire à la valeur xij de l’individu i appartenant au groupe j la moyenne globale de l’ensemble de l’échantillon toutes strates confondues, notée x̄·· : xij, GMC = xij – x̄··. Sous cette transformation, le zéro statistique continue d’incarner l’individu moyen de l’ensemble de la population échantillonnée. En revanche, le Group-Mean Centering (CWC) soustrait à chaque observation individuelle la moyenne spécifique du cluster ou groupe auquel cet individu appartient, notée x̄·j : xij, CWC = xij – x̄·j. Dans ce second cas, la valeur transformée ne quantifie plus la position absolue du sujet dans l’étude, mais exclusivement son écart relatif ou son rang distinctif par rapport à ses pairs immédiats au sein de son propre micro-groupe.
La divergence entre ces deux méthodologies est fondamentale car elles ne mesurent absolument pas les mêmes construits psychologiques ou sociologiques. Le CWC décompose mathématiquement et orthogonalement la variance totale du prédicteur en isolant scrupuleusement la composante purement intra-groupe (within-group variance) de toute influence contextuelle globale. À l’inverse, le GMC amalgame de façon composite la dynamique interne à chaque groupe et les disparités macroscopiques inter-groupes (between-group variance), ce qui produit des coefficients de régression mixtes d’une complexité interprétative redoutable, souvent sources d’erreurs méthodologiques graves dans la littérature scientifique.
8.2 Implémentation du centrage intra-groupe avec dplyr::group_by()
La réalisation algorithmique d’un centrage au sein des groupes (CWC) pouvait s’avérer fastidieuse et propice aux erreurs de fusion sous d’anciens environnements de programmation. Grâce à la sémantique de regroupement contextuel intégrée à dplyr, cette opération s’exécute aujourd’hui en R avec une compacité et une sécurité computationnelle parfaites. L’architecture repose sur la combinaison du verbe group_by(), qui partitionne virtuellement la table de données selon les identifiants des grappes, et de mutate() qui applique la transformation localement à chaque partition.
L’implémentation rigoureuse d’un pipeline CWC s’articule comme suit :
df_multiniveau <- df |>

  group_by(id_classe) |>

  mutate(

    moyenne_groupe = mean(temps_etude, na.rm = TRUE),

    temps_etude_cwc = temps_etude - moyenne_groupe

  ) |>

  ungroup()
Plusieurs détails méthodologiques de premier ordre méritent d’être explicités au sein de cette syntaxe. Premièrement, il est hautement recommandé de calculer et de conserver explicitement la variable moyenne_groupe dans le tableau. Cette agrégation au niveau supérieur représente la composante contextuelle macroscopique qui pourra être réinjectée ultérieurement au niveau 2 de la régression multiniveau afin de modéliser l’effet direct de l’environnement de groupe. Deuxièmement, la fonction d’échappement ungroup() finale est absolument indispensable : elle dissout le partitionnement virtuel du data frame, prévenant ainsi des comportements inattendus lors des calculs ou résumés statistiques ultérieurs qui n’auraient pas vocation à être segmentés par classe.
8.3 Applications psychologiques concrètes : dynamiques scolaires et organisationnelles
L’illustration la plus célèbre et paradigmatique de la nécessité absolue du centrage intra-groupe (CWC) réside dans l’investigation empirique de ce que la psychologie de l’éducation nomme l’effet « Grand poisson dans un petit bassin » (Big-Fish-Little-Pond Effect ou BFLPE), conceptualisé par Herbert W. Marsh. Ce phénomène démontre que le sentiment d’auto-efficacité académique d’un élève ne dépend pas seulement de ses aptitudes cognitives absolues, mais de sa performance relative comparée à celle de ses camarades de classe immédiats.
Si un chercheur commet l’erreur d’utiliser un prédicteur brut ou centré sur la moyenne globale (GMC) pour prédire l’estime de soi scolaire à partir des notes d’évaluation, le modèle est incapable de démêler la réalité psychologique sous-jacente. En appliquant le CWC, le prédicteur note_cwc quantifie si l’élève est meilleur ou moins bon que la moyenne de sa propre classe. Simultanément, en introduisant la variable de niveau 2 note_moyenne_classe (centrée sur la moyenne globale des classes), le modèle sépare distinctement les deux processus psychologiques : un effet individuel positif (au sein de ma classe, être meilleur que mes pairs renforce mon estime) et un effet contextuel souvent négatif (être scolarisé dans une classe d’élite au niveau moyen très élevé abaisse l’estime de soi par comparaison sociale ascendante permanente).
Le même impératif méthodologique prévaut en psychologie du travail et des organisations lors de l’étude du climat de sécurité psychosociale. Confondre le climat perçu au niveau individuel et le consensus normatif de l’équipe expose le chercheur à la redoutable erreur écologique (attribuer aux individus une relation statistique observée entre les groupes) ou à son pendant symétrique, l’erreur atomistique. Seul un centrage CWC scrupuleusement exécuté garantit une étanchéité analytique parfaite entre les dynamiques psychologiques individuelles (niveau 1) et les déterminants sociologiques structurels (niveau 2).
9. Rôle du centrage dans les modèles de régression et l’analyse de modération
9.1 Facilitation du diagnostic de l’effet modérateur
Dans l’architecture de la modélisation statistique avancée, l’évaluation formelle d’une hypothèse de modération vise à déterminer dans quelle mesure l’intensité ou la trajectoire directionnelle de la relation unissant un prédicteur focal X à une variable critère Y est fonctionnellement conditionnée par les oscillations d’un tiers facteur modérateur M. Le modèle linéaire canonique sous-tendant cette hypothèse s’exprime classiquement par l’adjonction d’un terme d’interaction multiplicatif : Y = β0 + β1X + β2M + β3(X × M) + ε.
Lorsque les variables prédictrices X et M sont introduites sous leur forme métrique brute non centrée, la lecture des coefficients statistiques d’ordre inférieur β1 et β2 se heurte à un écueil interprétatif majeur. En vertu des principes élémentaires du calcul différentiel appliqué à la modélisation linéaire, la dérivée partielle de Y par rapport à X est formalisée par l’expression : ∂Y / ∂X = β1 + β3M. Cette formulation mathématique met en lumière une vérité analytique cruciale : le paramètre β1 ne capture nullement l’effet global, moyen ou principal de la variable X ; il quantifie très restrictivement l’effet conditionnel marginal de X sur Y lorsque le modérateur M prend une valeur strictement égale à zéro.
Si la valeur M = 0 est dénuée de sens substantiel ou se situe en dehors de l’espace empirique observable de la cohorte d’étude, le coefficient β1 devient un artéfact mathématique dépourvu de toute pertinence clinique ou scientifique. En revanche, lorsque les deux régresseurs ont été rigoureusement centrés autour de leurs moyennes empiriques respectives avant la génération du produit d’interaction, la dérivée partielle s’évalue désormais à Mcentré = 0, ce qui correspond fidèlement à la situation où le modérateur se positionne à son niveau moyen exact. Par conséquent, au sein du modèle centré, le coefficient β1 s’interprète avec une limpidité parfaite comme l’effet marginal exercé par X sur Y pour tout individu affichant un score parfaitement moyen sur le modérateur M.
9.2 Calcul et visualisation des pentes simples (Simple Slopes)
Une fois la présence statistique d’un effet modérateur formellement authentifiée par la significativité du coefficient multiplicatif β3, le protocole méthodologique exige d’explorer en profondeur la topographie de cette modération. Cette étape analytique cruciale repose sur la technique des pentes simples (simple slopes analysis), immortalisée dans les sciences comportementales par les travaux fondateurs de Leona Aiken et Stephen West. L’objectif fondamental consiste à calculer et à tester la significativité statistique de la relation linéaire reliant X à Y à des niveaux stratégiques spécifiques et représentatifs de la variable modératrice M.
Conventionnellement, l’investigation empirique décompose le gradient du modérateur en trois ancrages étalons : la moyenne empirique (M̄), un niveau modérateur substantiellement bas positionné à un écart-type en deçà de la moyenne (M̄ – 1 SD), et un niveau substantiellement élevé situé à un écart-type au-dessus de la moyenne (M̄ + 1 SD). Dans l’écosystème R moderne, l’exécution manuelle de ces régressions conditionnelles répétées est avantageusement supplantée par des bibliothèques de calcul marginal de haute précision, au premier rang desquelles figurent marginaleffects et interactions.
Grâce à la commande sim_slopes(modele, pred = X, modx = M, centered = "none") issue du package interactions, le chercheur extrait en une fraction de seconde l’estimation ponctuelle des trois pentes conditionnelles, leurs erreurs-types respectives, les statistiques de Student associées ainsi que les intervalles de confiance correspondants. De surcroît, ces environnements computationnels permettent de dépasser la discrétisation arbitraire à ±1 écart-type en implémentant la rigoureuse technique de Johnson-Neyman. Cette méthode cartographie l’intégralité du continuum continu du modérateur pour identifier avec une exactitude chirurgicale les points de bascule mathématiques—c’est-à-dire les seuils quantitatifs précis de M au-delà ou en deçà desquels l’effet marginal de X passe d’un état non statistiquement significatif à un état statistiquement significatif au seuil alpha spécifié.
9.3 Correction empirique du mythe de la réduction de colinéarité
Il est impératif de dissiper avec la plus grande fermeté méthodologique une croyance erronée tenace et omniprésente dans la littérature académique, que plusieurs statisticiens de renom ont qualifiée de « mythe persistant du centrage ». Selon ce postulat fallacieux, le centrage des variables prédictrices au sein d’une régression avec modération posséderait la vertu magique d’accroître la puissance statistique globale du test de modération et d’atténuer la multicolinéarité inhérente à l’interaction.
Une démonstration algébrique rigoureuse atteste que le centrage des prédicteurs ne modifie en rien, absolument en rien, les propriétés statistiques fondamentales du terme multiplicatif de plus haut niveau. La valeur du coefficient d’interaction non standardisé β3, son erreur-type exacte, la statistique t associée, la valeur p de significativité, ainsi que le gain de variance expliquée globale (l’incrément de R2 consécutif à l’introduction du produit) demeurent strictement identiques et invariants, que les variables soient centrées ou conservées sous leur forme brute d’origine. Le centrage n’a aucun pouvoir magique de résurrection d’un effet d’interaction non significatif.
Ce que le centrage modifie de façon spectaculaire et salvatrice relève exclusivement de la structure de dépendance linéaire reliant les effets d’ordre inférieur (X et M) au terme composite (X × M). En soustrayant les moyennes, la multicolinéarité non essentielle est évacuée, ce qui a pour effet immédiat et observable d’effondrer les indices de Facteur d’Inflation de la Variance (VIF) des termes linéaires isolés vers des valeurs sereines et parfaitement conformes aux standards diagnostiques. En apaisant ces instabilités d’estimation sur les prédicteurs simples, le centrage restaure la validité empirique des tests d’hypothèses univariés sans jamais dénaturer la mécanique sous-jacente du phénomène d’interaction globale.
10. Centrage robuste et variantes non paramétriques
10.1 Centrage par rapport à la médiane (Médiane-centrage)
L’ensemble des développements méthodologiques exposés jusqu’ici repose sur un postulat implicite de relative régularité de la distribution empirique : le recours universel à la moyenne arithmétique comme point d’ancrage du centrage. Or, la moyenne arithmétique souffre d’une faiblesse asymptotique bien connue en statistique mathématique : son point de rupture (breakdown point) est rigoureusement égal à 0. Cette vulnérabilité signifie qu’une unique valeur aberrante extrême (outlier), issue par exemple d’une erreur de saisie ou d’un événement idiosyncratique rarissime, possède le pouvoir d’attirer arbitrairement la moyenne vers des territoires périphériques, décentrant de facto l’ensemble des observations valides de l’échantillon.
Face à des données hautement asymétriques—phénomène ubiquitaire lors du recueil de données de temps de réaction chronométrique en neuropsychologie cognitive ou dans l’étude des distributions de revenus en socio-économie—, le centrage par rapport à la médiane (ou médiane-centrage) s’impose comme une alternative robuste d’une pertinence absolue. La formulation mathématique de la transformation devient : xi, med_centré = xi – Médiane(X). La médiane possédant un point de rupture optimal de 50 %, la nouvelle origine 0 correspond très précisément au 50e centile de l’échantillon, garantissant qu’exactement la moitié des observations se positionne au-dessus de l’origine et l’autre moitié en dessous, quelle que soit la violence des valeurs aberrantes peuplant les queues de distribution.
En langage R, l’implémentation algorithmique de cette variante non paramétrique se réalise avec une simplicité déconcertante en substituant la primitive médiane à la moyenne au sein d’une fonction vectorisée directe : x_med_centre <- x - median(x, na.rm = TRUE). Cette transformation offre une résistance exceptionnelle lors de l’application ultérieure de modélisations semi-paramétriques, d’estimations par régression quantile ou d’analyses de survie où la préservation de la structure ordinale autour du point de bascule médian prime sur l’alignement barycentrique classique.
10.2 Centrage fondé sur la moyenne tronquée (Trimmed Mean)
Pour le méthodologiste refusant d’abandonner intégralement les propriétés arithmétiques de la moyenne mais soucieux de juguler la nocivité des observations atypiques, le centrage fondé sur la moyenne tronquée (trimmed mean centering) représente un compromis d’ingénierie statistique particulièrement sophistiqué. Cette démarche s’inscrit au cœur des statistiques robustes formalisées par Peter Rousseeuw et Rand Wilcox, conçues spécifiquement pour conférer aux inférences statistiques une insensibilité prouvée aux déviations de normalité.
Le calcul de la moyenne tronquée consiste à éliminer préalablement un pourcentage fixe symétrique α des observations les plus extrêmes situées aux deux extrémités de la distribution ordonnée avant de calculer la moyenne arithmétique sur le sous-ensemble résiduel d’observations centrales. La fonction native mean() de l’écosystème R intègre nativement cette possibilité computationnelle via son argument dédié trim. Par exemple, l’appel mean(x, trim = 0.1, na.rm = TRUE) ordonne les données numériques, élague rigoureusement les 10 % des valeurs les plus basses ainsi que les 10 % des valeurs les plus hautes, puis calcule la moyenne sur les 80 % d’observations restantes.
Centrer un prédicteur à l’aide de cette mesure de tendance centrale s’exécute par l’instruction : x_tronque_centre <- x - mean(x, trim = 0.2, na.rm = TRUE) (pour une troncature classique de 20 % de part et d’autre, totalisant 40 % d’élagage protecteur). Cette approche s’avère providentielle dans l’analyse de scores psychométriques présentant des queues de distribution épaisses (distributions leptokurtiques ou lois de Student à faibles degrés de liberté), garantissant que le point d’ancrage statistique nul ne soit pas corrompu par des profils cliniques extrêmes tout en conservant une métrique arithmétique d’une grande stabilité stochastique.
10.3 Diagnostics graphiques comparatifs avant et après centrage
L’exercice du prétraitement statistique des données ne saurait être considéré comme achevé sans une étape formelle de validation visuelle et diagnostique. Le recours aux visualisations graphiques de haute définition conçues sous le package ggplot2 offre au statisticien la certitude empirique que la transformation de centrage—qu’elle soit classique, médiane ou robuste—a scrupuleusement respecté les invariants structurels de la distribution sans introduire d’artéfacts logiciels indésirables.
Le premier diagnostic graphique s’articule autour de la superposition ou de la mise en vis-à-vis des courbes d’estimation de densité de probabilité (geom_density()). En représentant graphiquement la distribution brute et la distribution centrée sur des panneaux juxtaposés (facet_wrap()), l’analyste doit observer une identité topologique absolue des profils : les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) calculés avant et après centrage doivent être numériquement indiscernables. L’unique métamorphose constatable doit résider exclusivement dans la translation de l’axe des abscisses, le centre de masse devant coïncider rigoureusement avec la droite verticale repère x = 0.
Le second examen diagnostique convoque l’inspection des diagrammes de dispersion bivariés (geom_point()) croisant le prédicteur avec d’autres variables de l’étude. Ces représentations permettent de confirmer visuellement la conservation intégrale de l’ordonnancement géométrique et de vérifier la modification souhaitée de la position de l’axe des ordonnées. Cette rigueur diagnostique par l’image immunise le chercheur contre les erreurs d’inattention, telles que l’application accidentelle d’une réduction par l’écart-type qui écraserait visiblement l’amplitude de dispersion des points sur le graphique.
11. Erreurs fréquentes, pièges diagnostiques et solutions pratiques
11.1 Confusion pernicieuse entre centrage et standardisation
Dans la taxonomie des bévues d’analyse statistique en environnement R, la confusion sémantique et computationnelle entre le centrage simple et la standardisation complète trône incontestablement au premier rang. Cette méprise tire son origine directe du comportement par défaut de la fonction native scale(). Un nombre incalculable de scripts de recherche comporte la commande laconique df$variable_centree <- scale(df$variable), rédigée par un utilisateur présumant en toute bonne foi que le verbe anglophone to scale opère simplement une mise à l’échelle ou un centrage.
En omettant de désactiver explicitement le paramètre de division par la dispersion métrique via scale = FALSE, l’utilisateur déclenche à son insu une division par l’écart-type empirique, générant un score Z. Si cette bévue peut sembler anodine à un profane, ses répercussions sur l’édifice interprétatif de la recherche sont colossales. La division par l’écart-type détruit irrémédiablement l’unité de mesure native de l’instrument de recueil. Les coefficients de régression non standardisés (paramètres b) issus de ce modèle ne s’expriment plus en unités physiques ou psychologiques réelles (par exemple, des points d’anxiété, des millisecondes ou des milligrammes par décilitre), mais en unités arbitraires d’écarts-types.
Cette altération intempestive complique dramatiquement la formulation d’inférences cliniques ou pratiques et vicie les futures méta-analyses quantitatives qui s’appuient sur la comparabilité des échelles brutes. Pour se prémunir de façon définitive contre ce piège, les équipes méthodologiques doivent proscrire les appels non supervisés à scale() sans arguments explicites au sein de leurs revues de code, ou lui préférer systématiquement des fonctions personnalisées dédiées ou la syntaxe arithmétique directe native du Tidyverse, où aucun calcul de réduction implicite n’est dissimulé.
11.2 Fuite de données (Data Leakage) dans les protocoles d’apprentissage automatique
L’hybridation croissante entre la modélisation statistique inférentielle et les architectures d’apprentissage automatique supervisé (Machine Learning) expose les analystes à un piège méthodologique d’une toxicité absolue : la fuite de données (communément désignée par l’anglicisme Data Leakage). Cette pathologie algorithmique survient lorsqu’une bribe d’information statistique provenant du jeu de données de test contamine insidieusement la phase d’entraînement du modèle prédictif.
L’erreur prototypique se produit lorsque le statisticien exécute son opération de centrage sur l’ensemble exhaustif de sa base de données consolidée avant de procéder au partitionnement aléatoire scindant l’échantillon en sous-ensemble d’apprentissage (training set) et sous-ensemble d’évaluation (test set). Dans ce scénario défectueux, la moyenne globale ayant servi à centrer les variables intègre mathématiquement les valeurs des sujets du jeu de test. Le modèle prédictif bénéficie ainsi d’une clairvoyance rétrospective illégitime sur la distribution globale, ce qui gonfle artificiellement ses métriques de performance diagnostique et conduit à des désillusions sévères lors de son déploiement sur de véritables données prospectives entièrement indépendantes.
Le protocole rigoureux de science des données impose d’étanchéifier hermétiquement la chaîne de traitement selon les étapes séquentielles suivantes :
- Partitionner d’abord la base de données brutes en jeux d’entraînement et de test indépendants.
- Calculer la moyenne empirique de centrage x̄train exclusivement sur les observations du jeu d’entraînement.
- Centrer le jeu d’entraînement à l’aide de cette moyenne spécifique : xtrain, centré = xtrain – x̄train.
- Appliquer impérativement cette même moyenne d’entraînement pour centrer les observations du jeu de test : xtest, centré = xtest – x̄train, sans jamais recalculer de moyenne sur le jeu de test.
L’utilisation de frameworks standardisés tels que le package recipes au sein de l’écosystème tidymodels permet d’automatiser cette rigueur procédurale via l’étape step_center(), qui encapsule et gèle l’estimation des moyennes au moment du prep() pour les appliquer aveuglément lors du bake(), garantissant une absence totale de contamination croisée.
11.3 Altération involontaire de la structure de classes d’objets R
Un autre désagrément technique récurrent lors de l’application de transformations statistiques en R concerne la métamorphose clandestine de la classe des conteneurs de données. L’environnement R repose sur une polymorphie d’objets où des structures visuellement similaires peuvent obéir à des mécanismes d’évaluation fondamentalement incompatibles. Le comportement de la fonction scale() appliquée à un data.frame entier ou à un bloc de plusieurs colonnes illustre parfaitement cette friction logicielle.
Lorsqu’un analyste transmet une sélection rectangulaire de plusieurs variables continues à scale(), par exemple df[, 2:5] <- scale(df[, 2:5], center = TRUE, scale = FALSE), la fonction effectue une coercition automatique de l’ensemble des colonnes en un objet de classe formelle matrix. Bien que l’assignation par crochets semble fonctionner sans message d’erreur apparent, les colonnes ainsi réinsérées peuvent conserver une nature matricielle bidimensionnelle encapsulée au sein de chaque cellule verticale du data frame. L’objet data.frame devient alors structurellement pathologique.
Cette altération invisible fait voler en éclats de nombreuses opérations d’analyse en aval. Par exemple, l’appel ultérieur de fonctions d’ajustement de modèles comme lm() peut échouer mystérieusement à résoudre les formules matricielles croisées, tandis que des fonctions d’exportation de données (telles que write.csv() ou haven::write_sav()) lèvent des exceptions cryptiques lors de la sérialisation des colonnes composites. Pour conjurer ce risque d’instabilité structurelle, le développeur consciencieux doit systématiquement encapsuler ses sorties dans un appel explicite de rétablissement de classe, tel que as.data.frame() ou as_tibble(), ou formater individuellement chaque variable sous forme de vecteur atomique univarié pur.
12. Automatisation et création de fonctions personnalisées de centrage en R
12.1 Programmation d’une fonction modulaire et réutilisable
Afin d’éradiquer définitivement les risques d’erreurs syntaxiques répétitives et de garantir une reproductibilité parfaite à travers l’ensemble des projets d’analyse d’un laboratoire ou d’une institution, la démarche logicielle la plus noble réside dans la programmation d’une fonction personnalisée robuste et modulaire. Cette fonction, que nous pouvons formaliser sous le nom de center_variable(), doit intégrer des mécanismes de validation défensive des types d’entrée, une gestion paramétrable des valeurs manquantes et l’assurance absolue de restituer un vecteur atomique épuré de tout attribut matriciel parasite.
Une implémentation défensive et hautement optimisée s’articule autour de la syntaxe algorithmique suivante :
center_variable <- function(x, na.rm = TRUE) {

  # Assertion défensive de type

  if (!is.numeric(x)) {

    stop("L'argument d'entrée 'x' doit impérativement être de nature numérique.", call. = FALSE)

  }


  # Calcul robuste de la moyenne arithmétique

  moyenne_valeur <- mean(x, na.rm = na.rm)


  # Soustraction arithmétique vectorisée pure

  x_centre <- x - moyenne_valeur


  # Garantie de restitution sous forme de vecteur atomique plat

  return(as.vector(x_centre))

}
Cette fonction élémentaire mais invulnérable intègre une assertion formelle via if (!is.numeric(x)) qui bloque immédiatement l’exécution avec un message explicite si un utilisateur imprudent tente de lui adresser une variable catégorielle factorielle ou textuelle. En fixant na.rm = TRUE par défaut tout en autorisant sa désactivation si le protocole exige une politique de tolérance zéro envers les données manquantes, elle neutralise le poison statistique de propagation des NA. Enfin, le recours final à as.vector() garantit que la donnée renvoyée s’intègre harmonieusement dans n’importe quel conteneur de données sans aucune pollution structurelle.
12.2 Déploiement pour de très grandes bases de données avec data.table
Lors de l’exploitation de registres hospitaliers massifs, de cohortes épidémiologiques pan-nationales ou de flux de télémétrie comportementale en ligne excédant plusieurs millions d’enregistrements, les mécanismes d’allocation mémoire et de duplication d’objets propres à R de base ou au Tidyverse peuvent saturer rapidement la mémoire vive disponible. Pour ces environnements critiques de traitement à très haute performance, l’extension data.table constitue la référence computationnelle absolue en matière de rapidité et d’économie de ressources matérielles.
La puissance inégalée de data.table repose sur son paradigme de modification par référence, instrumenté par l’opérateur symbolique :=. Contrairement aux approches traditionnelles qui créent systématiquement une copie intégrale du tableau en mémoire vive à chaque transformation de variable, data.table localise directement les adresses mémoire des colonnes existantes et réécrit leurs valeurs in situ sans aucune réallocation de structure globale. Pour centrer une variable sur une table massive de 50 millions de lignes, l’expression s’exécute en une fraction de seconde :
library(data.table)

setDT(large_df)

large_df[, temps_reaction_cent := temps_reaction - mean(temps_reaction, na.rm = TRUE)]
Cette syntaxe ultra-véloce peut également être couplée à une logique de centrage par groupe (CWC multiniveau à haute performance) en spécifiant simplement l’argument de partitionnement by : large_df[, score_cent_groupe := score - mean(score, na.rm = TRUE), by = id_centre_medical]. Grâce à son moteur écrit en C hautement optimisé avec parallélisation multicoeur native via OpenMP, data.table pulvérise tous les temps de calcul traditionnels et s’impose comme l’outil privilégié pour les statisticiens confrontés aux défis vertigineux du Big Data en santé mentale et en génomique quantitative.
12.3 Intégration systématique dans un pipeline de recherche reproductible
L’étape terminale d’une ingénierie de données aboutie consiste à encastrer ces opérations de centrage au sein d’un pipeline d’analyse entièrement automatisé, conteneurisé et reproductible de bout en bout. La conception d’un script d’analyse ne doit jamais être pensée comme une suite disparate de manipulations ad hoc exécutées manuellement dans une console interactive, mais comme un flux ordonné et déterministe reliant des données sources brutes en lecture seule à un rapport d’inférence final auditable par des pairs.
Dans ce cadre rigoureux, le centrage des variables doit intervenir au sein d’un script dédié au nettoyage et à la préparation des données (couramment baptisé 01_data_cleaning.R ou prep_data.R). Ce module computationnel assure le chargement des données brutes, l’application documentée des fonctions de centrage, la consignation explicite des moyennes retranchées dans un fichier de métadonnées d’audit (au format RDS ou JSON), et la sauvegarde finale de la table transformée prête pour l’estimation modélisatrice. Cette séparation fonctionnelle étanche évite les recalculs opportunistes et scelle la traçabilité des transformations appliquées à chaque variable.
Enfin, pour couronner l’architecture de reproductibilité de la recherche, l’environnement logiciel complet de R doit être rigoureusement encapsulé à l’aide d’outils de gestion de dépendances déterministes tels que renv. En figeant les versions exactes des bibliothèques mobilisées (comme dplyr, interactions ou data.table) dans un fichier de verrouillage renv.lock, le chercheur offre à la communauté scientifique l’assurance absolue que les algorithmes de centrage produiront des résultats strictement identiques au bit près, quelles que soient les évolutions futures du système d’exploitation ou du moteur d’exécution sous-jacent. Le centrage statistique passe ainsi du statut de simple bricolage algorithmique à celui de brique méthodologique fondamentale, garante de la robustesse, de la transparence et de l’immutabilité des découvertes empiriques contemporaines.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373-400. https://doi.org/10.1207/s15327906mbr4003_5
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121-138. https://doi.org/10.1037/1082-989X.12.2.121
- Kromrey, J. D., & Foster-Johnson, L. (1998). Mean centering in moderated multiple regression: Much ado about nothing. Educational and Psychological Measurement, 58(1), 42-67. https://doi.org/10.1177/0013164498058001005
- Marsh, H. W., Trautwein, U., Lüdtke, O., Köller, O., & Baumert, J. (2008). Integration of multidimensional self-concept and core personality constructs: Construct validation and test of the Big-Fish-Little-Pond Effect. Journal of Personality and Social Psychology, 94(4), 542-563. https://doi.org/10.1037/0022-3514.94.4.542
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Rousseeuw, P. J., & Hubert, M. (2011). Robust statistics for outlier detection. WIREs Data Mining and Knowledge Discovery, 1(1), 73-79. https://doi.org/10.1002/widm.2
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-590. https://doi.org/10.1093/biomet/63.3.581
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., Takahashi, K., Vaughan, D., Wilke, C., Woo, K., & Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.