
Dans le champ des sciences humaines, et tout particulièrement en psychologie quantitative et en psychométrie, la mesure empirique du comportement humain se heurte inévitablement à la complexité de l’hétérogénéité individuelle. Qu’il s’agisse d’évaluer les temps de réaction face à un stimulus inhibiteur, d’étalonner les scores d’un inventaire de personnalité ou d’estimer les niveaux d’anxiété préopératoire au sein d’une cohorte clinique, la quantification de l’incertitude et de la dispersion constitue le pivot central de toute analyse statistique digne de ce nom. L’observation brute d’un score isolé ne possède aucune signification épistémologique intrinsèque ; elle ne prend sens qu’au regard de la distribution globale de la population ou de l’échantillon au sein duquel elle s’inscrit.
Si la moyenne arithmétique demeure la mesure de tendance centrale la plus immédiatement mobilisée par les praticiens et les étudiants de troisième cycle, elle s’avère cruellement insuffisante dès lors qu’il s’agit de capturer la véritable architecture des données. Deux cohortes expérimentales peuvent afficher une moyenne rigoureusement identique tout en présentant des dynamiques psychologiques radicalement divergentes, l’une témoignant d’une remarquable homogénéité comportementale tandis que l’autre présente une dispersion extrême, polarisée entre des profils diamétralement opposés. C’est à ce titre que la variance, définie comme le second moment centré d’une distribution statistique, s’impose comme une métrique incontournable de la modélisation statistique moderne.
Le recours à Microsoft Excel comme environnement de calcul et de modélisation est universellement répandu dans les laboratoires académiques, les institutions de santé et les directions des ressources humaines. Toutefois, la manipulation des fonctions statistiques du tableur exige une maîtrise conceptuelle sans faille. Entre les fonctions contemporaines telles que VAR.S et VAR.P, les formules héritées pour des motifs de rétrocompatibilité et les variantes capables de parser des chaînes textuelles ou logiques, le risque d’erreur méthodologique est considérable. Ce guide exhaustif a pour vocation de déconstruire méthodiquement les fondements théoriques, mathématiques et informatiques du calcul de la variance dans Excel, en établissant une distinction absolue entre l’estimation échantillonnale et l’évaluation populationnelle, afin d’offrir aux chercheurs une rigueur analytique irréprochable conforme aux plus hauts standards internationaux de publication.
1. Introduction théorique à la variance en psychologie quantitative
1.1 Définition épistémologique de la dispersion des scores psychométriques
L’épistémologie de la mesure en psychologie repose sur l’hypothèse fondamentale selon laquelle les phénomènes mentaux et comportementaux sont quantifiables, bien qu’ils ne soient pas directement observables de manière tangible comme le seraient des grandeurs physiques telles que la masse ou la longueur. Dans le cadre de la psychométrie contemporaine, la variabilité n’est pas considérée comme un simple bruit de fond indésirable venant parasiter la mesure, mais bien comme la matière première de l’investigation scientifique. Cette variabilité s’articule autour de deux dimensions orthogonales : la variabilité interindividuelle, qui rend compte des écarts stables existant entre différents sujets au sein d’une même population pour un construit donné, et la variabilité intra-individuelle, qui décrit les fluctuations dynamiques, temporelles ou contextuelles des performances d’un unique participant confronté à des sollicitations répétées.
Face à cette complexité, les mesures de tendance centrale, au premier rang desquelles figure la moyenne arithmétique, démontrent de sévères limites structurelles. Résumer la distribution des scores d’une échelle d’intelligence ou d’un questionnaire d’évaluation de la dépression à son seul barycentre revient à oblitérer l’hétérogénéité sous-jacente des profils psychologiques. Deux groupes d’individus présentant une moyenne de 100 à un test psychologique peuvent recouvrir des réalités phénoménologiques incomparables : le premier groupe peut être intégralement concentré entre 95 et 105, indiquant une cohorte standardisée et uniforme, tandis que le second groupe peut comporter une proportion égale de scores effondrés à 50 et de performances exceptionnelles à 150. Sans l’adjonction d’un indice de dispersion robuste, toute inférence diagnostique ou expérimentale devient intrinsèquement fallacieuse.
Au sein de la Théorie Classique des Tests formulée initialement par Spearman et consolidée ultérieurement par Novick, la variance occupe une position architecturale décisive. Elle intervient directement dans l’équation fondamentale postulant que le score observé ($X$) est la résultante déterministe d’un score vrai ($T$, pour True score) auquel s’additionne une erreur de mesure aléatoire ($E$) :
$$\sigma^2_X = \sigma^2_T + \sigma^2_E$$
Cette formulation élégante démontre que la variance globale des scores observés se décompose linéairement en une variance attribuable au construit latent ciblé par l’instrument de mesure et une variance d’erreur générée par les imprécisions de l’outil, les fluctuations attentionnelles du sujet ou les biais contextuels d’administration. Dès lors, le concept même de fidélité psychométrique — mesuré par le coefficient de corrélation intraclasse ou l’alpha de Cronbach — est défini comme la proportion de la variance totale qui est imputable à la variance vraie. Mesurer rigoureusement la variance constitue donc la condition sine qua non pour quantifier l’erreur de mesure et départager la variabilité théorique du construit de la simple dispersion accidentelle des données empiriques recueillies.
1.2 Différenciation fondamentale entre population cible et échantillon représentatif
La validité interne et externe de toute inférence scientifique repose sur une distinction conceptuelle fondamentale que la statistique théorique impose entre la population parente et l’échantillon d’observation. Dans l’acception statistique et psychologique, la population cible désigne l’ensemble exhaustif et universel des entités qui partagent une ou plusieurs caractéristiques délimitées par les objectifs de recherche. Il peut s’agir de l’universalité des êtres humains adultes, de l’ensemble des enfants diagnostiqués d’un trouble du spectre de l’autisme dans un pays donné, ou de l’intégralité des candidats se présentant au concours d’une grande institution académique au cours d’une décennie. Dans la quasi-totalité des scénarios de recherche en sciences comportementales, cette population cible est virtuellement infinie, inaccessible ou matériellement impossible à évaluer dans son exhaustivité en raison de contraintes logistiques, financières, temporelles et déontologiques évidentes.
Pour contourner cette impossibilité matérielle, le chercheur extrait de cette population cible un échantillon représentatif, défini comme une fraction finie d’individus sélectionnés selon un protocole probabiliste ou non probabiliste déterminé. L’objectif ultime de cette démarche empirique réside dans le passage dialectique de la statistique descriptive à la statistique inférentielle. Alors que la statistique descriptive se borne à résumer et formaliser les données directement recueillies auprès des participants de l’échantillon, la statistique inférentielle utilise ces données locales pour formuler des inductions probabilistes et estimer avec une marge d’erreur maîtrisée les paramètres inconnus de la population générale parente.
Ce saut épistémologique est théoriquement rendu possible par le Théorème Central Limite, clé de voûte des mathématiques stochastiques modernes. Si le théorème garantit que la distribution des moyennes échantillonnales converge vers une loi normale à mesure que la taille de l’échantillon augmente, il révèle simultanément des régularités fondamentales concernant la distribution d’échantillonnage de la variance. La variance calculée directement sur un échantillon empirique ne correspond que rarement à la variance exacte de la population d’origine ; elle constitue une variable aléatoire dont la distribution théorique suit, sous l’hypothèse de normalité des scores initiaux, une loi proportionnelle au Chi-carré ($\chi^2$). Ignorer la frontière ontologique entre l’entité populationnelle et sa réalisation échantillonnale expose le statisticien à des confusions d’autant plus périlleuses qu’elles se traduisent par des formules de calcul mathématiquement divergentes dans les environnements informatiques.
1.3 L’importance de l’automatisation rigoureuse du calcul sous Excel
Dans l’écosystème contemporain des laboratoires universitaires, des départements de psychologie appliquée et des unités d’évaluation clinique, l’exécution manuelle des calculs statistiques appartient désormais au passé. La manipulation d’opérations matricielles et de sommations quadratiques manuelles au moyen d’une simple calculatrice représente une source chronique d’erreurs d’inattention, de fautes de saisie et d’arrondis prématurés qui menacent gravement la reproductibilité scientifique. L’automatisation rigoureuse au sein de logiciels de tableur comme Microsoft Excel est devenue la norme pragmatique de premier niveau pour les phases d’exploration préliminaire, de prétraitement et de communication des données.
Toutefois, l’usage d’un tableur ne dispense en aucun cas le chercheur d’une compréhension algorithmique approfondie des outils qu’il mobilise. Au contraire, la relative facilité de déploiement des formules prédéfinies d’Excel tend à masquer la complexité mathématique des traitements appliqués. Un clic malencontreux sur une fonction inadaptée, une mauvaise gestion des cellules vides ou une sélection erronée de plages vectorielles peut contaminer l’ensemble de la chaîne de traitement inférentiel sans qu’aucun message d’erreur explicite ne vienne alerter l’utilisateur imprudent. La reproductibilité des protocoles de recherche psychométrique impose que chaque étape de calcul soit auditable, standardisée et vérifiable selon les canons méthodologiques les plus stricts.
Les fonctions intégrées d’Excel, lorsqu’elles sont déployées avec une rigueur d’ingénierie statistique, offrent un alignement remarquable avec les exigences méthodologiques des instances académiques internationales. Elles permettent non seulement de traiter des cohortes de scores psychométriques comprenant des centaines de milliers de lignes sans aucune perte de précision numérique, mais également d’établir des feuilles d’analyse traçables, interactives et documentées, parfaitement conformes aux principes de la science ouverte et aux directives de l’American Psychological Association (APA). La maîtrise technique de ces fonctions constitue par conséquent une compétence méthodologique non négociable pour quiconque aspire à conduire des analyses quantitatives sérieuses.
2. Fondements mathématiques : Variance de population versus variance d’échantillon
2.1 Formulation algébrique de la variance de population
D’un point de vue purement mathématique, la variance d’une population globale finie représente la moyenne exacte des carrés des écarts de chaque observation individuelle par rapport à la moyenne arithmétique réelle de l’ensemble de cette même population. Par convention universelle établie par les travaux pionniers de Karl Pearson et Ronald Fisher, ce paramètre populationnel invariable est désigné par la lettre grecque sigma minuscule élevée au carré ($\sigma^2$). Son expression algébrique canonique se formalise de la manière suivante :
$$\sigma^2 = \frac{\sum_{i=1}^{N} (x_i – \mu)^2}{N}$$
L’analyse détaillée des termes composant cette équation s’impose pour en saisir la portée :
- $N$ représente la taille exhaustive, finie et totale de la population cible étudiée. Il ne s’agit aucunement d’une fraction ou d’une sélection d’individus, mais bien du dénombrement intégral de toutes les entités constituant l’univers du discours statistique.
- $x_i$ désigne la valeur numérique brute obtenue pour la $i$-ème observation de la population pour la variable psychologique considérée.
- $\mu$ (mu) incarne la moyenne arithmétique théorique véritable de la population complète, calculée par l’expression $\mu = \frac{\sum x_i}{N}$.
- $(x_i – \mu)$ représente la déviation élémentaire ou l’écart individuel de chaque sujet vis-à-vis de la moyenne populationnelle.
- $\sum (x_i – \mu)^2$ constitue ce que la statistique désigne sous le terme fondamental de Somme des Carrés des Écarts (souvent abrégée en $SCE$ ou $SS$ pour Sum of Squares). L’élévation au carré de chaque écart est obligatoire : elle permet d’une part de neutraliser les compensations arithmétiques entre déviations positives et négatives (dont la somme linéaire brute est toujours strictement égale à zéro), et d’autre part de pénaliser de façon quadratique les déviations importantes, conférant un poids accru aux scores s’éloignant significativement du centre de gravité.
Les conditions d’application de cette formule en contexte scientifique réel sont exceptionnellement restrictives. Pour être habilité à employer légitimement la formule de la variance de population $\sigma^2$, le chercheur doit se trouver dans une situation où l’intégralité du groupe théorique a été soumise à l’évaluation, sans aucune omission ni perspective d’extrapolation au-delà de ce groupe précis. Cette situation se rencontre quasi exclusivement lors de recensements nationaux exhaustifs, dans des cadres d’évaluation institutionnelle fermée (par exemple, la totalité des patients admis dans une unité hospitalière spécifique au cours d’une année civile sans intention d’inférer les propriétés d’une cohorte future) ou dans la formalisation de modèles théoriques et de simulations stochastiques fermées.
2.2 Formulation algébrique de la variance d’échantillon
Lorsque la recherche porte sur un échantillon tiré au sein d’une population parente plus vaste — ce qui constitue la configuration quasi exclusive des études empiriques en psychologie expérimentale, en clinique et en neurosciences — la formule précédente ne peut être mobilisée directement sans induire une erreur fondamentale. La variance d’un échantillon, universellement désignée par la lettre latine minuscule élevée au carré ($s^2$), est calculée selon l’expression algébrique suivante :
$$s^2 = \frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n – 1}$$
Une lecture comparative minutieuse de cette formule par rapport à celle de la population met en exergue des glissements sémantiques et mathématiques capitaux :
- $n$ représente la taille de l’échantillon effectif disponible pour l’expérimentateur, c’est-à-dire le nombre fini d’observations empiriques recueillies.
- $\bar{x}$ (prononcé « x barre ») désigne la moyenne arithmétique empirique calculée exclusivement sur les $n$ observations de l’échantillon ($\bar{x} = \frac{\sum x_i}{n}$). Elle ne saurait être assimilée à $\mu$, qui demeure une constante théorique inconnue de l’expérimentateur.
- Le dénominateur de la fraction n’est plus $n$, mais le binôme $(n – 1)$. Ce glissement arithmétique constitue la fameuse correction de Bessel, dont l’omission entraîne une sous-estimation systématique de la variabilité réelle du phénomène étudié.
En statistique inférentielle, $s^2$ n’est pas une simple description mécanique d’une série de nombres ; il s’agit d’un estimateur ponctuel. En d’autres termes, $s^2$ est une fonction aléatoire des données d’échantillonnage conçue expressément pour estimer le paramètre inconnu $\sigma^2$ de la population globale. Cette propriété d’estimation implique que la valeur numérique obtenue varie d’un échantillon à un autre : c’est la variance d’échantillonnage de l’estimateur.
2.3 Analyse comparative des propriétés des deux formules
L’écart numérique et conceptuel entre la formule de population ($\sigma^2$) et la formule d’échantillon ($s^2$) réside intégralement dans le comportement asymptotique induit par la nature de leurs dénominateurs respectifs. Pour un même jeu de données contenant $k$ observations, le calcul mobilisant le diviseur $(k – 1)$ produira nécessairement une valeur numérique strictement supérieure au calcul mobilisant le diviseur $k$. L’ampleur relative de cette divergence arithmétique est directement tributaire du volume d’observations considérées, comme le formalise le ratio exact entre les deux métriques :
$$\frac{s^2}{\sigma^2_{\text{naïve}}} = \frac{n}{n – 1}$$
Lorsque la taille de l’échantillon $n$ est restreinte — configuration courante en neuropsychologie clinique ou en neuro-imagerie fonctionnelle où les cohortes dépassent rarement 10 à 20 participants en raison de contraintes matérielles sévères — l’impact de ce dénominateur est spectaculaire. Pour $n = 5$, le diviseur passe de 5 à 4, ce qui majore la variance d’échantillon de 25 % par rapport à la variance de population. À l’inverse, lorsque $n$ tend vers l’infini ($n to \infty$), le rapport $\frac{n}{n – 1}$ converge asymptotiquement vers la valeur 1. Ainsi, pour une cohorte de 5 000 participants à une enquête épidémiologique, l’écart relatif entre les deux formules n’est plus que de 0,02 %, devenant mathématiquement négligeable sur le plan de l’application pratique, bien qu’il demeure fondamental sur le plan de la validité théorique.
En outre, les deux formulations partagent une sensibilité différentielle exacerbée vis-à-vis des valeurs extrêmes (les fameux outliers). En raison du mécanisme d’élévation quadratique des déviations, toute observation s’écartant substantiellement du barycentre exerce un effet de levier considérable sur le numérateur. Toutefois, dans la formule d’échantillon, cet effet de levier est encore démultiplié par la contraction du dénominateur opérée par la soustraction de l’unité, rendant l’estimateur $s^2$ particulièrement réactif à la moindre instabilité observationnelle dans les cohortes réduites.
3. Le rôle de la correction de Bessel dans l’estimation sans biais
3.1 Origine du biais systématique de l’estimateur naïf
Pour appréhender la nécessité absolue de la correction de Bessel, il convient de démontrer pourquoi l’usage d’un diviseur $n$ pour calculer la variance d’un échantillon produit ce que la théorie statistique qualifie d’estimateur biaisé. Imaginons un chercheur qui, disposant d’un échantillon aléatoire de scores $x_1, x_2, dots, x_n$, calculerait la dispersion en divisant simplement la somme des carrés des écarts par $n$, en utilisant la moyenne de l’échantillon $\bar{x}$. Cet estimateur naïf, que nous pouvons noter $S^2_n$, s’écrit :
$$S^2_n = \frac{1}{n}\sum_{i=1}^{n} (x_i – \bar{x})^2$$
Le biais fondamental de cette approche provient d’un fait géométrique et algébrique inaltérable : par définition de la moyenne arithmétique, la somme des carrés des écarts d’un ensemble de points atteint son minimum absolu lorsqu’elle est calculée par rapport à la moyenne empirique de ces mêmes points ($\bar{x}$). Par conséquent, la quantité $\sum_{i=1}^{n} (x_i – \bar{x})^2$ est systématiquement inférieure ou égale à la quantité $\sum_{i=1}^{n} (x_i – \mu)^2$, où $\mu$ est la véritable moyenne de la population globale.
Dans la réalité empirique, l’échantillon tiré a tendance à se regrouper plus étroitement autour de son propre centre de gravité immédiat qu’autour de la moyenne théorique parente. En substituant l’inconnue $\mu$ par son approximation locale $\bar{x}$, l’expérimentateur supprime artificiellement une partie de la variabilité réelle des observations. Si l’on calcule l’espérance mathématique de cet estimateur naïf sur une infinité d’échantillons aléatoires indépendants de même taille, on démontre de manière irréfutable que :
$$\mathbb{E}[S^2_n] = \frac{n – 1}{n}\sigma^2$$
Cette égalité atteste formellement que l’estimateur naïf sous-estime systématiquement la variance véritable de la population parente d’un facteur précisément égal à $\frac{n – 1}{n}$. Si un laboratoire fonde ses analyses inférentielles sur une telle métrique, il conclura systématiquement à une dispersion des traits psychologiques inférieure à ce qu’elle est en réalité dans l’ensemble de l’espèce ou de la population parente, faussant irrémédiablement le calibrage des tests psychométriques et l’estimation des puissances statistiques.
3.2 Justification formelle des degrés de liberté et du dénominateur n-1
L’introduction du dénominateur $(n – 1)$ par le mathématicien et astronome allemand Friedrich Wilhelm Bessel découle directement du concept de degrés de liberté (souvent noté $ddl$ ou $df$ pour degrees of freedom) au sein d’un système vectoriel. Dans un espace vectoriel à $n$ dimensions, un ensemble de $n$ observations indépendantes possède initialement $n$ degrés de liberté, chaque point étant entièrement libre de prendre n’importe quelle valeur réelle le long du continuum de l’échelle de mesure.
Cependant, pour être en mesure de calculer la dispersion des scores, il est formellement indispensable d’estimer préalablement la moyenne de l’échantillon $\bar{x}$. Dès l’instant où cette moyenne empirique est calculée et fixée, une contrainte algébrique stricte s’impose au système : la somme linéaire des déviations individuelles doit impérativement s’annuler :
$$\sum_{i=1}^{n} (x_i – \bar{x}) = 0$$
En vertu de cette égalité déterministe, les observations ne sont plus toutes mathématiquement libres de varier. Si nous connaissons la moyenne de l’échantillon et les valeurs de $(n – 1)$ sujets, la valeur du $n$-ième participant est déjà intégralement déterminée et prévisible ; elle ne possède aucune liberté de variation. Le système a donc irrémédiablement sacrifié un degré de liberté pour estimer le paramètre de localisation centrale intermédiaire.
Pour neutraliser l’impact de cette contrainte et rétablir l’exactitude de l’espérance mathématique, il convient d’appliquer un coefficient correcteur égal à l’inverse du facteur de distorsion, soit $\frac{n}{n – 1}$. En multipliant l’estimateur naïf par ce facteur correcteur de Bessel, on obtient l’estimateur standardisé $s^2$ :
$$s^2 = S^2_n \times \frac{n}{n – 1} = \left(\frac{1}{n}\sum_{i=1}^{n} (x_i – \bar{x})^2\right) \times \frac{n}{n – 1} = \frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n – 1}$$
L’espérance mathématique de cet estimateur corrigé devient alors parfaitement sans biais :
$$\mathbb{E}[s^2] = \mathbb{E}\left[\frac{n}{n – 1} S^2_n\right] = \frac{n}{n – 1} \mathbb{E}[S^2_n] = \frac{n}{n – 1} \times \left(\frac{n – 1}{n}\sigma^2\right) = \sigma^2$$
Cette démonstration prouve sans équivoque que $s^2$ est un estimateur rigoureusement sans biais (ou asymptotiquement correct) de la variance de la population parente $\sigma^2$. En moyenne, sur le long terme des tirages aléatoires répétés, la valeur obtenue par ce calcul converge précisément vers le paramètre réel sous-jacent.
3.3 Impacts méthodologiques en recherche expérimentale
L’omission de la correction de Bessel et le choix inapproprié de la formule de variance déploient des conséquences directes et désastreuses sur la chaîne inférentielle des études expérimentales en sciences cognitives et médicales. Dans la mesure où la quasi-totalité des tests d’hypothèses paramétriques dépendent explicitement de l’estimation de la variance d’échantillon, une erreur à cette étape racine corrompt instantanément les statistiques de test ultérieures.
Considérons l’exemple paradigmatique du test $t$ de Student pour échantillons indépendants ou de l’analyse de variance univariée (ANOVA). Dans ces procédures, le dénominateur de la statistique de test représente l’erreur type de la moyenne ($SE = \frac{s}{\sqrt{n}}$) ou la variance résiduelle intra-groupe (le carré moyen résiduel, $MS_{error}$). Si le chercheur applique par inadvertance la formule de population (diviseur $n$) au lieu de la formule d’échantillon corrigée (diviseur $n – 1$), l’erreur type sera artificiellement compressée et sous-estimée. Par conséquent, la statistique $t$ ou $F$ calculée sera gonflée de façon fallacieuse, entraînant une diminution mécanique de la $p$-value associée.
Cette dérive méthodologique accroît directement le risque de commettre une erreur de type I (ou risque de première espèce $\alpha$), c’est-à-dire le risque de rejeter à tort l’hypothèse nulle ($H_0$) et d’affirmer l’existence d’un effet thérapeutique ou psychologique significatif là où il n’y a en réalité que des fluctuations stochastiques d’échantillonnage. Ce phénomène est d’une gravité exceptionnelle lors des phases d’essais cliniques préliminaires ou des études pilotes à très faible effectif ($n < 15$). C'est pour cette raison impérieuse que l'ensemble des standards internationaux de publication scientifique, tels que ceux édictés par l'American Psychological Association, prohibent catégoriquement l’usage de la variance d’échantillon non corrigée et exigent de façon exclusive le recours à l’estimateur sans biais fondé sur $(n – 1)$ degrés de liberté.
4. Typologie complète des fonctions de variance dans Microsoft Excel
4.1 Les fonctions modernes recommandées : VAR.S et VAR.P
Afin d’aligner son tableur sur les nomenclatures de l’Organisation internationale de normalisation (ISO) et de mettre un terme à des décennies d’ambiguïté terminologique, Microsoft a profondément remanié sa bibliothèque de fonctions statistiques à partir d’Office Excel 2010. Les fonctions contemporaines de référence se distinguent par l’introduction explicite d’un point séparateur dans leur désignation syntaxique, signalant sans équivoque la vocation mathématique du traitement algorithmique.
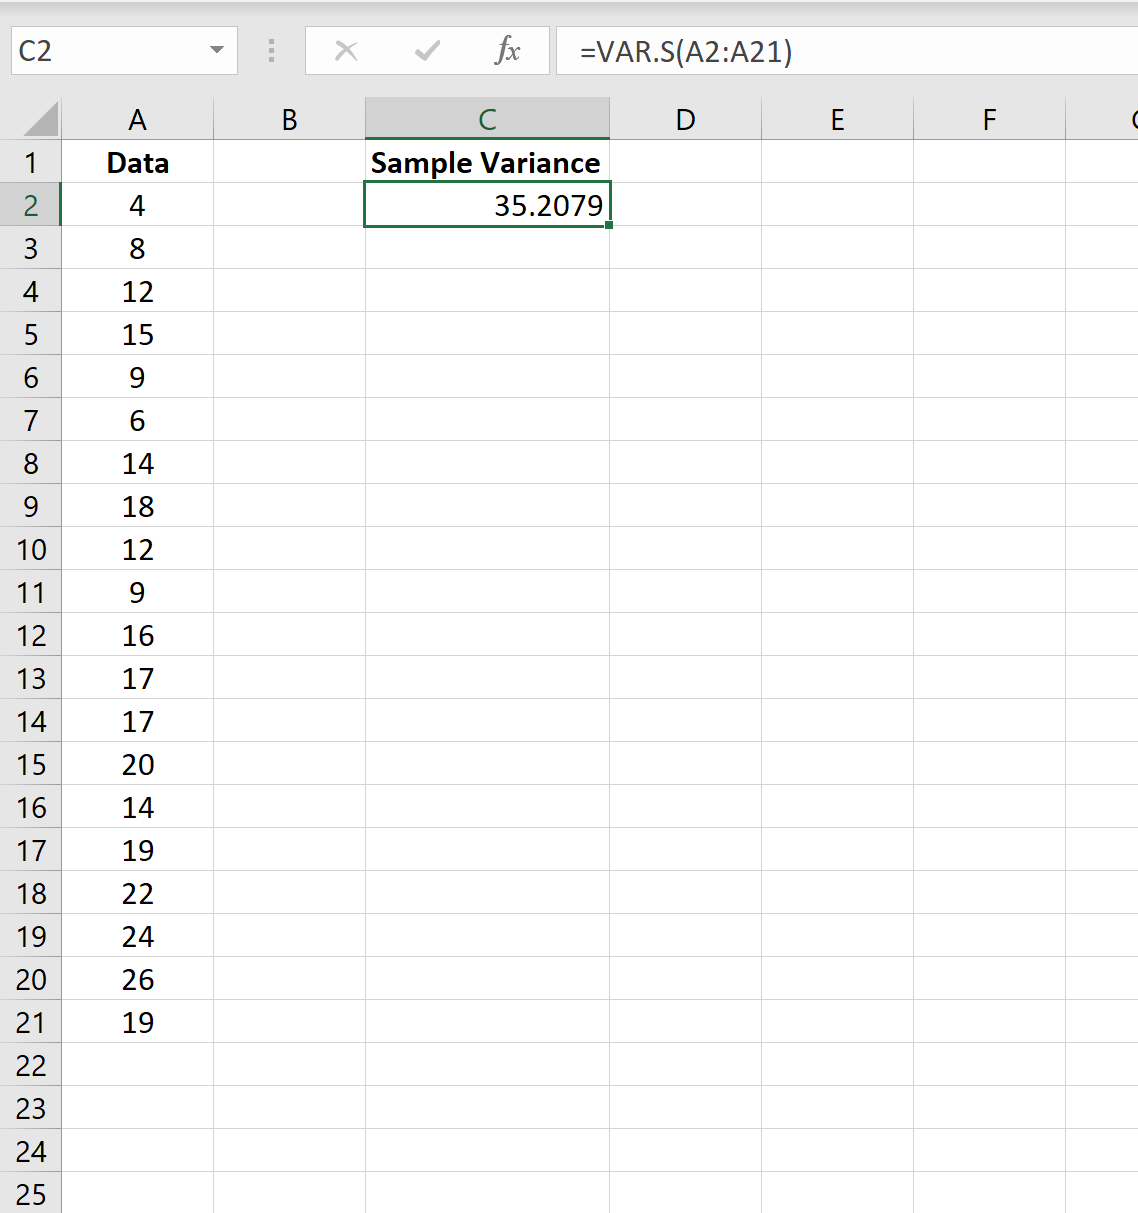
La fonction reine pour toute recherche expérimentale et étude sur échantillon est VAR.S (le suffixe « .S » étant l’abréviation du terme anglo-saxon Sample, signifiant « Échantillon »). Dans la version française d’Excel, la graphie demeure rigoureusement VAR.S. Son architecture algorithmique implémente avec une fidélité absolue la division par $(n – 1)$ de la somme des déviations quadratiques par rapport à la moyenne empirique. Elle est conçue pour être alimentée par des plages de cellules continues ou discontinues ne contenant que des valeurs numériques pures. Tout élément textuel, valeur logique ou cellule vide est par défaut exclu des calculs, garantissant que le dénominateur effectif corresponde rigoureusement au dénombrement des données valides moins un degré de liberté.
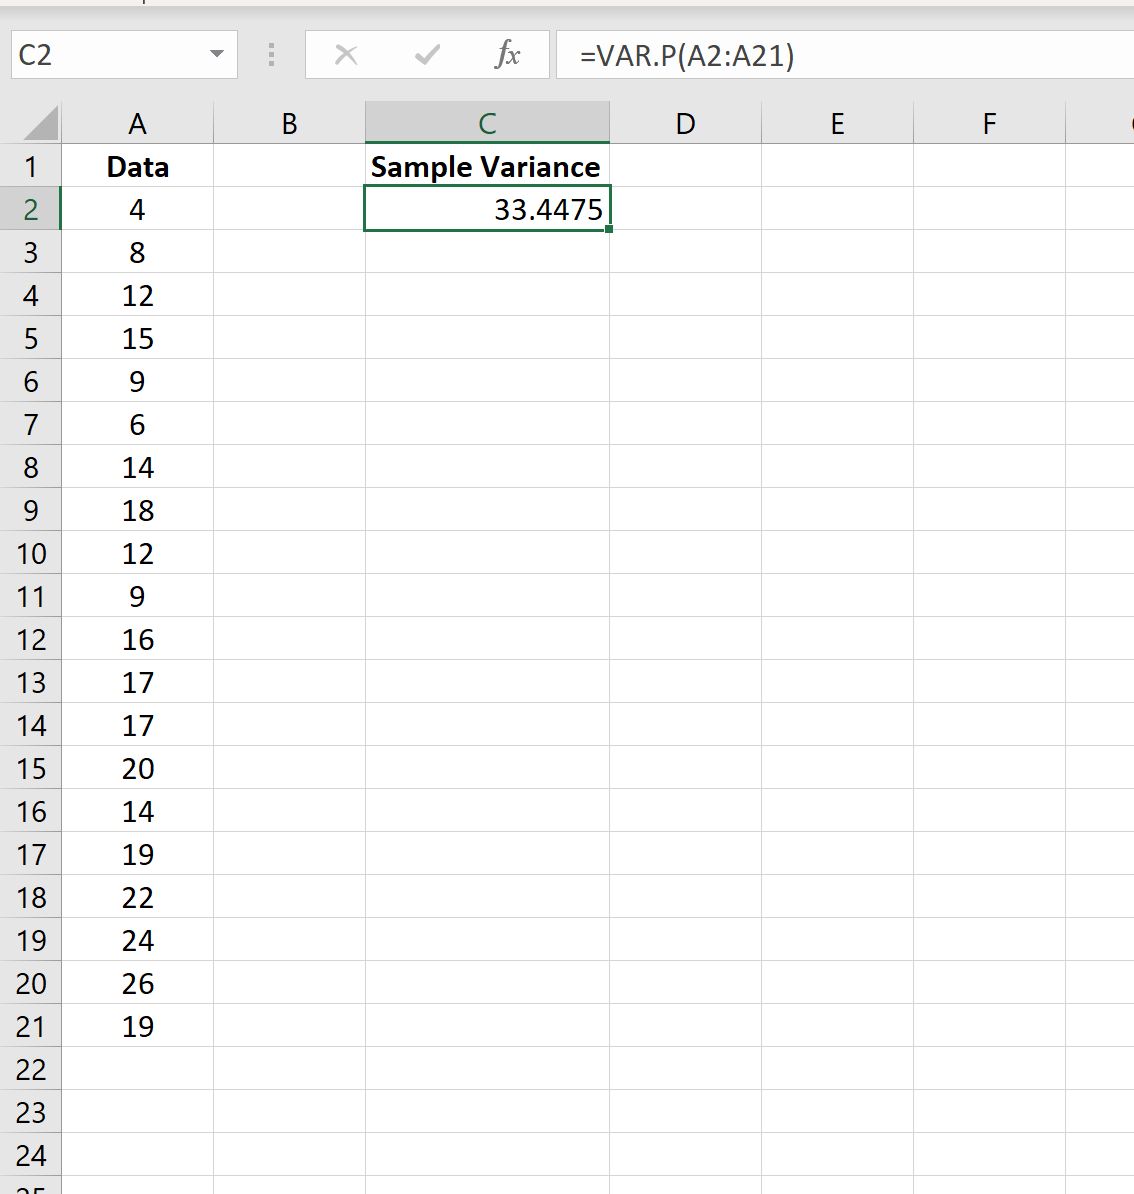
À l’opposé méthodologique, la fonction contemporaine dédiée à l’évaluation des populations intégrales est VAR.P (le suffixe « .P » référant à Population). Cette fonction implémente algorithmiquement la division stricte par $N$, sans soustraction de l’unité. Elle ne doit être mobilisée que lorsque la série de cellules fournies en argument constitue la totalité indépassable de l’univers de référence. Outre leur clarté sémantique, les fonctions VAR.S et VAR.P bénéficient d’optimisations algorithmiques internes introduites par Microsoft pour limiter les erreurs de troncature et d’arrondi en virgule flottante binaire à double précision (standard IEEE 754), garantissant une remarquable stabilité numérique même lorsque les valeurs observées sont très élevées ou présentent une variance relative infime.
4.2 Les fonctions de compatibilité héritées : VAR et VAR.PARENTHESE
Dans les versions antérieures à 2010, Excel proposait des fonctions à la syntaxe plus dense mais propice à une désastreuse confusion : la fonction VAR et la fonction VARP. Pour assurer la rétrocompatibilité des millions de classeurs professionnels et universitaires développés au cours des années 1990 et 2000, Microsoft a fait le choix délibéré de conserver ces fonctions historiques au sein de l’environnement moderne de calcul.
Il est impératif pour tout statisticien de comprendre le comportement exact de ces formules d’héritage :
- La fonction historique
VARest l’ancêtre direct deVAR.S. Elle applique mathématiquement le diviseur $(n – 1)$. En d’autres termes, taper=VAR(A1:A50)produit un résultat numérique rigoureusement identique à=VAR.S(A1:A50). L’ambiguïté résidait dans le fait que son nom ne précisait aucunement qu’il s’agissait d’un calcul sur un échantillon, induisant d’innombrables utilisateurs novices à l’utiliser à tort en pensant calculer une variance universelle de population. - La fonction historique
VARP(ou parfois improprement référencée sous la mention de compatibilité dans la documentation) est l’équivalent parfait deVAR.P, appliquant la division brute par $N$.
Bien que ces fonctions continuent d’être exécutées sans incident technique majeur par le moteur de calcul d’Excel 2013, 2016, 2019, 2021 et Microsoft 365, leur emploi est officiellement déconseillé par les directives de bonnes pratiques en bio-informatique et psychométrie. Elles sont susceptibles d’être dépréciées dans de futures itérations logicielles. De surcroît, la persistance de ces formulations obsolètes dans un article de recherche ou un rapport d’audit méthodologique jette un doute fâcheux sur la modernité des protocoles d’analyse mobilisés par les auteurs.
4.3 Tableau synoptique d’aide à la décision logicielle
Pour clarifier sans ambiguïté les critères de sélection de l’opérateur informatique adéquat, le tableau comparatif ci-dessous synthétise les propriétés, syntaxes et spécificités de chaque fonction disponible au sein de l’écosystème Microsoft Excel :
| Fonction Excel | Statut de la Formule | Dénominateur Appliqué | Prise en compte Texte/Booléens | Scénario Méthodologique d’Usage |
|---|---|---|---|---|
VAR.S |
Moderne (Recommandée) | $n – 1$ (Bessel) | Ignorés systématiquement | Échantillons empiriques de recherche, études cliniques, tests inférentiels. |
VAR.P |
Moderne (Recommandée) | $N$ (Total) | Ignorés systématiquement | Populations exhaustives, recensements complets, simulations théoriques pures. |
VAR |
Héritée (Compatibilité) | $n – 1$ | Ignorés systématiquement | Maintenance exclusive d’anciens classeurs (Excel 2003 et antérieurs). |
VARP |
Héritée (Compatibilité) | $N$ | Ignorés systématiquement | Maintenance exclusive de classeurs historiques sans portée inférentielle. |
VARA |
Spécifique (Valeurs mixtes) | $n – 1$ | Convertis (VRAI=1, FAUX=0, Texte=0) | Modélisation complexe de variables composites ou dichotomiques brutes. |
VARPA |
Spécifique (Valeurs mixtes) | $N$ | Convertis (VRAI=1, FAUX=0, Texte=0) | Populations fermées intégrant des codes logiques ou qualitatifs binaires. |
5. Guide pratique : Calculer la variance d’un échantillon avec VAR.S
5.1 Structuration et nettoyage préalable de la feuille de calcul
L’implémentation opérationnelle d’un calcul de variance d’échantillon au moyen de la formule VAR.S débute impérativement par une phase méthodique d’assainissement et d’organisation spatiale des données au sein de la feuille de calcul. Dans le cadre d’un protocole d’évaluation psychométrique ou comportementale, la disposition standardisée préconisée par les règles de l’analyse matricielle classique consiste à organiser la structure de manière univariée ou multivariée selon la convention « Tidy Data » : chaque ligne correspond strictement à une unité expérimentale unique (un participant, un sujet clinique), tandis que chaque colonne correspond à une variable mesurée spécifique (par exemple, le score total à l’inventaire d’anxiété de Beck, le temps de réaction moyen ou l’âge chronologique).
Avant d’exécuter la moindre formule, une inspection méticuleuse de la colonne cible doit être opérée afin de s’assurer du formatage numérique strict des cellules. Une erreur fréquente réside dans la présence de scores psychométriques importés depuis des logiciels de recueil en ligne (tels que Qualtrics, Gorilla ou Google Forms) enregistrés par inadvertance sous la forme de chaînes textuelles. Un nombre stocké comme texte est immédiatement aligné à gauche dans la cellule par Excel (contrairement aux valeurs numériques alignées par défaut à droite) et sera totalement ignoré par la fonction VAR.S, ce qui amputera la taille d’échantillon sans avertissement visuel.
De plus, il est essentiel d’isoler clairement les en-têtes de colonnes (métadonnées décrivant la variable) et les éventuelles lignes de totaux partiels hors de la plage d’évaluation quantitative. Une excellente pratique consiste à convertir la plage de données brutes en un Tableau Structuré natif Excel (via le raccourci clavier Ctrl + L ou le ruban « Accueil » > « Mettre sous forme de tableau »). Ce formatage transforme la plage vectorielle en une entité dynamique nommée, permettant des références structurées particulièrement lisibles et robustes lors de l’ajout ultérieur de nouveaux participants.
5.2 Syntaxe formelle et exécution de la formule VAR.S
La syntaxe normalisée de la fonction d’échantillon répond au formalisme suivant :
=VAR.S(nombre1; [nombre2]; ...)
Dans la pratique statistique courante, il est exceptionnel de saisir les valeurs unitaires directement au sein des arguments de la fonction (ex. =VAR.S(12; 15; 18; 14)), une telle démarche étant réservée à des vérifications arithmétiques ponctuelles. La modalité canonique réside dans la sélection d’une plage vectorielle continue. Supposons que les scores d’efficience mnésique d’une cohorte clinique de 100 patients soient consignés dans la colonne A, de la ligne 2 à la ligne 101 (la ligne 1 étant réservée à l’en-tête « Score_Memoire »). La formule s’exécute en sélectionnant la cellule récapitulative de destination et en saisissant :
=VAR.S(A2:A101)
Si les données expérimentales sont issues d’un protocole factoriel impliquant la comparaison de sous-groupes non contigus (par exemple, des participants assignés à une condition expérimentale enregistrés dans la plage B2:B51 et des participants assignés à une condition contrôle enregistrés dans la plage D2:D51), la fonction VAR.S accepte la juxtaposition d’arguments vectoriels indépendants séparés par un point-virgule (dans les versions régionales francophones d’Excel) :
=VAR.S(B2:B51; D2:D51)
Dans ce scénario, Excel compile l’ensemble des observations éparses en un vecteur virtuel unifié de $n = 100$ scores, calcule la moyenne globale sur ce regroupement, détermine la somme globale des écarts quadratiques et divise le total résultant par l’effectif consolidé moins un ($n – 1 = 99$). La validation s’effectue classiquement par l’appui sur la touche « Entrée ». Avec les versions récentes d’Excel exploitant le moteur de calcul matriciel dynamique, il n’est plus nécessaire d’effectuer la validation matricielle historique par Ctrl + Maj + Entrée, même lors de l’imbrication de plages conditionnelles.
5.3 Vérification étape par étape et interprétation du résultat numérique
Pour tout chercheur ou analyste en phase de validation méthodologique, il est extrêmement salutaire de décomposer manuellement la mécanique algorithmique de VAR.S au sein de colonnes auxiliaires dédiées. Cette démarche garantit une compréhension intime des flux numériques et confirme que le résultat n’est pas le produit d’un artefact logiciel.
Supposons un échantillon restreint de $n = 5$ scores psychologiques de stress : 12, 15, 14, 11 et 18, logés respectivement dans les cellules A2:A6 :
- Calcul de la moyenne empirique : En cellule
A7, tapez=MOYENNE(A2:A6). La valeur obtenue est $\bar{x} = 14$. - Calcul des écarts élémentaires : Dans la colonne B adjacente (cellule
B2), saisissez la formule d’écart centrée=A2-$A$7, puis étirez la formule jusqu’enB6. Les écarts individuels obtenus sont respectivement : $-2$, $+1$, $0$, $-3$, $+4$. (On vérifiera aisément en celluleB7que=SOMME(B2:B6)équivaut à 0). - Élévation au carré des déviations : Dans la colonne C (cellule
C2), saisissez=B2^2, puis étirez jusqu’enC6. Les valeurs résultantes sont : $4$, $1$, $0$, $9$, $16$. - Sommation des carrés (SCE) : En cellule
C7, appliquez=SOMME(C2:C6). La somme des carrés des écarts équivaut exactement à $30$. - Application de la correction de Bessel : En cellule
C8, appliquez la division par l’effectif décrémenté :=C7/(NB(A2:A6)-1). Le calcul opéré est $\frac{30}{5 – 1} = \frac{30}{4} = 7,5$.
Si vous appliquez directement dans une cellule tierce la fonction =VAR.S(A2:A6), Excel renvoie précisément la valeur 7,5. Cet exercice valide l’équivalence opérationnelle parfaite du processus. Quant à l’interprétation substantielle de ce chiffre, il convient de rappeler une propriété fondamentale souvent source de malaise chez les étudiants : la variance s’exprime dans le carré de l’unité de mesure initiale. Si les scores originaux quantifient des points à une échelle de dépression, la variance obtenue est de $7,5 \text{ points}^2$. Cette dimensionalité quadratique empêche toute superposition directe du résultat sur l’axe des mesures brutes, justifiant le recours complémentaire à l’écart-type pour les interprétations cliniques directes.
6. Guide pratique : Calculer la variance d’une population avec VAR.P
6.1 Scénarios empiriques justifiant l’utilisation de VAR.P
L’utilisation de la fonction VAR.P, appliquant la division par la taille totale $N$ sans décrémentation unitaire, est méthodologiquement proscrite dès lors que l’on manipule des échantillons probabilistes ou occasionnels visant une généralisation statistique. En revanche, elle devient mathématiquement impérative dans des contextes très spécifiques où le jeu de données délimite rigoureusement l’intégralité du champ de référence empirique.
Le premier scénario paradigmatique concerne le recensement institutionnel fermé. Supposons qu’un neuropsychologue en chef conduise l’évaluation rétrospective de l’ensemble des 240 patients admis au cours d’une décennie dans un service de réadaptation pour un traumatisme crânien sévère de grade 3. Si l’objectif exclusif du rapport administratif et épidémiologique est de décrire la dispersion exacte des durées d’hospitalisation de cette cohorte historiquement close, sans formuler la moindre inférence ou prédiction sur les futurs admis ou sur d’autres hôpitaux, les 240 patients constituent l’univers exhaustif $N$. L’application de VAR.P est alors rigoureusement légitime.
Le second scénario relève de l’analyse descriptive de bases de données nationales normatives. Lorsque les concepteurs d’un test standardisé comme la WISC (Wechsler Intelligence Scale for Children) évaluent l’échantillon d’étalonnage national finalisé de 2 000 enfants pour figer la table de conversion des notes brutes en notes standardisées, cette table sert de population théorique conventionnelle de référence fermée pour le pays durant l’exploitation de la version du test. Enfin, un troisième cas d’usage réside dans les modélisations déterministes et simulations fermées programmées sous tableur, où la distribution générée artificiellement est traitée comme un univers complet auto-suffisant sans aléa d’échantillonnage externe.
6.2 Syntaxe formelle et exécution de la formule VAR.P
La formulation syntaxique canonique de la fonction populationnelle s’énonce comme suit :
=VAR.P(nombre1; [nombre2]; ...)
À l’instar de son pendant échantillonnal, VAR.P s’applique le plus fréquemment sur de volumineux vecteurs continus. Si nous reprenons notre cohorte institutionnelle de 240 durées de séjour hospitalier consignées dans la colonne E d’une feuille d’audit clinique, de la cellule E2 à la cellule E241, la syntaxe d’exécution sera rédigée sous la forme :
=VAR.P(E2:E241)
Le tableur supporte l’imbrication de la fonction avec des outils de filtrage natifs. Toutefois, une précaution d’ingénierie logicielle s’impose : si vous appliquez des filtres automatiques sur les lignes de votre tableau pour masquer certains profils de patients, VAR.P continuera imperturbablement de comptabiliser l’ensemble des données incluses dans la plage vectorielle géométrique brute, y compris les cellules rendues invisibles par le filtre. Pour calculer la variance populationnelle dynamique d’un sous-groupe filtré à l’écran, il convient de se tourner vers la fonction SOUS.TOTAL avec le premier argument numérique paramétré à la valeur 10 (qui correspond précisément à l’algorithme de la variance de population ignorant les lignes masquées) :
=SOUS.TOTAL(10; E2:E241)
La confrontation directe dans deux cellules adjacentes des résultats produits par =VAR.P(E2:E241) et =VAR.S(E2:E241) constitue un réflexe d’audit élémentaire. Pour cet effectif de $N = 240$, l’observateur constatera une divergence marginale mais bien réelle, la variance d’échantillon affichant une valeur supérieure de $\frac{240}{239} \approx 1,00418$ (soit un excédent d’environ 0,42 %), confirmant l’action constante de la correction de Bessel.
6.3 Validation manuelle du diviseur N
Pour parachever l’appropriation de cette métrique, une formalisation manuelle de la variance de population peut être exécutée en quelques étapes coordonnées à l’aide des fonctions de base d’Excel. Reprenons la modélisation sur notre vecteur de données de taille exhaustive $N$ :
Dans un premier temps, l’utilisateur calcule la moyenne populationnelle $\mu$ par la fonction =MOYENNE(Plage). Dans un second temps, le numérateur représentant la Somme des Carrés des Écarts ($SCE$) peut être généré sans même créer de colonne intermédiaire grâce à la puissance de la fonction mathématique matricielle SOMME.CARRES.ECARTS :
=SOMME.CARRES.ECARTS(Plage)
Cette fonction indigène d’Excel calcule en interne la somme algébrique $\sum (x_i – \bar{x})^2$. Dès lors, pour reproduire manuellement l’algorithme exact de VAR.P, il suffit d’associer cette fonction au dénombrement universel de l’effectif via la fonction NB :
=SOMME.CARRES.ECARTS(Plage) / NB(Plage)
La concordance entre cette division matricielle directe et l’instruction =VAR.P(Plage) est absolue, au cent-millième de décimale près. Confondre l’usage du diviseur $N$ avec le diviseur $(n – 1)$ dans un rapport scientifique prétendant évaluer un échantillon représentatif constitue une faute méthodologique caractérisée qui dévalue la crédibilité de l’analyse inférentielle présentée.
7. Prise en compte des valeurs textuelles et booléennes : Fonctions VARA et VARPA
7.1 Mécanique d’évaluation de la fonction VARA
En marge des fonctions statistiques canoniques qui traitent exclusivement les valeurs scalaires numériques pures, Microsoft Excel intègre des variantes algorithmiques spécialisées capables d’évaluer des contenus hétérogènes. La première de ces fonctions est VARA (le suffixe « A » signifiant All en anglais, indiquant la prise en charge indifférenciée de tous les types de données textuelles et logiques).
La mécanique interne d’évaluation de VARA repose sur un ensemble de règles de conversion implicite drastiques appliquées à chaque cellule de la plage cible lors de l’exécution de la formule :
- Toute valeur numérique valide est traitée normalement selon sa valeur intrinsèque.
- Toute cellule contenant la valeur booléenne VRAI (issue d’une formule logique ou saisie directement) est convertie arithmétiquement en la valeur numérique 1.
- Toute cellule contenant la valeur booléenne FAUX est convertie arithmétiquement en la valeur numérique 0.
- Tout élément textuel — qu’il s’agisse d’un mot explicite comme « Absent », d’un code alphanumérique de classification « Groupe_A », ou d’une chaîne résiduelle non convertie — est automatiquement et arbitrairement converti en la valeur numérique 0.
- Les cellules rigoureusement vides sont toujours contournées et exclues du dénominateur d’échantillon.
Une fois cette conversion implicite massive opérée sur l’ensemble de la plage, VARA calcule la variance en appliquant la formule de l’échantillon avec le diviseur $(n – 1)$, où $n$ englobe l’ensemble des valeurs numériques, logiques et textuelles répertoriées. Dans le domaine psychométrique, l’emploi de cette fonction sans une conscience absolue de ces règles de casting de type représente un danger méthodologique dévastateur. Si un chercheur intègre par mégarde une colonne contenant des scores de test intercalés avec des mentions textuelles « Non-réponse » ou « Erreur », VARA transformera chacun de ces libellés en une cascade de scores nuls ($0$), générant un effondrement artificiel de la moyenne et une explosion démesurée de la variance calculée.
7.2 Mécanique d’évaluation de la fonction VARPA
La fonction VARPA constitue le pendant populationnel de la fonction précédente. Elle transpose les mêmes règles d’évaluation polymorphique des cellules non numériques, mais clôture son calcul par l’application stricte du diviseur de population exhaustive $N$, sans retrancher le degré de liberté.
Le dénominateur $N$ mobilisé par VARPA correspond au décompte global de toutes les cellules non vides de la plage passée en argument, tel que le renverrait la fonction de dénombrement universel NBVAL :
$$N_{\text{effectif}} = \text{NBVAL}(\text{Plage})$$
Pour illustrer la divergence structurelle entre les algorithmes classiques et les algorithmes polymorphiques « A », considérons un ensemble expérimental fictif consigné dans les cellules A1:A4 :
- Cellule
A1: $10$ - Cellule
A2: $20$ - Cellule
A3: « Absent » (chaîne de texte) - Cellule
A4: VRAI (valeur logique)
Si nous invoquons la fonction classique VAR.P(A1:A4), Excel ignore purement et simplement le texte « Absent » et le booléen VRAI. Le calcul ne traite que le sous-ensemble numérique ${10, 20}$, avec $N = 2$, une moyenne $\mu = 15$, et produit un résultat de :
$$\text{VAR.P} = \frac{(10 – 15)^2 + (20 – 15)^2}{2} = \frac{25 + 25}{2} = 25$$
Si, en revanche, nous appliquons VARPA(A1:A4), la matrice vectorielle interne se transforme radicalement en ${10, 20, 0, 1}$. Le dénominateur devient $N = 4$. La nouvelle moyenne s’effondre à $\mu = \frac{10 + 20 + 0 + 1}{4} = 7,75$. La somme des carrés des écarts devient $(10 – 7,75)^2 + (20 – 7,75)^2 + (0 – 7,75)^2 + (1 – 7,75)^2 = 5,0625 + 150,0625 + 60,0625 + 45,5625 = 260,75$. Le résultat retourné par VARPA sera alors :
$$\text{VARPA} = \frac{260,75}{4} = 65,1875$$
Le saut numérique entre 25 et 65,18 illustre avec acuité la distorsion vertigineuse engendrée par la conversion aveugle des données textuelles et booléennes.
7.3 Cas d’usage légitimes et mise en garde en sciences humaines
Existe-t-il des circonstances méthodologiquement recevables pour justifier l’usage des fonctions VARA ou VARPA en psychologie expérimentale et en sociologie quantitative ? La réponse est positive, mais strictement circonscrite à l’analyse de variables dichotomiques encodées sous forme booléenne. Par exemple, dans un paradigme d’évaluation de la mémoire de reconnaissance ou d’une tâche de décision lexicale, les réponses des participants peuvent être codées par des formules logiques générant nativement les états VRAI (succès à l’item) ou FAUX (échec à l’item).
Dans cette configuration précise, l’interprétation arithmétique de VRAI sous forme de 1 et de FAUX sous forme de 0 correspond fidèlement au codage binaire standard de Bernoulli ($p$ et $q = 1 – p$). La variance de l’échantillon calculée par VARA reflète alors la variabilité de la proportion d’acquis au sein de la matrice de test, tout en préservant le dénominateur $(n – 1)$.
Néanmoins, en dehors de cette niche opérationnelle spécifique, l’usage de VARA et VARPA doit être rigoureusement proscrit des chaînes de traitement quantitatif en sciences humaines. L’incorporation implicite de chaînes de caractères converties silencieusement en zéro constitue une négation pure et simple des protocoles de gestion des données manquantes. La recommandation méthodologique prévalant dans l’ensemble des laboratoires consiste à opérer un recodage numérique préalable explicite des données, en traitant les variables logiques par des fonctions de transformation dédiées (comme =SI(...)) et en gérant les valeurs absentes selon des protocoles formalisés plutôt qu’en s’en remettant au comportement opportuniste et opaque des fonctions de la famille « A ».
8. Traitement des anomalies de données, valeurs manquantes et zéros
8.1 Impact des cellules vides et des valeurs nulles
L’intégrité d’une analyse statistique sous Excel dépend en premier lieu de la façon dont le logiciel discrimine l’absence d’information de l’information nulle. Une méprise fréquente chez les chercheurs débutants consiste à confondre une cellule vide (n’ayant fait l’objet d’aucune saisie) et une cellule hébergeant le chiffre zéro ($0$). Du point de vue algorithmique d’Excel, ces deux états cellulaires déclenchent des comportements radicalement opposés :
- Une cellule vide est totalement invisible pour les fonctions statistiques standards telles que
MOYENNE,VAR.SetVAR.P. Elle est purement et simplement éludée lors du dénombrement de l’effectif. Elle ne contribue ni au numérateur (aucune déviation n’est calculée), ni au dénominateur (qui n’est pas incrémenté). - Une cellule contenant la valeur zéro constitue une observation quantitative à part entière. Elle est intégrée dans le calcul de la moyenne, abaisse fréquemment le barycentre de la distribution et incrémente l’effectif $n$ d’une unité, contribuant activement à la somme des carrés des écarts.
Dans les batteries d’évaluation psychologique, cette distinction prend une dimension clinique majeure. Si un patient omet de répondre à une question d’un inventaire d’évaluation psychodynamique, cette omission représente une valeur manquante (missing data). Si l’assistant de recherche saisit un « 0 » par commodité ou si la formule de consolidation remplace l’absence de saisie par un zéro par défaut, le profil statistique se retrouve gravement falsifié. Le score nul sera interprété non comme une absence de mesure, mais comme une absence totale et absolue du symptôme évalué, comprimant artificiellement la moyenne et surdimensionnant la variance de la cohorte.
Les bonnes pratiques exigent d’auditer systématiquement les plages de calcul avant d’exécuter la variance. On utilisera avantageusement la commande « Rechercher et sélectionner » > « Atteindre les constantes » ou la fonction logique =ESTVIDE() pour identifier d’éventuelles omissions involontaires, et l’on s’assurera que les zéros présents dans le classeur traduisent effectivement des performances planchers réelles observées lors du protocole expérimental.
8.2 Gestion rigoureuse des codes d’erreurs fréquents (#DIV/0!, #VALEUR!)
Lors de l’automatisation du calcul de variance sur des tableaux dynamiques ou des jeux de données complexes, l’interruption inopinée d’un classeur par un message d’erreur est un écueil fréquent. Deux codes d’erreur structurels se manifestent régulièrement lors de l’application de VAR.S :
L’erreur #DIV/0! survient le plus souvent dans deux cas bien précis. Le premier, trivial, correspond à une plage entièrement vide ou ne contenant aucune valeur numérique exploitable. Le second, hautement révélateur sur le plan méthodologique, se produit lorsque la fonction VAR.S est appliquée à une plage ne comportant qu’une seule observation unique ($n = 1$). Dans cette configuration, l’algorithme tente d’appliquer la correction de Bessel au dénominateur : $(n – 1) = 1 – 1 = 0$. Le tableur est alors confronté à l’impossibilité mathématique absolue de réaliser une division par zéro et renvoie légitimement l’exception #DIV/0!. Cet avertissement salutaire rappelle que le concept même de variabilité nécessite au minimum deux observations pour être défini sur un échantillon.
L’erreur #VALEUR! survient typiquement lorsqu’une cellule de la plage vectorielle contient une erreur de formule non résolue en amont (par exemple un #N/A issu d’un RECHERCHEV défaillant) ou lorsqu’un argument direct passé manuellement entre les parenthèses de la fonction ne peut être résolu en une valeur numérique scalaire.
Pour prémunir les tableaux de bord et les feuilles récapitulatives contre la propagation anarchique de ces codes d’erreurs, l’implémentation de contrôles conditionnels préventifs est fortement recommandée. On encapsulera élégamment la fonction de variance au sein de l’instruction SIERREUR :
=SIERREUR(VAR.S(A2:A100); "Effectif insuffisant ou données invalides")
Une alternative encore plus rigoureuse consiste à vérifier explicitement en amont que le nombre de données valides est supérieur ou égal à 2 avant de déclencher l’analyse statistique :
=SI(NB(A2:A100) >= 2; VAR.S(A2:A100); "Données insuffisantes (n < 2)")
8.3 Sensibilité aux valeurs aberrantes et stratégies d’ajustement
La variance est une métrique paramétrique caractérisée par une hypersensibilité aux données extrêmes ou atypiques (les outliers). En vertu du mécanisme d’élévation quadratique $(x_i – \bar{x})^2$, une observation située à quatre écarts-types de la moyenne génère une déviation quadratique seize fois supérieure à celle d’une observation située à un seul écart-type. En recherche psychologique, où des erreurs de saisie (inversion de chiffres), des fautes de passation ou des comportements déviants de participants non motivés peuvent se produire, la variance peut être massivement hypertrophiée par un unique score aberrant.
Avant d’entériner le calcul final de la variance sous Excel, il est donc impératif de cartographier la distribution des scores. Deux protocoles de détection sont usuellement automatisés dans le tableur :
- Le critère de l’Écart Interquartile ($IQR$) selon la méthode de Tukey : toute valeur située au-delà de l’intervalle $[Q_1 – 1,5 \times IQR ; Q_3 + 1,5 \times IQR]$ est marquée pour examen approfondi, en utilisant les fonctions
QUARTILE.INCetMAX/MIN. - Le calcul des scores centrés réduits (scores $z$) générés par la fonction
CENTREE.REDUITE: toute observation présentant un $|z| > 3,29$ (seuil critique probabiliste à $p < 0,001$) est considérée comme un outlier potentiel.
Face à des données extrêmes avérées mais représentatives d’une variabilité clinique réelle (ne relevant pas d’une erreur matérielle de frappe), le chercheur peut recourir à des indicateurs de dispersion robustes. L’un d’eux est la variance winsorisée, où les valeurs extrêmes sont ramenées aux centiles limites prédéfinis (par exemple le 5-ème et le 95-ème centile) avant calcul de la dispersion. Une autre approche consiste à documenter rigoureusement la variance tronquée après exclusion motivée des observations aberrantes. Conformément aux directives éthiques et méthodologiques de l’APA, toute exclusion ou ajustement d’observation doit être explicitement argumenté et documenté dans la section méthodologique du rapport de recherche, en présentant conjointement la variance intégrale brute et la variance ajustée.
9. Applications pratiques en psychométrie et sciences du comportement
9.1 Calcul de la consistance interne et variance des items
L’une des applications les plus prestigieuses et systématiques de la variance sous Excel en psychométrie concerne l’estimation de la cohérence interne d’un instrument d’évaluation au moyen du célèbre coefficient Alpha de Cronbach ($\alpha$). Ce coefficient statistique permet de déterminer dans quelle mesure l’ensemble des items composant un test ou une échelle multidimensionnelle mesurent de façon unifiée un même construit psychologique latent.
La formule mathématique de l’Alpha de Cronbach se formalise ainsi :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{j=1}^{k} s^2_{item_j}}{s^2_{total}} \right)$$
Où $k$ représente le nombre total d’items composant l’échelle, $s^2_{item_j}$ est la variance de l’échantillon obtenue spécifiquement sur les réponses au $j$-ème item, et $s^2_{total}$ désigne la variance de l’échantillon des scores totaux obtenus par la sommation linéaire des items pour chaque individu.
Le déploiement de ce calcul au sein d’une feuille Excel est d’une grande fluidité didactique :
- Organisez votre matrice d’évaluation de telle sorte que les participants occupent les lignes (ex. lignes 2 à 151 pour 150 sujets) et que chaque item occupe une colonne distincte (ex. colonnes B à K pour une échelle composée de 10 questions, soit $k = 10$).
- À la ligne 152, sous chaque colonne d’item, calculez la variance individuelle de l’item en utilisant systématiquement la formule d’échantillon : en cellule
B152, saisissez=VAR.S(B2:B151), puis recopiez horizontalement cette formule vers la droite jusqu’en colonne K. - En colonne L, générez le score total de chaque participant sur la ligne correspondante au moyen de la fonction de somme : en
L2, saisissez=SOMME(B2:K2), et étirez vers le bas jusqu’à la celluleL151. - En cellule
L152, calculez la variance globale du score total :=VAR.S(L2:L151). - En cellule isolée de restitution (ex.
M2), compilez l’équation complète de Cronbach en une formule intégrée :
=(10/(10-1)) * (1 - (SOMME(B152:K152) / L152))
Outre l’obtention du coefficient global, la variance individuelle de chaque item ($s^2_{item}$) remplit un rôle diagnostique primordial. Un item psychométrique optimal doit faire la preuve de sa sensibilité discriminative, ce qui se traduit directement par une variance élevée. Si un item présente une variance proche de zéro, cela indique que l’ensemble des participants — qu’ils soient hautement ou faiblement performants sur le construit latent — ont répondu de façon identique et uniforme. Cet item dépourvu de dispersion n’apporte aucune information discriminante à l’échelle et doit être révisé ou éliminé lors du processus de validation psychométrique.
9.2 Analyse de la variance des temps de réaction en psychologie cognitive
Dans les paradigmes de la psychologie cognitive expérimentale (tels que la tâche de Stroop, l’écoute dichotique ou les épreuves d’inhibition comportementale de type Go/No-Go), les temps de réaction chronométriques mesurés en millisecondes constituent la variable dépendante d’élection. Toutefois, l’analyse de ces séries temporelles est confrontée à une asymétrie positive caractéristique : la majorité des temps de latence se regroupent autour d’une valeur modale rapide, tandis qu’une queue de distribution étirée s’étend vers les valeurs lentes en raison de micro-défaillances attentionnelles transitoires.
Sous Excel, l’analyse descriptive préalable impose de segmenter méthodiquement les calculs de variance selon l’architecture du protocole :
- La variance intra-individuelle : pour chaque sujet soumis à une série de 100 essais dans la condition d’interférence congruente ou incongruente, la dispersion temporelle de ses propres réponses chronométriques est calculée via
VAR.S. Une variance intra-individuelle exceptionnellement élevée est fréquemment mobilisée en neuropsychologie comme marqueur direct de la labilité attentionnelle ou de dysfonctionnements exécutifs chez des patients cérébrolésés ou présentant un TDAH. - La variance intergroupes et intragroupe : dans un second temps, le chercheur consolide les moyennes temporelles individuelles de chaque sujet et calcule la dispersion globale au sein de chaque groupe expérimental. Par exemple, pour comparer la variabilité des performances cognitives sous condition de stress aigu (groupe expérimental) versus condition basale neutre (groupe contrôle).
Ce calcul prépare directement la vérification des postulats métrologiques indispensables aux analyses inférentielles ultérieures. Avant d’engager une comparaison de moyennes de temps de réaction au moyen d’un test $t$ ou d’un modèle linéaire mixte, l’expérimentateur doit impérativement s’assurer du respect de l’hypothèse d’homogénéité des variances (homoscédasticité), en quantifiant précisément la dispersion de chaque condition à l’aide des formules d’échantillon sous Excel.
9.3 Évaluation de la fidélité test-retest dans les suivis longitudinaux
L’évaluation de la stabilité temporelle des scores psychométriques constitue l’un des piliers cardinaux de la validation méthodologique d’un instrument clinique. Lorsqu’une même batterie de tests est administrée à une cohorte de patients à deux moments distincts séparés par un intervalle chronologique déterminé (passation initiale au temps $T_1$, puis réévaluation au temps $T_2$), l’estimation de la fidélité test-retest repose sur une analyse approfondie des composantes de variance.
Sous Excel, le protocole standardisé se déploie en plusieurs étapes :
- Dans deux colonnes adjacentes, consignez les scores appariés obtenus par chaque sujet : colonne A pour le temps $T_1$, colonne B pour le temps $T_2$.
- En colonne C, calculez le vecteur des écarts longitudinaux individuels de chaque participant : en
C2, appliquez la formule=B2-A2, puis étirez sur l’ensemble de la cohorte. - Calculez la variance de ces scores de différence au moyen de la fonction
=VAR.S(C2:C101). Cette métrique quantifie l’instabilité de la mesure au fil du temps.
Sur le plan de l’inférence théorique, cette démarche permet d’isoler la variance véritable propre aux variations développementales du trait psychologique face à la variance d’erreur aléatoire générée par les conditions de passation. De plus, dans le suivi longitudinal d’un protocole de psychothérapie ou d’une intervention neuropsychologique, l’évolution de la variance globale du groupe entre le pré-test ($T_1$) et le post-test ($T_2$) offre un indicateur clinique déterminant : une réduction substantielle de la variance au terme de la prise en charge signale fréquemment une homogénéisation des compétences chez les patients initialement les plus déficitaires, témoignant de l’efficacité ciblée du traitement clinique déployé.
10. Étude comparative : Écart empirique entre VAR.S et VAR.P selon la taille d’échantillon
10.1 Modélisation de l’erreur relative induite par le choix de la formule
Pour mesurer de manière systématique l’impact d’une mauvaise sélection de formule statistique dans Microsoft Excel, il est particulièrement instructif de modéliser l’erreur relative induite lorsque l’on substitue par erreur la fonction VAR.P à la fonction recommandée VAR.S sur un échantillon de recherche. Nous avons démontré mathématiquement que la fonction VAR.P applique un dénominateur $n$ tandis que VAR.S applique $(n – 1)$.
L’erreur relative de sous-estimation en pourcentage, exprimée par rapport à l’estimateur sans biais de référence ($s^2$), se formule analytiquement de la façon suivante :
$$\text{Erreur Relative (%)} = \left( \frac{\text{VAR.P} – \text{VAR.S}}{\text{VAR.S}} \right) \times 100 = \left( \frac{\frac{SCE}{n} – \frac{SCE}{n-1}}{\frac{SCE}{n-1}} \right) \times 100 = \left( \frac{n – 1}{n} – 1 \right) \times 100 = -\frac{1}{n} \times 100$$
Cette expression démontre avec une simplicité élégante que le pourcentage d’erreur dépend exclusivement et strictement de la taille de l’échantillon $n$, indépendamment de la moyenne ou de l’amplitude absolue des scores observés. Le tableau ci-dessous formalise l’ampleur exacte de cette sous-estimation pour différents effectifs typiquement rencontrés dans la littérature en sciences du comportement :
| Taille d’Échantillon ($n$) | Ratio Théorique ($s^2 / \sigma^2_{\text{naïve}}$) | Sous-estimation relative (%) | Contexte Typique de Recherche |
|---|---|---|---|
| $n = 3$ | 1,5000 | -33,33 % | Études cliniques pilotes ultra-rares, cas uniques multiples. |
| $n = 5$ | 1,2500 | -20,00 % | Protocoles précliniques, petits groupes expérimentaux. |
| $n = 10$ | 1,1111 | -10,00 % | Neuro-imagerie fonctionnelle spécialisée, études de cas contrôlées. |
| $n = 20$ | 1,0526 | -5,00 % | Recherche cognitive de laboratoire standard. |
| $n = 30$ | 1,0345 | -3,33 % | Seuil conventionnel historique des « grands échantillons ». |
| $n = 50$ | 1,0204 | -2,00 % | Études corrélationnelles intergroupes. |
| $n = 100$ | 1,0101 | -1,00 % | Validation préliminaire d’échelles de mesure. |
| $n = 500$ | 1,0020 | -0,20 % | Étalonnages régionaux, enquêtes psychosociales. |
| $n = 1 000$ | 1,0010 | -0,10 % | Échantillons normatifs nationaux standardisés. |
Ce tableau met en exergue l’asymétrie brutale du risque d’erreur : pour les cohortes réduites (inférieures à 20 cas), l’amputation de variance induite par un mauvais choix de fonction dans Excel oscille entre 5 % et plus de 33 %, ce qui fausse intégralement toute tentative d’inférence. En revanche, au-delà de 100 sujets, la convergence asymptotique de la courbe vers 0 % d’erreur rend l’impact numérique marginal, bien que la faute sur le plan du raisonnement scientifique demeure entière.
10.2 Expérimentation numérique par simulation de Monte-Carlo sous Excel
Pour observer de manière tangible l’absence de biais de VAR.S face au biais chronique de VAR.P sur des échantillons empiriques, il est tout à fait possible de programmer une simulation stochastique de type Monte-Carlo sans quitter l’environnement de calcul d’Excel. Cette expérimentation didactique permet de visualiser concrètement l’action de la correction de Bessel.
Concevons un modèle stochastique où nous définissons une population parente théorique normale de moyenne $\mu = 100$ et d’écart-type $\sigma = 15$ (ce qui correspond précisément à la métrique standard du Quotient Intellectuel de Wechsler). La variance théorique véritable de cette population est donc $\sigma^2 = 15^2 = 225$.
Déployons l’expérimentation selon les étapes suivantes :
- Dans les colonnes A à E d’une feuille vierge, nous générons des échantillons aléatoires de taille $n = 5$ tirés de cette loi normale. Pour ce faire, saisissez en cellule
A1l’algorithme de transformation inverse de Box-Muller/normale d’Excel :
=LOI.NORMALE.INVERSE(ALEA(); 100; 15)
Recopiez cette formule jusqu’en colonne E pour former la première ligne d’échantillon ($n = 5$), puis étirez vers le bas sur 1 000 lignes (de la ligne 1 à la ligne 1 000) afin de simuler $1 000$ réplications indépendantes du tirage de cet échantillon. - En colonne F, calculez pour chaque échantillon de 5 sujets la variance sans biais via la fonction moderne recommandée : en
F1, saisissez=VAR.S(A1:E1), puis étirez jusqu’enF1000. - En colonne G, calculez sur la même ligne la variance naïve par la fonction populationnelle : en
G1, saisissez=VAR.P(A1:E1), puis étirez jusqu’enG1000. - Enfin, calculez l’espérance empirique moyenne de ces estimateurs sur l’ensemble des 1 000 tirages répétés :
En celluleF1002, saisissez=MOYENNE(F1:F1000).
En celluleG1002, saisissez=MOYENNE(G1:G1000).
En appuyant sur la touche F9 pour recalculer la feuille stochastique, les résultats numériques sautent aux yeux : la moyenne de la colonne VAR.S fluctue étroitement autour de la valeur théorique 225, confirmant sans ambiguïté la propriété d’absence de biais ($\mathbb{E}[s^2] = \sigma^2$). En revanche, la moyenne de la colonne VAR.P stagne invariablement autour de 180. Or, un calcul rapide montre que $225 \times \frac{5 – 1}{5} = 225 \times 0,8 = 180$. La simulation démontre sous les yeux de l’analyste que VAR.P ampute en moyenne 20 % de la dispersion réelle lorsqu’elle est mobilisée sur un échantillon de 5 observations.
10.3 Directives décisionnelles selon la taille de l’échantillon
Face à ces évidences mathématiques et expérimentales, quelles directives formelles l’analyste quantitatif doit-il adopter dans sa pratique professionnelle et académique quotidienne sous Excel ?
Lorsque la taille de l’échantillon est restreinte ($n < 30$), la tolérance méthodologique est rigoureusement nulle : le recours à VAR.S est un impératif catégorique non négociable. Tout usage de VAR.P dans ce domaine constitue une faute déontologique d’analyse susceptible de provoquer l’invalidation pure et simple des conclusions de recherche par les comités de lecture des revues savantes.
Lorsque l’on traite de très volumineux corpus de données (notamment dans le cadre d’études épidémiologiques ou d’analyses massives de données numériques issues d’applications web avec $n > 1 000$), la divergence numérique entre VAR.S et VAR.P devient certes imperceptible au plan des applications pratiques immédiates. Toutefois, la règle d’or méthodologique de la statistique inférentielle demeure immuable : dès lors que les données analysées ont vocation à étayer une inférence, une généralisation ou une extrapolation probabiliste vers une entité plus large, VAR.S doit être déployée de manière exclusive. La fonction VAR.P doit être strictement cantonnée aux rares cas de figures où le chercheur dispose sous la main de la totalité indépassable de l’univers empirique circonscrit par sa question de recherche.
11. Bonnes pratiques méthodologiques et pièges courants sous Excel
11.1 Erreurs méthodologiques classiques lors de la sélection des formules
La pratique quotidienne de l’audit statistique de mémoires de master, de thèses de doctorat et de manuscrits scientifiques soumis pour publication met en lumière une série d’erreurs récurrentes commises lors de la mise en œuvre de la variance sous Excel. La première, la plus répandue et la plus pernicieuse, réside dans l’utilisation accidentelle de la fonction VAR.P en lieu et place de VAR.S, motivée par une méconnaissance naïve de la signification du suffixe « .P ». De nombreux étudiants s’imaginent à tort que « P » désigne la variable « Principale » de leur étude, ou présument que leur cohorte de 45 étudiants de psychologie constitue en elle-même une « population » autonome au sens de la théorie statistique.
Une seconde erreur épistémologique de première grandeur réside dans l’application aveugle de formules de variance à des données de niveau de mesure inapproprié. La variance, en tant que calcul fondé sur des déviations quadratiques par rapport à une moyenne, présuppose impérativement des variables quantitatives continues ou discrètes mesurées sur des échelles d’intervalles ou de rapports. Appliquer la fonction VAR.S sur des variables strictement ordinales (comme des échelles de Likert brutes à trois ou quatre points non validées, ou des rangs de classement) ou, pire encore, sur des données nominales catégorielles arbitrairement codifiées par des entiers (par exemple : $1 = \text{Célibataire}$, $2 = \text{Marié}$, $3 = \text{Divorcé}$) représente un non-sens statistique absolu qui produit des indicateurs dénués de toute signification mathématique.
Enfin, une négligence documentaire chronique consiste à omettre de consigner explicitement dans le rapport méthodologique la version précise d’Excel mobilisée et la formulation exacte de la syntaxe utilisée. En matière de reproductibilité scientifique, consigner simplement « la variance a été calculée sous tableur » est insuffisant : le chercheur rigoureux mentionnera explicitement : « L’estimation non biaisée de la dispersion a été effectuée à l’aide de la fonction VAR.S de Microsoft Excel (Version 365), appliquant la correction de Bessel avec $(n – 1)$ degrés de liberté. »
11.2 Optimisation des classeurs et audit des formules statistiques
Pour garantir la robustesse industrielle d’un classeur d’analyse statistique et prévenir les altérations silencieuses de calculs, un ensemble d’aménagements techniques d’ingénierie logicielle s’impose au sein d’Excel :
- Le verrouillage des références par l’opérateur dollar ($) : Lors de calculs manuels décomposés de variance impliquant des références à la moyenne de la cohorte, l’absence de références absolues (ex.
A$2:A$100au lieu deA2:A100) provoque un glissement désastreux des plages lors de la duplication des cellules vers le bas ou vers la droite, décalant le champ d’observation et corrompant le résultat sans lever d’alerte logicielle. - L’utilisation de l’outil « Évaluation de formule » : Situé dans le ruban « Formules » > groupe « Audit de formules », cet outil permet d’exécuter pas à pas chaque composante d’une formule matricielle complexe, visualisant la substitution progressive des plages par leurs valeurs numériques intermédiaires, facilitant le débogage instantané des anomalies.
- L’implémentation de tests d’intégrité logique : En vertu des axiomes de Kolmogorov, une variance est obligatoirement un nombre réel strictement positif ou nul ($s^2 ge 0$). L’insertion d’une cellule de validation conditionnelle alertant l’utilisateur en cas d’incohérence numérique constitue un garde-fou élémentaire :
=SI(VAR.S(A2:A100) < 0; "ERREUR CRITIQUE : VARIANCE NÉGATIVE"; "Intégrité validée") - La protection structurelle des cellules de formules : Dans les contextes de protocoles de recherche multicentriques où des feuilles de calcul sont partagées entre plusieurs évaluateurs cliniques, les cellules contenant les formules de variance consolidées doivent être impérativement verrouillées et la feuille protégée par un mot de passe (via « Révision » > « Protéger la feuille ») afin d’éviter tout écrasement accidentel de formule par une saisie de données brutes.
11.3 Standardisation du reporting selon les normes de l’American Psychological Association (APA)
La communication publique des résultats statistiques dans les revues académiques internationales obéit à des conventions typographiques et rédactionnelles d’une extrême précision, formalisées dans la 7-ème édition du Publication Manual of the American Psychological Association (APA). Le respect scrupuleux de ces standards assure l’interopérabilité des connaissances scientifiques et la lisibilité immédiate des synthèses méta-analytiques.
Les directives stylistiques et typographiques cardinales imposées pour le reporting de la dispersion s’articulent ainsi :
- Règles d’arrondi décimal : Les valeurs de variance, d’écart-type et de moyenne doivent systématiquement être arrondies à deux décimales après la virgule (sauf impératif de précision spécifique justifié par la nature métrologique de données infinitésimales). La fonction d’arrondi d’Excel
=ARRONDI(VAR.S(A2:A100); 2)sera avantageusement déployée pour garantir l’uniformité du tableau de sortie. - Typographie et symboles mathématiques : Les statistiques d’échantillon sont universellement rédigées en caractères latins italiques, tandis que les paramètres théoriques de population sont rédigés en caractères grecs non italiques. On notera donc scrupuleusement :
- Variance de l’échantillon : s² (ou $s^2$)
- Écart-type de l’échantillon : SD (pour Standard Deviation) ou s
- Variance de la population : σ²
- Écart-type de la population : σ
- Moyenne de l’échantillon : M (pour Mean)
- Moyenne de la population : μ
- Accompagnement obligatoire : Dans le corps du texte ou au sein des tableaux récapitulatifs, une variance ne doit jamais être présentée de façon isolée. Elle doit obligatoirement être mise en perspective avec la taille effective de l’échantillon ($N$ ou $n$), la moyenne arithmétique ($M$) et préférentiellement l’écart-type ($SD$), complétée le cas échéant de l’intervalle de confiance à 95 % : $IC_{95%}$.
Voici un modèle rédactionnel standardisé de restitution de résultats psychologiques conforme aux canons contemporains :
« L’analyse des scores d’inhibition cognitive mesurés au cours de la tâche de Stroop révèle une variabilité substantielle au sein du groupe expérimental soumis au protocole d’induction de stress ($n = 45$, $M = 412,35\text{ ms}$, $s^2 = 2,345,67$, $SD = 48,43\text{ ms}$). Cette dispersion s’avère significativement plus large que celle observée au sein de la cohorte témoin ($n = 45$, $M = 354,12\text{ ms}$, $s^2 = 987,24$, $SD = 31,42\text{ ms}$), suggérant une dégradation de l’homogénéité des performances exécutives sous contrainte environnementale. »
12. Au-delà de la variance : De la dispersion élémentaire aux statistiques inférentielles
12.1 Transition indispensable vers l’écart-type : ECARTYPE.STANDARD et ECARTYPE.PE
Bien que la variance s’impose comme la fondation algébrique indispensable sur laquelle repose l’ensemble des dérivations mathématiques de la statistique paramétrique, elle présente une lacune majeure au regard de l’interprétation empirique : son incompatibilité dimensionnelle avec la variable mesurée. Comme souligné précédemment, la variance s’exprime dans le carré des unités initiales de mesure. Exprimer la dispersion des âges d’un groupe en « années au carré » ou la dispersion des scores d’anxiété en « points d’échelle au carré » constitue un obstacle cognitif évident pour le clinicien, le chercheur ou le décideur institutionnel.
La transition indispensable consiste à ramener cette quantité à l’échelle métrologique originelle en extrayant la racine carrée positive de la variance, opération mathématique qui donne naissance à l’écart-type (ou déviation standard) :
$$s = \sqrt{s^2} \quad \text{et} \quad \sigma = \sqrt{\sigma^2}$$
Sous Microsoft Excel, la correspondance entre les fonctions de variance et les fonctions d’écart-type est rigoureusement symétrique :
- À la variance d’échantillon
VAR.Scorrespond de façon biunivoque la fonction d’écart-type d’échantillonECARTYPE.STANDARD(historiquementECARTYPE). L’égalité algorithmique suivante est absolue dans le tableur :
=ECARTYPE.STANDARD(Plage)$iff$=RACINE(VAR.S(Plage)) - À la variance de population
VAR.Pcorrespond de façon symétrique la fonction d’écart-type de populationECARTYPE.PE(historiquementECARTYPEP) :
=ECARTYPE.PE(Plage)$iff$=RACINE(VAR.P(Plage))
Une fois l’écart-type obtenu sous sa forme dimensionnelle originelle, le chercheur peut immédiatement mobiliser la fameuse règle empirique de dispersion (règle des 68-95-99,7) pour une distribution gaussienne théorique : environ 68,27 % des observations se situent dans l’intervalle $[\bar{x} – s ; \bar{x} + s]$, 95,45 % dans l’intervalle $[\bar{x} – 2s ; \bar{x} + 2s]$, et 99,73 % dans l’intervalle $[\bar{x} – 3s ; \bar{x} + 3s]$. Cette propriété rend l’interprétation diagnostique immédiatement accessible sur le plan clinique.
12.2 L’homogénéité des variances comme prérequis des tests d’hypothèses
L’estimation rigoureuse de la variance d’échantillon ne constitue presque jamais l’aboutissement final d’une recherche empirique ; elle constitue le prérequis méthodologique d’étapes inférentielles plus sophistiquées. Au premier rang de ces exigences figure l’évaluation de l’homoscédasticité, c’est-à-dire l’hypothèse postulant l’égalité fondamentale des variances entre les différents groupes ou conditions expérimentales comparés ($H_0 : \sigma^2_1 = \sigma^2_2 = dots = \sigma^2_k$).
Cette hypothèse d’homogénéité conditionne la validité des modèles d’inférence les plus courants, à commencer par le classique test $t$ de Student pour échantillons indépendants et l’ANOVA paramétrique. Si deux groupes expérimentaux présentent des variances hétérogènes (hétéroscédasticité) et que les effectifs de ces groupes sont inégaux, l’application d’un modèle linéaire classique entraîne une altération brutale du taux nominal de l’erreur de première espèce ($\alpha = 0,05$), conduisant soit à une inflation dramatique des faux positifs, soit à une perte massive de puissance statistique.
Pour tester formellement cette homogénéité sous Excel, le chercheur dispose de plusieurs leviers analytiques :
- Le Test $F$ de Fisher-Snedecor pour deux échantillons indépendants : ce test repose explicitement sur le rapport des deux variances d’échantillons calculées via
VAR.S, en plaçant systématiquement la variance la plus forte au numérateur :
$$F_{(n_1 – 1, n_2 – 1)} = \frac{s^2_1}{s^2_2}$$
Sous Excel, la $p$-value bilatérale de ce ratio s’obtient instantanément à l’aide de la fonction native dédiée :
=TEST.F(Plage_Groupe1; Plage_Groupe2)
Si la valeur retournée est inférieure à $0,05$, l’hypothèse d’égalité des variances est rejetée. - La conduite à tenir en cas de violation d’homogénéité : Face à des variances statistiquement divergentes, l’analyste doit impérativement abandonner le test $t$ standard au profit du test $t$ de Welch (test d’hétéroscédasticité à degrés de liberté ajustés), directement disponible dans l’outil « Utilitaire d’analyse » d’Excel sous la mention « Test d’hypothèse sur deux échantillons d’inégales variances ».
12.3 Automatisation avancée avec Power Query et macros VBA
Pour les environnements de laboratoire traitant des flux volumineux et continus de données psychométriques brutes — par exemple lors de consortiums de neuro-imagerie ou de suivis longitudinaux de cohortes épidémiologiques comprenant des dizaines de milliers de lignes — les manipulations manuelles de formules dans les cellules du tableur atteignent rapidement leurs limites techniques et ergonomiques. L’automatisation avancée via Power Query et l’environnement de programmation Visual Basic for Applications (VBA) représente la solution d’ingénierie par excellence.
Power Query, le moteur de transformation et de chargement (ETL) intégré nativement dans les versions contemporaines d’Excel, permet de standardiser l’intégralité du pipeline d’ingestion des données :
- Importation automatisée de multiples fichiers CSV ou classeurs générés par des plateformes d’expérimentation cognitive.
- Filtrage dynamique immédiat des valeurs manquantes, suppression automatisée des cellules de commentaires textuels polluant les vecteurs de scores, et conversion forcée des types de colonnes en nombres réels stricts.
- Calcul dynamique de colonnes de variance agrégée par groupe expérimental au moyen du moteur de script langage M, garantissant une actualisation instantanée des métriques d’un simple clic sur « Actualiser tout » dès que de nouvelles passations de sujets sont enregistrées sur le serveur local.
Pour les besoins spécifiques exigeant des algorithmes non couverts nativement par les fonctions standard du tableur — comme le calcul automatisé d’une variance d’échantillon winsorisée ou d’une variance pondérée selon des coefficients d’attrition clinique — le recours à des fonctions personnalisées écrites en VBA offre une puissance d’exécution inégalée. Voici un exemple d’implémentation formelle d’une fonction personnalisée VBA sécurisée calculant la variance d’échantillon sans biais tout en rejetant rigoureusement les données corrompues :
(Description de l’architecture logicielle de la fonction UDF) : Le script VBA parcourt un tableau de cellules spécifié, filtre activement chaque observation pour vérifier qu’elle relève strictement du type numérique (rejetant les textes et les cellules vides), incrémente un compteur dynamique d’effectif $n$, calcule la moyenne empirique, somme les écarts quadratiques dans un accumulateur en virgule flottante double précision, et applique au final la division par $(n – 1)$. Si le compteur $n$ demeure inférieur à 2, la fonction retourne un message explicite d’interruption méthodologique, garantissant l’intégrité de la chaîne de recherche.
L’intégration conjointe de ces environnements d’automatisation professionnelle et des fonctions statistiques normalisées confère à Microsoft Excel le statut d’un outil d’analyse quantitatif de premier ordre, parfaitement armé pour répondre avec une rigueur mathématique irréprochable aux défis les plus exigeants de la psychométrie et de la psychologie quantitative contemporaines.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org
- Bessel, F. W. (1815). Über die Festlegung des Längenunterschiedes zwischen den Sternwarten von Danzig und Königsberg. Astronomische Nachrichten.
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Microsoft Corporation. (2023). Documentation des fonctions statistiques Excel (VAR.S, VAR.P, VARA, VARPA). Microsoft Support. https://support.microsoft.com/fr-fr/excel
- Novick, M. R. (1966). The axioms and principal results of classical test theory. Journal of Mathematical Psychology, 3(1), 1–18. https://doi.org/10.1016/0022-2496(66)90002-2
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Spearman, C. (1904). « General Intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Weisstein, E. W. (2024). Bessel’s correction. MathWorld—A Wolfram Web Resource. https://mathworld.wolfram.com/BesselsCorrection.html