
L’analyse quantitative des données en sciences comportementales et psychologiques repose fondamentalement sur la capacité du chercheur à isoler les effets expérimentaux authentiques du bruit stochastique inhérent à l’échantillonnage humain. Lorsque l’on cherche à comparer deux cohortes indépendantes — qu’il s’agisse de mesurer l’efficacité différentielle d’une prise en charge psychothérapeutique par rapport à une condition témoin, ou d’évaluer l’impact d’une lésion neuropsychologique sur les temps de réaction —, la simple confrontation des moyennes arithmétiques demeure insuffisante. Pour établir une inférence statistique valide, il est indispensable de modéliser la variabilité sous-jacente des populations étudiées. C’est précisément à cette jonction méthodologique que s’impose la notion de variance combinée (ou pooled variance en littérature anglo-saxonne), une métrique pivot qui agrège l’information de dispersion de plusieurs sous-échantillons afin de fournir un estimateur global plus robuste et statistiquement efficient.
Dans la pratique académique contemporaine, bien que des environnements de programmation tels que R, Python ou des logiciels dédiés comme SPSS soient fréquemment sollicités, le tableur Microsoft Excel demeure un instrument d’une prévalence universelle dans les laboratoires, les structures hospitalières et les centres de recherche clinique. Sa flexibilité, son accessibilité immédiate et la transparence algorithmique qu’il autorise en font un outil d’apprentissage et de contrôle indispensable. Maîtriser le calcul pas à pas de la variance combinée au sein d’Excel ne constitue pas uniquement un exercice technique de calcul matriciel ou arithmétique : cela permet au praticien d’acquérir une compréhension granulaire des mécanismes internes qui régissent les tests d’hypothèses, la détermination de l’erreur type et le calcul des tailles d’effet standardisées.
Le présent traité propose une immersion exhaustive, théorique et opérationnelle, dans le calcul de la variance combinée sous Excel. Nous examinerons rigoureusement ses soubassements statistiques issus des travaux canoniques de Student et de Ronald Fisher, détaillerons sa dérivation algébrique, évaluerons les postulats paramétriques qui conditionnent sa légitimité, puis déclinerons une procédure séquentielle minutieuse sous Excel, allant de la structuration brute des jeux de données jusqu’à l’automatisation via l’Utilitaire d’analyse et les fonctions intégrées. Enfin, nous aborderons les diagnostics d’erreurs récurrents et l’interprétation des résultats selon les normes de publication les plus strictes de l’American Psychological Association (APA).
1. Fondements théoriques de la variance combinée en recherche psychologique
1.1 Définition conceptuelle et utilité en psychométrie
D’un point de vue conceptuel, la variance combinée représente une moyenne pondérée des variances d’échantillons indépendants, pondérée spécifiquement par leurs degrés de liberté respectifs. En psychométrie, la variabilité des scores observés reflète non seulement les différences interindividuelles stables — telles que les traits de personnalité, les capacités cognitives ou le tempérament —, mais également l’erreur de mesure aléatoire inhérente aux instruments d’évaluation (questionnaires auto-rapportés, épreuves chronométrées, inventaires psychologiques). Lorsque deux groupes d’individus sont extraits d’une même population parente ou de deux populations partageant une structure de dispersion identique, l’estimation conjointe de cette dispersion permet d’annuler les fluctuations d’échantillonnage locales qui affectent isolément chaque sous-groupe.
La variance combinée joue un rôle central dans l’estimation de l’erreur type commune entre groupes expérimentaux. Plutôt que de considérer séparément la dispersion du groupe contrôle et celle du groupe expérimental, la statistique inférentielle postule que si ces deux groupes partagent une variance populationnelle sous-jacente homogène, l’information issue des deux ensembles doit être fusionnée pour maximiser la fidélité de l’estimation. Cela confère à la métrique une importance capitale dans les protocoles d’évaluation clinique et comportementale, où la fidélité des mesures conditionne le diagnostic de troubles anxieux, de profils neuro-développementaux ou de gains thérapeutiques longitudinaux.
Il est impératif d’établir une distinction théorique nette entre la variance intra-groupe (qui mesure l’écartement des observations individuelles autour de la moyenne de leur sous-groupe spécifique) et la variance combinée globale. Alors que la première caractérise une entité empirique isolée, la seconde constitue un estimateur mutualisé synthétique, fondé sur l’hypothèse de stationnarité de la variance à travers les différentes conditions expérimentales. Cette mutualisation garantit une assise d’inférence mathématique indispensable à la construction des statistiques de décision.
1.2 Le test t de Student pour échantillons indépendants
L’intégration de la variance combinée au sein du dénominateur de la statistique dans le cadre du test t de Student pour échantillons indépendants constitue l’un des piliers de l’analyse inférentielle classique. La formule canonique du test t compare l’écart entre les moyennes empiriques de deux cohortes au regard de la variabilité résiduelle attendue sous l’hypothèse nulle. Cette variabilité résiduelle est précisément modélisée par l’erreur type de la différence de moyennes, laquelle incorpore directement la racine carrée de la variance combinée pondérée par les inverses des effectifs :
Dans le protocole typique comparant un groupe contrôle recevant un placebo à un groupe expérimental bénéficiant d’une thérapie d’activation comportementale, la statistique t permet d’évaluer si la différence constatée dépasse ce qui pourrait être raisonnablement attribué aux seuls aléas de l’échantillonnage. En mutualisant les variances, l’analyste préserve la puissance statistique du test face aux fluctuations mineures, évitant ainsi que la variabilité inhabituellement faible ou élevée d’un sous-groupe restreint ne biaise indûment la statistique de décision globale.
Une mauvaise estimation de la variance combinée — qu’elle résulte d’une erreur d’implémentation arithmétique ou de la méconnaissance d’une asymétrie de dispersion — entraîne des répercussions désastreuses sur le taux d’erreur de type I (rejet erroné de l’hypothèse nulle en l’absence d’effet réel). Si la variance combinée est sous-estimée, le dénominateur de la statistique t devient artificiellement restreint, ce qui gonfle la valeur de t et conduit à déclarer des résultats fallacieusement significatifs. À l’inverse, sa surévaluation entraîne une inflation du risque de type II, masquant des découvertes cliniques potentiellement décisives pour le domaine de la santé mentale.
1.3 Calcul de la taille d’effet et d de Cohen
Au-delà de la significativité statistique, l’évaluation de la pertinence clinique et pragmatique des résultats en sciences du comportement exige la quantification de la magnitude de l’effet. C’est ici qu’intervient l’écart-type combiné (la racine carrée de la variance combinée), instrumenté pour la standardisation des différences de moyennes dans le calcul du célèbre d de Cohen. Alors que le test t dépend étroitement de la taille de l’échantillon — pouvant atteindre un seuil significatif même pour des divergences minimes lorsque N devient très volumineux —, la taille d’effet standardisée offre une métrique universelle, exempte de l’influence mécanique du volume d’échantillonnage.
La formulation mathématique liant la variance combinée à la métrique de Jacob Cohen s’exprime par le ratio entre la différence absolue des moyennes des deux groupes et l’écart-type combiné des populations. L’utilisation rigoureuse de la variance combinée au dénominateur assure que l’unité de mesure standardisée reflète fidèlement la variabilité commune au sein de laquelle s’expriment les scores comportementaux. Dans la littérature psychologique, l’interprétation clinique suit classiquement les seuils conventionnels formulés par Cohen : un d de 0,2 correspond à un effet modeste, 0,5 à un effet intermédiaire, et 0,8 ou au-delà à un effet massif, susceptible d’induire des changements observables à l’échelle du comportement quotidien.
Dans le paradigme contemporain de la science ouverte et des synthèses quantitatives, l’extraction précise de la variance combinée est le prérequis cardinal pour la réalisation de méta-analyses. Les modélisateurs ont besoin de cet estimateur pour convertir les résultats issus de multiples protocoles empiriques hétérogènes en une métrique commune d’effet standardisé. Une imprécision dans le calcul de la variance combinée au sein d’un rapport primaire contamine inévitablement les modèles à effets fixes ou aléatoires des méta-analyses futures, altérant durablement l’état des connaissances scientifiques.
2. Formulation mathématique et dérivation de la variance combinée
2.1 Décomposition algébrique de la formule standard
L’expression mathématique fondamentale de la variance combinée pour deux échantillons indépendants s’articule comme suit :
sp² = [ (n1 – 1)s1² + (n2 – 1)s2² ] / (n1 + n2 – 2)
Pour appréhender la mécanique intime de cette équation, il est indispensable de disséquer ses composantes algébriques. Le numérateur, représenté par la somme pondérée (n1 – 1)s1² + (n2 – 1)s2², correspond en réalité à la somme des carrés des écarts à la moyenne respective de chaque groupe, souvent notée SCE (Somme des Carrés des Écarts) ou Sum of Squares (SS) en anglais. Sachant que la variance empirique d’un échantillon s1² est définie par le quotient de sa somme des carrés par ses degrés de liberté (n1 – 1), la multiplication préalable de s1² par (n1 – 1) rétablit rigoureusement la somme brute des déviations quadratiques individuelles.
Le dénominateur, quant à lui, formalise la somme des degrés de liberté associés aux deux cohortes indépendantes : (n1 – 1) + (n2 – 1) = n1 + n2 – 2. En divisant la somme totale des variations quadratiques intra-groupes par l’ensemble des degrés de liberté disponibles, on procède à une moyenne pondérée par l’information statistique effective apportée par chaque sous-échantillon. Cette décomposition algébrique démontre avec élégance que la variance combinée n’est en rien une moyenne arithmétique naïve des variances, sauf dans le cas particulier et strict où les deux échantillons possèdent un effectif rigoureusement identique.
Sur le plan théorique, cette formule standard s’étend sans rupture épistémologique au cas général de k groupes d’échantillons indépendants, qui préfigure l’analyse de variance univariée (ANOVA). L’estimateur de la variance intra-groupe (ou carré moyen résiduel, Mean Square Error) n’est alors rien d’autre que la généralisation de la variance combinée calculée sur l’ensemble des k conditions expérimentales, consolidant l’unité structurelle des statistiques paramétriques univariées.
2.2 Rôle et calcul des degrés de liberté
La notion de degrés de liberté (notés couramment ddl ou df pour degrees of freedom) renvoie au nombre de valeurs d’un calcul statistique qui sont libres de varier lorsque certaines contraintes algébriques ont été imposées. Pour un échantillon isolé de taille n, le calcul de la moyenne arithmétique introduit une contrainte linéaire : la somme des déviations par rapport à cette moyenne doit impérativement être égale à zéro. Dès lors que la moyenne est fixée, seules n – 1 observations demeurent indépendantes, ce qui justifie la division par n – 1 dans l’estimateur de la variance d’échantillon pour assurer l’absence de biais.
Lorsque deux échantillons distincts sont mutualisés dans l’espace multidimensionnel des observations, deux paramètres populationnels doivent être estimés préalablement à partir des données : la moyenne du premier groupe et celle du second groupe. Chaque estimation de moyenne consomme un degré de liberté géométrique. La mutualisation des contraintes mathématiques se traduit donc inexorablement par la soustraction de deux unités à l’effectif global cumulé, ce qui aboutit au terme n1 + n2 – 2. Cette perte de deux degrés de liberté constitue le coût paramétrique incompressible pour ancrer l’estimation non biaisée de la dispersion résiduelle.
Il importe de souligner la sensibilité des degrés de liberté aux disparités d’effectifs entre sous-groupes. Lorsqu’une cohorte clinique présente une dissymétrie marquée — par exemple n1 = 100 dans le groupe contrôle et n2 = 15 dans le groupe d’une pathologie rare —, les degrés de liberté du grand échantillon (99) dominent écrasamment le dénominateur de la formule. Par conséquent, la variance combinée s’alignera très majoritairement sur la dispersion du groupe le plus abondant, traduisant le fait que ce dernier fournit une assise observationnelle infiniment plus stable et moins sensible aux fluctuations d’échantillonnage singulières.
2.3 Propriétés statistiques de l’estimateur combiné
L’estimateur de la variance combinée sp² possède des caractéristiques mathématiques formelles qui expliquent sa prééminence dans l’inférence paramétrique. En premier lieu, il s’agit d’un estimateur sans biais de la variance populationnelle commune σ². Cela signifie formellement que l’espérance mathématique de sp² est égale à σ² : E[sp²] = σ². Contrairement aux estimateurs maximisant la vraisemblance sans correction, qui tendent à sous-estimer la variance dans les petits échantillons, la correction intégrée au dénominateur via les degrés de liberté compense exactement cette tendance géométrique au rétrécissement.
En second lieu, l’estimateur présente la propriété fondamentale de convergence asymptotique (consistance). À mesure que les effectifs n1 et n2 tendent vers l’infini, la variance combinée converge en probabilité vers la véritable variance théorique de la population parente. L’erreur standard de cet estimateur diminue proportionnellement à la racine carrée de la somme des effectifs, garantissant une précision accrue par rapport à n’importe quelle estimation isolée s1² ou s2² calculée de façon discontinue.
Enfin, au regard du critère d’efficacité relative, la variance combinée atteint la borne de Cramér-Rao pour les modèles paramétriques gaussiens. Parmi l’ensemble des estimateurs non biaisés envisageables pour agréger des dispersions issues de populations normales homoscédastiques, sp² possède la variance d’échantillonnage minimale. Cela confère aux tests dérivés, comme le test t de Student standard, la puissance statistique la plus élevée théoriquement accessible sous les postulats de la normalité.
3. Postulats méthodologiques et vérification de l’homogénéité des variances
3.1 Le postulat d’homoscédasticité
L’application légitime de la formule de la variance combinée est subordonnée à une condition méthodologique non négociable : le postulat d’homogénéité des variances, techniquement désigné sous le terme d’homoscédasticité. Ce postulat stipule que, nonobstant les écarts éventuels constatés entre leurs moyennes arithmétiques, les deux populations théoriques dont sont extraits les échantillons partagent une variance identique, soit σ1² = σ2² = σ². La variance empirique observée dans chaque groupe ne doit être considérée que comme une instanciation imparfaite de cette réalité stochastique commune.
La violation de cette exigence fondamentale — condition qualifiée d’hétéroscédasticité — compromet gravement l’intégrité inférentielle du modèle. Lorsque les variances réelles des populations s’écartent substantiellement, agréger s1² et s2² au sein d’une métrique combinée unique revient à fusionner deux paramètres discordants. Il en résulte un estimateur hybride qui ne correspond à aucune réalité physique ou psychologique quantifiable, faussant la métrique de dispersion sur laquelle reposera l’ensemble du raisonnement probabiliste.
Les conséquences pratiques de l’hétéroscédasticité sont particulièrement dramatiques lorsque l’inégalité des variances est couplée à un déséquilibre d’effectif entre les groupes (plans expérimentaux non orthogonaux). Deux configurations antagonistes se présentent alors :
- Configuration permissive (anti-conservatrice) : Le plus petit échantillon présente la plus grande variance. L’estimateur combiné sp², dominé par le grand échantillon à faible variance, sous-estime l’erreur type réelle de la différence. La statistique t s’envole artificiellement, provoquant une inflation catastrophique du taux d’erreur de type I. Le chercheur conclut à l’existence d’un effet psychologique inexistant.
- Configuration conservative : Le plus grand échantillon présente la plus grande variance. Dans ce schéma, sp² surestime l’erreur type conjointe, comprimant artificiellement la statistique t et augmentant démesurément le risque d’erreur de type II. Le protocole devient incapable de déceler des répercussions cliniques authentiques.
3.2 Tests préalables à réaliser sous Excel
Avant d’engager le calcul de la variance combinée dans une feuille de calcul Excel, le praticien doit impérativement soumettre ses données à une évaluation d’homoscédasticité. L’outil privilégié pour confronter deux variances indépendantes dans un cadre standard est le test F de Snedecor-Fisher. Ce test repose sur l’évaluation du ratio empirique des deux variances : F = s1² / s2² (ou inversement, en plaçant systématiquement la variance la plus élevée au numérateur afin de respecter la convention tabulaire unilatérale).
Excel propose une fonction native particulièrement directe pour automatiser cette vérification : =TEST.F(matrice1; matrice2). Cette fonction calcule le ratio des variances pour les deux plages d’arguments fournies et retourne la probabilité bilatérale (p-valeur) que l’écart constaté soit imputable au simple hasard de l’échantillonnage sous l’hypothèse nulle d’égalité des variances. Si la p-valeur générée par la fonction TEST.F s’avère inférieure au seuil alpha prédéterminé (usuellement α = 0,05), l’hypothèse d’homoscédasticité doit être formellement rejetée, invalidant l’usage non corrigé de la variance combinée standard.
Cependant, l’analyste rigoureux doit garder à l’esprit les limitations inhérentes au test F sous Excel. Ce test manifeste une extrême sensibilité aux écarts par rapport à la distribution normale des données (asymétrie, aplatissement leptokurtique). Dans les situations où les distributions psychométriques s’écartent de la gaussianité, un test F significatif peut simplement révéler une déformation de la loi de distribution sous-jacente plutôt qu’une hétéroscédasticité pure. Pour une évaluation empirique plus nuancée, il est recommandé de calculer les résidus individuels (écarts des scores à la moyenne de leur groupe respectif) et d’examiner visuellement leur dispersion via un diagramme de dispersion ou de boîtes à moustaches.
3.3 Alternatives méthodologiques en cas de violation de l’hypothèse
Lorsque le test d’homogénéité des variances conclut sans ambiguïté à une hétéroscédasticité sévère, le recours à la variance combinée classique doit être suspendu au profit d’alternatives méthodologiques robustes. La procédure de référence internationale est l’application de la correction de Welch-Satterthwaite. Au lieu de contraindre les données à une variance combinée unique, le test t de Welch traite chaque variance d’échantillon de manière autonome dans le calcul de l’erreur standard :
SEWelch = RACINE( s1²/n1 + s2²/n2 )
L’innovation majeure de l’approche de Welch réside dans l’ajustement dynamique des degrés de liberté, qui ne sont plus calculés par l’expression linéaire n1 + n2 – 2, mais au moyen d’une équation rationnelle complexe intégrant les ratios de variances et d’effectifs. Cette adaptation garantit que le risque de type I demeure strictement borné au seuil nominal de 5 %, neutralisant totalement l’effet dévastateur du déséquilibre d’effectif couplé à l’inégalité des dispersions.
Une seconde approche consiste à appliquer des transformations mathématiques univariées aux données brutes avant tout traitement inférentiel. Dans de nombreux paradigmes comportementaux (temps de latence, scores de gravité symptomatique), la variance tend à s’accroître proportionnellement à la moyenne. L’application d’une transformation logarithmique y = ln(x) ou d’une transformation racine carrée y = RACINE(x) permet de stabiliser la variance across conditions, rétablissant ainsi l’homoscédasticité requise pour le calcul classique de la variance combinée. Enfin, si les violations distributionnelles sont inextricables et les effectifs restreints, le recours à la statistique non paramétrique — singulièrement le test U de Mann-Whitney — s’impose pour contourner toute modélisation de la dispersion métrique.
4. Préparation et organisation rigoureuse du classeur Excel
4.1 Architecture optimale de la feuille de calcul
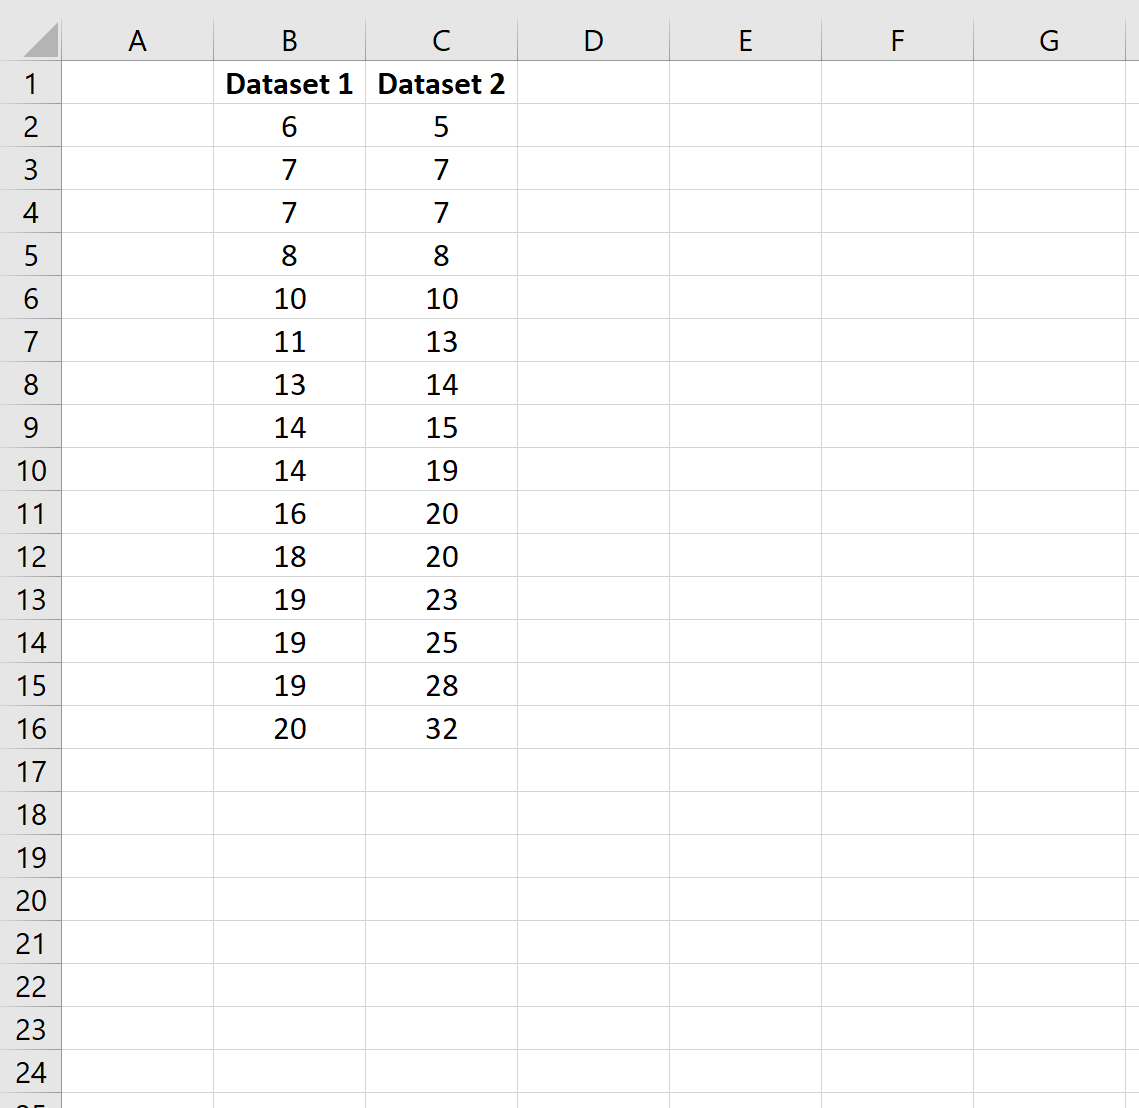
La crédibilité d’une analyse quantitative repose sur la transparence, l’ergonomie et la traçabilité intégrale des opérations algorithmiques. Trop souvent, les erreurs de calcul statistique sous Excel résultent d’un agencement anarchique des données, favorisant la sélection incorrecte de plages ou le chevauchement de formules. Une feuille de calcul destinée au calcul de la variance combinée doit obéir à une typologie structurelle stricte, partitionnée en trois zones distinctes : la zone de saisie des données brutes, la zone des métadonnées et un panneau latéral dédié aux statistiques intermédiaires.
Il est préconisé de réserver les premières colonnes (par exemple Colonne A et Colonne B) à la réception des séries de scores expérimentaux, chaque colonne représentant un groupe indépendant clairement libellé. Chaque ligne doit correspondre à une unité d’observation unique (le participant), avec une colonne initiale dédiée à l’identifiant alphanumérique non nominatif du sujet. Le panneau latéral, positionné à partir de la colonne D ou E, accueille les opérations d’agrégation descriptive (effectifs, moyennes, sommes des carrés, variances élémentaires). Cette séparation physique entre les matrices de données brutes et les modules de calcul algorithmique prévient tout risque d’écrasement de formule lors de l’extension ultérieure de la base d’échantillonnage.
Enfin, l’impératif de reproductibilité scientifique commande de documenter chaque étape de calcul au moyen de commentaires de cellules natifs d’Excel ou de notes explicatives intégrées. Le chercheur doit expliciter la fonction mathématique mobilisée, le renvoi d’hypothèse associé (par exemple : « Calcul de la variance non biaisée de l’échantillon sous hypothèse d’homoscédasticité ») et la convention d’arrondi adoptée. Cette démarche d’assurance qualité statistique permet à un réviseur indépendant ou à un pair universitaire d’auditer la feuille de calcul sans la moindre ambiguïté d’interprétation.
4.2 Nettoyage et validation préalable des données
L’injection directe de scores psychométriques bruts dans un moteur d’inférence sans un protocole de nettoyage préalable constitue une faute méthodologique critique. Les protocoles psychologiques sont fréquemment entachés de données manquantes (sujet n’ayant pas répondu à une sous-échelle) ou de saisies erronées (frappe accidentelle d’un score hors bornes de l’inventaire psychométrique). Avant de calculer les variances individuelles, il convient d’exécuter un filtrage de cohérence dimensionnelle.
Excel offre un module puissant via la fonctionnalité de Validation des données (accessible via l’onglet Données > Validation des données). Cet outil permet de contraindre rigoureusement la plage de valeurs permises au sein des colonnes de saisie. Par exemple, si l’évaluation de l’anxiété repose sur une échelle d’auto-évaluation graduée de 0 à 60, la règle de validation doit rejeter systématiquement toute tentative de saisie d’une valeur négative ou d’un score supérieur à 60, éliminant d’emblée les aberrations de frappe.
Parallèlement, la détection des valeurs aberrantes extrêmes (outliers) doit être opérée par le calcul préliminaire des scores standardisés Z. En combinant les fonctions MOYENNE et ECARTYPE.STANDARD dans une colonne adjacente, le chercheur repère immédiatement les observations dont l’amplitude excède 2,5 ou 3 écarts-types par rapport au centre de gravité du groupe. Ces points extrêmes, susceptibles de gonfler unilatéralement la variance d’un sous-échantillon et de simuler une hétéroscédasticité fallacieuse, doivent faire l’objet d’une analyse clinique rigoureuse pour déterminer s’ils relèvent d’une anomalie technique de mesure ou de la variabilité clinique réelle du tableau pathologique.
4.3 Utilisation des tableaux structurés Excel
L’une des innovations ergonomiques les plus déterminantes dans l’écosystème moderne de Microsoft Excel réside dans l’utilisation des Tableaux structurés (générés via le raccourci clavier standard Ctrl + L ou Ctrl + T). Convertir une plage de cellules standard en tableau structuré transforme des données statiques en un objet relationnel dynamique doté de propriétés computationnelles avancées, particulièrement adaptées au traitement des designs expérimentaux vivants.
Les avantages statistiques des références structurées pour le calcul de la variance combinée sont multiples :
- Actualisation dynamique des plages de calcul : Lorsque de nouveaux participants sont recrutés et insérés au bas de la colonne, le tableau structuré s’étend automatiquement. Les formules calculant les effectifs (n) ou les variances individuelles (s²) n’ont nullement besoin d’être redéfinies manuellement ; elles englobent instantanément les nouvelles entrées sans risque d’omission spatiale.
- Remplacement des adresses absolues par une syntaxe sémantique : Une formule référençant des plages figées telles que
VAR.S(A2:A50)devientVAR.S(Tableau_Controle[Score]). Cette syntaxe explicite améliore radicalement la lisibilité du classeur, éliminant les erreurs d’inversion entre le groupe contrôle et le groupe expérimental. - Immunité contre les décalages de cellules : L’insertion inopinée de lignes d’annotation ou de cellules isolées au sein de la feuille n’altère pas la définition de la variable intégrée au tableau, préservant la stabilité algorithmique des calculs en aval.
5. Étape 1 : Saisie et structuration des deux séries de données
5.1 Modélisation d’une étude de cas psychologique
Afin de concrétiser l’ensemble de notre démonstration méthodologique sous Excel, nous formalisons une étude de cas clinique représentative des protocoles évaluatifs en neuropsychologie et thérapie cognitivo-comportementale. Imaginons un essai contrôlé randomisé conçu pour évaluer l’impact d’un programme d’entraînement cognitif informatisé ciblant la mémoire de travail chez des adultes présentant un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH). La variable dépendante continue correspond au score normalisé obtenu à une épreuve complexe d’empan de travail à l’issue de huit semaines de suivi.
Le protocole comporte deux séries d’observations rigoureusement indépendantes :
- Groupe Témoin (Condition Contrôle Actif) : Les participants ont visionné des documentaires éducatifs durant le même volume temporel. Les scores de ces 20 sujets sont inscrits dans la Colonne A, couvrant strictement la plage
A2:A21. - Groupe Expérimental (Condition Entraînement Cognitif) : Les participants ont suivi le protocole interactif de stimulation de la mémoire de travail. Les scores de ces 20 sujets sont transcrits dans la Colonne B, couvrant rigoureusement la plage
B2:B21.
Le chercheur doit vérifier scrupuleusement l’indépendance statistique absolue des unités d’observation. Aucun participant ne peut appartenir simultanément aux deux conditions, et aucun appariement dyadique (comme des fratries ou des couples) n’est présent, garantissant que l’estimation de la variance intra-groupe reflète une variabilité univariée pure, exempte de toute covariance intra-sujet qui relèverait d’un test t pour mesures répétées.
5.2 Formatage typographique et lisibilité des variables
L’excellence méthodologique sous Excel requiert un soin typographique particulier pour rendre la structure des données immédiatement compréhensible et prémunir le chercheur contre les bévues de saisie. En ligne 1 de votre feuille de calcul, définissez des étiquettes sémantiques univoques : la cellule A1 recevra l’intitulé Score_Controle tandis que la cellule B1 accueillera Score_Experimental. Il est déconseillé d’insérer des caractères accentués ou des espaces dans les étiquettes si l’on projette ultérieurement d’exporter ces matrices vers des scripts de traitement automatisés sous R ou Python.
Standardisez immédiatement le formatage numérique des données métriques. Sélectionnez l’intégralité des plages numériques (A2:B21), effectuez un clic droit, choisissez Format de cellule, puis sélectionnez la catégorie Nombre en configurant l’affichage sur deux décimales et en alignant les valeurs sur la droite des cellules. Cet alignement décimal uniforme permet une détection visuelle instantanée des anomalies potentielles, telles que des nombres encodés sous forme textuelle en raison d’une divergence de séparateur décimal (point au lieu d’une virgule dans la version francophone d’Excel).
Enfin, appliquez un code couleur rigoureux pour compartimenter l’architecture décisionnelle de la feuille : assignez un fond de remplissage pastel neutre (bleu très pâle ou gris) pour les cellules de saisie de données brutes, et un fond distinctif (vert tendre ou jaune pâle) pour les cellules destinées à recevoir les calculs d’agrégation et les paramètres combinés. Une fois la matrice initiale consolidée, il est prudent d’activer la protection de la feuille (onglet Révision > Protéger la feuille) en verrouillant exclusivement les cellules de données brutes afin d’empêcher toute manipulation malencontreuse durant les phases de calcul subséquentes.
6. Étape 2 : Calcul automatisé des effectifs d’échantillon
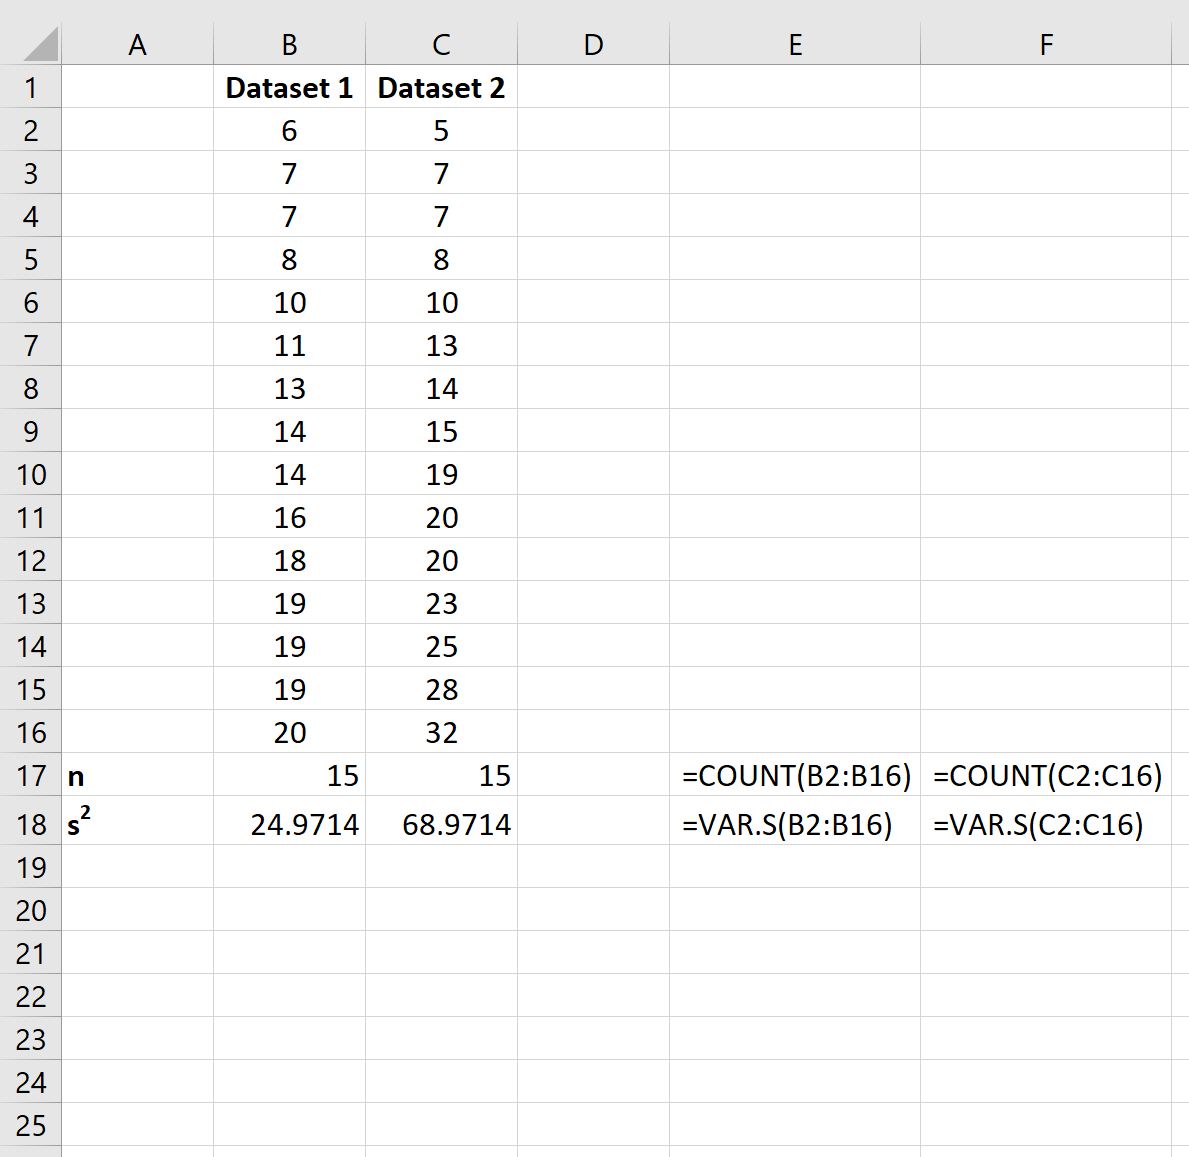
6.1 Mise en œuvre de la fonction NB pour déterminer n1 et n2
L’extraction précise du volume de chaque échantillon conditionne l’ensemble de la pondération mathématique de la variance combinée. Dans Excel, cette détermination doit impérativement être automatisée au moyen de formules dédiées et ne jamais être saisie sous forme de constante numérique figée dans les cellules finales de calcul. Cette règle d’automatisation garantit que si une observation venait à être retirée pour des motifs cliniques fondés, le dénominateur de la variance s’adapterait instantanément sans rupture logique.
Pour quantifier l’effectif n1 du groupe témoin, positionnez votre curseur dans la cellule D2 (libellée en D1 par l’étiquette n1_Controle) et insérez la syntaxe suivante :
=NB(A2:A21)
De façon symétrique, pour extraire l’effectif n2 du groupe expérimental, positionnez-vous dans la cellule E2 (libellée par n2_Experimental) et appliquez l’instruction :
=NB(B2:B21)
Il est capital de maîtriser la nuance algorithmique fondamentale qui sépare la fonction NB de la fonction NBVAL dans Excel :
- La fonction
NBdénombre exclusivement les cellules contenant des entités numériques valides. Si une cellule de la plage contient une chaîne de caractères, un espace masqué ou une valeur textuelle, elle sera ignorée par le comptage. C’est l’outil requis pour les variables psychométriques continues. - La fonction
NBVAL, en revanche, comptabilise toute cellule non vide, y compris les chaînes textuelles, les codes d’erreur ou les annotations marginales. Si un opérateur a saisi la mention « absent » dans une cellule psychométrique,NBVALincrémentera le compteur d’une unité, faussant l’effectif réel de l’échantillon et introduisant un biais majeur dans les degrés de liberté finaux.
6.2 Gestion des échantillons de tailles inégales
Dans la recherche comportementale en conditions réelles, l’orthogonalité parfaite des effectifs (n1 = n2) constitue une rareté. Les abandons en cours d’intervention (attrition expérimentale), l’inobservance thérapeutique ou les contraintes de recrutement de populations spécifiques induisent structurellement des tailles d’échantillons asymétriques. Le moteur de calcul d’Excel gère sans difficulté des colonnes de longueurs divergentes, pourvu que les plages référencées dans les formules correspondent précisément à l’étendue matérielle de chaque sous-groupe.
Toutefois, la présence d’un déséquilibre quantitatif marqué exerce une influence théorique massive sur la variance combinée. Comme nous l’avons établi dans la section 2, la formule opère une pondération linéaire stricte par les degrés de liberté. Dès lors que n1 diverge sensiblement de n2, la dispersion du groupe le plus nombreux s’impose de façon prépondérante dans la variance combinée. Si le chercheur néglige cette dynamique, il s’expose à des interprétations biaisées en croyant analyser une variance conjointe équitablement partagée alors qu’il examine en réalité un paramètre quasi-identique à la variance du groupe sur-représenté.
Pour surveiller en temps réel ce déséquilibre d’effectif au sein de votre classeur, il est judicieux d’implémenter une formule conditionnelle de contrôle dans la cellule F2 :
=MAX(D2; E2) / MIN(D2; E2)
Cette formule calcule le ratio d’asymétrie entre les effectifs. Vous pouvez ensuite coupler cette cellule à une Mise en forme conditionnelle : si le ratio franchit le seuil critique de 1,5 ou 2,0, la cellule se colore automatiquement en rouge pour alerter l’analyste. Ce déséquilibre signale en effet une vulnérabilité potentielle du test t standard face aux déviations, même modérées, de l’homoscédasticité, imposant une vérification redoublée de l’égalité des variances sous-jacentes.
7. Étape 3 : Calcul des variances d’échantillon individuelles
7.1 Sélection de la fonction de variance adéquate dans Excel
L’environnement Microsoft Excel dispose de plusieurs fonctions de variance dans sa bibliothèque statistique, ce qui engendre régulièrement une confusion redoutable chez les praticiens non statisticiens. On recense principalement deux familles d’instructions : VAR.S (anciennement VAR) et VAR.P (anciennement VAR.P ou VARP). Le choix entre ces deux opérateurs n’est pas une simple formalité logicielle ; il repose sur une distinction mathématique de fond.
La fonction VAR.P calcule la variance de la population globale. Son algorithme divise la somme des carrés des écarts par l’effectif brut total N. En revanche, la fonction VAR.S calcule la variance d’un échantillon extrait d’une population plus vaste. Son dénominateur intègre automatiquement la correction de Bessel en divisant la somme des carrés par n – 1. Cette soustraction unitaire neutralise le biais mathématique systématique qui conduit un échantillon fini à sous-estimer la dispersion de sa population parente.
Dans la dérivation de la variance combinée, l’utilisation de VAR.S est absolument impérative. Employer VAR.P au lieu de VAR.S pour obtenir s1² et s2² introduirait une double distorsion : les variances individuelles seraient sous-estimées, puis leur recombinaison au sein d’un dénominateur fondé sur les degrés de liberté d’échantillon produirait un résultat mathématiquement incohérent. Cela comprimerait artificiellement l’estimation de l’erreur type, exposant le chercheur à une grave inflation des erreurs d’inférence.
7.2 Application des formules de variance aux séries de données
Une fois la distinction théorique posée, nous procédons à l’implémentation algorithmique directe sur nos données de mémoire de travail. Nous assignons la cellule D3 au recueil de la variance empirique du groupe témoin (s1²) et la cellule E3 à celle du groupe expérimental (s2²). Les cellules d’en-tête correspondantes peuvent être libellées respectivement Var_Controle et Var_Experimental.
Dans la cellule D3, saisissez précisément la formule suivante :
=VAR.S(A2:A21)
Dans la cellule E3, saisissez l’expression parallèle :
=VAR.S(B2:B21)
Dès la validation par la touche Entrée, Excel restitue les valeurs numériques correspondant aux variances sans biais de chaque cohorte. Il est alors recommandé d’effectuer un contrôle intermédiaire de cohérence dimensionnelle. La variance s’exprimant dans le carré de l’unité de mesure d’origine (des « points d’empan au carré »), sa valeur doit être un nombre strictement positif. Si votre variable psychologique s’échelonne sur des scores compris entre 10 et 50, une variance individuelle de l’ordre de 15 à 40 apparaît plausible ; une variance affichant 0,02 ou 1500 trahirait instantanément une erreur matérielle dans la sélection de la plage ou dans le formatage décimal des entrées.
Pour consolider la vérification, vous pouvez également calculer manuellement la somme des carrés des écarts (SCE) via la fonction native SOMME.CARRES.ECART(A2:A21) et vous assurer que la division de ce résultat par (D2 - 1) restitue rigoureusement la valeur obtenue dans votre cellule de variance D3.
7.3 Extraction conjointe des écarts-types individuels
Bien que la variance combinée manipule formellement des variances quadratiques, la restitution des résultats psychologiques et l’inspection clinique de la distribution exigent la conversion conjointe de ces paramètres en écarts-types d’échantillon (s1 et s2). L’écart-type possède en effet l’avantage inestimable de s’exprimer dans la même échelle métrique que la variable observée (les points d’empan bruts).
Pour extraire les écarts-types individuels, deux options computationnelles totalement équivalentes s’offrent à l’analyste sous Excel :
- Par racine carrée directe de la variance : Dans la cellule
D4, insérez=RACINE(D3). - Par la fonction native d’écart-type d’échantillon : Dans la cellule
D4, appliquez directement=ECARTYPE.STANDARD(A2:A21).
Procédez de façon identique pour le second groupe en cellule E4 avec =ECARTYPE.STANDARD(B2:B21).
La confrontation immédiate de ces deux écarts-types apporte un premier diagnostic qualitatif précieux sur la dispersion comparée des deux populations :
Si s1 et s2 présentent des grandeurs comparables (par exemple s1 = 4,2 et s2 = 4,8), la vraisemblance d’une homoscédasticité satisfaisante est renforcée. Si en revanche s1 excède le double ou le triple de s2, cette divergence annonce une probable violation du postulat paramétrique. Sur le plan de la communication visuelle, ces écarts-types serviront immédiatement à paramétrer les barres d’erreur dans vos graphiques en colonnes sous Excel, illustrant la dispersion intra-groupe de manière standardisée avant toute agrégation combinée.
8. Étape 4 : Détermination explicite des degrés de liberté globaux
8.1 Construction de la cellule des degrés de liberté dans Excel
L’étape suivante consiste à matérialiser dans une cellule unique de la feuille de calcul le terme correspondant aux degrés de liberté globaux qui formeront le dénominateur de la formule de la variance combinée. Nous isolons ce paramètre dans la cellule D5, surmontée de l’étiquette sémantique Degres_de_Liberte_df.
Pour construire ce paramètre, référencez directement les cellules contenant les effectifs partiels calculés lors de l’Étape 2. Deux formulations algorithmiques rigoureusement superposables peuvent être implémentées dans la cellule D5 :
=(D2 - 1) + (E2 - 1)
ou sous sa forme condensée :
=D2 + E2 - 2
L’utilisation de références de cellules dynamiques (D2 et E2) est cruciale : elle garantit que les degrés de liberté s’adapteront instantanément en cas d’adjonction ou de suppression de participants dans les plages de données initiales. Vérifiez immédiatement la concordance arithmétique de votre tableau : si le groupe contrôle dénombre 20 sujets (D2 = 20) et le groupe expérimental 20 sujets (E2 = 20), la cellule D5 doit impérativement afficher la valeur 38.
Cette grandeur numérique n’est pas qu’un simple artifice de division. Elle constituera le paramètre fondamental requis pour aller consulter la distribution théorique du t de Student dans les tables de probabilité d’Excel, notamment via les fonctions LOI.STUDENT.INVERSE ou LOI.STUDENT.BILATERALE lors de la détermination de la valeur critique et de la prise de décision statistique.
8.2 Rôle des degrés de liberté dans la pondération statistique
La compréhension du rôle pondérateur joué par les degrés de liberté constitue l’essence même de l’inférence combinée. Dans la formule algébrique développée, le poids affecté à chaque variance individuelle n’est pas son effectif brut n, mais sa contribution informationnelle nette formalisée par n – 1. Cette distinction évite de surpondérer la dispersion d’échantillons au détriment des contraintes de centrage déjà consommées par le calcul des moyennes.
Pour appréhender cette mécanique, examinons deux cas de figure méthodologiques opposés :
- Hypothèse d’orthogonalité stricte (n1 = n2) : Si les deux groupes disposent d’un effectif rigoureusement équivalent, alors (n1 – 1) = (n2 – 1). Les termes de pondération se factorisent au numérateur et se simplifient exactement avec le dénominateur 2(n – 1). Dans cette configuration géométrique exclusive, la variance combinée dégénère en une parfaite moyenne arithmétique simple des deux variances : sp² = (s1² + s2²) / 2.
- Hypothèse d’asymétrie marquée (n1 >> n2) : Si le premier groupe compte 100 individus et le second 10, le poids attribué à s1² est de 99, tandis que celui de s2² n’est que de 9. Le dénominateur total est de 108. La variance s1² représentera 91,6 % du résultat final de la variance combinée, l’information issue du petit échantillon étant reléguée à une contribution marginale de 8,4 %.
Cette dynamique pondératrice illustre la rationalité profonde des statistiques paramétriques : plus un échantillon est large, plus l’incertitude quant à sa dispersion s’amenuise, et plus la statistique doit lui confier la modélisation du paramètre de population sous-jacent. Des degrés de liberté élevés confèrent à l’estimateur combiné une stabilité asymptotique maximale, réduisant drastiquement l’intervalle d’erreur attaché aux inférences futures.
9. Étape 5 : Assemblage et calcul de la variance combinée dans Excel
9.1 Implémentation pas à pas de la formule standard
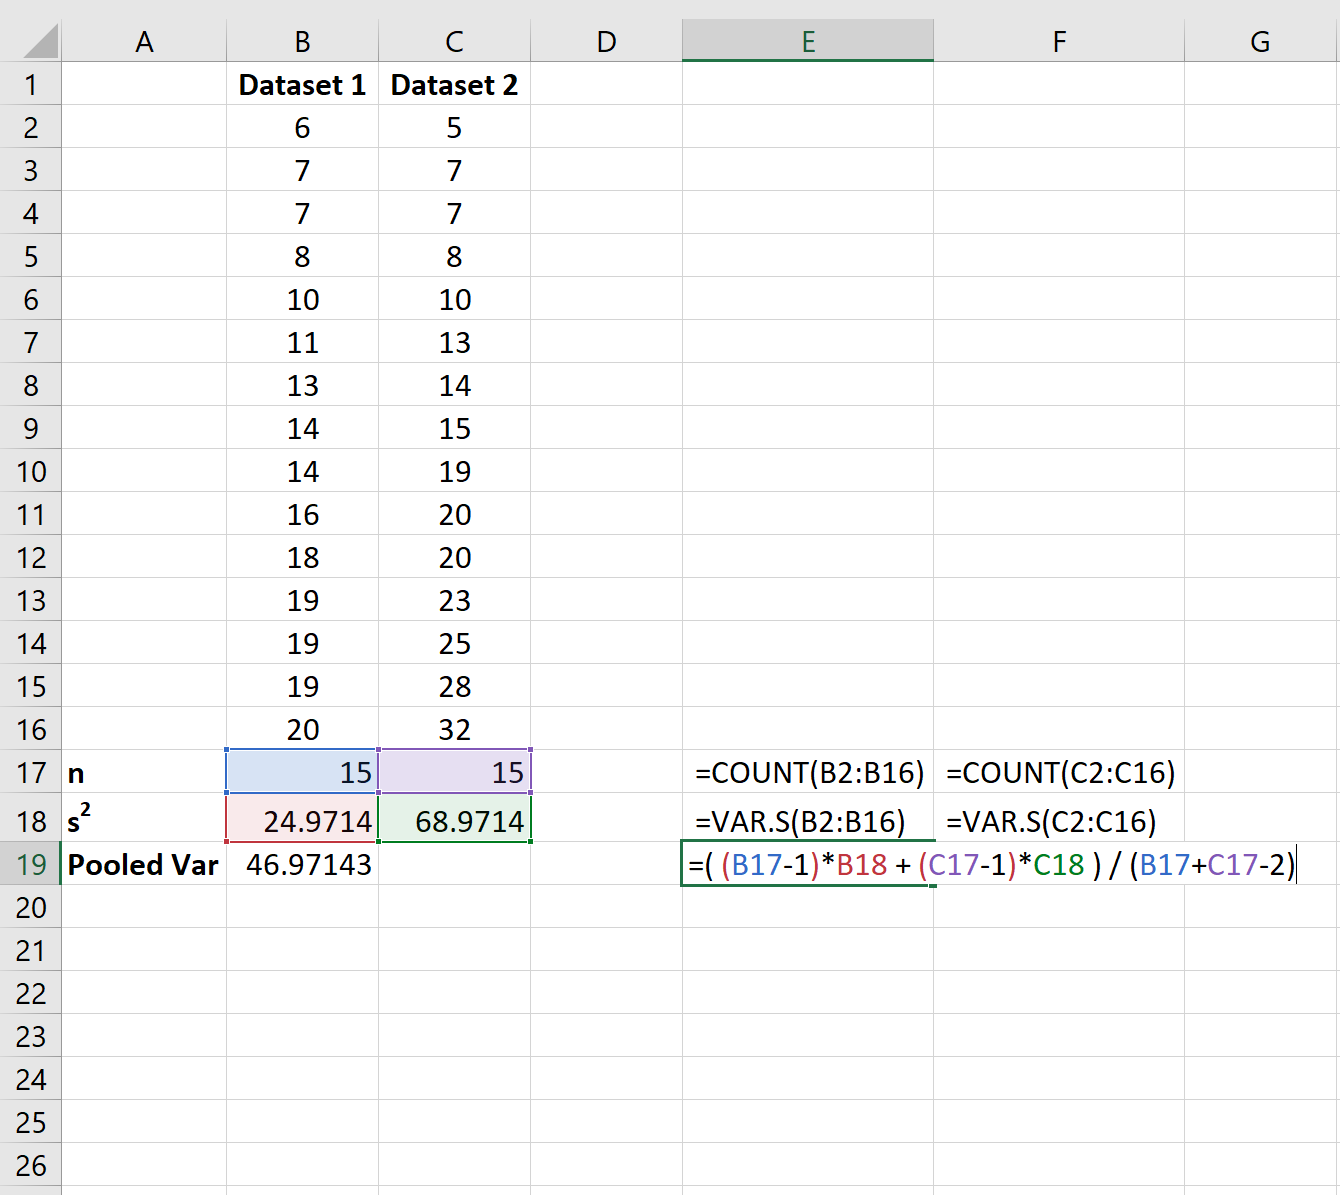
Nous abordons à présent le cœur opérationnel de notre démarche : la synthèse algorithmique des paramètres descriptifs au sein de la formule de la variance combinée. Pour assurer une transparence absolue et faciliter les vérifications ultérieures par un tiers, nous allons décomposer l’assemblage dans la cellule D6, que nous labellisons en D5:D6 par l’étiquette explicite Variance_Combinee_Sp2.
En référençant nos cellules intermédiaires précédemment validées — à savoir les effectifs en D2 et E2, les variances sans biais en D3 et E3, et les degrés de liberté totaux en D5 —, saisissez avec une rigueur absolue la formule mathématique suivante dans la cellule D6 :
=((D2 - 1) * D3 + (E2 - 1) * E3) / D5
L’agencement des parenthèses au sein de cette syntaxe revêt une importance critique que l’on ne saurait sous-estimer. Le moteur d’évaluation des formules d’Excel applique les règles universelles de priorité arithmétique : les multiplications sont prioritaires sur les additions. Si l’on omet les parenthèses enserrant la totalité du numérateur, la formule sera interprétée par Excel comme (D2 – 1)*D3 + [((E2 – 1)*E3) / D5]. Dans cette configuration erronée, seule la seconde partie de l’expression serait divisée par les degrés de liberté, produisant un résultat mathématique aberrant et démesuré qui fausserait l’intégralité de la chaîne décisionnelle.
Une fois la variance combinée sp² obtenue en D6, déterminez immédiatement l’écart-type combiné (pooled standard deviation, noté sp) dans la cellule adjacente D7 (libellée Ecart_Type_Combine_Sp) en insérant la fonction de racine carrée :
=RACINE(D6)
Cette dernière grandeur servira immédiatement de dénominateur pour le d de Cohen et les standardisations méta-analytiques.
9.2 Formule compacte utilisant SOMME.CARRES.ECART
Bien que la méthode pas à pas détaillée ci-dessus soit la plus pédagogique et la plus sûre pour le contrôle des étapes de traitement, Excel propose une voie computationnelle plus directe, concise et numériquement plus élégante. Cette variante repose sur l’utilisation de la fonction matricielle univariée SOMME.CARRES.ECART (équivalent francophone de la fonction DEVSQ en version anglaise).
La fonction SOMME.CARRES.ECART extrait directement la somme des déviations quadratiques des observations individuelles par rapport à leur moyenne empirique, sans passer par l’intermédiaire de la division par n – 1 puis de sa re-multiplication compensatoire. Dès lors, le numérateur de la variance combinée peut être obtenu directement en additionnant les résultats de cette fonction pour les deux séries expérimentales.
Vous pouvez ainsi insérer dans une cellule autonome (par exemple D9) cette formule condensée remarquable :
=(SOMME.CARRES.ECART(A2:A21) + SOMME.CARRES.ECART(B2:B21)) / (NB(A2:A21) + NB(B2:B21) - 2)
Sur le plan de l’analyse numérique, cette approche compacte présente un avantage algorithmique appréciable : elle minimise l’accumulation des erreurs d’arrondi machine à virgule flottante. Lors du calcul manuel intermédiaire, les variances sont souvent arrondies à quelques décimales par le logiciel avant d’être réinjectées au numérateur. La fonction SOMME.CARRES.ECART conserve l’intégralité de la précision binaire interne d’Excel sur l’ensemble de la chaîne de sommation, fournissant une exactitude optimale jusqu’à la quinzième décimale.
9.3 Validation du résultat à l’aide d’un calcul témoin
Avant d’entériner la valeur obtenue et d’en tirer des conclusions psychologiques, tout analyste quantitatif chevronné procède à un ensemble de vérifications de cohérence interne et de tests de robustesse (sanity checks). Le premier principe logique que doit impérativement respecter la variance combinée est le principe de confinement borné :
La variance combinée sp² doit se situer strictement entre la variance minimale et la variance maximale des deux échantillons :
MIN(s1²; s2²) ≤ sp² ≤ MAX(s1²; s2²)
Si la variance de votre groupe témoin est égale à 12,50 et celle de votre groupe expérimental à 18,20, la variance combinée obtenue dans votre cellule doit obligatoirement être comprise entre 12,50 et 18,20. Si votre calcul retourne un score de 9,80 ou de 24,10, cela signale de manière infaillible une erreur de syntaxe logicielle — presque systématiquement attribuable à un placement défectueux des parenthèses délimitant le numérateur et le dénominateur.
Un second test témoin consiste à examiner le cas particulier où les effectifs sont identiques (n1 = n2). Calculez dans une cellule temporaire la moyenne arithmétique simple des deux variances : =(D3 + E3) / 2. La valeur obtenue doit être rigoureusement identique, au centième de décimale près, au résultat affiché par votre formule de variance combinée dans la cellule D6. Si ces deux valeurs divergent alors que vos effectifs en D2 et E2 sont strictement égaux, votre formule comporte une défaillance de référencement spatial qu’il convient de corriger immédiatement.
10. Vérification automatisée via l’Utilitaire d’analyse de données
10.1 Activation et configuration de l’utilitaire d’analyse
Microsoft Excel intègre un environnement de calcul statistique avancé nommé l’Utilitaire d’analyse (ou Analysis ToolPak en anglais). Cet add-in natif compile des macro-commandes statistiques permettant d’exécuter des analyses multivariées, des régressions linéaires et des tests d’hypothèses complexes sans avoir à construire manuellement les équations sous-jacentes. Pour auditer la validité de nos calculs pas à pas, cet utilitaire constitue une ressource de contrôle croisé exceptionnelle.
Si l’utilitaire n’apparaît pas dans l’onglet Données de votre ruban Excel (à l’extrême droite sous l’appellation Analyse de données), son activation requiert la procédure séquentielle suivante :
- Cliquez sur l’onglet Fichier dans le coin supérieur gauche, puis sélectionnez Options tout en bas de la barre latérale.
- Dans la boîte de dialogue contextuelle, cliquez sur la rubrique Compléments située dans le menu vertical de gauche.
- Dans le menu déroulant inférieur intitulé Gérer, assurez-vous que la sélection affiche Compléments Excel, puis cliquez sur le bouton Atteindre….
- Une nouvelle boîte de dialogue s’ouvre : cochez impérativement la case intitulée Utilitaire d’analyse (inutile de cocher l’Utilitaire d’analyse – VBA pour nos besoins présents), puis validez en cliquant sur OK.
Dès cet instant, le bouton Analyse de données devient accessible au sein de l’onglet Données. Cliquez dessus, parcourez le menu déroulant des outils statistiques disponibles et sélectionnez l’option intitulée précisément : Test t : deux échantillons en supposant des variances égales.
Une interface de paramétrage apparaît : configurez la Plage de la variable 1 en sélectionnant $A$1:$A$21, et la Plage de la variable 2 avec $B$1:$B$21. Cochez impérativement la case Intitulés si vous avez inclus les cellules d’en-tête (ligne 1), fixez la Différence hypothétique entre les moyennes à 0 (modélisant l’hypothèse nulle d’absence d’effet), maintenez le niveau de risque Alpha à 0,05, et désignez une cellule de sortie libre dans votre feuille (par exemple G1).
10.2 Localisation et extraction de la variance combinée générée
Une fois l’analyse exécutée par validation sur OK, l’utilitaire d’analyse génère instantanément un tableau normé de résultats statistiques structuré sur deux colonnes. Ce tableau récapitule l’ensemble des paramètres inférentiels calculés par l’algorithme sous-jacent du test t homoscédastique.
Examinez avec attention les lignes constitutives de ce compte rendu statistique :
- Les premières lignes exposent les moyennes arithmétiques respectives et les variances individuelles des deux séries d’observations. Vous pouvez immédiatement vérifier la parfaite concordance de ces valeurs avec vos cellules
D3etE3calculées à l’Étape 3. - Scrollez vers le milieu du tableau généré : vous découvrirez une ligne explicite libellée Variance combinée (ou Pooled Variance si votre version linguistique d’Excel est paramétrée en anglais).
La valeur numérique inscrite en face de l’intitulé Variance combinée doit correspondre très exactement, jusqu’à la dernière décimale affichée, au résultat que vous avez programmé manuellement dans votre cellule D6 via la formule algébrique standard. Cette identité absolue entre votre dérivation pas à pas et le résultat du moteur d’analyse statistique institutionnel de Microsoft apporte la preuve irréfutable de la validité algorithmique de votre classeur.
Le tableau généré par l’utilitaire d’analyse fournit également la statistique t observée (Stat t), les degrés de liberté (Degrés de liberté = 38), ainsi que les p-valeurs critiques pour les configurations unilatérales et bilatérales. L’ensemble de ces grandeurs confirme que votre chaîne de calcul est prête à être auditée lors de la soumission de vos travaux scientifiques à des comités de lecture exigeants.
10.3 Utilisation conjointe de la fonction TEST.ETUDIANT
En complément de l’Utilitaire d’analyse — dont l’inconvénient est de générer un tableau statique qui ne s’actualise pas automatiquement si les données brutes sont modifiées —, Excel met à la disposition des chercheurs une fonction dynamique de pointe : TEST.ETUDIANT (ou T.TEST dans les versions internationales).
La syntaxe canonique de cette fonction se structure autour de quatre arguments indispensables :
=TEST.ETUDIANT(matrice1; matrice2; unilatéral/bilatéral; type)
Les deux premiers arguments correspondent naturellement aux plages d’échantillons (A2:A21 et B2:B21). Le troisième argument définit le sens de la région critique : saisissez 2 pour tester une hypothèse bilatérale classique (la moyenne du groupe entraîné diffère de celle du groupe contrôle, sans préjuger a priori de la direction de la supériorité clinique). Le quatrième argument, capital, définit la nature du test t implémenté :
- Si vous saisissez type = 1, Excel exécute un test t pour échantillons appariés (mesures répétées sur les mêmes sujets). Ce choix serait conceptuellement faux pour des groupes indépendants.
- Si vous saisissez type = 2, Excel applique le test t pour deux échantillons indépendants en supposant des variances égales. Dans les entrailles algorithmiques du logiciel, la fonction
TEST.ETUDIANT(A2:A21; B2:B21; 2; 2)calcule en interne la variance combinée selon la formule standard sp², en extrait la racine carrée, dérive l’erreur type et produit la p-valeur bilatérale exacte. - Si vous saisissez type = 3, le logiciel bascule vers l’algorithme hétéroscédastique du test de Welch, ignorant la variance combinée et adaptant les degrés de liberté selon la formule fractionnaire de Welch-Satterthwaite.
En insérant cette formule dans une cellule dédiée de votre feuille, vous disposez d’un indicateur de décision probabiliste dynamique en prise directe avec vos données, dont le comportement mathématique repose intégralement sur la présomption de régularité de la variance combinée calculée aux étapes précédentes.
11. Applications pratiques et interprétation des résultats en sciences comportementales
11.1 Calcul de l’erreur type de la différence de moyennes
Une fois la variance combinée consolidée dans la cellule D6, son exploitation clinique immédiate réside dans la détermination de l’erreur type de la différence de moyennes (communément abrégée SEdiff pour Standard Error of the Difference). Cette grandeur quantifie l’incertitude théorique qui entoure la différence observée entre les deux moyennes d’échantillons si l’on répétait l’expérimentation une infinité de fois dans des conditions identiques.
La formulation analytique de l’erreur type conjointe s’énonce comme suit :
SEdiff = RACINE( sp² * (1/n1 + 1/n2) )
Dans votre feuille de calcul Excel, vous pouvez implémenter cette relation fondamentale dans la cellule D8 (libellée Erreur_Type_Difference) au moyen de l’expression algorithmique :
=RACINE(D6 * (1/D2 + 1/E2))
Grâce à cette valeur, vous pouvez ériger l’Intervalle de Confiance à 95 % autour de la différence de moyennes (MOYENNE(B2:B21) - MOYENNE(A2:A21)). Pour ce faire, déterminez la valeur critique t* au seuil bilatéral de 5 % via la fonction Excel =LOI.STUDENT.INVERSE.BILATERALE(0,05; D5), puis calculez la marge d’erreur : marge = t_critique * SE_diff.
Les bornes inférieure et supérieure de l’intervalle s’obtiennent par simple soustraction et addition de cette marge d’erreur à la différence des moyennes constatée. Dans un compte rendu neuropsychologique, la présentation de cet intervalle de confiance est infiniment plus informative que la seule p-valeur : si l’intervalle à 95 % est entièrement circonscrit au-dessus de zéro (par exemple [2,15 ; 6,85]), le praticien peut affirmer avec un risque d’erreur consenti de 5 % que le gain cognitif réel induit par le programme d’entraînement n’est pas nul et se situe au moins à 2,15 points d’empan de travail.
11.2 Standardisation des effets dans les méta-analyses psychologiques
L’autre prolongement indispensable de la variance combinée concerne l’estimation de la taille d’effet standardisée. Bien que le d de Cohen calculé via la formule standard d = (Moyenne_1 - Moyenne_2) / Sp soit universellement employé, les statisticiens méthodologistes ont démontré qu’il présente un léger biais positif dans les études mobilisant de petits effectifs (N global inférieur à 30 ou 40 sujets). Il a tendance à surestimer systématiquement la magnitude réelle de l’effet dans la population.
Pour corriger cette distorsion dans les synthèses méta-analytiques contemporaines, on privilégie l’estimateur non biaisé développé par Larry Hedges, universellement désigné sous le vocable de g de Hedges. Le g de Hedges applique un facteur multiplicatif d’ajustement polynomial direct au d de Cohen, fonction exclusive des degrés de liberté totaux déjà calculés en D5 :
Facteur d’ajustement J = 1 – (3 / (4 * ddl – 1))
g de Hedges = d de Cohen * J
Dans votre tableau Excel, vous pouvez automatiser ce raffinement métamathématique dans la cellule D10 au moyen de la formule suivante :
=((MOYENNE(B2:B21) - MOYENNE(A2:A21)) / D7) * (1 - (3 / (4 * D5 - 1)))
La précision de cet indice dépend viscéralement de la correction rigoureuse de la dispersion combinée opérée en amont. Une défaillance dans l’estimation de la variance mutualisée se répercute de façon décuplée sur l’estimation de la taille d’effet. Lors de l’exportation subséquente de vos paramètres Excel vers des logiciels méta-analytiques professionnels (tels que Comprehensive Meta-Analysis, RevMan ou les packages metafor sous R), la fourniture conjointe des moyennes, des effectifs et de la variance combinée garantit l’exactitude de l’assignation des poids d’inverse de variance aux études primaires.
11.3 Étude d’un cas clinique complet et rédaction des résultats
Pour illustrer la transposition académique de l’ensemble de notre chaîne de calcul sous Excel, considérons l’aboutissement formel de notre étude sur la mémoire de travail chez les adultes TDAH. Supposons que les calculs exécutés dans votre feuille Excel aient livré les paramètres descriptifs et inférentiels suivants :
- Groupe Témoin (n1 = 20) : Moyenne M1 = 22,40 ; Variance s1² = 14,25 ; Écart-type s1 = 3,77.
- Groupe Expérimental (n2 = 20) : Moyenne M2 = 27,10 ; Variance s2² = 16,80 ; Écart-type s2 = 4,10.
- Paramètres Combinés (ddl = 38) : Variance combinée sp² = 15,525 ; Écart-type combiné sp = 3,940 ; Erreur type SEdiff = 1,246.
- Statistique Inférentielle : t(38) = 3,772 ; p = 0,00055 ; d de Cohen = 1,193 ; g de Hedges = 1,169.
La rédaction de ces résultats au sein d’un article soumis à une revue affiliée à l’APA exige une mise en forme textuelle standardisée, éliminant tout jargon propre au tableur pour ne retenir que la quintessence méthodologique. Voici le modèle rédactionnel type devant figurer dans la section Résultats :
« Une analyse comparative des scores d’empan mnésique à l’issue des huit semaines de suivi a été conduite au moyen d’un test t de Student pour échantillons indépendants. L’évaluation préalable de l’homoscédasticité via le test F de Snedecor n’a révélé aucune violation significative de l’égalité des variances (F(19, 19) = 1,18, p = 0,70), justifiant la modélisation conjointe de la dispersion via la variance combinée (sp² = 15,53 ; sp = 3,94). Les participants ayant bénéficié de l’entraînement cognitif ont présenté des performances de mémoire de travail significativement supérieures (M = 27,10 ; ET = 4,10) à celles observées chez les sujets de la condition contrôle actif (M = 22,40 ; ET = 3,77), t(38) = 3,77, p < 0,001. La différence de moyennes s’élève à 4,70 points, IC à 95 % [2,18 ; 7,22]. L’ampleur de cet effet clinique s’avère particulièrement robuste, comme en témoigne la taille d’effet standardisée ajustée pour petits échantillons (g de Hedges = 1,17). »
Cette formalisation exemplaire met en lumière l’enchaînement logique complet : de la vérification des postulats jusqu’à la standardisation de l’ampleur clinique du phénomène, la variance combinée constitue le pivot mathématique qui sous-tend l’ensemble du raisonnement inférentiel.
12. Diagnostics, erreurs courantes sous Excel et solutions méthodologiques
12.1 Erreurs algorithmiques et syntaxiques classiques
L’exploitation quotidienne d’Excel pour l’analyse de données expose le chercheur à des écueils techniques récurrents, capables de ruiner la validité de calculs en apparence simples. La première faille, évoquée précédemment mais dont l’occurrence demeure omniprésente dans les laboratoires, réside dans l’oubli des parenthèses délimitatrices lors de la saisie de l’équation standard. Taper =(D2-1)*D3 + (E2-1)*E3 / D5 tronque dramatiquement le résultat : la division prioritaire ne s’applique qu’au dernier terme, délivrant une variance combinée démesurée. La parade méthodologique absolue consiste à scinder l’opération en deux cellules étanches : l’une pour le numérateur SOMME_CARRES_TOTALE et l’autre pour le dénominateur DEGRES_DE_LIBERTE, avant de réaliser le quotient dans une troisième cellule.
La seconde source classique de distorsion tient à la confusion entre les fonctions d’écartement : VAR.S, VAR.P, VARA et VAR.PA. Les fonctions se terminant par le suffixe « A » traitent les valeurs logiques (VRAI/FAUX) et le texte comme des zéros mathématiques au lieu de les exclure du traitement statistique. Si un score manquant a été encodé par l’abréviation « ND » (Non Déterminé), la fonction VARA intégrera ce libellé comme un zéro métrique absolu, faussant radicalement le calcul de la moyenne, gonflant artificiellement la variance et corrompant irréversiblement l’estimateur combiné.
Enfin, la propagation des codes d’erreur standards d’Excel doit être interceptée et traitée immédiatement :
- #DIV/0! : Cette erreur survient si la cellule des degrés de liberté
D5renvoie une valeur nulle (par exemple si les plages sélectionnées ne comportent aucune valeur numérique valide ou si les effectifs sont nuls). - #VALEUR! : Elle signale qu’une formule mathématique tente d’opérer sur une cellule au format textuel ou contenant un espace insécable invisible issu d’un copier-coller depuis un questionnaire en ligne.
- #NOM? : Elle dénonce une coquille d’écriture dans l’intitulé de la fonction Excel, par exemple l’oubli d’un point dans
VAR.S(orthographiéVARS) ou la transposition d’un libellé anglophone au sein d’une suite logicielle francophone.
Pour prévenir la dégradation visuelle de vos tableaux de bord décisionnels, vous pouvez envelopper vos formules maîtresses dans l’instruction de protection SIERREUR :
=SIERREUR(((D2 - 1) * D3 + (E2 - 1) * E3) / D5; "Erreur de paramétrage")
12.2 Mauvaise gestion des données psychométriques manquantes
La gestion des données absentes (missing data) représente un défi méthodologique structurel en psychométrie. Sous Excel, une équivoque gravissime persiste quant à la manipulation des cellules vides par opposition aux cellules contenant la valeur numérique zéro (0). Pour le logiciel, une cellule laissée totalement vide est spontanément éludée par la fonction NB ou VAR.S. En revanche, une cellule dans laquelle le chiffre 0 a été consigné est appréhendée comme une mesure psychométrique authentique.
Dans de nombreuses échelles d’évaluation de la dépression ou de l’anxiété (telles que le BDI-II ou le STAI), le score 0 correspond à une absence absolue de symptôme. Si un opérateur encode un participant n’ayant pas répondu au test en inscrivant 0 au lieu de laisser la cellule vide, il injecte une fausse observation clinique extrême. Cette distorsion tire artificiellement la moyenne vers le bas et augmente dramatiquement la somme des carrés des écarts, altérant lourdement la variance du sous-groupe et, par ricochet, la variance combinée globale.
Un autre piège fréquent réside dans l’utilisation anachronique de codes d’absence historiques tels que -99, -999 ou 999. Si ces données ne sont pas nettoyées préalablement à l’analyse, Excel les incorporera dans ses calculs d’écarts quadratiques sans générer d’alerte logicielle, produisant des variances combinées astronomiques totalement dénuées de sens. Il est impératif d’activer des filtres automatiques sur l’ensemble des colonnes de scores afin d’inspecter les valeurs extrêmes et de supprimer ou recoder en cellules vides toute occurrence de données d’absence préalablement à l’application des fonctions statistiques.
12.3 Bonnes pratiques pour un modèle Excel pérenne et réutilisable
Pour immuniser vos travaux contre l’obsolescence et optimiser le temps d’analyse lors des protocoles expérimentaux récurrents, il est fortement recommandé de construire un classeur modèle d’analyse standardisé (enregistré sous l’extension .xltx pour constituer un modèle Excel pérenne). Un tel gabarit doit incorporer des automatisations structurelles fondées sur les principes de la reproductibilité scientifique et de la science ouverte.
La première bonne pratique réside dans la définition de noms de plages dynamiques. Plutôt que de figer les arguments des formules sur des coordonnées statiques telles que A2:A100, créez des noms via le Gestionnaire de noms (onglet Formules) en utilisant la fonction DECALER combinée à NBVAL :
=DECALER(Feuil1!$A$2; 0; 0; NB(Feuil1!$A:$A); 1)
Nommez cette plage Scores_Controle. La plage s’ajustera désormais d’elle-même, pixel par pixel, à chaque adjonction de nouvelles données cliniques, conférant à vos formules de variances combinées une pérennité absolue exempte de toute maintenance manuelle.
La seconde recommandation consiste à intégrer un module décisionnel conditionnel automatisé. Vous pouvez programmer une cellule qui compare la p-valeur du test F préalable au seuil nominal de 0,05. Si le test F est non significatif, la cellule affiche : « Variances homogènes : Utiliser la Variance Combinée et le Test t Standard ». Si le test F s’avère significatif, la cellule renvoie une alerte visuelle : « Attention : Violation d’homoscédasticité — Basculer vers l’approximation de Welch ». Ce type de garde-fou méthodologique garantit que les utilisateurs moins rompus à la technicité statistique ne commettront pas d’erreurs d’inférence en exploitant votre classeur.
Enfin, assurez la pleine conformité de votre fichier aux impératifs du partage des données scientifiques (normes FAIR : Facile à trouver, Accessible, Interopérable, Réutilisable). Intégrez systématiquement un premier onglet de votre classeur intitulé Dictionnaire des données (Codebook), explicitant la nature de chaque variable mesurée, les unités dimensionnelles, les dates de recueil, les versions d’algorithmes mobilisées et la documentation des fonctions Excel utilisées. En transformant un simple tableau de chiffres en un écosystème d’analyse documenté et auditable, vous hissez vos calculs de variance combinée au niveau d’exigence méthodologique le plus rigoureux de la recherche translationnelle contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Hedges, L. V., & Olkin, I. (1985). Statistical methods for meta-analysis. Academic Press.
- Microsoft Corporation. (2024). Fonctions statistiques (référence) – Support Microsoft. Microsoft. https://support.microsoft.com/fr-fr/office/fonctions-statistiques-r%C3%A9f%C3%A9rence-624decba-ebaf-4d62-bb9c-ab3a3fa22482
- National Institute of Standards and Technology. (2023). NIST/SEMATECH e-Handbook of Statistical Methods. NIST. https://www.itl.nist.gov/div898/handbook/
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 1–9. https://doi.org/10.1038/sdata.2016.18